Upgrade to Pro — share decks privately, control downloads, hide ads and more …

section情報の最適な持ち方の検討〜dmp section latest on Delta〜

section情報の最適な持ち方の検討〜dmp section latest on Delta〜

Supershipでは、分析のためにsection情報と呼ばれるユーザ属性情報を用いる。
このデータは事前に集計する必要があるが、そのためのETLやデータの維持に多くのコストが掛かってしまう。
そこで、Databricks inc.が開発したDelta Lakeというフォーマットを用い、これらを解決する方法を提案する。

Avatar for Hikaru

Hikaru

May 24, 2019

Other Decks in Technology

Transcript

  1. 2 自己紹介 • 名前 • 村上 光 • 所属 •

    DBD-DSE-DS • タスクとミッション • DBD / DSのシスアド(セキュリティ) • 内外への権限発行 • セキュリティ強化のための施策 • DSのデータエンジニア(高速/効率化) • R&D • sparkのより効率的な使い方 • フレームワーク / ミドルウェアの調査 • 小うるさいコードレビュー • Git/CI/CDの布教 • その他 • 音楽制作が趣味 • 殴り合えるVocalさん募集中です • ドライブも趣味 • carecoおすすめ • 最近お金がなくてやってない
  2. 3 アジェンダ • プロローグ • section情報とは? • dmp_section_accumulativeとその問題、 そしてそれに対する解決案 •

    Delta Lakeとは • dmp_section_latest on Delta Lake 構成と実験結果 • まとめと今後の課題
  3. 4 プロローグ 〜section情報とは〜 • DBDのミッションはいくつかある • 広告ターゲッティングのための分析支援はその一つ • 分析において、ユーザの属性情報というのは重要な意味を持つ •

    年齢とか、性別とか、居住都道府県とか分かると嬉しいことが多い • 我々は、section情報と呼ばれるデータ群を持ち、利用している • section情報 = ユーザの属性情報 • 性年代...20代男性とか。 • アンケート結果とか。 • ScaleOutの広告配信ターゲッティングに使われているものを転用
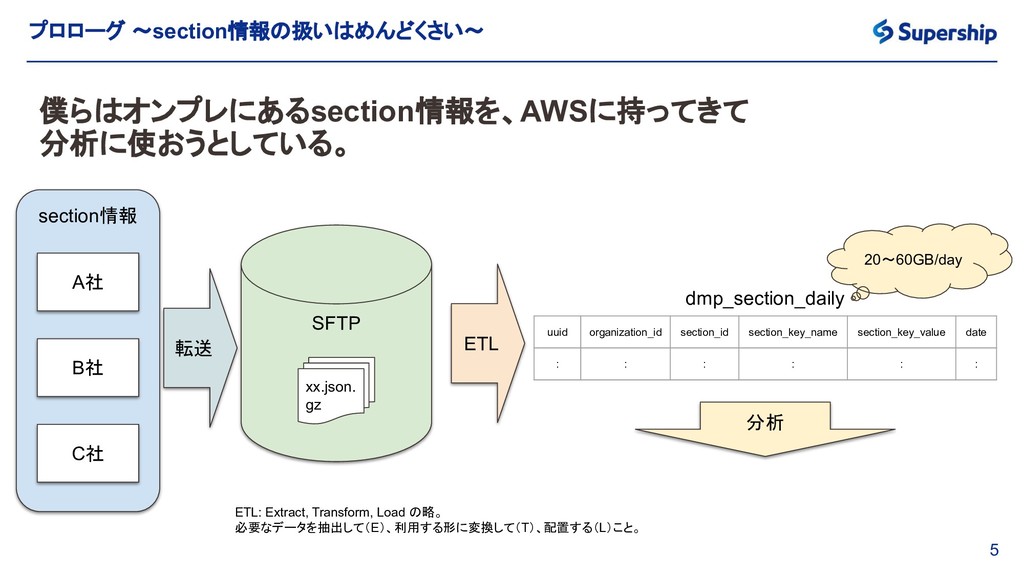
  4. 5 プロローグ 〜section情報の扱いはめんどくさい〜 僕らはオンプレにあるsection情報を、AWSに持ってきて 分析に使おうとしている。 section情報 A社 B社 C社 転送

    uuid organization_id section_id section_key_name section_key_value date : : : : : : dmp_section_daily SFTP xx.json. gz ETL 20〜60GB/day 分析 ETL: Extract, Transform, Load の略。 必要なデータを抽出して(E)、利用する形に変換して(T)、配置する(L)こと。
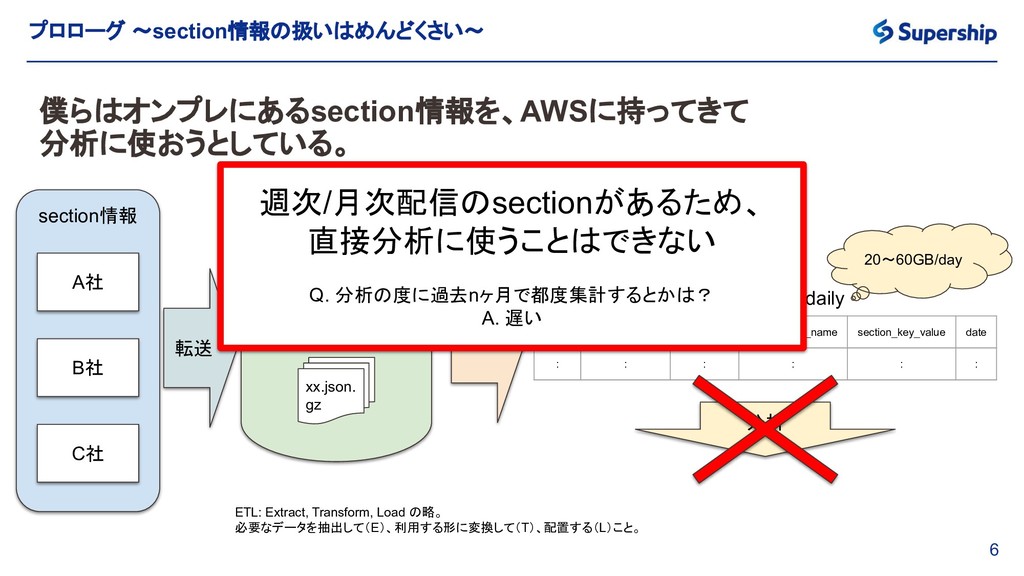
  5. 6 プロローグ 〜section情報の扱いはめんどくさい〜 僕らはオンプレにあるsection情報を、AWSに持ってきて 分析に使おうとしている。 section情報 A社 B社 C社 転送

    uuid organization_id section_id section_key_name section_key_value date : : : : : : dmp_section_daily SFTP xx.json. gz ETL 20〜60GB/day 分析 ETL: Extract, Transform, Load の略。 必要なデータを抽出して(E)、利用する形に変換して(T)、配置する(L)こと。 週次/月次配信のsectionがあるため、 直接分析に使うことはできない Q. 分析の度に過去nヶ月で都度集計するとかは? A. 遅い
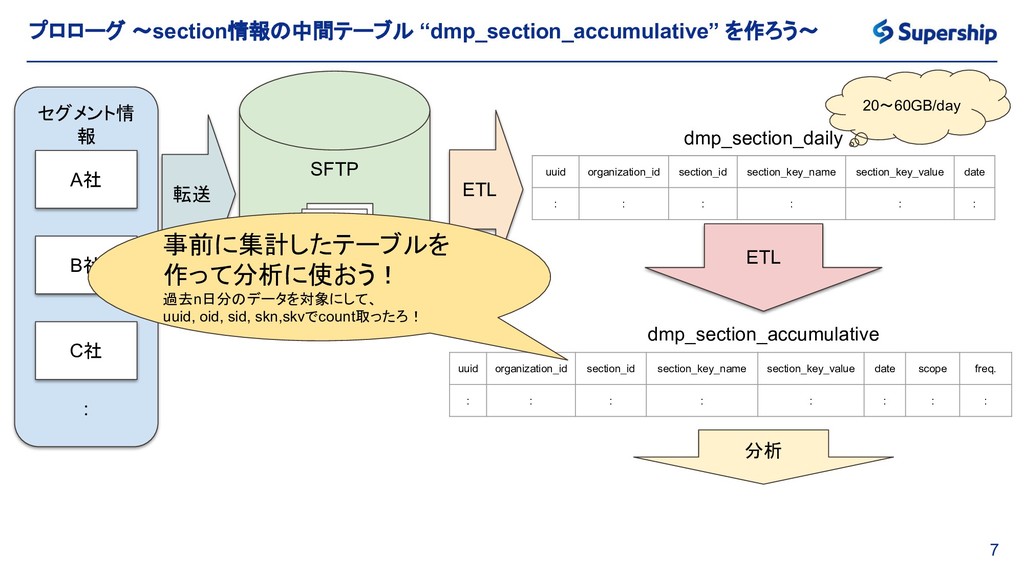
  6. 7 セグメント情 報 プロローグ 〜section情報の中間テーブル “dmp_section_accumulative” を作ろう〜 A社 B社 C社

    転送 : uuid organization_id section_id section_key_name section_key_value date : : : : : : dmp_section_daily SFTP xx.json. gz uuid organization_id section_id section_key_name section_key_value date scope freq. : : : : : : : : dmp_section_accumulative ETL ETL 20〜60GB/day 分析 事前に集計したテーブルを 作って分析に使おう! 過去n日分のデータを対象にして、 uuid, oid, sid, skn,skvでcount取ったろ!
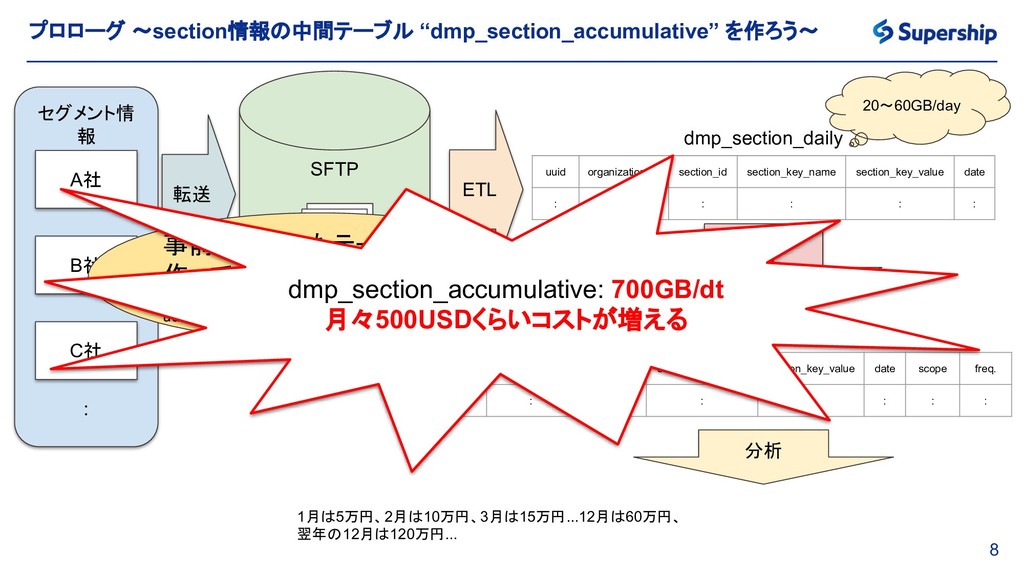
  7. 8 セグメント情 報 プロローグ 〜section情報の中間テーブル “dmp_section_accumulative” を作ろう〜 A社 B社 C社

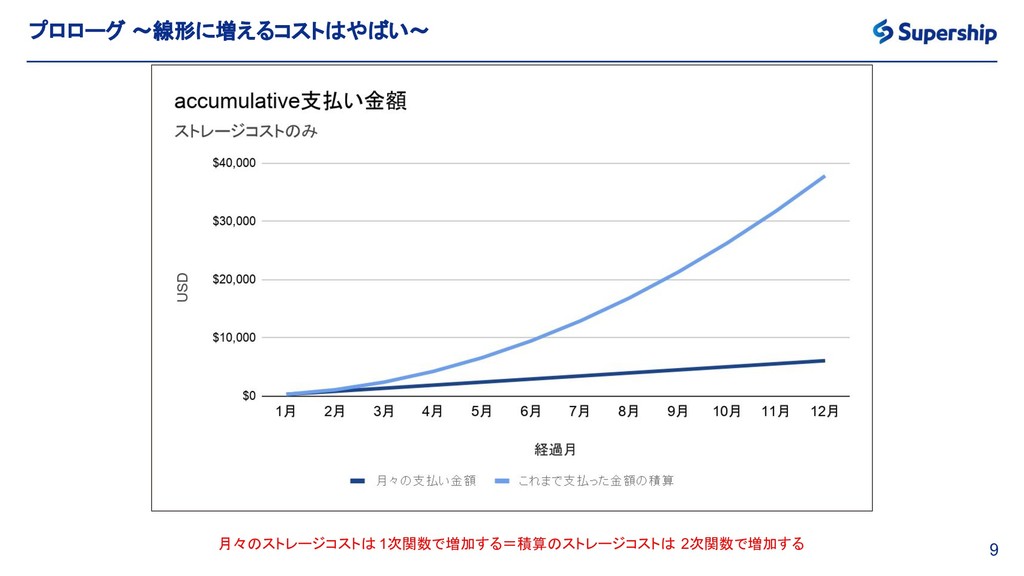
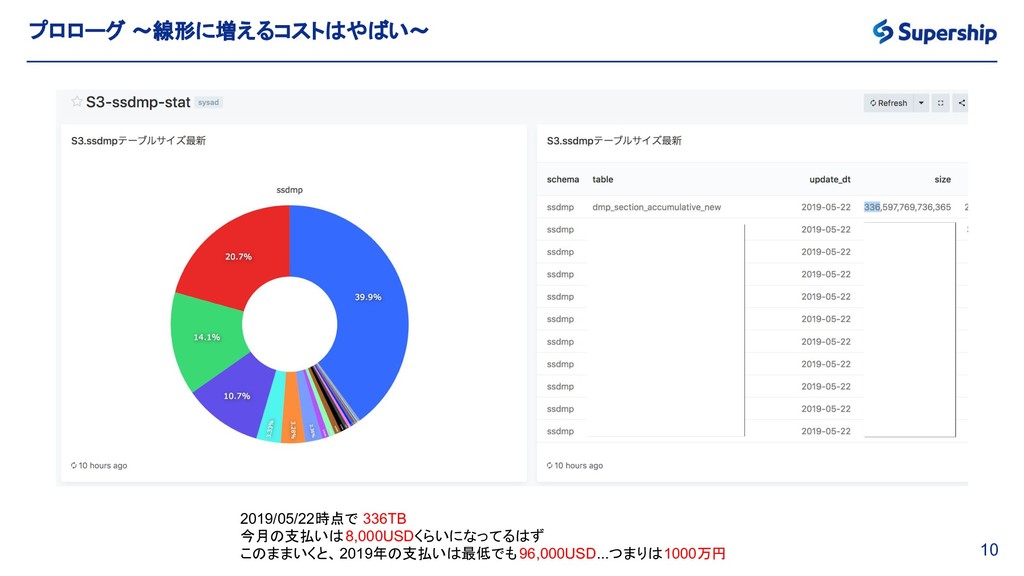
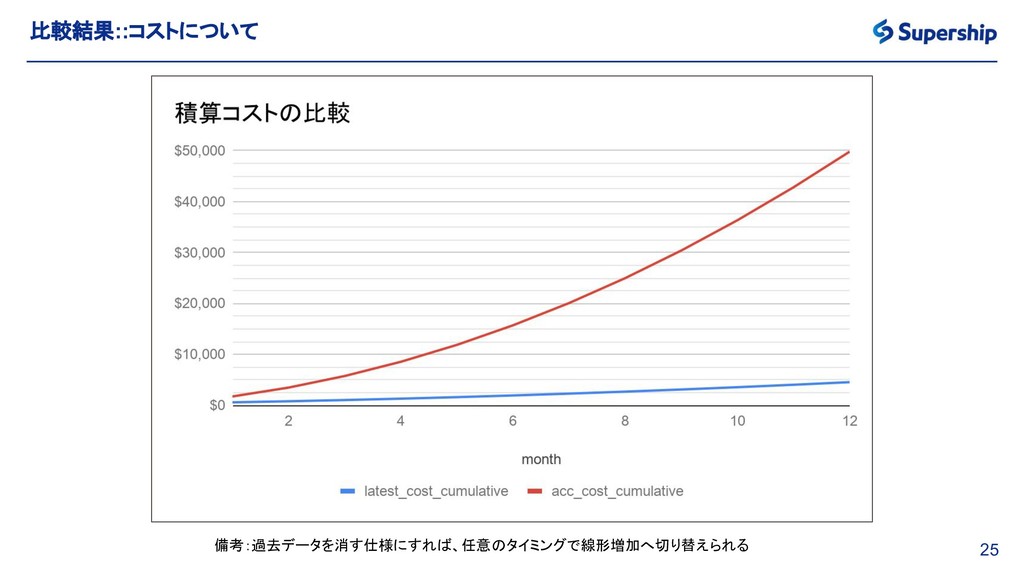
    転送 : uuid organization_id section_id section_key_name section_key_value date : : : : : : dmp_section_daily SFTP xx.json. gz uuid organization_id section_id section_key_name section_key_value date scope freq. : : : : : : : : dmp_section_accumulative ETL ETL 20〜60GB/day 分析 事前に集計したテーブルを 作って分析に使おう! 過去n日分のデータを対象にして、 uuid, oid, sid, skn,skvでcount取ったろ! dmp_section_accumulative: 700GB/dt 月々500USDくらいコストが増える 1月は5万円、2月は10万円、3月は15万円...12月は60万円、 翌年の12月は120万円...
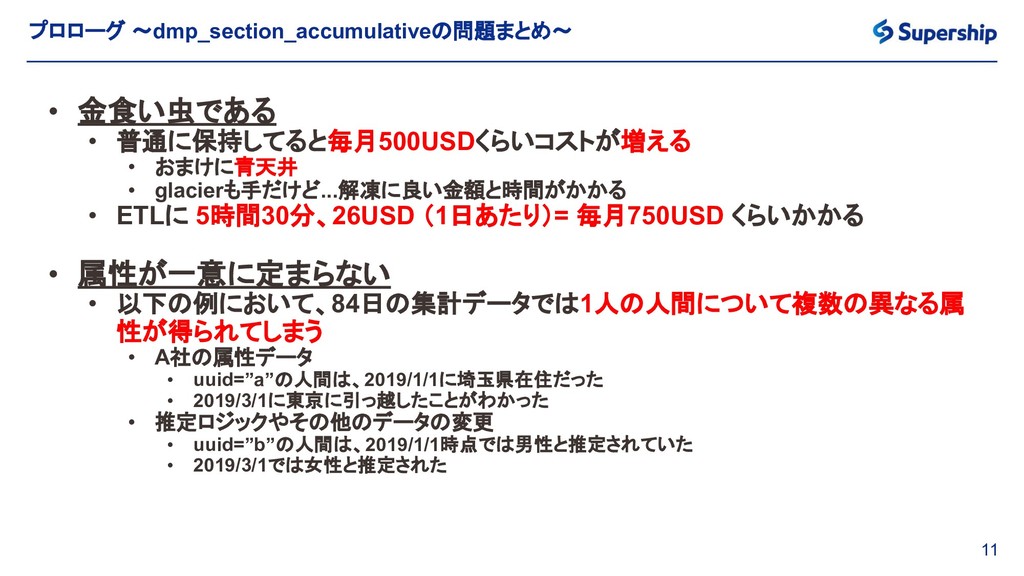
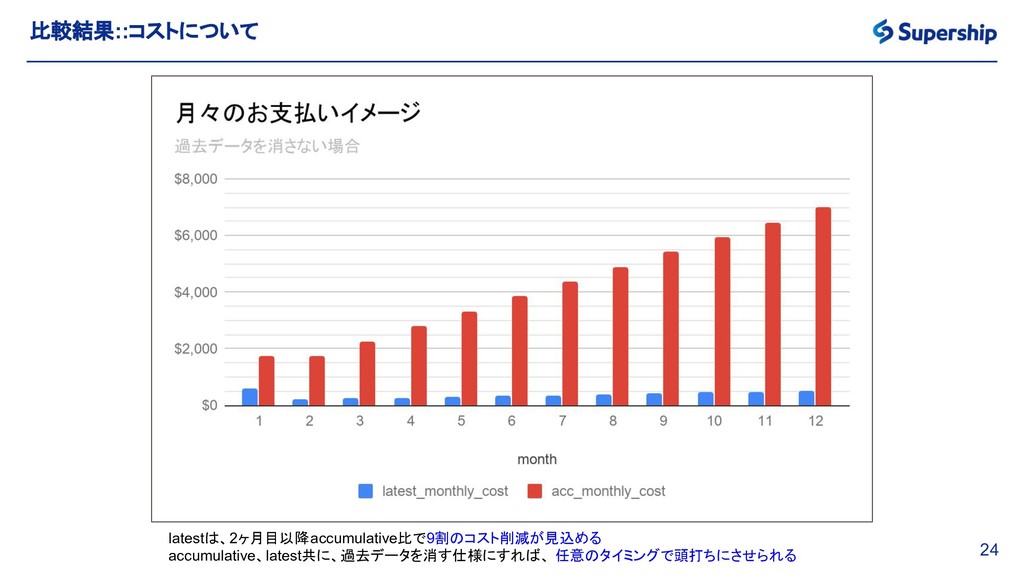
  8. 11 プロローグ 〜dmp_section_accumulativeの問題まとめ〜 • 金食い虫である • 普通に保持してると毎月500USDくらいコストが増える • おまけに青天井 •

    glacierも手だけど...解凍に良い金額と時間がかかる • ETLに 5時間30分、26USD (1日あたり)= 毎月750USD くらいかかる • 属性が一意に定まらない • 以下の例において、84日の集計データでは1人の人間について複数の異なる属 性が得られてしまう • A社の属性データ • uuid=”a”の人間は、2019/1/1に埼玉県在住だった • 2019/3/1に東京に引っ越したことがわかった • 推定ロジックやその他のデータの変更 • uuid=”b”の人間は、2019/1/1時点では男性と推定されていた • 2019/3/1では女性と推定された
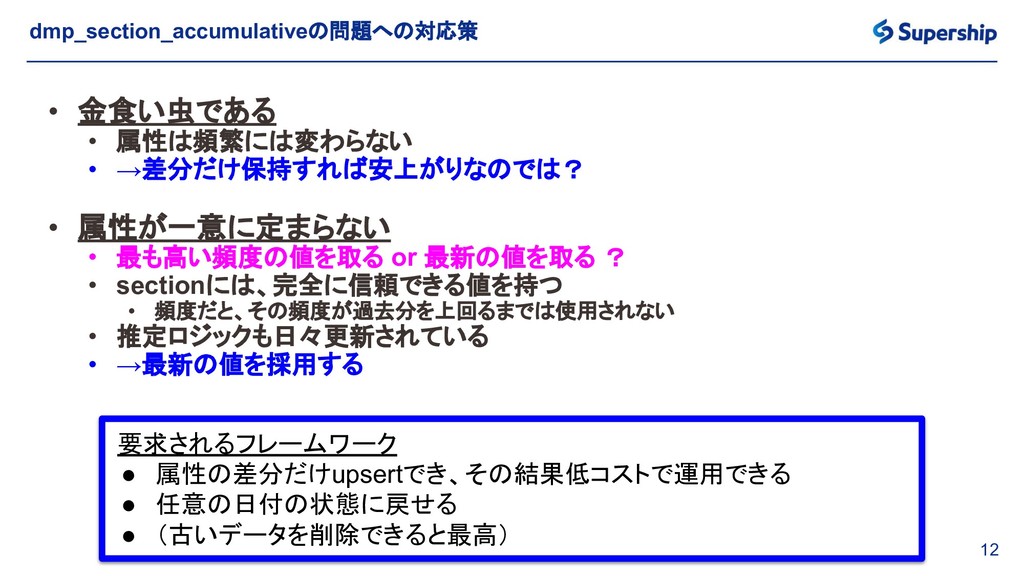
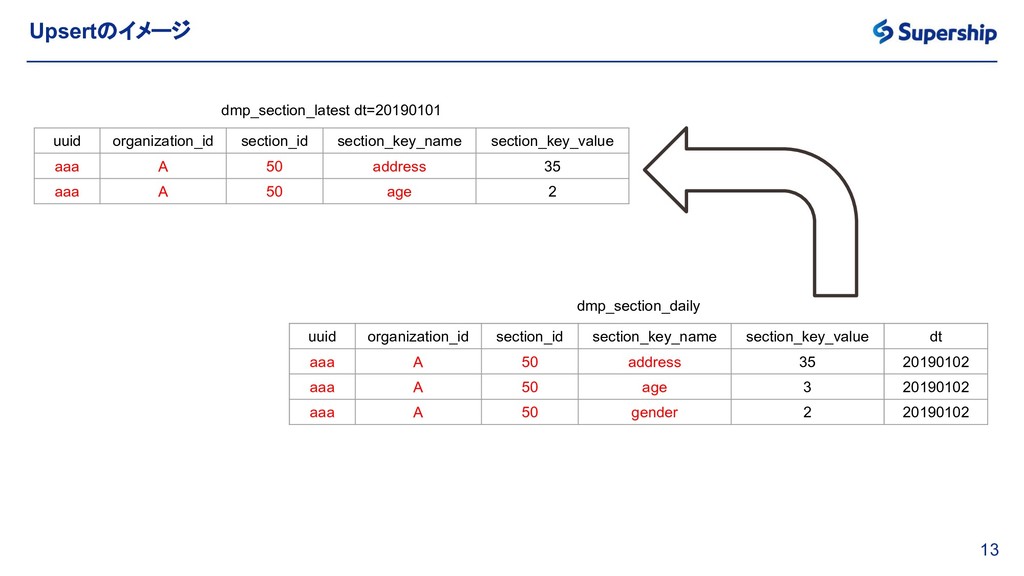
  9. 12 dmp_section_accumulativeの問題への対応策 • 金食い虫である • 属性は頻繁には変わらない • →差分だけ保持すれば安上がりなのでは? • 属性が一意に定まらない

    • 最も高い頻度の値を取る or 最新の値を取る ? • sectionには、完全に信頼できる値を持つ • 頻度だと、その頻度が過去分を上回るまでは使用されない • 推定ロジックも日々更新されている • →最新の値を採用する 要求されるフレームワーク • 属性の差分だけupsertでき、その結果低コストで運用できる • 任意の日付の状態に戻せる • (古いデータを削除できると最高)
  10. 13 Upsertのイメージ uuid organization_id section_id section_key_name section_key_value aaa A 50

    address 35 aaa A 50 age 2 uuid organization_id section_id section_key_name section_key_value dt aaa A 50 address 35 20190102 aaa A 50 age 3 20190102 aaa A 50 gender 2 20190102 dmp_section_latest dt=20190101 dmp_section_daily
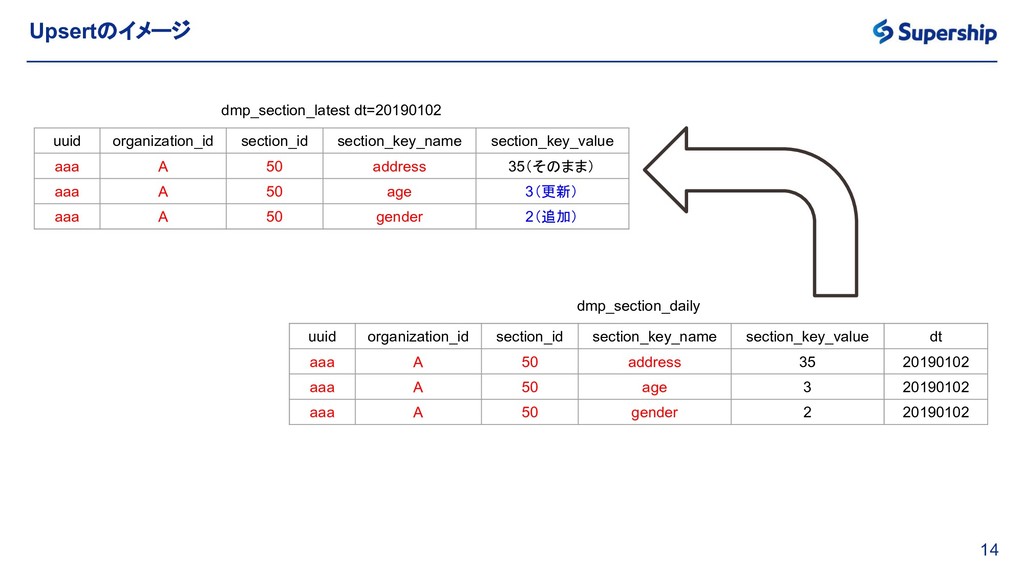
  11. 14 dmp_section_latest dt=20190102 uuid organization_id section_id section_key_name section_key_value aaa A

    50 address 35(そのまま) aaa A 50 age 3(更新) aaa A 50 gender 2(追加) Upsertのイメージ uuid organization_id section_id section_key_name section_key_value dt aaa A 50 address 35 20190102 aaa A 50 age 3 20190102 aaa A 50 gender 2 20190102 dmp_section_daily
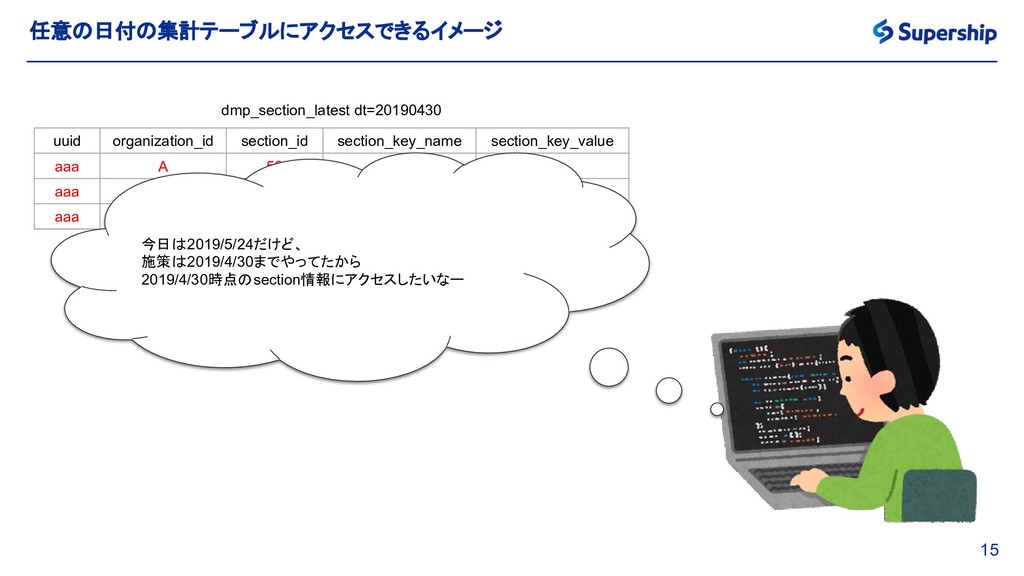
  12. 15 任意の日付の集計テーブルにアクセスできるイメージ uuid organization_id section_id section_key_name section_key_value aaa A 50

    address 35 aaa A 50 age 3(更新) aaa A 50 gender 2(追加) dmp_section_latest dt=20190430 今日は2019/5/24だけど、 施策は2019/4/30までやってたから 2019/4/30時点のsection情報にアクセスしたいなー
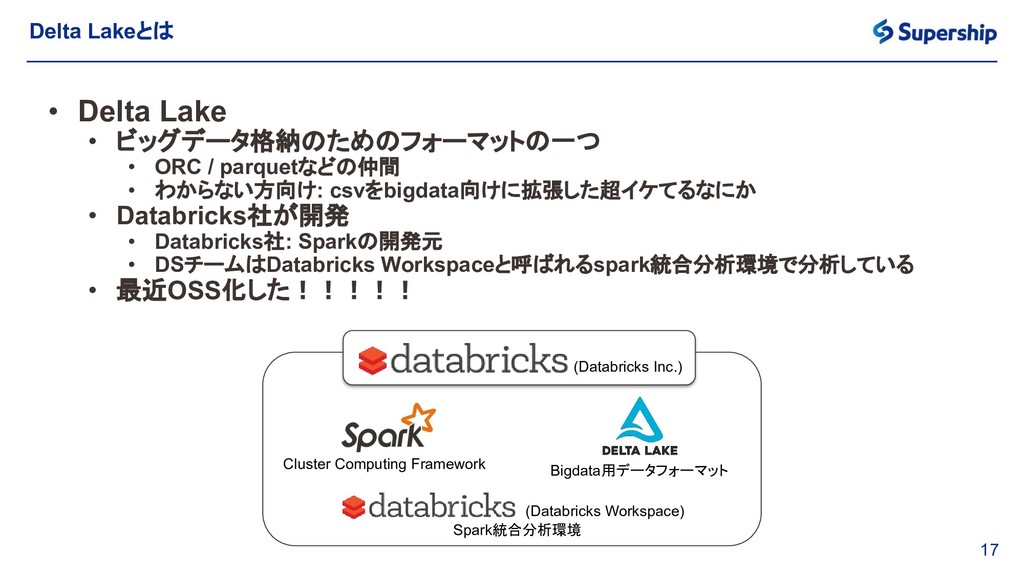
  13. 17 Delta Lakeとは • Delta Lake • ビッグデータ格納のためのフォーマットの一つ • ORC

    / parquetなどの仲間 • わからない方向け: csvをbigdata向けに拡張した超イケてるなにか • Databricks社が開発 • Databricks社: Sparkの開発元 • DSチームはDatabricks Workspaceと呼ばれるspark統合分析環境で分析している • 最近OSS化した!!!!! (Databricks Inc.) Cluster Computing Framework (Databricks Workspace) Spark統合分析環境 Bigdata用データフォーマット
  14. 18 Delta Lakeの特徴 • CRUDができる • ACIDトランザクションが提供されている • バージョン管理されており、time travelが可能

    • insert/update/delete/optimizeしたときに都度versionが管理される • バージョンに対応するparquetファイルが存在する • OPTIMIZE機能による、断片化したファイルの結合 • hadoopでは、しばしば数KB-数MBの小さいファイルが大量に生成され クエリが遅くなる事があるが、それを抑止する事ができる • Z-ORDERINGによる空間index • 速いときは速くなる
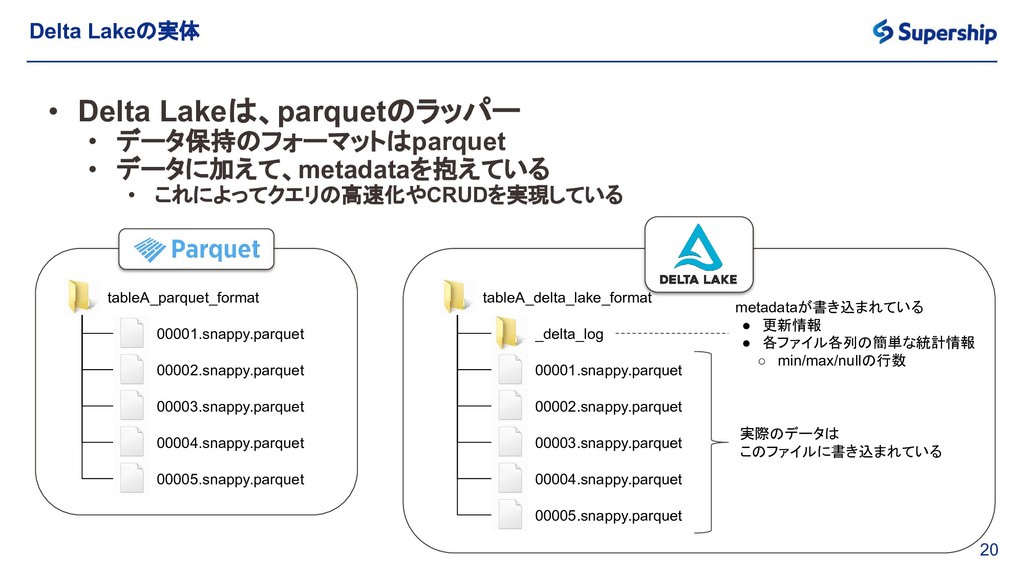
  15. 20 Delta Lakeの実体 • Delta Lakeは、parquetのラッパー • データ保持のフォーマットはparquet • データに加えて、metadataを抱えている

    • これによってクエリの高速化やCRUDを実現している tableA_delta_lake_format 00001.snappy.parquet 00002.snappy.parquet 00004.snappy.parquet 00003.snappy.parquet 00005.snappy.parquet _delta_log 実際のデータは このファイルに書き込まれている metadataが書き込まれている • 更新情報 • 各ファイル各列の簡単な統計情報 ◦ min/max/nullの行数 tableA_parquet_format 00001.snappy.parquet 00002.snappy.parquet 00004.snappy.parquet 00003.snappy.parquet 00005.snappy.parquet
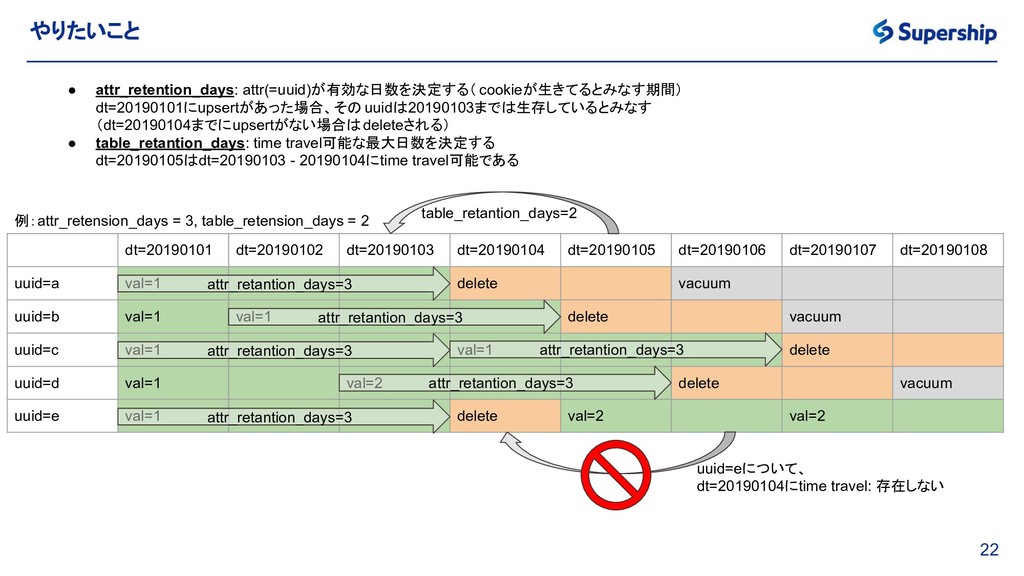
  16. 22 やりたいこと 例:attr_retension_days = 3, table_retension_days = 2 dt=20190101 dt=20190102

    dt=20190103 dt=20190104 dt=20190105 dt=20190106 dt=20190107 dt=20190108 uuid=a val=1 delete vacuum uuid=b val=1 val=1 delete vacuum uuid=c val=1 val=1 delete uuid=d val=1 val=2 delete vacuum uuid=e val=1 delete val=2 val=2 table_retantion_days=2 • attr_retention_days: attr(=uuid)が有効な日数を決定する( cookieが生きてるとみなす期間) dt=20190101にupsertがあった場合、その uuidは20190103までは生存しているとみなす (dt=20190104までにupsertがない場合はdeleteされる) • table_retantion_days: time travel可能な最大日数を決定する dt=20190105はdt=20190103 - 20190104にtime travel可能である attr_retantion_days=3 attr_retantion_days=3 attr_retantion_days=3 attr_retantion_days=3 uuid=eについて、 dt=20190104にtime travel: 存在しない attr_retantion_days=3 attr_retantion_days=3
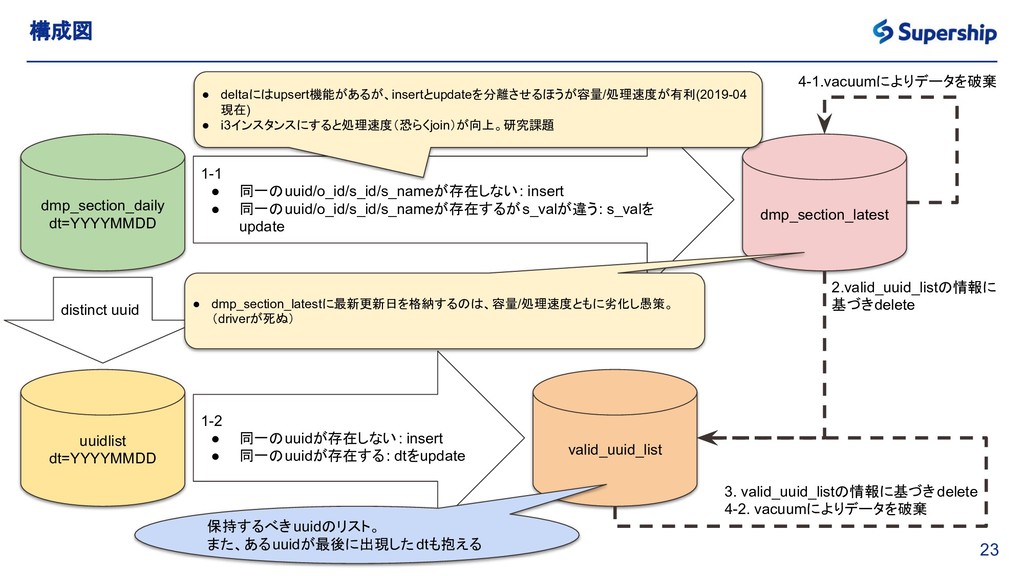
  17. 23 3. valid_uuid_listの情報に基づきdelete 構成図 dmp_section_daily dt=YYYYMMDD dmp_section_latest 1-1 • 同一のuuid/o_id/s_id/s_nameが存在しない:

    insert • 同一のuuid/o_id/s_id/s_nameが存在するがs_valが違う: s_valを update valid_uuid_list 1-2 • 同一のuuidが存在しない: insert • 同一のuuidが存在する: dtをupdate uuidlist dt=YYYYMMDD distinct uuid 2.valid_uuid_listの情報に 基づきdelete 4-2. vacuumによりデータを破棄 4-1.vacuumによりデータを破棄 • deltaにはupsert機能があるが、insertとupdateを分離させるほうが容量/処理速度が有利(2019-04 現在) • i3インスタンスにすると処理速度(恐らくjoin)が向上。研究課題 • dmp_section_latestに最新更新日を格納するのは、容量/処理速度ともに劣化し愚策。 (driverが死ぬ) 保持するべきuuidのリスト。 また、あるuuidが最後に出現したdtも抱える
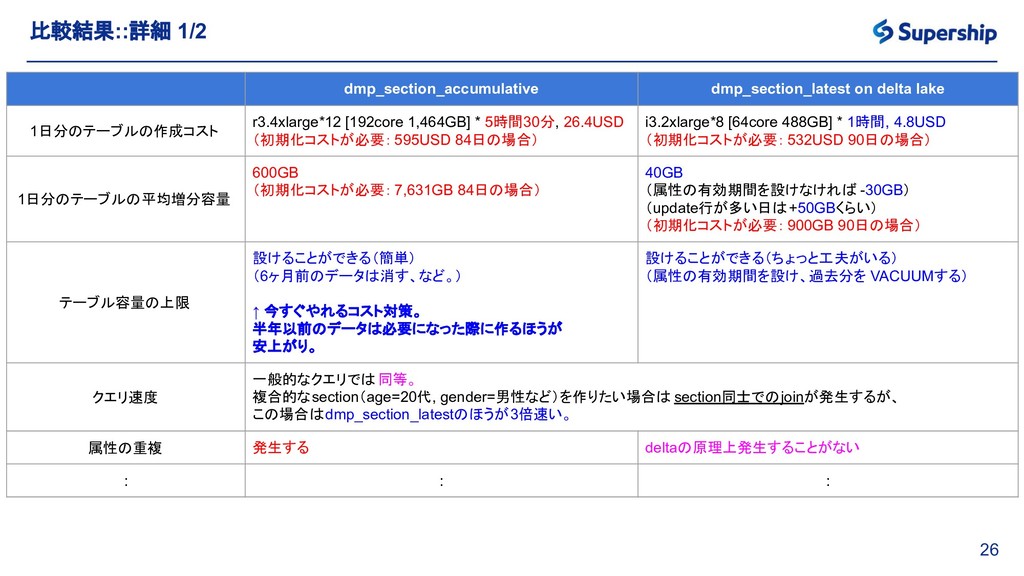
  18. 26 比較結果::詳細 1/2 dmp_section_accumulative dmp_section_latest on delta lake 1日分のテーブルの作成コスト r3.4xlarge*12

    [192core 1,464GB] * 5時間30分, 26.4USD (初期化コストが必要: 595USD 84日の場合) i3.2xlarge*8 [64core 488GB] * 1時間, 4.8USD (初期化コストが必要: 532USD 90日の場合) 1日分のテーブルの平均増分容量 600GB (初期化コストが必要: 7,631GB 84日の場合) 40GB (属性の有効期間を設けなければ -30GB) (update行が多い日は+50GBくらい) (初期化コストが必要: 900GB 90日の場合) テーブル容量の上限 設けることができる(簡単) (6ヶ月前のデータは消す、など。) ↑ 今すぐやれるコスト対策。 半年以前のデータは必要になった際に作るほうが 安上がり。 設けることができる(ちょっと工夫がいる) (属性の有効期間を設け、過去分を VACUUMする) クエリ速度 一般的なクエリでは同等。 複合的なsection(age=20代, gender=男性など)を作りたい場合は section同士でのjoinが発生するが、 この場合はdmp_section_latestのほうが3倍速い。 属性の重複 発生する deltaの原理上発生することがない : : :
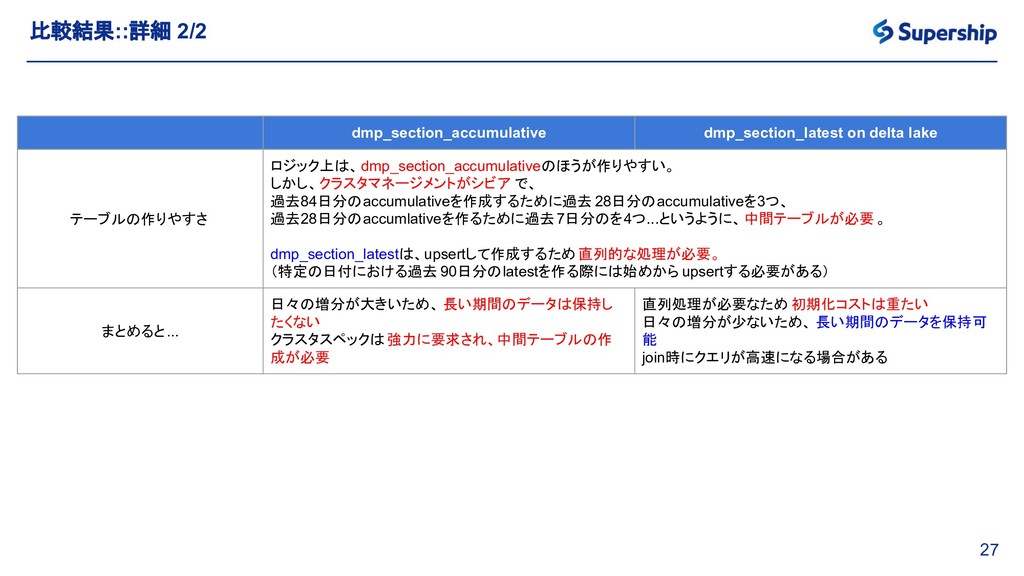
  19. 27 比較結果::詳細 2/2 dmp_section_accumulative dmp_section_latest on delta lake テーブルの作りやすさ ロジック上は、dmp_section_accumulativeのほうが作りやすい。

    しかし、クラスタマネージメントがシビア で、 過去84日分のaccumulativeを作成するために過去 28日分のaccumulativeを3つ、 過去28日分のaccumlativeを作るために過去7日分のを4つ...というように、中間テーブルが必要 。 dmp_section_latestは、upsertして作成するため直列的な処理が必要。 (特定の日付における過去 90日分のlatestを作る際には始めから upsertする必要がある) まとめると... 日々の増分が大きいため、 長い期間のデータは保持し たくない クラスタスペックは強力に要求され、中間テーブルの作 成が必要 直列処理が必要なため 初期化コストは重たい 日々の増分が少ないため、 長い期間のデータを保持可 能 join時にクエリが高速になる場合がある
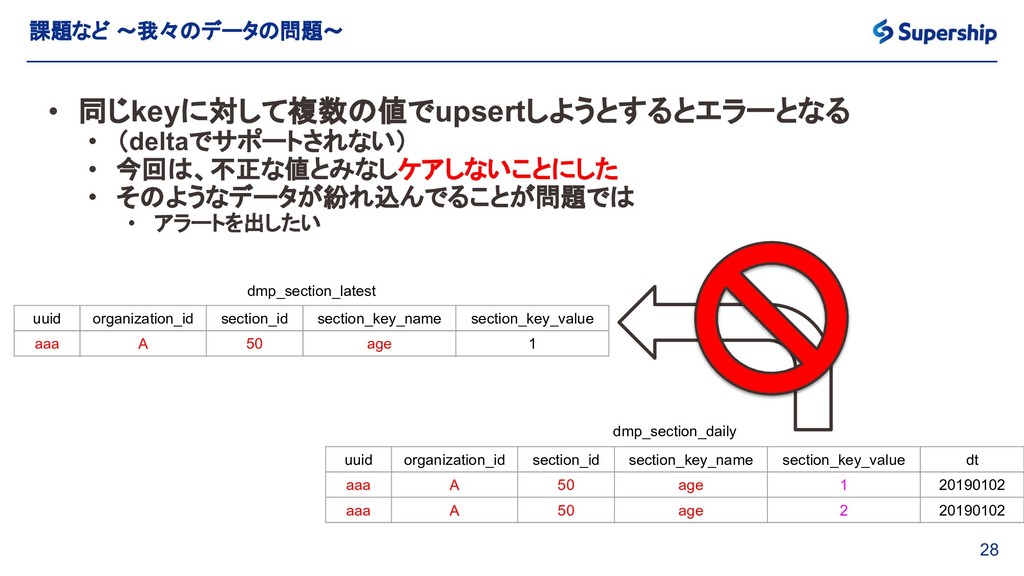
  20. 28 課題など ~我々のデータの問題~ • 同じkeyに対して複数の値でupsertしようとするとエラーとなる • (deltaでサポートされない) • 今回は、不正な値とみなしケアしないことにした •

    そのようなデータが紛れ込んでることが問題では • アラートを出したい uuid organization_id section_id section_key_name section_key_value aaa A 50 age 1 uuid organization_id section_id section_key_name section_key_value dt aaa A 50 age 1 20190102 aaa A 50 age 2 20190102 dmp_section_daily dmp_section_latest
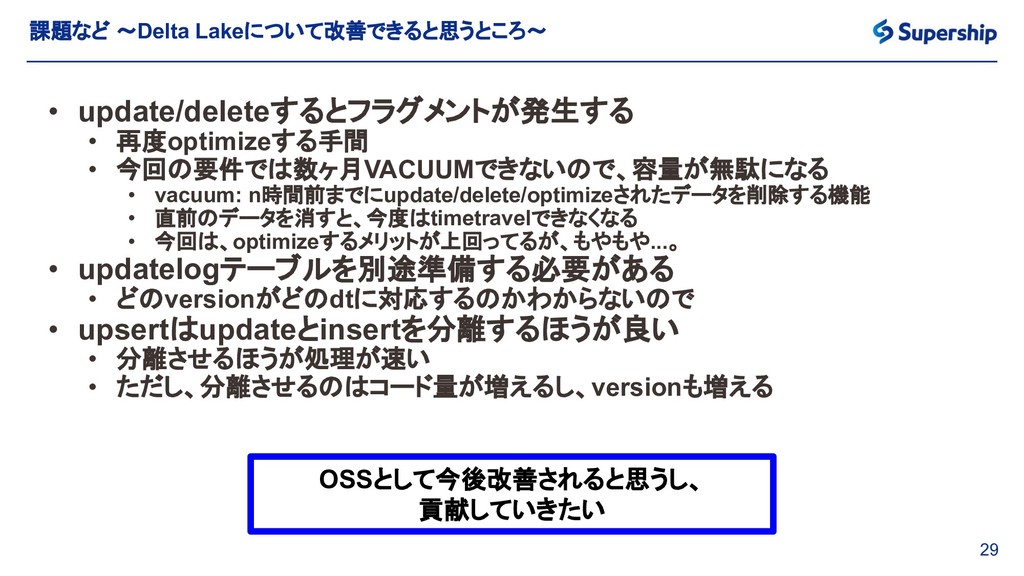
  21. 29 • update/deleteするとフラグメントが発生する • 再度optimizeする手間 • 今回の要件では数ヶ月VACUUMできないので、容量が無駄になる • vacuum: n時間前までにupdate/delete/optimizeされたデータを削除する機能

    • 直前のデータを消すと、今度はtimetravelできなくなる • 今回は、optimizeするメリットが上回ってるが、もやもや...。 • updatelogテーブルを別途準備する必要がある • どのversionがどのdtに対応するのかわからないので • upsertはupdateとinsertを分離するほうが良い • 分離させるほうが処理が速い • ただし、分離させるのはコード量が増えるし、versionも増える 課題など ~Delta Lakeについて改善できると思うところ~ OSSとして今後改善されると思うし、 貢献していきたい
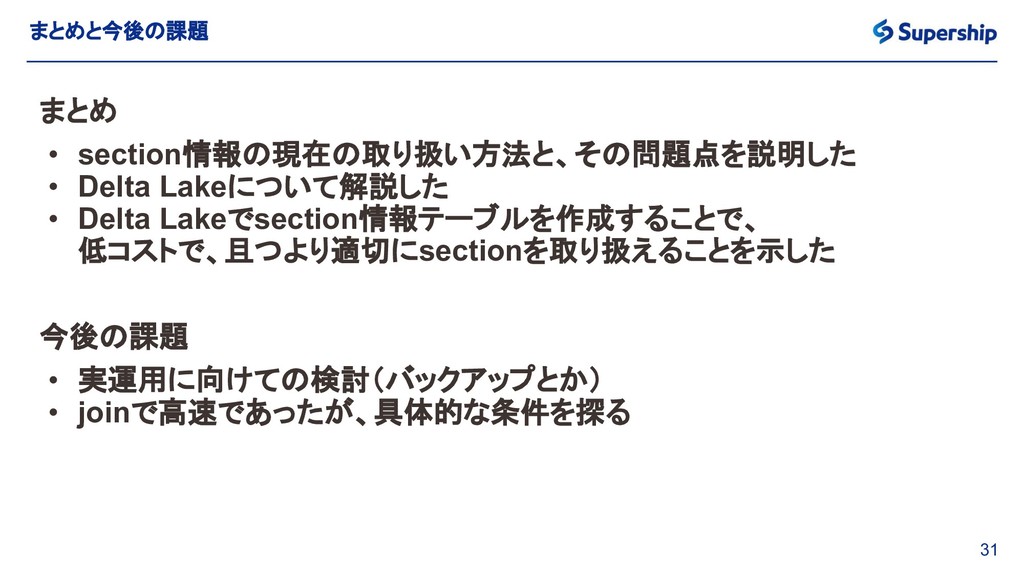
  22. 31 まとめと今後の課題 まとめ • section情報の現在の取り扱い方法と、その問題点を説明した • Delta Lakeについて解説した • Delta

    Lakeでsection情報テーブルを作成することで、 低コストで、且つより適切にsectionを取り扱えることを示した 今後の課題 • 実運用に向けての検討(バックアップとか) • joinで高速であったが、具体的な条件を探る