Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Mind Your Outliers! Investigating the Negative ...
Search
HwichanKim
September 19, 2021
Technology
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Mind Your Outliers! Investigating the Negative Impact of Outliers on Active Learning for Visual Question Answering
HwichanKim
September 19, 2021
Other Decks in Technology
See All in Technology
DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修
colopl
0
130
古い指輪から広がった JAVA コミュニティ とのつながり
yamad
0
130
Temporal 最高!でも改めて「日付」について調べたら人類の負債すぎる件
riyaamemiya
0
180
Running Kotlin + Quarkus with Lambda
nealle
1
4k
Classmethod Company Deck
satoshi7
1
730
実践! SRE × AI - ABEMA における AIOps -
tetsuya28
8
3.1k
AI時代のPRレビューにどう向き合うか?
kairim0
1
240
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
190
事業成長とデータ活用を止めないためのマネジメントへ挑戦
hiracky16
0
400
パスキーの自動テストはどこまでいけるのか
teamlab
PRO
0
280
大型犬好きによるPugの紹介
yamanoku
1
160
Gemini Intelligence 入門 ― AppFunctions と Gemini Nano
takuroabe
0
300
Featured
See All Featured
The World Runs on Bad Software
bkeepers
PRO
72
12k
Groundhog Day: Seeking Process in Gaming for Health
codingconduct
0
420
Paper Plane (Part 1)
katiecoart
PRO
2
12k
Redefining SEO in the New Era of Traffic Generation
szymonslowik
1
480
A Soul's Torment
seathinner
8
3.8k
First, design no harm
axbom
PRO
2
1.3k
Crafting Experiences
bethany
1
380
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
780
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
430
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
540
Transcript
ACL 2021 Outstanding paper 紹介者:金輝燦(TMU M2 小町研) 2021/09/16 @第13回最先端NLP勉強会
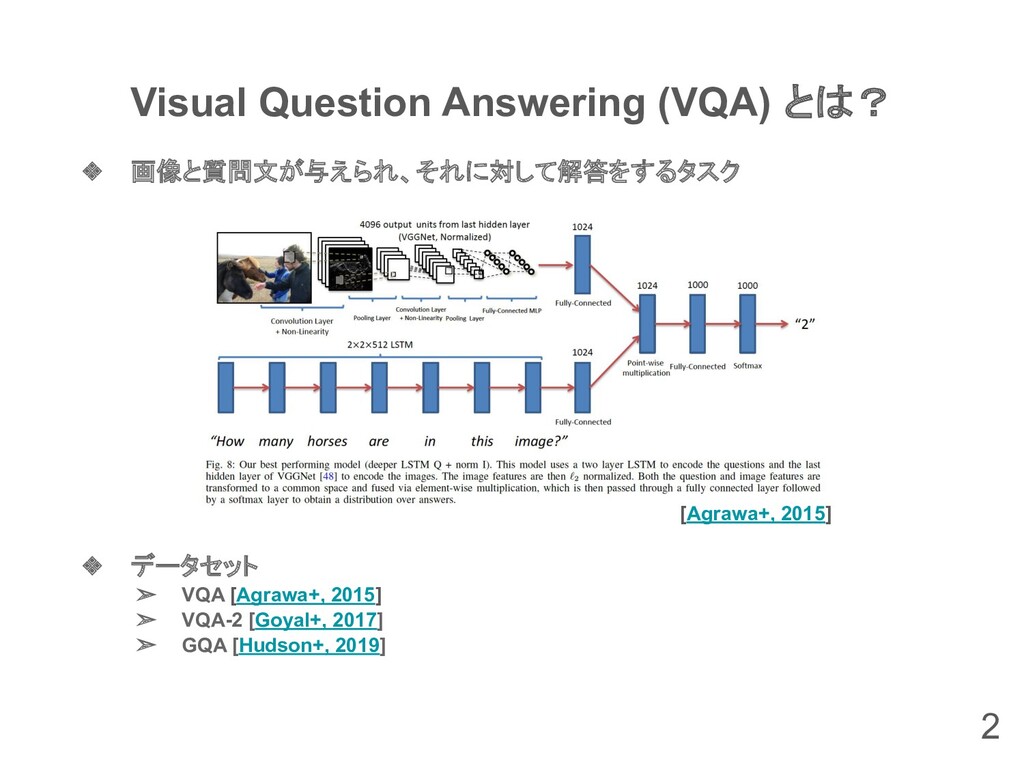
Visual Question Answering (VQA) とは? 2 ❖ 画像と質問文が与えられ、それに対して解答をするタスク ❖ データセット
➢ VQA [Agrawa+, 2015] ➢ VQA-2 [Goyal+, 2017] ➢ GQA [Hudson+, 2019] [Agrawa+, 2015]
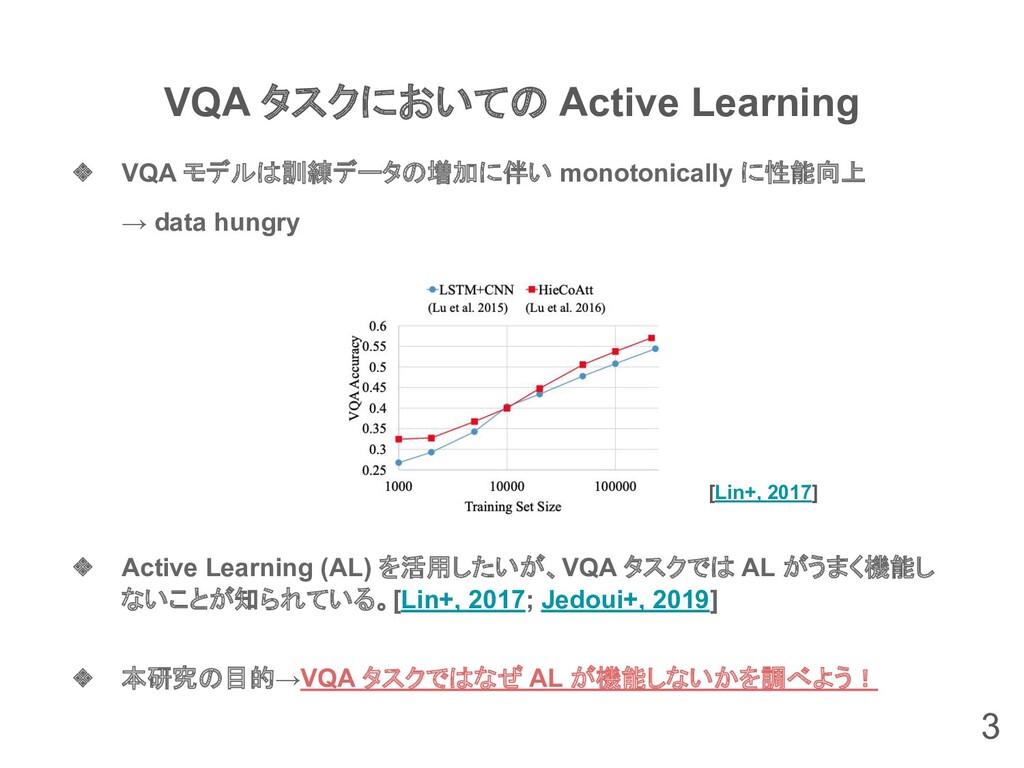
VQA タスクにおいての Active Learning 3 ❖ VQA モデルは訓練データの増加に伴い monotonically に性能向上
→ data hungry ❖ Active Learning (AL) を活用したいが、VQA タスクでは AL がうまく機能し ないことが知られている。[Lin+, 2017; Jedoui+, 2019] ❖ 本研究の目的→VQA タスクではなぜ AL が機能しないかを調べよう! [Lin+, 2017]
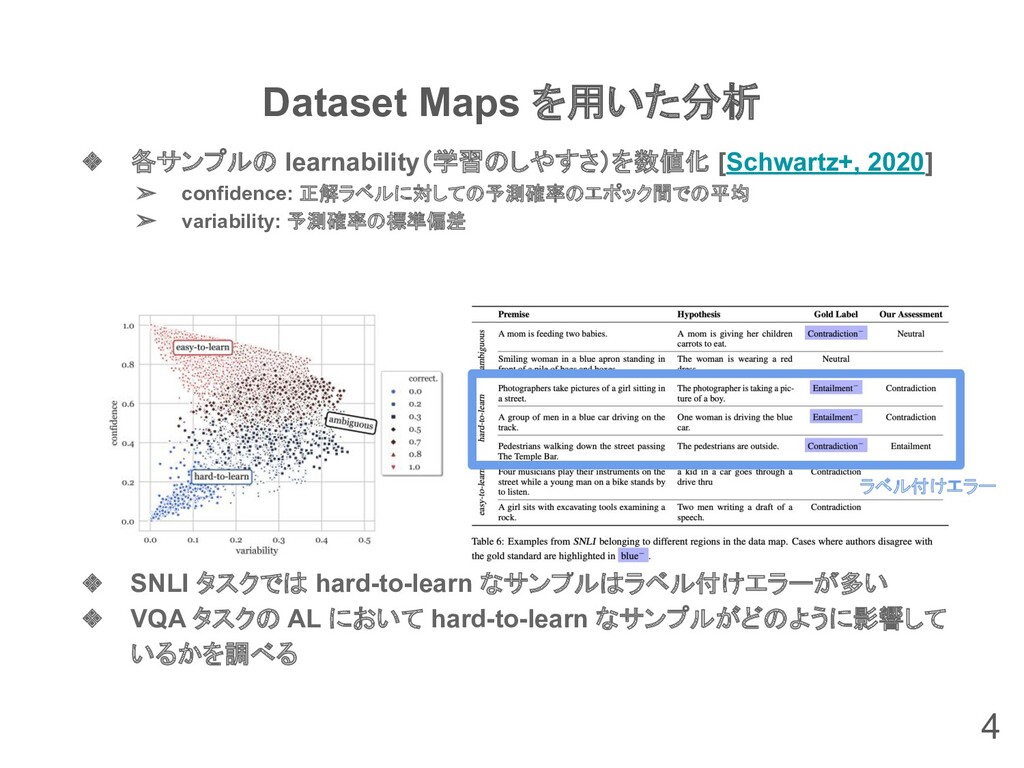
Dataset Maps を用いた分析 4 ❖ 各サンプルの learnability(学習のしやすさ)を数値化 [Schwartz+, 2020] ➢
confidence: 正解ラベルに対しての予測確率のエポック間での平均 ➢ variability: 予測確率の標準偏差 ❖ SNLI タスクでは hard-to-learn なサンプルはラベル付けエラーが多い ❖ VQA タスクの AL において hard-to-learn なサンプルがどのように影響して いるかを調べる ラベル付けエラー
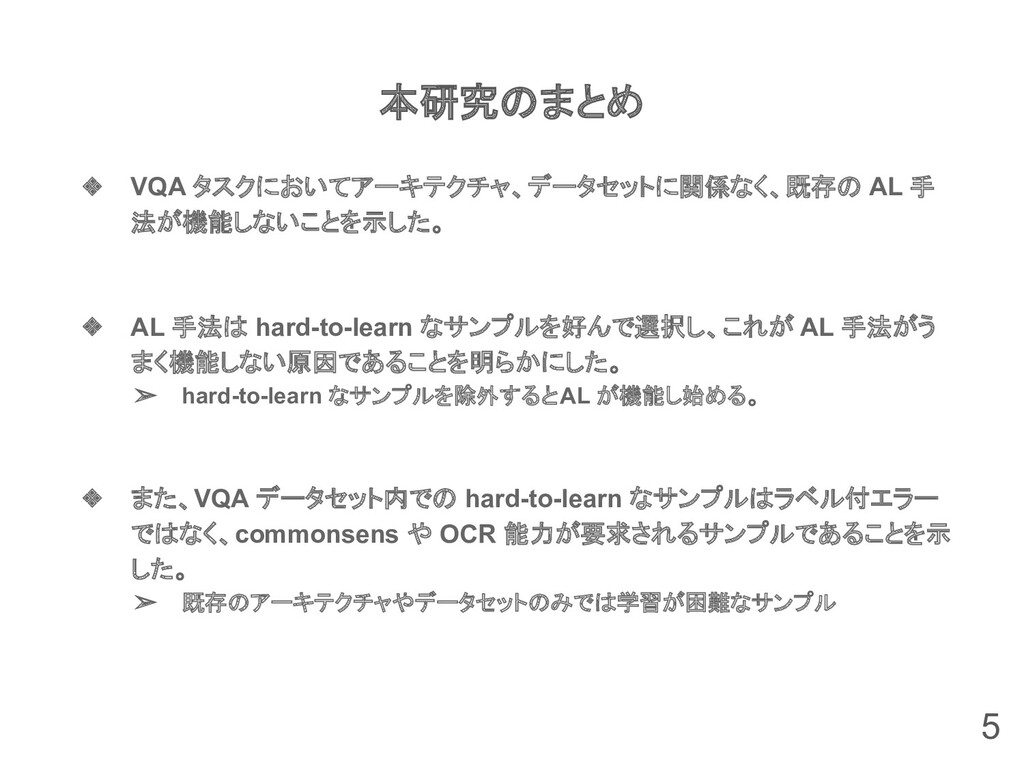
本研究のまとめ 5 ❖ VQA タスクにおいてアーキテクチャ、データセットに関係なく、既存の AL 手 法が機能しないことを示した。 ❖ AL
手法は hard-to-learn なサンプルを好んで選択し、これが AL 手法がう まく機能しない原因であることを明らかにした。 ➢ hard-to-learn なサンプルを除外すると AL が機能し始める。 ❖ また、VQA データセット内での hard-to-learn なサンプルはラベル付エラー ではなく、commonsens や OCR 能力が要求されるサンプルであることを示 した。 ➢ 既存のアーキテクチャやデータセットのみでは学習が困難なサンプル
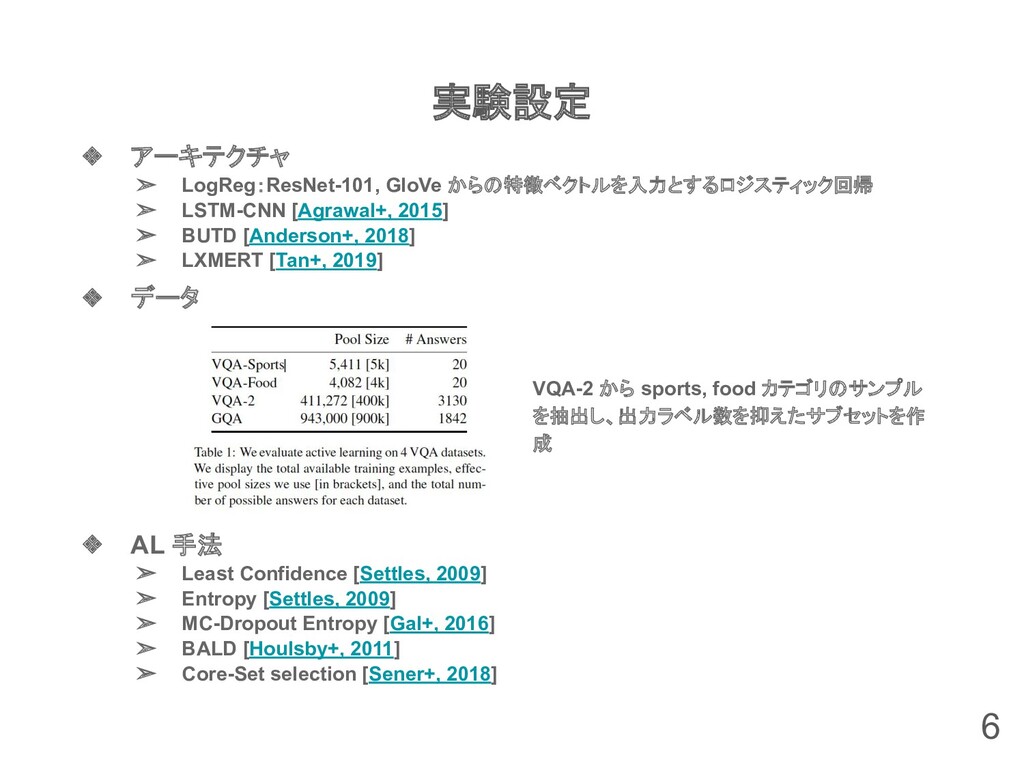
実験設定 6 ❖ アーキテクチャ ➢ LogReg:ResNet-101, GloVe からの特徴ベクトルを入力とするロジスティック回帰 ➢ LSTM-CNN
[Agrawal+, 2015] ➢ BUTD [Anderson+, 2018] ➢ LXMERT [Tan+, 2019] ❖ データ ❖ AL 手法 ➢ Least Confidence [Settles, 2009] ➢ Entropy [Settles, 2009] ➢ MC-Dropout Entropy [Gal+, 2016] ➢ BALD [Houlsby+, 2011] ➢ Core-Set selection [Sener+, 2018] VQA-2 から sports, food カテゴリのサンプル を抽出し、出力ラベル数を抑えたサブセットを作 成
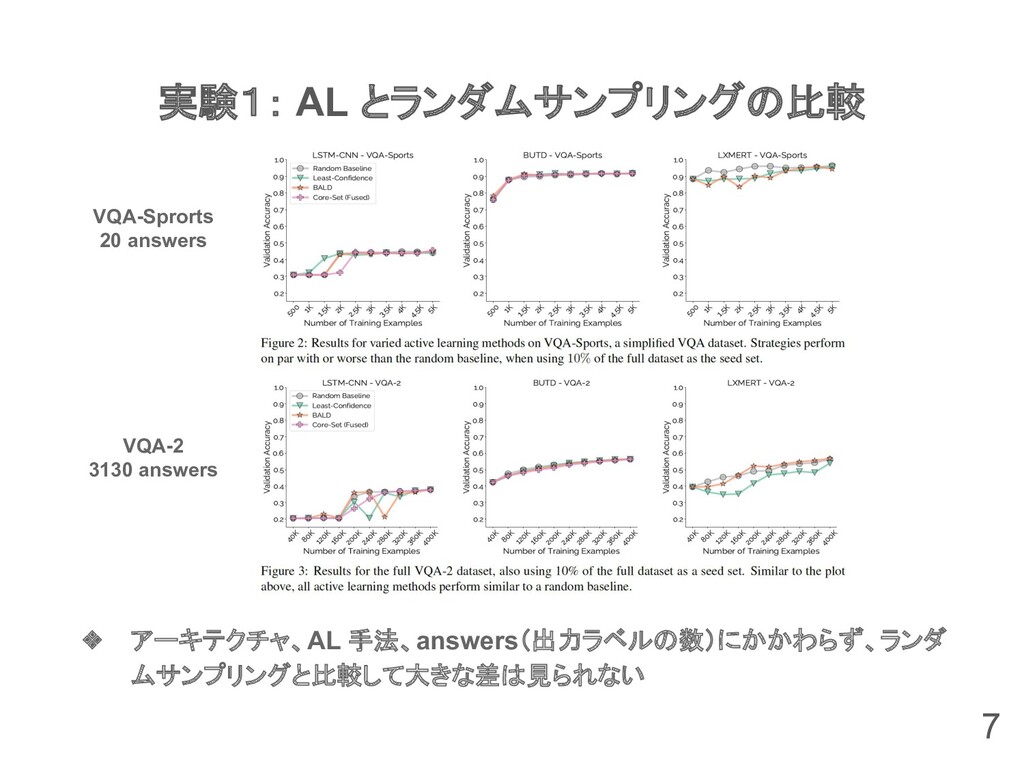
実験1: AL とランダムサンプリングの比較 7 ❖ アーキテクチャ、AL 手法、answers(出力ラベルの数)にかかわらず、ランダ ムサンプリングと比較して大きな差は見られない VQA-Sprorts 20
answers VQA-2 3130 answers
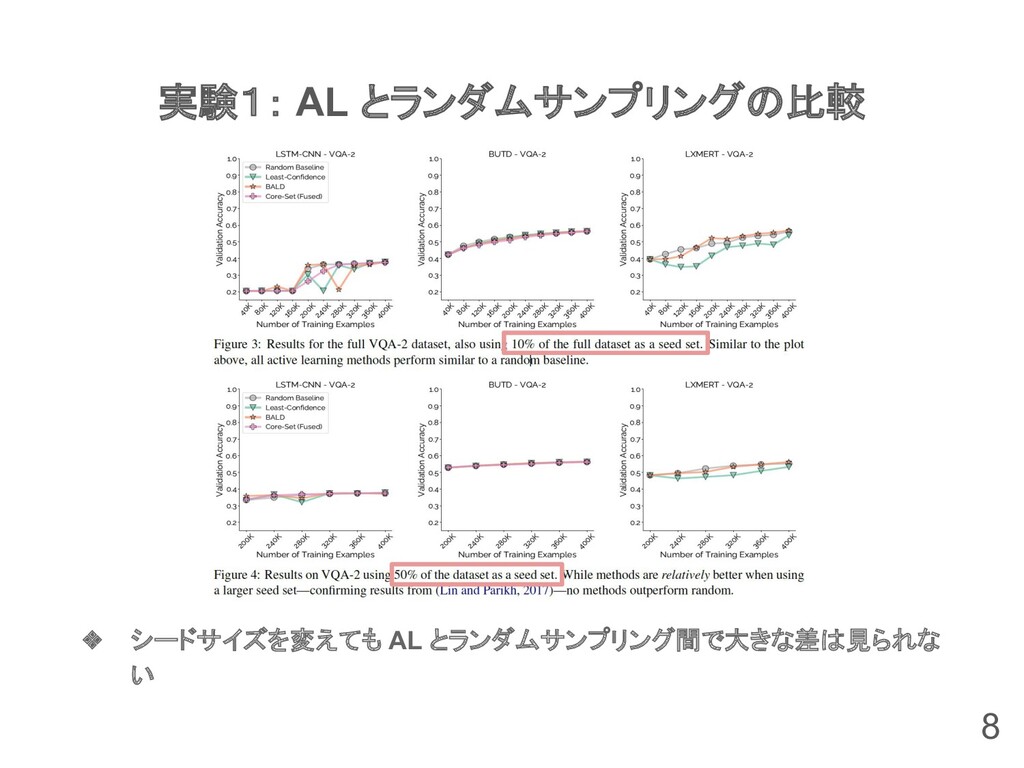
実験1: AL とランダムサンプリングの比較 8 ❖ シードサイズを変えても AL とランダムサンプリング間で大きな差は見られな い
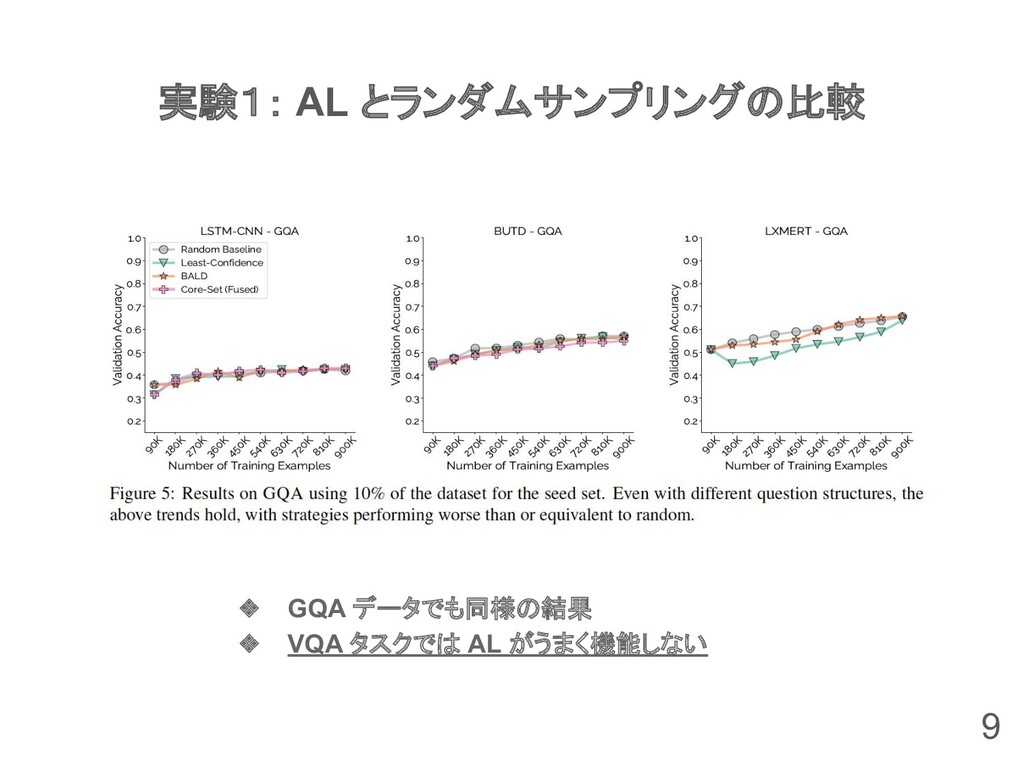
実験1: AL とランダムサンプリングの比較 9 ❖ GQA データでも同様の結果 ❖ VQA タスクでは
AL がうまく機能しない
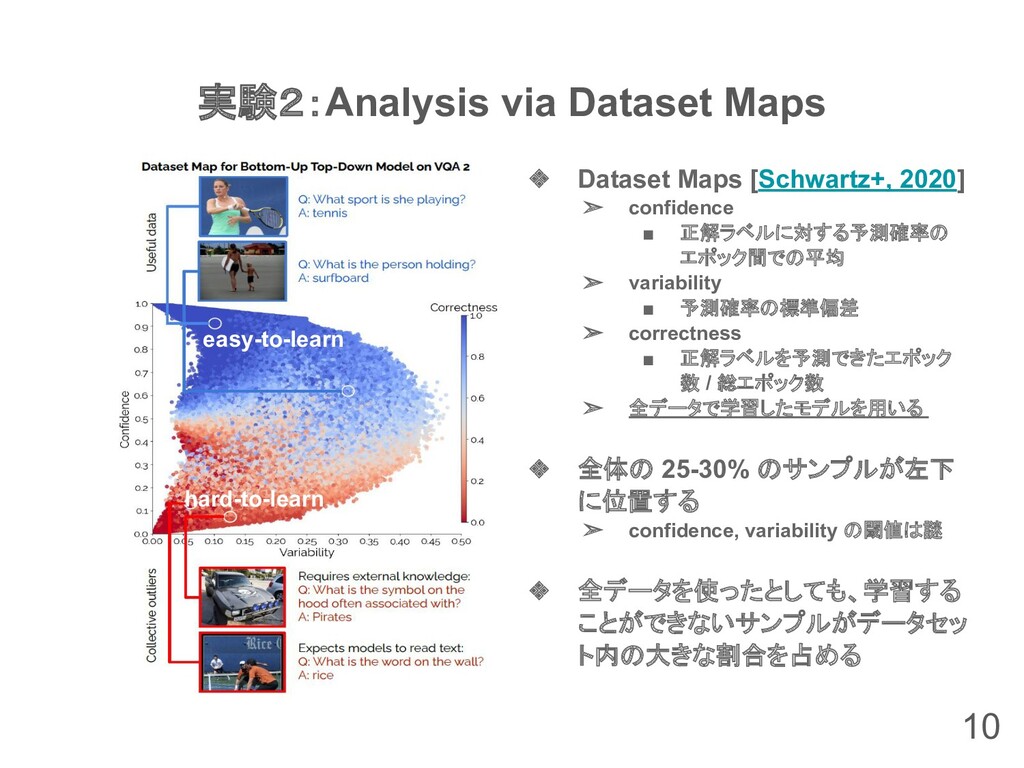
実験2:Analysis via Dataset Maps 10 ❖ Dataset Maps [Schwartz+, 2020]
➢ confidence ▪ 正解ラベルに対する予測確率の エポック間での平均 ➢ variability ▪ 予測確率の標準偏差 ➢ correctness ▪ 正解ラベルを予測できたエポック 数 / 総エポック数 ➢ 全データで学習したモデルを用いる ❖ 全体の 25-30% のサンプルが左下 に位置する ➢ confidence, variability の閾値は謎 ❖ 全データを使ったとしても、学習する ことができないサンプルがデータセッ ト内の大きな割合を占める hard-to-learn easy-to-learn
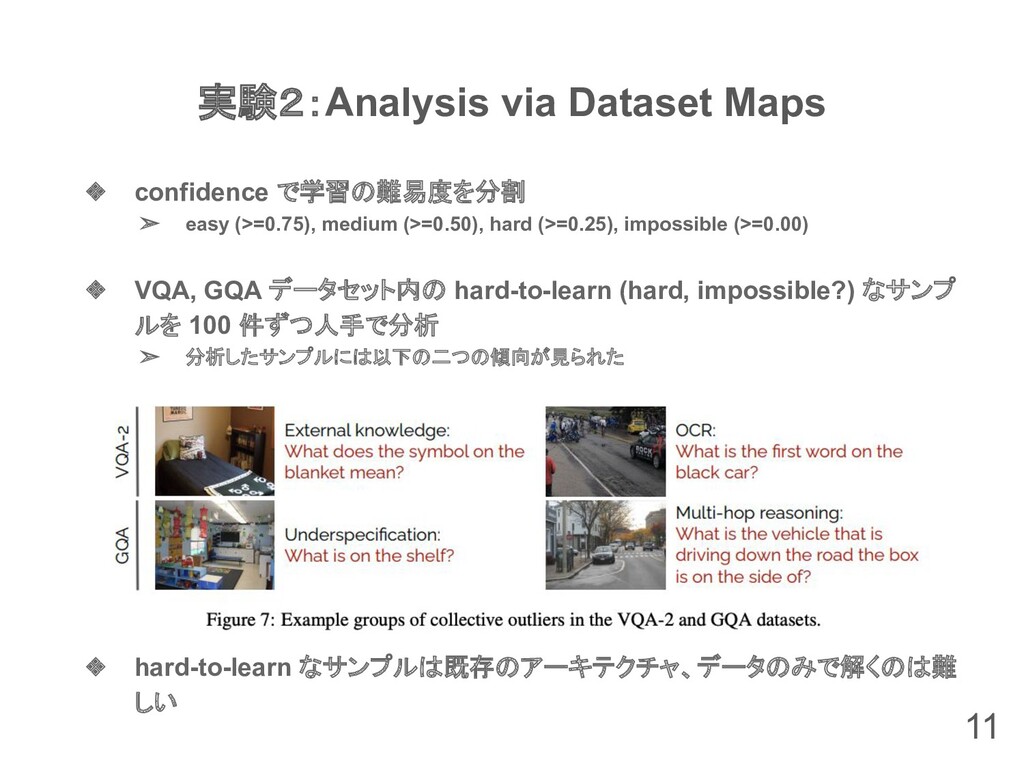
実験2:Analysis via Dataset Maps 11 ❖ confidence で学習の難易度を分割 ➢ easy
(>=0.75), medium (>=0.50), hard (>=0.25), impossible (>=0.00) ❖ VQA, GQA データセット内の hard-to-learn (hard, impossible?) なサンプ ルを 100 件ずつ人手で分析 ➢ 分析したサンプルには以下の二つの傾向が見られた ❖ hard-to-learn なサンプルは既存のアーキテクチャ、データのみで解くのは難 しい
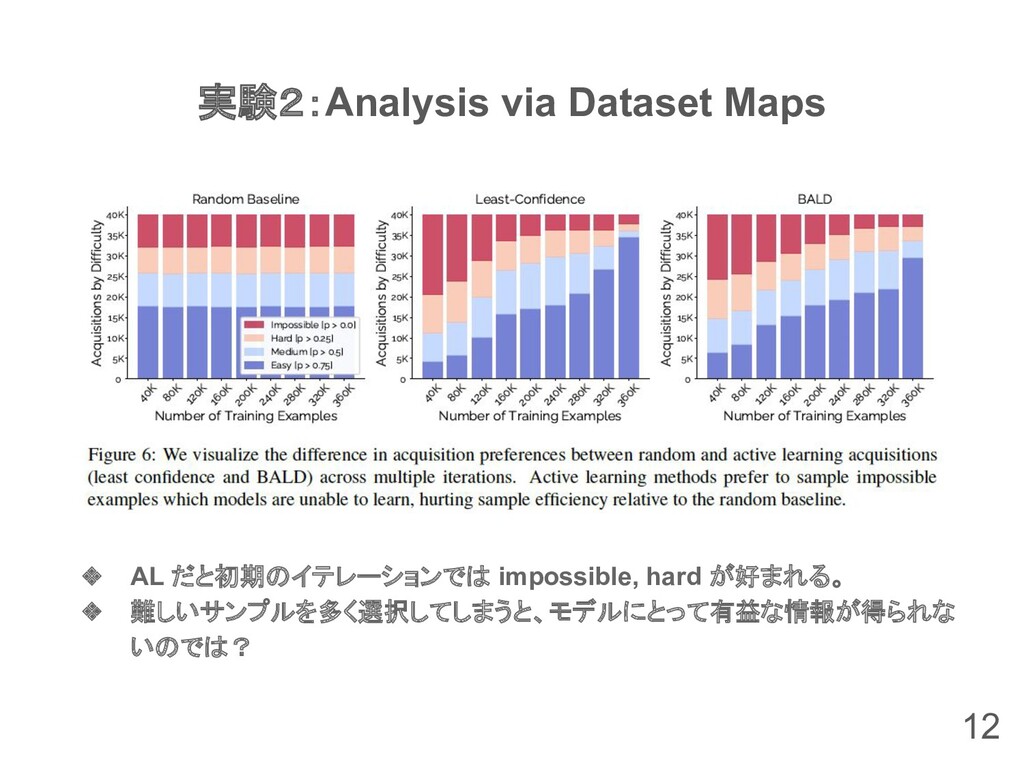
実験2:Analysis via Dataset Maps 12 ❖ AL だと初期のイテレーションでは impossible, hard
が好まれる。 ❖ 難しいサンプルを多く選択してしまうと、モデルにとって有益な情報が得られな いのでは?
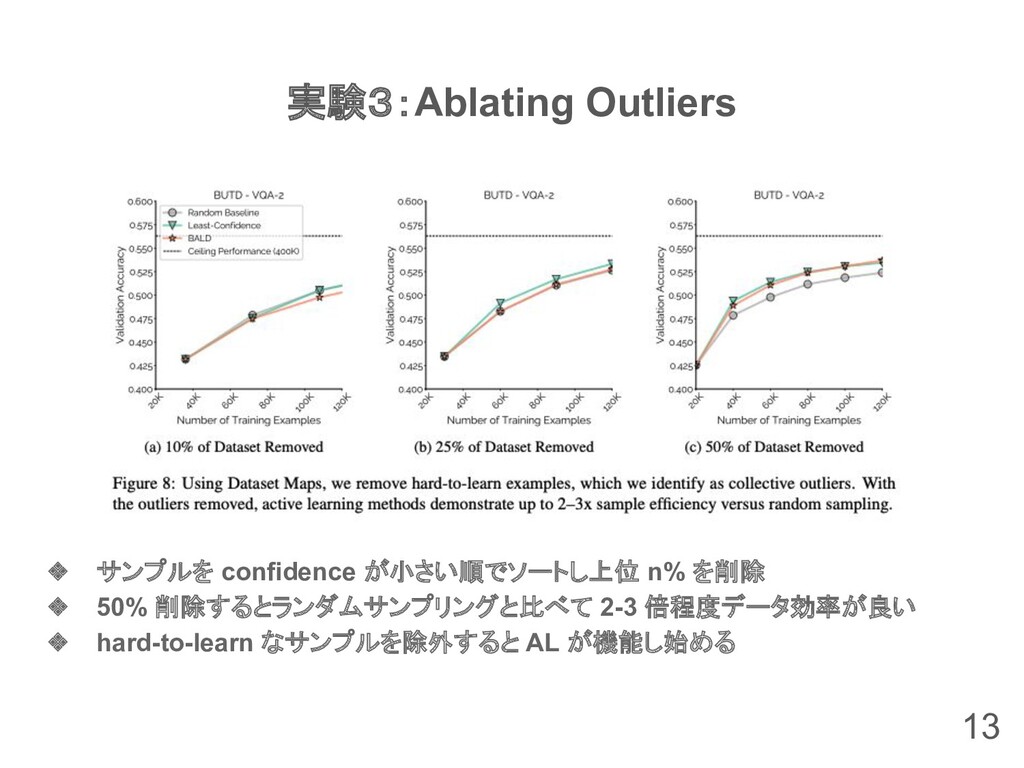
実験3:Ablating Outliers 13 ❖ サンプルを confidence が小さい順でソートし上位 n% を削除 ❖
50% 削除するとランダムサンプリングと比べて 2-3 倍程度データ効率が良い ❖ hard-to-learn なサンプルを除外すると AL が機能し始める
まとめと今後の展望 14 ❖ VQA において、なぜ AL が機能しないかを Dataset Maps を用いて分析
❖ hard-to-learn なサンプルを除外すると AL が機能し始めた ➢ AL 手法が hard-to-learn なサンプルを多く選択してしまうことが原因だった ❖ VQA タスクのデータセットにおいての hard-to-learn なサンプルとは、 commonsens や OCR 能力が要求されるサンプル ➢ 既存のアーキテクチャやデータセットのみでは学習することは難しい ❖ 今後は、全く新しいサンプルが hard-to-learn かどうかを区別する手法を検討 ➢ Dataset Maps は全データでモデルを学習する必要があり実用的ではない ➢ in-domain か out-of-domain かを分類する手法を活用できそう [Kamath+, 2020]


 colopl
 yamad
 riyaamemiya
 nealle
 satoshi7
 tetsuya28
 kairim0
 jtakeda
 hiracky16
 teamlab
 yamanoku
 takuroabe
 bkeepers
 codingconduct
 katiecoart
 szymonslowik
 seathinner
 axbom
 bethany
 portentint
 greggifford
 tammyeverts
 marketingsoph
 jacobtomlinson