Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
生成AIと検索について落ち着いて考える(社内勉強会資料)
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
AITC - DENTSU SOKEN
October 13, 2026
Technology
13
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
生成AIと検索について落ち着いて考える(社内勉強会資料)
生成AIと検索について、社内勉強会(TechTalk)で共有した社内向け資料になります。
〇〇RAGという言葉で丸め込まれている様々な要素を、具体例を上げながら紹介しています。
AITC - DENTSU SOKEN
October 13, 2026
More Decks by AITC - DENTSU SOKEN
See All by AITC - DENTSU SOKEN
LLM-as-a-Judgeの具体的な取り組み
isidaitc
2
1.7k
AIエージェントを現場で実践する際の落とし穴.pdf
isidaitc
1
150
AIエージェントの評価ポイント紹介
isidaitc
0
180
長期・短期メモリを活用したエージェントの個別最適化
isidaitc
0
1k
電通総研の生成AI・エージェントの取り組み エンジニアリング業務向けAI活用事例紹介
isidaitc
1
2k
IR Reading 2025春 論文紹介「Do Images Clarify? A Study on the Effect of Images on Clarifying Questions in Conversational Search」
isidaitc
0
120
AIアプリケーション開発でAzure AI Searchを使いこなすためには
isidaitc
2
2.4k
IR Reading 2024秋 論文紹介「MeMemo On-device Retrieval Augmentation for Private and Personalized Text Generation」
isidaitc
0
1.9k
電通総研のLLMエージェントの技術開発や製造のAI活用事例紹介
isidaitc
3
5.6k
Other Decks in Technology
See All in Technology
AI 時代の Azure エンジニアリング ~ 私たちは何を磨き、何を任せるのか ~
chack411
1
560
今さら理解するウェブフォントver.2026
takanorip
3
590
プロダクト価値を、 チームが使える判断軸に変える
vivion
0
140
予測不能な実行エージェントを安全にサクッと試せるサンドボックス環境の話
sansantech
PRO
0
140
3つのアプローチで目指す チームを強くするAI駆動開発
thkt
0
150
「事実」を「計測」して、「解釈」する 〜AWS Lambdaのメモリ最適解の見つけ方〜
maimyyym
0
120
スキルを作る、その前に!複数人で使われるスキルを 作るためのプロセス
junkifurukawa
2
370
AIは爆速なのに、私が詰まっていた話 ― 音声入力と鳴くマスコットでボトルネックを削る
yama3133
0
580
FactoryBotアンチパターン / factory_bot anti-patterns
toshimaru
0
140
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
350
ai_cording_with_k8s_knowledge.pdf
mochizuki875
1
320
USB PDを使ってスマホを労わりたい
raspython3
0
110
Featured
See All Featured
Mobile First: as difficult as doing things right
swwweet
225
10k
Design in an AI World
tapps
1
350
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
370
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
300
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
Code Reviewing Like a Champion
maltzj
529
40k
A better future with KSS
kneath
240
18k
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
4
4.3k
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
480
Balancing Empowerment & Direction
lara
6
1.3k
RailsConf 2023
tenderlove
30
1.6k
First, design no harm
axbom
PRO
2
1.3k
Transcript
エーアイ × ト × ケンサク ~生成AIと検索について落ち着いて考える~ TechTalk 2026年3月17日 村本 直樹
注意点 この資料にすごく目新しいことは書いていません。 詳しい技術要素もなるべく省いています。 生成AI時代の熱狂の中、改めて「冷静に大事なことを考えましょう」 という思いも込めて作成された資料でございます。 また、本スライドの内容は個人の理解に基づいて書かれています。 厳密な定義、歴史、解釈とずれている部分もあると思いますが、 ご容赦いただければと思います。 (明確な間違いがあればご指摘ください) 2
このスライドの作成者について 趣味 仕事 内容 プライ ベート PC ・Jリーグ観戦(ヴィッセル神戸) ・F1(フェルスタッペン、ラッセル) ・映画鑑賞(アクション・ミュージカル)
・ミュージカル鑑賞 生成AIソリューション 「Know Narrator」の開発 ThinkPad X 13 Gen3 (AMD) 3
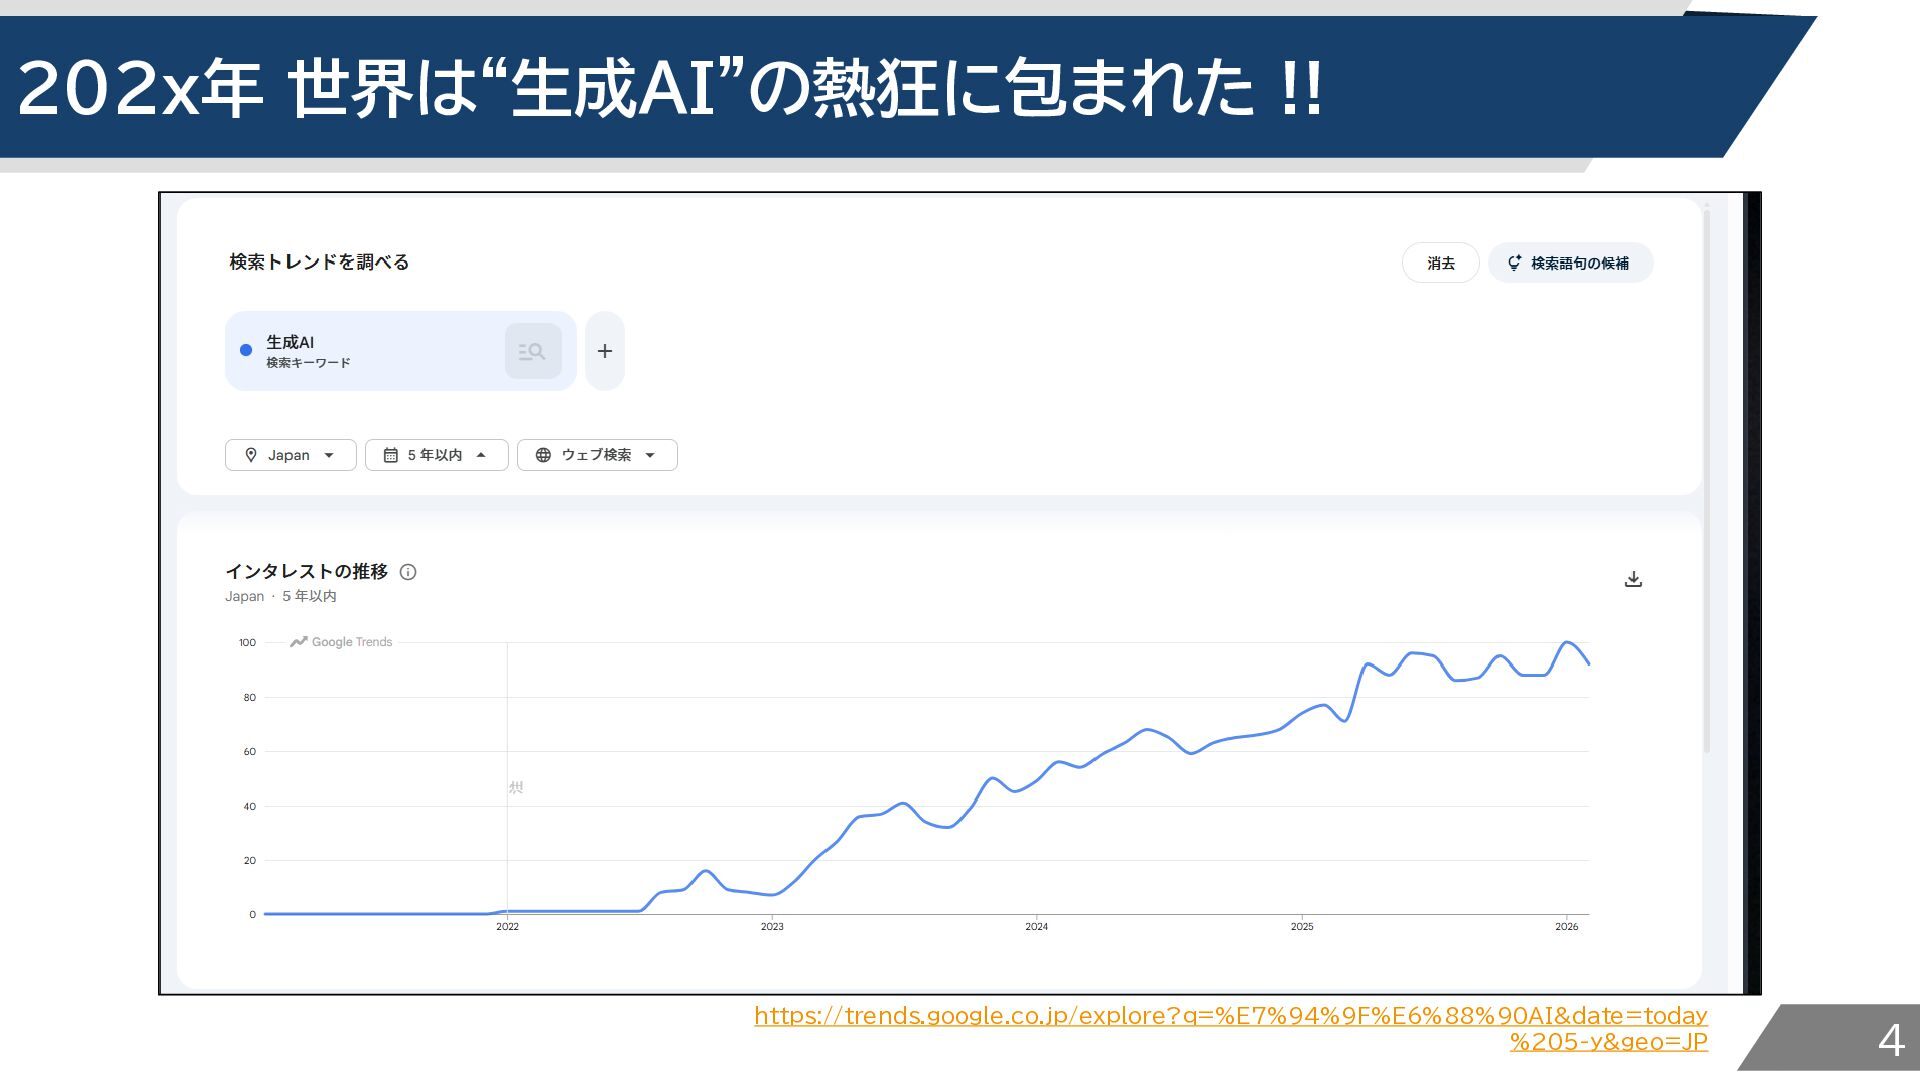
202x年 世界は“生成AI”の熱狂に包まれた !! https://trends.google.co.jp/explore?q=%E7%94%9F%E6%88%90AI&date=today %205-y&geo=JP 4
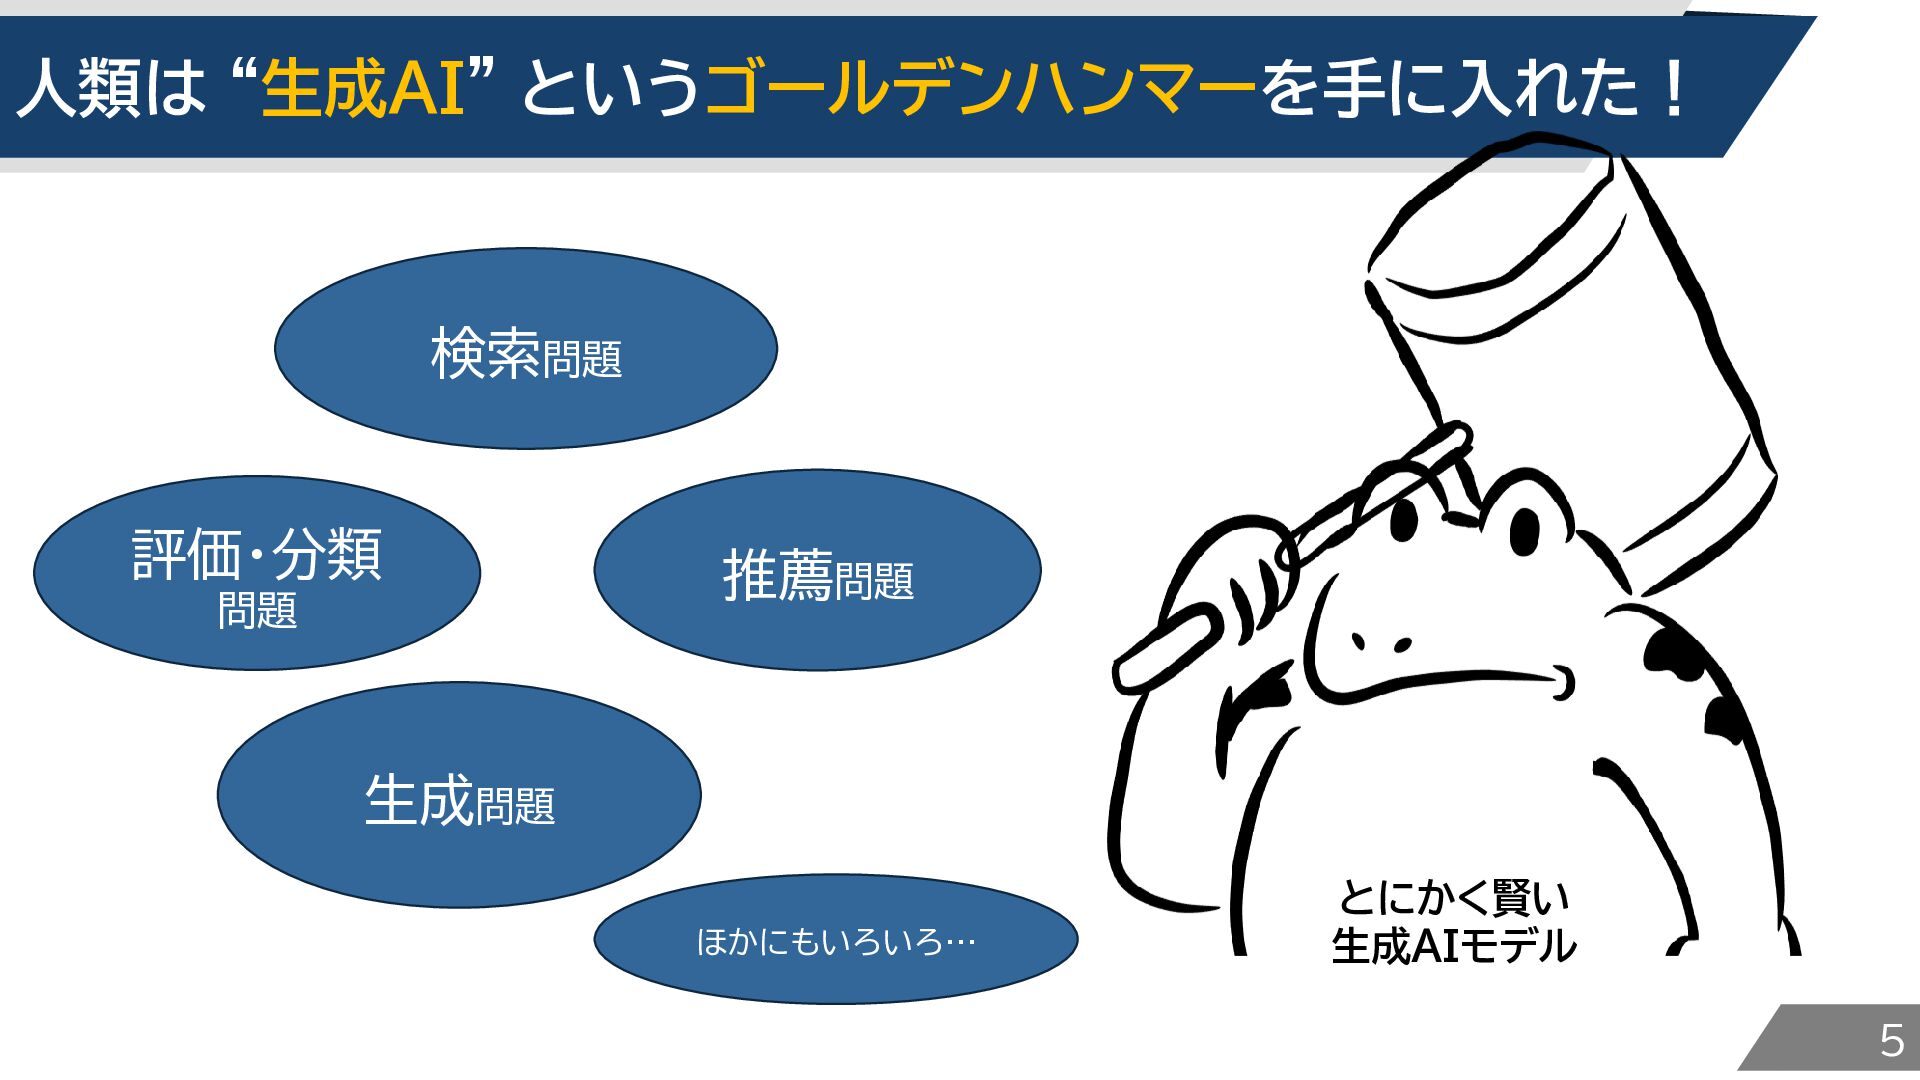
人類は “生成AI” というゴールデンハンマーを手に入れた! 検索問題 評価・分類 問題 推薦問題 生成問題 ほかにもいろいろ… とにかく賢い
生成AIモデル 5
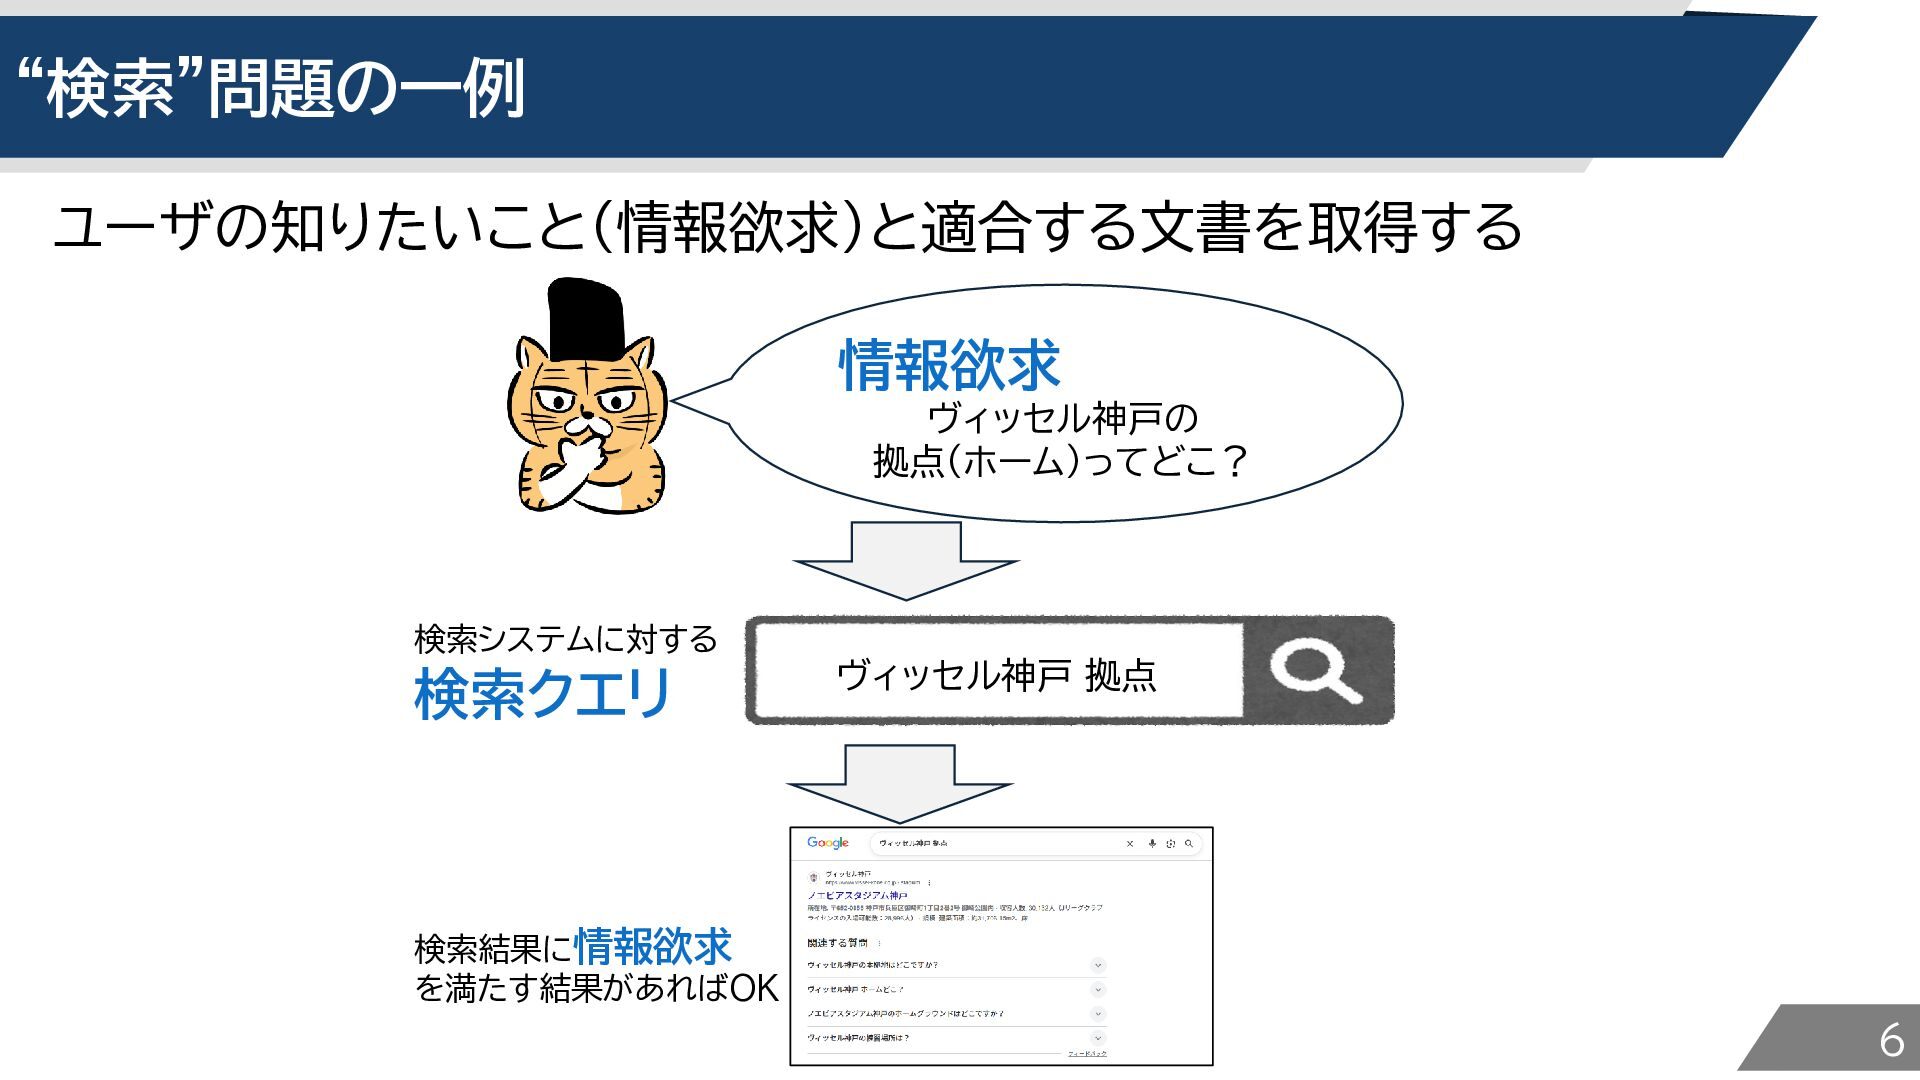
“検索”問題の一例 ユーザの知りたいこと(情報欲求)と適合する文書を取得する 情報欲求 ヴィッセル神戸の 拠点(ホーム)ってどこ? 検索システムに対する 検索クエリ ヴィッセル神戸 拠点 検索結果に情報欲求
を満たす結果があればOK 6
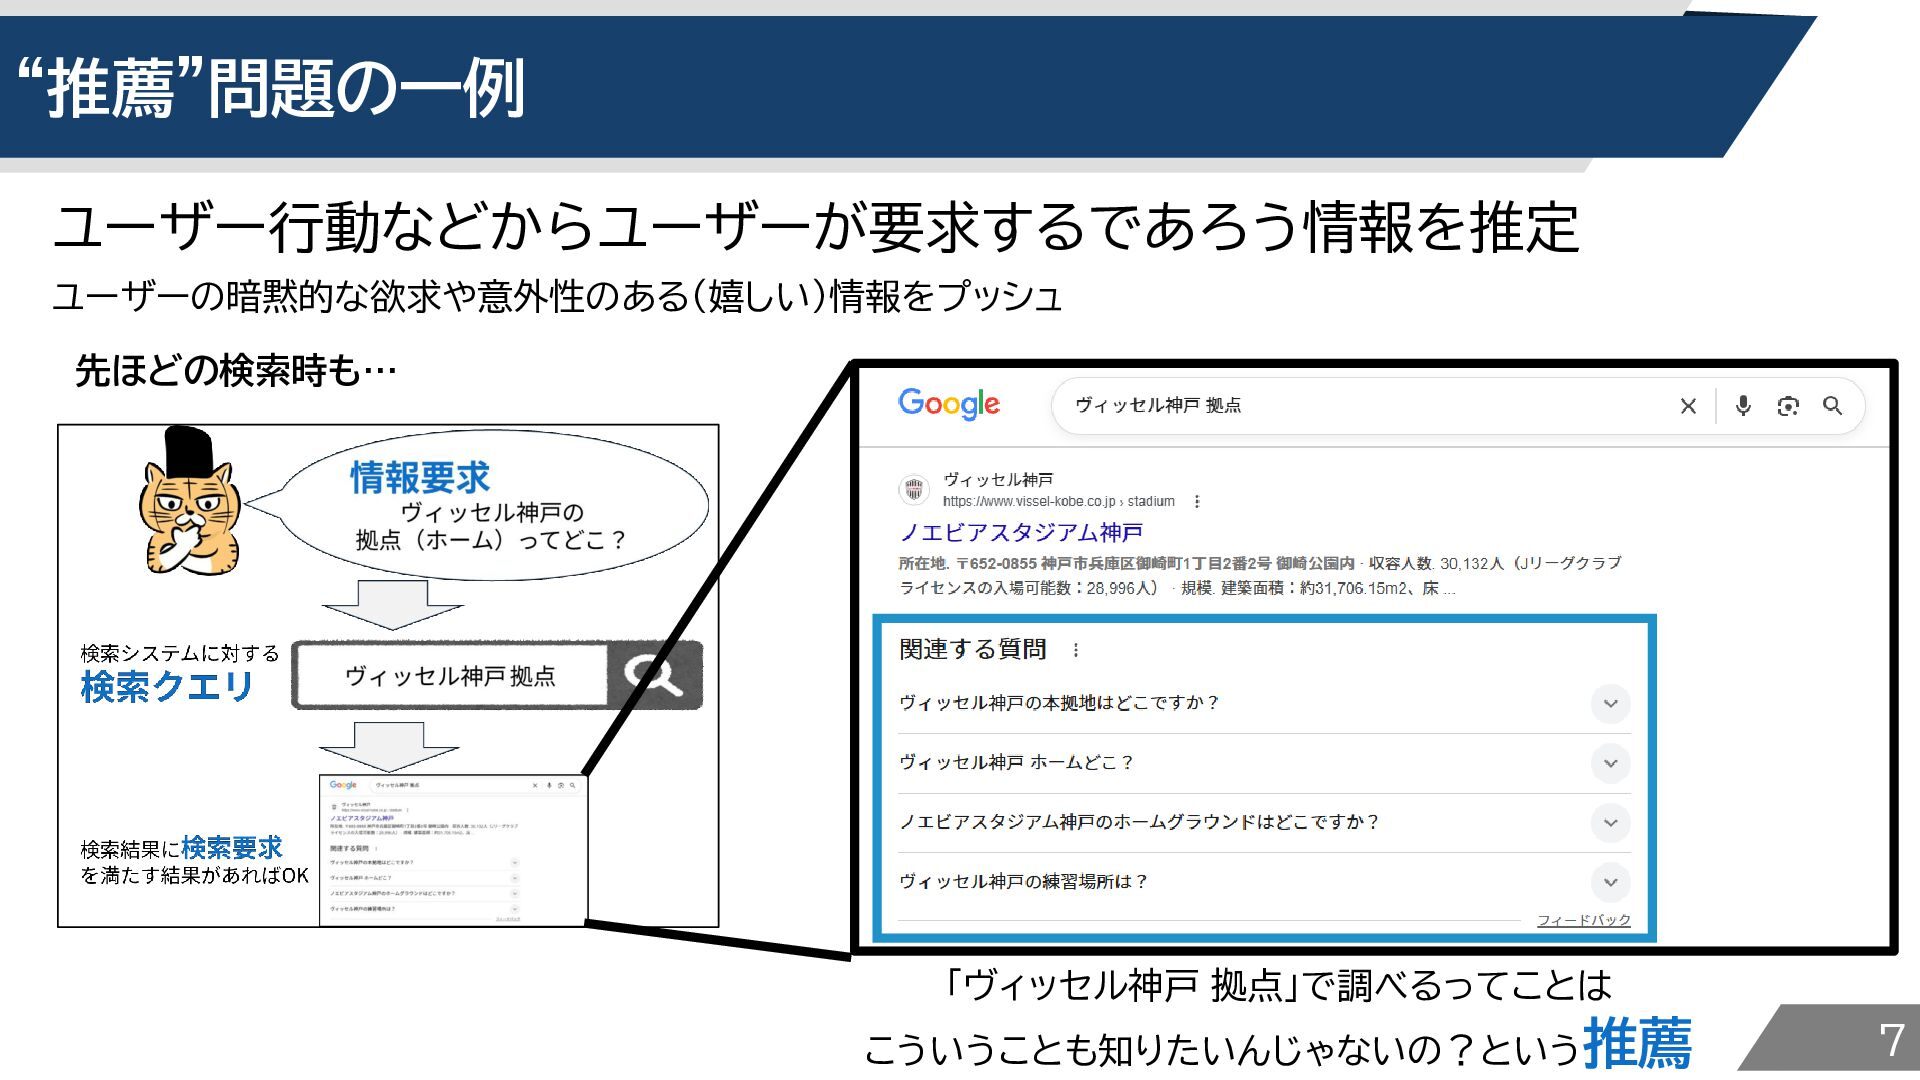
“推薦”問題の一例 ユーザー行動などからユーザーが要求するであろう情報を推定 ユーザーの暗黙的な欲求や意外性のある(嬉しい)情報をプッシュ 先ほどの検索時も… 「ヴィッセル神戸 拠点」で調べるってことは こういうことも知りたいんじゃないの?という推薦 7
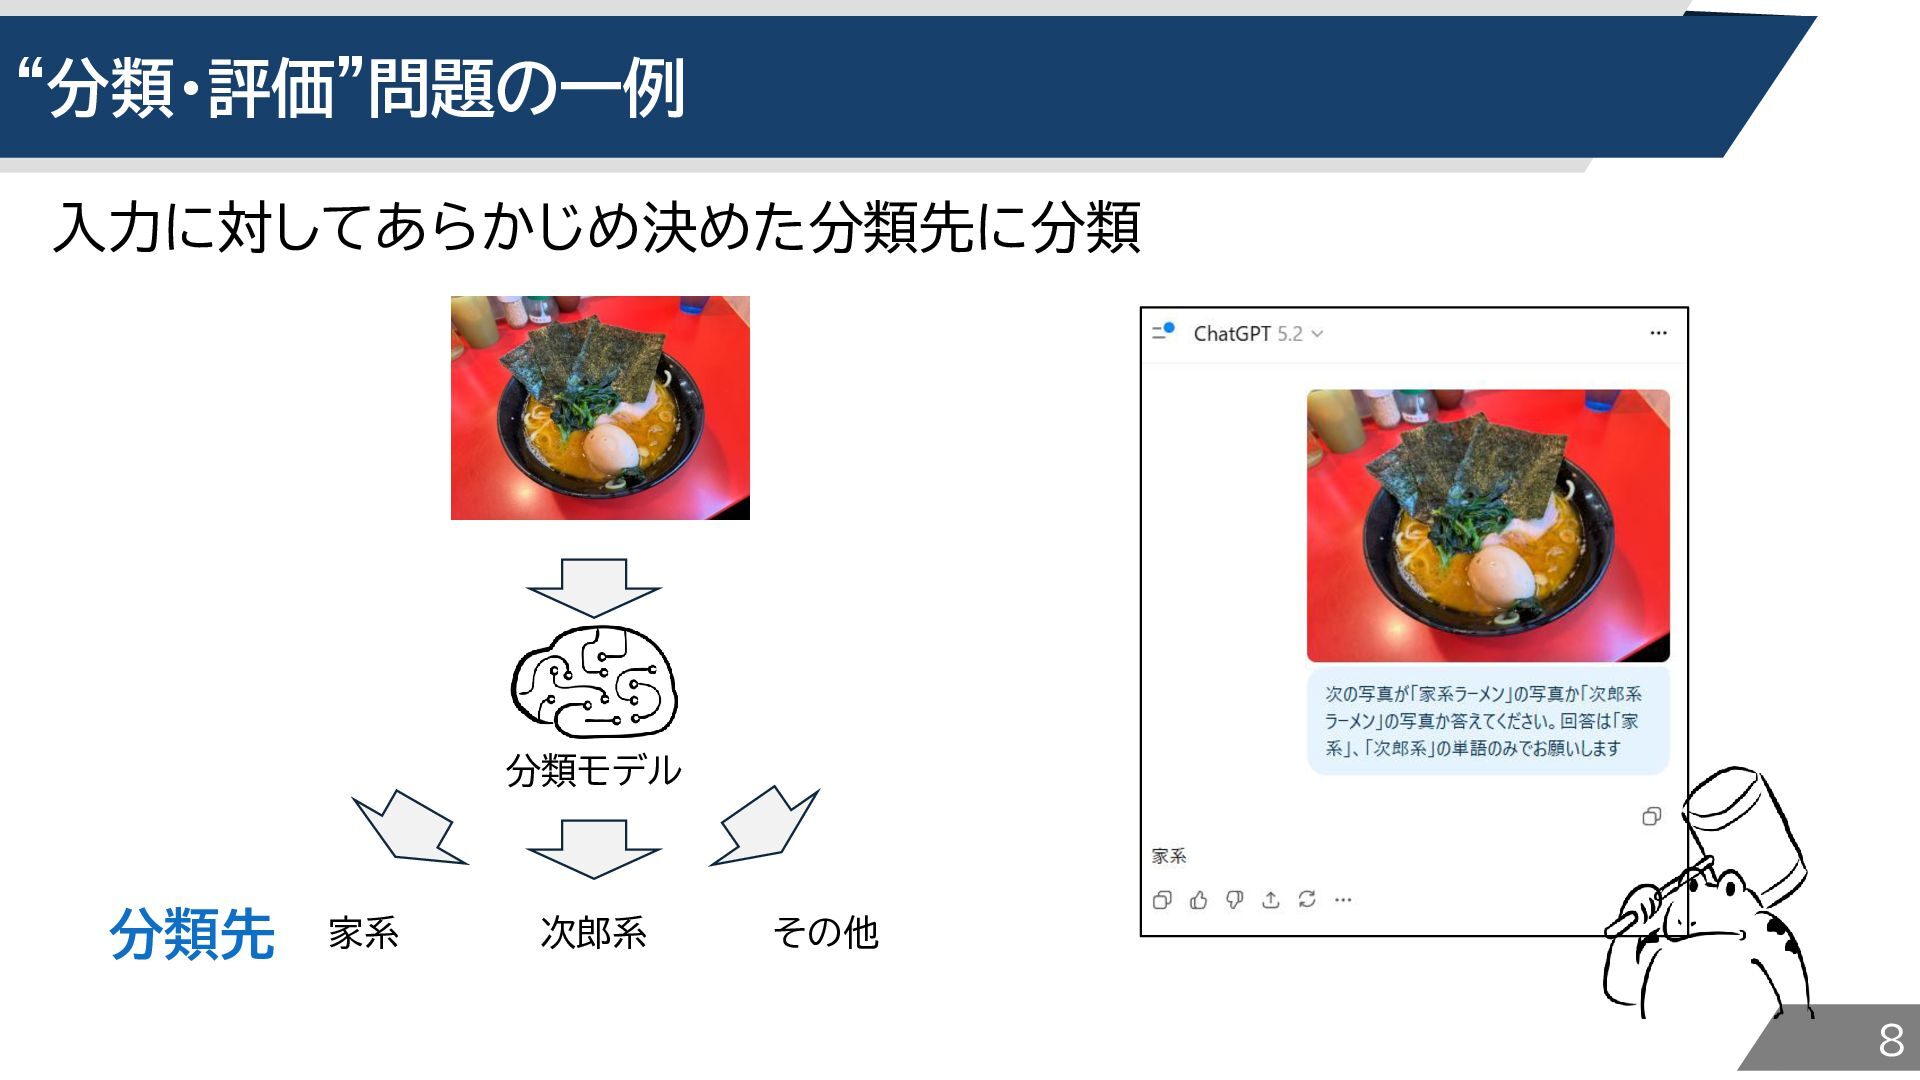
“分類・評価”問題の一例 入力に対してあらかじめ決めた分類先に分類 分類モデル 分類先 家系 次郎系 その他 8
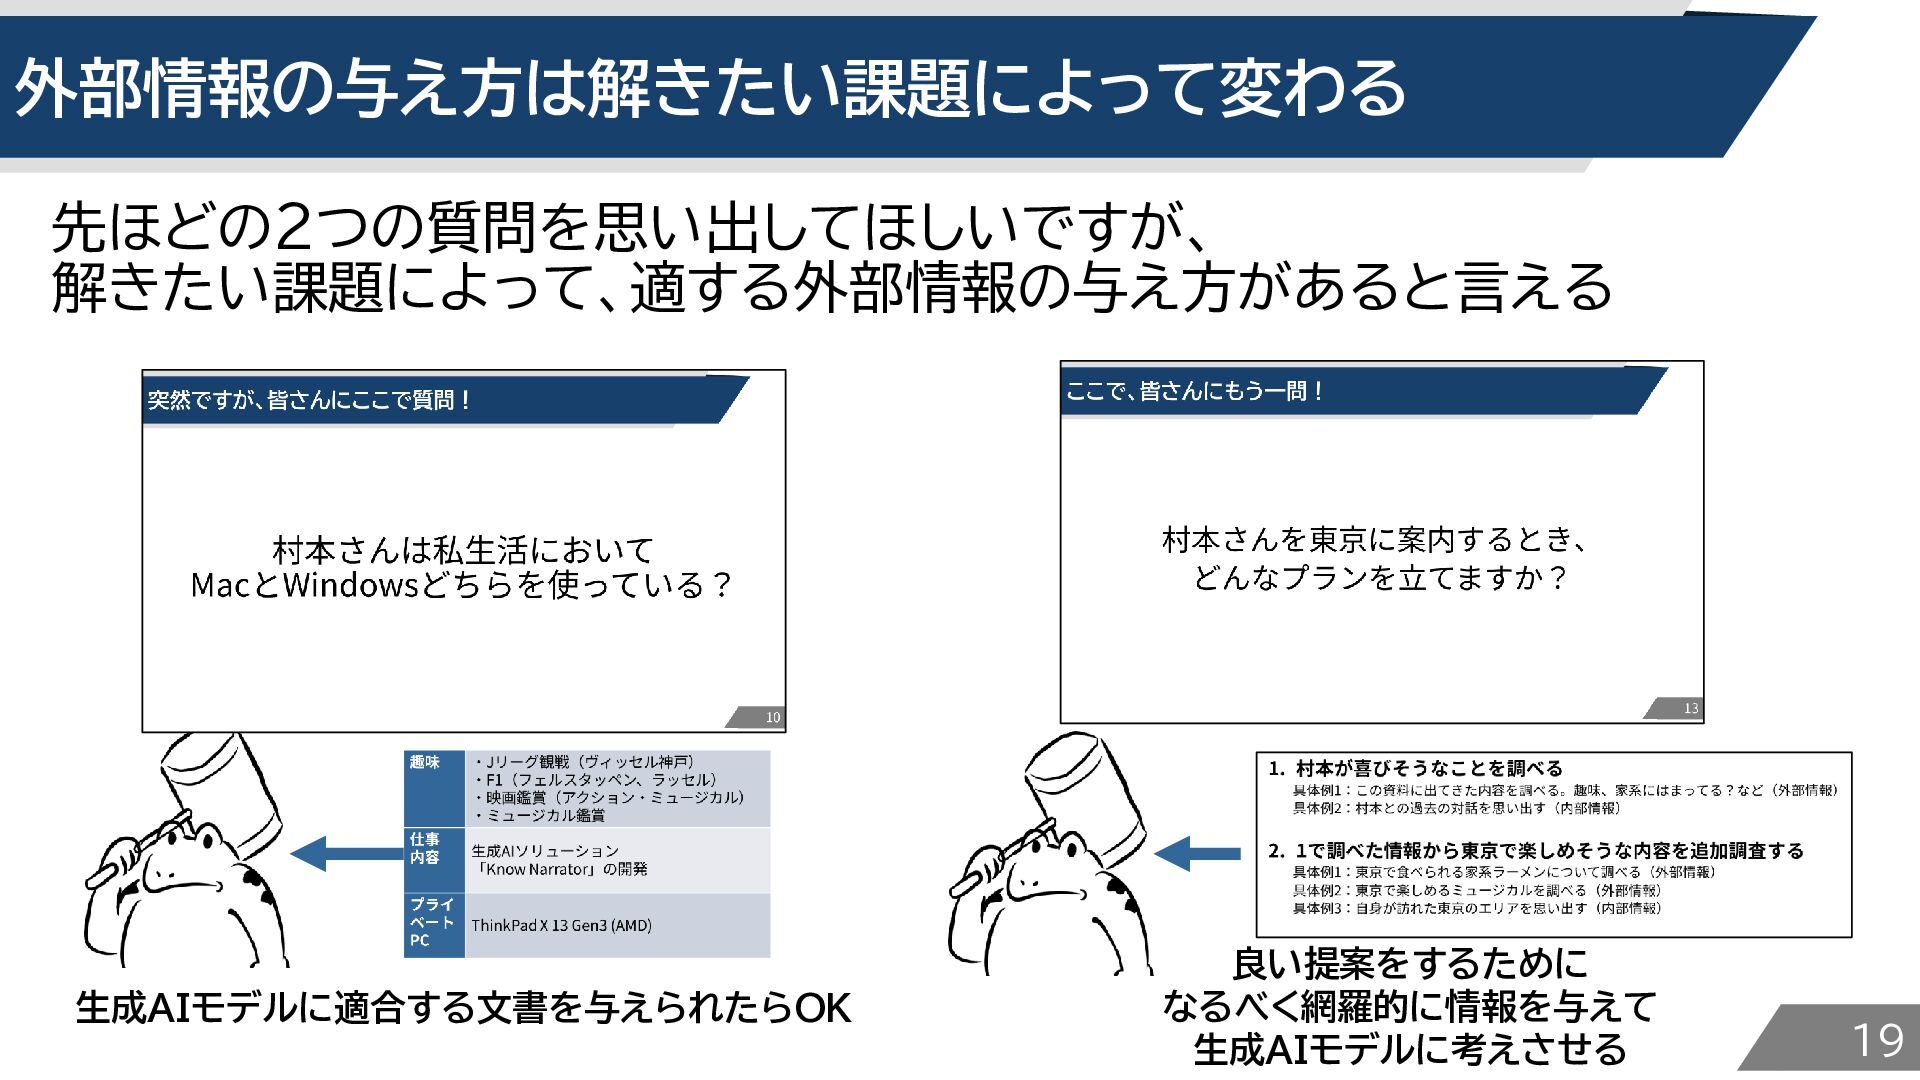
突然ですが、皆さんにここで質問! 村本さんは私生活において MacとWindowsどちらを使っている? 10
正解は… Windows!! 11
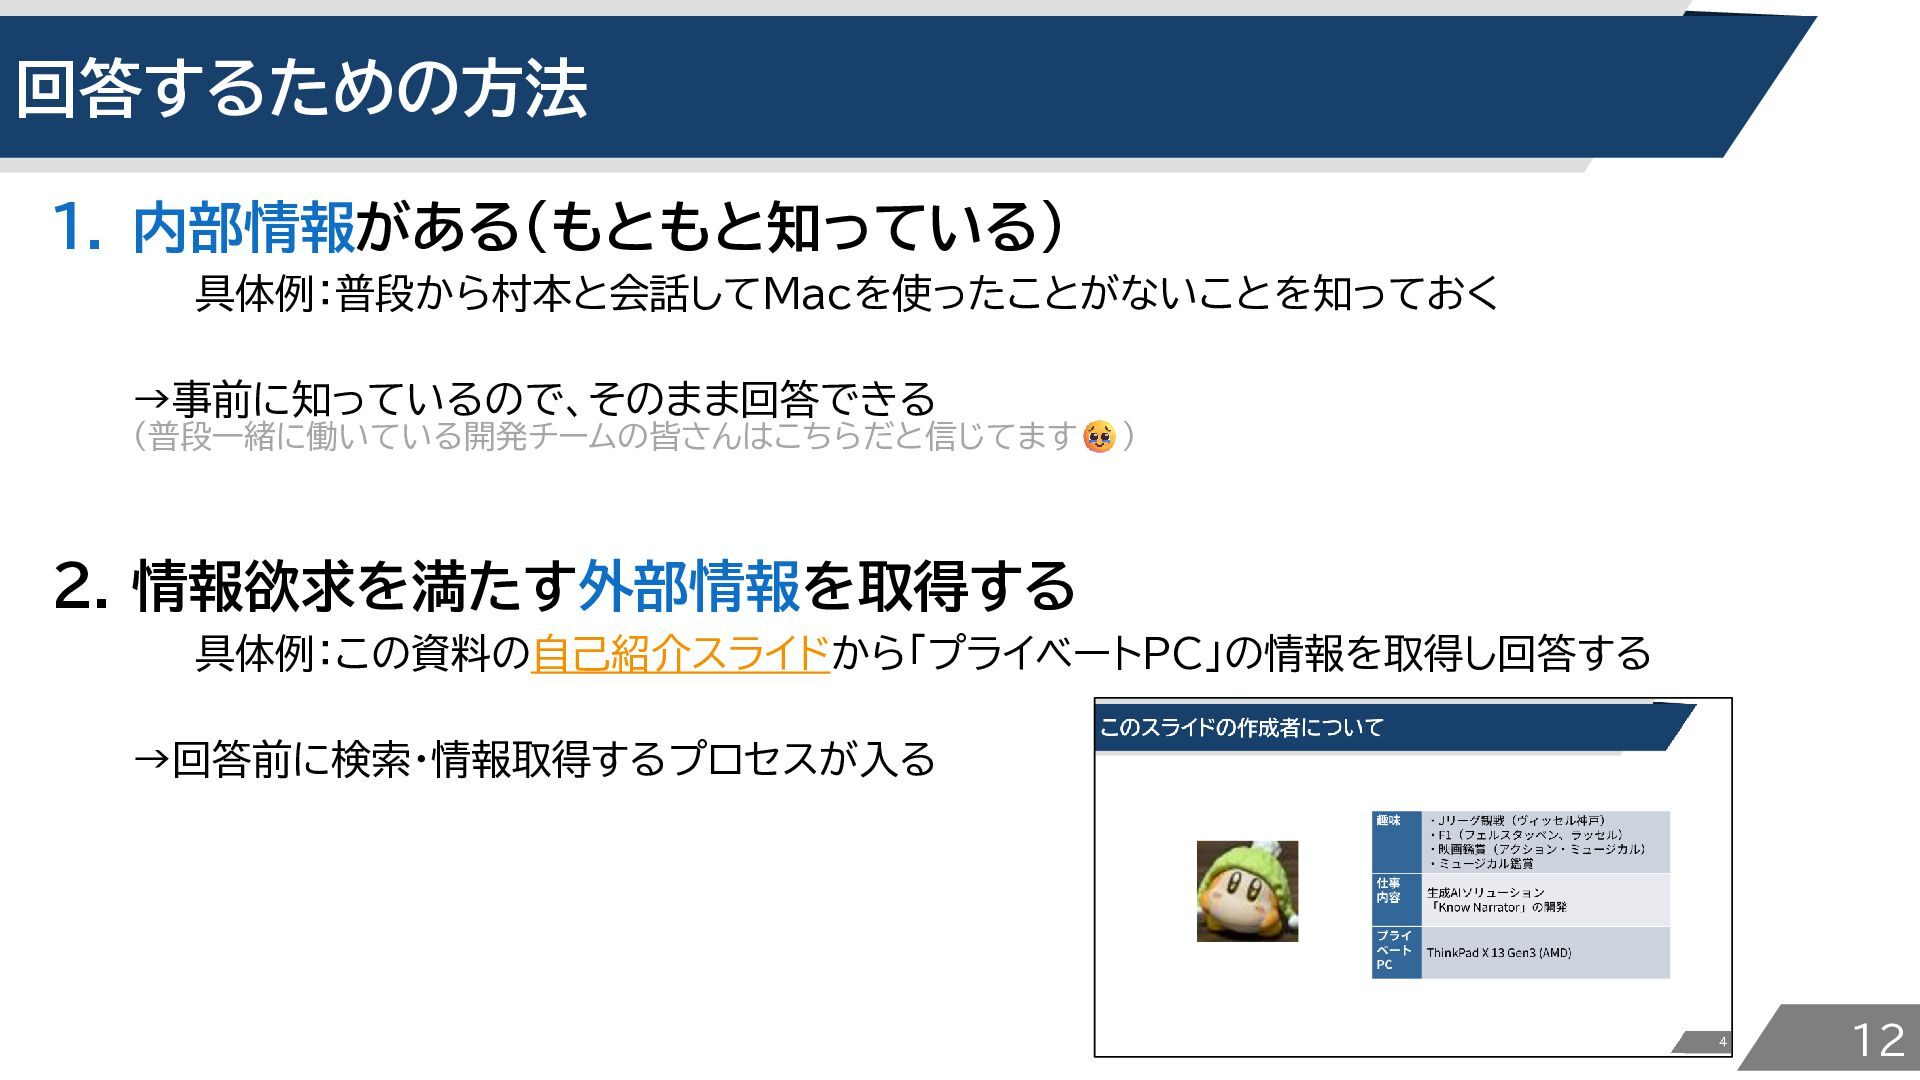
回答するための方法 1. 内部情報がある(もともと知っている) 具体例:普段から村本と会話してMacを使ったことがないことを知っておく →事前に知っているので、そのまま回答できる (普段一緒に働いている開発チームの皆さんはこちらだと信じてます ) 2. 情報欲求を満たす外部情報を取得する 具体例:この資料の自己紹介スライドから「プライベートPC」の情報を取得し回答する
→回答前に検索・情報取得するプロセスが入る 12
さらにもう一問! 村本さんを東京に案内するとき、 どんなプランを立てますか? 13
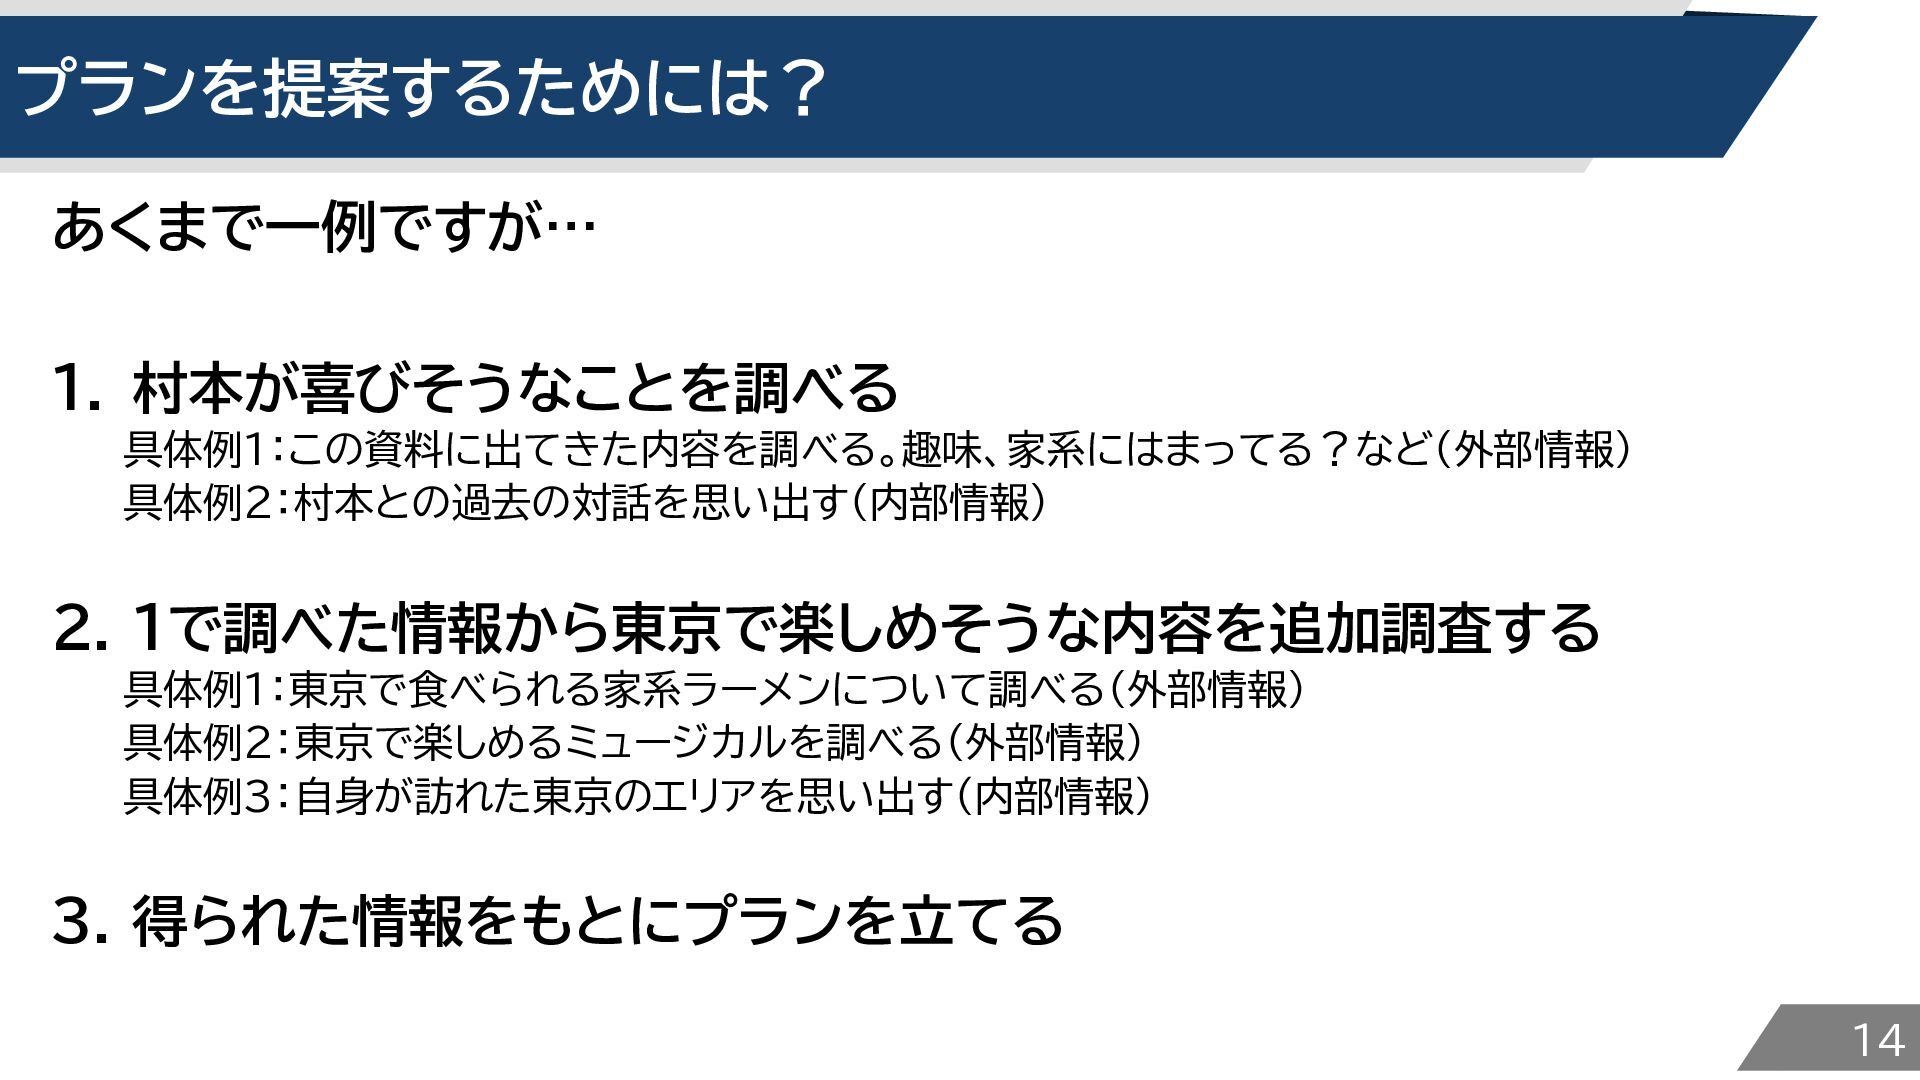
プランを提案するためには? あくまで一例ですが… 1. 村本が喜びそうなことを調べる 具体例1:この資料に出てきた内容を調べる。趣味、家系にはまってる?など(外部情報) 具体例2:村本との過去の対話を思い出す(内部情報) 2. 1で調べた情報から東京で楽しめそうな内容を追加調査する 具体例1:東京で食べられる家系ラーメンについて調べる(外部情報) 具体例2:東京で楽しめるミュージカルを調べる(外部情報)
具体例3:自身が訪れた東京のエリアを思い出す(内部情報) 3. 得られた情報をもとにプランを立てる 14
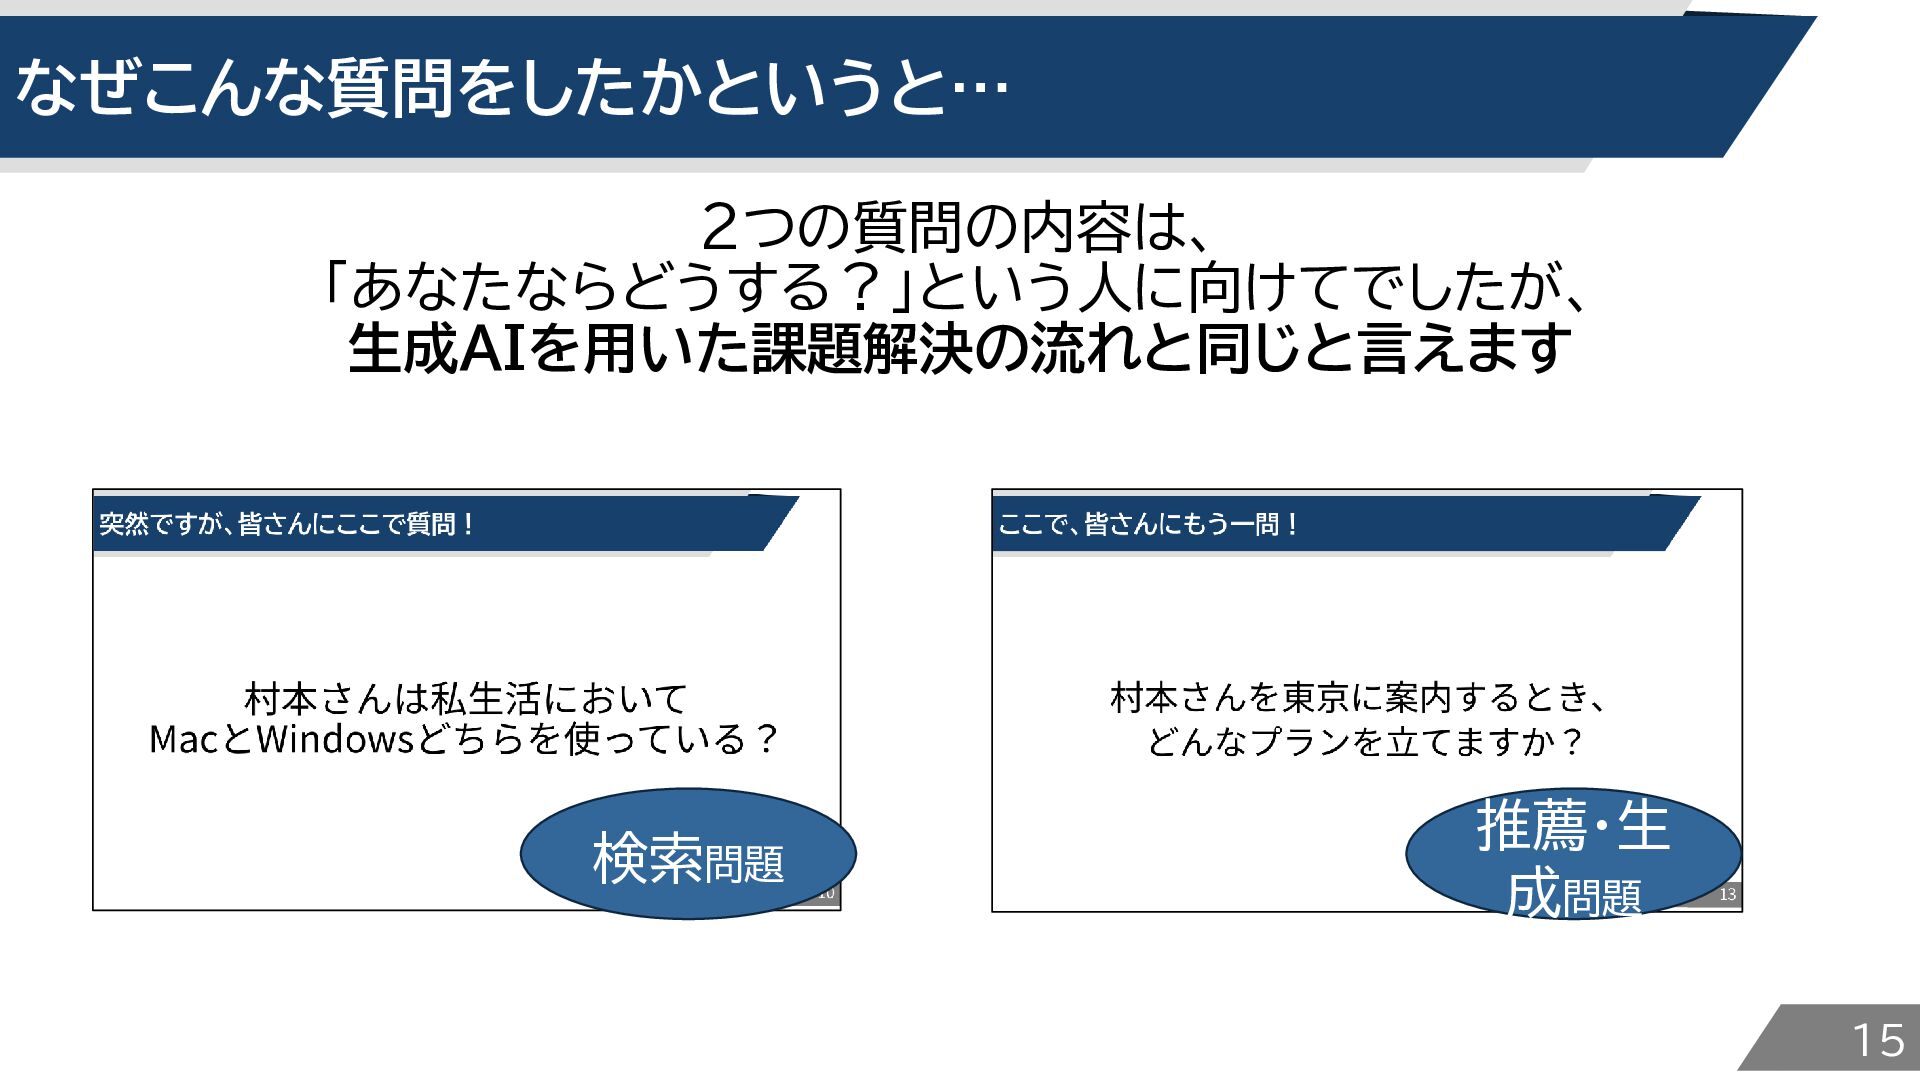
なぜこんな質問をしたかというと… 2つの質問の内容は、 「あなたならどうする?」という人に向けてでしたが、 生成AIを用いた課題解決の流れと同じと言えます 検索問題 推薦・生 成問題 15
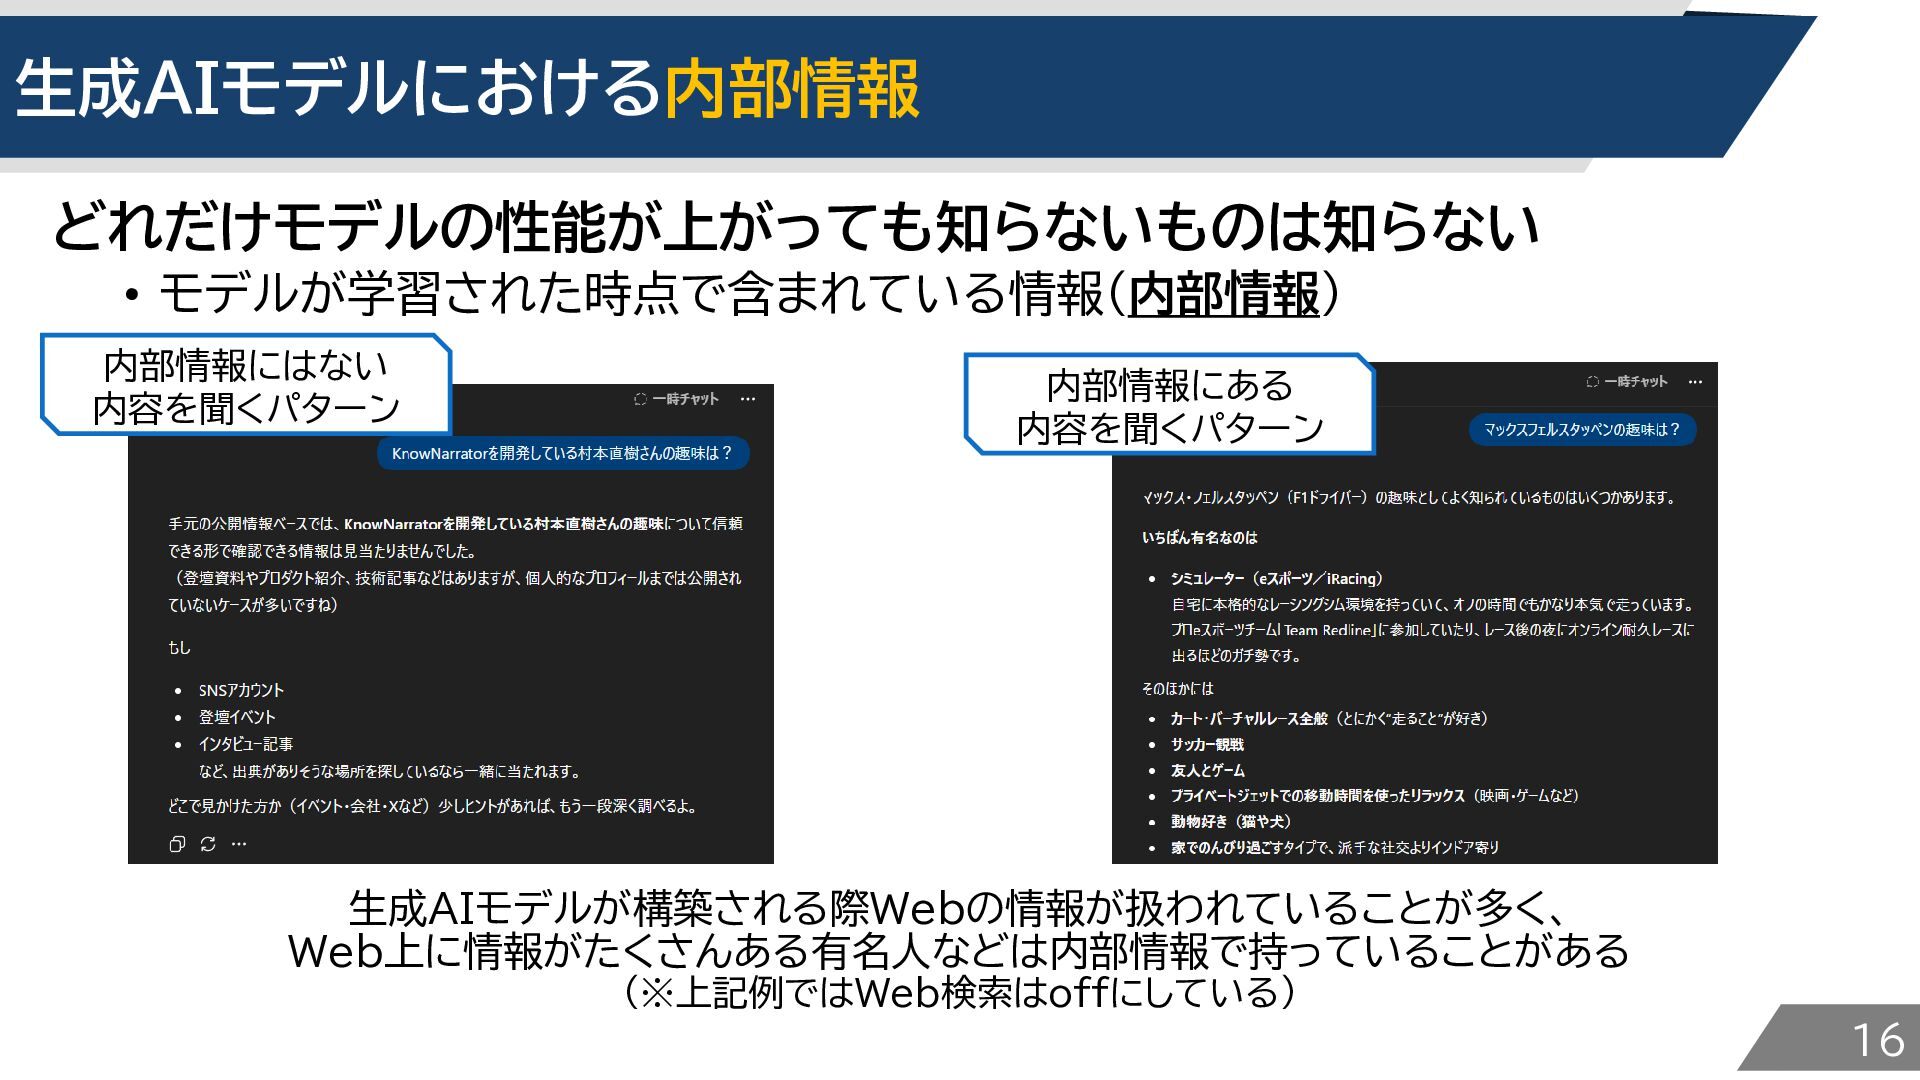
生成AIモデルにおける内部情報 どれだけモデルの性能が上がっても知らないものは知らない • モデルが学習された時点で含まれている情報(内部情報) 内部情報にはない 内容を聞くパターン 内部情報にある 内容を聞くパターン 生成AIモデルが構築される際Webの情報が扱われていることが多く、 Web上に情報がたくさんある有名人などは内部情報で持っていることがある
(※上記例ではWeb検索はoffにしている) 16
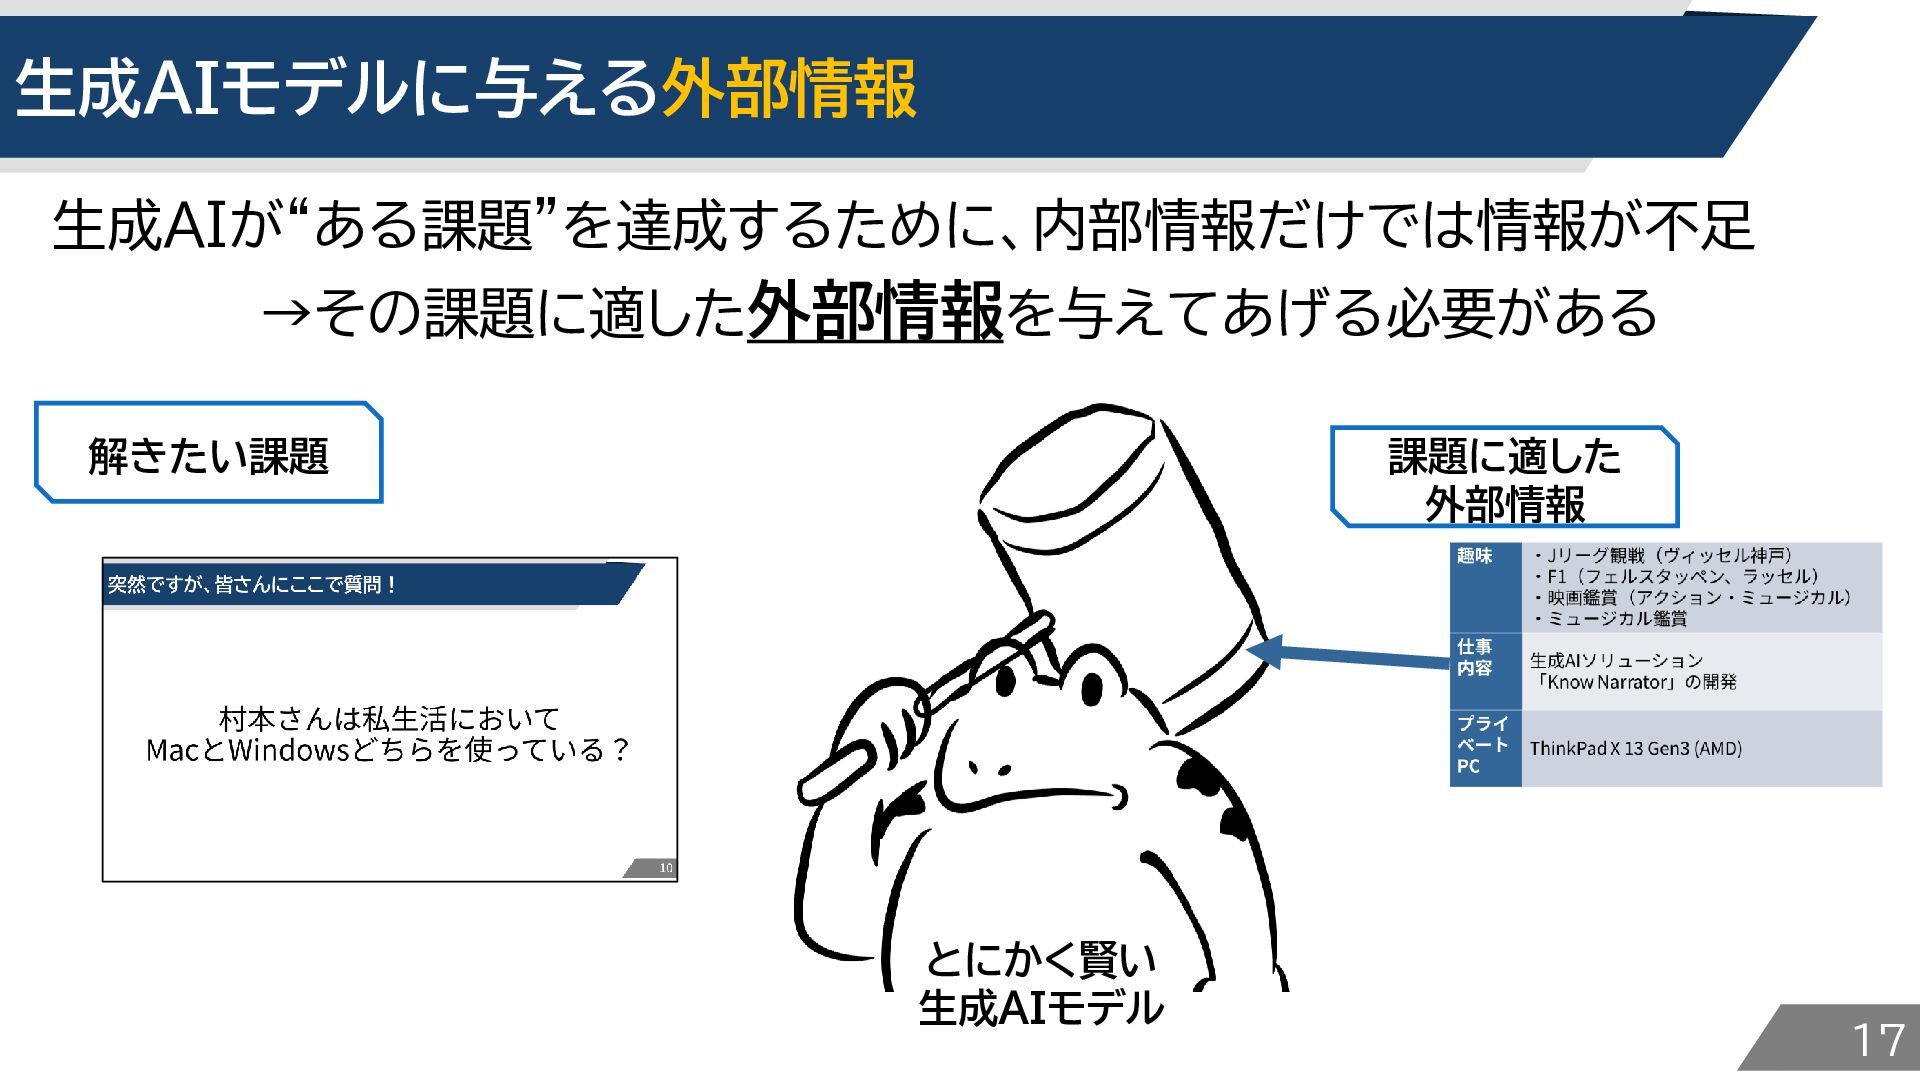
生成AIモデルに与える外部情報 生成AIが“ある課題”を達成するために、内部情報だけでは情報が不足 →その課題に適した外部情報を与えてあげる必要がある 解きたい課題 課題に適した 外部情報 とにかく賢い 生成AIモデル 17
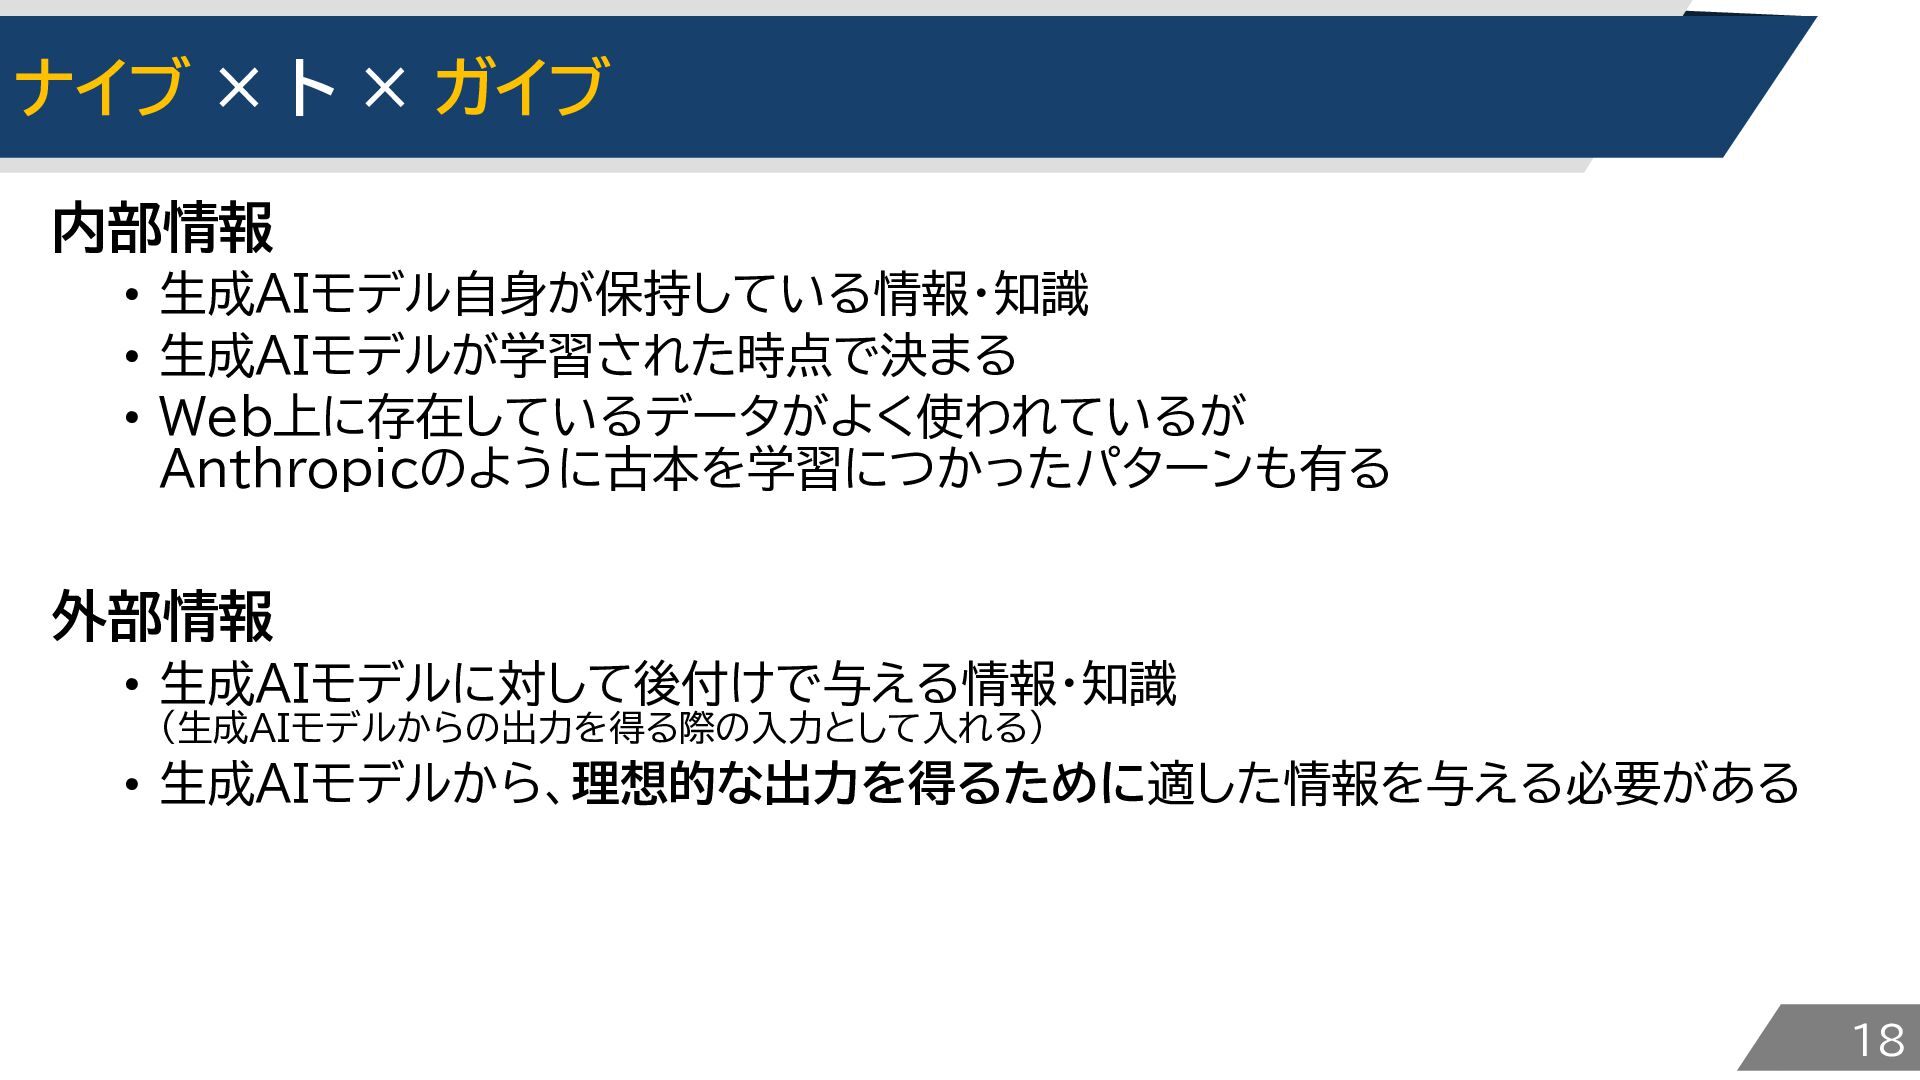
ナイブ × ト × ガイブ 内部情報 • 生成AIモデル自身が保持している情報・知識 • 生成AIモデルが学習された時点で決まる
• Web上に存在しているデータがよく使われているが Anthropicのように古本を学習につかったパターンも有る 外部情報 • 生成AIモデルに対して後付けで与える情報・知識 (生成AIモデルからの出力を得る際の入力として入れる) • 生成AIモデルから、理想的な出力を得るために適した情報を与える必要がある 18
外部情報の与え方は解きたい課題によって変わる 先ほどの2つの質問を思い出してほしいですが、 解きたい課題によって、適する外部情報の与え方があると言える 生成AIモデルに適合する文書を与えられたらOK 良い提案をするために なるべく網羅的に情報を与えて 生成AIモデルに考えさせる 19
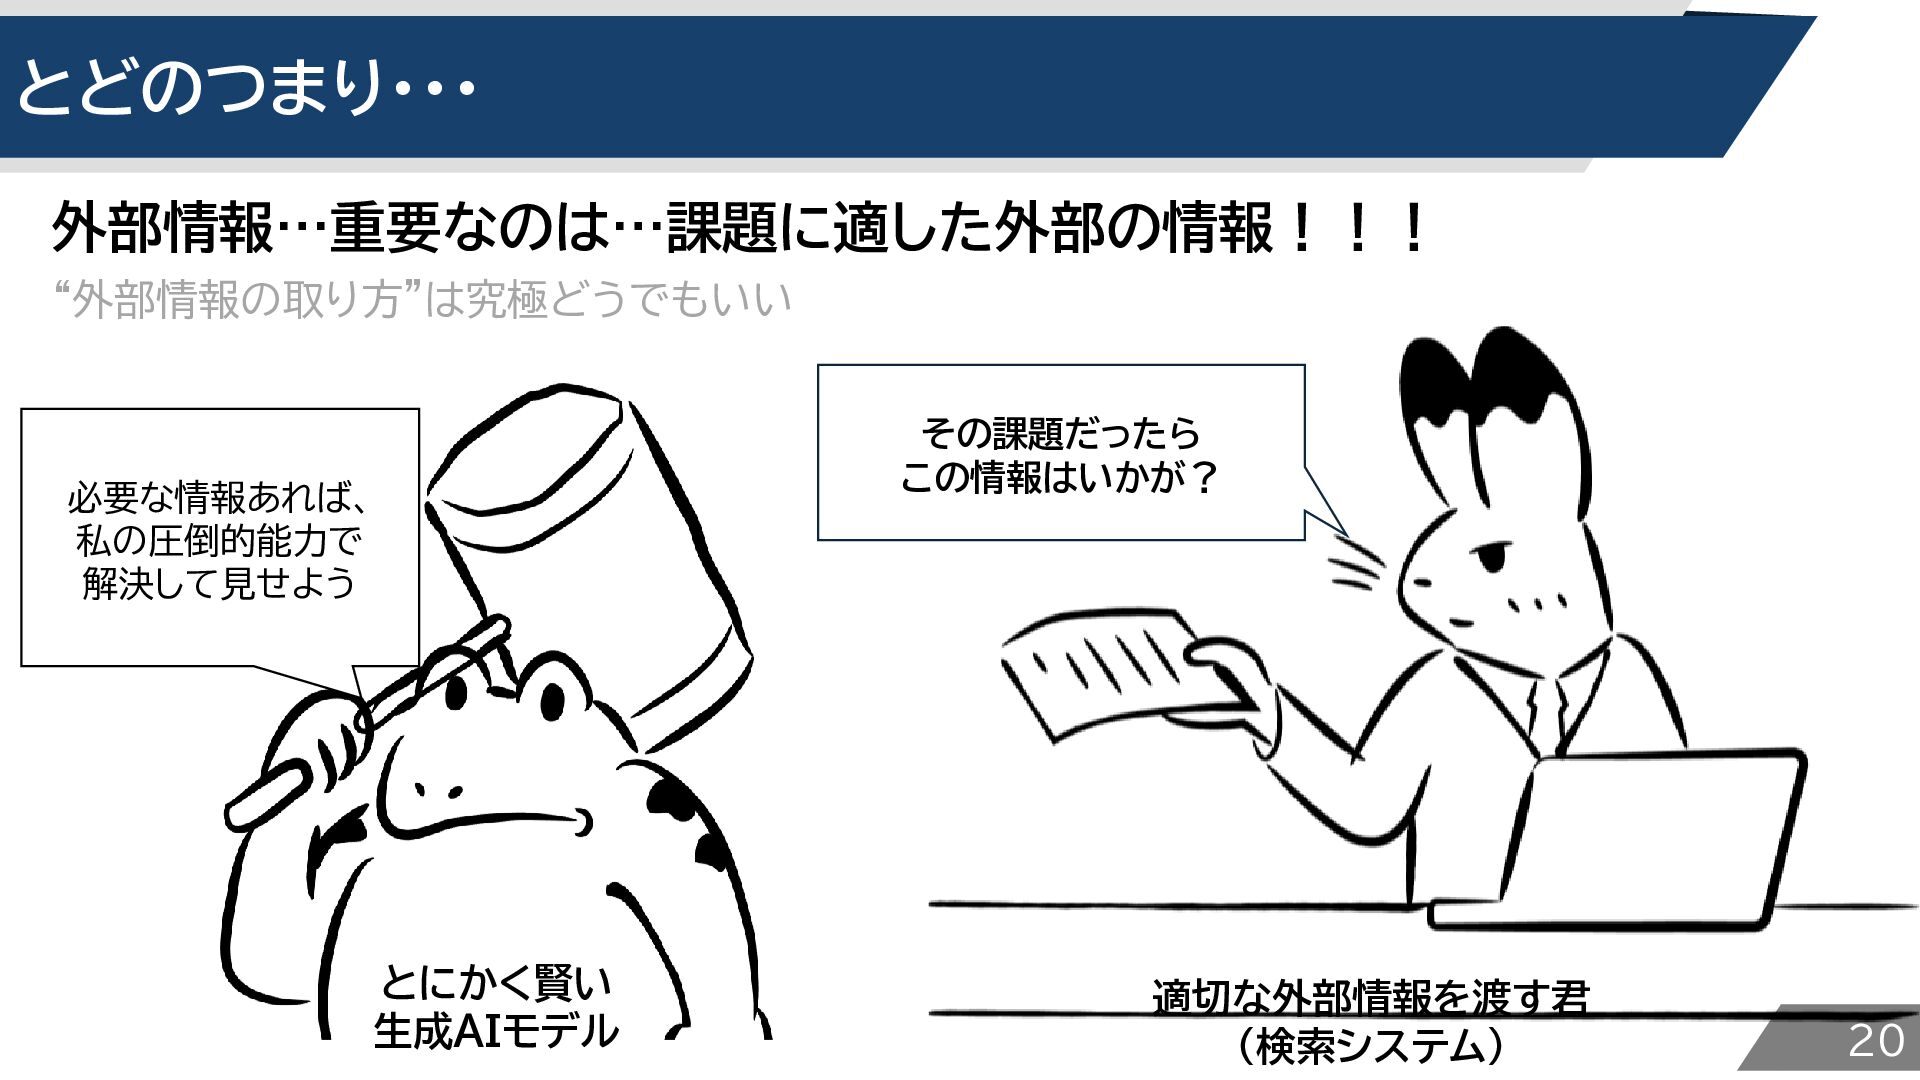
とどのつまり・・・ 外部情報…重要なのは…課題に適した外部の情報!!! “外部情報の取り方”は究極どうでもいい 必要な情報あれば、 私の圧倒的能力で 解決して見せよう とにかく賢い 生成AIモデル その課題だったら この情報はいかが?
適切な外部情報を渡す君 (検索システム) 20
ここで、少し実装寄りのお話 ~生成AIのAPIを実は一度も自分で実装したことない人はちゃんと見る~ 21
生成AIモデルへの入力ってどうなってるの? 「適切な外部情報!」とか色々言ってますが、 実際に実装レベルで見たときに、どのように生成AIモデルに情報が 渡されているかみてみましょう 22
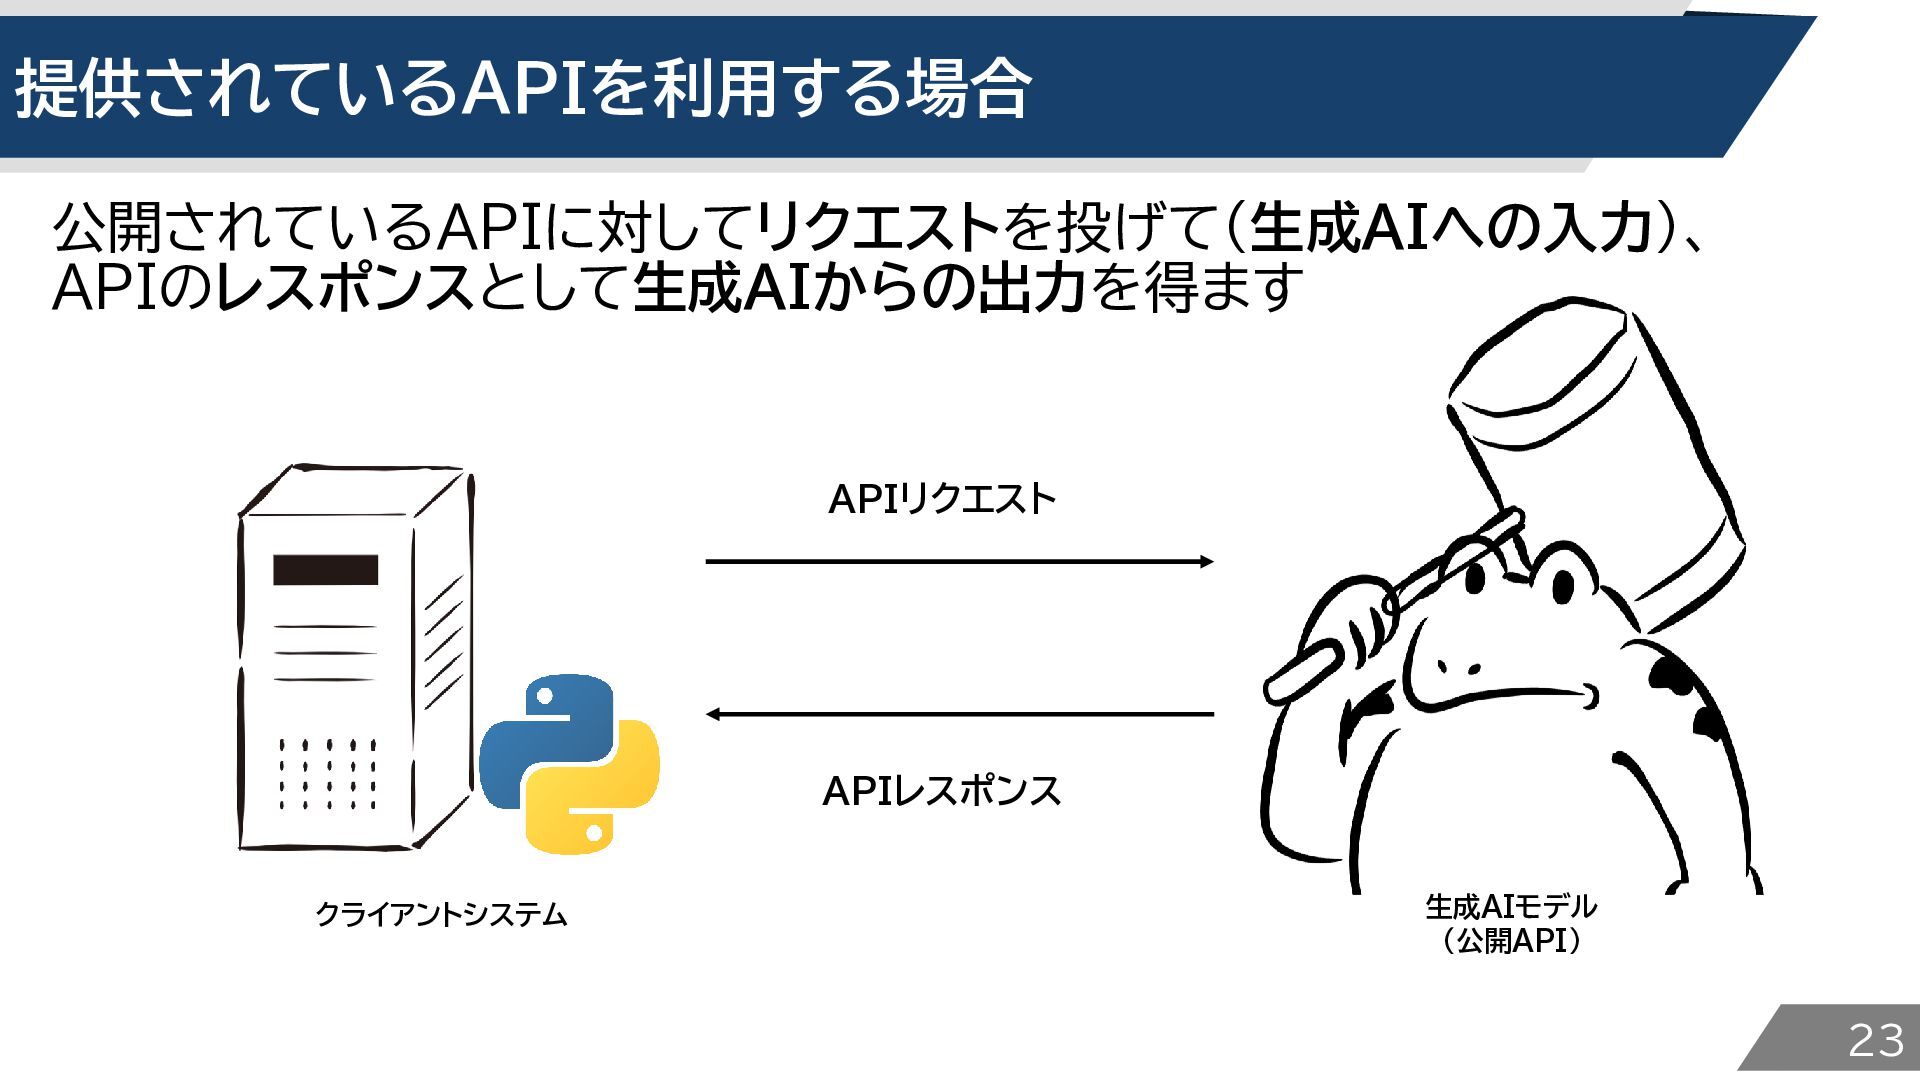
提供されているAPIを利用する場合 公開されているAPIに対してリクエストを投げて(生成AIへの入力)、 APIのレスポンスとして生成AIからの出力を得ます APIリクエスト APIレスポンス クライアントシステム 生成AIモデル (公開API) 23
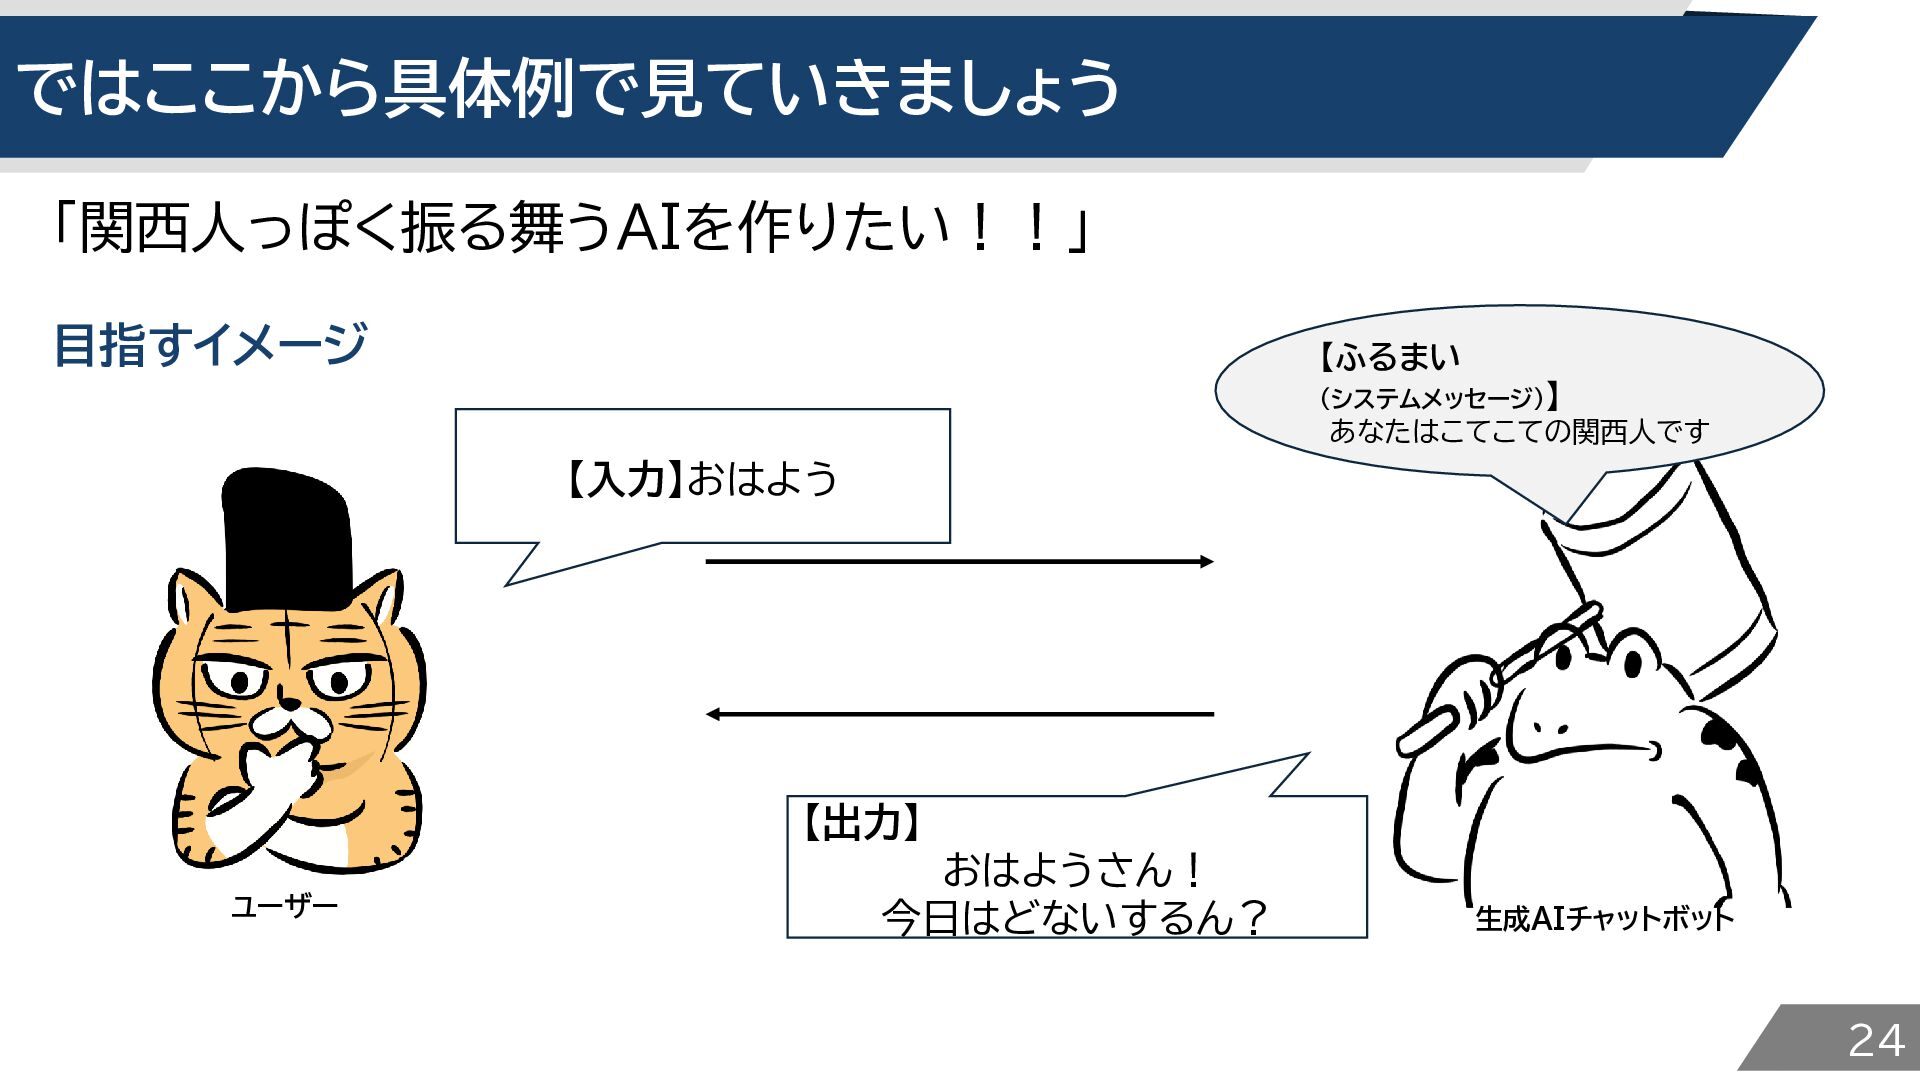
ではここから具体例で見ていきましょう 「関西人っぽく振る舞うAIを作りたい!!」 目指すイメージ 【ふるまい (システムメッセージ)】 あなたはこてこての関西人です 【入力】おはよう 【出力】 ユーザー おはようさん!
今日はどないするん? 生成AIチャットボット 24
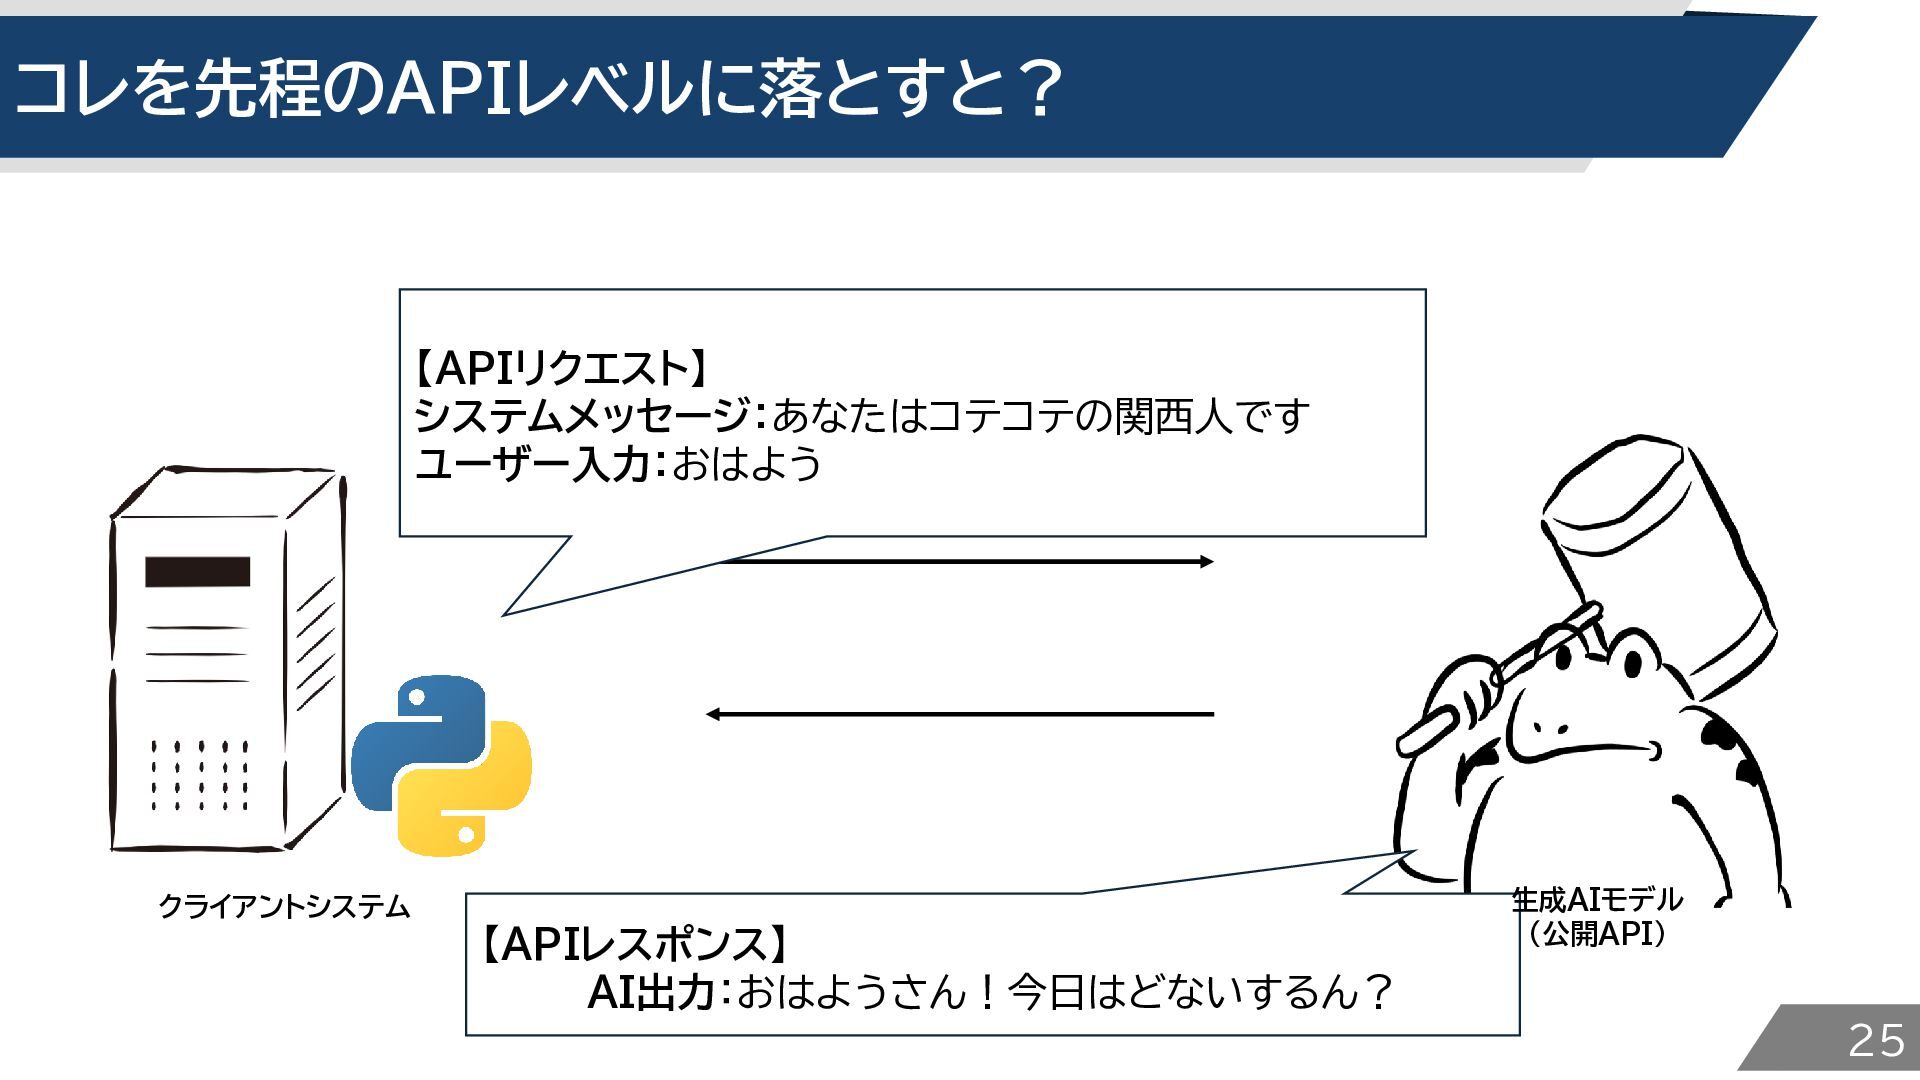
コレを先程のAPIレベルに落とすと? 【APIリクエスト】 システムメッセージ:あなたはコテコテの関西人です ユーザー入力:おはよう クライアントシステム 【APIレスポンス】 AI出力:おはようさん!今日はどないするん? 生成AIモデル (公開API) 25
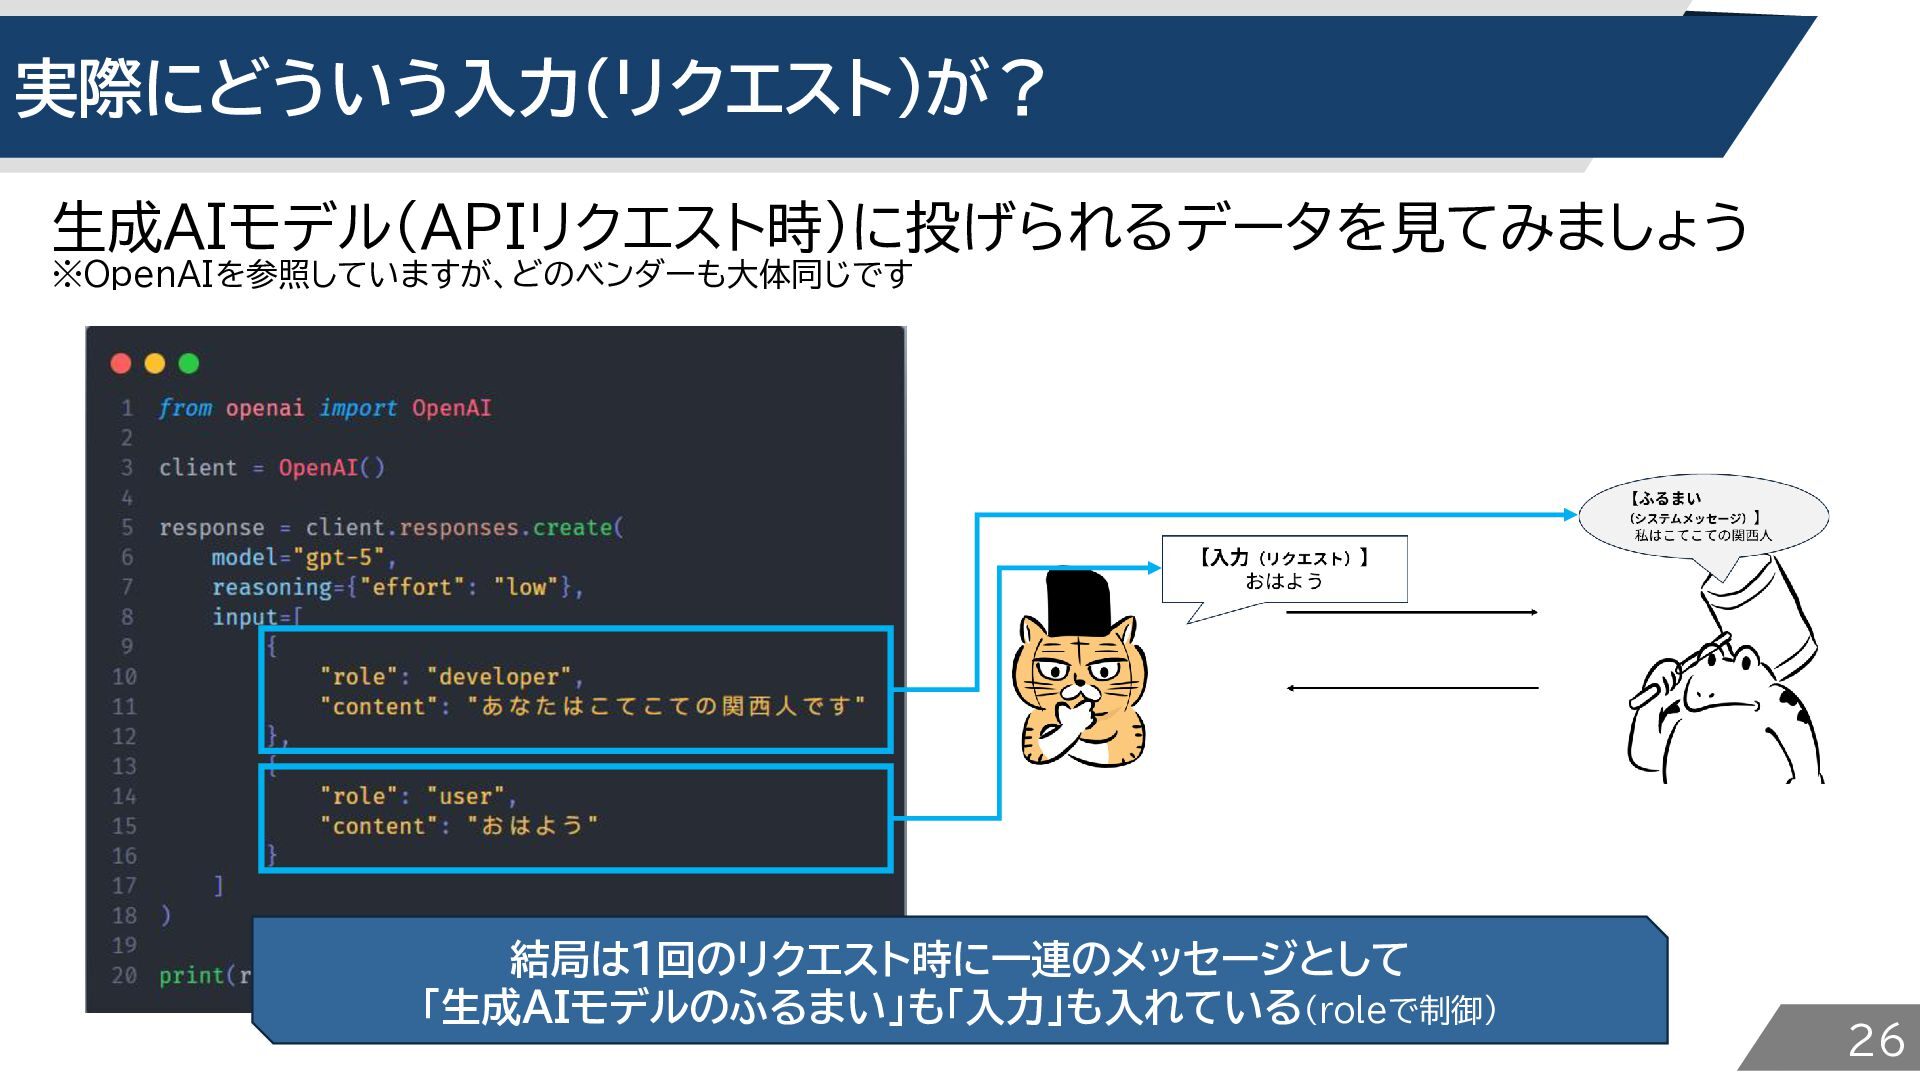
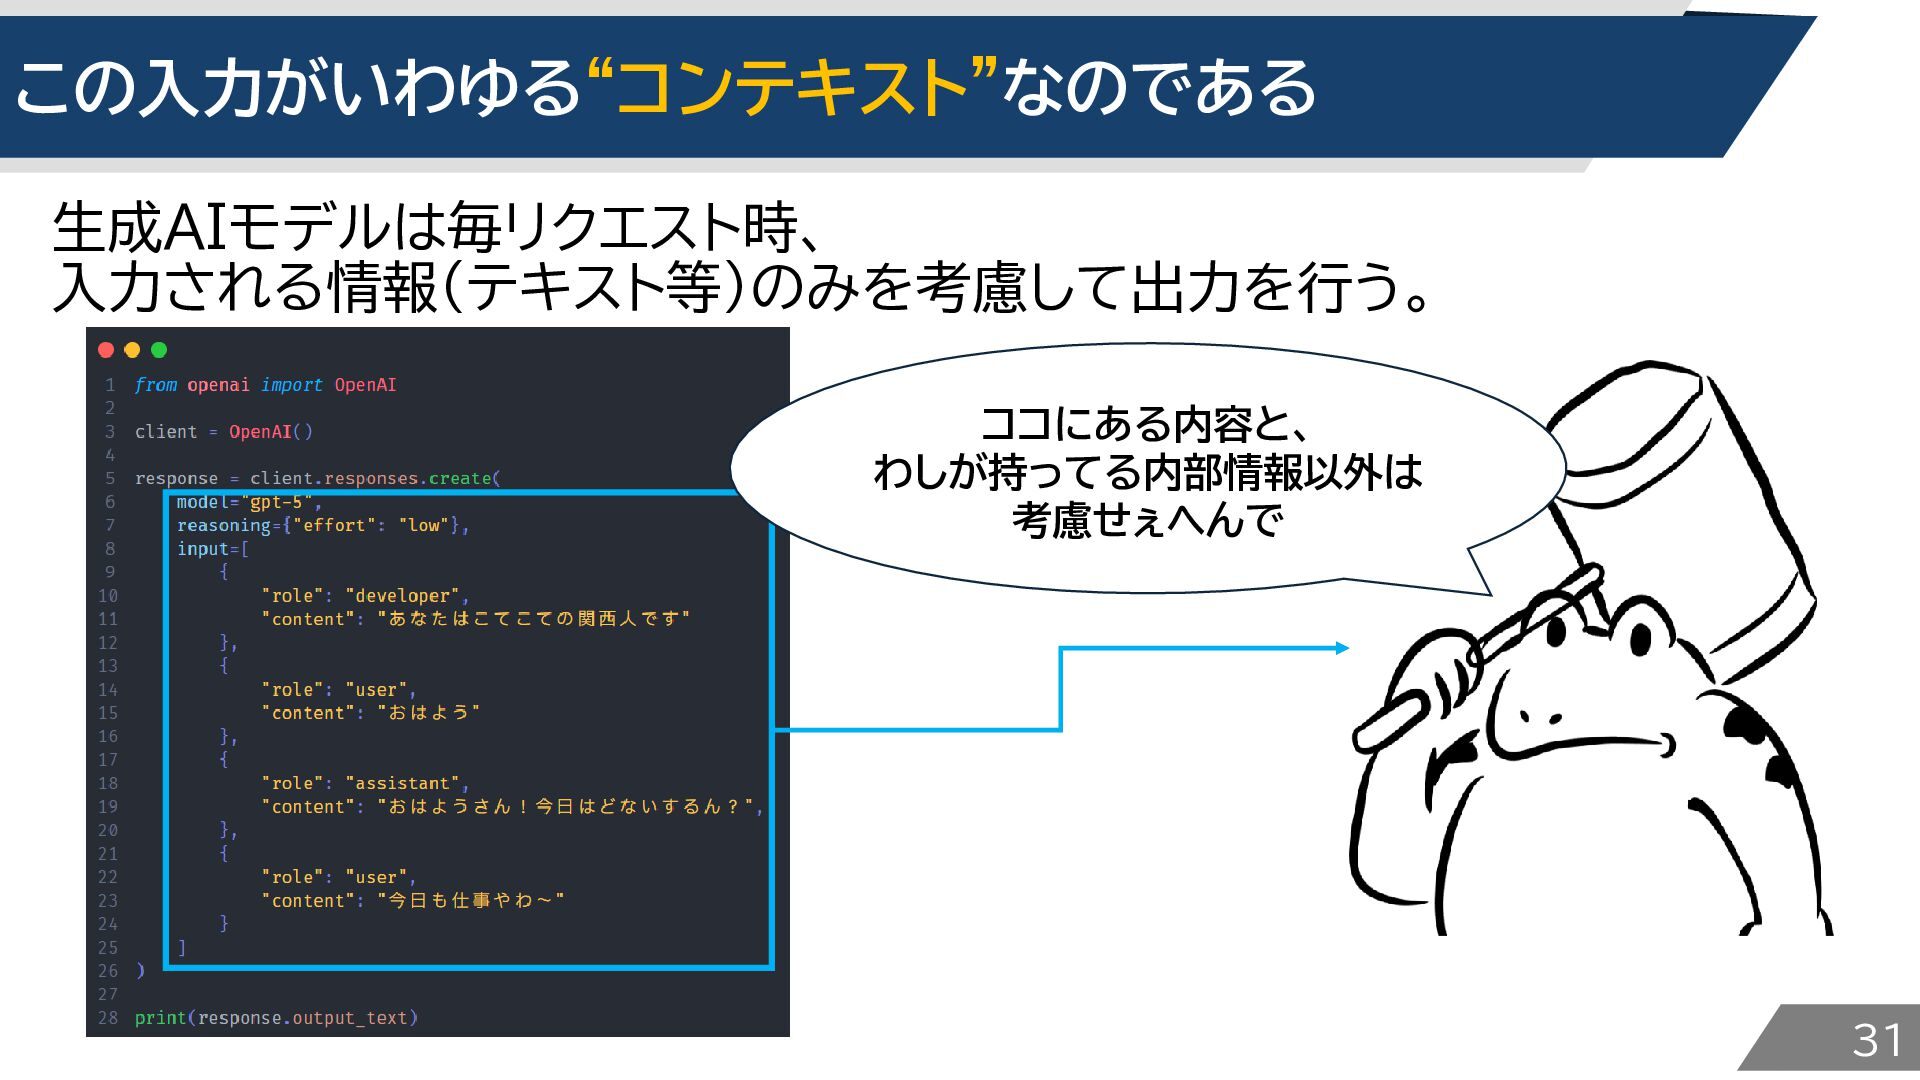
実際にどういう入力(リクエスト)が? 生成AIモデル(APIリクエスト時)に投げられるデータを見てみましょう ※OpenAIを参照していますが、どのベンダーも大体同じです 結局は1回のリクエスト時に一連のメッセージとして 「生成AIモデルのふるまい」も「入力」も入れている(roleで制御) 26
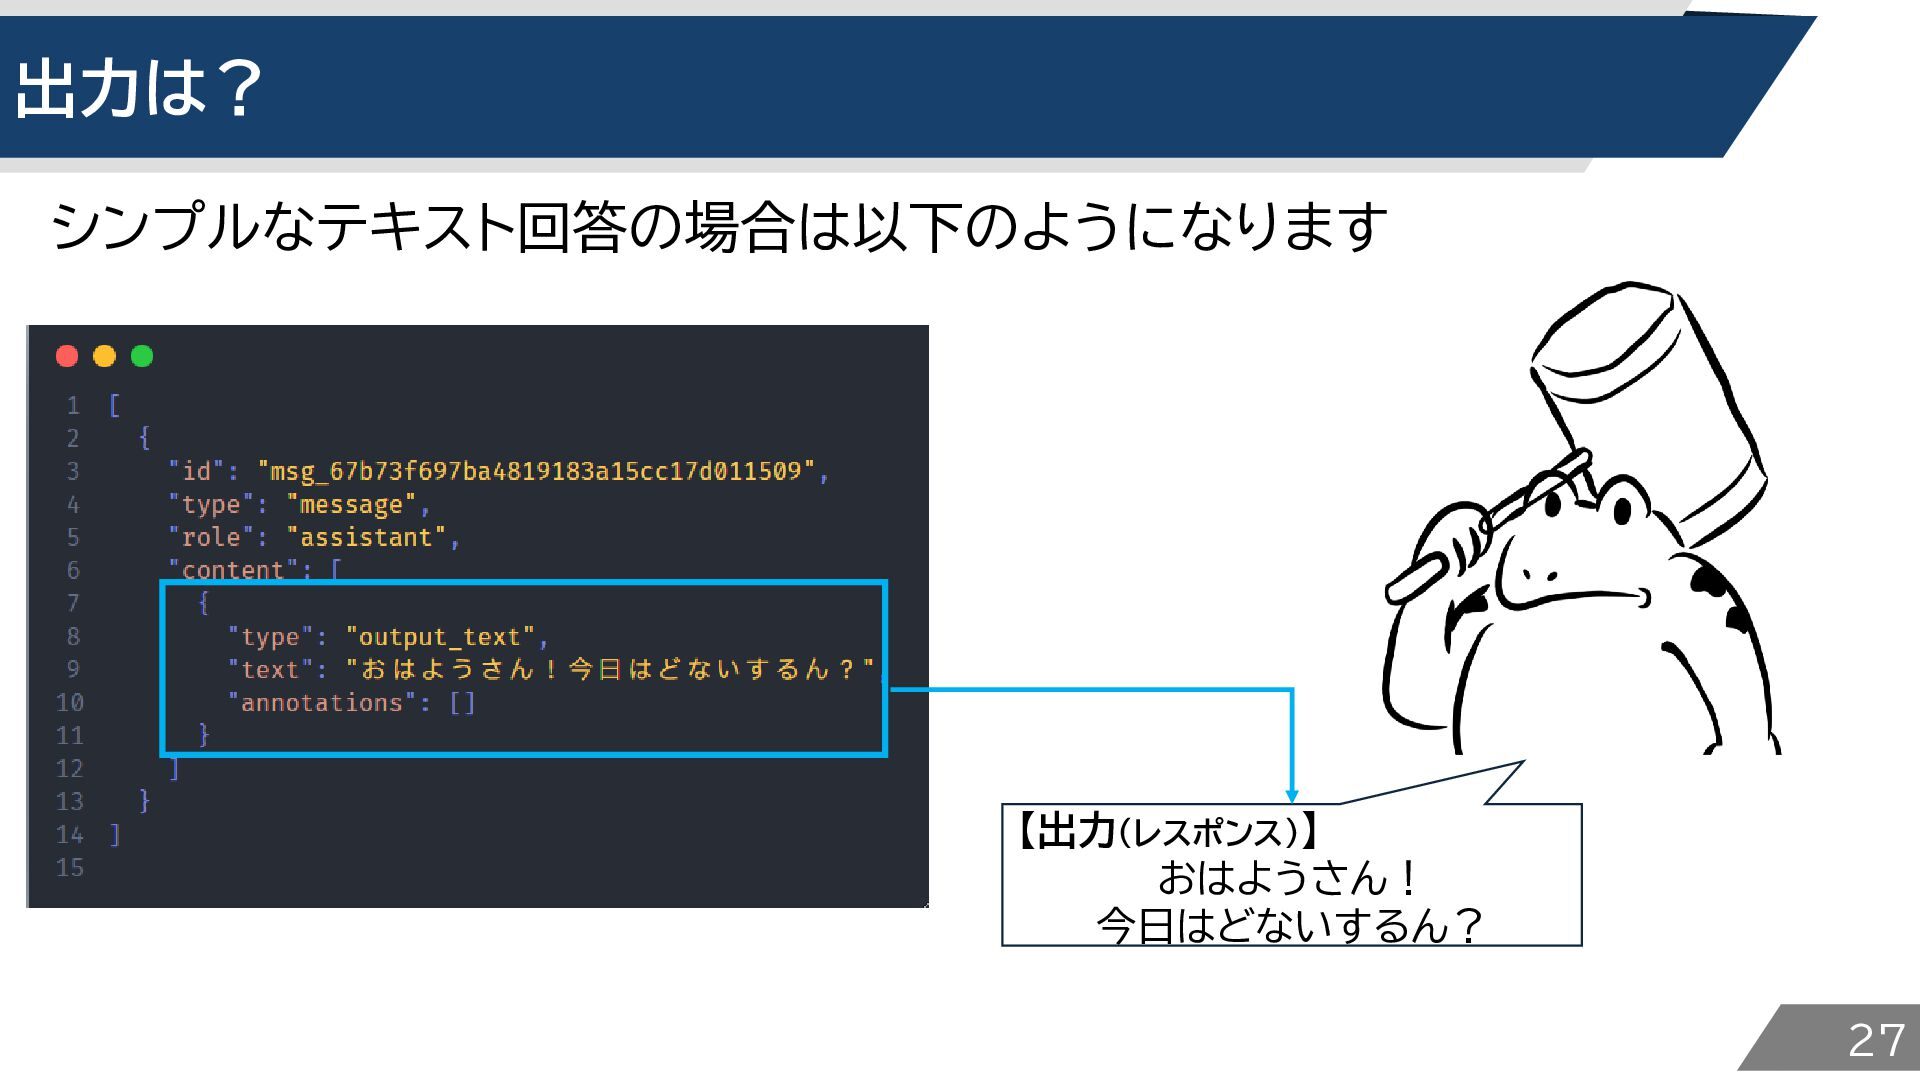
出力は? シンプルなテキスト回答の場合は以下のようになります 【出力(レスポンス)】 おはようさん! 今日はどないするん? 27
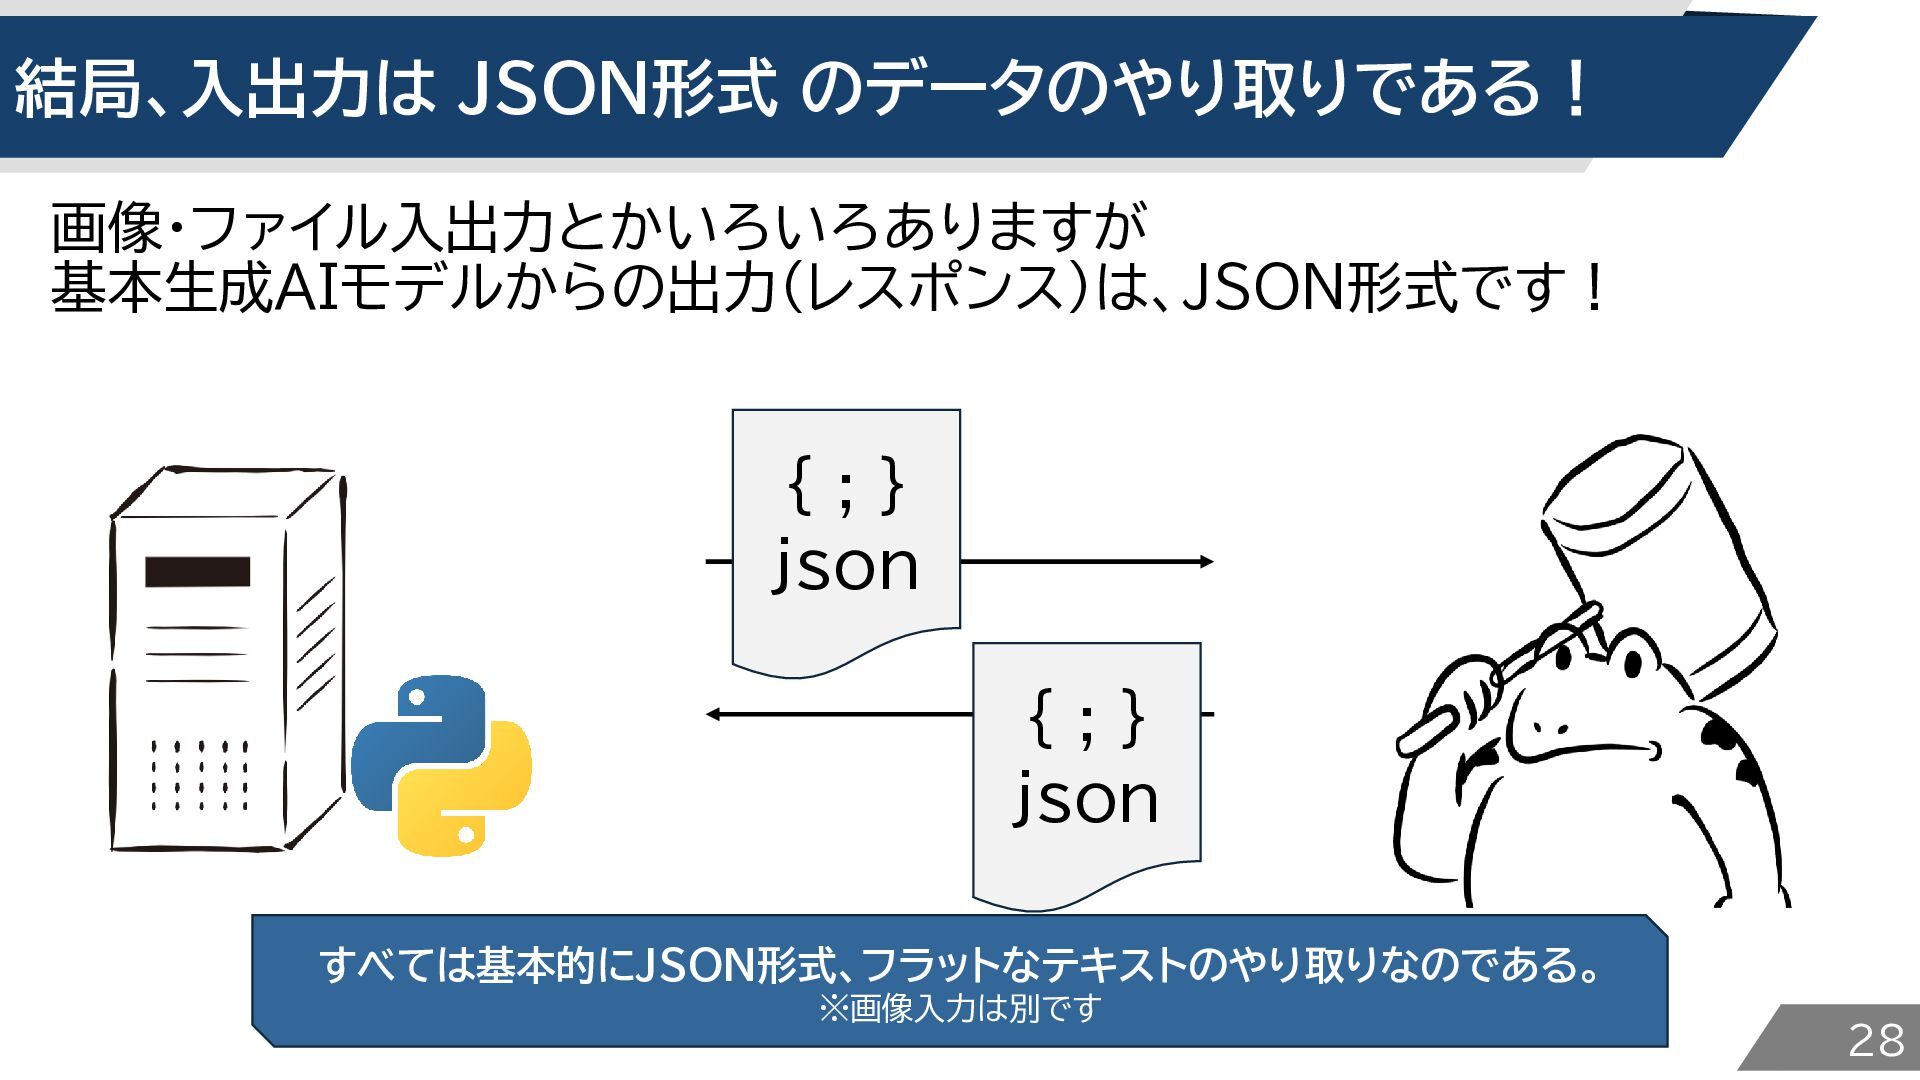
結局、入出力は JSON形式 のデータのやり取りである! 画像・ファイル入出力とかいろいろありますが 基本生成AIモデルからの出力(レスポンス)は、JSON形式です! {;} json {;} json すべては基本的にJSON形式、フラットなテキストのやり取りなのである。
※画像入力は別です 28
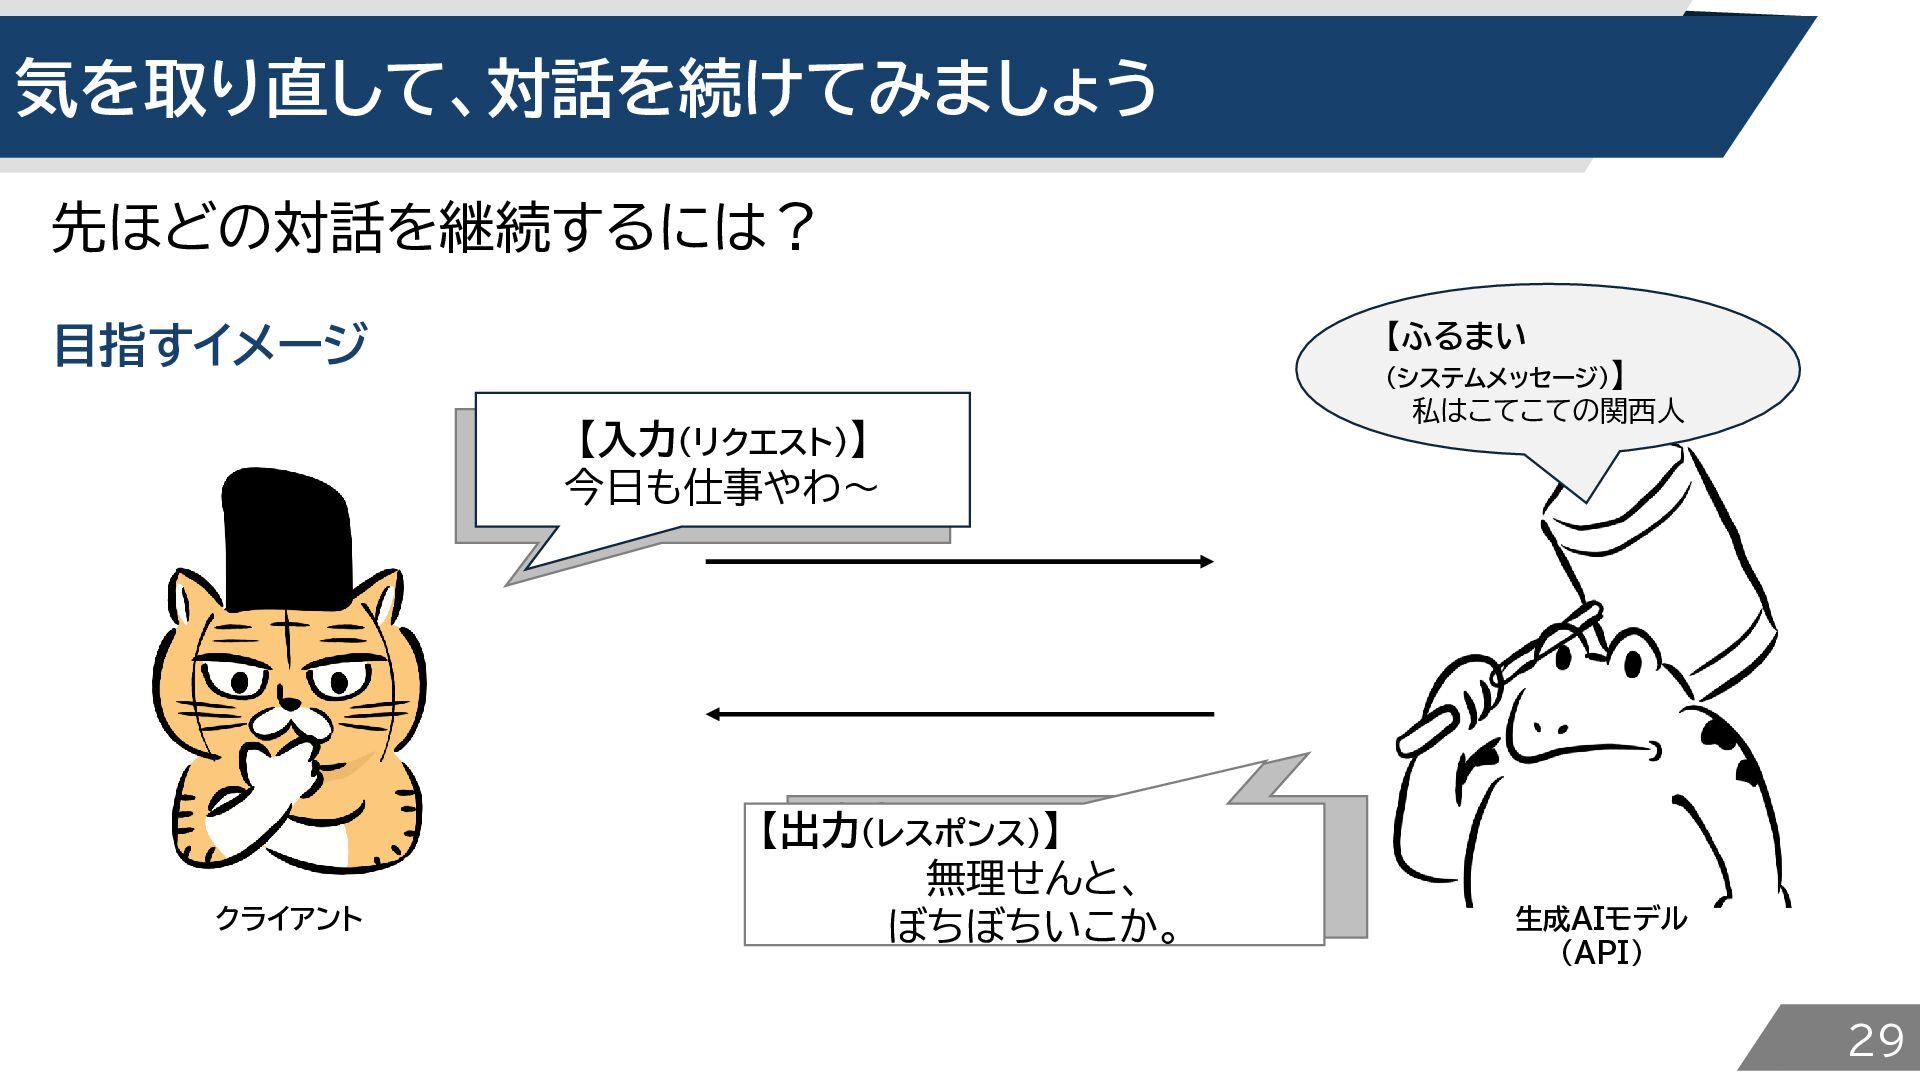
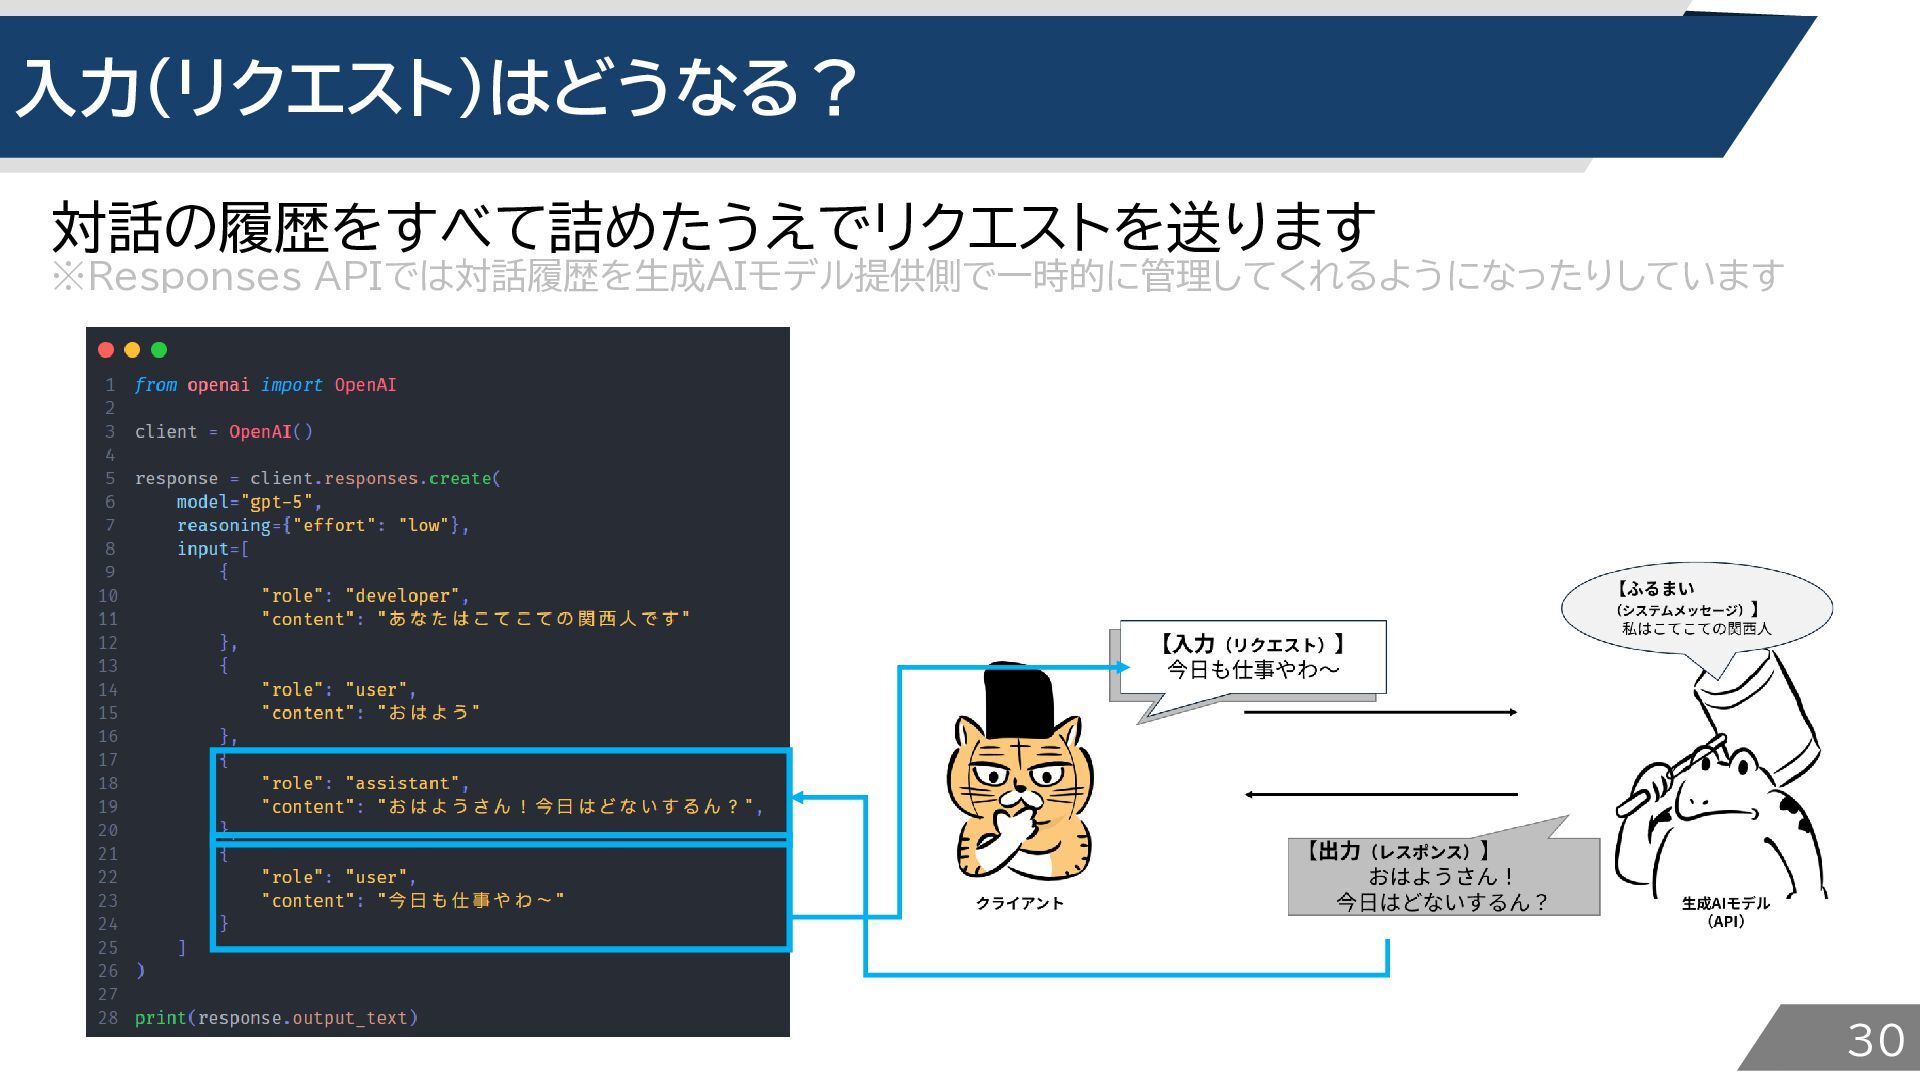
気を取り直して、対話を続けてみましょう 先ほどの対話を継続するには? 【ふるまい 目指すイメージ (システムメッセージ)】 【入力(リクエスト) (リクエスト)】 【入力 】 今日も仕事やわ~
おはよう クライアント 【出力 (レスポンス) 【出力 (レスポンス) 】 】 おはようさん! 無理せんと、 今日はどないするん? ぼちぼちいこか。 私はこてこての関西人 生成AIモデル (API) 29
入力(リクエスト)はどうなる? 対話の履歴をすべて詰めたうえでリクエストを送ります ※Responses APIでは対話履歴を生成AIモデル提供側で一時的に管理してくれるようになったりしています 30
この入力がいわゆる“コンテキスト”なのである 生成AIモデルは毎リクエスト時、 入力される情報(テキスト等)のみを考慮して出力を行う。 ココにある内容と、 わしが持ってる内部情報以外は 考慮せぇへんで 31
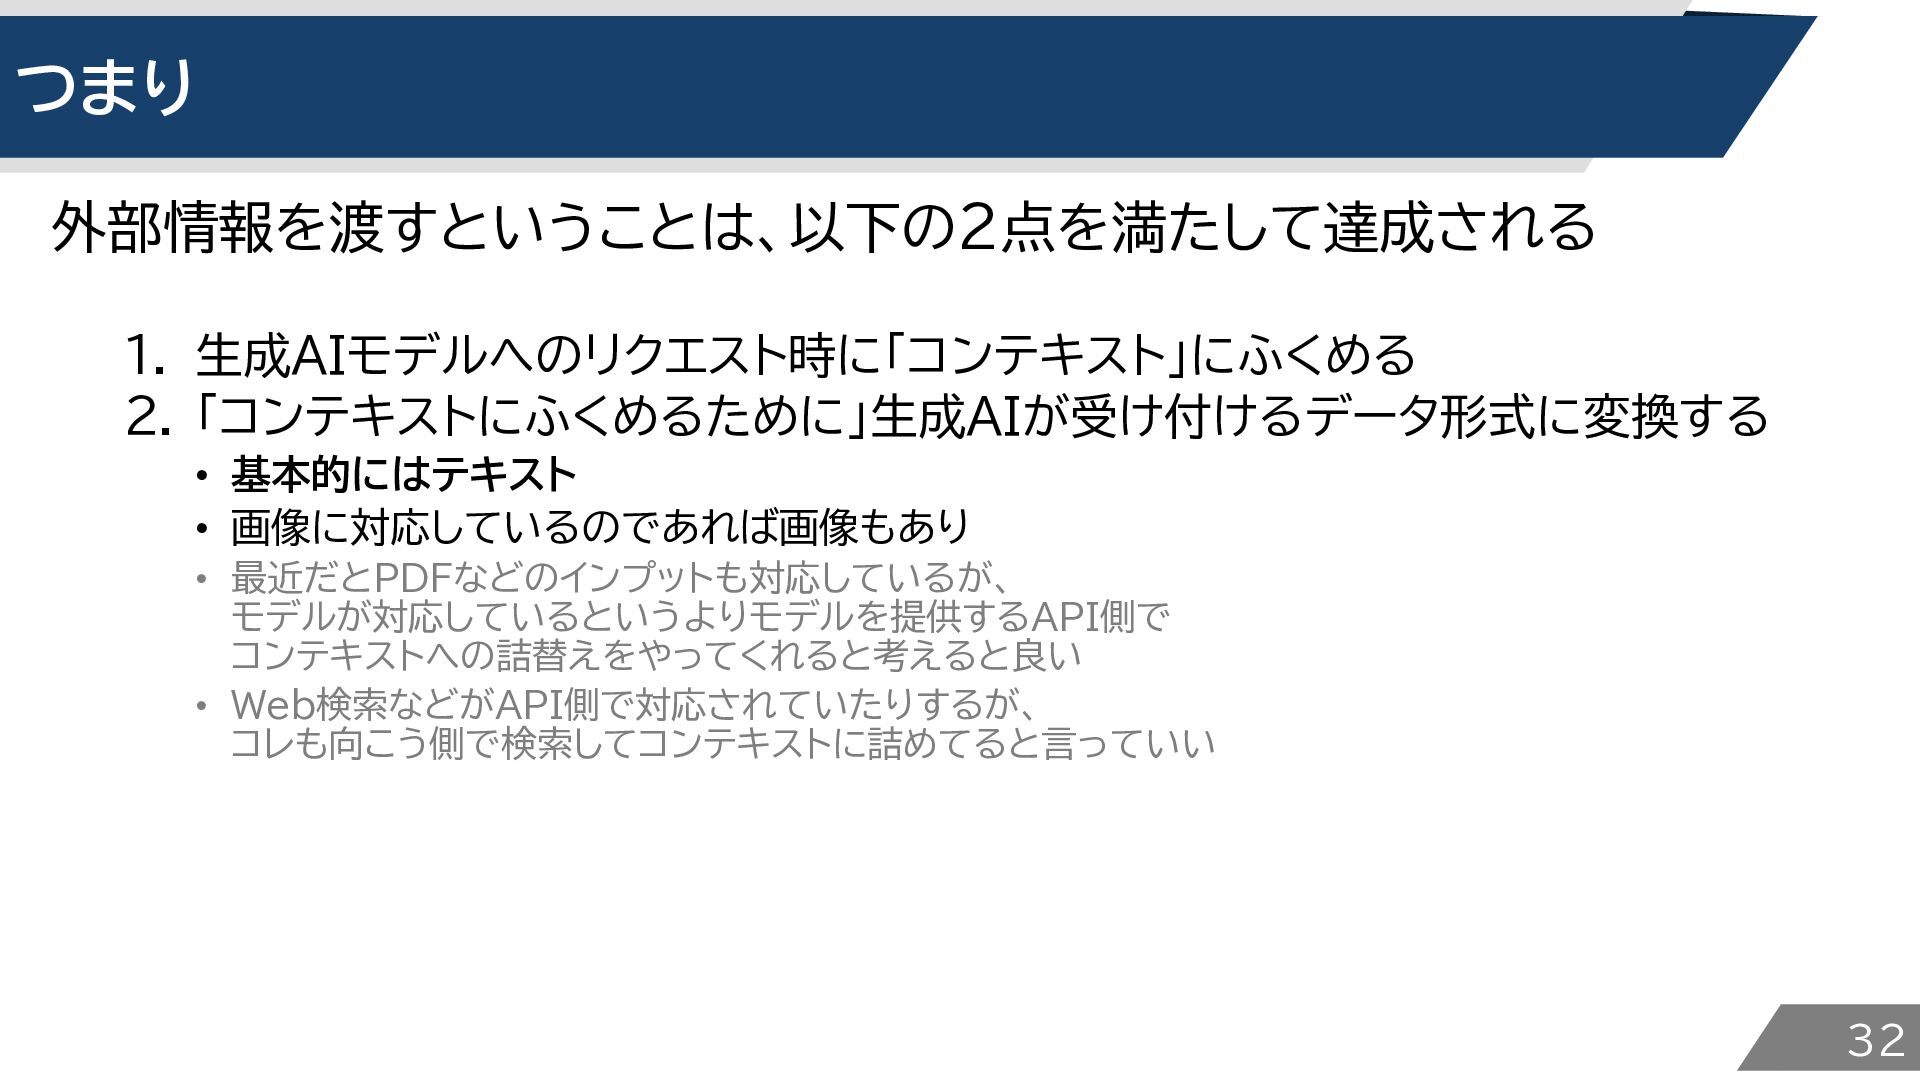
つまり 外部情報を渡すということは、以下の2点を満たして達成される 1. 生成AIモデルへのリクエスト時に「コンテキスト」にふくめる 2. 「コンテキストにふくめるために」生成AIが受け付けるデータ形式に変換する • 基本的にはテキスト • 画像に対応しているのであれば画像もあり
• 最近だとPDFなどのインプットも対応しているが、 モデルが対応しているというよりモデルを提供するAPI側で コンテキストへの詰替えをやってくれると考えると良い • Web検索などがAPI側で対応されていたりするが、 コレも向こう側で検索してコンテキストに詰めてると言っていい 32
話は戻って… 外部情報が大事なんです! 33
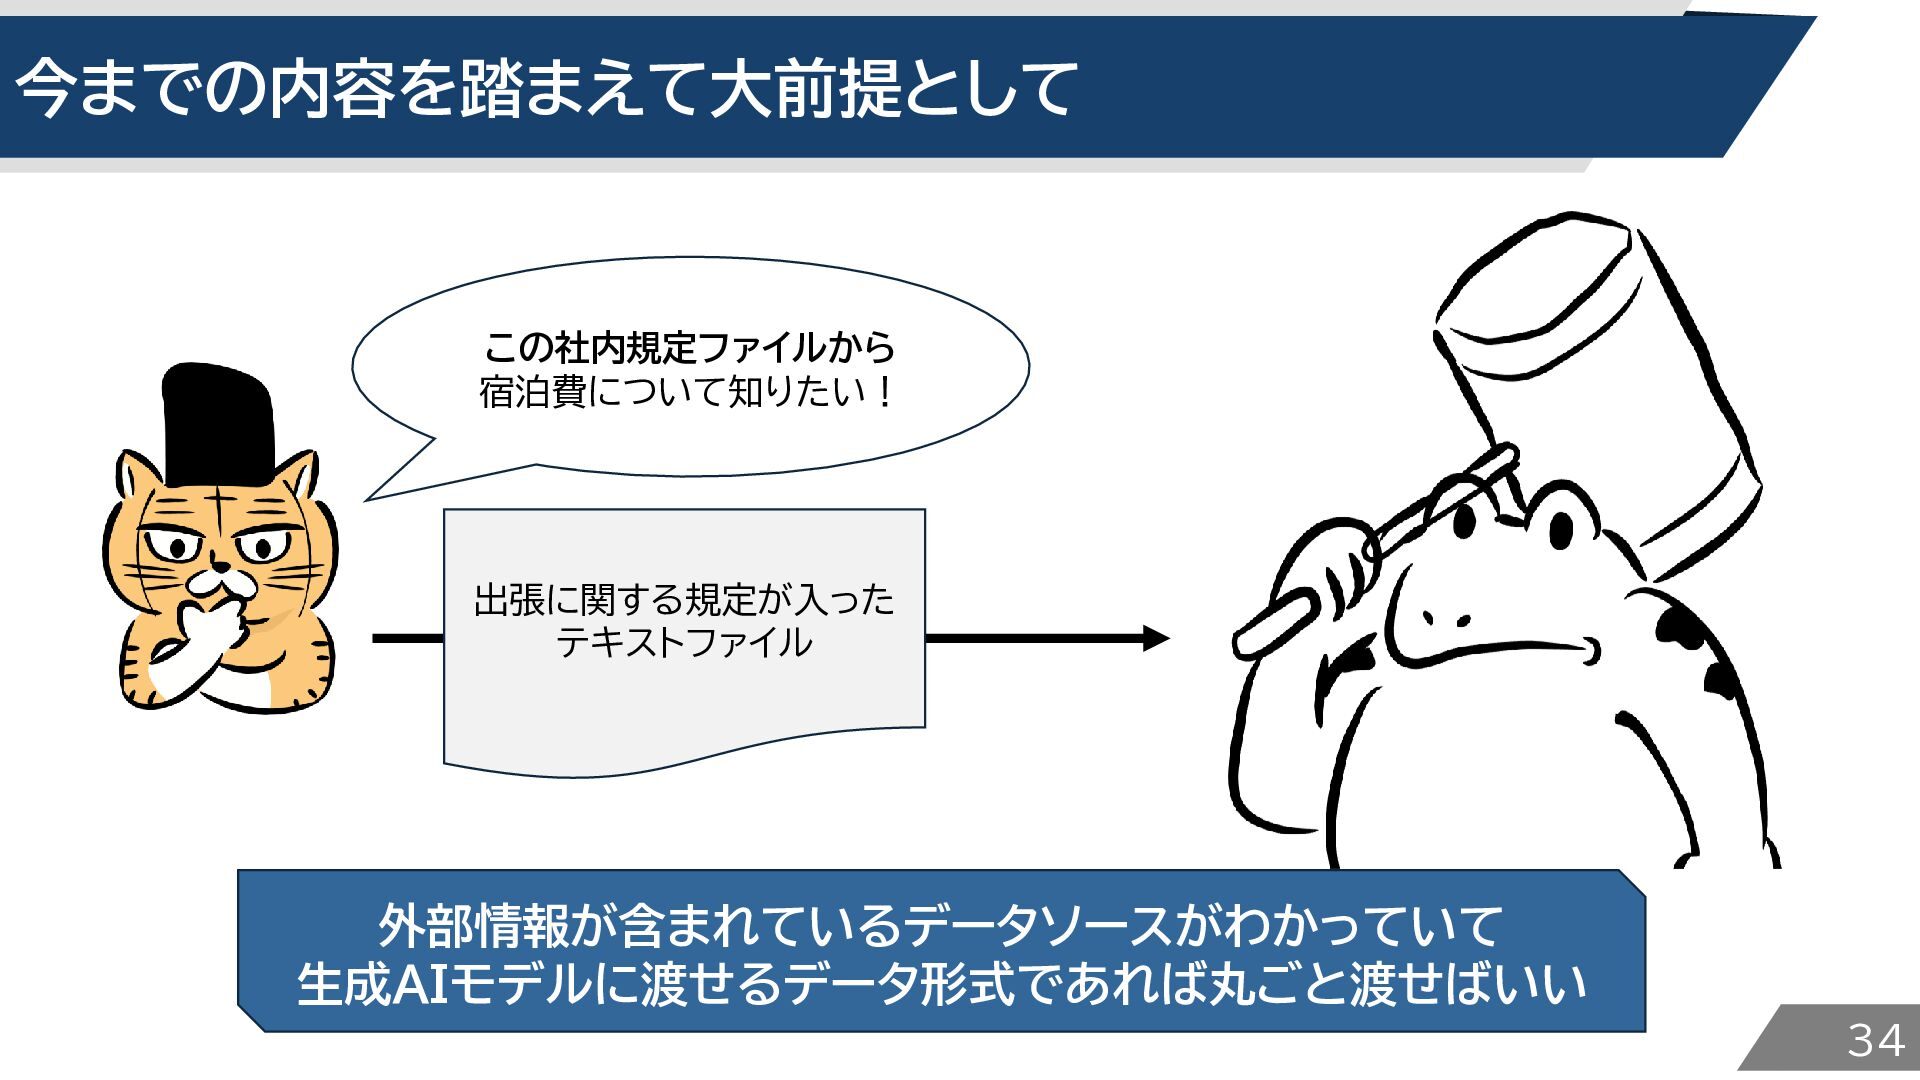
今までの内容を踏まえて大前提として この社内規定ファイルから 宿泊費について知りたい! 出張に関する規定が入った テキストファイル 外部情報が含まれているデータソースがわかっていて 生成AIモデルに渡せるデータ形式であれば丸ごと渡せばいい 34
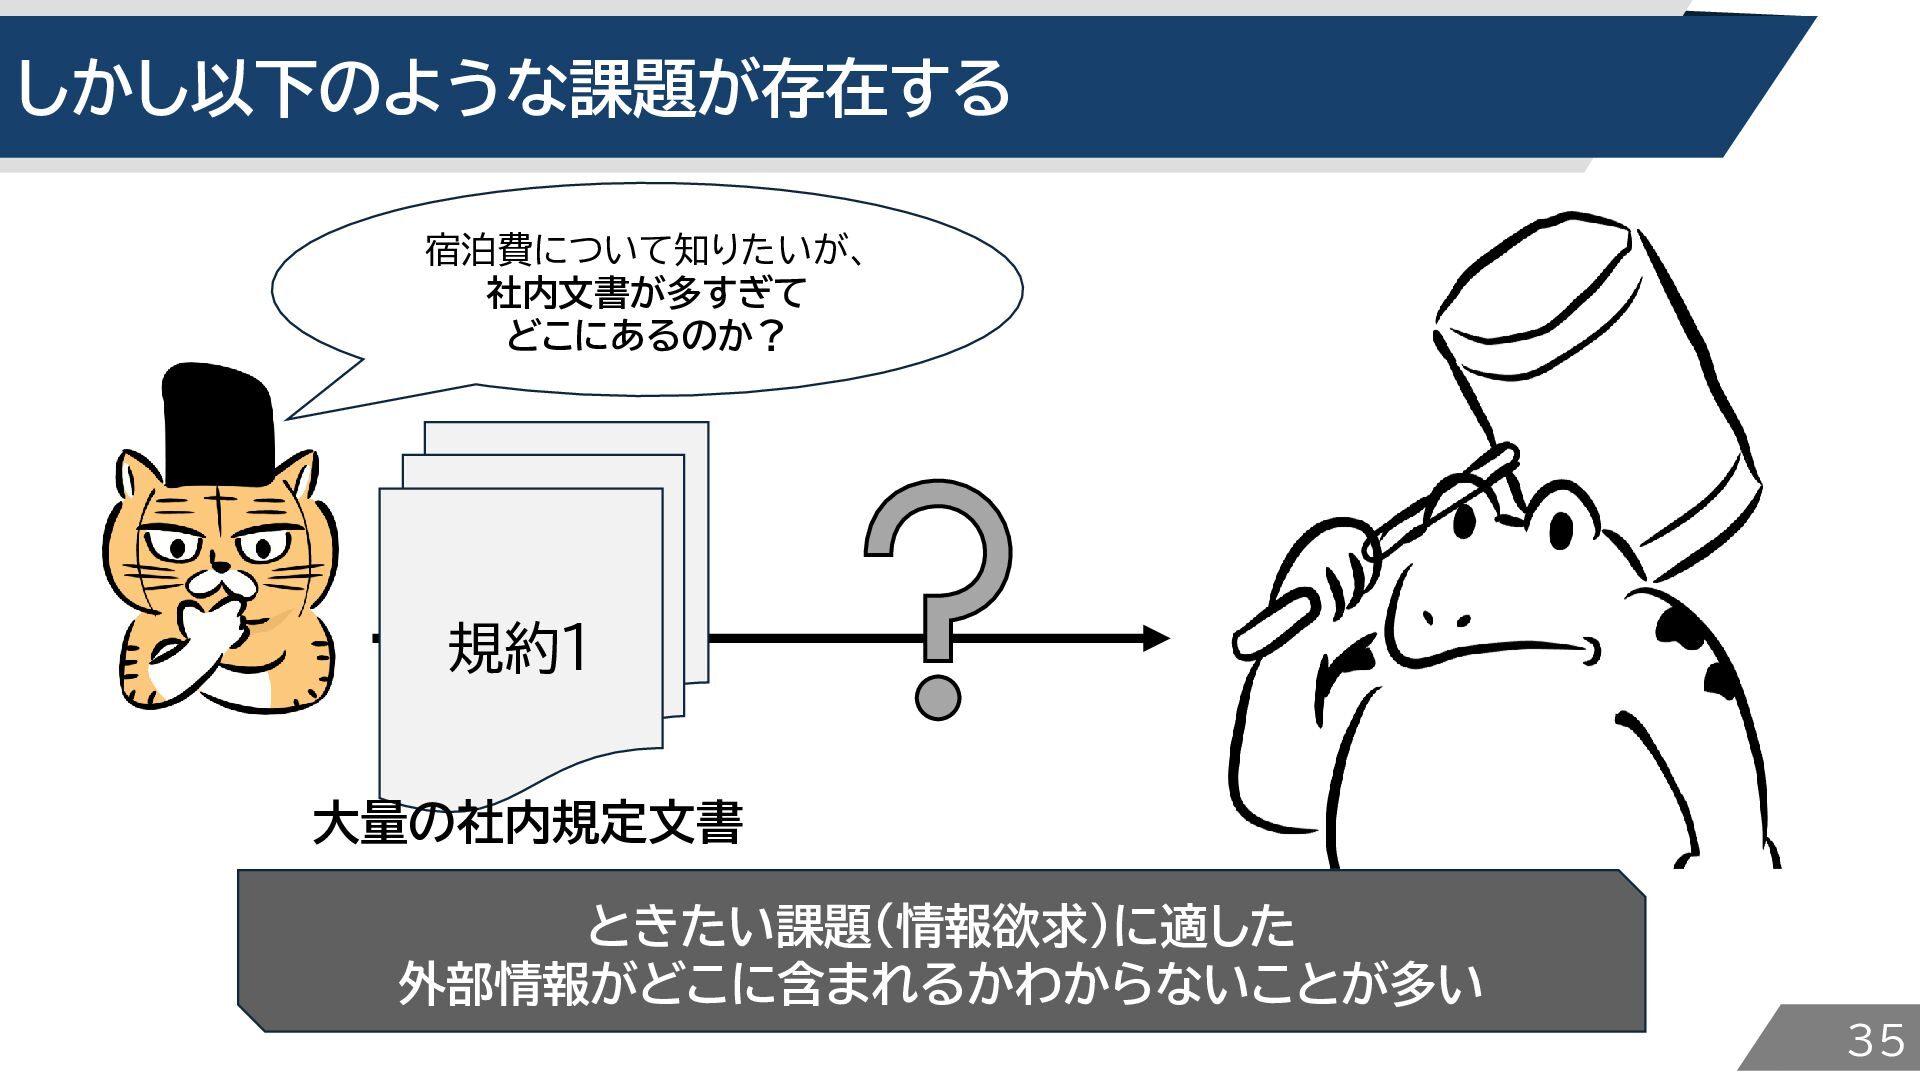
しかし以下のような課題が存在する 宿泊費について知りたいが、 社内文書が多すぎて どこにあるのか? 規約1 大量の社内規定文書 ときたい課題(情報欲求)に適した 外部情報がどこに含まれるかわからないことが多い 35
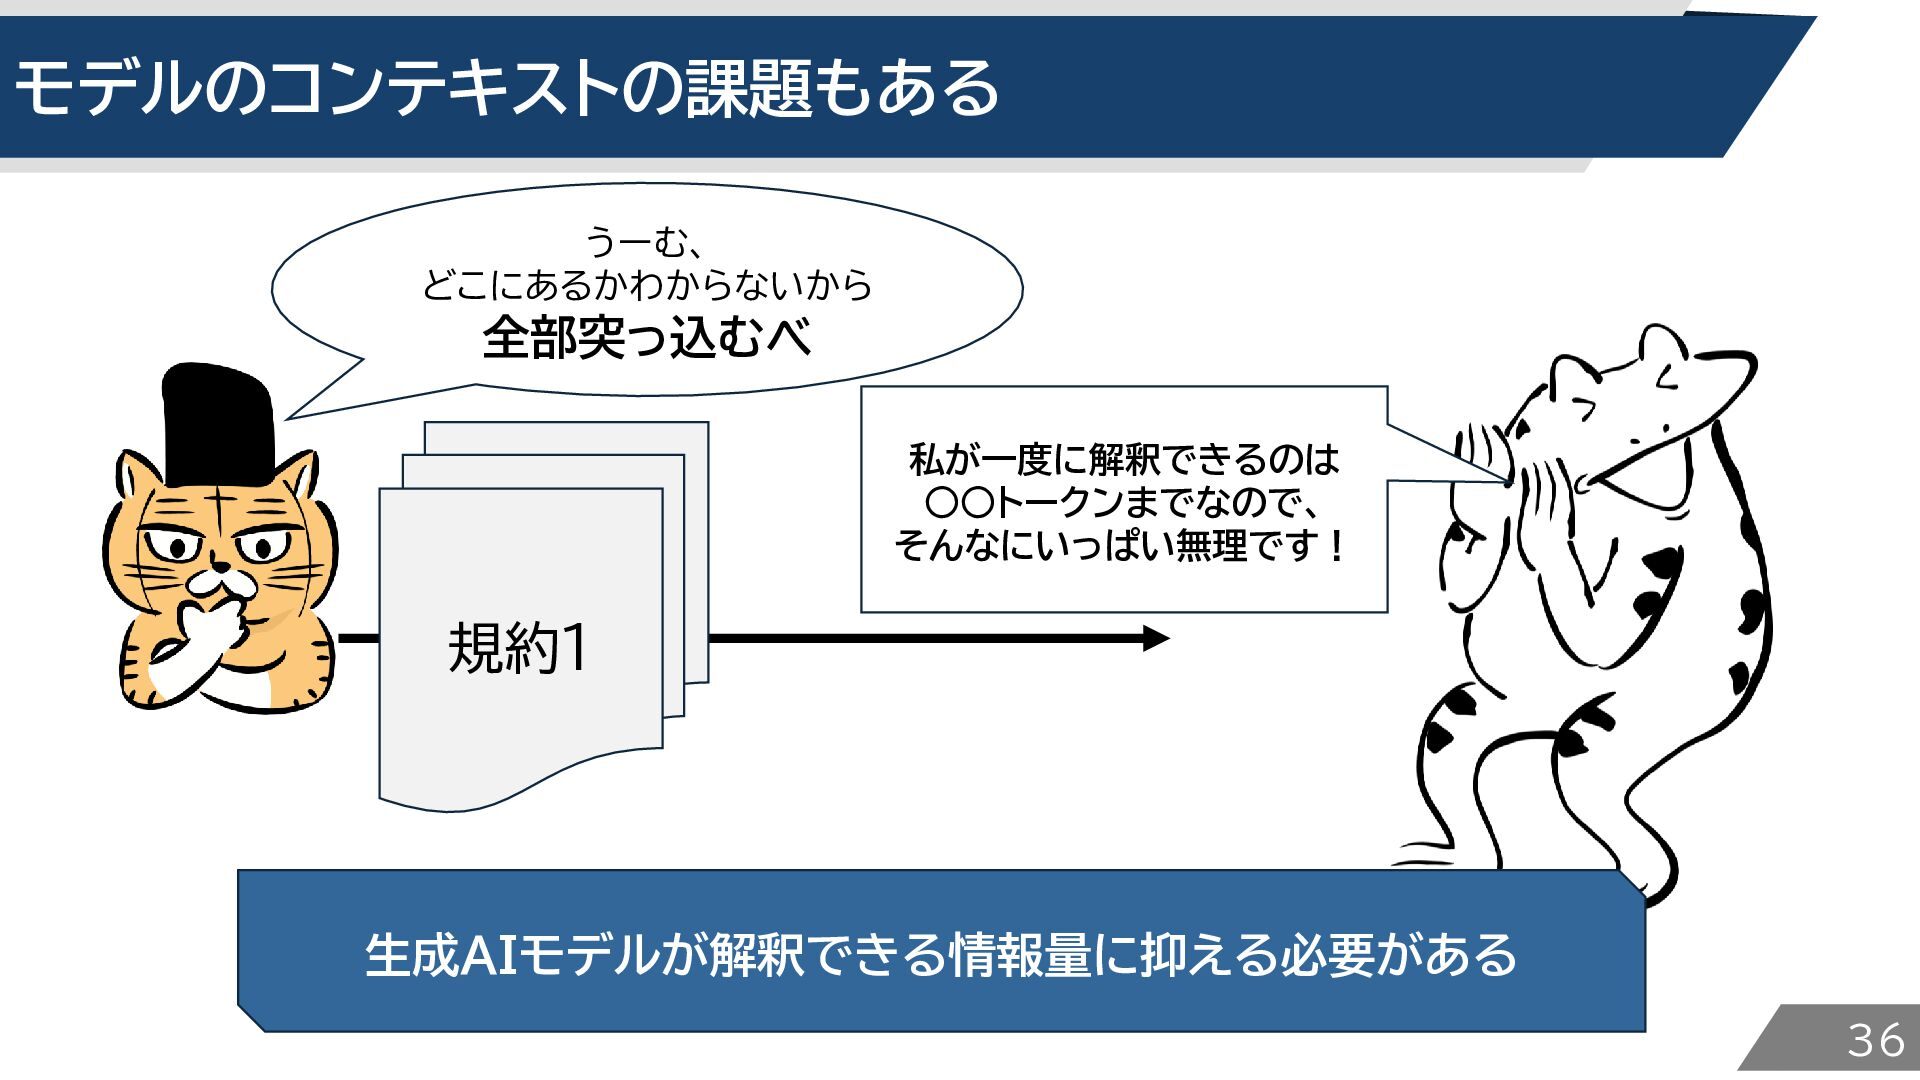
モデルのコンテキストの課題もある うーむ、 どこにあるかわからないから 全部突っ込むべ 私が一度に解釈できるのは ◦◦トークンまでなので、 そんなにいっぱい無理です! 規約1 生成AIモデルが解釈できる情報量に抑える必要がある 36
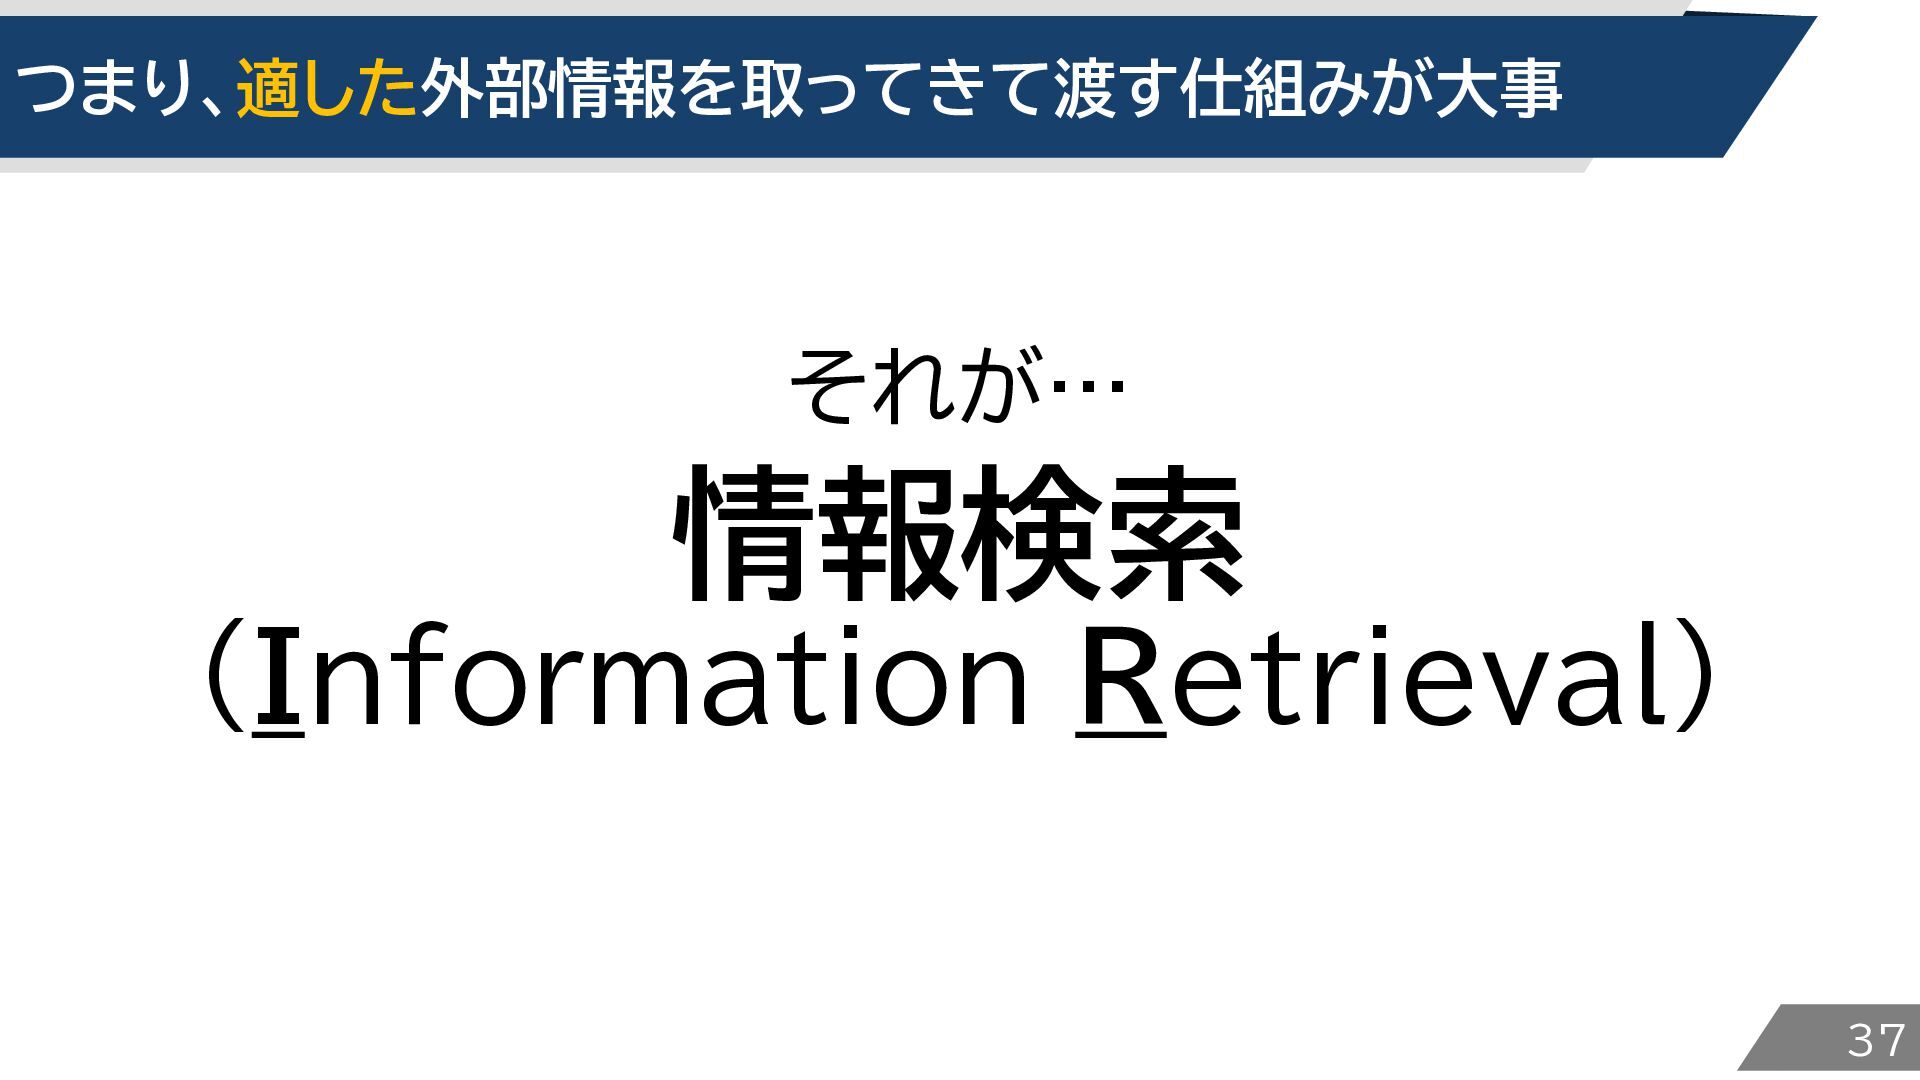
つまり、適した外部情報を取ってきて渡す仕組みが大事 それが… 情報検索 (Information Retrieval) 37
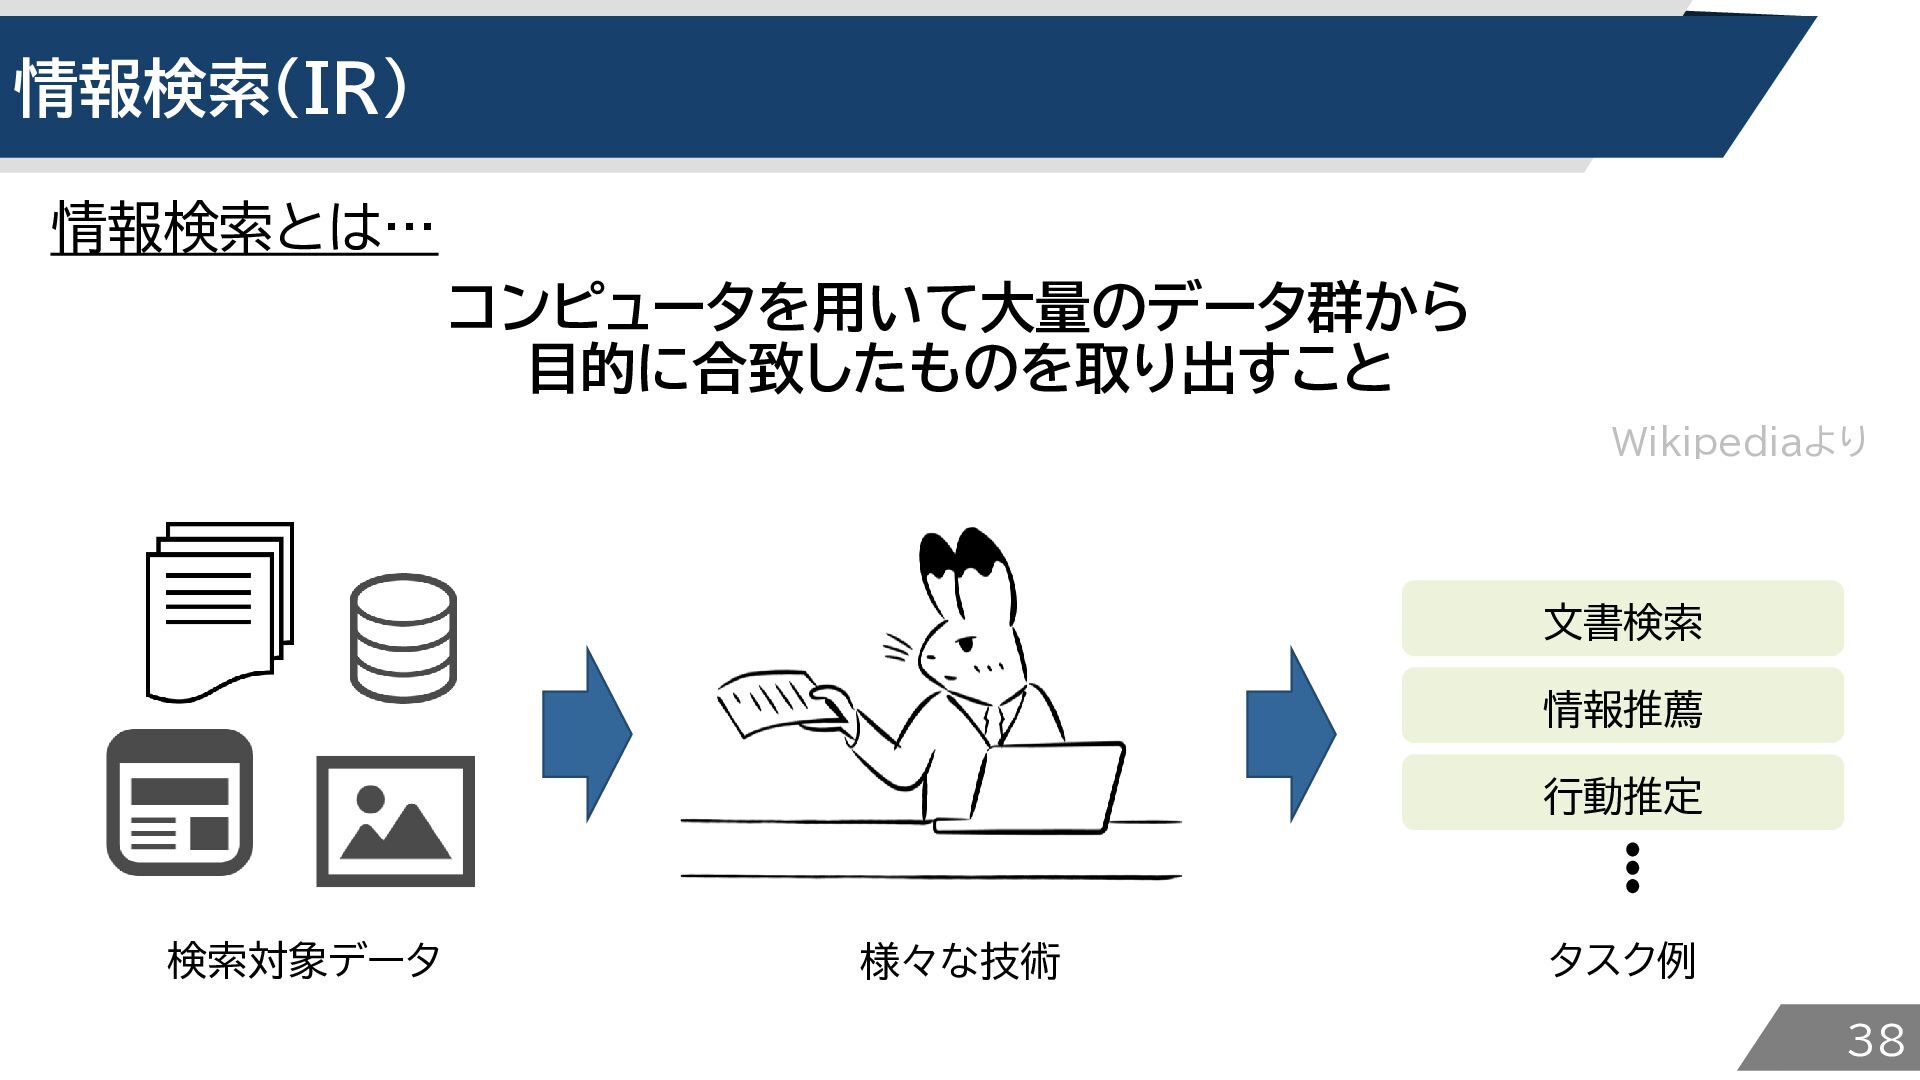
情報検索(IR) 情報検索とは… コンピュータを用いて大量のデータ群から 目的に合致したものを取り出すこと Wikipediaより 文書検索 情報推薦 行動推定 検索対象データ 様々な技術
タスク例 38
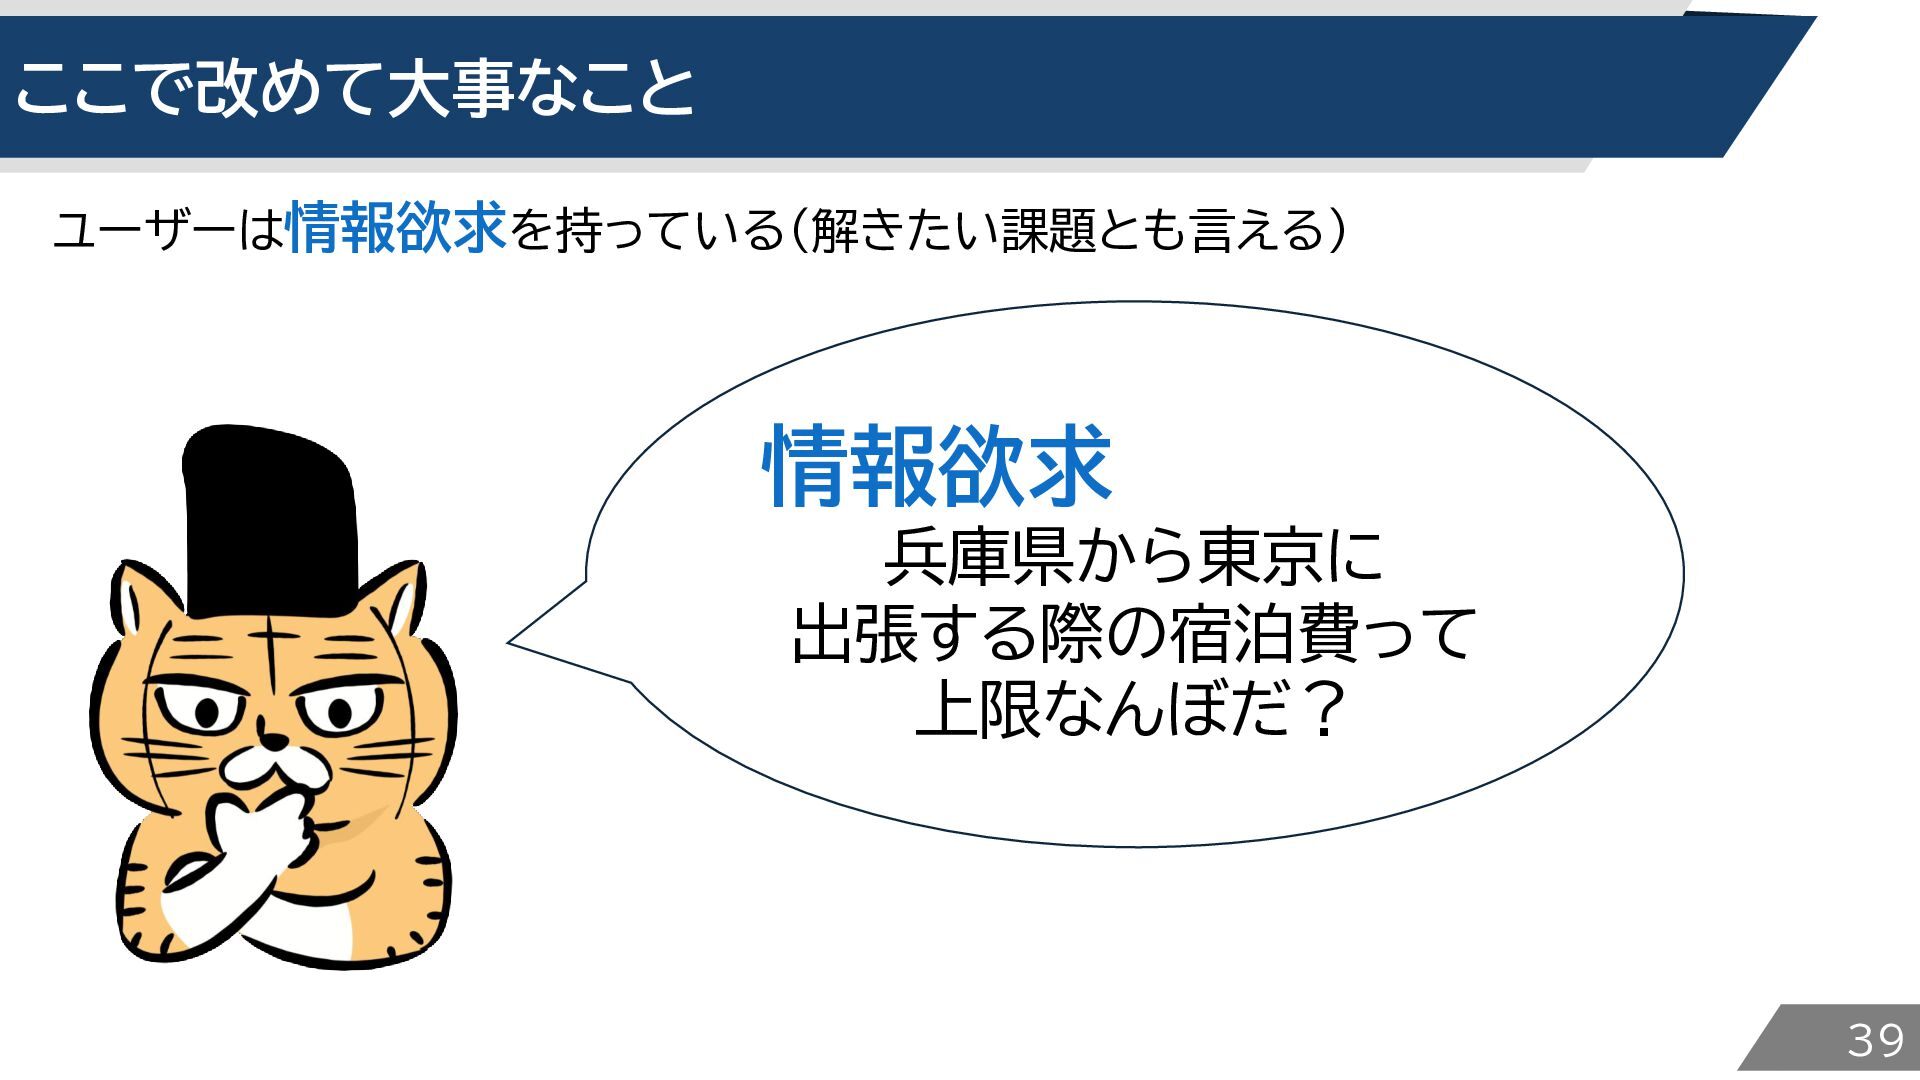
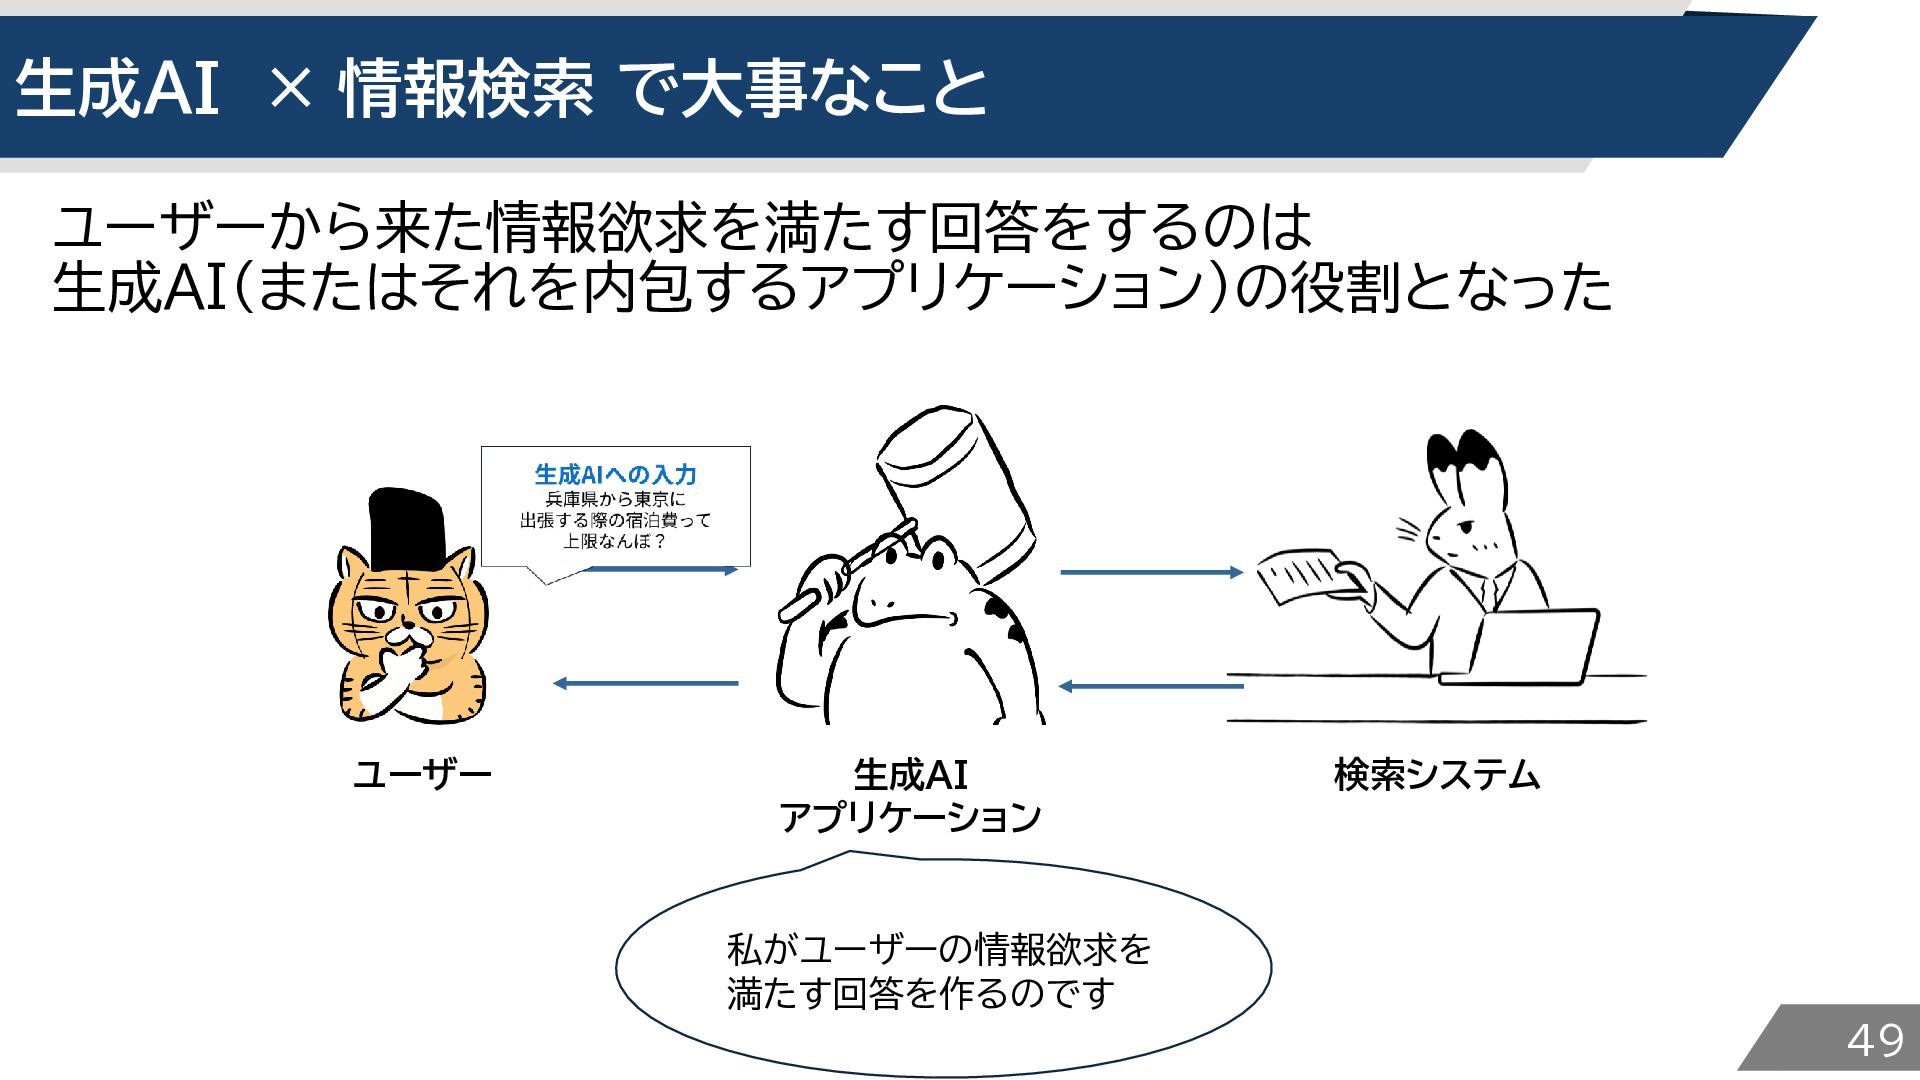
ここで改めて大事なこと ユーザーは情報欲求を持っている(解きたい課題とも言える) 情報欲求 兵庫県から東京に 出張する際の宿泊費って 上限なんぼだ? 39
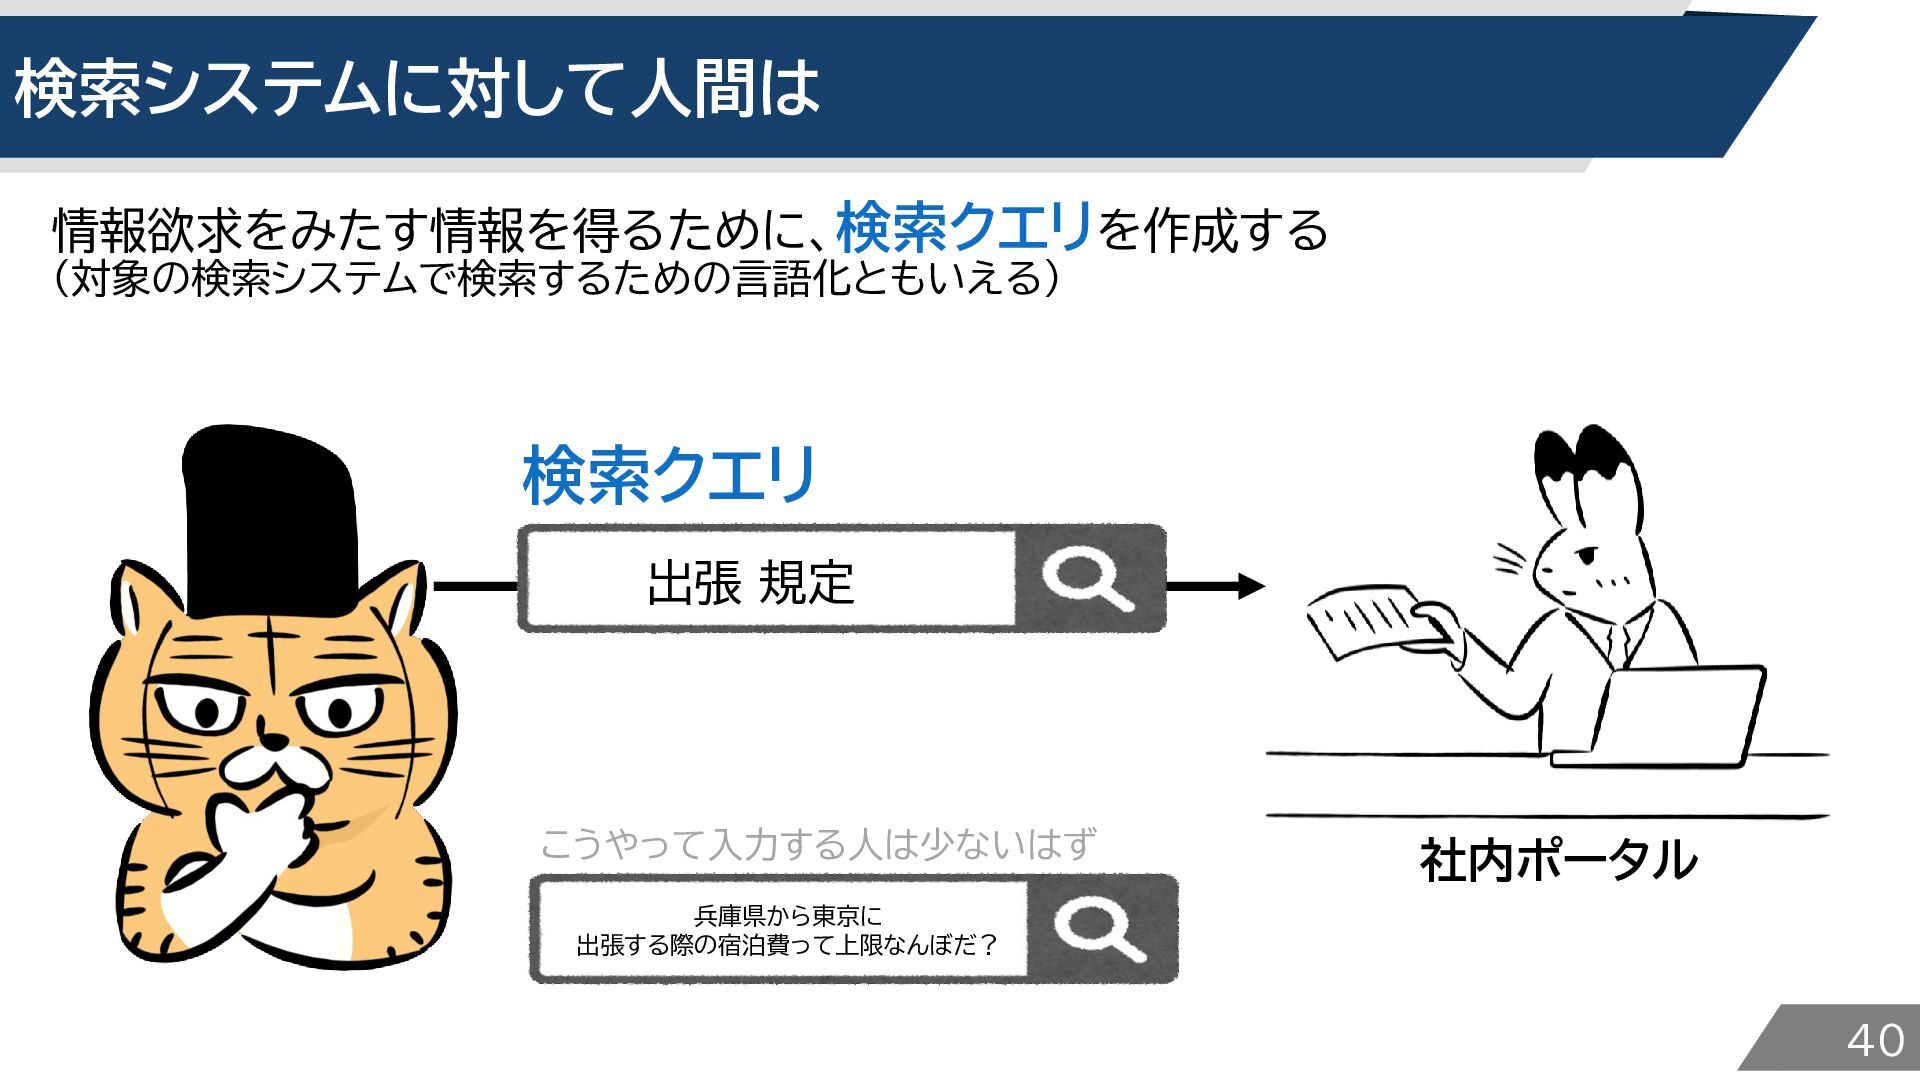
検索システムに対して人間は 情報欲求をみたす情報を得るために、検索クエリを作成する (対象の検索システムで検索するための言語化ともいえる) 検索クエリ 出張 規定 こうやって入力する人は少ないはず 社内ポータル 兵庫県から東京に 出張する際の宿泊費って上限なんぼだ?
40
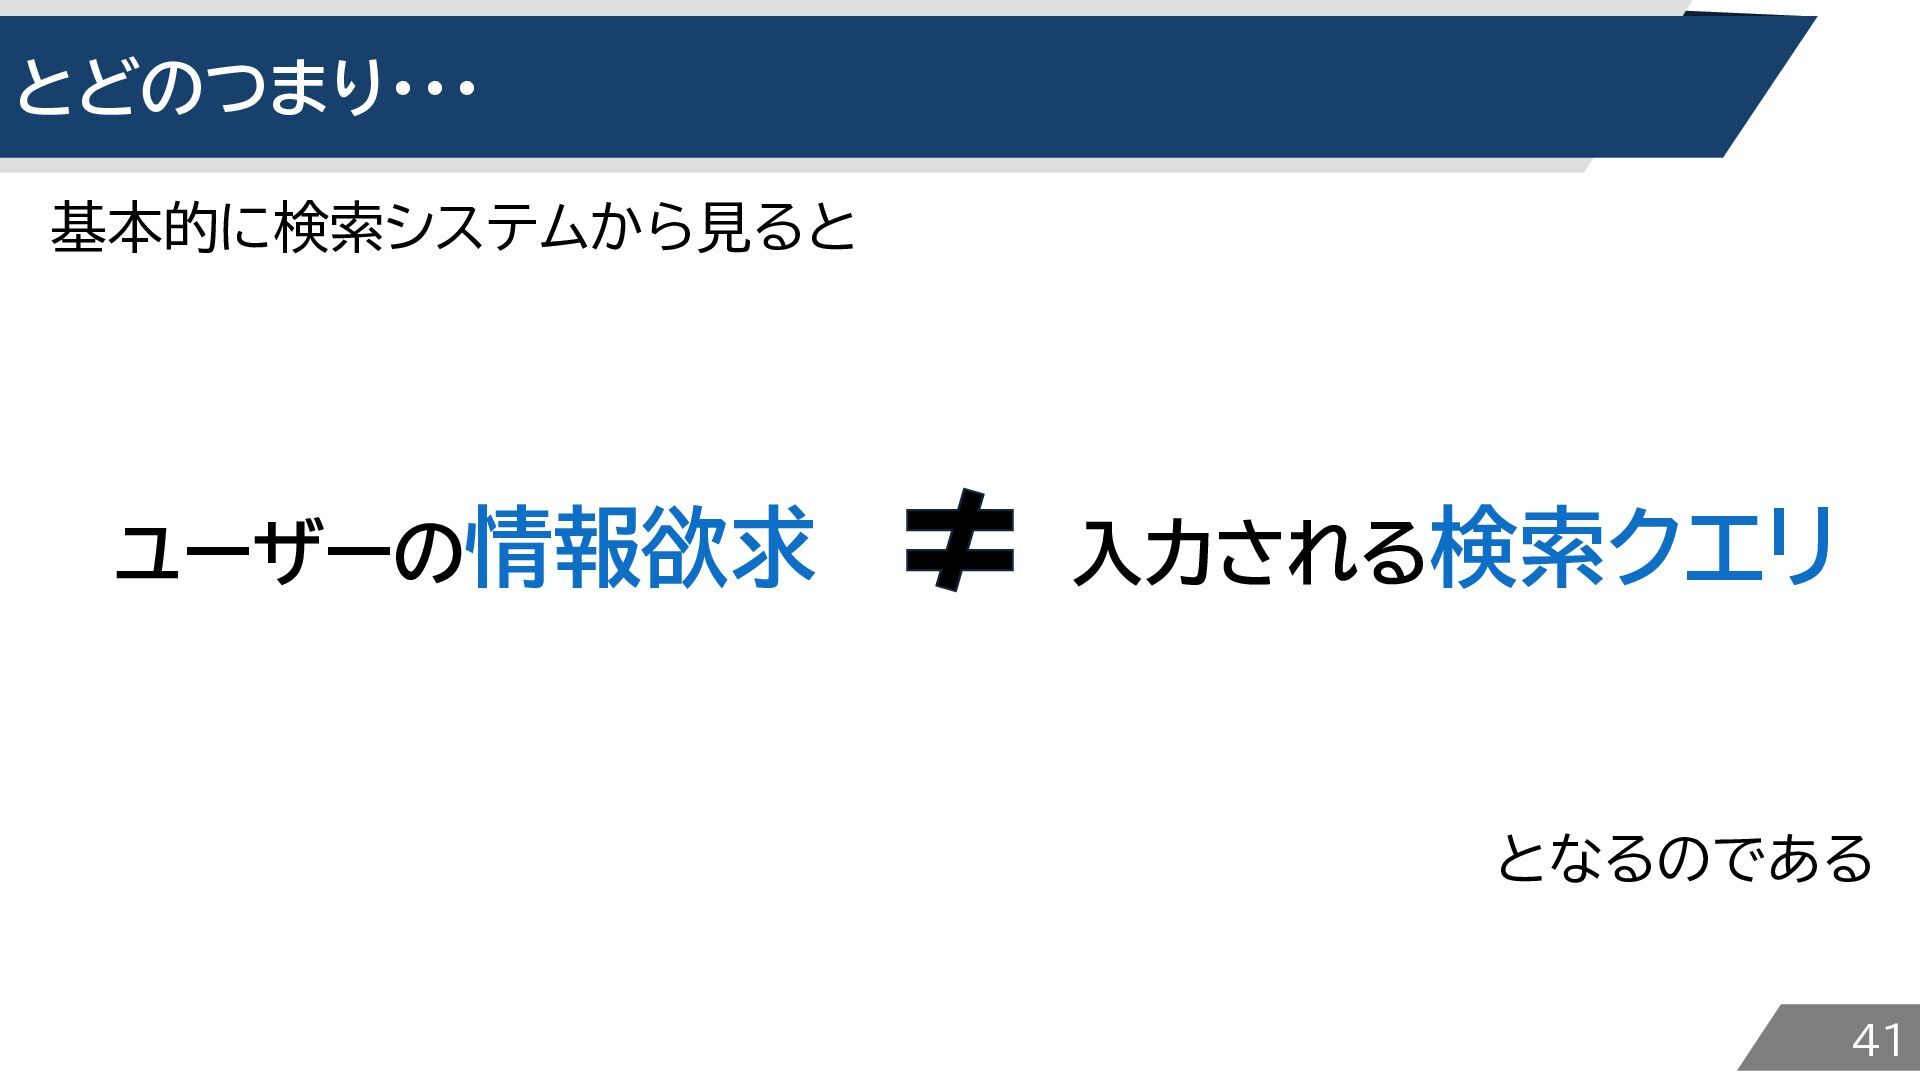
とどのつまり・・・ 基本的に検索システムから見ると ユーザーの情報欲求 入力される検索クエリ となるのである 41
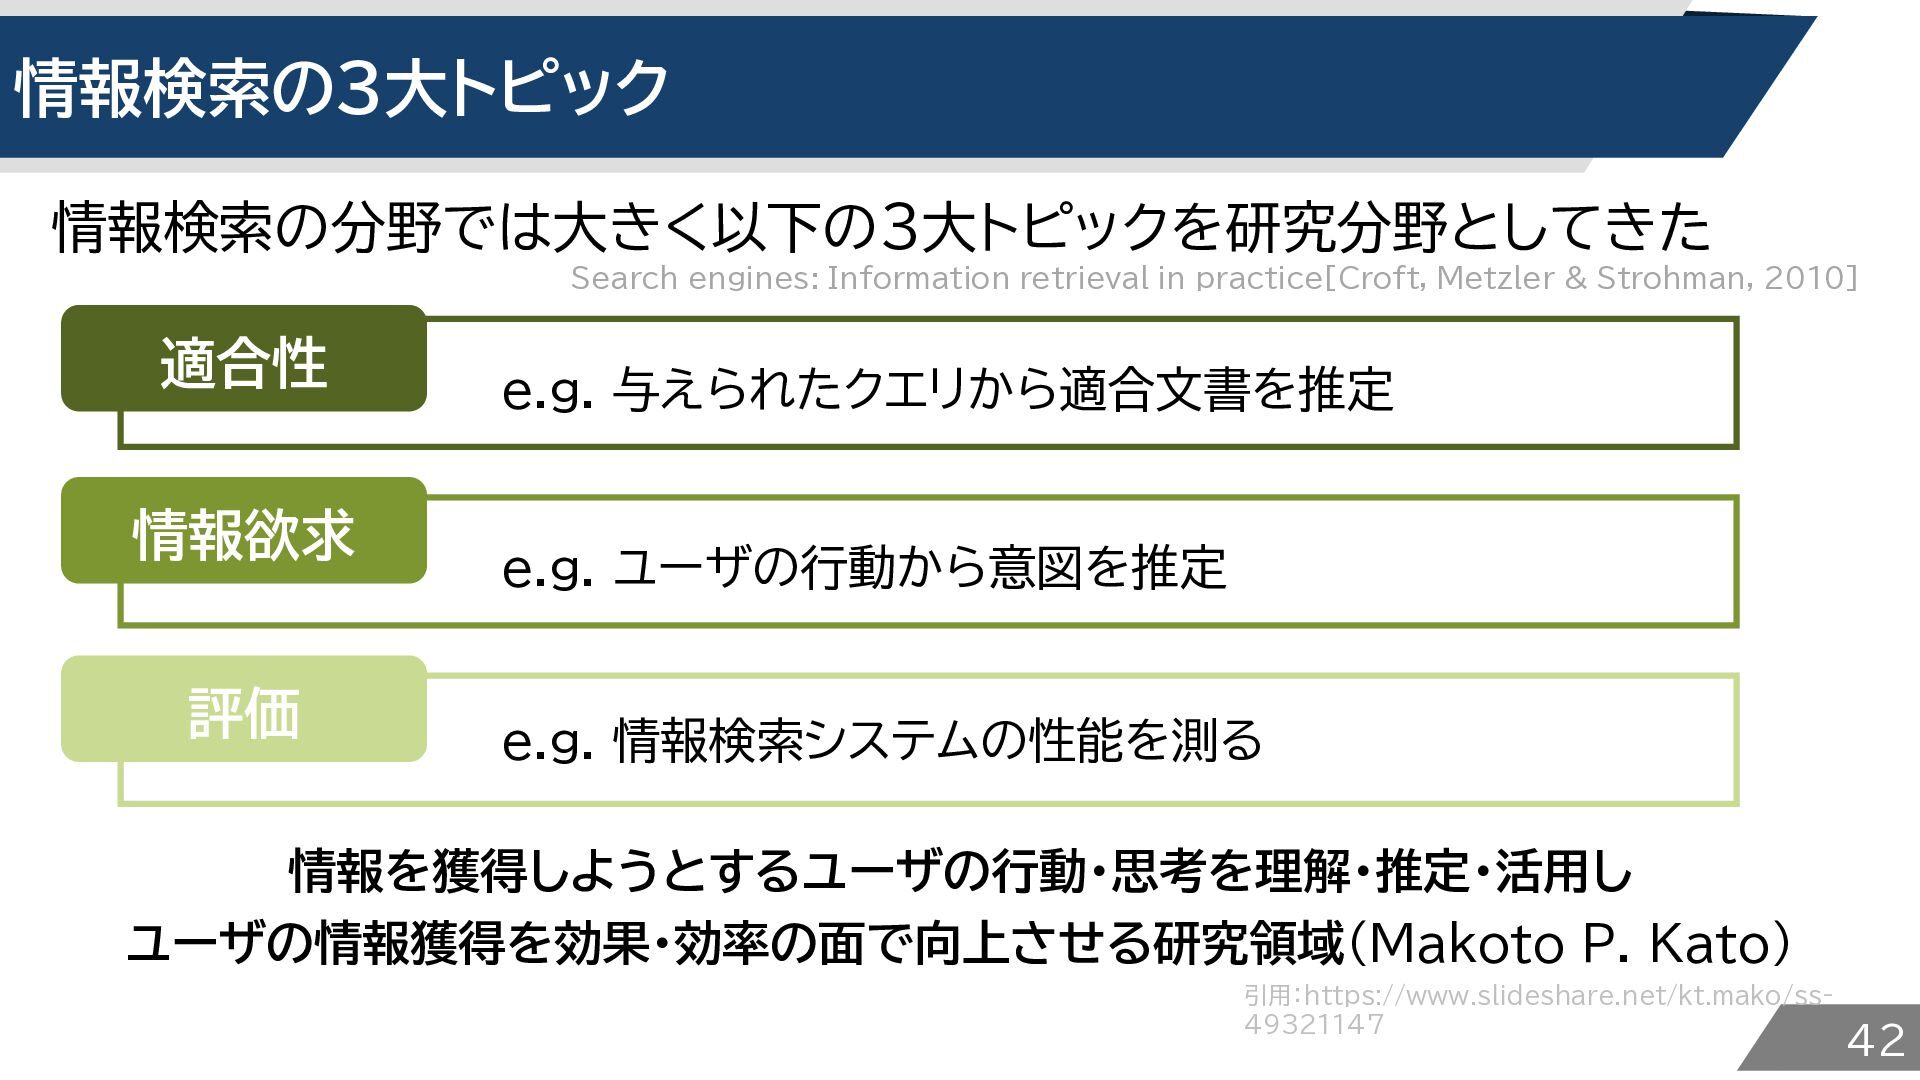
情報検索の3大トピック 情報検索の分野では大きく以下の3大トピックを研究分野としてきた Search engines: Information retrieval in practice[Croft, Metzler &
Strohman, 2010] 適合性 情報欲求 評価 e.g. 与えられたクエリから適合文書を推定 e.g. ユーザの行動から意図を推定 e.g. 情報検索システムの性能を測る 情報を獲得しようとするユーザの行動・思考を理解・推定・活用し ユーザの情報獲得を効果・効率の面で向上させる研究領域(Makoto P. Kato) 引用:https://www.slideshare.net/kt.mako/ss49321147 42
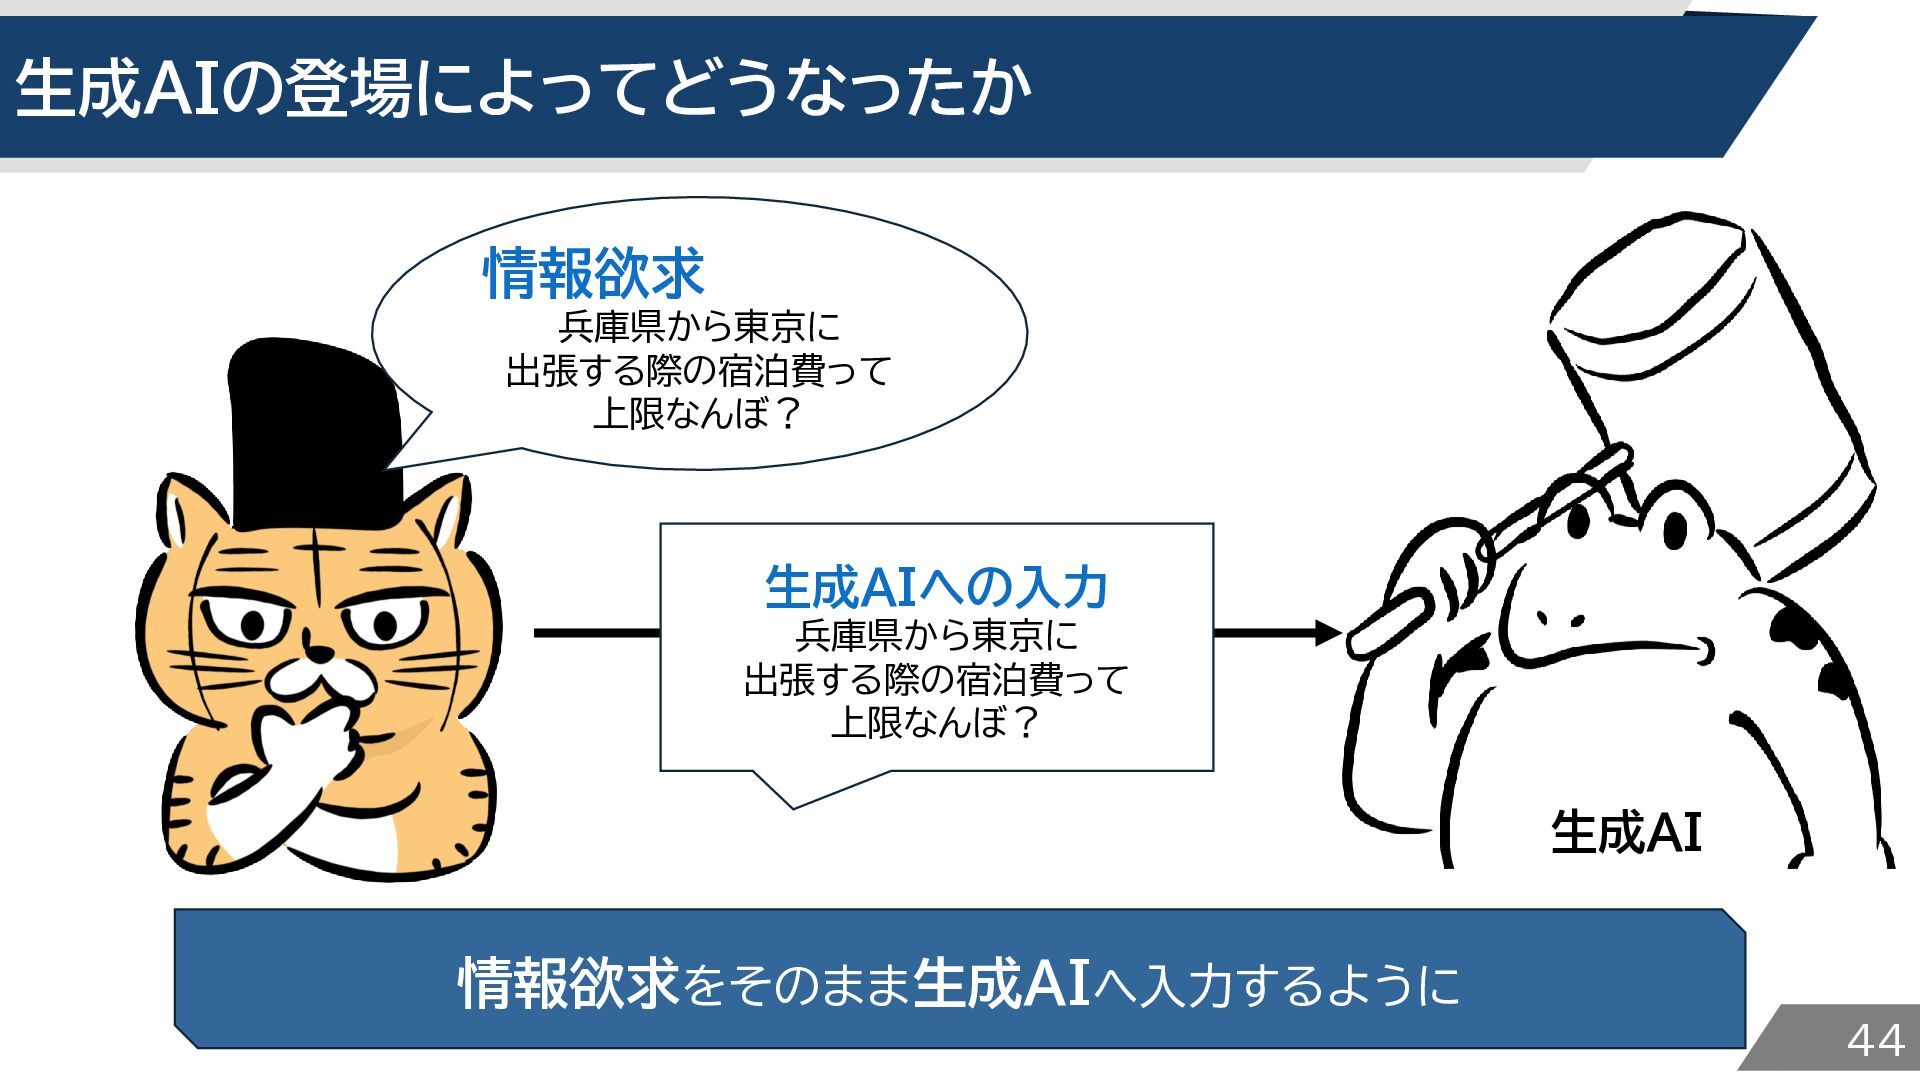
生成AIの登場によってどうなったか 情報欲求 兵庫県から東京に 出張する際の宿泊費って 上限なんぼ? 生成AIへの入力 兵庫県から東京に 出張する際の宿泊費って 上限なんぼ? 生成AI
情報欲求をそのまま生成AIへ入力するように 44
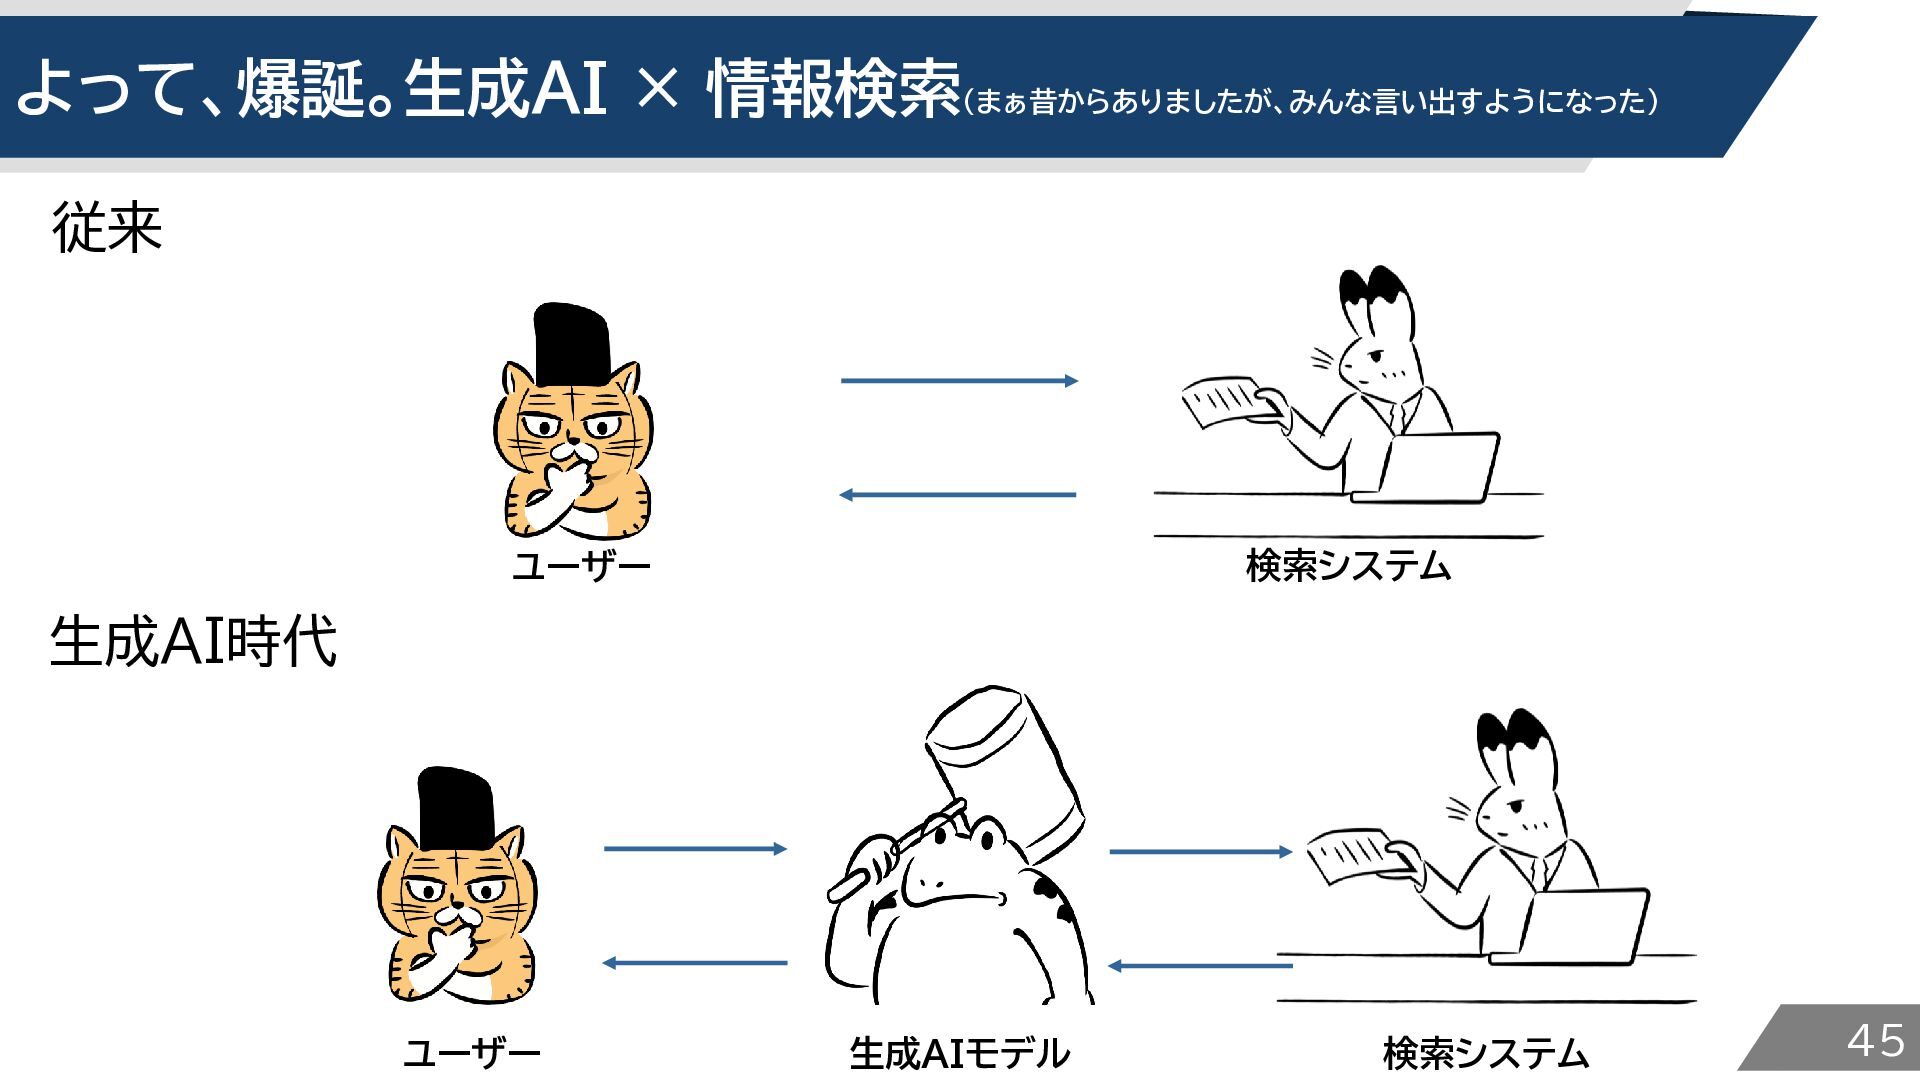
よって、爆誕。生成AI × 情報検索(まぁ昔からありましたが、みんな言い出すようになった) 従来 検索システム ユーザー 生成AI時代 ユーザー 生成AIモデル 検索システム
45
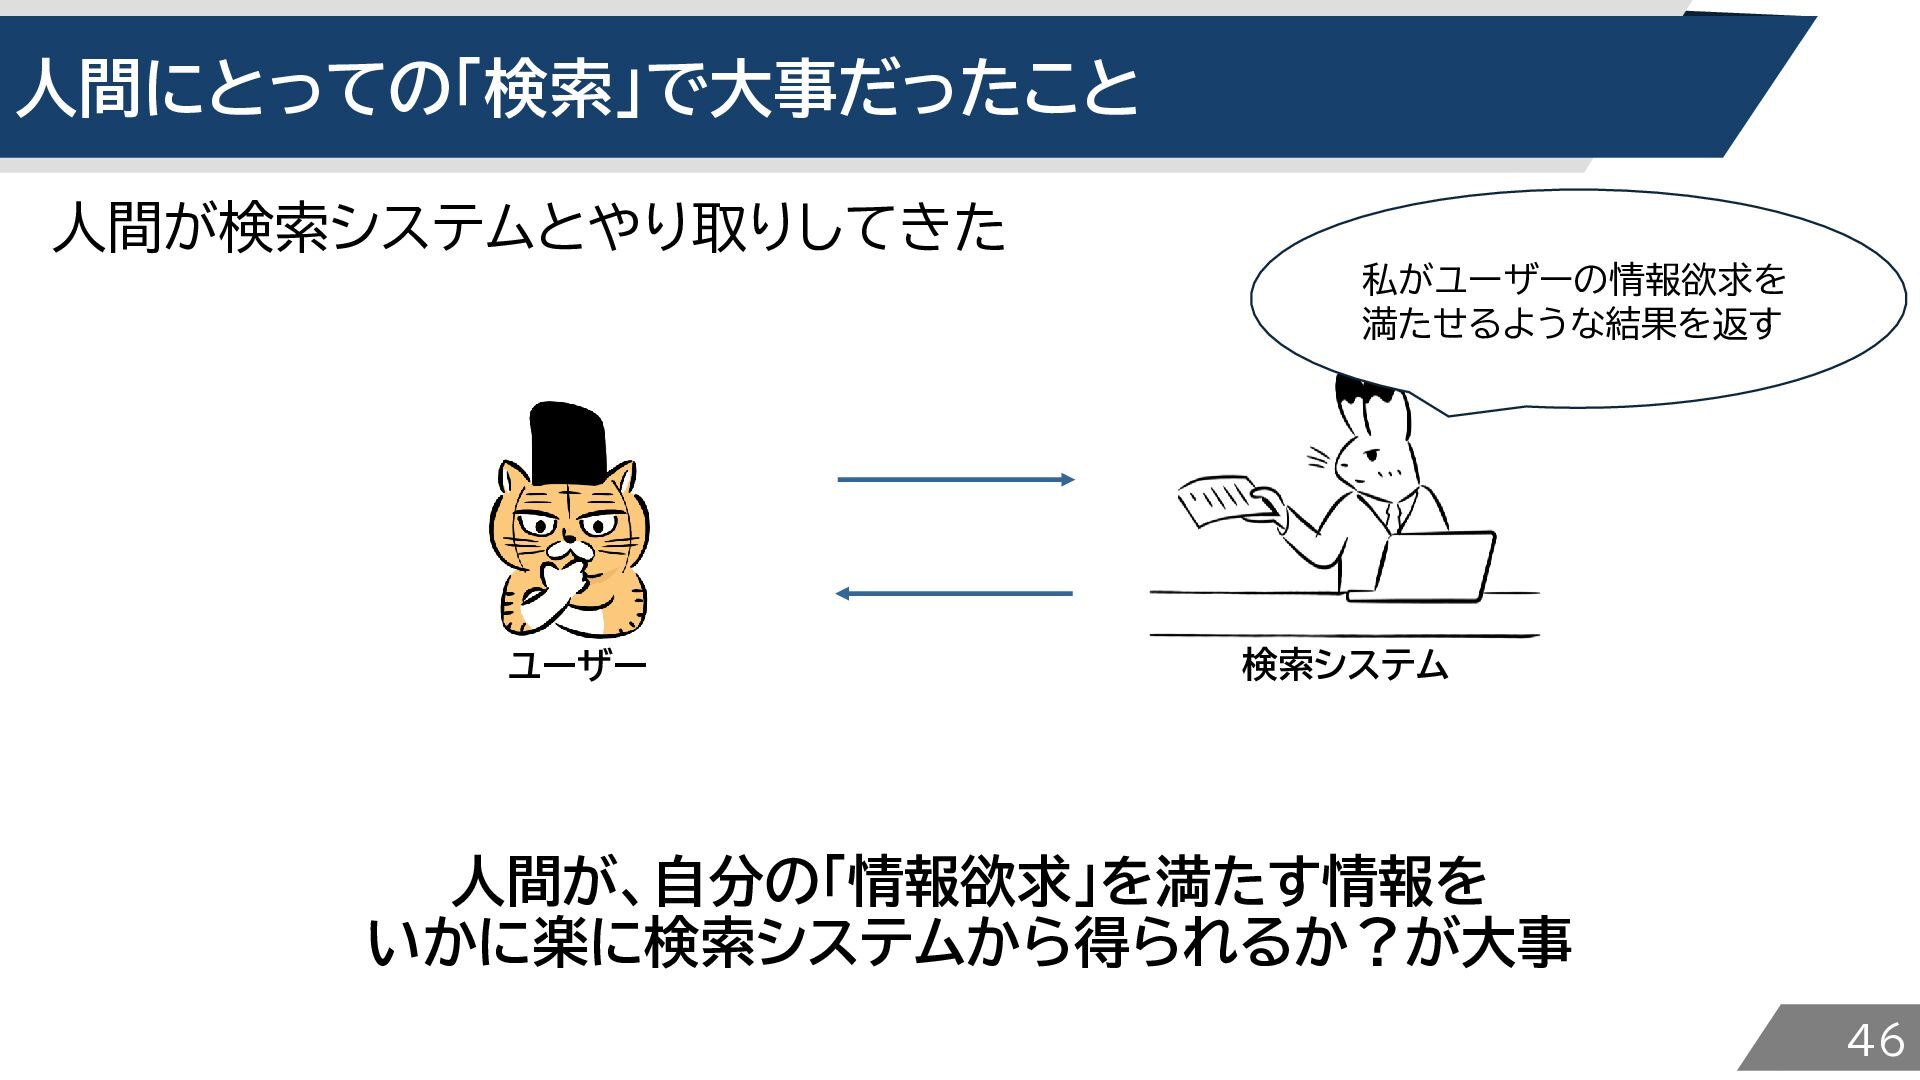
人間にとっての「検索」で大事だったこと 人間が検索システムとやり取りしてきた 私がユーザーの情報欲求を 満たせるような結果を返す ユーザー 検索システム 人間が、自分の「情報欲求」を満たす情報を いかに楽に検索システムから得られるか?が大事 46
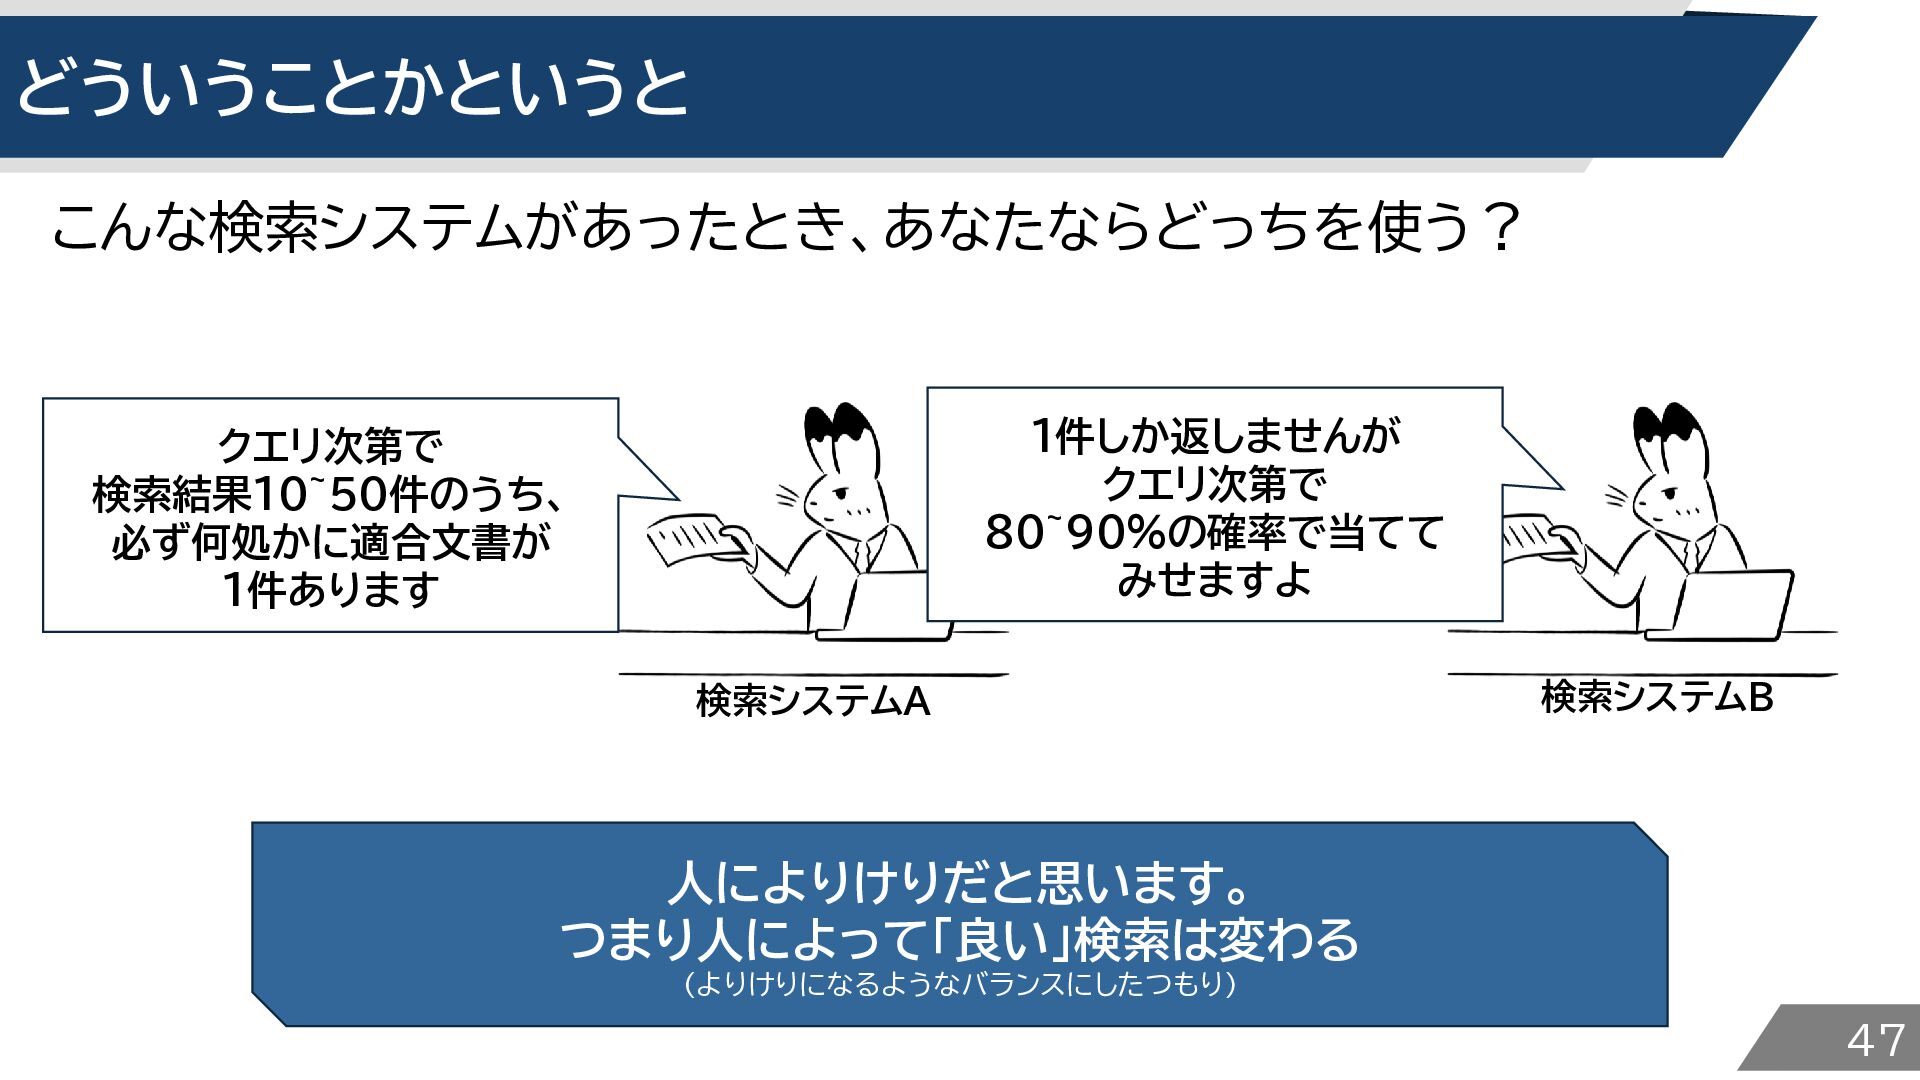
どういうことかというと こんな検索システムがあったとき、あなたならどっちを使う? 1件しか返しませんが クエリ次第で 80~90%の確率で当てて みせますよ クエリ次第で 検索結果10~50件のうち、 必ず何処かに適合文書が 1件あります
検索システムA 検索システムB 人によりけりだと思います。 つまり人によって「良い」検索は変わる (よりけりになるようなバランスにしたつもり) 47
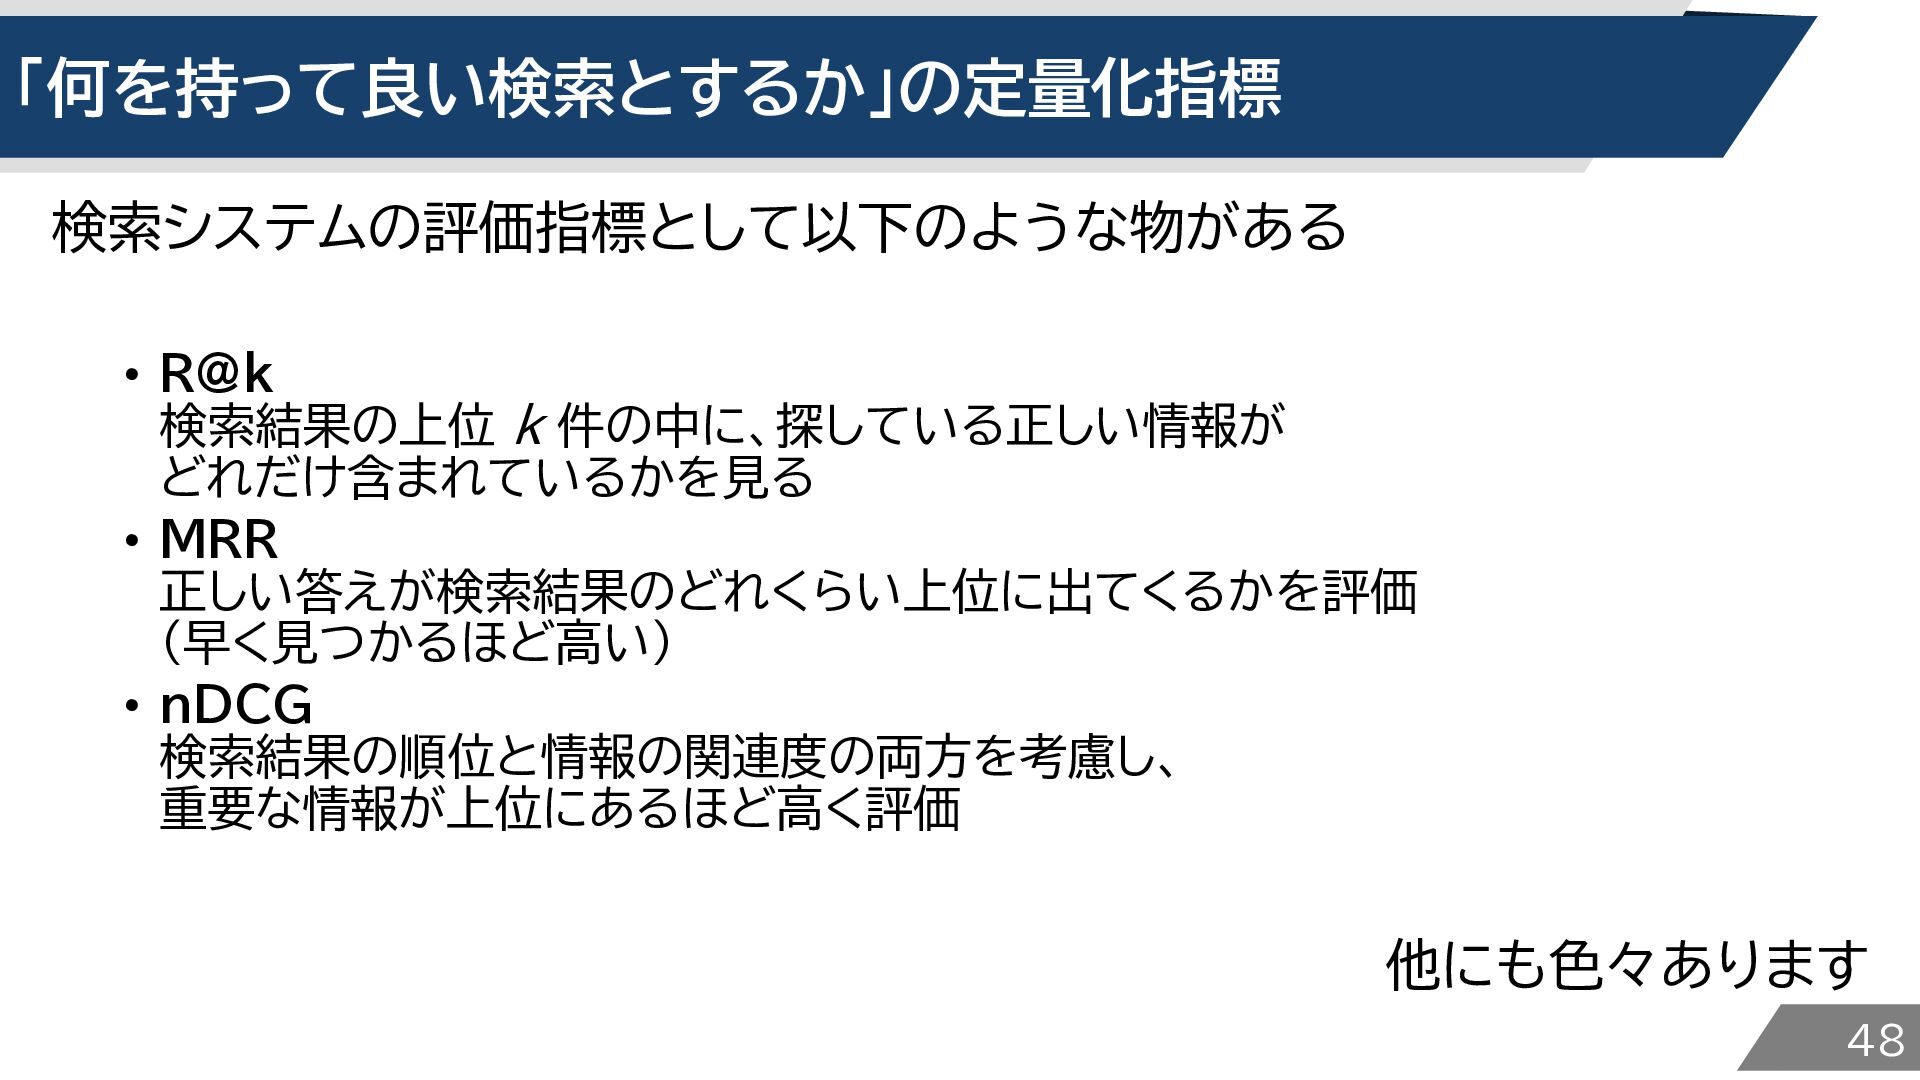
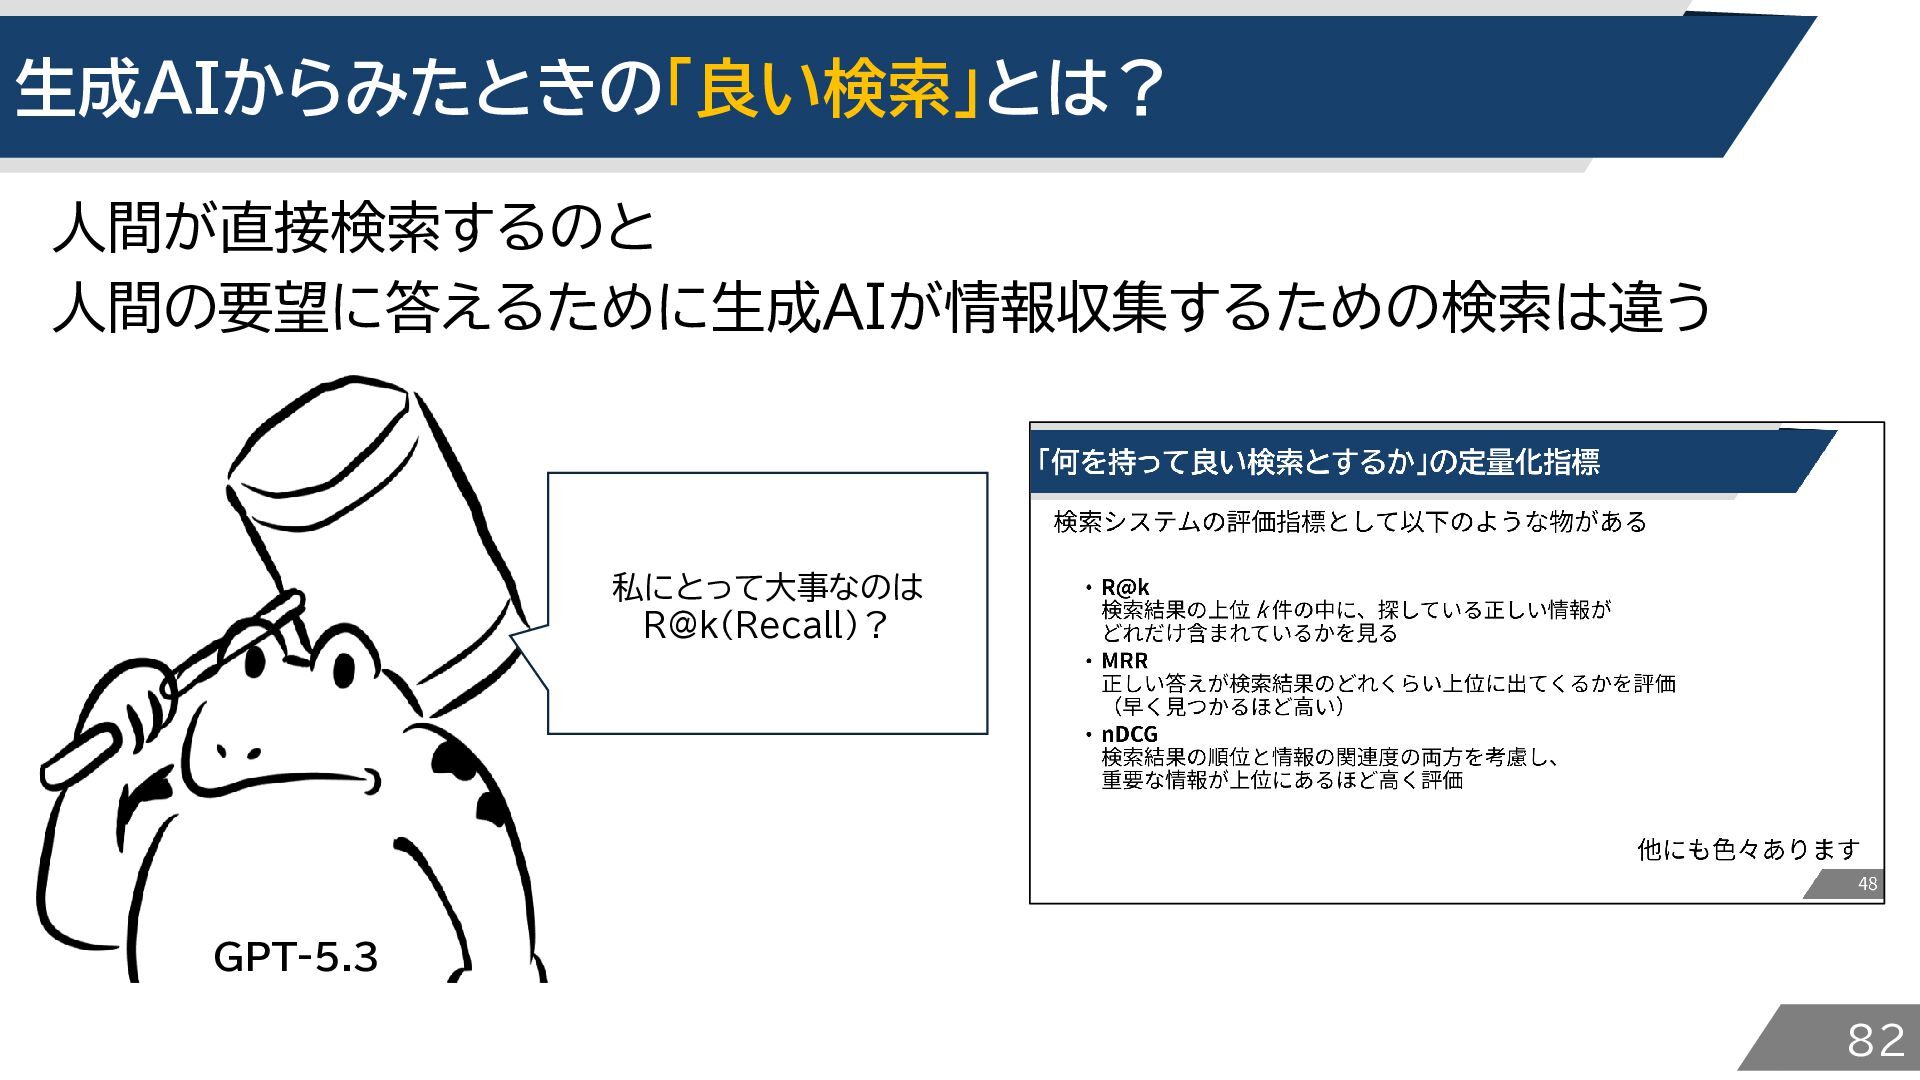
「何を持って良い検索とするか」の定量化指標 検索システムの評価指標として以下のような物がある • R@k 検索結果の上位 k 件の中に、探している正しい情報が どれだけ含まれているかを見る • MRR
正しい答えが検索結果のどれくらい上位に出てくるかを評価 (早く見つかるほど高い) • nDCG 検索結果の順位と情報の関連度の両方を考慮し、 重要な情報が上位にあるほど高く評価 他にも色々あります 48
生成AI × 情報検索 で大事なこと ユーザーから来た情報欲求を満たす回答をするのは 生成AI(またはそれを内包するアプリケーション)の役割となった ユーザー 生成AI アプリケーション 検索システム
私がユーザーの情報欲求を 満たす回答を作るのです 49
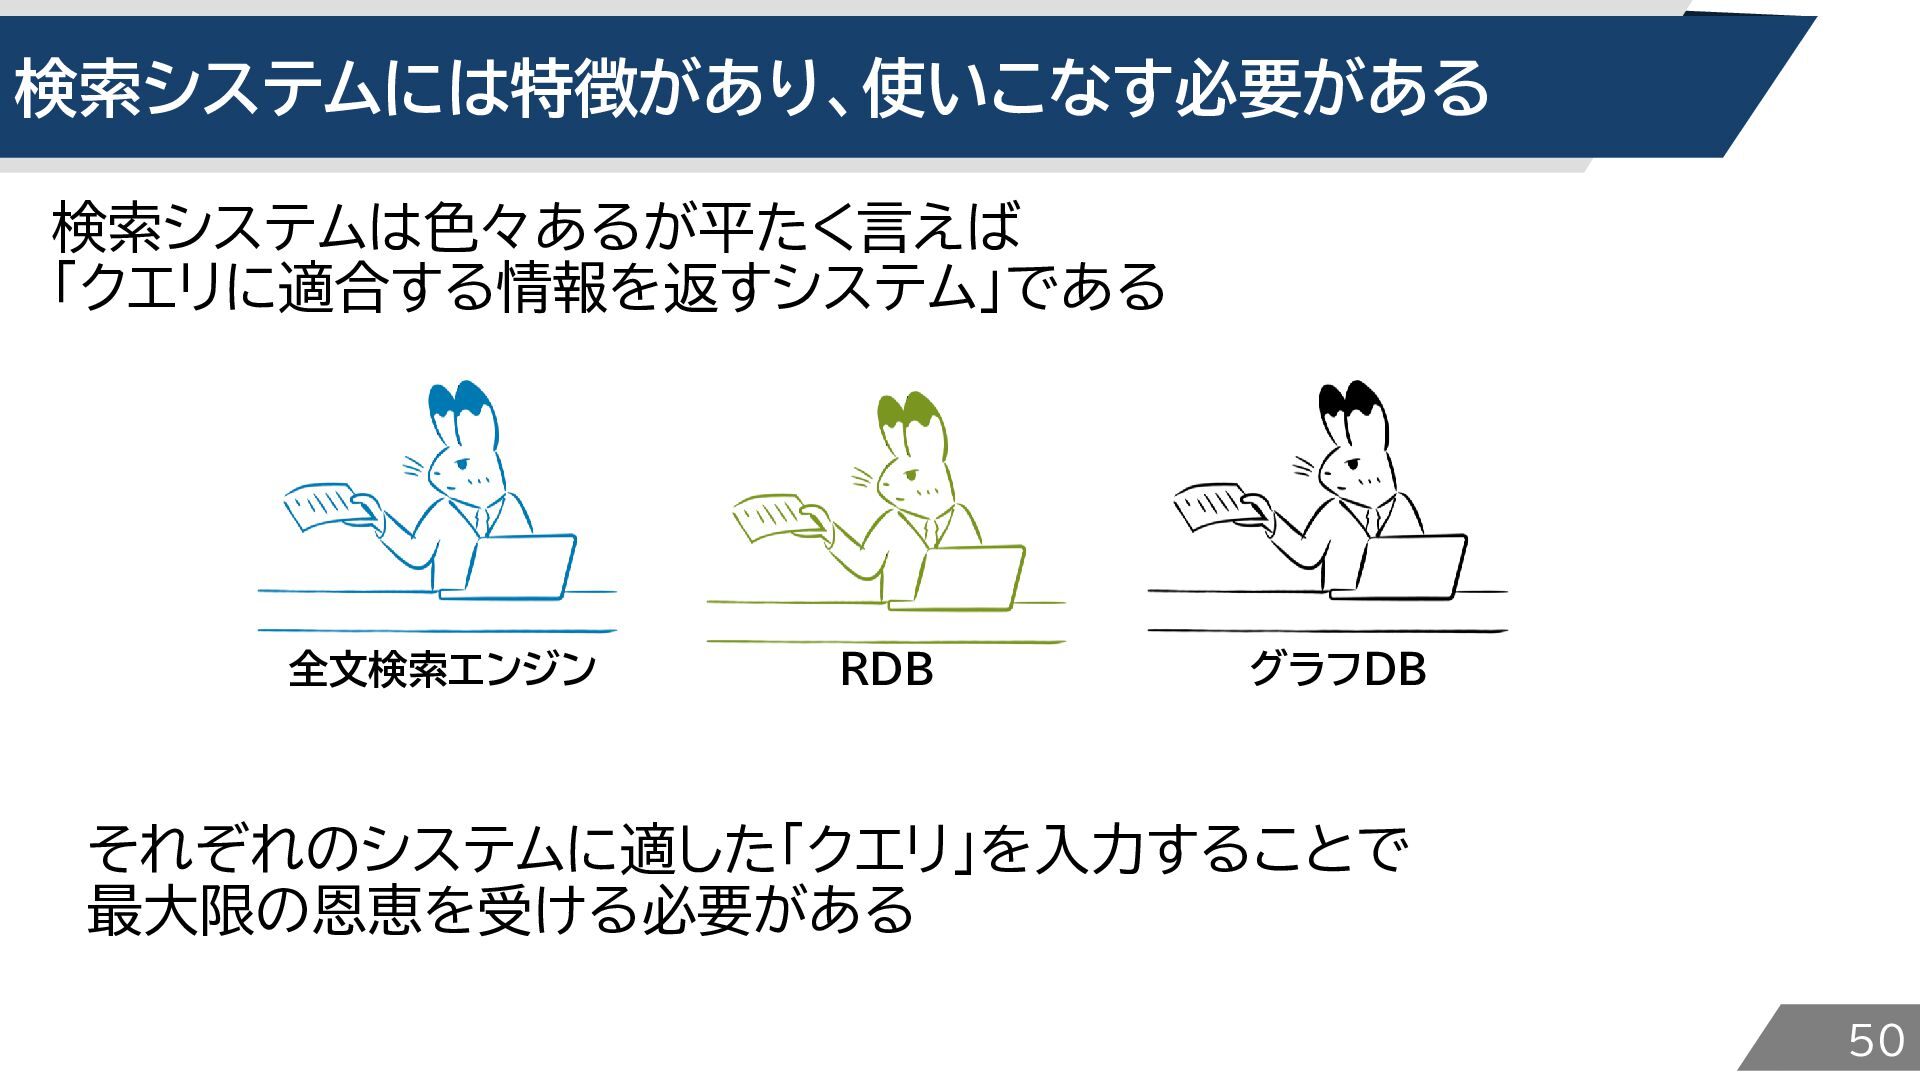
検索システムには特徴があり、使いこなす必要がある 検索システムは色々あるが平たく言えば 「クエリに適合する情報を返すシステム」である 全文検索エンジン RDB グラフDB それぞれのシステムに適した「クエリ」を入力することで 最大限の恩恵を受ける必要がある 50
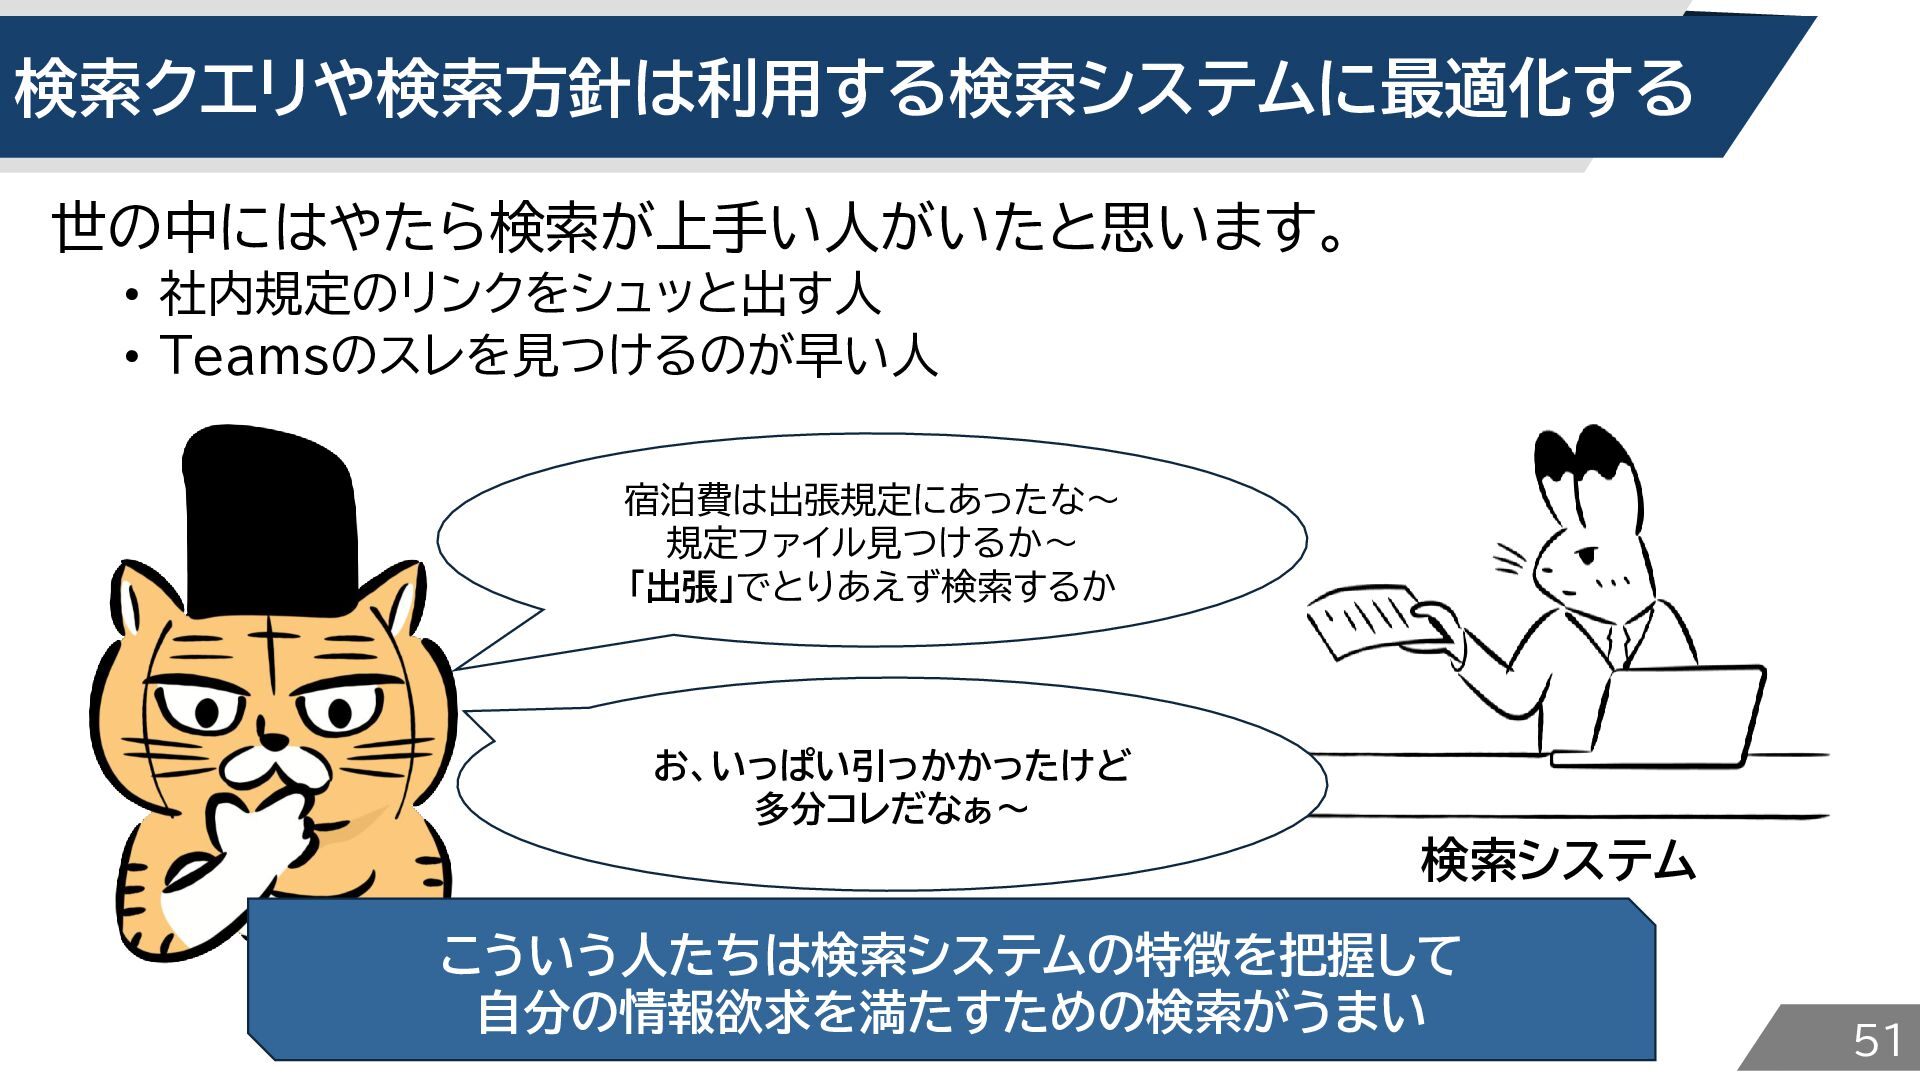
検索クエリや検索方針は利用する検索システムに最適化する 世の中にはやたら検索が上手い人がいたと思います。 • 社内規定のリンクをシュッと出す人 • Teamsのスレを見つけるのが早い人 宿泊費は出張規定にあったな~ 規定ファイル見つけるか~ 「出張」でとりあえず検索するか お、いっぱい引っかかったけど
多分コレだなぁ~ 検索システム こういう人たちは検索システムの特徴を把握して 自分の情報欲求を満たすための検索がうまい 51
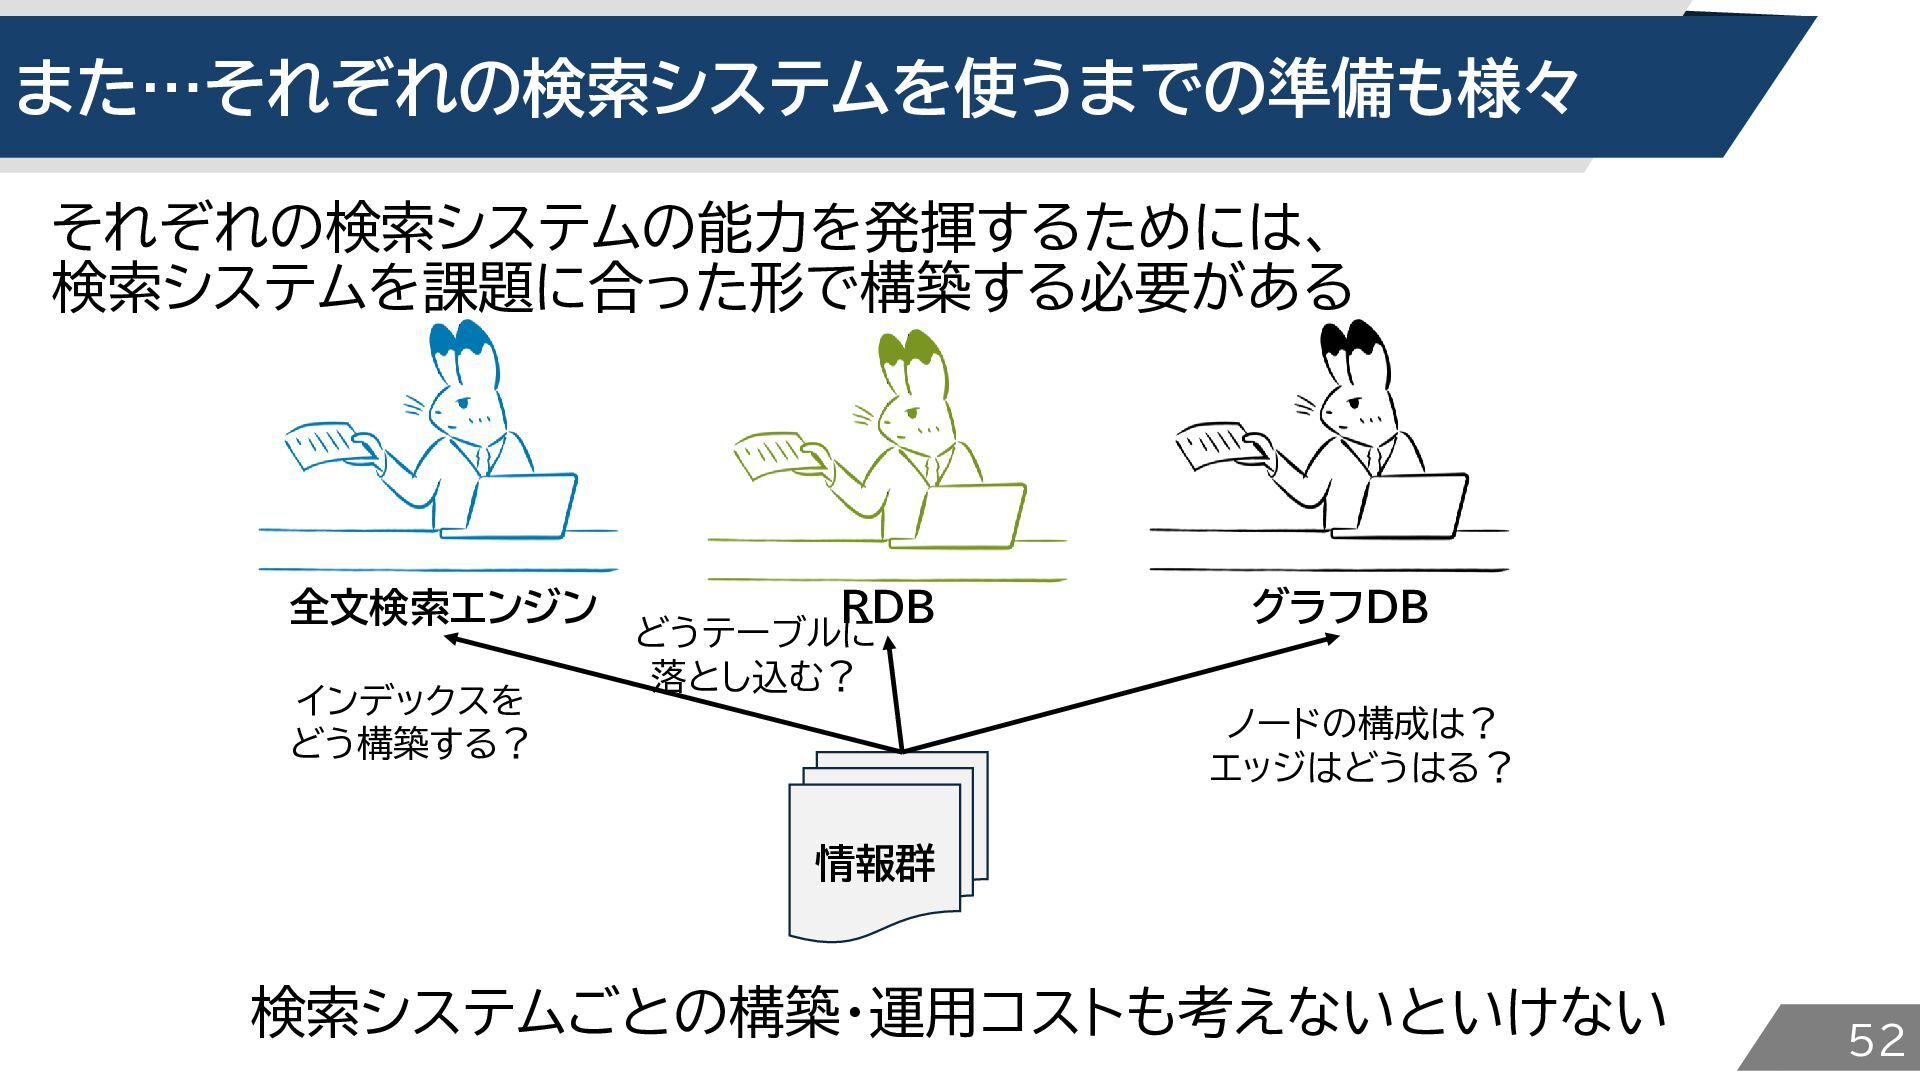
また…それぞれの検索システムを使うまでの準備も様々 それぞれの検索システムの能力を発揮するためには、 検索システムを課題に合った形で構築する必要がある 全文検索エンジン インデックスを どう構築する? RDB どうテーブルに 落とし込む? グラフDB
ノードの構成は? エッジはどうはる? 情報群 検索システムごとの構築・運用コストも考えないといけない 52
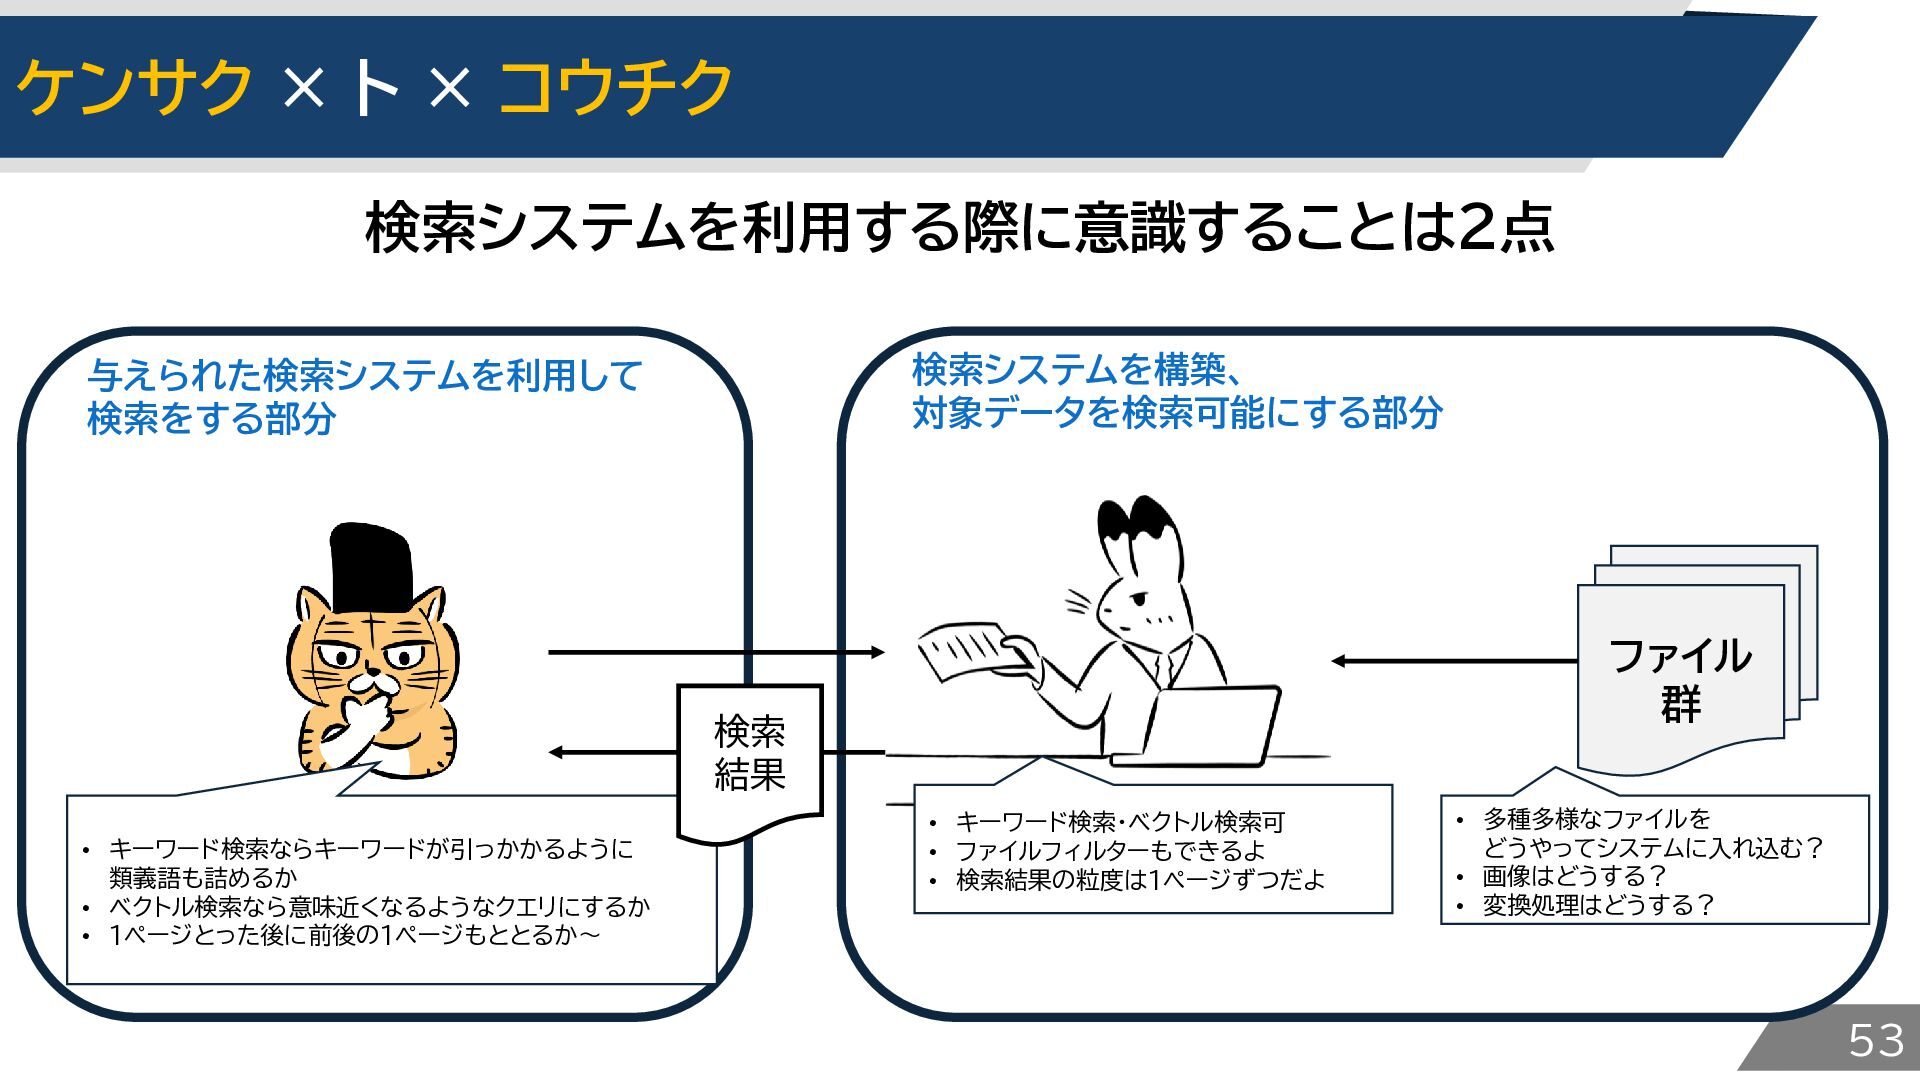
ケンサク × ト × コウチク 検索システムを利用する際に意識することは2点 検索システムを構築、 対象データを検索可能にする部分 与えられた検索システムを利用して 検索をする部分
ファイル 群 検索 結果 • キーワード検索ならキーワードが引っかかるように 類義語も詰めるか • ベクトル検索なら意味近くなるようなクエリにするか • 1ページとった後に前後の1ページもととるか~ • キーワード検索・ベクトル検索可 • ファイルフィルターもできるよ • 検索結果の粒度は1ページずつだよ • 多種多様なファイルを どうやってシステムに入れ込む? • 画像はどうする? • 変換処理はどうする? 53
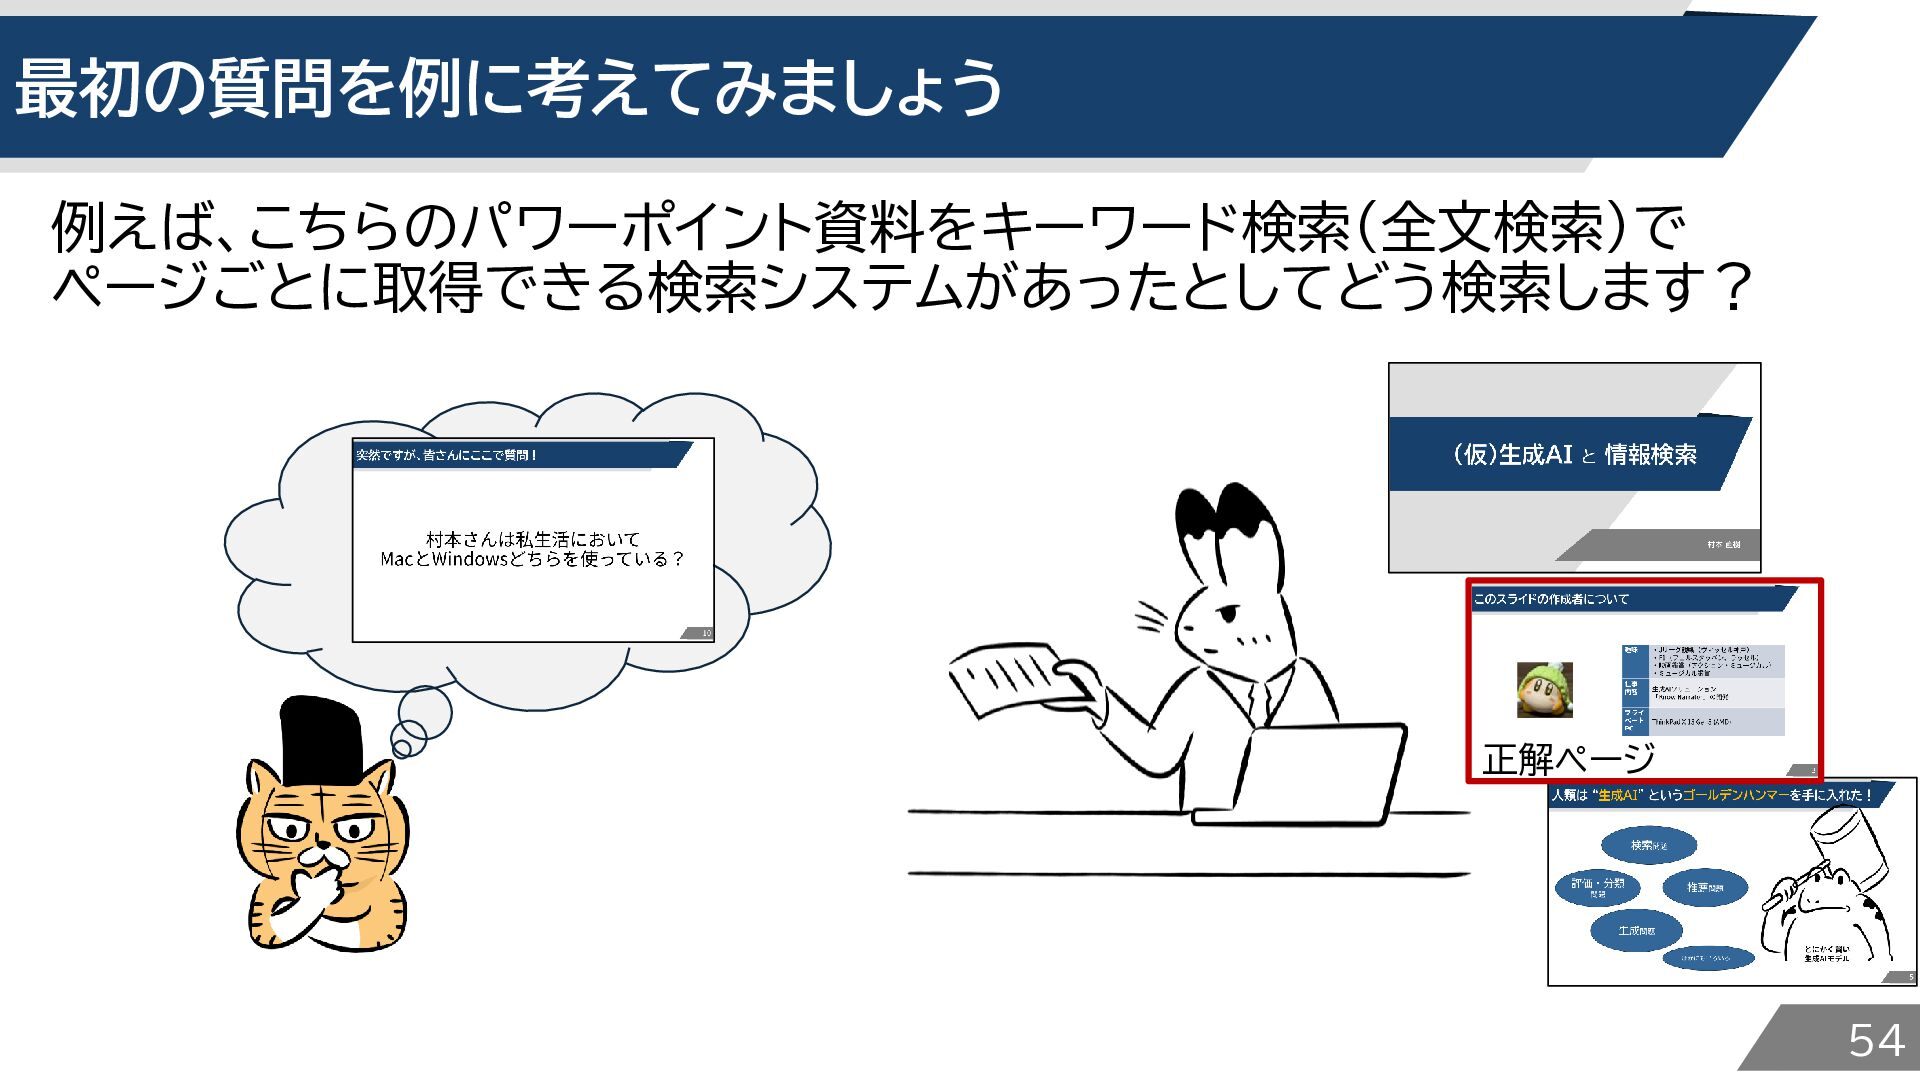
最初の質問を例に考えてみましょう 例えば、こちらのパワーポイント資料をキーワード検索(全文検索)で ページごとに取得できる検索システムがあったとしてどう検索します? 正解ページ 54
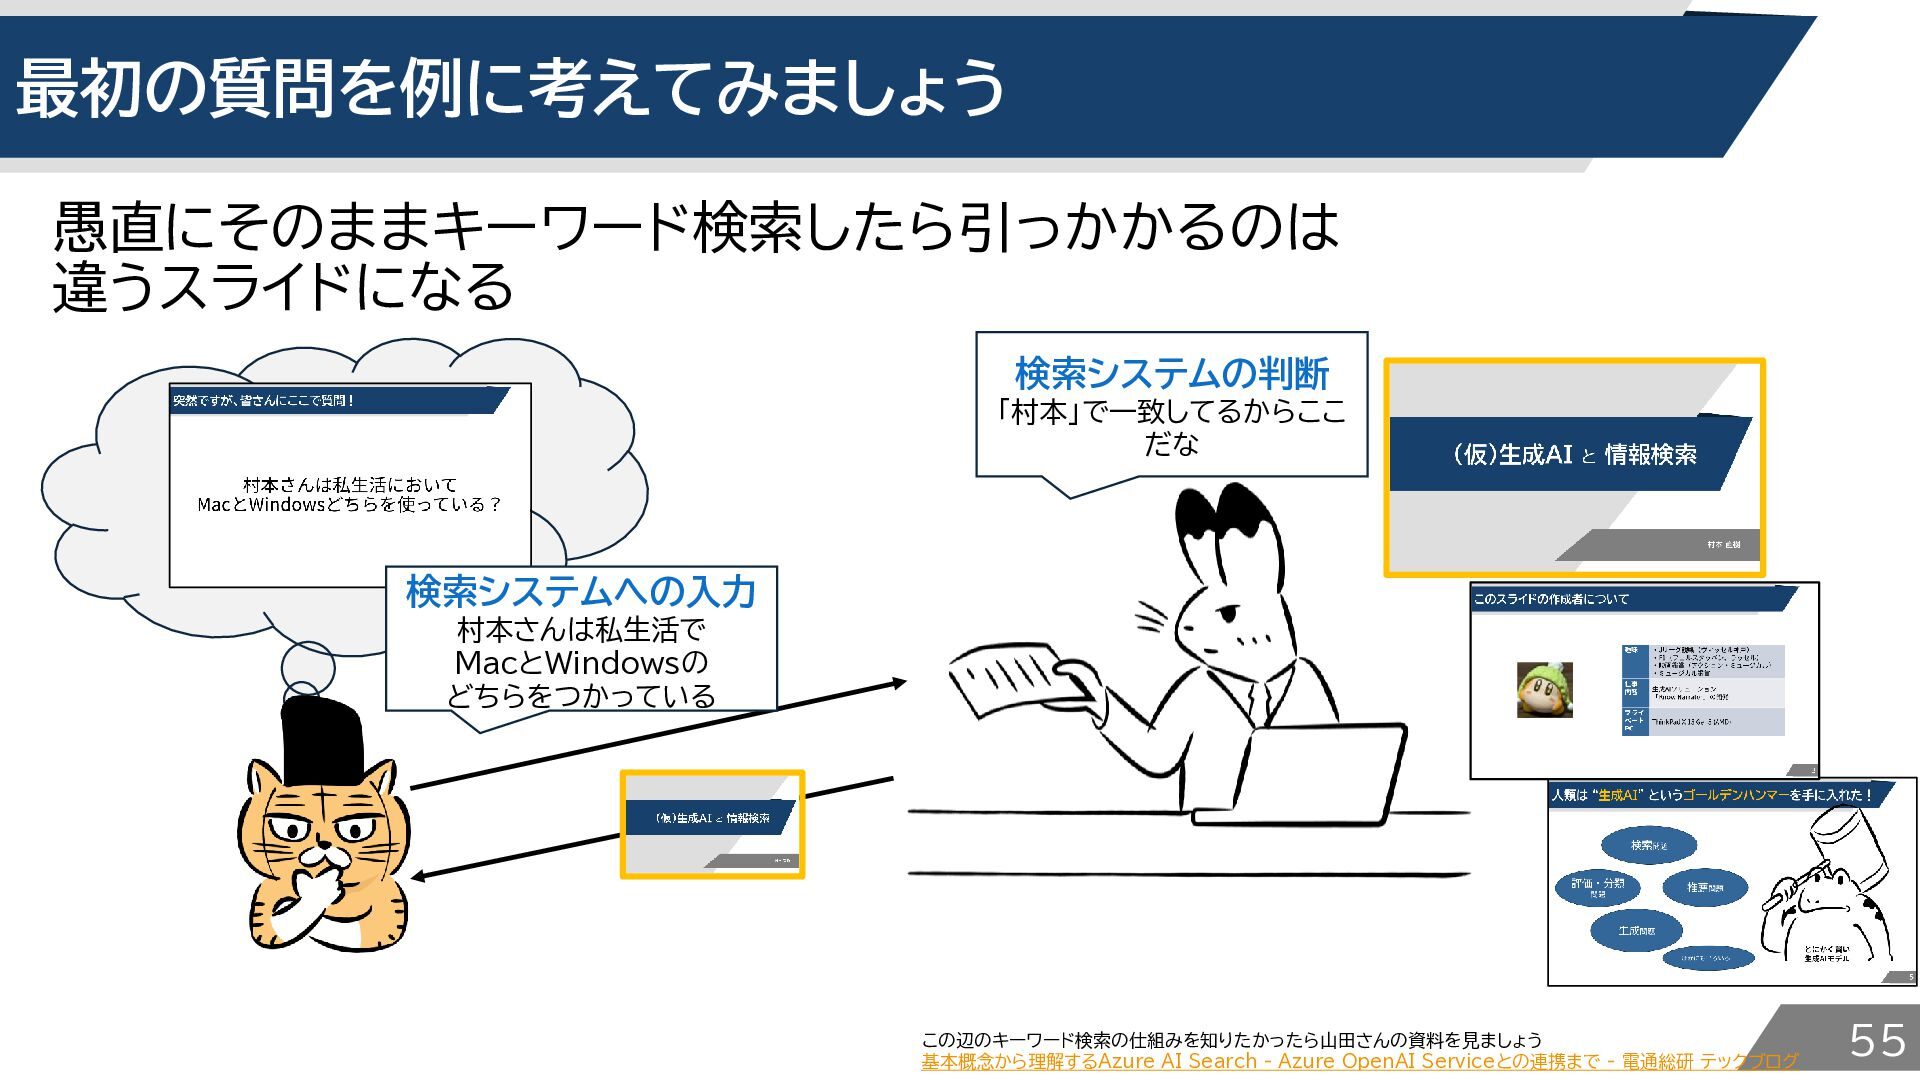
最初の質問を例に考えてみましょう 愚直にそのままキーワード検索したら引っかかるのは 違うスライドになる 検索システムの判断 「村本」で一致してるからここ だな 検索システムへの入力 村本さんは私生活で MacとWindowsの どちらをつかっている
この辺のキーワード検索の仕組みを知りたかったら山田さんの資料を見ましょう 基本概念から理解するAzure AI Search - Azure OpenAI Serviceとの連携まで - 電通総研 テックブログ 55
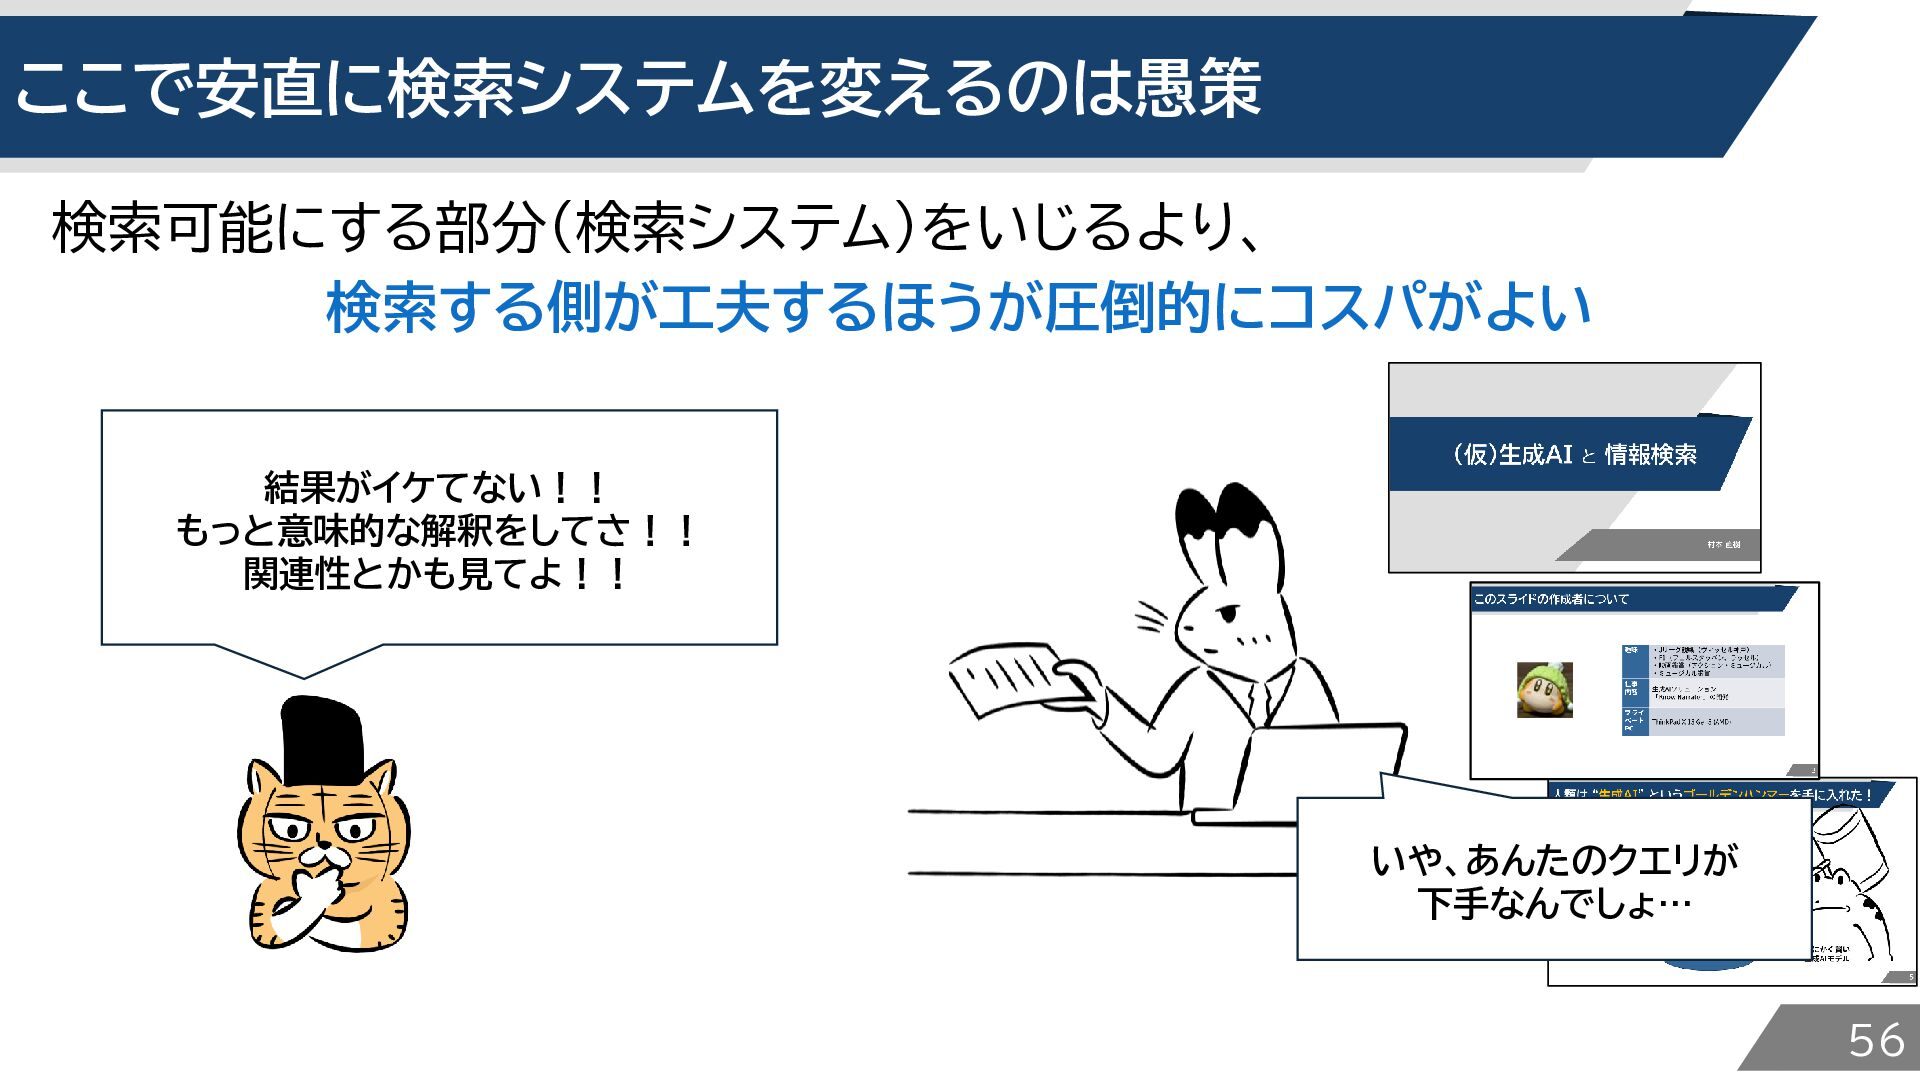
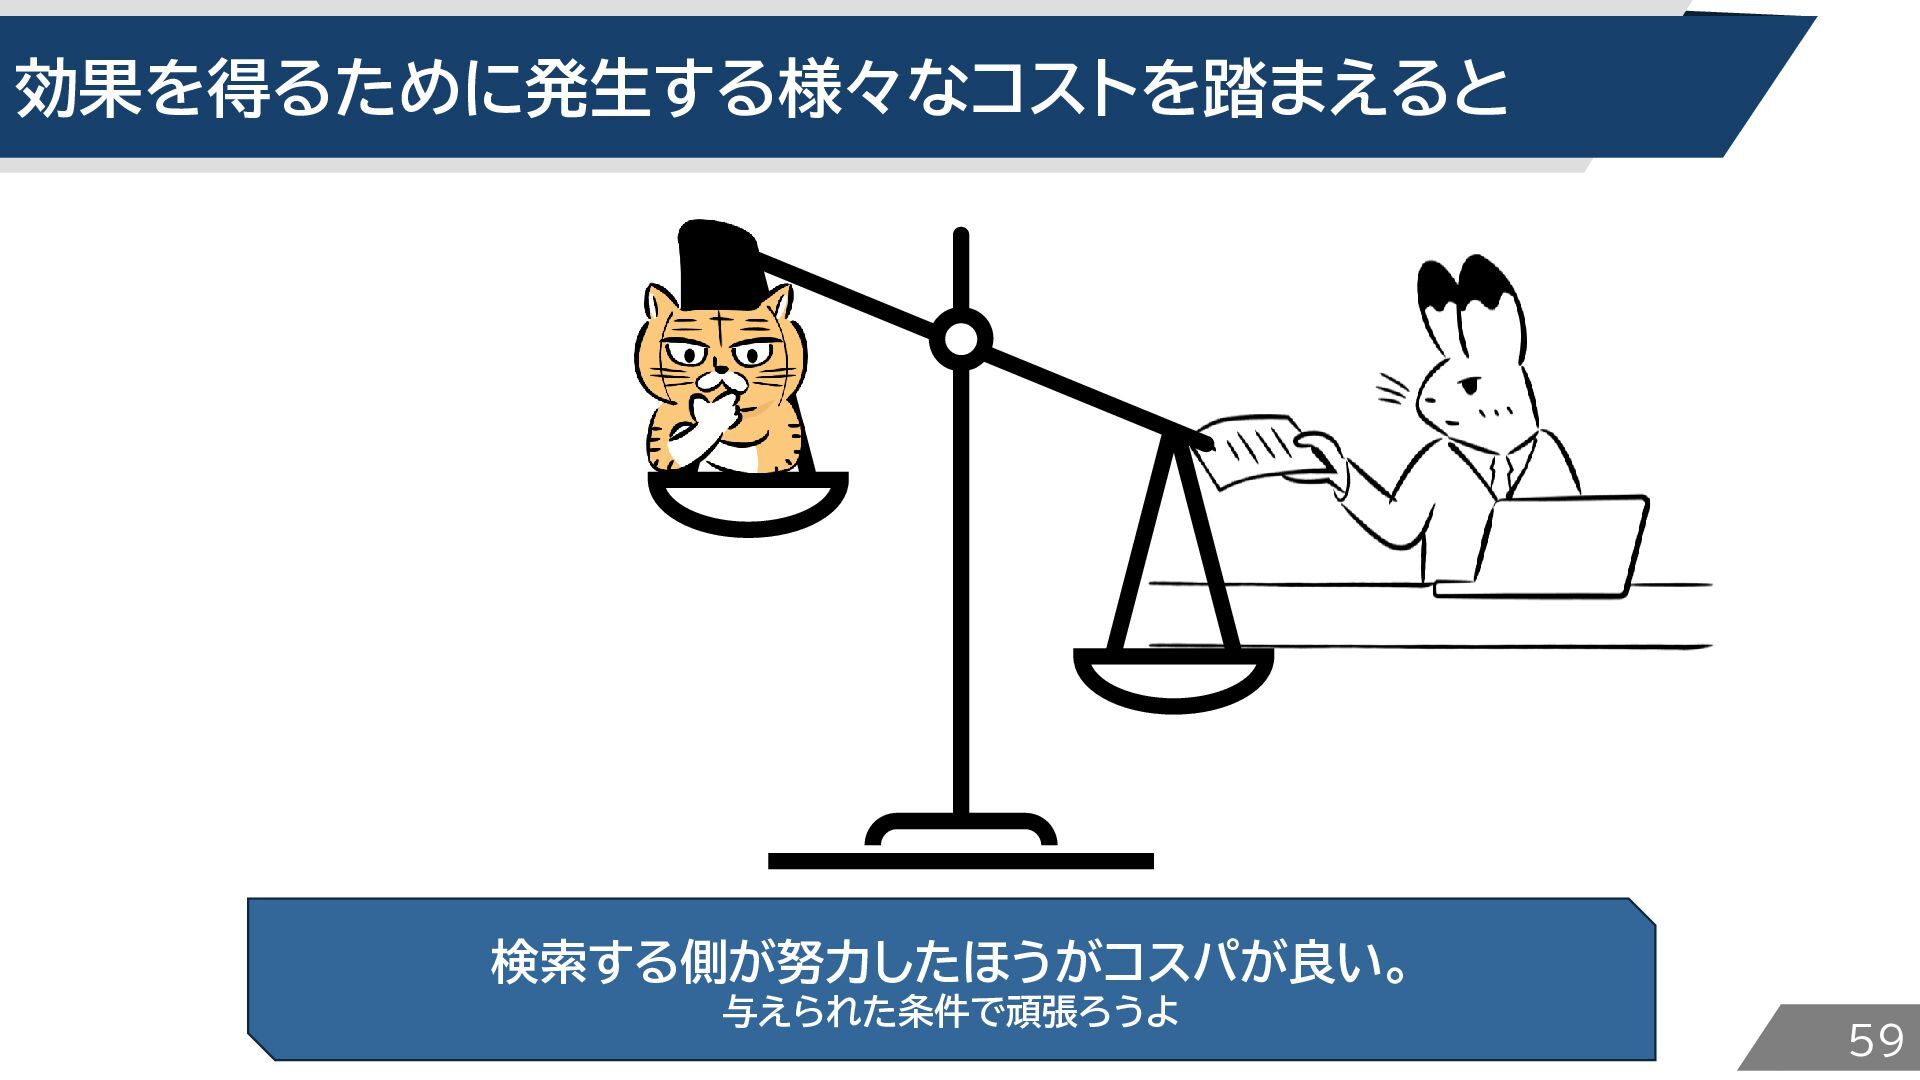
ここで安直に検索システムを変えるのは愚策 検索可能にする部分(検索システム)をいじるより、 検索する側が工夫するほうが圧倒的にコスパがよい 結果がイケてない!! もっと意味的な解釈をしてさ!! 関連性とかも見てよ!! いや、あんたのクエリが 下手なんでしょ… 56
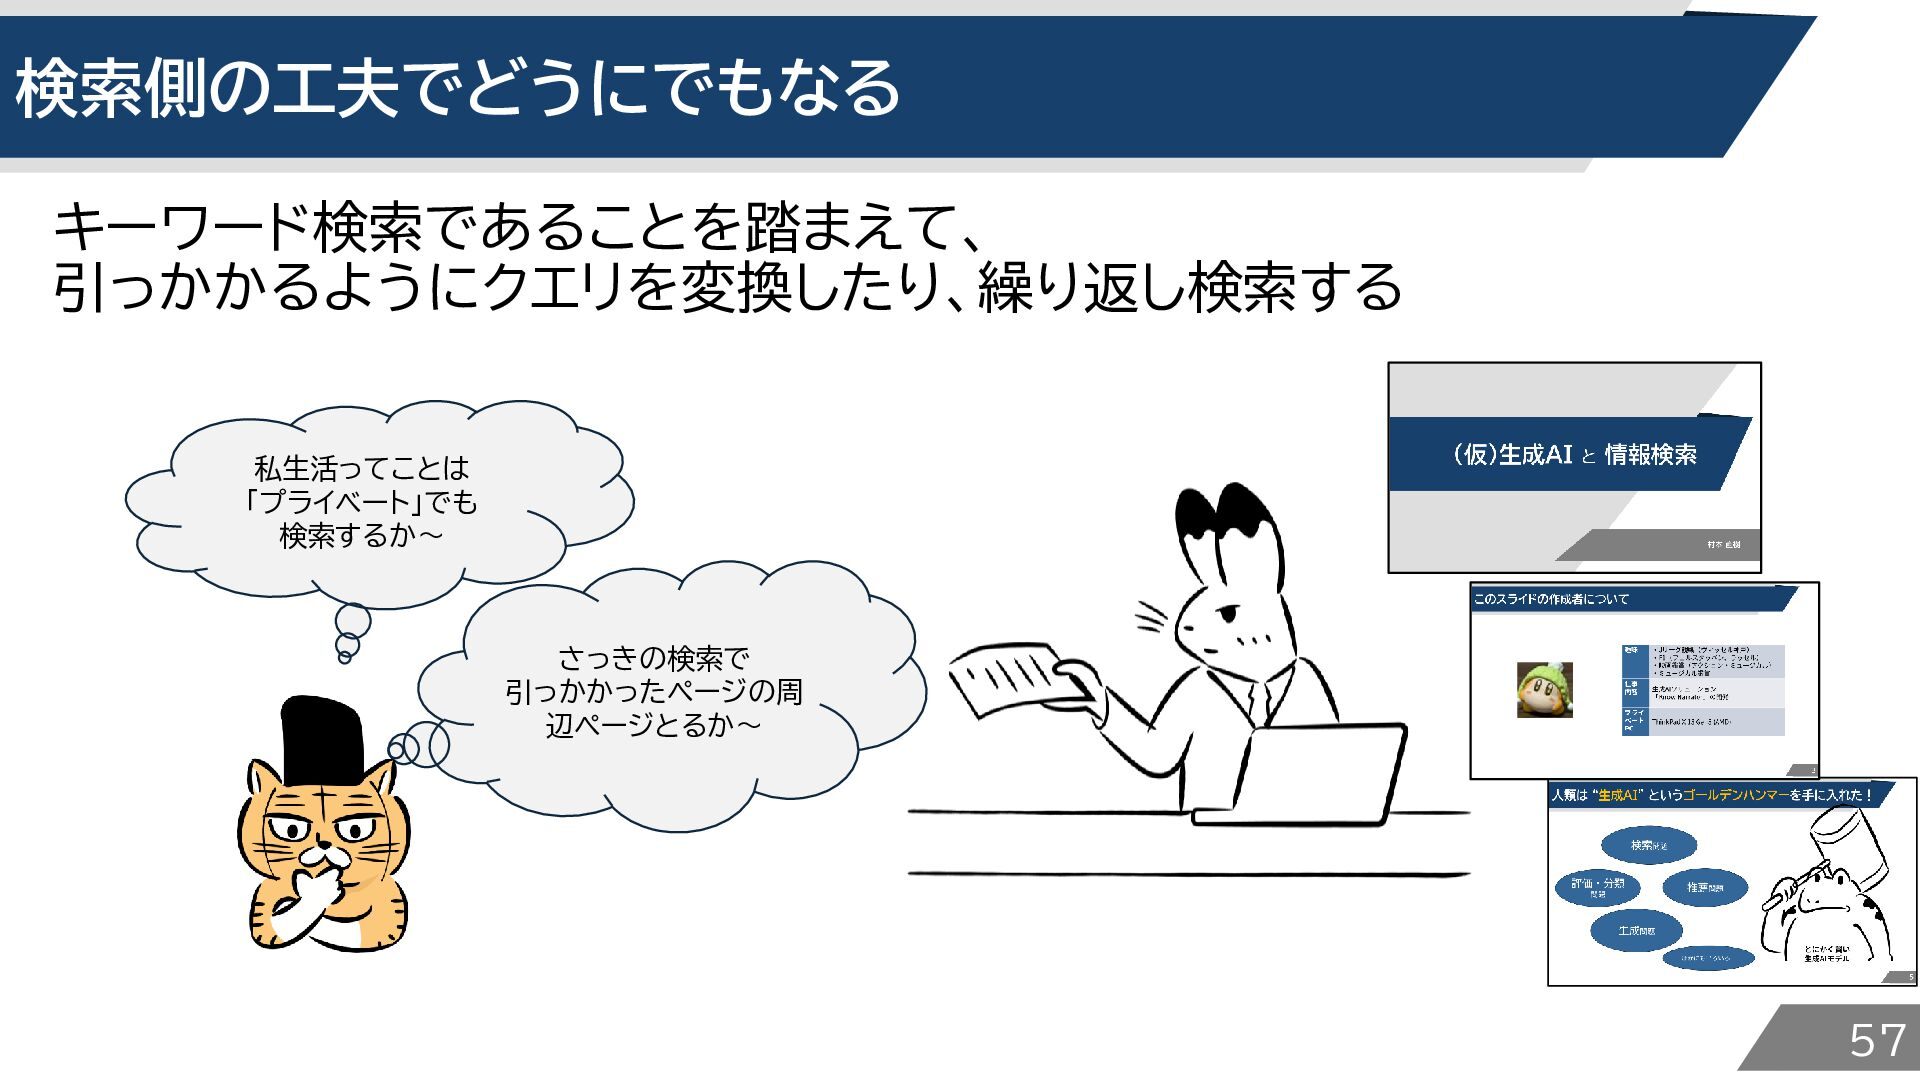
検索側の工夫でどうにでもなる キーワード検索であることを踏まえて、 引っかかるようにクエリを変換したり、繰り返し検索する 私生活ってことは 「プライベート」でも 検索するか~ さっきの検索で 引っかかったページの周 辺ページとるか~ 57
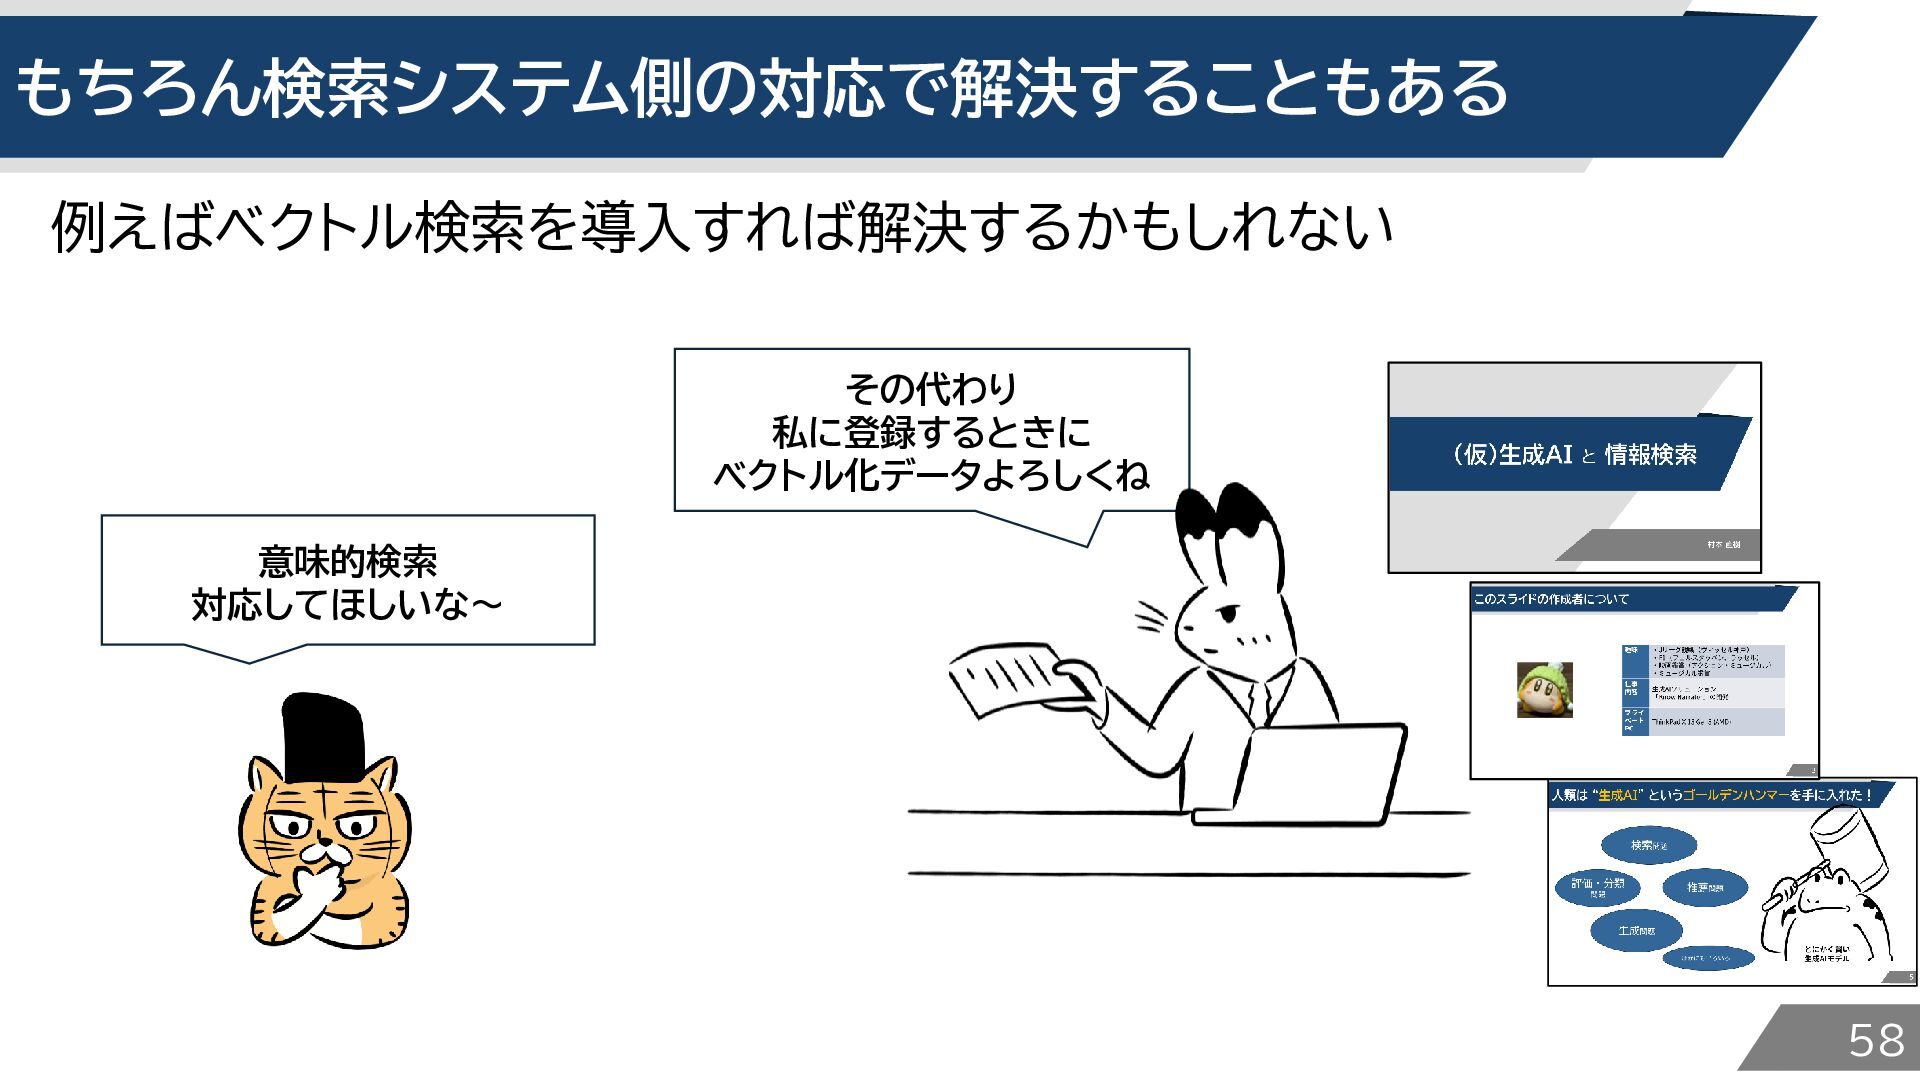
もちろん検索システム側の対応で解決することもある 例えばベクトル検索を導入すれば解決するかもしれない その代わり 私に登録するときに ベクトル化データよろしくね 意味的検索 対応してほしいな~ 58
効果を得るために発生する様々なコストを踏まえると 検索する側が努力したほうがコスパが良い。 与えられた条件で頑張ろうよ 59
様々な検索方法ご紹介 60
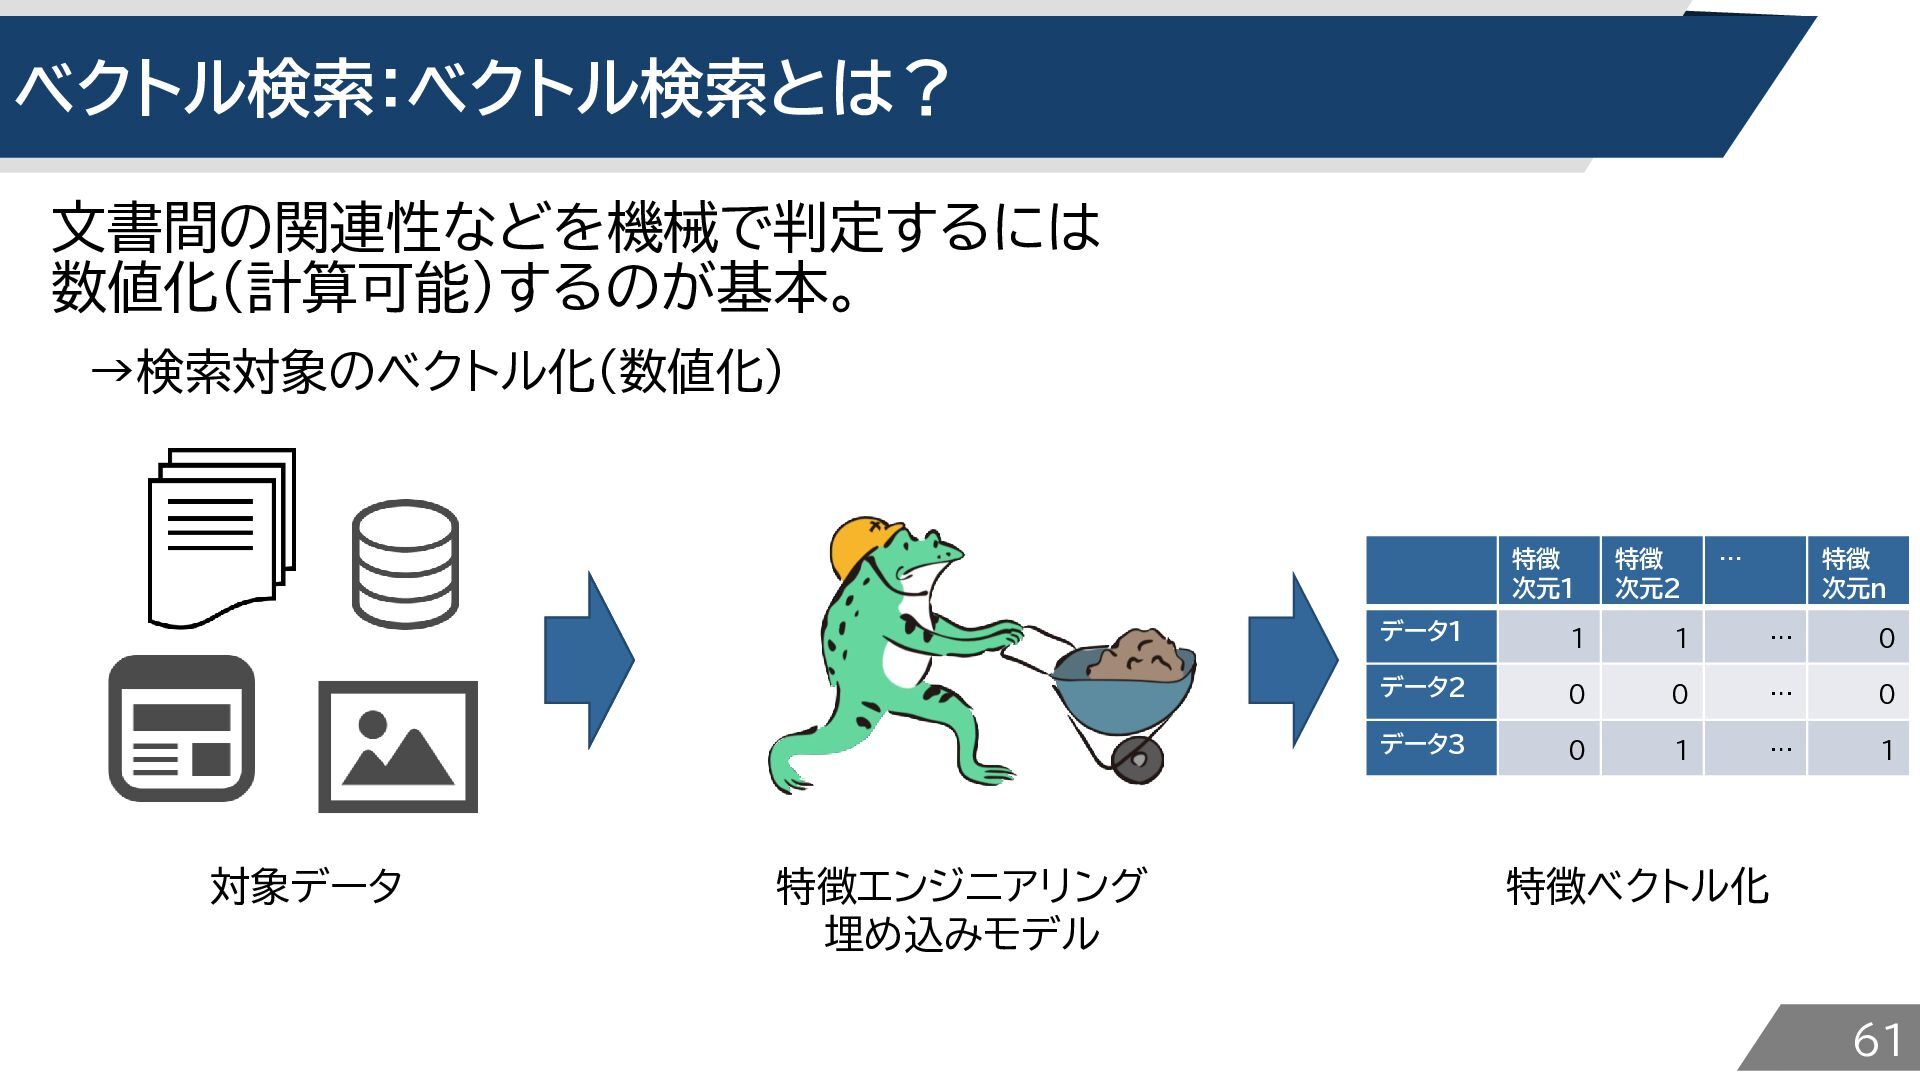
ベクトル検索:ベクトル検索とは? 文書間の関連性などを機械で判定するには 数値化(計算可能)するのが基本。 →検索対象のベクトル化(数値化) 対象データ 特徴エンジニアリング 埋め込みモデル 特徴 次元1 特徴
次元2 … 特徴 次元n データ1 1 1 … 0 データ2 0 0 … 0 データ3 0 1 … 1 特徴ベクトル化 61
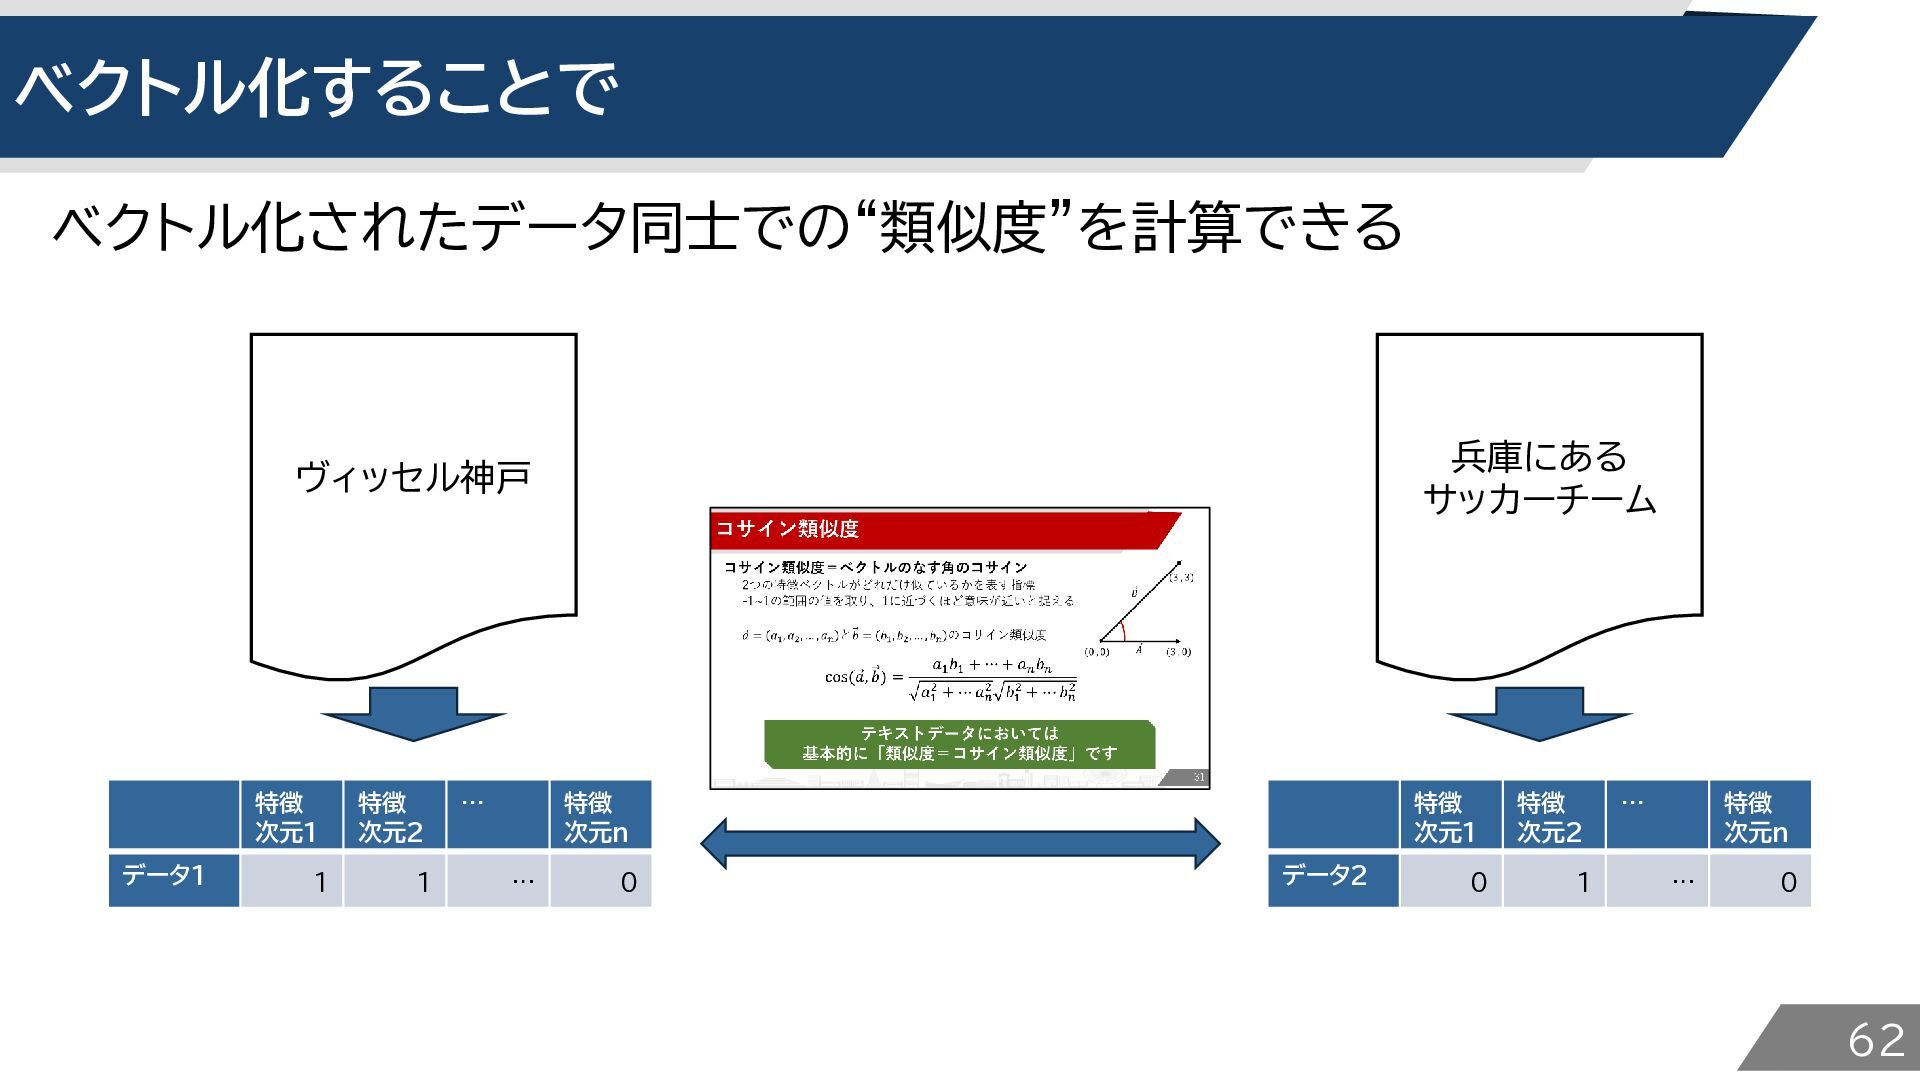
ベクトル化することで ベクトル化されたデータ同士での“類似度”を計算できる 兵庫にある サッカーチーム ヴィッセル神戸 データ1 特徴 次元1 特徴 次元2
1 1 … 特徴 次元n … 0 データ2 特徴 次元1 特徴 次元2 0 1 … 特徴 次元n … 0 62
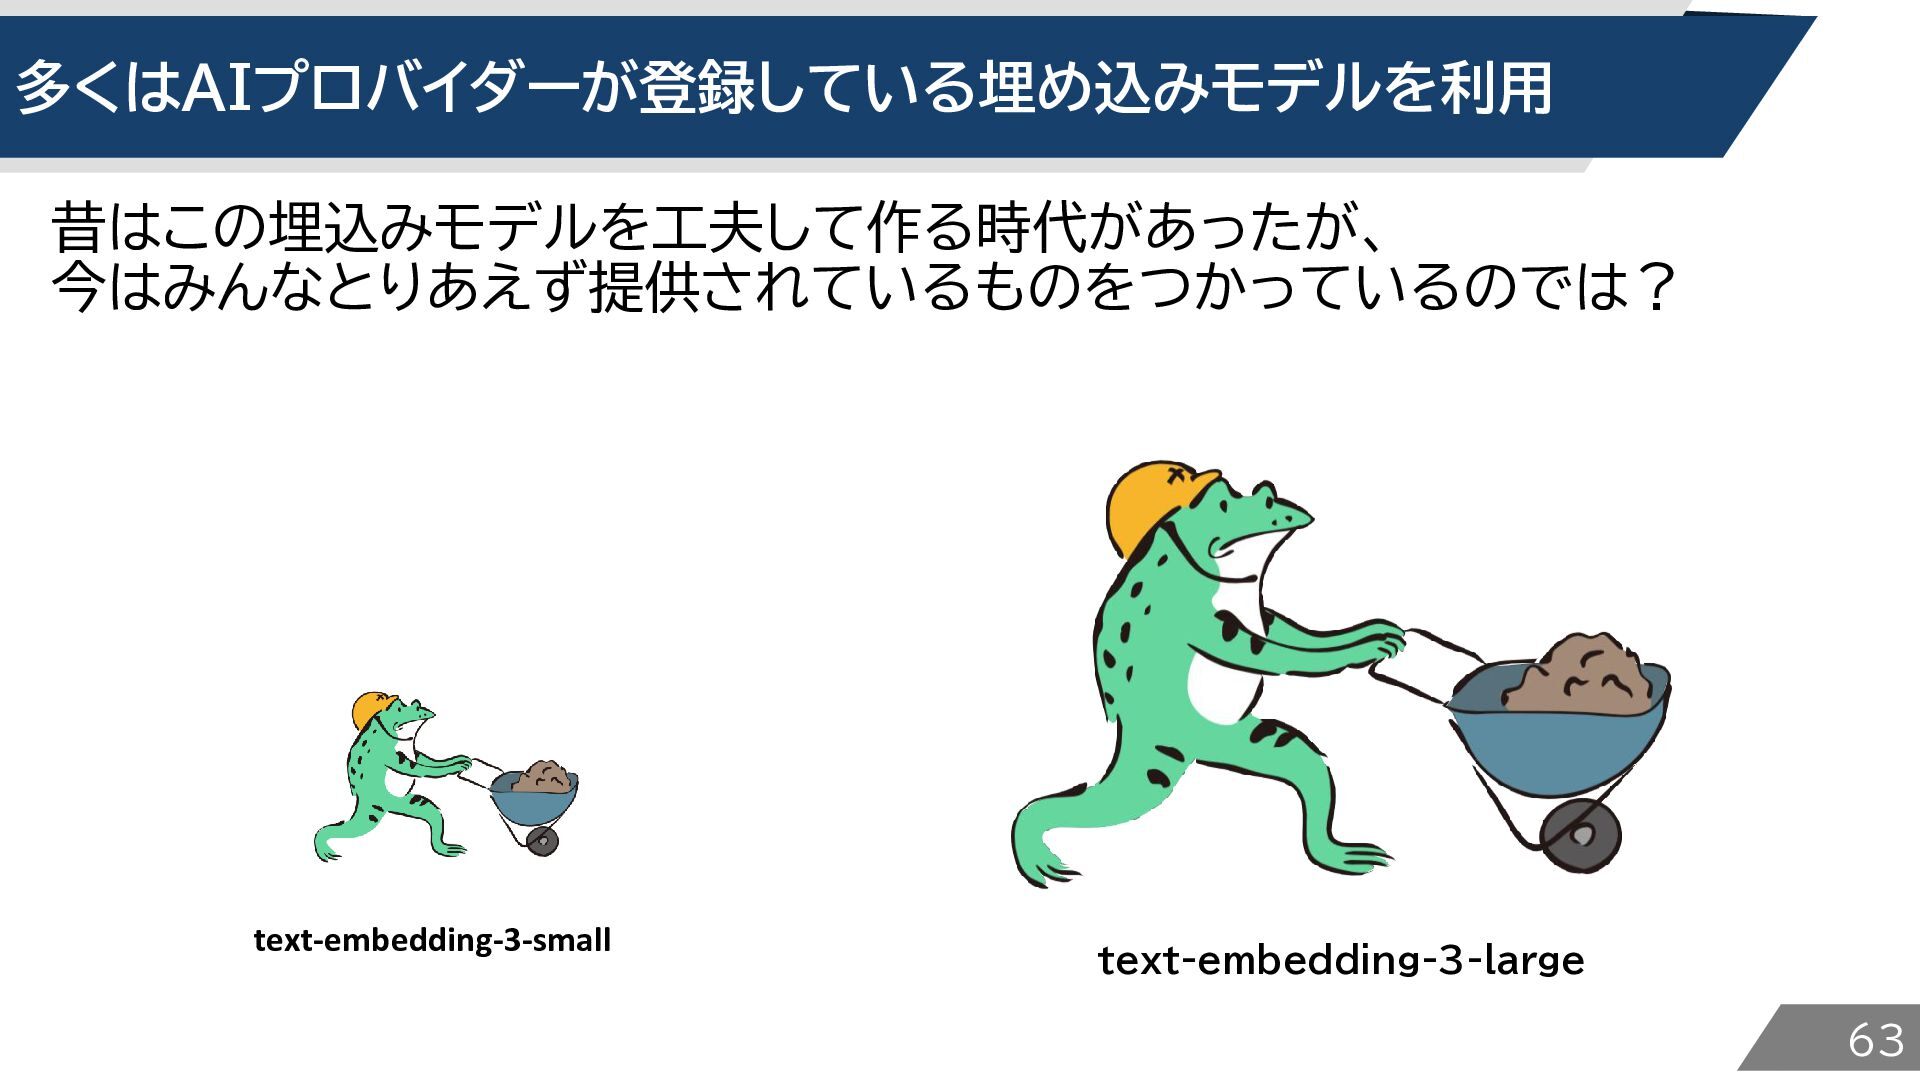
多くはAIプロバイダーが登録している埋め込みモデルを利用 昔はこの埋込みモデルを工夫して作る時代があったが、 今はみんなとりあえず提供されているものをつかっているのでは? text-embedding-3-small text-embedding-3-large 63
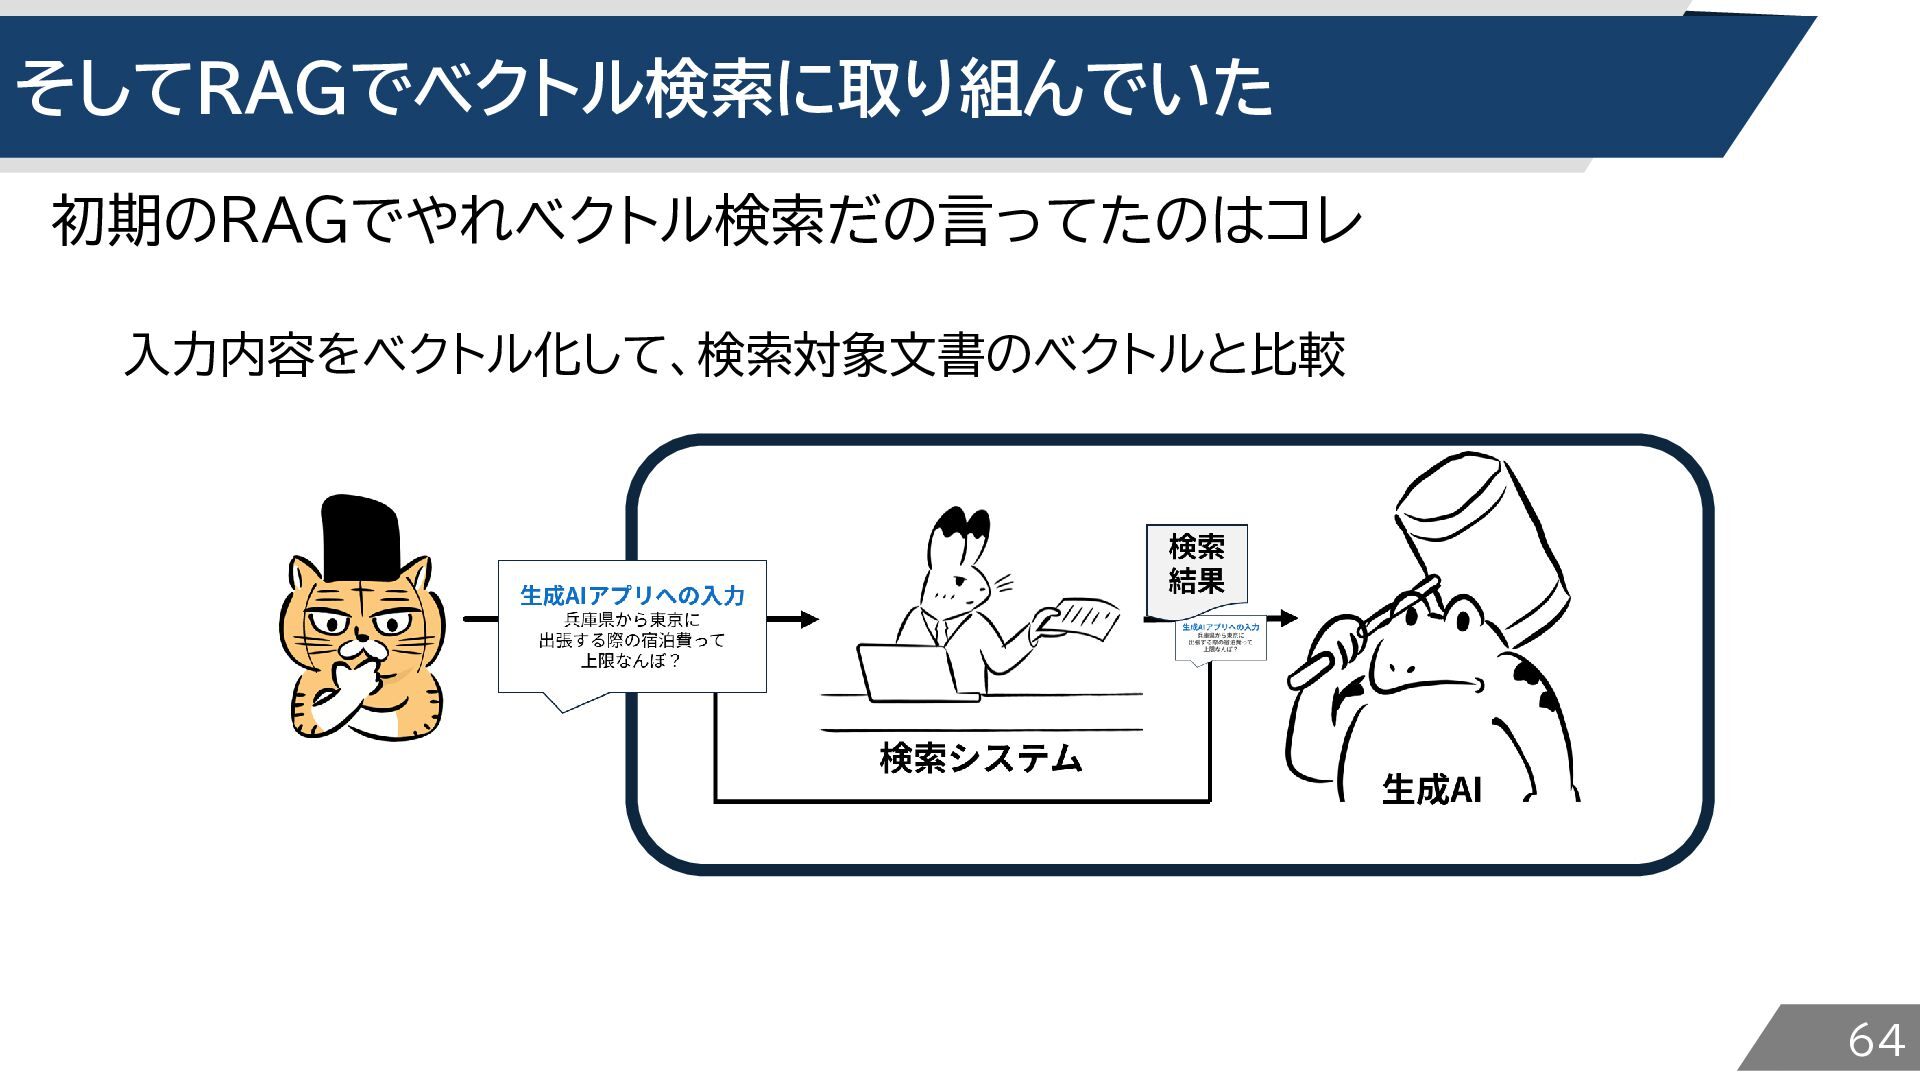
そしてRAGでベクトル検索に取り組んでいた 初期のRAGでやれベクトル検索だの言ってたのはコレ 入力内容をベクトル化して、検索対象文書のベクトルと比較 64
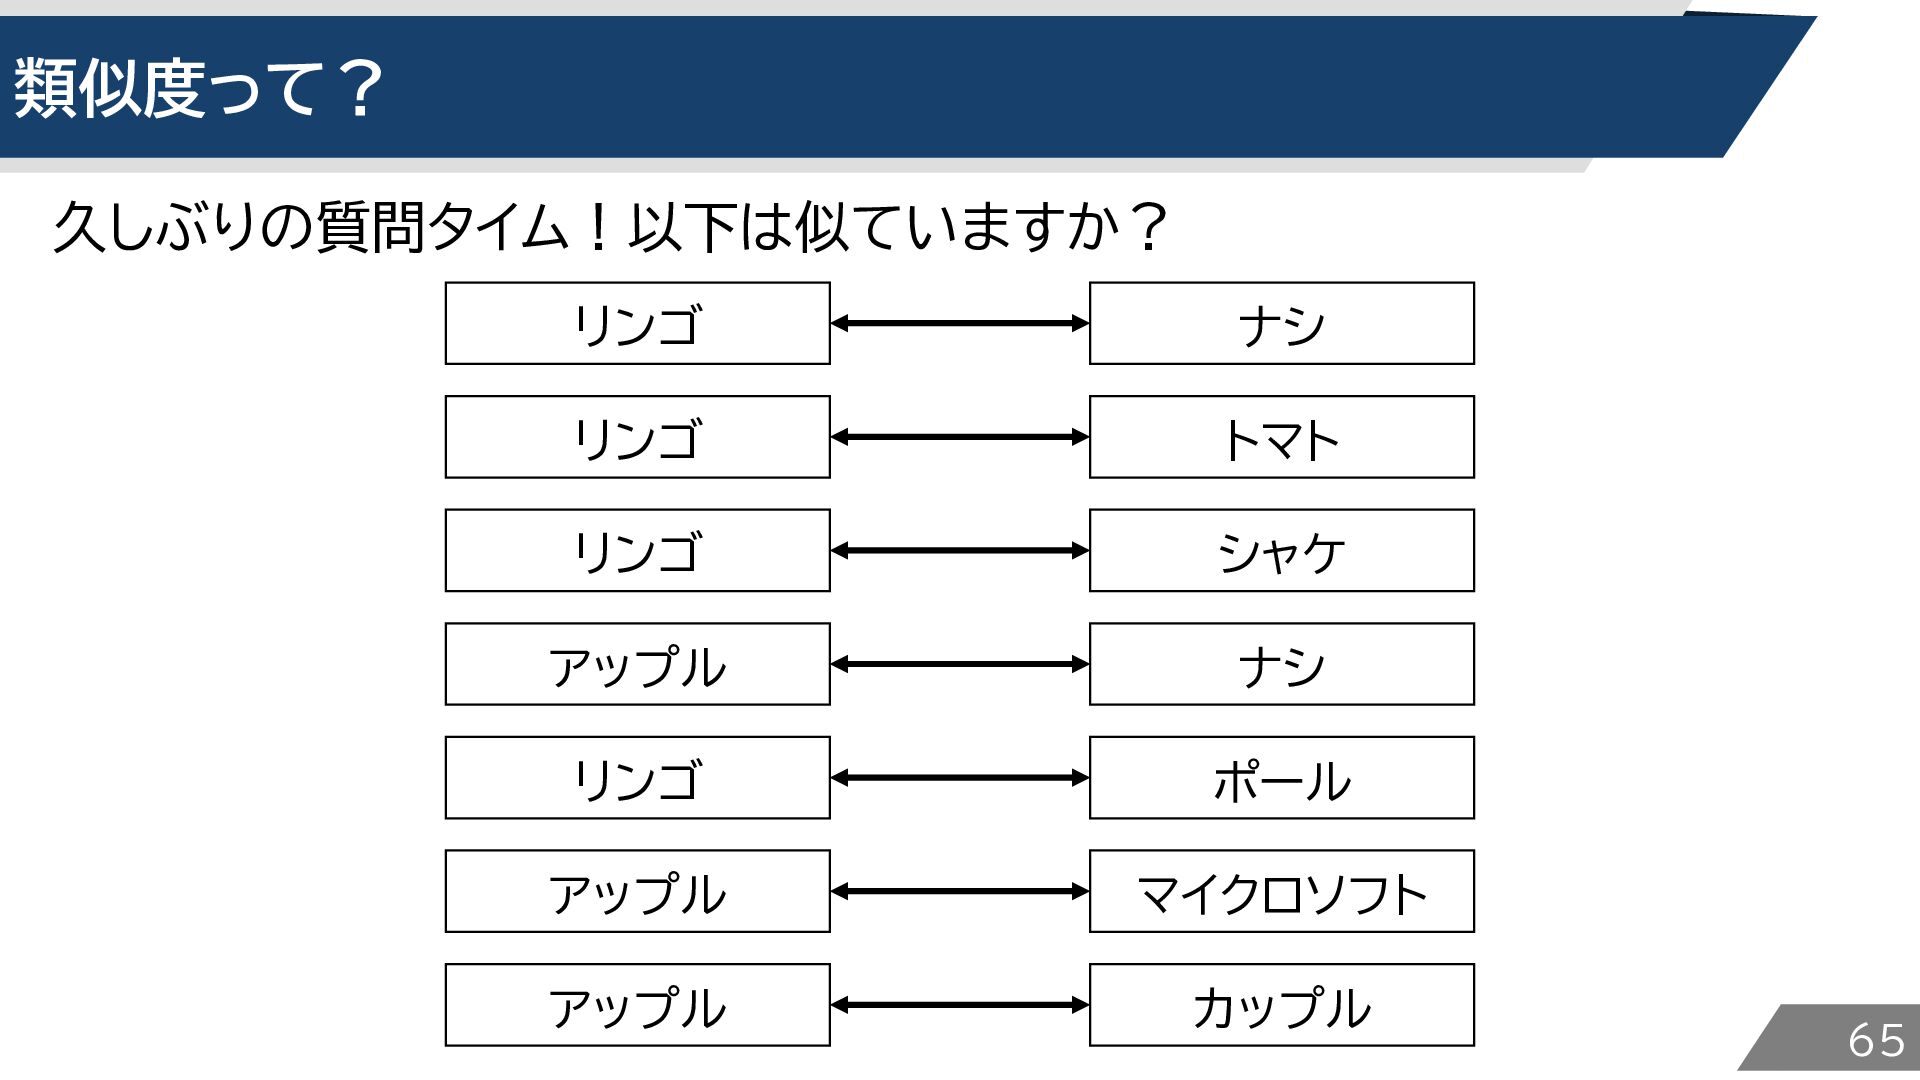
類似度って? 久しぶりの質問タイム!以下は似ていますか? リンゴ ナシ リンゴ トマト リンゴ シャケ アップル ナシ
リンゴ ポール アップル マイクロソフト アップル カップル 65
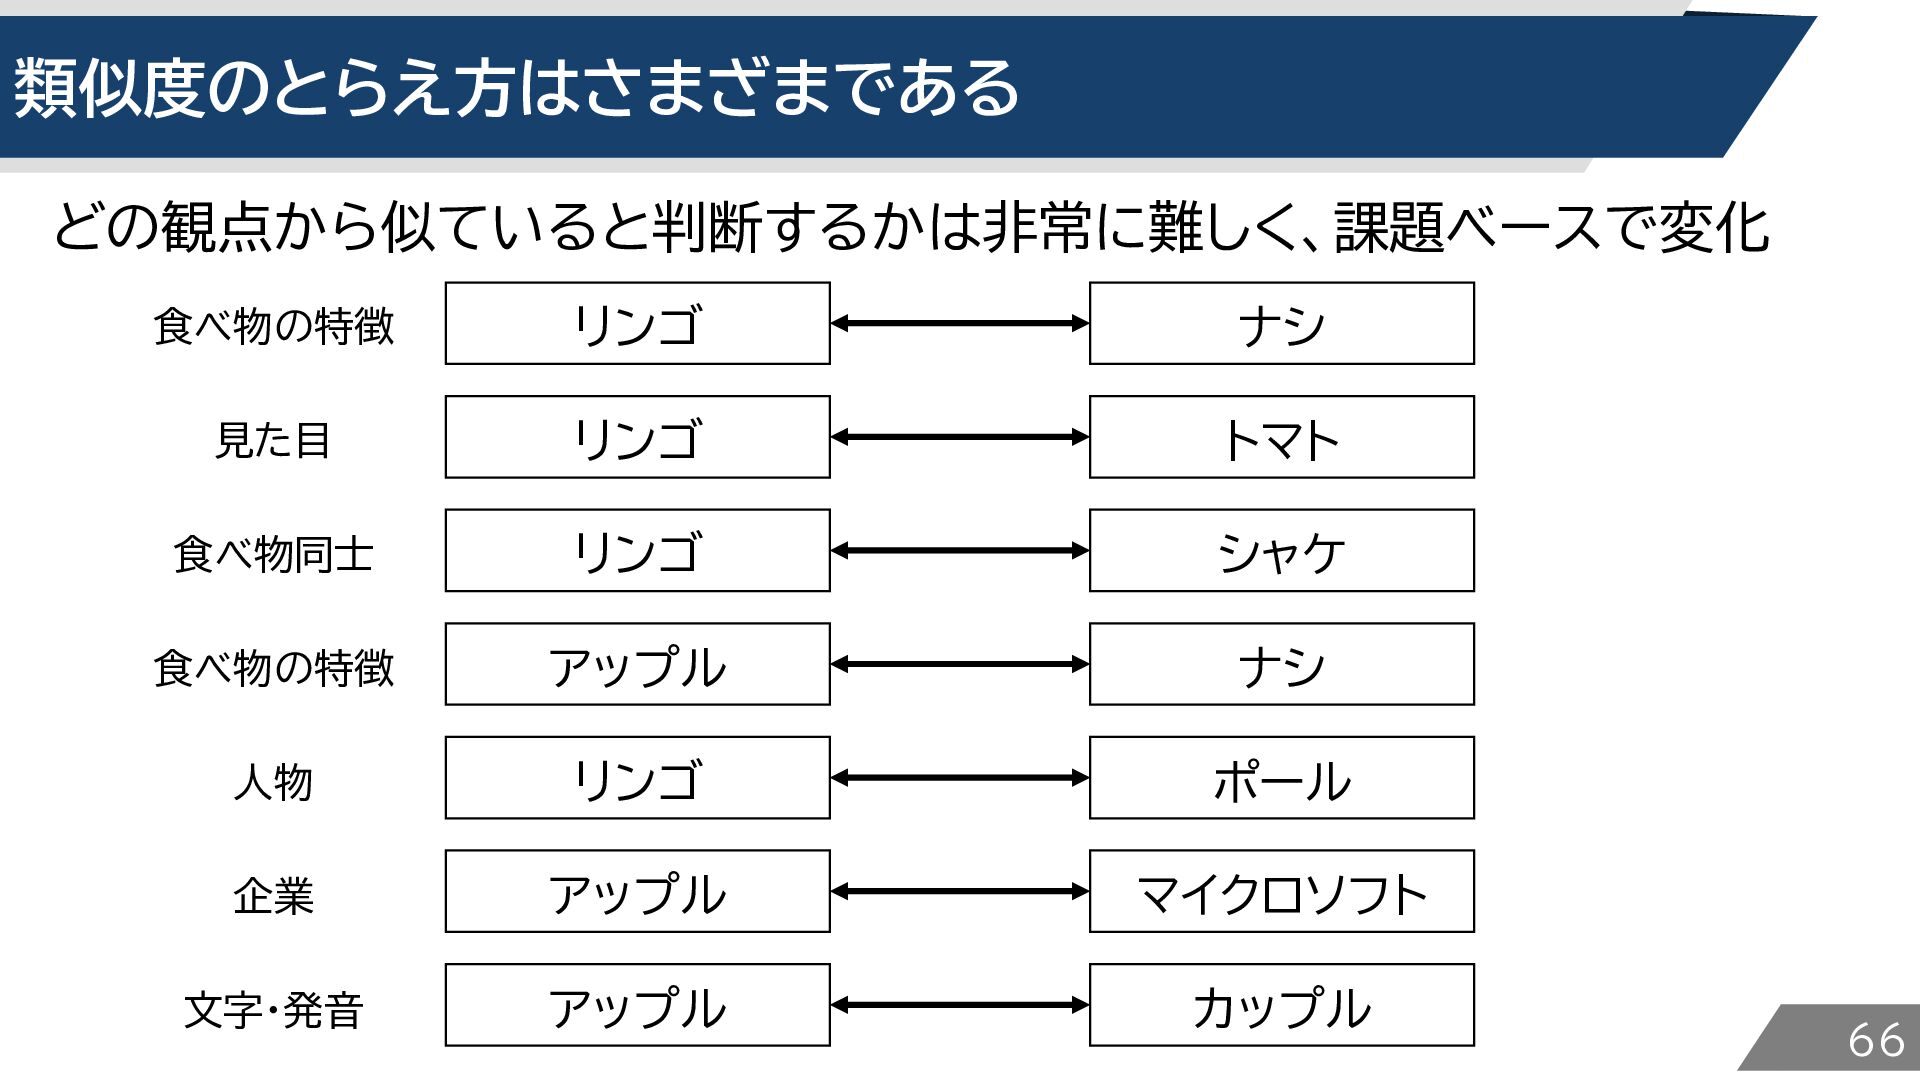
類似度のとらえ方はさまざまである どの観点から似ていると判断するかは非常に難しく、課題ベースで変化 食べ物の特徴 リンゴ ナシ 見た目 リンゴ トマト 食べ物同士 リンゴ
シャケ 食べ物の特徴 アップル ナシ 人物 リンゴ ポール 企業 アップル マイクロソフト 文字・発音 アップル カップル 66
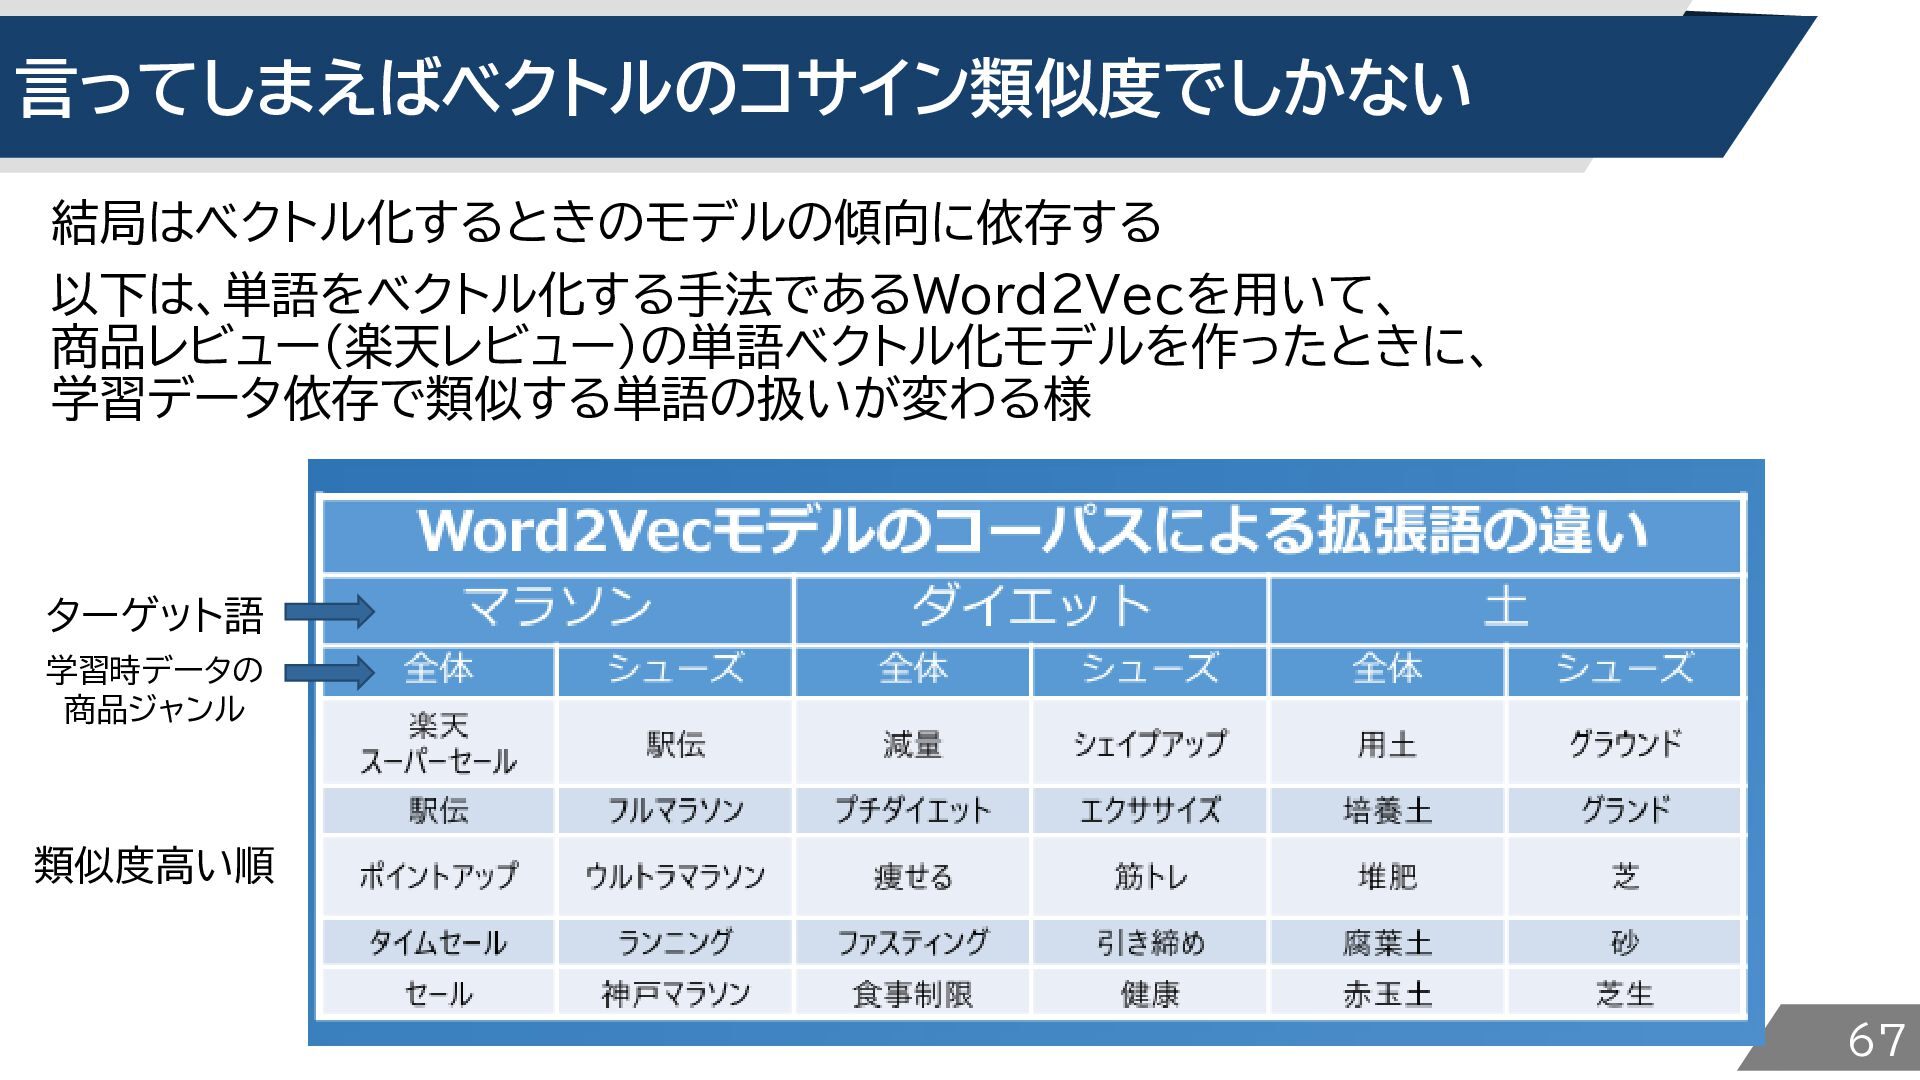
言ってしまえばベクトルのコサイン類似度でしかない 結局はベクトル化するときのモデルの傾向に依存する 以下は、単語をベクトル化する手法であるWord2Vecを用いて、 商品レビュー(楽天レビュー)の単語ベクトル化モデルを作ったときに、 学習データ依存で類似する単語の扱いが変わる様 ターゲット語 学習時データの 商品ジャンル 類似度高い順 67
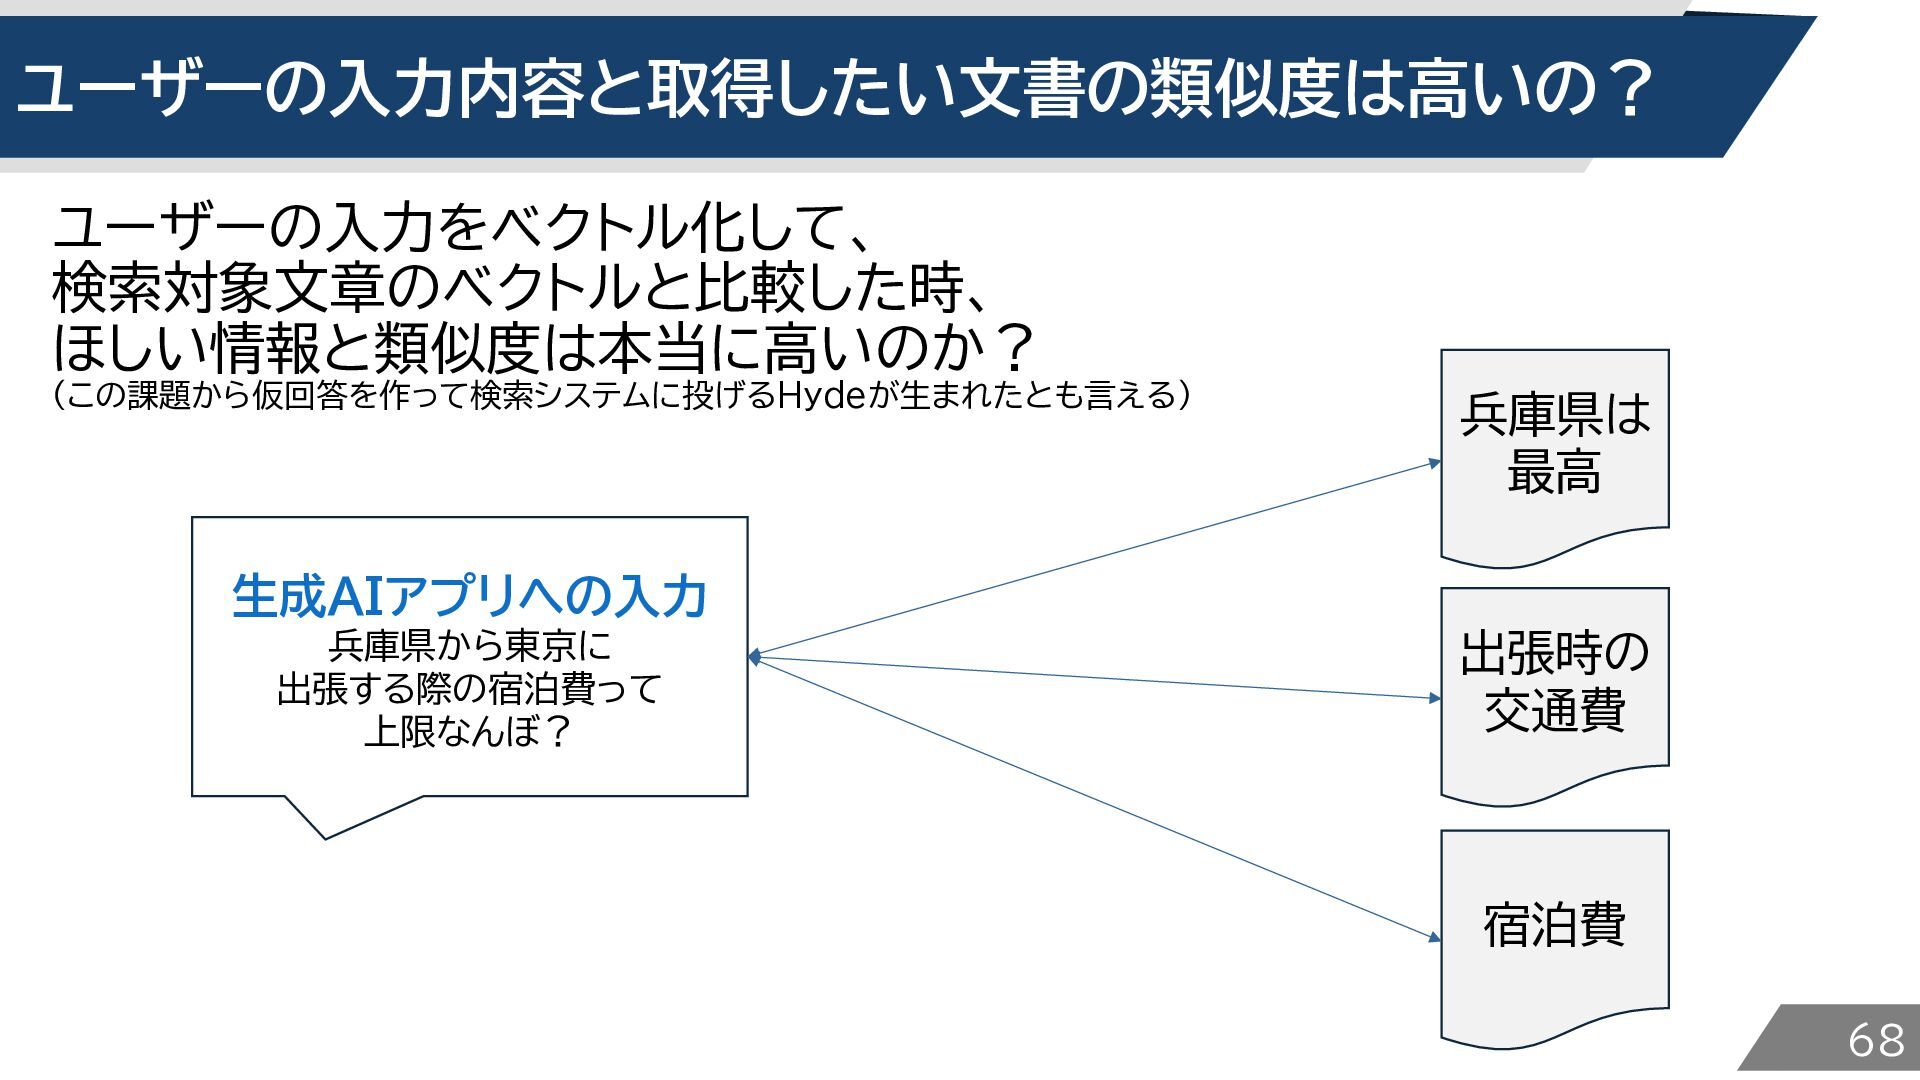
ユーザーの入力内容と取得したい文書の類似度は高いの? ユーザーの入力をベクトル化して、 検索対象文章のベクトルと比較した時、 ほしい情報と類似度は本当に高いのか? (この課題から仮回答を作って検索システムに投げるHydeが生まれたとも言える) 兵庫県は 最高 生成AIアプリへの入力 兵庫県から東京に 出張する際の宿泊費って
上限なんぼ? 出張時の 交通費 宿泊費 68
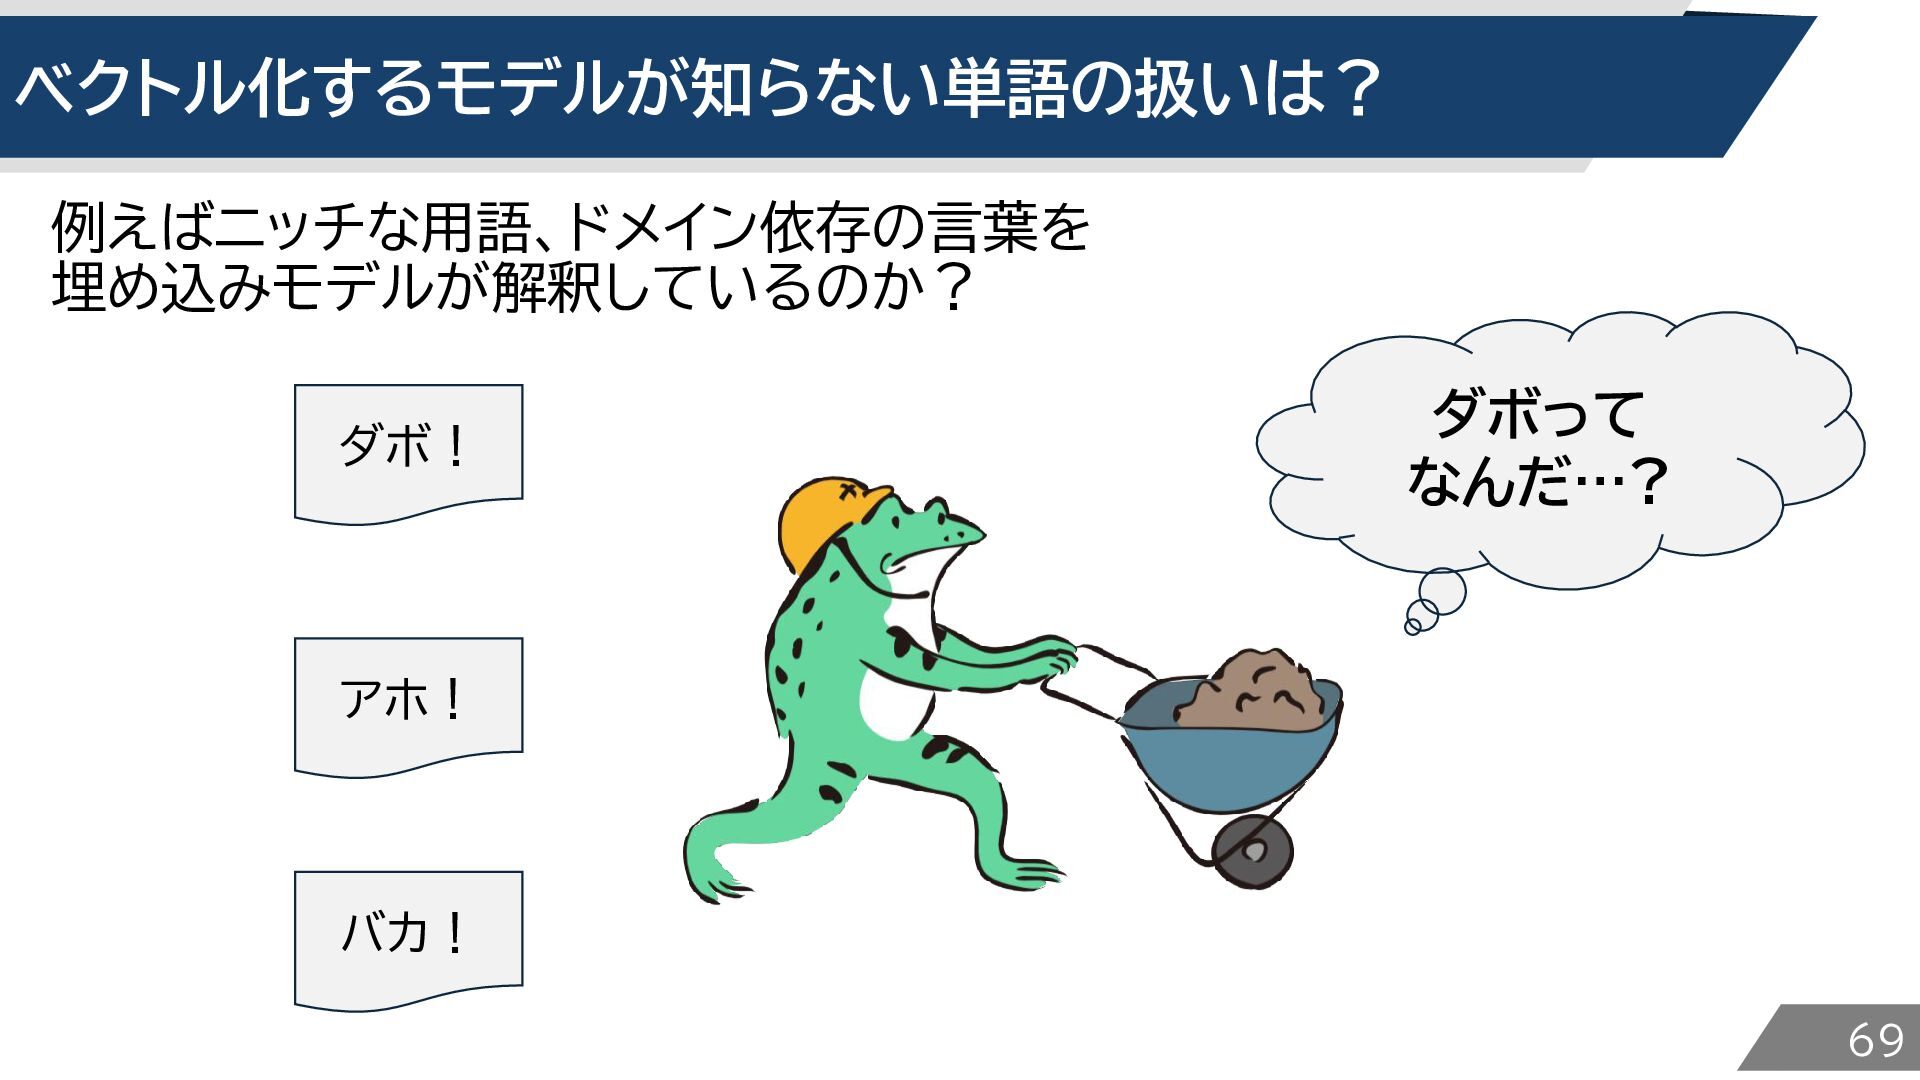
ベクトル化するモデルが知らない単語の扱いは? 例えばニッチな用語、ドメイン依存の言葉を 埋め込みモデルが解釈しているのか? ダボ! ダボって なんだ…? アホ! バカ! 69
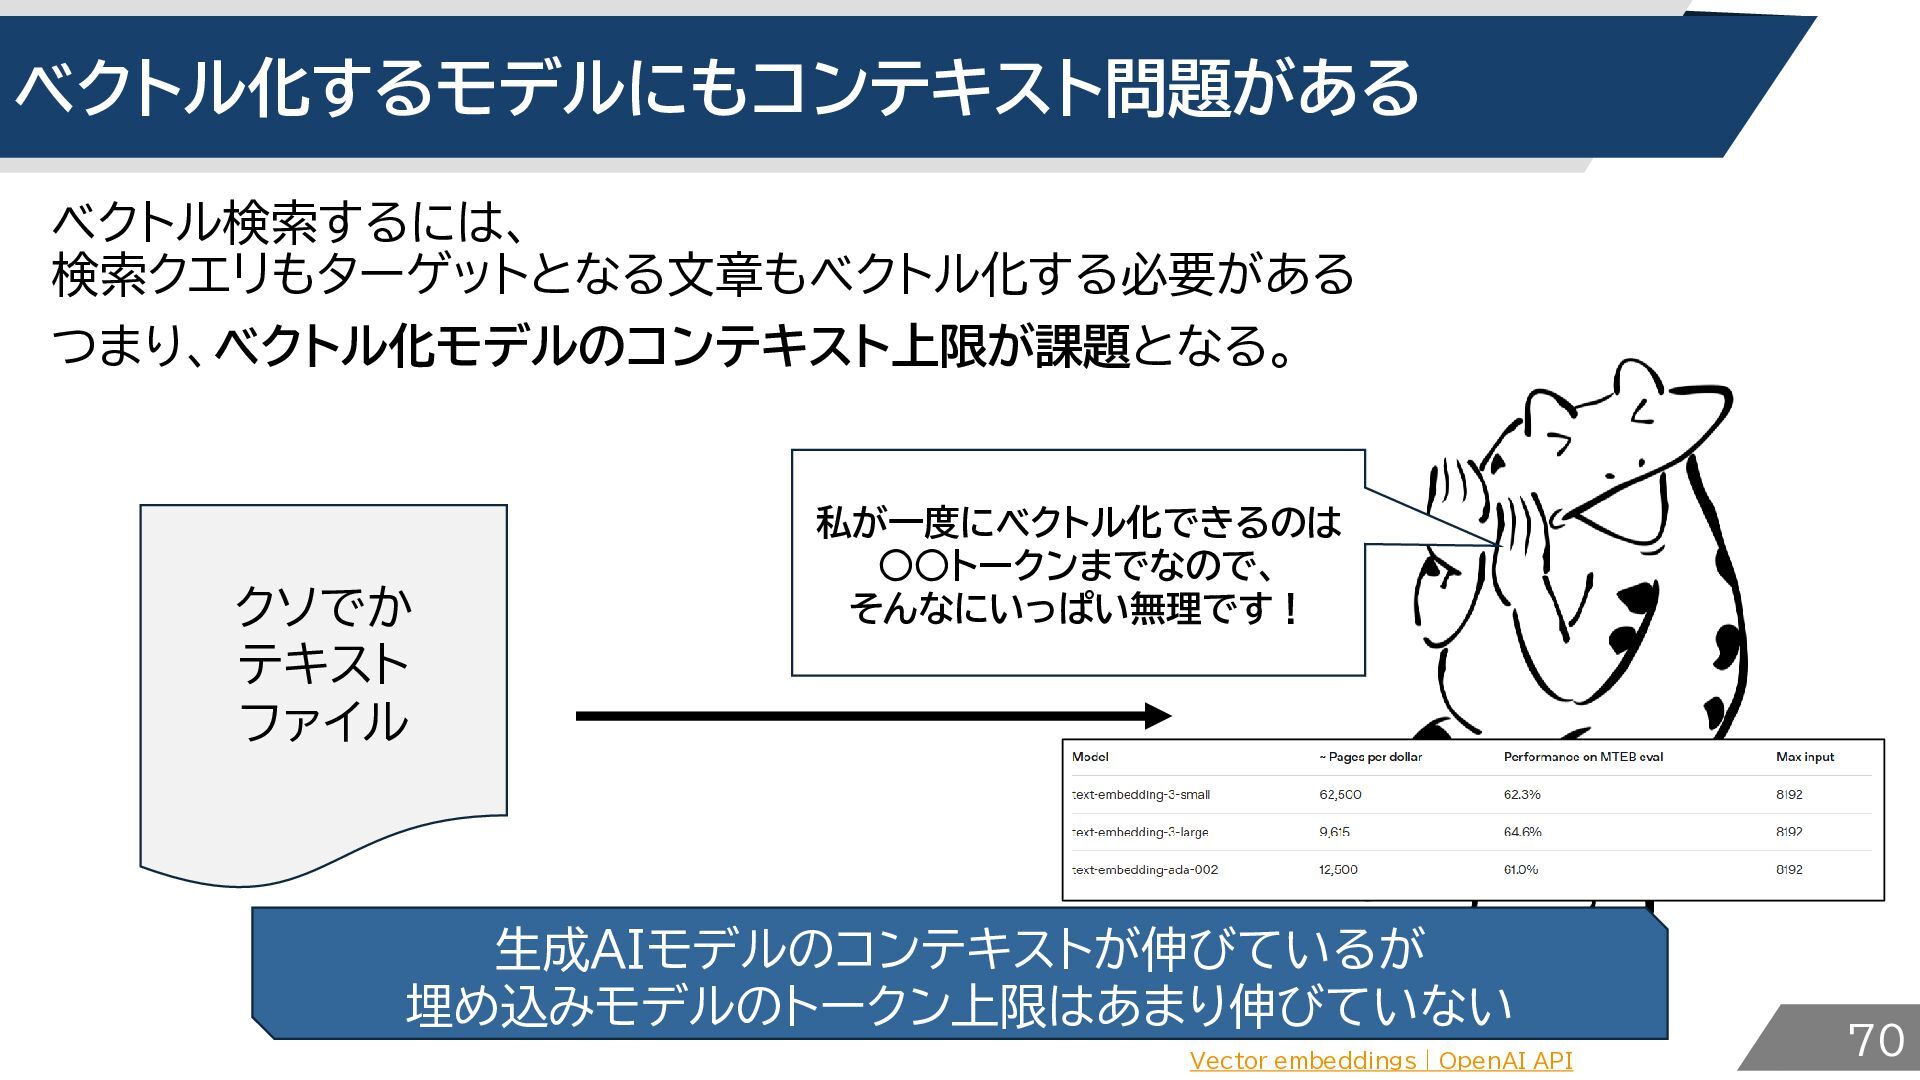
ベクトル化するモデルにもコンテキスト問題がある ベクトル検索するには、 検索クエリもターゲットとなる文章もベクトル化する必要がある つまり、ベクトル化モデルのコンテキスト上限が課題となる。 クソでか テキスト ファイル 私が一度にベクトル化できるのは ◦◦トークンまでなので、 そんなにいっぱい無理です!
生成AIモデルのコンテキストが伸びているが 埋め込みモデルのトークン上限はあまり伸びていない Vector embeddings | OpenAI API 70
さらにさらに ベクトル化を使った検索はいわゆるキーワード検索に比べて - 基本的に遅い - 全件索しているわけではない(HNSWなどの近傍検索をしている) - 検索可能な状態にするために 対象文書をベクトル化モデルに通し続ける必要がある ベクトル検索はとても良い手法であるが、
使い方を意識すること・システムとしてどう組み込むかが大事 71
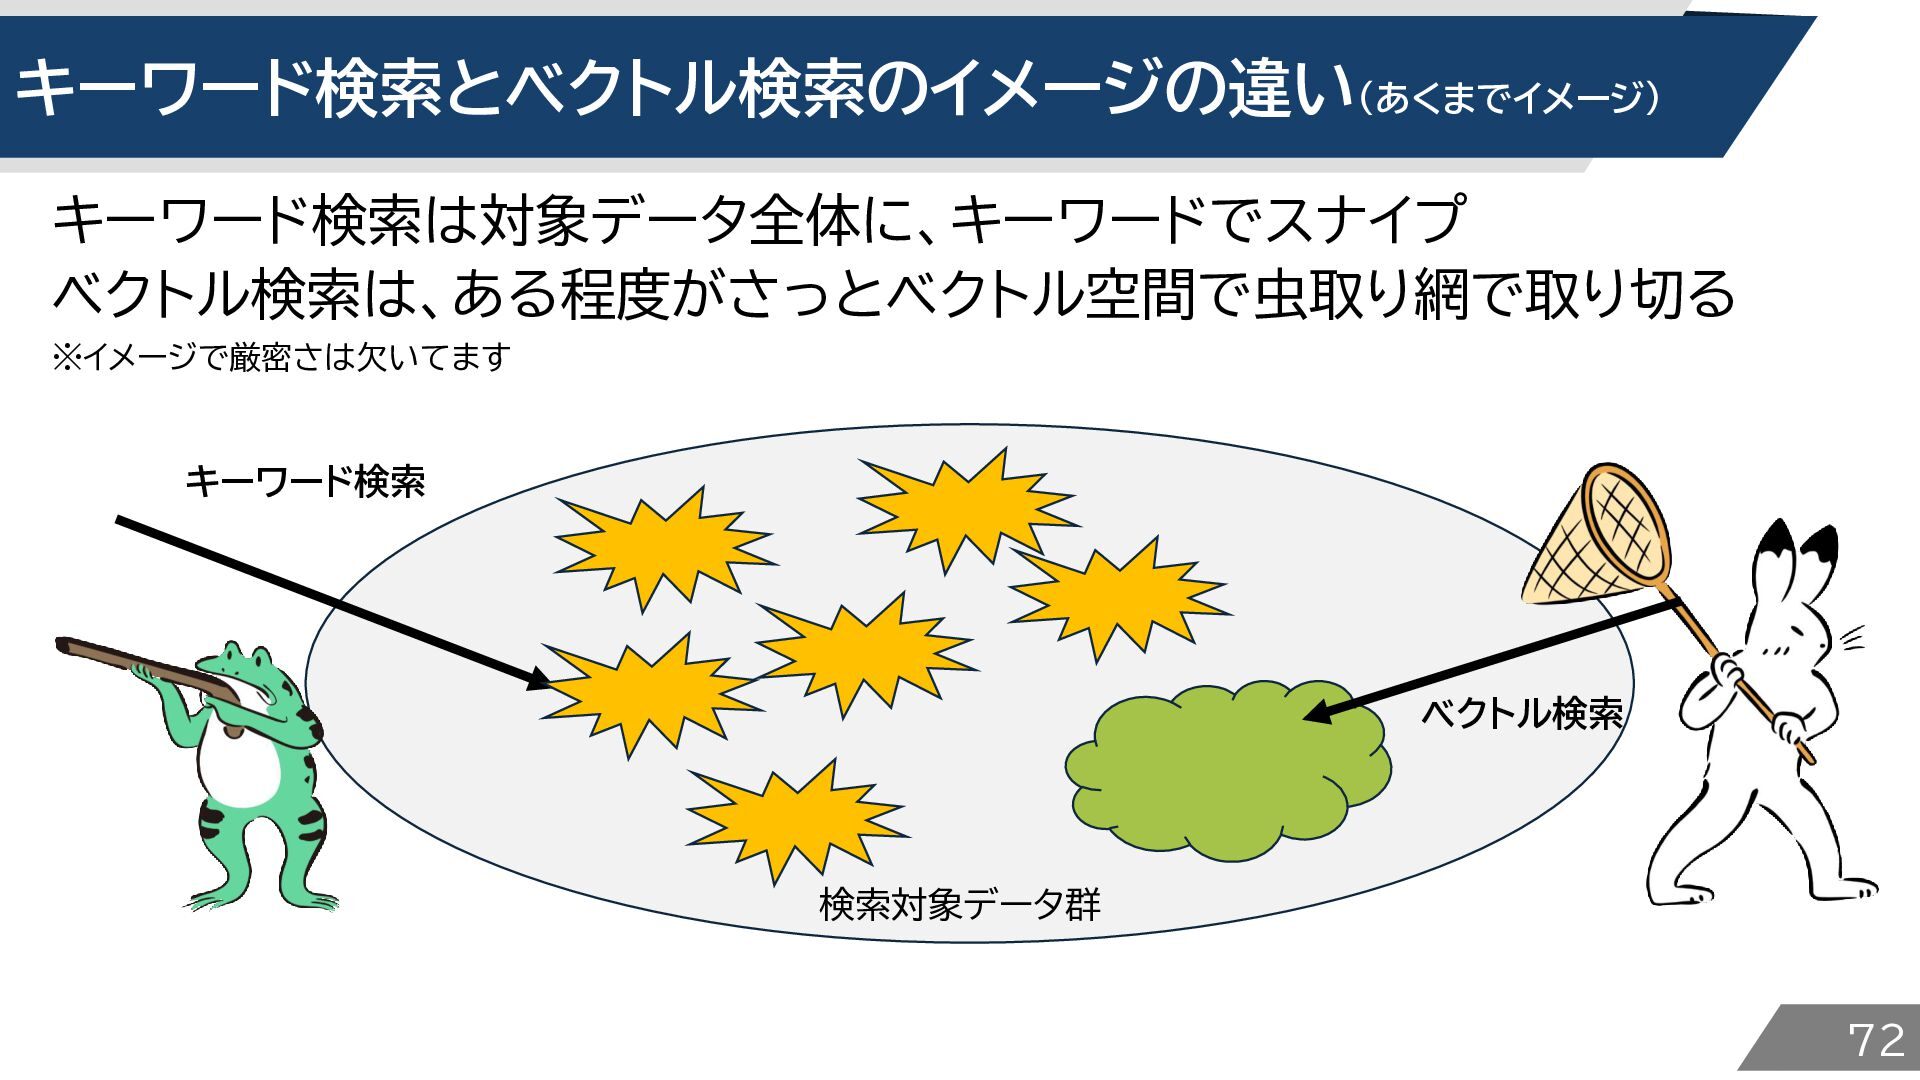
キーワード検索とベクトル検索のイメージの違い(あくまでイメージ) キーワード検索は対象データ全体に、キーワードでスナイプ ベクトル検索は、ある程度がさっとベクトル空間で虫取り網で取り切る ※イメージで厳密さは欠いてます キーワード検索 ベクトル検索 検索対象データ群 72
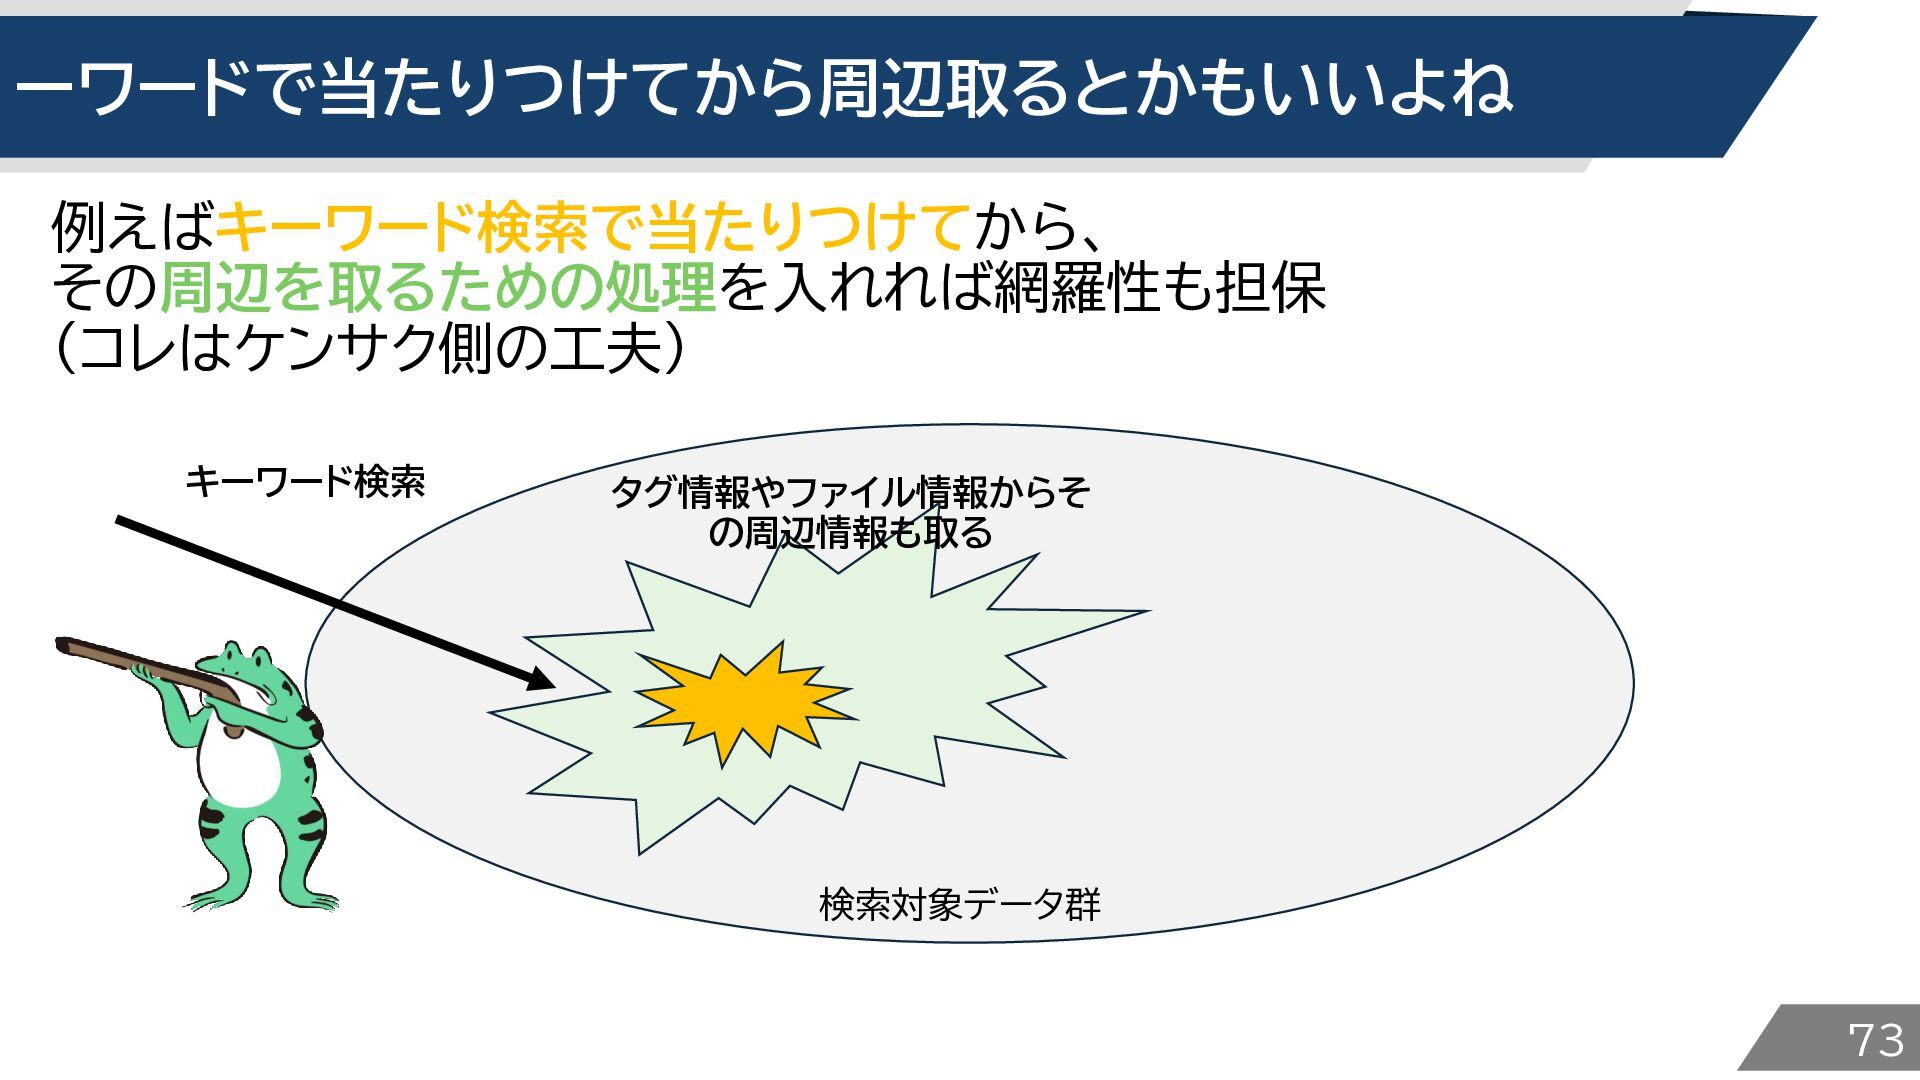
ーワードで当たりつけてから周辺取るとかもいいよね 例えばキーワード検索で当たりつけてから、 その周辺を取るための処理を入れれば網羅性も担保 (コレはケンサク側の工夫) キーワード検索 タグ情報やファイル情報からそ の周辺情報も取る 検索対象データ群 73
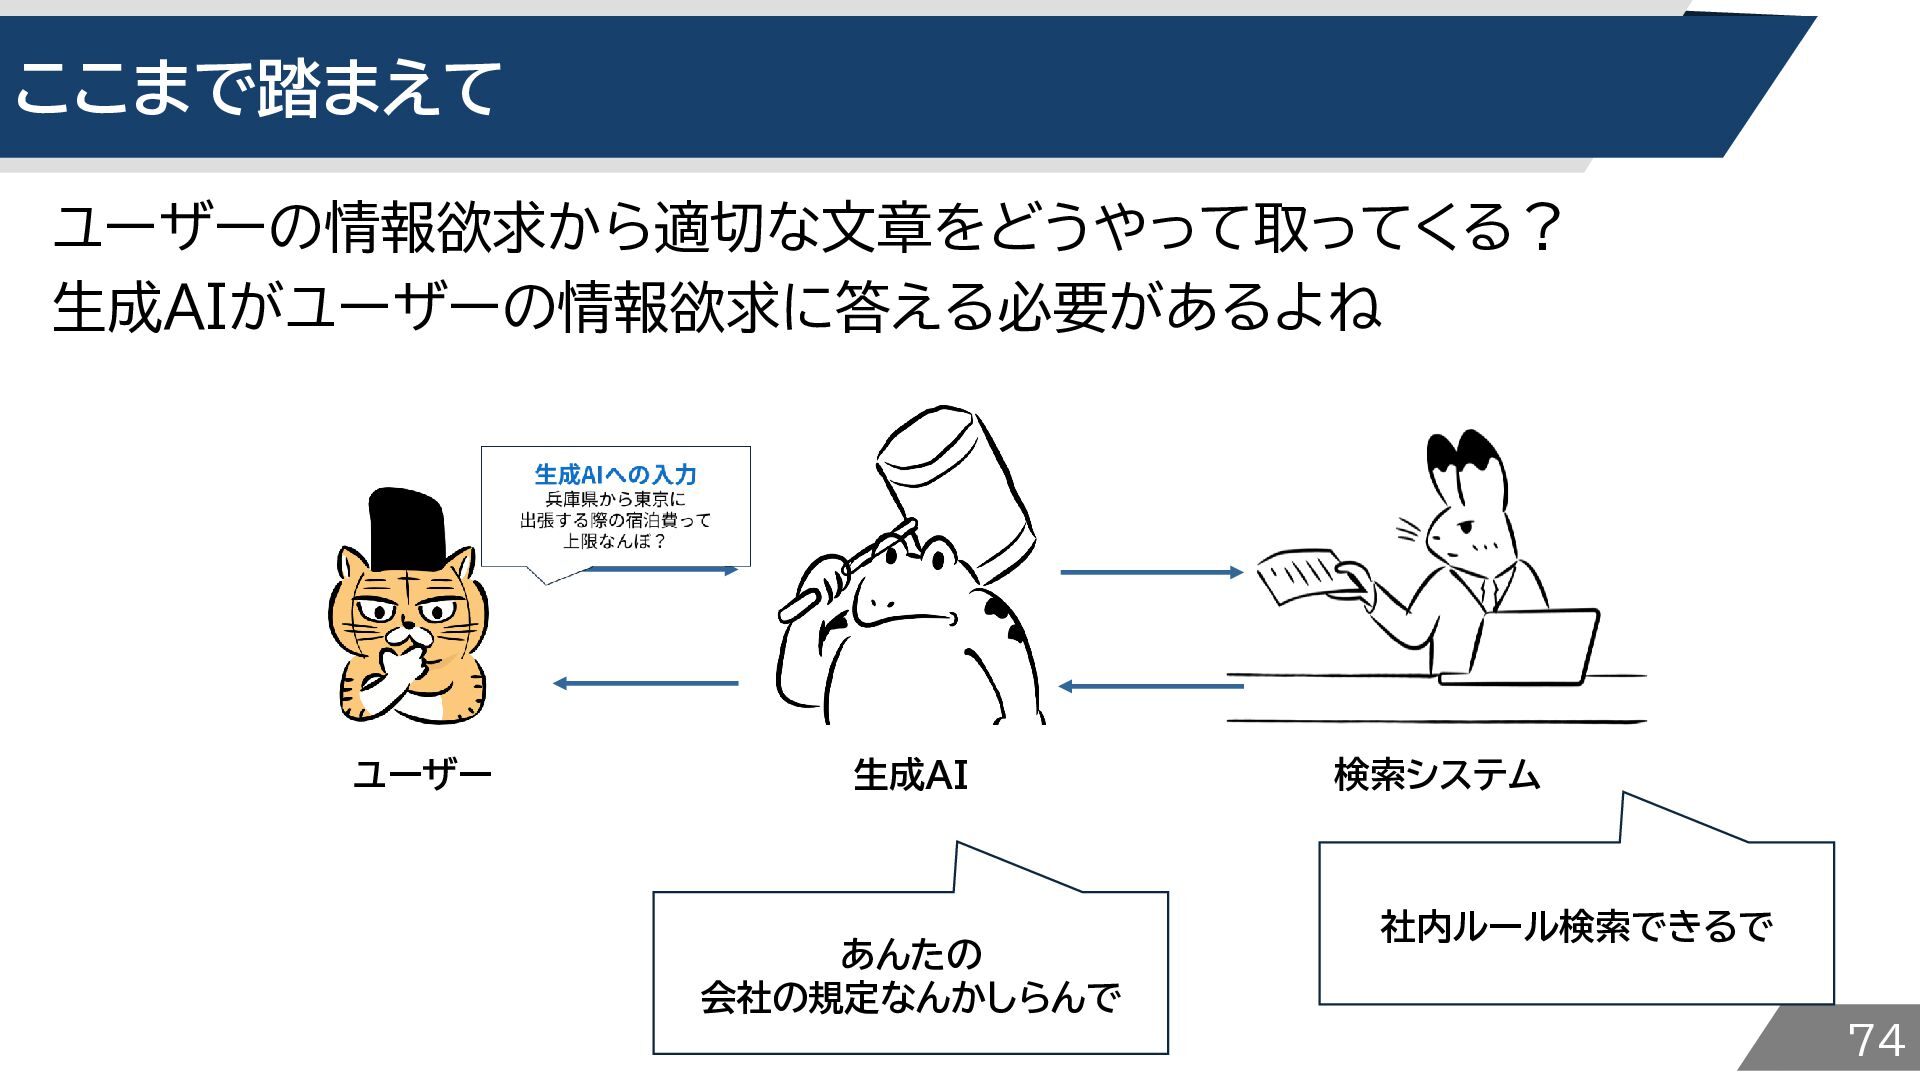
ここまで踏まえて ユーザーの情報欲求から適切な文章をどうやって取ってくる? 生成AIがユーザーの情報欲求に答える必要があるよね ユーザー 生成AI あんたの 会社の規定なんかしらんで 検索システム 社内ルール検索できるで 74
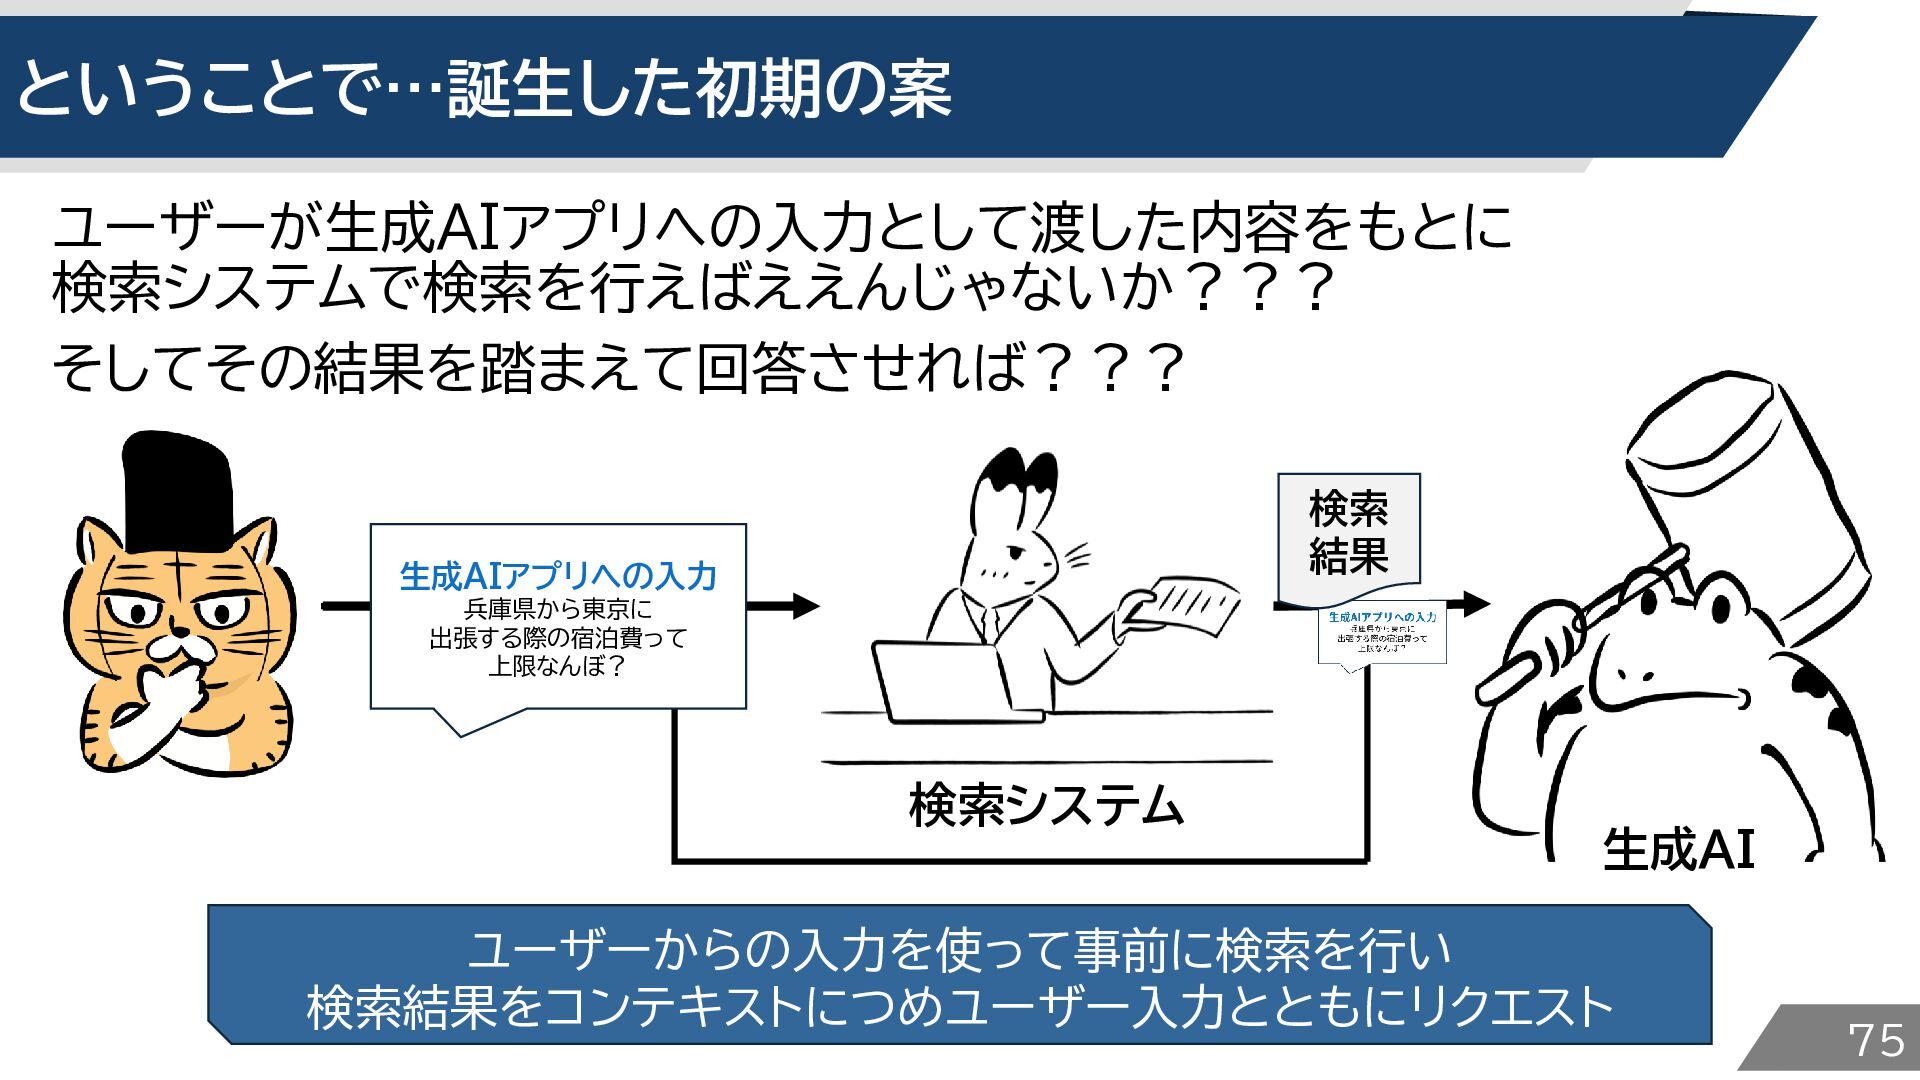
ということで…誕生した初期の案 ユーザーが生成AIアプリへの入力として渡した内容をもとに 検索システムで検索を行えばええんじゃないか??? そしてその結果を踏まえて回答させれば??? 検索 結果 生成AIアプリへの入力 兵庫県から東京に 出張する際の宿泊費って 上限なんぼ?
検索システム 生成AI ユーザーからの入力を使って事前に検索を行い 検索結果をコンテキストにつめユーザー入力とともにリクエスト 75
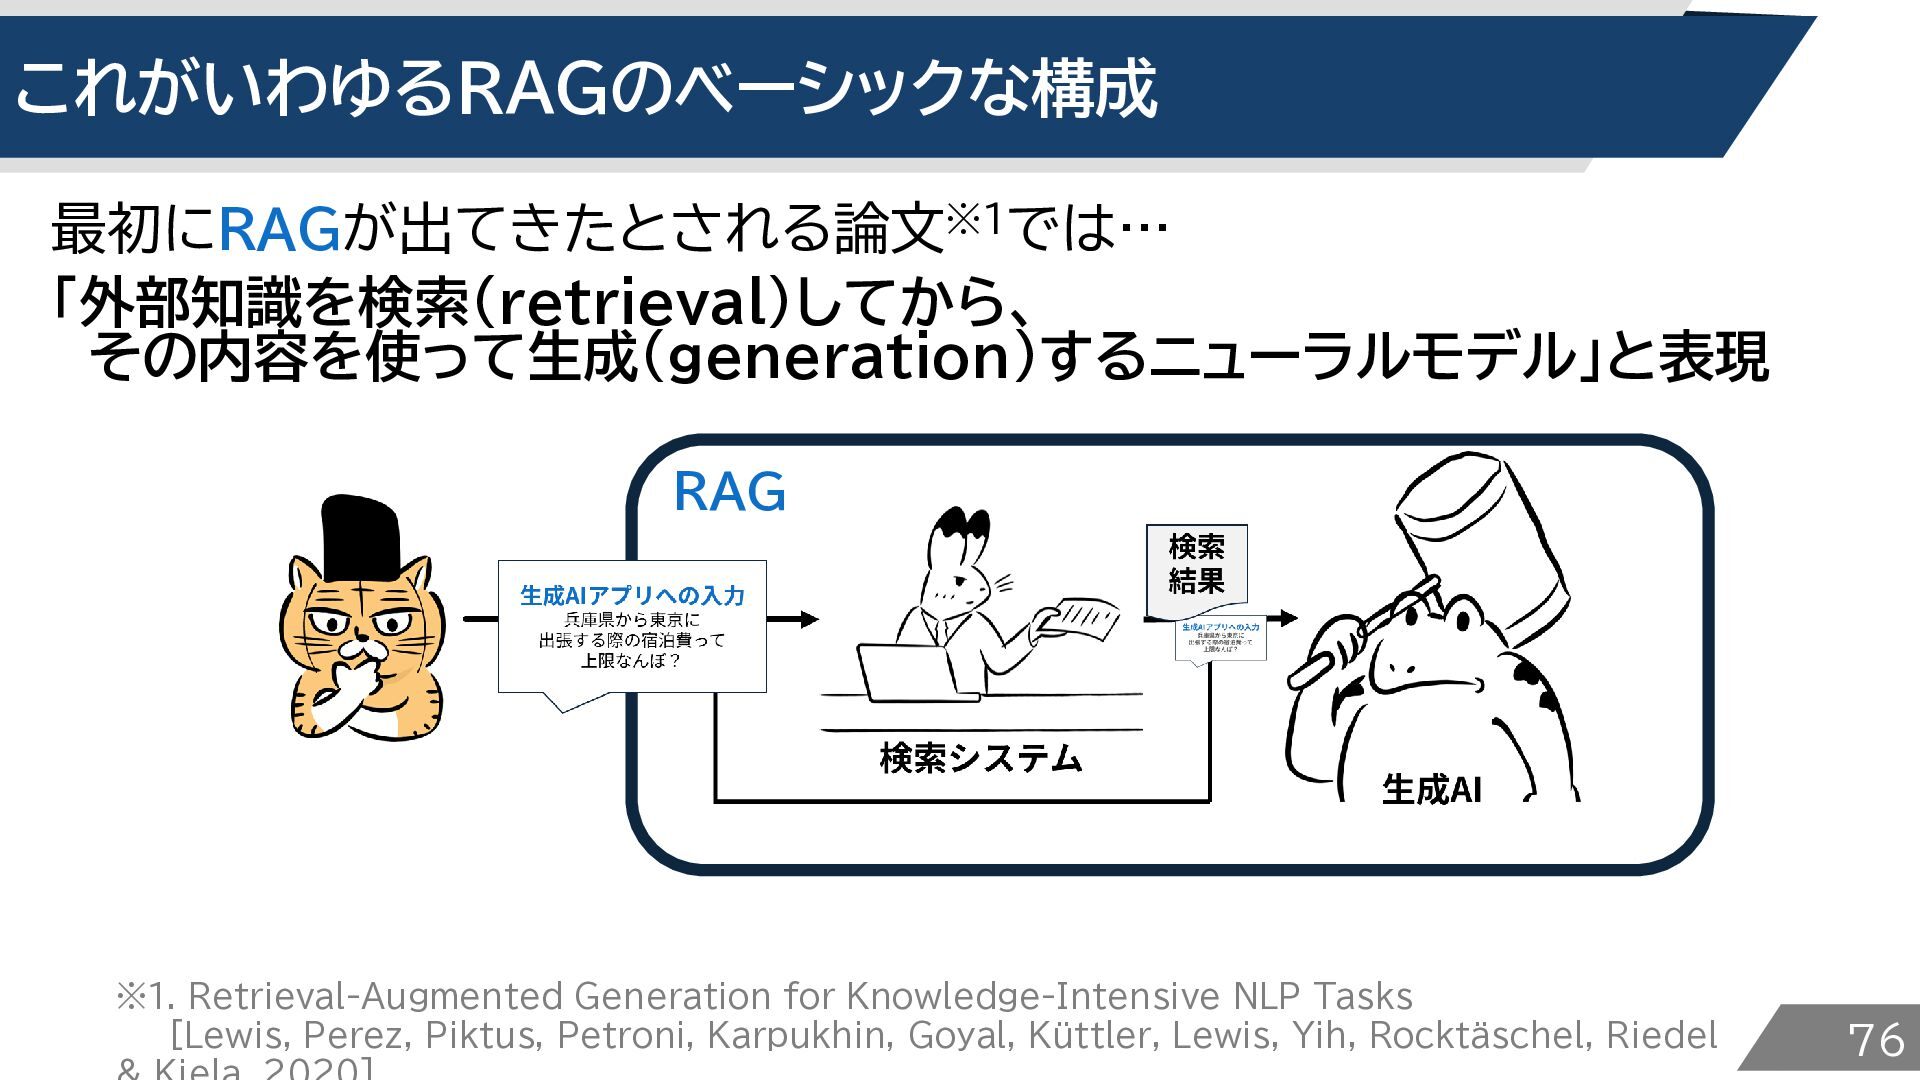
これがいわゆるRAGのベーシックな構成 最初にRAGが出てきたとされる論文※1では… 「外部知識を検索(retrieval)してから、 その内容を使って生成(generation)するニューラルモデル」と表現 RAG ※1. Retrieval-Augmented Generation for Knowledge-Intensive
NLP Tasks [Lewis, Perez, Piktus, Petroni, Karpukhin, Goyal, Küttler, Lewis, Yih, Rocktäschel, Riedel 76
寄り道:いまとなってはRAGという言葉の解釈も様々 Agentic RAG、GraphRAGといった◦◦RAGが大量にある 繰り返しになるが大事なのは、 「生成AIがユーザーの情報欲求を 満たす回答をするための外部情報を渡すこと」 と 「その外部情報をどうやって取得するか」 【個人的偏見】 ◦◦RAGはおおよそ
「何らかの検索システムから得られた検索結果をコンテキストとして与えた生成AIによる回答生成手法」 と理解してよい。と思います。それ以上でもそれ以下でもない。のであとはインパクトの世界 77
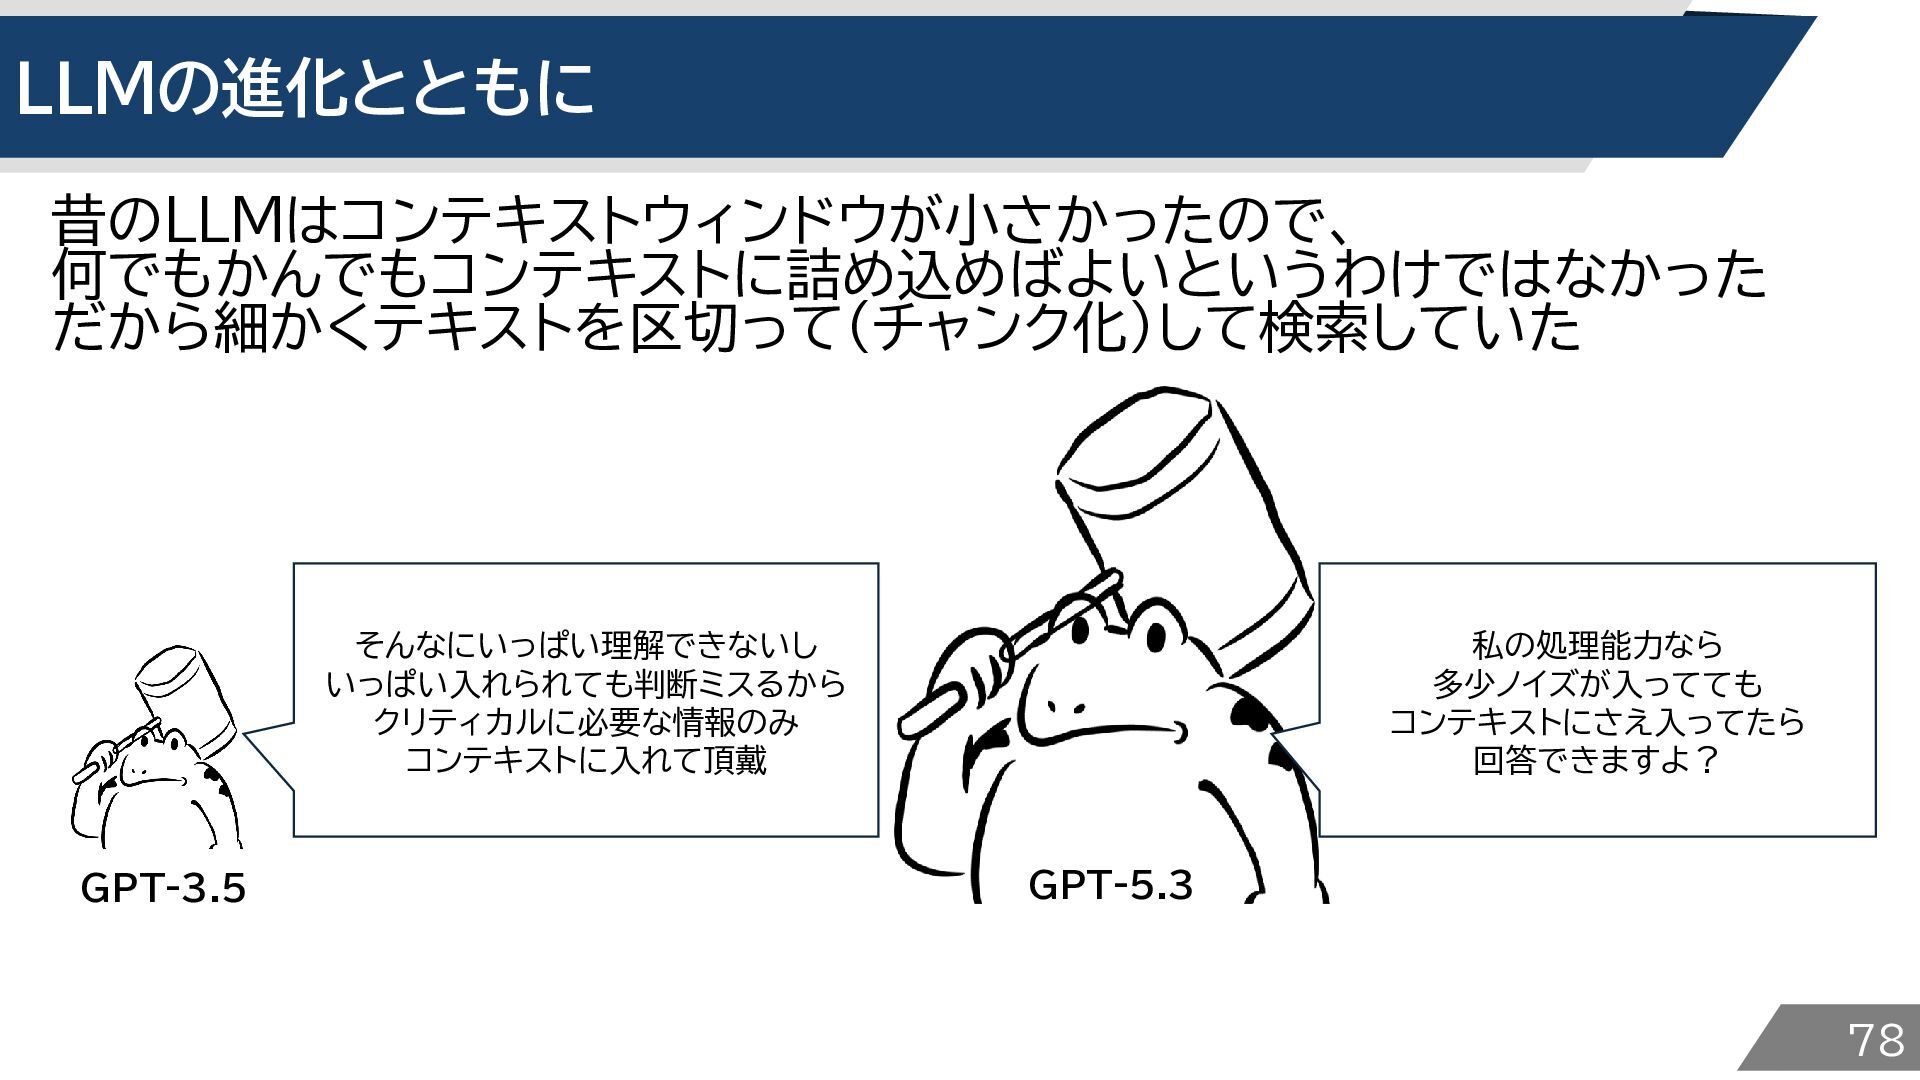
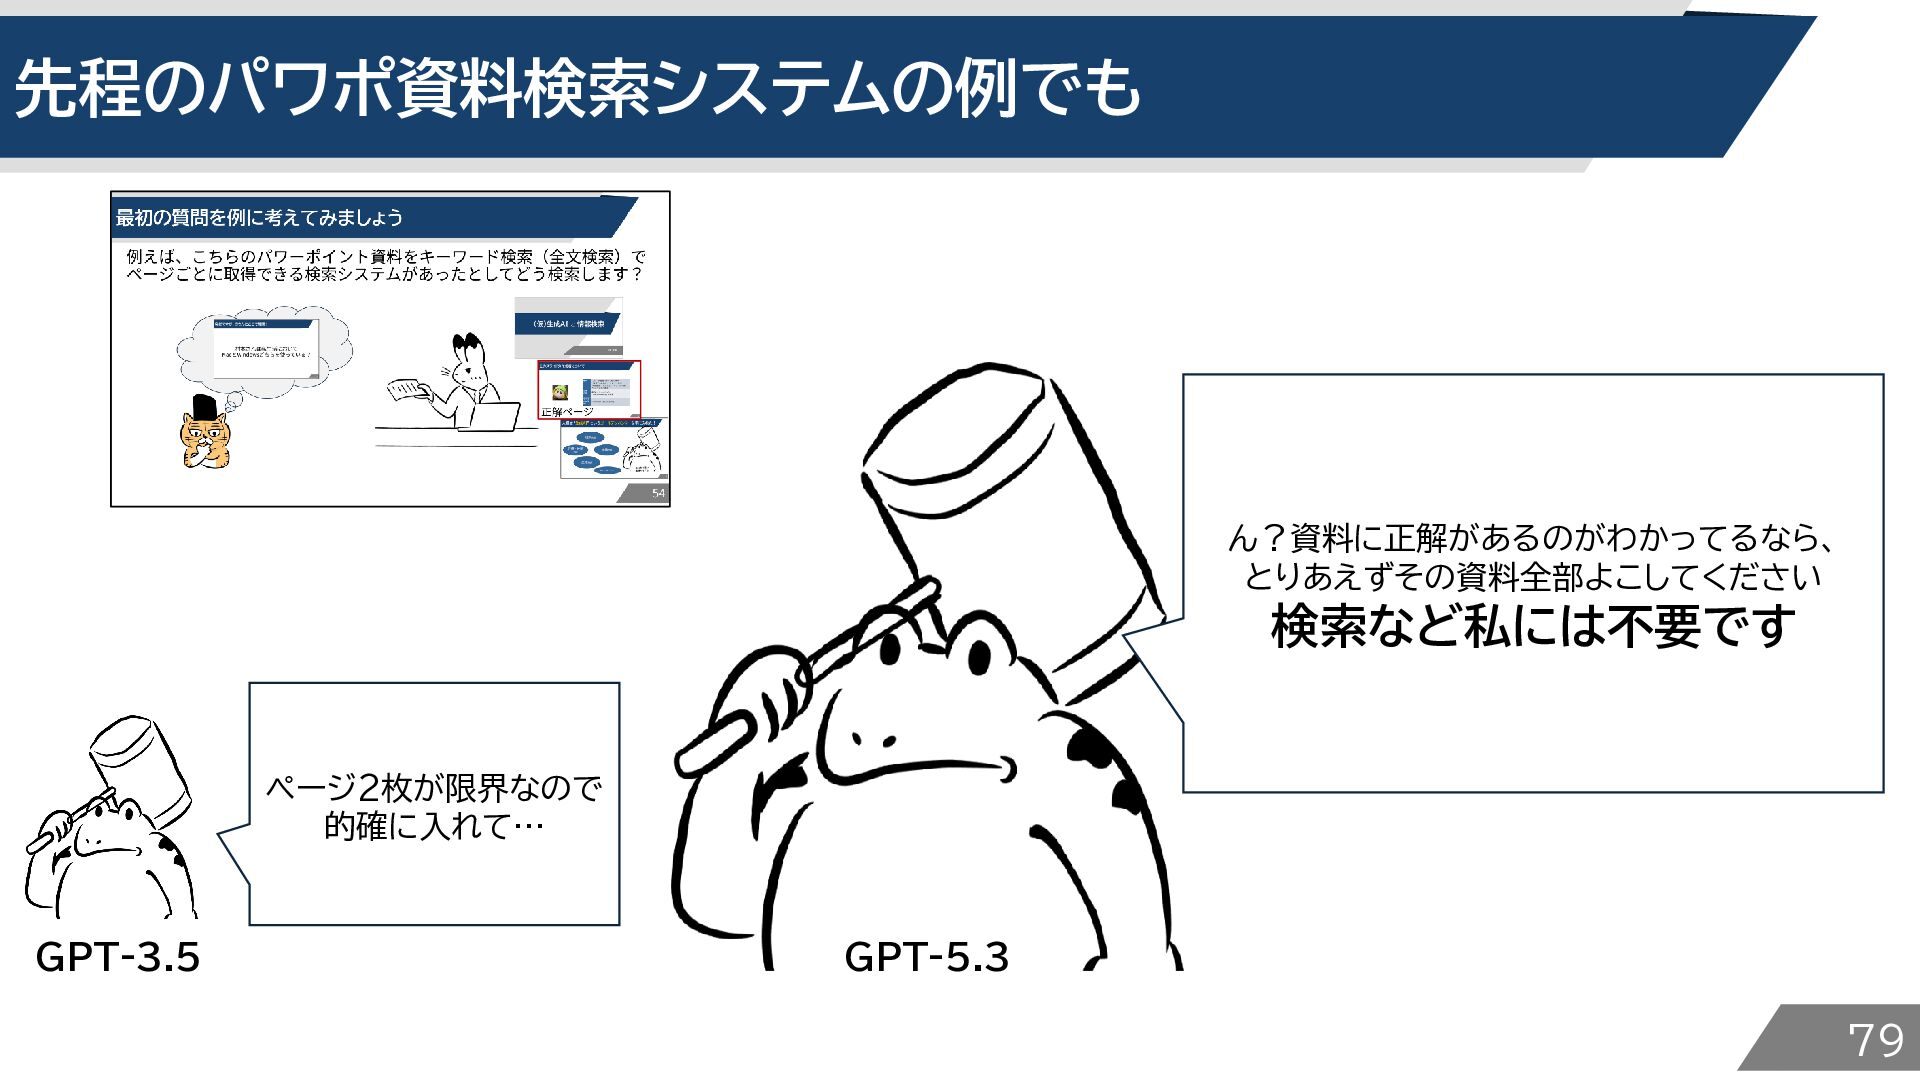
LLMの進化とともに 昔のLLMはコンテキストウィンドウが小さかったので、 何でもかんでもコンテキストに詰め込めばよいというわけではなかった だから細かくテキストを区切って(チャンク化)して検索していた そんなにいっぱい理解できないし いっぱい入れられても判断ミスるから クリティカルに必要な情報のみ コンテキストに入れて頂戴 GPT-3.5 私の処理能力なら
多少ノイズが入ってても コンテキストにさえ入ってたら 回答できますよ? GPT-5.3 78
先程のパワポ資料検索システムの例でも ん?資料に正解があるのがわかってるなら、 とりあえずその資料全部よこしてください 検索など私には不要です ページ2枚が限界なので 的確に入れて… GPT-3.5 GPT-5.3 79
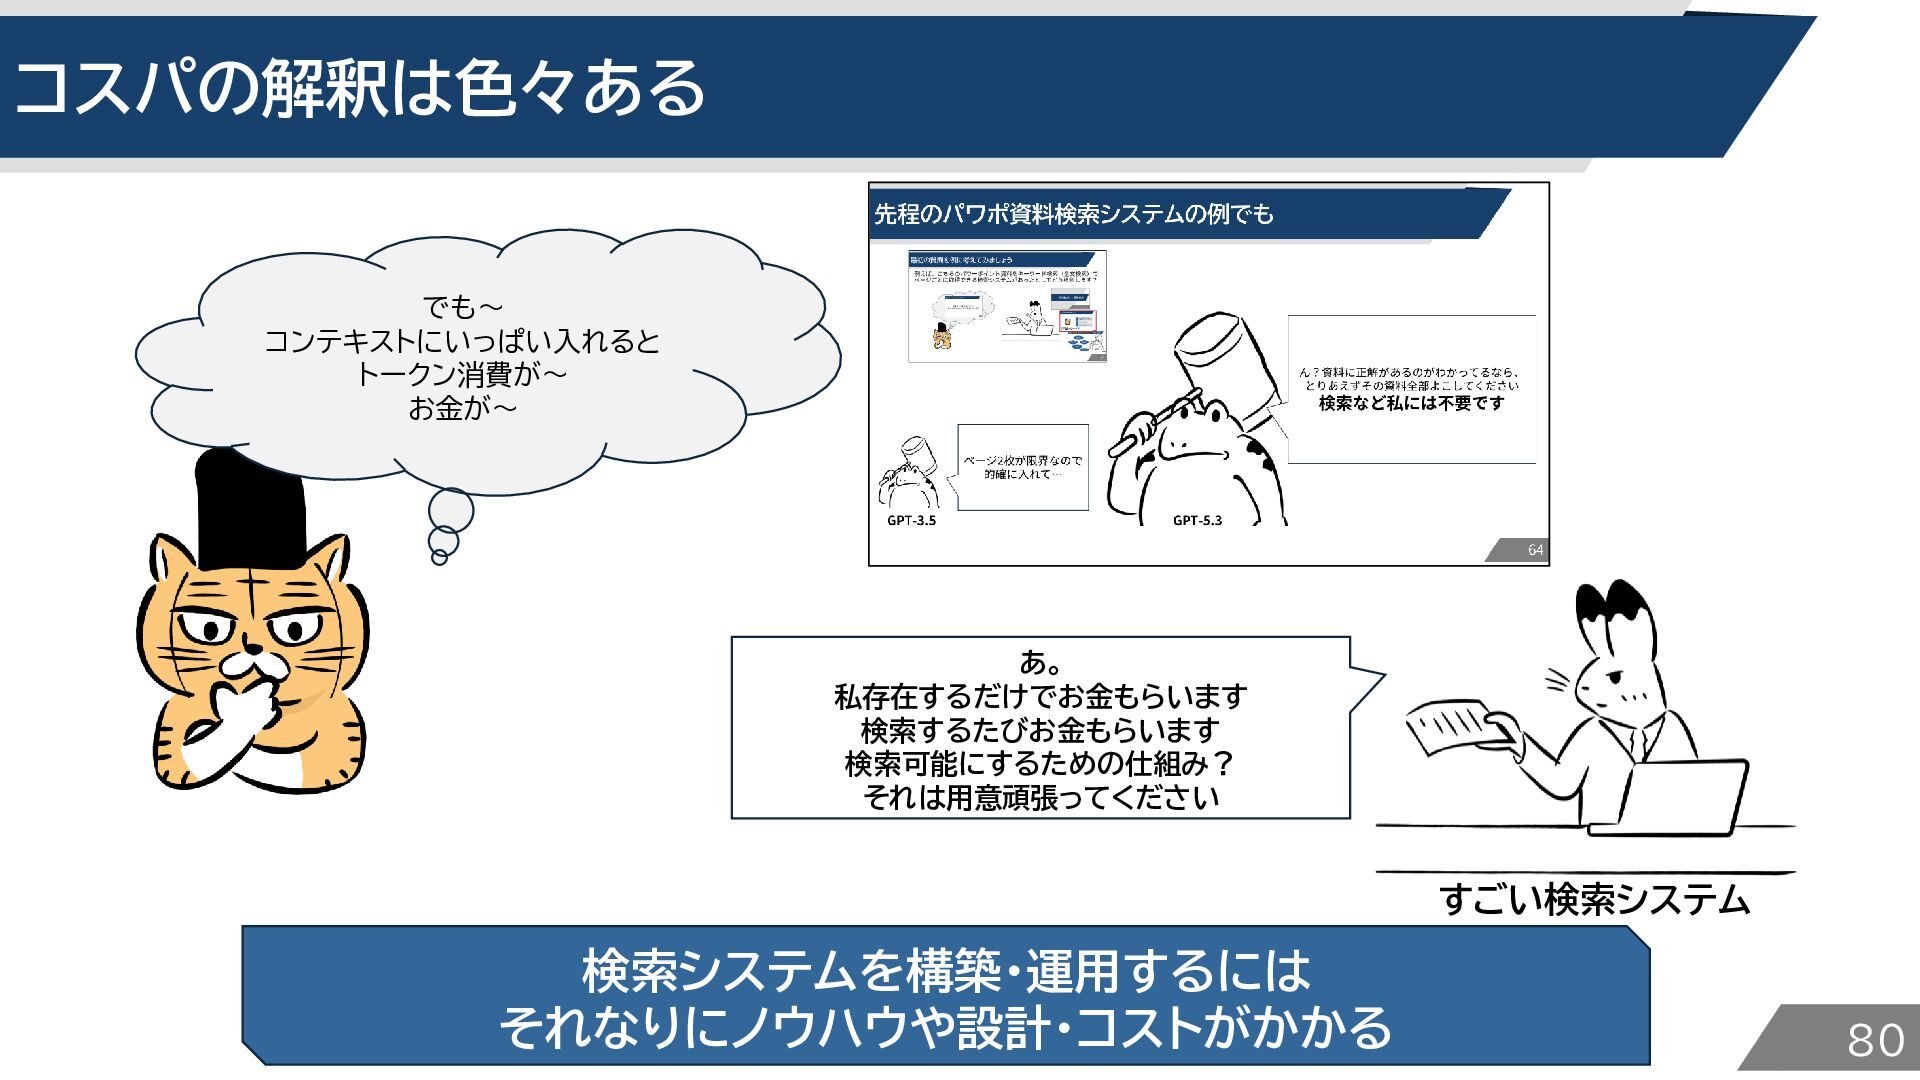
コスパの解釈は色々ある でも~ コンテキストにいっぱい入れると トークン消費が~ お金が~ あ。 私存在するだけでお金もらいます 検索するたびお金もらいます 検索可能にするための仕組み? それは用意頑張ってください
すごい検索システム 検索システムを構築・運用するには それなりにノウハウや設計・コストがかかる 80
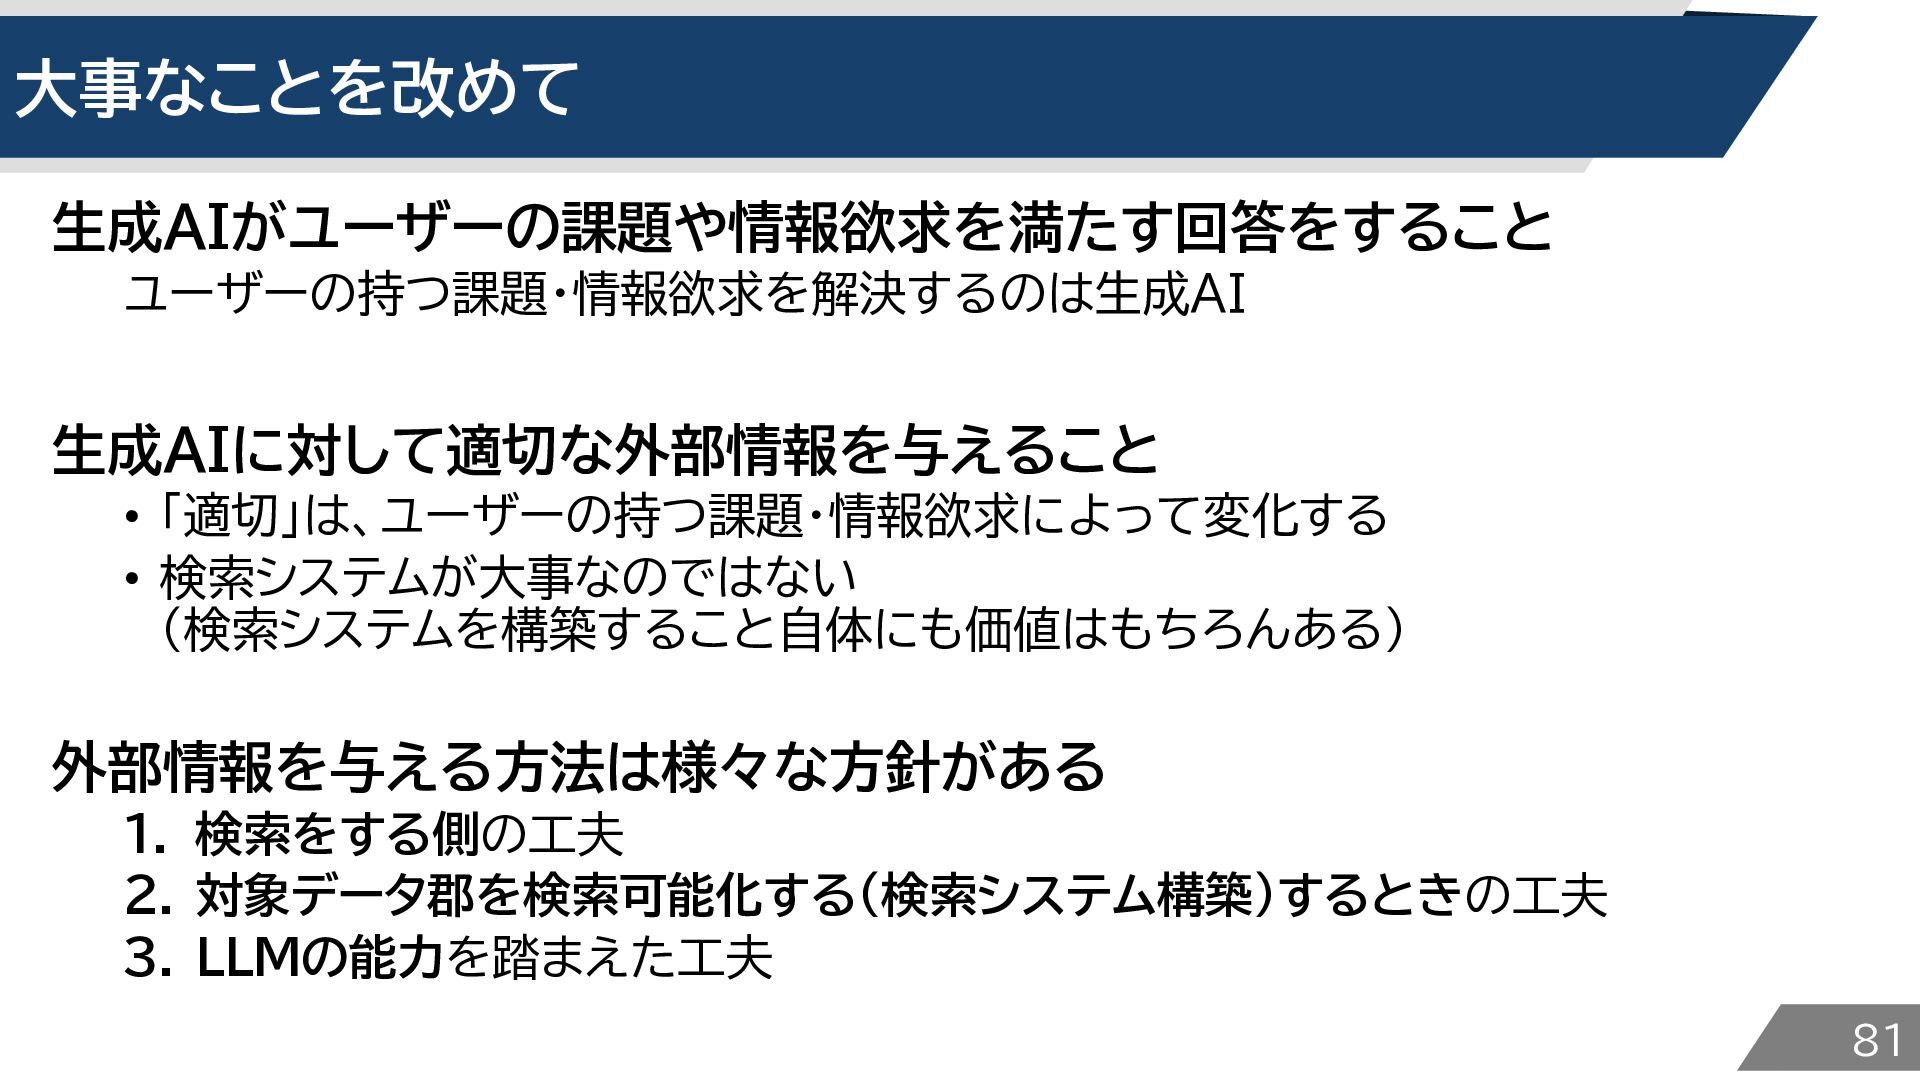
大事なことを改めて 生成AIがユーザーの課題や情報欲求を満たす回答をすること ユーザーの持つ課題・情報欲求を解決するのは生成AI 生成AIに対して適切な外部情報を与えること • 「適切」は、ユーザーの持つ課題・情報欲求によって変化する • 検索システムが大事なのではない (検索システムを構築すること自体にも価値はもちろんある) 外部情報を与える方法は様々な方針がある
1. 検索をする側の工夫 2. 対象データ郡を検索可能化する(検索システム構築)するときの工夫 3. LLMの能力を踏まえた工夫 81
生成AIからみたときの「良い検索」とは? 人間が直接検索するのと 人間の要望に答えるために生成AIが情報収集するための検索は違う 私にとって大事なのは R@k(Recall)? GPT-5.3 82
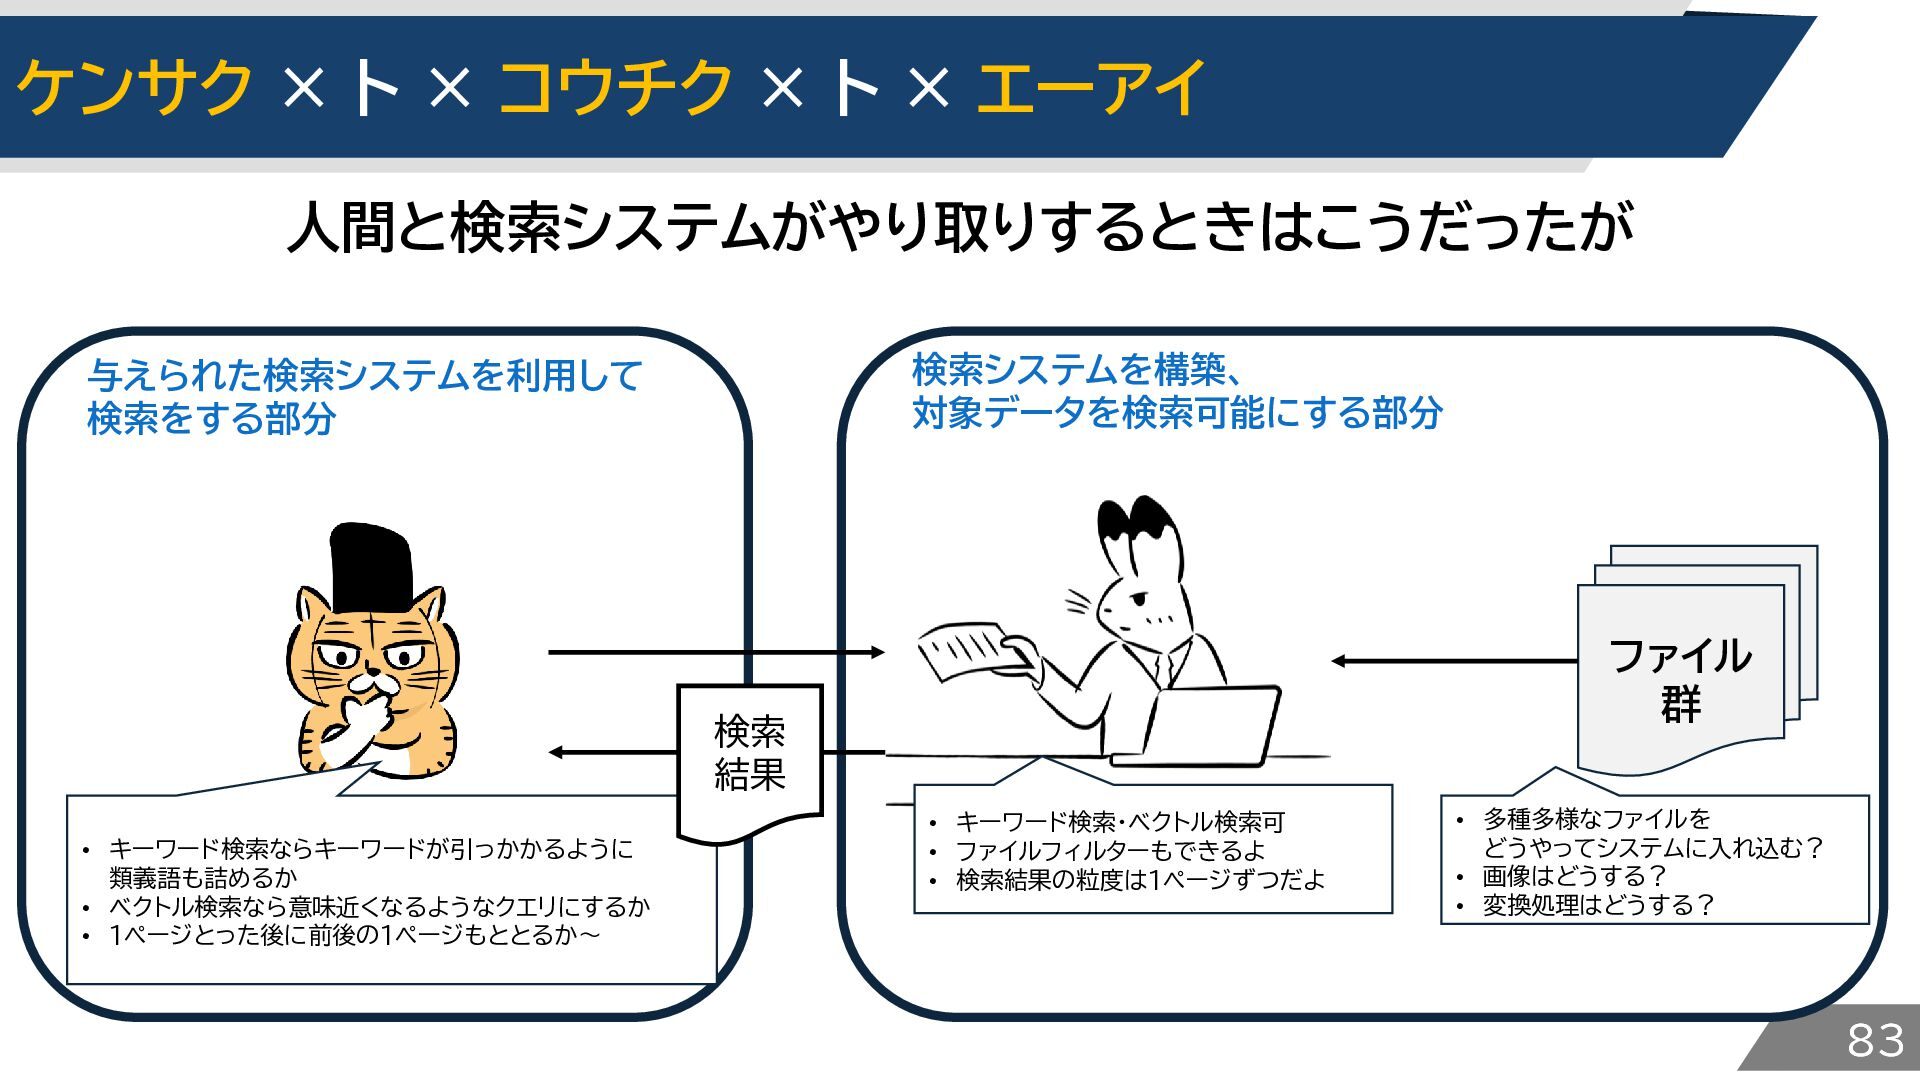
ケンサク × ト × コウチク × ト × エーアイ 人間と検索システムがやり取りするときはこうだったが
検索システムを構築、 対象データを検索可能にする部分 与えられた検索システムを利用して 検索をする部分 ファイル 群 検索 結果 • キーワード検索ならキーワードが引っかかるように 類義語も詰めるか • ベクトル検索なら意味近くなるようなクエリにするか • 1ページとった後に前後の1ページもととるか~ • キーワード検索・ベクトル検索可 • ファイルフィルターもできるよ • 検索結果の粒度は1ページずつだよ • 多種多様なファイルを どうやってシステムに入れ込む? • 画像はどうする? • 変換処理はどうする? 83
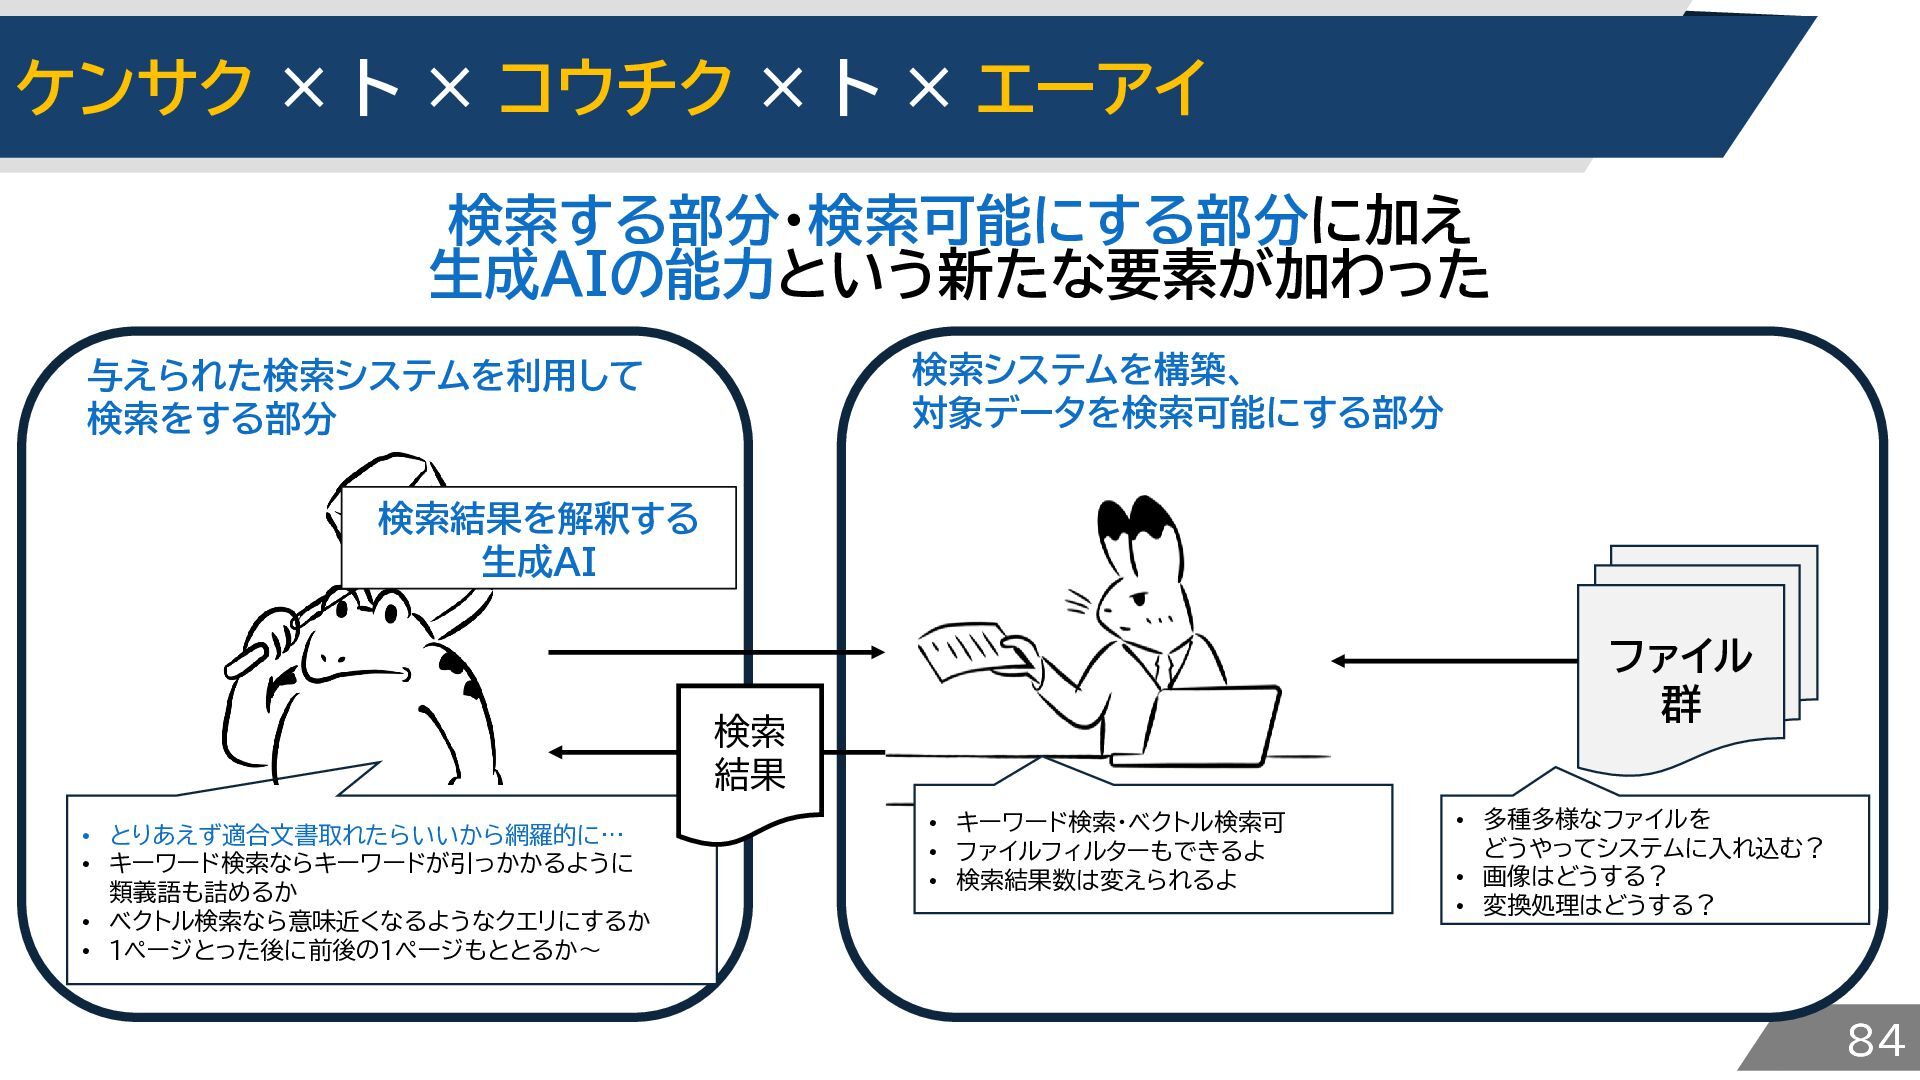
ケンサク × ト × コウチク × ト × エーアイ 検索する部分・検索可能にする部分に加え
生成AIの能力という新たな要素が加わった 検索システムを構築、 対象データを検索可能にする部分 与えられた検索システムを利用して 検索をする部分 検索結果を解釈する 生成AI ファイル 群 検索 結果 • とりあえず適合文書取れたらいいから網羅的に… • キーワード検索ならキーワードが引っかかるように 類義語も詰めるか • ベクトル検索なら意味近くなるようなクエリにするか • 1ページとった後に前後の1ページもととるか~ • キーワード検索・ベクトル検索可 • ファイルフィルターもできるよ • 検索結果数は変えられるよ • 多種多様なファイルを どうやってシステムに入れ込む? • 画像はどうする? • 変換処理はどうする? 84
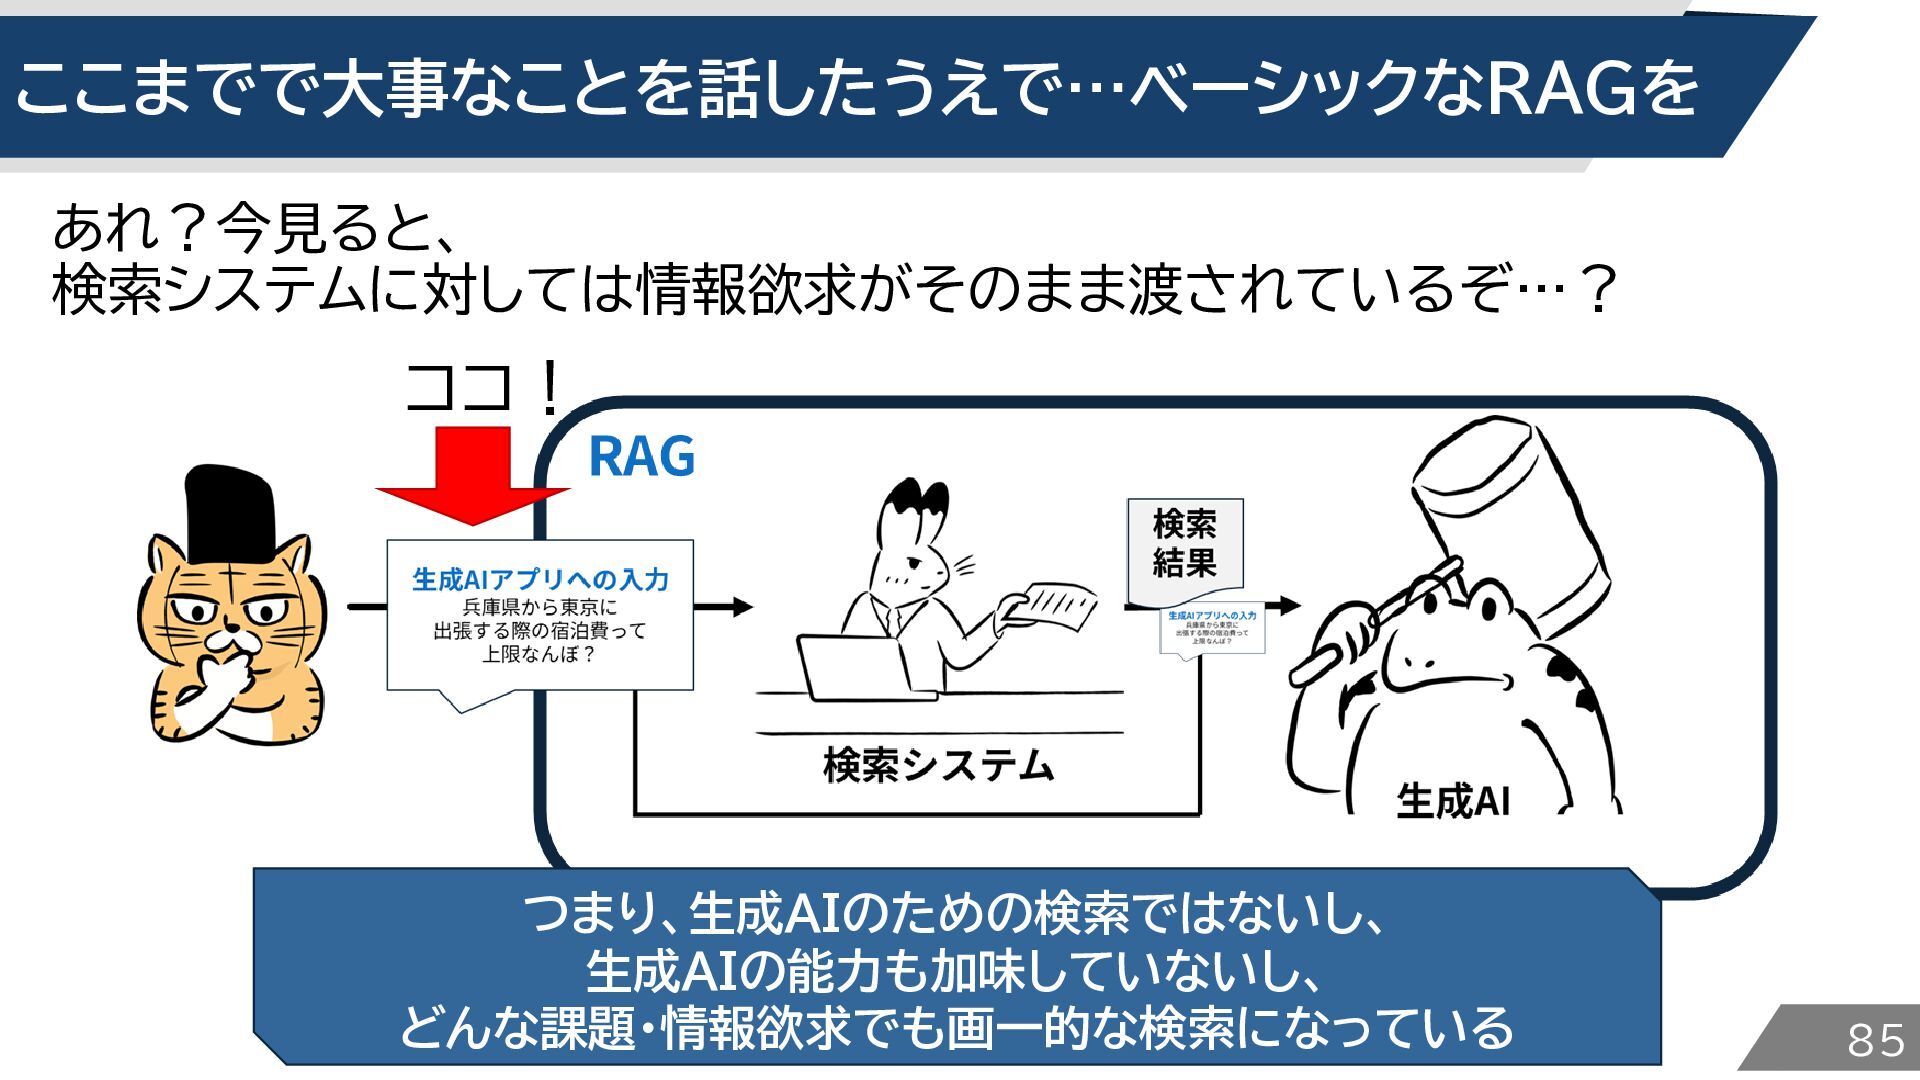
ここまでで大事なことを話したうえで…ベーシックなRAGを あれ?今見ると、 検索システムに対しては情報欲求がそのまま渡されているぞ…? ココ! つまり、生成AIのための検索ではないし、 生成AIの能力も加味していないし、 どんな課題・情報欲求でも画一的な検索になっている 85
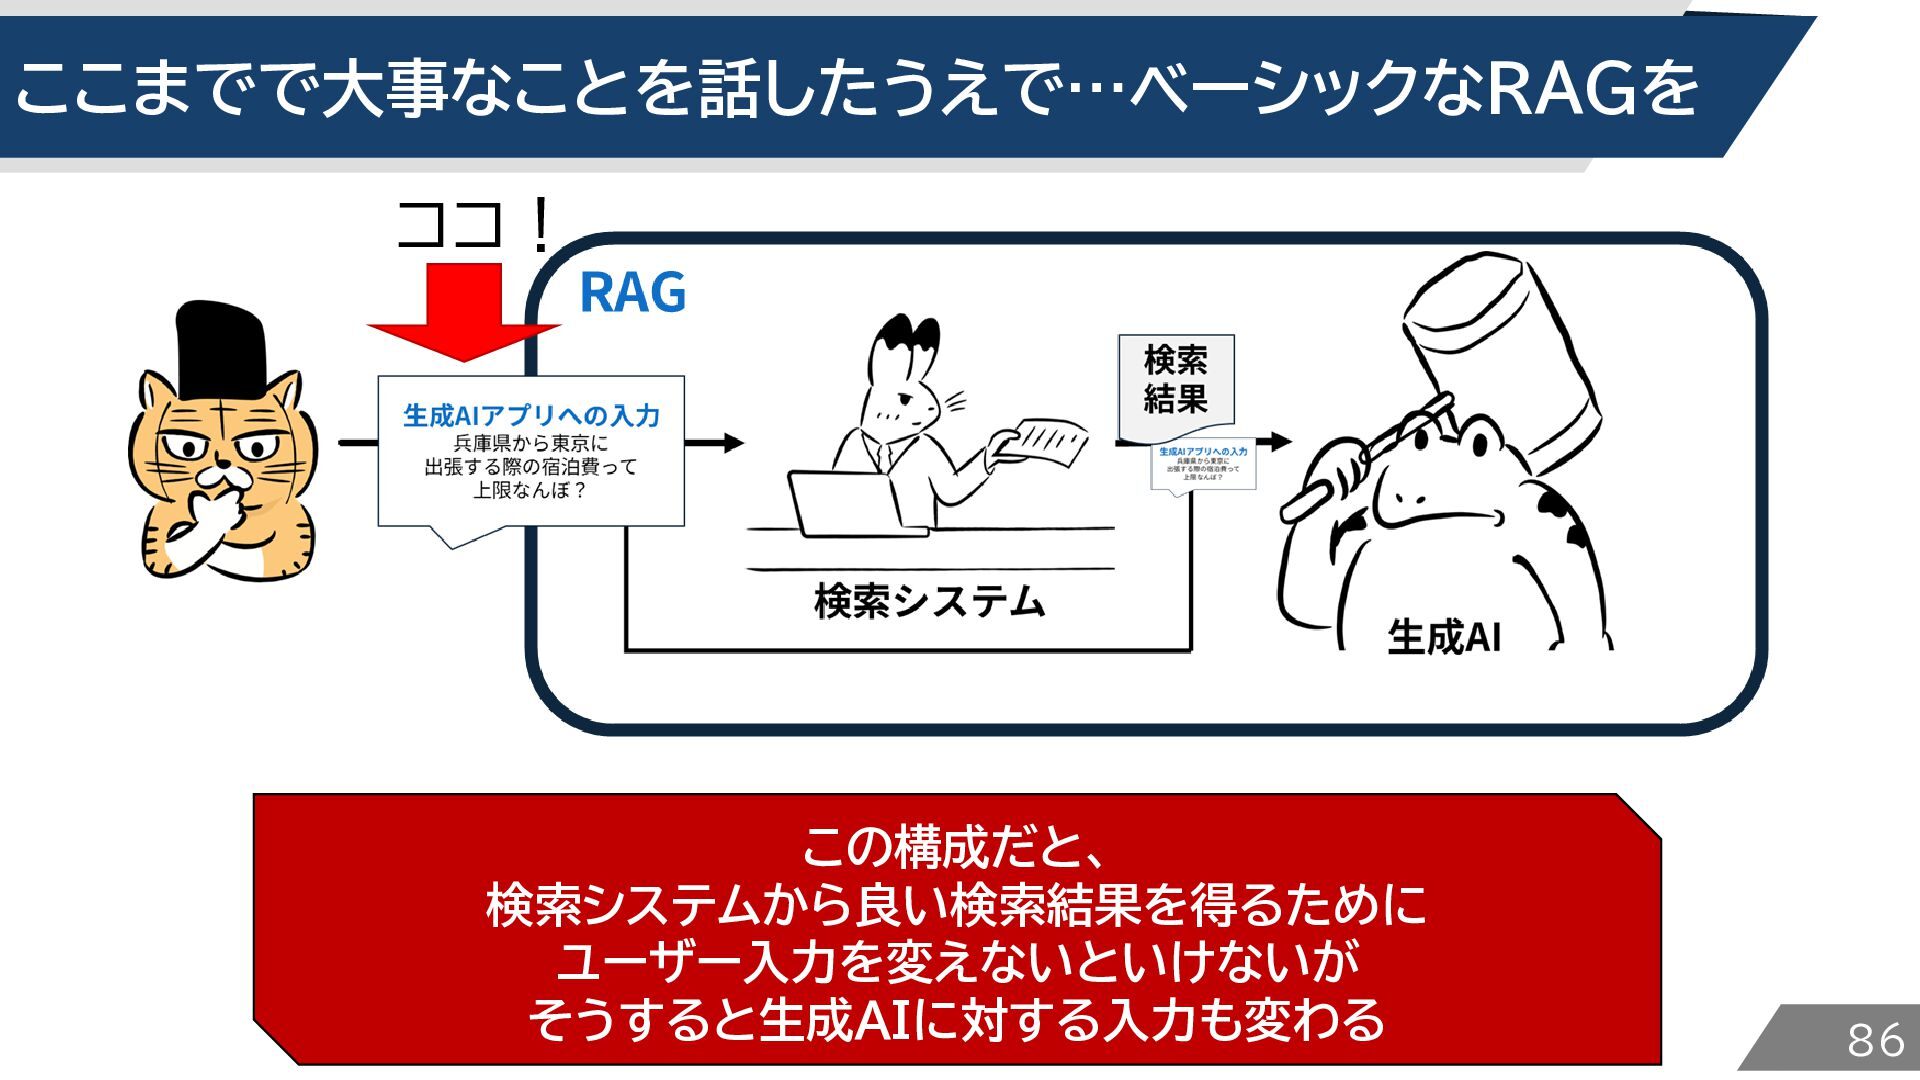
ここまでで大事なことを話したうえで…ベーシックなRAGを ココ! この構成だと、 検索システムから良い検索結果を得るために ユーザー入力を変えないといけないが そうすると生成AIに対する入力も変わる 86
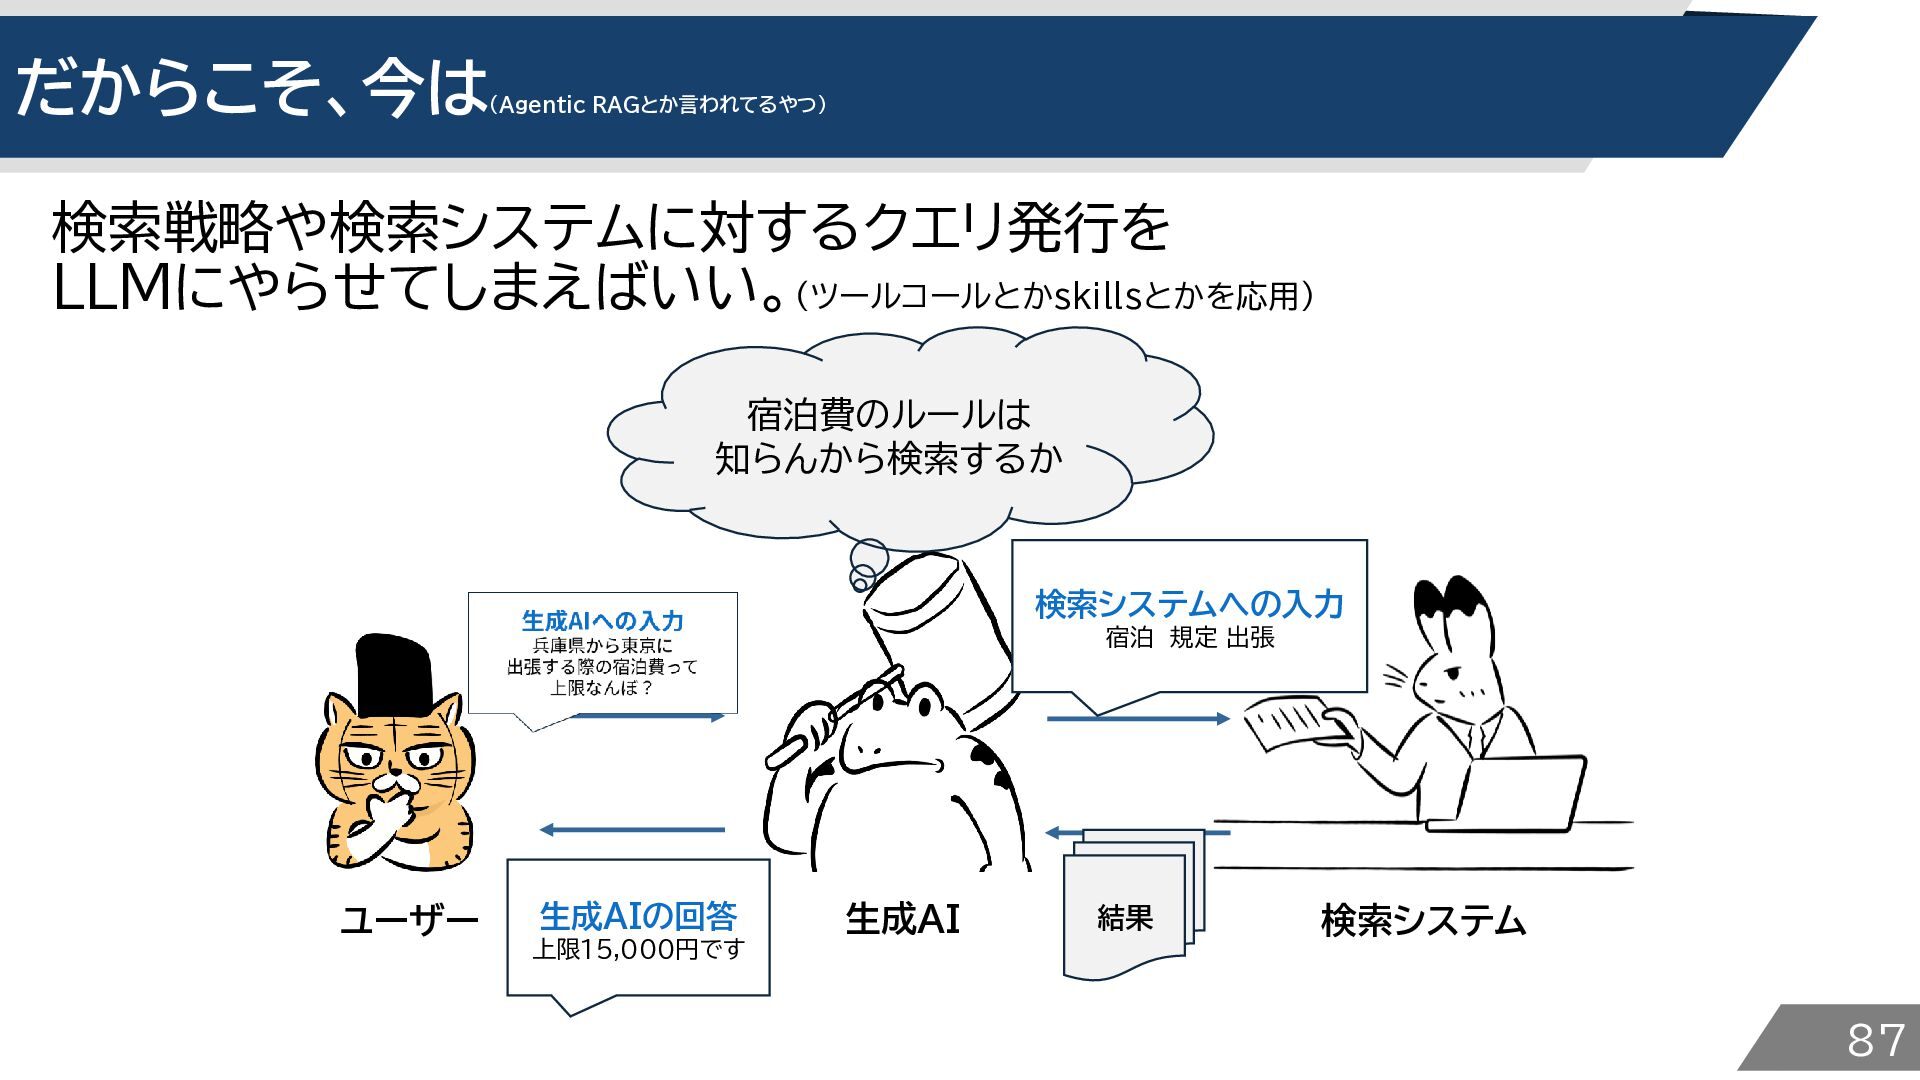
だからこそ、今は (Agentic RAGとか言われてるやつ) 検索戦略や検索システムに対するクエリ発行を LLMにやらせてしまえばいい。(ツールコールとかskillsとかを応用) 宿泊費のルールは 知らんから検索するか 検索システムへの入力 宿泊 規定
出張 ユーザー 生成AIの回答 上限15,000円です 生成AI 結果 検索システム 87
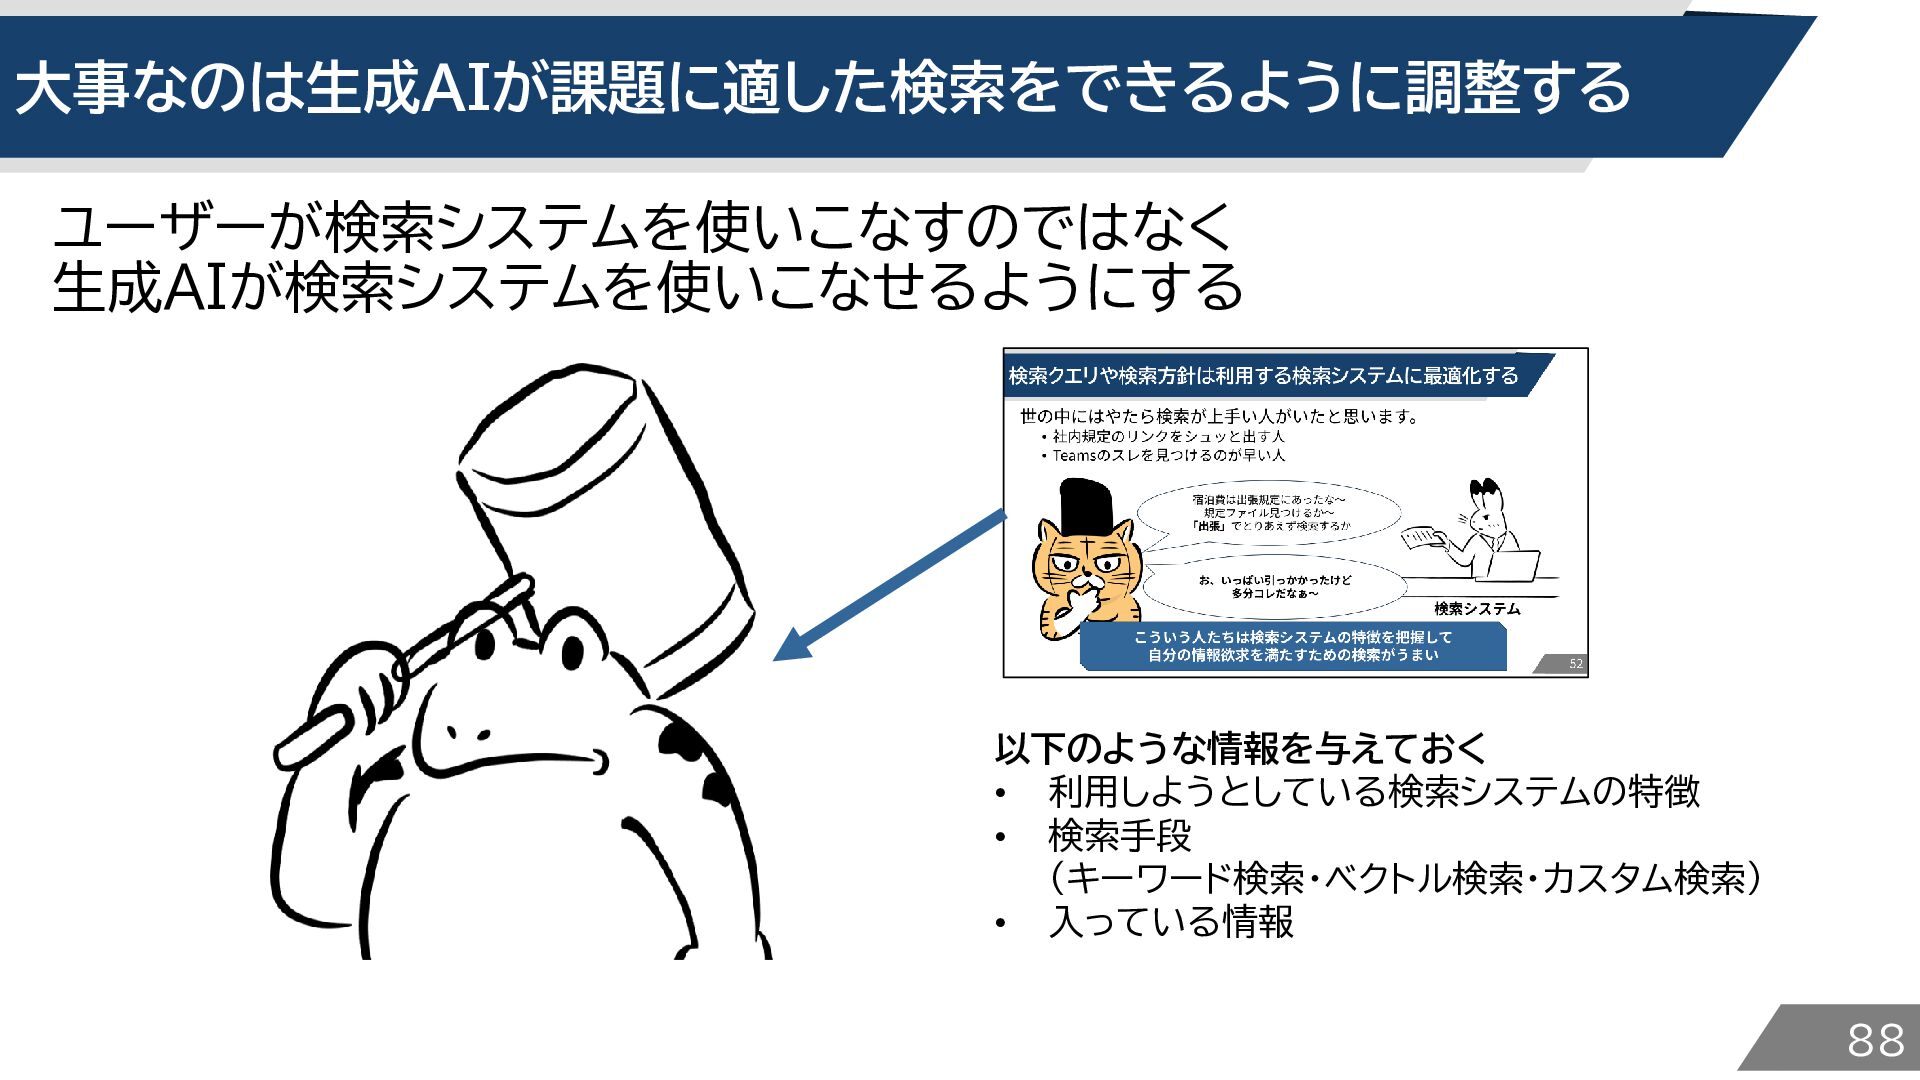
大事なのは生成AIが課題に適した検索をできるように調整する ユーザーが検索システムを使いこなすのではなく 生成AIが検索システムを使いこなせるようにする 以下のような情報を与えておく • 利用しようとしている検索システムの特徴 • 検索手段 (キーワード検索・ベクトル検索・カスタム検索) •
入っている情報 88
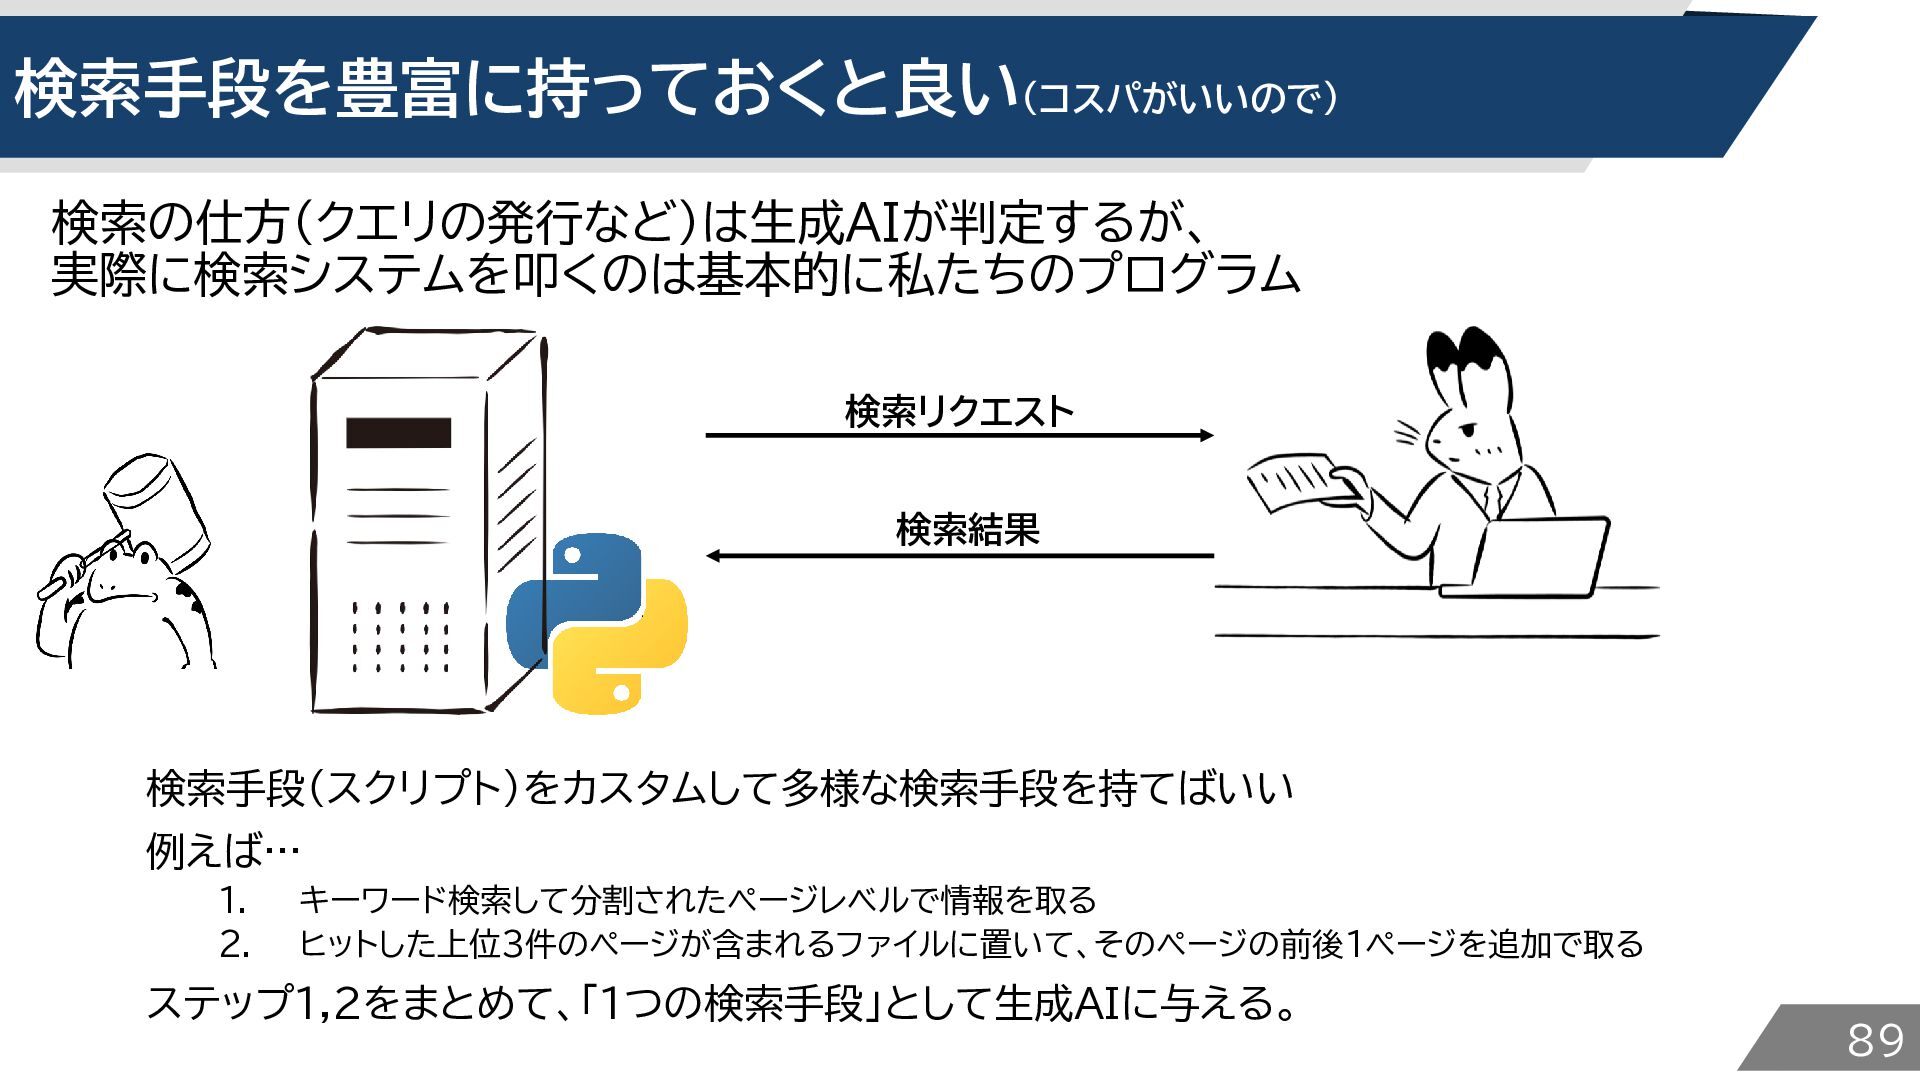
検索手段を豊富に持っておくと良い(コスパがいいので) 検索の仕方(クエリの発行など)は生成AIが判定するが、 実際に検索システムを叩くのは基本的に私たちのプログラム 検索リクエスト 検索結果 検索手段(スクリプト)をカスタムして多様な検索手段を持てばいい 例えば… 1. 2. キーワード検索して分割されたページレベルで情報を取る
ヒットした上位3件のページが含まれるファイルに置いて、そのページの前後1ページを追加で取る ステップ1,2をまとめて、「1つの検索手段」として生成AIに与える。 89
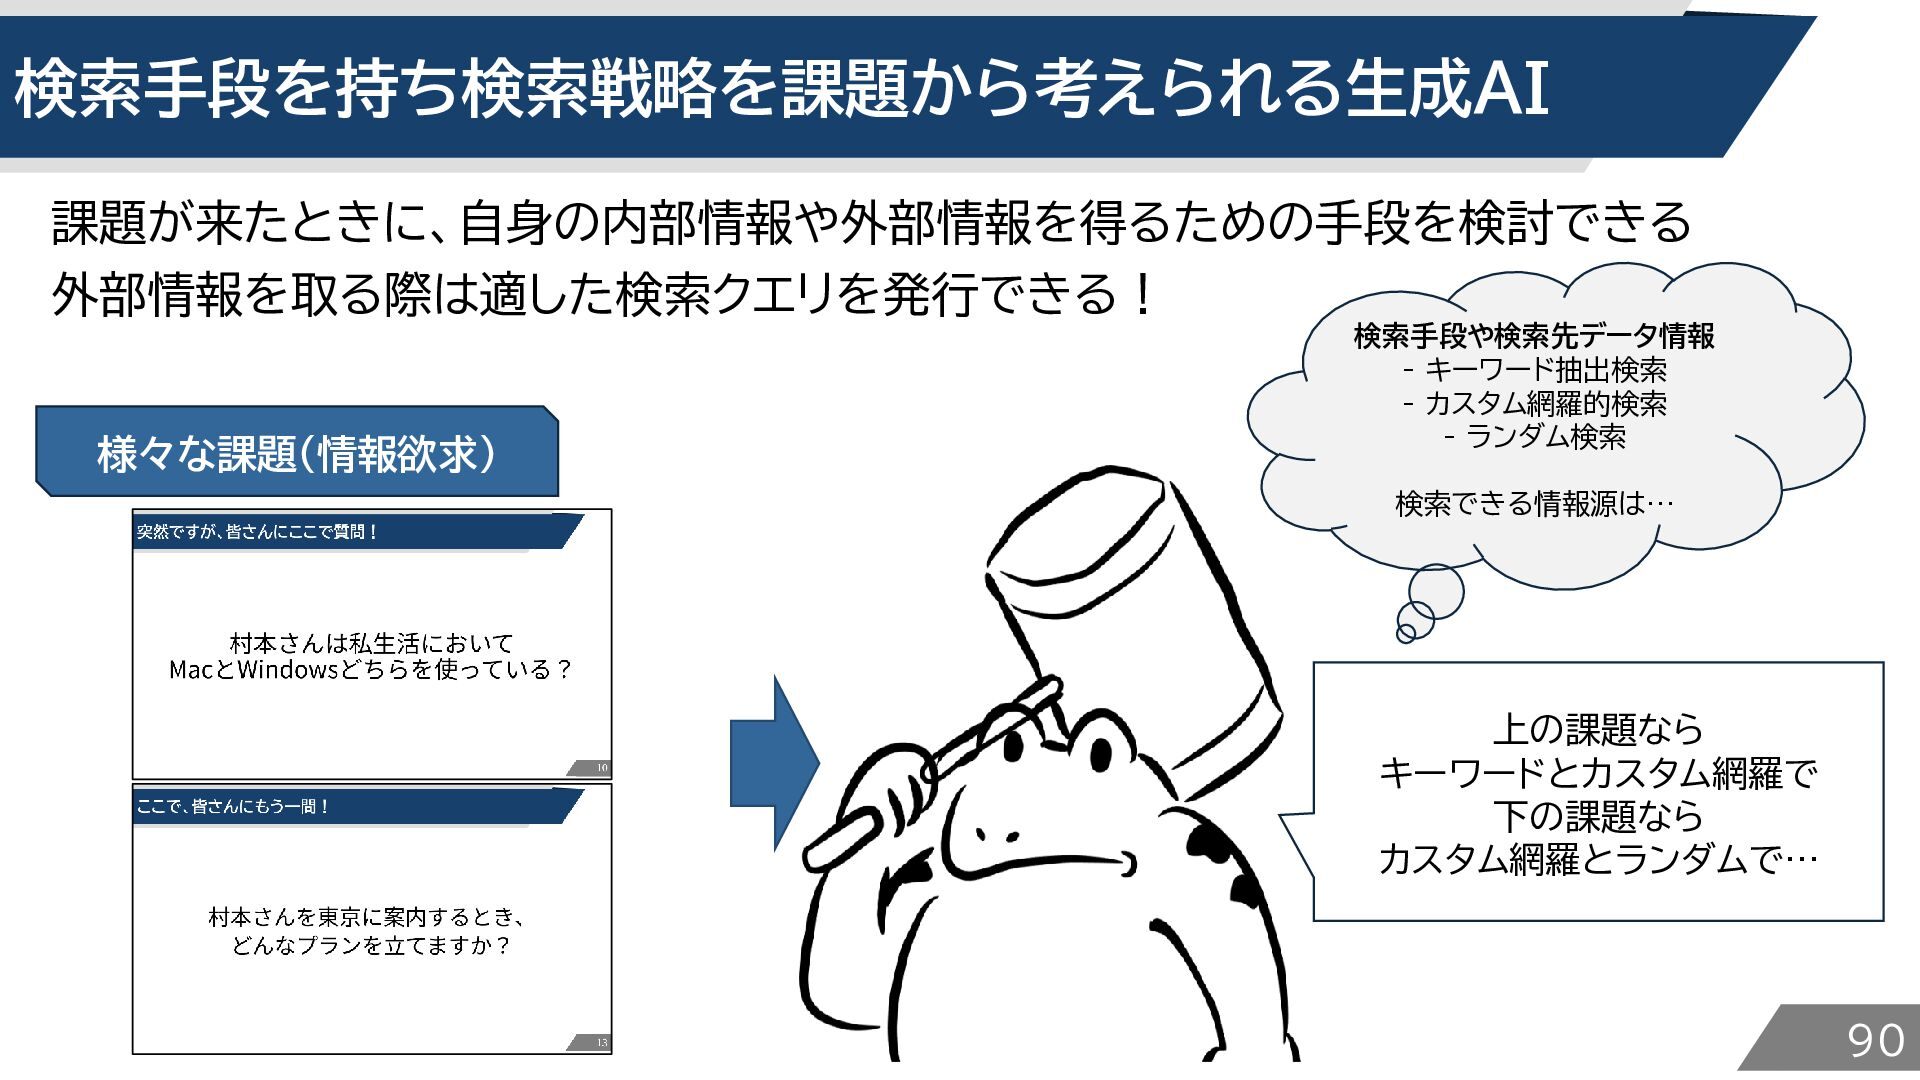
検索手段を持ち検索戦略を課題から考えられる生成AI 課題が来たときに、自身の内部情報や外部情報を得るための手段を検討できる 外部情報を取る際は適した検索クエリを発行できる! 様々な課題(情報欲求) 検索手段や検索先データ情報 - キーワード抽出検索 - カスタム網羅的検索 -
ランダム検索 検索できる情報源は… 上の課題なら キーワードとカスタム網羅で 下の課題なら カスタム網羅とランダムで… 90
とこんなふうに、色々やりようがあるのでした~ 覚えておきましょう! 1. 検索する部分の工夫(ケンサク) 2. 検索可能にする部分の工夫(コウチク) 3. 生成AIが回答するための情報を得る部分の工夫(エーアイ) 91


 isidaitc
 chack411
 takanorip
 vivion
 sansantech
 thkt
 maimyyym
 junkifurukawa
 yama3133
 toshimaru
 oikon48
 mochizuki875
 raspython3
 swwweet
 tapps
 jdejongh
 stephenakadiri
 aleyda
 maltzj
 kneath
 raygrieselhuber
 techseoconnect
 lara
 tenderlove
 axbom