Share
Embed

Transcript
88 slides
-
1部 1.Uplift Modelingとは 1-1. 目的 1-2. A/Bテスト 1-3. A/Bテストの問題点 1-4.
Uplift Modelingによる解決 1-5. 4つのセグメント 2.Uplift Modelingの具体的手法 2-1. 全体のフロー 2-2. モデル構築~結果解釈のフロー 2-3. 予測結果の解釈 2-4. 問題点 -
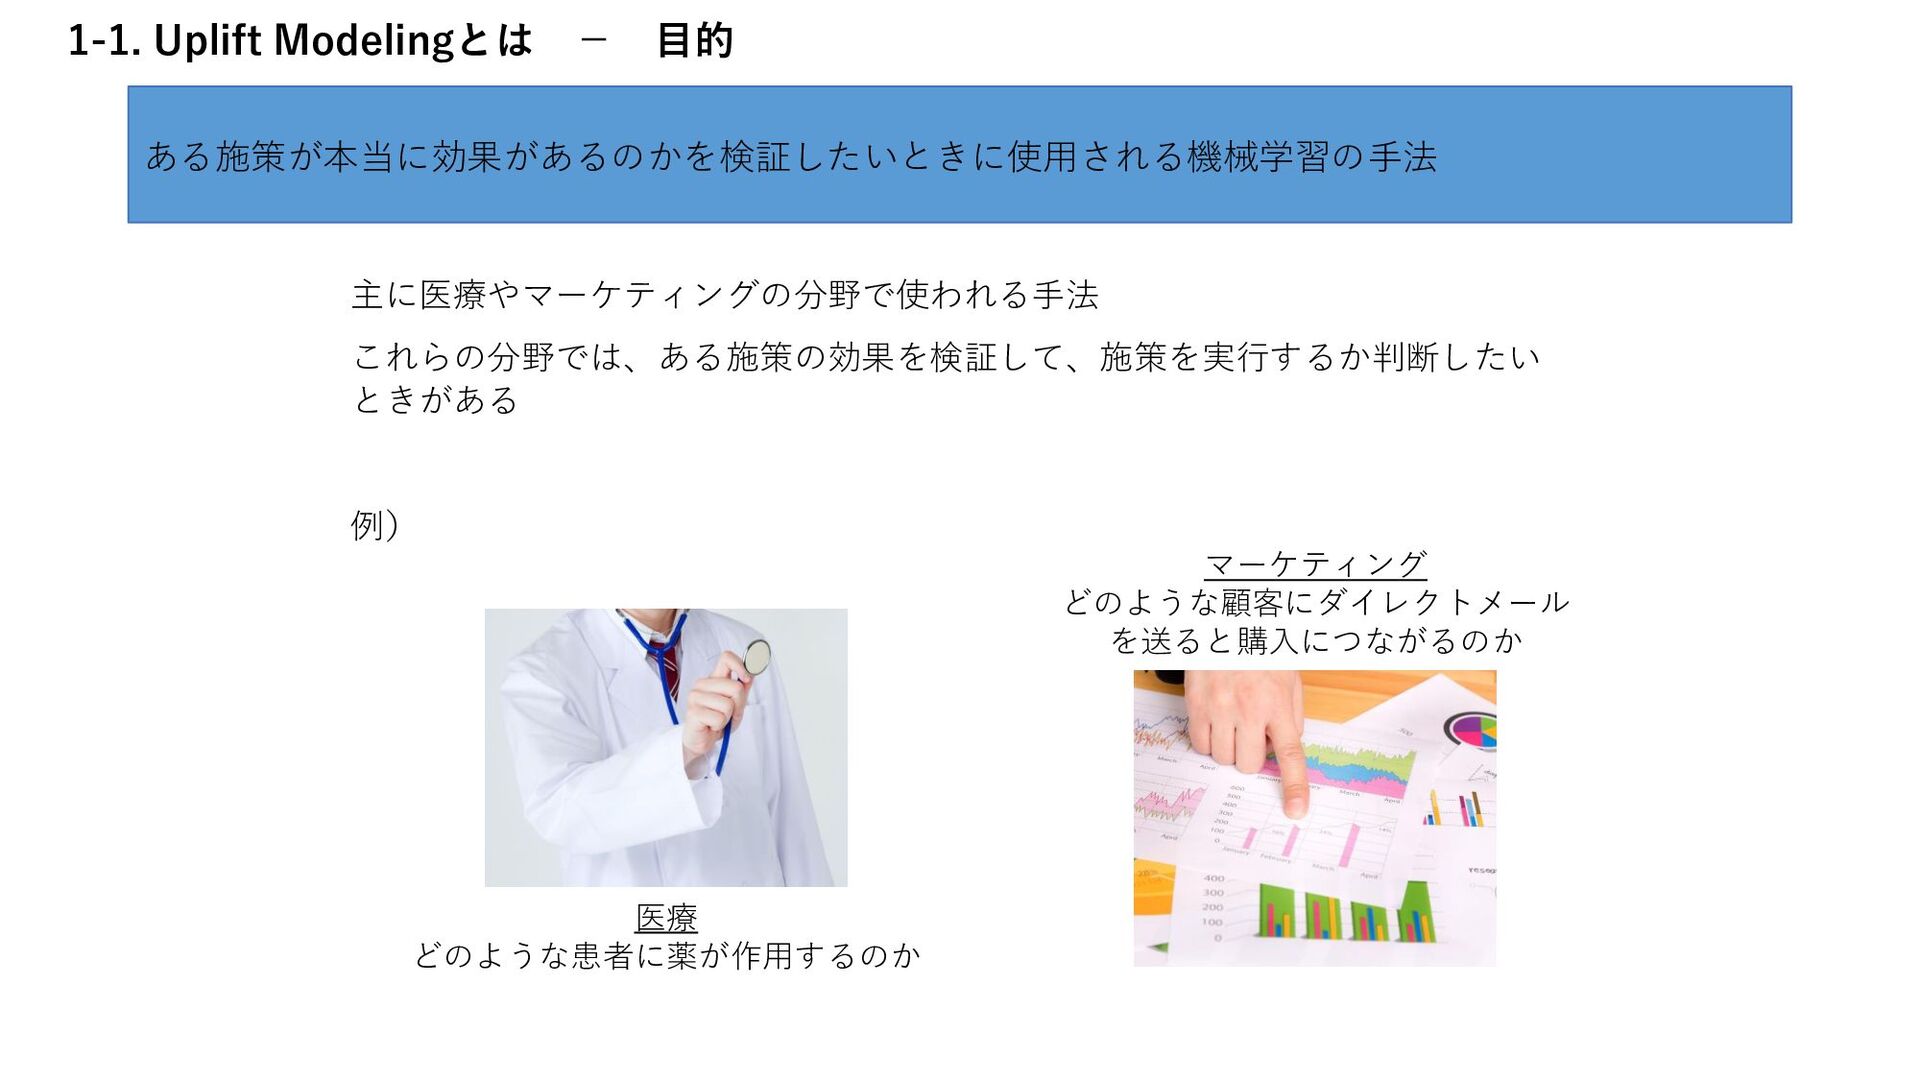
1-1. Uplift Modelingとは - 目的 ある施策が本当に効果があるのかを検証したいときに使用される機械学習の手法 主に医療やマーケティングの分野で使われる手法 これらの分野では、ある施策の効果を検証して、施策を実行するか判断したい ときがある 例)
医療 どのような患者に薬が作用するのか マーケティング どのような顧客にダイレクトメール を送ると購入につながるのか -
1-1. Uplift Modelingとは - 目的 ある施策が本当に効果があるのかを検証したいときに使用される機械学習の手法 <できること> 因果推論の観点では… 施策の本当の効果がわかる ビジネスの観点では…
施策を効率化し、施策の効果を増幅することができる 機械学習技術の観点では… データからパターンを見出し、ある特定のクラスタに分けることができる インプット/アウトプットの観点では… A/Bテストの結果をインプットとし、施策の対象候補を一部に絞った結果をアウトプットとな る -
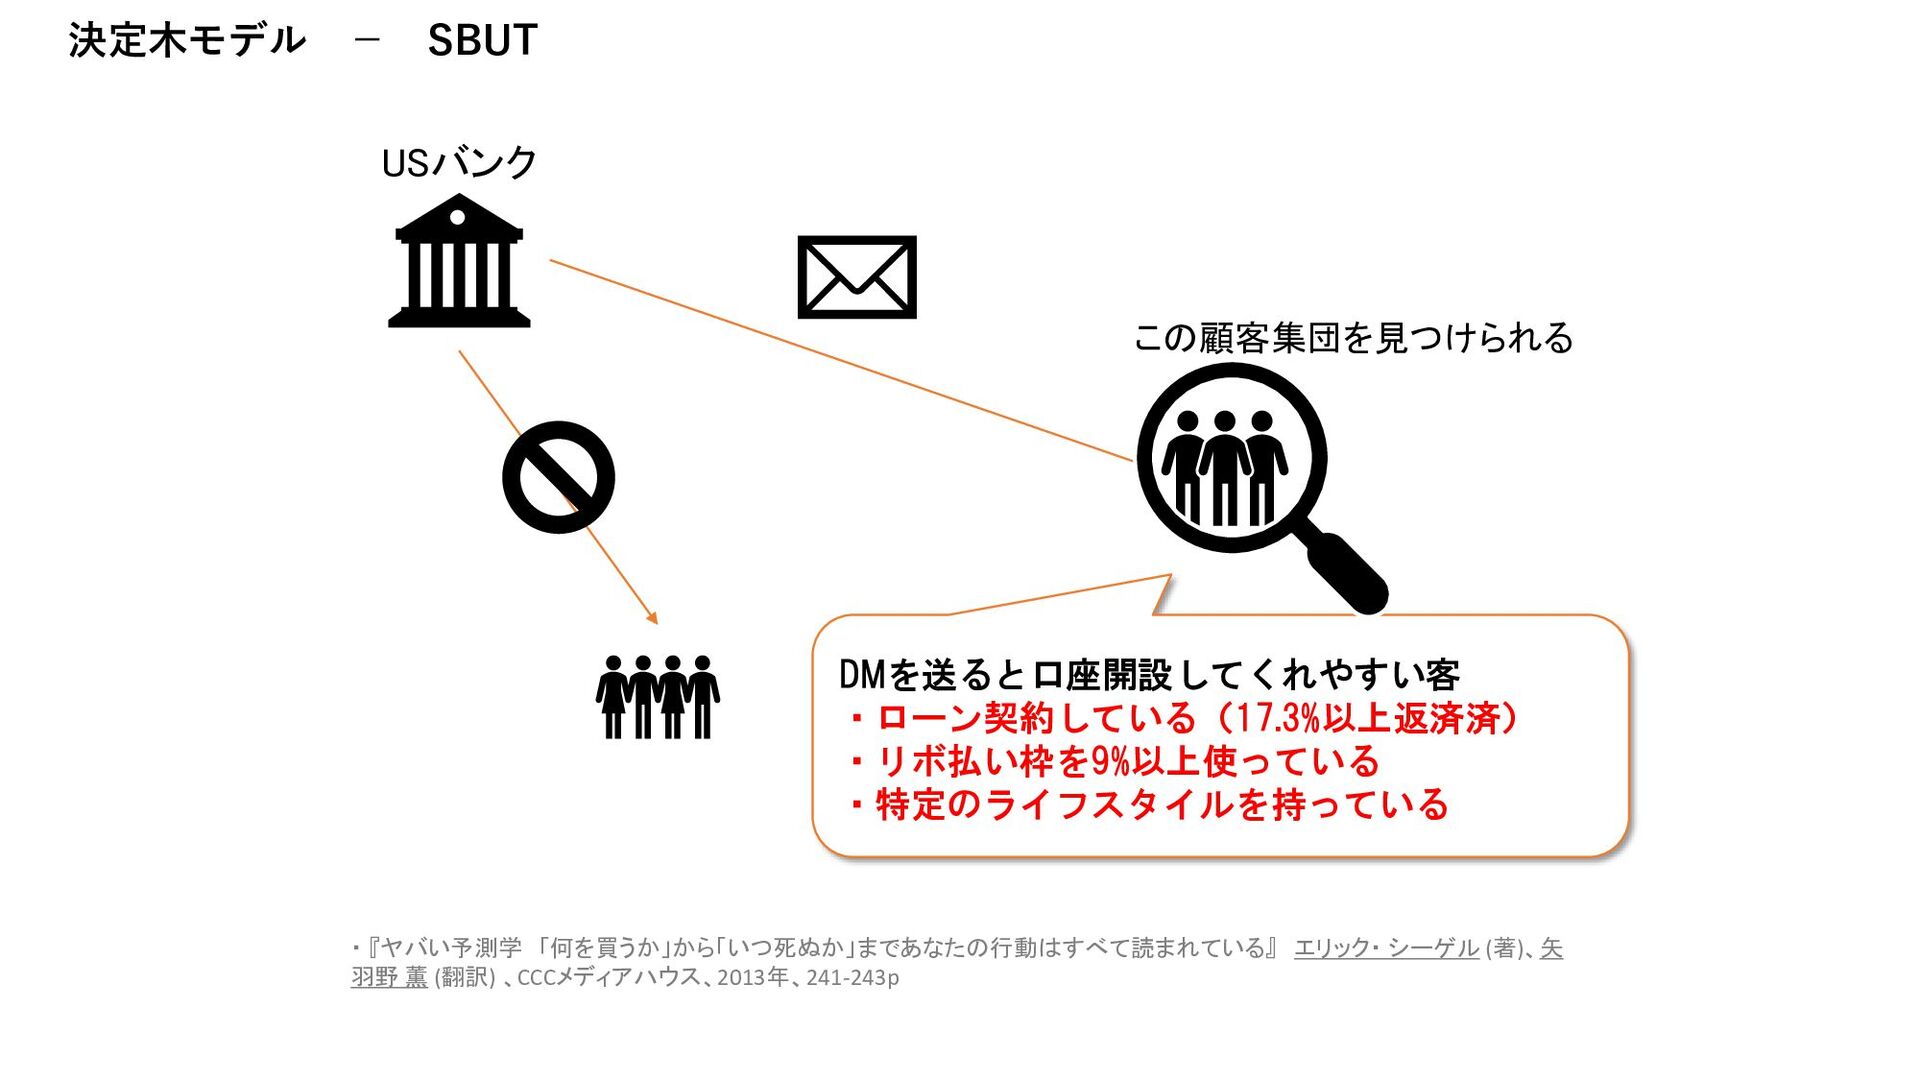
1-1. Uplift Modelingとは - 目的 【実例】 • USバンク アメリカ最大の地方銀行 <適用例>
• 施策:住宅担保ローン口座開設のダイレクトメールを既存の顧客に送る <実績> • 投資回収率(ROI)は以前の販促活動の5倍増(75%→400%) • 販促経費を40%削減 • 増収300%以上 ・ 『ヤバい予測学 「何を買うか」から「いつ死ぬか」まであなたの行動はすべて読まれている』 エリック・ シーゲル (著)、矢羽野 薫 (翻訳) 、CCCメディアハウス、2013年、241-243p -
1-1. Uplift Modelingとは - 目的 ・ 『ヤバい予測学 「何を買うか」から「いつ死ぬか」まであなたの行動はすべて読まれている』 エリック・ シーゲル
(著)、矢羽野 薫 (翻訳) 、CCCメディアハウス、2013年、241-243p DMを送ると口座開設してくれやすい客 ・ローン契約している(17.3%以上返済済) ・リボ払い枠を9%以上使っている ・特定のライフスタイルを持っている USバンク この顧客集団を見つけられる -
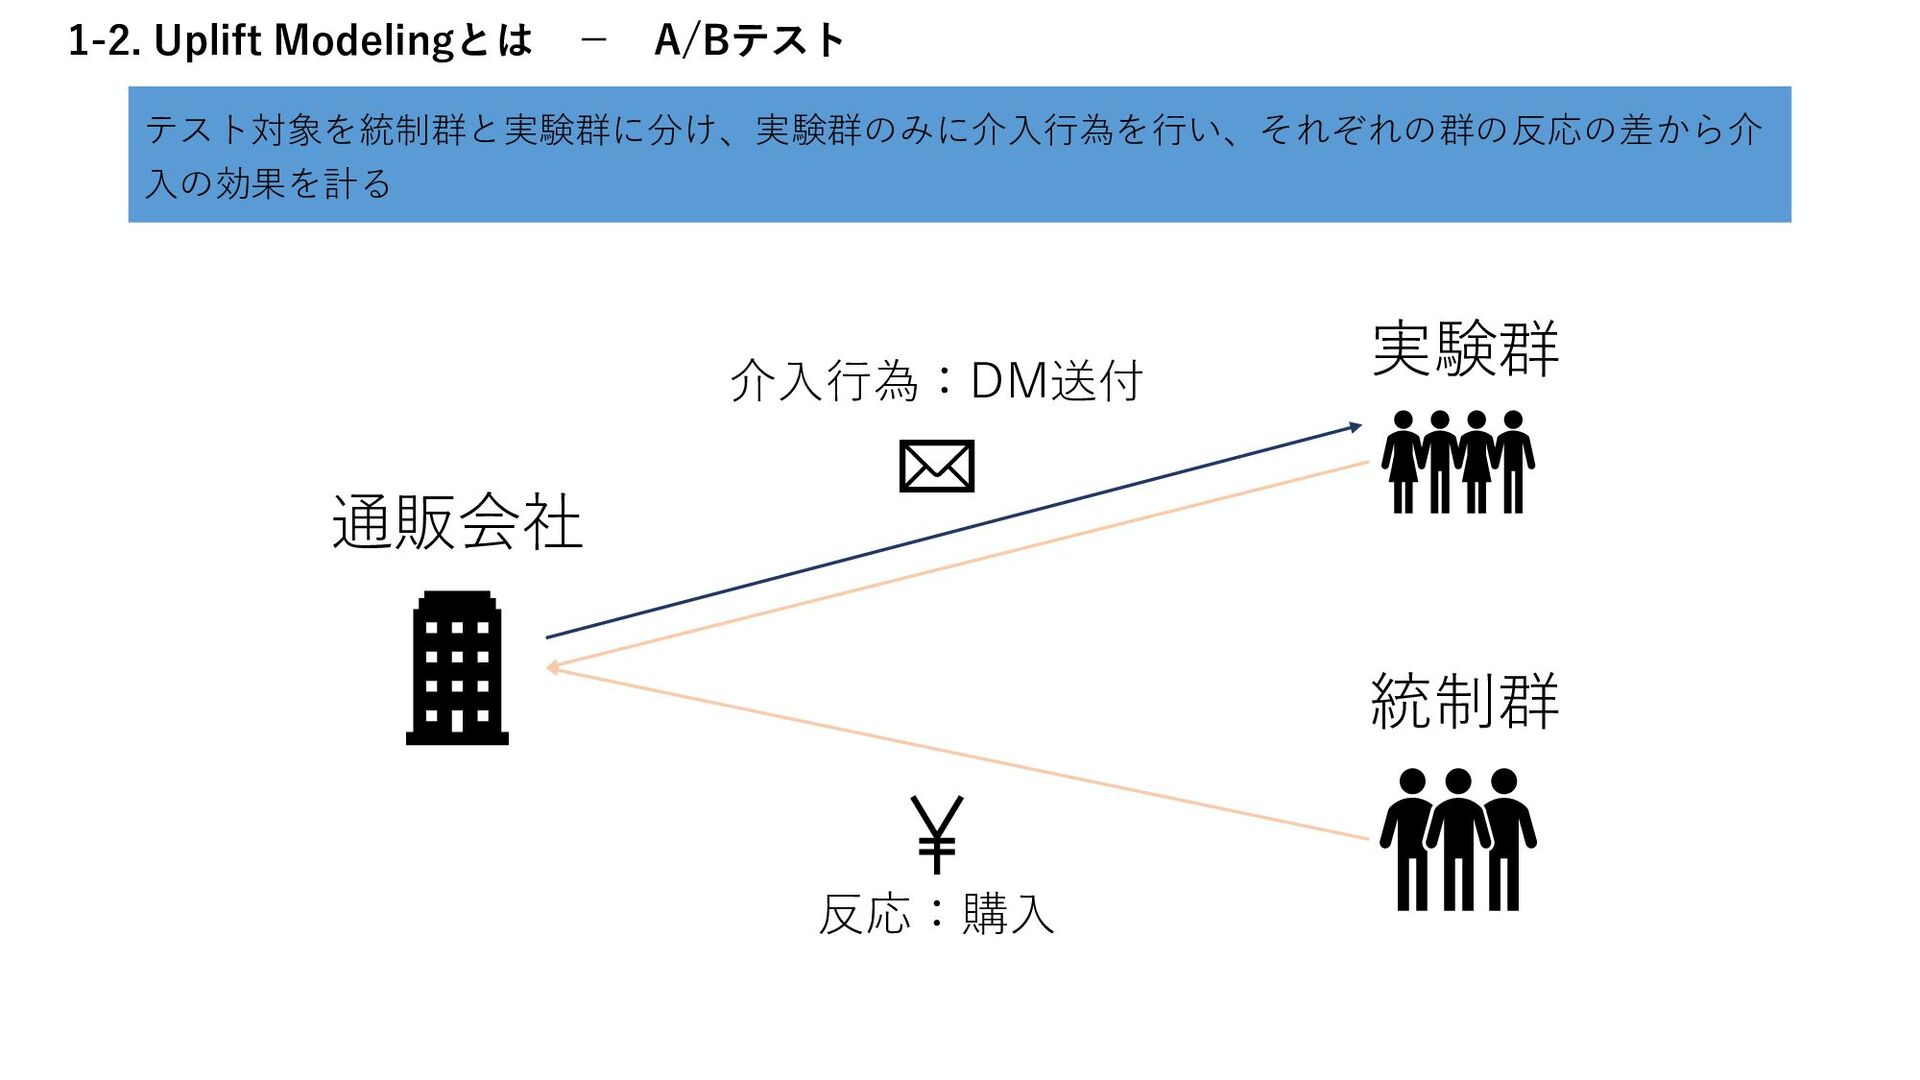
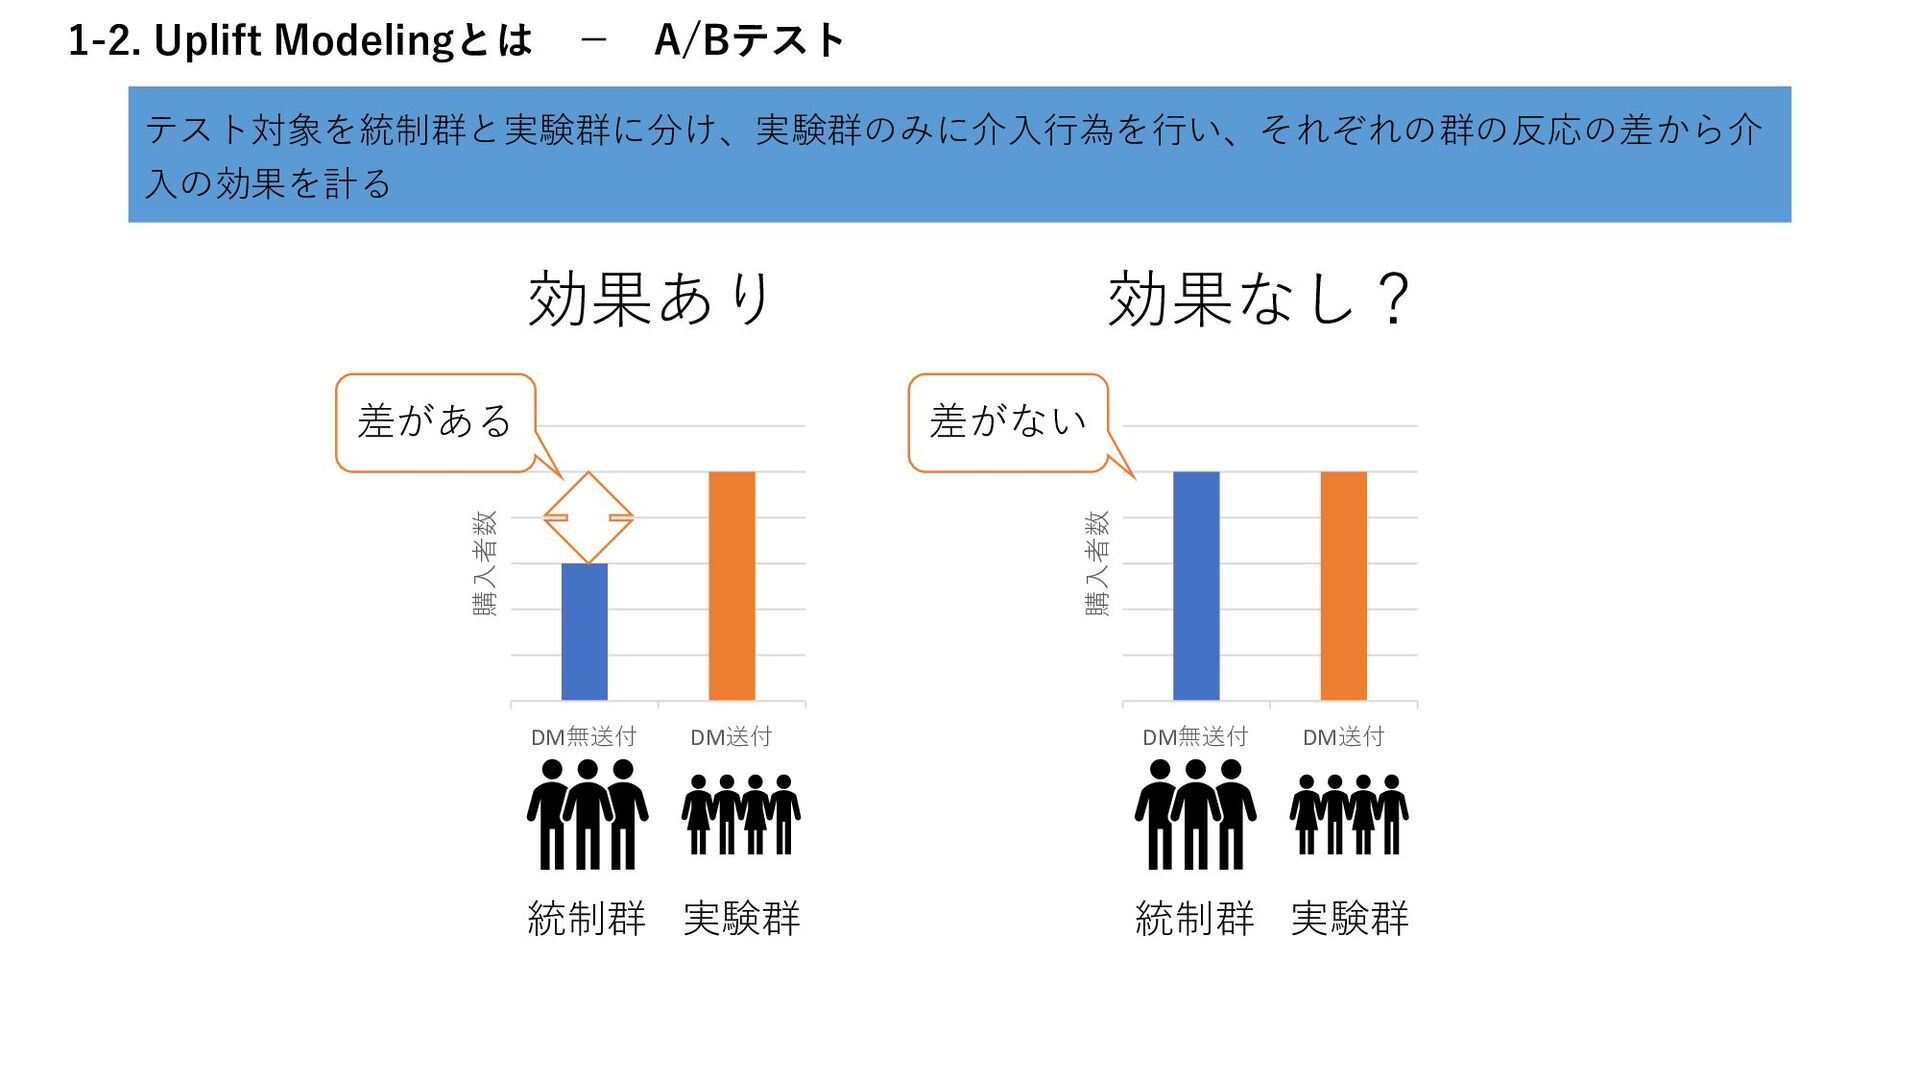
1-2. Uplift Modelingとは - A/Bテスト テスト対象を統制群と実験群に分け、実験群のみに介入行為を行い、それぞれの群の反応の差から介 入の効果を計る 例) ある通販会社で、商品Aを売りたいときに、DMを送って販促を行いたい このとき、A/Bテストを用いるとすると…
介入行為:DMを送ること 反応 :商品Aを買うこと(コンバージョン) 実験群 :DMを送る顧客 統制群 :DMを送らない顧客 効果 :反応の差=商品Aを買う顧客がどれだけ増えたか -
1-2. Uplift Modelingとは - A/Bテスト テスト対象を統制群と実験群に分け、実験群のみに介入行為を行い、それぞれの群の反応の差から介 入の効果を計る 統制群 実験群 DM無送付
DM送付 購入者数 統制群 実験群 DM無送付 DM送付 購入者数 差がある 効果あり 効果なし? 差がない -
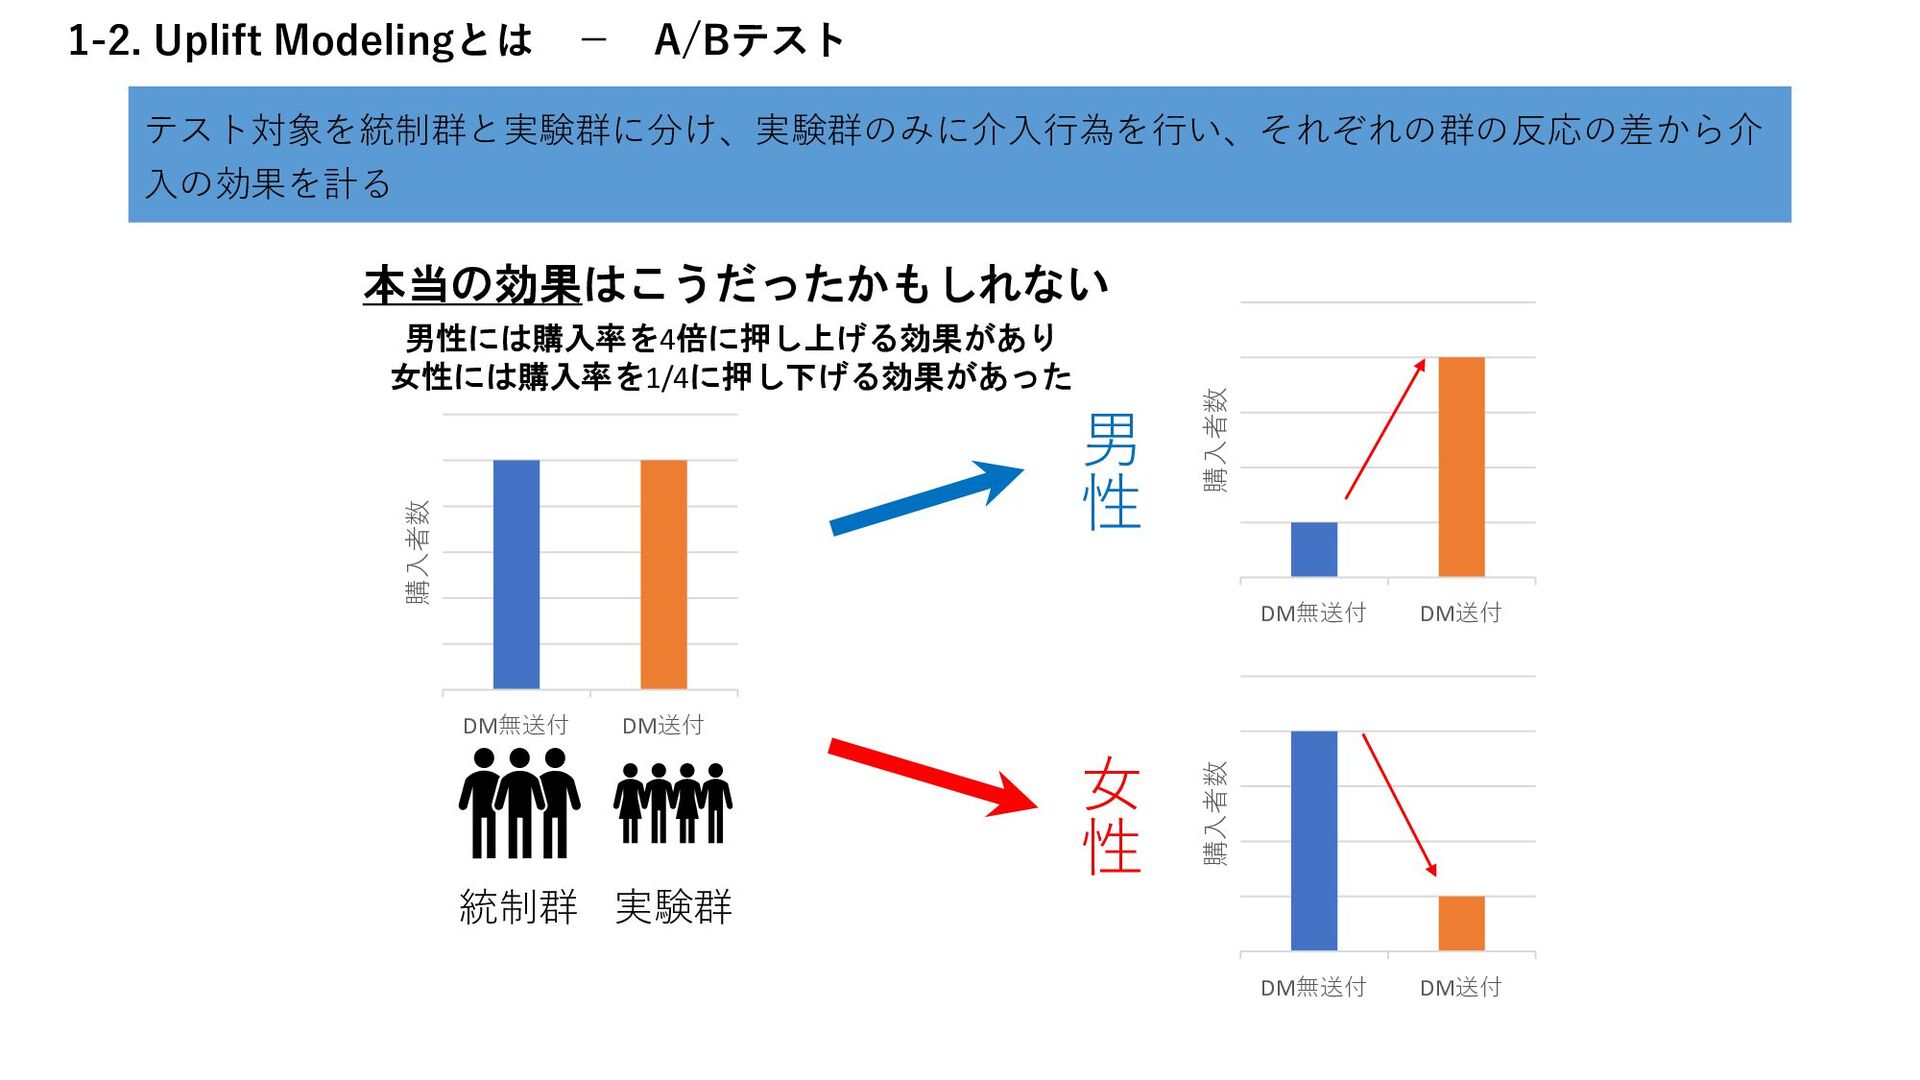
1-2. Uplift Modelingとは - A/Bテスト テスト対象を統制群と実験群に分け、実験群のみに介入行為を行い、それぞれの群の反応の差から介 入の効果を計る 統制群 実験群 DM無送付
DM送付 購入者数 DM無送付 DM送付 購入者数 DM無送付 DM送付 購入者数 男 性 女 性 本当の効果はこうだったかもしれない 男性には購入率を4倍に押し上げる効果があり 女性には購入率を1/4に押し下げる効果があった -
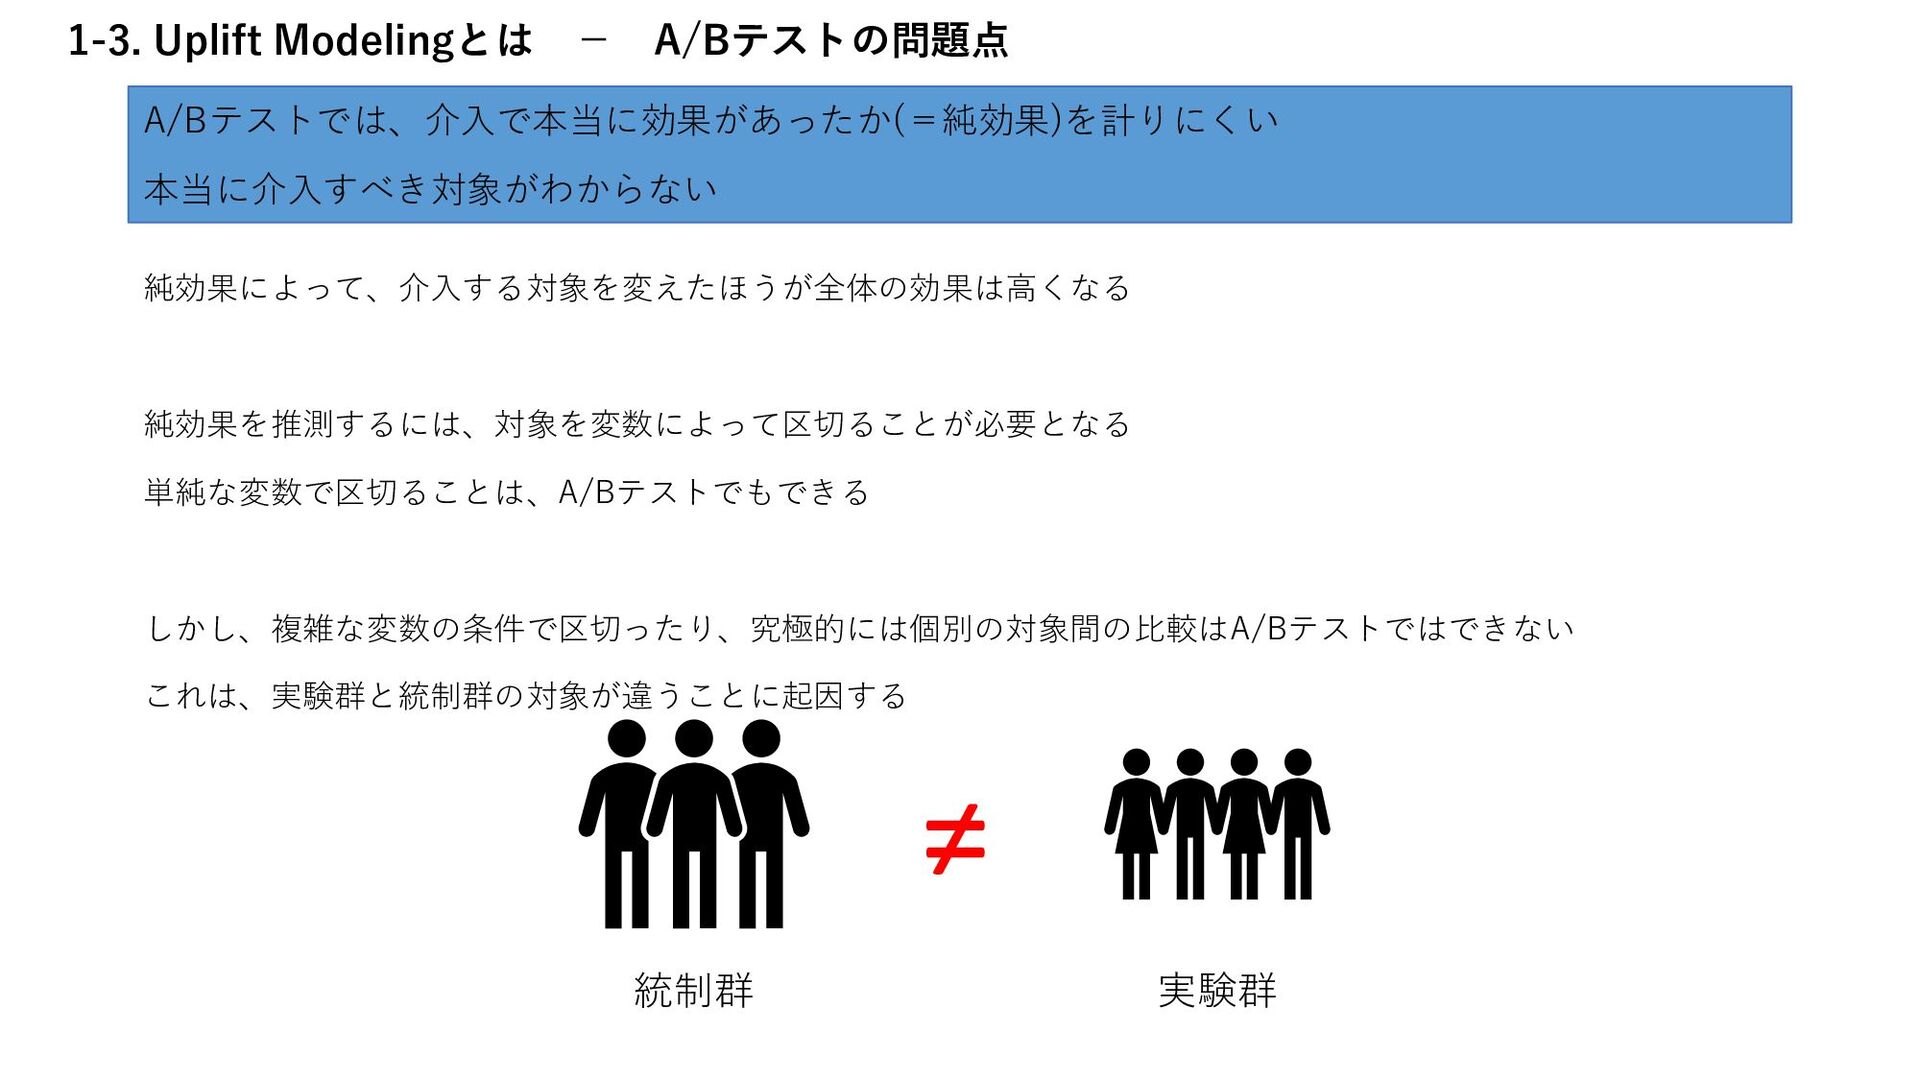
1-3. Uplift Modelingとは - A/Bテストの問題点 A/Bテストでは、介入で本当に効果があったか(=純効果)を計りにくい 本当に介入すべき対象がわからない 純効果によって、介入する対象を変えたほうが全体の効果は高くなる 純効果を推測するには、対象を変数によって区切ることが必要となる 単純な変数で区切ることは、A/Bテストでもできる
しかし、複雑な変数の条件で区切ったり、究極的には個別の対象間の比較はA/Bテストではできない これは、実験群と統制群の対象が違うことに起因する 統制群 実験群 ≠ -
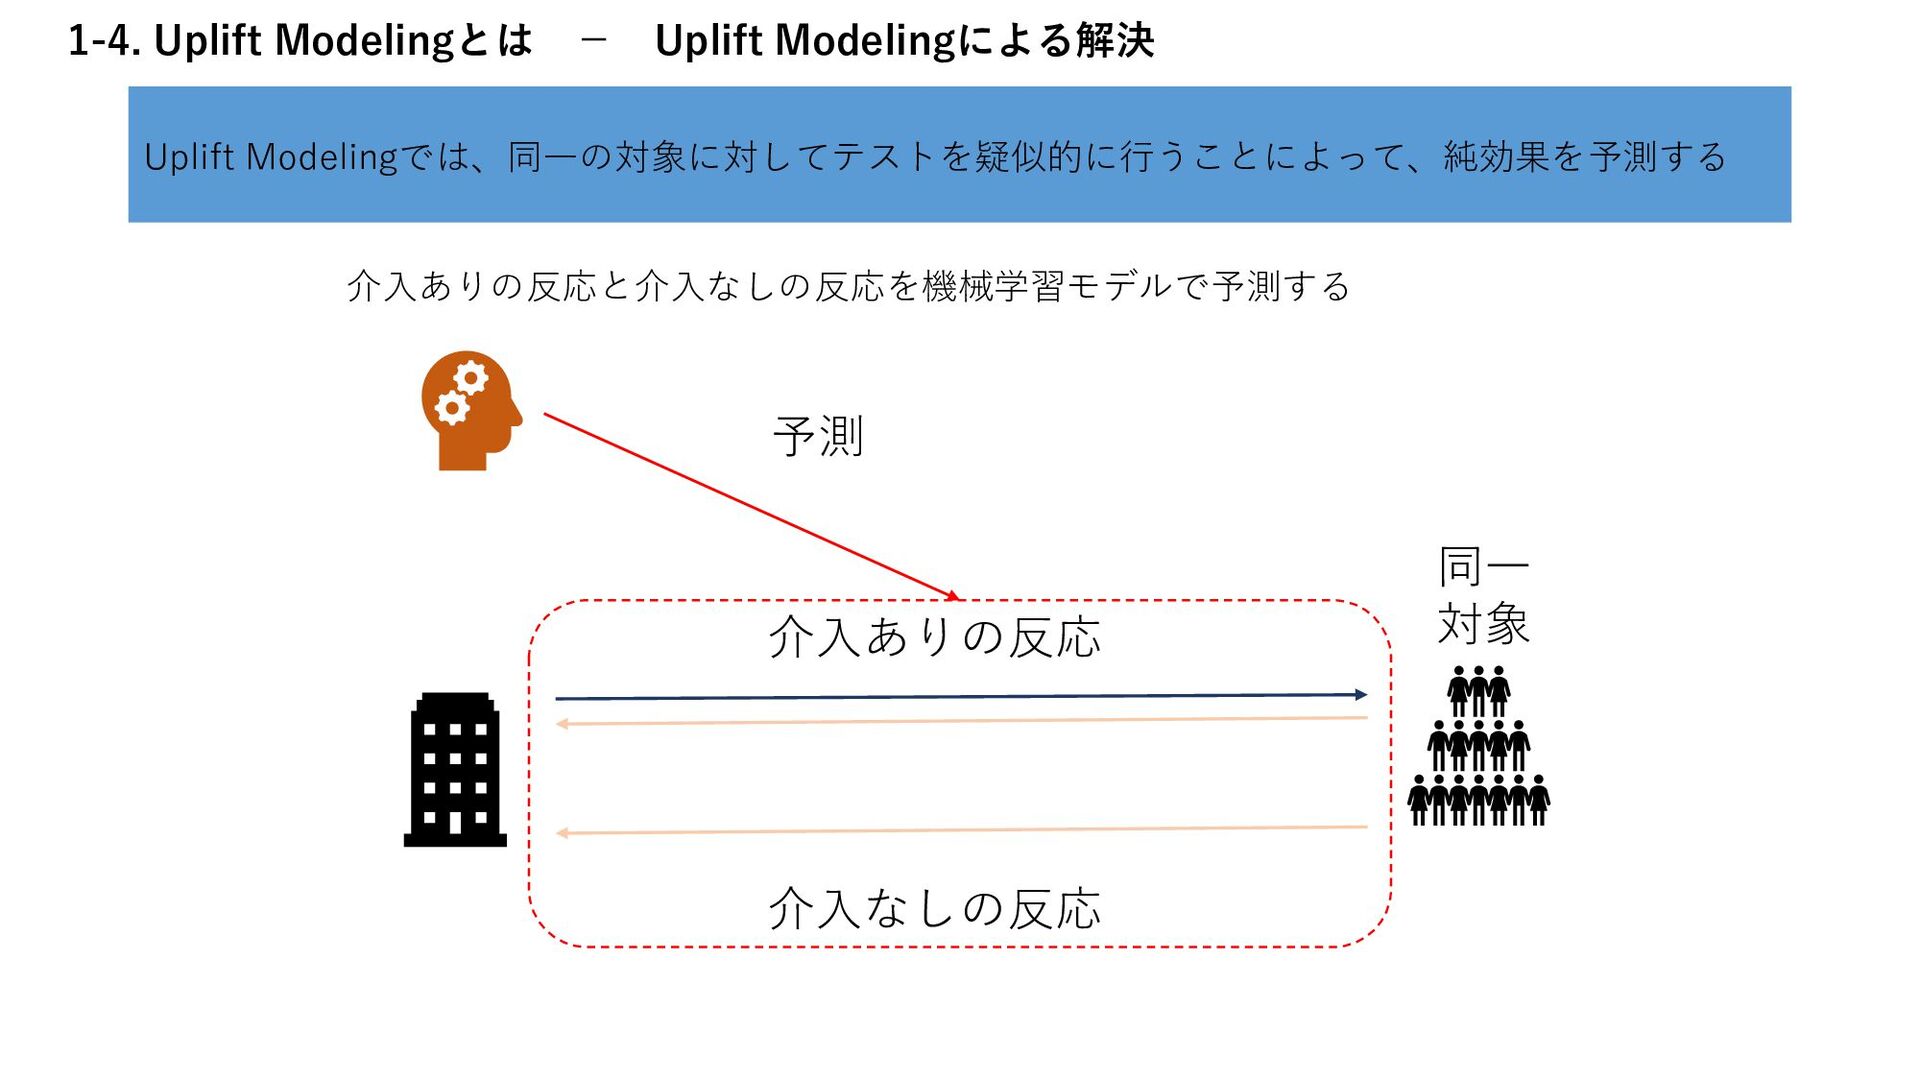
1-4. Uplift Modelingとは - Uplift Modelingによる解決 Uplift Modelingでは、同一の対象に対してテストを疑似的に行うことによって、純効果を予測する 介入ありの反応 介入なしの反応
介入ありの反応と介入なしの反応を機械学習モデルで予測する 同一 対象 予測 -
1-4. Uplift Modelingとは - Uplift Modelingによる解決 Uplift Modelingでは、同一の対象に対してテストを疑似的に行うことによって、純効果を予測する 同 一
対 象 に 対 し て テ ス ト で き る 対 象 間 の 比 較 が で き る 変 数 に 対 す る 反 応 が 評 価 で き る 純 効 果 が わ か る -
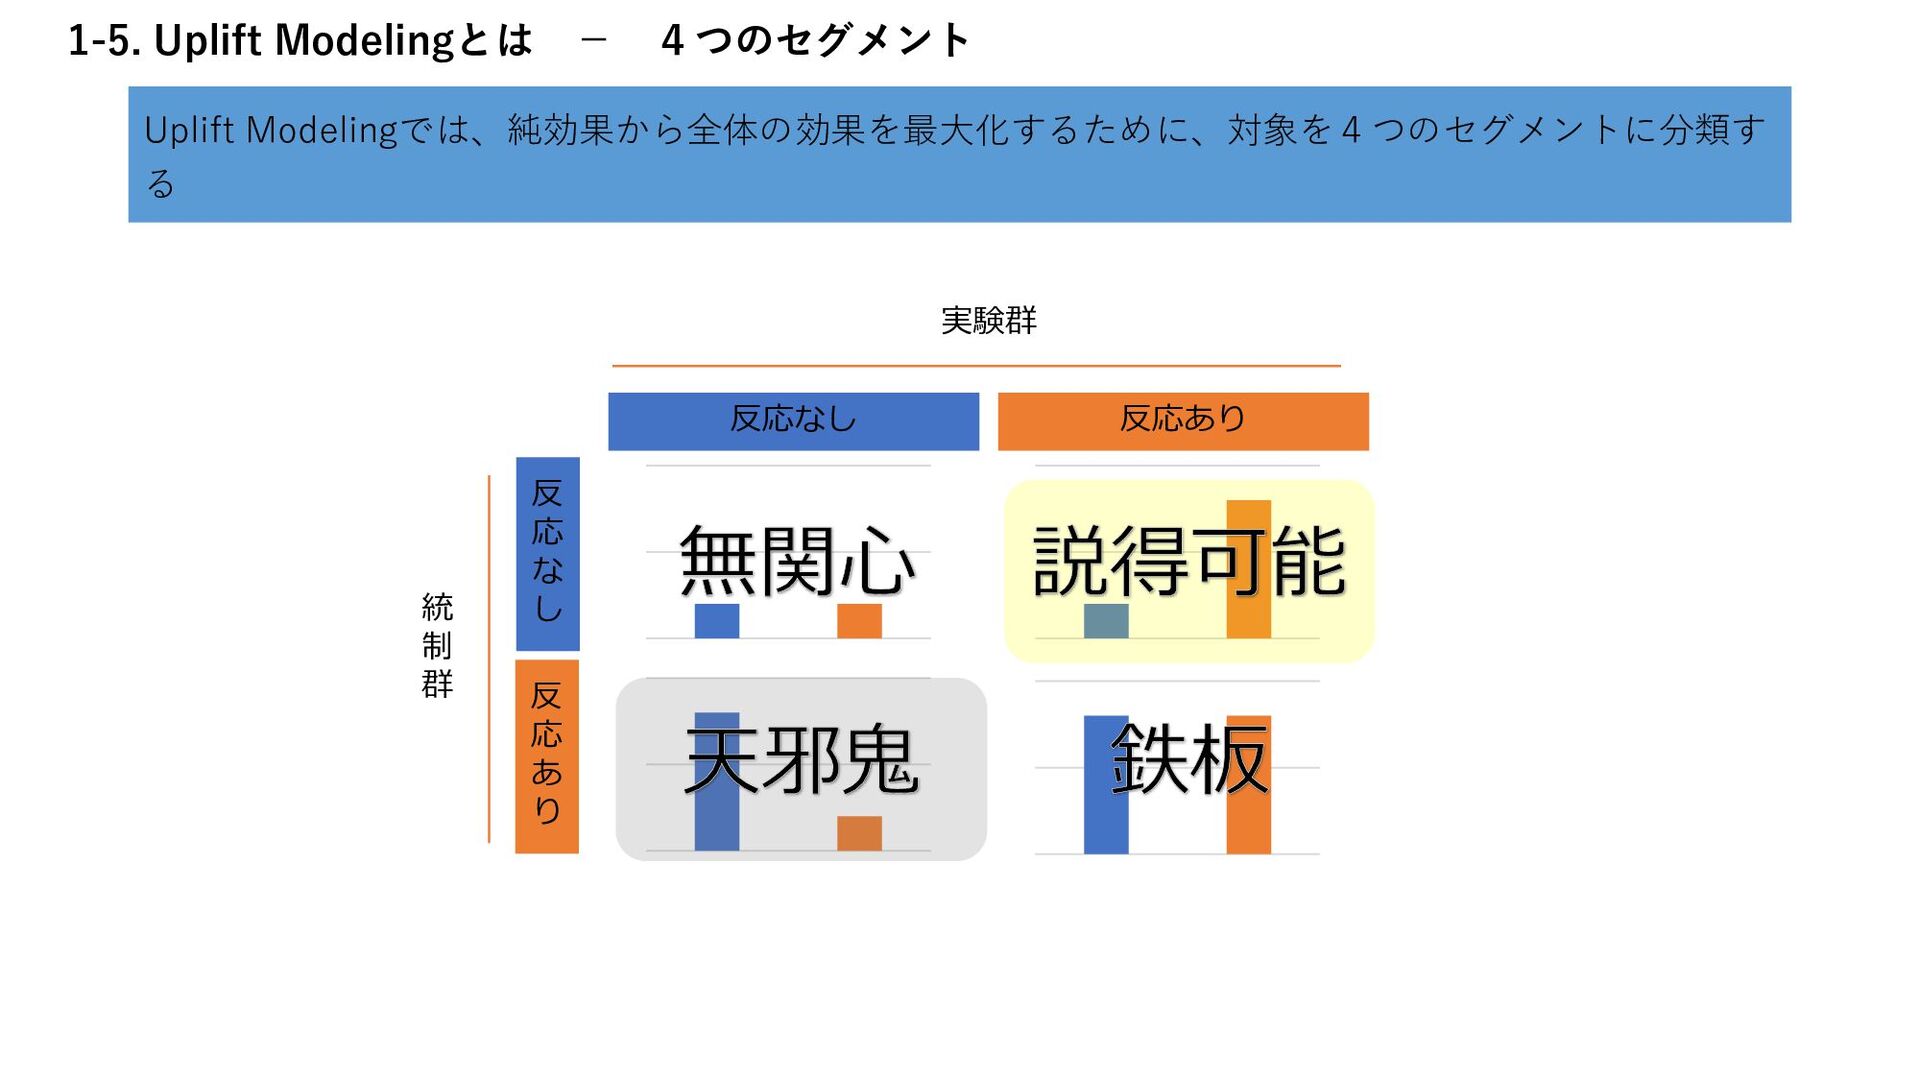
1-5. Uplift Modelingとは - 4つのセグメント Uplift Modelingでは、純効果から全体の効果を最大化するために、対象を4つのセグメントに分類す る 反 応
な し 統 制 群 反 応 あ り 実験群 反応なし 反応あり -
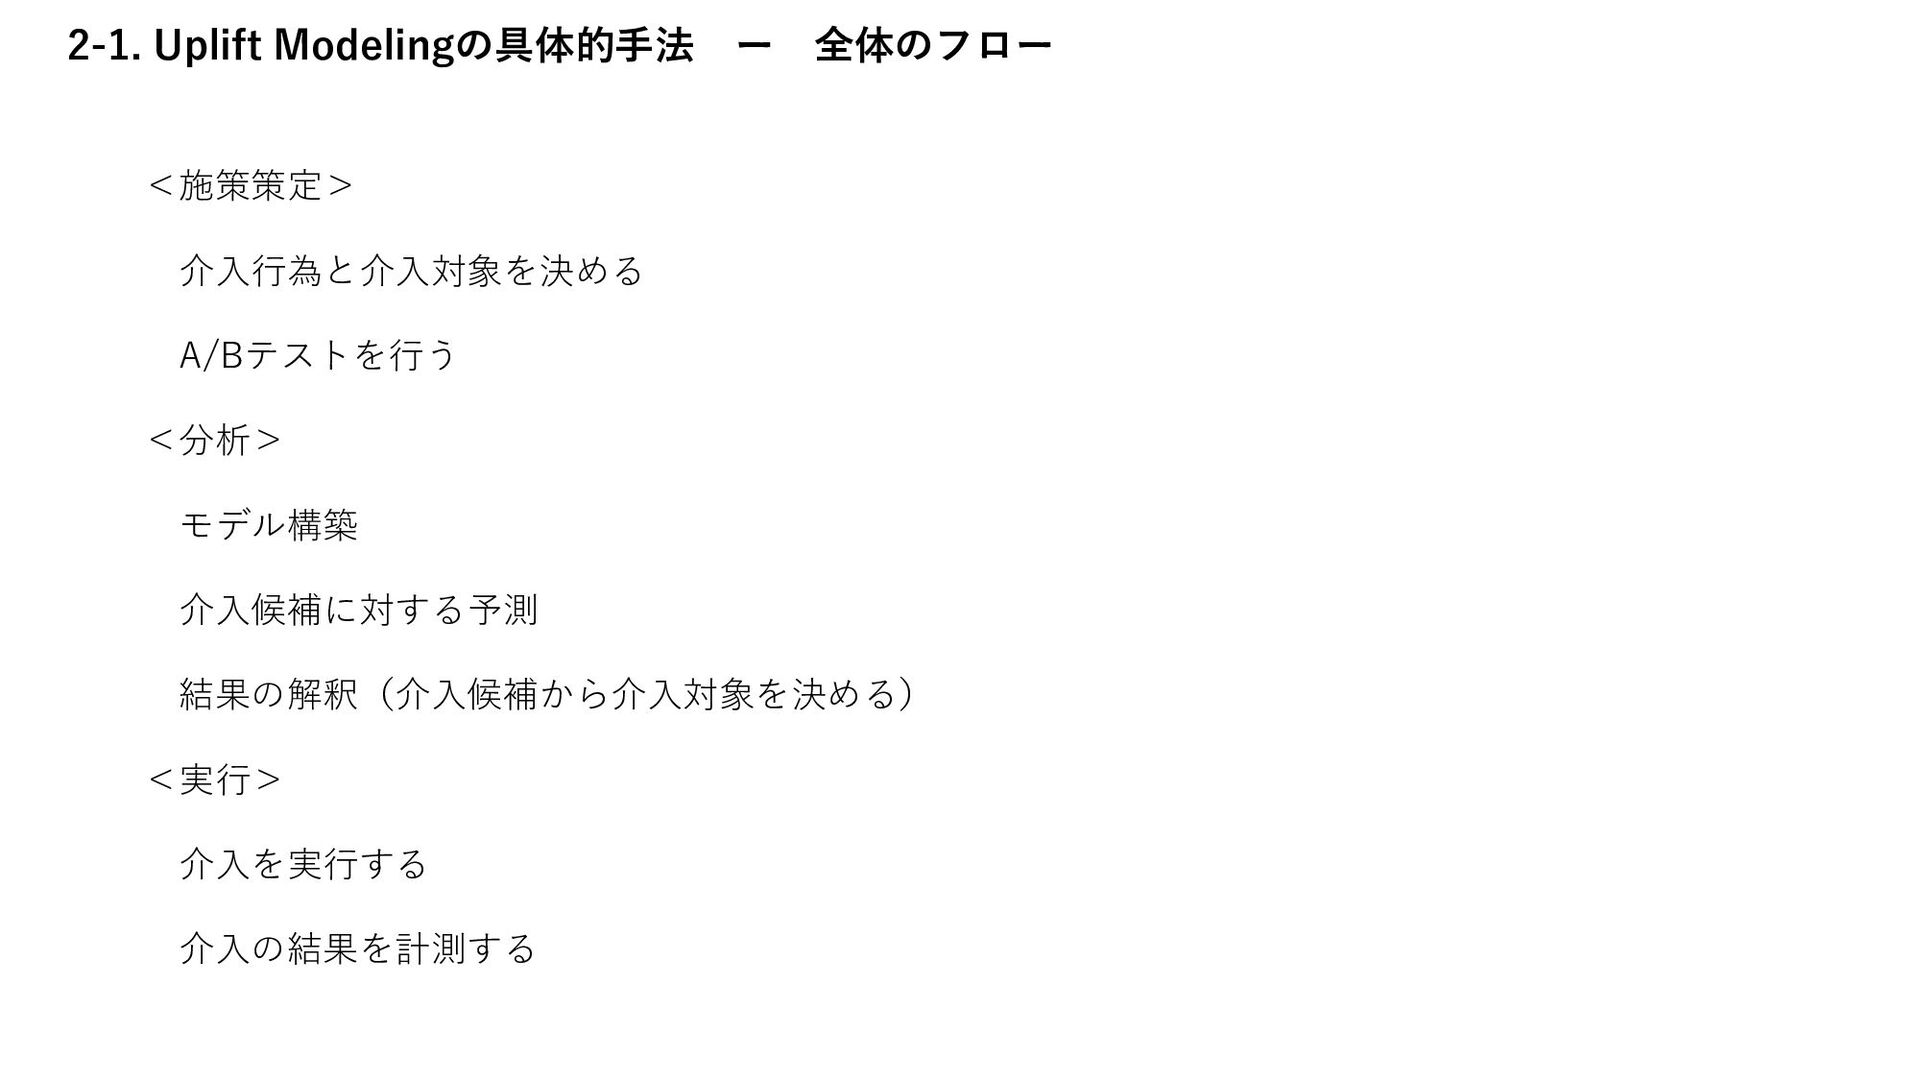
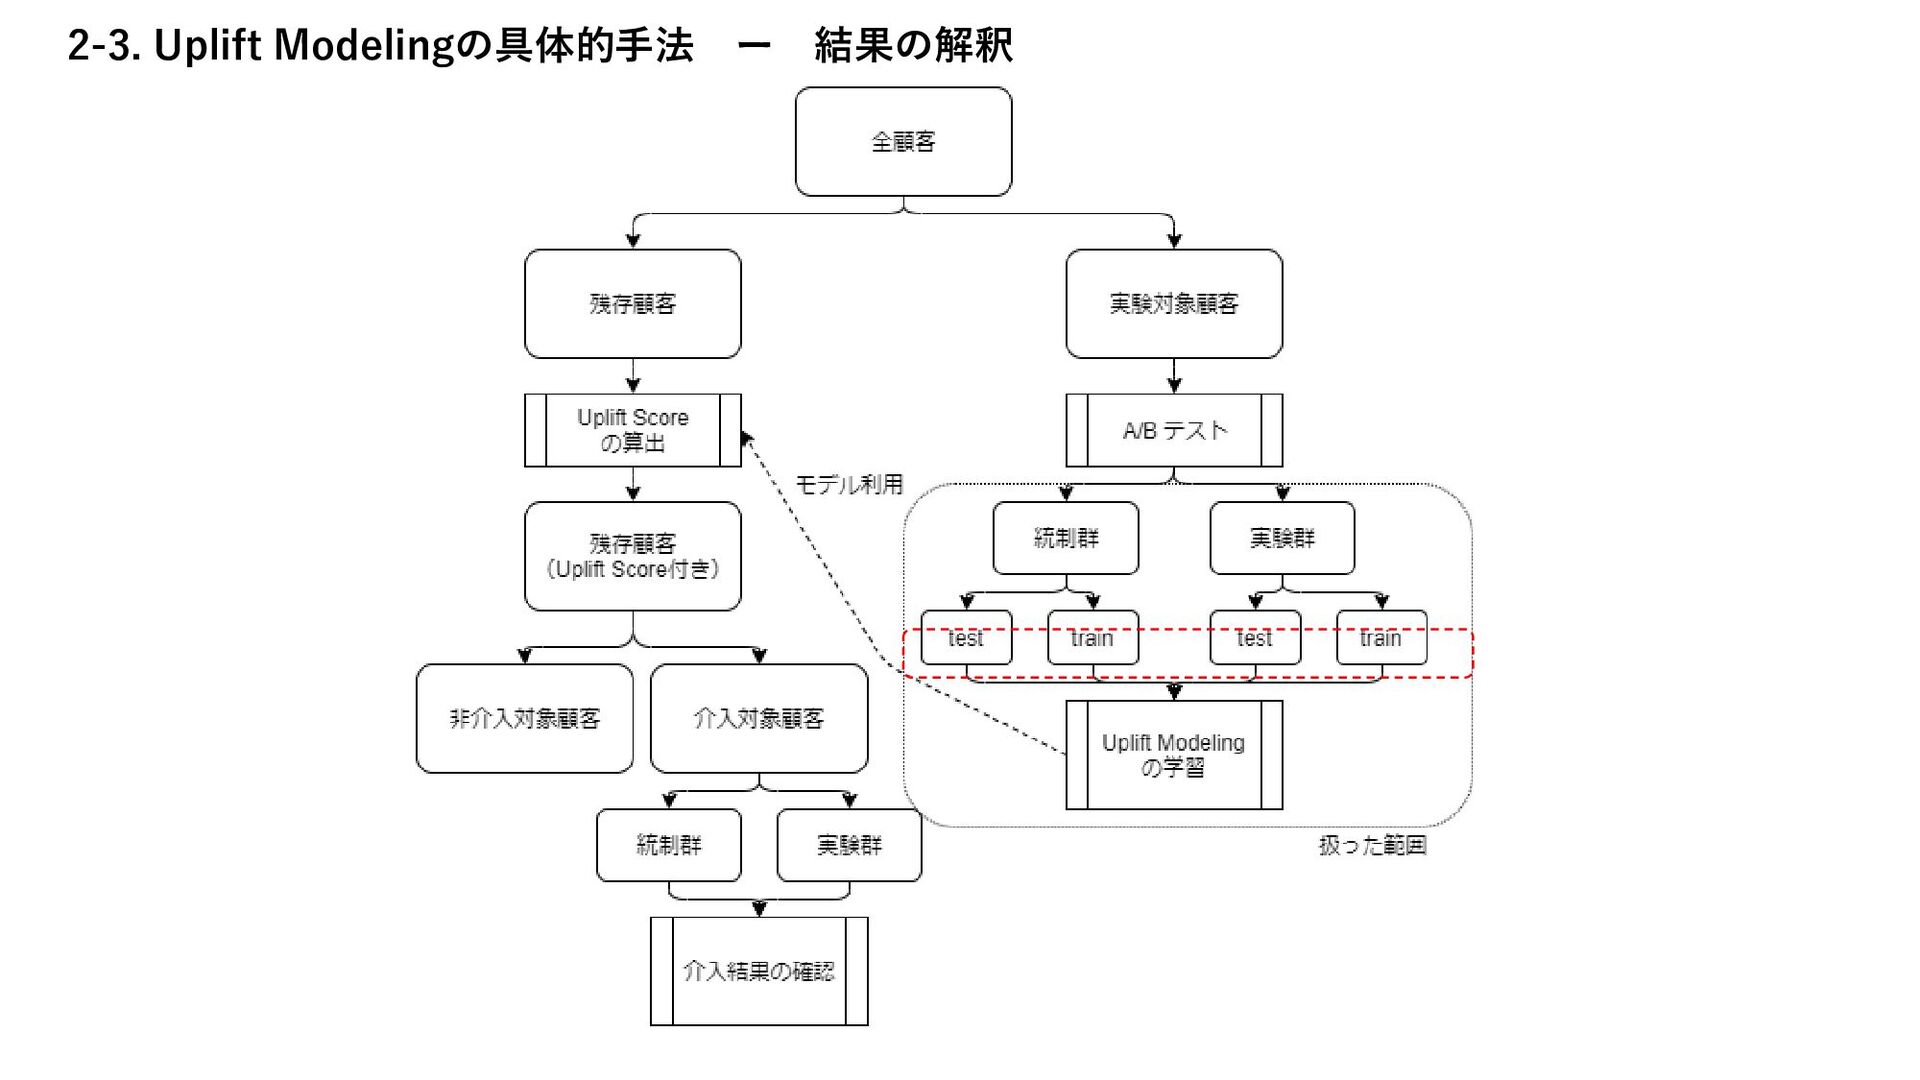
2-1. Uplift Modelingの具体的手法 ー 全体のフロー <施策策定> 介入行為と介入対象を決める A/Bテストを行う <分析> モデル構築
介入候補に対する予測 結果の解釈(介入候補から介入対象を決める) <実行> 介入を実行する 介入の結果を計測する -
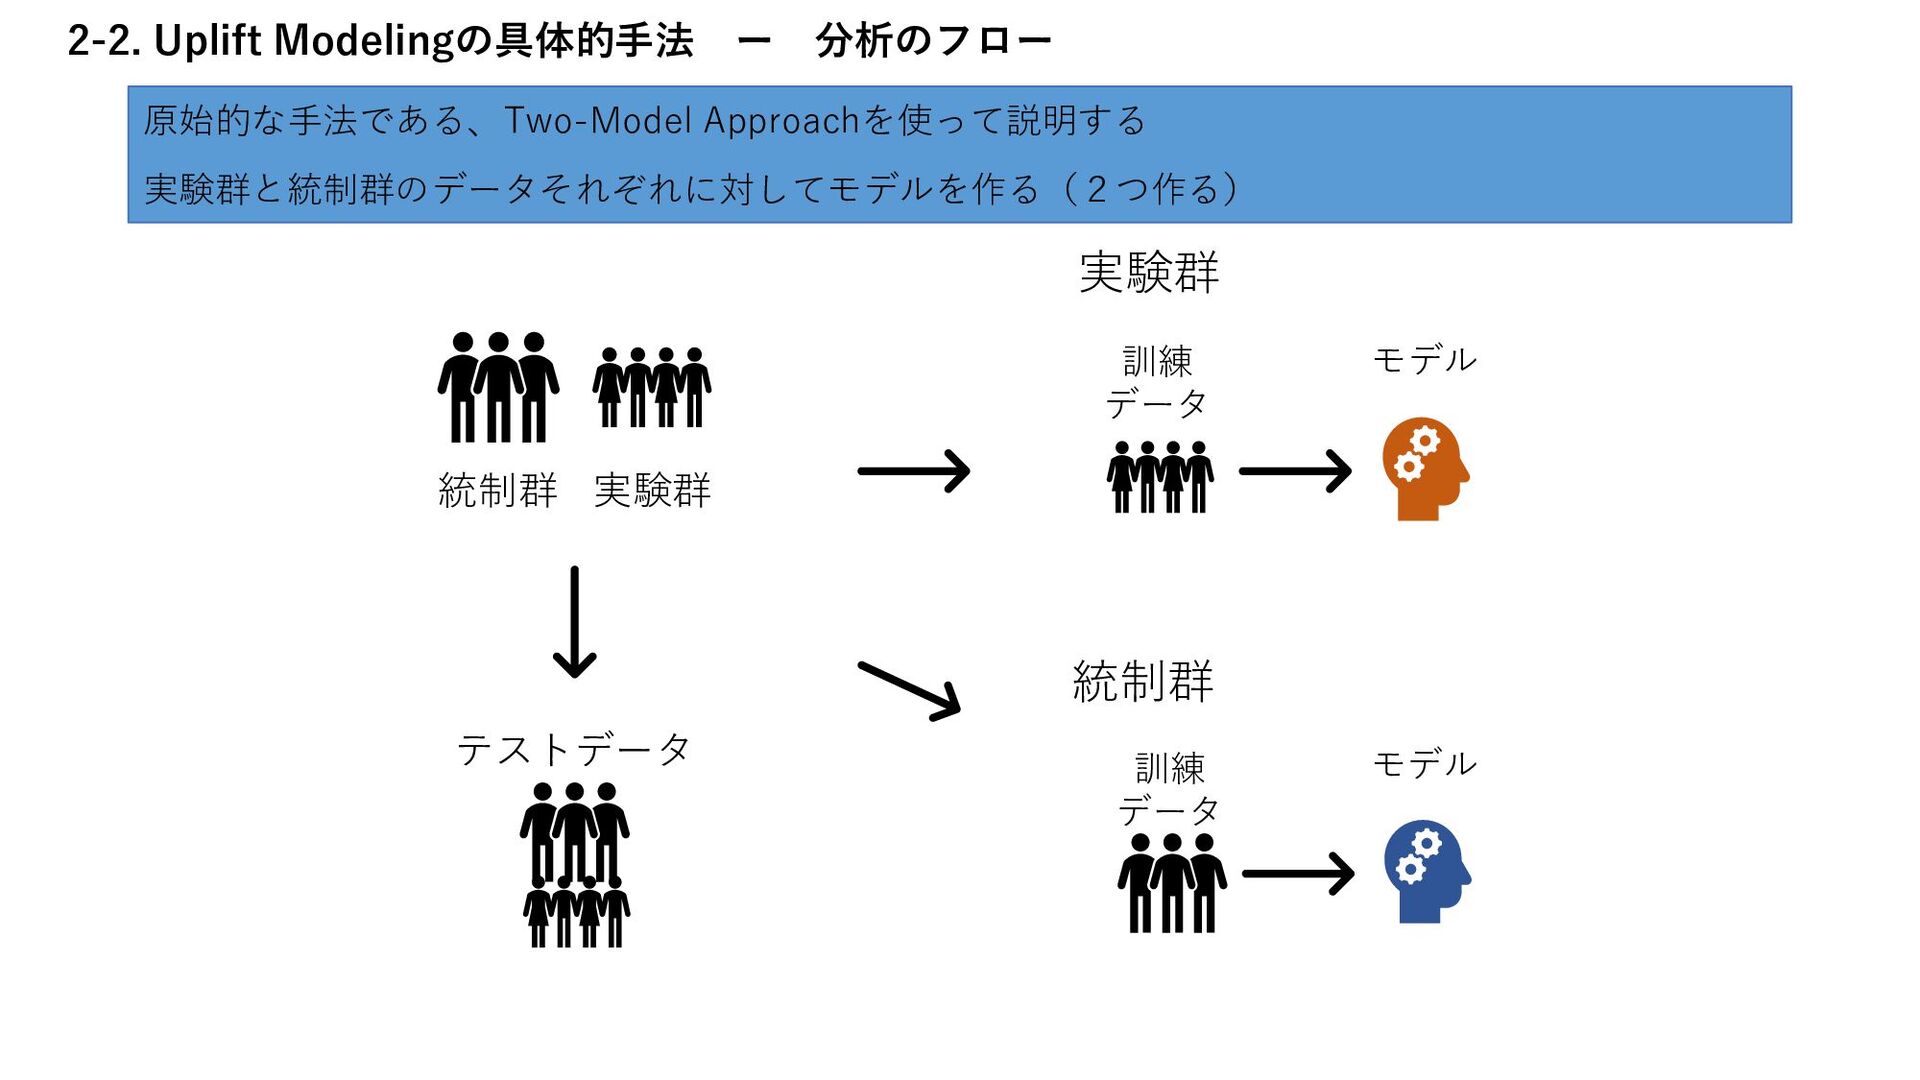
2-2. Uplift Modelingの具体的手法 ー 分析のフロー 原始的な手法である、Two-Model Approachを使って説明する 実験群と統制群のデータそれぞれに対してモデルを作る(2つ作る) 統制群 実験群
訓練 データ モデル 訓練 データ モデル テストデータ 統制群 実験群 -
2-2. Uplift Modelingの具体的手法 ー 分析のフロー テスト対象を二つのモデルに入力し、介入あり/介入なしの反応を予測し、二つの結果を統合して解 釈する テスト データ 介入ありの予測
介入なしの予測 実験群のモデル 統制群のモデル 分析結果 -
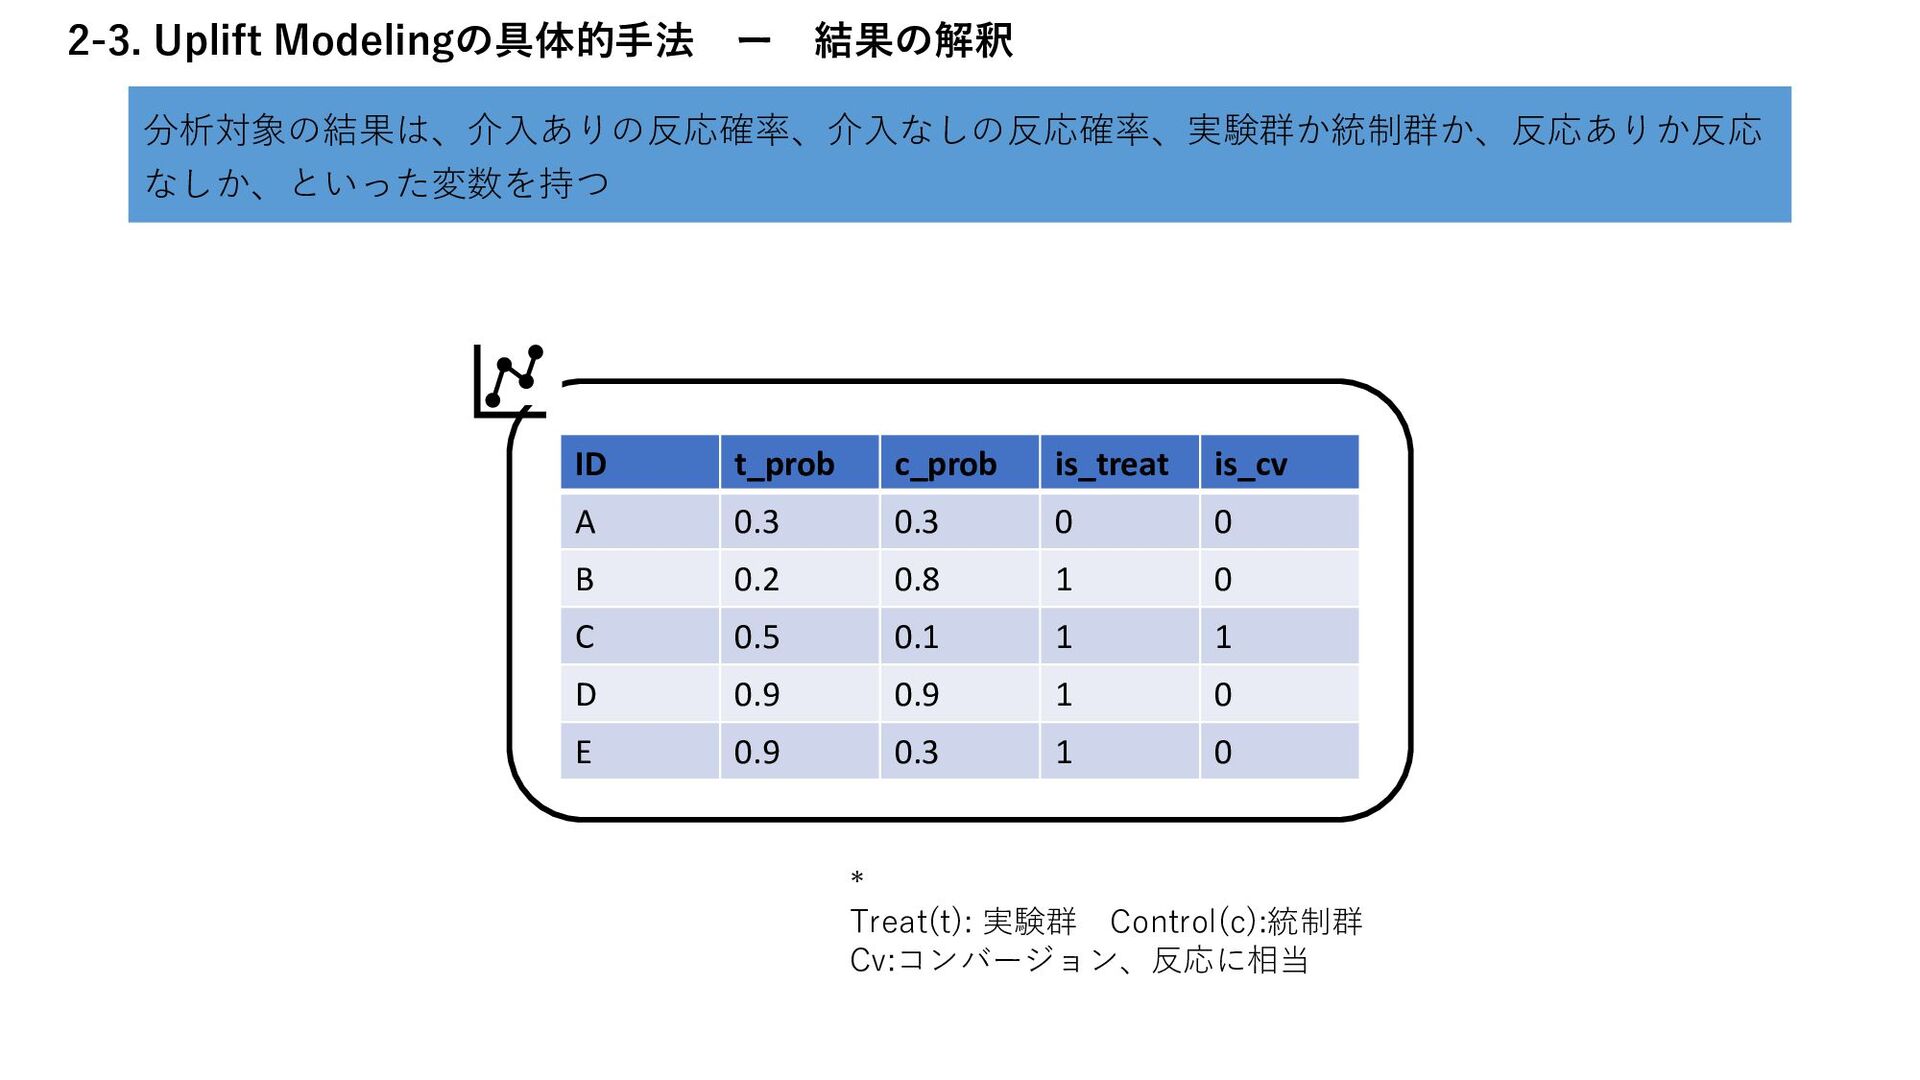
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 分析対象の結果は、介入ありの反応確率、介入なしの反応確率、実験群か統制群か、反応ありか反応 なしか、といった変数を持つ ID t_prob c_prob
is_treat is_cv A 0.3 0.3 0 0 B 0.2 0.8 1 0 C 0.5 0.1 1 1 D 0.9 0.9 1 0 E 0.9 0.3 1 0 * Treat(t): 実験群 Control(c):統制群 Cv:コンバージョン、反応に相当 -
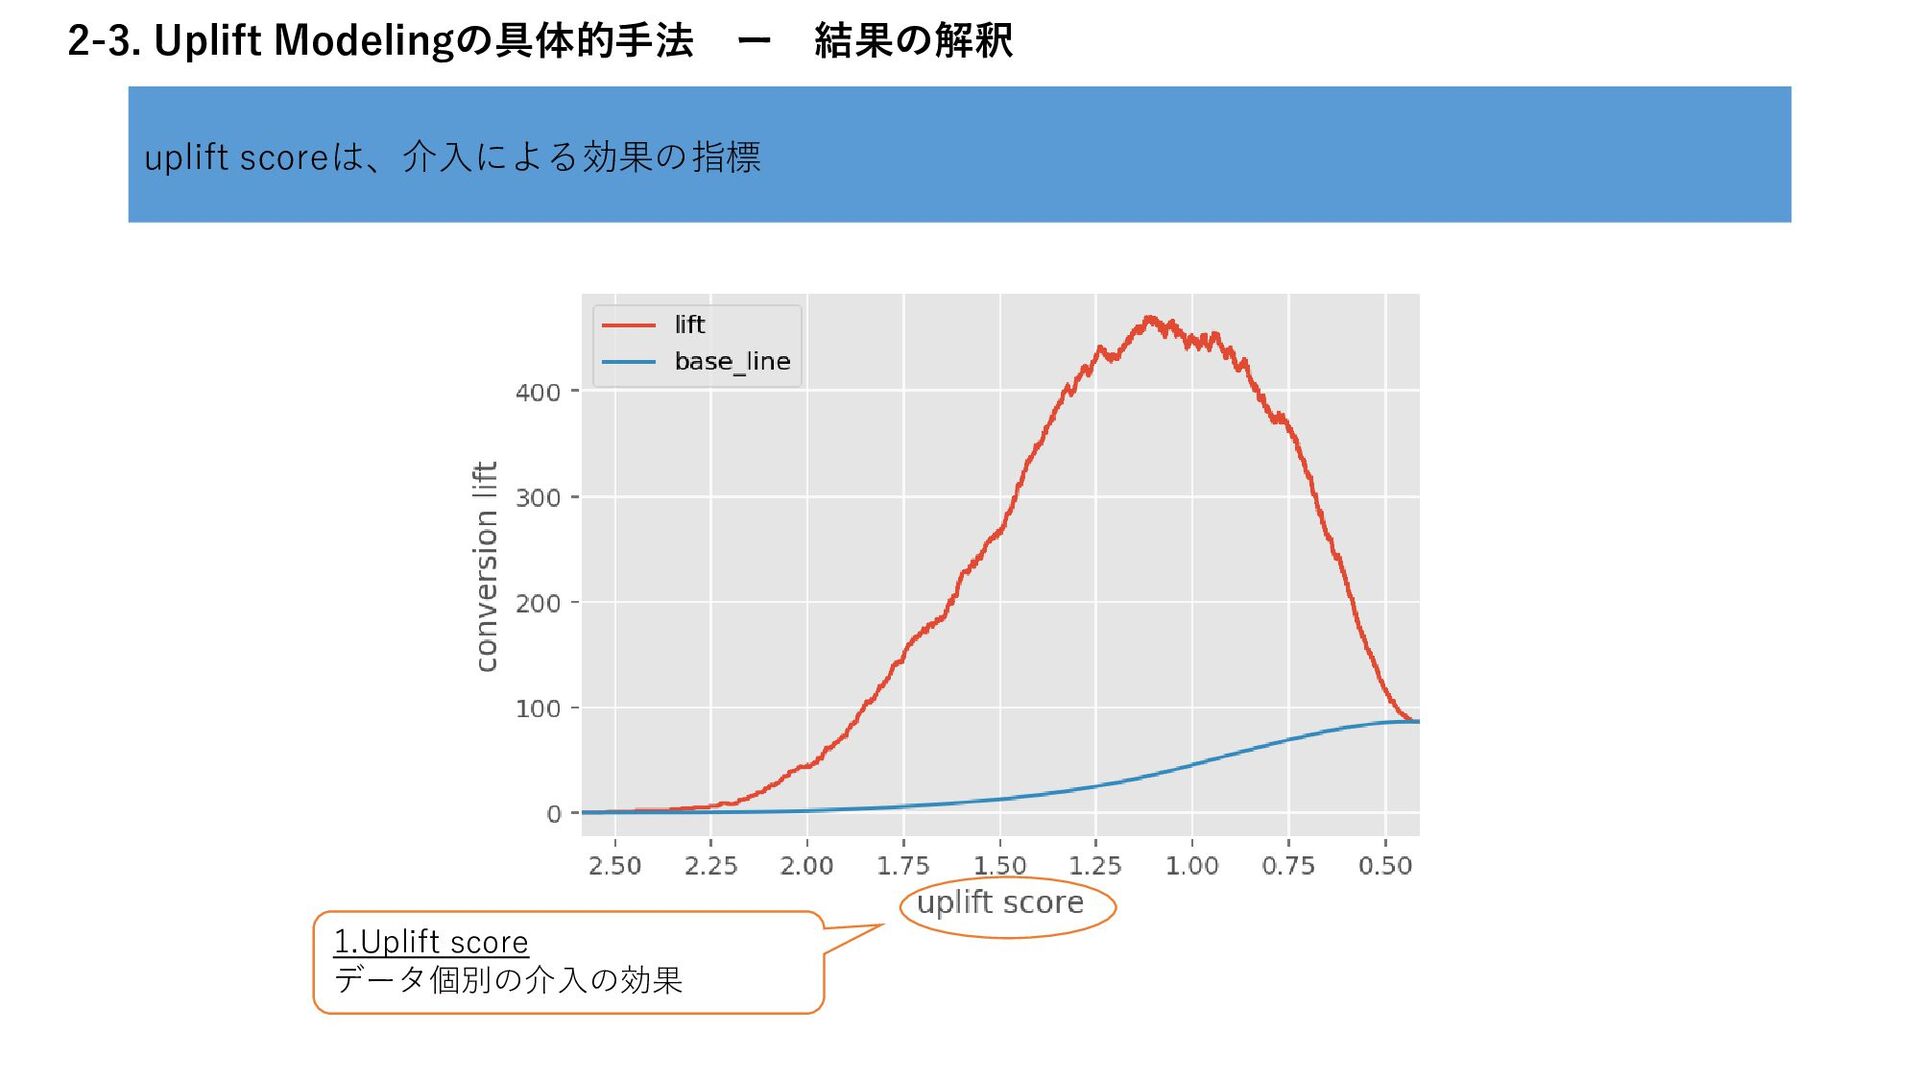
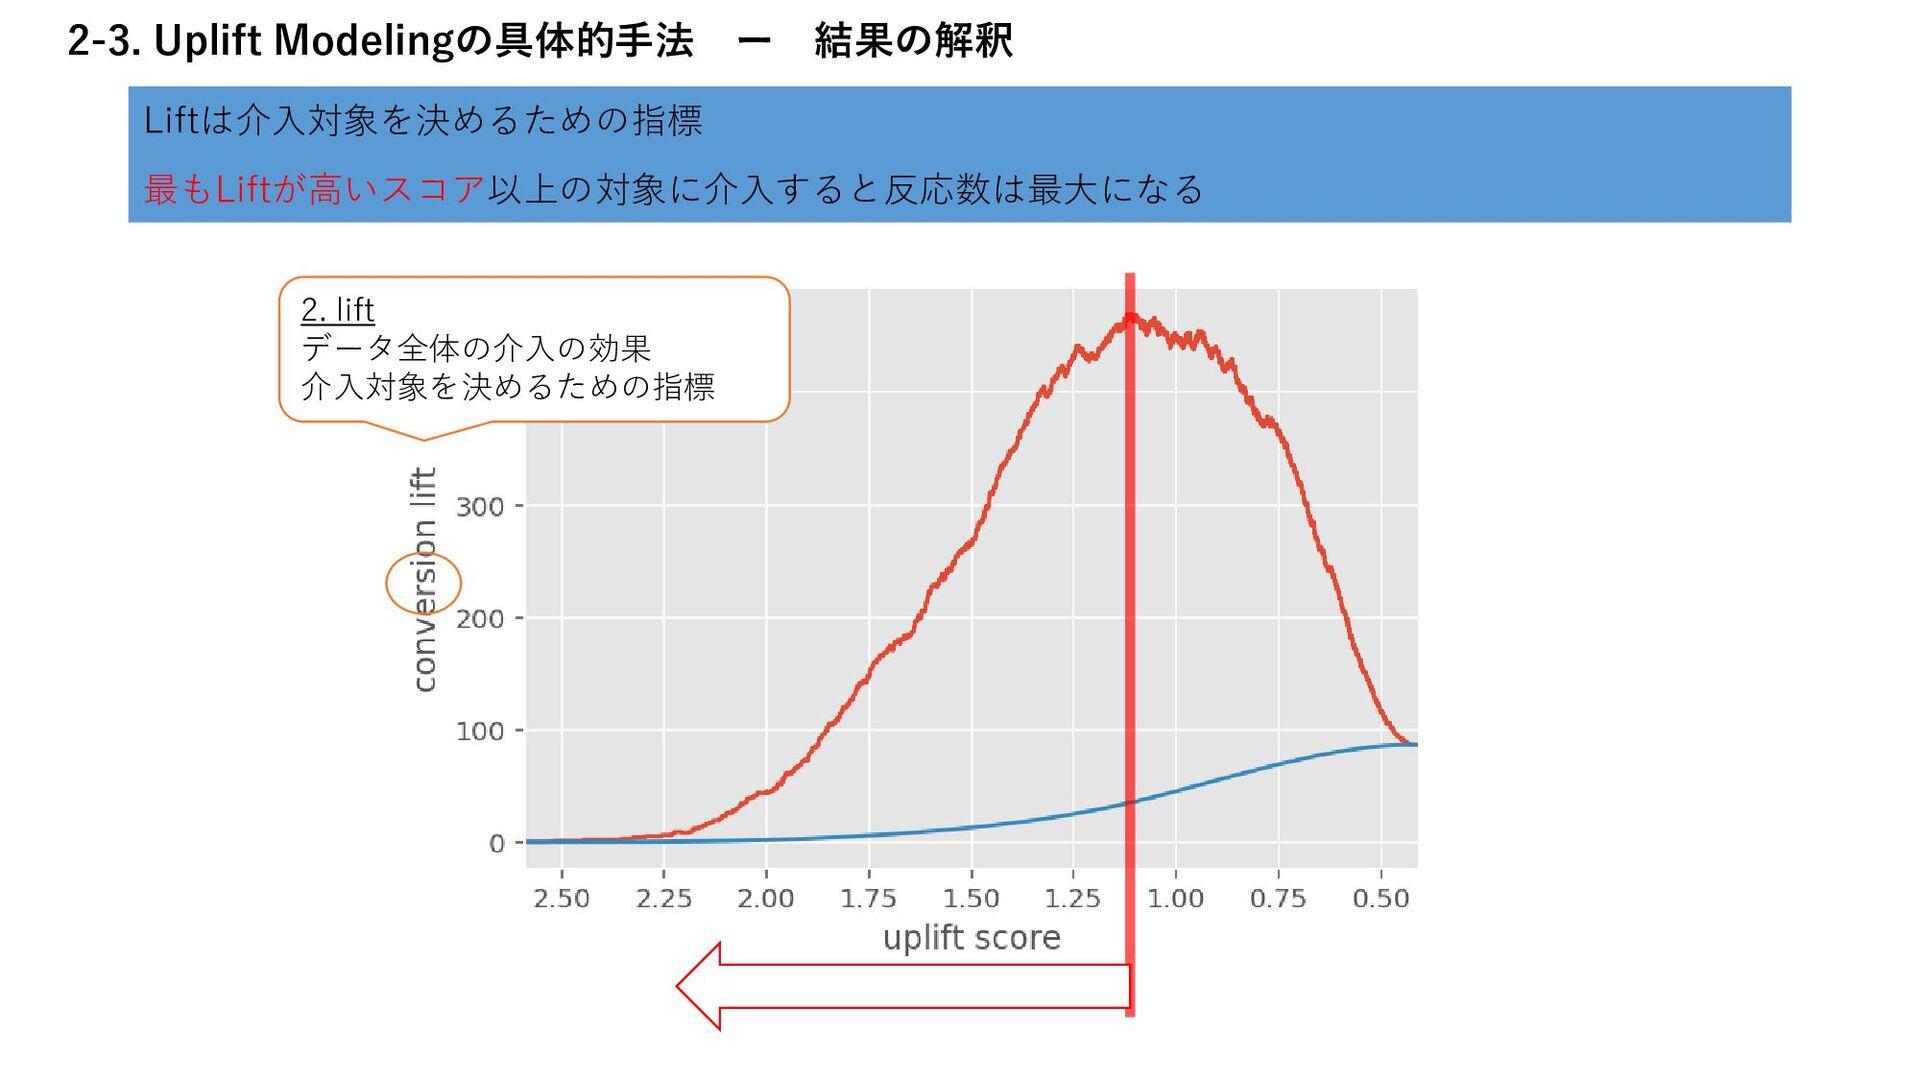
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 横軸にuplift score、縦軸にliftをとったグラフを解釈する 1.Uplift score データ個別の介入の効果
2. lift データ全体の介入の効果 介入対象を決めるための指標 3.AUUC Base lineとliftの間の面積 モデルの評価指標 -
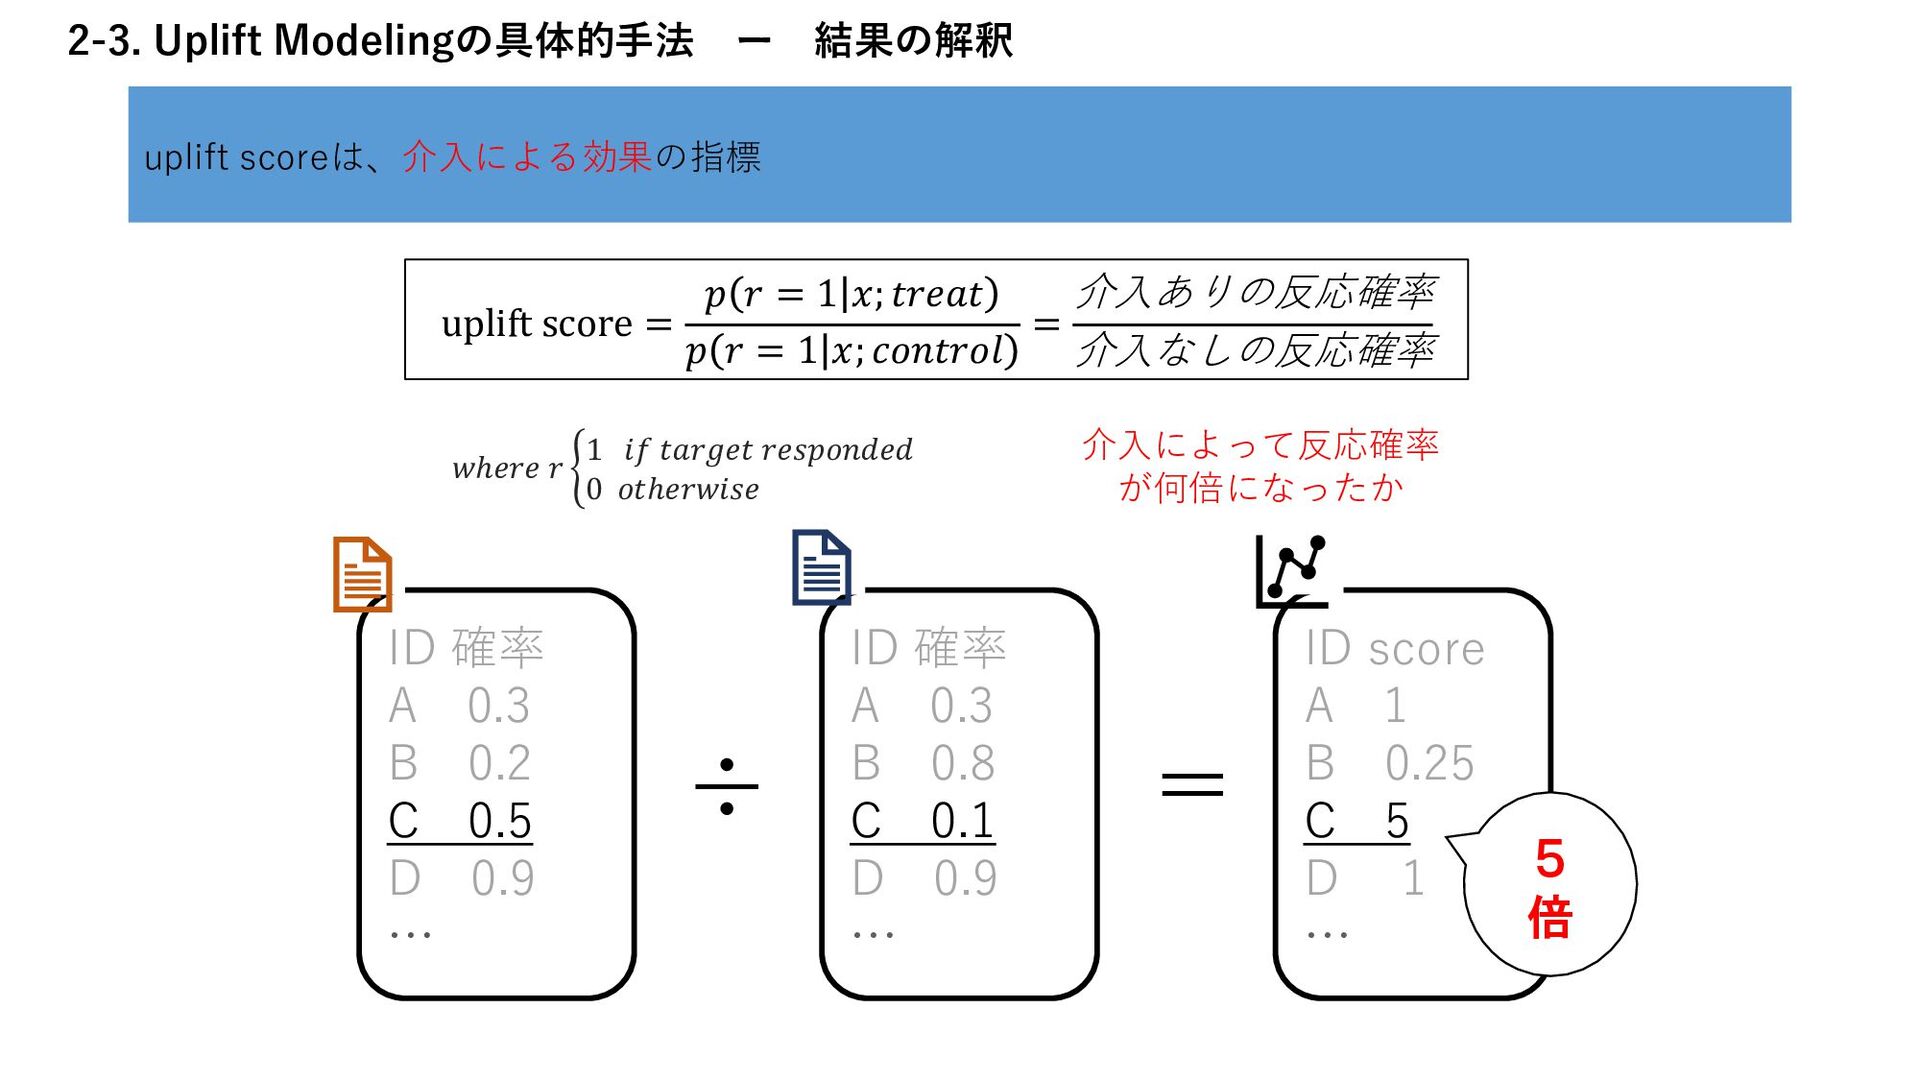
ID 確率 A 0.3 B 0.2 C 0.5 D 0.9
… ID 確率 A 0.3 B 0.8 C 0.1 D 0.9 … 2-3. Uplift Modelingの具体的手法 ー 結果の解釈 uplift scoreは、介入による効果の指標 ID score A 1 B 0.25 C 5 D 1 … ÷ = uplift score = 𝑝 𝑟 = 1 𝑥; 𝑡𝑟𝑒𝑎𝑡 𝑝 𝑟 = 1 𝑥; 𝑐𝑜𝑛𝑡𝑟𝑜𝑙 = 介入ありの反応確率 介入なしの反応確率 𝑤ℎ𝑒𝑟𝑒 𝑟 ቊ 1 𝑖𝑓 𝑡𝑎𝑟𝑔𝑒𝑡 𝑟𝑒𝑠𝑝𝑜𝑛𝑑𝑒𝑑 0 𝑜𝑡ℎ𝑒𝑟𝑤𝑖𝑠𝑒 介入によって反応確率 が何倍になったか 5 倍 -
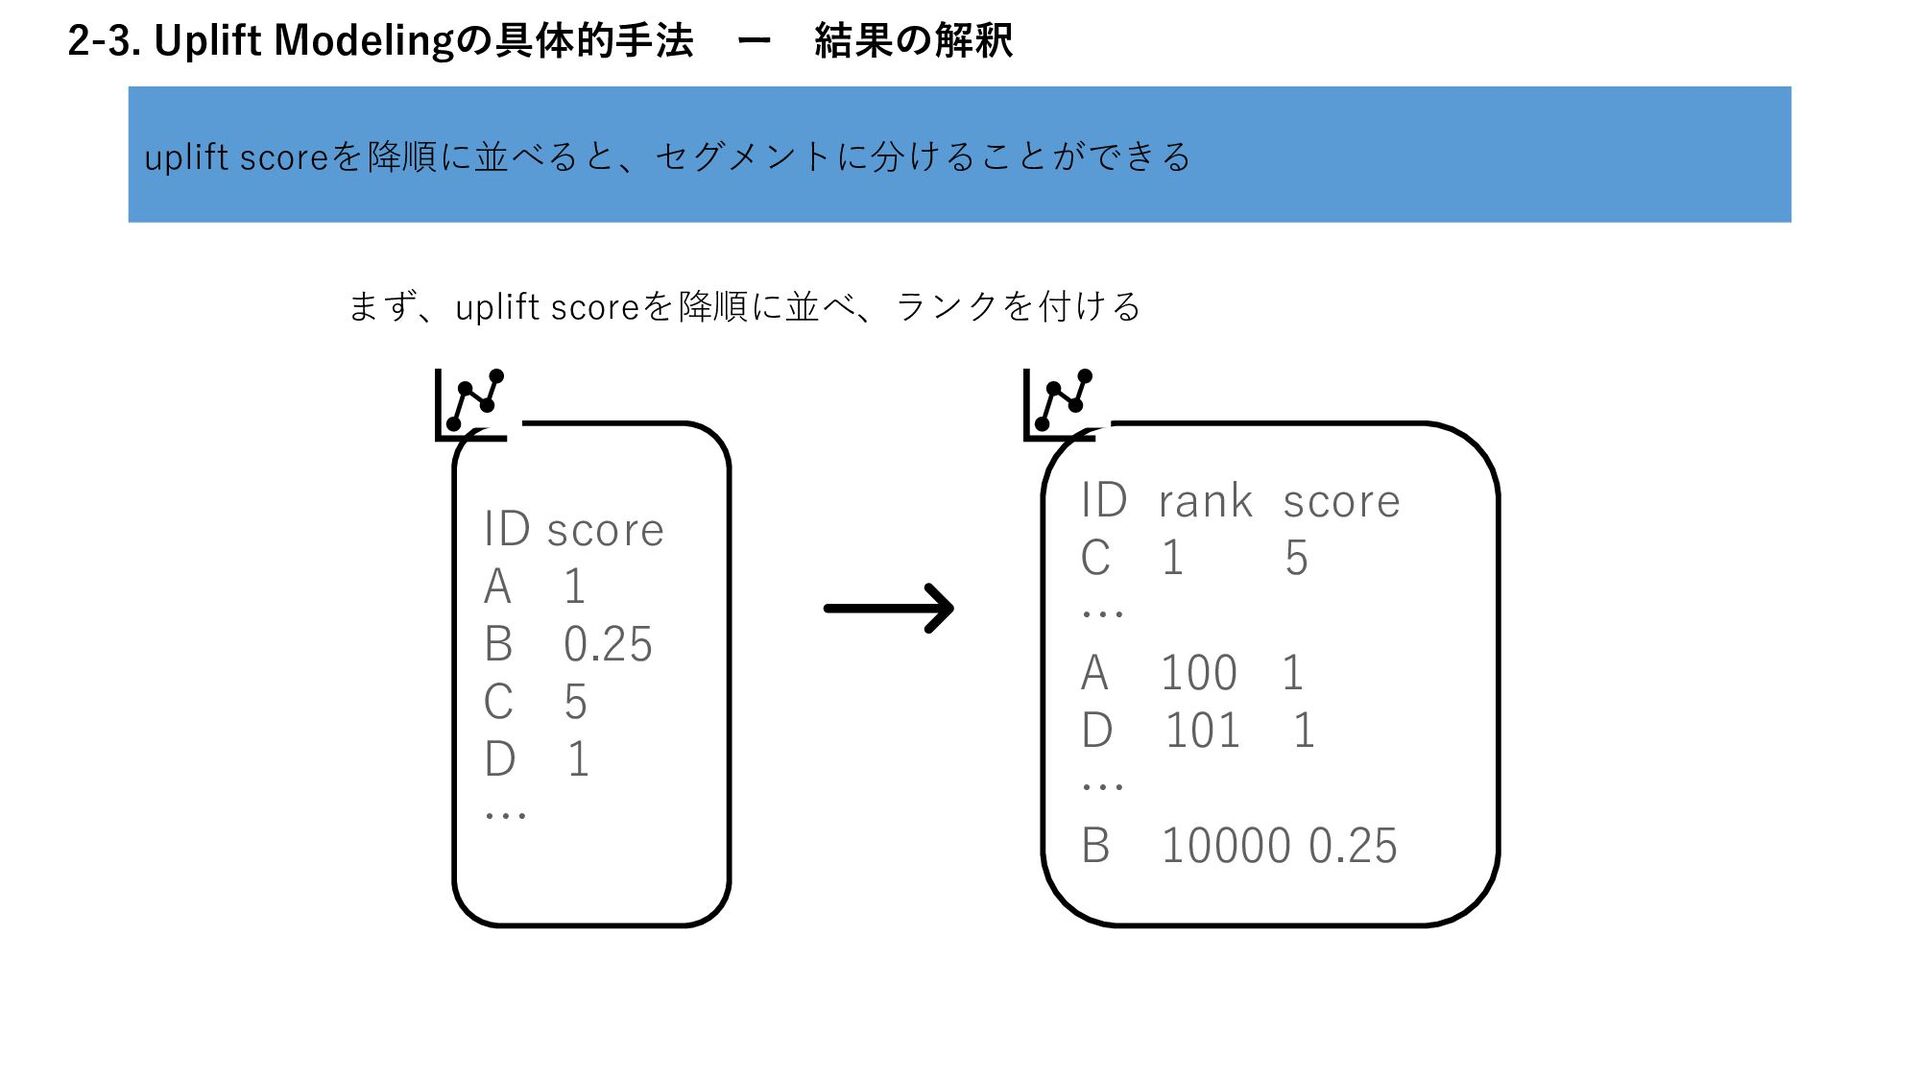
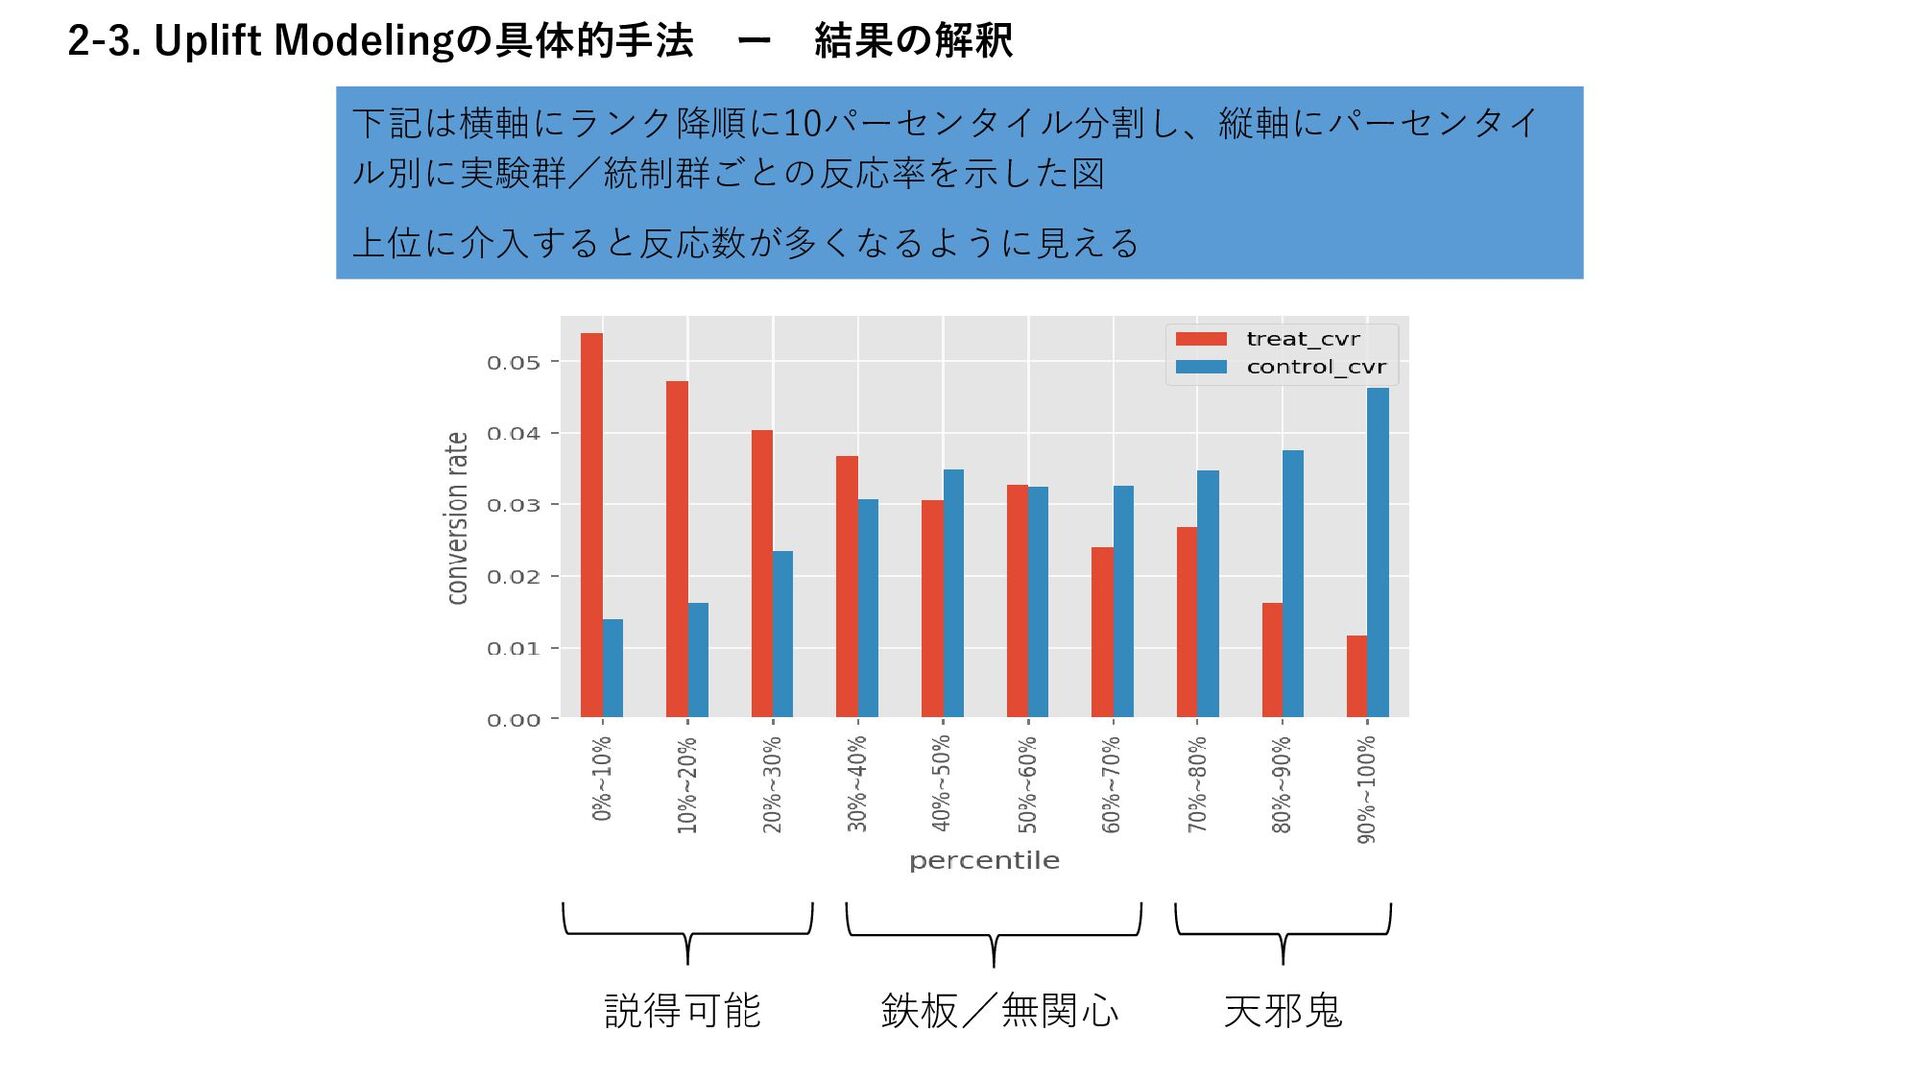
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 uplift scoreを降順に並べると、セグメントに分けることができる まず、uplift scoreを降順に並べ、ランクを付ける ID
score A 1 B 0.25 C 5 D 1 … ID rank score C 1 5 … A 100 1 D 101 1 … B 10000 0.25 -
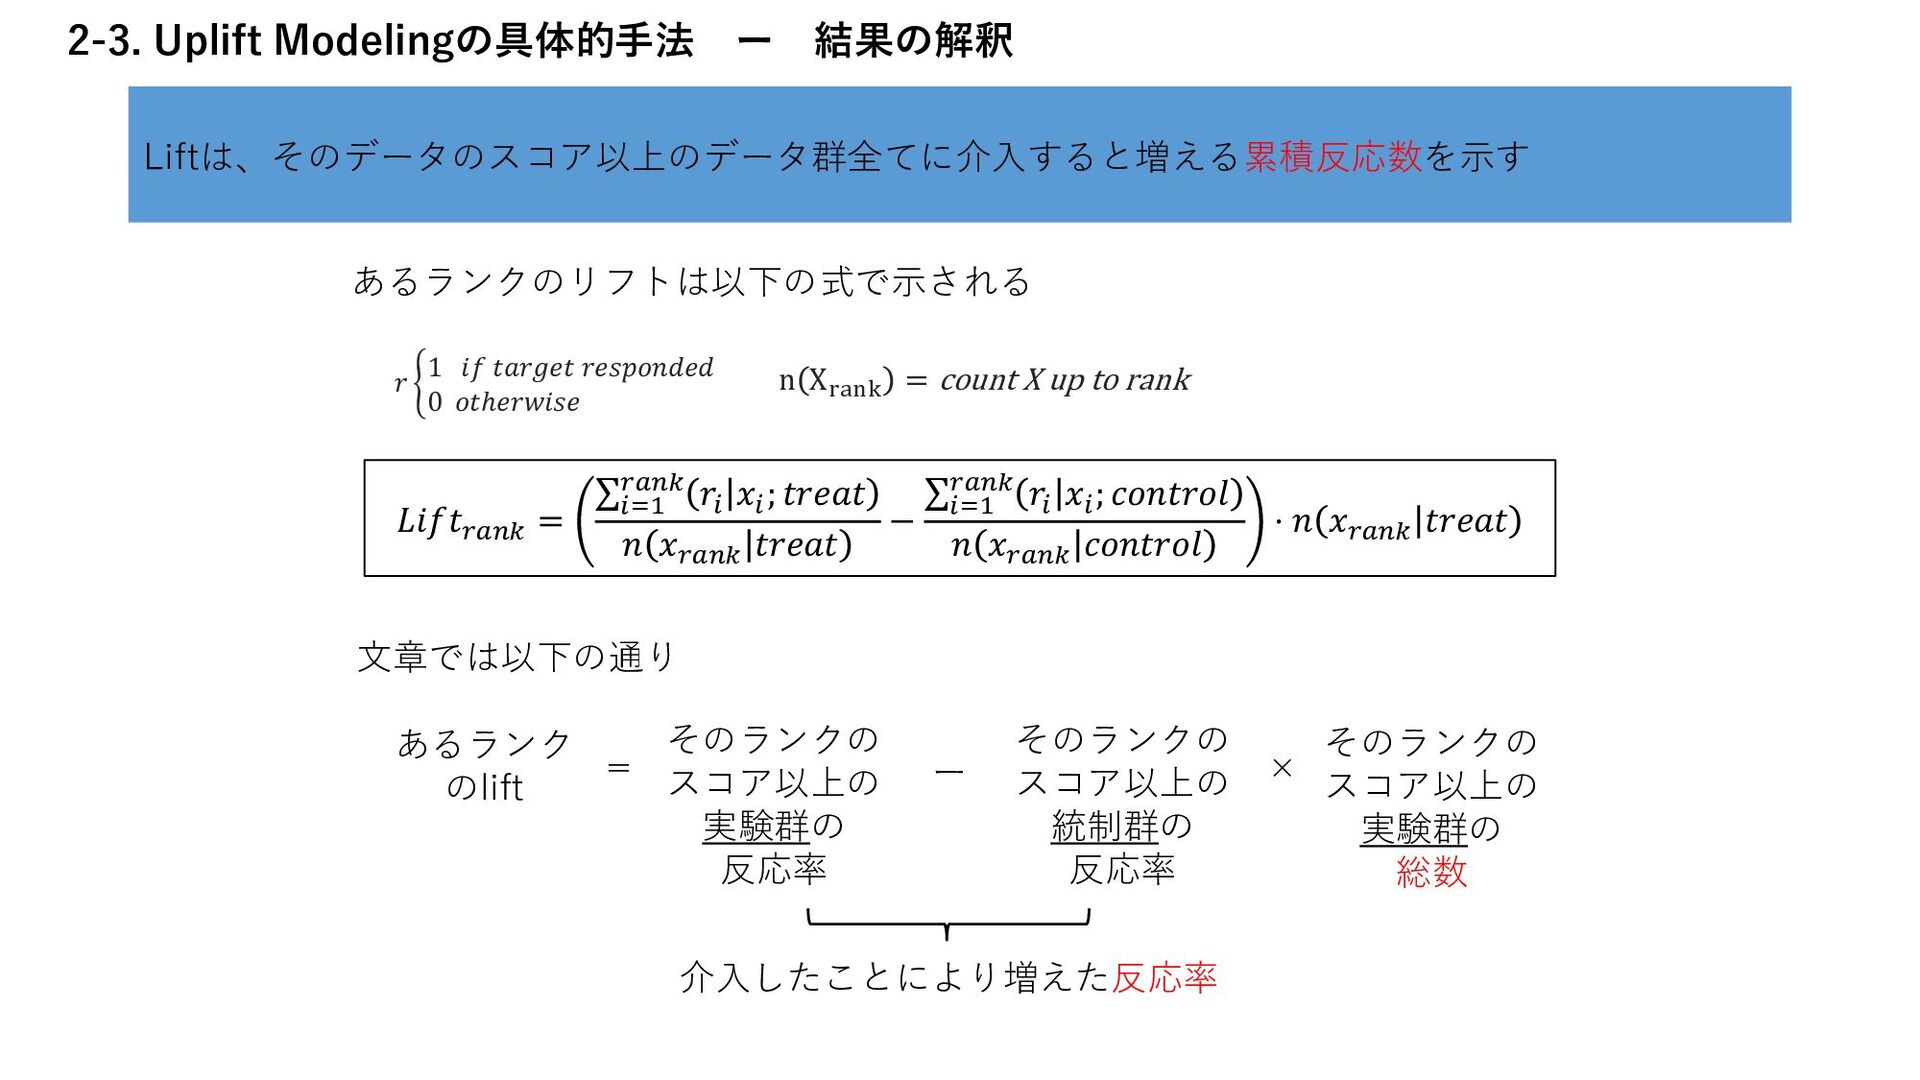
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 Liftは、そのデータのスコア以上のデータ群全てに介入すると増える累積反応数を示す あるランクのリフトは以下の式で示される 𝐿𝑖𝑓𝑡𝑟𝑎𝑛𝑘 = σ
𝑖=1 𝑟𝑎𝑛𝑘 𝑟𝑖 𝑥𝑖 ; 𝑡𝑟𝑒𝑎𝑡 𝑛 𝑥𝑟𝑎𝑛𝑘 𝑡𝑟𝑒𝑎𝑡 − σ 𝑖=1 𝑟𝑎𝑛𝑘 𝑟𝑖 𝑥𝑖 ; 𝑐𝑜𝑛𝑡𝑟𝑜𝑙 𝑛 𝑥𝑟𝑎𝑛𝑘 𝑐𝑜𝑛𝑡𝑟𝑜𝑙 ⋅ 𝑛 𝑥𝑟𝑎𝑛𝑘 𝑡𝑟𝑒𝑎𝑡 n Xrank = count X up to rank 𝑟 ቊ 1 𝑖𝑓 𝑡𝑎𝑟𝑔𝑒𝑡 𝑟𝑒𝑠𝑝𝑜𝑛𝑑𝑒𝑑 0 𝑜𝑡ℎ𝑒𝑟𝑤𝑖𝑠𝑒 あるランク のlift そのランクの スコア以上の 実験群の 反応率 そのランクの スコア以上の 統制群の 反応率 そのランクの スコア以上の 実験群の 総数 介入したことにより増えた反応率 ー × = 文章では以下の通り -
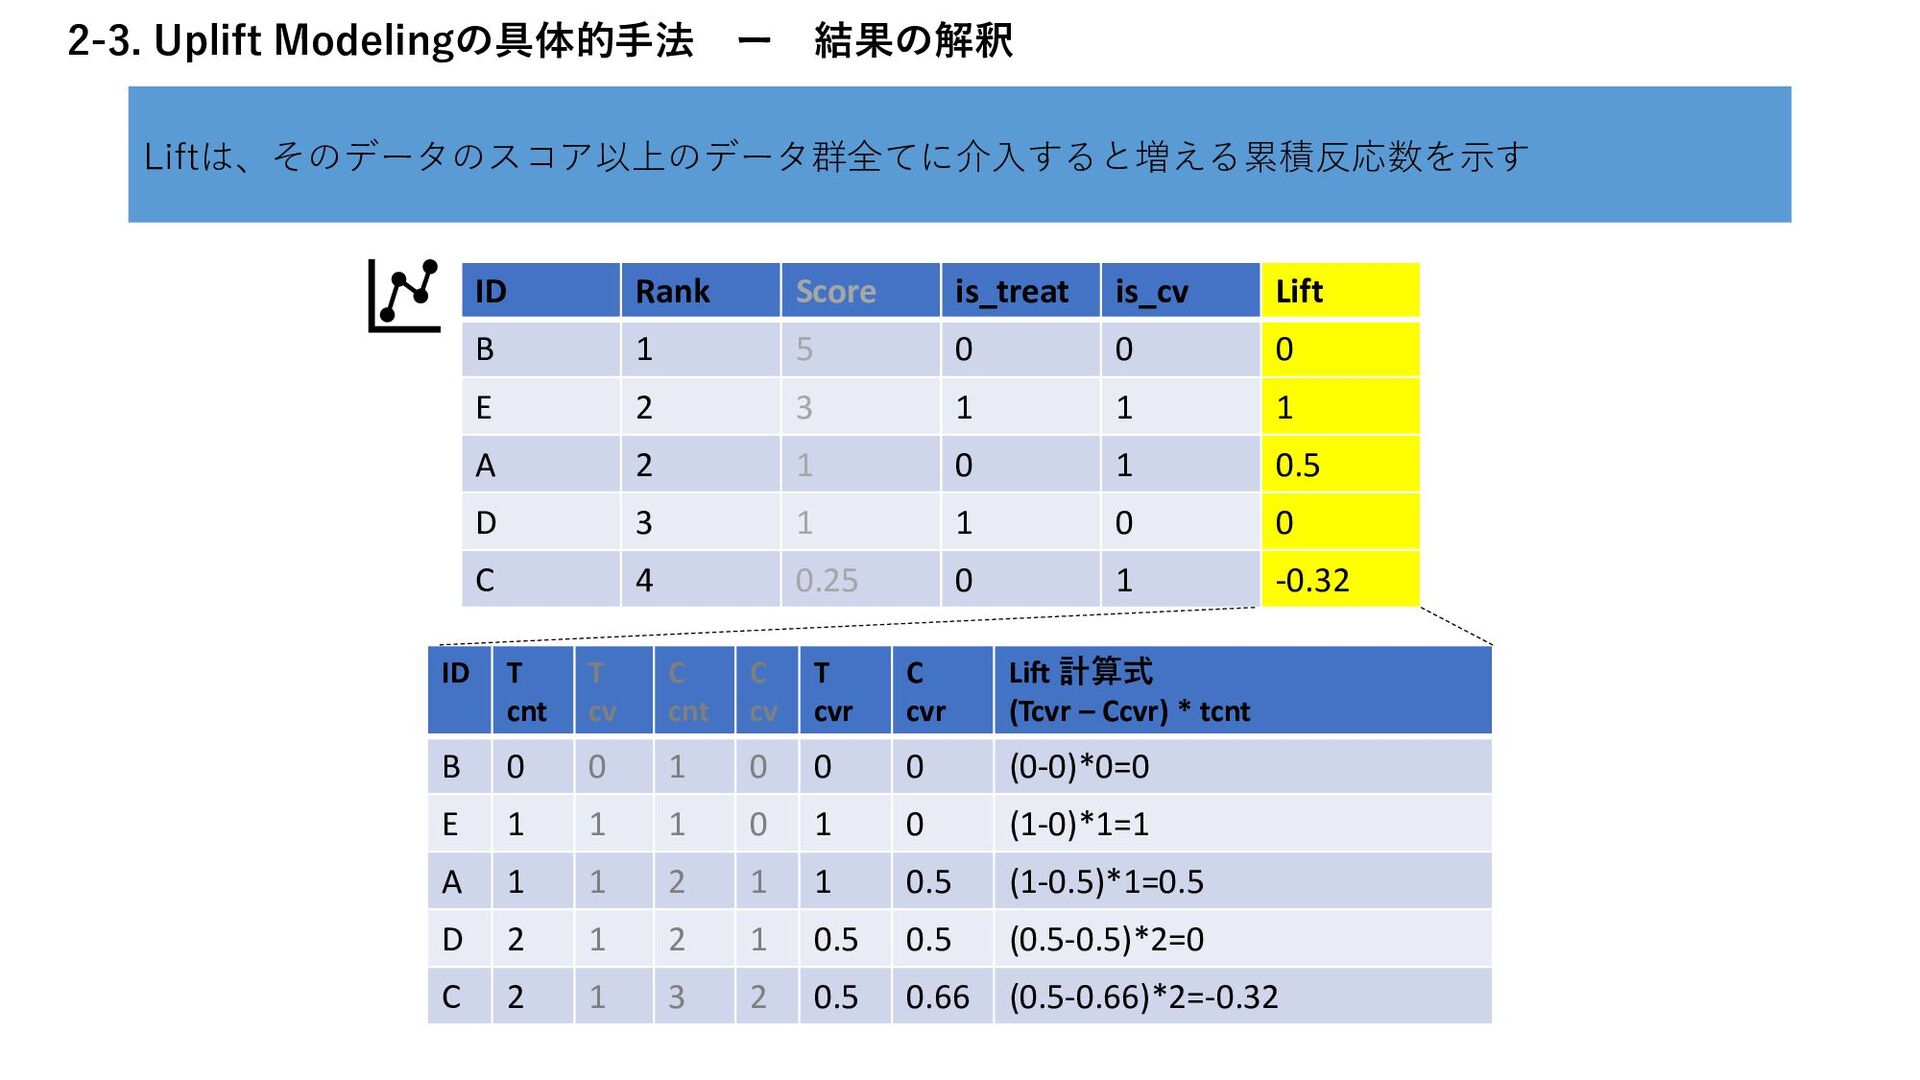
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 Liftは、そのデータのスコア以上のデータ群全てに介入すると増える累積反応数を示す ID Rank Score is_treat
is_cv Lift B 1 5 0 0 0 E 2 3 1 1 1 A 2 1 0 1 0.5 D 3 1 1 0 0 C 4 0.25 0 1 -0.32 ID T cnt T cv C cnt C cv T cvr C cvr Lift 計算式 (Tcvr – Ccvr) * tcnt B 0 0 1 0 0 0 (0-0)*0=0 E 1 1 1 0 1 0 (1-0)*1=1 A 1 1 2 1 1 0.5 (1-0.5)*1=0.5 D 2 1 2 1 0.5 0.5 (0.5-0.5)*2=0 C 2 1 3 2 0.5 0.66 (0.5-0.66)*2=-0.32 -
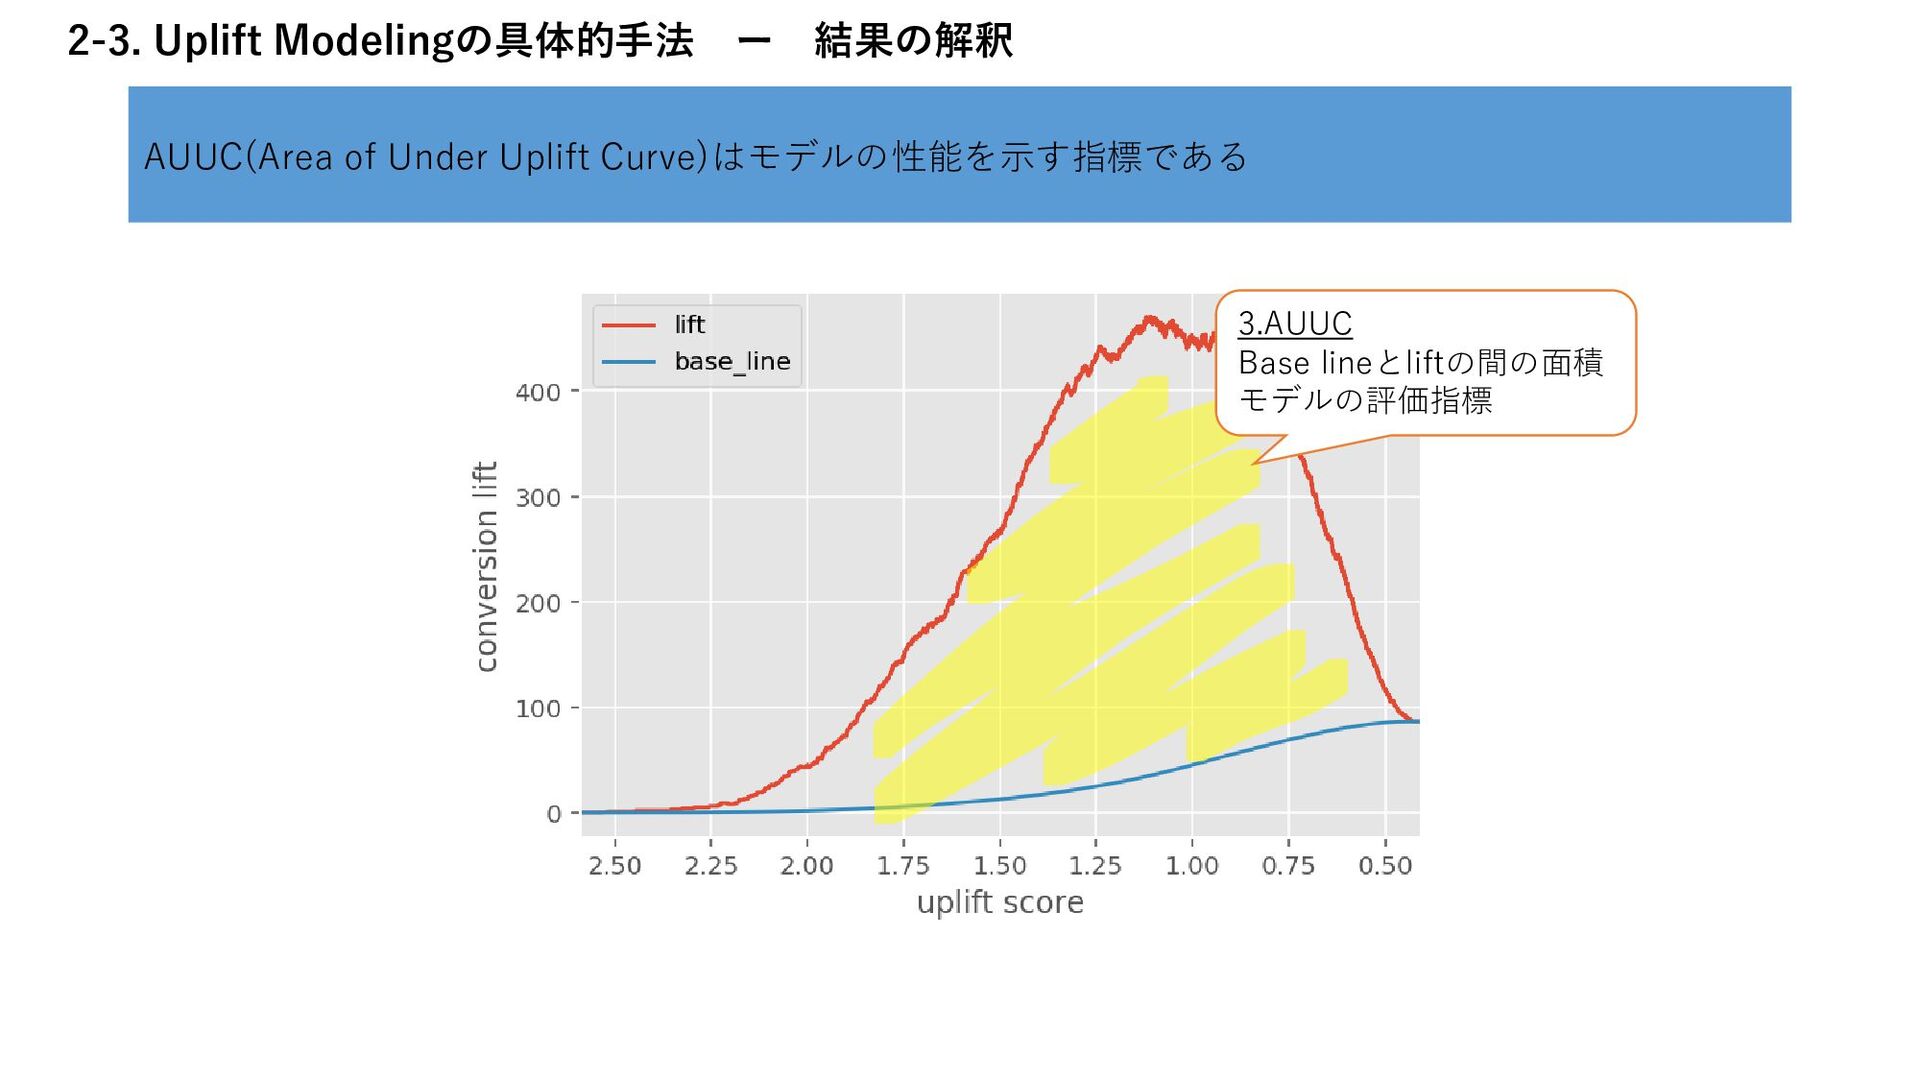
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 AUUC(Area of Under Uplift Curve)はモデルの性能を示す指標である
3.AUUC Base lineとliftの間の面積 モデルの評価指標 -
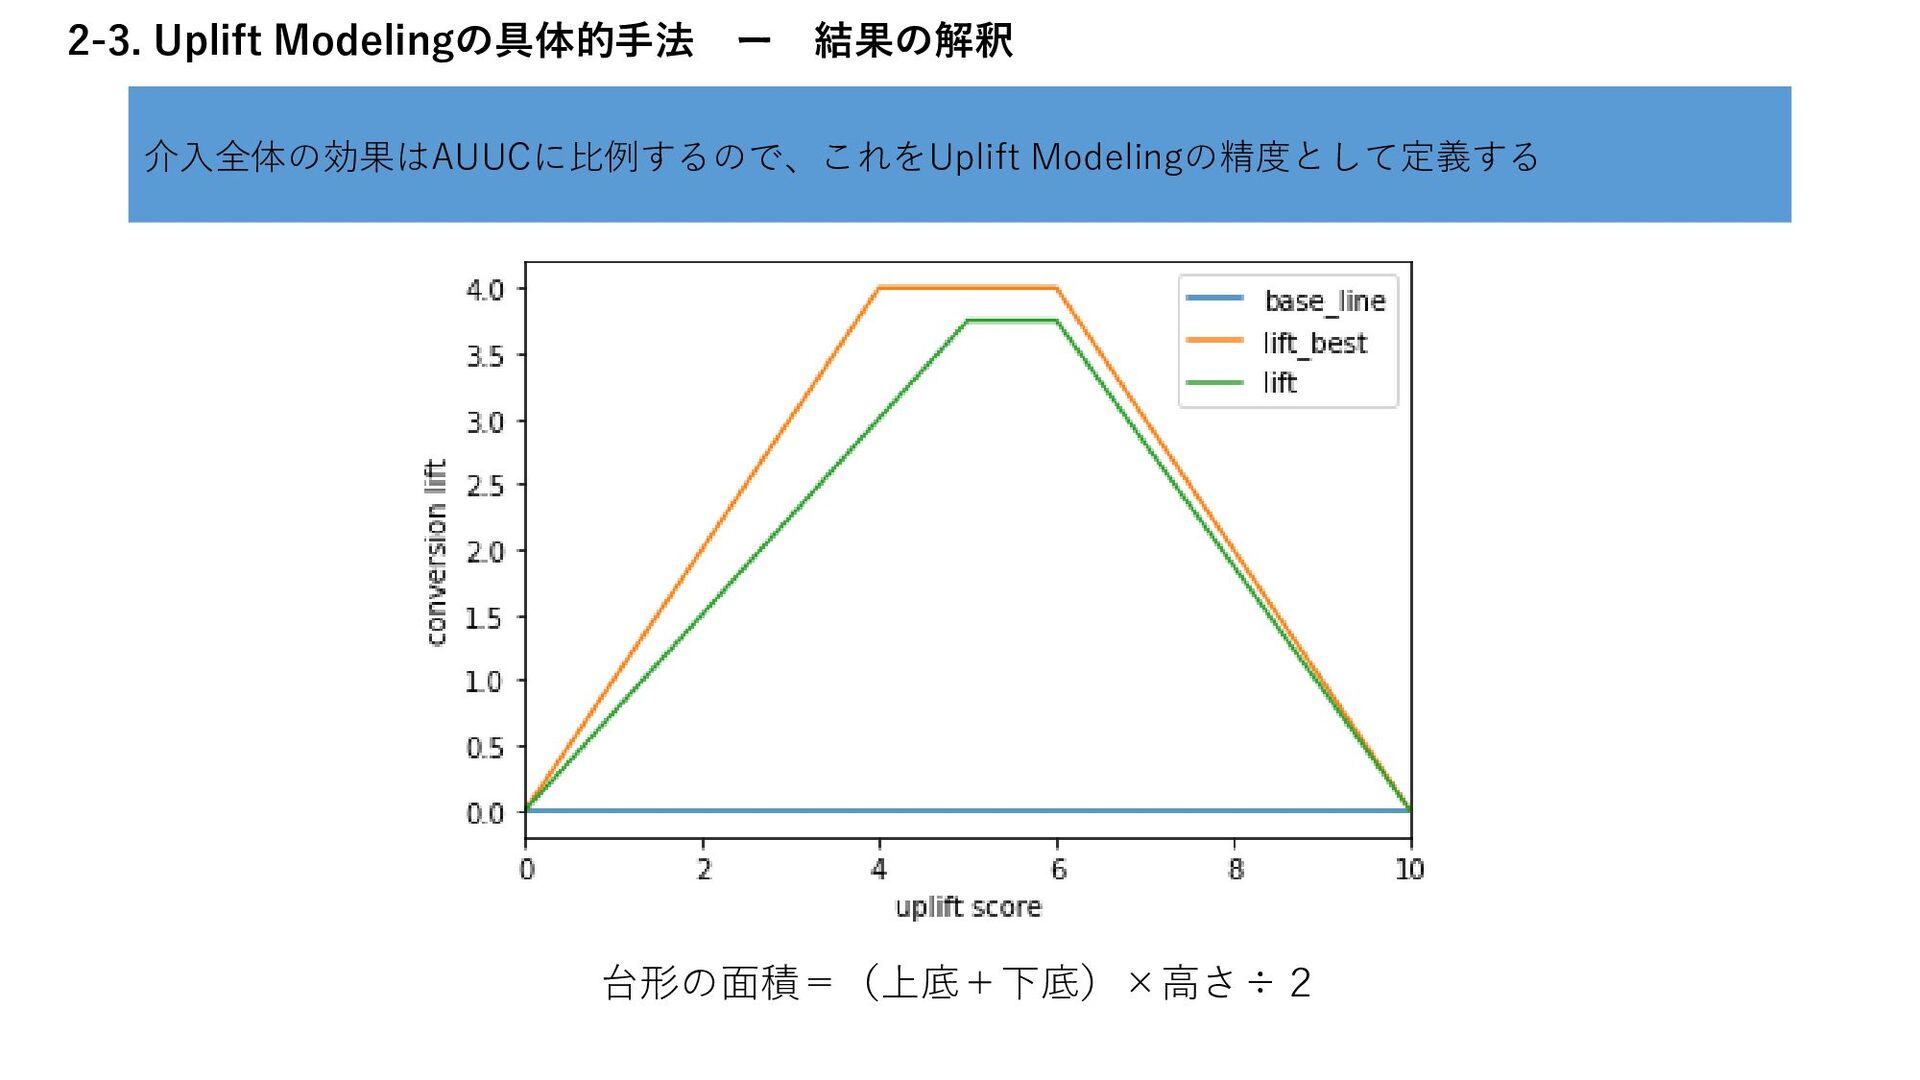
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 介入全体の効果はAUUCに比例するので、これをUplift Modelingの精度として定義する あるスコア以上の対象に介入すると決める、ということは、上位に説得可能な対象ができるだけ集 まったほうが、全体の効果は大きくなるということになる 上位に説得可能な対象ができるだけ集まると、Liftは最大効率で増加する
また、Liftの増加量は大きくなり、下位は逆の動きになる つまりこの場合、AUUCの形は次第に上に凸になる AUUCは、モデルの性能の比較やモデルのパラメータチューニングをするときに用いる -
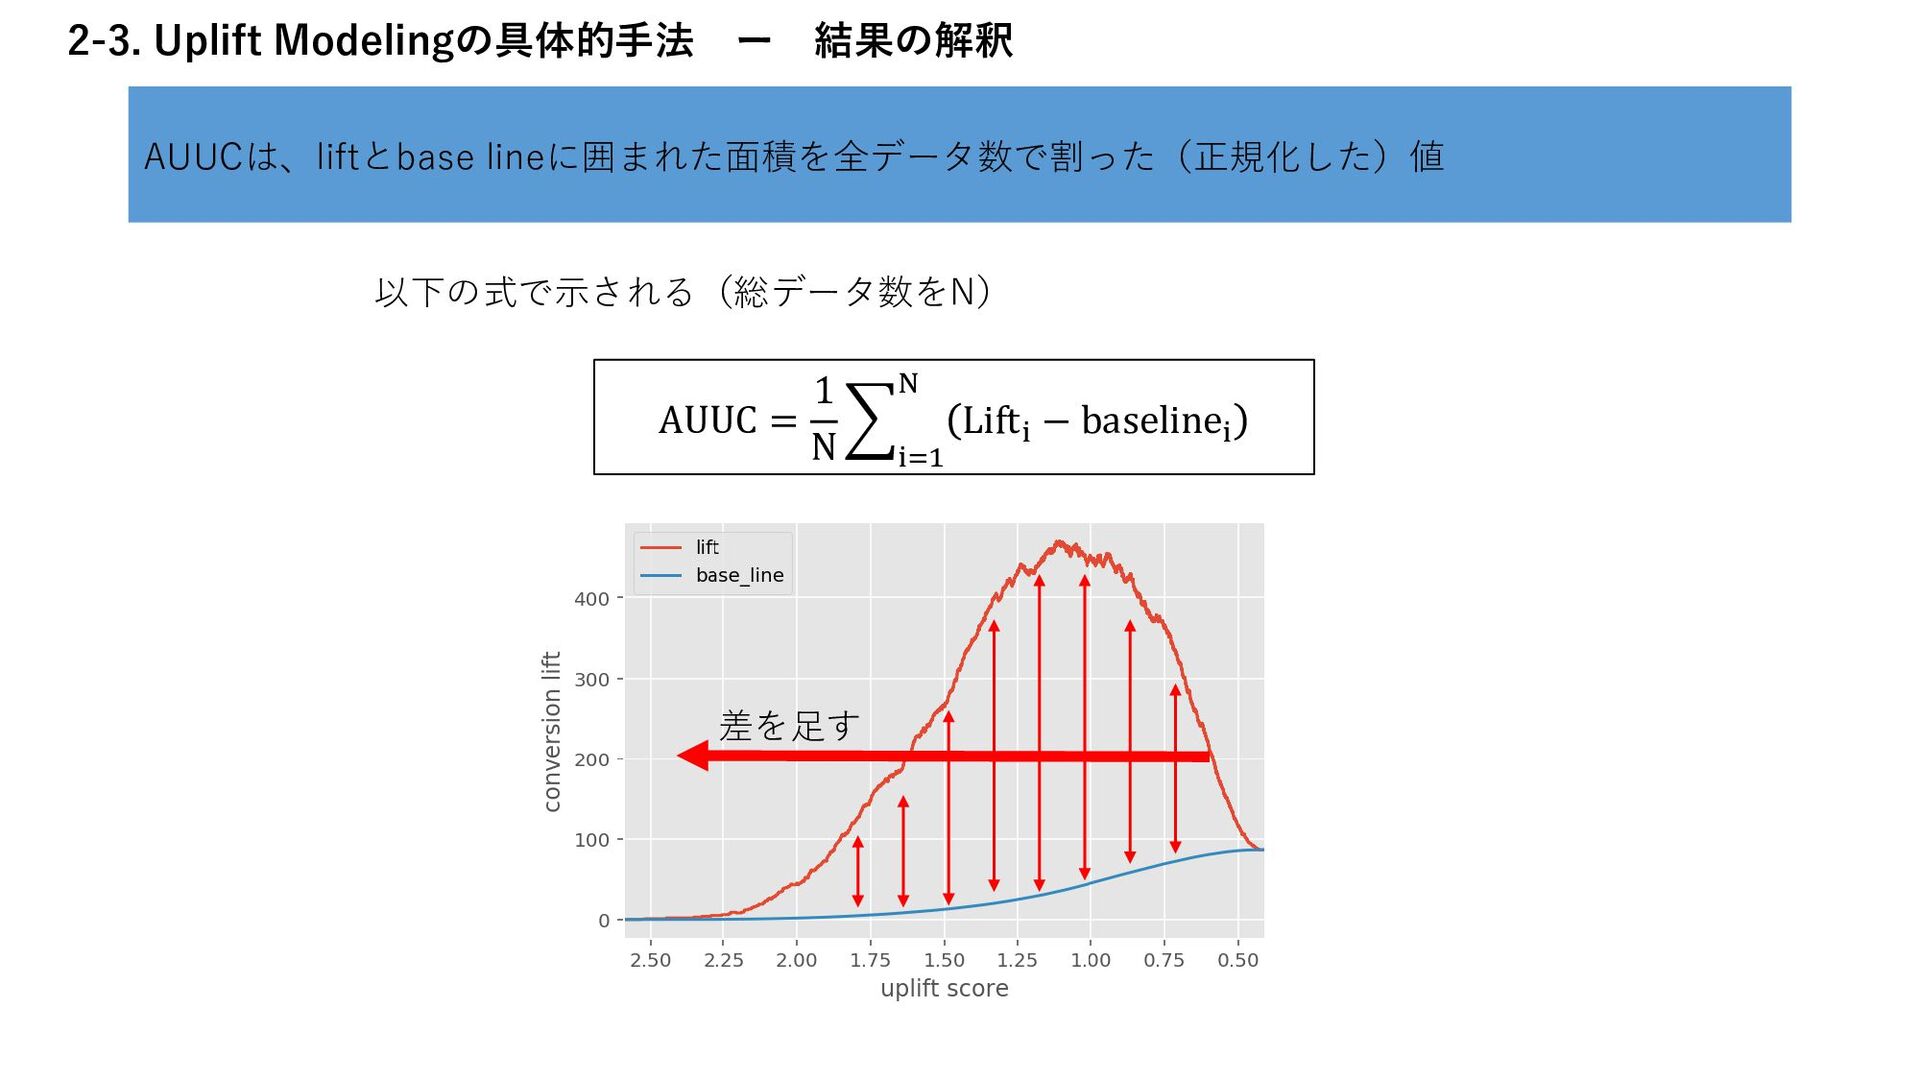
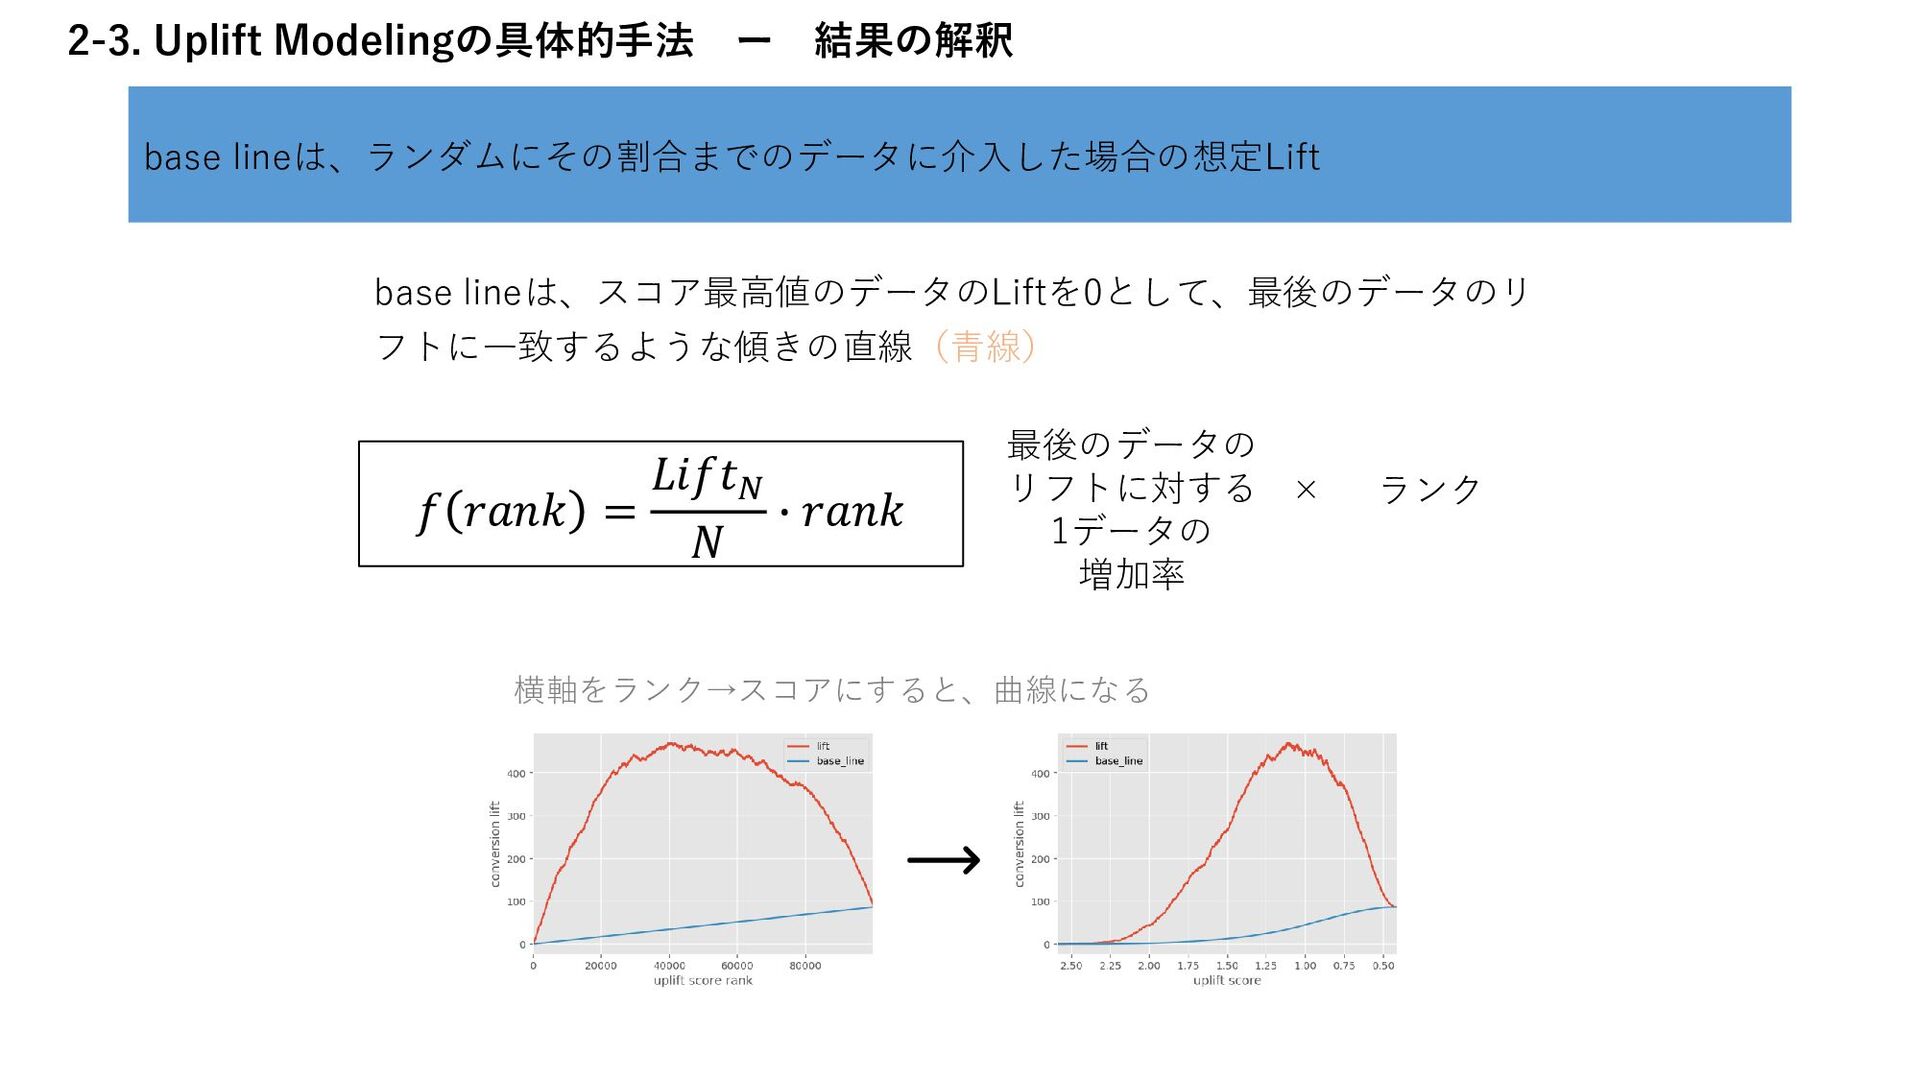
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 AUUCは、liftとbase lineに囲まれた面積を全データ数で割った(正規化した)値 AUUC = 1
N i=1 N Lifti − baselinei 以下の式で示される(総データ数をN) 差を足す -
2-3. Uplift Modelingの具体的手法 ー 結果の解釈 base lineは、ランダムにその割合までのデータに介入した場合の想定Lift base lineは、スコア最高値のデータのLiftを0として、最後のデータのリ フトに一致するような傾きの直線(青線)
𝑓 𝑟𝑎𝑛𝑘 = 𝐿𝑖𝑓𝑡𝑁 𝑁 ∙ 𝑟𝑎𝑛𝑘 最後のデータの リフトに対する 1データの 増加率 ランク × 横軸をランク→スコアにすると、曲線になる -
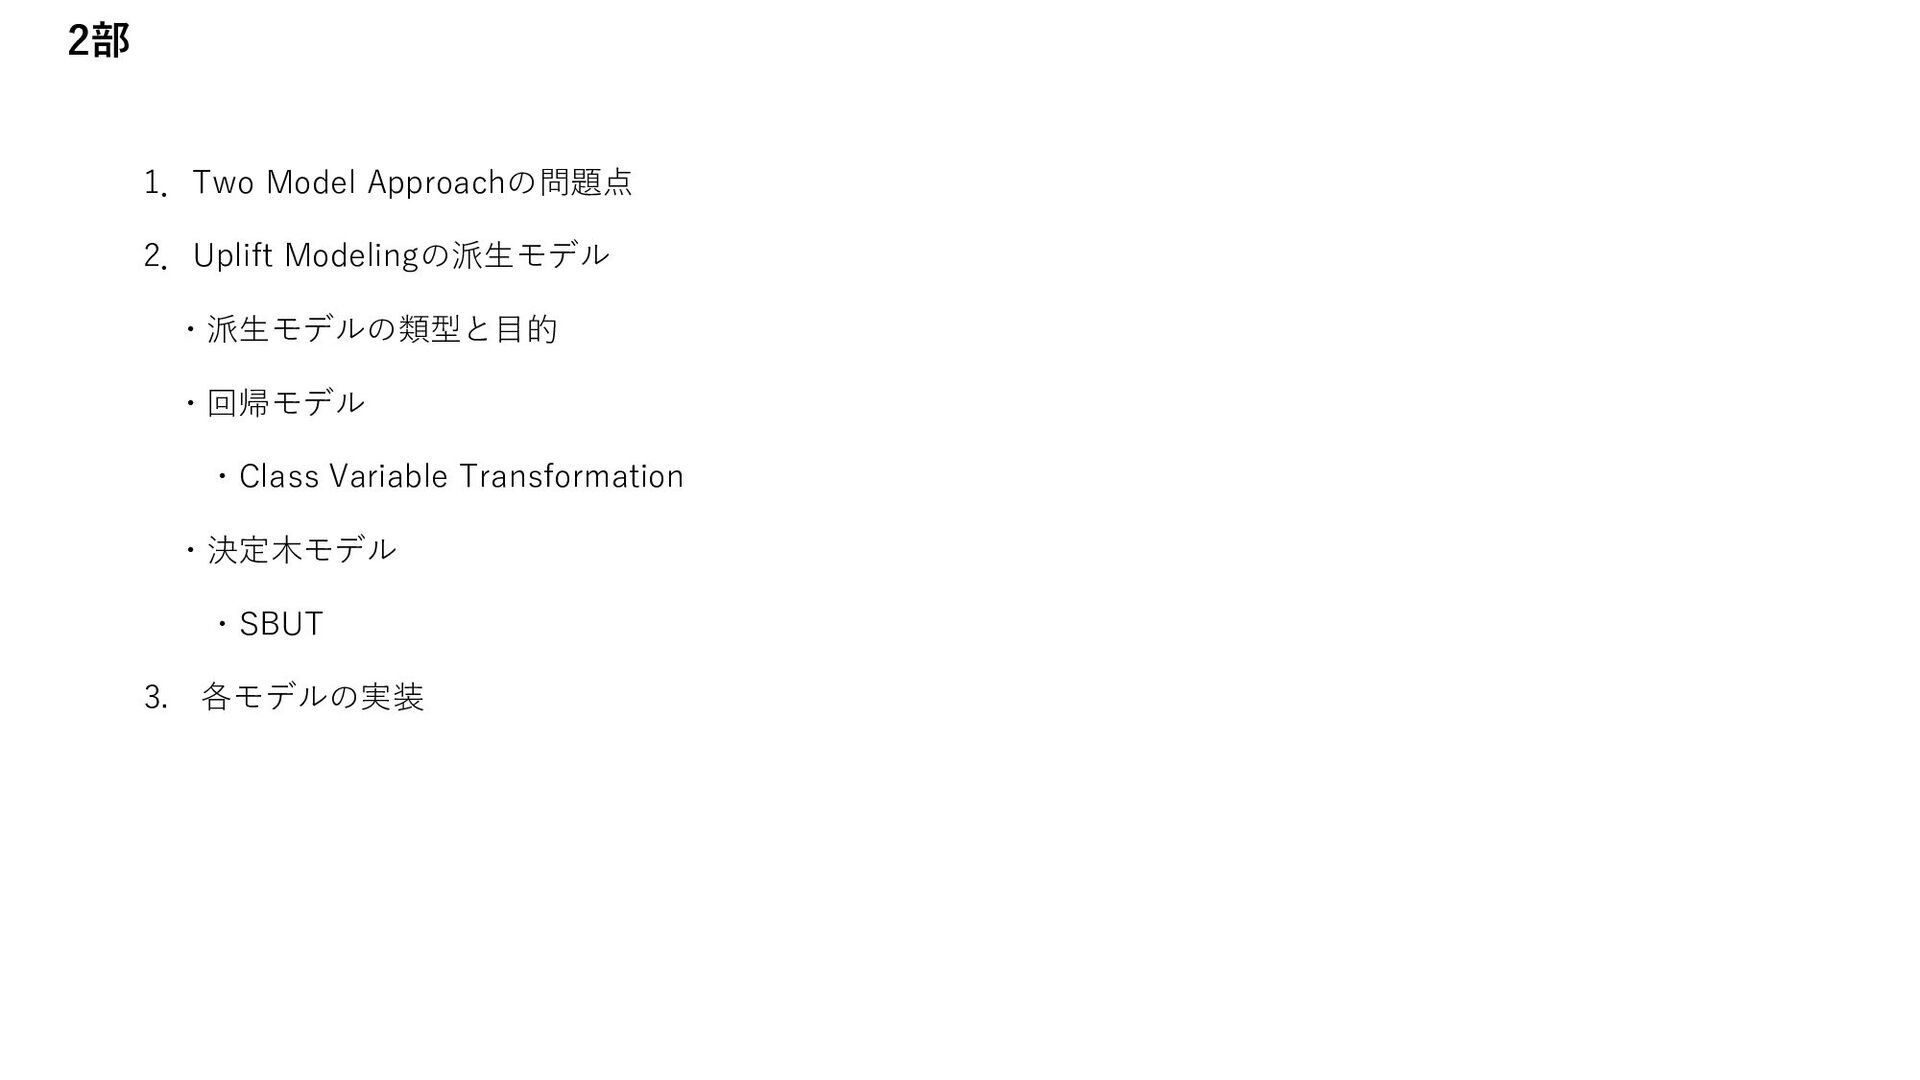
2部 1.Two Model Approachの問題点 2.Uplift Modelingの派生モデル ・派生モデルの類型と目的 ・回帰モデル ・Class Variable
Transformation ・決定木モデル ・SBUT 3. 各モデルの実装 -
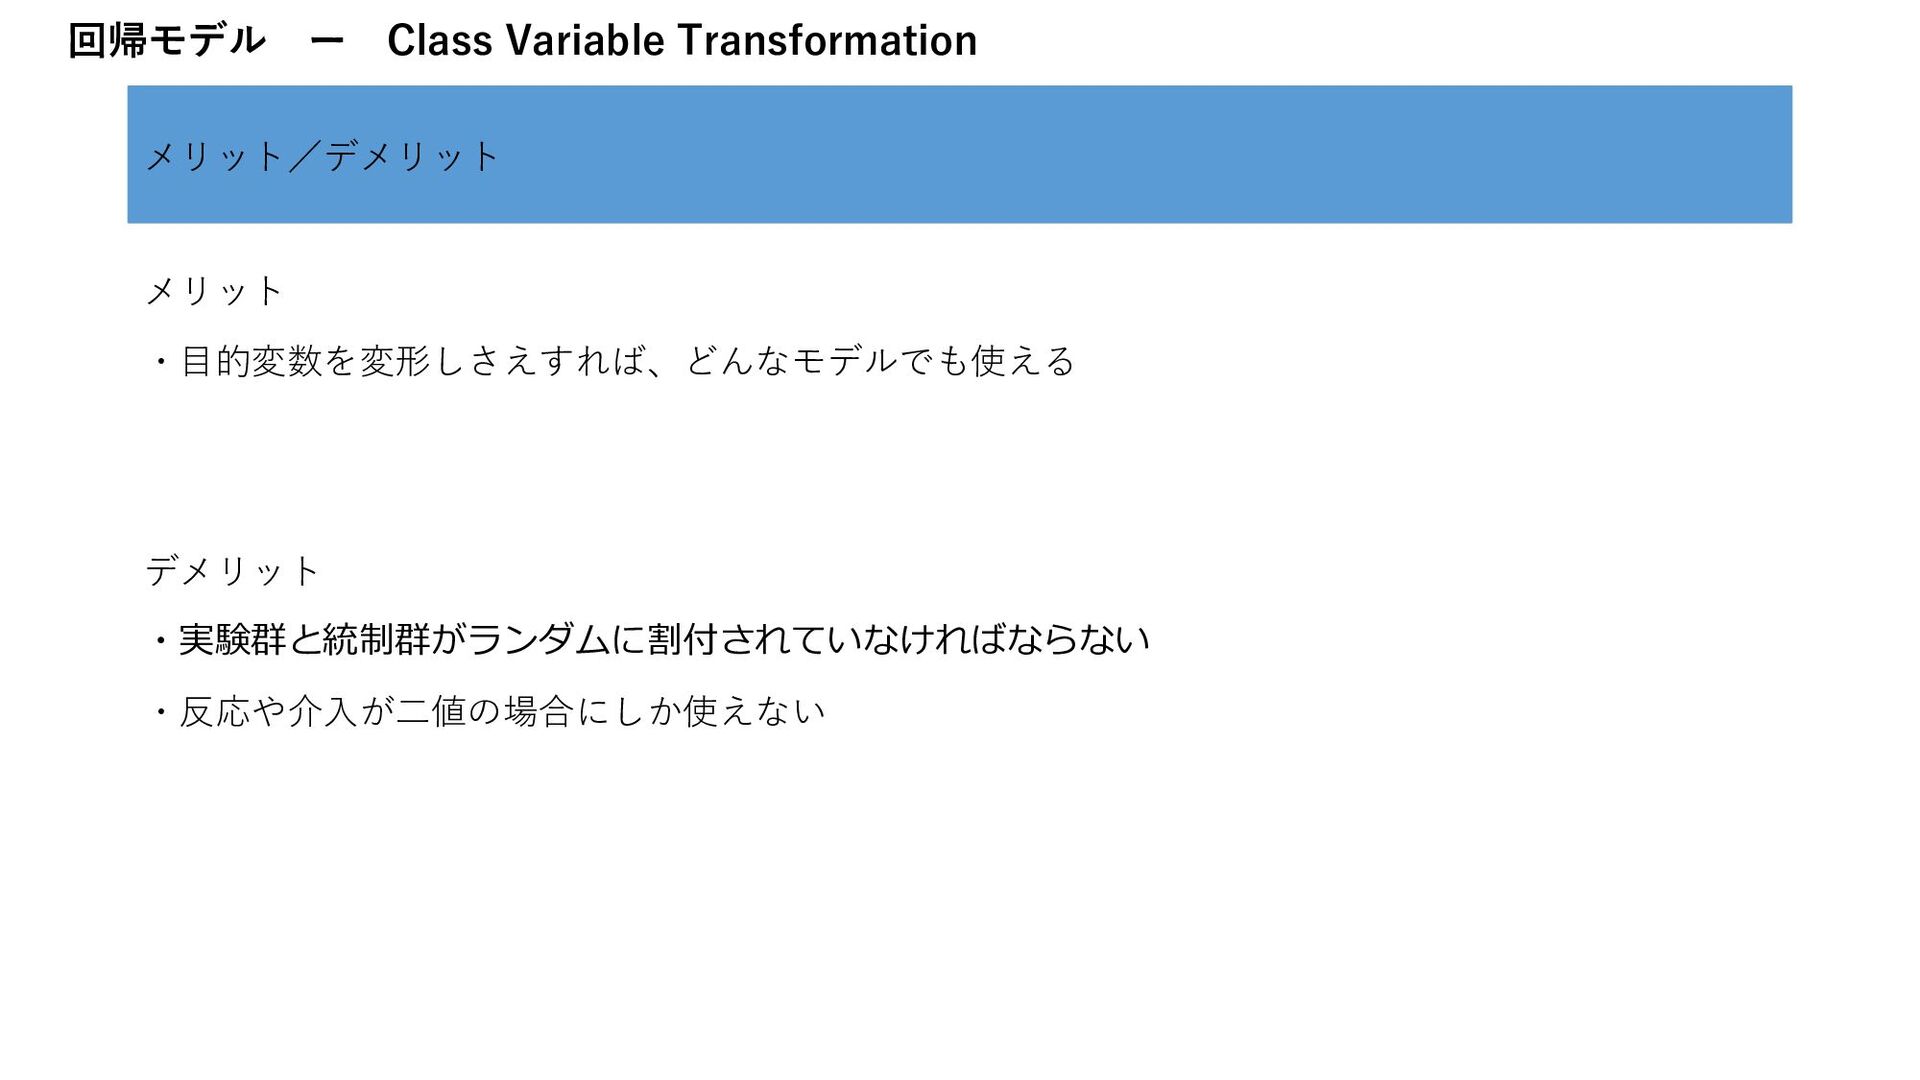
Two Model Approachの問題点 モデル利用上の問題点がある ・モデルのパラメータチューニングが困難 ・モデルの解釈が困難 ・AUUCが最良となるようなモデルのパラメータを探索できるが、 コーディングの難度が高くなり、試行するパラメータの組み合わせも 増えるため、パラメータチューニングが困難となる ・モデルの変数に対する評価を行うと、反応に関係のあるデータの
パターンがわかる 二つのモデルだと、二組の評価結果となるので解釈が困難 ex.ロジスティック回帰だと偏回帰係数、決定木だと重要度など -
Two Model Approachの問題点 そして、モデルの構造にも問題があり、現実の問題でうまくいくことは稀 Two Model Approachにおいて、各モデルの目的はアップリフトの予測ではなく、各 モデルに割り当てられた群の反応の予測 反応が介入より他の変数に従う場合には、その変数を重視して反応を予測をするよう なモデルになる
この場合、反応の予測がアップリフトの予測につながらない つまり、介入の効果を無視しがちなモデルになる そして、実は現実の問題はほとんどそうである Nicholas J. Radcliffe & Patrick D. Surry (2011) “Real-World Uplift Modelling with Significance-Based Uplift Trees“, p16-17 -
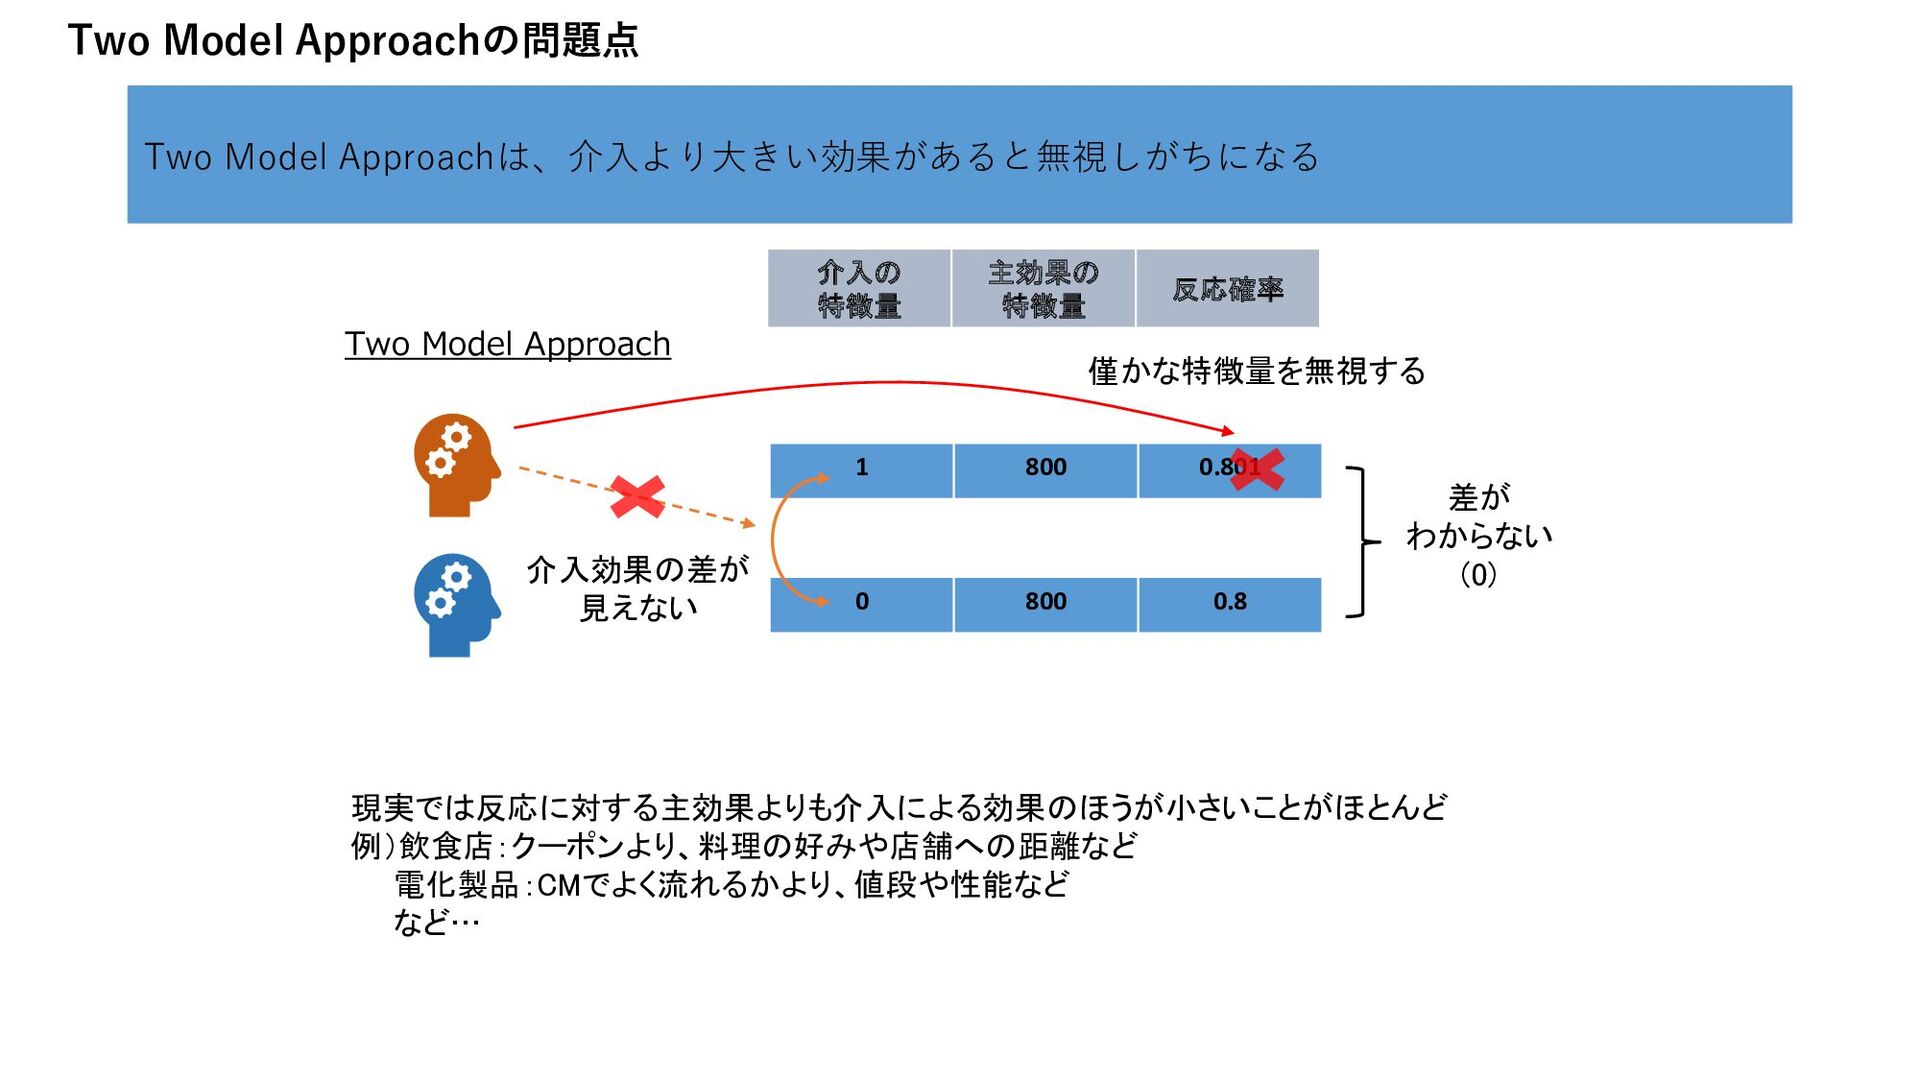
Two Model Approachの問題点 Two Model Approachは、介入より大きい効果があると無視しがちになる 0 800 0.8 介入の
特徴量 主効果の 特徴量 反応確率 1 800 0.801 Two Model Approach 介入効果の差が 見えない 僅かな特徴量を無視する 現実では反応に対する主効果よりも介入による効果のほうが小さいことがほとんど 例)飲食店:クーポンより、料理の好みや店舗への距離など 電化製品:CMでよく流れるかより、値段や性能など など… 差が わからない (0) -
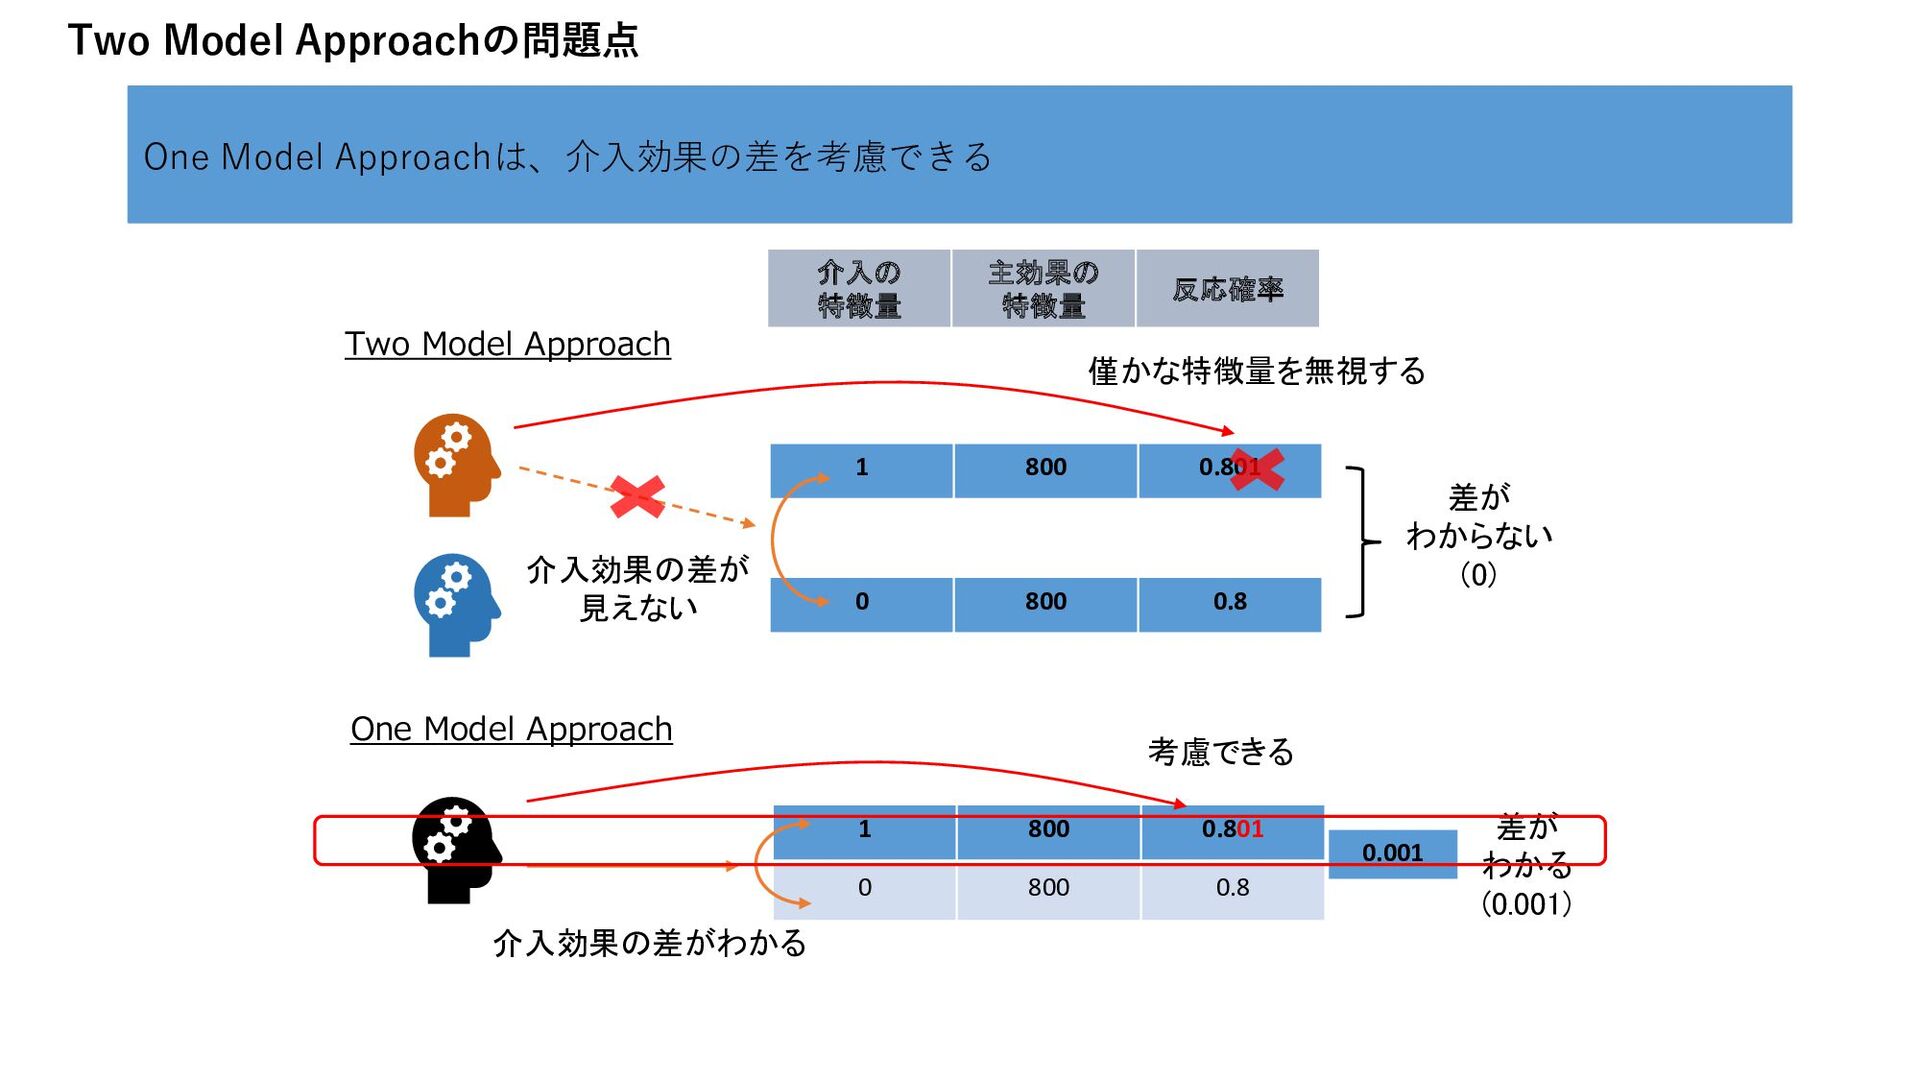
Two Model Approachの問題点 One Model Approachは、介入効果の差を考慮できる 0 800 0.8 介入の
特徴量 主効果の 特徴量 反応確率 1 800 0.801 1 800 0.801 0 800 0.8 Two Model Approach One Model Approach 介入効果の差が 見えない 僅かな特徴量を無視する 考慮できる 介入効果の差がわかる 差が わからない (0) 差が わかる (0.001) 0.001 -
Two Model Approachの問題点 One Model Approachならこれらの問題を解決できる Two Model Approachの問題 ・モデルのパラメータチューニングが困難
・モデルの解釈が困難 ・介入より大きい効果があると無視しがちになる → One Model Approachならすべて解決できる -
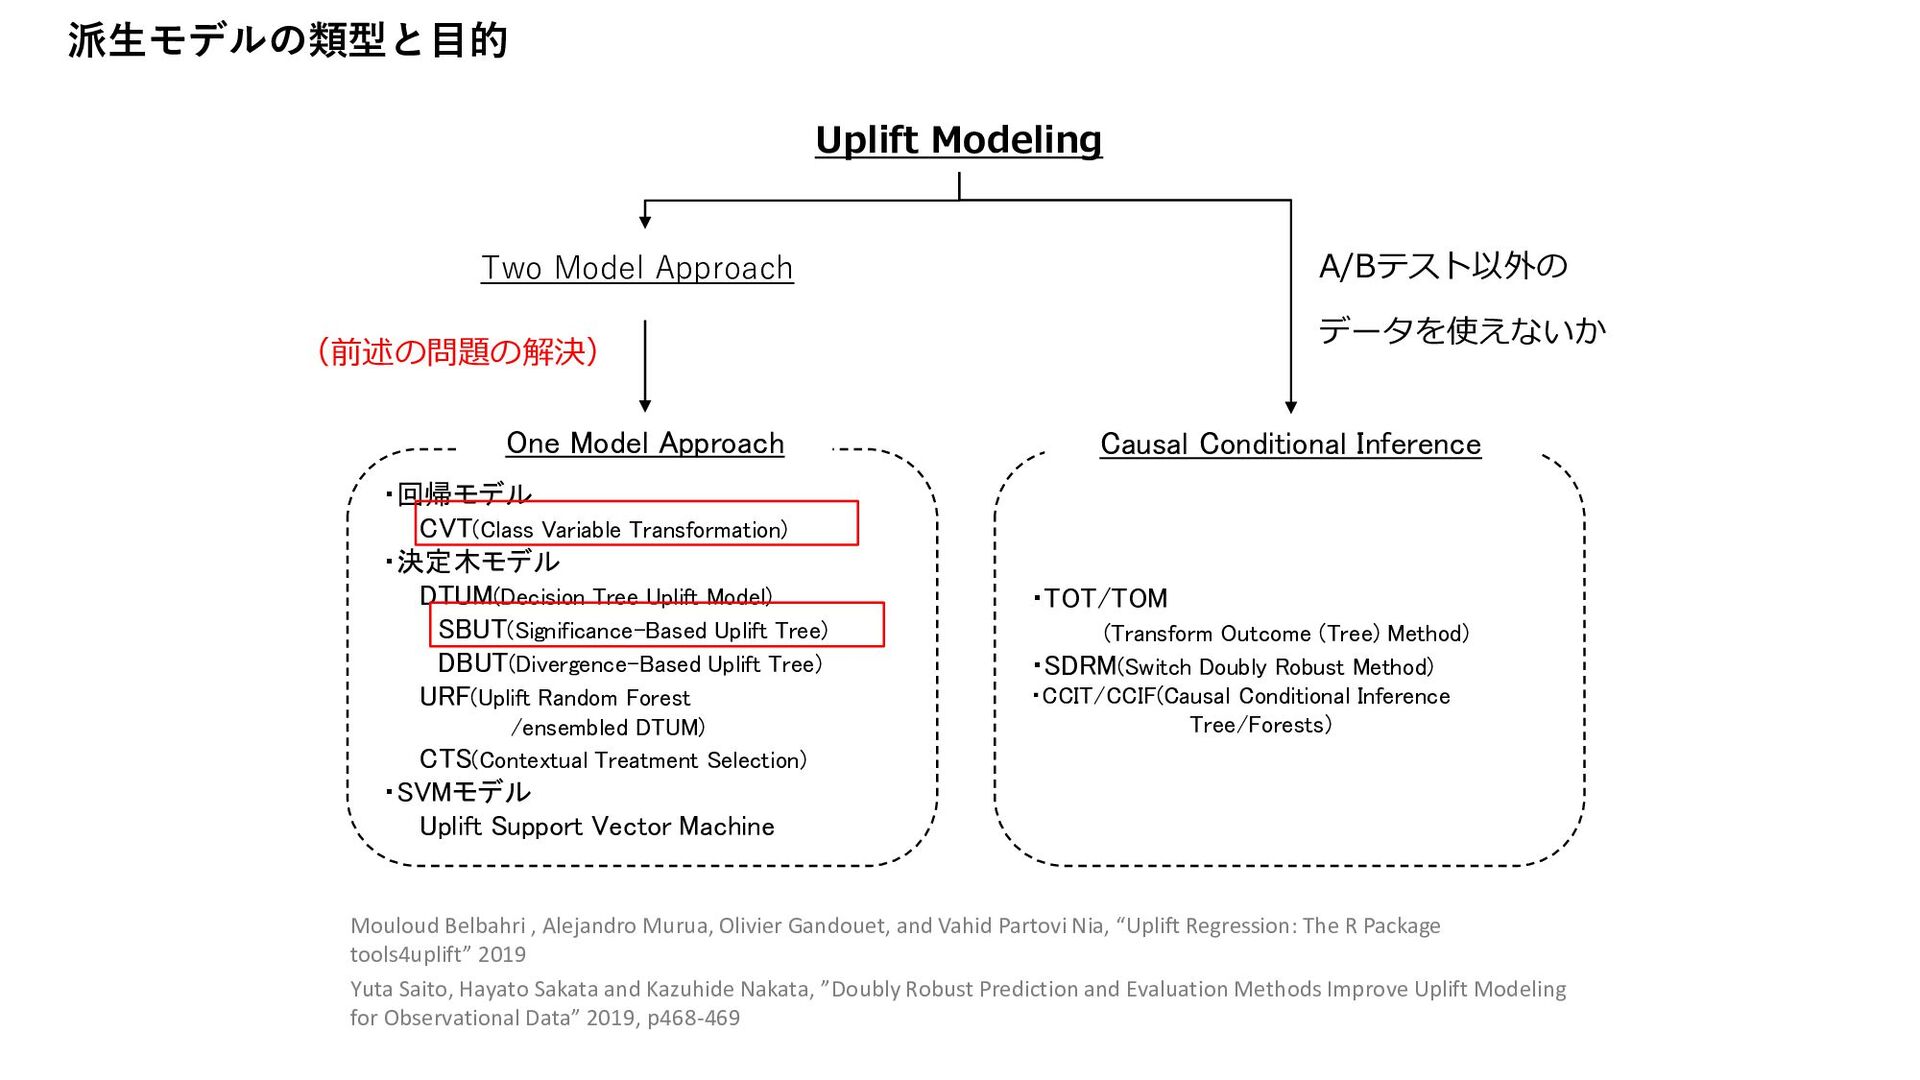
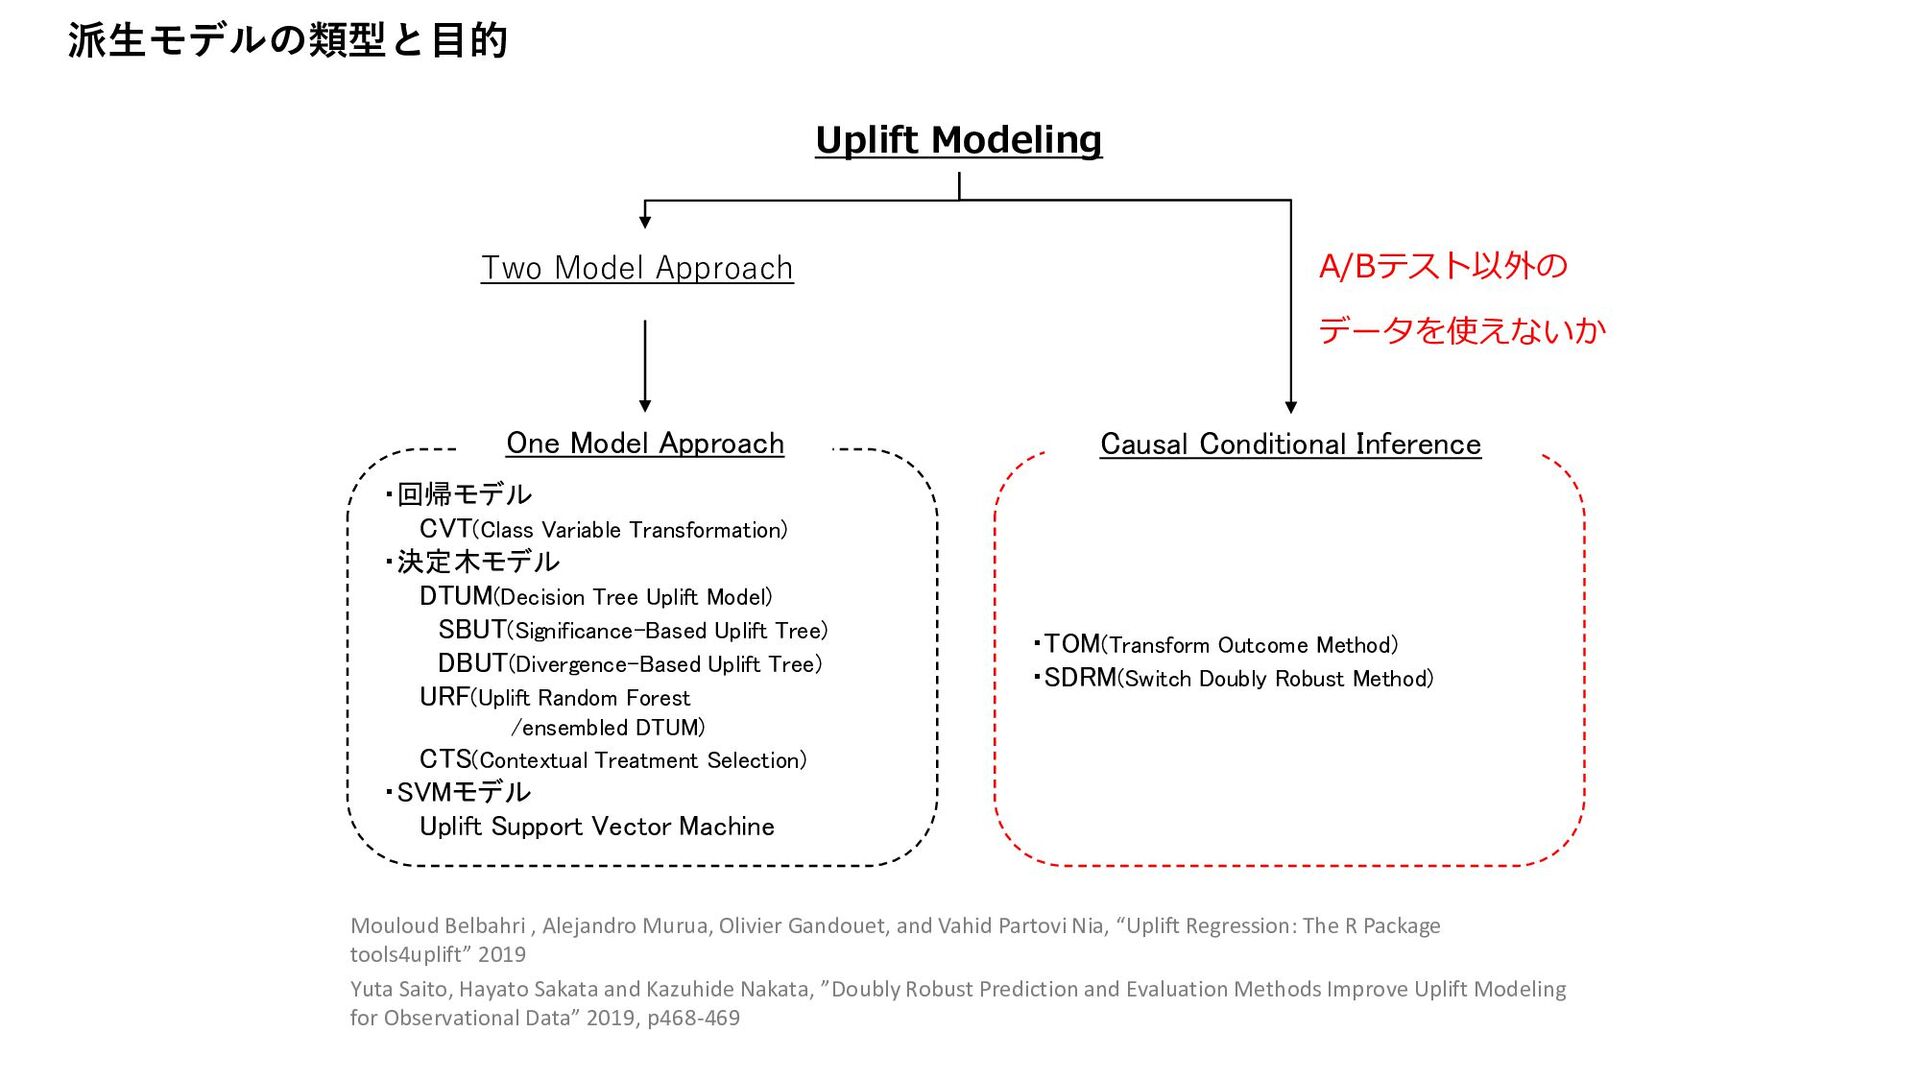
派生モデルの類型と目的 Two Model Approach Mouloud Belbahri , Alejandro Murua, Olivier
Gandouet, and Vahid Partovi Nia, “Uplift Regression: The R Package tools4uplift” 2019 Yuta Saito, Hayato Sakata and Kazuhide Nakata, ”Doubly Robust Prediction and Evaluation Methods Improve Uplift Modeling for Observational Data” 2019, p468-469 ・回帰モデル CVT(Class Variable Transformation) ・決定木モデル DTUM(Decision Tree Uplift Model) SBUT(Significance-Based Uplift Tree) DBUT(Divergence-Based Uplift Tree) URF(Uplift Random Forest /ensembled DTUM) CTS(Contextual Treatment Selection) ・SVMモデル Uplift Support Vector Machine One Model Approach ・TOT/TOM (Transform Outcome (Tree) Method) ・SDRM(Switch Doubly Robust Method) ・CCIT/CCIF(Causal Conditional Inference Tree/Forests) (前述の問題の解決) A/Bテスト以外の データを使えないか Causal Conditional Inference Uplift Modeling -
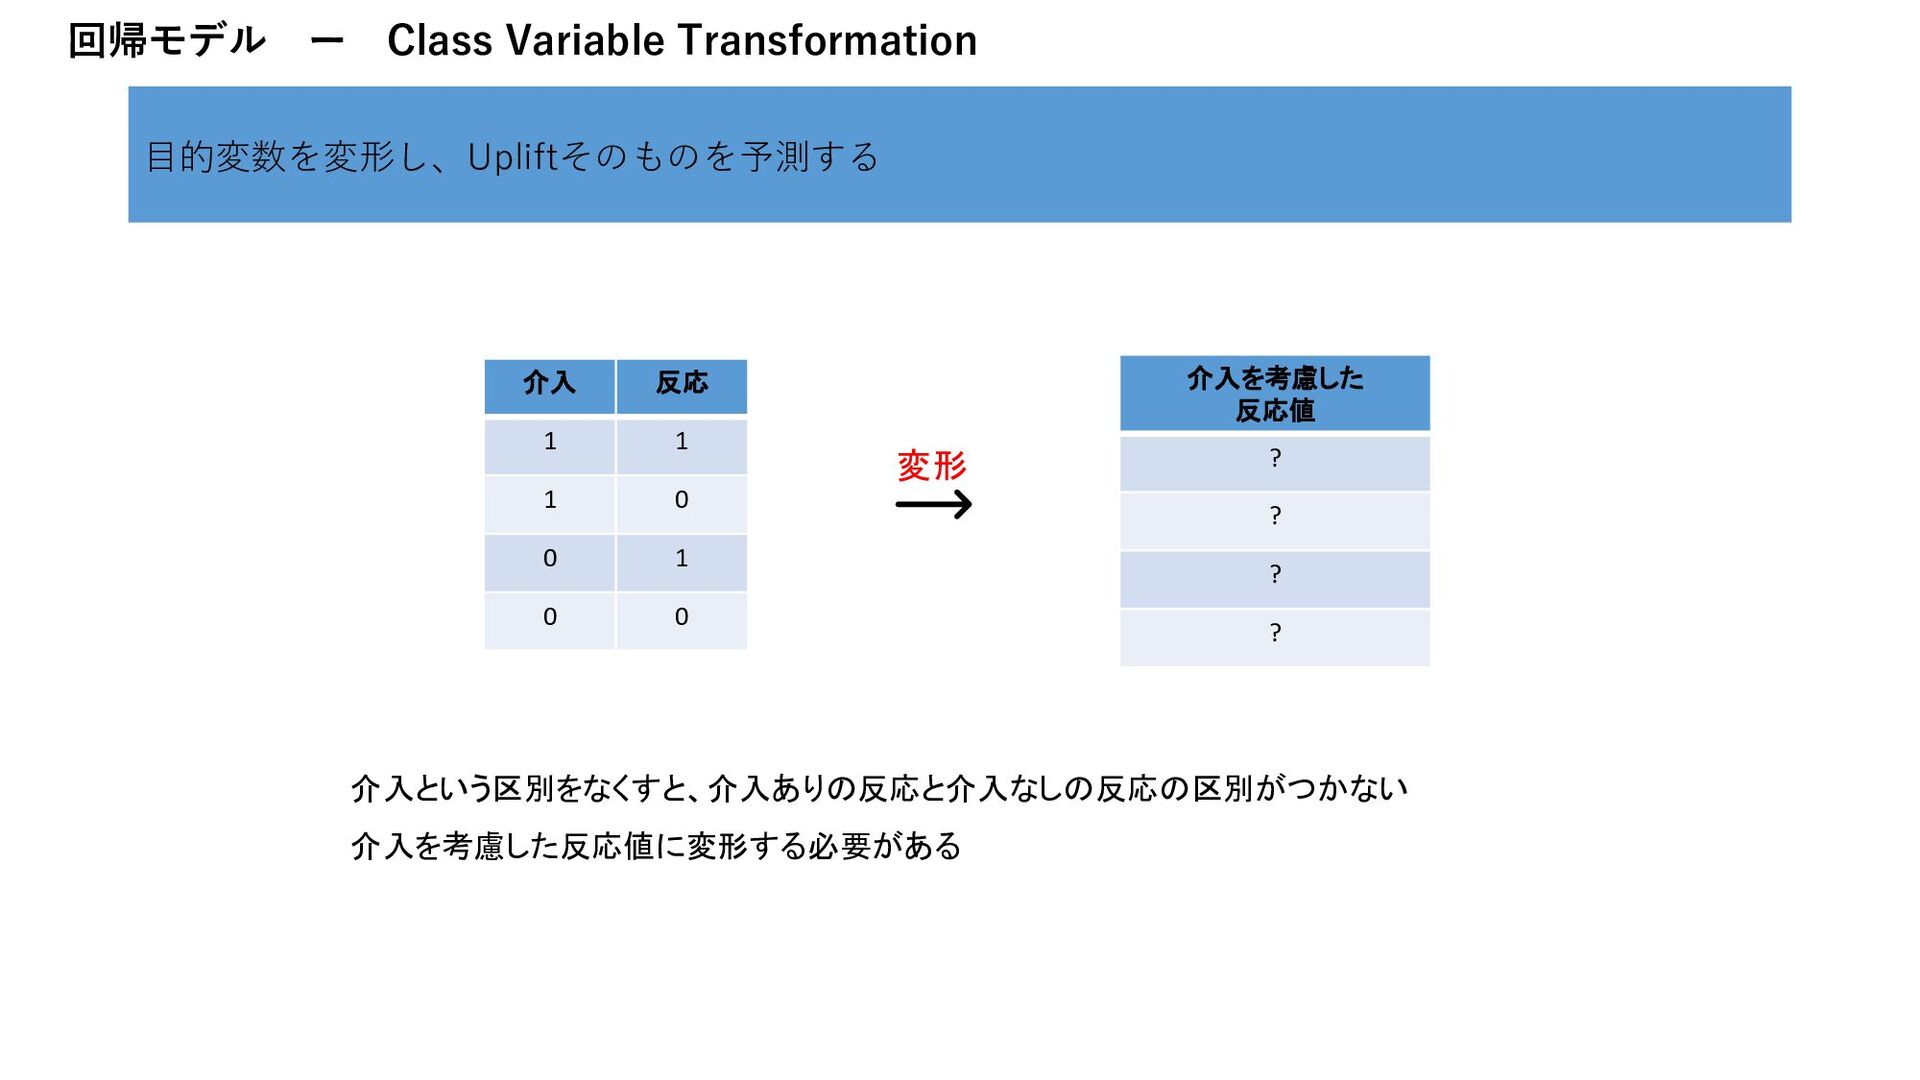
回帰モデル ー Class Variable Transformation 目的変数を変形し、Upliftそのものを予測する 変形 介入 反応 1
1 1 0 0 1 0 0 介入を考慮した 反応値 ? ? ? ? 介入という区別をなくすと、介入ありの反応と介入なしの反応の区別がつかない 介入を考慮した反応値に変形する必要がある -
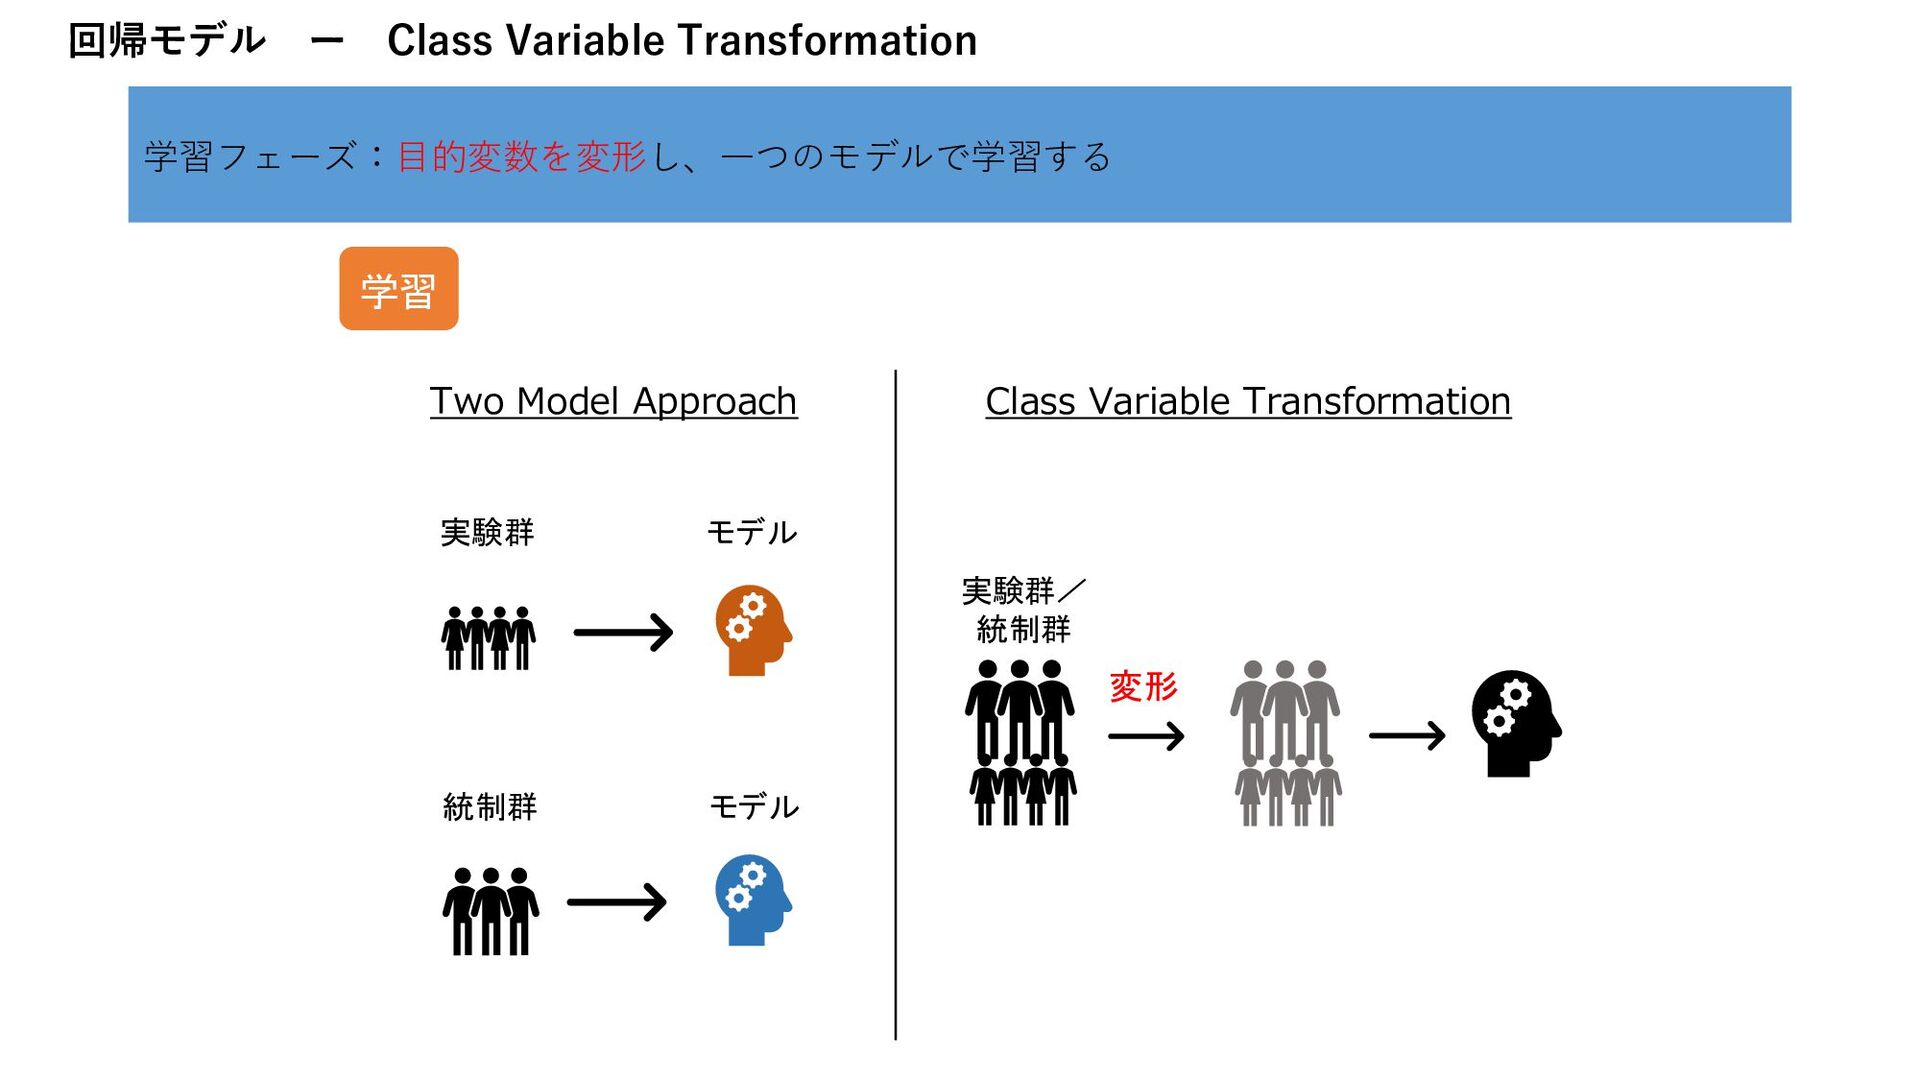
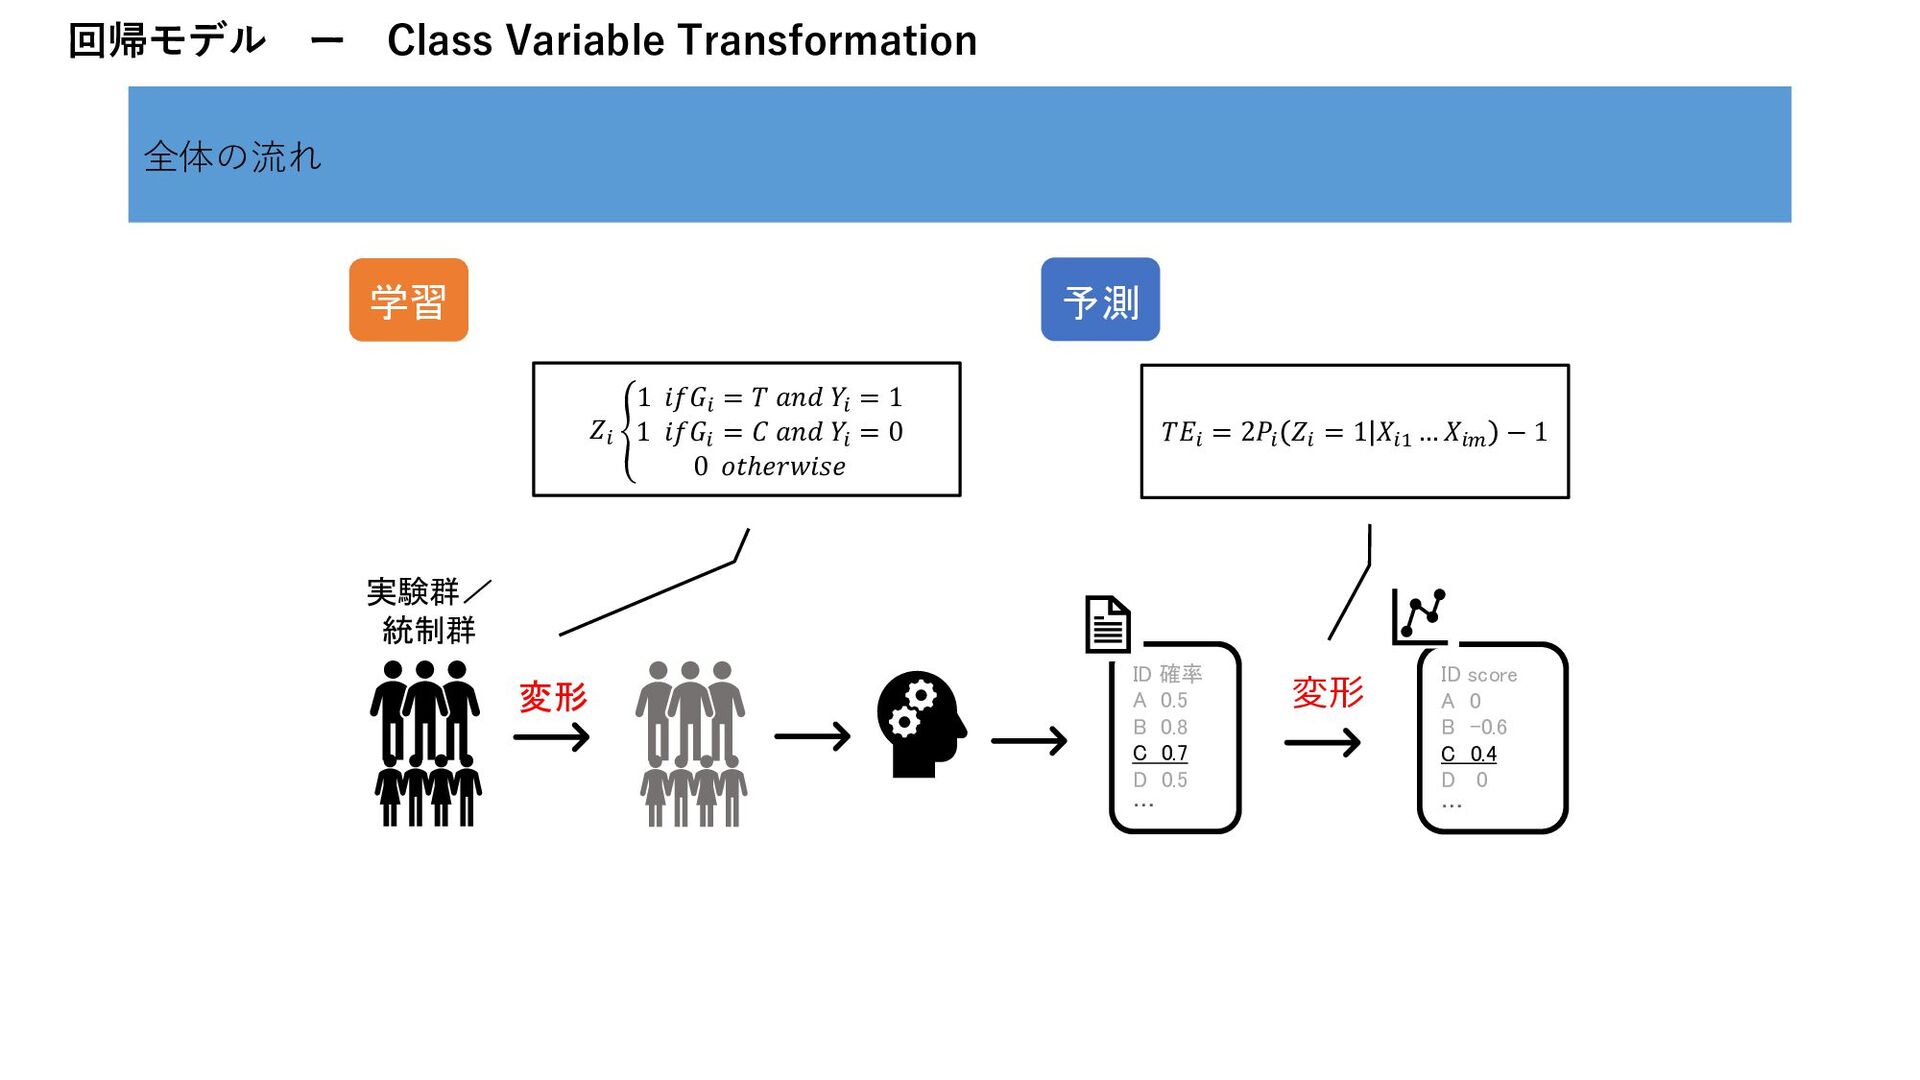
回帰モデル ー Class Variable Transformation 学習フェーズ:目的変数を変形し、一つのモデルで学習する Two Model Approach Class
Variable Transformation 実験群 モデル 統制群 モデル 実験群/ 統制群 変形 学習 -
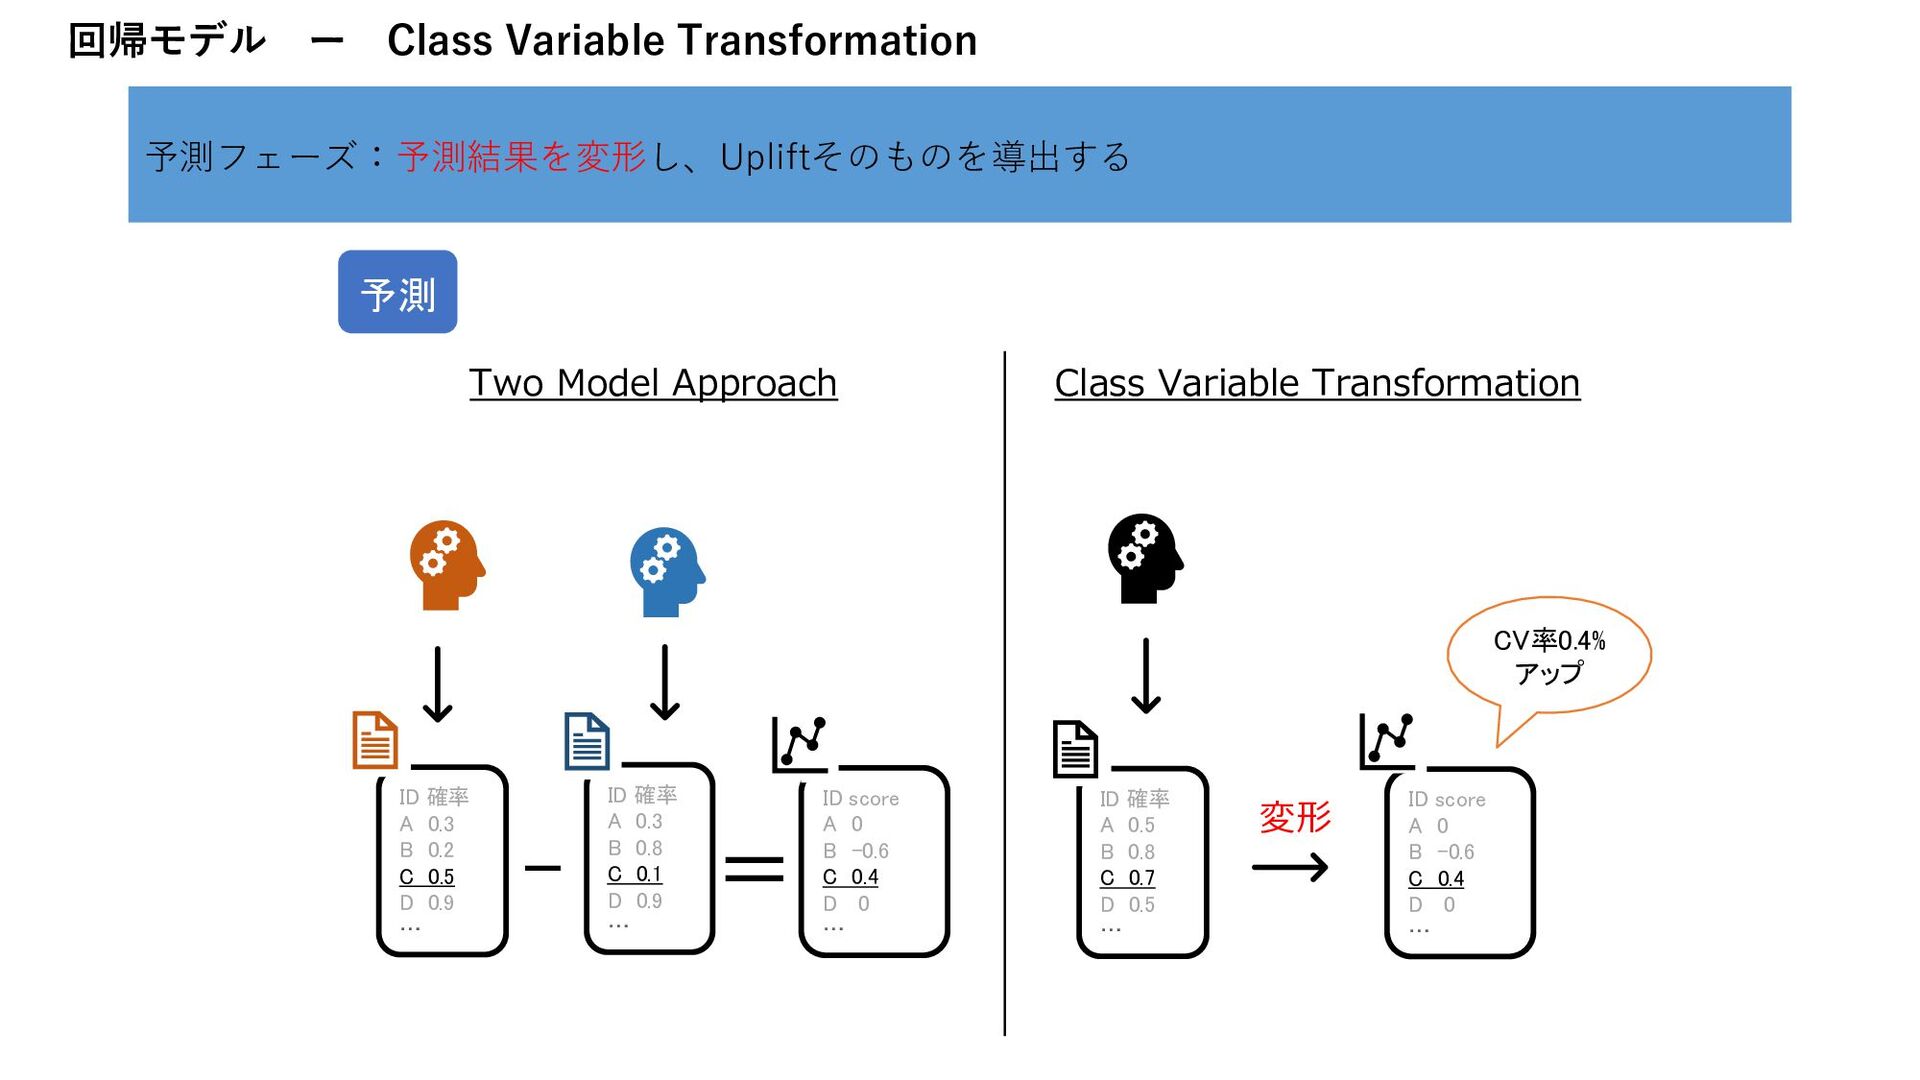
回帰モデル ー Class Variable Transformation 予測フェーズ:予測結果を変形し、Upliftそのものを導出する ID 確率 A 0.3
B 0.2 C 0.5 D 0.9 … ID 確率 A 0.3 B 0.8 C 0.1 D 0.9 … ID score A 0 B -0.6 C 0.4 D 0 … - = Two Model Approach Class Variable Transformation ID 確率 A 0.5 B 0.8 C 0.7 D 0.5 … ID score A 0 B -0.6 C 0.4 D 0 … 変形 予測 CV率0.4% アップ -
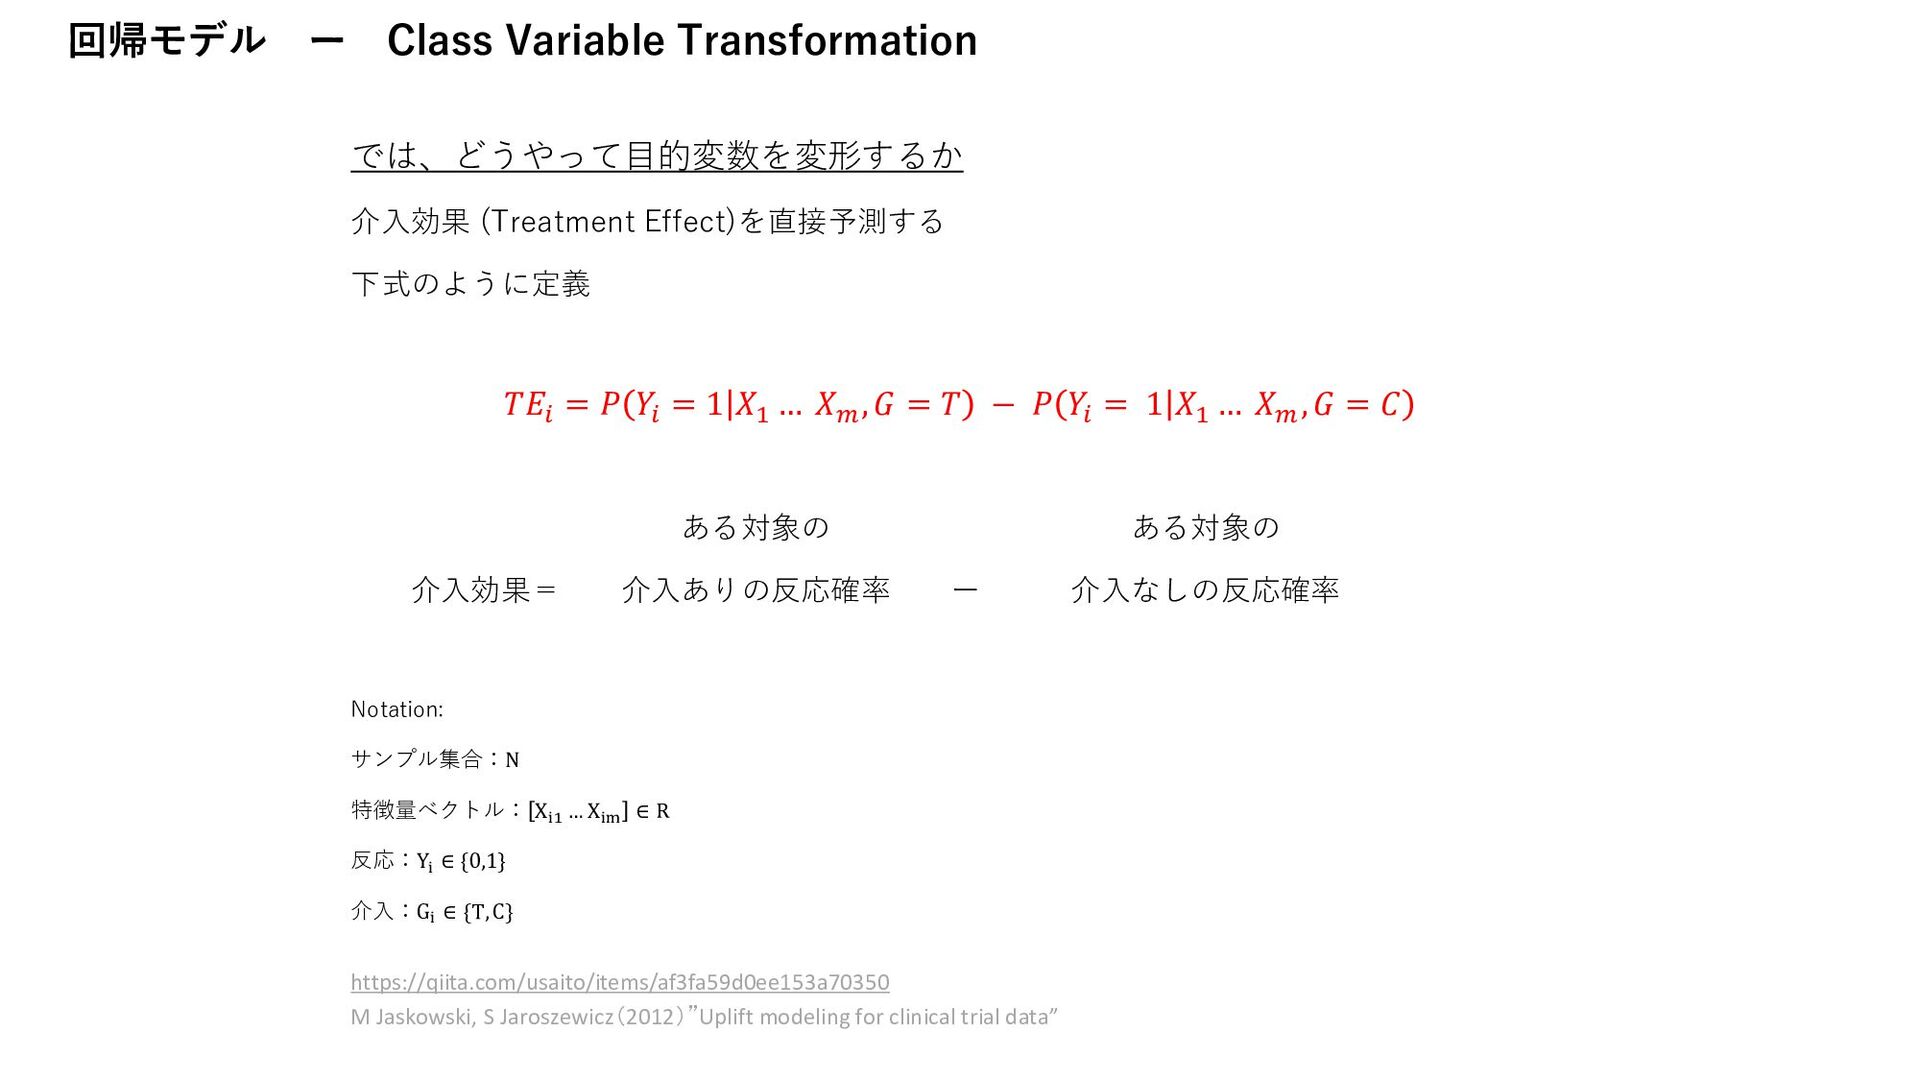
回帰モデル ー Class Variable Transformation では、どうやって目的変数を変形するか 介入効果 (Treatment Effect)を直接予測する 下式のように定義
𝑇𝐸𝑖 = 𝑃 𝑌𝑖 = 1 𝑋1 … 𝑋𝑚 , 𝐺 = 𝑇 − 𝑃 𝑌𝑖 = 1 𝑋1 … 𝑋𝑚 , 𝐺 = 𝐶 ある対象の ある対象の 介入効果= 介入ありの反応確率 ー 介入なしの反応確率 Notation: サンプル集合:N 特徴量ベクトル: Xi1 … Xim ∈ R 反応:Yi ∈ {0,1} 介入:Gi ∈ {T, C} https://qiita.com/usaito/items/af3fa59d0ee153a70350 M Jaskowski, S Jaroszewicz(2012)”Uplift modeling for clinical trial data” -
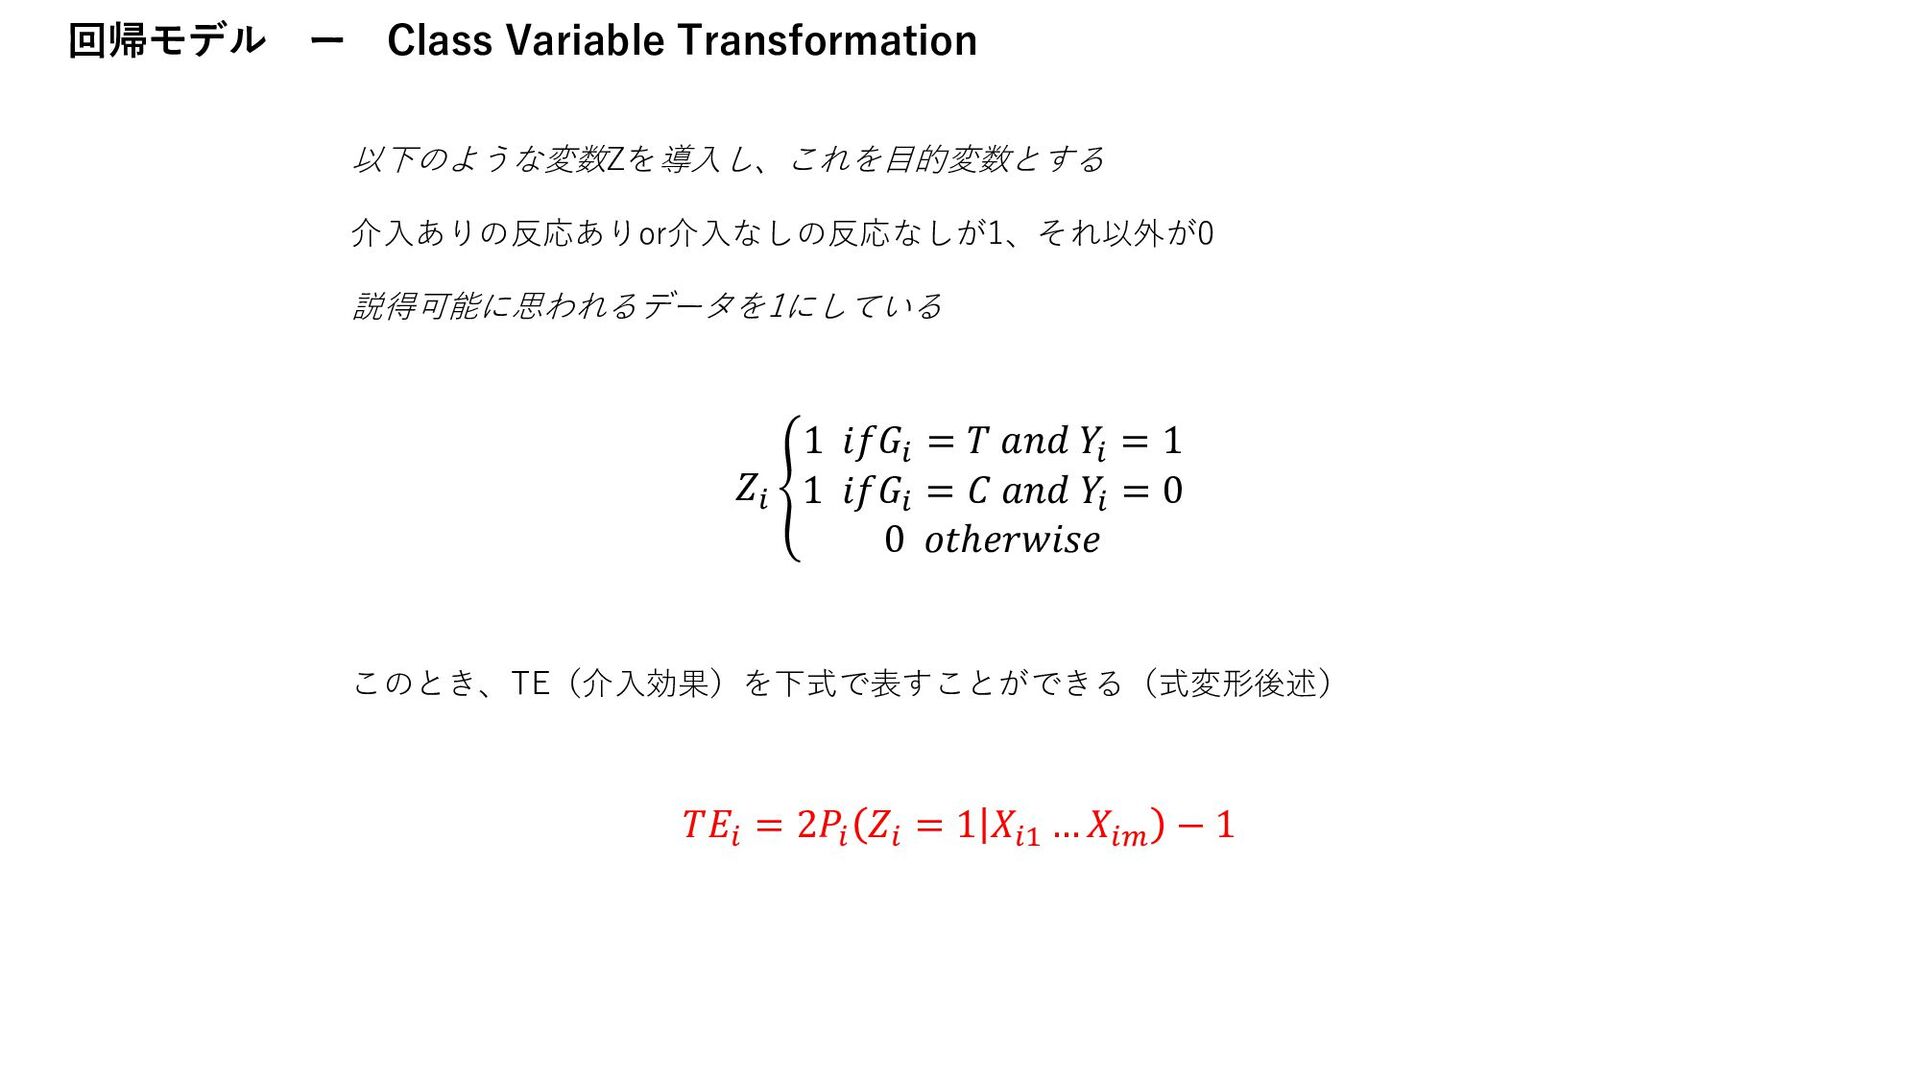
回帰モデル ー Class Variable Transformation 以下のような変数Zを導入し、これを目的変数とする 介入ありの反応ありor介入なしの反応なしが1、それ以外が0 説得可能に思われるデータを1にしている 𝑍𝑖 ቐ
1 𝑖𝑓𝐺𝑖 = 𝑇 𝑎𝑛𝑑 𝑌𝑖 = 1 1 𝑖𝑓𝐺𝑖 = 𝐶 𝑎𝑛𝑑 𝑌𝑖 = 0 0 𝑜𝑡ℎ𝑒𝑟𝑤𝑖𝑠𝑒 このとき、TE(介入効果)を下式で表すことができる(式変形後述) 𝑇𝐸𝑖 = 2𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 − 1 -
𝑇𝐸𝑖 = 2𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 −
1 𝑍𝑖 ቐ 1 𝑖𝑓𝐺𝑖 = 𝑇 𝑎𝑛𝑑 𝑌𝑖 = 1 1 𝑖𝑓𝐺𝑖 = 𝐶 𝑎𝑛𝑑 𝑌𝑖 = 0 0 𝑜𝑡ℎ𝑒𝑟𝑤𝑖𝑠𝑒 回帰モデル ー Class Variable Transformation 全体の流れ 実験群/ 統制群 変形 学習 予測 ID 確率 A 0.5 B 0.8 C 0.7 D 0.5 … ID score A 0 B -0.6 C 0.4 D 0 … 変形 -
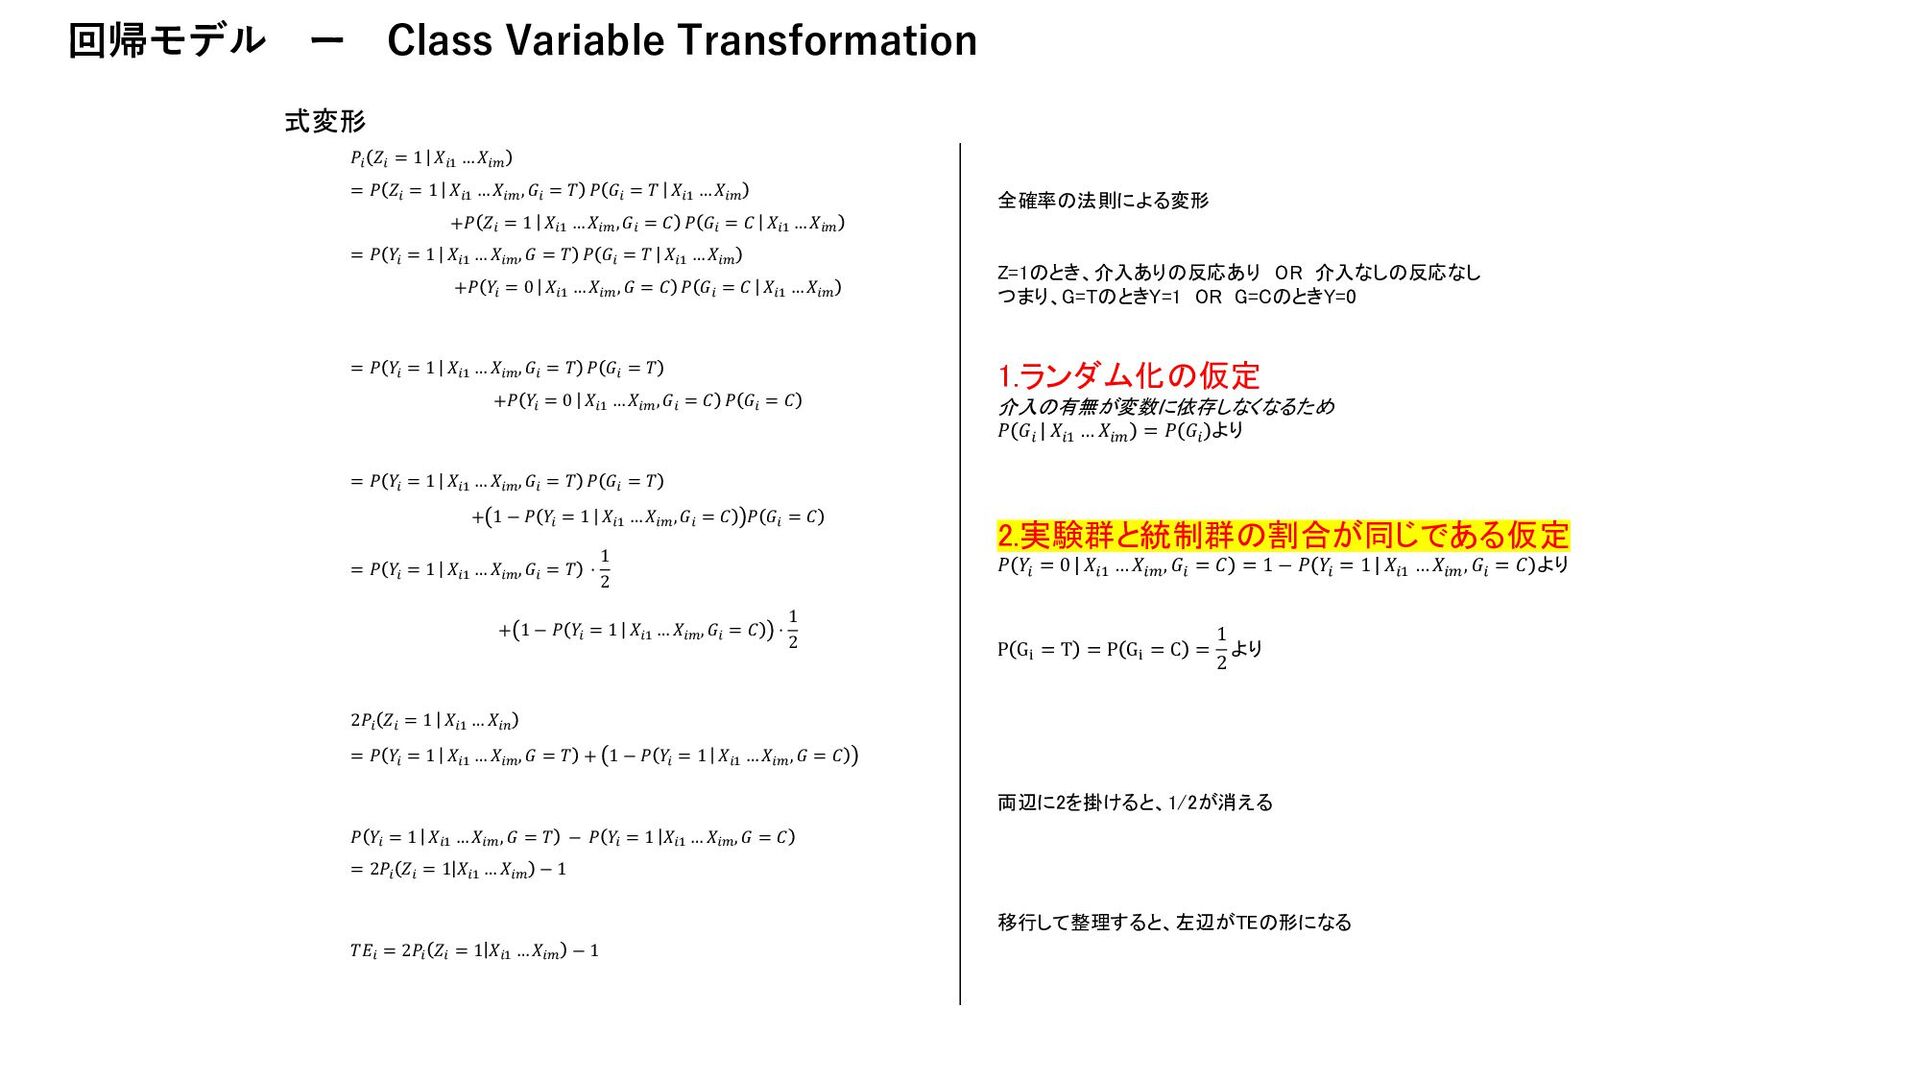
回帰モデル ー Class Variable Transformation 𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1
… 𝑋𝑖𝑚 = 𝑃 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝑇 𝑃 𝐺𝑖 = 𝑇 𝑋𝑖1 … 𝑋𝑖𝑚 +𝑃 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 𝑃 𝐺𝑖 = 𝐶 𝑋𝑖1 … 𝑋𝑖𝑚 = 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝑇 𝑃 𝐺𝑖 = 𝑇 𝑋𝑖1 … 𝑋𝑖𝑚 +𝑃 𝑌𝑖 = 0 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝐶 𝑃 𝐺𝑖 = 𝐶 𝑋𝑖1 … 𝑋𝑖𝑚 = 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝑇 𝑃 𝐺𝑖 = 𝑇 +𝑃 𝑌𝑖 = 0 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 𝑃 𝐺𝑖 = 𝐶 = 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝑇 𝑃 𝐺𝑖 = 𝑇 + 1 − 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 𝑃 𝐺𝑖 = 𝐶 = 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝑇 ⋅ 1 2 + 1 − 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 ⋅ 1 2 2𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑛 = 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝑇 + 1 − 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝐶 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝑇 − 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺 = 𝐶 = 2𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 − 1 𝑇𝐸𝑖 = 2𝑃𝑖 𝑍𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 − 1 全確率の法則による変形 Z=1のとき、介入ありの反応あり OR 介入なしの反応なし つまり、G=TのときY=1 OR G=CのときY=0 1.ランダム化の仮定 介入の有無が変数に依存しなくなるため 𝑃 𝐺𝑖 𝑋𝑖1 … 𝑋𝑖𝑚 = 𝑃 𝐺𝑖 より 2.実験群と統制群の割合が同じである仮定 𝑃 𝑌𝑖 = 0 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 = 1 − 𝑃 𝑌𝑖 = 1 𝑋𝑖1 … 𝑋𝑖𝑚 , 𝐺𝑖 = 𝐶 より P Gi = T = P Gi = C = 1 2 より 両辺に2を掛けると、1/2が消える 移行して整理すると、左辺がTEの形になる 式変形 -
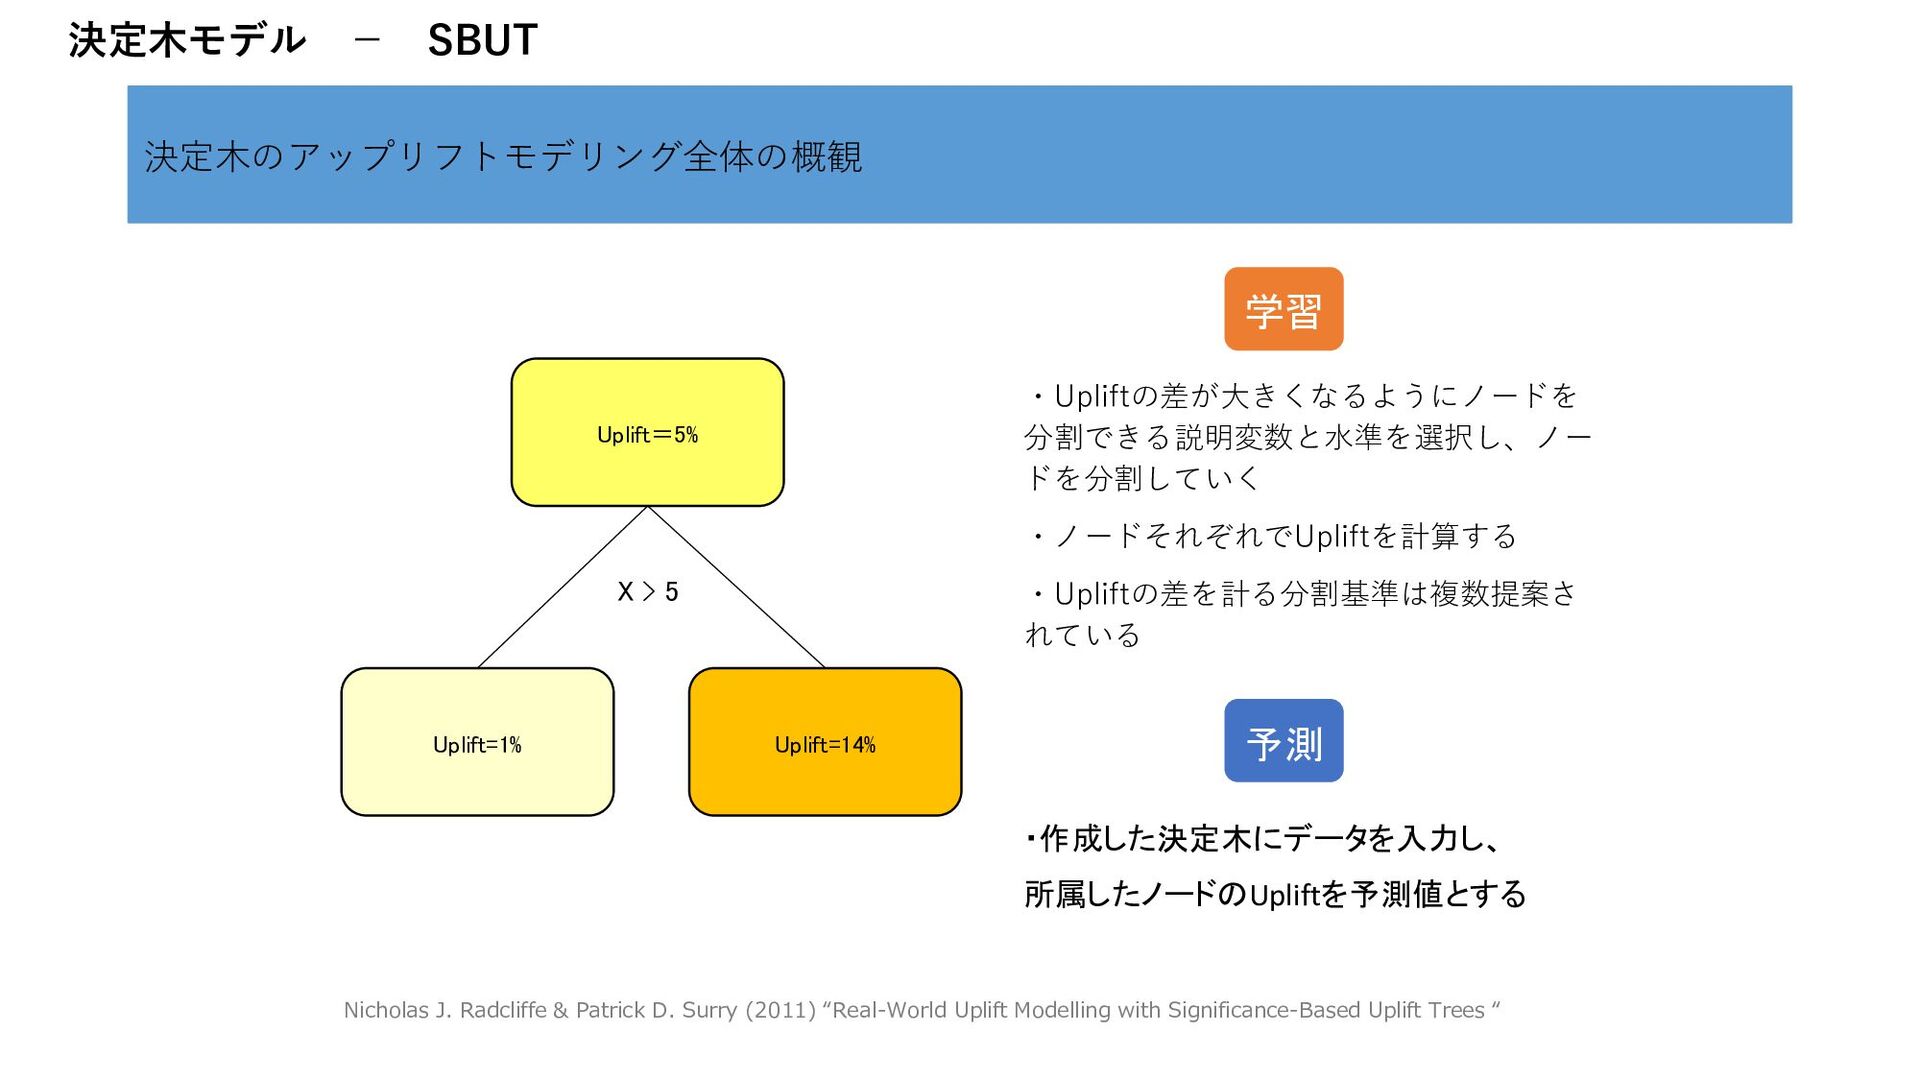
決定木モデル - SBUT 決定木のアップリフトモデリング全体の概観 Nicholas J. Radcliffe & Patrick D.
Surry (2011) “Real-World Uplift Modelling with Significance-Based Uplift Trees “ ・Upliftの差が大きくなるようにノードを 分割できる説明変数と水準を選択し、ノー ドを分割していく ・ノードそれぞれでUpliftを計算する ・Upliftの差を計る分割基準は複数提案さ れている Uplift=5% Uplift=1% Uplift=14% X > 5 学習 ・作成した決定木にデータを入力し、 所属したノードのUpliftを予測値とする 予測 -
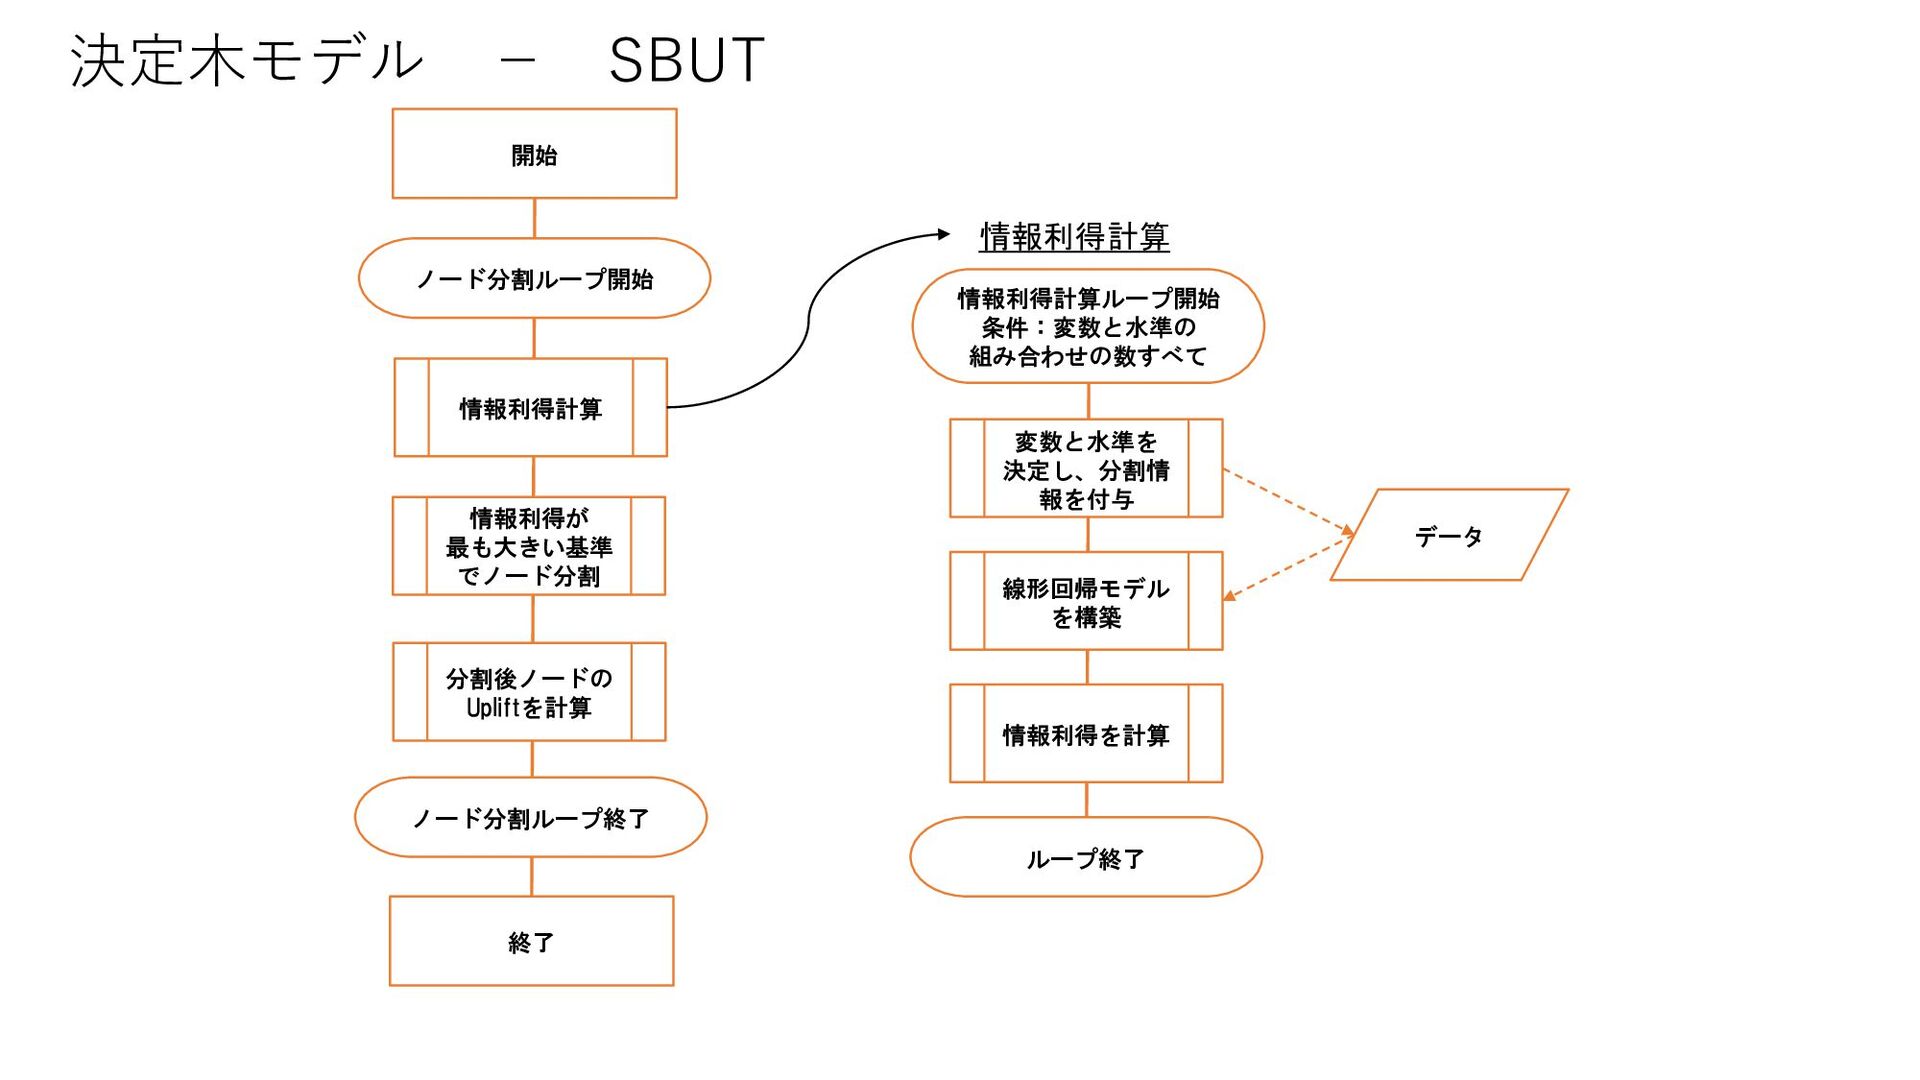
決定木モデル - SBUT 情報利得計算ループ開始 条件:変数と水準の 組み合わせの数すべて データ 変数と水準を 決定し、分割情 報を付与
線形回帰モデル を構築 情報利得を計算 ループ終了 ノード分割ループ開始 ノード分割ループ終了 情報利得計算 情報利得が 最も大きい基準 でノード分割 終了 開始 情報利得計算 分割後ノードの Upliftを計算 -
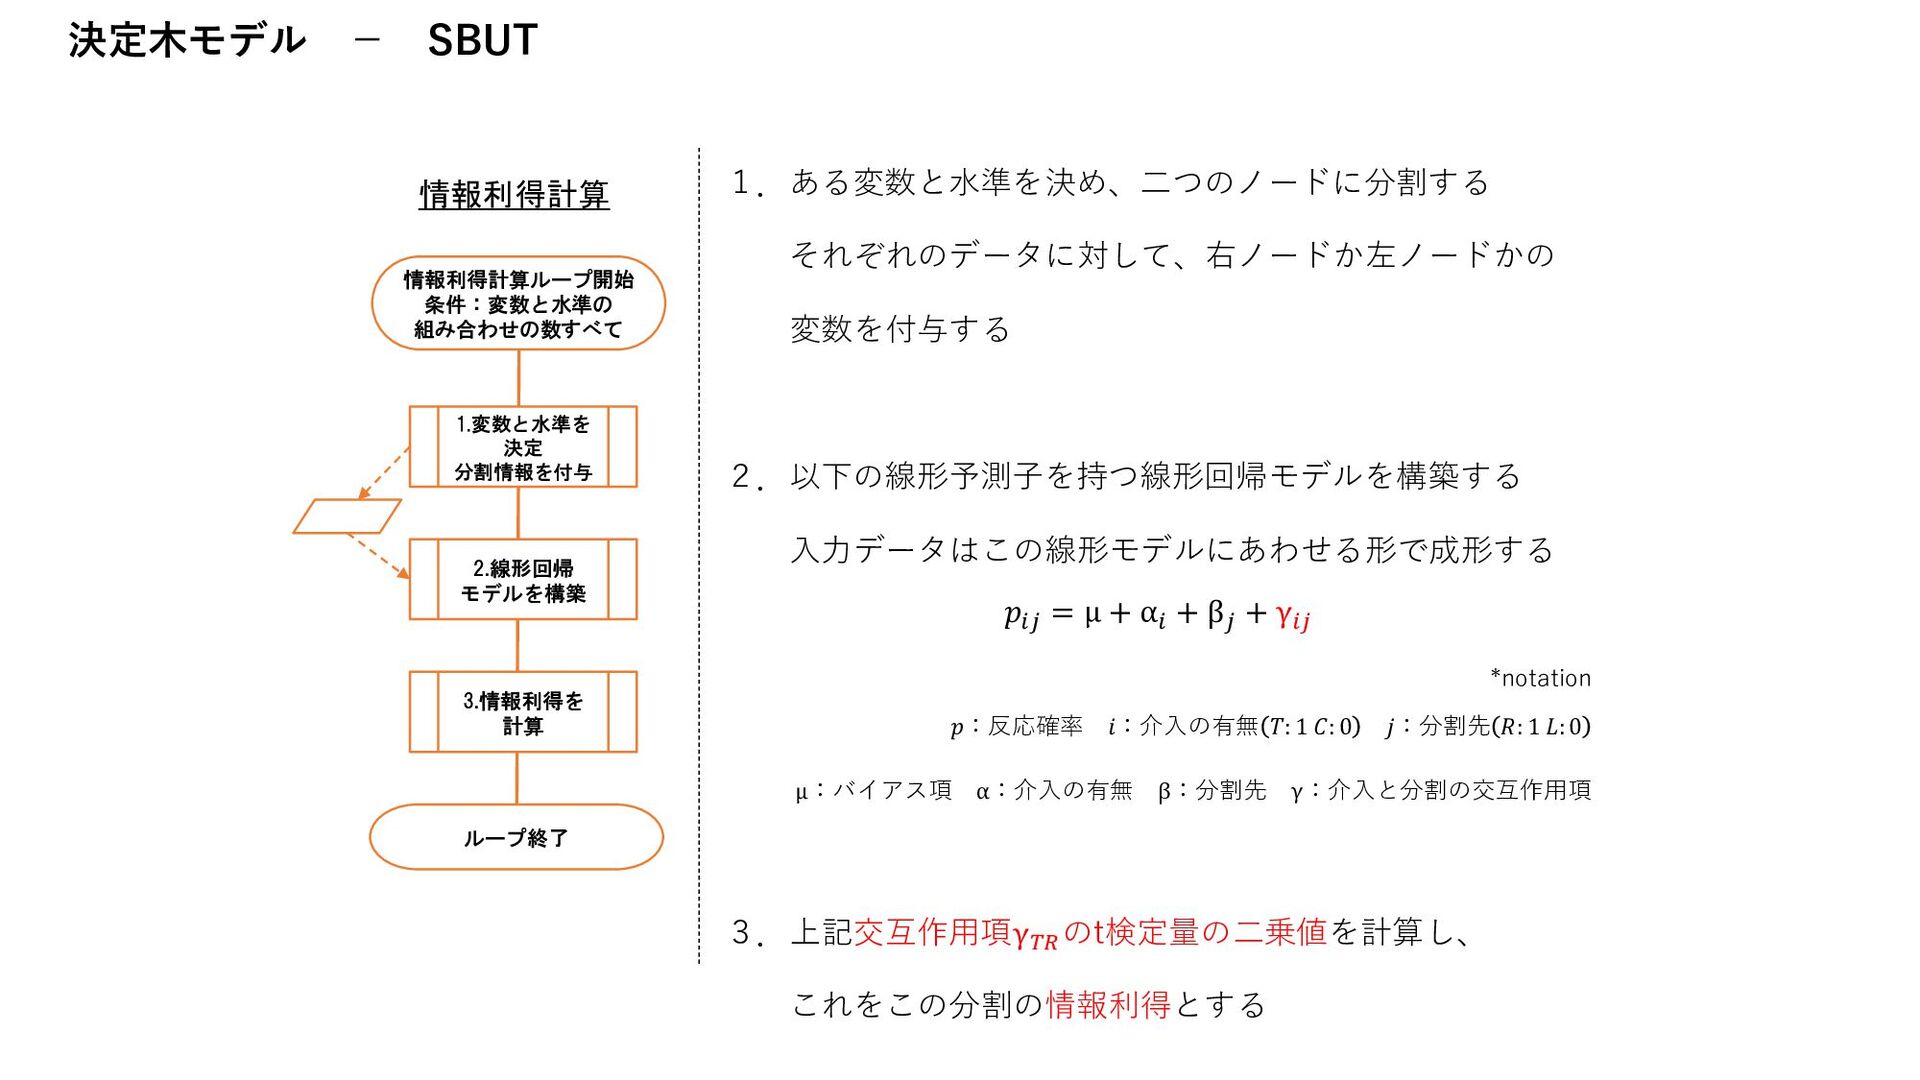
決定木モデル - SBUT 1.ある変数と水準を決め、二つのノードに分割する それぞれのデータに対して、右ノードか左ノードかの 変数を付与する 2.以下の線形予測子を持つ線形回帰モデルを構築する 入力データはこの線形モデルにあわせる形で成形する 𝑝𝑖𝑗 =
μ + α𝑖 + β𝑗 + γ𝑖𝑗 *notation 𝑝:反応確率 𝑖:介入の有無 𝑇: 1 𝐶: 0 𝑗:分割先 𝑅: 1 𝐿: 0 μ:バイアス項 α:介入の有無 β:分割先 γ:介入と分割の交互作用項 3.上記交互作用項γ𝑇𝑅 のt検定量の二乗値を計算し、 これをこの分割の情報利得とする 情報利得計算ループ開始 条件:変数と水準の 組み合わせの数すべて 1.変数と水準を 決定 分割情報を付与 2.線形回帰 モデルを構築 3.情報利得を 計算 ループ終了 情報利得計算 -
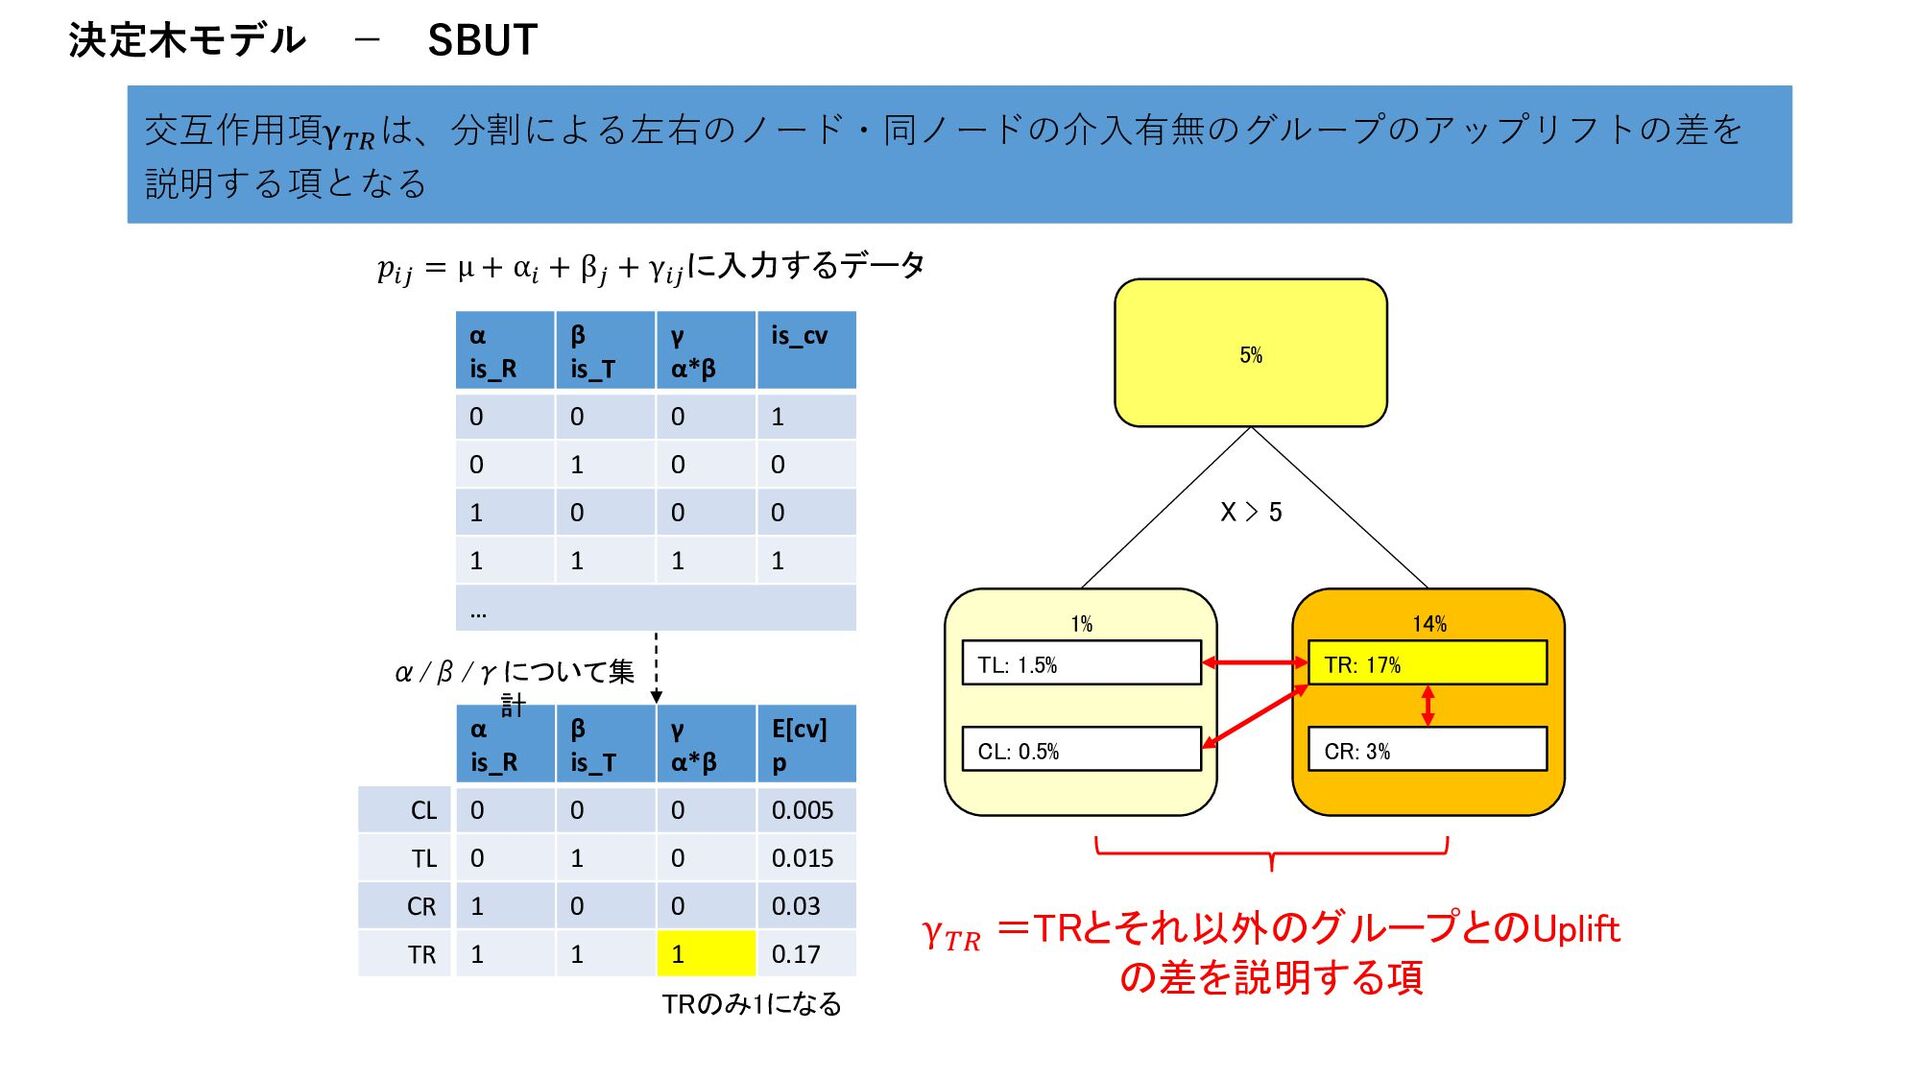
決定木モデル - SBUT 交互作用項γ𝑇𝑅 は、分割による左右のノード・同ノードの介入有無のグループのアップリフトの差を 説明する項となる α is_R β is_T
γ α*β E[cv] p 0 0 0 0.005 0 1 0 0.015 1 0 0 0.03 1 1 1 0.17 5% 1% 14% X > 5 TL: 1.5% CL: 0.5% TR: 17% CR: 3% α/β/γについて集 計 α is_R β is_T γ α*β is_cv 0 0 0 1 0 1 0 0 1 0 0 0 1 1 1 1 … CL TL CR TR γ𝑇𝑅 =TRとそれ以外のグループとのUplift の差を説明する項 TRのみ1になる 𝑝𝑖𝑗 = μ + α𝑖 + β𝑗 + γ𝑖𝑗 に入力するデータ -
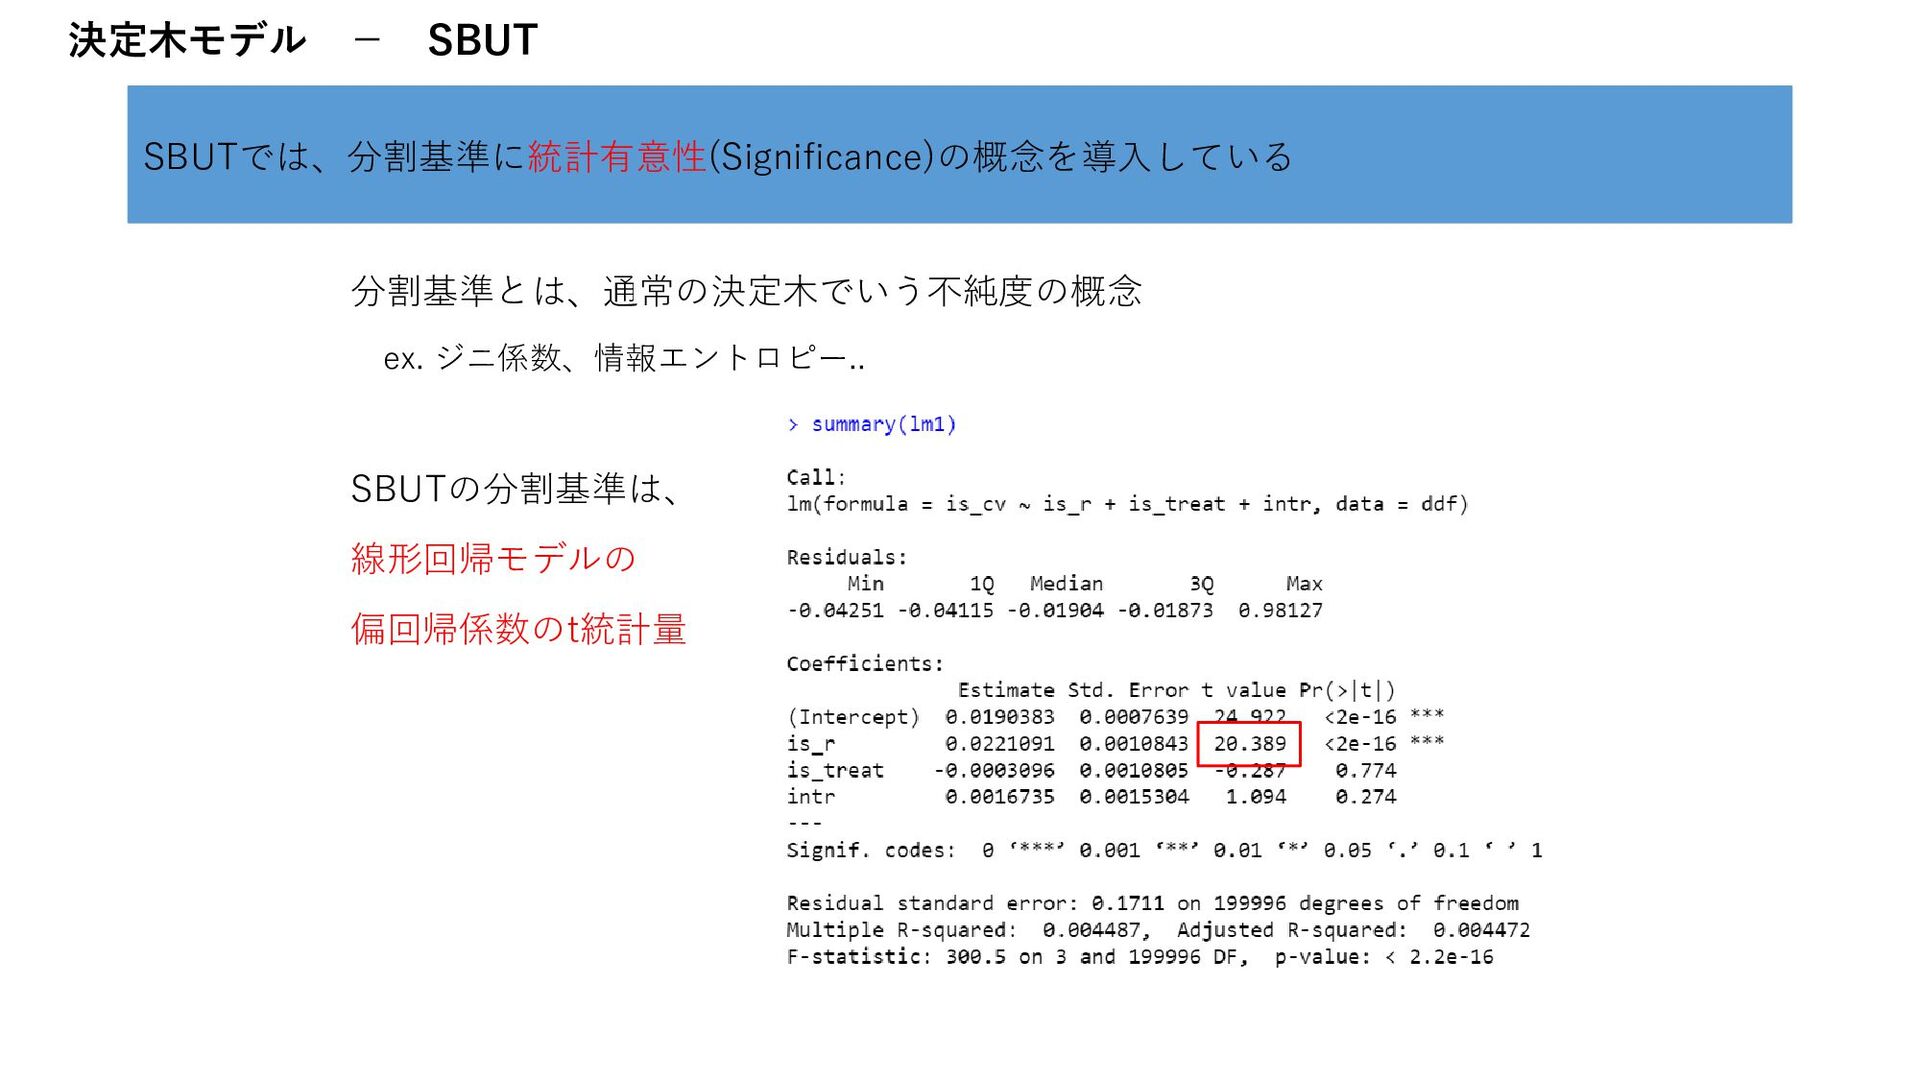
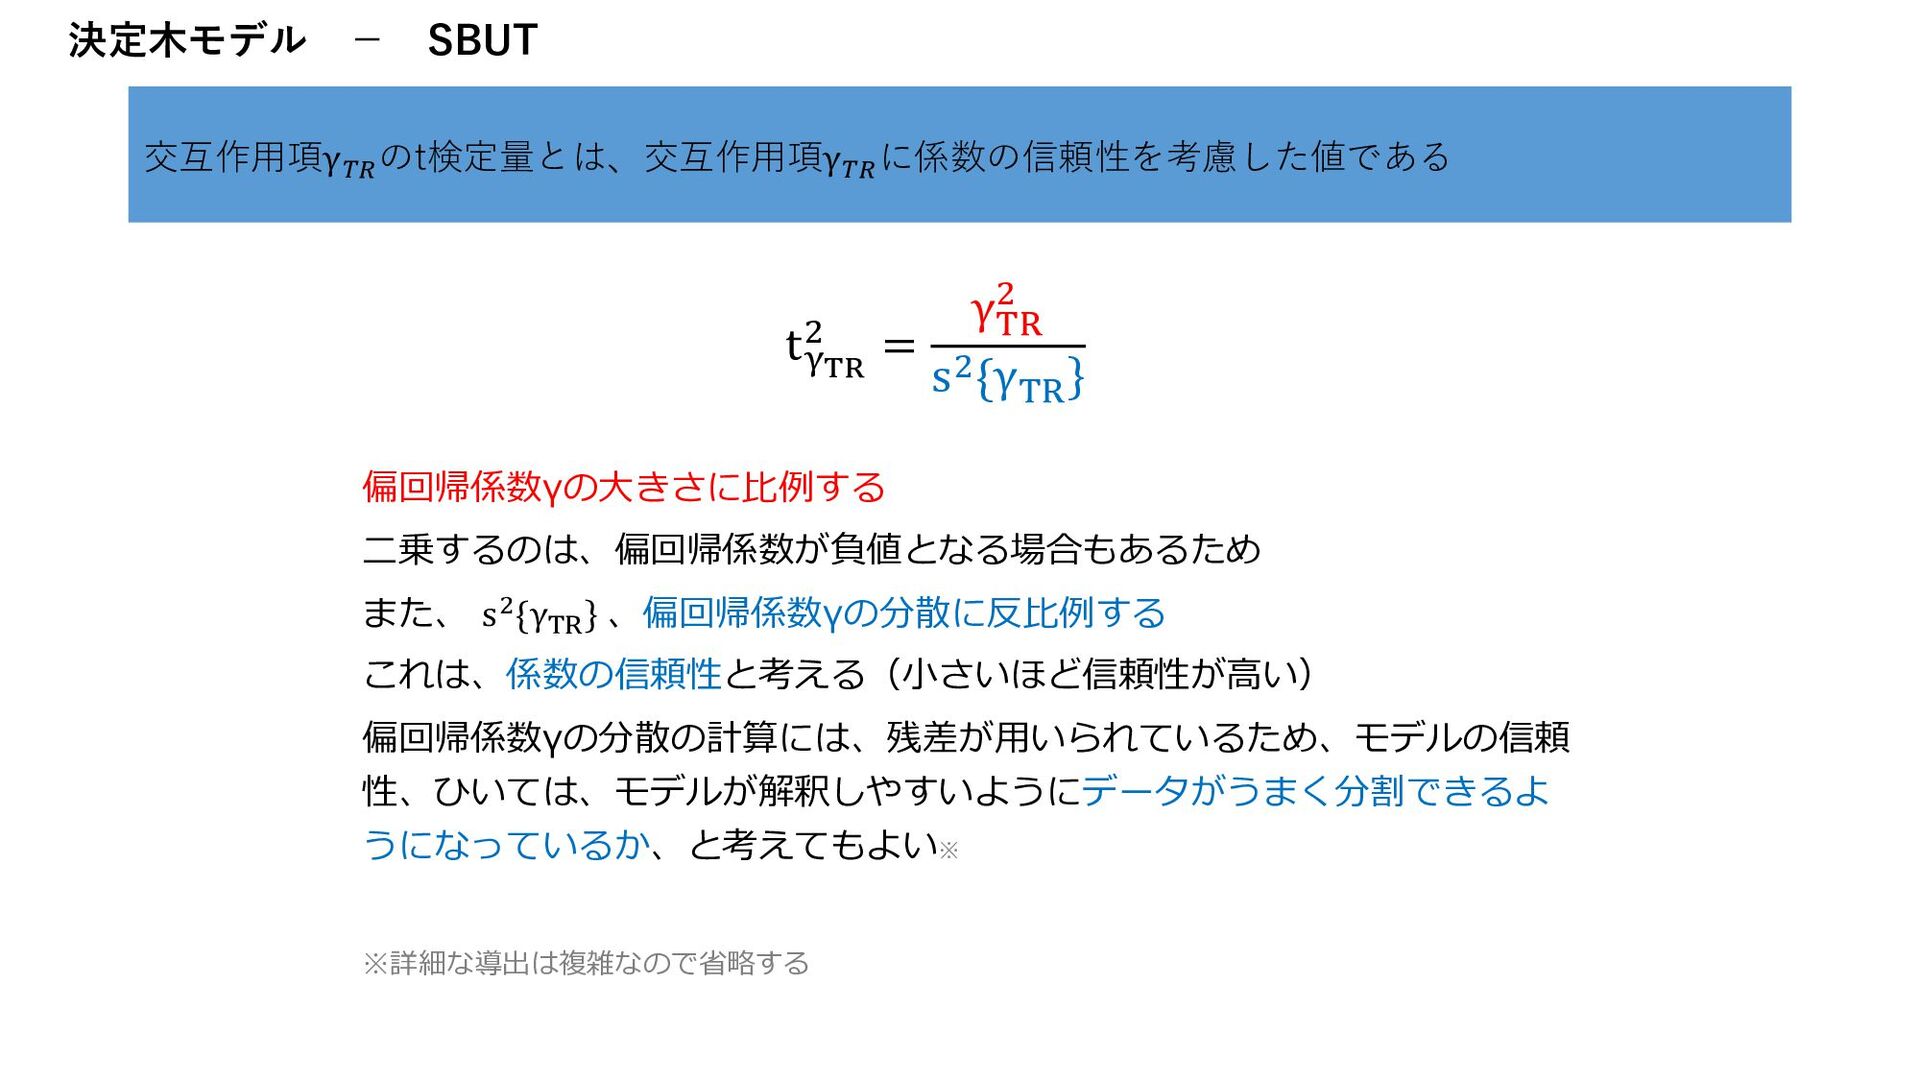
決定木モデル - SBUT 交互作用項γ𝑇𝑅 のt検定量とは、交互作用項γ𝑇𝑅 に係数の信頼性を考慮した値である tγTR 2 = γTR
2 } s2{γTR 偏回帰係数γの大きさに比例する 二乗するのは、偏回帰係数が負値となる場合もあるため また、 } s2{γTR 、偏回帰係数γの分散に反比例する これは、係数の信頼性と考える(小さいほど信頼性が高い) 偏回帰係数γの分散の計算には、残差が用いられているため、モデルの信頼 性、ひいては、モデルが解釈しやすいようにデータがうまく分割できるよ うになっているか、と考えてもよい※ ※詳細な導出は複雑なので省略する -
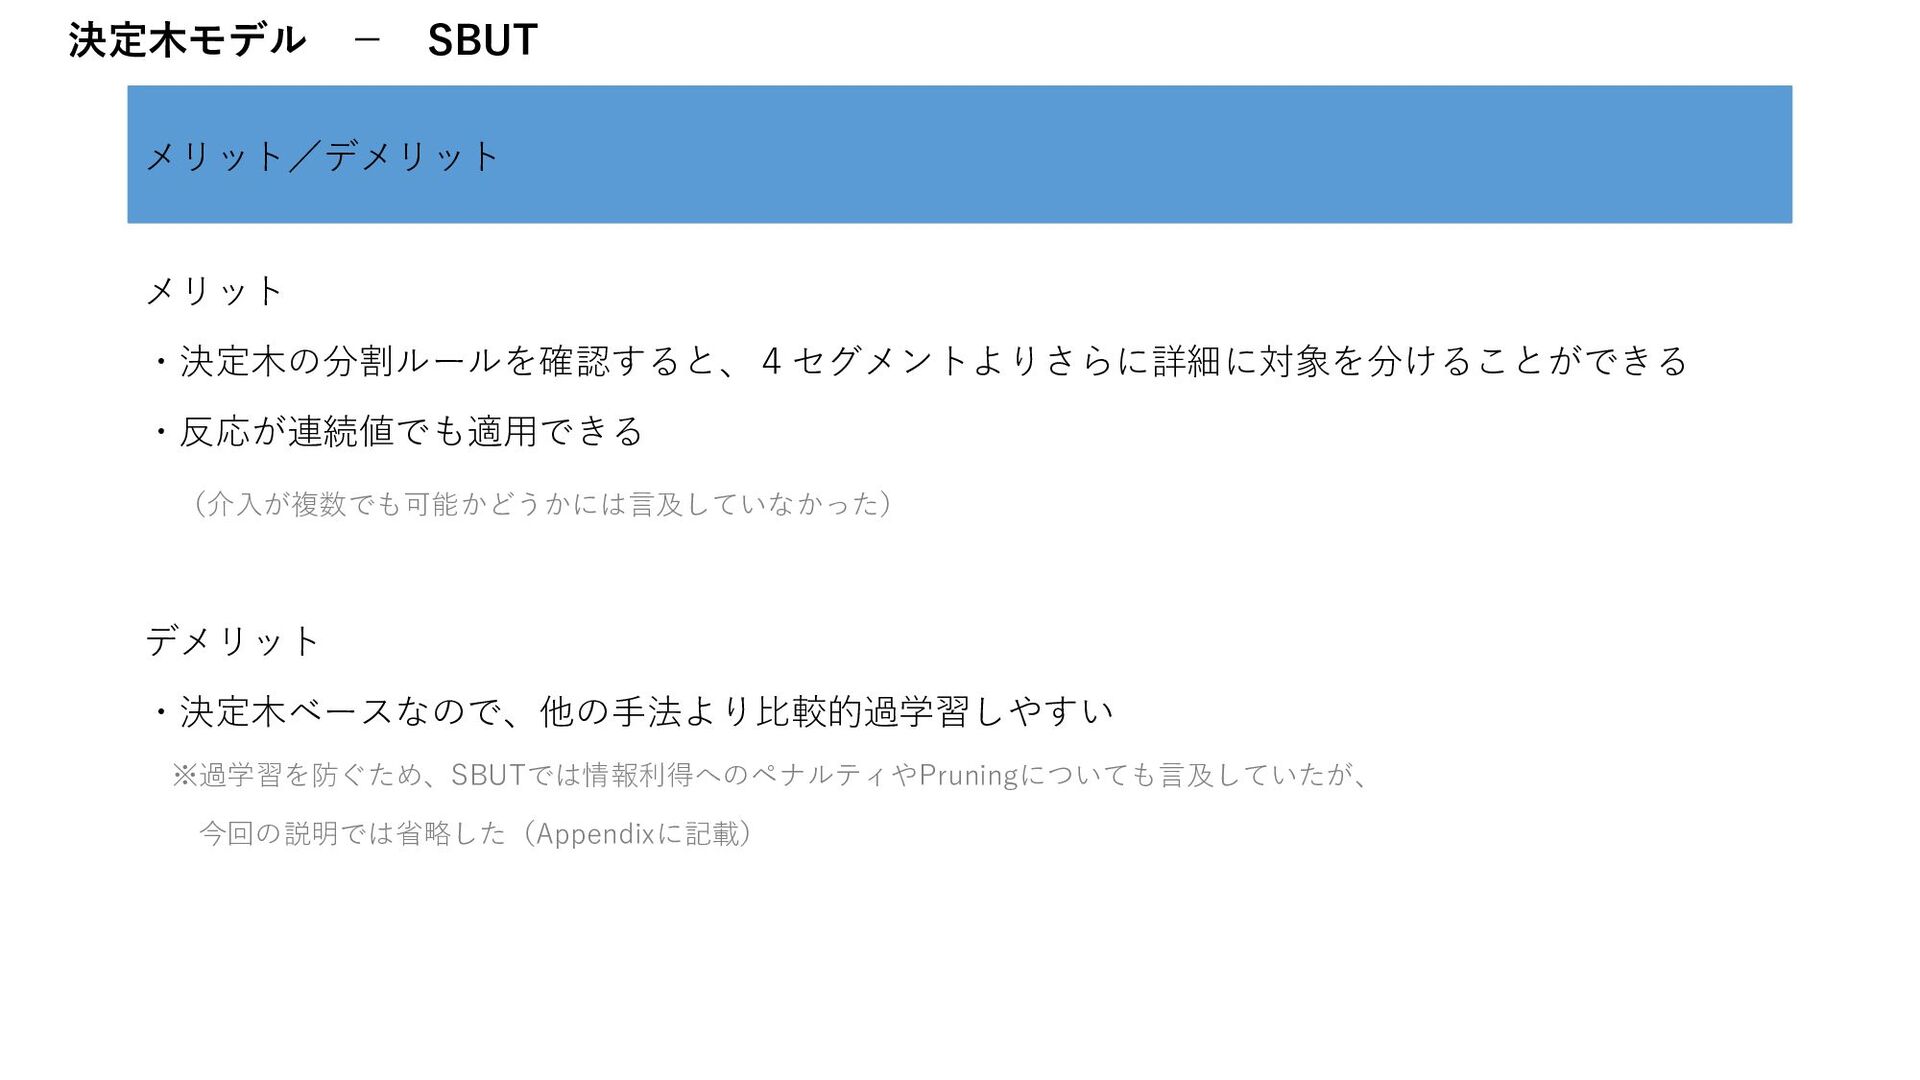
決定木モデル - SBUT メリット/デメリット メリット ・決定木の分割ルールを確認すると、4セグメントよりさらに詳細に対象を分けることができる ・反応が連続値でも適用できる (介入が複数でも可能かどうかには言及していなかった) デメリット ・決定木ベースなので、他の手法より比較的過学習しやすい
※過学習を防ぐため、SBUTでは情報利得へのペナルティやPruningについても言及していたが、 今回の説明では省略した(Appendixに記載) -
決定木モデル - SBUT ・ 『ヤバい予測学 「何を買うか」から「いつ死ぬか」まであなたの行動はすべて読まれている』 エリック・ シーゲル (著)、矢 羽野
薫 (翻訳) 、CCCメディアハウス、2013年、241-243p DMを送ると口座開設してくれやすい客 ・ローン契約している(17.3%以上返済済) ・リボ払い枠を9%以上使っている ・特定のライフスタイルを持っている USバンク この顧客集団を見つけられる -
派生モデルの類型と目的 Two Model Approach Mouloud Belbahri , Alejandro Murua, Olivier
Gandouet, and Vahid Partovi Nia, “Uplift Regression: The R Package tools4uplift” 2019 Yuta Saito, Hayato Sakata and Kazuhide Nakata, ”Doubly Robust Prediction and Evaluation Methods Improve Uplift Modeling for Observational Data” 2019, p468-469 ・回帰モデル CVT(Class Variable Transformation) ・決定木モデル DTUM(Decision Tree Uplift Model) SBUT(Significance-Based Uplift Tree) DBUT(Divergence-Based Uplift Tree) URF(Uplift Random Forest /ensembled DTUM) CTS(Contextual Treatment Selection) ・SVMモデル Uplift Support Vector Machine One Model Approach ・TOM(Transform Outcome Method) ・SDRM(Switch Doubly Robust Method) A/Bテスト以外の データを使えないか Causal Conditional Inference Uplift Modeling -
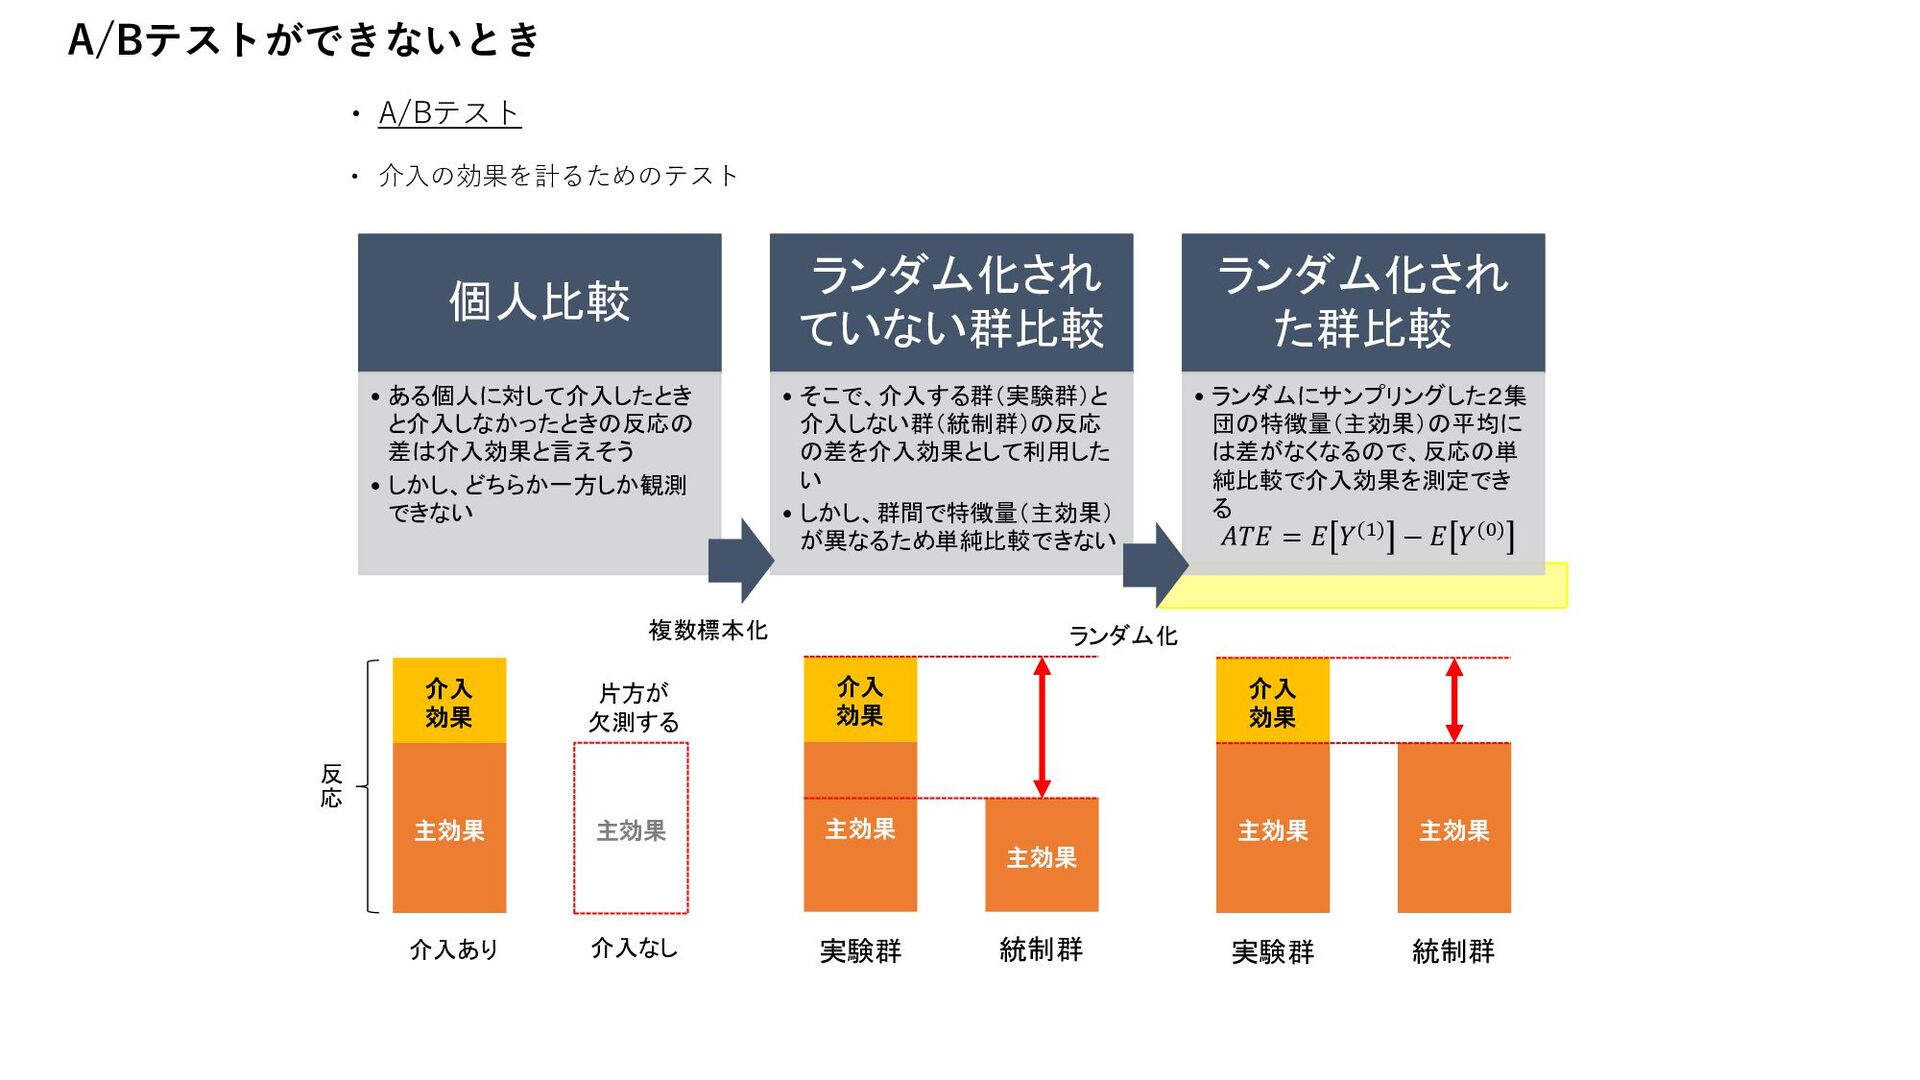
A/Bテストができないとき A/Bテスト 介入の効果を計るためのテスト 主効果 介入 効果 主効果 統制群
実験群 ランダム化 主効果 介入 効果 主効果 統制群 実験群 複数標本化 主効果 介入 効果 主効果 介入なし 介入あり 片方が 欠測する 個人比較 • ある個人に対して介入したとき と介入しなかったときの反応の 差は介入効果と言えそう • しかし、どちらか一方しか観測 できない ランダム化され ていない群比較 • そこで、介入する群(実験群)と 介入しない群(統制群)の反応 の差を介入効果として利用した い • しかし、群間で特徴量(主効果) が異なるため単純比較できない ランダム化され た群比較 • ランダムにサンプリングした2集 団の特徴量(主効果)の平均に は差がなくなるので、反応の単 純比較で介入効果を測定でき る 反 応 𝐴𝑇𝐸 = 𝐸 𝑌(1) − 𝐸 𝑌(0) -
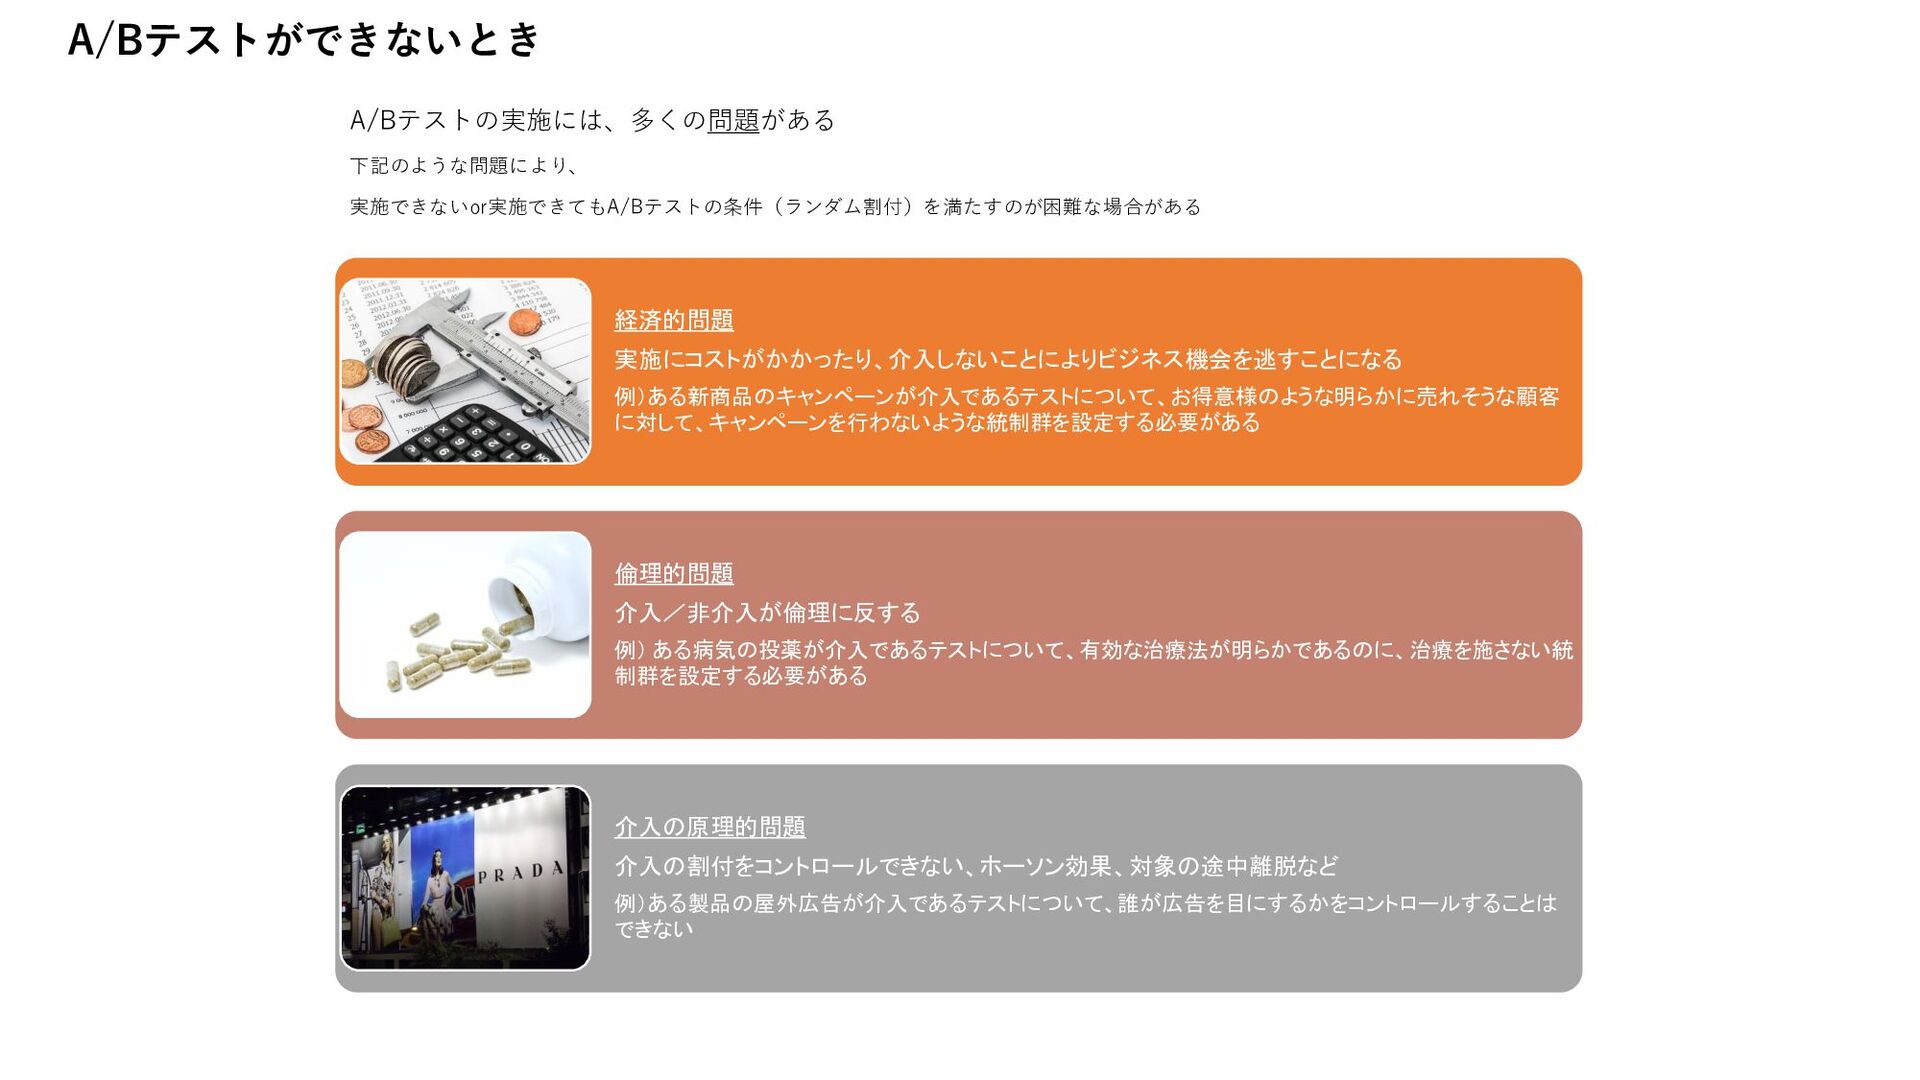
A/Bテストができないとき A/Bテストの実施には、多くの問題がある 下記のような問題により、 実施できないor実施できてもA/Bテストの条件(ランダム割付)を満たすのが困難な場合がある 経済的問題 実施にコストがかかったり、介入しないことによりビジネス機会を逃すことになる 例)ある新商品のキャンペーンが介入であるテストについて、お得意様のような明らかに売れそうな顧客 に対して、キャンペーンを行わないような統制群を設定する必要がある 倫理的問題 介入/非介入が倫理に反する
例) ある病気の投薬が介入であるテストについて、有効な治療法が明らかであるのに、治療を施さない統 制群を設定する必要がある 介入の原理的問題 介入の割付をコントロールできない、ホーソン効果、対象の途中離脱など 例)ある製品の屋外広告が介入であるテストについて、誰が広告を目にするかをコントロールすることは できない -
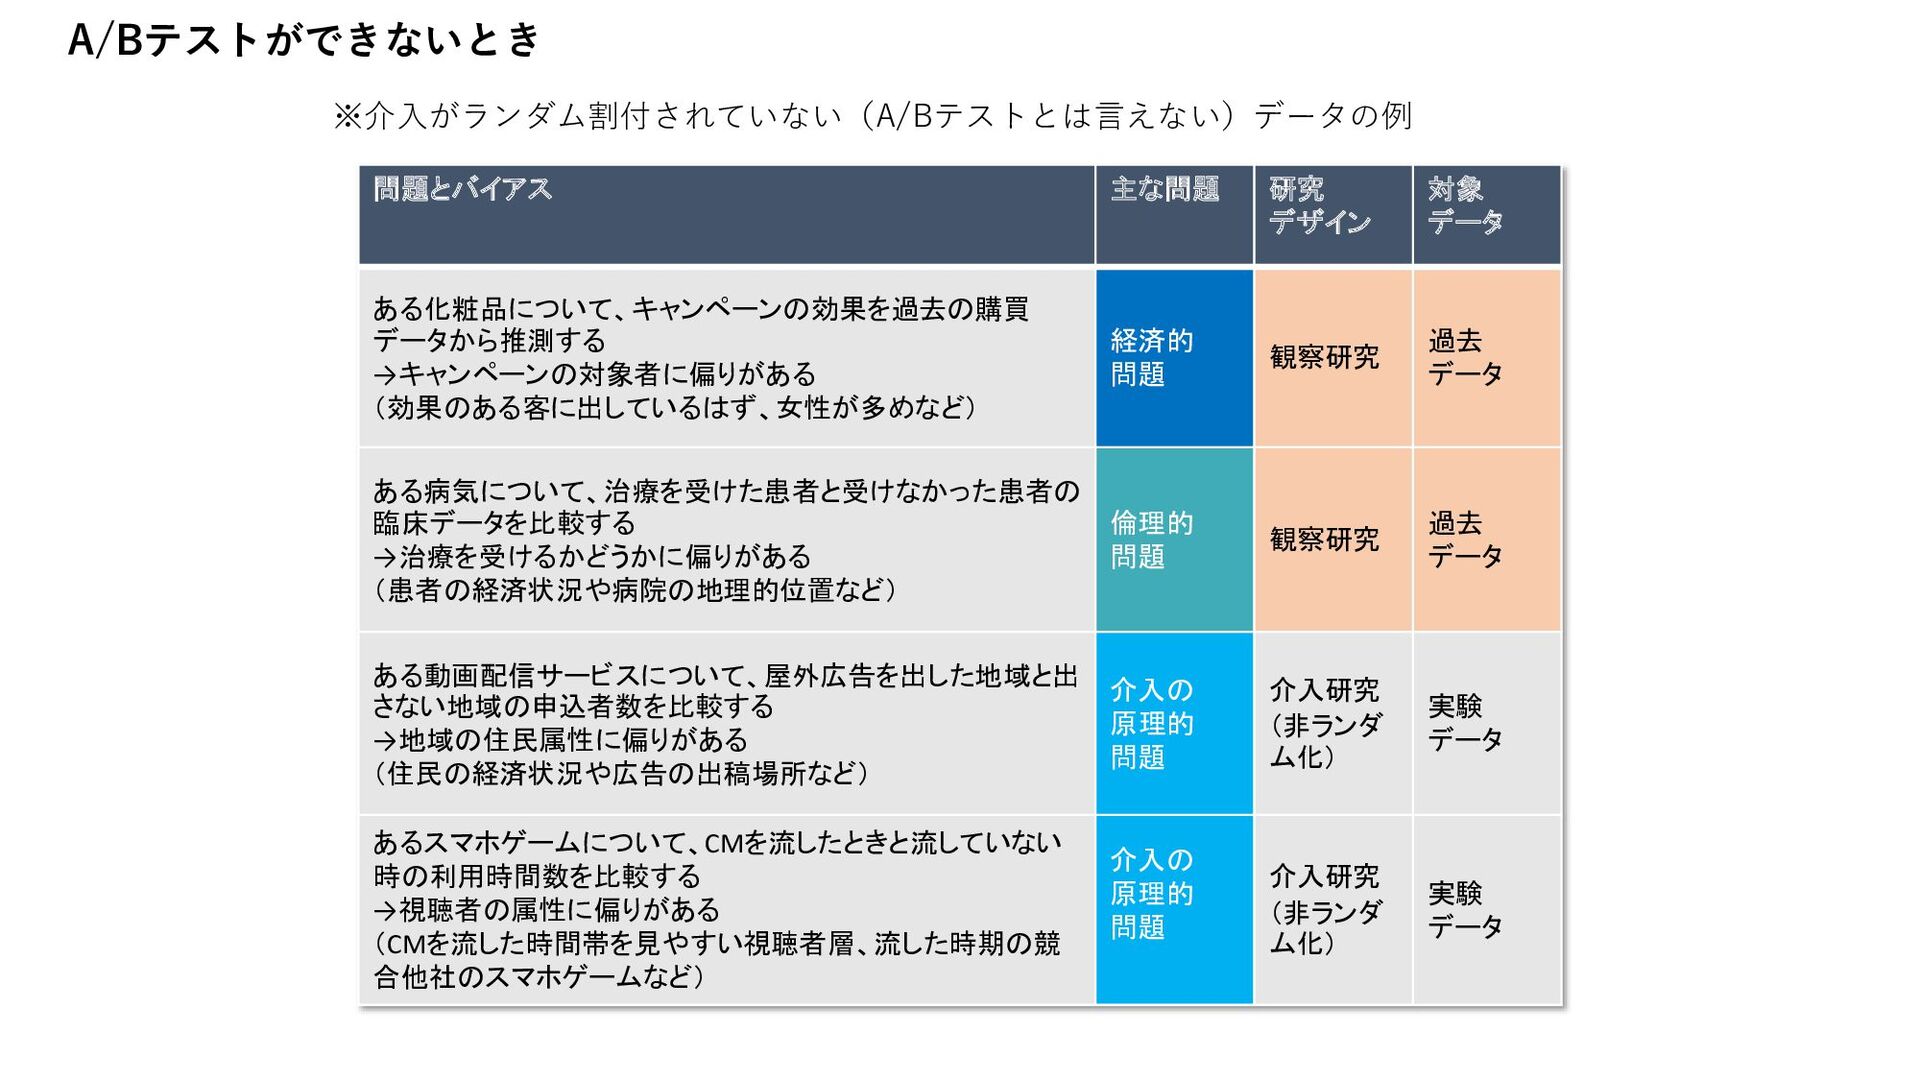
A/Bテストができないとき ※介入がランダム割付されていない(A/Bテストとは言えない)データの例 問題とバイアス 主な問題 研究 デザイン 対象 データ ある化粧品について、キャンペーンの効果を過去の購買 データから推測する
→キャンペーンの対象者に偏りがある (効果のある客に出しているはず、女性が多めなど) 経済的 問題 観察研究 過去 データ ある病気について、治療を受けた患者と受けなかった患者の 臨床データを比較する →治療を受けるかどうかに偏りがある (患者の経済状況や病院の地理的位置など) 倫理的 問題 観察研究 過去 データ ある動画配信サービスについて、屋外広告を出した地域と出 さない地域の申込者数を比較する →地域の住民属性に偏りがある (住民の経済状況や広告の出稿場所など) 介入の 原理的 問題 介入研究 (非ランダ ム化) 実験 データ あるスマホゲームについて、CMを流したときと流していない 時の利用時間数を比較する →視聴者の属性に偏りがある (CMを流した時間帯を見やすい視聴者層、流した時期の競 合他社のスマホゲームなど) 介入の 原理的 問題 介入研究 (非ランダ ム化) 実験 データ -
準実験法 準実験法は、介入がランダム割付されていない実験結果や観察結果に何らかの操作を行い、介入効果 を推定する方法 A/Bテスト、すなわち、ランダム化の利点は、特徴量が同一の2群を用意で き、反応をそのまま比較すれば自動的に介入効果を推定できること したがって、下記のような操作を行えば介入効果を推定できるというのが 準実験法の考え方 特徴量を揃えた二群を調整する/反応を補正する/介入効果のみを取り出す…など このとき操作する特徴量は、介入に関連があり、反応に因果関係がある特 徴を対象とする、これを交絡因子と呼ぶ
ランダム化されていないときは、交絡因子の存在が想定される 例) 学習意欲 学力 授業への出席 -
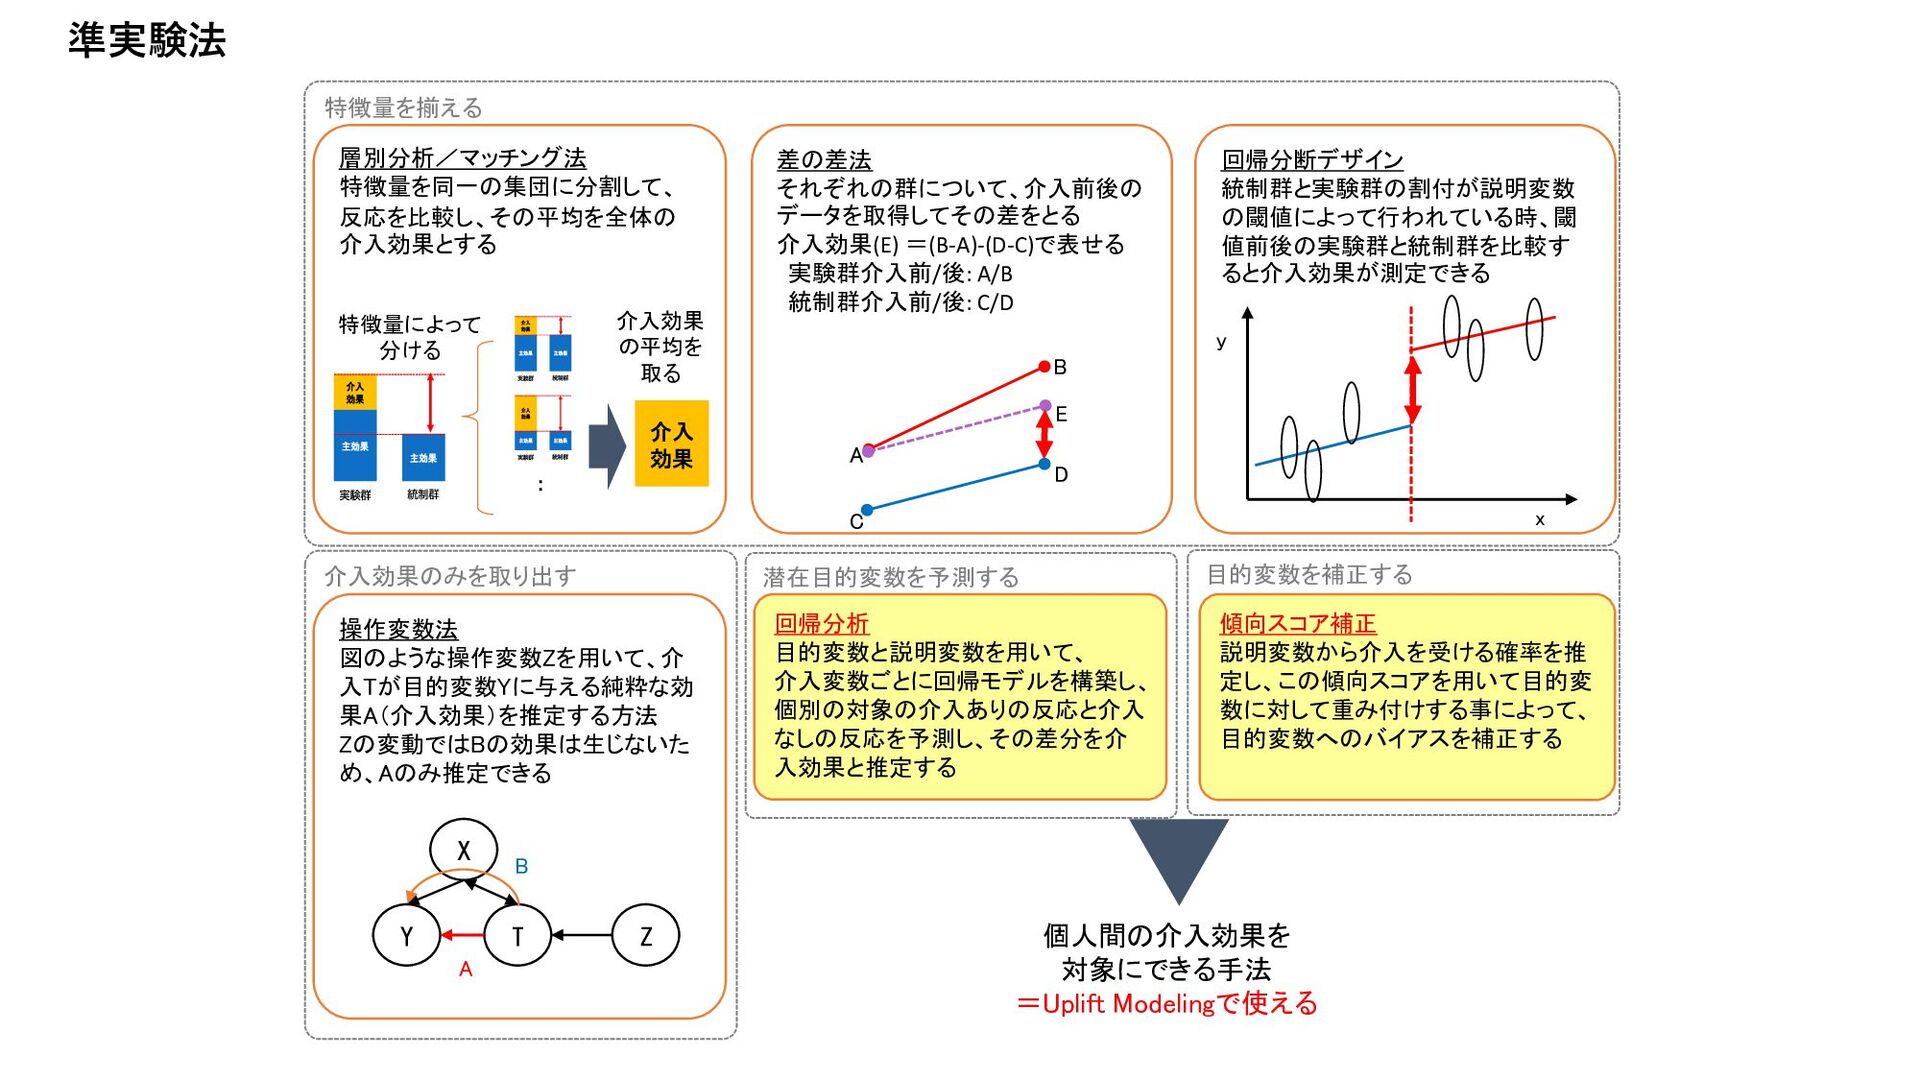
目的変数を補正する 潜在目的変数を予測する 介入効果のみを取り出す 特徴量を揃える 準実験法 回帰分析 目的変数と説明変数を用いて、 介入変数ごとに回帰モデルを構築し、 個別の対象の介入ありの反応と介入 なしの反応を予測し、その差分を介
入効果と推定する 回帰分断デザイン 統制群と実験群の割付が説明変数 の閾値によって行われている時、閾 値前後の実験群と統制群を比較す ると介入効果が測定できる 差の差法 それぞれの群について、介入前後の データを取得してその差をとる 介入効果(E) =(B-A)-(D-C)で表せる 実験群介入前/後: A/B 統制群介入前/後: C/D B E C A D x y 層別分析/マッチング法 特徴量を同一の集団に分割して、 反応を比較し、その平均を全体の 介入効果とする 介入 効果 介入効果 の平均を 取る 特徴量によって 分ける ・ ・ 傾向スコア補正 説明変数から介入を受ける確率を推 定し、この傾向スコアを用いて目的変 数に対して重み付けする事によって、 目的変数へのバイアスを補正する 操作変数法 図のような操作変数Zを用いて、介 入Tが目的変数Yに与える純粋な効 果A(介入効果)を推定する方法 Zの変動ではBの効果は生じないた め、Aのみ推定できる Y T Z X A B 個人間の介入効果を 対象にできる手法 =Uplift Modelingで使える -
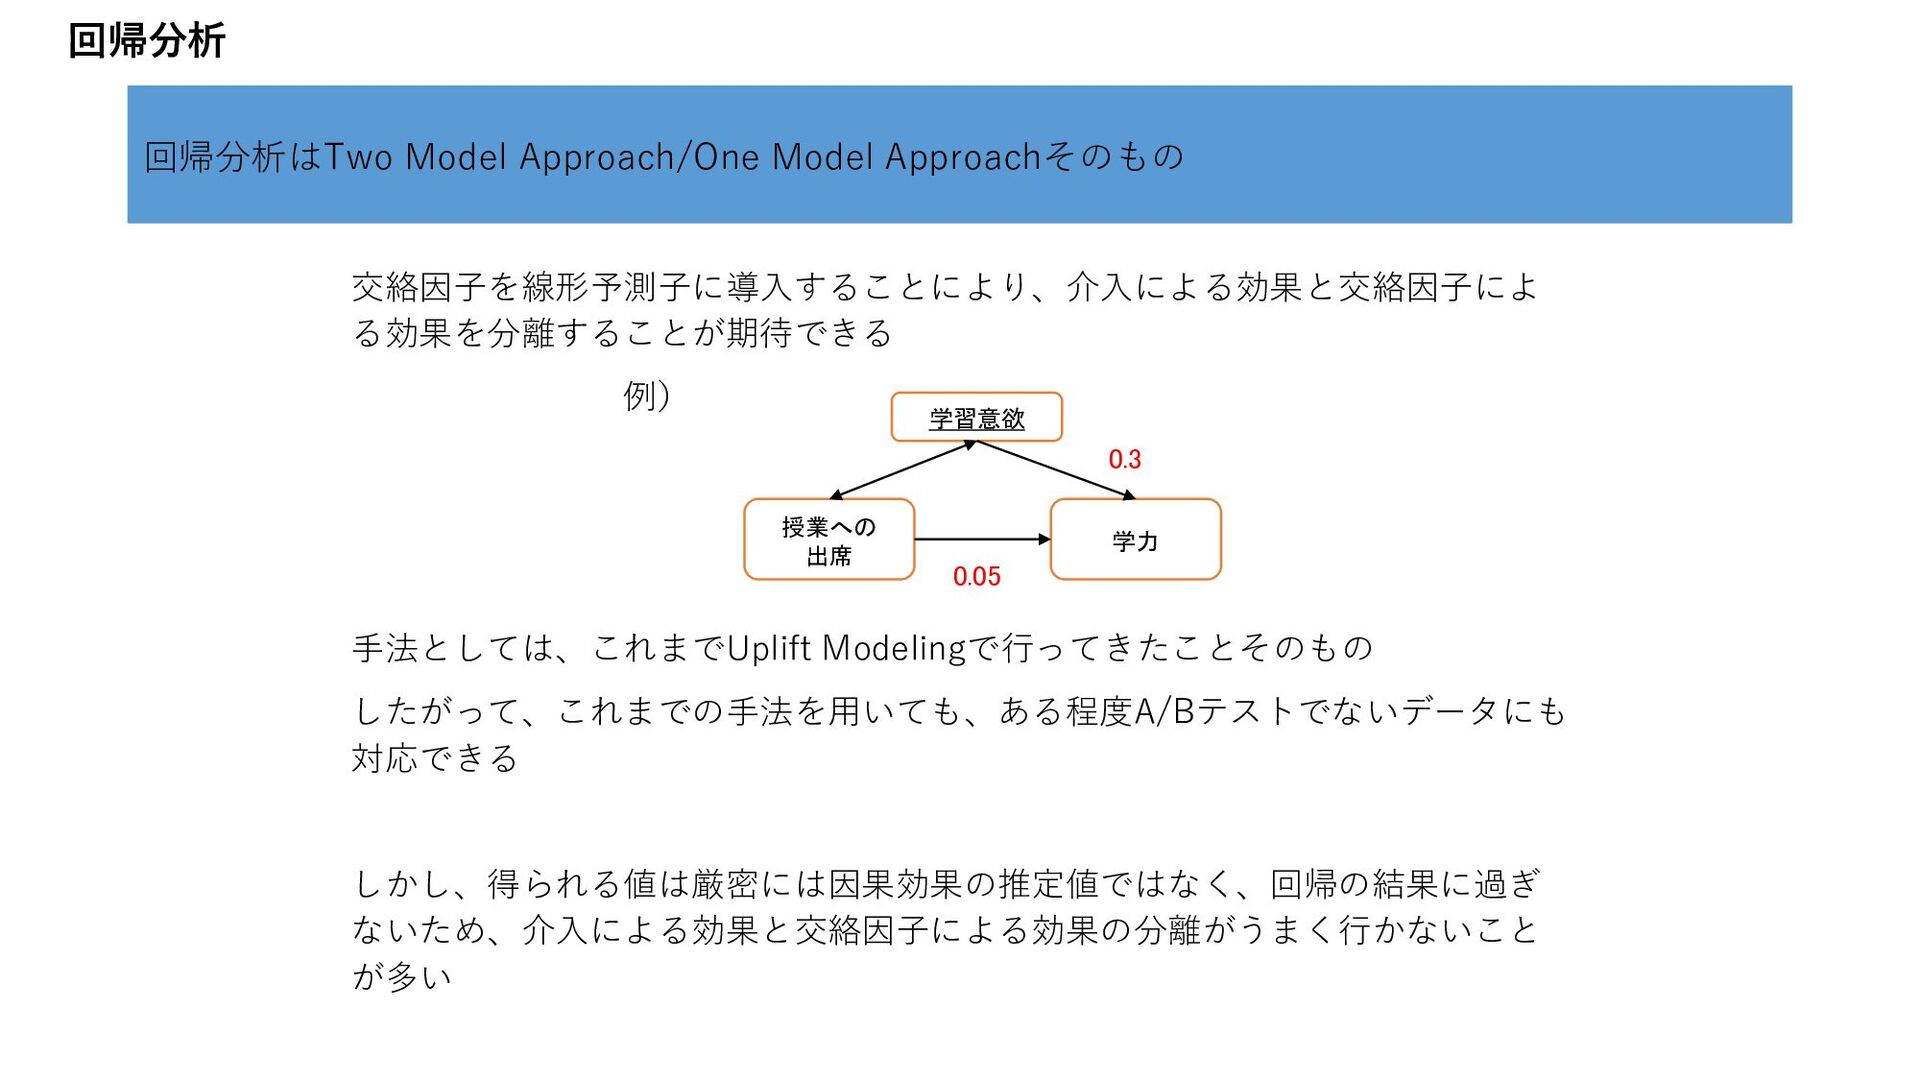
回帰分析 回帰分析はTwo Model Approach/One Model Approachそのもの 交絡因子を線形予測子に導入することにより、介入による効果と交絡因子によ る効果を分離することが期待できる 例) 手法としては、これまでUplift
Modelingで行ってきたことそのもの したがって、これまでの手法を用いても、ある程度A/Bテストでないデータにも 対応できる しかし、得られる値は厳密には因果効果の推定値ではなく、回帰の結果に過ぎ ないため、介入による効果と交絡因子による効果の分離がうまく行かないこと が多い 学習意欲 学力 授業への 出席 0.05 0.3 -
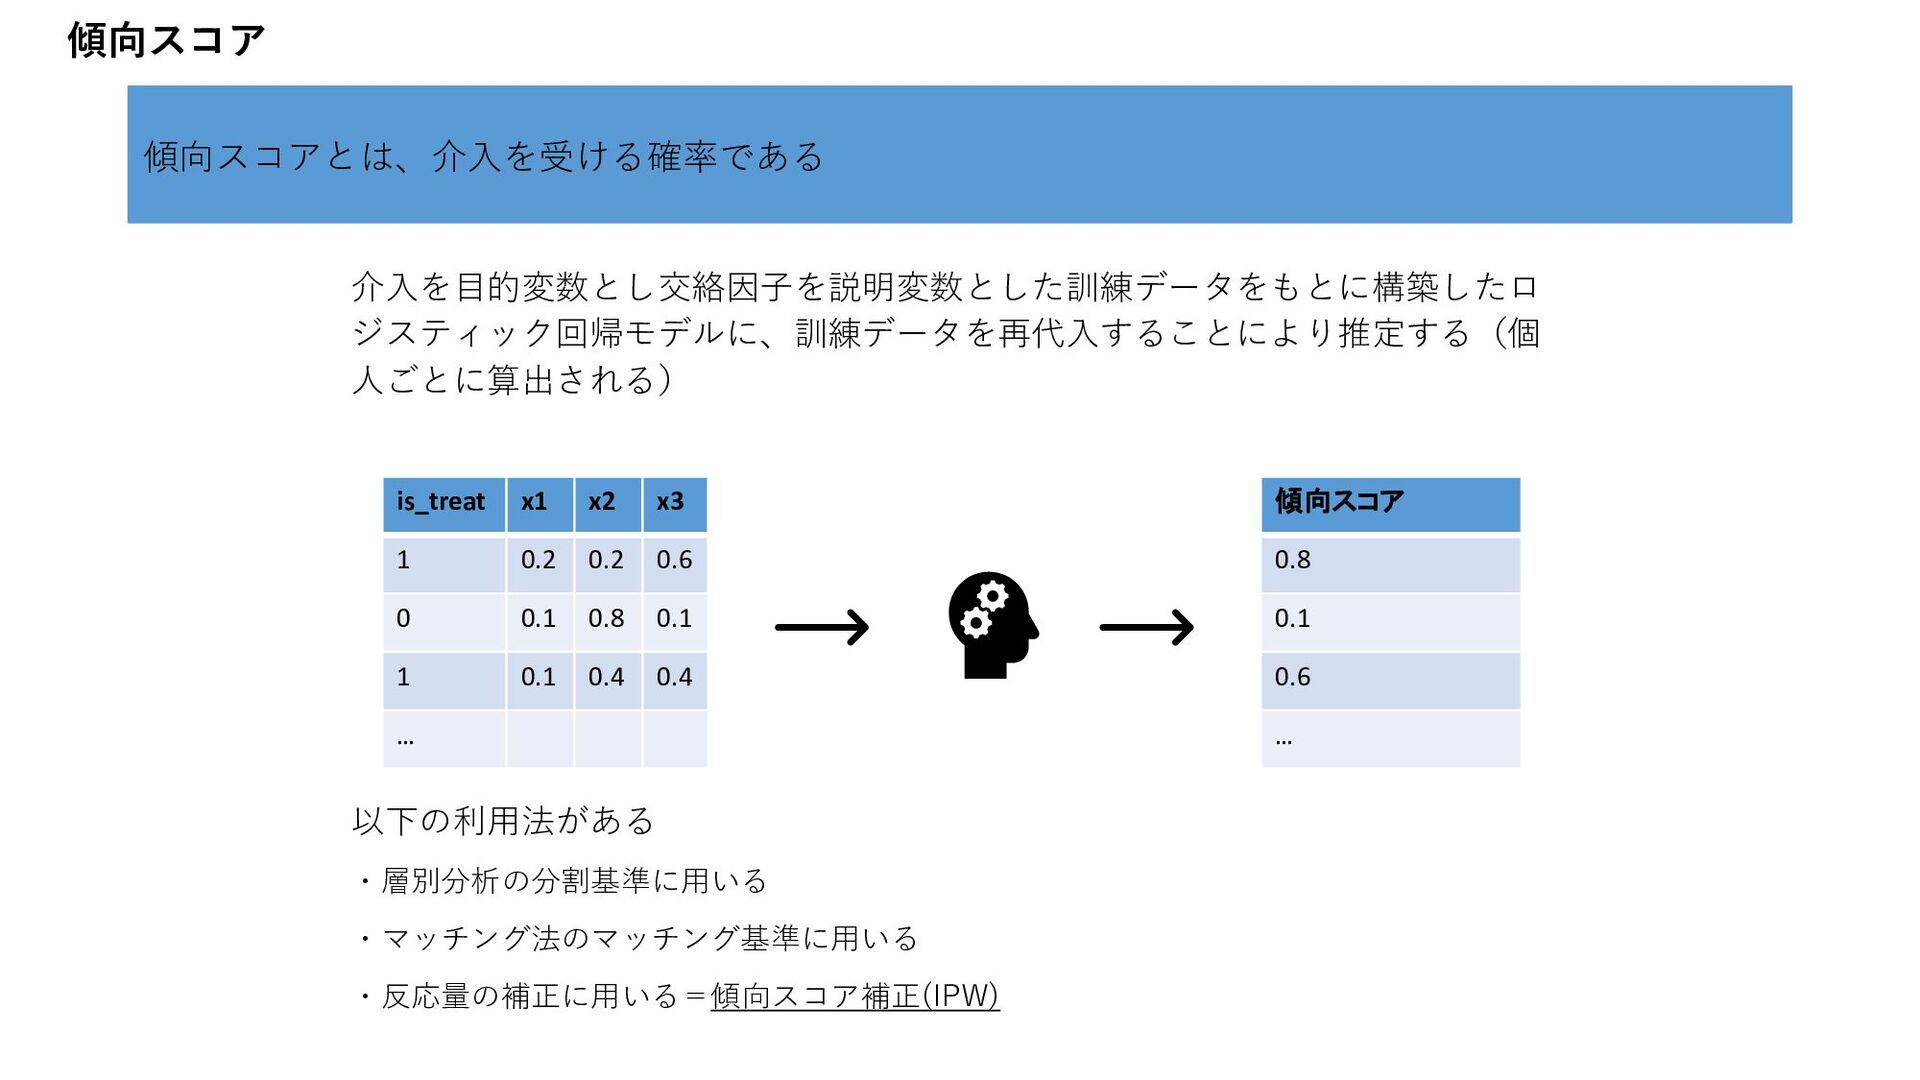
傾向スコア 傾向スコアとは、介入を受ける確率である 介入を目的変数とし交絡因子を説明変数とした訓練データをもとに構築したロ ジスティック回帰モデルに、訓練データを再代入することにより推定する(個 人ごとに算出される) 以下の利用法がある ・層別分析の分割基準に用いる ・マッチング法のマッチング基準に用いる ・反応量の補正に用いる=傾向スコア補正(IPW) is_treat
x1 x2 x3 1 0.2 0.2 0.6 0 0.1 0.8 0.1 1 0.1 0.4 0.4 … 傾向スコア 0.8 0.1 0.6 … -
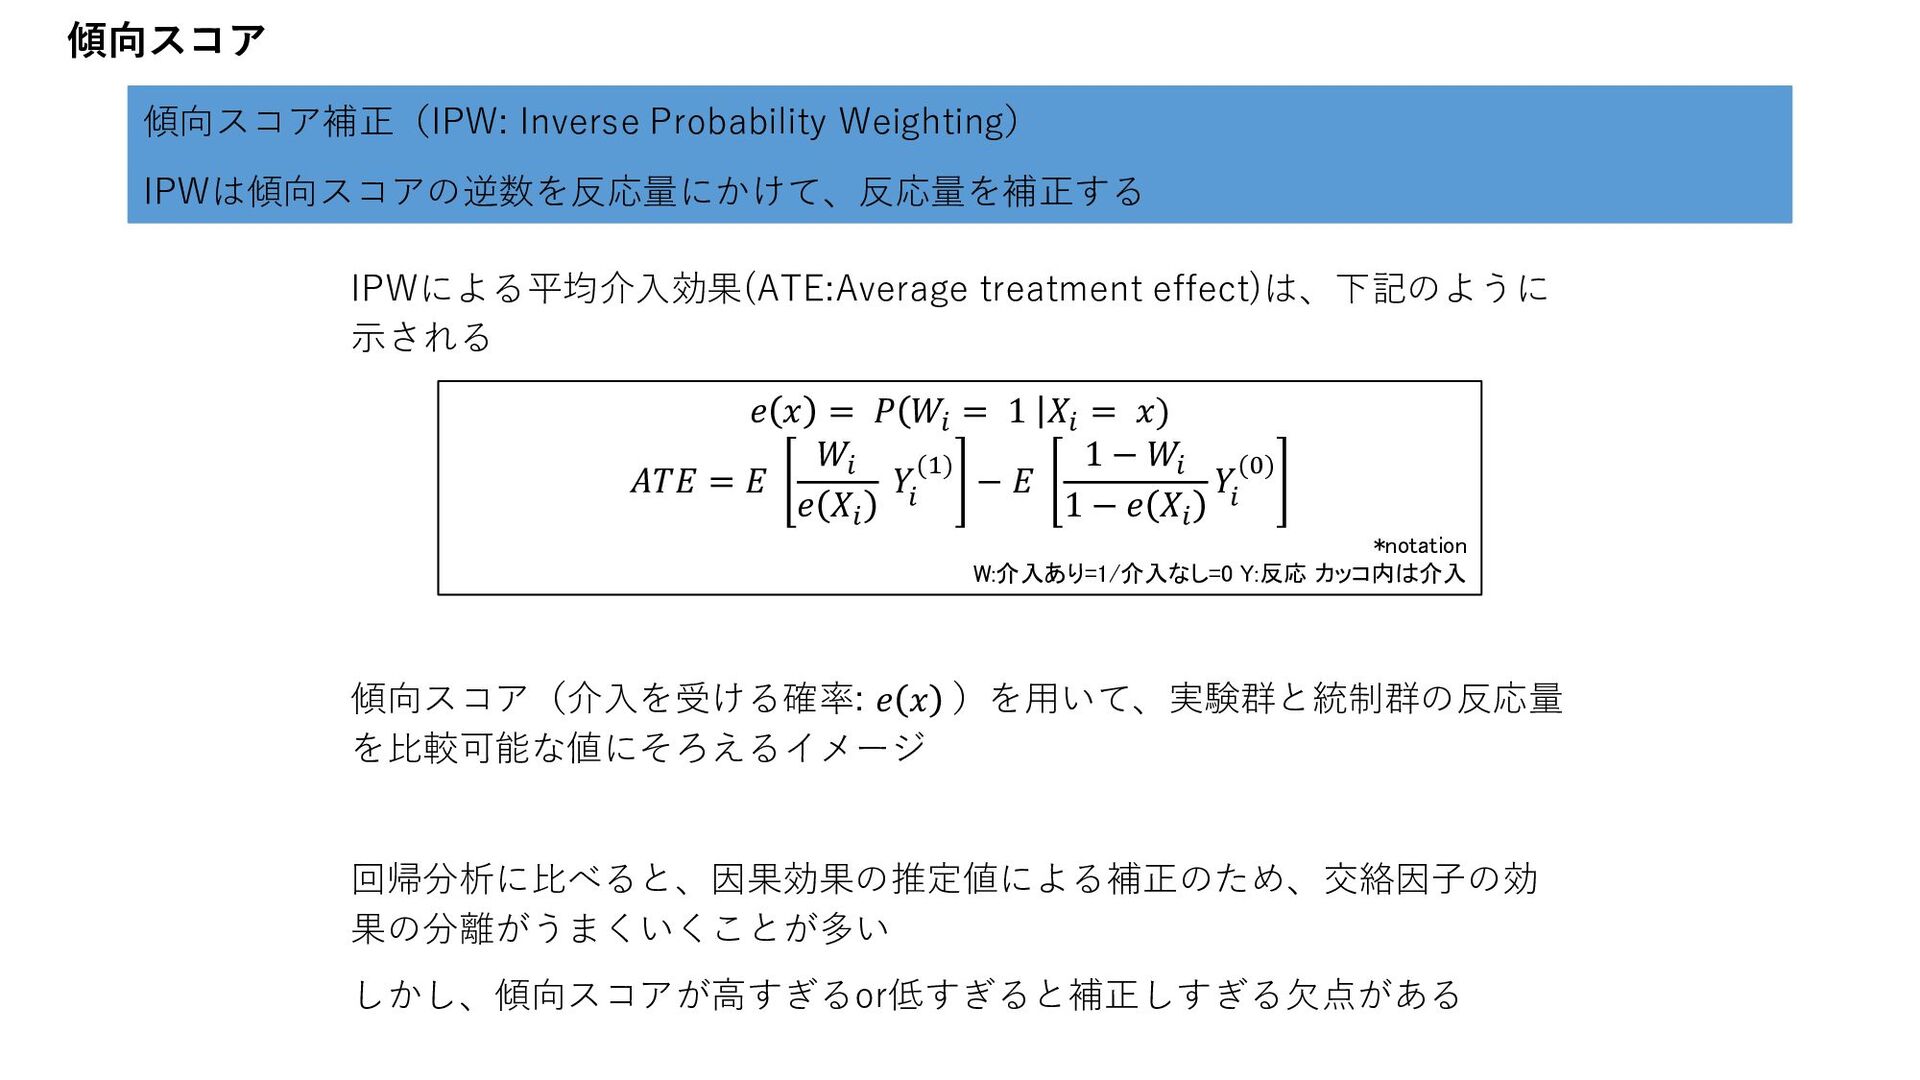
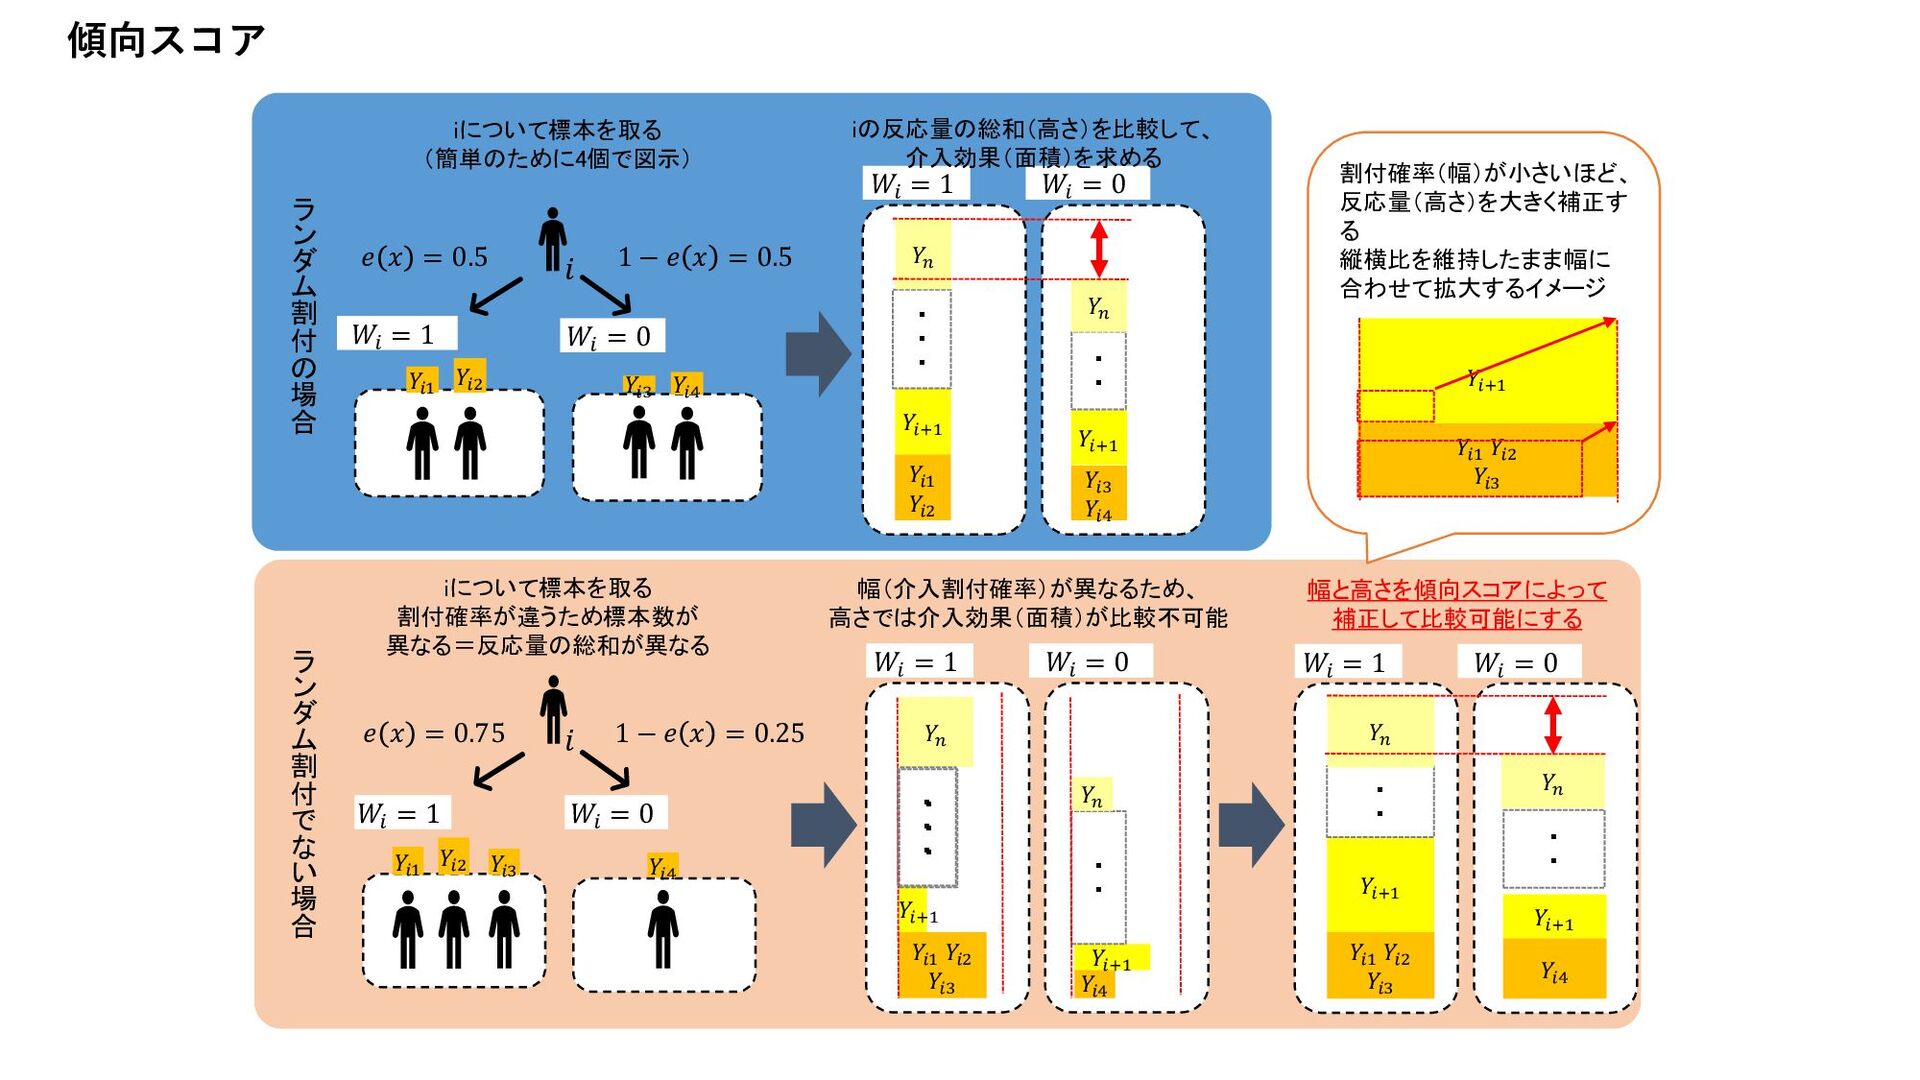
傾向スコア 傾向スコア補正(IPW: Inverse Probability Weighting) IPWは傾向スコアの逆数を反応量にかけて、反応量を補正する IPWによる平均介入効果(ATE:Average treatment effect)は、下記のように 示される
傾向スコア(介入を受ける確率: 𝑒 𝑥 )を用いて、実験群と統制群の反応量 を比較可能な値にそろえるイメージ 回帰分析に比べると、因果効果の推定値による補正のため、交絡因子の効 果の分離がうまくいくことが多い しかし、傾向スコアが高すぎるor低すぎると補正しすぎる欠点がある 𝑒 𝑥 = 𝑃 𝑊𝑖 = 1 𝑋𝑖 = 𝑥) 𝐴𝑇𝐸 = 𝐸 𝑊𝑖 𝑒 𝑋𝑖 𝑌 𝑖 (1) − 𝐸 1 − 𝑊𝑖 1 − 𝑒 𝑋𝑖 𝑌 𝑖 (0) *notation W:介入あり=1/介入なし=0 Y:反応 カッコ内は介入 -
傾向スコア 𝑊𝑖 = 0 𝑒 𝑥 = 0.75 1 −
𝑒 𝑥 = 0.25 𝑖 𝑊𝑖 = 1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 𝑌𝑖4 𝑊𝑖 = 0 𝑒 𝑥 = 0.5 1 − 𝑒 𝑥 = 0.5 𝑖 𝑊𝑖 = 1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 𝑌𝑖4 𝑊𝑖 = 0 𝑊𝑖 = 1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 𝑌𝑖4 𝑌𝑖+1 𝑌𝑖+1 ・ ・ ・ ・ ・ 𝑌𝑛 𝑌𝑛 𝑊𝑖 = 0 𝑊𝑖 = 1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 𝑌𝑖4 𝑌𝑖+1 𝑌𝑖+1 ・ ・ ・ ・ ・ 𝑌𝑛 𝑌𝑛 𝑊𝑖 = 0 𝑊𝑖 = 1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 𝑌𝑖4 𝑌𝑖+1 𝑌𝑖+1 ・ ・ ・ ・ 𝑌𝑛 𝑌𝑛 ラ ン ダ ム 割 付 の 場 合 ラ ン ダ ム 割 付 で な い 場 合 iについて標本を取る (簡単のために4個で図示) iの反応量の総和(高さ)を比較して、 介入効果(面積)を求める iについて標本を取る 割付確率が違うため標本数が 異なる=反応量の総和が異なる 幅(介入割付確率)が異なるため、 高さでは介入効果(面積)が比較不可能 幅と高さを傾向スコアによって 補正して比較可能にする ・ ・ ・ 割付確率(幅)が小さいほど、 反応量(高さ)を大きく補正す る 縦横比を維持したまま幅に 合わせて拡大するイメージ 𝑌𝑖+1 𝑌𝑖1 𝑌𝑖2 𝑌𝑖3 -
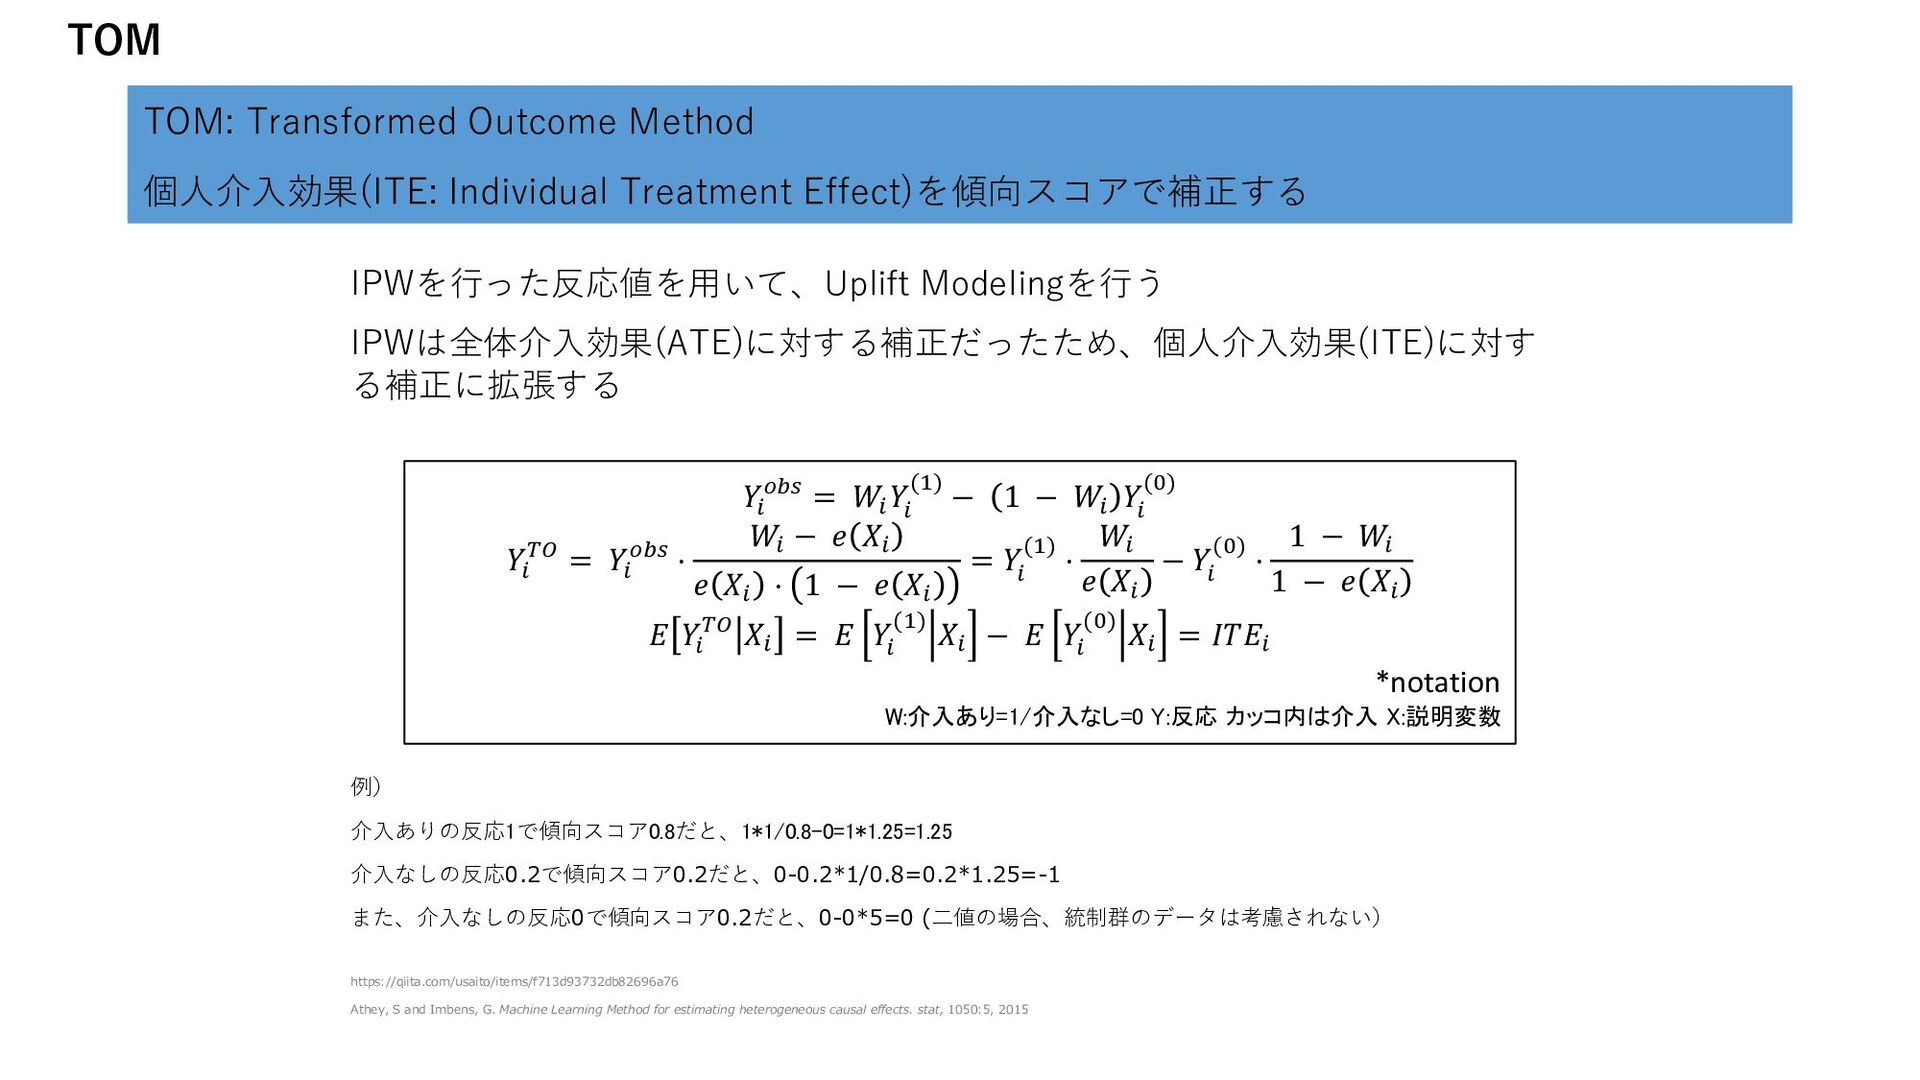
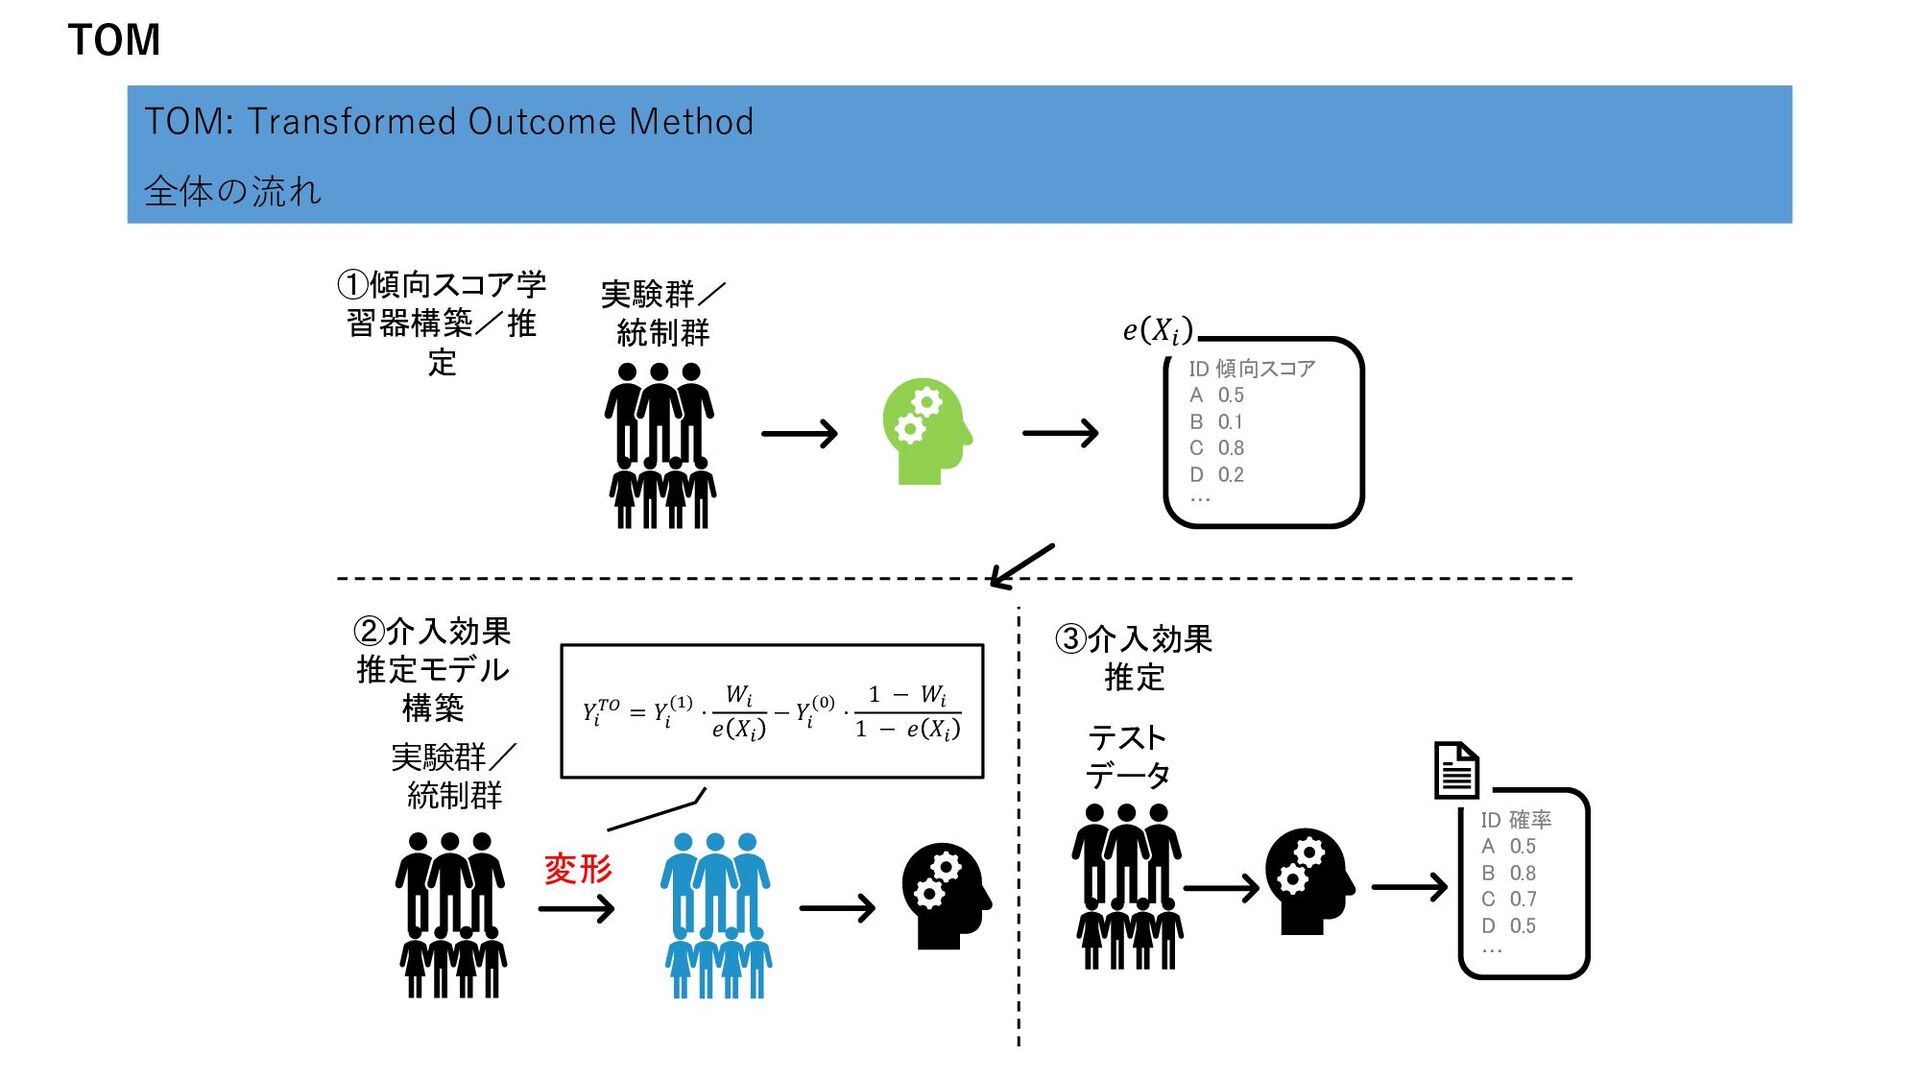
TOM TOM: Transformed Outcome Method 個人介入効果(ITE: Individual Treatment Effect)を傾向スコアで補正する https://qiita.com/usaito/items/f713d93732db82696a76
Athey, S and Imbens, G. Machine Learning Method for estimating heterogeneous causal effects. stat, 1050:5, 2015 IPWを行った反応値を用いて、Uplift Modelingを行う IPWは全体介入効果(ATE)に対する補正だったため、個人介入効果(ITE)に対す る補正に拡張する 例) 介入ありの反応1で傾向スコア0.8だと、1*1/0.8-0=1*1.25=1.25 介入なしの反応0.2で傾向スコア0.2だと、0-0.2*1/0.8=0.2*1.25=-1 また、介入なしの反応0で傾向スコア0.2だと、0-0*5=0 (二値の場合、統制群のデータは考慮されない) 𝑌𝑖 𝑜𝑏𝑠 = 𝑊𝑖 𝑌 𝑖 (1) − 1 − 𝑊𝑖 𝑌 𝑖 (0) 𝑌𝑖 𝑇𝑂 = 𝑌𝑖 𝑜𝑏𝑠 ⋅ 𝑊𝑖 − 𝑒 𝑋𝑖 𝑒 𝑋𝑖 ⋅ 1 − 𝑒 𝑋𝑖 = 𝑌 𝑖 (1) ⋅ 𝑊𝑖 𝑒 𝑋𝑖 − 𝑌 𝑖 (0) ⋅ 1 − 𝑊𝑖 1 − 𝑒 𝑋𝑖 𝐸 𝑌𝑖 𝑇𝑂 𝑋𝑖 = 𝐸 𝑌 𝑖 (1) 𝑋𝑖 − 𝐸 𝑌 𝑖 (0) 𝑋𝑖 = 𝐼𝑇𝐸𝑖 *notation W:介入あり=1/介入なし=0 Y:反応 カッコ内は介入 X:説明変数 -
TOM TOM: Transformed Outcome Method 全体の流れ 𝑌𝑖 𝑇𝑂 = 𝑌
𝑖 (1) ⋅ 𝑊𝑖 𝑒 𝑋𝑖 − 𝑌 𝑖 (0) ⋅ 1 − 𝑊𝑖 1 − 𝑒 𝑋𝑖 実験群/ 統制群 変形 実験群/ 統制群 ID 傾向スコア A 0.5 B 0.1 C 0.8 D 0.2 … 𝑒 𝑋𝑖 ②介入効果 推定モデル 構築 ①傾向スコア学 習器構築/推 定 ③介入効果 推定 ID 確率 A 0.5 B 0.8 C 0.7 D 0.5 … テスト データ -
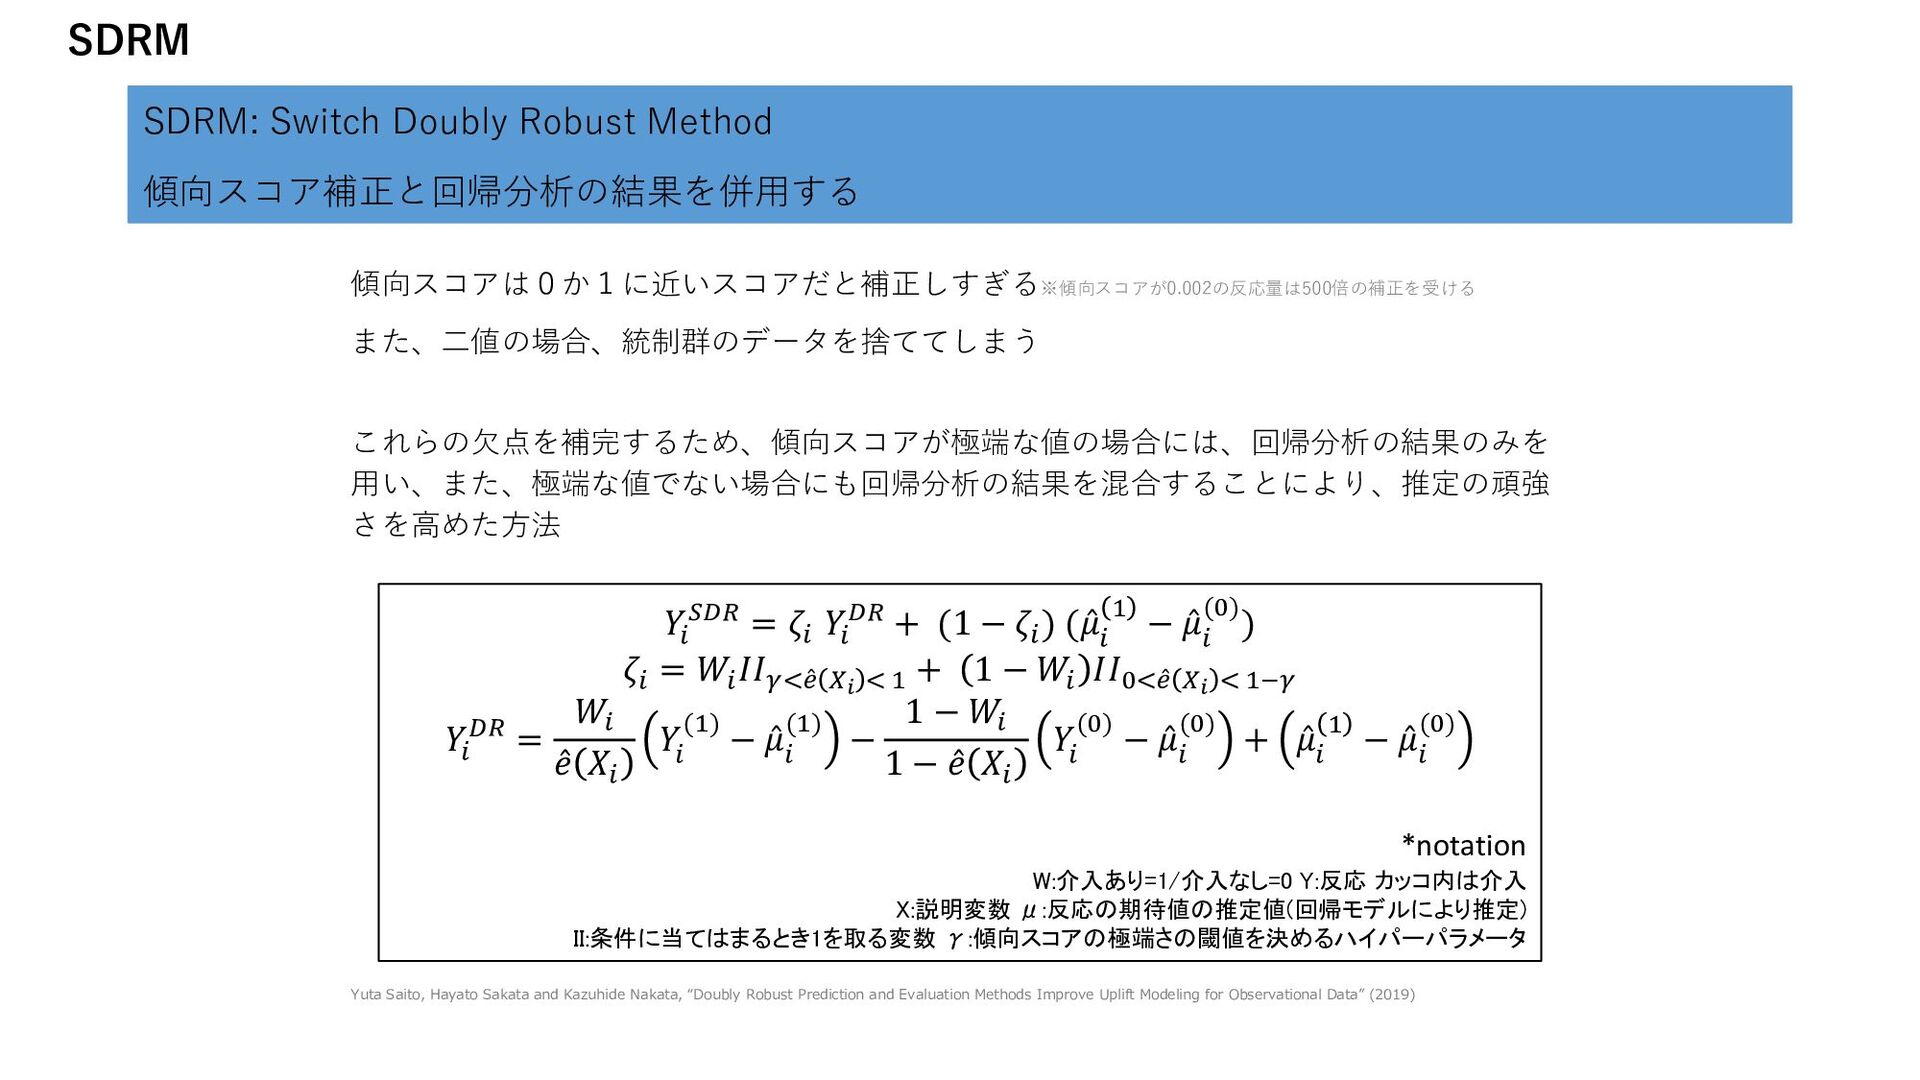
SDRM SDRM: Switch Doubly Robust Method 傾向スコア補正と回帰分析の結果を併用する Yuta Saito, Hayato
Sakata and Kazuhide Nakata, “Doubly Robust Prediction and Evaluation Methods Improve Uplift Modeling for Observational Data” (2019) 傾向スコアは0か1に近いスコアだと補正しすぎる※傾向スコアが0.002の反応量は500倍の補正を受ける また、二値の場合、統制群のデータを捨ててしまう これらの欠点を補完するため、傾向スコアが極端な値の場合には、回帰分析の結果のみを 用い、また、極端な値でない場合にも回帰分析の結果を混合することにより、推定の頑強 さを高めた方法 𝑌𝑖 𝑆𝐷𝑅 = 𝜁𝑖 𝑌𝑖 𝐷𝑅 + (1 − 𝜁𝑖 ) ( Ƹ 𝜇 𝑖 1 − Ƹ 𝜇 𝑖 (0)) 𝜁𝑖 = 𝑊𝑖 𝐼𝐼𝛾< Ƹ 𝑒 𝑋𝑖 < 1 + 1 − 𝑊𝑖 𝐼𝐼0< Ƹ 𝑒 𝑋𝑖 < 1−𝛾 𝑌𝑖 𝐷𝑅 = 𝑊𝑖 Ƹ 𝑒 𝑋𝑖 𝑌 𝑖 (1) − Ƹ 𝜇 𝑖 (1) − 1 − 𝑊𝑖 1 − Ƹ 𝑒 𝑋𝑖 𝑌 𝑖 (0) − Ƹ 𝜇 𝑖 (0) + Ƹ 𝜇 𝑖 1 − Ƹ 𝜇 𝑖 (0) *notation W:介入あり=1/介入なし=0 Y:反応 カッコ内は介入 X:説明変数 μ:反応の期待値の推定値(回帰モデルにより推定) II:条件に当てはまるとき1を取る変数 γ:傾向スコアの極端さの閾値を決めるハイパーパラメータ -
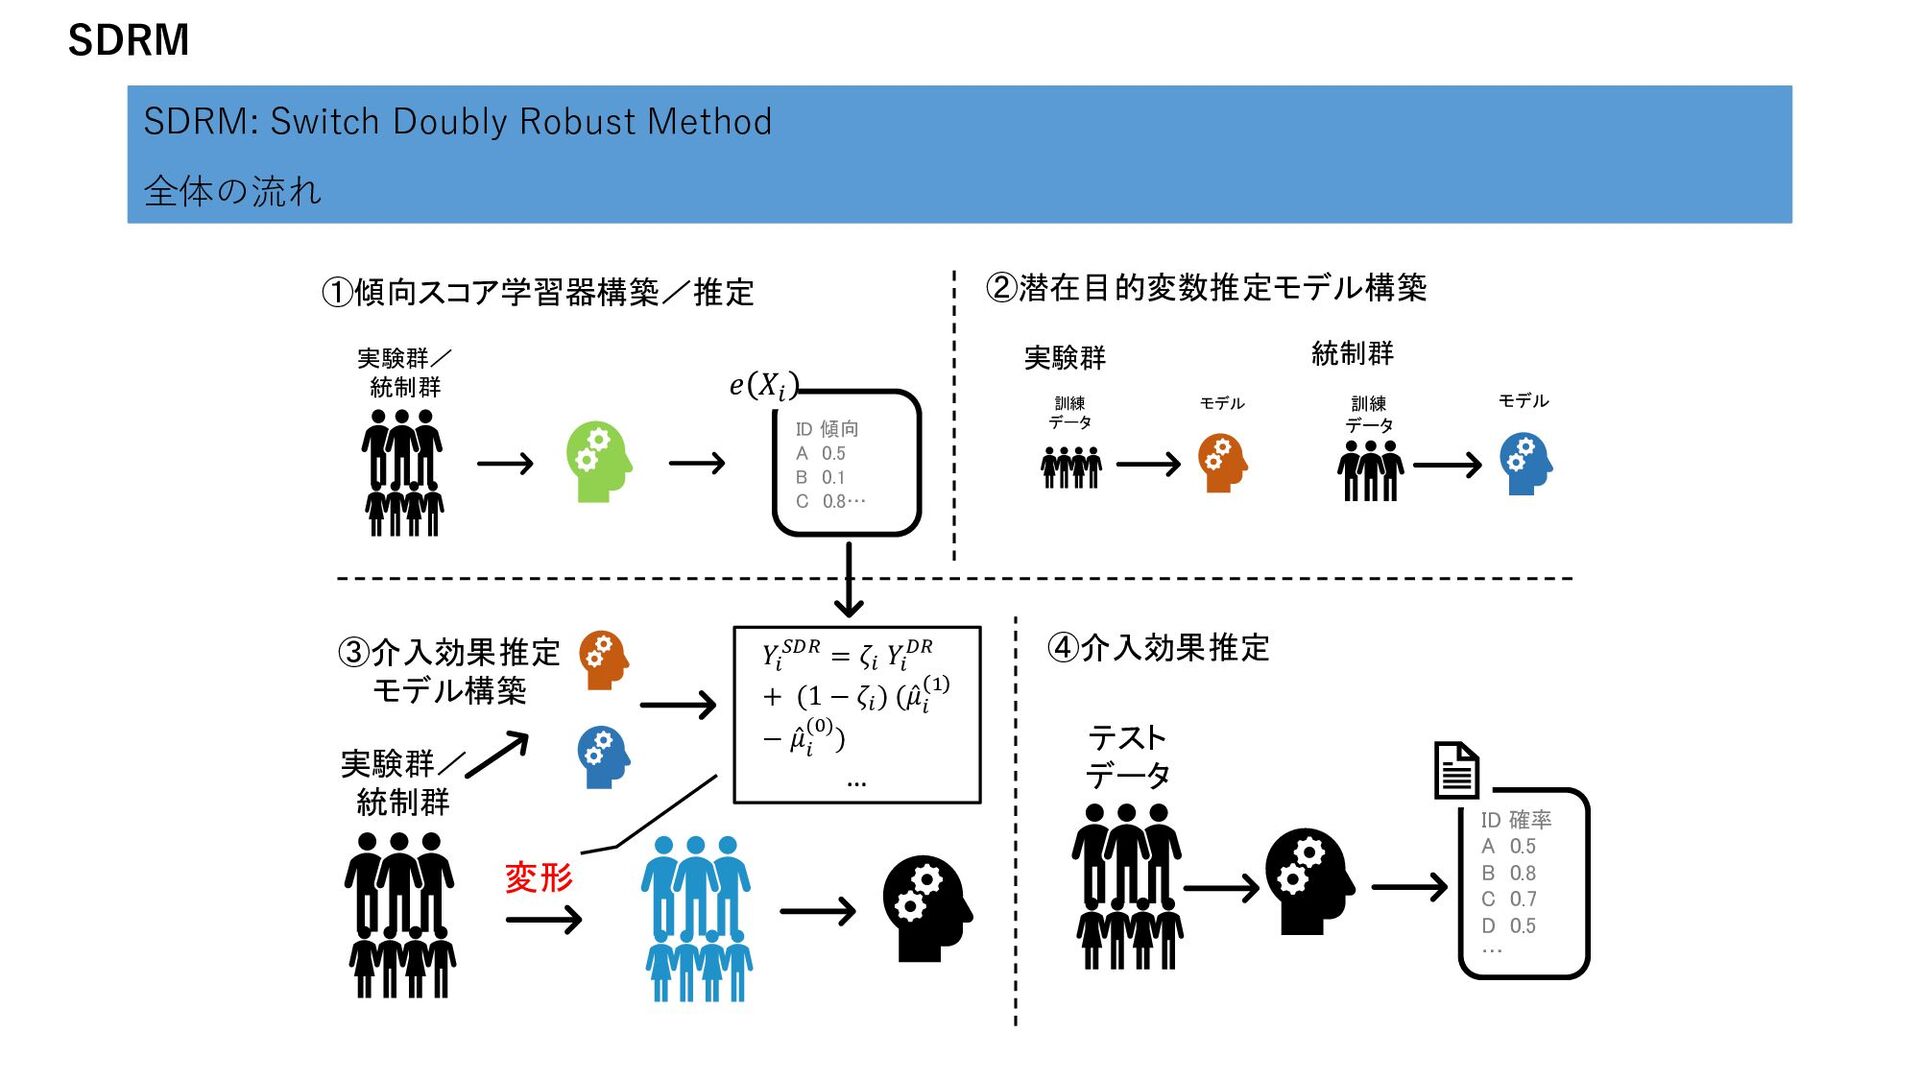
SDRM SDRM: Switch Doubly Robust Method 全体の流れ 𝑌𝑖 𝑆𝐷𝑅 =
𝜁𝑖 𝑌𝑖 𝐷𝑅 + (1 − 𝜁𝑖 ) ( Ƹ 𝜇 𝑖 1 − Ƹ 𝜇 𝑖 (0)) … 実験群/ 統制群 変形 ID 確率 A 0.5 B 0.8 C 0.7 D 0.5 … 実験群/ 統制群 ID 傾向 A 0.5 B 0.1 C 0.8… 𝑒 𝑋𝑖 ③介入効果推定 モデル構築 ①傾向スコア学習器構築/推定 ②潜在目的変数推定モデル構築 実験群 訓練 データ モデル 統制群 訓練 データ モデル ④介入効果推定 テスト データ -
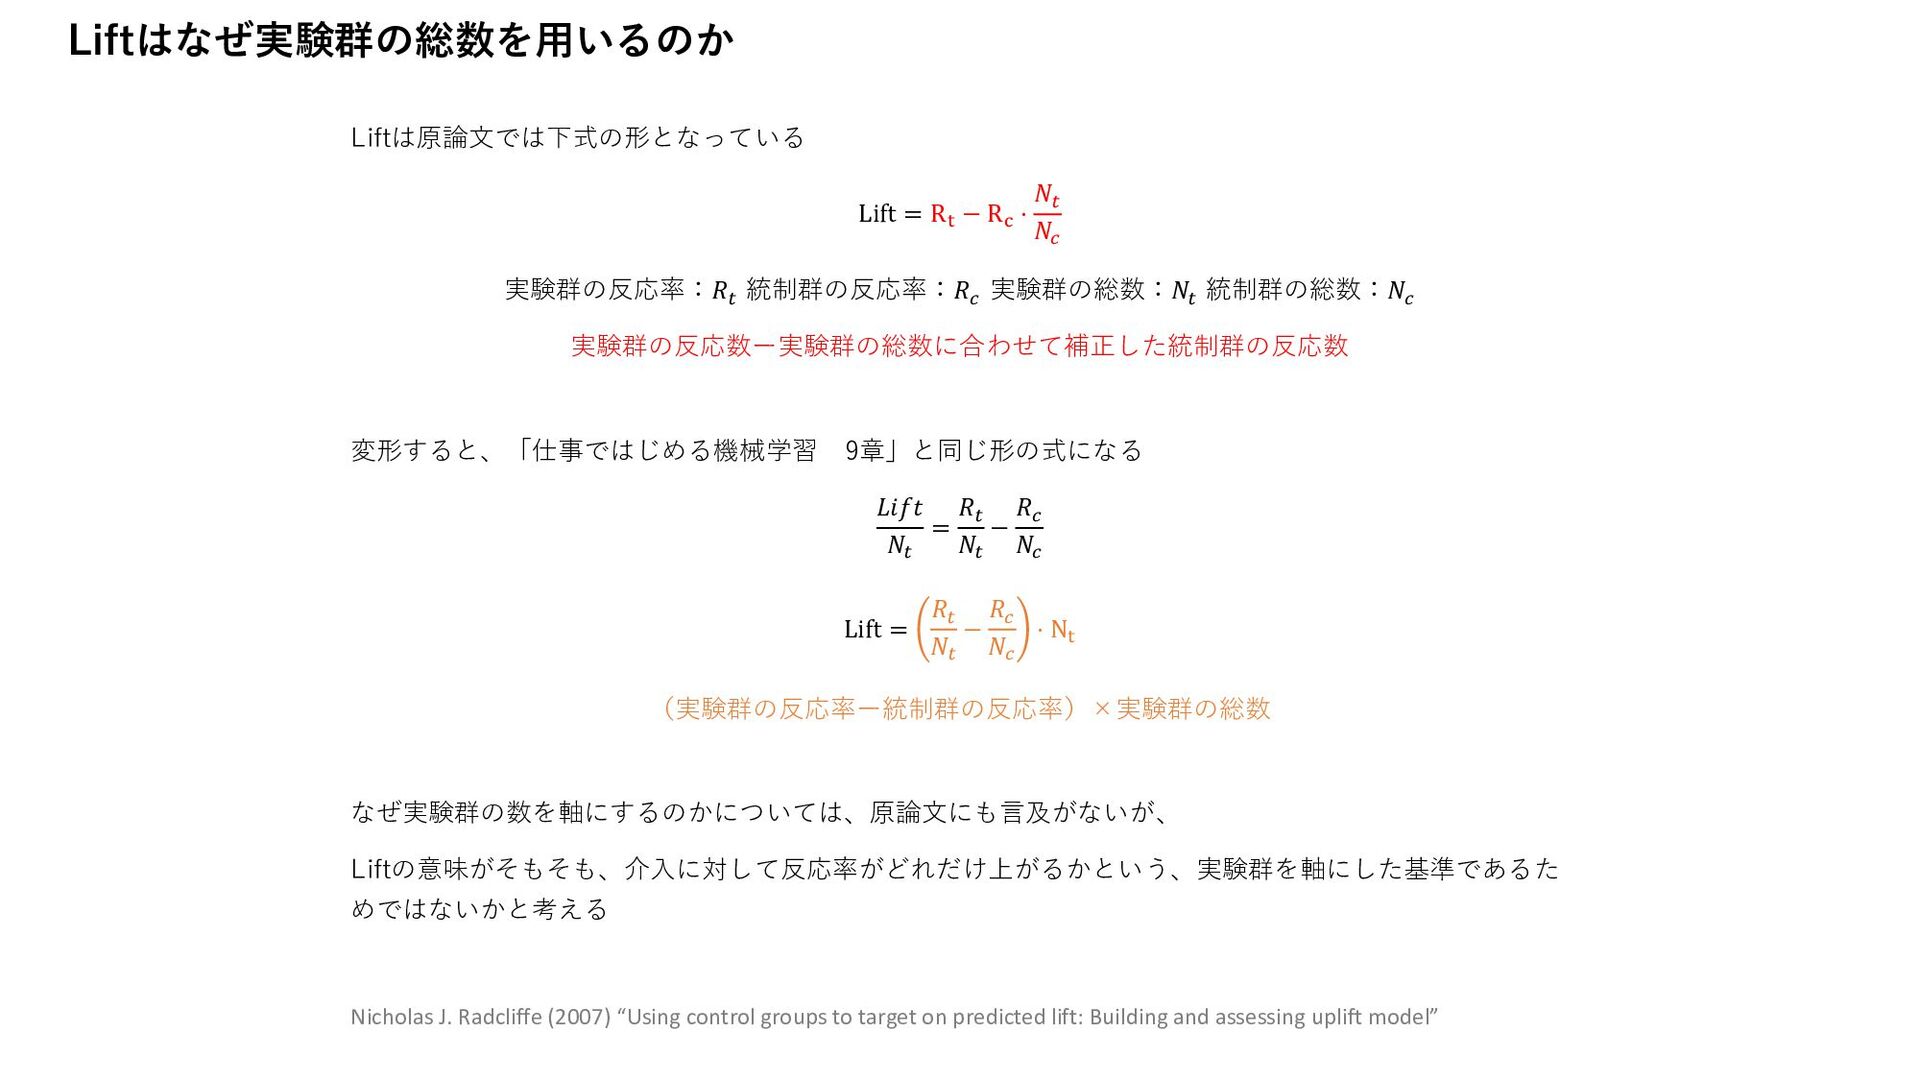
Liftはなぜ実験群の総数を用いるのか Liftは原論文では下式の形となっている Lift = Rt − Rc ⋅ 𝑁𝑡 𝑁𝑐
実験群の反応率:𝑅𝑡 統制群の反応率:𝑅𝑐 実験群の総数:𝑁𝑡 統制群の総数:𝑁𝑐 実験群の反応数ー実験群の総数に合わせて補正した統制群の反応数 変形すると、「仕事ではじめる機械学習 9章」と同じ形の式になる 𝐿𝑖𝑓𝑡 𝑁𝑡 = 𝑅𝑡 𝑁𝑡 − 𝑅𝑐 𝑁𝑐 Lift = 𝑅𝑡 𝑁𝑡 − 𝑅𝑐 𝑁𝑐 ⋅ Nt (実験群の反応率ー統制群の反応率)×実験群の総数 なぜ実験群の数を軸にするのかについては、原論文にも言及がないが、 Liftの意味がそもそも、介入に対して反応率がどれだけ上がるかという、実験群を軸にした基準であるた めではないかと考える Nicholas J. Radcliffe (2007) “Using control groups to target on predicted lift: Building and assessing uplift model” -
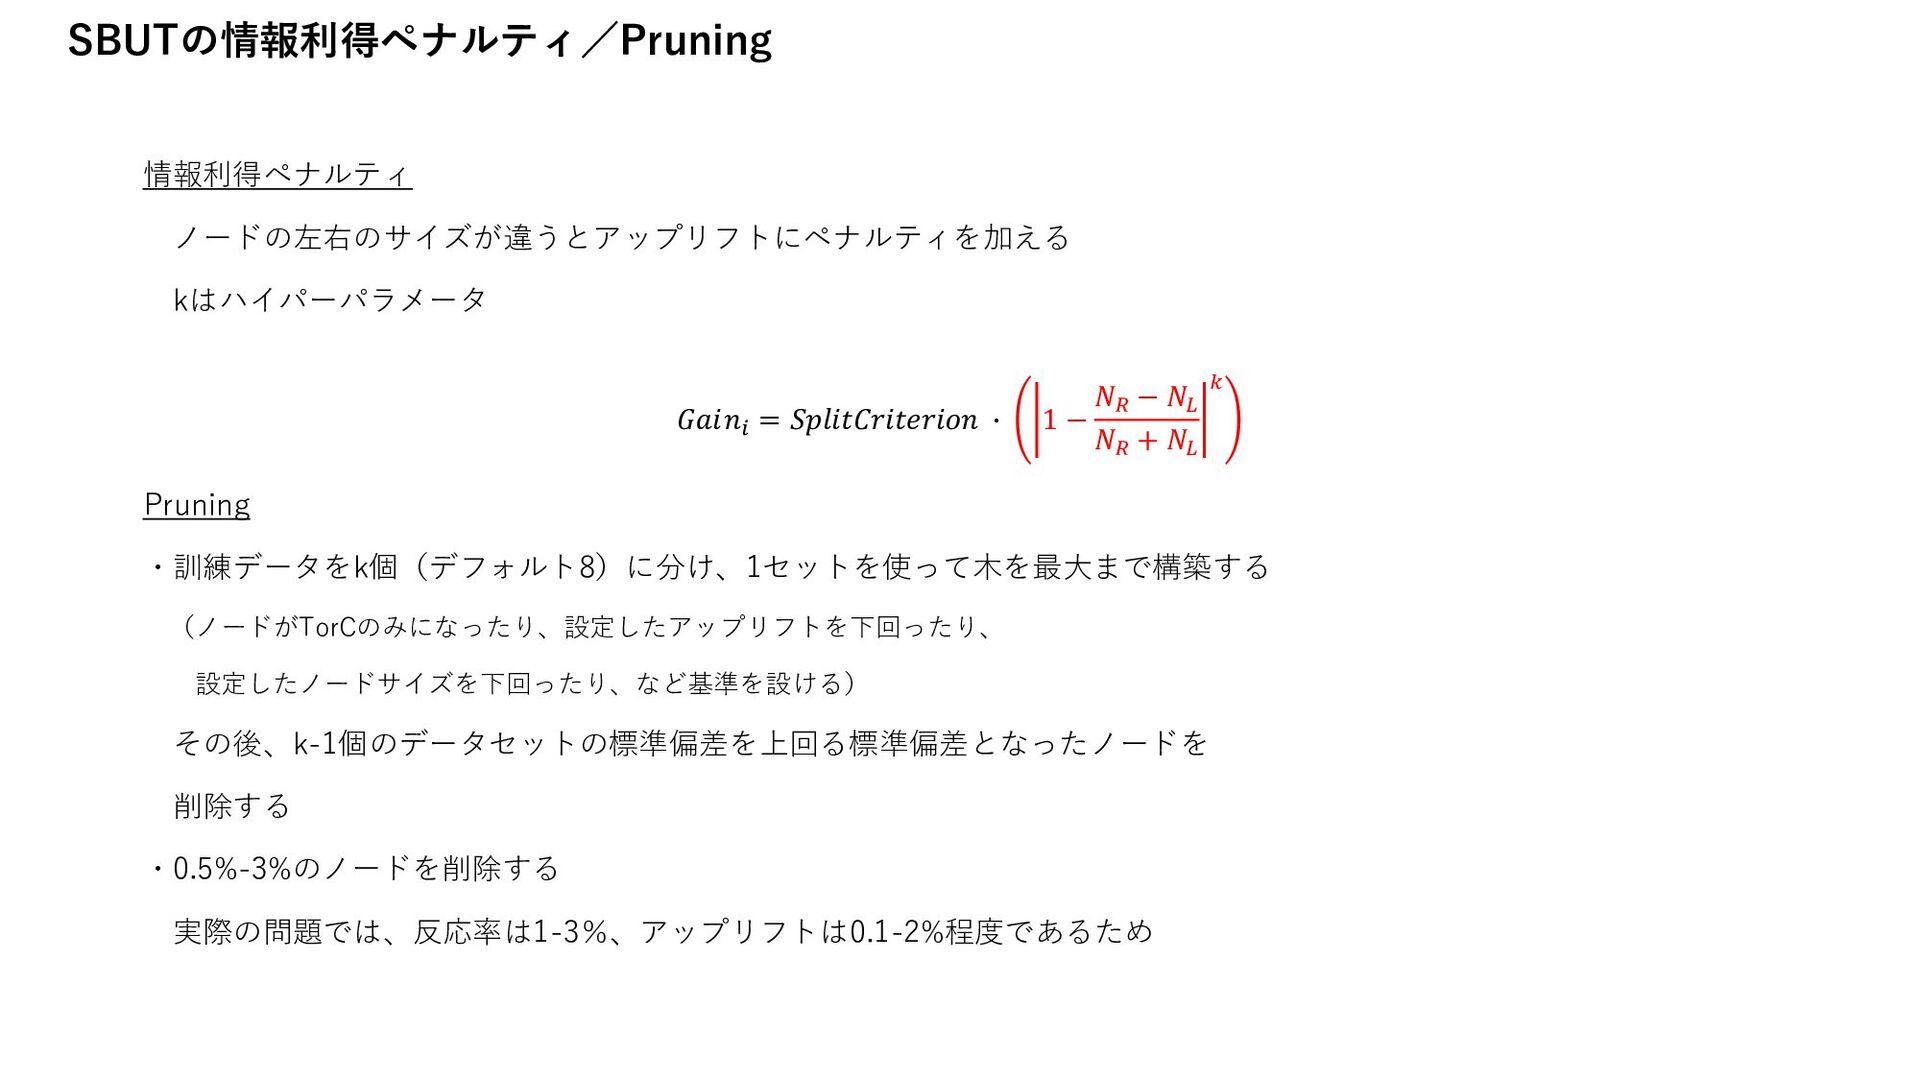
SBUTの情報利得ペナルティ/Pruning 情報利得ペナルティ ノードの左右のサイズが違うとアップリフトにペナルティを加える kはハイパーパラメータ 𝐺𝑎𝑖𝑛𝑖 = 𝑆𝑝𝑙𝑖𝑡𝐶𝑟𝑖𝑡𝑒𝑟𝑖𝑜𝑛 ∙ 1 −
𝑁𝑅 − 𝑁𝐿 𝑁𝑅 + 𝑁𝐿 𝑘 Pruning ・訓練データをk個(デフォルト8)に分け、1セットを使って木を最大まで構築する (ノードがTorCのみになったり、設定したアップリフトを下回ったり、 設定したノードサイズを下回ったり、など基準を設ける) その後、k-1個のデータセットの標準偏差を上回る標準偏差となったノードを 削除する ・0.5%-3%のノードを削除する 実際の問題では、反応率は1-3%、アップリフトは0.1-2%程度であるため
 jeyjeyjeey
 yuutosi
 grimoh
 wind111
 littlehands
 fortegp05
 daishukojima
 jcabot
 nealle
 falken
 kmotohas
 atalie2m
 iwamot
 jdejongh
 frankvandijk
 cromwellryan
 eileencodes
 dugsong
 techseoconnect
 apolaine
 sachag
 soudai
 kastner
 thekraken
 skoyamalab