Share
Embed
タイトルパタンによる文書の一文概要生成
長安 義夫, 山本 和英. タイトルパタンによる文書の一文概要生成. 言語処理学会第13回年次大会, pp.684-687 (2007.3)
自然言語処理研究室
March 31, 2007
Transcript
57 slides
-
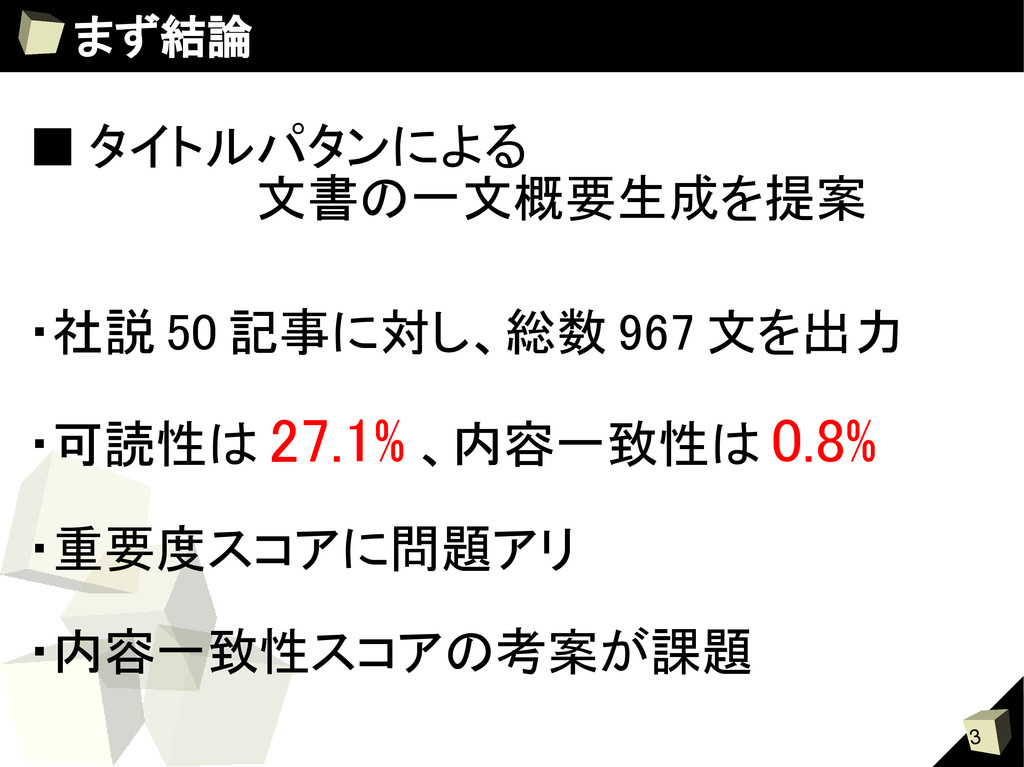
3 まず結論 ▪ タイトルパタンによる 文書の一文概要生成を提案 ・社説 50 記事に対し、総数 967 文を出力
・可読性は 27.1% 、内容一致性は 0.8% ・重要度スコアに問題アリ ・内容一致性スコアの考案が課題 -
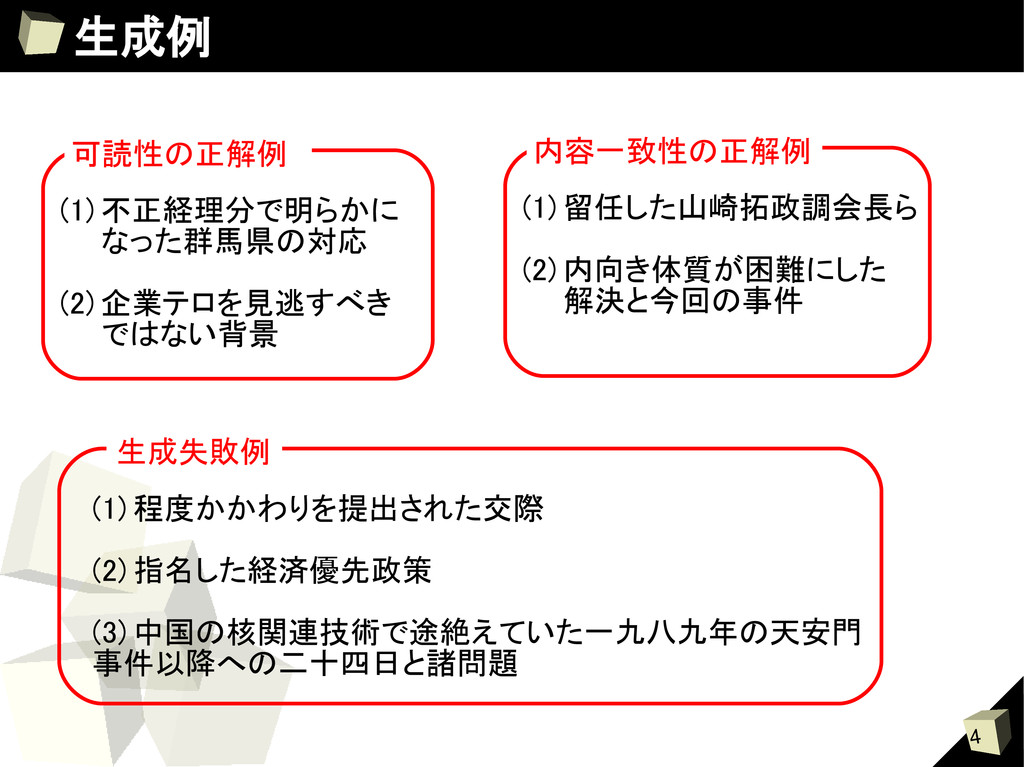
4 生成例 (1) 不正経理分で明らかに なった群馬県の対応 (2) 企業テロを見逃すべき ではない背景 可読性の正解例 (1)
留任した山崎拓政調会長ら (2) 内向き体質が困難にした 解決と今回の事件 内容一致性の正解例 (1) 程度かかわりを提出された交際 (2) 指名した経済優先政策 (3) 中国の核関連技術で途絶えていた一九八九年の天安門 事件以降への二十四日と諸問題 生成失敗例 -
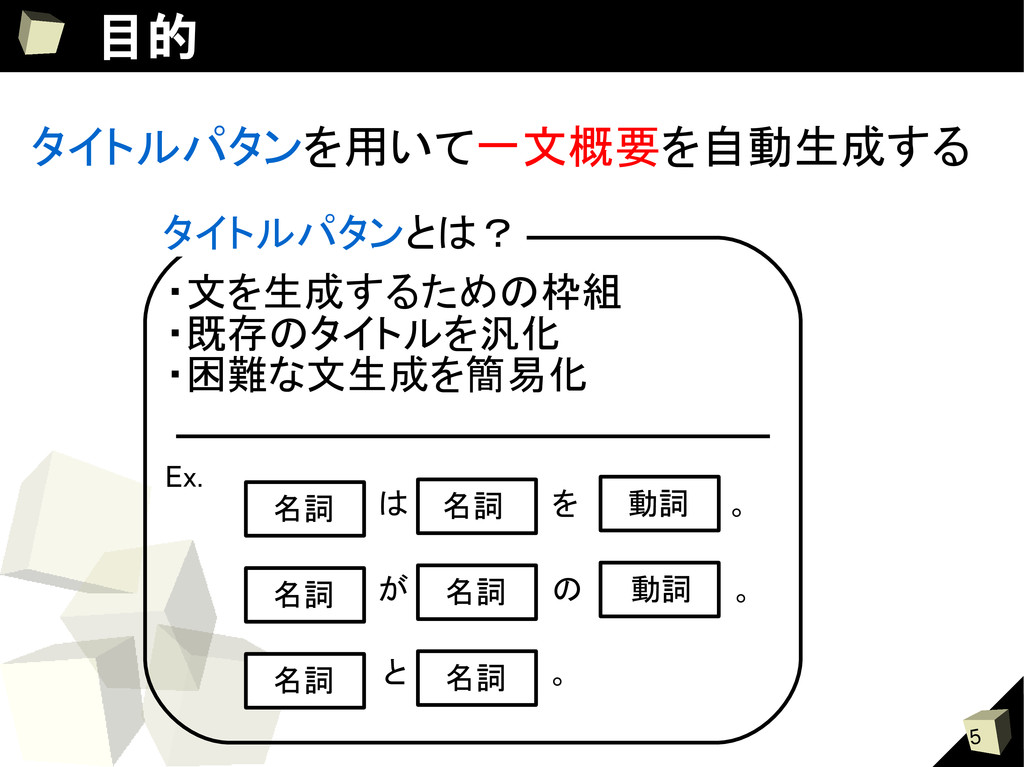
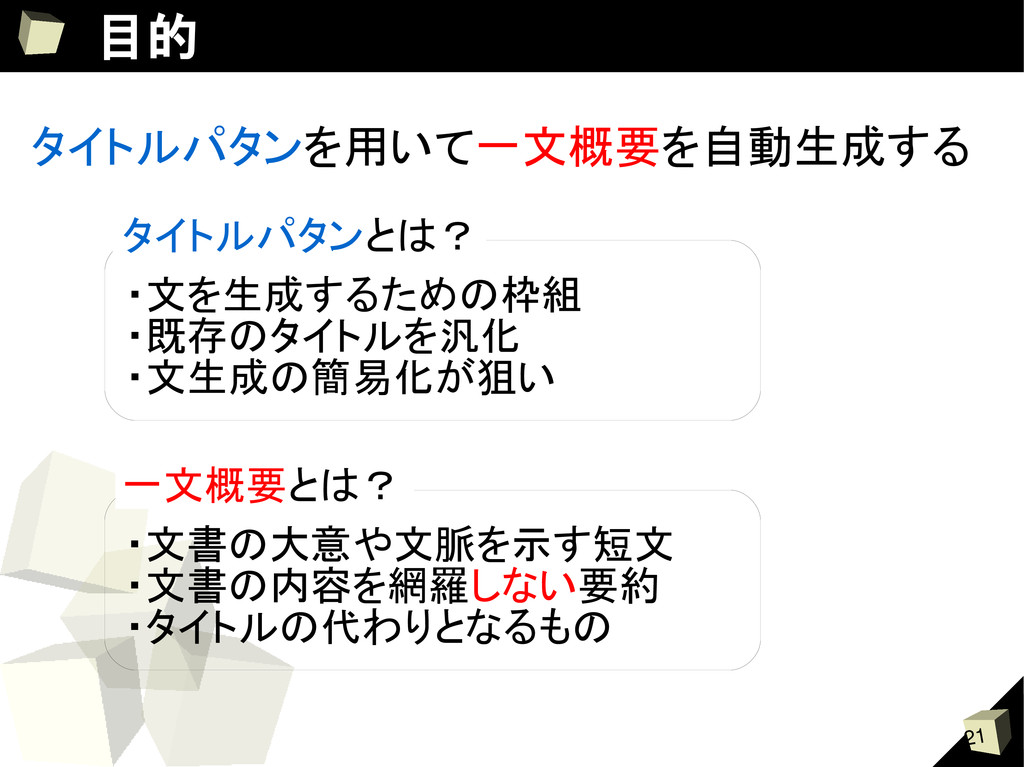
5 目的 タイトルパタンを用いて一文概要を自動生成する ・文を生成するための枠組 ・既存のタイトルを汎化 ・困難な文生成を簡易化 タイトルパタンとは? は を 。
名詞 名詞 動詞 が の 。 名詞 名詞 動詞 と 。 名詞 名詞 Ex. -
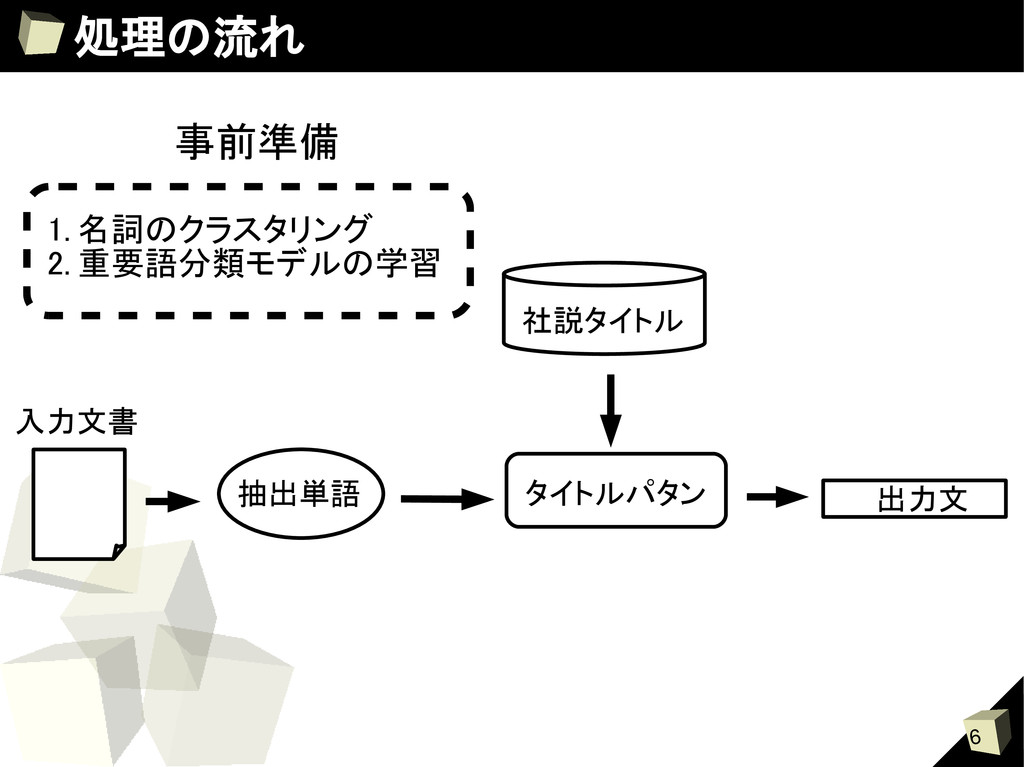
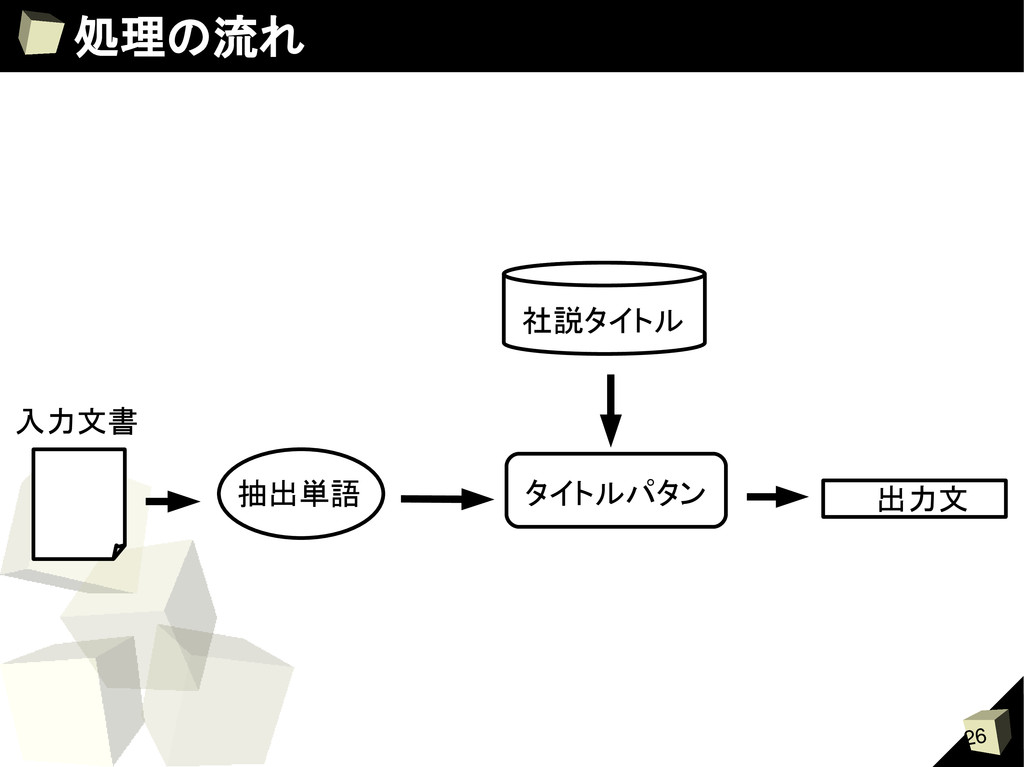
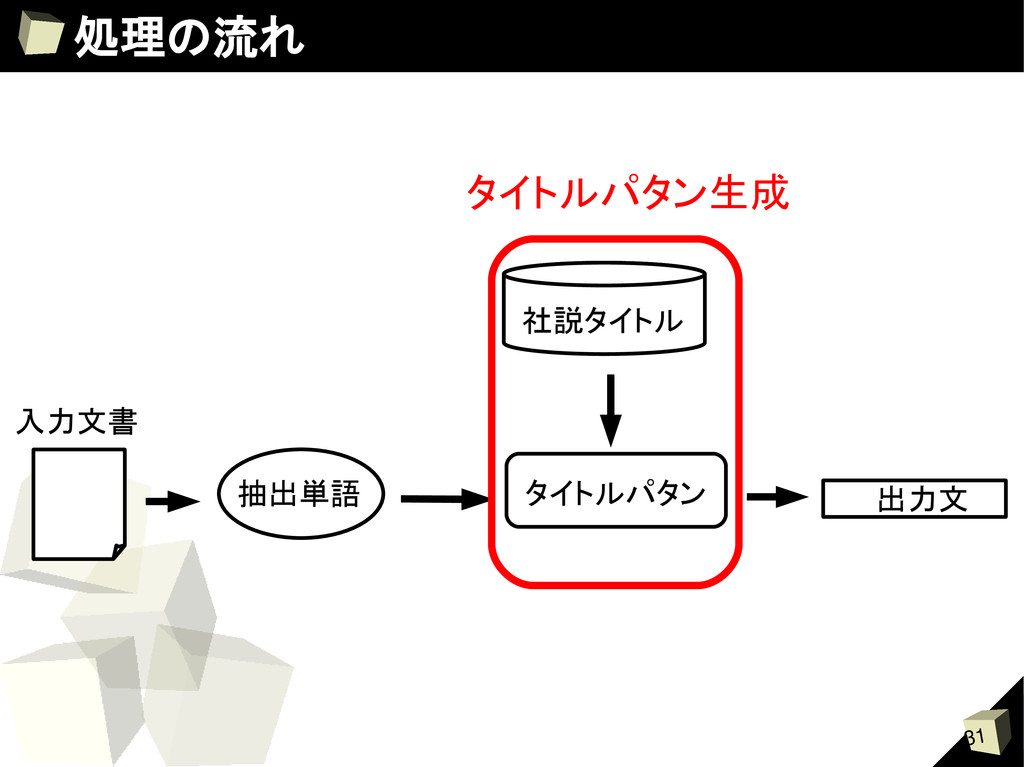
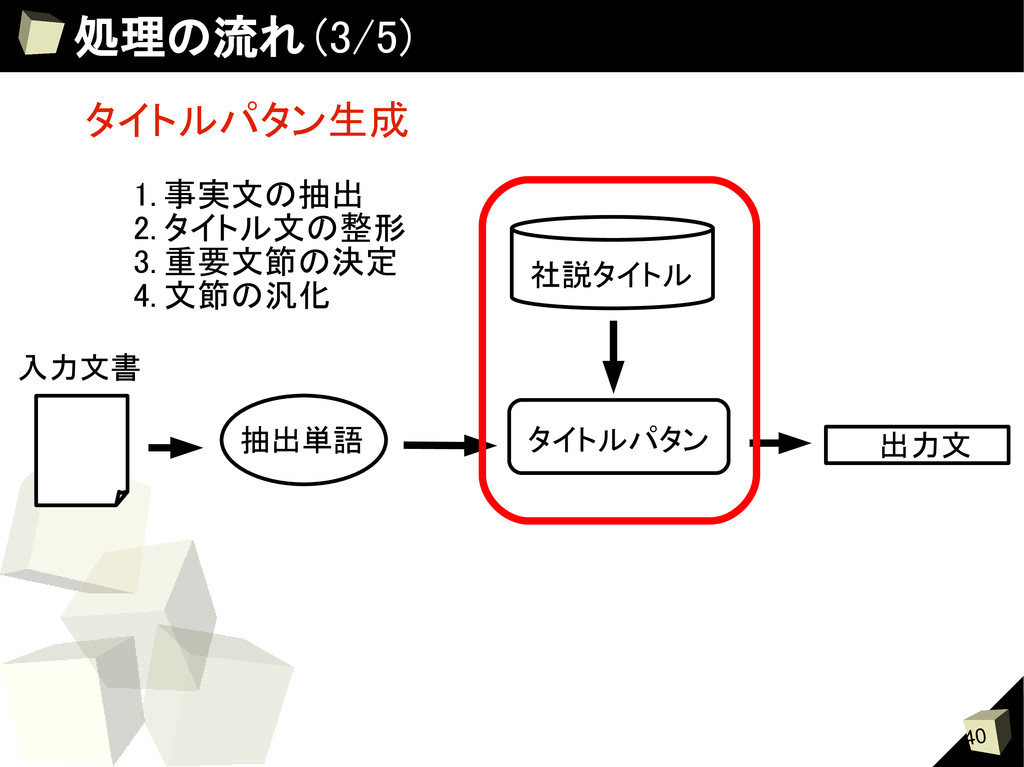
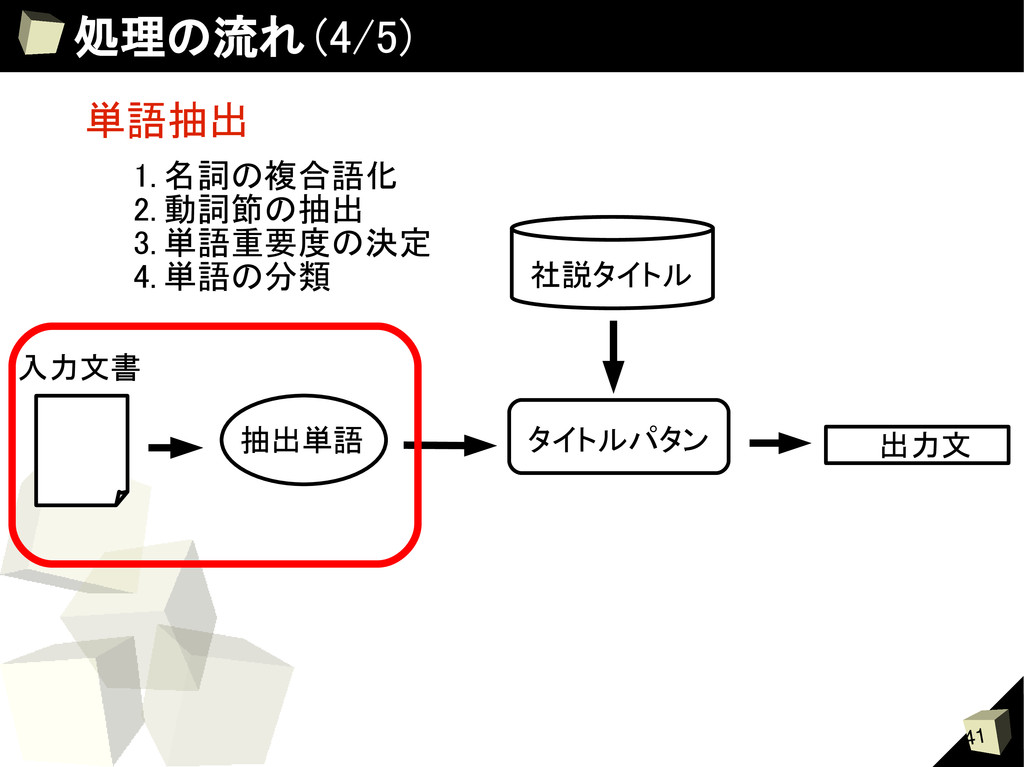
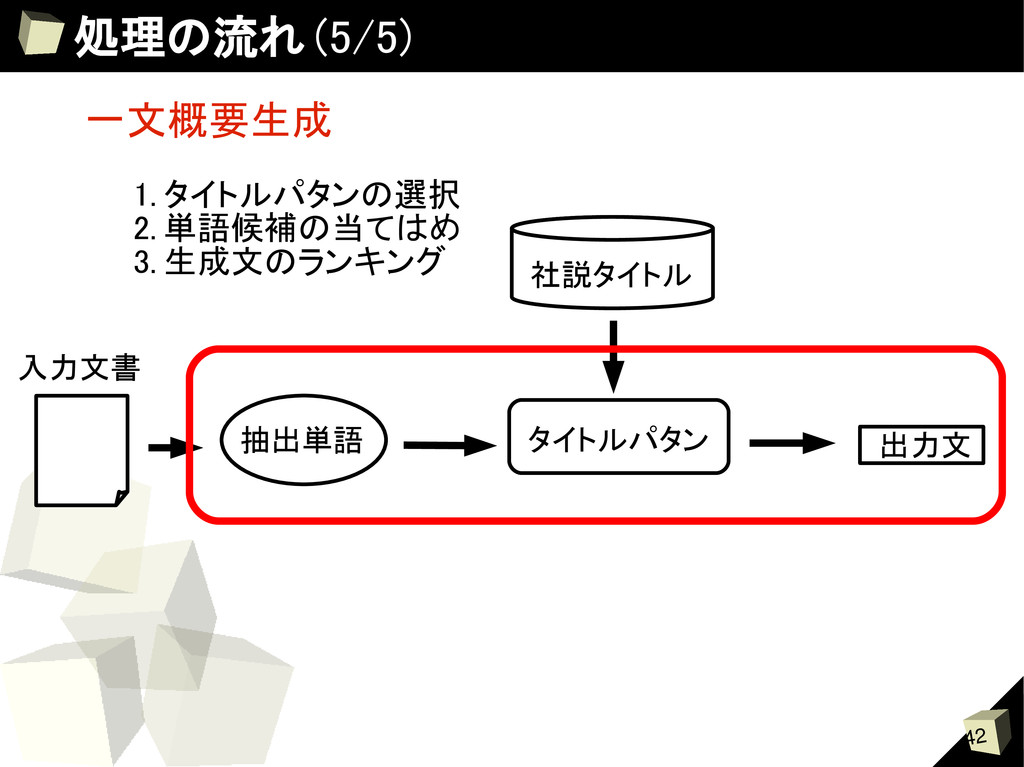
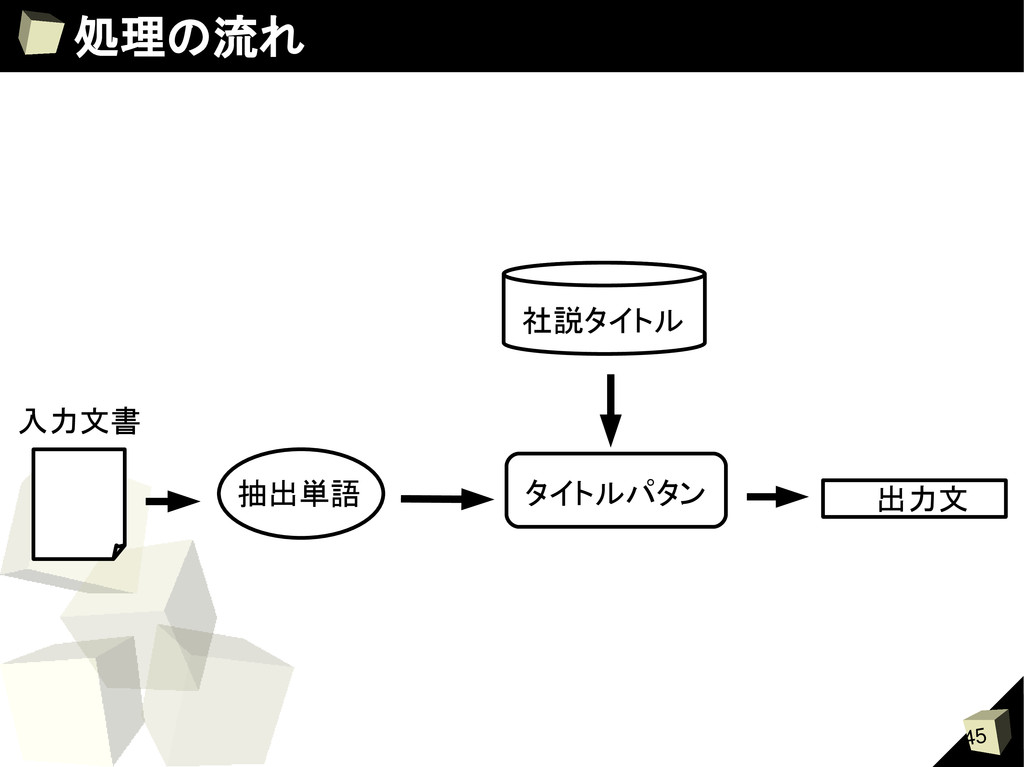
6 処理の流れ 入力文書 抽出単語 社説タイトル タイトルパタン 出力文 事前準備 1. 名詞のクラスタリング
2. 重要語分類モデルの学習 -
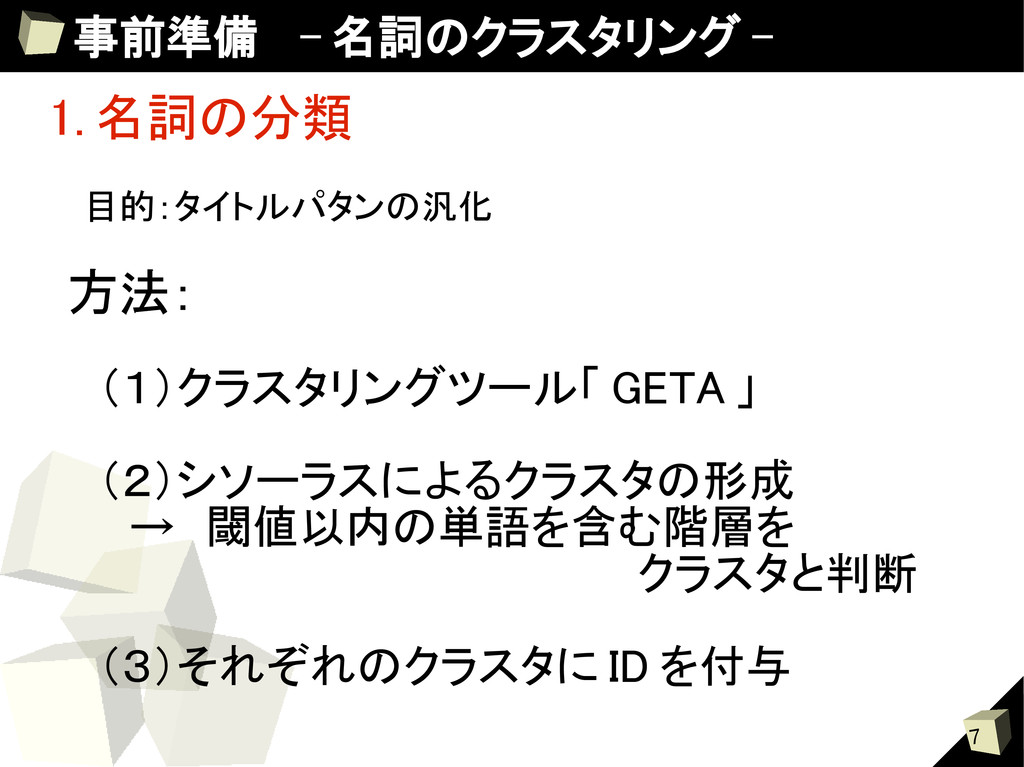
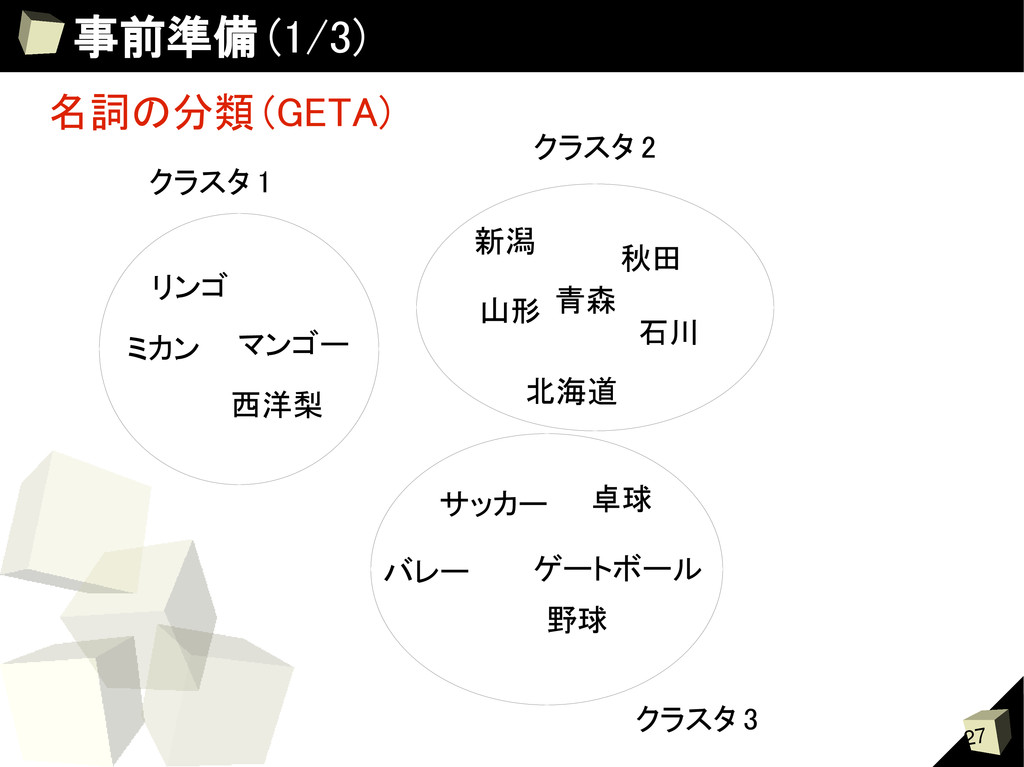
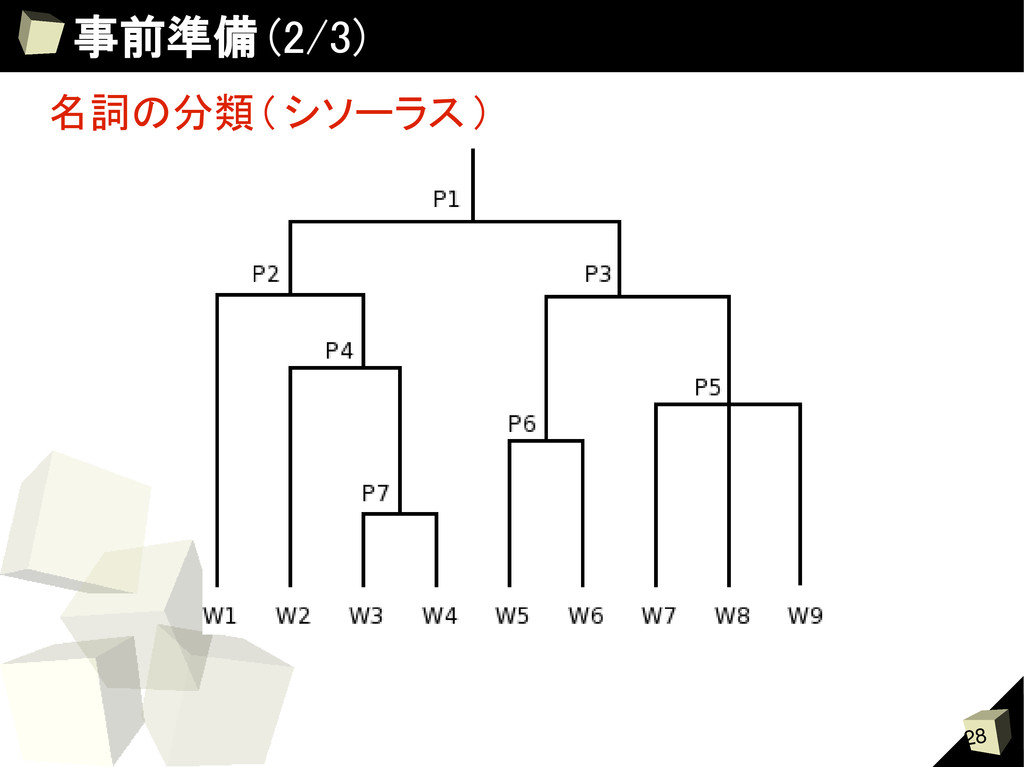
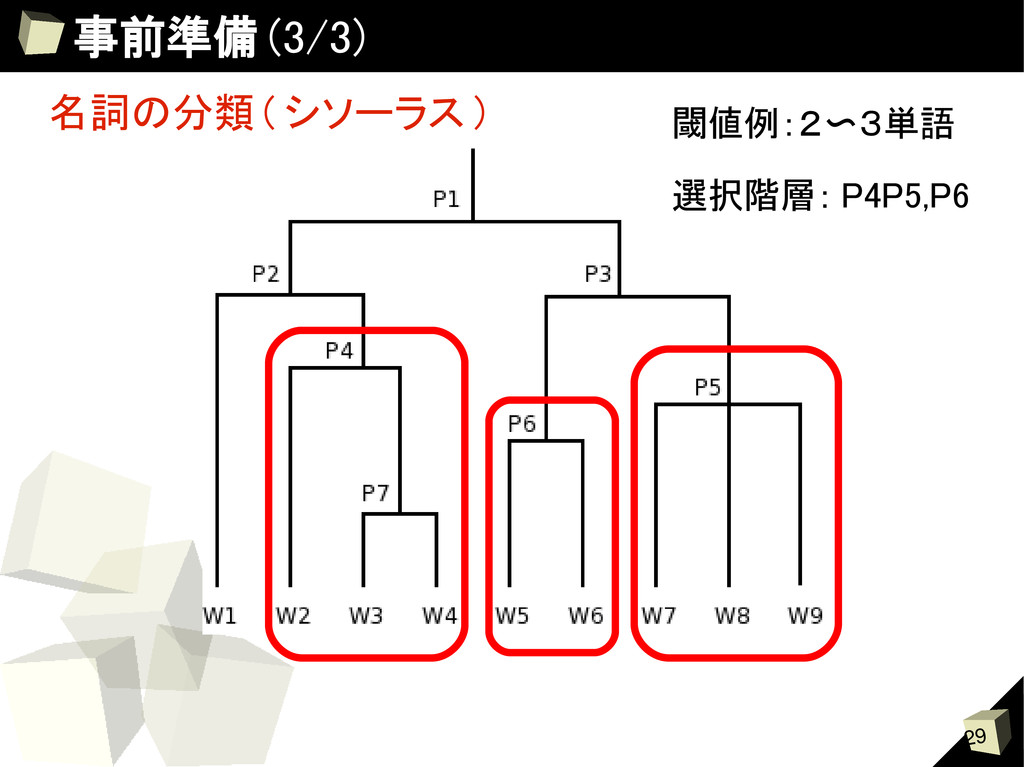
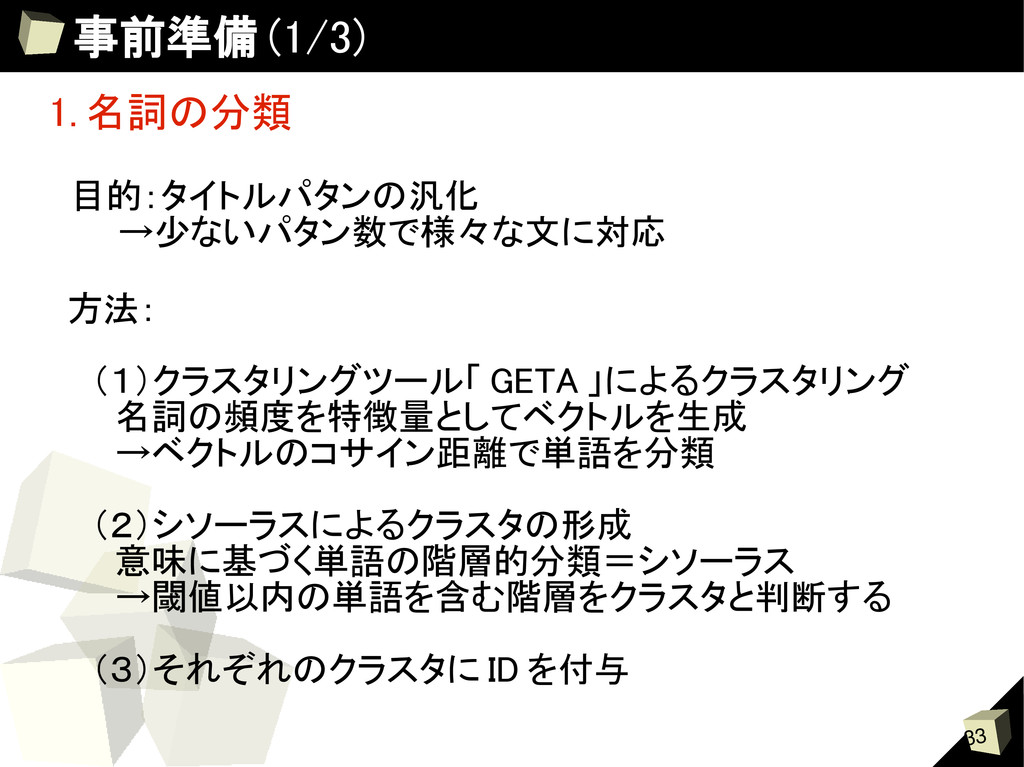
7 事前準備 - 名詞のクラスタリング - 1. 名詞の分類 目的:タイトルパタンの汎化 方法: (1)クラスタリングツール「
GETA 」 (2)シソーラスによるクラスタの形成 → 閾値以内の単語を含む階層を クラスタと判断 (3)それぞれのクラスタに ID を付与 -
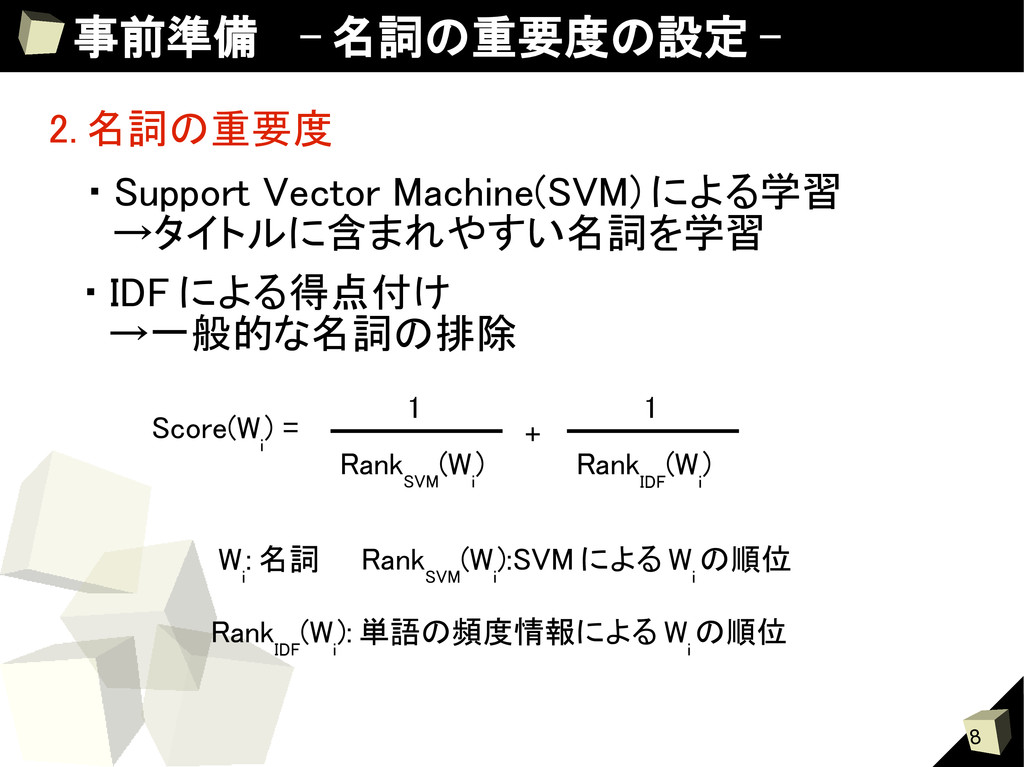
8 事前準備 - 名詞の重要度の設定 - 2. 名詞の重要度 ・ Support Vector
Machine(SVM) による学習 →タイトルに含まれやすい名詞を学習 ・ IDF による得点付け →一般的な名詞の排除 Score(W i ) = Rank SVM (W i ) 1 Rank IDF (W i ) 1 + W i : 名詞 Rank SVM (W i ):SVM による W i の順位 Rank IDF (W i ): 単語の頻度情報による W i の順位 -
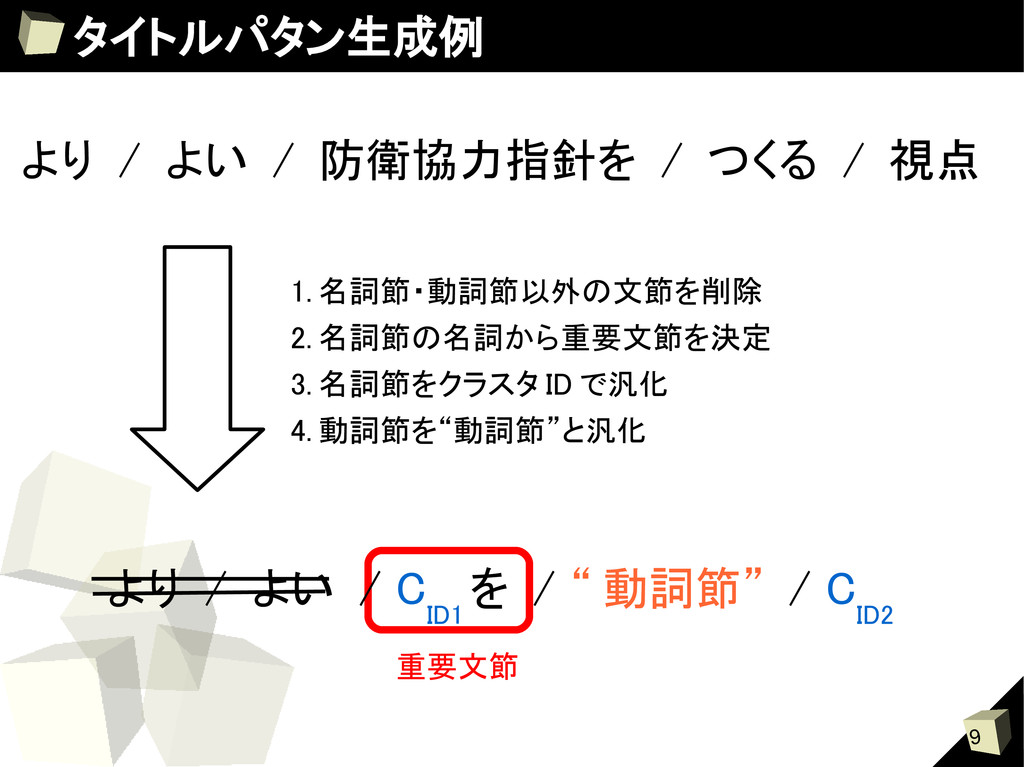
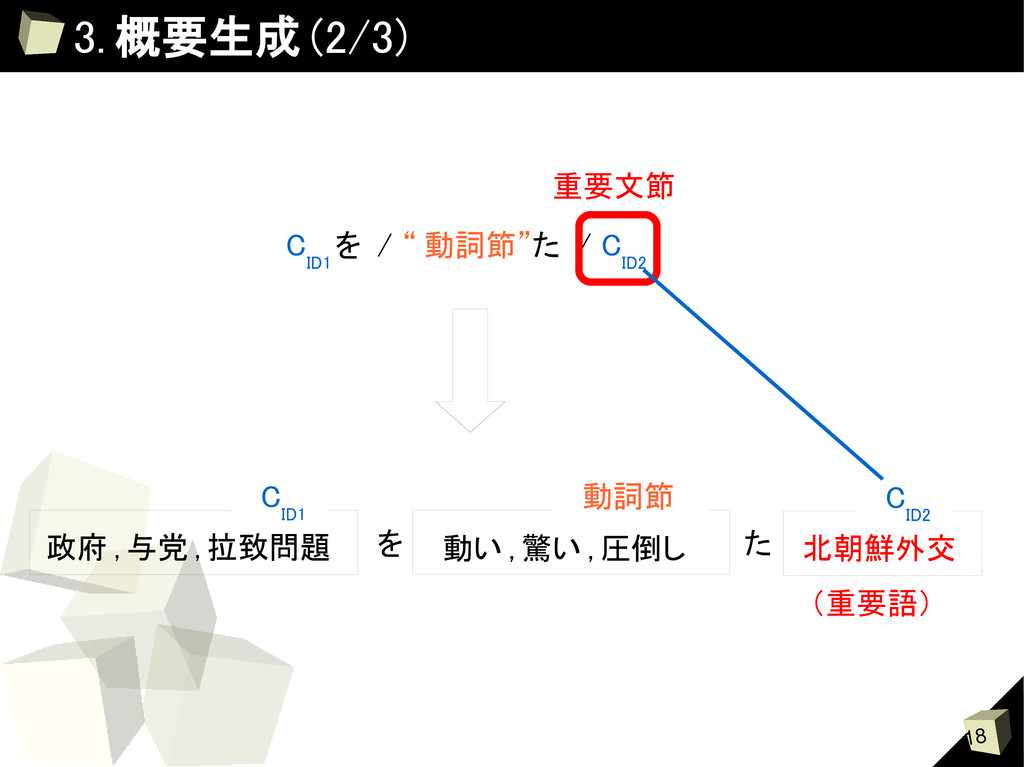
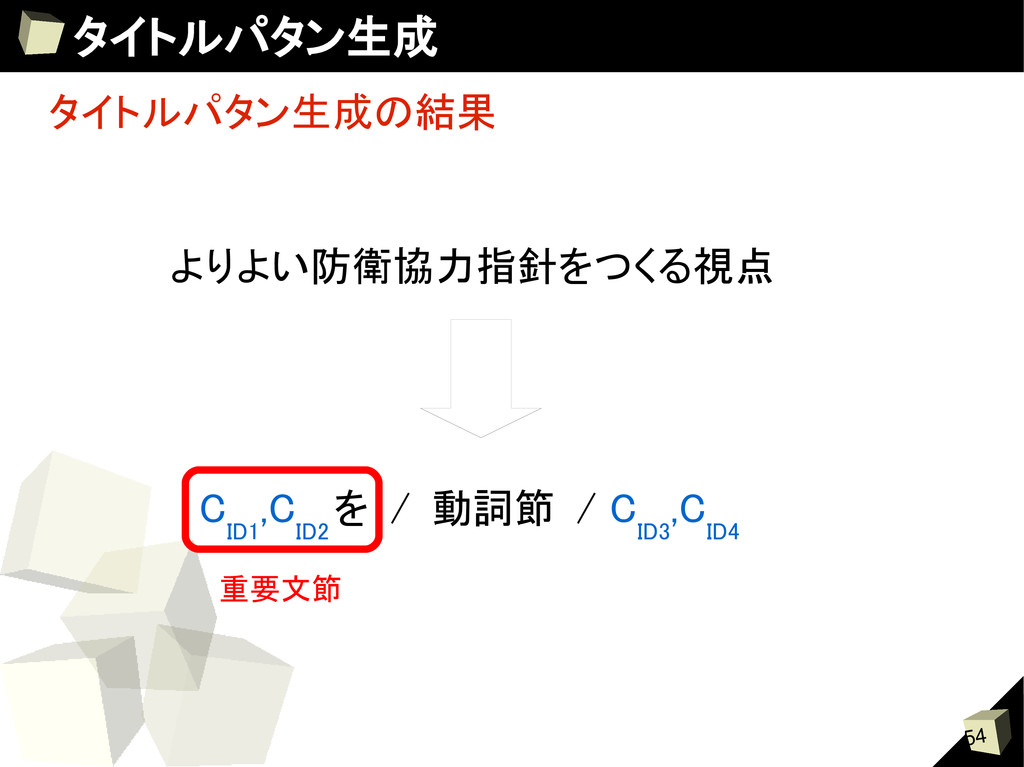
9 タイトルパタン生成例 重要文節 より / よい / C ID1 を
/ “ 動詞節” / C ID2 より / よい / 防衛協力指針を / つくる / 視点 1. 名詞節・動詞節以外の文節を削除 2. 名詞節の名詞から重要文節を決定 3. 名詞節をクラスタ ID で汎化 4. 動詞節を“動詞節”と汎化 -
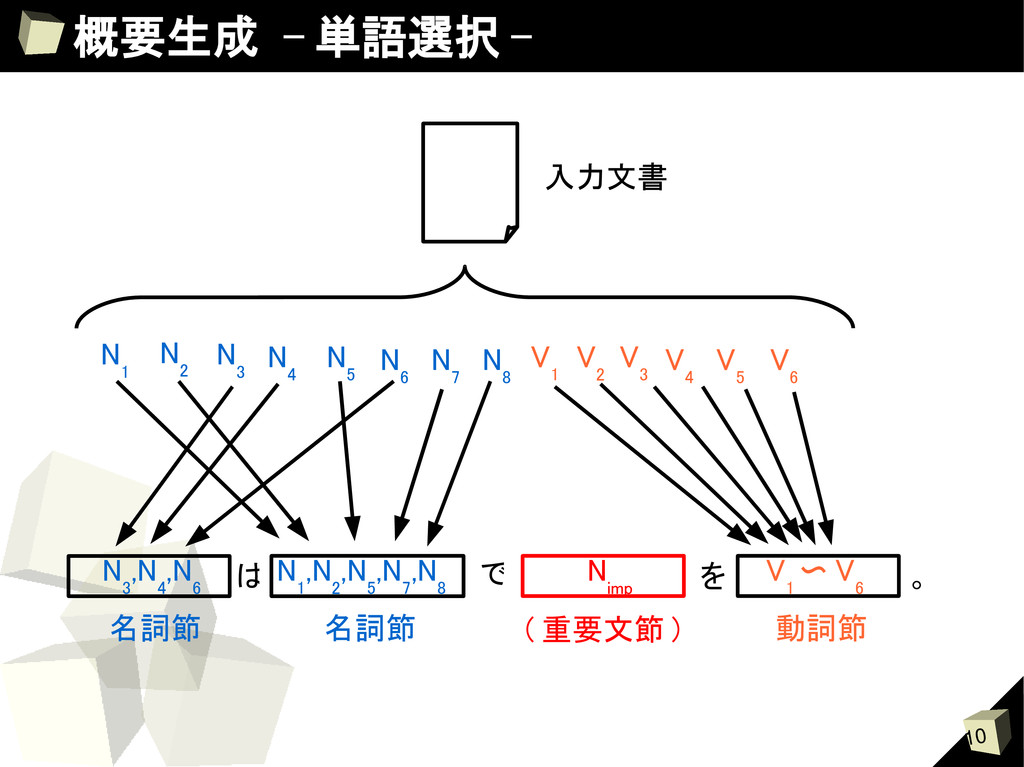
10 概要生成 - 単語選択 - 入力文書 N 1 N 2
N 3 N 4 N 5 N 6 N 7 N 8 V 1 V 2 V 3 V 4 V 5 V 6 は で を 。 N imp ( 重要文節 ) 名詞節 名詞節 動詞節 N 3 ,N 4 ,N 6 N 1 ,N 2 ,N 5 ,N 7 ,N 8 V 1 〜 V 6 -
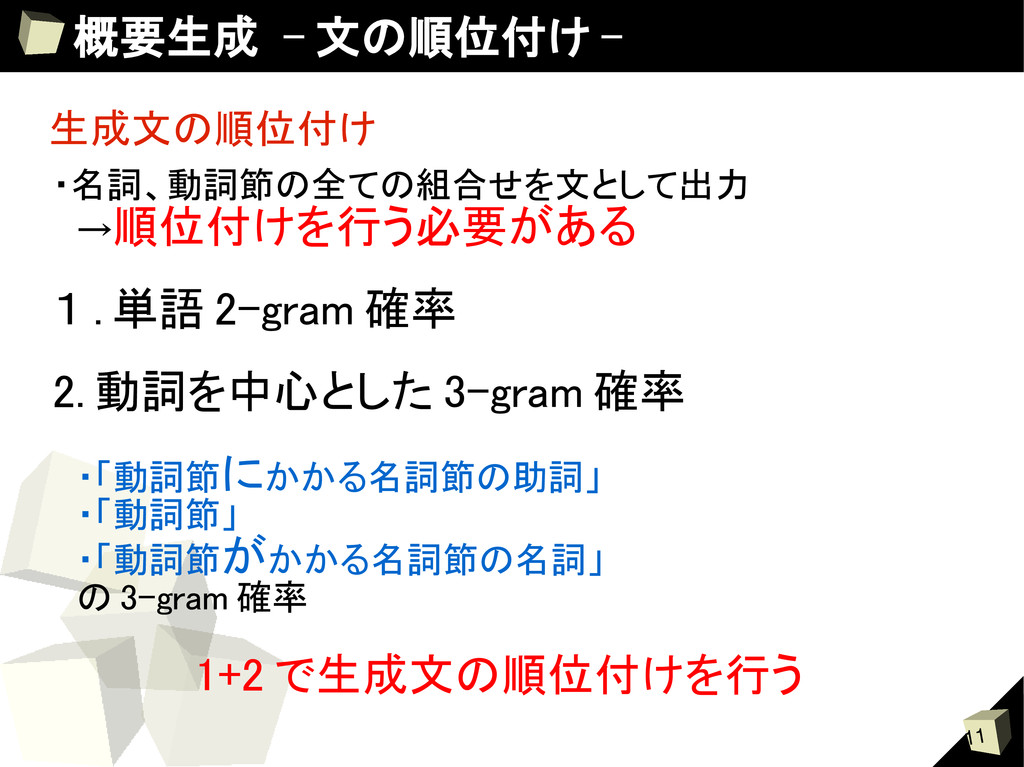
11 概要生成 - 文の順位付け - 生成文の順位付け ・名詞、動詞節の全ての組合せを文として出力 →順位付けを行う必要がある 1 .
単語 2-gram 確率 2. 動詞を中心とした 3-gram 確率 ・「動詞節にかかる名詞節の助詞」 ・「動詞節」 ・「動詞節がかかる名詞節の名詞」 の 3-gram 確率 1+2 で生成文の順位付けを行う -
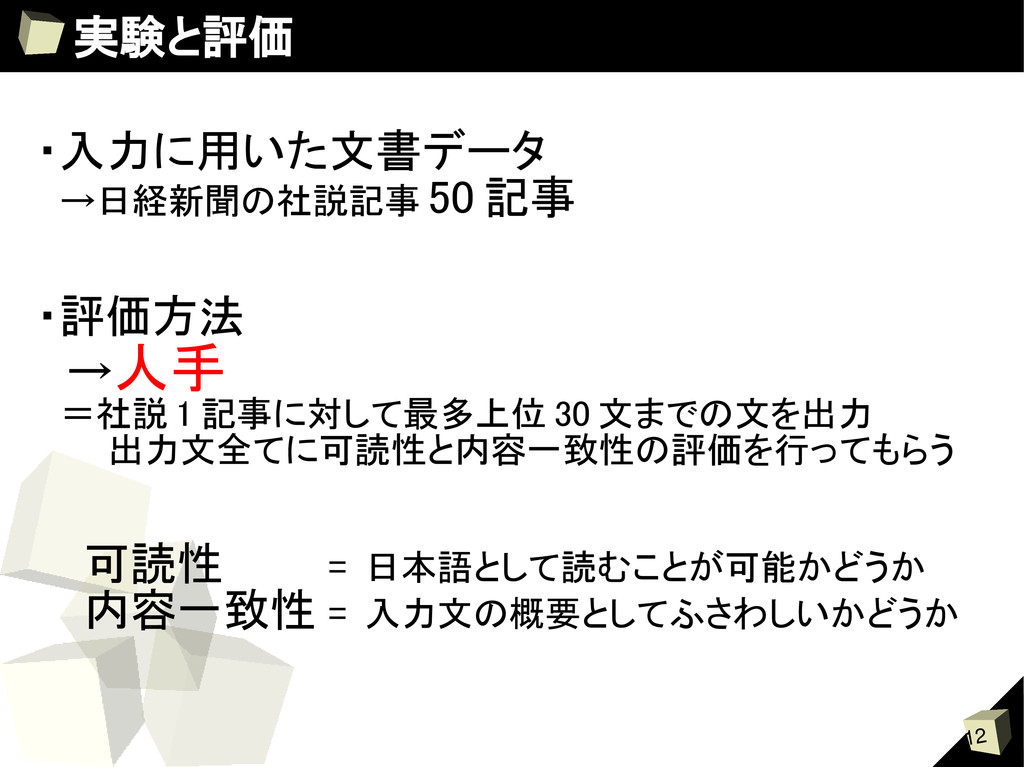
12 実験と評価 ・入力に用いた文書データ →日経新聞の社説記事 50 記事 ・評価方法 →人手 =社説 1
記事に対して最多上位 30 文までの文を出力 出力文全てに可読性と内容一致性の評価を行ってもらう 可読性 = 日本語として読むことが可能かどうか 内容一致性 = 入力文の概要としてふさわしいかどうか -
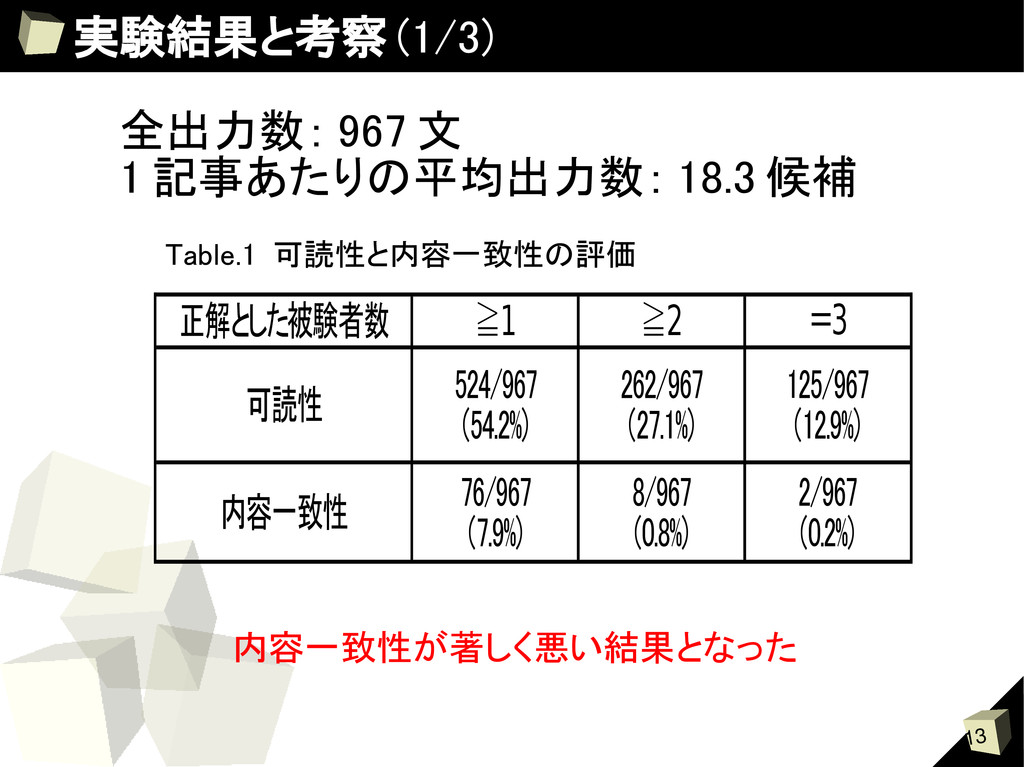
13 実験結果と考察 (1/3) 全出力数: 967 文 1 記事あたりの平均出力数: 18.3 候補
正解とした被験者数 1 ≧ 2 ≧ 可読性 内容一致性 =3 524/967 (54.2%) 262/967 (27.1%) 125/967 (12.9%) 76/967 (7.9%) 8/967 (0.8%) 2/967 (0.2%) Table.1 可読性と内容一致性の評価 内容一致性が著しく悪い結果となった -
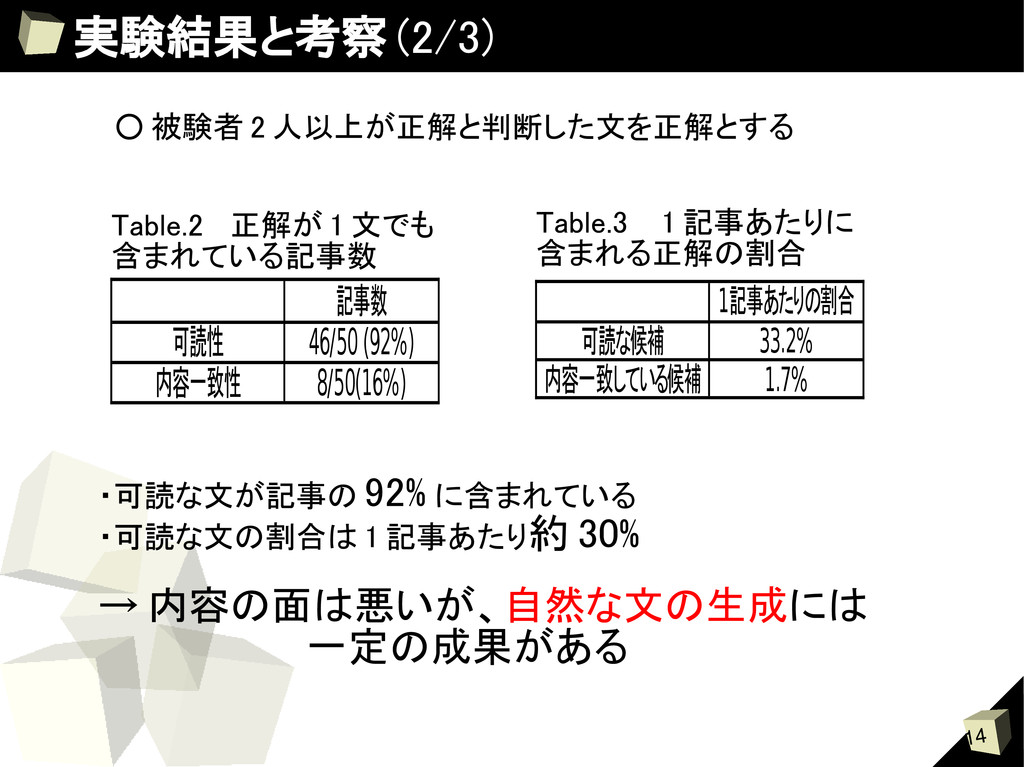
14 実験結果と考察 (2/3) 記事数 可読性 46/50 (92%) 内容一致性 8/50(16%) Table.2
正解が 1 文でも 含まれている記事数 可読な候補 33.2% 内容一致している候補 1.7% 1記事あたりの割合 Table.3 1 記事あたりに 含まれる正解の割合 ・可読な文が記事の 92% に含まれている ・可読な文の割合は 1 記事あたり約 30% → 内容の面は悪いが、自然な文の生成には 一定の成果がある ◦ 被験者 2 人以上が正解と判断した文を正解とする -
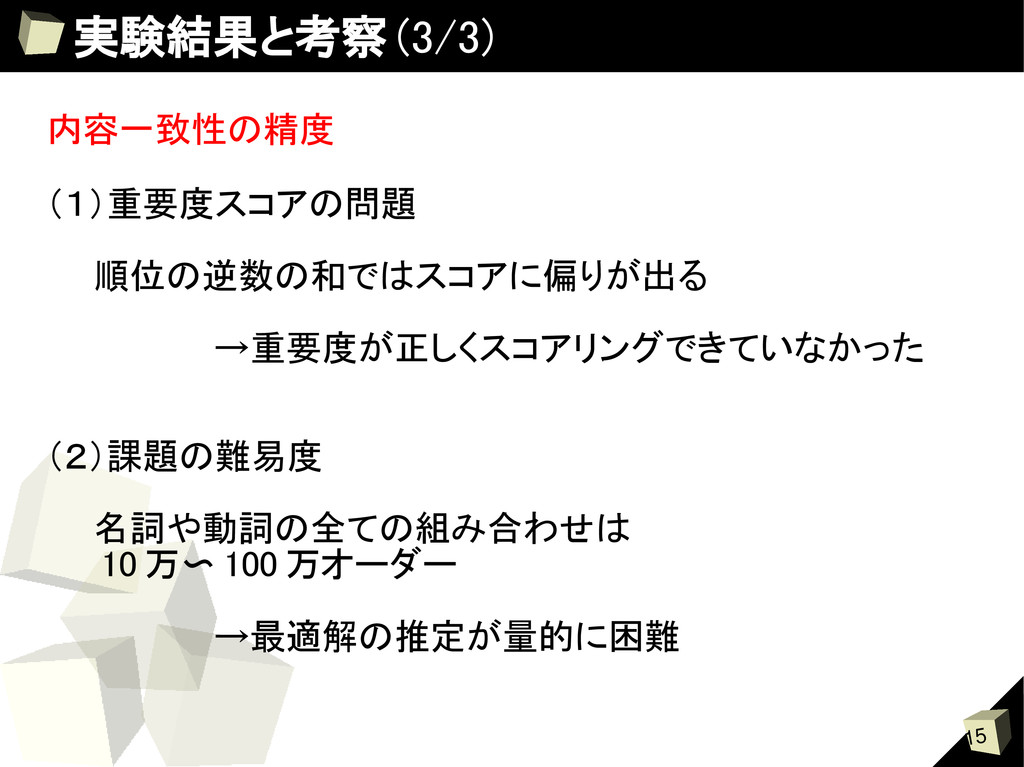
15 実験結果と考察 (3/3) 内容一致性の精度 (1)重要度スコアの問題 順位の逆数の和ではスコアに偏りが出る →重要度が正しくスコアリングできていなかった (2)課題の難易度 名詞や動詞の全ての組み合わせは
10 万〜 100 万オーダー →最適解の推定が量的に困難 -
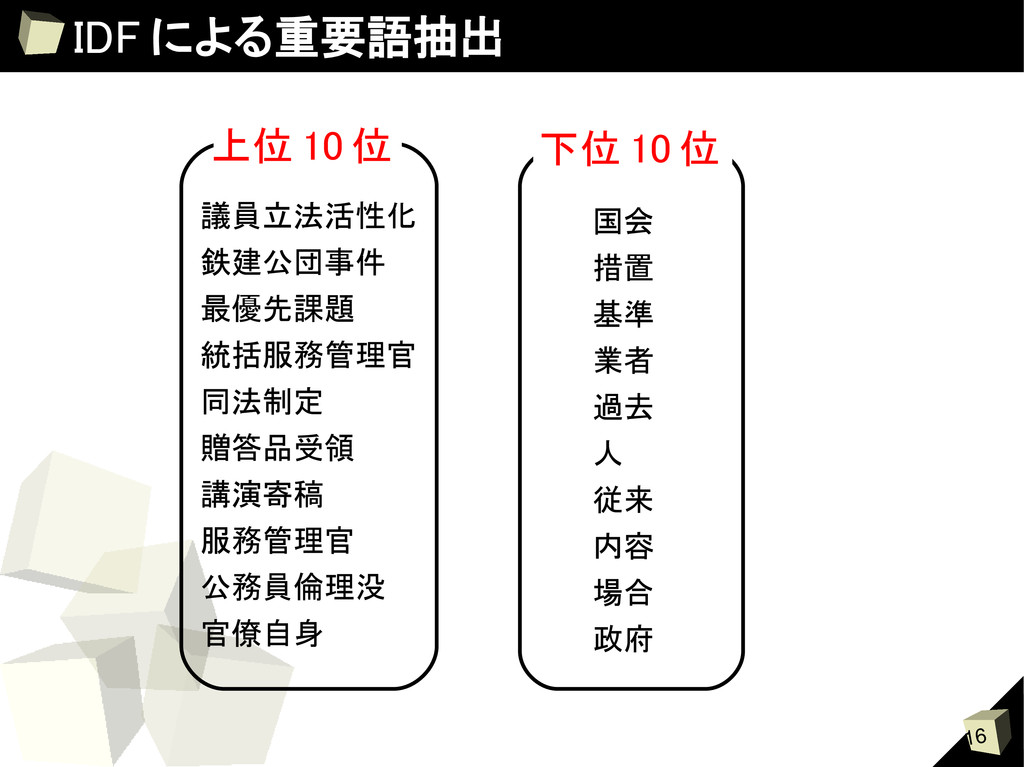
16 IDF による重要語抽出 議員立法活性化 鉄建公団事件 最優先課題 統括服務管理官 同法制定 贈答品受領 講演寄稿
服務管理官 公務員倫理没 官僚自身 国会 措置 基準 業者 過去 人 従来 内容 場合 政府 上位 10 位 下位 10 位 -
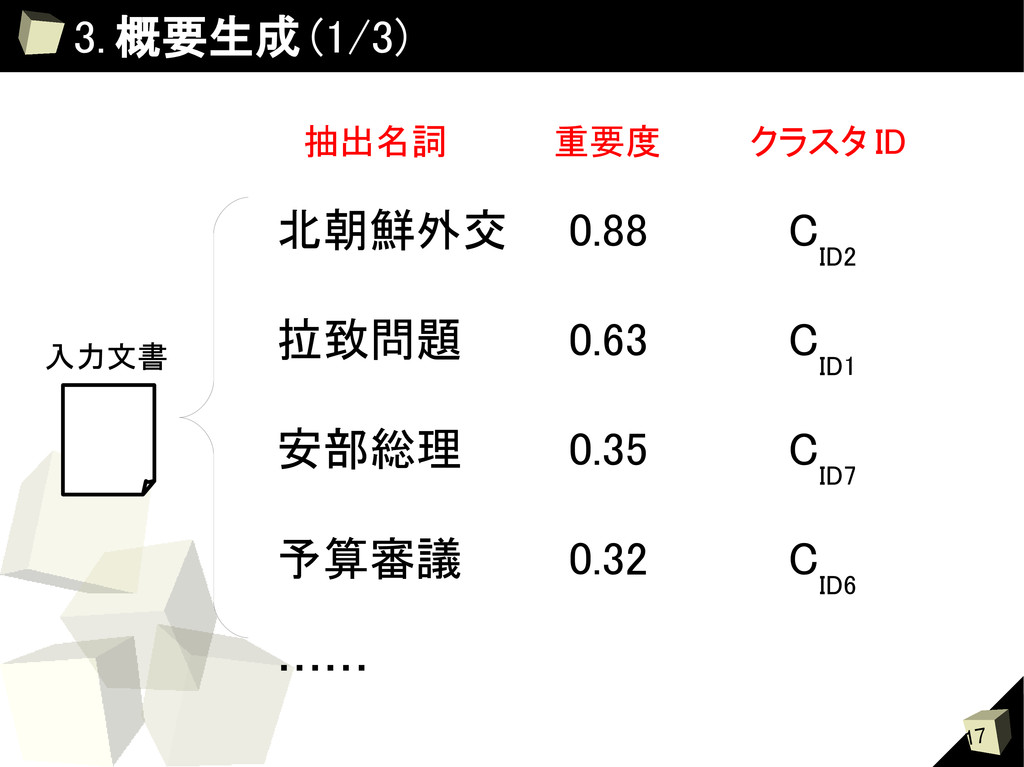
17 3. 概要生成 (1/3) 入力文書 北朝鮮外交 0.88 C ID2 拉致問題
0.63 C ID1 安部総理 0.35 C ID7 予算審議 0.32 C ID6 …… 抽出名詞 重要度 クラスタ ID -
18 3. 概要生成 (2/3) を た C
ID1 を / “ 動詞節”た / C ID2 重要文節 (重要語) 政府 , 与党 , 拉致問題 C ID1 動詞節 北朝鮮外交 C ID2 動い , 驚い , 圧倒し -
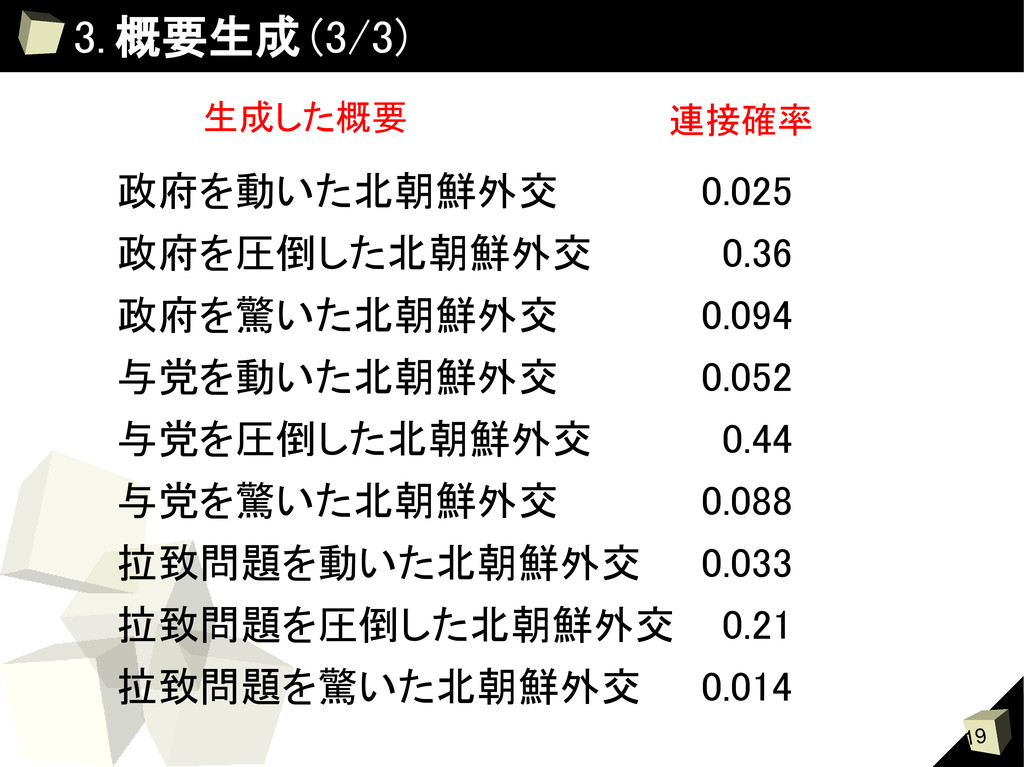
19 3. 概要生成 (3/3) 政府を動いた北朝鮮外交 0.025 政府を圧倒した北朝鮮外交 0.36 政府を驚いた北朝鮮外交 0.094
与党を動いた北朝鮮外交 0.052 与党を圧倒した北朝鮮外交 0.44 与党を驚いた北朝鮮外交 0.088 拉致問題を動いた北朝鮮外交 0.033 拉致問題を圧倒した北朝鮮外交 0.21 拉致問題を驚いた北朝鮮外交 0.014 生成した概要 連接確率 -
20 実験結果と考察 (2/2) 2. 名詞の重要度 ( 再掲 ) ・ Support
Vector Machine(SVM) による学習 →タイトルに含まれやすい名詞を学習 ・大規模テキストからの頻度情報 (IDF) →一般的な名詞の排除 Score(W i ) = Rank SVM (W i ) 1 Rank IDF (W i ) 1 + Wi: 名詞 Rank SVM (W i ):SVM による W i の順位 Rank IDF (W i ): 単語の頻度情報による W i の順位 -
22 考察 (1/2) 1. 内容一致性の低精度について (1) 重要語抽出の問題 順位の逆数の和では SVM と頻度情報のスコアを等価的
に扱えない。より正確なスコアへと改善する必要がある (2) 内容一致のスコアの考慮 内容一致性が重要語抽出に完全に依存 重要語以外に内容一致を表すスコアがない 重要語以外の指標によるスコアリングを加える必要がある -
23 考察 (2/2) 2. 生成失敗例について (1) 程度かかわりを提出された交際 「程度かかわり」が本文の文脈と切り離されている →文脈を保持できる語を補間 (2)
指名した経済優先政策 文の目的語がない →文法的側面からの単語の補間 (3) 中国の核関連技術で……と諸問題 一文が長すぎる →長文にも対応できるスコアの考慮 →長文を回避するようなタイトルパタンの生成 -
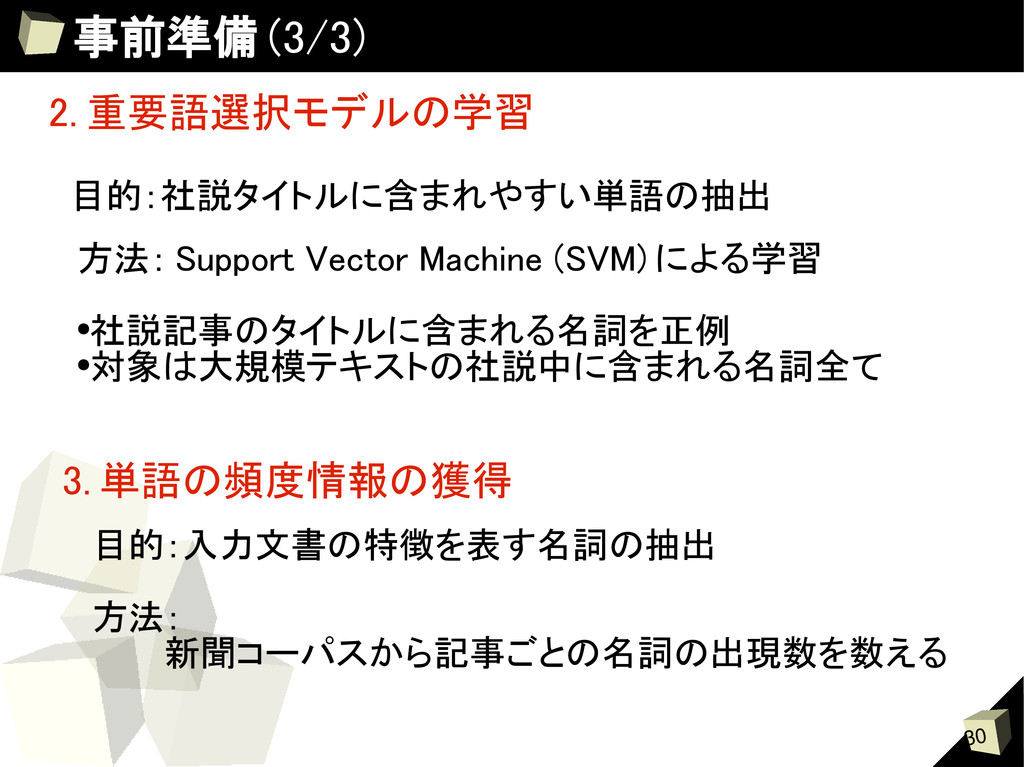
24 事前準備 3. 単語の頻度情報の獲得 2. 重要語選択モデルの学習 Support Vector Machine (SVM)
による学習 • 社説記事のタイトルに含まれる名詞を正例 • 対象は大規模テキストの社説中に含まれる名詞全て 新聞コーパスから記事ごとの名詞の出現数を数える -
25 タイトルパタン生成( 1/2 ) 1. 事実文の抽出 意見文: 例 「中年」よ、どこへ行く →口語的表現や倒置などが多く パタンとするには複雑
事実文: 例 核軍縮の長い道のり →事実や内容を端的に表し、表現も簡易で パタンとして適切 コーパス中の社説タイトルから事実文だけを抽出 -
27 事前準備 (1/3) リンゴ 名詞の分類 (GETA) ミカン マンゴー 西洋梨 新潟
山形 青森 秋田 北海道 石川 サッカー 野球 バレー 卓球 ゲートボール クラスタ 1 クラスタ 2 クラスタ 3 -
30 事前準備 (3/3) 3. 単語の頻度情報の獲得 2. 重要語選択モデルの学習 目的:社説タイトルに含まれやすい単語の抽出 方法: Support
Vector Machine (SVM) による学習 • 社説記事のタイトルに含まれる名詞を正例 •対象は大規模テキストの社説中に含まれる名詞全て 目的:入力文書の特徴を表す名詞の抽出 方法: 新聞コーパスから記事ごとの名詞の出現数を数える -
33 事前準備 (1/3) 1. 名詞の分類 目的:タイトルパタンの汎化 →少ないパタン数で様々な文に対応 方法: (1)クラスタリングツール「 GETA
」によるクラスタリング 名詞の頻度を特徴量としてベクトルを生成 →ベクトルのコサイン距離で単語を分類 (2)シソーラスによるクラスタの形成 意味に基づく単語の階層的分類=シソーラス →閾値以内の単語を含む階層をクラスタと判断する (3)それぞれのクラスタに ID を付与 -
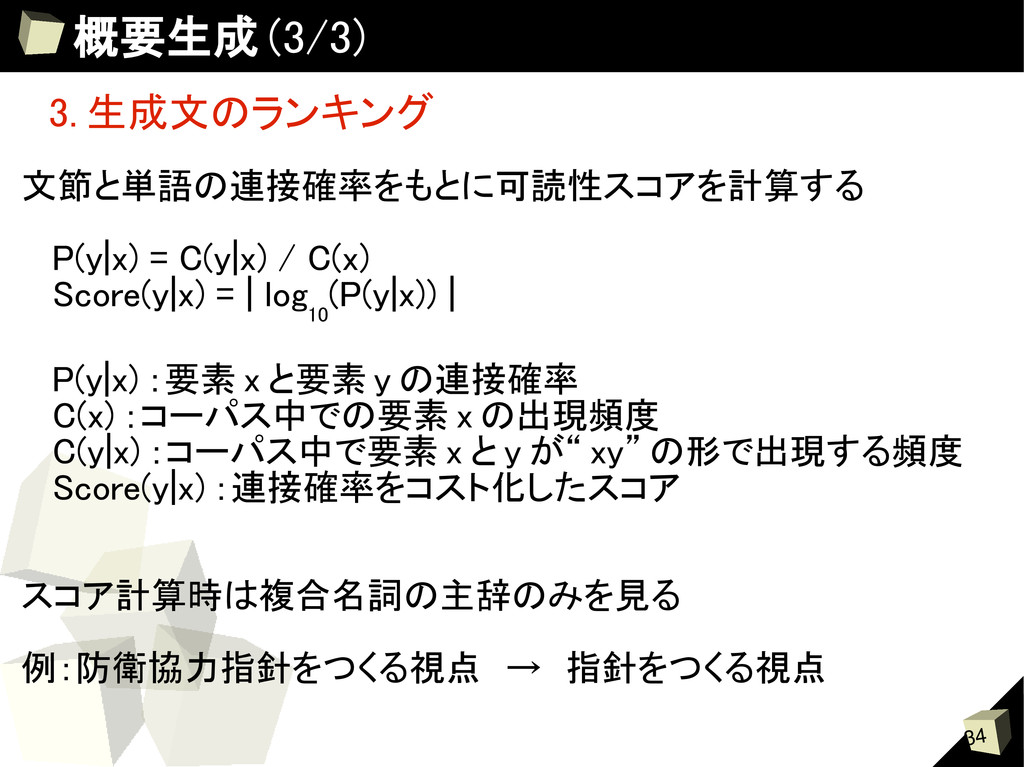
34 概要生成 (3/3) 3. 生成文のランキング 文節と単語の連接確率をもとに可読性スコアを計算する P(y|x) = C(y|x)
/ C(x) Score(y|x) = | log 10 (P(y|x)) | P(y|x) :要素 x と要素 y の連接確率 C(x) :コーパス中での要素 x の出現頻度 C(y|x) :コーパス中で要素 x と y が“ xy” の形で出現する頻度 Score(y|x) :連接確率をコスト化したスコア スコア計算時は複合名詞の主辞のみを見る 例:防衛協力指針をつくる視点 → 指針をつくる視点 -
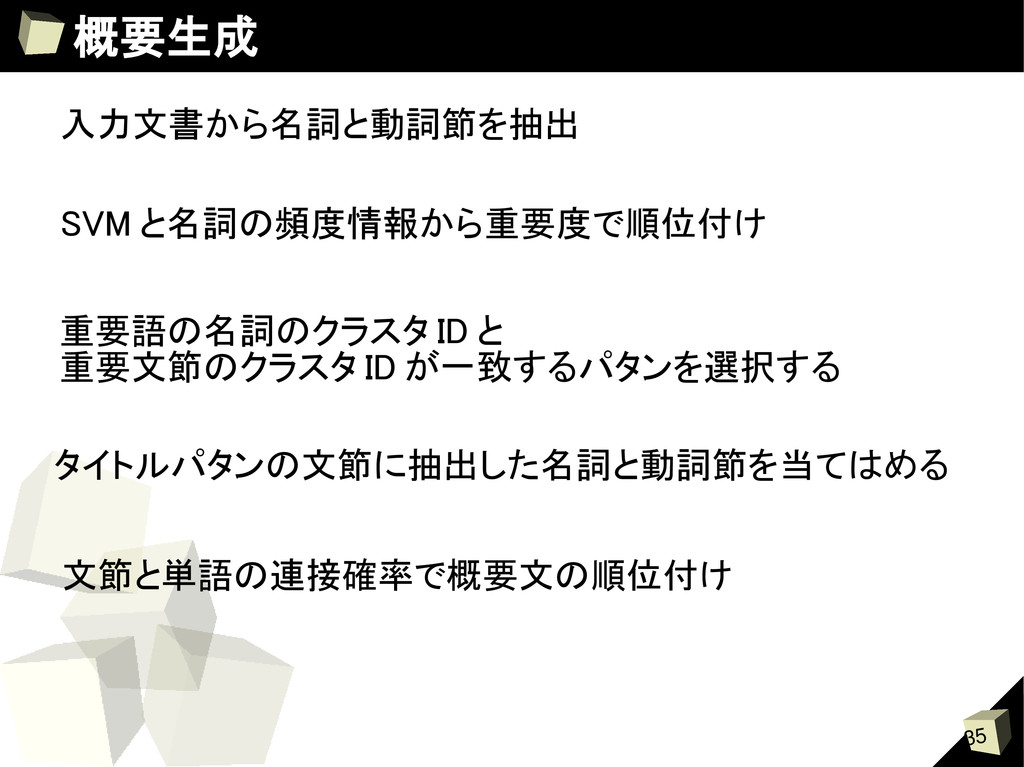
35 概要生成 SVM と名詞の頻度情報から重要度で順位付け 入力文書から名詞と動詞節を抽出 重要語の名詞のクラスタ ID と 重要文節のクラスタ ID
が一致するパタンを選択する タイトルパタンの文節に抽出した名詞と動詞節を当てはめる 文節と単語の連接確率で概要文の順位付け -
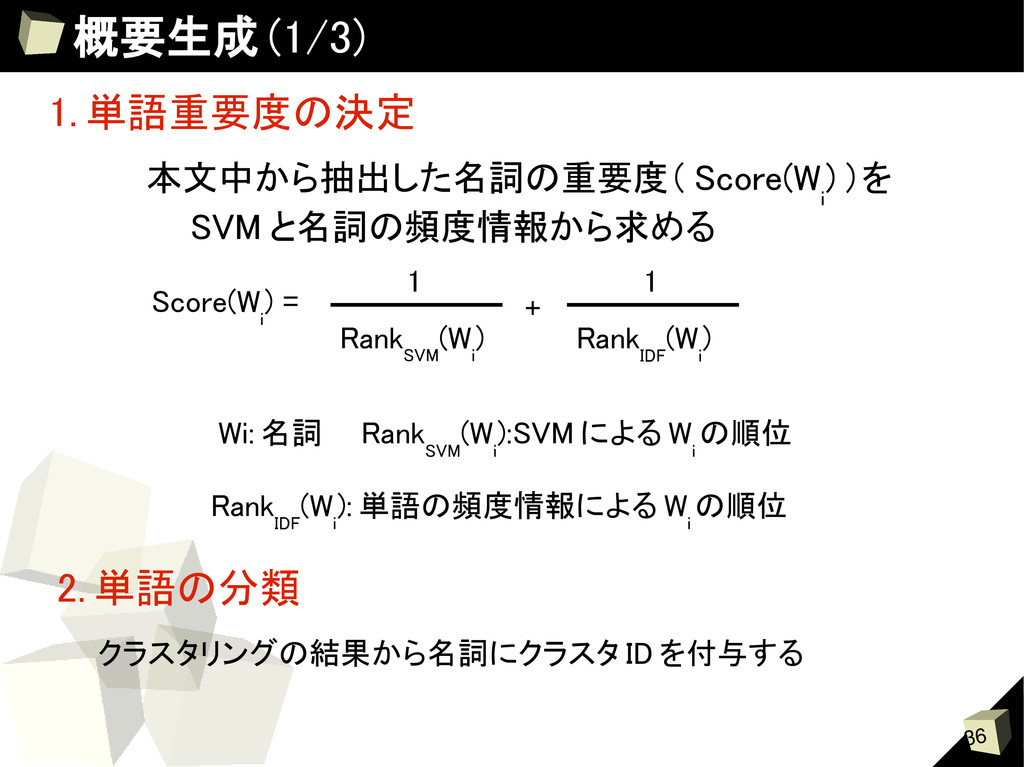
36 概要生成 (1/3) 1. 単語重要度の決定 本文中から抽出した名詞の重要度( Score(W i ) )を
SVM と名詞の頻度情報から求める Score(W i ) = Rank SVM (W i ) 1 Rank IDF (W i ) 1 + Wi: 名詞 Rank SVM (W i ):SVM による W i の順位 Rank IDF (W i ): 単語の頻度情報による W i の順位 2. 単語の分類 クラスタリングの結果から名詞にクラスタ ID を付与する -
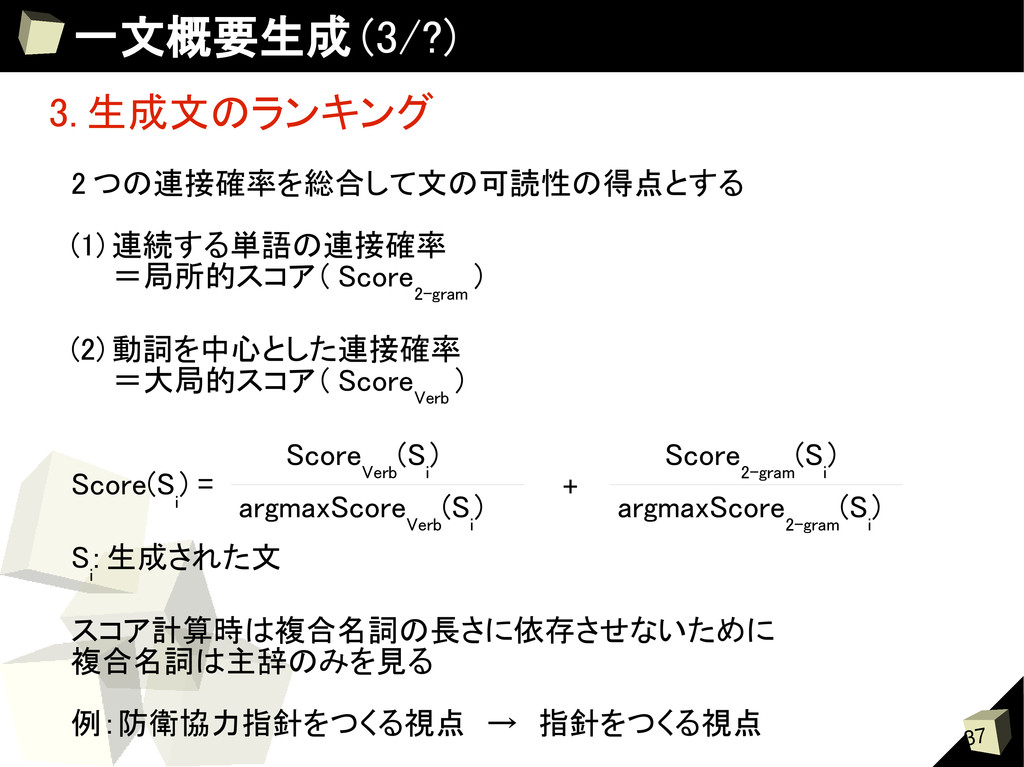
37 一文概要生成 (3/?) 3. 生成文のランキング 2 つの連接確率を総合して文の可読性の得点とする (1) 連続する単語の連接確率 =局所的スコア(
Score 2-gram ) (2) 動詞を中心とした連接確率 =大局的スコア( Score Verb ) Score(S i ) = S i : 生成された文 スコア計算時は複合名詞の長さに依存させないために 複合名詞は主辞のみを見る 例:防衛協力指針をつくる視点 → 指針をつくる視点 argmaxScore Verb (S i ) Score Verb (S i ) argmaxScore 2-gram (S i ) Score 2-gram (S i ) + -
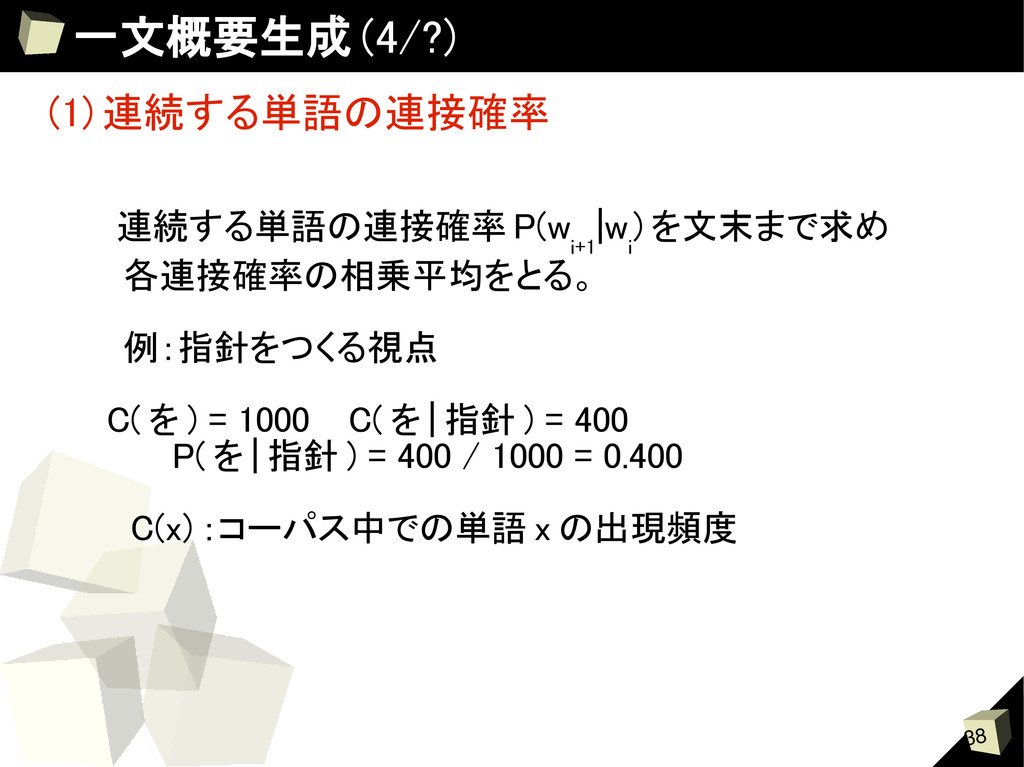
38 一文概要生成 (4/?) 連続する単語の連接確率 P(w i+1 |w i ) を文末まで求め
各連接確率の相乗平均をとる。 例:指針をつくる視点 C( を ) = 1000 C( を | 指針 ) = 400 P( を | 指針 ) = 400 / 1000 = 0.400 C(x) :コーパス中での単語 x の出現頻度 (1) 連続する単語の連接確率 -
39 一文概要生成 (5/?) 生成された文の係受け関係から 「動詞節にかかる名詞節の助詞」 「動詞節」 「動詞節がかかる名詞節の名詞」 の連接確率をコーパスから求める 例:指針をつくる視点
C(*| つくる ) = 500 C( つくる |*) = 700 C( 視点 | つくる ) = 100 C( つくる | を ) = 150 P( 視点 | をつくる ) = (100/500) * (150/700) = 0.0428 (2) 動詞を中心とした連接確率 -
40 処理の流れ (3/5) 入力文書 抽出単語 社説タイトル タイトルパタン 出力文 タイトルパタン生成 1.
事実文の抽出 2. タイトル文の整形 3. 重要文節の決定 4. 文節の汎化 -
41 処理の流れ (4/5) 入力文書 抽出単語 社説タイトル タイトルパタン 出力文 単語抽出 1.
名詞の複合語化 2. 動詞節の抽出 3. 単語重要度の決定 4. 単語の分類 -
42 処理の流れ (5/5) 入力文書 抽出単語 社説タイトル タイトルパタン 出力文 一文概要生成 1.
タイトルパタンの選択 2. 単語候補の当てはめ 3. 生成文のランキング -
43 提案手法 - 事前準備 - 2. 重要語選択モデルの学習 目的:社説タイトルに含まれやすい単語の抽出 方法:
Support Vector Machine (SVM) による学習 対象:社説記事中の単名詞全て 正例:社説タイトルに含まれる名詞 負例:それ以外 -
44 提案手法 - 事前準備 - 3. 単語の頻度情報の獲得 目的:入力文書の特徴を表す名詞 の抽出 考え方:
他の文書に多く出現する単語は その文書の特徴を表しにくい 他の文書にあまり出現しない語は その文書の特徴を表しやすい 方法: 新聞コーパスから記事ごとの 単名詞・複合名詞の出現数を数える -
47 考察 (1/2) 1. 内容一致性の低精度について (1) 重要語抽出の問題 順位の逆数の和では SVM と頻度情報のスコアを等価的
に扱えない。より正確なスコアへと改善する必要がある (2) 内容一致のスコアの考慮 内容一致性が重要語抽出に完全に依存 重要語以外に内容一致を表すスコアがない。 (3) 内容一致の正解例 正解例:「内向き体質が困難にした解決と今回の事件」 「今回の」という語から概要として不適切 →内容の一部を表現しつつも単語が十分でない 重要語以外の指標によるスコアリングを加える必要がある -
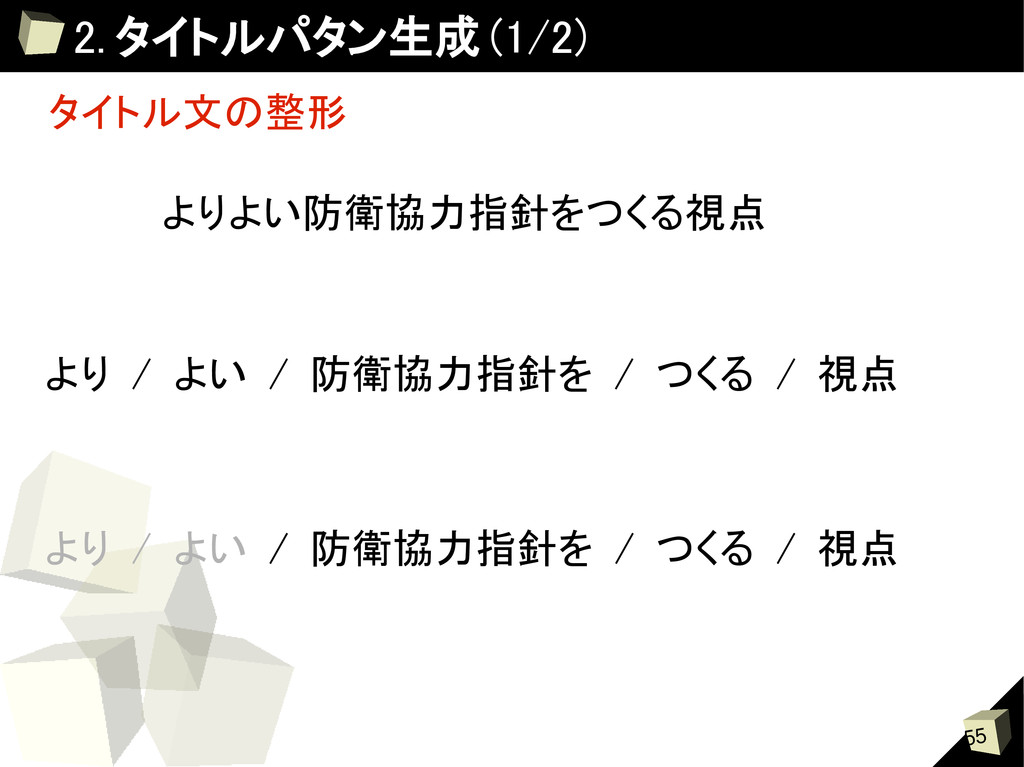
48 タイトルパタン生成 タイトル文の整形 より / よい / 防衛協力指針を / つくる
/ 視点 文を文節に切り分ける -
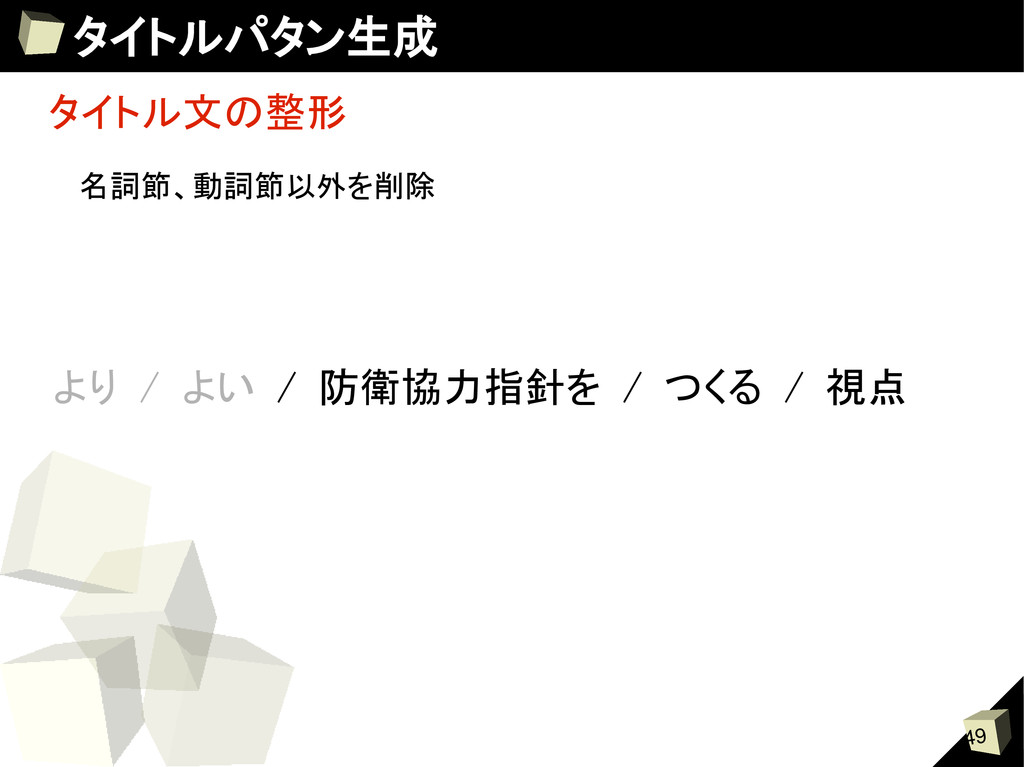
49 タイトルパタン生成 タイトル文の整形 より / よい / 防衛協力指針を / つくる
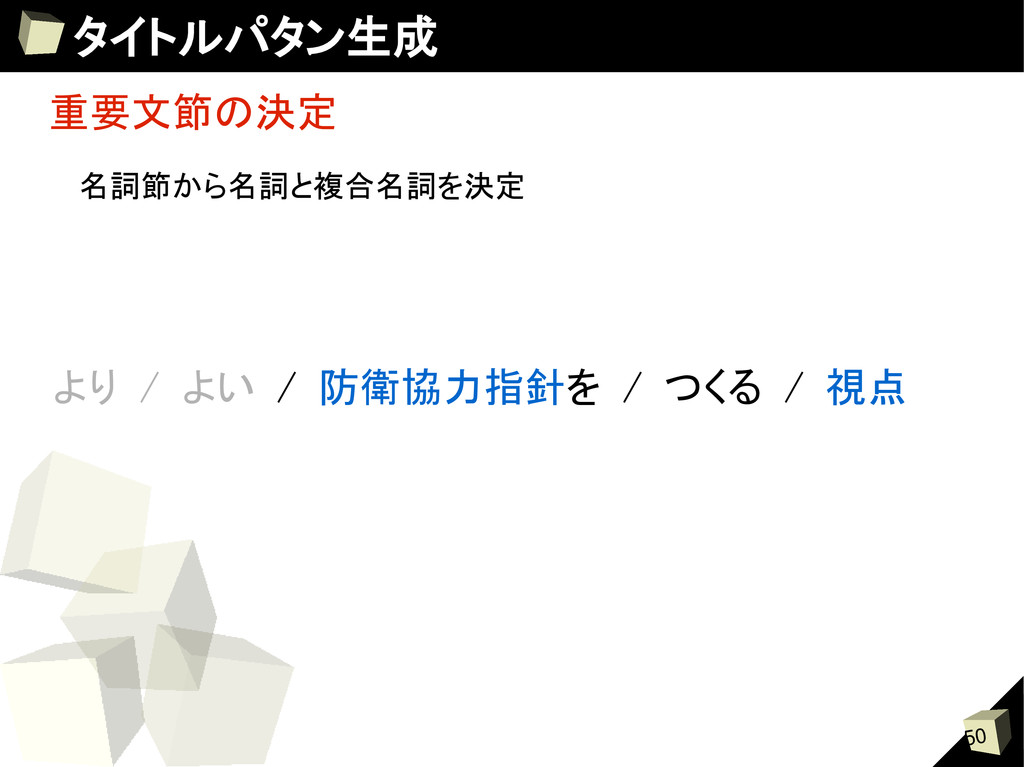
/ 視点 名詞節、動詞節以外を削除 -
50 タイトルパタン生成 重要文節の決定 より / よい / 防衛協力指針を / つくる
/ 視点 名詞節から名詞と複合名詞を決定 -
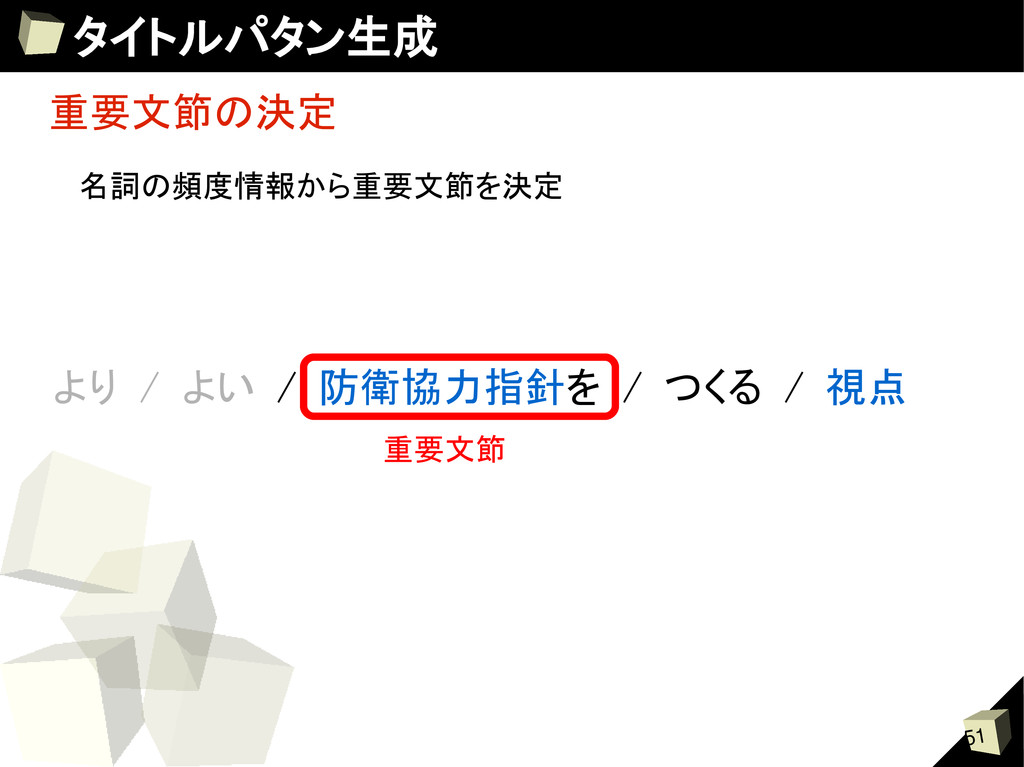
51 タイトルパタン生成 重要文節の決定 より / よい / 防衛協力指針を / つくる
/ 視点 重要文節 名詞の頻度情報から重要文節を決定 -
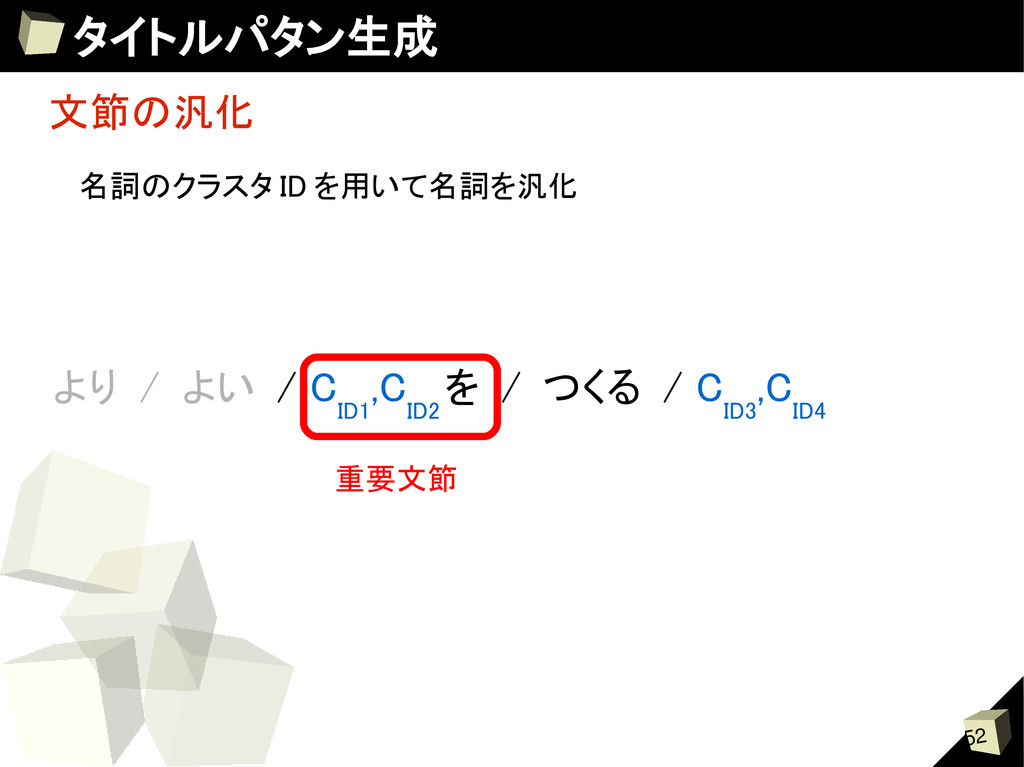
52 タイトルパタン生成 文節の汎化 より / よい / C ID1 ,C
ID2 を / つくる / C ID3 ,C ID4 重要文節 名詞のクラスタ ID を用いて名詞を汎化 -
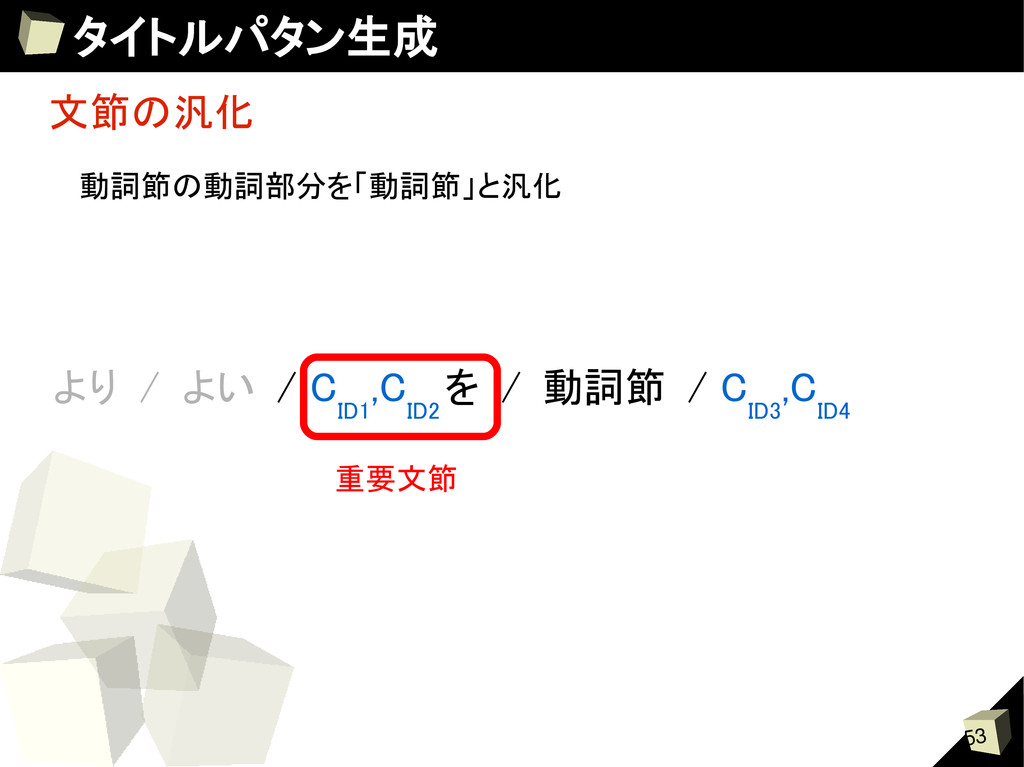
53 タイトルパタン生成 文節の汎化 より / よい / C ID1 ,C
ID2 を / 動詞節 / C ID3 ,C ID4 重要文節 動詞節の動詞部分を「動詞節」と汎化 -
54 タイトルパタン生成 タイトルパタン生成の結果 C ID1 ,C ID2 を / 動詞節
/ C ID3 ,C ID4 重要文節 よりよい防衛協力指針をつくる視点 -
55 2. タイトルパタン生成 (1/2) タイトル文の整形 よりよい防衛協力指針をつくる視点 より / よい /
防衛協力指針を / つくる / 視点 より / よい / 防衛協力指針を / つくる / 視点 -
56 2. タイトルパタン生成 (2/2) 文節の汎化 より / よい / 防衛協力指針を
/ つくる / 視点 より / よい / C ID1 を / つくる / C ID2 重要文節 より / よい / C ID1 を / “ 動詞節” / C ID2 重要文節 -
57 概要生成 1. パタン中の重要部分と重要語のクラスタ ID のマッチングによってタイ トルパタンを選択 2. パタンに本文中から抽出した複合名詞及び動詞節を当てはめていく 3.
全組合せの文を生成する 4. 単語 2-gram 確率と動詞を中心とした係り受け 2-gram 確率を使用し て生成された文をランキングする 5.