Share
Embed
Elasticsearch クエリとスキーマ定義の細かい話
http://elasticsearch.doorkeeper.jp/events/19923
第8回elasticsearch勉強会 #elasticsearch #elasticsearchjp
2015-02-13(金)19:30 - 21:30
[訂正 2015/02/13]
負荷試験で心にとめていることの誤字を修正
jtodo
February 13, 2015
Transcript
63 slides
-
自己紹介 藤堂 淳也 株式会社ドワンゴ Twitter Qiita jtodo (@junya_todo) jtodo 検索チームに所属、ES勉強会は聴く側に5回
プラットフォーム事業部 サービス基盤開発部 汎用コアセクション -
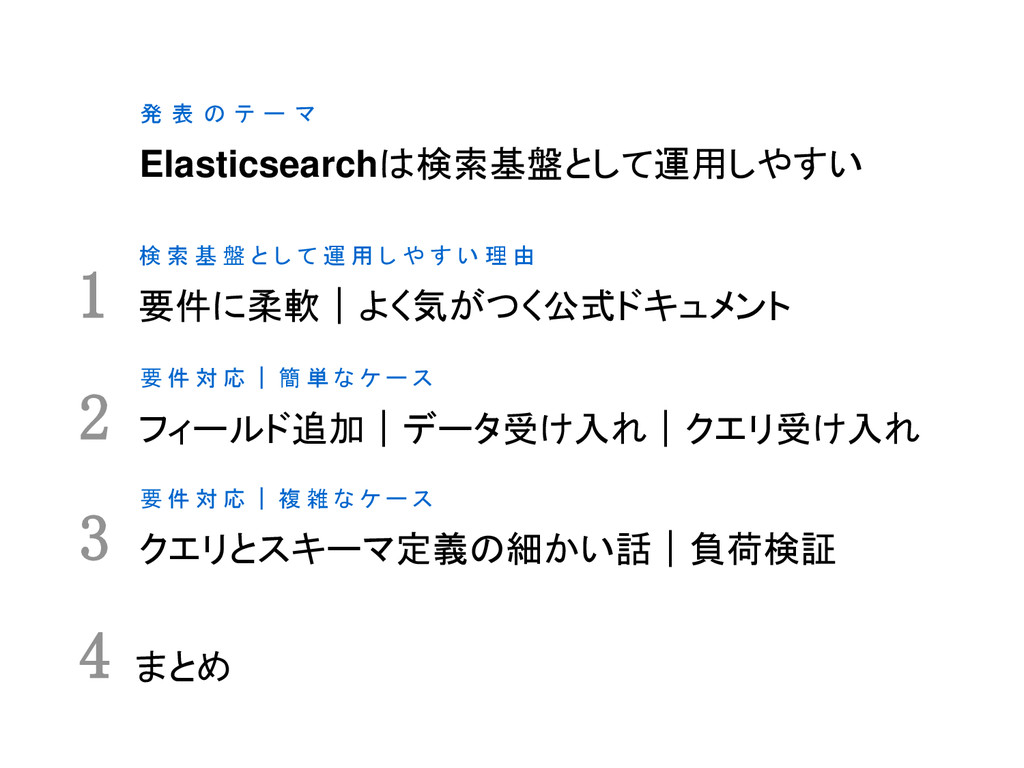
発 表 の テ ー マ Elasticsearchは検索基盤として運用しやすい 1 検 索
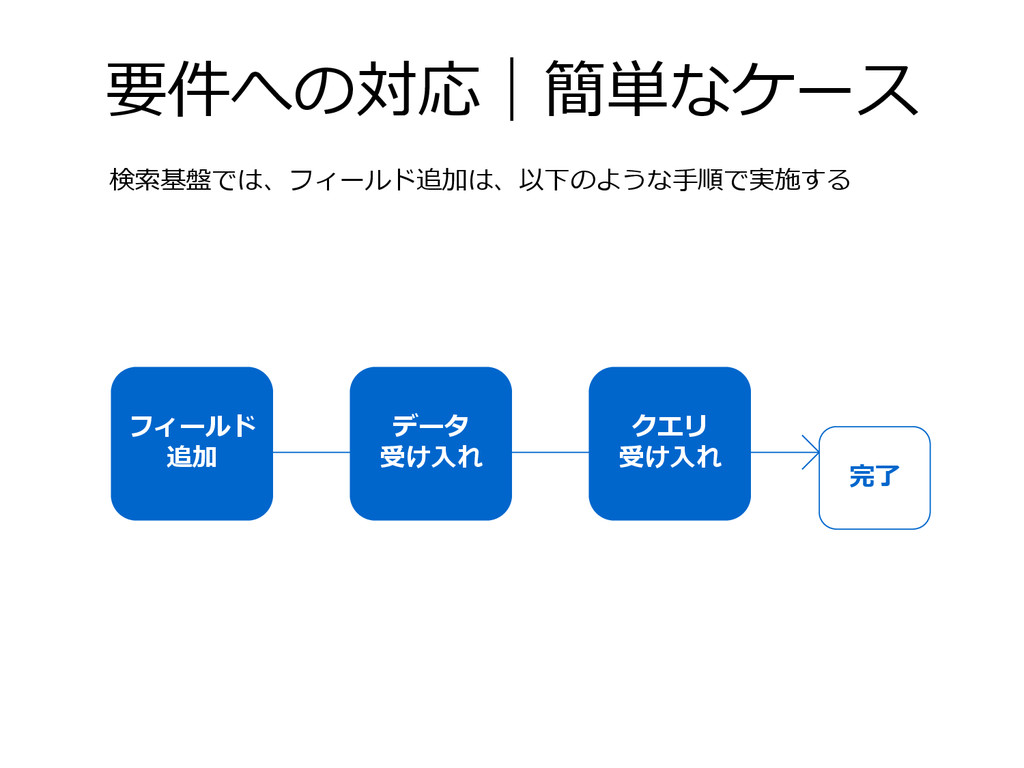
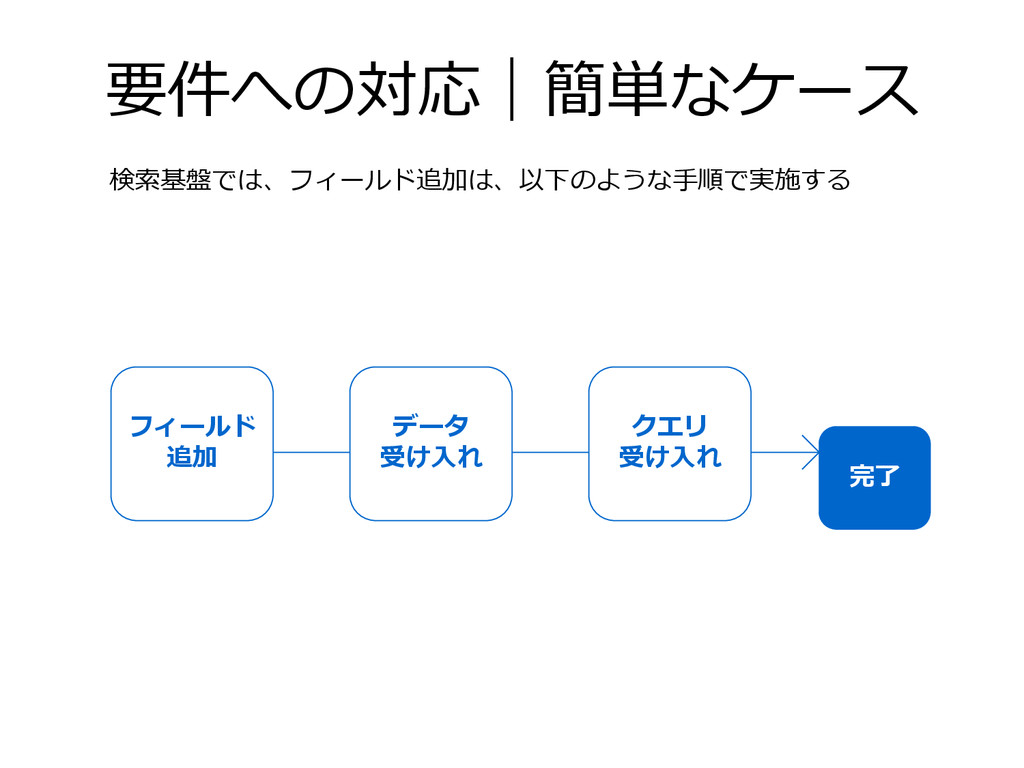
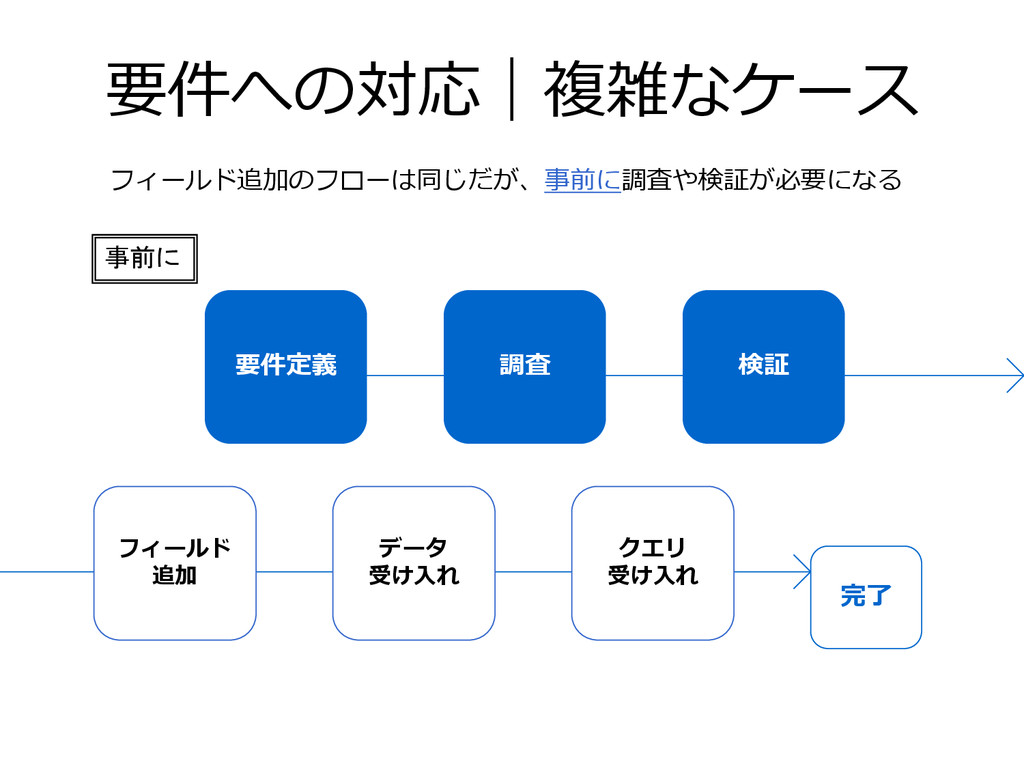
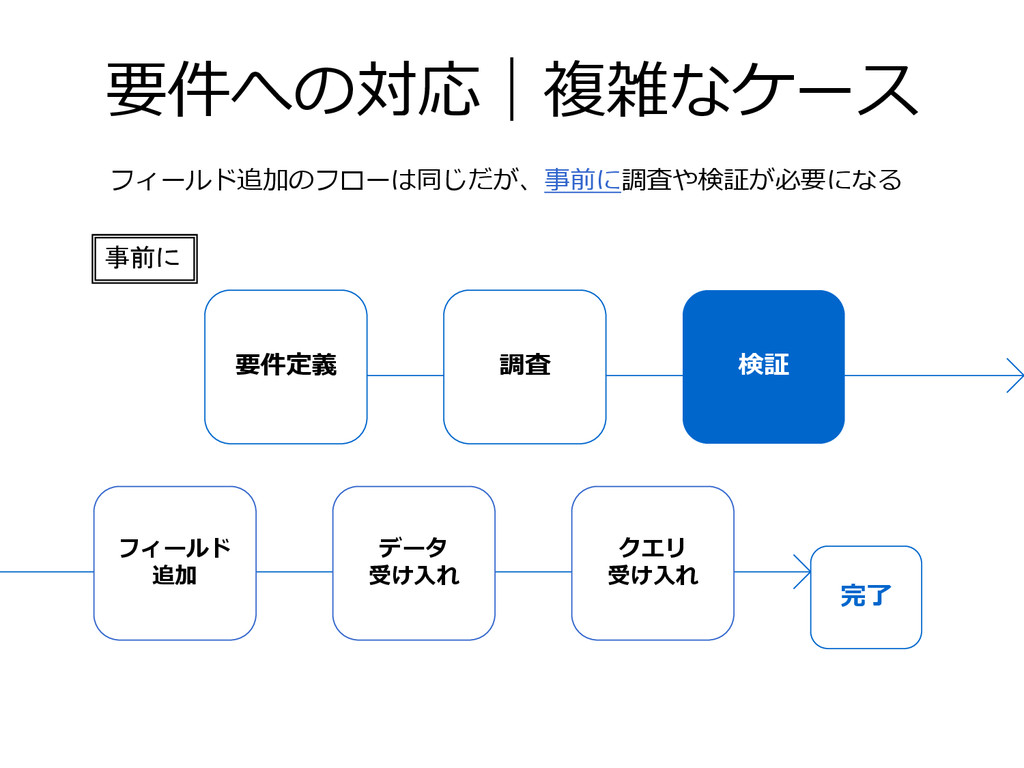
基 盤 と し て 運 用 し や す い 理 由 要件に柔軟|よく気がつく公式ドキュメント 2 要 件 対 応 | 簡 単 な ケ ー ス フィールド追加|データ受け入れ|クエリ受け入れ 4 まとめ 3 要 件 対 応 | 複 雑 な ケ ー ス クエリとスキーマ定義の細かい話|負荷検証 -
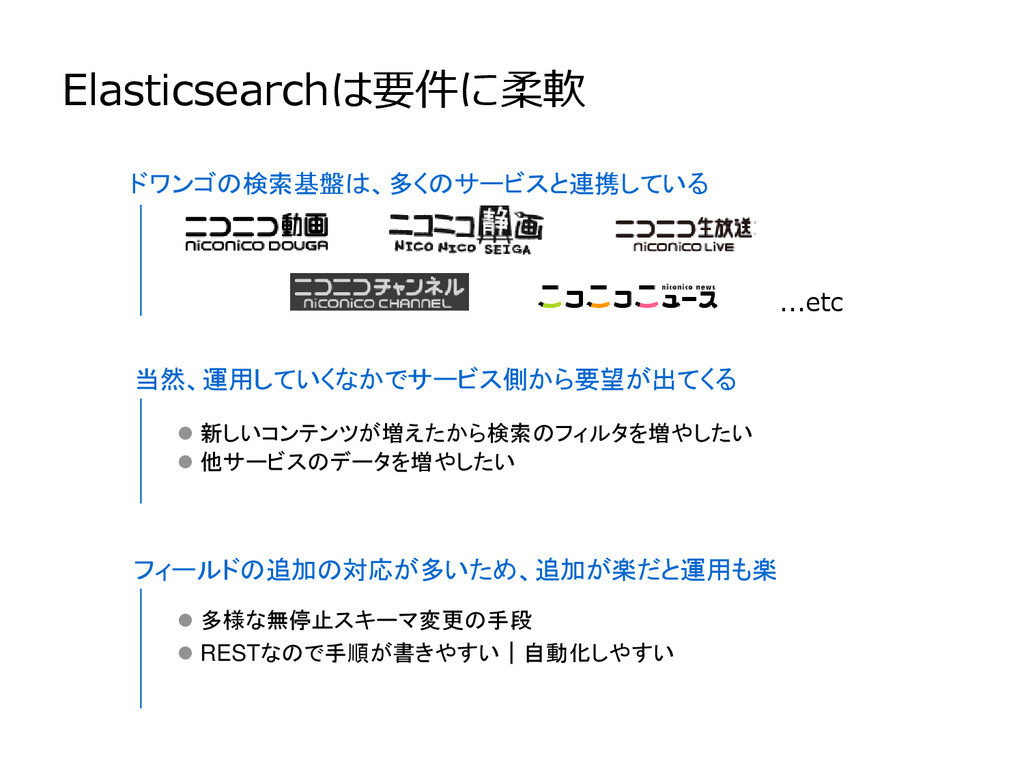
Elasticsearchは要件に柔軟 ...etc 新しいコンテンツが増えたから検索のフィルタを増やしたい 他サービスのデータを増やしたい ドワンゴの検索基盤は、多くのサービスと連携している 当然、運用していくなかでサービス側から要望が出てくる フィールドの追加の対応が多いため、追加が楽だと運用も楽
多様な無停止スキーマ変更の手段 RESTなので手順が書きやすい|自動化しやすい -
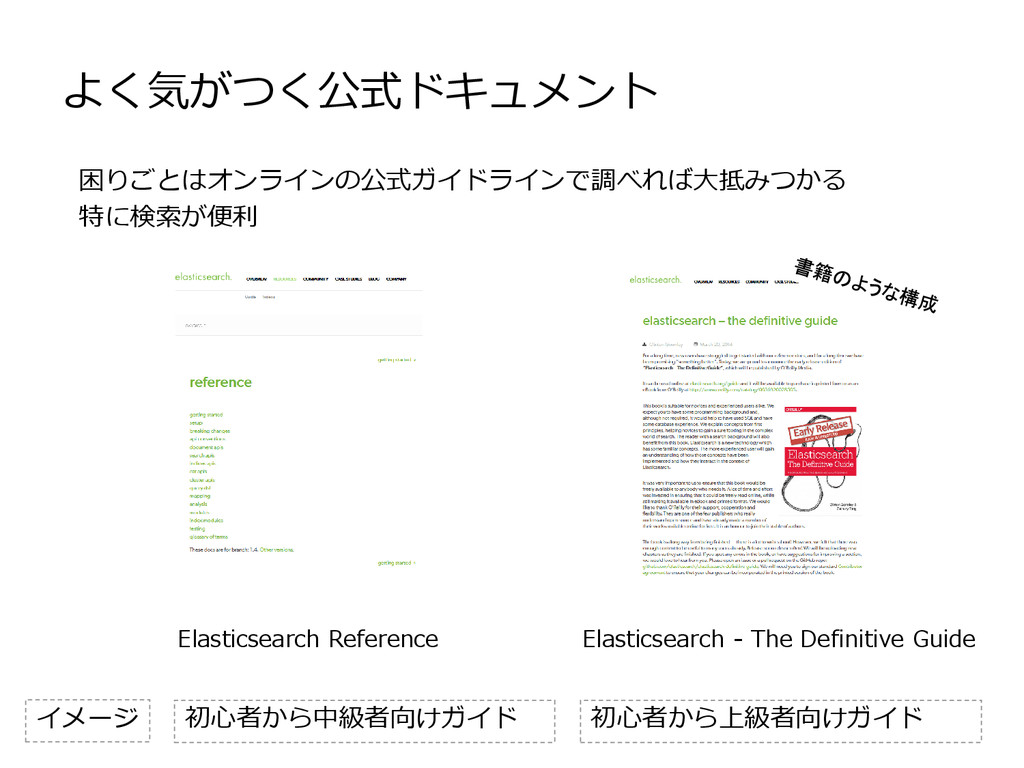
よく気がつく公式ドキュメント 困りごとはオンラインの公式ガイドラインで調べれば大抵みつかる 特に検索が便利 Elasticsearch Reference Elasticsearch - The Definitive Guide
初心者から中級者向けガイド 初心者から上級者向けガイド イメージ -
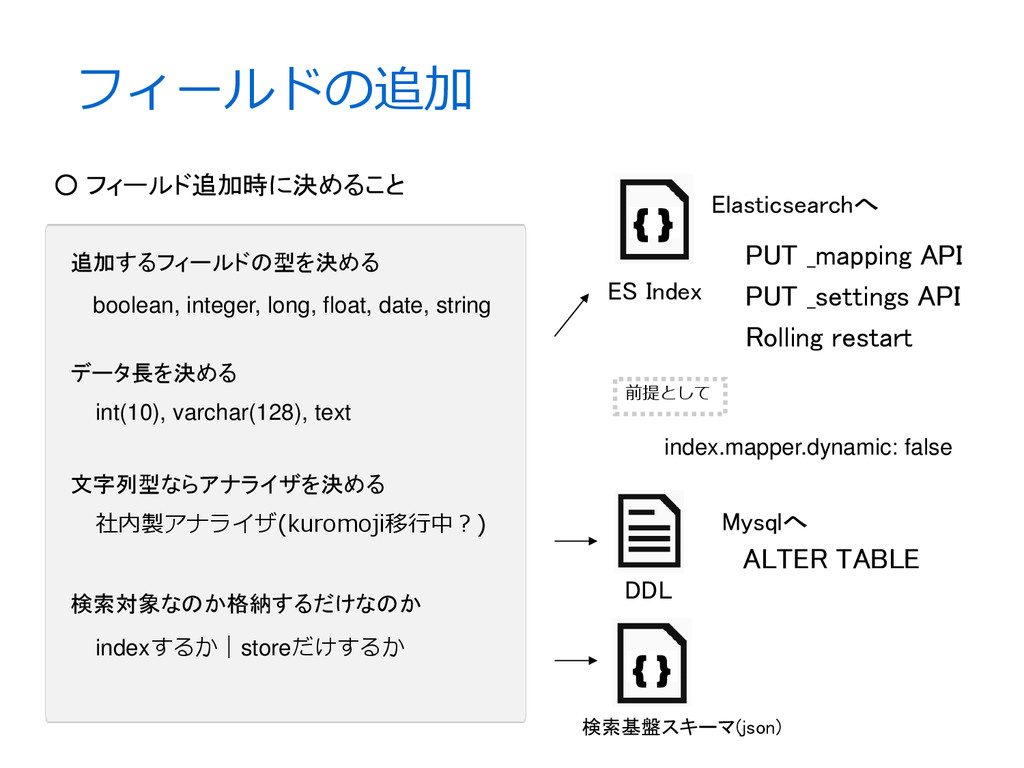
フィールドの追加 データ長を決める int(10), varchar(128), text index.mapper.dynamic: false { } {
} DDL 検索基盤スキーマ(json) ES Index Mysqlへ Elasticsearchへ PUT _mapping API PUT _settings API Rolling restart ALTER TABLE indexするか|storeだけするか 文字列型ならアナライザを決める 検索対象なのか格納するだけなのか 追加するフィールドの型を決める boolean, integer, long, float, date, string 社内製アナライザ(kuromoji移行中?) 前提として ◦ フィールド追加時に決めること -
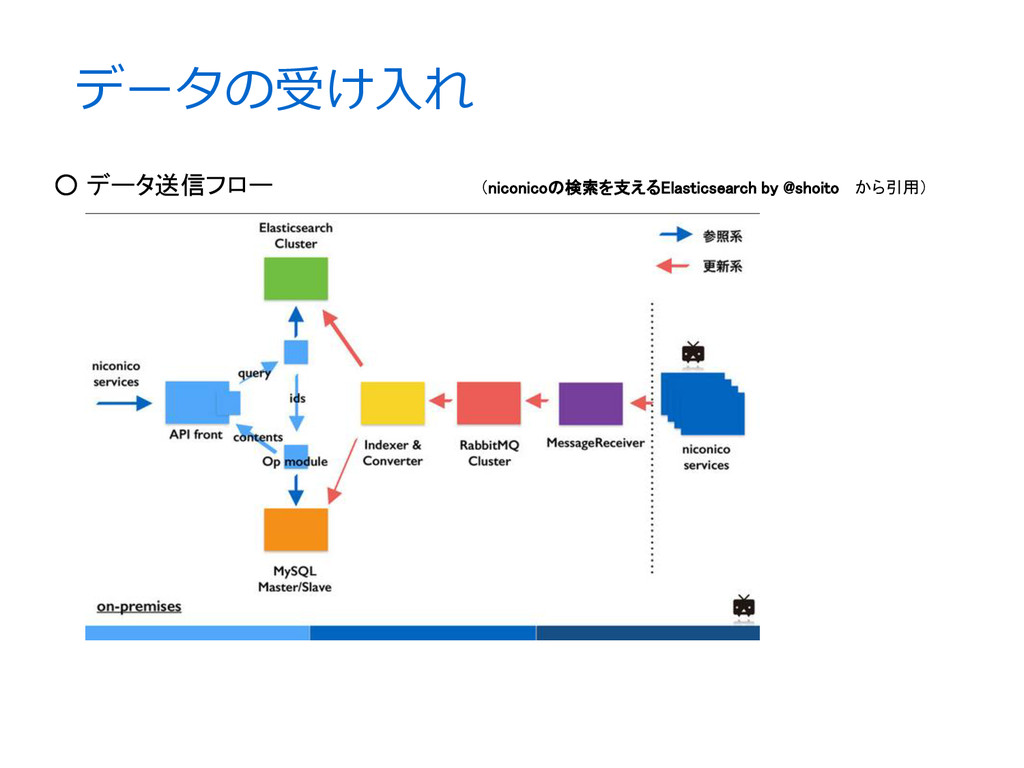
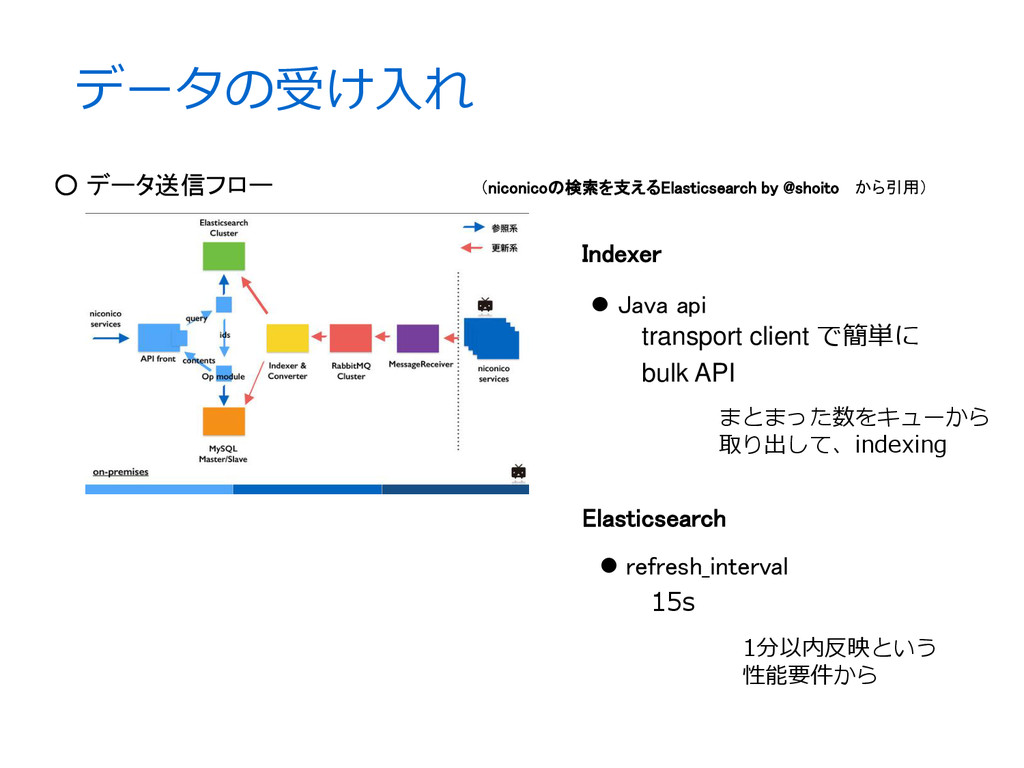
データの受け入れ ◦ データ送信フロー (niconicoの検索を支えるElasticsearch by @shoito から引用) Indexer Java
api transport client で簡単に bulk API Elasticsearch refresh_interval 15s まとまった数をキューから 取り出して、indexing 1分以内反映という 性能要件から -
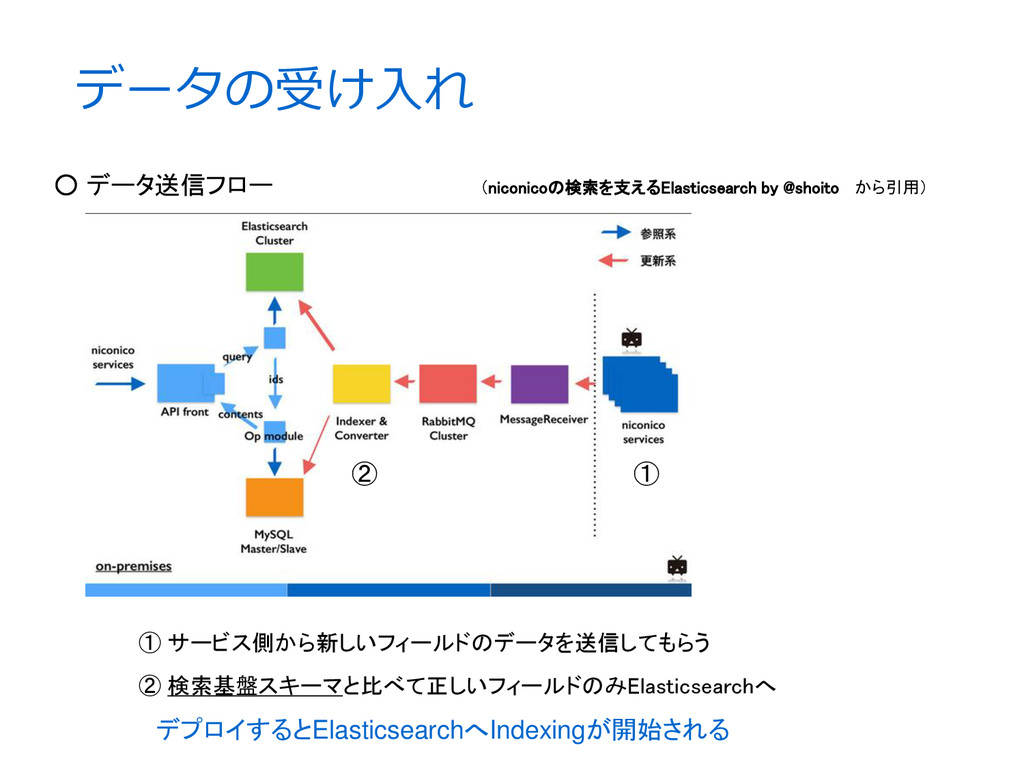
データの受け入れ ◦ データ送信フロー (niconicoの検索を支えるElasticsearch by @shoito から引用) ① ② ①
サービス側から新しいフィールドのデータを送信してもらう ② 検索基盤スキーマと比べて正しいフィールドのみElasticsearchへ デプロイするとElasticsearchへIndexingが開始される -
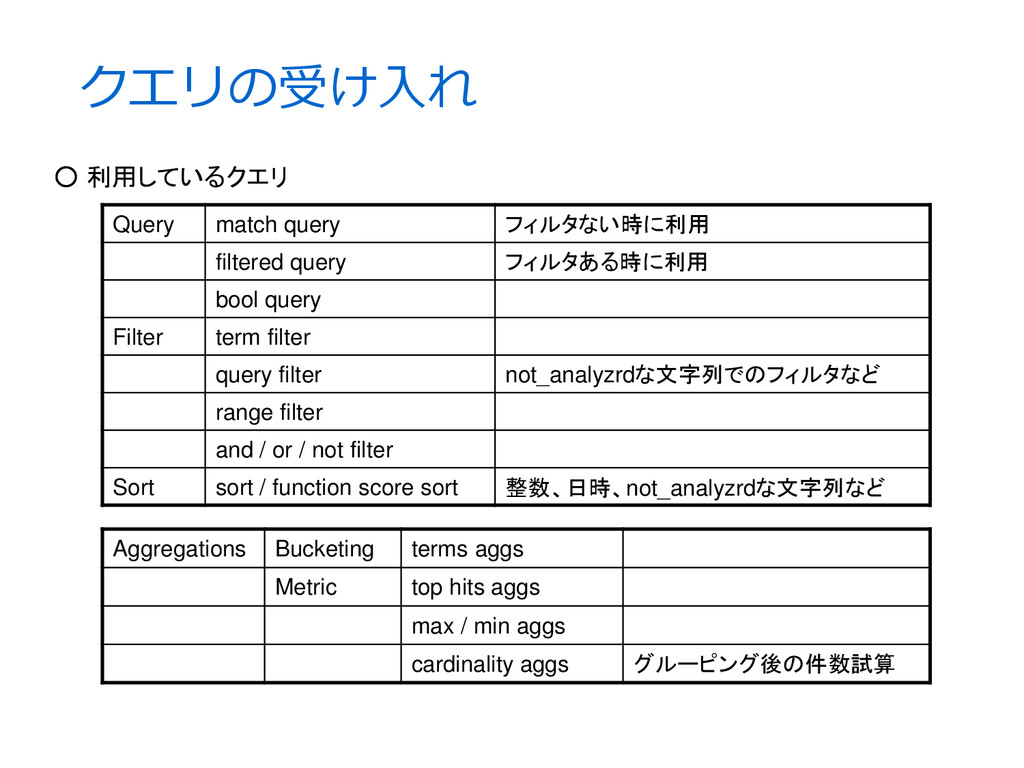
クエリの受け入れ ◦ 利用しているクエリ Query match query フィルタない時に利用 filtered query フィルタある時に利用
bool query Filter term filter query filter not_analyzrdな文字列でのフィルタなど range filter and / or / not filter Sort sort / function score sort 整数、日時、not_analyzrdな文字列など Aggregations Bucketing terms aggs Metric top hits aggs max / min aggs cardinality aggs グルーピング後の件数試算 -
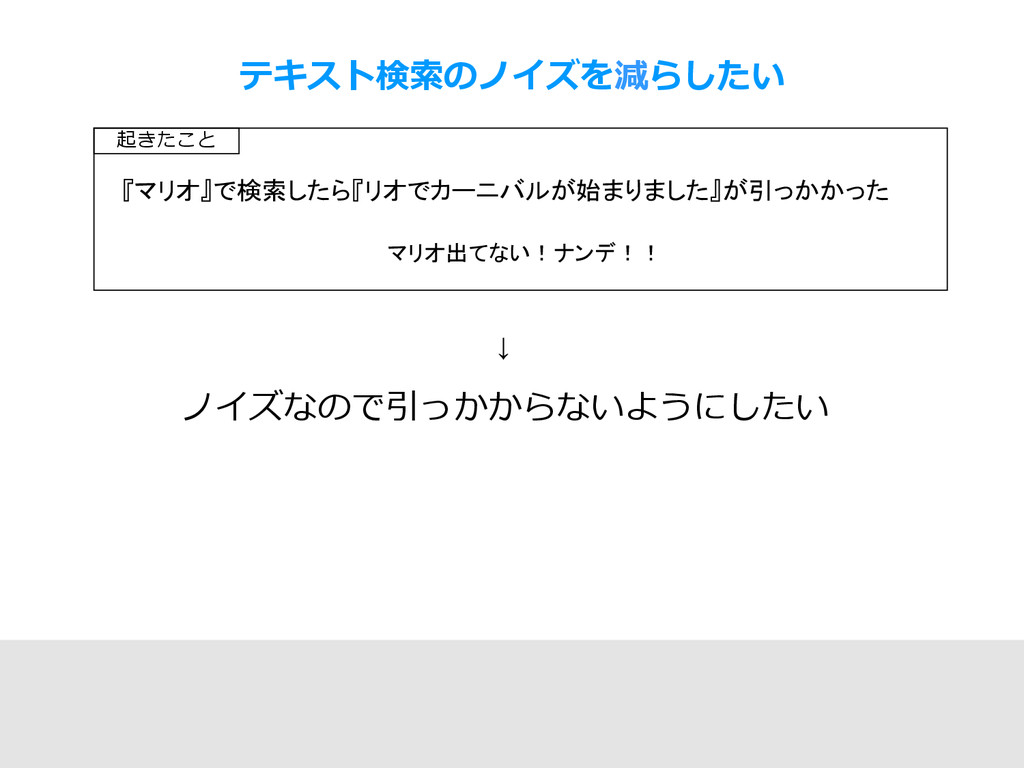
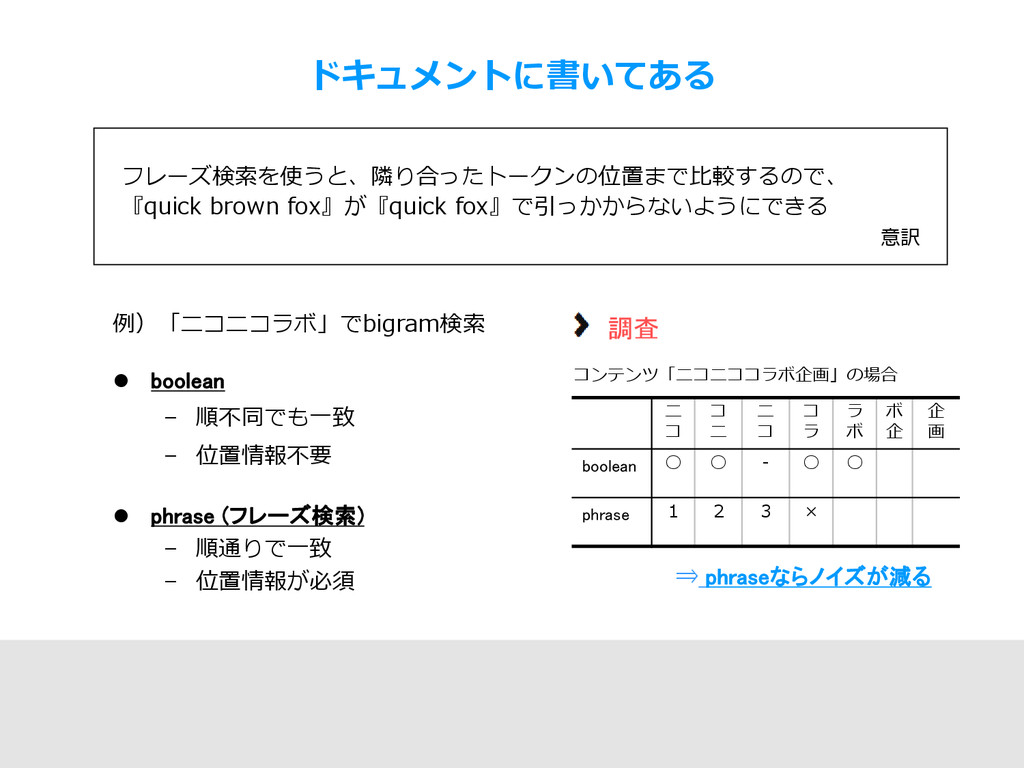
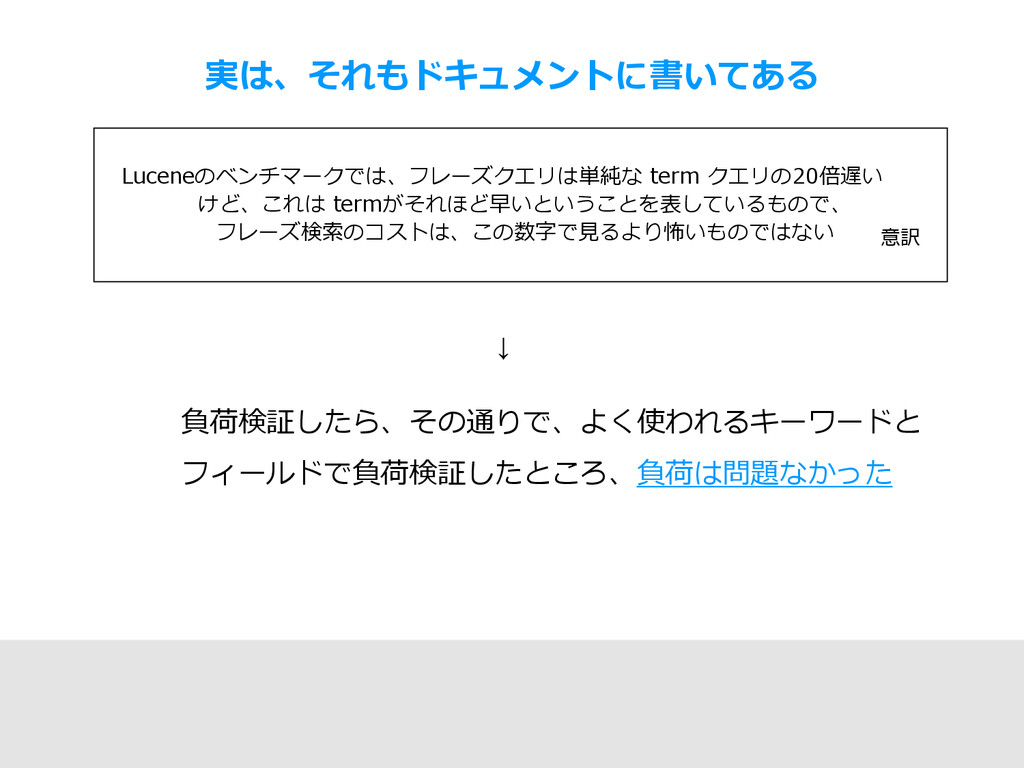
ドキュメントに書いてある フレーズ検索を使うと、隣り合ったトークンの位置まで比較するので、 『quick brown fox』が『quick fox』で引っかからないようにできる 意訳 ニ コ コ
ニ ニ コ コ ラ ラ ボ ボ 企 企 画 boolean ◦ ◦ - ◦ ◦ phrase 1 2 3 × boolean – 順不同でも一致 – 位置情報不要 phrase (フレーズ検索) – 順通りで一致 – 位置情報が必須 コンテンツ「ニコニココラボ企画」の場合 ⇒ phraseならノイズが減る 調査 例)「ニコニコラボ」でbigram検索 -
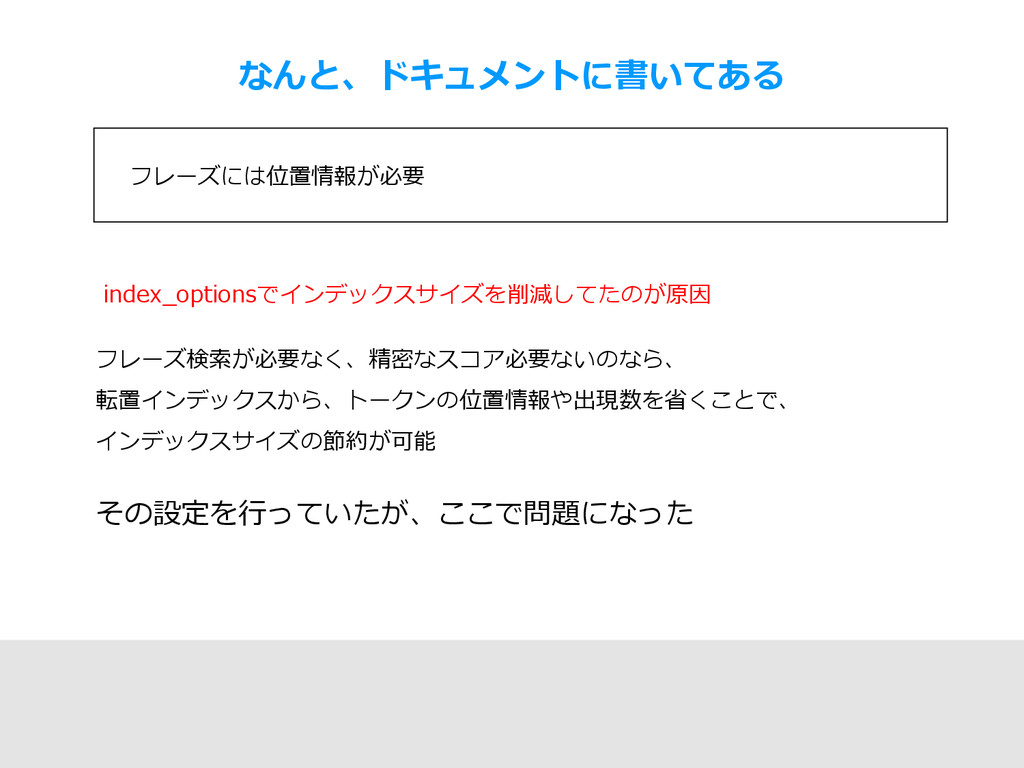
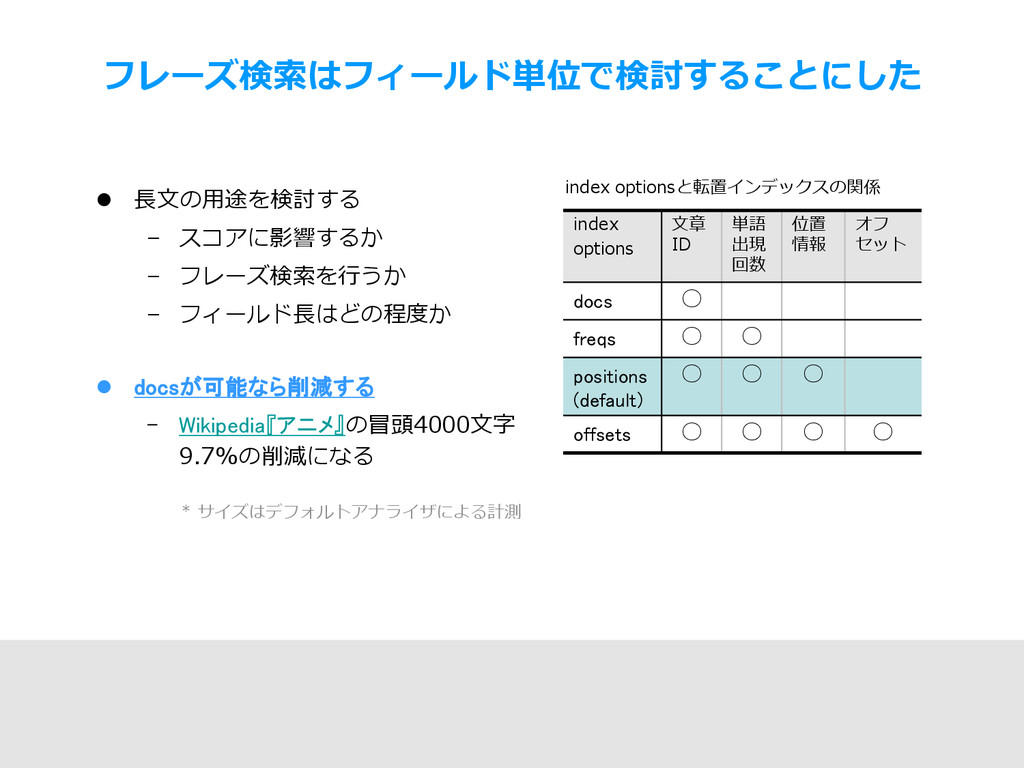
フレーズ検索はフィールド単位で検討することにした index options 文章 ID 単語 出現 回数 位置 情報
オフ セット docs ◦ freqs ◦ ◦ positions (default) ◦ ◦ ◦ offsets ◦ ◦ ◦ ◦ 長文の用途を検討する – スコアに影響するか – フレーズ検索を行うか – フィールド長はどの程度か docsが可能なら削減する – Wikipedia『アニメ』の冒頭4000文字 9.7%の削減になる * サイズはデフォルトアナライザによる計測 index optionsと転置インデックスの関係 -
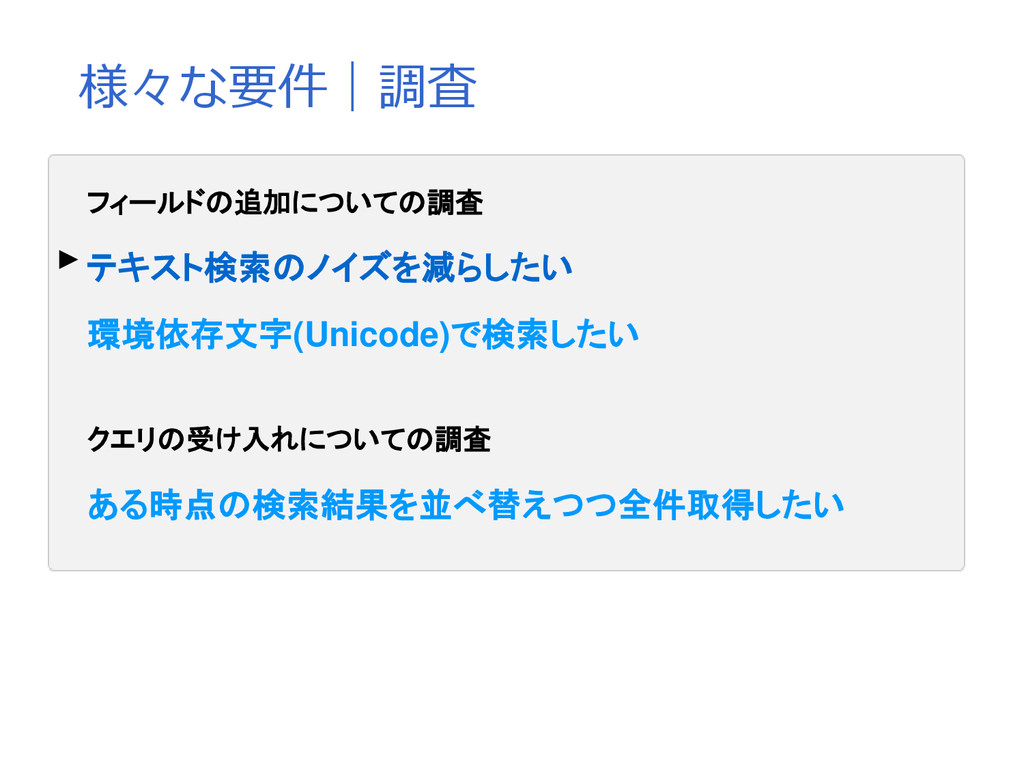
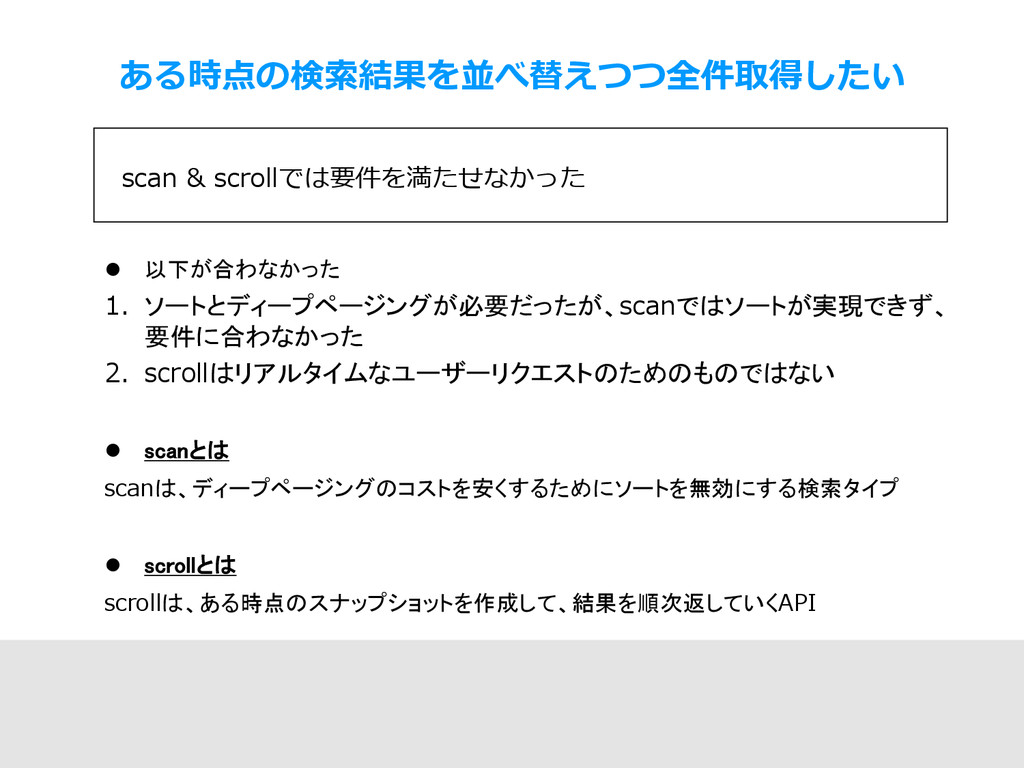
ある時点の検索結果を並べ替えつつ全件取得したい 以下が合わなかった 1. ソートとディープページングが必要だったが、scanではソートが実現できず、 要件に合わなかった 2. scrollはリアルタイムなユーザーリクエストのためのものではない scanとは
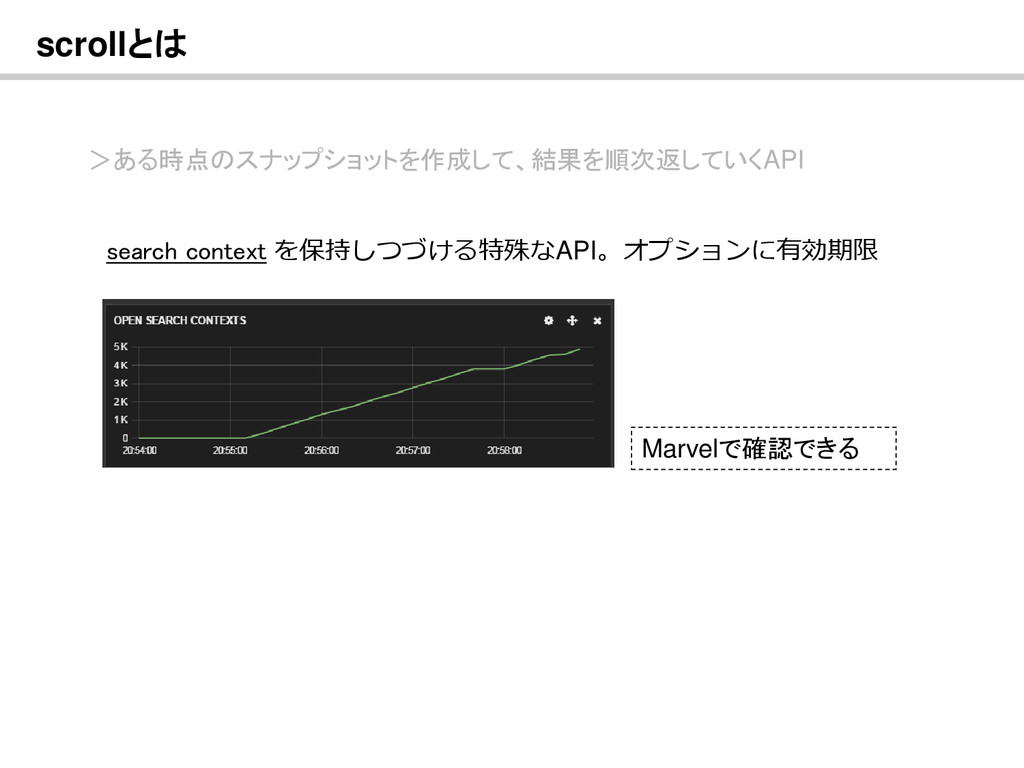
scanは、ディープページングのコストを安くするためにソートを無効にする検索タイプ scrollとは scrollは、ある時点のスナップショットを作成して、結果を順次返していくAPI scan & scrollでは要件を満たせなかった -
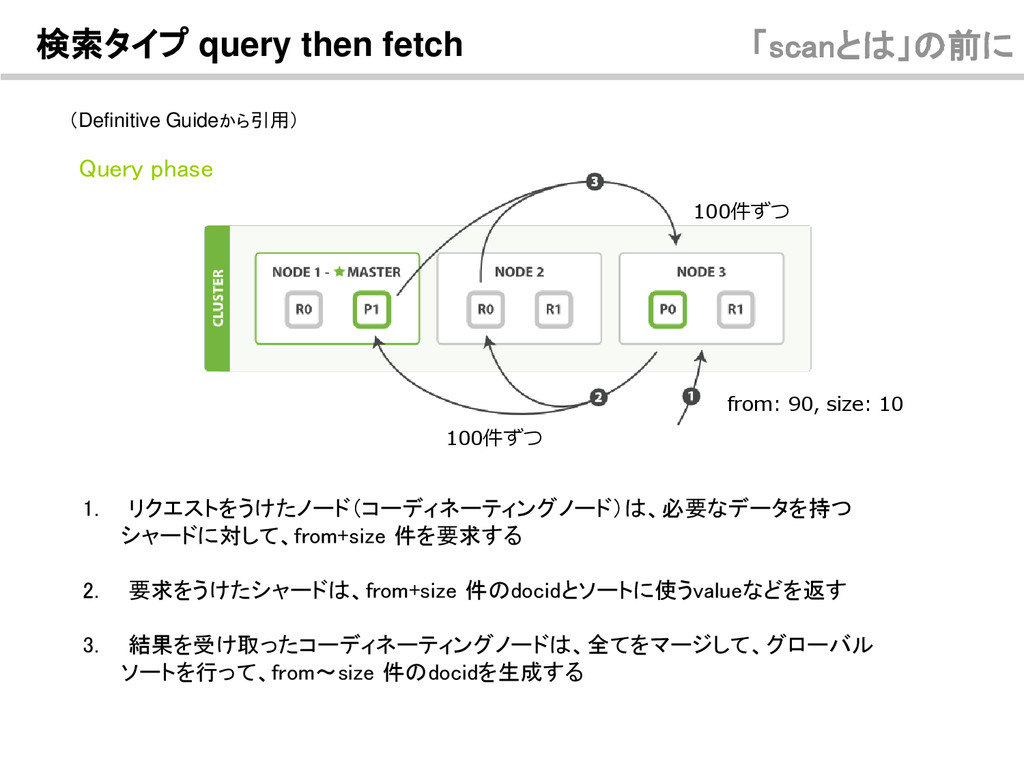
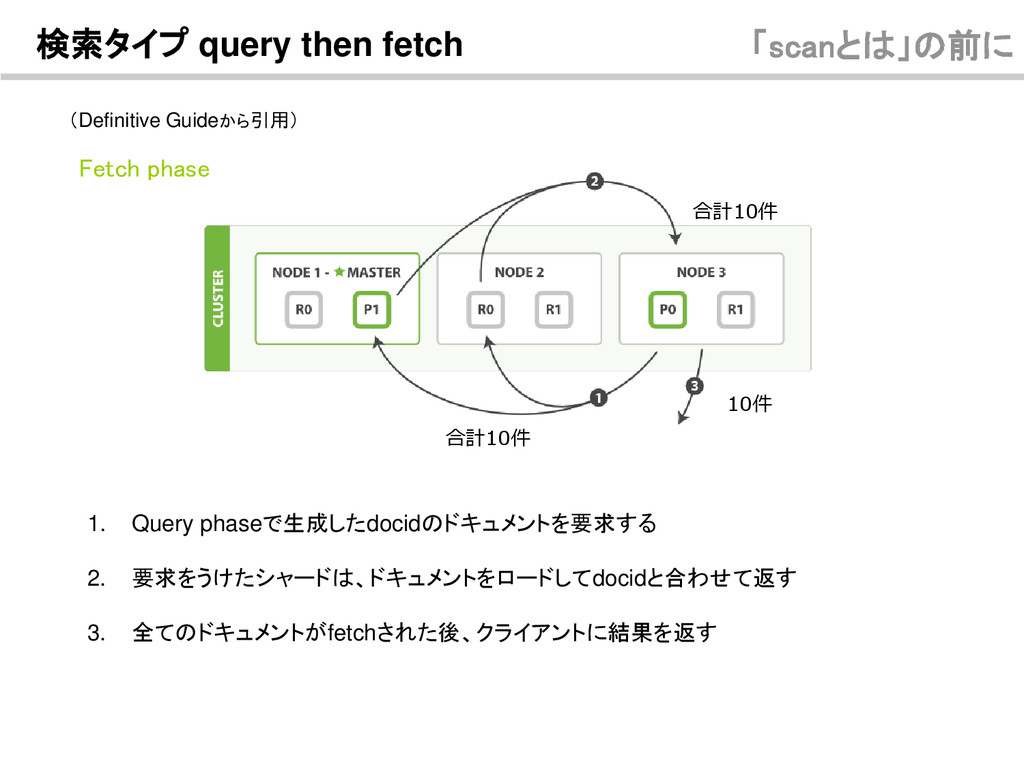
1. リクエストをうけたノード(コーディネーティングノード)は、必要なデータを持つ シャードに対して、from+size 件を要求する 2. 要求をうけたシャードは、from+size 件のdocidとソートに使うvalueなどを返す 3. 結果を受け取ったコーディネーティングノードは、全てをマージして、グローバル ソートを行って、from~size
件のdocidを生成する from: 90, size: 10 100件ずつ 100件ずつ Query phase (Definitive Guideから引用) 「scanとは」の前に 検索タイプ query then fetch -
1. Query phaseで生成したdocidのドキュメントを要求する 2. 要求をうけたシャードは、ドキュメントをロードしてdocidと合わせて返す 3. 全てのドキュメントがfetchされた後、クライアントに結果を返す Fetch phase 10件
合計10件 合計10件 「scanとは」の前に 検索タイプ query then fetch (Definitive Guideから引用) -
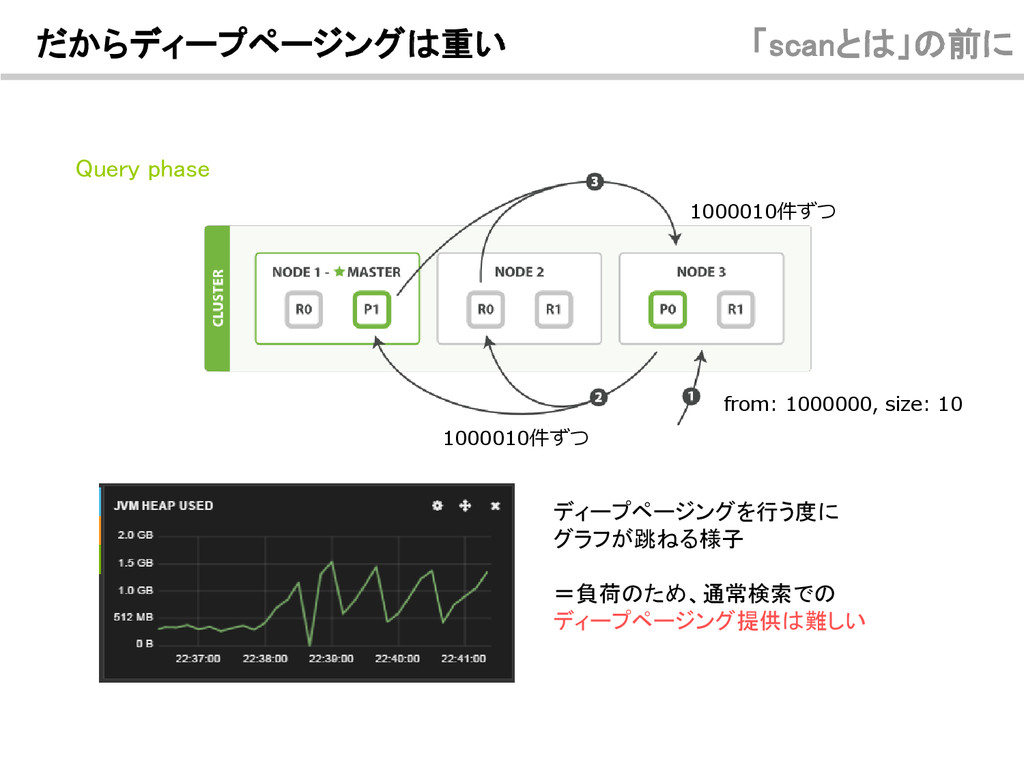
Query phase from: 1000000, size: 10 1000010件ずつ 1000010件ずつ ディープページングを行う度に グラフが跳ねる様子
=負荷のため、通常検索での ディープページング提供は難しい 「scanとは」の前に だからディープページングは重い -
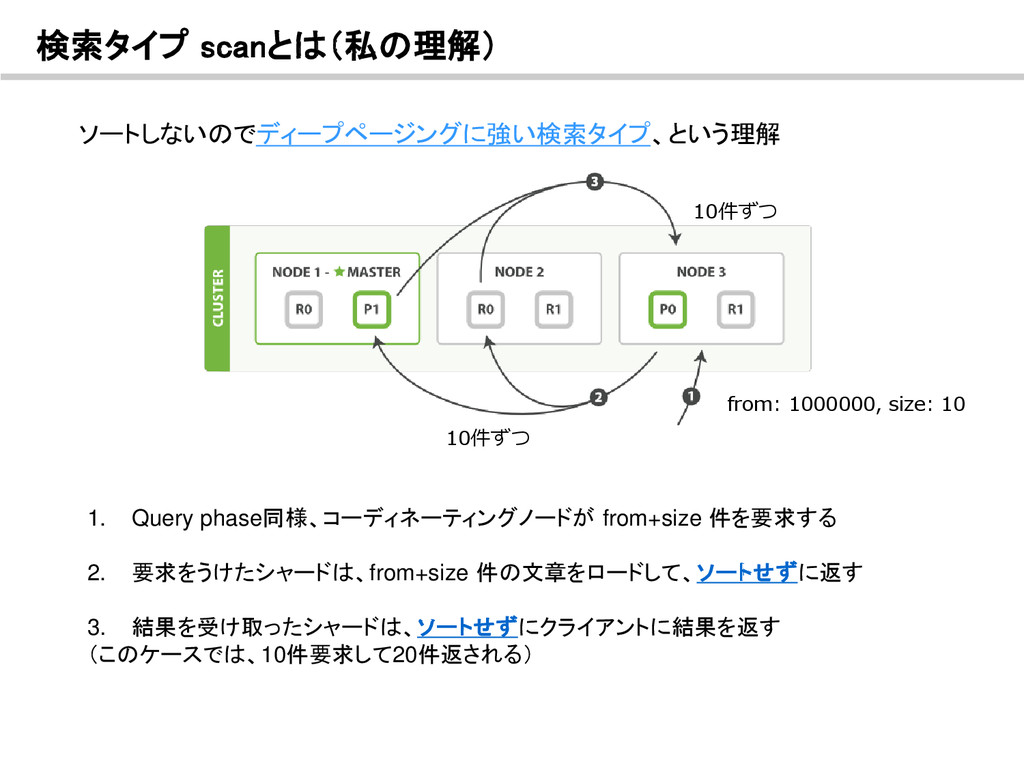
検索タイプ scanとは(私の理解) 1. Query phase同様、コーディネーティングノードが from+size 件を要求する 2. 要求をうけたシャードは、from+size 件の文章をロードして、ソートせずに返す
3. 結果を受け取ったシャードは、ソートせずにクライアントに結果を返す (このケースでは、10件要求して20件返される) from: 1000000, size: 10 10件ずつ 10件ずつ ソートしないのでディープページングに強い検索タイプ、という理解 -
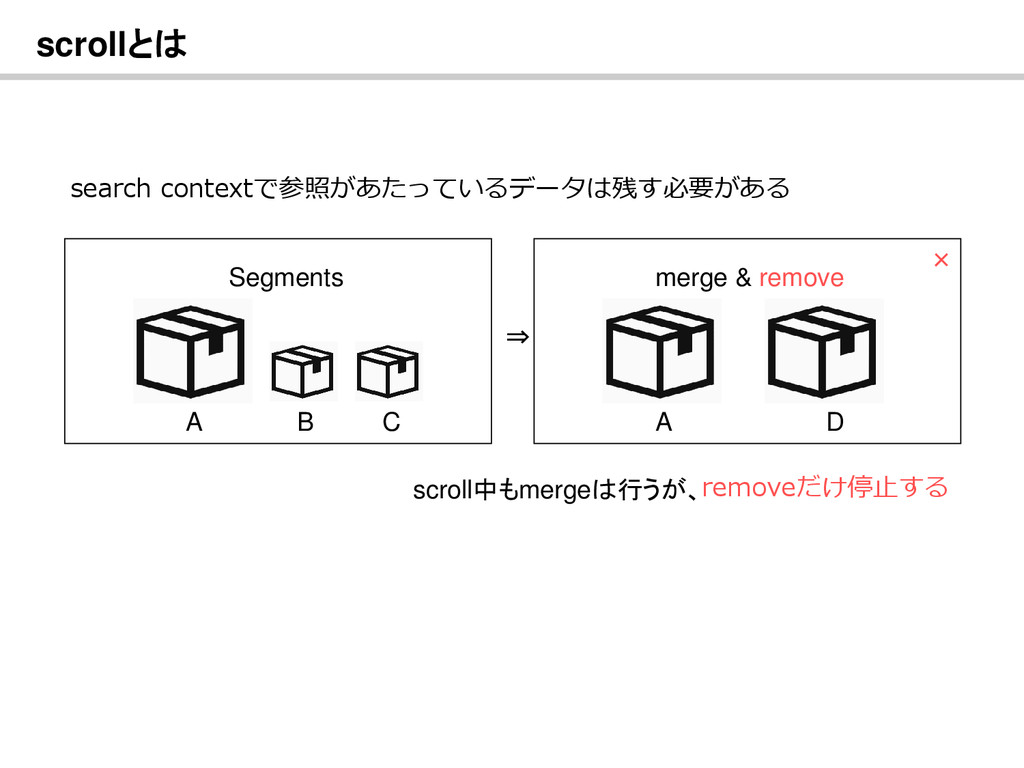
search contextで参照があたっているデータは残す必要がある merge & remove A D Segments A B
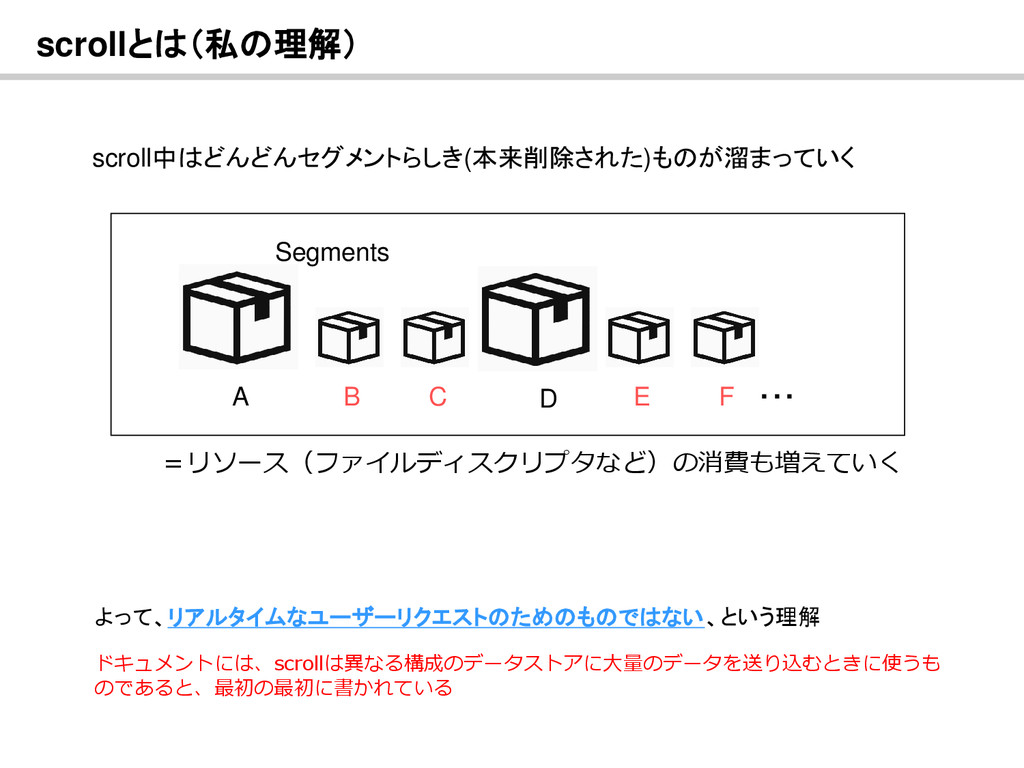
C × scrollとは ⇒ scroll中もmergeは行うが、 removeだけ停止する -
Segments A B C E F ・・・ scroll中はどんどんセグメントらしき(本来削除された)ものが溜まっていく よって、リアルタイムなユーザーリクエストのためのものではない、という理解 ドキュメントには、scrollは異なる構成のデータストアに大量のデータを送り込むときに使うも
のであると、最初の最初に書かれている D =リソース(ファイルディスクリプタなど)の消費も増えていく scrollとは(私の理解) -
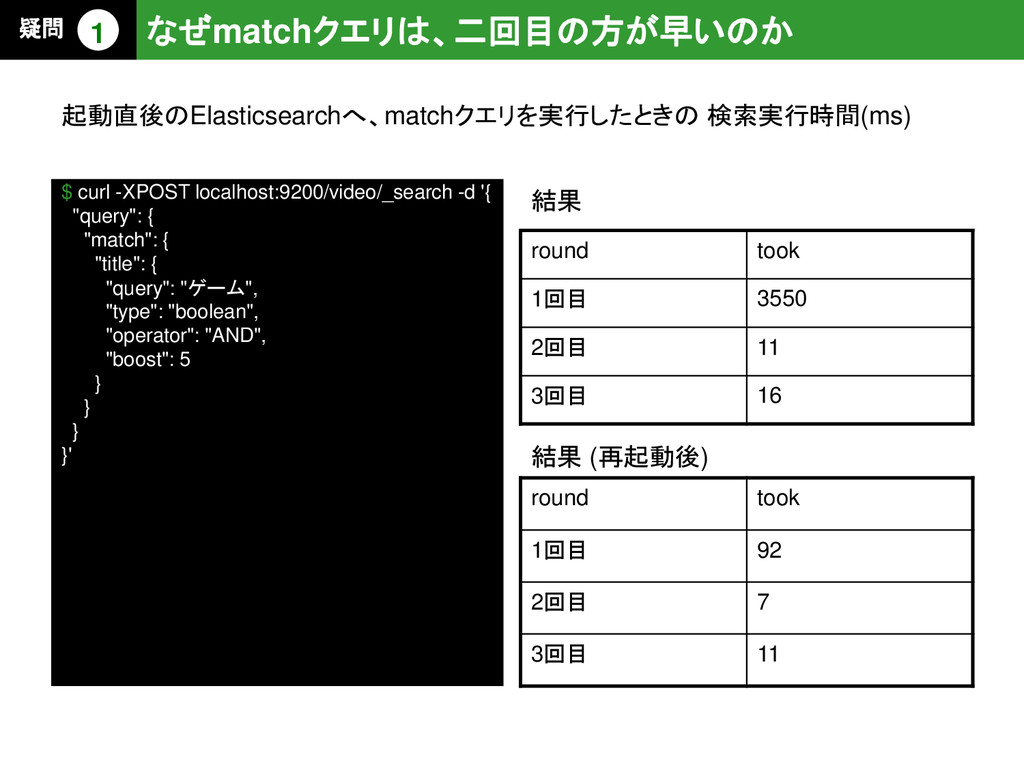
$ curl -XPOST localhost:9200/video/_search -d '{ "query": { "match": {
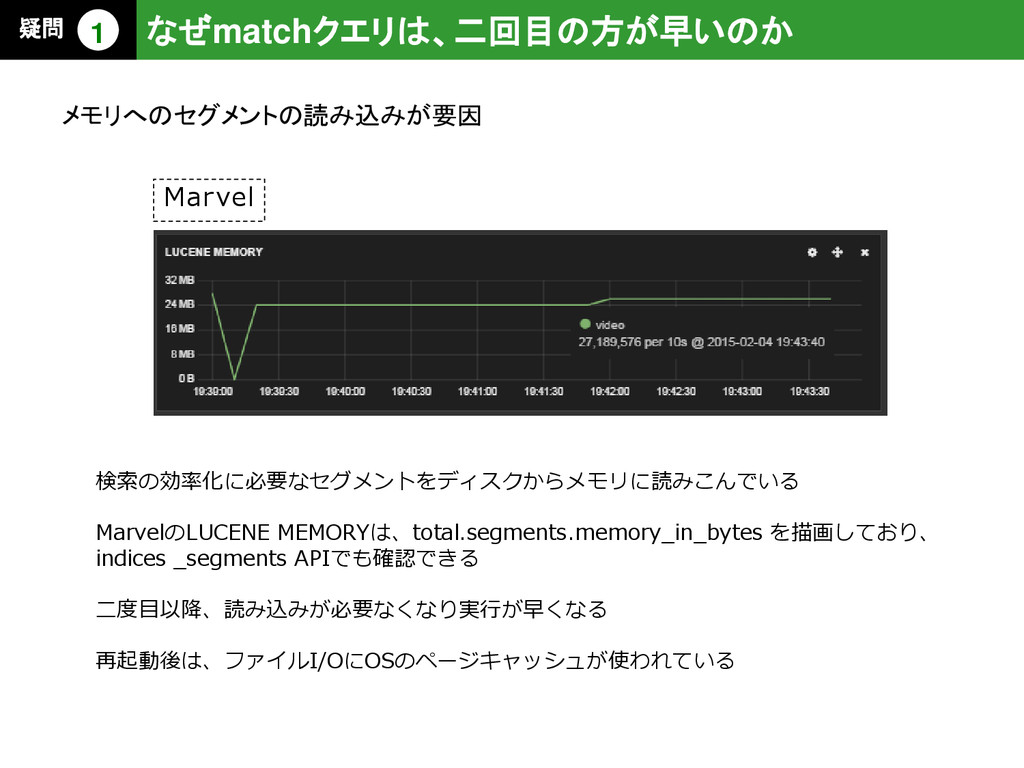
"title": { "query": "ゲーム", "type": "boolean", "operator": "AND", "boost": 5 } } } }' round took 1回目 3550 2回目 11 3回目 16 結果 round took 1回目 92 2回目 7 3回目 11 結果 (再起動後) なぜmatchクエリは、二回目の方が早いのか 疑問 起動直後のElasticsearchへ、matchクエリを実行したときの 検索実行時間(ms) 1 -
$ curl -XPOST localhost:9200/video/_search?pretty -d ' { "query": { "filtered":
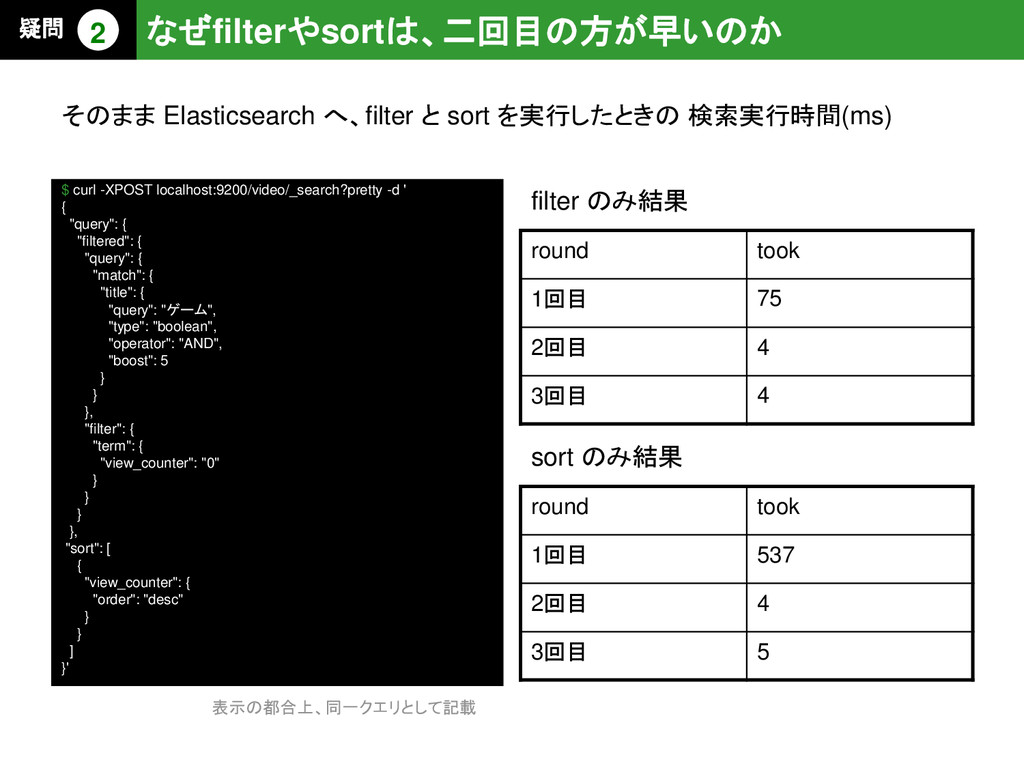
{ "query": { "match": { "title": { "query": "ゲーム", "type": "boolean", "operator": "AND", "boost": 5 } } }, "filter": { "term": { "view_counter": "0" } } } }, "sort": [ { "view_counter": { "order": "desc" } } ] }' round took 1回目 75 2回目 4 3回目 4 filter のみ結果 round took 1回目 537 2回目 4 3回目 5 sort のみ結果 なぜfilterやsortは、二回目の方が早いのか 疑問 2 そのまま Elasticsearch へ、filter と sort を実行したときの 検索実行時間(ms) 表示の都合上、同一クエリとして記載 -
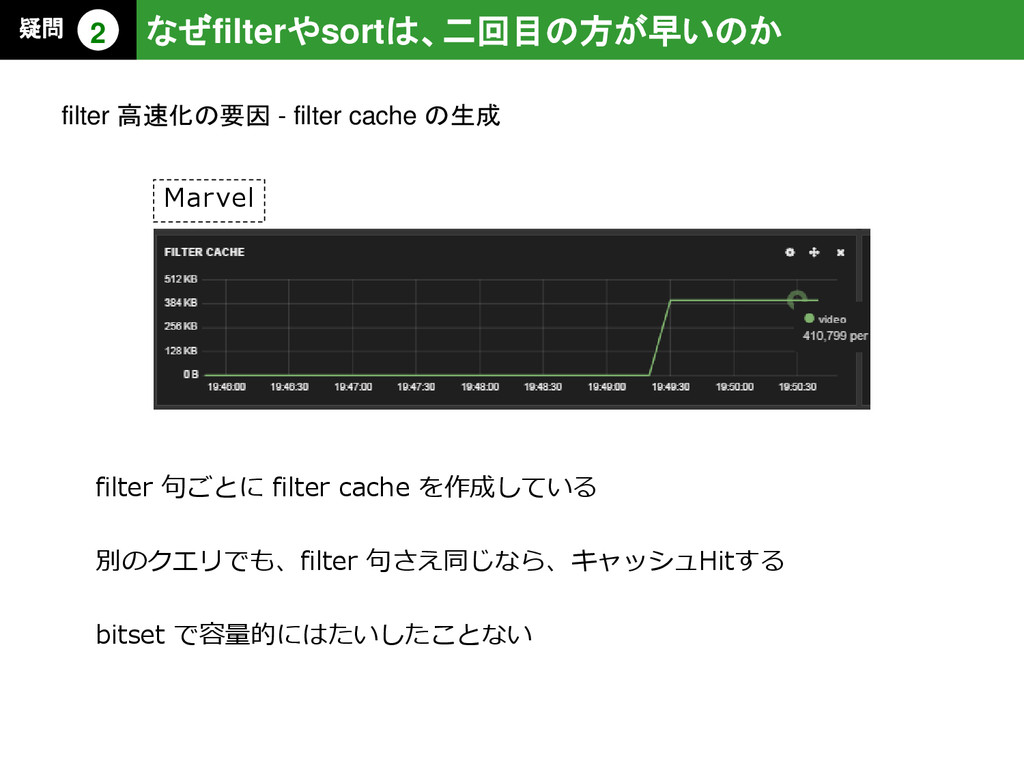
Marvel なぜfilterやsortは、二回目の方が早いのか 疑問 2 filter 句ごとに filter cache を作成している 別のクエリでも、filter
句さえ同じなら、キャッシュHitする bitset で容量的にはたいしたことない filter 高速化の要因 - filter cache の生成 -
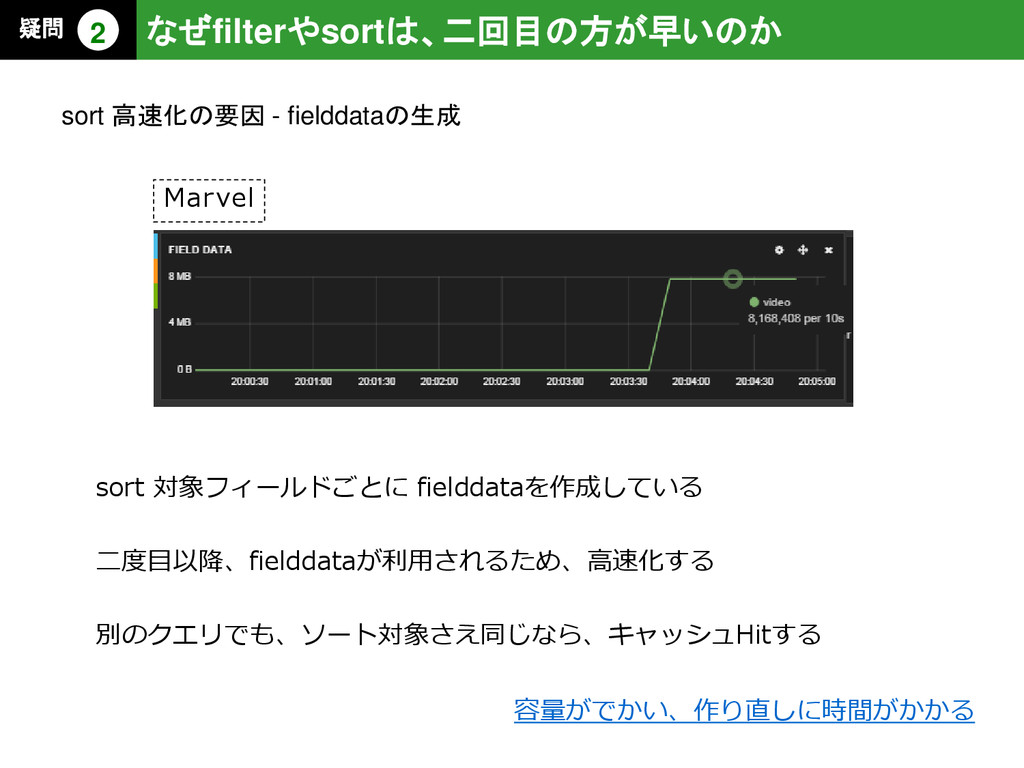
sort 対象フィールドごとに fielddataを作成している 二度目以降、fielddataが利用されるため、高速化する 別のクエリでも、ソート対象さえ同じなら、キャッシュHitする なぜfilterやsortは、二回目の方が早いのか 疑問 2 sort 高速化の要因
- fielddataの生成 Marvel 容量がでかい、作り直しに時間がかかる -
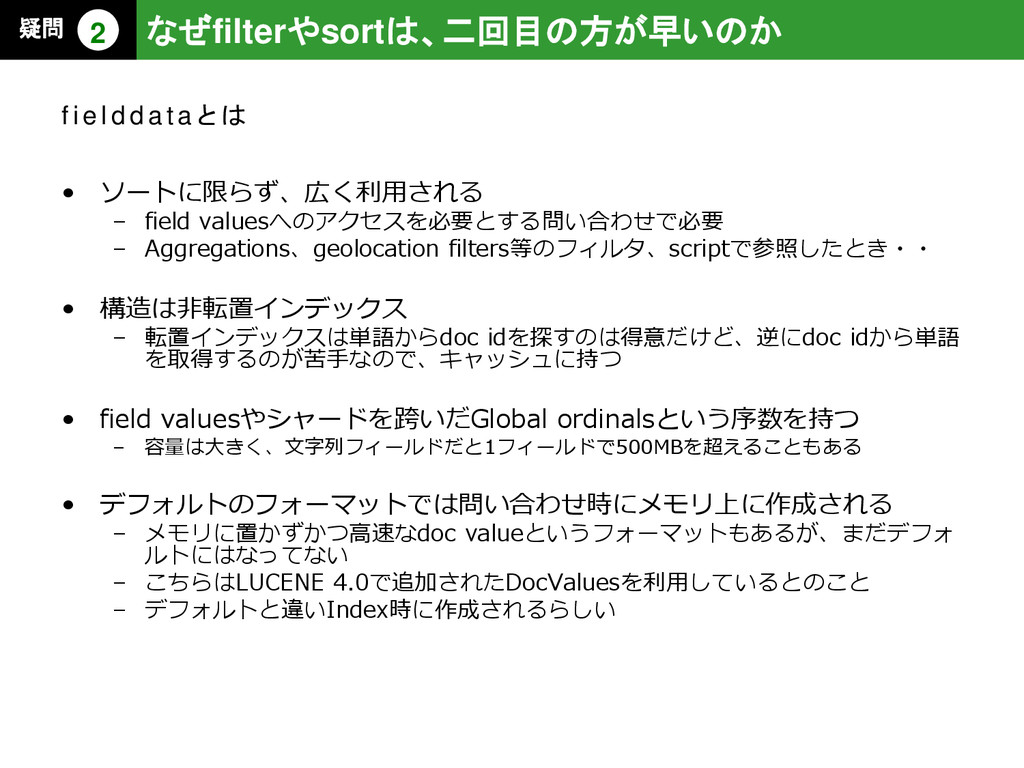
• ソートに限らず、広く利用される – field valuesへのアクセスを必要とする問い合わせで必要 – Aggregations、geolocation filters等のフィルタ、scriptで参照したとき・・ • 構造は非転置インデックス
– 転置インデックスは単語からdoc idを探すのは得意だけど、逆にdoc idから単語 を取得するのが苦手なので、キャッシュに持つ • field valuesやシャードを跨いだGlobal ordinalsという序数を持つ – 容量は大きく、文字列フィールドだと1フィールドで500MBを超えることもある • デフォルトのフォーマットでは問い合わせ時にメモリ上に作成される – メモリに置かずかつ高速なdoc valueというフォーマットもあるが、まだデフォ ルトにはなってない – こちらはLUCENE 4.0で追加されたDocValuesを利用しているとのこと – デフォルトと違いIndex時に作成されるらしい なぜfilterやsortは、二回目の方が早いのか 疑問 2 f i e l d d a t a と は -
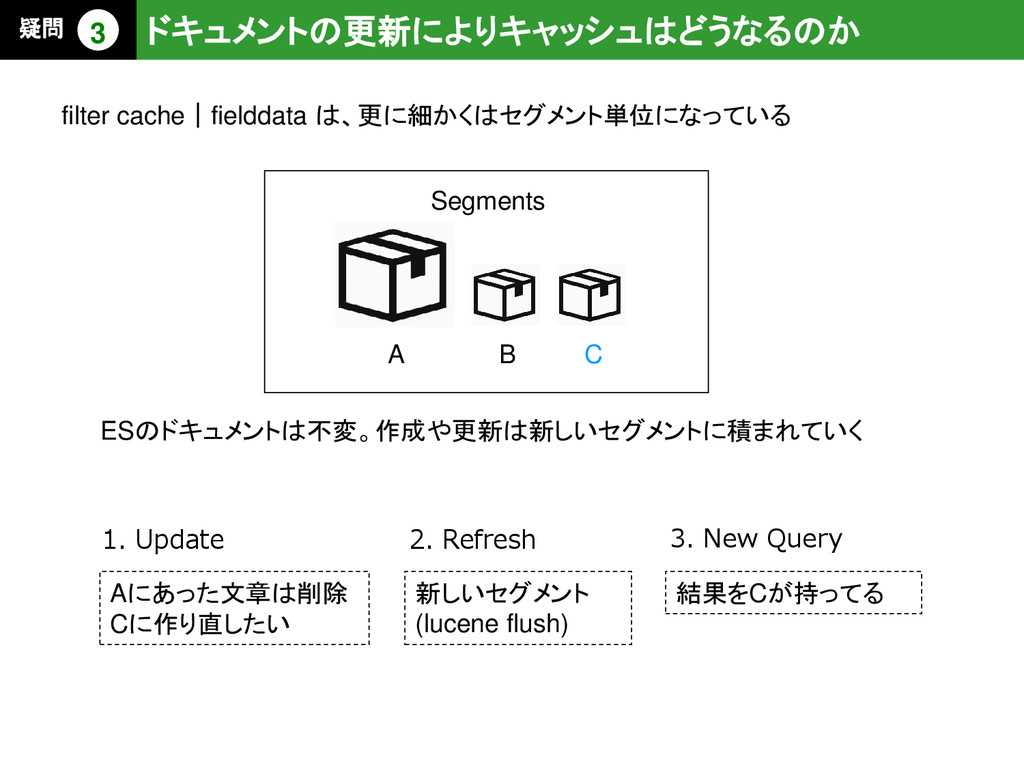
Segments A B C ドキュメントの更新によりキャッシュはどうなるのか 疑問 3 filter cache|fielddata は、更に細かくはセグメント単位になっている
ESのドキュメントは不変。作成や更新は新しいセグメントに積まれていく 新しいセグメント (lucene flush) 3. New Query 結果をCが持ってる 1. Update Aにあった文章は削除 Cに作り直したい 2. Refresh -
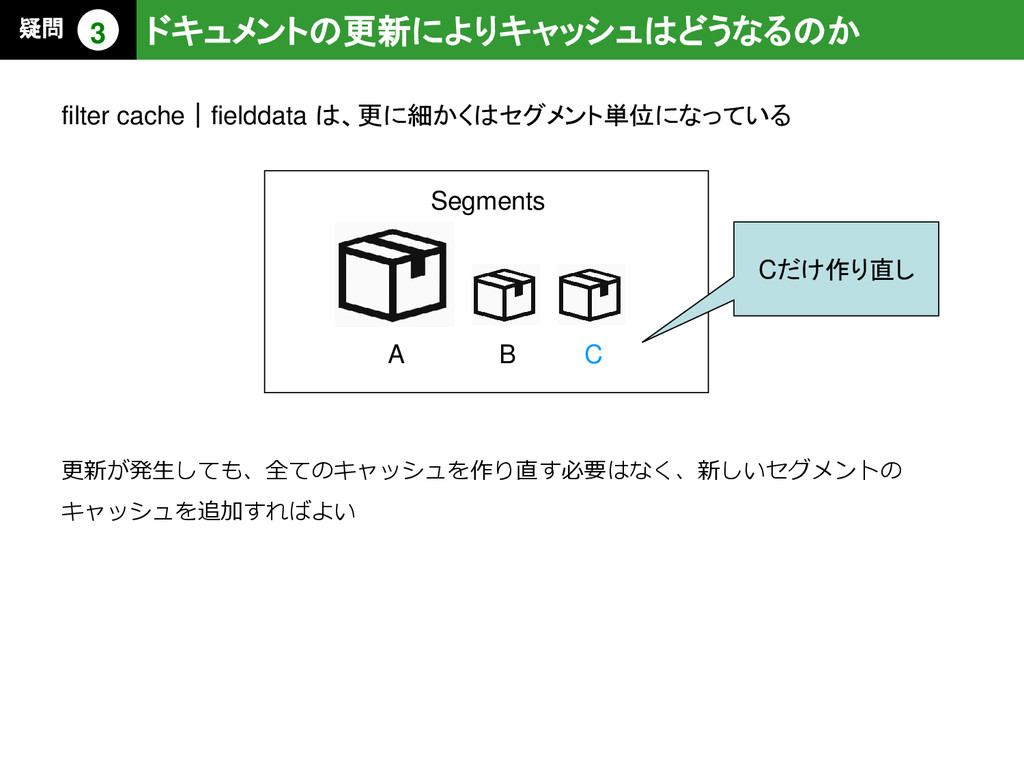
更新が発生しても、全てのキャッシュを作り直す必要はなく、新しいセグメントの キャッシュを追加すればよい Segments A B C ドキュメントの更新によりキャッシュはどうなるのか 疑問 3 filter
cache|fielddata は、更に細かくはセグメント単位になっている Cだけ作り直し -
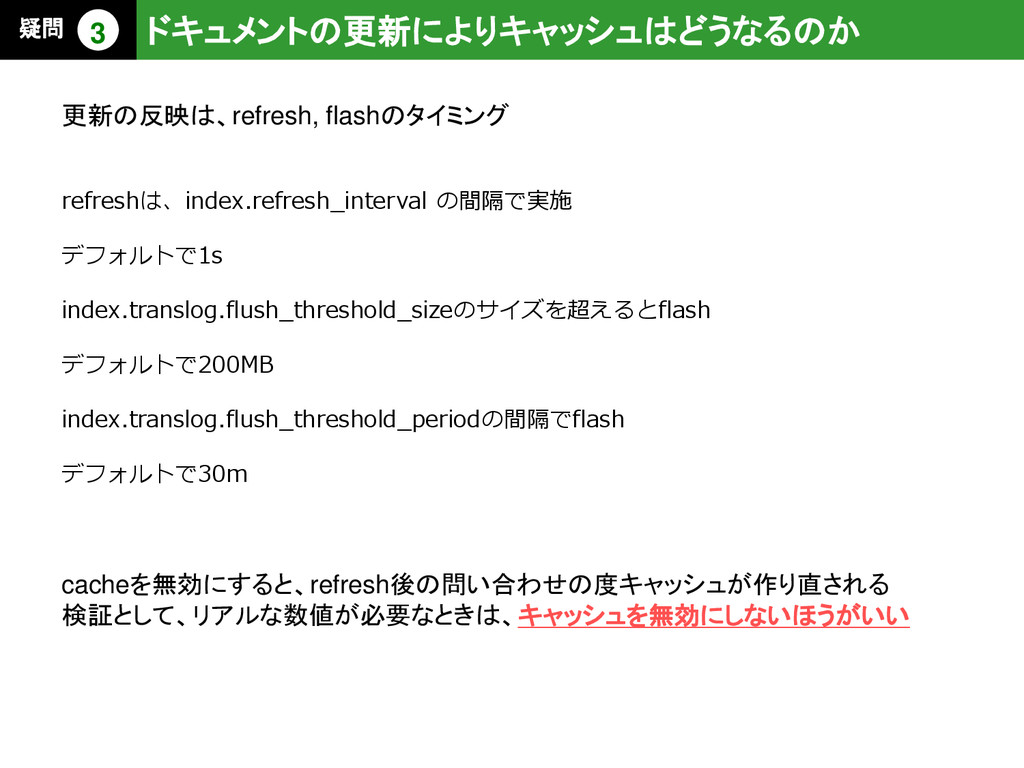
ドキュメントの更新によりキャッシュはどうなるのか 疑問 3 refreshは、index.refresh_interval の間隔で実施 デフォルトで1s index.translog.flush_threshold_sizeのサイズを超えるとflash デフォルトで200MB index.translog.flush_threshold_periodの間隔でflash デフォルトで30m
cacheを無効にすると、refresh後の問い合わせの度キャッシュが作り直される 検証として、リアルな数値が必要なときは、キャッシュを無効にしないほうがいい 更新の反映は、refresh, flashのタイミング -
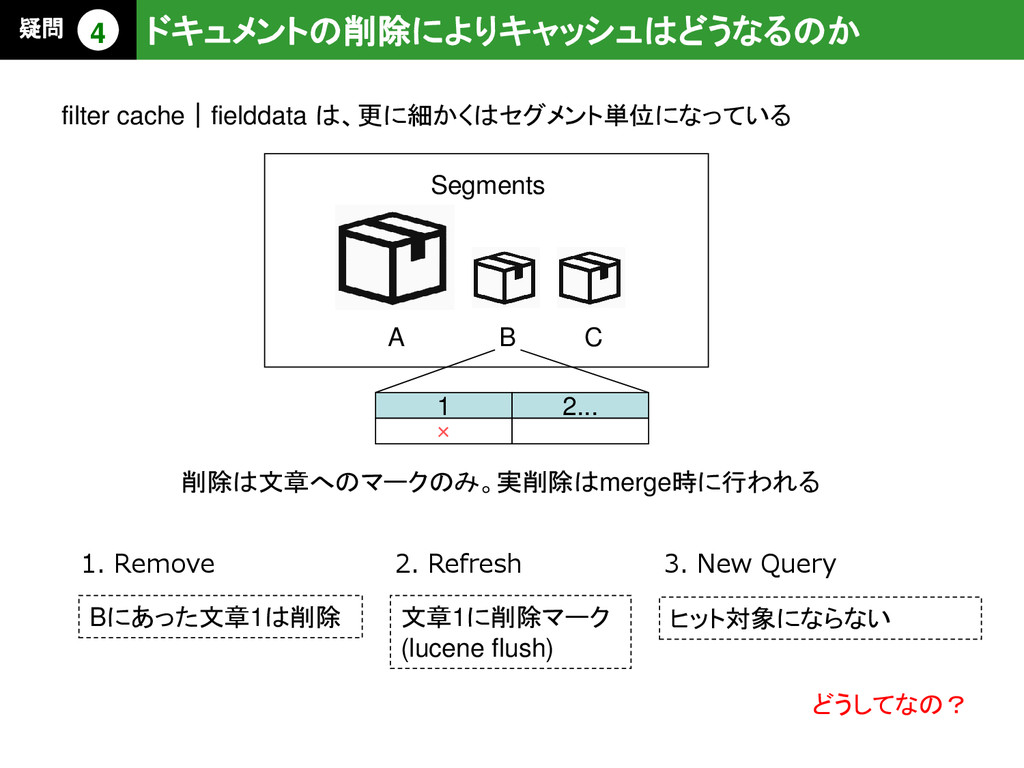
Segments 削除は文章へのマークのみ。実削除はmerge時に行われる A B C 文章1に削除マーク (lucene flush) 1. Remove
Bにあった文章1は削除 2. Refresh 1 × 2... ドキュメントの削除によりキャッシュはどうなるのか 疑問 4 filter cache|fielddata は、更に細かくはセグメント単位になっている -
Segments A B C 文章1に削除マーク (lucene flush) 1. Remove Bにあった文章1は削除
2. Refresh 3. New Query ヒット対象にならない 1 × 2... ドキュメントの削除によりキャッシュはどうなるのか 疑問 4 filter cache|fielddata は、更に細かくはセグメント単位になっている 削除は文章へのマークのみ。実削除はmerge時に行われる どうしてなの? -
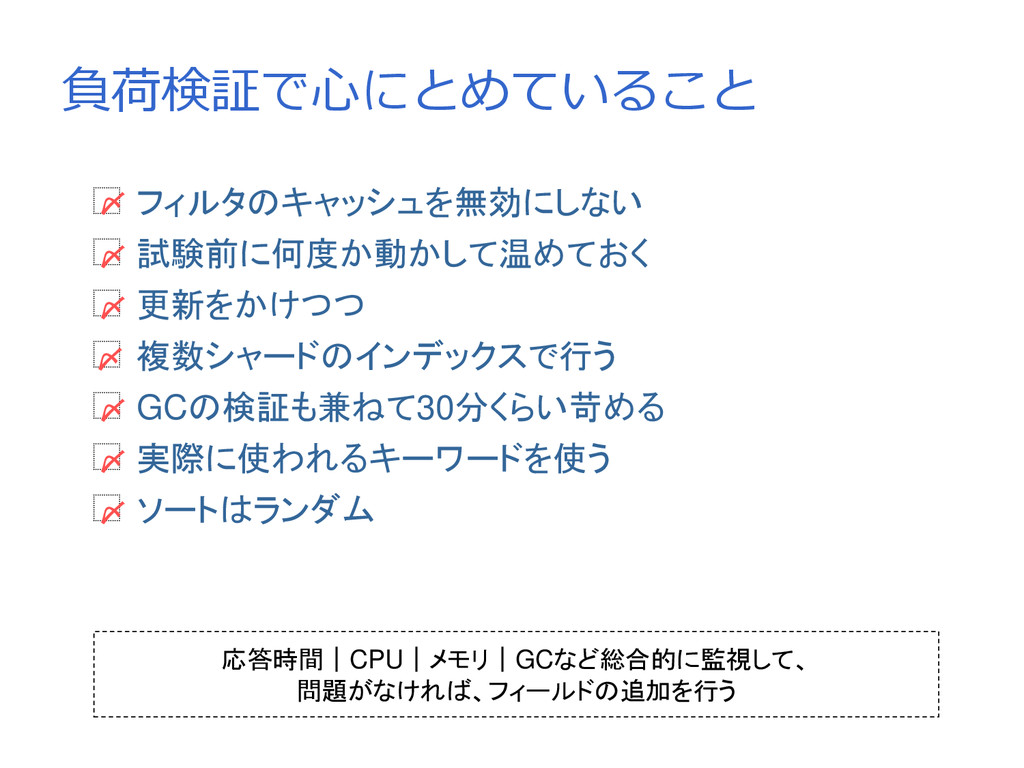
負荷検証で心にとめていること フィルタのキャッシュを無効にしない 試験前に何度か動かして温めておく 更新をかけつつ 複数シャードのインデックスで行う GCの検証も兼ねて30分くらい苛める 実際に使われるキーワードを使う ソートはランダム 〆 〆
〆 〆 〆 〆 〆 応答時間|CPU|メモリ|GCなど総合的に監視して、 問題がなければ、フィールドの追加を行う -
発 表 の テ ー マ Elasticsearchは検索基盤として運用しやすい 負荷検証やクエリやスキーマ定義の細かい話は、 ほとんどドキュメントに書いてあること 深い内容までドキュメントに記載されているので、
複雑な要件時の細かい挙動を調査しやすい 要件対応にはスキーマ定義が付きまとうが、 Elasticsearchはフィールド追加の対応が、とても楽 まとめ