Share
Embed
카카오 하둡 플랫폼의 아키텍처와 개발/운영에 대한 이야기
#Hadoop
카카오 자체 개발 하둡 플랫폼인 KHP(Kakao Hadoop Platform)를 소개합니다. 아키텍처를 중점적으로 설명하고 개발 및 마이그레이션, 운영하며 겪었던 경험들을 공유 드립니다.
발표자 : elixir.kook
카카오 내 하둡 클러스터를 효율적으로 운영하기 위해 힘쓰고 있습니다. KHP 프로젝트 중에는 배포판 PL을 맡았으며, 최근에는 Spark, Kafka 관련 업무를 수행하고 있습니다.
kakao
December 09, 2022
Transcript
58 slides
-
카카오 하둡 플랫폼의 아키텍처와 개발/운영에 대한 이야기 Copyright 2022. Kakao
Corp. All rights reserved. Redistribution or public display is not permitted without written permission from Kakao. Kakao Hadoop Platform (KHP) 국성표 elixir.kook 카카오 if(kakao)2022 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
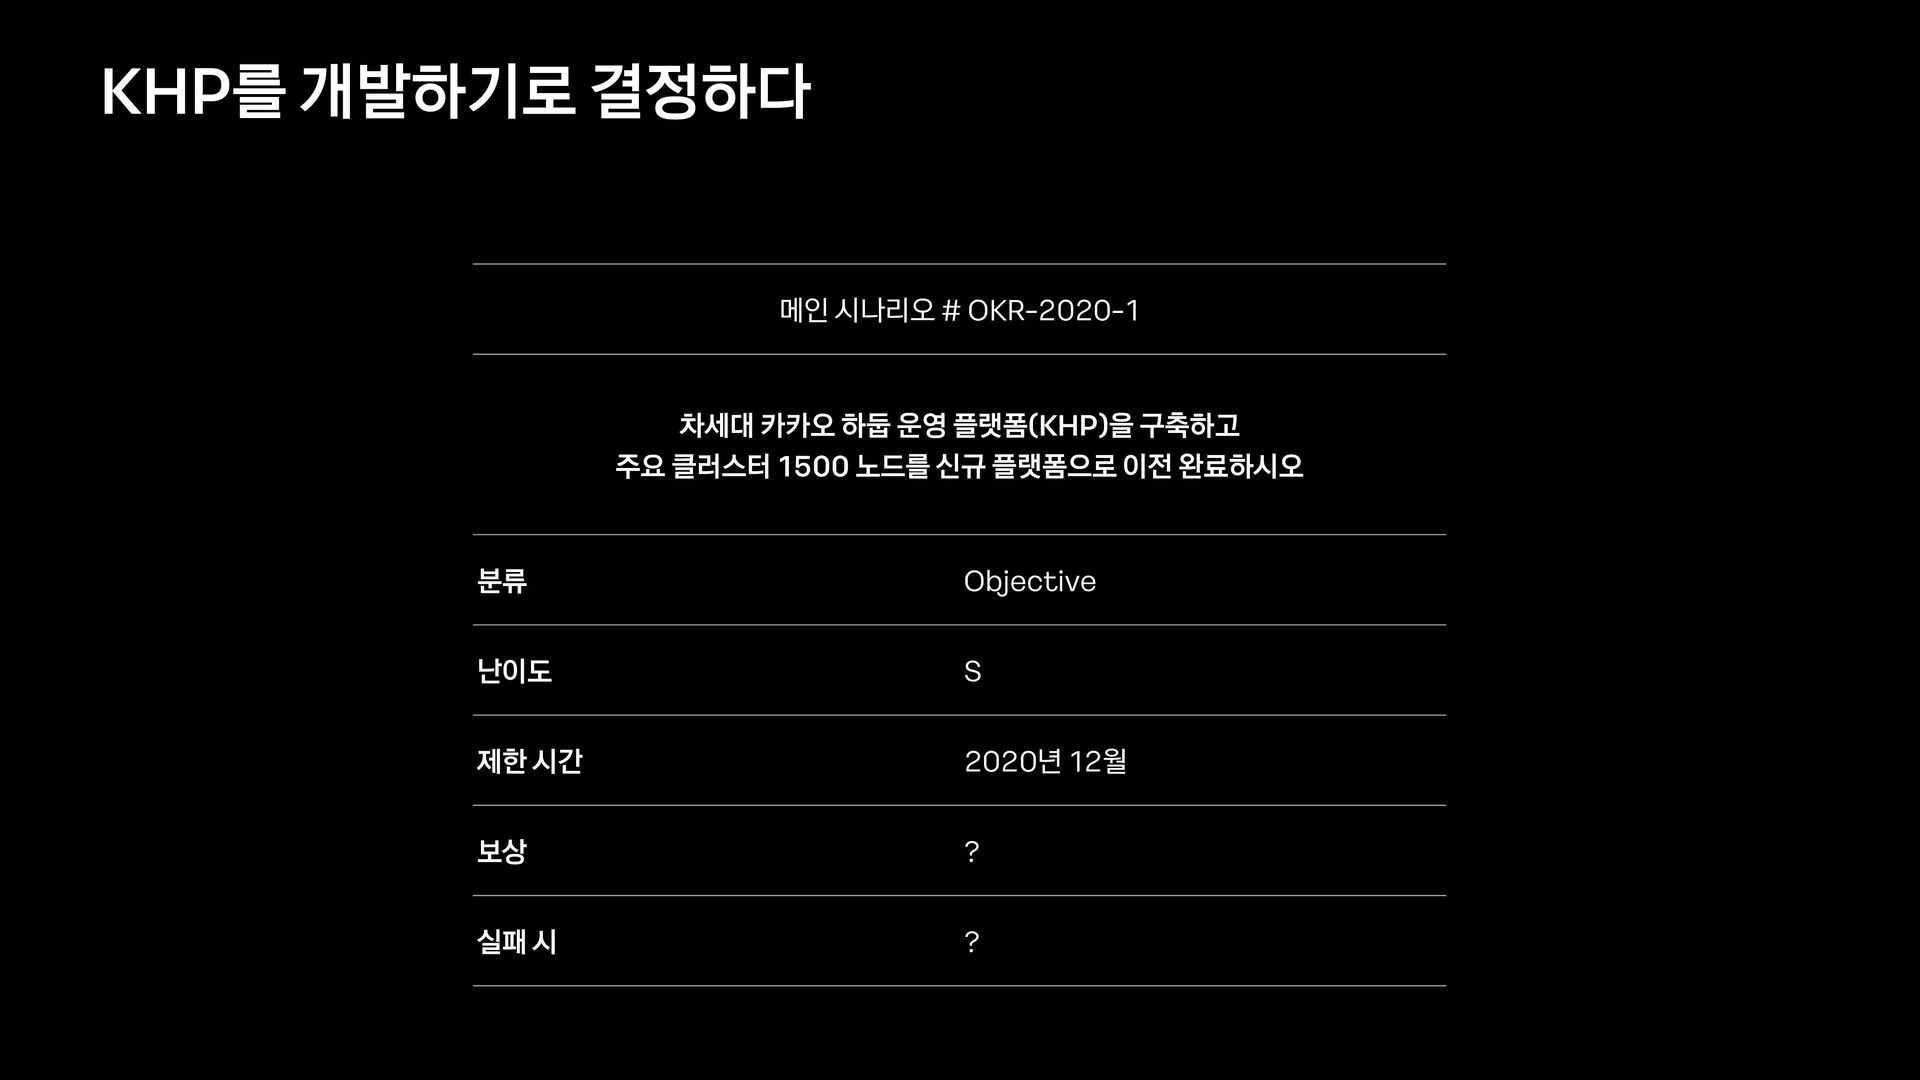
KHP를 개발하기로 결정하다 메인 시나리오 # OKR-2020-1 차세대 카카오 하둡
운영 플랫폼(KHP)을 구축하고 주요 클러스터 1500 노드를 신규 플랫폼으로 이전 완료하시오 분류 Objective 난이도 S 제한 시간 2020년 12월 보상 ? 실패 시 ? -
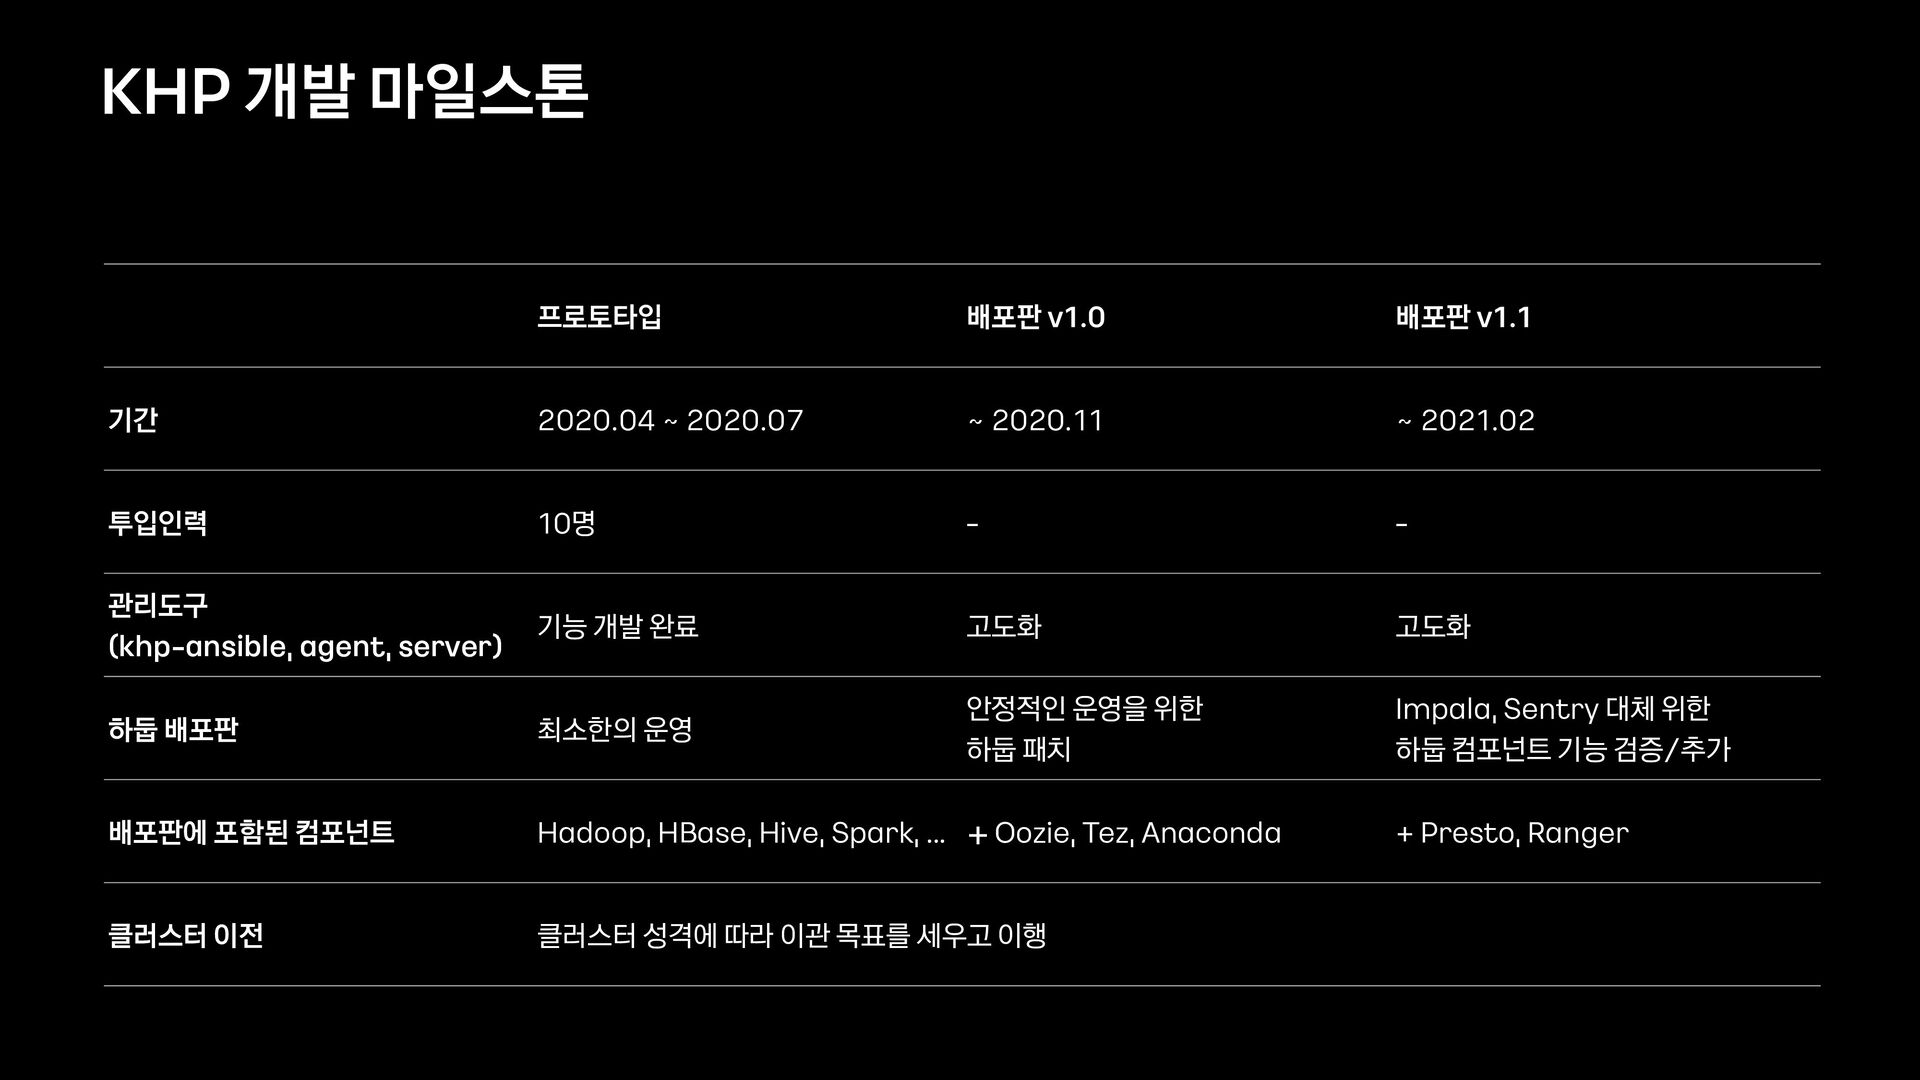
프로토타입 배포판 v1.0 배포판 v1.1 기간 2020.04 ~ 2020.07 ~
2020.11 ~ 2021.02 투입인력 10명 - - 관리도구 (khp - ansible, agent, server) 기능 개발 완료 고도화 고도화 하둡 배포판 최소한의 운영 안정적인 운영을 위한 하둡 패치 Impala, Sentry 대체 위한 하둡 컴포넌트 기능 검증/추가 배포판에 포함된 컴포넌트 Hadoop, HBase, Hive, Spark, … +Oozie, Tez, Anaconda + Presto, Ranger 클러스터 이전 클러스터 성격에 따라 이관 목표를 세우고 이행 KHP 개발 마일스톤 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
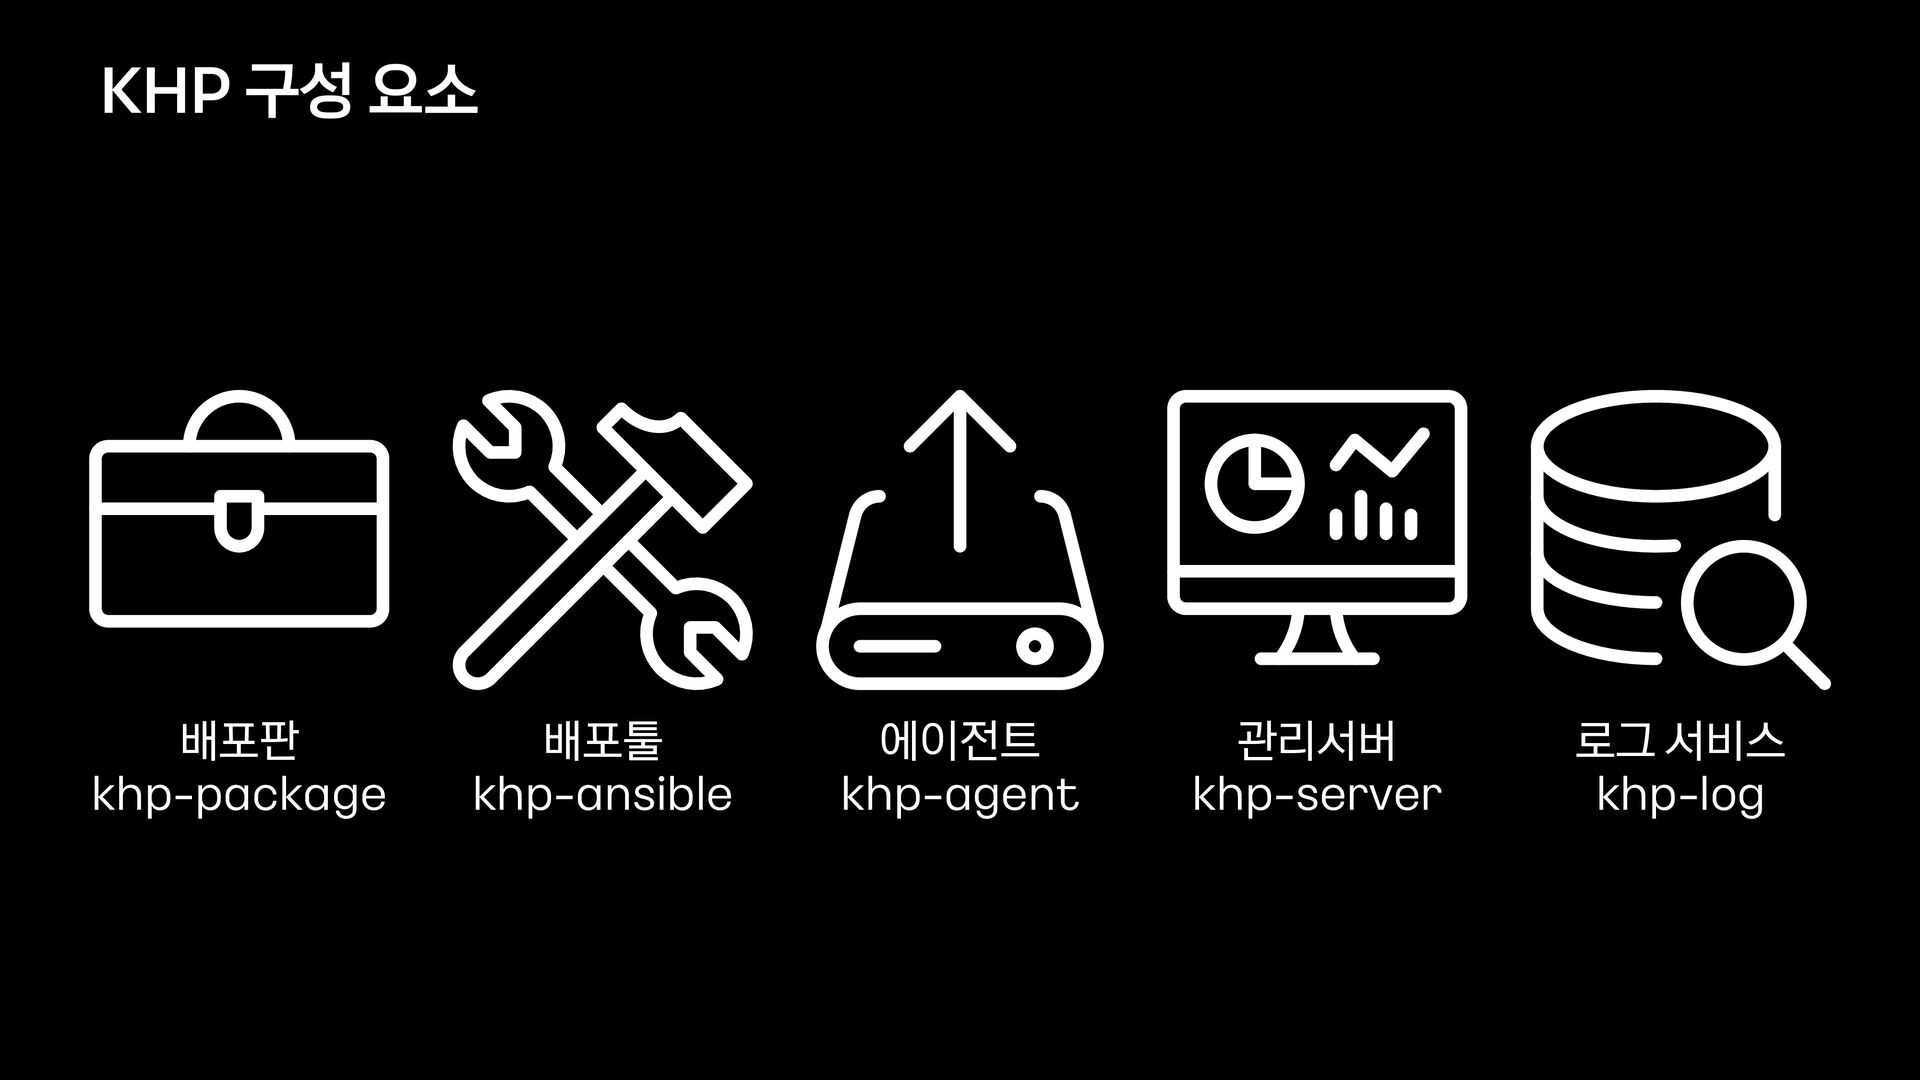
배포판 khp - package 배포툴 khp - ansible 에이전트 khp
- agent 관리서버 khp - server KHP 구성 요소 로그 서비스 khp - log -
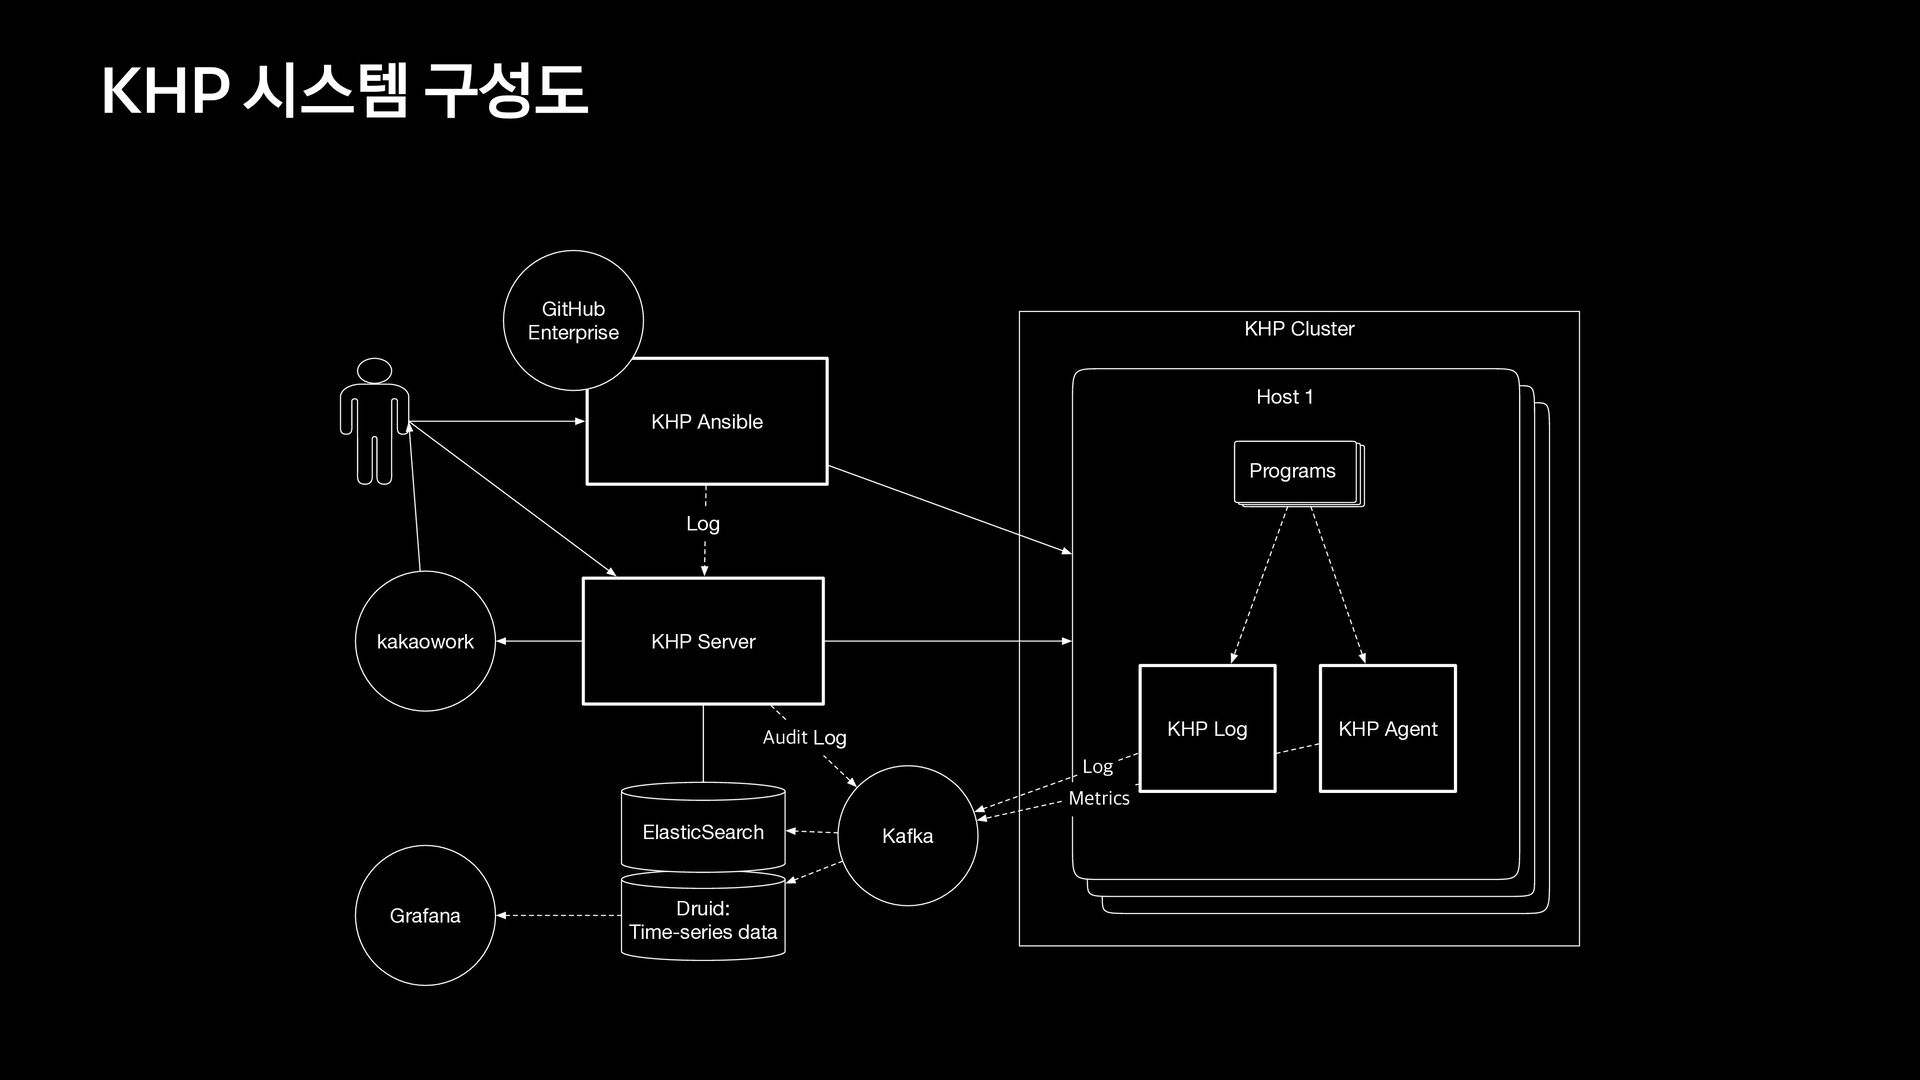
KHP 시스템 구성도 KHP Cluster Host 1 KHP Agent Programs
Druid: Time-series data kakaowork Grafana KHP Ansible KHP Server "VEJULog KHP Log Kafka -PH GitHub Enterprise .FUSJDT Log ElasticSearch -
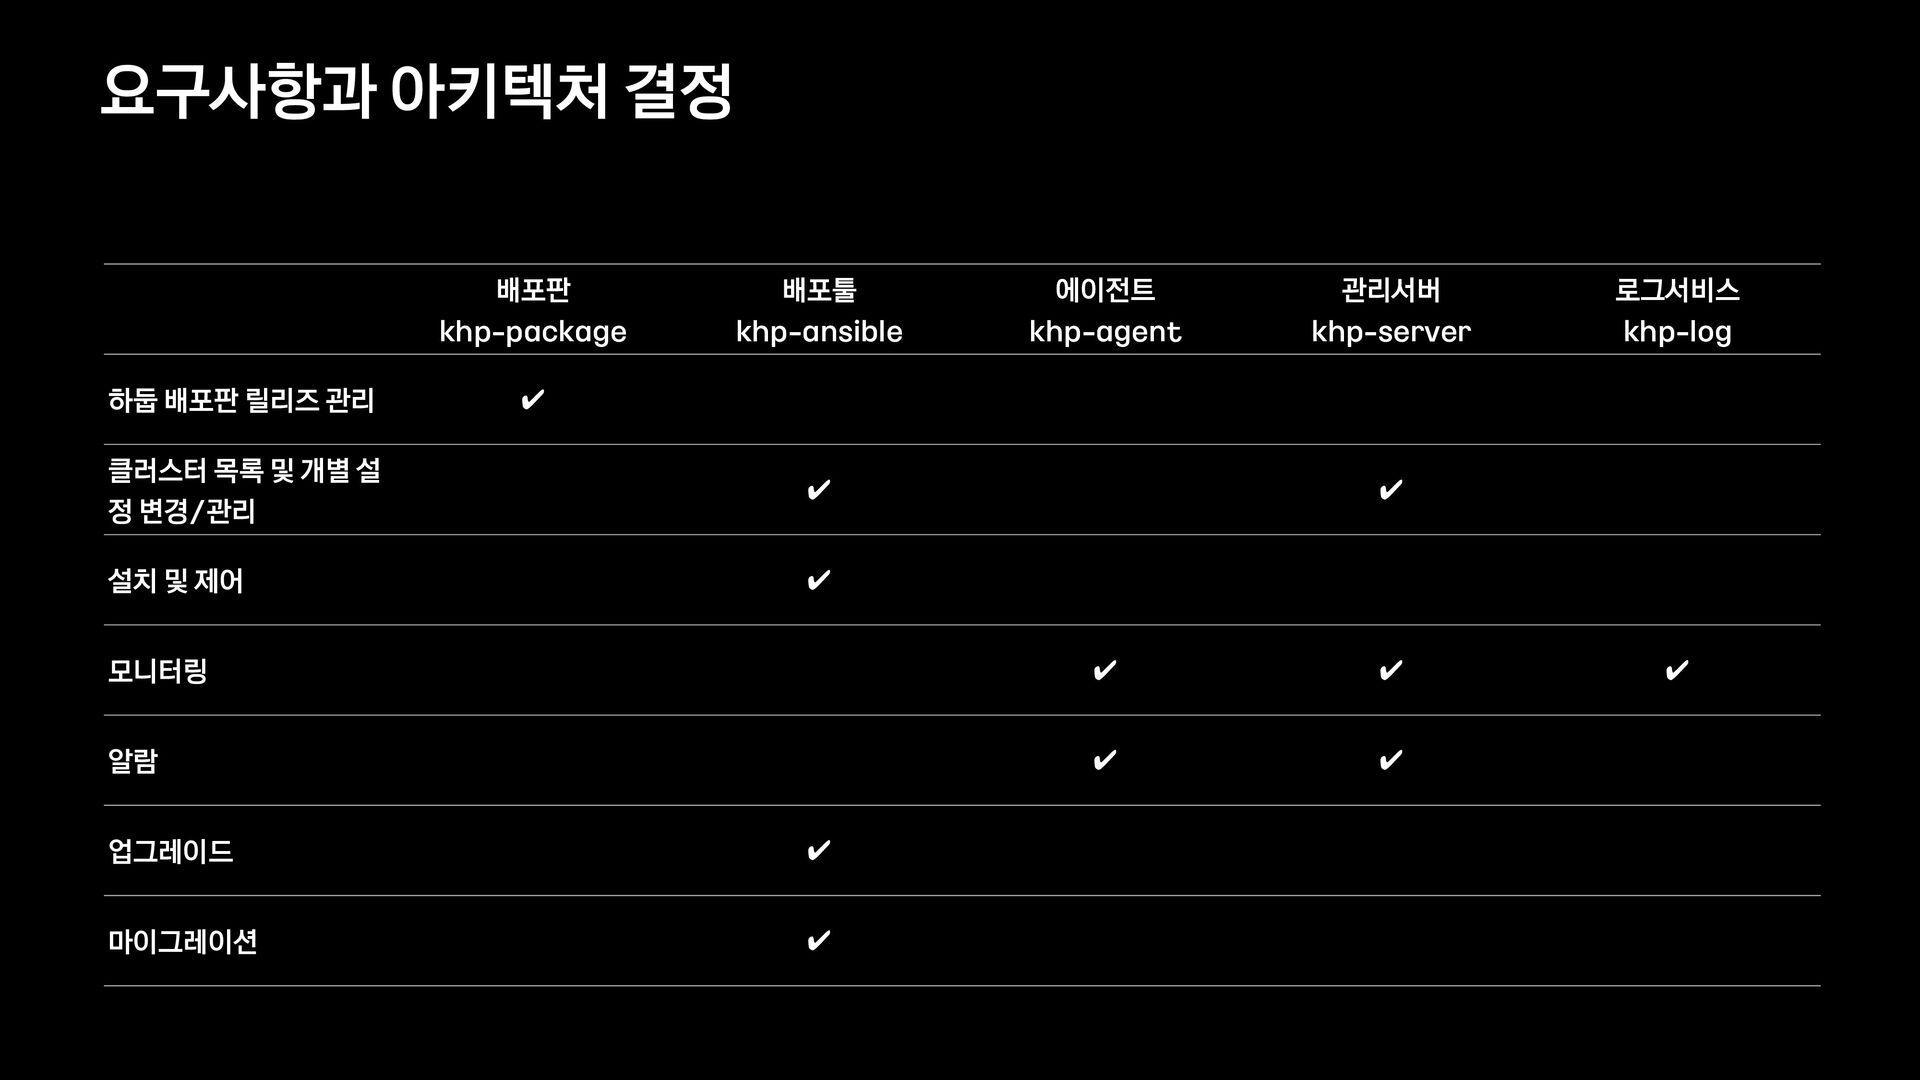
요구사항과 아키텍처 결정 배포판 khp - package 배포툴 khp -
ansible 에이전트 khp - agent 관리서버 khp - server 로그서비스 khp - log 하둡 배포판 릴리즈 관리 ✔ 클러스터 목록 및 개별 설 정 변경/관리 ✔ ✔ 설치 및 제어 ✔ 모니터링 ✔ ✔ ✔ 알람 ✔ ✔ 업그레이드 ✔ 마이그레이션 ✔ -
유닛 테스트 통합 테스트 패키지 릴리즈 변경 배포 배포판 (khp
- package) -
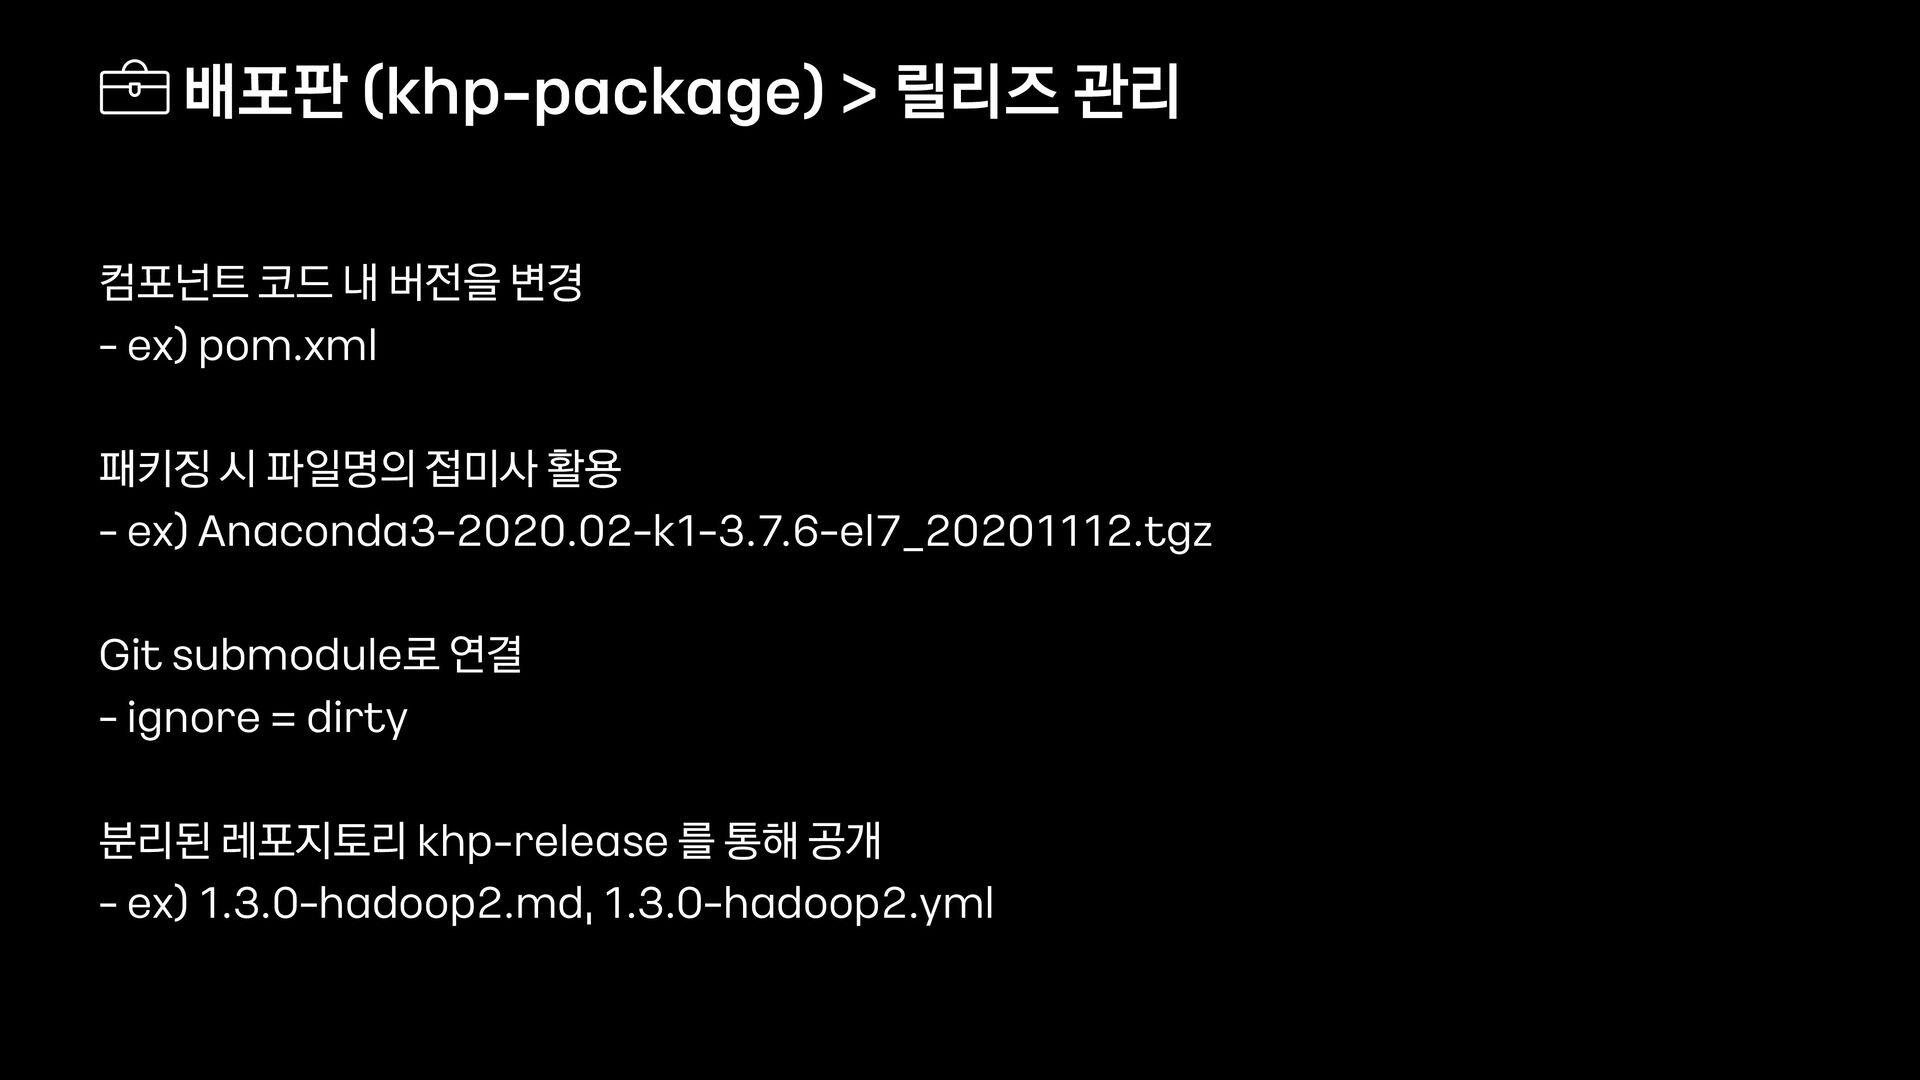
컴포넌트 코드 내 버전을 변경 - ex) pom.xml 패키징 시
파일명의 접미사 활용 - ex) Anaconda3-2020.02-k1-3.7.6-el7_20201112.tgz Git submodule로 연결 - ignore = dirty 분리된 레포지토리 khp - release 를 통해 공개 - ex) 1.3.0-hadoop2.md, 1.3.0-hadoop2.yml 배포판 (khp - package) > 릴리즈 관리 -
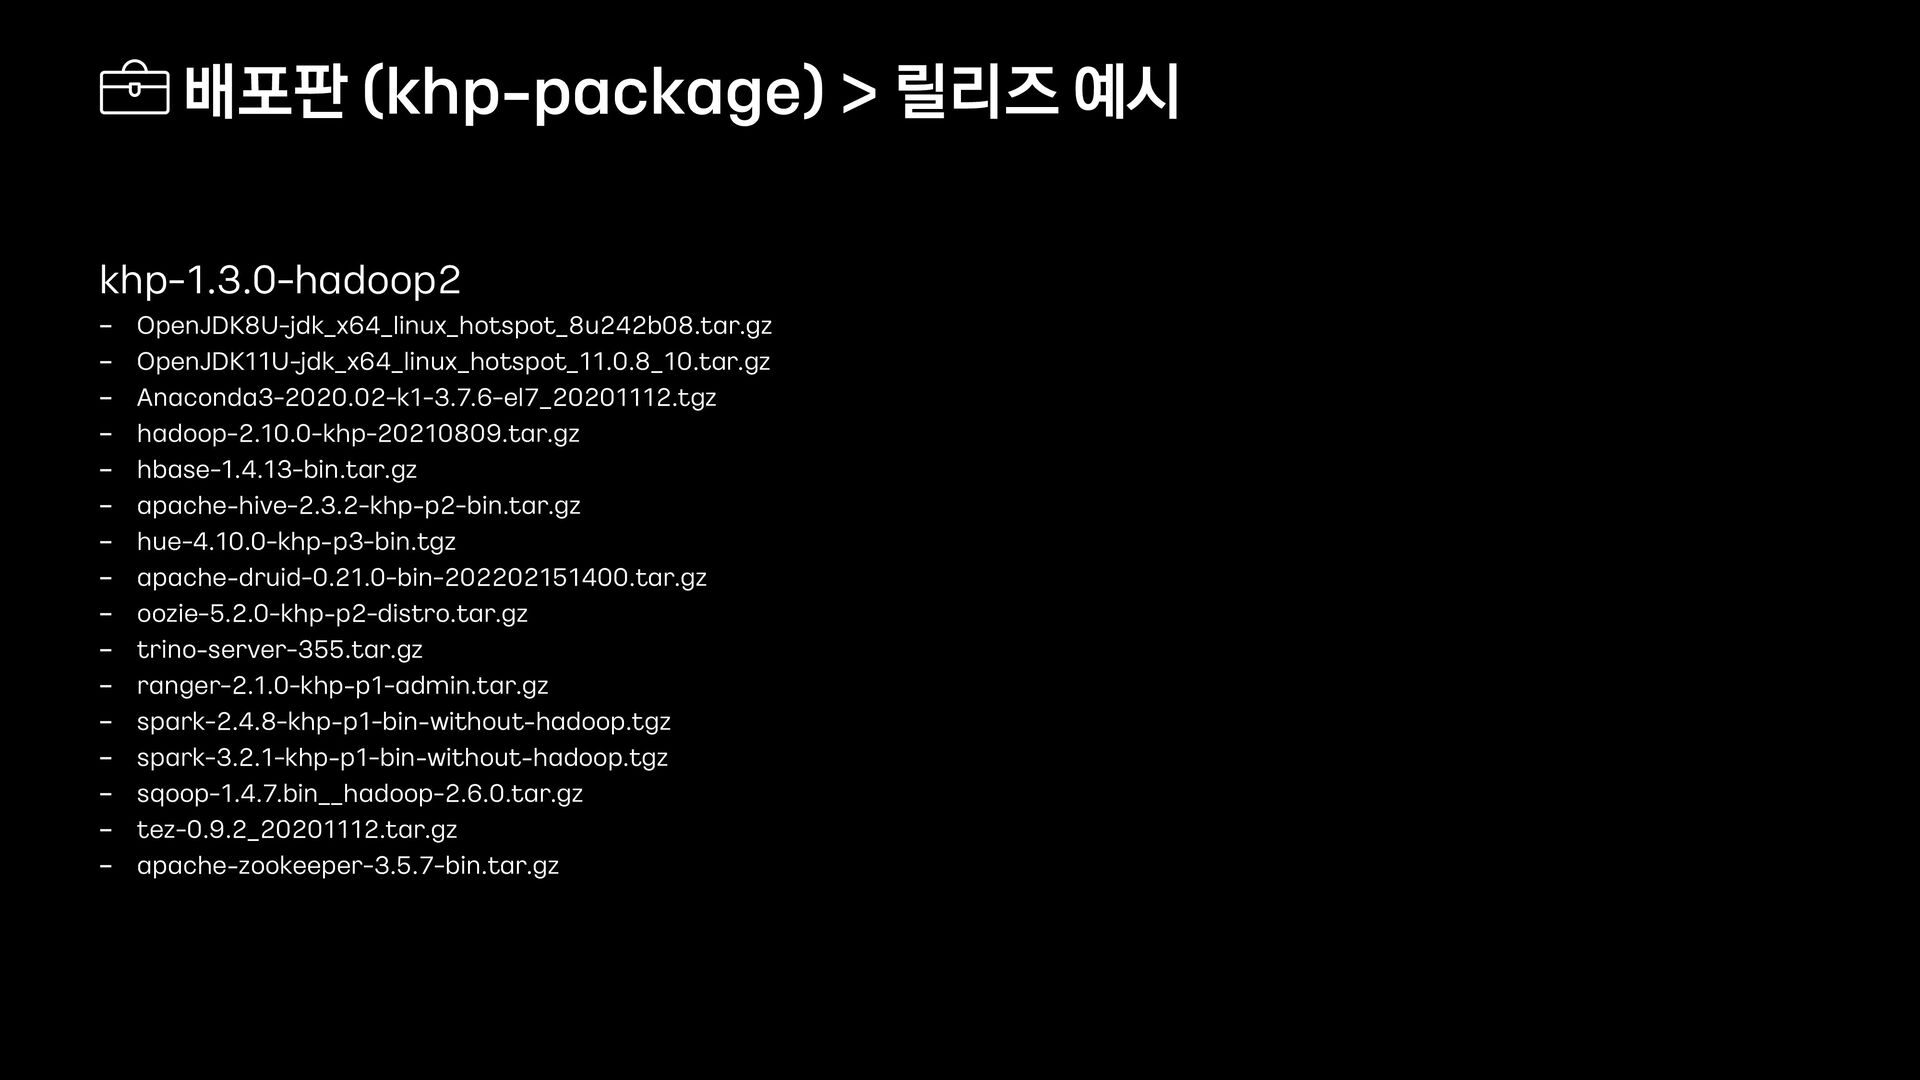
khp-1.3.0-hadoop2 - OpenJDK8U-jdk_x64_linux_hotspot_8u242b08.tar.gz - OpenJDK11U-jdk_x64_linux_hotspot_11.0.8_10.tar.gz - Anaconda3-2020.02-k1-3.7.6-el7_20201112.tgz - hadoop-2.10.0-khp-20210809.tar.gz -
hbase-1.4.13-bin.tar.gz - apache - hive-2.3.2-khp - p2-bin.tar.gz - hue-4.10.0-khp - p3-bin.tgz - apache - druid-0.21.0-bin-202202151400.tar.gz - oozie-5.2.0-khp - p2-distro.tar.gz - trino - server-355.tar.gz - ranger-2.1.0-khp - p1-admin.tar.gz - spark-2.4.8-khp - p1-bin - without - hadoop.tgz - spark-3.2.1-khp - p1-bin - without - hadoop.tgz - sqoop-1.4.7.bin__hadoop-2.6.0.tar.gz - tez-0.9.2_20201112.tar.gz - apache - zookeeper-3.5.7-bin.tar.gz 배포판 (khp - package) > 릴리즈 예시 -
Ansible을 사용하여 클러스터 전반의 제어를 담당 Ansible®은 오픈소스 IT 자동화
툴로서, 프로비저닝, 구성 관리, 애플리케이션 배포, 오케스트레이션, 기타 여러 가지 수동 IT 프로세스를 자동화합니다. - IaC (Infrastructure as Code) - Playbook (.yaml) - Inventory (.ini) 배포툴 (khp - ansible) -
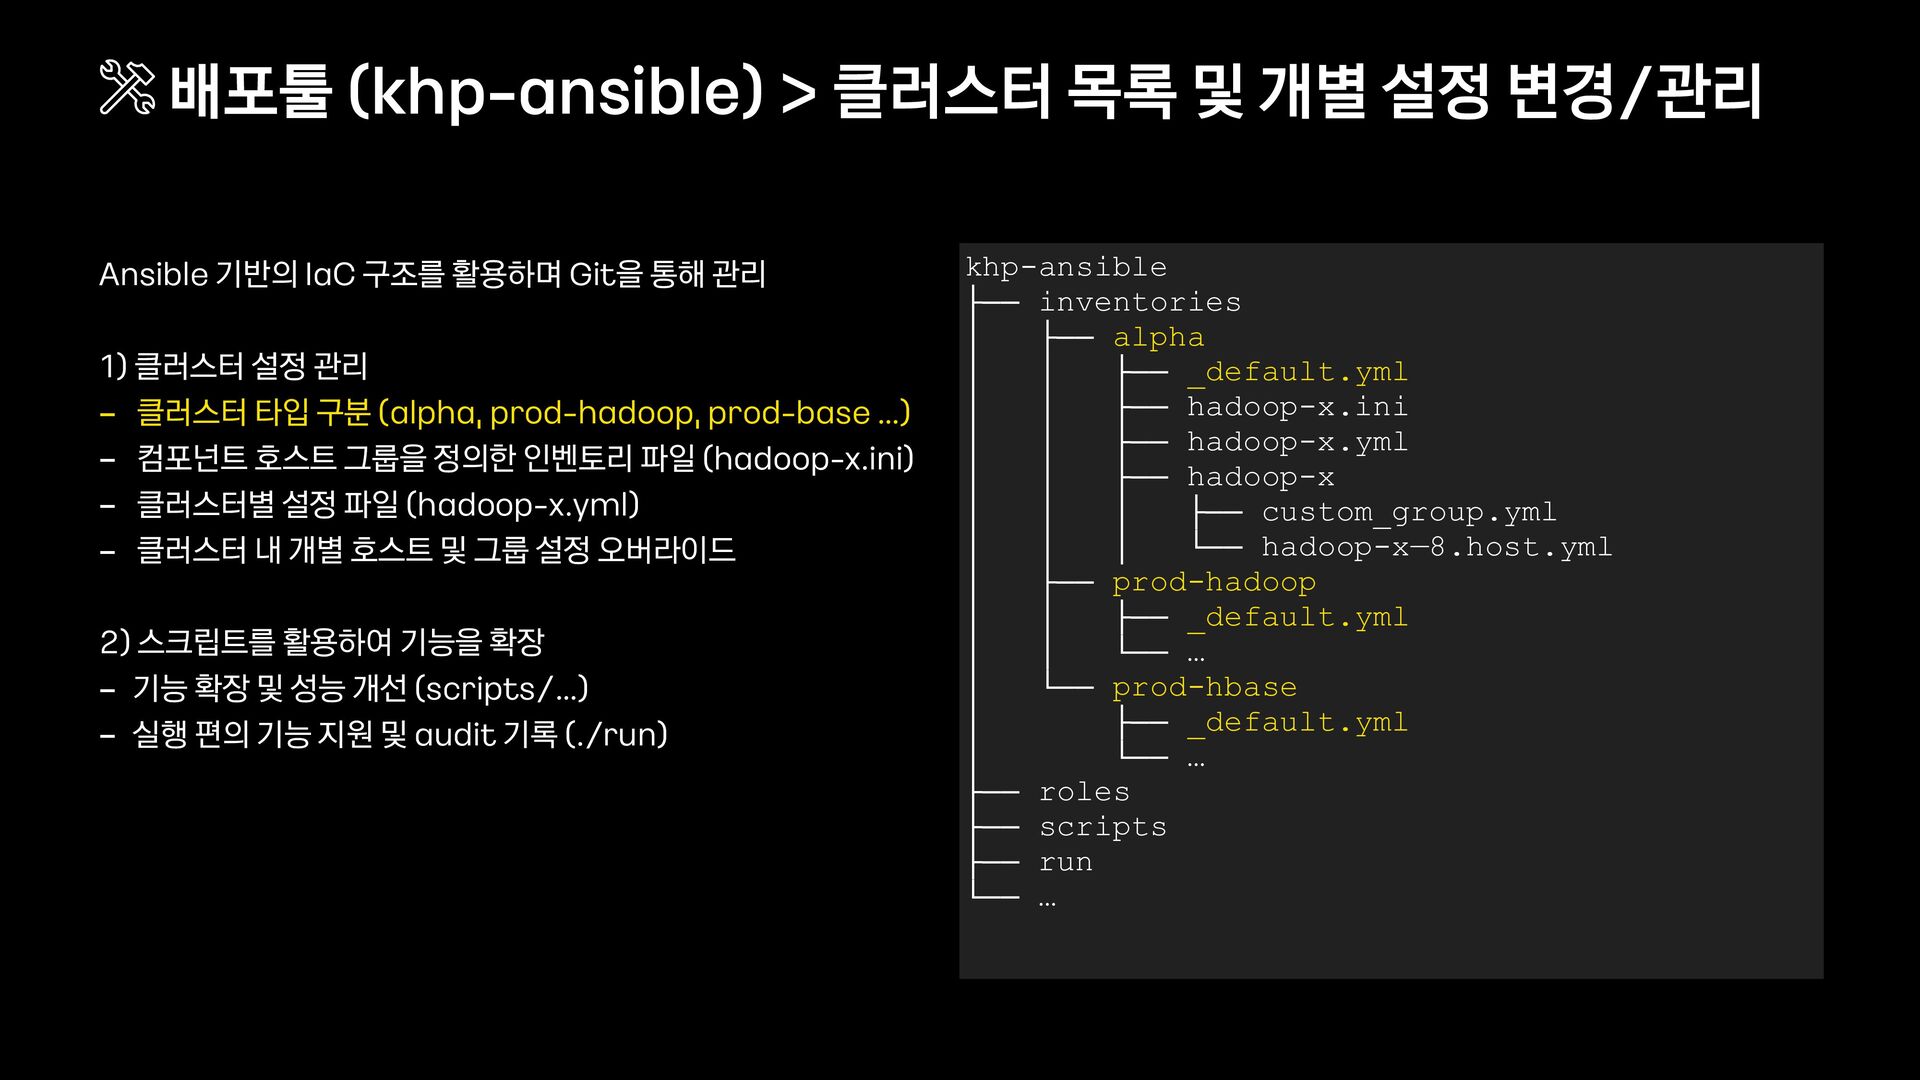
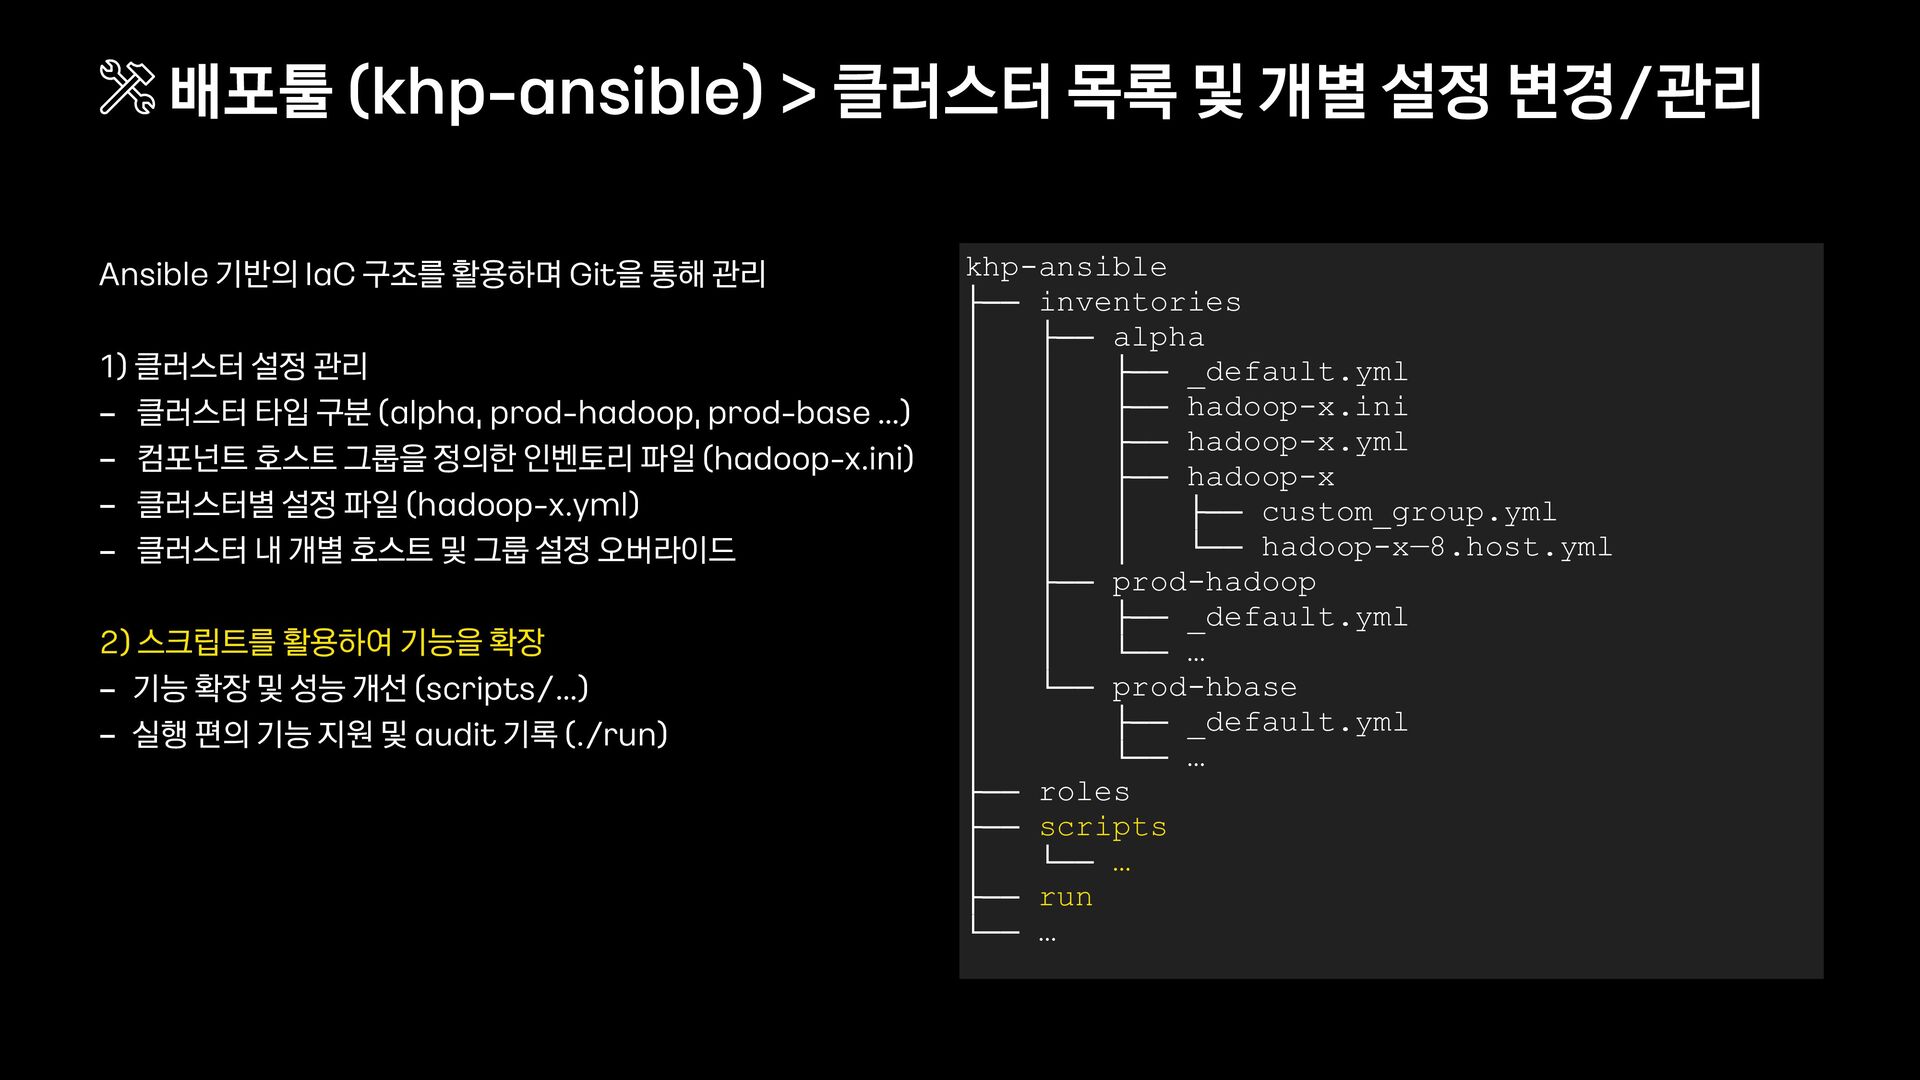
Ansible 기반의 IaC 구조를 활용하며 Git을 통해 관리 1) 클러스터
설정 관리 - 클러스터 타입 구분 (alpha, prod - hadoop, prod - base …) - 컴포넌트 호스트 그룹을 정의한 인벤토리 파일 (hadoop - x.ini) - 클러스터별 설정 파일 (hadoop - x.yml) - 클러스터 내 개별 호스트 및 그룹 설정 오버라이드 2) 스크립트를 활용하여 기능을 확장 - 기능 확장 및 성능 개선 (scripts/…) - 실행 편의 기능 지원 및 audit 기록 (./run) 배포툴 (khp - ansible) > 클러스터 목록 및 개별 설정 변경/관리 khp-ansible ├── inventories │ ├── alpha │ │ ├── _default.yml │ │ ├── hadoop-x.ini │ │ ├── hadoop-x.yml │ │ ├── hadoop-x │ │ │ ├── custom_group.yml │ │ │ └── hadoop-x—8.host.yml │ ├── prod-hadoop │ │ ├── _default.yml │ │ └── … │ └── prod-hbase │ ├── _default.yml │ └── … ├── roles ├── scripts ├── run └── … -
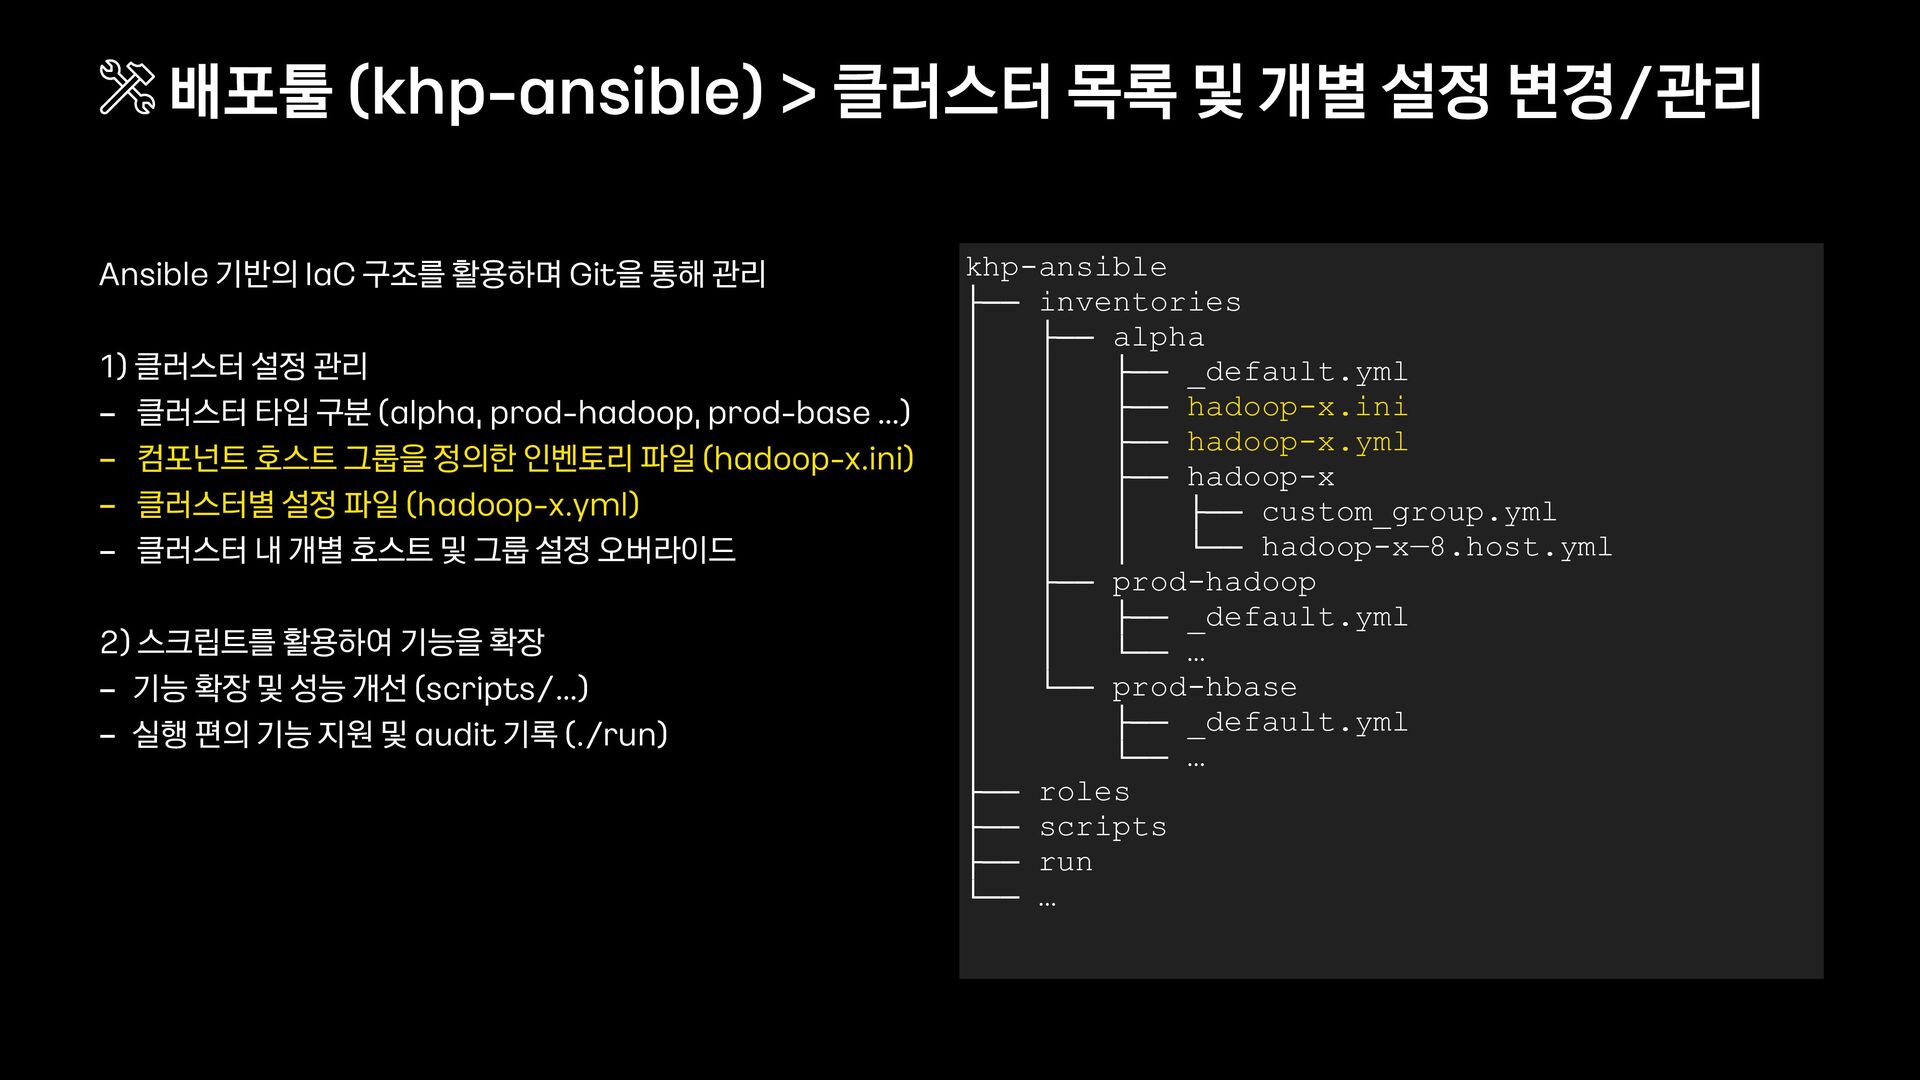
Ansible 기반의 IaC 구조를 활용하며 Git을 통해 관리 1) 클러스터
설정 관리 - 클러스터 타입 구분 (alpha, prod - hadoop, prod - base …) - 컴포넌트 호스트 그룹을 정의한 인벤토리 파일 (hadoop - x.ini) - 클러스터별 설정 파일 (hadoop - x.yml) - 클러스터 내 개별 호스트 및 그룹 설정 오버라이드 2) 스크립트를 활용하여 기능을 확장 - 기능 확장 및 성능 개선 (scripts/…) - 실행 편의 기능 지원 및 audit 기록 (./run) 배포툴 (khp - ansible) > 클러스터 목록 및 개별 설정 변경/관리 khp-ansible ├── inventories │ ├── alpha │ │ ├── _default.yml │ │ ├── hadoop-x.ini │ │ ├── hadoop-x.yml │ │ ├── hadoop-x │ │ │ ├── custom_group.yml │ │ │ └── hadoop-x—8.host.yml │ ├── prod-hadoop │ │ ├── _default.yml │ │ └── … │ └── prod-hbase │ ├── _default.yml │ └── … ├── roles ├── scripts ├── run └── … -
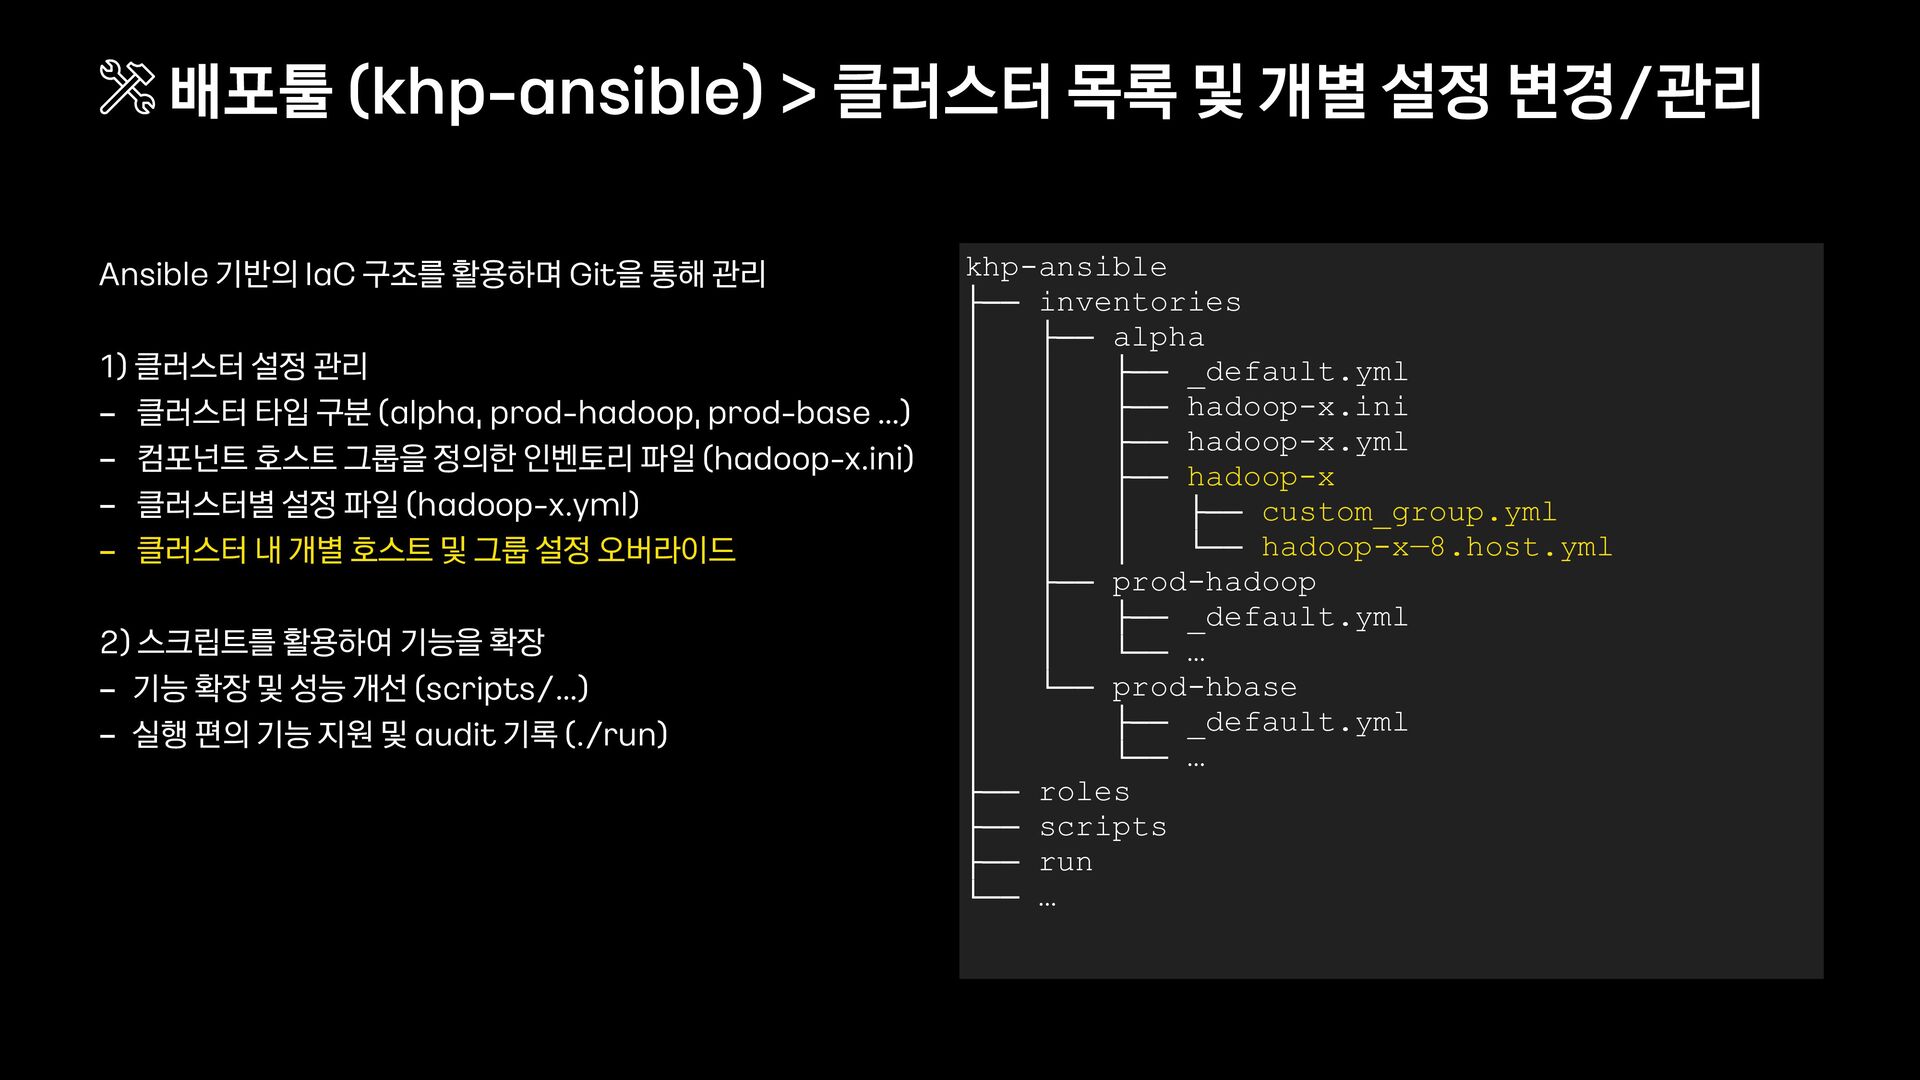
Ansible 기반의 IaC 구조를 활용하며 Git을 통해 관리 1) 클러스터
설정 관리 - 클러스터 타입 구분 (alpha, prod - hadoop, prod - base …) - 컴포넌트 호스트 그룹을 정의한 인벤토리 파일 (hadoop - x.ini) - 클러스터별 설정 파일 (hadoop - x.yml) - 클러스터 내 개별 호스트 및 그룹 설정 오버라이드 2) 스크립트를 활용하여 기능을 확장 - 기능 확장 및 성능 개선 (scripts/…) - 실행 편의 기능 지원 및 audit 기록 (./run) 배포툴 (khp - ansible) > 클러스터 목록 및 개별 설정 변경/관리 khp-ansible ├── inventories │ ├── alpha │ │ ├── _default.yml │ │ ├── hadoop-x.ini │ │ ├── hadoop-x.yml │ │ ├── hadoop-x │ │ │ ├── custom_group.yml │ │ │ └── hadoop-x—8.host.yml │ ├── prod-hadoop │ │ ├── _default.yml │ │ └── … │ └── prod-hbase │ ├── _default.yml │ └── … ├── roles ├── scripts ├── run └── … -
Ansible 기반의 IaC 구조를 활용하며 Git을 통해 관리 1) 클러스터
설정 관리 - 클러스터 타입 구분 (alpha, prod - hadoop, prod - base …) - 컴포넌트 호스트 그룹을 정의한 인벤토리 파일 (hadoop - x.ini) - 클러스터별 설정 파일 (hadoop - x.yml) - 클러스터 내 개별 호스트 및 그룹 설정 오버라이드 2) 스크립트를 활용하여 기능을 확장 - 기능 확장 및 성능 개선 (scripts/…) - 실행 편의 기능 지원 및 audit 기록 (./run) 배포툴 (khp - ansible) > 클러스터 목록 및 개별 설정 변경/관리 khp-ansible ├── inventories │ ├── alpha │ │ ├── _default.yml │ │ ├── hadoop-x.ini │ │ ├── hadoop-x.yml │ │ ├── hadoop-x │ │ │ ├── custom_group.yml │ │ │ └── hadoop-x—8.host.yml │ ├── prod-hadoop │ │ ├── _default.yml │ │ └── … │ └── prod-hbase │ ├── _default.yml │ └── … ├── roles ├── scripts │ └── … ├── run └── … -
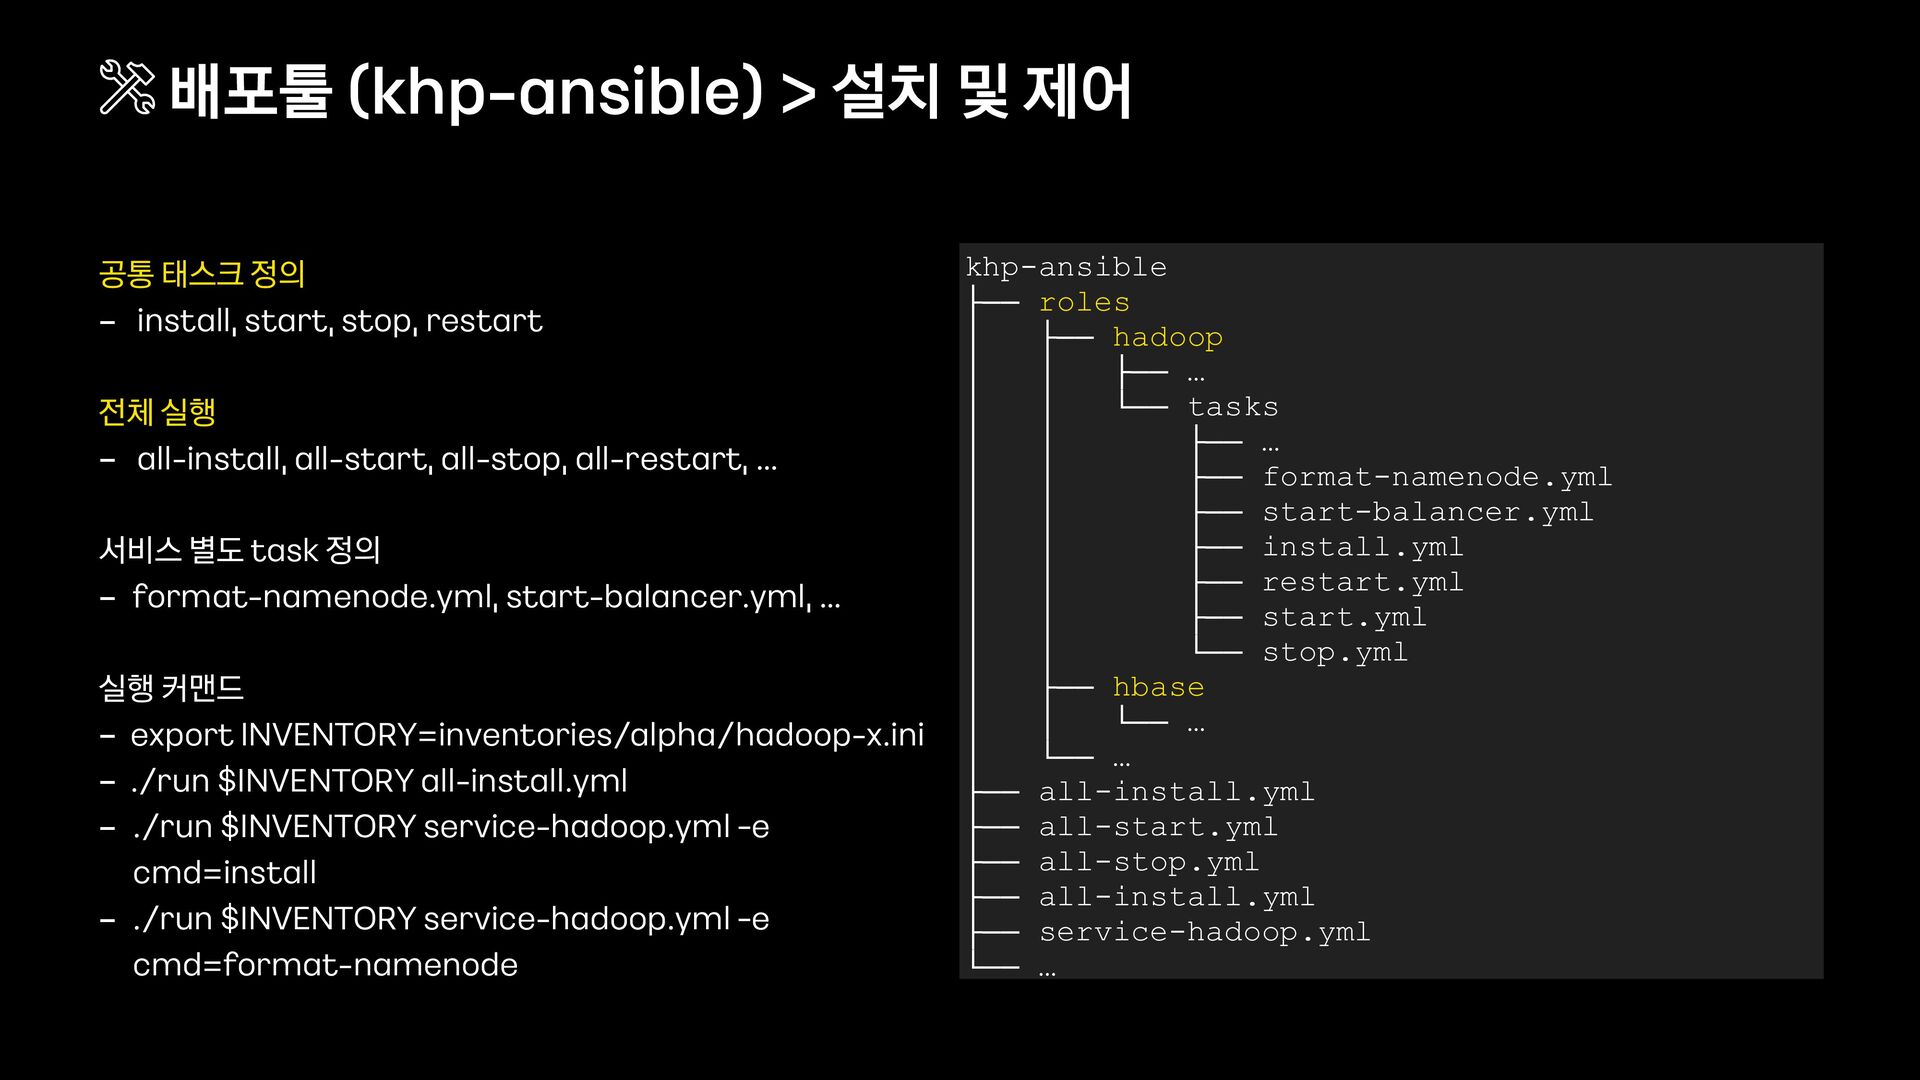
공통 태스크 정의 - install, start, stop, restart 전체 실행
- all - install, all - start, all - stop, all - restart, … 서비스 별도 task 정의 - format - namenode.yml, start - balancer.yml, … 실행 커맨드 - export INVENTORY=inventories/alpha/hadoop - x.ini - ./run $INVENTORY all - install.yml - ./run $INVENTORY service - hadoop.yml -e cmd=install - ./run $INVENTORY service - hadoop.yml -e cmd=format - namenode 배포툴 (khp - ansible) > 설치 및 제어 khp-ansible ├── roles │ ├── hadoop │ │ ├── … │ │ └── tasks │ │ ├── … │ │ ├── format-namenode.yml │ │ ├── start-balancer.yml │ │ ├── install.yml │ │ ├── restart.yml │ │ ├── start.yml │ │ └── stop.yml │ ├── hbase │ │ └── … │ └── … ├── all-install.yml ├── all-start.yml ├── all-stop.yml ├── all-install.yml ├── service-hadoop.yml └── … -
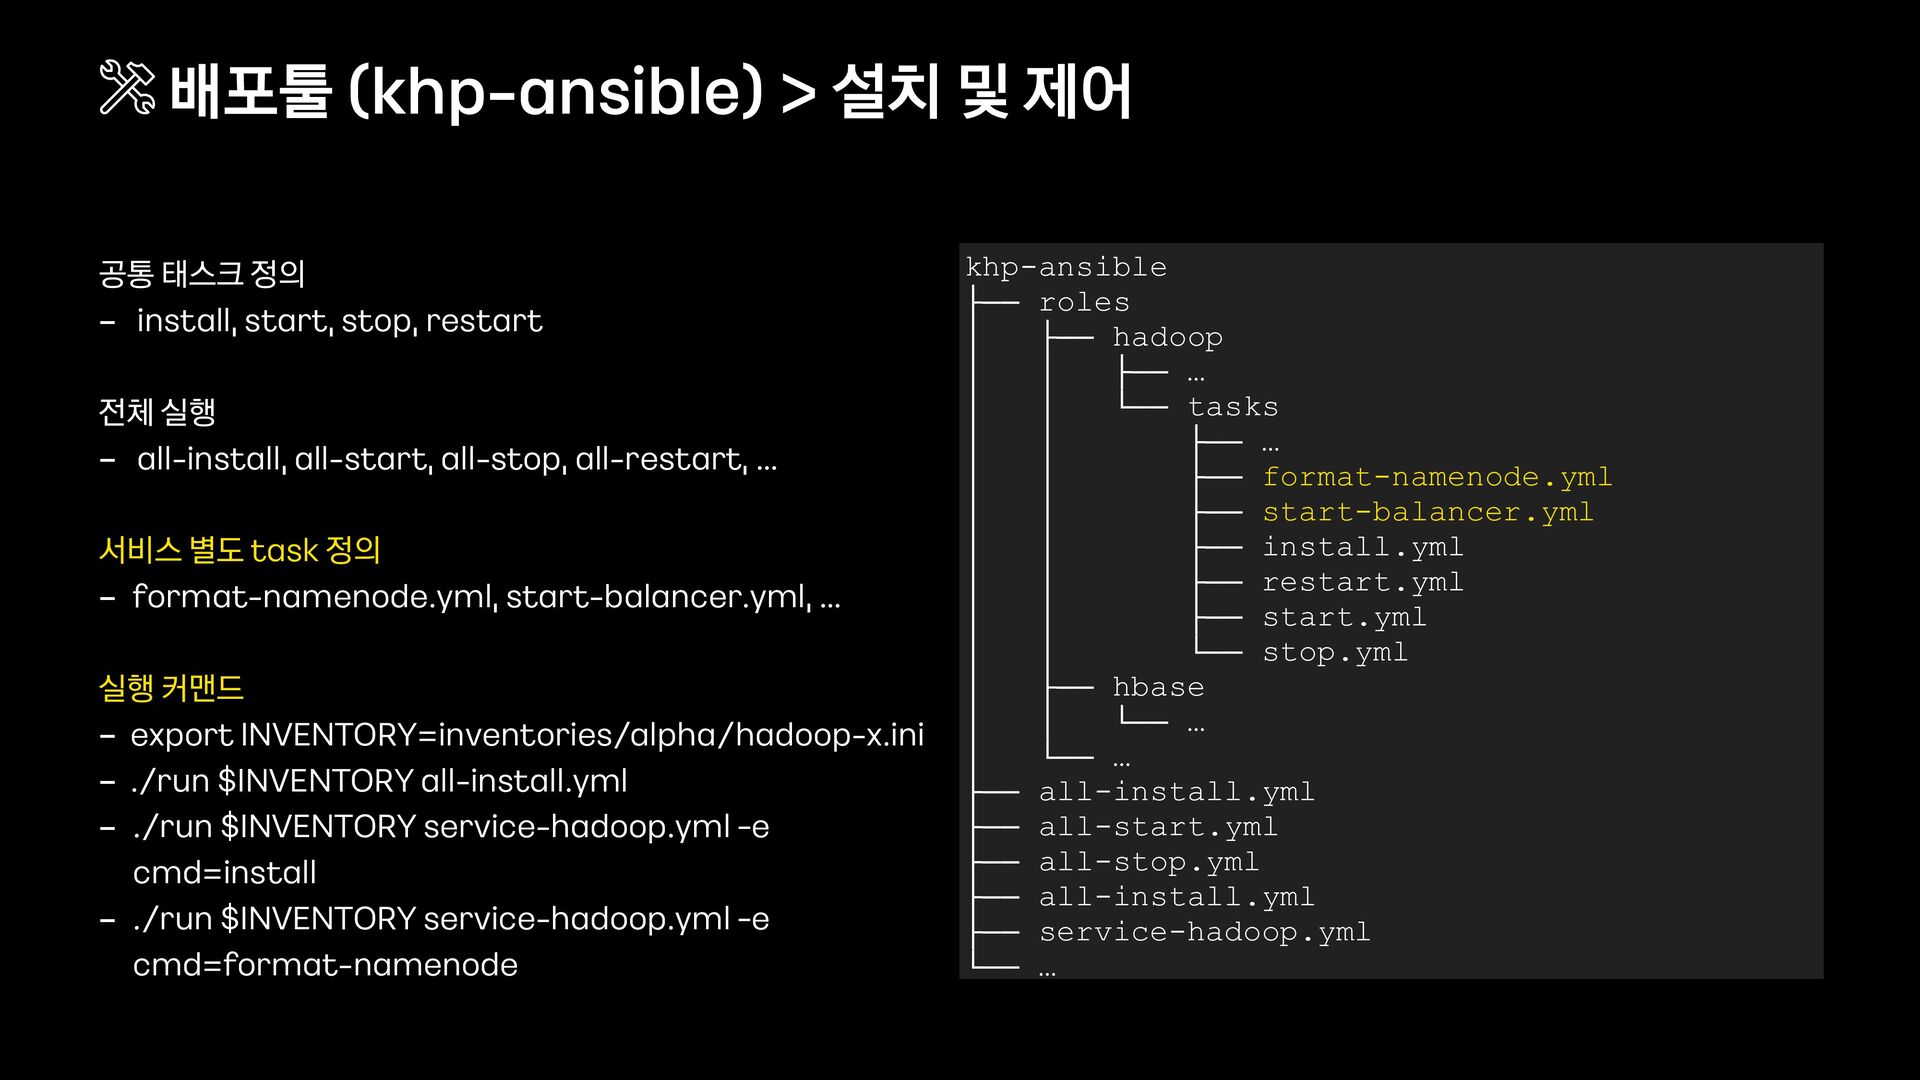
공통 태스크 정의 - install, start, stop, restart 전체 실행
- all - install, all - start, all - stop, all - restart, … 서비스 별도 task 정의 - format - namenode.yml, start - balancer.yml, … 실행 커맨드 - export INVENTORY=inventories/alpha/hadoop - x.ini - ./run $INVENTORY all - install.yml - ./run $INVENTORY service - hadoop.yml -e cmd=install - ./run $INVENTORY service - hadoop.yml -e cmd=format - namenode 배포툴 (khp - ansible) > 설치 및 제어 khp-ansible ├── roles │ ├── hadoop │ │ ├── … │ │ └── tasks │ │ ├── … │ │ ├── format-namenode.yml │ │ ├── start-balancer.yml │ │ ├── install.yml │ │ ├── restart.yml │ │ ├── start.yml │ │ └── stop.yml │ ├── hbase │ │ └── … │ └── … ├── all-install.yml ├── all-start.yml ├── all-stop.yml ├── all-install.yml ├── service-hadoop.yml └── … -
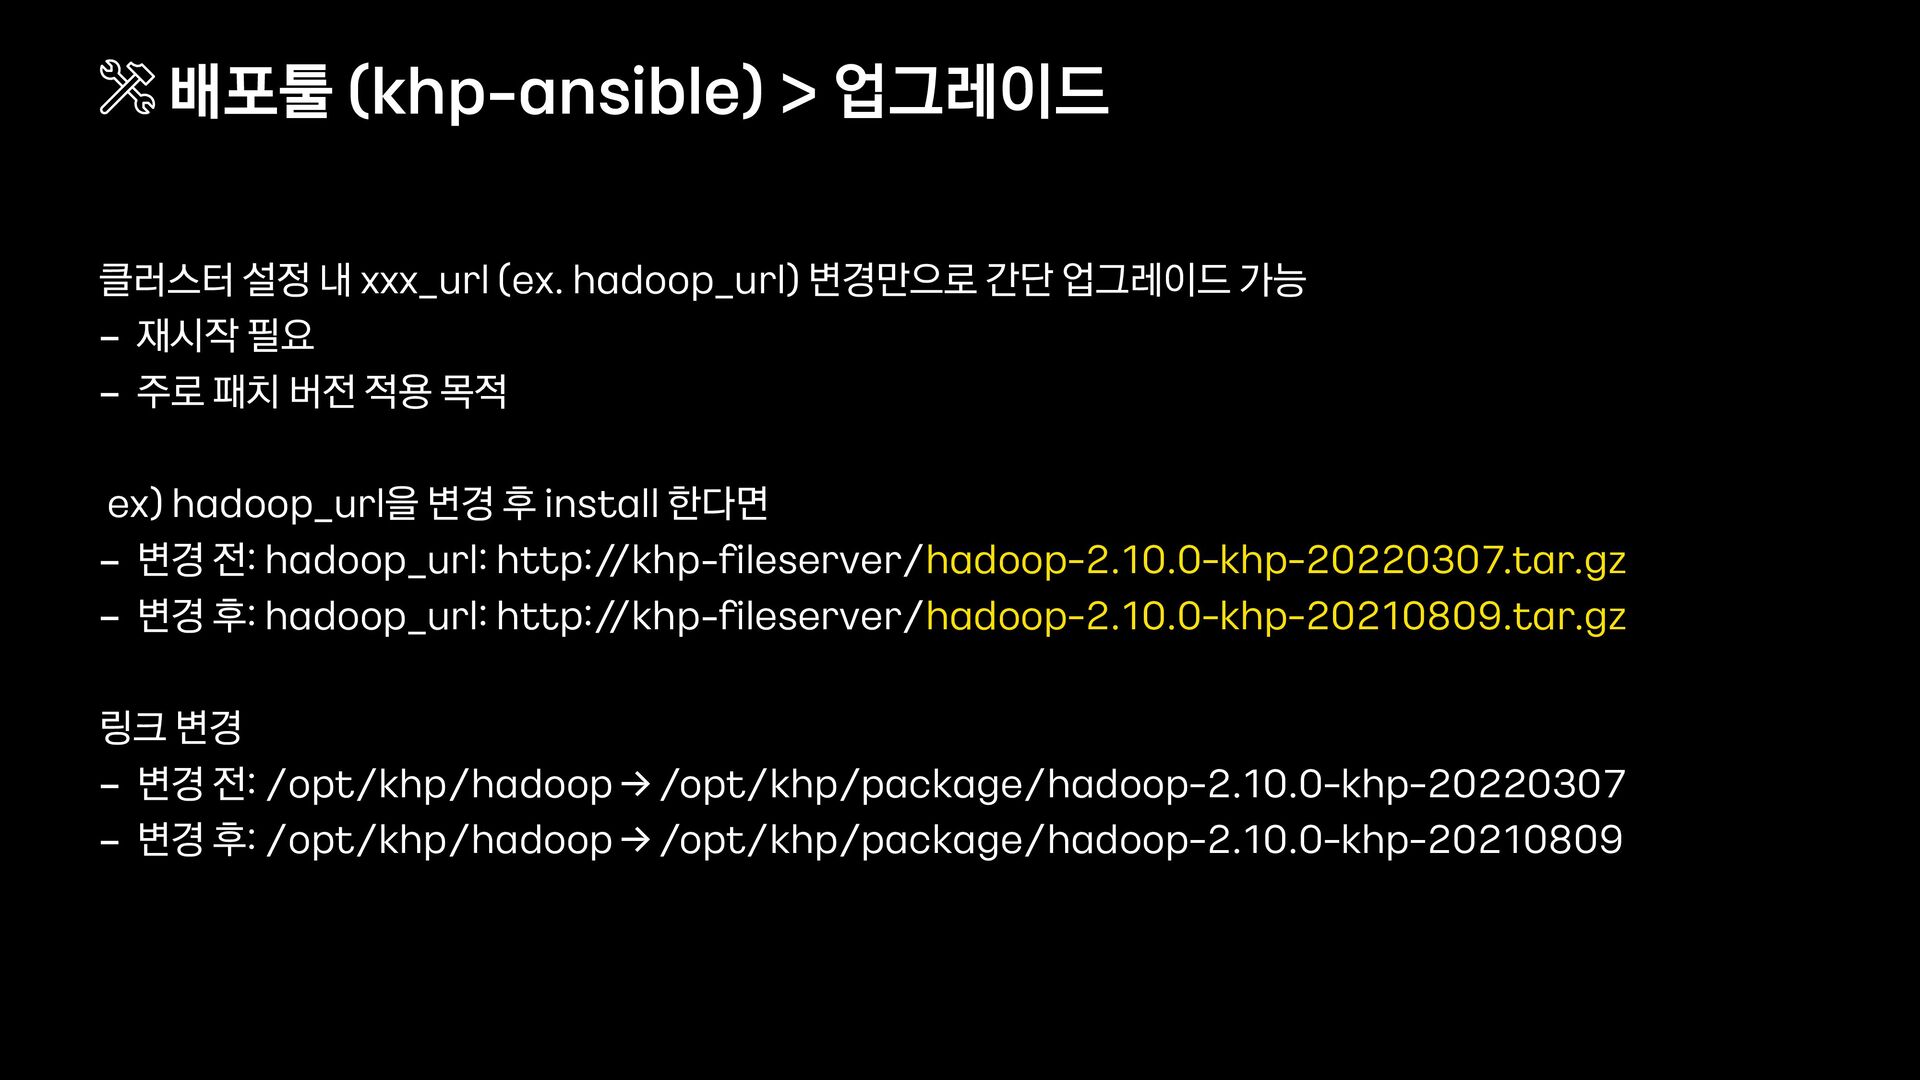
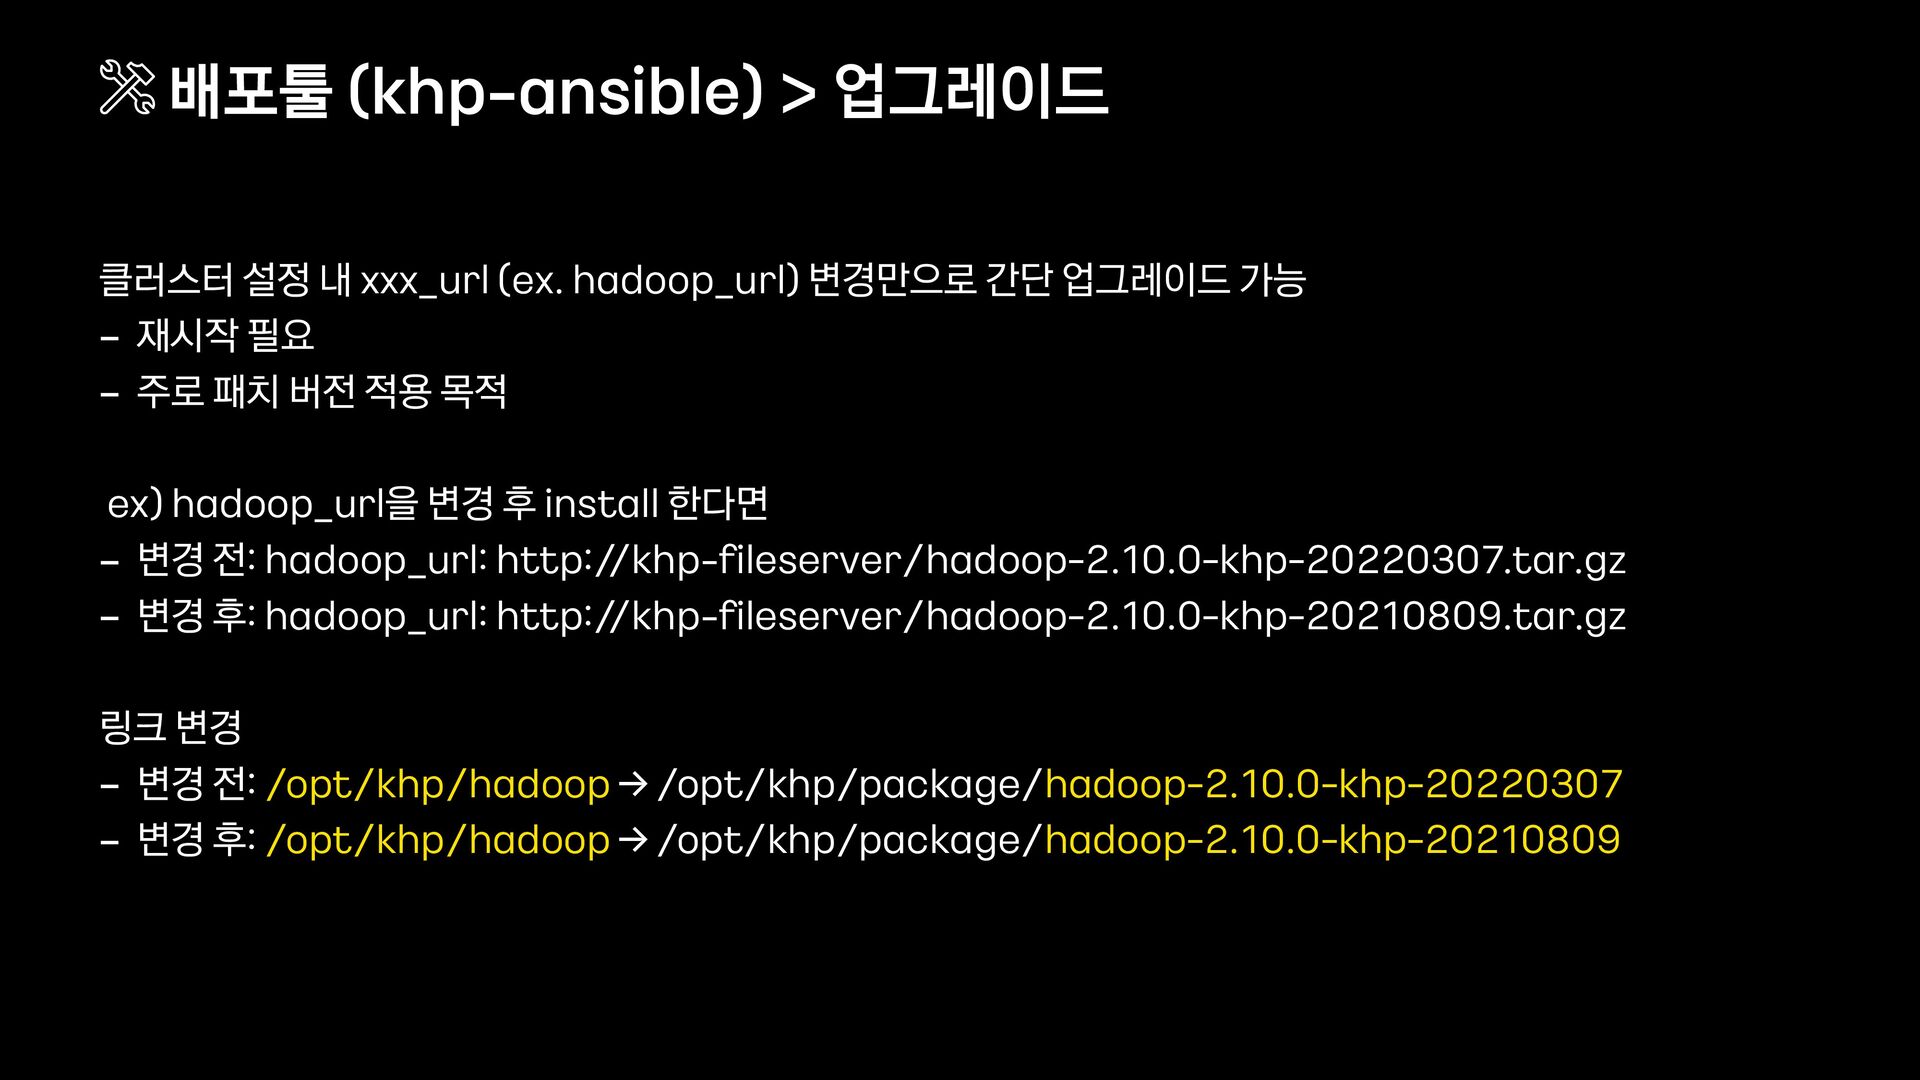
클러스터 설정 내 xxx_url (ex. hadoop_url) 변경만으로 간단 업그레이드 가능
- 재시작 필요 - 주로 패치 버전 적용 목적 ex) hadoop_url을 변경 후 install 한다면 - 변경 전: hadoop_url: http:/ /khp - fi leserver/hadoop-2.10.0-khp-20220307.tar.gz - 변경 후: hadoop_url: http:/ /khp - fi leserver/hadoop-2.10.0-khp-20210809.tar.gz 링크 변경 - 변경 전: /opt/khp/hadoop -> /opt/khp/package/hadoop-2.10.0-khp-20220307 - 변경 후: /opt/khp/hadoop -> /opt/khp/package/hadoop-2.10.0-khp-20210809 배포툴 (khp - ansible) > 업그레이드 -
클러스터 설정 내 xxx_url (ex. hadoop_url) 변경만으로 간단 업그레이드 가능
- 재시작 필요 - 주로 패치 버전 적용 목적 ex) hadoop_url을 변경 후 install 한다면 - 변경 전: hadoop_url: http:/ /khp - fi leserver/hadoop-2.10.0-khp-20220307.tar.gz - 변경 후: hadoop_url: http:/ /khp - fi leserver/hadoop-2.10.0-khp-20210809.tar.gz 링크 변경 - 변경 전: /opt/khp/hadoop -> /opt/khp/package/hadoop-2.10.0-khp-20220307 - 변경 후: /opt/khp/hadoop -> /opt/khp/package/hadoop-2.10.0-khp-20210809 배포툴 (khp - ansible) > 업그레이드 -
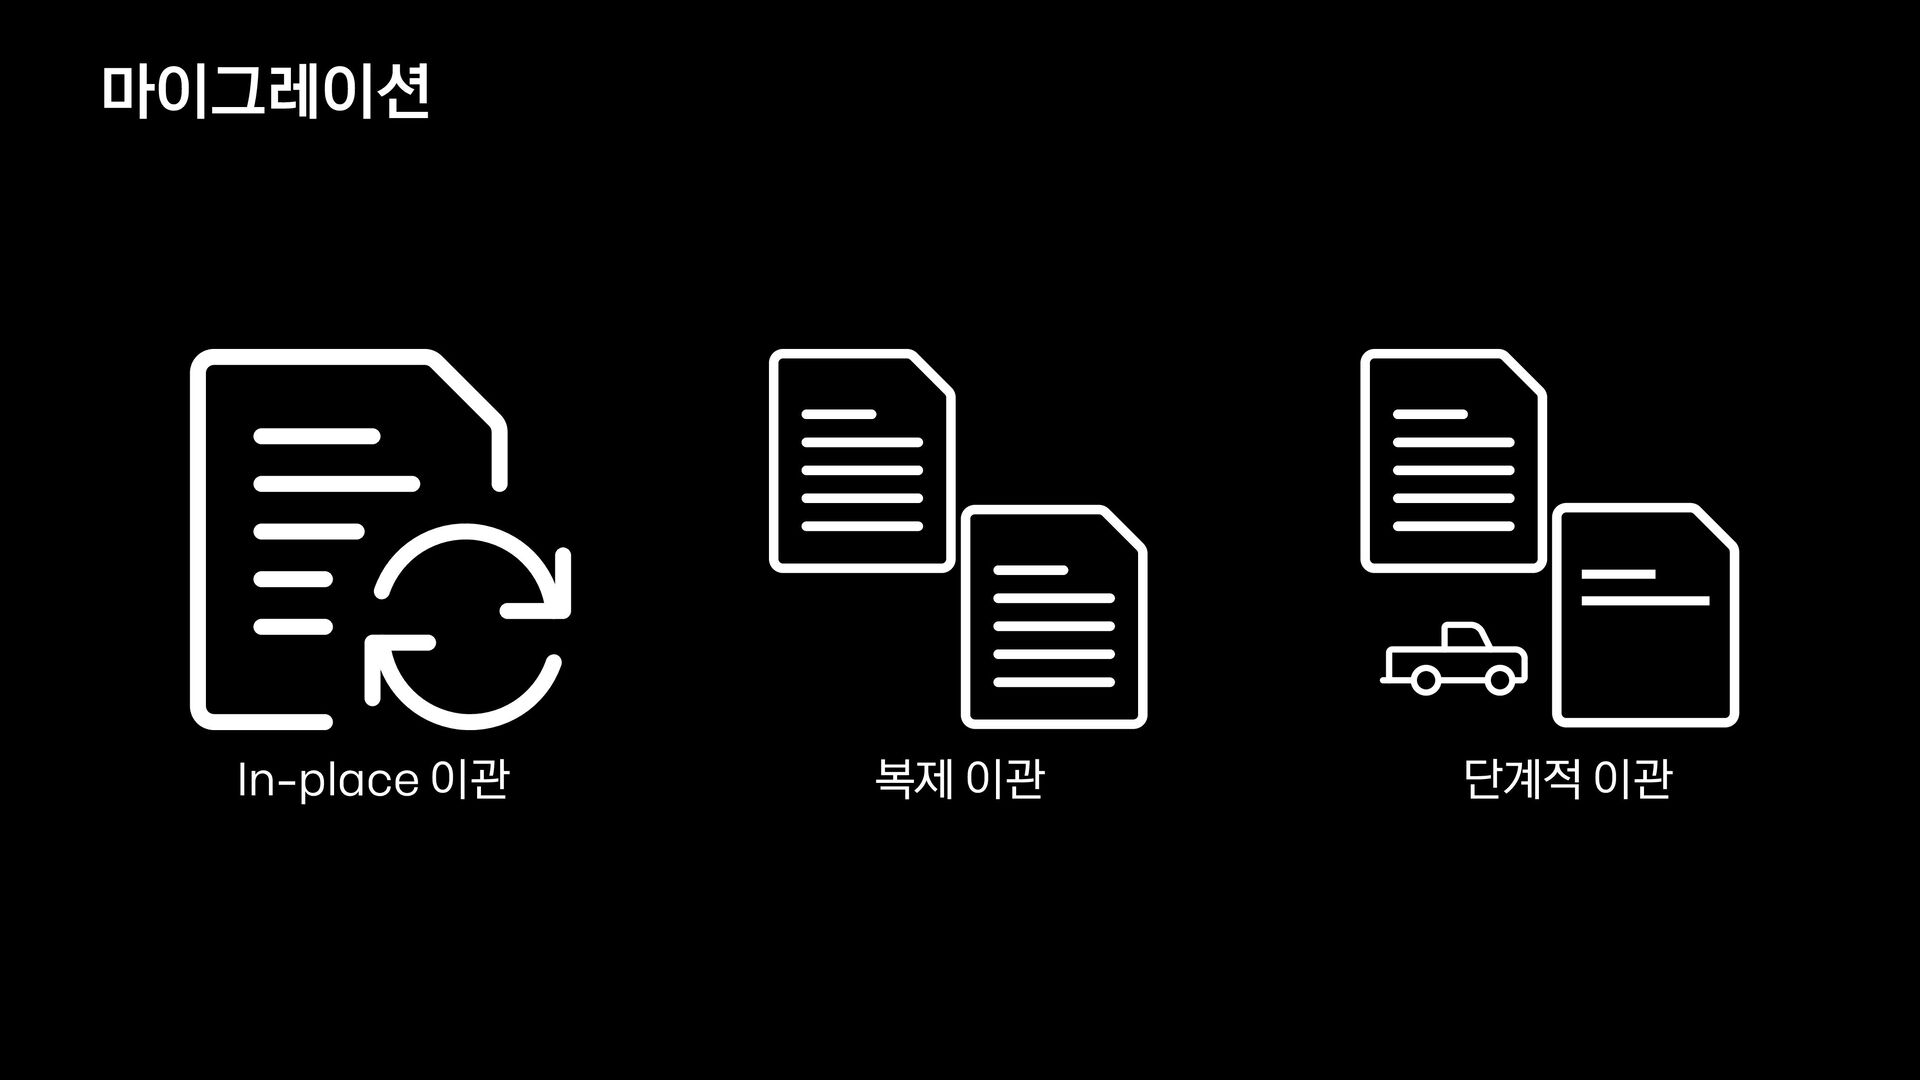
In - place Migration - 하둡 바이너리만 교체하여 마이그레이션 -
HDFS 롤링 업그레이드를 통한 마이그레이션 배포툴 (khp - ansible) > 마이그레이션 -
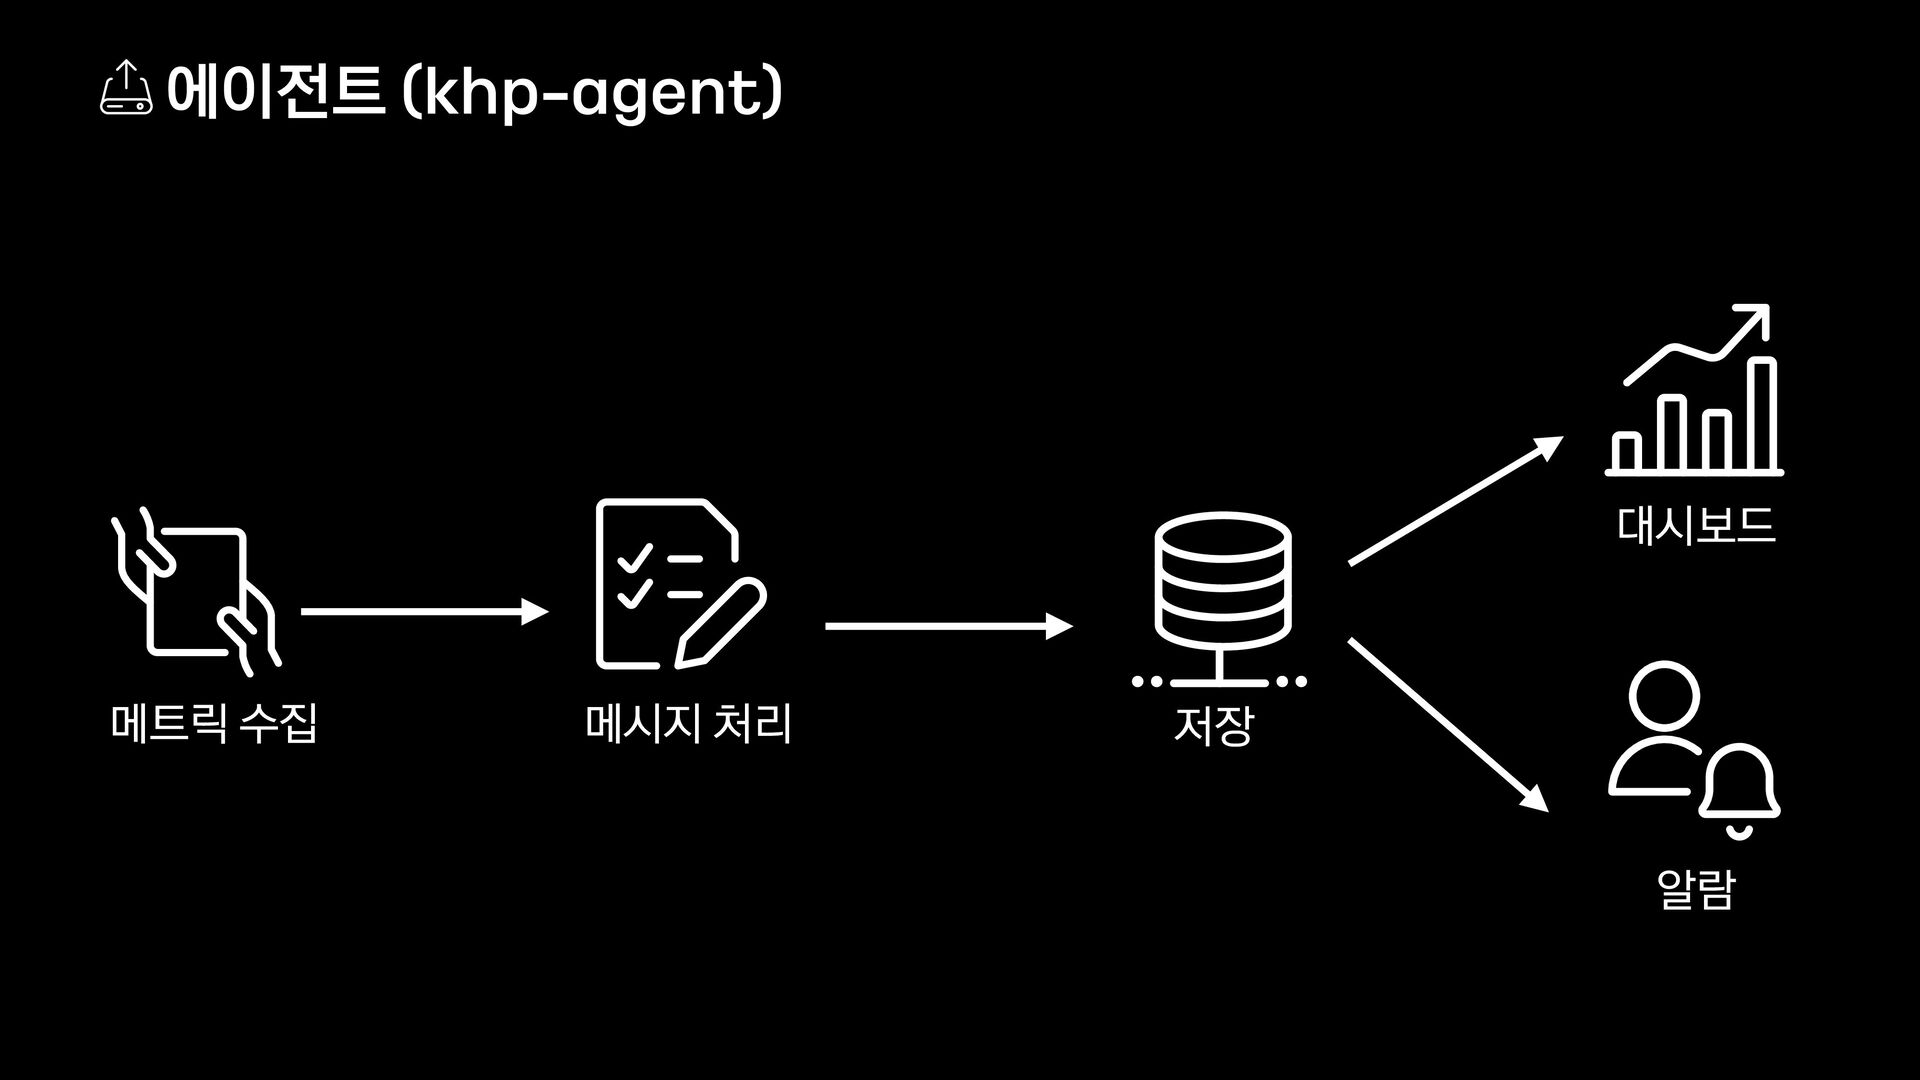
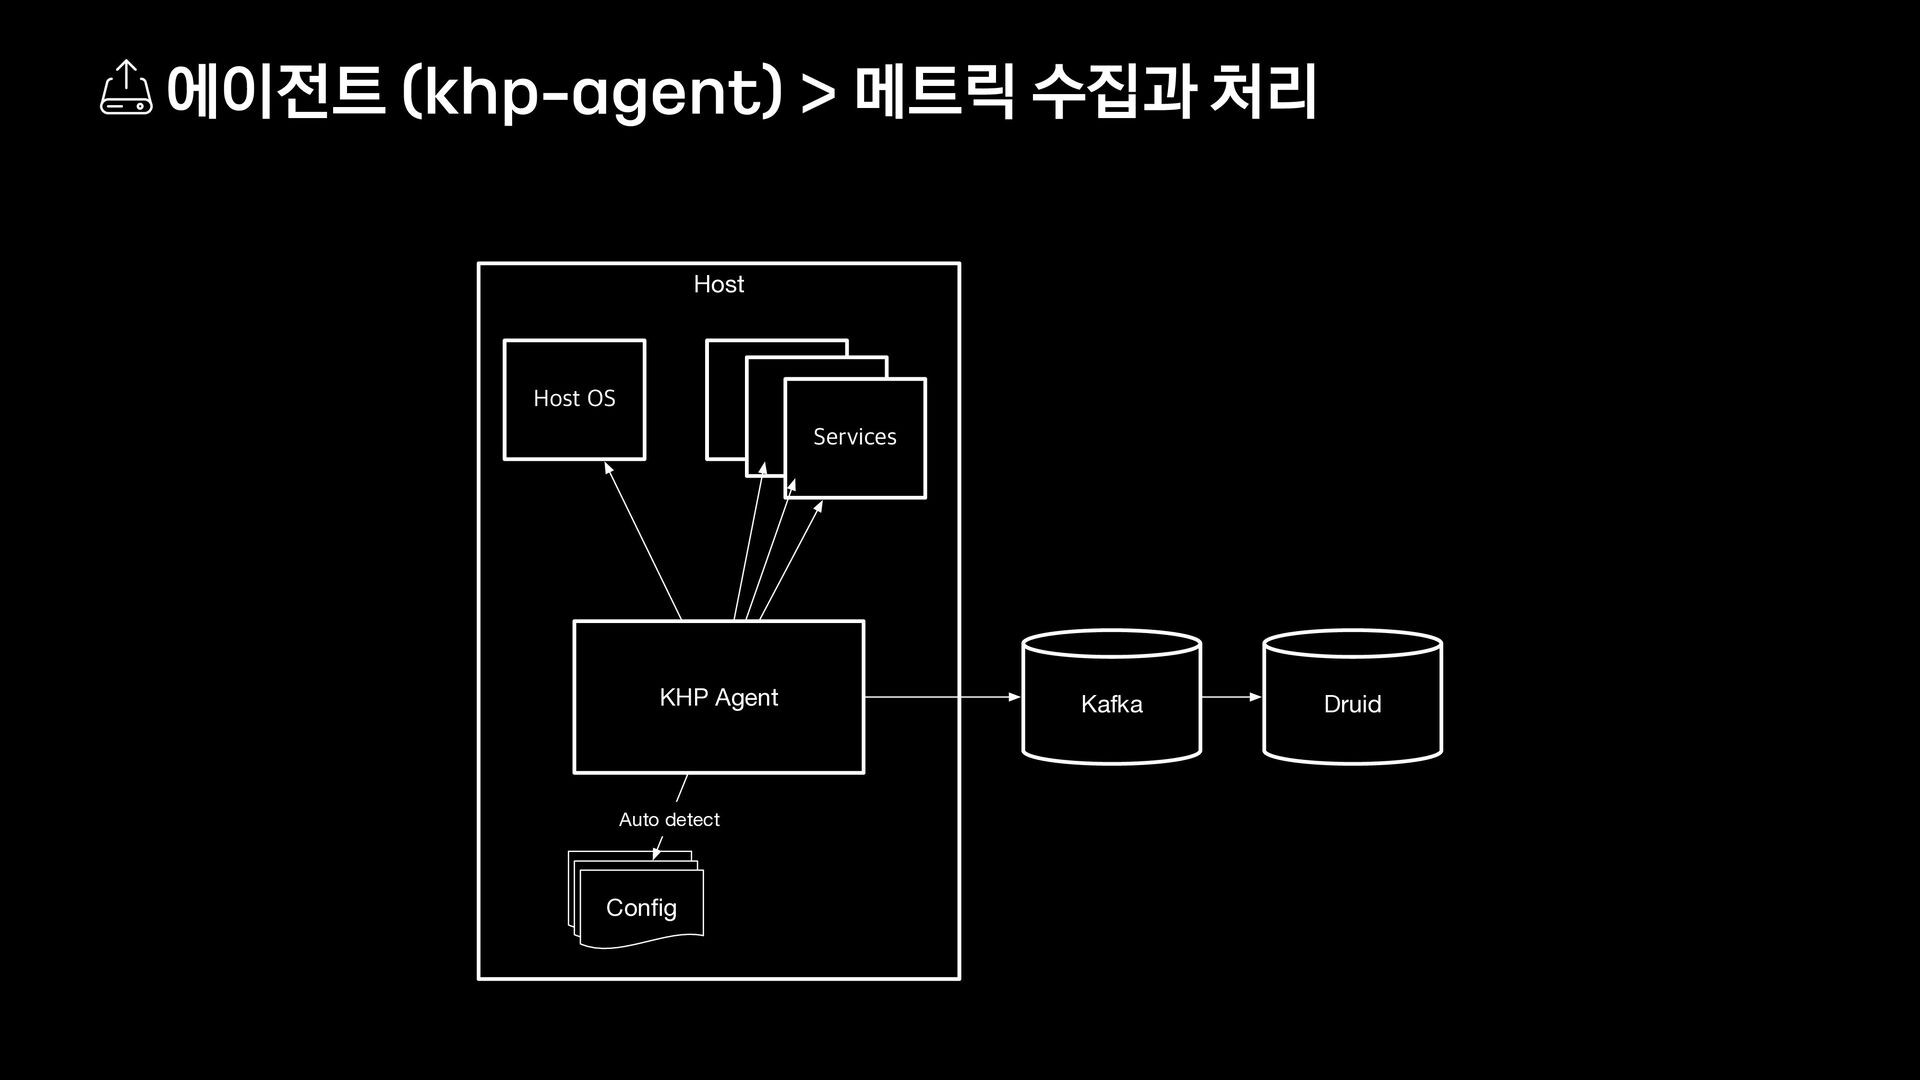
에이전트 (khp - agent) > 메트릭 수집과 처리 Host KHP
Agent Config Config Config Auto detect 4FSWJDFT )PTU04 Kafka Druid -
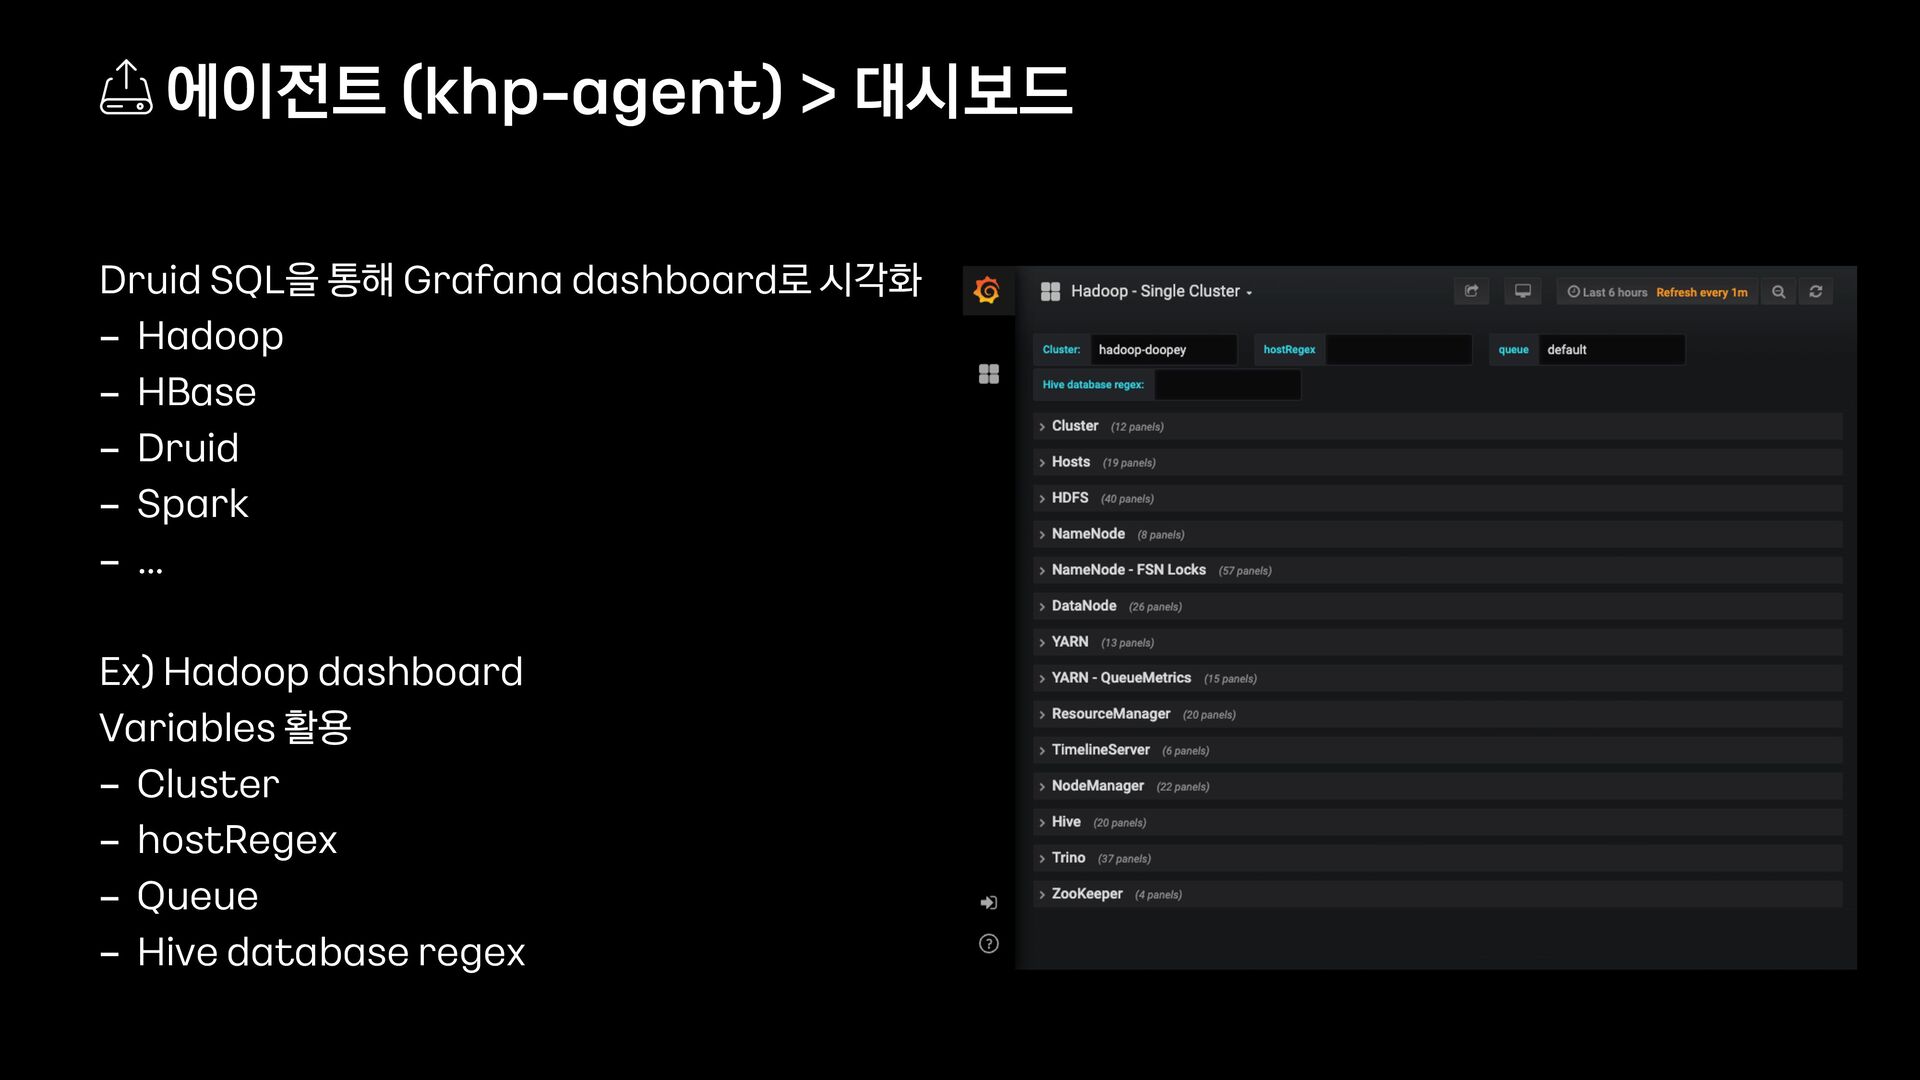
Druid SQL을 통해 Grafana dashboard로 시각화 - Hadoop - HBase
- Druid - Spark - … Ex) Hadoop dashboard Variables 활용 - Cluster - hostRegex - Queue - Hive database regex 에이전트 (khp - agent) > 대시보드 -
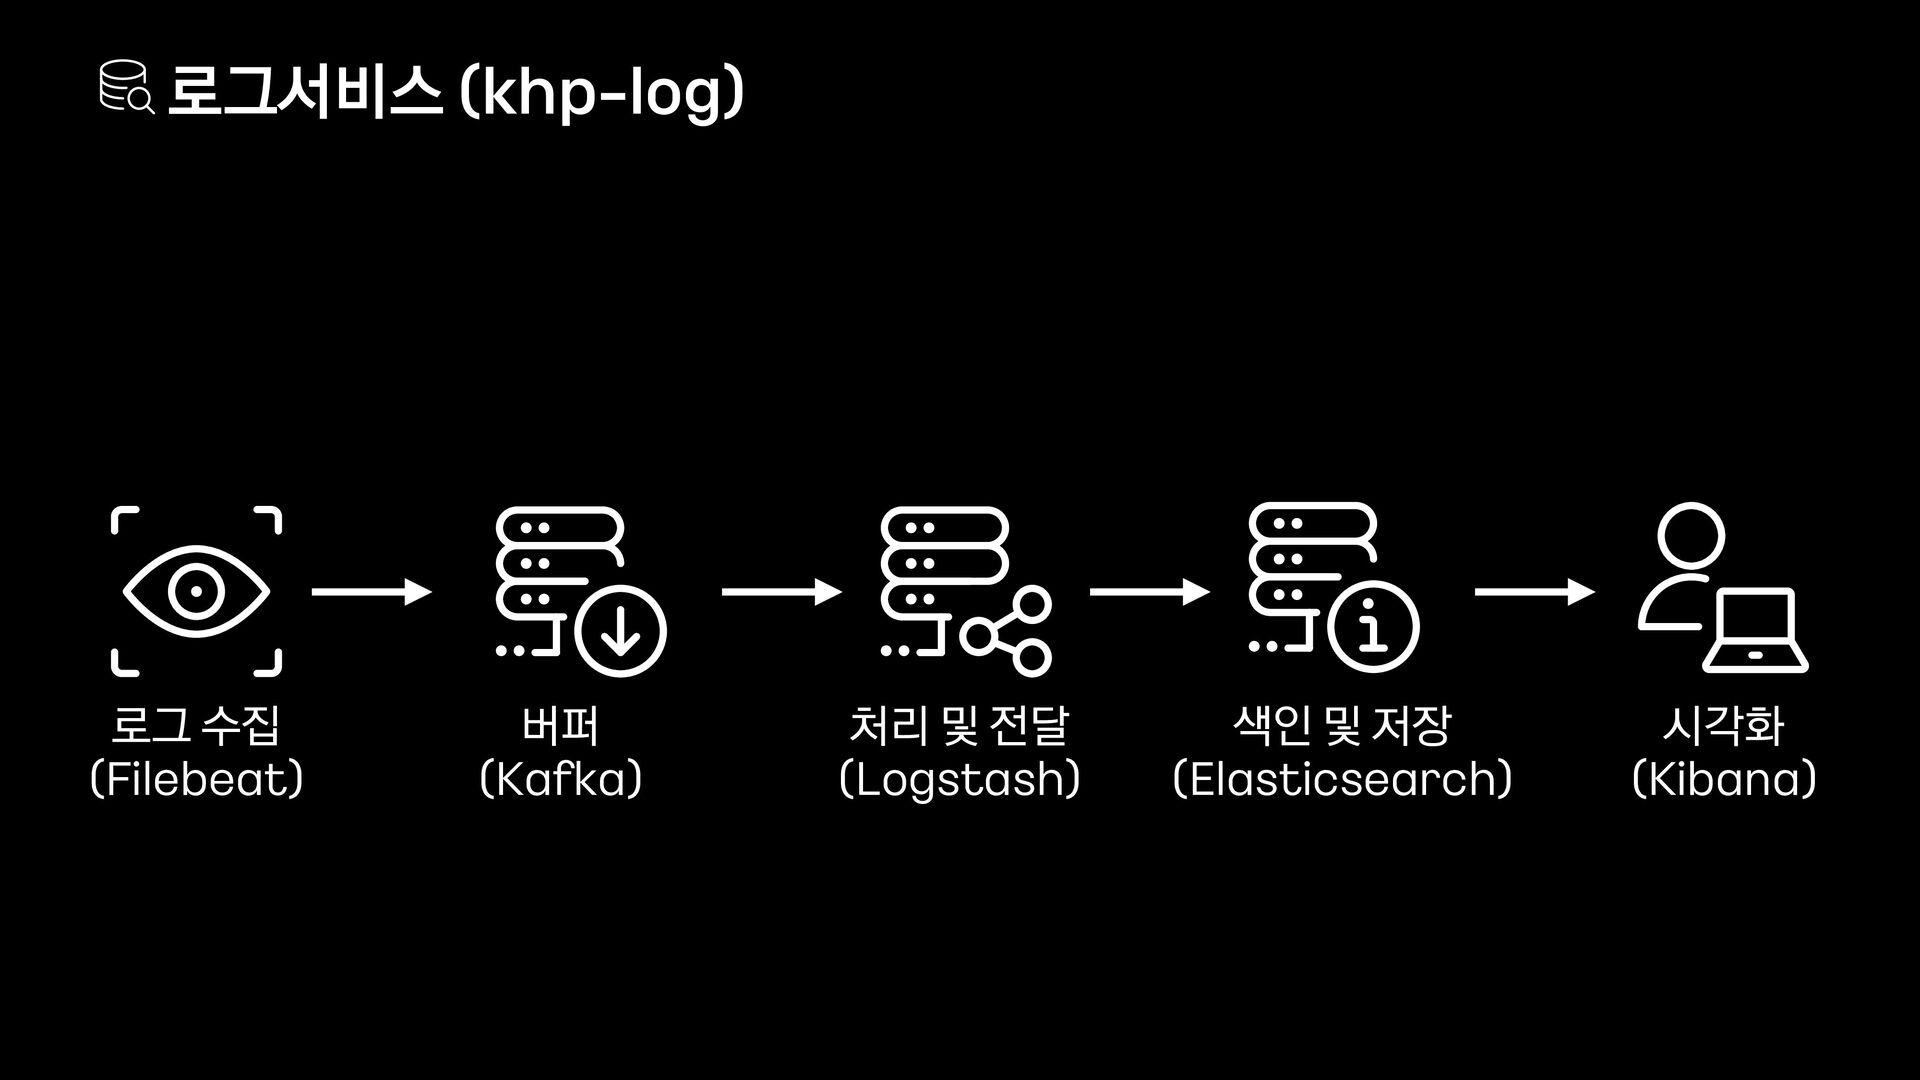
로그서비스 (khp - log) 버퍼 (Kafka) 처리 및 전달 (Logstash)
색인 및 저장 (Elasticsearch) 로그 수집 (Filebeat) 시각화 (Kibana) -
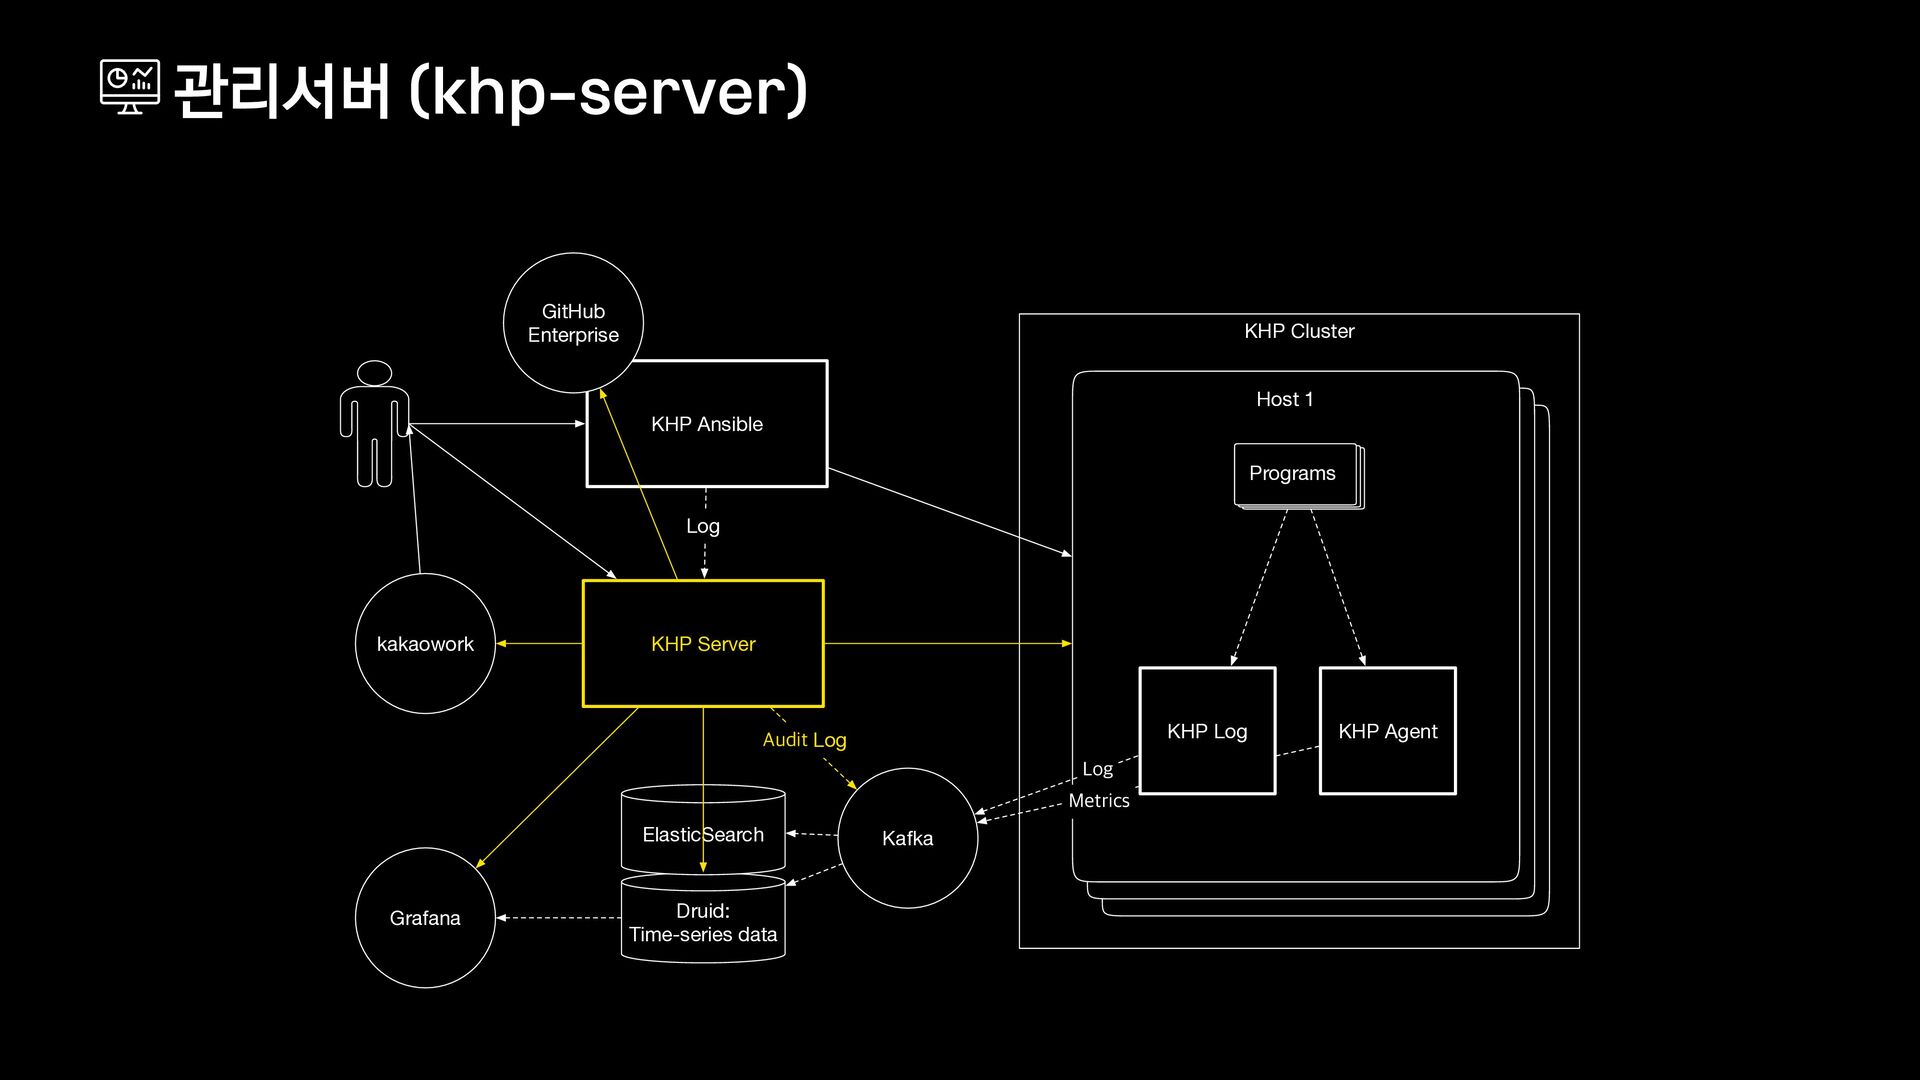
관리서버 (khp - server) KHP Cluster Host 1 KHP Agent
Programs Druid: Time-series data kakaowork Grafana KHP Ansible ElasticSearch KHP Server "VEJULog KHP Log Kafka -PH GitHub Enterprise .FUSJDT Log -
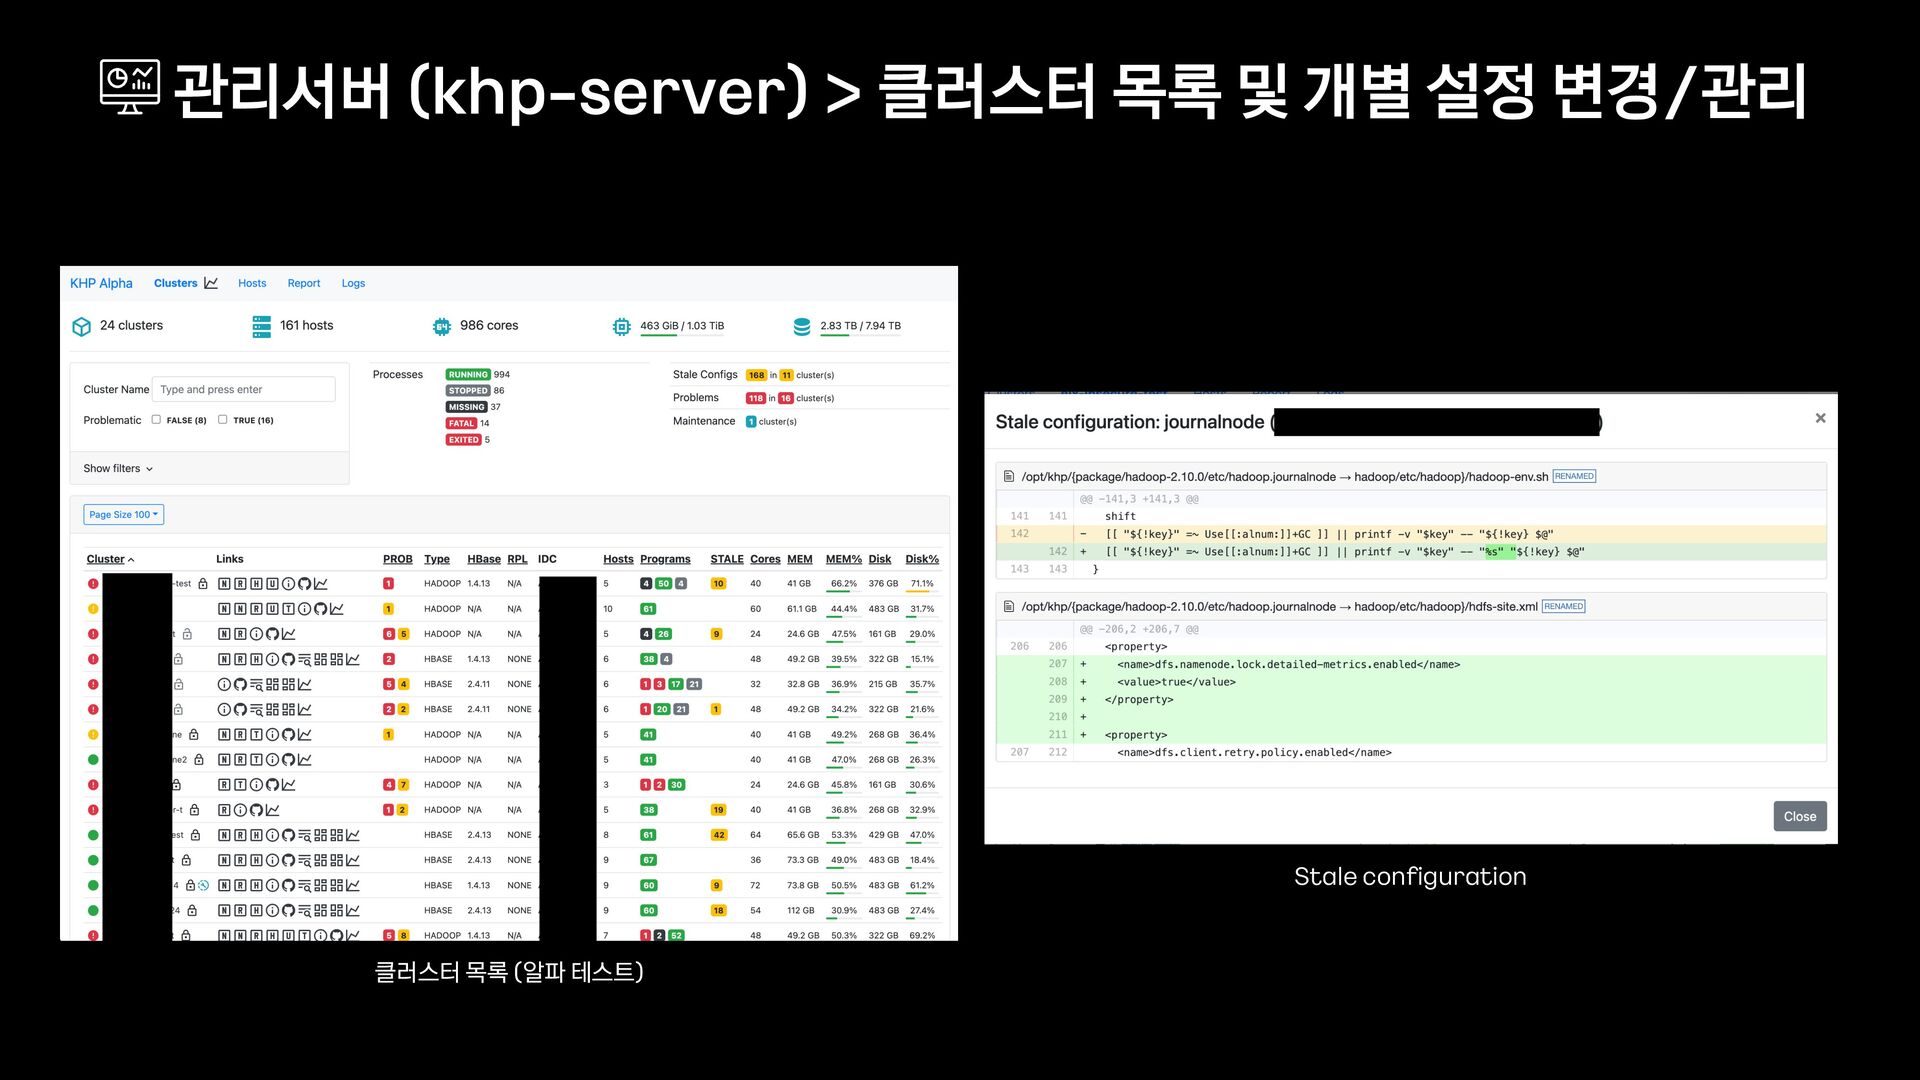
관리서버 (khp - server) > 클러스터 목록 및 개별 설정
변경/관리 Stale con fi guration 클러스터 목록 (알파 테스트) -
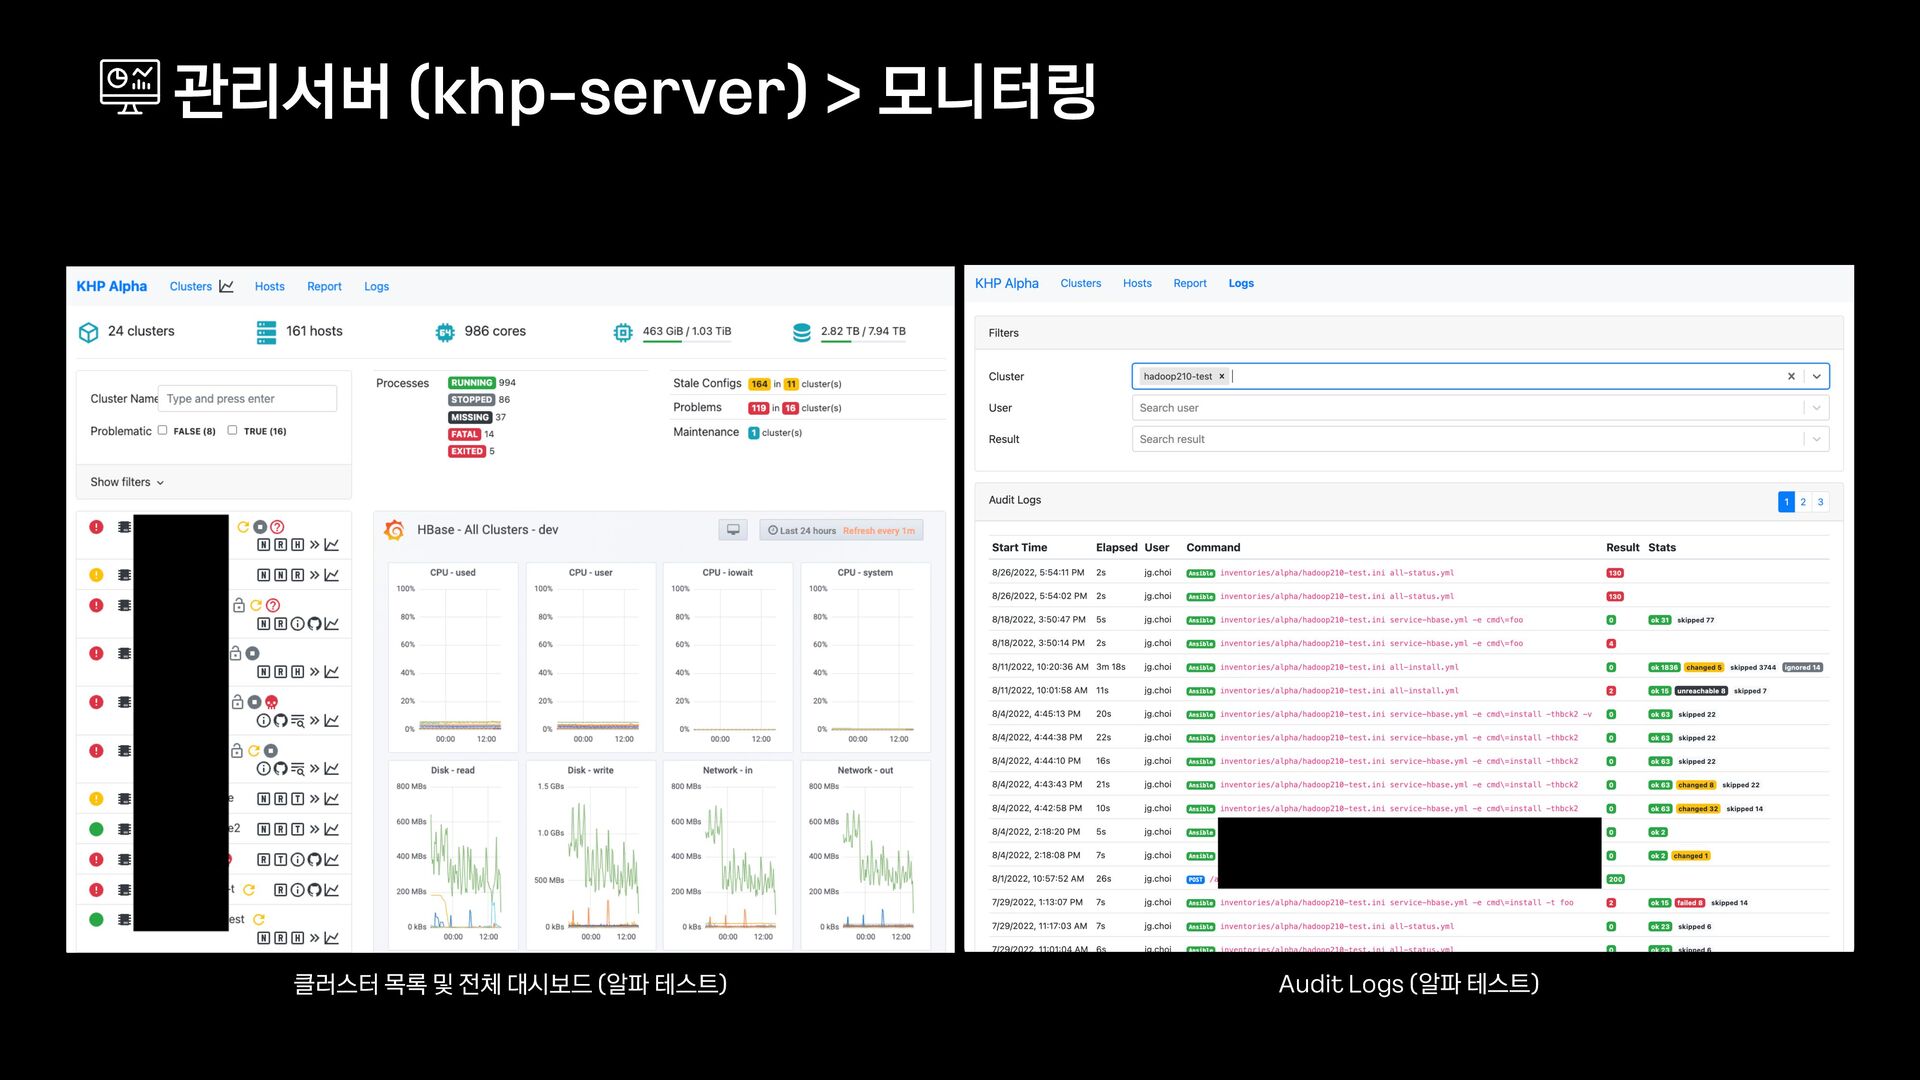
관리서버 (khp - server) > 모니터링 Audit Logs (알파 테스트)
클러스터 목록 및 전체 대시보드 (알파 테스트) -
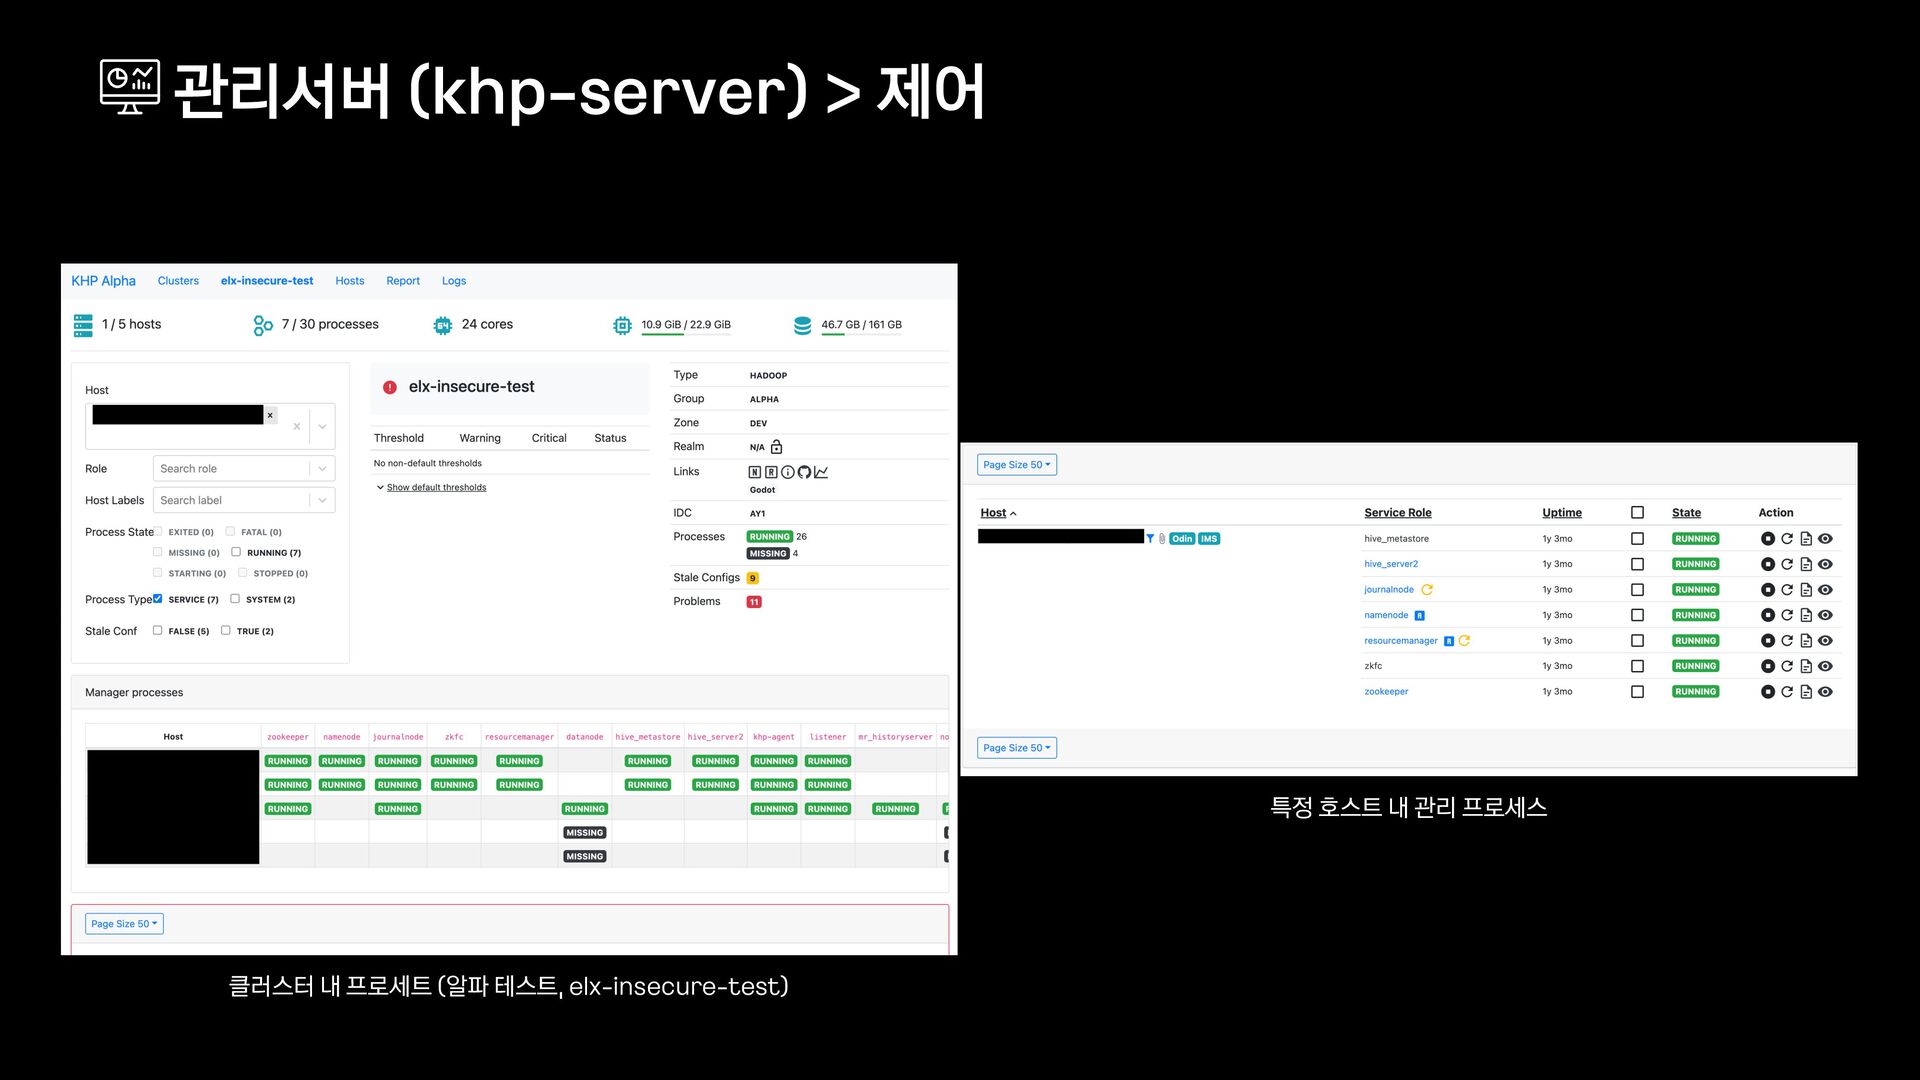
관리서버 (khp - server) > 제어 클러스터 내 프로세트 (알파
테스트, elx - insecure - test) 특정 호스트 내 관리 프로세스 -
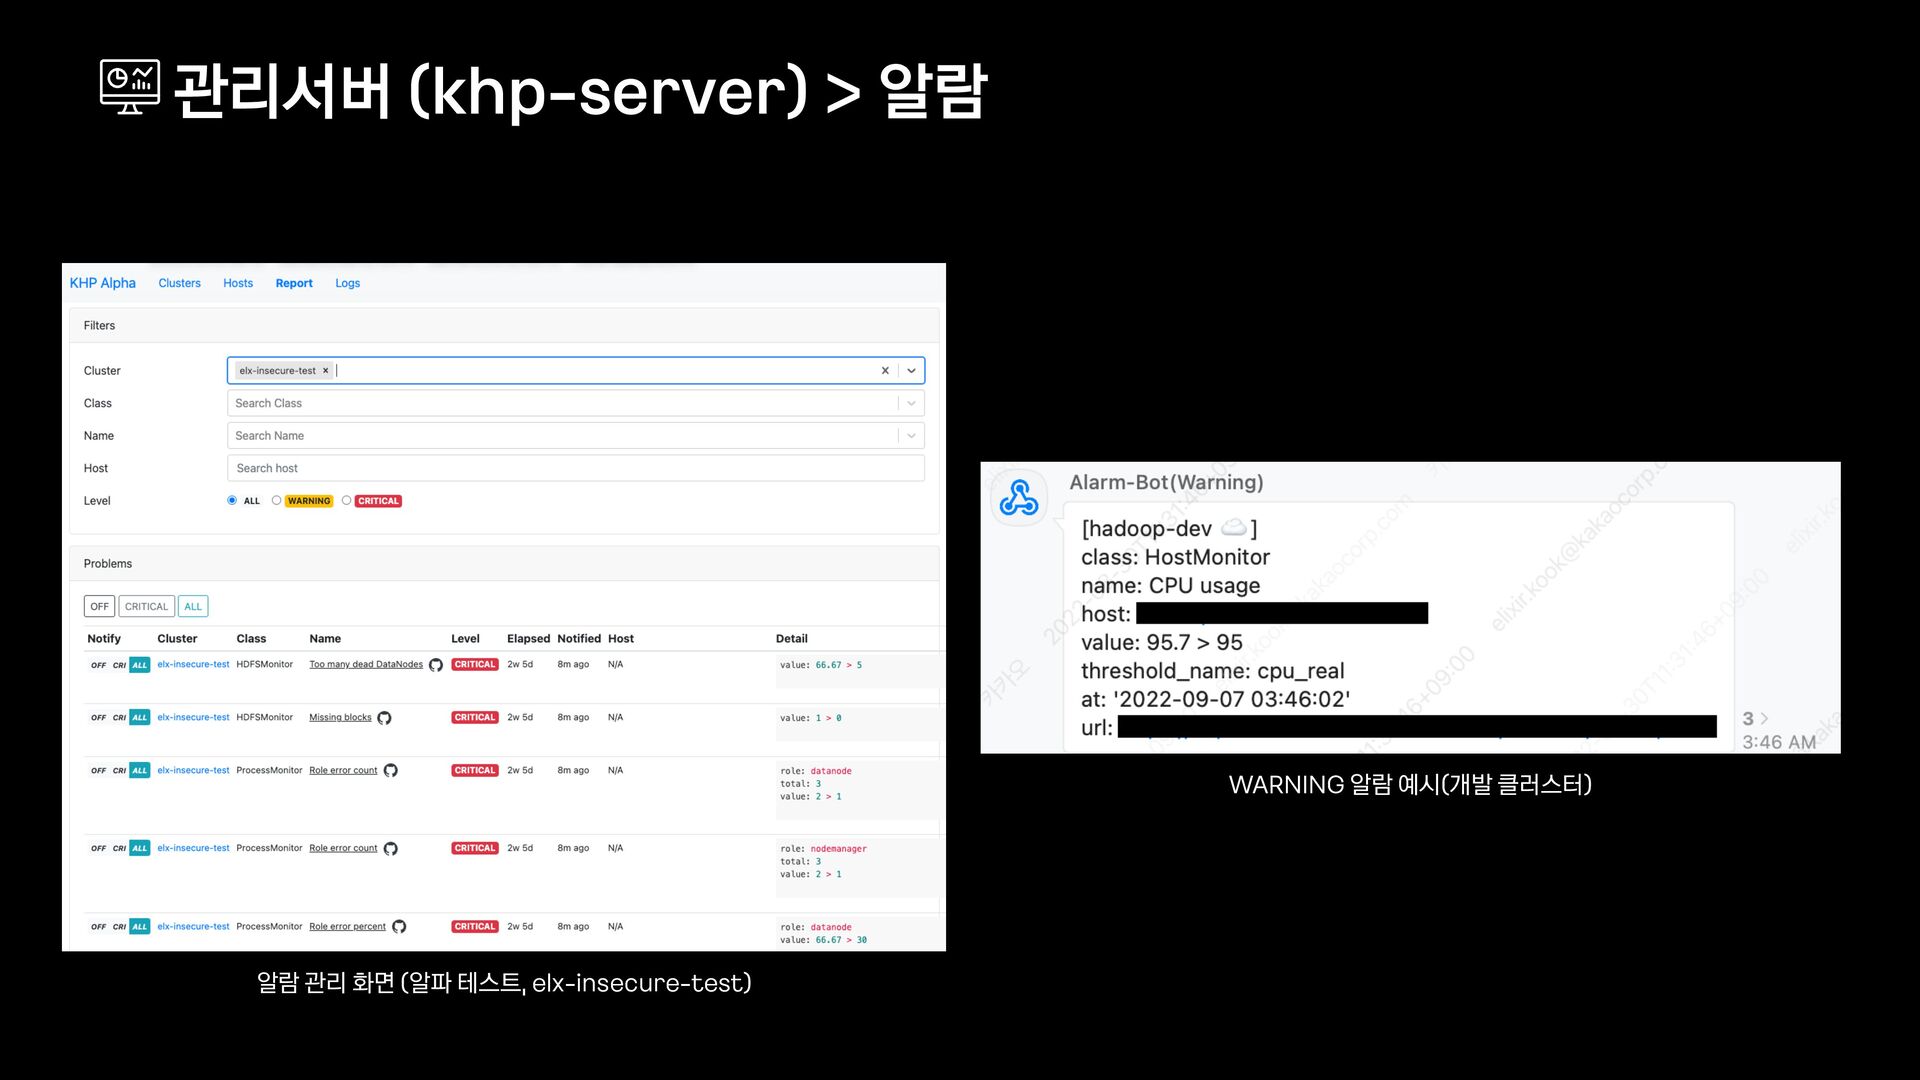
관리서버 (khp - server) > 알람 알람 관리 화면 (알파
테스트, elx - insecure - test) WARNING 알람 예시(개발 클러스터) -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
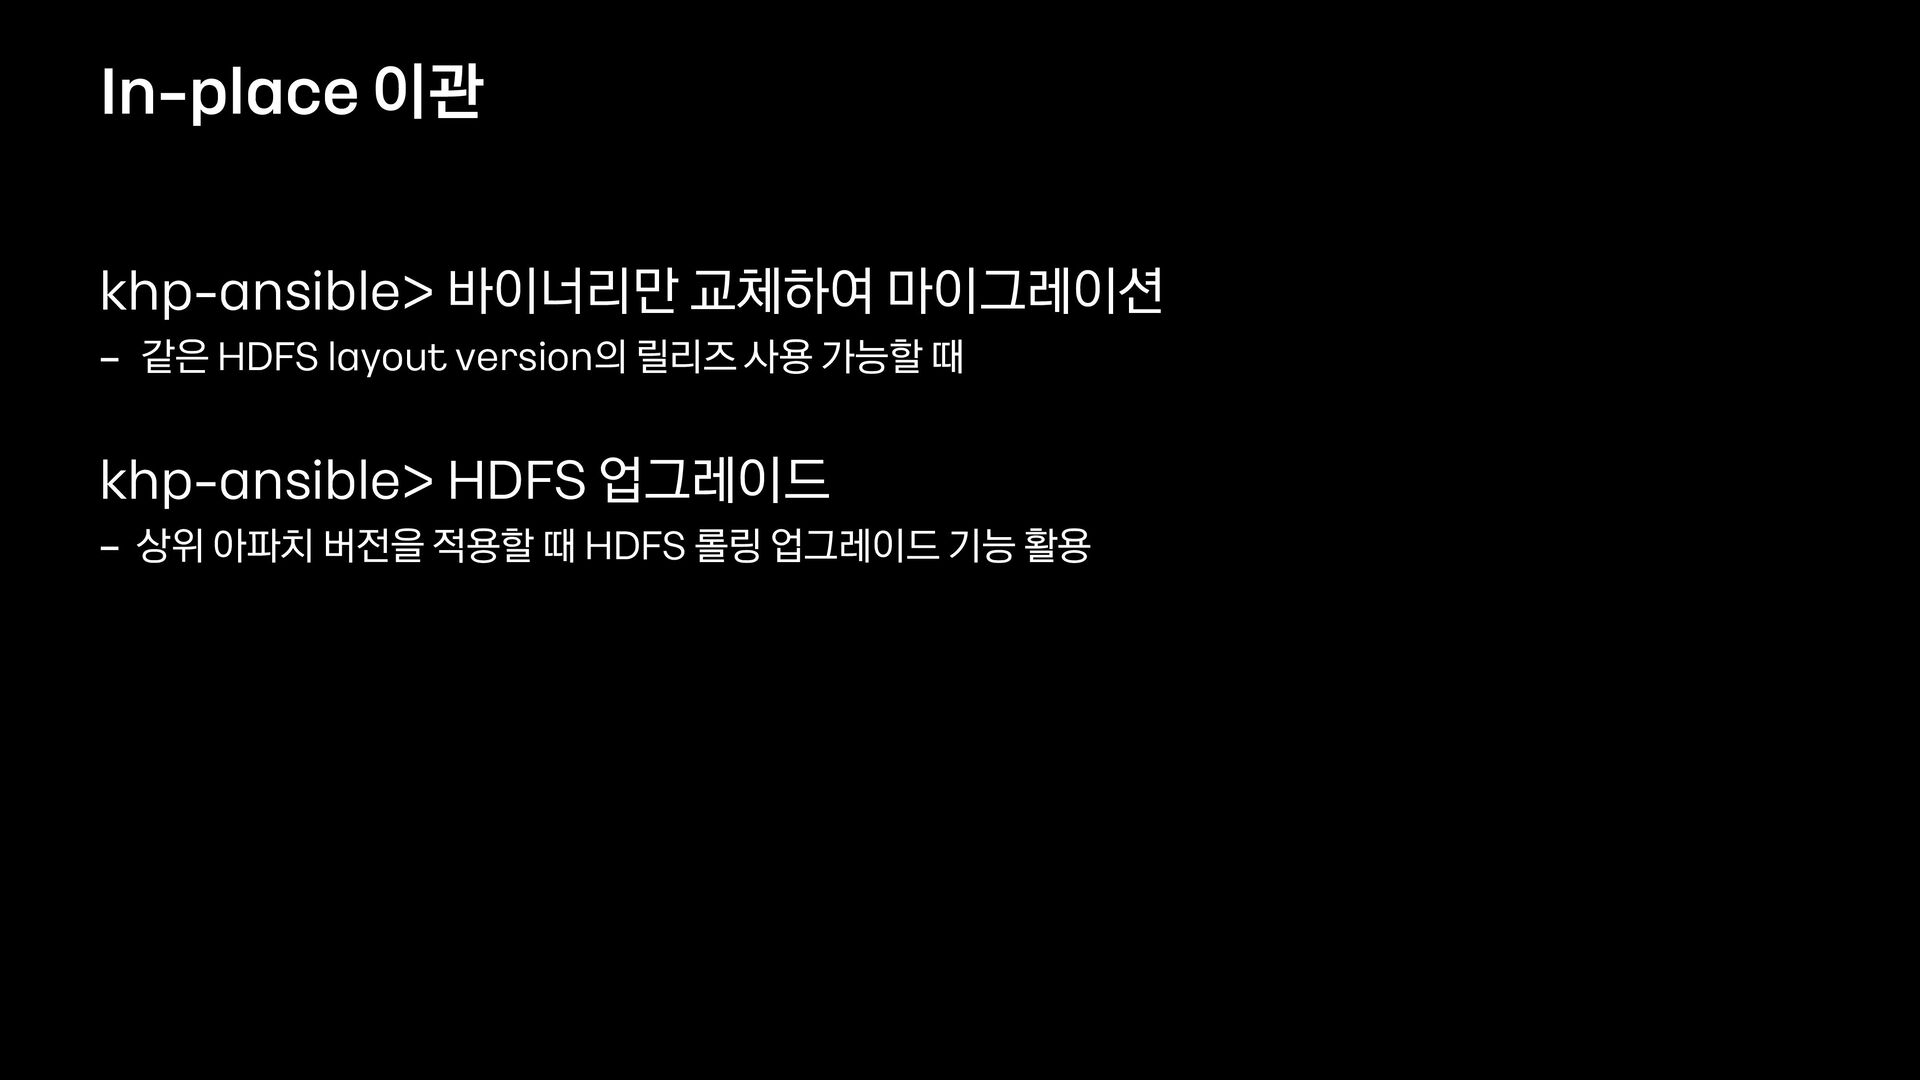
khp - ansible> 바이너리만 교체하여 마이그레이션 - 같은 HDFS layout
version의 릴리즈 사용 가능할 때 khp - ansible> HDFS 업그레이드 - 상위 아파치 버전을 적용할 때 HDFS 롤링 업그레이드 기능 활용 In - place 이관 -
khp - ansible> 바이너리만 교체하여 마이그레이션 - 같은 HDFS layout
version의 릴리즈 사용 가능할 때 khp - ansible> HDFS 업그레이드 - 상위 아파치 버전을 적용할 때 HDFS 롤링 업그레이드 기능 활용 In - place 이관 -
khp - ansible> 바이너리만 교체하여 마이그레이션 - 같은 HDFS layout
version의 릴리즈 사용 가능할 때 khp - ansible> HDFS 업그레이드 - 상위 아파치 버전을 적용할 때 HDFS 롤링 업그레이드 기능 활용 In - place 이관 -
HBase replication 활용 - 안정적으로 마이그레이션 가능 - 그대로 복제하기
때문에 장비가 2배로 필요함 복제 이관 -
클러스터 사용자가 직접 데이터 및 작업을 이관 1) 새로운 클러스터
설치 2) 기존 클러스터로부터 데이터 복제 또는 이동 3) 기존 클러스터로부터 실행 중인 그리고 실행될 잡 이동 4) 데이터 및 잡 이관 완료 후 기존 클러스터 삭제 특징 - 새로운 클러스터 구성 시 컴포넌트 버전 선택이 상대적으로 자유롭다 - 사용자가 직접 작업 이관을 처리해야 한다 - 대규모 마이그레이션 작업 시 시스템 리소스 외에도 네트워크 대역폭에 대한 관리가 필요하다 - 이관이 이뤄짐에 따라 기존 클러스터 정리와 신규 클러스터 확대를 병행한다 단계적 이관 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
성과 - 대다수의 클러스터를 KHP로 마이그레이션 완료 - 운영 비용(및
리스크) 크게 감소 조직 변화 - 하둡 기술 전문화 - 기술 변화 대응 용이 KHP 적용 후 달라진 점 -
성과 - 대다수의 클러스터를 KHP로 마이그레이션 완료 - 운영 비용(및
리스크) 크게 감소 조직 변화 - 하둡 기술 전문화 - 기술 변화 대응 용이 KHP 적용 후 달라진 점 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
오픈 소스 컴포넌트를 유지보수하며 운영하기 (Hue, Hive 사례) 새로운 컴포넌트
도입하기 (Ranger 사례) 대규모 클러스터 대상 Ansible 성능 이슈 사례 공유 -
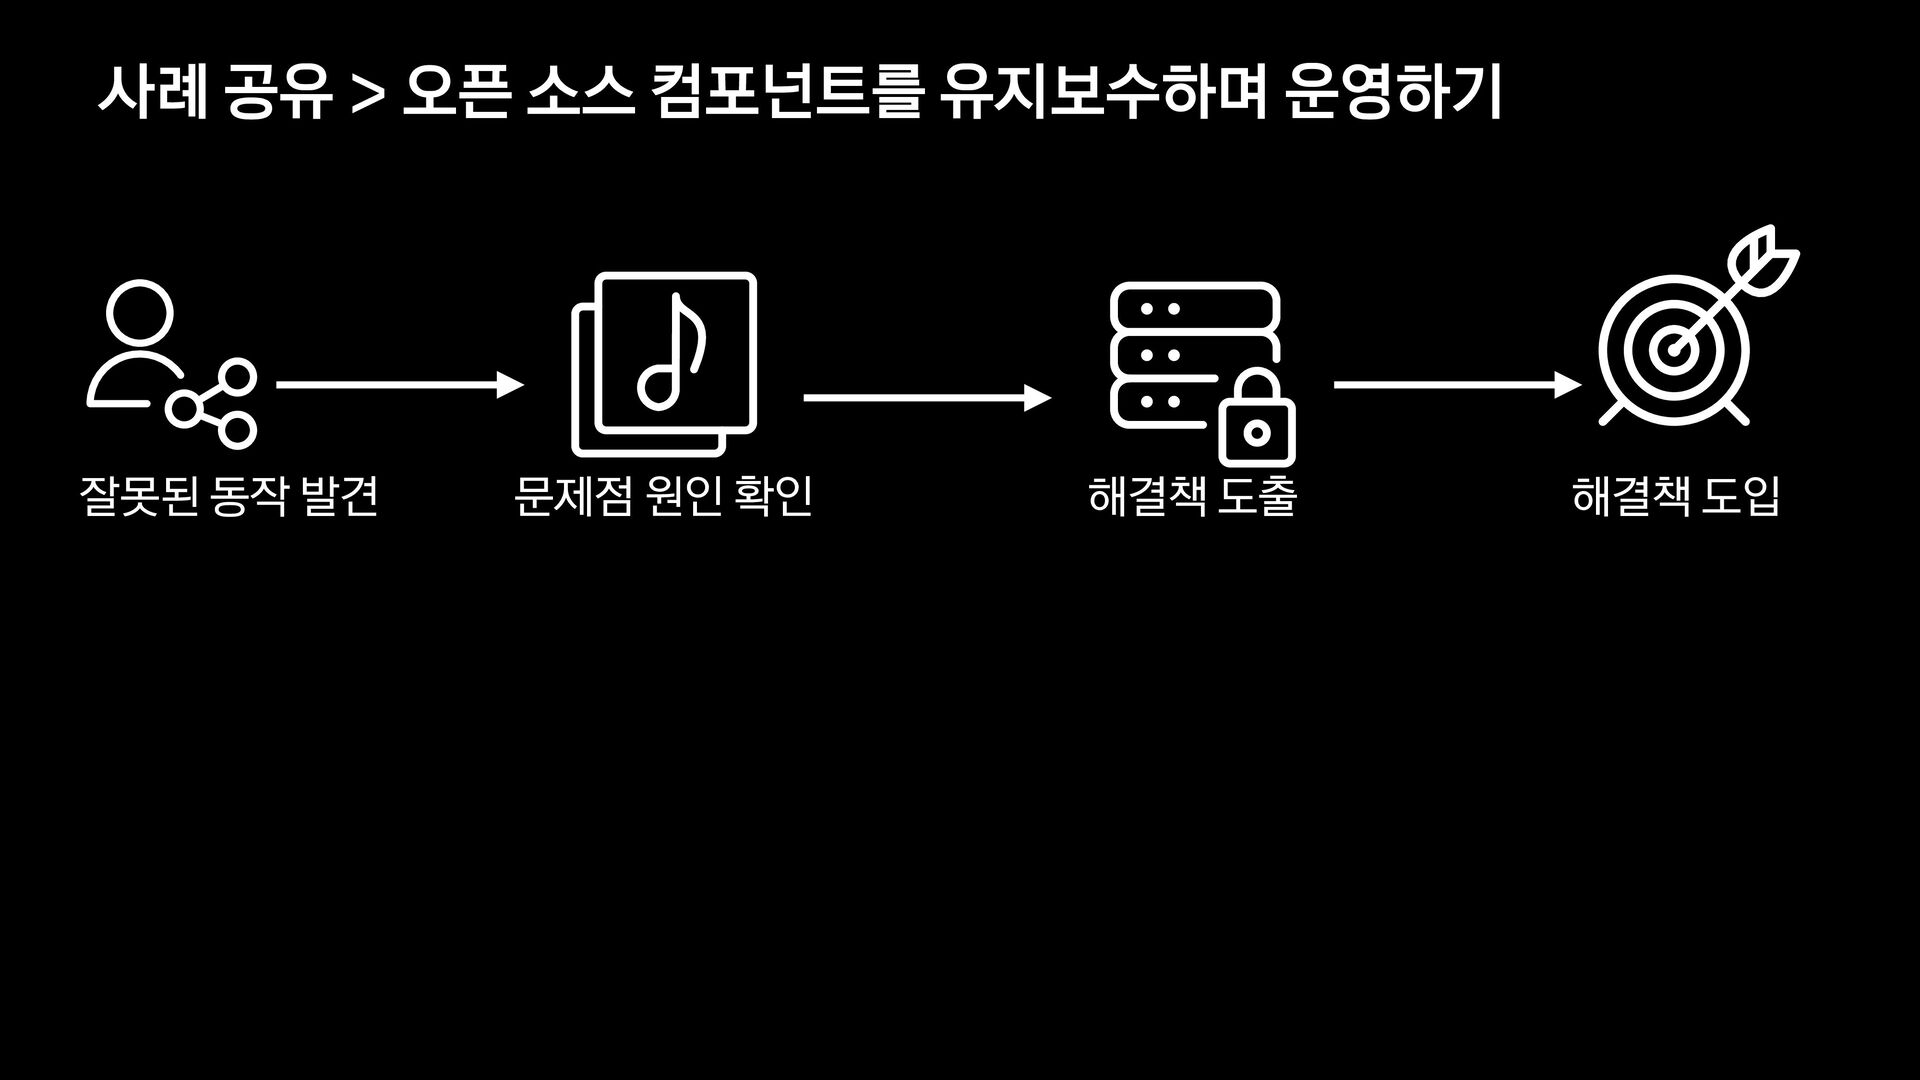
사례 공유 > 오픈 소스 컴포넌트를 유지보수하며 운영하기 문제점 원인
확인 해결책 도출 해결책 도입 잘못된 동작 발견 -
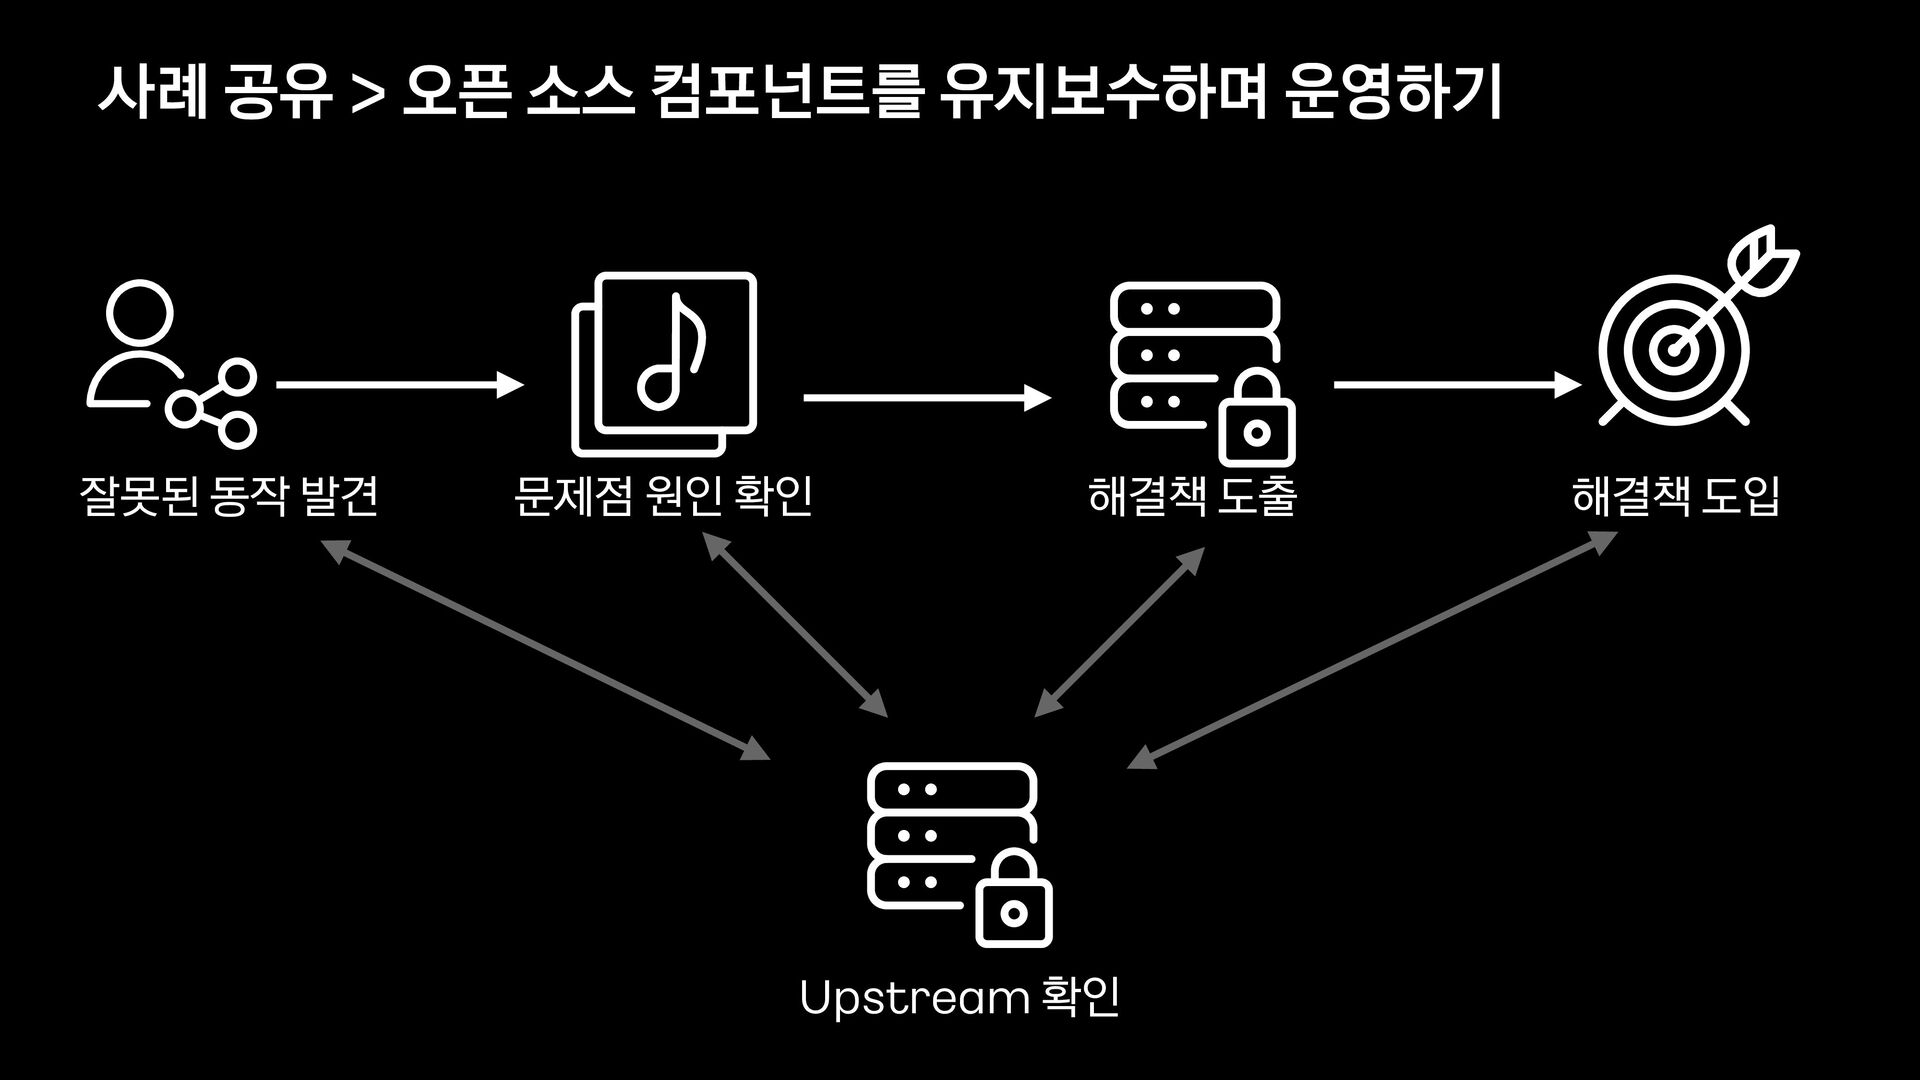
사례 공유 > 오픈 소스 컴포넌트를 유지보수하며 운영하기 문제점 원인
확인 해결책 도출 해결책 도입 잘못된 동작 발견 Upstream 확인 -
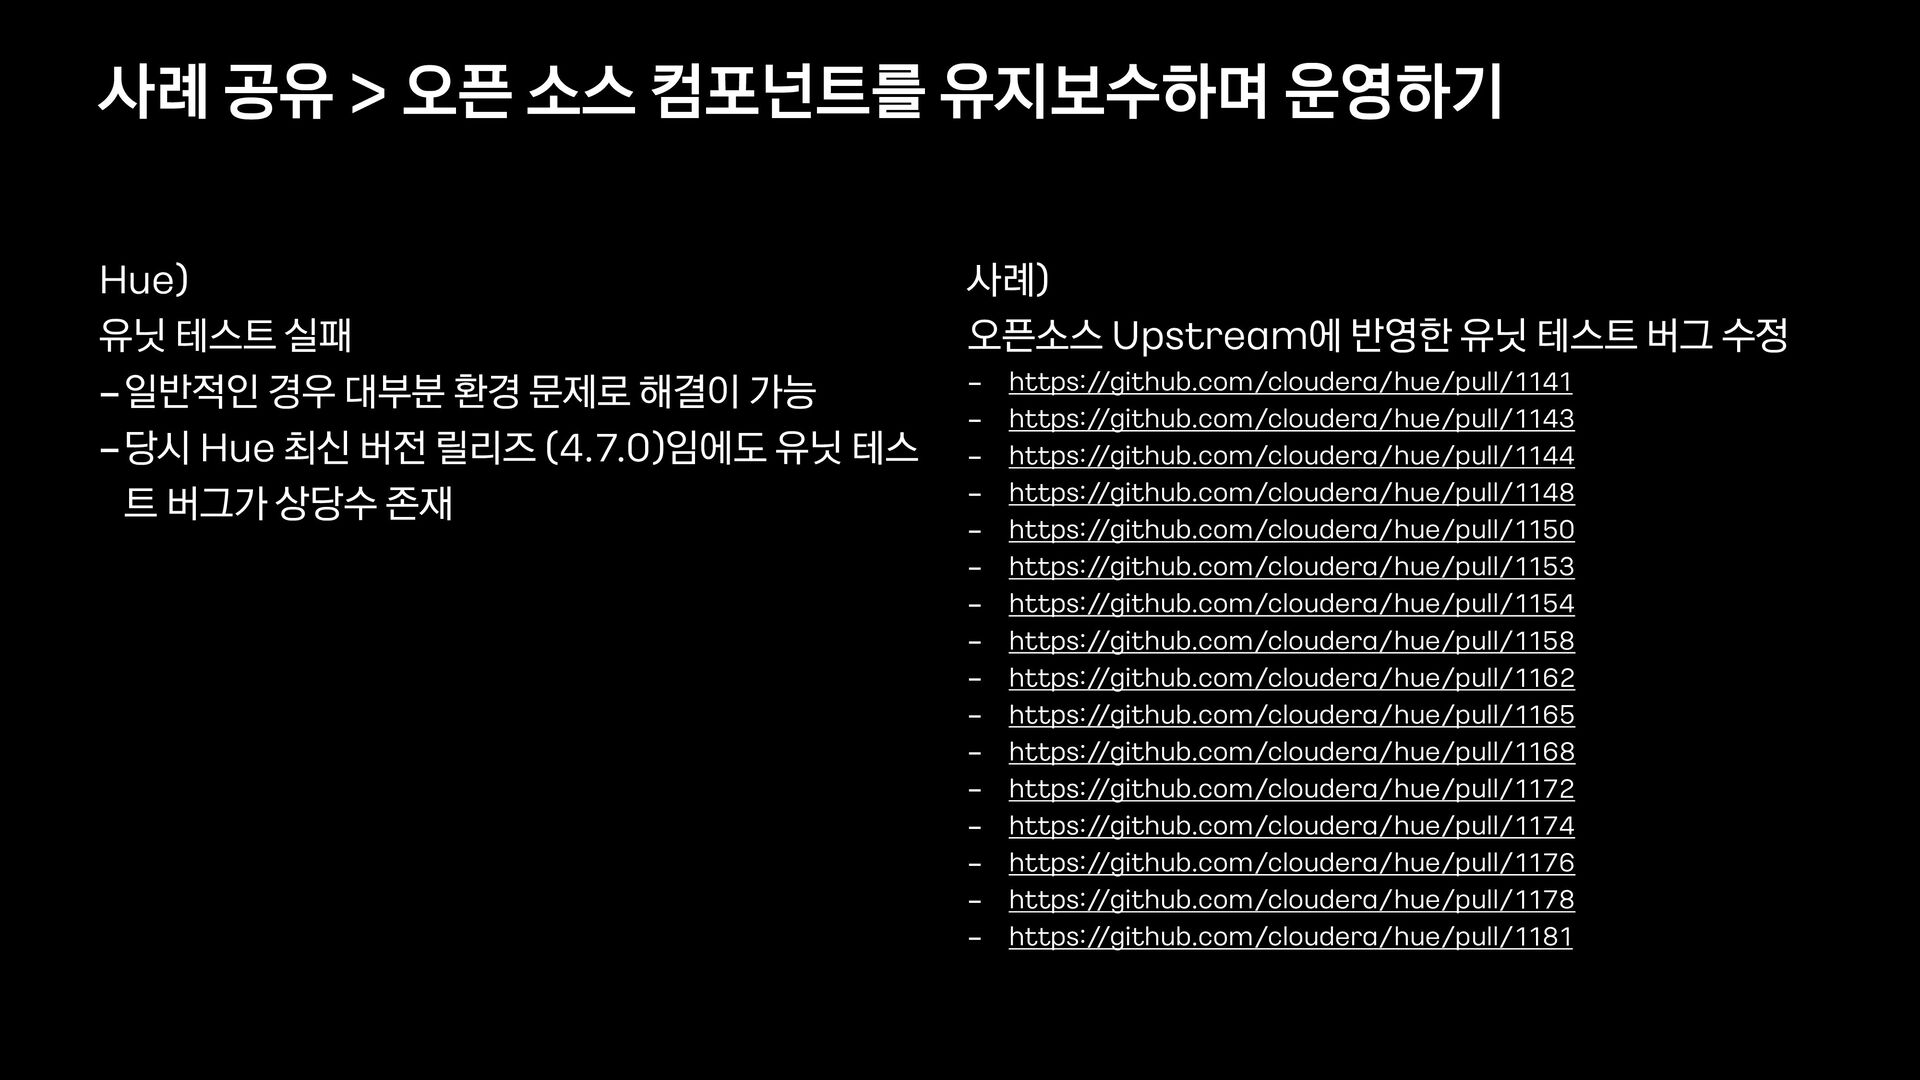
Hue) 유닛 테스트 실패 -일반적인 경우 대부분 환경 문제로 해결이
가능 -당시 Hue 최신 버전 릴리즈 (4.7.0)임에도 유닛 테스 트 버그가 상당수 존재 사례 공유 > 오픈 소스 컴포넌트를 유지보수하며 운영하기 사례) 오픈소스 Upstream에 반영한 유닛 테스트 버그 수정 - https:/ /github.com/cloudera/hue/pull/1141 - https:/ /github.com/cloudera/hue/pull/1143 - https:/ /github.com/cloudera/hue/pull/1144 - https:/ /github.com/cloudera/hue/pull/1148 - https:/ /github.com/cloudera/hue/pull/1150 - https:/ /github.com/cloudera/hue/pull/1153 - https:/ /github.com/cloudera/hue/pull/1154 - https:/ /github.com/cloudera/hue/pull/1158 - https:/ /github.com/cloudera/hue/pull/1162 - https:/ /github.com/cloudera/hue/pull/1165 - https:/ /github.com/cloudera/hue/pull/1168 - https:/ /github.com/cloudera/hue/pull/1172 - https:/ /github.com/cloudera/hue/pull/1174 - https:/ /github.com/cloudera/hue/pull/1176 - https:/ /github.com/cloudera/hue/pull/1178 - https:/ /github.com/cloudera/hue/pull/1181 -
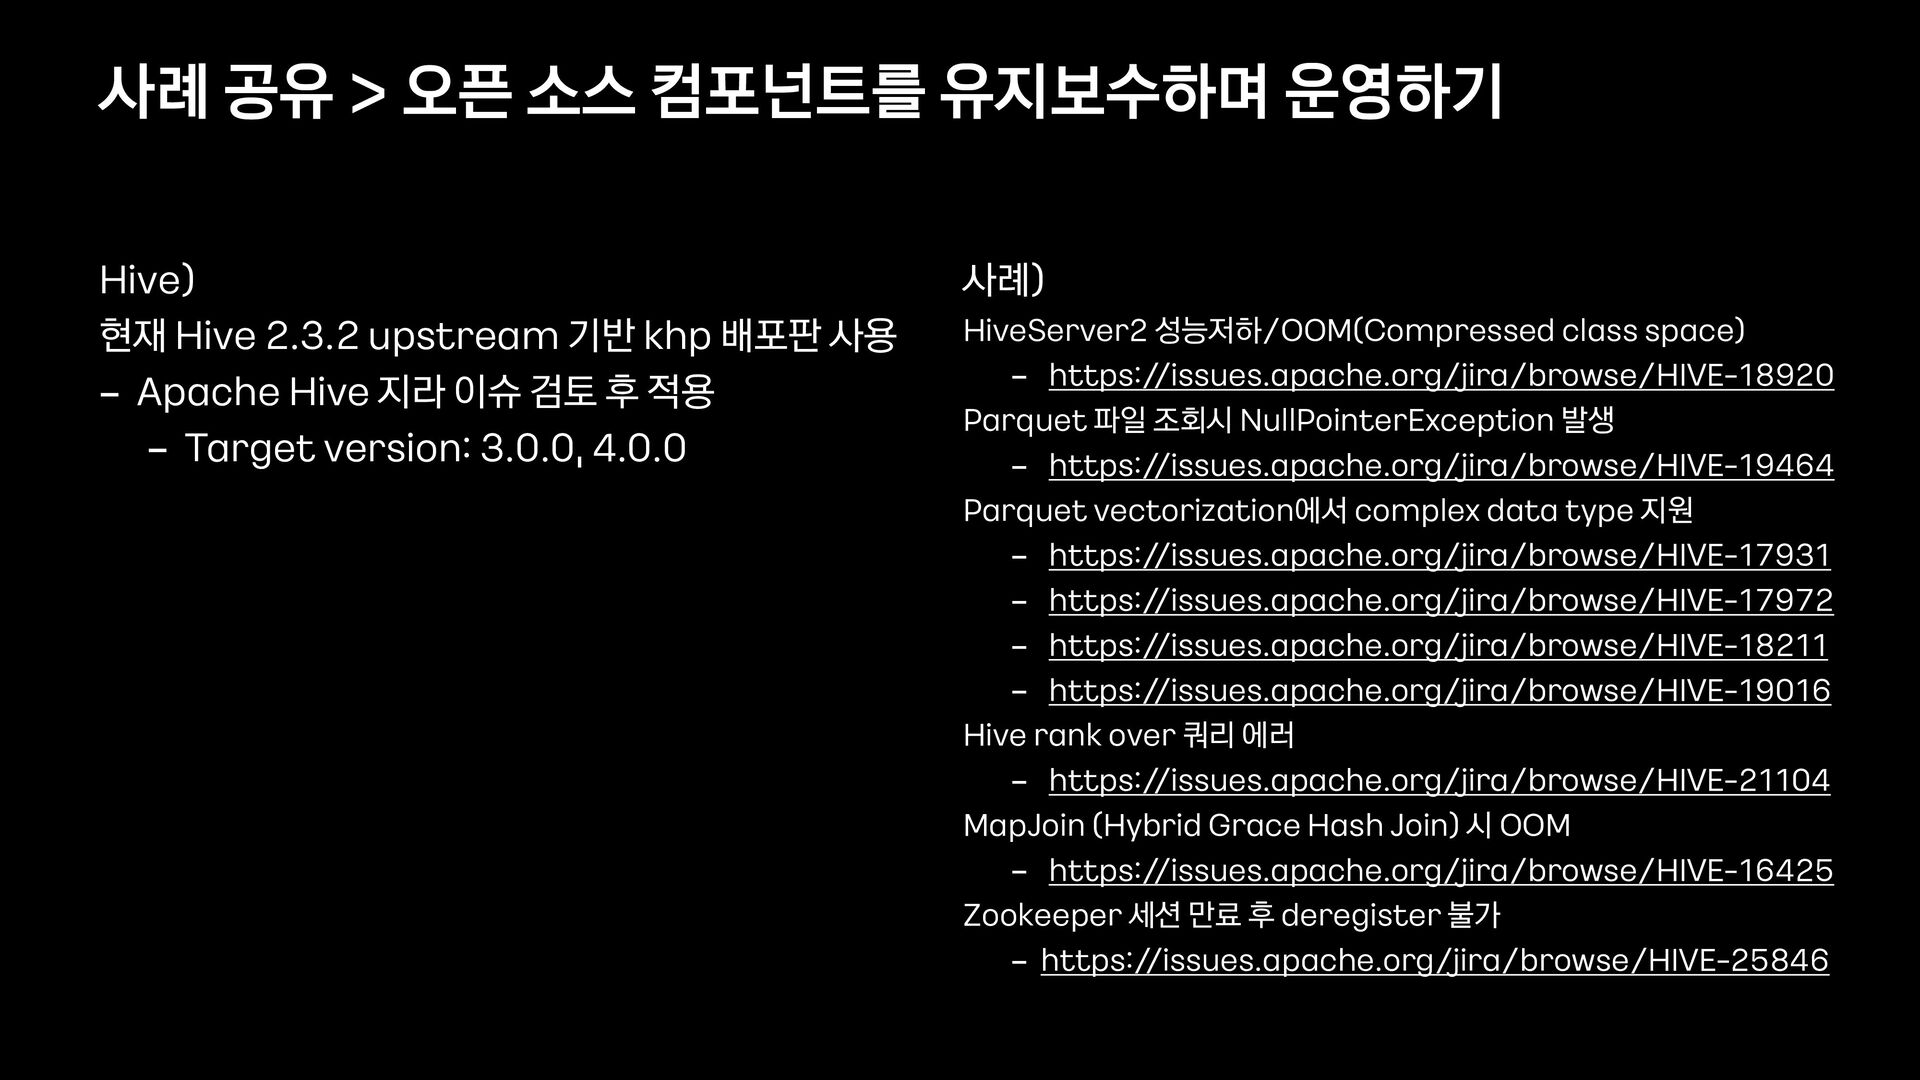
Hive) 현재 Hive 2.3.2 upstream 기반 khp 배포판 사용 -
Apache Hive 지라 이슈 검토 후 적용 - Target version: 3.0.0, 4.0.0 사례 공유 > 오픈 소스 컴포넌트를 유지보수하며 운영하기 사례) HiveServer2 성능저하/OOM(Compressed class space) - https:/ /issues.apache.org/jira/browse/HIVE-18920 Parquet 파일 조회시 NullPointerException 발생 - https:/ /issues.apache.org/jira/browse/HIVE-19464 Parquet vectorization에서 complex data type 지원 - https:/ /issues.apache.org/jira/browse/HIVE-17931 - https:/ /issues.apache.org/jira/browse/HIVE-17972 - https:/ /issues.apache.org/jira/browse/HIVE-18211 - https:/ /issues.apache.org/jira/browse/HIVE-19016 Hive rank over 쿼리 에러 - https:/ /issues.apache.org/jira/browse/HIVE-21104 MapJoin (Hybrid Grace Hash Join) 시 OOM - https:/ /issues.apache.org/jira/browse/HIVE-16425 Zookeeper 세션 만료 후 deregister 불가 - https:/ /issues.apache.org/jira/browse/HIVE-25846 -
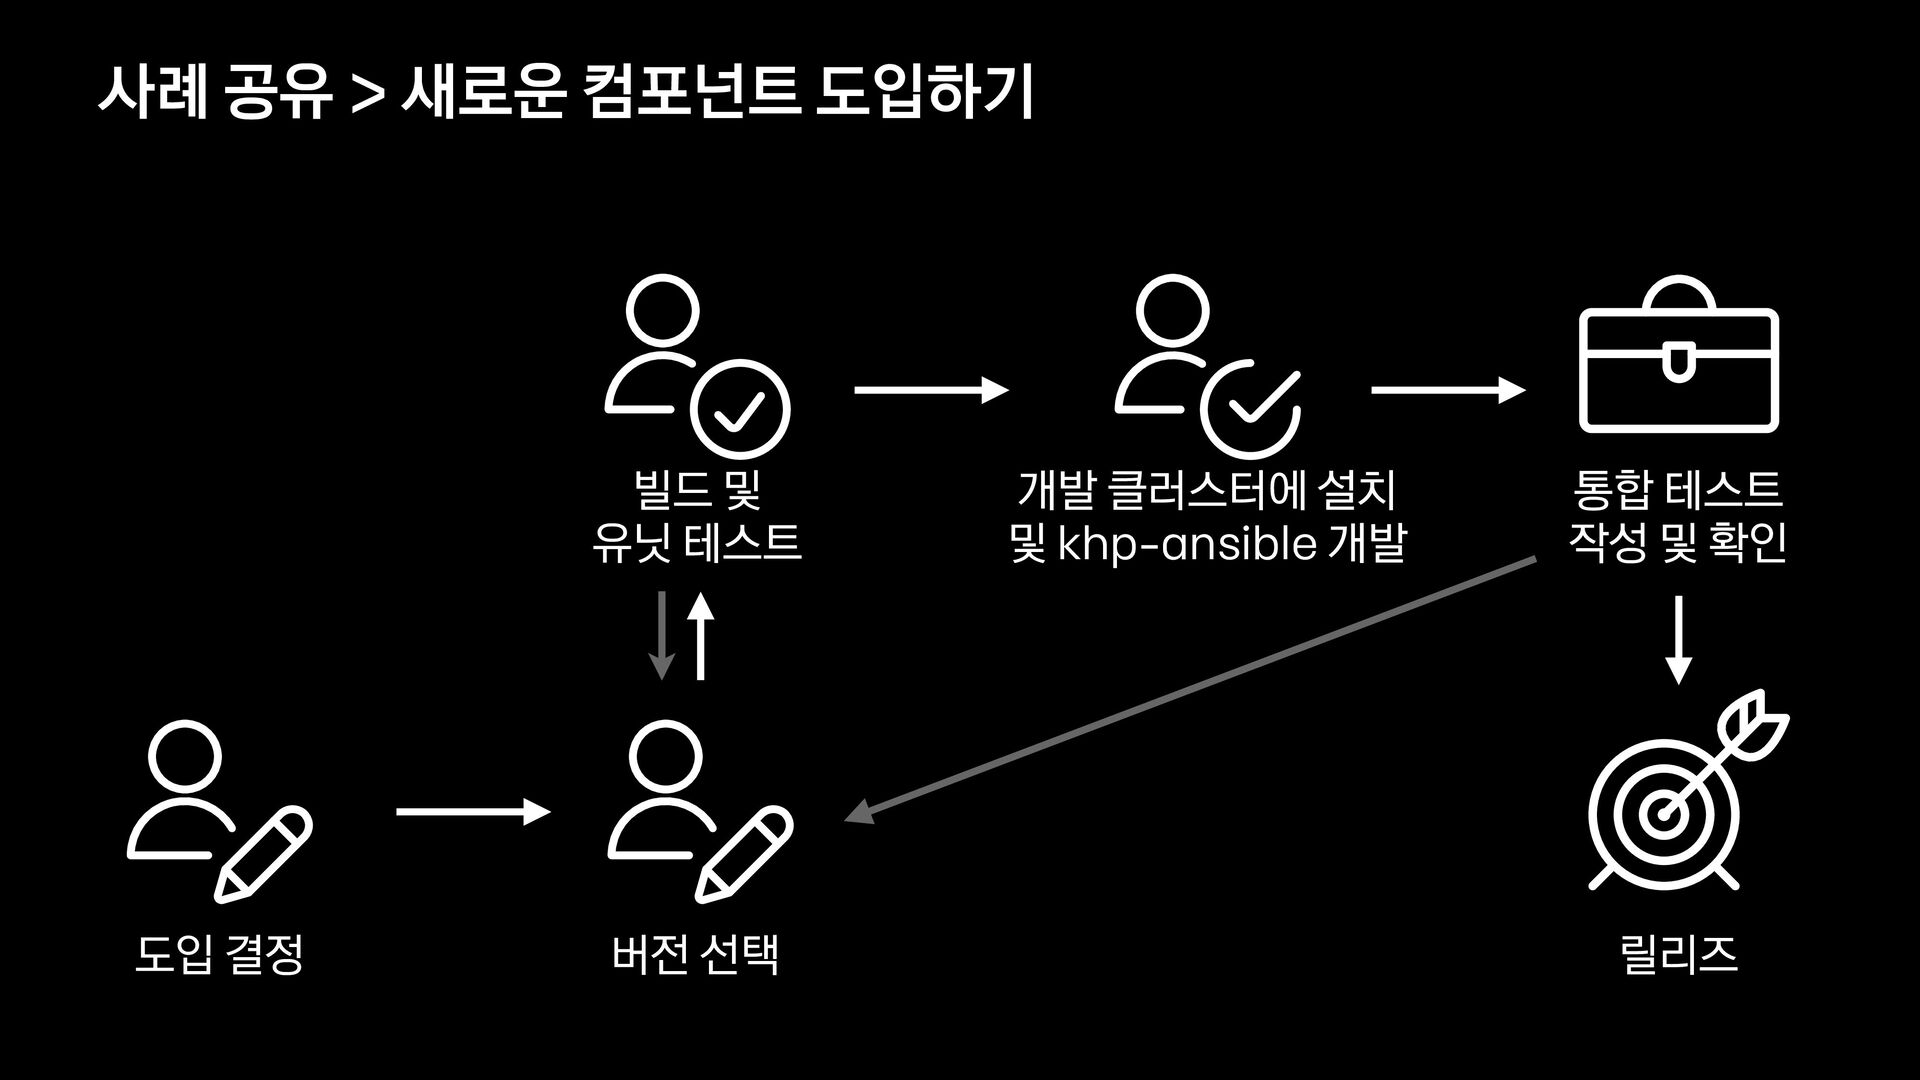
사례 공유 > 새로운 컴포넌트 도입하기 빌드 및 유닛 테스트
개발 클러스터에 설치 및 khp - ansible 개발 통합 테스트 작성 및 확인 버전 선택 릴리즈 도입 결정 -
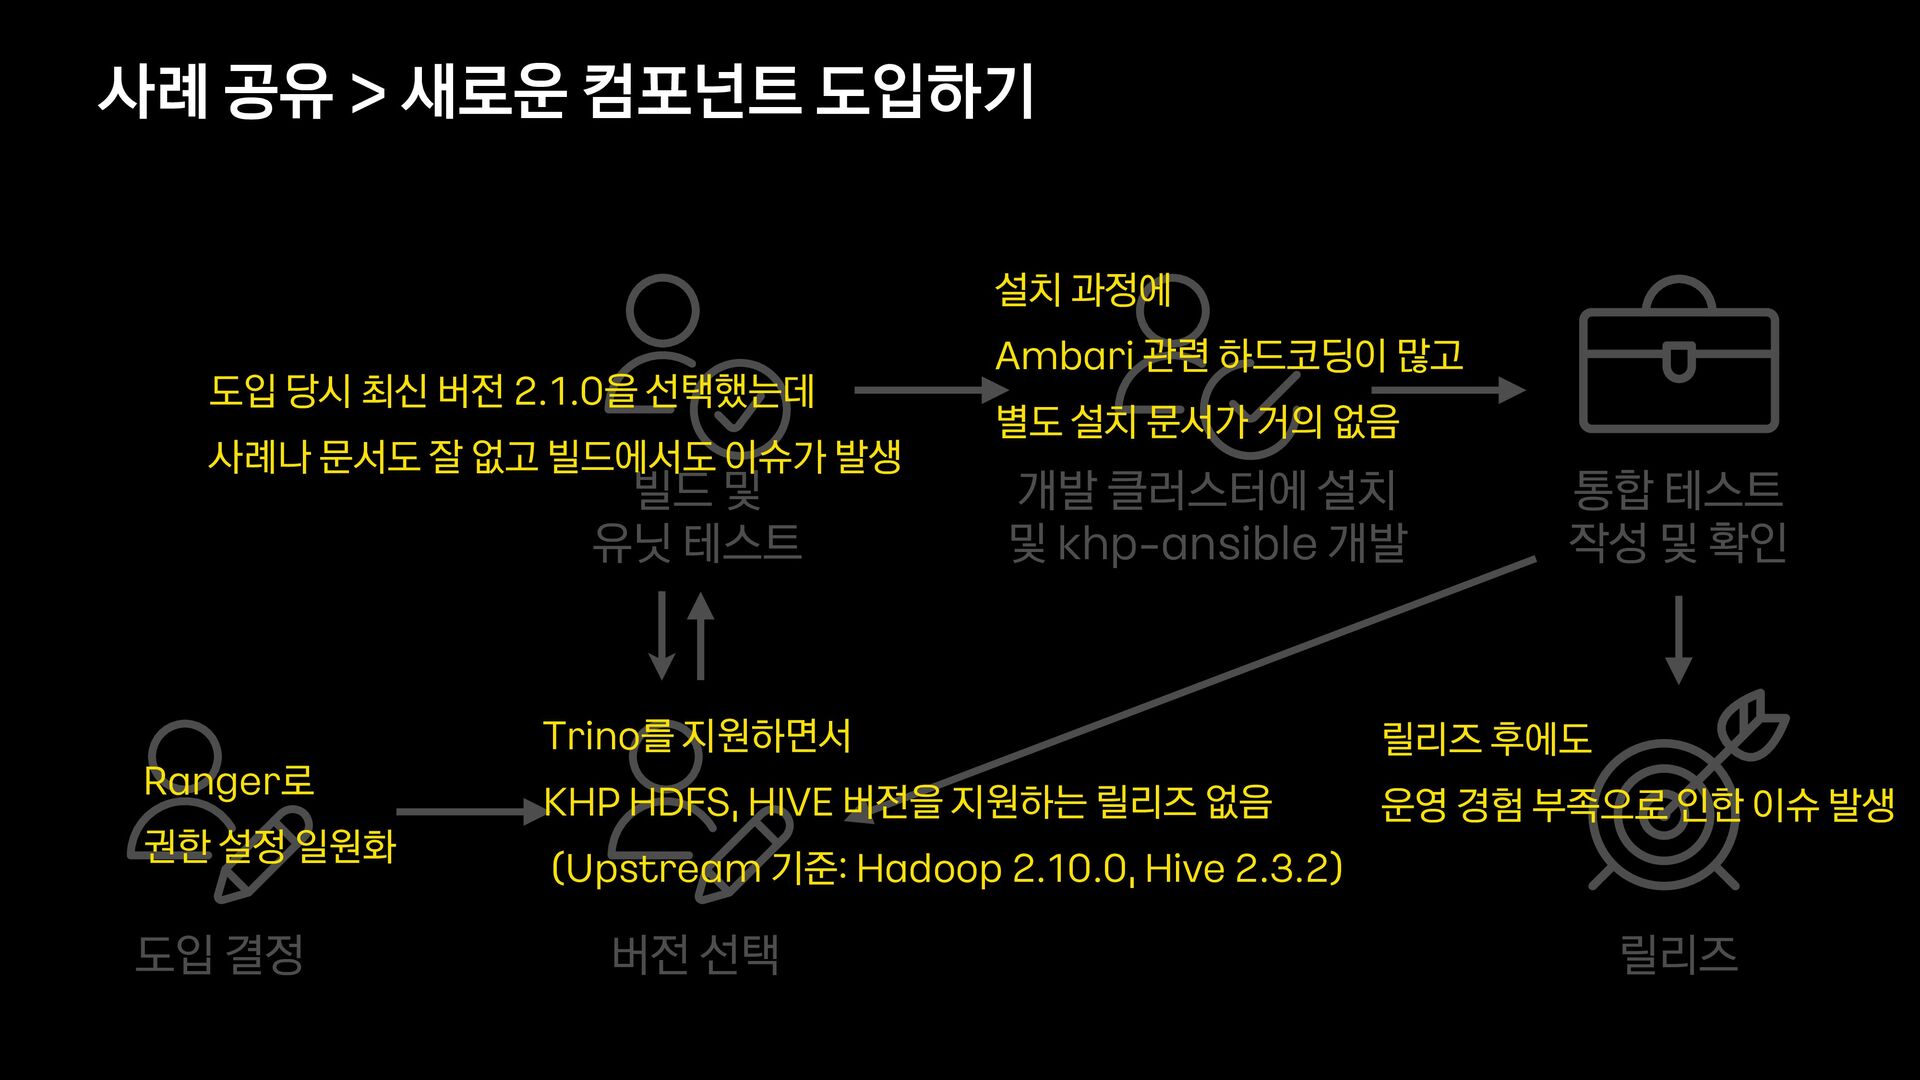
사례 공유 > 새로운 컴포넌트 도입하기 빌드 및 KHP HDFS,
HIVE 버전을 지원하는 릴리즈 없음 (Upstream 기준: Hadoop 2.10.0, Hive 2.3.2) 설치 과정에 Ambari 관련 하드코딩이 많고 별도 설치 문서가 거의 없음 도입 당시 최신 버전 2.1.0을 선택했는데 사례나 문서도 잘 없고 빌드에서도 이슈가 발생 릴리즈 후에도 운영 경험 부족으로 인한 이슈 발생 Ranger로 권한 설정 일원화 -
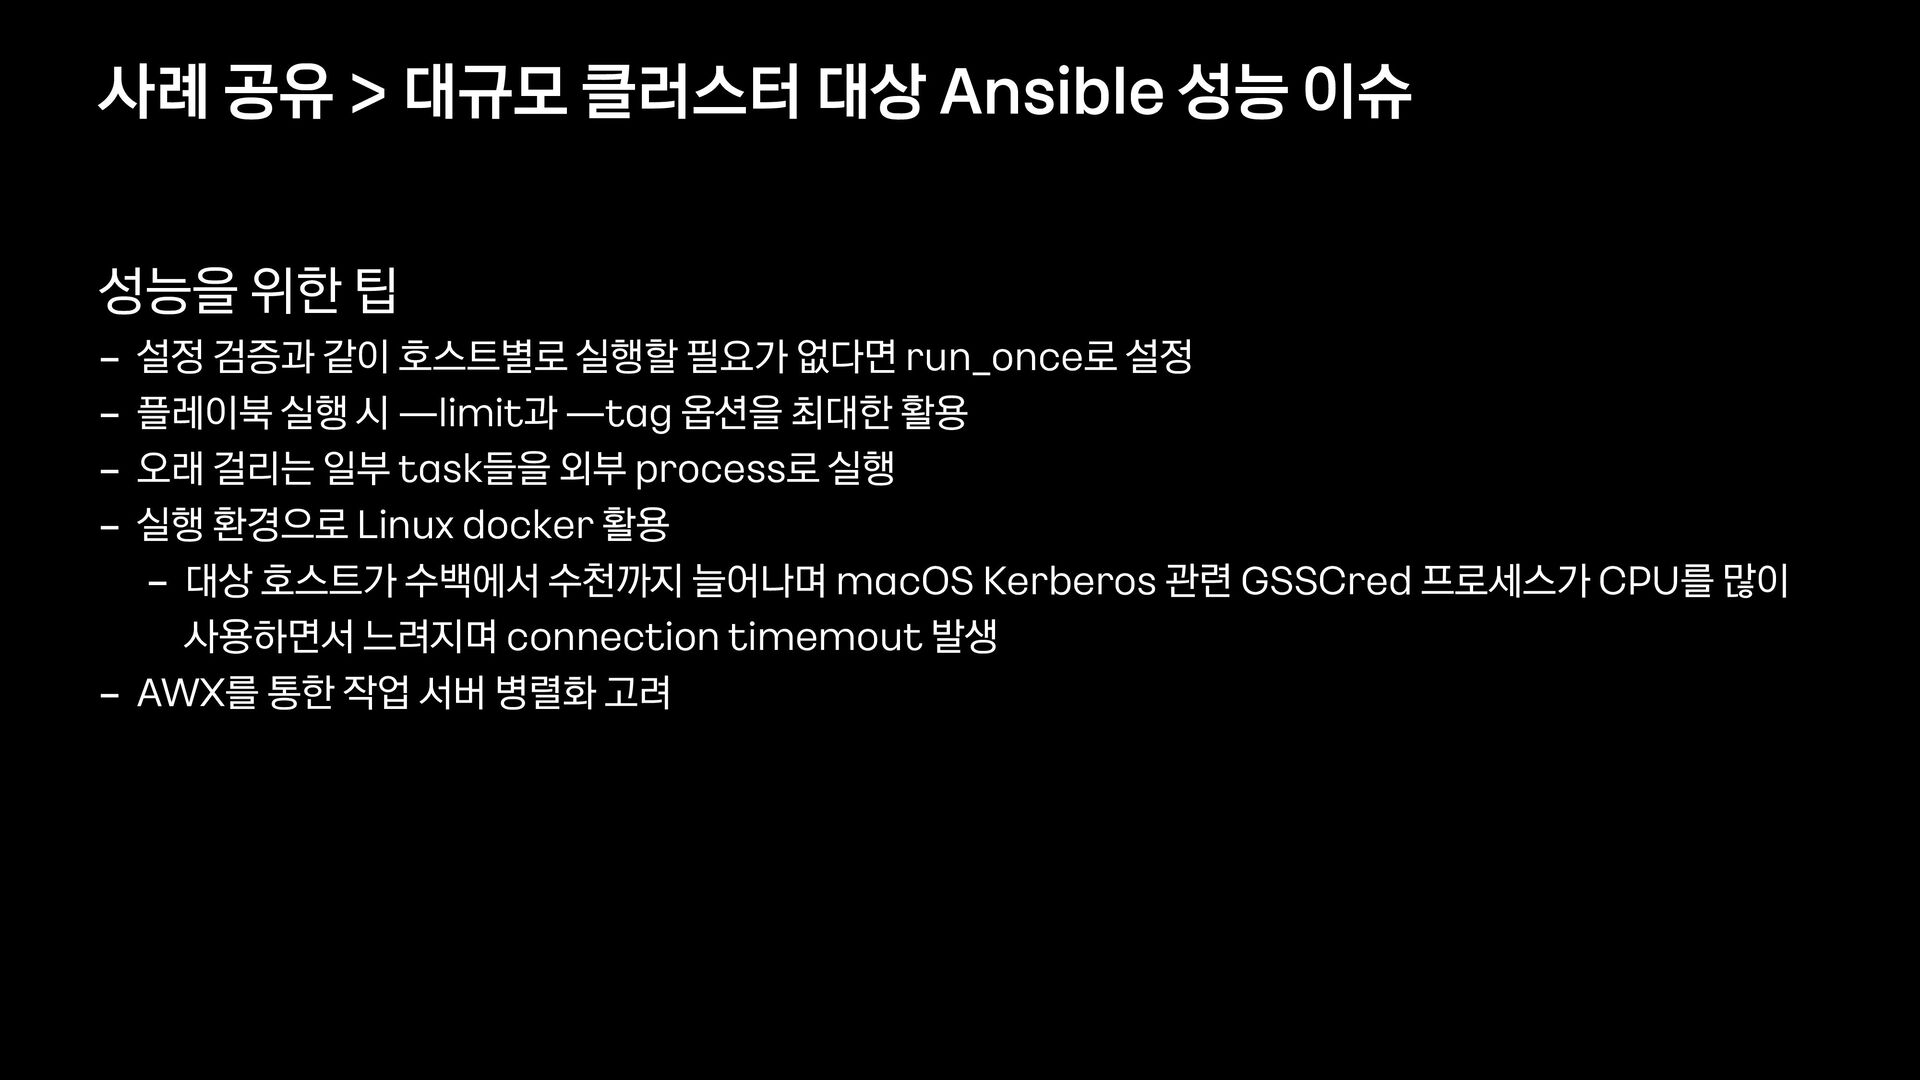
성능을 위한 팁 - 설정 검증과 같이 호스트별로 실행할 필요가
없다면 run_once로 설정 - 플레이북 실행 시 —limit과 —tag 옵션을 최대한 활용 - 오래 걸리는 일부 task들을 외부 process로 실행 - 실행 환경으로 Linux docker 활용 - 대상 호스트가 수백에서 수천까지 늘어나며 macOS Kerberos 관련 GSSCred 프로세스가 CPU를 많이 사용하면서 느려지며 connection timemout 발생 - AWX를 통한 작업 서버 병렬화 고려 사례 공유 > 대규모 클러스터 대상 Ansible 성능 이슈 -
Kakao Hadoop Platform (KHP) 소개 개발 과정 아키텍처 마이그레이션 KHP
적용 후 달라진 점 사례 공유 앞으로의 계획 -
- Hadoop 3 지원 - HBase 2 지원 - KHP
on AWS - KHP 관련 기술 블로그 작성 앞으로의 계획