Share
Embed
データ分析基盤におけるオブザーバビリティの取り組み
GMOペパボ株式会社では主にGoogle Cloud Platformのサービスを利用してデータ分析基盤を構築し運用しています。その中心となるのがデータウェアハウスのBigQueryとワークフローエンジンのCloud Composerです。また、社内向けのデータ可視化(ダッシュボード)システムではCloud Runを利用しています。
データ分析基盤から得られる情報を重要な意思決定に用いるためには、ユーザーに提供しているインフラと同様に、可用性を明らかにし、継続的に可用性を高める Realiability エンジニアリングが必要となります。本講演ではGCPで構築されているデータ分析基盤を題材として、データ分析基盤に求められる可用性や、小規模なチームにおけるオブザーバビリティへの取り組みについてご紹介します。
Koji Matsumoto
March 11, 2022
Transcript
47 slides
-
Observabilityが必要な背景 ~データ分析基盤~ - データ活用のニーズに対応すべく、スケーラブルな設計が求められる - クラウドサービスやコンテナの組み合わせで構成することが多い → 問題発生時の原因切り分けに時間を要する - データパイプラインの上で起きるデータに関する問題も効率的に把握できるようにしたい -
少人数でも効率よく運用したい - データ分析基盤は組織の重要な判断で使われる基盤 7 -
テレメトリーデータ - Metrics - 特定期間のシステムに関する集計データ - Log - システムのイベントや状態を表すテキストデータ -
Trace - トランザクションなどの単位で複数のコンポーネント間で連携する状態を表すデータ 9 -
Observabilityに関するまとめ - Observabilityがあると... - サービスで問題が発生したときに効率的にシステムの状態を把握できる - システムのパフォーマンスや品質の向上などの改善活動を推し進めることができる - データ分析基盤でも Observabilityは重要
- 多数のコンポーネントによる複雑なシステム構成 - 組織の重要な判断に使用されるシステム基盤 - Observabilityを実現するプロセス - テレメトリデータの収集・分析・可視化 - テレメトリデータ - Metrics・Log・Trace 10 -
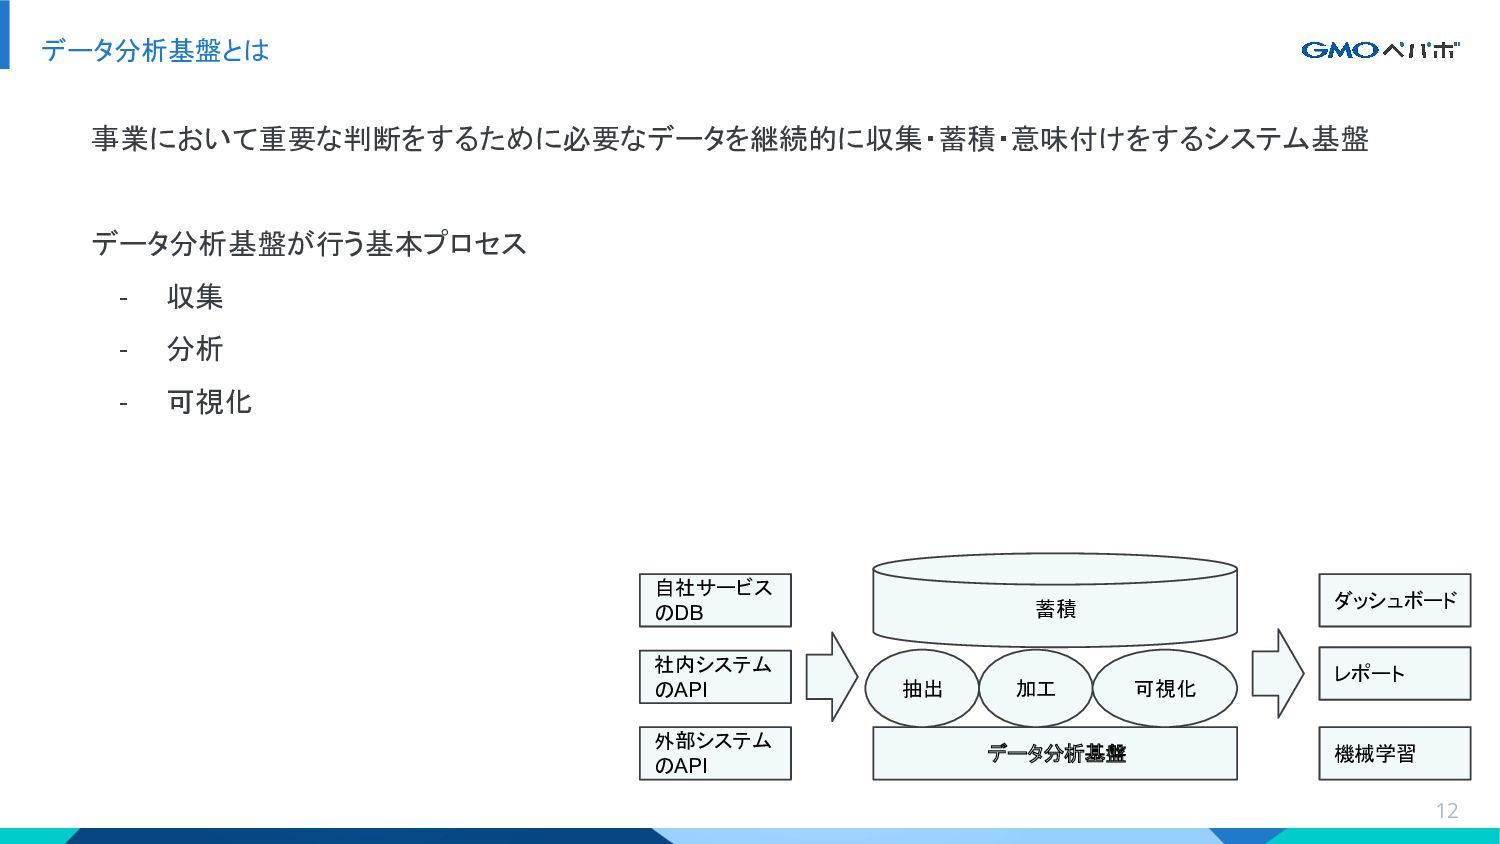
データ分析基盤とは 事業において重要な判断をするために必要なデータを継続的に収集・蓄積・意味付けをするシステム基盤 データ分析基盤が行う基本プロセス - 収集 - 分析 - 可視化 自社サービス
のDB 外部システム のAPI 社内システム のAPI データ分析基盤 抽出 加工 可視化 蓄積 ダッシュボード レポート 機械学習 12 -
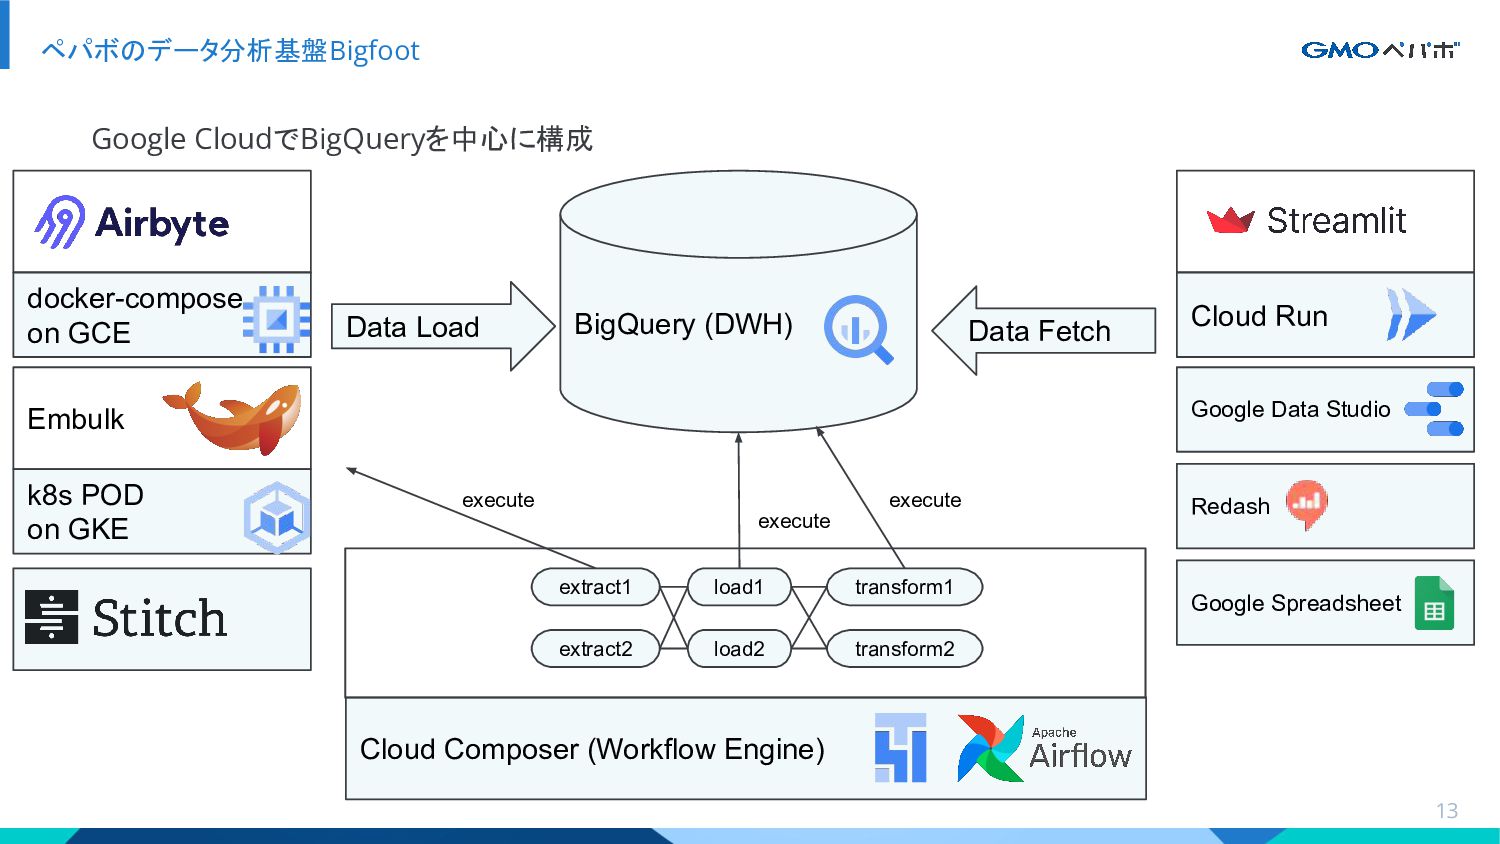
Google Spreadsheet Redash Google Data Studio ペパボのデータ分析基盤 Bigfoot Cloud Composer
(Workflow Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute Google CloudでBigQueryを中心に構成 13 -
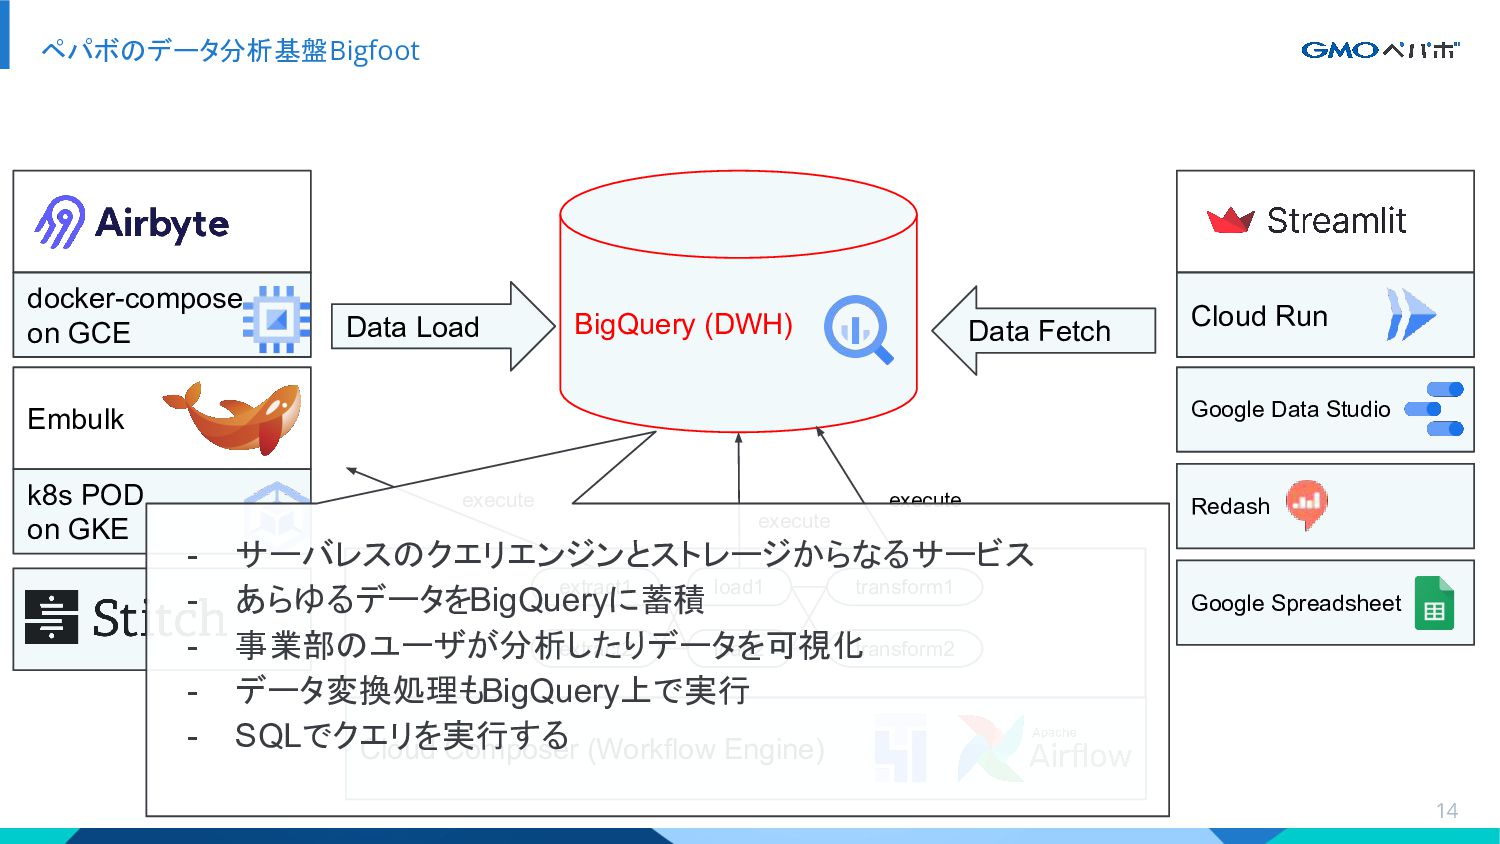
Google Spreadsheet Redash Google Data Studio ペパボのデータ分析基盤 Bigfoot Cloud Composer
(Workflow Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute - サーバレスのクエリエンジンとストレージからなるサービス - あらゆるデータをBigQueryに蓄積 - 事業部のユーザが分析したりデータを可視化 - データ変換処理もBigQuery上で実行 - SQLでクエリを実行する 14 -
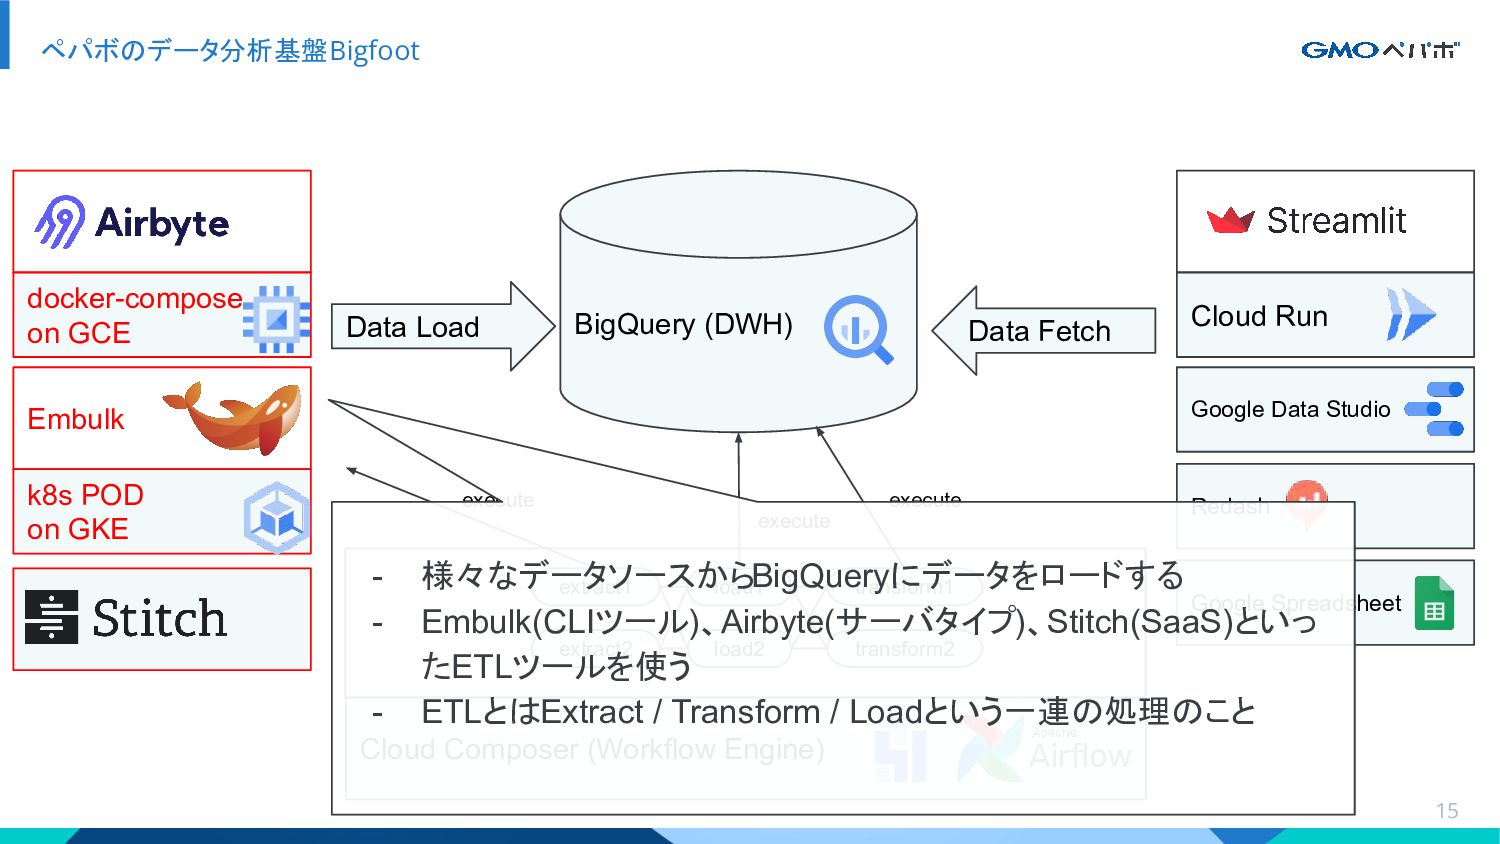
Google Spreadsheet Redash Google Data Studio ペパボのデータ分析基盤 Bigfoot Cloud Composer
(Workflow Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute - 様々なデータソースからBigQueryにデータをロードする - Embulk(CLIツール)、Airbyte(サーバタイプ)、Stitch(SaaS)といっ たETLツールを使う - ETLとはExtract / Transform / Loadという一連の処理のこと 15 -
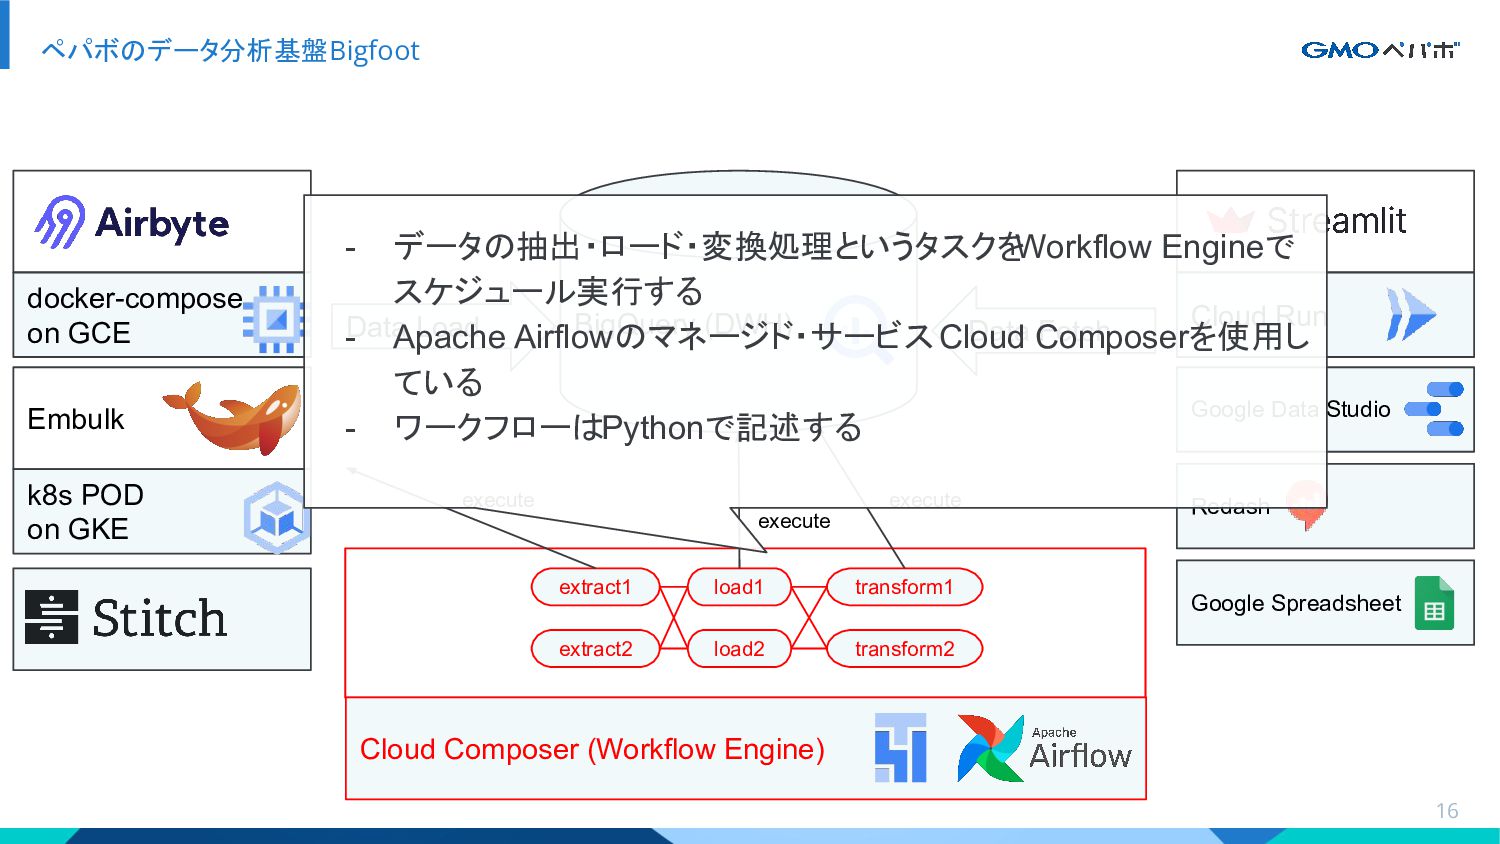
Google Spreadsheet Redash Google Data Studio ペパボのデータ分析基盤 Bigfoot Cloud Composer
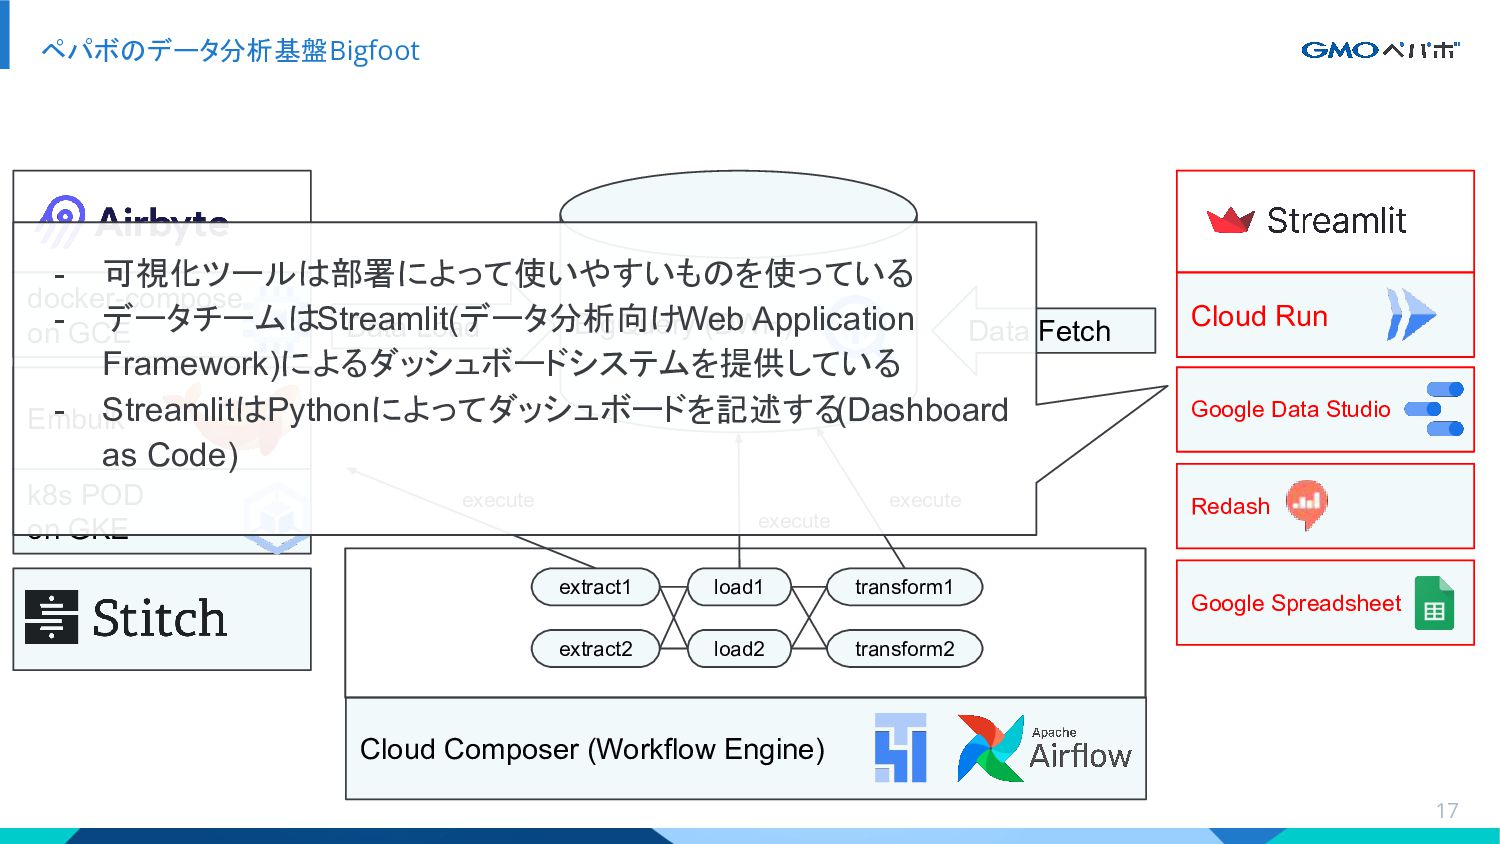
(Workflow Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute - データの抽出・ロード・変換処理というタスクを Workflow Engineで スケジュール実行する - Apache Airflowのマネージド・サービス Cloud Composerを使用し ている - ワークフローはPythonで記述する 16 -
Google Spreadsheet Redash Google Data Studio ペパボのデータ分析基盤 Bigfoot Cloud Composer
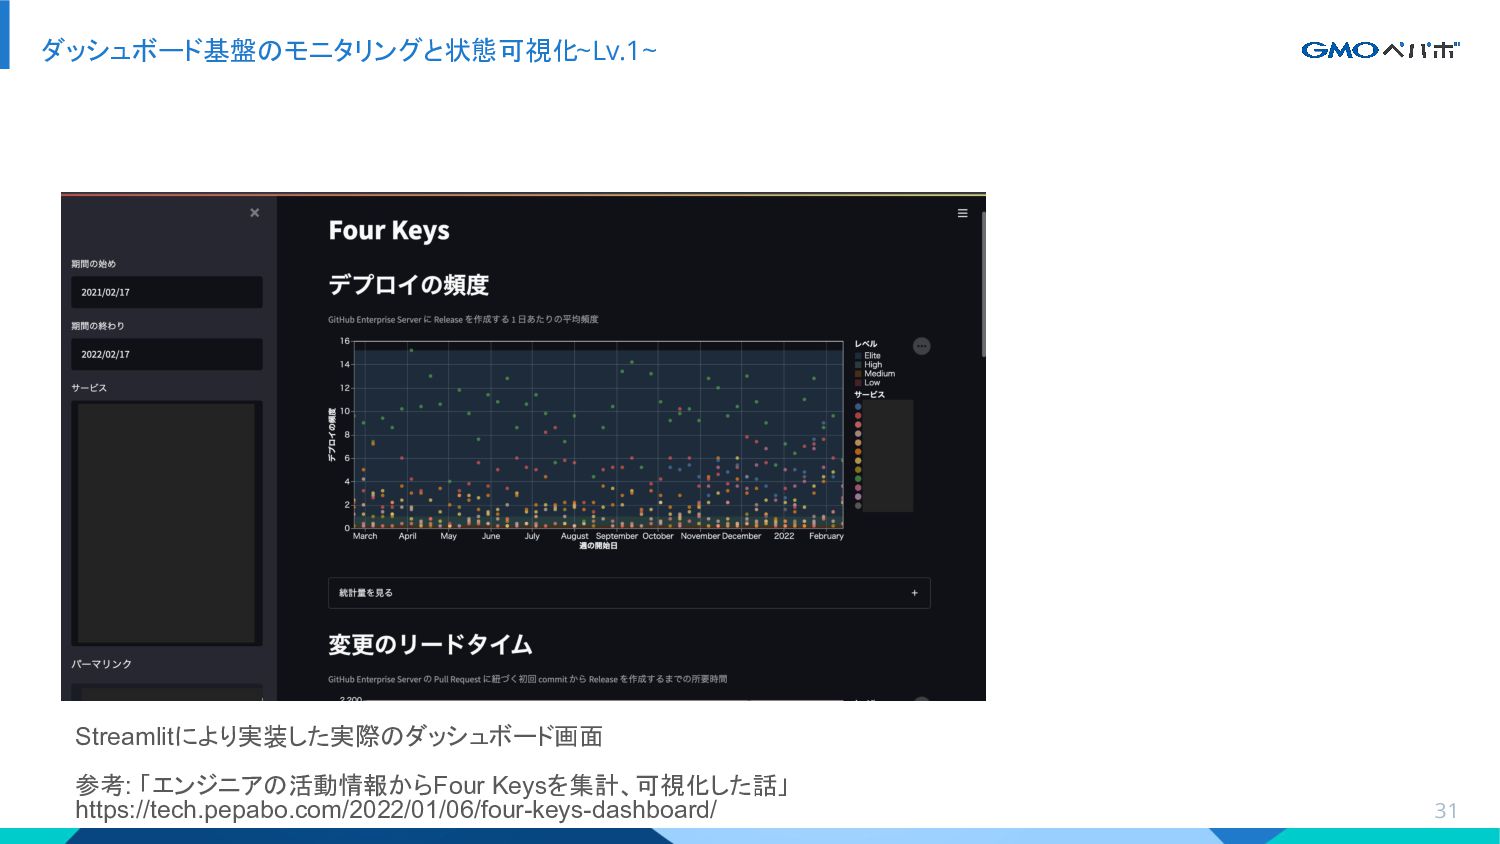
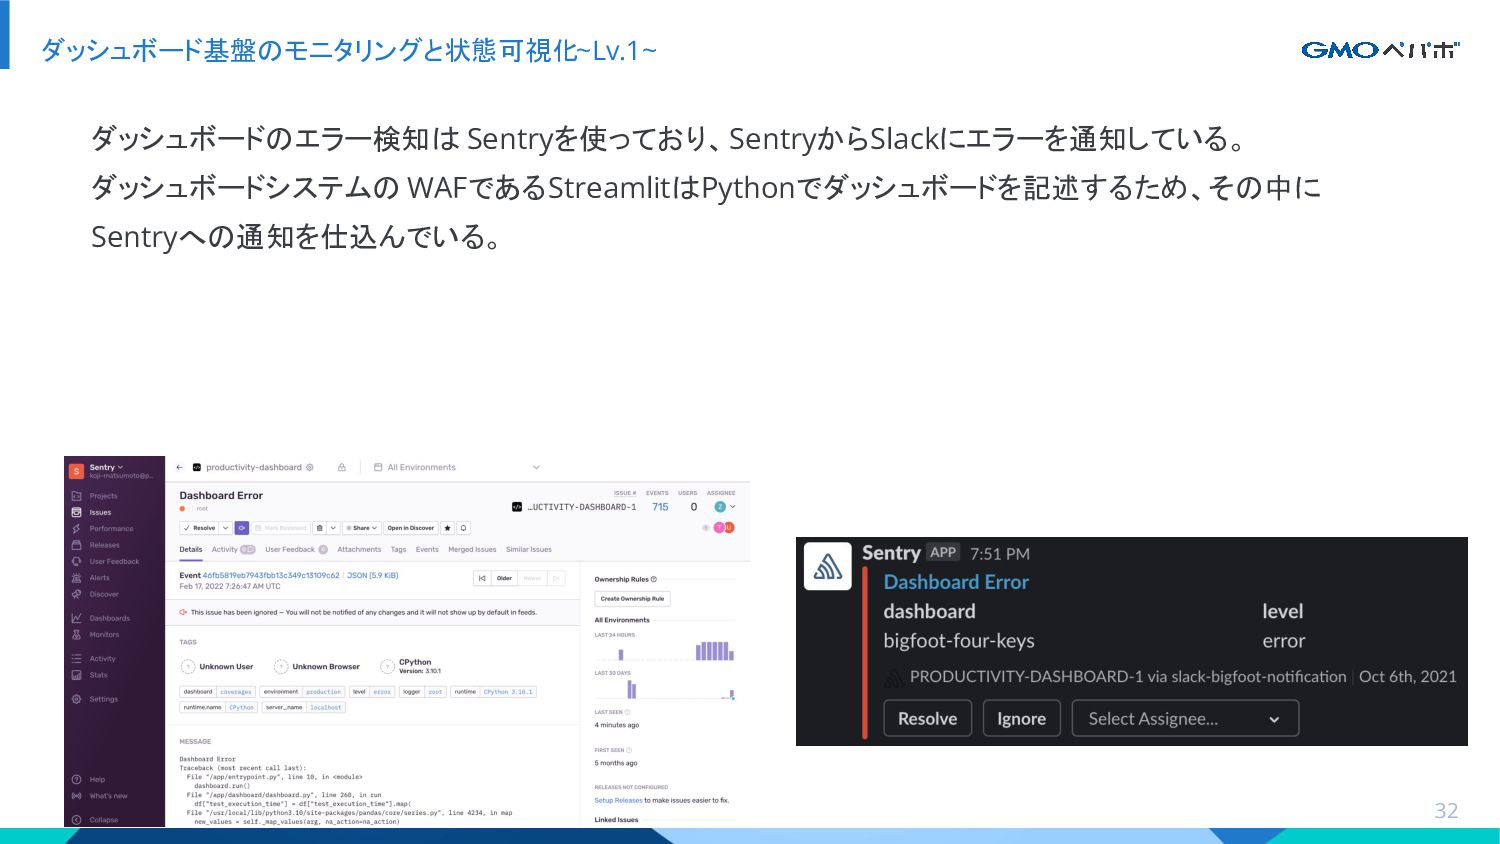
(Workflow Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute - 可視化ツールは部署によって使いやすいものを使っている - データチームはStreamlit(データ分析向けWeb Application Framework)によるダッシュボードシステムを提供している - StreamlitはPythonによってダッシュボードを記述する (Dashboard as Code) 17 -
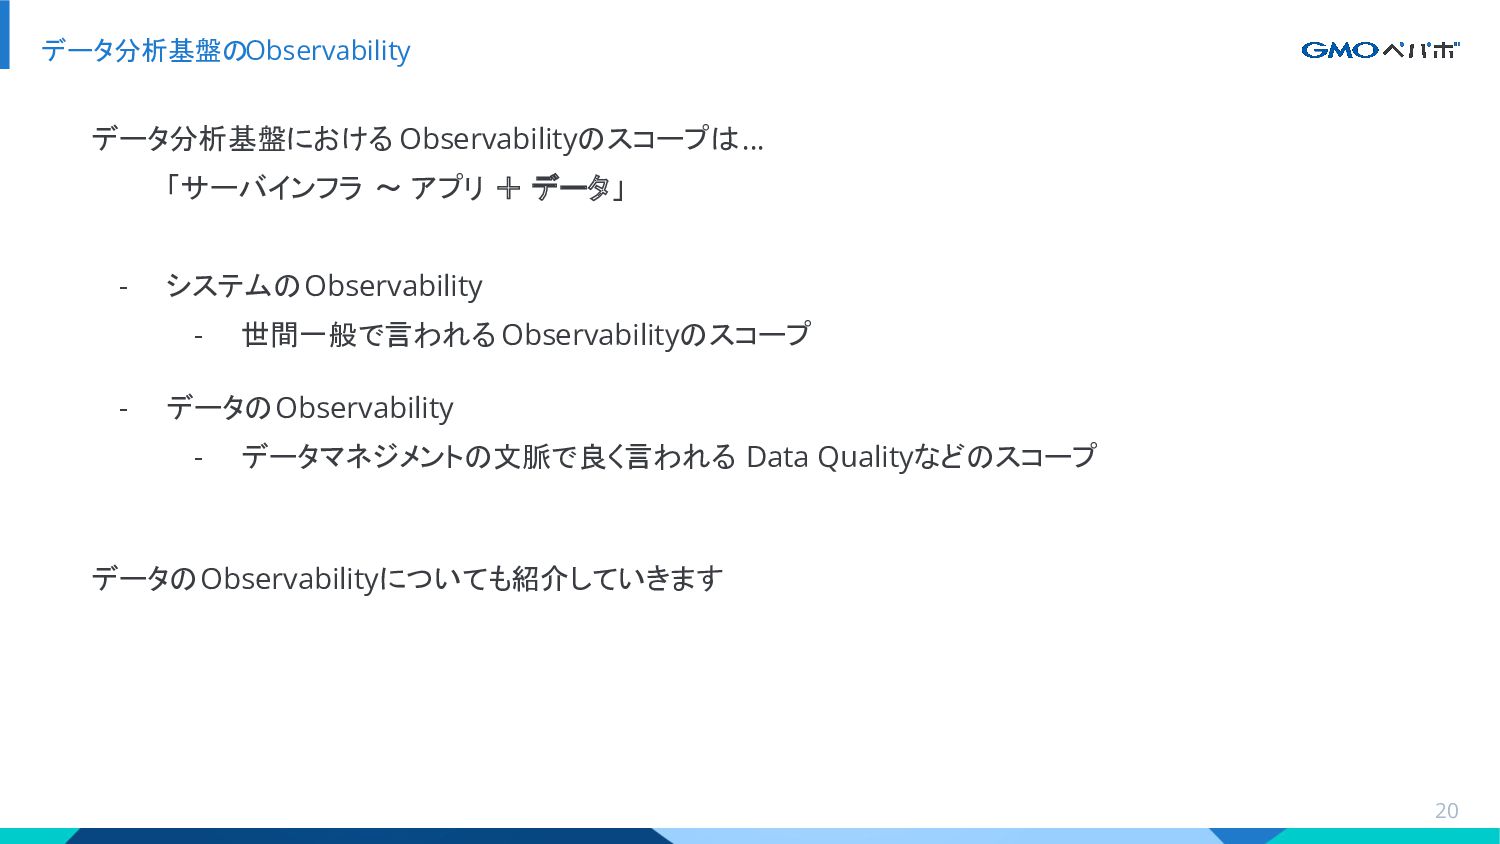
データ分析基盤のObservability データ分析基盤における Observabilityのスコープは... 「サーバインフラ 〜 アプリ + データ」 - システムのObservability
- 世間一般で言われる Observabilityのスコープ - データのObservability - データマネジメントの文脈で良く言われる Data Qualityなどのスコープ データのObservabilityについても紹介していきます 20 -
BigfootにおけるObservabilityの現状 Google Spreadsheet Redash Google Data Studio Cloud Composer (Workflow
Engine) Embulk docker-compose on GCE k8s POD on GKE BigQuery (DWH) Cloud Run extract1 load1 transform1 extract2 load2 transform2 Data Load Data Fetch execute execute execute Lv.2 Lv.1 Lv.1 Lv.1 22 -
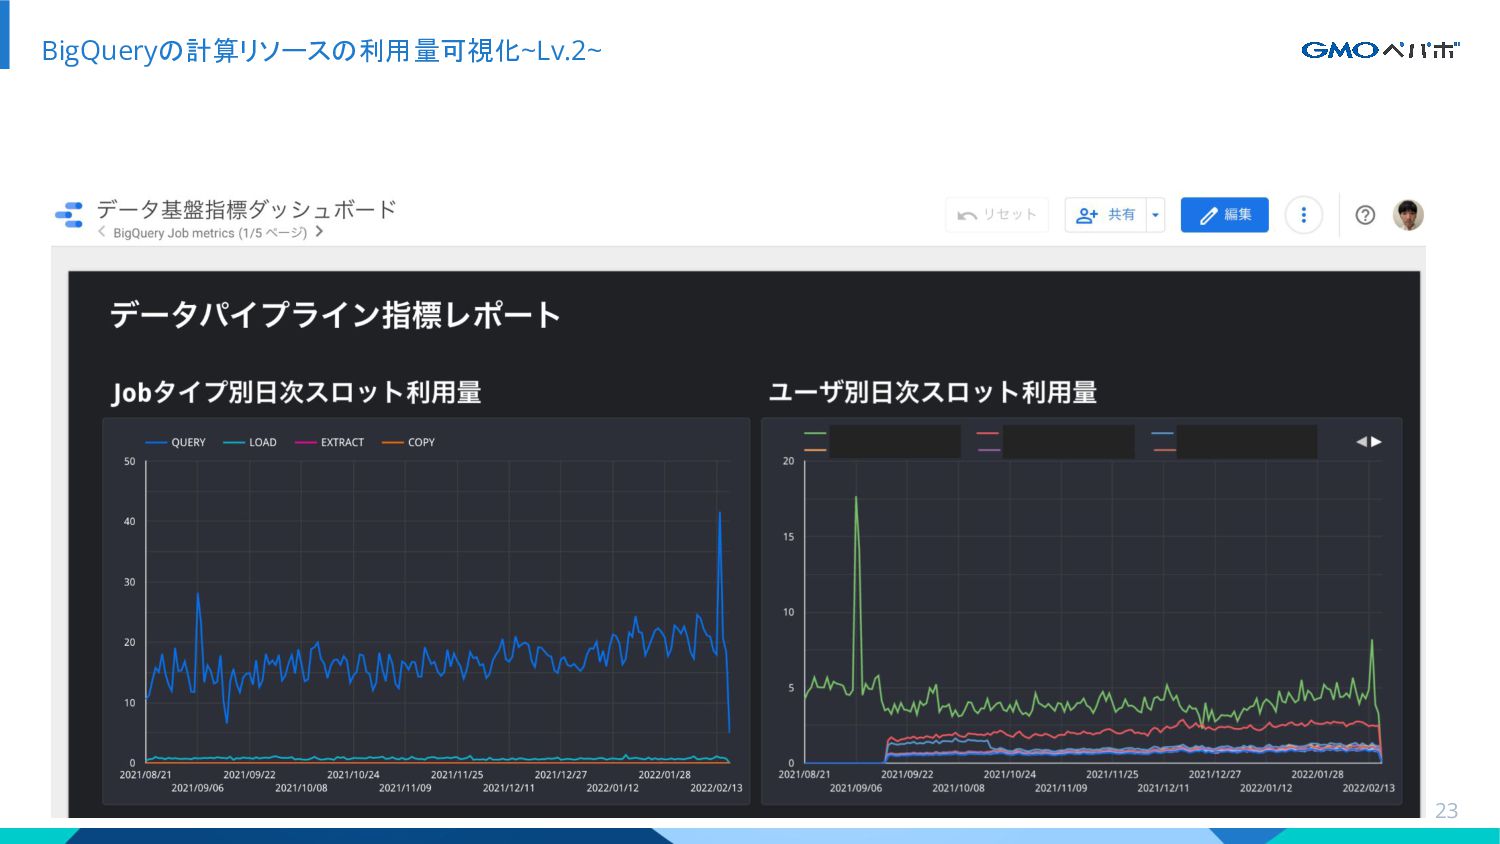
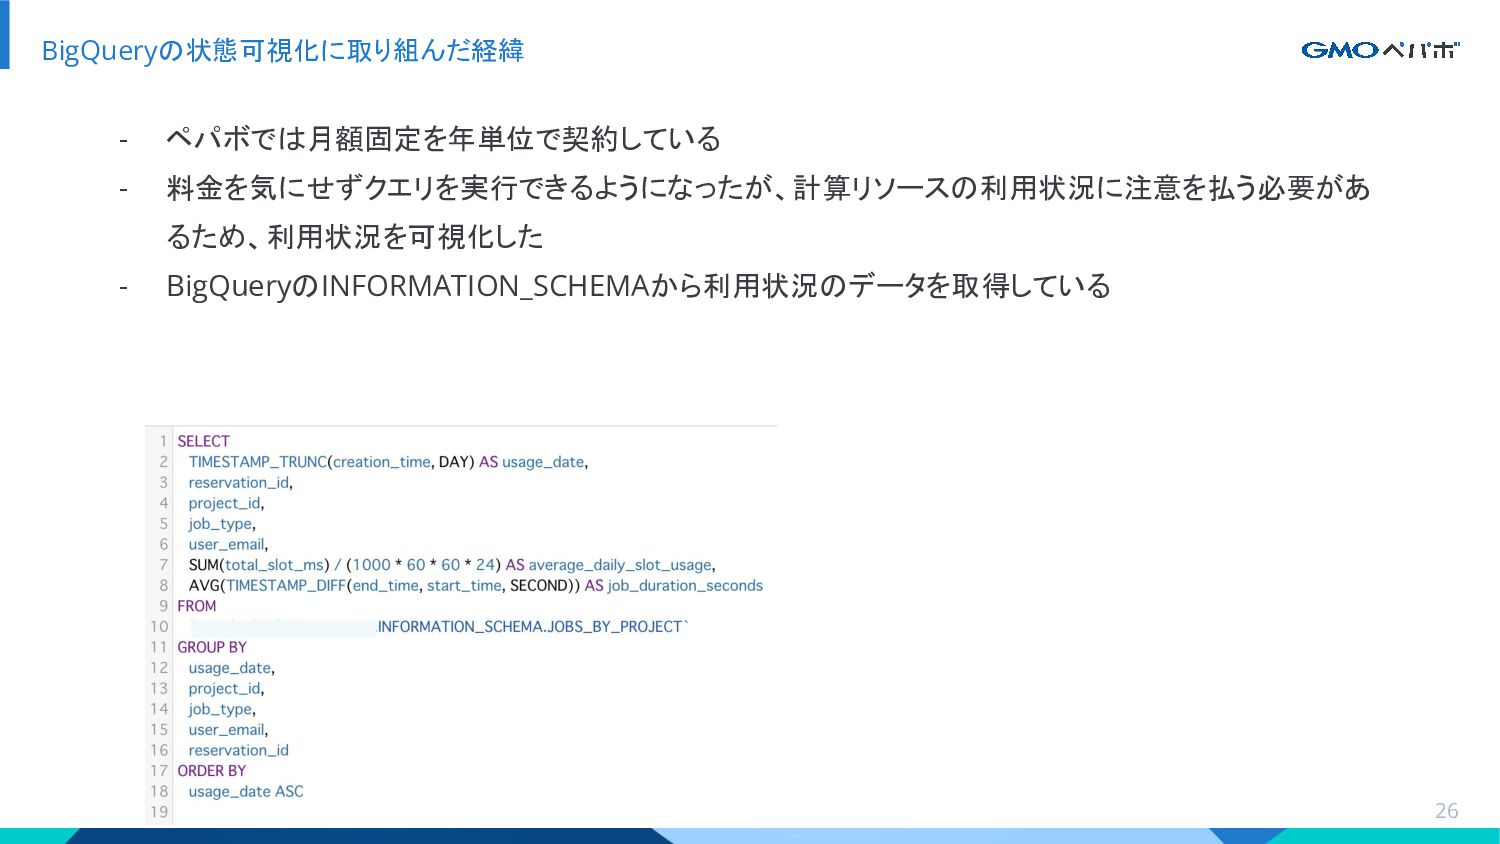
BigQueryの状態可視化に取り組んだ経緯 - BigQueryの契約には、従量課金と月額固定がある - 従量課金 - 使用計算リソース量はベストエフォート - クエリ時のデータスキャン量によって課金される -
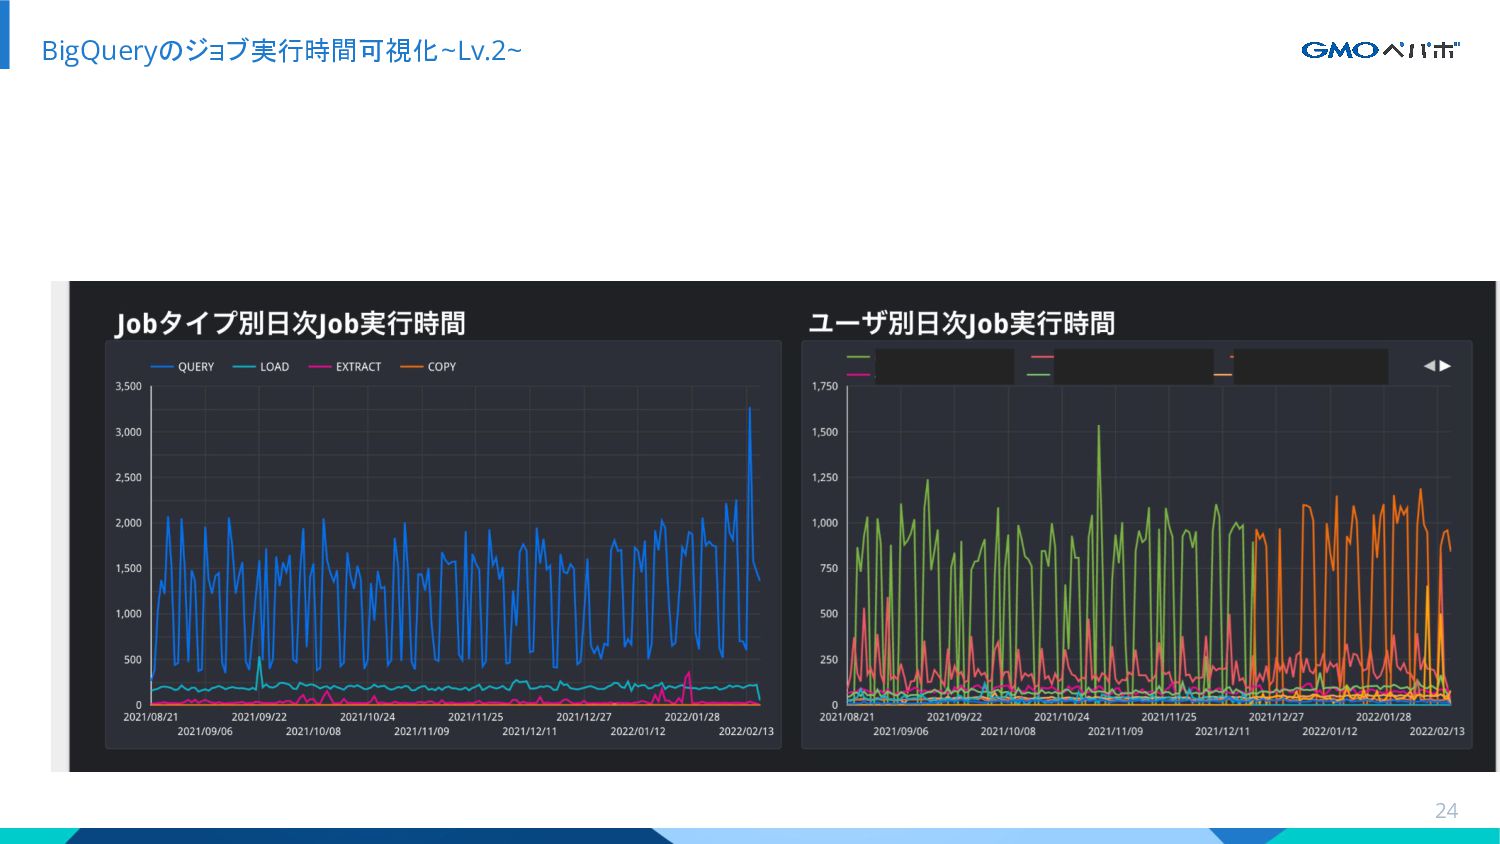
月額固定 - 使用計算リソース量の上限を設ける - クエリ時のデータスキャン量に関係なく定額料金 - 月額固定は費用が予測しやすくなるが、クエリが集中した場合は計算リソース不足で実行時間が伸 びる可能性がある - 月額固定の契約期間は月・年単位だが、秒単位で契約できる Flex Slotもある 25 -
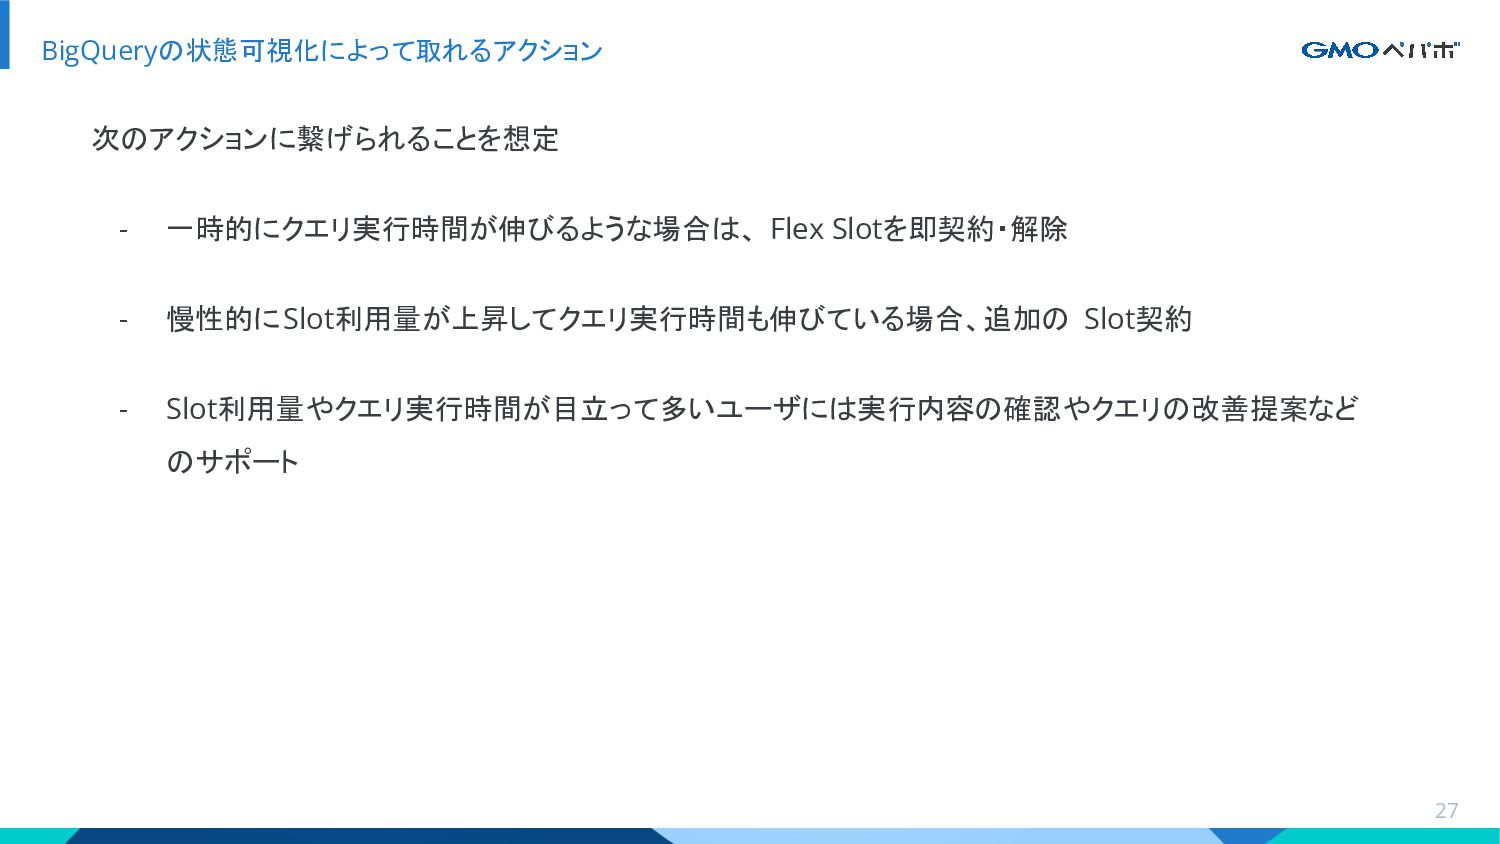
BigQueryの状態可視化によって取れるアクション 次のアクションに繋げられることを想定 - 一時的にクエリ実行時間が伸びるような場合は、 Flex Slotを即契約・解除 - 慢性的にSlot利用量が上昇してクエリ実行時間も伸びている場合、追加の Slot契約 -
Slot利用量やクエリ実行時間が目立って多いユーザには実行内容の確認やクエリの改善提案など のサポート 27 -
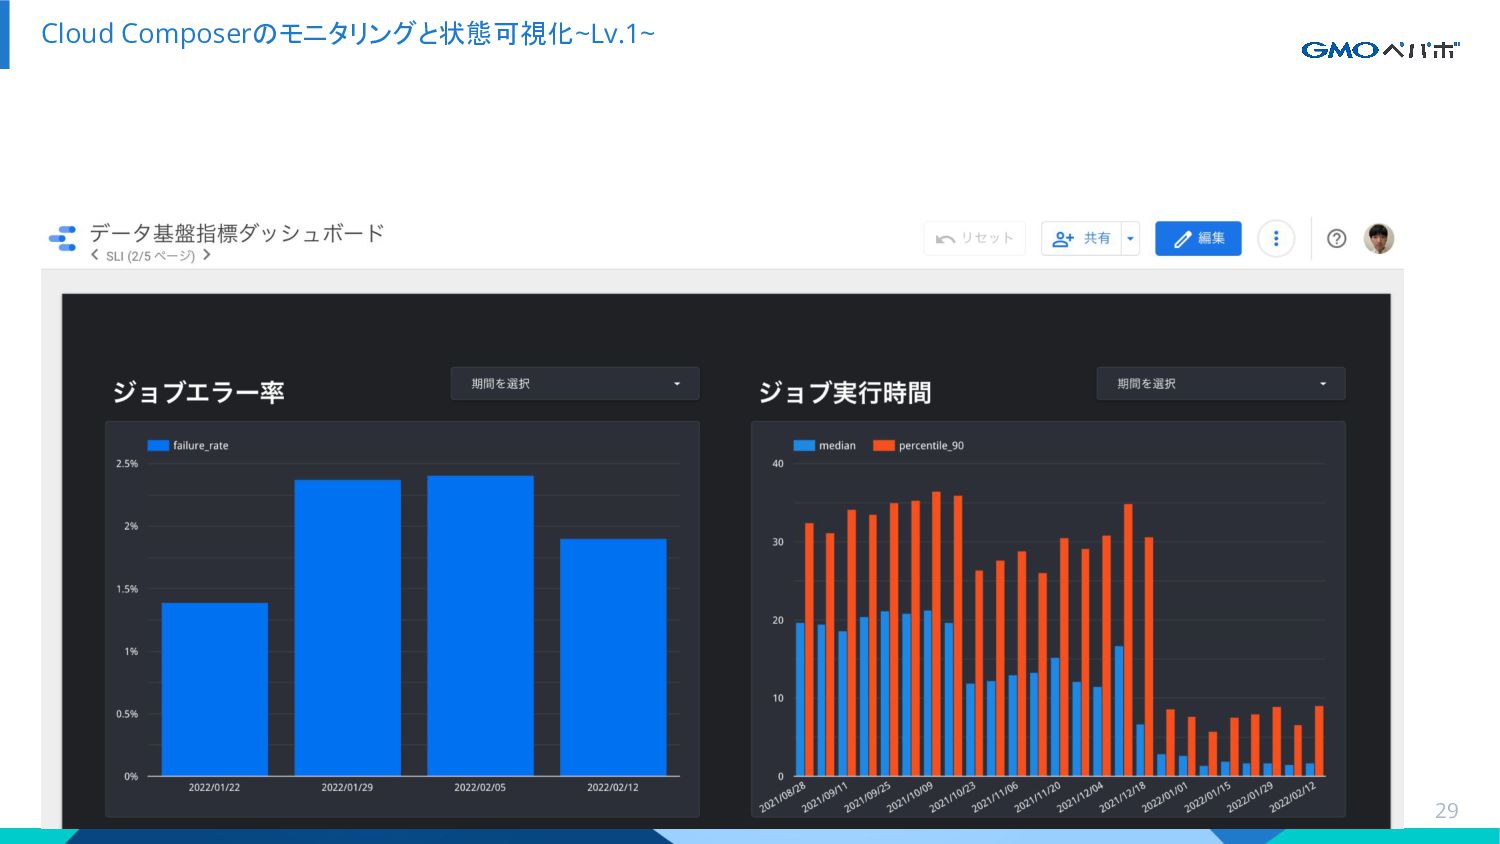
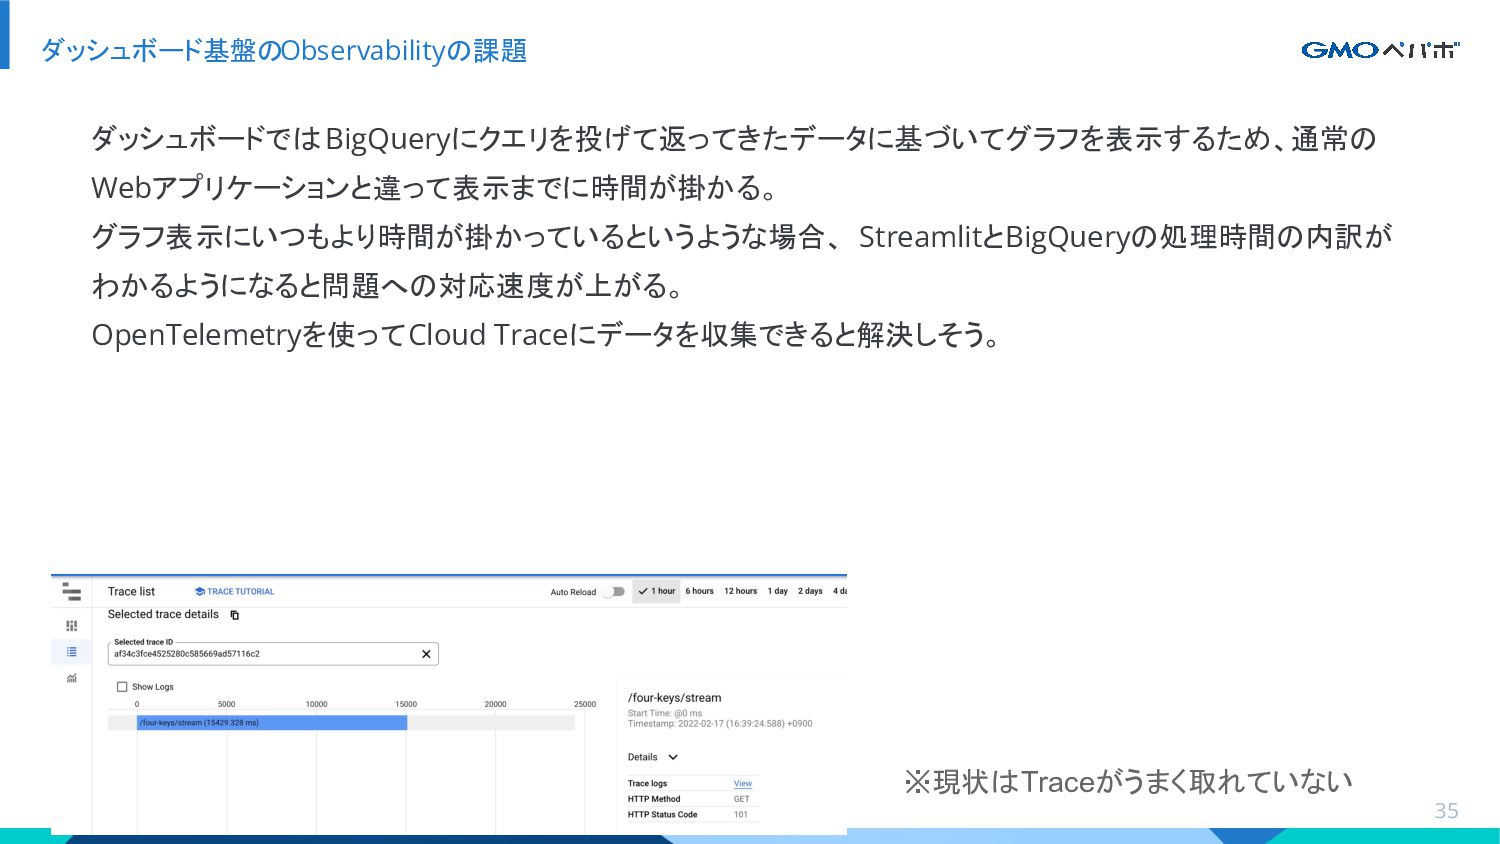
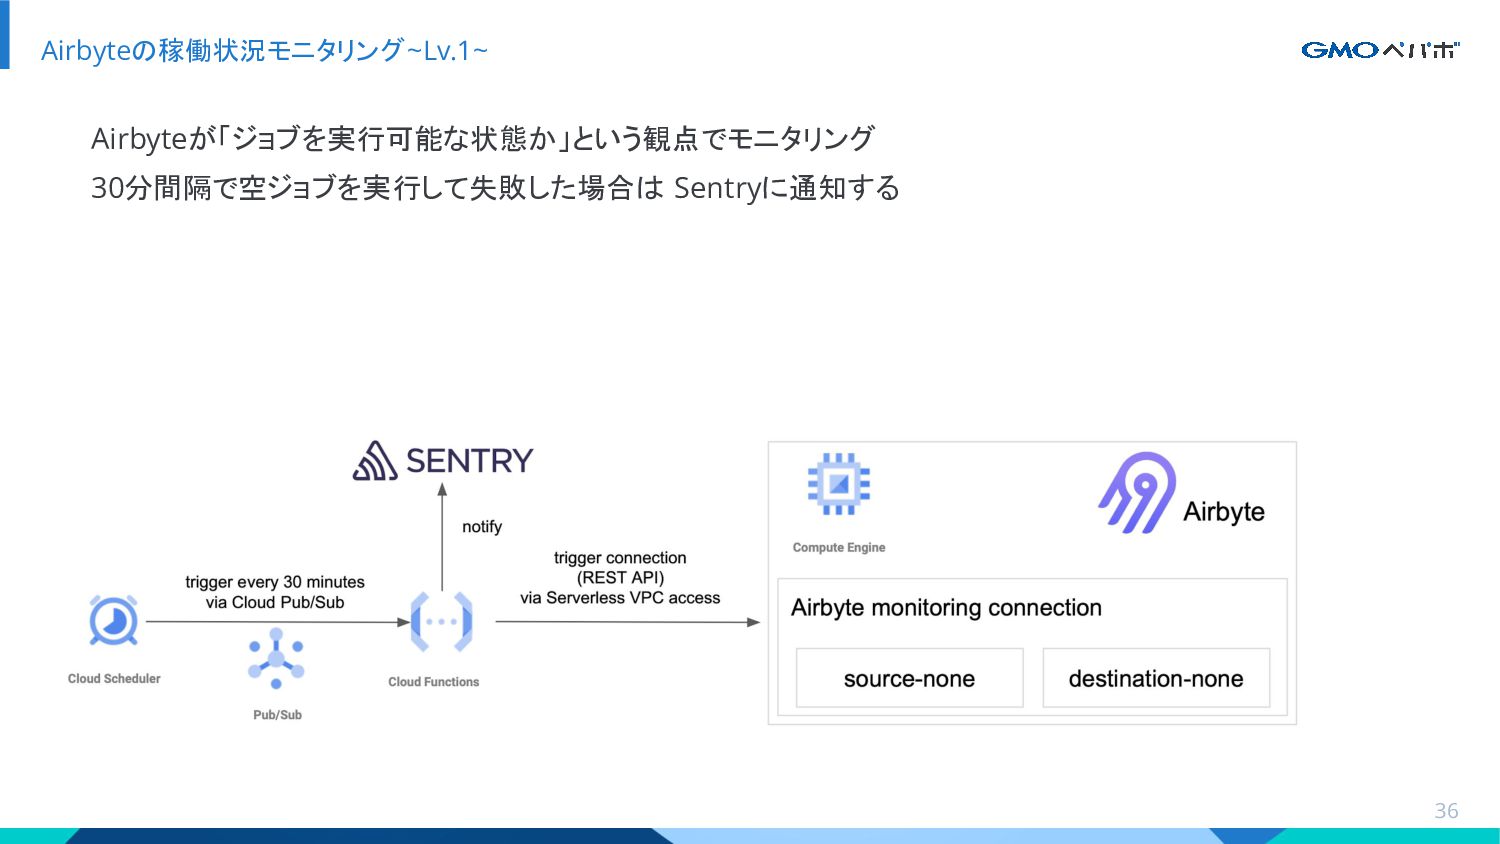
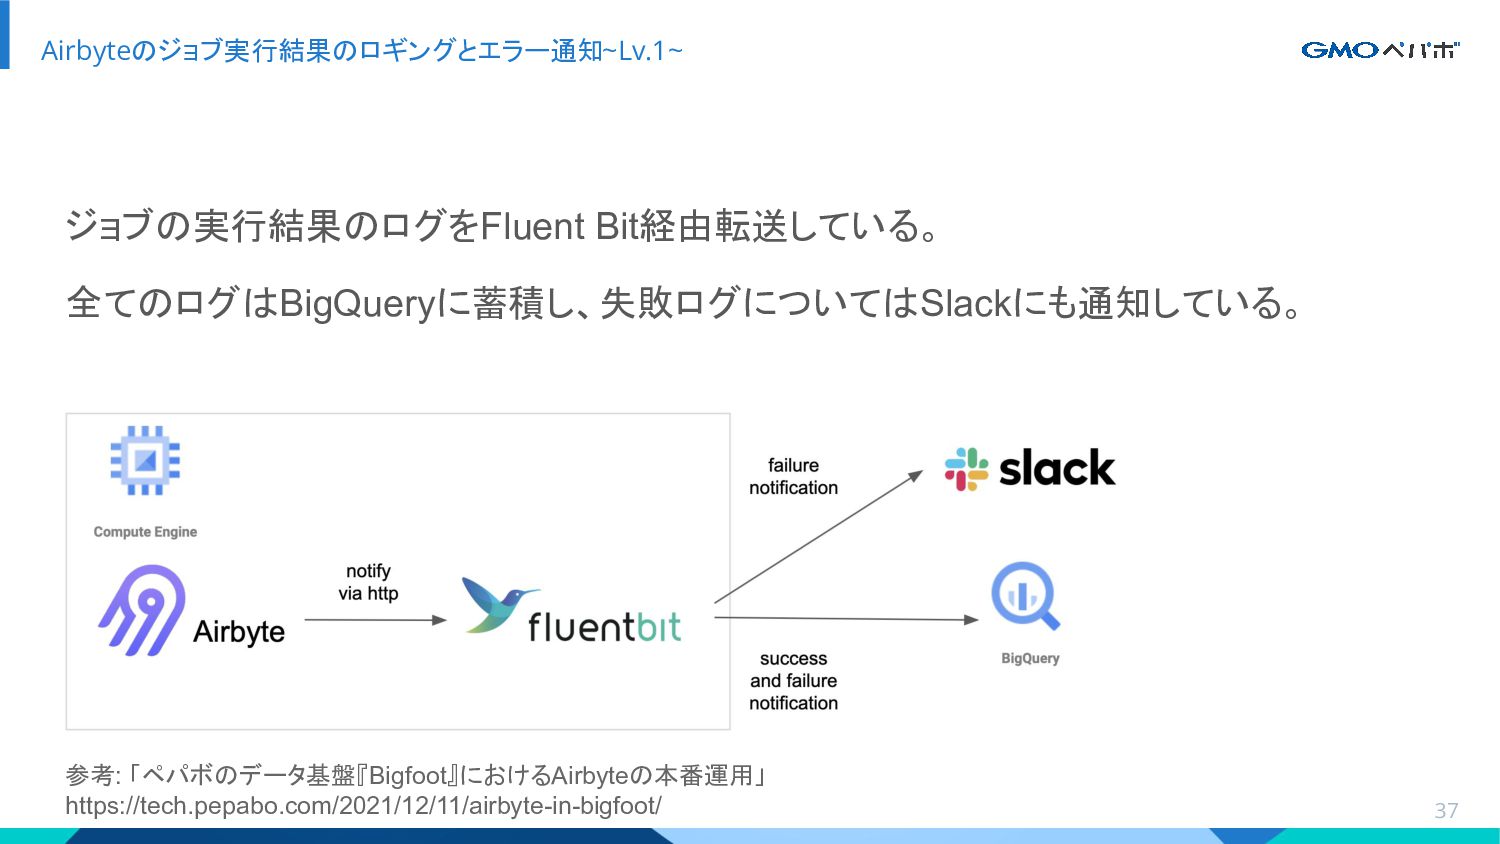
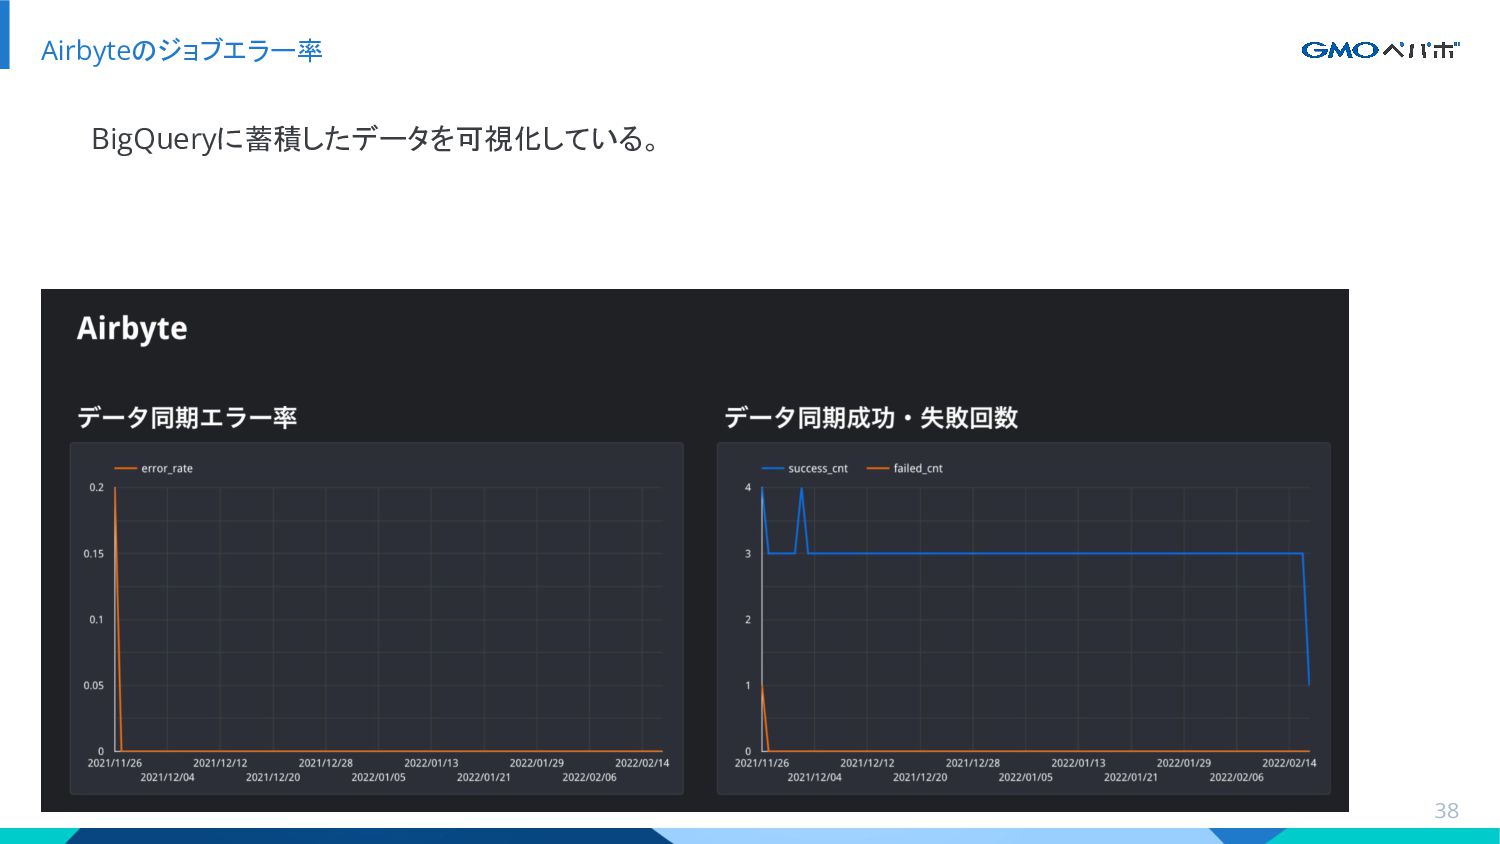
Cloud Composerの現在のObservability - ユーザ目線での高レイヤでのチェックによる異常検知とサービス状態可視化ができている - システムに係る低レイヤのチェックについては効率的にできていない状況 - 低レイヤのMetricsの収集や、Traceを活用をしてObservabilityを高めていきたい - Cloud
Composerをver.1からver.2にバージョンアップするとワーカーのオートスケーリング機能が使 えるようになるため、動的に変化する環境に対応できるよう Observability向上は必須 30 -
BigfootにおけるObservabilityの課題 - Cloud Composerのジョブ失敗時の原因が不明のままとりあえず復旧して様子見として終わりとして いることが多い - Cloud Composerとそのworkflow上で実行されるk8sなどの様々なワークロードを辿って問題 を追跡していくのは時間が掛かる -
Cloud Logging、Metrics、Traceを活用してLv.2を目指す - データパイプラインで生成されるテーブル間の依存関係を辿るのに時間が掛かる - 依存関係を辿る作業を効率化する仕組みとしてデータリネージがある - チームメンバーがOSSのデータリネージツール Stairlight (https://github.com/tosh2230/stairlight)を開発中 - データリネージツールとデータクオリティツールを活用してデータの Observabilityも向上させた い 44 -
BigfootにおけるObservabilityの課題への対応 - Cloud Logging、Cloud Metrics、Cloud Traceを使いこなすことでシステムの Observabilityを向上さ せる - 引き続き、Observabilityに関するデータをBigQueryに蓄積し、分析・可視化をやっていく
- データのObservabilityへの取り組みを優先度上げてやっていく 45 -
BigfootにおけるObservabilityの今後 - BigfootはGoogle CloudからAWSに基盤を拡張している - ペパボのサービスが稼働している AWSやその他のプラットフォームからデータを収集するため に、Google CloudからAWSに跨って機能拡張を進めている -
Cloud ComposerからEmbulk on AWS BatchでサービスのRDSからデータを抽出して BigQueryに同期するというもの - マルチクラウド環境での Observabilityに取り組んでいく必要がある - MLOpsへの取り組みも始まった - ペパボのサービス→データ分析基盤→機械学習システム→ペパボのサービス というサイクル が生まれる - よりリアルタイム性も求められるようになるので問題への効率的な対応が求められる 46 -
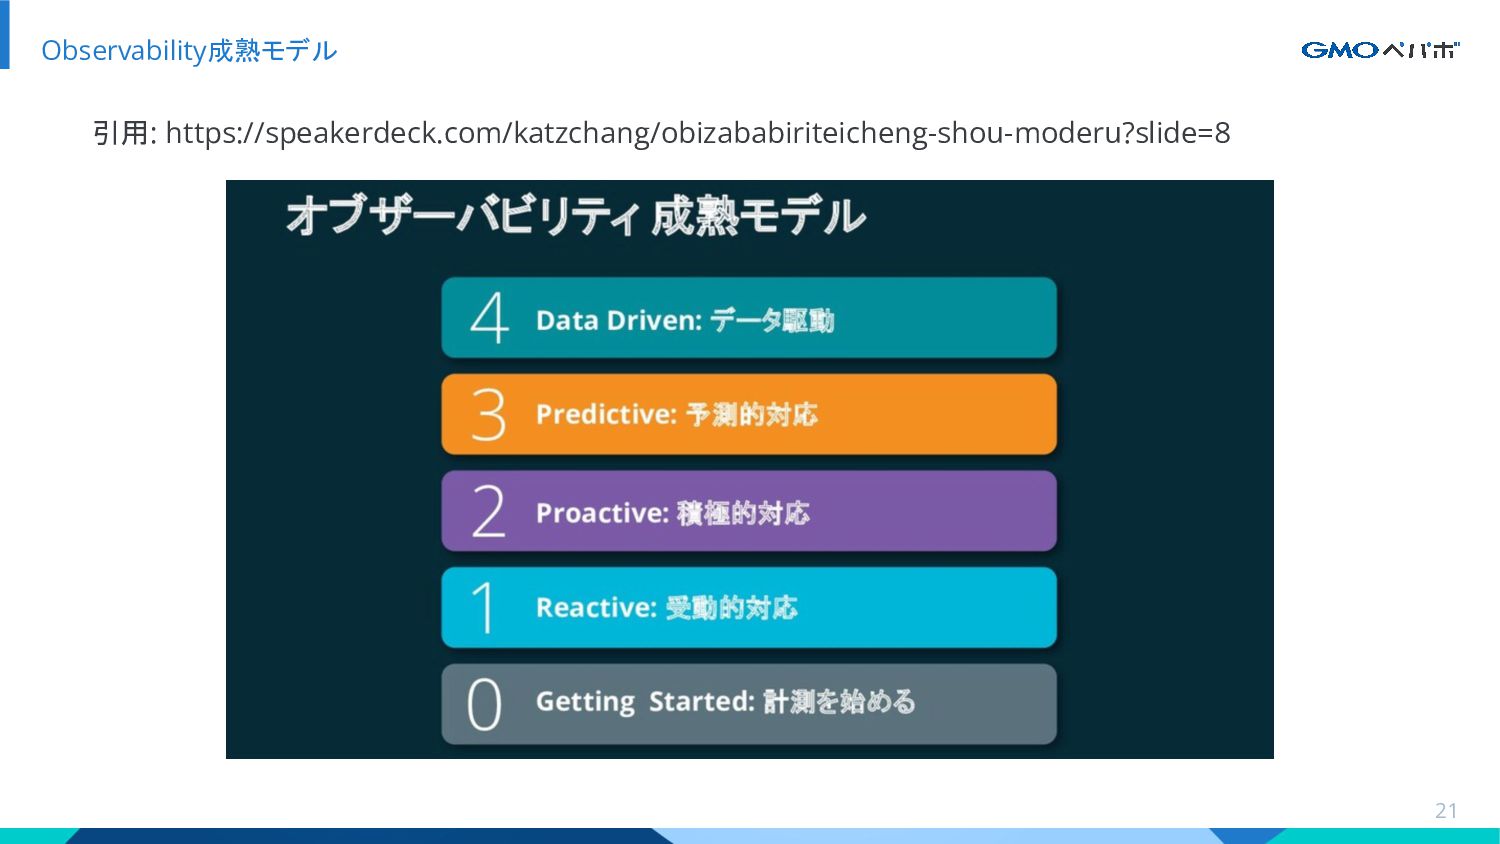
まとめ - Observability成熟モデルに基づいて現在のペパボのデータ分析基盤の Observabilityについてアセ スメントした - 殆どLv.1 - データ駆動が進めば基盤の重要性が増し、更なる品質とスピードも求められてくるので少しず つでもレベルアップを図っていきたい
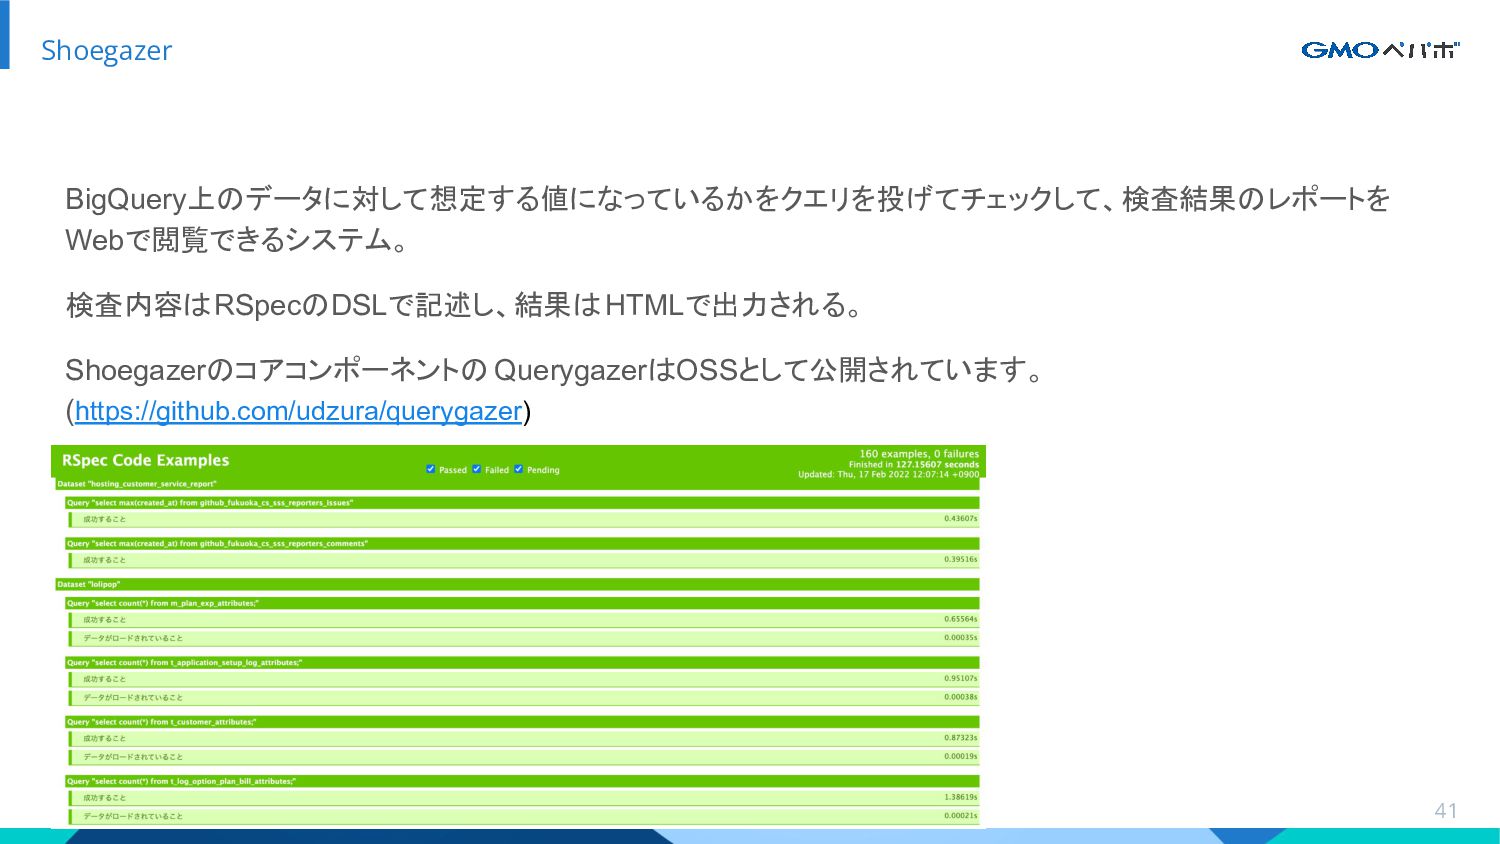
- データのObservabilityについても取り組みを紹介した - データの正常性を定期的にチェックする仕組みとして Shoegazerを紹介した - 今後、機械学習が組み込まれてヒトが介在しないサイクルへ発展することが予想される - データパイプラインの状態を効率的に把握できるようにデータの Observability向上にも力を入 れていきたい 47