Patroni failure stories, or How to crash yout P...

Share
Embed
Patroni failure stories, or How to crash yout PostgreSQL cluster
Slides from my talk at Highload++ conference 2019 Moscow

Alexey Lesovsky
November 07, 2019
Transcript
74 slides
-
Про докладчика Linux system administrator PostgreSQL database administrator Data Egret,
2014 — now Linux, виртуализация, контейнеры, мониторинг, репликация и т.п. -
О чем доклад В postgres нет «HA» из HA» из
ко» из коробки Patroni решает вопрос «HA» из HA» из ко» Иногда случаются проблемы разной степени тяжести Расскажу, с чем сталкивались мы у наших клиентов Как диагностировали, что подкрутили в итоге -
Чего НЕ будет в докладе Не будет: • Инструкций по
установке • Примеров конфигураций • Историй, основанных на чужом опыте • Проблем за пределом Patroni и PostgreSQL -
Disclaimer Все рассмотренные истории являются результатом собственного опыта, восстановленые по
постмортемам. За давностью времени часть деталей либо подзабылась, либо просто не была исследована в ходе спешной починки. -
Перед тем, как начать Patroni: • Шаблон для построения HA»
из ко • Агентская служба, init-системасистема для postgres • Хранит «состояние кластера» в DCS • Автофайловер включен по умолчанию • ... есть много других вещей -
Перед тем, как начать Основная задача Patroni — хорошо делать
автофайловер * - Patroni не должен следить за оборудованием, слать нотификации в слак, делать сложные вещи по потенциальному предотвращению аварий и т.п. -
Перед тем, как начать Что может сломаться? • Postgres •
Patroni • DCS • Сеть -
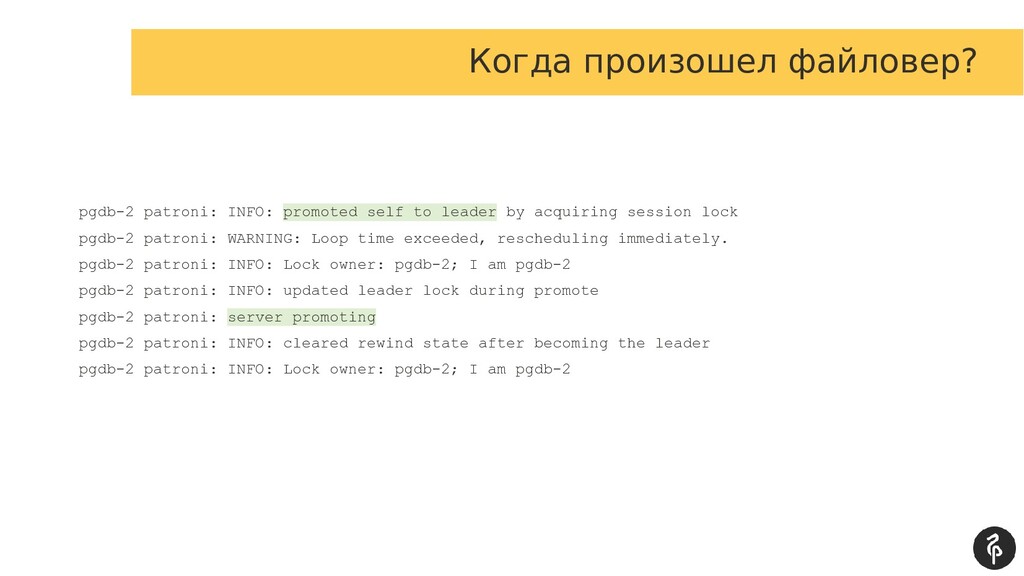
Когда произошел файловер? Первым делом интересует сам файловер В какое
время он произошел: Когда начался? Когда закончился? Все события делятся на «HA» из до», «HA» из во время» и «HA» из после файловера» -
Когда произошел файловер? pgdb-2 patroni: INFO: promoted self to leader
by acquiring session lock pgdb-2 patroni: WARNING: Loop time exceeded, rescheduling immediately. pgdb-2 patroni: INFO: Lock owner: pgdb-2; I am pgdb-2 pgdb-2 patroni: INFO: updated leader lock during promote pgdb-2 patroni: server promoting pgdb-2 patroni: INFO: cleared rewind state after becoming the leader pgdb-2 patroni: INFO: Lock owner: pgdb-2; I am pgdb-2 -
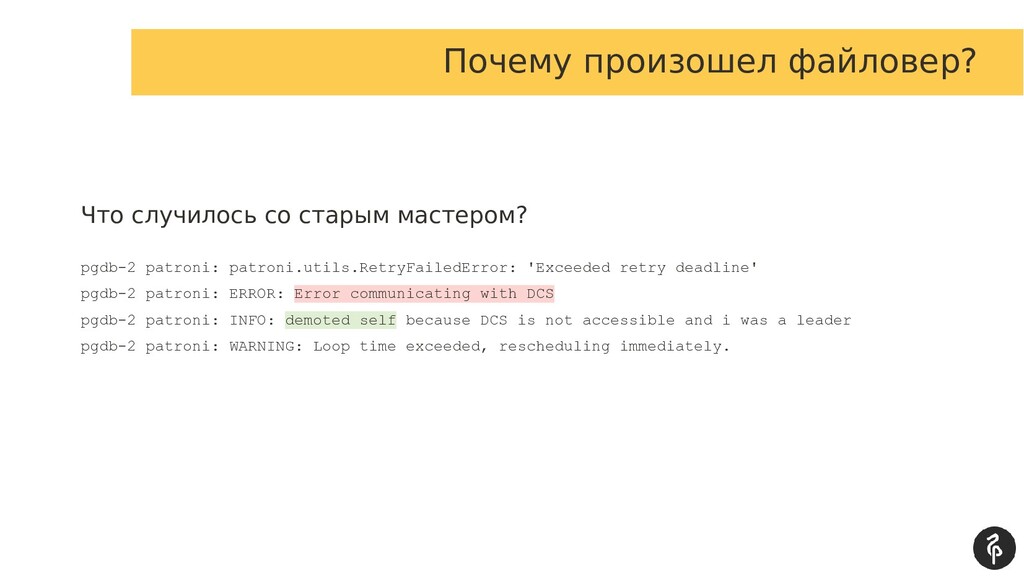
Почему произошел файловер? Что случилось со старым мастером? pgdb-2 patroni:
patroni.utils.RetryFailedError: 'Exceeded retry deadline' pgdb-2 patroni: ERROR: Error communicating with DCS pgdb-2 patroni: INFO: demoted self because DCS is not accessible and i was a leader pgdb-2 patroni: WARNING: Loop time exceeded, rescheduling immediately. -
Что предшествовало файловеру? pgdb-2 patroni: ERROR: touch_member ... python trace
pgdb-2 patroni: socket.timeout: timed out pgdb-2 patroni: During handling of the above exception, another exception occurred: ... python trace pgdb-2 patroni: raise ReadTimeoutError(self, url, "Read timed out. (read timeout=%s)" % timeout_value) pgdb-2 patroni: urllib3.exceptions.ReadTimeoutError: HTTPConnectionPool(host='127.0.0.1', port=8500): Read timed out. (read timeout=3.3333333333333335) pgdb-2 patroni: During handling of the above exception, another exception occurred: ... python trace pgdb-2 patroni: raise MaxRetryError(_pool, url, error or ResponseError(cause)) pgdb-2 patroni: urllib3.exceptions.MaxRetryError: HTTPConnectionPool(host='127.0.0.1', port=8500): Max retries exceeded with url: /v1/kv/service/pgdb/members/pgdb-2?acquire=19598b72-c0d5-f066-5d24-09c1a9ad61ee&dc=maindb (Caused by ReadTimeoutError("HTTPConnectionPool(host='127.0.0.1', port=8500): Read timed out. (read timeout=3.3333333333333335)",)) pgdb-2 patroni: INFO: no action. i am the leader with the lock pgdb-2 patroni: WARNING: Loop time exceeded, rescheduling immediately. -
Все вернулось, как было pgdb-2 patroni: INFO: promoted self to
leader by acquiring session lock pgdb-2 patroni: WARNING: Loop time exceeded, rescheduling immediately. pgdb-2 patroni: INFO: Lock owner: pgdb-2; I am pgdb-2 pgdb-2 patroni: INFO: updated leader lock during promote pgdb-2 patroni: server promoting pgdb-2 patroni: INFO: cleared rewind state after becoming the leader pgdb-2 patroni: INFO: Lock owner: pgdb-2; I am pgdb-2 -
Ложная сработка? Или не ложная? Нагрузка на диски: тяжелый запрос
по IO, временные файлы, автовакуумы, миграции, бэкап и т. п. Нагрузка на CPU: много запросов, новый релиз и т.п. -
Домашнее задание Любая серьезная нагрузка влияет на работу с DCS
Вынести DCS на отдельные узлы Возможно пересмотреть параметры ttl, loop_wait, retry_timeout -
Похожая история с DCS maindb-1 patroni: ERROR: get_cluster maindb-1 patroni:
Traceback (most recent call last): ... python trace maindb-1 patroni: RetryFailedError: 'Exceeded retry deadline' maindb-1 patroni: ERROR: Error communicating with DCS maindb-1 patroni: INFO: closed patroni connection to the postgresql cluster maindb-1 patroni: INFO: postmaster pid=214121 ... ... maindb-1 patroni: INFO: demoted self because DCS is not accessible and i was a leader maindb-1 patroni: WARNING: Loop time exceeded, rescheduling immediately. Когда и почему произошел файловер? -
Старый мастер становится репликой maindb-1 patroni: INFO: Lock owner: maindb-2;
I am maindb-1 maindb-1 patroni: INFO: does not have lock maindb-1 patroni: INFO: running pg_rewind from maindb-2 maindb-1 patroni: INFO: running pg_rewind from user=postgres host=192.168.11.18 port=5432 ... maindb-1 patroni: servers diverged at WAL location 1FA/A38FF4F8 on timeline 6 maindb-1 patroni: rewinding from last common checkpoint at 1FA/A38FF450 on timeline 6 maindb-1 patroni: INFO: Lock owner: maindb-2; I am maindb-1 maindb-1 patroni: INFO: running pg_rewind from maindb-2 in progress maindb-1 patroni: Done! -
Ищем первое место, где что-системато начинает идти не так maindb-1
patroni: INFO: Lock owner: maindb-1; I am maindb-1 maindb-1 patroni: INFO: no action. i am the leader with the lock maindb-1 patroni: INFO: Lock owner: maindb-1; I am maindb-1 maindb-1 patroni: INFO: no action. i am the leader with the lock maindb-1 patroni: INFO: Lock owner: maindb-1; I am maindb-1 maindb-1 patroni: INFO: no action. i am the leader with the lock Что предшествовало файловеру? -
Cоседи по consul-системакластеру стали сомневаться в вашем существовании maindb-2 consul[11581]:
serf: EventMemberFailed: maindb-1 192.168.11.19 maindb-2 consul[11581]: [INFO] serf: EventMemberFailed: maindb-1 192.168.11.19 maindb-2 consul[11581]: memberlist: Suspect maindb-1 has failed, no acks received maindb-2 consul[11581]: [INFO] memberlist: Suspect maindb-1 has failed, no acks received Они сомневаются в существовании и других соседей тоже... И вы тоже сомневаетесь... Что предшествовало файловеру? -
consul-системаагент испытывает сложности с коммуникацией maindb-1 consul: memberlist: Suspect lbs-4
has failed, no acks received maindb-1 consul: [ERR] yamux: keepalive failed: i/o deadline reached maindb-1 consul: yamux: keepalive failed: i/o deadline reached maindb-1 consul: [ERR] consul: "KVS.List" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: [ERR] http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 maindb-1 consul: [ERR] consul: "KVS.List" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: [ERR] http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 maindb-1 consul: [ERR] consul: "Coordinate.Update" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: [ERR] agent: Coordinate update error: rpc error making call: EOF maindb-1 consul: [ERR] http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 maindb-1 consul: consul: "KVS.List" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 maindb-1 consul: consul: "KVS.List" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 maindb-1 consul: consul: "Coordinate.Update" RPC failed to server 192.168.11.115:8300: rpc error making call: EOF maindb-1 consul: agent: Coordinate update error: rpc error making call: EOF maindb-1 consul: http: Request GET /v1/kv/service/sam_prod/?recurse=1, error: rpc error making call: EOF from=192.168.11.19 Что предшествовало файловеру? -
Чинить сеть Еще варианты: • Отключить consul-системапроверки — checks: []
• Перепроверить raft_multiplier • renice -n -10 consul • Не использовать consul? • Пересмотреть значения параметров ttl, loop_wait, retry_timeout Домашнее задание -
$ patronictl list +-----------------+-------------------------+--------------+--------+---------+-----------+ | Cluster | Member | Host
| Role | State | Lag in MB | +-----------------+-------------------------+--------------+--------+---------+-----------+ | patroni_cluster | pg01.dev.zirconus.local | 10.202.1.101 | | running | 0.0 | | patroni_cluster | pg03.dev.zirconus.local | 10.202.1.103 | Leader | running | 0.0 | +-----------------+-------------------------+--------------+--------+---------+-----------+ -
Почему произошел файловер? Мастер pg02 не смог обновить мастер-системаключ: pg02
patroni[1425]: ERROR: failed to update leader lock Pg02 patroni[1425]: INFO: demoted self because failed to update leader lock in DCS pg02 patroni[1425]: WARNING: Loop time exceeded, rescheduling immediately. pg02 patroni[1425]: INFO: Lock owner: None; I am pg02.dev.zirconus.local pg02 patroni[1425]: INFO: not healthy enough for leader race pg02 patroni[1425]: INFO: starting after demotion in progress -
Пока все по плану мастером становится db03 pg03 patroni[9648]: INFO:
promoted self to leader by acquiring session lock pg03 patroni[9648]: server promoting pg03 patroni[9648]: INFO: cleared rewind state after becoming the leader -
А что со старым мастером? pg02, решив стать репликой, начал
с перемотки журнала транзакций pg02 patroni[1425]: INFO: running pg_rewind from pg03 pg02 patroni[1425]: INFO: running pg_rewind from user=postgres host=10.202.1.103 port=5432 ... pg02 patroni[1425]: servers diverged at WAL location 33F/68E6AD10 on timeline 28 pg02 patroni[1425]: could not open file "/data/pgdb/11/pg_wal/0000001C0000033F00000059": No such file or directory pg02 patroni[1425]: could not find previous WAL record at 33F/59FFE368 pg02 patroni[1425]: Failure, exiting pg02 patroni[1425]: ERROR: Failed to rewind from healty master: pg03 pg02 patroni[1425]: WARNING: Postgresql is not running. -
Почему не оказалось журналов? Новый мастер сделал чекпоинт и переименовал
часть старых сегментов на будущее LOG: checkpoint complete: wrote 62928 buffers (16.0%); 0 WAL file(s) added, 0 removed, 23 recycled; write=12.872 s, sync=0.020 s, total=13.001 s; sync files=16, longest=0.009 s, average=0.001 s; distance=520220 kB, estimate=520220 kB -
Почему не оказалось журналов? 2019-08-26 00:06:11,369 LOG: checkpoint complete 2019-08-26
00:06:11,517 INFO: running pg_rewind -
Домашнее задание Слоты репликации Мастер при переходе в реплику удаляет
слоты + WA» из коL Подняли wal_keep_segments Актуально и для продолжительных maintenance -
Все начинается с файловера Production-системабаза Происходит файловер Проверили кластер, всё
и все на месте Продуктовая команда сообщает, что в базе не хватает данных Идем смотреть... -
Когда произошел файловер? pgdb-1 patroni[17836]: INFO: promoted self to leader
by acquiring session lock pgdb-1 patroni[17836]: server promoting pgdb-1 patroni[17836]: INFO: cleared rewind state after becoming the leader pgdb-1 patroni[17836]: INFO: Lock owner: pgdb-1; I am pgdb-1 -
Когда произошел файловер? Cтарый мастер после перезагрузки запускает Patroni Patroni
запускает Postgres Включает Postgres в качестве реплики Часть WA» из коL отматывается pg_rewind -
Что там со старым мастером? pgdb-2 patroni[4149]: INFO: running pg_rewind
from pgdb-1 pgdb-2 patroni[4149]: Lock owner: pgdb-1; I am pgdb-2 pgdb-2 patroni[4149]: Deregister service pgdb/pgdb-2 pgdb-2 patroni[4149]: running pg_rewind from pgdb-1 in progress pgdb-2 patroni[4149]: running pg_rewind from user=replica host=10.10.1.31 port=5432 ... pgdb-2 patroni[4149]: servers diverged at WAL location 0/5AD1BFD8 on timeline 66 pgdb-2 patroni[4149]: rewinding from last common checkpoint at 0/59DD1070 on timeline 66 pgdb-2 patroni[4149]: Done! -
Считаем потери pgdb-2 patroni[4149]: INFO: Local timeline=66 lsn=0/5BDA8EB8 pgdb-2 patroni[4149]:
INFO: master_timeline=67 ... pgdb-2 patroni[4149]: servers diverged at WAL location 0/5AD1BFD8 on timeline 66 postgres=# select pg_wal_lsn_diff('0/5BDA8EB8','0/5AD1BFD8'); pg_wal_lsn_diff ----------------- 17354464 -
Домашнее задание Всегда ли нам нужен автозапуск? maximum_lag_on_failover • Не
realtime • Риск «HA» из потеряшек» остается: • В худшем случае: maximum_lag_on_failover + ttl • В среднем случае: maximum_lag_on_failover + (loop_wait / 2) Хорошая новость — в «HA» из потеряшках» могут быть WA» из коL от фоновых процессов -
maximum_lag_on_failover pgdb-1 patroni[6202]: INFO: Lock owner: None; I am pgdb-1
pgdb-1 patroni[6202]: INFO: not healthy enough for leader race pgdb-1 patroni[6202]: INFO: changing primary_conninfo and restarting in progress ... pgdb-1 patroni[6202]: INFO: following a different leader because i am not the healthiest node pgdb-1 patroni[6202]: INFO: following a different leader because i am not the healthiest node pgdb-1 patroni[6202]: INFO: following a different leader because i am not the healthiest node pgdb-1 patroni[6202]: INFO: following a different leader because i am not the healthiest node pgdb-1 patroni[6202]: INFO: following a different leader because i am not the healthiest node -
Мастер недоступен по SSH Автофайловер не происходит Отправили принудительно в
reboot После перезагрузки идем смотреть, что было... -
Диски [COMMIT] LOG: duration: 1138.868 ms statement: COMMIT ... []
WARNING: autovacuum worker started without a worker entry ... [SELECT] LOG: temporary file: path "base/pgsql_tmp/pgsql_tmp11247.983", size 532996096 ... -
md/raid10:md2: sde3: rescheduling sector 351273392 blk_update_request: I/O error, dev sde,
sector 64404728 md/raid10:md2: sde3: rescheduling sector 63161592 blk_update_request: I/O error, dev sde, sector 64404760 ... md2 : active raid10 sda3[0] sdc3[2] sdd3[3] sdb3[1] sdh3[7] sdf3[5] sdg3[6] 15623340032 blocks super 1.2 512K chunks 2 near-copies [8/7] [UUUUUUU_] bitmap: 58/59 pages [232KB], 131072KB chunk -
Старый мастер не мог стать нормальной репликой Далее весь разбор
согласно пост-системамортему Кластер-системасимулянт -
Локальный ад на мастере, коммиты длятся по 1-система2-система3 секунды 14:48:55.601
[COMMIT] LOG: duration: 1478.118 ms statement: COMMIT 14:48:56.287 [COMMIT] LOG: duration: 1290.203 ms statement: COMMIT 14:48:56.287 [COMMIT] LOG: duration: 1778.465 ms statement: COMMIT 14:48:56.287 [COMMIT] LOG: duration: 1778.449 ms statement: COMMIT -
Обрывы соединений 14:48:58.078 [idle in transaction] LOG: could not send
data to client: Broken pipe 14:48:58.078 [idle] LOG: could not send data to client: Broken pipe 14:48:58.078 [idle] FATAL: connection to client lost 14:48:58.107 [idle in transaction] FATAL: connection to client lost -
Ожидания и блокировки разной степени тяжести 14:49:26.929 [UPDATE waiting] LOG:
process 4298 acquired ExclusiveLock on tuple (2,10) of relation 52082 of database 50587 after 52487.463 ms 14:49:26.929 [UPDATE waiting] STATEMENT: UPDATE sessions SET lastaccess='1565005714' WHERE sessionid=... 14:49:27.929 [UPDATE waiting] LOG: process 4298 still waiting for ShareLock on transaction 364118337 after 1000.088 ms 14:49:27.929 [UPDATE waiting] DETAIL: Process holding the lock: 4294. Wait queue: 4298. 14:49:27.929 [UPDATE waiting] CONTEXT: while locking tuple (7,60) in relation "sessions" 14:49:27.929 [UPDATE waiting] STATEMENT: UPDATE sessions SET lastaccess='1565005714' WHERE sessionid=... -
В общем, явно проблемы с дисками 14:49:04.766 [SELECT] LOG: using
stale statistics instead of current ones because stats collector is not responding ... 14:48:06.067 [SELECT] LOG: temporary file: path "base/pgsql_tmp/pgsql_tmp10554.1495", size 145616368 14:49:18.278 [SELECT] LOG: temporary file: path "base/pgsql_tmp/pgsql_tmp10554.4197", size 2396890 ... -
immediate shutdown request 14:49:34.102 MSK 5335 @ from [] LOG:
received immediate shutdown request 14:49:34.689 [authentication] WARNING: terminating connection because of crash of another server process 14:49:34.689 [authentication] DETAIL: The postmaster has commanded this server process to roll back the current transaction and exit, because another server process exited abnormally and possibly corrupted shared memory -
Patroni не писал в лог довольно долго — 54 секунды
За это время одна из реплик сделала «HA» из promote» pgsql03 patroni: 14:48:25,000 INFO: Lock owner: pgsql03; I am pgsql03 pgsql03 patroni: 14:48:25,013 INFO: no action. i am the leader with the lock pgsql03 patroni: 14:48:37,159 INFO: Lock owner: pgsql03; I am pgsql03 pgsql03 patroni: 14:49:31,155 WARNING: Exception hened during processing of request from 10.1.0.12 pgsql03 patroni: 14:49:31,297 WARNING: Exception hened during processing of request from 10.1.0.11 pgsql03 patroni: 14:49:31,298 WARNING: Exception hened during processing of request from 10.1.0.11 -
Собственно, сам promote pgsql01 patroni: 14:48:57,136 INFO: promoted self to
leader by acquiring session lock pgsql01 patroni: server promoting pgsql01 patroni: 14:48:57,214 INFO: cleared rewind state after becoming the leader pgsql01 patroni: 14:49:05,013 INFO: Lock owner: pgsql01; I am pgsql01 pgsql01 patroni: 14:49:05,023 INFO: updated leader lock during promote -
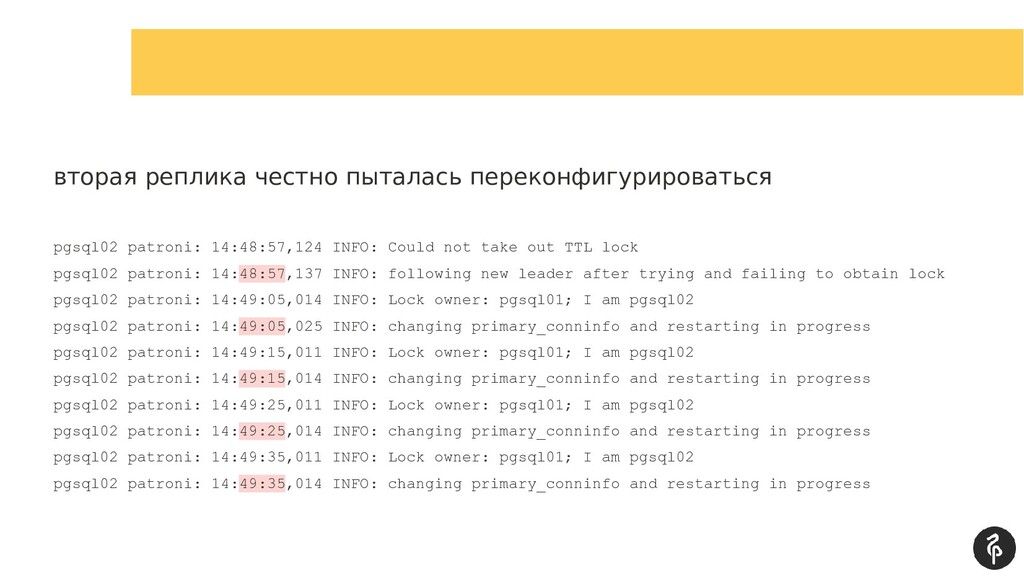
вторая реплика честно пыталась переконфигурироваться pgsql02 patroni: 14:48:57,124 INFO: Could
not take out TTL lock pgsql02 patroni: 14:48:57,137 INFO: following new leader after trying and failing to obtain lock pgsql02 patroni: 14:49:05,014 INFO: Lock owner: pgsql01; I am pgsql02 pgsql02 patroni: 14:49:05,025 INFO: changing primary_conninfo and restarting in progress pgsql02 patroni: 14:49:15,011 INFO: Lock owner: pgsql01; I am pgsql02 pgsql02 patroni: 14:49:15,014 INFO: changing primary_conninfo and restarting in progress pgsql02 patroni: 14:49:25,011 INFO: Lock owner: pgsql01; I am pgsql02 pgsql02 patroni: 14:49:25,014 INFO: changing primary_conninfo and restarting in progress pgsql02 patroni: 14:49:35,011 INFO: Lock owner: pgsql01; I am pgsql02 pgsql02 patroni: 14:49:35,014 INFO: changing primary_conninfo and restarting in progress -
В это время на старый мастер прилетел тот самый immediate
Реплика аварийно перезапускается и начинает recovery Recovery прерывается, т.к. старый мастер в это время выключался 14:49:34.293 [idle] LOG: received replication command: IDENTIFY_SYSTEM WARNING: terminating connection because of crash of another server process DETAIL: The postmaster has commanded this server process to roll back the current transaction and exit, because another server process exited abnormally and possibly corrupted shared memory. 14:49:35.232 FATAL: could not receive data from WAL stream: server closed the connection unexpectedly This probably means the server terminated abnormally before or while processing the request. 14:49:35.232 LOG: record with incorrect prev-link 142D46/315602C at 14CF/CF38C160 14:49:35.305 FATAL: could not connect to the primary server: FATAL: the database system is shutting down 14:49:40.241 FATAL: could not connect to the primary server: FATAL: the database system is shutting down -
После recovery репликация не смогла запуститься 14:50:14.024 [] LOG: record
with incorrect prev-link 142D46/315602C at 14CF/CF38C160 14:50:14.028 [] LOG: fetching timeline history file for timeline 72 from primary server 14:50:14.104 [] FATAL: could not start WAL streaming: ERROR: requested starting point 14CF/CF000000 on timeline 71 is not in this server's history DETAIL: This server's history forked from timeline 71 at 14CF/CEC32E40. 14:50:14.104 [] LOG: new timeline 72 forked off current database system timeline 71 before current recovery point 14CF/CF38C160 -
Patroni запустил реплику, реплика работает, но есть лаг +-----------------+----------+--------------+--------+---------+-----------+ |
Cluster | Member | Host | Role | State | Lag in MB | +-----------------+----------+--------------+--------+---------+-----------+ | patroni_cluster | pgsql01 | 10.2.200.151 | Leader | running | 0.0 | | patroni_cluster | pgsql02 | 10.2.200.152 | | running | 9153.0 | | patroni_cluster | pgsql03 | 10.2.200.153 | | running | 0.0 | +-----------------+----------+--------------+--------+---------+-----------+ -
Postgres каждые 5 секунд сообщает об ошибке 14:50:44.143 FA» из
коTA» из коL: could not start WA» из коL streaming: ERROR: requested starting point 14CF/watchdoCF000000 on timeline 71 is not in this server's history DETA» из коIL: This server's history forked from timeline 71 at 14CF/watchdoCEC32E40. 14:50:44.143 LOG: new timeline 72 forked off current database system timeline 71 before current recovery point 14CF/watchdoCF38C160 -
Через 30 минут приходит админ, рестартует Patroni на реплике Cнова
идет recovery, и даже база открылась 15:14:13.511 LOG: consistent recovery state reached at 14CF/A3F657B0 15:14:13.511 LOG: database system is ready to accept read only connections -
Репликация запустилась 15:14:17.072 LOG: record with incorrect prev-link 142D46/315602C at
14CF/CF38C160 15:14:17.077 LOG: started streaming WAL from primary at 14CF/CF000000 on timeline 72 15:14:17.536 LOG: invalid record length at 14CF/CF38C160: wanted 24, got 1 и через минуту отвалилась 15:15:27.823 FATAL: terminating walreceiver process due to administrator command 15:15:27.895 LOG: invalid record length at 14CF/CF38C160: wanted 24, got 1 15:15:27.895 LOG: invalid record length at 14CF/CF38C160: wanted 24, got 1 -
Еще раз рестартим Patroni, база открывается на том же месте
15:17:33.553 LOG: consistent recovery state reached at 14CF/A3F657B0 15:17:33.554 LOG: database system is ready to accept read only connections -
стартует репликация, но позиция уже раньше, хм… 15:17:37.299 LOG: invalid
contrecord length 5913 at 14CF/CEFFF7B0 15:17:37.304 LOG: started streaming WAL from primary at 14CF/CE000000 on timeline 72 и снова останавливается, причем сообщение уже другое 15:18:12.208 FATAL: terminating walreceiver process due to administrator command 15:18:12.240 LOG: record with incorrect prev-link 60995000/589DF000 at 14CF/CEFFF7B0 15:18:12.240 LOG: record with incorrect prev-link 60995000/589DF000 at 14CF/CEFFF7B0 -
Рестартуем снова, база открывается на том же месте 15:21:25.135 LOG:
consistent recovery state reached at 14CF/A3F657B0 15:21:25.135 LOG: database system is ready to accept read only connections -
Запускаем пару чекпоинтов с идеей подвинуть историю чуть вперед Репликация
запускается уже с другого места и больше не рвется 15:22:43.727 LOG: invalid record length at 14D1/BCF3610: wanted 24, got 0 15:22:43.731 LOG: started streaming WAL from primary at 14D1/B000000 on timeline 72 -
Patroni может отработать, как надо, но это не гарантия, что
все хорошо После файловера нужно перепроверить, что все действительно ок Домашнее задание -
Мониторинг о том, что произошел файловер После каждого файловера проверяем
кластер • количество реплик • лаг репликации • ошибки в логах Автоматика может успешно отработать, но при этом объекты автоматики могут находиться в полурабочем состоянии Нужно уметь чинить руками Иметь в виду при эксплуатации Patroni -
Когда произошел файловер? Это точка отсчета до и после •
Файловер имеет два timestamp — начало и конец Почему произошел файловер? Ищем по логам первые события, когда что-системато пошло не так: • Логи patroni • Логи postgres • Логи DCS • Логи системы Этапы диагностики -
Patroni, на мой взгляд, лучшее что есть сегодня Рекомендую ли
я Patroni? Определенно, да Хотите больше интересных историй? https://github.com/zalando/patroni/issues Спасибо Zalando, A» из коlexander Kukushkin, Oleksii Kliukin и всем контрибьюторам Послесловие
 lesovsky
 ivargrimstad
 raeminkang
 kumaiu
 kosukesaigusa
 kmkim
 yuta_onishi_97
 sodainc
 fornewid
 umigishiaoi
 nakamizu
 kamina_zzz
 sarafernandez
 gr2m
 addyosmani
 lemiorhan
 szymonslowik
 bethany
 gurzu
 rkendrick25
 cassininazir
 techseoconnect
 thoeni
 reverentgeek