Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
動画生成と三次元生成を融合して最強の生成モデルを作ろう
Search
小島瑞貴
June 01, 2026
Science
66
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
動画生成と三次元生成を融合して最強の生成モデルを作ろう
小島瑞貴
June 01, 2026
More Decks by 小島瑞貴
See All by 小島瑞貴
画像生成モデルは1つの損失関数(FID)を入れるだけで性能が激変するらしい
mickey_0226
0
1.7k
【Zozo Research 技術共有会】三次元領域の現在と展望
mickey_0226
3
610
学術バーQってどんなところ??
mickey_0226
0
170
さわって動かす人工知能
mickey_0226
0
72
CVPR2026_VGGTとその仲間たち
mickey_0226
0
1.1k
Transformerの推論を線形時間にして皆を驚かせましょう
mickey_0226
0
72
Other Decks in Science
See All in Science
2026 Introduction to University Math 01
kanaya
0
140
(CVPR2026) Back to Basics: Let Denoising Generative Models Denoise
shumpei777
0
350
不動産業界における業界特化のデータ整備とAI活用 ─Vertical DataとVertical AI─
estie
1
960
データベース11: 正規化(1/2) - 望ましくない関係スキーマ
trycycle
PRO
0
1.7k
GKE上でオセロの強化学習やってみた
akasan
0
110
機械学習 - 授業概要
trycycle
PRO
0
620
Bリーグのショットデータを活用した得点期待値モデルの構築 / Construction of expected points model using shot data of B.LEAGUE
konakalab
0
210
医療 LLM ベンチマークの現在地:多面的評価 と日本ローカライズ
analokmaus
1
690
[TMLR 2026, Featured Certification] Double Bounded α-Divergence Optimization for Density Estimation
gkazunii
1
120
因果推論と機械学習
sshimizu2006
1
1.4k
科学で迫る勝敗の法則-スポーツデータ分析の最前線 (刈谷市連携講座.2026年7月) / The principle of victory discovered by science. at Kariya City, 2027.07
konakalab
0
160
機械学習 - DBSCAN
trycycle
PRO
0
2.1k
Featured
See All Featured
Amusing Abliteration
ianozsvald
1
290
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.7k
How STYLIGHT went responsive
nonsquared
100
6.3k
The World Runs on Bad Software
bkeepers
PRO
72
12k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.6k
BBQ
matthewcrist
89
10k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
420
The Mindset for Success: Future Career Progression
greggifford
PRO
0
490
Color Theory Basics | Prateek | Gurzu
gurzu
0
460
WENDY [Excerpt]
tessaabrams
13
39k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
230
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
570
Transcript
Vist3A 東京科学大学 小島 瑞貴 Text-to-3D by stitching a multi-view reconstruction
network to a video generator
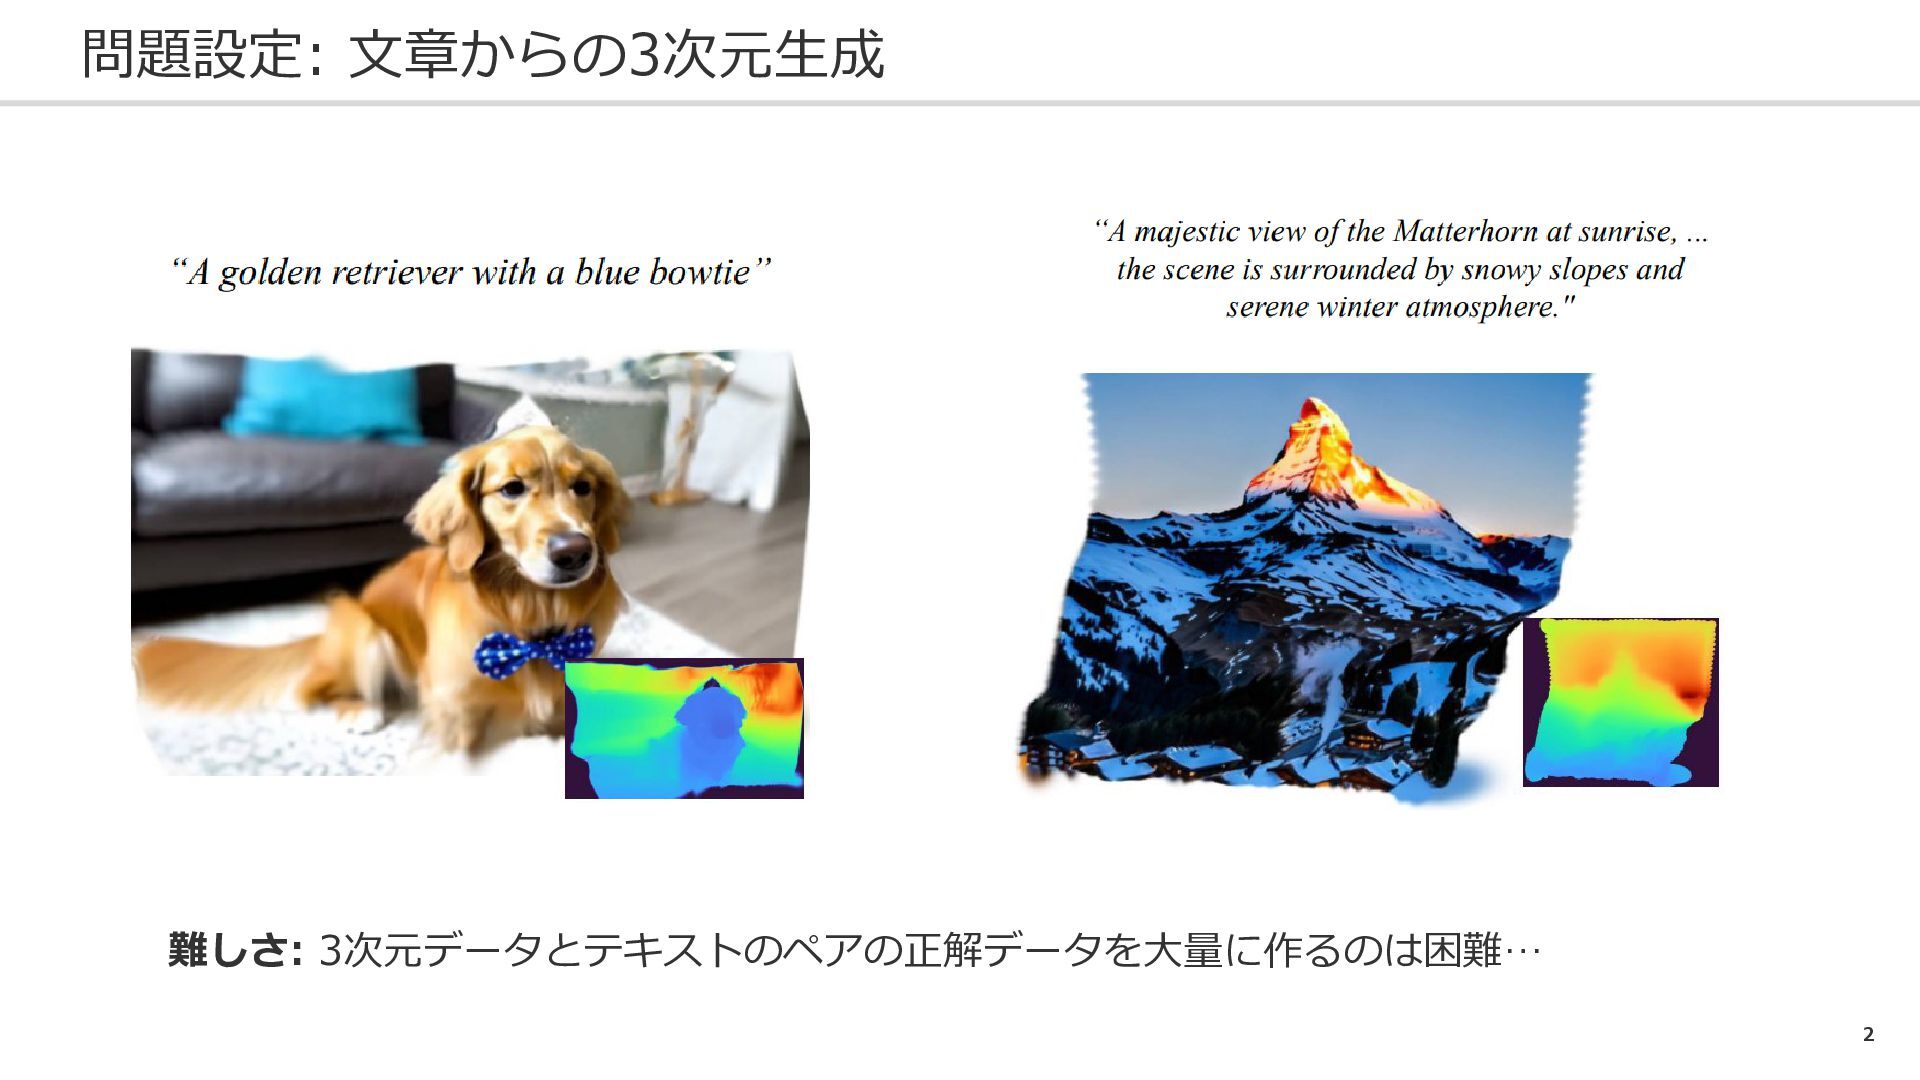
2 問題設定: 文章からの3次元生成 難しさ: 3次元データとテキストのペアの正解データを大量に作るのは困難…
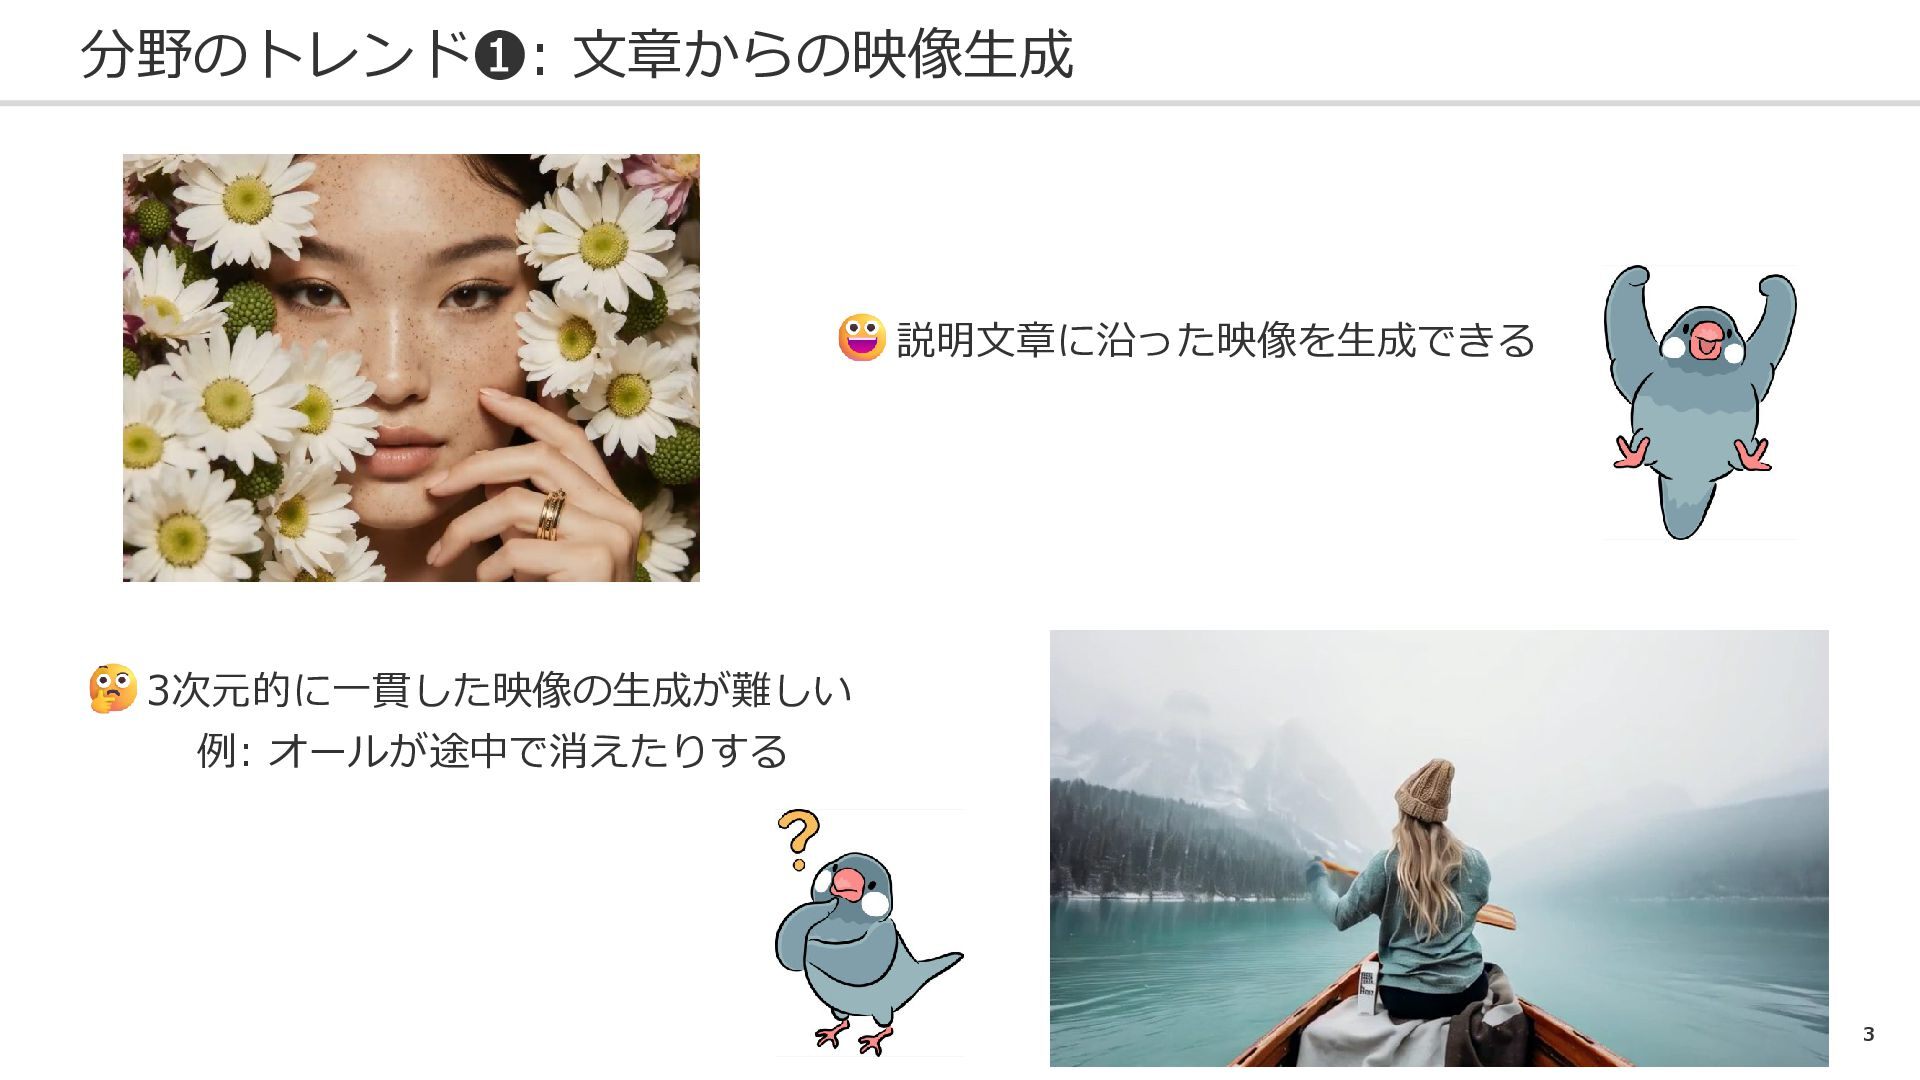
3 分野のトレンド❶: 文章からの映像生成 説明文章に沿った映像を生成できる 3次元的に一貫した映像の生成が難しい 例: オールが途中で消えたりする
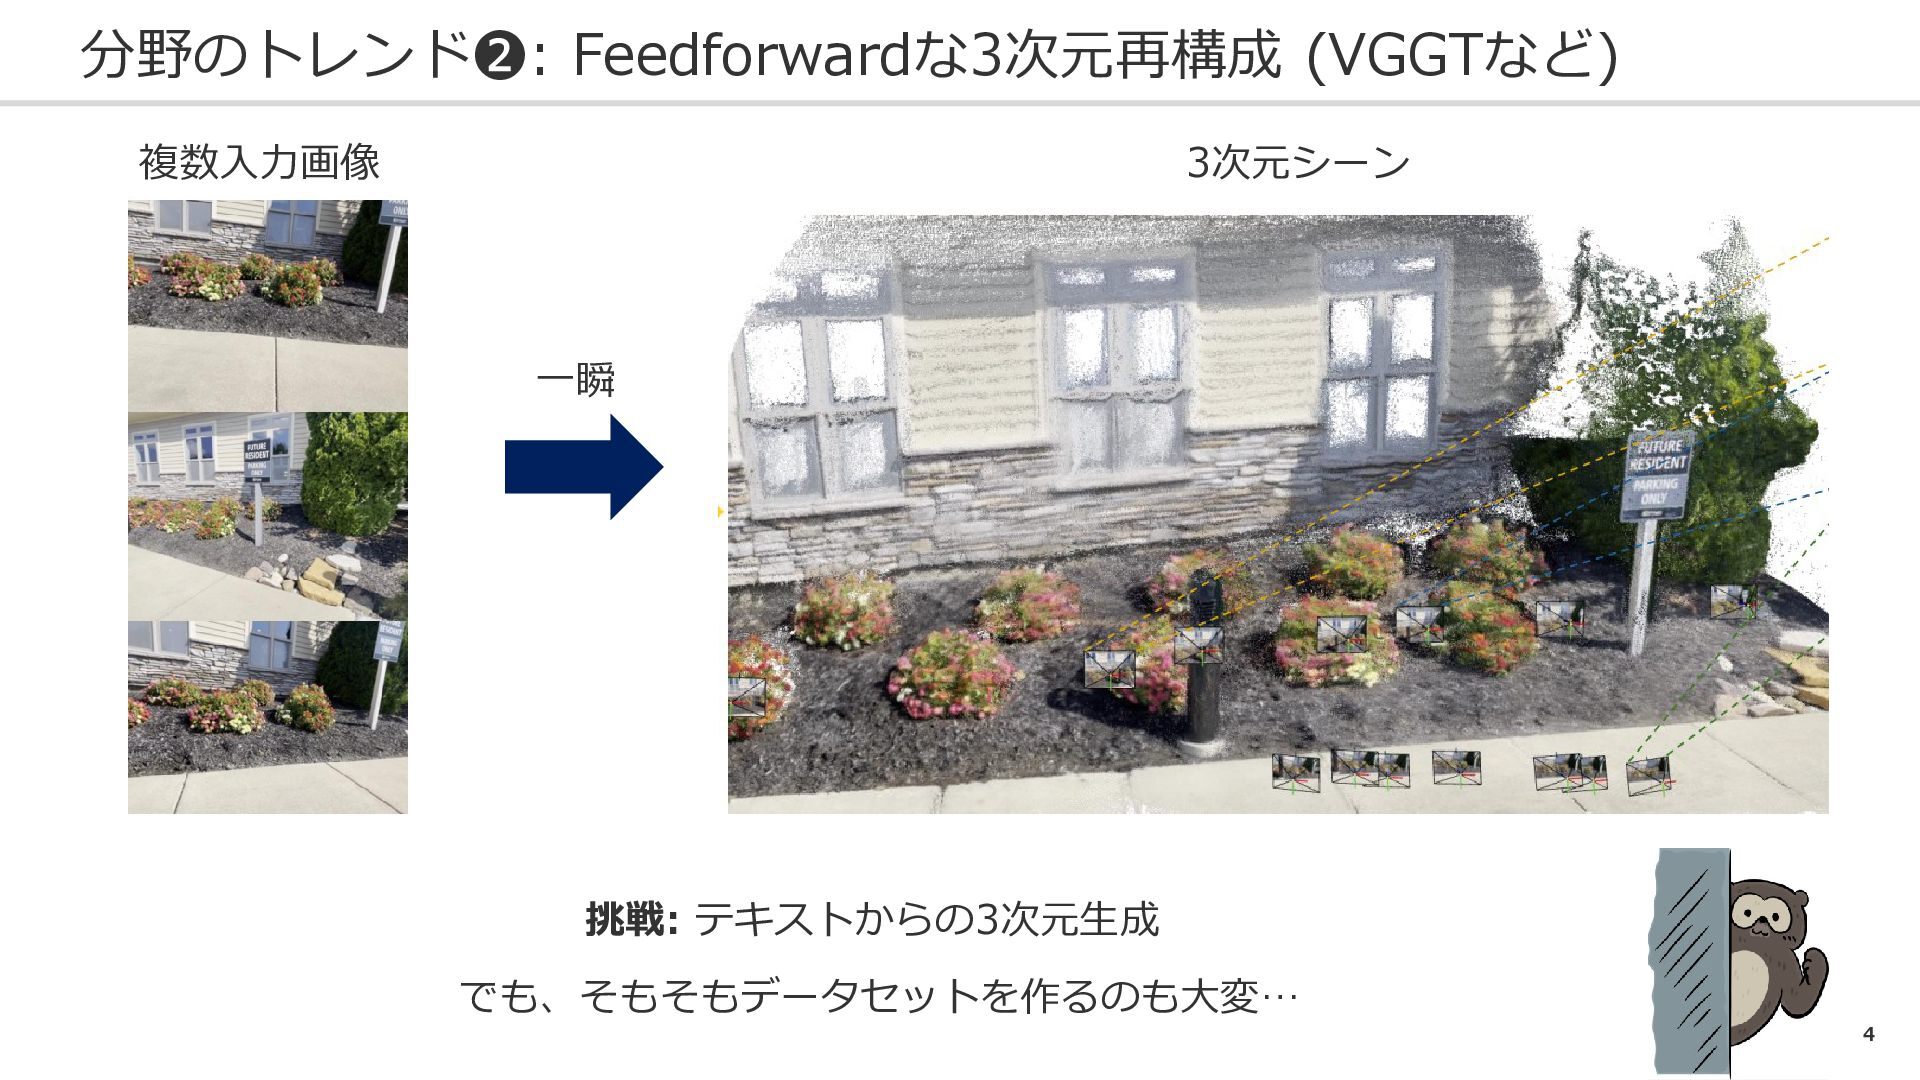
4 分野のトレンド❷: Feedforwardな3次元再構成 (VGGTなど) 複数入力画像 3次元シーン 一瞬 挑戦: テキストからの3次元生成 でも、そもそもデータセットを作るのも大変…
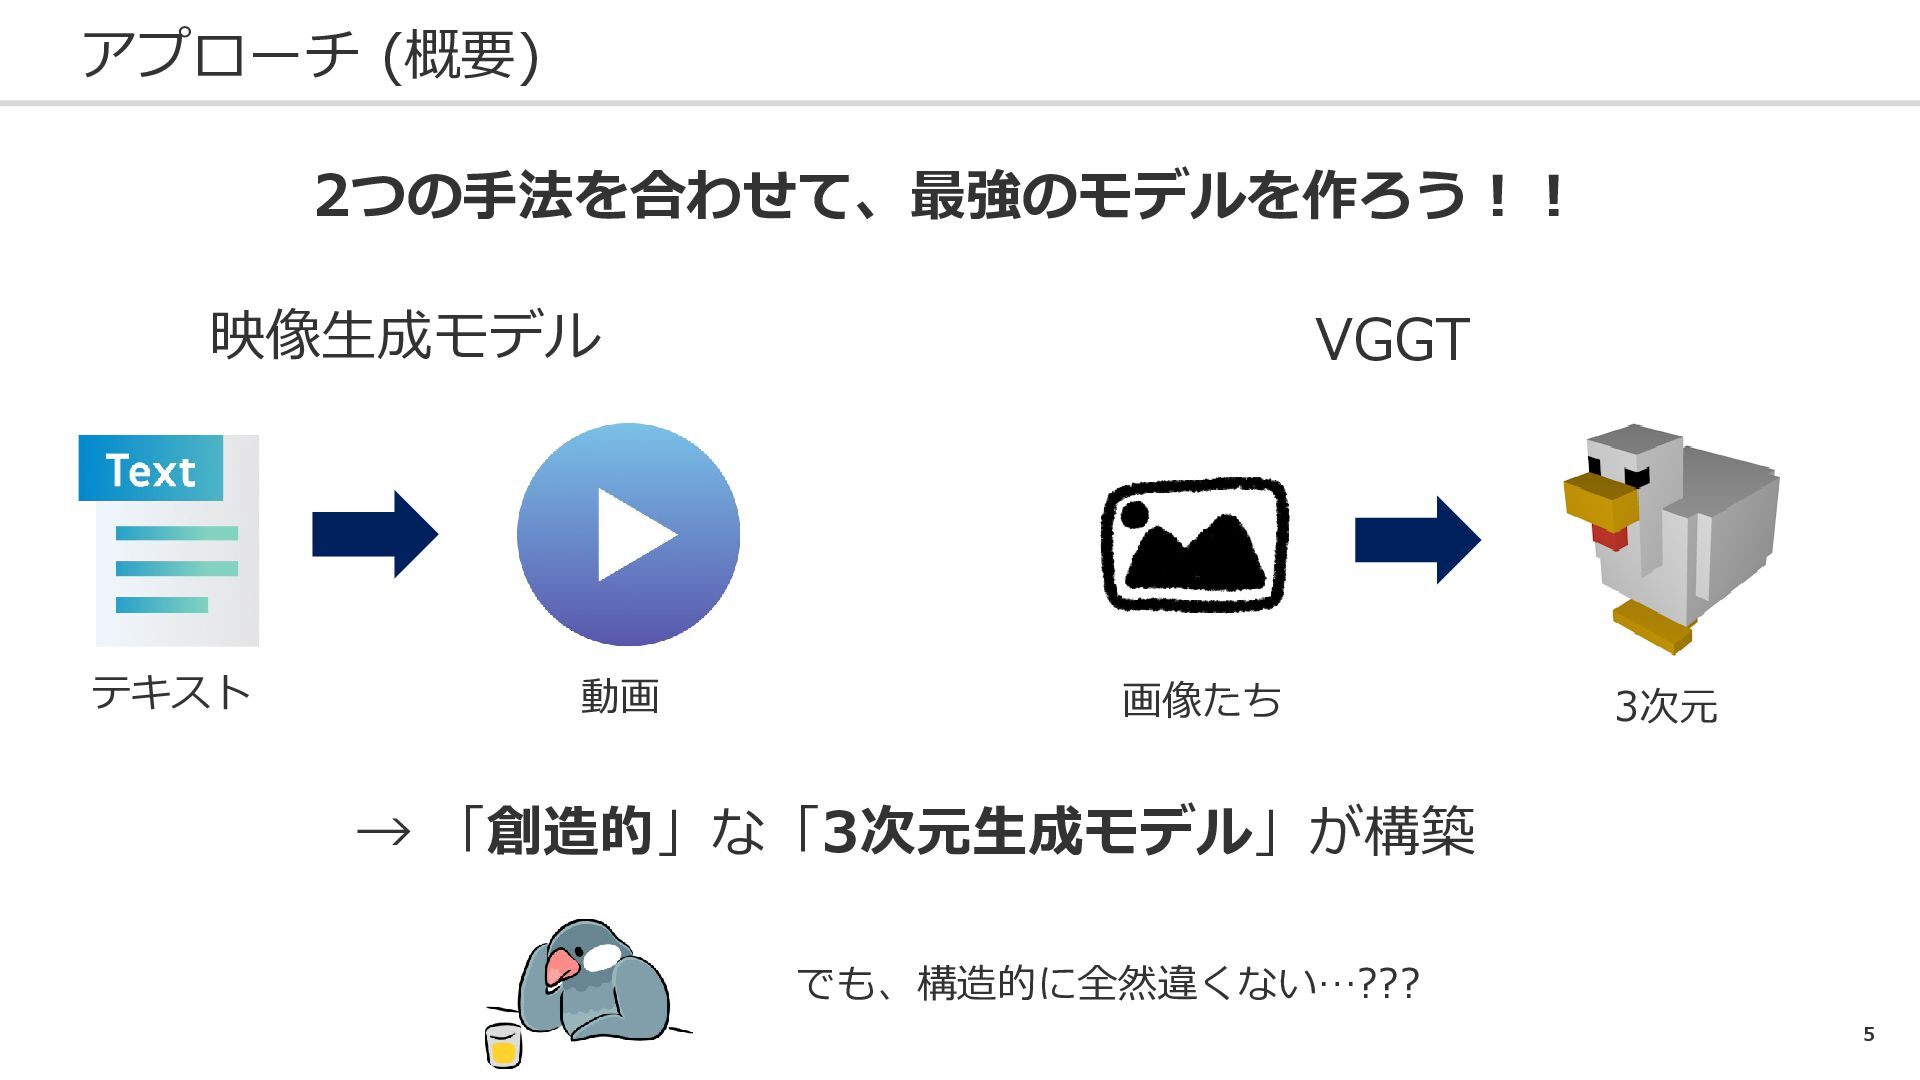
5 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 画像たち 3次元 2つの手法を合わせて、最強のモデルを作ろう!!
でも、構造的に全然違くない…??? → 「創造的」な「3次元生成モデル」が構築
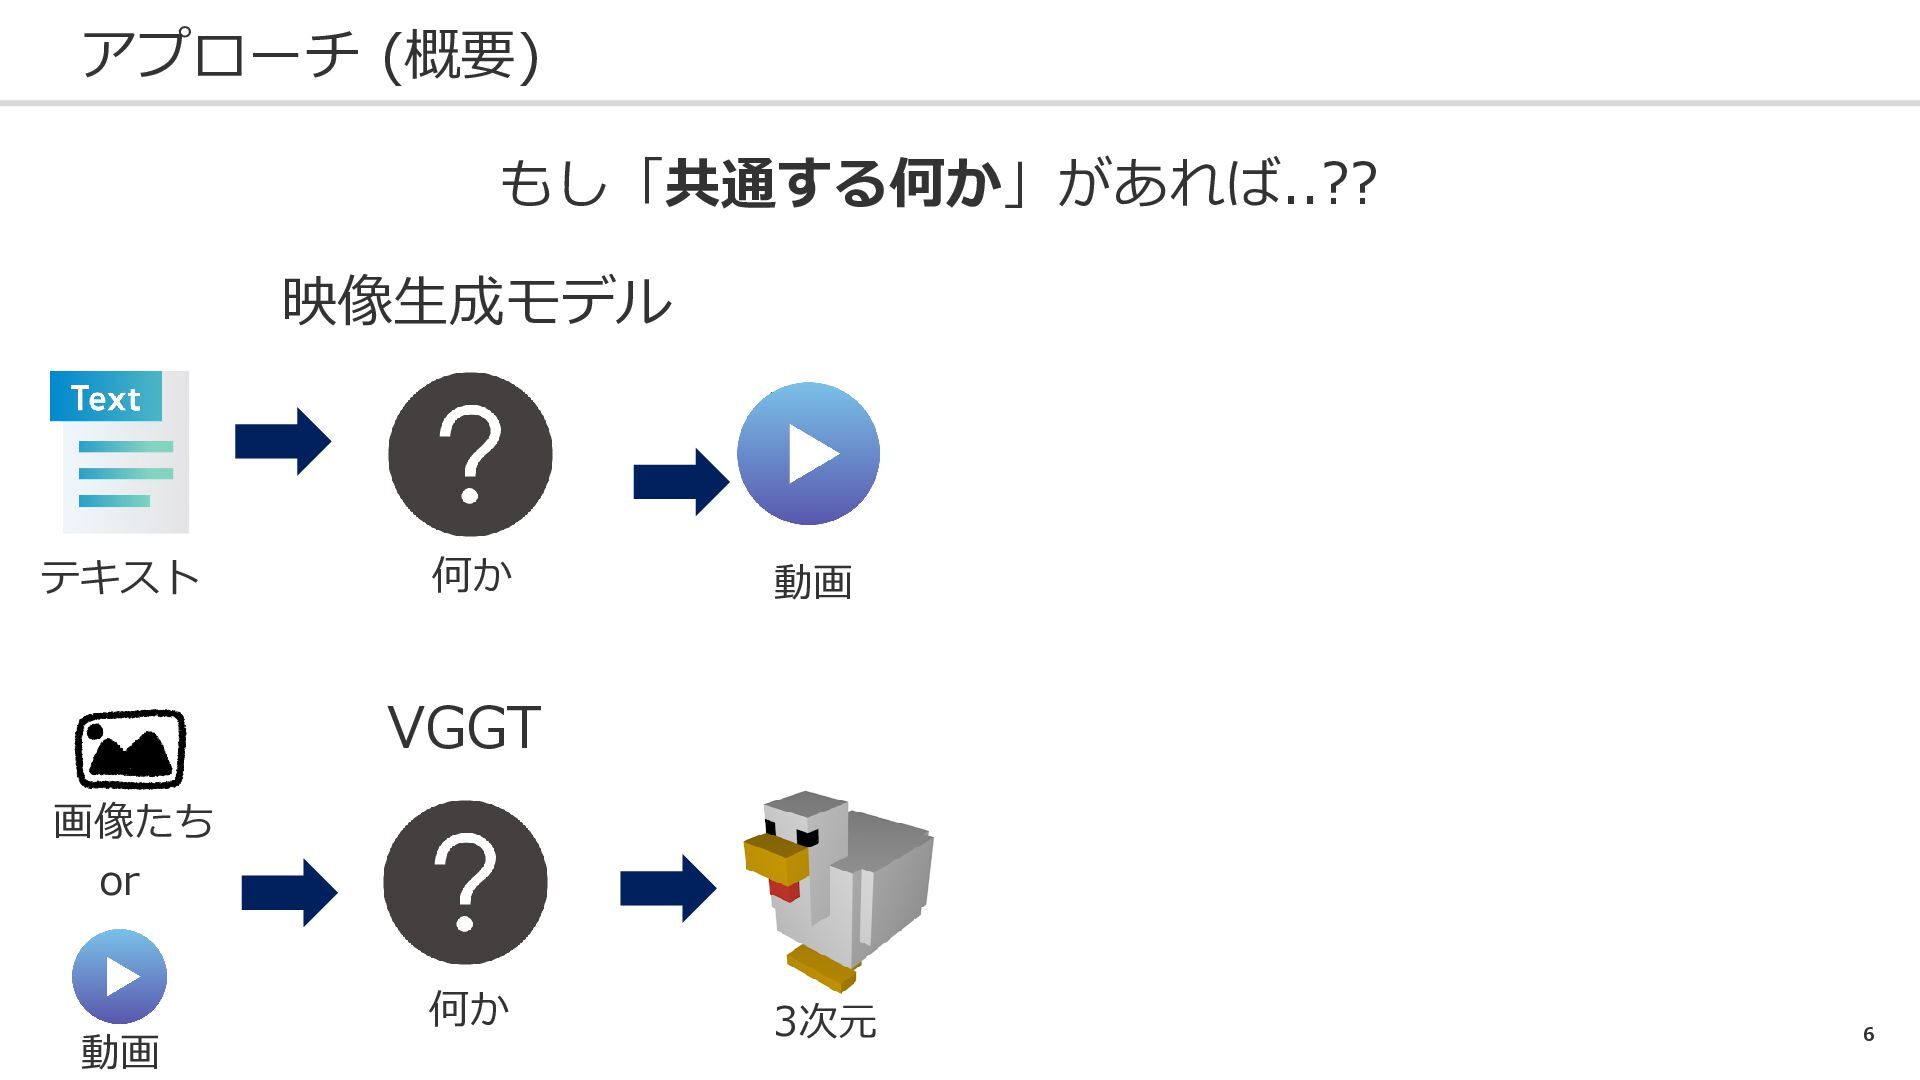
6 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 3次元 もし「共通する何か」があれば..?? 何か
何か 画像たち or 動画
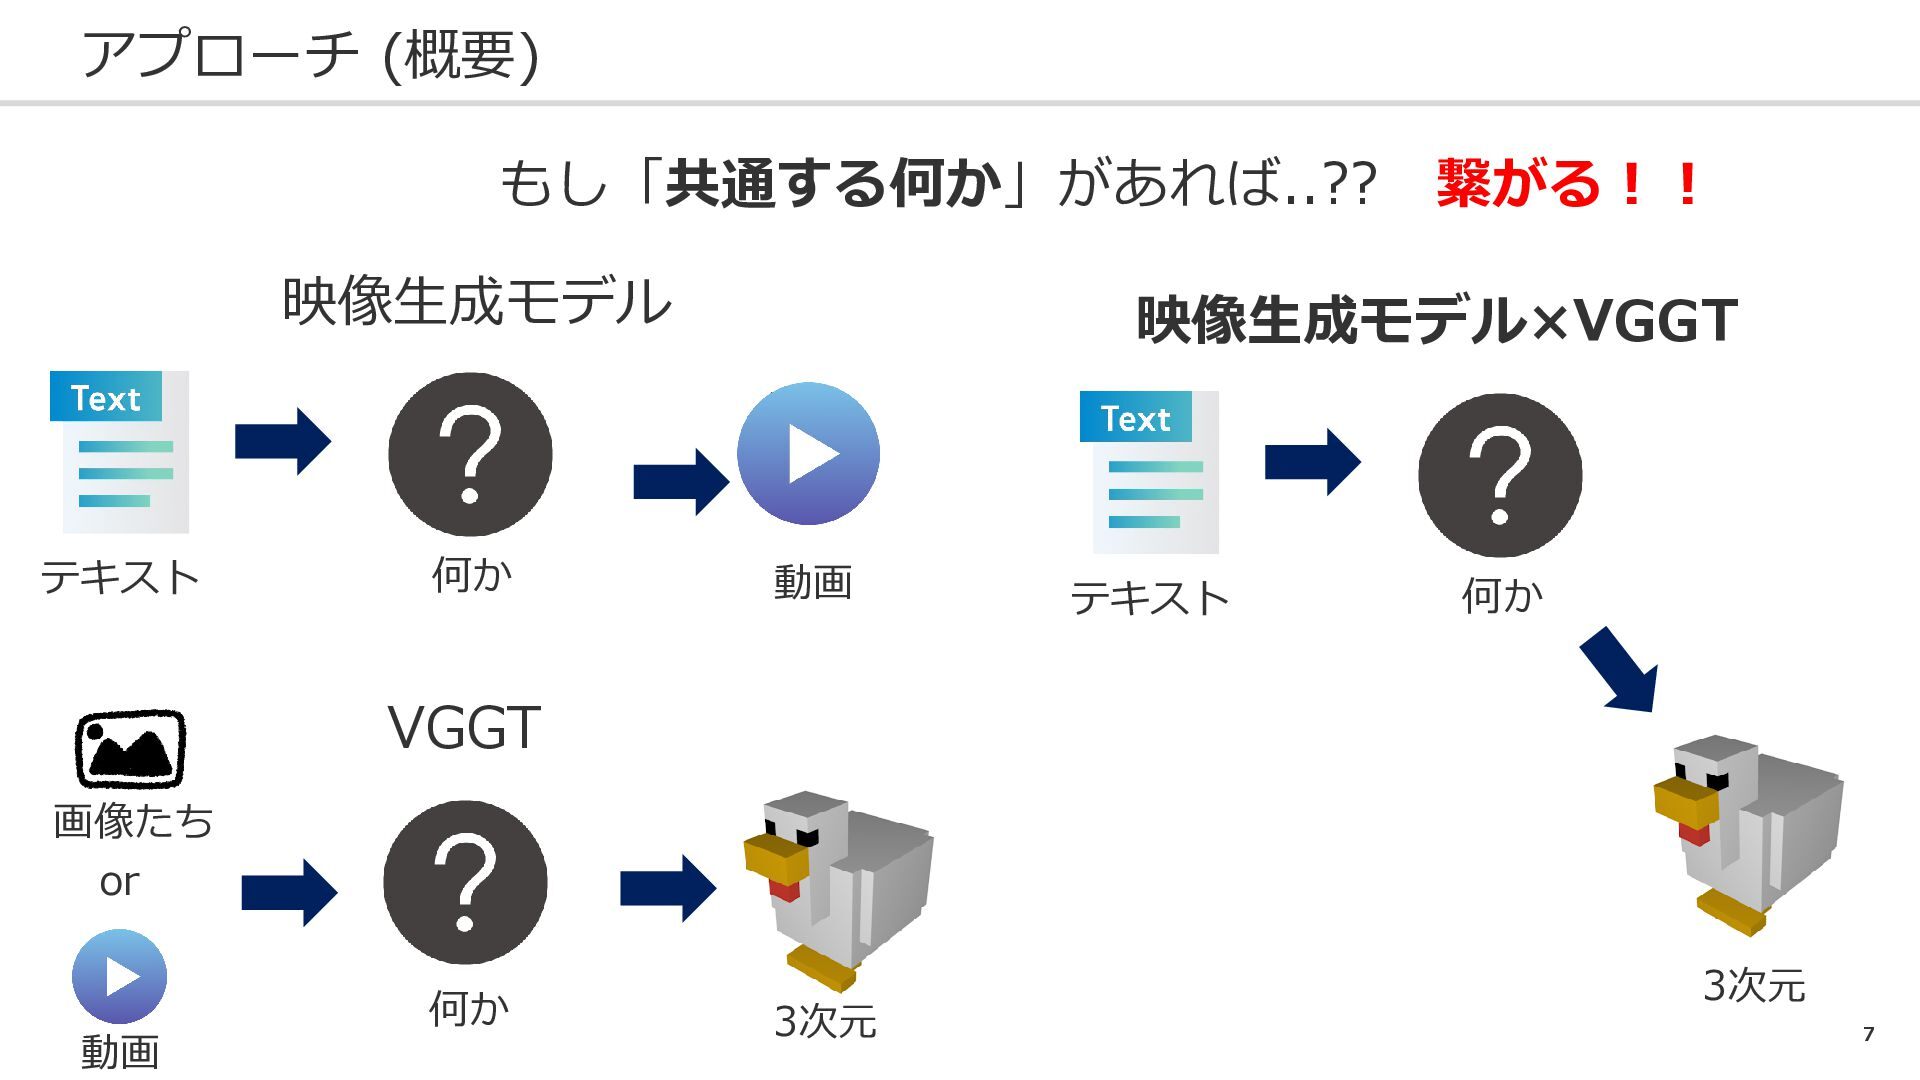
7 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 画像たち 3次元 もし「共通する何か」があれば..??
繋がる!! 何か 何か テキスト 何か 3次元 映像生成モデル×VGGT or 動画
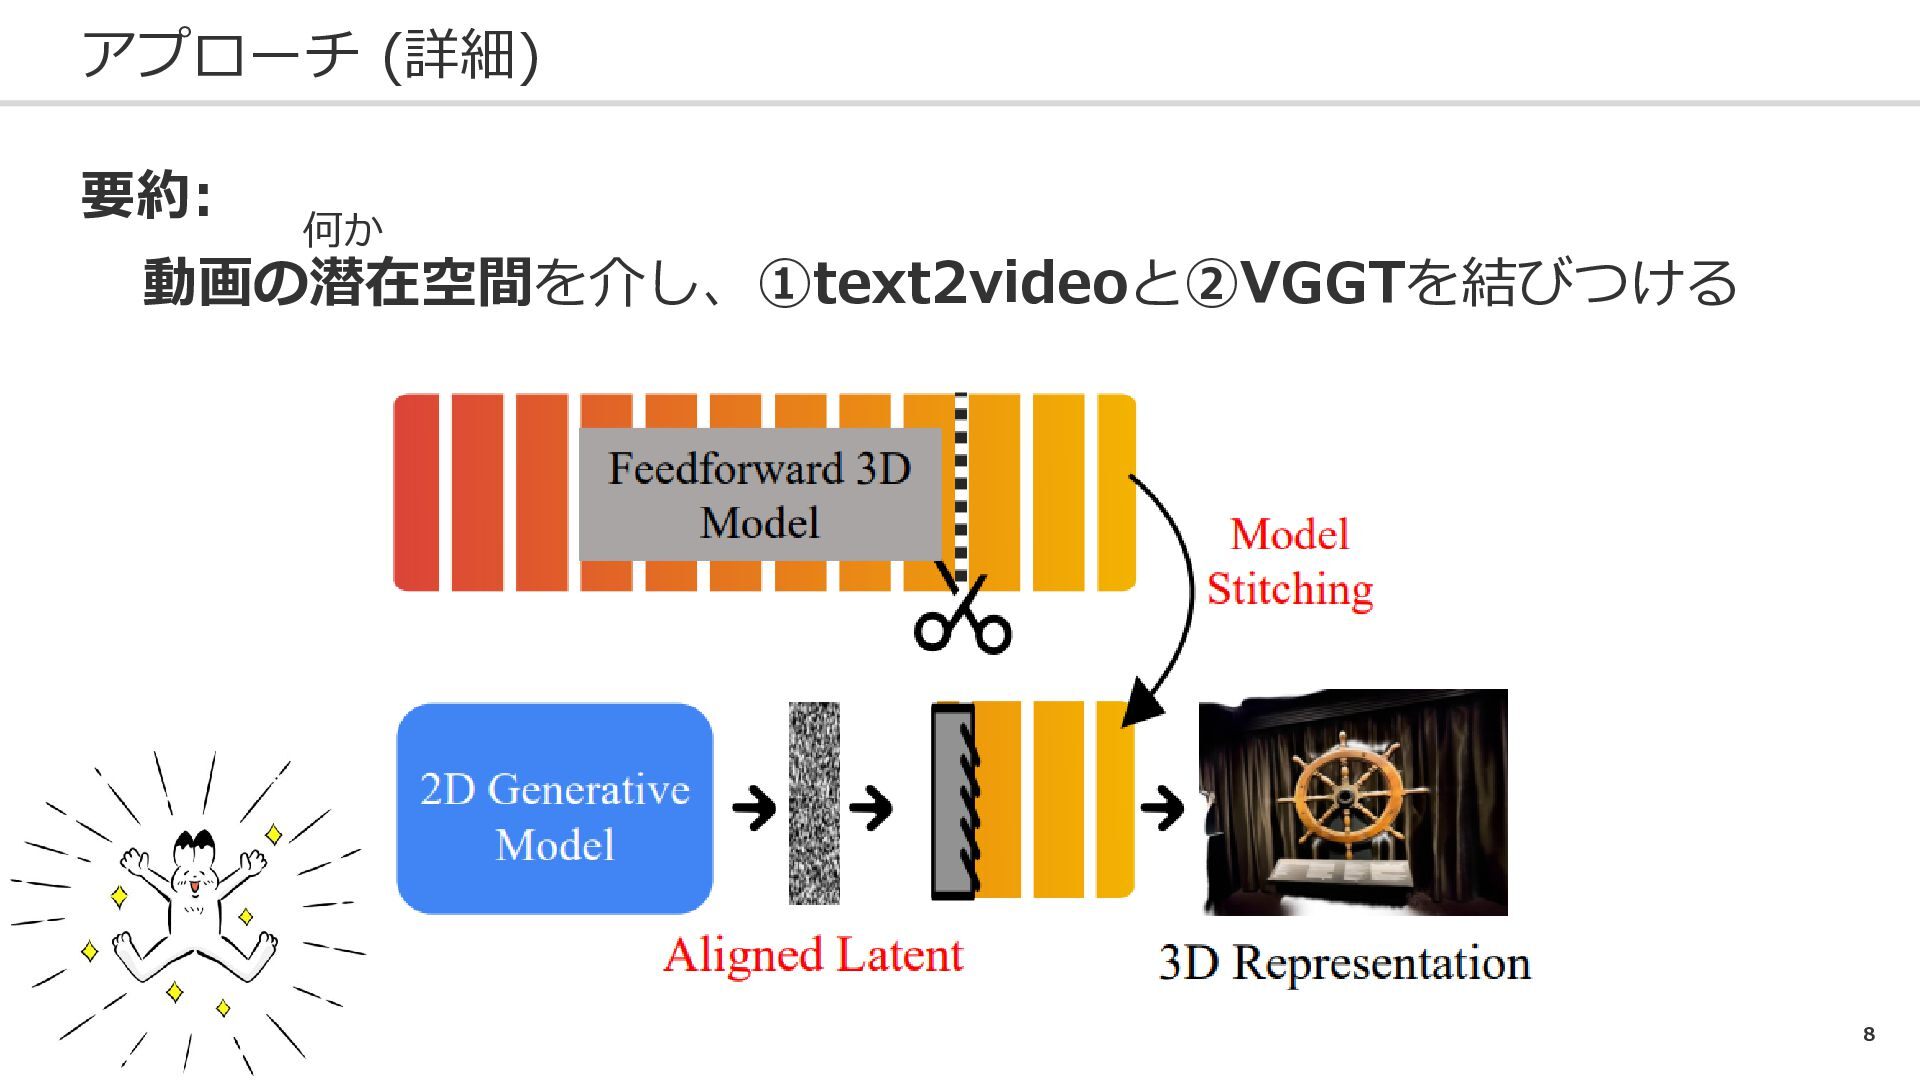
8 アプローチ (詳細) 要約: 動画の潜在空間を介し、①text2videoと②VGGTを結びつける 何か
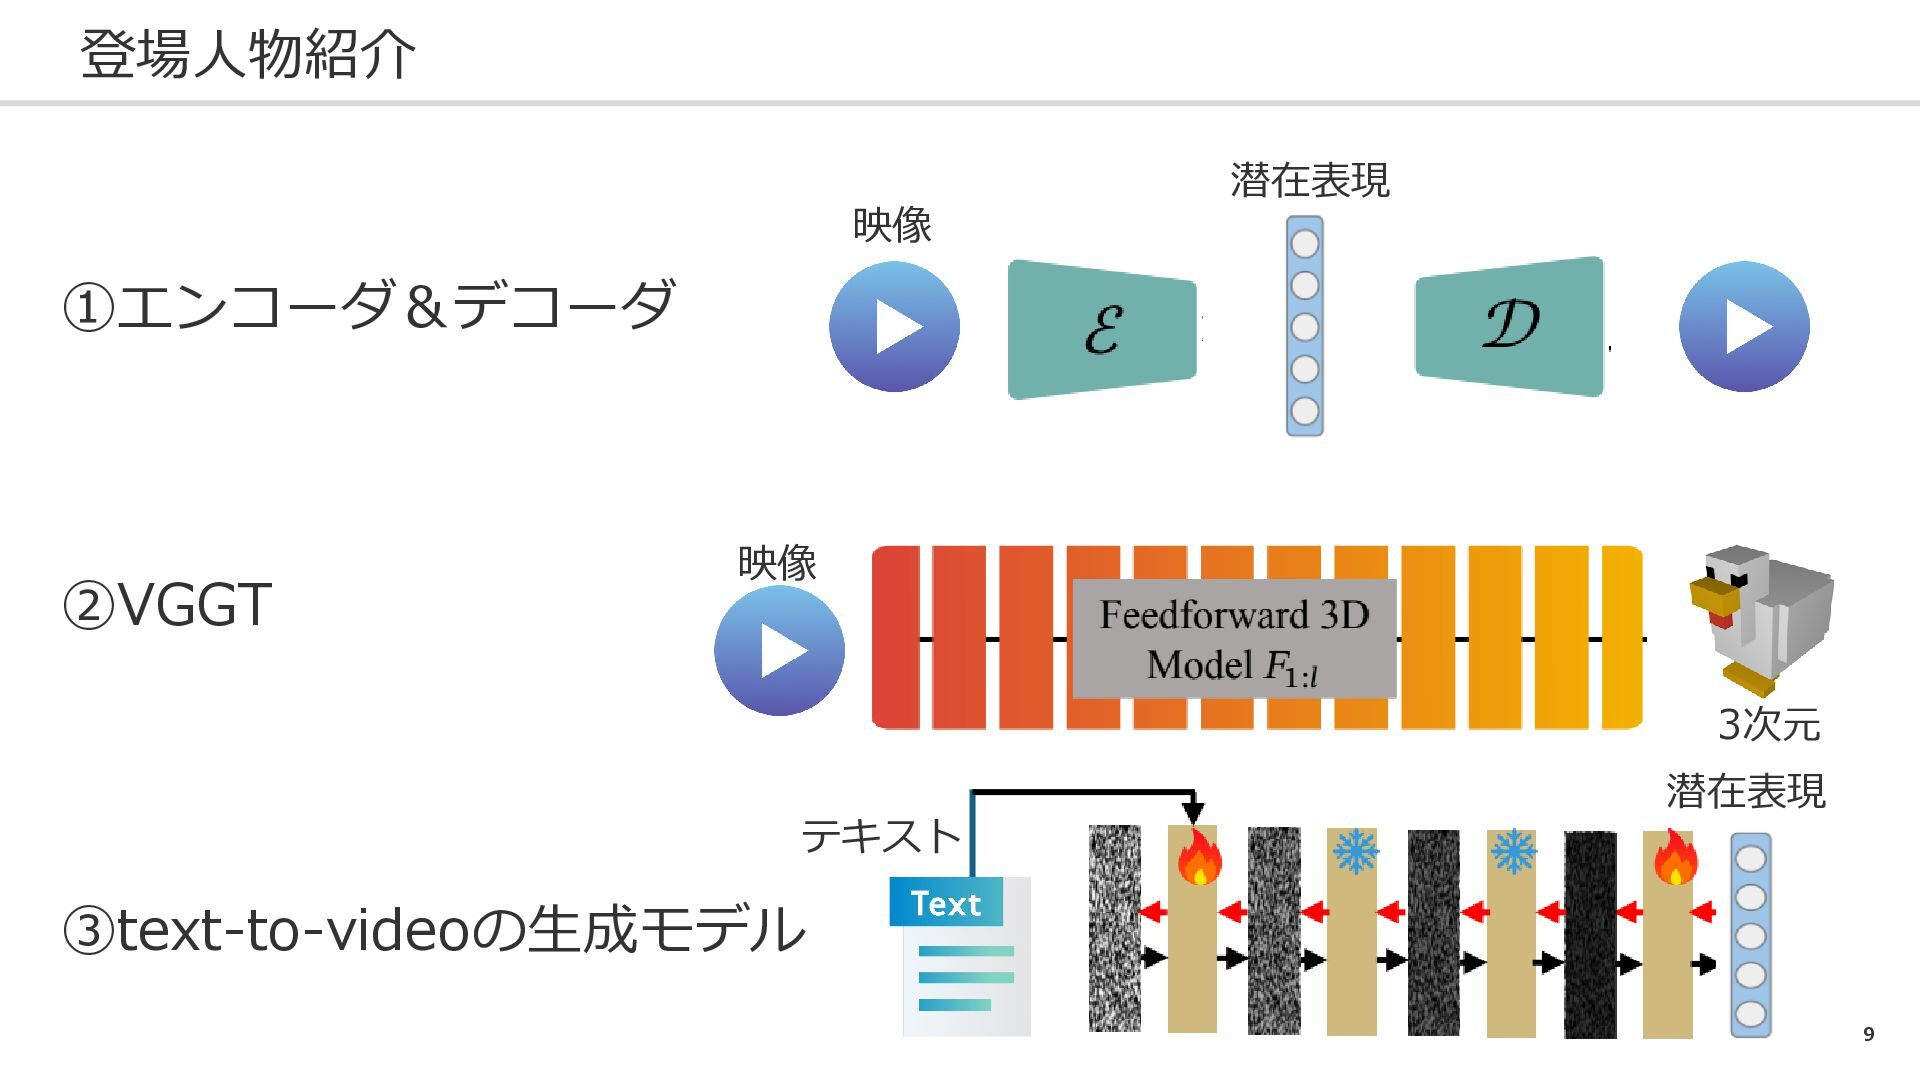
9 登場人物紹介 ①エンコーダ&デコーダ ②VGGT ③text-to-videoの生成モデル 潜在表現 映像 テキスト 潜在表現 映像
3次元
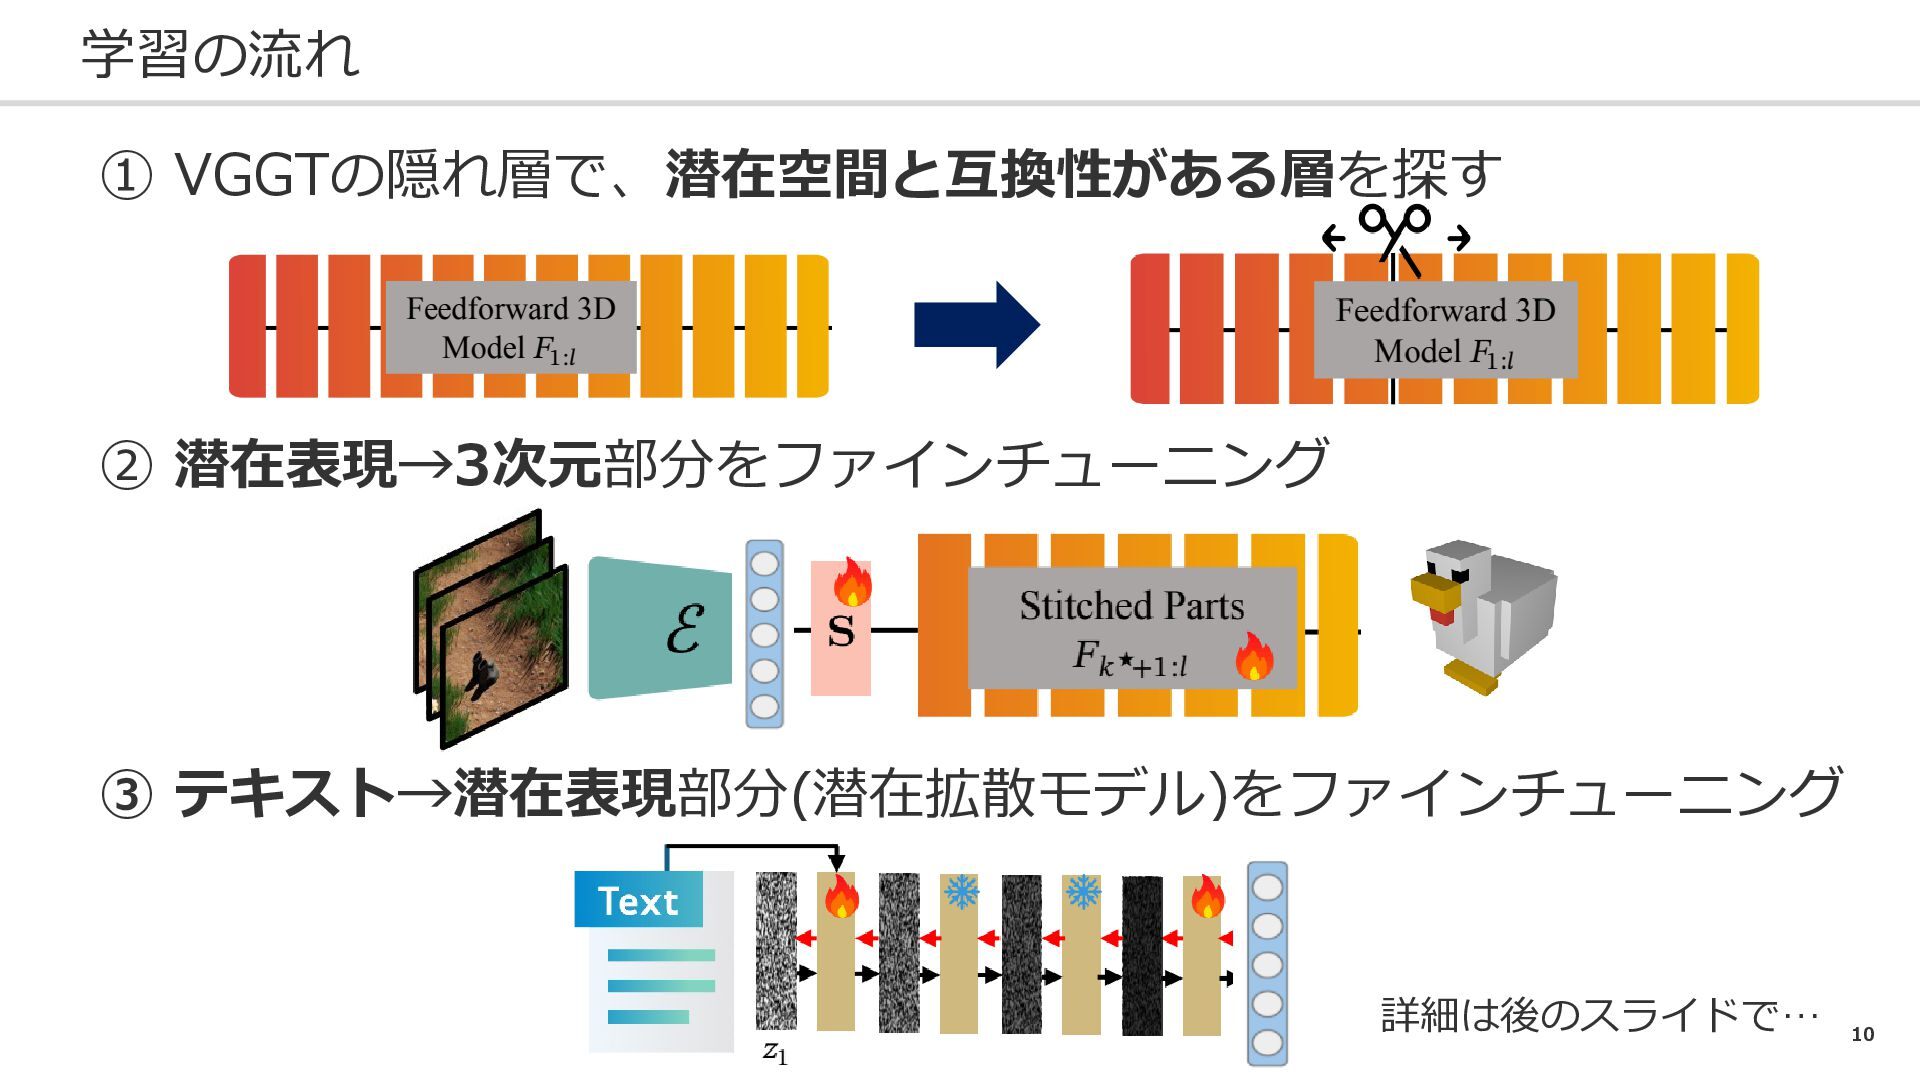
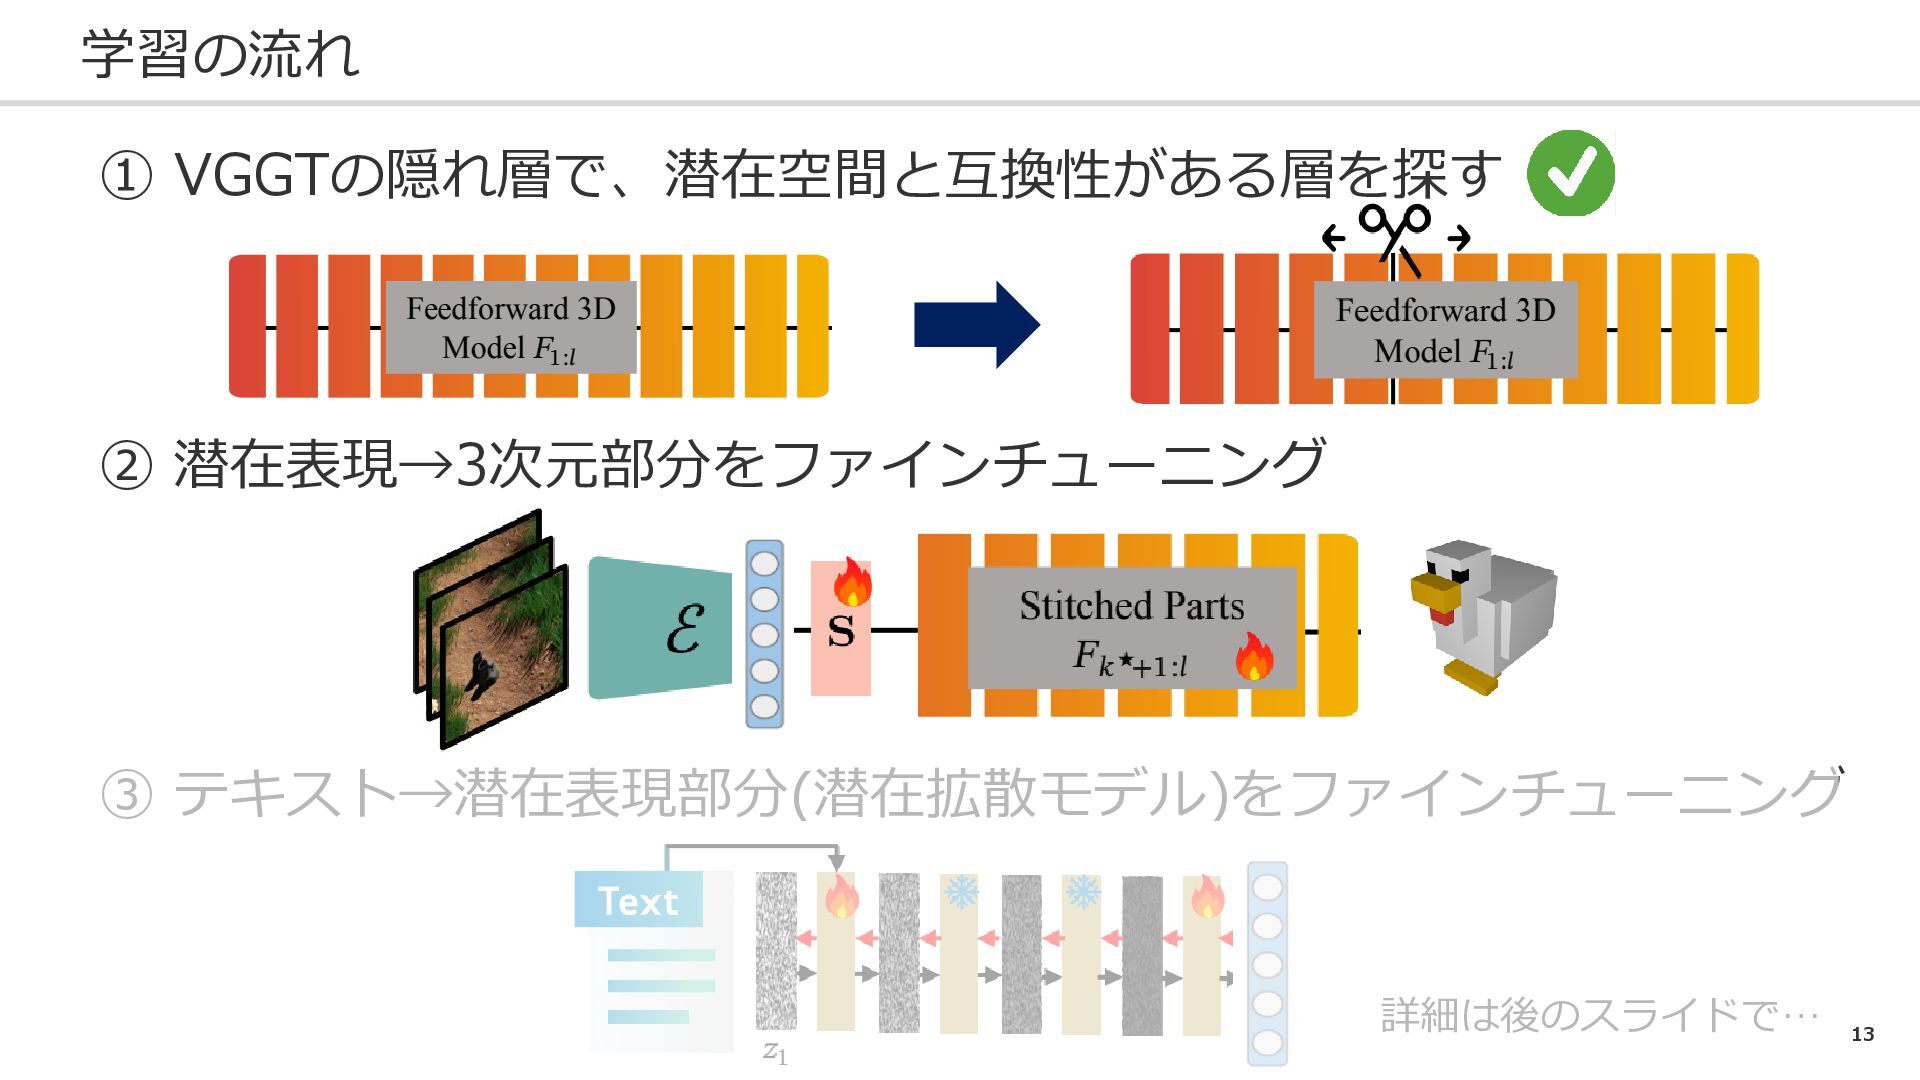
10 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
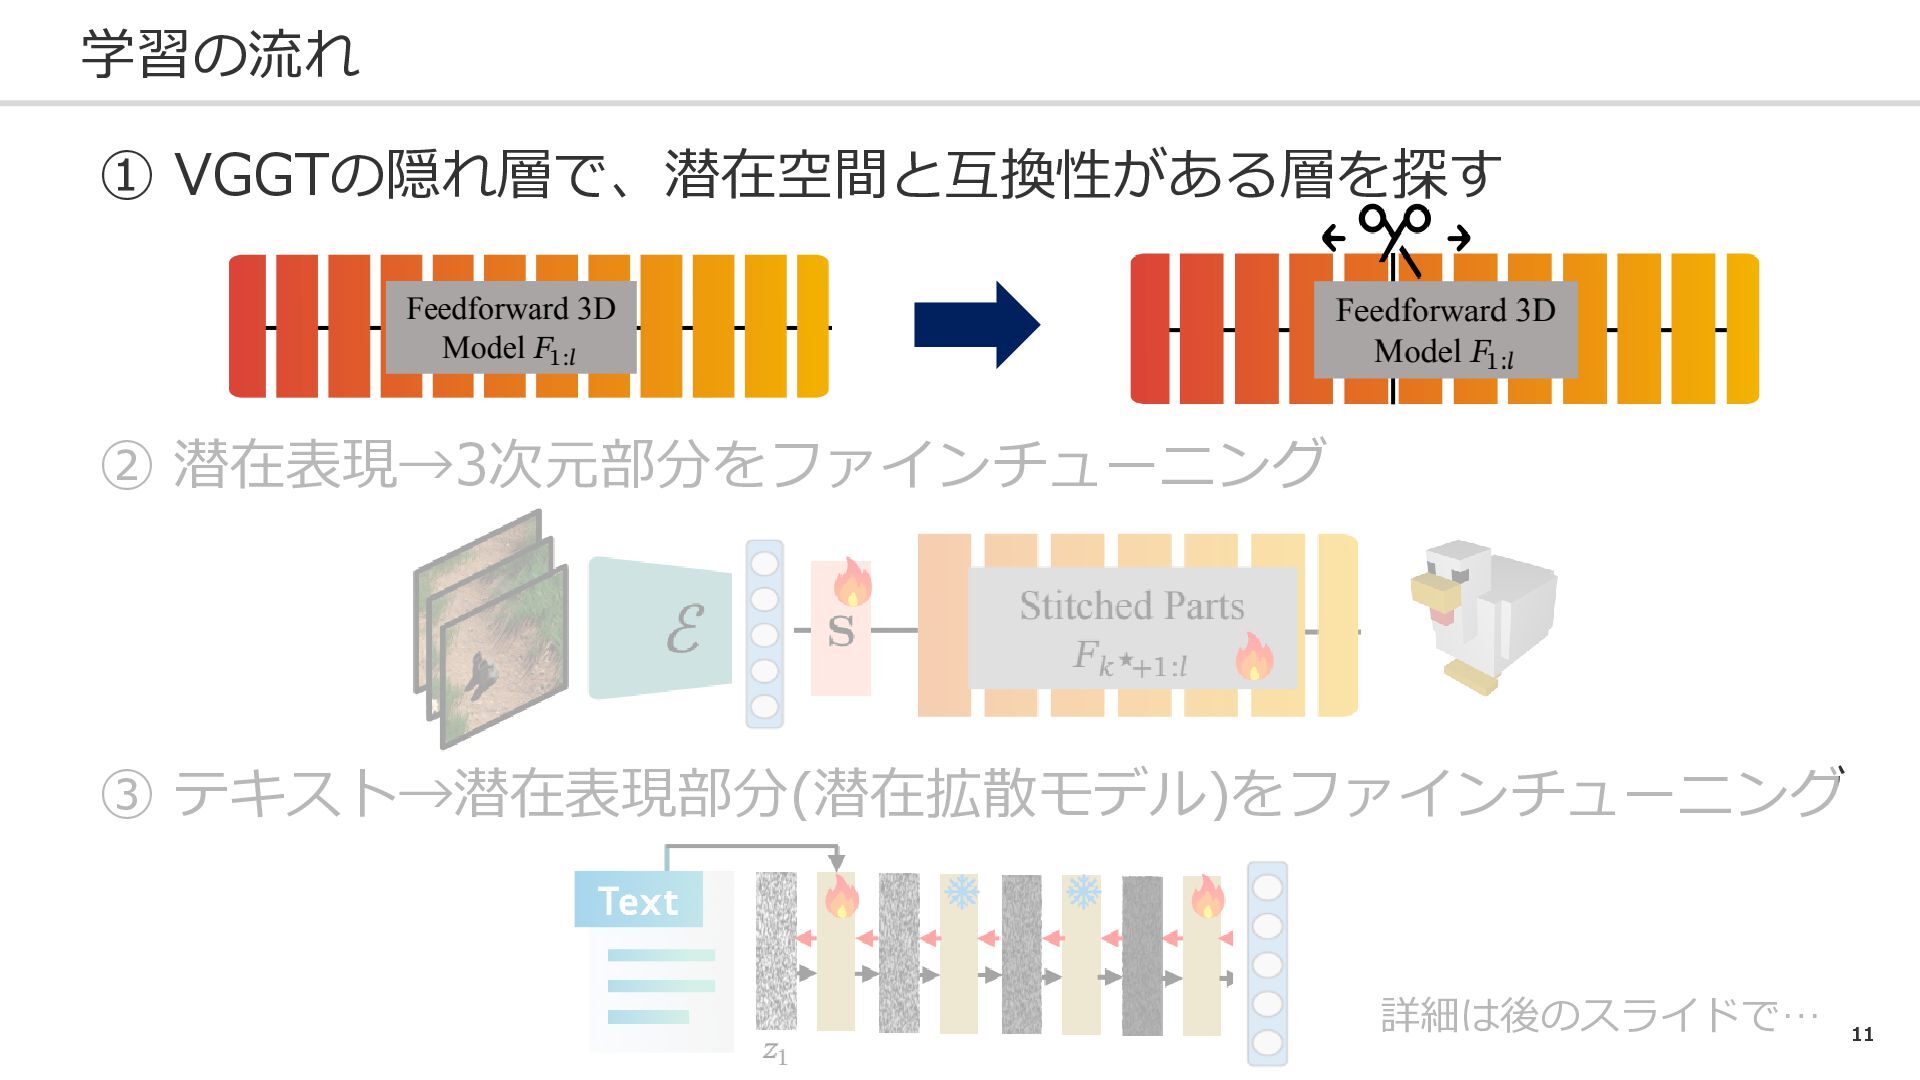
11 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
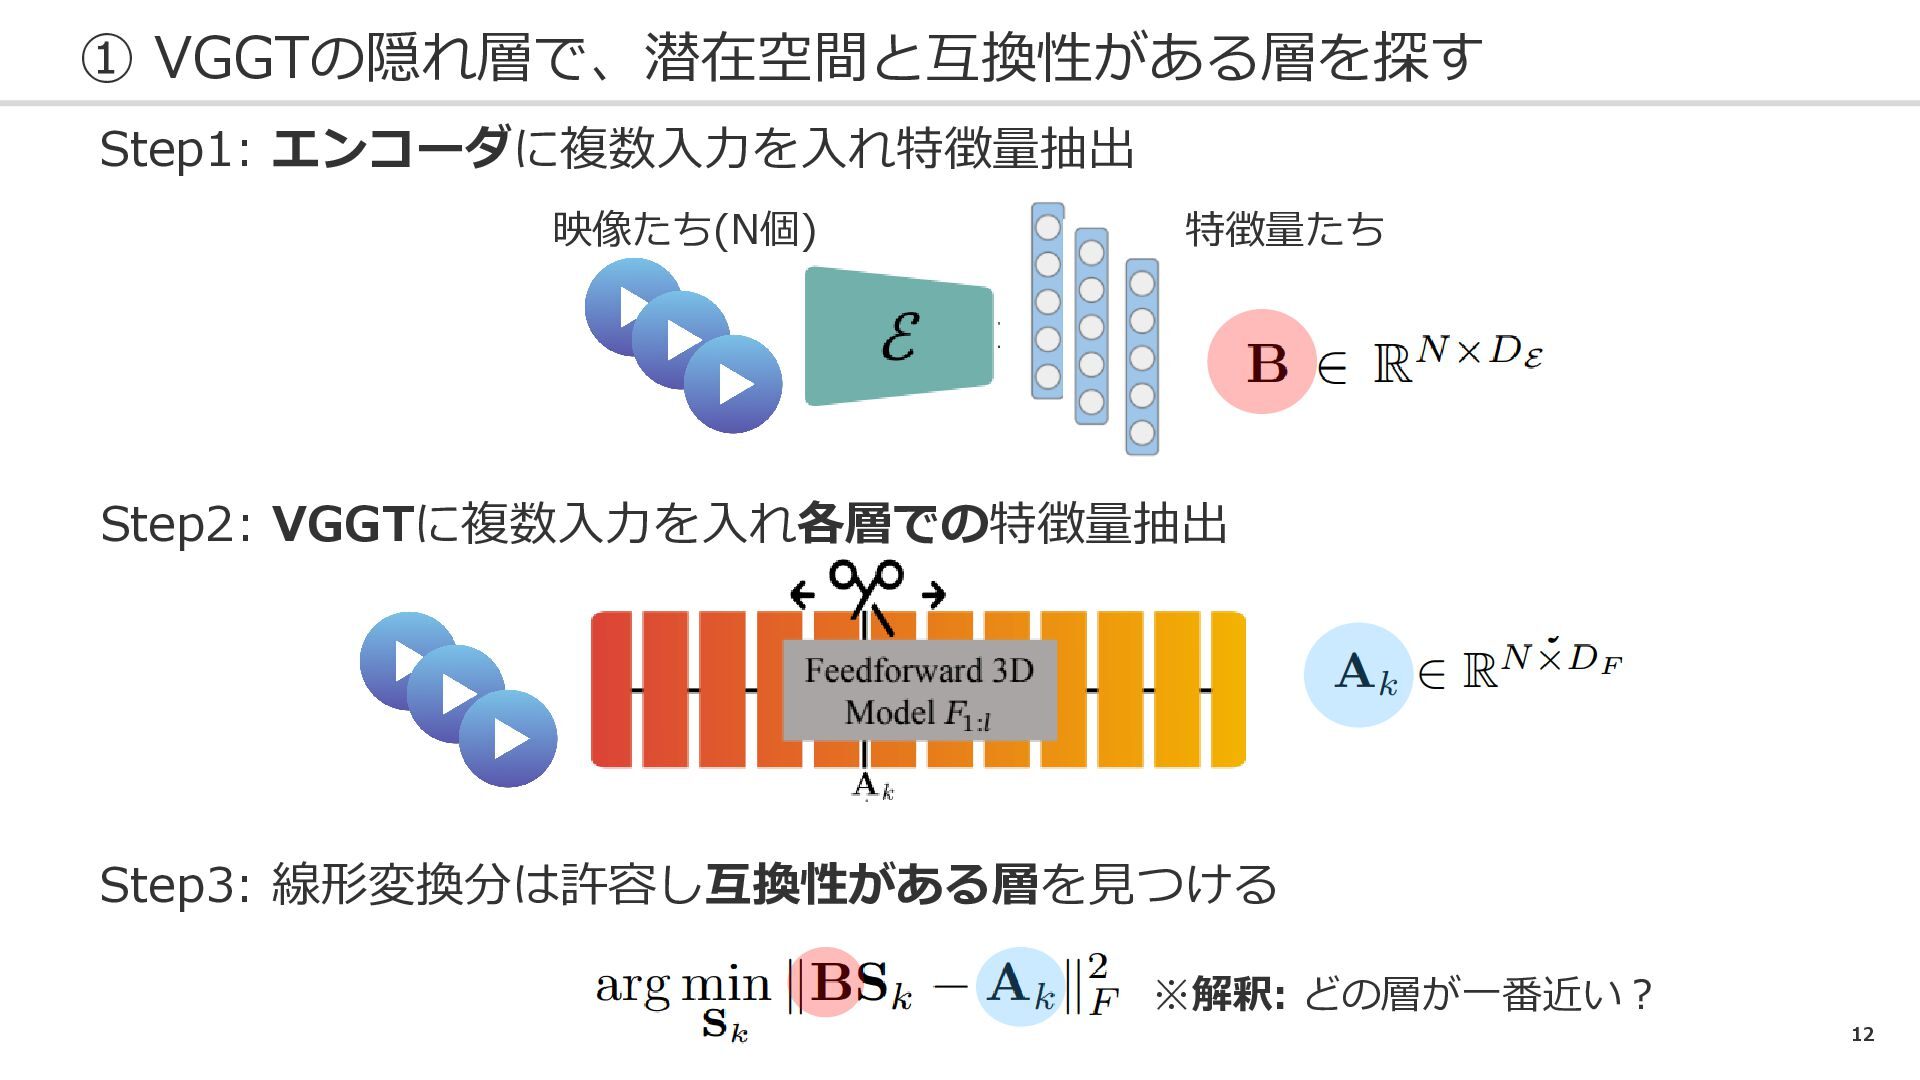
12 ① VGGTの隠れ層で、潜在空間と互換性がある層を探す Step1: エンコーダに複数入力を入れ特徴量抽出 映像たち(N個) 特徴量たち Step2: VGGTに複数入力を入れ各層での特徴量抽出 Step3:
線形変換分は許容し互換性がある層を見つける ※解釈: どの層が一番近い?
13 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
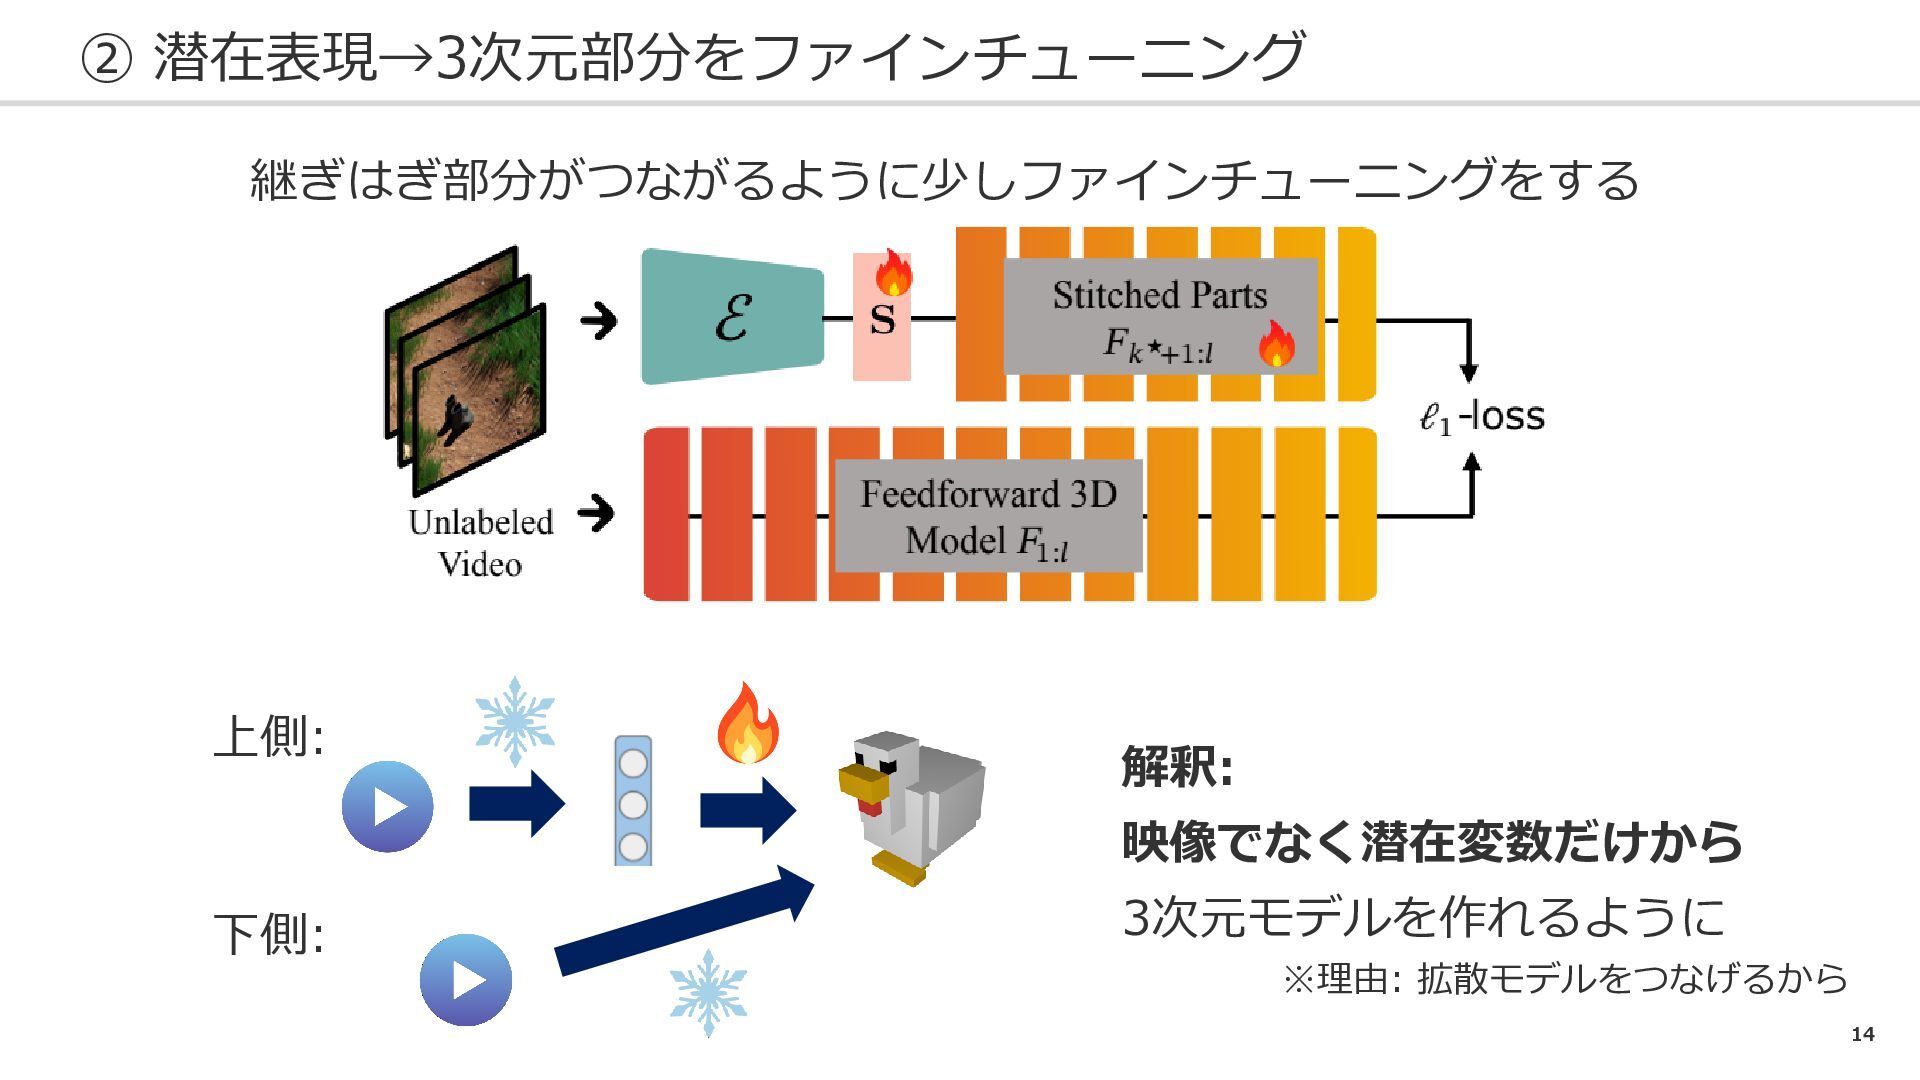
14 ② 潜在表現→3次元部分をファインチューニング 上側: 下側: 継ぎはぎ部分がつながるように少しファインチューニングをする 解釈: 映像でなく潜在変数だけから 3次元モデルを作れるように ※理由:
拡散モデルをつなげるから
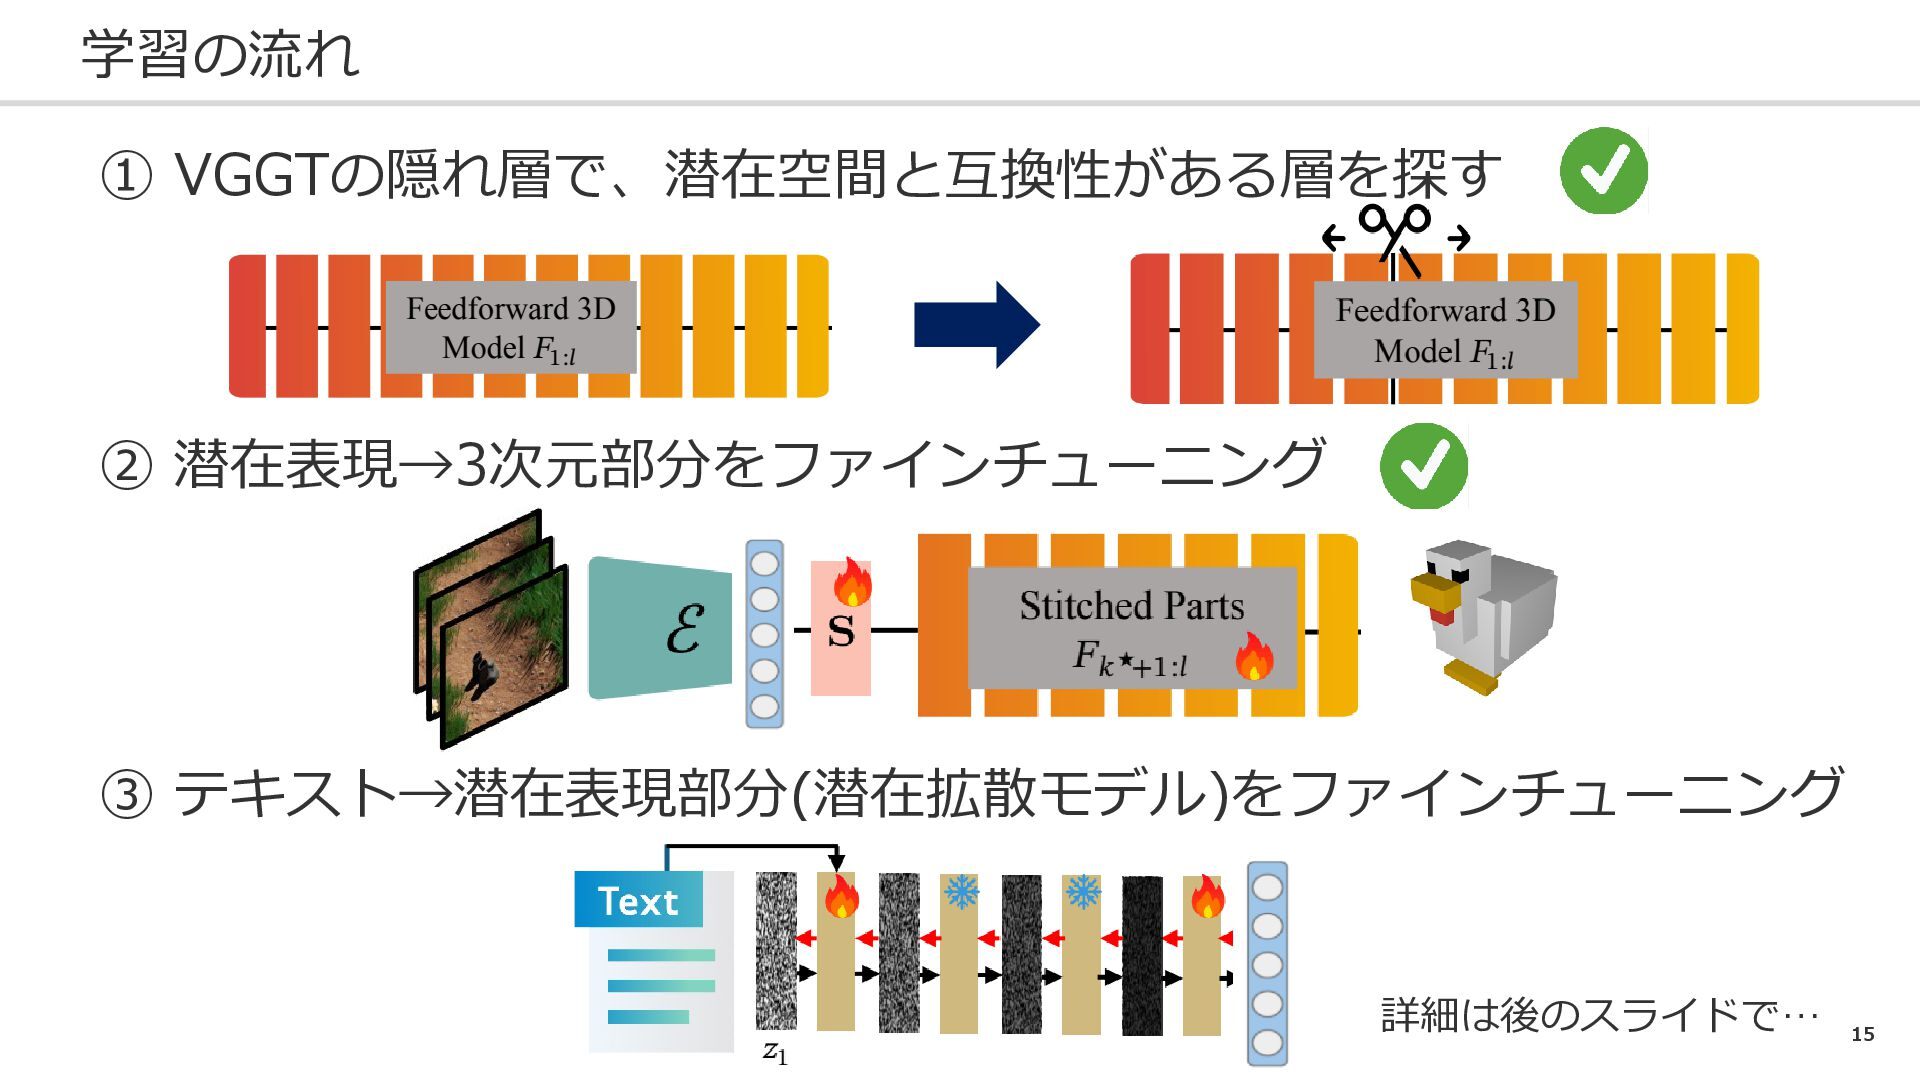
15 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
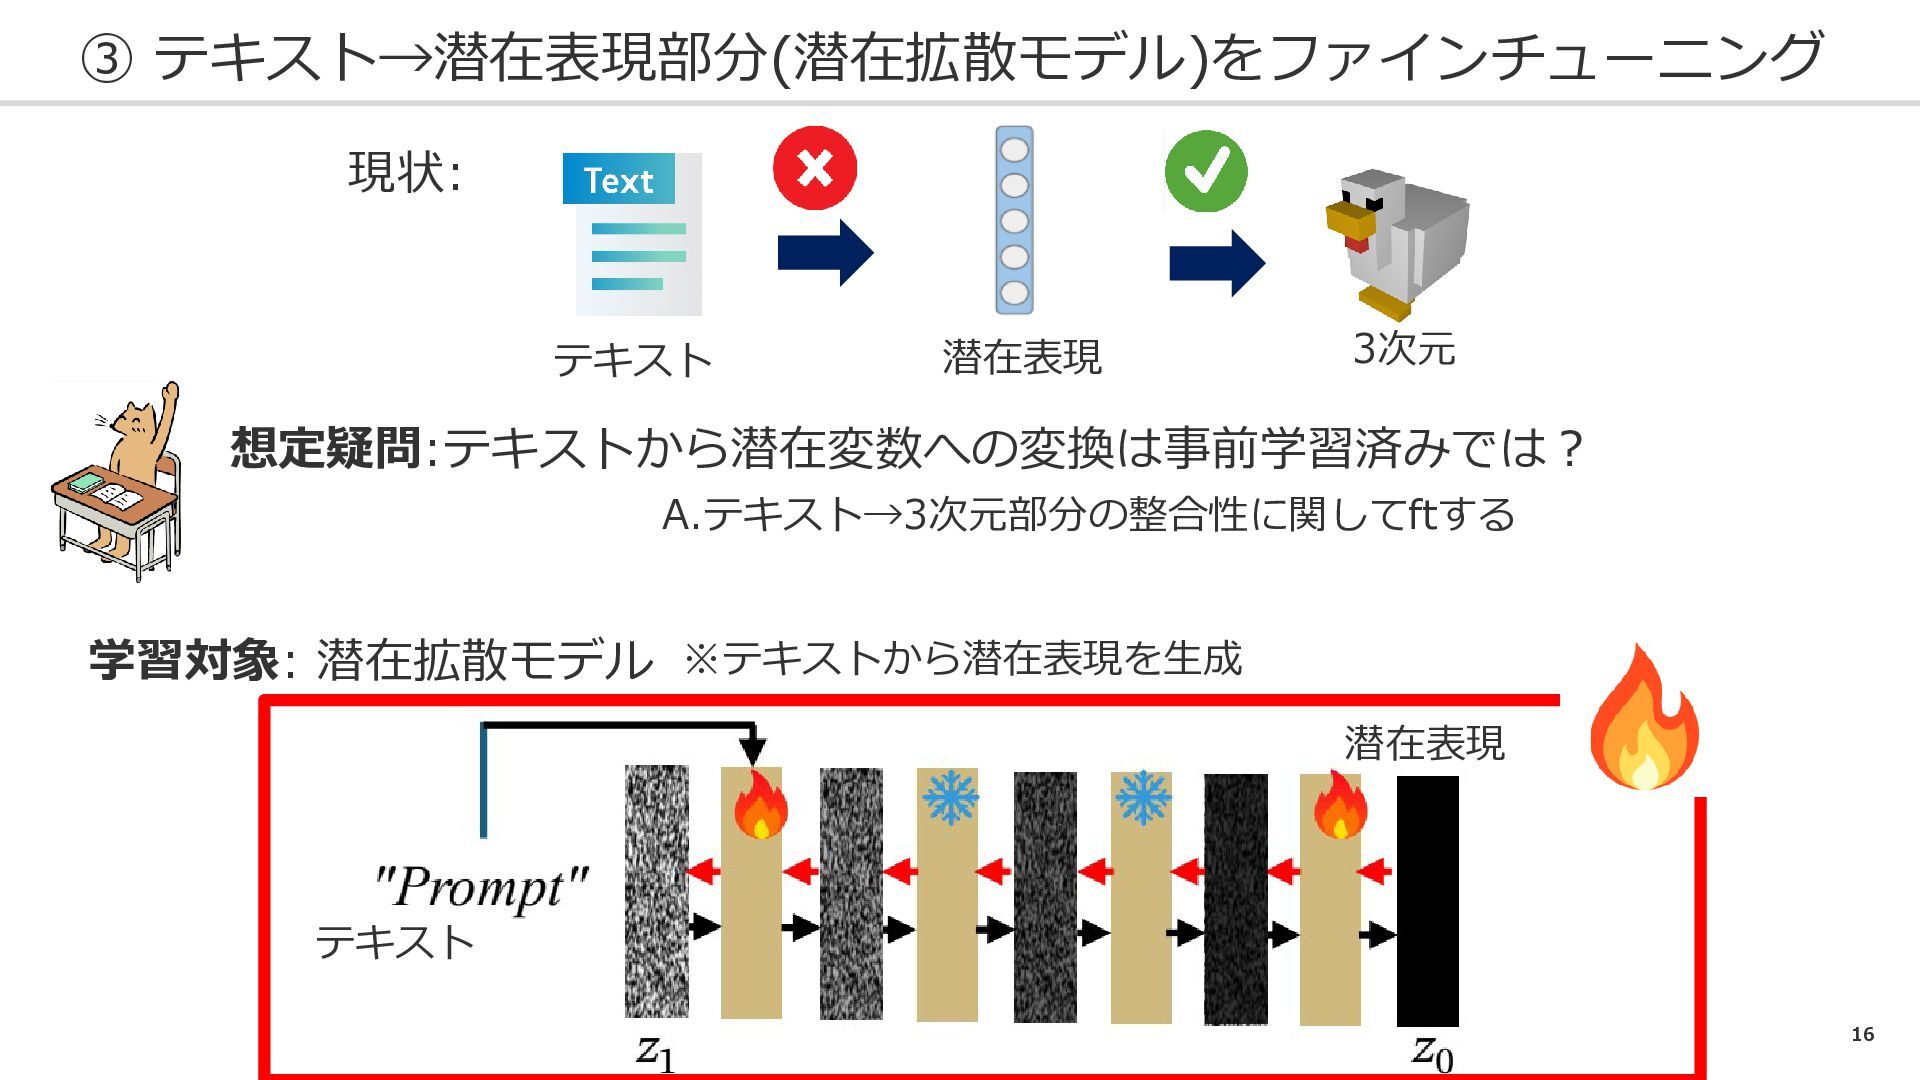
16 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 現状: テキスト 潜在表現 3次元 学習対象: 潜在拡散モデル ※テキストから潜在表現を生成
潜在表現 テキスト 想定疑問:テキストから潜在変数への変換は事前学習済みでは? A.テキスト→3次元部分の整合性に関してftする
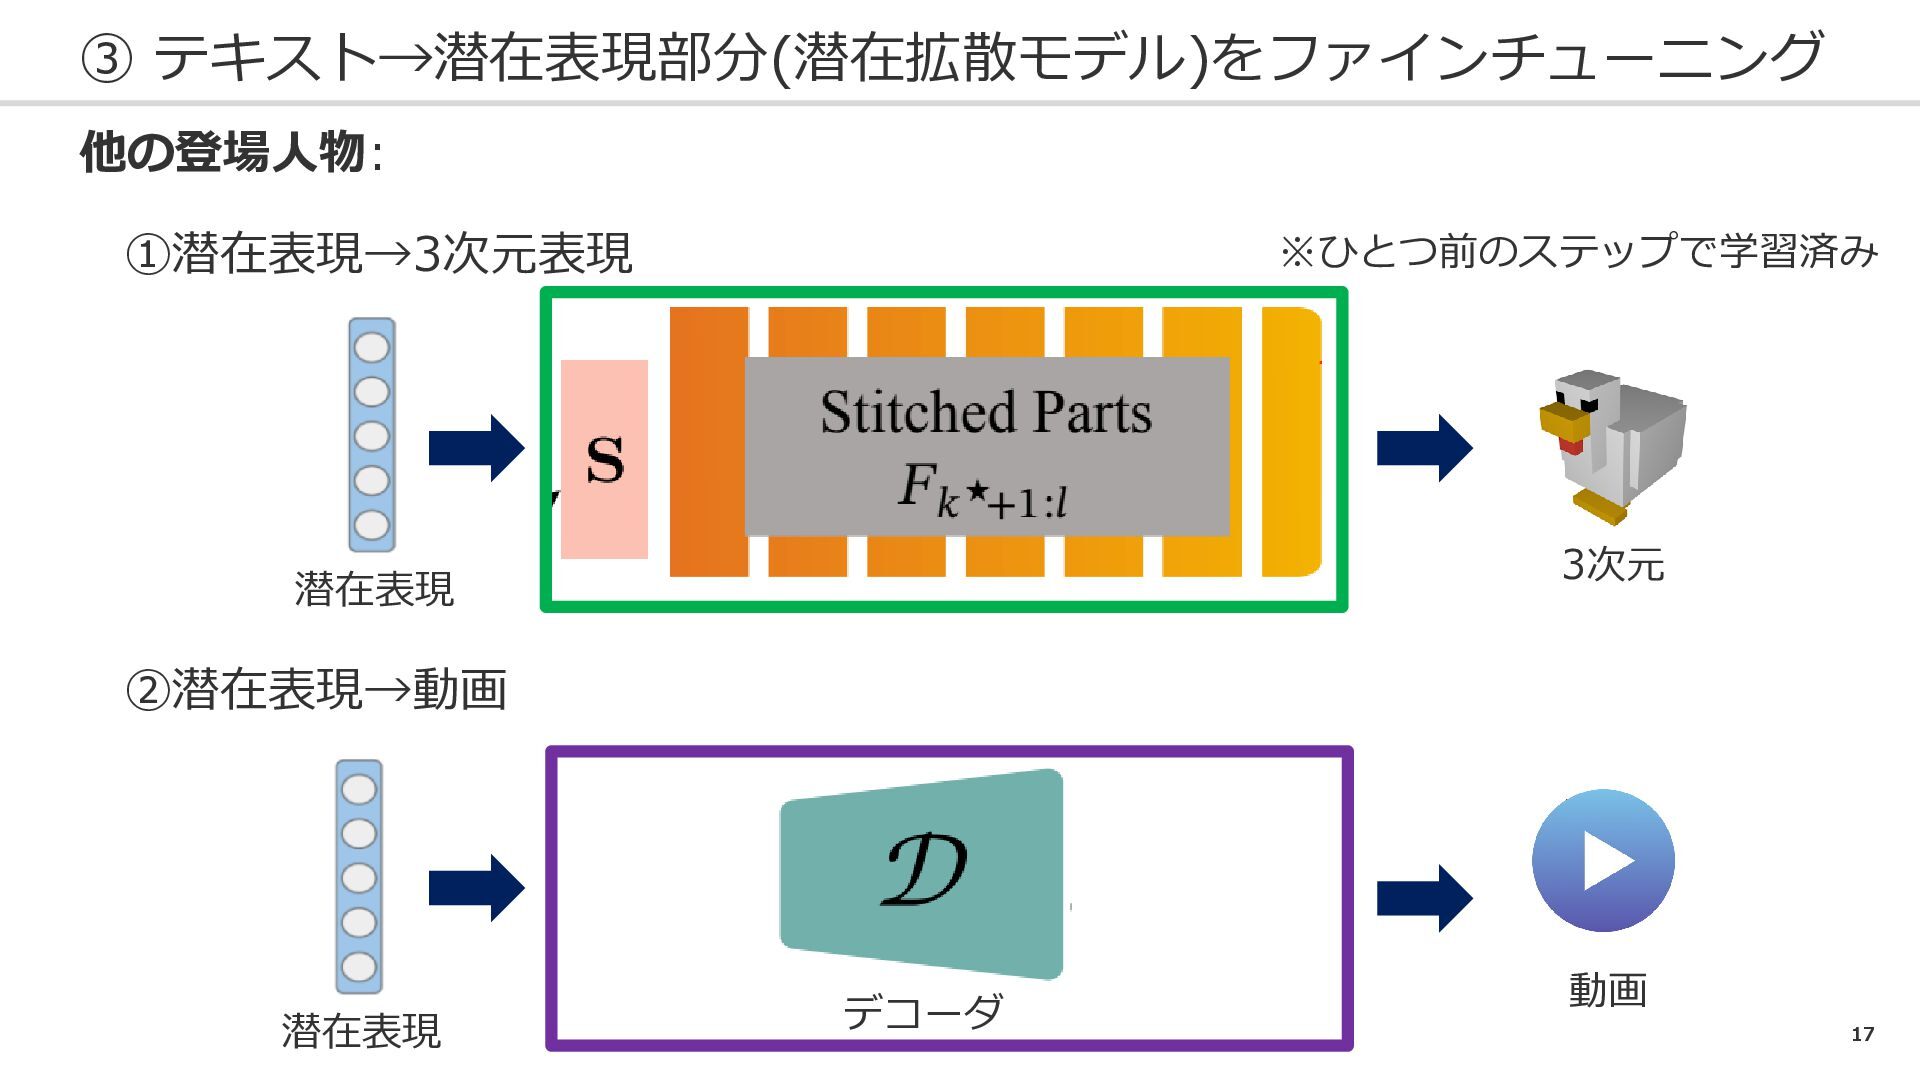
17 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 他の登場人物: ①潜在表現→3次元表現 潜在表現 3次元 ※ひとつ前のステップで学習済み ②潜在表現→動画 潜在表現
デコーダ 動画
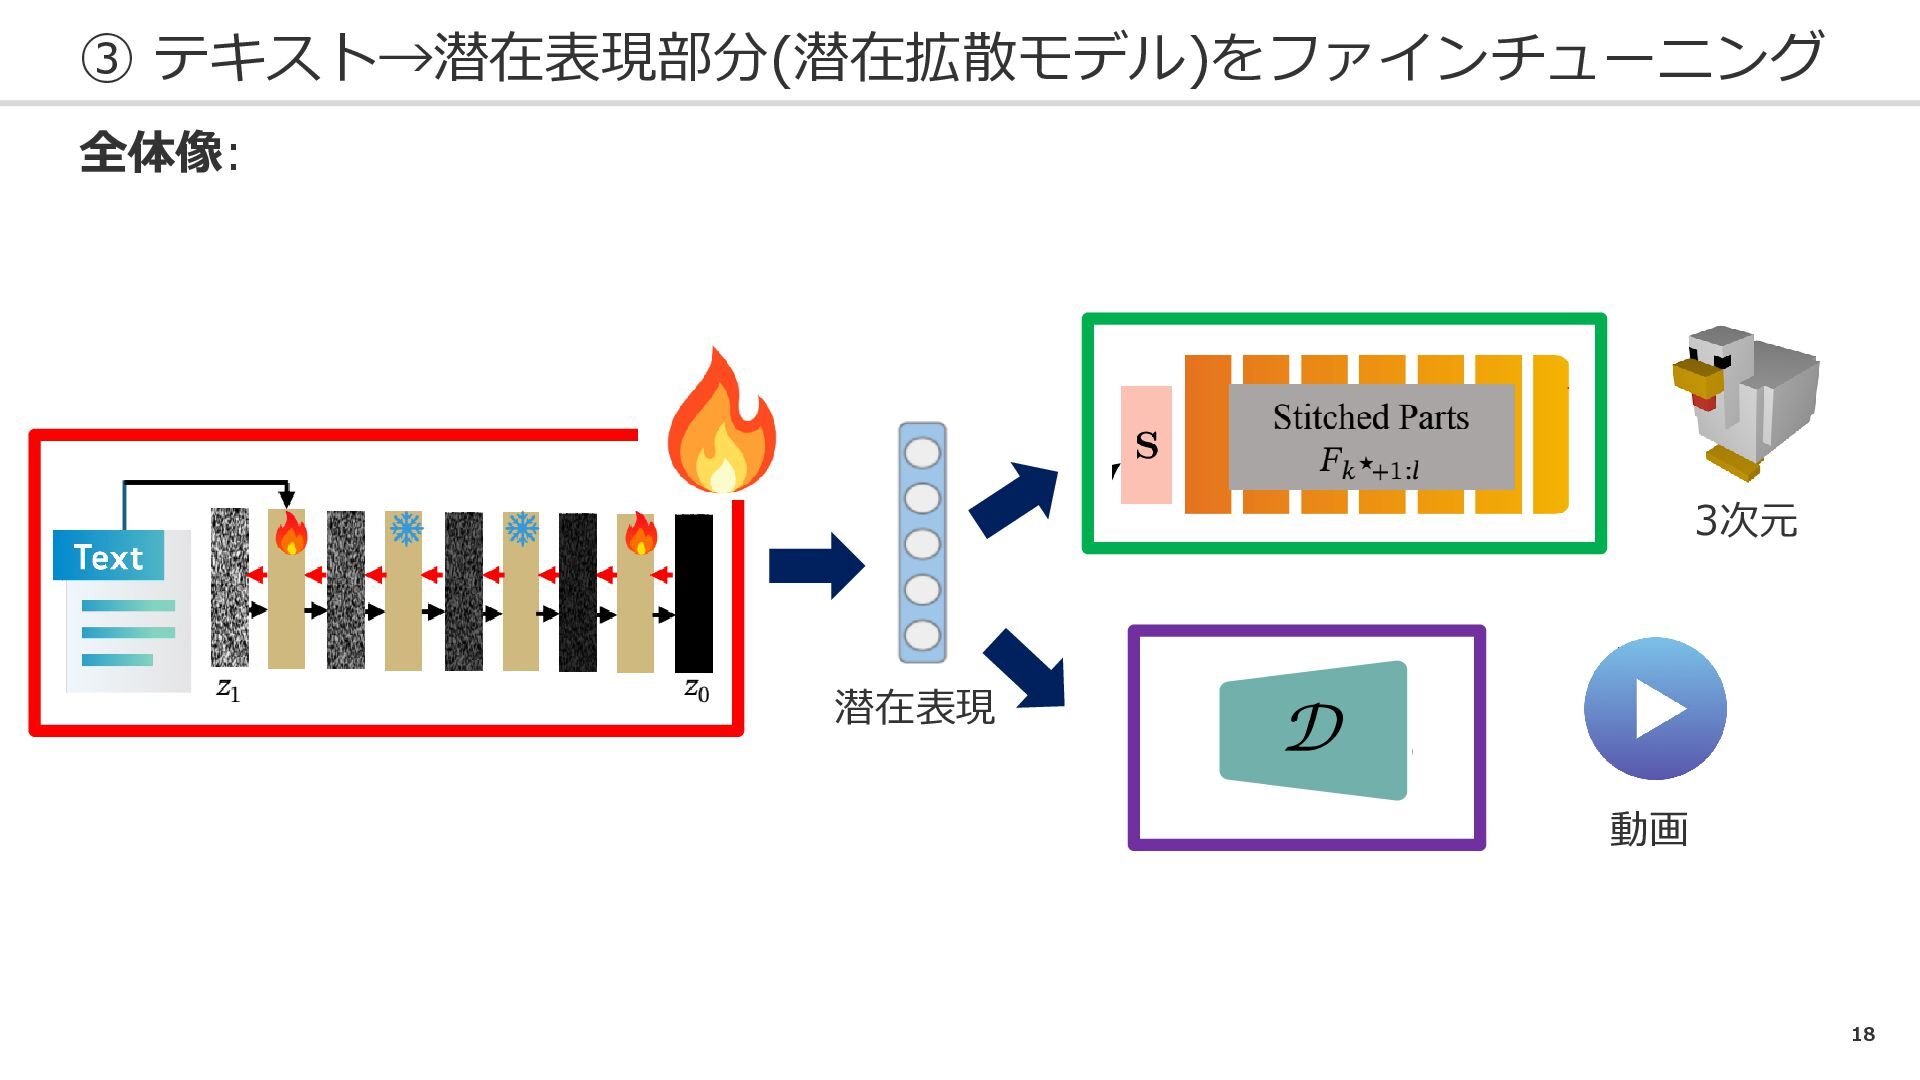
18 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 全体像: 潜在表現 3次元 動画
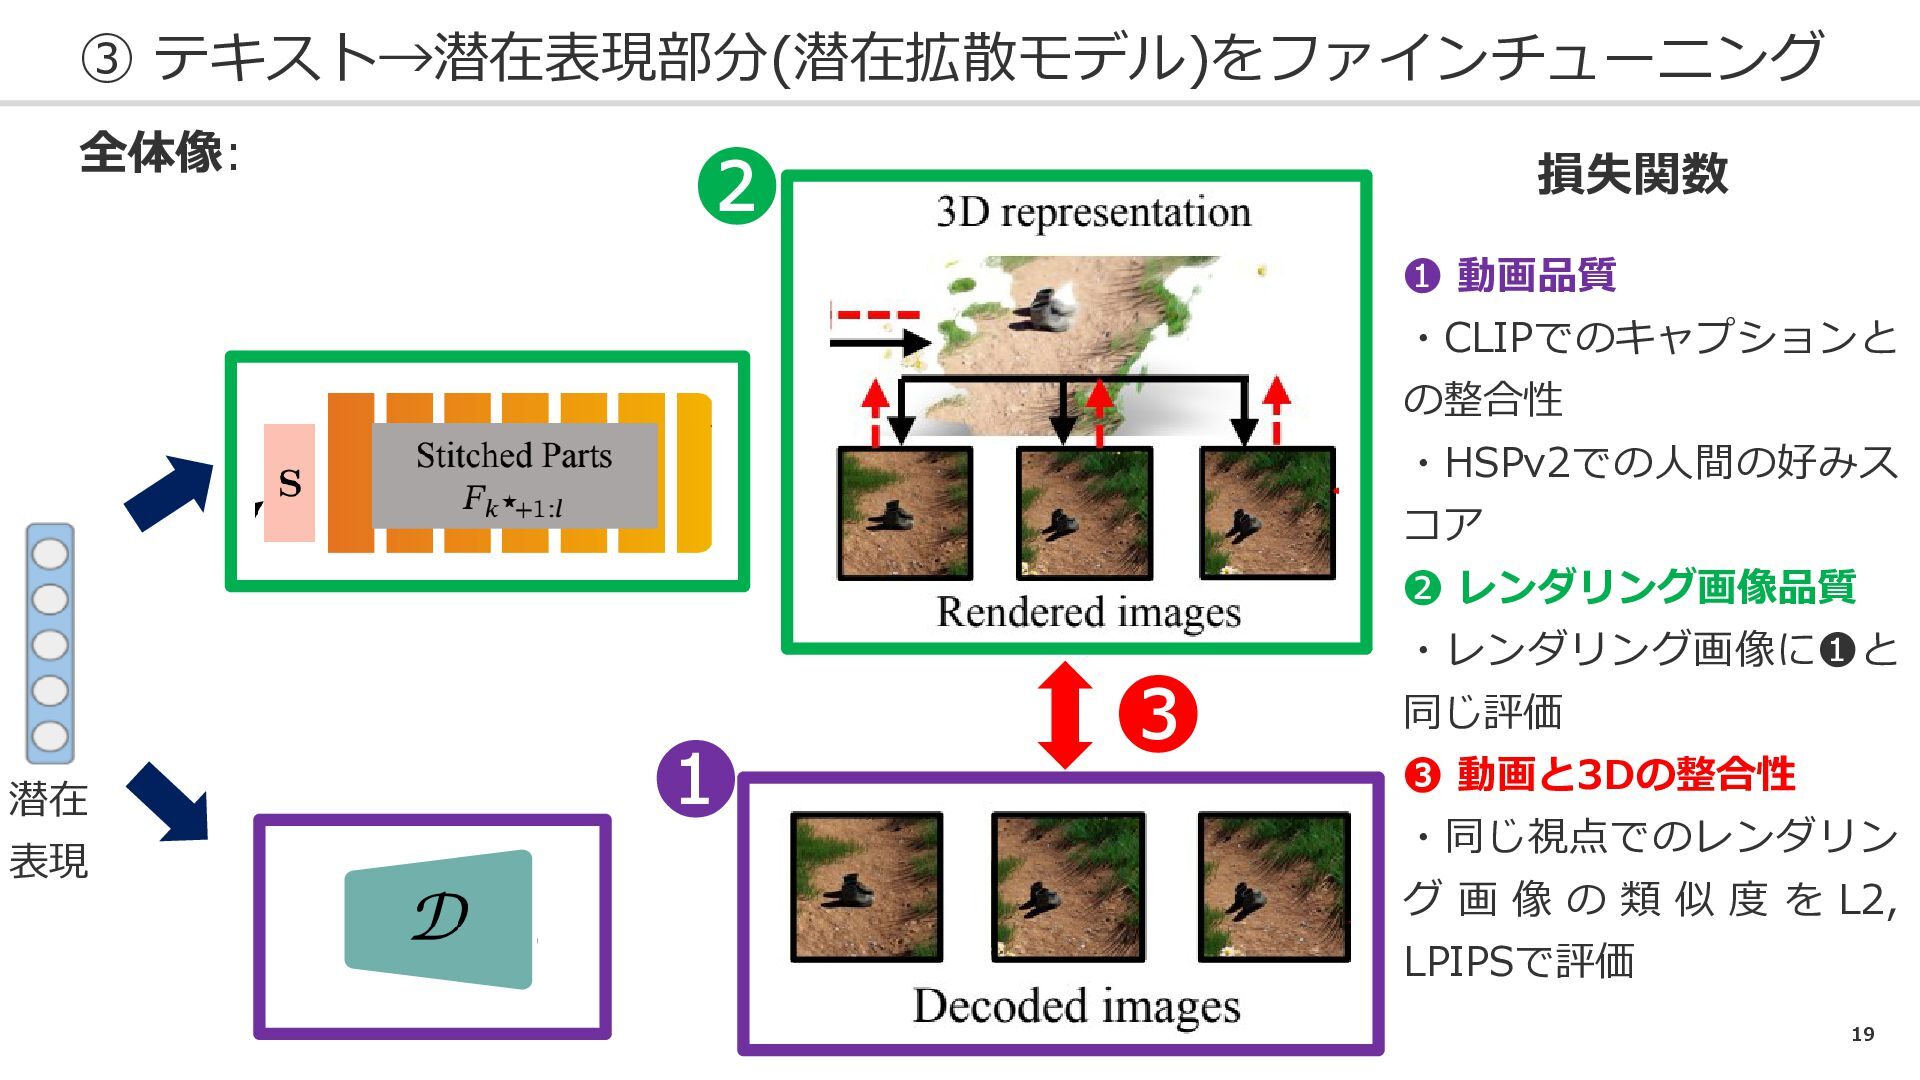
19 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 全体像: 損失関数 ❶ 動画品質 ・CLIPでのキャプションと の整合性 ・HSPv2での人間の好みス
コア ❷ レンダリング画像品質 ・レンダリング画像に❶と 同じ評価 ❸ 動画と3Dの整合性 ・同じ視点でのレンダリン グ 画 像 の 類 似 度 を L2, LPIPSで評価 ❶ ❷ ❸ 潜在 表現
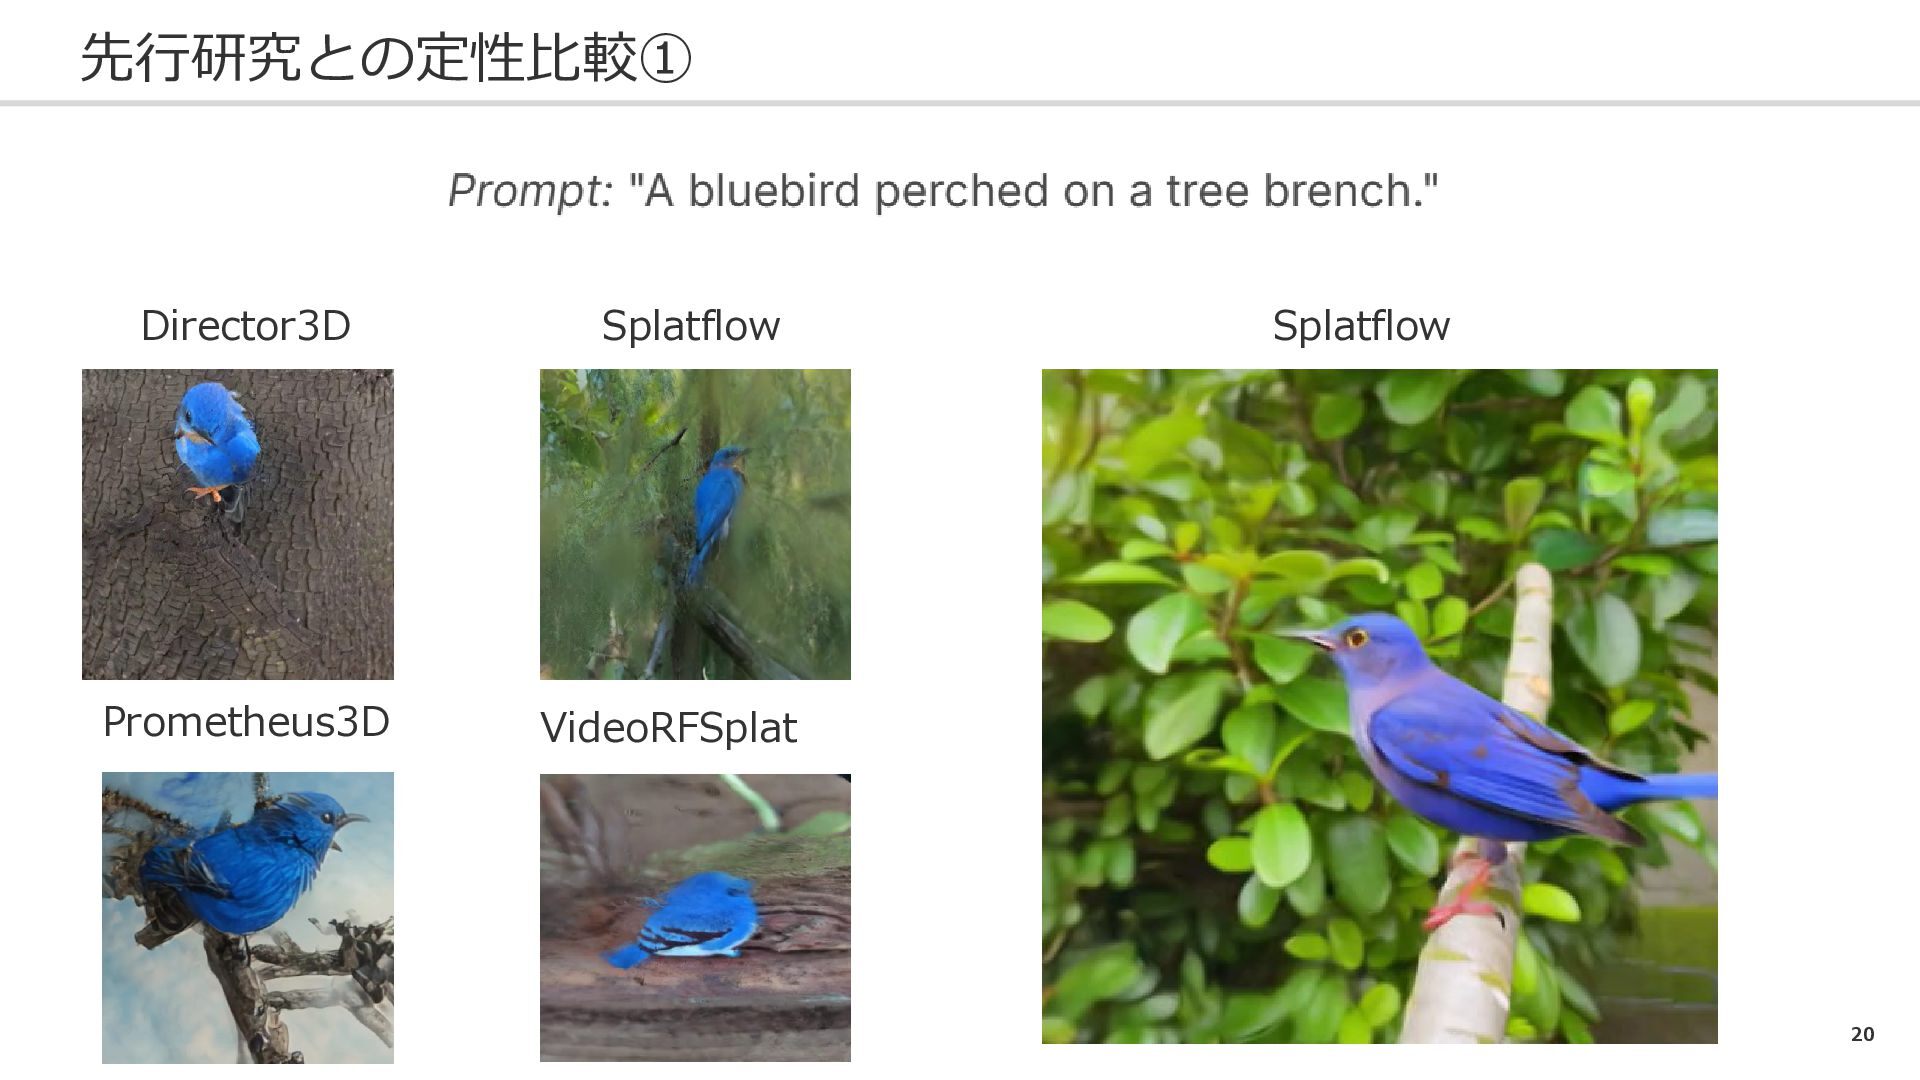
20 先行研究との定性比較① Director3D Splatflow Prometheus3D VideoRFSplat Splatflow
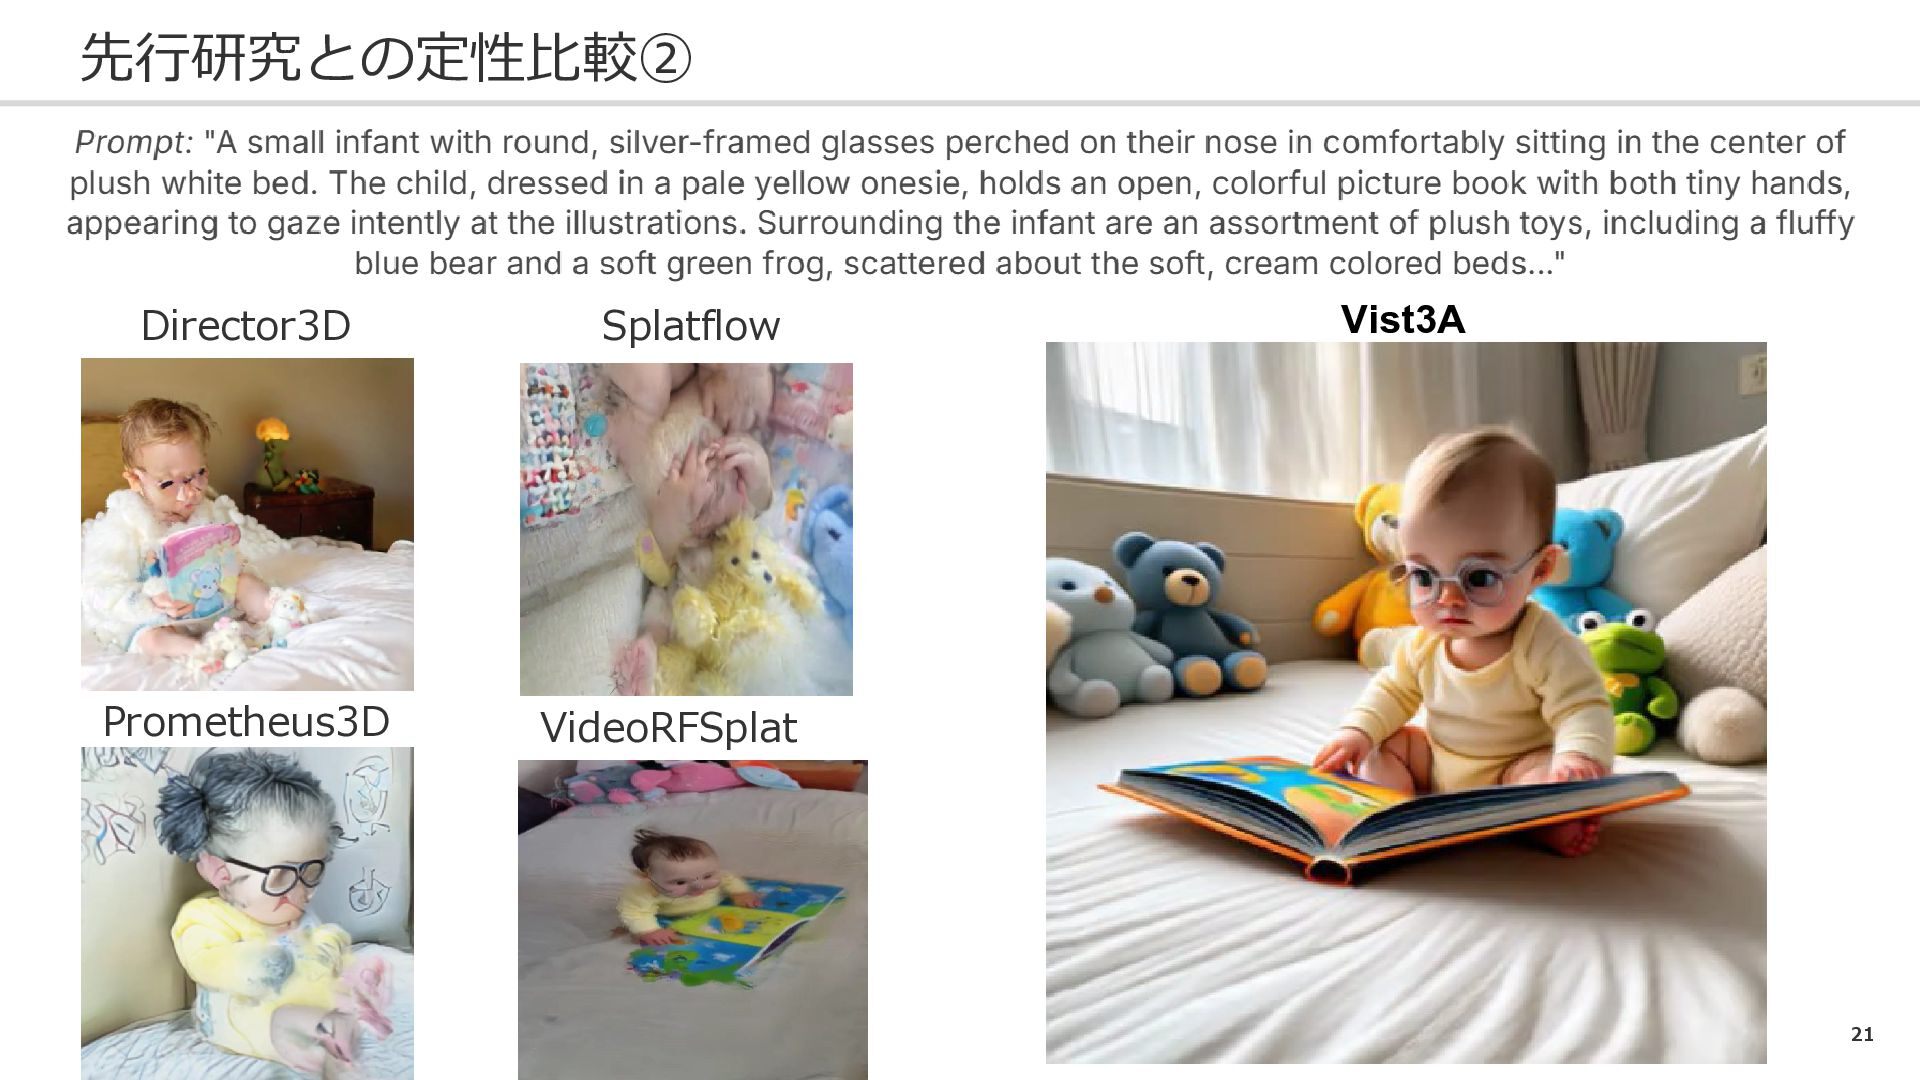
21 先行研究との定性比較② Director3D Splatflow Prometheus3D VideoRFSplat Vist3A


 mickey_0226
 kanaya
 shumpei777
 estie
 trycycle
 akasan
 konakalab
 analokmaus
 gkazunii
 sshimizu2006
 ianozsvald
 signer
 nonsquared
 bkeepers
 eileencodes
 matthewcrist
 apolaine
 greggifford
 gurzu
 tessaabrams
 tmiket
 marktimemedia