Share
Embed
DESENVOLVIMENTO DE MODELOS DE APRENDIZADO DE MÁQUINA PARA QUANTIFICAR ATORES PRESENTES EM CENAS ACÚSTICAS
Apresentação da dissertação de Mestrado em Engenharia de Software
AUTOR: PAULO HENRIQUE DE SOUSA
ORIENTADORA: PROFª DRA. ANA PAULA CARVALHO CAVALCANTI FURTADO
COORIENTADOR: PROFº DR. PÉRICLES BARBOSA CUNHA DE MIRANDA
Paulo Henrique
April 27, 2025
Transcript
42 slides
-
DESENVOLVIMENTO DE MODELOS DE APRENDIZADO DE MÁQUINA PARA QUANTIFICAR ATORES
PRESENTES EM CENAS ACÚSTICAS AUTOR: PAULO HENRIQUE DE SOUSA ORIENTADORA: PROFª DRA. ANA PAULA CARVALHO CAVALCANTI FURTADO COORIENTADOR: PROFº DR. PÉRICLES BARBOSA CUNHA DE MIRANDA CESAR SCHOOL 2022 1 -
CONTEXTO • HEAR (Helping Everyone to Actively React). • Violência
contra a mulher; • Tecnologia no combate à violência; • Inteligência artificial; • Classificação de Cenas acústicas; 2 -
MOTIVAÇÃO • Combate à violência contra a mulher; • Classificação
de Cenas Acústicas; • A quantificação de atores presentes em cenas acústicas podem corroborar com classificadores que identifiquem violência contra a mulher. 3 -
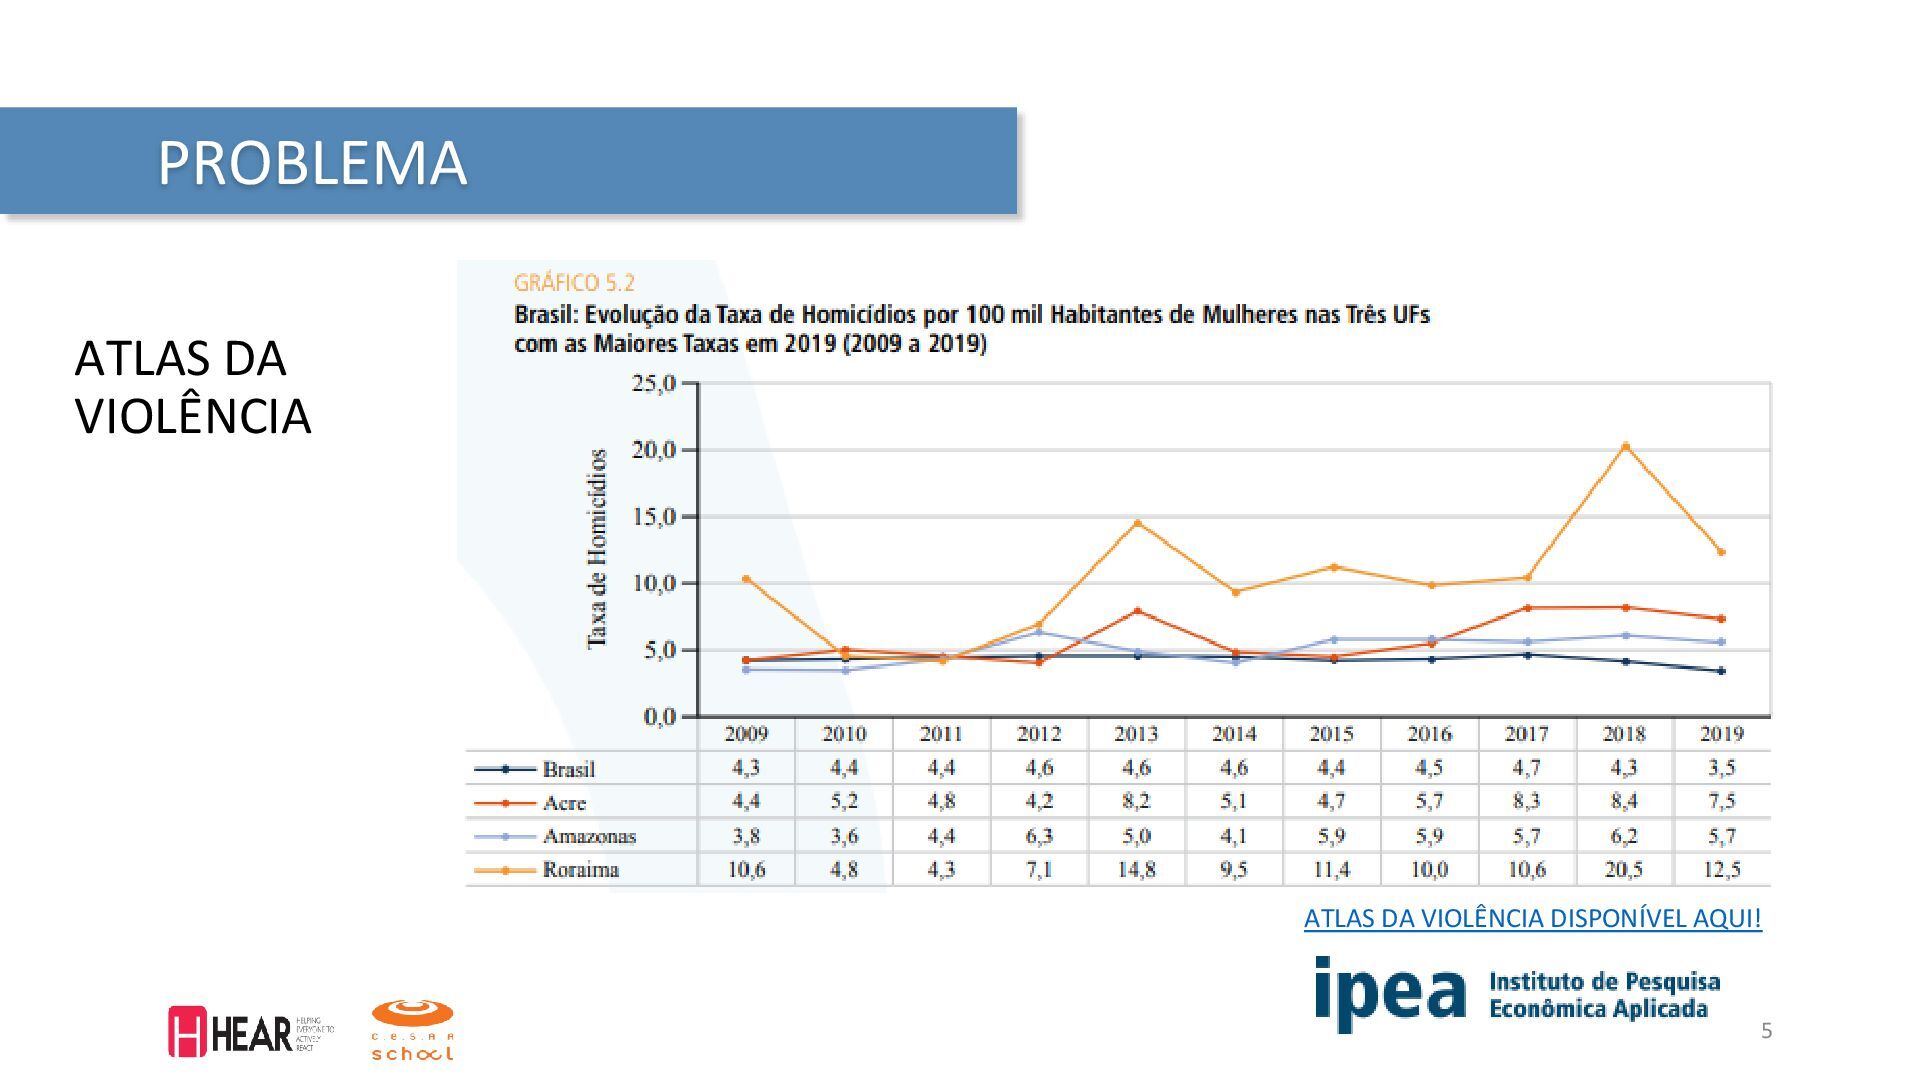
ATLAS DA VIOLÊNCIA 5 PROBLEMA ATLAS DA VIOLÊNCIA ATLAS DA
VIOLÊNCIA DISPONÍVEL AQUI! -
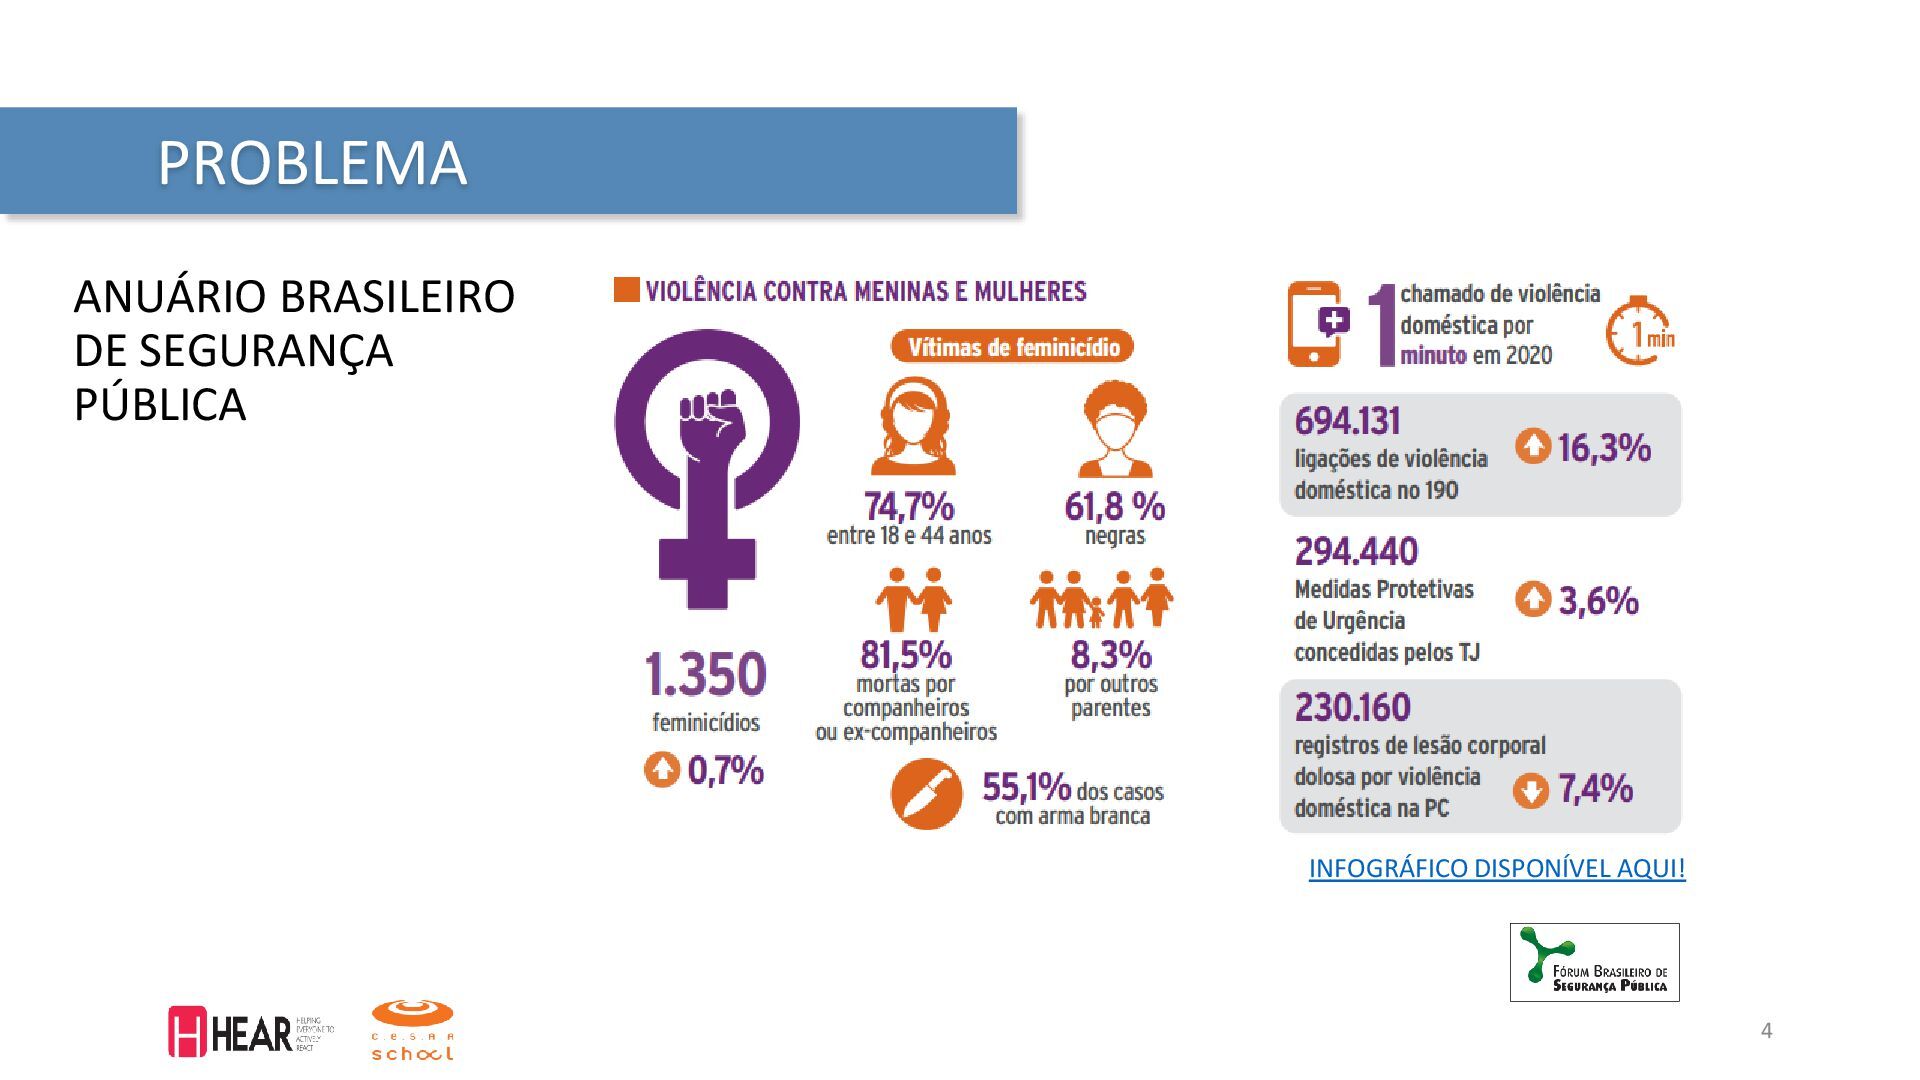
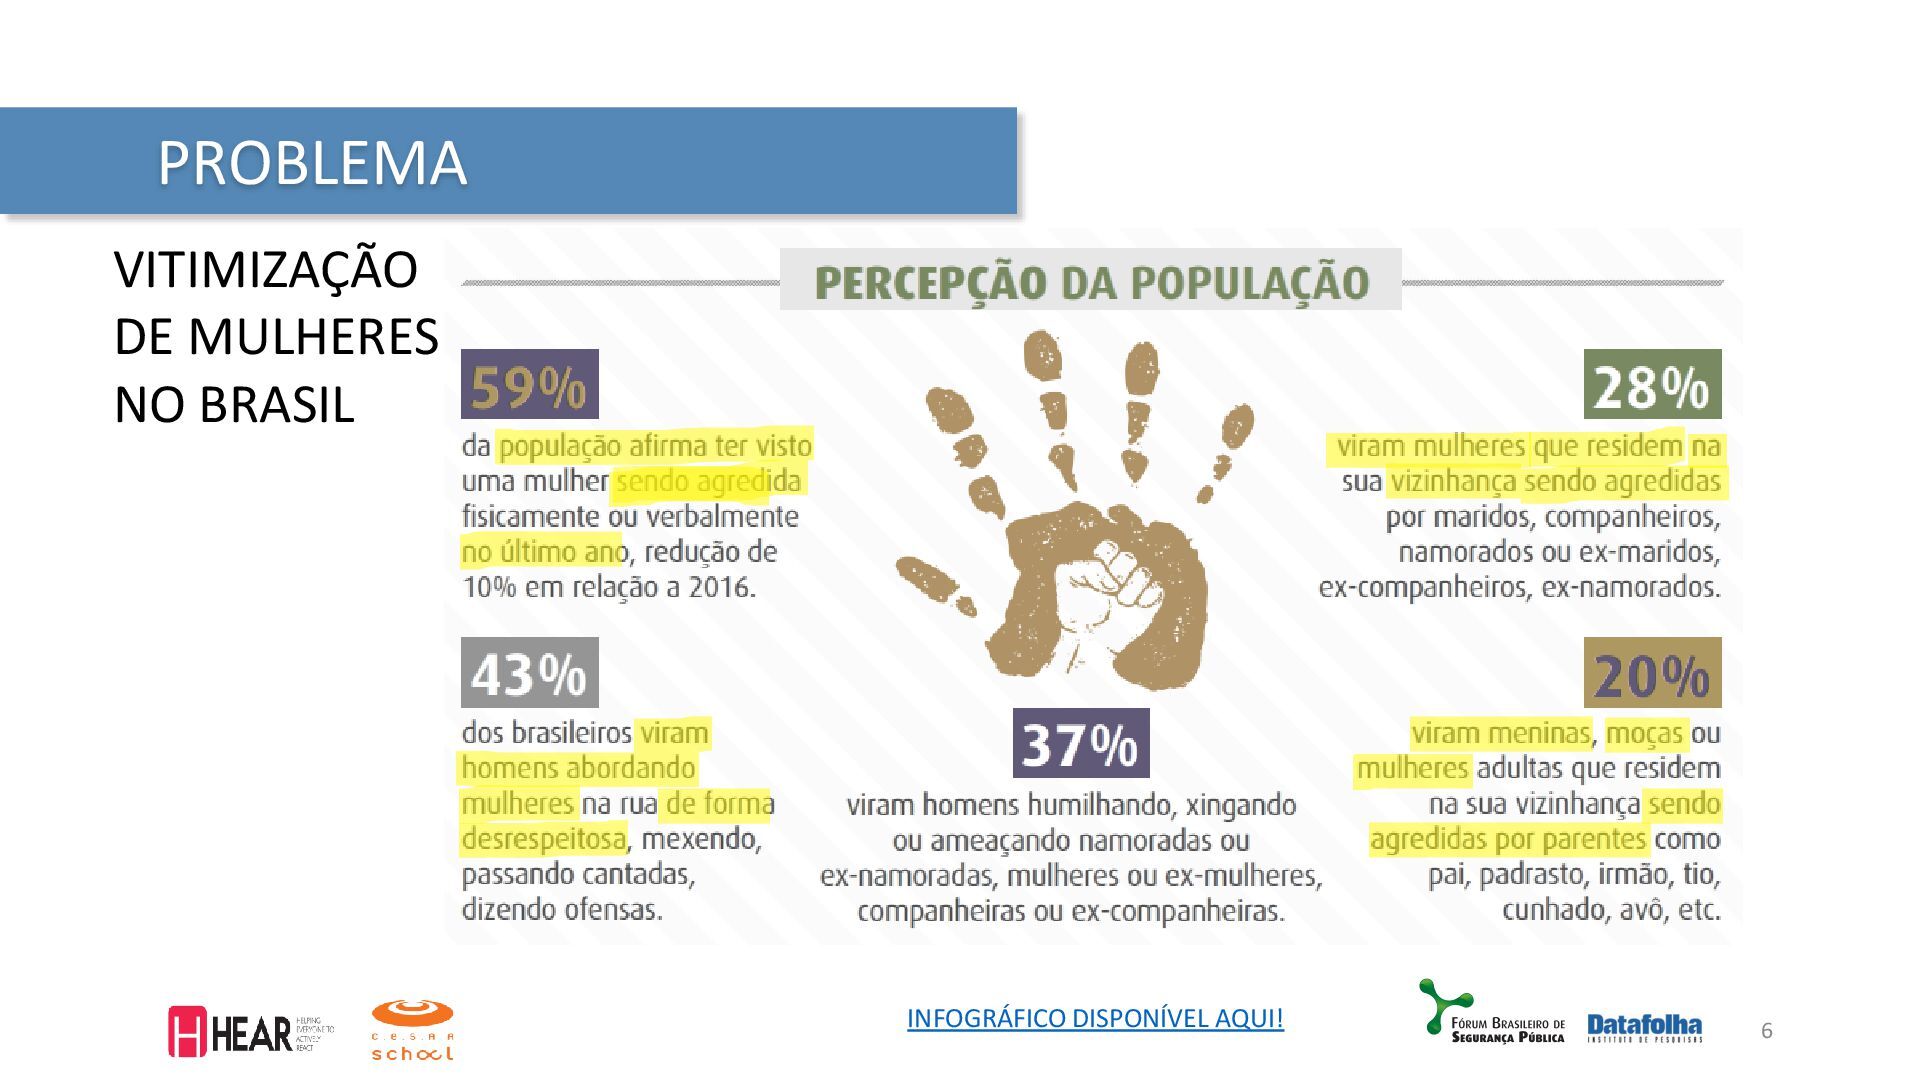
PROBLEMA 6 VITIMIZAÇÃO DE MULHERES NO BRASIL INFOGRÁFICO DISPONÍVEL AQUI!
INFOGRÁFICO DISPONÍVEL AQUI! -
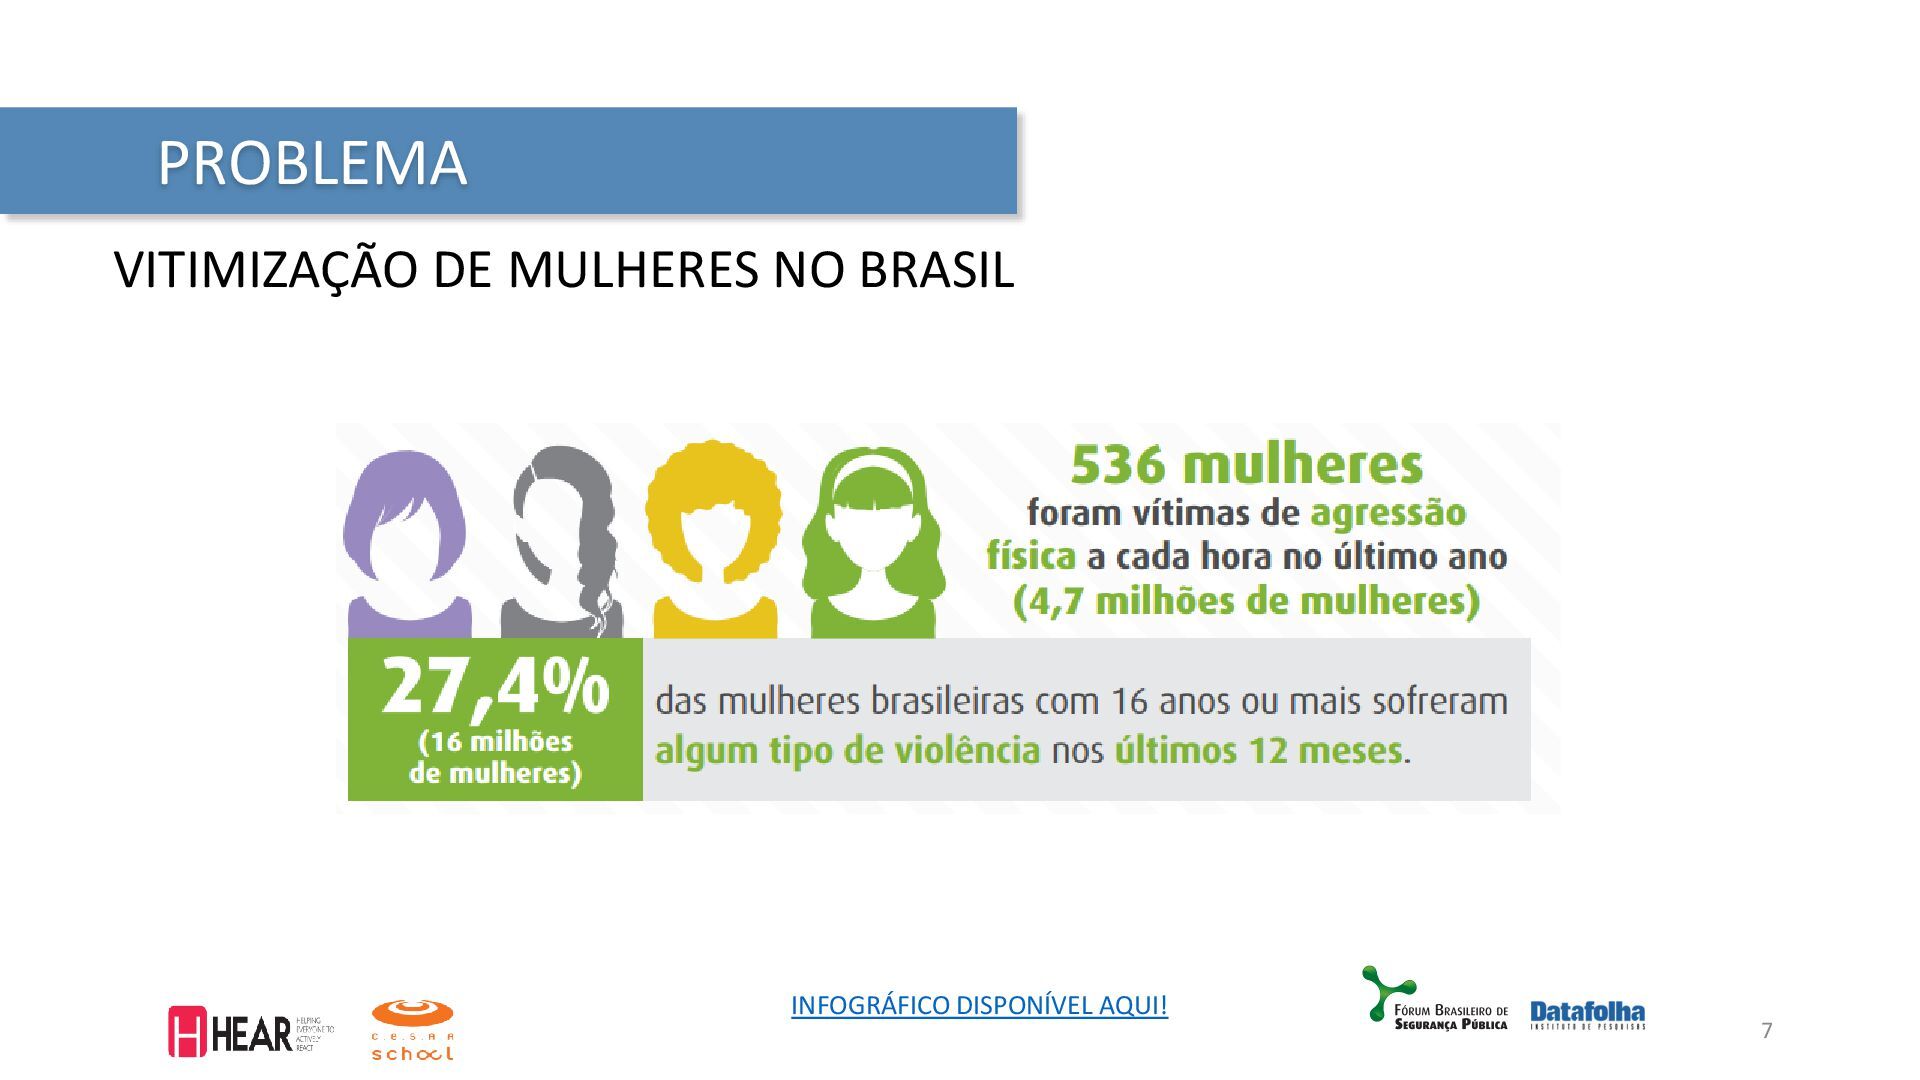
PROBLEMA 7 VITIMIZAÇÃO DE MULHERES NO BRASIL INFOGRÁFICO DISPONÍVEL AQUI!
INFOGRÁFICO DISPONÍVEL AQUI! -
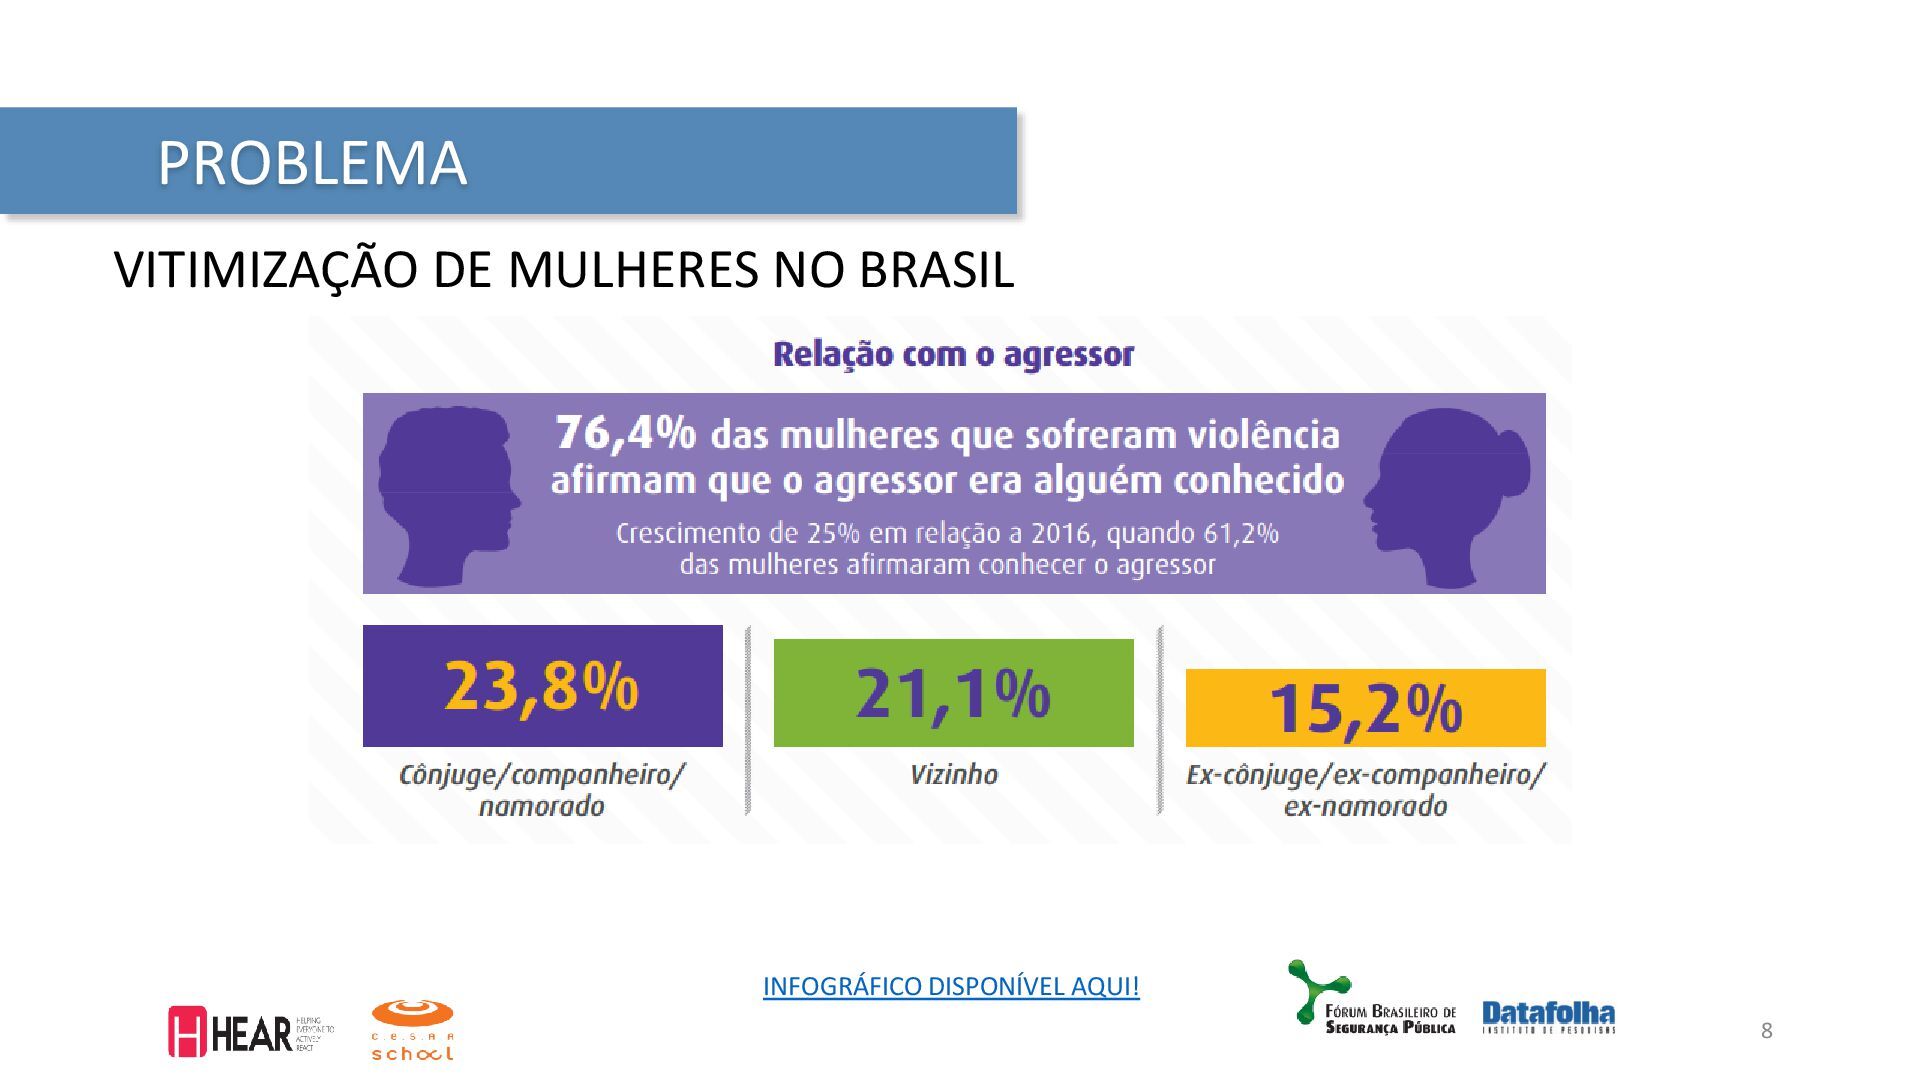
PROBLEMA 8 VITIMIZAÇÃO DE MULHERES NO BRASIL INFOGRÁFICO DISPONÍVEL AQUI!
INFOGRÁFICO DISPONÍVEL AQUI! -
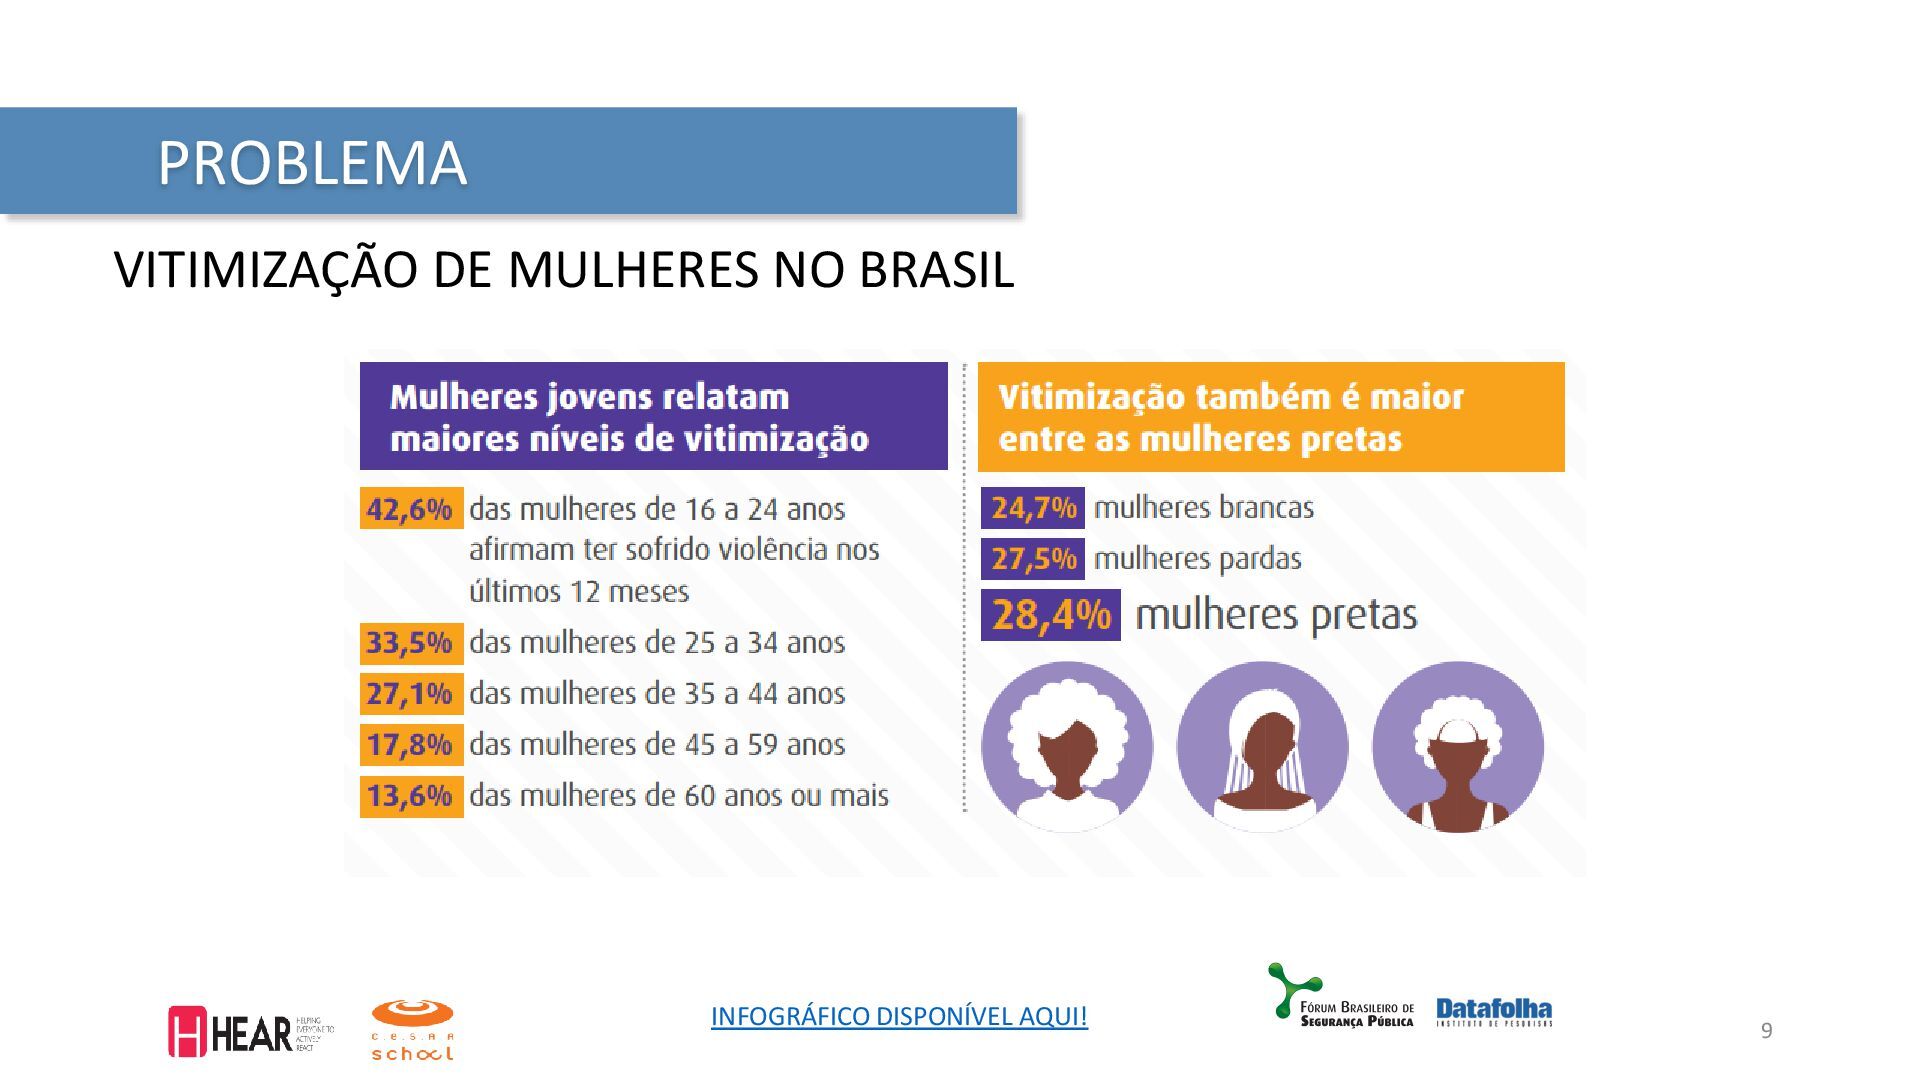
PROBLEMA 9 VITIMIZAÇÃO DE MULHERES NO BRASIL INFOGRÁFICO DISPONÍVEL AQUI!
INFOGRÁFICO DISPONÍVEL AQUI! -
PROBLEMÁTICA DA PESQUISA Diante da elevada incidência de agressões contra
a mulher, como quantificar atores presentes em cenas acústicas utilizando redes neurais para apoiar no detalhamento das ocorrências? 10 -
GERAIS • Construir modelos de aprendizagem de máquina para predizer
a quantidade de atores numa cena acústica. ESPECÍFICOS • Gerar uma coleção de áudios rotuladas com o número de locutores; • Realizar experimentos de aprendizado de máquina com redes neurais artificiais; • Comparar as métricas de modelos de aprendizado de máquina. 11 OBJETIVOS -
REVISÃO DE LITERATURA • String de Busca • Limite de
tempo de publicação • Critérios de inclusão e exclusão EXPERIMENTOS • Pesquisa por datasets com vozes de uma única pessoa • Criação do conjunto de dados rotulados com o numero de locutores • Execução de experimentos com arquiteturas de redes neurais • Metodologia CRISP-DM 12 METODOLOGIA -
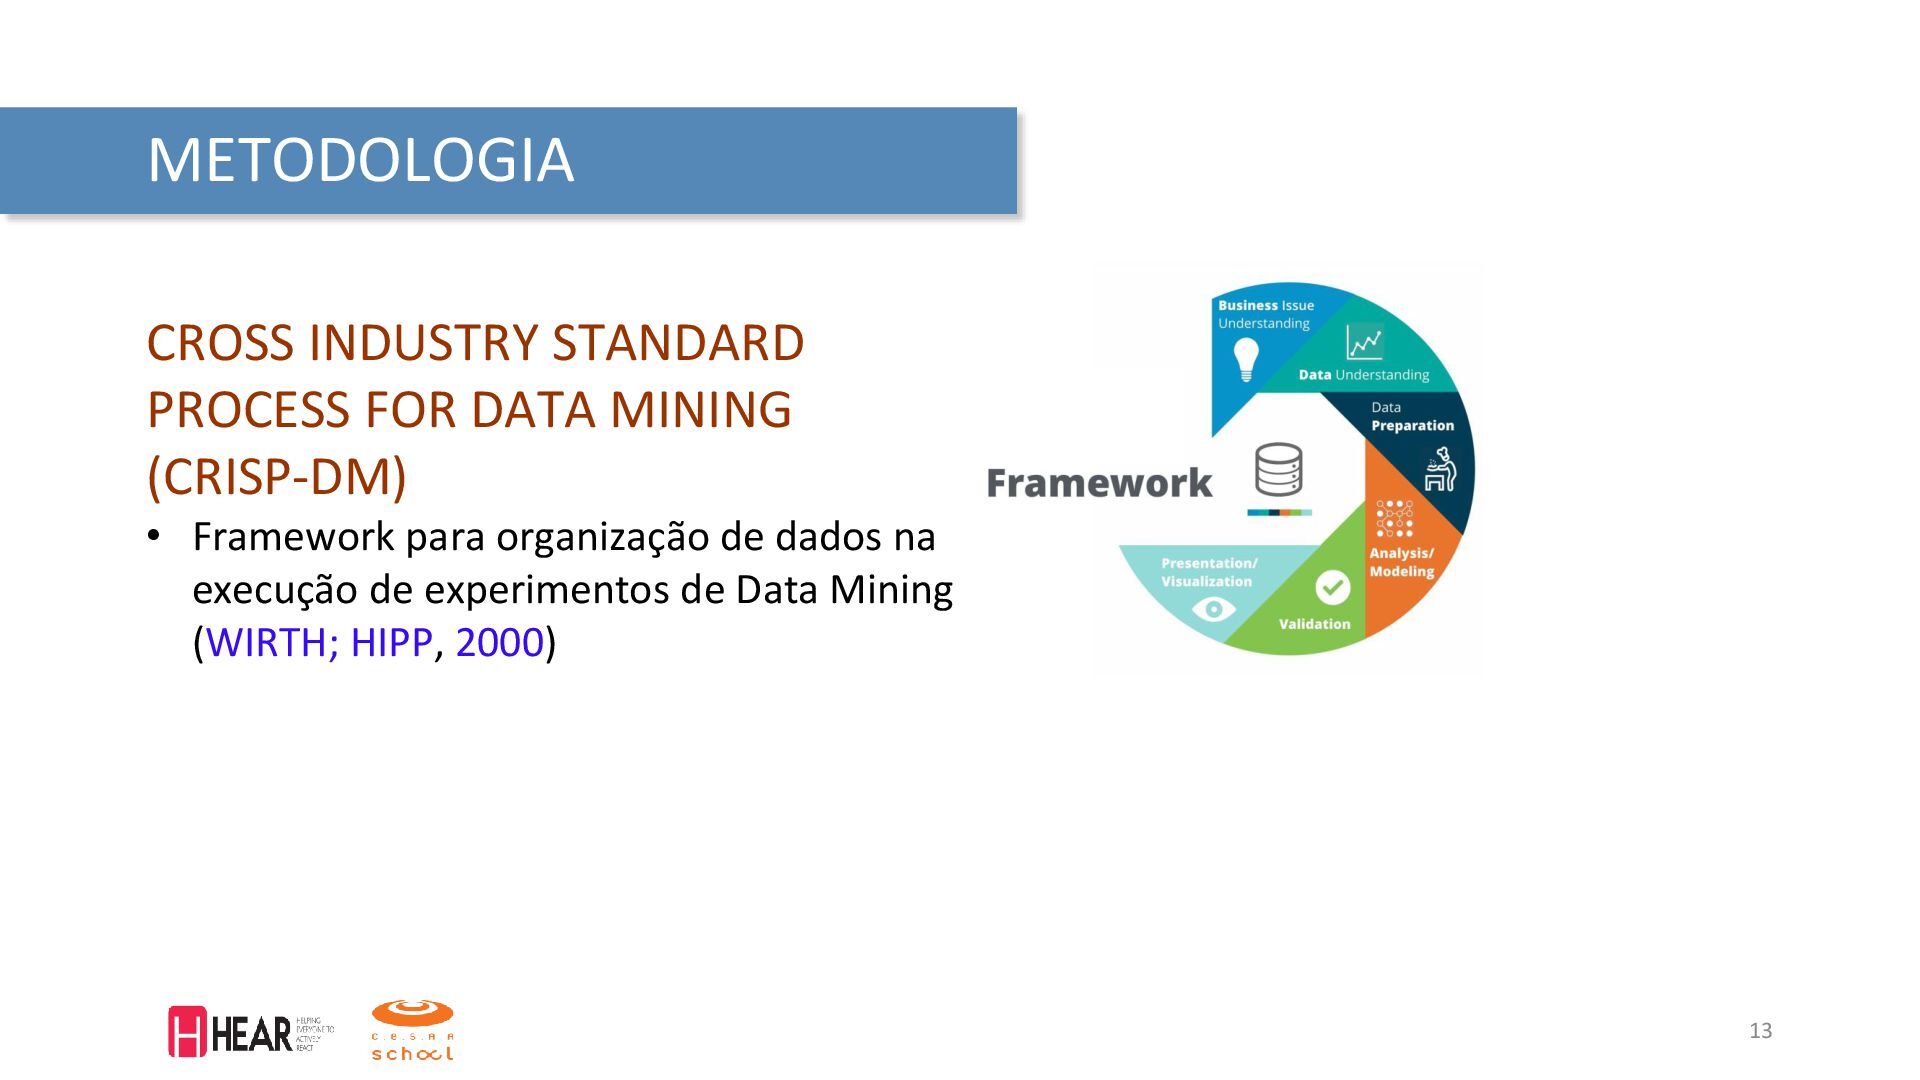
13 METODOLOGIA CROSS INDUSTRY STANDARD PROCESS FOR DATA MINING (CRISP-DM)
• Framework para organização de dados na execução de experimentos de Data Mining (WIRTH; HIPP, 2000) -
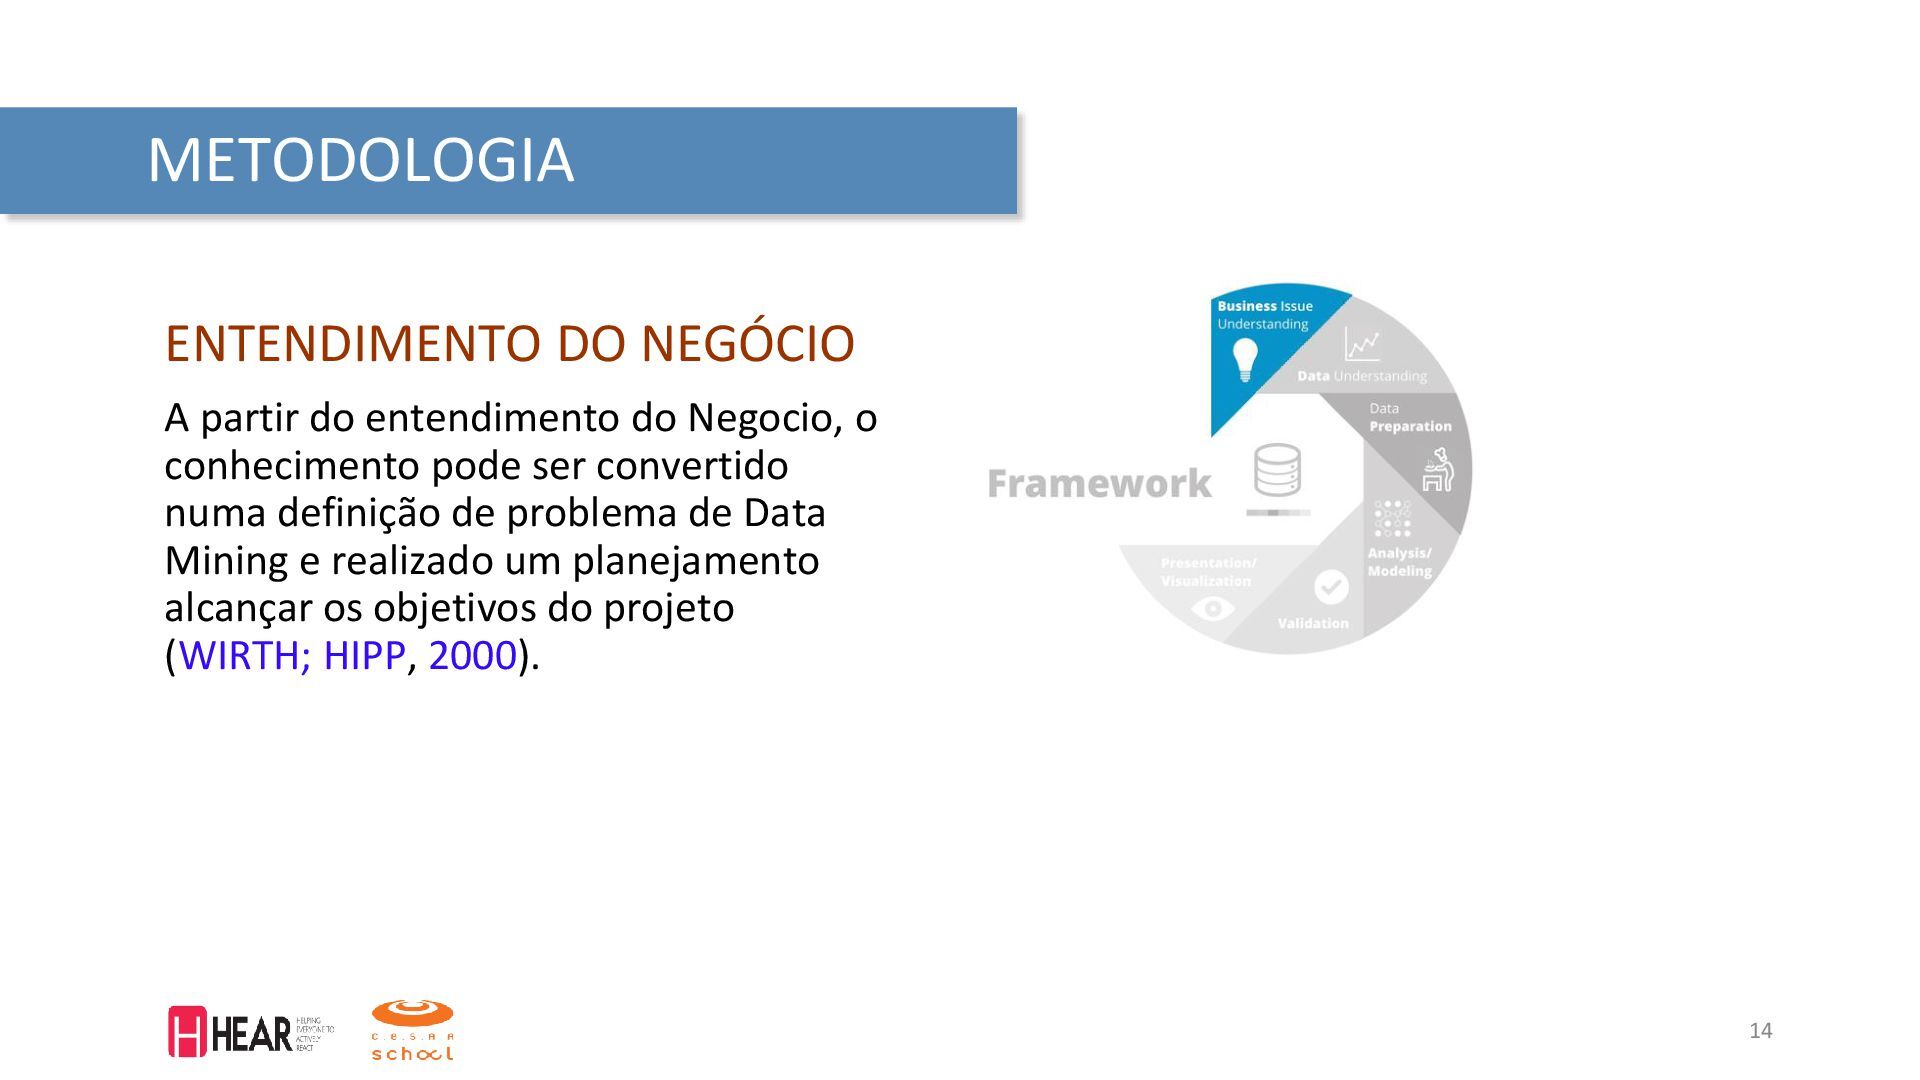
ENTENDIMENTO DO NEGÓCIO A partir do entendimento do Negocio, o
conhecimento pode ser convertido numa definição de problema de Data Mining e realizado um planejamento alcançar os objetivos do projeto (WIRTH; HIPP, 2000). 14 METODOLOGIA METODOLOGIA -
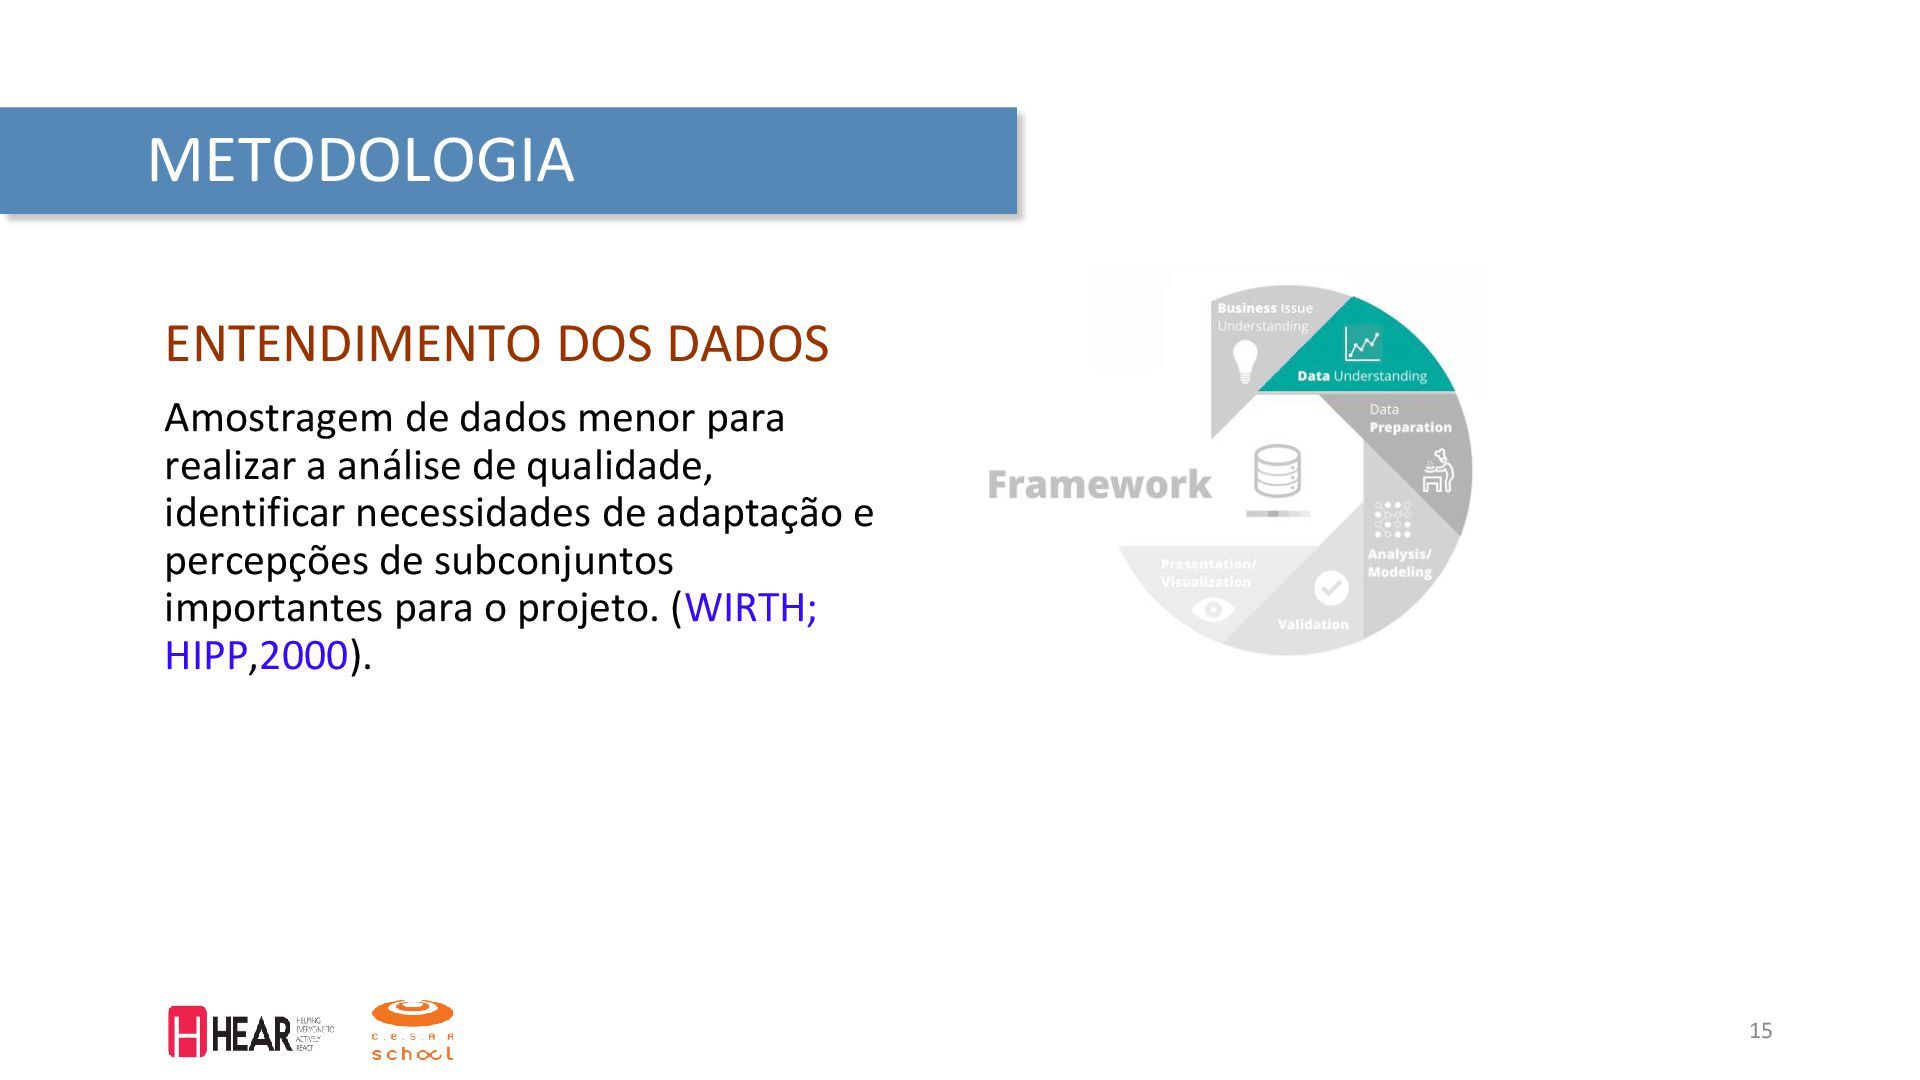
ENTENDIMENTO DOS DADOS Amostragem de dados menor para realizar a
análise de qualidade, identificar necessidades de adaptação e percepções de subconjuntos importantes para o projeto. (WIRTH; HIPP,2000). 15 METODOLOGIA -
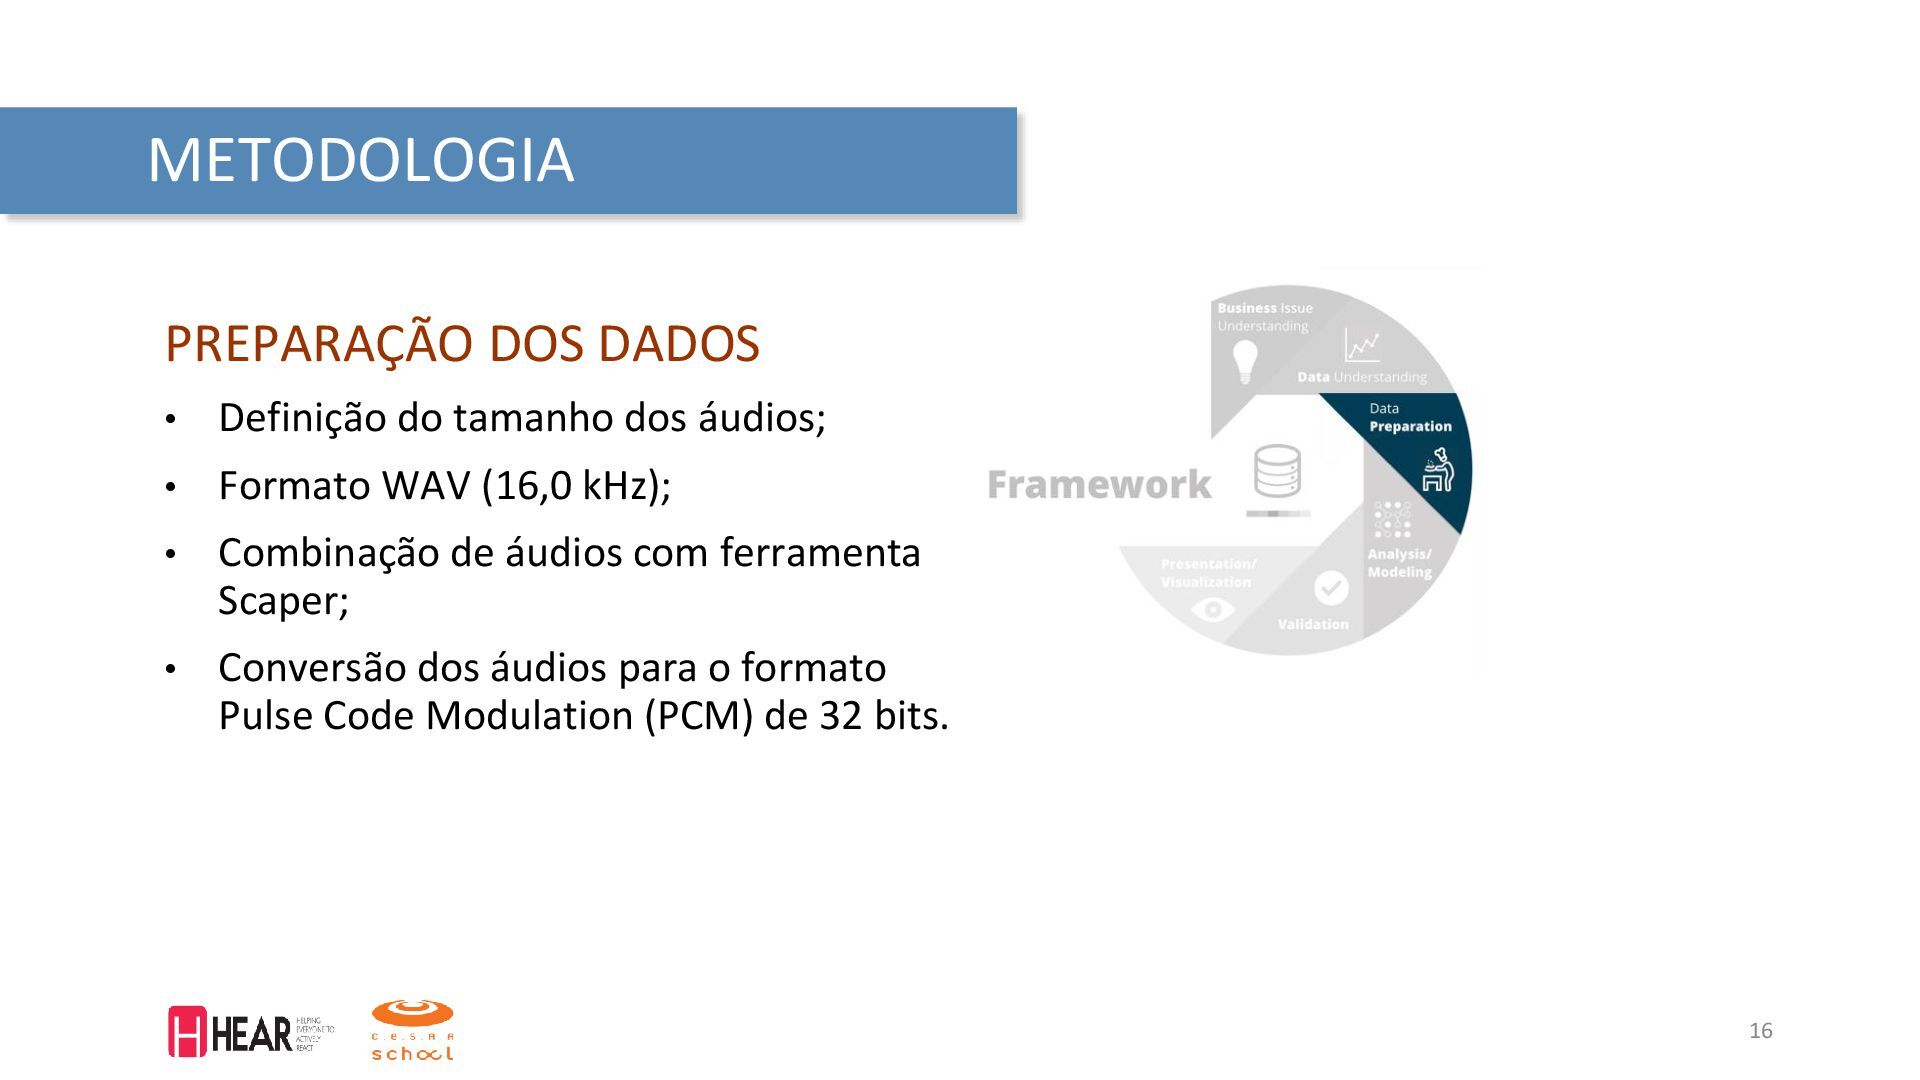
PREPARAÇÃO DOS DADOS • Definição do tamanho dos áudios; •
Formato WAV (16,0 kHz); • Combinação de áudios com ferramenta Scaper; • Conversão dos áudios para o formato Pulse Code Modulation (PCM) de 32 bits. 16 METODOLOGIA -
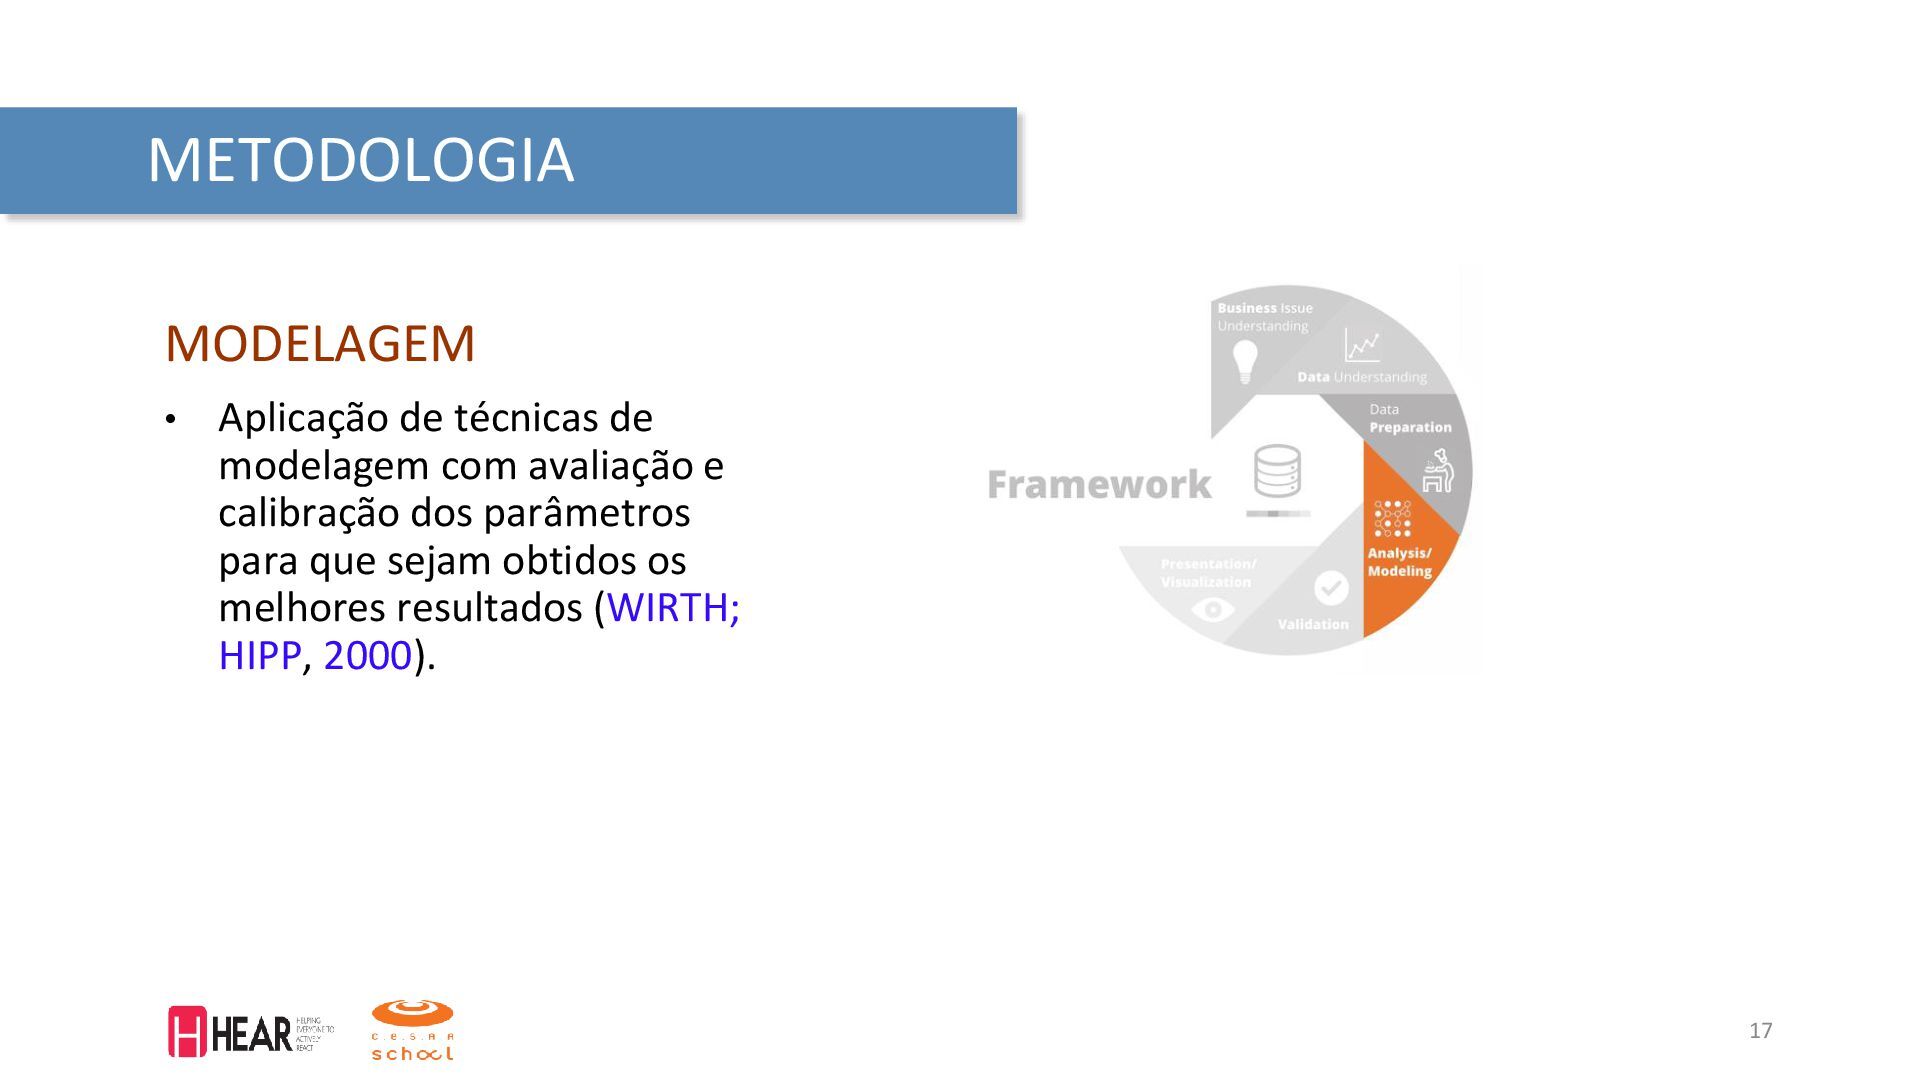
MODELAGEM • Aplicação de técnicas de modelagem com avaliação e
calibração dos parâmetros para que sejam obtidos os melhores resultados (WIRTH; HIPP, 2000). 17 METODOLOGIA -
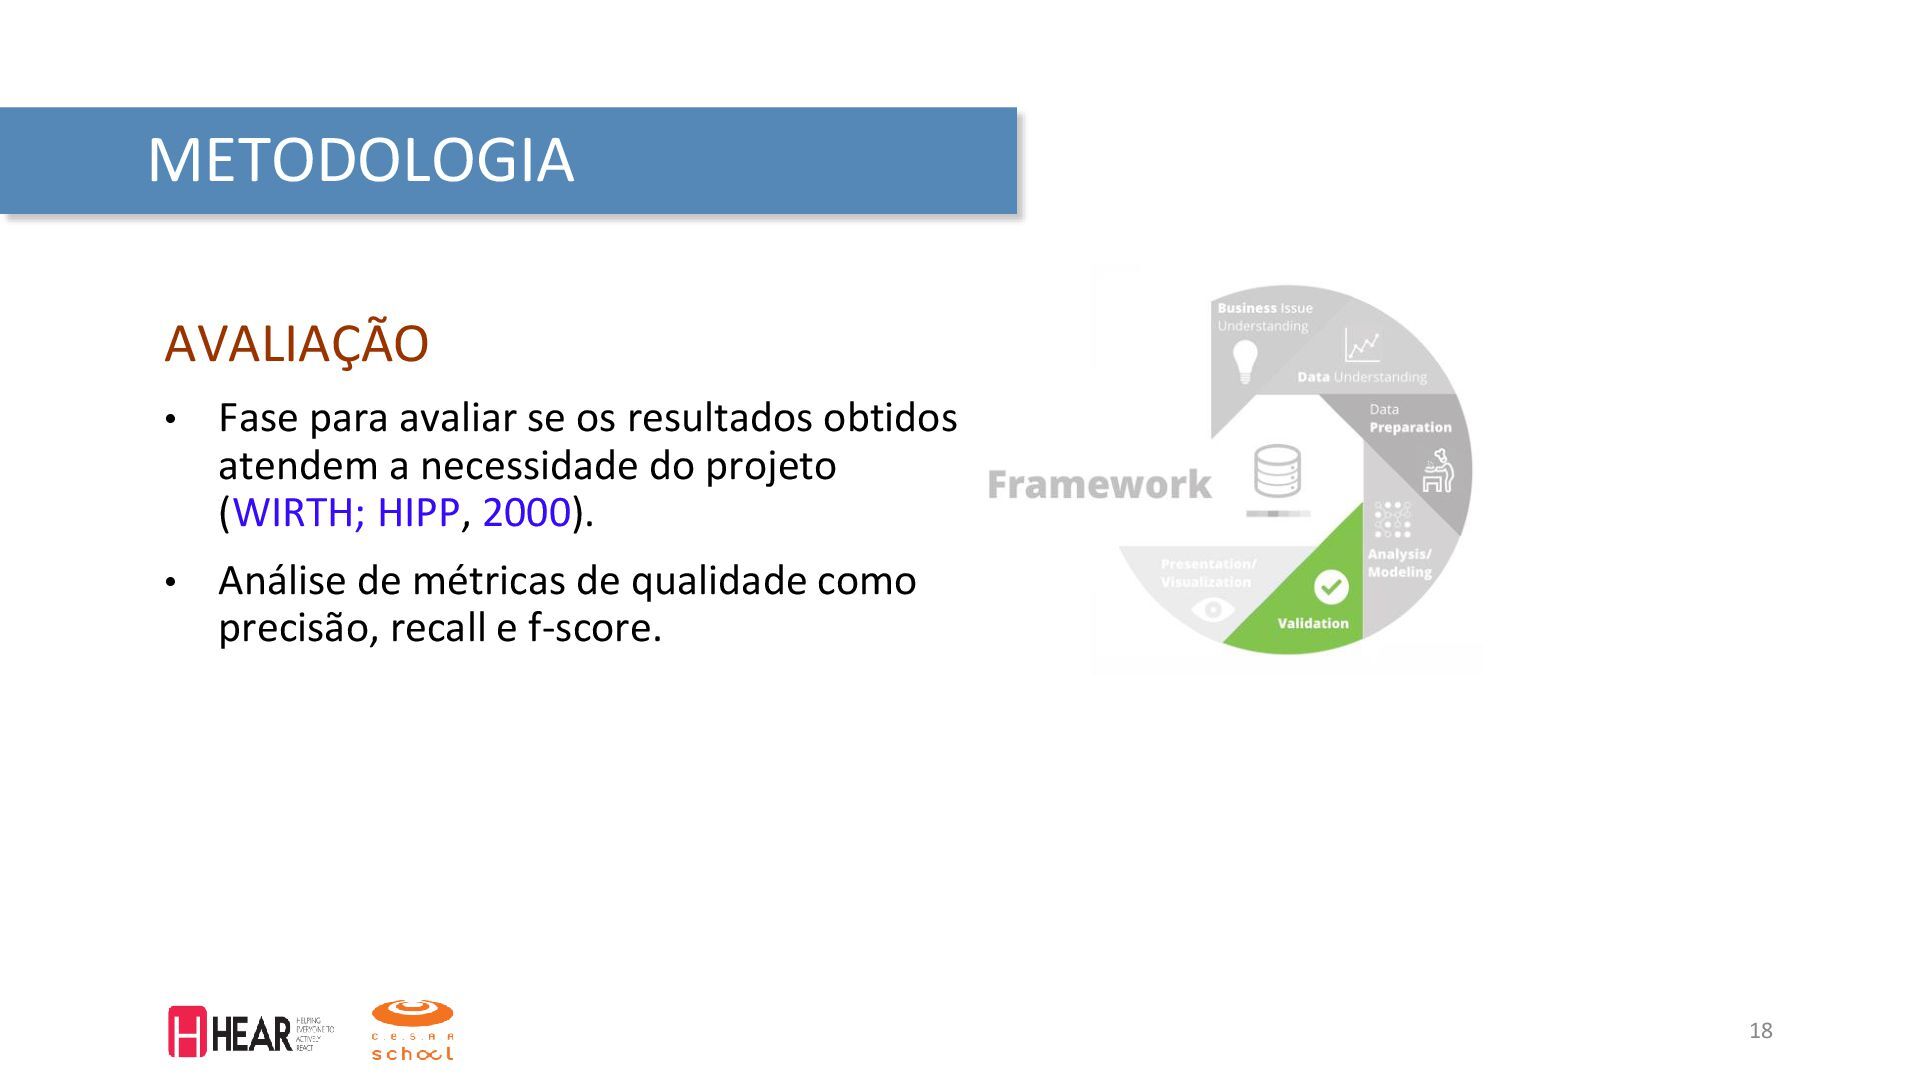
AVALIAÇÃO • Fase para avaliar se os resultados obtidos atendem
a necessidade do projeto (WIRTH; HIPP, 2000). • Análise de métricas de qualidade como precisão, recall e f-score. 18 METODOLOGIA -
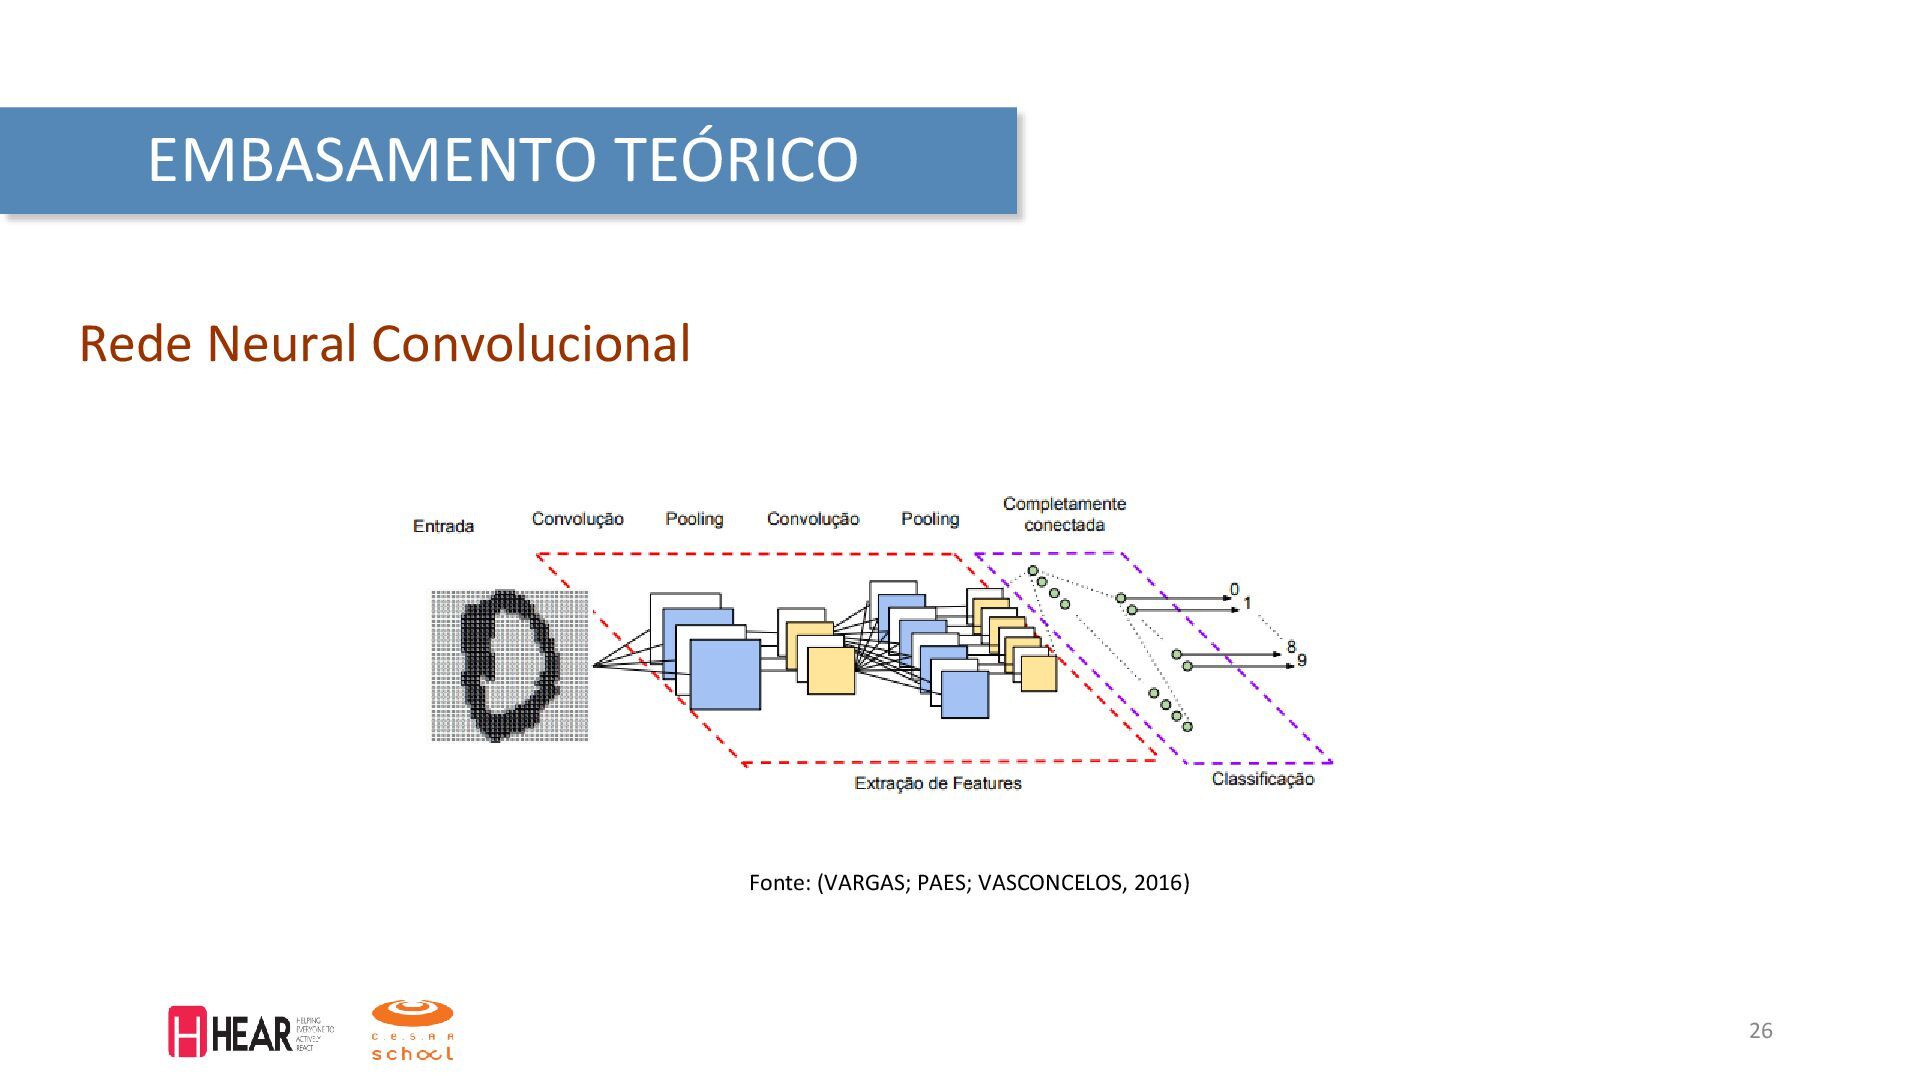
• Inteligência artificial • Aprendizado de Máquina • Classificação de
Cenas Acústicas • Redes Neurais Artificiais 20 EMBASAMENTO TEÓRICO -
VISÃO COMPUTACIONAL Campo da inteligência artificial que permite que computadores
e sistemas obtenham informações significativas de imagens digitais, vídeos e outras entradas visuais (IBM, 2021). 21 EMBASAMENTO TEÓRICO -
ÉTICA NA INTELIGÊNCIA ARTIFICIAL • Privacidade • Confiança • Segurança
de dados • Transparência e explicabilidade • Controle 22 EMBASAMENTO TEÓRICO -
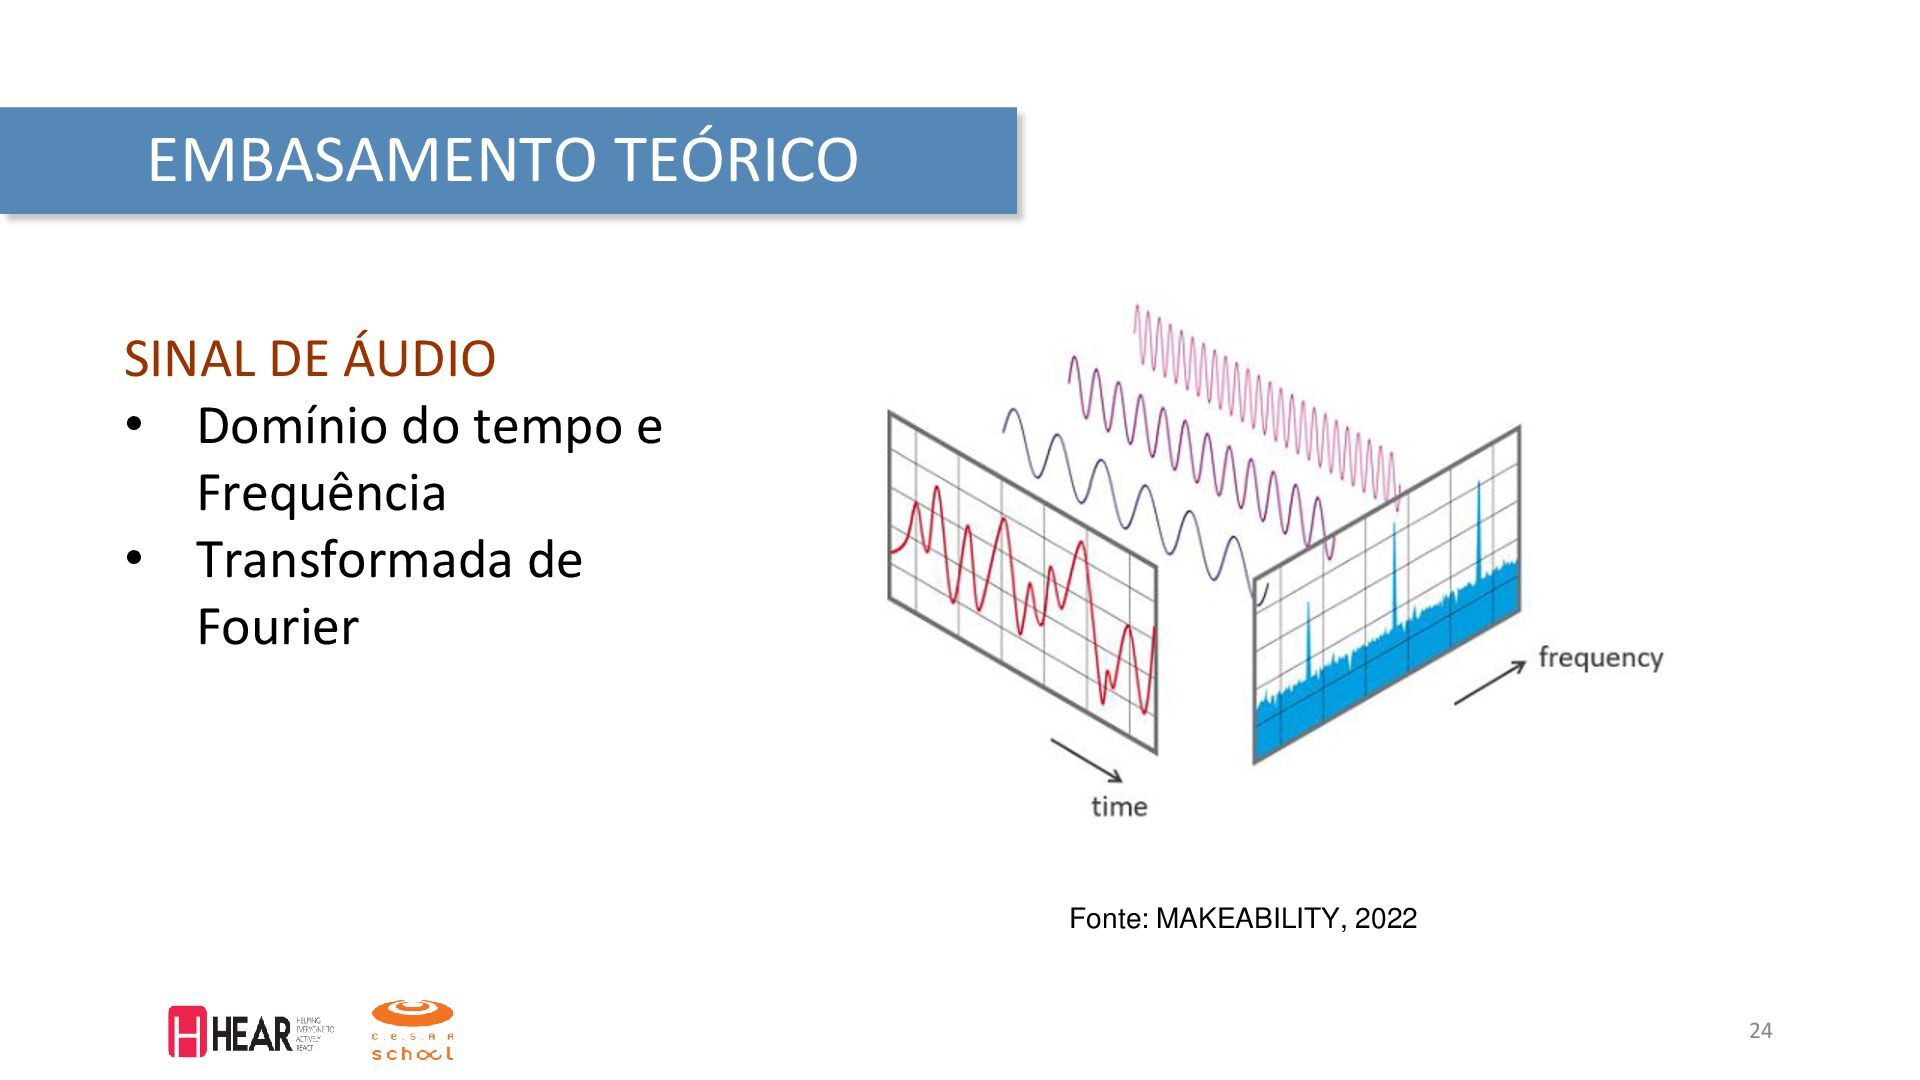
24 EMBASAMENTO TEÓRICO SINAL DE ÁUDIO • Domínio do tempo
e Frequência • Transformada de Fourier Fonte: MAKEABILITY, 2022 -
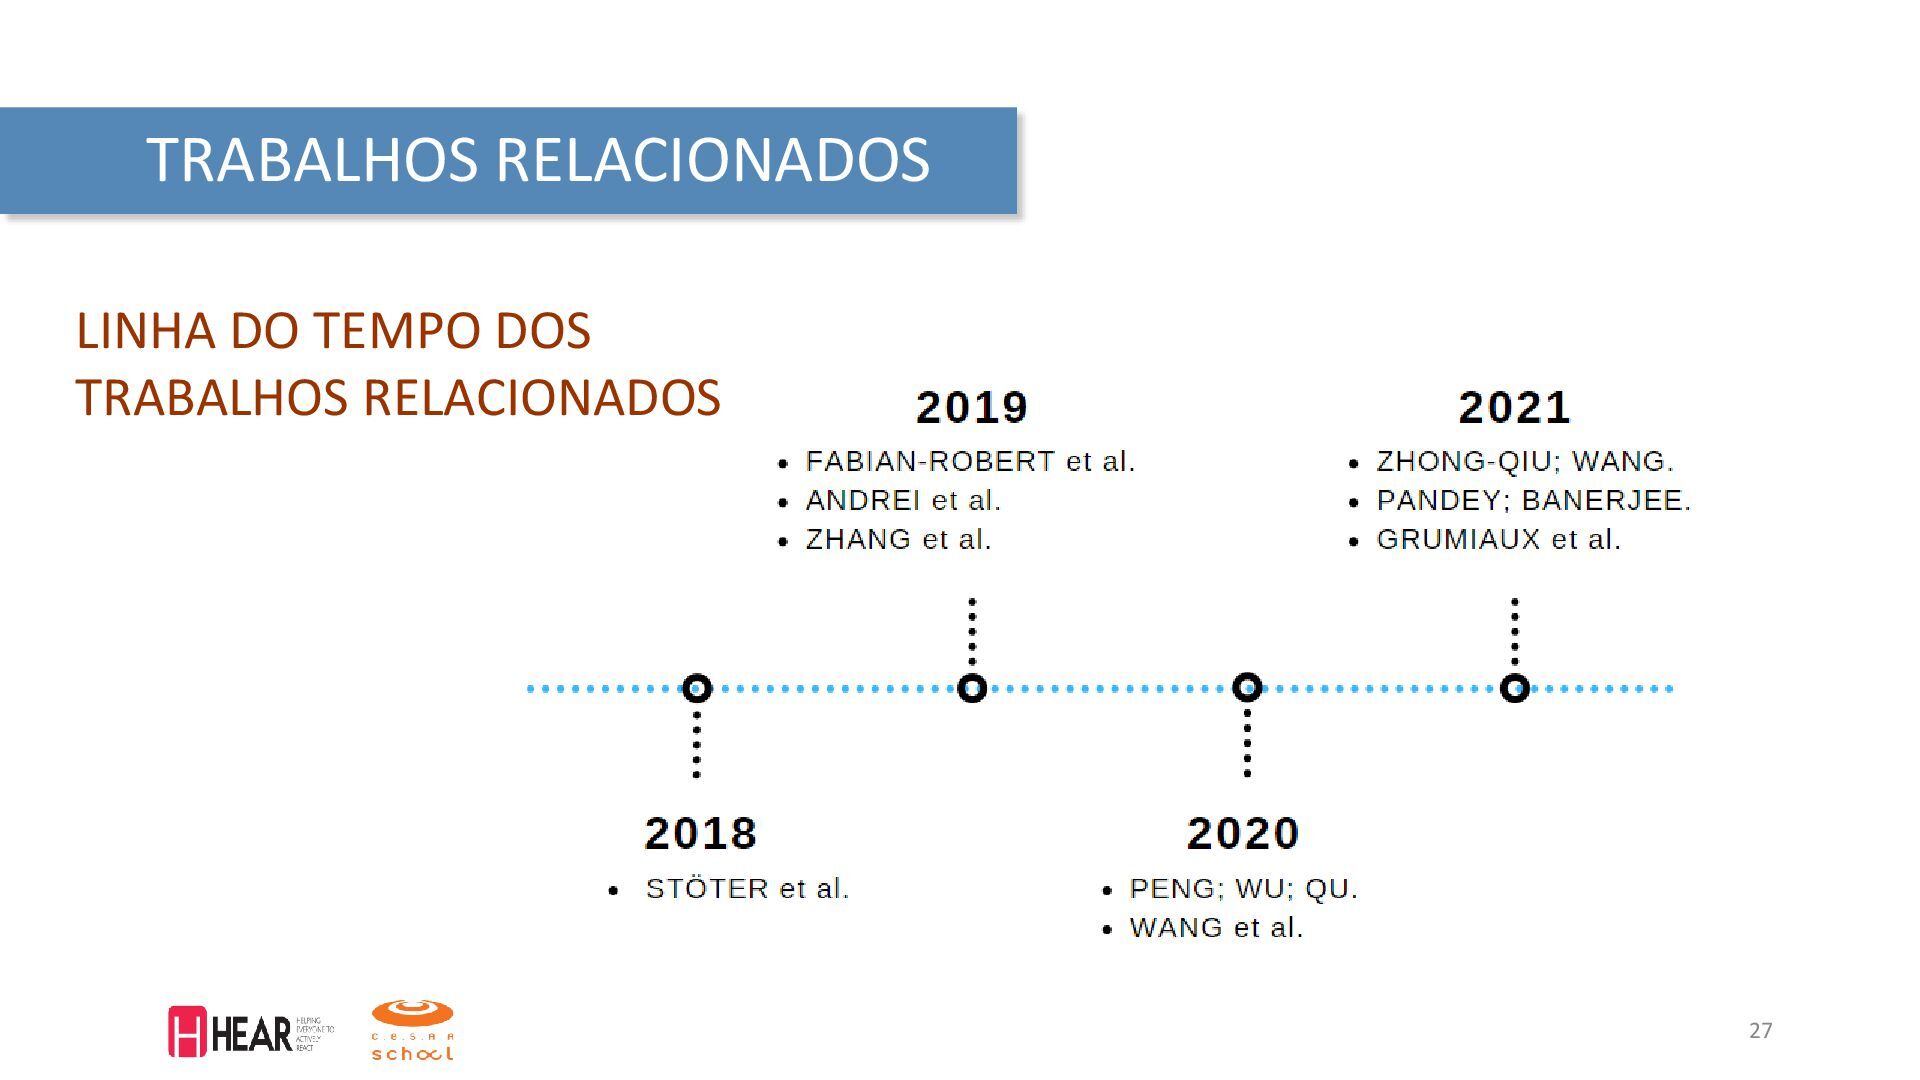
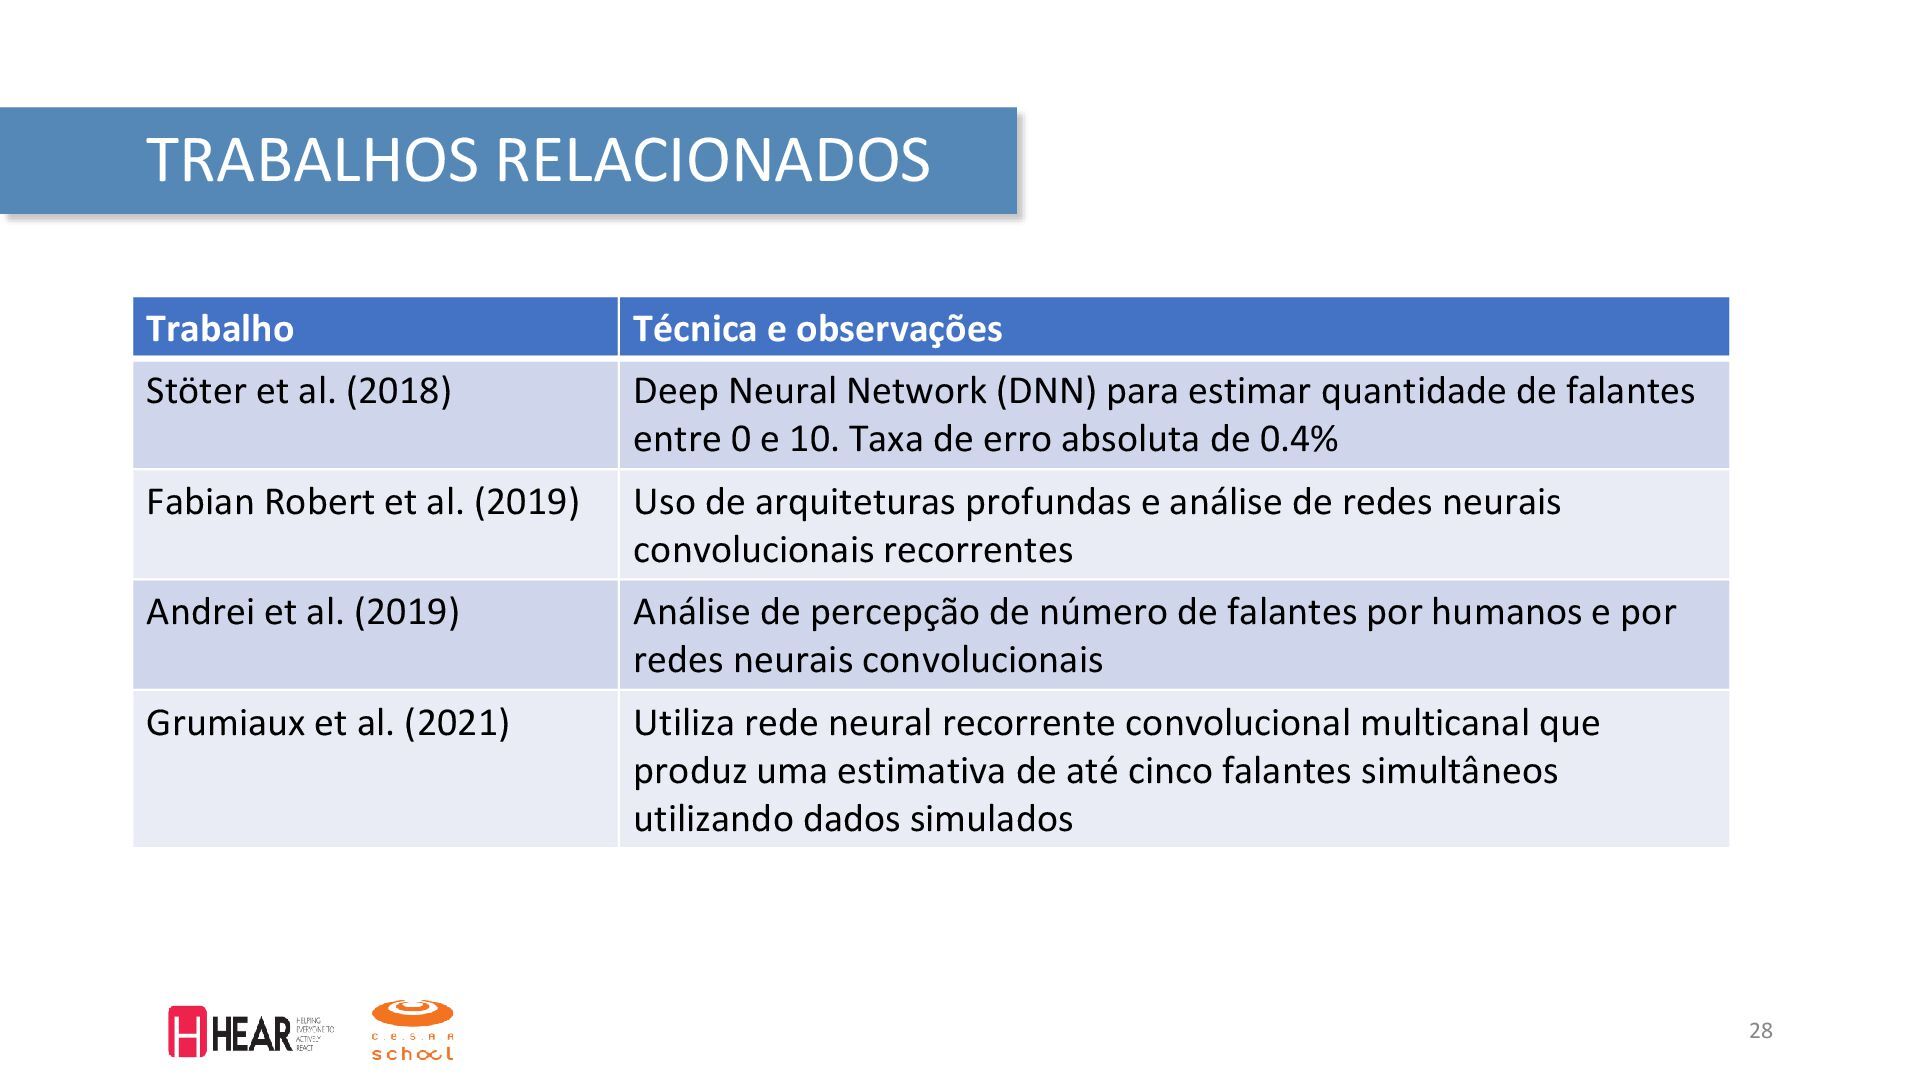
28 TRABALHOS RELACIONADOS Trabalho Técnica e observações Stöter et al.
(2018) Deep Neural Network (DNN) para estimar quantidade de falantes entre 0 e 10. Taxa de erro absoluta de 0.4% Fabian Robert et al. (2019) Uso de arquiteturas profundas e análise de redes neurais convolucionais recorrentes Andrei et al. (2019) Análise de percepção de número de falantes por humanos e por redes neurais convolucionais Grumiaux et al. (2021) Utiliza rede neural recorrente convolucional multicanal que produz uma estimativa de até cinco falantes simultâneos utilizando dados simulados -
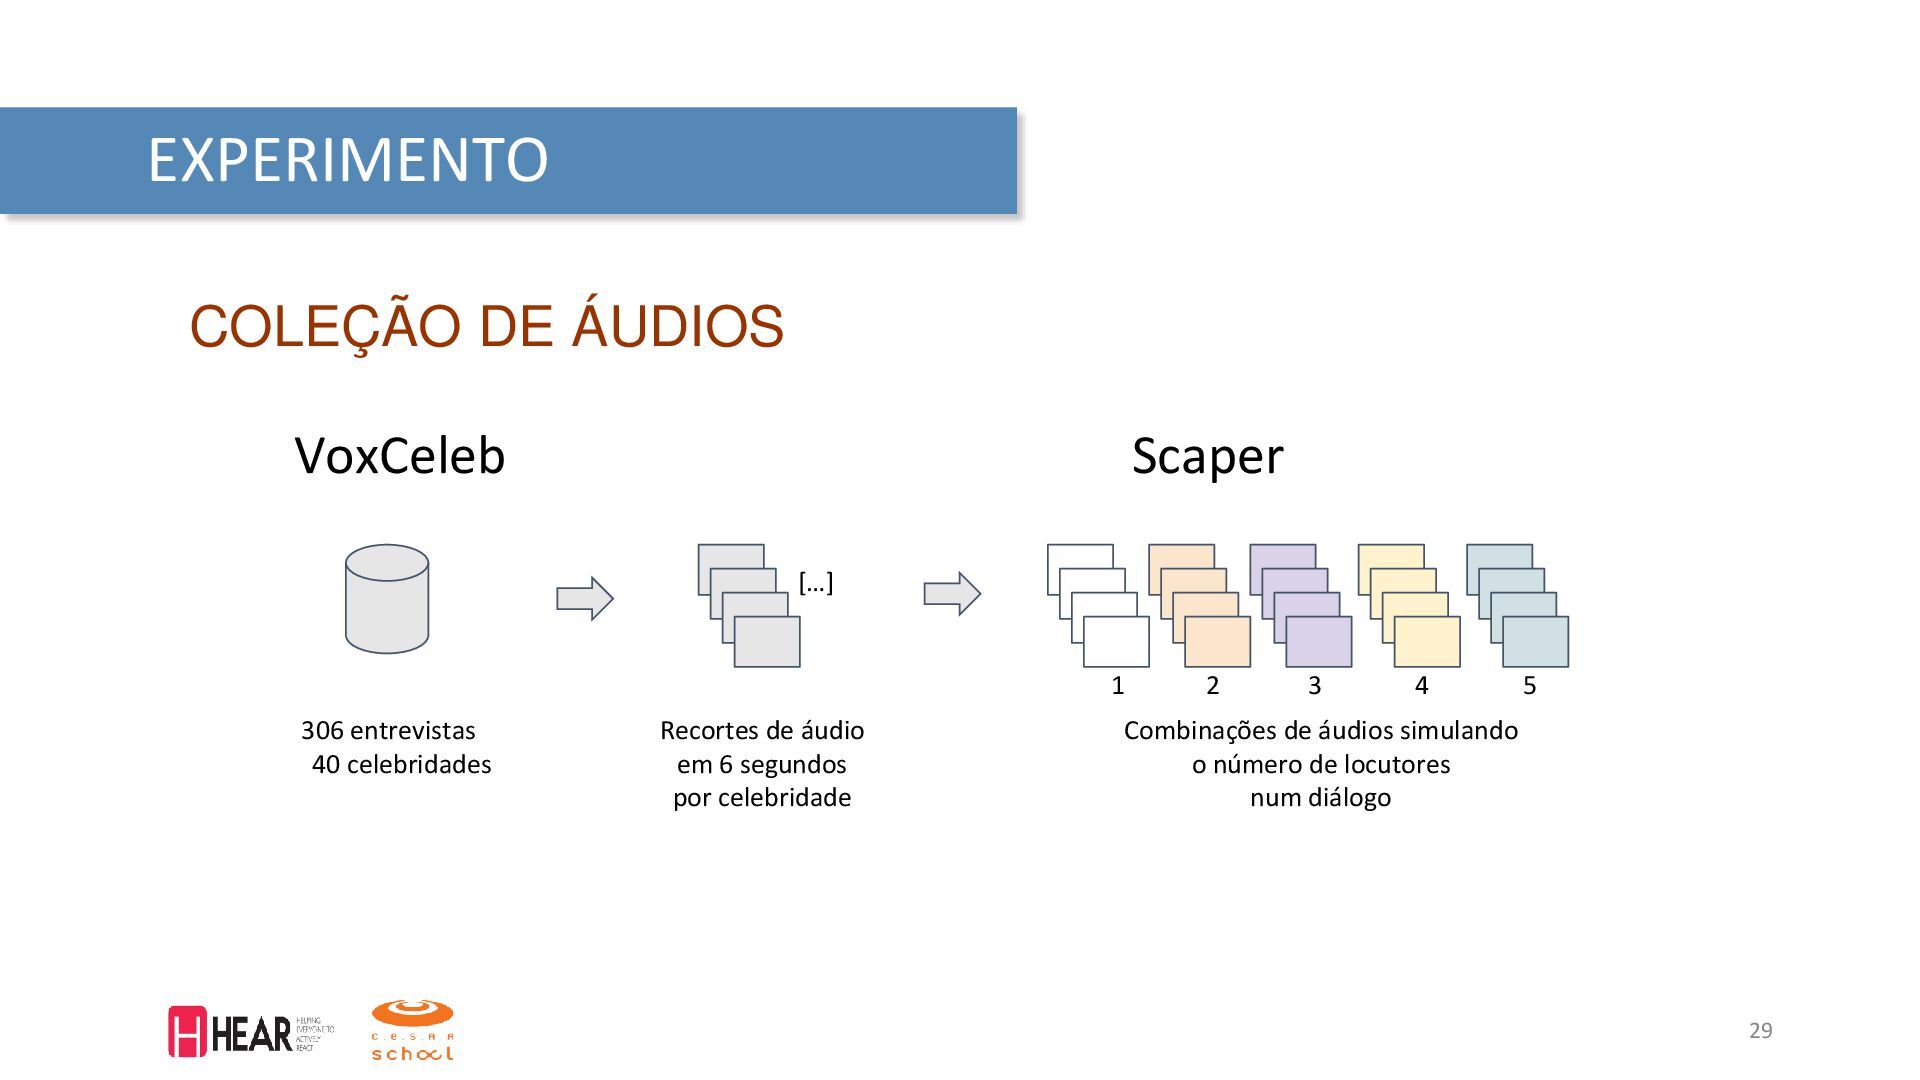
VoxCeleb Scaper 29 306 entrevistas 40 celebridades Recortes de áudio
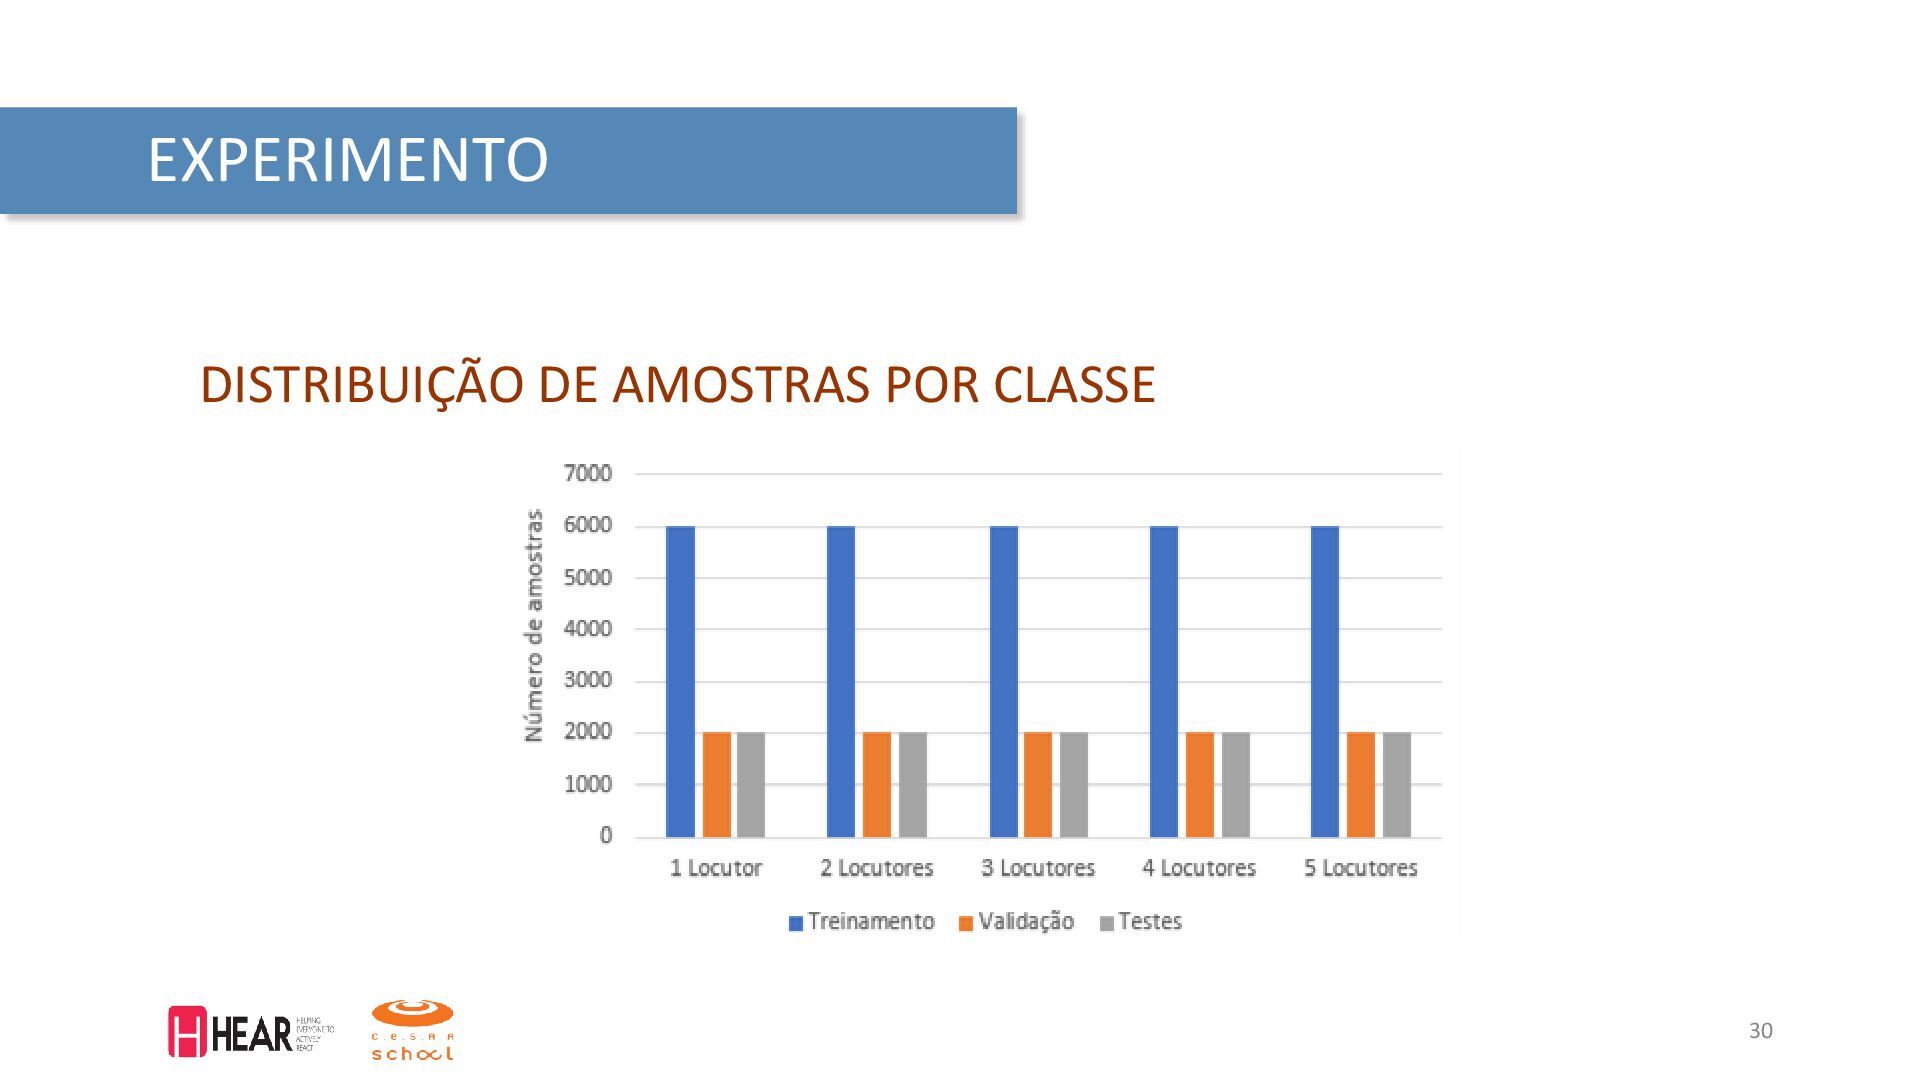
em 6 segundos por celebridade […] 1 2 3 4 5 Combinações de áudios simulando o número de locutores num diálogo EXPERIMENTO COLEÇÃO DE ÁUDIOS -
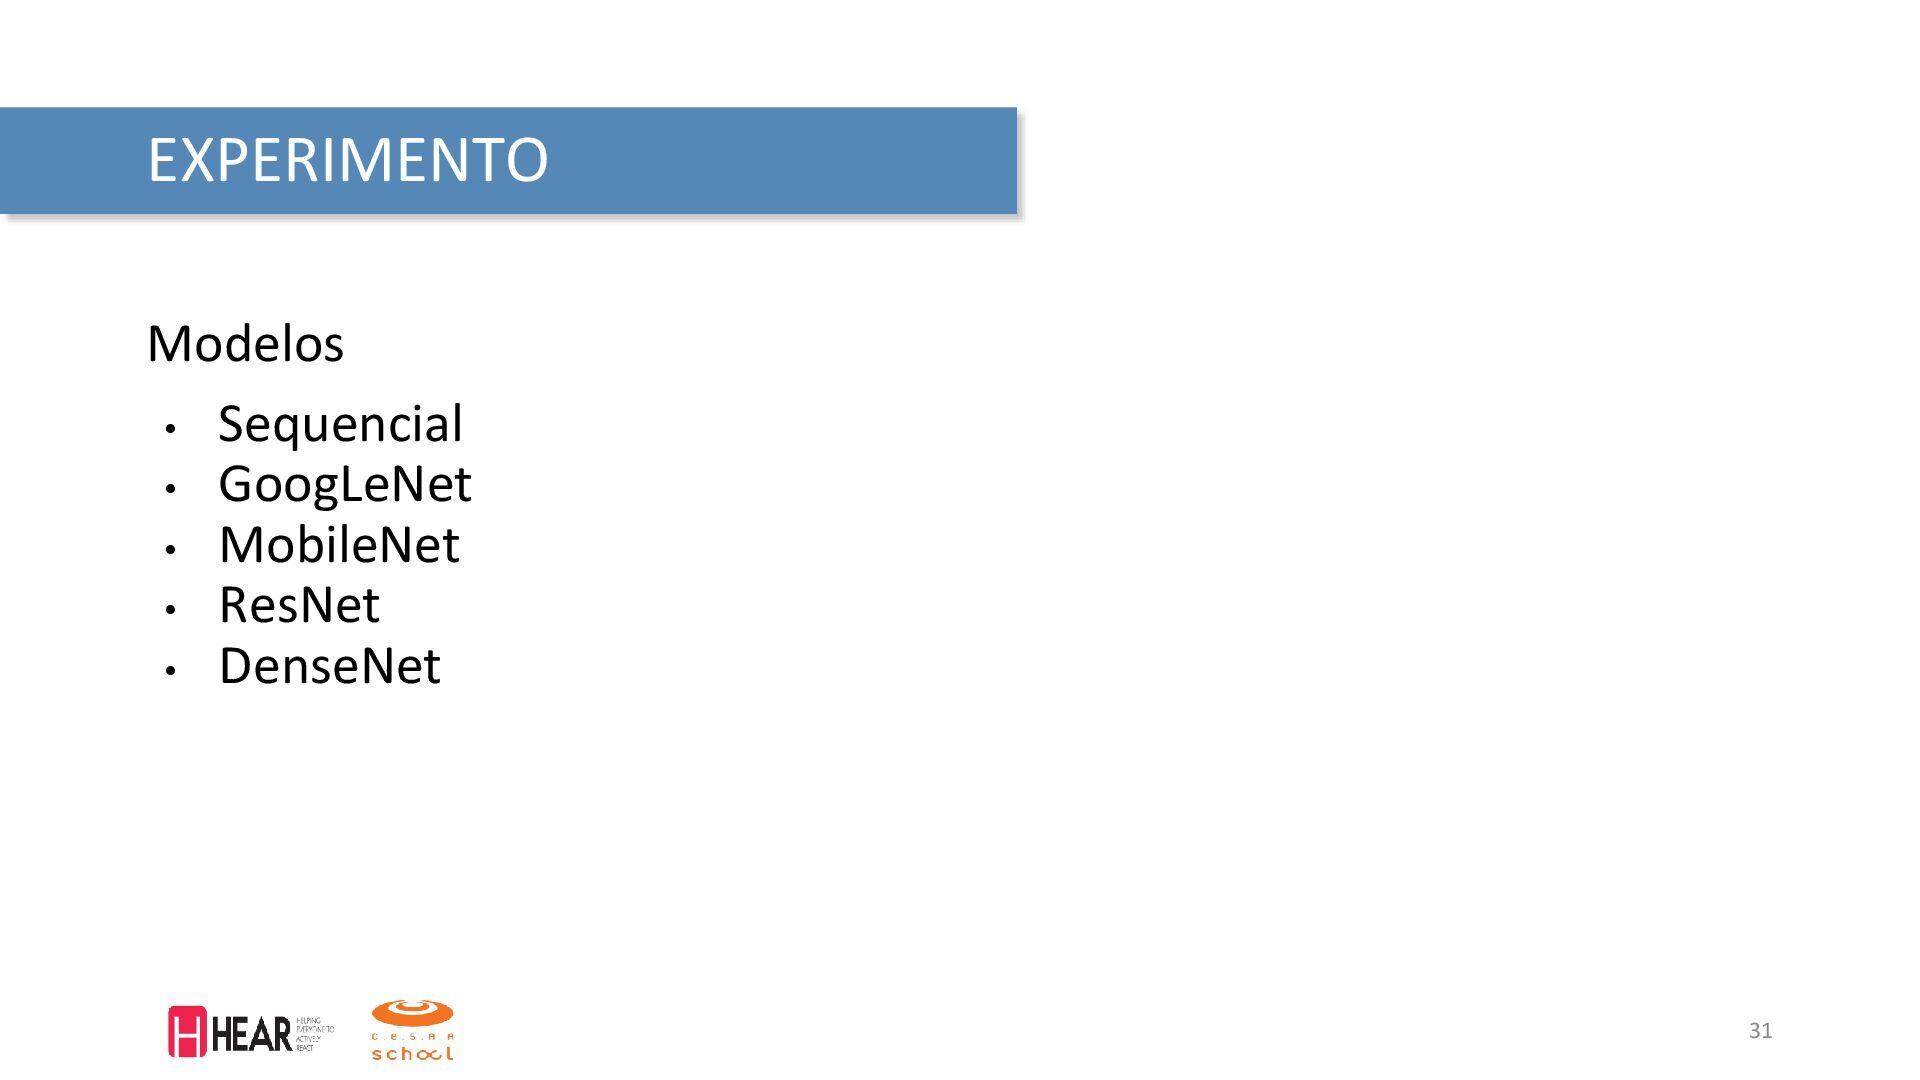
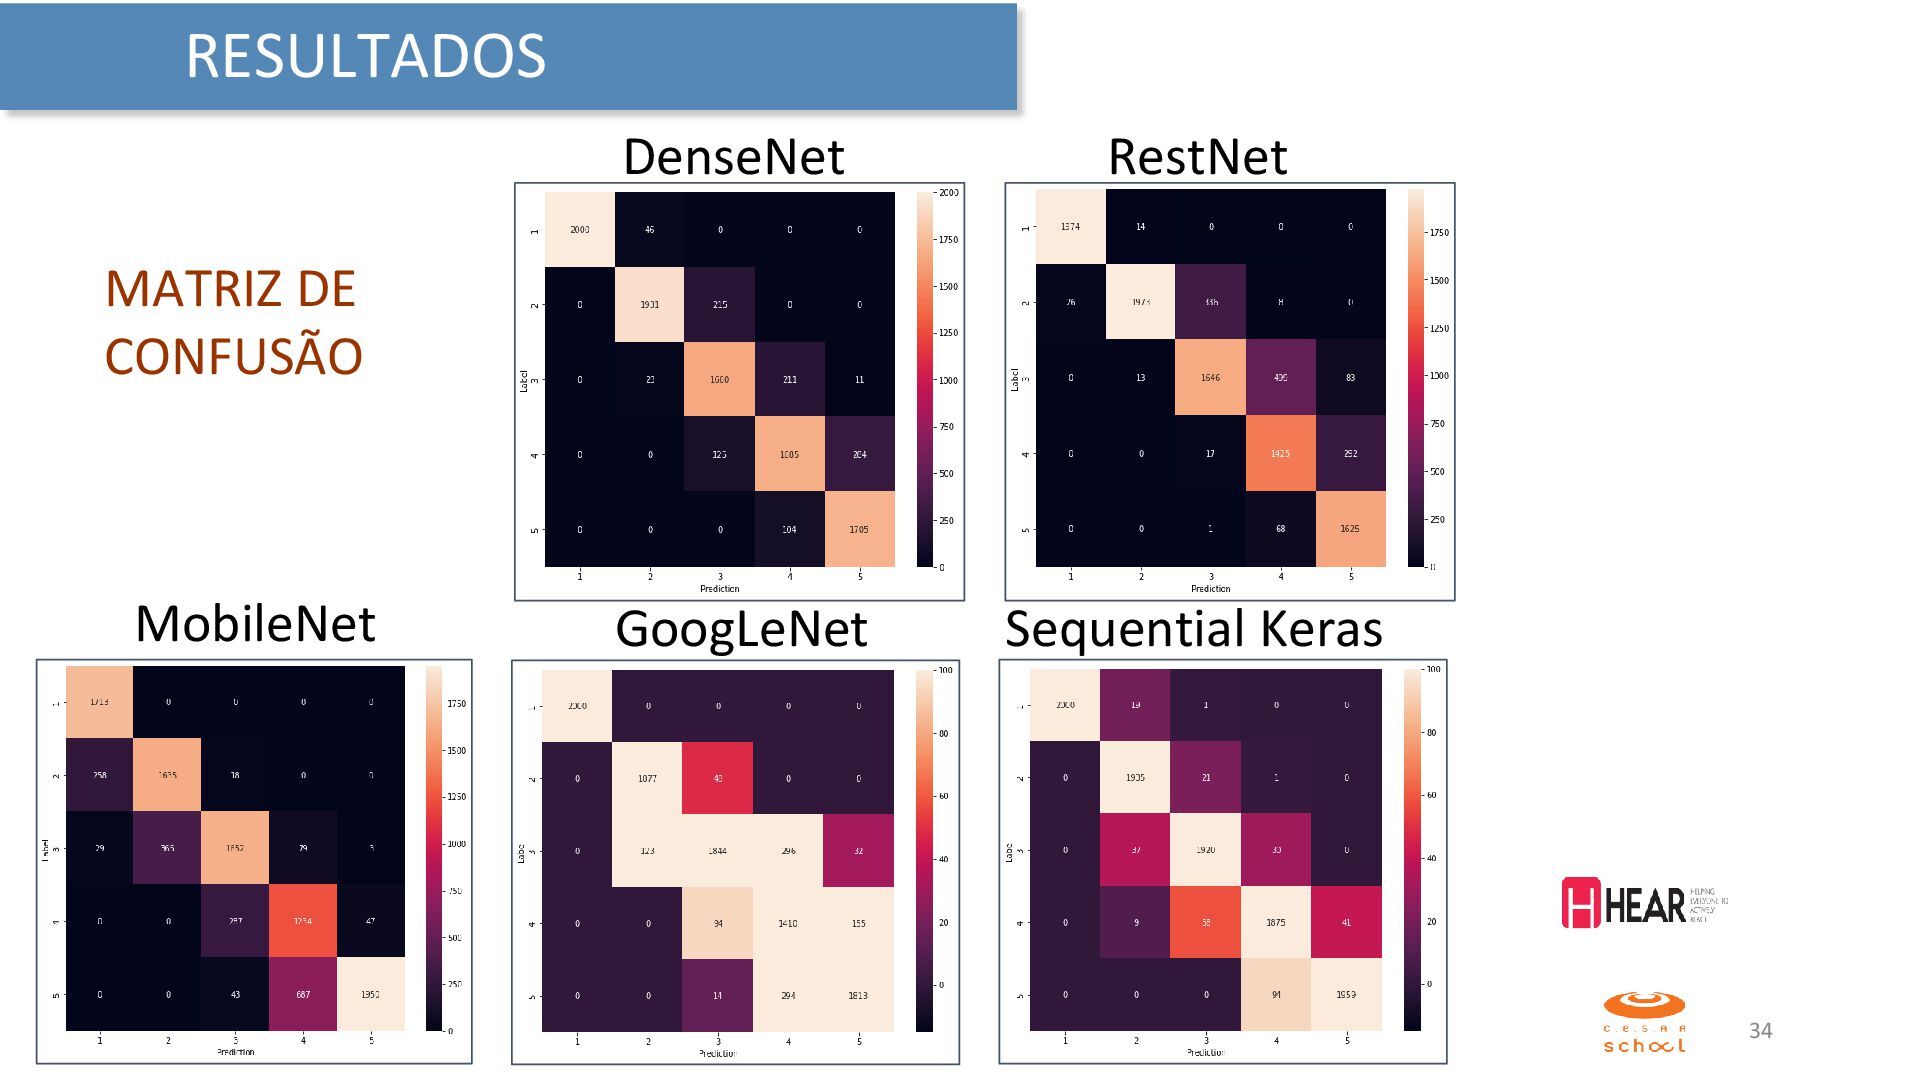
Modelos • Sequencial • GoogLeNet • MobileNet • ResNet •
DenseNet 31 EXPERIMENTO -
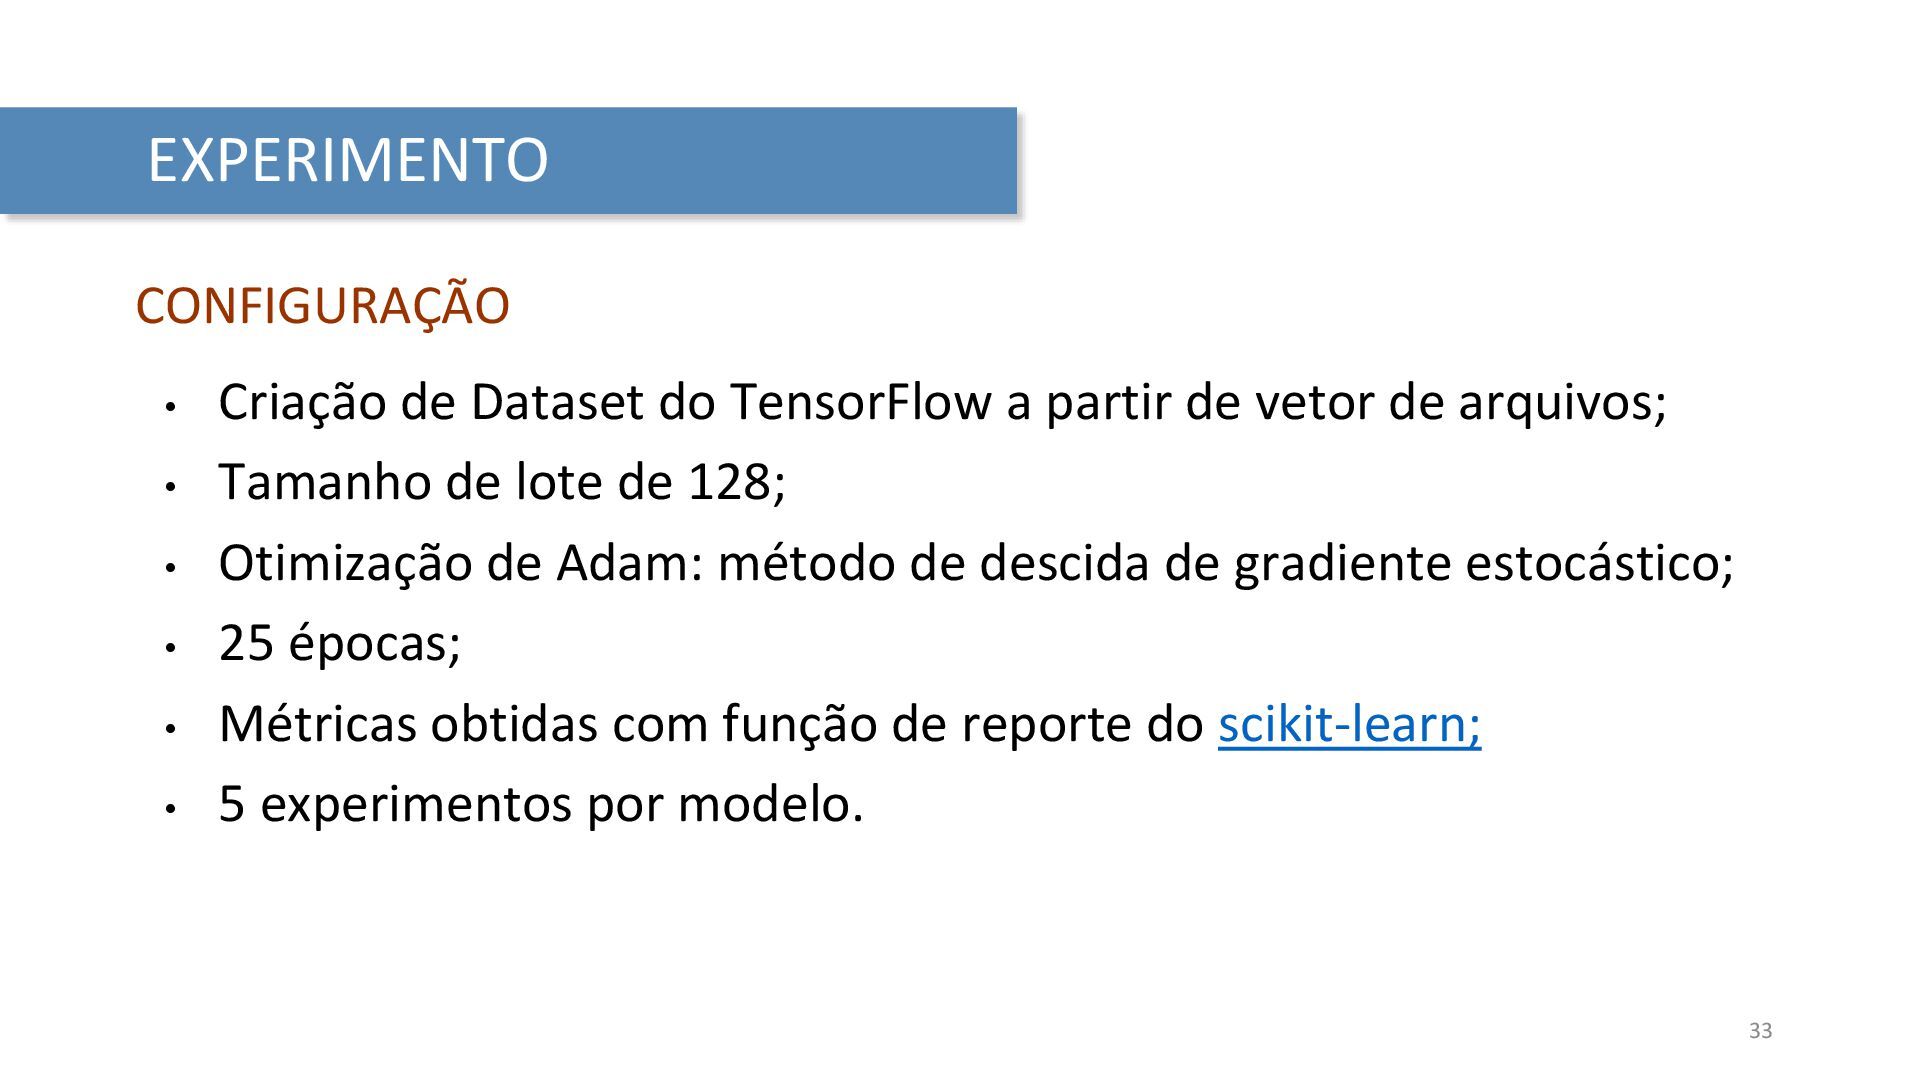
• Criação de Dataset do TensorFlow a partir de vetor
de arquivos; • Tamanho de lote de 128; • Otimização de Adam: método de descida de gradiente estocástico; • 25 épocas; • Métricas obtidas com função de reporte do scikit-learn; • 5 experimentos por modelo. 33 EXPERIMENTO CONFIGURAÇÃO -
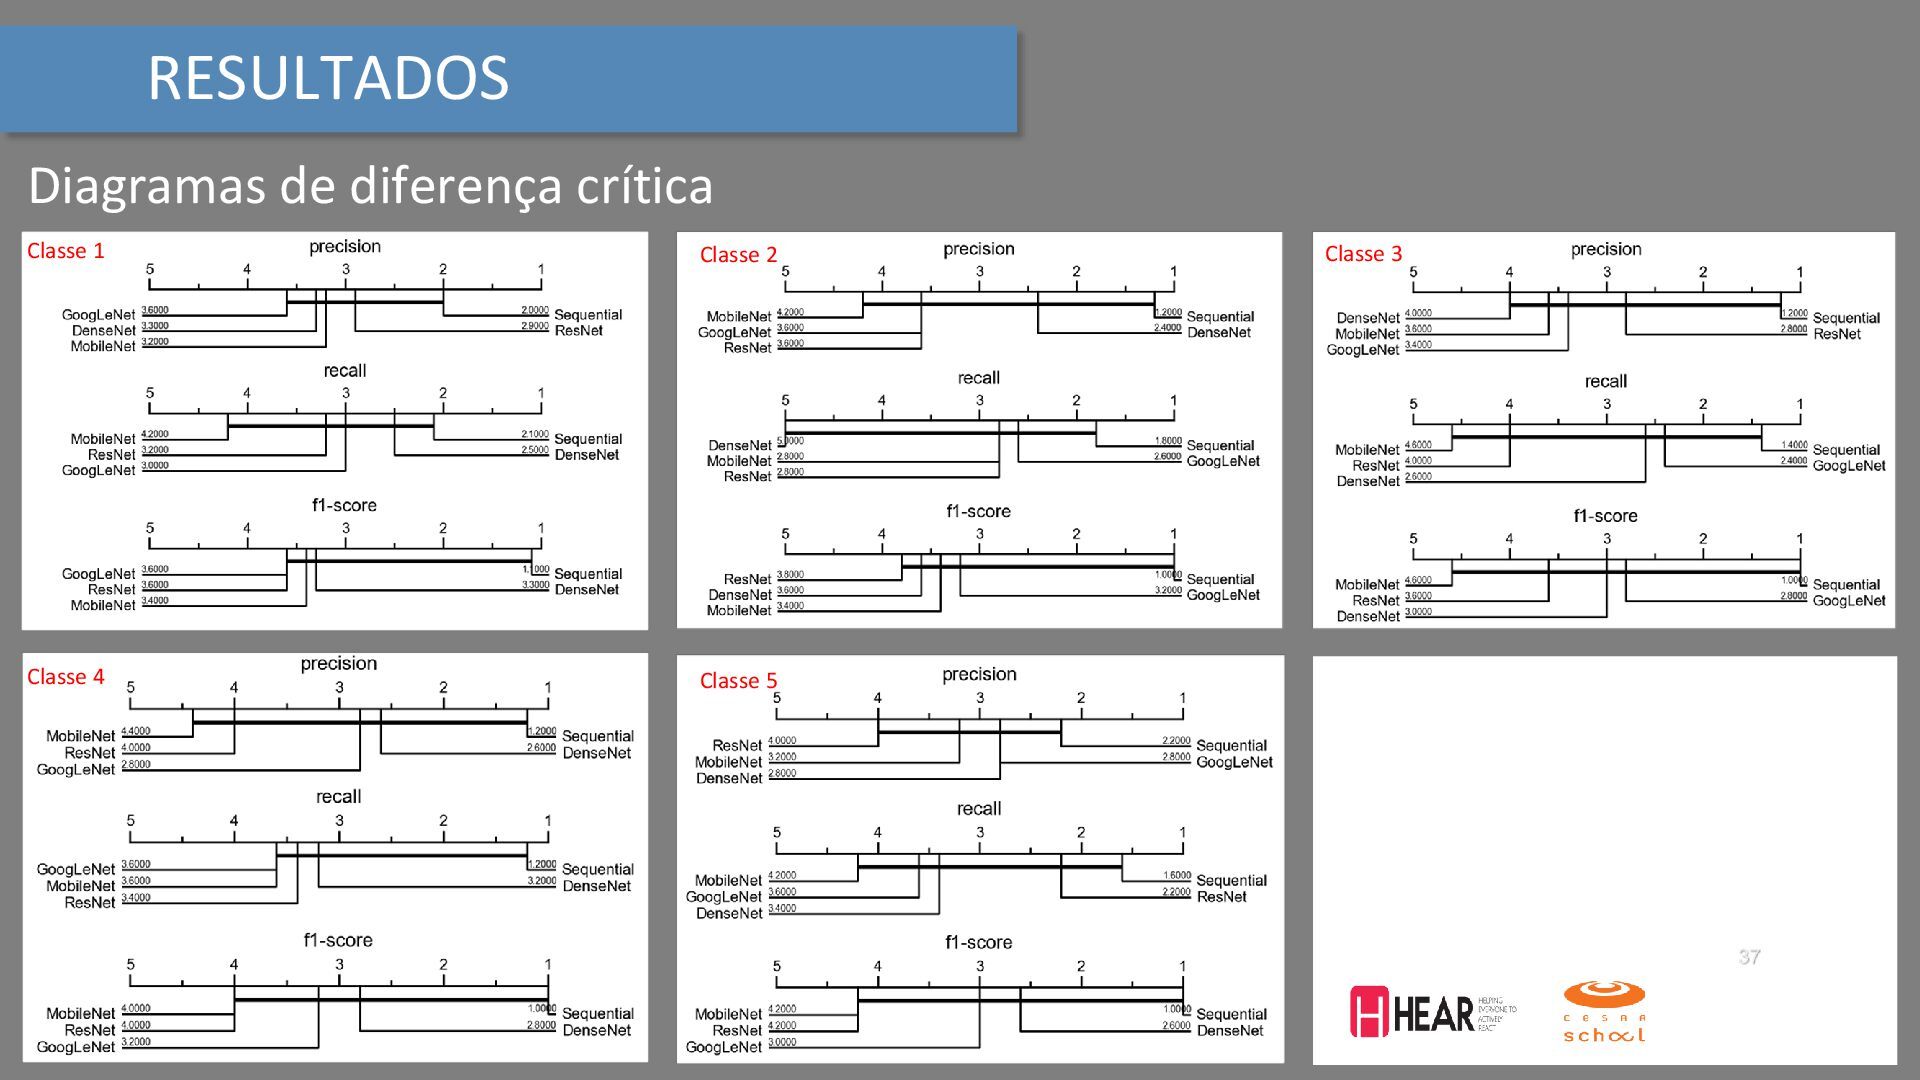
37 Classe 1 Classe 2 Classe 3 Classe 4 Classe
5 Diagramas de diferença crítica RESULTADOS -
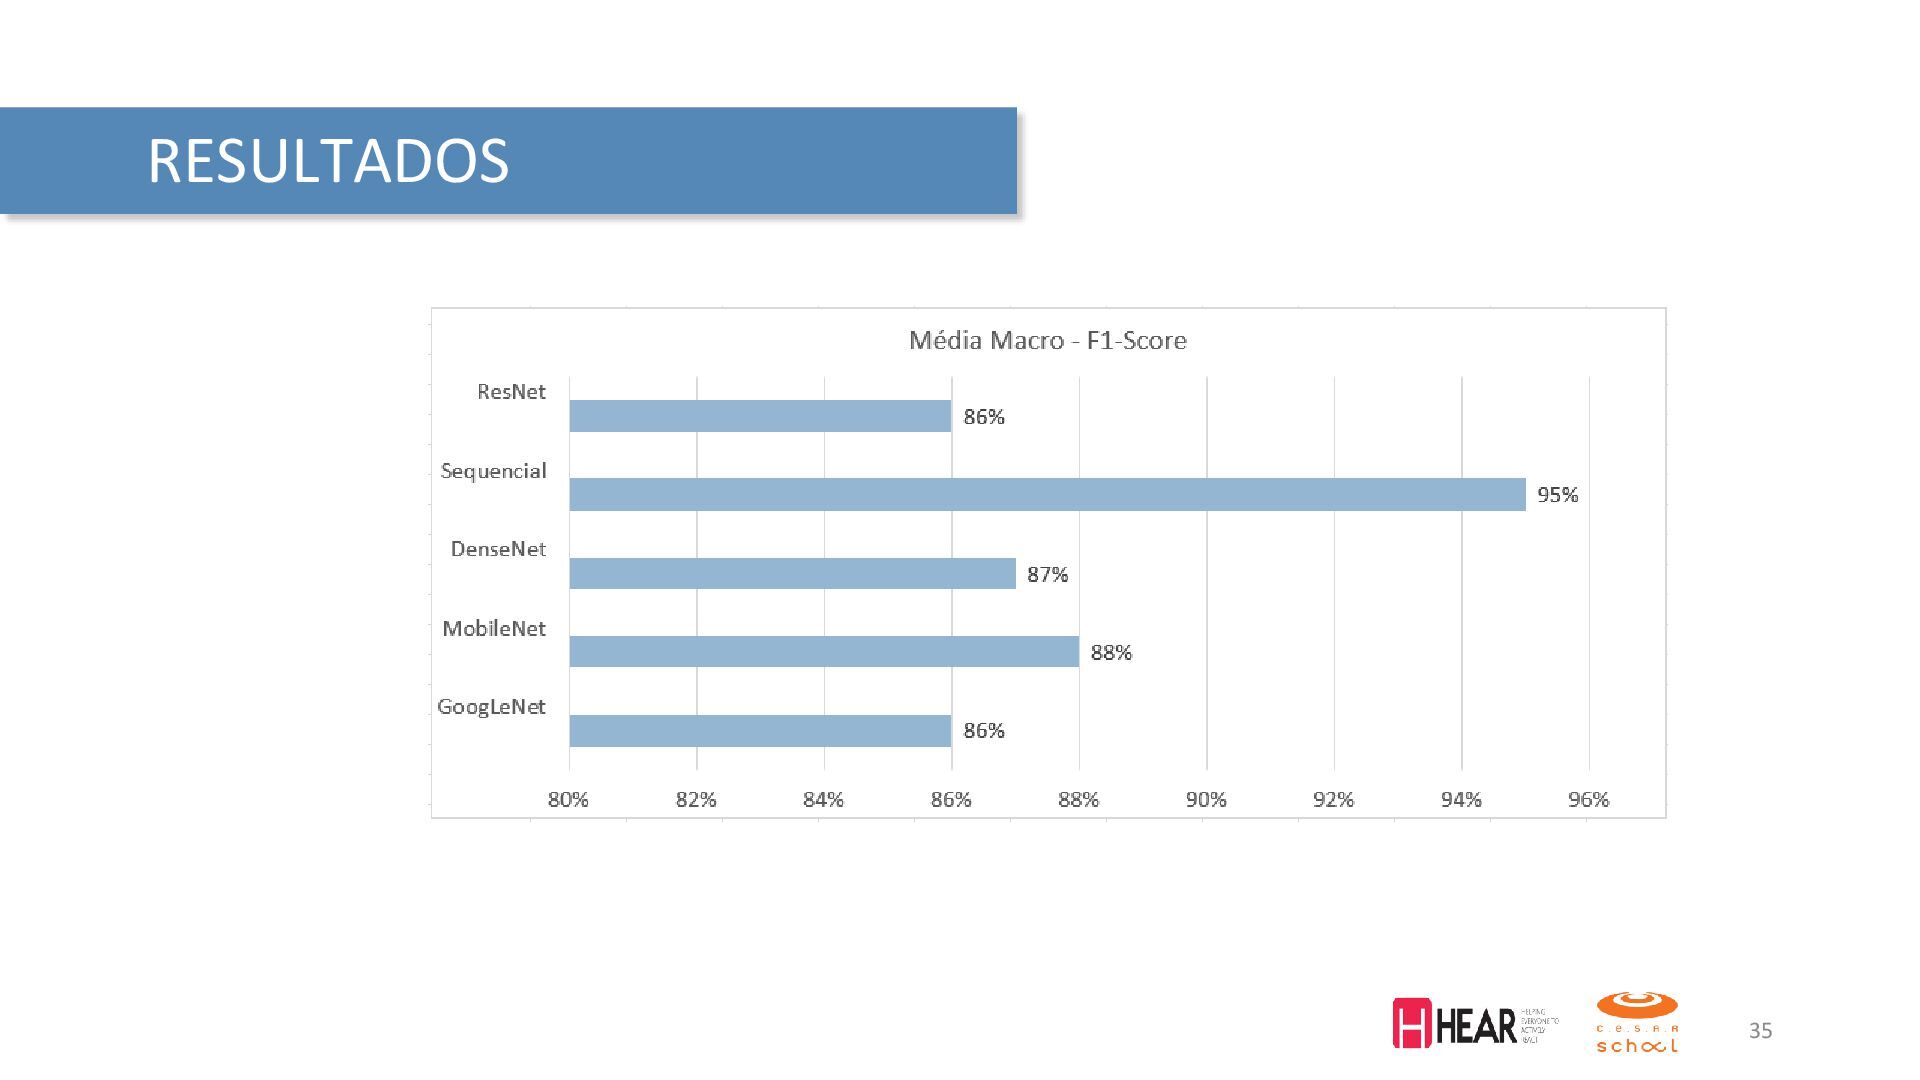
• O uso de CNN é adequado para classificação de
cenas acústicas; • Obtido alto valor de f1-score para todos os modelos; • Modelo Sequencial Keras obteve resultado satisfatório com 95% de f-score e se sobressaiu quanto aos demais modelos utilizados. 38 CONSIDERAÇÕES FINAIS -
• Mapeamento de fala; • Identificação de atores; • Comparativo
com outros tipos de espectrogramas. 39 LIMITAÇÕES -
• Ambiente simulado; • Falta uma investigação com relação à
influência do tempo dos áudios; • Não houve implantação para testes isolados. 40 AMEAÇAS A VALIDADE -
AWASTHI. Solving Data Science problems using CRISP-DM. Ago. 2018. Disponível
em: <https://www.kaggle.com/ananta/solving-data-science-problems-usingcrisp-dm/notebook>. Acesso em: 15 de dezembro de 2021. IBM. What is computer vision? 2021. Disponível em: <https://www.ibm.com/topics/computer-vision>. Acesso em: 30 de janeiro de 2021. MAKEABILITY, Lab. Signals: Frequency Analysis. 2020. Disponível em: <https://makeabilitylab.github.io/physcomp/signals/FrequencyAnalysis/index.html>. Acesso em: 04 de março de 2022. VARGAS, A; PAES, A; VASCONCELOS, C. Um estudo sobre redes neurais convolucionais e sua aplicação em detecção de pedestres. In: PROCEEDINGS of the XXIX Conference on Graphics, Patterns and Images. [S.l.: s.n.], 2016. P. 1–4. Fórum de Segurança Pública. Segurança em Números. Julho 2021. Disponível em: < https://forumseguranca.org.br/wp-content/uploads/2021/07/infografico-2020-v6.pdf> Fórum de SP. Infográfico visível e invisível. Maio 2021. Disponível em: <https://forumseguranca.org.br/wp-content/uploads/2021/05/infografico-visivel-e-invisivel-2ed.pdf> ANDREI, Valentin et al. Overlapped Speech Detection and Competing Speaker Counting—Humans Versus Deep Learning. IEEE Journal of Selected Topics in Signal Processing, v. 13, n. 4, p. 850–862, 2019. FABIAN-ROBERT et al. CountNet: Estimating the Number of Concurrent Speakers Using Supervised Learning. IEEE/ACM Transactions on Audio, Speech, and Language Processing, v. 27, n. 2, p. 268–282, 2019. GRUMIAUX, Pierre-Amaury et al. High-Resolution Speaker Counting in Reverberant Rooms Using CRNN with Ambisonics Features. In: 2020 28th European Signal Processing Conference (EUSIPCO). [S.l.: s.n.], 2021. P. 71–75. PANDEY, S.; BANERJEE, A. A. Distributed Approach to Speaker Count Problem in na Open-Set Scenario by Clustering Pitch Features. IEEE Signal Processing Magazine, abr. 2021. PENG, Chao; WU, Xihong; QU, Tianshu. Competing Speaker Count Estimation on the Fusion of the Spectral and Spatial Embedding Space. In: PROC. Interspeech 2020. [S.l.: s.n.], 2020. P. 3077–3081. ZHANG, Wangyou et al. End-to-End Overlapped Speech Detection and Speaker Counting with Raw Waveform. In: 2019 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU). [S.l.: s.n.], 2019. P. 660–666. ZHONG-QIU, Wang; WANG, DeLiang. Count And Separate: Incorporating Speaker Counting For Continuous Speaker Separation. In: ICASSP 2021 - 2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). [S.l.: s.n.], 2021. P. 11–15. WANG, Wei et al. Speaker Counting Model based on Transfer Learning from SincNet Bottleneck Layer. In: 2020 IEEE International Conference on Pervasive Computing and Communications (PerCom). [S.l.: s.n.], 2020. P. 1–8. WIRTH, Rüdiger; HIPP, Jochen. CRISP-DM: Towards a Standard Process Model for Data Mining. In: PROCEEDINGS of the Fourth International Conference on the Practical Application of Knowledge Discovery and Data Mining. [S.l.: s.n.], 2000. P. 29–39. 41 REFERÊNCIAS BIBLIOGRÁFICAS