Share
Embed
Full-Text Search in Django with PostgreSQL PGDay.IT
Originally presented at #PGDay.IT 2017
http://2017.pgday.it/en/schedule/#session-10
Paolo Melchiorre
October 13, 2017
Transcript
39 slides
-
Full-Text Search in Django with PostgreSQL PGDay.IT 2017 - Milan,
2017-10-13 Paolo Melchiorre - @pauloxnet | -
Paolo Melchiorre | ▪Computer Science Engineer ▪Backend Python Developer
(>10yrs) ▪Django Developer (~5yrs) ▪Senior Software Engineer @ 20Tab ▪Happy Remote Worker ▪PostgreSQL user, not a DBA 2 -
Goal | To show how we have used Django
Full-Text Search and PostgreSQL in a real project 3 -
Motivation | To implement Full-Text Search using only Django
and PostgreSQL, without resorting to external tools. 4 -
Agenda | ▪Full-Text Search ▪Existing Solutions ▪PostgreSQL Full-Text Search
▪Django Full-Text Search Support ▪www.concertiaroma.com project ▪What’s next ▪Conclusions ▪Questions 5 -
Full-Text Search | “… Full-Text Search* refers to techniques
for searching a single computer-stored document or a collection in a Full-Text Database …” -- Wikipedia * FTS = Full-Text Search 6 -
Features of a FTS | ▪Stemming ▪Ranking ▪Stop-words ▪Multiple
languages support ▪Accent support ▪Indexing ▪Phrase search 7 -
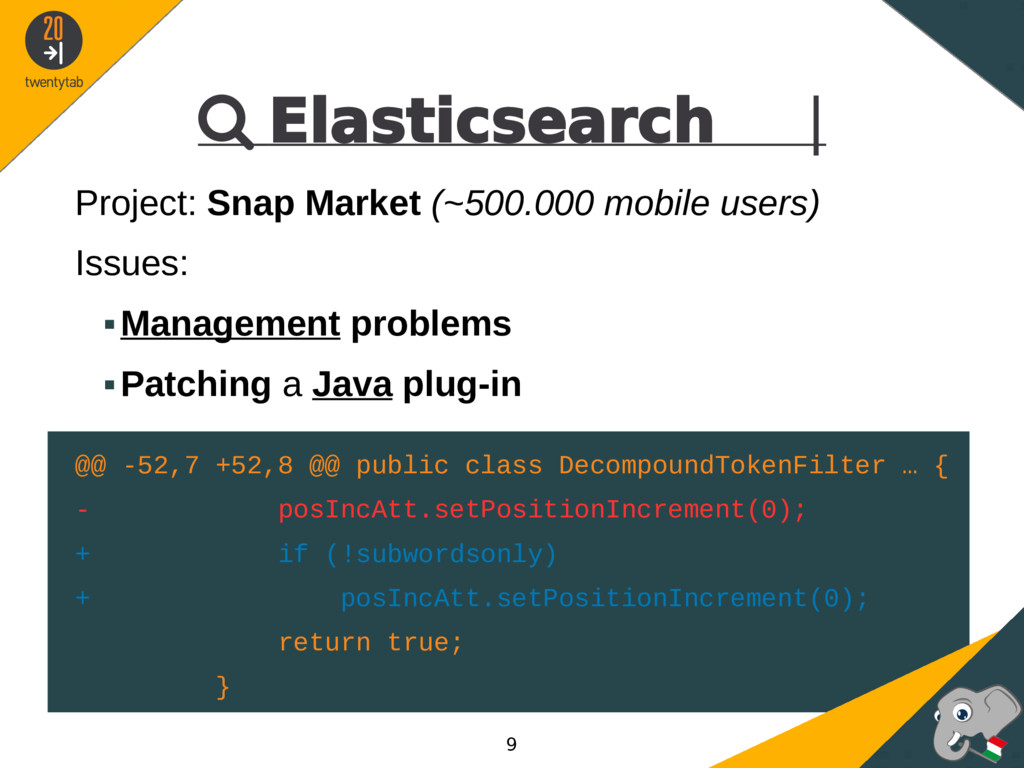
Elasticsearch | Project: Snap Market (~500.000 mobile users) Issues:
▪Management problems ▪Patching a Java plug-in @@ -52,7 +52,8 @@ public class DecompoundTokenFilter … { - posIncAtt.setPositionIncrement(0); + if (!subwordsonly) + posIncAtt.setPositionIncrement(0); return true; } 9 -
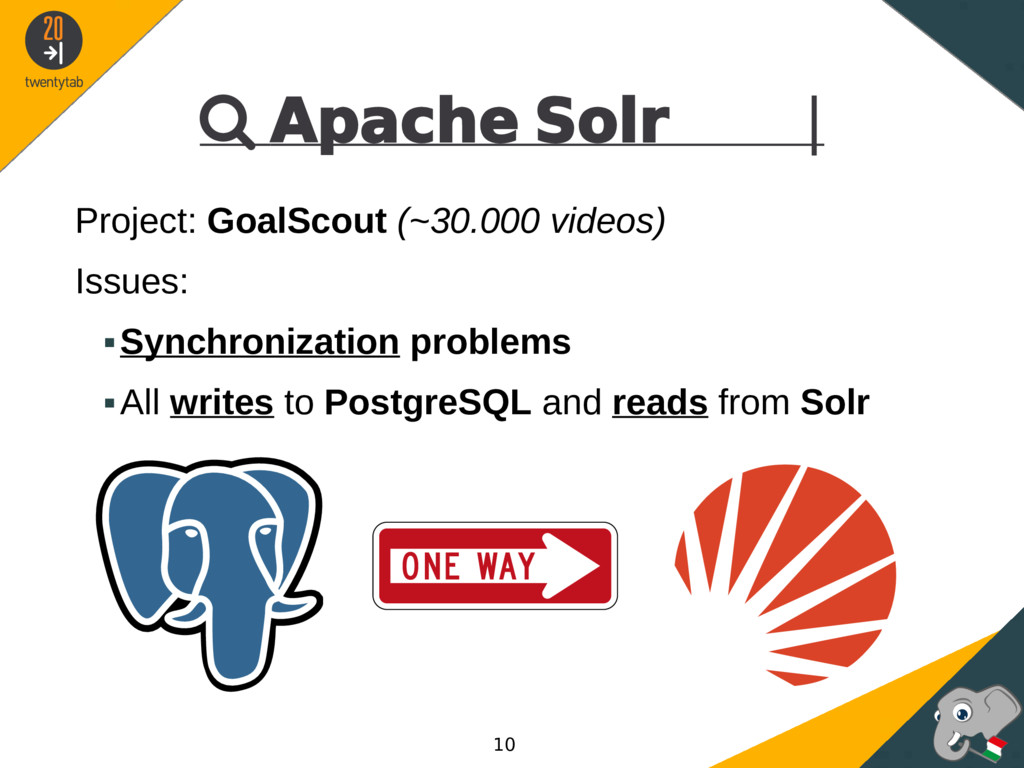
Apache Solr | Project: GoalScout (~30.000 videos) Issues: ▪Synchronization
problems ▪All writes to PostgreSQL and reads from Solr 10 -
Existing Solutions | PROS ▪Full featured solutions ▪Resources
(documentations, articles, …) CONS ▪Synchronization ▪Mandatory use of driver (haystack, bungiesearch…) ▪Ops Oriented: focus on system integrations 11 -
FTS in PostgreSQL | ▪FTS Support since version 8.3
(~2008) ▪TSVECTOR to represent text data ▪TSQUERY to represent search predicates ▪Special Indexes (GIN, GIST) ▪Phrase Search since version 9.6 (~2016) ▪FTS for JSON[b] since version 10 (~2017) 12 -
What are documents | “… a document is the
unit of searching in a Full-Text Search system; for example, a magazine article or email message …” -- PostgreSQL documentation 13 -
Django Support | ▪Module: django.contrib.postgres ▪FTS Support since version
1.10 (2016) ▪BRIN and GIN indexes since version 1.11 (2017) ▪Dev Oriented: focus on programming 14 -
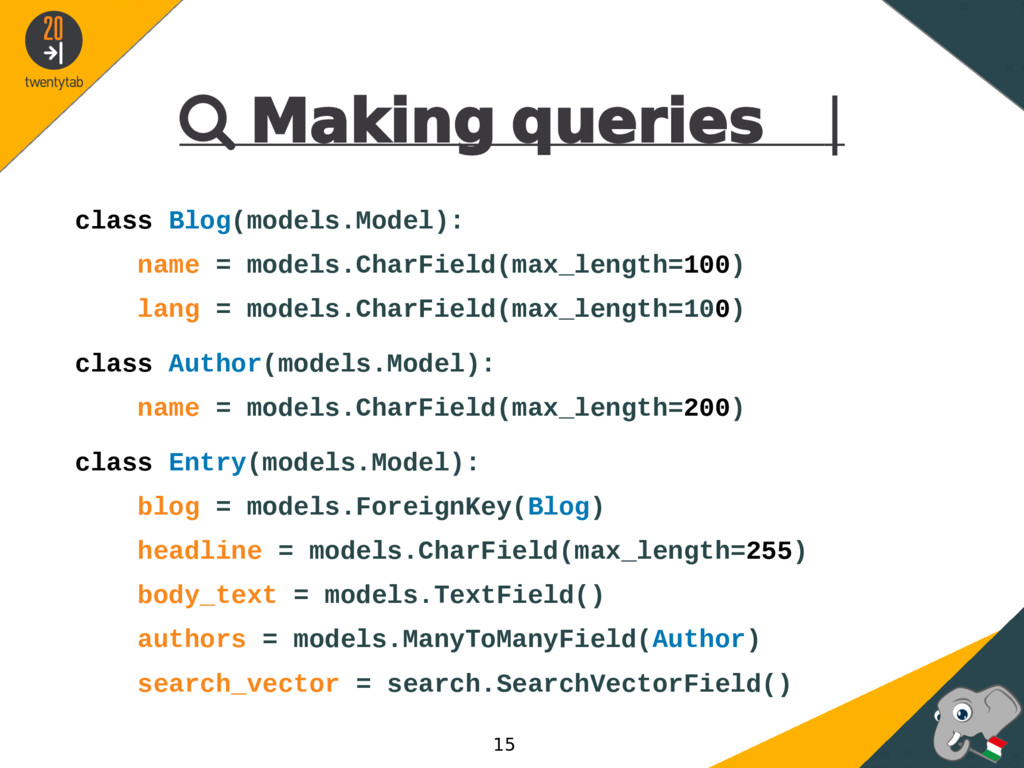
Making queries | class Blog(models.Model): name = models.CharField(max_length=100) lang
= models.CharField(max_length=100) class Author(models.Model): name = models.CharField(max_length=200) class Entry(models.Model): blog = models.ForeignKey(Blog) headline = models.CharField(max_length=255) body_text = models.TextField() authors = models.ManyToManyField(Author) search_vector = search.SearchVectorField() 15 -
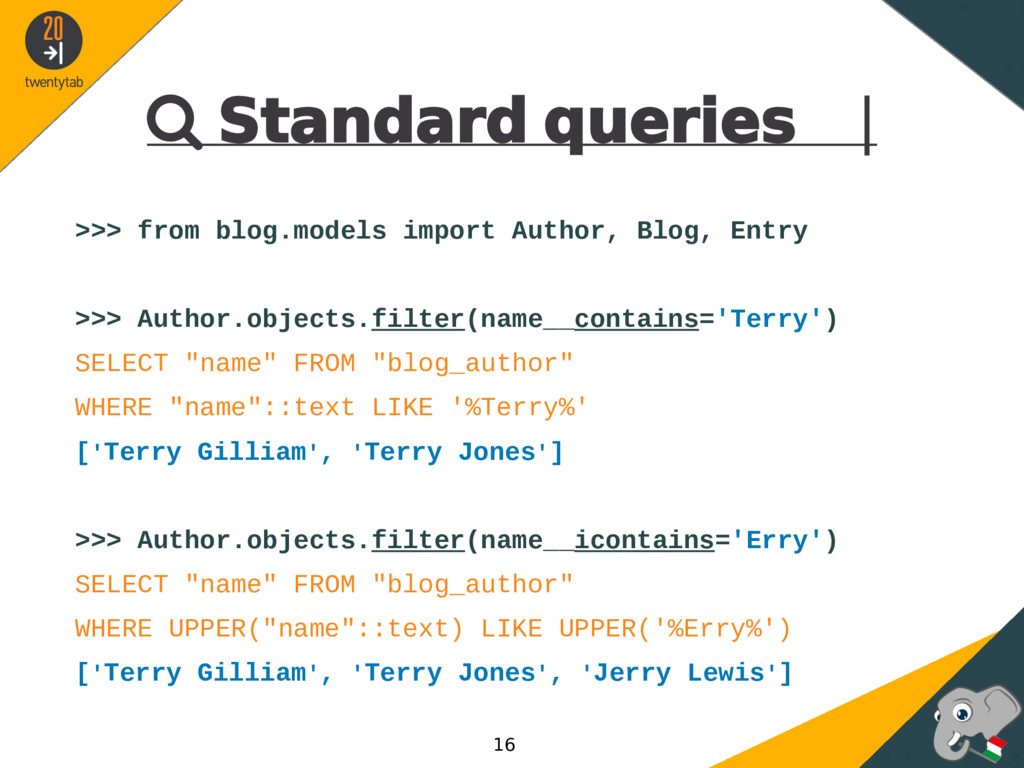
Standard queries | >>> from blog.models import Author, Blog,
Entry >>> Author.objects.filter(name__contains='Terry') SELECT "name" FROM "blog_author" WHERE "name"::text LIKE '%Terry%' ['Terry Gilliam', 'Terry Jones'] >>> Author.objects.filter(name__icontains='Erry') SELECT "name" FROM "blog_author" WHERE UPPER("name"::text) LIKE UPPER('%Erry%') ['Terry Gilliam', 'Terry Jones', 'Jerry Lewis'] 16 -
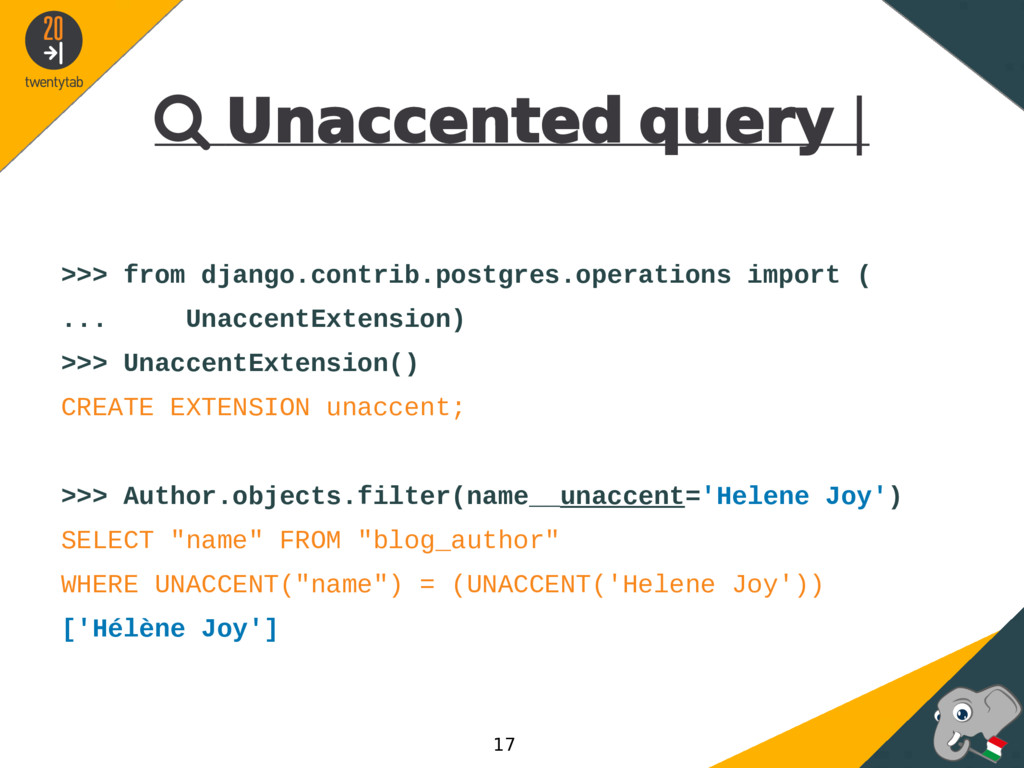
Unaccented query | >>> from django.contrib.postgres.operations import ( ...
UnaccentExtension) >>> UnaccentExtension() CREATE EXTENSION unaccent; >>> Author.objects.filter(name__unaccent='Helene Joy') SELECT "name" FROM "blog_author" WHERE UNACCENT("name") = (UNACCENT('Helene Joy')) ['Hélène Joy'] 17 -
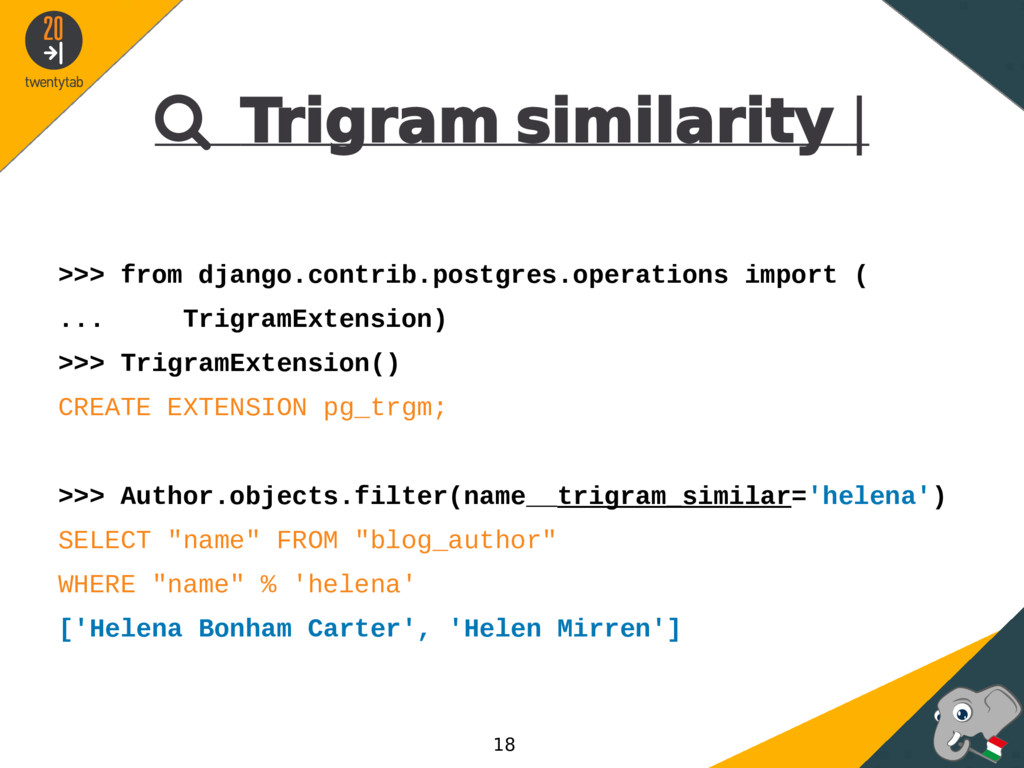
Trigram similarity | >>> from django.contrib.postgres.operations import ( ...
TrigramExtension) >>> TrigramExtension() CREATE EXTENSION pg_trgm; >>> Author.objects.filter(name__trigram_similar='helena') SELECT "name" FROM "blog_author" WHERE "name" % 'helena' ['Helena Bonham Carter', 'Helen Mirren'] 18 -
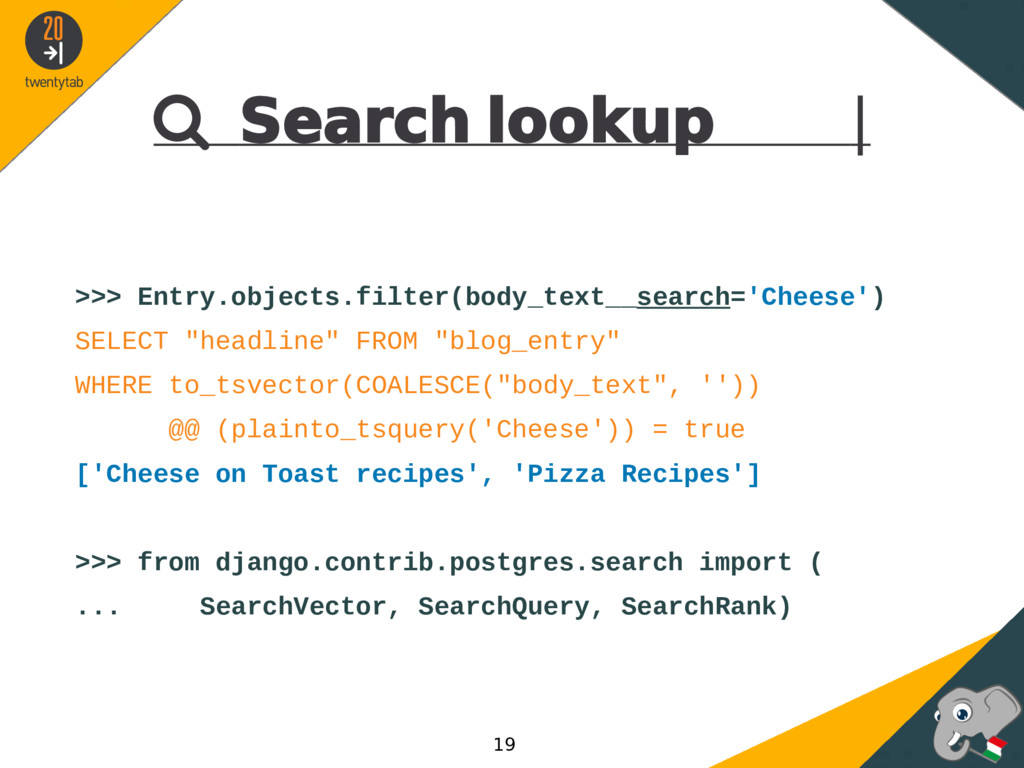
Search lookup | >>> Entry.objects.filter(body_text__search='Cheese') SELECT "headline" FROM "blog_entry"
WHERE to_tsvector(COALESCE("body_text", '')) @@ (plainto_tsquery('Cheese')) = true ['Cheese on Toast recipes', 'Pizza Recipes'] >>> from django.contrib.postgres.search import ( ... SearchVector, SearchQuery, SearchRank) 19 -
SearchVector | >>> vector = SearchVector('body_text', 'blog__name') >>> Entry.objects.annotate(search=vector).filter(
... search='Cheese') SELECT "headline" FROM "blog_entry" INNER JOIN "blog_blog" ON ("blog_id" = "blog_blog"."id") WHERE to_tsvector(COALESCE("body_text", '') || ' ' || COALESCE("name", '')) @@ (plainto_tsquery('Cheese')) = true ['Cheese on Toast recipes', 'Pizza Recipes'] 20 -
SearchQuery | >>> q = ~SearchQuery('toast') >>> v =
SearchVector('body_text') >>> Entry.objects.annotate(search=v).filter(search=q) SELECT "headline" FROM "blog_entry" WHERE to_tsvector(COALESCE("body_text", '')) @@ (!!(plainto_tsquery('toast'))) = true ['Pizza Recipes', 'Pain perdu'] >>> query = SearchQuery('cheese') | SearchQuery('toast') ['Pizza Recipes', 'Cheese on Toast recipes'] >>> query = SearchQuery('cheese') & SearchQuery('toast') ['Cheese on Toast recipes'] 21 -
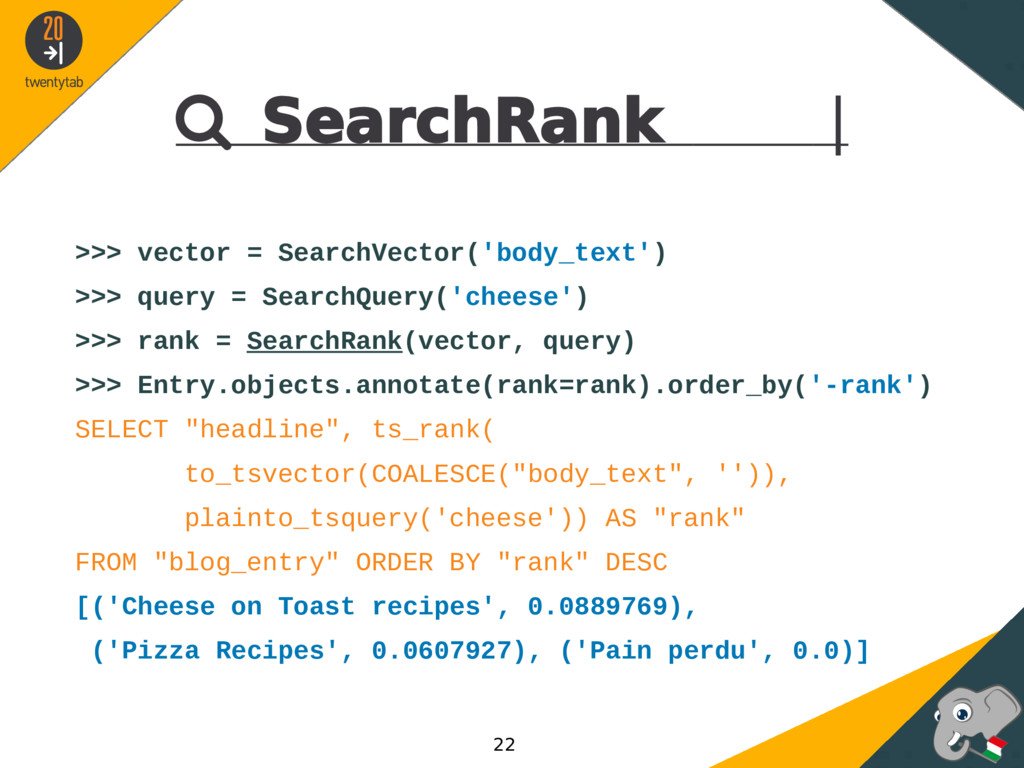
SearchRank | >>> vector = SearchVector('body_text') >>> query =
SearchQuery('cheese') >>> rank = SearchRank(vector, query) >>> Entry.objects.annotate(rank=rank).order_by('-rank') SELECT "headline", ts_rank( to_tsvector(COALESCE("body_text", '')), plainto_tsquery('cheese')) AS "rank" FROM "blog_entry" ORDER BY "rank" DESC [('Cheese on Toast recipes', 0.0889769), ('Pizza Recipes', 0.0607927), ('Pain perdu', 0.0)] 22 -
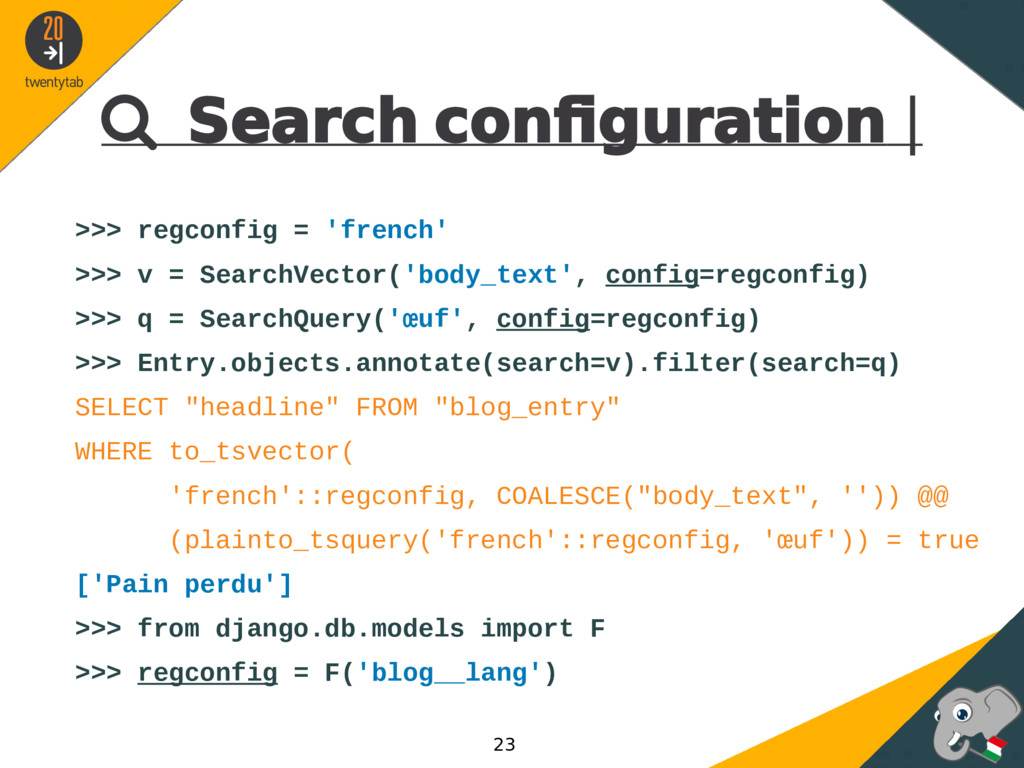
Search confguration | >>> regconfig = 'french' >>> v
= SearchVector('body_text', config=regconfig) >>> q = SearchQuery('œuf', config=regconfig) >>> Entry.objects.annotate(search=v).filter(search=q) SELECT "headline" FROM "blog_entry" WHERE to_tsvector( 'french'::regconfig, COALESCE("body_text", '')) @@ (plainto_tsquery('french'::regconfig, 'œuf')) = true ['Pain perdu'] >>> from django.db.models import F >>> regconfig = F('blog__lang') 23 -
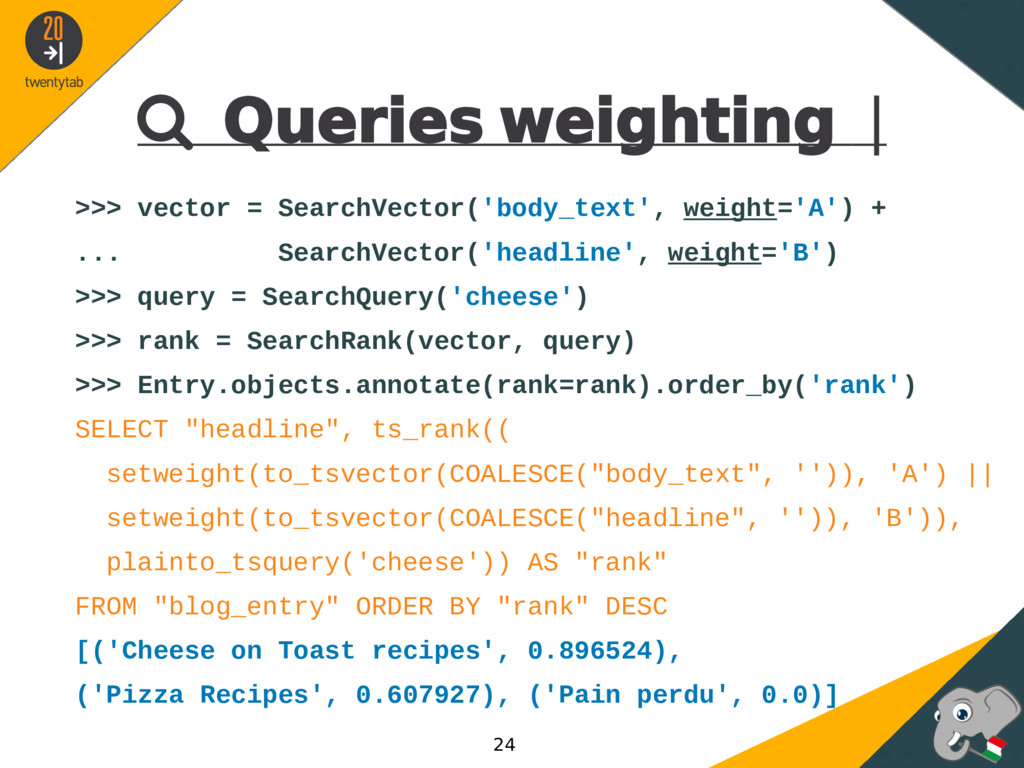
Queries weighting | >>> vector = SearchVector('body_text', weight='A') +
... SearchVector('headline', weight='B') >>> query = SearchQuery('cheese') >>> rank = SearchRank(vector, query) >>> Entry.objects.annotate(rank=rank).order_by('rank') SELECT "headline", ts_rank(( setweight(to_tsvector(COALESCE("body_text", '')), 'A') || setweight(to_tsvector(COALESCE("headline", '')), 'B')), plainto_tsquery('cheese')) AS "rank" FROM "blog_entry" ORDER BY "rank" DESC [('Cheese on Toast recipes', 0.896524), ('Pizza Recipes', 0.607927), ('Pain perdu', 0.0)] 24 -
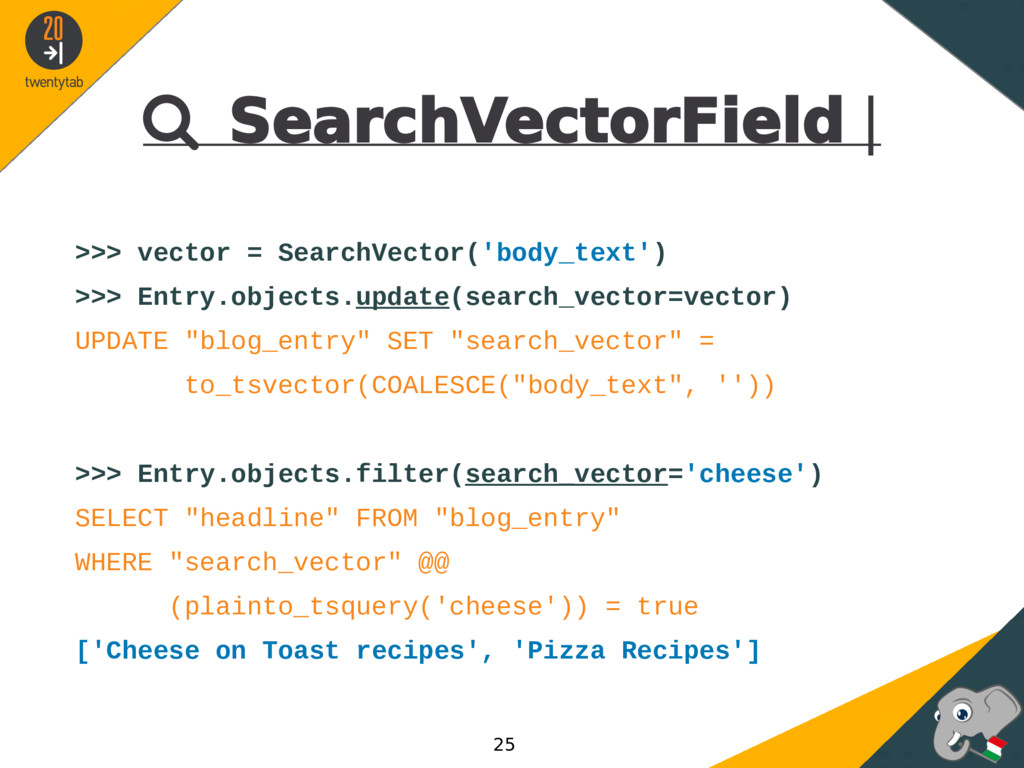
SearchVectorField | >>> vector = SearchVector('body_text') >>> Entry.objects.update(search_vector=vector) UPDATE
"blog_entry" SET "search_vector" = to_tsvector(COALESCE("body_text", '')) >>> Entry.objects.filter(search_vector='cheese') SELECT "headline" FROM "blog_entry" WHERE "search_vector" @@ (plainto_tsquery('cheese')) = true ['Cheese on Toast recipes', 'Pizza Recipes'] 25 -
www.concertiaroma.com| “… today's shows in the Capital” * The
numbers of the project: ~ 1.000 venues > 13.000 bands > 16.000 shows ~ 200 festivals ~ 30.000 user/month * since 2014 26 -
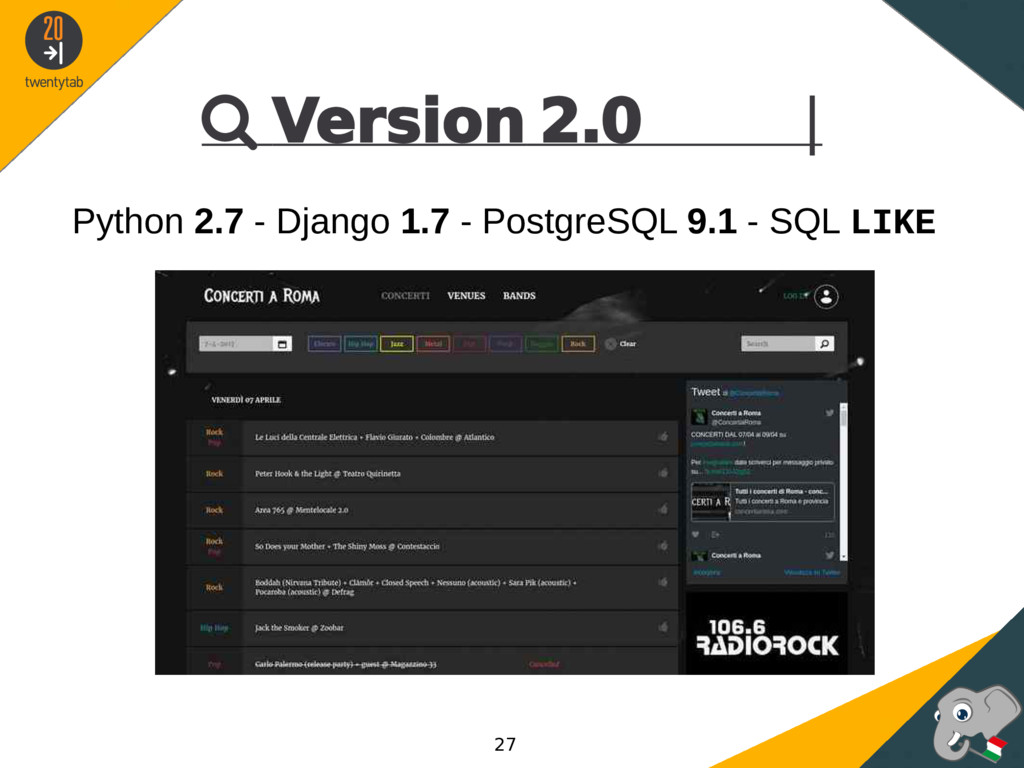
Version 2.0 | Python 2.7 - Django 1.7 -
PostgreSQL 9.1 - SQL LIKE 27 -
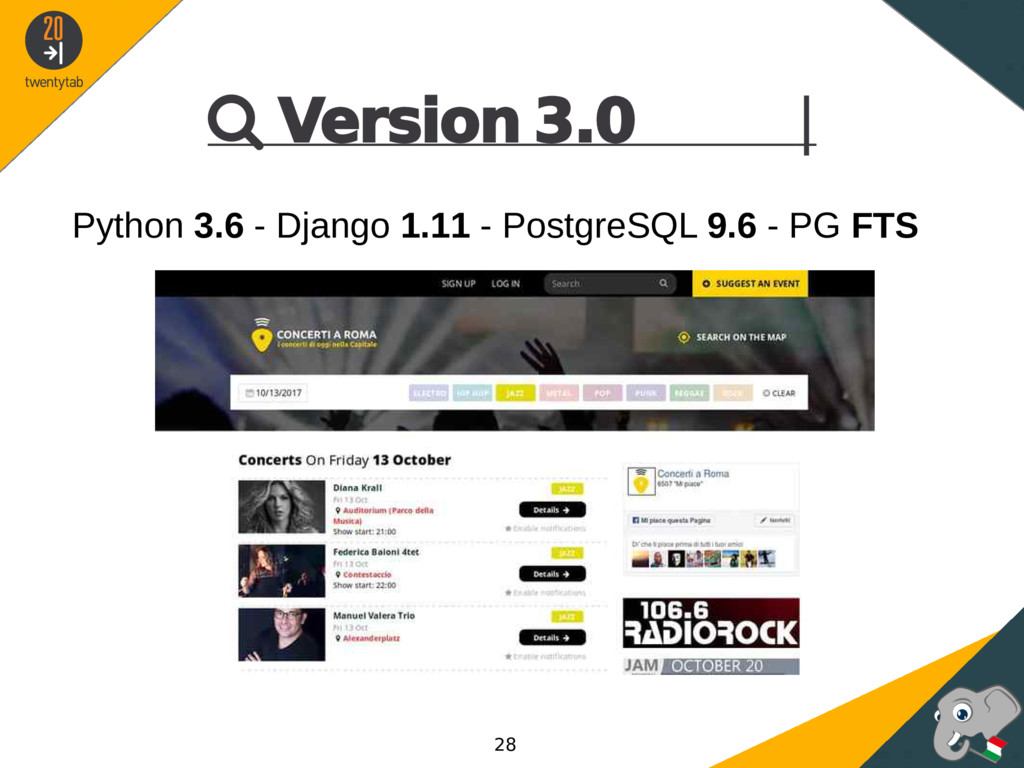
Version 3.0 | Python 3.6 - Django 1.11 -
PostgreSQL 9.6 - PG FTS 28 -
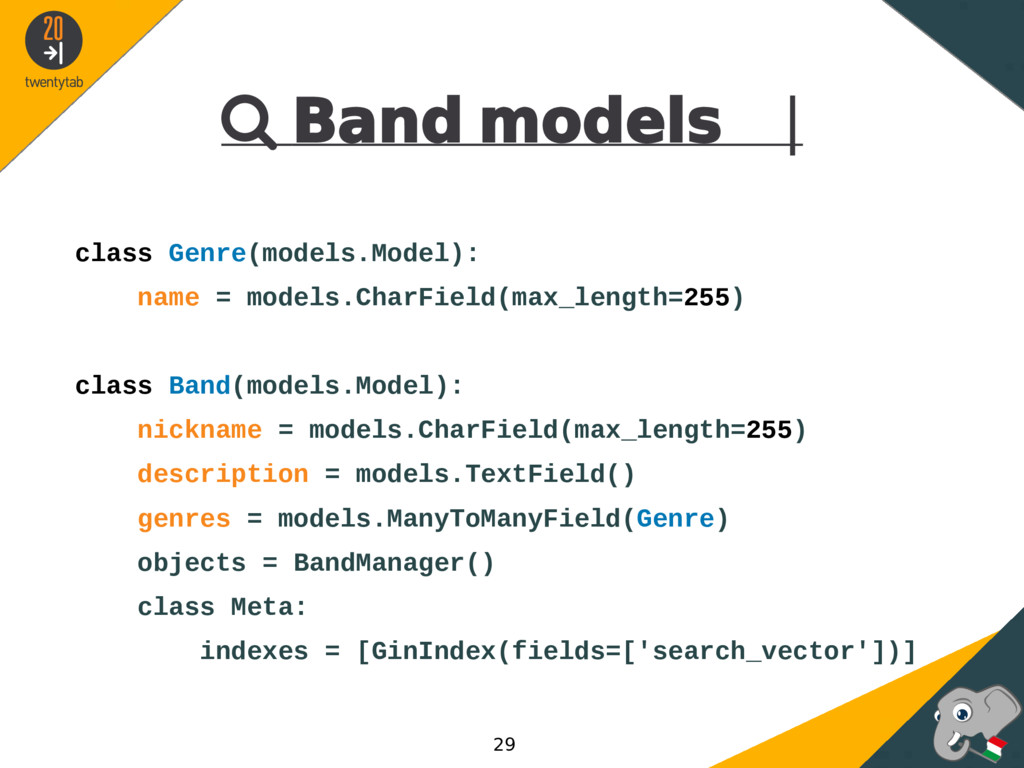
Band models | class Genre(models.Model): name = models.CharField(max_length=255) class
Band(models.Model): nickname = models.CharField(max_length=255) description = models.TextField() genres = models.ManyToManyField(Genre) objects = BandManager() class Meta: indexes = [GinIndex(fields=['search_vector'])] 29 -
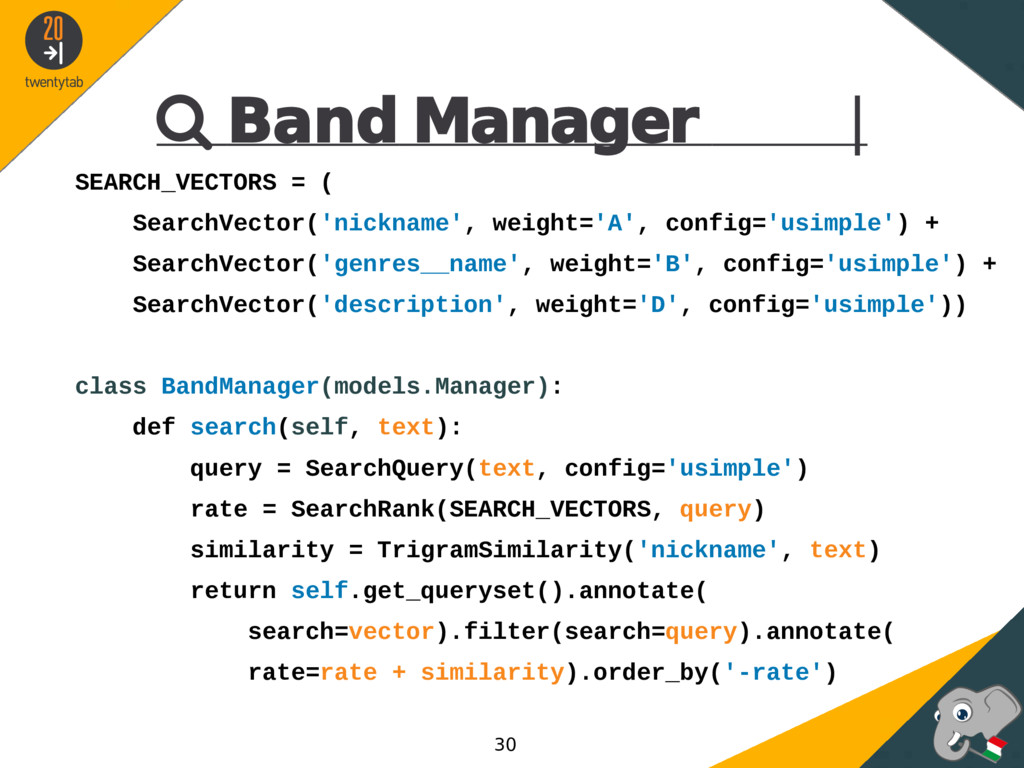
Band Manager | SEARCH_VECTORS = ( SearchVector('nickname', weight='A', config='usimple')
+ SearchVector('genres__name', weight='B', config='usimple') + SearchVector('description', weight='D', config='usimple')) class BandManager(models.Manager): def search(self, text): query = SearchQuery(text, config='usimple') rate = SearchRank(SEARCH_VECTORS, query) similarity = TrigramSimilarity('nickname', text) return self.get_queryset().annotate( search=vector).filter(search=query).annotate( rate=rate + similarity).order_by('-rate') 30 -
Band Test Setup | class BandTest(TestCase): def setUp(self): metal,
_ = Genre.objects.get_or_create(name='Metal') doom, _ = Genre.objects.get_or_create(name='Doom') doomraiser, _ = Band.objects.get_or_create( nickname='Doom raiser', description='Lorem…') doomraiser.genres.add(doom) forgotten_tomb, _ = Band.objects.get_or_create( nickname='Forgotten Tomb', description='Lorem…') forgotten_tomb.genres.add(doom) ... 31 -
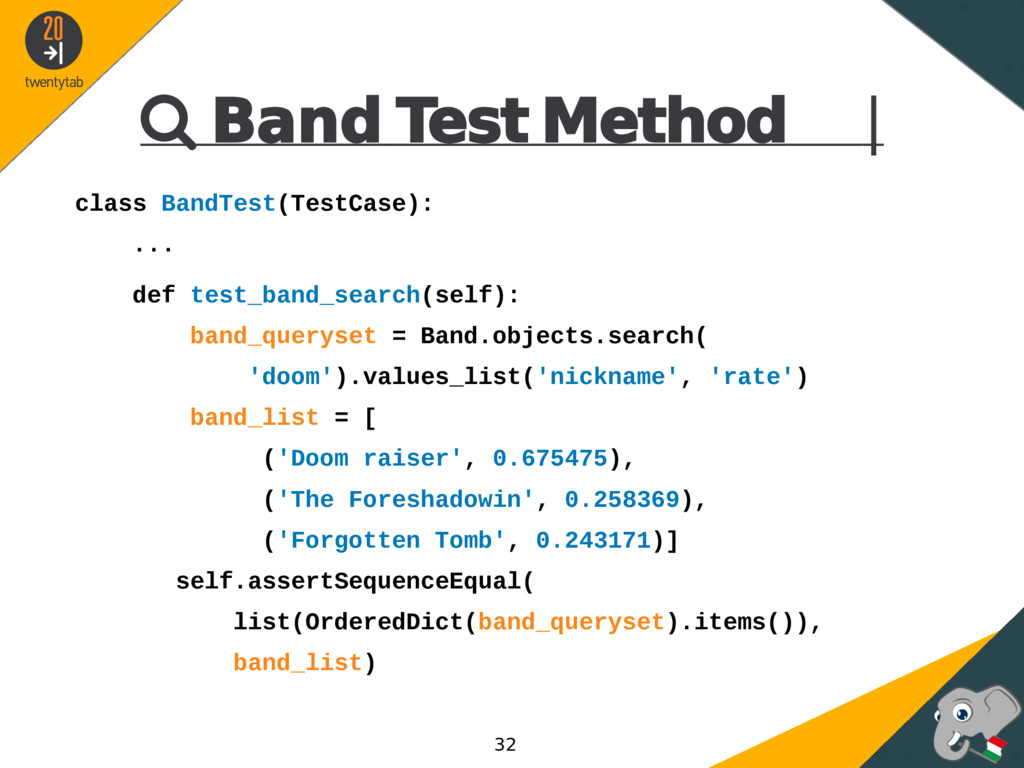
Band Test Method | class BandTest(TestCase): ... def test_band_search(self):
band_queryset = Band.objects.search( 'doom').values_list('nickname', 'rate') band_list = [ ('Doom raiser', 0.675475), ('The Foreshadowin', 0.258369), ('Forgotten Tomb', 0.243171)] self.assertSequenceEqual( list(OrderedDict(band_queryset).items()), band_list) 32 -
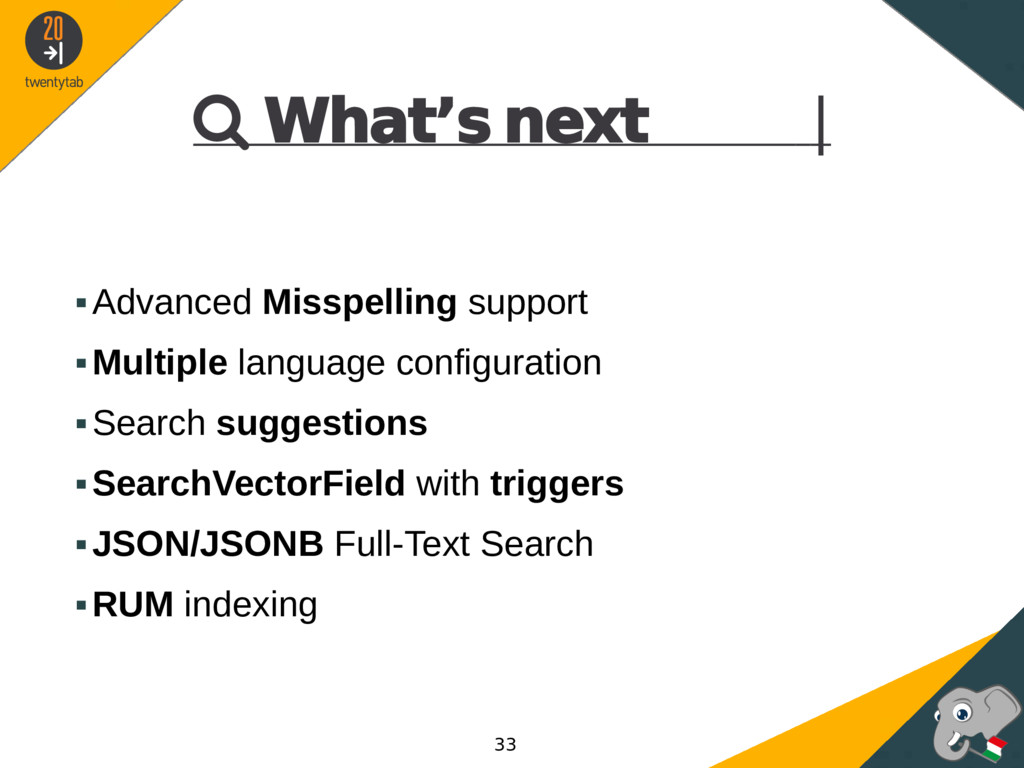
What’s next | ▪Advanced Misspelling support ▪Multiple language configuration
▪Search suggestions ▪SearchVectorField with triggers ▪JSON/JSONB Full-Text Search ▪RUM indexing 33 -
Conclusions | Conditions to implement this solution: ▪No extra
dependencies ▪Not too complex searches ▪Easy management ▪No need to synchronize data ▪PostgreSQL already in your stack ▪Python-only environment 34 -
Acknowledgements | Marc Tamlyn for all the Support for
django.contrib.postgres www.20tab.com github.com/mjtamlyn 36 -
Thank you | BY - SA
(Attribution-ShareAlike) creativecommons.org/licenses/by-sa Source Code github.com/pauloxnet/django_queries Slides speakerdeck.com/pauloxnet 37 -
Contacts | www.paulox.net twitter.com/pauloxnet linkedin.com/in/paolomelchiorre
github.com/pauloxnet 39