Share
Embed
監視ってなんだっけ_.pdf
ryotaro kobayashi
April 17, 2022
Transcript
64 slides
-
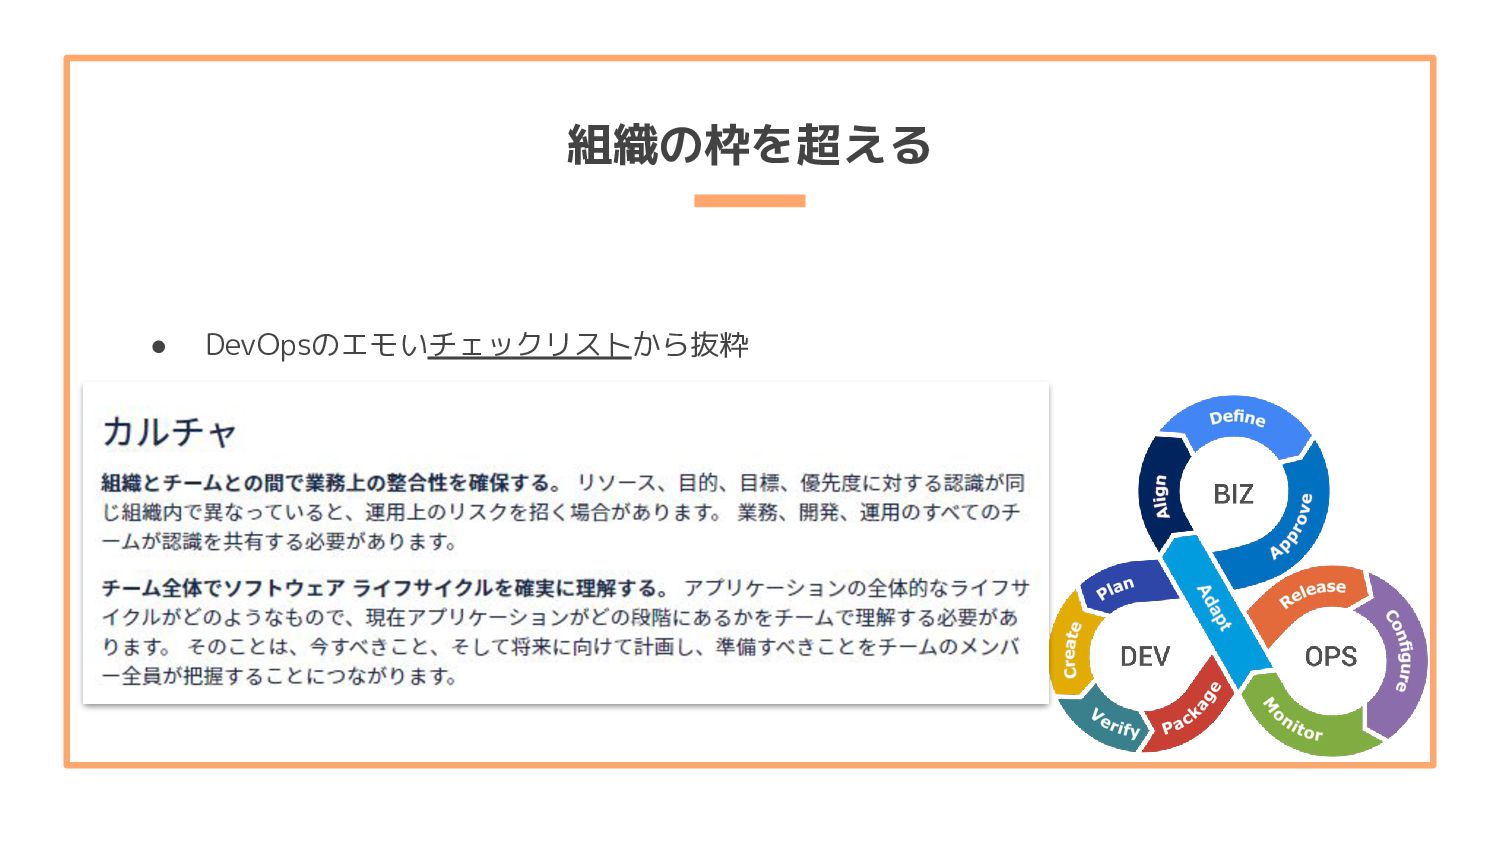
計測するということ • DevOpsのエモいチェックリストを作りました • 監視についても書きました。以下引用 ◦ 運用チームは、システムやサービスの正常性と状態を絶え ず明確に把握しておく必要があります。 状態を監視するた めの外部の正常性エンドポイントをセットアップすると共
に、運用上のメトリックをインストルメント化するようア プリケーションをコーディングしてください。 システムの 枠を越えてイベントを相互に関連付けることができる一般 的かつ一貫性のあるスキーマを使用しましょう。 Red Method 、USE Method 、The Four Golden Signals は、システムの正常性と状態を追跡する標準的な手法で す。 -
The Four Golden Signals • 以下の4つのメトリクス ◦ Latency(The time it
takes to service a request) ◦ Traffic(A measure of how much demand is being placed on your system) ◦ Errors(The rate of requests that fail) ◦ Saturation(How "full" your service is) • ユーザーが直接利用するシステムで、メトリクスを4つだけ計測 できるなら、この4つに集中してください。 https://landing.google.com/sre/sre-book/chapters/monitoring-distributed-systems/#xref_monitoring_ golden-signals -
SLI/SLO/SLA • SLI ◦ サービスレベルの指標(Indicator)の略 ◦ サービスレベルの性質に関して定義された指標(エラー率 やリクエストのレイテンシ) ◦ 可用性も含まれる
• SLO ◦ サービスレベル目標(Objective)の略 ◦ 開発側のゴールに設定することができる ▪ 例)平均レイテンシ100ミリ秒以下 https://www.oreilly.co.jp/books/9784873117911/ -
SLI/SLO/SLA • SLA ◦ サービスレベルの合意(Agreement)の略 ◦ ユーザとの間で結ぶ、明示的あるいは暗黙の契約であり、 その中に含まれるSLOを満たした場合(あるいは満たせな かった場合)に関する規定が含まれている ◦
公表する場合はSLOより低い値にすることが多い https://www.oreilly.co.jp/books/9784873117911/ -
SLI/SLO/SLA • 実践的な話 ◦ SLAを持っているか否かに関わらず、SLIやSLOを定義し、 その下でサービスを管理する事には意義がある ◦ モニタリングで追跡できるメトリクスのすべてをSLIにする べきではない ◦
ユーザとやり取りをするサーバシステムでは可用性、レイ テンシ、スループットに注意 ▪ 可用性はユーザがそのサービスを利用できる時間の比率 https://www.oreilly.co.jp/books/9784873117911/ -
USE Method • 以下の頭文字 ◦ Utilization (% time that the
resource was busy) ◦ Saturation (amount of work resource has to do, often queue length) ◦ Errors (count of error events) • サーバやNWに用いられることが多い ◦ CPU、メモリの使用率 ◦ ストレージの容量、Read/Writeキューの長さ ◦ messageログに出ているエラー • 確かに有用なんだけど、もうちょっとサービス指向のが欲しい The RED Method: How to Instrument Your Services https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/ -
RED Method • 以下の頭文字 ◦ Rate (the number of requests
per second) ◦ Errors (the number of those requests that are failing) ◦ Duration (the amount of time those requests take) • USE Method に比べてBlackbox的 • Webサービスの外形監視と相性が良い。こういう値の方が気にな りませんか? ◦ 毎分当たりのリクエスト数 ◦ 5xxエラーの数 ◦ どのくらいの時間でリクエストを捌いてるのか The RED Method: How to Instrument Your Services https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/ -
RED Method サービスに関わる誰もがエラー率、リ クエスト率、そしてそれらのリクエス トのレイテンシの分布を理解する必要 があります。 サービス監視の観点に一貫性を持たす ことができ、開発側が意図していない コードのへの問い合わせも行えます。 15
The RED Method: How to Instrument Your Services https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/ -
RED Method RED Methodはユーザの満足度を示す 優れた指標です。エラー率が高い場 合、それは基本的にユーザーに影響が あり、ページ読み込みエラーが発生し ます。表示時間が長いとWebサイトの 表示が遅くなります。これらは、意味 のあるアラートを作成し、SLA
を測定 するための優れた測定基準です。 16 The RED Method: How to Instrument Your Services https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/ -
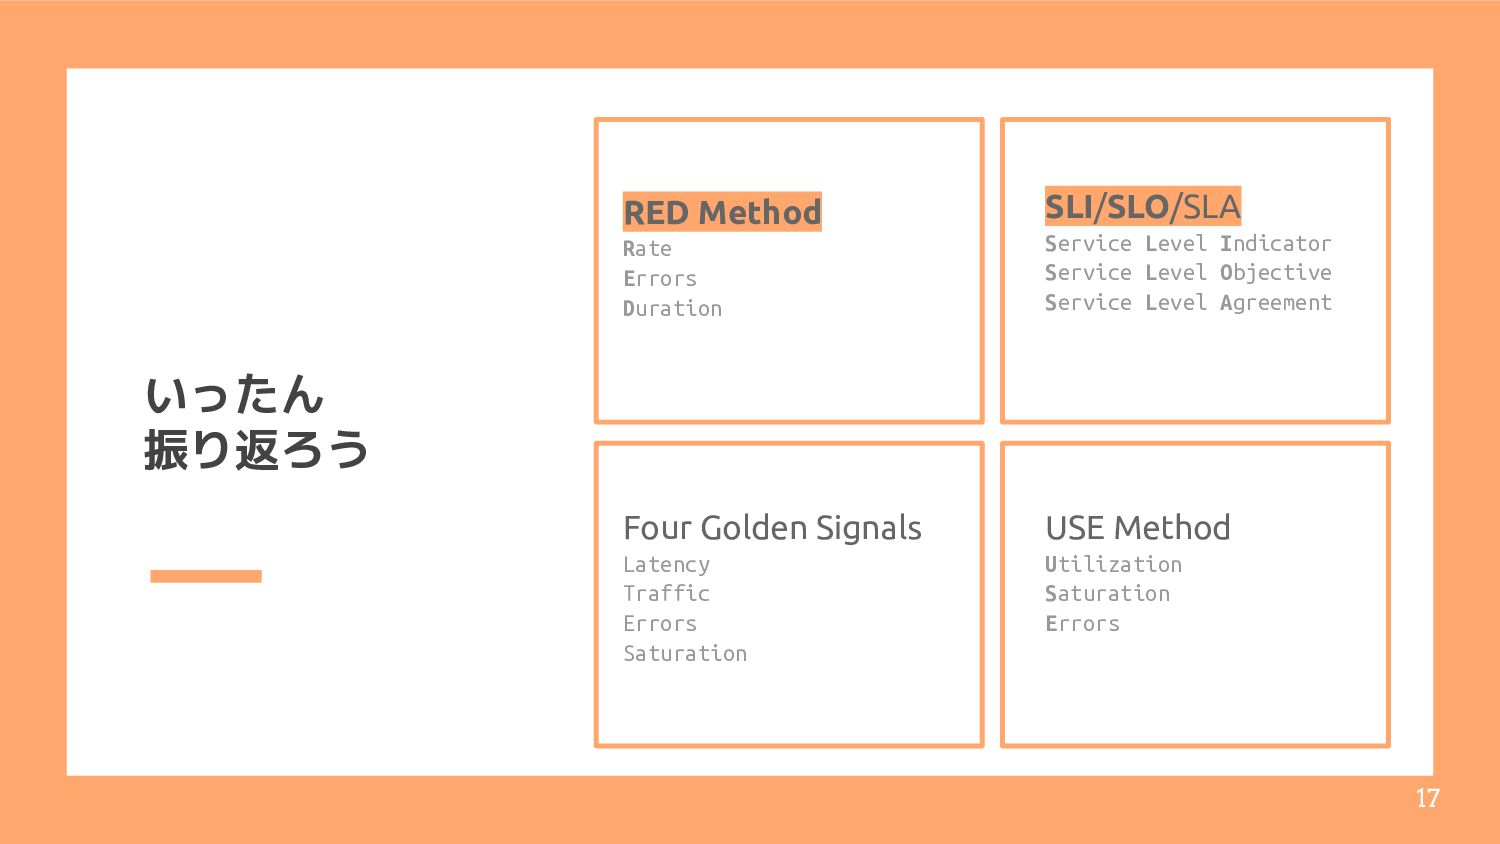
RED Method Rate Errors Duration SLI/SLO/SLA Service Level Indicator Service
Level Objective Service Level Agreement Four Golden Signals Latency Traffic Errors Saturation USE Method Utilization Saturation Errors 17 いったん 振り返ろう -
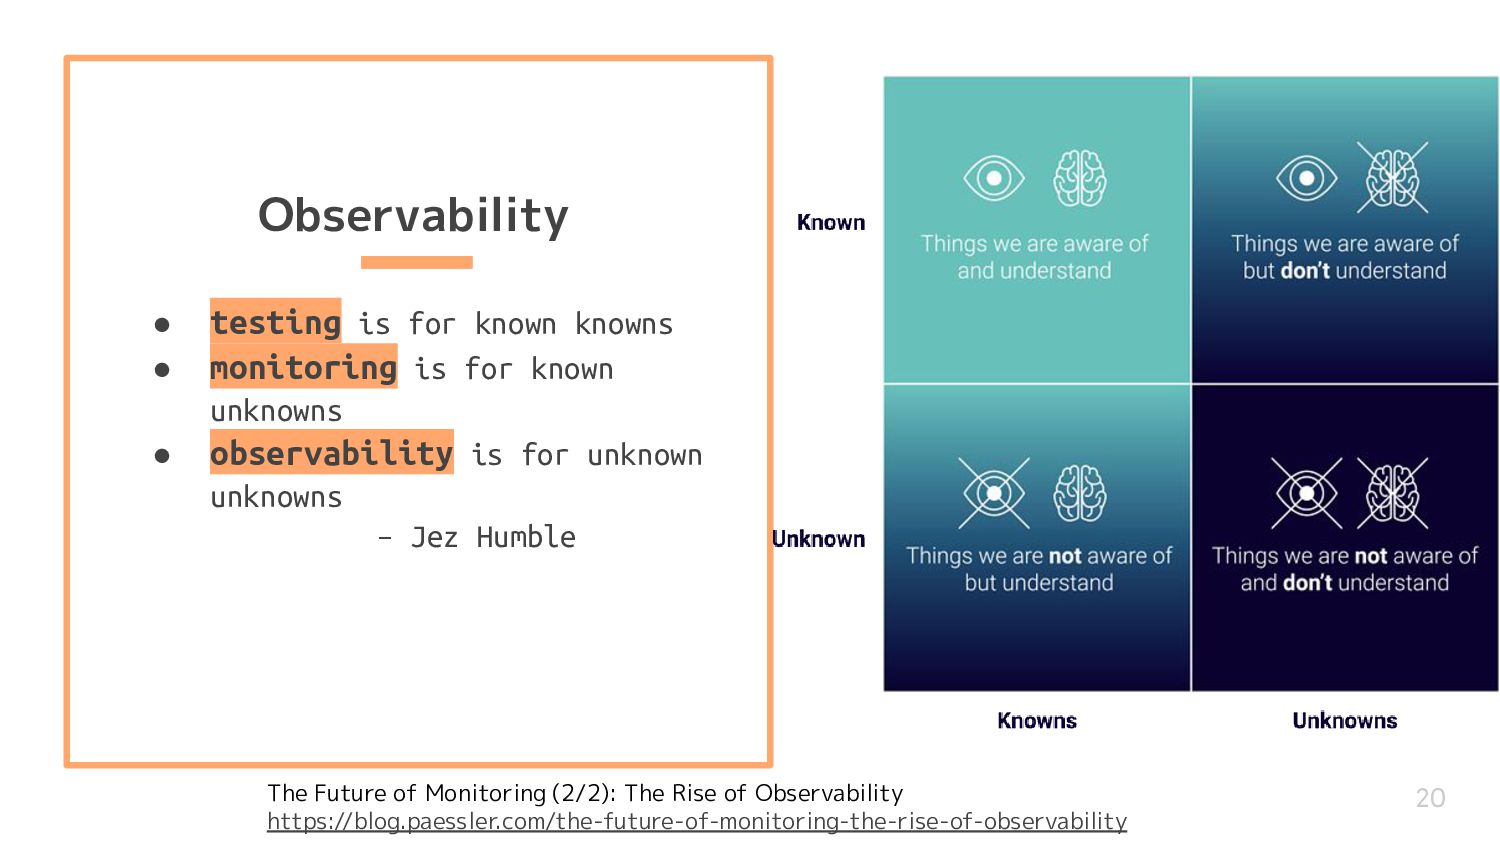
Observability • testing is for known knowns • monitoring is
for known unknowns • observability is for unknown unknowns – Jez Humble 20 The Future of Monitoring (2/2): The Rise of Observability https://blog.paessler.com/the-future-of-monitoring-the-rise-of-observability -
Observability • クラウドネイティブ技術は、パブリッククラウド、プライベート クラウド、ハイブリッドクラウドなどの近代的でダイナミックな 環境において、スケーラブルなアプリケーションを構築および実 行するための能力を組織にもたらす • このアプローチの代表例に、コンテナ、サービスメッシュ、マイ クロサービス、イミュータブルインフラストラクチャ、および宣 言型APIがある
• これらの手法により、回復性、管理力、および可観測性のある疎 結合システムが実現できる • これらを堅牢な自動化と組み合わせることで、エンジニアはイン パクトのある変更を最小限の労力で頻繁かつ予測どおりに行うこ とができるようになる CNCF Cloud Native Definition v1.0 https://github.com/cncf/toc/blob/master/DEFINITION.md -
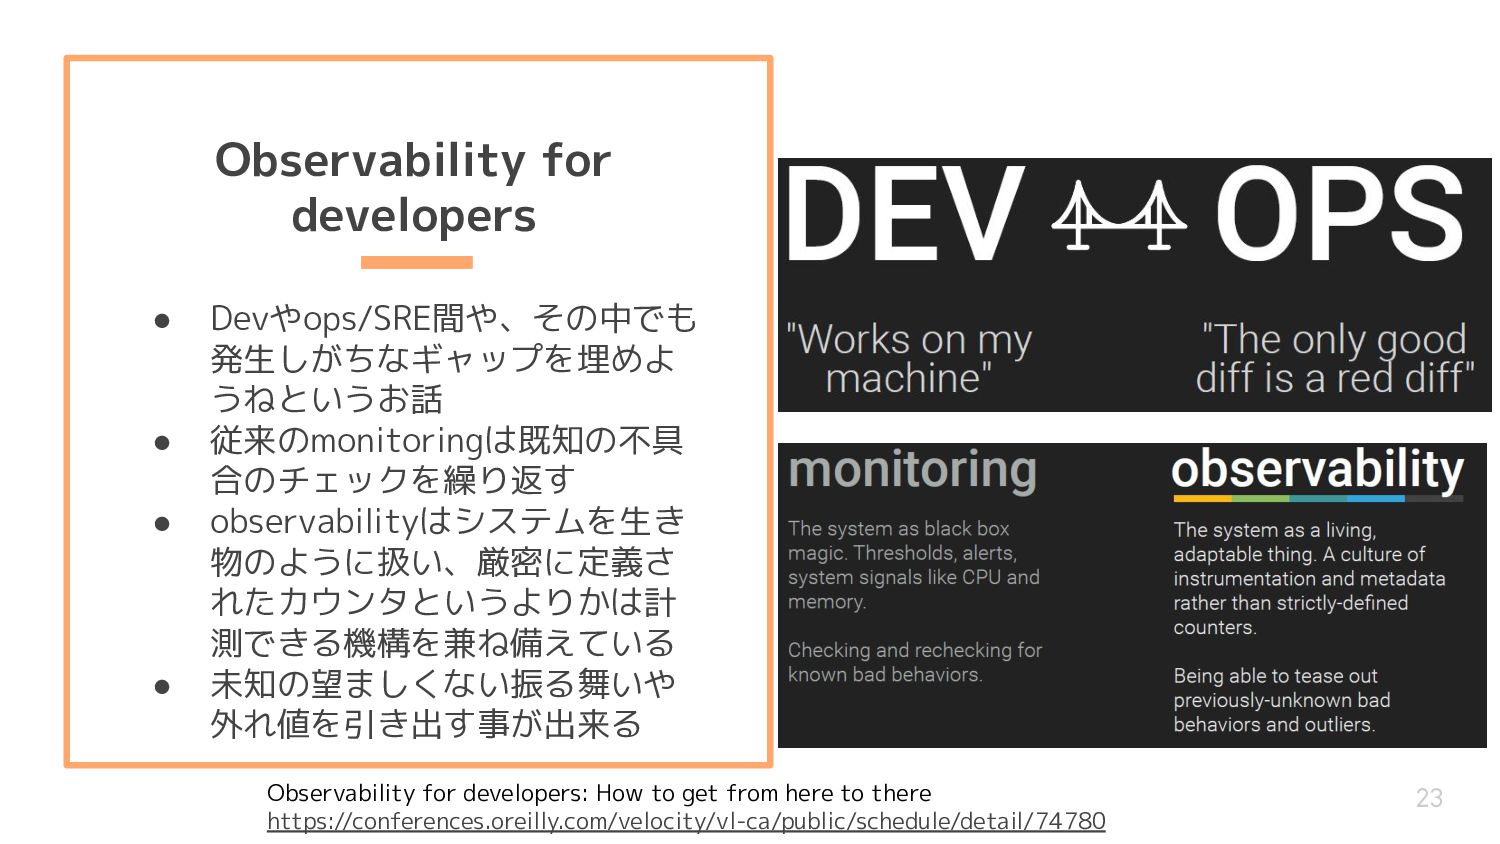
Observability for developers • Devやops/SRE間や、その中でも 発生しがちなギャップを埋めよ うねというお話 • 従来のmonitoringは既知の不具 合のチェックを繰り返す
• observabilityはシステムを生き 物のように扱い、厳密に定義さ れたカウンタというよりかは計 測できる機構を兼ね備えている • 未知の望ましくない振る舞いや 外れ値を引き出す事が出来る 23 Observability for developers: How to get from here to there https://conferences.oreilly.com/velocity/vl-ca/public/schedule/detail/74780 -
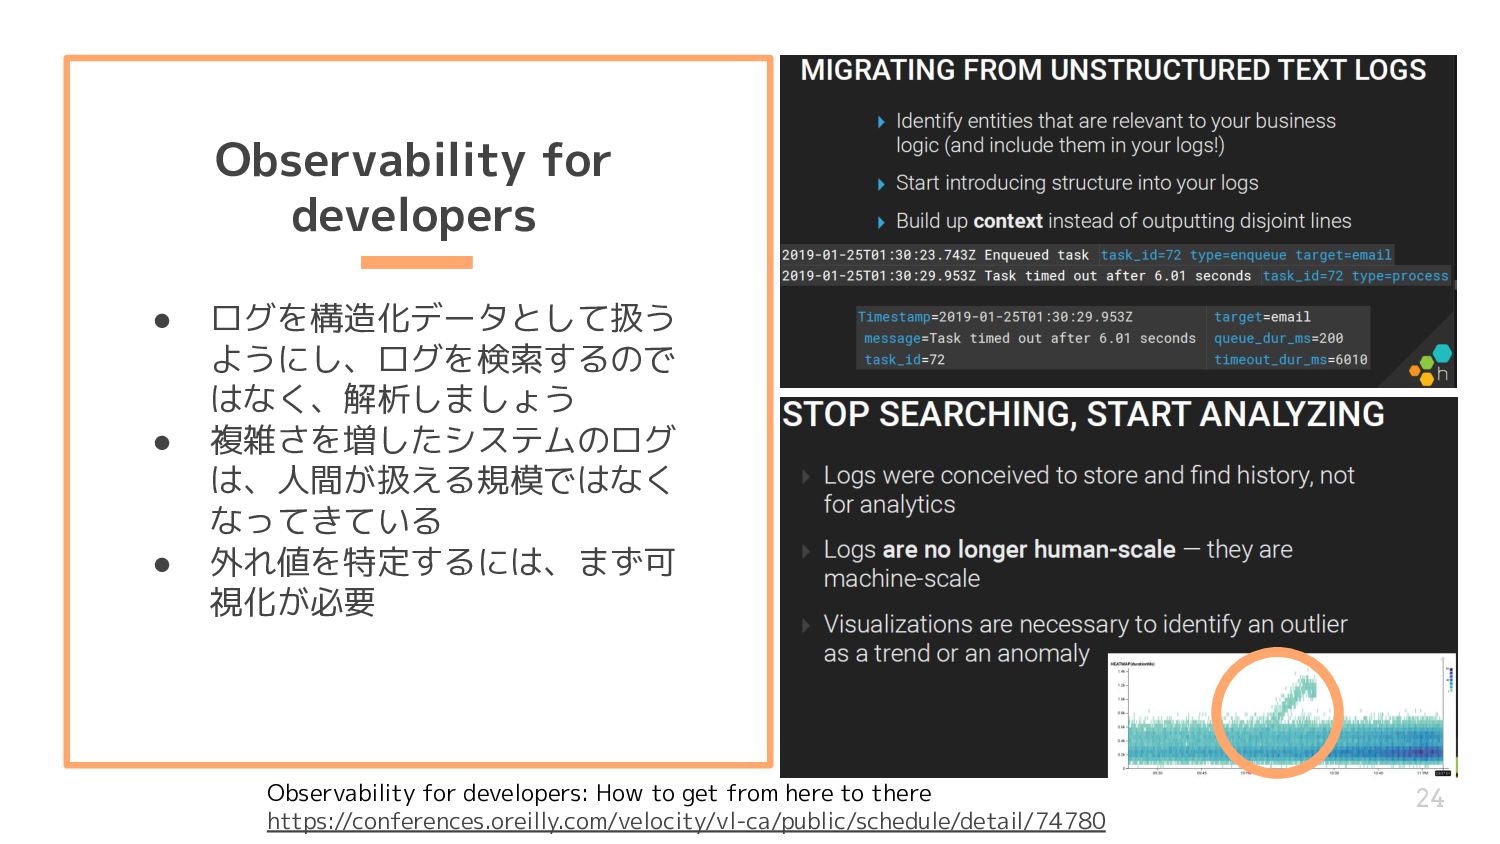
Observability for developers • ログを構造化データとして扱う ようにし、ログを検索するので はなく、解析しましょう • 複雑さを増したシステムのログ は、人間が扱える規模ではなく
なってきている • 外れ値を特定するには、まず可 視化が必要 24 Observability for developers: How to get from here to there https://conferences.oreilly.com/velocity/vl-ca/public/schedule/detail/74780 -
Observability • 「観測可能な」システムの設計および構築の目標は、本番環境で 実行したときに担当のオペレーターが、好ましくない振る舞い (サービスのダウンタイム、エラー、反応の遅延など)を検知 し、根本原因を特定するための効果的な方法(詳細なイベントロ グ、リソース使用に関する細かい情報、アプリケーションのト レースなど)で実用的な情報を得られるようにすることです。 • 可観測性の3つの柱。これらを統合的に見れるツールが重要
◦ メトリック(Prometheus、CloudWatch) ◦ アプリケーションのトレース(Sentry、New Relic) ◦ ログ(Elasticsearch、Loki、Promtail) ◦ 可視化(Kibana、Grafana) https://www.elastic.co/jp/blog/observability-with-the-elastic-stack -
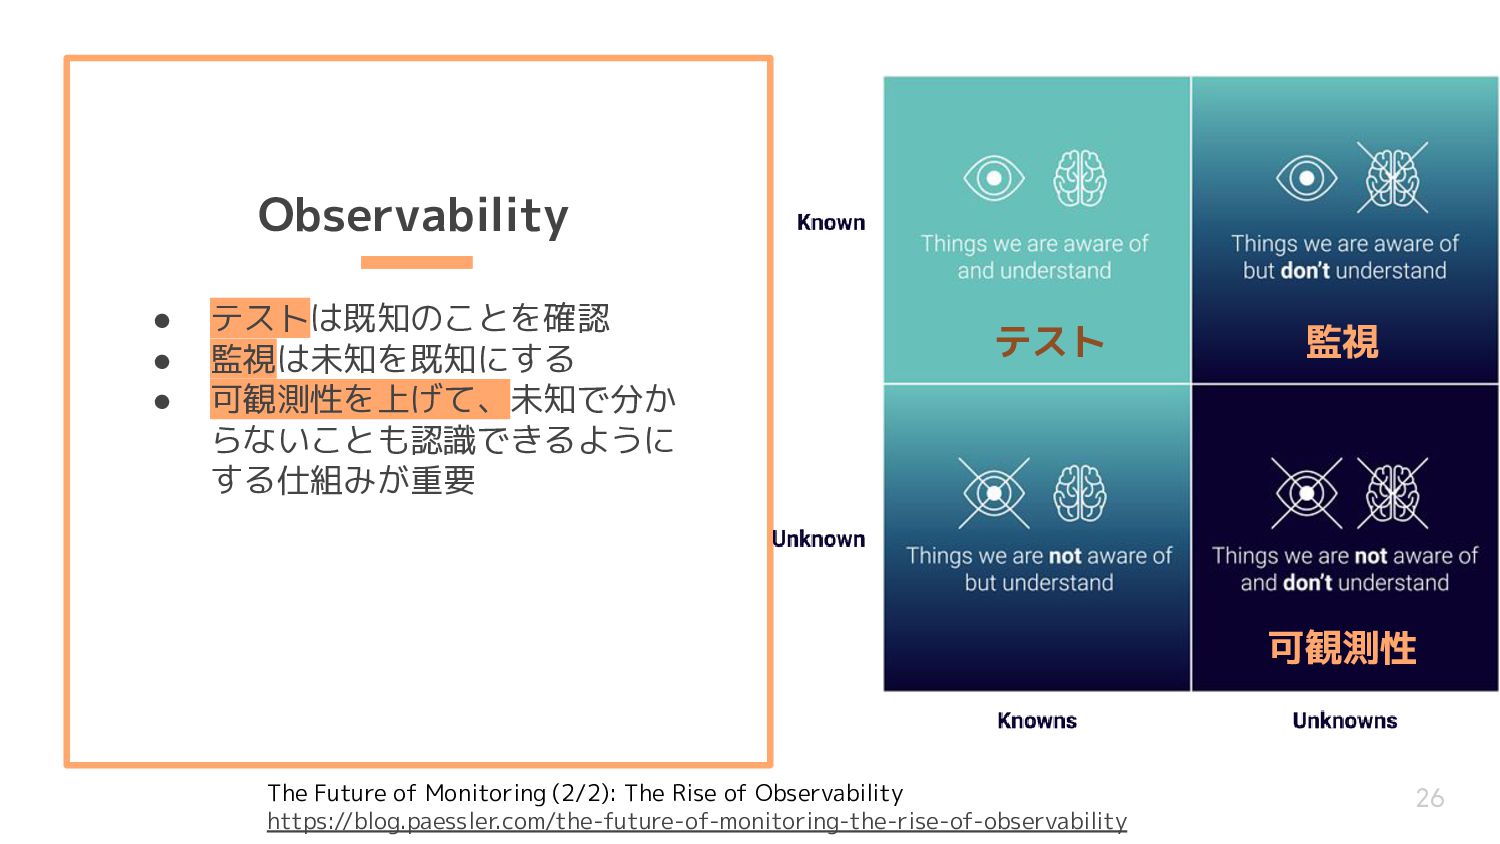
Observability • テストは既知のことを確認 • 監視は未知を既知にする • 可観測性を上げて、未知で分か らないことも認識できるように する仕組みが重要 26
The Future of Monitoring (2/2): The Rise of Observability https://blog.paessler.com/the-future-of-monitoring-the-rise-of-observability テスト 監視 可観測性 -
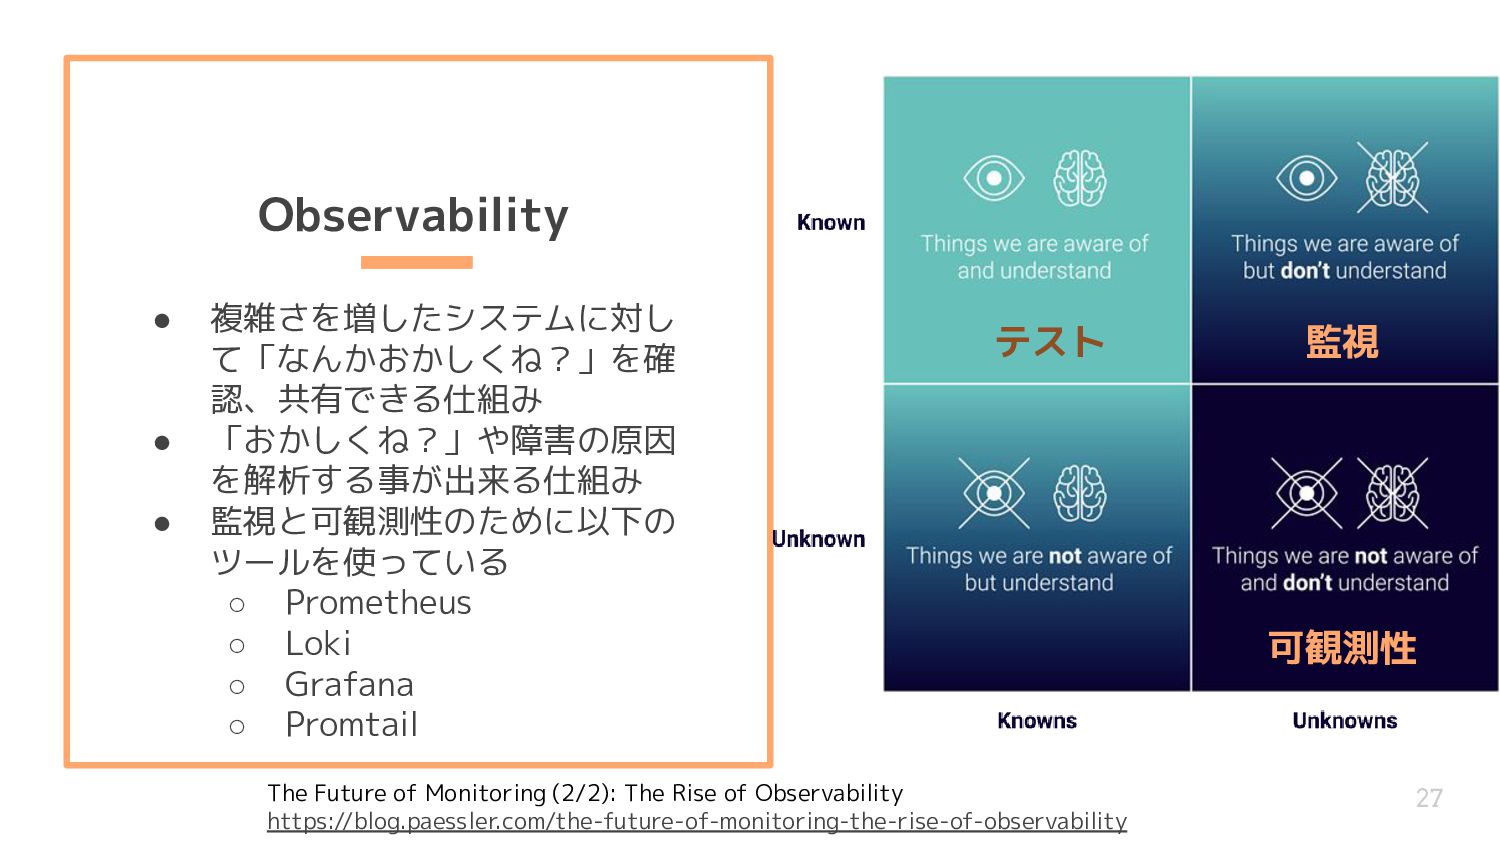
Observability • 複雑さを増したシステムに対し て「なんかおかしくね?」を確 認、共有できる仕組み • 「おかしくね?」や障害の原因 を解析する事が出来る仕組み • 監視と可観測性のために以下の
ツールを使っている ◦ Prometheus ◦ Loki ◦ Grafana ◦ Promtail 27 The Future of Monitoring (2/2): The Rise of Observability https://blog.paessler.com/the-future-of-monitoring-the-rise-of-observability テスト 監視 可観測性 -
監視と DevOps • 作って終わりではない世界 • 絶えず、内的/外的変化に対応し ていく必要がある ◦ KPI ◦
SLI/SLO/SLA ◦ RED/USE Method ◦ Observability 28 -
監視と DevOps • Willgateが使っているツール ◦ Google Analytics ◦ Grafana ◦
Loki ◦ Prometheus ◦ Sentry ◦ New Relic ◦ Sitespeed.io ◦ Google Data Studio 29 -
監視と DevOps • Willgateが使っているツール ◦ Google Analytics ◦ Grafana ◦
Loki ◦ Prometheus ◦ Sentry ◦ New Relic ◦ Sitespeed.io ◦ Google Data Studio 30 -
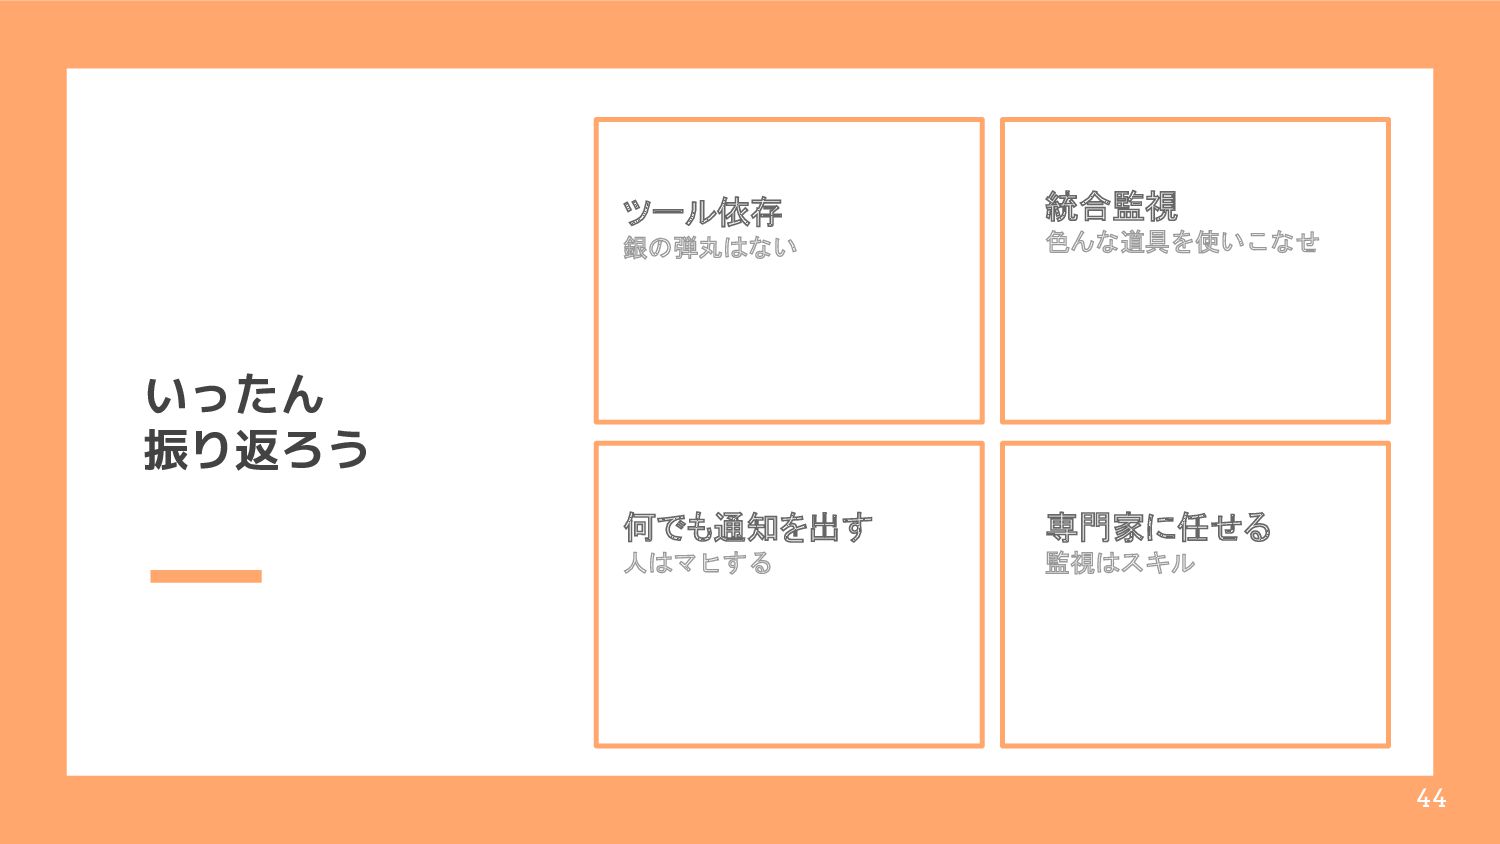
ツールありき • ツールは手段です。導入それ自体を 目的にしてはいけません • ツールを導入することで解決する問 題はありません • 何を監視したいのかハッキリさせま しょう
• MackerelやDatadogなんかのSaaSも 全然あり • 全てをいい感じに監視するツールは ありません • 銀の弾丸はありません -
甘美な響き -統合監視- • 人は1つのダッシュボードに情報を集約させたくなります • そこにこだわらなくても良いです • 色んなツールを使いこなした方がいいです • 『監視』は複雑な問題をまとめたもの
• 用途に応じてツールを使い分け、情報を共有しましょう -
なんでも通知を出す • その通知は担当者を叩き起こす必要はありますか • 多すぎる通知は人を麻痺させます • 対応が必要なものを通知するようにしましょう • 3段階に分けて通知の仕方を整理しましょう ◦
Error(すぐ対応して欲しい) ◦ Warning(認識しておく必要あり) ◦ Info(定期的に見るくらい) -
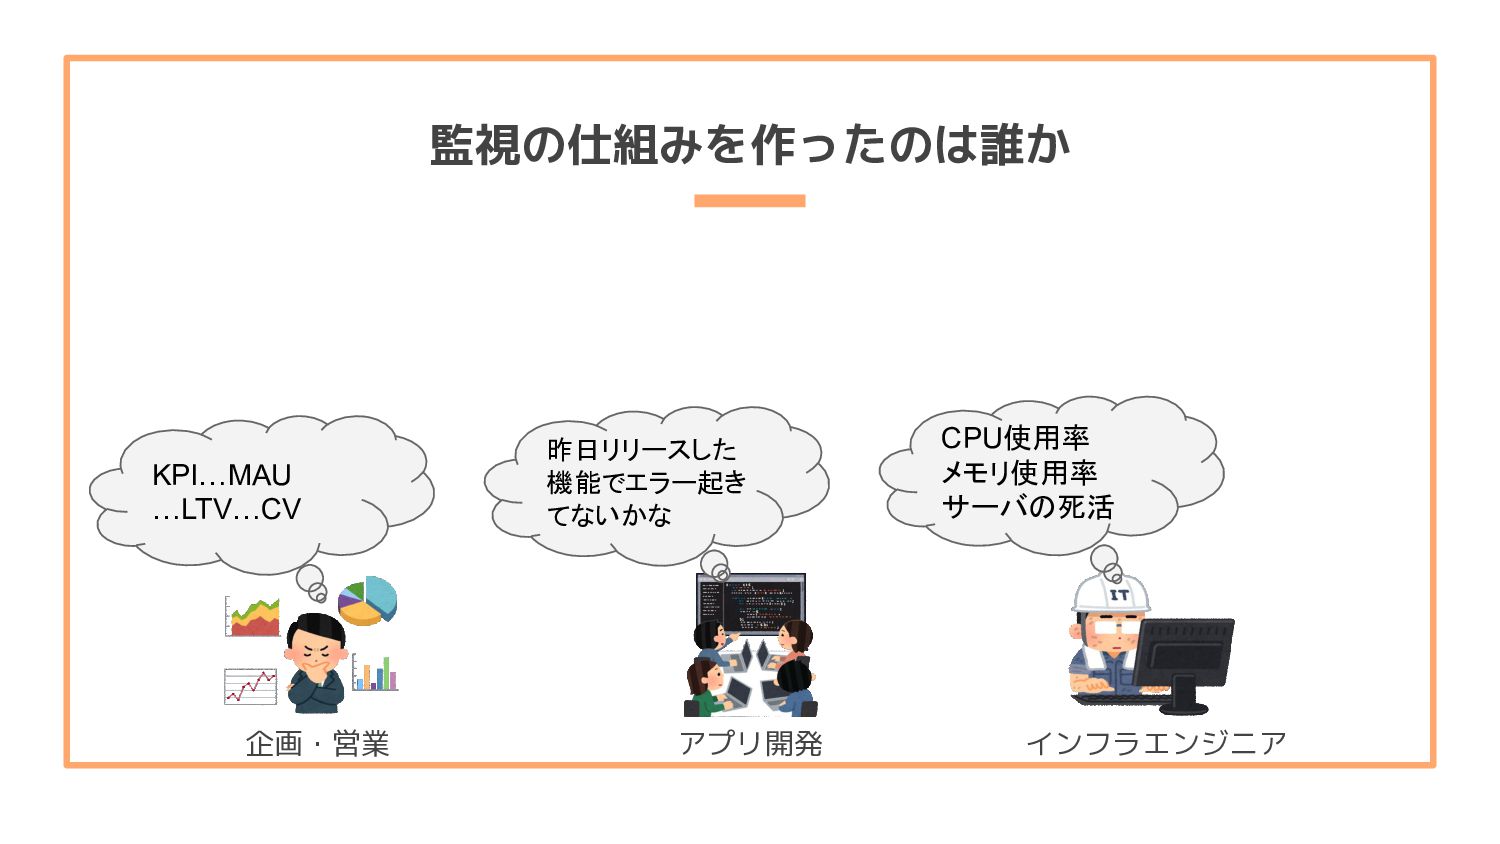
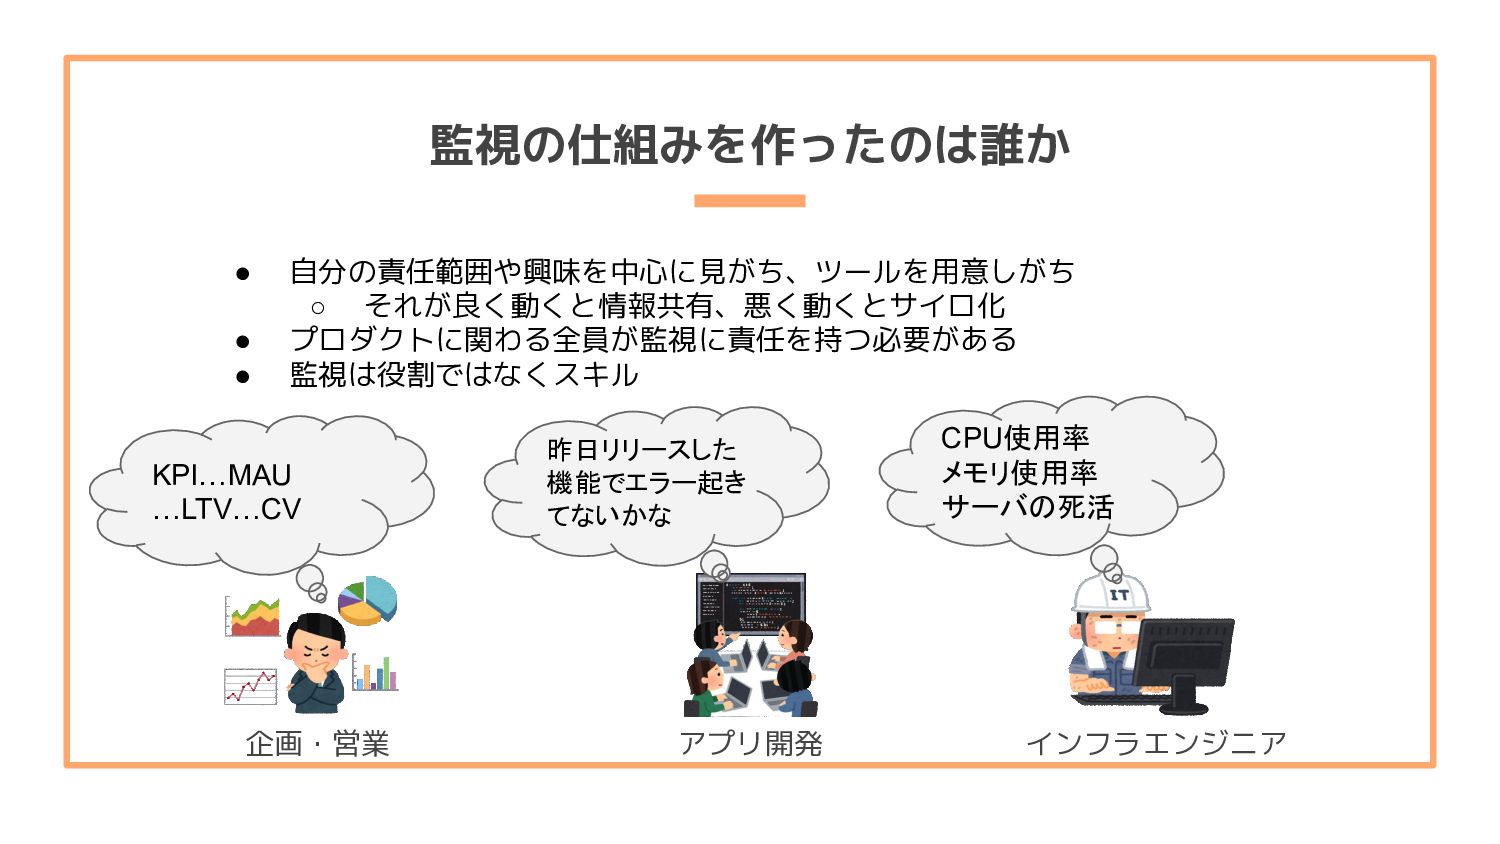
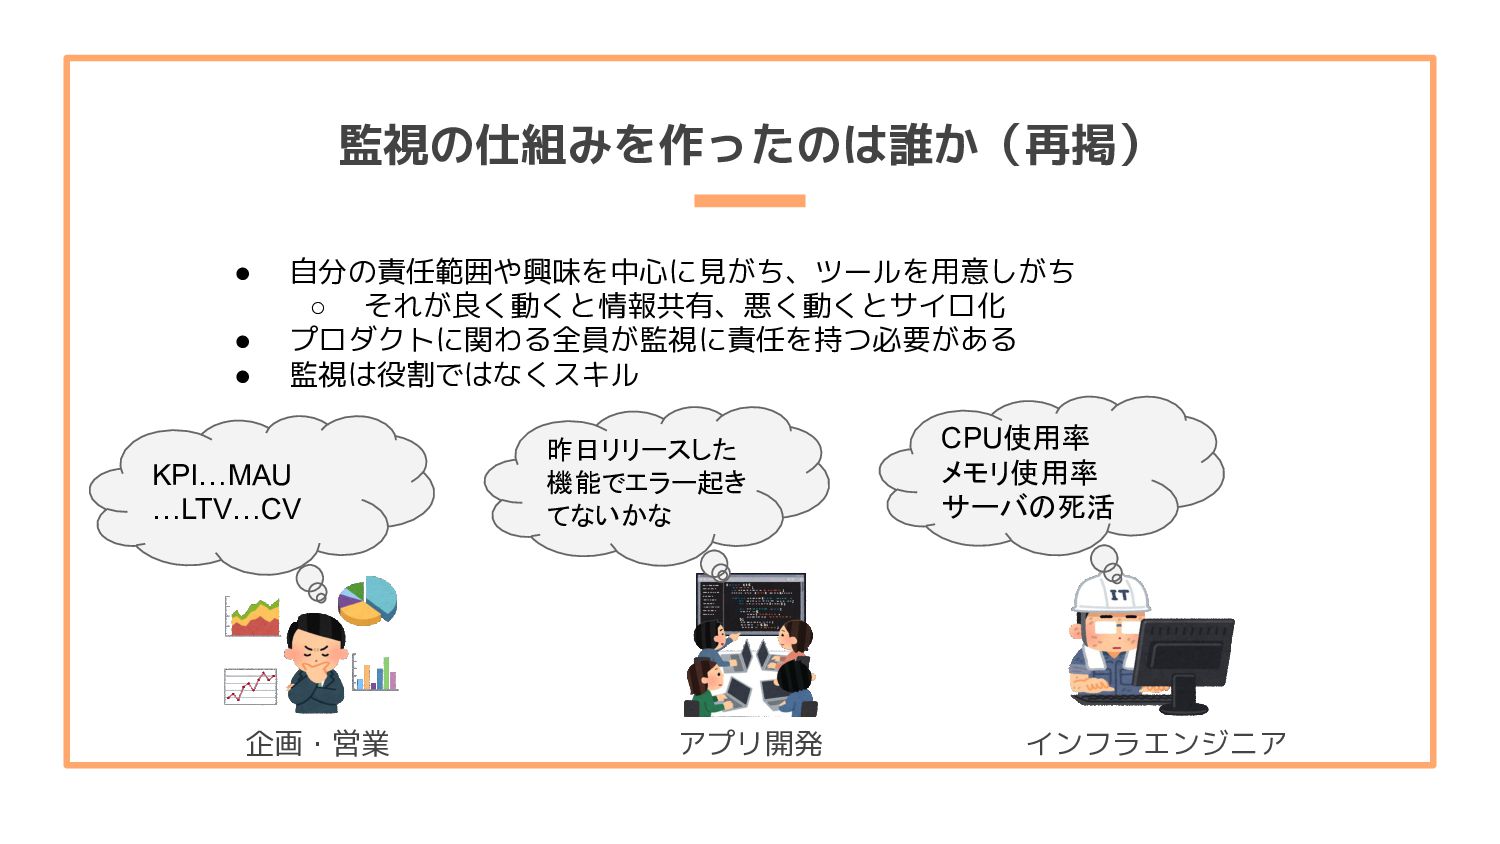
監視の仕組みを作ったのは誰か 企画・営業 アプリ開発 インフラエンジニア • 自分の責任範囲や興味を中心に見がち、ツールを用意しがち ◦ それが良く動くと情報共有、悪く動くとサイロ化 • プロダクトに関わる全員が監視に責任を持つ必要がある
• 監視は役割ではなくスキル KPI…MAU …LTV…CV 昨日リリースした 機能でエラー起き てないかな CPU使用率 メモリ使用率 サーバの死活 -
RED Method(再掲) RED Methodはユーザの満足度を示す 優れた指標です。エラー率が高い場 合、それは基本的にユーザーに影響が あり、ページ読み込みエラーが発生し ます。表示時間が長いとWebサイトの 表示が遅くなります。これらは、意味 のあるアラートを作成し、SLA
を測定 するための優れた測定基準です。 47 The RED Method: How to Instrument Your Services https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/ -
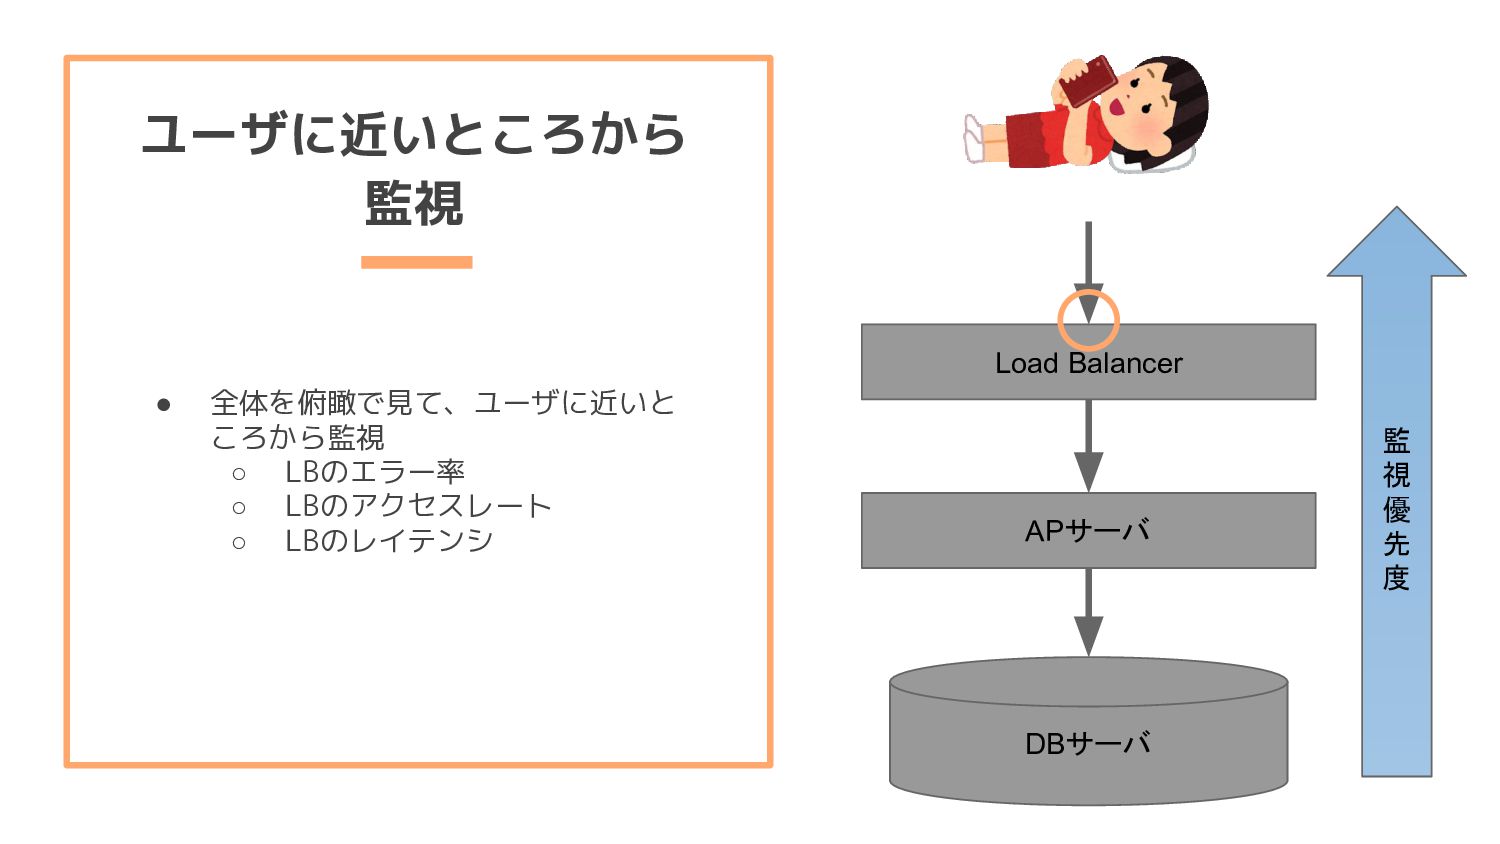
ユーザに近いところから 監視 • 全体を俯瞰で見て、ユーザに近いと ころから監視 ◦ LBのエラー率 ◦ LBのアクセスレート ◦
LBのレイテンシ Load Balancer DBサーバ APサーバ 監 視 優 先 度 -
ユーザに近いところから 監視 • 全体を俯瞰で見て、ユーザに近いと ころから監視 ◦ LBのエラー率 ◦ LBのアクセスレート ◦
LBのレイテンシ • その中でも重要なものを決めてSLIと し、計測を開始する • 計測結果からSLOを決めて改善 • SLOを適時見直してシステムパ フォーマンスを改善していく 今月の目標 LBのレイテンシ10ms→5msに短縮! LBのエラー率5%未満! -
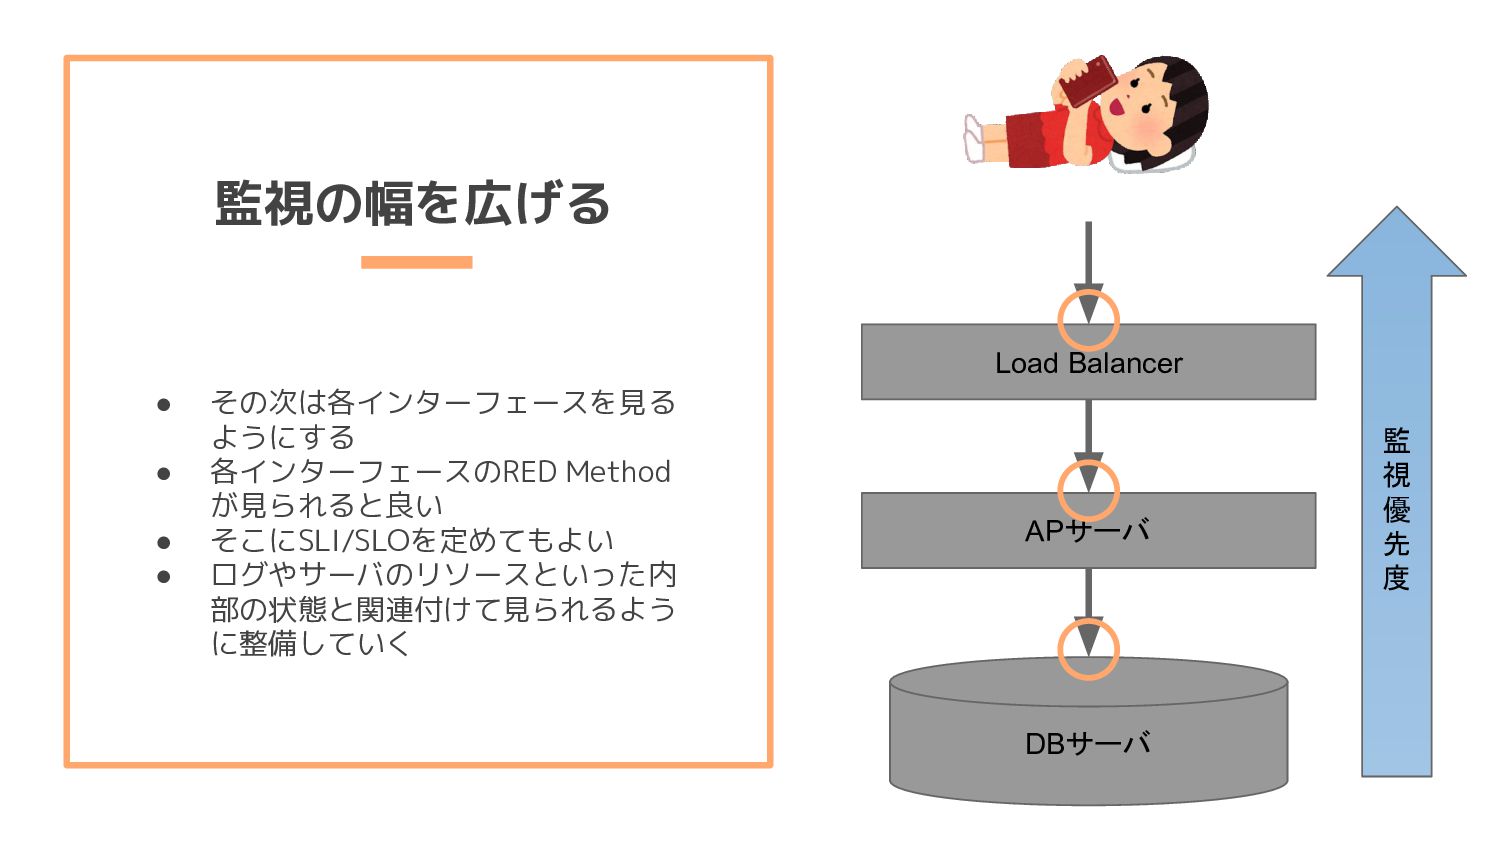
監視の幅を広げる • その次は各インターフェースを見る ようにする • 各インターフェースのRED Method が見られると良い • そこにSLI/SLOを定めてもよい
• ログやサーバのリソースといった内 部の状態と関連付けて見られるよう に整備していく Load Balancer DBサーバ APサーバ 監 視 優 先 度 -
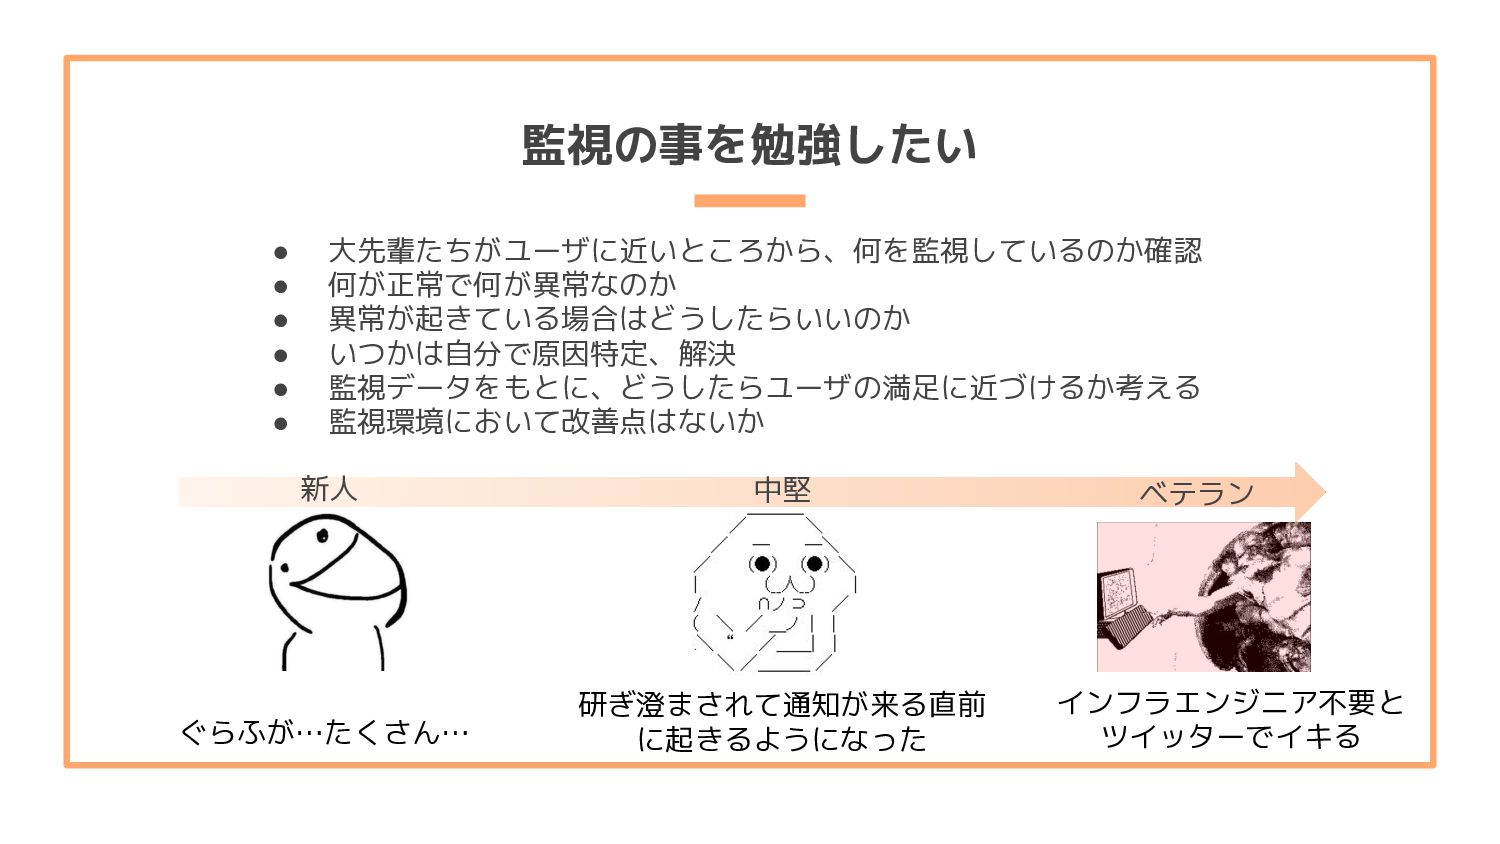
• 大先輩たちがユーザに近いところから、何を監視しているのか確認 • 何が正常で何が異常なのか • 異常が起きている場合はどうしたらいいのか • いつかは自分で原因特定、解決 • 監視データをもとに、どうしたらユーザの満足に近づけるか考える
• 監視環境において改善点はないか 監視の事を勉強したい ぐらふが…たくさん… 研ぎ澄まされて通知が来る直前 に起きるようになった インフラエンジニア不要と ツイッターでイキる 新人 中堅 ベテラン -
監視の仕組みを作ったのは誰か(再掲) 企画・営業 アプリ開発 インフラエンジニア • 自分の責任範囲や興味を中心に見がち、ツールを用意しがち ◦ それが良く動くと情報共有、悪く動くとサイロ化 • プロダクトに関わる全員が監視に責任を持つ必要がある
• 監視は役割ではなくスキル KPI…MAU …LTV…CV 昨日リリースした 機能でエラー起き てないかな CPU使用率 メモリ使用率 サーバの死活 -
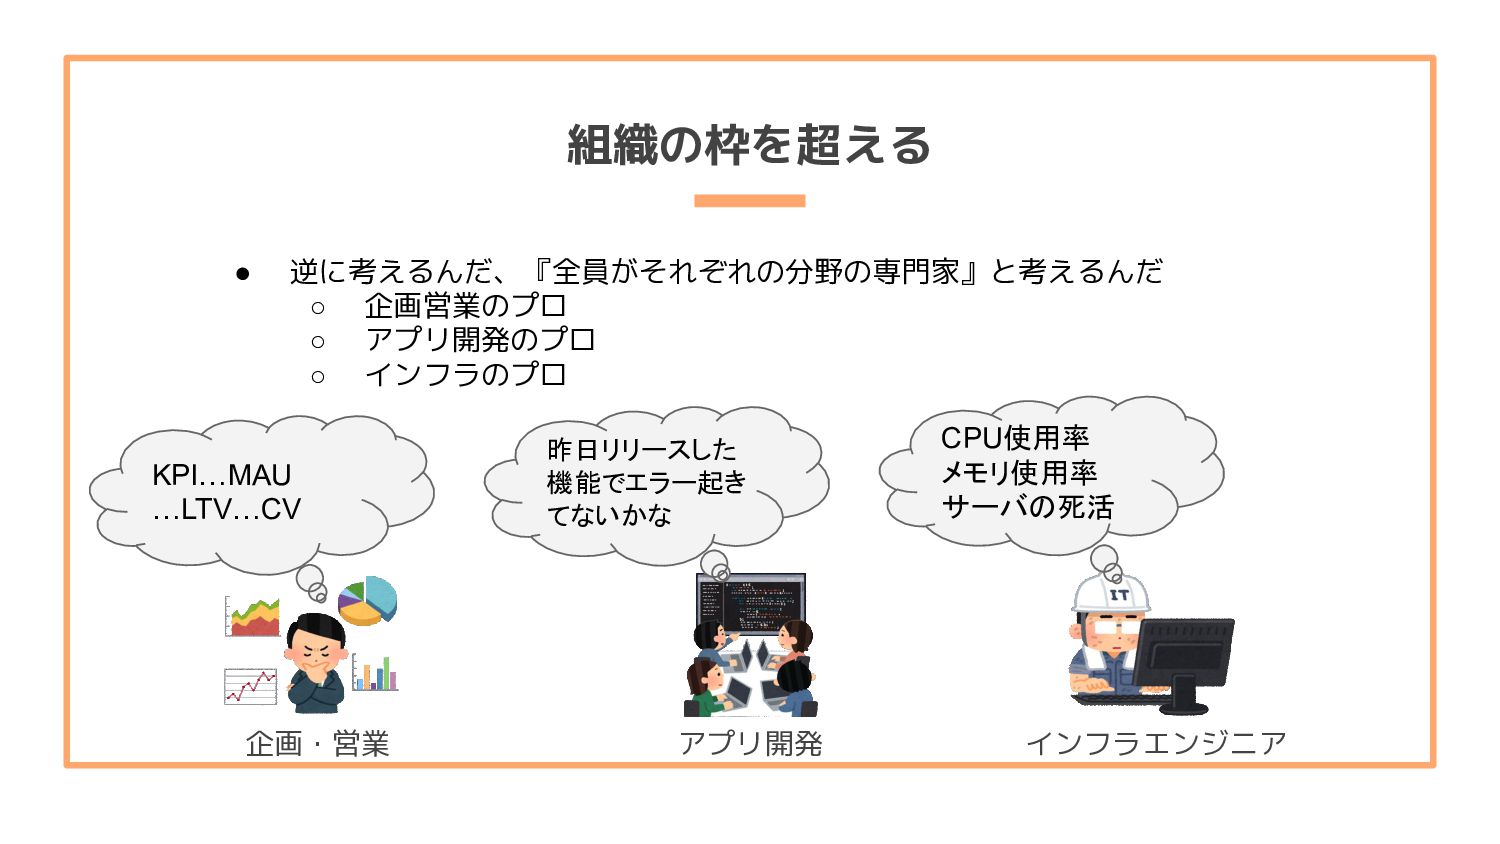
組織の枠を超える 企画・営業 アプリ開発 インフラエンジニア • 逆に考えるんだ、『全員がそれぞれの分野の専門家』と考えるんだ ◦ 企画営業のプロ ◦ アプリ開発のプロ
◦ インフラのプロ KPI…MAU …LTV…CV 昨日リリースした 機能でエラー起き てないかな CPU使用率 メモリ使用率 サーバの死活 -
我々は何がしたいのか • 働かなくても、死ぬまで毎月1000万振り込まれ続けたい • 良いサービスを提供し社会に貢献し、5000兆円欲しい • PVやMAUといったビジネス上のKPIは、エンジニアも把握した方が良い • 共有する情報が多いとシンドイので、分かりやすい数字から ◦
ビジネス→開発へは、「その事業のドライバーとなっている数字」 ◦ 開発→ビジネスへは、「そのKPIと相関がありそうなSLI/SLO」 • それらを共有できる仕組みを整える • 無理やり1つのツールやダッシュボードに収めようとしない 企画・営業 アプリ開発 インフラエンジニア -
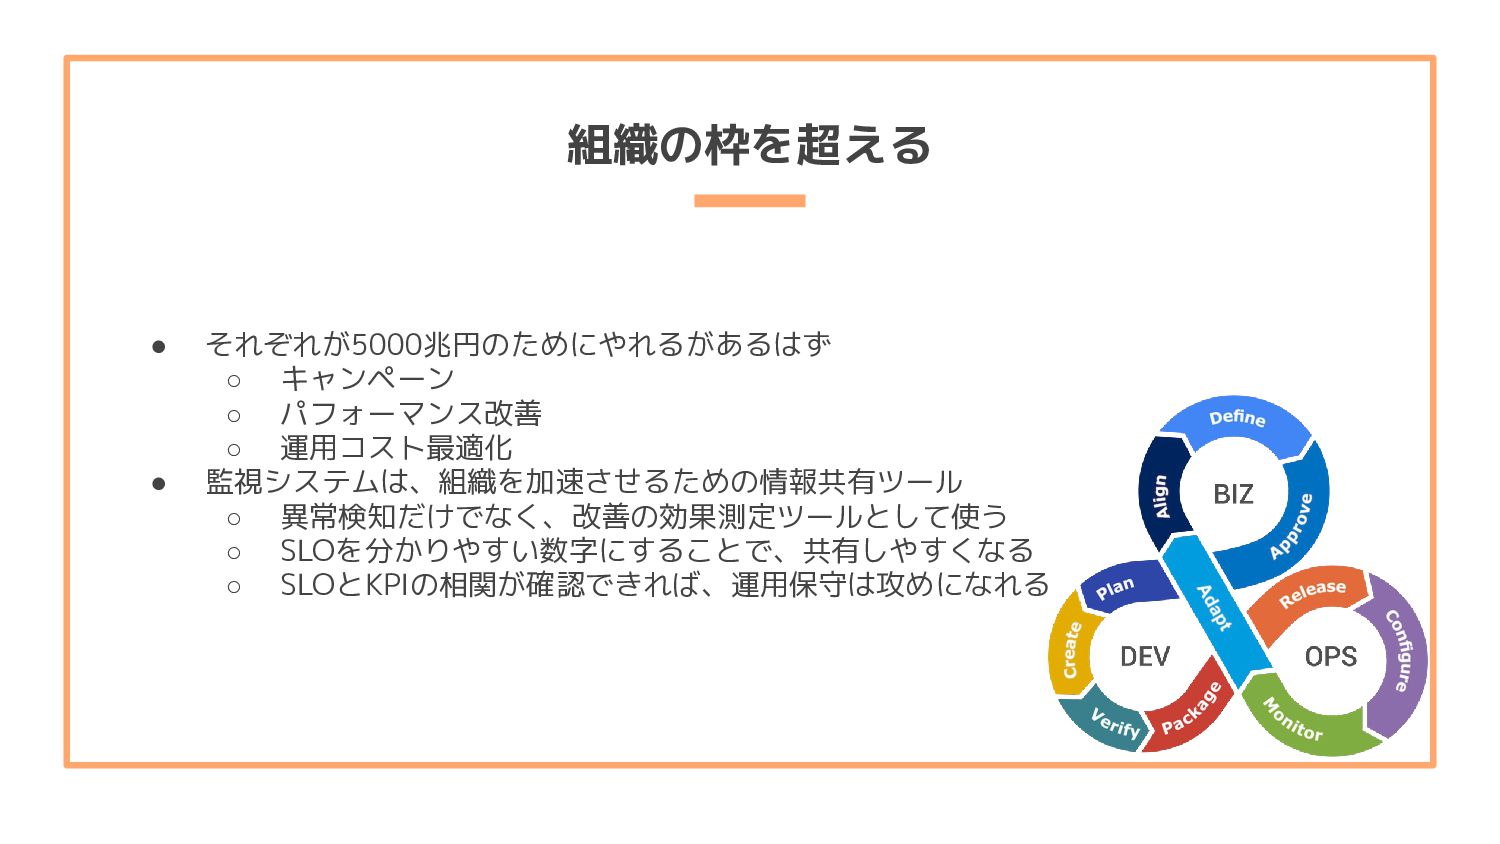
組織の枠を超える • それぞれが5000兆円のためにやれるがあるはず ◦ キャンペーン ◦ パフォーマンス改善 ◦ 運用コスト最適化 •
監視システムは、組織を加速させるための情報共有ツール ◦ 異常検知だけでなく、改善の効果測定ツールとして使う ◦ SLOを分かりやすい数字にすることで、共有しやすくなる ◦ SLOとKPIの相関が確認できれば、運用保守は攻めになれる -
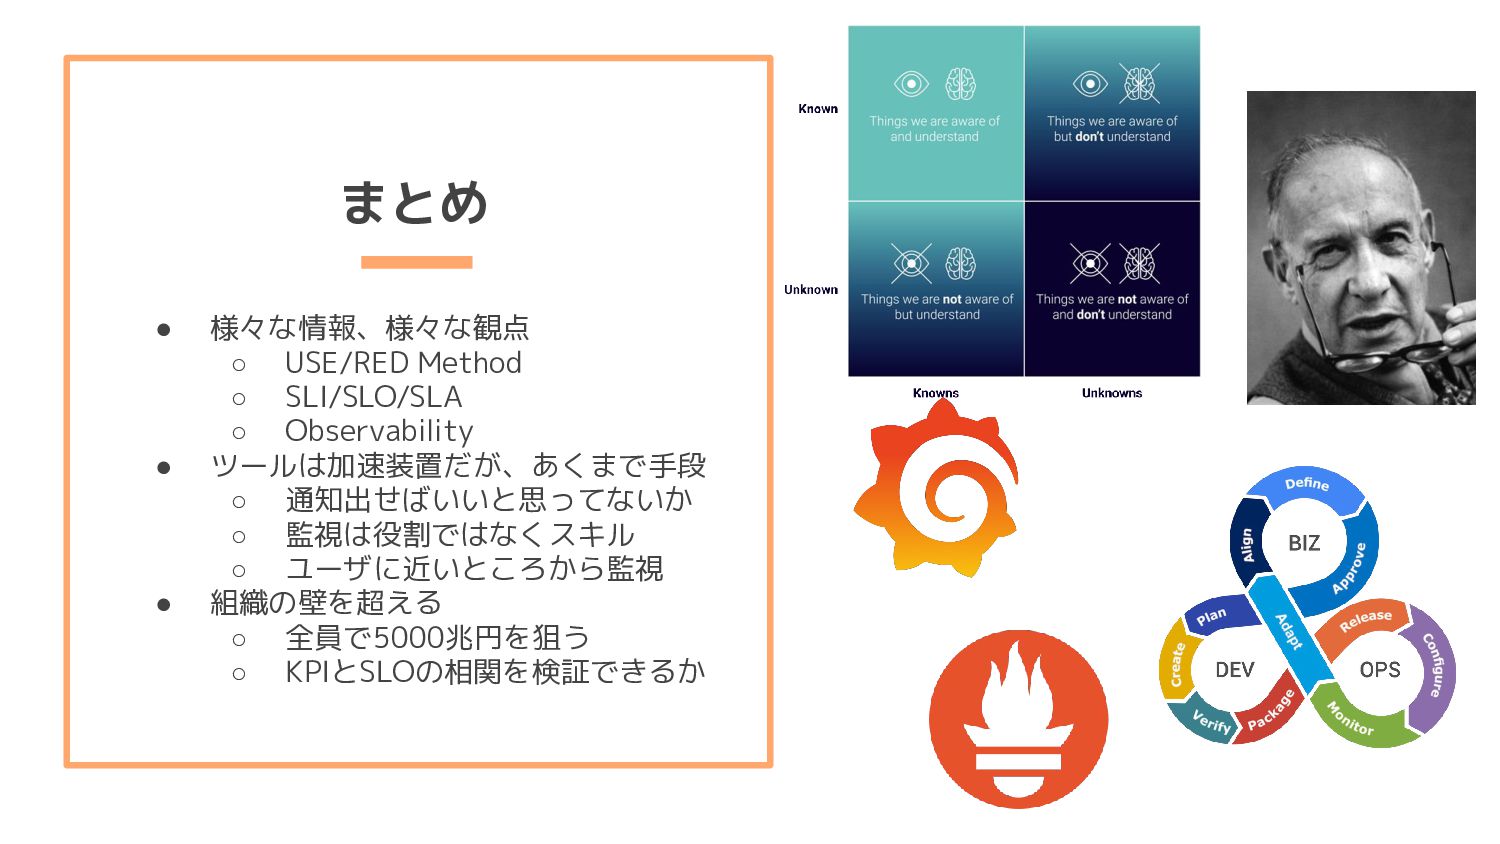
まとめ • 様々な情報、様々な観点 ◦ USE/RED Method ◦ SLI/SLO/SLA ◦ Observability
• ツールは加速装置だが、あくまで手段 ◦ 通知出せばいいと思ってないか ◦ 監視は役割ではなくスキル ◦ ユーザに近いところから監視 • 組織の壁を超える ◦ 全員で5000兆円を狙う ◦ KPIとSLOの相関を検証できるか