Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SREの組織構造と実践.
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
ryuichi1208
May 02, 2026
320
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SREの組織構造と実践.
ryuichi1208
May 02, 2026
More Decks by ryuichi1208
See All by ryuichi1208
そのasync、止まってない? ”鉄板”イベントループ ブロッキング処理検出術
ryuichi1208
1
2.2k
AIでサービス運用はどう変わるのか
ryuichi1208
0
210
入門 再発防止策
ryuichi1208
17
7.8k
信頼性・システムの観測・障害対応.pdf
ryuichi1208
0
0
障害対応からの学びと体制づくり
ryuichi1208
0
1.2k
金曜日デプロイ、するかしないか.pdf
ryuichi1208
1
490
会話で作る信頼性
ryuichi1208
0
200
シグナル(Unix)と仲良くなる
ryuichi1208
1
210
LiteLLM Proxyの紹介
ryuichi1208
1
93
Featured
See All Featured
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.2k
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
420
Scaling GitHub
holman
464
140k
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
510
It's Worth the Effort
3n
188
29k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Rails Girls Zürich Keynote
gr2m
96
14k
Into the Great Unknown - MozCon
thekraken
41
2.8k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
440
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
0
260
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Transcript
SREの組織構造と実践 SREを0から学ぶ会 #2 渡部 龍一
INTRODUCTION 自己紹介 Ryuichi Watanabe 株式会社IVRy SRE(電話自動応答 / 音声AI SaaS) 『SREの知識地図』
(技術評論社 ) 本講義の指定図書。共著者として執筆 SRE NEXT Co-Chair 国内最大級のSREカンファレンスを運営 (写真) 登壇・執筆 SRE・オブザーバビリティ・低レイヤ技術(eBPF等)を中心に発信 保守運用とSRE 第2回 2
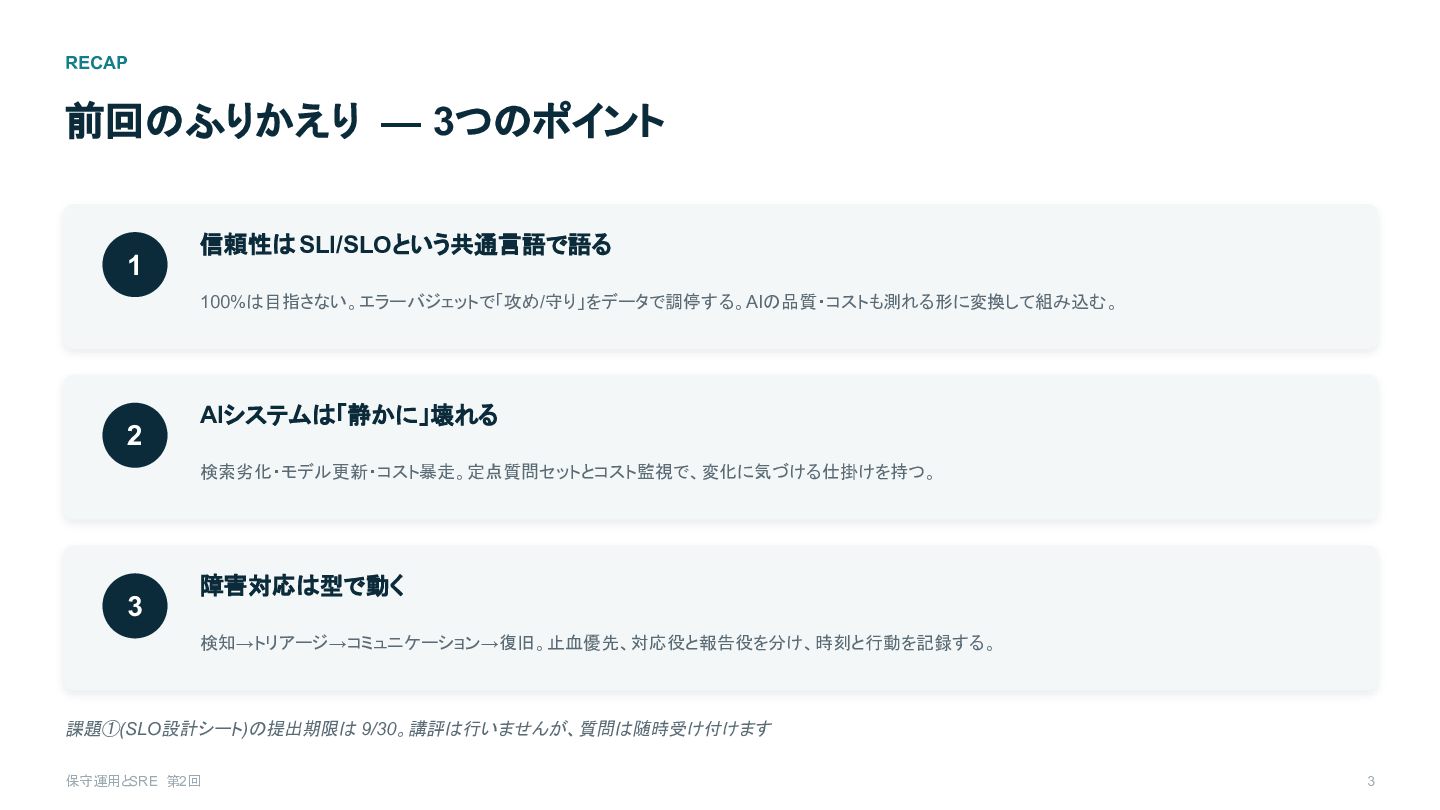
RECAP 前回のふりかえり — 3つのポイント 1 信頼性は SLI/SLOという共通言語で語る 100%は目指さない。エラーバジェットで「攻め/守り」をデータで調停する。AIの品質・コストも測れる形に変換して組み込む。 2 AIシステムは「静かに」壊れる
検索劣化・モデル更新・コスト暴走。定点質問セットとコスト監視で、変化に気づける仕掛けを持つ。 3 障害対応は型で動く 検知→トリアージ→コミュニケーション→復旧。止血優先、対応役と報告役を分け、時刻と行動を記録する。 課題①(SLO設計シート)の提出期限は 9/30。講評は行いませんが、質問は随時受け付けます 保守運用とSRE 第2回 3
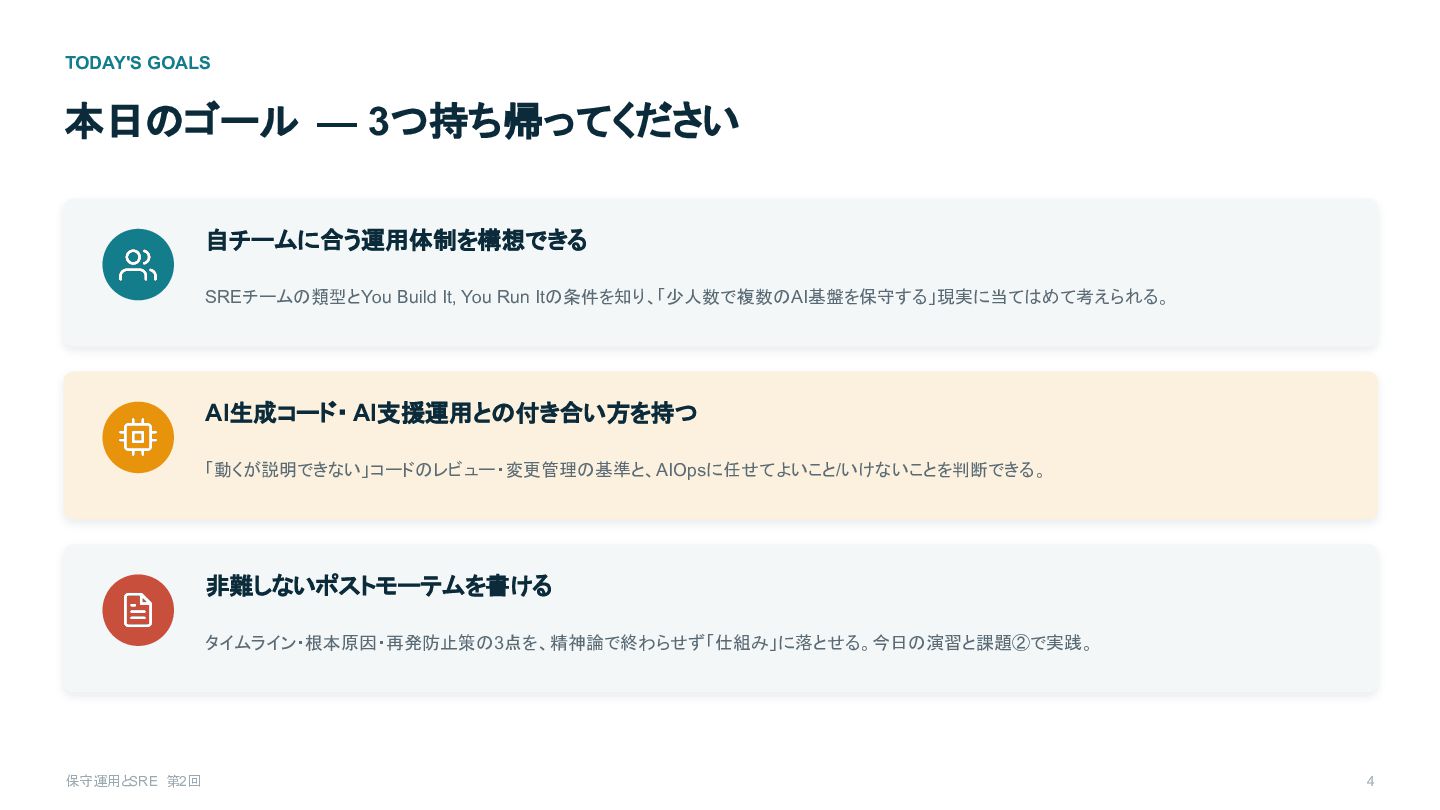
TODAY'S GOALS 本日のゴール — 3つ持ち帰ってください 自チームに合う運用体制を構想できる SREチームの類型とYou Build It, You
Run Itの条件を知り、「少人数で複数のAI基盤を保守する」現実に当てはめて考えられる。 AI生成コード・ AI支援運用との付き合い方を持つ 「動くが説明できない」コードのレビュー・変更管理の基準と、AIOpsに任せてよいこと/いけないことを判断できる。 非難しないポストモーテムを書ける タイムライン・根本原因・再発防止策の3点を、精神論で終わらせず「仕組み」に落とせる。今日の演習と課題②で実践。 保守運用とSRE 第2回 4
01 SREの組織構造 誰が信頼性に責任を持つのか — チームの形とオンコールの現実 45 min 保守運用とSRE 第2回 5
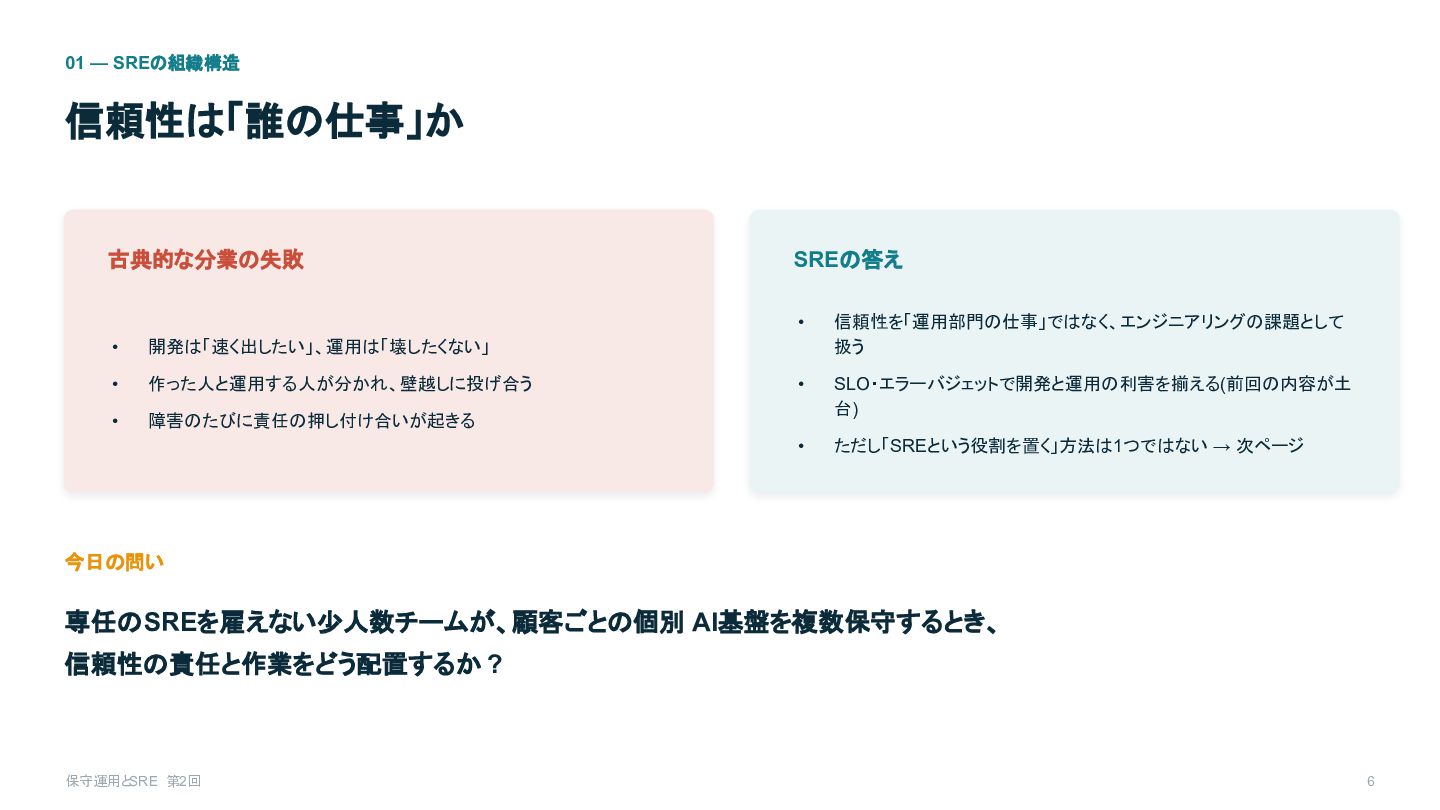
01 — SREの組織構造 信頼性は「誰の仕事」か 古典的な分業の失敗 • 開発は「速く出したい」、運用は「壊したくない」 • 作った人と運用する人が分かれ、壁越しに投げ合う •
障害のたびに責任の押し付け合いが起きる SREの答え • 信頼性を「運用部門の仕事」ではなく、エンジニアリングの課題として 扱う • SLO・エラーバジェットで開発と運用の利害を揃える(前回の内容が土 台) • ただし「SREという役割を置く」方法は1つではない → 次ページ 今日の問い 専任のSREを雇えない少人数チームが、顧客ごとの個別 AI基盤を複数保守するとき、 信頼性の責任と作業をどう配置するか ? 保守運用とSRE 第2回 6
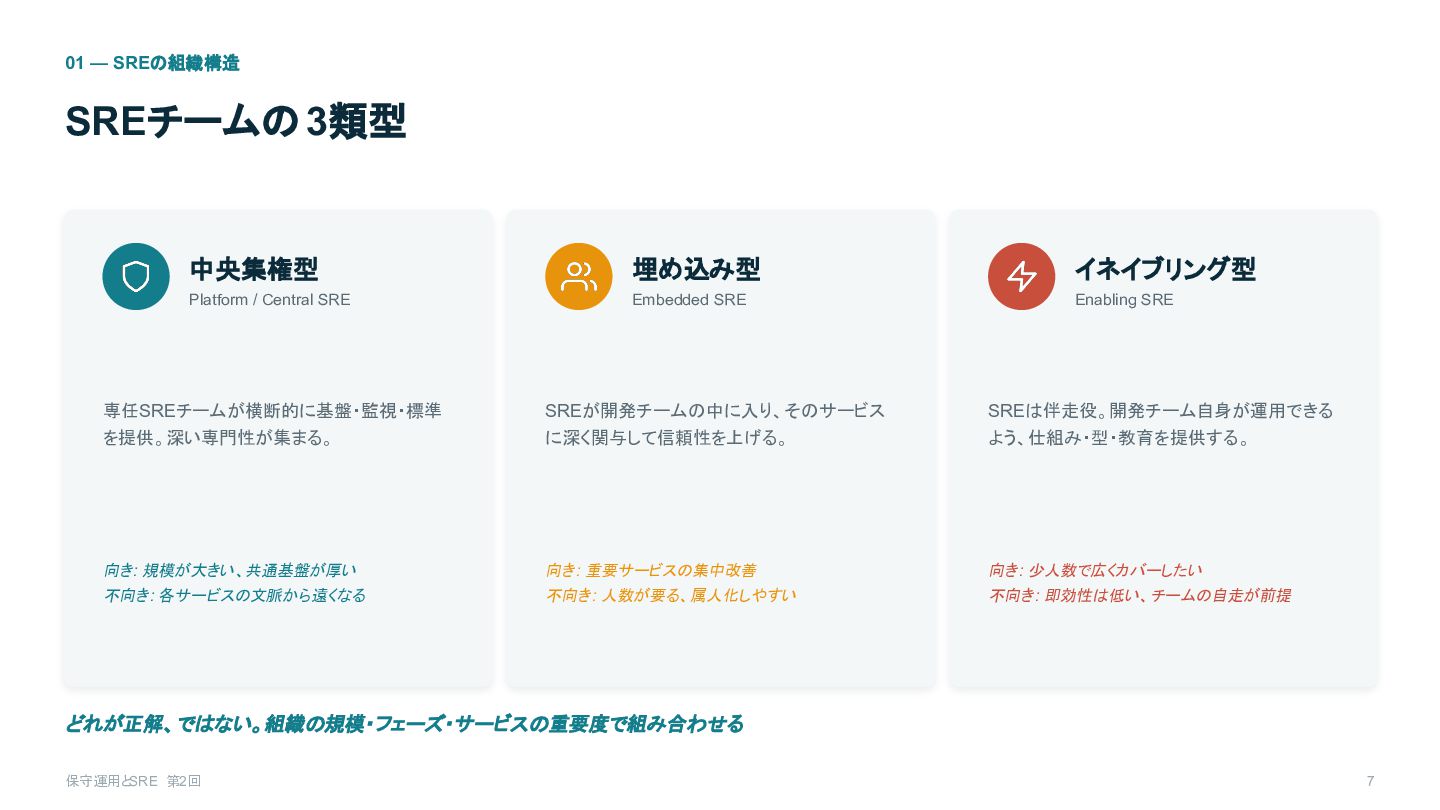
01 — SREの組織構造 SREチームの 3類型 中央集権型 埋め込み型 イネイブリング型 Platform /
Central SRE Embedded SRE Enabling SRE 専任SREチームが横断的に基盤・監視・標準 を提供。深い専門性が集まる。 SREが開発チームの中に入り、そのサービス に深く関与して信頼性を上げる。 SREは伴走役。開発チーム自身が運用できる よう、仕組み・型・教育を提供する。 向き : 規模が大きい、共通基盤が厚い 向き : 重要サービスの集中改善 向き : 少人数で広くカバーしたい 不向き : 各サービスの文脈から遠くなる 不向き : 人数が要る、属人化しやすい 不向き : 即効性は低い、チームの自走が前提 どれが正解、ではない。組織の規模・フェーズ・サービスの重要度で組み合わせる 保守運用とSRE 第2回 7
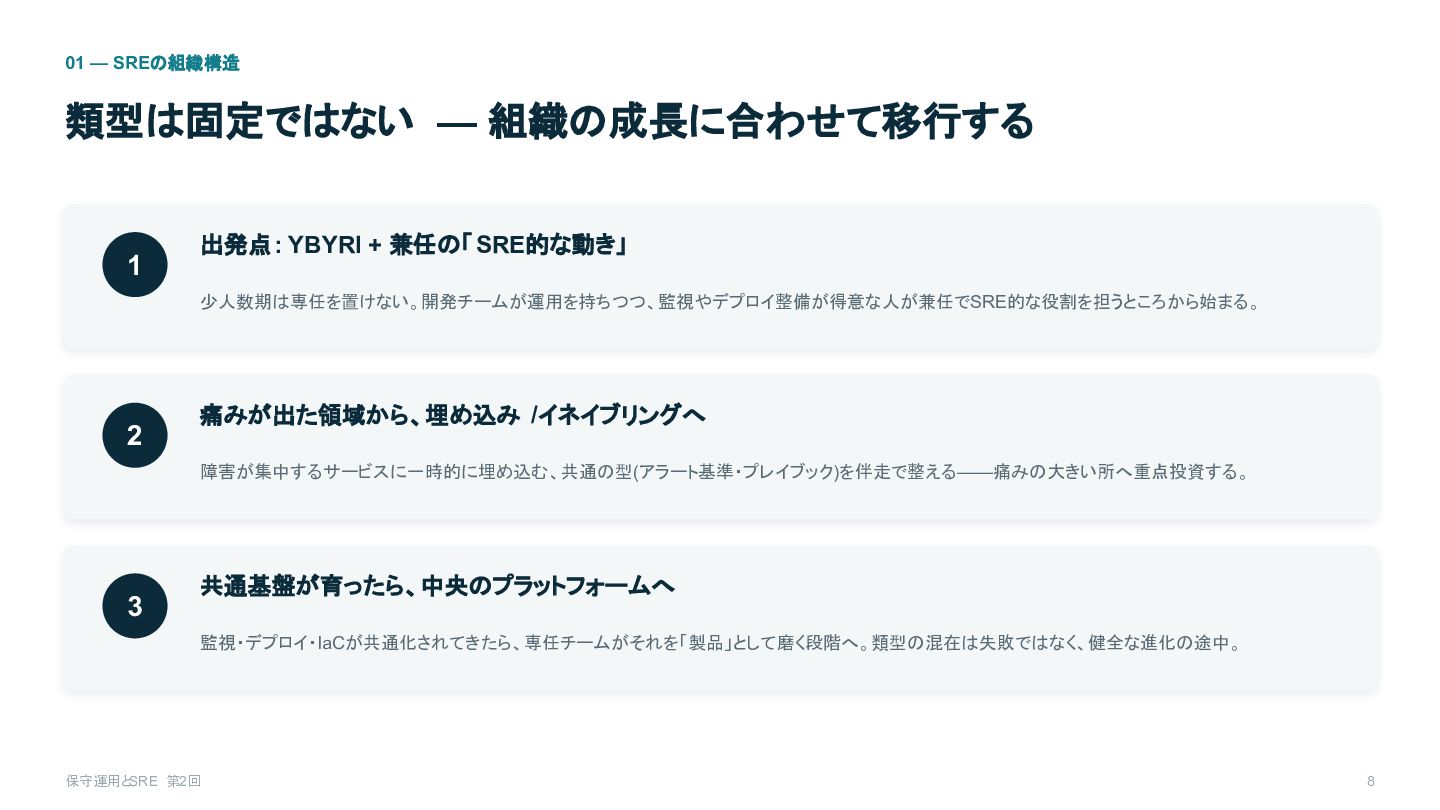
01 — SREの組織構造 類型は固定ではない — 組織の成長に合わせて移行する 1 出発点: YBYRI +
兼任の「 SRE的な動き」 少人数期は専任を置けない。開発チームが運用を持ちつつ、監視やデプロイ整備が得意な人が兼任でSRE的な役割を担うところから始まる。 2 痛みが出た領域から、埋め込み /イネイブリングへ 障害が集中するサービスに一時的に埋め込む、共通の型(アラート基準・プレイブック)を伴走で整える——痛みの大きい所へ重点投資する。 3 共通基盤が育ったら、中央のプラットフォームへ 監視・デプロイ・IaCが共通化されてきたら、専任チームがそれを「製品」として磨く段階へ。類型の混在は失敗ではなく、健全な進化の途中。 保守運用とSRE 第2回 8
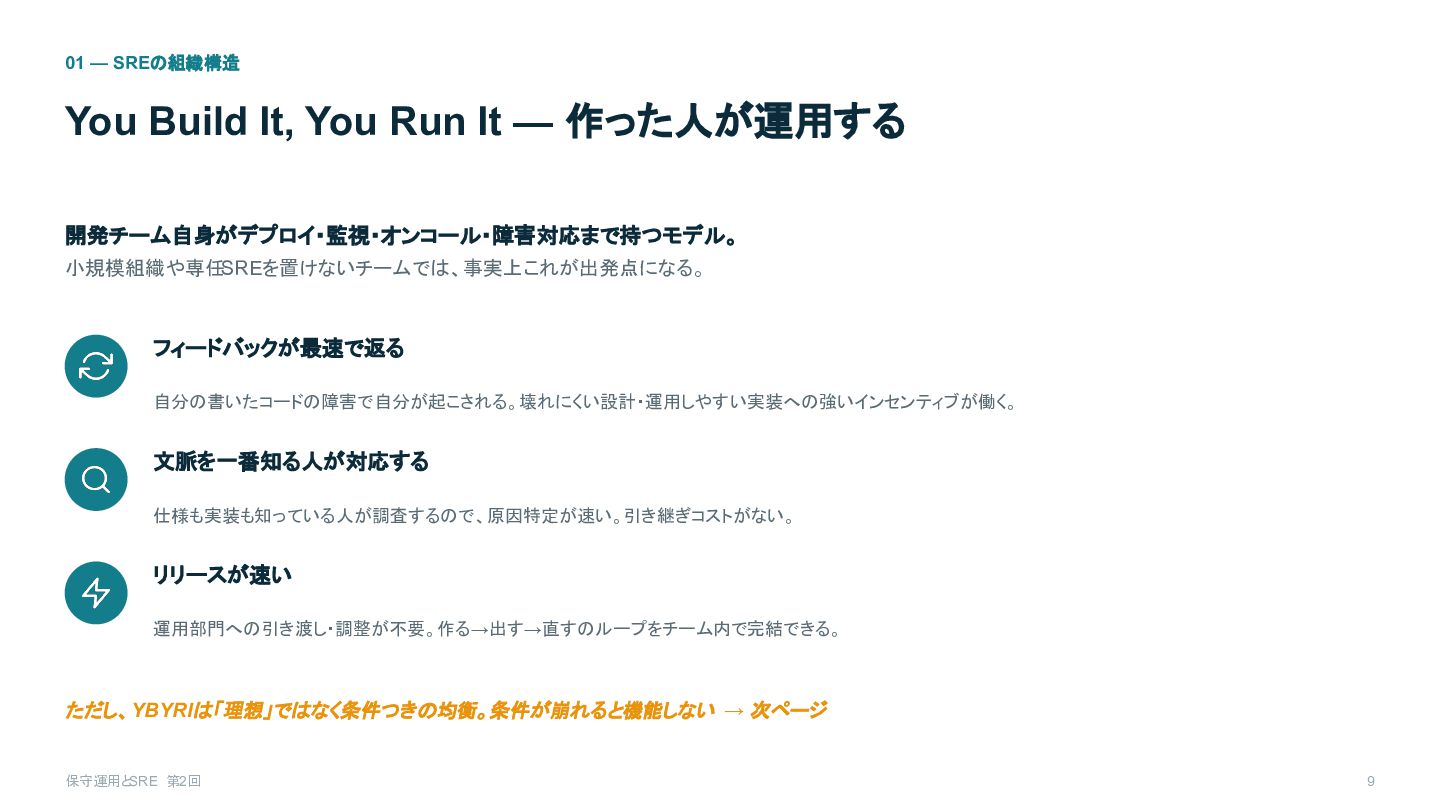
01 — SREの組織構造 You Build It, You Run It —
作った人が運用する 開発チーム自身がデプロイ・監視・オンコール・障害対応まで持つモデル。 小規模組織や専任SREを置けないチームでは、事実上これが出発点になる。 フィードバックが最速で返る 自分の書いたコードの障害で自分が起こされる。壊れにくい設計・運用しやすい実装への強いインセンティブが働く。 文脈を一番知る人が対応する 仕様も実装も知っている人が調査するので、原因特定が速い。引き継ぎコストがない。 リリースが速い 運用部門への引き渡し・調整が不要。作る→出す→直すのループをチーム内で完結できる。 ただし、 YBYRIは「理想」ではなく条件つきの均衡。条件が崩れると機能しない → 次ページ 保守運用とSRE 第2回 9
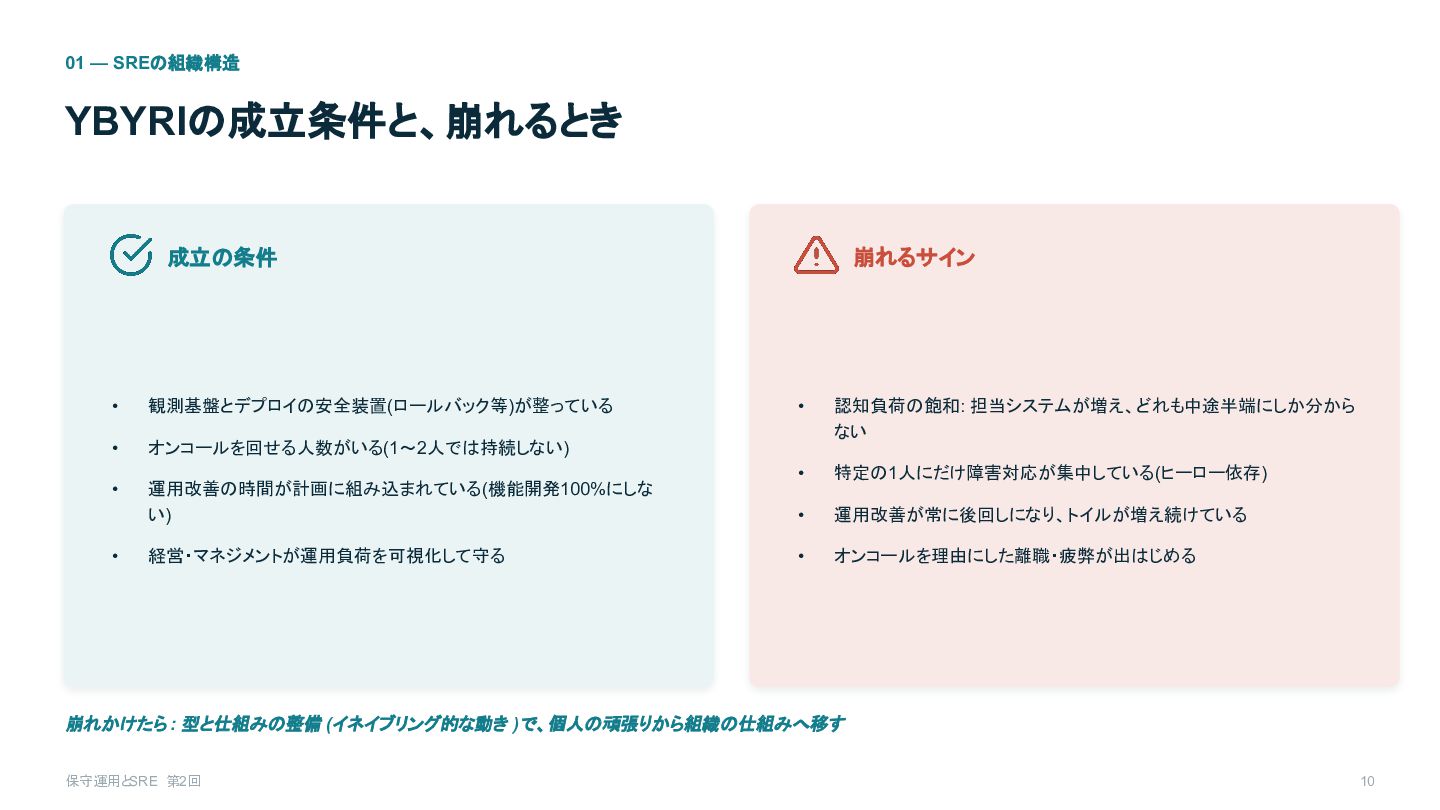
01 — SREの組織構造 YBYRIの成立条件と、崩れるとき 成立の条件 • 観測基盤とデプロイの安全装置(ロールバック等)が整っている • オンコールを回せる人数がいる(1〜2人では持続しない) •
運用改善の時間が計画に組み込まれている(機能開発100%にしな い) • 経営・マネジメントが運用負荷を可視化して守る 崩れるサイン • 認知負荷の飽和: 担当システムが増え、どれも中途半端にしか分から ない • 特定の1人にだけ障害対応が集中している(ヒーロー依存) • 運用改善が常に後回しになり、トイルが増え続けている • オンコールを理由にした離職・疲弊が出はじめる 崩れかけたら : 型と仕組みの整備 (イネイブリング的な動き )で、個人の頑張りから組織の仕組みへ移す 保守運用とSRE 第2回 10
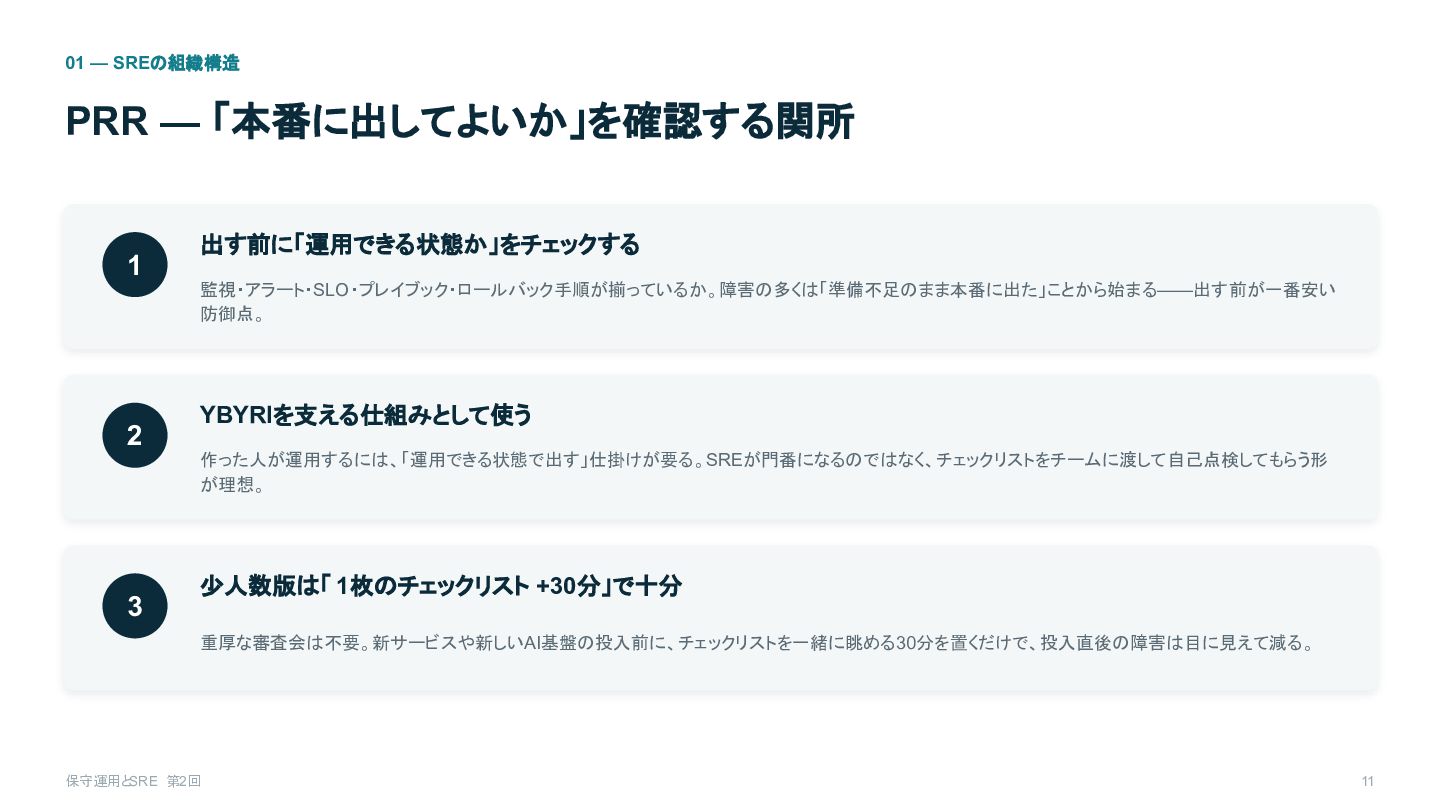
01 — SREの組織構造 PRR — 「本番に出してよいか」を確認する関所 1 2 3 出す前に「運用できる状態か」をチェックする
監視・アラート・SLO・プレイブック・ロールバック手順が揃っているか。障害の多くは「準備不足のまま本番に出た」ことから始まる——出す前が一番安い 防御点。 YBYRIを支える仕組みとして使う 作った人が運用するには、「運用できる状態で出す」仕掛けが要る。SREが門番になるのではなく、チェックリストをチームに渡して自己点検してもらう形 が理想。 少人数版は「 1枚のチェックリスト +30分」で十分 重厚な審査会は不要。新サービスや新しいAI基盤の投入前に、チェックリストを一緒に眺める30分を置くだけで、投入直後の障害は目に見えて減る。 保守運用とSRE 第2回 11
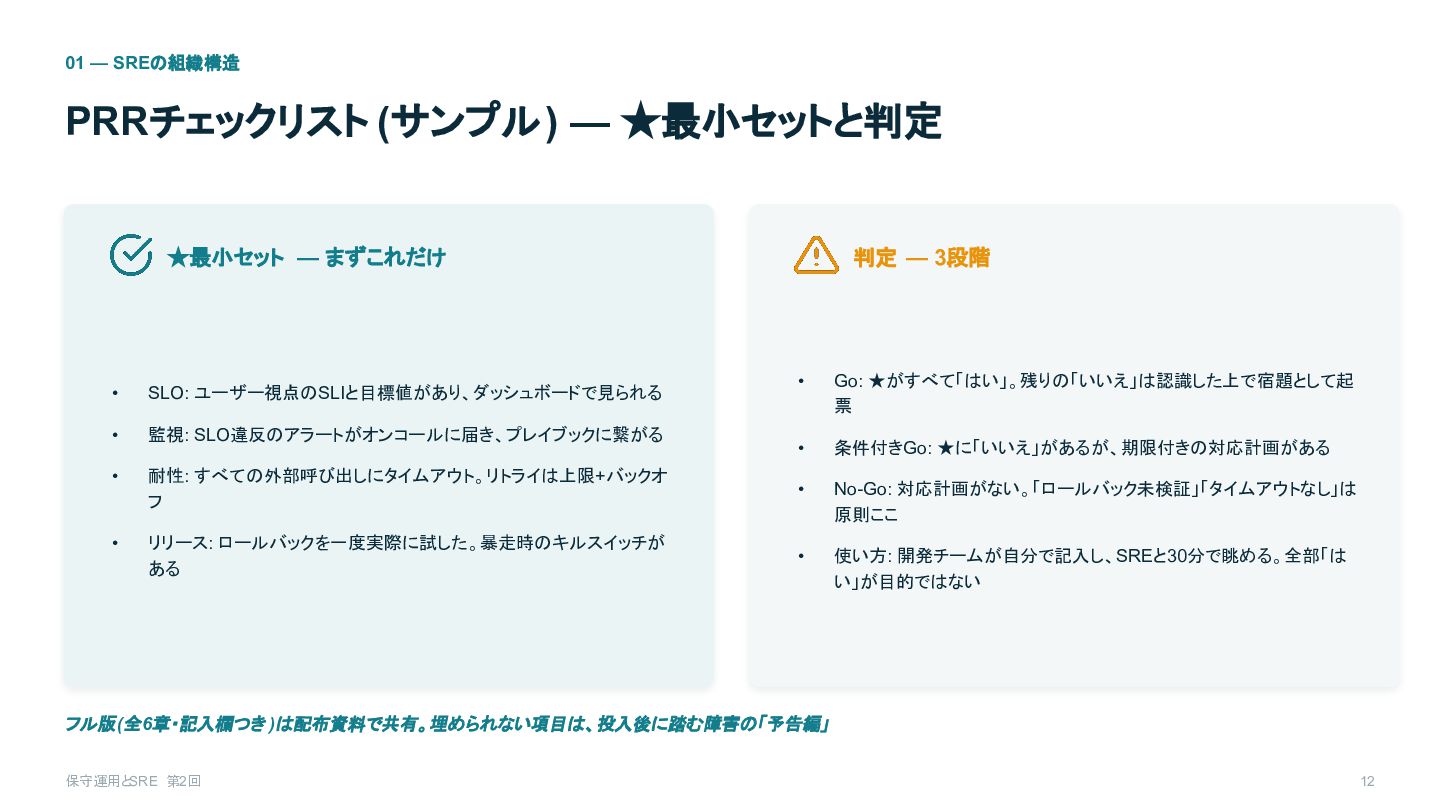
01 — SREの組織構造 PRRチェックリスト (サンプル ) — ★最小セットと判定 ★最小セット —
まずこれだけ 判定 — 3段階 • Go: ★がすべて「はい」。残りの「いいえ」は認識した上で宿題として起 票 • 条件付きGo: ★に「いいえ」があるが、期限付きの対応計画がある 耐性: すべての外部呼び出しにタイムアウト。リトライは上限+バックオ フ • No-Go: 対応計画がない。「ロールバック未検証」「タイムアウトなし」は 原則ここ リリース: ロールバックを一度実際に試した。暴走時のキルスイッチが ある • 使い方: 開発チームが自分で記入し、SREと30分で眺める。全部「は い」が目的ではない • SLO: ユーザー視点のSLIと目標値があり、ダッシュボードで見られる • 監視: SLO違反のアラートがオンコールに届き、プレイブックに繋がる • • フル版 (全 6章・記入欄つき )は配布資料で共有。埋められない項目は、投入後に踏む障害の「予告編」 保守運用とSRE 第2回 12
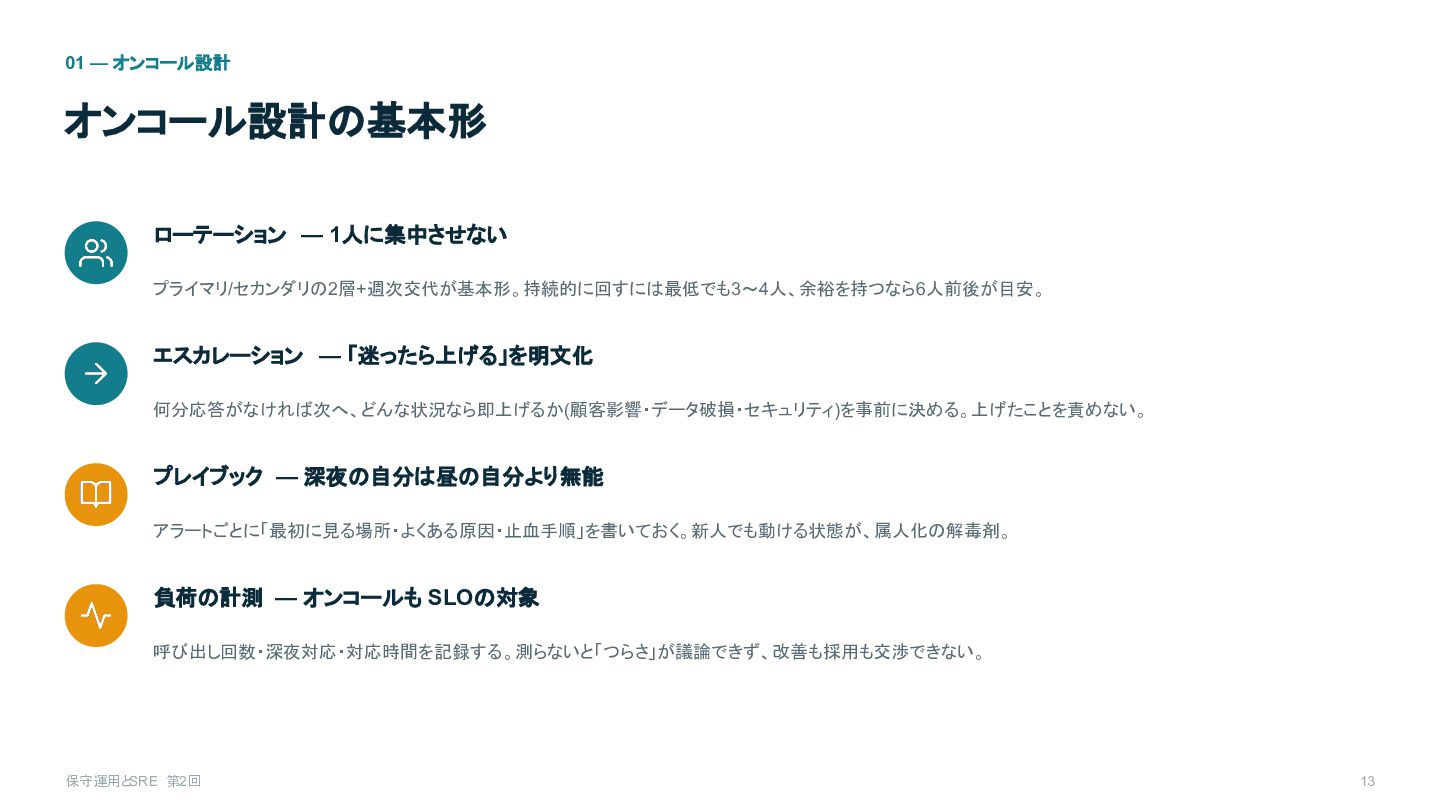
01 — オンコール設計 オンコール設計の基本形 ローテーション — 1人に集中させない プライマリ/セカンダリの2層+週次交代が基本形。持続的に回すには最低でも3〜4人、余裕を持つなら6人前後が目安。 エスカレーション —
「迷ったら上げる」を明文化 何分応答がなければ次へ、どんな状況なら即上げるか(顧客影響・データ破損・セキュリティ)を事前に決める。上げたことを責めない。 プレイブック — 深夜の自分は昼の自分より無能 アラートごとに「最初に見る場所・よくある原因・止血手順」を書いておく。新人でも動ける状態が、属人化の解毒剤。 負荷の計測 — オンコールも SLOの対象 呼び出し回数・深夜対応・対応時間を記録する。測らないと「つらさ」が議論できず、改善も採用も交渉できない。 保守運用とSRE 第2回 13
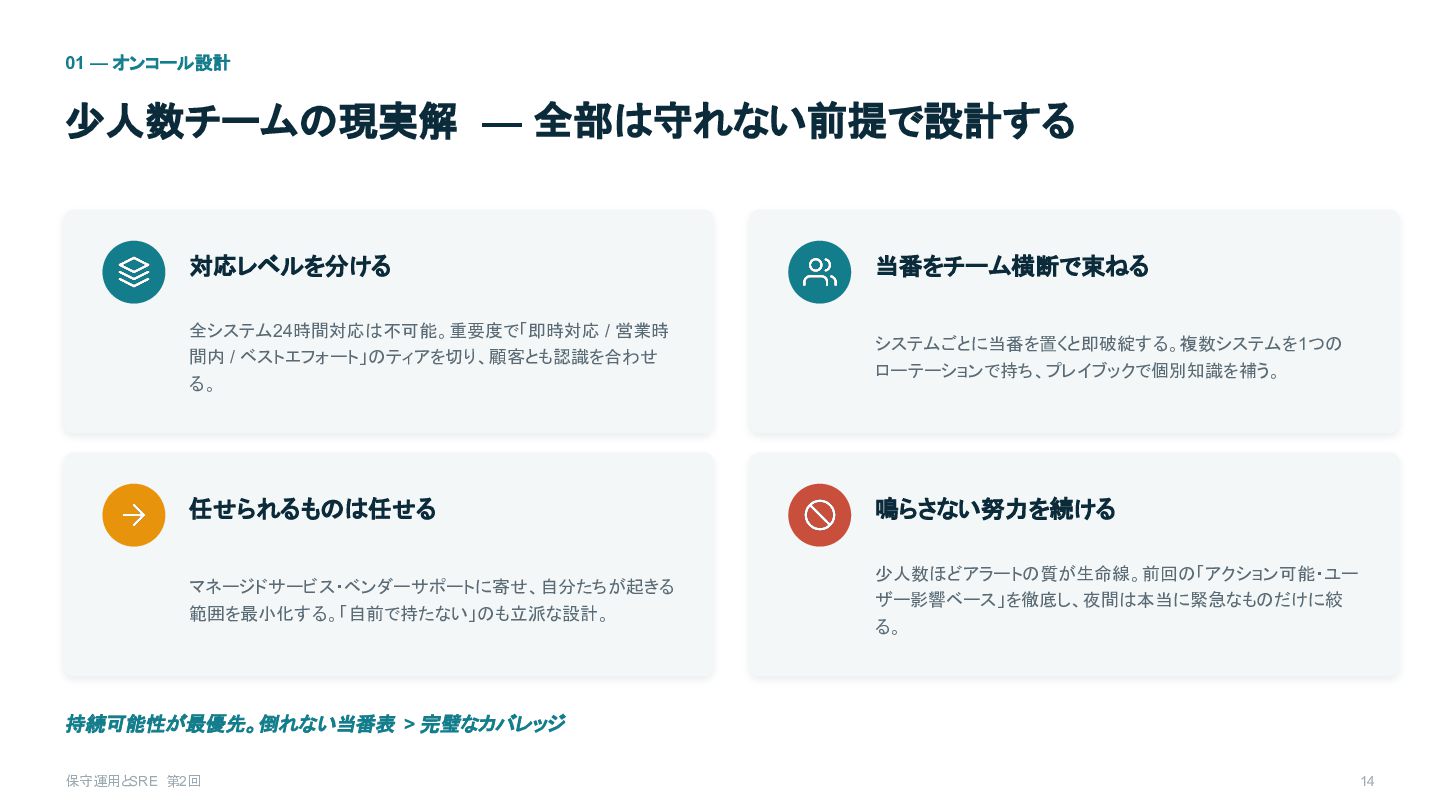
01 — オンコール設計 少人数チームの現実解 — 全部は守れない前提で設計する 対応レベルを分ける 当番をチーム横断で束ねる 全システム24時間対応は不可能。重要度で「即時対応 /
営業時 間内 / ベストエフォート」のティアを切り、顧客とも認識を合わせ る。 システムごとに当番を置くと即破綻する。複数システムを1つの ローテーションで持ち、プレイブックで個別知識を補う。 任せられるものは任せる 鳴らさない努力を続ける マネージドサービス・ベンダーサポートに寄せ、自分たちが起きる 範囲を最小化する。「自前で持たない」のも立派な設計。 少人数ほどアラートの質が生命線。前回の「アクション可能・ユー ザー影響ベース」を徹底し、夜間は本当に緊急なものだけに絞 る。 持続可能性が最優先。倒れない当番表 > 完璧なカバレッジ 保守運用とSRE 第2回 14
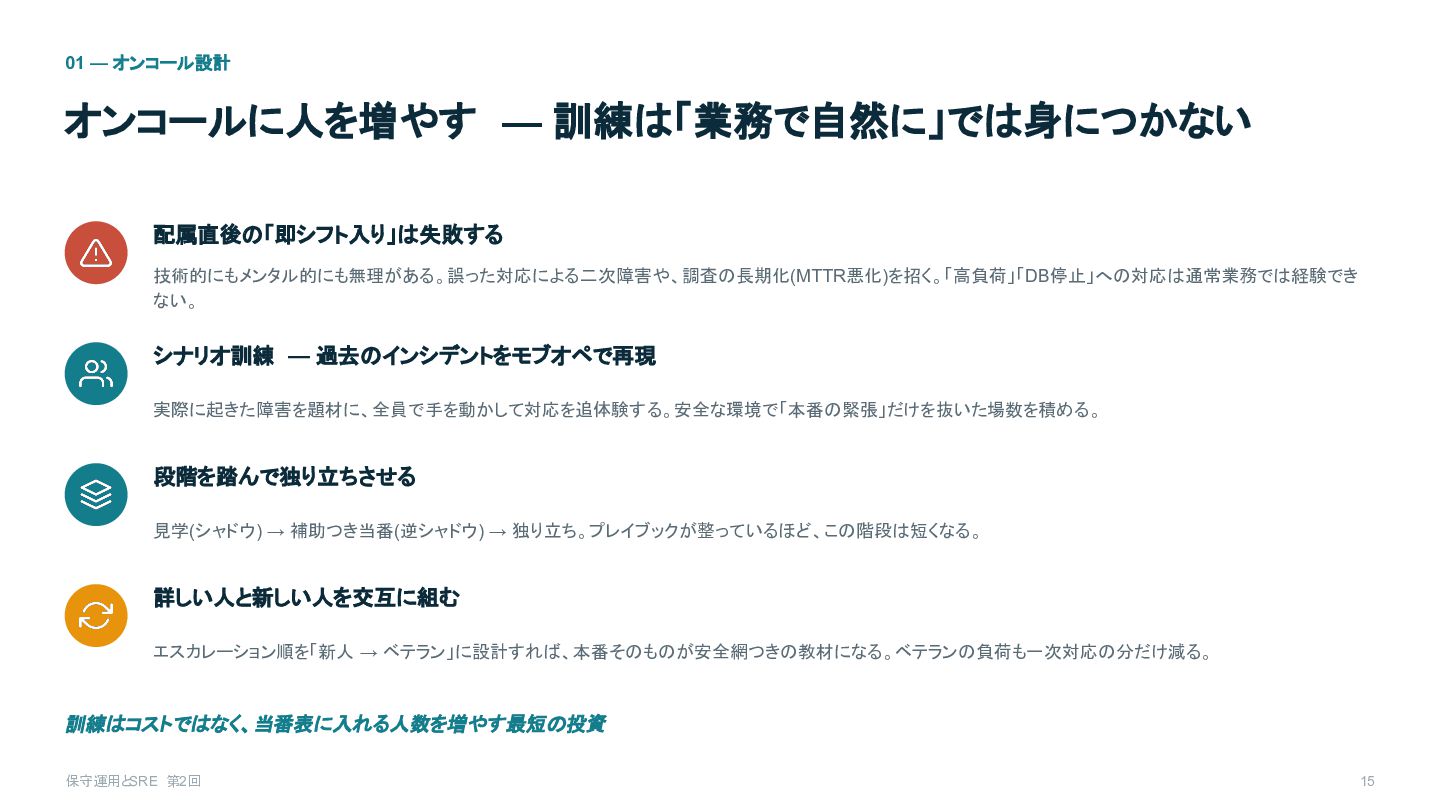
01 — オンコール設計 オンコールに人を増やす — 訓練は「業務で自然に」では身につかない 配属直後の「即シフト入り」は失敗する 技術的にもメンタル的にも無理がある。誤った対応による二次障害や、調査の長期化(MTTR悪化)を招く。「高負荷」「DB停止」への対応は通常業務では経験でき ない。 シナリオ訓練
— 過去のインシデントをモブオペで再現 実際に起きた障害を題材に、全員で手を動かして対応を追体験する。安全な環境で「本番の緊張」だけを抜いた場数を積める。 段階を踏んで独り立ちさせる 見学(シャドウ) → 補助つき当番(逆シャドウ) → 独り立ち。プレイブックが整っているほど、この階段は短くなる。 詳しい人と新しい人を交互に組む エスカレーション順を「新人 → ベテラン」に設計すれば、本番そのものが安全網つきの教材になる。ベテランの負荷も一次対応の分だけ減る。 訓練はコストではなく、当番表に入れる人数を増やす最短の投資 保守運用とSRE 第2回 15
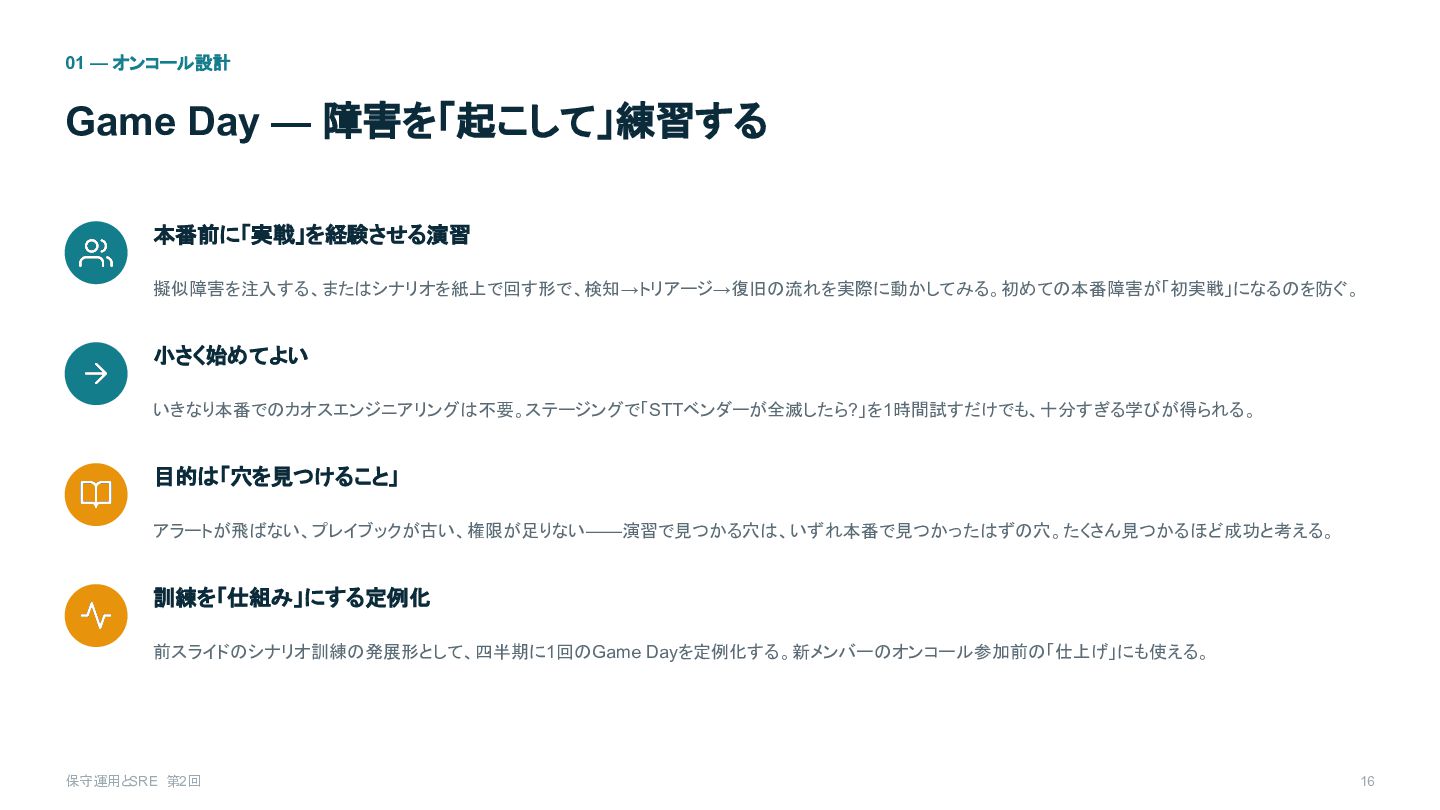
01 — オンコール設計 Game Day — 障害を「起こして」練習する 本番前に「実戦」を経験させる演習 擬似障害を注入する、またはシナリオを紙上で回す形で、検知→トリアージ→復旧の流れを実際に動かしてみる。初めての本番障害が「初実戦」になるのを防ぐ。 小さく始めてよい
いきなり本番でのカオスエンジニアリングは不要。ステージングで「STTベンダーが全滅したら?」を1時間試すだけでも、十分すぎる学びが得られる。 目的は「穴を見つけること」 アラートが飛ばない、プレイブックが古い、権限が足りない——演習で見つかる穴は、いずれ本番で見つかったはずの穴。たくさん見つかるほど成功と考える。 訓練を「仕組み」にする定例化 前スライドのシナリオ訓練の発展形として、四半期に1回のGame Dayを定例化する。新メンバーのオンコール参加前の「仕上げ」にも使える。 保守運用とSRE 第2回 16
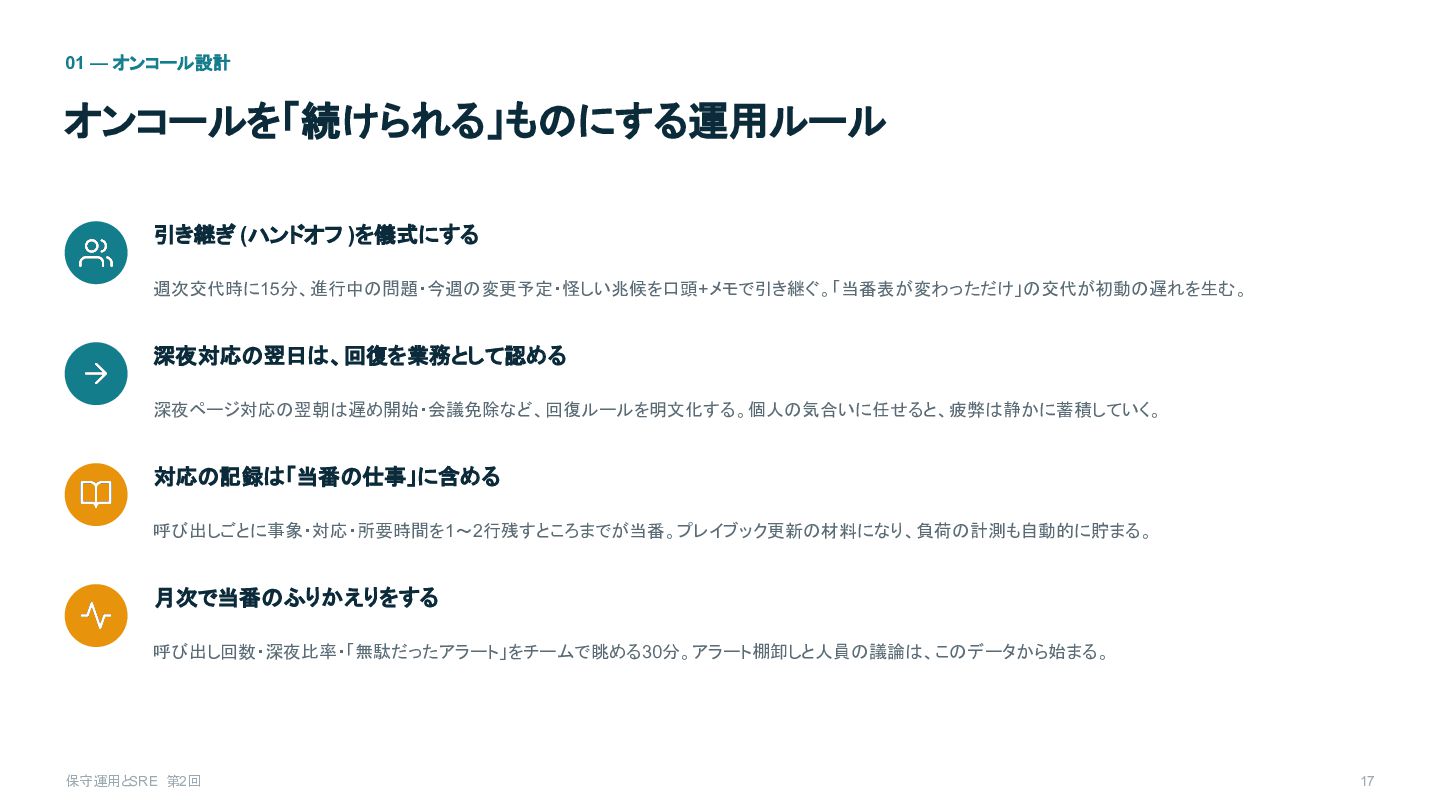
01 — オンコール設計 オンコールを「続けられる」ものにする運用ルール 引き継ぎ (ハンドオフ )を儀式にする 週次交代時に15分、進行中の問題・今週の変更予定・怪しい兆候を口頭+メモで引き継ぐ。「当番表が変わっただけ」の交代が初動の遅れを生む。 深夜対応の翌日は、回復を業務として認める 深夜ページ対応の翌朝は遅め開始・会議免除など、回復ルールを明文化する。個人の気合いに任せると、疲弊は静かに蓄積していく。
対応の記録は「当番の仕事」に含める 呼び出しごとに事象・対応・所要時間を1〜2行残すところまでが当番。プレイブック更新の材料になり、負荷の計測も自動的に貯まる。 月次で当番のふりかえりをする 呼び出し回数・深夜比率・「無駄だったアラート」をチームで眺める30分。アラート棚卸しと人員の議論は、このデータから始まる。 保守運用とSRE 第2回 17
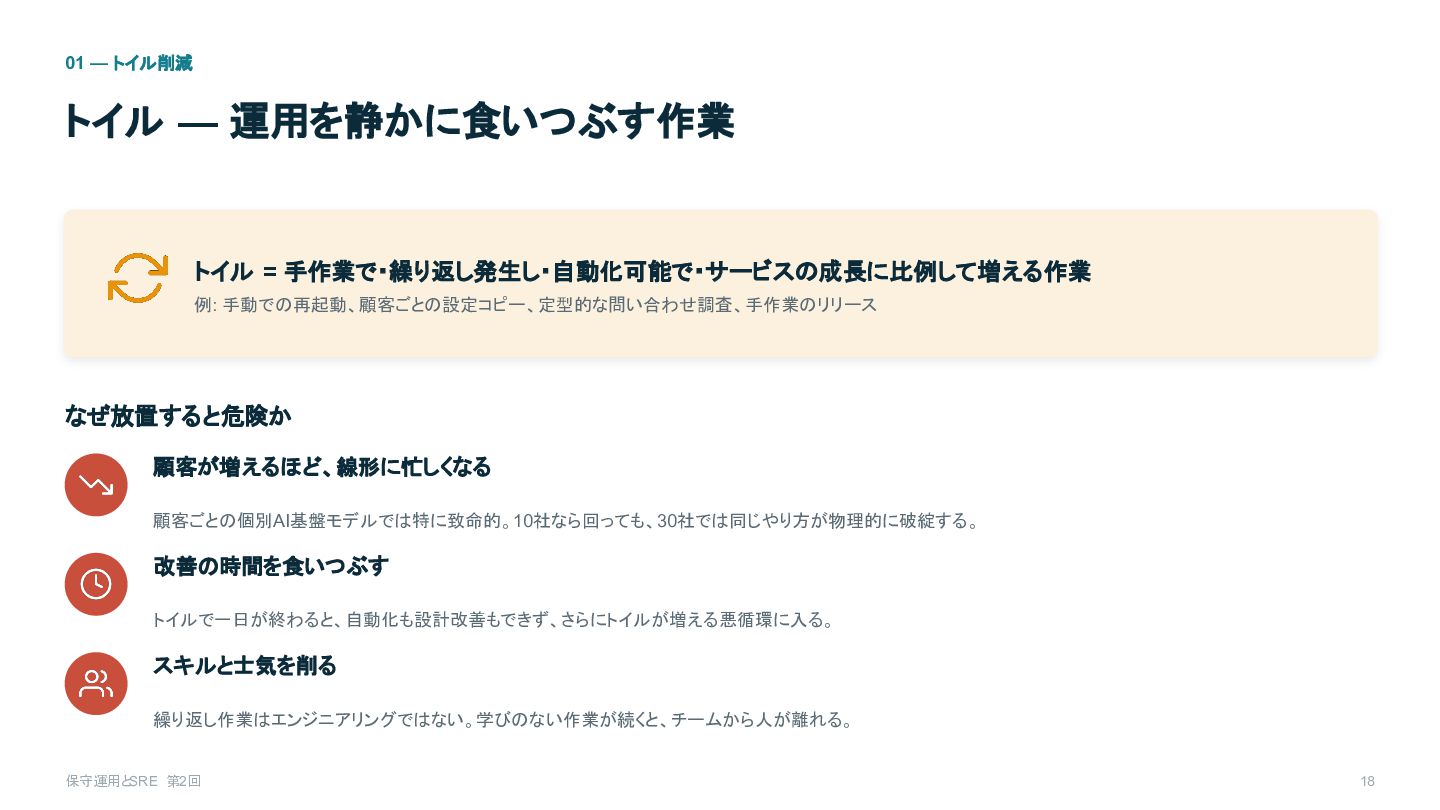
01 — トイル削減 トイル — 運用を静かに食いつぶす作業 トイル = 手作業で・繰り返し発生し・自動化可能で・サービスの成長に比例して増える作業 例:
手動での再起動、顧客ごとの設定コピー、定型的な問い合わせ調査、手作業のリリース なぜ放置すると危険か 顧客が増えるほど、線形に忙しくなる 顧客ごとの個別AI基盤モデルでは特に致命的。10社なら回っても、30社では同じやり方が物理的に破綻する。 改善の時間を食いつぶす トイルで一日が終わると、自動化も設計改善もできず、さらにトイルが増える悪循環に入る。 スキルと士気を削る 繰り返し作業はエンジニアリングではない。学びのない作業が続くと、チームから人が離れる。 保守運用とSRE 第2回 18
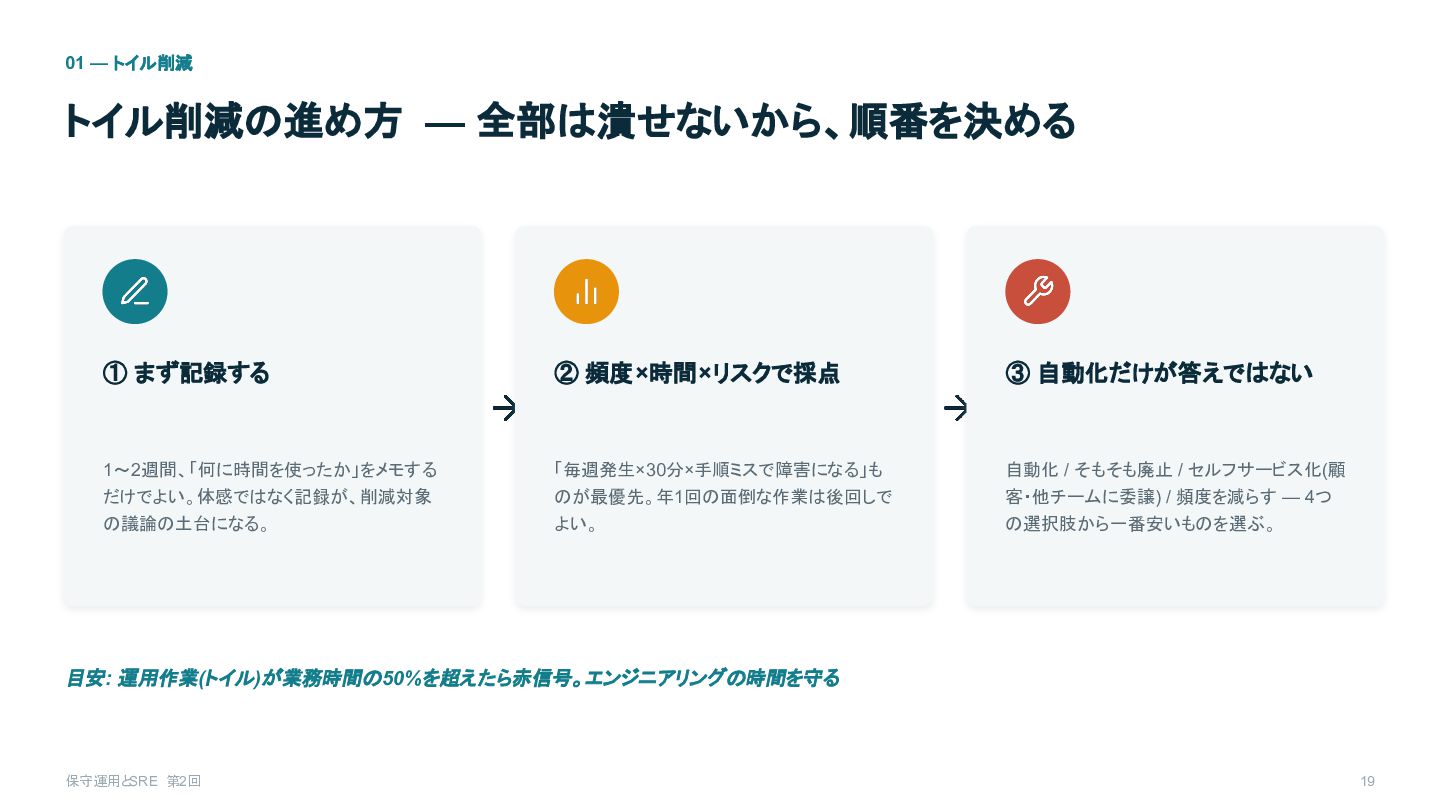
01 — トイル削減 トイル削減の進め方 — 全部は潰せないから、順番を決める ① まず記録する ② 頻度×時間×リスクで採点
③ 自動化だけが答えではない 1〜2週間、「何に時間を使ったか」をメモする だけでよい。体感ではなく記録が、削減対象 の議論の土台になる。 「毎週発生×30分×手順ミスで障害になる」も のが最優先。年1回の面倒な作業は後回しで よい。 自動化 / そもそも廃止 / セルフサービス化(顧 客・他チームに委譲) / 頻度を減らす — 4つ の選択肢から一番安いものを選ぶ。 目安: 運用作業(トイル)が業務時間の 50%を超えたら赤信号。エンジニアリングの時間を守る 保守運用とSRE 第2回 19
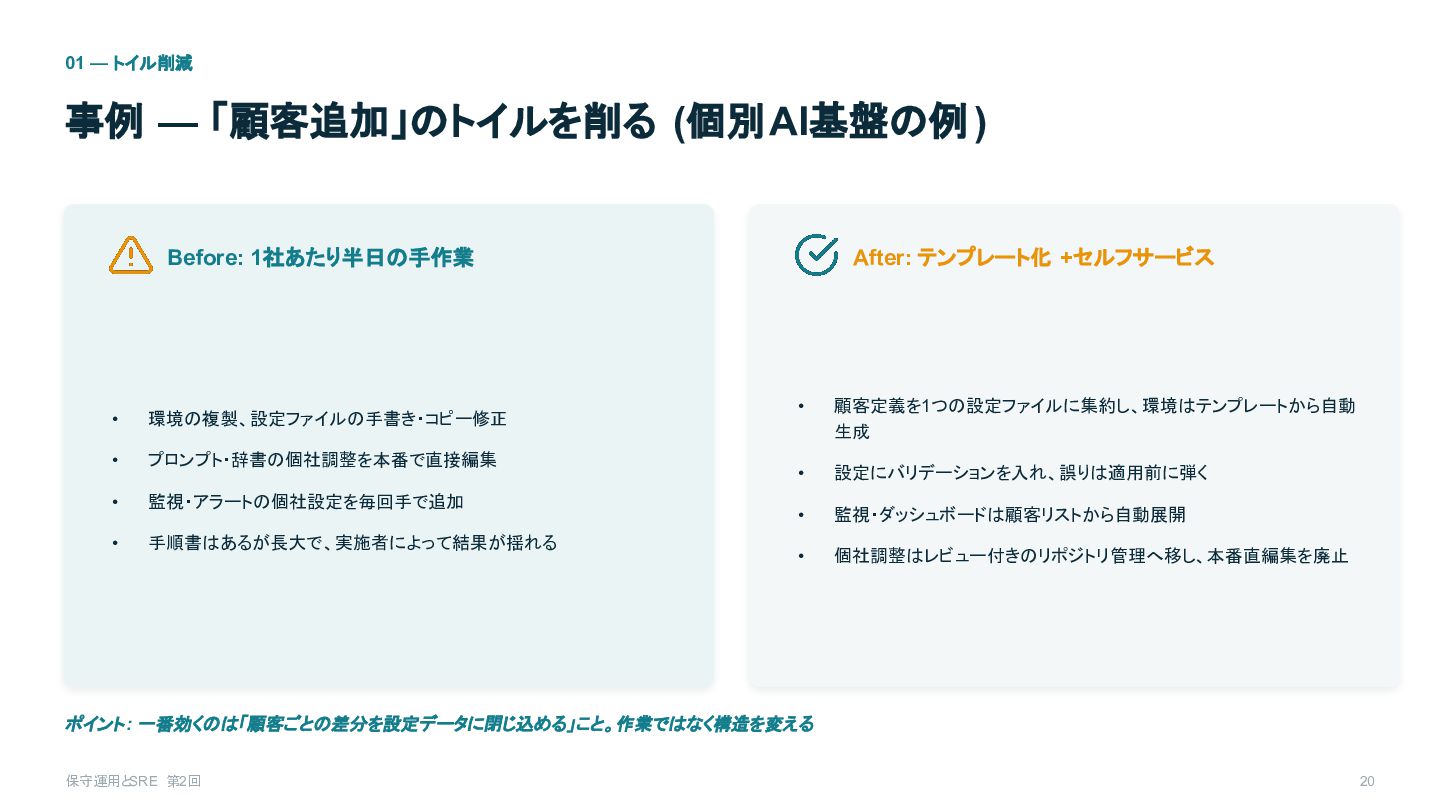
01 — トイル削減 事例 — 「顧客追加」のトイルを削る (個別AI基盤の例 ) After: テンプレート化
+セルフサービス Before: 1社あたり半日の手作業 • 環境の複製、設定ファイルの手書き・コピー修正 • プロンプト・辞書の個社調整を本番で直接編集 • 監視・アラートの個社設定を毎回手で追加 • 手順書はあるが長大で、実施者によって結果が揺れる • 顧客定義を1つの設定ファイルに集約し、環境はテンプレートから自動 生成 • 設定にバリデーションを入れ、誤りは適用前に弾く • 監視・ダッシュボードは顧客リストから自動展開 • 個社調整はレビュー付きのリポジトリ管理へ移し、本番直編集を廃止 ポイント : 一番効くのは「顧客ごとの差分を設定データに閉じ込める」こと。作業ではなく構造を変える 保守運用とSRE 第2回 20
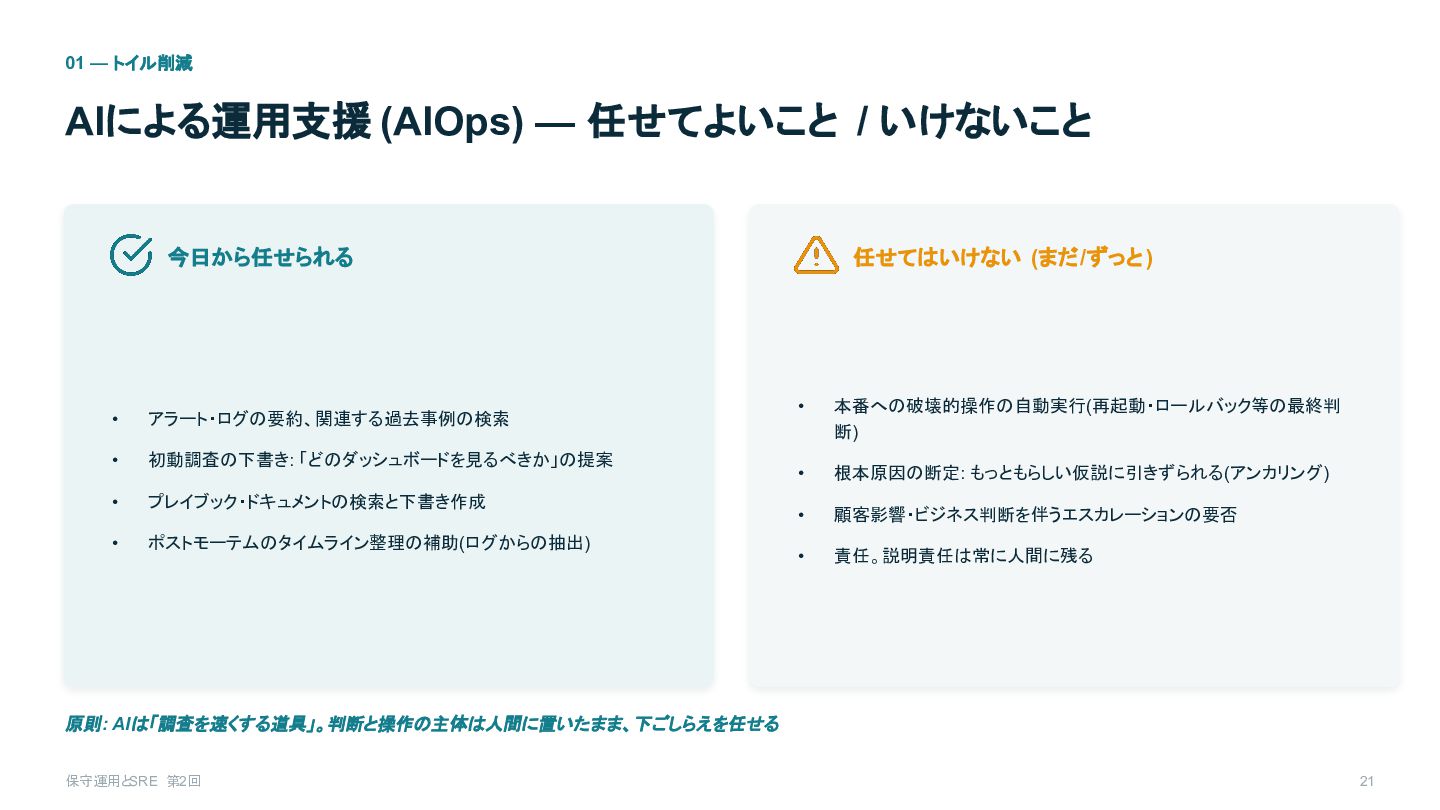
01 — トイル削減 AIによる運用支援 (AIOps) — 任せてよいこと / いけないこと 今日から任せられる
• アラート・ログの要約、関連する過去事例の検索 • 初動調査の下書き: 「どのダッシュボードを見るべきか」の提案 • プレイブック・ドキュメントの検索と下書き作成 • ポストモーテムのタイムライン整理の補助(ログからの抽出) 任せてはいけない (まだ /ずっと ) • 本番への破壊的操作の自動実行(再起動・ロールバック等の最終判 断) • 根本原因の断定: もっともらしい仮説に引きずられる(アンカリング) • 顧客影響・ビジネス判断を伴うエスカレーションの要否 • 責任。説明責任は常に人間に残る 原則 : AIは「調査を速くする道具」。判断と操作の主体は人間に置いたまま、下ごしらえを任せる 保守運用とSRE 第2回 21
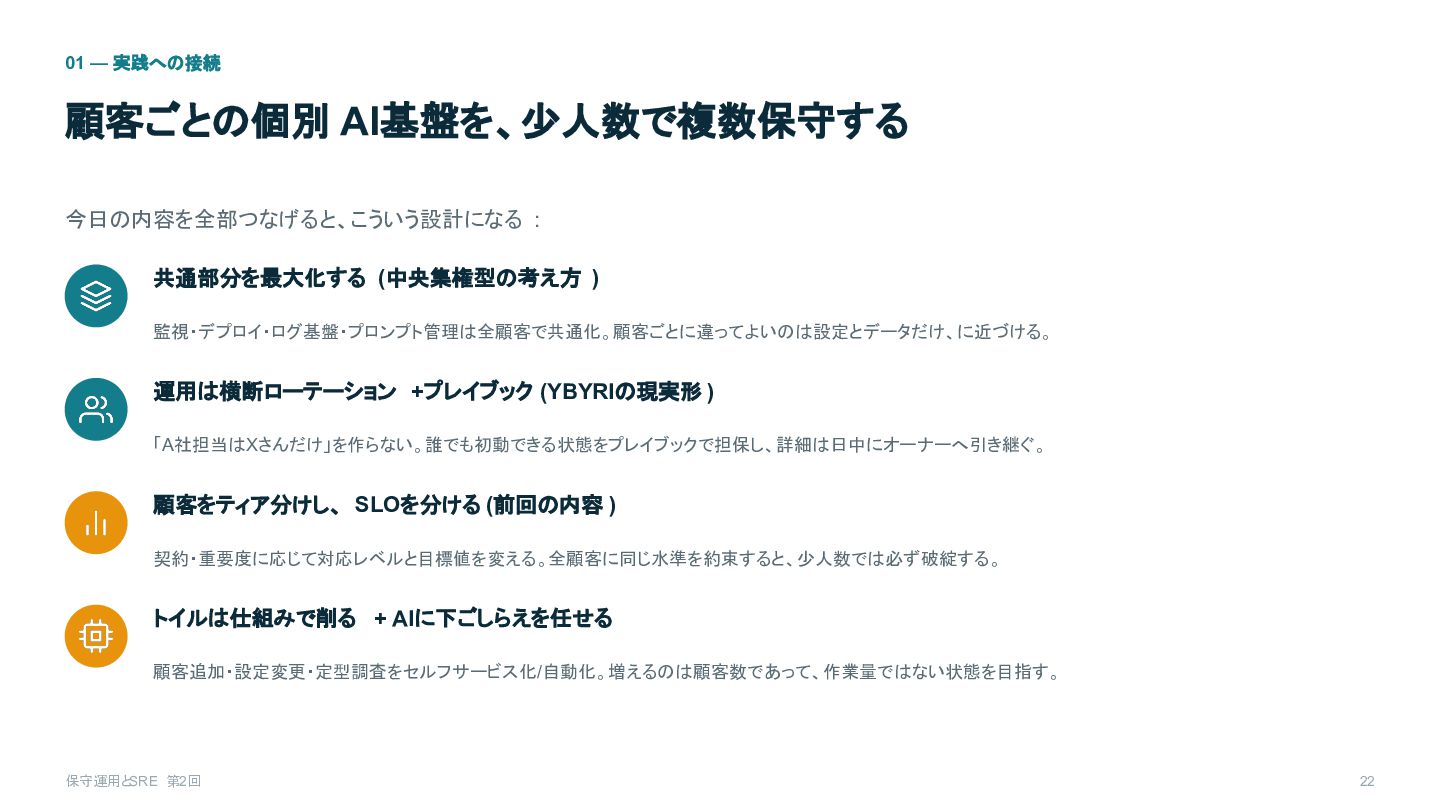
01 — 実践への接続 顧客ごとの個別 AI基盤を、少人数で複数保守する 今日の内容を全部つなげると、こういう設計になる : 共通部分を最大化する (中央集権型の考え方 )
監視・デプロイ・ログ基盤・プロンプト管理は全顧客で共通化。顧客ごとに違ってよいのは設定とデータだけ、に近づける。 運用は横断ローテーション +プレイブック (YBYRIの現実形 ) 「A社担当はXさんだけ」を作らない。誰でも初動できる状態をプレイブックで担保し、詳細は日中にオーナーへ引き継ぐ。 顧客をティア分けし、 SLOを分ける (前回の内容 ) 契約・重要度に応じて対応レベルと目標値を変える。全顧客に同じ水準を約束すると、少人数では必ず破綻する。 トイルは仕組みで削る + AIに下ごしらえを任せる 顧客追加・設定変更・定型調査をセルフサービス化/自動化。増えるのは顧客数であって、作業量ではない状態を目指す。 保守運用とSRE 第2回 22
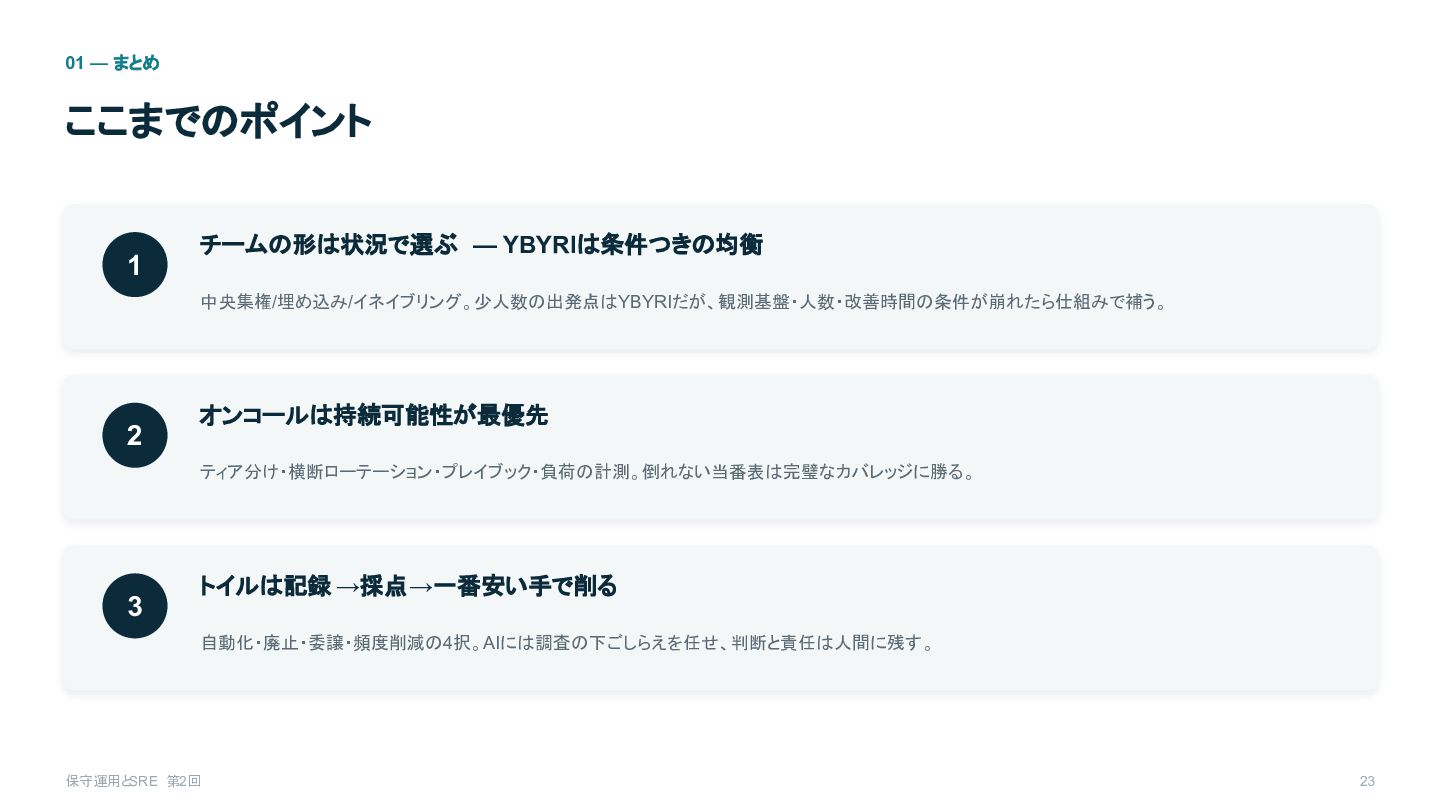
01 — まとめ ここまでのポイント 1 チームの形は状況で選ぶ — YBYRIは条件つきの均衡 中央集権/埋め込み/イネイブリング。少人数の出発点はYBYRIだが、観測基盤・人数・改善時間の条件が崩れたら仕組みで補う。 2
オンコールは持続可能性が最優先 ティア分け・横断ローテーション・プレイブック・負荷の計測。倒れない当番表は完璧なカバレッジに勝る。 3 トイルは記録 →採点→一番安い手で削る 自動化・廃止・委譲・頻度削減の4択。AIには調査の下ごしらえを任せ、判断と責任は人間に残す。 保守運用とSRE 第2回 23
02 AI時代の保守運用とポストモーテム 「動くが説明できない」と付き合い、失敗を組織の学びに変える 40 min 保守運用とSRE 第2回 25
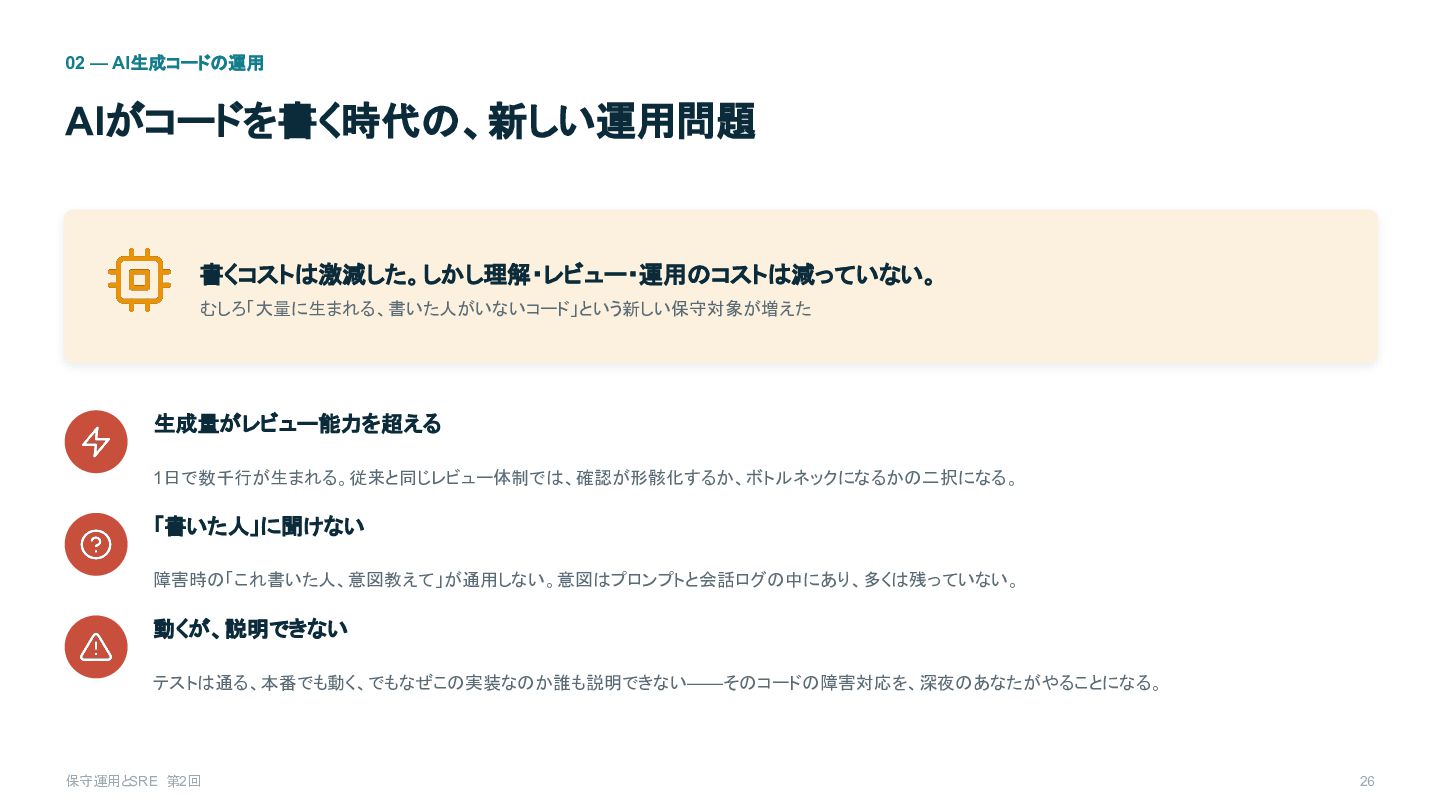
02 — AI生成コードの運用 AIがコードを書く時代の、新しい運用問題 書くコストは激減した。しかし理解・レビュー・運用のコストは減っていない。 むしろ「大量に生まれる、書いた人がいないコード」という新しい保守対象が増えた 生成量がレビュー能力を超える 1日で数千行が生まれる。従来と同じレビュー体制では、確認が形骸化するか、ボトルネックになるかの二択になる。 「書いた人」に聞けない 障害時の「これ書いた人、意図教えて」が通用しない。意図はプロンプトと会話ログの中にあり、多くは残っていない。
動くが、説明できない テストは通る、本番でも動く、でもなぜこの実装なのか誰も説明できない——そのコードの障害対応を、深夜のあなたがやることになる。 保守運用とSRE 第2回 26
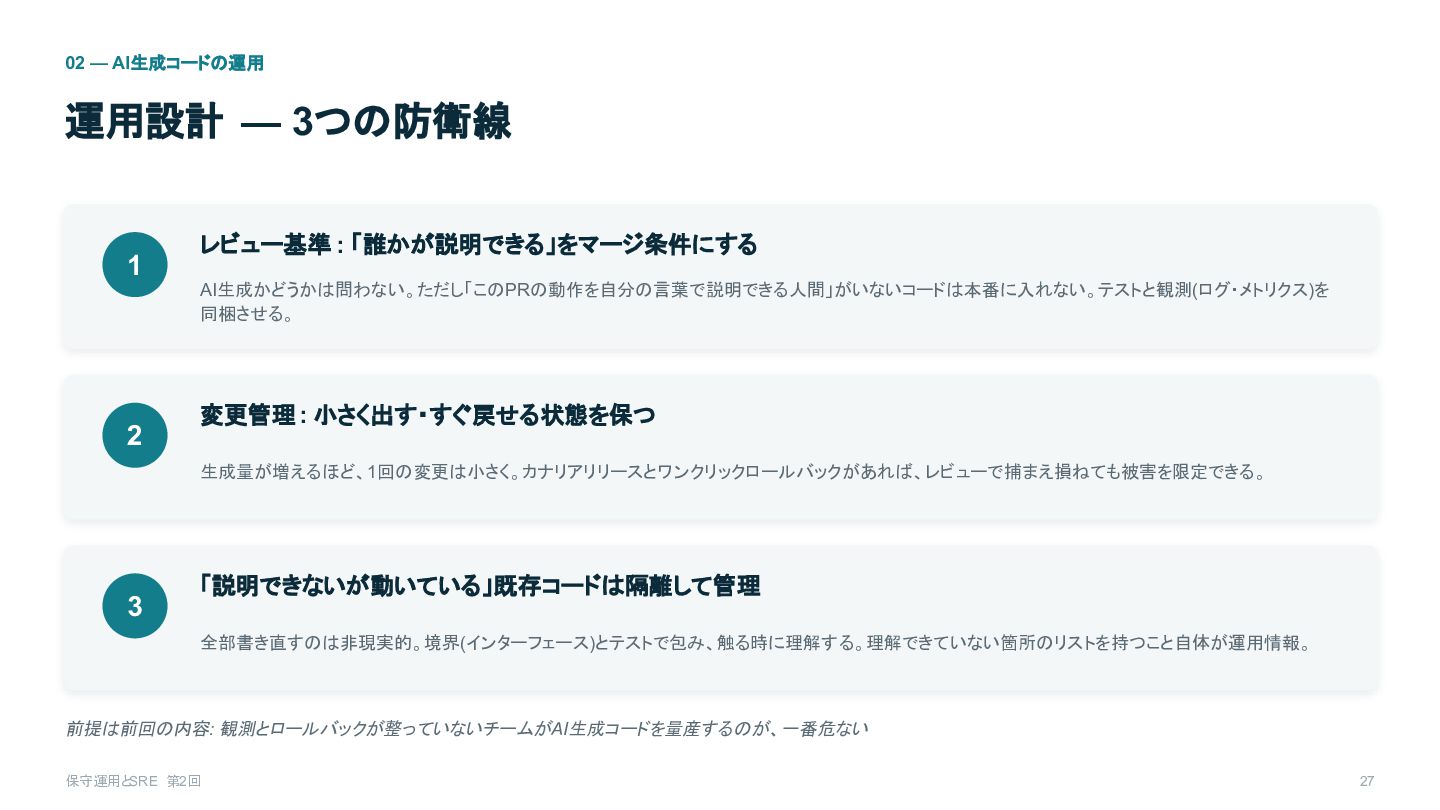
02 — AI生成コードの運用 運用設計 — 3つの防衛線 1 レビュー基準 : 「誰かが説明できる」をマージ条件にする
AI生成かどうかは問わない。ただし「このPRの動作を自分の言葉で説明できる人間」がいないコードは本番に入れない。テストと観測(ログ・メトリクス)を 同梱させる。 2 変更管理 : 小さく出す・すぐ戻せる状態を保つ 生成量が増えるほど、1回の変更は小さく。カナリアリリースとワンクリックロールバックがあれば、レビューで捕まえ損ねても被害を限定できる。 3 「説明できないが動いている」既存コードは隔離して管理 全部書き直すのは非現実的。境界(インターフェース)とテストで包み、触る時に理解する。理解できていない箇所のリストを持つこと自体が運用情報。 前提は前回の内容: 観測とロールバックが整っていないチームがAI生成コードを量産するのが、一番危ない 保守運用とSRE 第2回 27
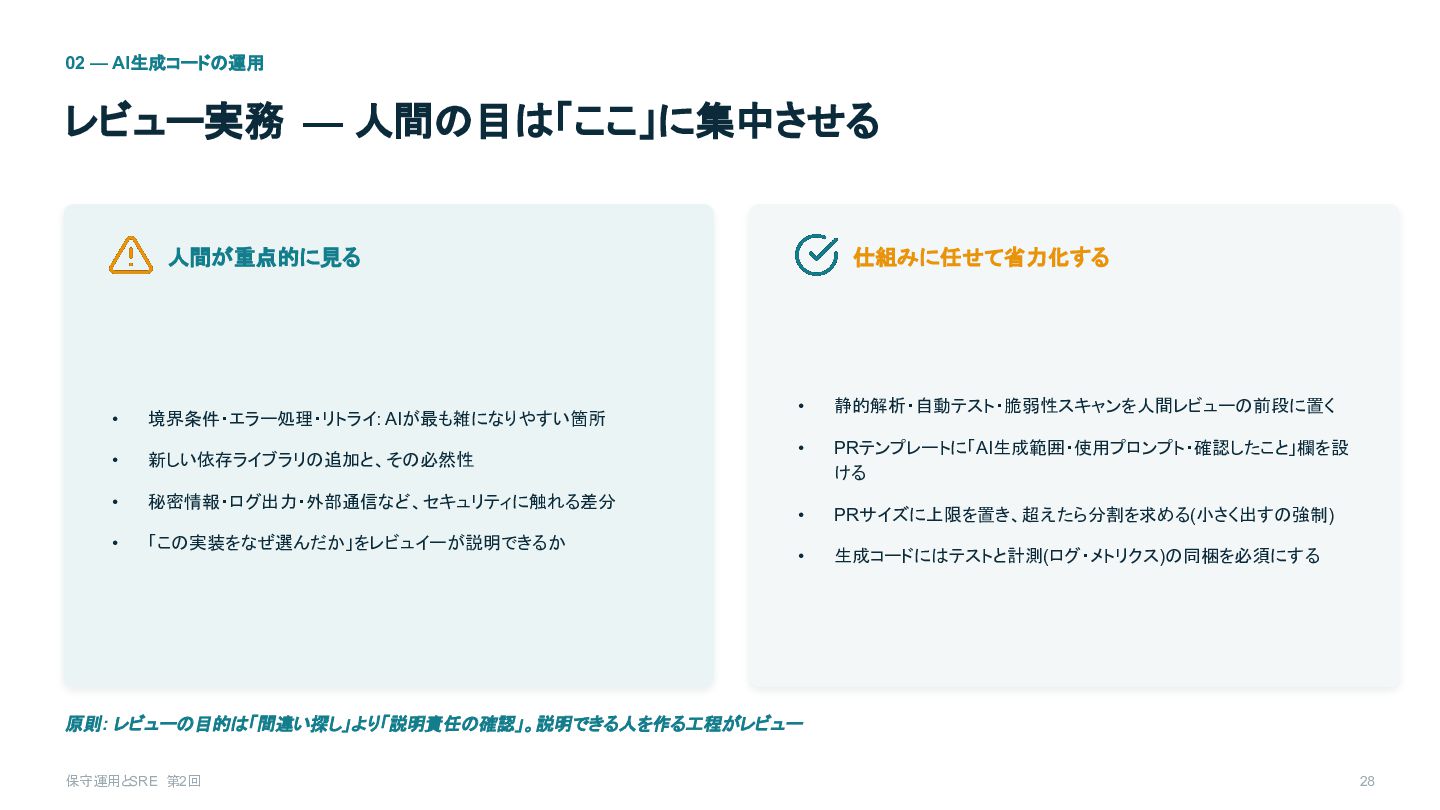
02 — AI生成コードの運用 レビュー実務 — 人間の目は「ここ」に集中させる 人間が重点的に見る • 境界条件・エラー処理・リトライ: AIが最も雑になりやすい箇所
• 新しい依存ライブラリの追加と、その必然性 • 秘密情報・ログ出力・外部通信など、セキュリティに触れる差分 • 「この実装をなぜ選んだか」をレビュイーが説明できるか 仕組みに任せて省力化する • 静的解析・自動テスト・脆弱性スキャンを人間レビューの前段に置く • PRテンプレートに「AI生成範囲・使用プロンプト・確認したこと」欄を設 ける • PRサイズに上限を置き、超えたら分割を求める(小さく出すの強制) • 生成コードにはテストと計測(ログ・メトリクス)の同梱を必須にする 原則 : レビューの目的は「間違い探し」より「説明責任の確認」。説明できる人を作る工程がレビュー 保守運用とSRE 第2回 28
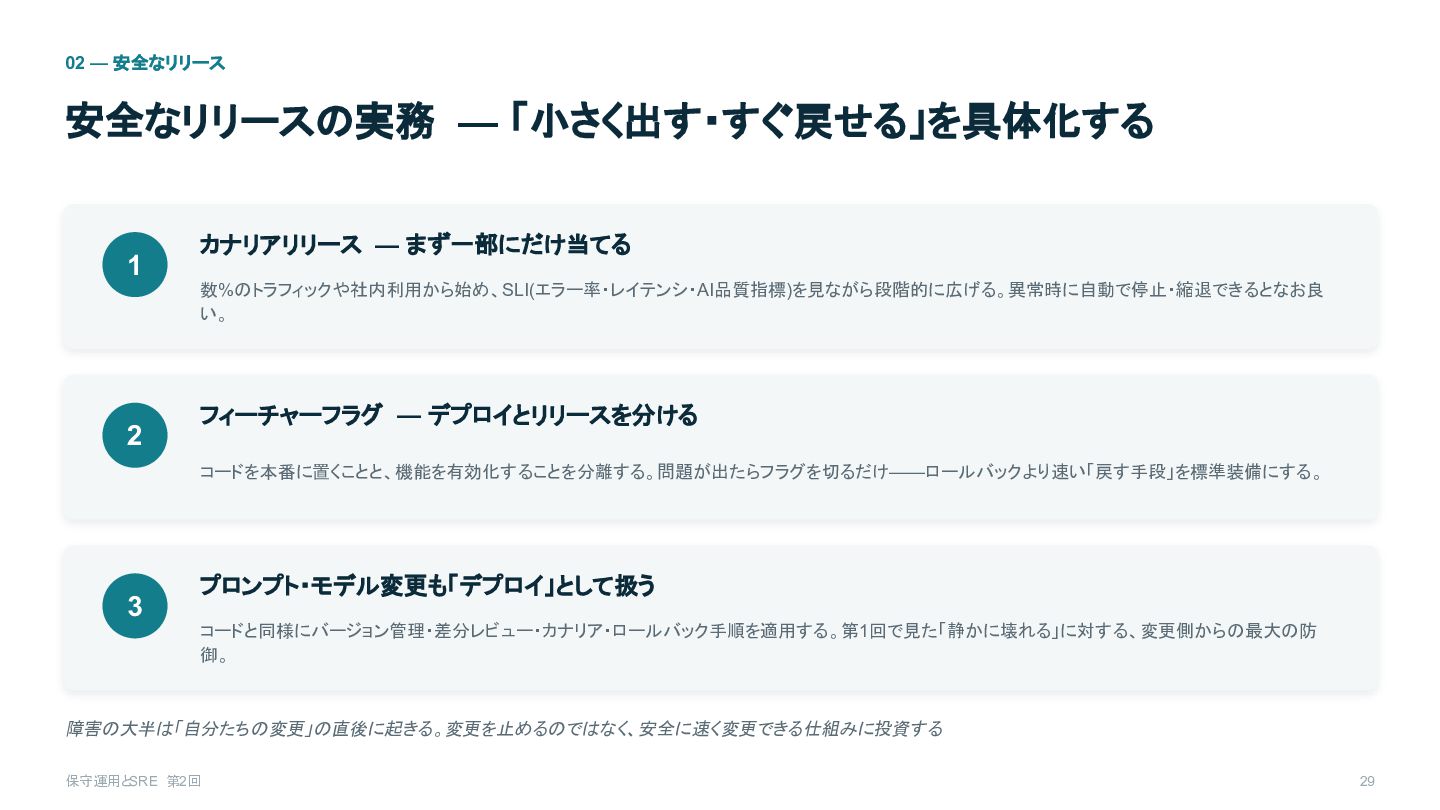
02 — 安全なリリース 安全なリリースの実務 — 「小さく出す・すぐ戻せる」を具体化する 1 2 カナリアリリース —
まず一部にだけ当てる 数%のトラフィックや社内利用から始め、SLI(エラー率・レイテンシ・AI品質指標)を見ながら段階的に広げる。異常時に自動で停止・縮退できるとなお良 い。 フィーチャーフラグ — デプロイとリリースを分ける コードを本番に置くことと、機能を有効化することを分離する。問題が出たらフラグを切るだけ——ロールバックより速い「戻す手段」を標準装備にする。 3 プロンプト・モデル変更も「デプロイ」として扱う コードと同様にバージョン管理・差分レビュー・カナリア・ロールバック手順を適用する。第1回で見た「静かに壊れる」に対する、変更側からの最大の防 御。 障害の大半は「自分たちの変更」の直後に起きる。変更を止めるのではなく、安全に速く変更できる仕組みに投資する 保守運用とSRE 第2回 29
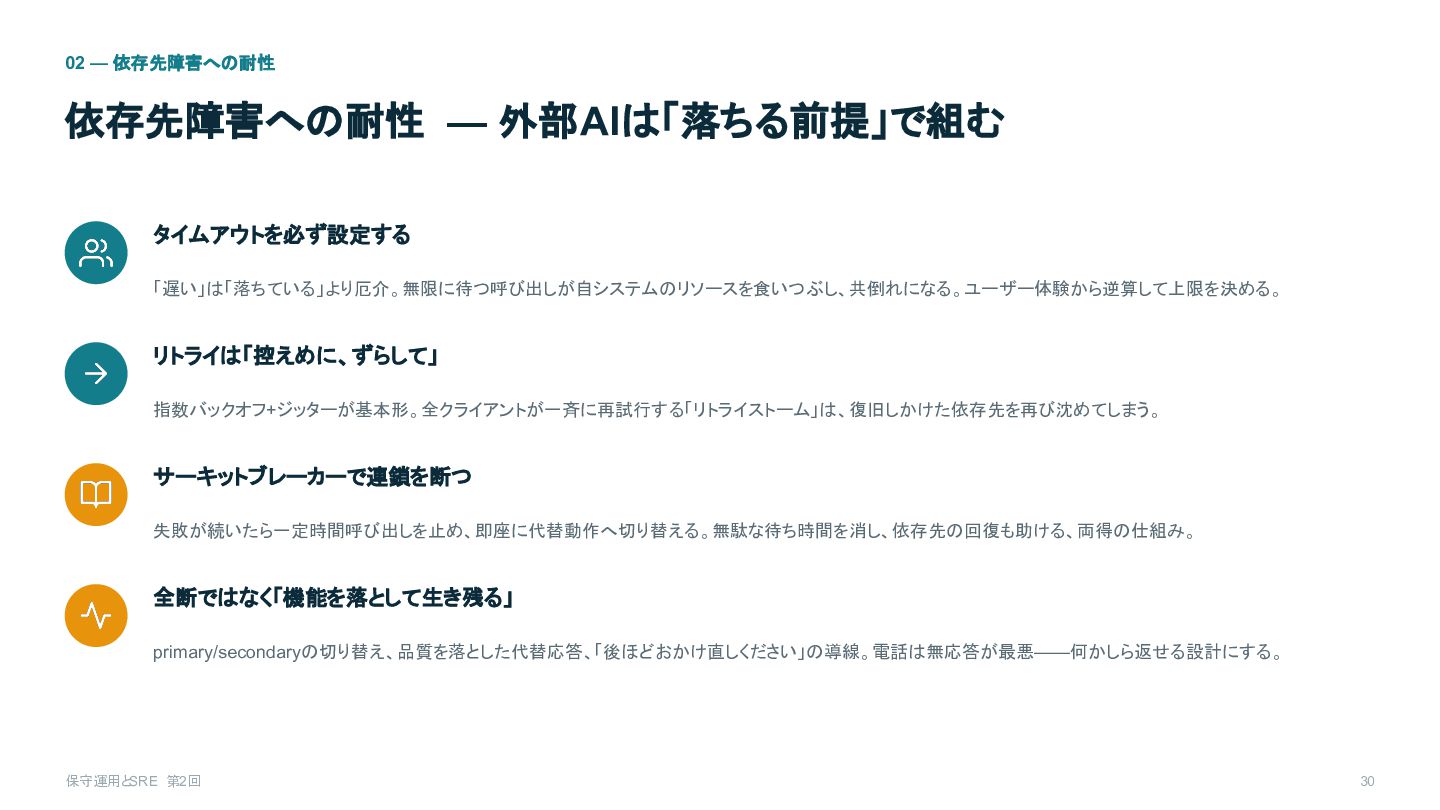
02 — 依存先障害への耐性 依存先障害への耐性 — 外部AIは「落ちる前提」で組む タイムアウトを必ず設定する 「遅い」は「落ちている」より厄介。無限に待つ呼び出しが自システムのリソースを食いつぶし、共倒れになる。ユーザー体験から逆算して上限を決める。 リトライは「控えめに、ずらして」 指数バックオフ+ジッターが基本形。全クライアントが一斉に再試行する「リトライストーム」は、復旧しかけた依存先を再び沈めてしまう。
サーキットブレーカーで連鎖を断つ 失敗が続いたら一定時間呼び出しを止め、即座に代替動作へ切り替える。無駄な待ち時間を消し、依存先の回復も助ける、両得の仕組み。 全断ではなく「機能を落として生き残る」 primary/secondaryの切り替え、品質を落とした代替応答、「後ほどおかけ直しください」の導線。電話は無応答が最悪——何かしら返せる設計にする。 保守運用とSRE 第2回 30
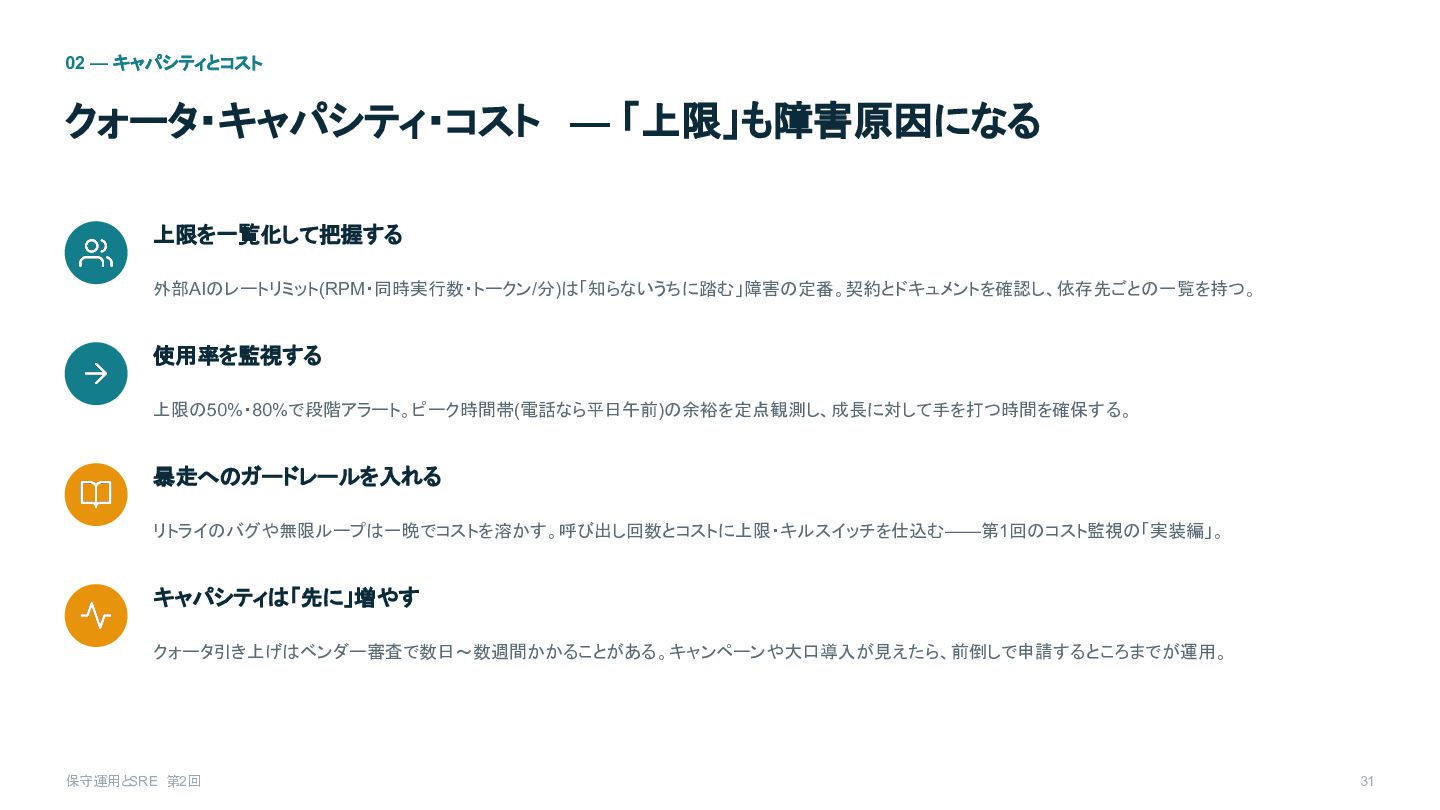
02 — キャパシティとコスト クォータ・キャパシティ・コスト — 「上限」も障害原因になる 上限を一覧化して把握する 外部AIのレートリミット(RPM・同時実行数・トークン/分)は「知らないうちに踏む」障害の定番。契約とドキュメントを確認し、依存先ごとの一覧を持つ。 使用率を監視する 上限の50%・80%で段階アラート。ピーク時間帯(電話なら平日午前)の余裕を定点観測し、成長に対して手を打つ時間を確保する。
暴走へのガードレールを入れる リトライのバグや無限ループは一晩でコストを溶かす。呼び出し回数とコストに上限・キルスイッチを仕込む——第1回のコスト監視の「実装編」。 キャパシティは「先に」増やす クォータ引き上げはベンダー審査で数日〜数週間かかることがある。キャンペーンや大口導入が見えたら、前倒しで申請するところまでが運用。 保守運用とSRE 第2回 31
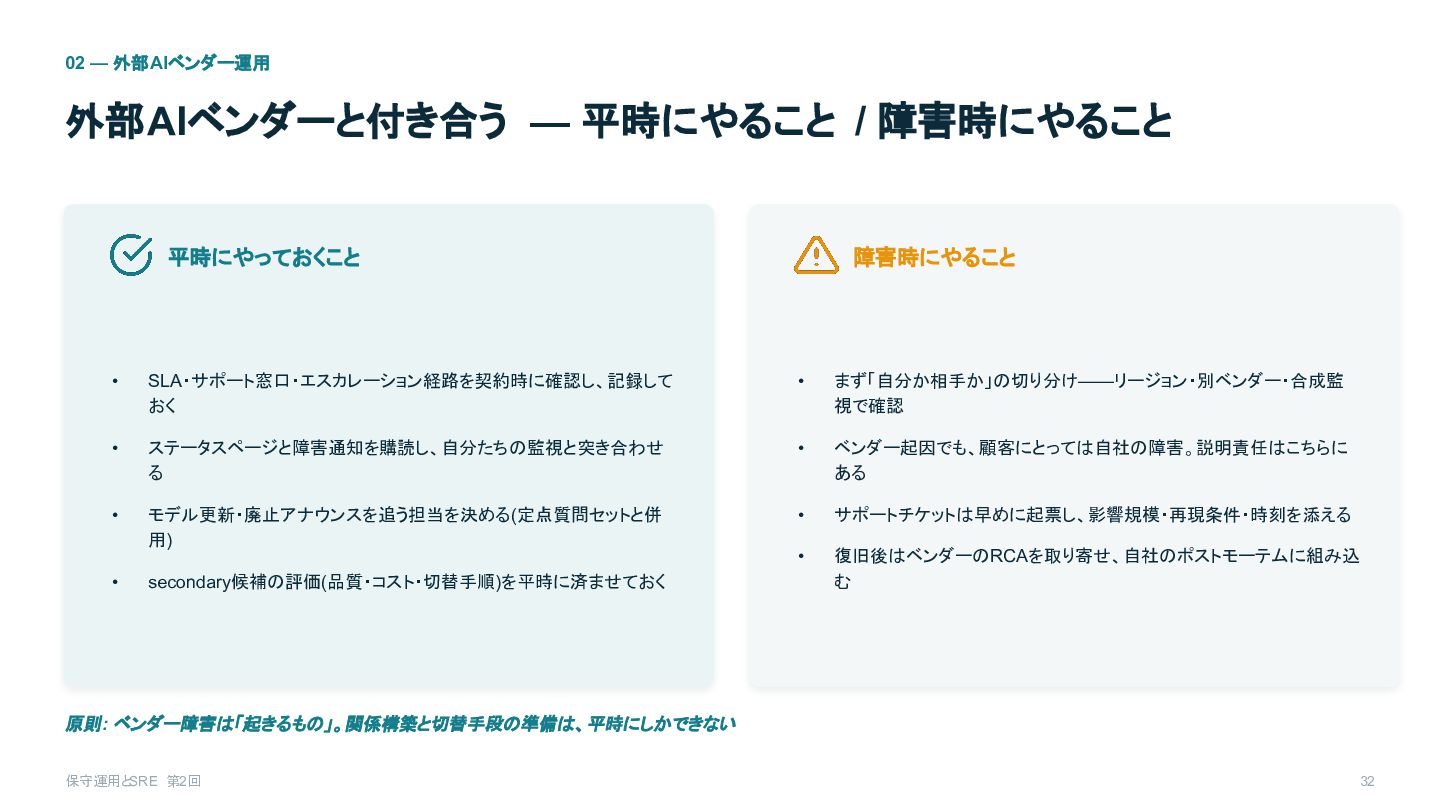
02 — 外部AIベンダー運用 外部AIベンダーと付き合う — 平時にやること / 障害時にやること 平時にやっておくこと 障害時にやること
• SLA・サポート窓口・エスカレーション経路を契約時に確認し、記録して おく • まず「自分か相手か」の切り分け——リージョン・別ベンダー・合成監 視で確認 • ステータスページと障害通知を購読し、自分たちの監視と突き合わせ る • ベンダー起因でも、顧客にとっては自社の障害。説明責任はこちらに ある • モデル更新・廃止アナウンスを追う担当を決める(定点質問セットと併 用) • サポートチケットは早めに起票し、影響規模・再現条件・時刻を添える • • secondary候補の評価(品質・コスト・切替手順)を平時に済ませておく 復旧後はベンダーのRCAを取り寄せ、自社のポストモーテムに組み込 む 原則 : ベンダー障害は「起きるもの」。関係構築と切替手段の準備は、平時にしかできない 保守運用とSRE 第2回 32
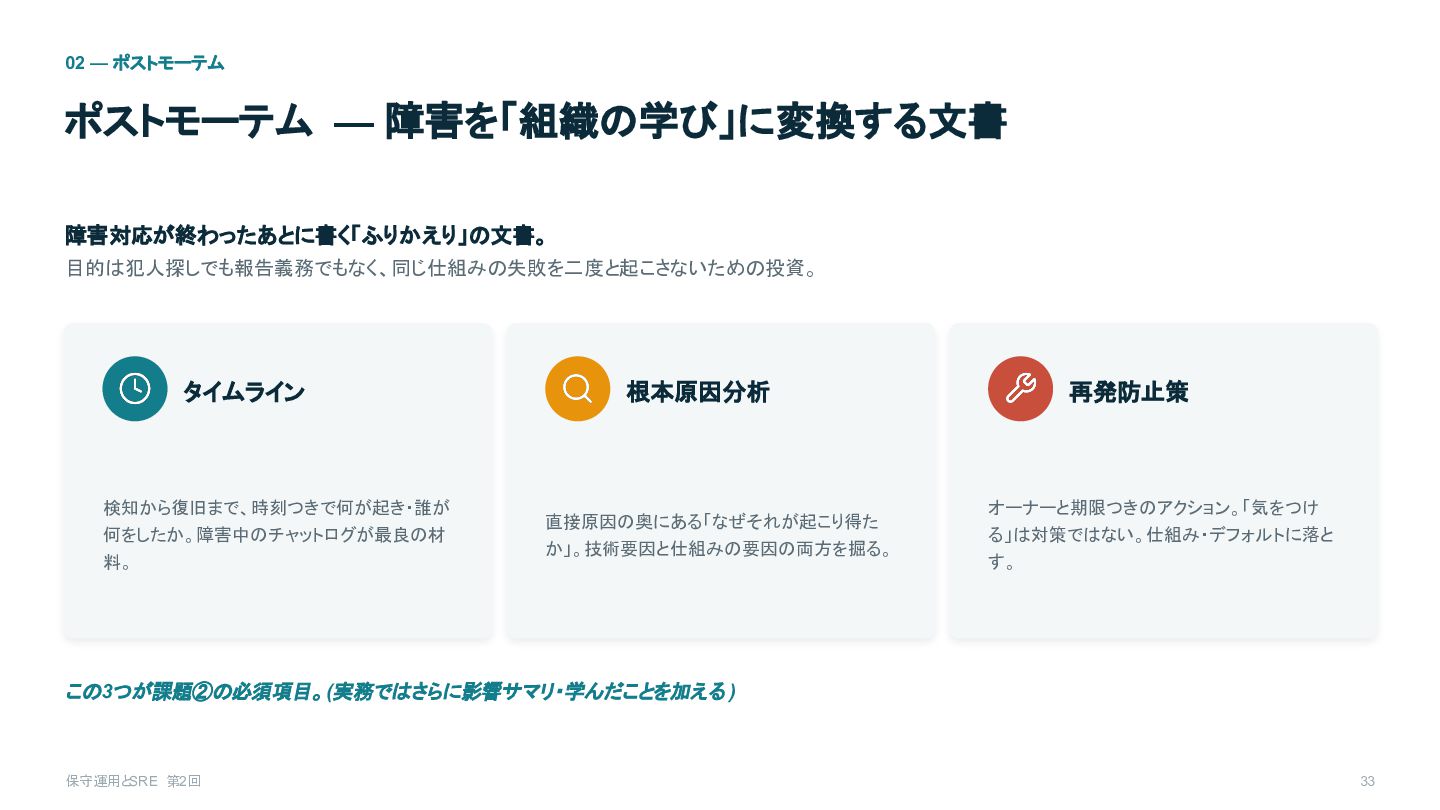
02 — ポストモーテム ポストモーテム — 障害を「組織の学び」に変換する文書 障害対応が終わったあとに書く「ふりかえり」の文書。 目的は犯人探しでも報告義務でもなく、同じ仕組みの失敗を二度と起こさないための投資。 タイムライン 検知から復旧まで、時刻つきで何が起き・誰が
何をしたか。障害中のチャットログが最良の材 料。 根本原因分析 直接原因の奥にある「なぜそれが起こり得た か」。技術要因と仕組みの要因の両方を掘る。 再発防止策 オーナーと期限つきのアクション。「気をつけ る」は対策ではない。仕組み・デフォルトに落と す。 この3つが課題②の必須項目。 (実務ではさらに影響サマリ・学んだことを加える ) 保守運用とSRE 第2回 33
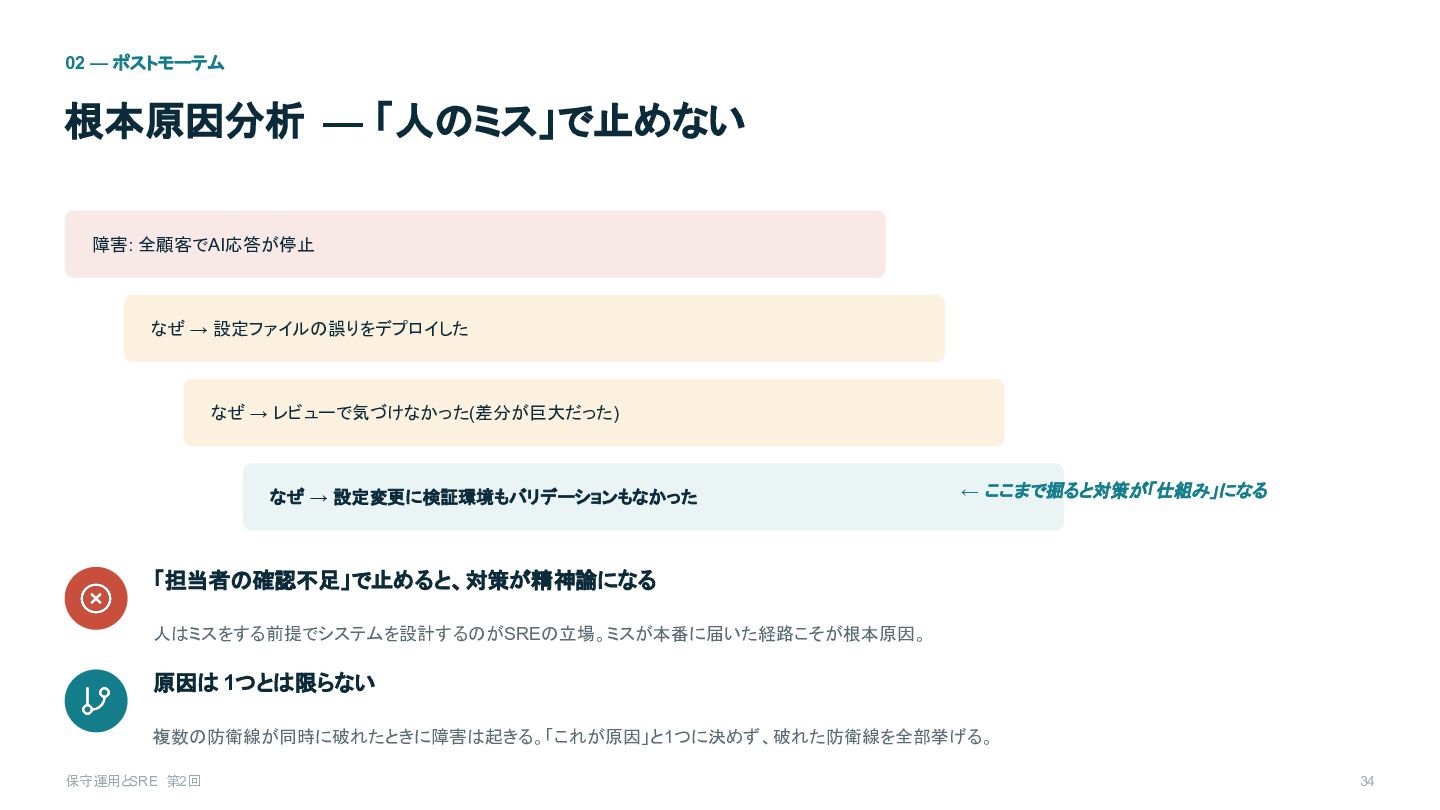
02 — ポストモーテム 根本原因分析 — 「人のミス」で止めない 障害: 全顧客でAI応答が停止 なぜ →
設定ファイルの誤りをデプロイした なぜ → レビューで気づけなかった(差分が巨大だった) なぜ → 設定変更に検証環境もバリデーションもなかった ← ここまで掘ると対策が「仕組み」になる 「担当者の確認不足」で止めると、対策が精神論になる 人はミスをする前提でシステムを設計するのがSREの立場。ミスが本番に届いた経路こそが根本原因。 原因は 1つとは限らない 複数の防衛線が同時に破れたときに障害は起きる。「これが原因」と1つに決めず、破れた防衛線を全部挙げる。 保守運用とSRE 第2回 34
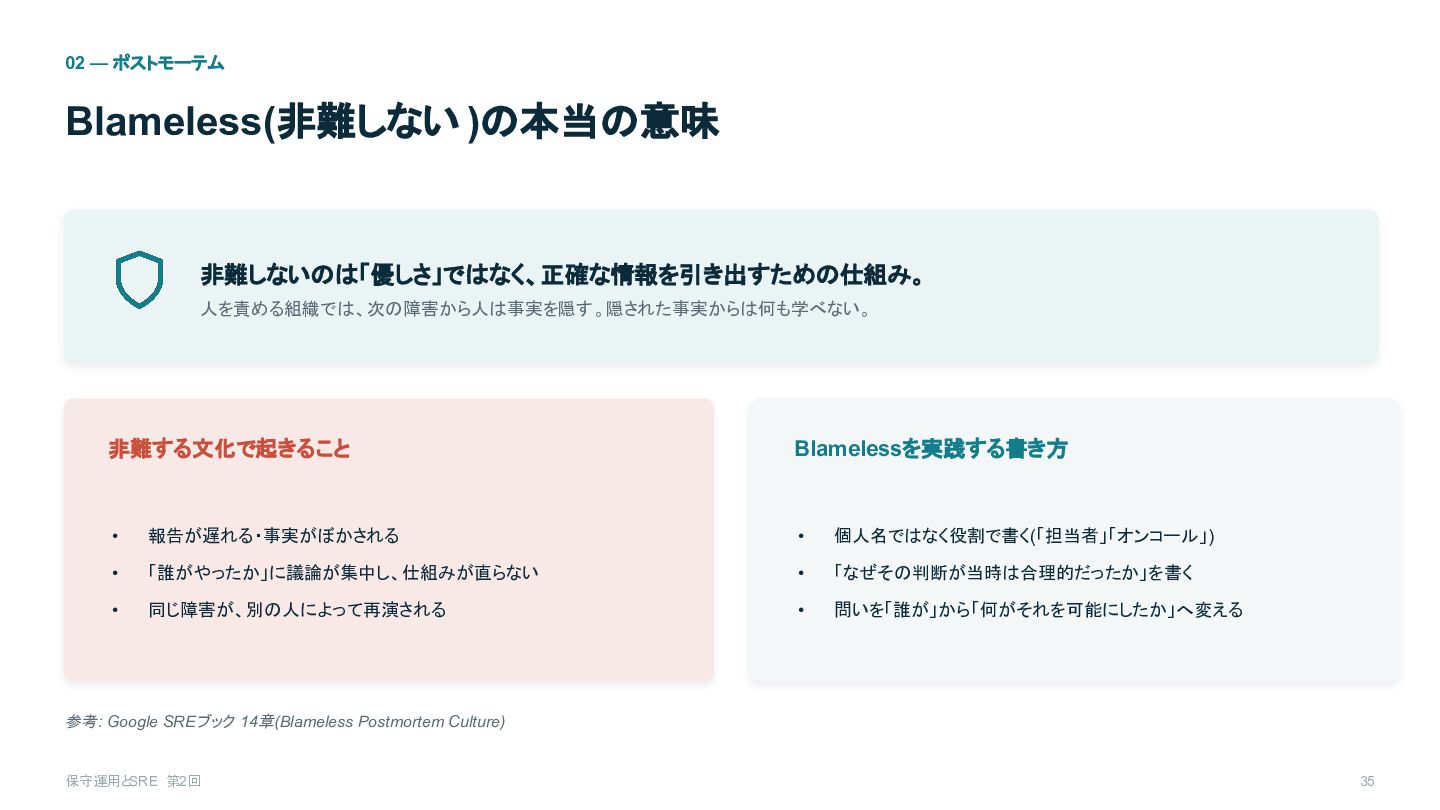
02 — ポストモーテム Blameless(非難しない )の本当の意味 非難しないのは「優しさ」ではなく、正確な情報を引き出すための仕組み。 人を責める組織では、次の障害から人は事実を隠す。隠された事実からは何も学べない。 非難する文化で起きること Blamelessを実践する書き方 •
報告が遅れる・事実がぼかされる • 個人名ではなく役割で書く(「担当者」「オンコール」) • 「誰がやったか」に議論が集中し、仕組みが直らない • 「なぜその判断が当時は合理的だったか」を書く • 同じ障害が、別の人によって再演される • 問いを「誰が」から「何がそれを可能にしたか」へ変える 参考 : Google SREブック 14章 (Blameless Postmortem Culture) 保守運用とSRE 第2回 35
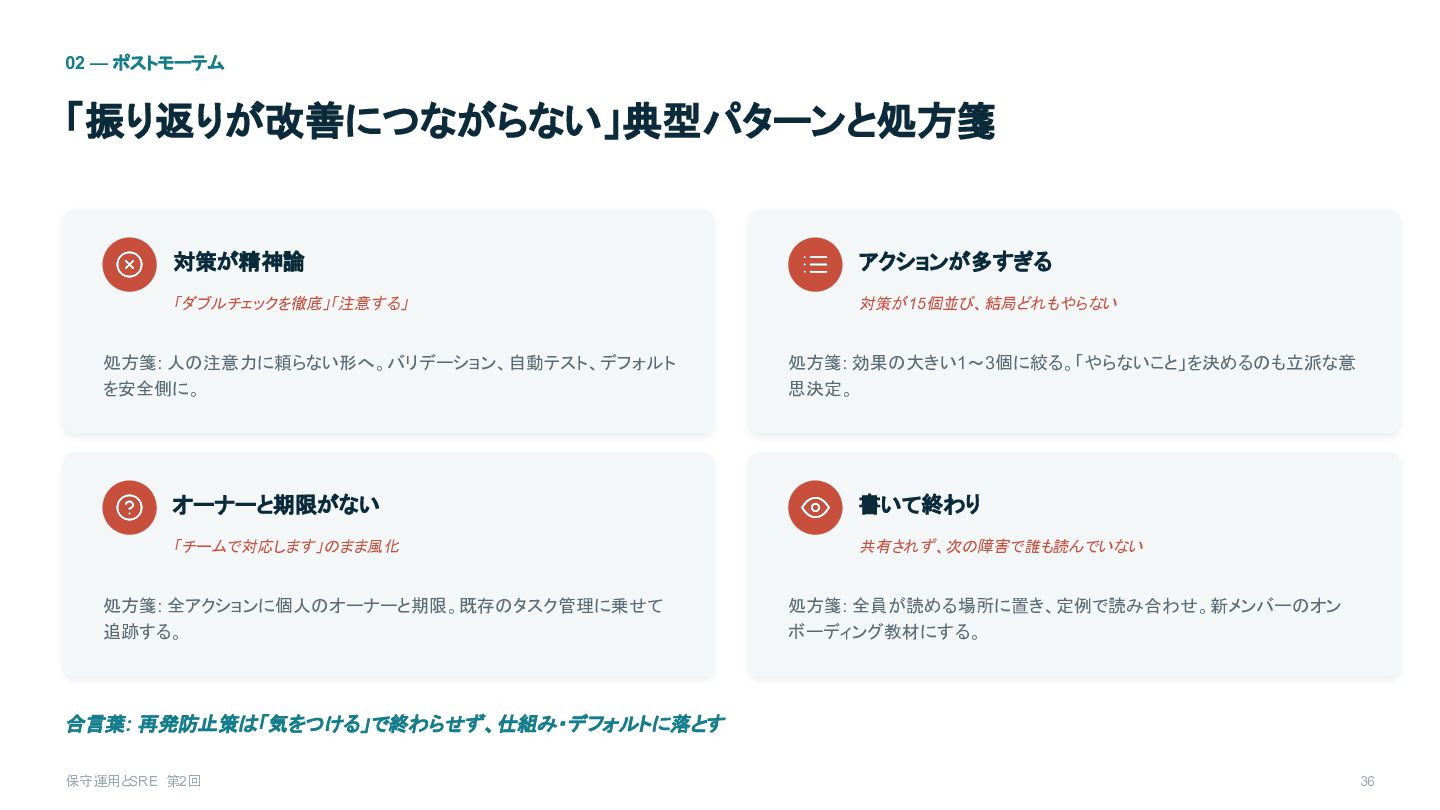
02 — ポストモーテム 「振り返りが改善につながらない」典型パターンと処方箋 対策が精神論 アクションが多すぎる 「ダブルチェックを徹底」「注意する」 対策が 15個並び、結局どれもやらない 処方箋:
人の注意力に頼らない形へ。バリデーション、自動テスト、デフォルト を安全側に。 処方箋: 効果の大きい1〜3個に絞る。「やらないこと」を決めるのも立派な意 思決定。 オーナーと期限がない 書いて終わり 「チームで対応します」のまま風化 共有されず、次の障害で誰も読んでいない 処方箋: 全アクションに個人のオーナーと期限。既存のタスク管理に乗せて 追跡する。 処方箋: 全員が読める場所に置き、定例で読み合わせ。新メンバーのオン ボーディング教材にする。 合言葉: 再発防止策は「気をつける」で終わらせず、仕組み・デフォルトに落とす 保守運用とSRE 第2回 36
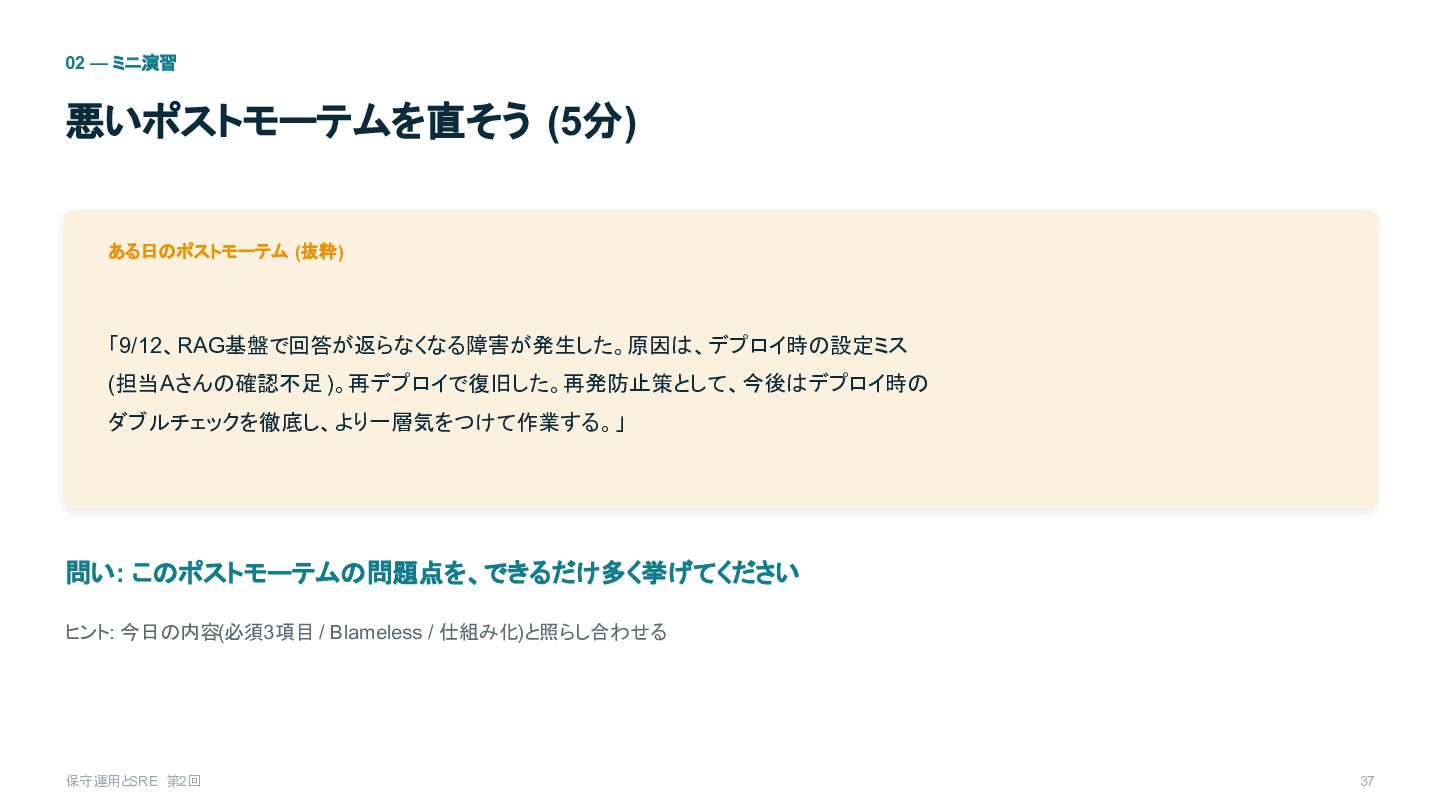
02 — ミニ演習 悪いポストモーテムを直そう (5分) ある日のポストモーテム (抜粋) 「9/12、RAG基盤で回答が返らなくなる障害が発生した。原因は、デプロイ時の設定ミス (担当Aさんの確認不足 )。再デプロイで復旧した。再発防止策として、今後はデプロイ時の
ダブルチェックを徹底し、より一層気をつけて作業する。」 問い: このポストモーテムの問題点を、できるだけ多く挙げてください ヒント: 今日の内容(必須3項目 / Blameless / 仕組み化)と照らし合わせる 保守運用とSRE 第2回 37
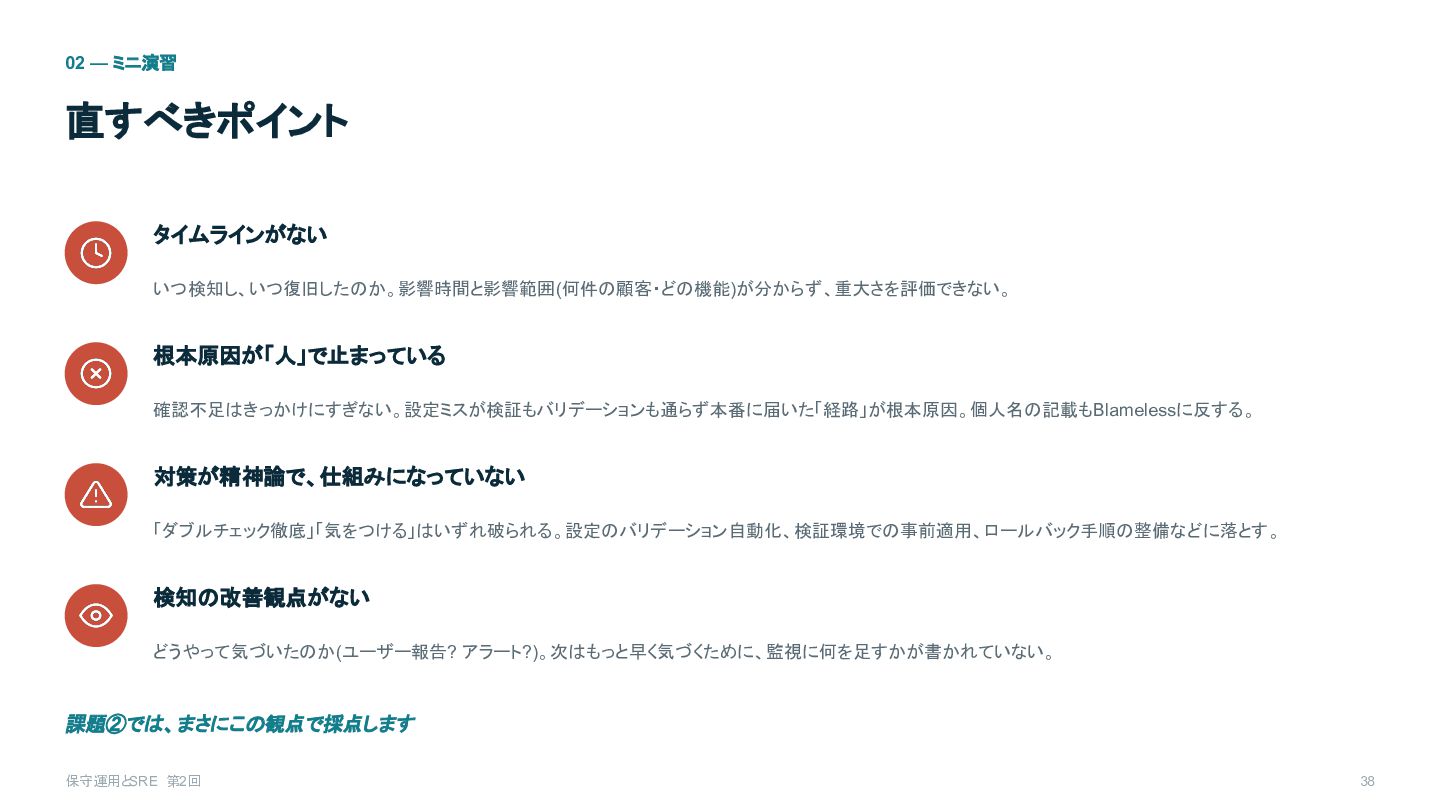
02 — ミニ演習 直すべきポイント タイムラインがない いつ検知し、いつ復旧したのか。影響時間と影響範囲(何件の顧客・どの機能)が分からず、重大さを評価できない。 根本原因が「人」で止まっている 確認不足はきっかけにすぎない。設定ミスが検証もバリデーションも通らず本番に届いた「経路」が根本原因。個人名の記載もBlamelessに反する。 対策が精神論で、仕組みになっていない 「ダブルチェック徹底」「気をつける」はいずれ破られる。設定のバリデーション自動化、検証環境での事前適用、ロールバック手順の整備などに落とす。
検知の改善観点がない どうやって気づいたのか(ユーザー報告? アラート?)。次はもっと早く気づくために、監視に何を足すかが書かれていない。 課題②では、まさにこの観点で採点します 保守運用とSRE 第2回 38
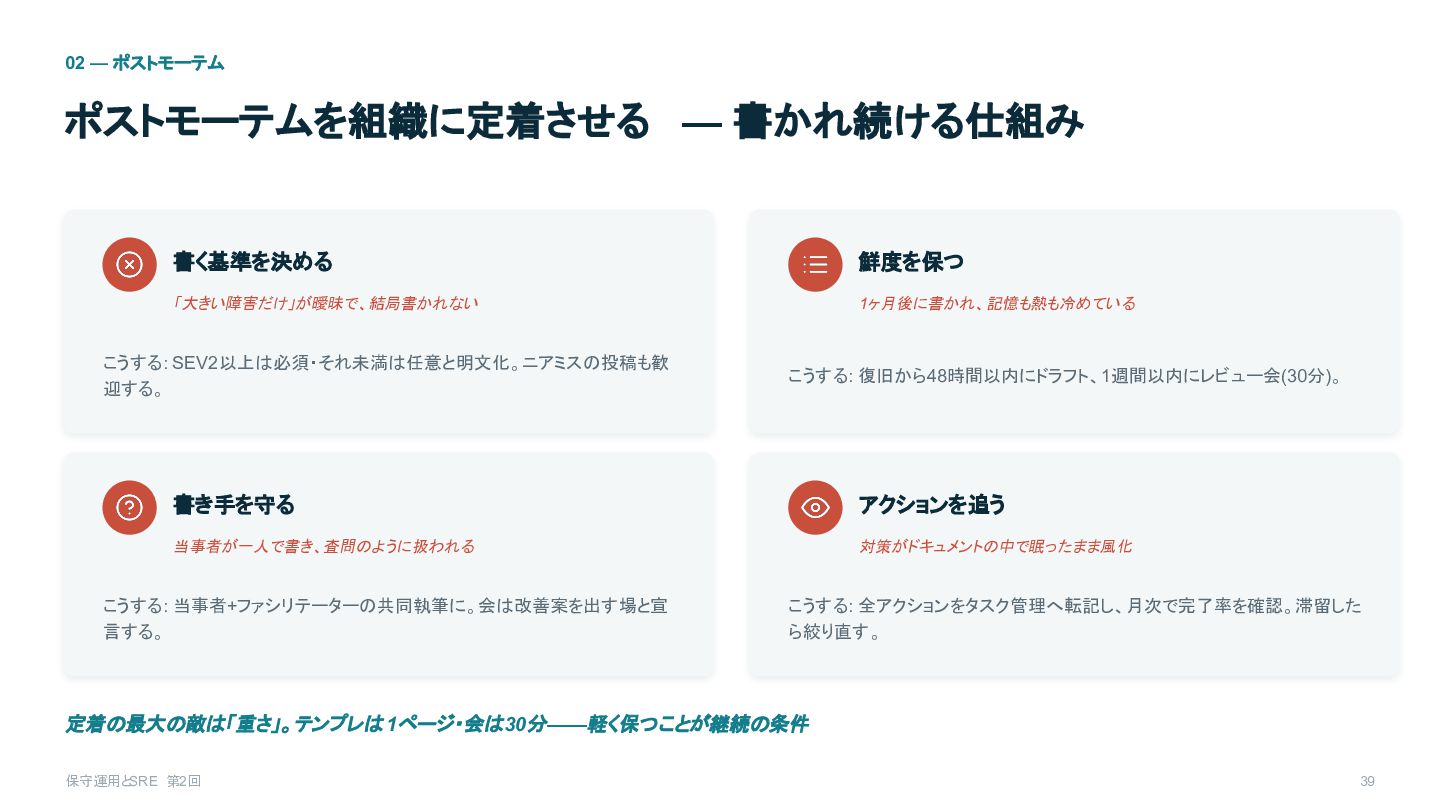
02 — ポストモーテム ポストモーテムを組織に定着させる — 書かれ続ける仕組み 書く基準を決める 鮮度を保つ 「大きい障害だけ」が曖昧で、結局書かれない 1ヶ月後に書かれ、記憶も熱も冷めている
こうする: SEV2以上は必須・それ未満は任意と明文化。ニアミスの投稿も歓 迎する。 こうする: 復旧から48時間以内にドラフト、1週間以内にレビュー会(30分)。 書き手を守る アクションを追う 当事者が一人で書き、査問のように扱われる 対策がドキュメントの中で眠ったまま風化 こうする: 当事者+ファシリテーターの共同執筆に。会は改善案を出す場と宣 言する。 こうする: 全アクションをタスク管理へ転記し、月次で完了率を確認。滞留した ら絞り直す。 定着の最大の敵は「重さ」。テンプレは 1ページ・会は 30分——軽く保つことが継続の条件 保守運用とSRE 第2回 39
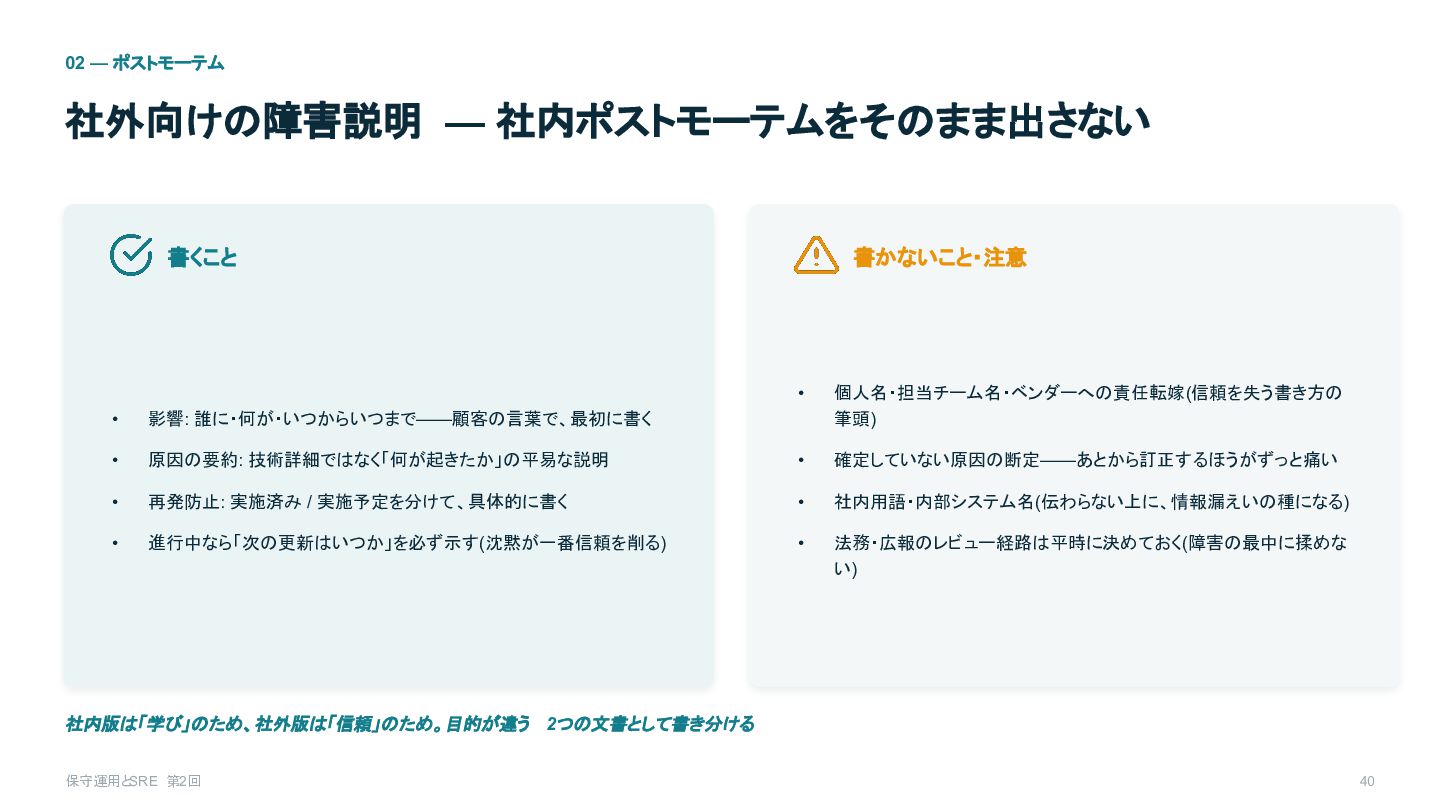
02 — ポストモーテム 社外向けの障害説明 — 社内ポストモーテムをそのまま出さない 書くこと 書かないこと・注意 • 個人名・担当チーム名・ベンダーへの責任転嫁(信頼を失う書き方の
筆頭) • 影響: 誰に・何が・いつからいつまで——顧客の言葉で、最初に書く • 原因の要約: 技術詳細ではなく「何が起きたか」の平易な説明 • 確定していない原因の断定——あとから訂正するほうがずっと痛い • 再発防止: 実施済み / 実施予定を分けて、具体的に書く • 社内用語・内部システム名(伝わらない上に、情報漏えいの種になる) • 進行中なら「次の更新はいつか」を必ず示す(沈黙が一番信頼を削る) • 法務・広報のレビュー経路は平時に決めておく(障害の最中に揉めな い) 社内版は「学び」のため、社外版は「信頼」のため。目的が違う 2つの文書として書き分ける 保守運用とSRE 第2回 40
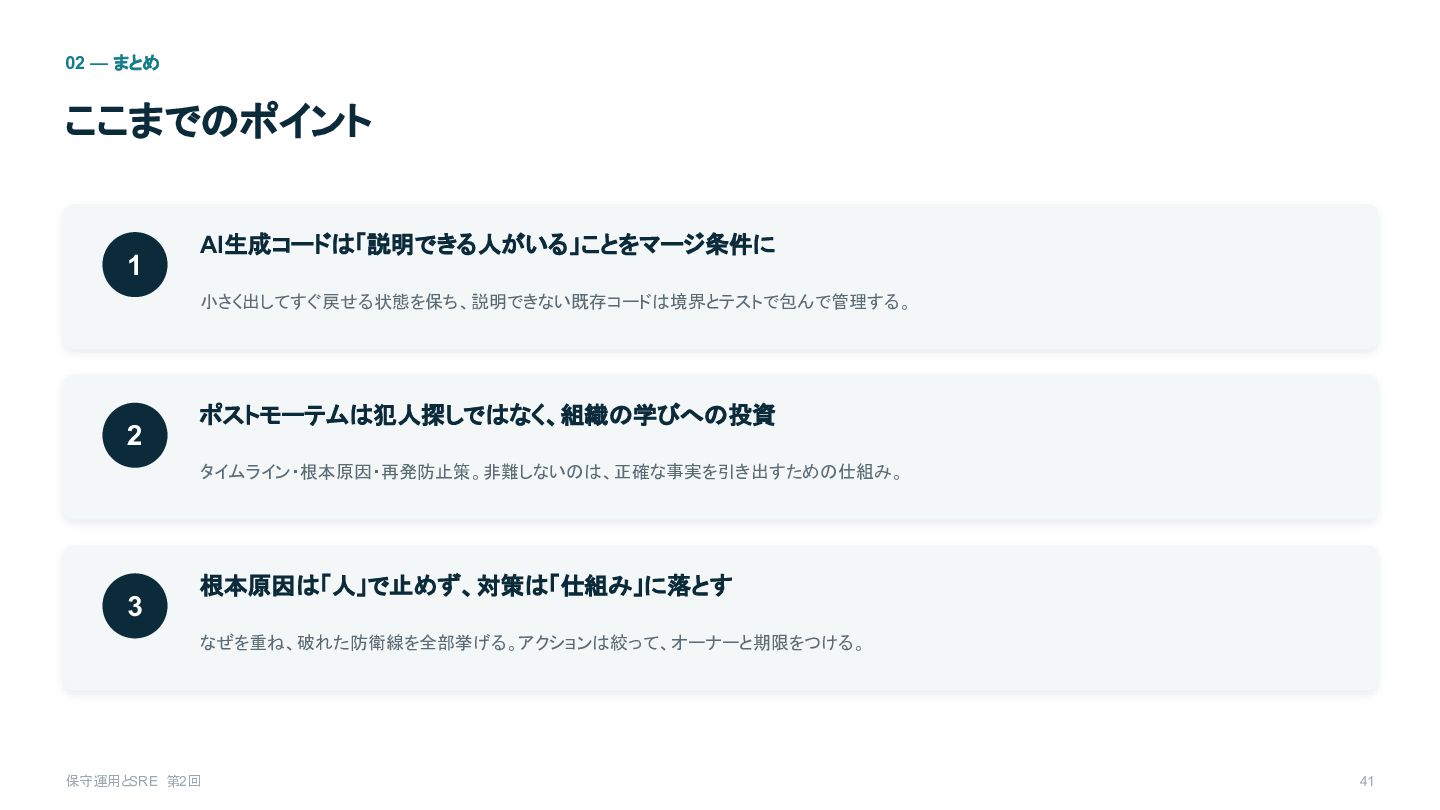
02 — まとめ ここまでのポイント 1 AI生成コードは「説明できる人がいる」ことをマージ条件に 小さく出してすぐ戻せる状態を保ち、説明できない既存コードは境界とテストで包んで管理する。 2 ポストモーテムは犯人探しではなく、組織の学びへの投資 タイムライン・根本原因・再発防止策。非難しないのは、正確な事実を引き出すための仕組み。
3 根本原因は「人」で止めず、対策は「仕組み」に落とす なぜを重ね、破れた防衛線を全部挙げる。アクションは絞って、オーナーと期限をつける。 保守運用とSRE 第2回 41
03 課題②の説明 模擬インシデントのポストモーテムを書く— 今日の演習の実践版 10 min 保守運用とSRE 第2回 42
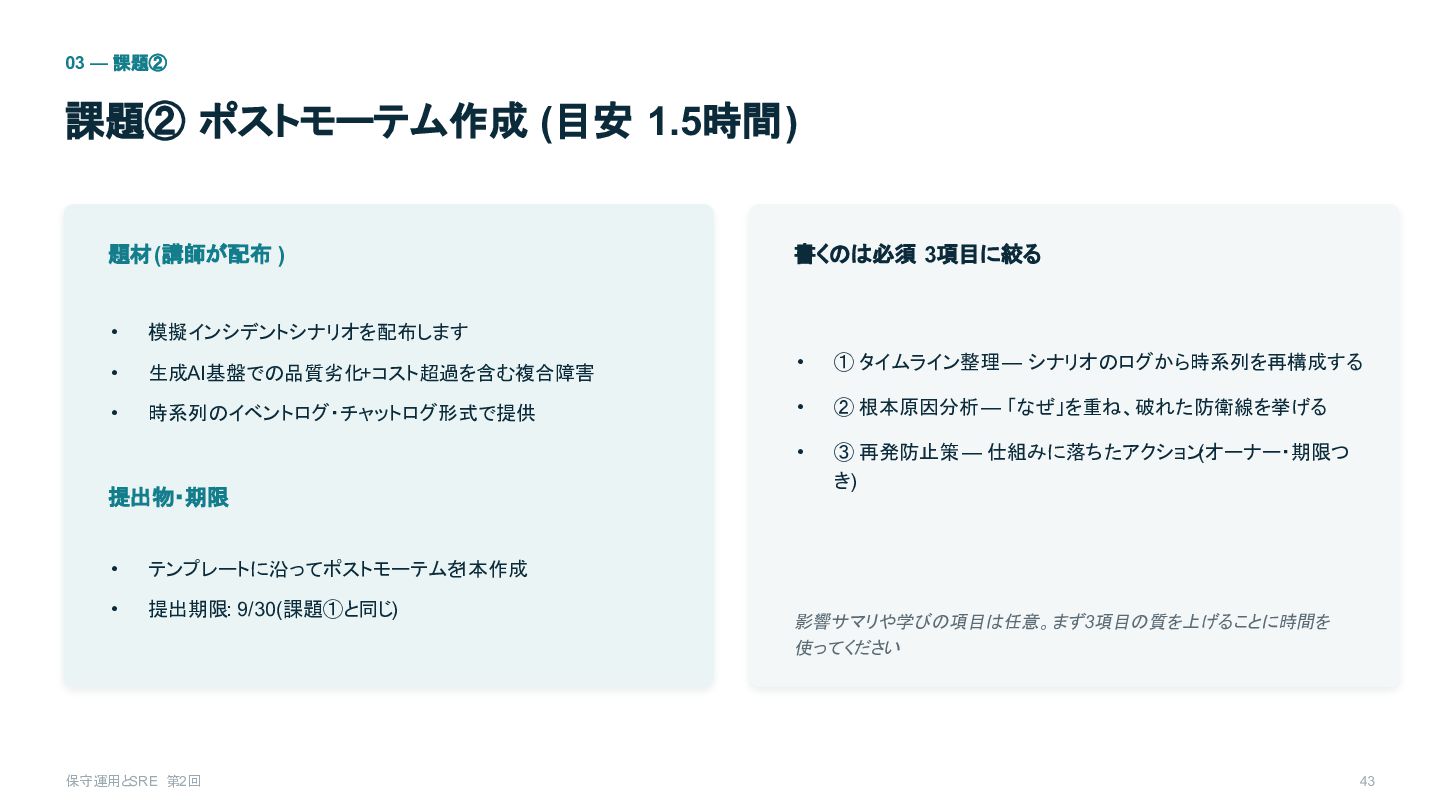
03 — 課題② 課題② ポストモーテム作成 (目安 1.5時間) 題材 (講師が配布 )
書くのは必須 3項目に絞る • 模擬インシデントシナリオを配布します • 生成AI基盤での品質劣化+コスト超過を含む複合障害 • ① タイムライン整理 — シナリオのログから時系列を再構成する • 時系列のイベントログ・チャットログ形式で提供 • ② 根本原因分析 — 「なぜ」を重ね、破れた防衛線を挙げる • ③ 再発防止策 — 仕組みに落ちたアクション(オーナー・期限つ き) 提出物・期限 • テンプレートに沿ってポストモーテムを1本作成 • 提出期限: 9/30(課題①と同じ) 保守運用とSRE 第2回 影響サマリや学びの項目は任意。まず3項目の質を上げることに時間を 使ってください 43
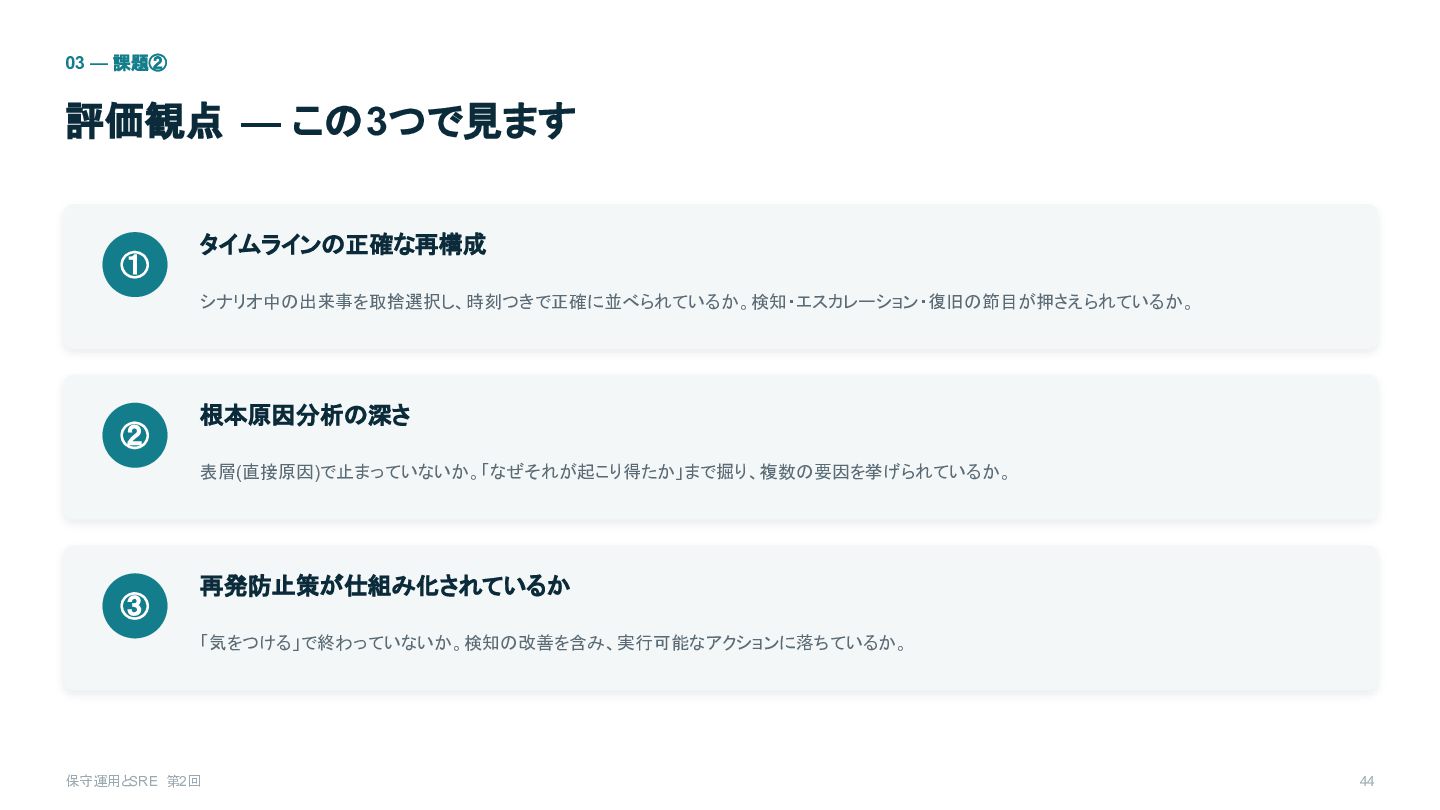
03 — 課題② 評価観点 — この3つで見ます ① タイムラインの正確な再構成 シナリオ中の出来事を取捨選択し、時刻つきで正確に並べられているか。検知・エスカレーション・復旧の節目が押さえられているか。 ②
根本原因分析の深さ 表層(直接原因)で止まっていないか。「なぜそれが起こり得たか」まで掘り、複数の要因を挙げられているか。 ③ 再発防止策が仕組み化されているか 「気をつける」で終わっていないか。検知の改善を含み、実行可能なアクションに落ちているか。 保守運用とSRE 第2回 44
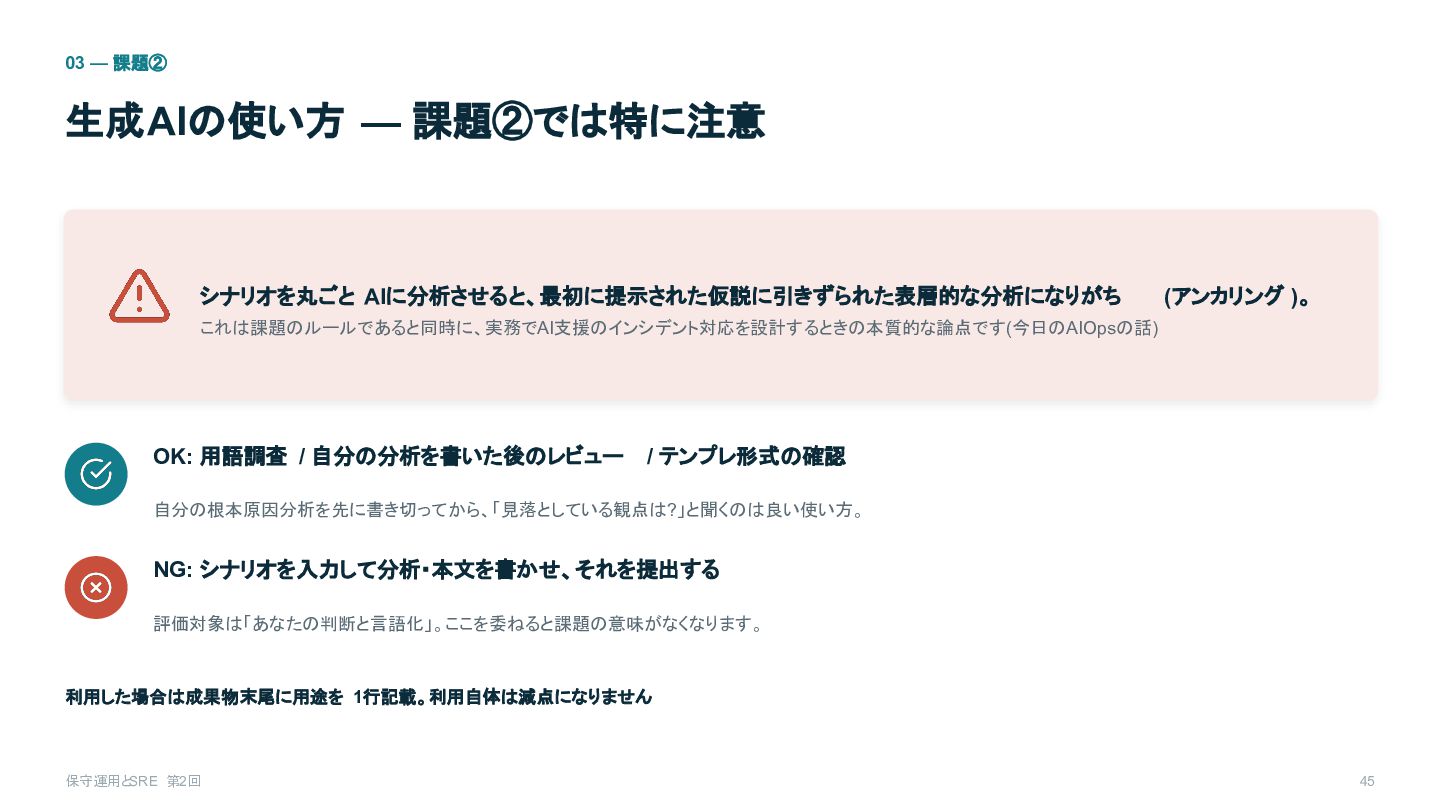
03 — 課題② 生成AIの使い方 — 課題②では特に注意 シナリオを丸ごと AIに分析させると、最初に提示された仮説に引きずられた表層的な分析になりがち (アンカリング )。
これは課題のルールであると同時に、実務でAI支援のインシデント対応を設計するときの本質的な論点です(今日のAIOpsの話) OK: 用語調査 / 自分の分析を書いた後のレビュー / テンプレ形式の確認 自分の根本原因分析を先に書き切ってから、「見落としている観点は?」と聞くのは良い使い方。 NG: シナリオを入力して分析・本文を書かせ、それを提出する 評価対象は「あなたの判断と言語化」。ここを委ねると課題の意味がなくなります。 利用した場合は成果物末尾に用途を 1行記載。利用自体は減点になりません 保守運用とSRE 第2回 45
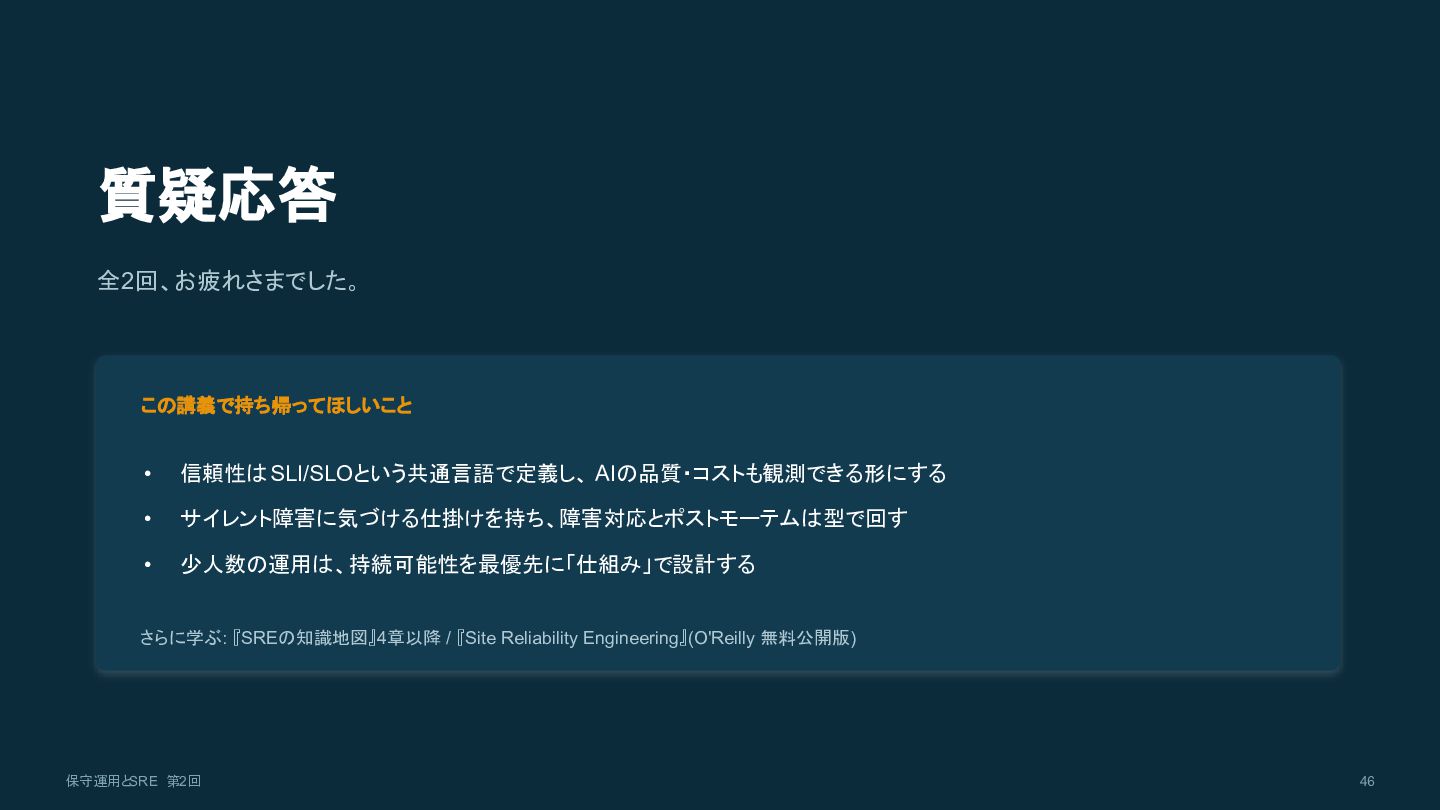
質疑応答 全2回、お疲れさまでした。 この講義で持ち帰ってほしいこと • 信頼性はSLI/SLOという共通言語で定義し、 AIの品質・コストも観測できる形にする • サイレント障害に気づける仕掛けを持ち、障害対応とポストモーテムは型で回す • 少人数の運用は、持続可能性を最優先に「仕組み」で設計する
さらに学ぶ: 『SREの知識地図』4章以降 / 『Site Reliability Engineering』(O'Reilly 無料公開版) 保守運用とSRE 第2回 46
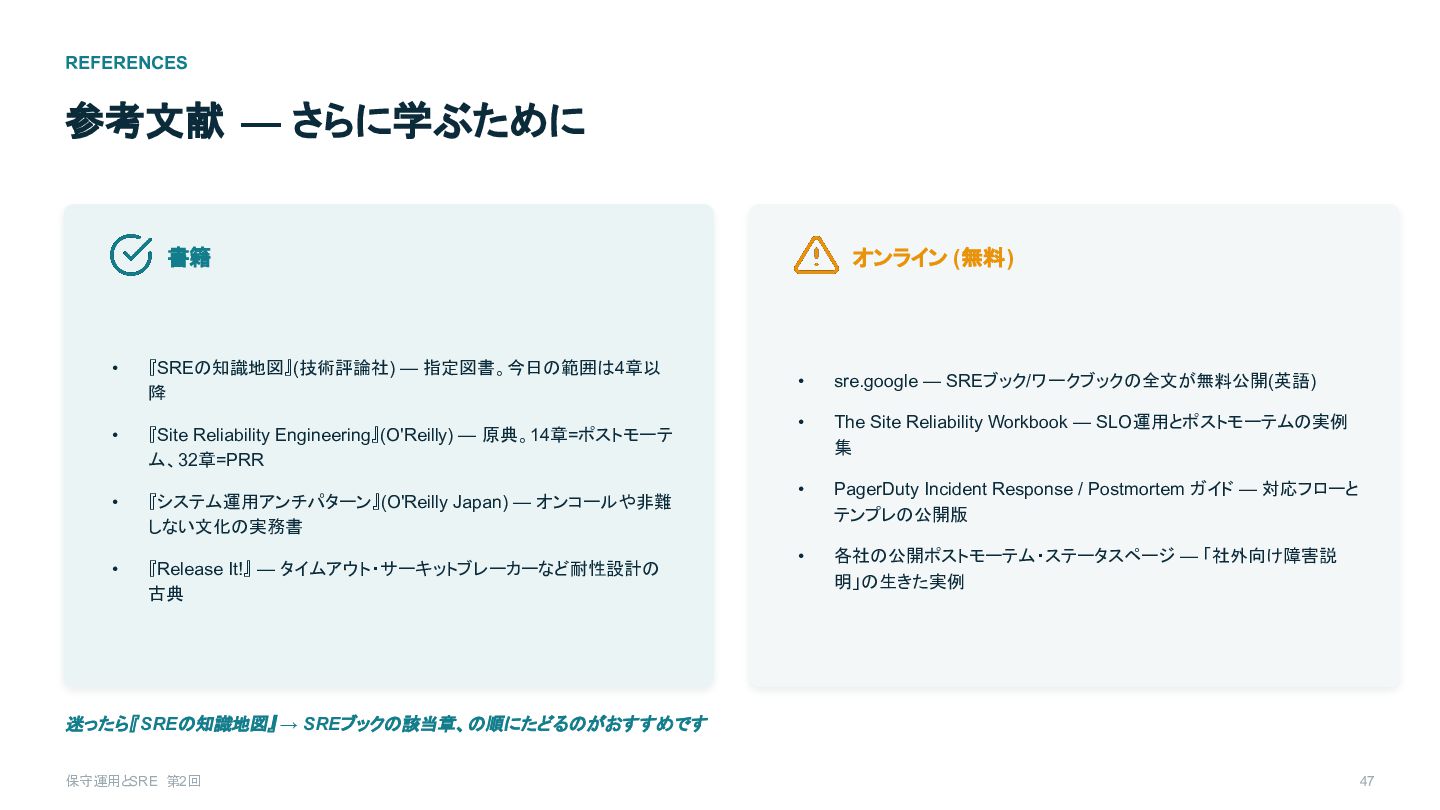
REFERENCES 参考文献 — さらに学ぶために 書籍 • 『SREの知識地図』(技術評論社) — 指定図書。今日の範囲は4章以 降
• 『Site Reliability Engineering』(O'Reilly) — 原典。14章=ポストモーテ ム、32章=PRR • 『システム運用アンチパターン』(O'Reilly Japan) — オンコールや非難 しない文化の実務書 • 『Release It!』 — タイムアウト・サーキットブレーカーなど耐性設計の 古典 オンライン (無料 ) • sre.google — SREブック/ワークブックの全文が無料公開(英語) • The Site Reliability Workbook — SLO運用とポストモーテムの実例 集 • PagerDuty Incident Response / Postmortem ガイド — 対応フローと テンプレの公開版 • 各社の公開ポストモーテム・ステータスページ — 「社外向け障害説 明」の生きた実例 迷ったら『 SREの知識地図』 → SREブックの該当章、の順にたどるのがおすすめです 保守運用とSRE 第2回 47


 ryuichi1208
 uxyall
 minecr
 holman
 nikkihalliwell
 3n
 addyosmani
 inesmontani
 gr2m
 thekraken
 marketingsoph
 chriscoyier