Upgrade to Pro — share decks privately, control downloads, hide ads and more …

OneLakeをデータソースにした AI Search(Foundry IQ)の ライフサイクル管理

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →
Avatar for Ryusei Iida Ryusei Iida
October 29, 2026

OneLakeをデータソースにした AI Search(Foundry IQ)の ライフサイクル管理

Microsoft FabricのOneLakeをデータソースにして、Azure AI Search(Foundry IQ)で検索・RAGを行う際の、データの追加・更新・削除のライフサイクル管理を解説します。

特に注目するのは、「元データを削除したのに、検索結果には削除された情報が残ってしまう」という課題です。構造化データではCopy jobとAzure SQL Databaseを介した連携方法を、物理削除・論理削除を検索インデックスへ反映する方法を紹介しています。
非構造化データでは、OneLake上のファイル削除を検知し、Activatorを起点に対象ドキュメントを特定して削除する流れを、実行イメージとともに説明します。

認証情報の扱いやサンプルNotebook・UDFにも触れながら、追加や更新だけでなく、削除まで含めて検索データを最新に保つための構成と注意点をまとめました。OneLakeとAI Searchを組み合わせた検索基盤の構築・運用を検討している方におすすめです。

Avatar for Ryusei Iida

Ryusei Iida

October 29, 2026

More Decks by Ryusei Iida

Other Decks in Technology

Transcript

  1. Microsoft Fabric × Azure AI Search OneLakeをデータソースにした AI Search(Foundry IQ)の

    ライフサイクル管理 追加・更新だけでなく「削除」まで同期させるために Ryusei Iida Analytics Day | 2026.10.29
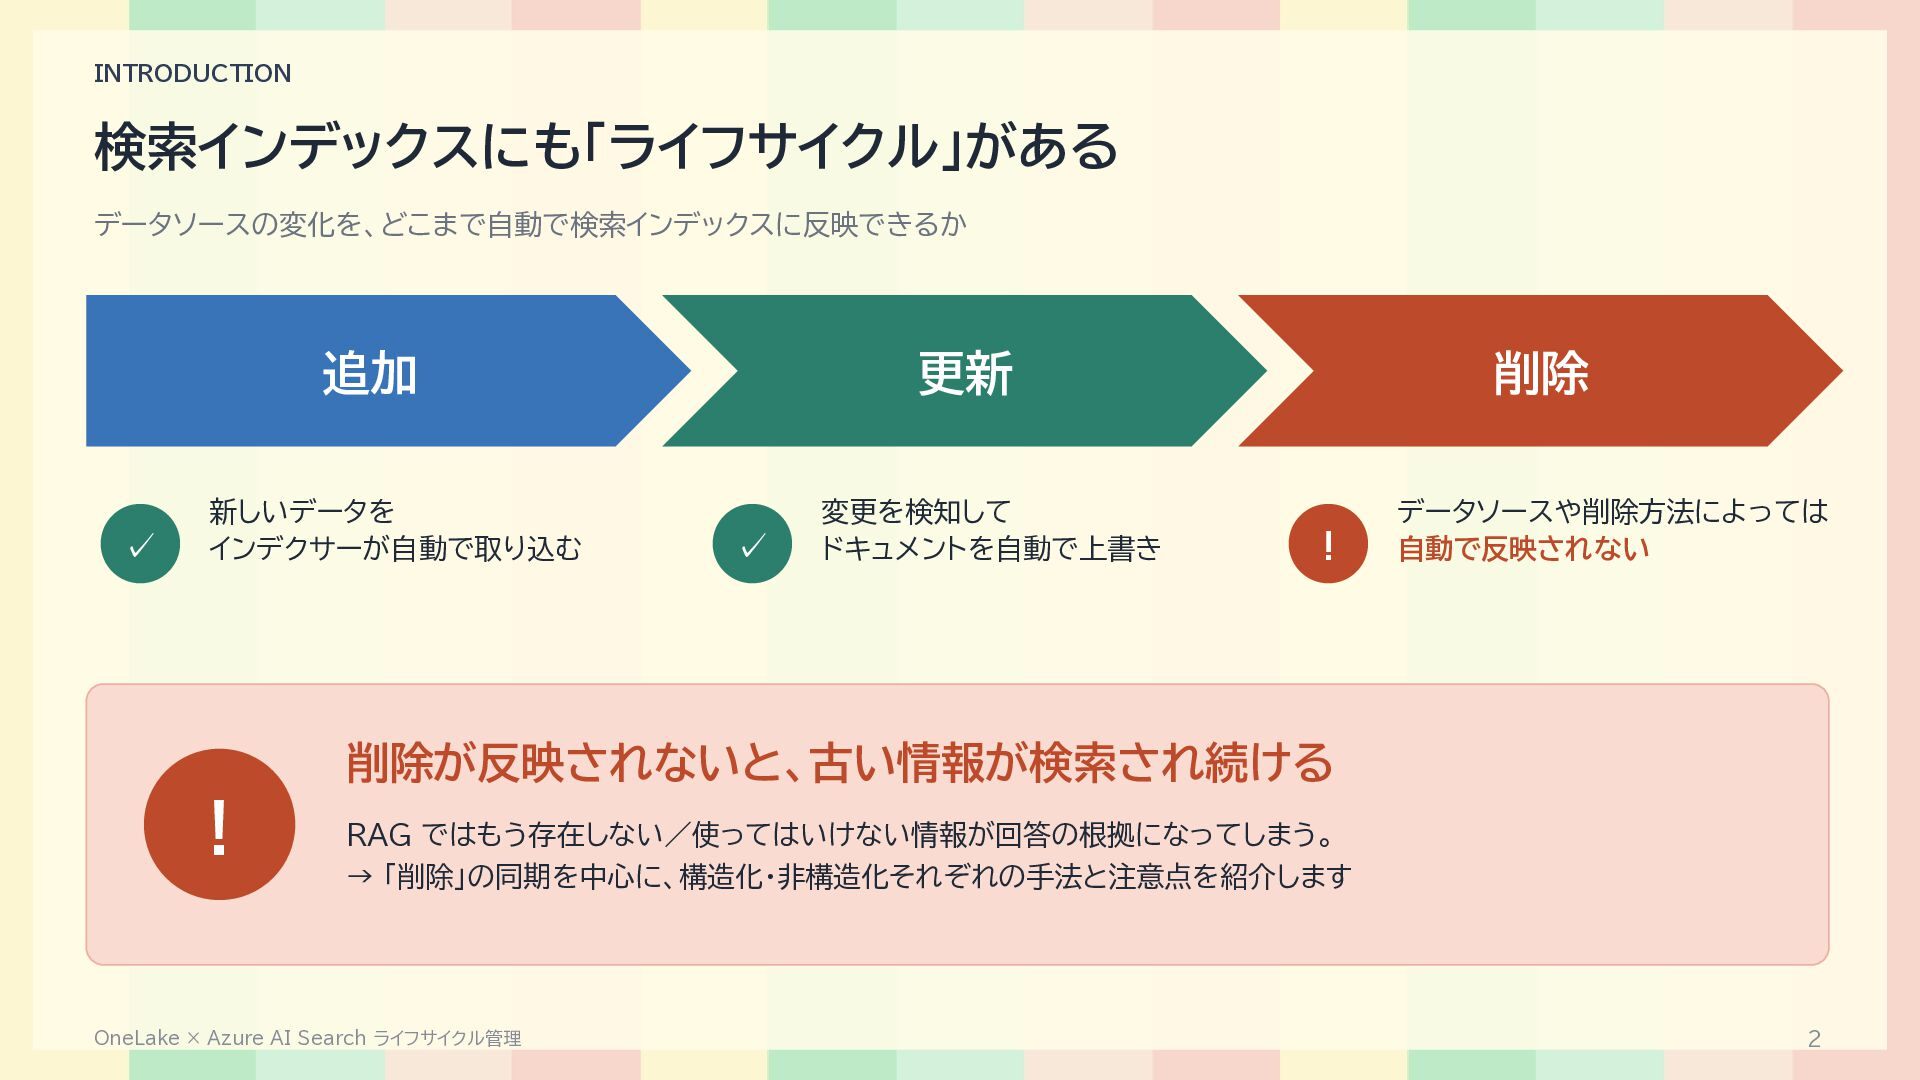
  2. INTRODUCTION 検索インデックスにも「ライフサイクル」がある データソースの変化を、どこまで自動で検索インデックスに反映できるか 追加 ✓ 新しいデータを インデクサーが自動で取り込む 更新 ✓ 変更を検知して

    ドキュメントを自動で上書き 削除 ! データソースや削除方法によっては 自動で反映されない 削除が反映されないと、古い情報が検索され続ける ! RAG ではもう存在しない/使ってはいけない情報が回答の根拠になってしまう。 → 「削除」の同期を中心に、構造化・非構造化それぞれの手法と注意点を紹介します OneLake × Azure AI Search ライフサイクル管理 2
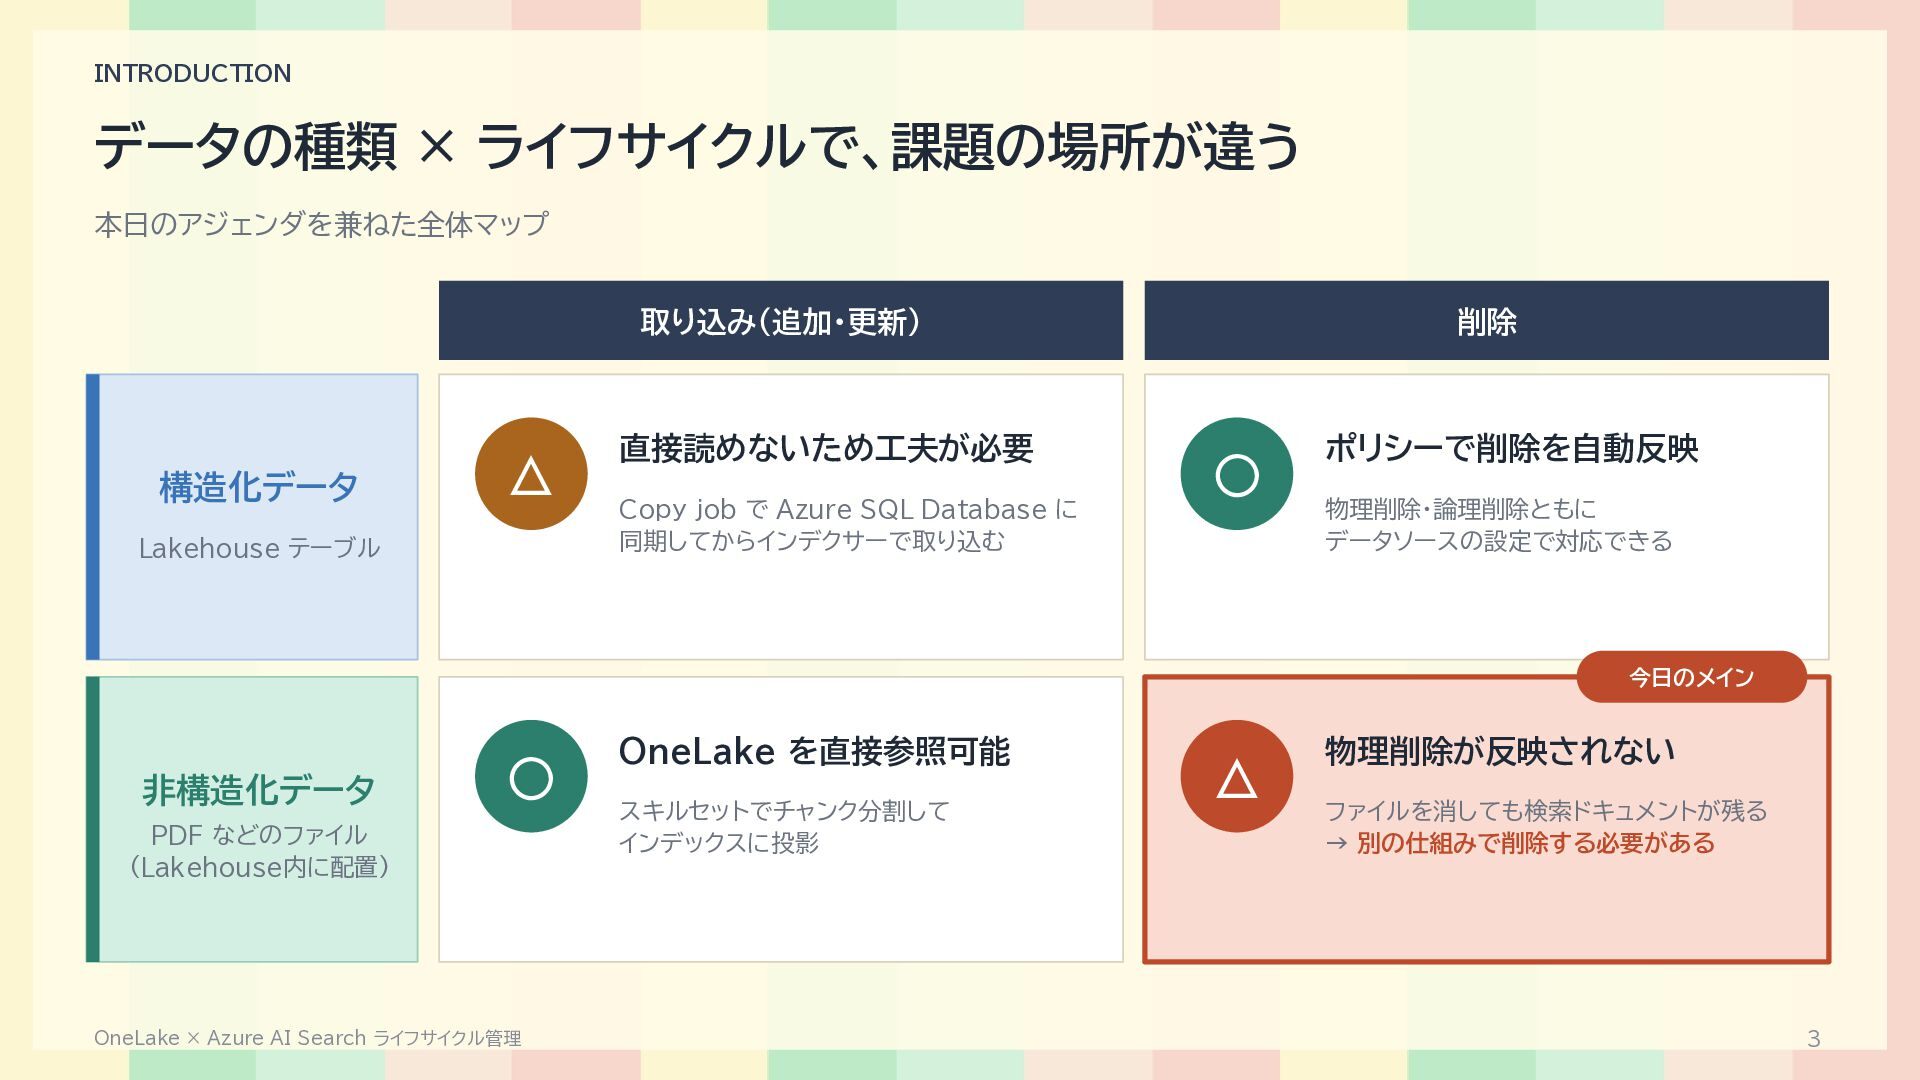
  3. INTRODUCTION データの種類 × ライフサイクルで、課題の場所が違う 本日のアジェンダを兼ねた全体マップ 取り込み(追加・更新) 構造化データ △ Lakehouse テーブル

    直接読めないため工夫が必要 Copy job で Azure SQL Database に 同期してからインデクサーで取り込む 削除 ◦ ポリシーで削除を自動反映 物理削除・論理削除ともに データソースの設定で対応できる 今日のメイン 非構造化データ ◦ PDF などのファイル (Lakehouse内に配置) OneLake × Azure AI Search ライフサイクル管理 OneLake を直接参照可能 スキルセットでチャンク分割して インデックスに投影 △ 物理削除が反映されない ファイルを消しても検索ドキュメントが残る → 別の仕組みで削除する必要がある 3
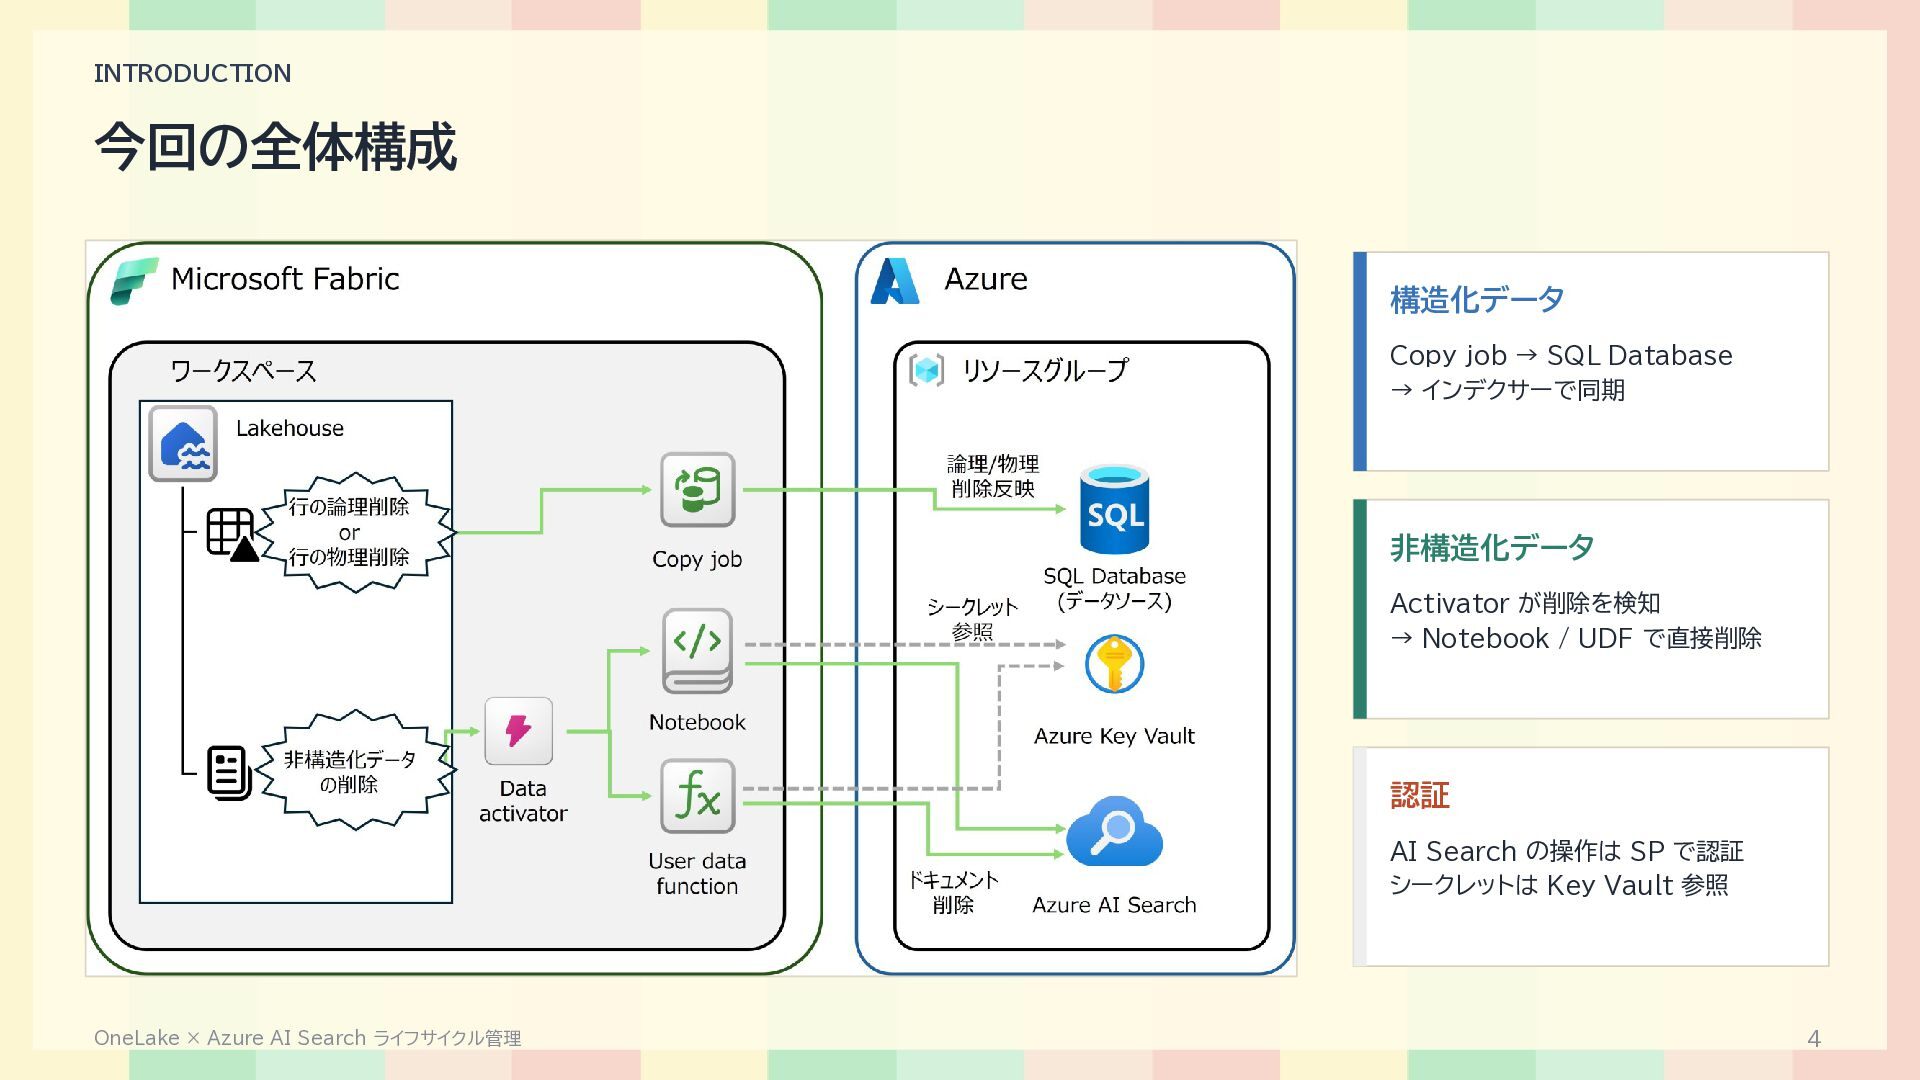
  4. INTRODUCTION 今回の全体構成 構造化データ Copy job → SQL Database → インデクサーで同期

    非構造化データ Activator が削除を検知 → Notebook / UDF で直接削除 認証 AI Search の操作は SP で認証 シークレットは Key Vault 参照 OneLake × Azure AI Search ライフサイクル管理 4
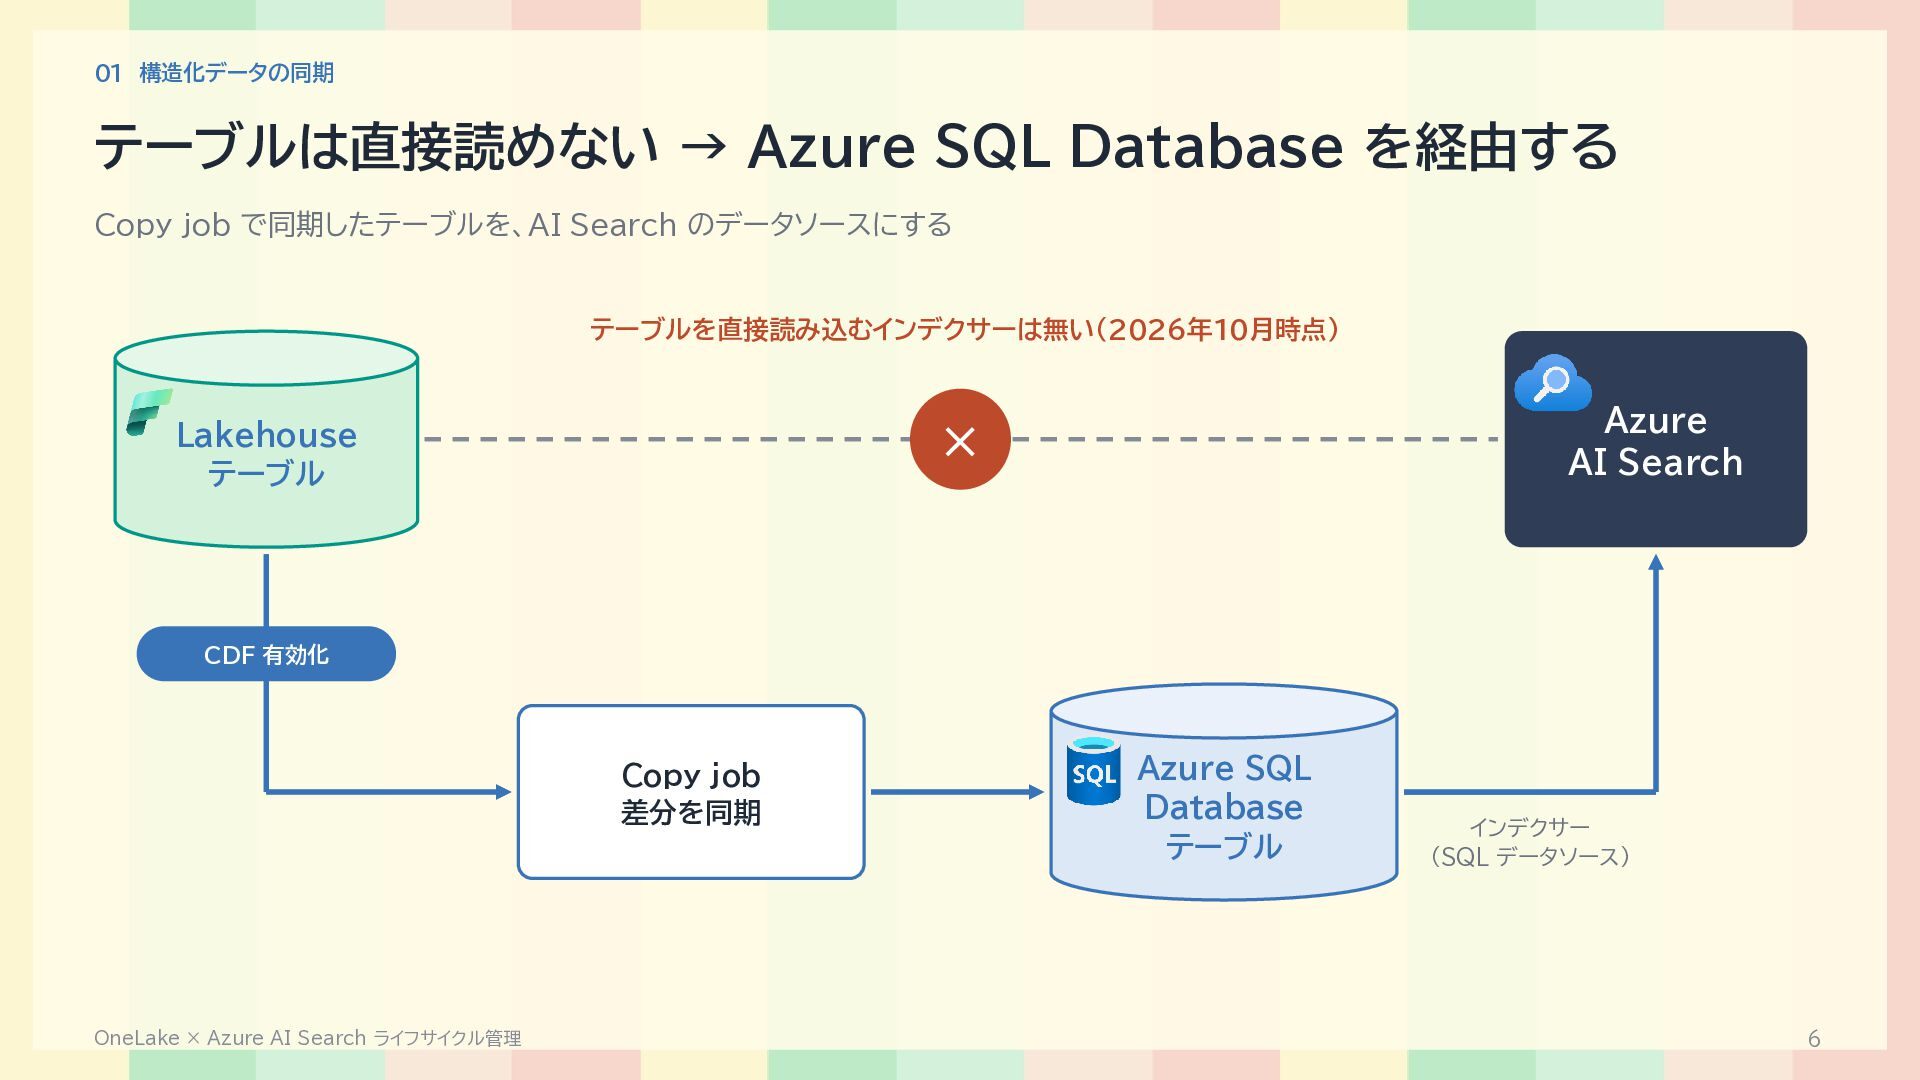
  5. 01 構造化データの同期 テーブルは直接読めない → Azure SQL Database を経由する Copy job

    で同期したテーブルを、AI Search のデータソースにする テーブルを直接読み込むインデクサーは無い(2026年10月時点) Azure AI Search × Lakehouse テーブル CDF 有効化 Copy job 差分を同期 OneLake × Azure AI Search ライフサイクル管理 Azure SQL Database テーブル インデクサー (SQL データソース) 6
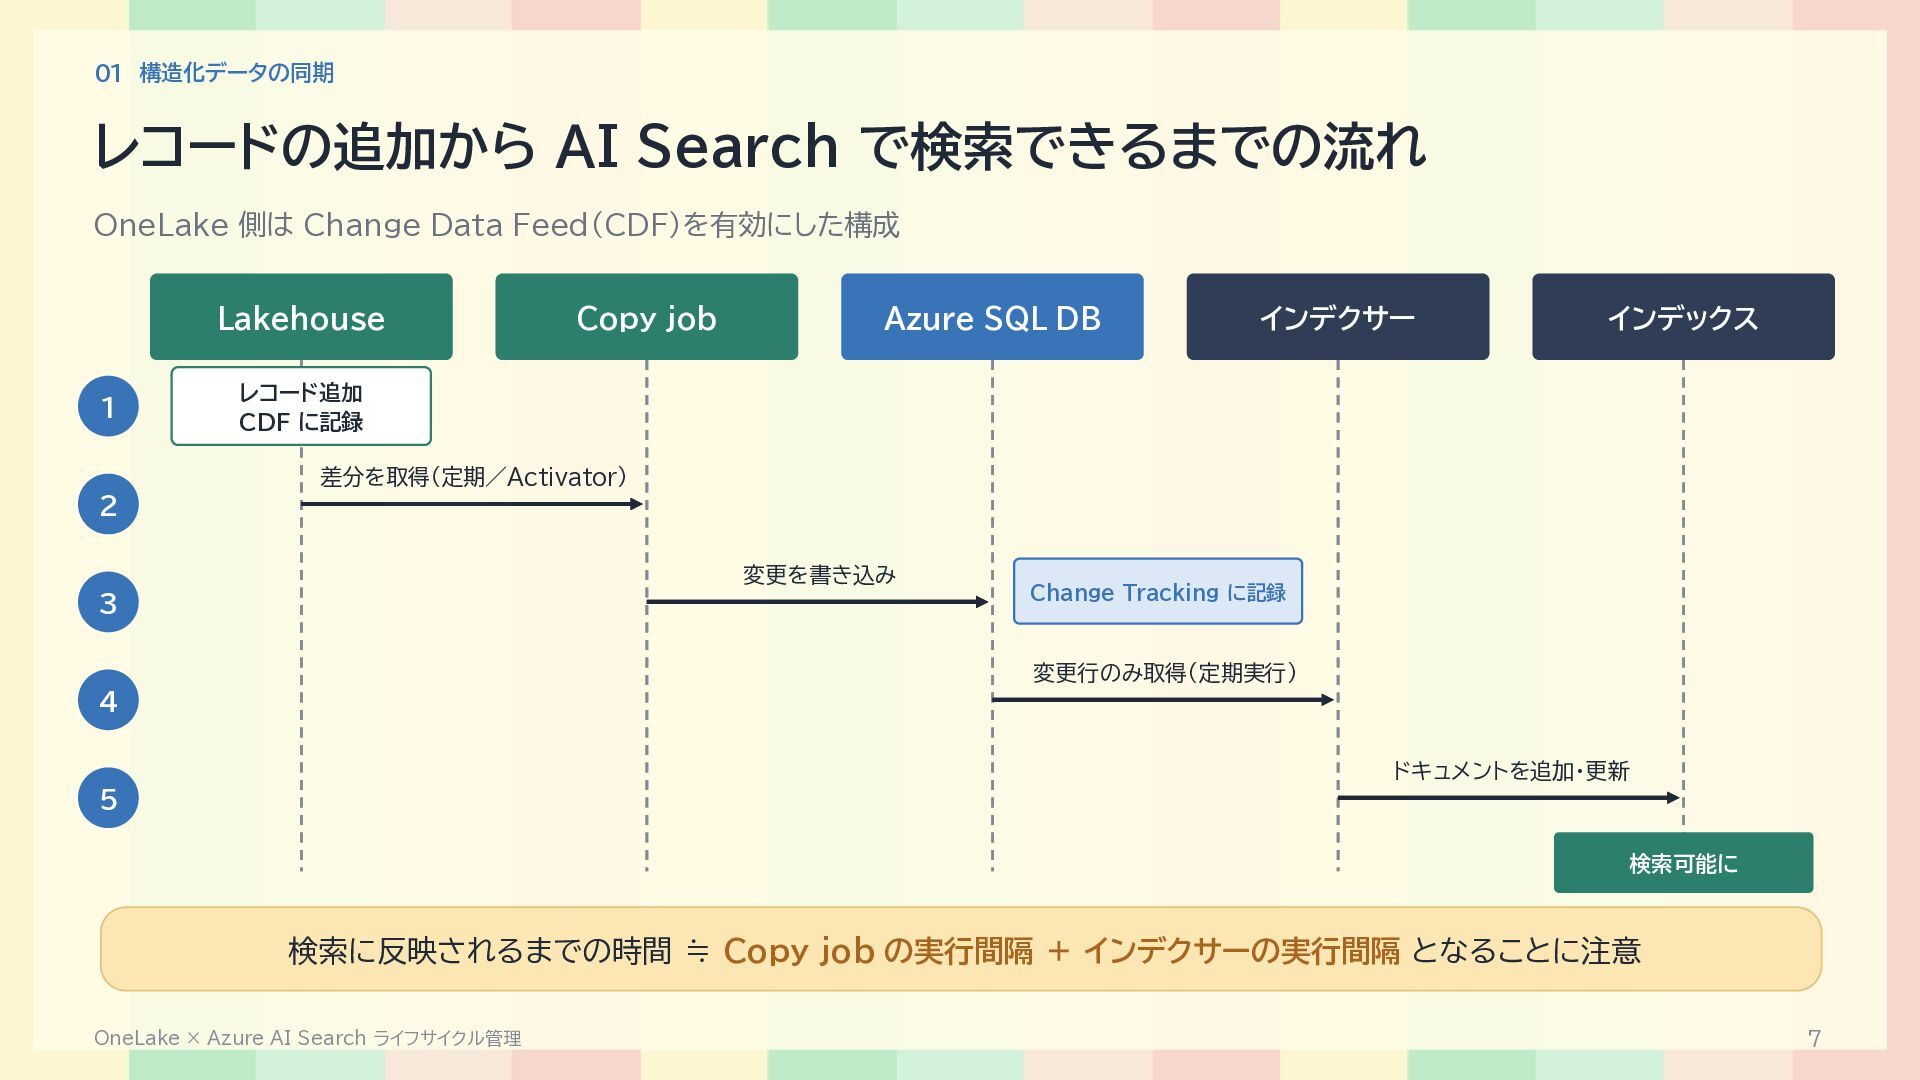
  6. 01 構造化データの同期 レコードの追加から AI Search で検索できるまでの流れ OneLake 側は Change Data

    Feed(CDF)を有効にした構成 Lakehouse 1 Copy job Azure SQL DB インデクサー インデックス レコード追加 CDF に記録 差分を取得(定期/Activator) 2 変更を書き込み 3 Change Tracking に記録 変更行のみ取得(定期実行) 4 ドキュメントを追加・更新 5 検索可能に 検索に反映されるまでの時間 ≒ Copy job の実行間隔 + インデクサーの実行間隔 となることに注意 OneLake × Azure AI Search ライフサイクル管理 7
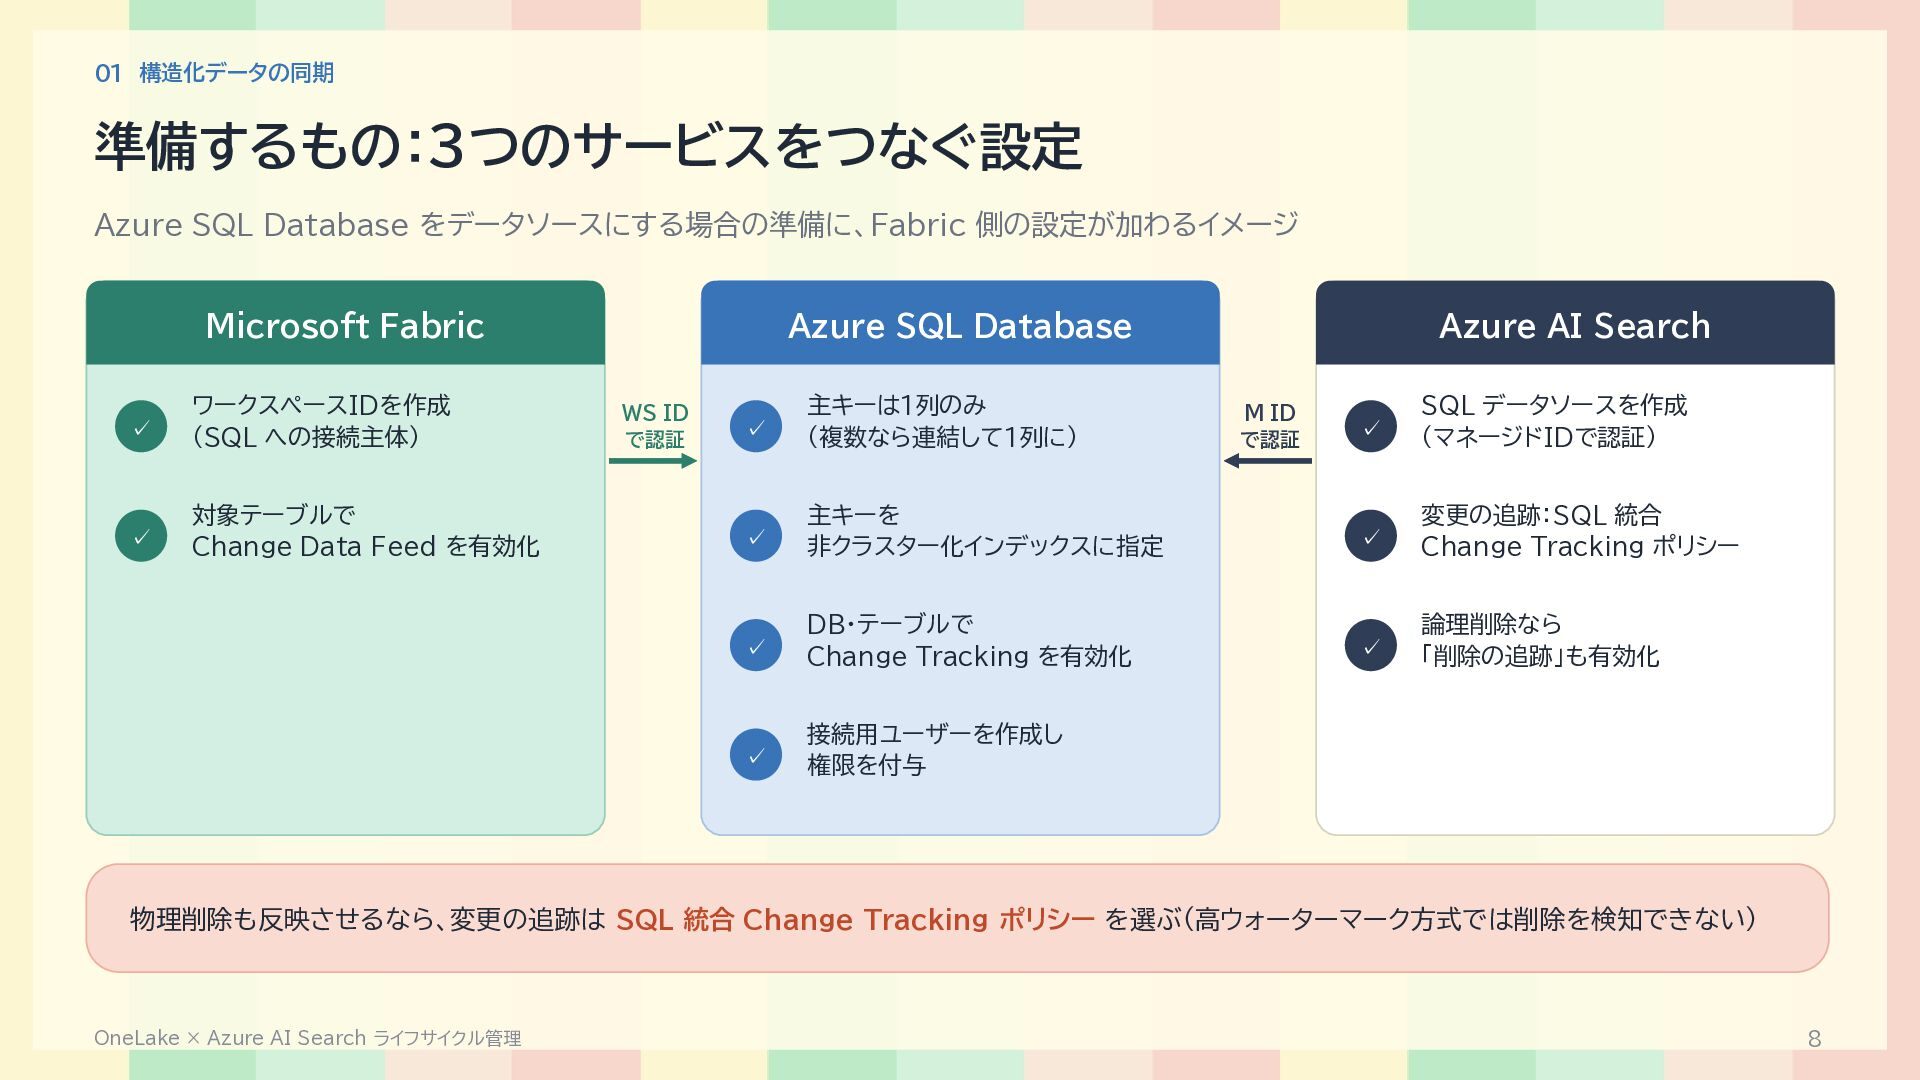
  7. 01 構造化データの同期 準備するもの:3つのサービスをつなぐ設定 Azure SQL Database をデータソースにする場合の準備に、Fabric 側の設定が加わるイメージ Microsoft Fabric

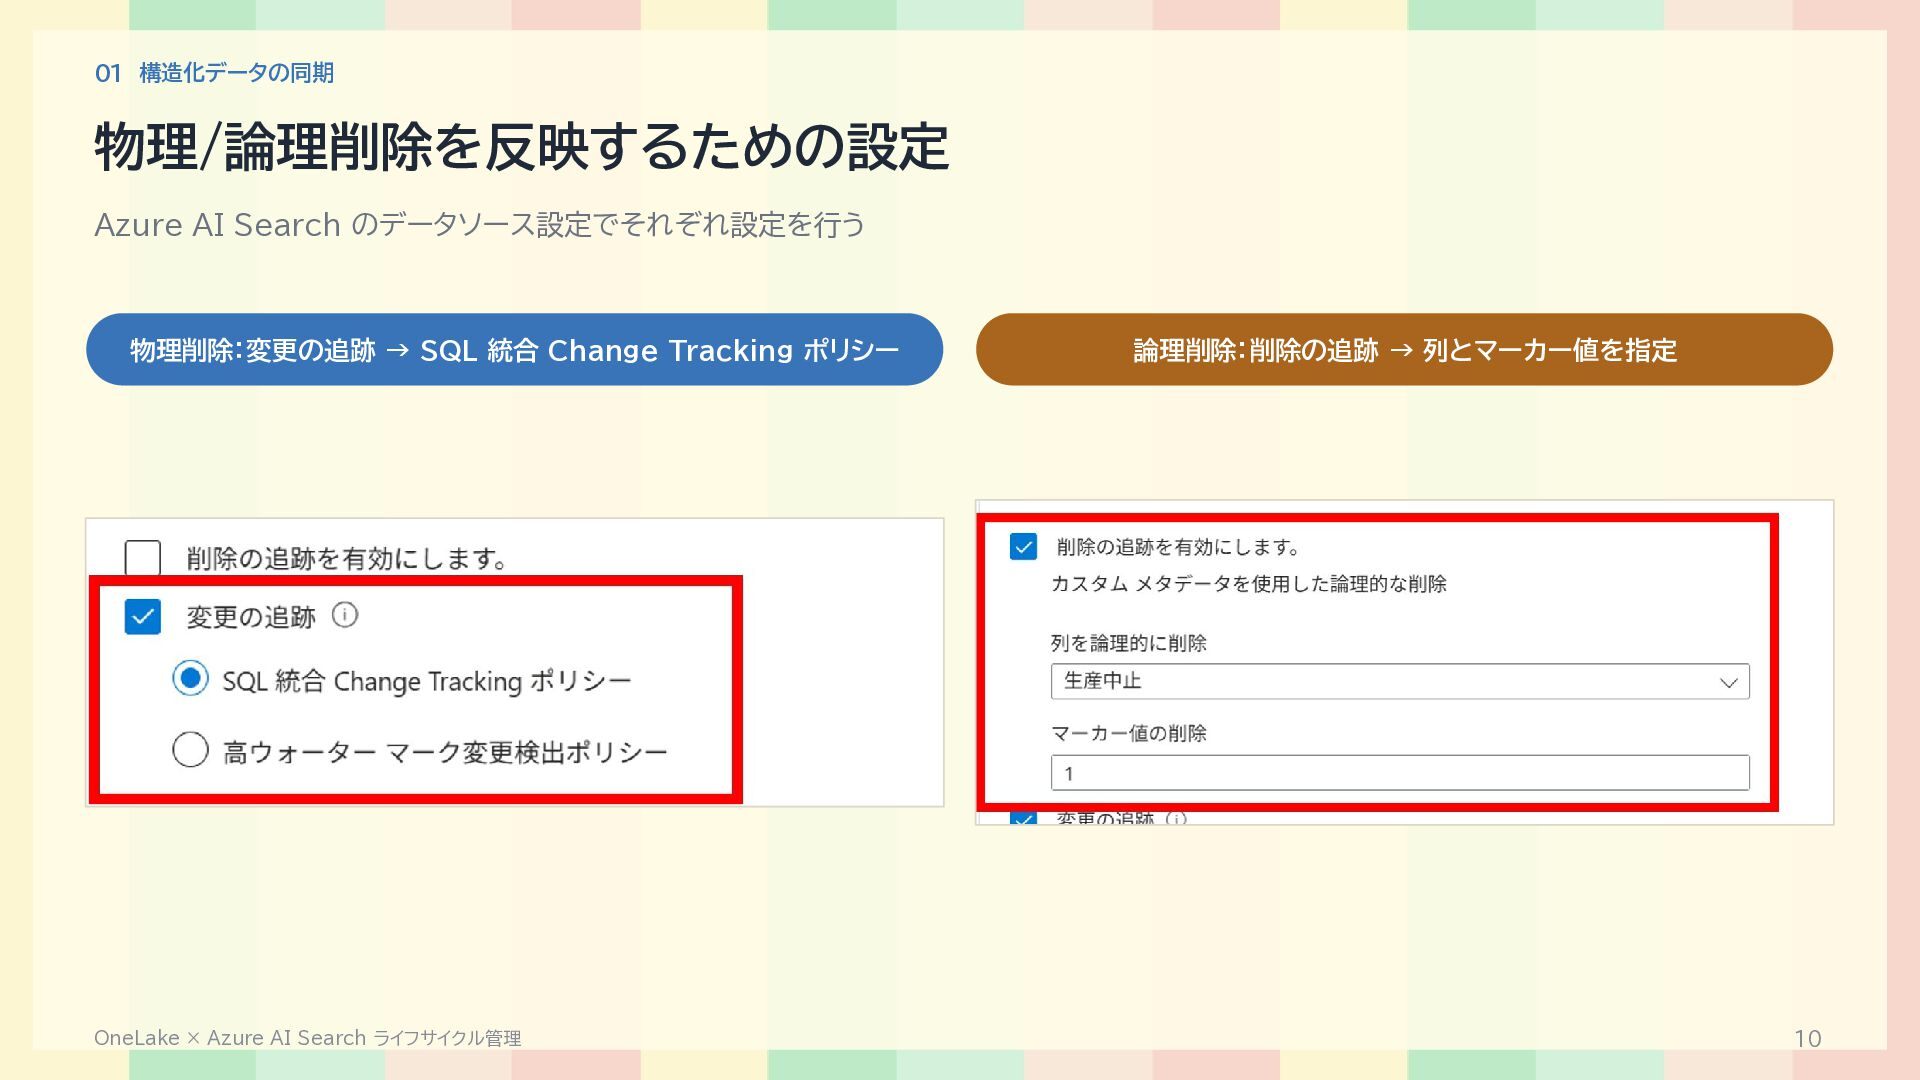
    ✓ ワークスペースIDを作成 (SQL への接続主体) ✓ 対象テーブルで Change Data Feed を有効化 Azure SQL Database WS ID で認証 ✓ 主キーは1列のみ (複数なら連結して1列に) ✓ Azure AI Search ✓ SQL データソースを作成 (マネージドIDで認証) 主キーを 非クラスター化インデックスに指定 ✓ 変更の追跡:SQL 統合 Change Tracking ポリシー ✓ DB・テーブルで Change Tracking を有効化 ✓ 論理削除なら 「削除の追跡」も有効化 ✓ 接続用ユーザーを作成し 権限を付与 M ID で認証 物理削除も反映させるなら、変更の追跡は SQL 統合 Change Tracking ポリシー を選ぶ(高ウォーターマーク方式では削除を検知できない) OneLake × Azure AI Search ライフサイクル管理 8
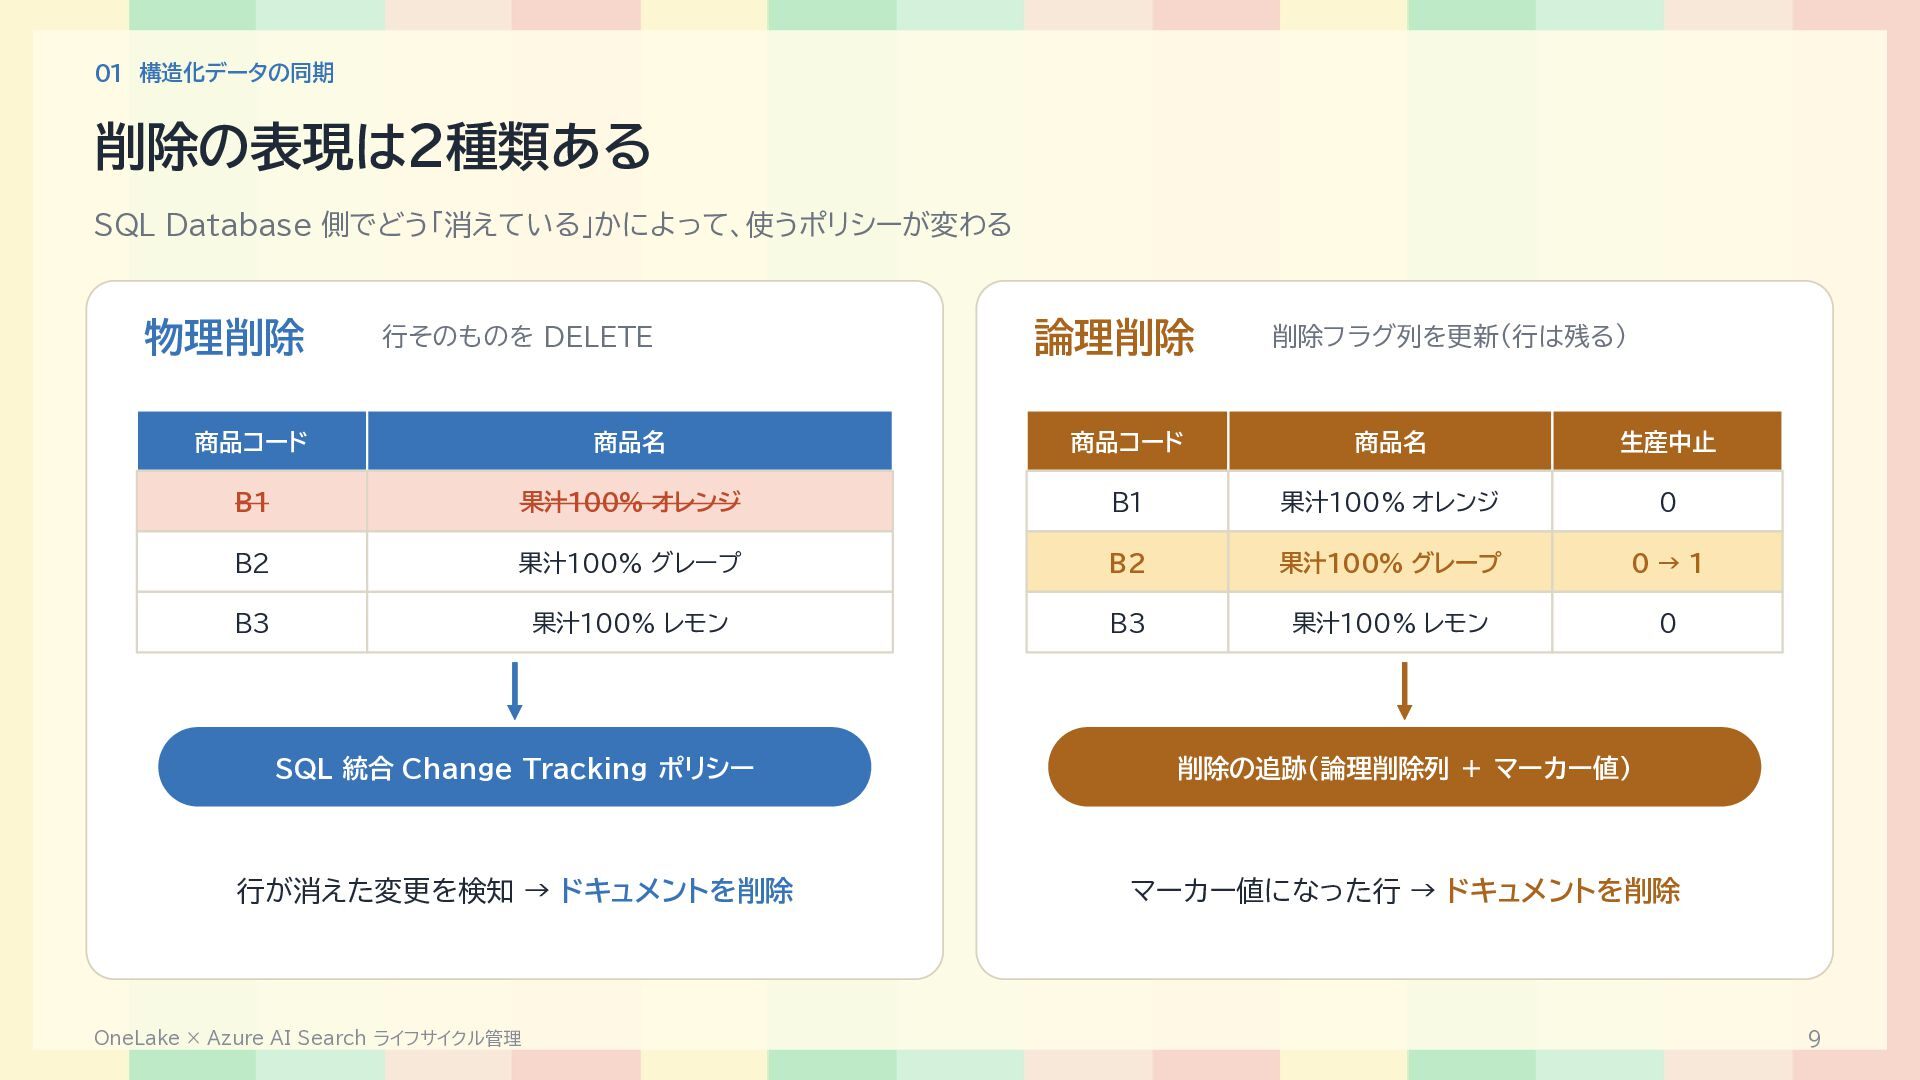
  8. 01 構造化データの同期 削除の表現は2種類ある SQL Database 側でどう「消えている」かによって、使うポリシーが変わる 物理削除 行そのものを DELETE 論理削除

    商品コード 商品名 商品コード 商品名 生産中止 B1 果汁100% オレンジ B1 果汁100% オレンジ 0 B2 果汁100% グレープ B2 果汁100% グレープ 0→1 B3 果汁100% レモン B3 果汁100% レモン 0 削除フラグ列を更新(行は残る) SQL 統合 Change Tracking ポリシー 削除の追跡(論理削除列 + マーカー値) 行が消えた変更を検知 → ドキュメントを削除 マーカー値になった行 → ドキュメントを削除 OneLake × Azure AI Search ライフサイクル管理 9
  9. 01 構造化データの同期 物理/論理削除を反映するための設定 Azure AI Search のデータソース設定でそれぞれ設定を行う 物理削除:変更の追跡 → SQL

    統合 Change Tracking ポリシー OneLake × Azure AI Search ライフサイクル管理 論理削除:削除の追跡 → 列とマーカー値を指定 10
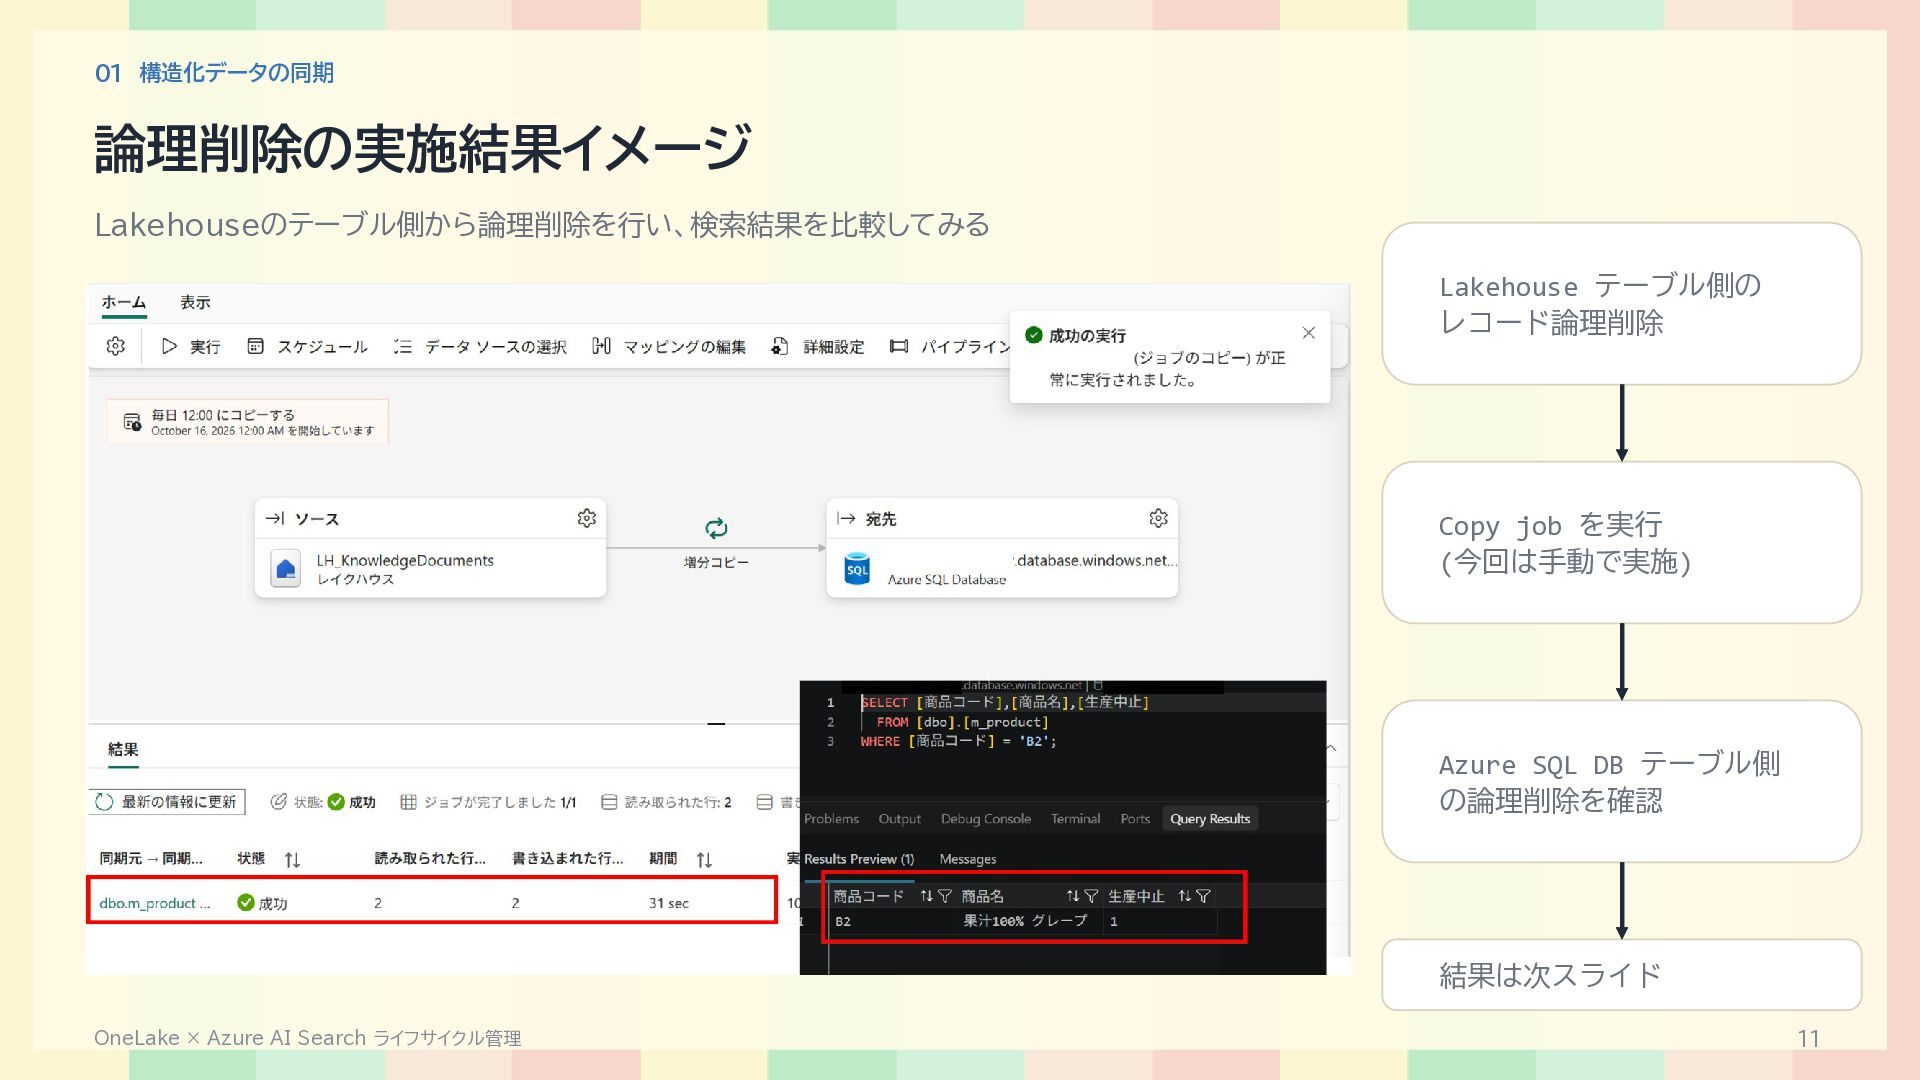
  10. 01 構造化データの同期 論理削除の実施結果イメージ Lakehouseのテーブル側から論理削除を行い、検索結果を比較してみる Lakehouse テーブル側の レコード論理削除 Copy job を実行

    (今回は手動で実施) Azure SQL DB テーブル側 の論理削除を確認 結果は次スライド OneLake × Azure AI Search ライフサイクル管理 11
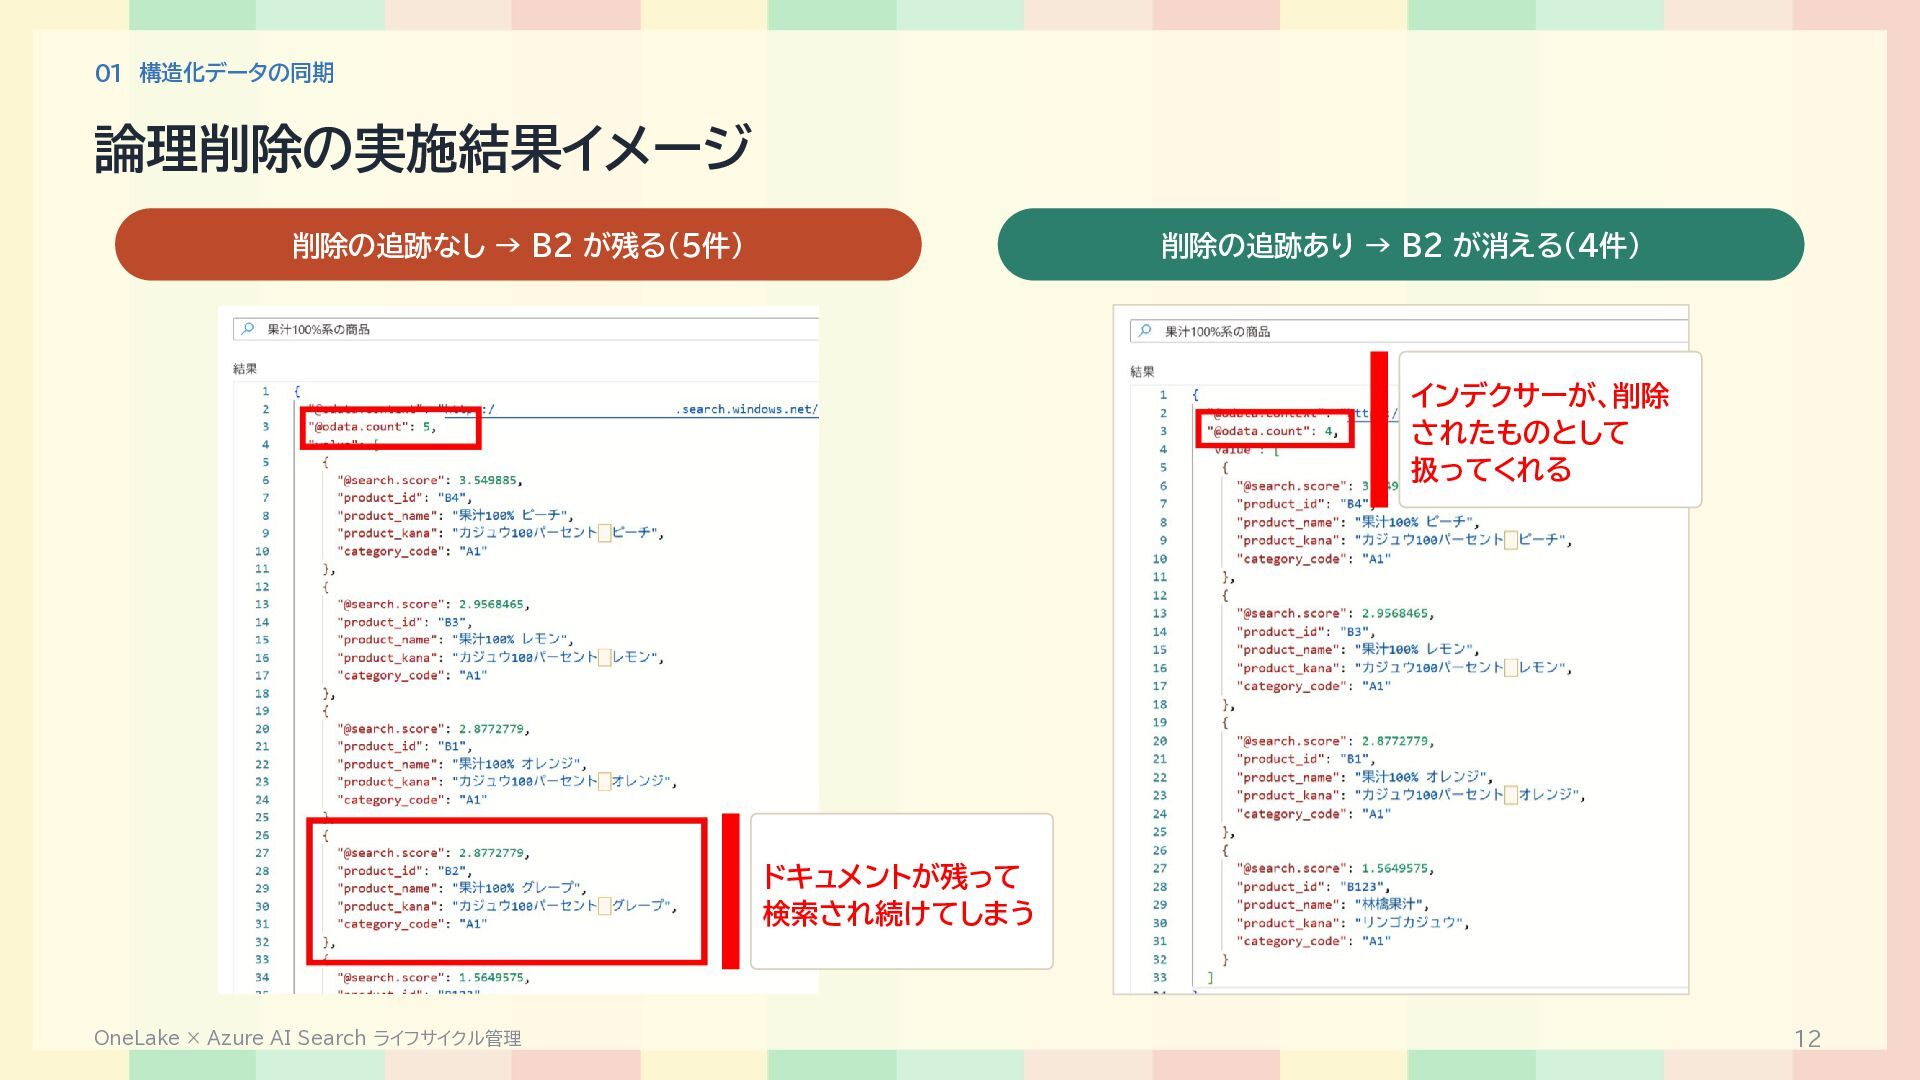
  11. 01 構造化データの同期 論理削除の実施結果イメージ 削除の追跡なし → B2 が残る(5件) 削除の追跡あり → B2

    が消える(4件) インデクサーが、削除 されたものとして 扱ってくれる ドキュメントが残って 検索され続けてしまう OneLake × Azure AI Search ライフサイクル管理 12
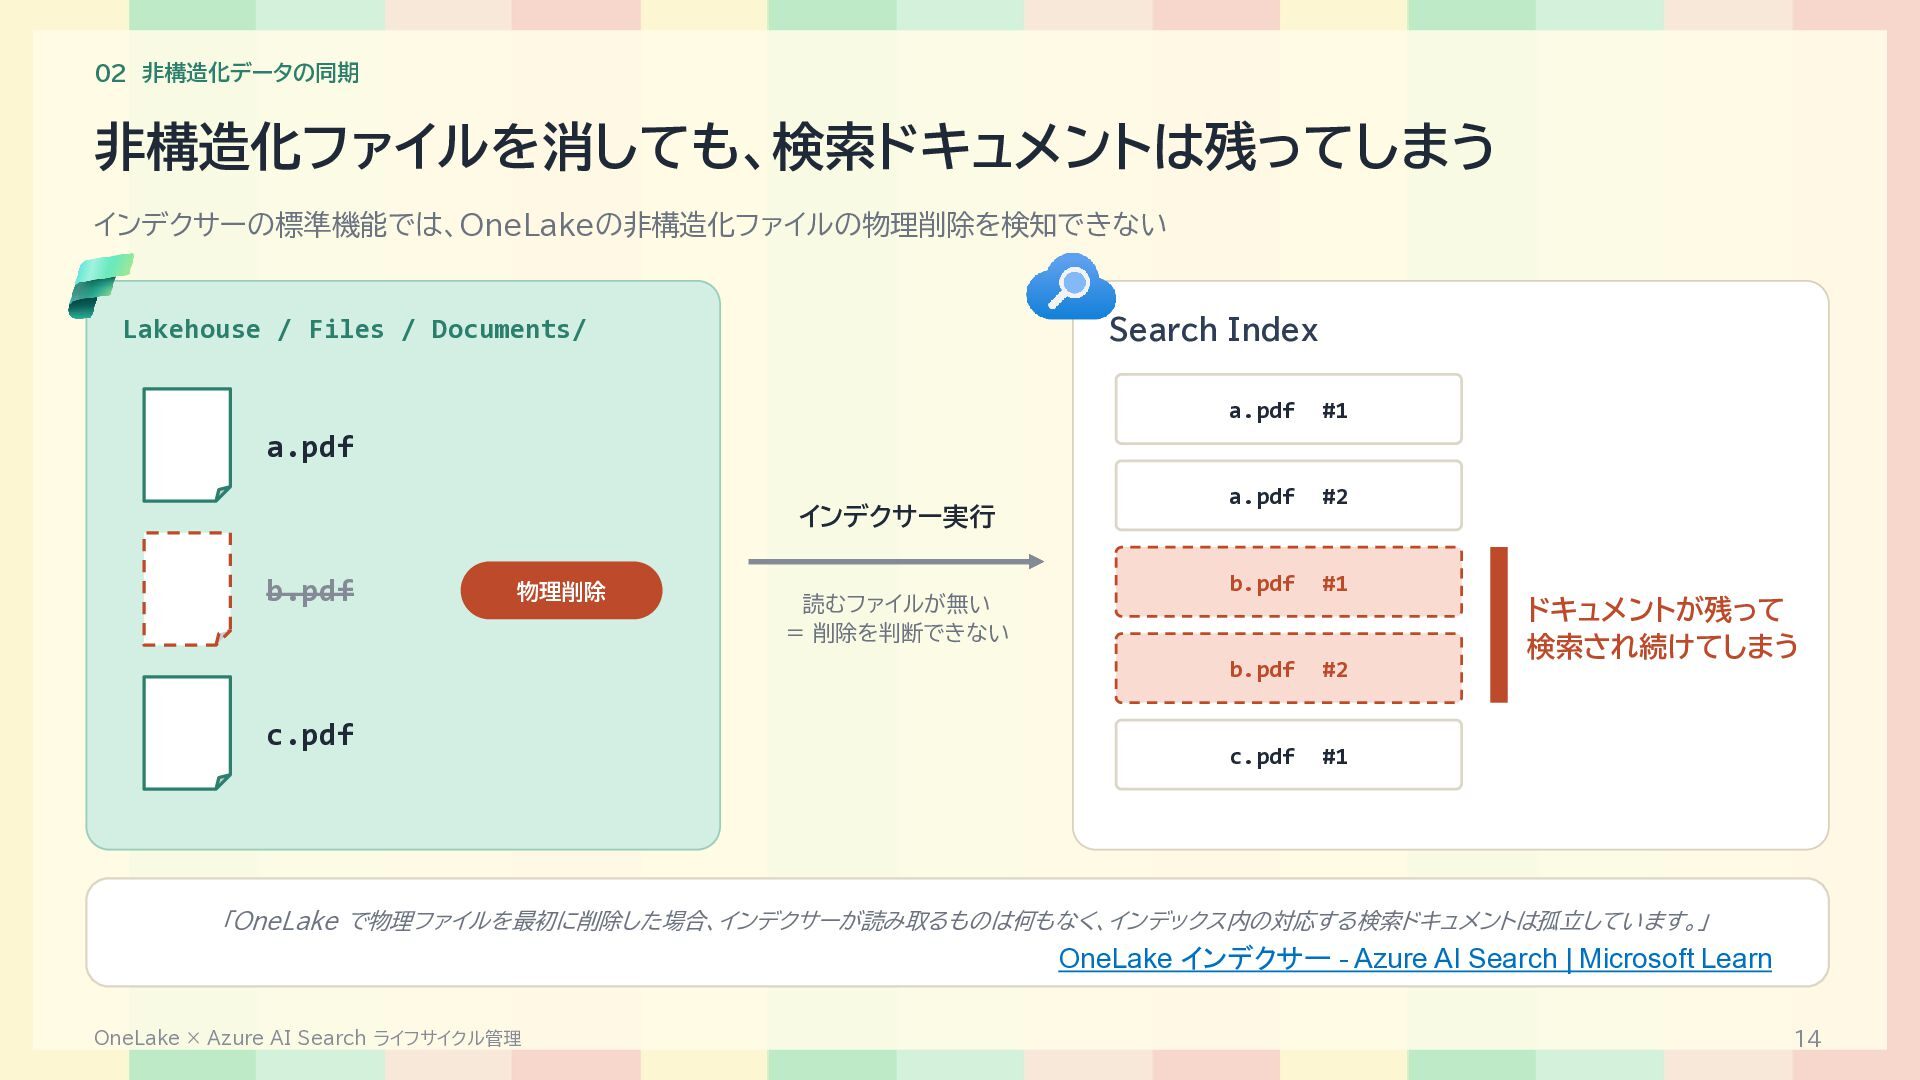
  12. 02 非構造化データの同期 非構造化ファイルを消しても、検索ドキュメントは残ってしまう インデクサーの標準機能では、OneLakeの非構造化ファイルの物理削除を検知できない Search Index Lakehouse / Files /

    Documents/ a.pdf #1 a.pdf #2 b.pdf #1 b.pdf #2 c.pdf #1 a.pdf インデクサー実行 b.pdf 物理削除 c.pdf 読むファイルが無い = 削除を判断できない ドキュメントが残って 検索され続けてしまう 「OneLake で物理ファイルを最初に削除した場合、インデクサーが読み取るものは何もなく、インデックス内の対応する検索ドキュメントは孤立しています。」 OneLake インデクサー - Azure AI Search | Microsoft Learn OneLake × Azure AI Search ライフサイクル管理 14
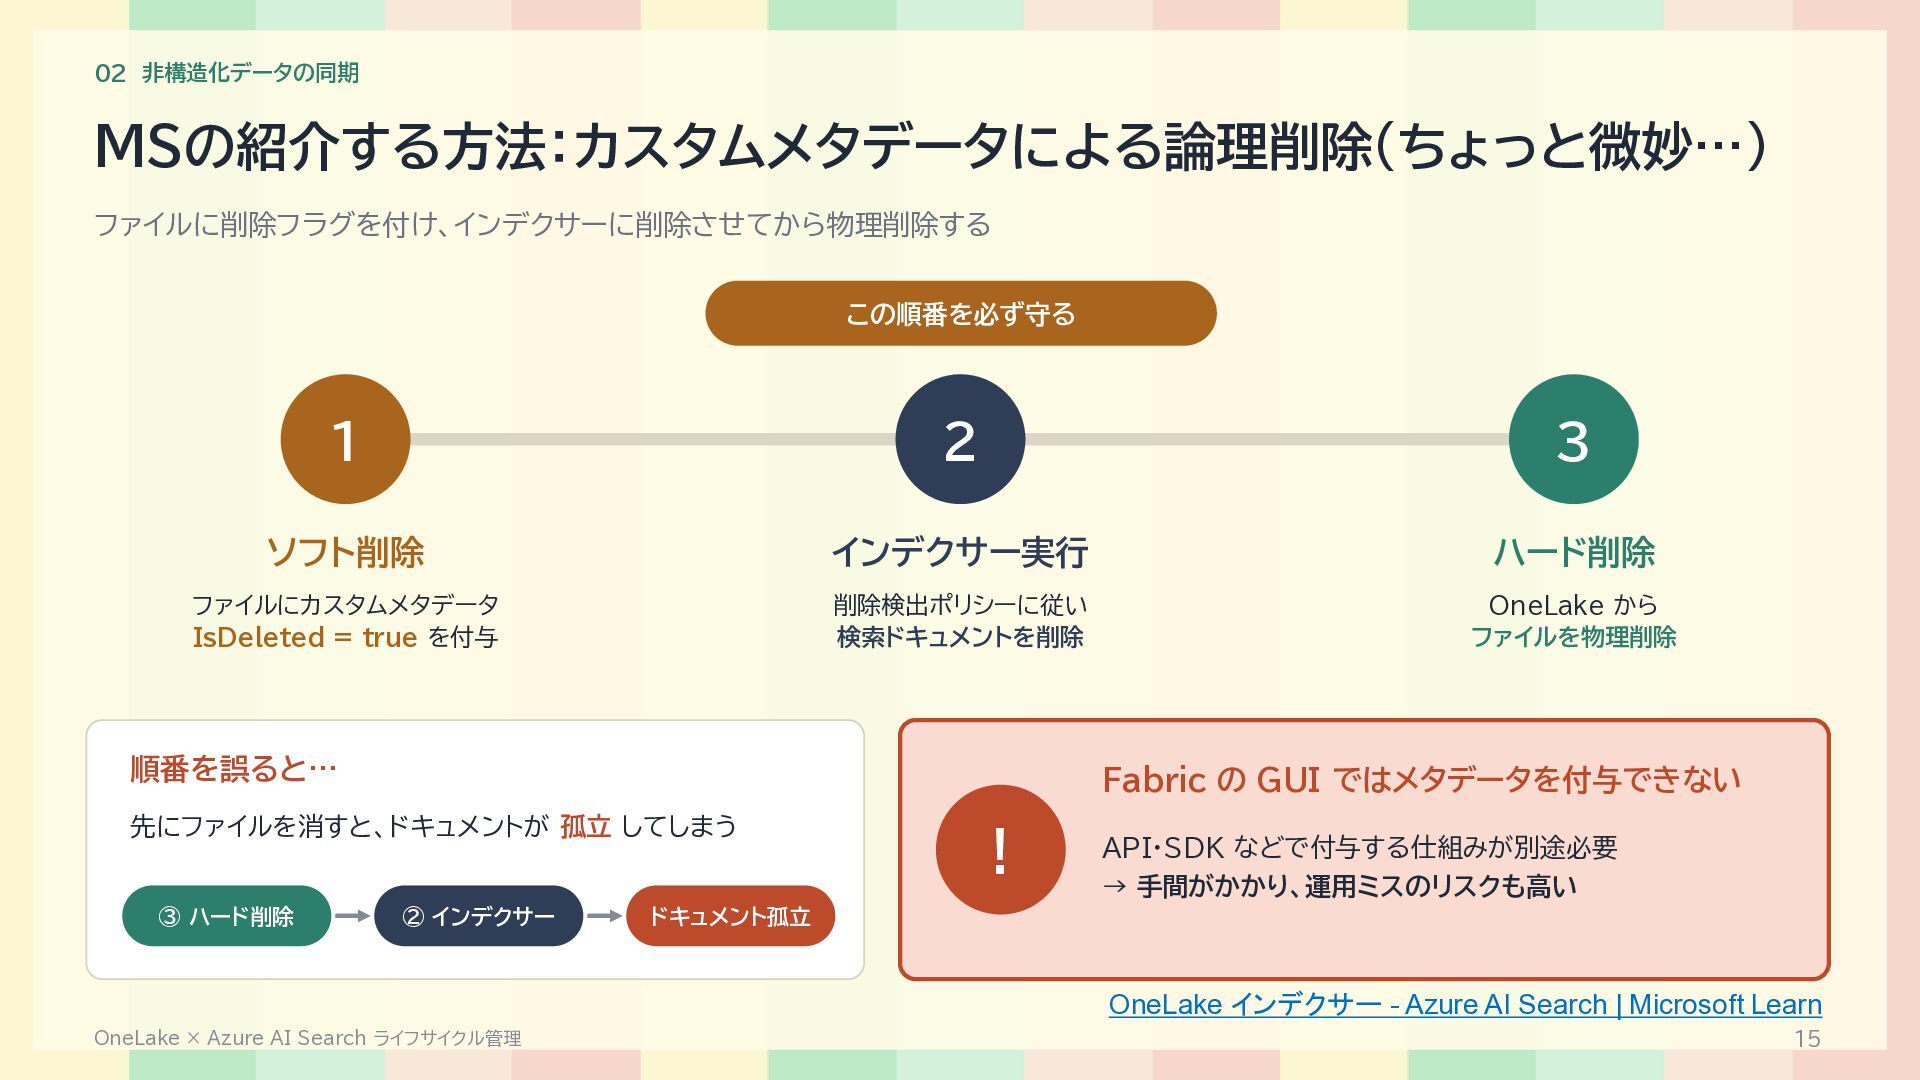
  13. 02 非構造化データの同期 MSの紹介する方法:カスタムメタデータによる論理削除(ちょっと微妙…) ファイルに削除フラグを付け、インデクサーに削除させてから物理削除する この順番を必ず守る 1 2 3 ソフト削除 インデクサー実行

    ハード削除 ファイルにカスタムメタデータ IsDeleted = true を付与 削除検出ポリシーに従い 検索ドキュメントを削除 OneLake から ファイルを物理削除 順番を誤ると… Fabric の GUI ではメタデータを付与できない 先にファイルを消すと、ドキュメントが 孤立 してしまう ③ ハード削除 ② インデクサー ! API・SDK などで付与する仕組みが別途必要 → 手間がかかり、運用ミスのリスクも高い ドキュメント孤立 OneLake インデクサー - Azure AI Search | Microsoft Learn OneLake × Azure AI Search ライフサイクル管理 15
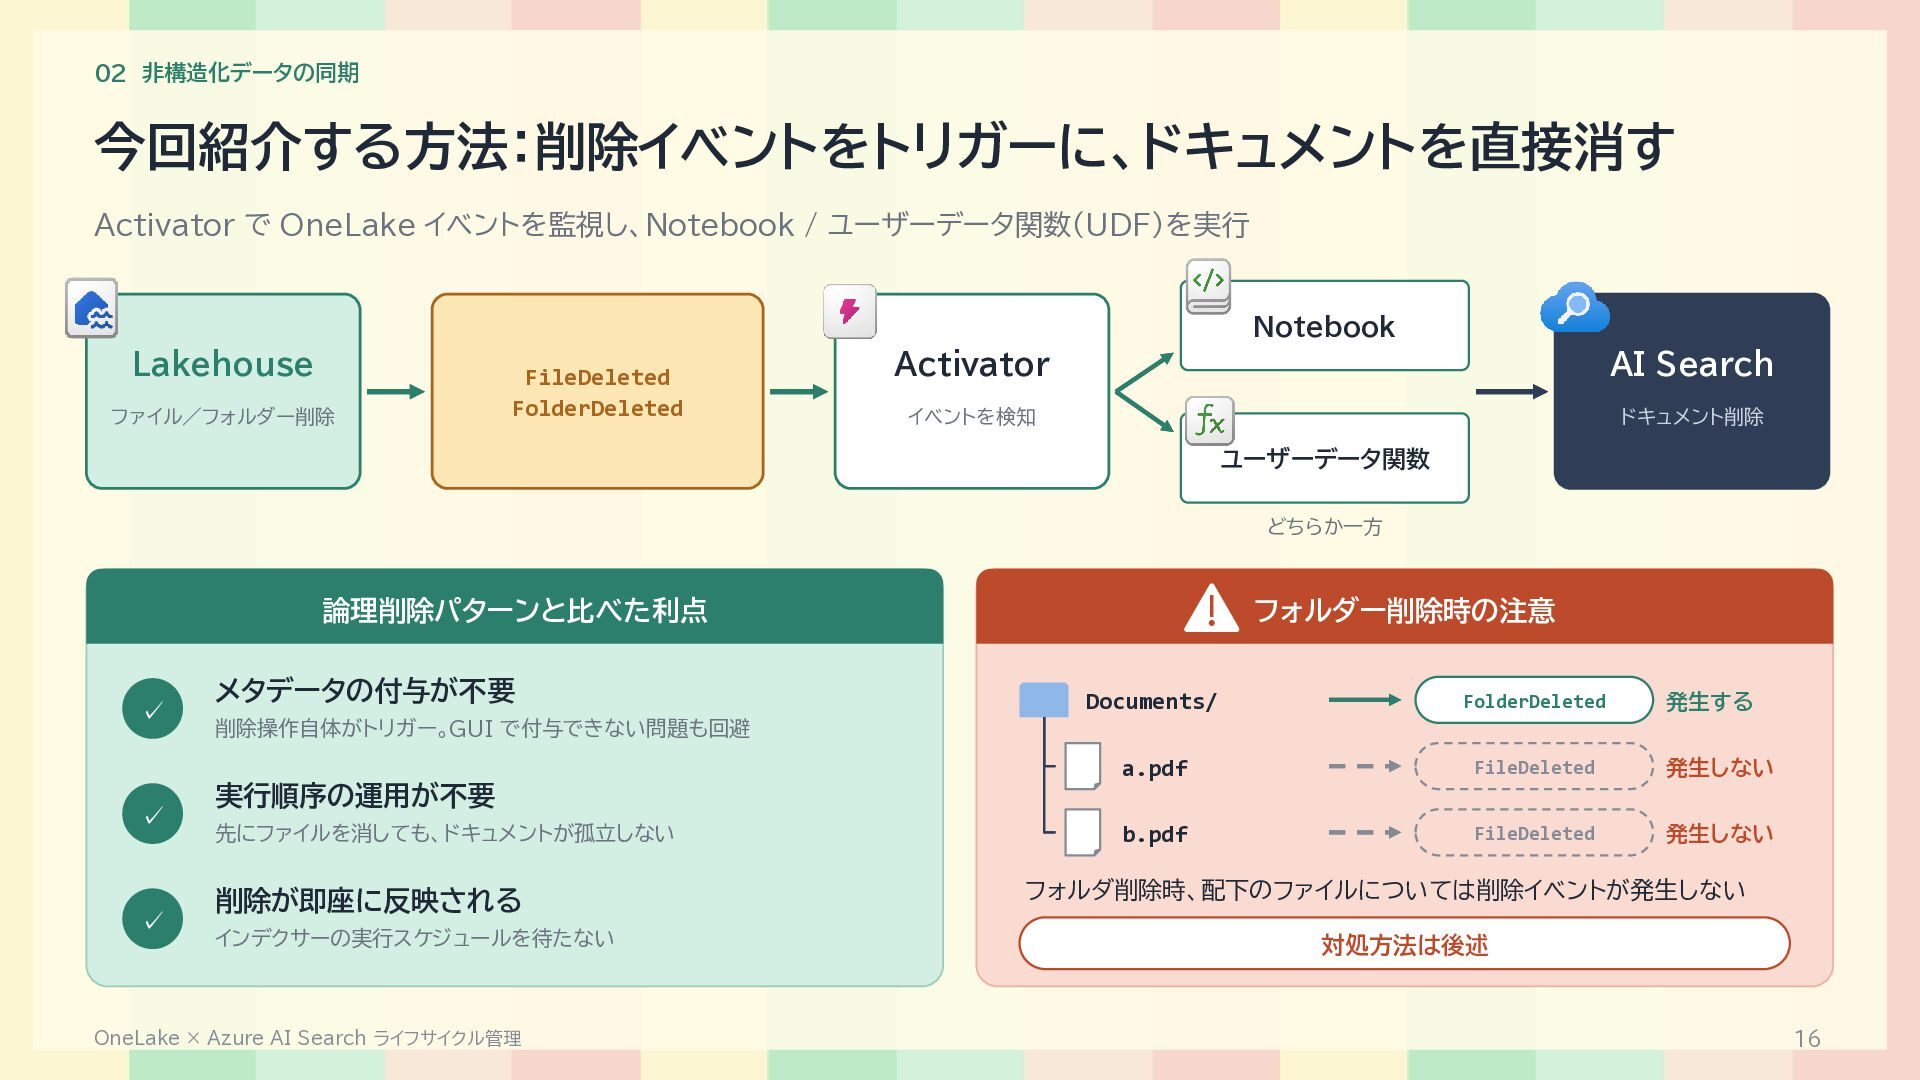
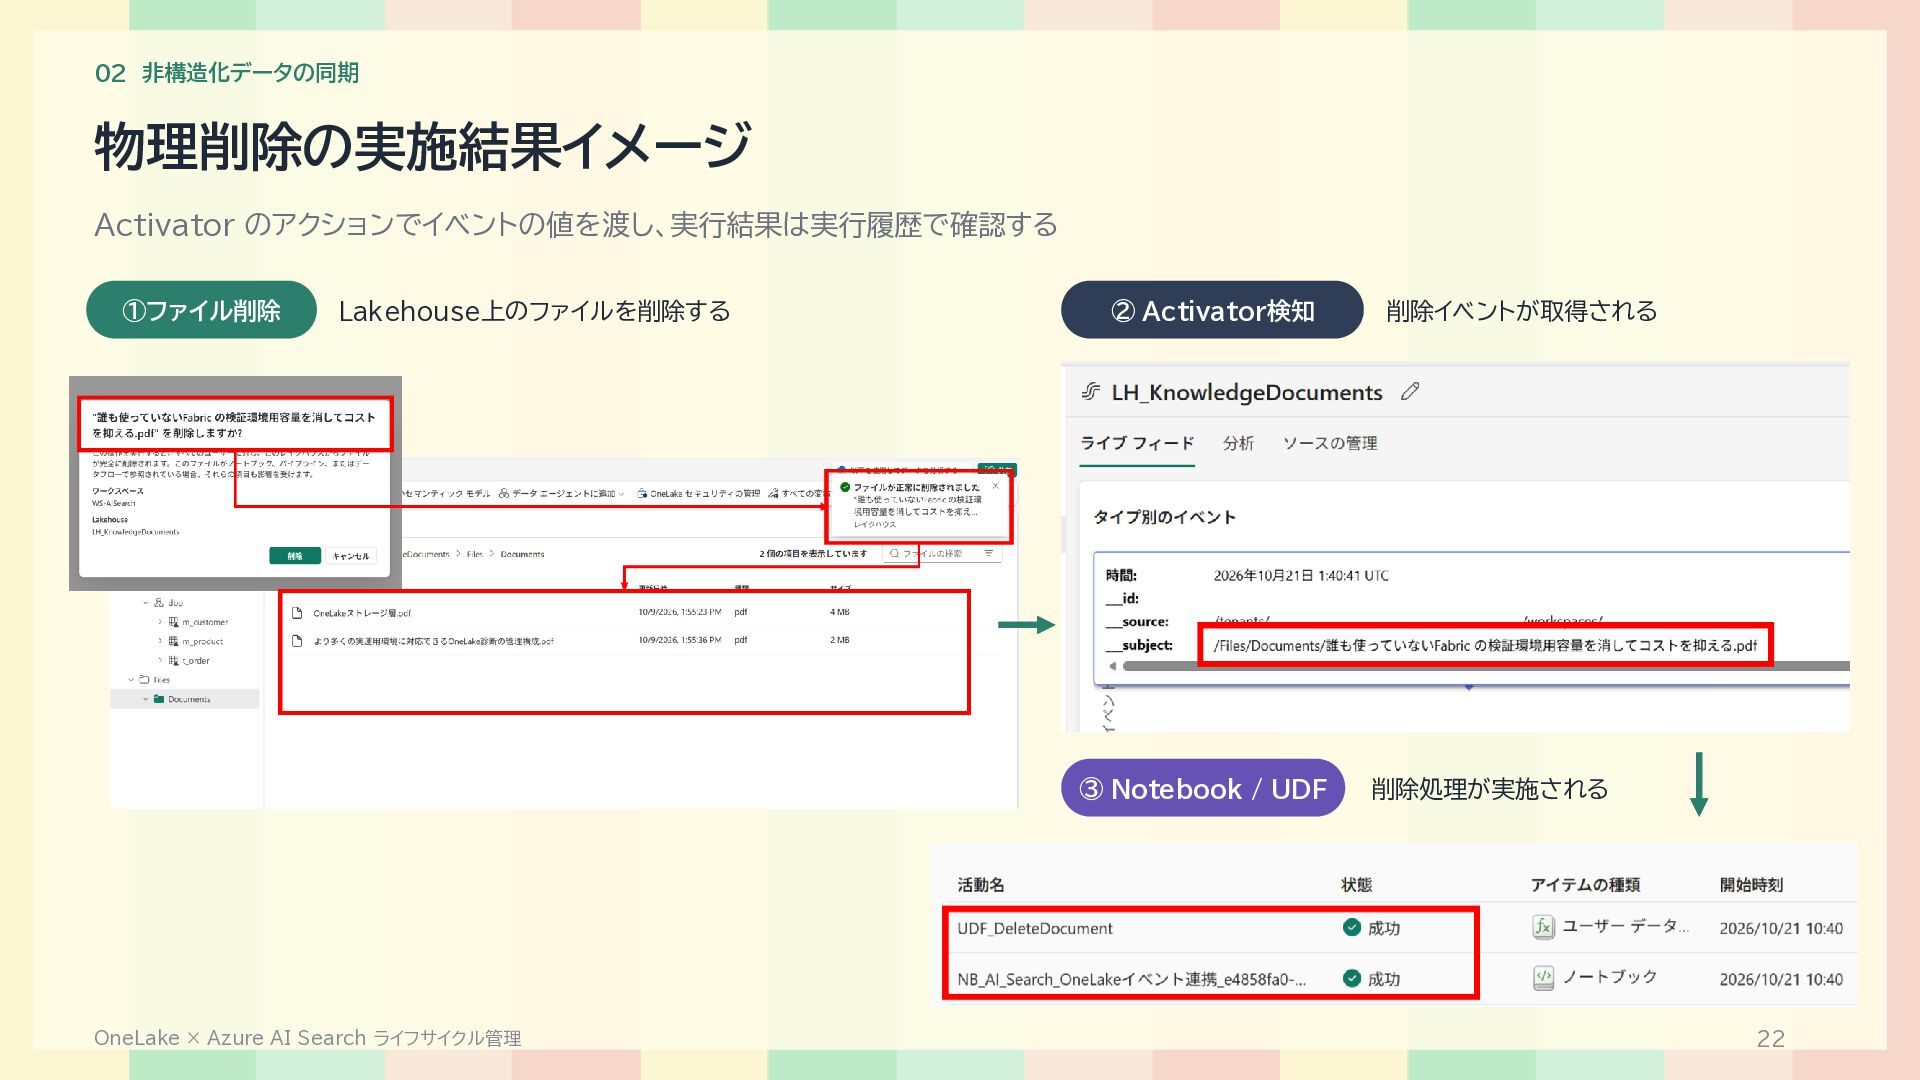
  14. 02 非構造化データの同期 今回紹介する方法:削除イベントをトリガーに、ドキュメントを直接消す Activator で OneLake イベントを監視し、Notebook / ユーザーデータ関数(UDF)を実行 Notebook

    Lakehouse ファイル/フォルダー削除 FileDeleted FolderDeleted Activator AI Search イベントを検知 ドキュメント削除 ユーザーデータ関数 どちらか一方 論理削除パターンと比べた利点 ✓ ✓ ✓ メタデータの付与が不要 フォルダー削除時の注意 Documents/ FolderDeleted 発生する a.pdf FileDeleted 発生しない b.pdf FileDeleted 発生しない 削除操作自体がトリガー。GUI で付与できない問題も回避 実行順序の運用が不要 先にファイルを消しても、ドキュメントが孤立しない 削除が即座に反映される インデクサーの実行スケジュールを待たない OneLake × Azure AI Search ライフサイクル管理 フォルダ削除時、配下のファイルについては削除イベントが発生しない 対処方法は後述 16
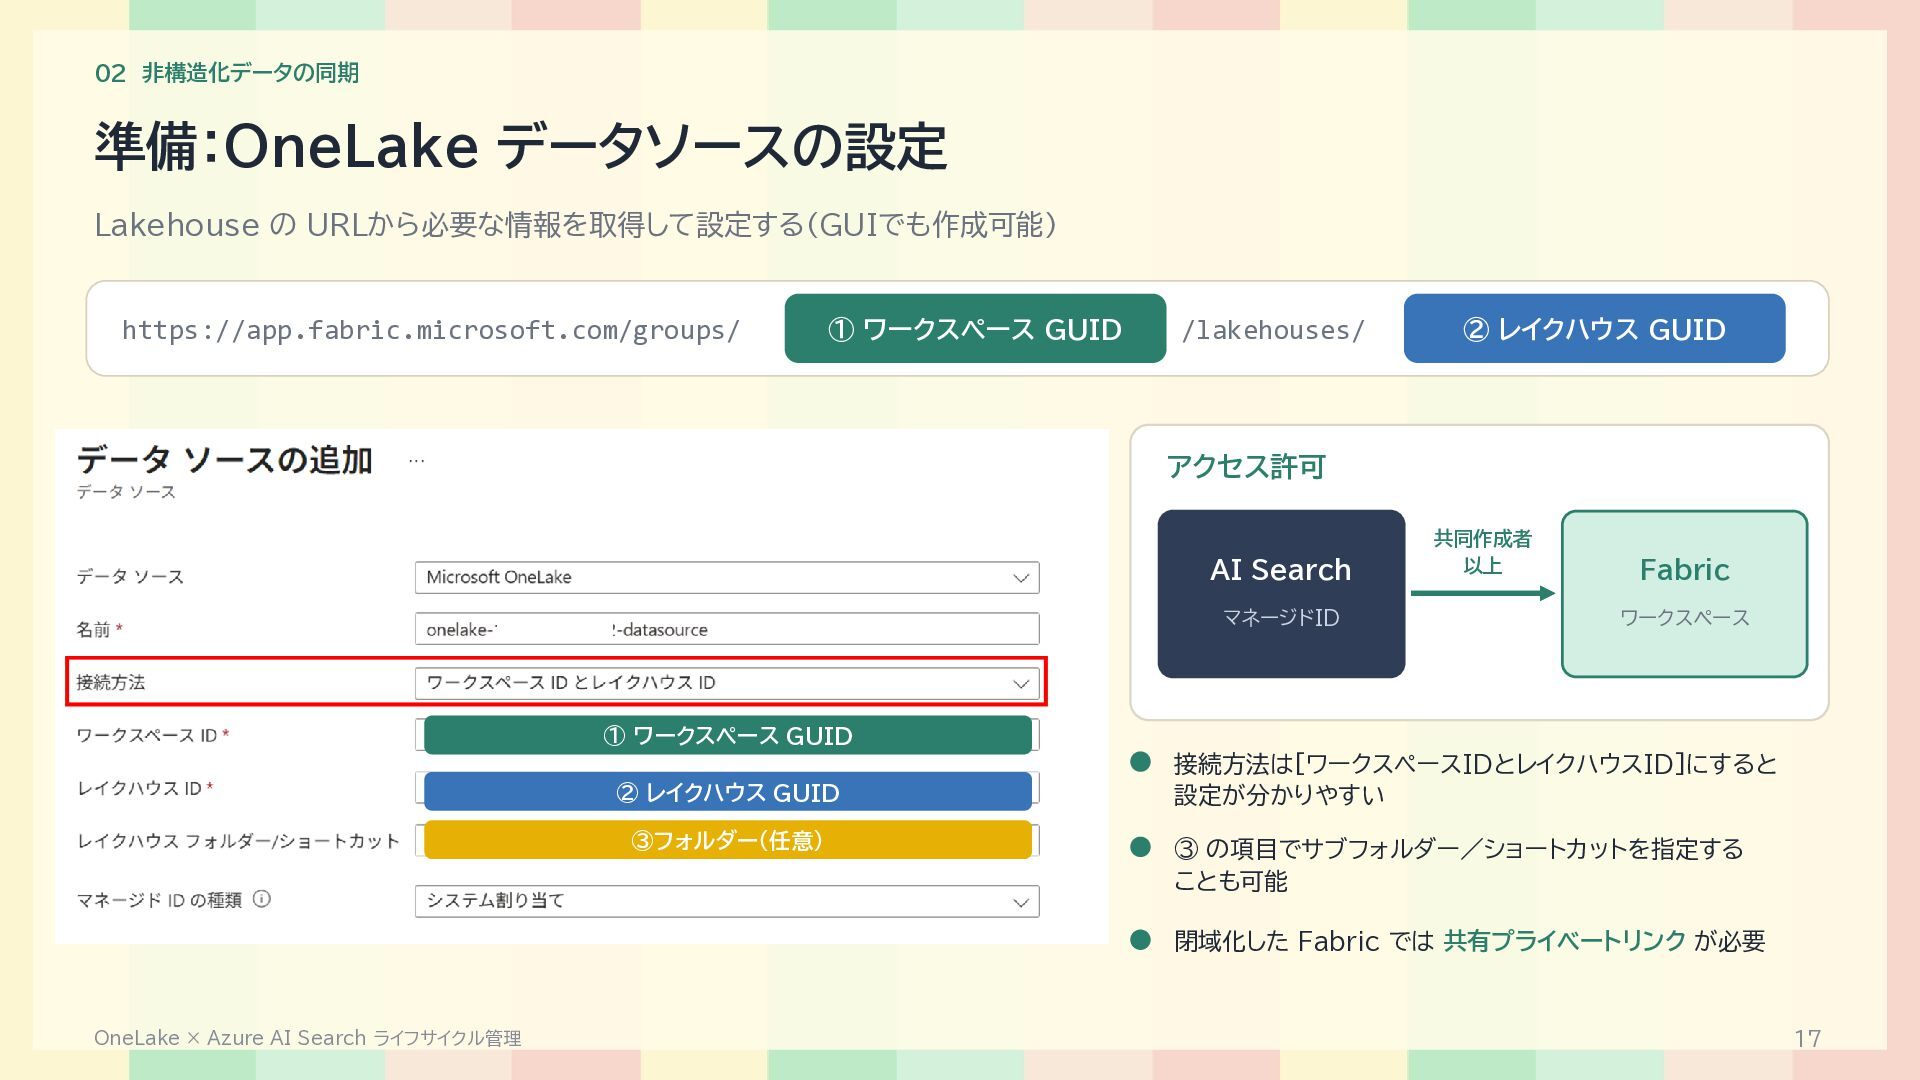
  15. 02 非構造化データの同期 準備:OneLake データソースの設定 Lakehouse の URLから必要な情報を取得して設定する(GUIでも作成可能) https://app.fabric.microsoft.com/groups/ ① ワークスペース

    GUID /lakehouses/ ② レイクハウス GUID アクセス許可 AI Search マネージドID 共同作成者 以上 Fabric ワークスペース ① ワークスペース GUID ② レイクハウス GUID ③フォルダー(任意) 接続方法は[ワークスペースIDとレイクハウスID]にすると 設定が分かりやすい ③ の項目でサブフォルダー/ショートカットを指定する ことも可能 閉域化した Fabric では 共有プライベートリンク が必要 OneLake × Azure AI Search ライフサイクル管理 17
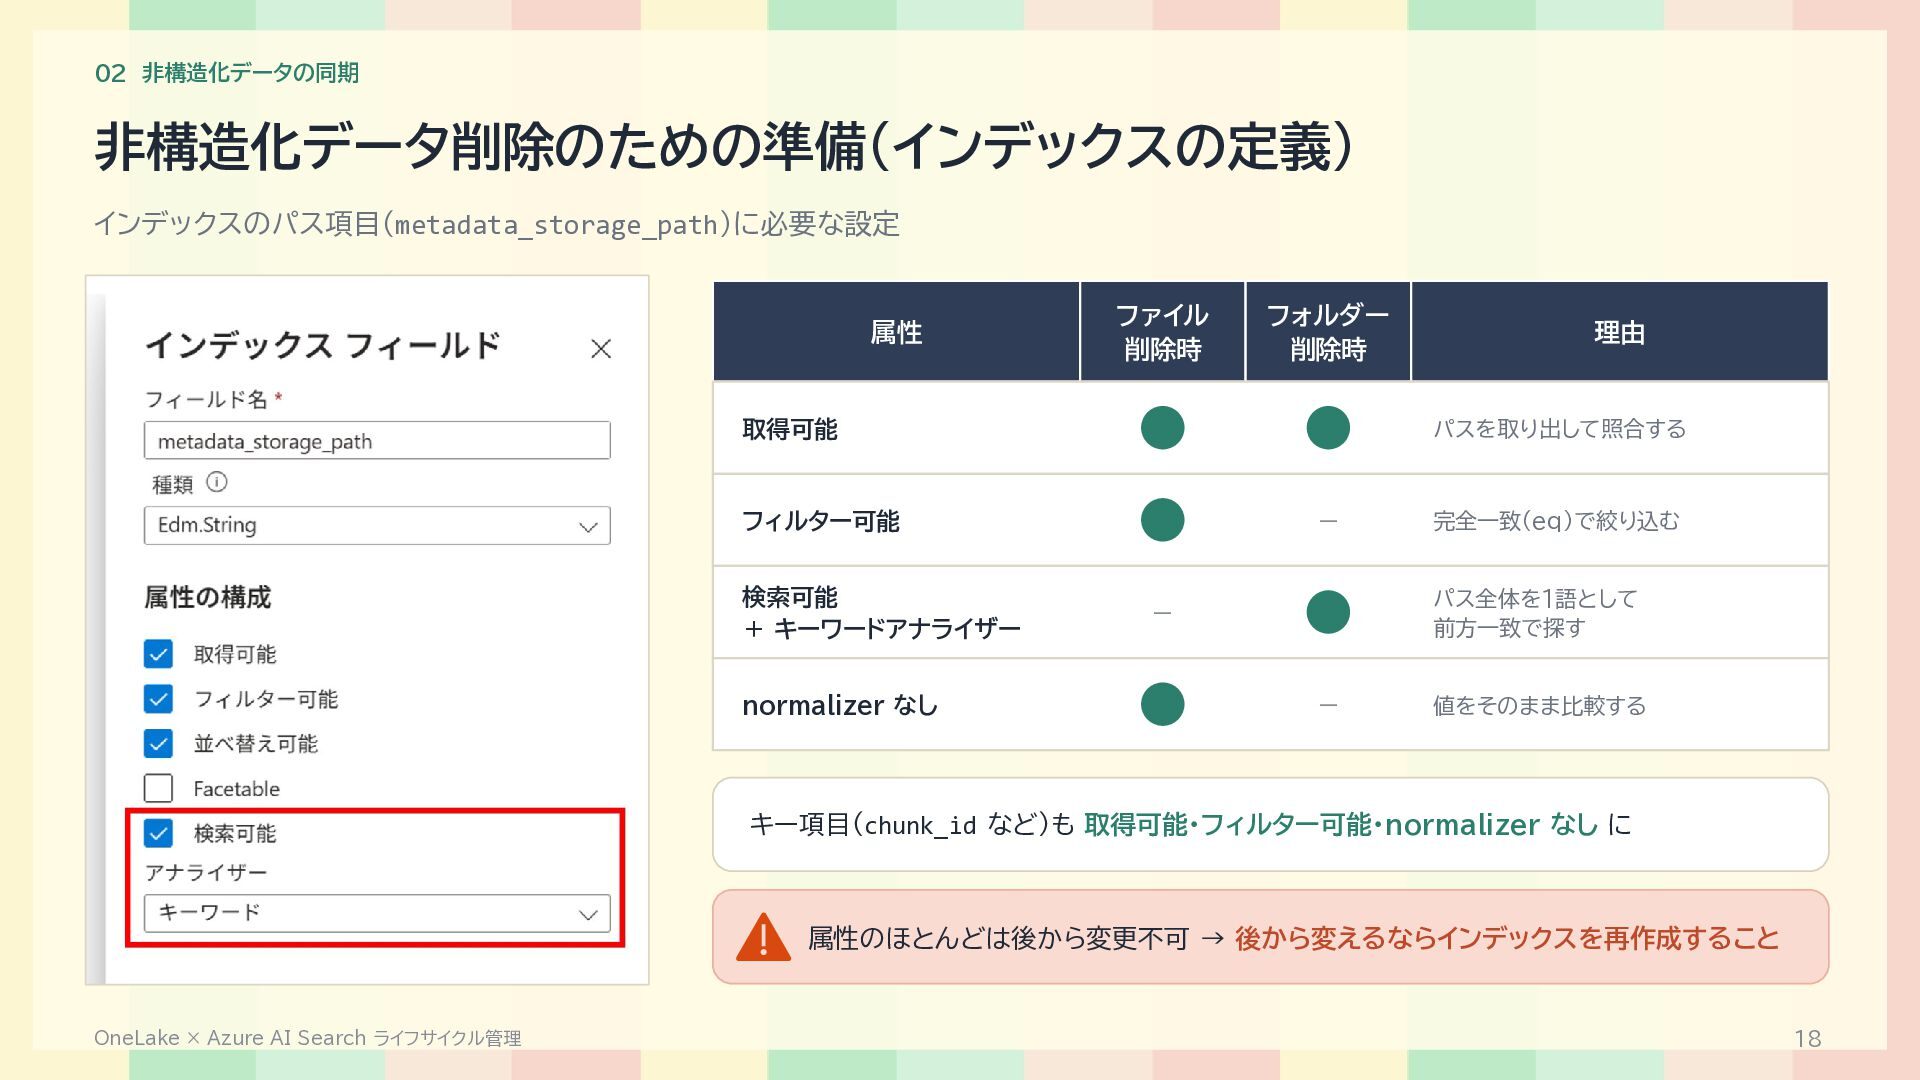
  16. 02 非構造化データの同期 非構造化データ削除のための準備(インデックスの定義) インデックスのパス項目(metadata_storage_path)に必要な設定 属性 ファイル 削除時 フォルダー 削除時 取得可能

    パスを取り出して照合する - フィルター可能 検索可能 + キーワードアナライザー normalizer なし 理由 完全一致(eq)で絞り込む パス全体を1語として 前方一致で探す - - 値をそのまま比較する キー項目(chunk_id など)も 取得可能・フィルター可能・normalizer なし に 属性のほとんどは後から変更不可 → 後から変えるならインデックスを再作成すること OneLake × Azure AI Search ライフサイクル管理 18
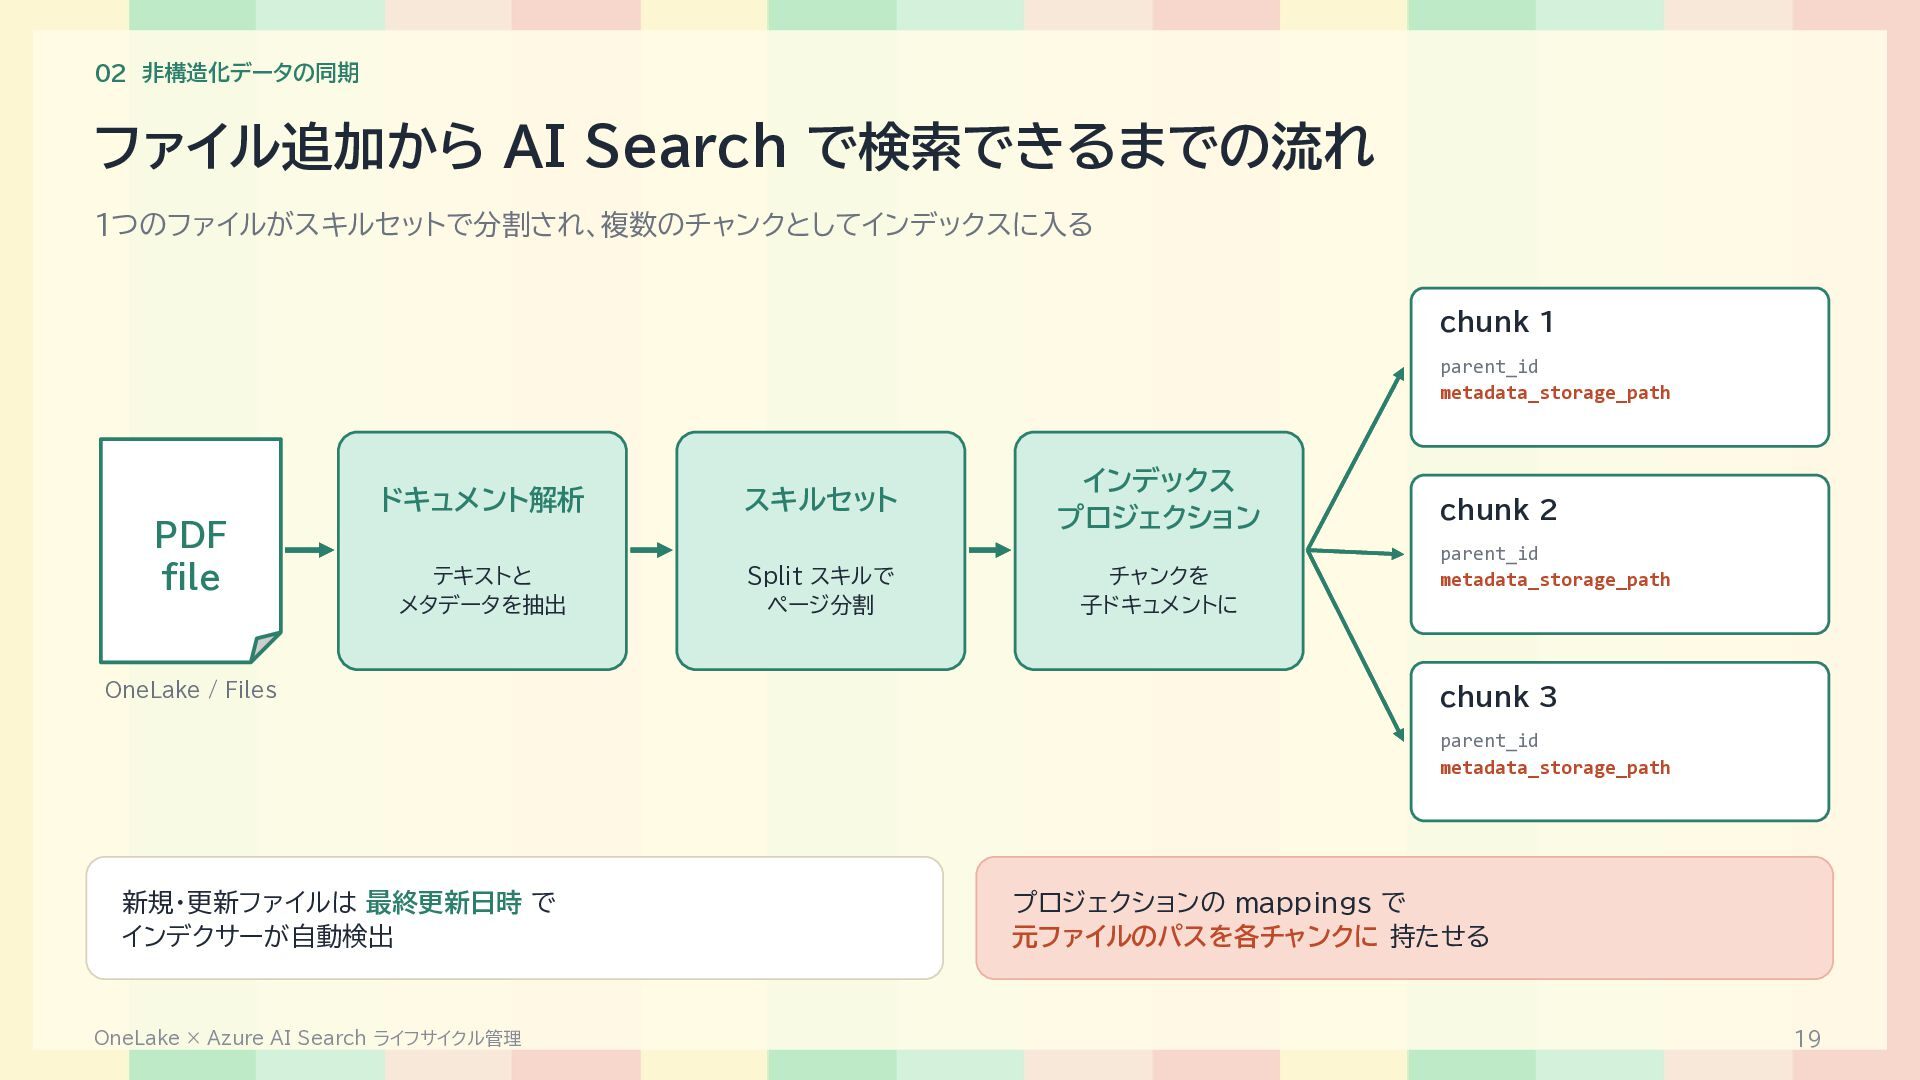
  17. 02 非構造化データの同期 ファイル追加から AI Search で検索できるまでの流れ 1つのファイルがスキルセットで分割され、複数のチャンクとしてインデックスに入る chunk 1 parent_id

    metadata_storage_path PDF file ドキュメント解析 スキルセット インデックス プロジェクション テキストと メタデータを抽出 Split スキルで ページ分割 チャンクを 子ドキュメントに OneLake / Files chunk 2 parent_id metadata_storage_path chunk 3 parent_id metadata_storage_path 新規・更新ファイルは 最終更新日時 で インデクサーが自動検出 OneLake × Azure AI Search ライフサイクル管理 プロジェクションの mappings で 元ファイルのパスを各チャンクに 持たせる 19
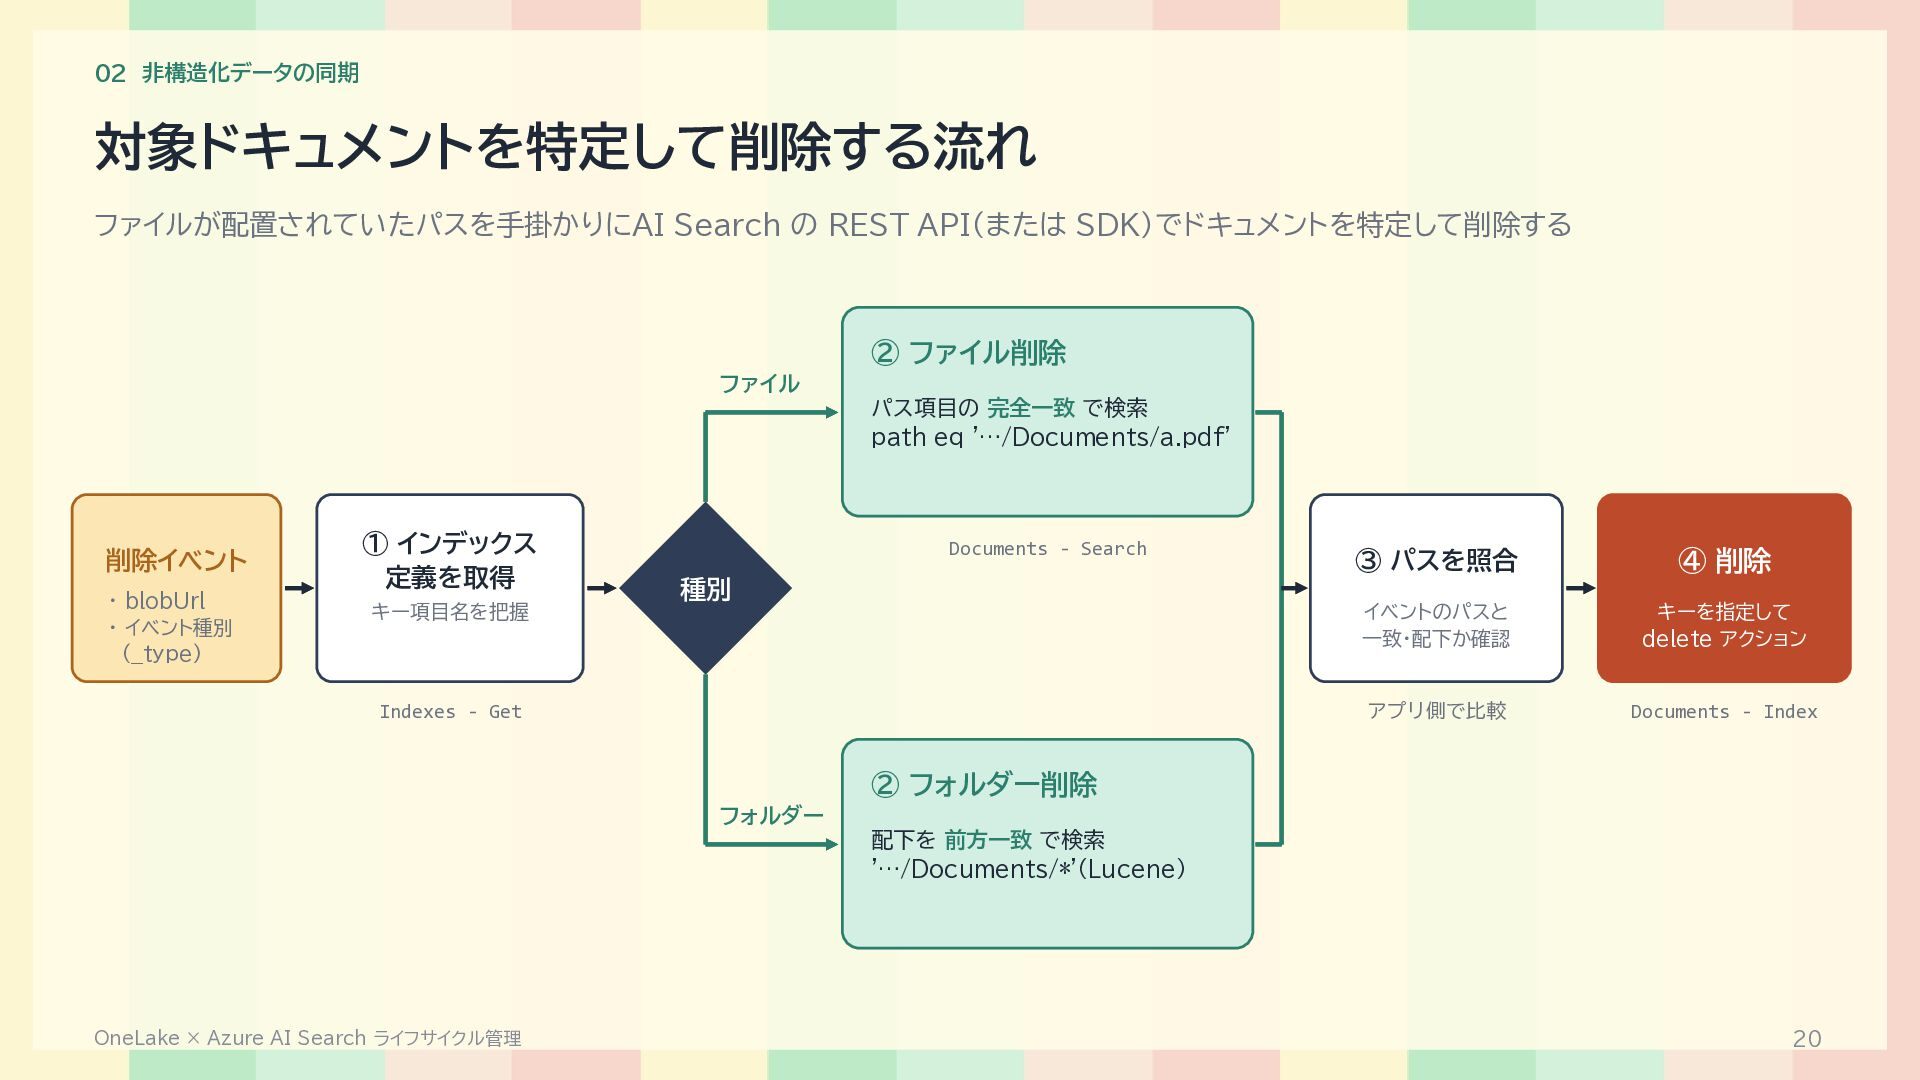
  18. 02 非構造化データの同期 対象ドキュメントを特定して削除する流れ ファイルが配置されていたパスを手掛かりにAI Search の REST API(または SDK)でドキュメントを特定して削除する ②

    ファイル削除 ファイル パス項目の 完全一致 で検索 path eq '…/Documents/a.pdf' 削除イベント ・ blobUrl ・ イベント種別 (__type) ① インデックス 定義を取得 キー項目名を把握 Documents - Search 種別 Indexes - Get ③ パスを照合 ④ 削除 イベントのパスと 一致・配下か確認 キーを指定して delete アクション アプリ側で比較 Documents - Index ② フォルダー削除 フォルダー 配下を 前方一致 で検索 '…/Documents/*'(Lucene) OneLake × Azure AI Search ライフサイクル管理 20
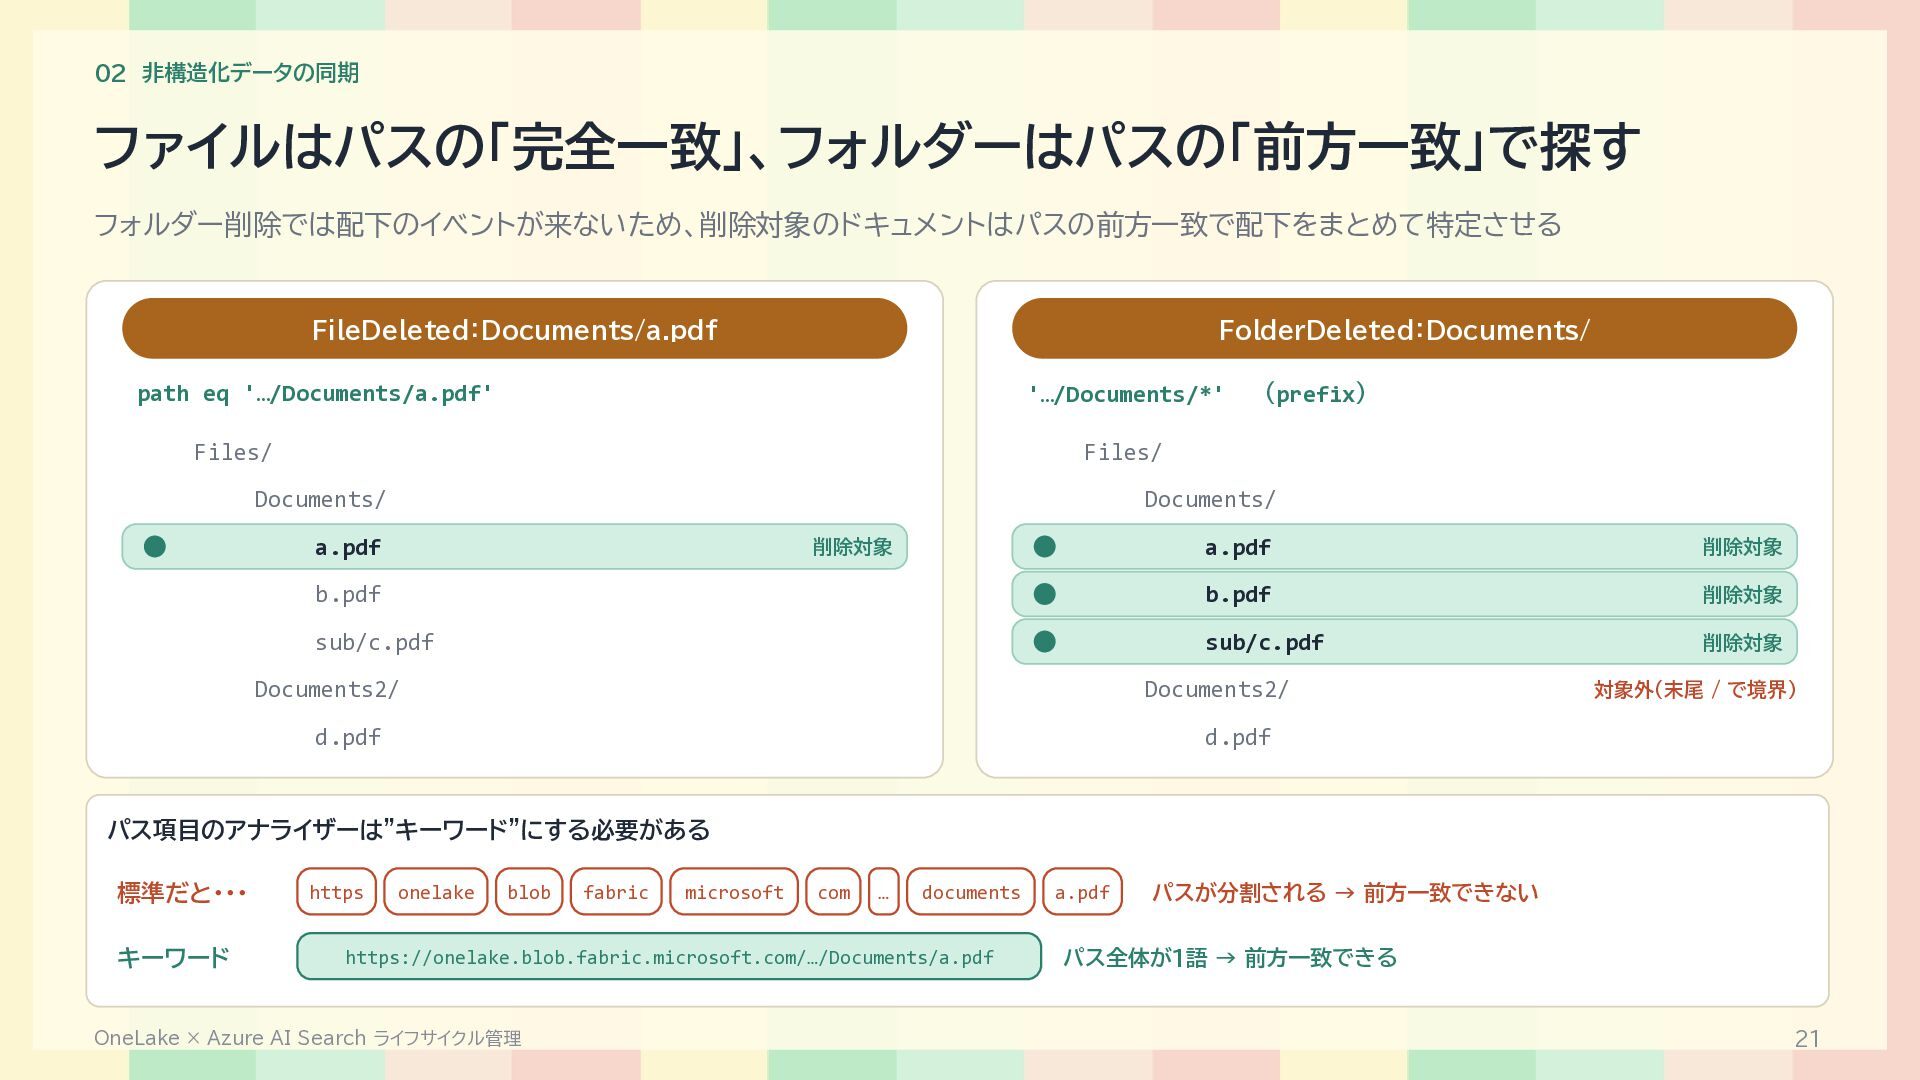
  19. 02 非構造化データの同期 ファイルはパスの「完全一致」、フォルダーはパスの「前方一致」で探す フォルダー削除では配下のイベントが来ないため、削除対象のドキュメントはパスの前方一致で配下をまとめて特定させる FileDeleted:Documents/a.pdf FolderDeleted:Documents/ path eq '…/Documents/a.pdf' '…/Documents/*'

    Files/ (prefix) Files/ Documents/ Documents/ a.pdf a.pdf 削除対象 b.pdf b.pdf 削除対象 sub/c.pdf sub/c.pdf 削除対象 削除対象 Documents2/ Documents2/ d.pdf 対象外(末尾 / で境界) d.pdf パス項目のアナライザーは”キーワード”にする必要がある 標準だと・・・ キーワード https onelake blob fabric microsoft com … documents https://onelake.blob.fabric.microsoft.com/…/Documents/a.pdf OneLake × Azure AI Search ライフサイクル管理 a.pdf パスが分割される → 前方一致できない パス全体が1語 → 前方一致できる 21
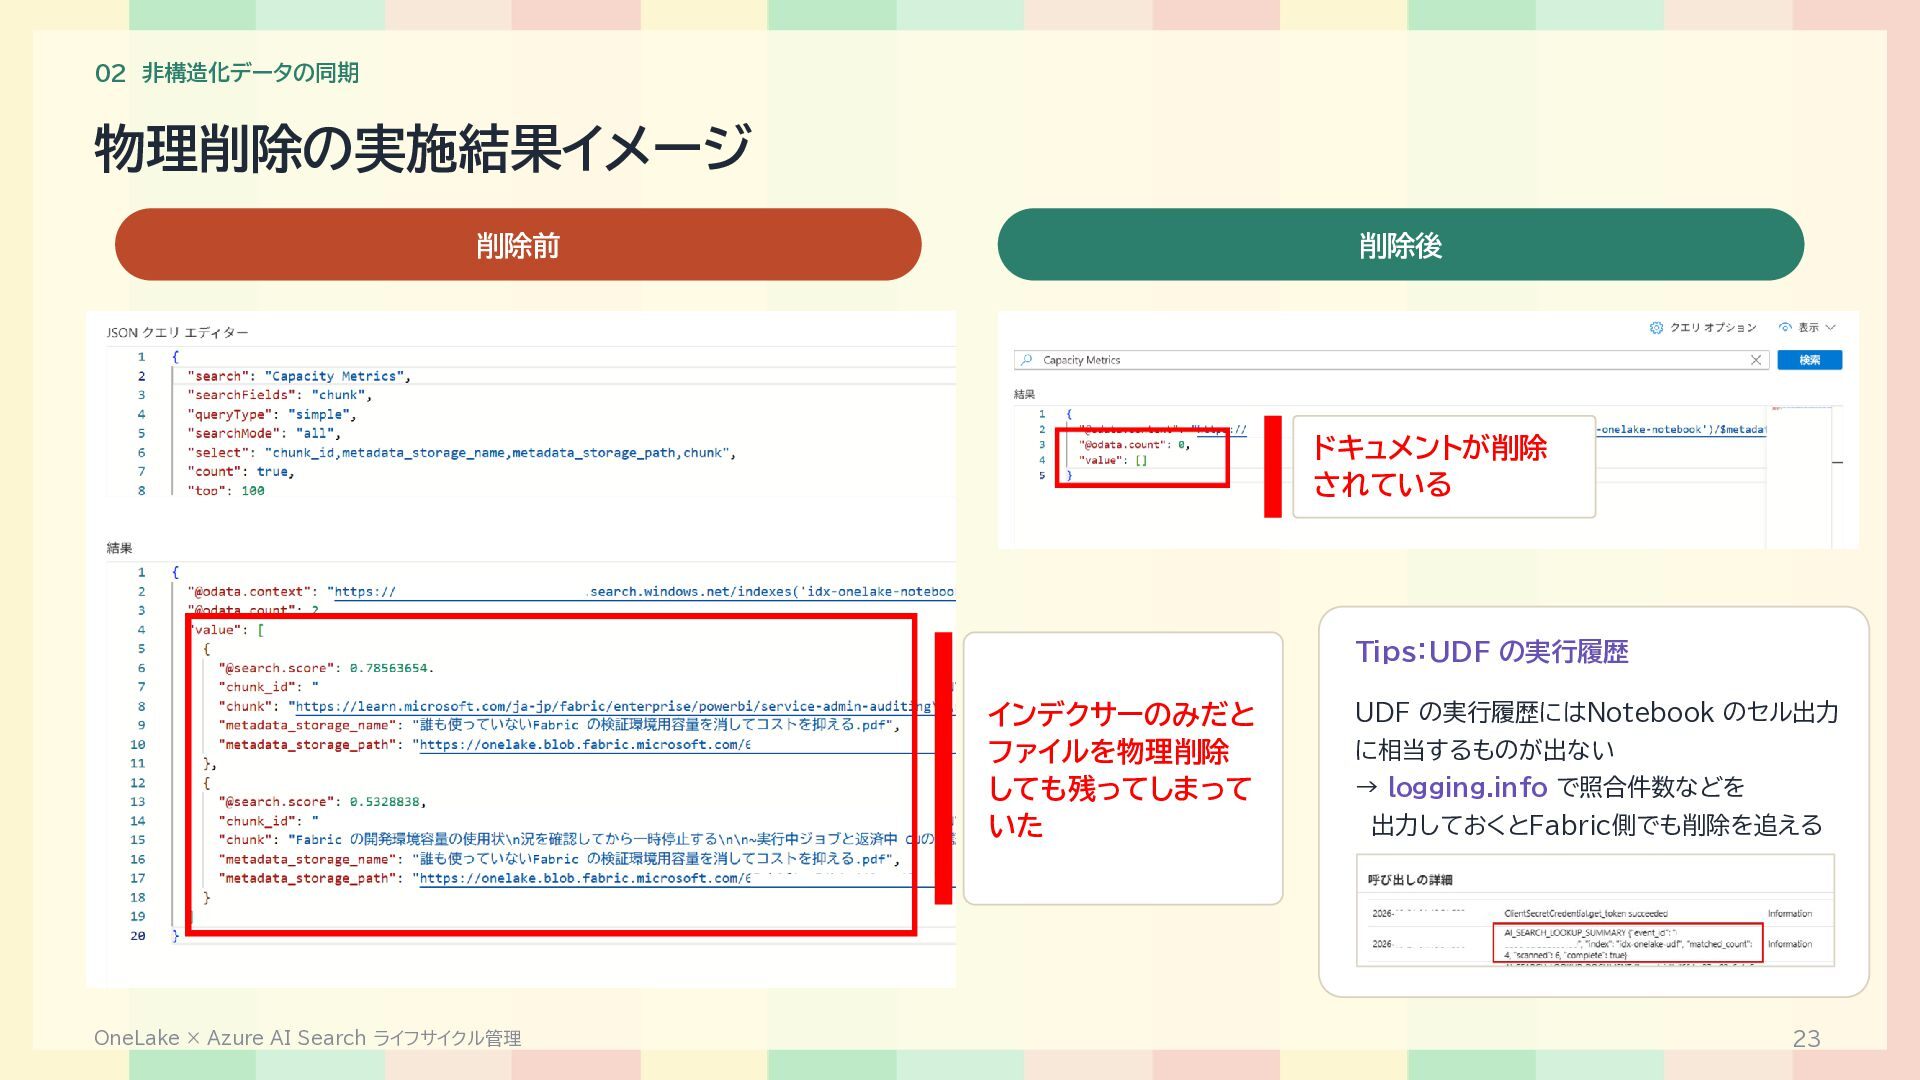
  20. 02 非構造化データの同期 物理削除の実施結果イメージ 削除前 削除後 ドキュメントが削除 されている Tips:UDF の実行履歴 インデクサーのみだと

    ファイルを物理削除 しても残ってしまって いた OneLake × Azure AI Search ライフサイクル管理 UDF の実行履歴にはNotebook のセル出力 に相当するものが出ない → logging.info で照合件数などを 出力しておくとFabric側でも削除を追える 23
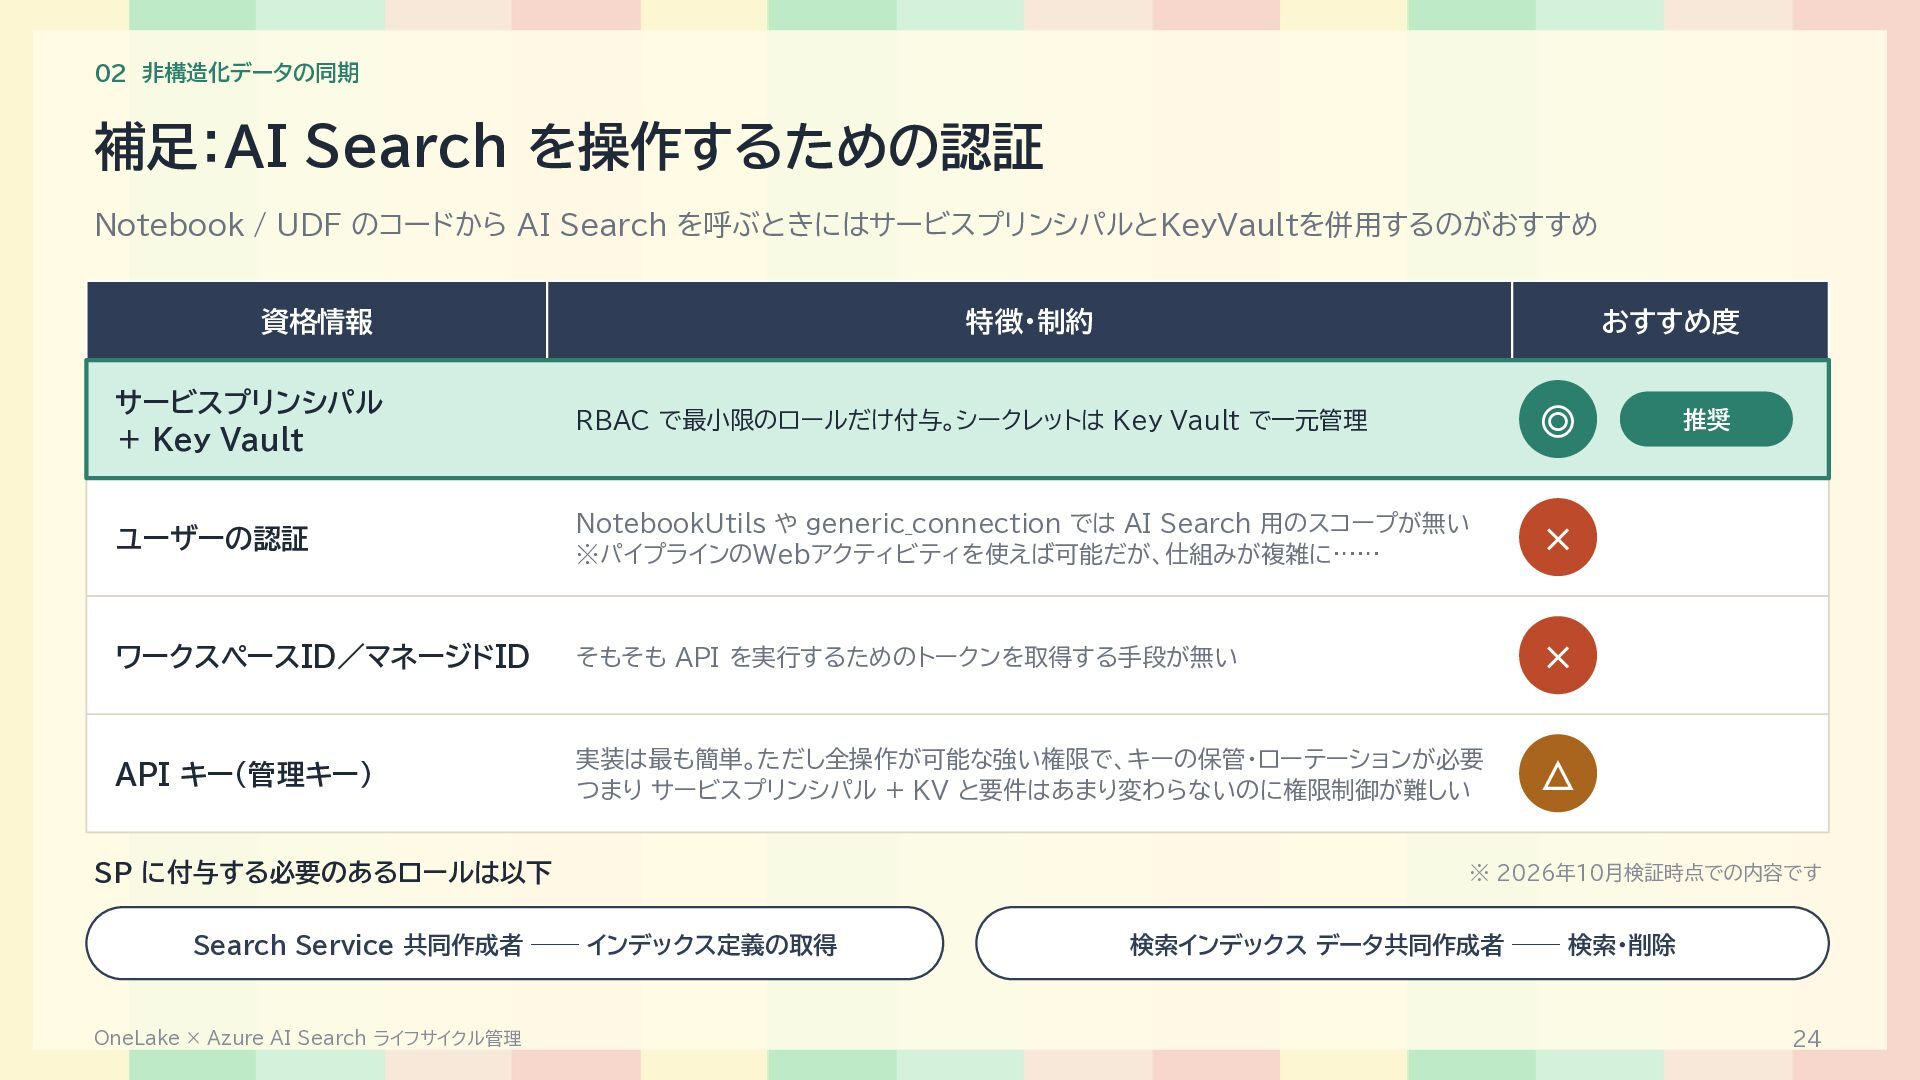
  21. 02 非構造化データの同期 補足:AI Search を操作するための認証 Notebook / UDF のコードから AI

    Search を呼ぶときにはサービスプリンシパルとKeyVaultを併用するのがおすすめ 資格情報 特徴・制約 おすすめ度 サービスプリンシパル + Key Vault RBAC で最小限のロールだけ付与。シークレットは Key Vault で一元管理 ◎ ユーザーの認証 NotebookUtils や generic_connection では AI Search 用のスコープが無い ※パイプラインのWebアクティビティを使えば可能だが、仕組みが複雑に…… × ワークスペースID/マネージドID そもそも API を実行するためのトークンを取得する手段が無い × API キー(管理キー) 実装は最も簡単。ただし全操作が可能な強い権限で、キーの保管・ローテーションが必要 つまり サービスプリンシパル + KV と要件はあまり変わらないのに権限制御が難しい △ SP に付与する必要のあるロールは以下 Search Service 共同作成者 ── インデックス定義の取得 OneLake × Azure AI Search ライフサイクル管理 推奨 ※ 2026年10月検証時点での内容です 検索インデックス データ共同作成者 ── 検索・削除 24
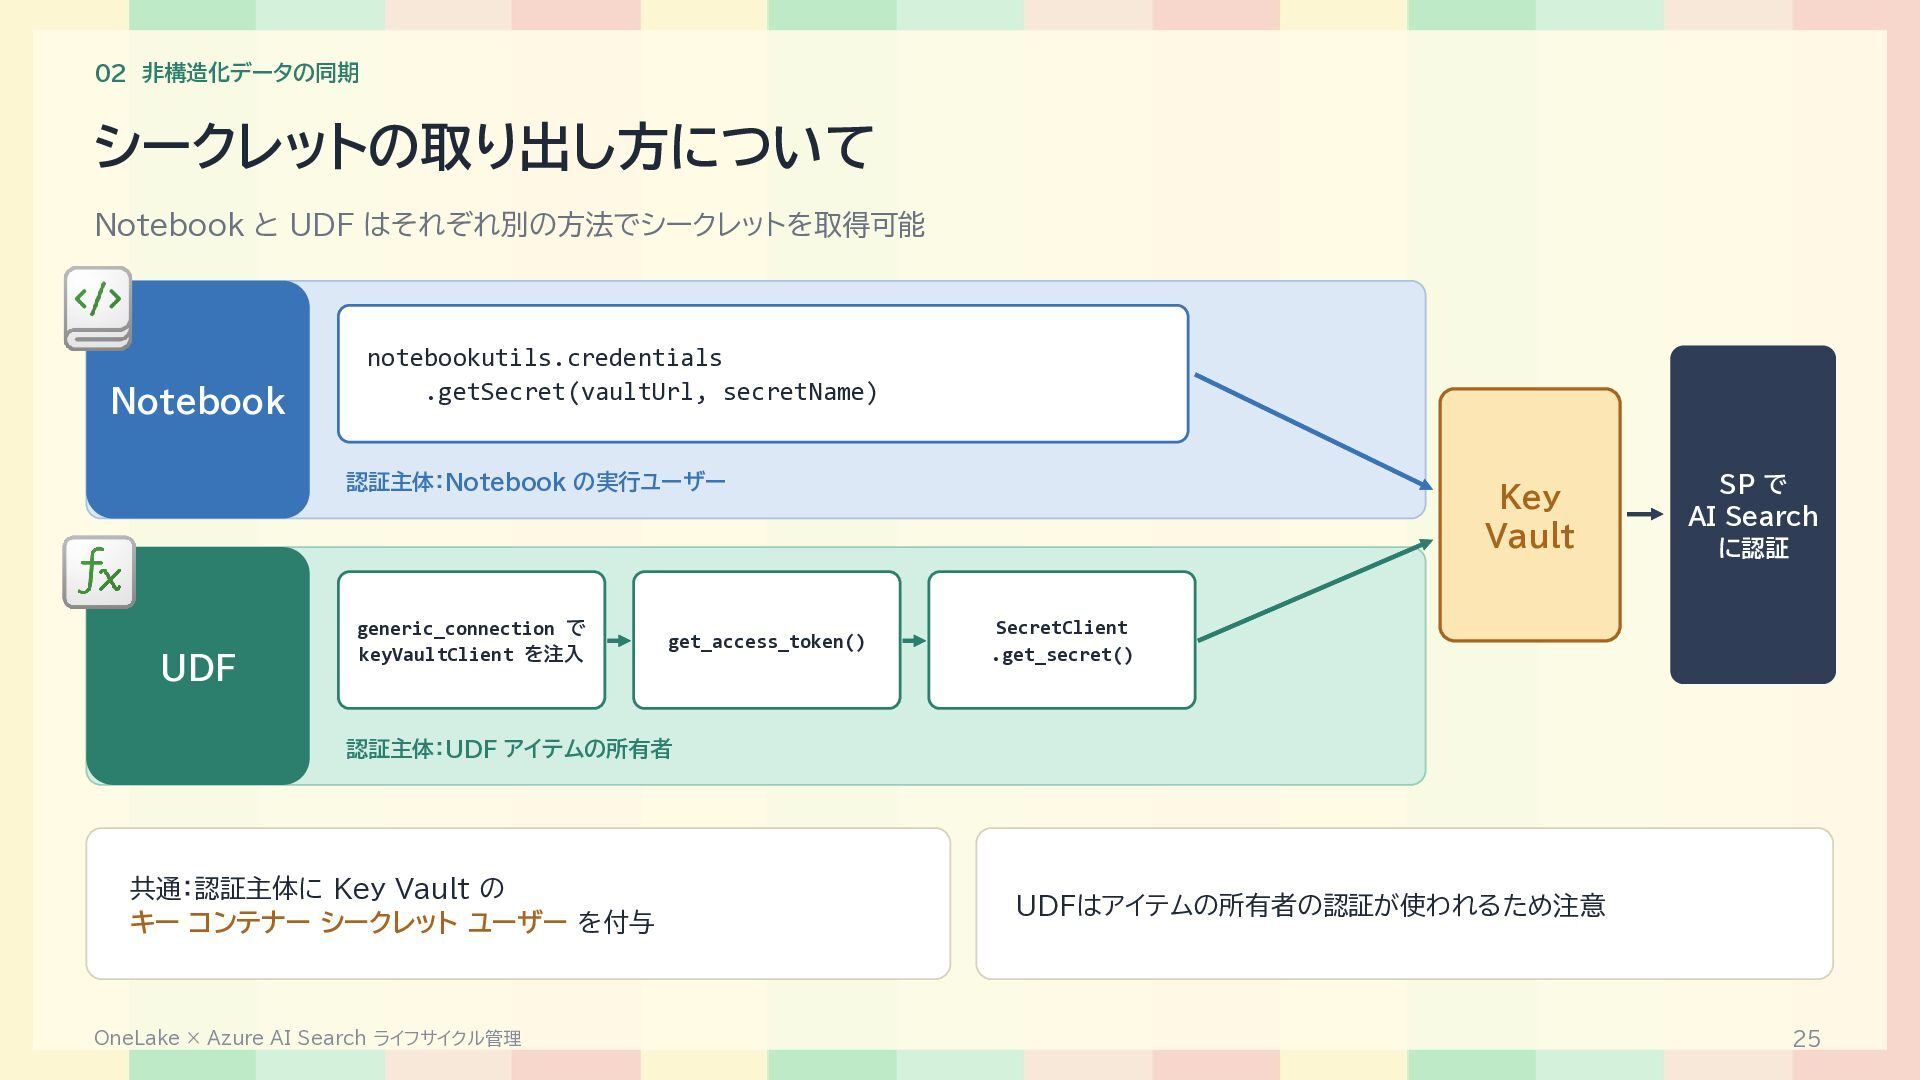
  22. 02 非構造化データの同期 シークレットの取り出し方について Notebook と UDF はそれぞれ別の方法でシークレットを取得可能 Notebook notebookutils.credentials .getSecret(vaultUrl,

    secretName) 認証主体:Notebook の実行ユーザー UDF generic_connection で keyVaultClient を注入 get_access_token() Key Vault SP で AI Search に認証 SecretClient .get_secret() 認証主体:UDF アイテムの所有者 共通:認証主体に Key Vault の キー コンテナー シークレット ユーザー を付与 OneLake × Azure AI Search ライフサイクル管理 UDFはアイテムの所有者の認証が使われるため注意 25
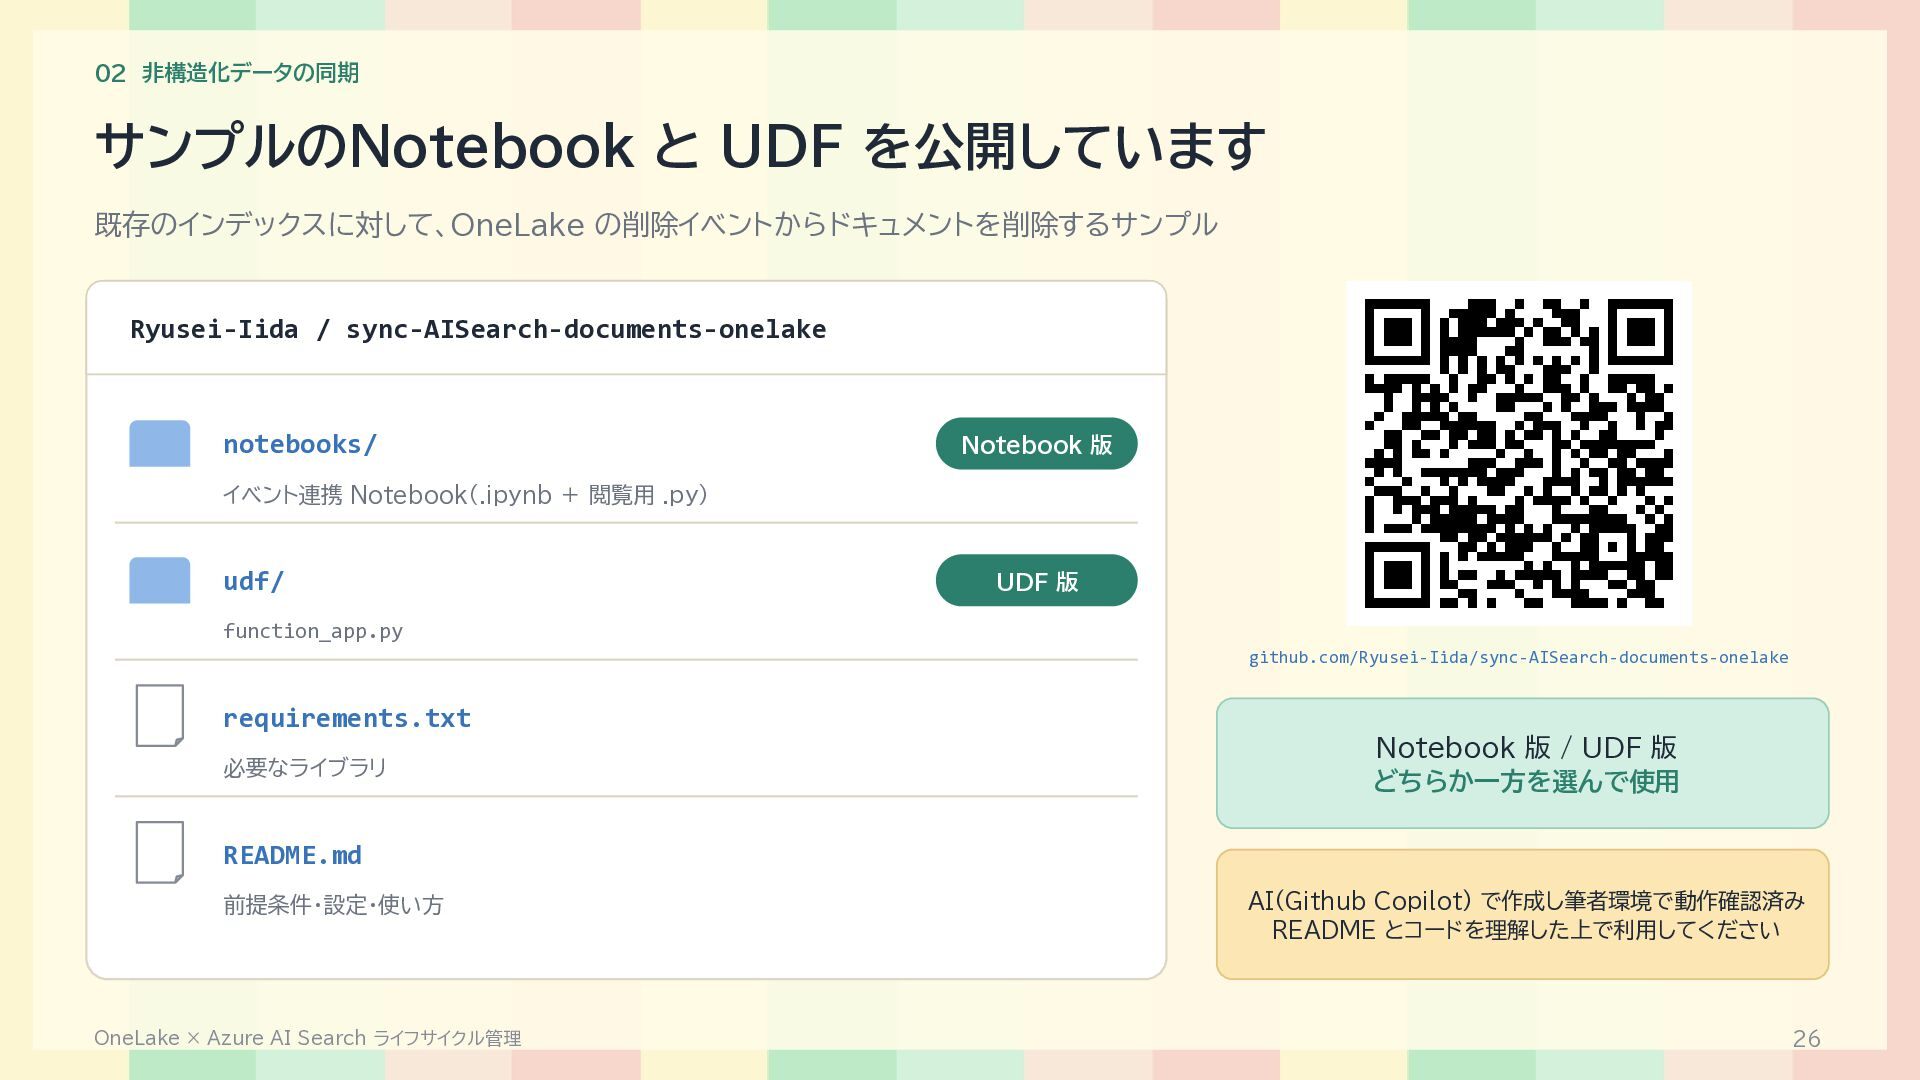
  23. 02 非構造化データの同期 サンプルのNotebook と UDF を公開しています 既存のインデックスに対して、OneLake の削除イベントからドキュメントを削除するサンプル Ryusei-Iida /

    sync-AISearch-documents-onelake notebooks/ Notebook 版 イベント連携 Notebook(.ipynb + 閲覧用 .py) udf/ UDF 版 function_app.py github.com/Ryusei-Iida/sync-AISearch-documents-onelake requirements.txt 必要なライブラリ Notebook 版 / UDF 版 どちらか一方を選んで使用 README.md 前提条件・設定・使い方 OneLake × Azure AI Search ライフサイクル管理 AI(Github Copilot) で作成し筆者環境で動作確認済み README とコードを理解した上で利用してください 26
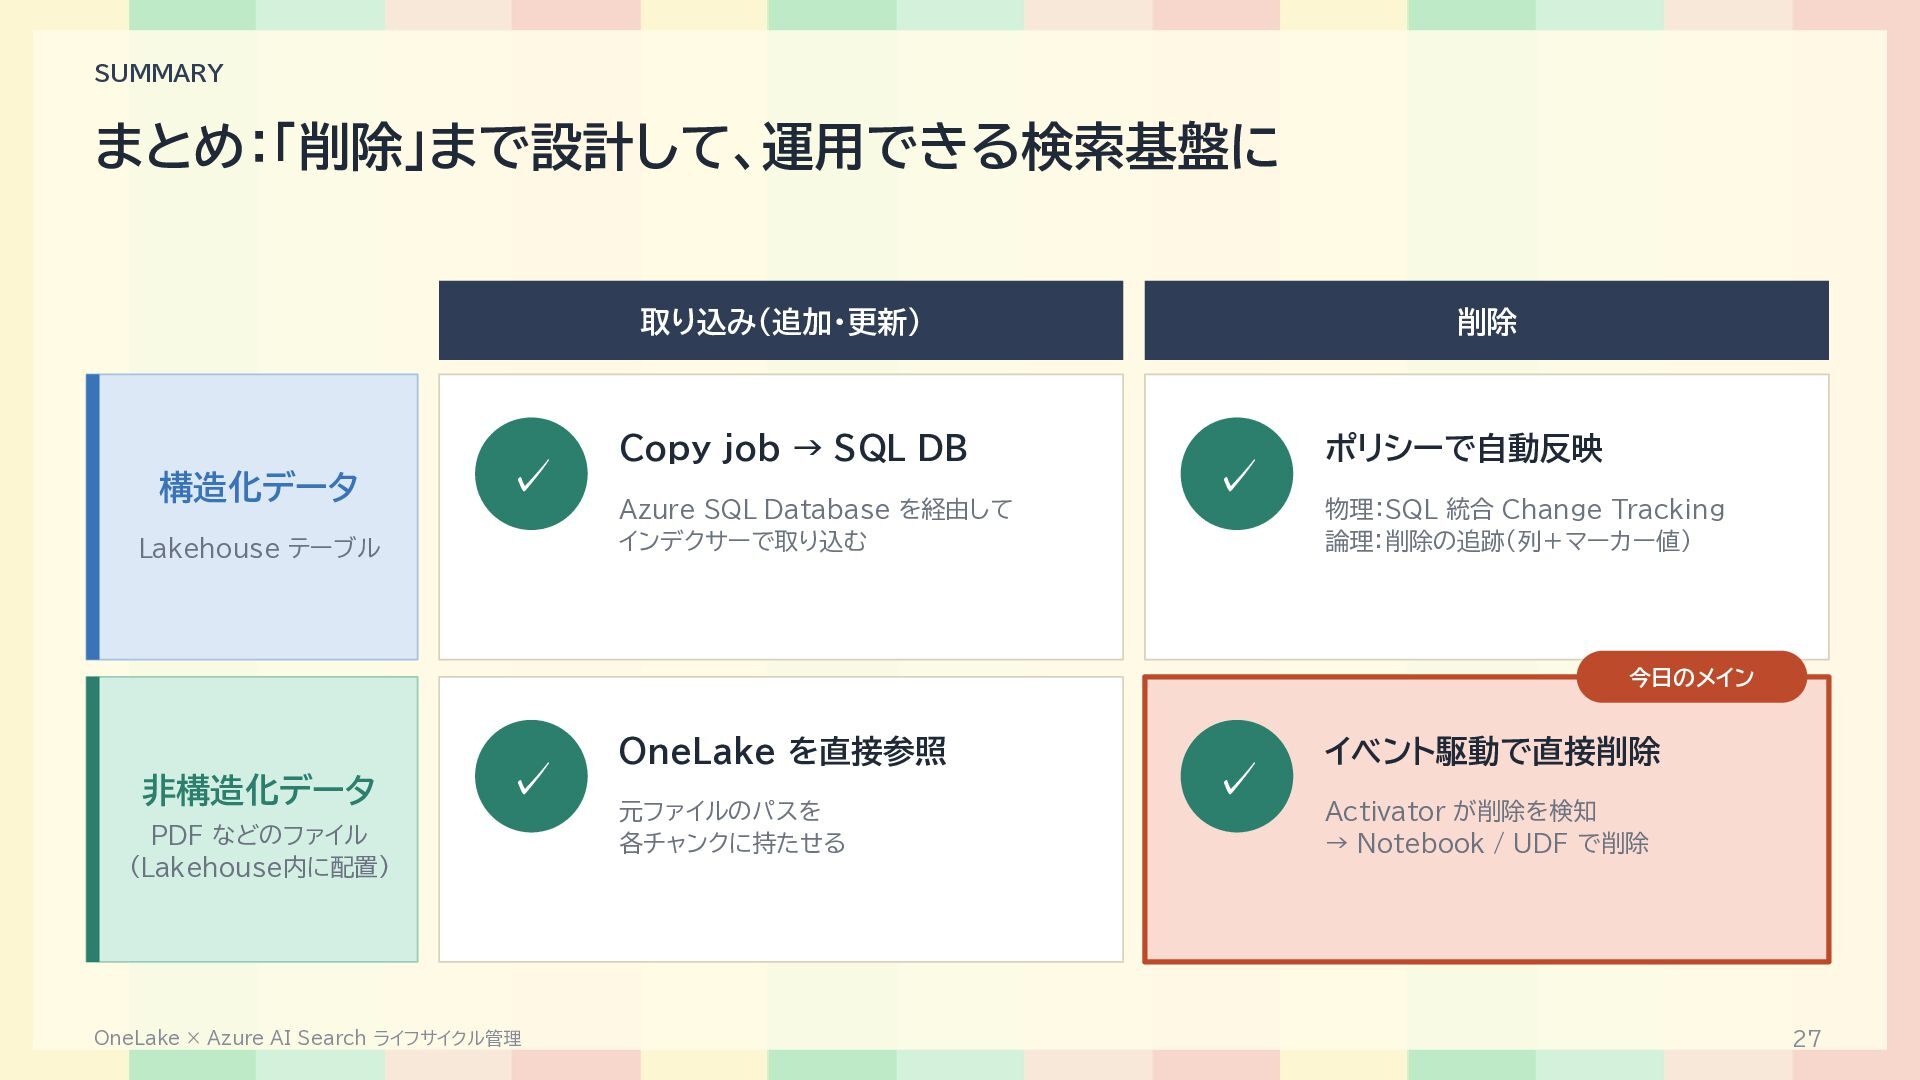
  24. SUMMARY まとめ:「削除」まで設計して、運用できる検索基盤に 取り込み(追加・更新) 構造化データ ✓ Lakehouse テーブル Copy job →

    SQL DB Azure SQL Database を経由して インデクサーで取り込む 削除 ✓ ポリシーで自動反映 物理:SQL 統合 Change Tracking 論理:削除の追跡(列+マーカー値) 今日のメイン 非構造化データ ✓ PDF などのファイル (Lakehouse内に配置) OneLake × Azure AI Search ライフサイクル管理 OneLake を直接参照 元ファイルのパスを 各チャンクに持たせる ✓ イベント駆動で直接削除 Activator が削除を検知 → Notebook / UDF で削除 27
  25. Thank you ! 構造化ファイルの削除 について Azure SQL インデクサー - Azure

    AI Search | Microsoft Learn 非構造化ファイルの削除 について OneLake インデクサー - Azure AI Search | Microsoft Learn コピー ジョブを使用して Azure SQL Database からデータ キャプチャを変更 する - Microsoft Fabric | Microsoft Learn Fabric 用 NotebookUtils 資格情報ユーティリティ - Microsoft Fabric | Microsoft Learn Fabricユーザーデータ関数のためのPythonプログラミングモデル - Microsoft Fabric | Microsoft Learn Indexes - Get - REST API (Azure Search Service) | Microsoft Learn Documents - Search Post - REST API (Azure Search Service) | Microsoft Learn Documents - Index - REST API (Azure Search Service) | Microsoft Learn クイック スタート - Fabric ユーザー データ関数項目の呼び出しログを表示する - Microsoft Fabric | Microsoft Learn