Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【AI×DevOps Study #25】AIが答えをくれる時代に、クラウドインフラをどう学ぶか

【AI×DevOps Study #25】AIが答えをくれる時代に、クラウドインフラをどう学ぶか

■ AI×DevOps Study #24の概要
2026年10月14日に開催した「AI×DevOps Study」第25回の勉強会資料です。

「AI×DevOps Study」は、AI駆動開発やそこに関係するマイクロサービスについて理解を深める場になります。
株式会社ScalarではAIを使ったチーム開発を進めており、参画しているメンバーや協力会社の方から、具体的なAI駆動開発を実施する方法、その中で生まれたマイクロサービスアーキテクチャを使用したAI駆動開発の事例や実際に使えるエージェントについてお話頂き、参加者の皆様と知識の共有や交換を目的としています。
(弊社製品であるScalarDBも絡んだお話も一部出てきますが、汎用的な内容となっておりますのでフラットにお楽しみいいただけます)

■ 今回のテーマ
今回のテーマは、「AIが答えをくれる時代に、クラウドインフラをどう学ぶか」です。

AIに聞けば、Terraform の書き方も Kubernetes のエラーの意味もすぐ答えが返ってきます。 ただ、答えをもらった数だけ自分が分かるようになるかというと、そうではありませんでした。 クラウドインフラのテンプレートを作る実務のなかで、「困った」を起点にAIに聞き、試し、 想定とのズレを掘る——という学び方を、AWS/GCP・CI・Kubernetes の実例で紹介します。

【内容(アジェンダ案)】

主に以下の流れで、自身の経験をベースに話します。

1.AI時代の「リアルな」勉強法
2.知識を増やす学習サイクル
3.実務での具体例(インフラ業務より) 上記サイクルを回した実例を3つ紹介します。
 ・環境構築
 ・CIの改善
 ・Kubernetes

■ 登壇者情報(敬称略)
樋口

株式会社BREXA SOLVIA クラウドエンジニア。異業界の看護師を経て、AIの可能性に惹かれてこの世界に飛び込みました。2025年10月よりエンジニアとしてのキャリアをスタートし、エンジニア歴1年。現在は監視スタックを中心にクラウドインフラ構築テンプレートの開発を行っています。わからないことだらけの中でも、「なぜこの仕組みが必要なのか」を大切にしながら日々探求しています。

■関連コンテンツ
・Youtube(過去の勉強会動画も公開中!)
www.youtube.com/@scalar-labs

・Zenn ブログ
https://zenn.dev/p/scalar_sol_blog

・イベントページ(connpass)
https://scalar.connpass.com/

Avatar for Scalar, Inc.

Scalar, Inc. PRO

October 14, 2026

More Decks by Scalar, Inc.

Other Decks in Technology

Transcript

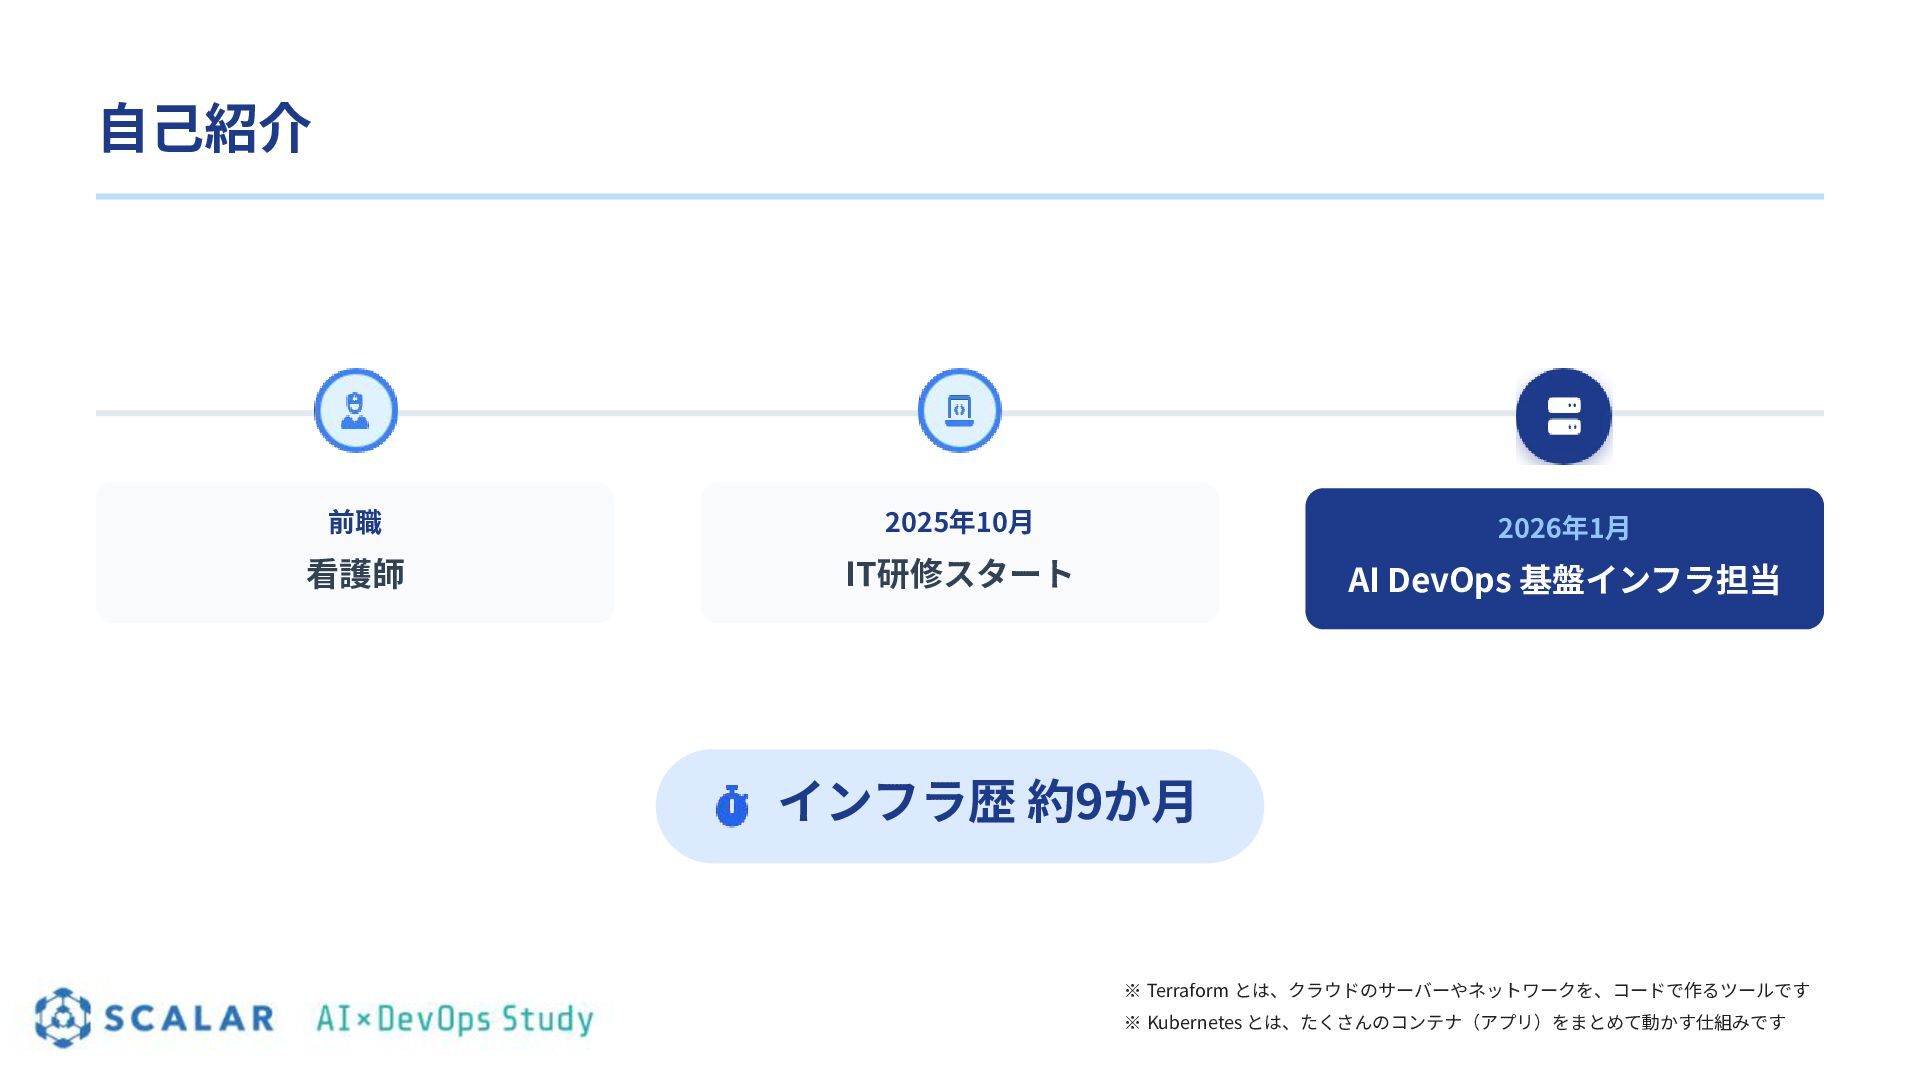
  1. ⾃⼰紹介 前職 2025年10⽉ 2026年1⽉ 看護師 IT研修スタート AI DevOps 基盤インフラ担当 インフラ歴

    約9か⽉ ※ Terraform とは、クラウドのサーバーやネットワークを、コードで作るツールです ※ Kubernetes とは、たくさんのコンテナ(アプリ)をまとめて動かす仕組みです
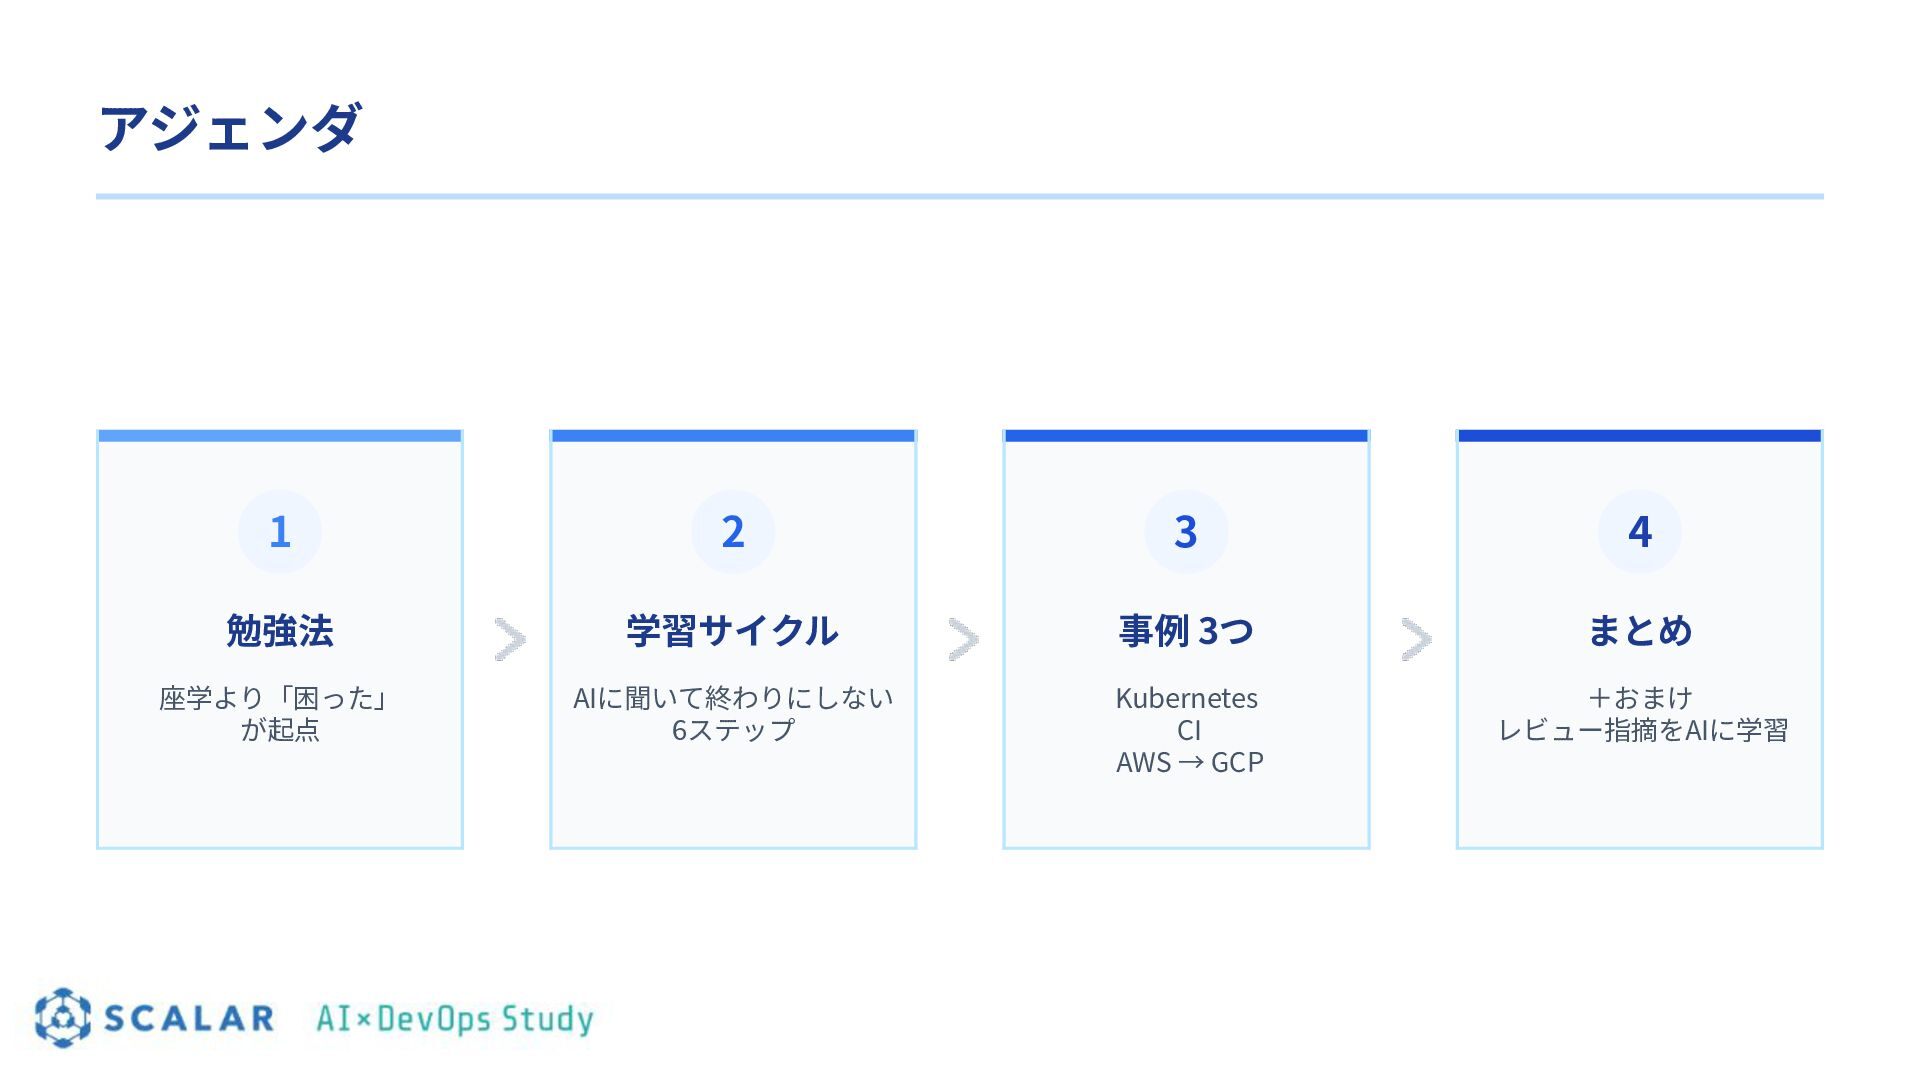
  2. アジェンダ 1 2 3 4 勉強法 学習サイクル 事例 3つ まとめ

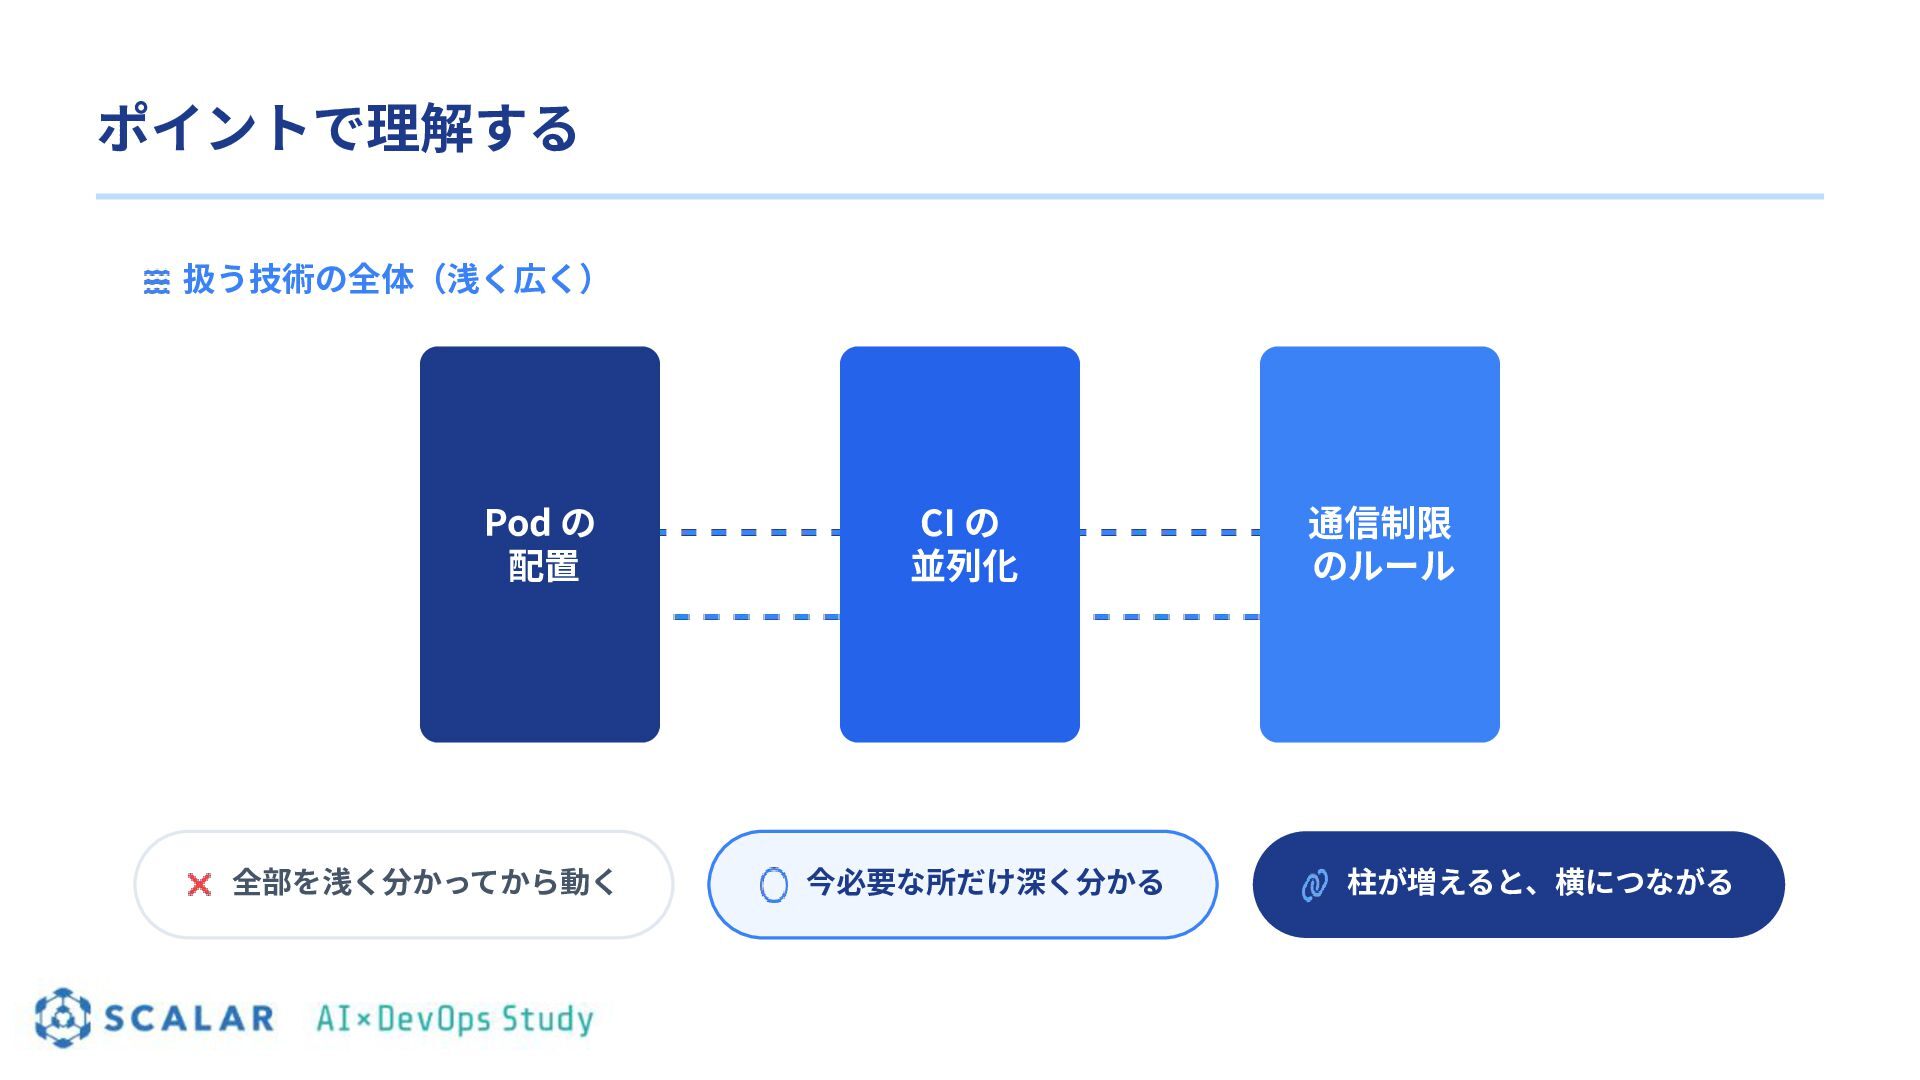
    座学より「困った」 が起点 AIに聞いて終わりにしない 6ステップ Kubernetes CI AWS → GCP +おまけ レビュー指摘をAIに学習
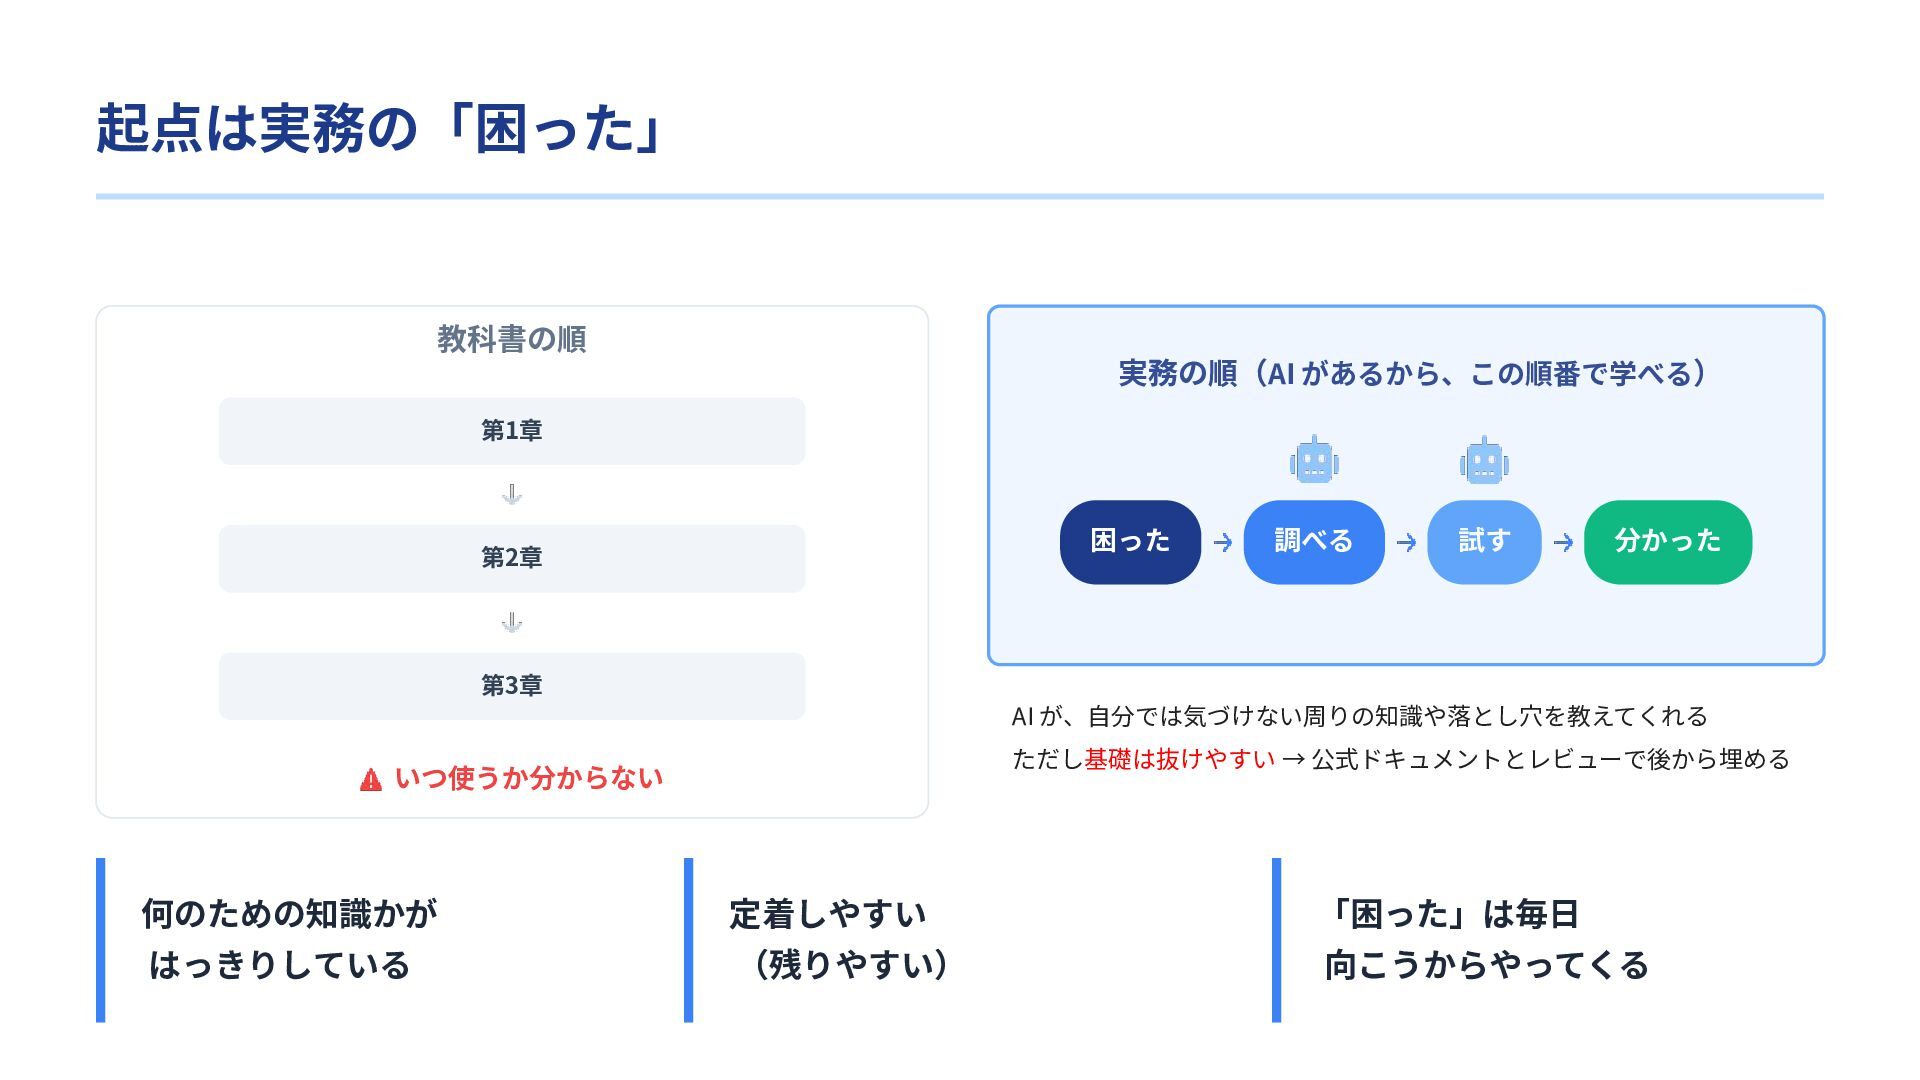
  3. 起点は実務の「困った」 教科書の順 実務の順(AI があるから、この順番で学べる) 第1章 困った 第2章 調べる 試す 分かった

    第3章 AI が、⾃分では気づけない周りの知識や落とし⽳を教えてくれる ただし基礎は抜けやすい → 公式ドキュメントとレビューで後から埋める いつ使うか分からない 何のための知識かが 定着しやすい 「困った」は毎⽇ はっきりしている (残りやすい) 向こうからやってくる
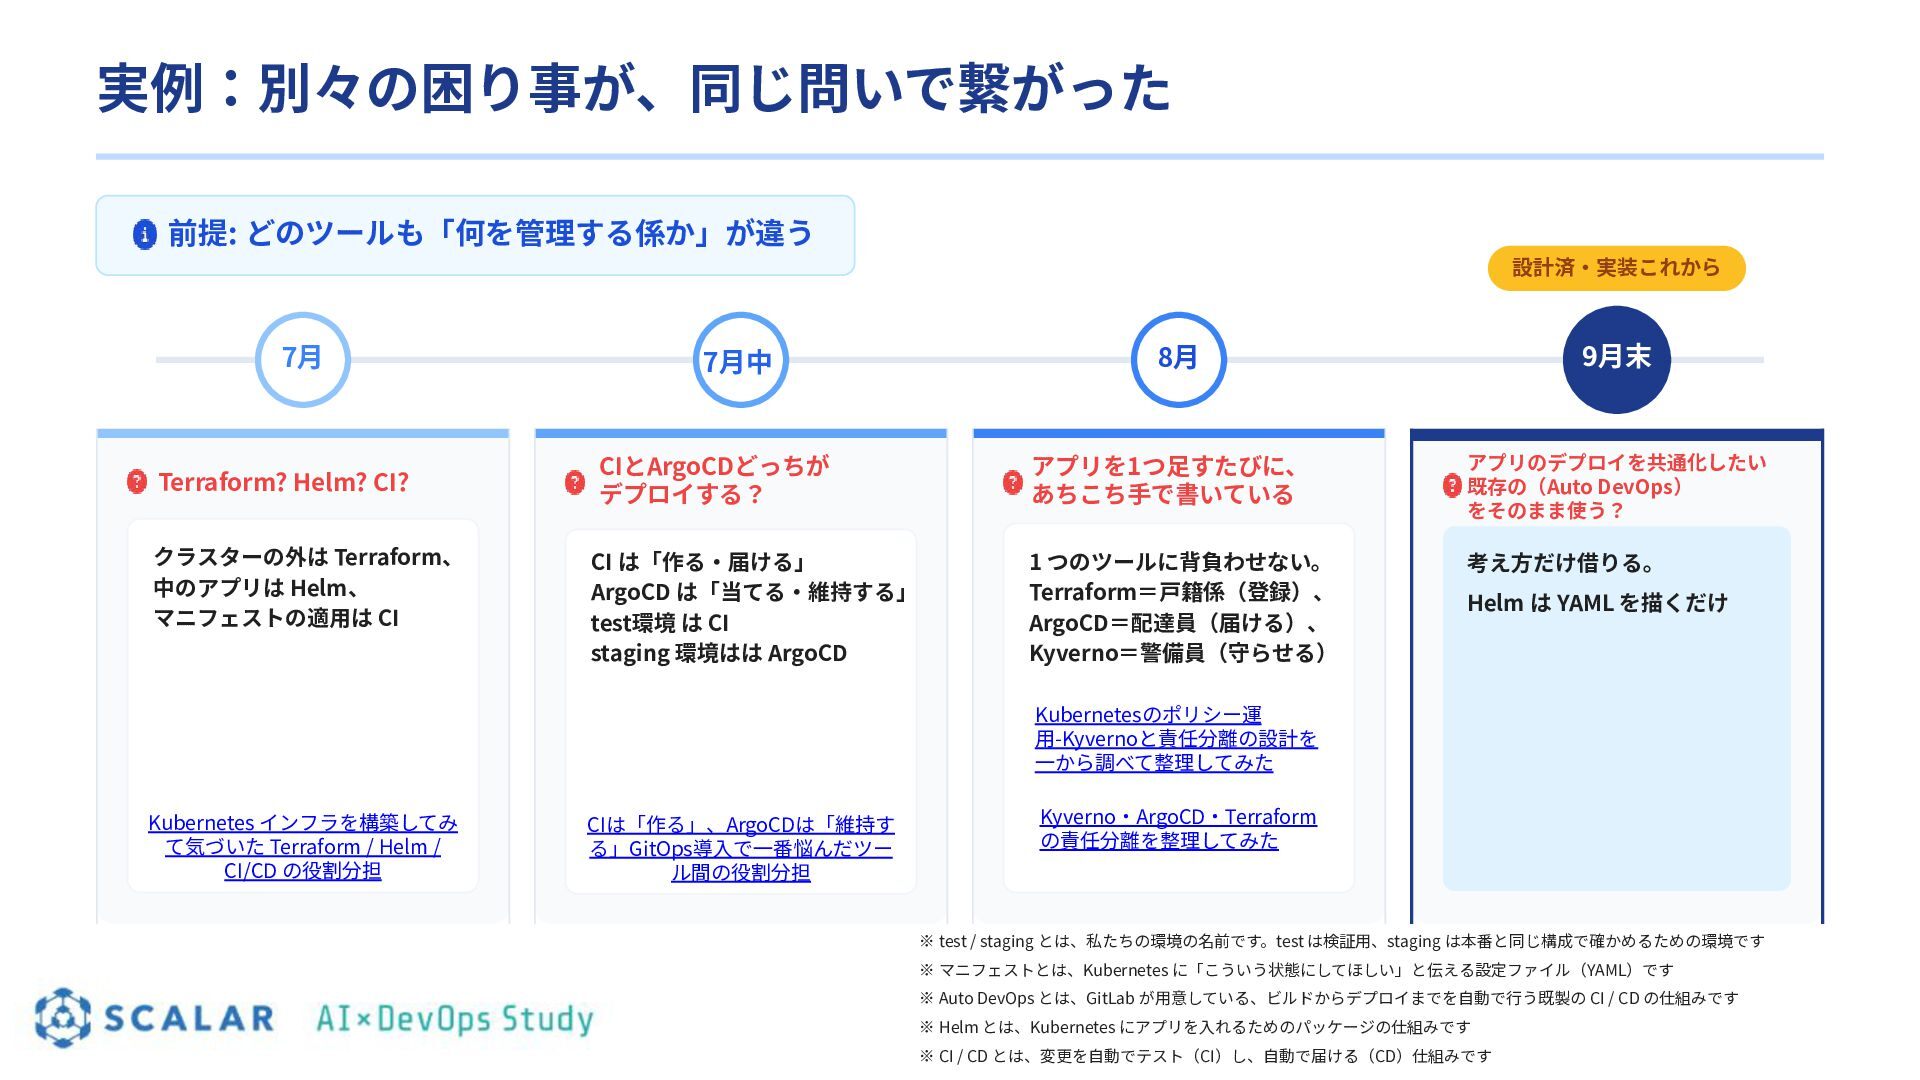
  4. 実例:別々の困り事が、同じ問いで繋がった 前提: どのツールも「何を管理する係か」が違う 設計済‧実装これから 7⽉ Terraform? Helm? CI? クラスターの外は Terraform、

    中のアプリは Helm、 マニフェストの適⽤は CI 8⽉ 9⽉末 CIとArgoCDどっちが デプロイする? アプリを1つ⾜すたびに、 あちこち⼿で書いている アプリのデプロイを共通化したい 既存の(Auto DevOps) をそのまま使う? CI は「作る‧届ける」 ArgoCD は「当てる‧維持する」 test環境 は CI staging 環境はは ArgoCD 1 つのツールに背負わせない。 Terraform=⼾籍係(登録)、 ArgoCD=配達員(届ける)、 Kyverno=警備員(守らせる) 考え⽅だけ借りる。 7⽉中 Helm は YAML を描くだけ Kubernetesのポリシー運 ⽤-Kyvernoと責任分離の設計を ⼀から調べて整理してみた Kubernetes インフラを構築してみ て気づいた Terraform / Helm / CI/CD の役割分担 CIは「作る」、ArgoCDは「維持す る」GitOps導⼊で⼀番悩んだツー ル間の役割分担 Kyverno‧ArgoCD‧Terraform の責任分離を整理してみた ※ test / staging とは、私たちの環境の名前です。test は検証⽤、staging は本番と同じ構成で確かめるための環境です ※ マニフェストとは、Kubernetes に「こういう状態にしてほしい」と伝える設定ファイル(YAML)です ※ Auto DevOps とは、GitLab が⽤意している、ビルドからデプロイまでを⾃動で⾏う既製の CI / CD の仕組みです ※ Helm とは、Kubernetes にアプリを⼊れるためのパッケージの仕組みです ※ CI / CD とは、変更を⾃動でテスト(CI)し、⾃動で届ける(CD)仕組みです
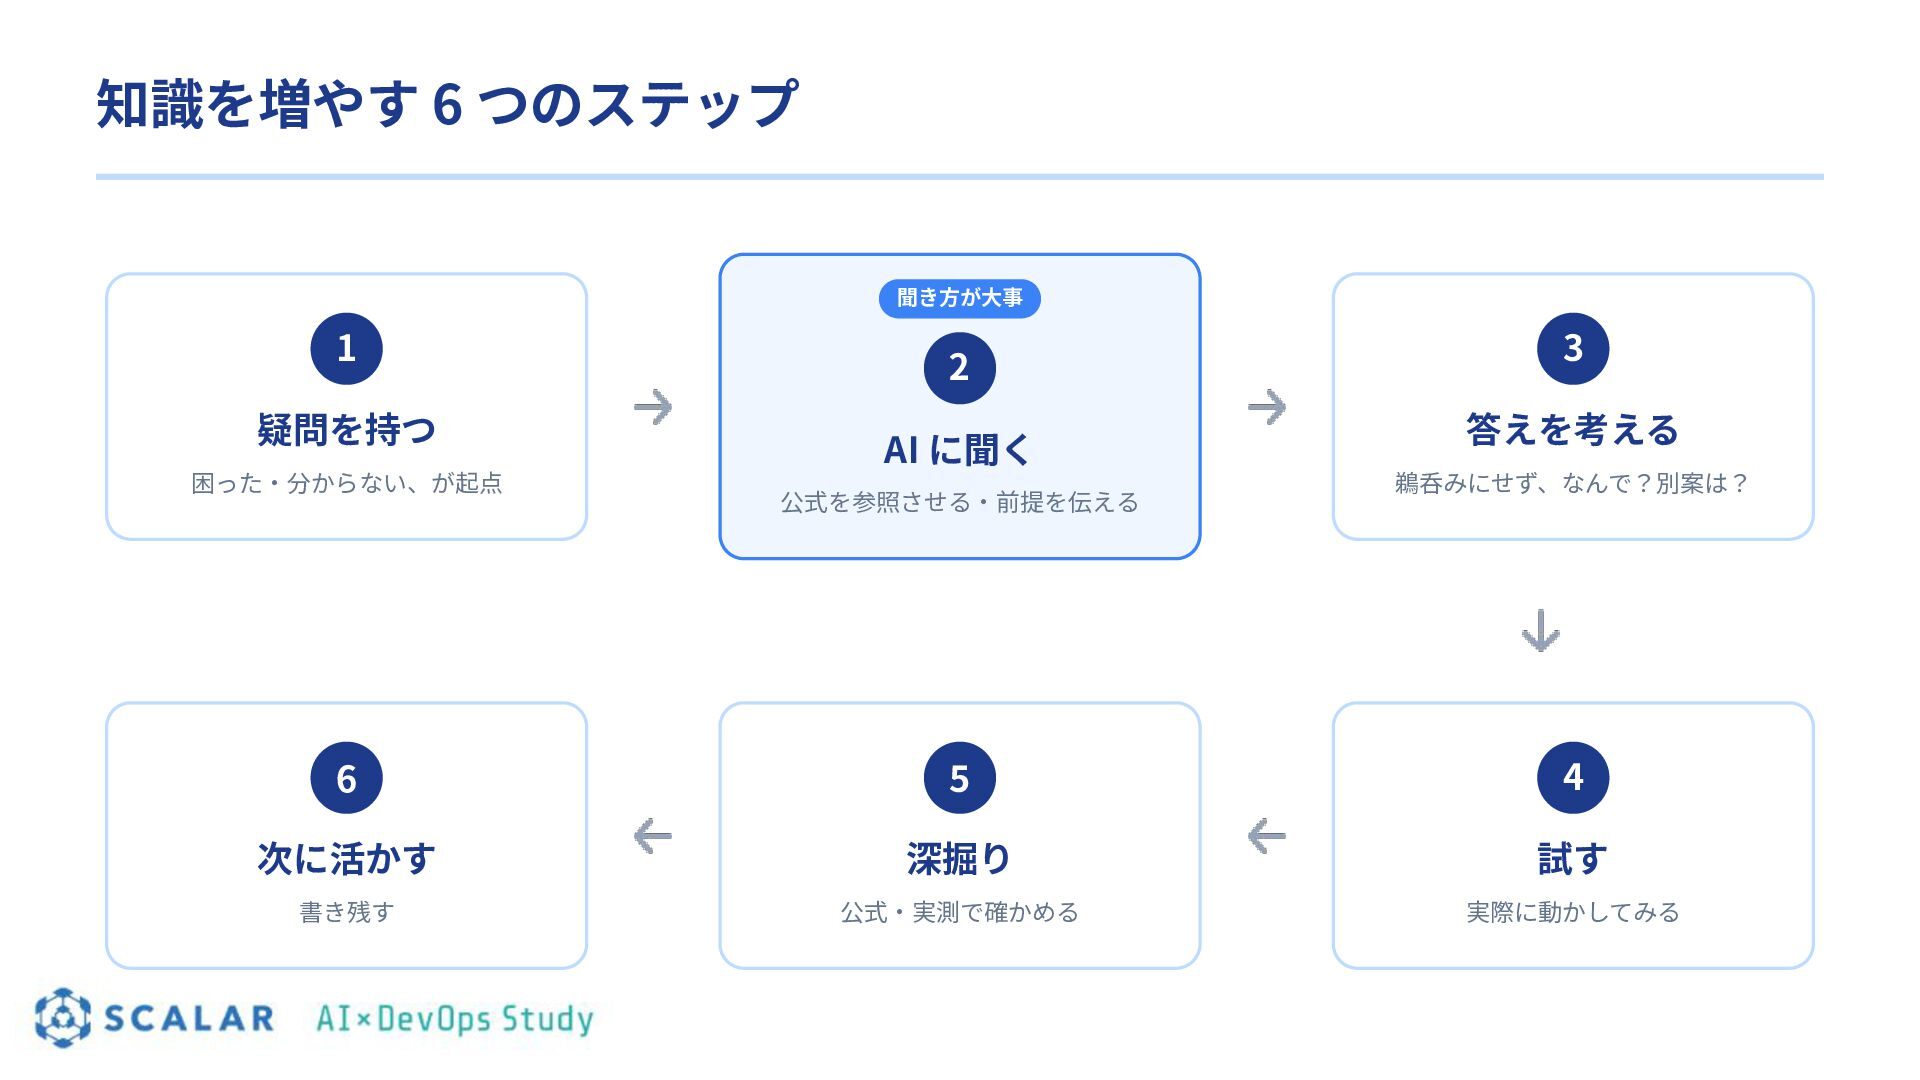
  5. 知識を増やす 6 つのステップ 聞き⽅が⼤事 1 疑問を持つ 困った‧分からない、が起点 2 AI に聞く

    公式を参照させる‧前提を伝える 3 答えを考える 鵜呑みにせず、なんで?別案は? 6 5 4 次に活かす 深掘り 試す 書き残す 公式‧実測で確かめる 実際に動かしてみる
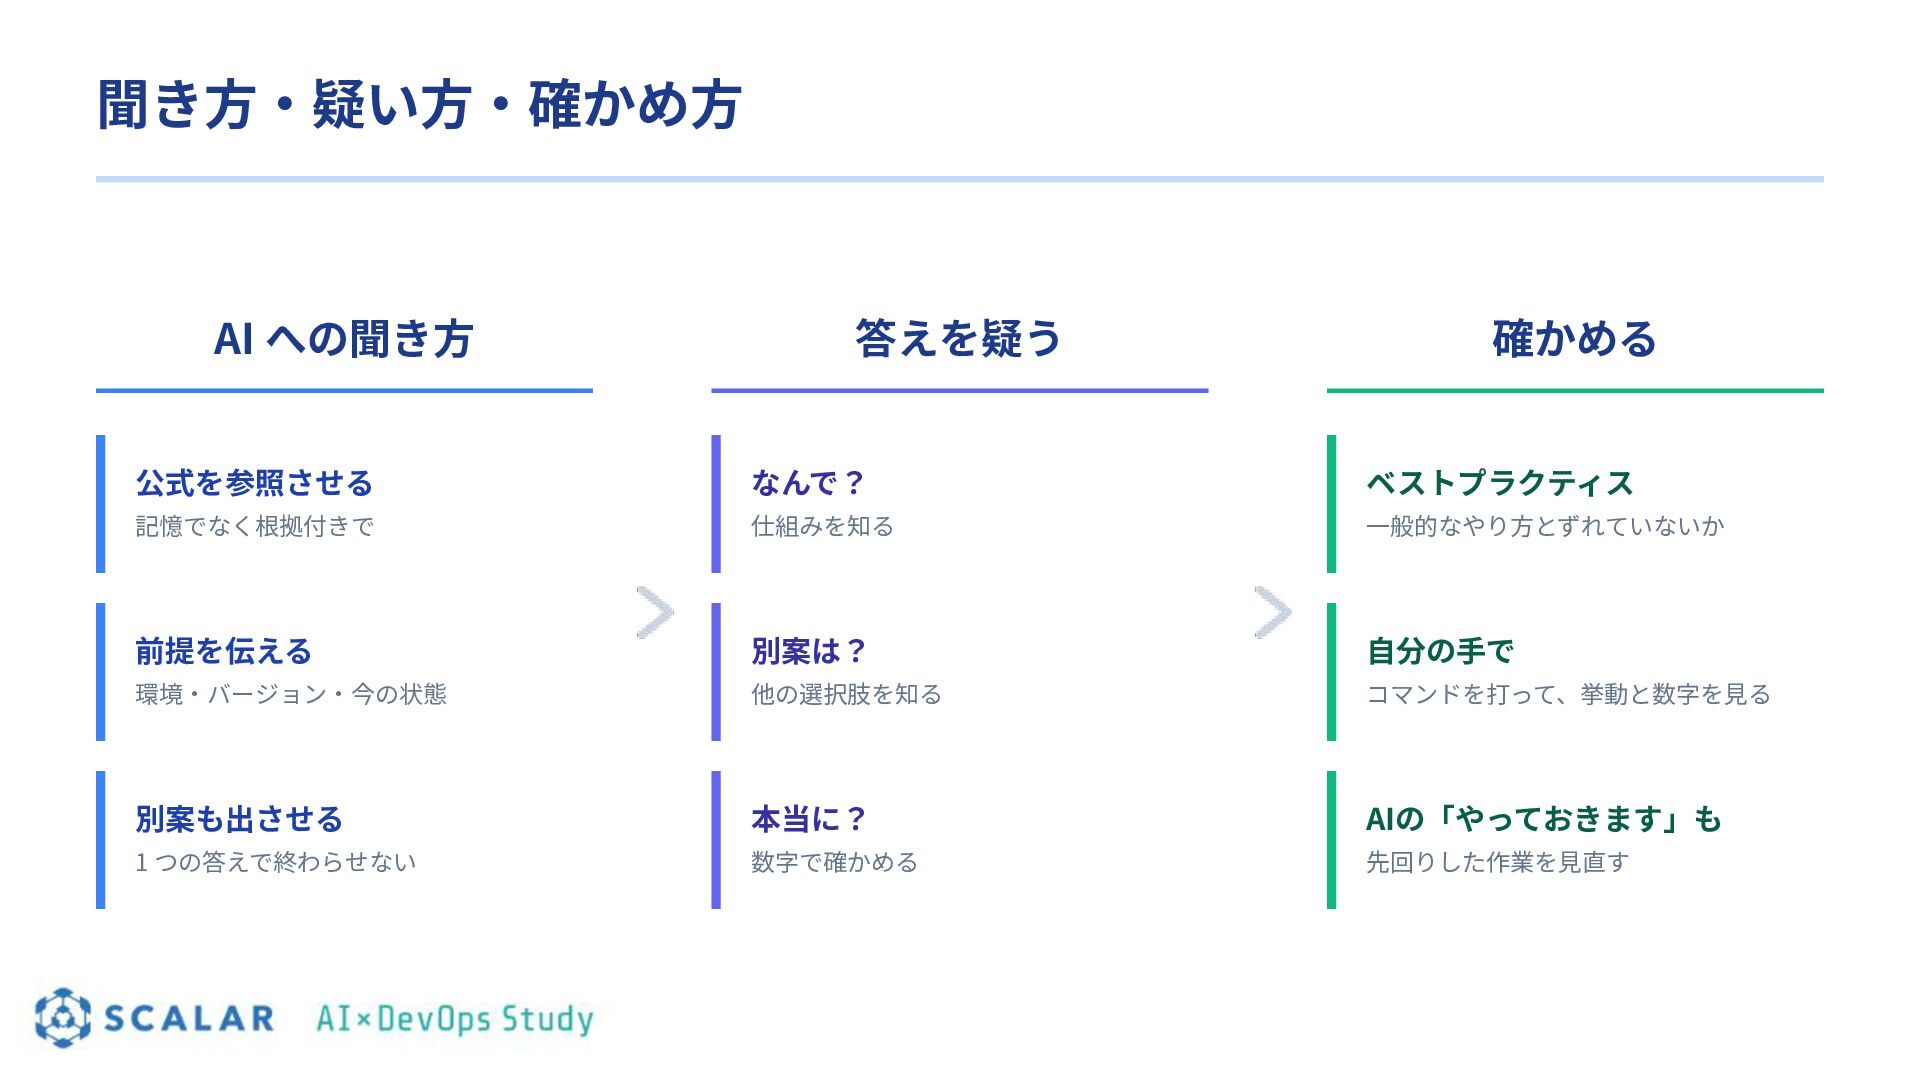
  6. 聞き⽅‧疑い⽅‧確かめ⽅ AI への聞き⽅ 答えを疑う 確かめる 公式を参照させる なんで? ベストプラクティス 記憶でなく根拠付きで 仕組みを知る

    ⼀般的なやり⽅とずれていないか 前提を伝える 別案は? ⾃分の⼿で 環境‧バージョン‧今の状態 他の選択肢を知る コマンドを打って、挙動と数字を⾒る 別案も出させる 本当に? AIの「やっておきます」も 1 つの答えで終わらせない 数字で確かめる 先回りした作業を⾒直す
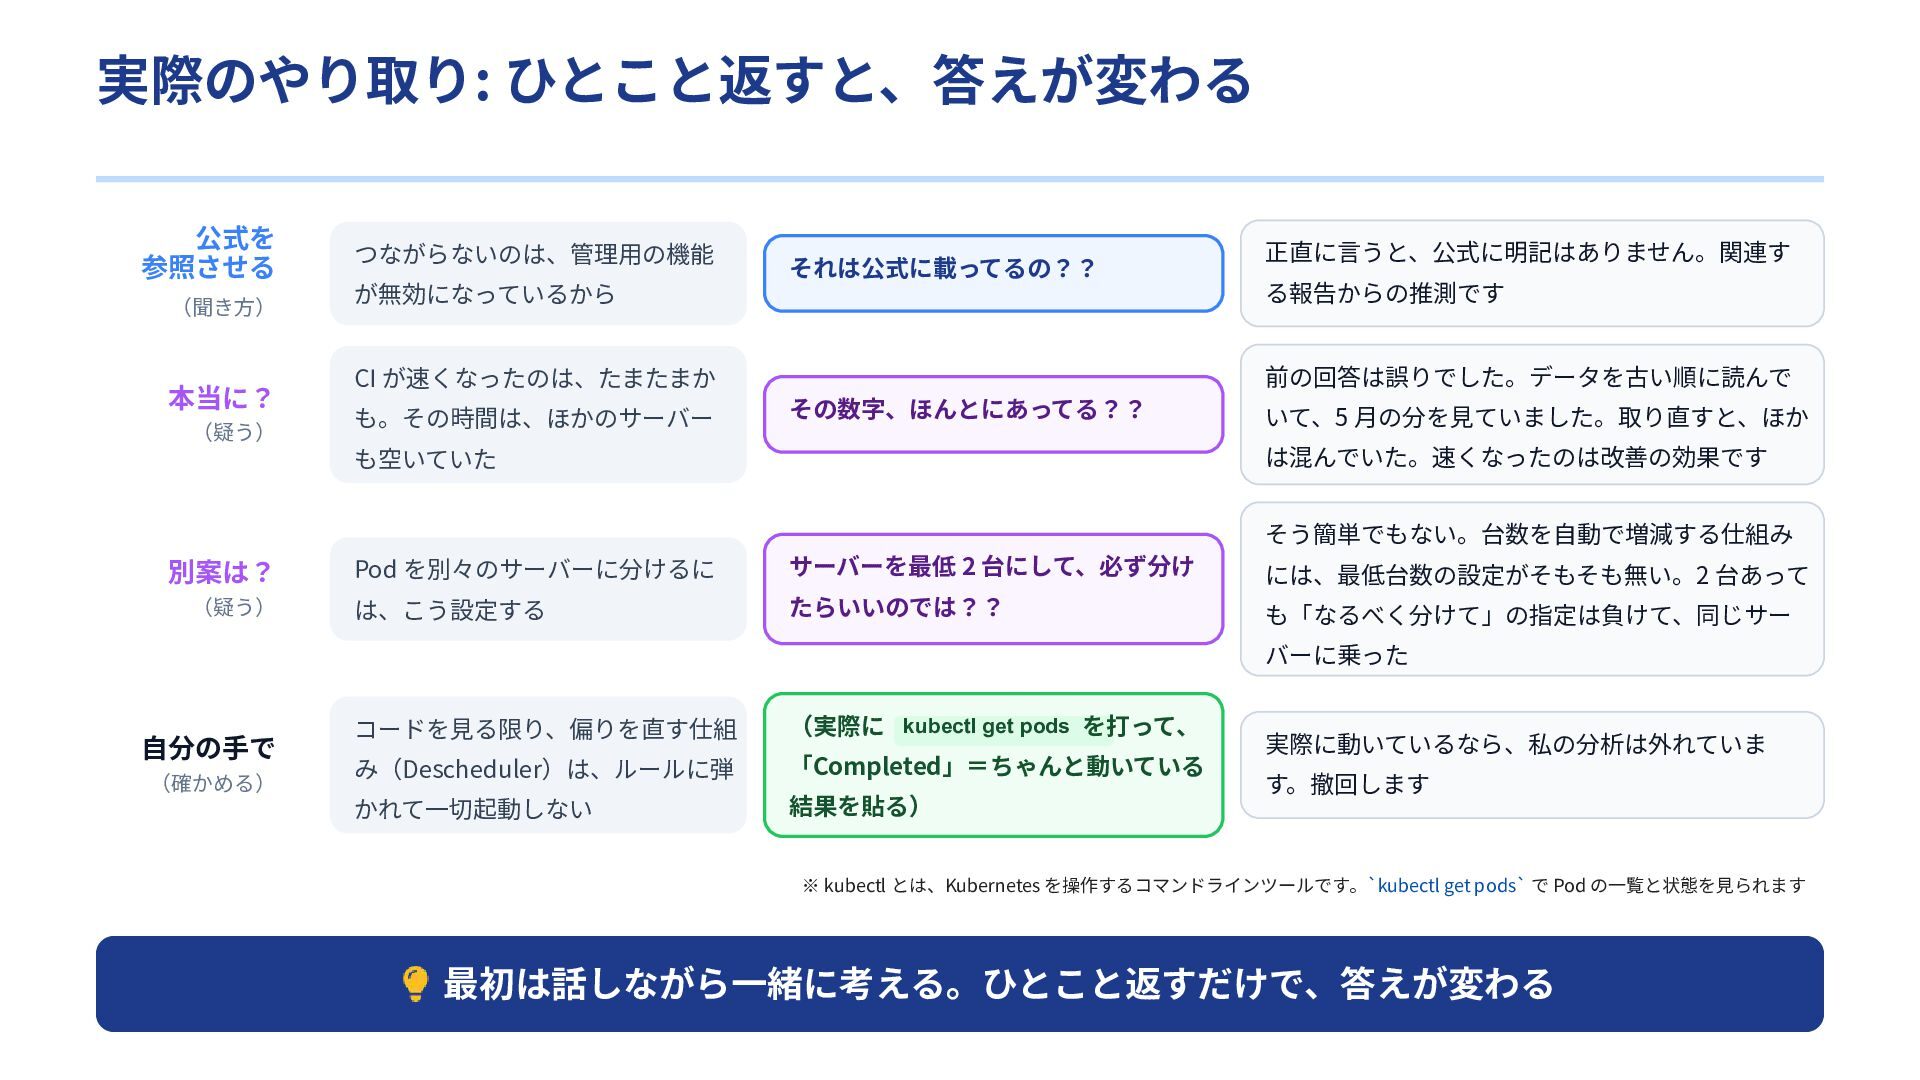
  7. 実際のやり取り: ひとこと返すと、答えが変わる 公式を 参照させる (聞き⽅) 本当に? (疑う) つながらないのは、管理⽤の機能 それは公式に載ってるの?? 正直に⾔うと、公式に明記はありません。関連す

    が無効になっているから る報告からの推測です CI が速くなったのは、たまたまか 前の回答は誤りでした。データを古い順に読んで も。その時間は、ほかのサーバー その数字、ほんとにあってる?? いて、5 ⽉の分を⾒ていました。取り直すと、ほか は混んでいた。速くなったのは改善の効果です も空いていた そう簡単でもない。台数を⾃動で増減する仕組み 別案は? (疑う) Pod を別々のサーバーに分けるに サーバーを最低 2 台にして、必ず分け には、最低台数の設定がそもそも無い。2 台あって は、こう設定する たらいいのでは?? も「なるべく分けて」の指定は負けて、同じサー バーに乗った ⾃分の⼿で (確かめる) コードを⾒る限り、偏りを直す仕組 (実際に kubectl get pods を打って、 み(Descheduler)は、ルールに弾 「Completed」=ちゃんと動いている かれて⼀切起動しない 結果を貼る) 実際に動いているなら、私の分析は外れていま す。撤回します ※ kubectl とは、Kubernetes を操作するコマンドラインツールです。`kubectl get pods` で Pod の⼀覧と状態を⾒られます 最初は話しながら⼀緒に考える。ひとこと返すだけで、答えが変わる
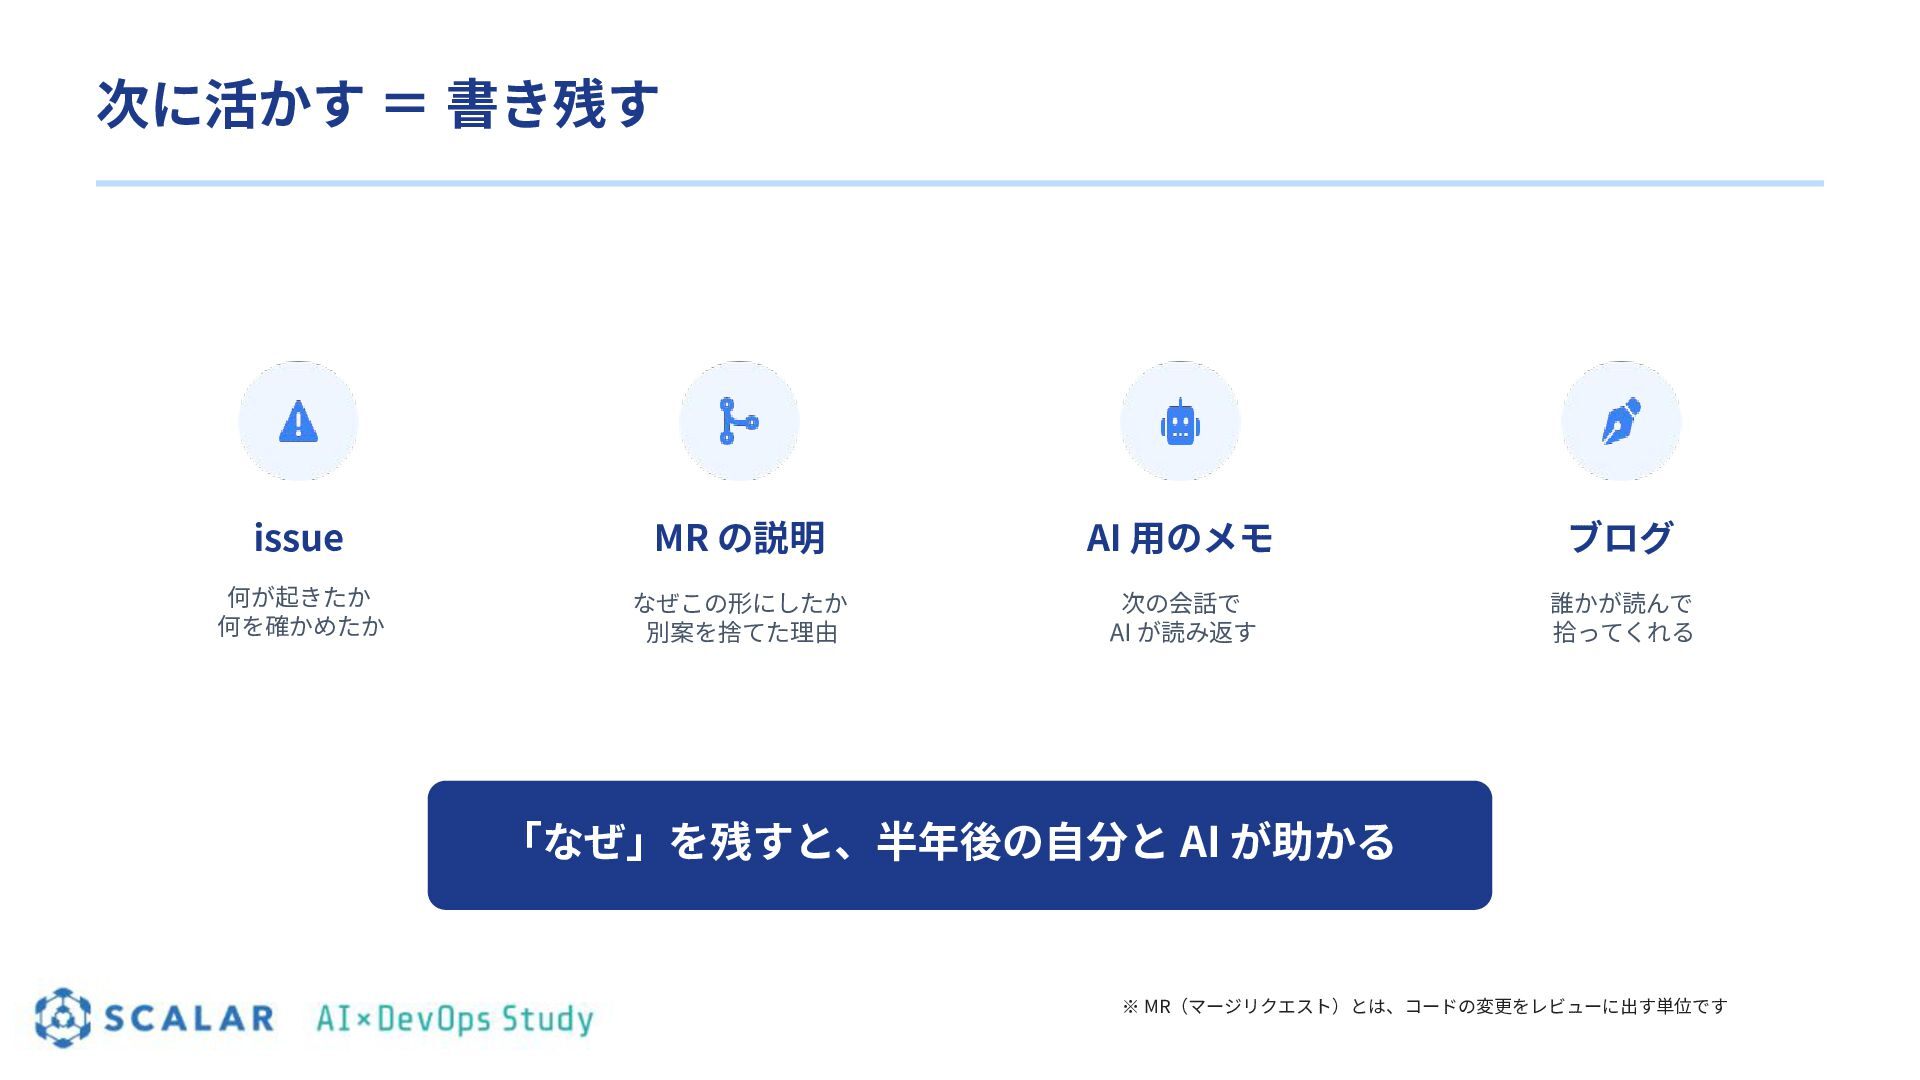
  8. 次に活かす = 書き残す issue MR の説明 AI ⽤のメモ ブログ 何が起きたか

    何を確かめたか なぜこの形にしたか 別案を捨てた理由 次の会話で AI が読み返す 誰かが読んで 拾ってくれる 「なぜ」を残すと、半年後の⾃分と AI が助かる ※ MR(マージリクエスト)とは、コードの変更をレビューに出す単位です
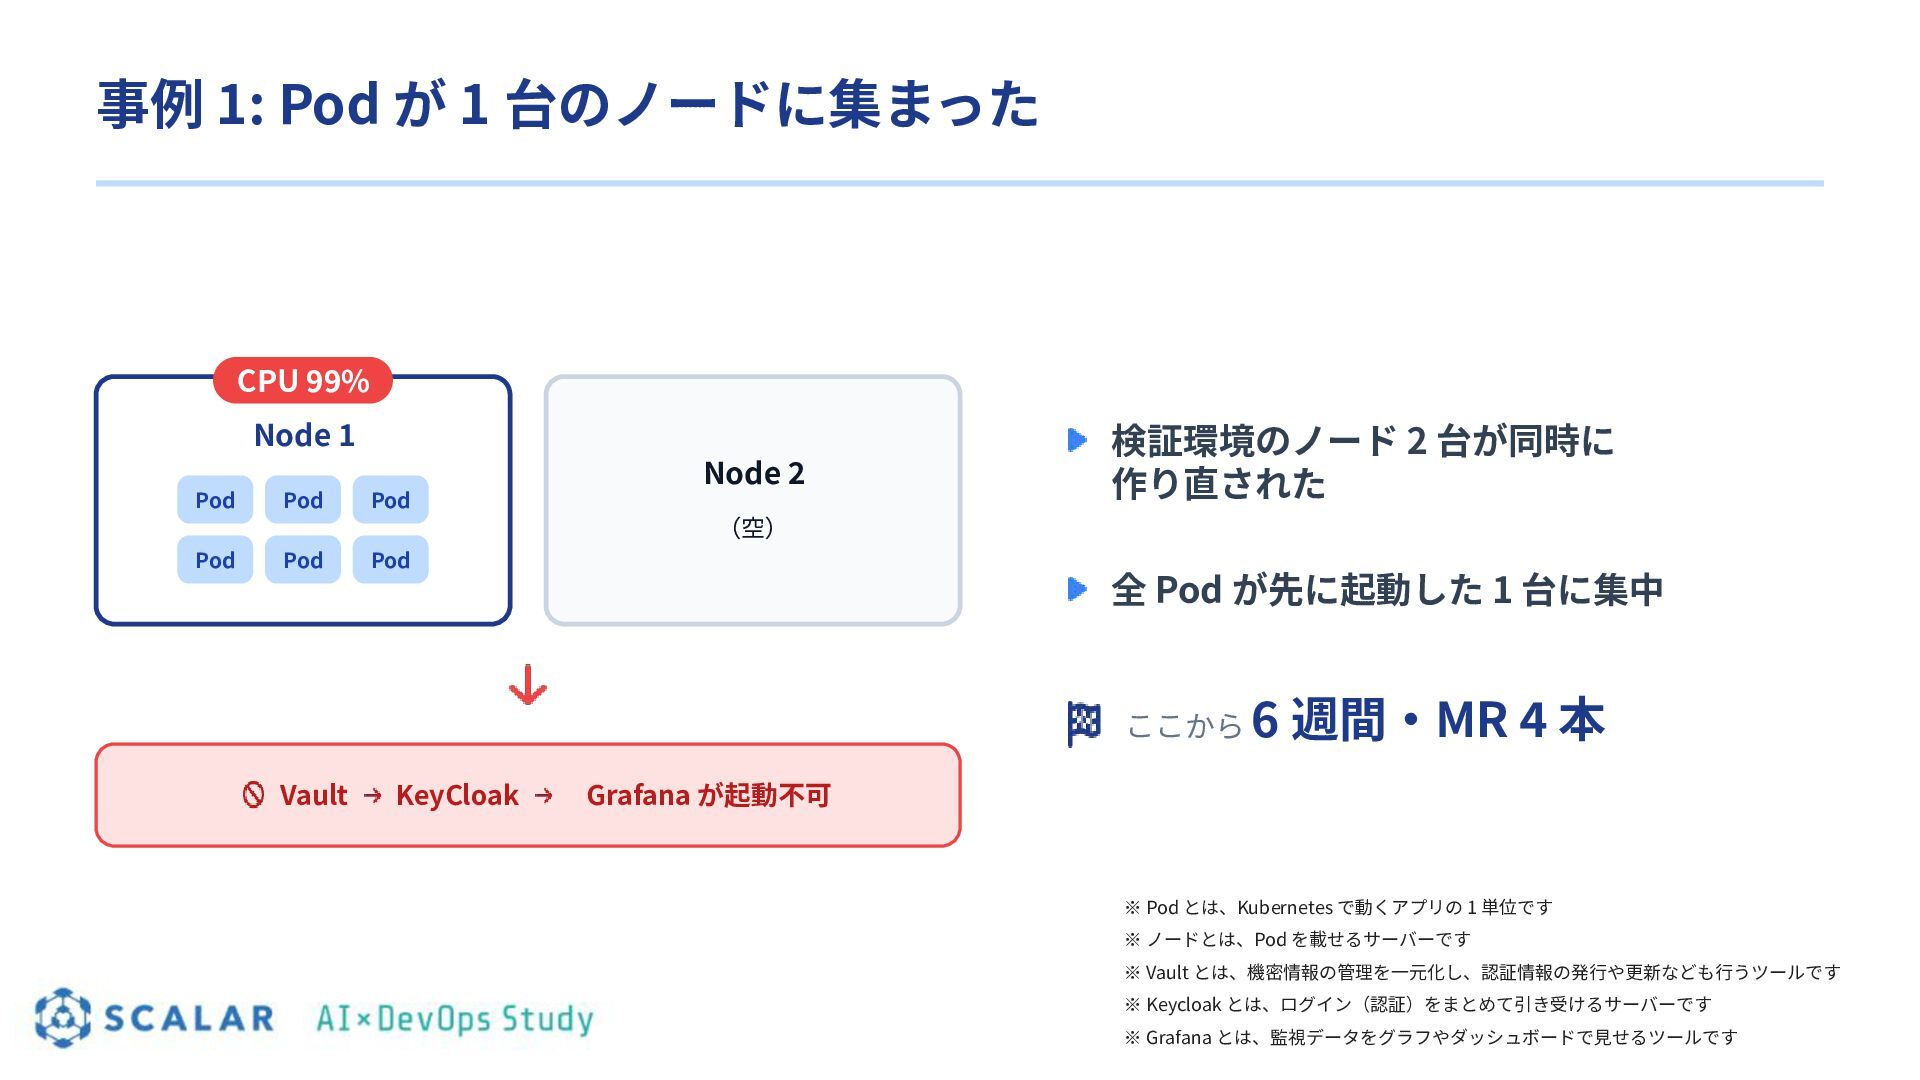
  9. 事例 1: Pod が 1 台のノードに集まった CPU 99% Node 1

    Node 2 Pod Pod Pod Pod Pod Pod 検証環境のノード 2 台が同時に 作り直された (空) 全 Pod が先に起動した 1 台に集中 ここから Vault KeyCloak 6 週間‧MR 4 本 Grafana が起動不可 ※ Pod とは、Kubernetes で動くアプリの 1 単位です ※ ノードとは、Pod を載せるサーバーです ※ Vault とは、機密情報の管理を⼀元化し、認証情報の発⾏や更新なども⾏うツールです ※ Keycloak とは、ログイン(認証)をまとめて引き受けるサーバーです ※ Grafana とは、監視データをグラフやダッシュボードで⾒せるツールです
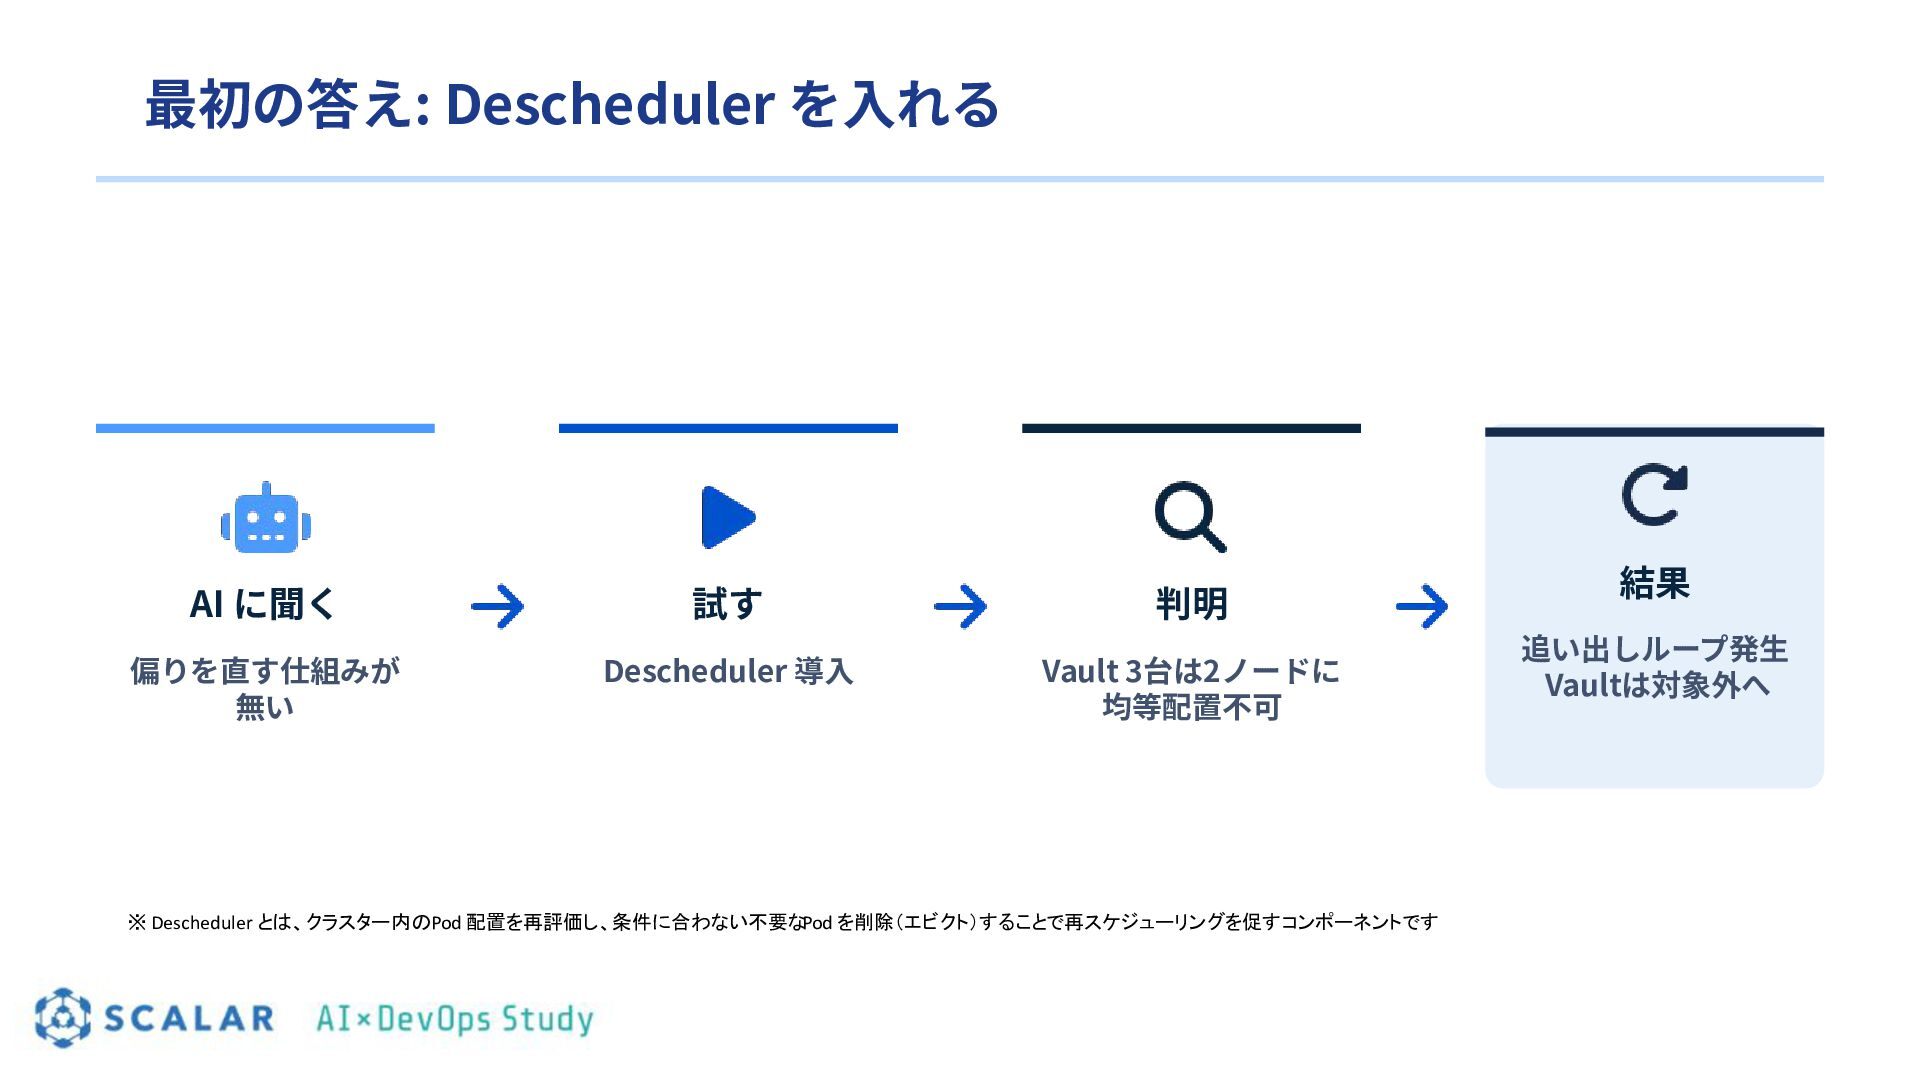
  10. 最初の答え: Descheduler を⼊れる AI に聞く 試す 判明 偏りを直す仕組みが 無い Descheduler

    導⼊ Vault 3台は2ノードに 均等配置不可 ※ Descheduler とは、クラスター内のPod 配置を再評価し、条件に合わない不要なPod を削除(エビクト)することで再スケジューリングを促すコンポーネントです 結果 追い出しループ発⽣ Vaultは対象外へ
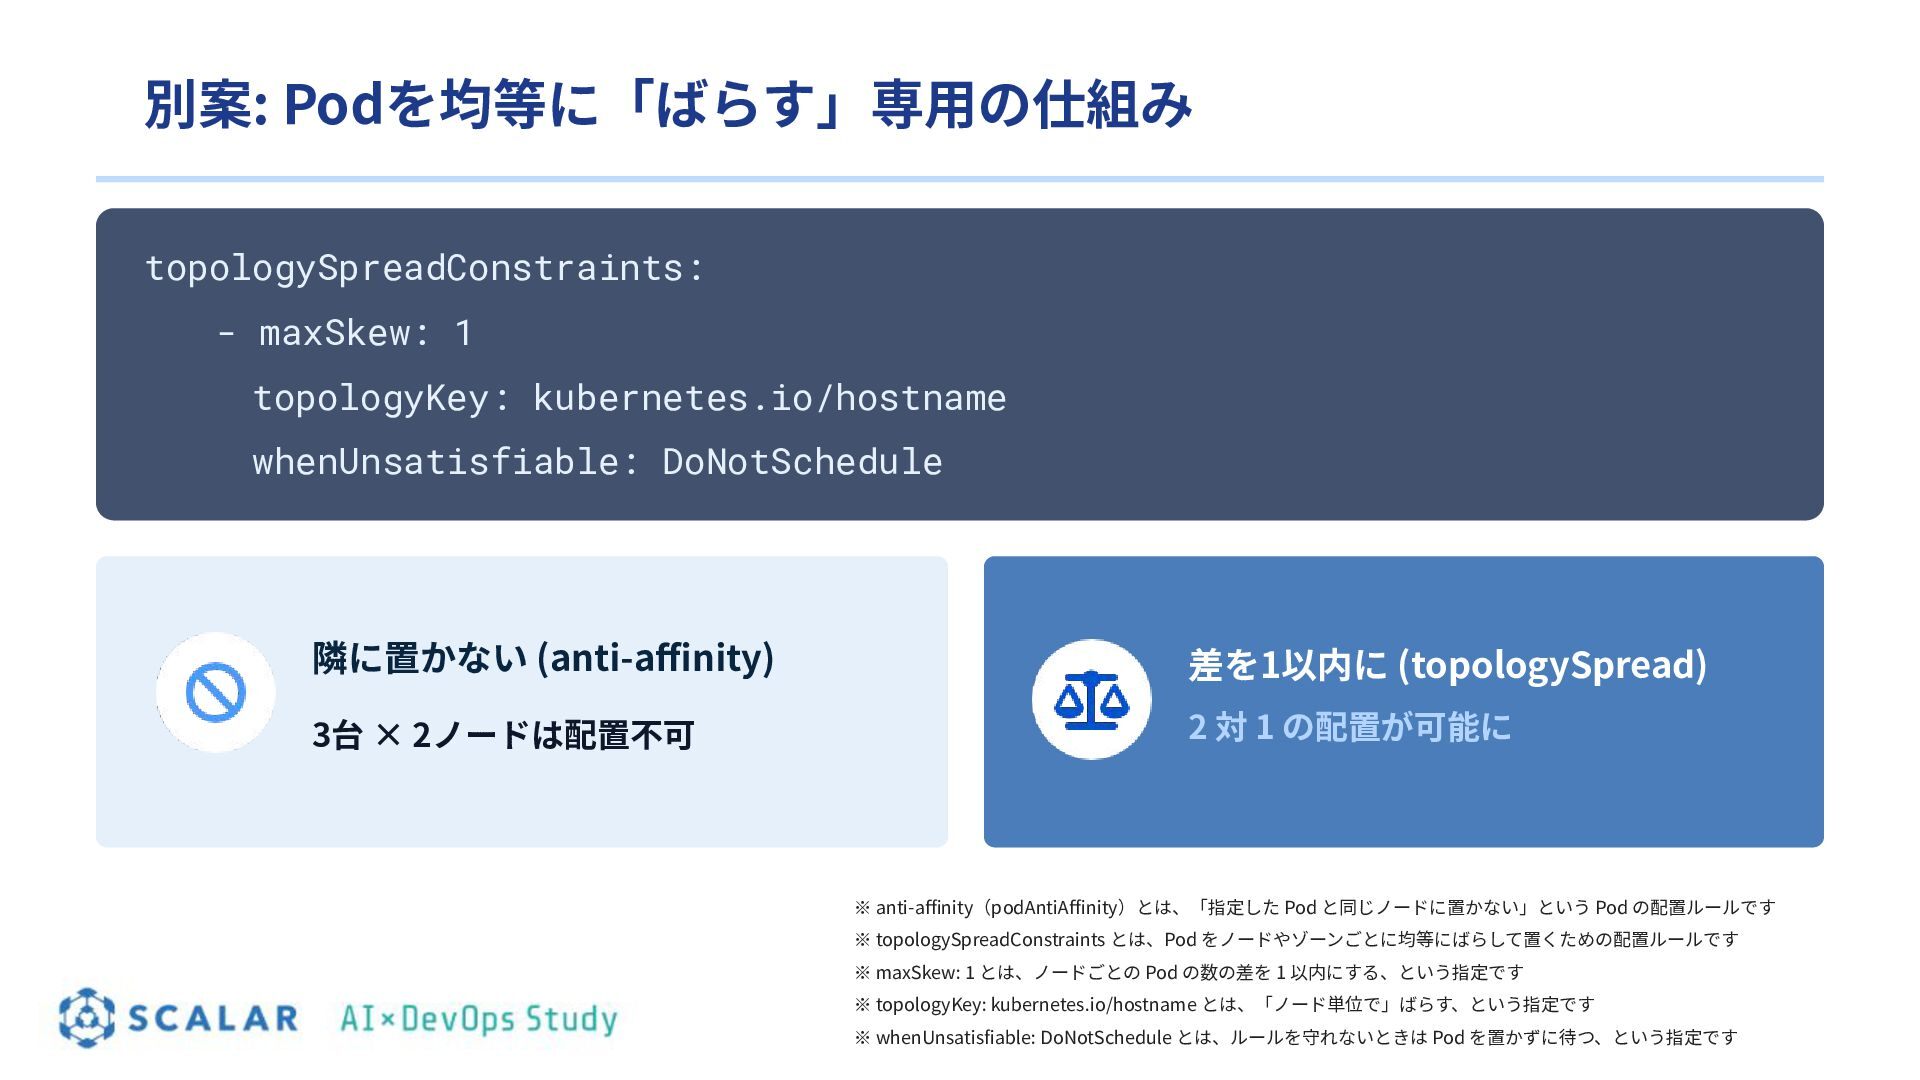
  11. 別案: Podを均等に「ばらす」専⽤の仕組み topologySpreadConstraints: - maxSkew: 1 topologyKey: kubernetes.io/hostname whenUnsatisfiable: DoNotSchedule

    隣に置かない (anti-affinity) 差を1以内に (topologySpread) 3台 × 2ノードは配置不可 2 対 1 の配置が可能に ※ anti-affinity(podAntiAffinity)とは、「指定した Pod と同じノードに置かない」という Pod の配置ルールです ※ topologySpreadConstraints とは、Pod をノードやゾーンごとに均等にばらして置くための配置ルールです ※ maxSkew: 1 とは、ノードごとの Pod の数の差を 1 以内にする、という指定です ※ topologyKey: kubernetes.io/hostname とは、「ノード単位で」ばらす、という指定です ※ whenUnsatisfiable: DoNotSchedule とは、ルールを守れないときは Pod を置かずに待つ、という指定です
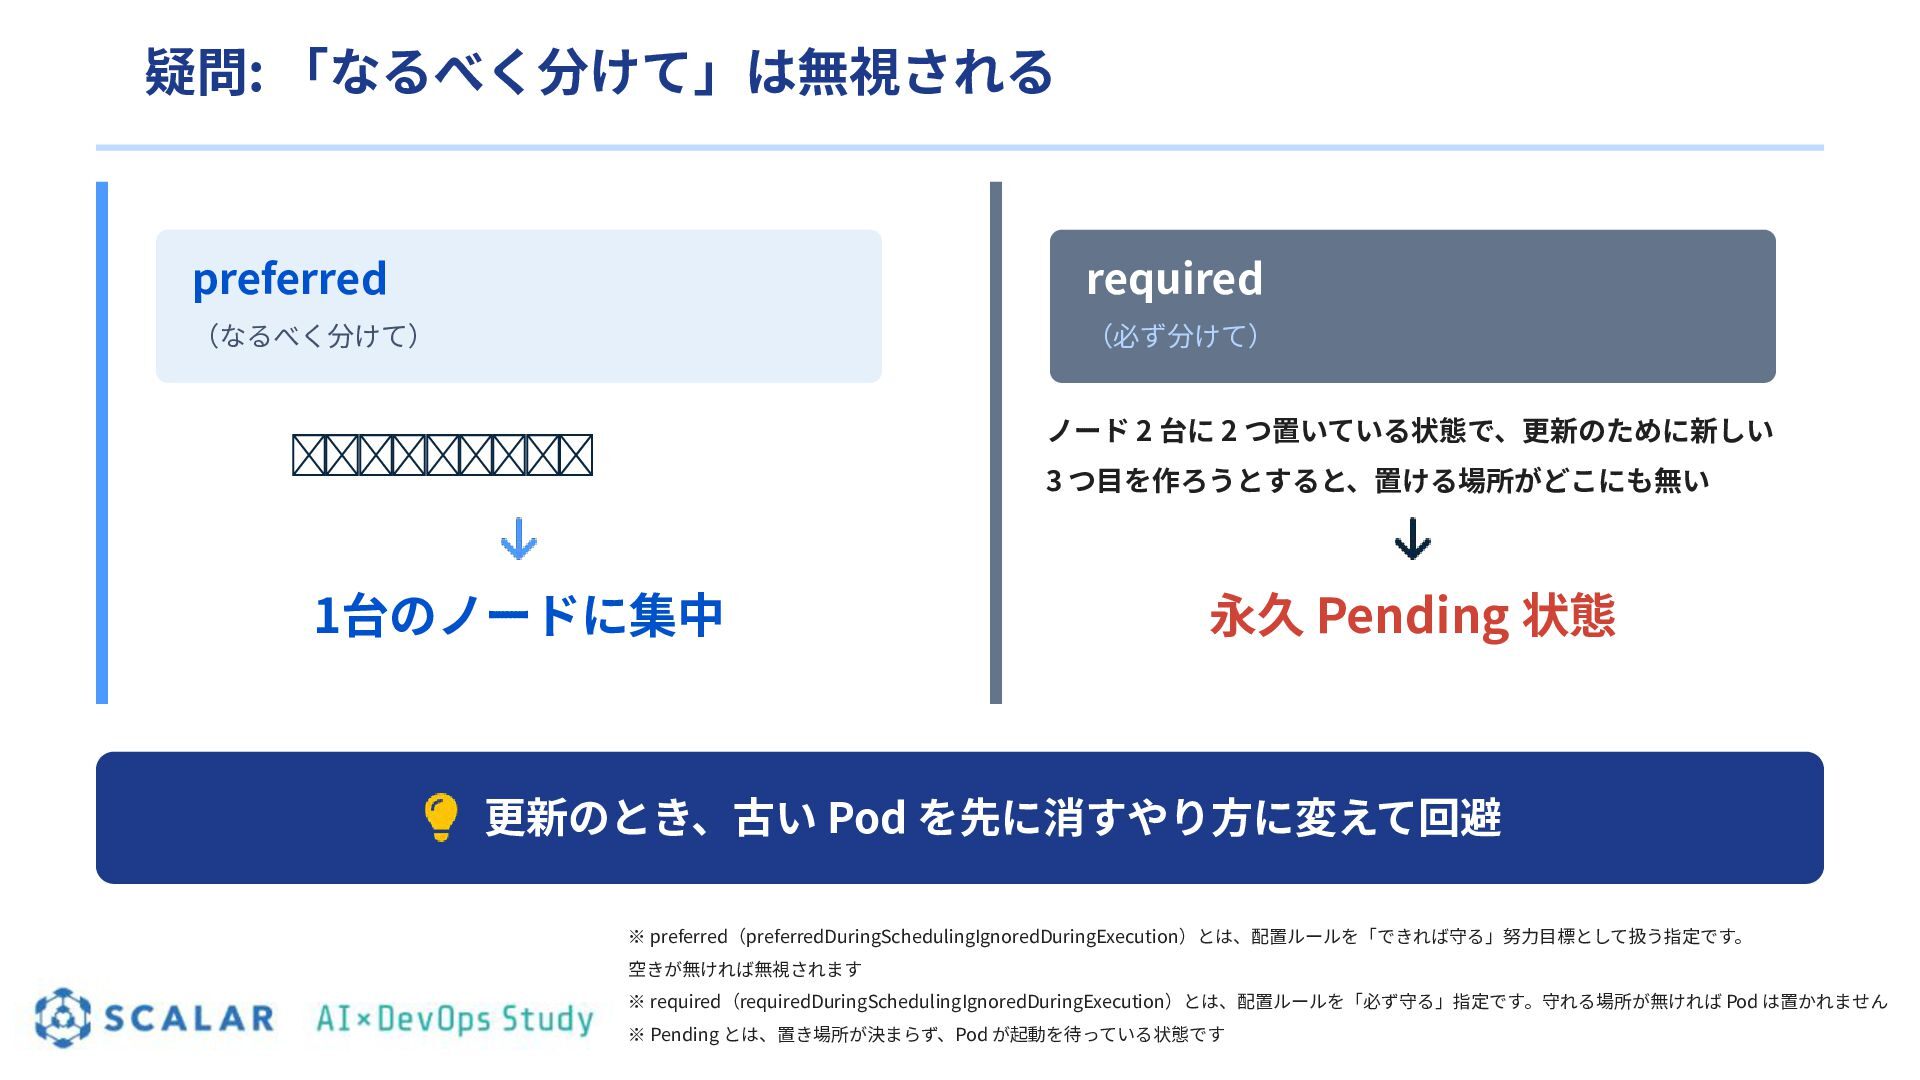
  12. 疑問: 「なるべく分けて」は無視される preferred required (なるべく分けて) (必ず分けて) 余裕が無いと無視される 1台のノードに集中 ノード 2

    台に 2 つ置いている状態で、更新のために新しい 3 つ⽬を作ろうとすると、置ける場所がどこにも無い 永久 Pending 状態 更新のとき、古い Pod を先に消すやり⽅に変えて回避 ※ preferred(preferredDuringSchedulingIgnoredDuringExecution)とは、配置ルールを「できれば守る」努⼒⽬標として扱う指定です。 空きが無ければ無視されます ※ required(requiredDuringSchedulingIgnoredDuringExecution)とは、配置ルールを「必ず守る」指定です。守れる場所が無ければ Pod は置かれません ※ Pending とは、置き場所が決まらず、Pod が起動を待っている状態です
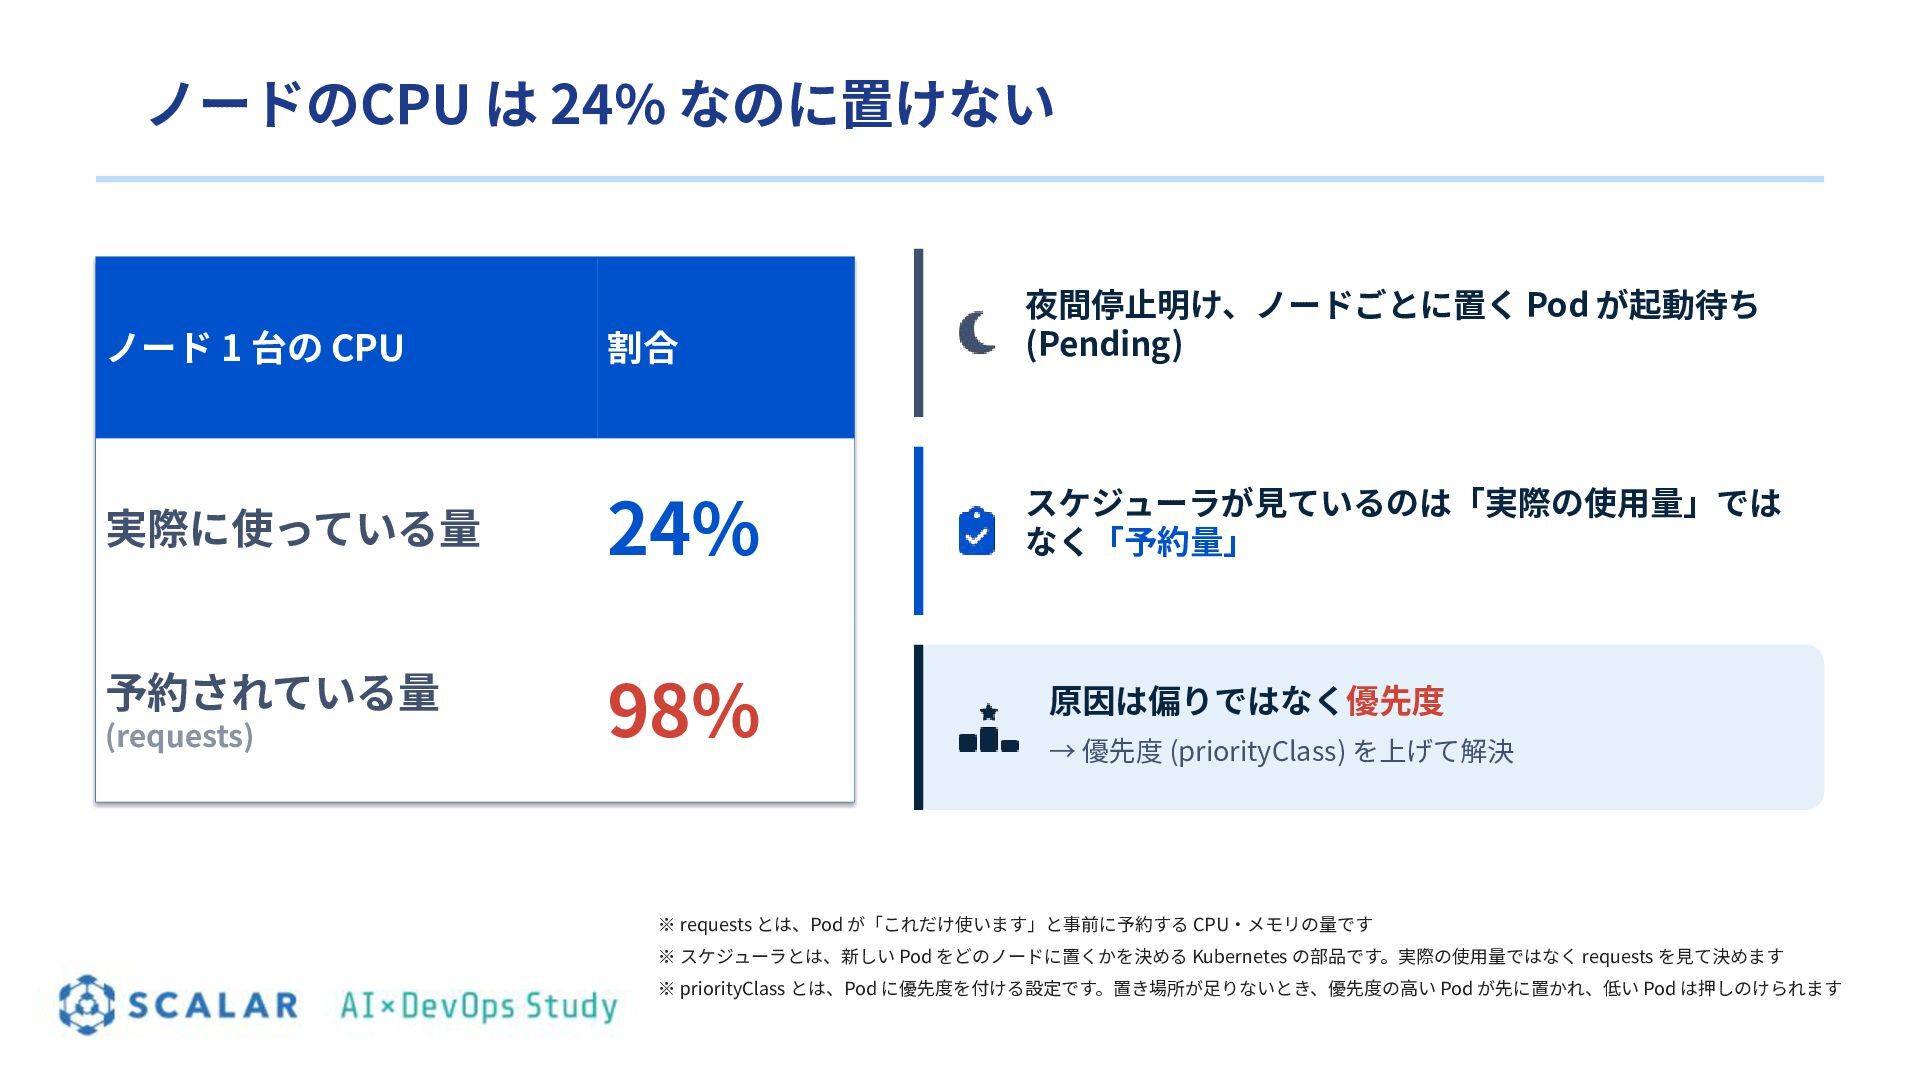
  13. ノードのCPU は 24% なのに置けない 割合 夜間停⽌明け、ノードごとに置く Pod が起動待ち (Pending) 実際に使っている量

    24% スケジューラが⾒ているのは「実際の使⽤量」では なく「予約量」 予約されている量 98% ノード 1 台の CPU (requests) 原因は偏りではなく優先度 → 優先度 (priorityClass) を上げて解決 ※ requests とは、Pod が「これだけ使います」と事前に予約する CPU‧メモリの量です ※ スケジューラとは、新しい Pod をどのノードに置くかを決める Kubernetes の部品です。実際の使⽤量ではなく requests を⾒て決めます ※ priorityClass とは、Pod に優先度を付ける設定です。置き場所が⾜りないとき、優先度の⾼い Pod が先に置かれ、低い Pod は押しのけられます
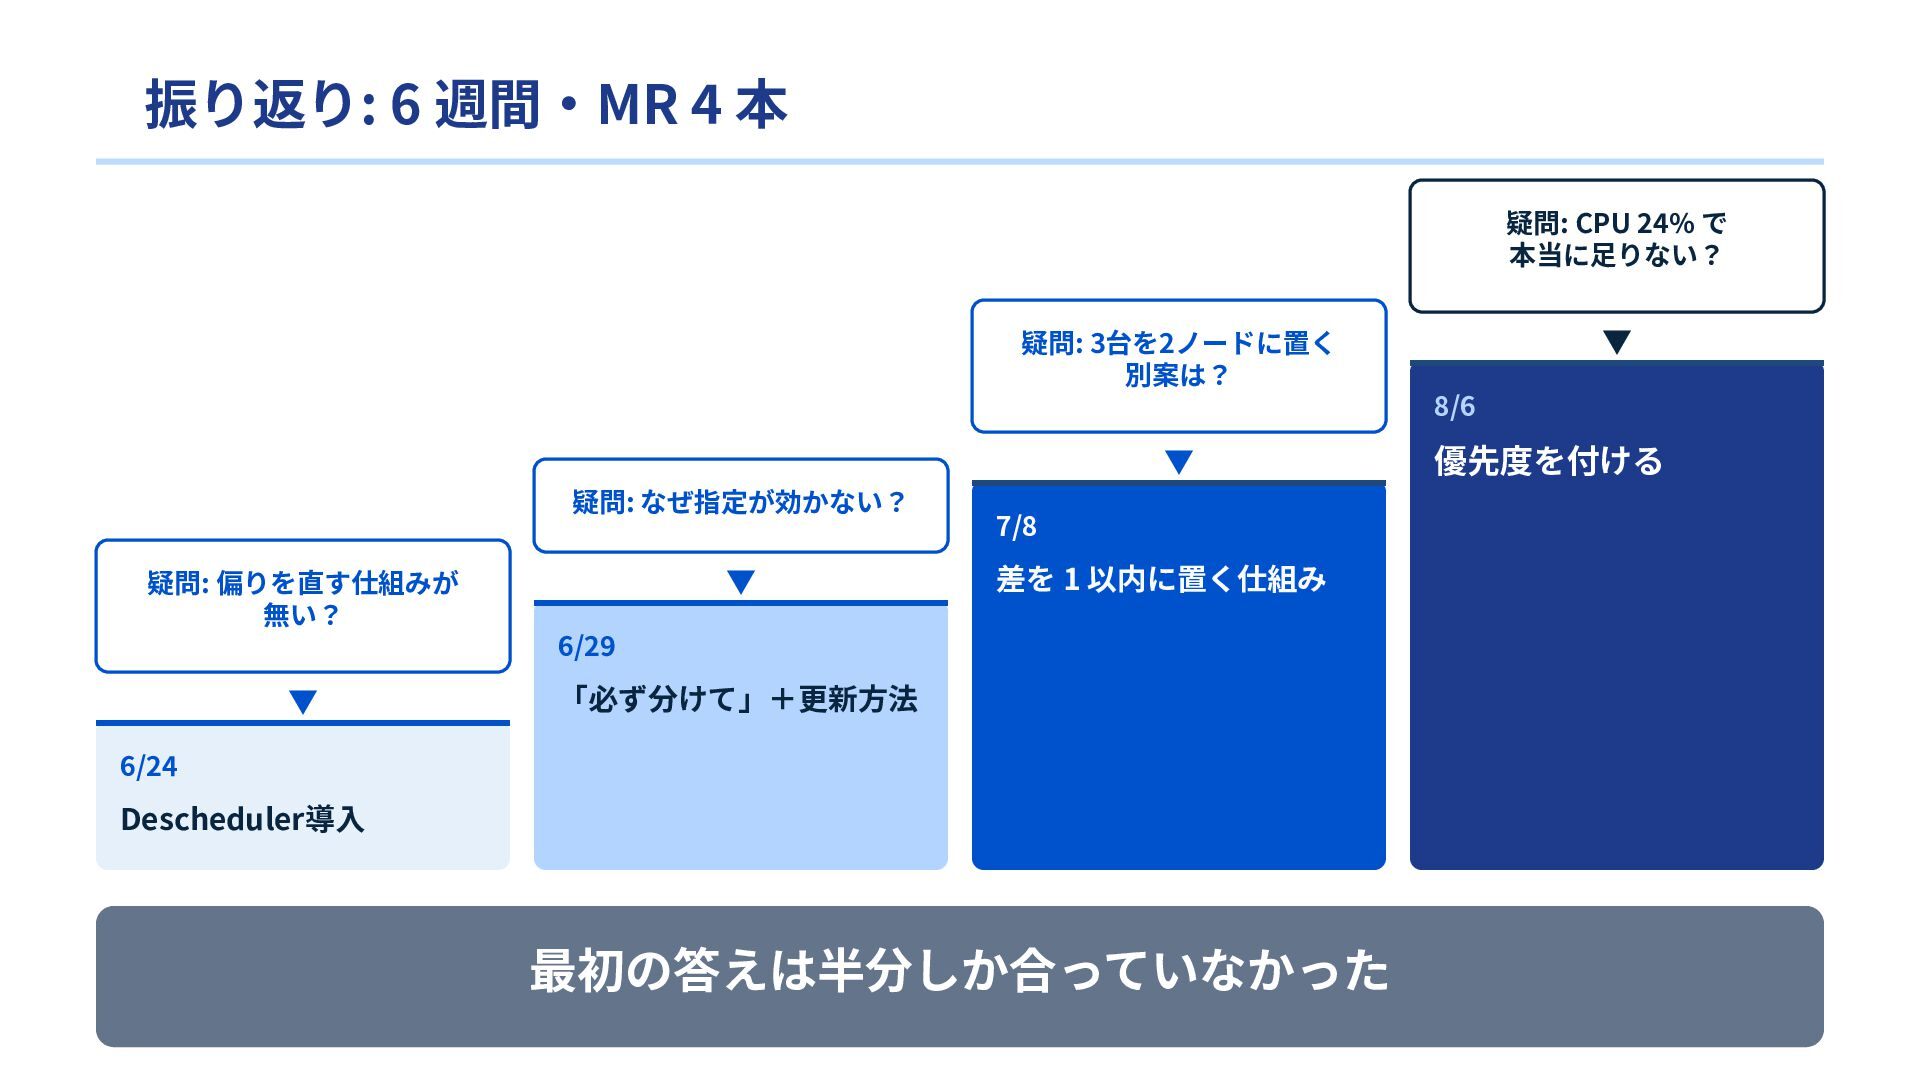
  14. 振り返り: 6 週間‧MR 4 本 疑問: CPU 24% で 本当に⾜りない?

    ▼ 疑問: 3台を2ノードに置く 別案は? 8/6 ▼ 疑問: なぜ指定が効かない? ▼ 疑問: 偏りを直す仕組みが 無い? 7/8 差を 1 以内に置く仕組み 6/29 ▼ 「必ず分けて」+更新⽅法 6/24 Descheduler導⼊ 最初の答えは半分しか合っていなかった 優先度を付ける
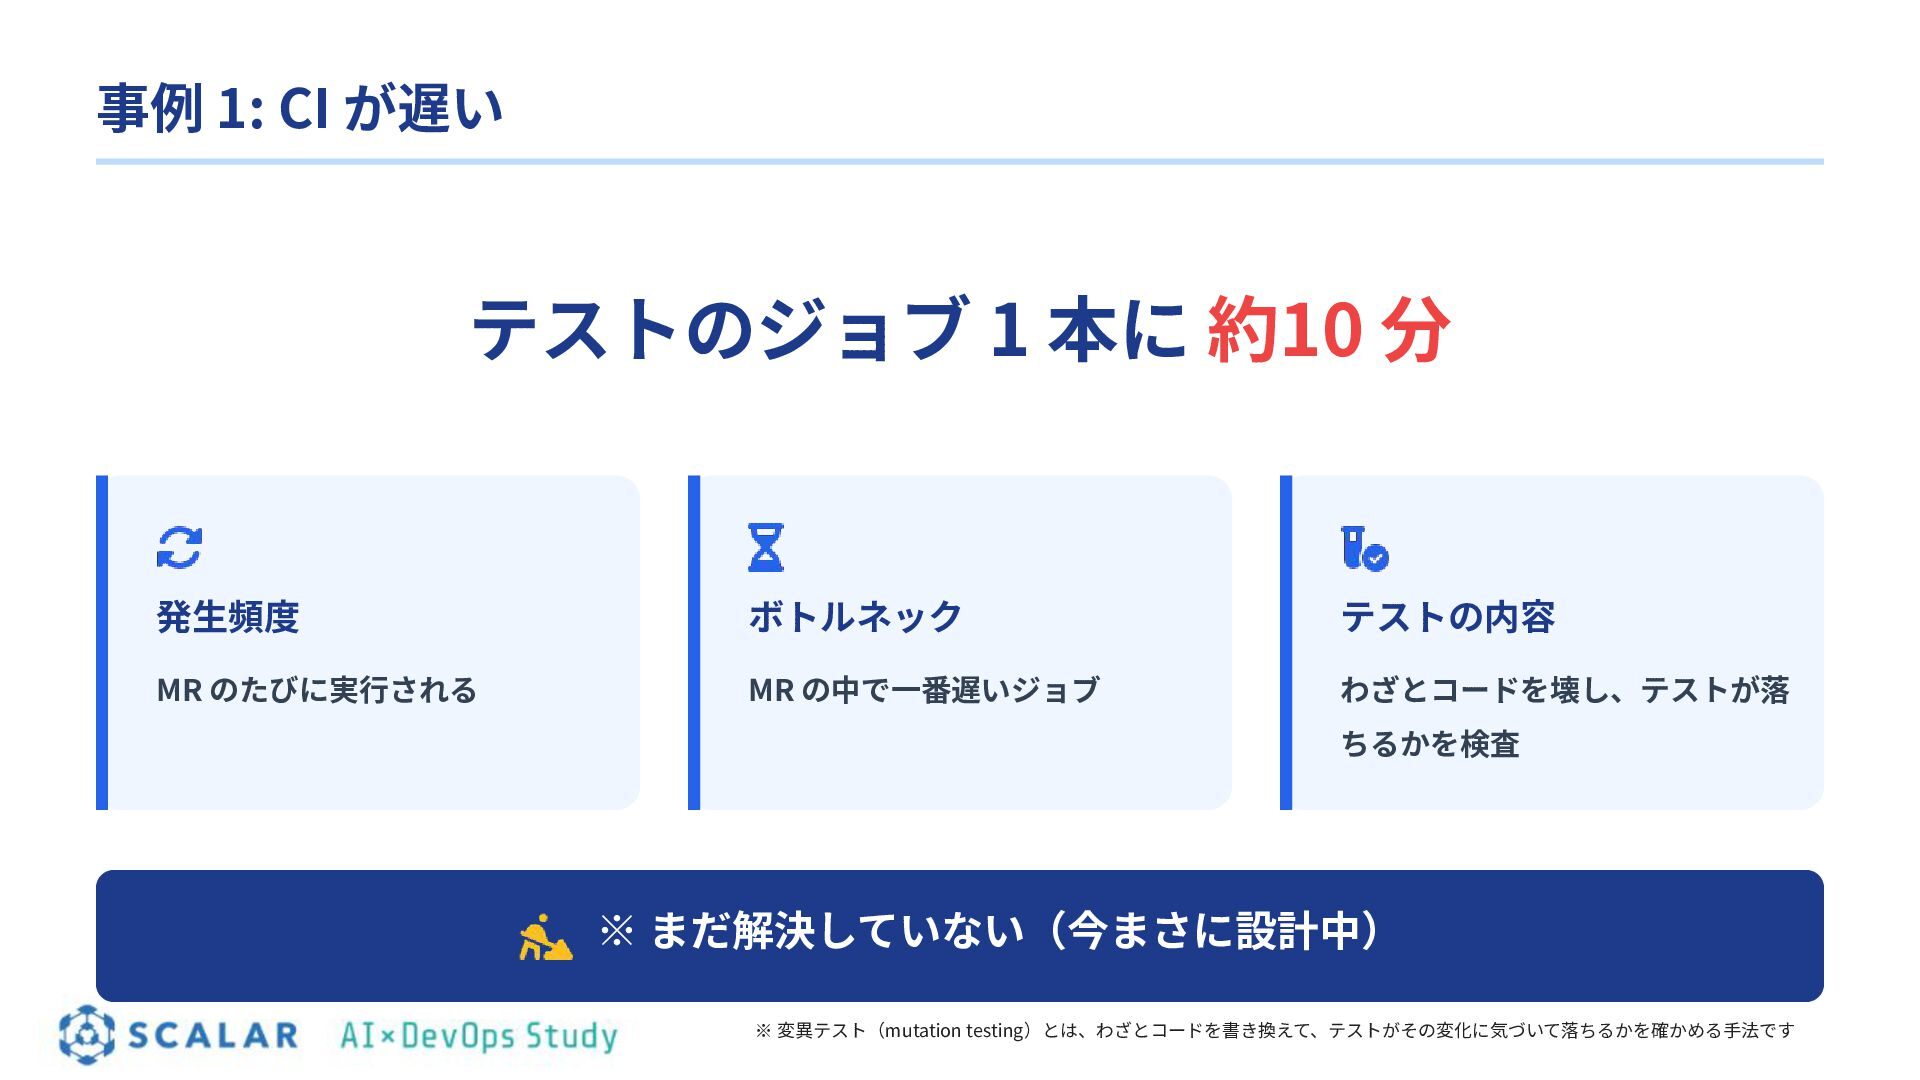
  15. 事例 1: CI が遅い テストのジョブ 1 本に 約10 分 発⽣頻度

    ボトルネック テストの内容 MR のたびに実⾏される MR の中で⼀番遅いジョブ わざとコードを壊し、テストが落 ちるかを検査 ※ まだ解決していない(今まさに設計中) ※ 変異テスト(mutation testing)とは、わざとコードを書き換えて、テストがその変化に気づいて落ちるかを確かめる⼿法です
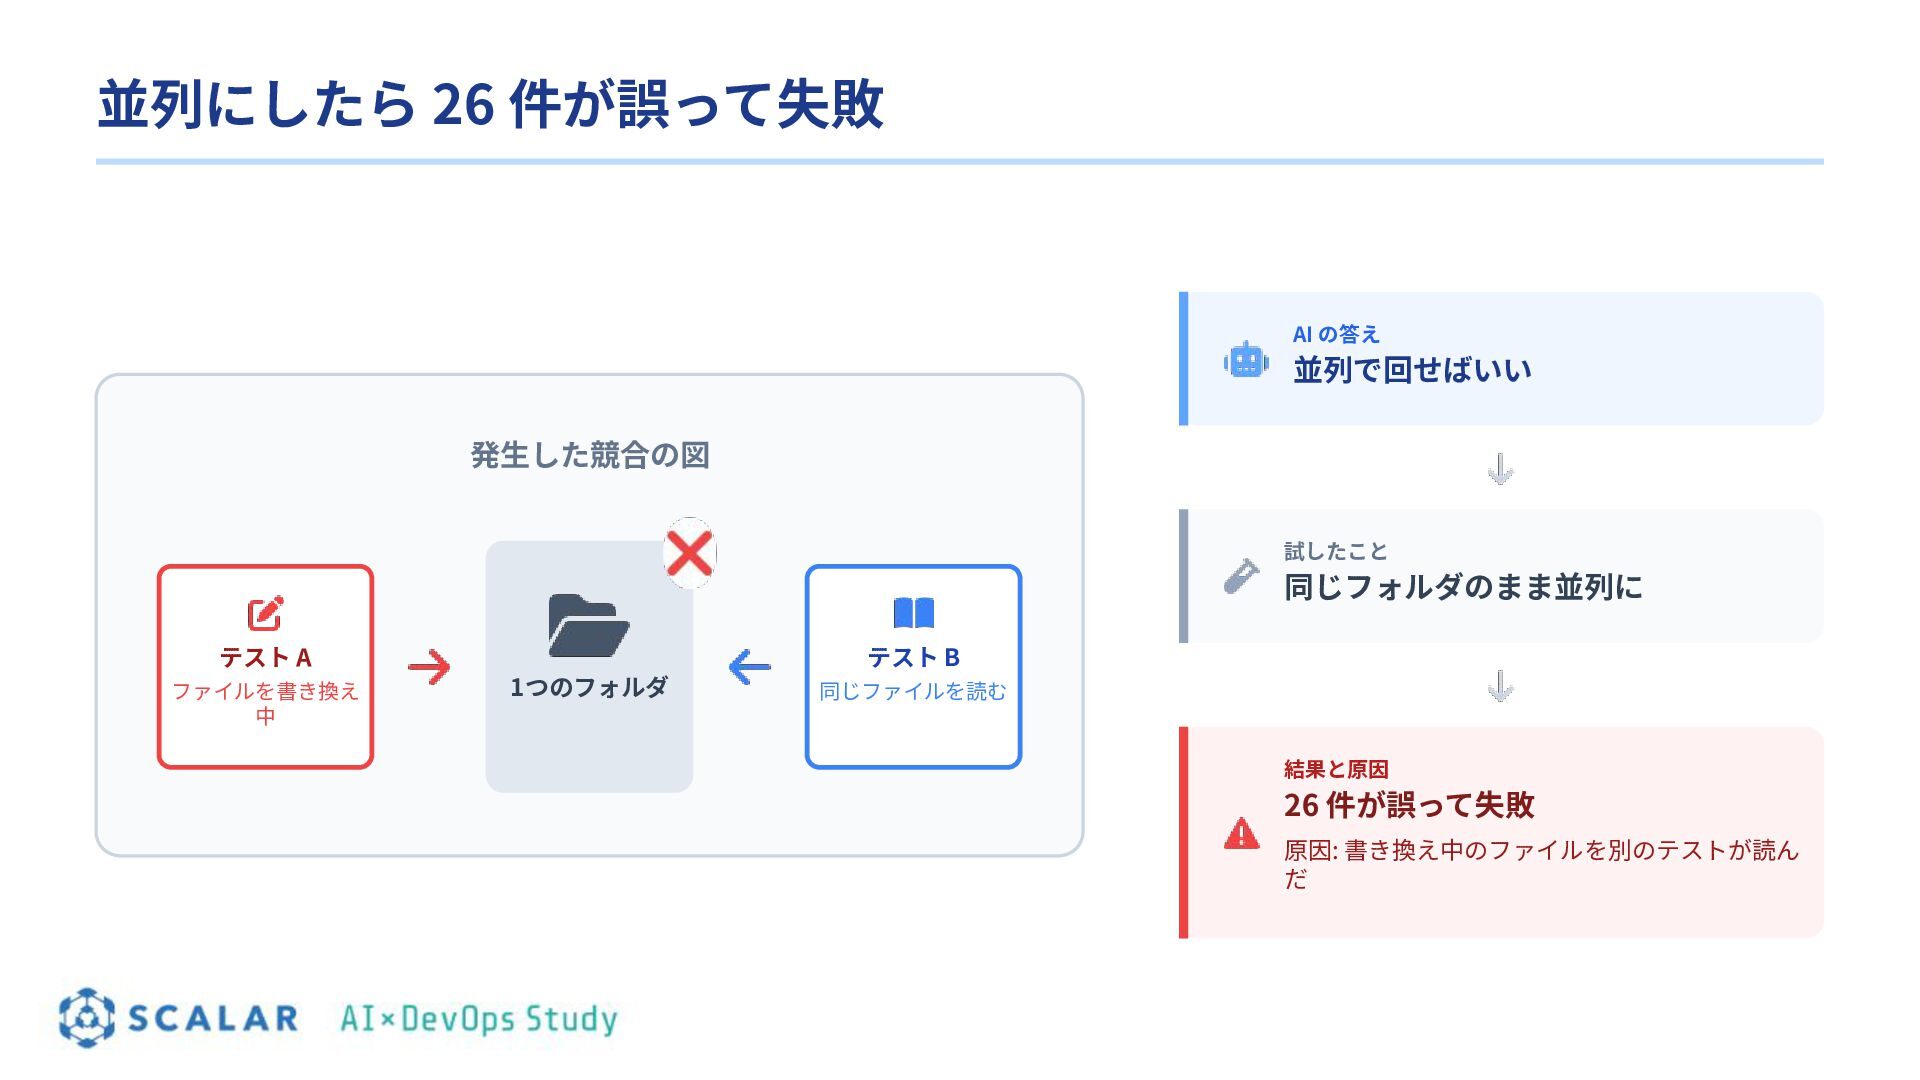
  16. 並列にしたら 26 件が誤って失敗 AI の答え 並列で回せばいい 発⽣した競合の図 試したこと 同じフォルダのまま並列に テスト

    A ファイルを書き換え 中 テスト B 1つのフォルダ 同じファイルを読む 結果と原因 26 件が誤って失敗 原因: 書き換え中のファイルを別のテストが読ん だ
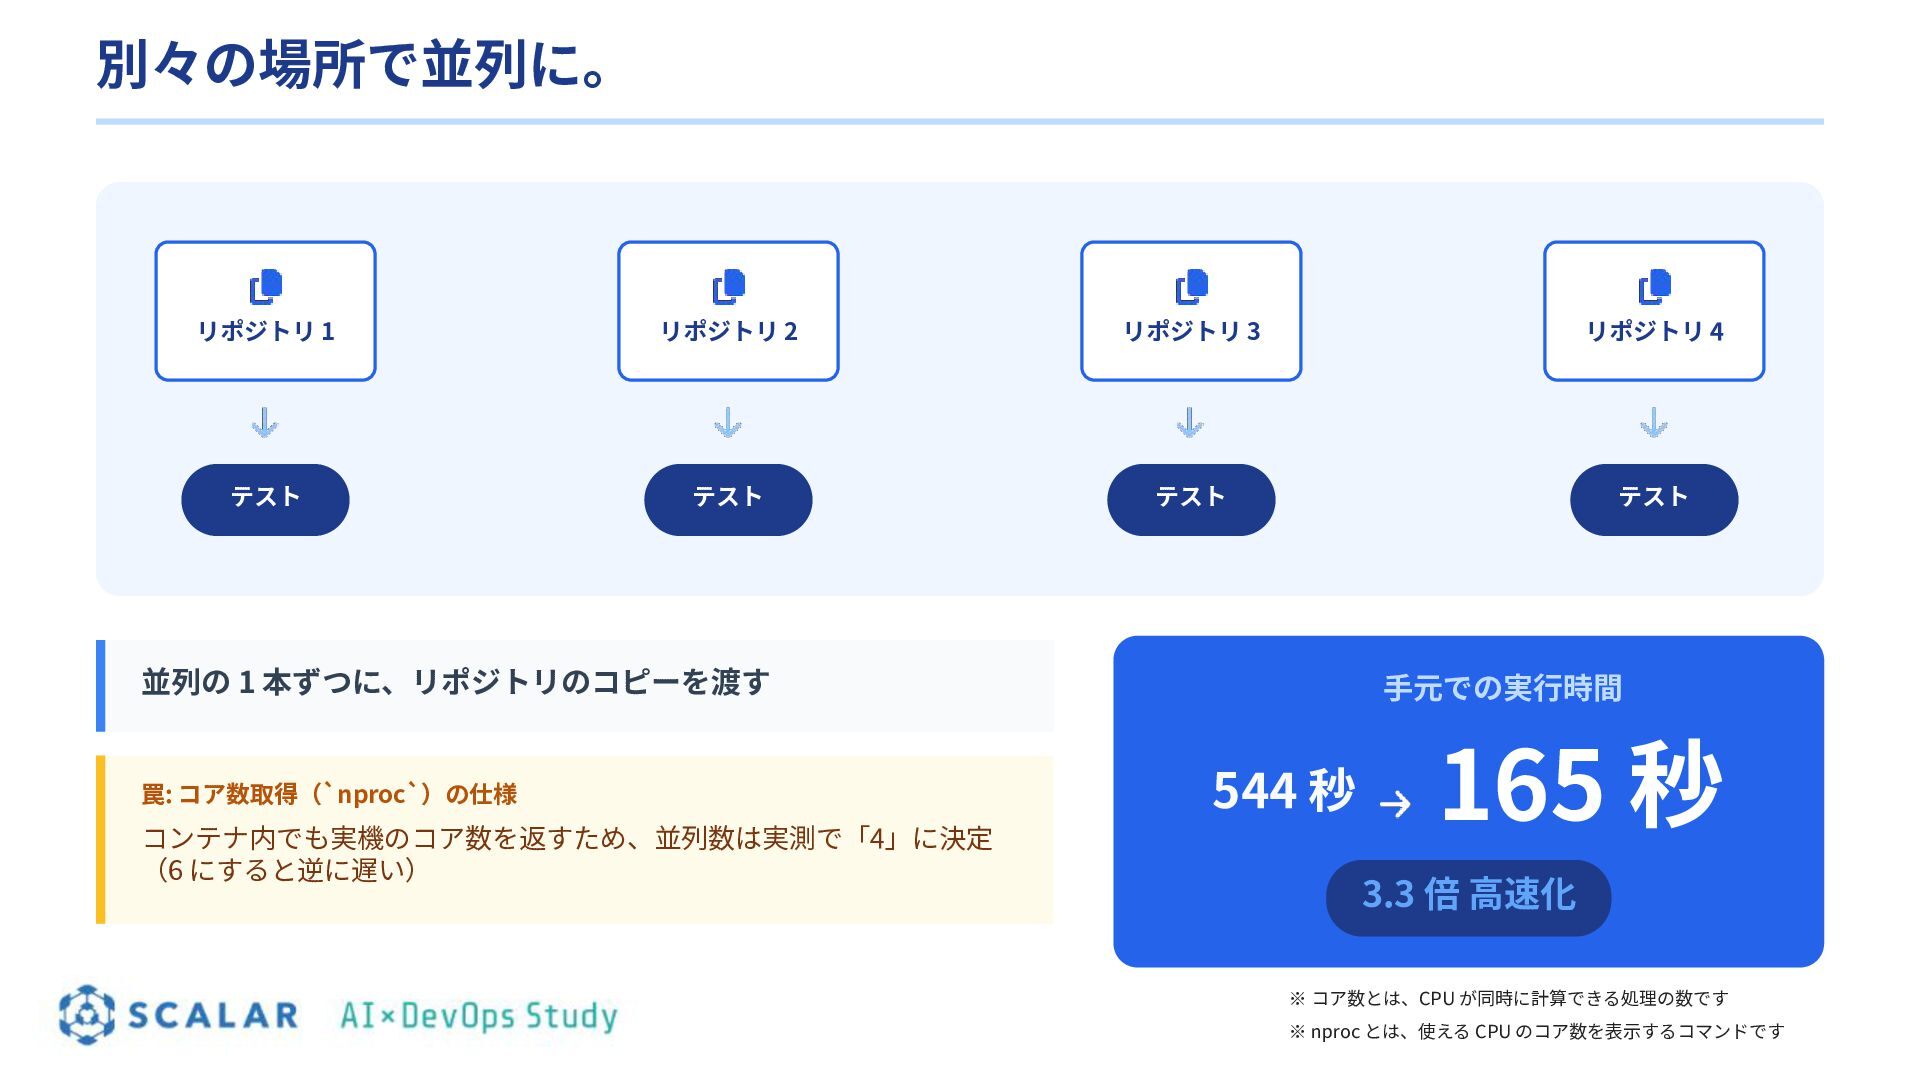
  17. 別々の場所で並列に。 リポジトリ 1 リポジトリ 2 リポジトリ 3 リポジトリ 4 テスト

    テスト テスト テスト 並列の 1 本ずつに、リポジトリのコピーを渡す 罠: コア数取得(`nproc`)の仕様 コンテナ内でも実機のコア数を返すため、並列数は実測で「4」に決定 (6 にすると逆に遅い) ⼿元での実⾏時間 544 秒 165 秒 3.3 倍 ⾼速化 ※ コア数とは、CPU が同時に計算できる処理の数です ※ nproc とは、使える CPU のコア数を表⽰するコマンドです
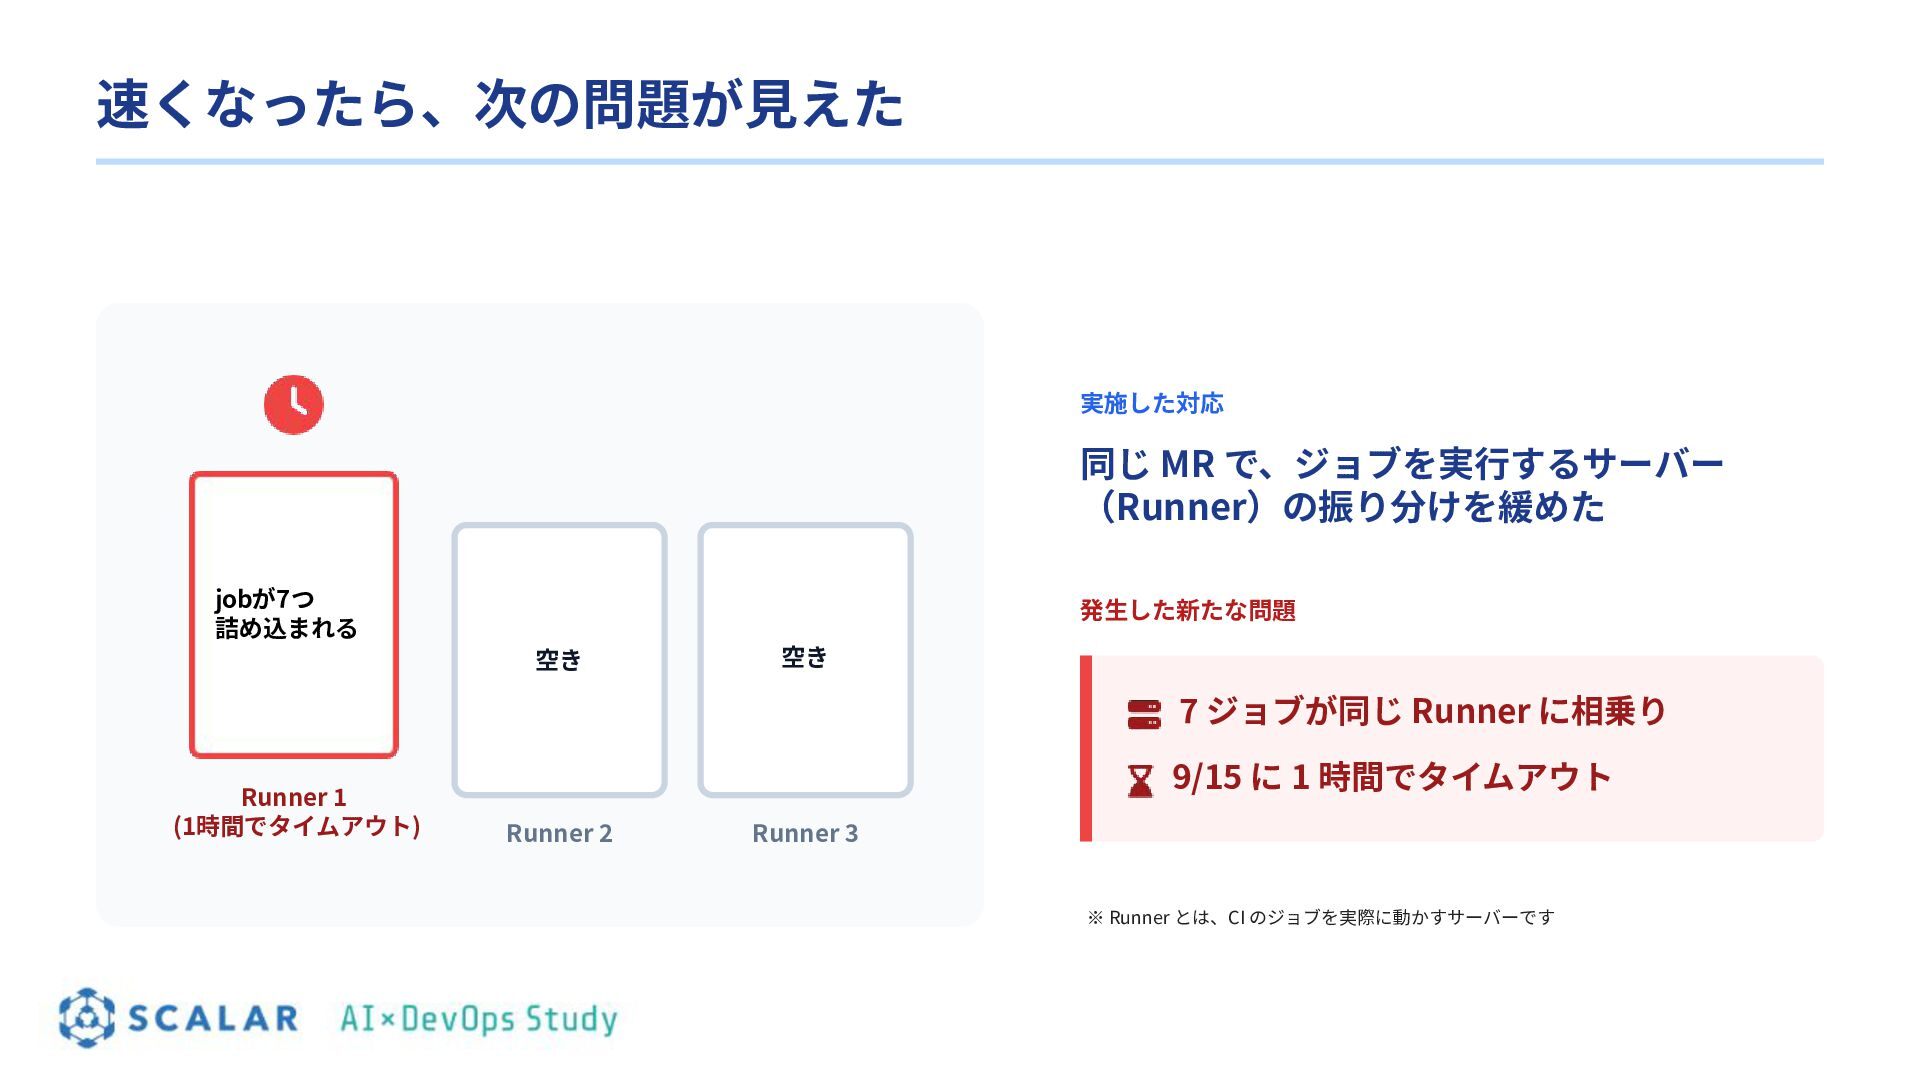
  18. 速くなったら、次の問題が⾒えた 実施した対応 同じ MR で、ジョブを実⾏するサーバー (Runner)の振り分けを緩めた jobが7つ 詰め込まれる 発⽣した新たな問題 空き

    空き 7 ジョブが同じ Runner に相乗り Runner 1 (1時間でタイムアウト) 9/15 に 1 時間でタイムアウト Runner 2 Runner 3 ※ Runner とは、CI のジョブを実際に動かすサーバーです
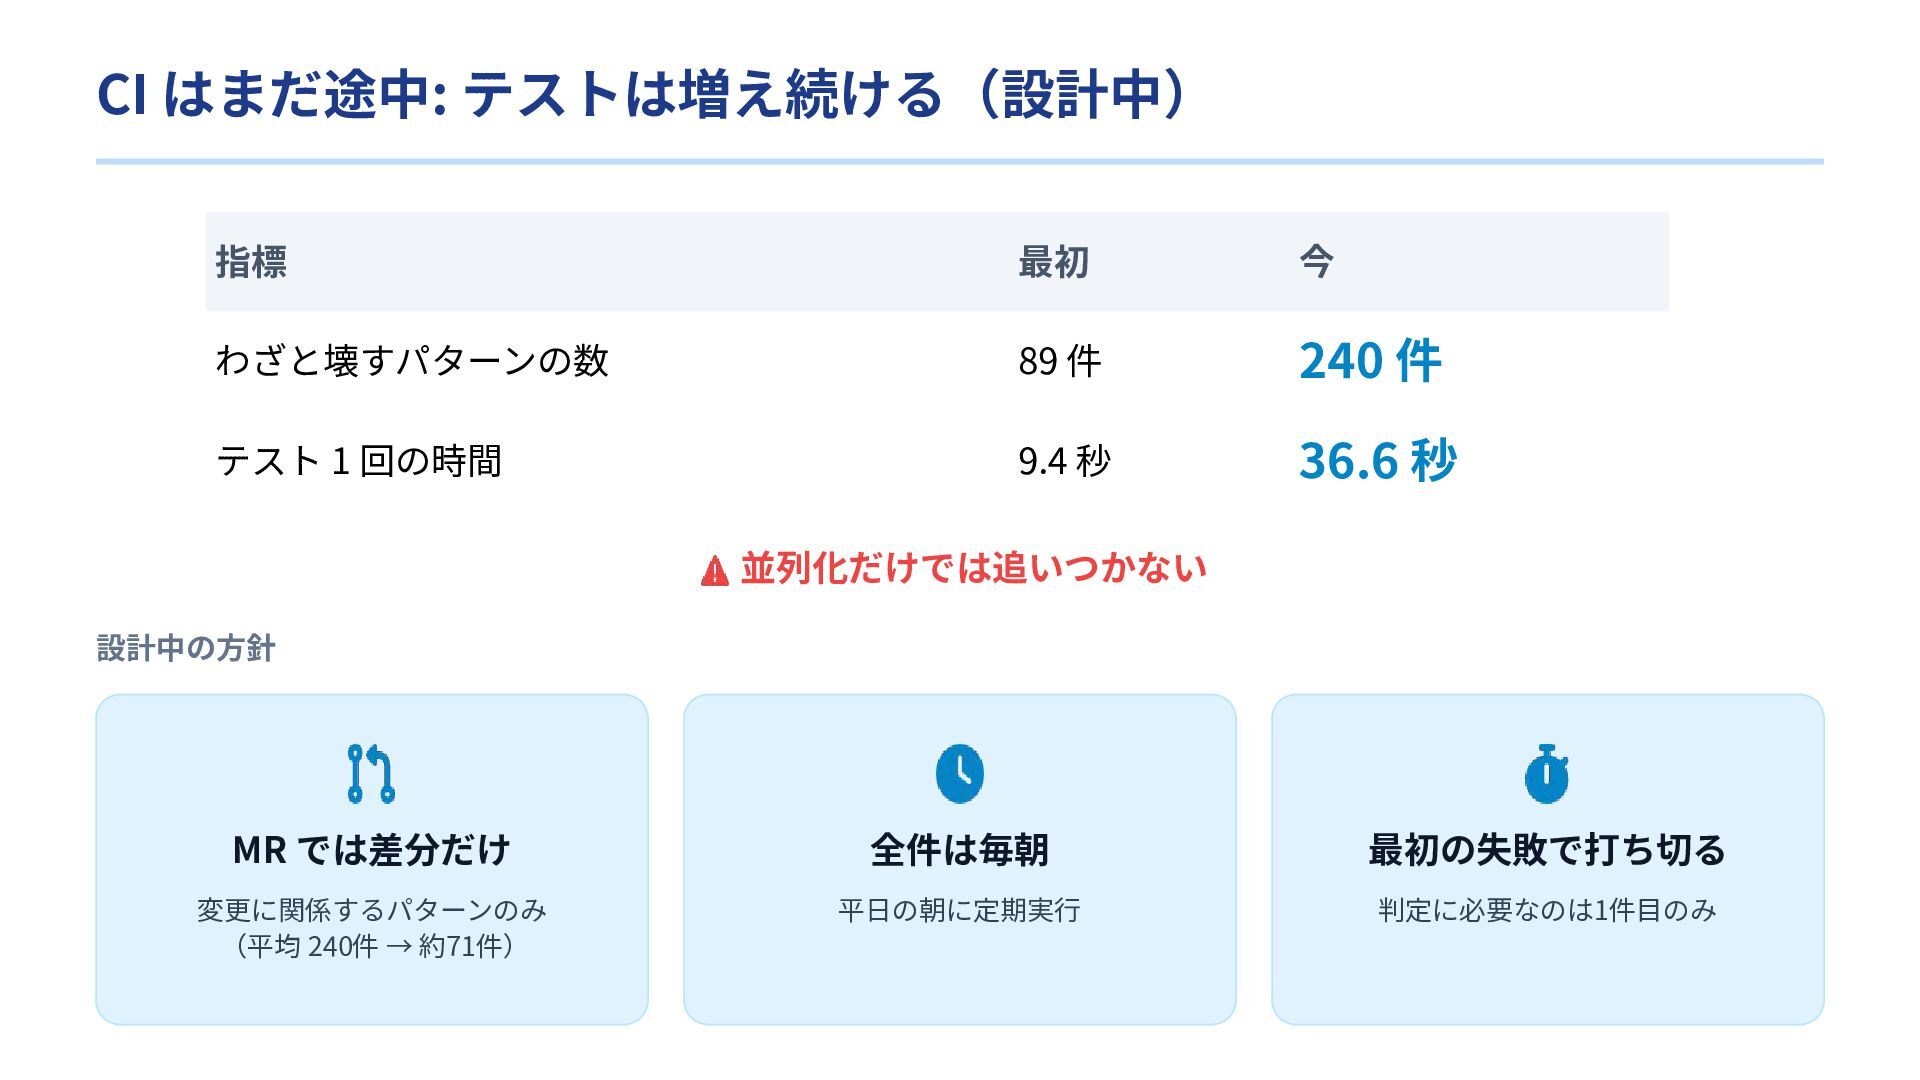
  19. CI はまだ途中: テストは増え続ける(設計中) 指標 最初 今 わざと壊すパターンの数 89 件 240

    件 テスト 1 回の時間 9.4 秒 36.6 秒 並列化だけでは追いつかない 設計中の⽅針 MR では差分だけ 全件は毎朝 最初の失敗で打ち切る 変更に関係するパターンのみ (平均 240件 → 約71件) 平⽇の朝に定期実⾏ 判定に必要なのは1件⽬のみ
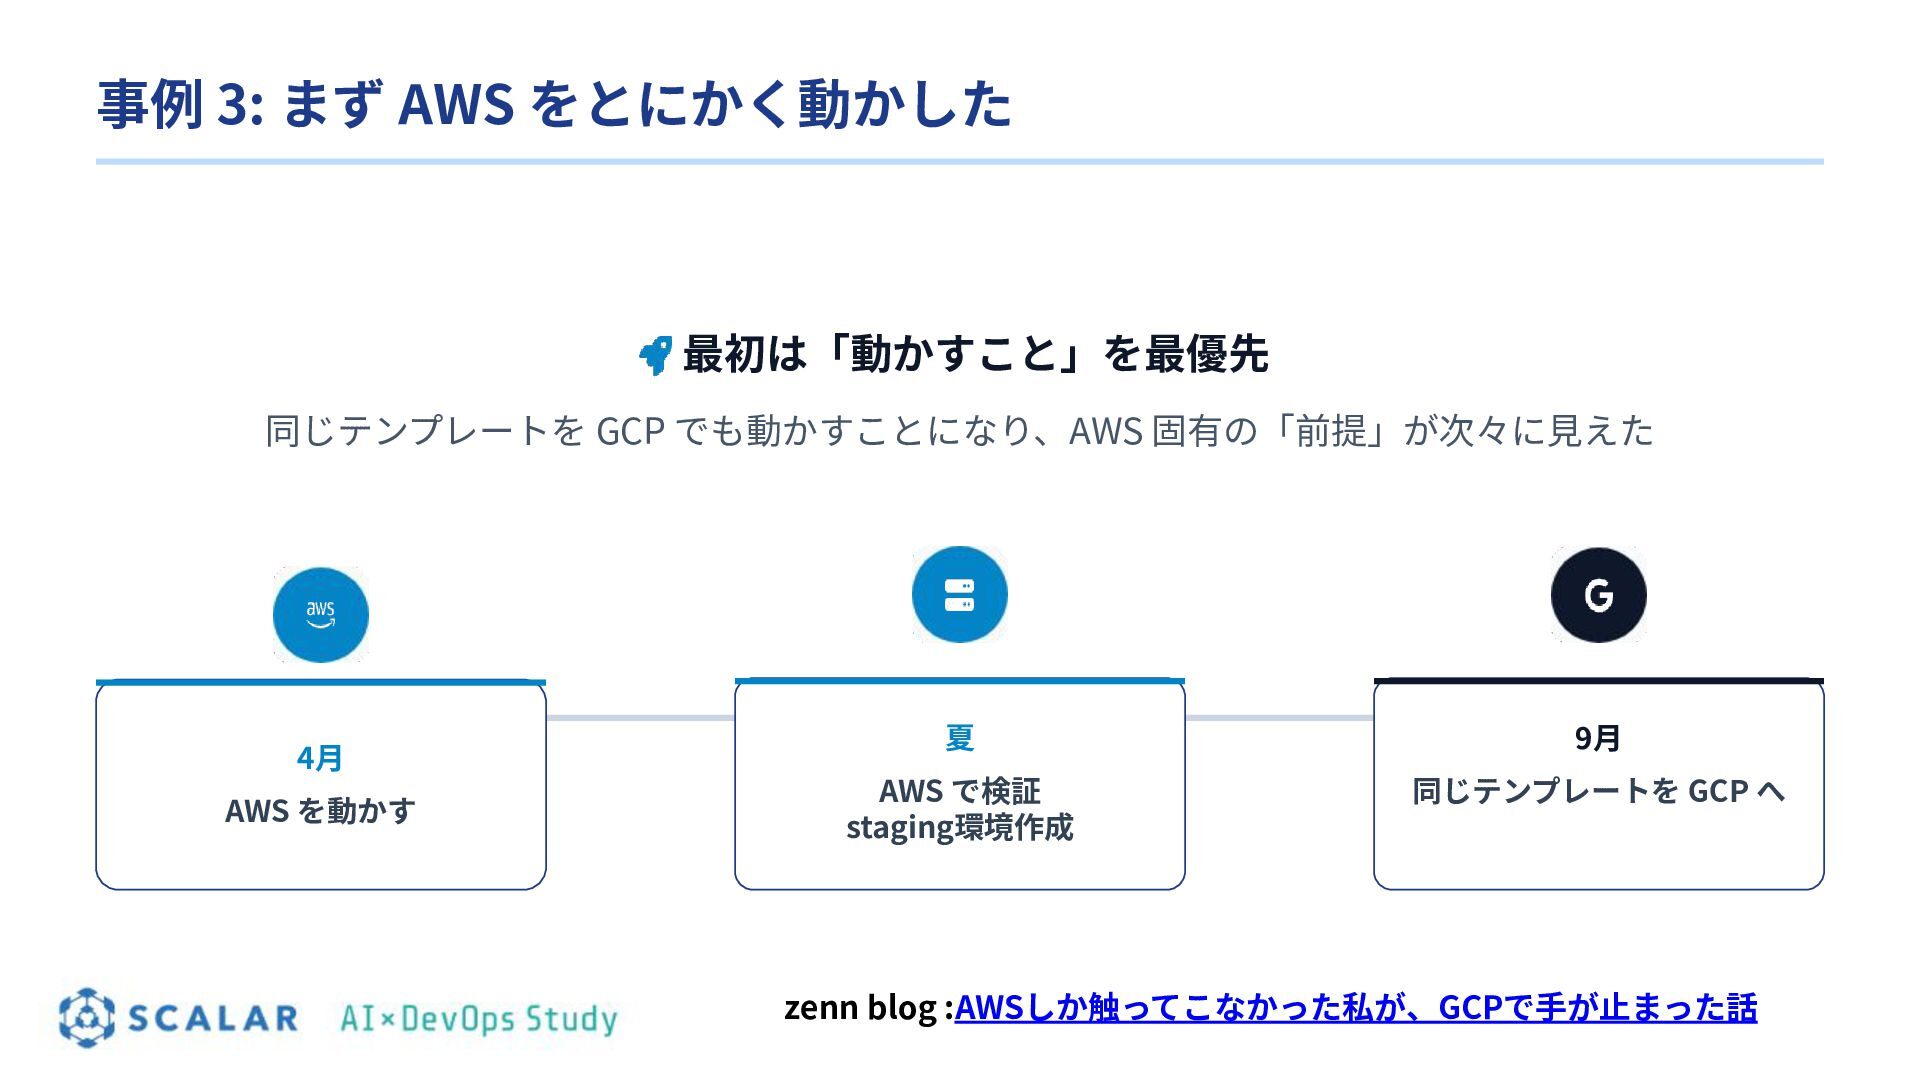
  20. 事例 3: まず AWS をとにかく動かした 最初は「動かすこと」を最優先 同じテンプレートを GCP でも動かすことになり、AWS 固有の「前提」が次々に⾒えた

    4⽉ AWS を動かす 夏 9⽉ AWS で検証 staging環境作成 同じテンプレートを GCP へ zenn blog :AWSしか触ってこなかった私が、GCPで⼿が⽌まった話
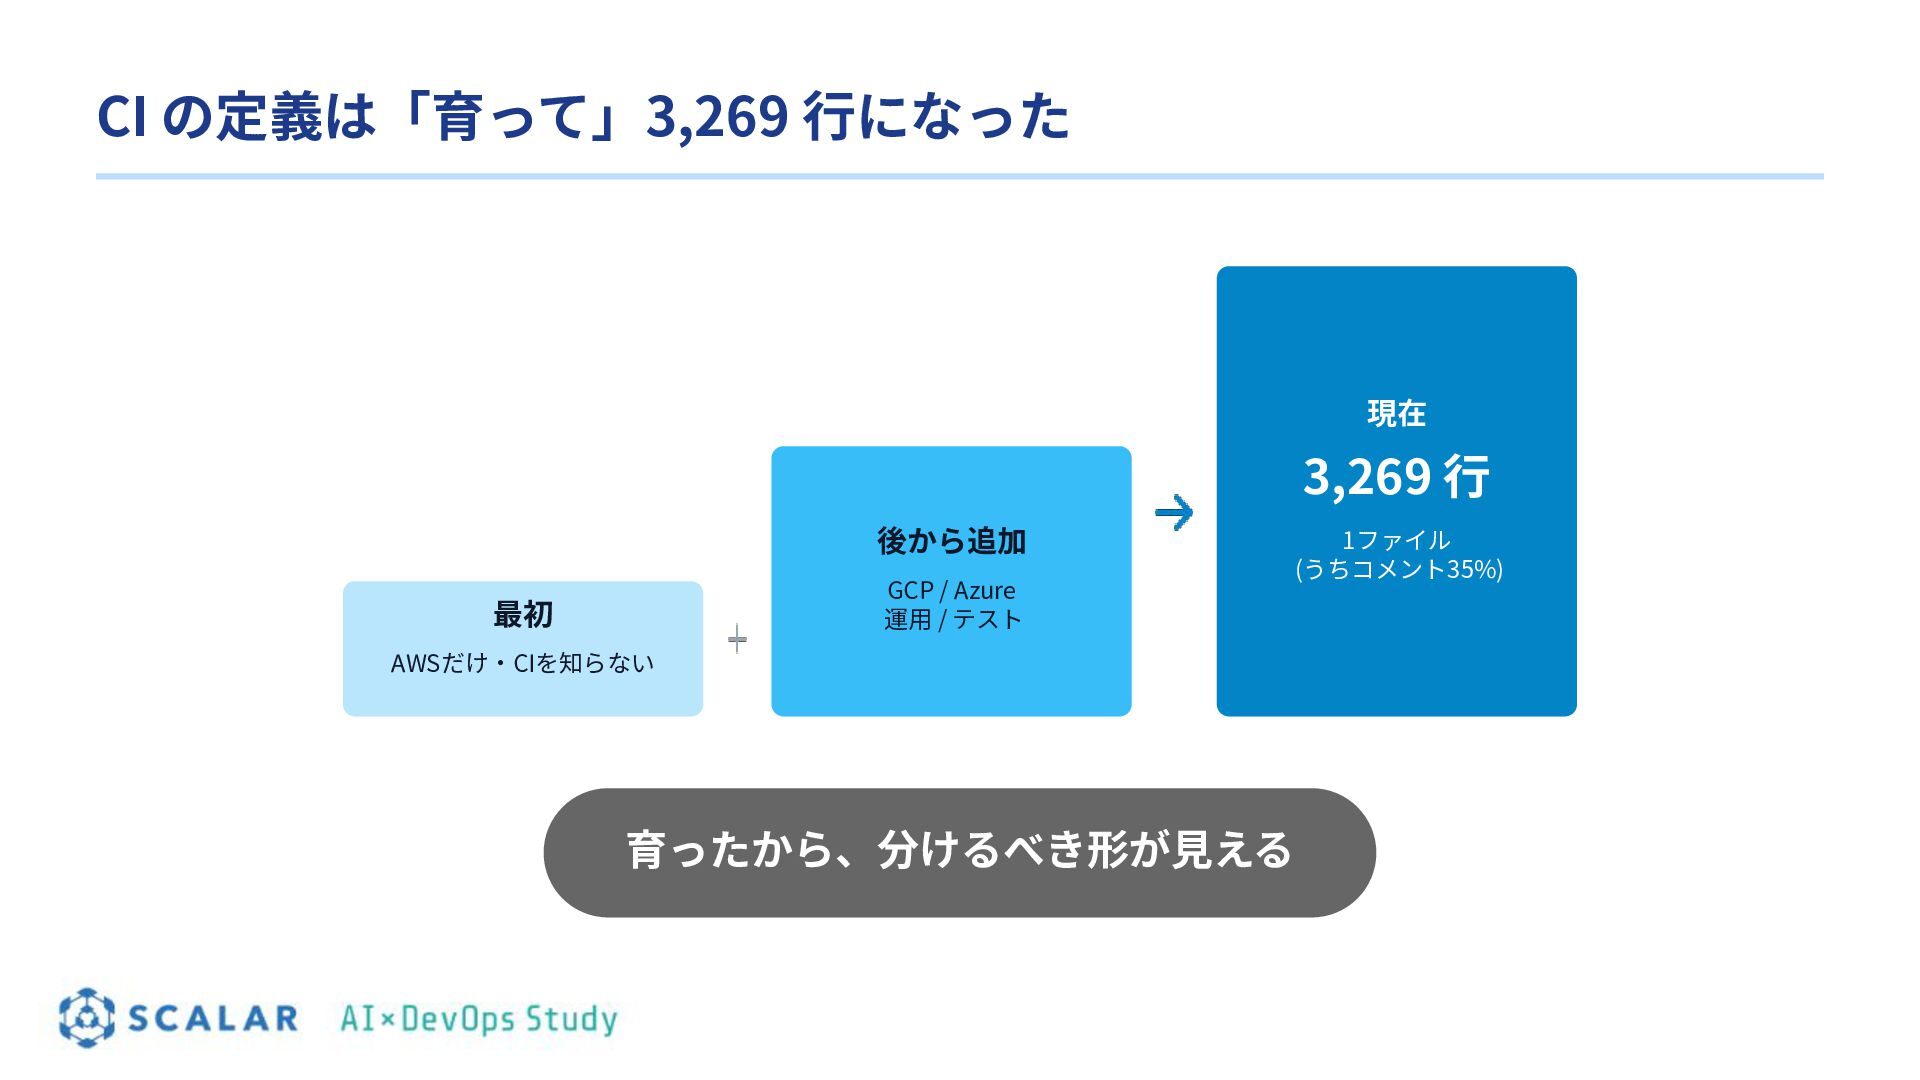
  21. CI の定義は「育って」3,269 ⾏になった 現在 3,269 ⾏ 後から追加 GCP / Azure

    運⽤ / テスト 最初 1ファイル (うちコメント35%) AWSだけ‧CIを知らない 育ったから、分けるべき形が⾒える
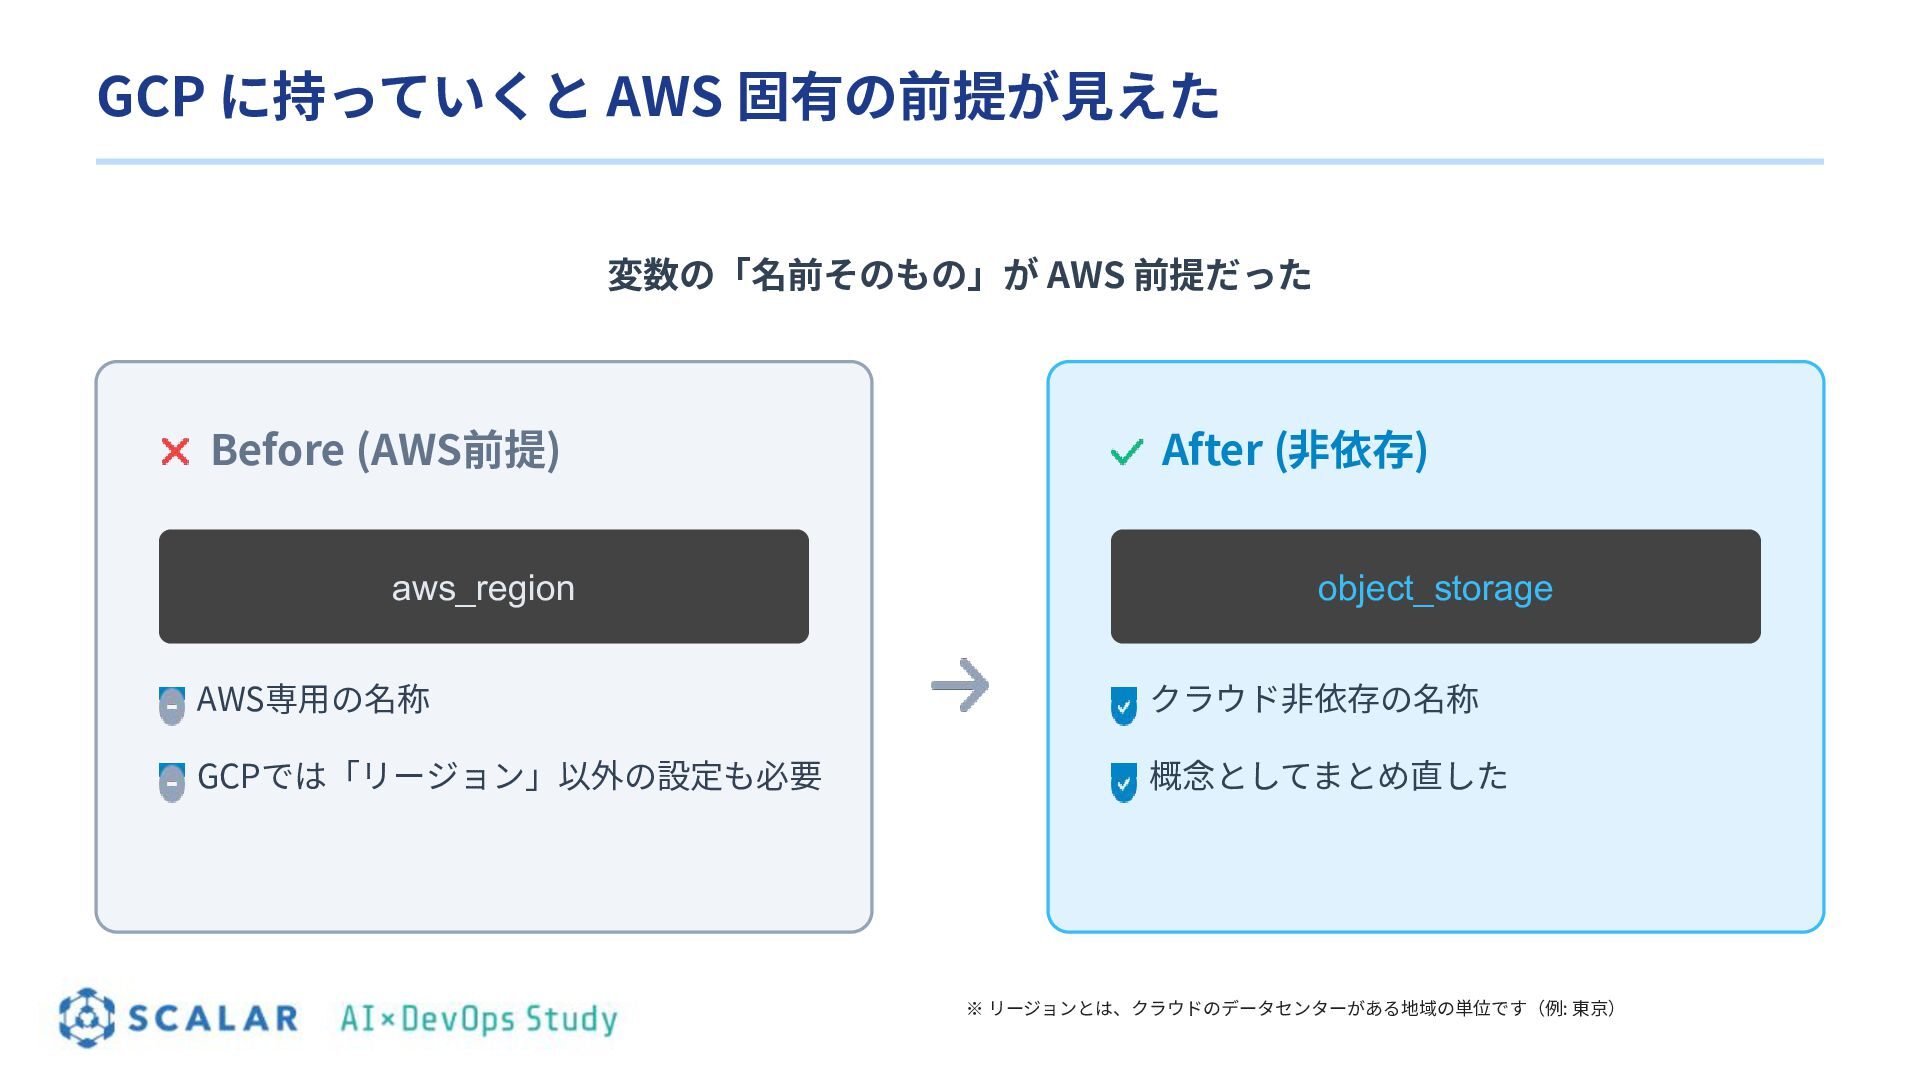
  22. GCP に持っていくと AWS 固有の前提が⾒えた 変数の「名前そのもの」が AWS 前提だった Before (AWS前提) aws_region

    After (⾮依存) object_storage AWS専⽤の名称 クラウド⾮依存の名称 GCPでは「リージョン」以外の設定も必要 概念としてまとめ直した ※ リージョンとは、クラウドのデータセンターがある地域の単位です(例: 東京)
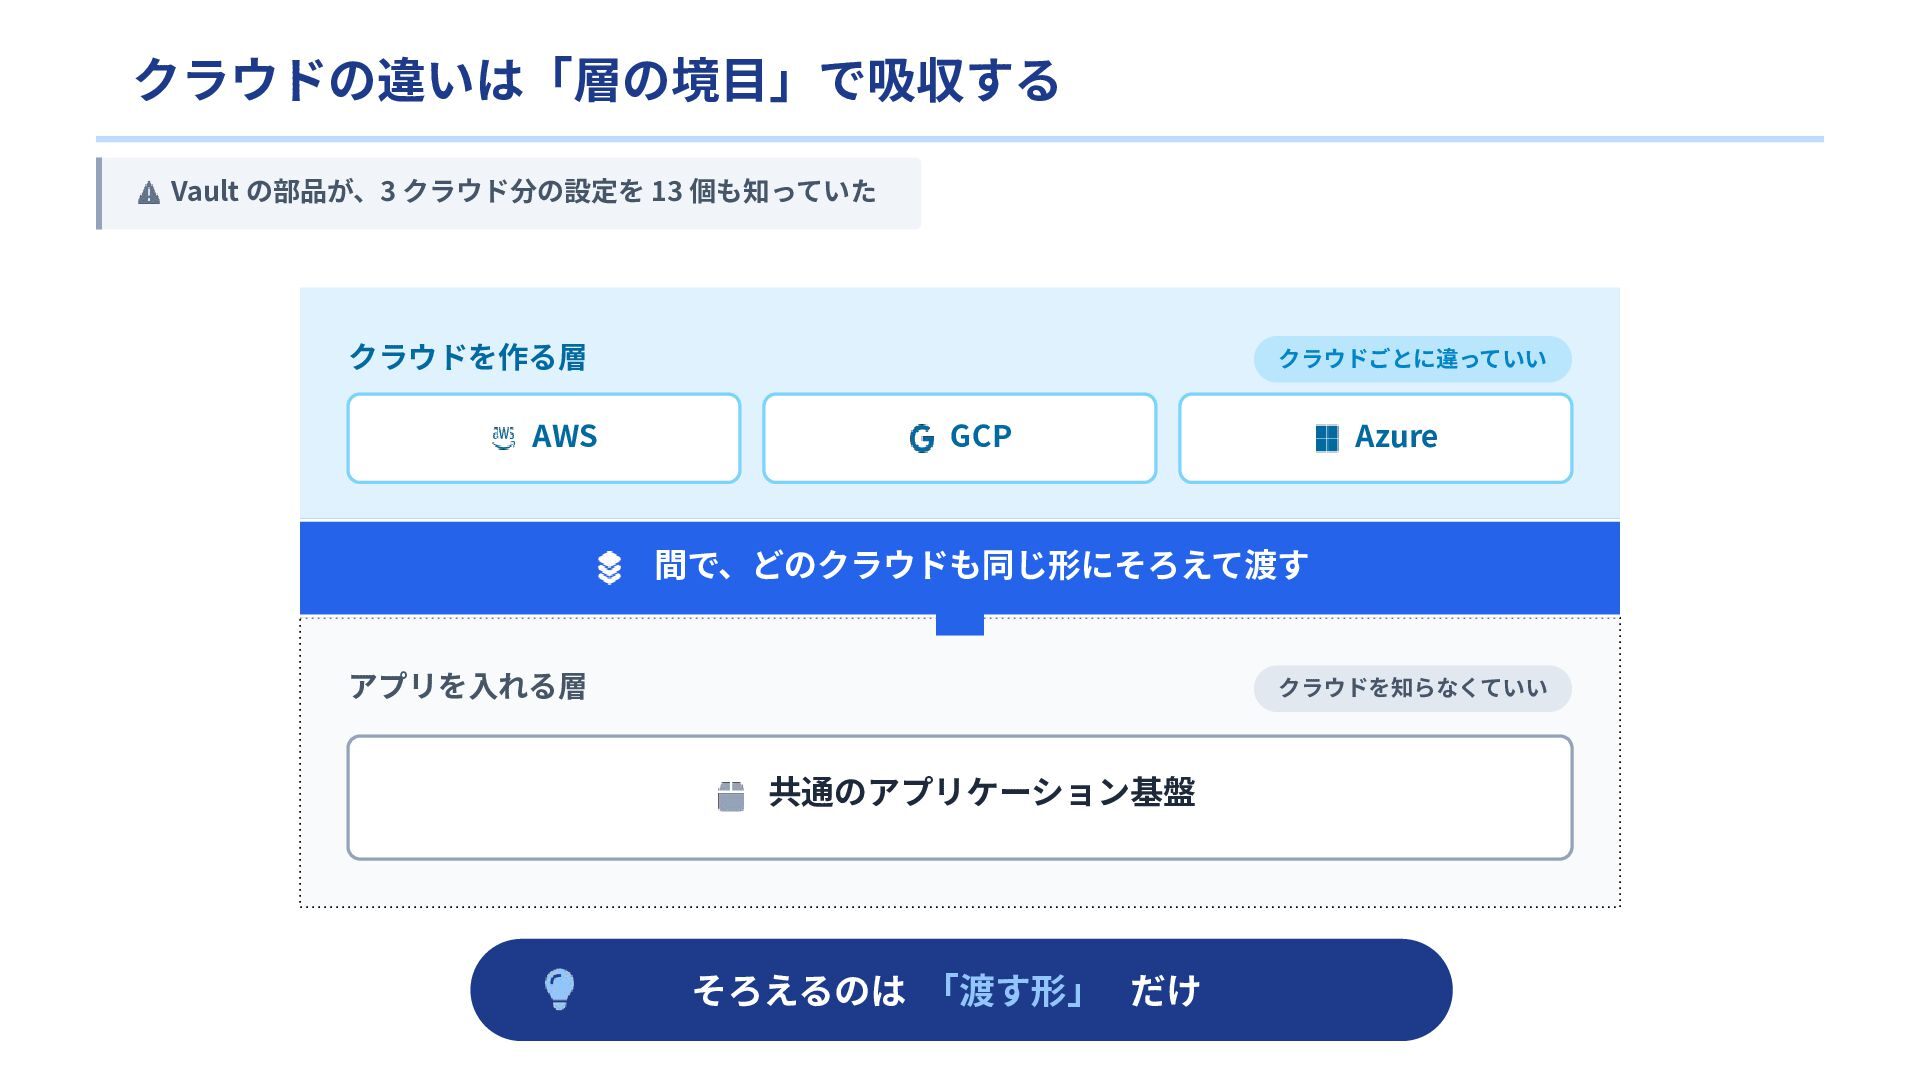
  23. クラウドの違いは「層の境⽬」で吸収する Vault の部品が、3 クラウド分の設定を 13 個も知っていた クラウドを作る層 AWS クラウドごとに違っていい GCP

    Azure 間で、どのクラウドも同じ形にそろえて渡す アプリを⼊れる層 クラウドを知らなくていい 共通のアプリケーション基盤 そろえるのは 「渡す形」 だけ
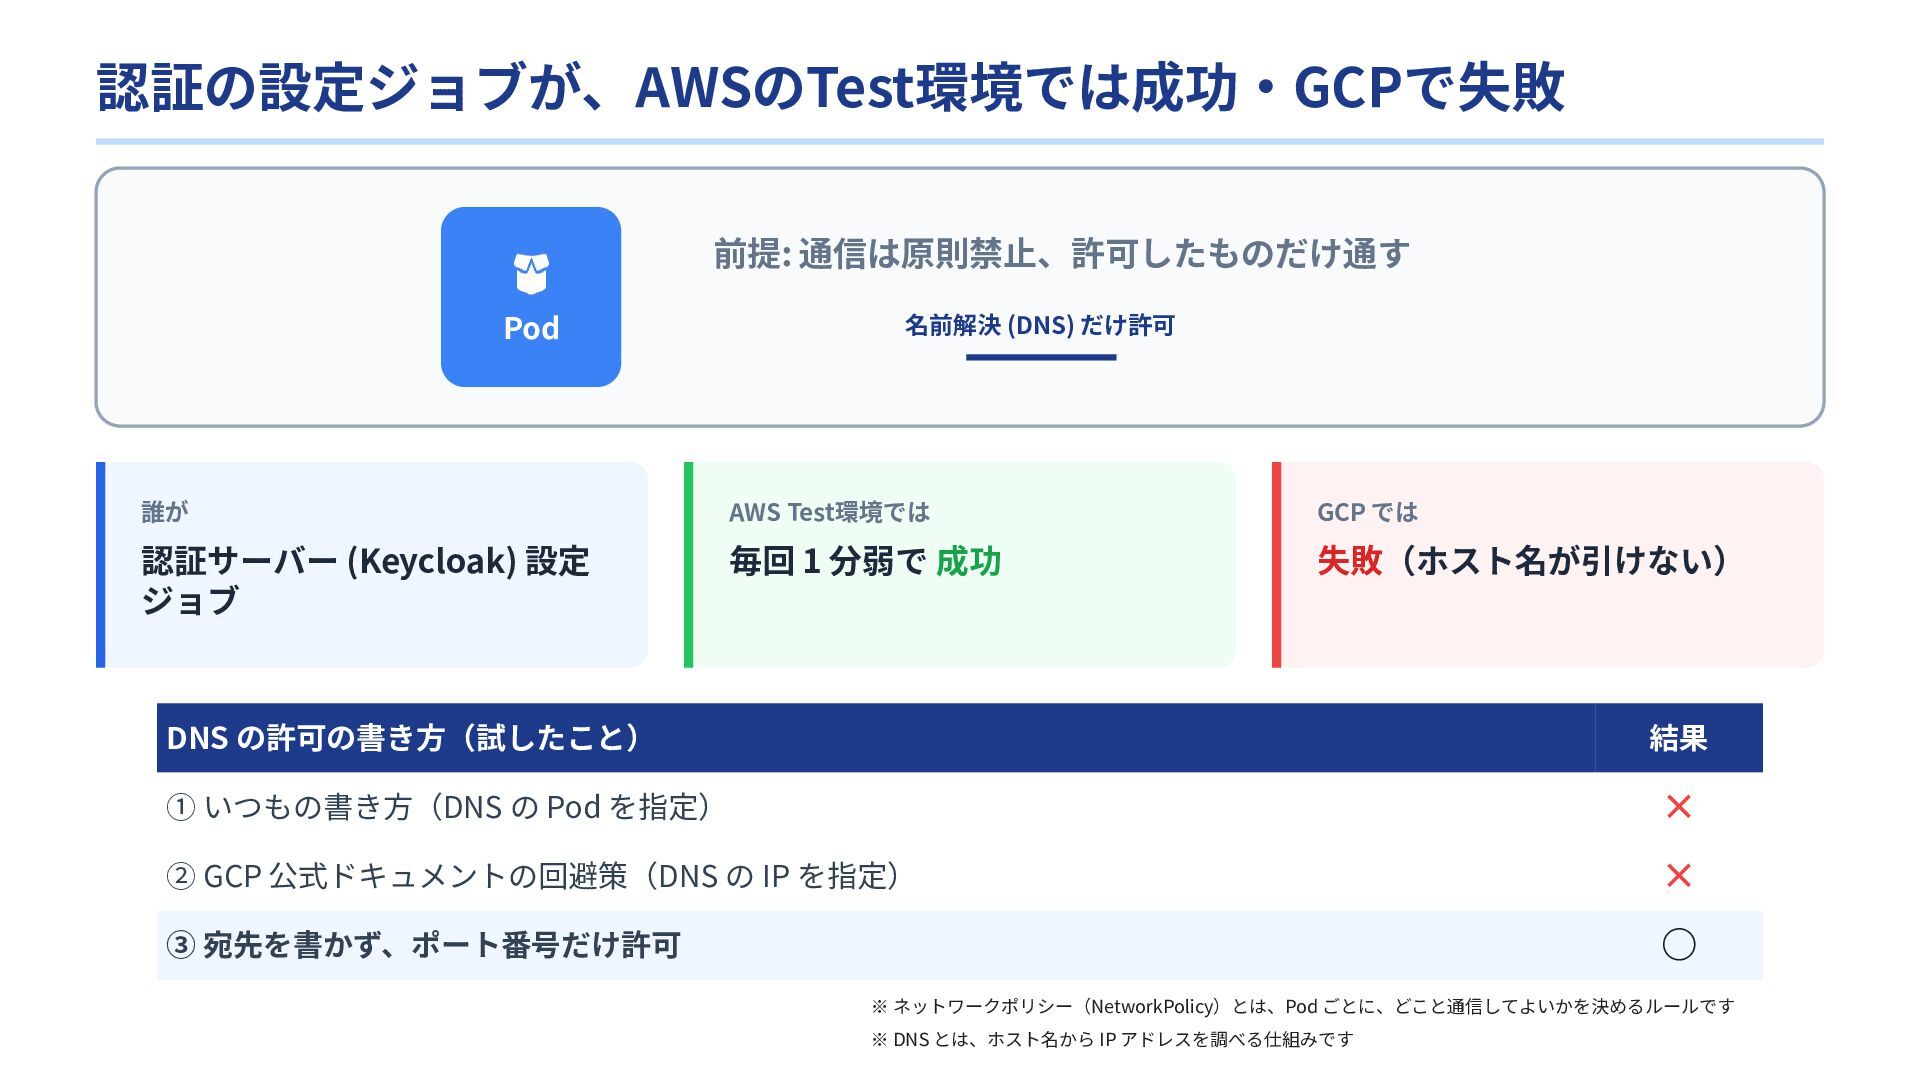
  24. 認証の設定ジョブが、AWSのTest環境では成功‧GCPで失敗 前提: 通信は原則禁⽌、許可したものだけ通す Pod 名前解決 (DNS) だけ許可 誰が AWS Test環境では

    GCP では 認証サーバー (Keycloak) 設定 ジョブ 毎回 1 分弱で 成功 失敗(ホスト名が引けない) DNS の許可の書き⽅(試したこと) 結果 ① いつもの書き⽅(DNS の Pod を指定) × ② GCP 公式ドキュメントの回避策(DNS の IP を指定) × ③ 宛先を書かず、ポート番号だけ許可 ◦ ※ ネットワークポリシー(NetworkPolicy)とは、Pod ごとに、どこと通信してよいかを決めるルールです ※ DNS とは、ホスト名から IP アドレスを調べる仕組みです
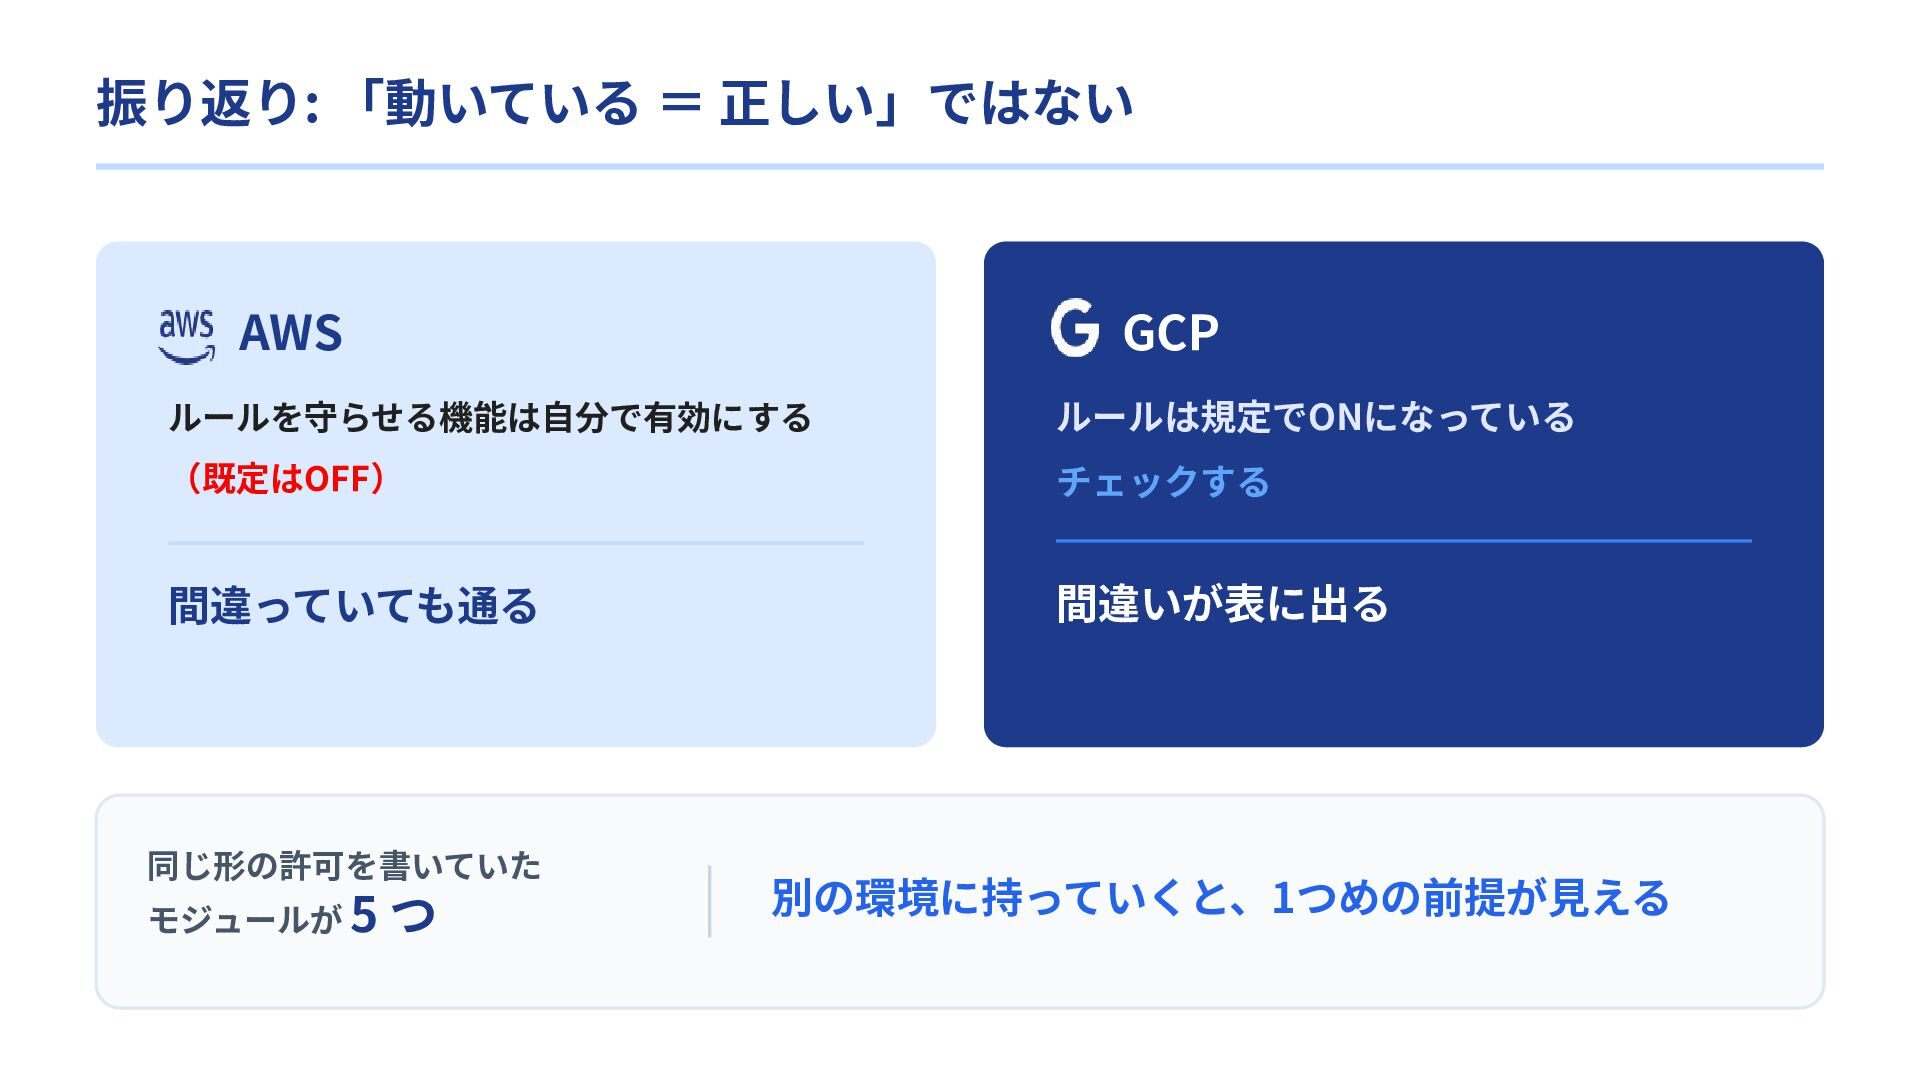
  25. 振り返り: 「動いている = 正しい」ではない AWS GCP ルールを守らせる機能は⾃分で有効にする ルールは規定でONになっている (既定はOFF) チェックする

    間違っていても通る 間違いが表に出る 同じ形の許可を書いていた モジュールが 5 つ 別の環境に持っていくと、1つめの前提が⾒える
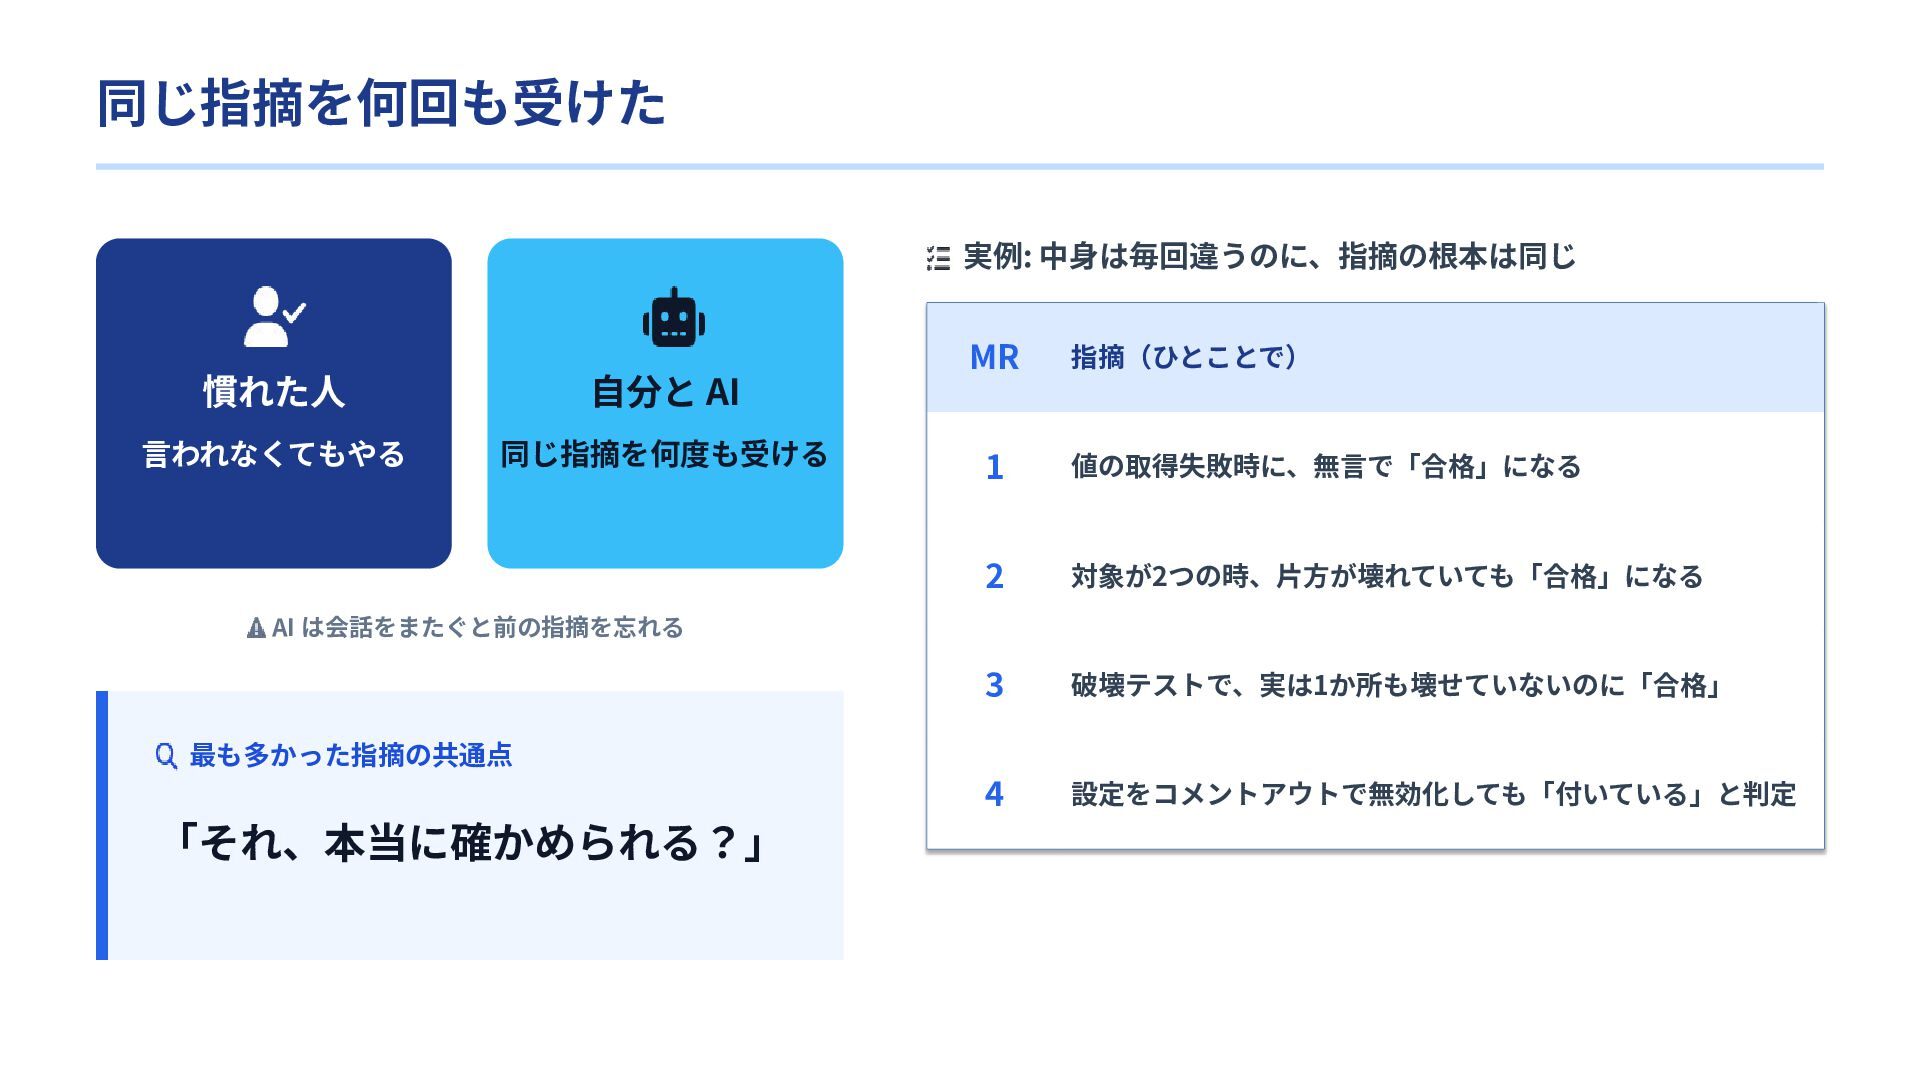
  26. 同じ指摘を何回も受けた 実例: 中⾝は毎回違うのに、指摘の根本は同じ 慣れた⼈ ⾃分と AI ⾔われなくてもやる 同じ指摘を何度も受ける MR 指摘(ひとことで)

    1 値の取得失敗時に、無⾔で「合格」になる 2 対象が2つの時、⽚⽅が壊れていても「合格」になる 3 破壊テストで、実は1か所も壊せていないのに「合格」 4 設定をコメントアウトで無効化しても「付いている」と判定 AI は会話をまたぐと前の指摘を忘れる 最も多かった指摘の共通点 「それ、本当に確かめられる?」
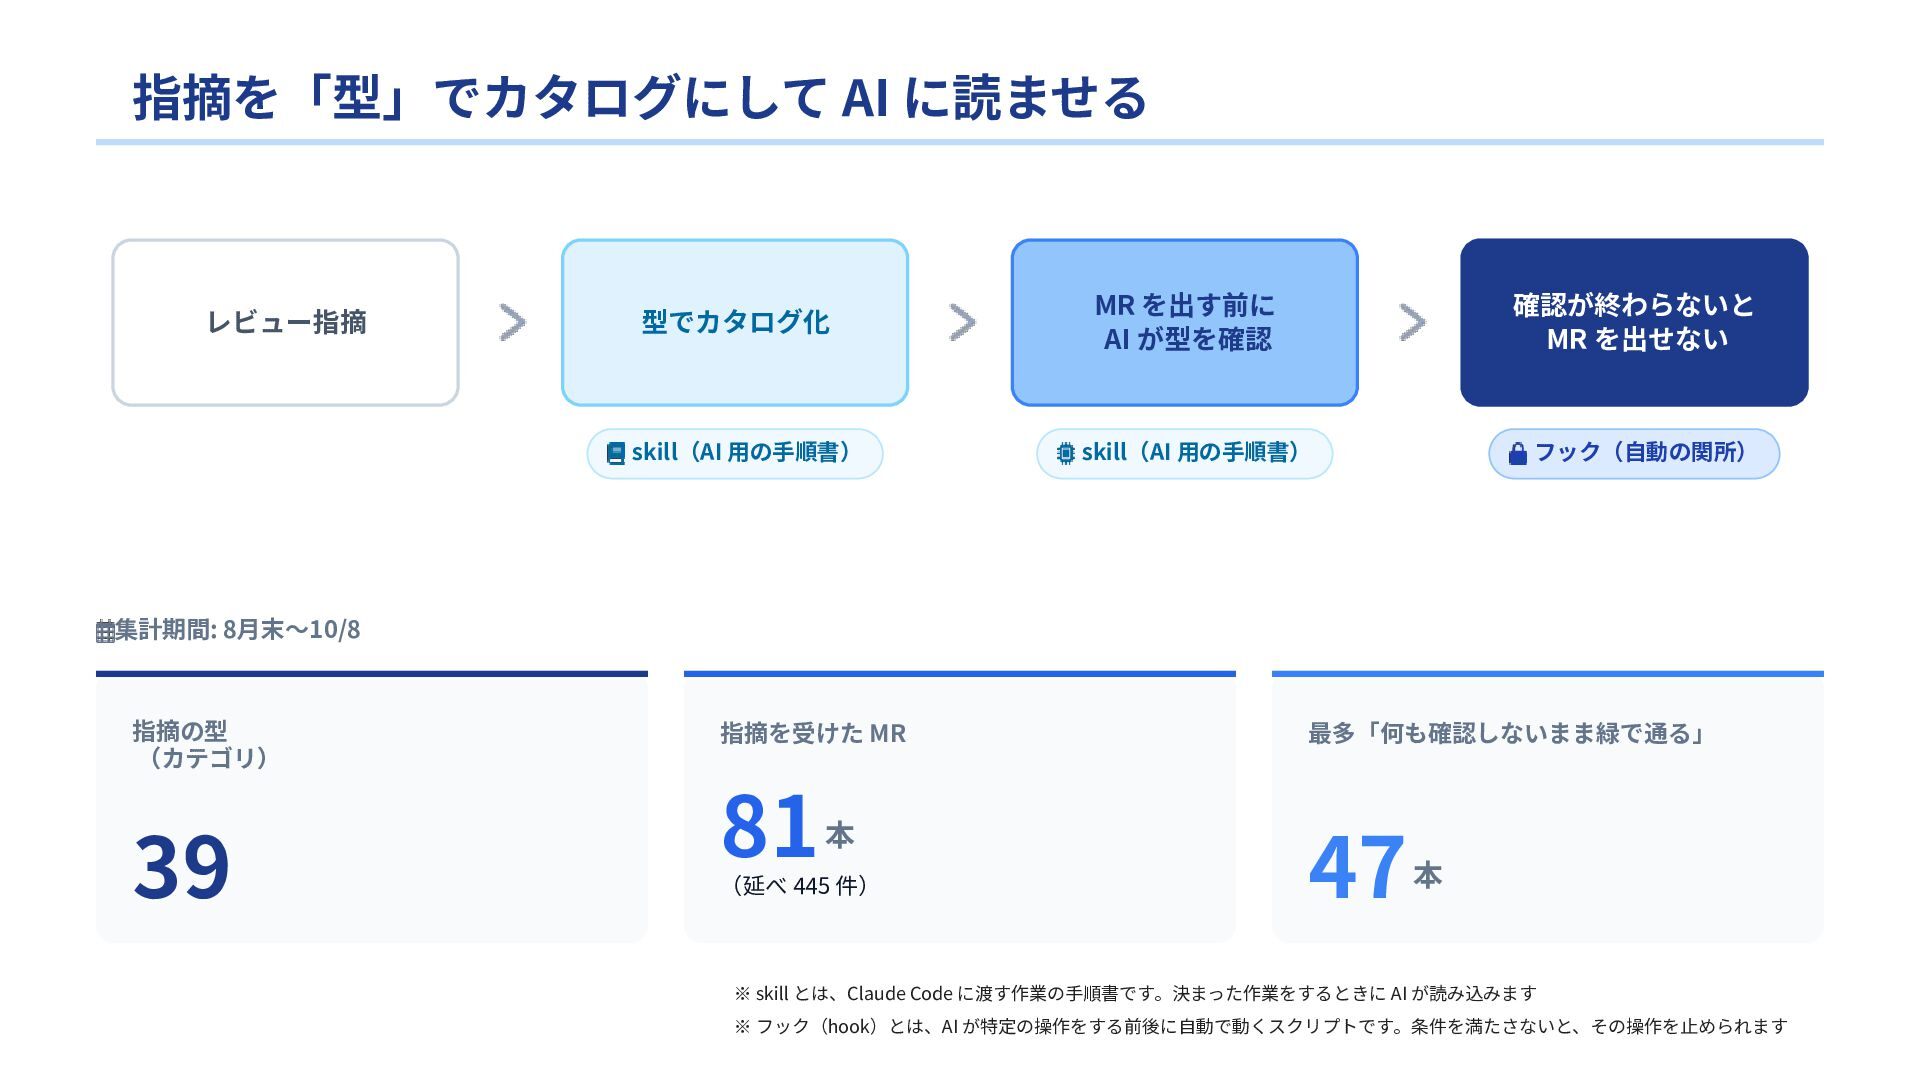
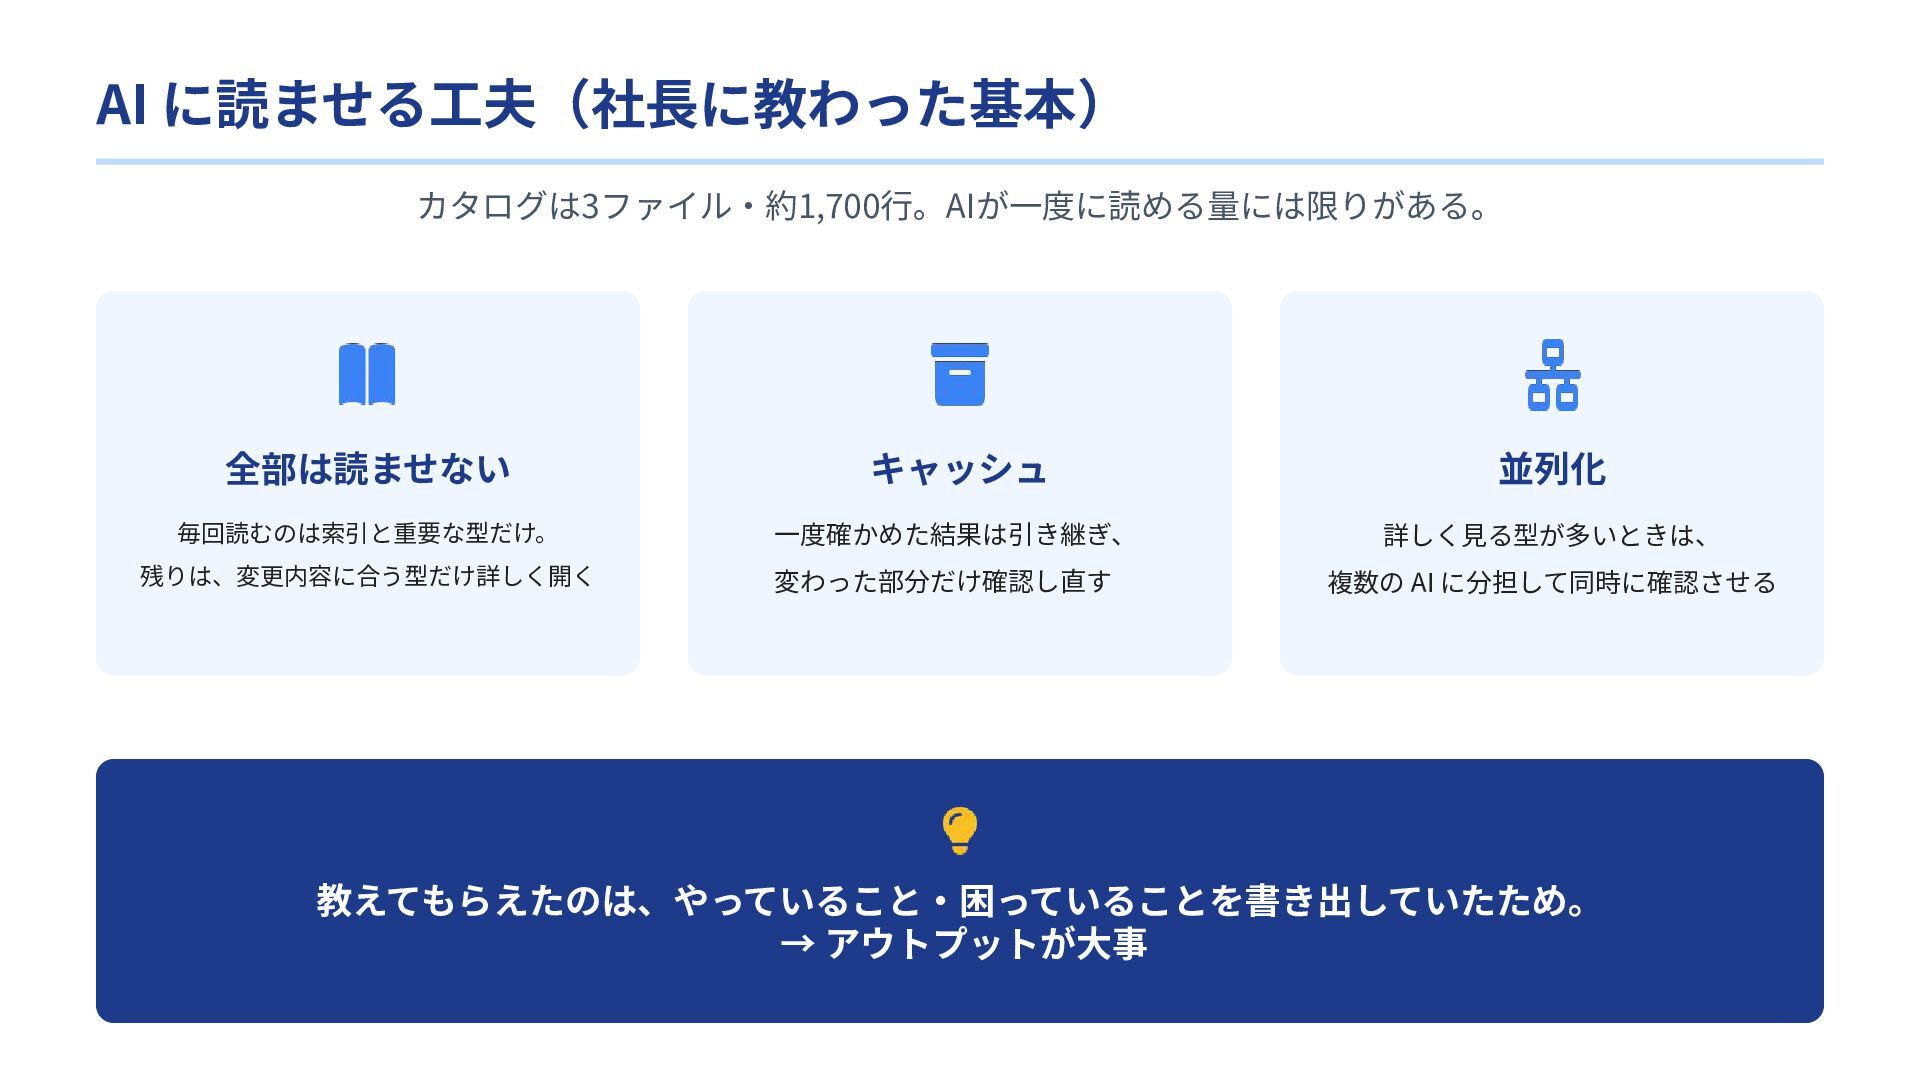
  27. 指摘を「型」でカタログにして AI に読ませる レビュー指摘 型でカタログ化 MR を出す前に AI が型を確認 確認が終わらないと

    MR を出せない skill(AI ⽤の⼿順書) skill(AI ⽤の⼿順書) フック(⾃動の関所) 集計期間: 8⽉末〜10/8 指摘の型 (カテゴリ) 39 指摘を受けた MR 81 本 (延べ 445 件) 最多「何も確認しないまま緑で通る」 47 本 ※ skill とは、Claude Code に渡す作業の⼿順書です。決まった作業をするときに AI が読み込みます ※ フック(hook)とは、AI が特定の操作をする前後に⾃動で動くスクリプトです。条件を満たさないと、その操作を⽌められます
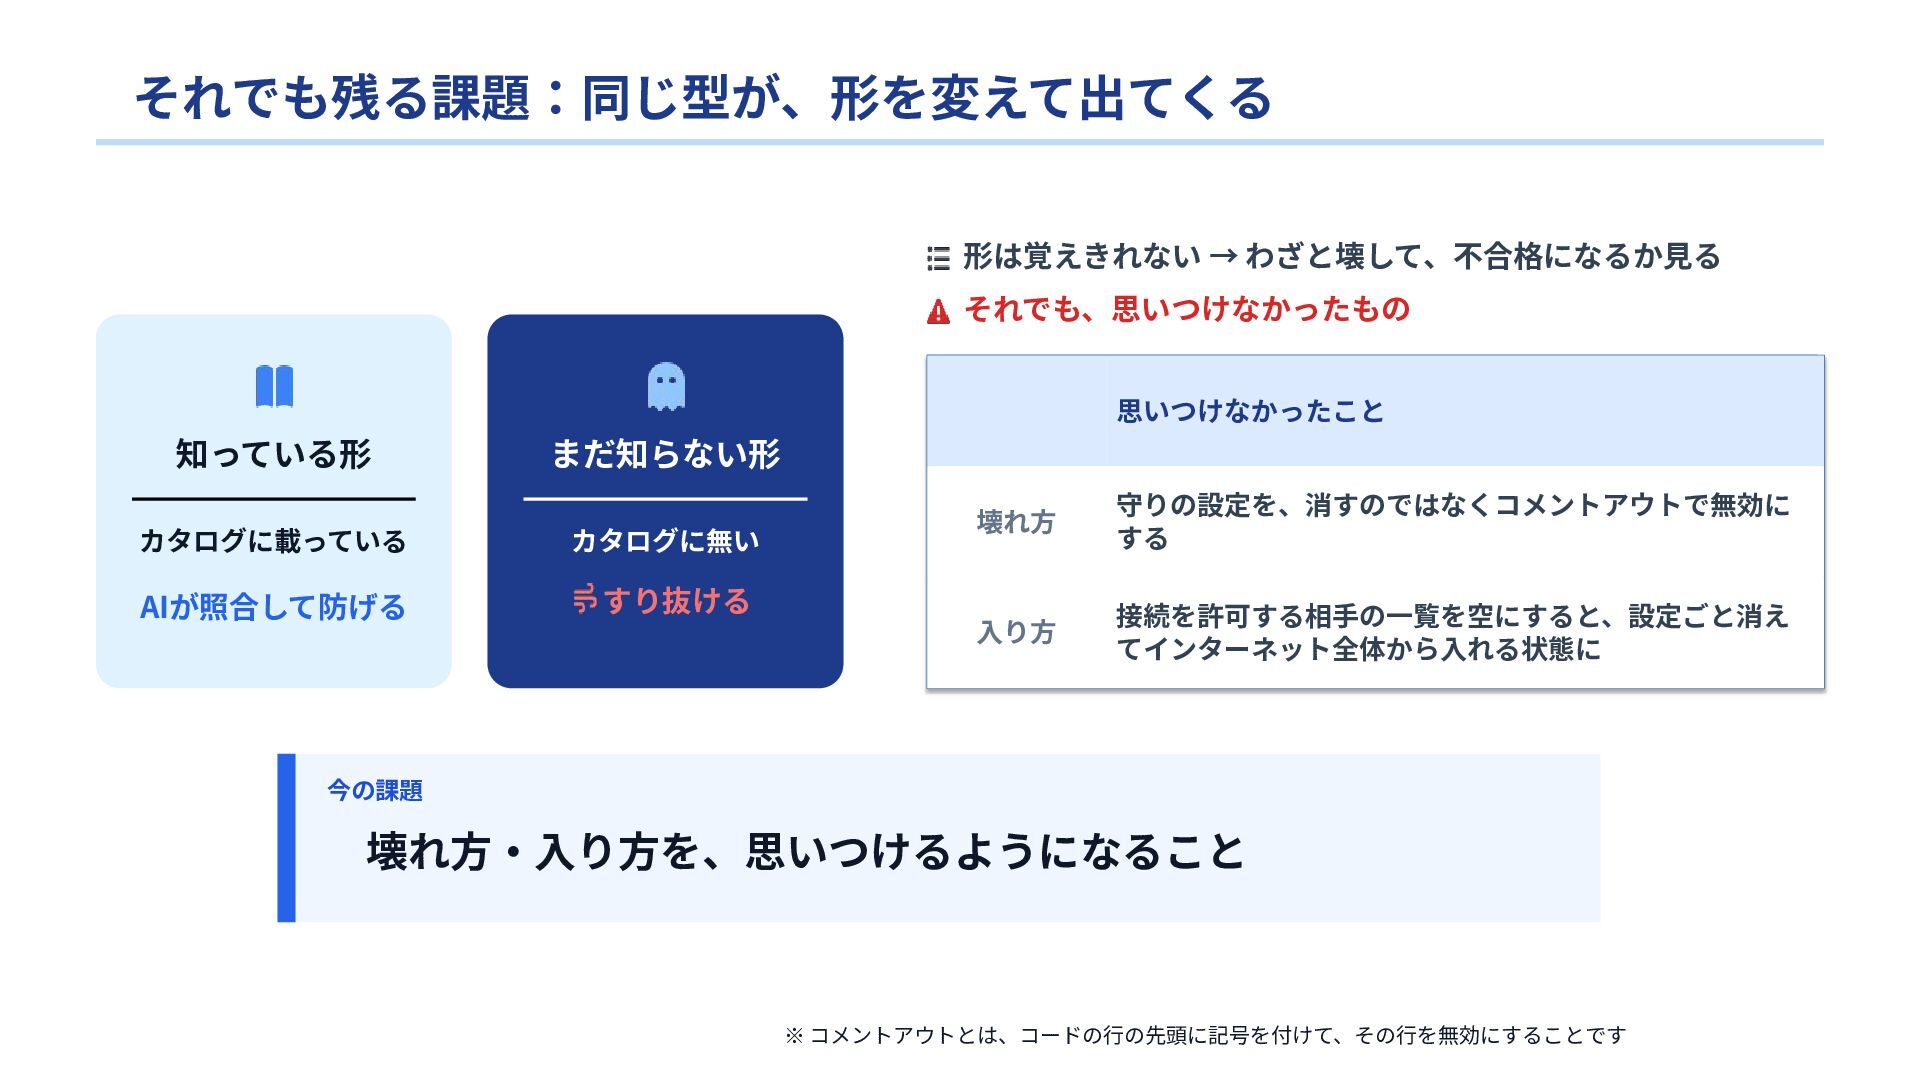
  28. それでも残る課題:同じ型が、形を変えて出てくる 形は覚えきれない → わざと壊して、不合格になるか⾒る それでも、思いつけなかったもの 思いつけなかったこと 知っている形 まだ知らない形 カタログに載っている カタログに無い

    AIが照合して防げる すり抜ける 壊れ⽅ 守りの設定を、消すのではなくコメントアウトで無効に する ⼊り⽅ 接続を許可する相⼿の⼀覧を空にすると、設定ごと消え てインターネット全体から⼊れる状態に 今の課題 壊れ⽅‧⼊り⽅を、思いつけるようになること ※ コメントアウトとは、コードの⾏の先頭に記号を付けて、その⾏を無効にすることです
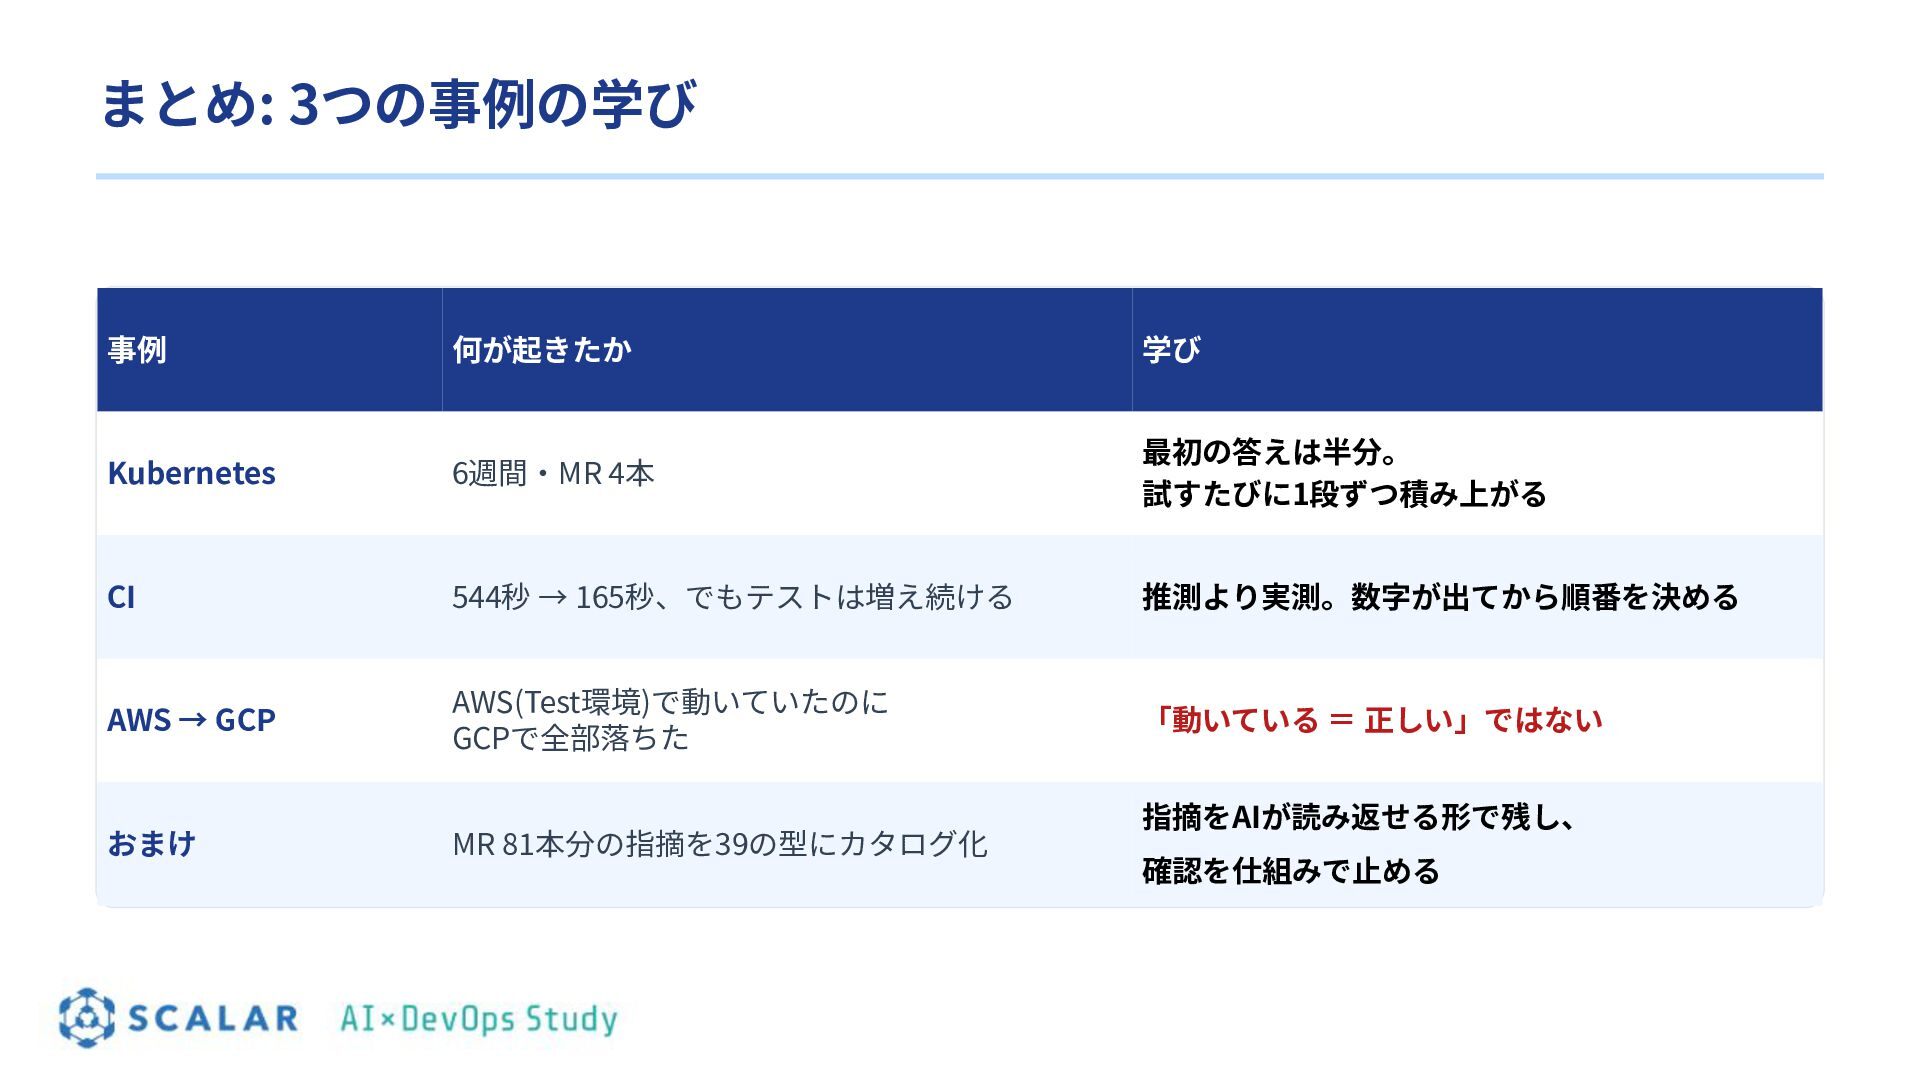
  29. まとめ: 3つの事例の学び 事例 何が起きたか 学び Kubernetes 6週間‧MR 4本 最初の答えは半分。 試すたびに1段ずつ積み上がる

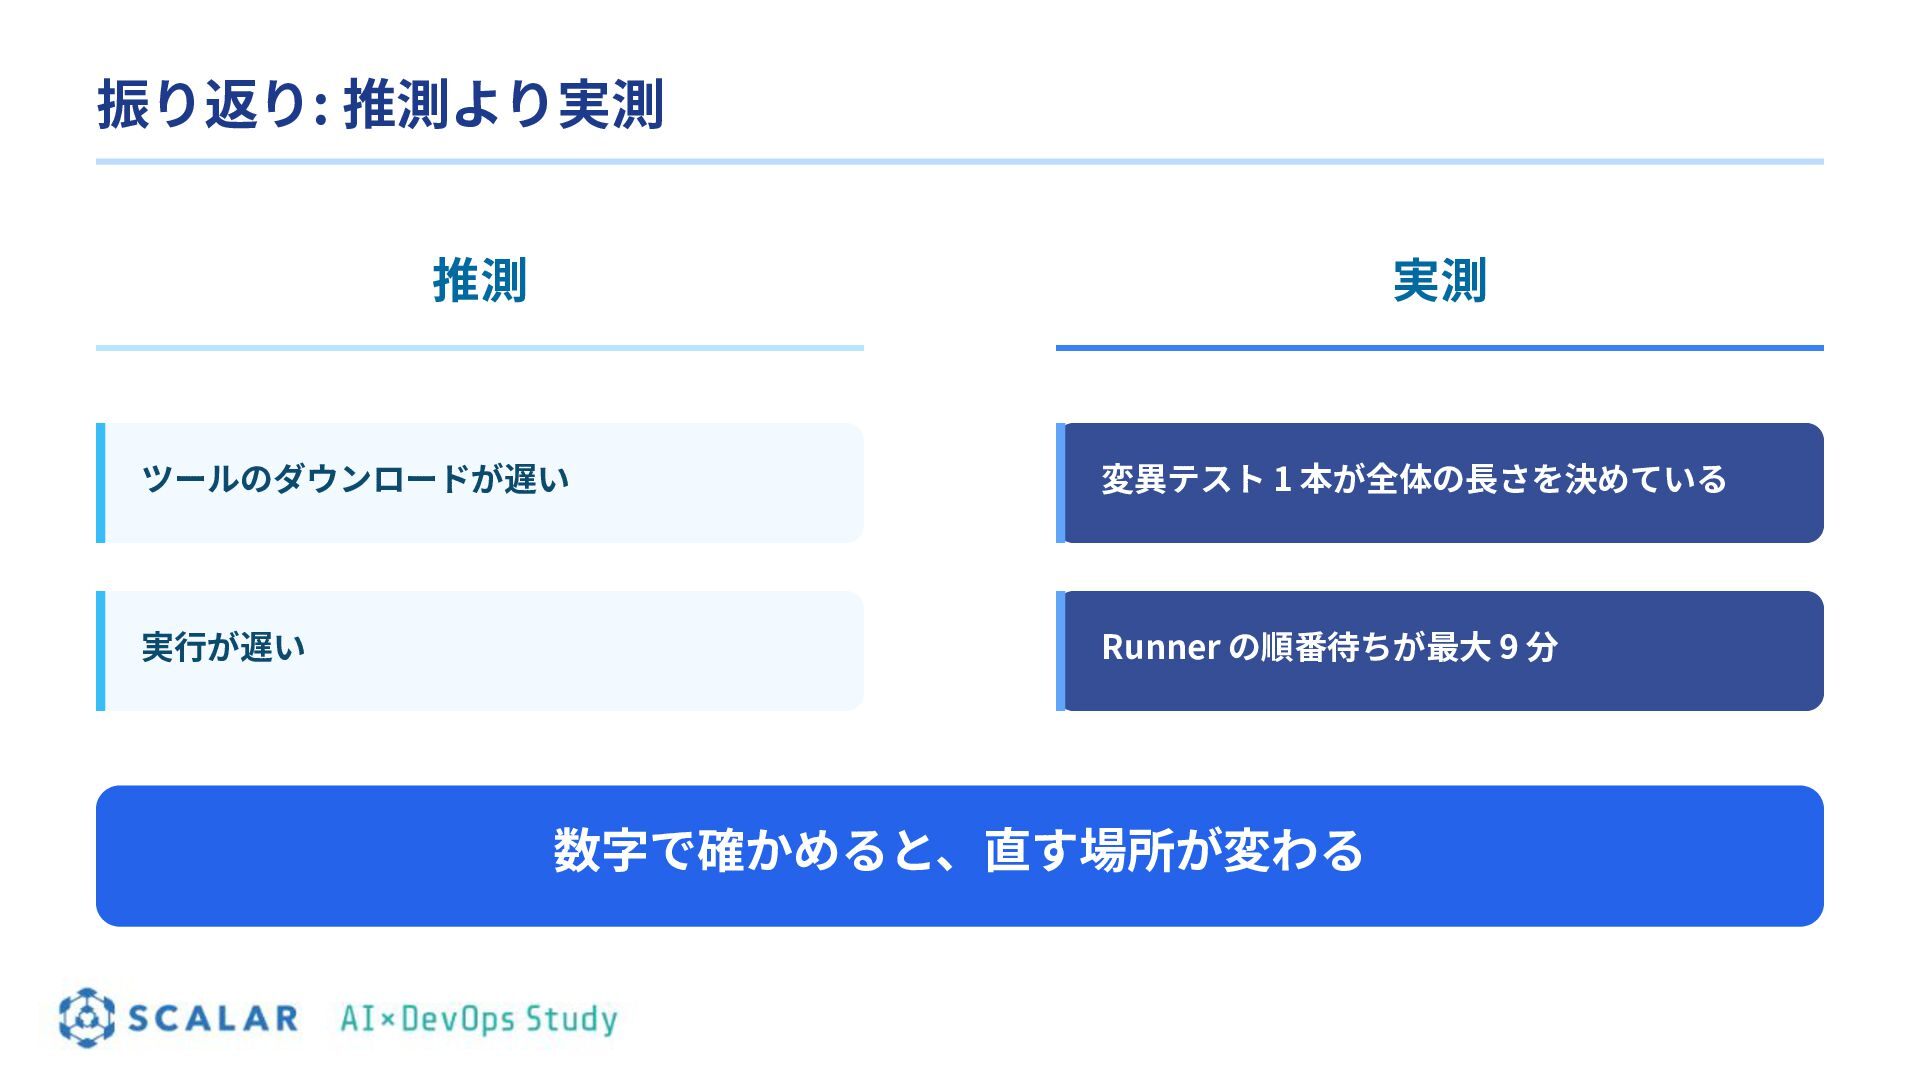
    CI 544秒 → 165秒、でもテストは増え続ける 推測より実測。数字が出てから順番を決める AWS → GCP AWS(Test環境)で動いていたのに GCPで全部落ちた 「動いている = 正しい」ではない おまけ MR 81本分の指摘を39の型にカタログ化 指摘をAIが読み返せる形で残し、 確認を仕組みで⽌める
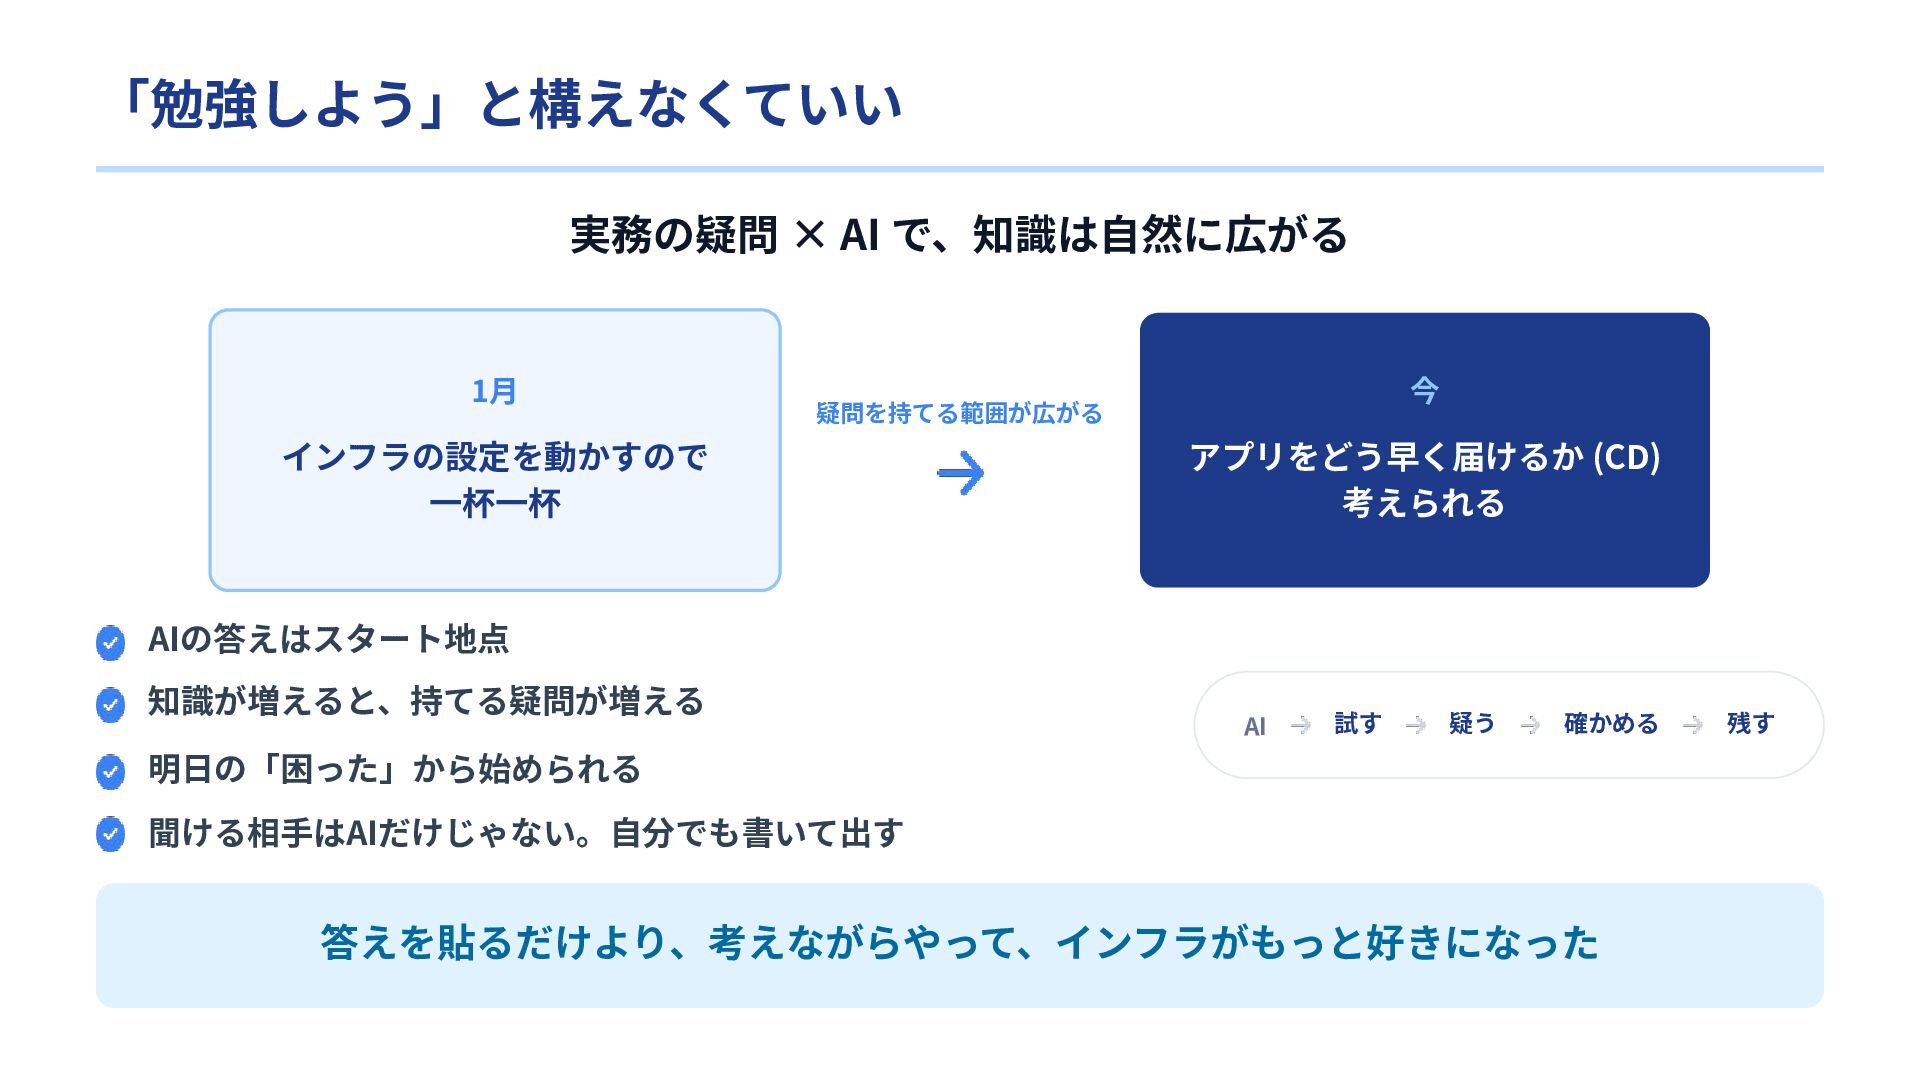
  30. 「勉強しよう」と構えなくていい 実務の疑問 × AI で、知識は⾃然に広がる 1⽉ 今 疑問を持てる範囲が広がる インフラの設定を動かすので ⼀杯⼀杯

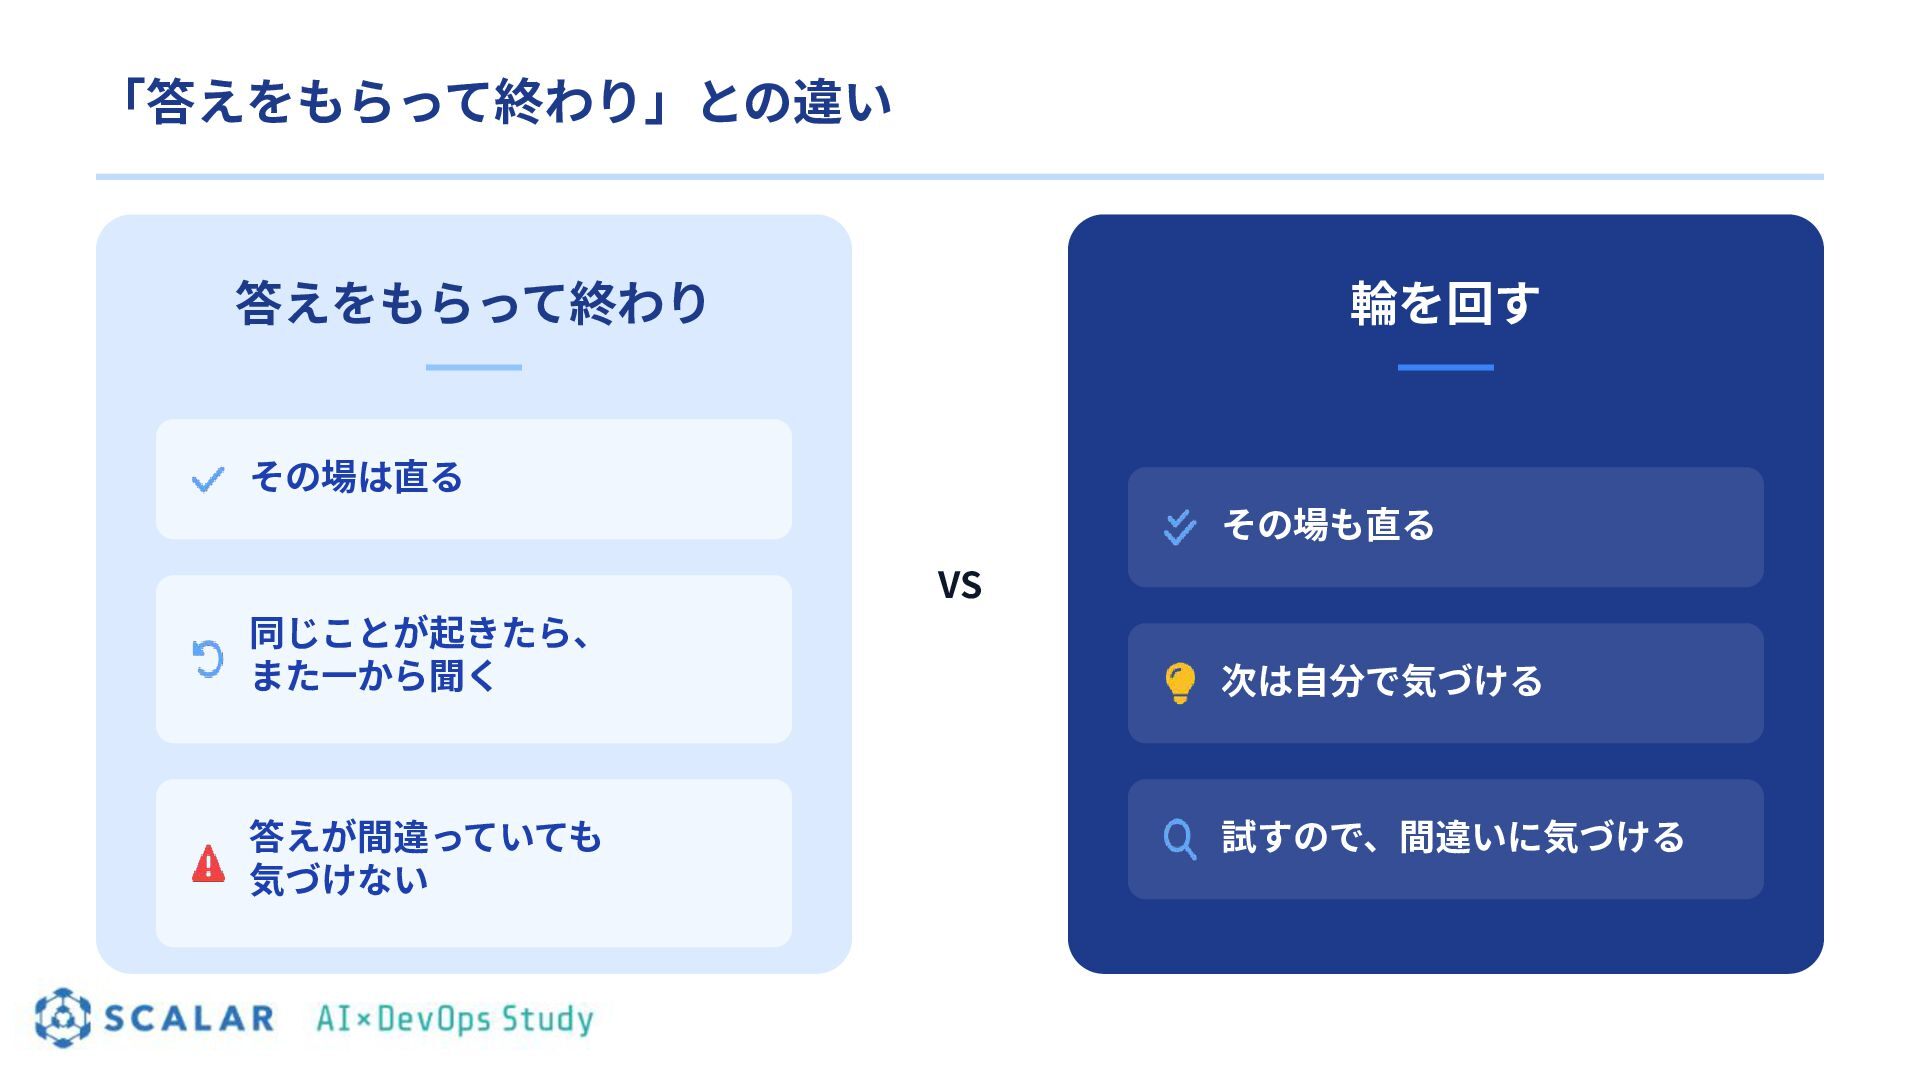
    アプリをどう早く届けるか (CD) 考えられる AIの答えはスタート地点 知識が増えると、持てる疑問が増える AI 試す 疑う 確かめる 明⽇の「困った」から始められる 聞ける相⼿はAIだけじゃない。⾃分でも書いて出す 答えを貼るだけより、考えながらやって、インフラがもっと好きになった 残す
  31. Please give us a star on GitH ub! udy AIxDevOps

    St 毎週⽕曜開催 connpass Scalar GitHub scalar-labs/scalardb ご質問、感想などお気軽にどうぞ!