Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ハイブリッドクラウドに対応したログ集約・解析プラットフォームのためのHEC活⽤法
Search
Shuichiro MAKIGAKI
June 21, 2019
Technology
210
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ハイブリッドクラウドに対応したログ集約・解析プラットフォームのためのHEC活⽤法
Shuichiro MAKIGAKI
June 21, 2019
More Decks by Shuichiro MAKIGAKI
See All by Shuichiro MAKIGAKI
「みんなのDWH」のためのSnowflake設計
shuichiromakigaki
0
1.1k
OpenStackとIngress Controllerで作るContainer-nativeロードバランシング
shuichiromakigaki
2
2k
Other Decks in Technology
See All in Technology
HQ駆動開発で最高のAI-Contextを作ろう
sansantech
PRO
1
110
超⼩型・多⾔語検索モデル Bekko Embedding
hotchpotch
1
110
登壇はいいぞ! 〜Kaigi on Railsに登壇して起きた3つの変化〜
occhi
0
110
増え続けるプロダクトの品質をどう担保するか。ProductSpecとTypeScriptによる取り組み
joere
3
500
自律的なチームを作るためにTechPMがやらないこと
ny7760
1
520
分析作業をどこまで任せるか自分で決められる AIネイティブBI『Golden Analytics』が 良さげな話 /golden-analytics-is-ai-native-bi
shinyaa31
0
120
Metadata - Section 3 : Dublin Core Standard · DC
mohab1
0
110
ゼロから作るWebアプリの新定番!?Amplify Gen 2 × AWS Blocksで実現する「開発速度とRDBの柔軟性のいいとこ取り」
amixedcolor
1
160
新米を「売り越さない」、Aurora DSQLで作る在庫ゼロ死守の限定ドロップEC
yama3133
0
180
現場を動かすAIエージェント#2_製造業現場でのAI活用から見た、ハマる罠と実践知
kintotechdev
2
180
業務でAWSをあまり使っていない私が、AWSへのモチベを保つ方法
smt7174
0
170
2026 Apache Flink Community Checkpoint
rmetzger
0
190
Featured
See All Featured
Building a Scalable Design System with Sketch
lauravandoore
464
34k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
Groundhog Day: Seeking Process in Gaming for Health
codingconduct
0
470
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Kristin Tynski - Automating Marketing Tasks With AI
techseoconnect
PRO
0
580
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
New Earth Scene 8
popppiees
4
2.8k
How to Think Like a Performance Engineer
csswizardry
28
2.9k
The Art of Programming - Codeland 2020
erikaheidi
57
14k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.8k
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
670
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Transcript
ハイブリッドクラウドに対応したログ集約・解 析プラットフォームのためのHEC活⽤法 牧垣 秀⼀朗 (
[email protected]
) Shuichiro MAKIGAKI 株式会社サイバーエージェント 全社システム本部 GOJAS
2019-06
はじめに
はじめに • 好きです、Splunk 「⼀度Splunkに⼊れさえすれば、あとはなんとでもなる」という安⼼感 ログのパース・検索・データの統合・統計処理が強⼒ 運⽤する上で気にすることが少ない(ディスク容量とライセンス使⽤量くらい︖) グラフもアラートも作れる • 思考停⽌⽒「んーと……もうSplunkでいいんじゃね︖︖︖」
ご時世 • ハイブリッドクラウド • IBM「ハイブリッド・クラウドとは何か」https://www.ibm.com/blogs/solutions/jp-ja/what-is-hybrid-cloud/ 広く⼀般のユーザーと同じ環境を利⽤するパブリック・クラウド、専⽤の環境を利⽤するプライ ベート・クラウド、そしてすでに保有している⾃社のIT資産(オンプレミス)を組み合わせて最 適なITインフラを構築するという考え⽅を指します。 • RedHat「ハイブリッドクラウドとは」https://www.redhat.com/ja/topics/cloud-computing/what-is-hybrid-cloud
パブリッククラウドとプライベートクラウド環境を 1 つまたは複数組み合わせたものです。これ は、サードパーティ企業が所有し管理するハードウェアと、クラウドを使⽤する企業が所有して いるハードウェアからなる仮想リソースのプールです。
オンプレ+AWS • オンプレのActive Directory • オンプレのファイルサーバー • バッチ的なLambda • 社内サービスを集約したECSクラスタ
ちょっとしたもの、を動かすのに便利 SSOパスワード変更、サービスステータスページ、IPAM、など ……だけだったはずが、慣れてきて、社内端末のRadiusサーバーまでECSに乗せはじめる始末︕ • 多様な場所からログを集める必要がでてきた 認証周りのAuditとか、バッチのアラートとか
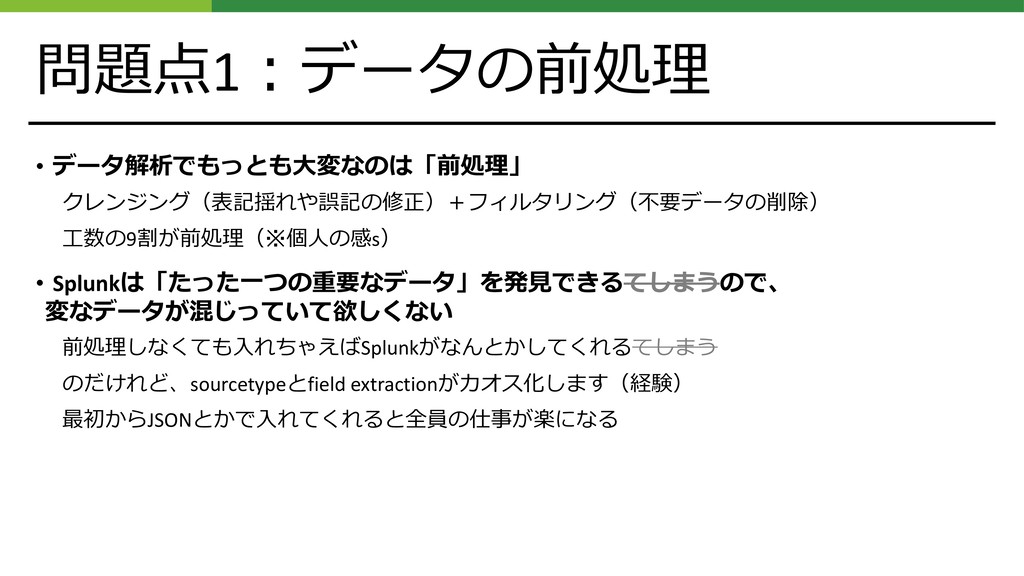
問題点1︓データの前処理 • データ解析でもっとも⼤変なのは「前処理」 クレンジング(表記揺れや誤記の修正)+フィルタリング(不要データの削除) ⼯数の9割が前処理(※個⼈の感s) • Splunkは「たった⼀つの重要なデータ」を発⾒できるてしまうので、 変なデータが混じっていて欲しくない 前処理しなくても⼊れちゃえばSplunkがなんとかしてくれるてしまう のだけれど、sourcetypeとfield
extractionがカオス化します(経験) 最初からJSONとかで⼊れてくれると全員の仕事が楽になる
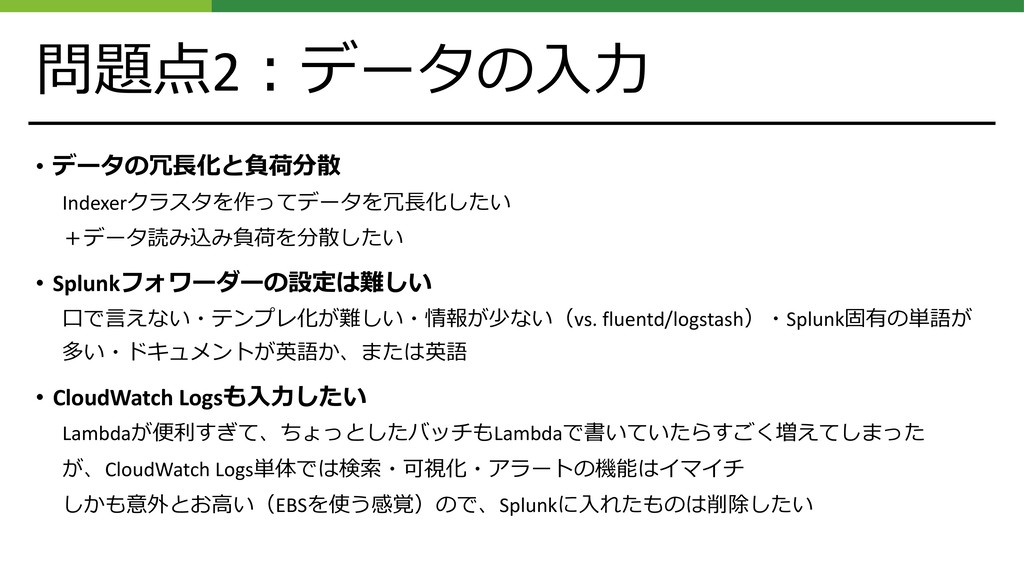
問題点2︓データの⼊⼒ • データの冗⻑化と負荷分散 Indexerクラスタを作ってデータを冗⻑化したい +データ読み込み負荷を分散したい • Splunkフォワーダーの設定は難しい ⼝で⾔えない・テンプレ化が難しい・情報が少ない(vs. fluentd/logstash)・Splunk固有の単語が 多い・ドキュメントが英語か、または英語
• CloudWatch Logsも⼊⼒したい Lambdaが便利すぎて、ちょっとしたバッチもLambdaで書いていたらすごく増えてしまった が、CloudWatch Logs単体では検索・可視化・アラートの機能はイマイチ しかも意外とお⾼い(EBSを使う感覚)ので、Splunkに⼊れたものは削除したい
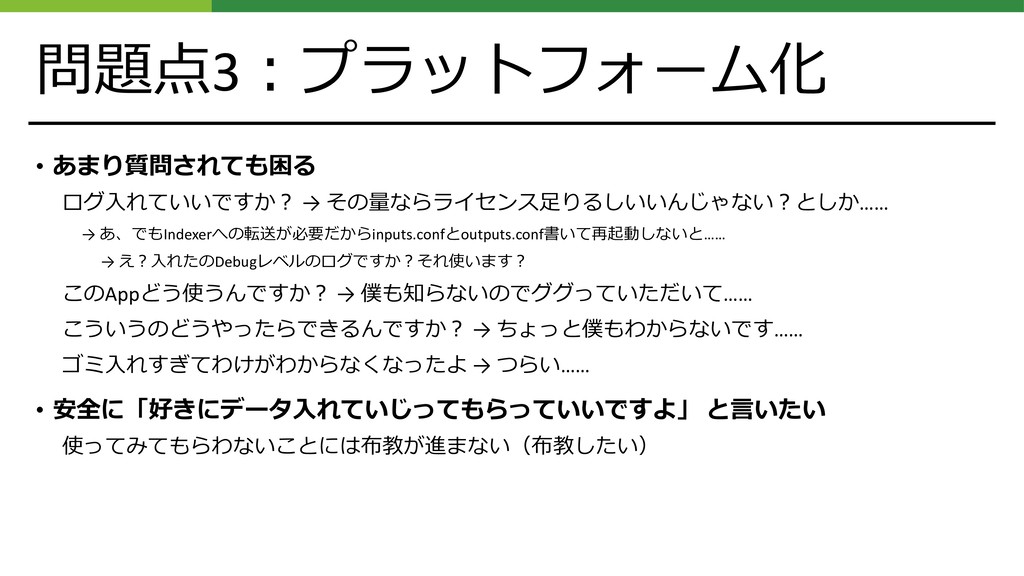
問題点3︓プラットフォーム化 • あまり質問されても困る ログ⼊れていいですか︖ → その量ならライセンス⾜りるしいいんじゃない︖としか…… → あ、でもIndexerへの転送が必要だからinputs.confとoutputs.conf書いて再起動しないと…… → え︖⼊れたのDebugレベルのログですか︖それ使います︖
このAppどう使うんですか︖ → 僕も知らないのでググっていただいて…… こういうのどうやったらできるんですか︖ → ちょっと僕もわからないです…… ゴミ⼊れすぎてわけがわからなくなったよ → つらい…… • 安全に「好きにデータ⼊れていじってもらっていいですよ」 と⾔いたい 使ってみてもらわないことには布教が進まない(布教したい)
やりたいこと • データ前処理の脱職⼈芸 • 簡単で安全なデータ⼊⼒ • プラットフォーム化による脱⼿運⽤ • ……による⼯数の削減と諦めの防⽌を狙う
これ、HTTP Event Collectorでなんと かできるのでは︖
Splunk側の実装 2
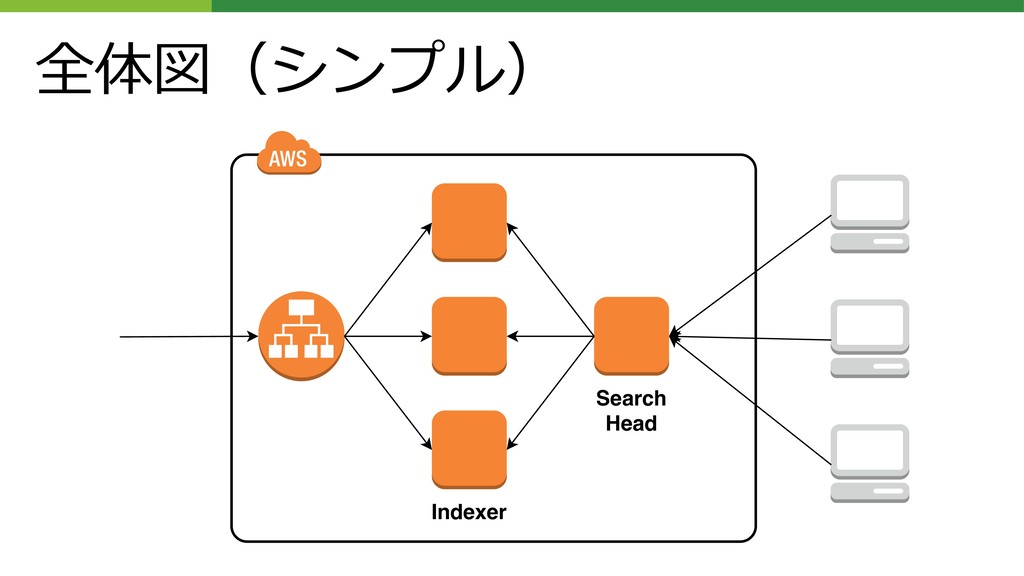
全体図(シンプル) Indexer Search Head
HTTP Event Collector (HEC) • HTTPでログ(イベント)を⼊⼒できる 既定のJSONフォーマットでエンドポイントにHTTP POSTする トークン認証 •
HTTPなので(⻑) HTTPバランサで冗⻑構成と負荷分散が可能 Fluentd、Logstash、AWS Kinesis Firehoseなど、HEC対応のログソースが多数 • HTTPなので(短) 速度はHTTPの程度 圧縮はできない(たぶん)
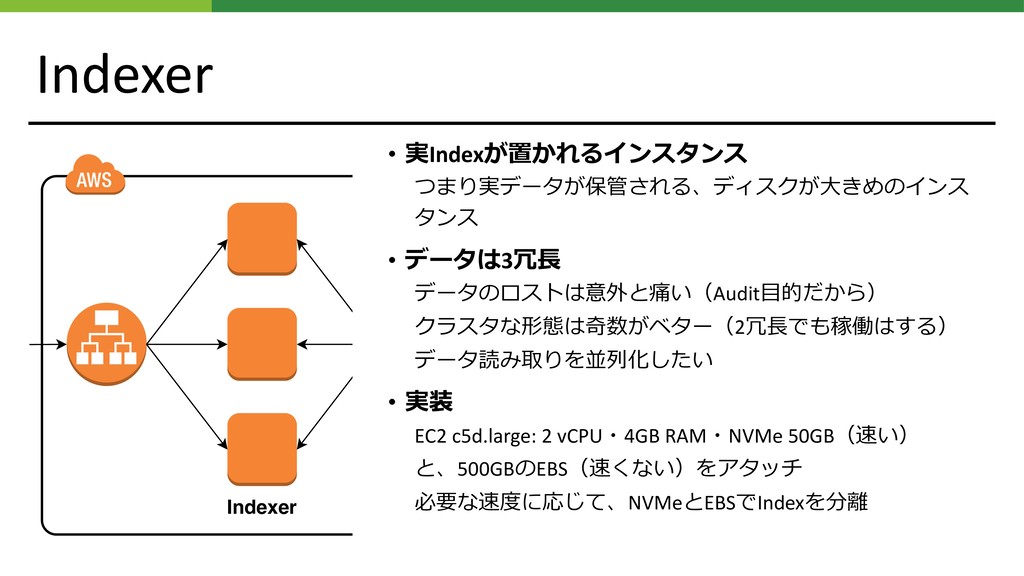
Indexer • 実Indexが置かれるインスタンス つまり実データが保管される、ディスクが⼤きめのインス タンス • データは3冗⻑ データのロストは意外と痛い(Audit⽬的だから) クラスタな形態は奇数がベター(2冗⻑でも稼働はする) データ読み取りを並列化したい
• 実装 EC2 c5d.large: 2 vCPU・4GB RAM・NVMe 50GB(速い) と、500GBのEBS(速くない)をアタッチ 必要な速度に応じて、NVMeとEBSでIndexを分離 Indexer Search Head
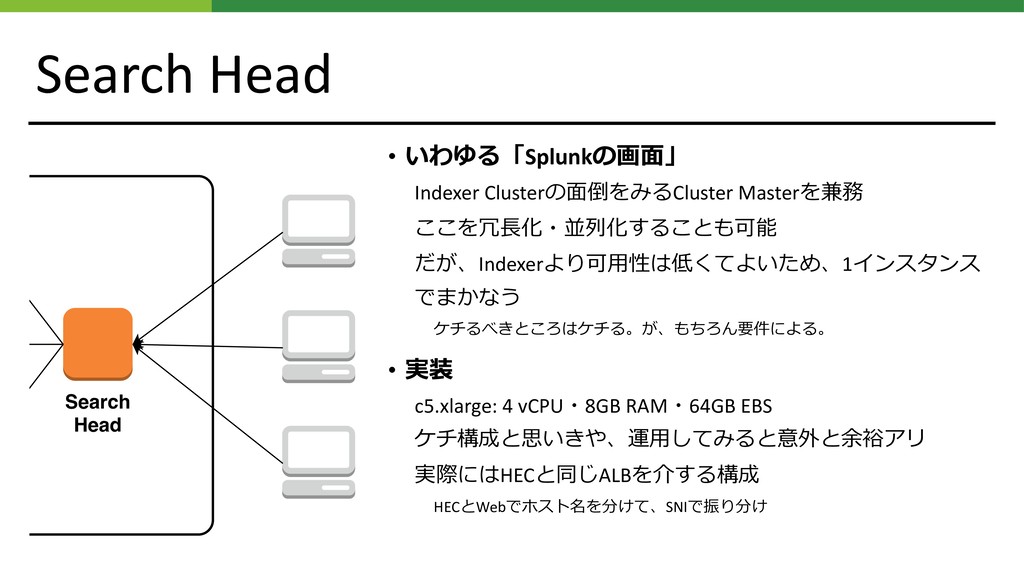
Search Head • いわゆる「Splunkの画⾯」 Indexer Clusterの⾯倒をみるCluster Masterを兼務 ここを冗⻑化・並列化することも可能 だが、Indexerより可⽤性は低くてよいため、1インスタンス でまかなう
ケチるべきところはケチる。が、もちろん要件による。 • 実装 c5.xlarge: 4 vCPU・8GB RAM・64GB EBS ケチ構成と思いきや、運⽤してみると意外と余裕アリ 実際にはHECと同じALBを介する構成 HECとWebでホスト名を分けて、SNIで振り分け Search Head
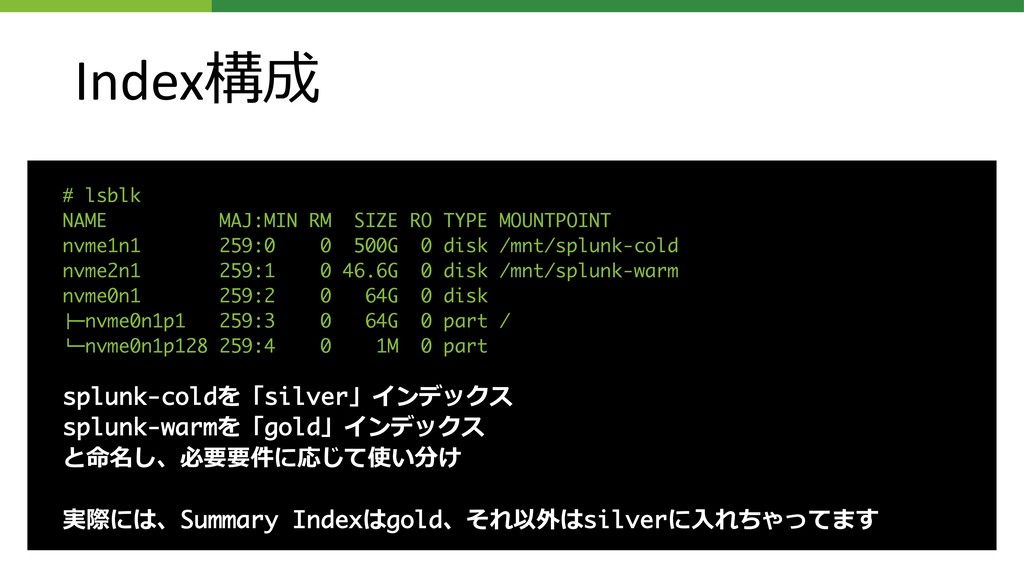
Index構成 # lsblk NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT
nvme1n1 259:0 0 500G 0 disk /mnt/splunk-cold nvme2n1 259:1 0 46.6G 0 disk /mnt/splunk-warm nvme0n1 259:2 0 64G 0 disk !"nvme0n1p1 259:3 0 64G 0 part / #"nvme0n1p128 259:4 0 1M 0 part splunk-coldを「silver」インデックス splunk-warmを「gold」インデックス と命名し、必要要件に応じて使い分け 実際には、Summary Indexはgold、それ以外はsilverに⼊れちゃってます
AWS側の実装 3
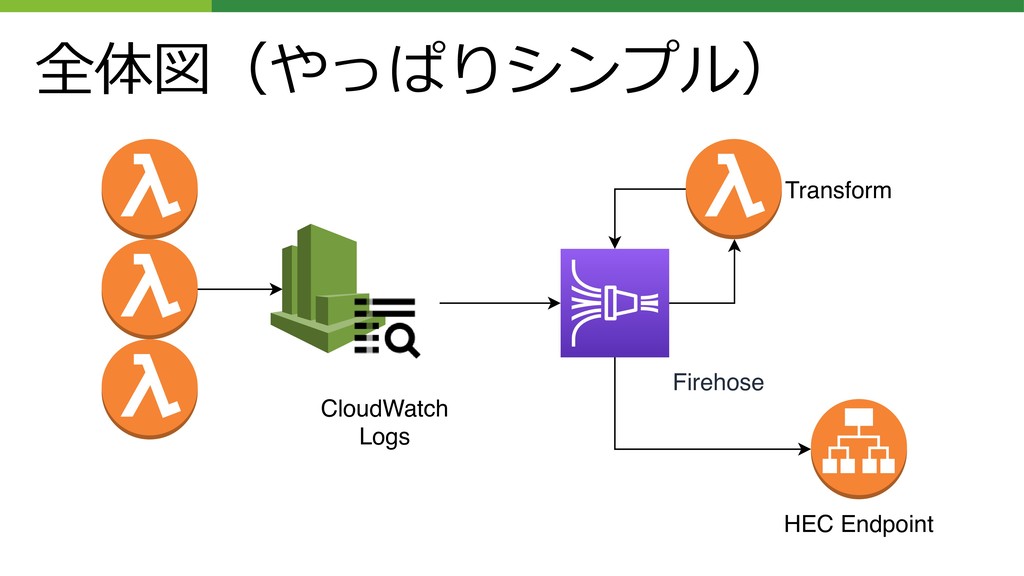
全体図(やっぱりシンプル) Firehose CloudWatch Logs Transform HEC Endpoint
AWS CloudWatch Logs • AWSで出るログはほとんどここに集まる Lambdaからも マネージドサービスのログも Subscription Filterという機能で、特定のログをFirehoseに転送 できる
そしてFirehoseからSplunkへ転送できる(後述) ログのライフサイクルは短めに設定する Firehose CloudWatch Logs Transform HEC Endpoint
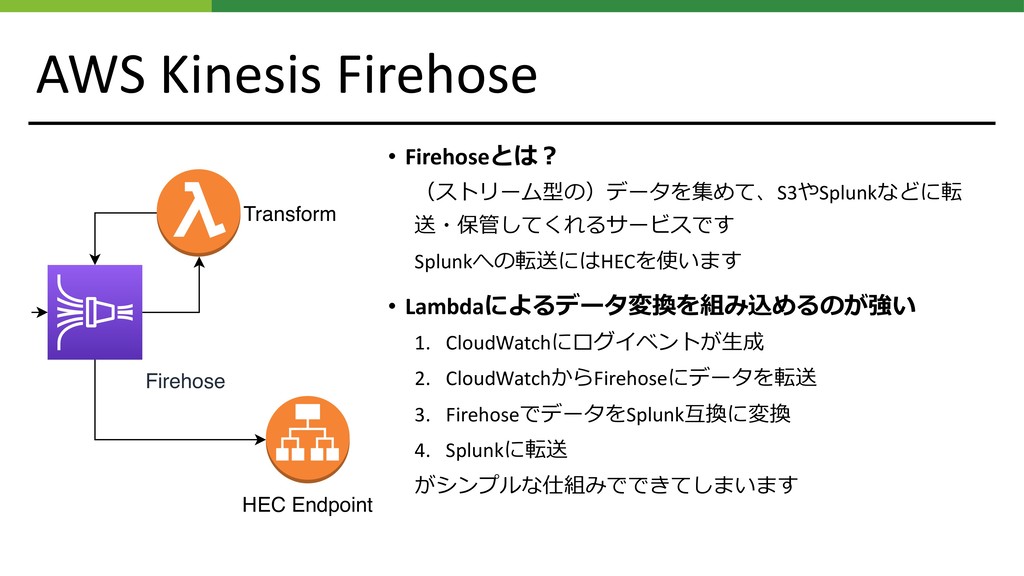
AWS Kinesis Firehose • Firehoseとは︖ (ストリーム型の)データを集めて、S3やSplunkなどに転 送・保管してくれるサービスです Splunkへの転送にはHECを使います • Lambdaによるデータ変換を組み込めるのが強い
1. CloudWatchにログイベントが⽣成 2. CloudWatchからFirehoseにデータを転送 3. FirehoseでデータをSplunk互換に変換 4. Splunkに転送 がシンプルな仕組みでできてしまいます Firehose Transform HEC Endpoint
⼯夫 4
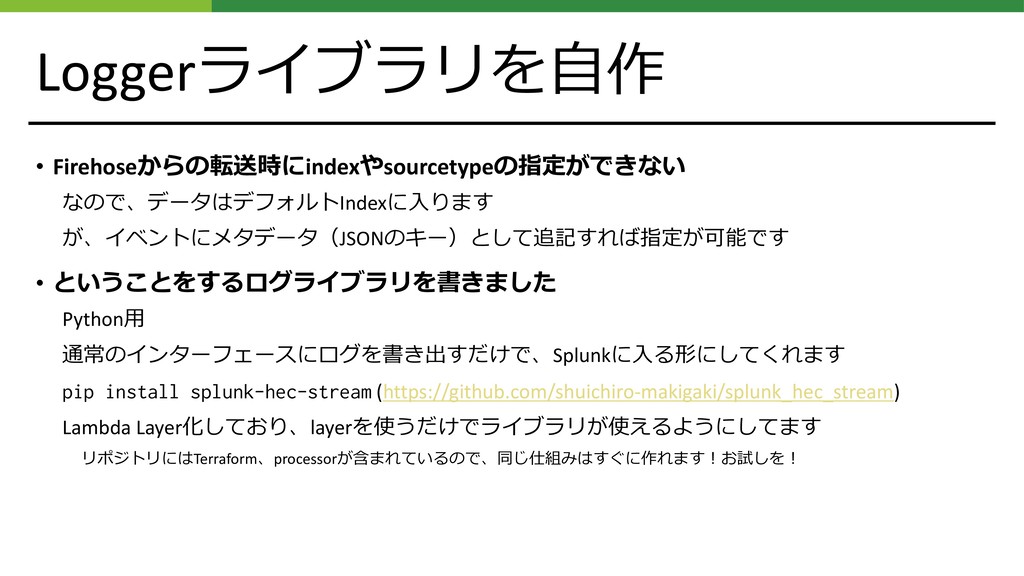
Loggerライブラリを⾃作 • Firehoseからの転送時にindexやsourcetypeの指定ができない なので、データはデフォルトIndexに⼊ります が、イベントにメタデータ(JSONのキー)として追記すれば指定が可能です • ということをするログライブラリを書きました Python⽤ 通常のインターフェースにログを書き出すだけで、Splunkに⼊る形にしてくれます pip
install splunk-hec-stream (https://github.com/shuichiro-makigaki/splunk_hec_stream) Lambda Layer化しており、layerを使うだけでライブラリが使えるようにしてます リポジトリにはTerraform、processorが含まれているので、同じ仕組みはすぐに作れます︕お試しを︕
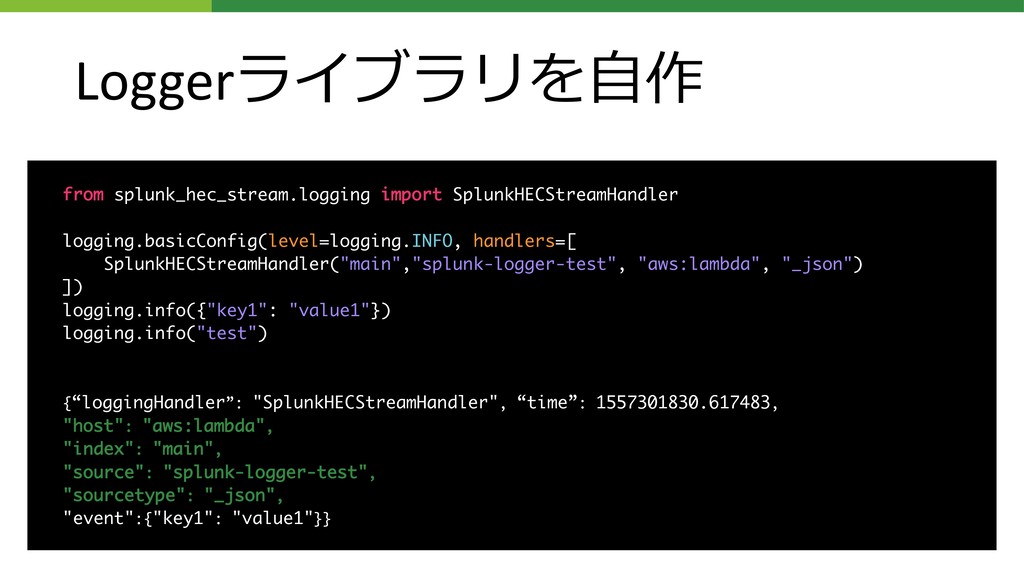
Loggerライブラリを⾃作 from splunk_hec_stream.logging import SplunkHECStreamHandler logging.basicConfig(level=logging.INFO, handlers=[ SplunkHECStreamHandler("main","splunk-logger-test", "aws:lambda", "_json")
]) logging.info({"key1": "value1"}) logging.info("test") {“loggingHandler”: "SplunkHECStreamHandler", “time”: 1557301830.617483, "host": "aws:lambda", "index": "main", "source": "splunk-logger-test", "sourcetype": "_json", "event":{"key1": "value1"}}
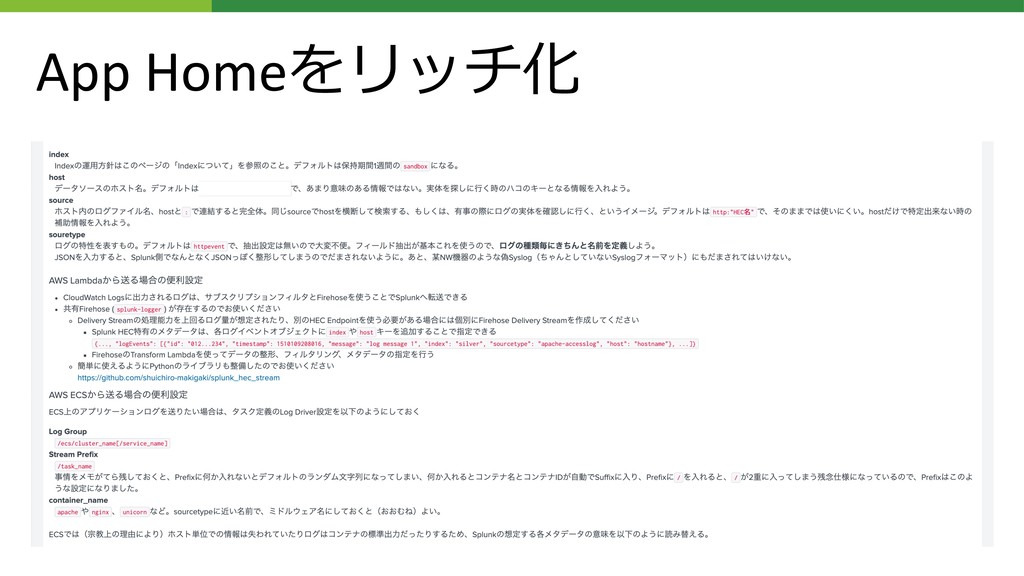
App Homeをリッチ化
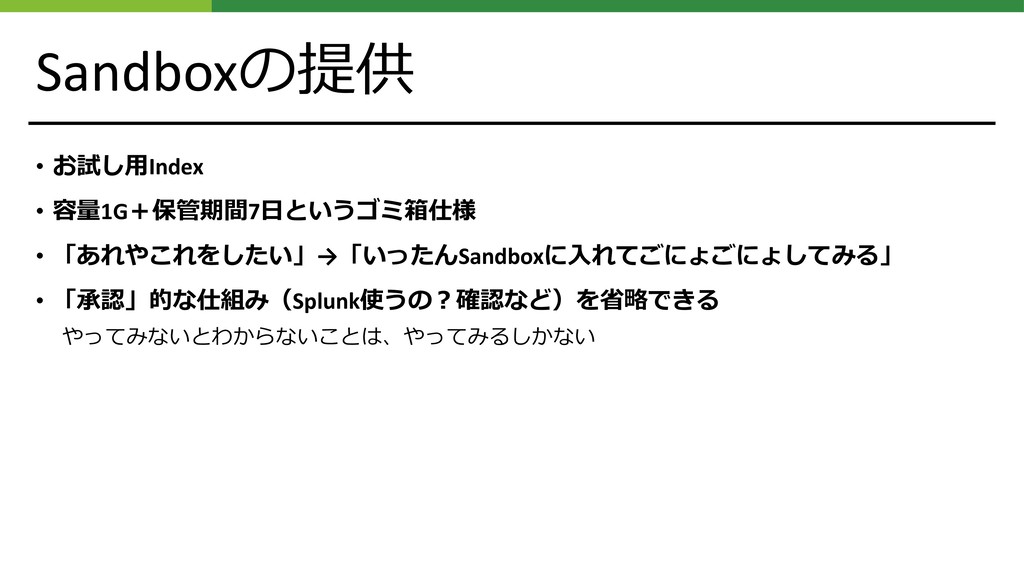
Sandboxの提供 • お試し⽤Index • 容量1G+保管期間7⽇というゴミ箱仕様 • 「あれやこれをしたい」→「いったんSandboxに⼊れてごにょごにょしてみる」 • 「承認」的な仕組み(Splunk使うの︖確認など)を省略できる やってみないとわからないことは、やってみるしかない
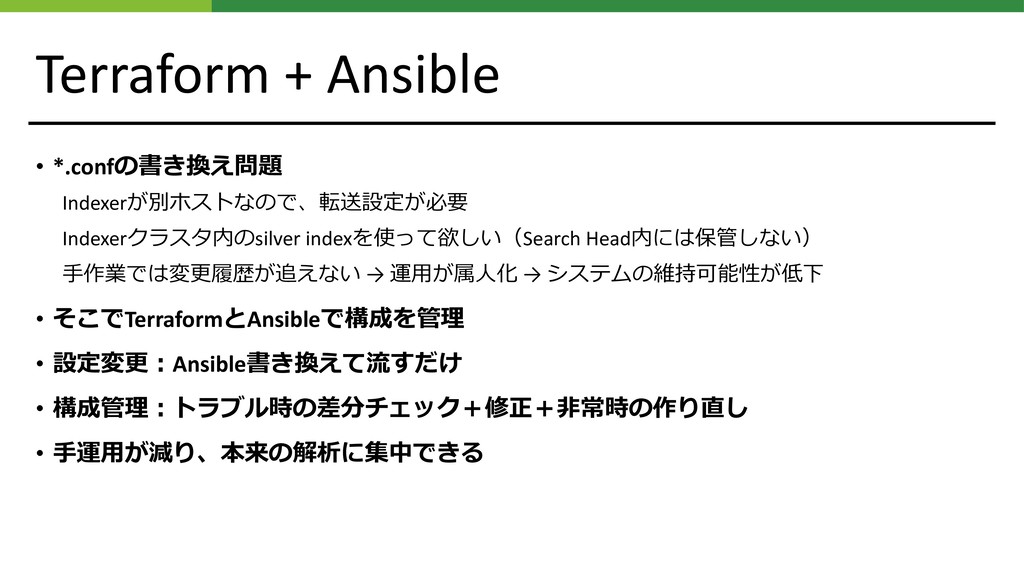
Terraform + Ansible • *.confの書き換え問題 Indexerが別ホストなので、転送設定が必要 Indexerクラスタ内のsilver indexを使って欲しい(Search Head内には保管しない) ⼿作業では変更履歴が追えない
→ 運⽤が属⼈化 → システムの維持可能性が低下 • そこでTerraformとAnsibleで構成を管理 • 設定変更︓Ansible書き換えて流すだけ • 構成管理︓トラブル時の差分チェック+修正+⾮常時の作り直し • ⼿運⽤が減り、本来の解析に集中できる
現在の様⼦ 5
例 • HEC経由 MACアドレス認証ログ Radius認証ログ テレビ会議端末監視(Zoom Rooms) • その他も ActiveDirectory認証ログ
Infoblox DHCPログ、など • AWS Appも使⽤ EC2インスタンス情報との統合検索が可能に
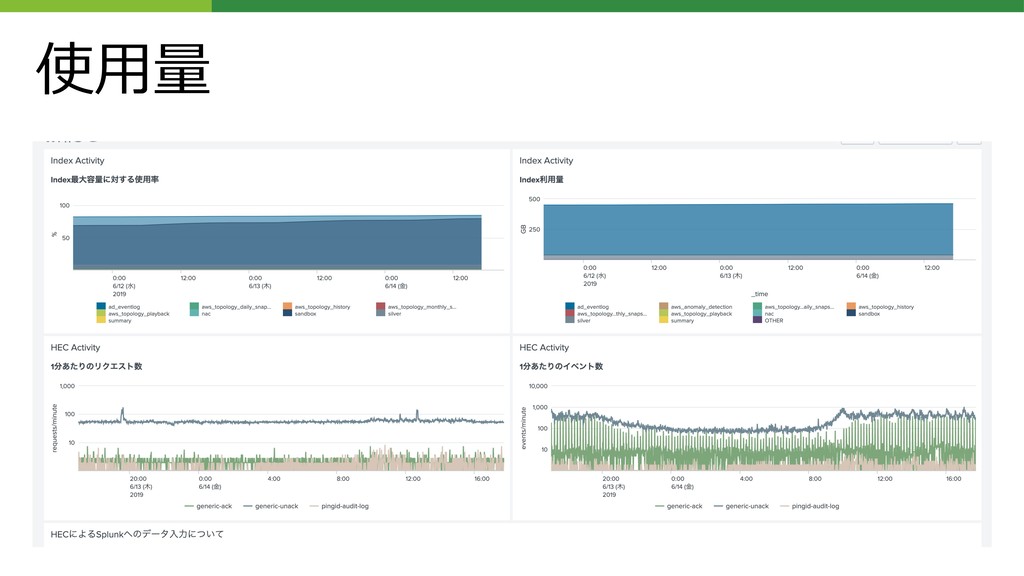
使⽤量
お⾦ 0 2 4 6 8 10 12 2019/6/17 2019/6/18
2019/6/19 2019/6/20 USD Kinesis Firehose EC2 その他 EC2 ELB EC2 インスタンス
まとめ 6
作ってみて • やりたかったことはおおむね実現 データの前処理の脱職⼈芸・簡単で安全なデータ⼊⼒・プラットフォーム化で脱⼿運⽤ • なにより、ログの集約や解析という⾏為が浸透した(と思う) 「ログ……︖は、特に⾒てないですね……。」といったことはなくなりつつある 作った物の使われ具合を⾒える化できるようになった • 解決できていない課題
検索クエリの書き⽅⾃体の助けにはなっていない もはやSplunkから抜け出せない︕
ありがとうございました


 shuichiromakigaki
 sansantech
 hotchpotch
 occhi
 joere
 ny7760
 shinyaa31
 mohab1
 amixedcolor
 yama3133
 kintotechdev
 smt7174
 rmetzger
 lauravandoore
 cassininazir
 codingconduct
 inesmontani
 techseoconnect
 denniskardys
 popppiees
 csswizardry
 erikaheidi
 eileencodes
 retrage
 addyosmani