Share
Embed
Transcript
37 slides
-
東京大学「Agile-X」のFPGA AIデザインハッカソンを制した ソニーのAI最適化-TL#16 湯澤 凌芽 1,2 高木 佑 1 杉岡
基行 1 1ソニー株式会社 – 技術センター イメージングシステム技術部門 2 University of California, Berkeley - Visiting Researcher Copyright 2025 Sony Corporation -
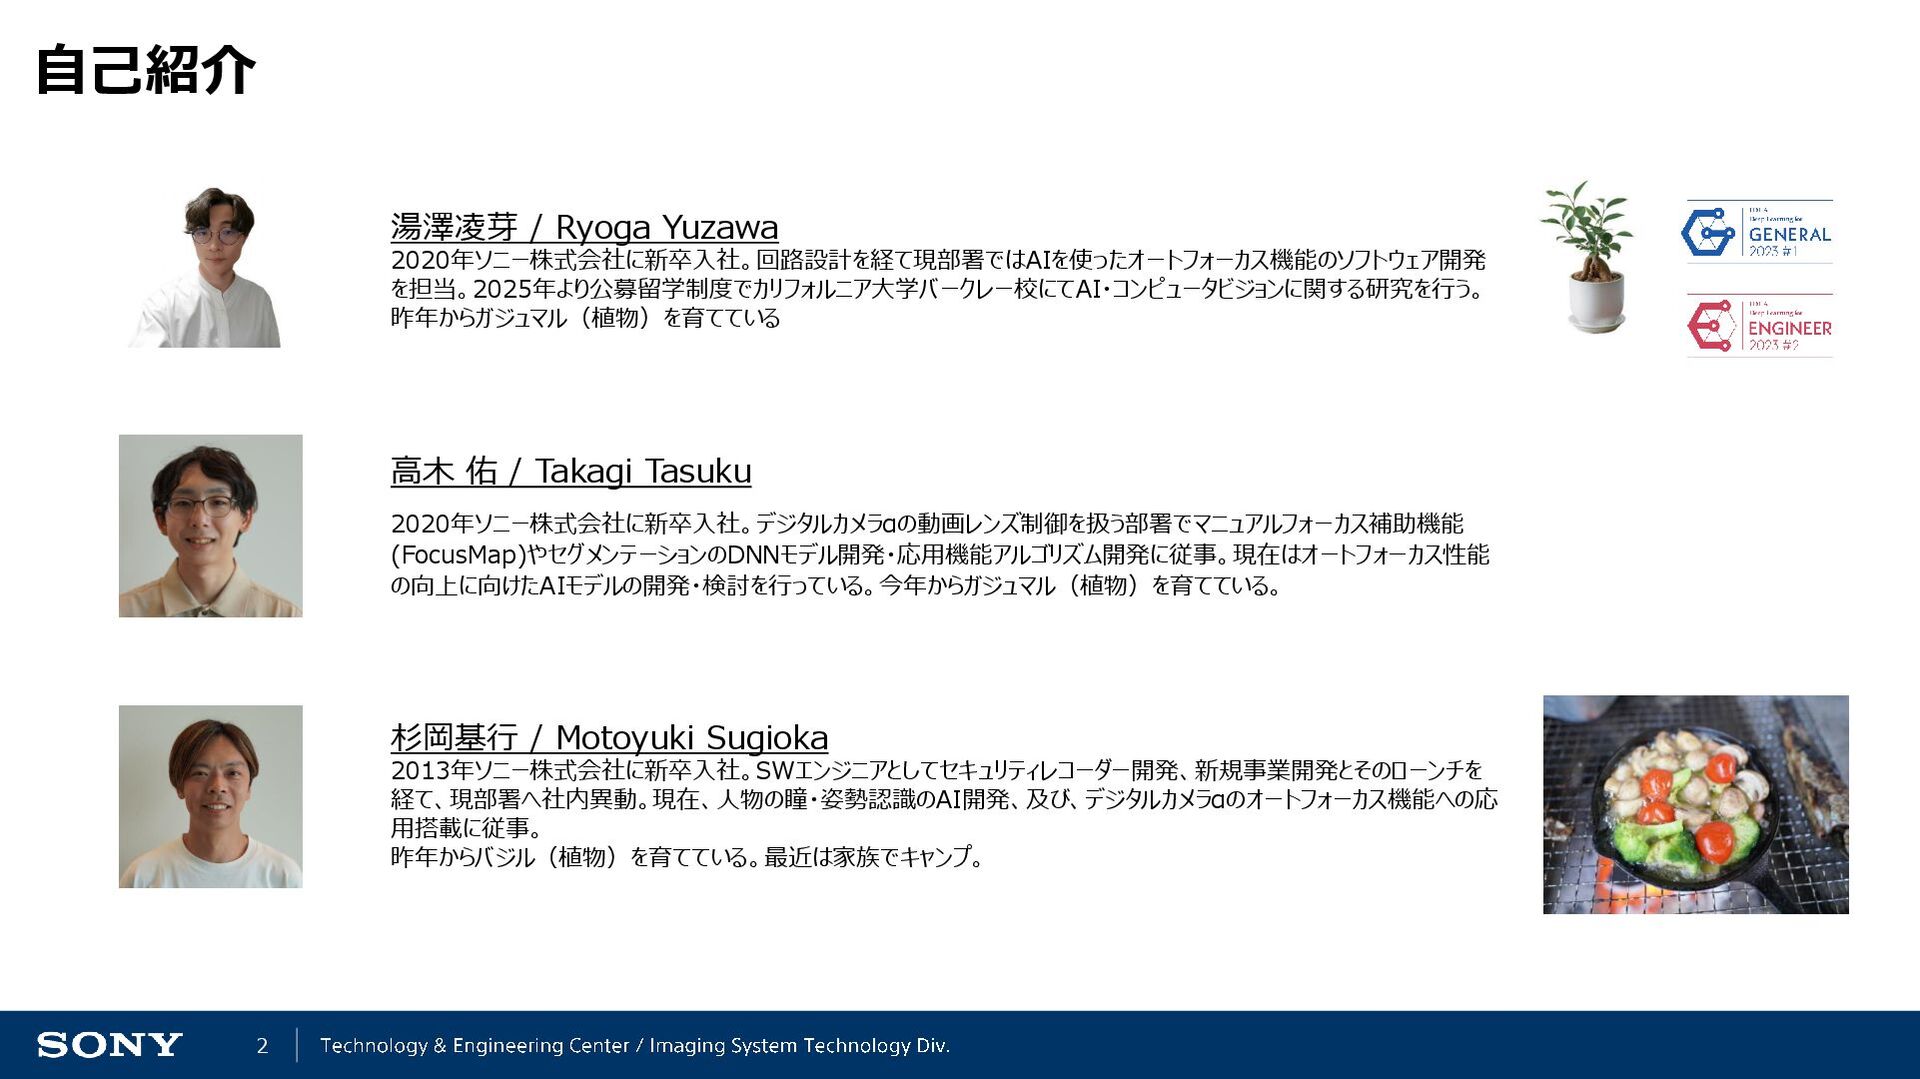
2 自己紹介 湯澤凌芽 / Ryoga Yuzawa 2020年ソニー株式会社に新卒入社。回路設計を経て現部署ではAIを使ったオートフォーカス機能のソフトウェア開発 を担当。2025年より公募留学制度でカリフォルニア大学バークレー校にてAI・コンピュータビジョンに関する研究を行う。 昨年からガジュマル(植物)を育てている 杉岡基行
/ Motoyuki Sugioka 2013年ソニー株式会社に新卒入社。SWエンジニアとしてセキュリティレコーダー開発、新規事業開発とそのローンチを 経て、現部署へ社内異動。現在、人物の瞳・姿勢認識のAI開発、及び、デジタルカメラαのオートフォーカス機能への応 用搭載に従事。 昨年からバジル(植物)を育てている。最近は家族でキャンプ。 高木 佑 / Takagi Tasuku 2020年ソニー株式会社に新卒入社。デジタルカメラαの動画レンズ制御を扱う部署でマニュアルフォーカス補助機能 (FocusMap)やセグメンテーションのDNNモデル開発・応用機能アルゴリズム開発に従事。現在はオートフォーカス性能 の向上に向けたAIモデルの開発・検討を行っている。今年からガジュマル(植物)を育てている。 -
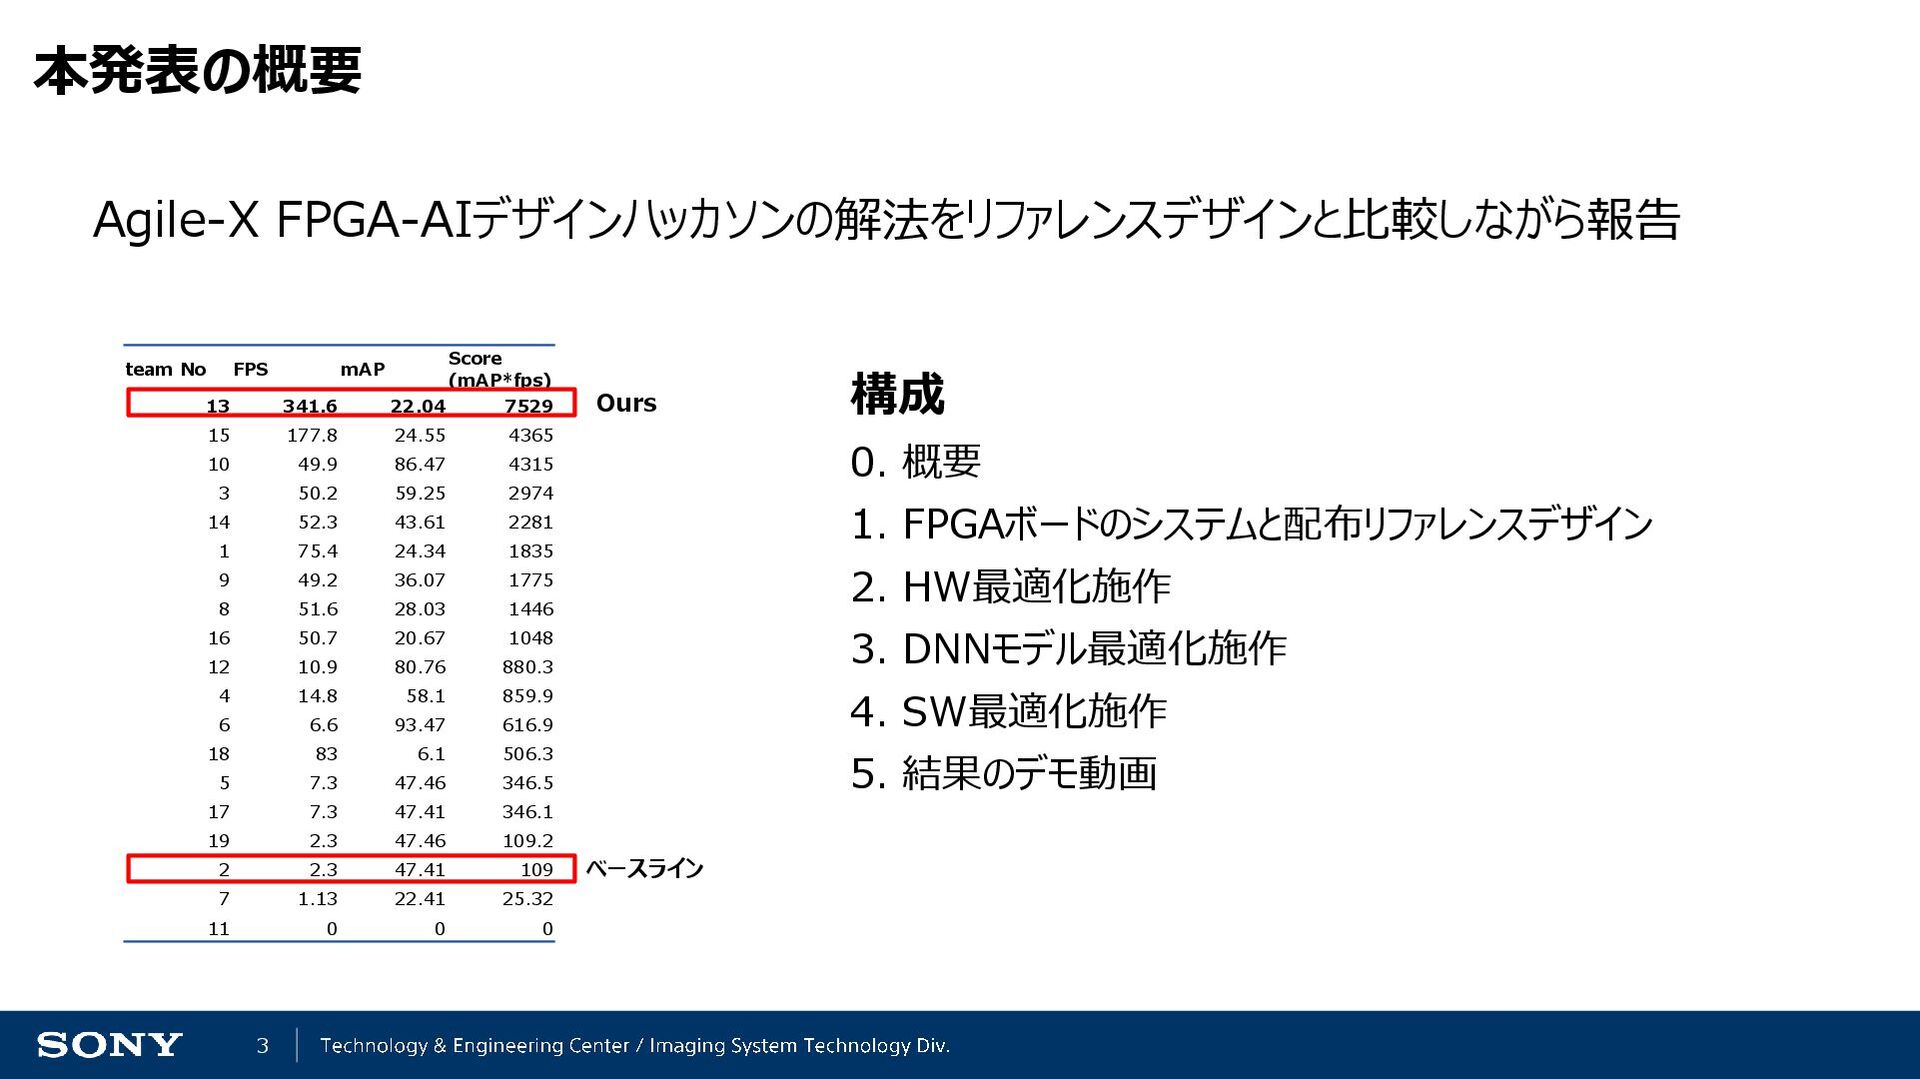
3 本発表の概要 team No FPS mAP Score (mAP*fps) 13 341.6
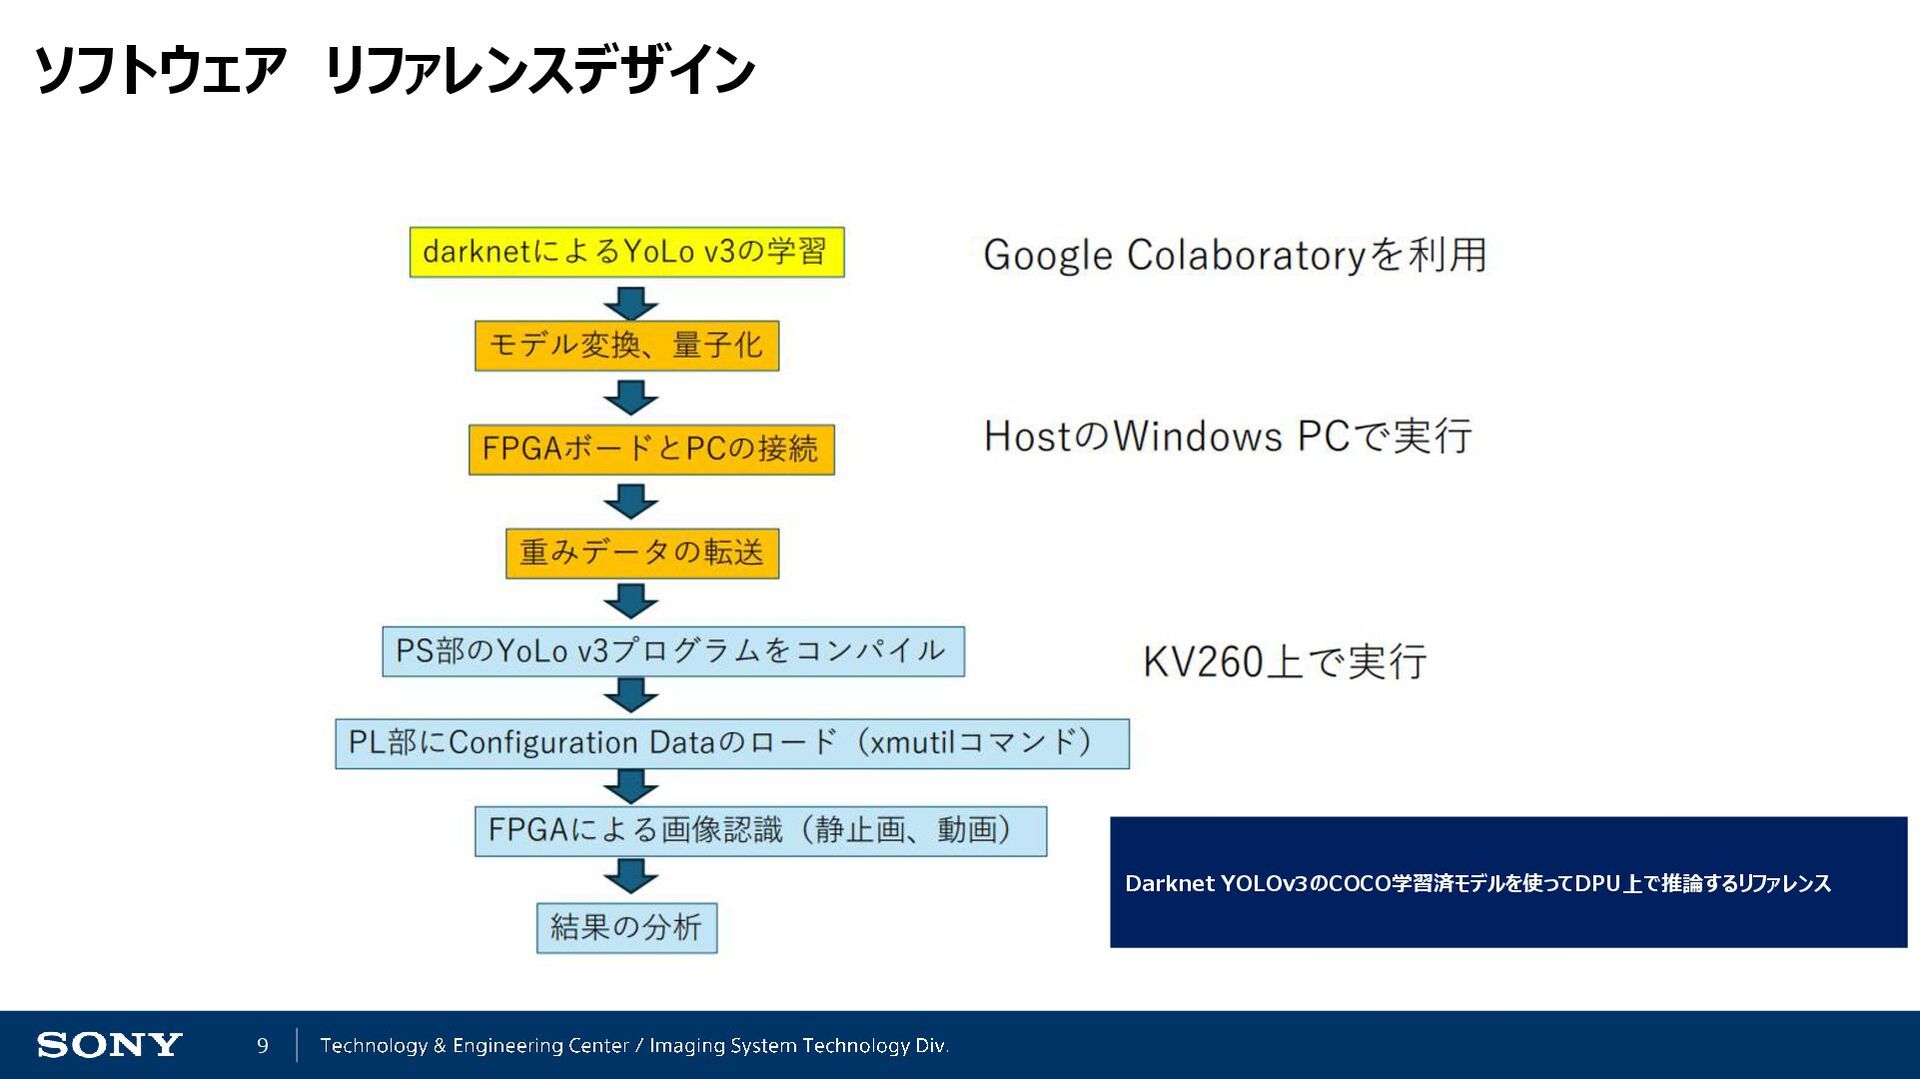
22.04 7529 15 177.8 24.55 4365 10 49.9 86.47 4315 3 50.2 59.25 2974 14 52.3 43.61 2281 1 75.4 24.34 1835 9 49.2 36.07 1775 8 51.6 28.03 1446 16 50.7 20.67 1048 12 10.9 80.76 880.3 4 14.8 58.1 859.9 6 6.6 93.47 616.9 18 83 6.1 506.3 5 7.3 47.46 346.5 17 7.3 47.41 346.1 19 2.3 47.46 109.2 2 2.3 47.41 109 7 1.13 22.41 25.32 11 0 0 0 ベースライン Ours 構成 0. 概要 1. FPGAボードのシステムと配布リファレンスデザイン 2. HW最適化施作 3. DNNモデル最適化施作 4. SW最適化施作 5. 結果のデモ動画 Agile-X FPGA-AIデザインハッカソンの解法をリファレンスデザインと比較しながら報告 -
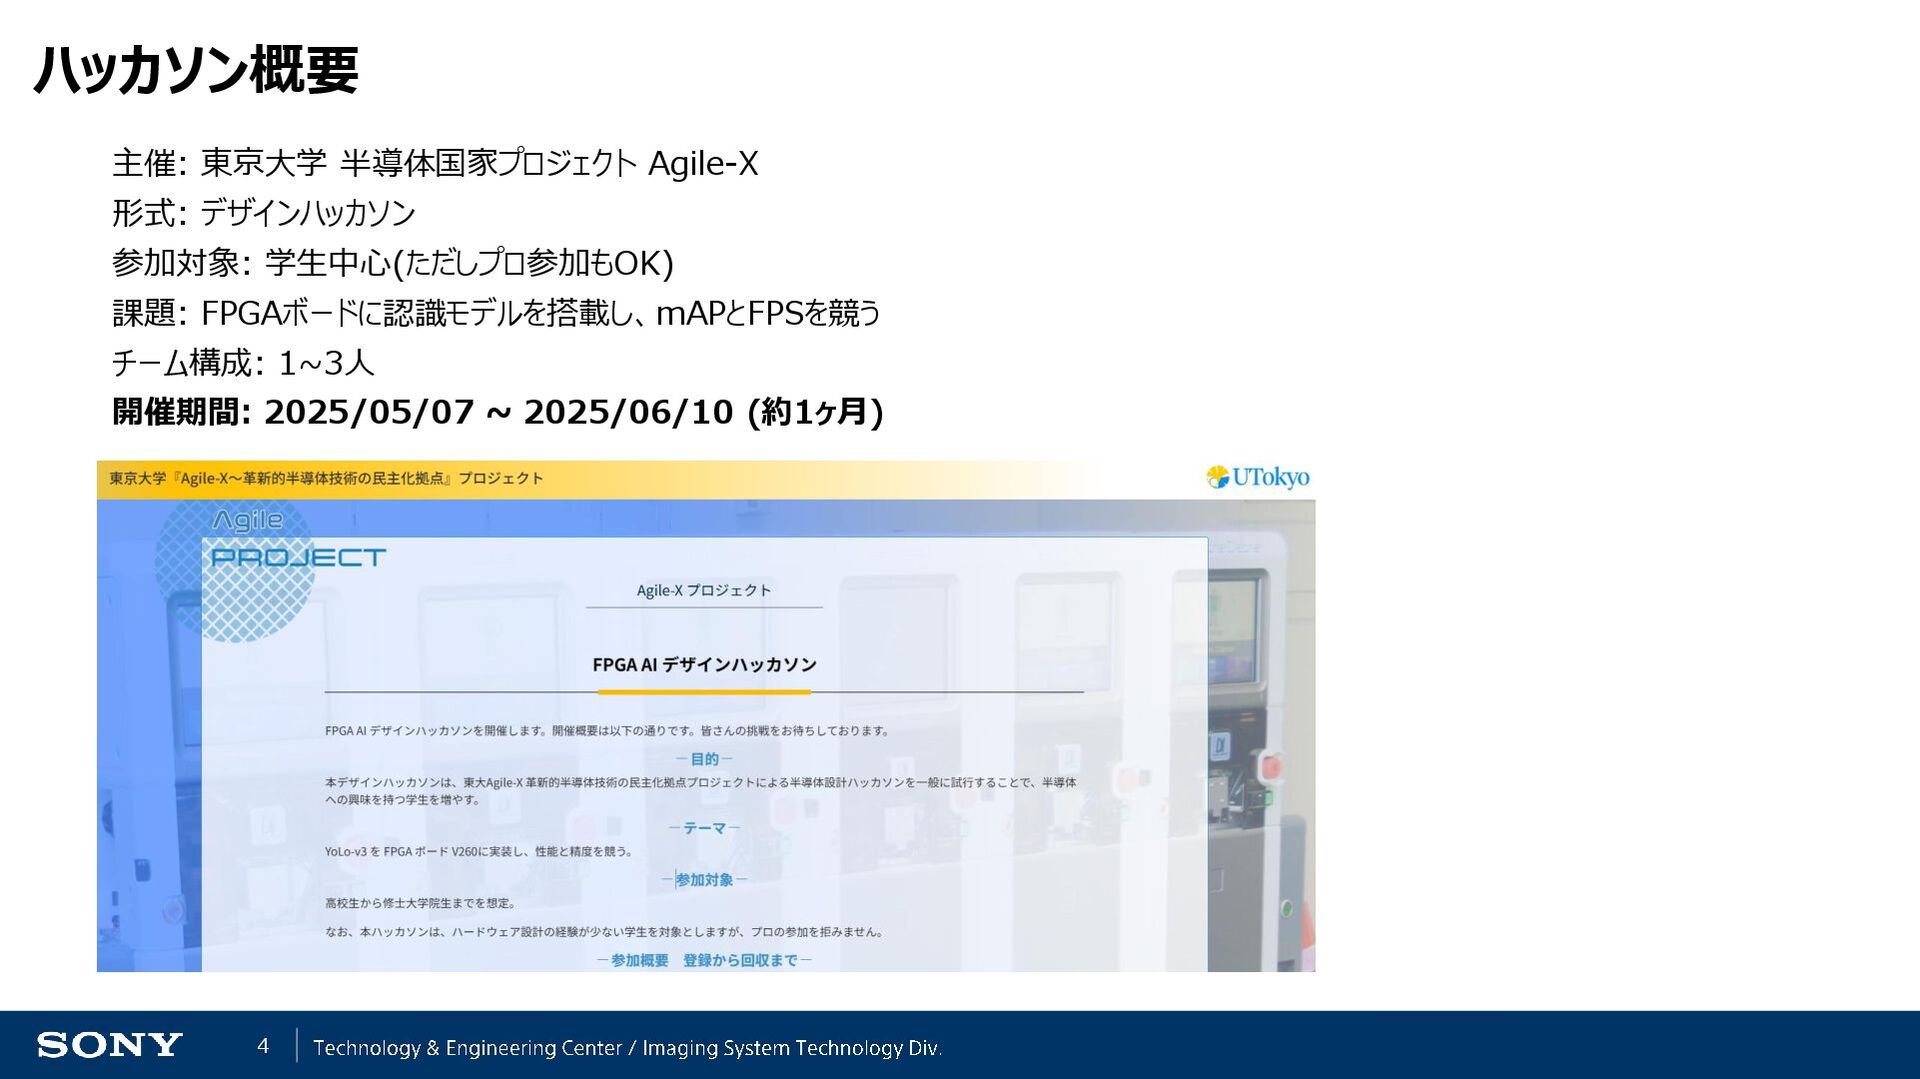
4 ハッカソン概要 主催: 東京大学 半導体国家プロジェクト Agile-X 形式: デザインハッカソン 参加対象: 学生中心(ただしプロ参加もOK)
課題: FPGAボードに認識モデルを搭載し、mAPとFPSを競う チーム構成: 1~3人 開催期間: 2025/05/07 ~ 2025/06/10 (約1ヶ月) -
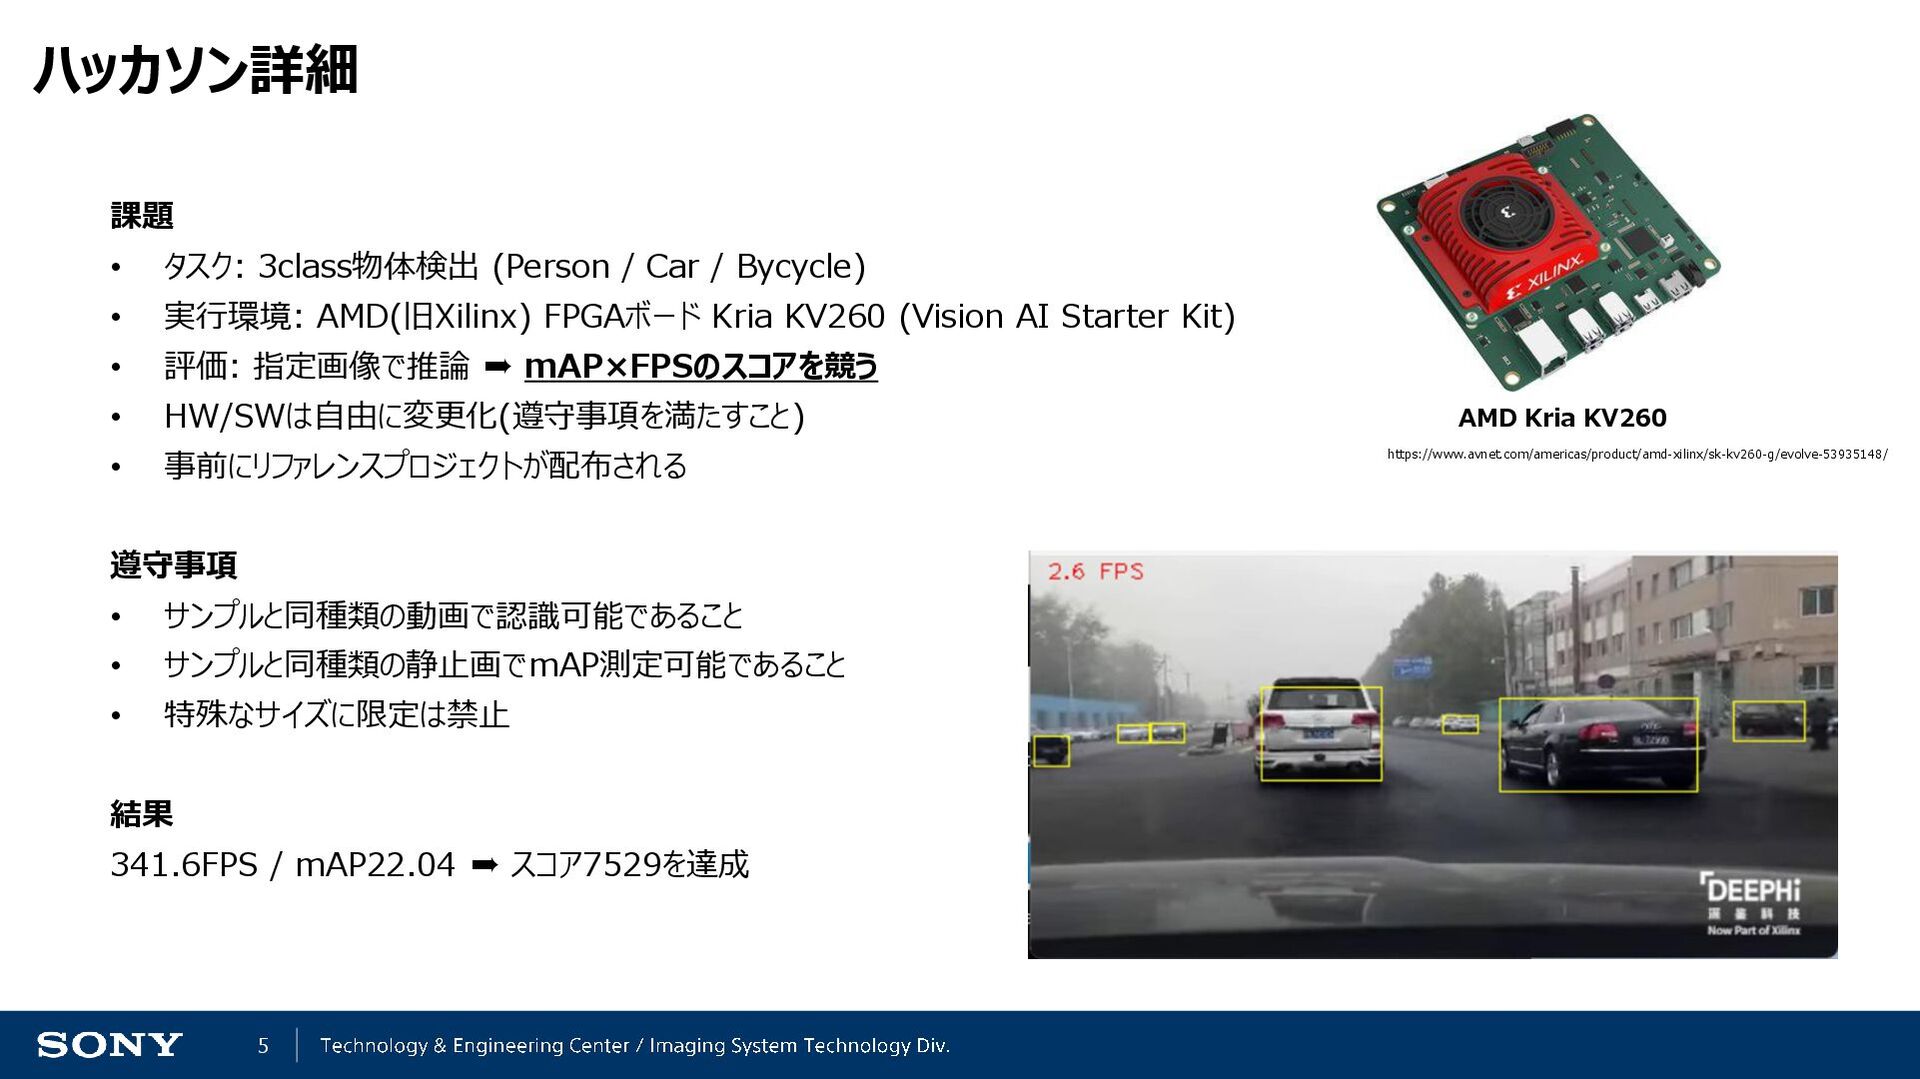
5 ハッカソン詳細 課題 • タスク: 3class物体検出 (Person / Car /
Bycycle) • 実行環境: AMD(旧Xilinx) FPGAボード Kria KV260 (Vision AI Starter Kit) • 評価: 指定画像で推論 ➨ mAP×FPSのスコアを競う • HW/SWは自由に変更化(遵守事項を満たすこと) • 事前にリファレンスプロジェクトが配布される 遵守事項 • サンプルと同種類の動画で認識可能であること • サンプルと同種類の静止画でmAP測定可能であること • 特殊なサイズに限定は禁止 結果 341.6FPS / mAP22.04 ➨ スコア7529を達成 AMD Kria KV260 https://www.avnet.com/americas/product/amd-xilinx/sk-kv260-g/evolve-53935148/ -
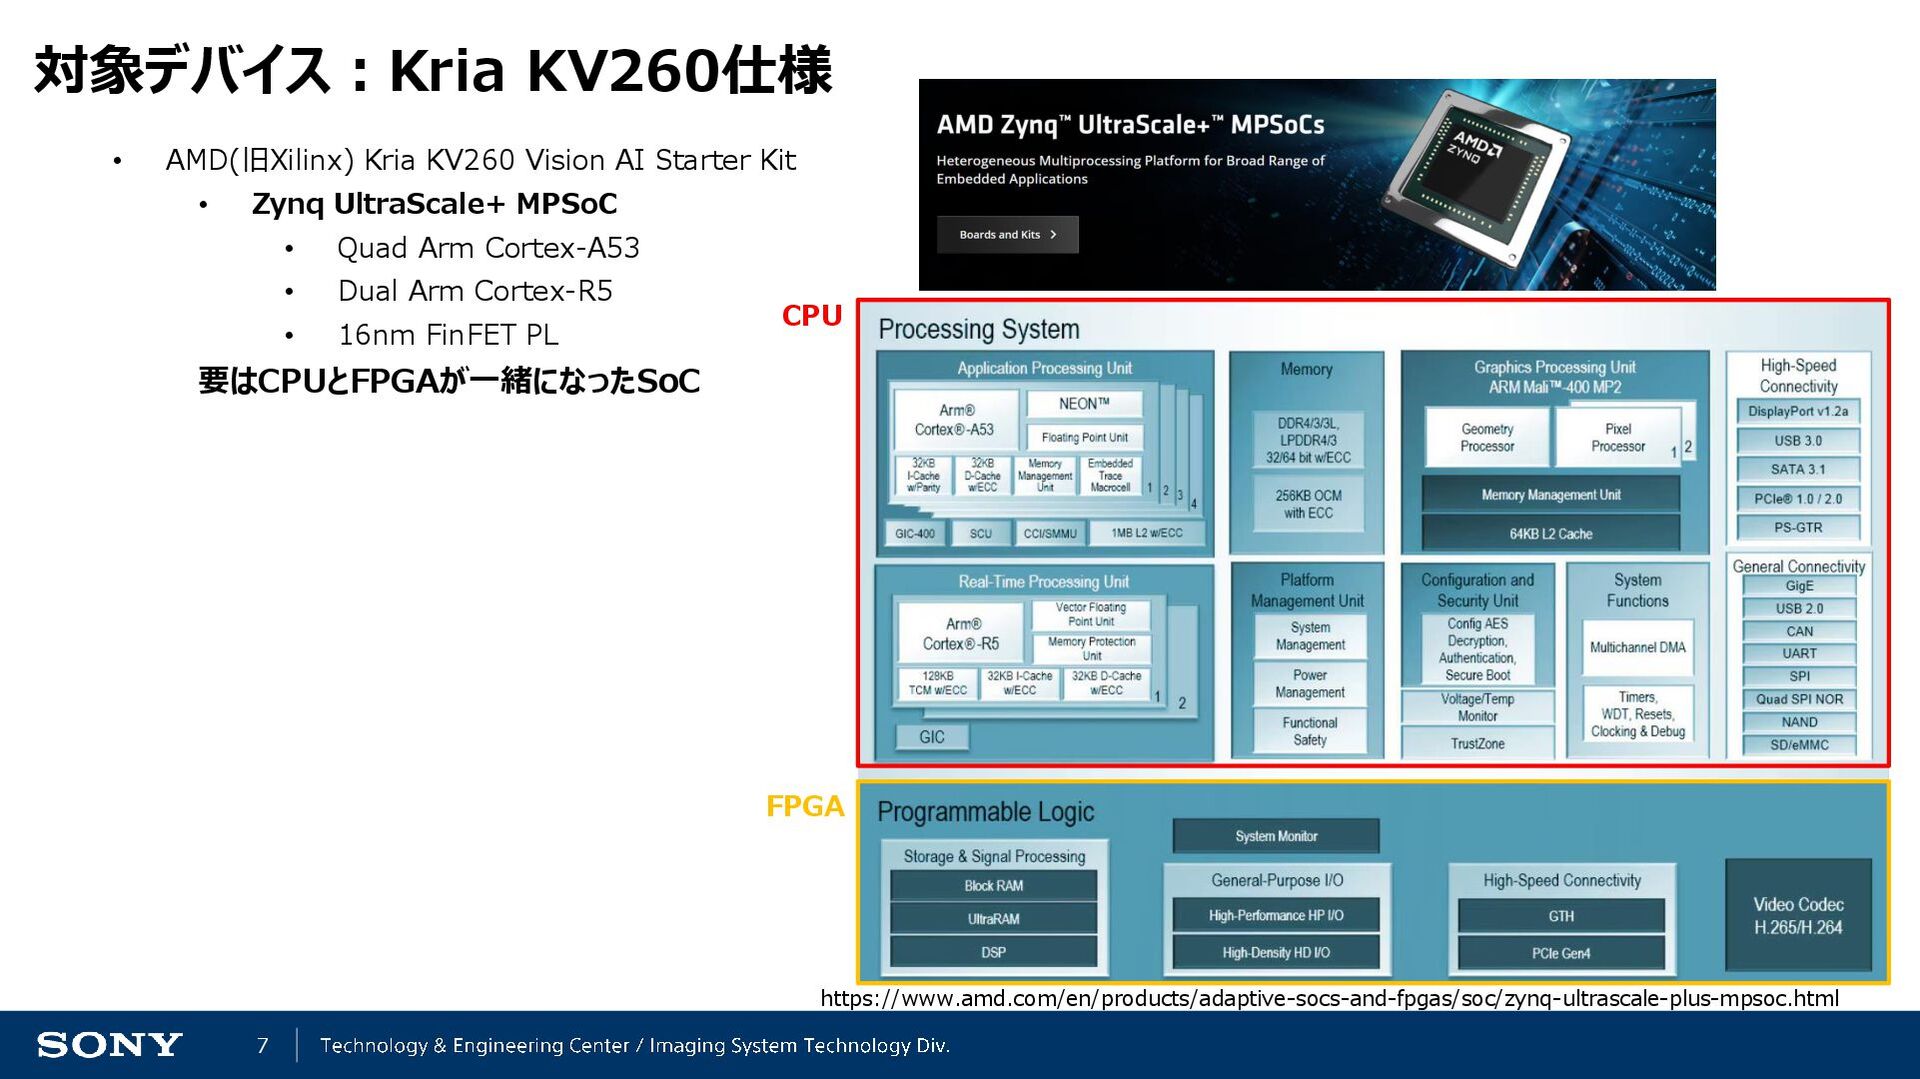
7 対象デバイス:Kria KV260仕様 • AMD(旧Xilinx) Kria KV260 Vision AI Starter
Kit • Zynq UltraScale+ MPSoC • Quad Arm Cortex-A53 • Dual Arm Cortex-R5 • 16nm FinFET PL 要はCPUとFPGAが一緒になったSoC CPU FPGA https://www.amd.com/en/products/adaptive-socs-and-fpgas/soc/zynq-ultrascale-plus-mpsoc.html -
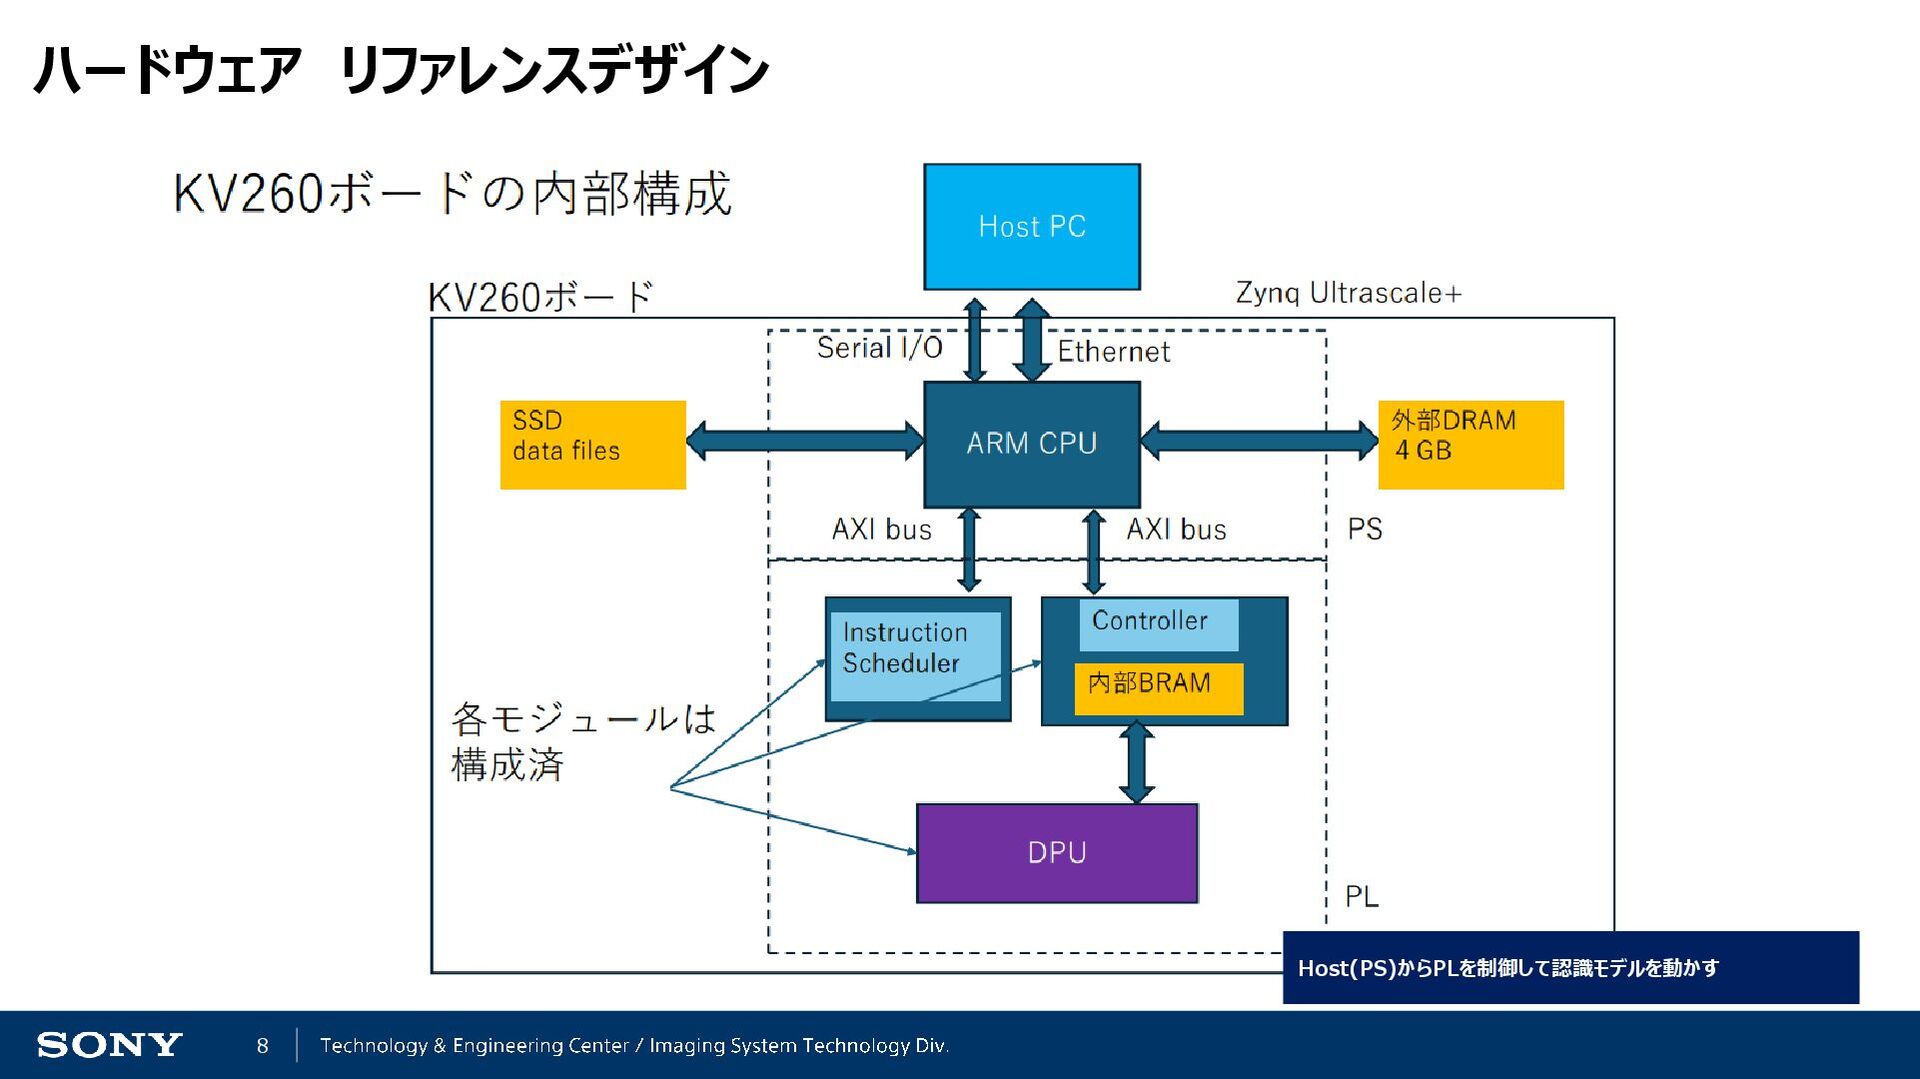
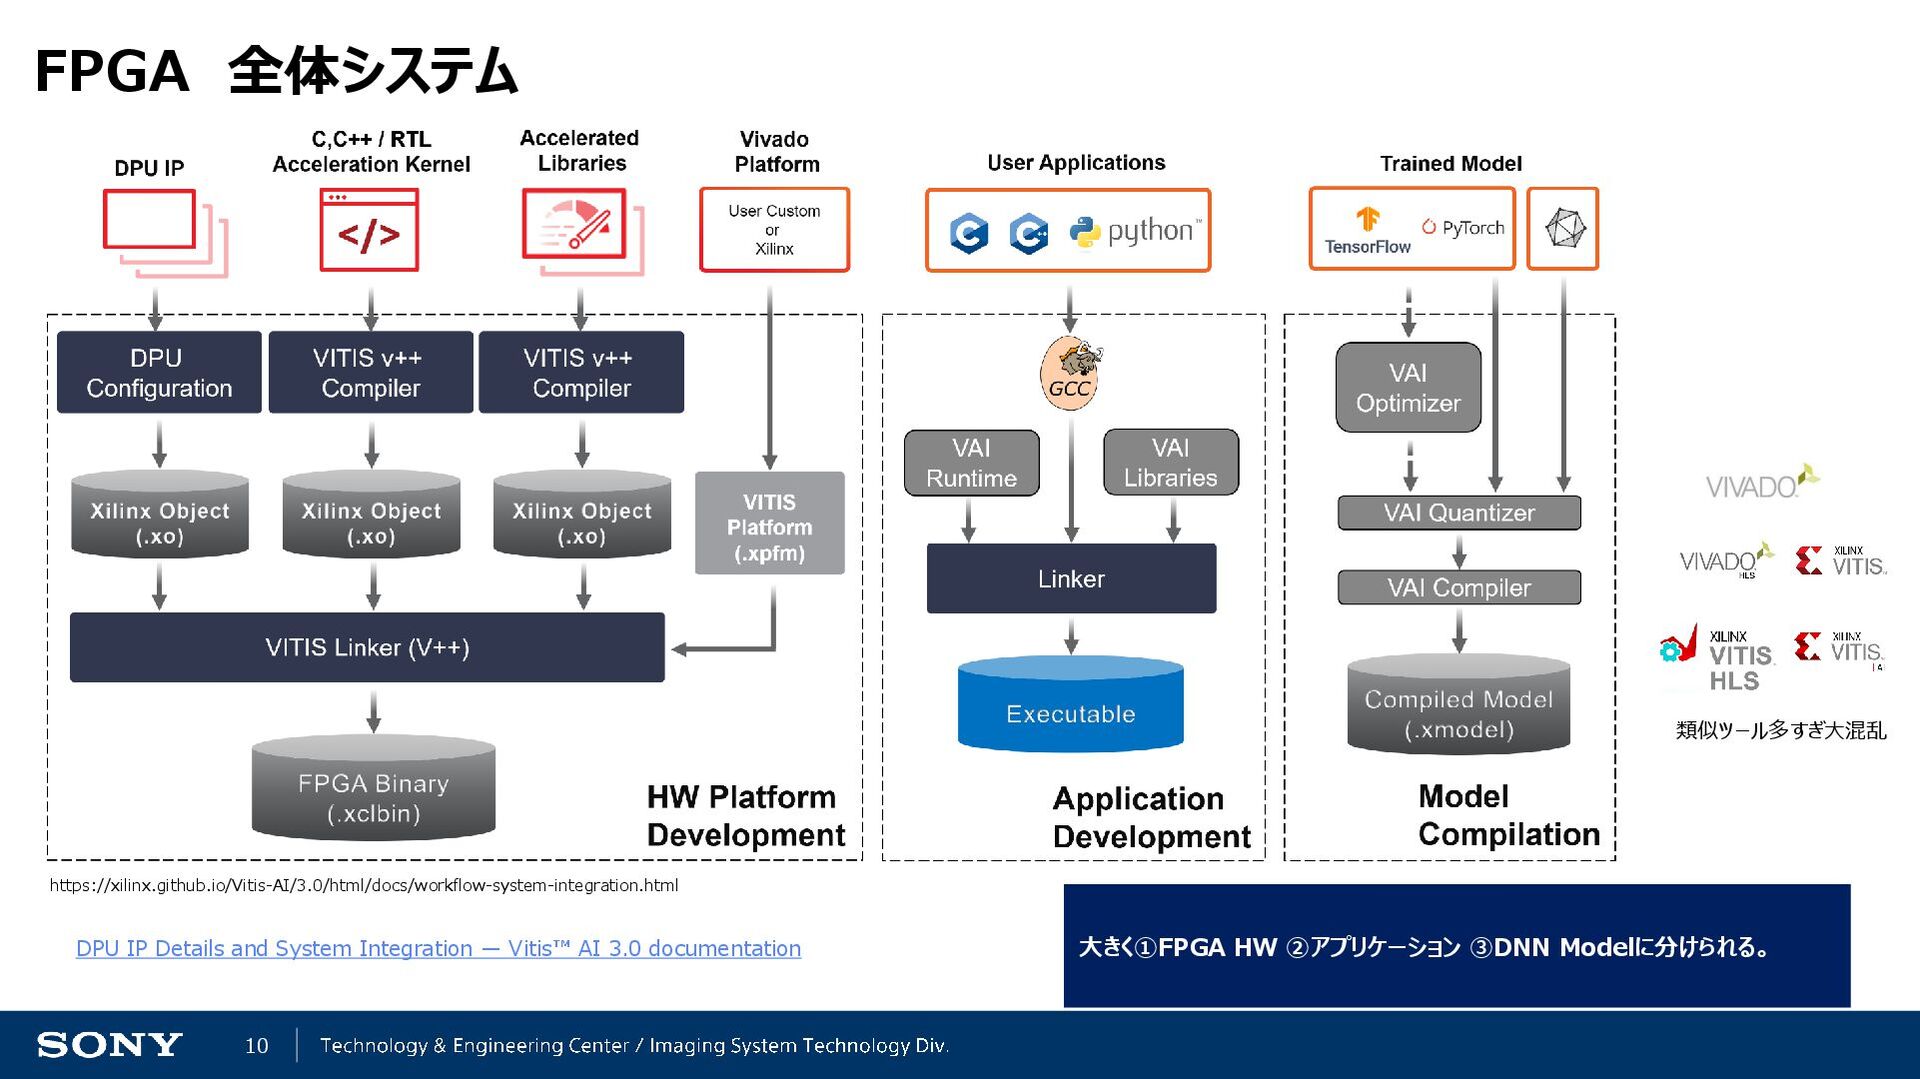
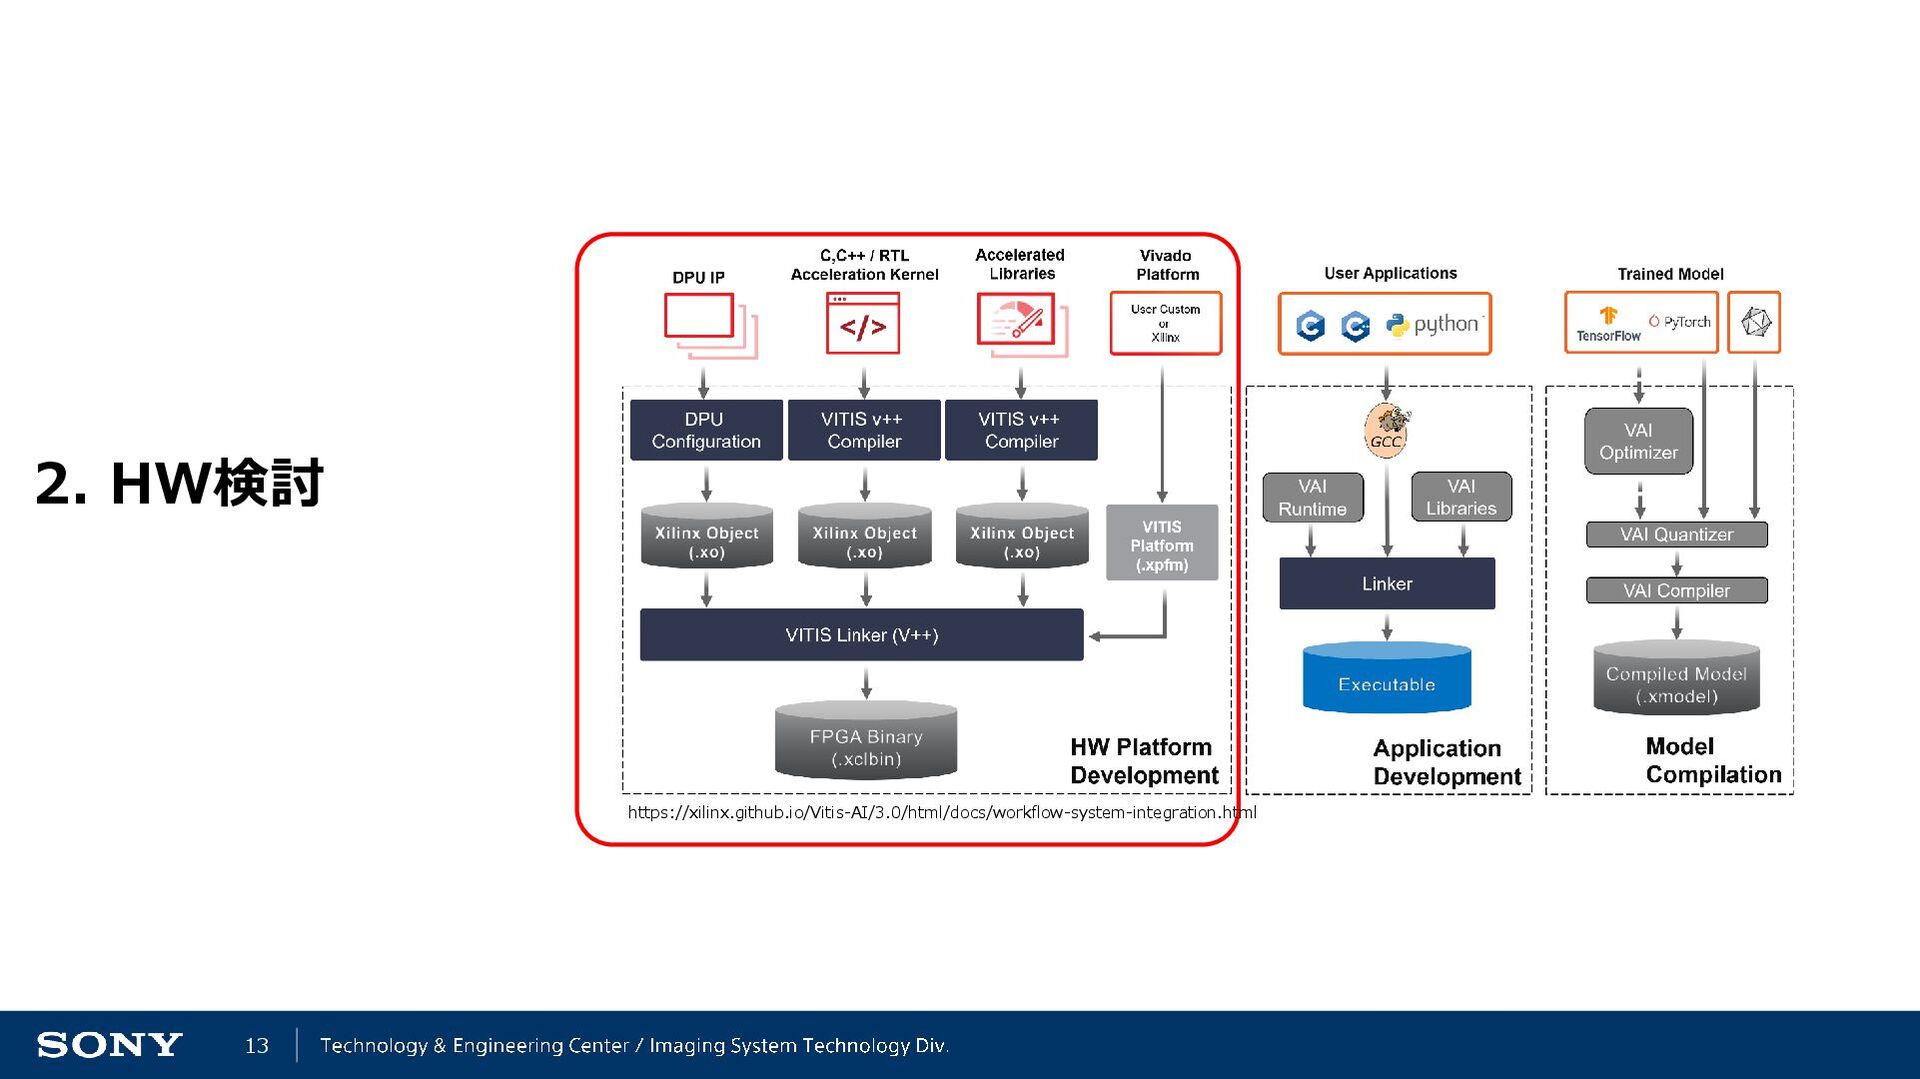
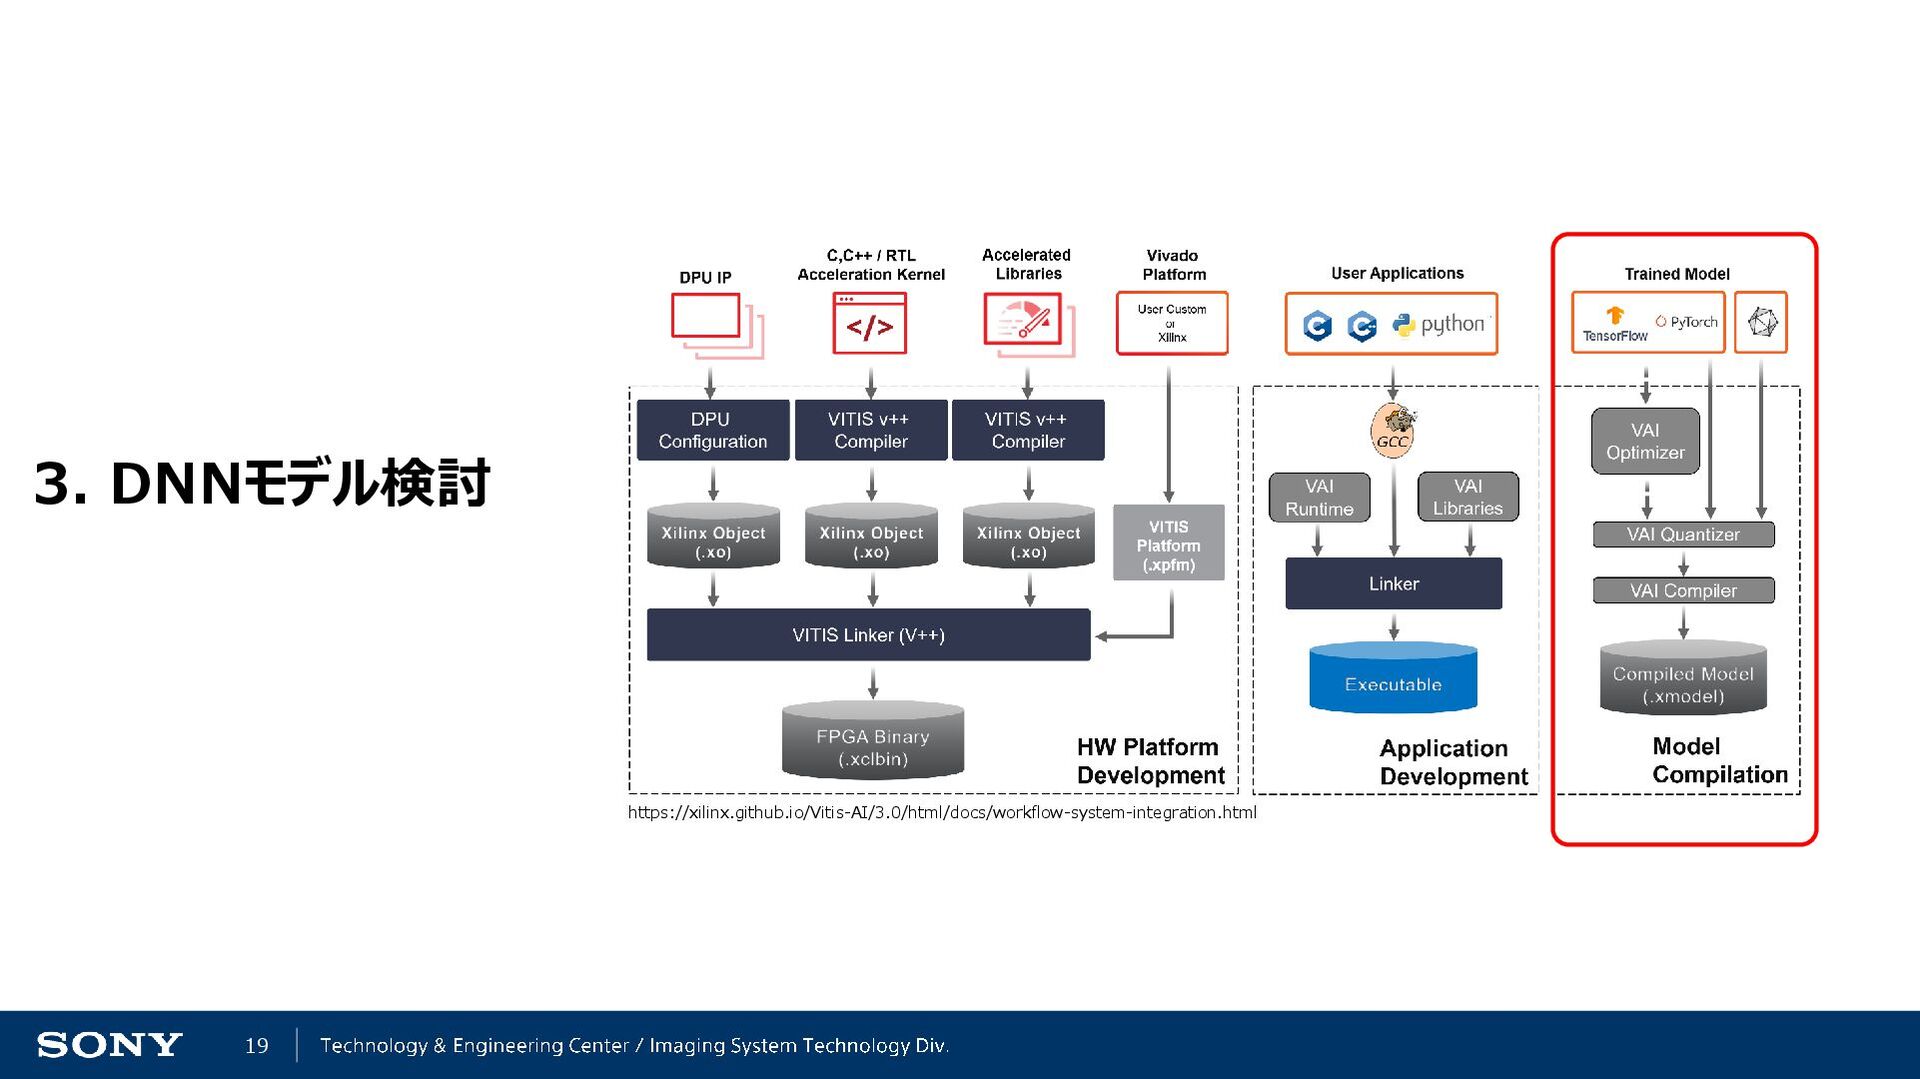
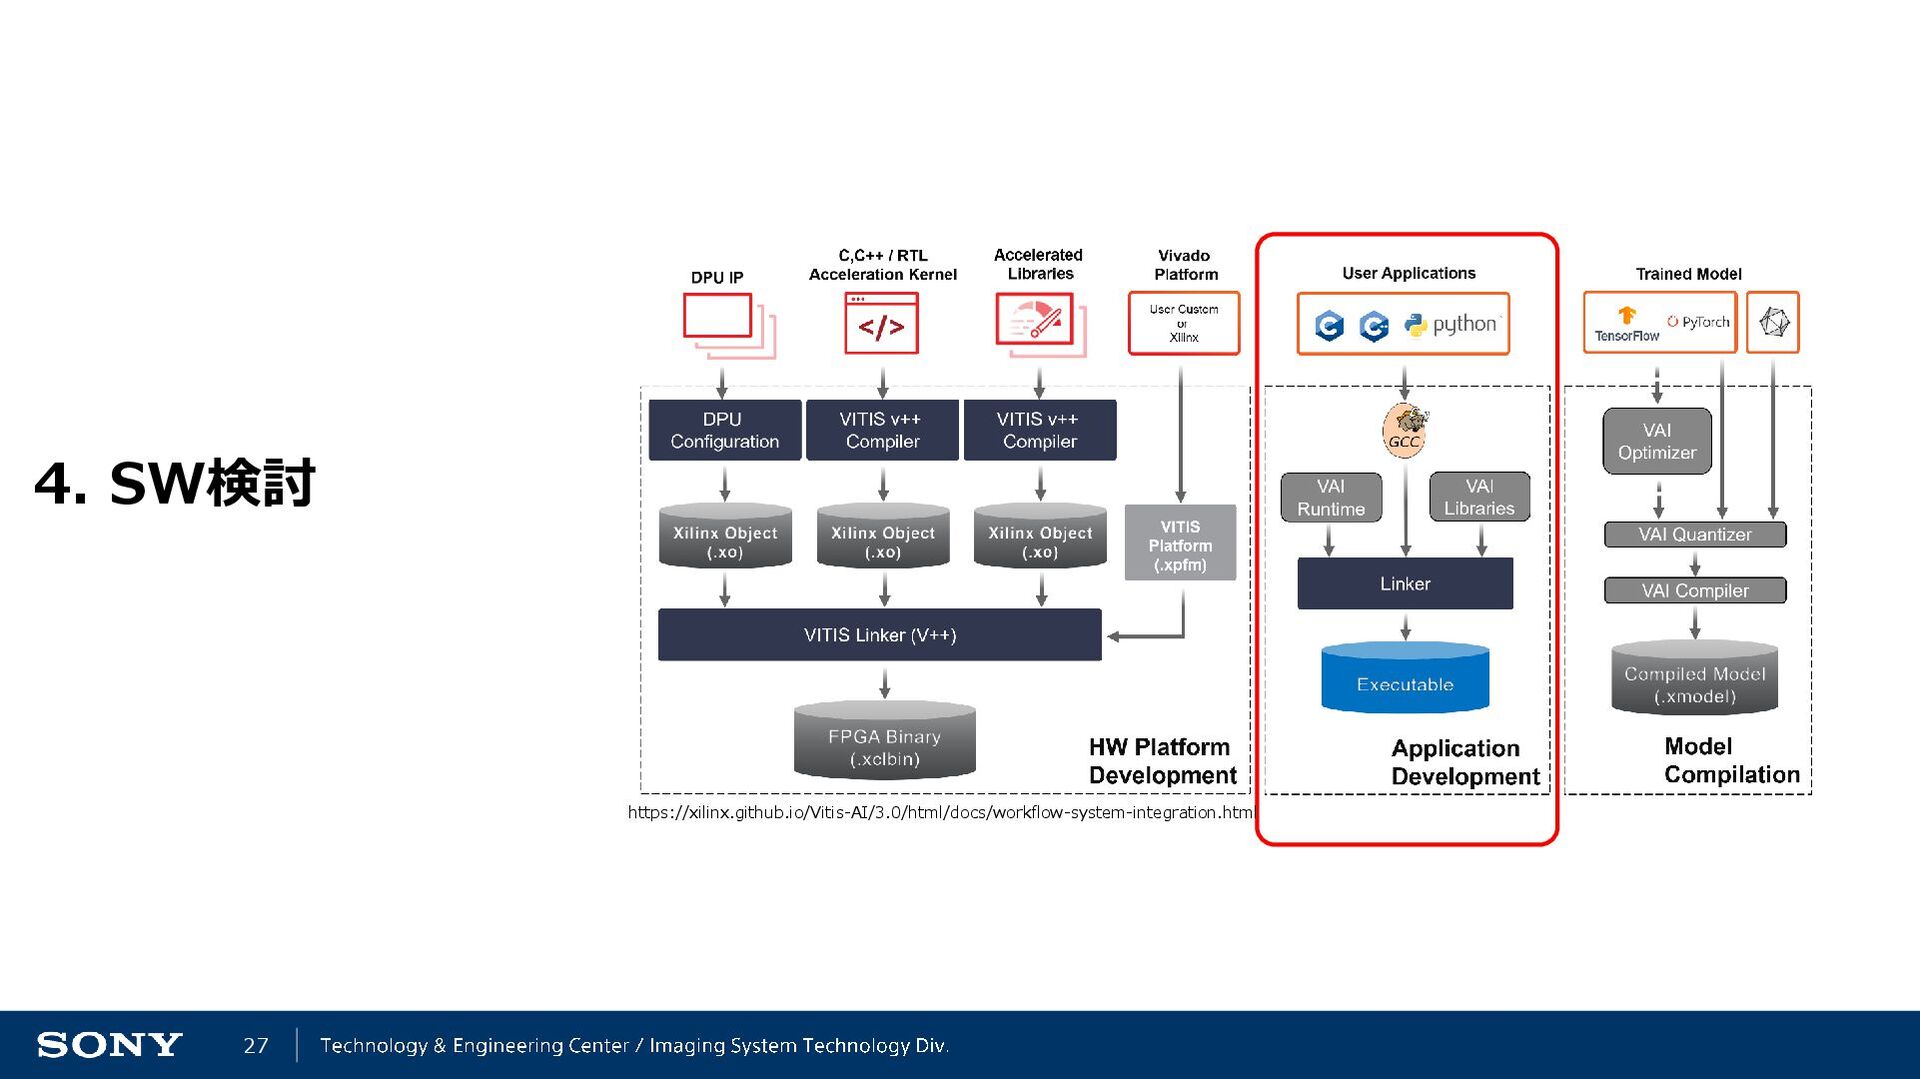
10 FPGA 全体システム DPU IP Details and System Integration —
Vitis AI 3.0 documentation 大きく①FPGA HW ②アプリケーション ③DNN Modelに分けられる。 類似ツール多すぎ大混乱 https://xilinx.github.io/Vitis-AI/3.0/html/docs/workflow-system-integration.html -
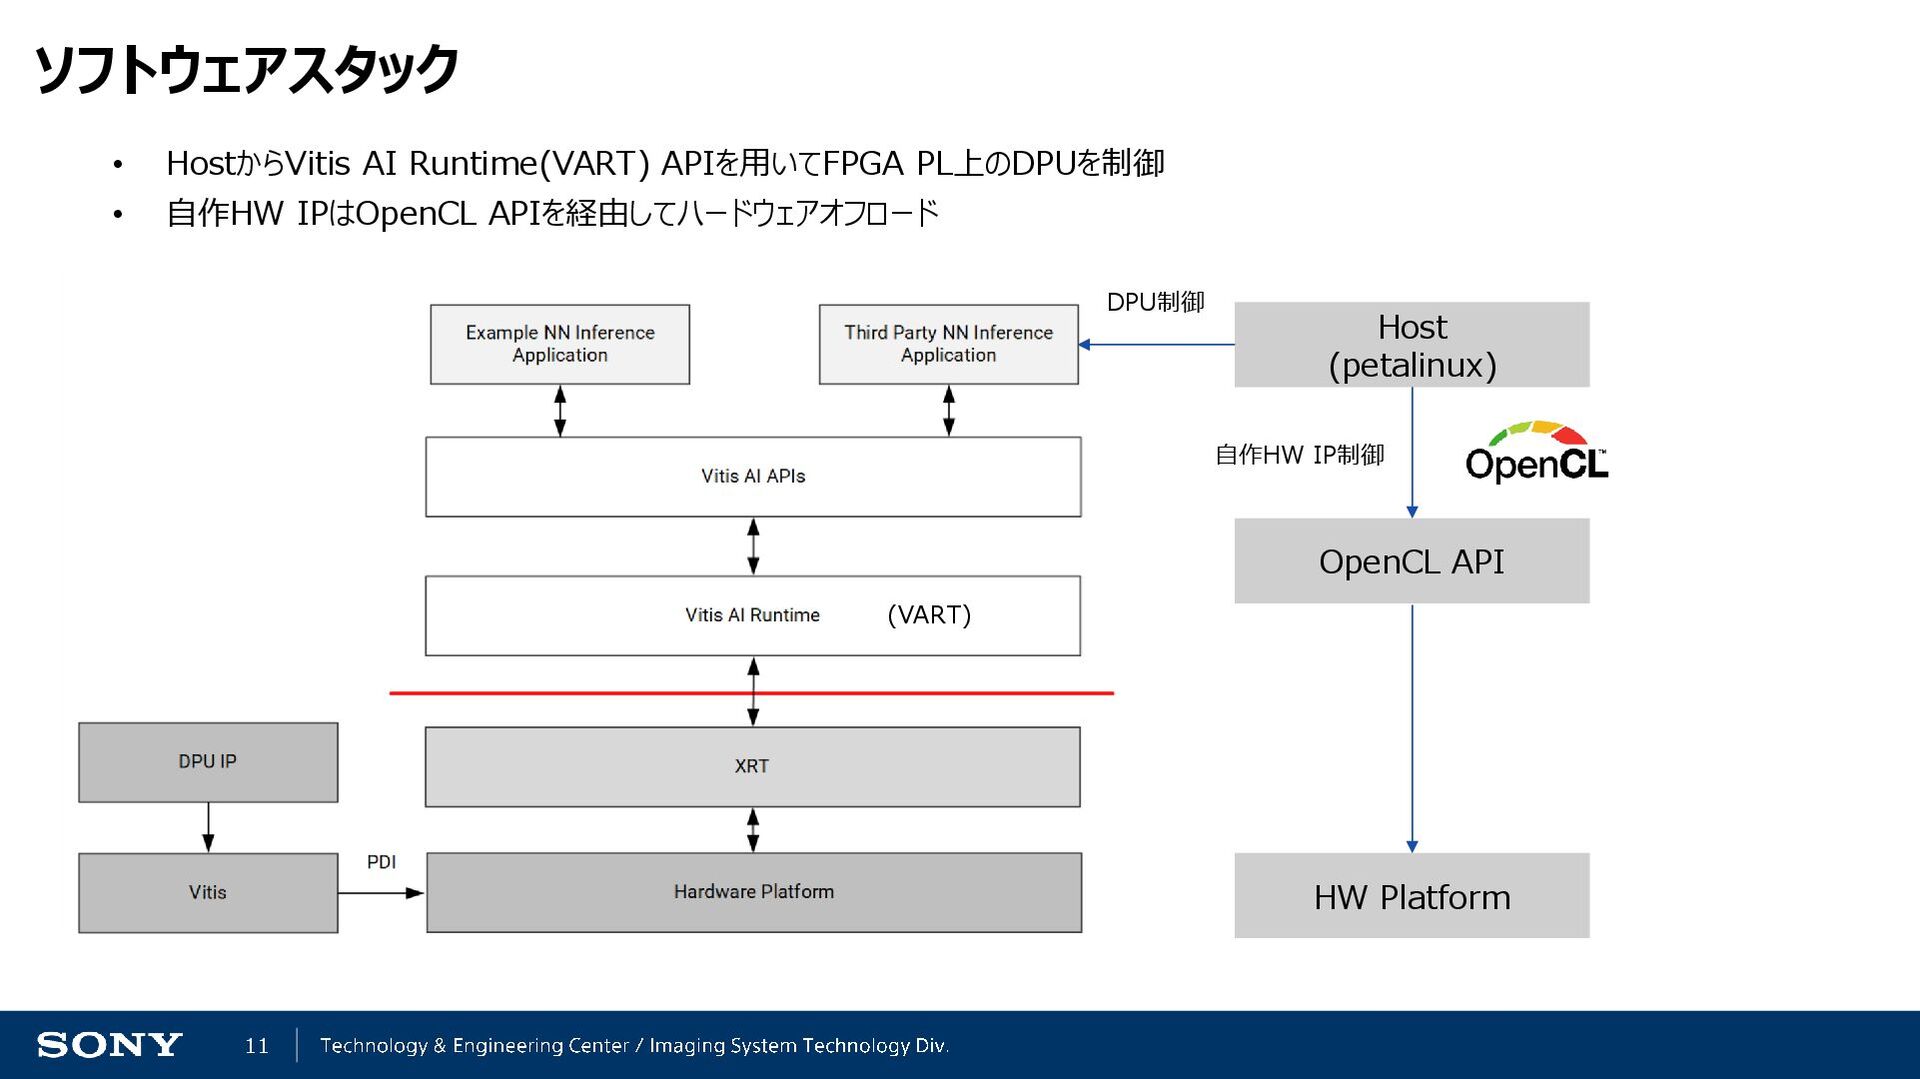
11 ソフトウェアスタック • HostからVitis AI Runtime(VART) APIを用いてFPGA PL上のDPUを制御 • 自作HW
IPはOpenCL APIを経由してハードウェアオフロード Host (petalinux) OpenCL API HW Platform (VART) DPU制御 自作HW IP制御 -
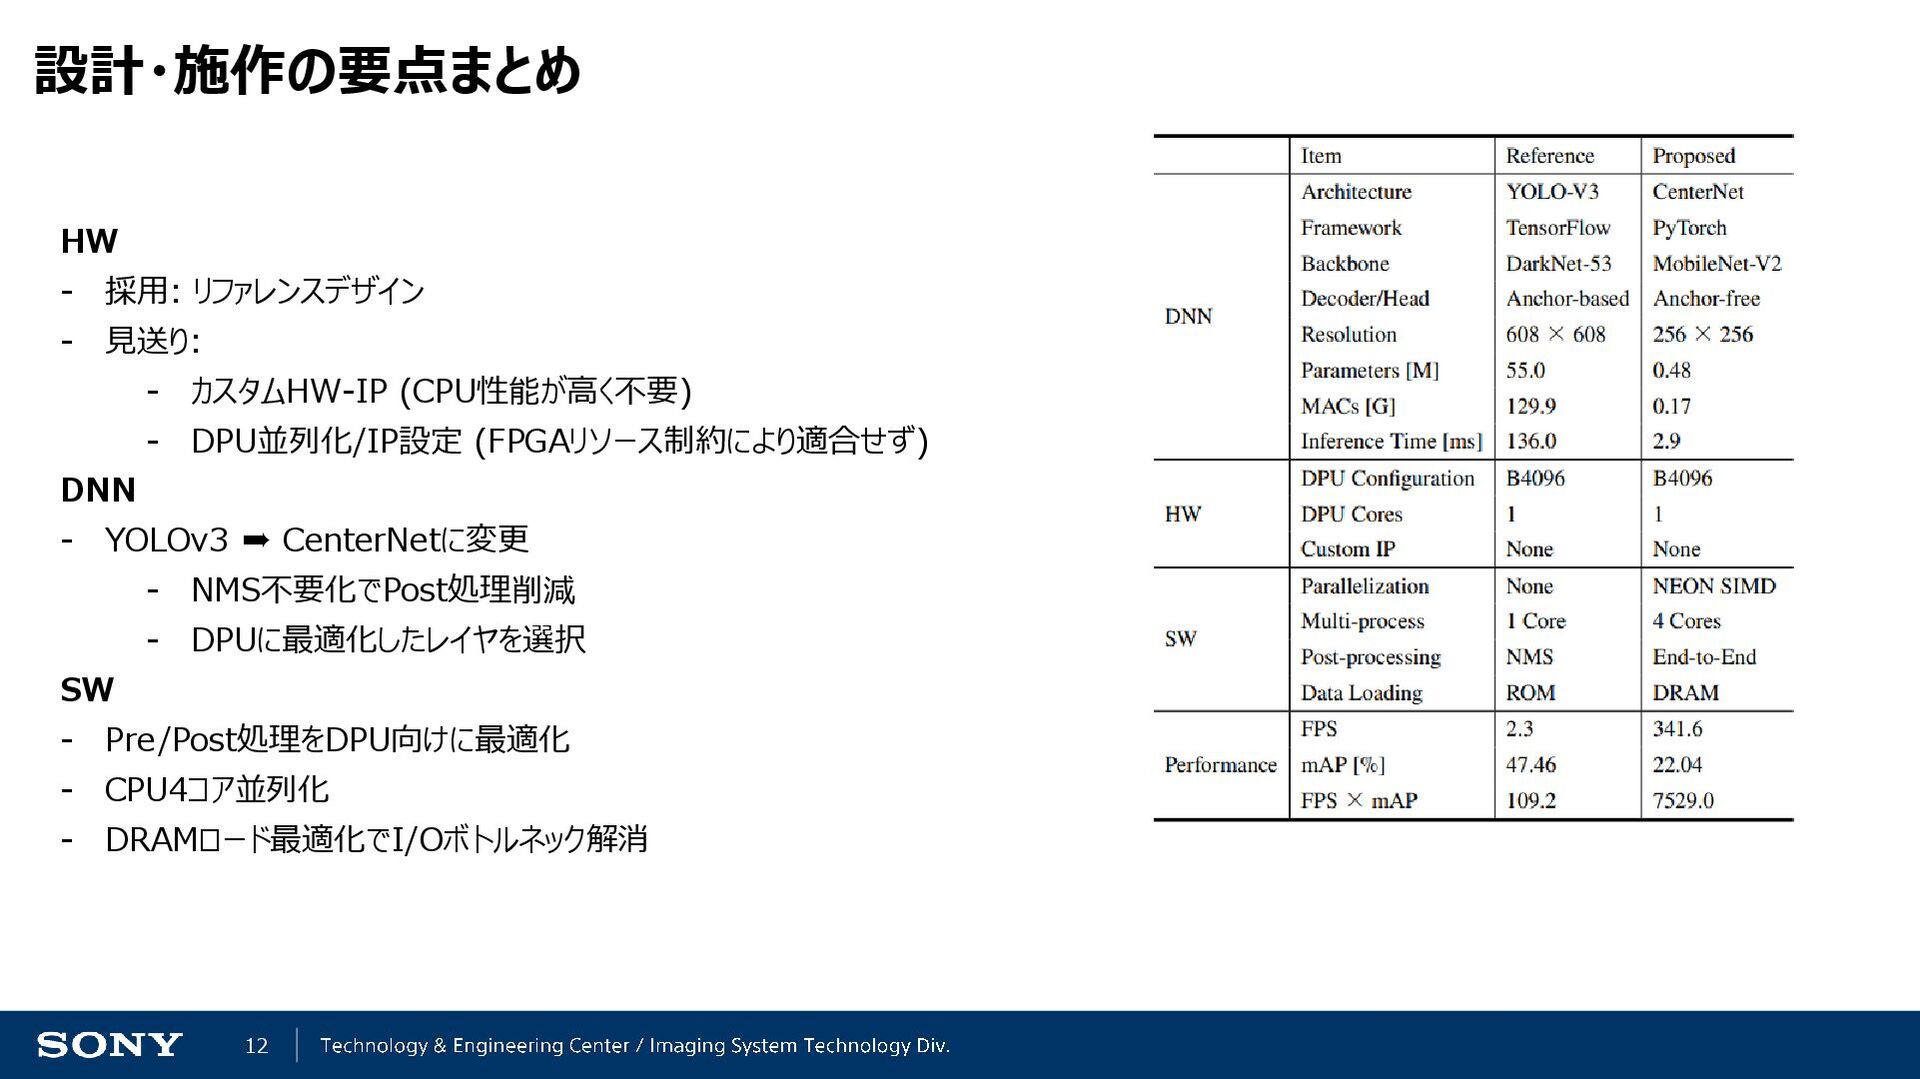
12 設計・施作の要点まとめ HW - 採用: リファレンスデザイン - 見送り: - カスタムHW-IP
(CPU性能が高く不要) - DPU並列化/IP設定 (FPGAリソース制約により適合せず) DNN - YOLOv3 ➨ CenterNetに変更 - NMS不要化でPost処理削減 - DPUに最適化したレイヤを選択 SW - Pre/Post処理をDPU向けに最適化 - CPU4コア並列化 - DRAMロード最適化でI/Oボトルネック解消 -
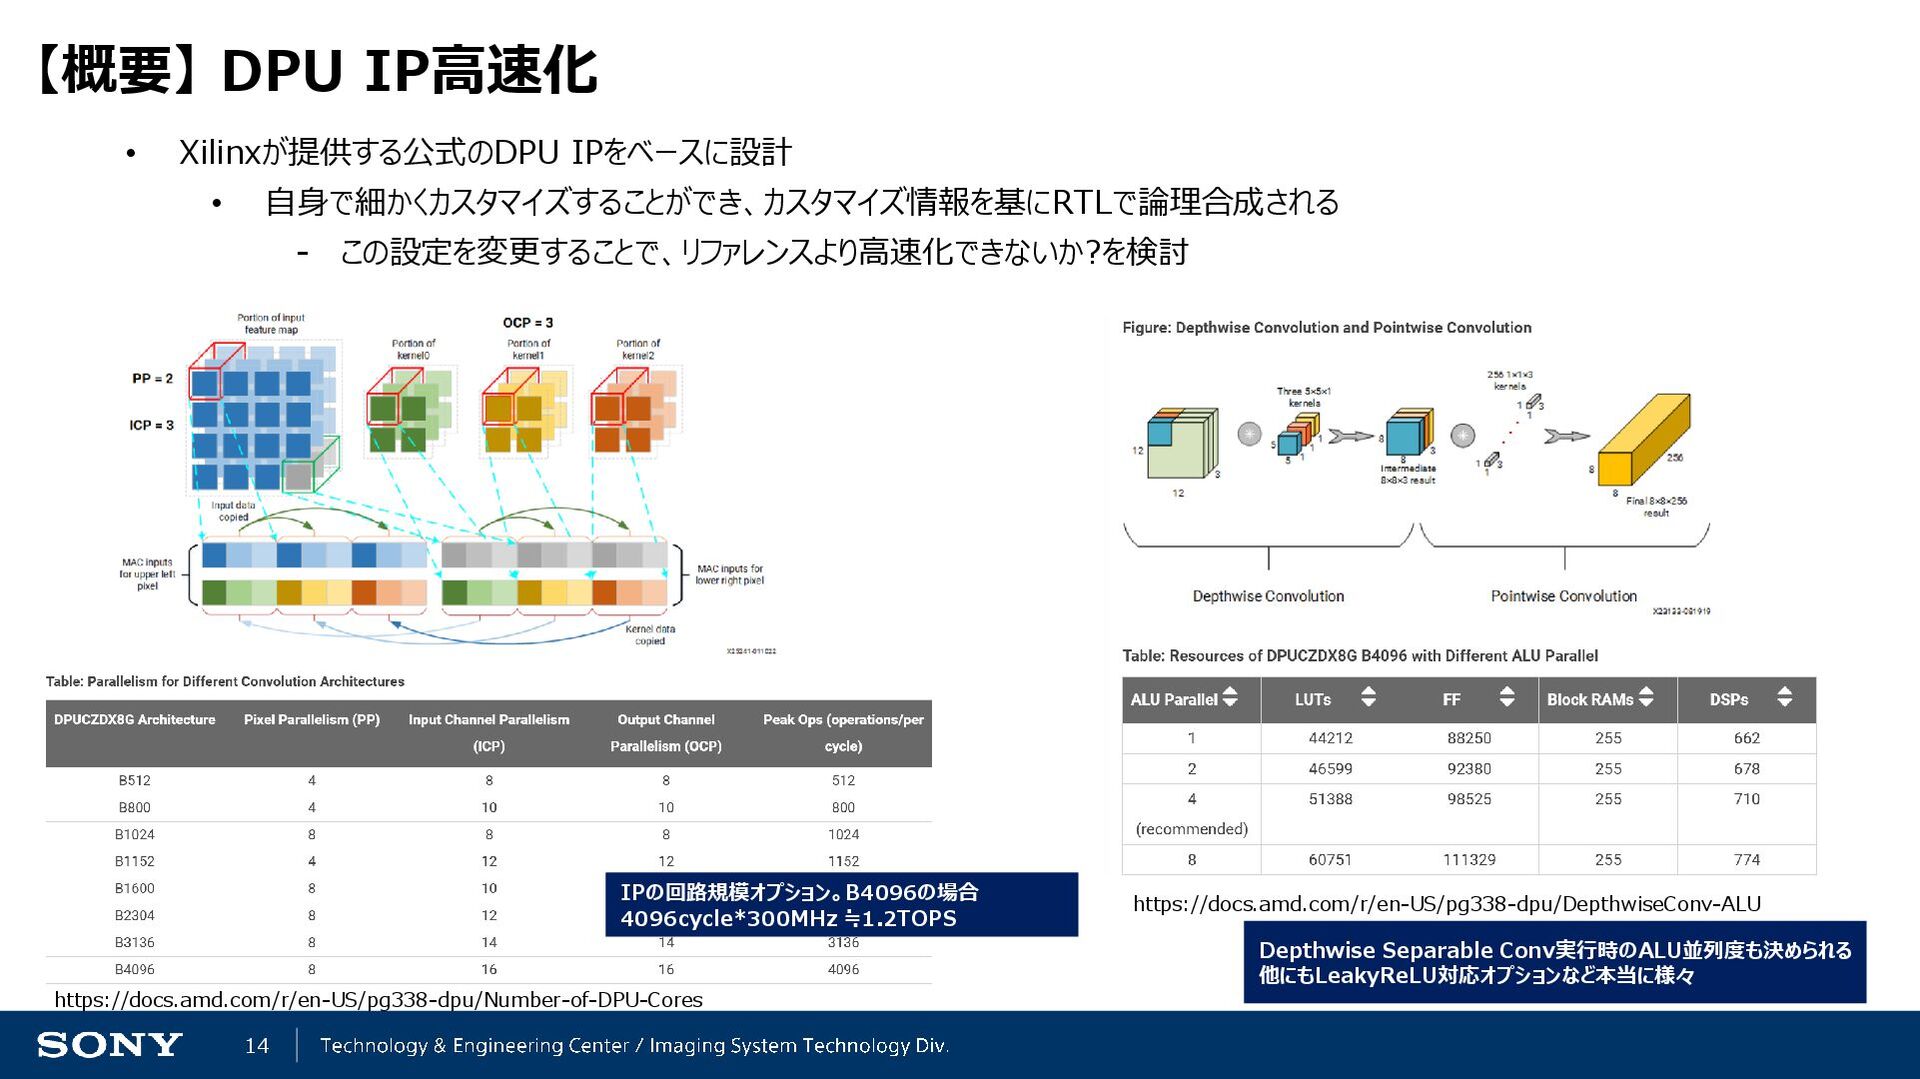
14 【概要】 DPU IP高速化 • Xilinxが提供する公式のDPU IPをベースに設計 • 自身で細かくカスタマイズすることができ、カスタマイズ情報を基にRTLで論理合成される -
この設定を変更することで、リファレンスより高速化できないか?を検討 Depthwise Separable Conv実行時のALU並列度も決められる 他にもLeakyReLU対応オプションなど本当に様々 IPの回路規模オプション。B4096の場合 4096cycle*300MHz ≒1.2TOPS https://docs.amd.com/r/en-US/pg338-dpu/Number-of-DPU-Cores https://docs.amd.com/r/en-US/pg338-dpu/DepthwiseConv-ALU -
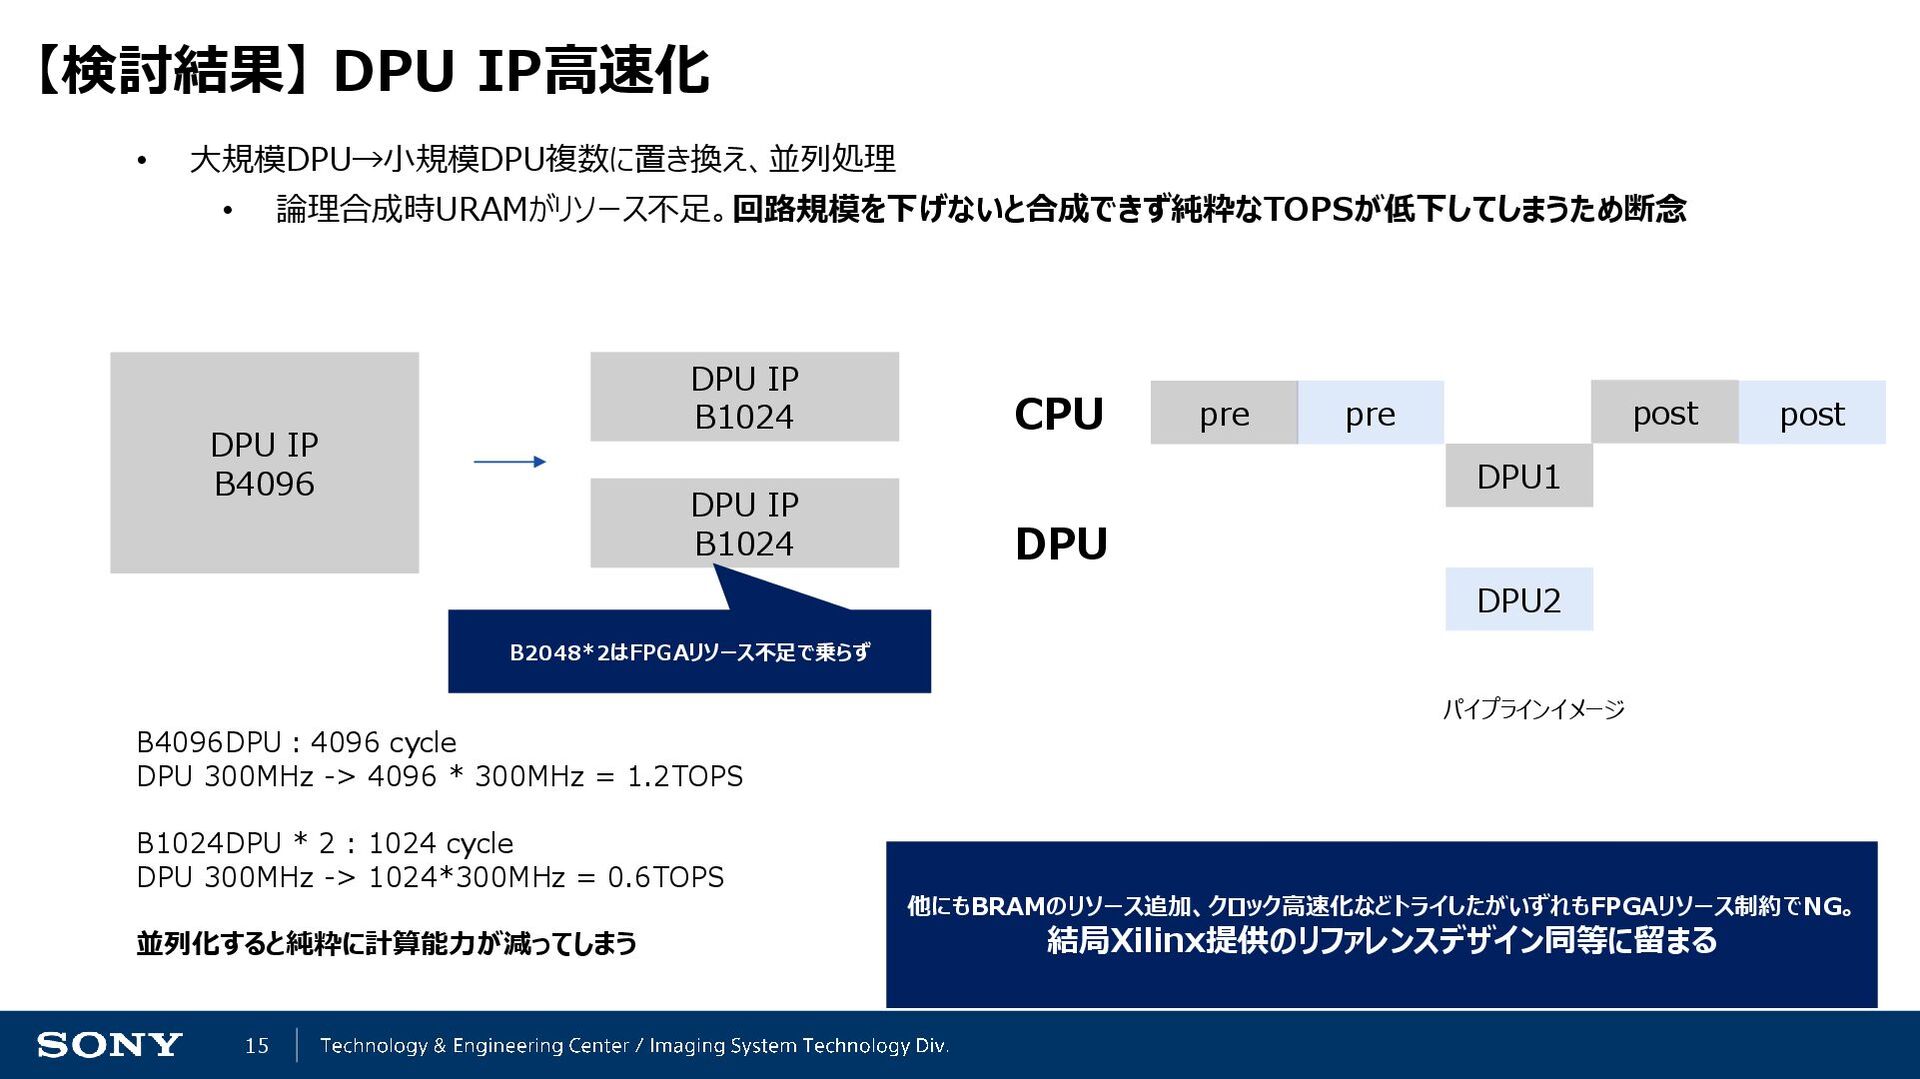
15 【検討結果】 DPU IP高速化 • 大規模DPU→小規模DPU複数に置き換え、並列処理 • 論理合成時URAMがリソース不足。回路規模を下げないと合成できず純粋なTOPSが低下してしまうため断念 DPU IP
B4096 DPU IP B1024 DPU IP B1024 pre DPU1 post pre DPU2 post B4096DPU:4096 cycle DPU 300MHz -> 4096 * 300MHz = 1.2TOPS B1024DPU * 2 : 1024 cycle DPU 300MHz -> 1024*300MHz = 0.6TOPS 並列化すると純粋に計算能力が減ってしまう B2048*2はFPGAリソース不足で乗らず 他にもBRAMのリソース追加、クロック高速化などトライしたがいずれもFPGAリソース制約でNG。 結局Xilinx提供のリファレンスデザイン同等に留まる CPU DPU パイプラインイメージ -
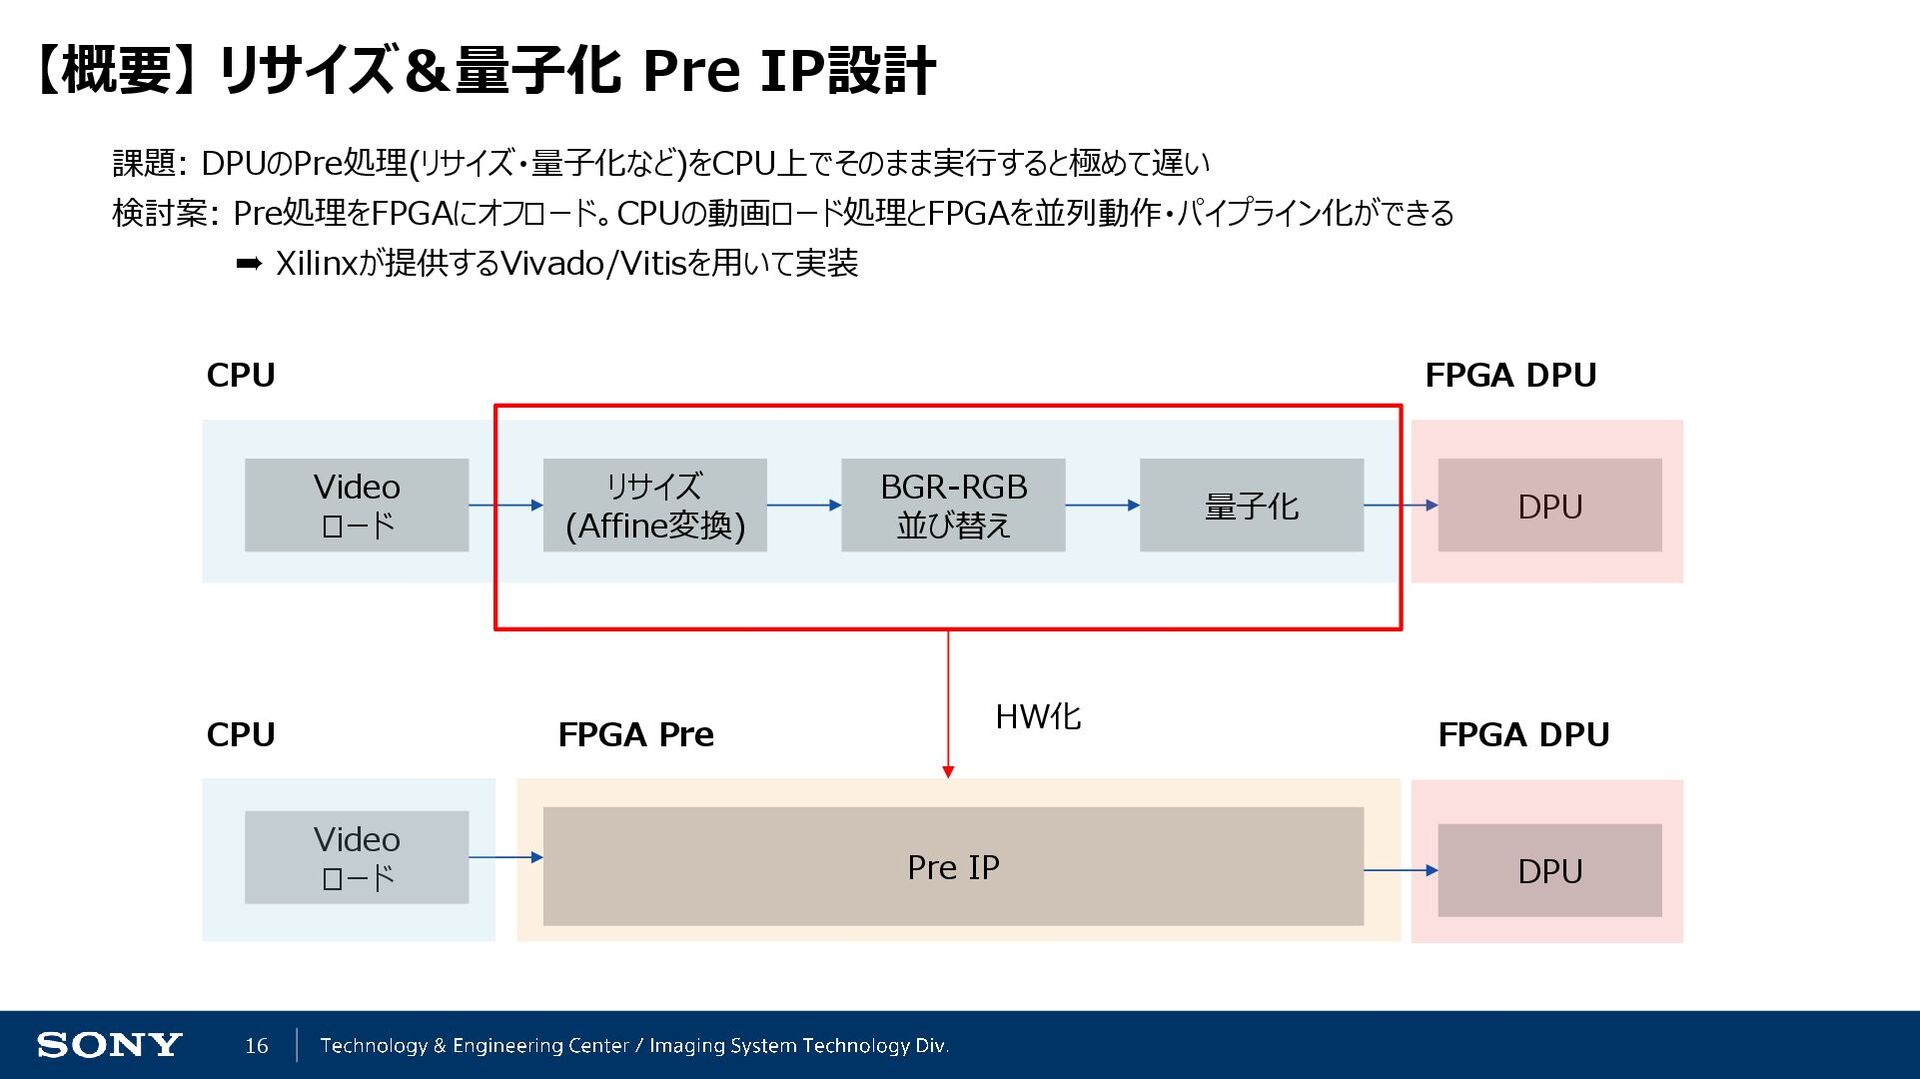
16 【概要】 リサイズ&量子化 Pre IP設計 課題: DPUのPre処理(リサイズ・量子化など)をCPU上でそのまま実行すると極めて遅い 検討案: Pre処理をFPGAにオフロード。CPUの動画ロード処理とFPGAを並列動作・パイプライン化ができる ➨
Xilinxが提供するVivado/Vitisを用いて実装 Video ロード リサイズ (Affine変換) BGR-RGB 並び替え 量子化 DPU Pre IP Video ロード DPU HW化 CPU CPU FPGA Pre FPGA DPU FPGA DPU -
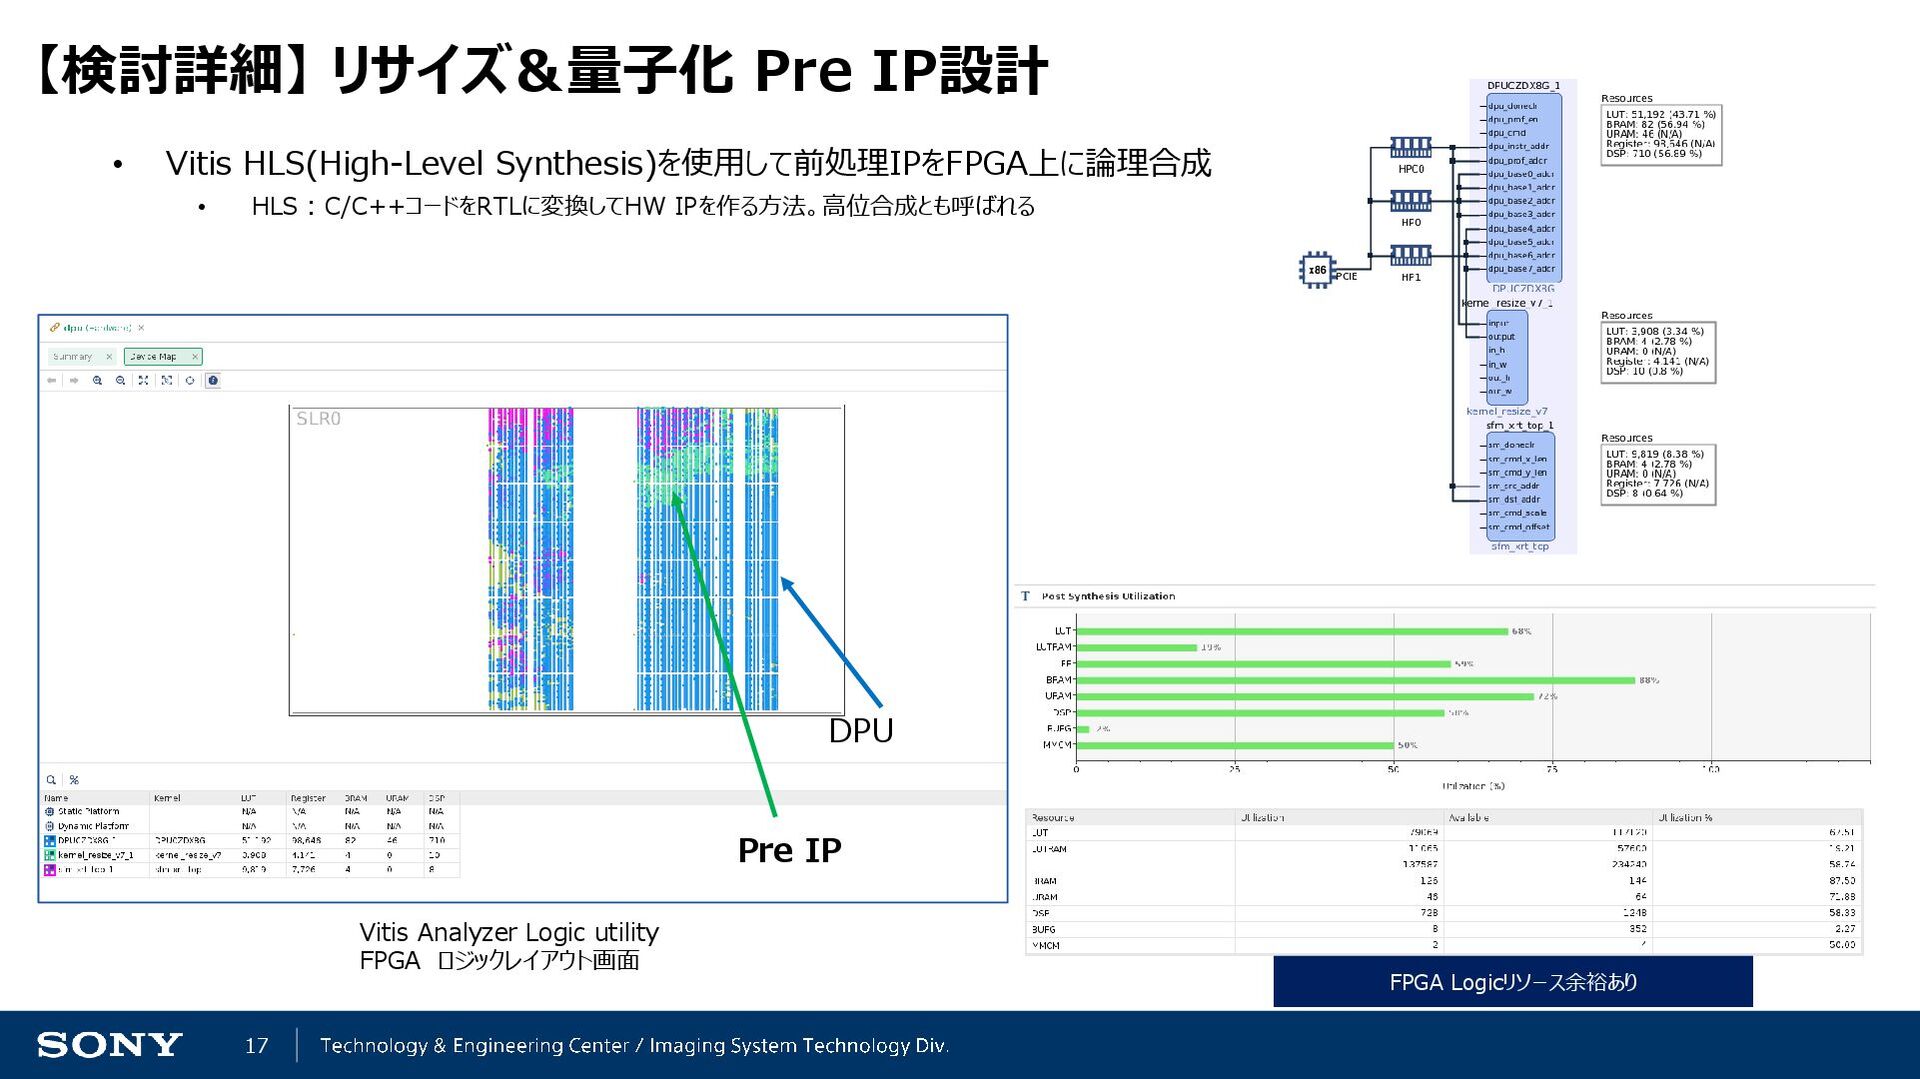
17 【検討詳細】 リサイズ&量子化 Pre IP設計 • Vitis HLS(High-Level Synthesis)を使用して前処理IPをFPGA上に論理合成 •
HLS : C/C++コードをRTLに変換してHW IPを作る方法。高位合成とも呼ばれる Pre IP Vitis Analyzer Logic utility FPGA ロジックレイアウト画面 DPU FPGA Logicリソース余裕あり -
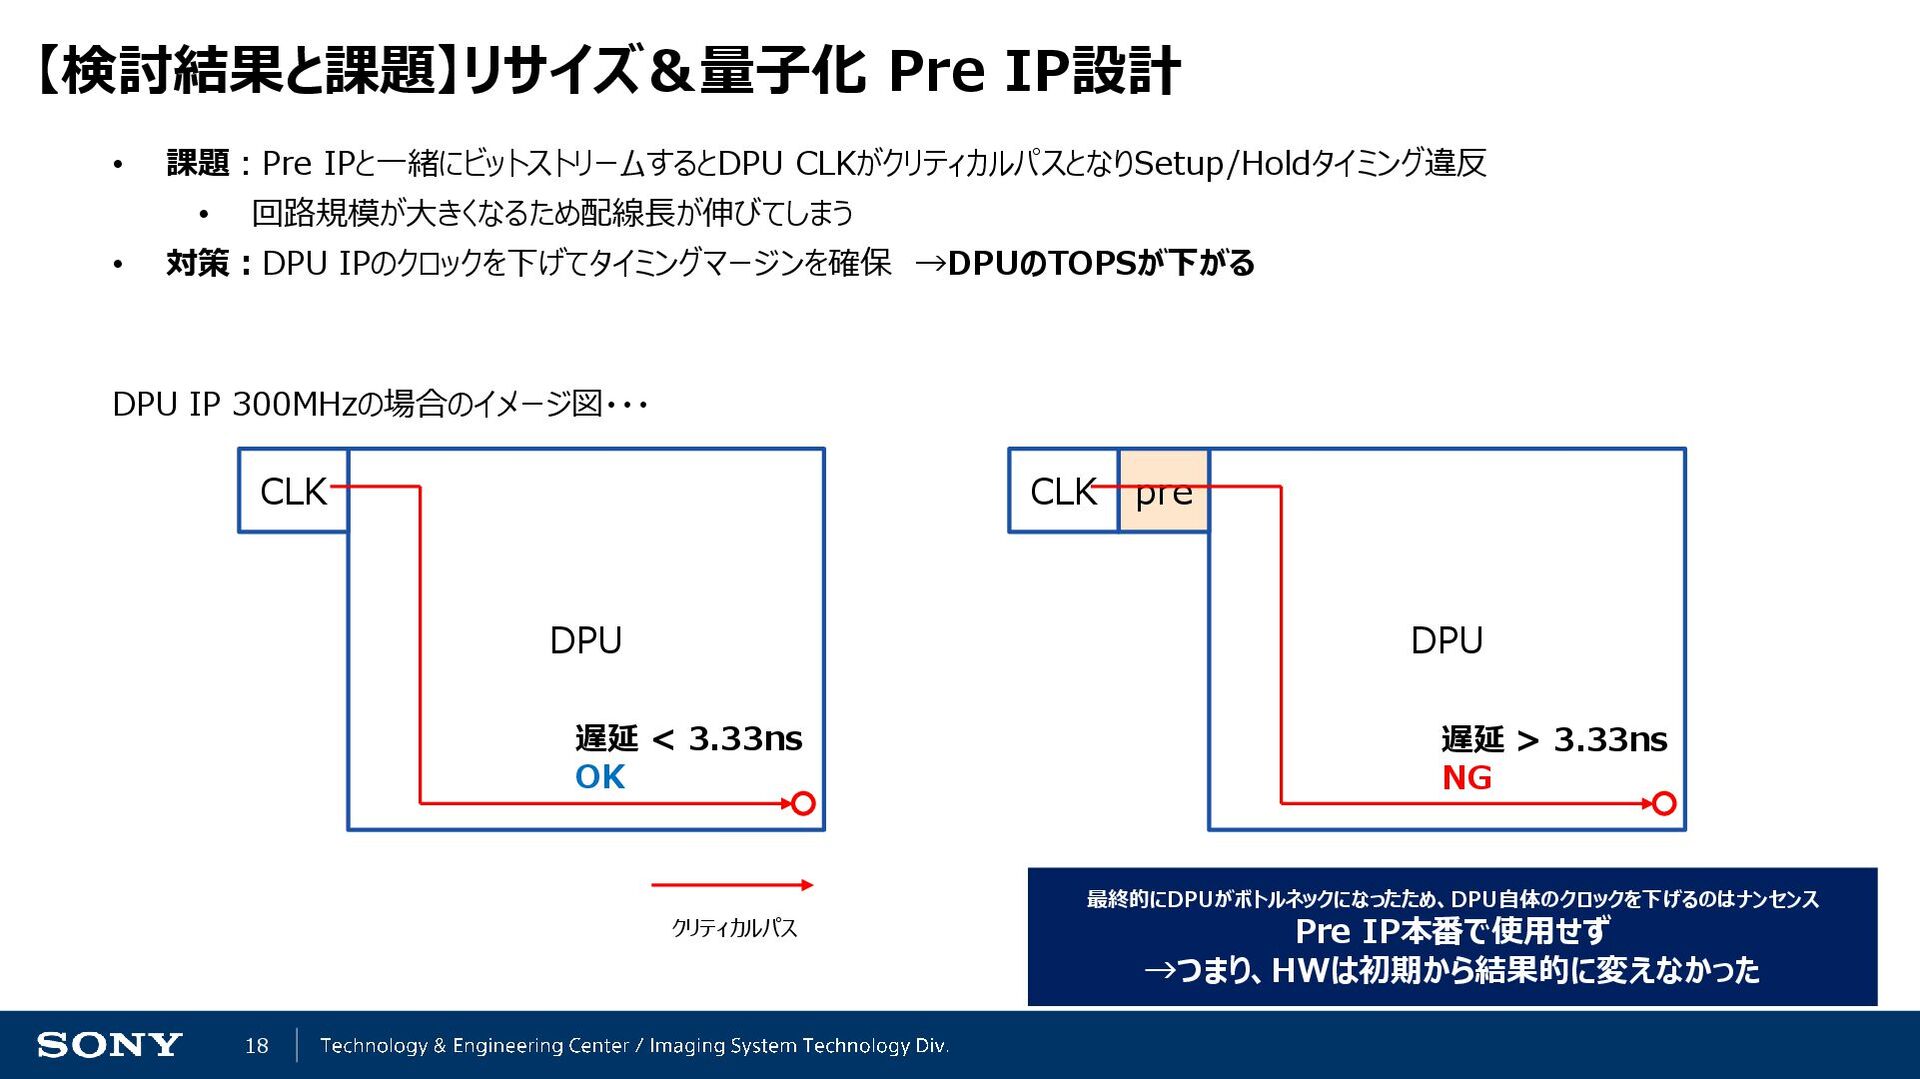
18 【検討結果と課題】リサイズ&量子化 Pre IP設計 • 課題:Pre IPと一緒にビットストリームするとDPU CLKがクリティカルパスとなりSetup/Holdタイミング違反 • 回路規模が大きくなるため配線長が伸びてしまう
• 対策:DPU IPのクロックを下げてタイミングマージンを確保 →DPUのTOPSが下がる DPU CLK DPU CLK pre 遅延 < 3.33ns OK 遅延 > 3.33ns NG DPU IP 300MHzの場合のイメージ図・・・ クリティカルパス 最終的にDPUがボトルネックになったため、DPU自体のクロックを下げるのはナンセンス Pre IP本番で使用せず →つまり、HWは初期から結果的に変えなかった -
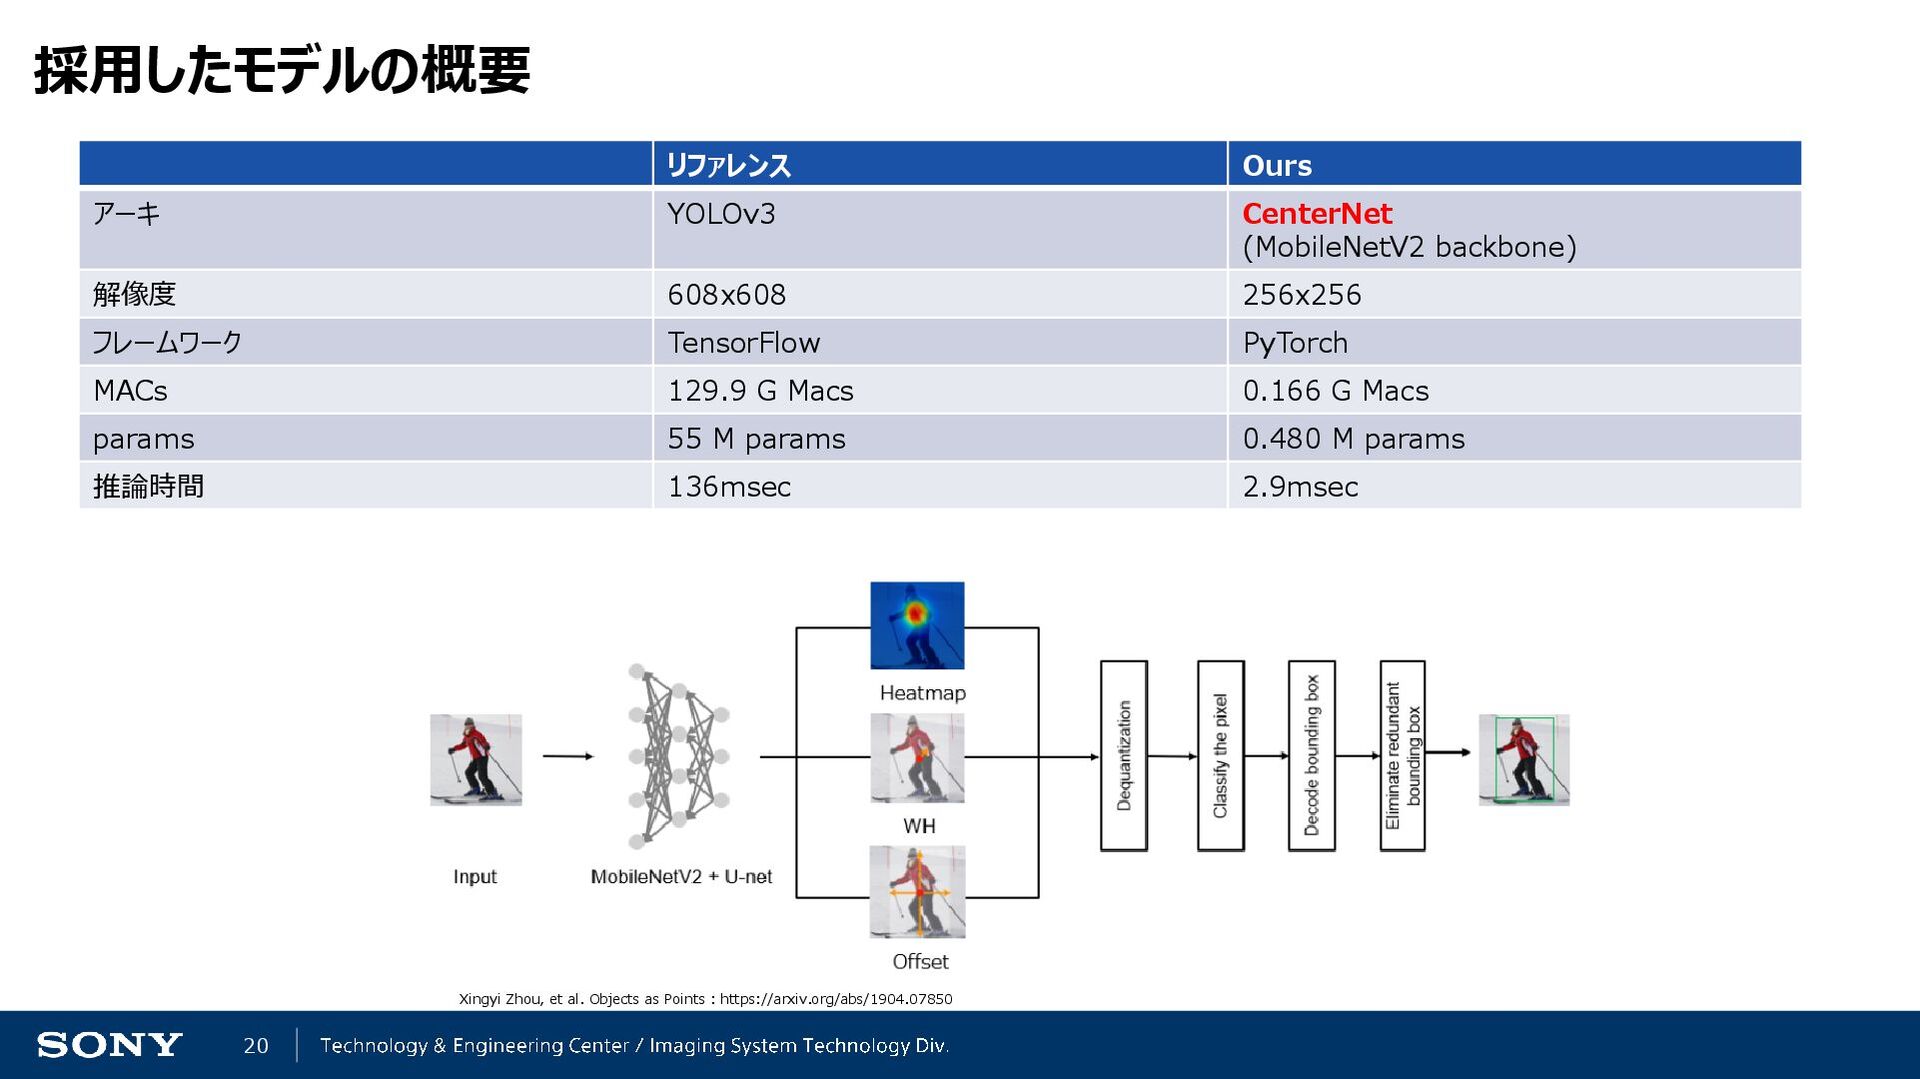
20 採用したモデルの概要 リファレンス Ours アーキ YOLOv3 CenterNet (MobileNetV2 backbone) 解像度
608x608 256x256 フレームワーク TensorFlow PyTorch MACs 129.9 G Macs 0.166 G Macs params 55 M params 0.480 M params 推論時間 136msec 2.9msec Xingyi Zhou, et al. Objects as Points : https://arxiv.org/abs/1904.07850 -
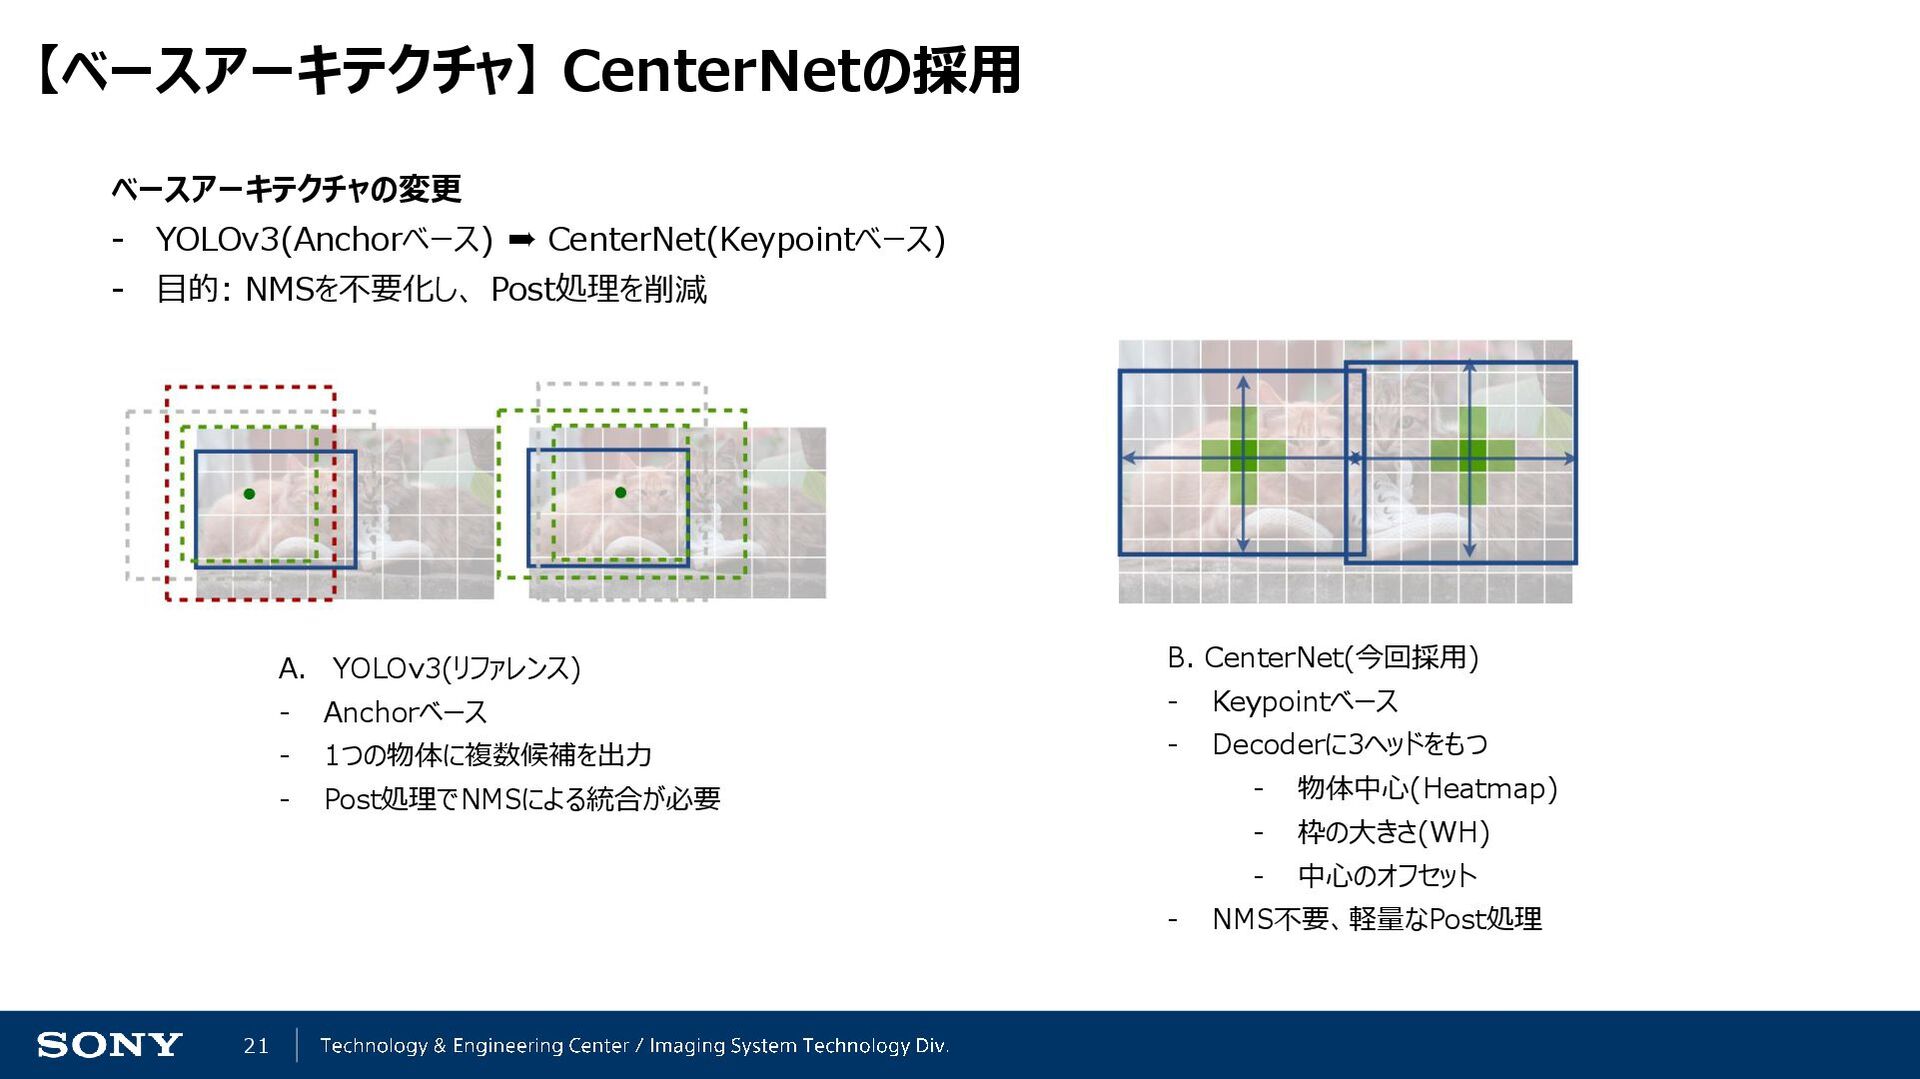
21 【ベースアーキテクチャ】 CenterNetの採用 A. YOLOv3(リファレンス) - Anchorベース - 1つの物体に複数候補を出力 -
Post処理でNMSによる統合が必要 B. CenterNet(今回採用) - Keypointベース - Decoderに3ヘッドをもつ - 物体中心(Heatmap) - 枠の大きさ(WH) - 中心のオフセット - NMS不要、軽量なPost処理 ベースアーキテクチャの変更 - YOLOv3(Anchorベース) ➨ CenterNet(Keypointベース) - 目的: NMSを不要化し、 Post処理を削減 -
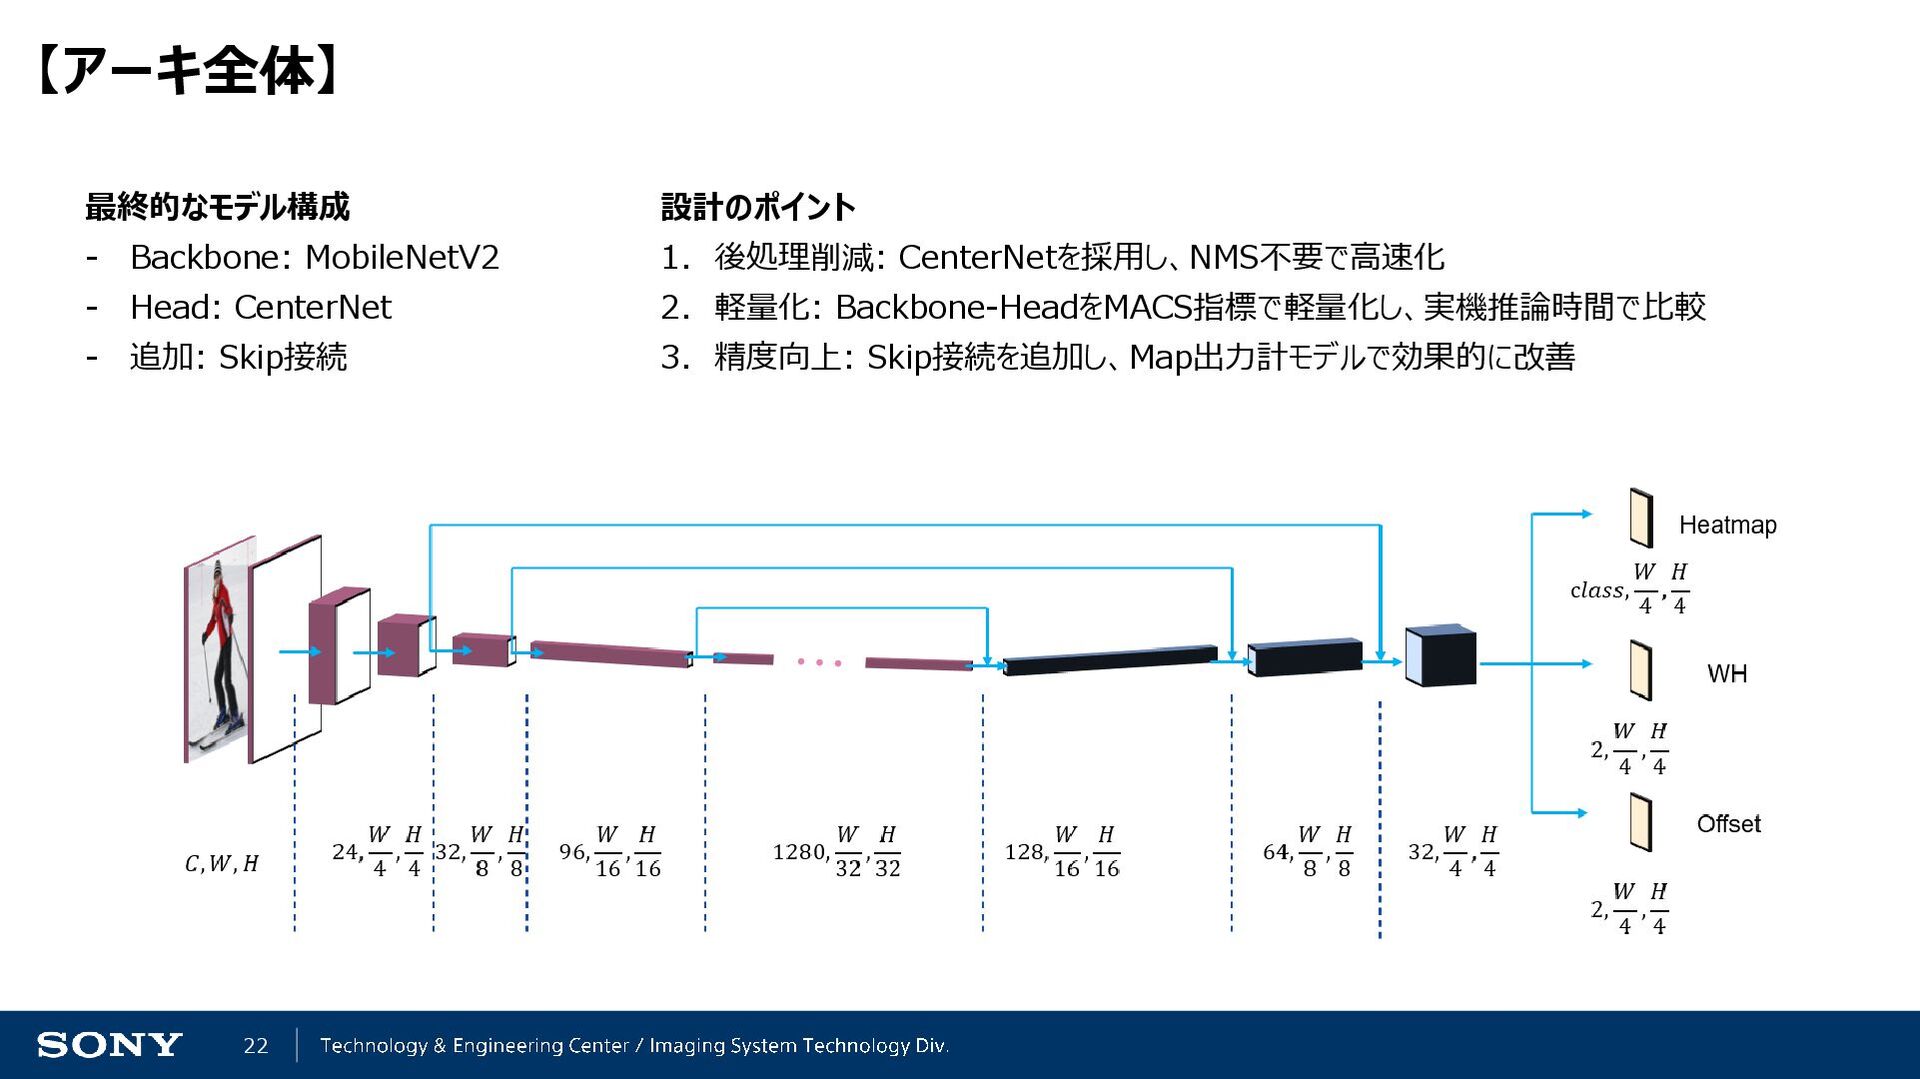
22 【アーキ全体】 最終的なモデル構成 - Backbone: MobileNetV2 - Head: CenterNet -
追加: Skip接続 設計のポイント 1. 後処理削減: CenterNetを採用し、NMS不要で高速化 2. 軽量化: Backbone-HeadをMACS指標で軽量化し、実機推論時間で比較 3. 精度向上: Skip接続を追加し、Map出力計モデルで効果的に改善 -
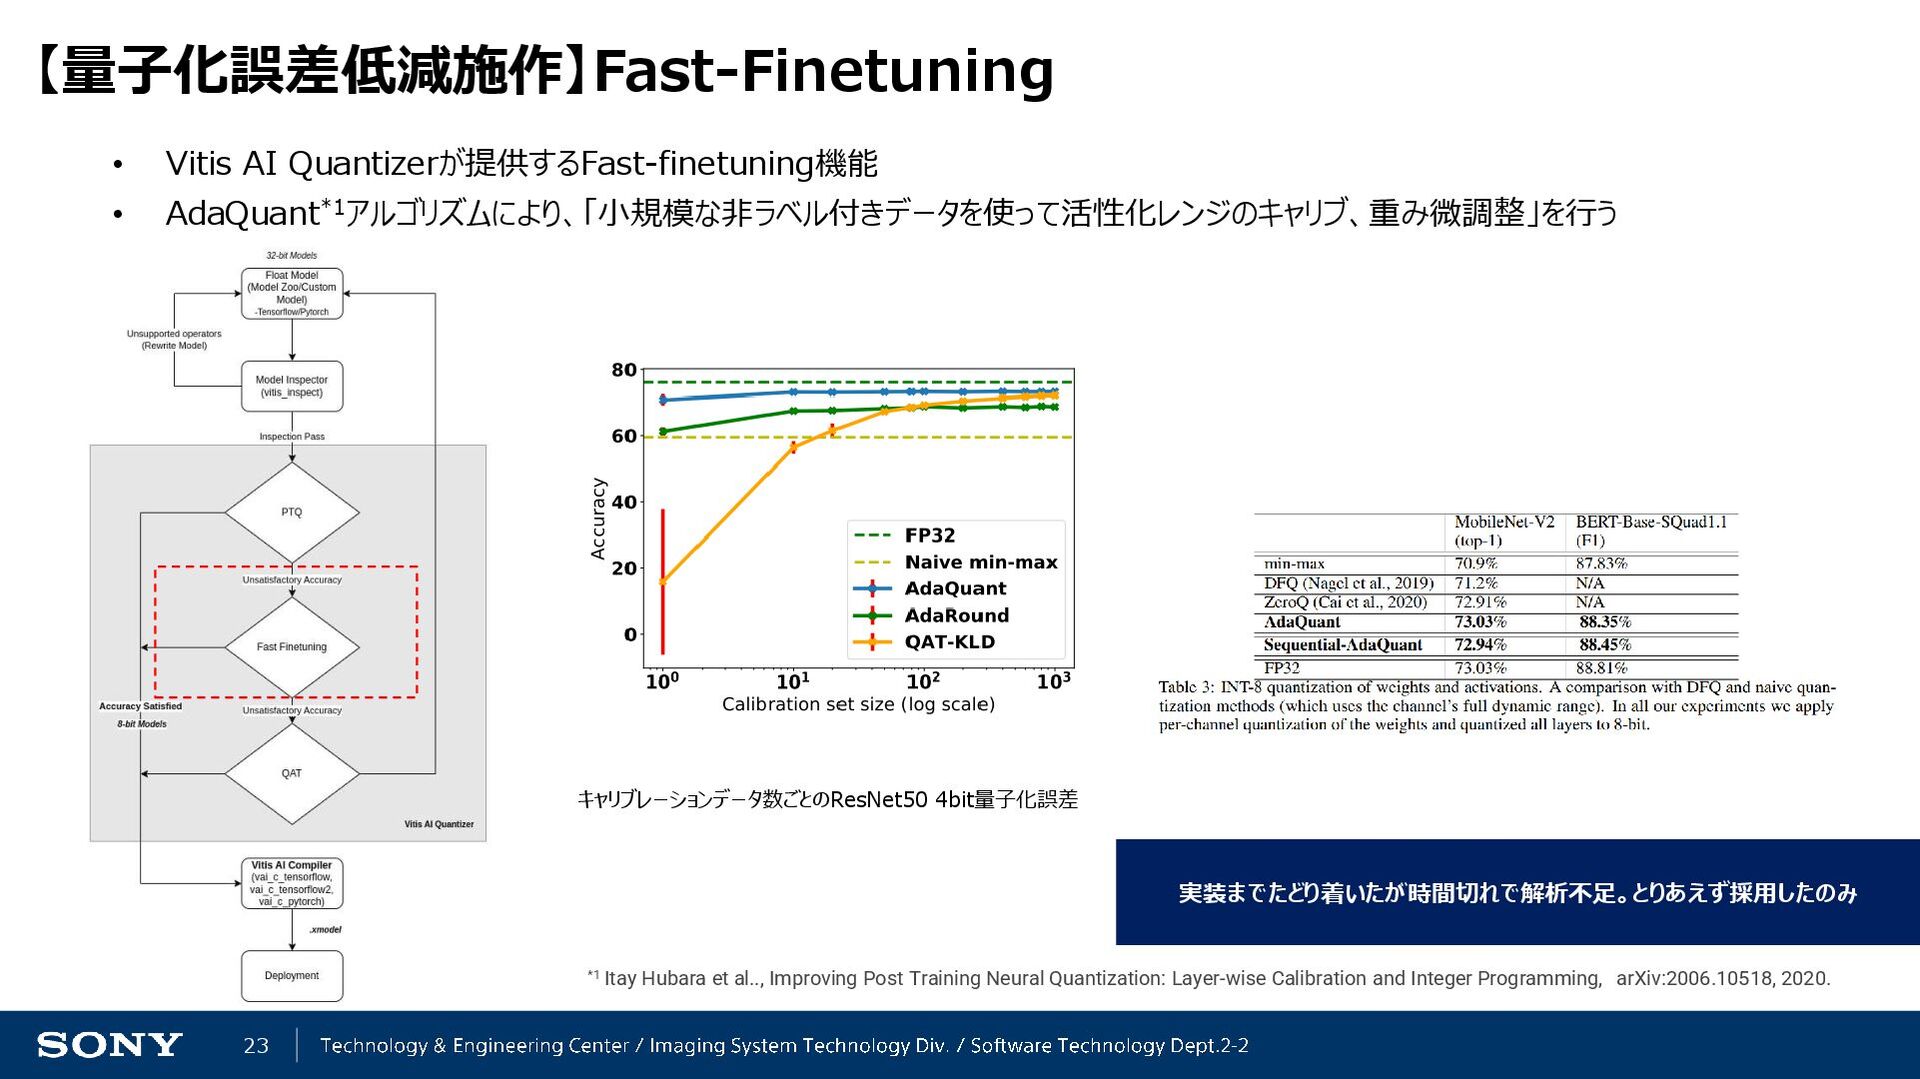
23 【量子化誤差低減施作】Fast-Finetuning • Vitis AI Quantizerが提供するFast-finetuning機能 • AdaQuant*1アルゴリズムにより、「小規模な非ラベル付きデータを使って活性化レンジのキャリブ、重み微調整」を行う *1 Itay
Hubara et al.., Improving Post Training Neural Quantization: Layer-wise Calibration and Integer Programming, arXiv:2006.10518, 2020. キャリブレーションデータ数ごとのResNet50 4bit量子化誤差 実装までたどり着いたが時間切れで解析不足。とりあえず採用したのみ -
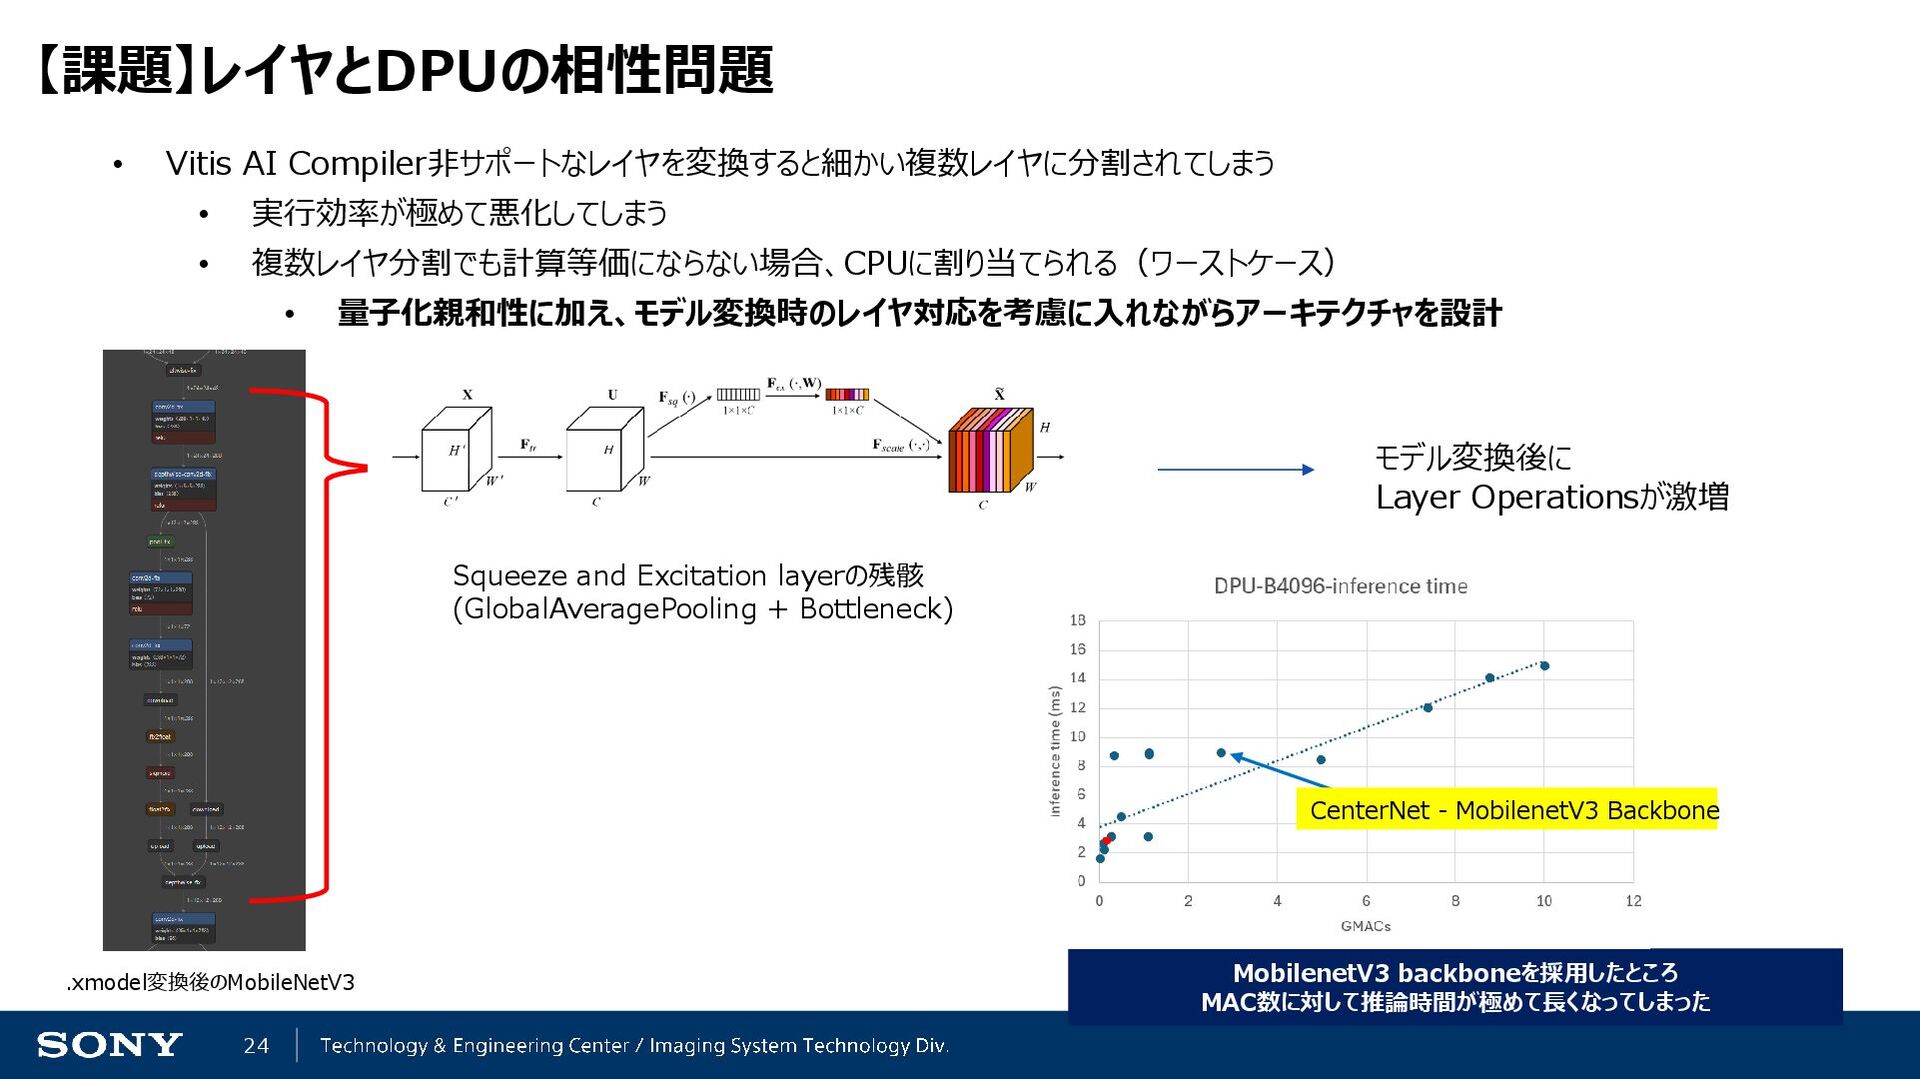
24 【課題】レイヤとDPUの相性問題 • Vitis AI Compiler非サポートなレイヤを変換すると細かい複数レイヤに分割されてしまう • 実行効率が極めて悪化してしまう • 複数レイヤ分割でも計算等価にならない場合、CPUに割り当てられる(ワーストケース)
• 量子化親和性に加え、モデル変換時のレイヤ対応を考慮に入れながらアーキテクチャを設計 MobilenetV3 backboneを採用したところ MAC数に対して推論時間が極めて長くなってしまった Squeeze and Excitation layerの残骸 (GlobalAveragePooling + Bottleneck) モデル変換後に Layer Operationsが激増 .xmodel変換後のMobileNetV3 CenterNet - MobilenetV3 Backbone -
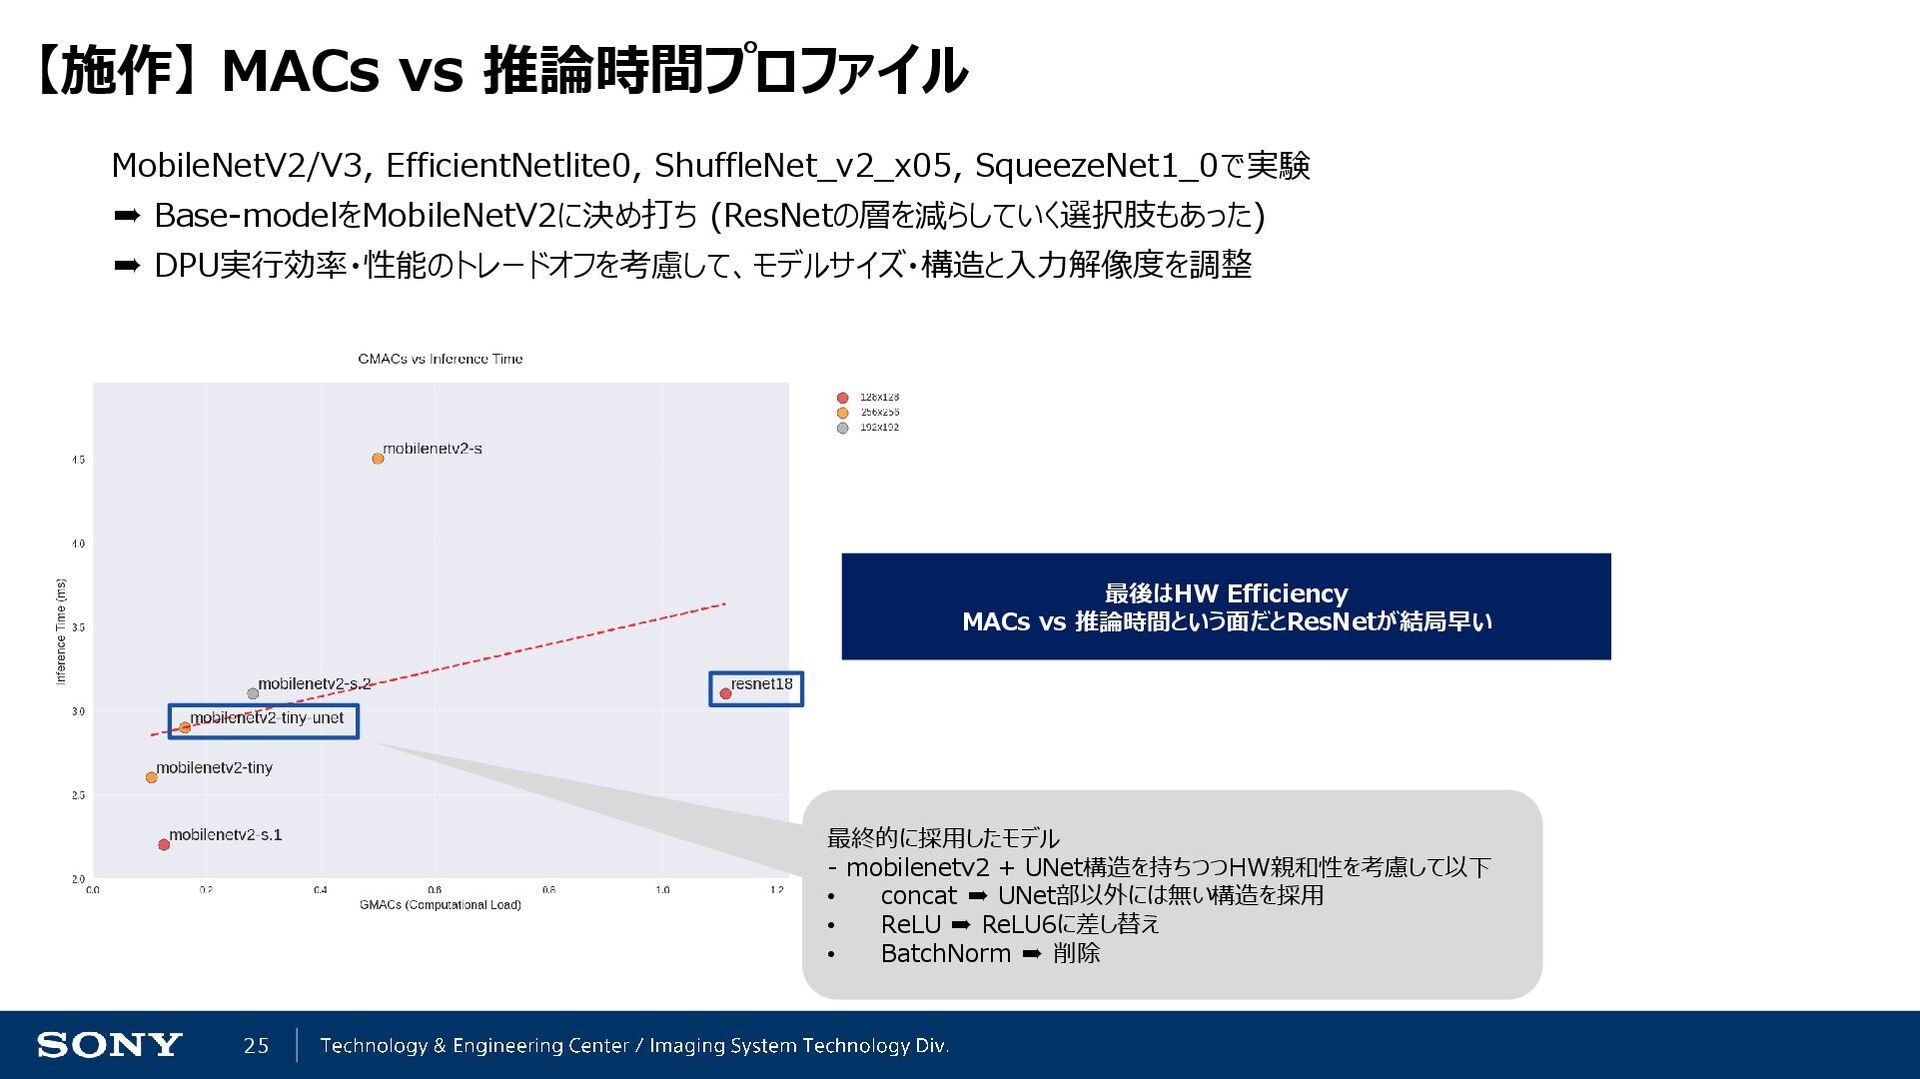
25 【施作】 MACs vs 推論時間プロファイル MobileNetV2/V3, EfficientNetlite0, ShuffleNet_v2_x05, SqueezeNet1_0で実験 ➨
Base-modelをMobileNetV2に決め打ち (ResNetの層を減らしていく選択肢もあった) ➨ DPU実行効率・性能のトレードオフを考慮して、モデルサイズ・構造と入力解像度を調整 最終的に採用したモデル - mobilenetv2 + UNet構造を持ちつつHW親和性を考慮して以下 • concat ➨ UNet部以外には無い構造を採用 • ReLU ➨ ReLU6に差し替え • BatchNorm ➨ 削除 最後はHW Efficiency MACs vs 推論時間という面だとResNetが結局早い -
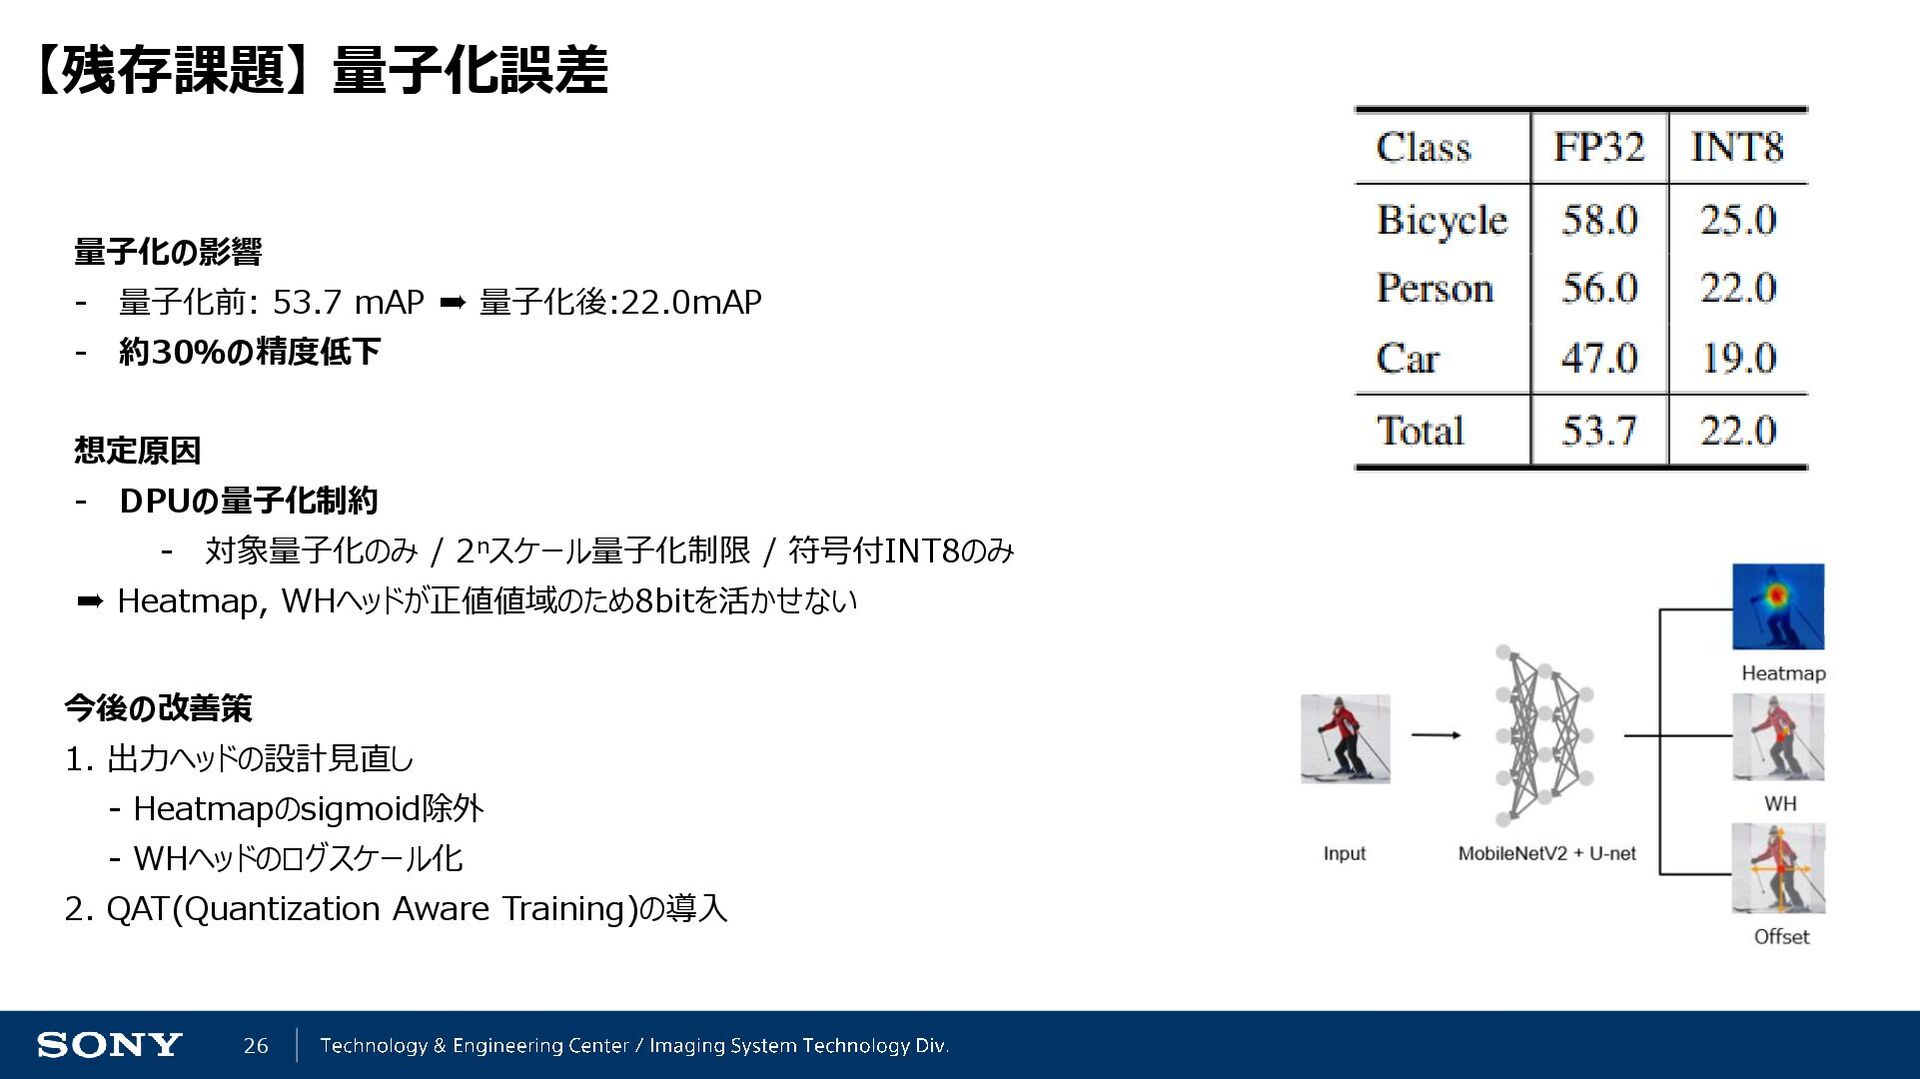
26 【残存課題】 量子化誤差 今後の改善策 1. 出力ヘッドの設計見直し - Heatmapのsigmoid除外 - WHヘッドのログスケール化
2. QAT(Quantization Aware Training)の導入 量子化の影響 - 量子化前: 53.7 mAP ➨ 量子化後:22.0mAP - 約30%の精度低下 想定原因 - DPUの量子化制約 - 対象量子化のみ / 2nスケール量子化制限 / 符号付INT8のみ ➨ Heatmap, WHヘッドが正値値域のため8bitを活かせない -
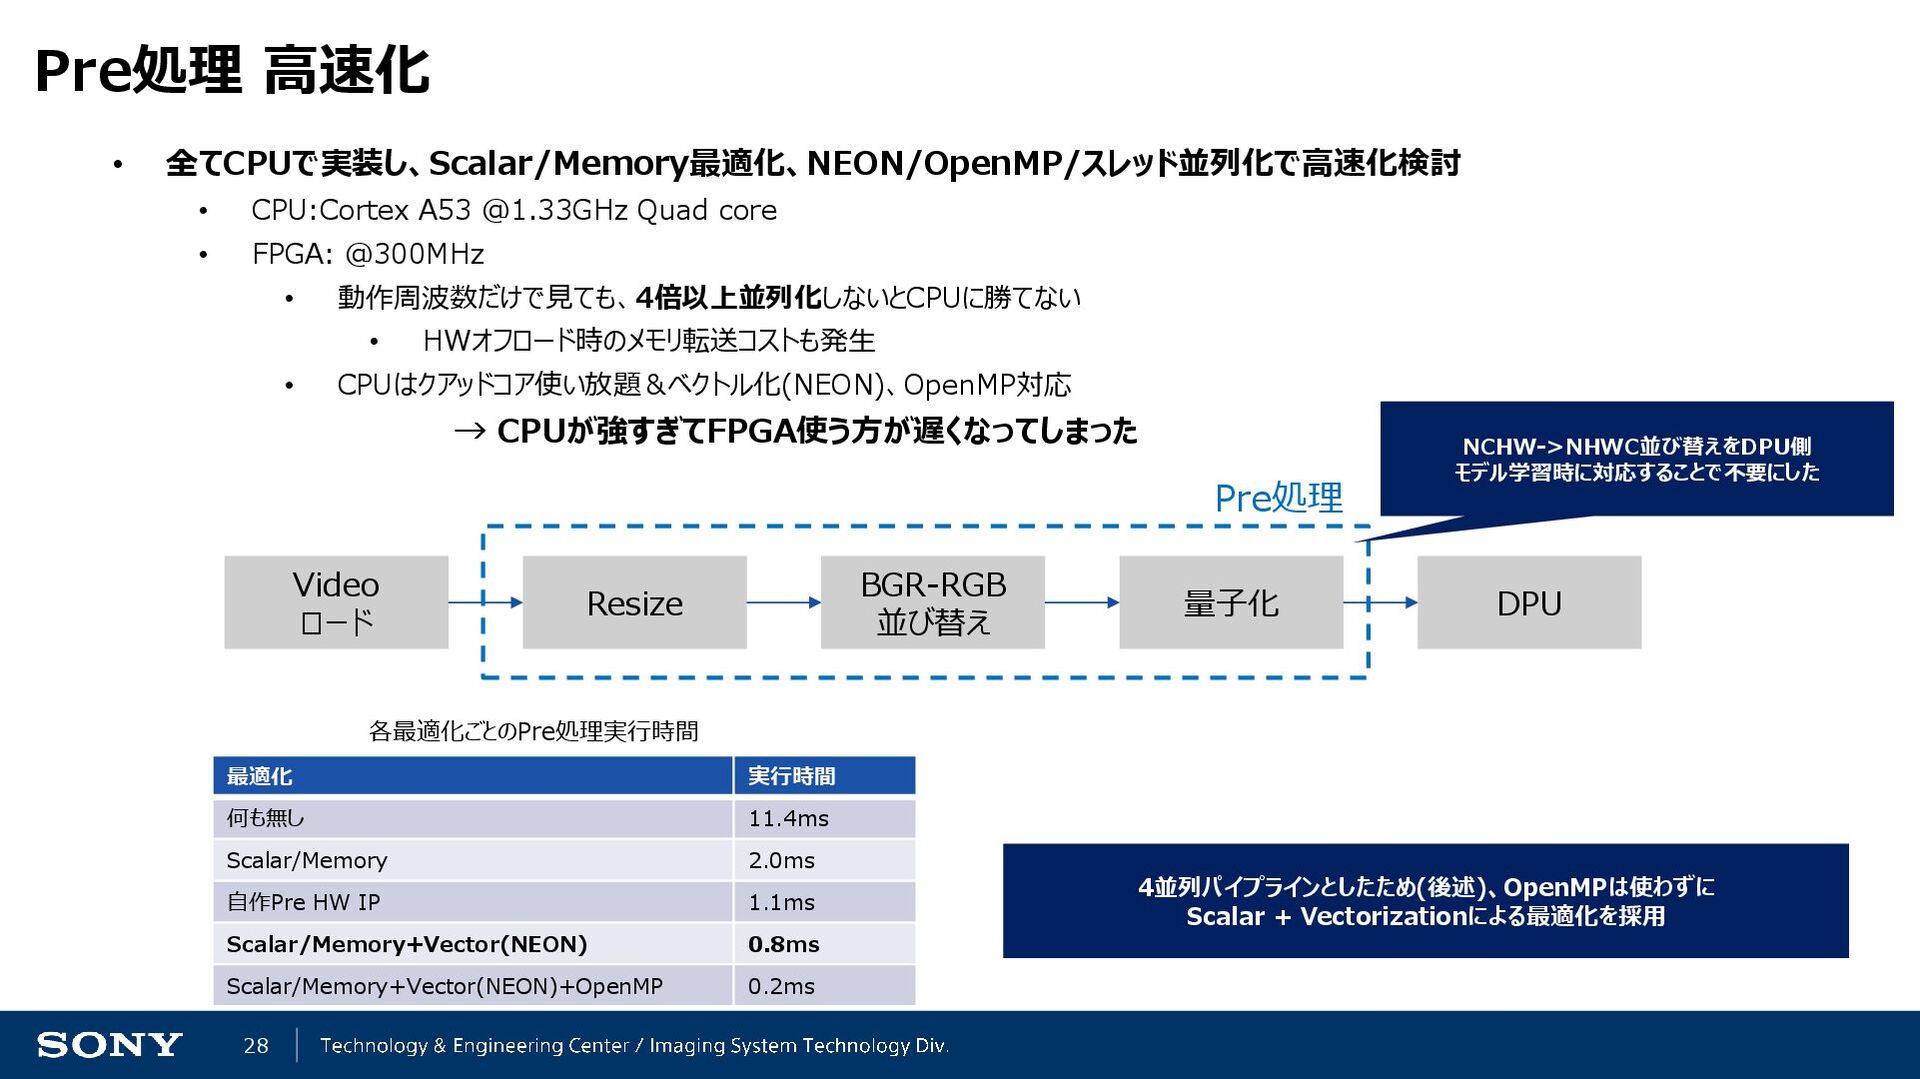
28 Pre処理 高速化 • 全てCPUで実装し、Scalar/Memory最適化、NEON/OpenMP/スレッド並列化で高速化検討 • CPU:Cortex A53 @1.33GHz Quad
core • FPGA: @300MHz • 動作周波数だけで見ても、4倍以上並列化しないとCPUに勝てない • HWオフロード時のメモリ転送コストも発生 • CPUはクアッドコア使い放題&ベクトル化(NEON)、OpenMP対応 → CPUが強すぎてFPGA使う方が遅くなってしまった Video ロード Resize BGR-RGB 並び替え 量子化 DPU 最適化 実行時間 何も無し 11.4ms Scalar/Memory 2.0ms 自作Pre HW IP 1.1ms Scalar/Memory+Vector(NEON) 0.8ms Scalar/Memory+Vector(NEON)+OpenMP 0.2ms 各最適化ごとのPre処理実行時間 4並列パイプラインとしたため(後述)、OpenMPは使わずに Scalar + Vectorizationによる最適化を採用 Pre処理 NCHW->NHWC並び替えをDPU側 モデル学習時に対応することで不要にした -
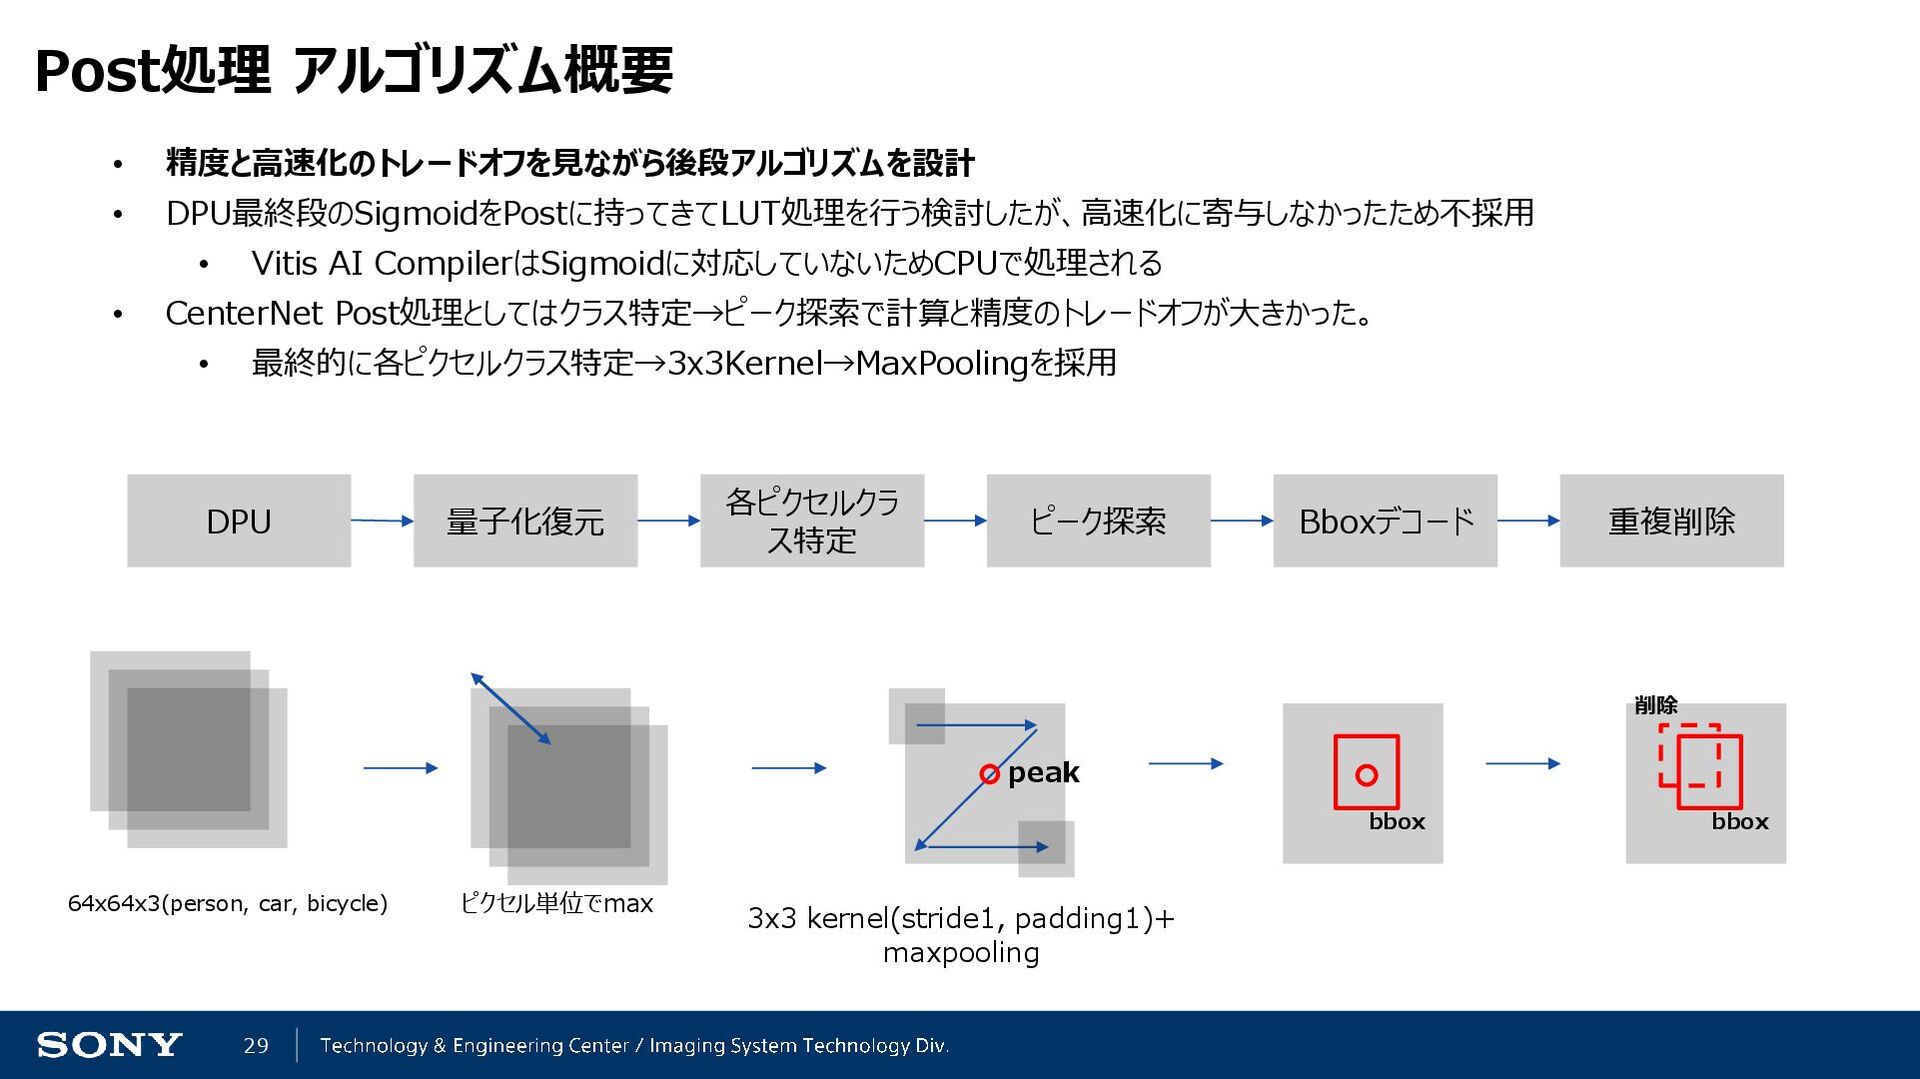
29 Post処理 アルゴリズム概要 • 精度と高速化のトレードオフを見ながら後段アルゴリズムを設計 • DPU最終段のSigmoidをPostに持ってきてLUT処理を行う検討したが、高速化に寄与しなかったため不採用 • Vitis AI
CompilerはSigmoidに対応していないためCPUで処理される • CenterNet Post処理としてはクラス特定→ピーク探索で計算と精度のトレードオフが大きかった。 • 最終的に各ピクセルクラス特定→3x3Kernel→MaxPoolingを採用 量子化復元 ピーク探索 Bboxデコード 重複削除 DPU 各ピクセルクラ ス特定 64x64x3(person, car, bicycle) ピクセル単位でmax peak bbox bbox 削除 3x3 kernel(stride1, padding1)+ maxpooling -
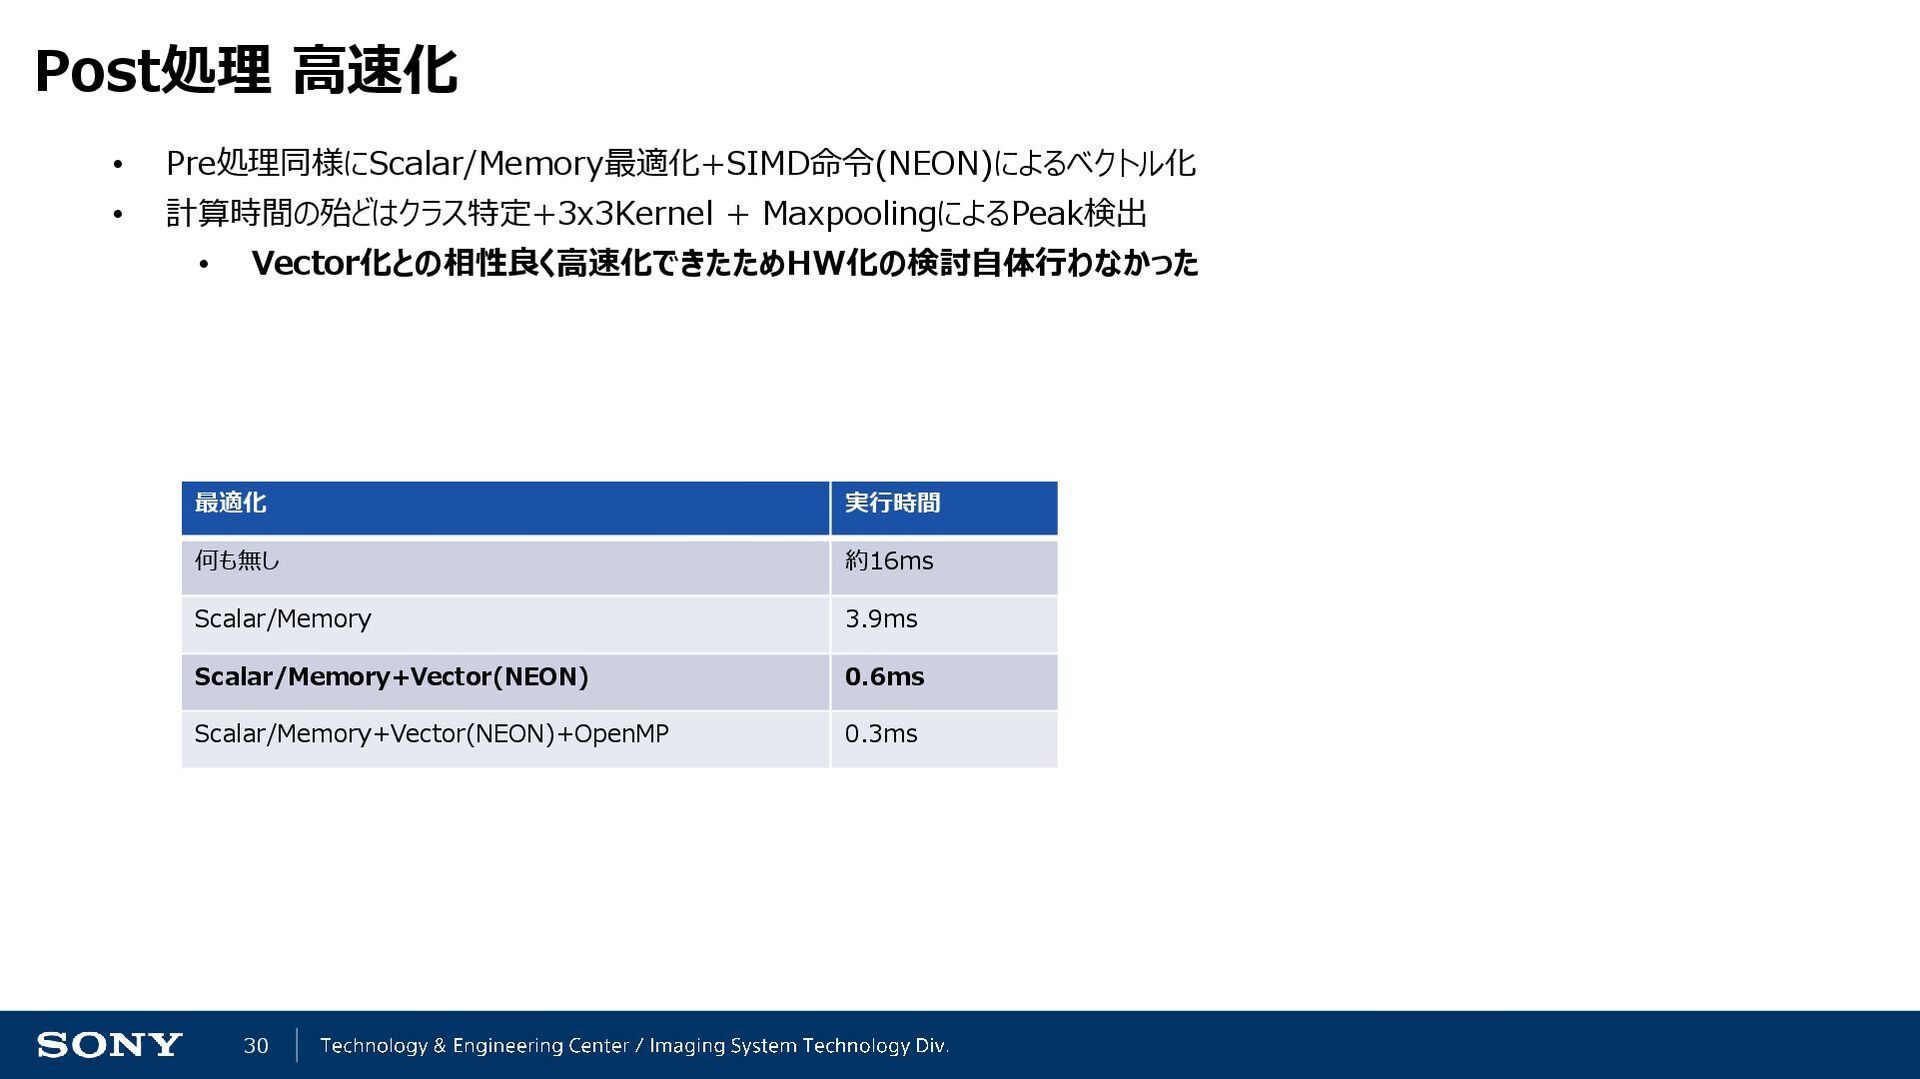
30 Post処理 高速化 • Pre処理同様にScalar/Memory最適化+SIMD命令(NEON)によるベクトル化 • 計算時間の殆どはクラス特定+3x3Kernel + MaxpoolingによるPeak検出 •
Vector化との相性良く高速化できたためHW化の検討自体行わなかった 最適化 実行時間 何も無し 約16ms Scalar/Memory 3.9ms Scalar/Memory+Vector(NEON) 0.6ms Scalar/Memory+Vector(NEON)+OpenMP 0.3ms -
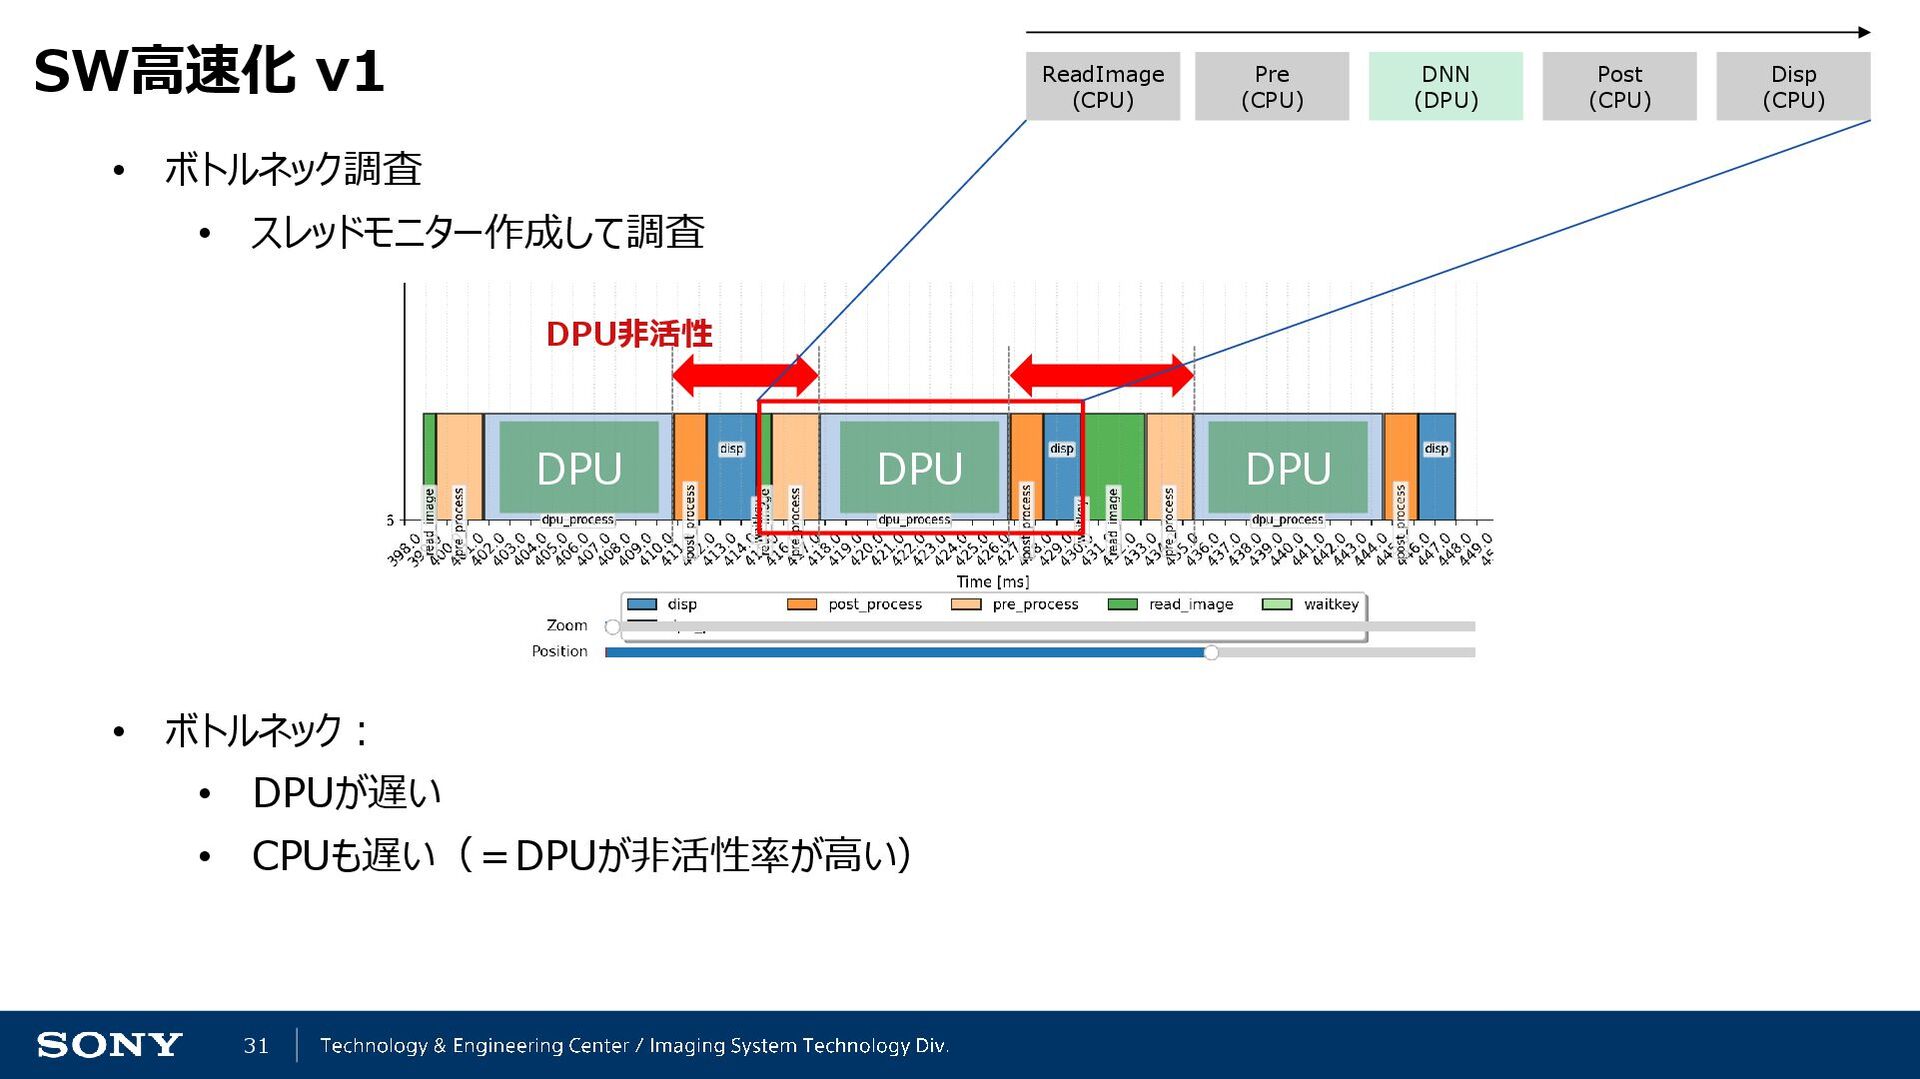
31 SW高速化 v1 • ボトルネック調査 • スレッドモニター作成して調査 • ボトルネック: •
DPUが遅い • CPUも遅い(=DPUが非活性率が高い) Pre (CPU) DNN (DPU) Post (CPU) ReadImage (CPU) Disp (CPU) DPU DPU DPU DPU非活性 -
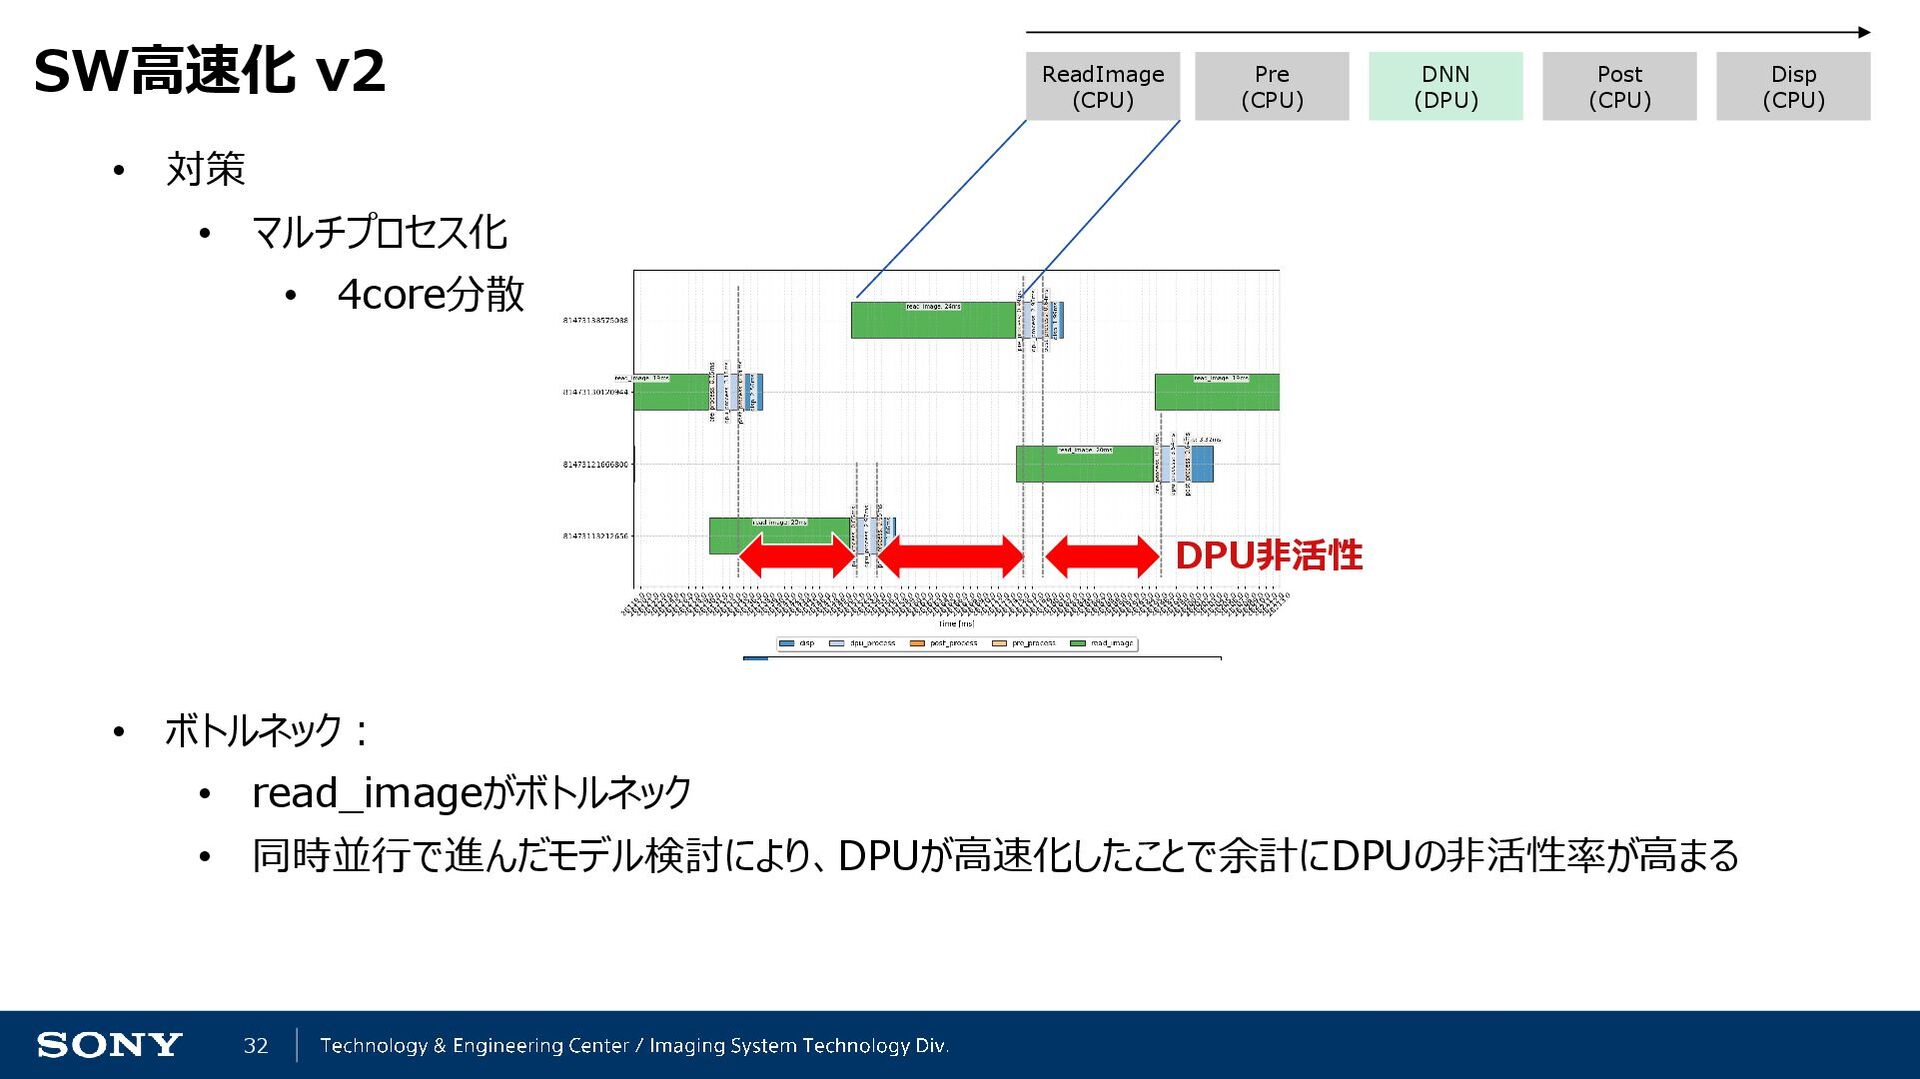
32 SW高速化 v2 • 対策 • マルチプロセス化 • 4core分散 •
ボトルネック: • read_imageがボトルネック • 同時並行で進んだモデル検討により、DPUが高速化したことで余計にDPUの非活性率が高まる Pre (CPU) DNN (DPU) Post (CPU) ReadImage (CPU) Disp (CPU) DPU非活性 -
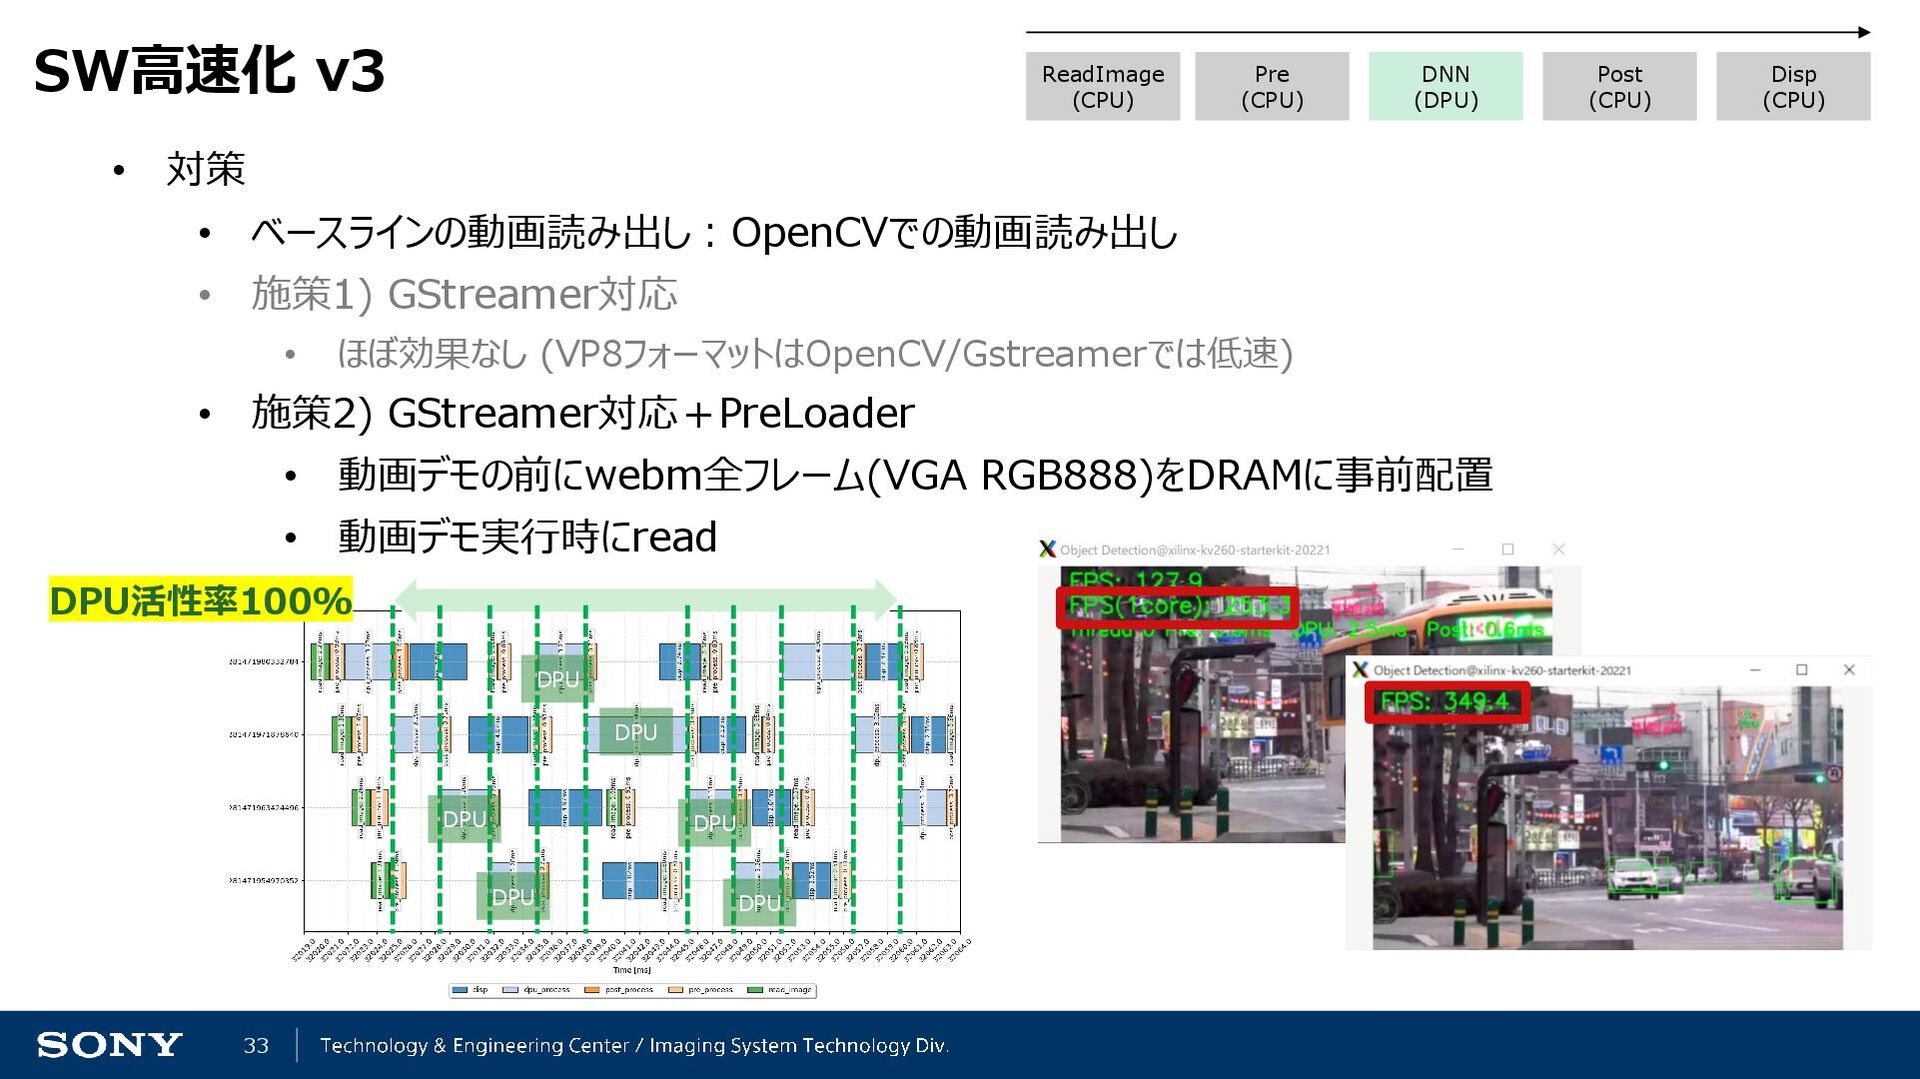
33 SW高速化 v3 • 対策 • ベースラインの動画読み出し:OpenCVでの動画読み出し • 施策1) GStreamer対応
• ほぼ効果なし (VP8フォーマットはOpenCV/Gstreamerでは低速) • 施策2) GStreamer対応+PreLoader • 動画デモの前にwebm全フレーム(VGA RGB888)をDRAMに事前配置 • 動画デモ実行時にread Pre (CPU) DNN (DPU) Post (CPU) ReadImage (CPU) Disp (CPU) DPU活性率100% DPU DPU DPU DPU DPU DPU -
34 実際の動画 *開発途中のものなのでFPS表示が違うが、実際は340FPS - リファレンスデザインだとこの動画の全推論に10分34秒かかる - 実行中、会場ではどよめきが沸き起こった KV260-[LAN/SSH]-Windowsという構成なのでX11 serverでデモライブ表示するが、 我々のモジュールの処理が速すぎてX11
server起動(オバーヘッド)より前にデモを完走してしまうため、 事前にX11 serverを起動しておくようにしている (これをやっておかないと審査員が記録を残せない) -
35 まとめと今後の課題 まとめ: 約1ヶ月で、HW/DNNモデル/SWを多角的に高速化設計し、FPGA上で341.6FPS/22.04mAPを実現。 - HW: Pre/Post処理はCPU処理、DPUはリファレンスデザインを活用。 - DNNモデル: CenterNetをベースにDPU上で実行効率が良いレイヤを採用。
- SW: 4コア並列化と各種処理最適化により、DPU活性率100%を達成。 今後の課題 1. DNNモデルの量子化誤差 - 精度劣化が大きく、DPUの量子化制約との相性が課題。 ➨ QAT導入やデコーダーヘッド改良で改善を検討。 2. HW構成の最適化 - FPSを優先しと強力な4コアCPUリソース活用のため、今回はリファレンスのHW構成を採用。 ➨ 電力効率などHWの強みを活かした設計評価への発展を検討。 3. CPUとDPUの活性率のバランス - 結果的にDPUの活性率100%に対してCPUに空きが出てしまった。 ➨ CPUの処理をリッチにして精度を上げる/DPUをより高速化するなどの協調的な設計。