Share
Embed
【論文紹介】Is CLIP ideal? No. Can we fix it?Yes! 第65回 コンピュータビジョン勉強会@関東
第65回 コンピュータビジョン勉強会で使用したスライドです.
Shun Makino
November 16, 2025
Transcript
23 slides
-
【論文紹介】 Is CLIP ideal? No. Can we fix it? Yes!
第65回 コンピュータビジョン勉強会@関東 牧野 舜(@ShuN057721) -
自己紹介 • 牧野 舜 (Makino Shun) ◦ AIエンジニア @株式会社 MIXI
開発本部 • 簡単な経歴 ◦ 物理(物性理論)で修士 ◦ 企業(前職)でR&D ▪ トピック: 数理最適化,強化学習,GNNとか ▪ ML, 数理最適化のPoC ▪ 去年のIBISでポスター出したり ◦ 2025年4月からMIXI • 趣味など ◦ 釣り(オフショアメイン),麻雀,千葉ロッテマリーンズ -
紹介する論文 • Is CLIP ideal? No. Can we fix it?
Yes!., Kang et al. ◦ https://arxiv.org/abs/2503.08723 • 主なcontribution ◦ CLIPの特徴空間についてに数学的に考察 ▪ 既存のCLIPの構造的な問題を指摘 ◦ CLIPの中間層の出力を使用した手法を提案 ▪ 結果によると,これまでのCLIPの手法を上回る精度がでた -
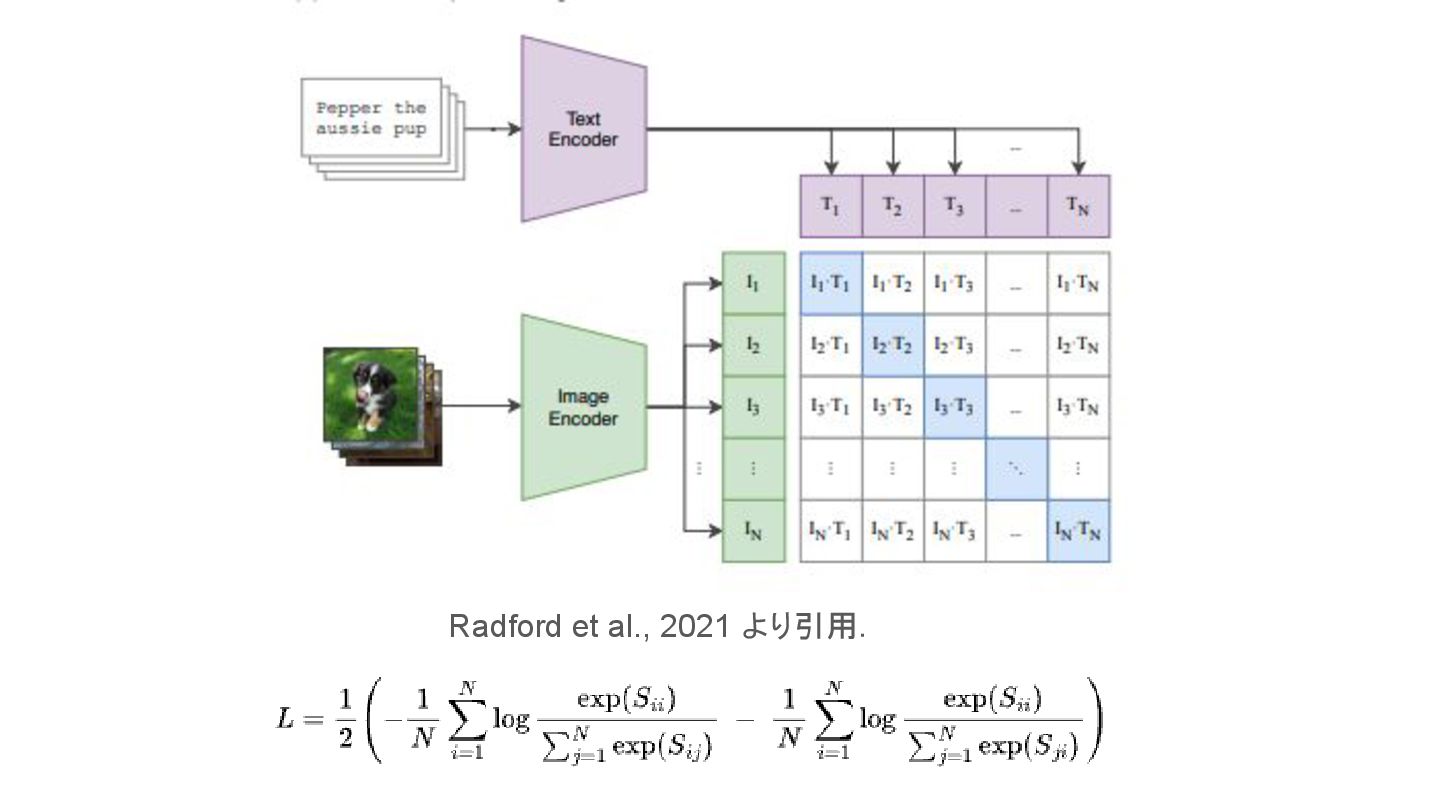
• Contrastive Language-Image Pre-Training (CLIP)., 2021 ◦ Textとimageを同じ特徴空間にmapping ◦ 意味的に近いimageとtextのベクトルが特徴空間で近づくように学習する
▪ 原論文(Radford et al., 2021.)から引用 CLIP learns a multi-modal embedding space by jointly training an image encoder and text encoder to maximize the cosine similarity of the image and text embeddings of the N real pairs in the batch while minimizing the cosine similarity of the embeddings of the N*N − N incorrect pairings. 背景 -
背景 • CLIPはマルチモーダルモデルの基礎として重要な役割 ◦ Visionとtextの橋渡し ▪ 例: 代表的なタスク,モデル • 画像キャプション
• 画像検索,テキスト検索 • ゼロショット分類 • VLM -
課題 • 弱点が知られている ◦ 空間的な推論(spatial reasoning), 構成的理解(compositionality) ▪ 例: the
cone is above the cylinder • the cone is below the cylinderにも高スコアを返す場合あり • 位置関係や語順の違いを反映できない ▪ 例: I saw this bird today • 特定の鳥であることの考慮がされずに鳥全般に反応する場合あり ◦ attribute bindings ▪ 例: sky is blue • sky is orangeにも高スコアを返す場合がある • 対象と属性の対応づけが曖昧 -
課題 • 弱点が知られている(続) ◦ 否定(negation) ▪ 例: yellow coat •
not a yellow coatでも高スコアを返す場合がある • 否定語が上手く反映されない ◦ textとimageの複雑な複雑な相互作用を記述できない • これらの弱点は下流タスクにも影響する ◦ 例えば,基盤モデルの中核moduleになっている -
先行研究 • 学習データや学習方法によるアプローチ ◦ 学習データを増やしてmodality gapを減らすなど ▪ CLIPの特徴空間が抱える根本的な課題にはアプローチできていない • 幾何学的なアプローチ
◦ CLIPの特徴空間の異方性を考察 ◦ CLIPの特徴空間をtext, imageから単位超球面上への写像と定義 (参考) ◦ 双曲空間に写像してローレンツ距離で類似度を測ったり (参考) ▪ CLIPの特徴空間に関する理論的な考察が不十分 -
提案手法 • 理想的なCLIPの特徴空間が持つ性質を定義 ◦ これらの性質はpopular VLM benchmarksに応えられるように定義 • 単位超球面上のcosine類似度を使用したこれまでのCLIPでは それらの条件を満たせないことを示す
• 軽量な下流CNNを導入することで特徴空間(score)を改善 -
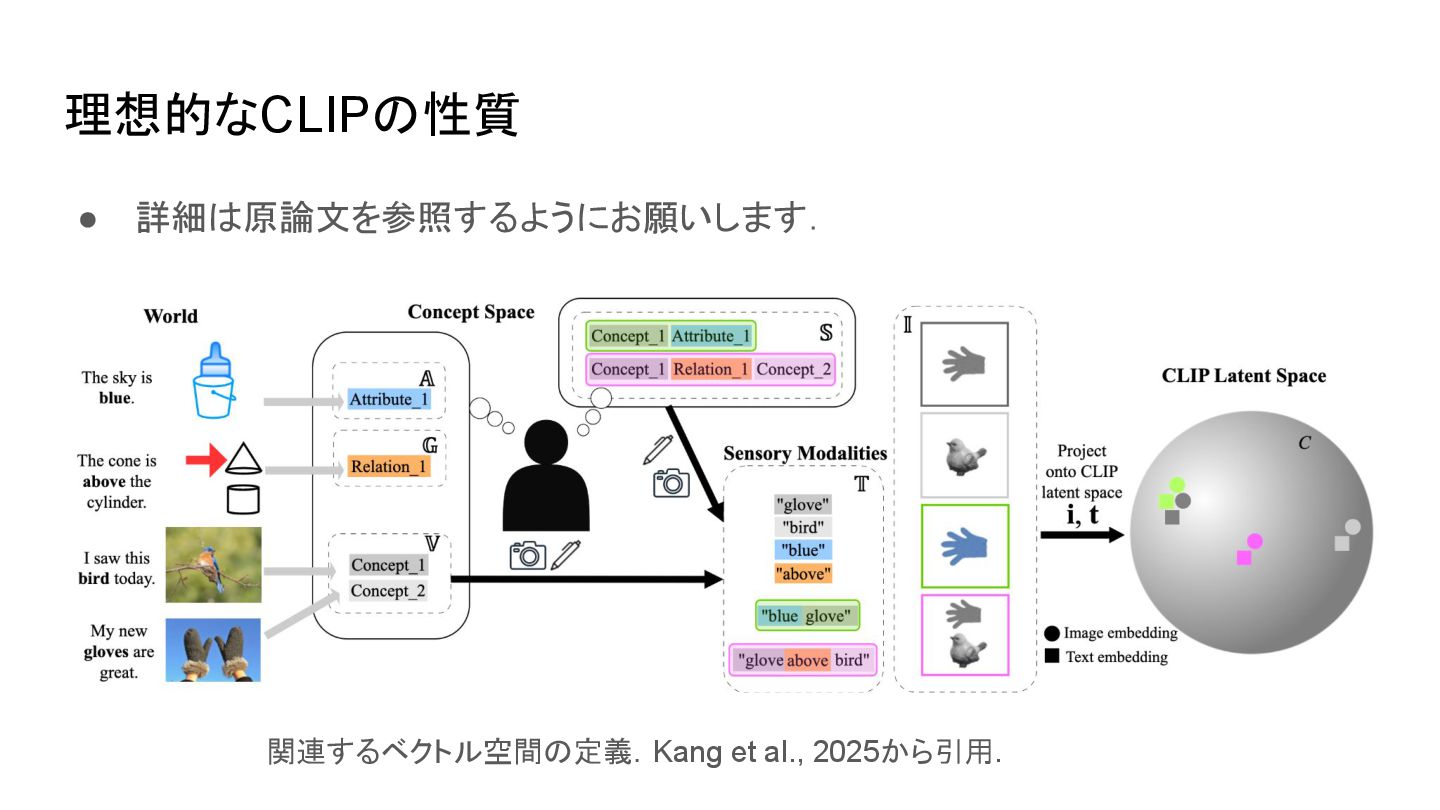
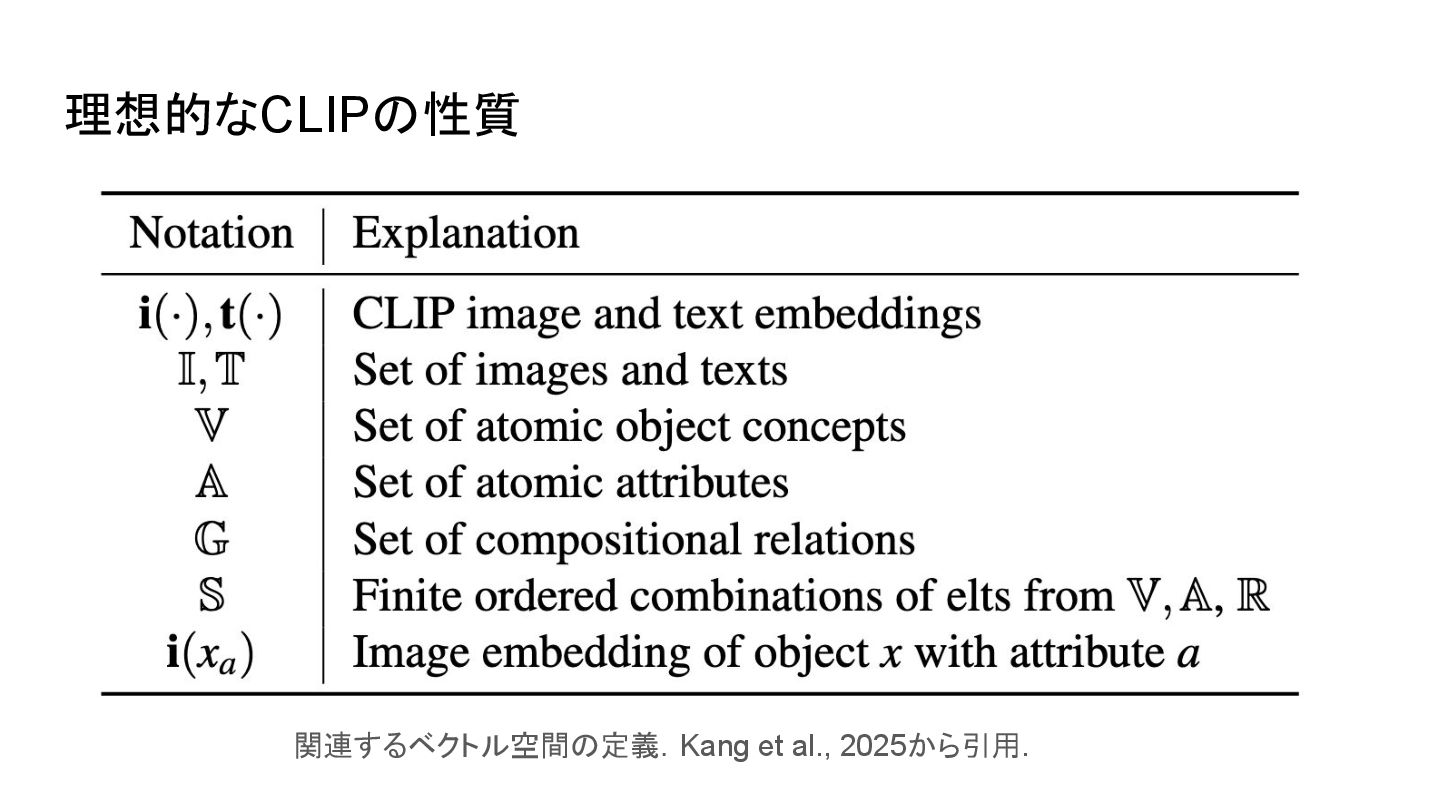
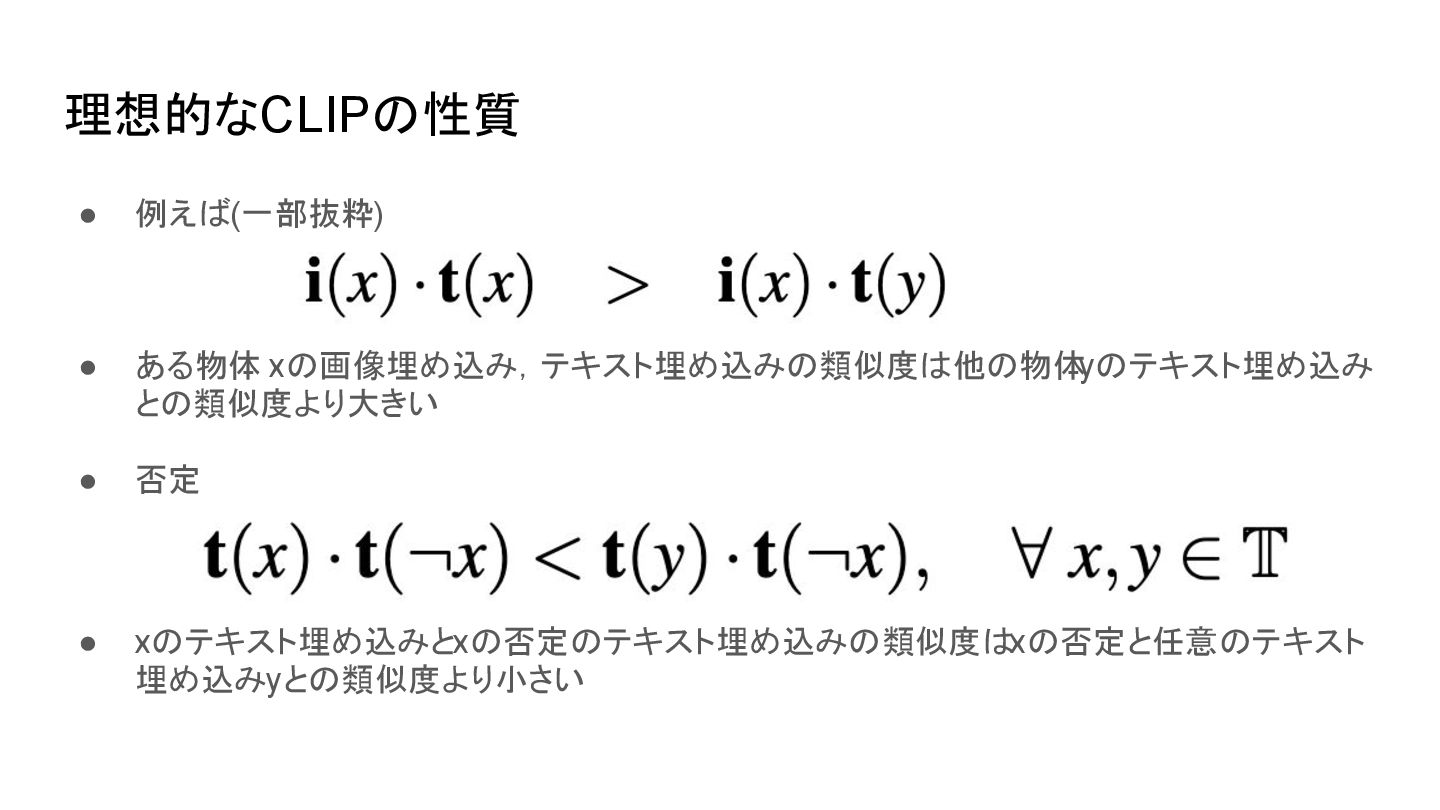
理想的なCLIPの性質 • 例えば(一部抜粋) • ある物体 xの画像埋め込み,テキスト埋め込みの類似度は他の物体 yのテキスト埋め込み との類似度より大きい • 否定
• xのテキスト埋め込みとxの否定のテキスト埋め込みの類似度はxの否定と任意のテキスト 埋め込みyとの類似度より小さい -
• 従来のcosine類似度ベースのCLIPではこの論文で考察した性質を満たすよう な特徴空間を作ることができない ◦ 列挙した条件を全て満たすことができない.条件同士で矛盾が生じる場合がある • 本文より引用 ◦ This means
Conditions 3.1 and 3.2 cannot be simultaneously satisfied. ◦ This produces the following effect, violating Condition 4.3. ◦ ちなみに条件を満たせないのは以下に関連するもの ▪ Spatial Relationship ▪ Negation ▪ Attribute Binding 理想的なCLIPの空間は作れないと主張 -
Rescuing the CLIP Latent Space • いまの特徴空間(単位超球面上への写像)のままでは構成的理解,否 定を上手く表現することができない • idea
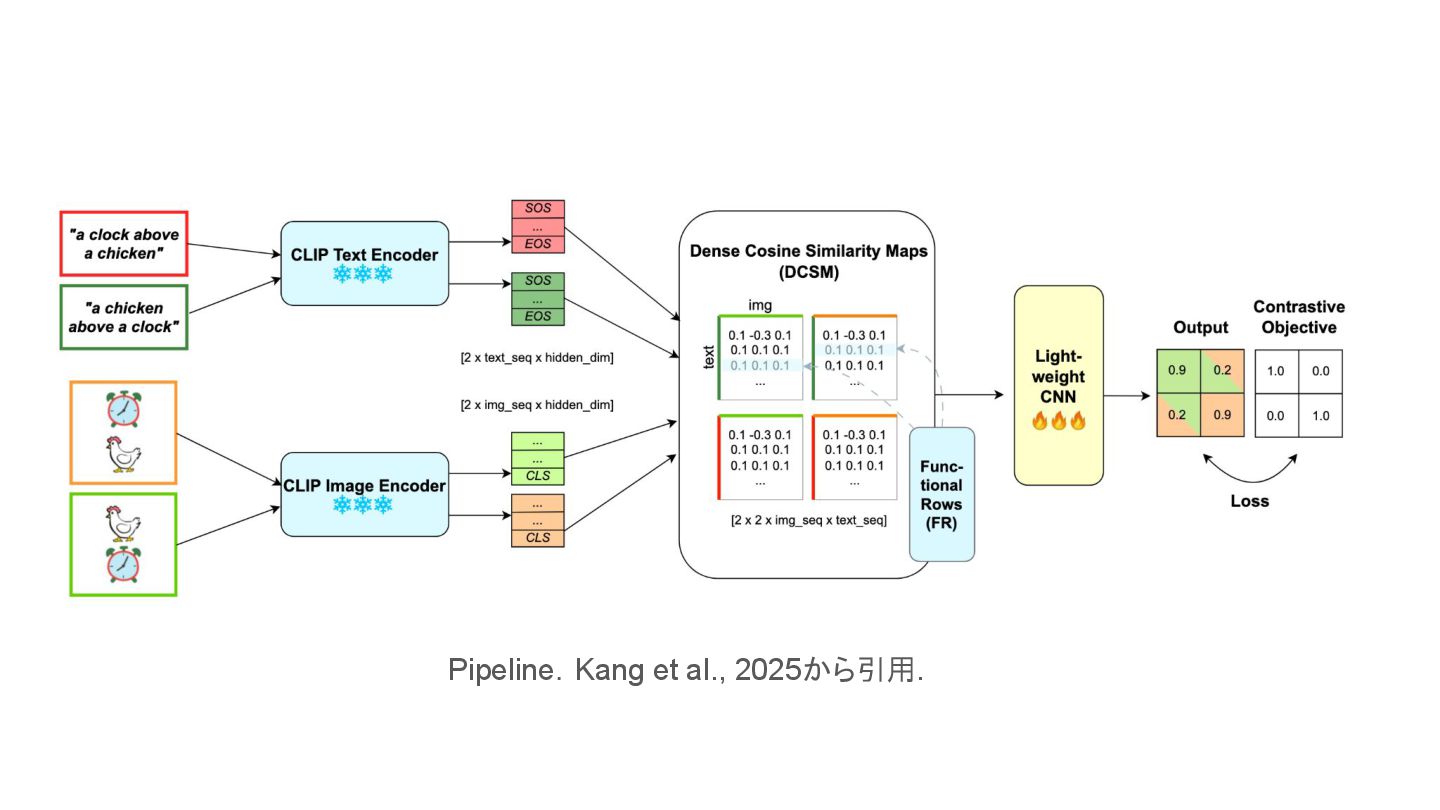
◦ text token, image patchを残す(文末tokenに代表させたりしない) ▪ ここが幾何学的な性質に関わるはず ◦ cosine類似度ではなく,学習済みのscore関数を使用する ◦ 空間関係語(above, below, left ofなど)は学習で表現を得るのではなく,定数的な ベクトルとして扱う -
• EOS tokenやCLS tokenを使用する代わりに,全てのtextトークンと image patchのcosine類似度を計算する ◦ 局所的な構造を捉えられるはず • これをCNNに入力してこれtext-imageのscoreとする.
◦ 論文ではこのscoring機構を学習している Dense Cosine Similarity Maps(DCSM) -
Functional Rows • functional words (例: left of, right of)
◦ 画像の中に直接対応するパッチがない ◦ CLIPの中間表現は直接対応するtokenに強く反応する傾向がある ▪ これがノイズになると主張 • functional wordsのtext tokenに対応するDCSMの行を定数化 ◦ functional wordは事前にリストアップ -
実験 • 提案したパイプラインを2通りのデータセットで学習 ◦ around 20000 samples(CLIPのミニバッチの1/1.5倍) ▪ synthetic data
created from Objaverse ▪ subset of COCO2017 ◦ ハイパラなど(詳細は論文の付録を参照) ▪ バッチサイズ: 8 -> CLIPの1/4000 (※ CLIPはpre-trainedの重みで frozen) ▪ loss: Binary cross-entropy • ペアが正解か不正解か -
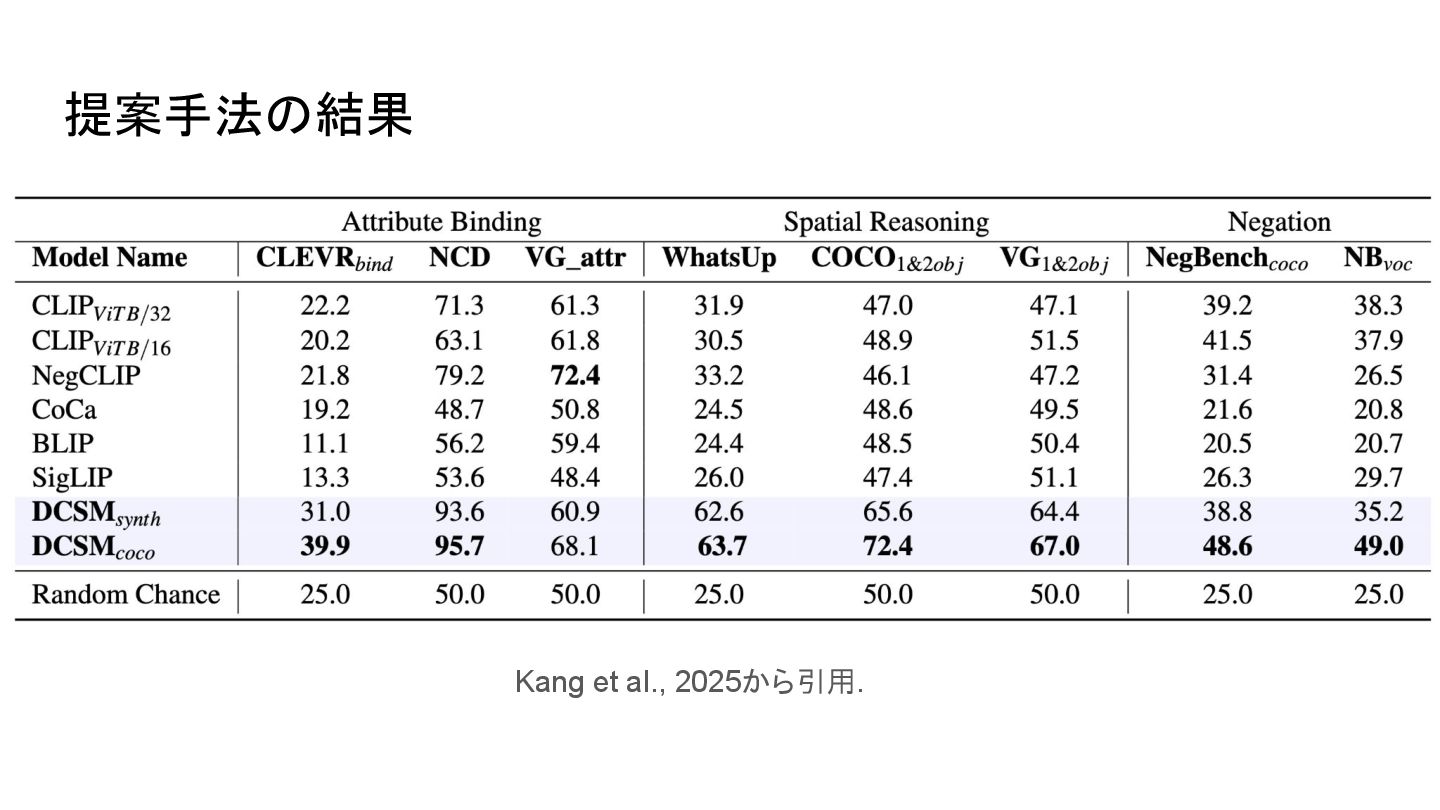
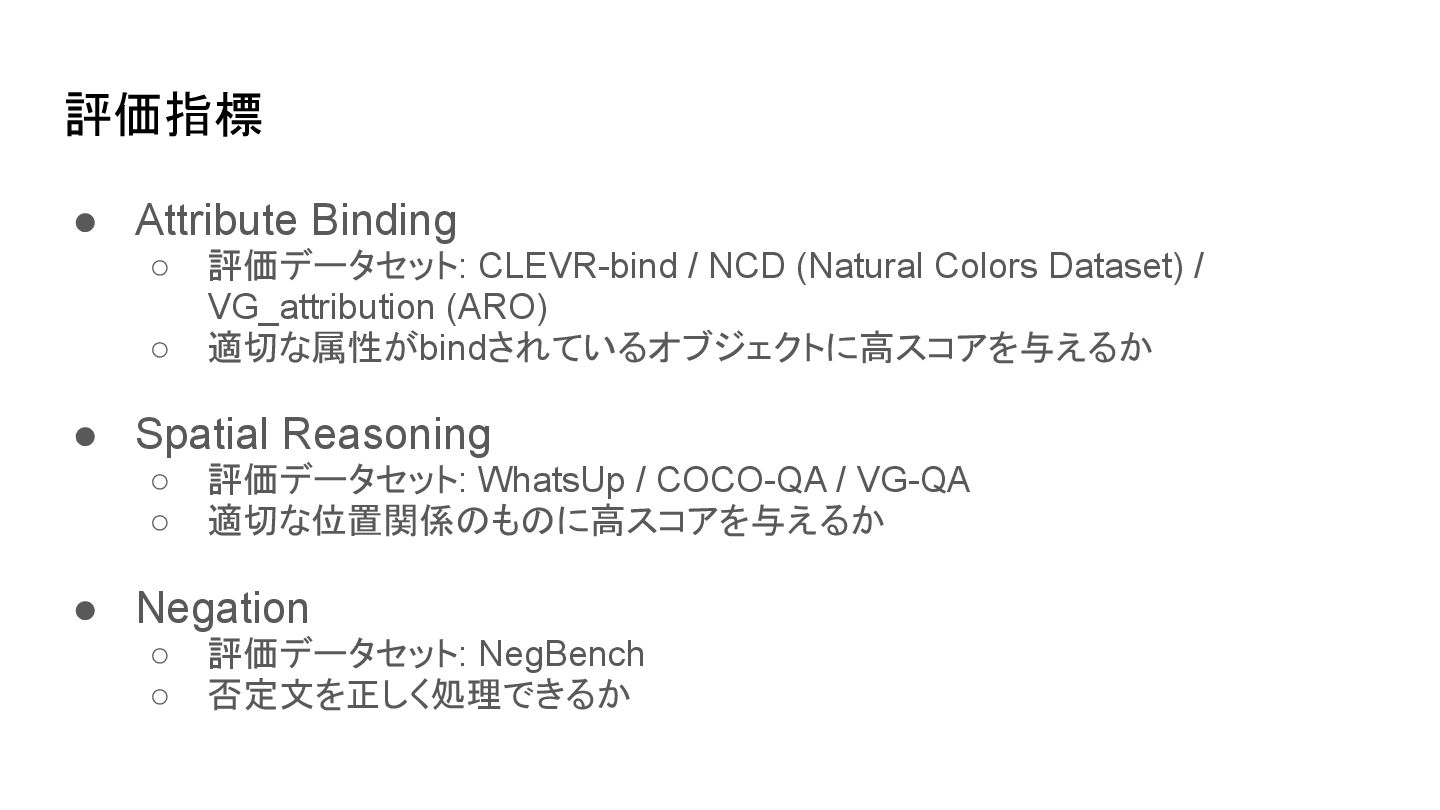
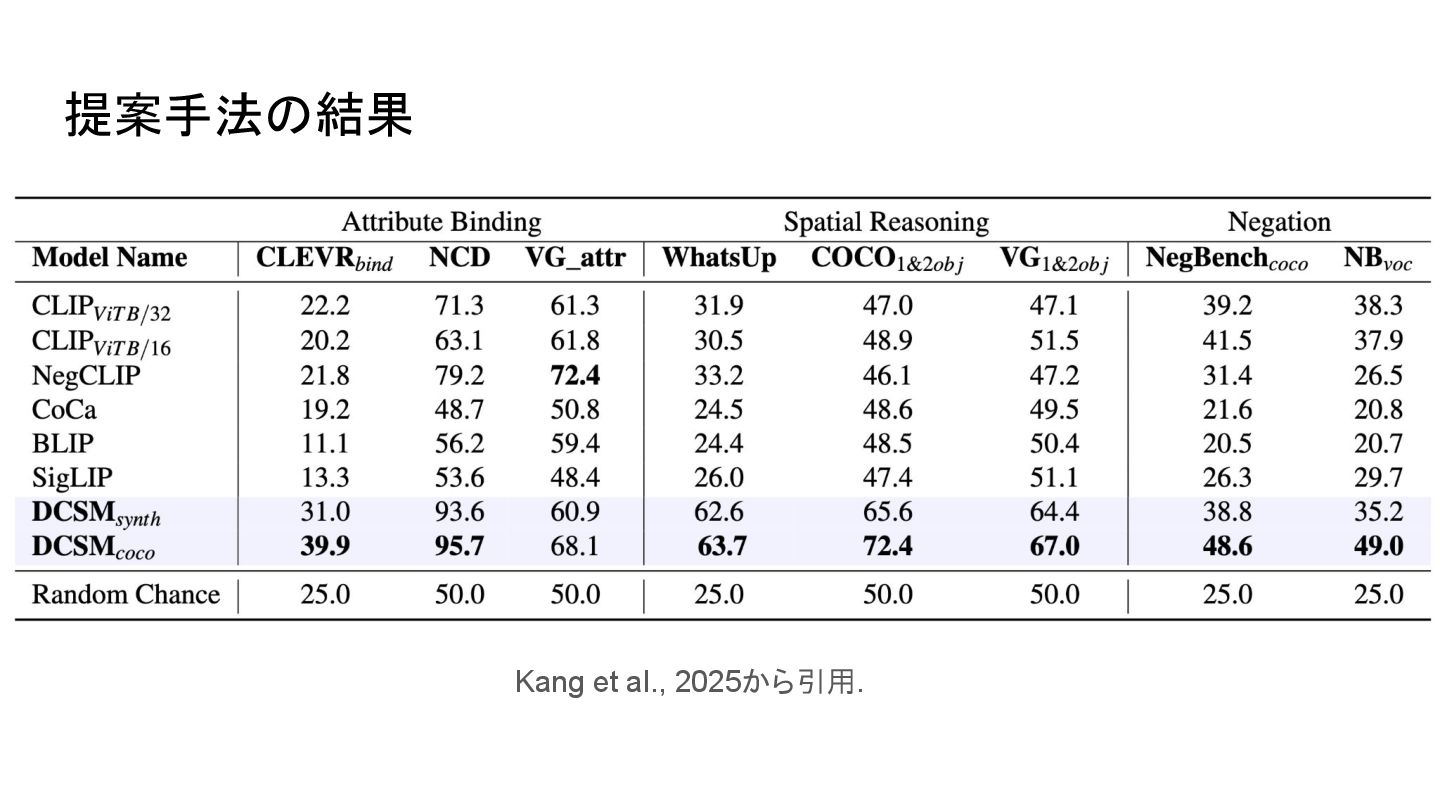
評価指標 • Attribute Binding ◦ 評価データセット: CLEVR-bind / NCD (Natural
Colors Dataset) / VG_attribution (ARO) ◦ 適切な属性がbindされているオブジェクトに高スコアを与えるか • Spatial Reasoning ◦ 評価データセット: WhatsUp / COCO-QA / VG-QA ◦ 適切な位置関係のものに高スコアを与えるか • Negation ◦ 評価データセット: NegBench ◦ 否定文を正しく処理できるか -
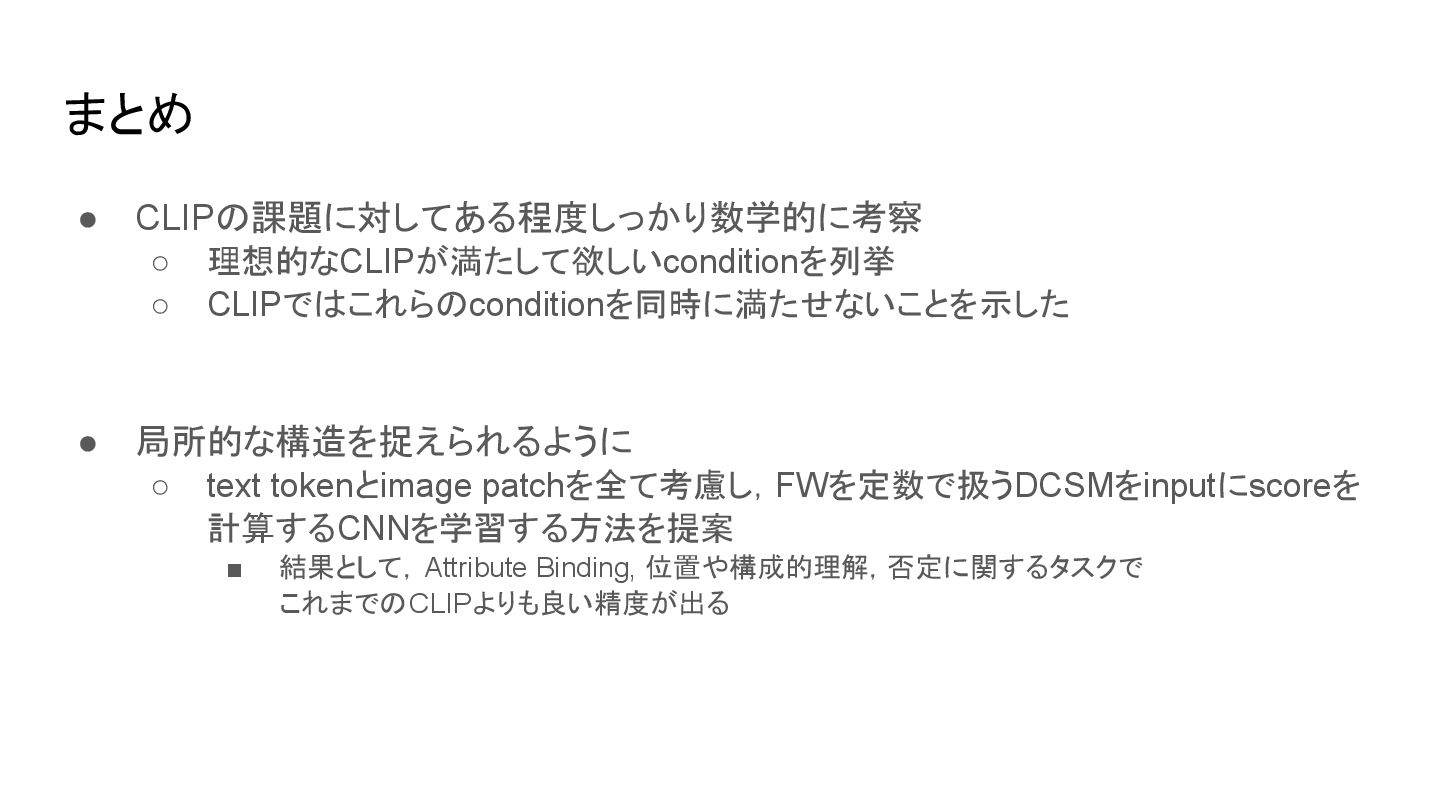
まとめ • CLIPの課題に対してある程度しっかり数学的に考察 ◦ 理想的なCLIPが満たして欲しいconditionを列挙 ◦ CLIPではこれらのconditionを同時に満たせないことを示した • 局所的な構造を捉えられるように ◦
text tokenとimage patchを全て考慮し,FWを定数で扱うDCSMをinputにscoreを 計算するCNNを学習する方法を提案 ▪ 結果として,Attribute Binding, 位置や構成的理解,否定に関するタスクで これまでのCLIPよりも良い精度が出る