Share
Embed
日本語・韓国語オノマトペにおける意味的・音韻的類似ペア抽出のための言語埋め込みを用いた分析
2025年度 ⼈⼯知能学会全国⼤会(第39回)
https://www.jstage.jst.go.jp/article/pjsai/JSAI2025/0/JSAI2025_4G1GS602/_article/-char/ja
Shunnosuke Motomura
May 29, 2025
Transcript
16 slides
-
⽇本語・韓国語オノマトペにおける 意味的・⾳韻的類似ペア抽出のための ⾔語埋め込みを⽤いた分析 2025年度 ⼈⼯知能学会全国⼤会(第39回) 〇本村 駿乃介1、久保 裕貴1、野崎 裕⼆1,2、坂本 真樹1,2
(1. 感性AI株式会社、2. 電気通信⼤学) © Kansei AI Co.,Ltd. 1 -
[背景] ⽇本語・韓国語におけるオノマトペ 両⾔語ともオノマトペ(擬⾳語・擬態語等)を多く持つ • 学習者にとって習得の難しさ • 各⾔語の⾳象徴についての分析・解明は重要な問題 • ⾳象徴:語の⾳と意味の間にある関連性 ⇒⾳と意味の2つの⽅向からの分析が不可⽋
• 研究者の各⾔語の知識や主観的な判断に影響 ⇒データ駆動的な⼿法の検討が待たれる [⽂慶 14] ⽂慶喆:⽇本語と韓国語における擬態語・擬⾳語について (2014) [Ramachandran & Hubbard 01] Ramachandran, Vilayanur S., and Edward M. Hubbard. "Synaesthesia--a window into perception, thought and language." (2001) 2 ! 1000~4500語 # 3000~8000語 [⽂慶 14] ブーバ キキ [Ramachandran & Hubbard 01] -
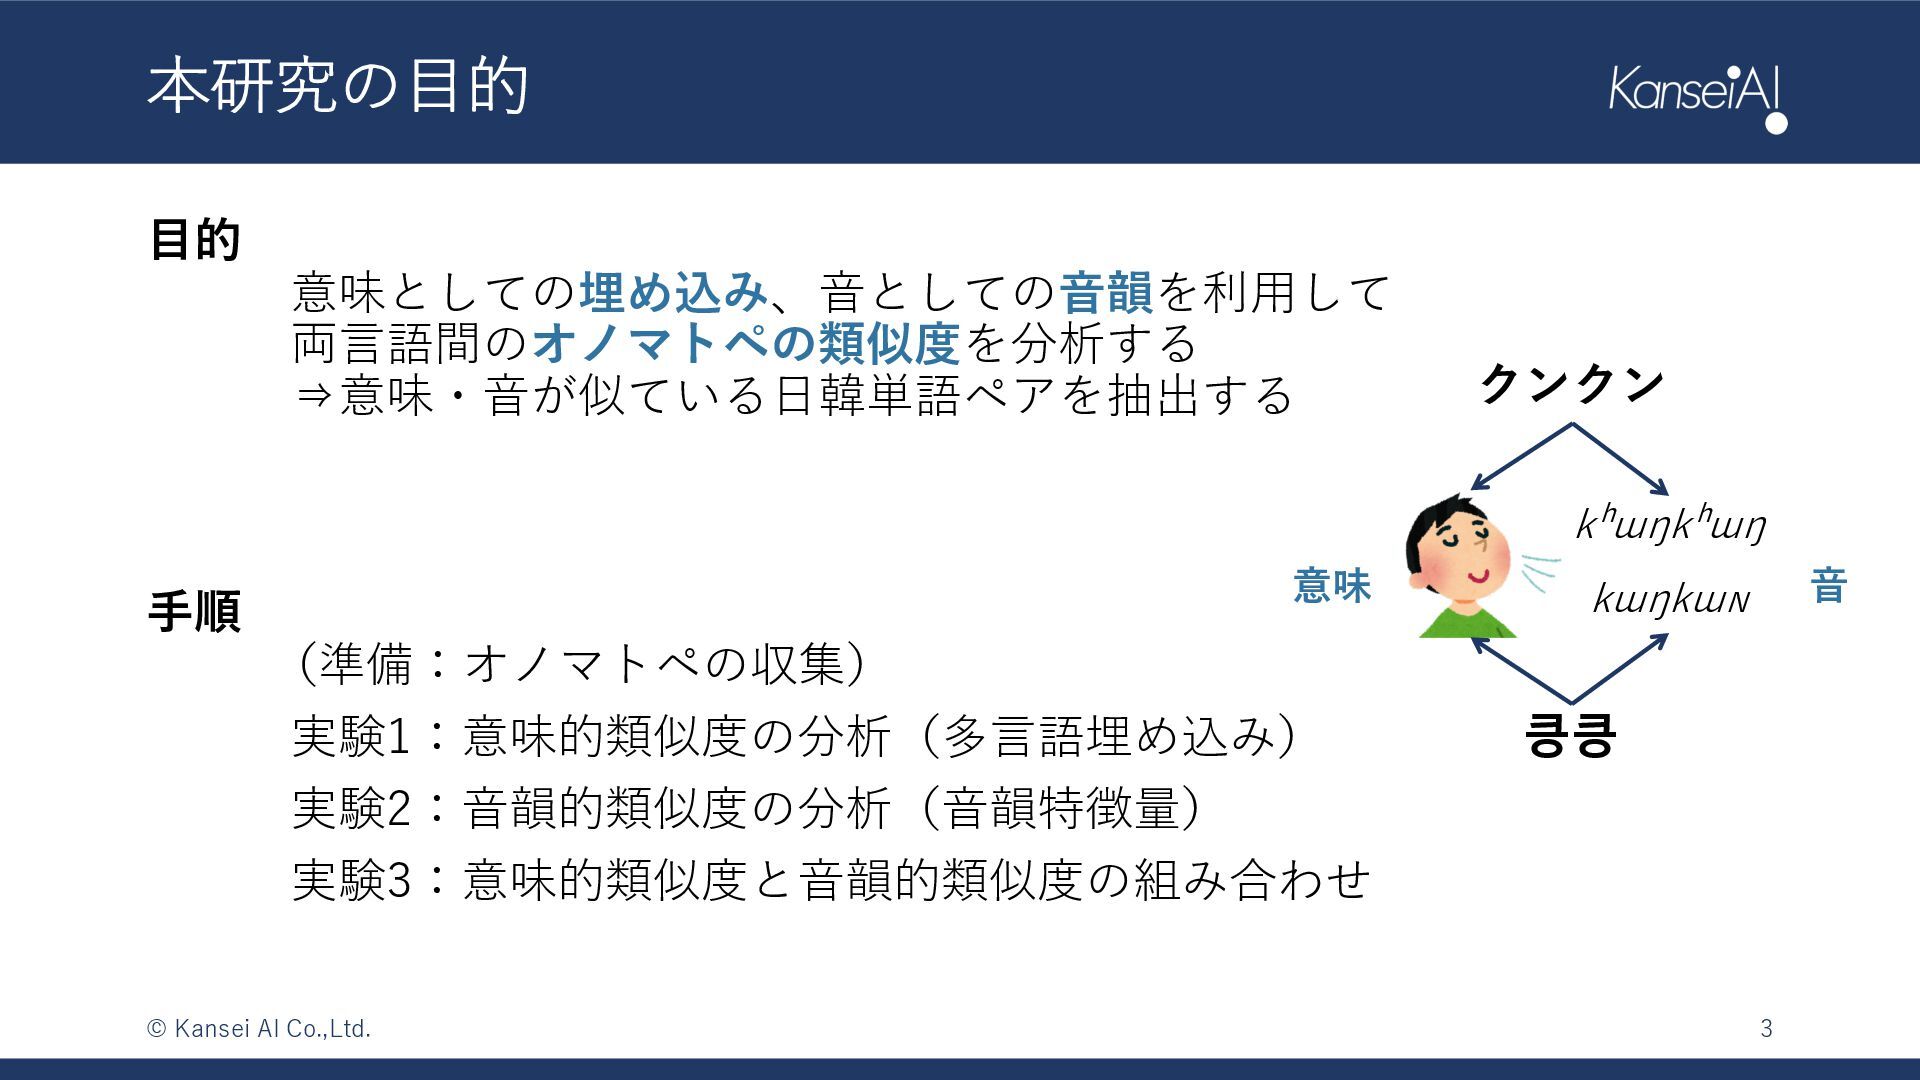
本研究の⽬的 ⽬的 意味としての埋め込み、⾳としての⾳韻を利⽤して 両⾔語間のオノマトペの類似度を分析する ⇒意味・⾳が似ている⽇韓単語ペアを抽出する ⼿順 (準備:オノマトペの収集) 実験1:意味的類似度の分析(多⾔語埋め込み) 実験2:⾳韻的類似度の分析(⾳韻特徴量) 実験3:意味的類似度と⾳韻的類似度の組み合わせ
3 © Kansei AI Co.,Ltd. クンクン 킁킁 kʰɯŋkʰɯŋ kɯŋkɯɴ 意味 ⾳ -
[補⾜] ハングルの構造 字⺟という単位を初声、中声、終声として組み合わせて1⽂字(≒1⾳節) • ⺟⾳(V): ㅏ, ㅑ, ㅓ, ㅕ, ㅗ,
ㅛ, ㅜ, ㅠ, ㅡ, ㅣ, (⼆重) ㅐ, ㅔ, ㅘ, ㅙ, ㅚ, ㅝ, ㅞ, ㅟ, ㅢ, ㅒ, ㅖ • ⼦⾳(C): ㄱ, ㄷ, ㅂ, ㅈ, ㅅ, ㄴ, ㄹ, ㅁ, ㅎ, ㄲ, ㄸ, ㅃ, ㅉ, ㅆ, ㅋ, ㅌ, ㅍ, ㅊ (ㅇ: 初声では⼦⾳無し) (C)Vパターン (C)VCパターン 4 © Kansei AI Co.,Ltd. 고 가 과 관 간 곤 긁 [ko] [ka] [kwa] 와 [wa] [kan] [kon] [kwan] [kɯk] ⇒オノマトペ抽出に 形態情報を利⽤ -
[準備] オノマトペの収集 ! ⽇本語:約870語 NINJAL-LWP for BCCWJのオノマトペ検索機能を利⽤して収集 • CVN-CVN型 (eg.
ガンガン [gan-gan]) • CVCV-CVCV型 (eg. ガタガタ [gata-gata]) # 韓国語:約5000語 韓国国⽴国語院の標準国語⼤辞典編纂⽤擬声擬態語⽬録から収集 • CV-CVC型 (eg. 부엉 [bue-ong]) • CVC-CVC型 (eg. 털컥 [teol-keok]) • CV-CVC-CV-CVC型 (eg. 꼬박꼬박 [kko-bak-kko-bak]) • CVC-CVC-CVC-CVC型 (eg. 꿀꺽꿀꺽 [kkul-kkeok-kkul-kkeok]) 対訳ペア:(約10000組) 2冊の書籍*と辞書サイトKpedia(副詞)から収集 *『絵でわかる韓国語のオノマトペ 表現が広がる擬声語・擬態語』『⾳で覚える韓国語の擬声語・擬態語』 5 ⇒畳語型 ⇒畳語型 -
[実験1: 意味的類似度の分析] 設定 仮説 対訳単語ペアの類似度>ランダムペアの類似度 ⇒よりその傾向が強い埋め込みモデルが良い ⼿順 2つのコサイン類似度分布を⽐較 *1 https://huggingface.co/intfloat/multilingual-e5-large,
*2 https://huggingface.co/google-bert/bert-base-multilingual-cased [Grave 18] Grave, E., et al: Learning Word Vectors for 157 Languages (2018) [Smith 17] Smith, S. L., et al: Offline bilingual word vectors, orthogonal transformations and the inverted softmax (2017) [Conneau 17] Conneau, A., et al: Word Translation Without Parallel Data (2017) 7 本発表での呼称 埋め込みモデル 多⾔語拡張 fastText_LIN fastText [Grave 18] 特異値分解 [Smith 17] fastText_MUSE 敵対的学習 [Conneau 17] e5 Multilingual-E5-large *1 - mbert BERT multilingual base model (cased) *2 - 対象単語リスト ! 1240語 (平+⽚仮名) # 1224語 対訳ペア 1066組 -
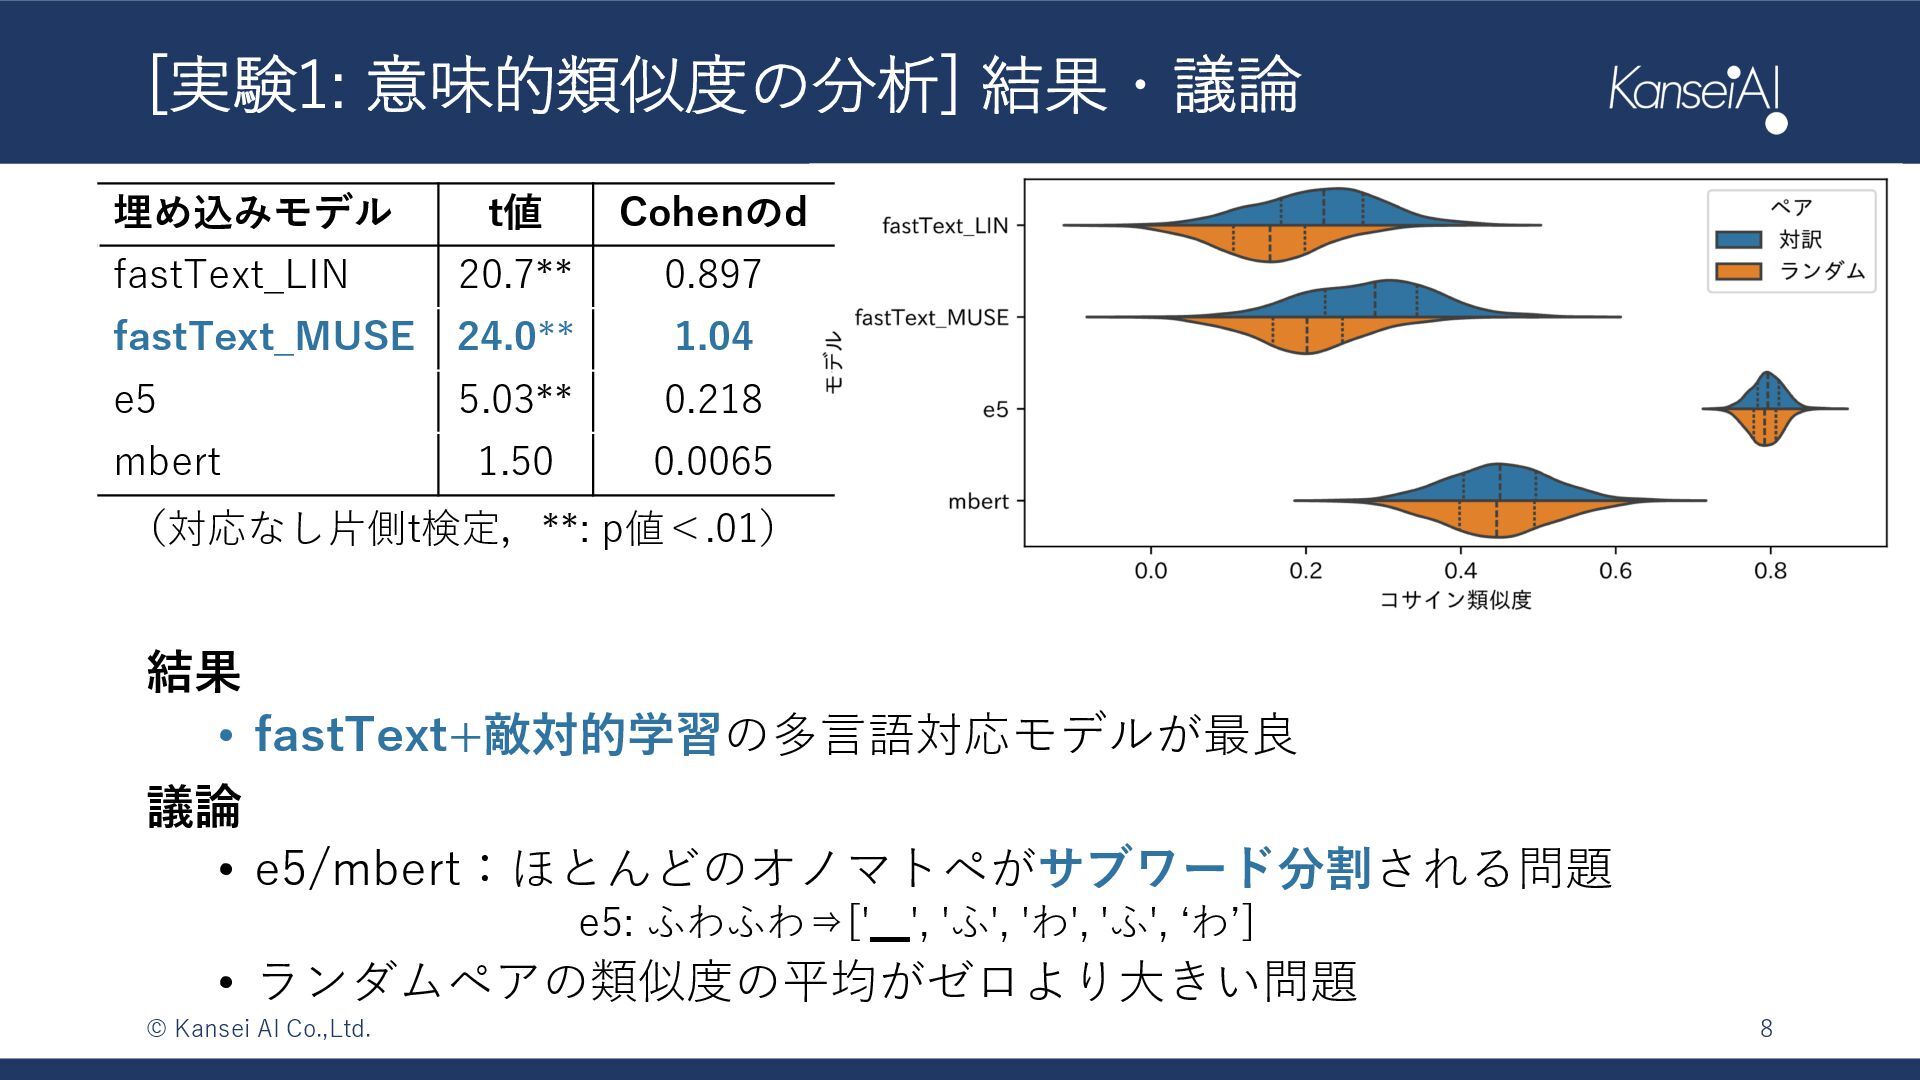
結果 • fastText+敵対的学習の多⾔語対応モデルが最良 議論 • e5/mbert:ほとんどのオノマトペがサブワード分割される問題 e5: ふわふわ⇒['▁', 'ふ', 'わ',
'ふ', ʻわʼ] • ランダムペアの類似度の平均がゼロより⼤きい問題 [実験1: 意味的類似度の分析] 結果・議論 埋め込みモデル t値 Cohenのd fastText_LIN 20.7** 0.897 fastText_MUSE 24.0** 1.04 e5 5.03** 0.218 mbert 1.50 0.0065 8 © Kansei AI Co.,Ltd. (対応なし⽚側t検定,**: p値<.01) -
[実験2: ⾳韻的類似度の分析] 設定 ⽬的 ⽇韓単語の発⾳がどの程度似て聞こえるのかをモデル化する 評価⽤データ [松島 15] • 単語リスト
: 2字漢字単語 435語(⽇本語) • 評価者 :⽇本語未習の韓国語話者23名 • 評価内容 :⽇本語発⾳⾳声とハングル表記との⾳韻的類似性 • 評定値 :7段階評価の平均値 ⼿順 1. 提案する類似度算出⼿法で、単語リストの両⾔語の類似度を予測 2. 予測した類似度と評定値との相関係数を調べる [松島 15] 松島弘枝:⽇本語 2 字漢字単語における韓国語漢字との形態・⾳韻類似性調査 (2015) 10 無料 무료 -
[実験2: ⾳韻的類似度の分析] ⼿法 以下の⼿法で得られた⽂字/ベクトル列の正規化編集距離を測る • ⼿法1:ローマ字表記(! 独⾃変換込み) ! ⽂化観光部 2000
年式ベース / # ヘボン式 • 1) ⽇本語にない⺟⾳の統⼀(eg. eu→u) • 2) 終声のㅇ(イウン:軟⼝蓋⿐⾳)の表記をng→n に変更 eg.) 킁킁 : keungkeung → 1) kungkung → 2) kunkun • ⼿法2:国際⾳声字⺟(IPA)表記を⾳韻特徴量ベクトル*に変換 #クンクン→ kʰɯŋkʰɯŋ → [[+1, -1, 0, ...], ...] !킁킁 → kɯŋkɯɴ → [[+1, -1, 0, ...], ...] *弁別的素性(12種類、{-, 0, +})を-1, -, +1に変換 11 -
結果 ローマ字表記を⽤いた⼿法が⼈間の主観とより⾼い相関関係 議論 ⼿法1:両⾔語の特徴を踏まえた設計の⽅が優れている ⼿法2:弁別的素性と編集距離の組み合わせだけでは難しい [実験2: ⾳韻的類似度の分析] 結果・議論 ピアソンの相関係数 ⼿法1
-0.775 ⼿法2 -0.542 12 © Kansei AI Co.,Ltd. 主観評価類似度 x 予測距離 ⇒相関係数は⼩さいほうが良い ⼿法1の予測距離 ⼿法2の予測距離 ⾳韻類似度の主観評価値 -
実験3:意味的・⾳韻的類似度の組み合わせ ⽬的 意味としての埋め込み、⾳としての⾳韻を利⽤して 両⾔語間のオノマトペの類似度を分析する ⇒意味・⾳が似ている⽇韓単語ペアを抽出する ⼿順 実験1:意味的類似度の分析(多⾔語埋め込み) ⇒敵対的学習で多⾔語対応したfastTextが最良 実験2:⾳韻的類似度の分析(⾳韻特徴量) ⇒ローマ字表記を⽤いた⼿法が最良
>実験3:意味的類似度と⾳韻的類似度の組み合わせ 13 © Kansei AI Co.,Ltd. -
[実験3: 意味的・⾳韻的類似度の組み合わせ] 設定 ⽬的 実験1と実験2で最良であった⼿法を⽤いて、 意味的類似度と⾳韻的類似度が⾼い単語ペアを抽出する 評価 各類似度条件に合致するペアのうち、対訳ペアに存在するものを カウントしたり、含まれないものを観察したりする 条件
• ⾳韻的距離の上限値{0.1, 0.2, 0.3, 0.4} • 意味的類似度の上位N個{10, 20, 50, 100, 200} 14 © Kansei AI Co.,Ltd. -
[実験3: 意味的・⾳韻的類似度の組み合わせ] 結果・議論 意味順位\⾳韻最⼤距離 0.1 0.2 0.3 0.4 @10 2
2 2 4 @20 3 3 2 4 @50 7 4 3 9 @100 7 8 5 14 @200 7 9 10 18 15 © Kansei AI Co.,Ltd. 対訳ペアにある例(@200\0.2のとき) • トボトボ /とぼとぼ-터벅터벅 [teobeokteobeok] • ポンポン/ぽんぽん-펑펑 [peongpeong] • パンパン/ぱんぱん-팡팡 [pangpang] • どんどん/ドンドン-동동 [dongdong] • クンクン-킁킁 [keungkeung] 条件に該当する対訳ペア単語数 対訳ペアにはないが意味が似ている例 • オンオン-엉엉 [eongeong] • ボンボン-봉봉 [bongbong] • ブンブン-붕붕 [bungbung] • コンコン-콩콩 [kongkong] • ポンポン-뻥뻥 [ppeongppeong] • ちゃかちゃか-척척 [cheokcheok] • むくむく-뭉클뭉클 [mungkeulmungkeul] • プルプル-푸들푸들 [pudeulpudeul] • パサパサ-바삭바삭 [basakbasak] 議論 類似ペア探索に寄与する 可能性が⽰された -
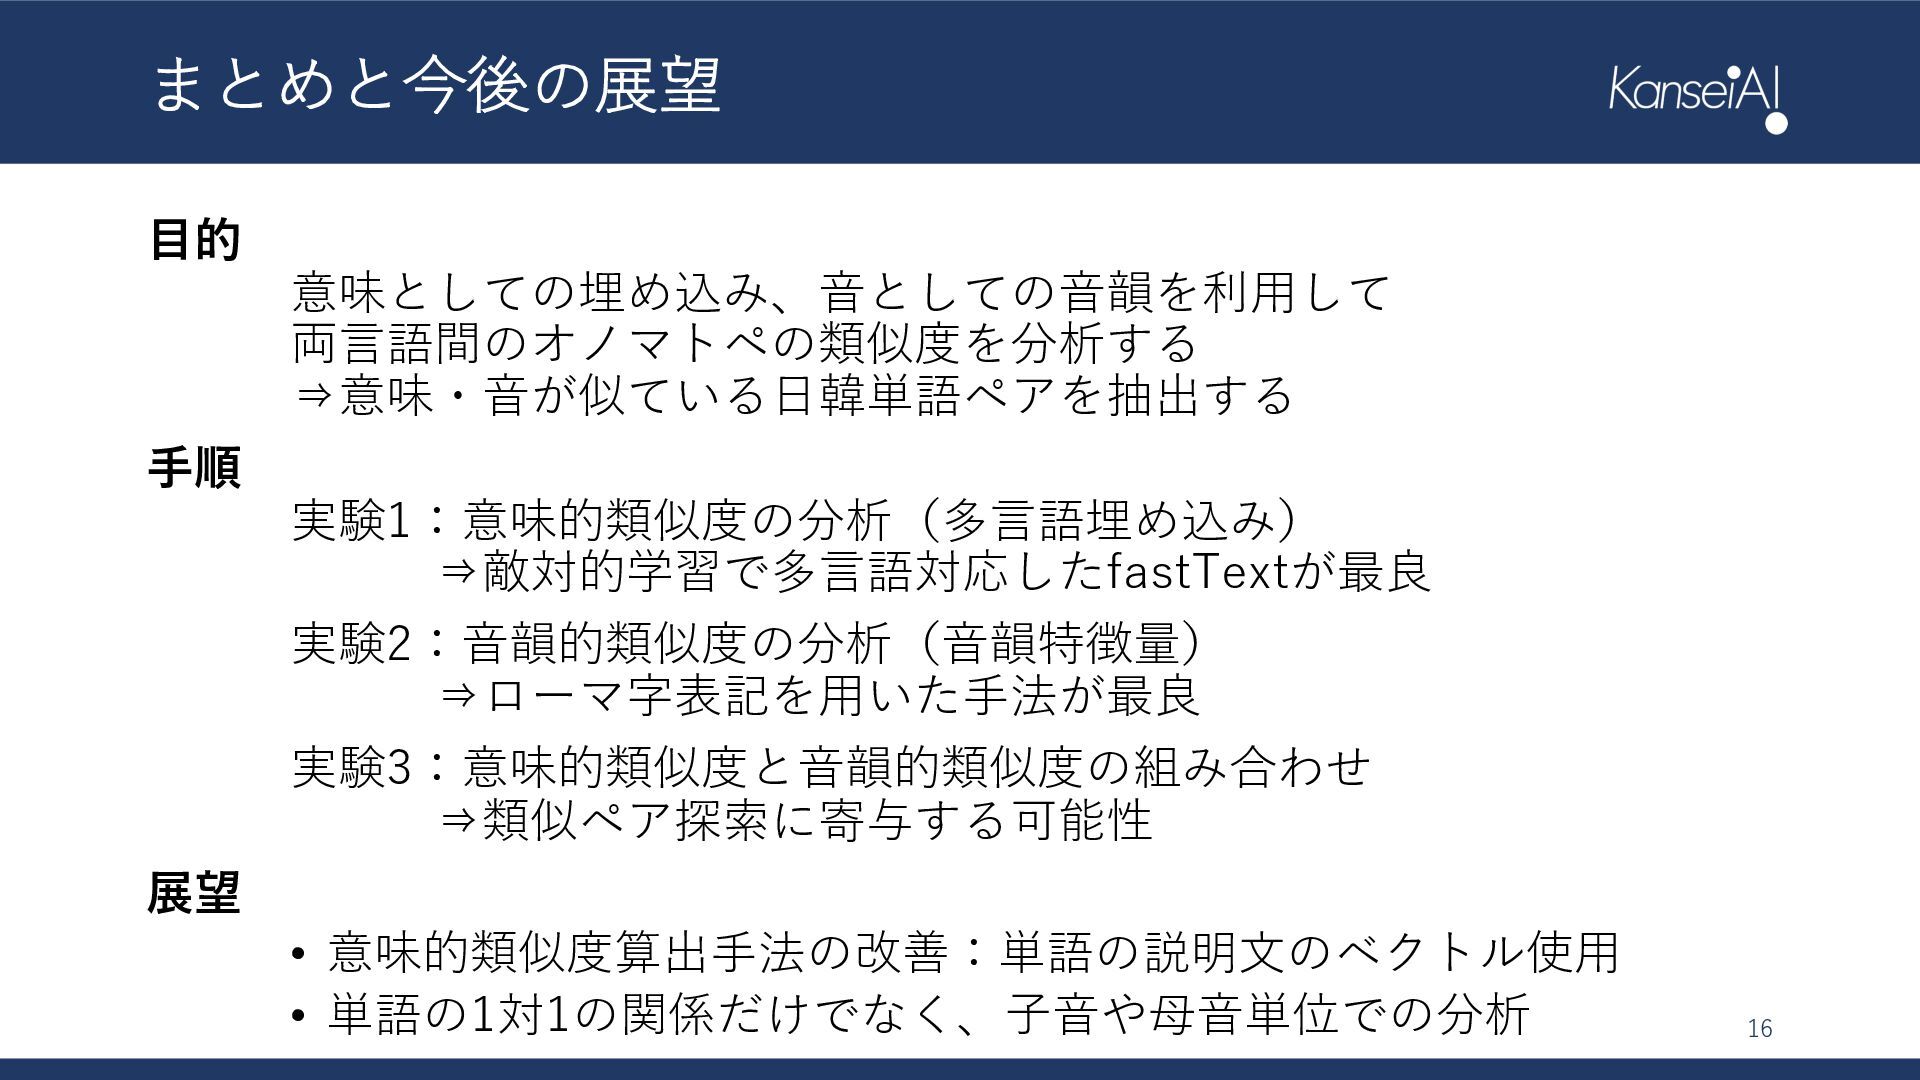
まとめと今後の展望 ⽬的 意味としての埋め込み、⾳としての⾳韻を利⽤して 両⾔語間のオノマトペの類似度を分析する ⇒意味・⾳が似ている⽇韓単語ペアを抽出する ⼿順 実験1:意味的類似度の分析(多⾔語埋め込み) ⇒敵対的学習で多⾔語対応したfastTextが最良 実験2:⾳韻的類似度の分析(⾳韻特徴量) ⇒ローマ字表記を⽤いた⼿法が最良
実験3:意味的類似度と⾳韻的類似度の組み合わせ ⇒類似ペア探索に寄与する可能性 展望 • 意味的類似度算出⼿法の改善:単語の説明⽂のベクトル使⽤ • 単語の1対1の関係だけでなく、⼦⾳や⺟⾳単位での分析 16