Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【統計情報】種類と役割【第1回】
Search
Shin
September 08, 2024
Programming
56
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【統計情報】種類と役割【第1回】
クエリの処理時間を1秒でも短縮するには、統計情報への理解が必要不可欠です。
そこで、統計情報の最初のとっかかりとして種類と役割についてピックアップしました。
Shin
September 08, 2024
More Decks by Shin
See All by Shin
【DWH】Snowflakeのクラスタリングキーについて
sk8er_boi_shin
0
24
【DWH】Snowflakeで等価条件なのにコストが変わる理由
sk8er_boi_shin
0
27
【DWH】 PostgreSQLとSnowFlake_設計思想とデータ管理の違い
sk8er_boi_shin
0
34
【PostgreSQL】メンテナンス系コマンドの種類
sk8er_boi_shin
0
38
【データベース】統計情報と物理順序
sk8er_boi_shin
0
82
【データベース】RedisとPostgreSQL
sk8er_boi_shin
0
210
【データベース】統計情報と単一カラムのヒストグラム
sk8er_boi_shin
0
38
【データベース】制約の種類と速度検証
sk8er_boi_shin
0
42
【データベース】インデックスの種類と役割
sk8er_boi_shin
0
28
Other Decks in Programming
See All in Programming
ChromeでローカルLLM
ryu1013
0
140
Domain-Driven Transformation
hschwentner
2
2.3k
Everything will be SERVERLESS — 信じて運用した10年の経験値 / Everything Will be Serverless — Lessons Learned from 10 Years of Operational Experience
seike460
PRO
1
1.1k
Findy - エンジニア向け会社紹介/Findy Company Deck
findyinc
6
400k
AIに “答え“を書かせるのを やめてみた
___akari11
0
120
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
半永久的に提供し続けられるプライベートクラウドを目指して ― 利用者の認知負荷を抑えるAPI抽象化とハードウェア世代交代の基盤設計
tomokon
0
500
TechTown - Creating Composable Callables in Contemporary C++
rollbear
0
130
機械に任せるテスト、人が見るテスト ⽣成AIで引き直した、運⽤保守フェーズの線引き
dske104
0
190
自サークルのIdPからログアウトできるようになるまで
taiseiue
1
140
残高管理から台帳サービスへの進化
artoy
1
200
Kotlinの15年とServer-Side Kotlin
n_takehata
1
150
Featured
See All Featured
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Building a Scalable Design System with Sketch
lauravandoore
464
34k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
310
How to Ace a Technical Interview
jacobian
280
24k
WCS-LA-2024
lcolladotor
0
890
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
600
The agentic SEO stack - context over prompts
schlessera
0
970
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
Transcript
【データベース】 統計情報の役割と種類
目次 1. 統計情報の役割 2. 統計情報の主要な種類 3. 統計情報がクエリに与える影響 4. まとめ
1.統計情報の役割 • 概要 データベースがデータの全体像を把握して クエリを早く実行するために必要なガイド情報
1.統計情報の役割 • 役割 データベースがクエリを最適に実行するために、 フルスキャンやインデックススキャンを 選択する際の判断材料として利用される。
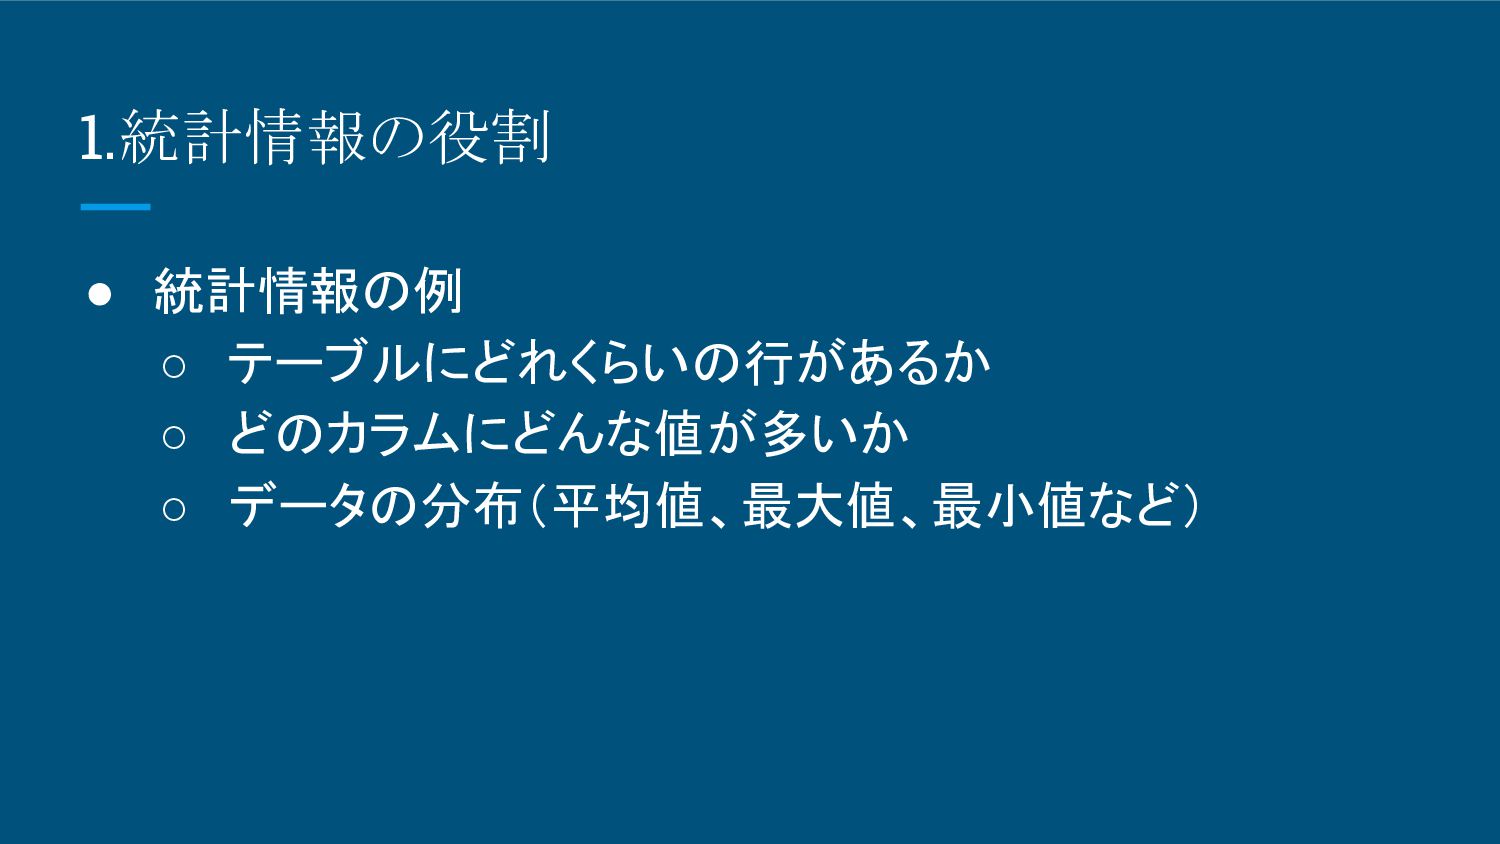
1.統計情報の役割 • 統計情報の例 ◦ テーブルにどれくらいの行があるか ◦ どのカラムにどんな値が多いか ◦ データの分布(平均値、最大値、最小値など)
2.統計情報の主要な種類 • テーブルレベルの統計情報 • カラムレベルの統計情報 • インデックスレベルの統計情報
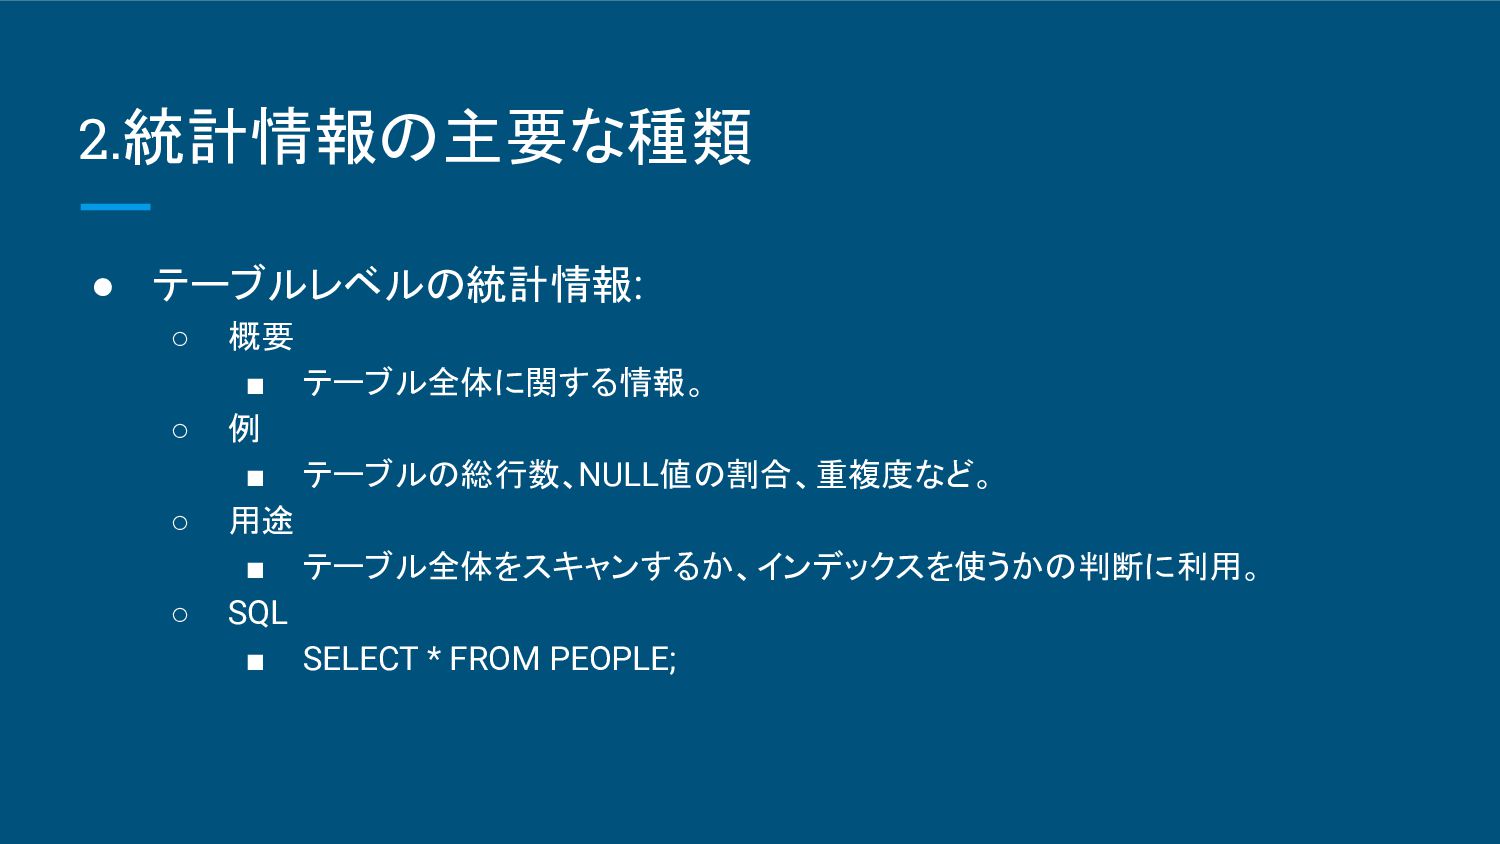
2.統計情報の主要な種類 • テーブルレベルの統計情報: ◦ 概要 ▪ テーブル全体に関する情報。 ◦ 例 ▪
テーブルの総行数、NULL値の割合、重複度など。 ◦ 用途 ▪ テーブル全体をスキャンするか、インデックスを使うかの判断に利用。 ◦ SQL ▪ SELECT * FROM PEOPLE;
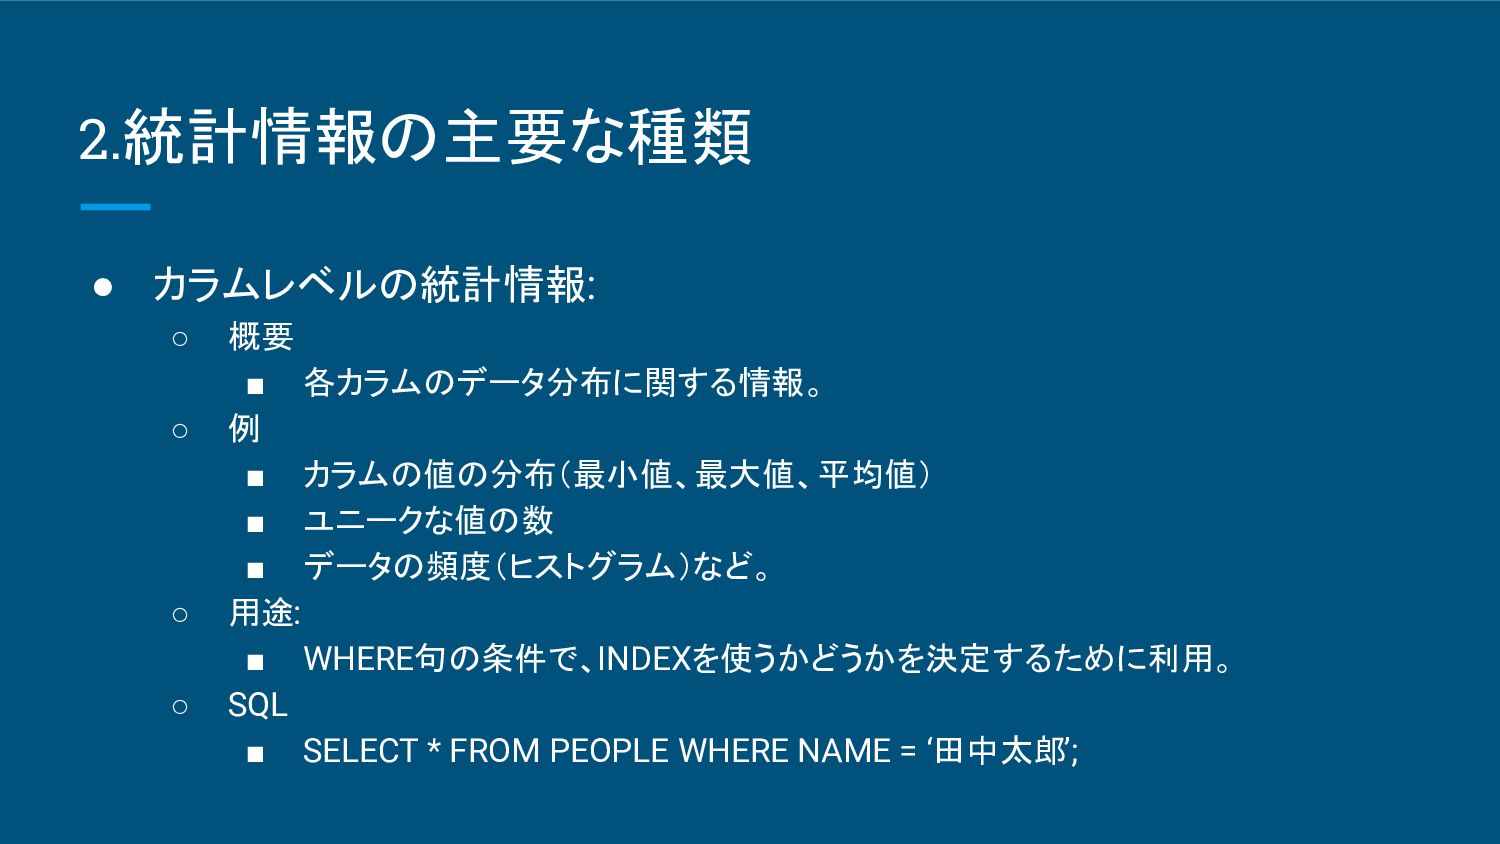
2.統計情報の主要な種類 • カラムレベルの統計情報: ◦ 概要 ▪ 各カラムのデータ分布に関する情報。 ◦ 例 ▪
カラムの値の分布(最小値、最大値、平均値) ▪ ユニークな値の数 ▪ データの頻度(ヒストグラム)など。 ◦ 用途: ▪ WHERE句の条件で、INDEXを使うかどうかを決定するために利用。 ◦ SQL ▪ SELECT * FROM PEOPLE WHERE NAME = ‘田中太郎’;
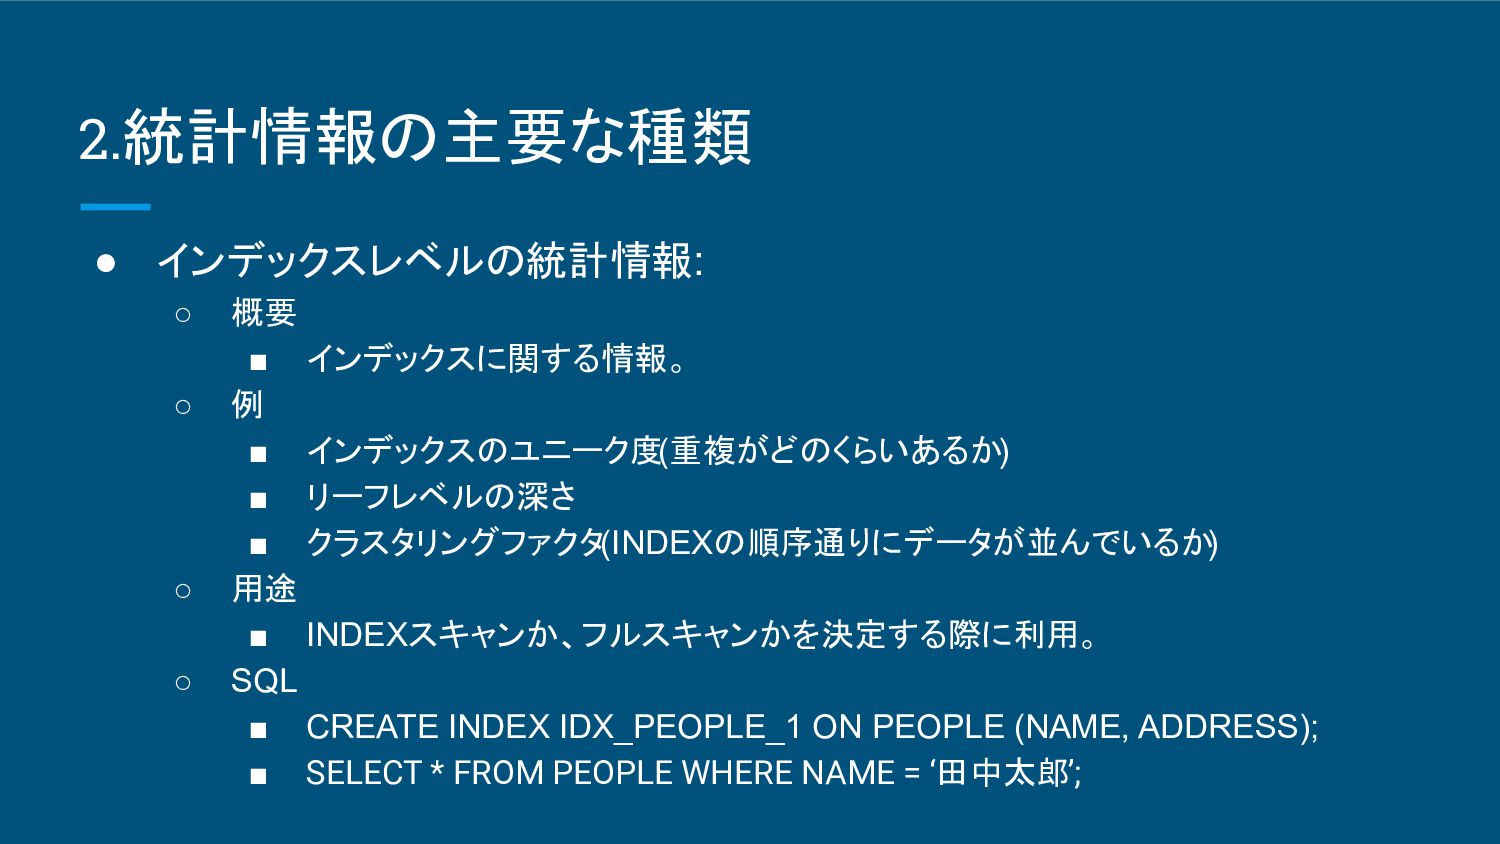
2.統計情報の主要な種類 • インデックスレベルの統計情報: ◦ 概要 ▪ インデックスに関する情報。 ◦ 例 ▪
インデックスのユニーク度(重複がどのくらいあるか) ▪ リーフレベルの深さ ▪ クラスタリングファクタ(INDEXの順序通りにデータが並んでいるか ) ◦ 用途 ▪ INDEXスキャンか、フルスキャンかを決定する際に利用。 ◦ SQL ▪ CREATE INDEX IDX_PEOPLE_1 ON PEOPLE (NAME, ADDRESS); ▪ SELECT * FROM PEOPLE WHERE NAME = ‘田中太郎’;
3.統計情報がクエリに与える影響 • ユニーク度(ヒストグラム) • 適切なインデックスの有無
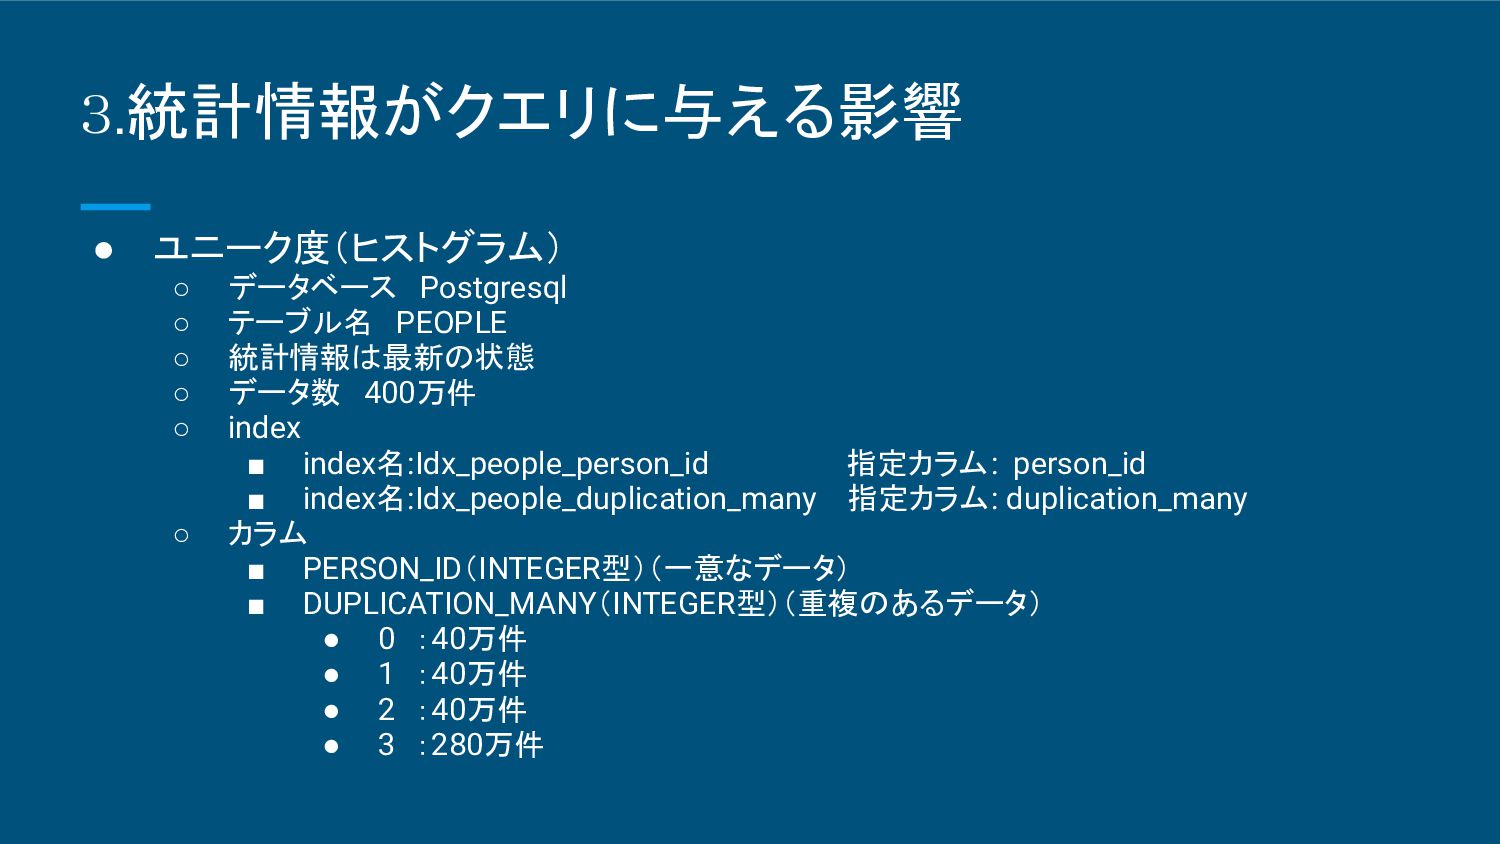
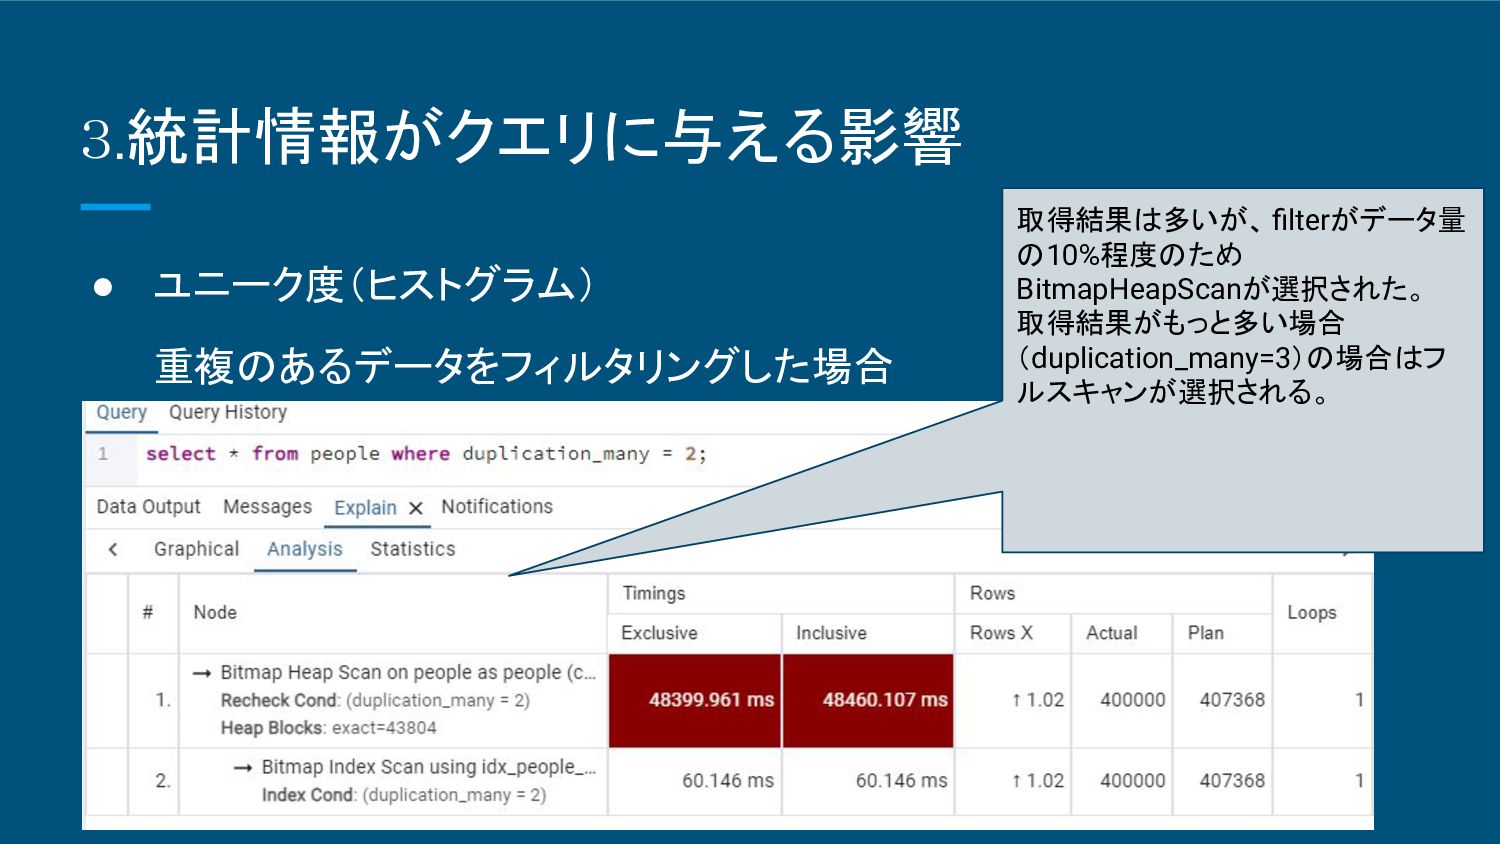
3.統計情報がクエリに与える影響 • ユニーク度(ヒストグラム) ◦ データベース Postgresql ◦ テーブル名 PEOPLE ◦ 統計情報は最新の状態 ◦
データ数 400万件 ◦ index ▪ index名:Idx_people_person_id 指定カラム: person_id ▪ index名:Idx_people_duplication_many 指定カラム: duplication_many ◦ カラム ▪ PERSON_ID(INTEGER型)(一意なデータ) ▪ DUPLICATION_MANY(INTEGER型)(重複のあるデータ) • 0 :40万件 • 1 :40万件 • 2 :40万件 • 3 :280万件
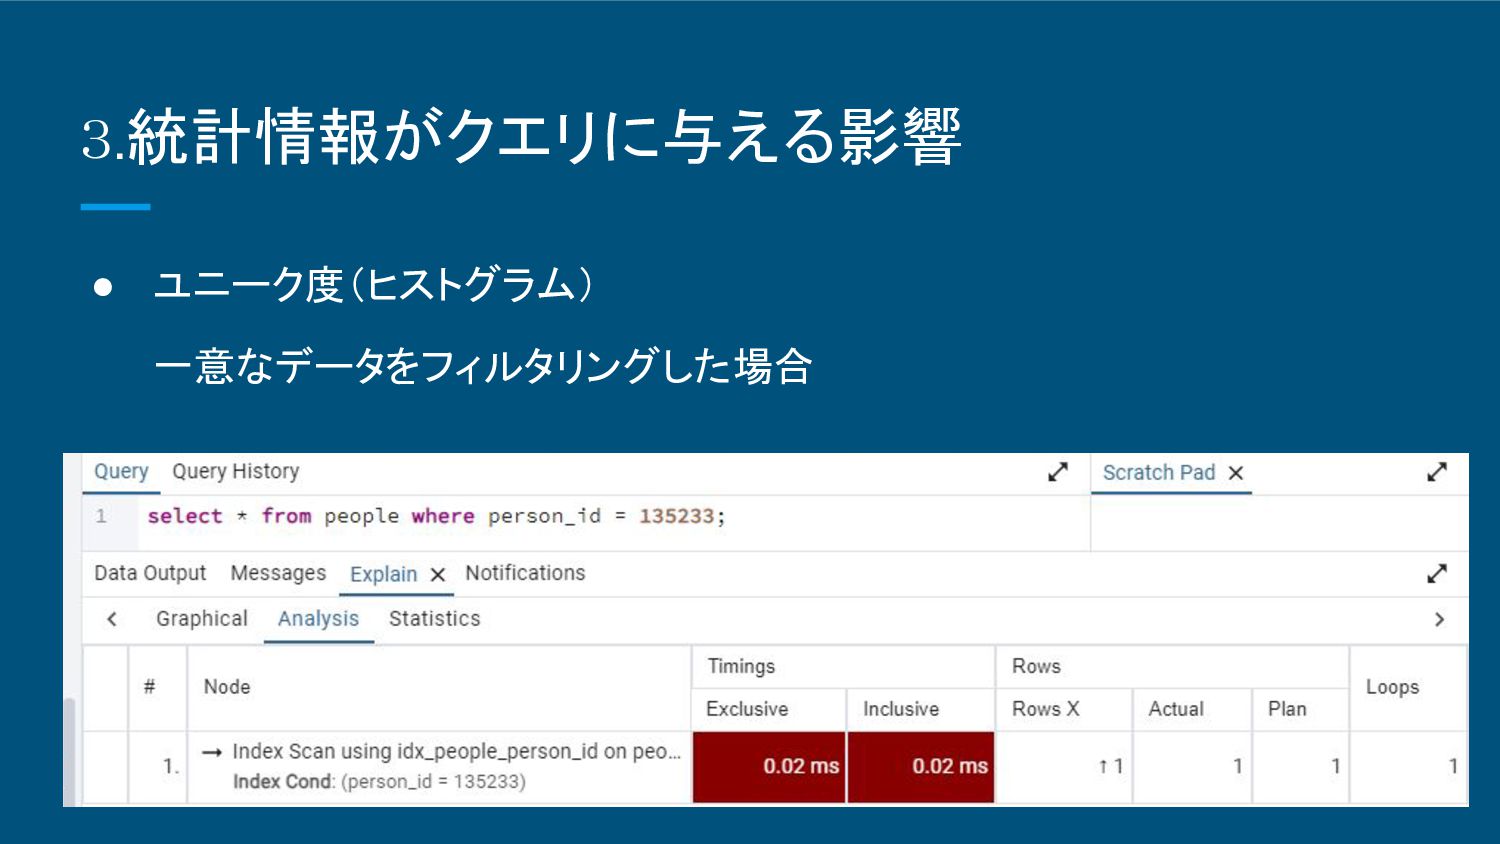
3.統計情報がクエリに与える影響 • ユニーク度(ヒストグラム) 一意なデータをフィルタリングした場合
3.統計情報がクエリに与える影響 • ユニーク度(ヒストグラム) 重複のあるデータをフィルタリングした場合 取得結果は多いが、 filterがデータ量 の10%程度のため BitmapHeapScanが選択された。 取得結果がもっと多い場合 (duplication_many=3)の場合はフ
ルスキャンが選択される。
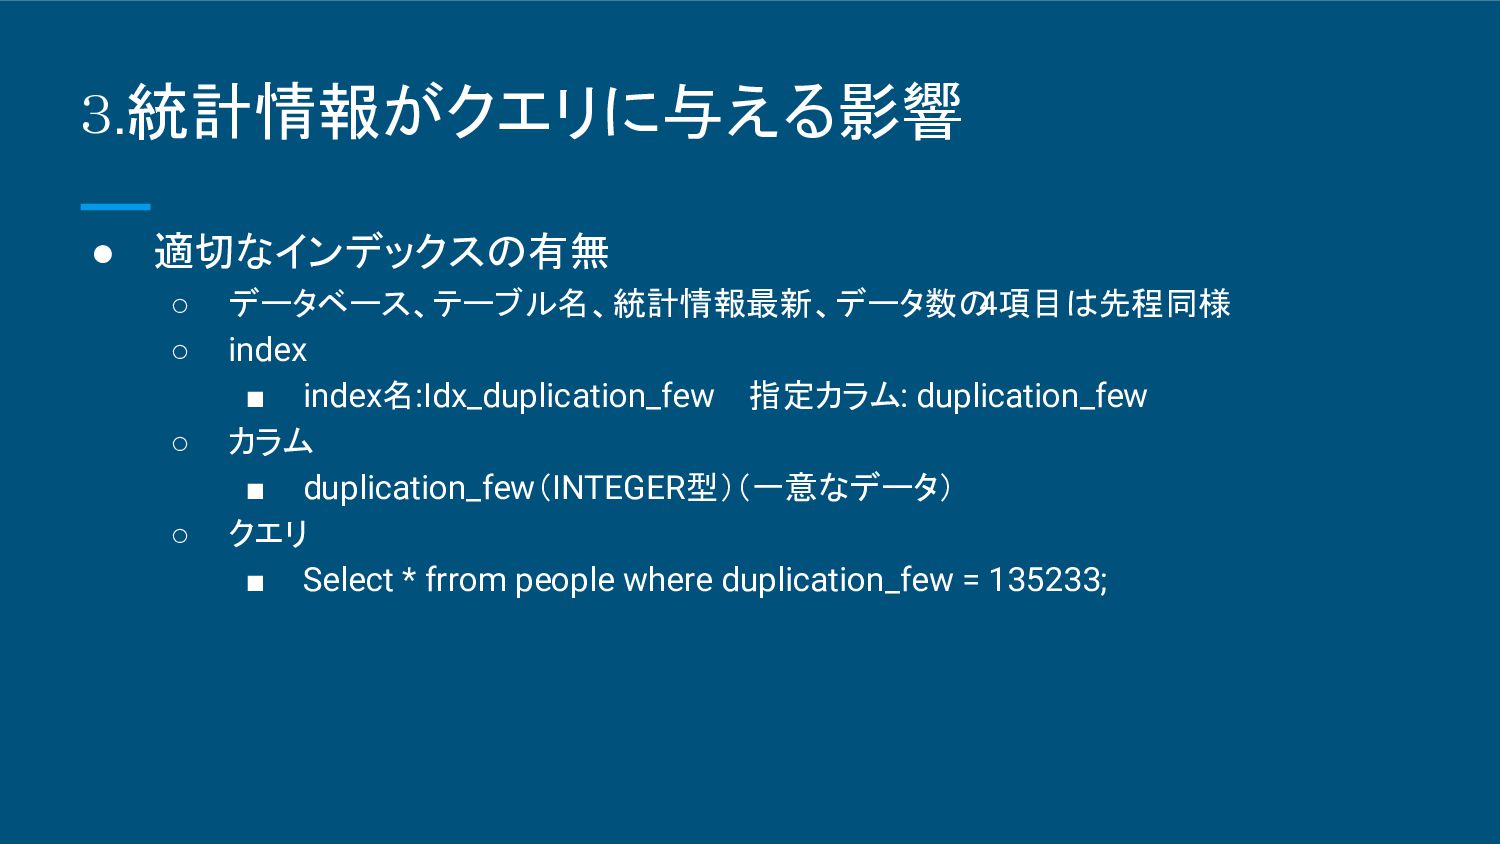
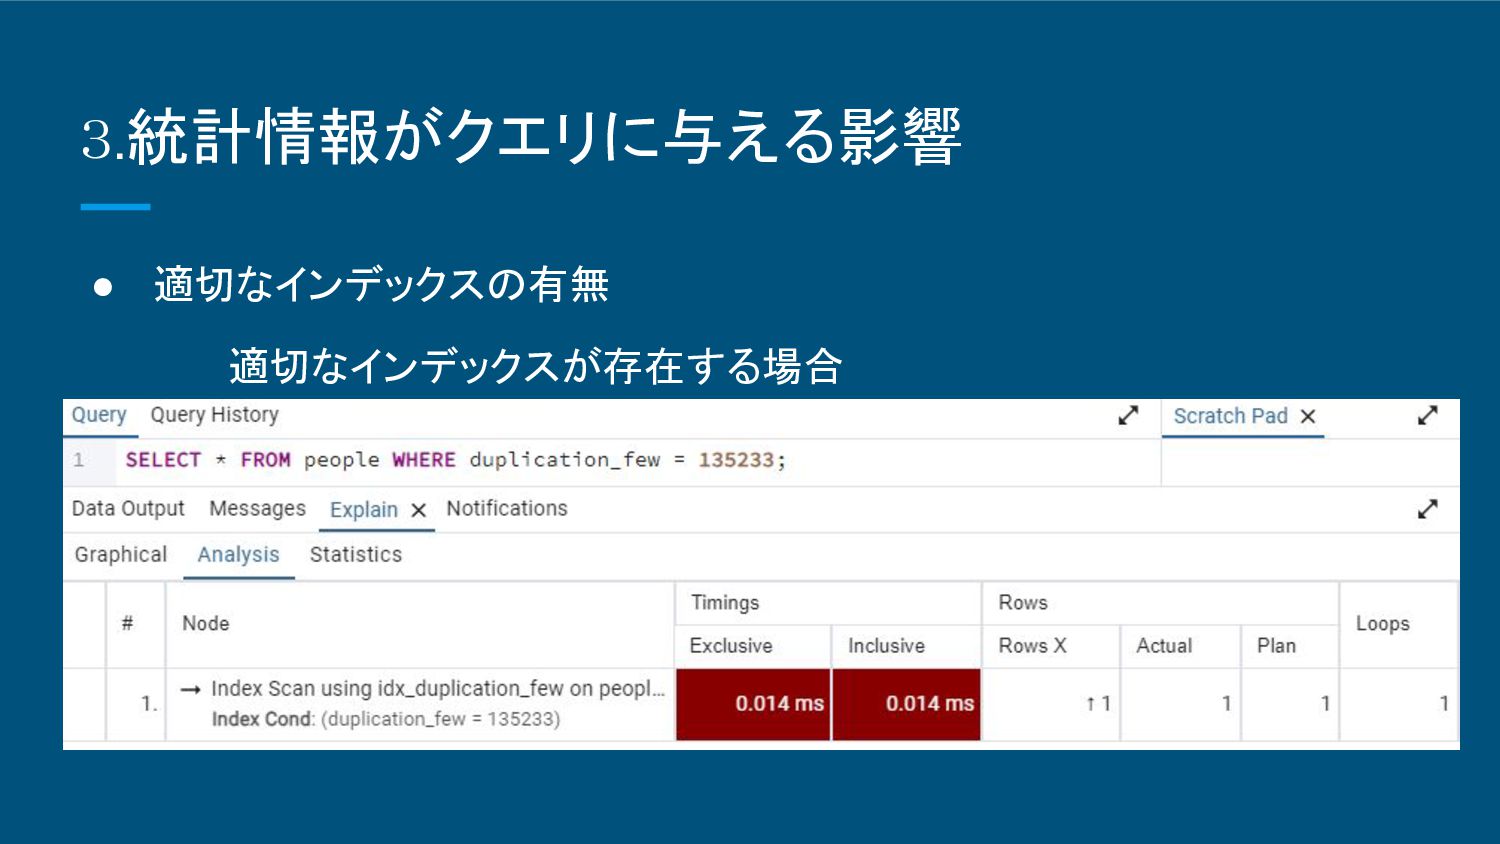
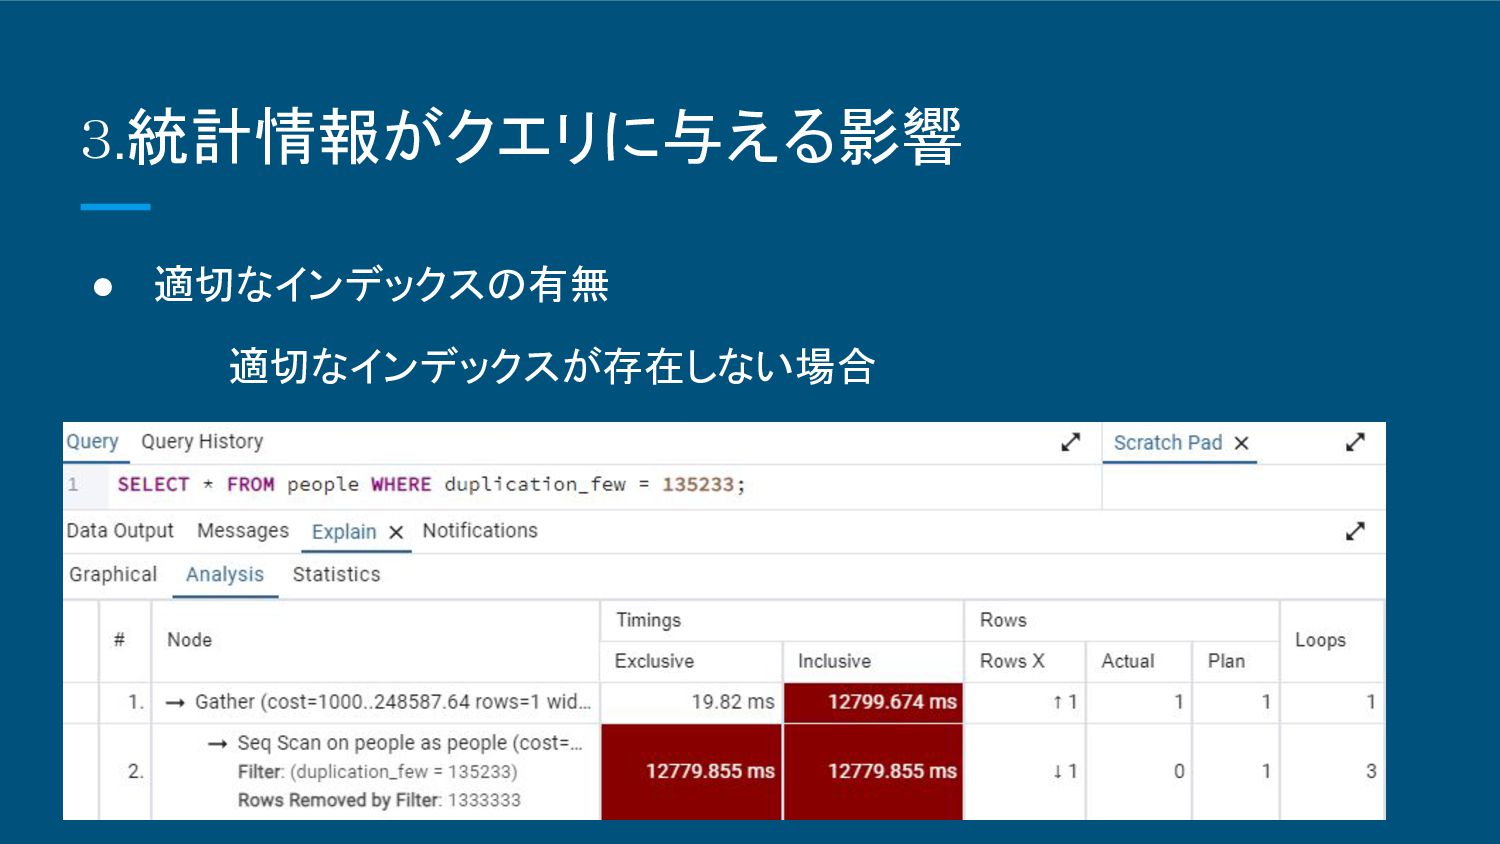
3.統計情報がクエリに与える影響 • 適切なインデックスの有無 ◦ データベース、テーブル名、統計情報最新、データ数の 4項目は先程同様 ◦ index ▪ index名:Idx_duplication_few
指定カラム: duplication_few ◦ カラム ▪ duplication_few(INTEGER型)(一意なデータ) ◦ クエリ ▪ Select * frrom people where duplication_few = 135233;
3.統計情報がクエリに与える影響 • 適切なインデックスの有無 適切なインデックスが存在する場合
3.統計情報がクエリに与える影響 • 適切なインデックスの有無 適切なインデックスが存在しない場合
4.まとめ • FROM、WHERE等を考慮しユニーク度の高いカラムからINDEXに定義 • ヒストグラムを意識したINDEX作成 ◦ 特にユニーク度が高いカラムには INDEXが効果的 ◦ ユニーク度が低くINDEXがあっても時間がかかる場合
▪ パーティション、キャッシュの利用、 LIMIT、OFFSET、非同期等


 sk8er_boi_shin
 ryu1013
 hschwentner
 seike460
 findyinc
 ___akari11
 kishida
 tomokon
 rollbear
 dske104
 taiseiue
 artoy
 n_takehata
 tammyeverts
 lauravandoore
 aleyda
 yeseniaperezcruz
 mkilby
 jacobian
 lcolladotor
 katarinadahlin
 davetheseo
 schlessera
 honnibal
 smashingmag