Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
本当はこわいエンコーディングの話
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
とみたまさひろ
January 13, 2013
Programming
10k
15
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
本当はこわいエンコーディングの話
東京Ruby会議10 で発表したスライド
とみたまさひろ
January 13, 2013
Transcript
59 slides
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 本当はこわい エンコーディングの話 とみたまさひろ 東京Ruby会議10 2013-01-13
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 自己紹介 とみた まさひろ http://tmtms.hatenablog.com https://twitter.com/tmtms
好きなもの/環境 Ruby, Rabbit, MySQL, Emacs, Git, Ubuntu, ThinkPad 所属など 長野県北部在住 / 某社プログラマー / 日本 MySQLユーザ会 / 長野ソフトウェア技術者 グループ(NSEG)
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディング
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディングとは 文字符号化方式 文字をどのようなバイト列で表現するか UTF-8 とか
EUC-JP とか SHIFT_JIS と かそーゆー奴 「charset」とか呼ばれたりする 「文字コード」とか呼ばれたりする
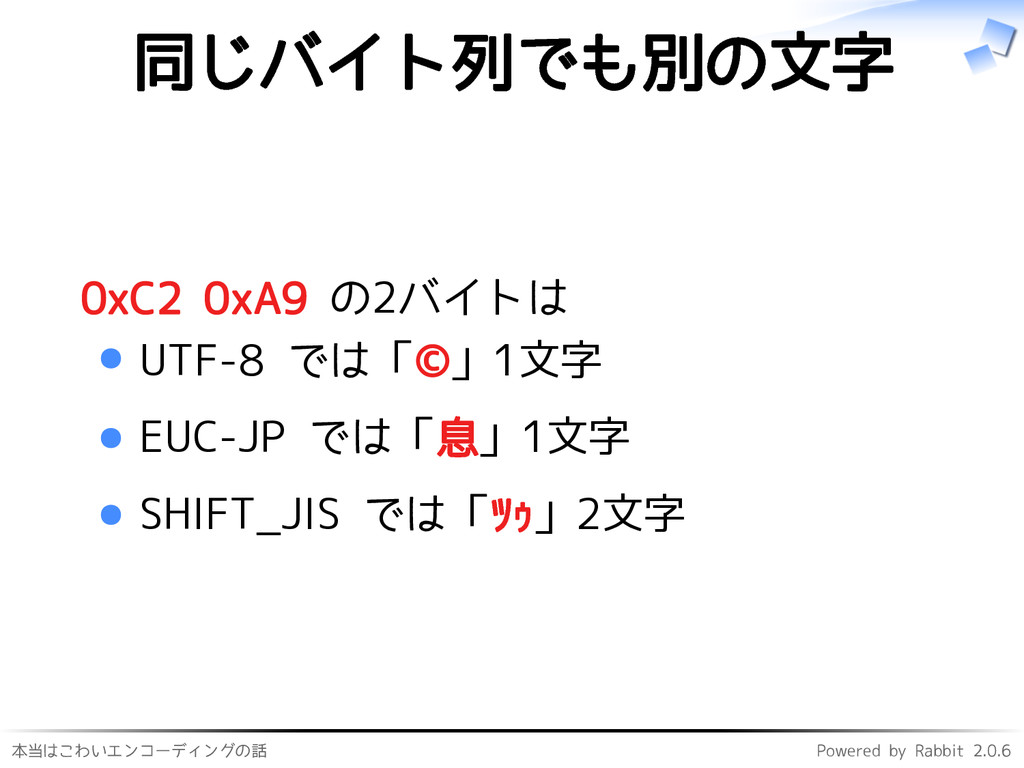
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 同じバイト列でも別の文字 0xC2 0xA9 の2バイトは UTF-8
では「©」1文字 EUC-JP では「息」1文字 SHIFT_JIS では「ツゥ」2文字
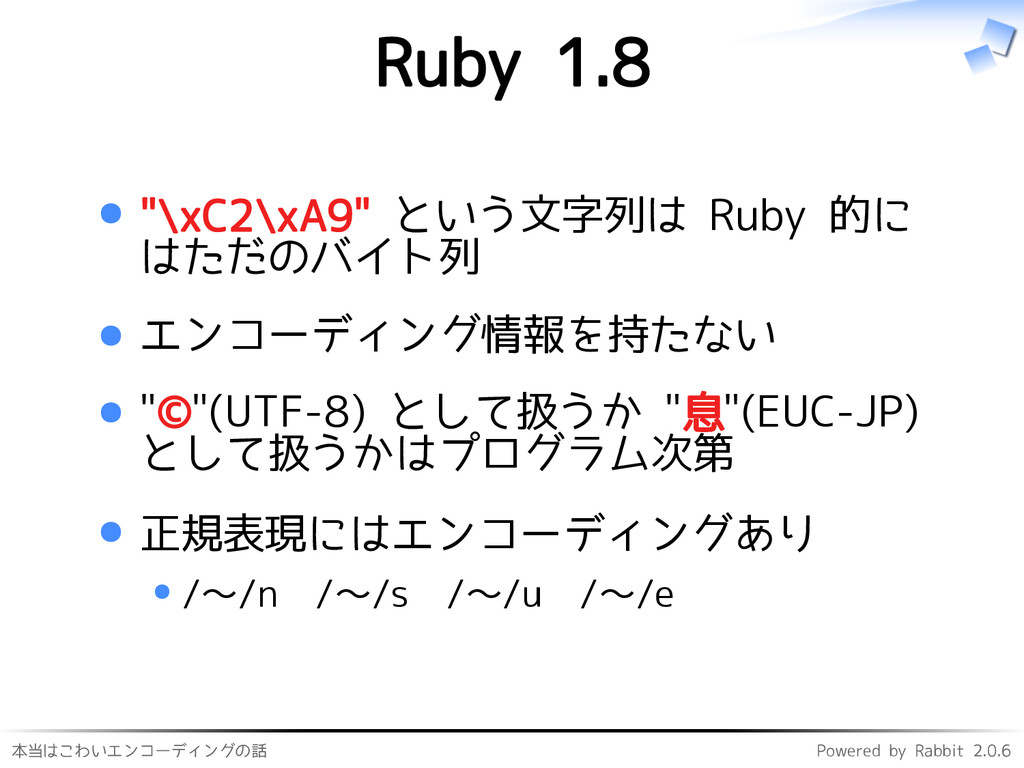
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 Ruby 1.8 "\xC2\xA9" という文字列は Ruby
的に はただのバイト列 エンコーディング情報を持たない "©"(UTF-8) として扱うか "息"(EUC-JP) として扱うかはプログラム次第 正規表現にはエンコーディングあり /〜/n /〜/s /〜/u /〜/e
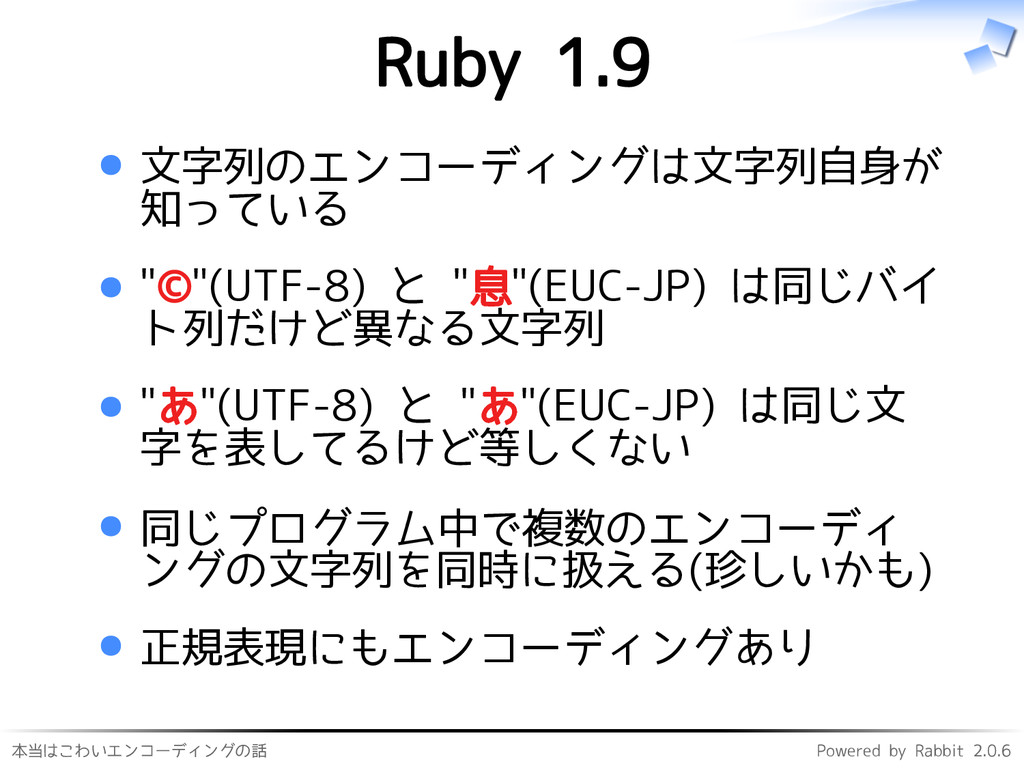
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 Ruby 1.9 文字列のエンコーディングは文字列自身が 知っている "©"(UTF-8)
と "息"(EUC-JP) は同じバイ ト列だけど異なる文字列 "あ"(UTF-8) と "あ"(EUC-JP) は同じ文 字を表してるけど等しくない 同じプログラム中で複数のエンコーディ ングの文字列を同時に扱える(珍しいかも) 正規表現にもエンコーディングあり
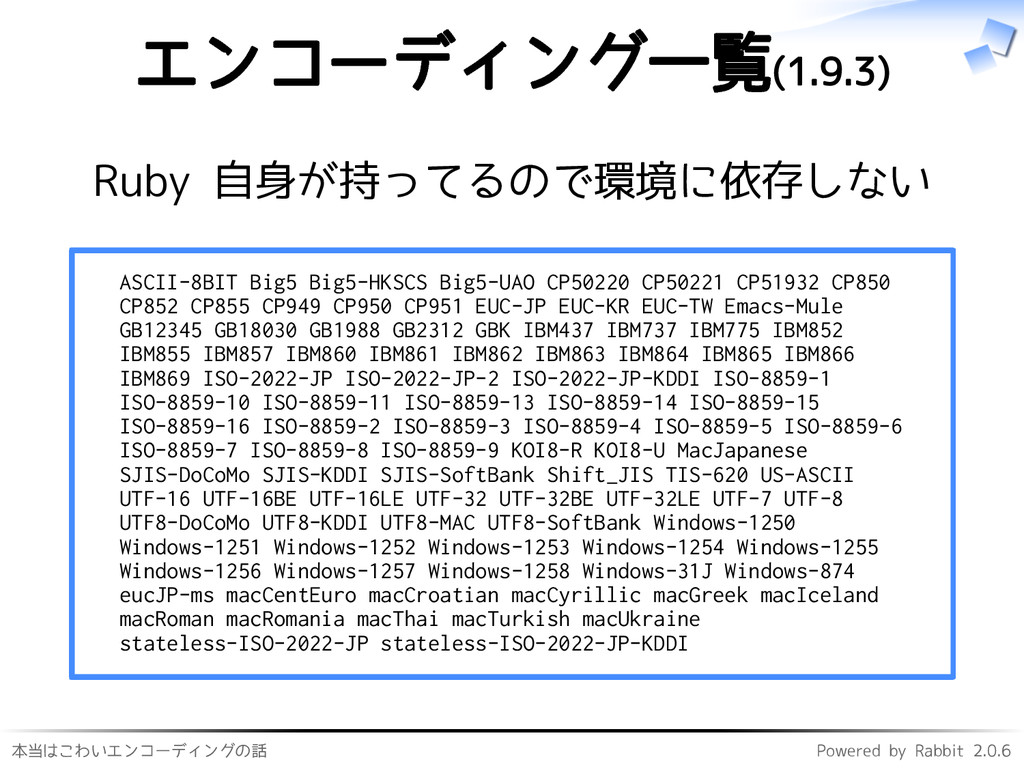
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディング一覧(1.9.3) Ruby 自身が持ってるので環境に依存しない ASCII-8BIT Big5
Big5-HKSCS Big5-UAO CP50220 CP50221 CP51932 CP850 CP852 CP855 CP949 CP950 CP951 EUC-JP EUC-KR EUC-TW Emacs-Mule GB12345 GB18030 GB1988 GB2312 GBK IBM437 IBM737 IBM775 IBM852 IBM855 IBM857 IBM860 IBM861 IBM862 IBM863 IBM864 IBM865 IBM866 IBM869 ISO-2022-JP ISO-2022-JP-2 ISO-2022-JP-KDDI ISO-8859-1 ISO-8859-10 ISO-8859-11 ISO-8859-13 ISO-8859-14 ISO-8859-15 ISO-8859-16 ISO-8859-2 ISO-8859-3 ISO-8859-4 ISO-8859-5 ISO-8859-6 ISO-8859-7 ISO-8859-8 ISO-8859-9 KOI8-R KOI8-U MacJapanese SJIS-DoCoMo SJIS-KDDI SJIS-SoftBank Shift_JIS TIS-620 US-ASCII UTF-16 UTF-16BE UTF-16LE UTF-32 UTF-32BE UTF-32LE UTF-7 UTF-8 UTF8-DoCoMo UTF8-KDDI UTF8-MAC UTF8-SoftBank Windows-1250 Windows-1251 Windows-1252 Windows-1253 Windows-1254 Windows-1255 Windows-1256 Windows-1257 Windows-1258 Windows-31J Windows-874 eucJP-ms macCentEuro macCroatian macCyrillic macGreek macIceland macRoman macRomania macThai macTurkish macUkraine stateless-ISO-2022-JP stateless-ISO-2022-JP-KDDI
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 うれしいこと
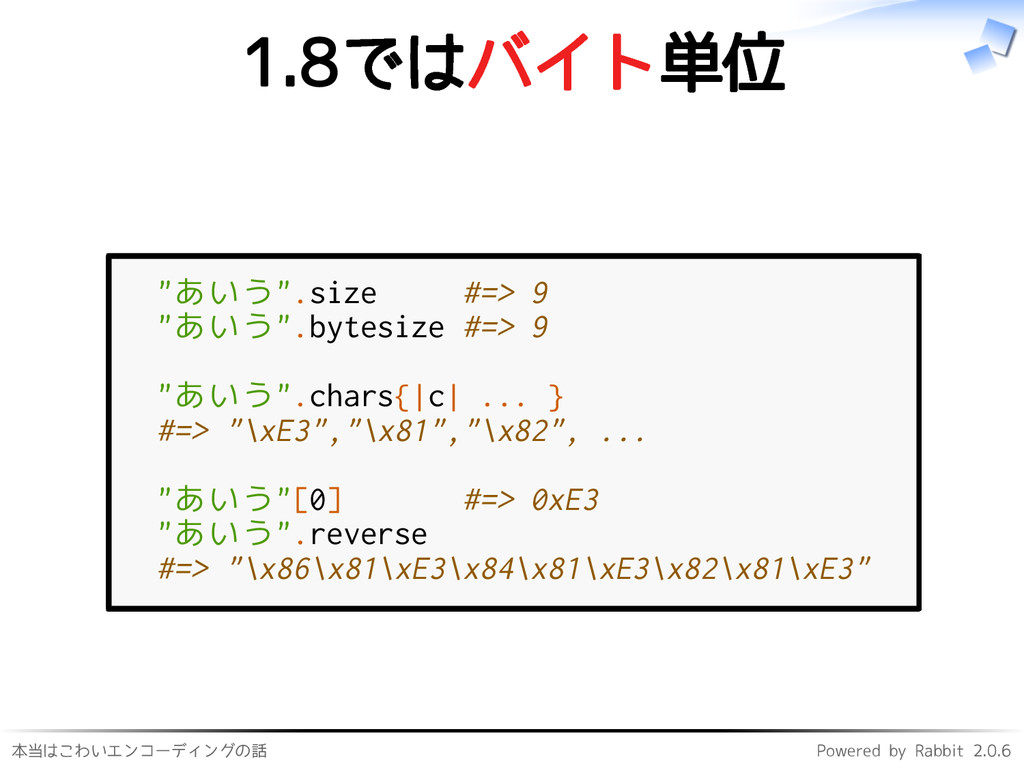
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 1.8ではバイト単位 "あいう".size #=> 9 "あいう".bytesize
#=> 9 "あいう".chars{|c| ... } #=> "\xE3","\x81","\x82", ... "あいう"[0] #=> 0xE3 "あいう".reverse #=> "\x86\x81\xE3\x84\x81\xE3\x82\x81\xE3"
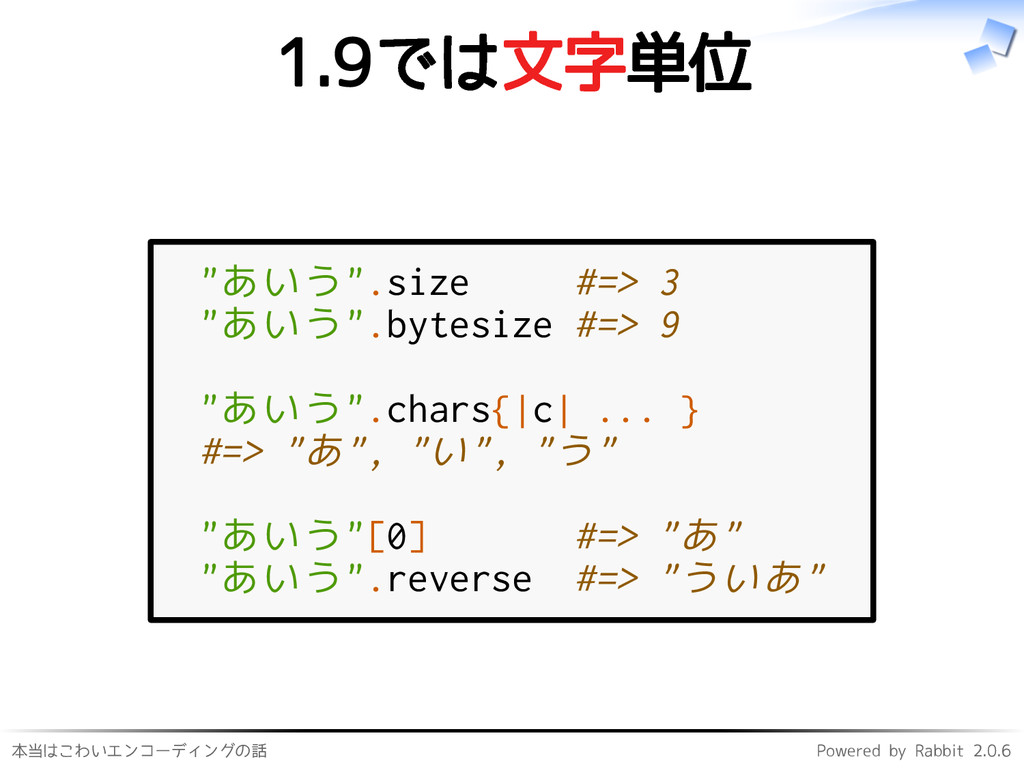
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 1.9では文字単位 "あいう".size #=> 3 "あいう".bytesize
#=> 9 "あいう".chars{|c| ... } #=> "あ", "い", "う" "あいう"[0] #=> "あ" "あいう".reverse #=> "ういあ"
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディング変換 # -*- coding: utf-8
-*- s = "あいう" #=> "\xE3\x81\x82\xE3\x81\x84\xE3\x81\x86" s.encoding #=> #<Encoding:UTF-8> s2 = s.encode("CP932") #=> "\x82\xA0\x82\xA2\x82\xA4" s2.encoding #=> #<Encoding:Windows-31J>
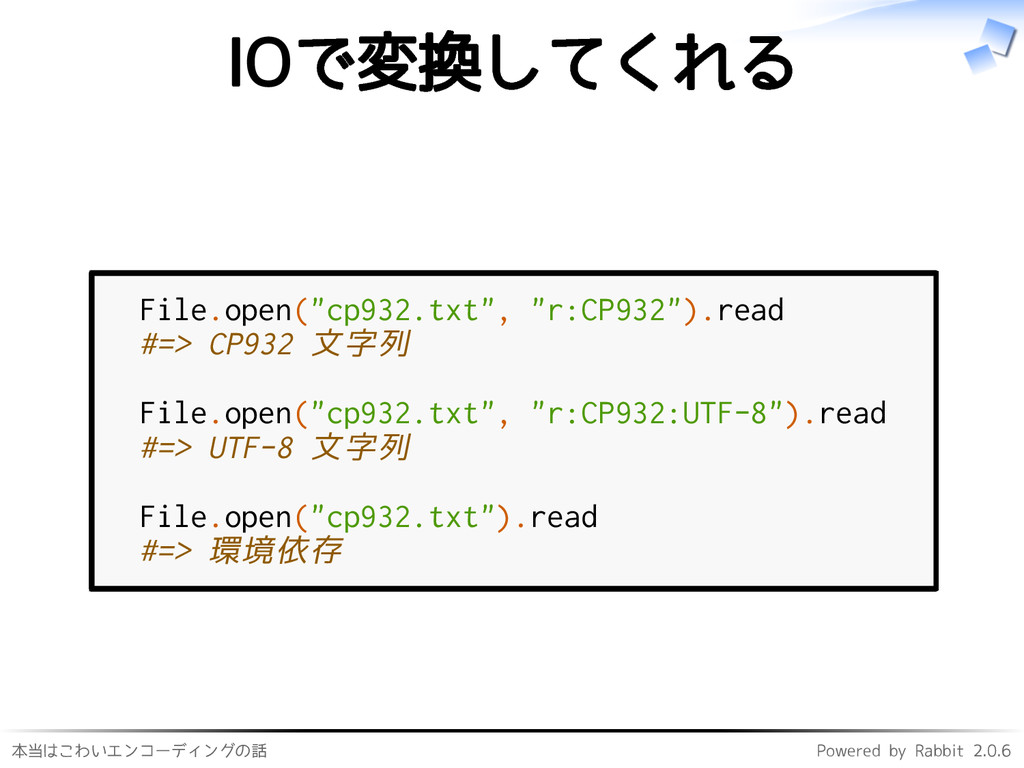
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 IOで変換してくれる File.open("cp932.txt", "r:CP932").read #=> CP932
文字列 File.open("cp932.txt", "r:CP932:UTF-8").read #=> UTF-8 文字列 File.open("cp932.txt").read #=> 環境依存
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 うれしいことばかりじゃない
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 変換先にない文字 # -*- coding: utf-8
-*- "あ♥".encode("CP932") #=> Encoding::UndefinedConversionError
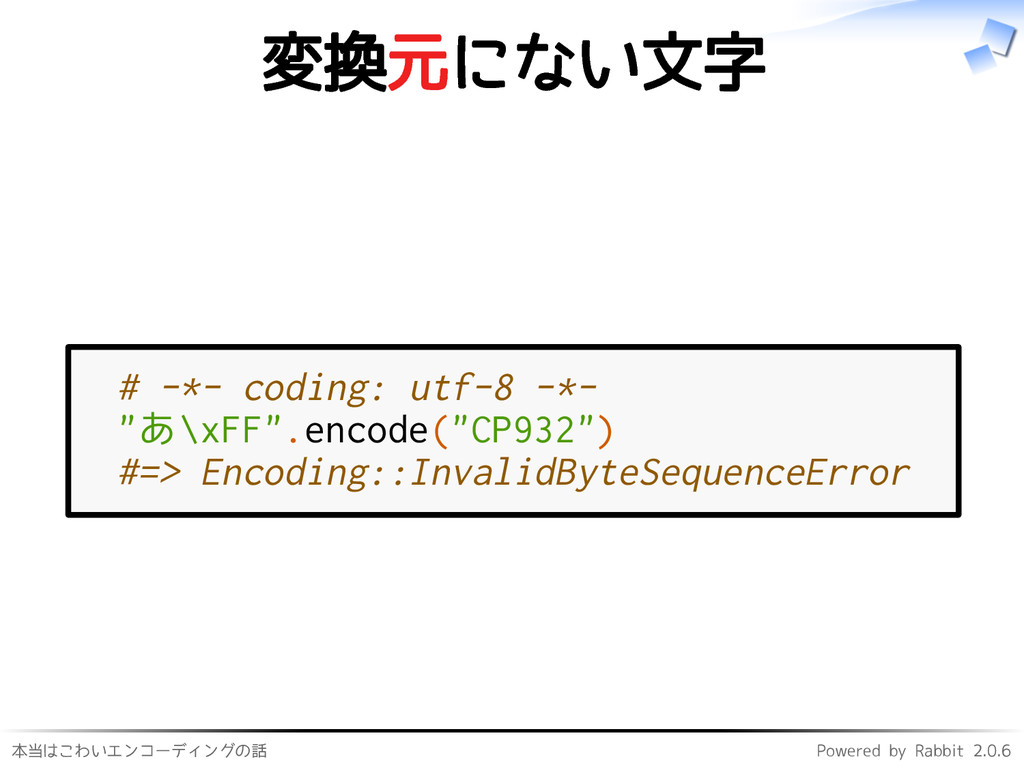
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 変換元にない文字 # -*- coding: utf-8
-*- "あ\xFF".encode("CP932") #=> Encoding::InvalidByteSequenceError
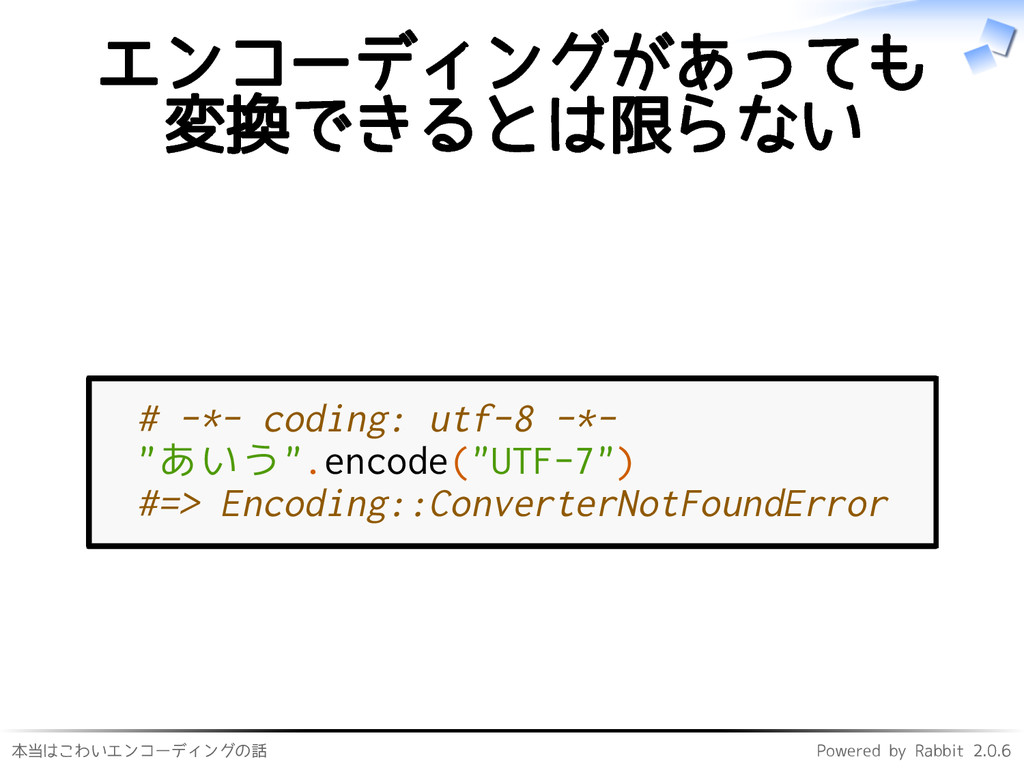
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディングがあっても 変換できるとは限らない # -*- coding:
utf-8 -*- "あいう".encode("UTF-7") #=> Encoding::ConverterNotFoundError
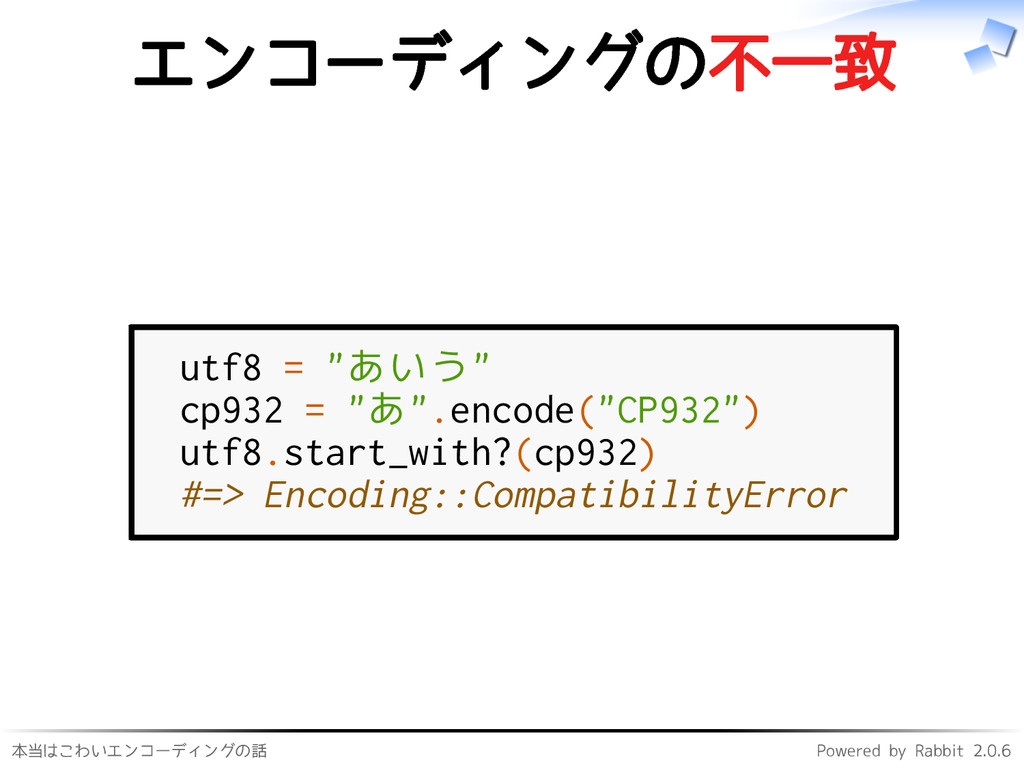
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディングの不一致 utf8 = "あいう" cp932
= "あ".encode("CP932") utf8.start_with?(cp932) #=> Encoding::CompatibilityError
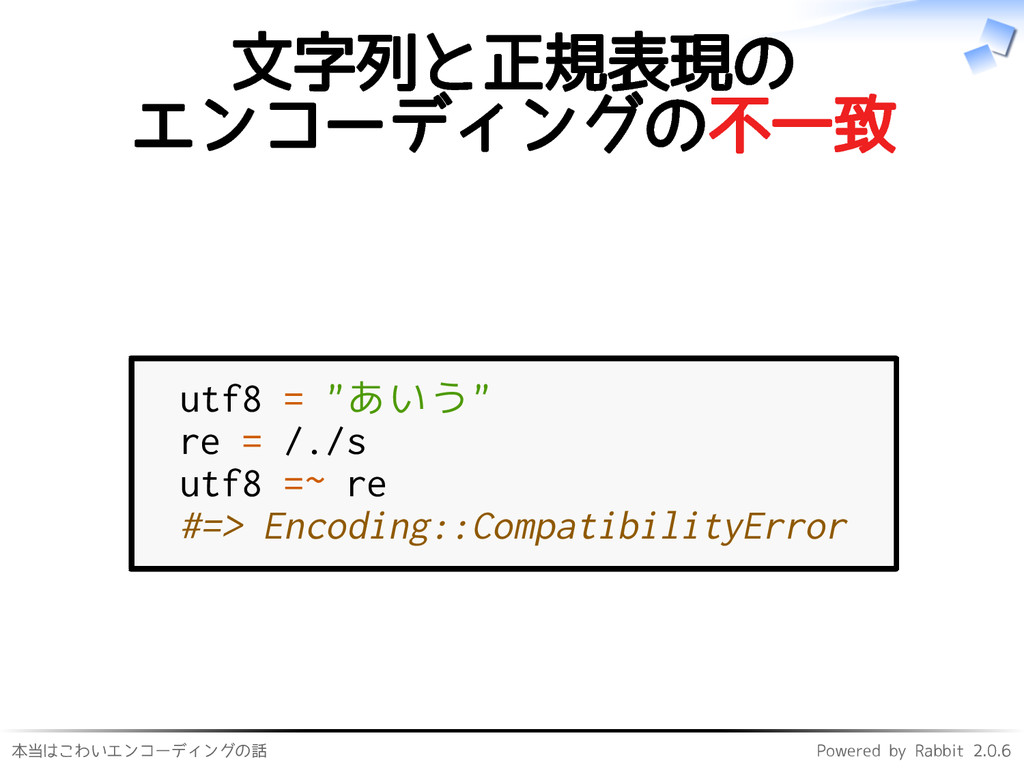
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 文字列と正規表現の エンコーディングの不一致 utf8 = "あいう"
re = /./s utf8 =~ re #=> Encoding::CompatibilityError
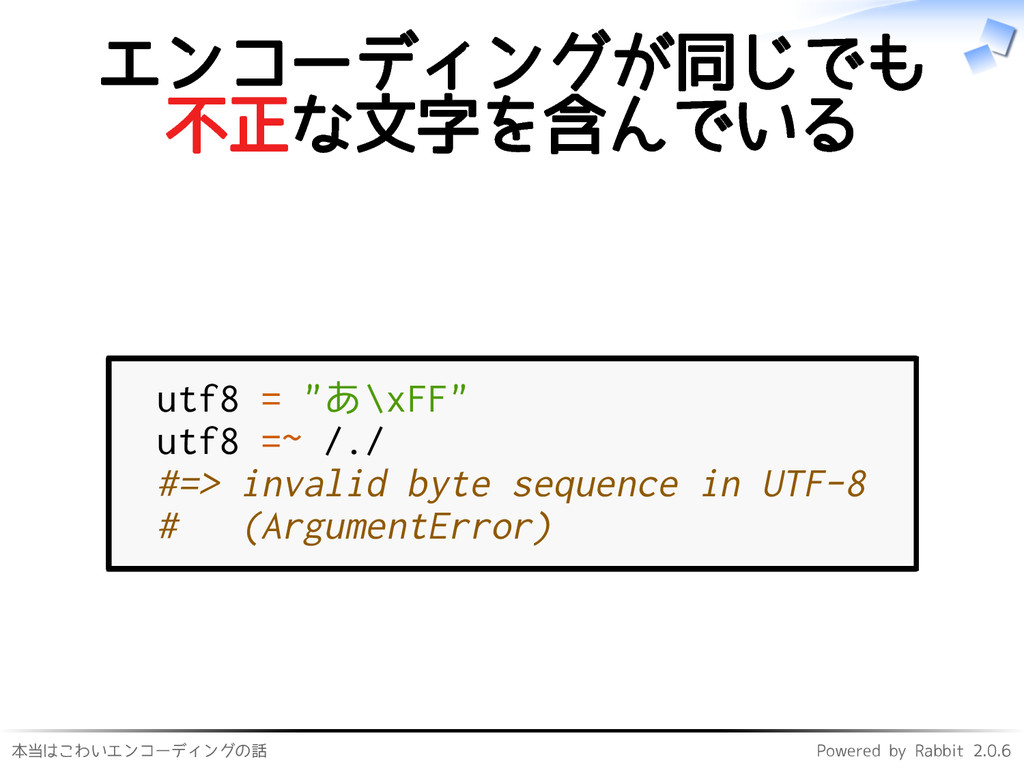
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディングが同じでも 不正な文字を含んでいる utf8 = "あ\xFF"
utf8 =~ /./ #=> invalid byte sequence in UTF-8 # (ArgumentError)
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 IO
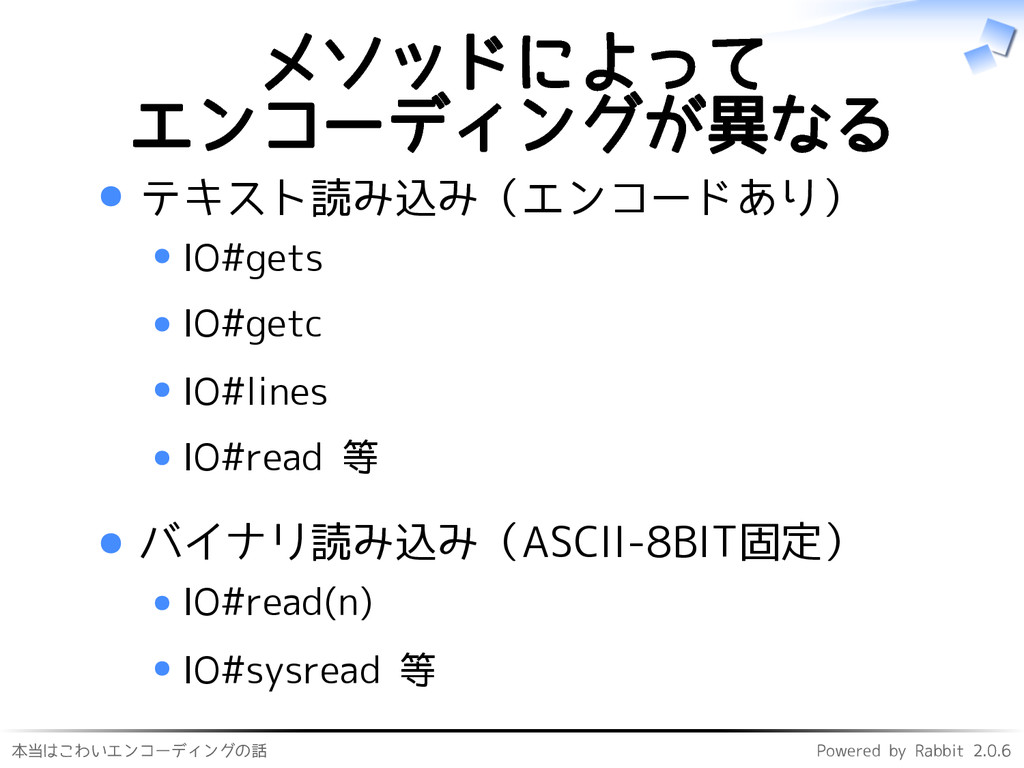
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 メソッドによって エンコーディングが異なる テキスト読み込み(エンコードあり) IO#gets IO#getc
IO#lines IO#read 等 バイナリ読み込み(ASCII-8BIT固定) IO#read(n) IO#sysread 等
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 IO#read IO#read(size) は ASCII-8BIT IO#read()
は外部エンコーディング依存 引数の有無によって結果のエンコーディ ングが異なる! なにそれこわい
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 外部エンコーディング ファイル自身は自分の内容のエンコーデ ィングを知らない ファイルから読み込んだ文字列の Ruby
内でのエンコーディングは何らかの方法 で指定する必要がある
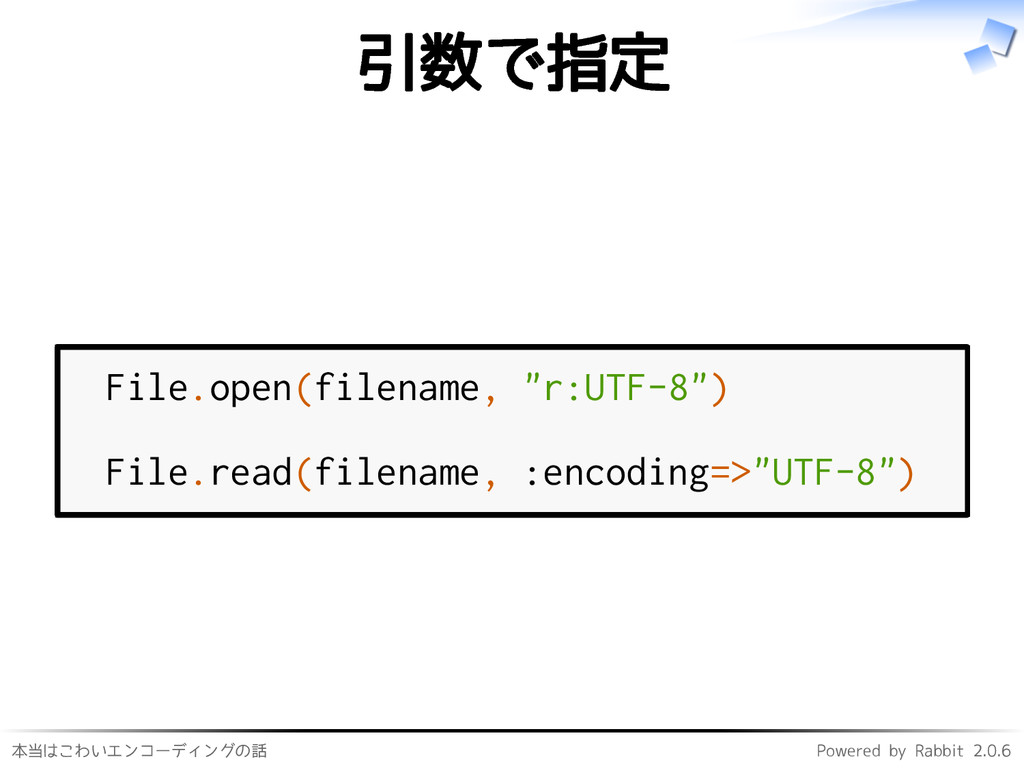
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 引数で指定 File.open(filename, "r:UTF-8") File.read(filename, :encoding=>"UTF-8")
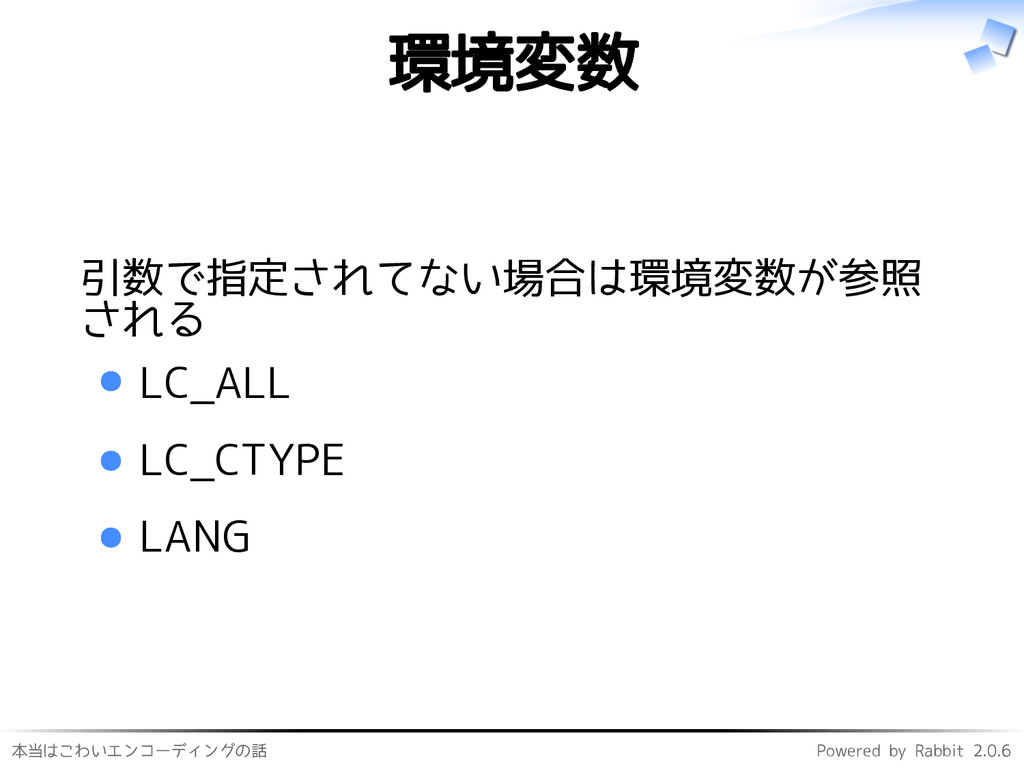
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 環境変数 引数で指定されてない場合は環境変数が参照 される LC_ALL LC_CTYPE
LANG
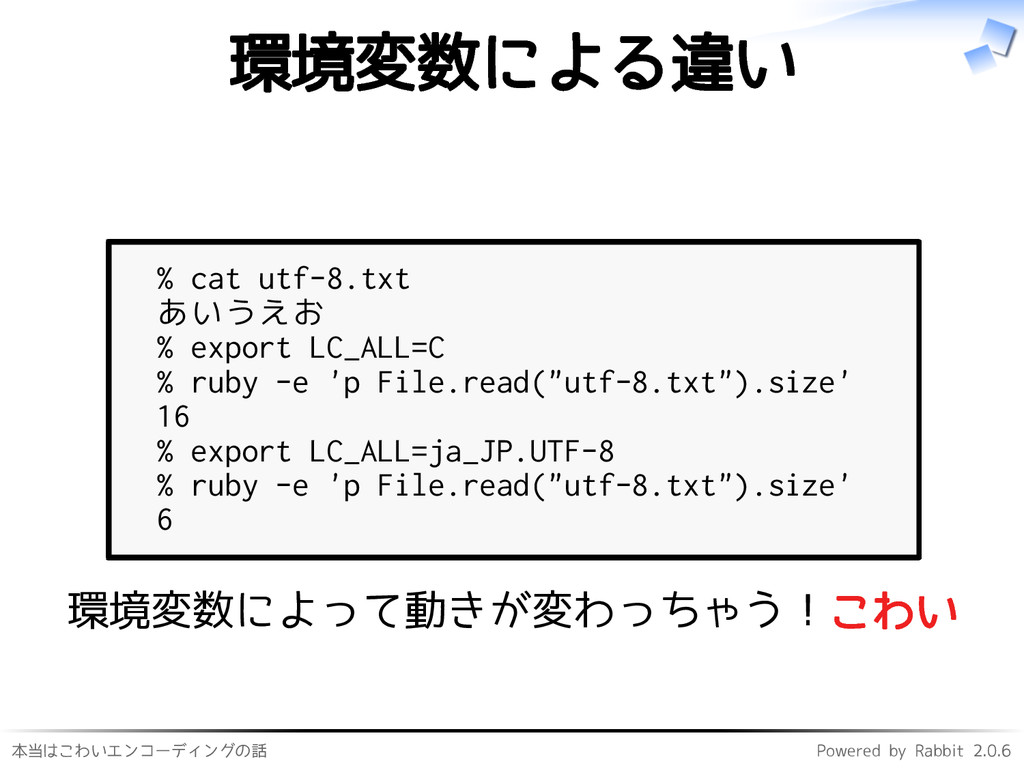
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 環境変数による違い % cat utf-8.txt あいうえお
% export LC_ALL=C % ruby -e 'p File.read("utf-8.txt").size' 16 % export LC_ALL=ja_JP.UTF-8 % ruby -e 'p File.read("utf-8.txt").size' 6 環境変数によって動きが変わっちゃう!こわい
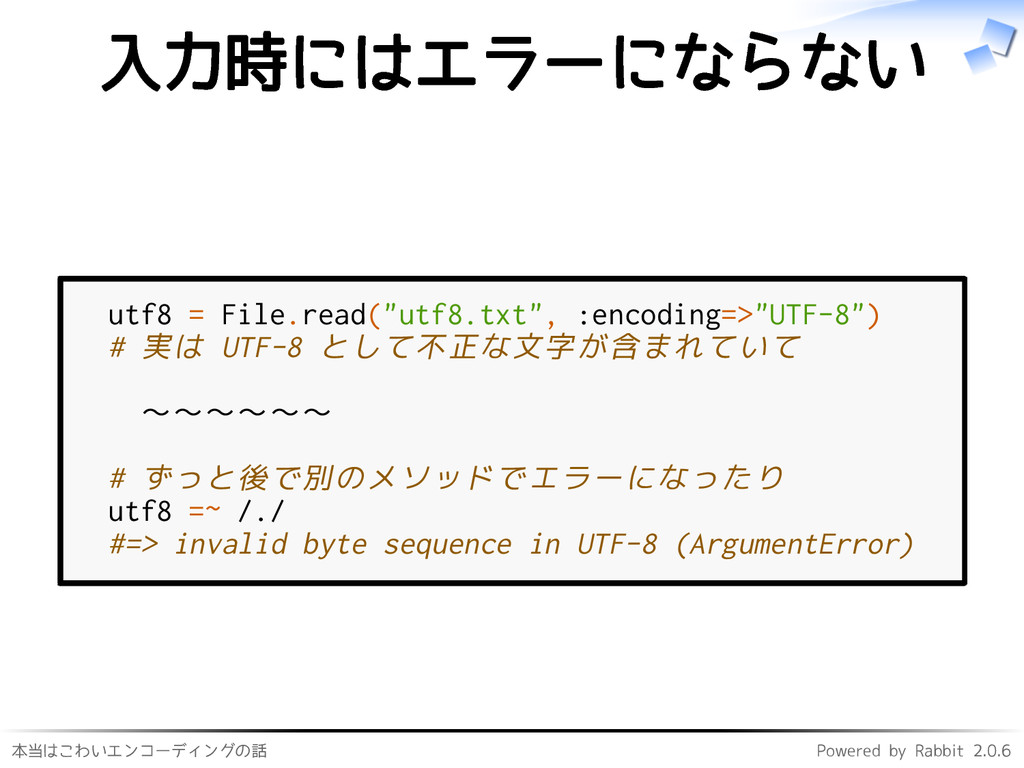
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 入力時にはエラーにならない utf8 = File.read("utf8.txt", :encoding=>"UTF-8")
# 実は UTF-8 として不正な文字が含まれていて 〜〜〜〜〜〜 # ずっと後で別のメソッドでエラーになったり utf8 =~ /./ #=> invalid byte sequence in UTF-8 (ArgumentError)
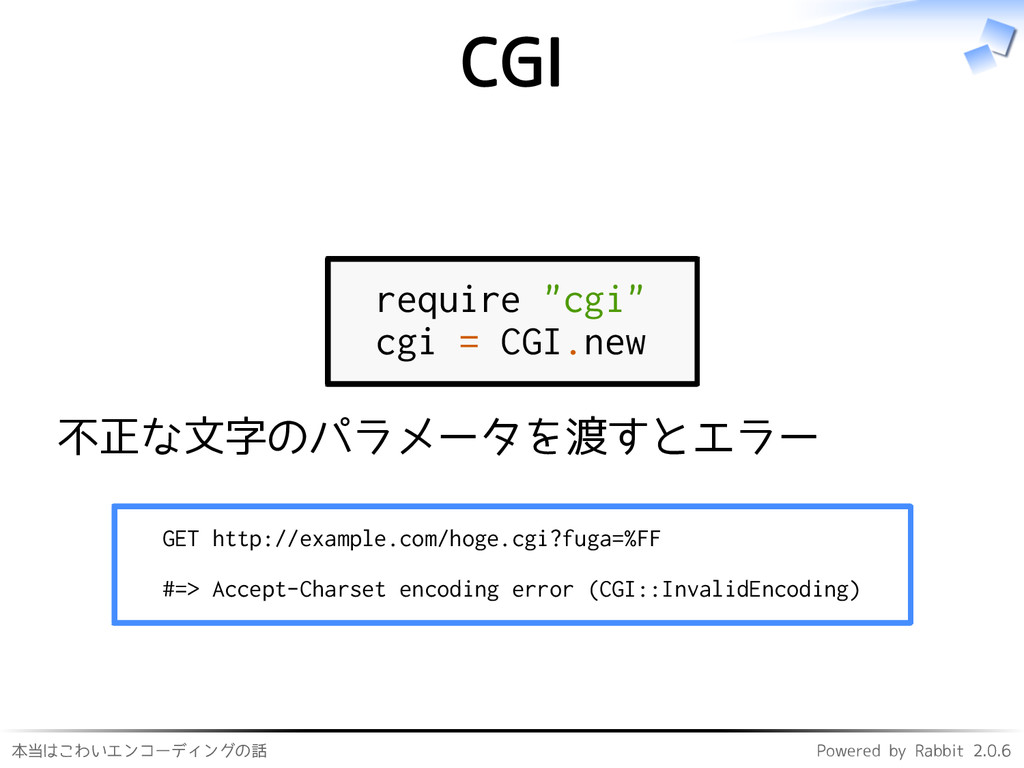
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 CGI require "cgi" cgi =
CGI.new 不正な文字のパラメータを渡すとエラー GET http://example.com/hoge.cgi?fuga=%FF #=> Accept-Charset encoding error (CGI::InvalidEncoding)
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 Rails 不正な文字のパラメータを渡すとエラー POST http://example.com/posts post[title]=%FF
#=> ArgumentError (invalid byte sequence in UTF-8)
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エラーになりすぎこわい!
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 対処
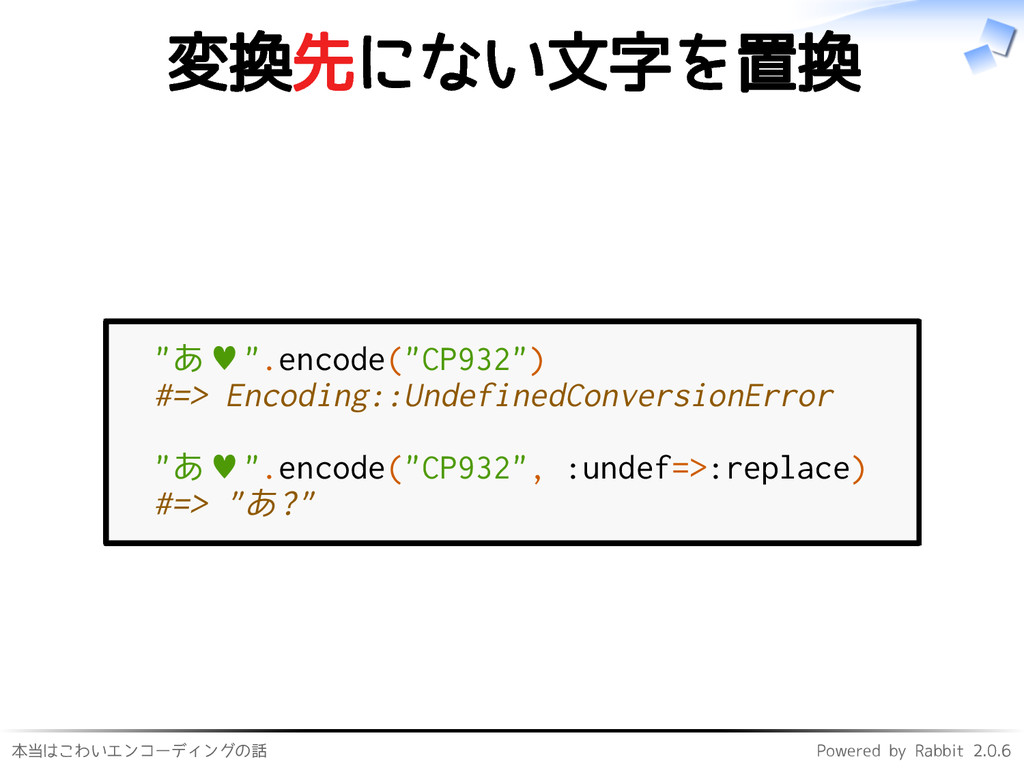
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 変換先にない文字を置換 "あ♥".encode("CP932") #=> Encoding::UndefinedConversionError "あ♥".encode("CP932",
:undef=>:replace) #=> "あ?"
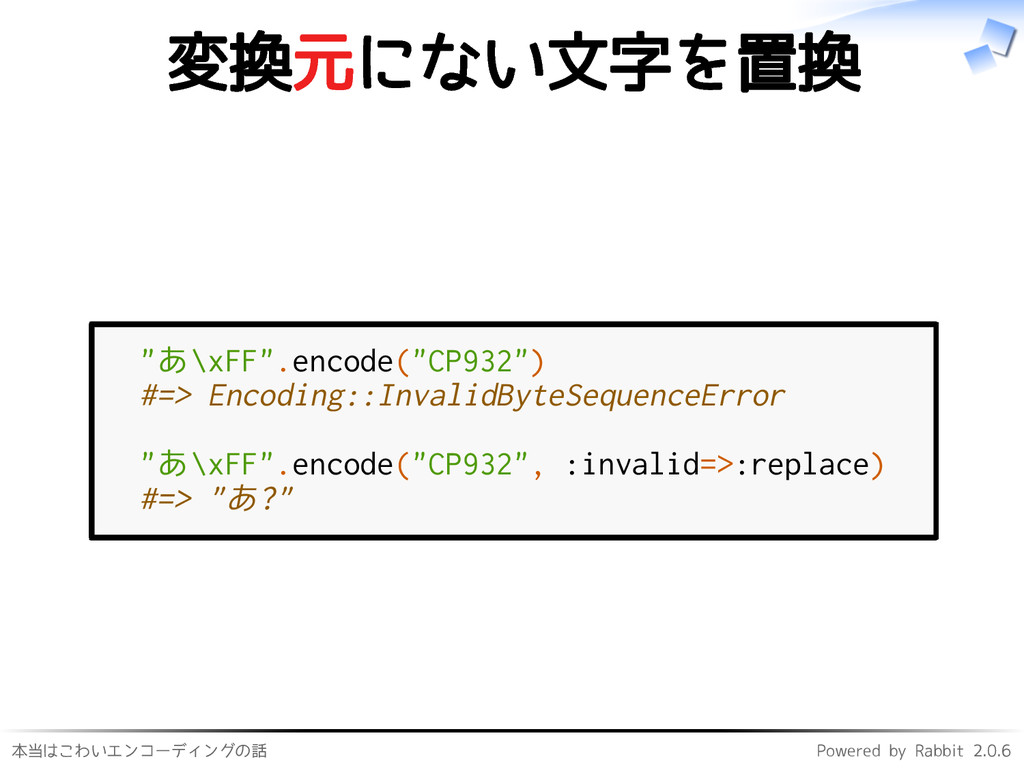
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 変換元にない文字を置換 "あ\xFF".encode("CP932") #=> Encoding::InvalidByteSequenceError "あ\xFF".encode("CP932",
:invalid=>:replace) #=> "あ?"
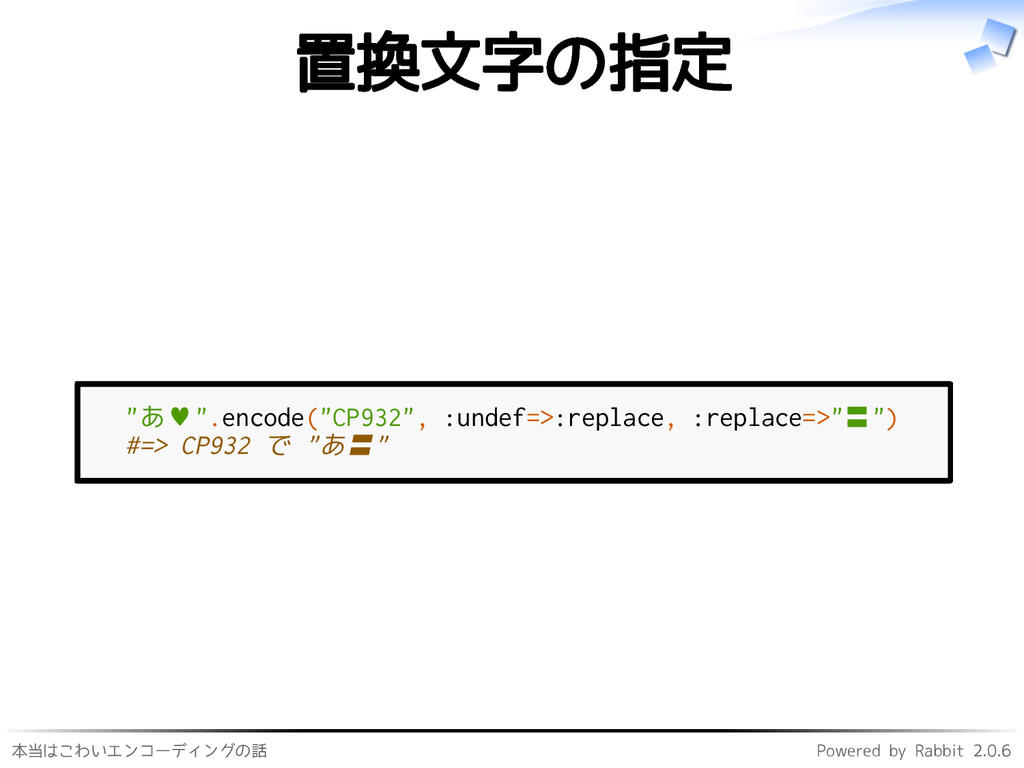
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 置換文字の指定 "あ♥".encode("CP932", :undef=>:replace, :replace=>"〓") #=>
CP932 で "あ〓"
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 そもそも変換が必要になるような ことをしないのが吉
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 UTF-8に統一すれば たいていは問題ない
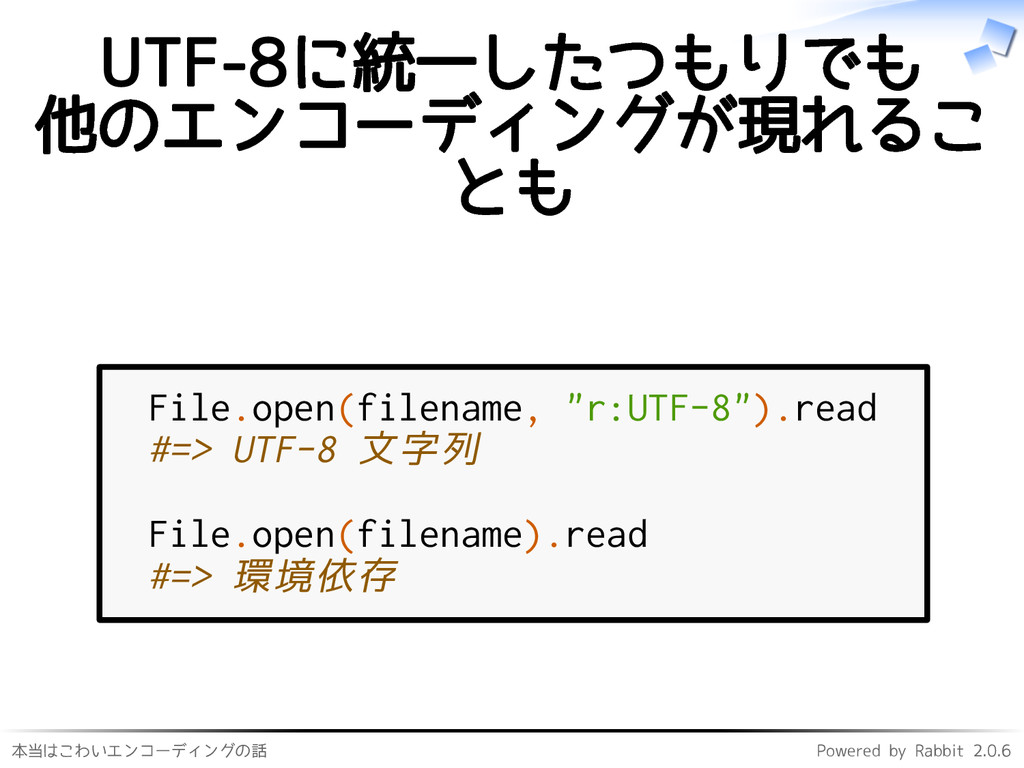
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 UTF-8に統一したつもりでも 他のエンコーディングが現れるこ とも File.open(filename, "r:UTF-8").read
#=> UTF-8 文字列 File.open(filename).read #=> 環境依存
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 いちいち引数で指定する?
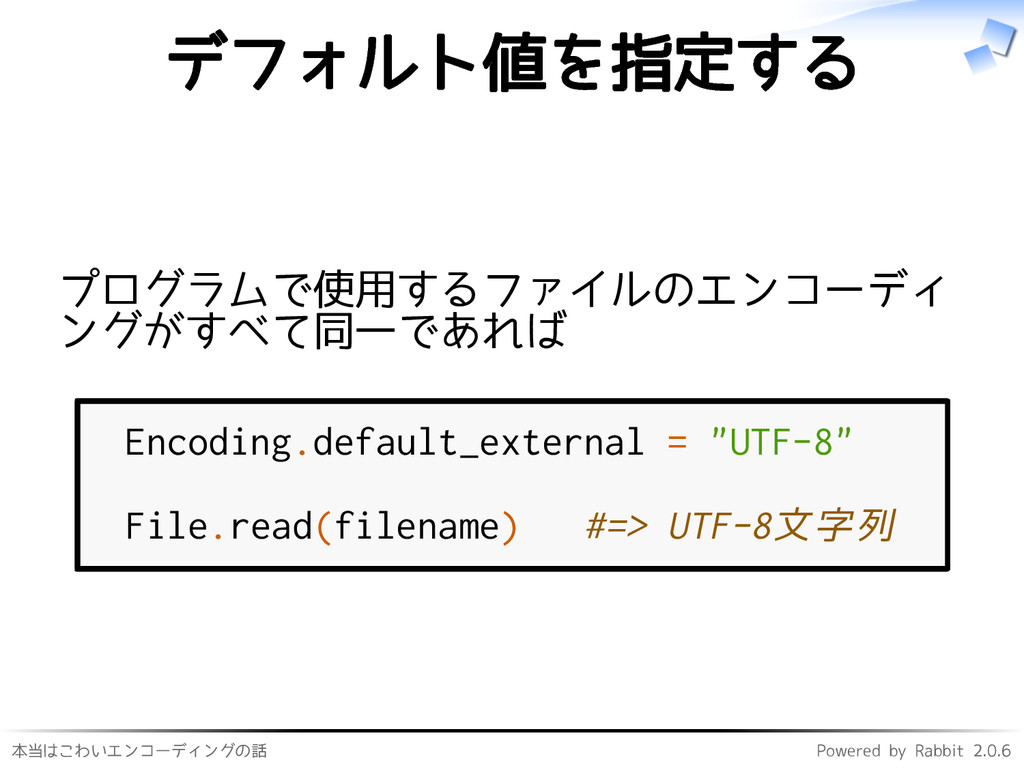
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 デフォルト値を指定する プログラムで使用するファイルのエンコーディ ングがすべて同一であれば Encoding.default_external =
"UTF-8" File.read(filename) #=> UTF-8文字列
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 これで問題ない?
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 ASCII-8BIT
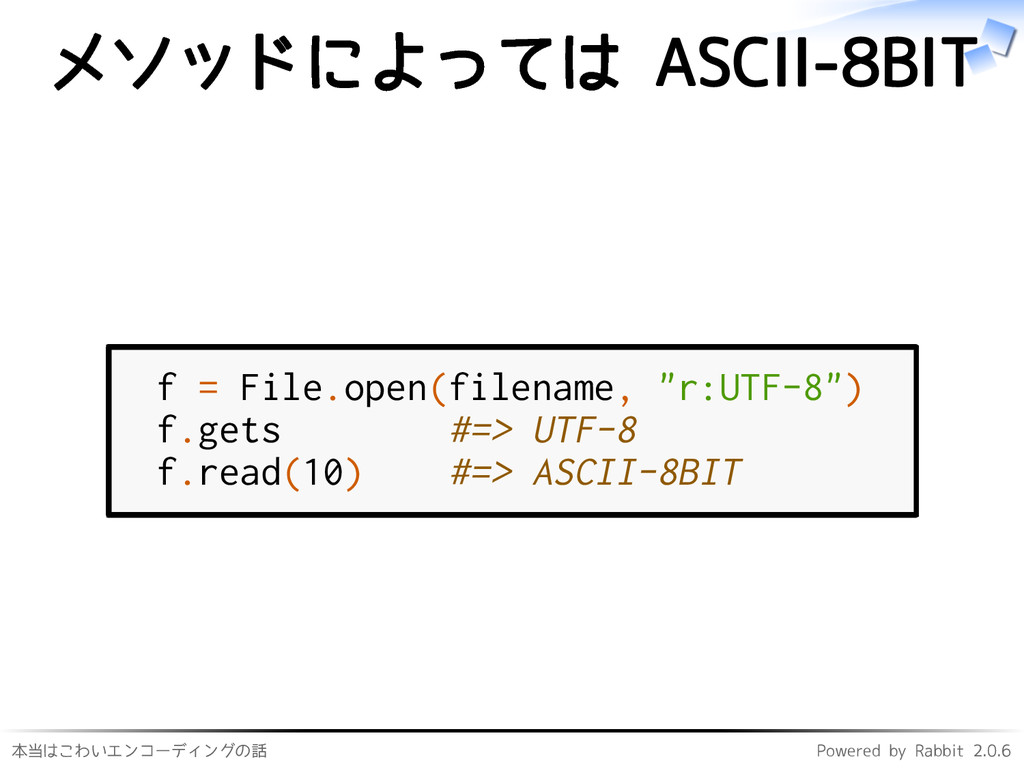
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 メソッドによっては ASCII-8BIT f = File.open(filename,
"r:UTF-8") f.gets #=> UTF-8 f.read(10) #=> ASCII-8BIT
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 ソケットは ASCII-8BIT require 'socket' Encoding.default_external
= "UTF-8" TCPSocket.new('127.0.0.1', 25).gets #=> ASCII-8BIT
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 気をつけるしかない
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 不正な文字
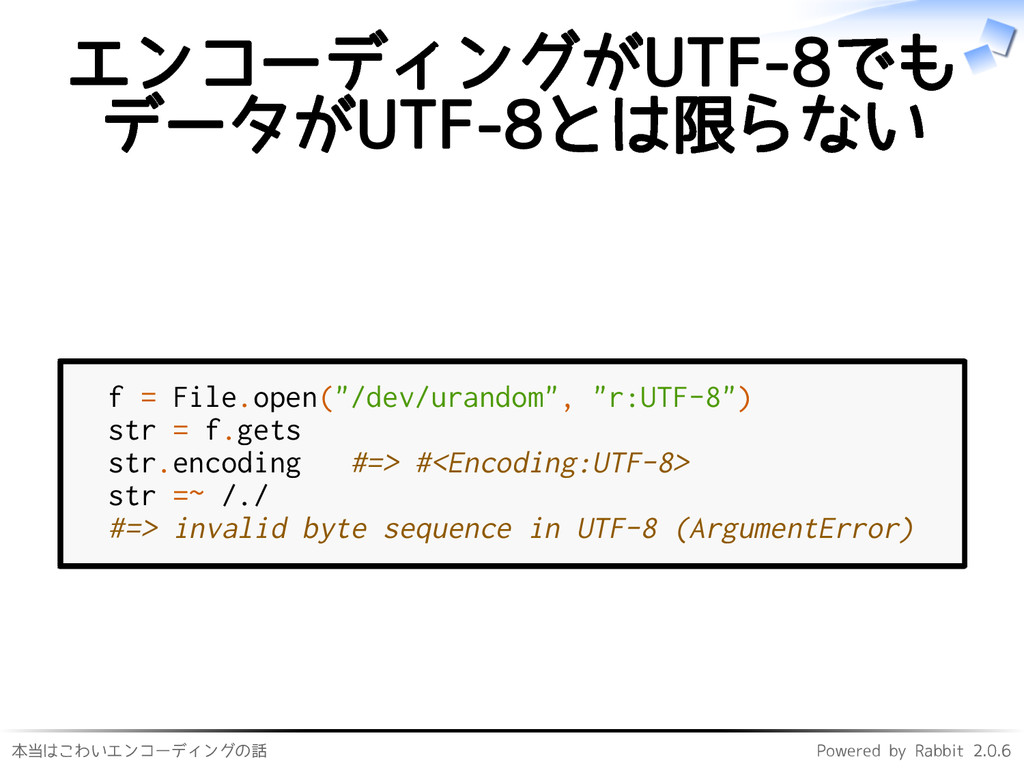
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 エンコーディングがUTF-8でも データがUTF-8とは限らない f = File.open("/dev/urandom",
"r:UTF-8") str = f.gets str.encoding #=> #<Encoding:UTF-8> str =~ /./ #=> invalid byte sequence in UTF-8 (ArgumentError)
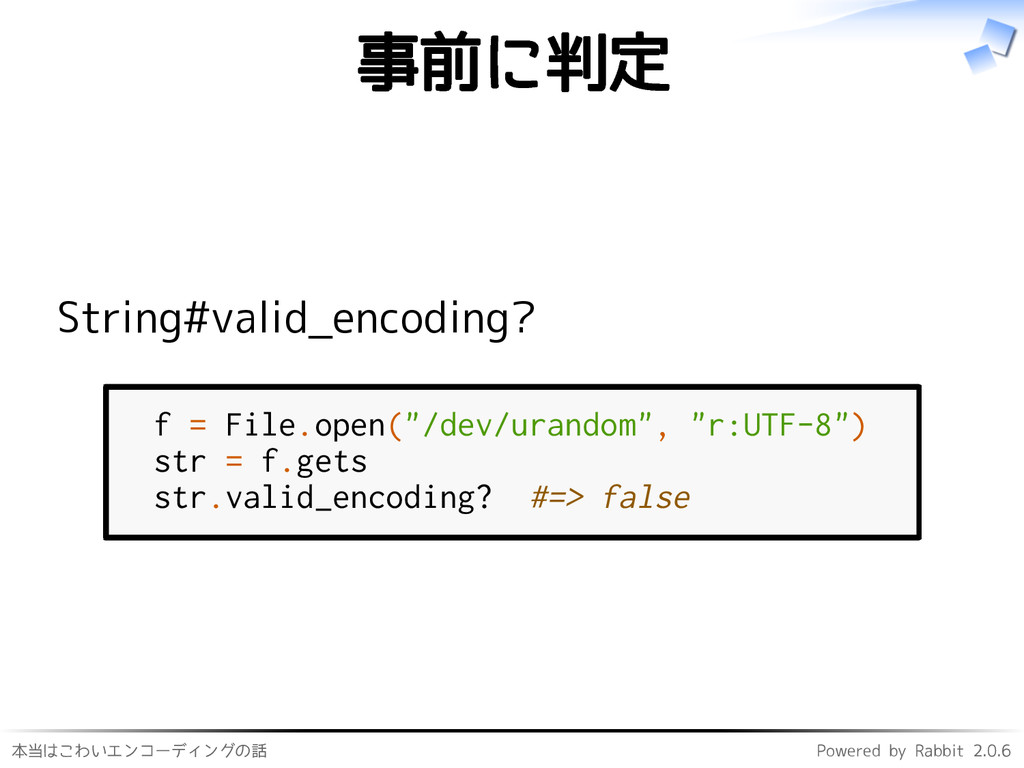
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 事前に判定 String#valid_encoding? f = File.open("/dev/urandom",
"r:UTF-8") str = f.gets str.valid_encoding? #=> false
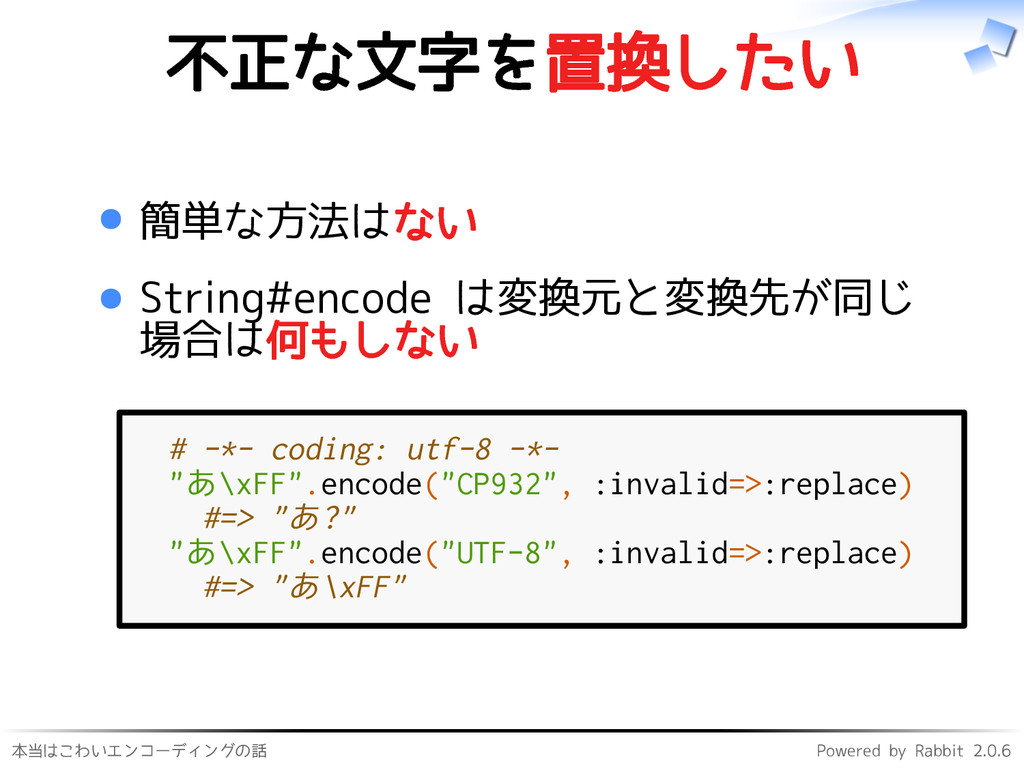
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 不正な文字を置換したい 簡単な方法はない String#encode は変換元と変換先が同じ 場合は何もしない
# -*- coding: utf-8 -*- "あ\xFF".encode("CP932", :invalid=>:replace) #=> "あ?" "あ\xFF".encode("UTF-8", :invalid=>:replace) #=> "あ\xFF"
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 Iconv ではできたけど… require "iconv" src
= "あい\xFFうえ" dst = "" iconv = Iconv.new("utf-8", "utf-8") begin dst.concat iconv.iconv(src) rescue Iconv::IllegalSequence => e dst.concat e.success dst.concat "〓" src = e.failed[1..-1] retry end dst #=> "あい〓うえ" Iconv は 2.0 で廃止
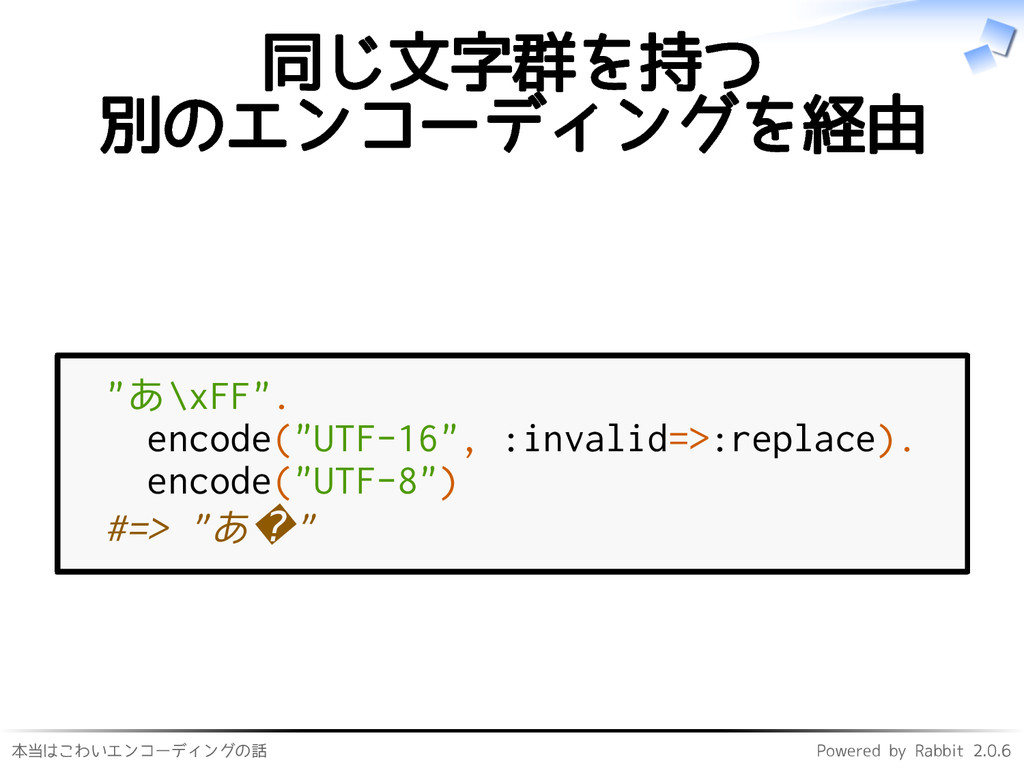
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 同じ文字群を持つ 別のエンコーディングを経由 "あ\xFF". encode("UTF-16", :invalid=>:replace).
encode("UTF-8") #=> "あ�"
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 2.0.xだとできるようになる?
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 CGI や Rails
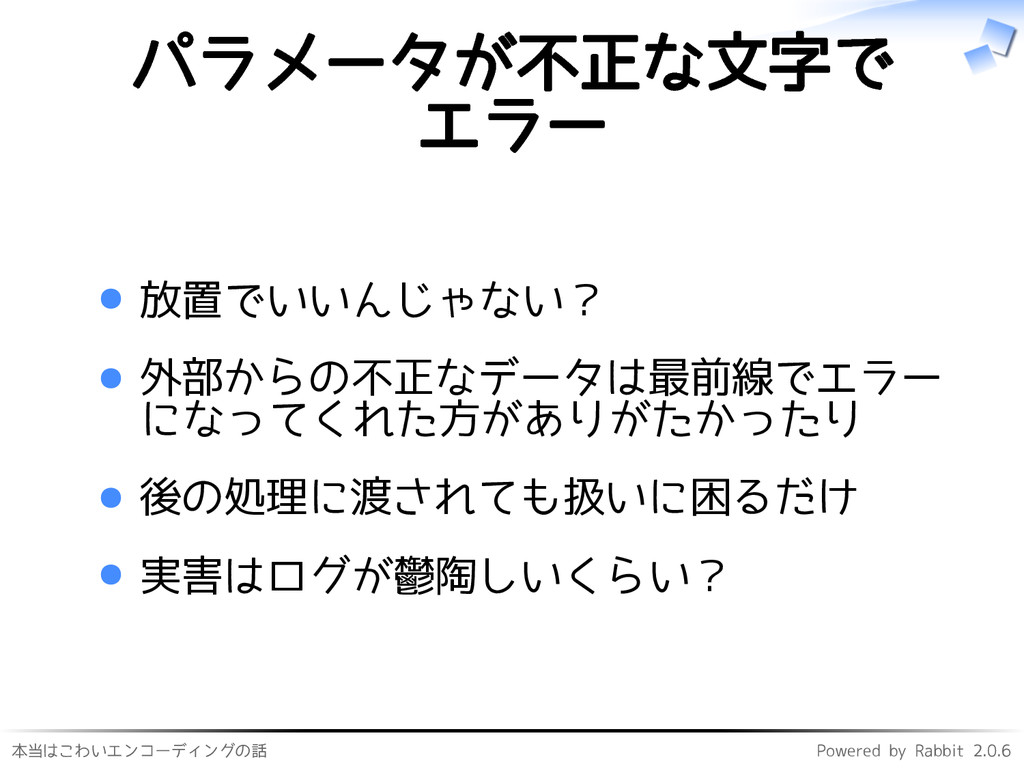
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 パラメータが不正な文字で エラー 放置でいいんじゃない? 外部からの不正なデータは最前線でエラー になってくれた方がありがたかったり
後の処理に渡されても扱いに困るだけ 実害はログが鬱陶しいくらい?
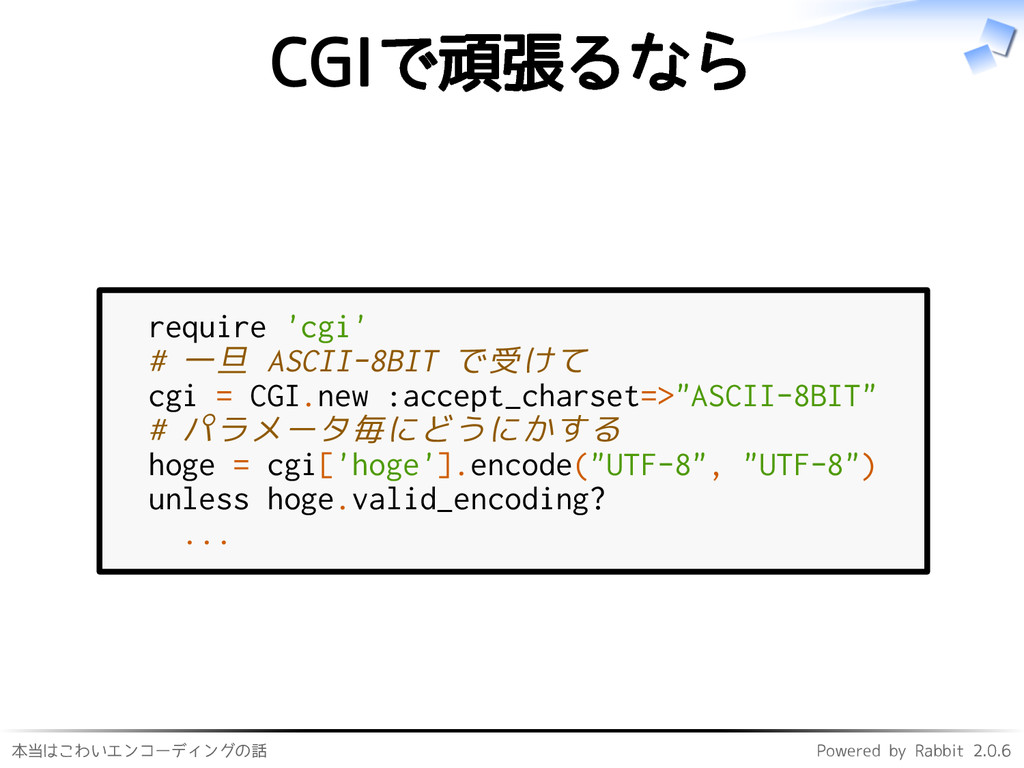
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 CGIで頑張るなら require 'cgi' # 一旦
ASCII-8BIT で受けて cgi = CGI.new :accept_charset=>"ASCII-8BIT" # パラメータ毎にどうにかする hoge = cgi['hoge'].encode("UTF-8", "UTF-8") unless hoge.valid_encoding? ...
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 Railsは... よくわかりません (><)
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 おまけ
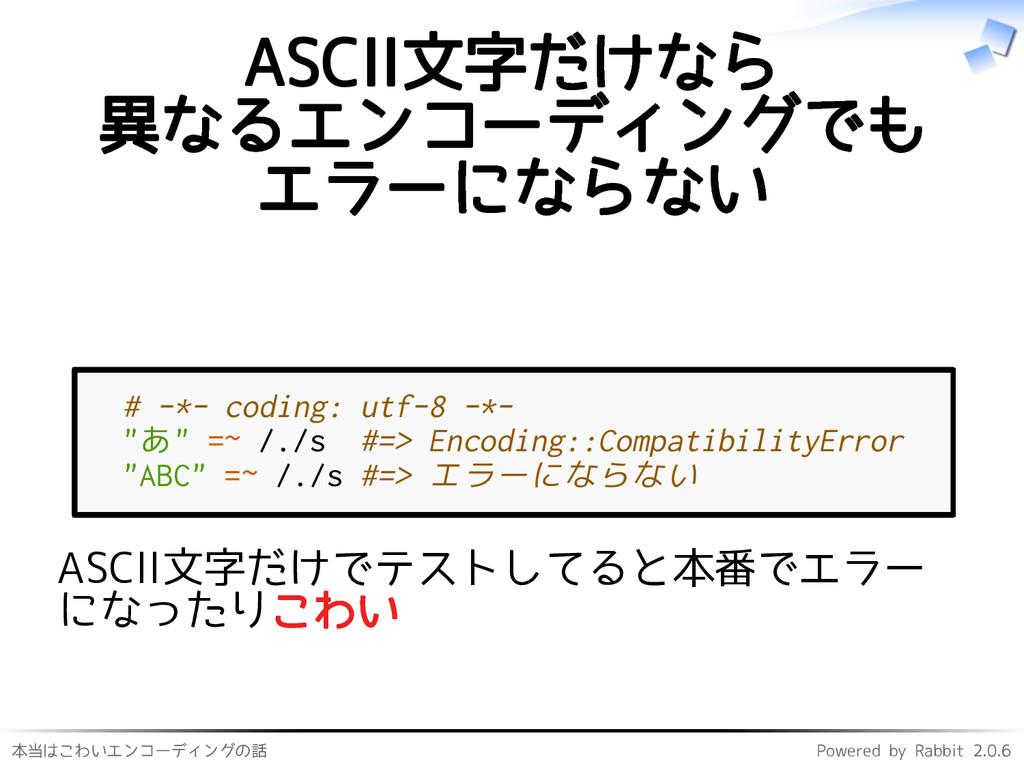
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 ASCII文字だけなら 異なるエンコーディングでも エラーにならない # -*-
coding: utf-8 -*- "あ" =~ /./s #=> Encoding::CompatibilityError "ABC" =~ /./s #=> エラーにならない ASCII文字だけでテストしてると本番でエラー になったりこわい
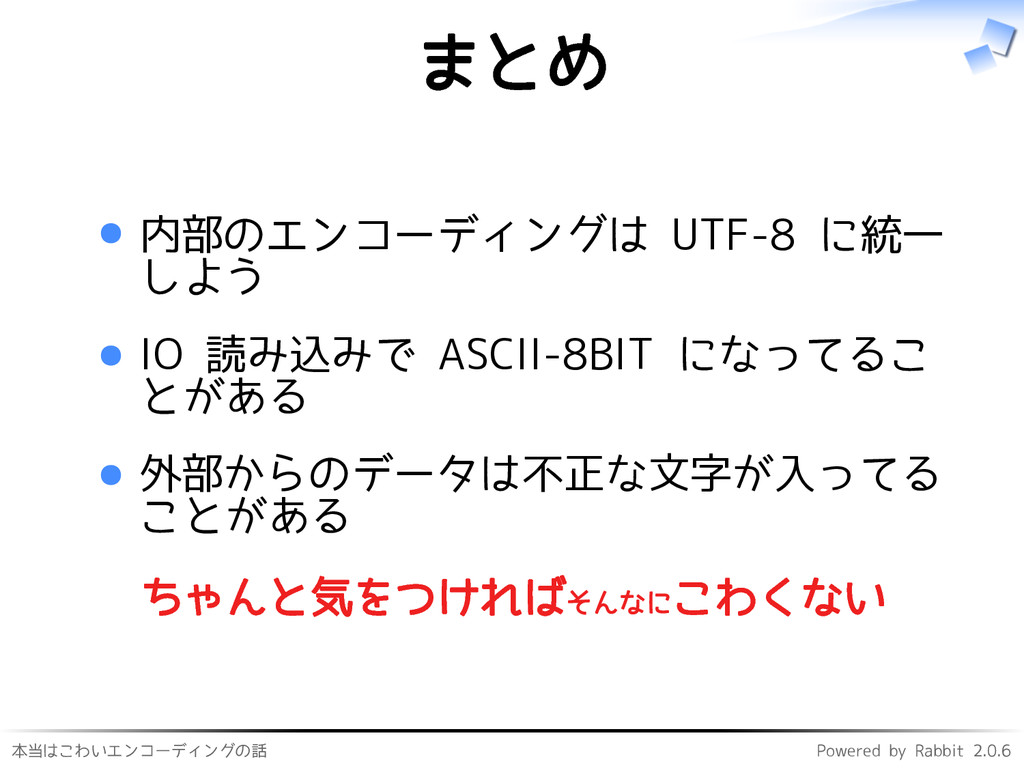
本当はこわいエンコーディングの話 Powered by Rabbit 2.0.6 まとめ 内部のエンコーディングは UTF-8 に統一 しよう
IO 読み込みで ASCII-8BIT になってるこ とがある 外部からのデータは不正な文字が入ってる ことがある ちゃんと気をつければそんなに こわくない
More Decks by とみたまさひろ
See All by とみたまさひろ
MySQLとPostgreSQLのコレーション / Collation of MySQL and PostgreSQL
tmtms
1
2k
文字列の並び順 / Unicode Collation
tmtms
4
1.4k
夢の印税生活 / Life on Royalties
tmtms
0
700
文字列の並び順 / String Collation
tmtms
1
300
日本MySQLユーザ会ができるまで / making MyNA
tmtms
1
1.2k
Ruby on Browser - RubyWorld Conference 2024
tmtms
1
1.7k
Ruby on Browser
tmtms
1
2.5k
私のRSpecの書き方 / How I write RSpec
tmtms
5
2.4k
ショートカットと端末 / shortcut & terminal
tmtms
2
1.1k
Other Decks in Programming
See All in Programming
Spec-driven Development with AI
simas
PRO
0
2.3k
TanStack Vue Query と Pinia Colada から学ぶ非同期状態の型設計
aoshi
0
670
React Native에 현대적인 빌드 도구 더하기: Rollipop 구현기
leegeunhyeok
0
180
AIが生成したコードは読むべきか?抽象化設計とコードの品質保証 / abstraction-design-and-quality
minodriven
16
9.1k
Vapor Mode でアクセシビリティは 壊れないか検証した話
fuqda
1
350
Railsのためのパスキー実践入門 〜マルチテナントSaaSでの意思決定〜
utakaha
4
4.3k
どうしても Eloquent でリポジトリパターンをやりたいんだ #phpcon_niigata / phpcon-niigata-2026
shogogg
0
140
Crash Auto Pipelines
veronikapj
1
410
クラウドエージェントは、 何がそんなに便利なのか / what makes cloud agents so useful
rkaga
5
860
AIが実装を担う時代の「技術設計」と「チームマネジメント」
kamina_zzz
2
260
AWS CDKを理解するために公式の定義を深掘って解説してみる / Understanding AWS CDK by Digging into Its Official Definition
akihisaikeda
3
300
TS 7.0 で baseUrl が使えなくなった今、パスエイリアスをどうするか
bicstone
2
640
Featured
See All Featured
A Tale of Four Properties
chriscoyier
163
24k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
1
310
Believing is Seeing
oripsolob
1
280
Design in an AI World
tapps
1
390
Discover your Explorer Soul
emna__ayadi
2
1.3k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
23k
Become a Pro
speakerdeck
PRO
31
6.4k
Being A Developer After 40
akosma
PRO
92
590k
Designing for humans not robots
tammielis
254
26k
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k


 tmtms
 simas
 aoshi
 leegeunhyeok
 minodriven
 fuqda
 utakaha
 shogogg
 veronikapj
 rkaga
 kamina_zzz
 akihisaikeda
 bicstone
 chriscoyier
 tmiket
 oripsolob
 tapps
 emna__ayadi
 aleyda
 smashingmag
 speakerdeck
 akosma
 tammielis
 tanoku
 427marketing