Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Features
Speaker Deck
PRO
Sign in
Sign up for free
Search
Search
計算量オーダーの話
Search
tsuda.a
May 25, 2024
Programming
480
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
計算量オーダーの話
計算量オーダーについて説明してみました。
tsuda.a
May 25, 2024
More Decks by tsuda.a
See All by tsuda.a
Git を GUI で 使う話
tsudaahr
0
130
マジカルインクリメントと指数表記
tsudaahr
0
280
バックアップしていますか?
tsudaahr
0
160
RDB以前のファイル設計の話でもしようか(ぇ
tsudaahr
0
170
NPUわからん
tsudaahr
0
230
クラウド初学者が抱える不安について
tsudaahr
0
470
キューとは何か
tsudaahr
0
300
等幅は死んだ(ぇ
tsudaahr
0
150
いくら眺めてもエラーの理由がわからないコードについて
tsudaahr
0
250
Other Decks in Programming
See All in Programming
ハーネス設計入門 〜プロンプト、コンテキストの次〜
kinopeee
55
36k
片田舎のおっさん、 Swift Buildのダイアモンド問題解決の不具合修正PRを出すが、解決方法がキャッシュをしないようにすることであり、ビルド時間が伸びると言われてマージされないので高速化もする/swiftbuild
yimajo
0
360
Laravelのアプリケーションをどこにデプロイするか #ツナギメオフライン.9
akase244
0
120
DroidKaigi 2026 「個人開発という実験場: Android エンジニアが手にする4つの自由」
slashnephy
0
220
コンパウンドプロダクト開発のためのローカルプロセスマネージャー再発明 #layerxgo
izumin5210
0
660
ALB ログから Trace を気合で繋げる技術
fohte
7
880
Vibes Containers 〜AIで変わるコンテナ設計と運用〜
tkikuc
2
500
What We Talk About When We Talk About XP
m_seki
2
390
PyO3 で既存 Python 評価器を Rust core 化する ー wasm-bindgen でブラウザにも配るための設計
kdash
1
550
RSSとCodexを使ってX投稿自動化してみた
ochtum
0
110
まだ間に合う!今年の夏こそSchemeのマクロ展開器を完全理解!
omasanori
0
640
XHTMLが残したもの
yosuke_furukawa
PRO
2
440
Featured
See All Featured
4 Signs Your Business is Dying
shpigford
187
23k
How GitHub (no longer) Works
holman
316
150k
The Spectacular Lies of Maps
axbom
PRO
1
980
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
440
Ethics towards AI in product and experience design
skipperchong
2
360
BBQ
matthewcrist
89
10k
Believing is Seeing
oripsolob
1
210
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
202
76k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
A Soul's Torment
seathinner
7
3.6k
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
Building AI with AI
inesmontani
PRO
1
1.2k
Transcript
計算量オーダーの話 LTDD 2024-5 #2 中国地方DB勉強会 #1 @tsuda_ahr
最初に免責 • 概念的なわかりやすさ(?)を重視して、誇張した表現を多用しています。 • いやその表現、誇張を超えて嘘だよね、みたいなのもあります。-_-; • なので正しくはこうだ!みたいなものは、各自調査/発信してください(汗
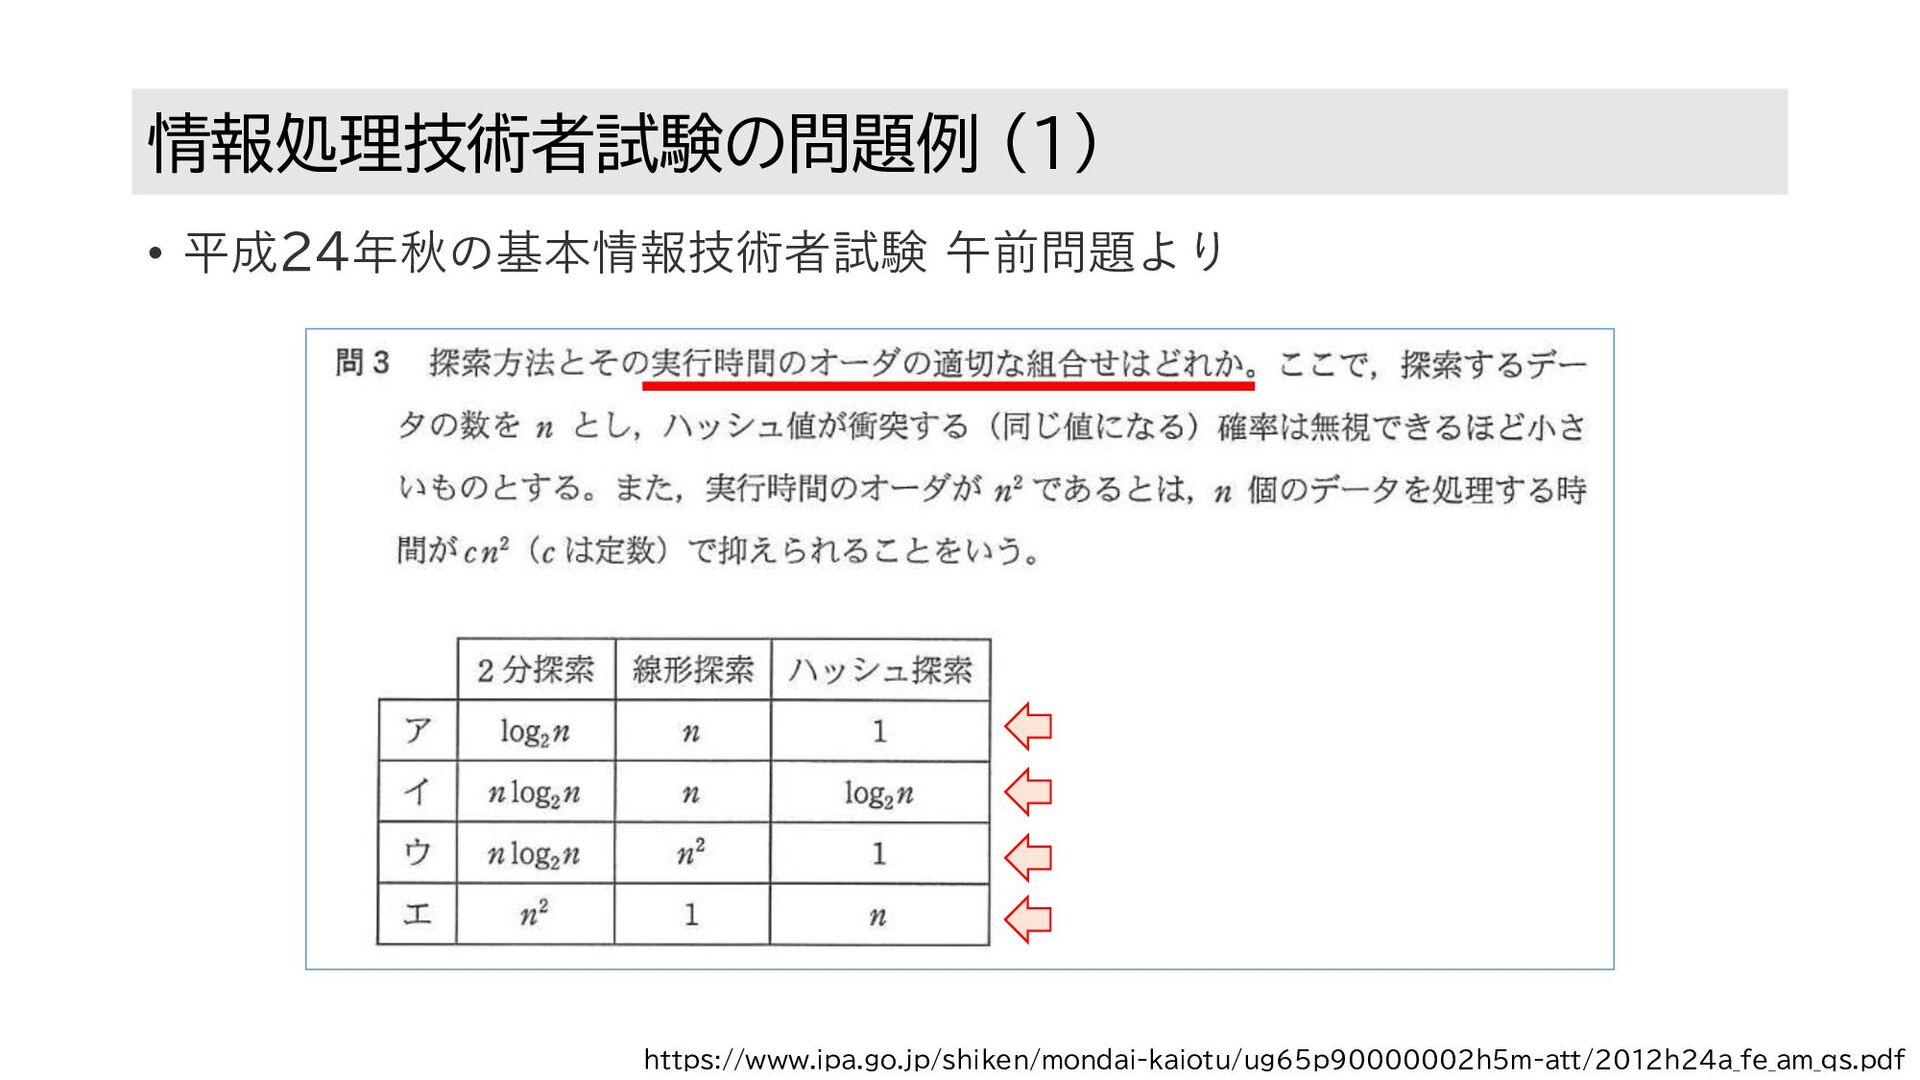
情報処理技術者試験の問題例 (1) https://www.ipa.go.jp/shiken/mondai-kaiotu/ug65p90000002h5m-att/2012h24a_fe_am_qs.pdf • 平成24年秋の基本情報技術者試験 午前問題より
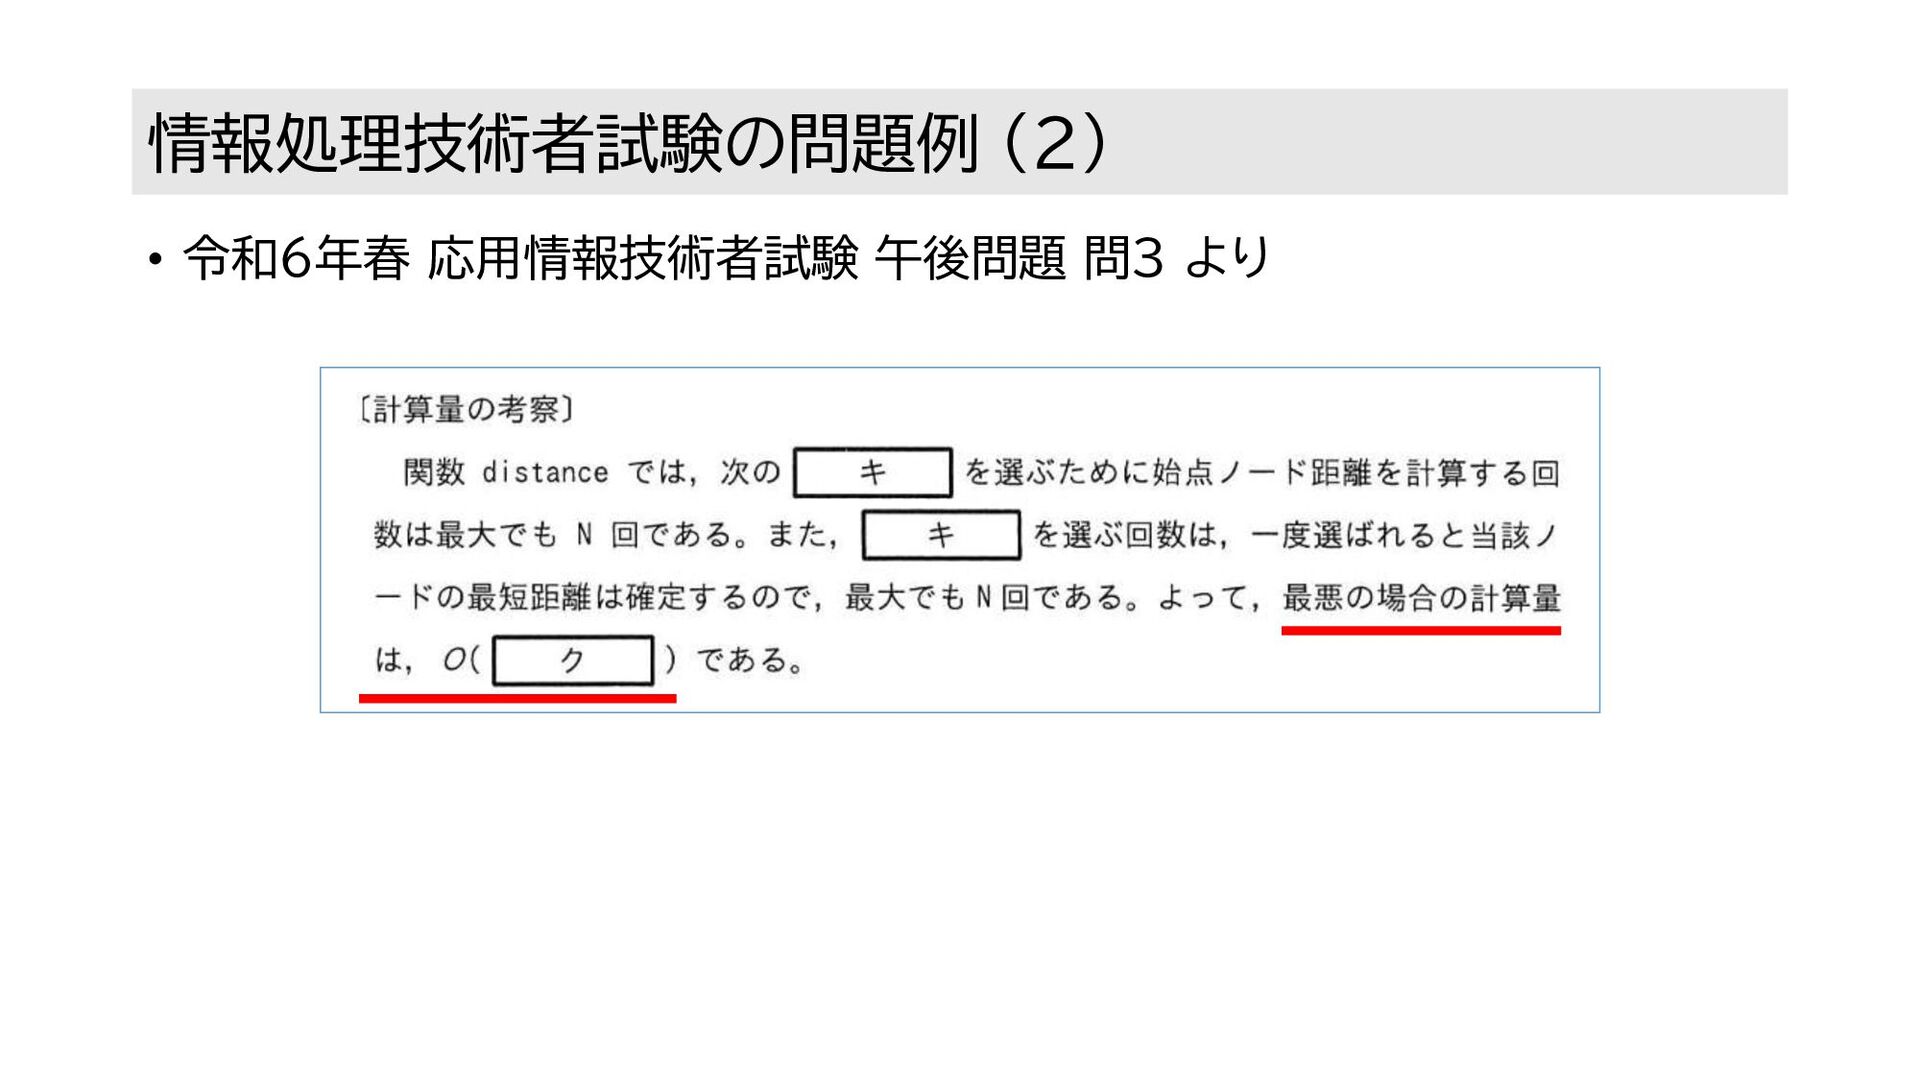
情報処理技術者試験の問題例 (2) • 令和6年春 応用情報技術者試験 午後問題 問3 より
O(n), O(n2) ってなんだ? • 計算量の指標 • データが n 件あったとき、何回計算するか?
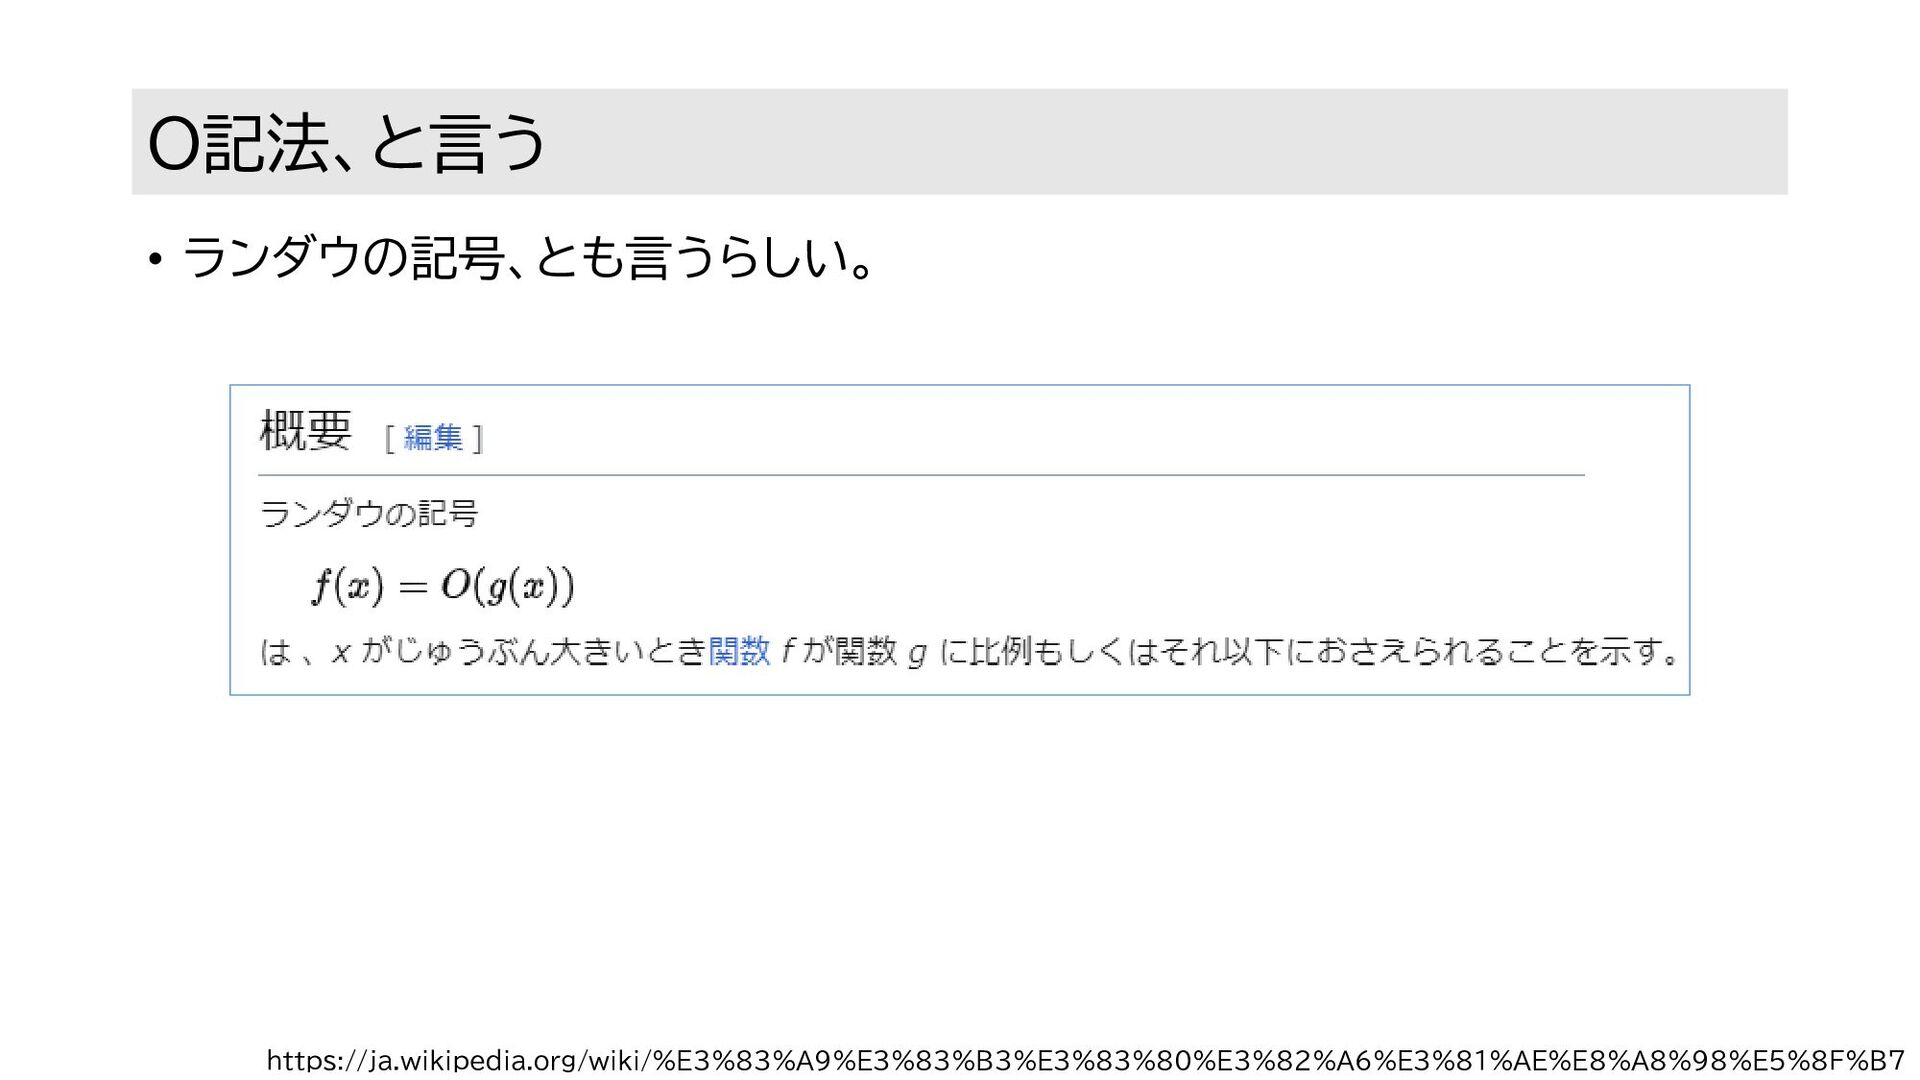
O記法、と言う • ランダウの記号、とも言うらしい。 https://ja.wikipedia.org/wiki/%E3%83%A9%E3%83%B3%E3%83%80%E3%82%A6%E3%81%AE%E8%A8%98%E5%8F%B7
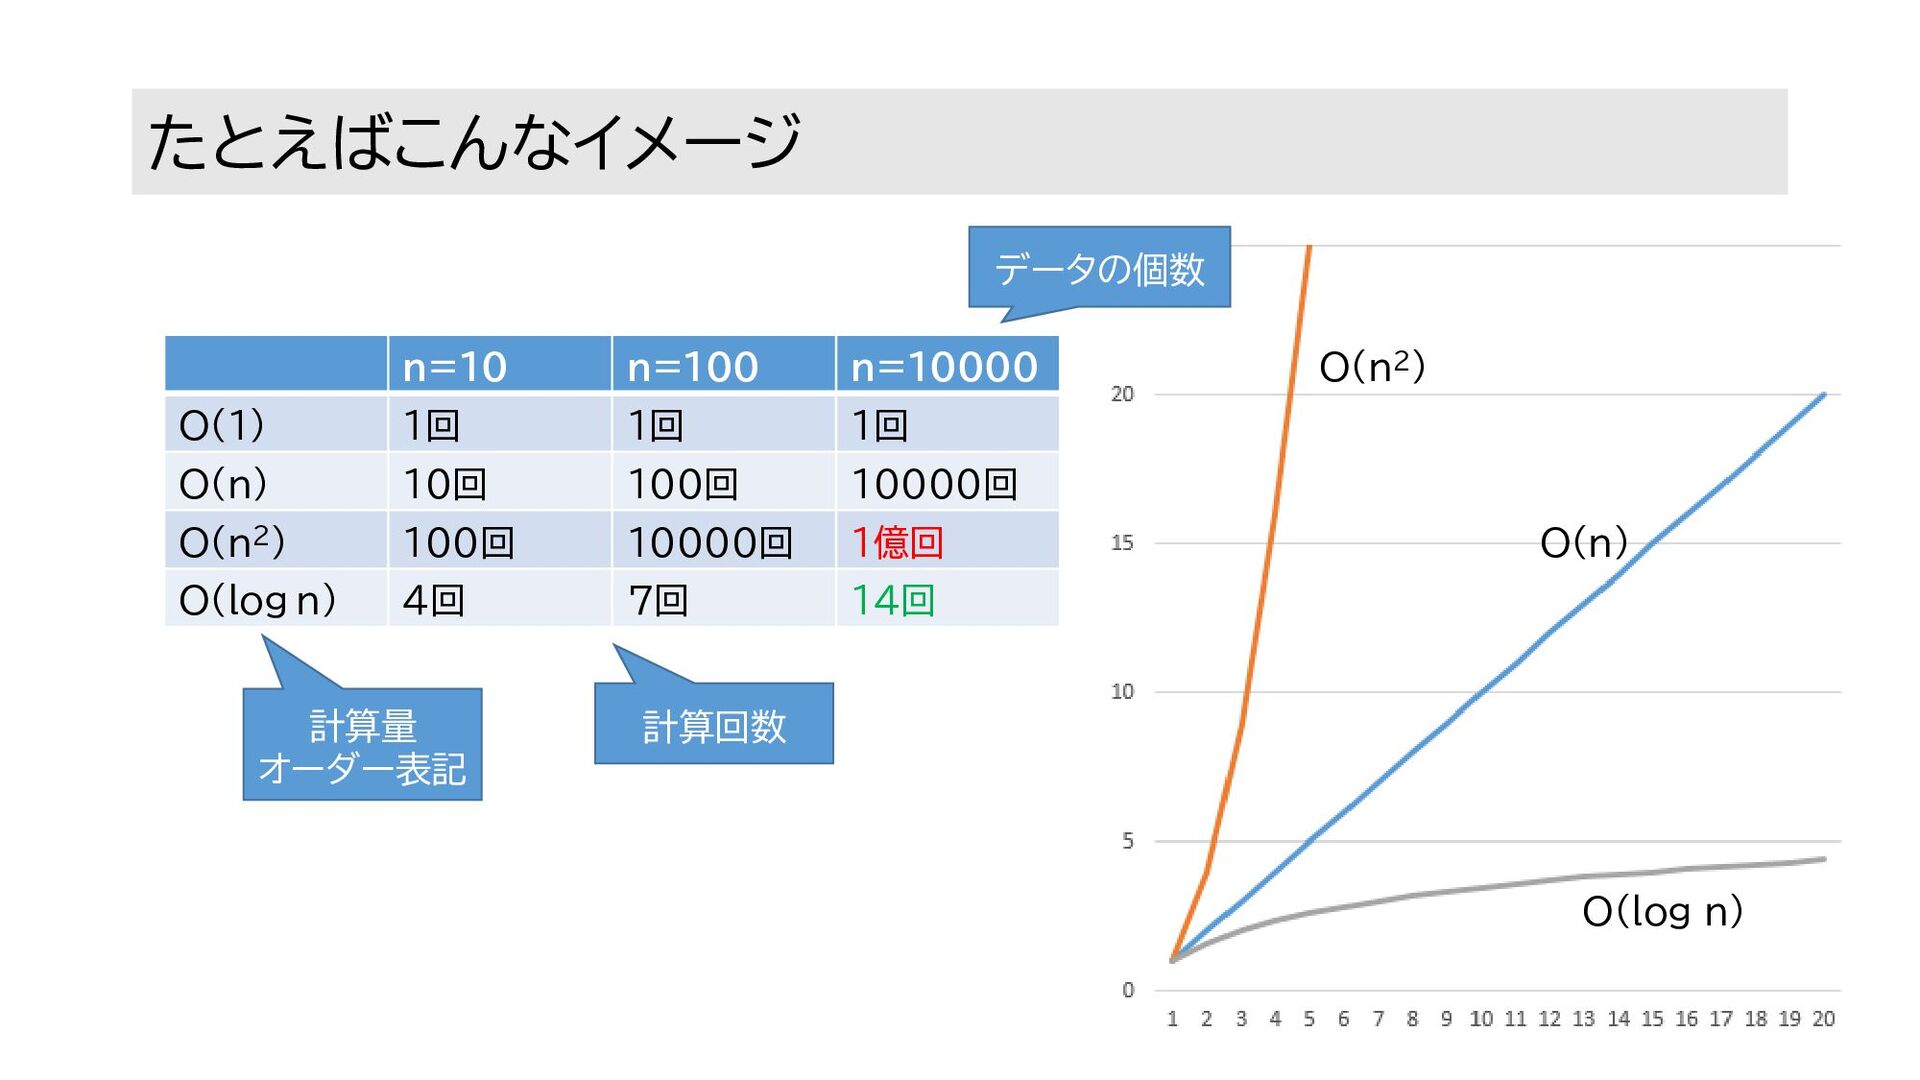
たとえばこんなイメージ n=10 n=100 n=10000 O(1) 1回 1回 1回 O(n) 10回
100回 10000回 O(n2) 100回 10000回 1億回 O(log n) 4回 7回 14回 データの個数 計算回数 計算量 オーダー表記 O(n) O(n2) O(log n)
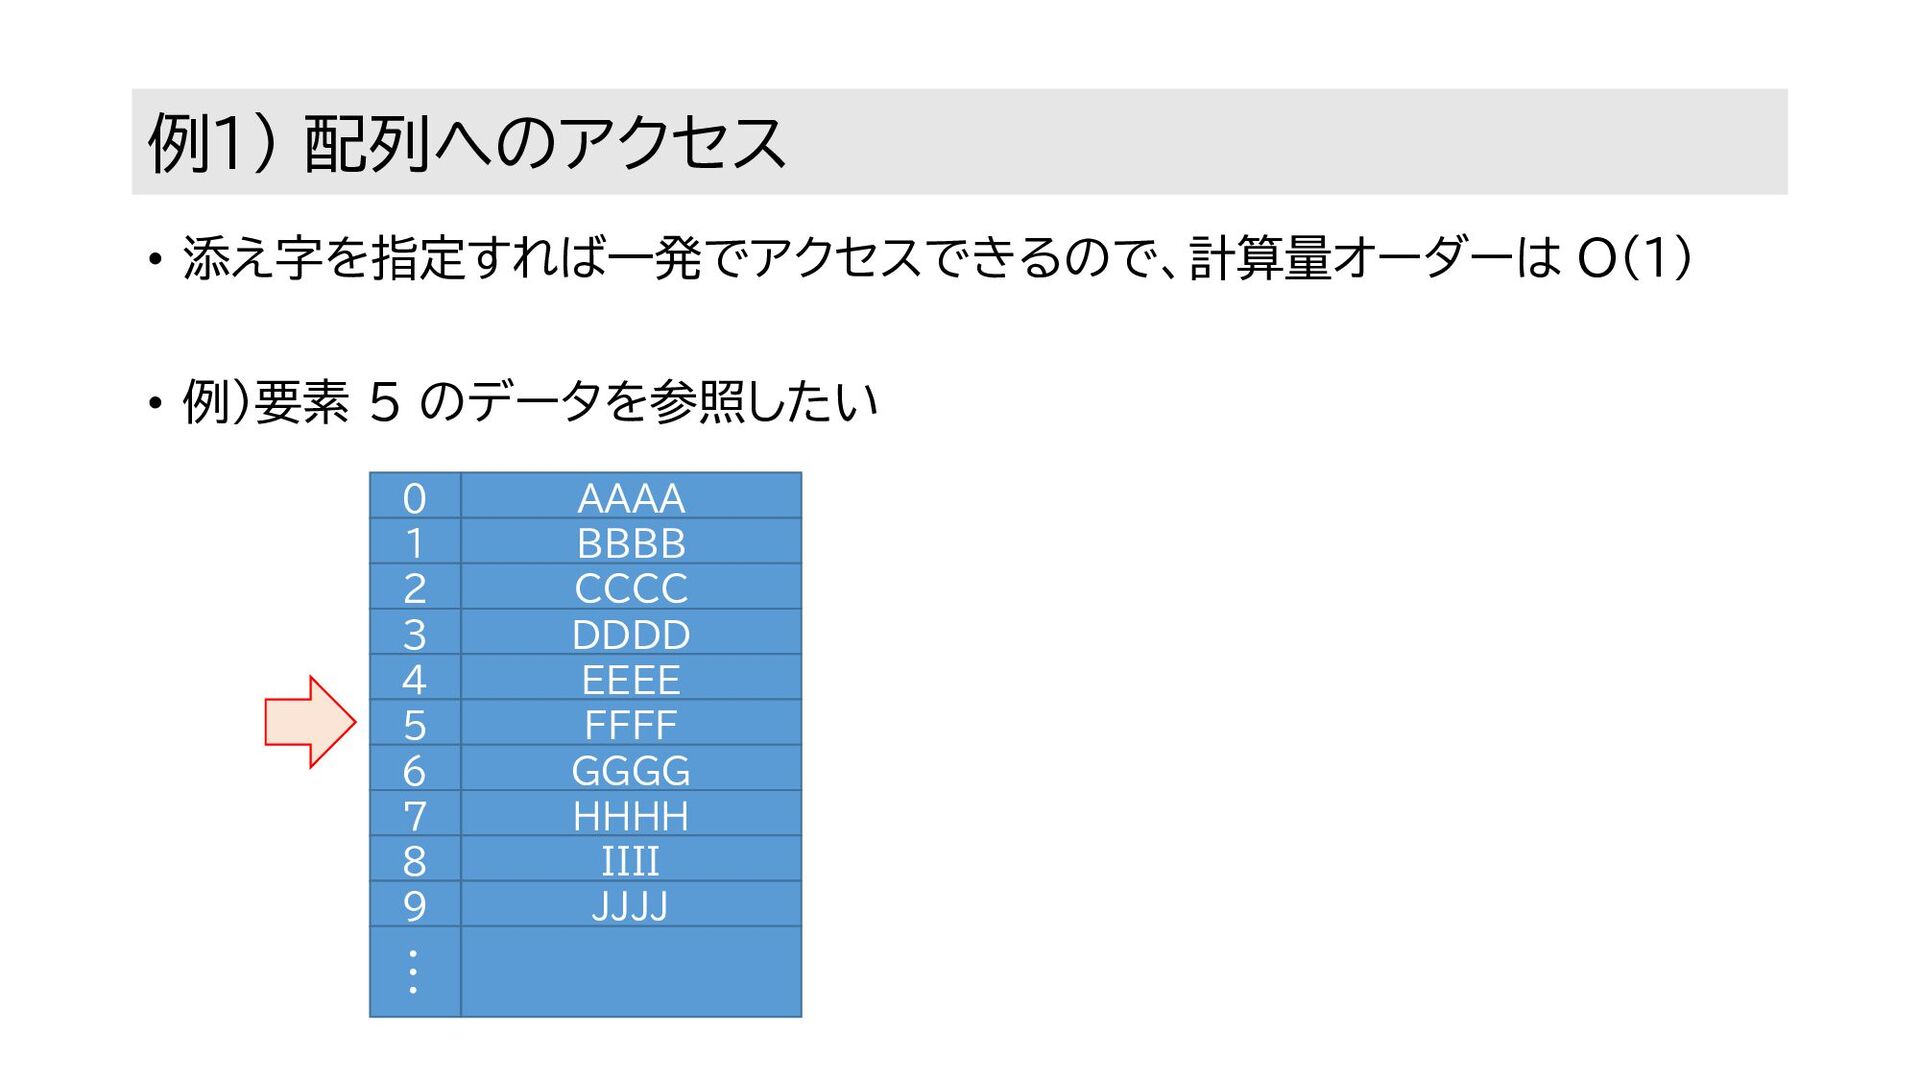
例1) 配列へのアクセス • 添え字を指定すれば一発でアクセスできるので、計算量オーダーは O(1) • 例)要素 5 のデータを参照したい 0
1 2 3 4 5 6 7 8 9 ・・・ AAAA BBBB CCCC DDDD EEEE FFFF GGGG HHHH IIII JJJJ
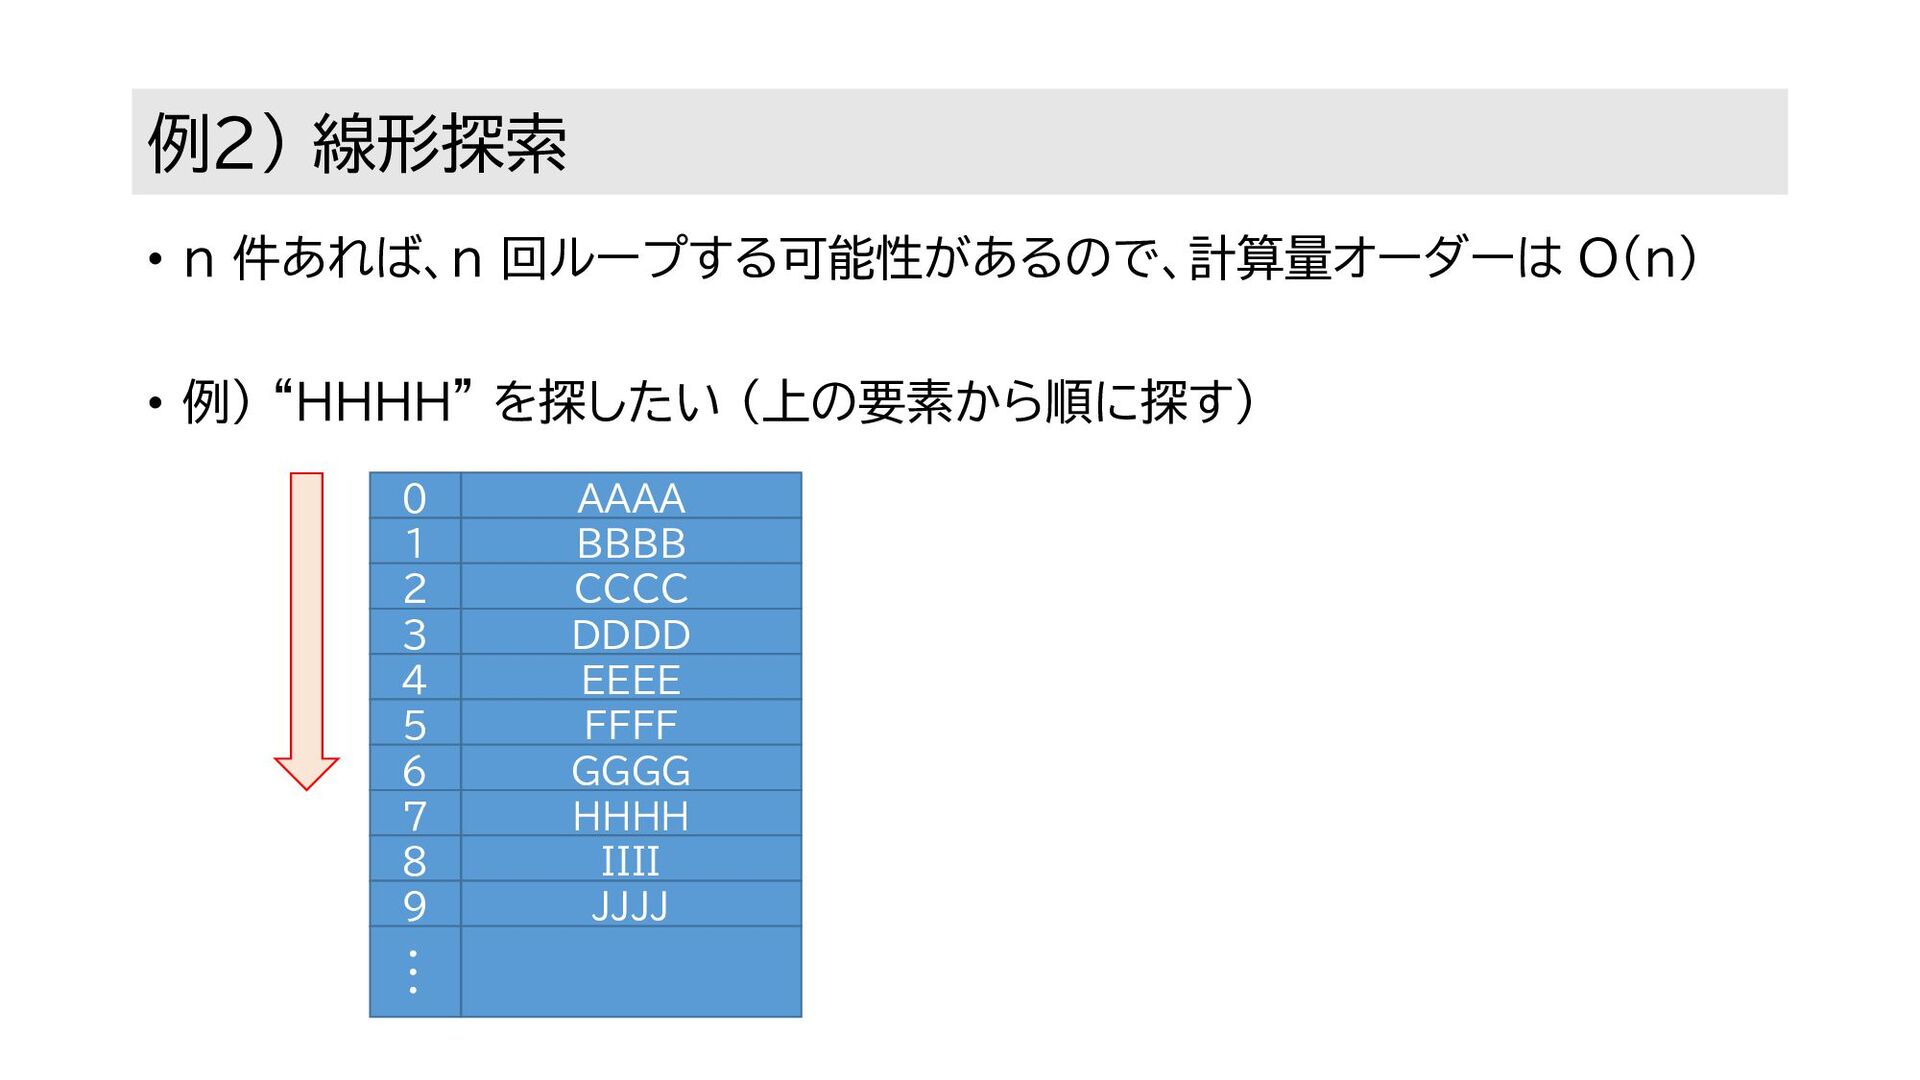
例2) 線形探索 • n 件あれば、n 回ループする可能性があるので、計算量オーダーは O(n) • 例) “HHHH”
を探したい (上の要素から順に探す) 0 1 2 3 4 5 6 7 8 9 ・・・ AAAA BBBB CCCC DDDD EEEE FFFF GGGG HHHH IIII JJJJ
ん?平均回数でみると、O(0.5n)になるのでは? • 係数部分は省略するらしいです。 • なので 0.000001n だろうと 10000000n だろうと O(n)
と表現する らしい。
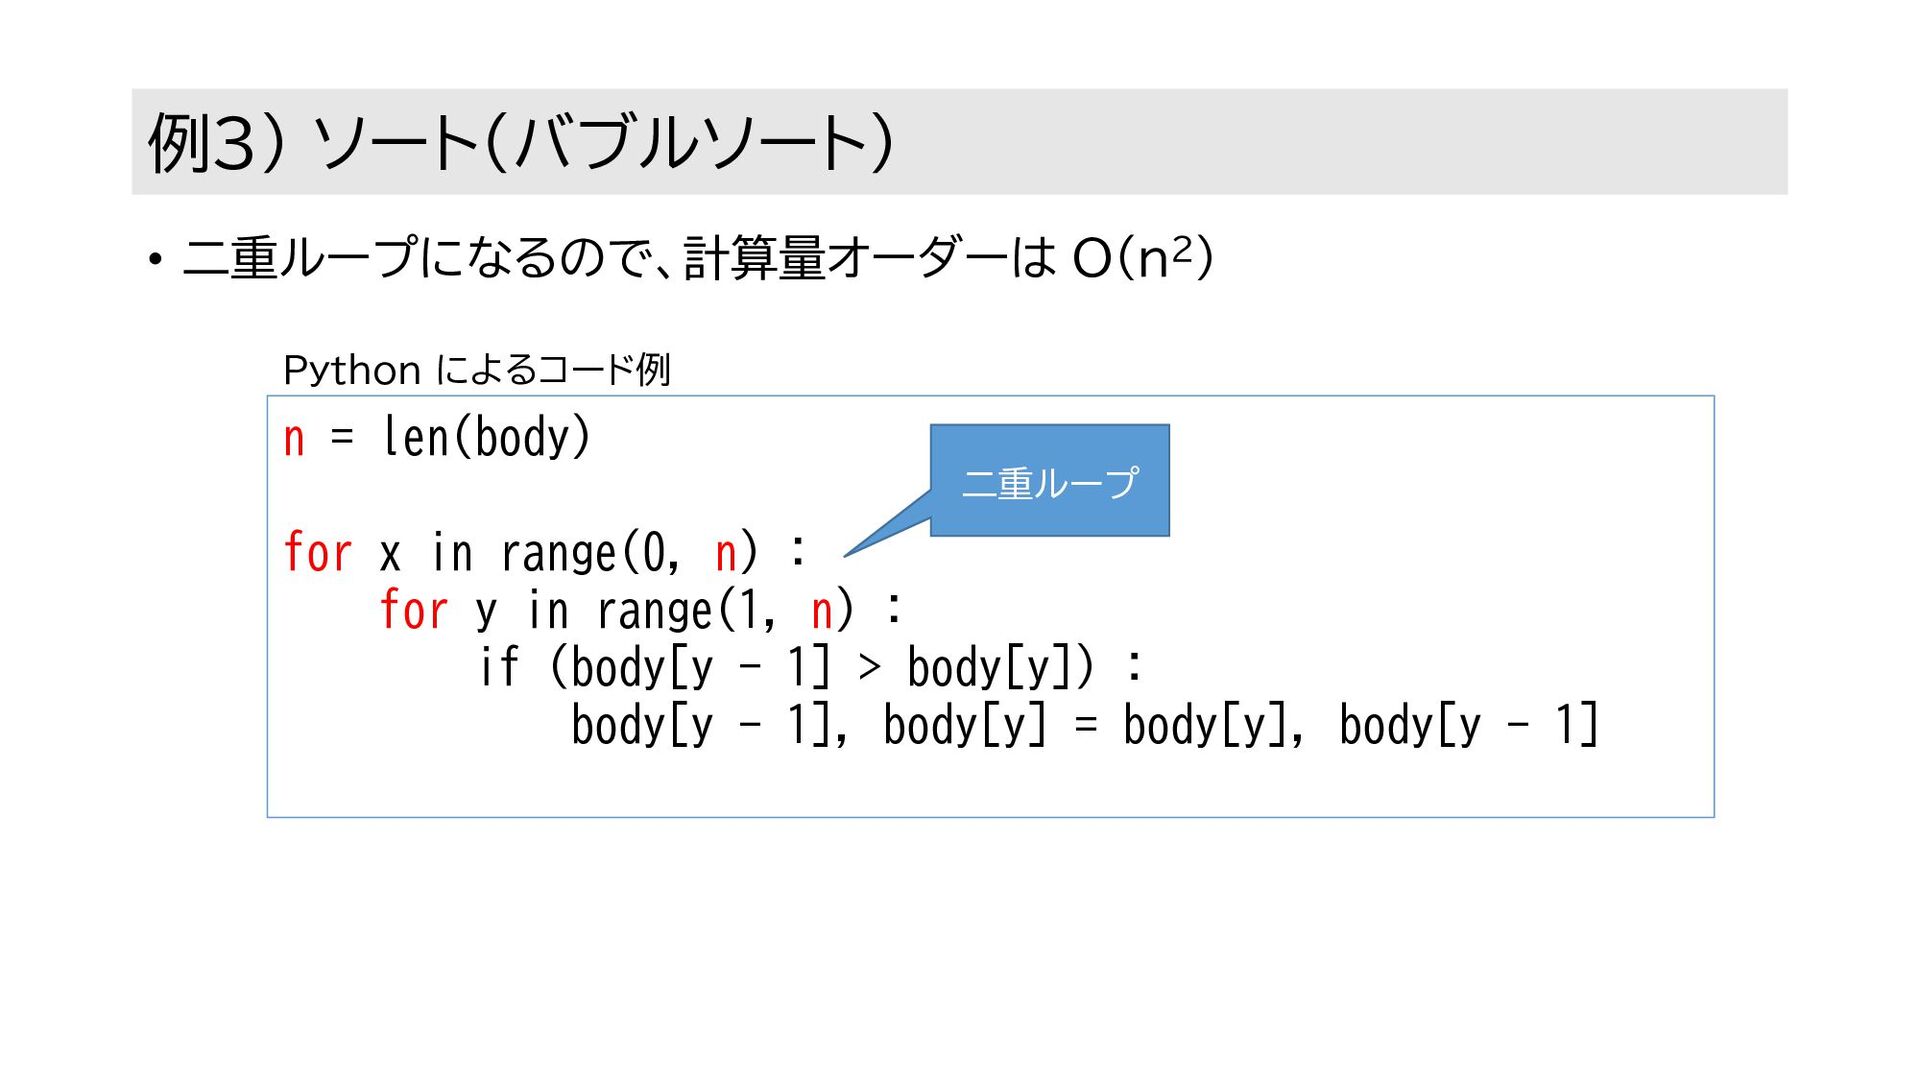
例3) ソート(バブルソート) • 二重ループになるので、計算量オーダーは O(n2) n = len(body) for x
in range(0, n) : for y in range(1, n) : if (body[y - 1] > body[y]) : body[y - 1], body[y] = body[y], body[y - 1] 二重ループ Python によるコード例
ループのネストが増えると? • 三重ループだと O(n3), 四重ループだと O(n4)・・・という感じになってい きます。
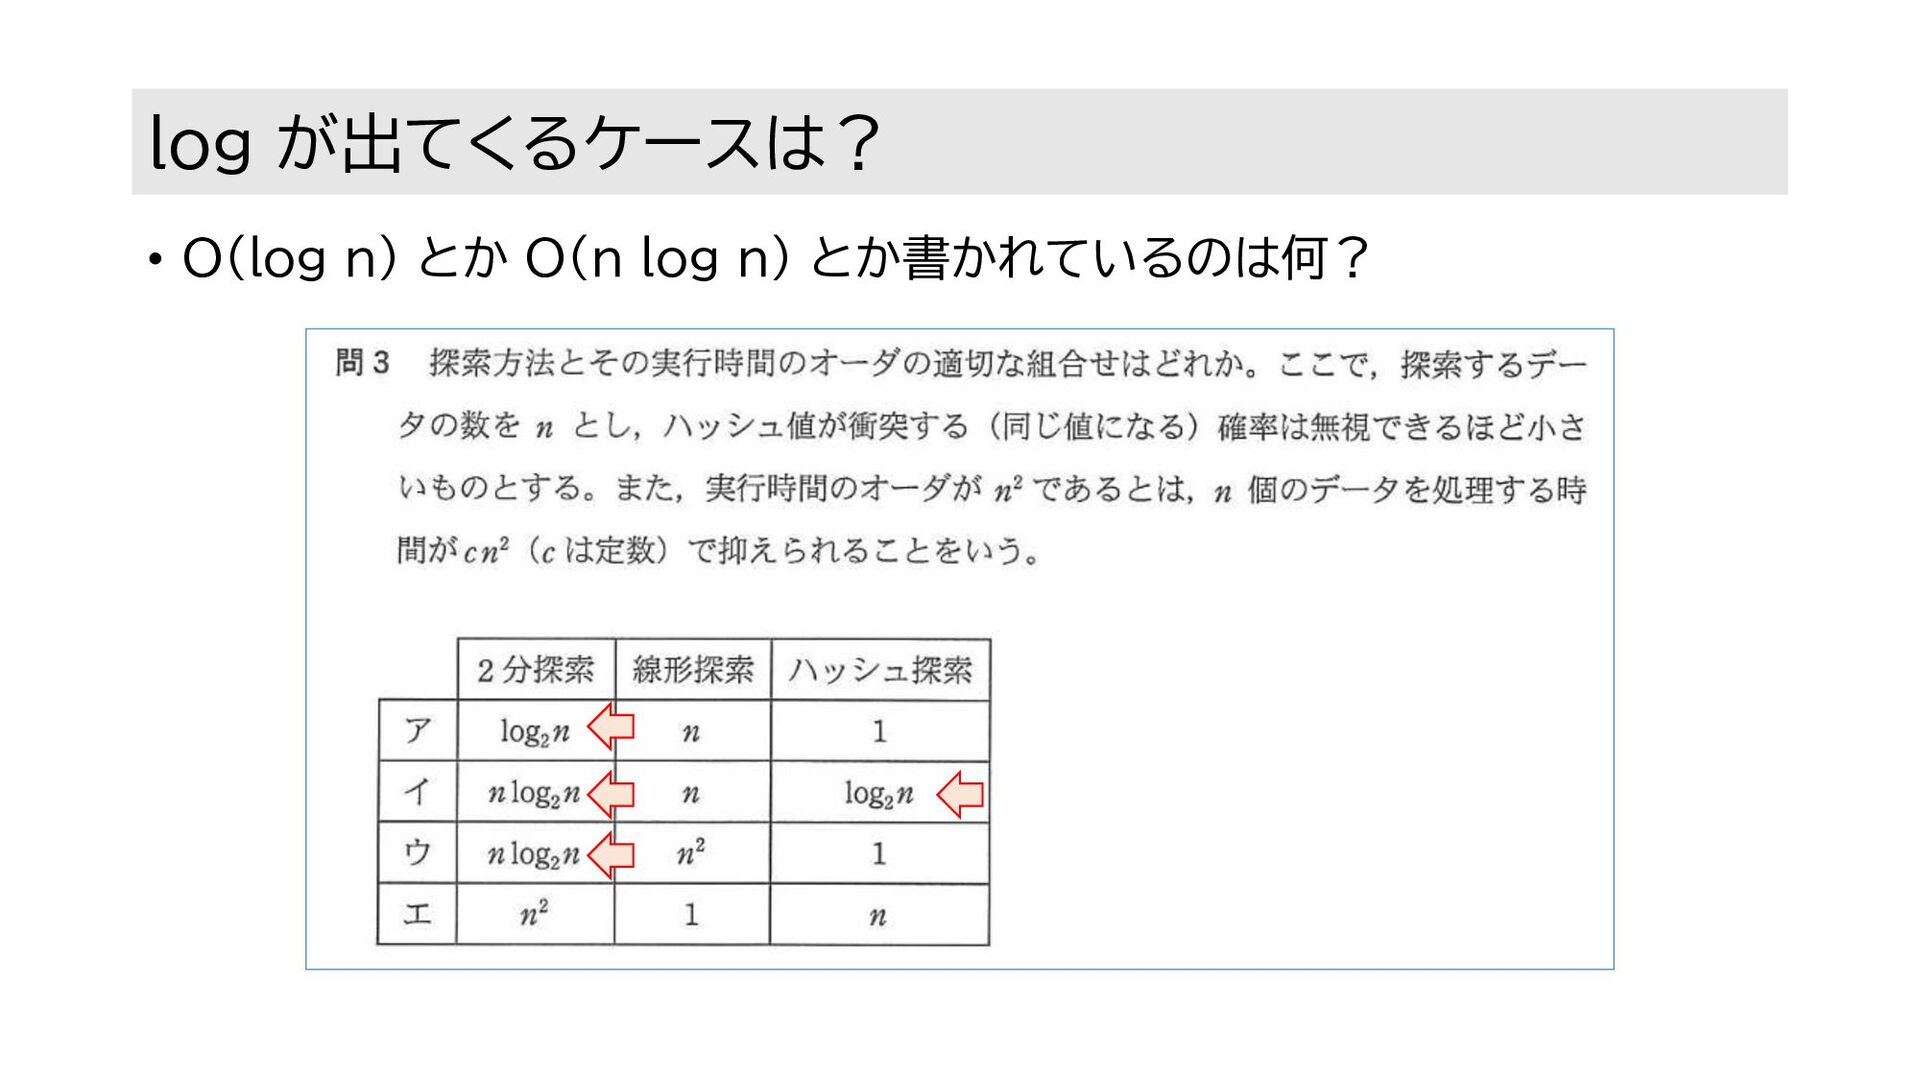
log が出てくるケースは? • O(log n) とか O(n log n) とか書かれているのは何?
例4) 二分岐探索 • 二分岐探索について考えてみます。 注) 二分岐探索(Binary Tree)は、データベースでよくつかわれている B 木とは 違います。
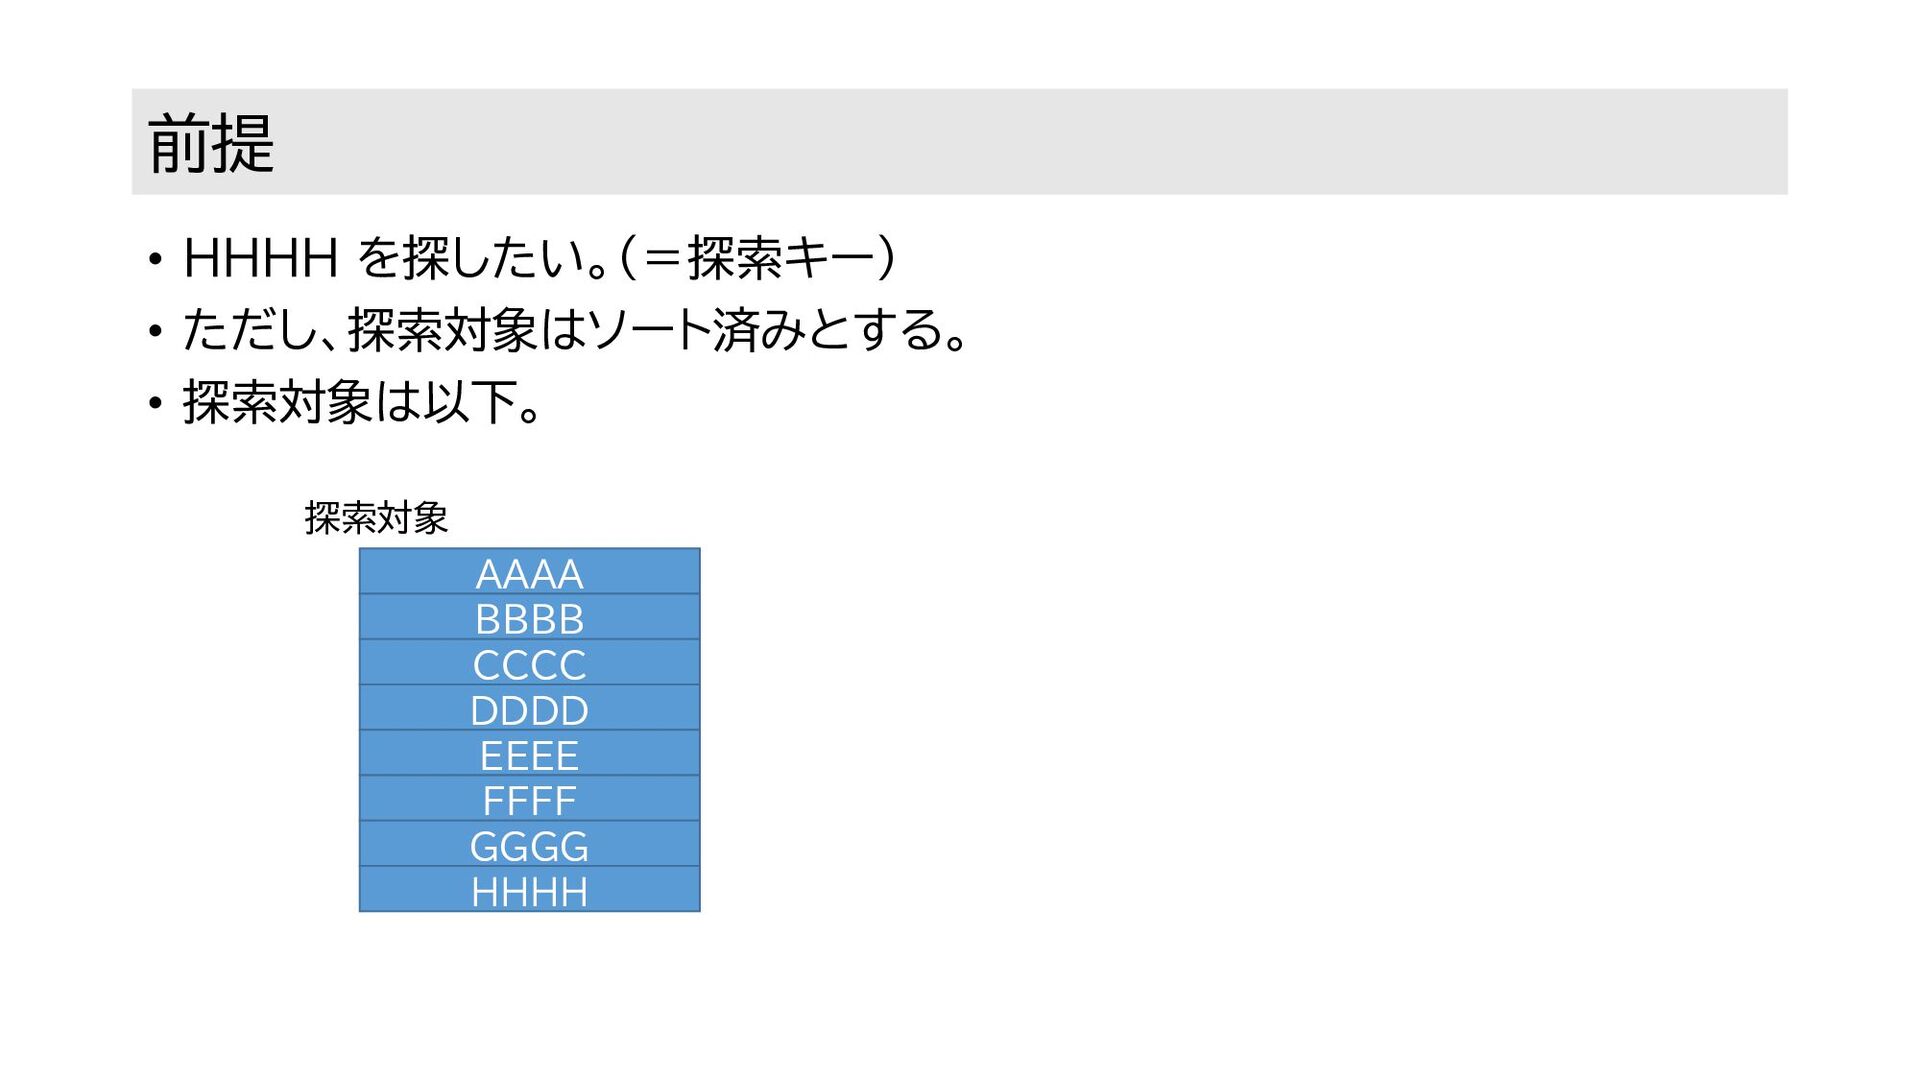
前提 • HHHH を探したい。(=探索キー) • ただし、探索対象はソート済みとする。 • 探索対象は以下。 AAAA BBBB
CCCC DDDD EEEE FFFF GGGG HHHH 探索対象
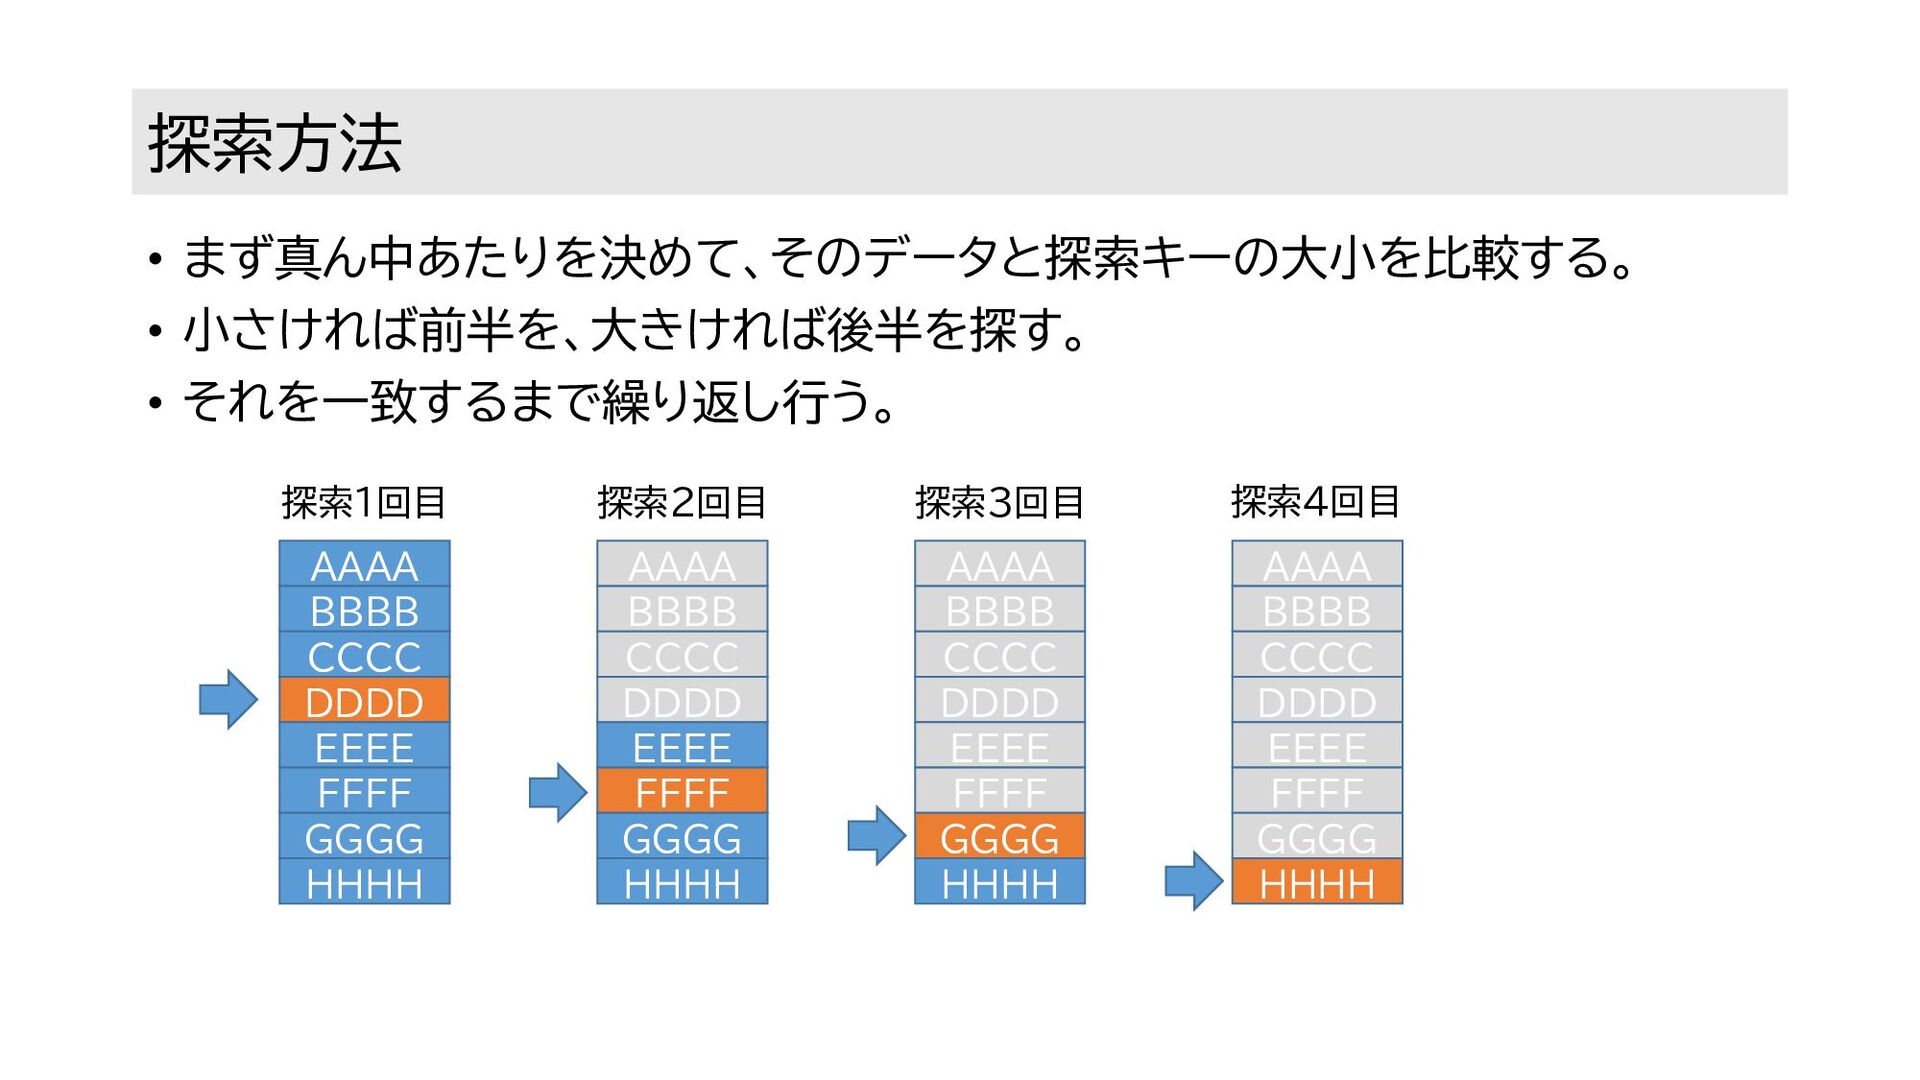
探索方法 • まず真ん中あたりを決めて、そのデータと探索キーの大小を比較する。 • 小さければ前半を、大きければ後半を探す。 • それを一致するまで繰り返し行う。 AAAA BBBB CCCC
DDDD EEEE FFFF GGGG HHHH AAAA BBBB CCCC DDDD EEEE FFFF GGGG HHHH AAAA BBBB CCCC DDDD EEEE FFFF GGGG HHHH AAAA BBBB CCCC DDDD EEEE FFFF GGGG HHHH 探索1回目 探索2回目 探索3回目 探索4回目
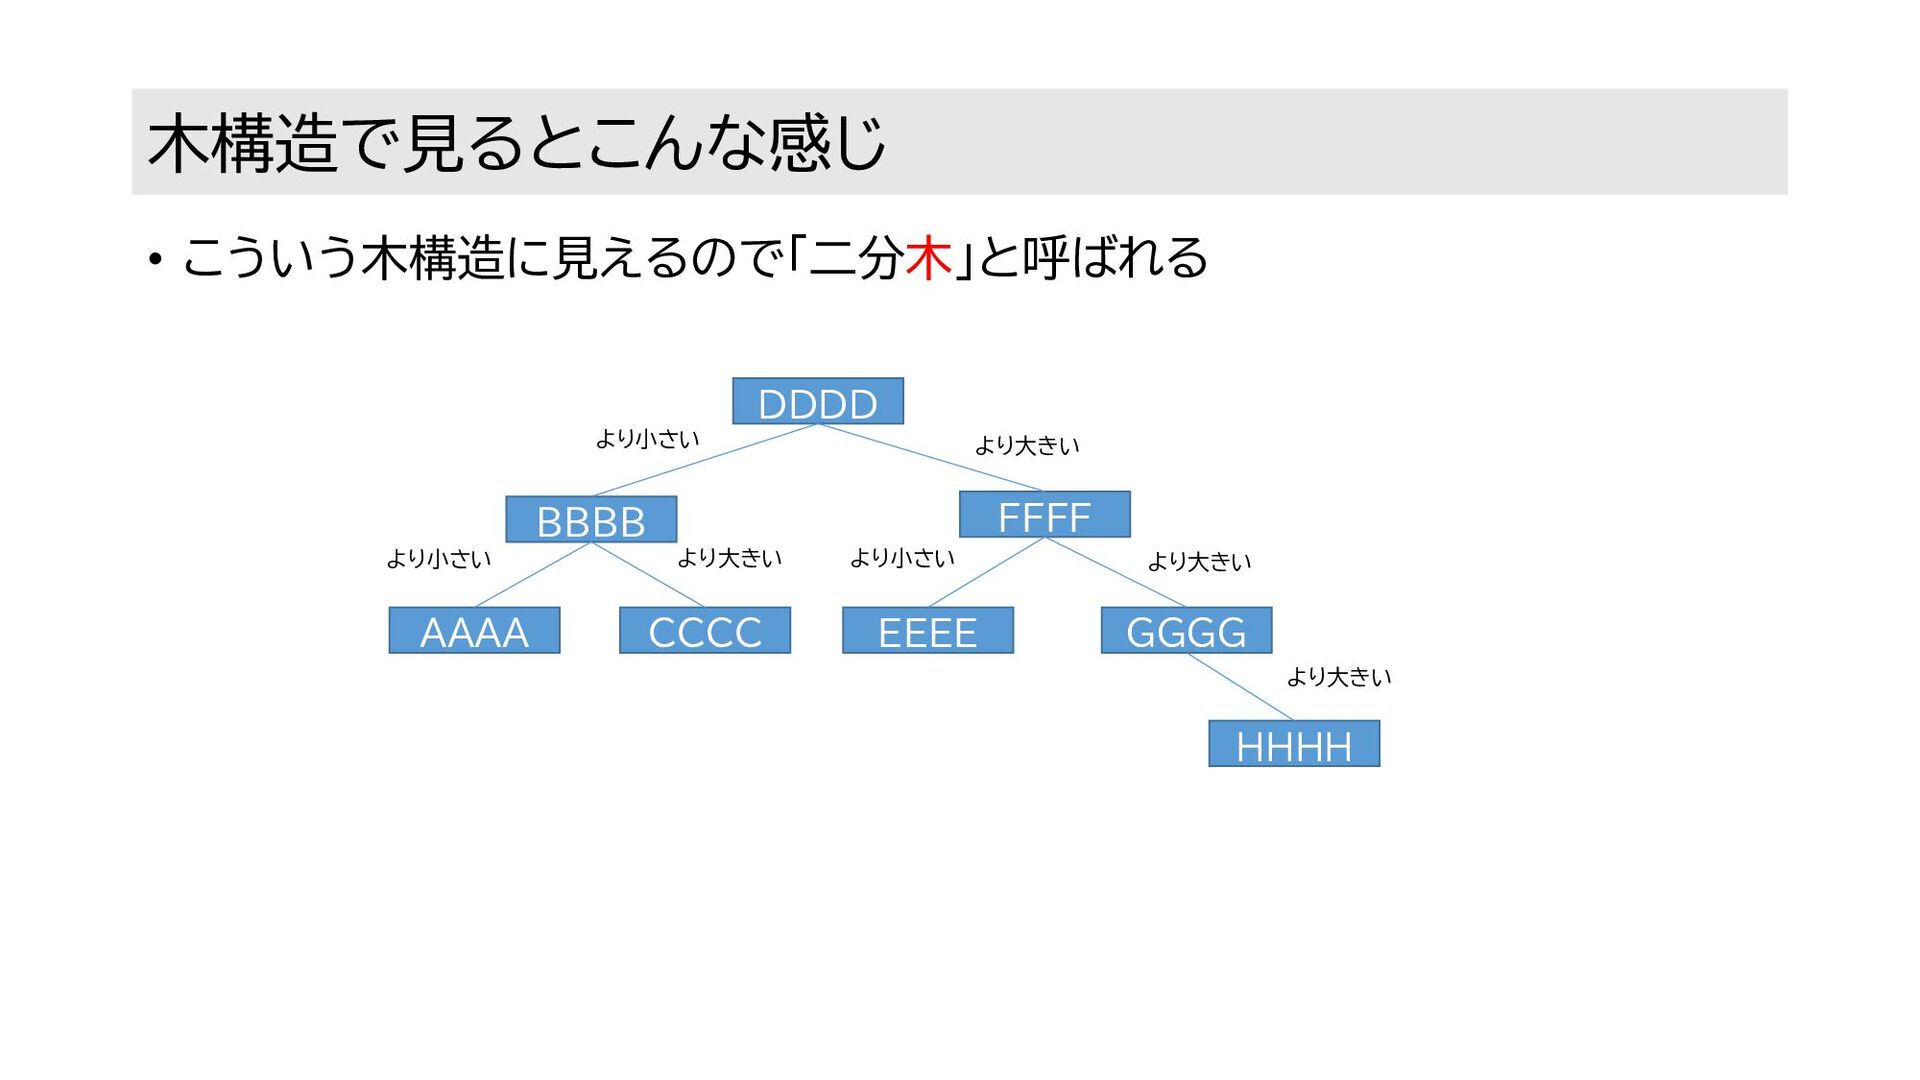
木構造で見るとこんな感じ • こういう木構造に見えるので「二分木」と呼ばれる AAAA BBBB CCCC DDDD EEEE FFFF GGGG
HHHH より小さい より大きい より小さい より小さい より大きい より大きい より大きい
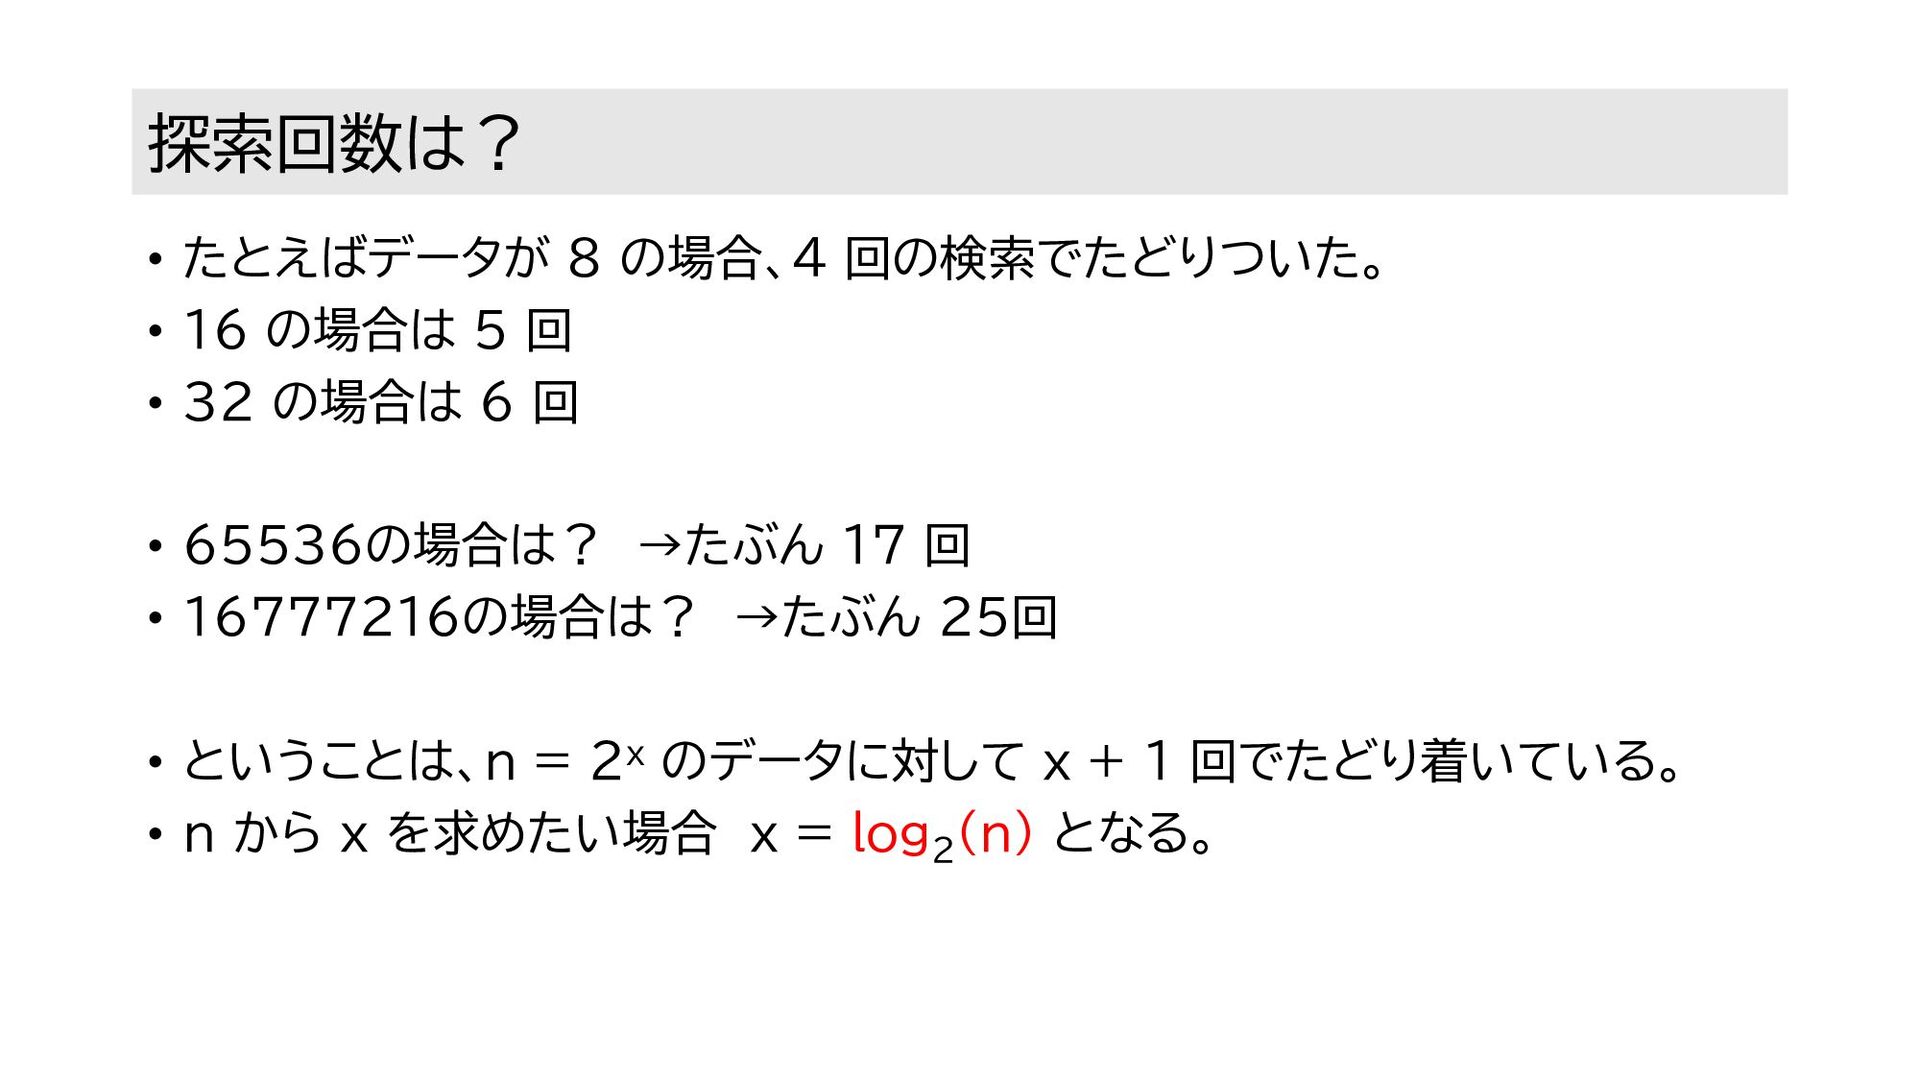
探索回数は? • たとえばデータが 8 の場合、4 回の検索でたどりついた。 • 16 の場合は 5
回 • 32 の場合は 6 回 • 65536の場合は? →たぶん 17 回 • 16777216の場合は? →たぶん 25回 • ということは、n = 2x のデータに対して x + 1 回でたどり着いている。 • n から x を求めたい場合 x = log 2 (n) となる。
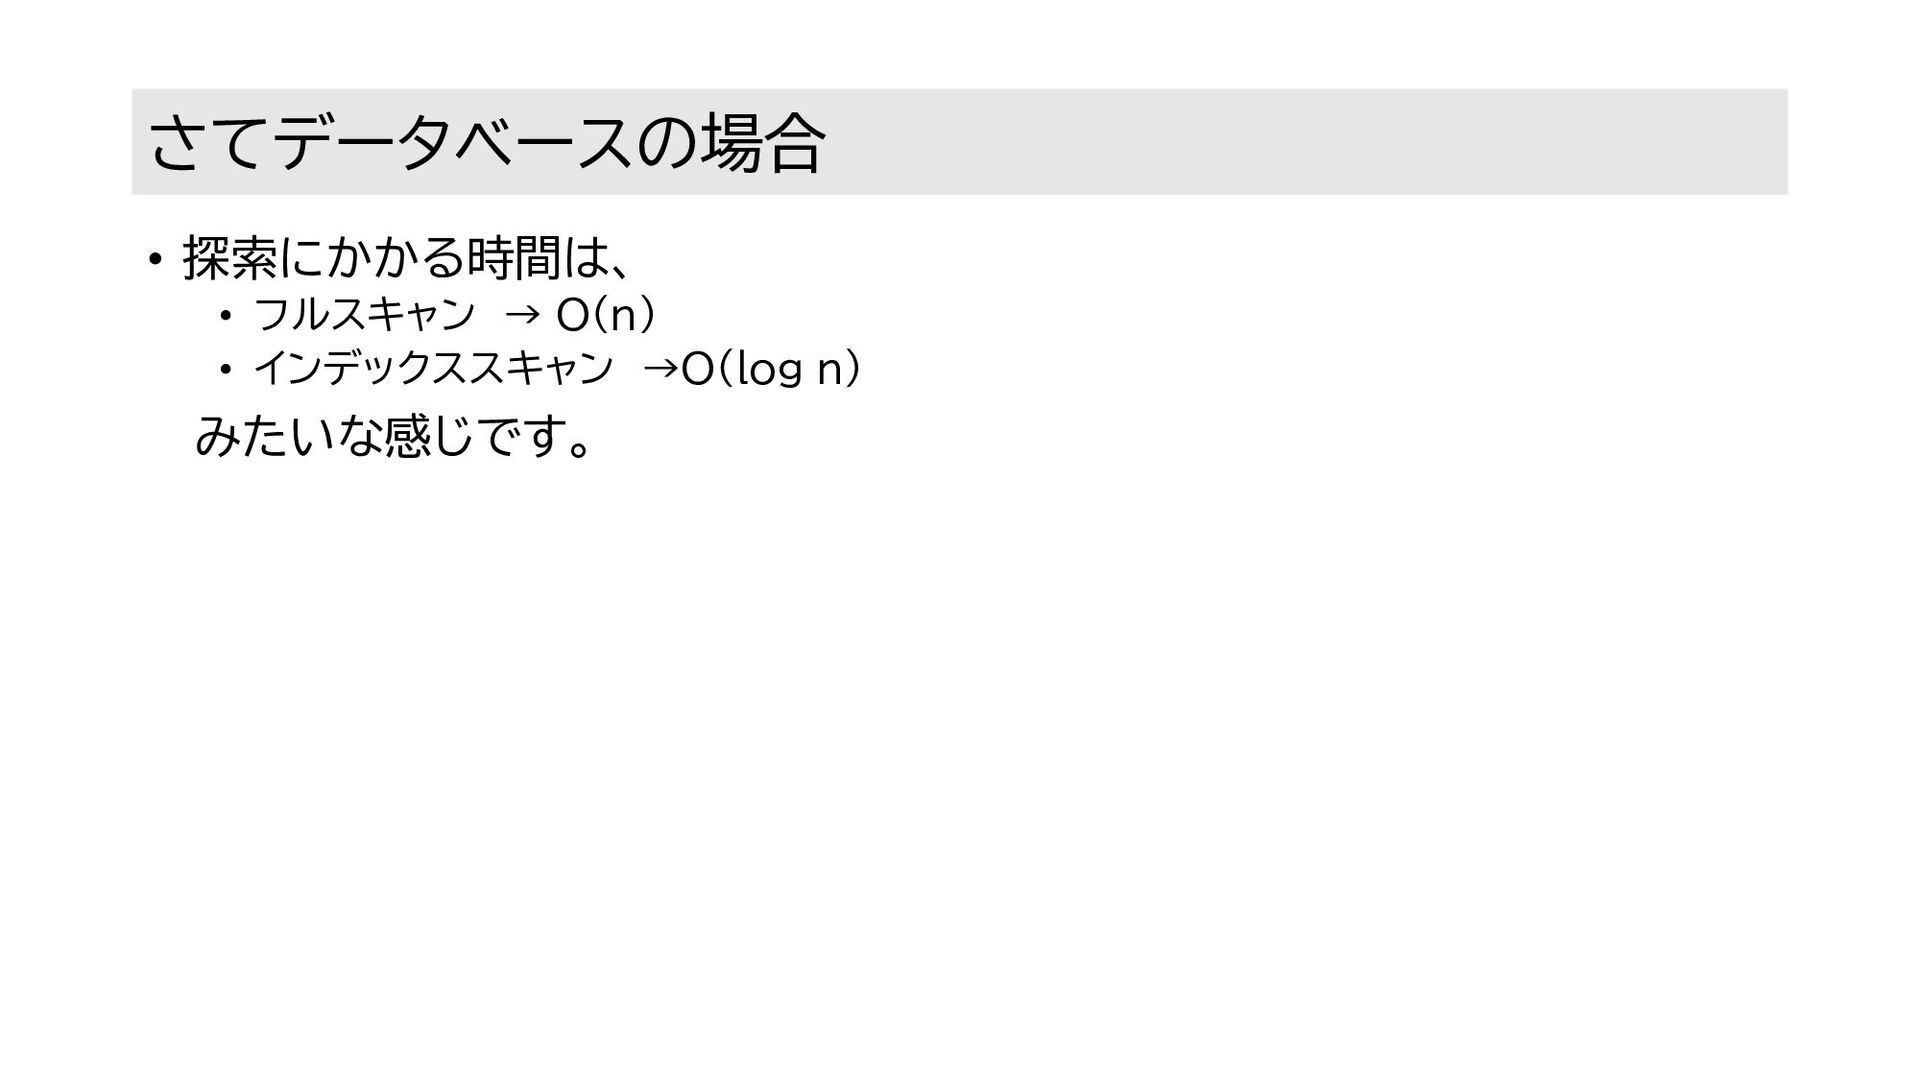
さてデータベースの場合 • 探索にかかる時間は、 • フルスキャン → O(n) • インデックススキャン →O(log
n) みたいな感じです。
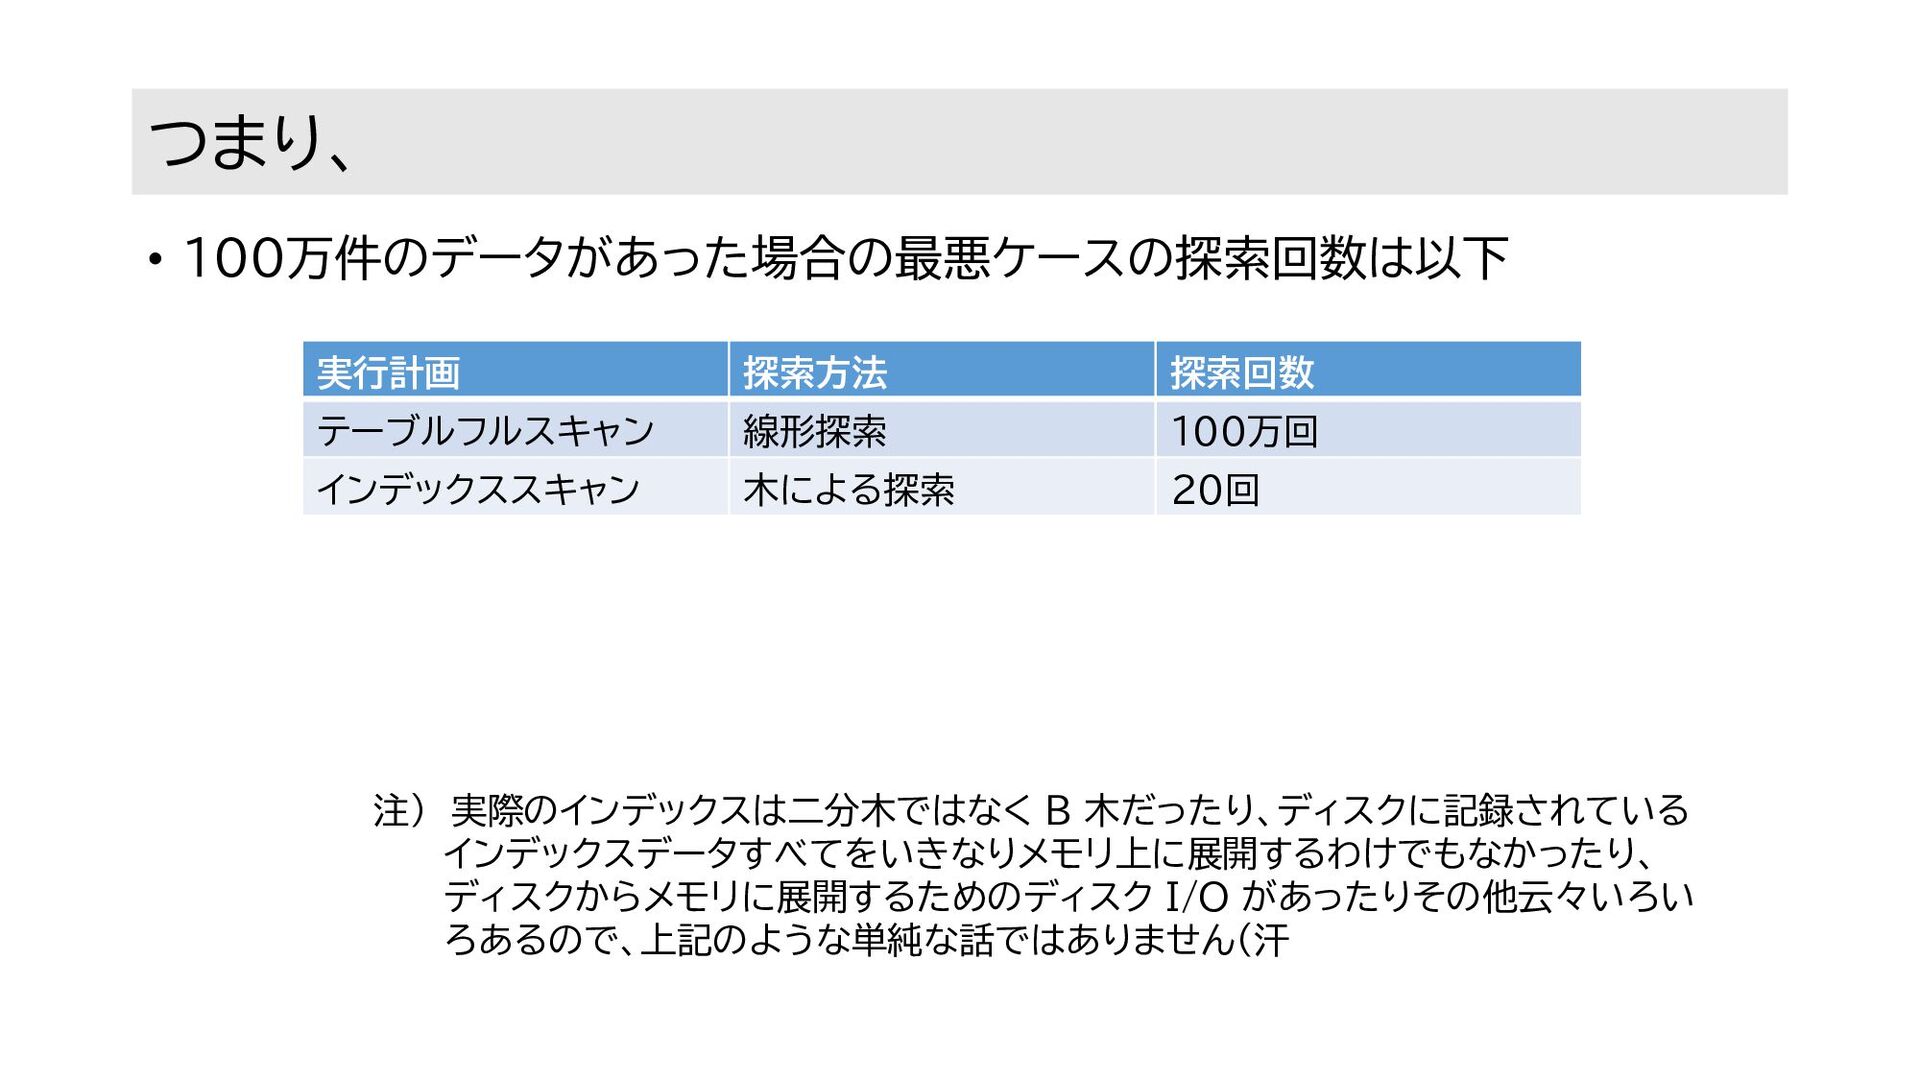
つまり、 • 100万件のデータがあった場合の最悪ケースの探索回数は以下 注) 実際のインデックスは二分木ではなく B 木だったり、ディスクに記録されている インデックスデータすべてをいきなりメモリ上に展開するわけでもなかったり、 ディスクからメモリに展開するためのディスク I/O
があったりその他云々いろい ろあるので、上記のような単純な話ではありません(汗 実行計画 探索方法 探索回数 テーブルフルスキャン 線形探索 100万回 インデックススキャン 木による探索 20回
圧倒的じゃないかインデックスは! • よし、じゃあインデックスを貼りまくれば万事解決!!
そんなわけない(汗 • 二分木探索のとき、必要だったのは「ソートされた」データでした。 • つまりインデックスにデータを追加するとき、インデックスのデータはソートさ れた状態を維持しなくてはならない。 • ソートされた状態を維持したままデータを追加するのはコストがかかる。 • したがってインデックスを作ると、検索
(select) のときは早いけど、データ の挿入(insert)や更新(update) のときに激重になる。
なので • インデックスを貼る場合は、検索頻度と更新頻度を考慮して、貼るカラムを選 定する必要があります。
こちらからは以上です • 探索とかソートする際は計算量を気にしましょう。


 tsudaahr
 kinopeee
 yimajo
 akase244
 slashnephy
 izumin5210
 fohte
 tkikuc
 m_seki
 kdash
 ochtum
 omasanori
 yosuke_furukawa
 shpigford
 holman
 axbom
 kimpetersen
 skipperchong
 matthewcrist
 oripsolob
 soudai
 scottboms
 seathinner
 marcduiker
 inesmontani