Share
Embed
Elastic On Tour Paris - Centralisation de grands volumes de logs
Vladislav Pernin
November 05, 2015
Transcript
31 slides
-
Vladislav Pernin 05/11/2015 @vladislavpernin 0 Centralisation de grands volumes de
logs Logstash, Apache Kafka, elasticsearch -
Agenda • Contexte • Cas d’utilisations • Architecture • Métriques
• Retour d’expérience 1 -
Contexte • Beaucoup de serveurs • Accès limité • Architecture
distribuée & asynchrone • Stop aux commandes : tail sed awk grep • Réduction du temps de détection & analyse • Vision sur le SI & sa performance 2 -
Cible • Temps réel • Robuste & scalable horizontalement •
Sans perte • Recherche facile • Complexité limitée 3 -
Cas d’utilisations 5 • Surveillance temps réel (dev -> prod)
• Aide aux équipes • Recherche de bugs & reproductibilité • Audit proactif • Chemin utilisateur & supervision flux • Statistiques fonctionnelles & expérience utilisateur • Compteurs communicants -
Métriques • En production depuis 4 ans • 8 projets,
50 environnements, 900 serveurs • 65 types de logs • 1,1 Md docs & 290 Go (primary store) • 250 logs/s minimum & 8000 en pic • 240 utilisateurs & 10 000 requêtes/j 7 -
Retour d’expérience 8 • Logstash • RabbitMQ & Apache Kafka
• elasticsearch • IHM • Points d’attention -
Logstash 9 • Le plus riche fonctionnellement • Tail «
intelligent » • Installation facile (tar.gz, deb, RPM, docker) • Rapide à mettre en œuvre • Extensible • Grande communauté • Support unifié avec elasticsearch -
Logstash 10 • Structurer ses logs (extraction champs) Découpage via
Grok o Puissant o Debug difficile o Tests unitaires & performances indispensables o Multiplier les nœuds (scalabilité horizontale) Directement au format JSON -
Logstash 11 • Encore jeune et mouvant • Problèmes de
jeunesse Rétro compatibilité 40s de démarrage Perte possible (queue persistante roadmap) Crash : désactivation invokedynamic JRuby Ligne log partielle : inodes recyclés, job nettoyage sincedb -
Logstash 12 • Efficience : rapport fonctionnalité / charge CPU
Ok : petite volumétrie Ko : 1500 lignes/s Beaucoup mieux versions récentes Streaming direct vers broker • Shipper plus léger, plus performant, moins de fonctionnalités (Logstash forwarder / Filebeat) -
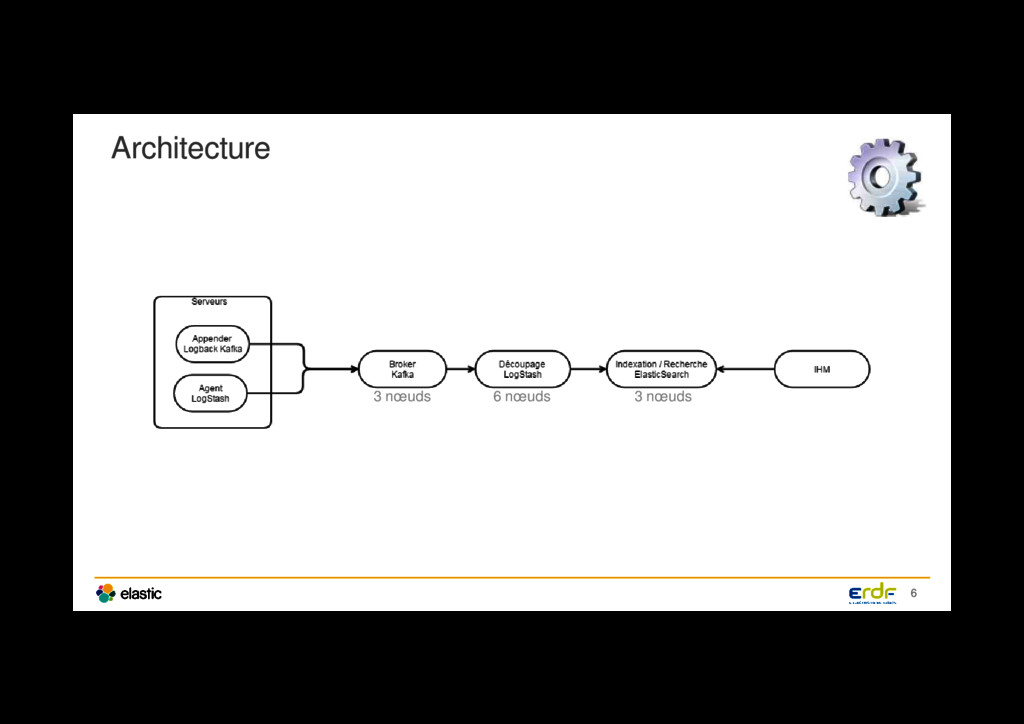
Transport via broker de messages 13 • RabbitMQ Sécurité Ok
jusqu’à 5000/s Empreinte CPU importante, scalabilité difficile • Apache Kafka Throughput important (200 000/s sans tuning) Nativement persistant, scalable, léger Quelques défauts de jeunesse (API, ops, sécurité) … surmontables Robuste & sûr -
elasticsearch 14 • Outil mature • Grande communauté • Documentation
de bonne qualité • Installation facile (tar.gz, deb, RPM, docker) • Release fréquente & upgrade aisé • Haute disponibilité & scalabilité -
elasticsearch 15 • Pas un use case natif en 2011
• Comparaison de nombreux outils (open source et propriétaire) • Très puissant : stocker et chercher des logs en temps réel • Alerting : percolation, voir désormais Watcher • D’autres uses cases @ ERDF (recherche clients & matériels, statistiques) -
elasticsearch 16 • Quelques problèmes Sur versions anciennes o Tri,
CorruptedIndex o OutOfMemory sur agrégation Recovery très long • River RabbitMQ Pratique (non interruption, queuing et reprise) Problèmes de robustesse, scale pas River déprécié, Logstash en push direct -
elasticsearch 17 • API query Puissante mais compliquée Agrégation /
sous agrégation / pipeline Join impossible • Mapping Connaître structure et types de recherche Montée en compétence indispensable Template par défaut de Logstash pour commencer -
elasticsearch 18 • Partitioning via nommage des index (un par
semaine) • Volumétrie fluctuante mais sharding fixe • Nouveau mapping : attendre rotation ou réindexer • Sécurité : aucune en natif, Shield (commerciale) • Outillage limité : plugins, Curator, Marvel (commerciale en 1.x) -
elasticsearch 19 • Performance : OK sur SAN et VMs
• Recherche : 100M en qq ms • Compression : 70 % de gain • Jamais le goulot d'étranglement • Paramétrage minimal à effectuer • Valeurs par défaut efficaces -
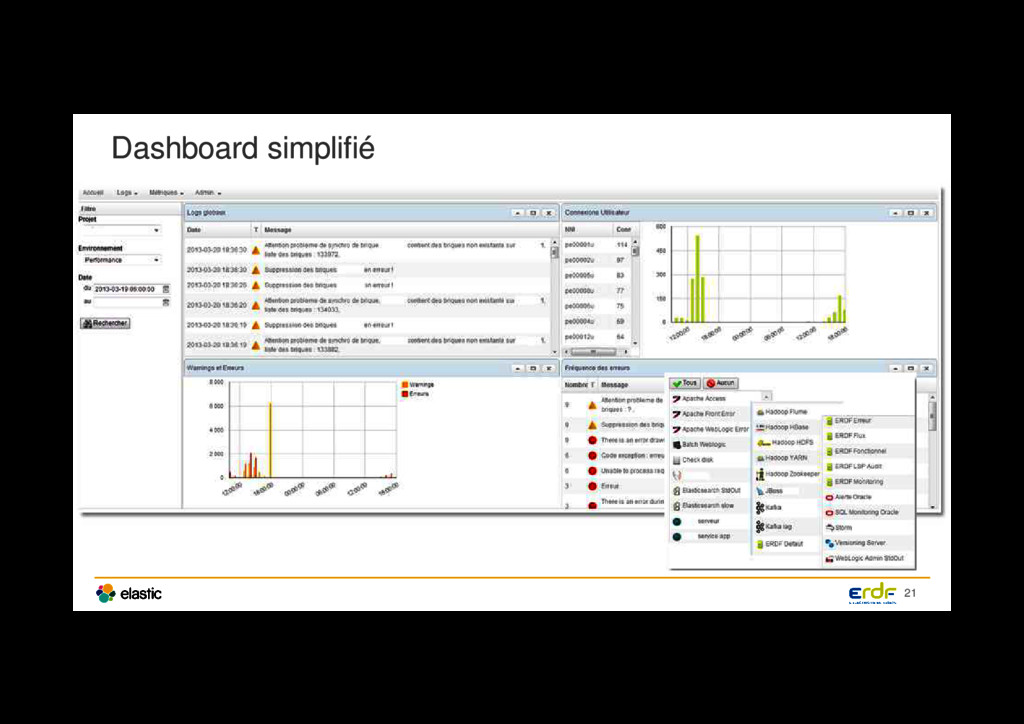
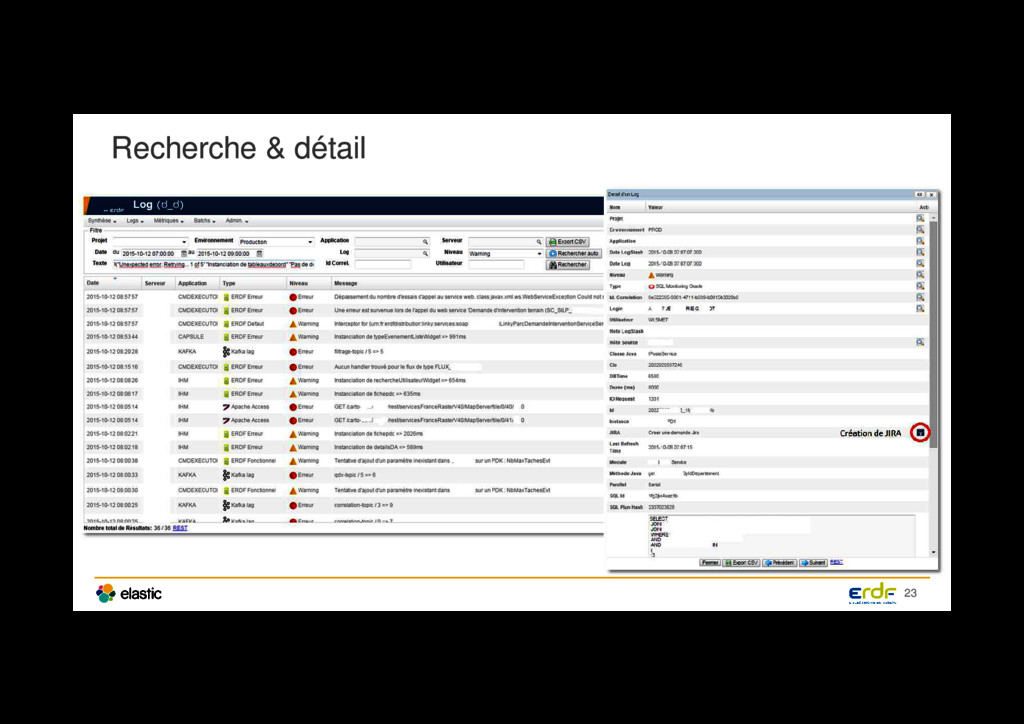
elasticsearch 20 • IHM En production depuis 2011 IHM de
Logstash KO, Kibana (PHP, Ruby puis AngularJS) Spécifique : intégration fine dans le SI • Kibana : rapport fonctionnalité / coût favorable -
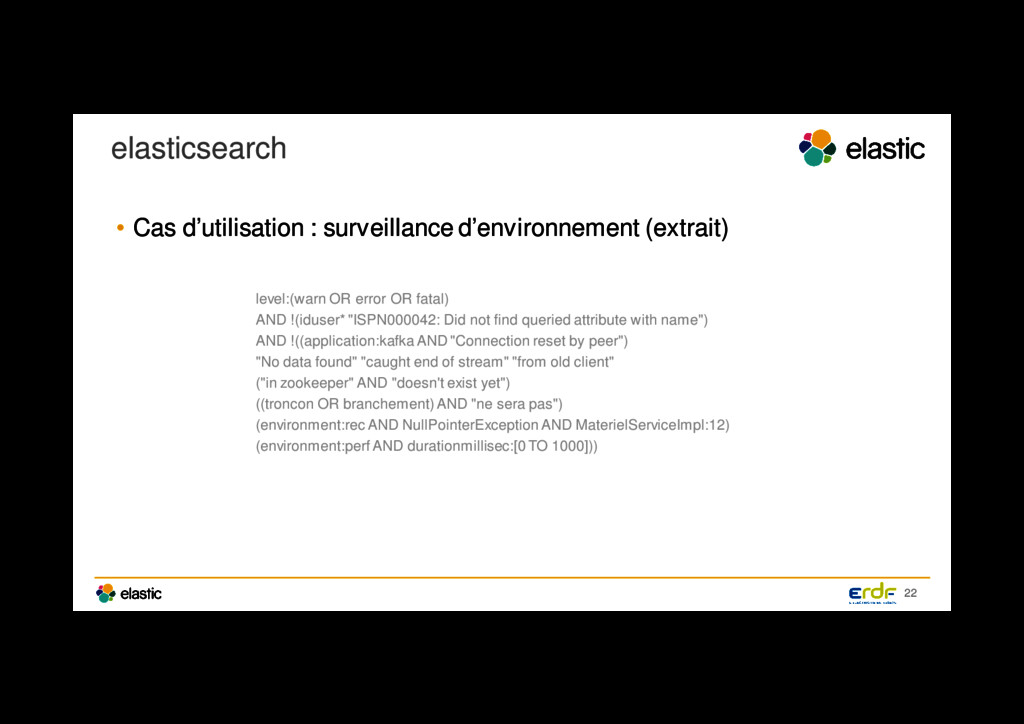
elasticsearch 22 • Cas d’utilisation : surveillance d’environnement (extrait) level:(warn
OR error OR fatal) AND !(iduser* "ISPN000042: Did not find queried attribute with name") AND !((application:kafka AND "Connection reset by peer") "No data found" "caught end of stream" "from old client" ("in zookeeper" AND "doesn't exist yet") ((troncon OR branchement) AND "ne sera pas") (environment:rec AND NullPointerException AND MaterielServiceImpl:12) (environment:perf AND durationmillisec:[0 TO 1000])) -
Remarques diverses 24 • Transparence sur la qualité des applications
• … et des logs eux-mêmes • Travail important sur la qualité des logs Uniformisation structure Enrichissement : env, projet et application Audit : identifiant de corrélation -
Remarques diverses 25 • Tout centraliser et partout • Déploiement
automatique • Questions Où groker : côté agent ou serveur ? Log brut sur fichier puis Logstash ou streaming JSON direct au broker ? Quid de la supervision et des logs de la stack ? -
Pour finir 26 • Nouvelles technologies Apprentissage, jeunesse, intégration, lobbying
• Déploiement : absorption différents env. • Volumétrie Ne pas sous estimer son augmentation RabbitMQ à remplacer Instances de Logstash à multiplier • Overhead : limité, rapport gain / perte OK -
Pour finir 27 • En plein mouvement • Stack technique
adaptée et scalable Logstash ou appender Apache Kafka elasticsearch • Mise en place initiale rapide Ne pas sous estimer le temps d’industrialisation -
Pour finir 28 • Visibilité & autonomie de toutes les
équipes • Temps de diagnostic réduit • Corrélation entre applications et SI • Indicateurs divers • A venir Volumétrie x100 : pic à 50 000 logs/s & 100 Md Déploiement continu automatique -
En synthèse 29 • Un système d’information sous surveillance •
Proactivité • Complexité limitée • Favorise implication et communication • Devenu un des outils le plus utilisé @ ERDF