Share
Embed
Transcript
50 slides
-
八木 橋 拓之 / yagipy • 株式会社サイバーエージェント AI事業本部 アドテクDiv ProFit-X
ソフトウェアエンジニア • 広告配信システム(SSP)の開発 • OSS開発 • maintidx (Owner) • ソースコードの保守性を計測する静的解析ツール • Althea (Owner) • 所有権付き参照カウントを備えたプログラミング 言 語 • golangci-lint (Maintainer) • Goの静的解析ツールをまとめて実 行 するツール • etc … @yagipy @yagipy_ 2 -
1 .基礎 2 .学習と活 用方 法 3 .課題 LLMを有効活 用
するために 押さえておきたい知識を話します 3 -
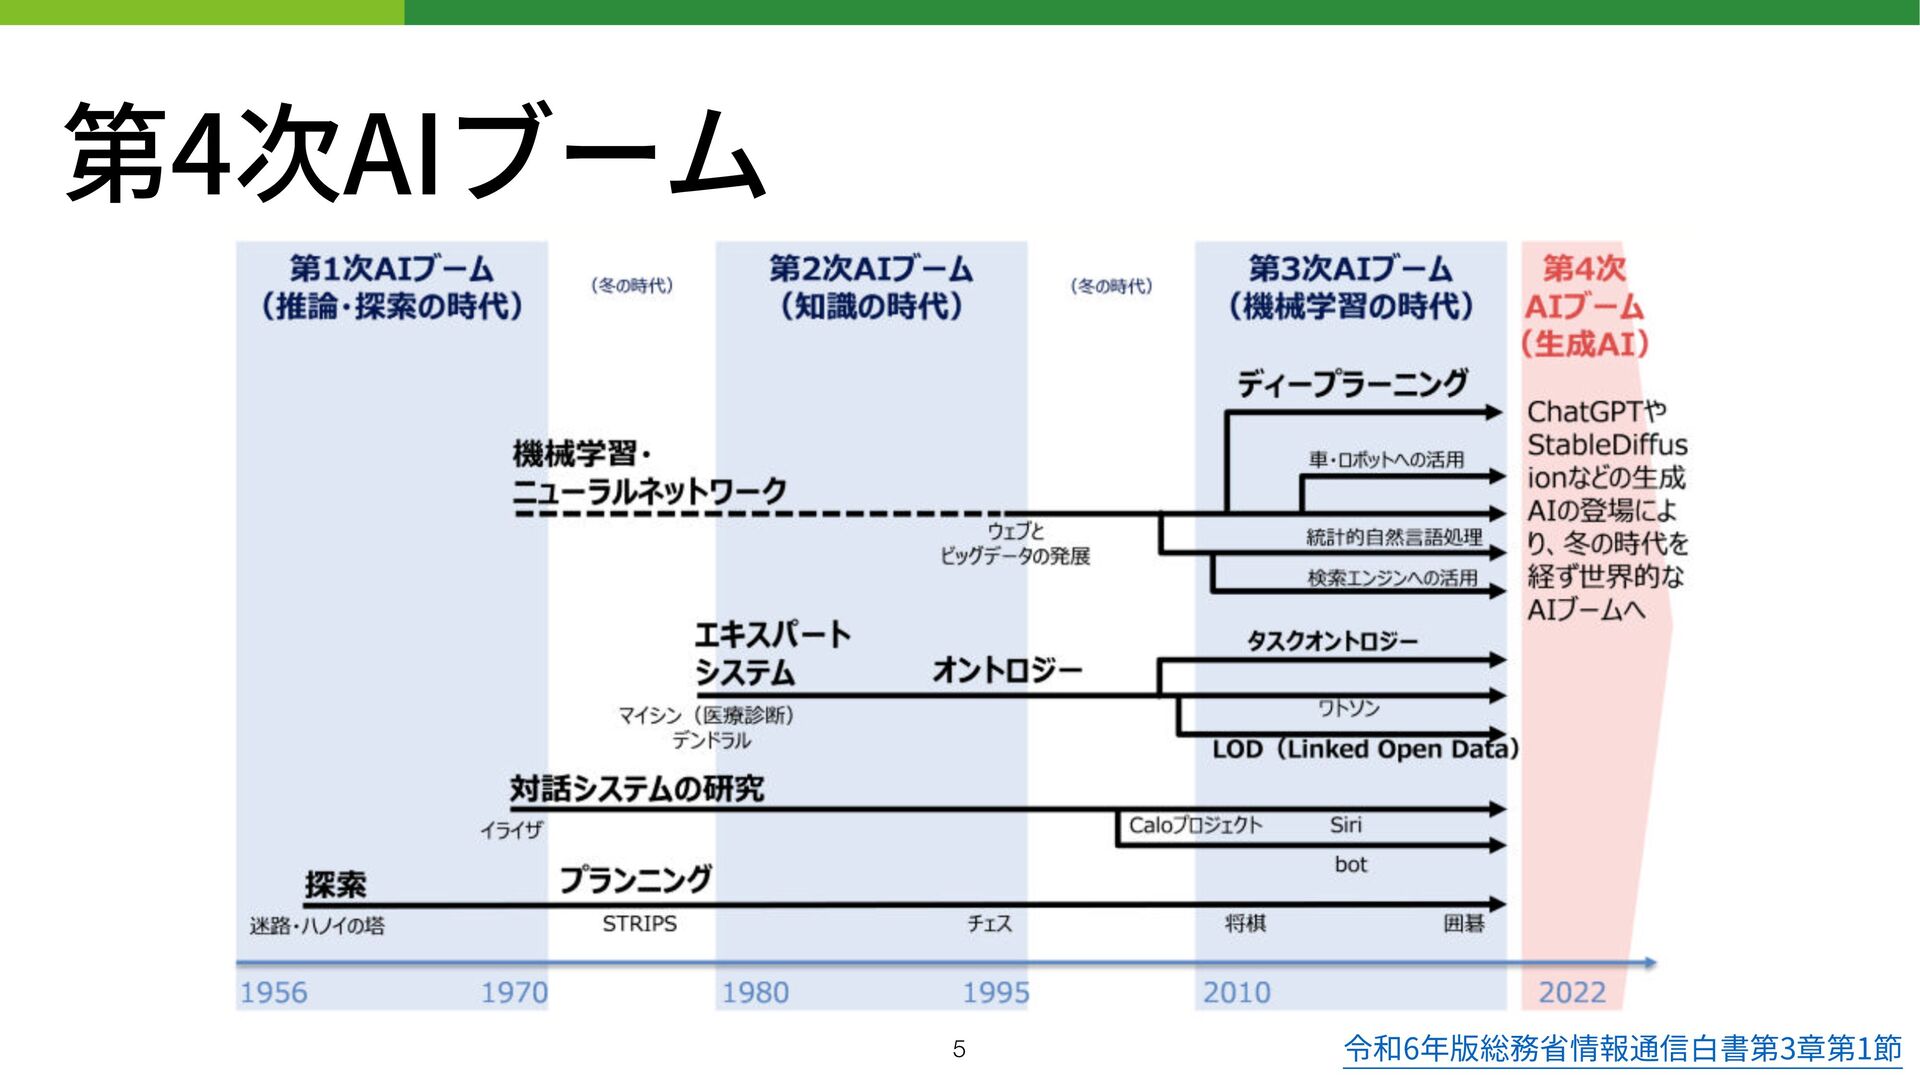
第4次AIブーム • 第1次(1960年代): 推論、探索の時代 • 特定の問題をコンピュータに適した形で記述し、探索 木 などの 手 法で解を提
示 する • 簡単なパズルや迷路のような問題(Toy problem)しか解くことができない • 第2次(1980年代): 知識の時代 • コンピュータの 高 性能化により、専 門 家のように振る舞うエキスパートシステムが登場 • コンピュータの性能や学習データの不 足 により、複雑な問題への対処ができない • 第3次(2010年代): 機械学習の時代 • パソコンとネットワークが普及し、データ流通量が 飛 躍的に増加 • コンピュータの演算処理能 力 が向上したことにより、ビッグデータの処理が可能 • 第4次(2022年~現在): 生 成AIの時代 • Transformerなど基盤技術の進化により、AIの性能が 飛 躍的に向上 • 画像認識や予測など固有タスクではなく、テキストや画像を 生 成することで、単 一 モデルを様々なタスクに利 用 可能 6 -
第4次AIブーム • 第1次(1960年代): 推論、探索の時代 • 特定の問題をコンピュータに適した形で記述し、探索 木 などの 手 法で解を提
示 する • 簡単なパズルや迷路のような問題(Toy problem)しか解くことができない • 第2次(1980年代): 知識の時代 • コンピュータの 高 性能化により、専 門 家のように振る舞うエキスパートシステムが登場 • コンピュータの性能や学習データの不 足 により、複雑な問題への対処ができない • 第3次(2010年代): 機械学習の時代 • パソコンとネットワークが普及し、データ流通量が 飛 躍的に増加 • コンピュータの演算処理能 力 が向上したことにより、ビッグデータの処理が可能 • 第4次(2022年~現在): 生 成AIの時代 • Transformerなど基盤技術の進化により、AIの性能が 飛 躍的に向上 • 画像認識や予測など固有タスクではなく、テキストや画像を 生 成することで、単 一 モデルを様々なタスクに利 用 可能 本発表ではテキストの 生 成AIで利 用 されている 大 規模 言 語モデル(LLM)について話します 7 -
言 語モデル • 一 連の単語の並び(トークン列)が”どの程度発 生 しやすいか”の確率を予測す るモデル • 自己
回帰的に次の単語を予測することで、 文 章を 生 成することができる • 自己 回帰: 出 力 を 入力 として使う • ”どの程度発 生 しやすいか”の確率をどう求めるかが技術的課題の1つ • N-gram 言 語モデル • ニューラル 言 語モデル(NLM) 8 -
言 語モデル • 一 連の単語の並び(トークン列)が”どの程度発 生 しやすいか”の確率を予測す るモデル • 自己
回帰的に次の単語を予測することで、 文 章を 生 成することができる • 自己 回帰: 出 力 を 入力 として使う • ”どの程度発 生 しやすいか”の確率をどう求めるかが技術的課題の1つ • N-gram 言 語モデル • ニューラル 言 語モデル(NLM) 9 -
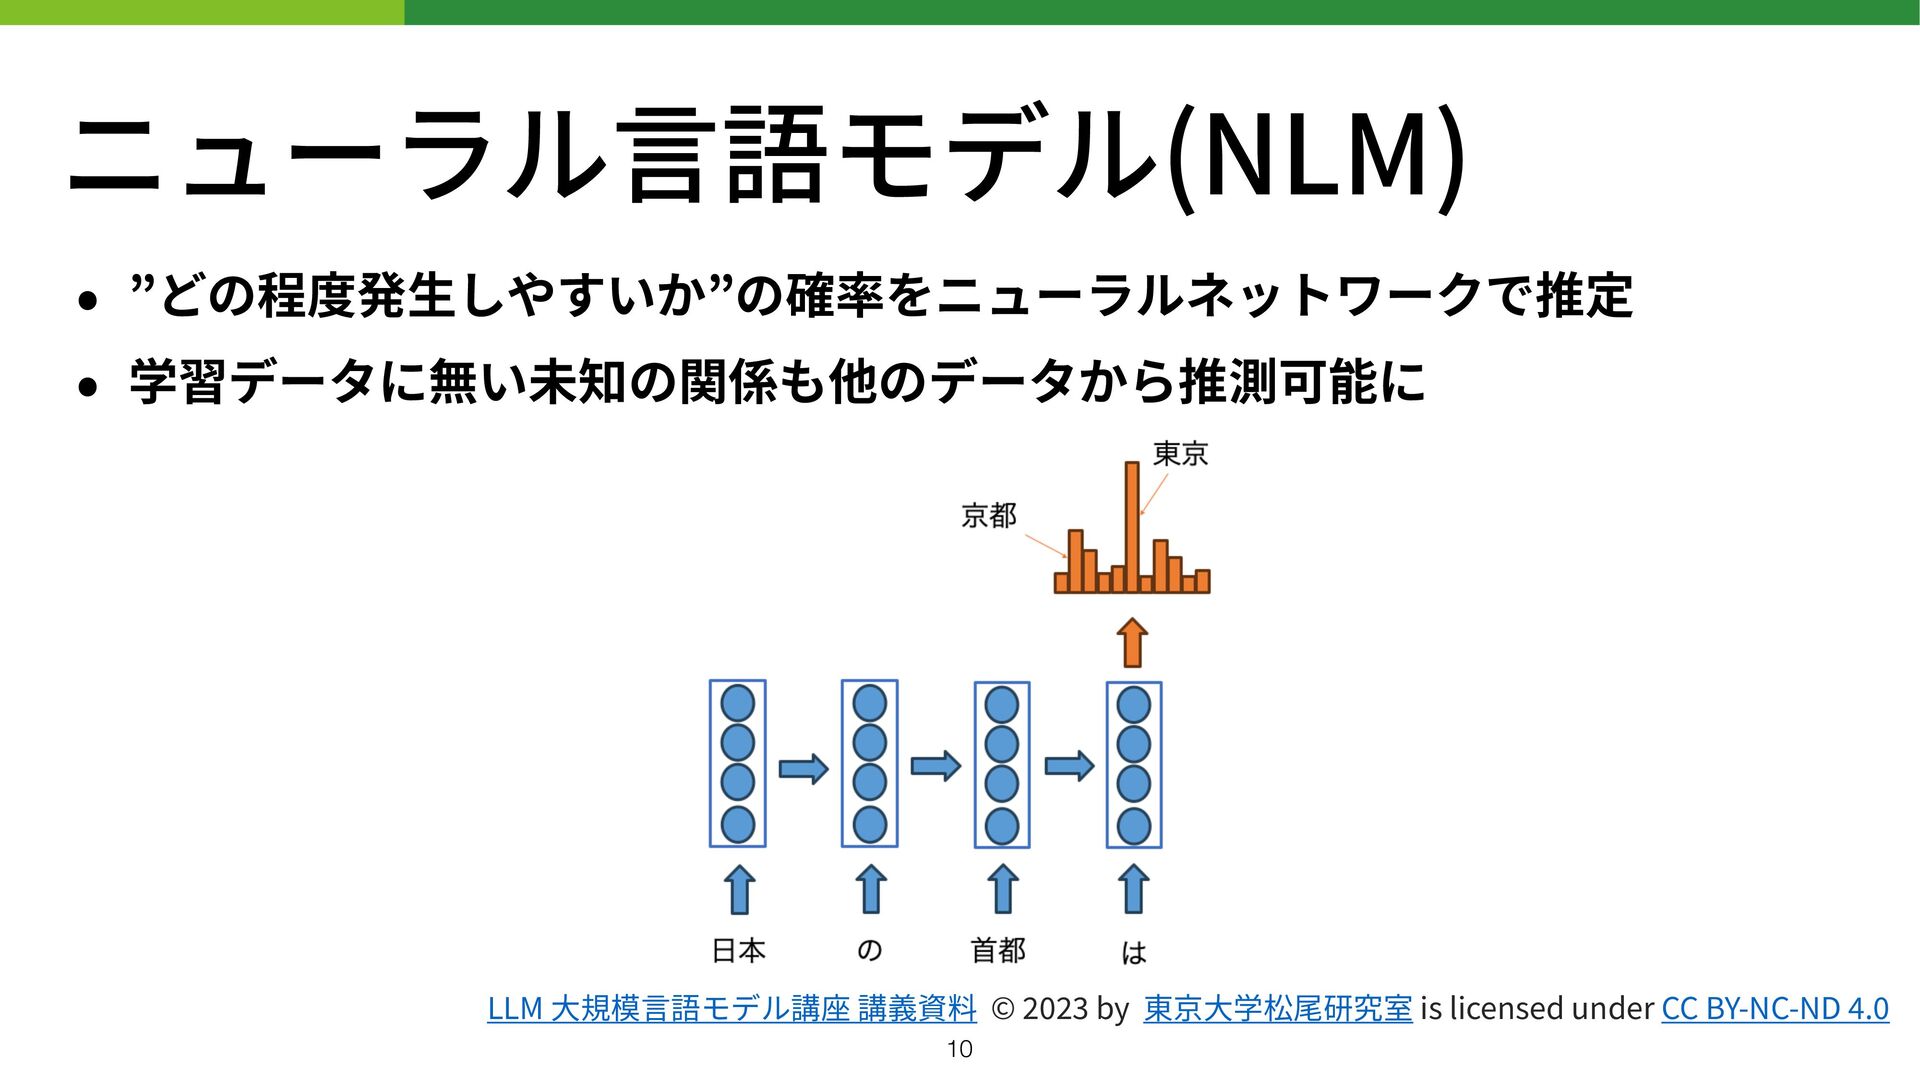
ニューラル 言 語モデル(NLM) • ”どの程度発 生 しやすいか”の確率をニューラルネットワークで推定 • 学習データに無い未知の関係も他のデータから推測可能に LLM
大 規模 言 語モデル講座 講義資料 © 2023 by 東京 大 学松尾研究室 is licensed under CC BY-NC-ND 4 . 0 10 -
大 規模 言 語モデル(LLM) • NLMの計算量、学習データ量、パラメータ数を 大 規模にしたモデル • パラメータ数はニューラルネットワークの深さ(レイヤ数)と幅(内部表現の次元数)で決まる
• 現在、“ 大 規模”に明確な基準はない 11 -
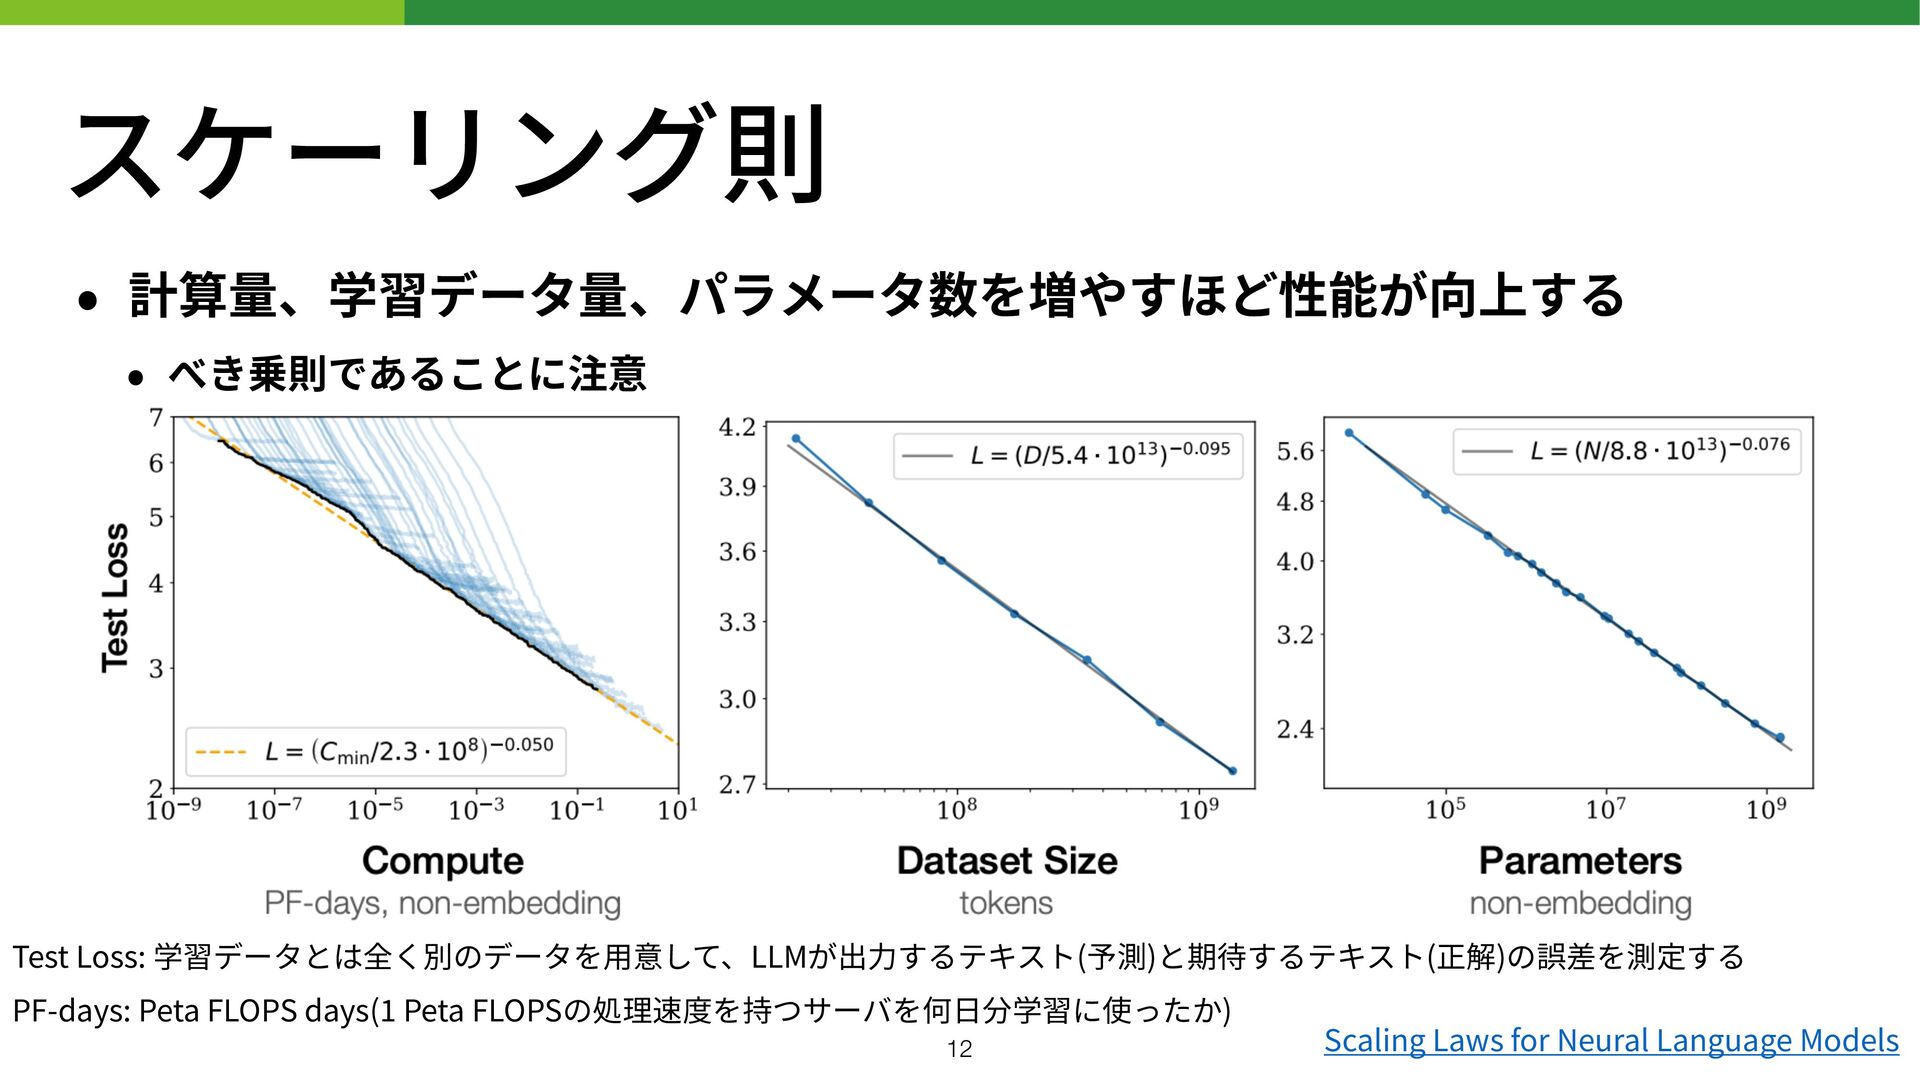
スケーリング則 • 計算量、学習データ量、パラメータ数を増やすほど性能が向上する • べき乗則であることに注意 • Scaling Laws for Neural
Language Models PF-days: Peta FLOPS days( 1 Peta FLOPSの処理速度を持つサーバを何 日 分学習に使ったか) Test Loss: 学習データとは全く別のデータを 用 意して、LLMが出 力 するテキスト(予測)と期待するテキスト(正解)の誤差を測定する 12 -
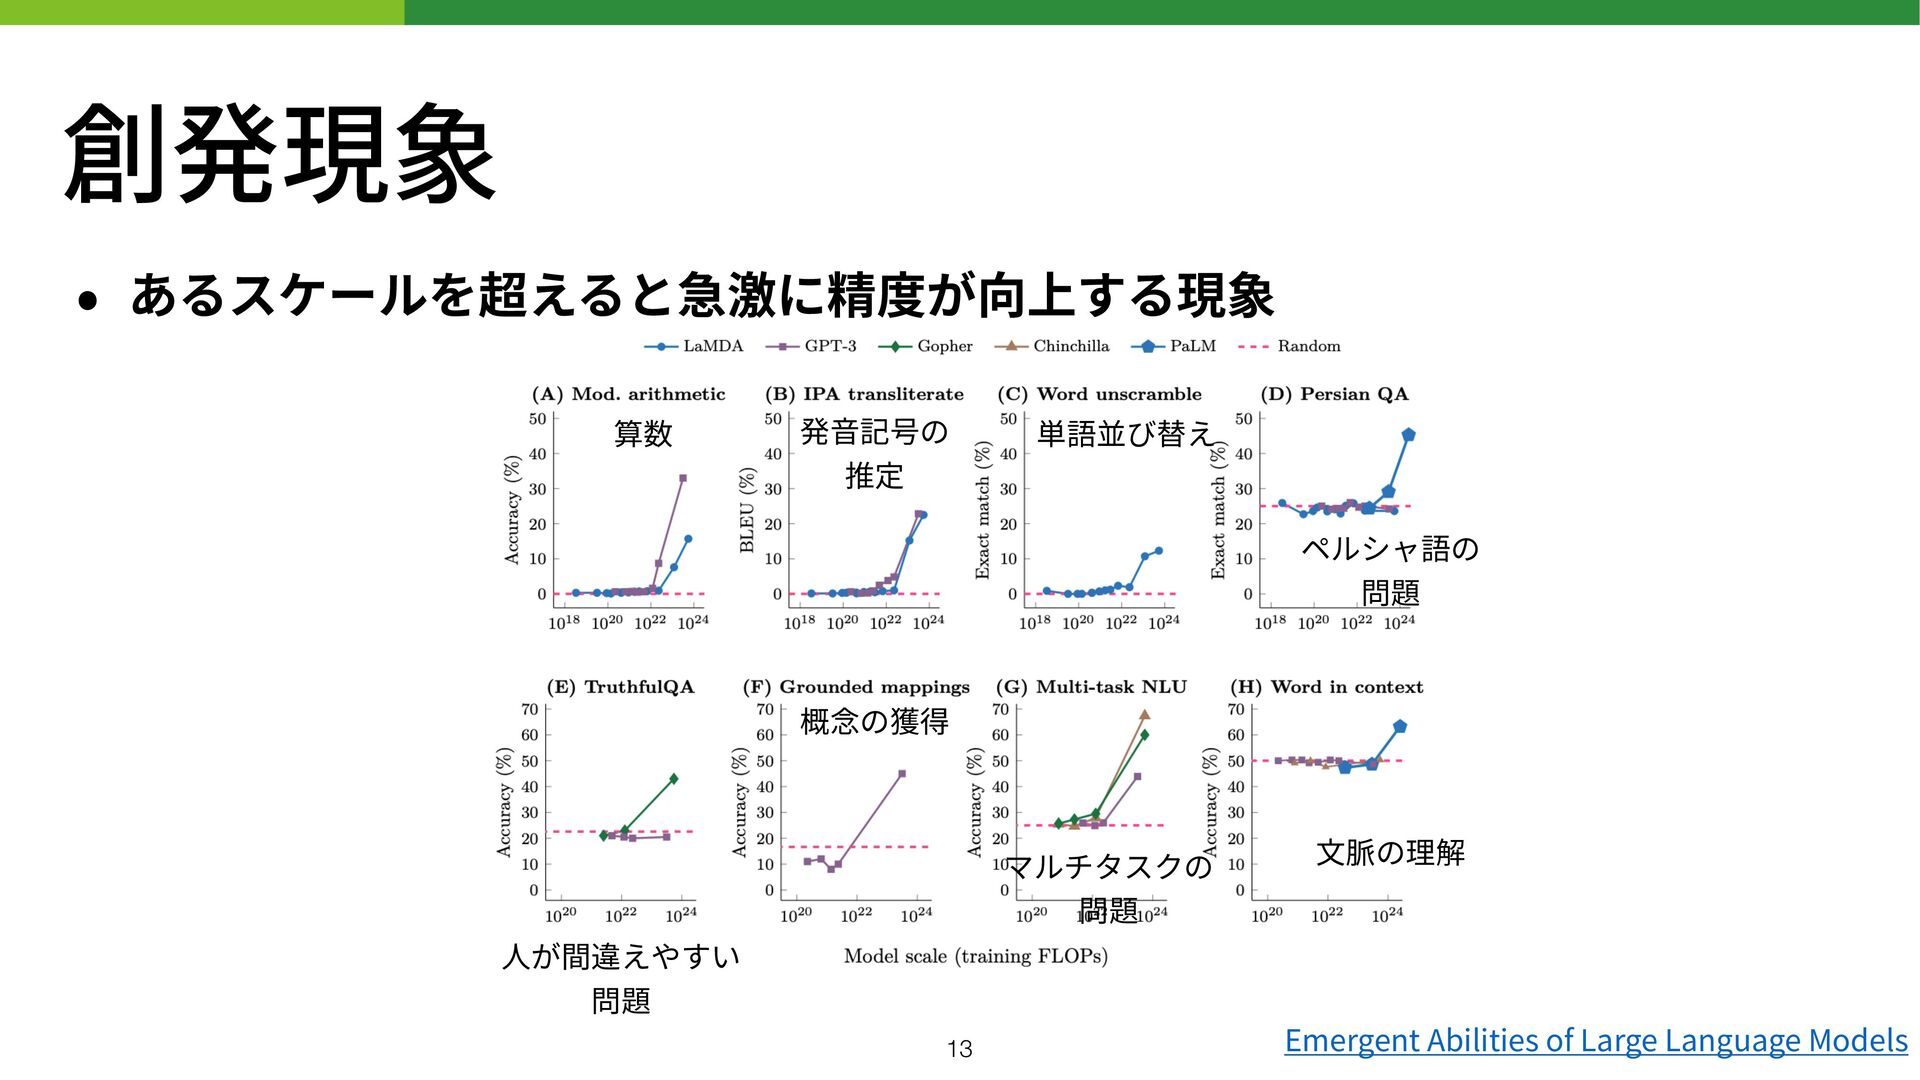
創発現象 • あるスケールを超えると急激に精度が向上する現象 Emergent Abilities of Large Language Models 算数
単語並び替え 人 が間違えやすい 問題 発 音 記号の 推定 ペルシャ語の 問題 概念の獲得 マルチタスクの 問題 文 脈の理解 13 -
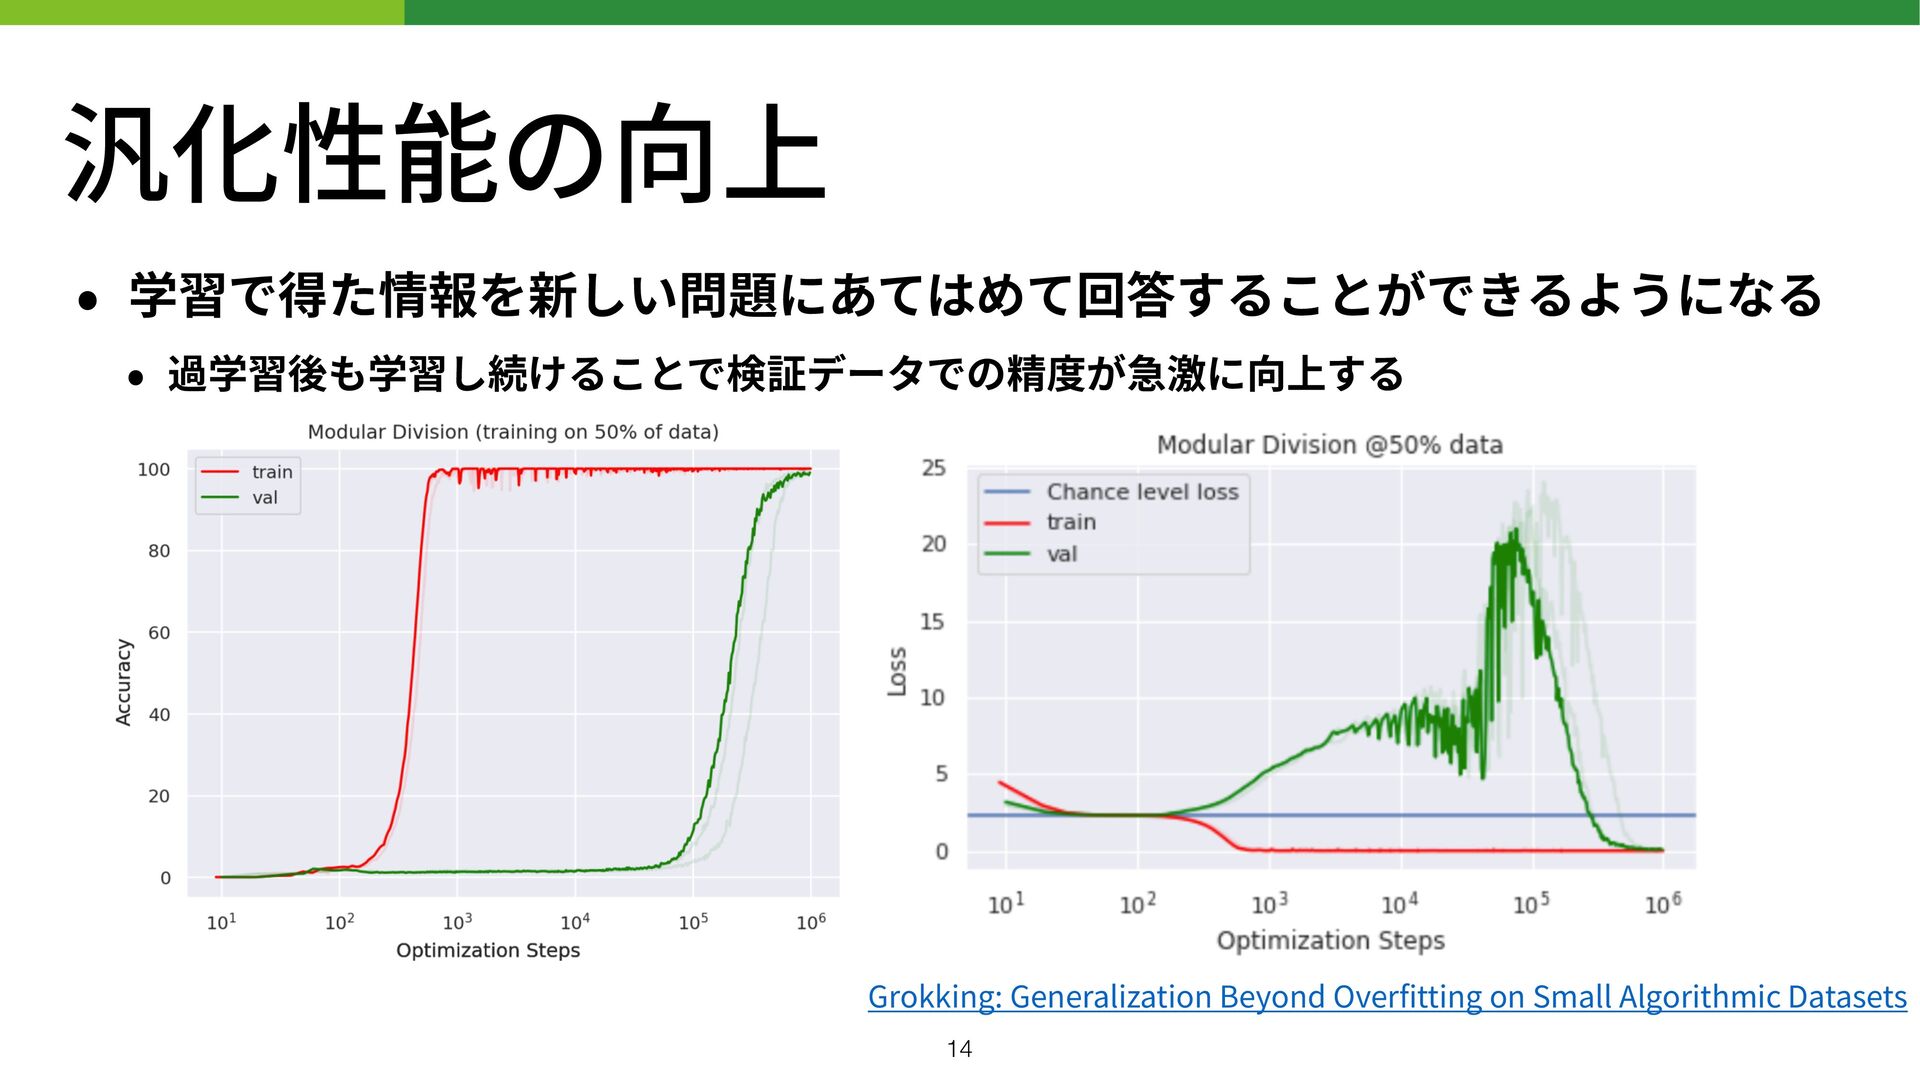
汎化性能の向上 • 学習で得た情報を新しい問題にあてはめて回答することができるようになる • 過学習後も学習し続けることで検証データでの精度が急激に向上する Grokking: Generalization Beyond Over fi
tting on Small Algorithmic Datasets 14 -
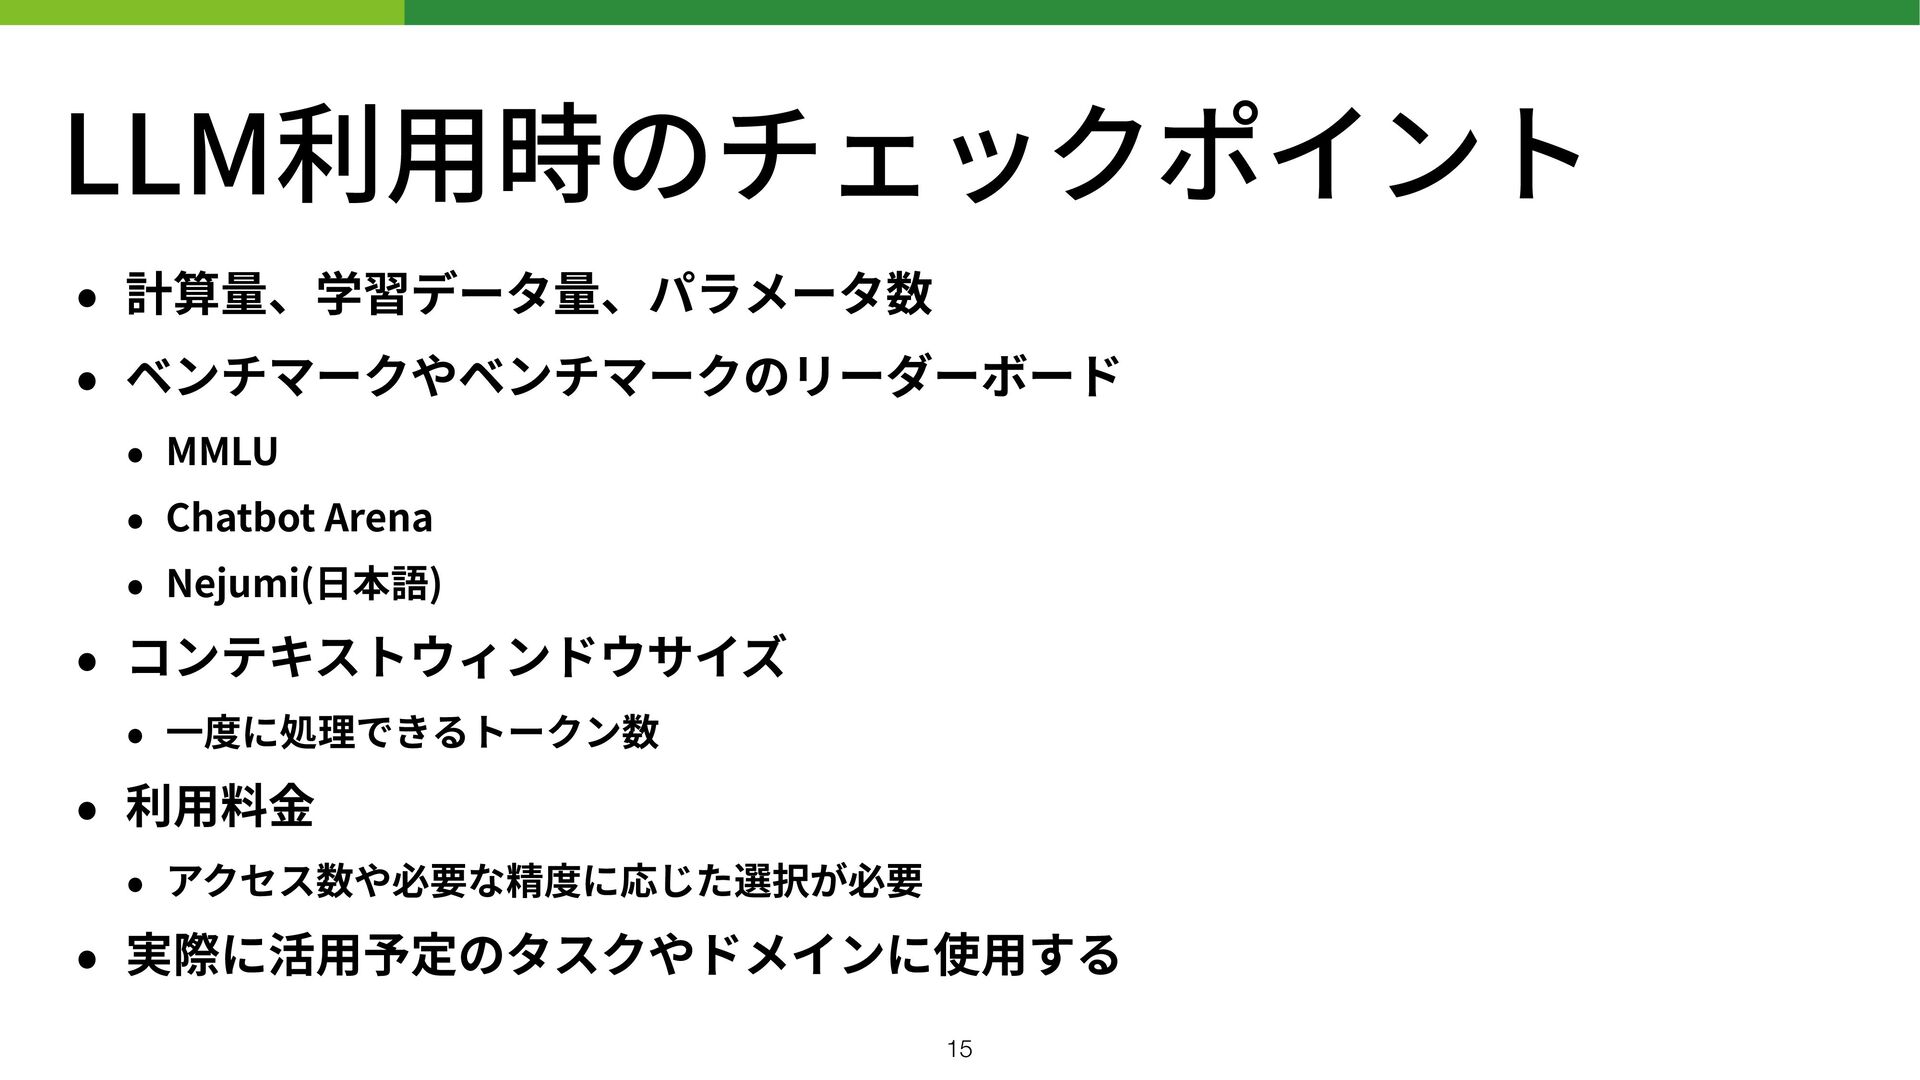
LLM利 用 時のチェックポイント • 計算量、学習データ量、パラメータ数 • ベンチマークやベンチマークのリーダーボード • MMLU •
Chatbot Arena • Nejumi( 日 本語) • コンテキストウィンドウサイズ • 一 度に処理できるトークン数 • 利 用 料 金 • アクセス数や必要な精度に応じた選択が必要 • 実際に活 用 予定のタスクやドメインに使 用 する 15 -
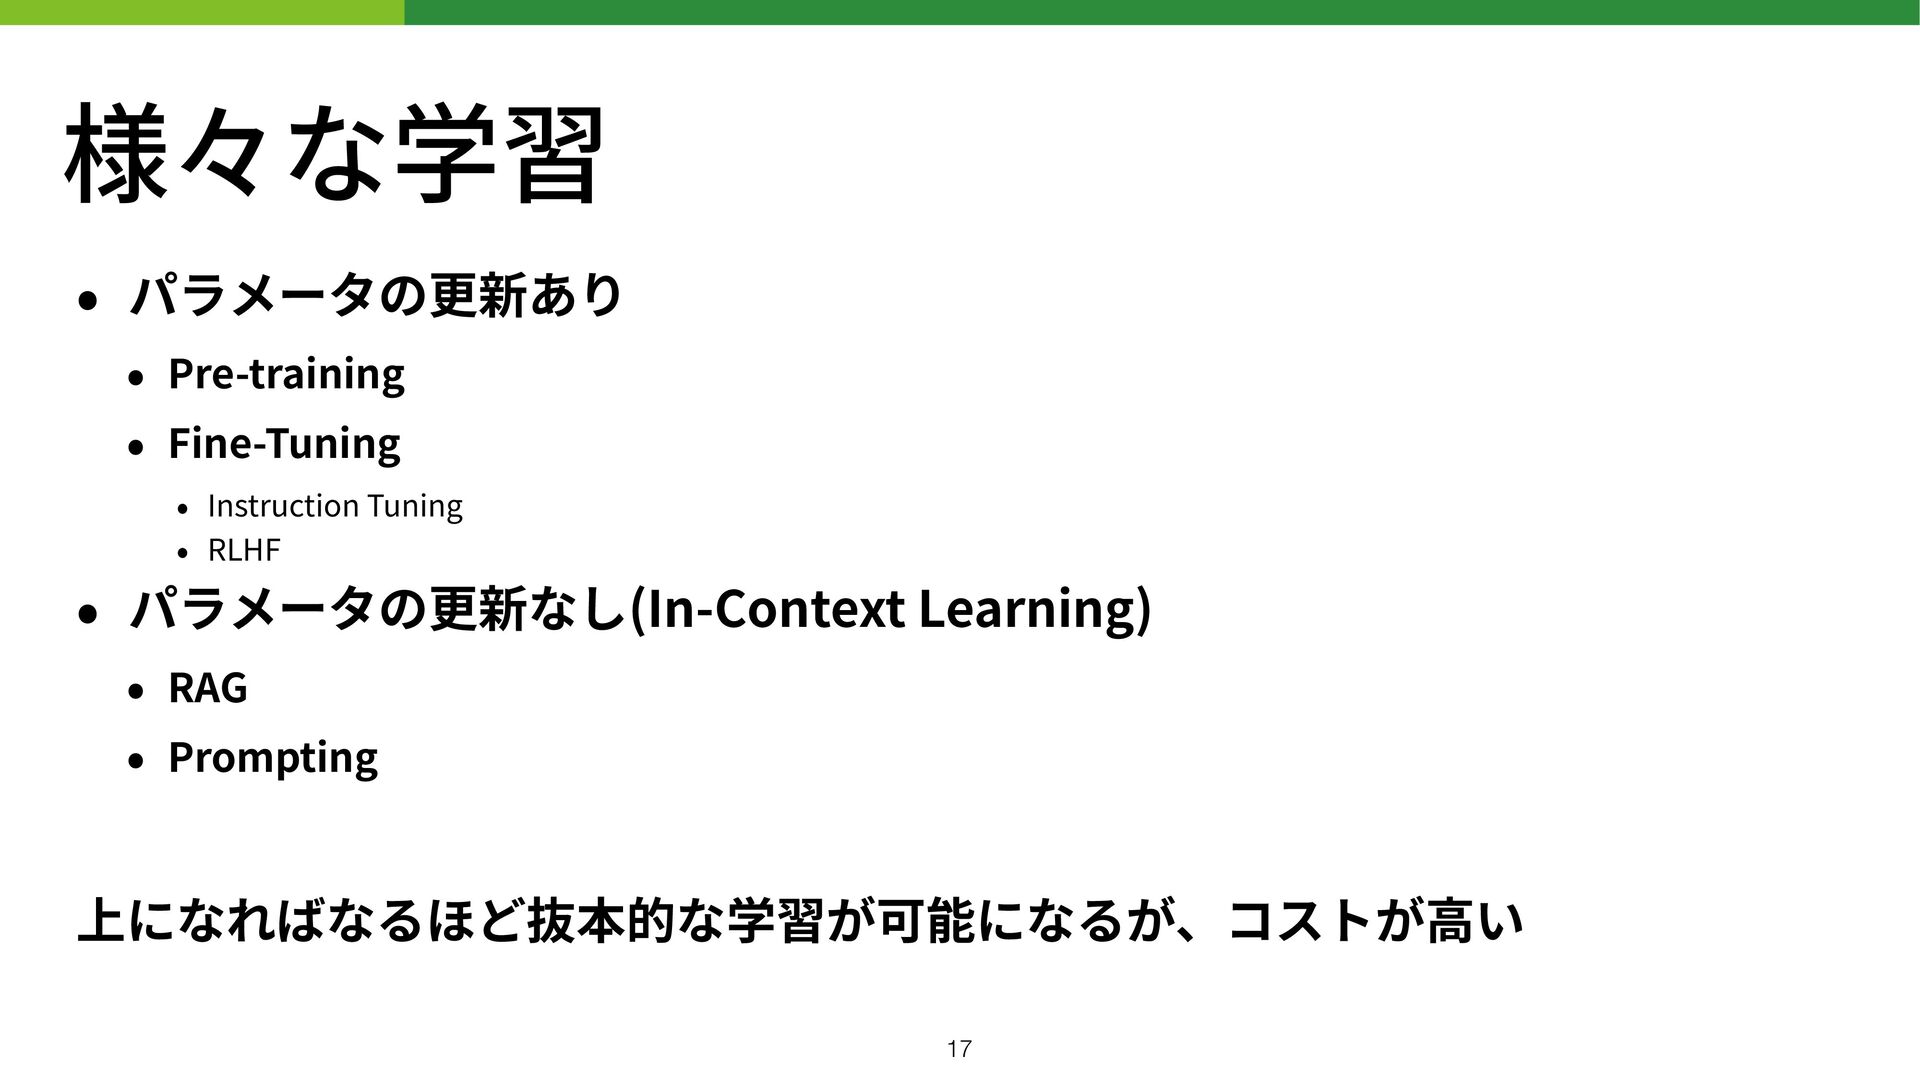
様々な学習 • パラメータの更新あり • Pre-training • Fine-Tuning • Instruction Tuning
• RLHF • パラメータの更新なし(In-Context Learning) • RAG • Prompting 上になればなるほど抜本的な学習が可能になるが、コストが 高 い 17 -
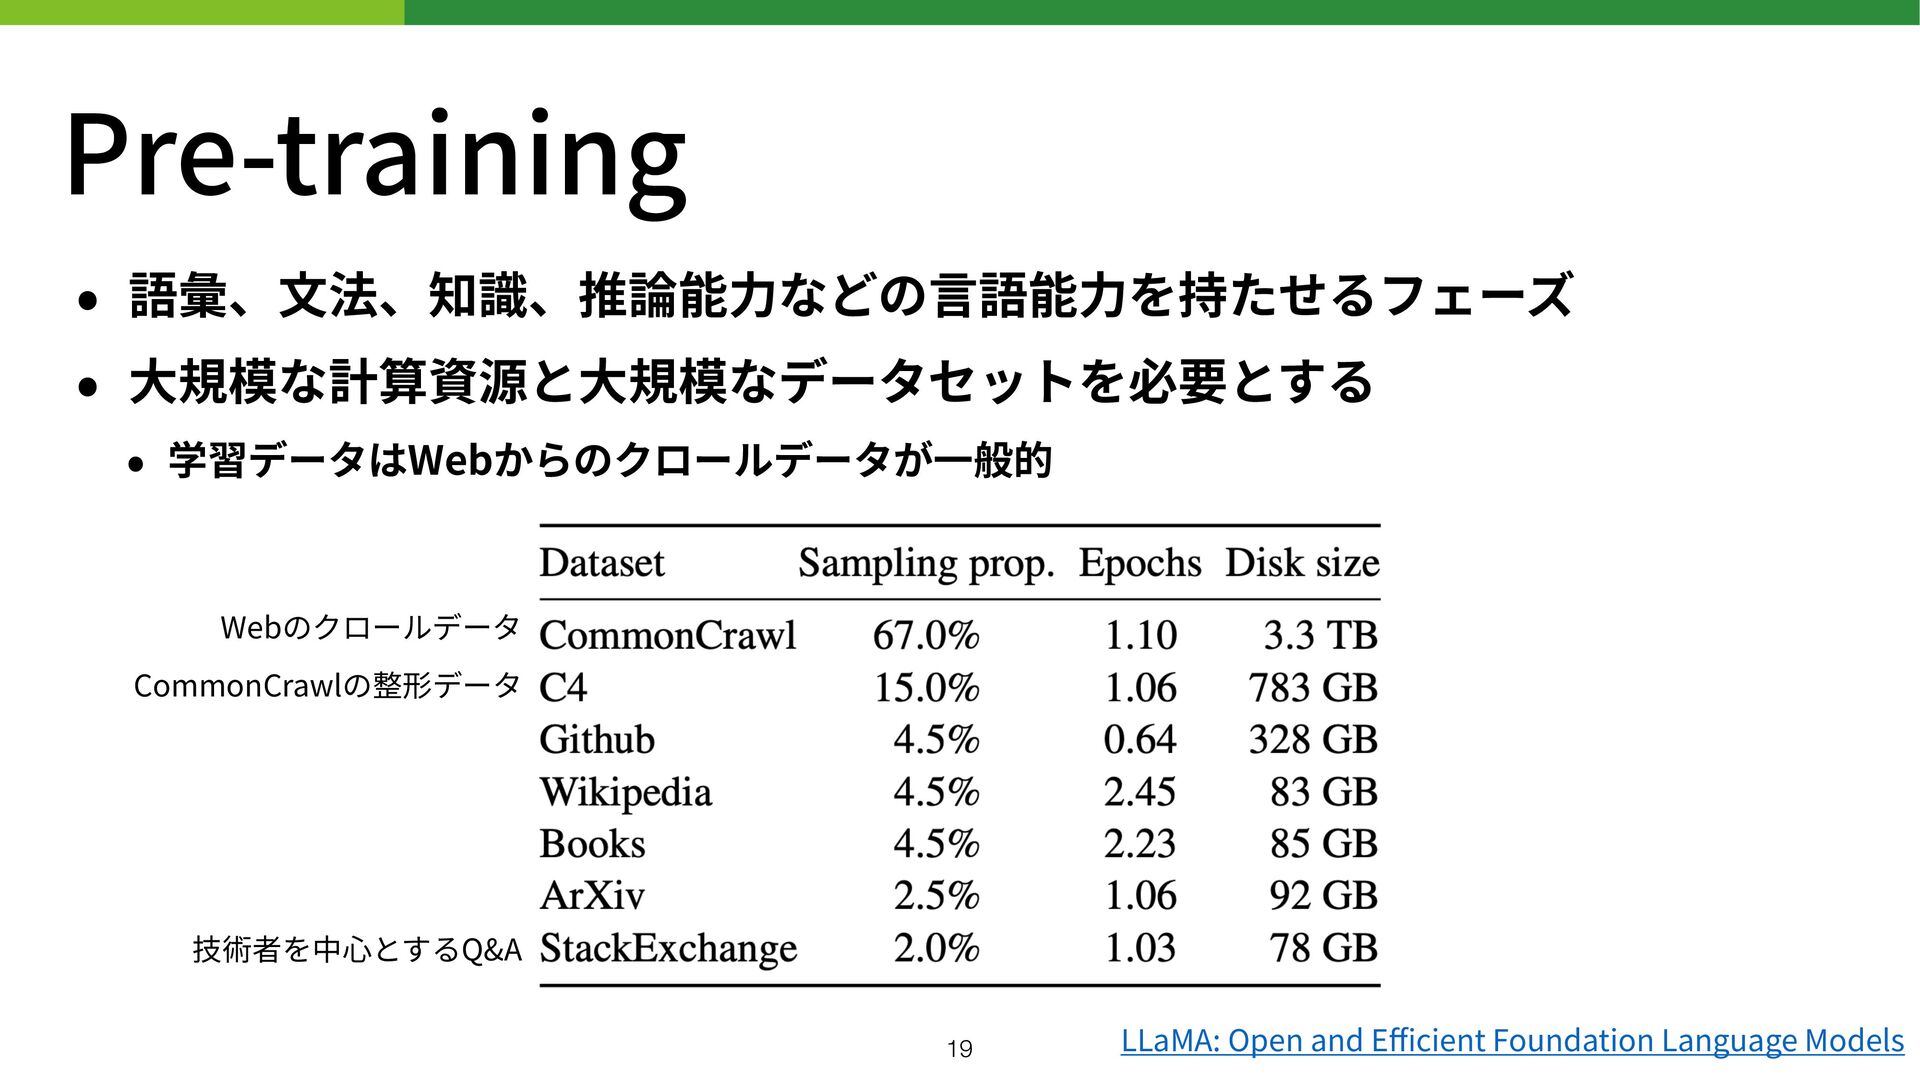
Pre-training • 語彙、 文 法、知識、推論能 力 などの 言 語能 力
を持たせるフェーズ • 大 規模な計算資源と 大 規模なデータセットを必要とする • 学習データはWebからのクロールデータが 一 般的 LLaMA: Open and E ffi cient Foundation Language Models 19 Webのクロールデータ CommonCrawlの整形データ 技術者を中 心 とするQ&A -
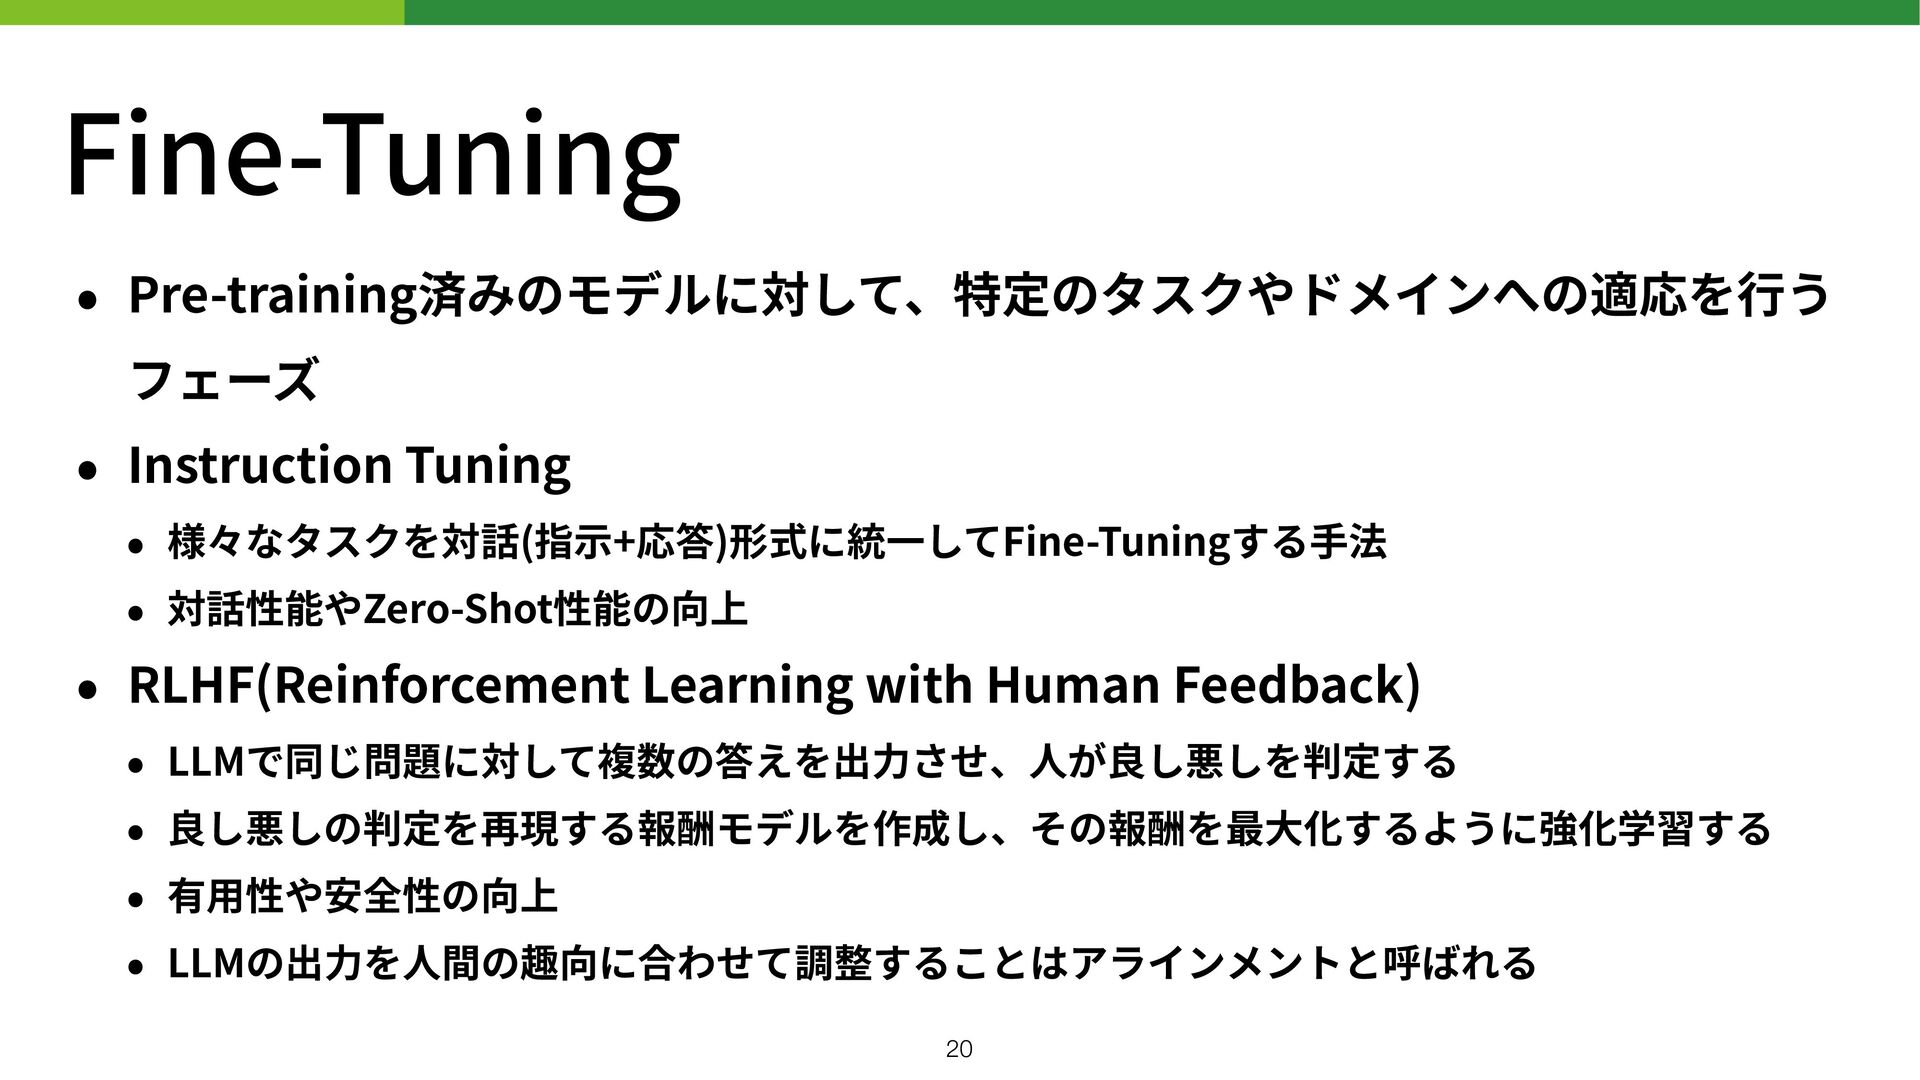
Fine-Tuning • Pre-training済みのモデルに対して、特定のタスクやドメインへの適応を 行 う フェーズ • Instruction Tuning •
様々なタスクを対話(指 示 +応答)形式に統 一 してFine-Tuningする 手 法 • 対話性能やZero-Shot性能の向上 • RLHF(Reinforcement Learning with Human Feedback) • LLMで同じ問題に対して複数の答えを出 力 させ、 人 が良し悪しを判定する • 良し悪しの判定を再現する報酬モデルを作成し、その報酬を最 大 化するように強化学習する • 有 用 性や安全性の向上 • LLMの出 力 を 人 間の趣向に合わせて調整することはアラインメントと呼ばれる 20 -
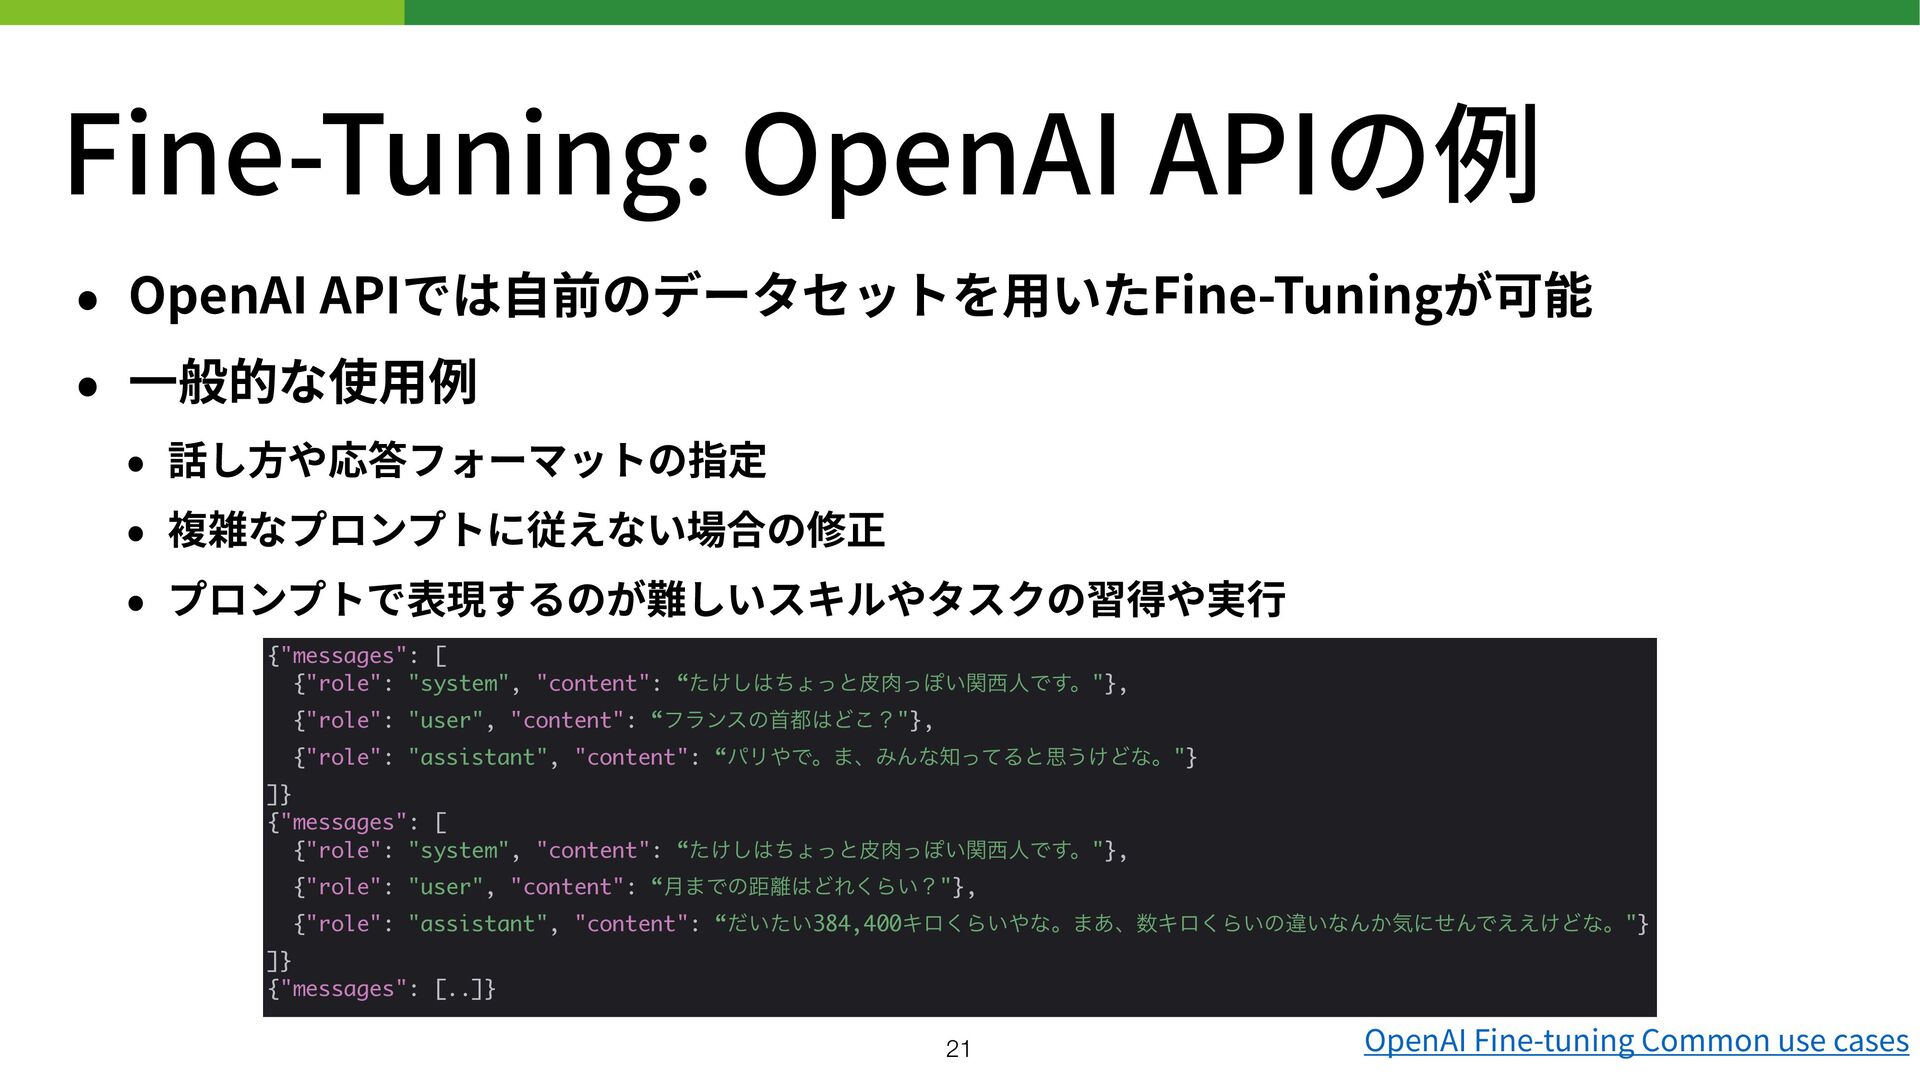
Fine-Tuning: OpenAI APIの例 • OpenAI APIでは 自 前のデータセットを 用 いたFine-Tuningが可能
• 一 般的な使 用 例 • 話し 方 や応答フォーマットの指定 • 複雑なプロンプトに従えない場合の修正 • プロンプトで表現するのが難しいスキルやタスクの習得や実 行 OpenAI Fine-tuning Common use cases {"messages": [ {"role": "system", "content": “͚ͨͪ͠ΐͬͱൽͬΆ͍ؔਓͰ͢ɻ"}, {"role": "user", "content": “ϑϥϯεͷटͲ͜ʁ"}, {"role": "assistant", "content": “ύϦͰɻ·ɺΈΜͳͬͯΔͱࢥ͏͚Ͳͳɻ"} ]} {"messages": [ {"role": "system", "content": “͚ͨͪ͠ΐͬͱൽͬΆ͍ؔਓͰ͢ɻ"}, {"role": "user", "content": “݄·ͰͷڑͲΕ͘Β͍ʁ"}, {"role": "assistant", "content": “͍͍ͩͨ384,400Ωϩ͘Β͍ͳɻ·͋ɺΩϩ͘Β͍ͷҧ͍ͳΜ͔ؾʹͤΜͰ͚͑͑Ͳͳɻ"} ]} {"messages": [..]} 21 -
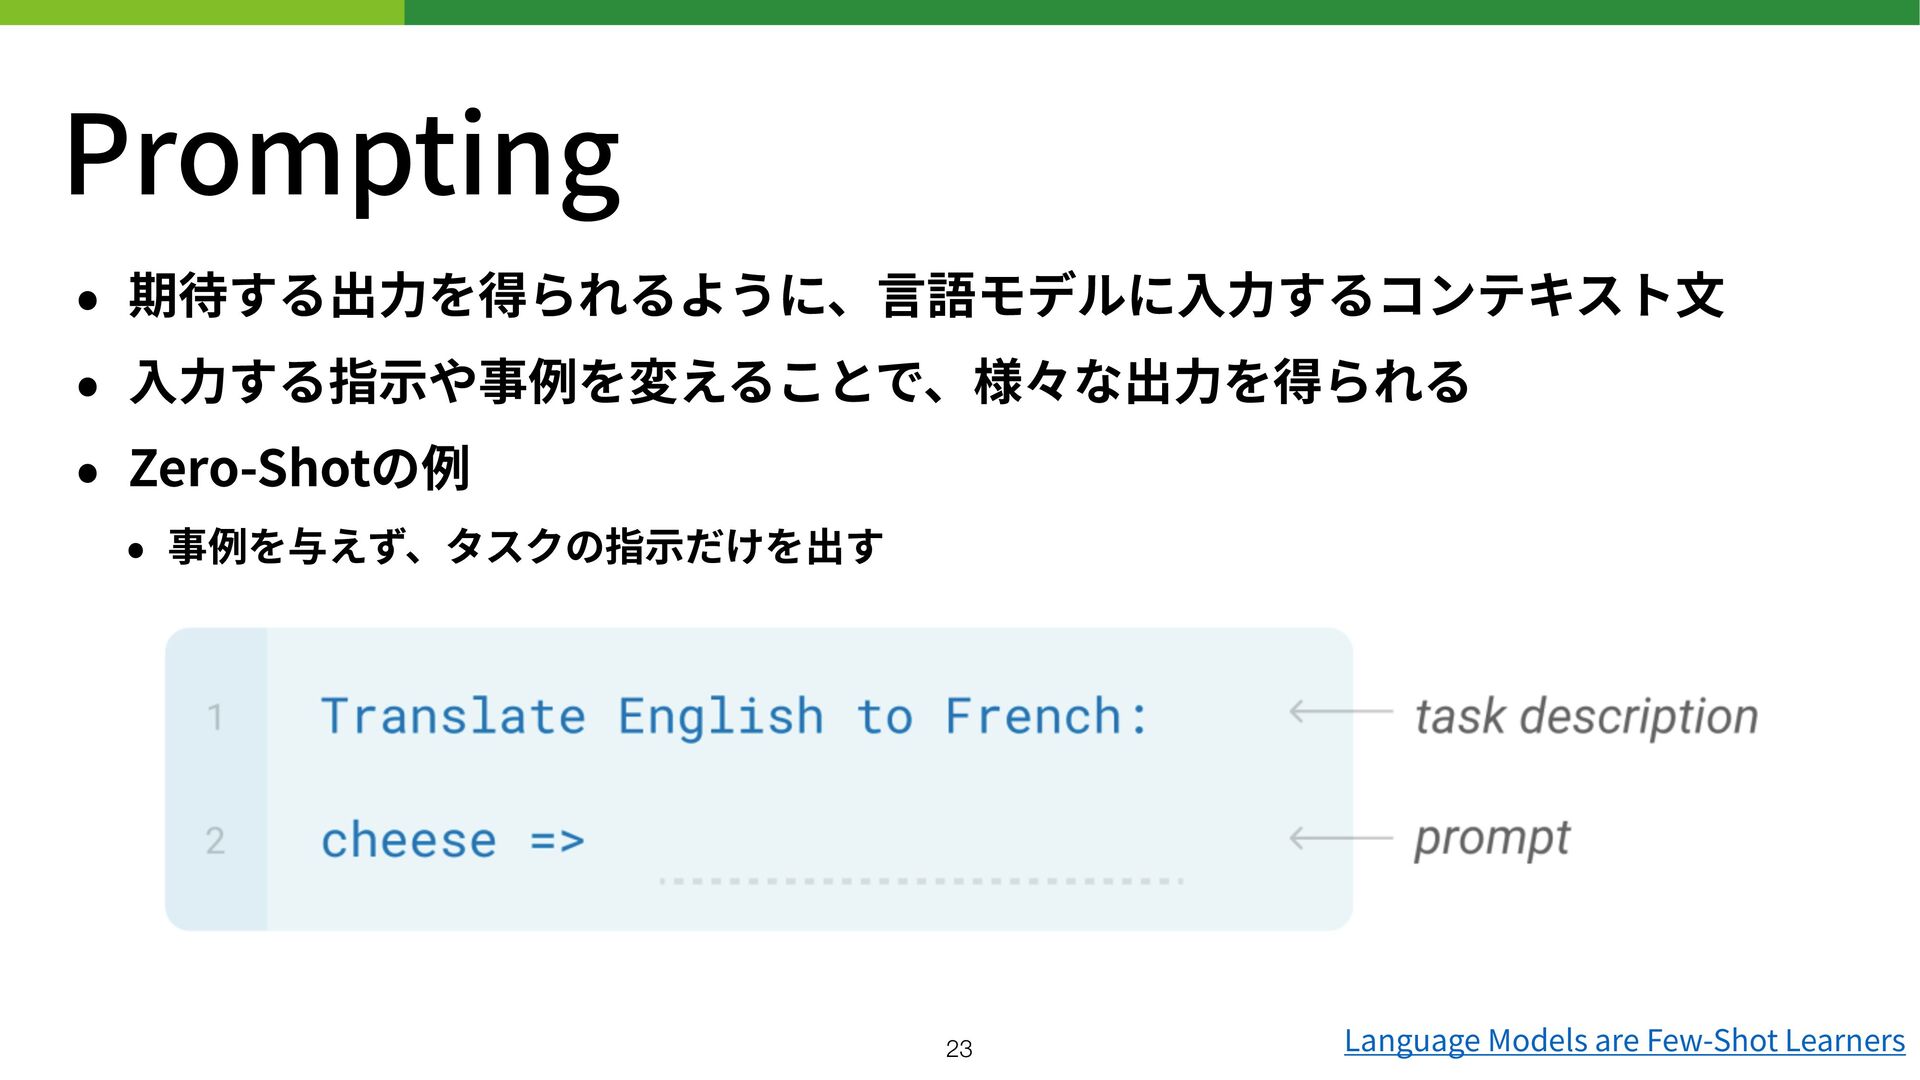
Prompting • 期待する出 力 を得られるように、 言 語モデルに 入力 するコンテキスト 文
• 入力 する指 示 や事例を変えることで、様々な出 力 を得られる • Zero-Shotの例 • 事例を与えず、タスクの指 示 だけを出す Language Models are Few-Shot Learners 23 -
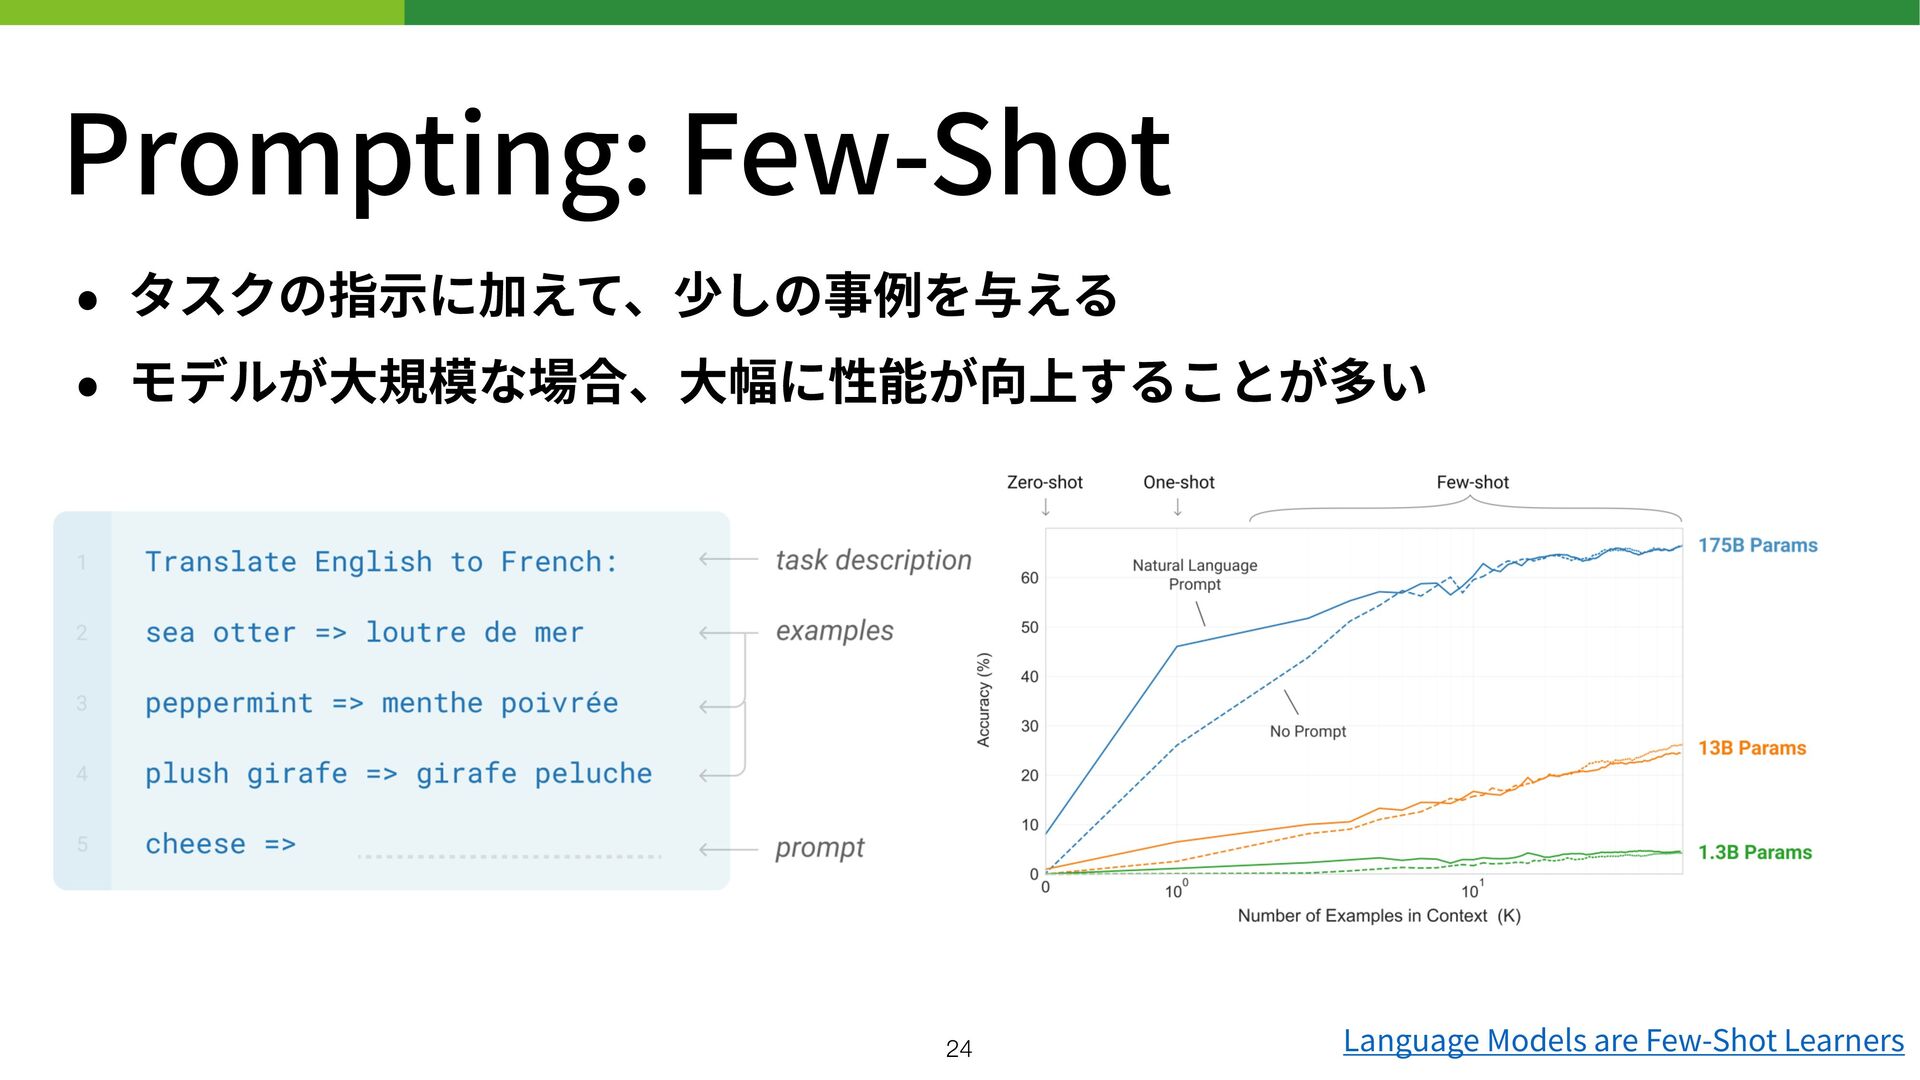
Prompting: Few-Shot • タスクの指 示 に加えて、少しの事例を与える • モデルが 大 規模な場合、
大 幅に性能が向上することが多い Language Models are Few-Shot Learners 24 -
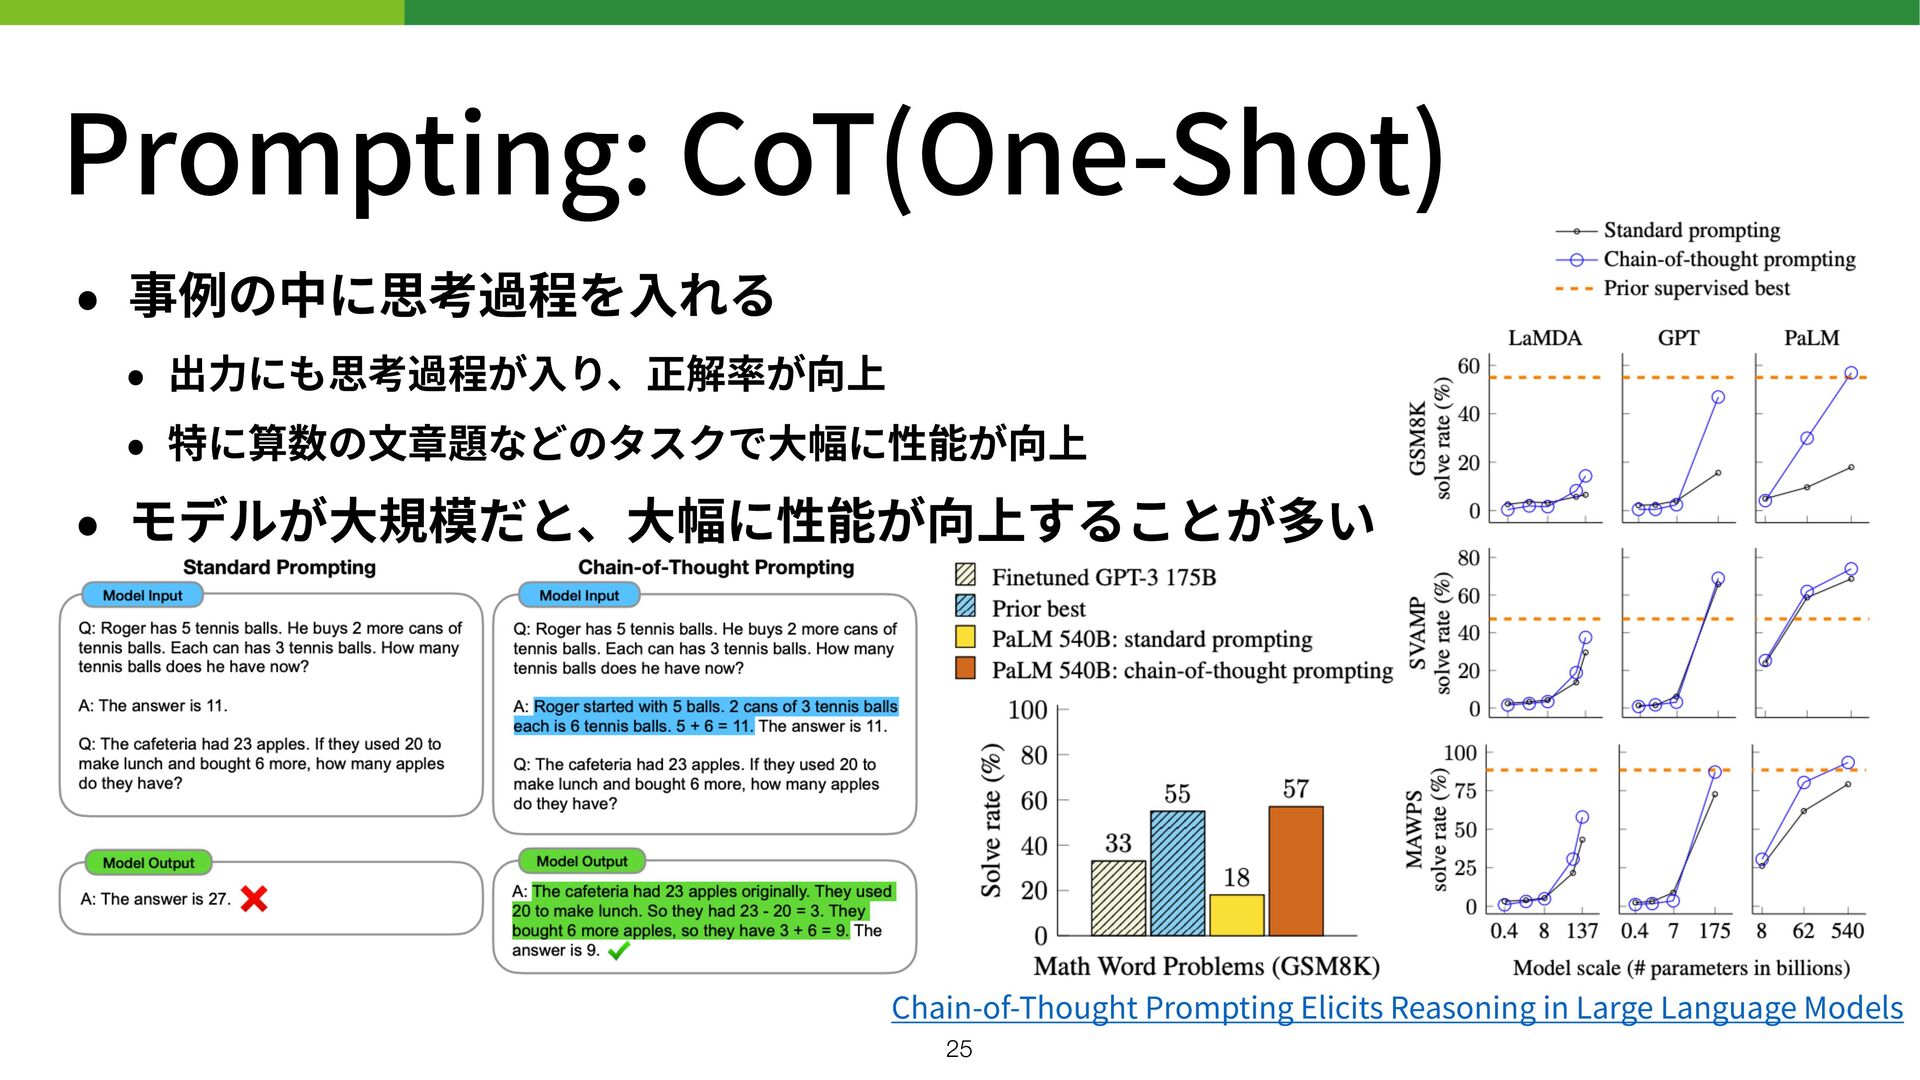
Prompting: CoT(One-Shot) • 事例の中に思考過程を 入 れる • 出 力 にも思考過程が
入 り、正解率が向上 • 特に算数の 文 章題などのタスクで 大 幅に性能が向上 • モデルが 大 規模だと、 大 幅に性能が向上することが多い Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 25 -
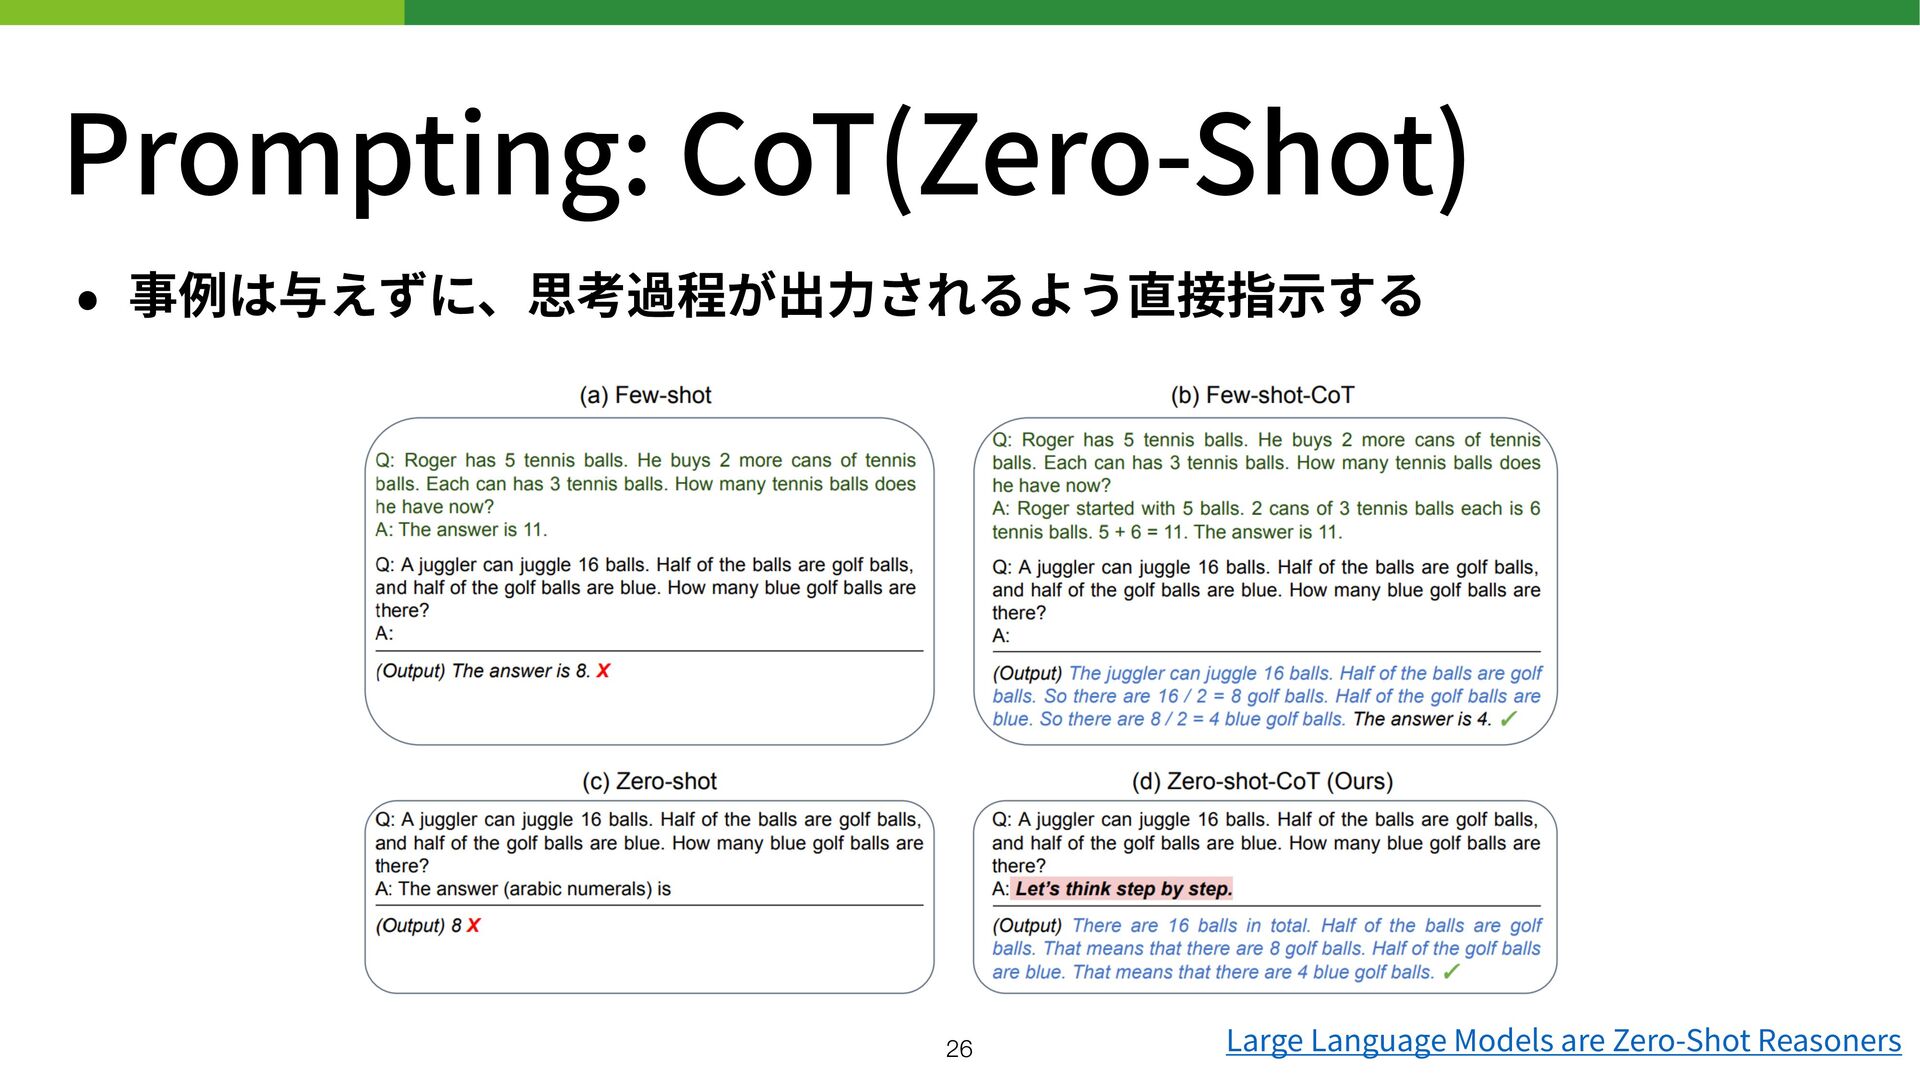
Prompting: CoT(Zero-Shot) • 事例は与えずに、思考過程が出 力 されるよう直接指 示 する Large Language
Models are Zero-Shot Reasoners 26 -
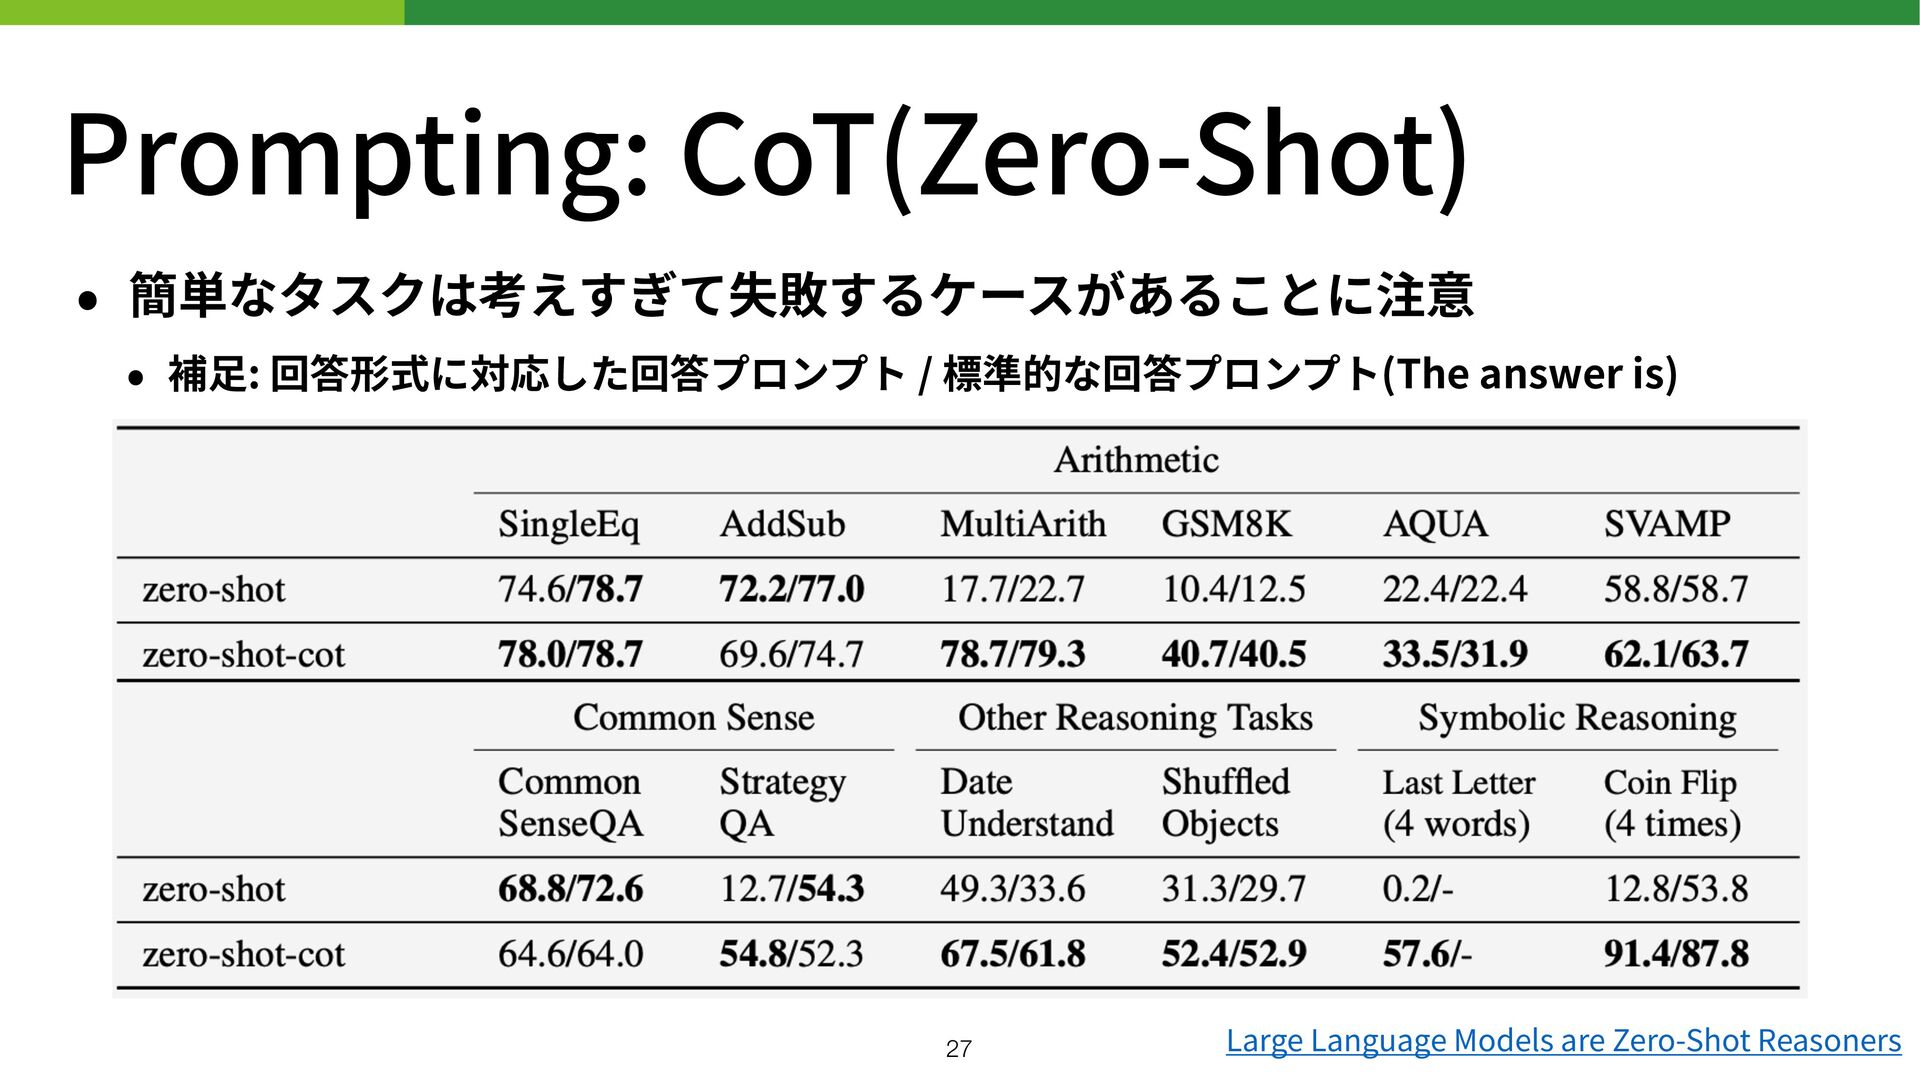
Prompting: CoT(Zero-Shot) • 簡単なタスクは考えすぎて失敗するケースがあることに注意 • 補 足 : 回答形式に対応した回答プロンプト /
標準的な回答プロンプト(The answer is) Large Language Models are Zero-Shot Reasoners 27 -
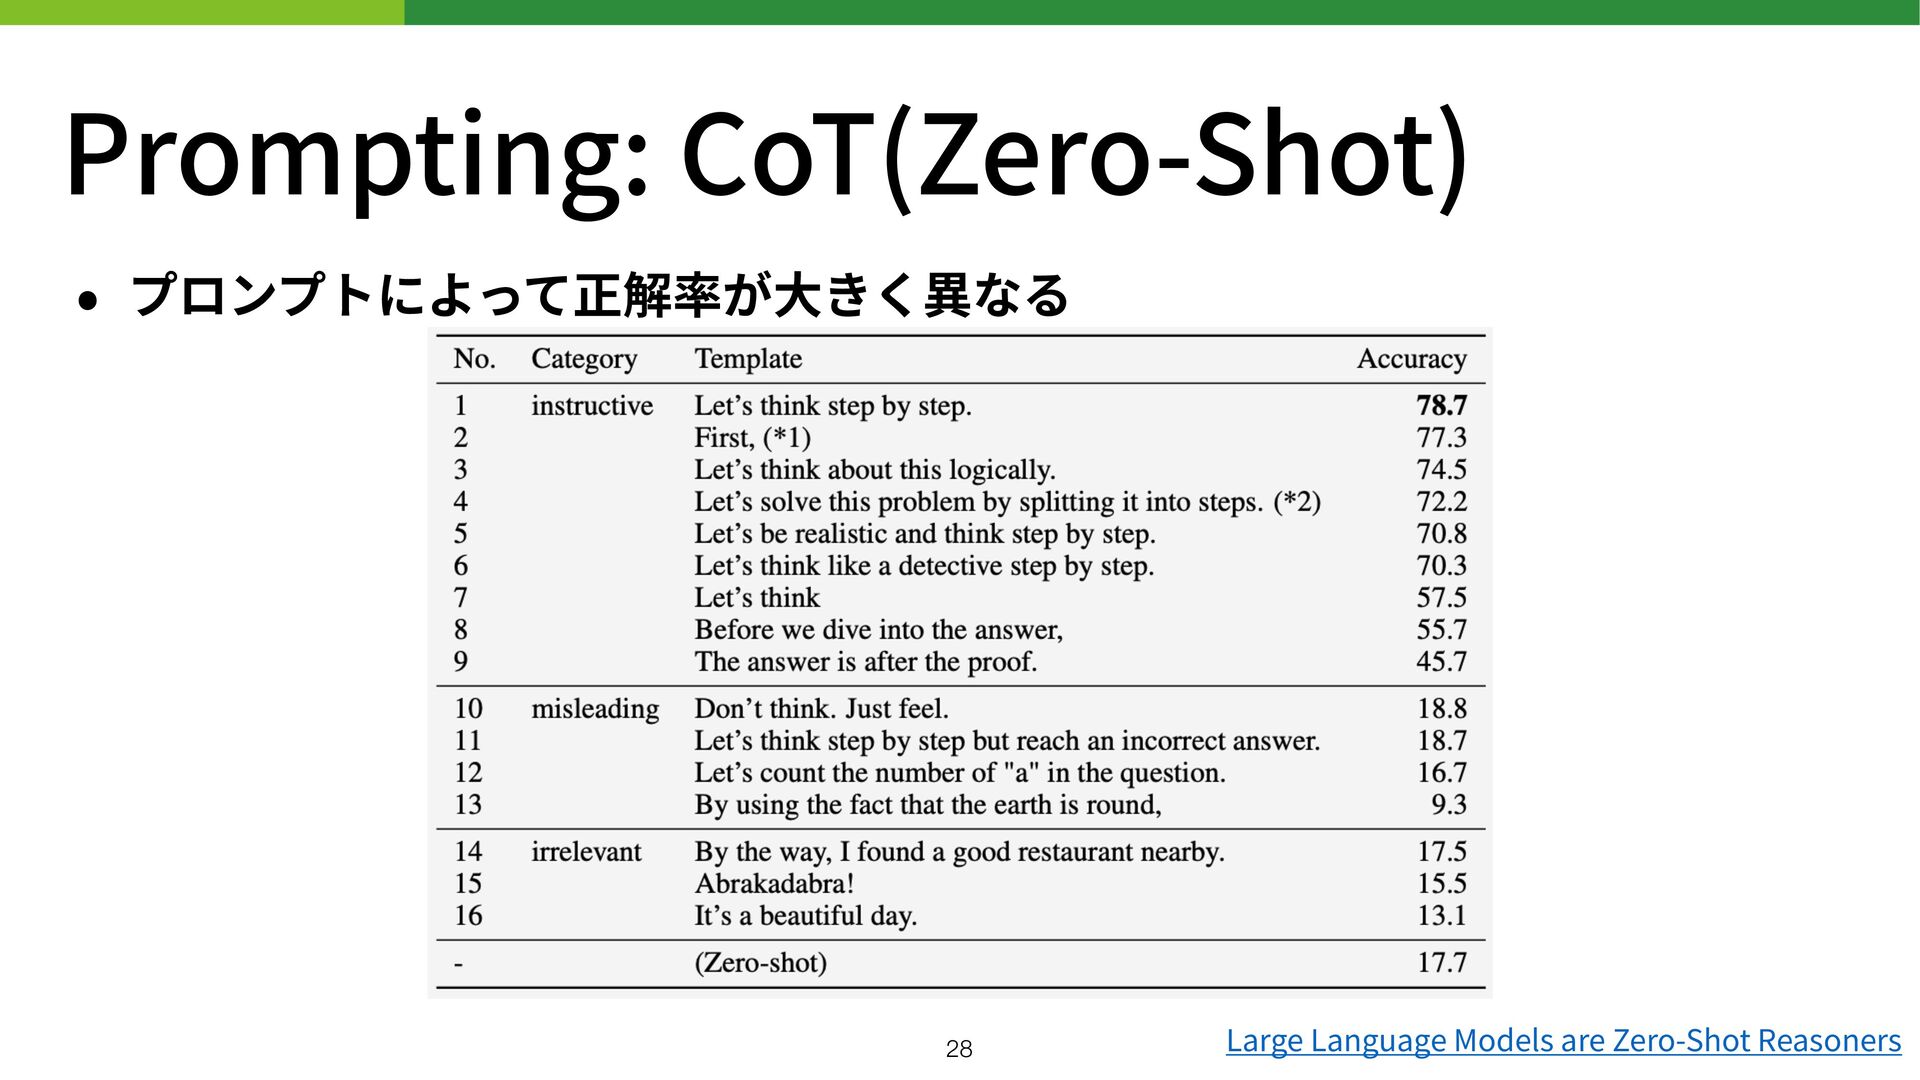
Prompting: CoT(Zero-Shot) • プロンプトによって正解率が 大 きく異なる Large Language Models are
Zero-Shot Reasoners 28 -
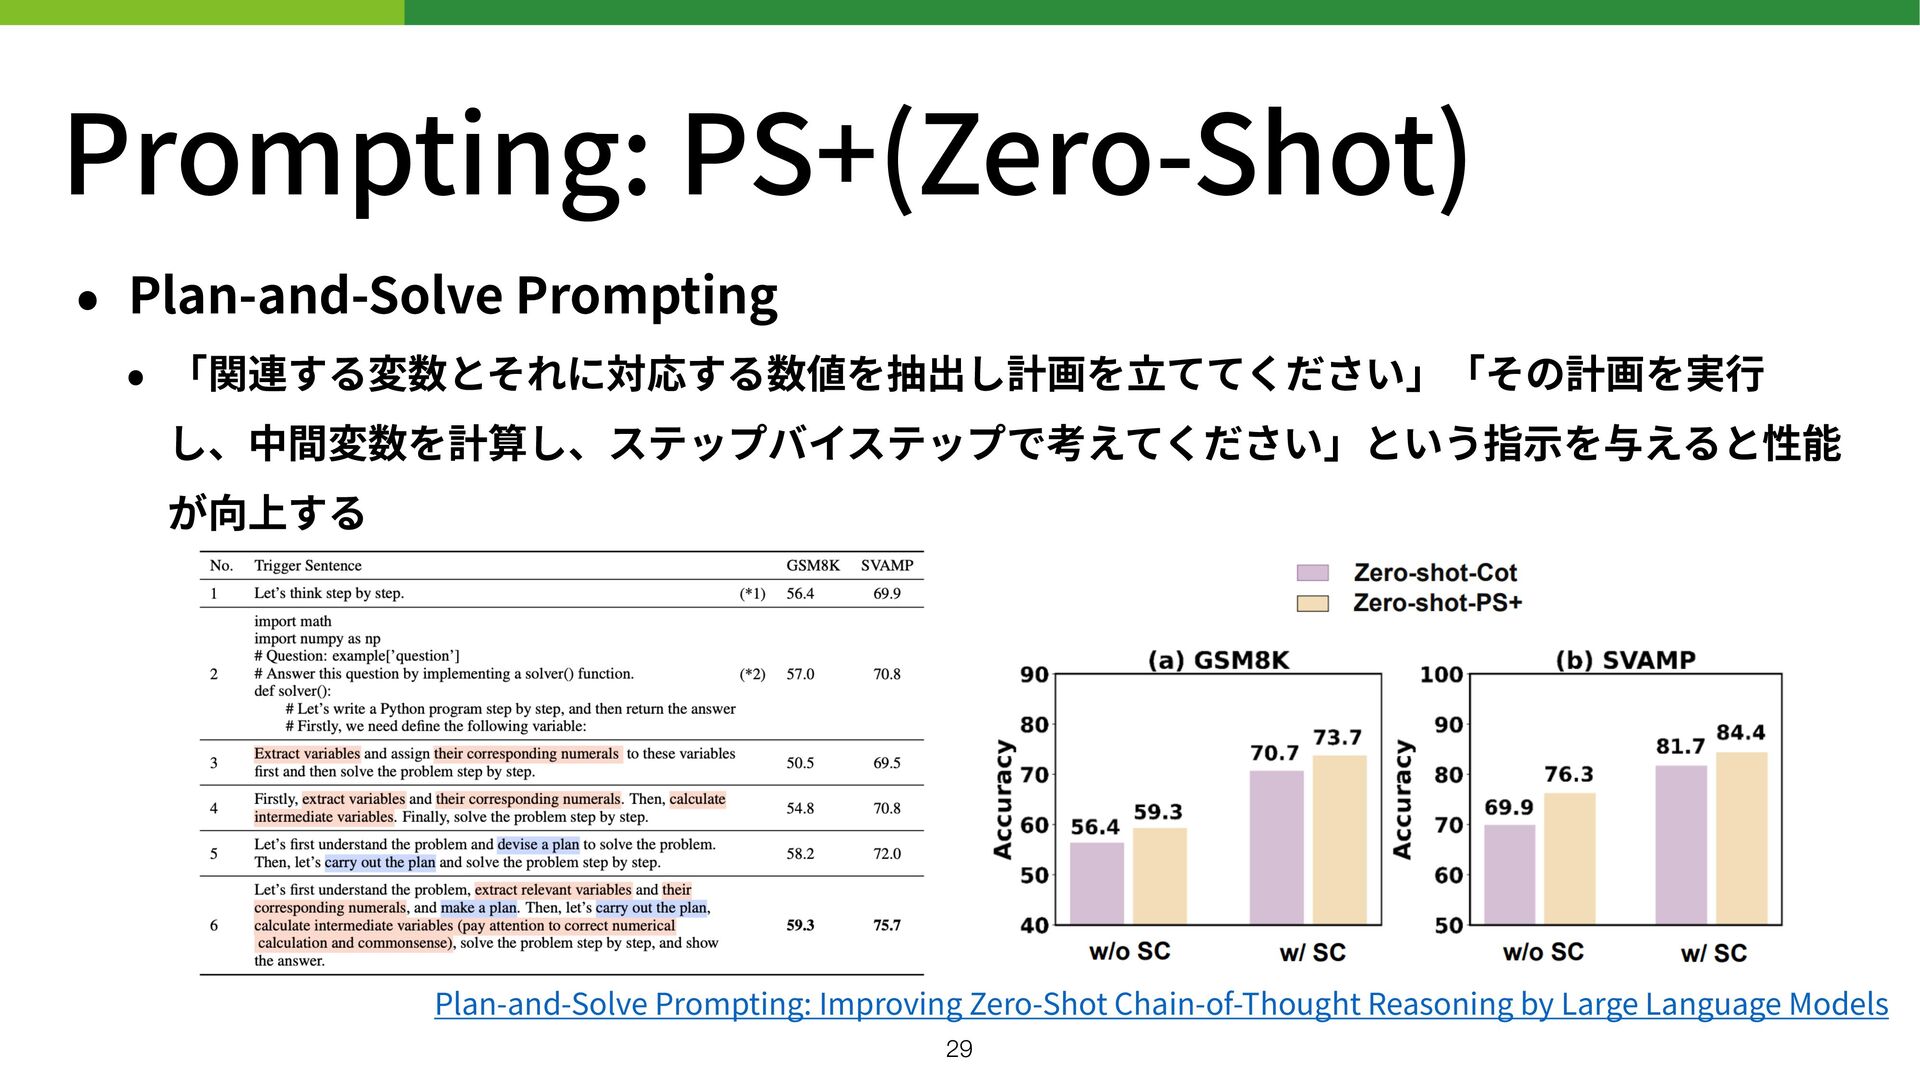
Prompting: PS+(Zero-Shot) • Plan-and-Solve Prompting • 「関連する変数とそれに対応する数値を抽出し計画を 立 ててください」「その計画を実 行
し、中間変数を計算し、ステップバイステップで考えてください」という指 示 を与えると性能 が向上する Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models 29 -
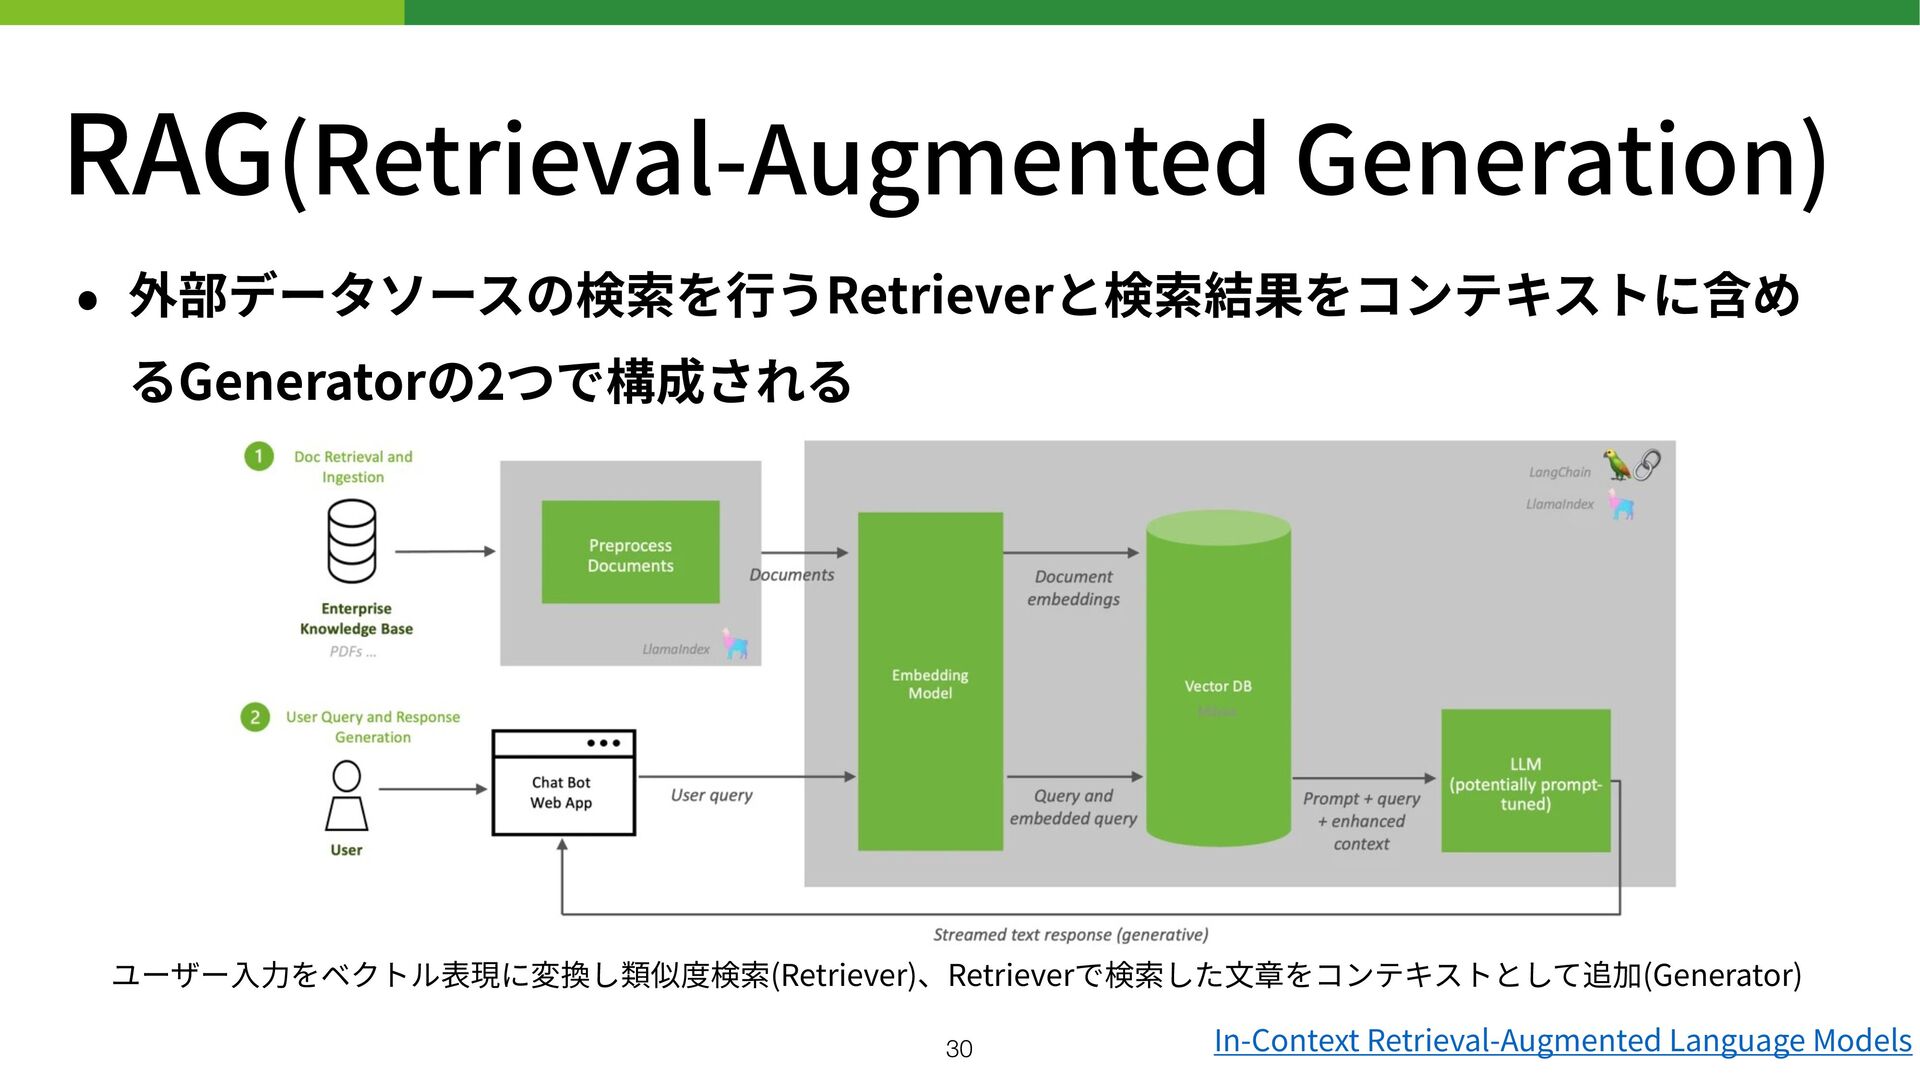
RAG(Retrieval-Augmented Generation) • 外部データソースの検索を 行 うRetrieverと検索結果をコンテキストに含め るGeneratorの2つで構成される In-Context Retrieval-Augmented Language
Models ユーザー 入力 をベクトル表現に変換し類似度検索(Retriever)、Retrieverで検索した 文 章をコンテキストとして追加(Generator) 30 -
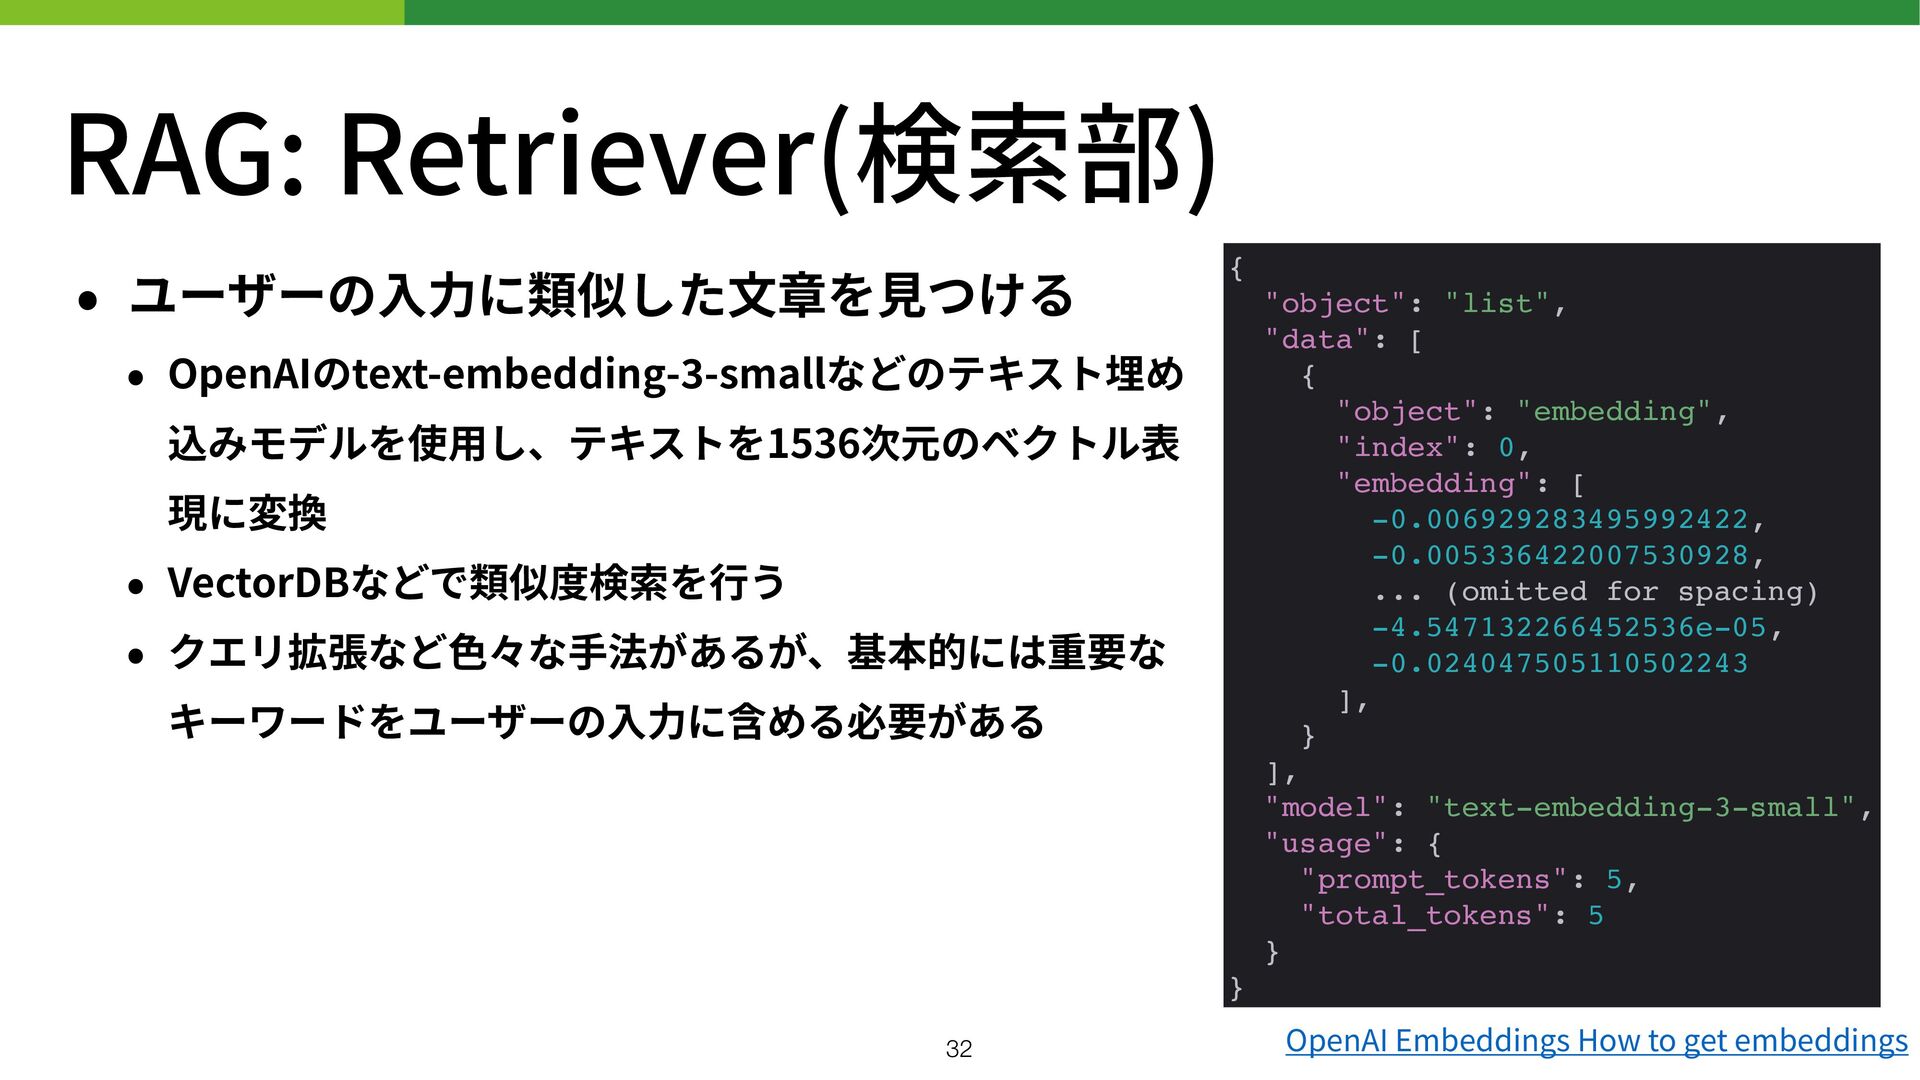
RAG: Retriever(検索部) • ユーザーの 入力 に類似した 文 章を 見 つける
• OpenAIのtext-embedding- 3 -smallなどのテキスト埋め 込みモデルを使 用 し、テキストを1536次元のベクトル表 現に変換 • VectorDBなどで類似度検索を 行 う • クエリ拡張など 色 々な 手 法があるが、基本的には重要な キーワードをユーザーの 入力 に含める必要がある { "object": "list", "data": [ { "object": "embedding", "index": 0, "embedding": [ -0.006929283495992422, -0.005336422007530928, ... (omitted for spacing) -4.547132266452536e-05, -0.024047505110502243 ], } ], "model": "text-embedding-3-small", "usage": { "prompt_tokens": 5, "total_tokens": 5 } } 32 OpenAI Embeddings How to get embeddings -
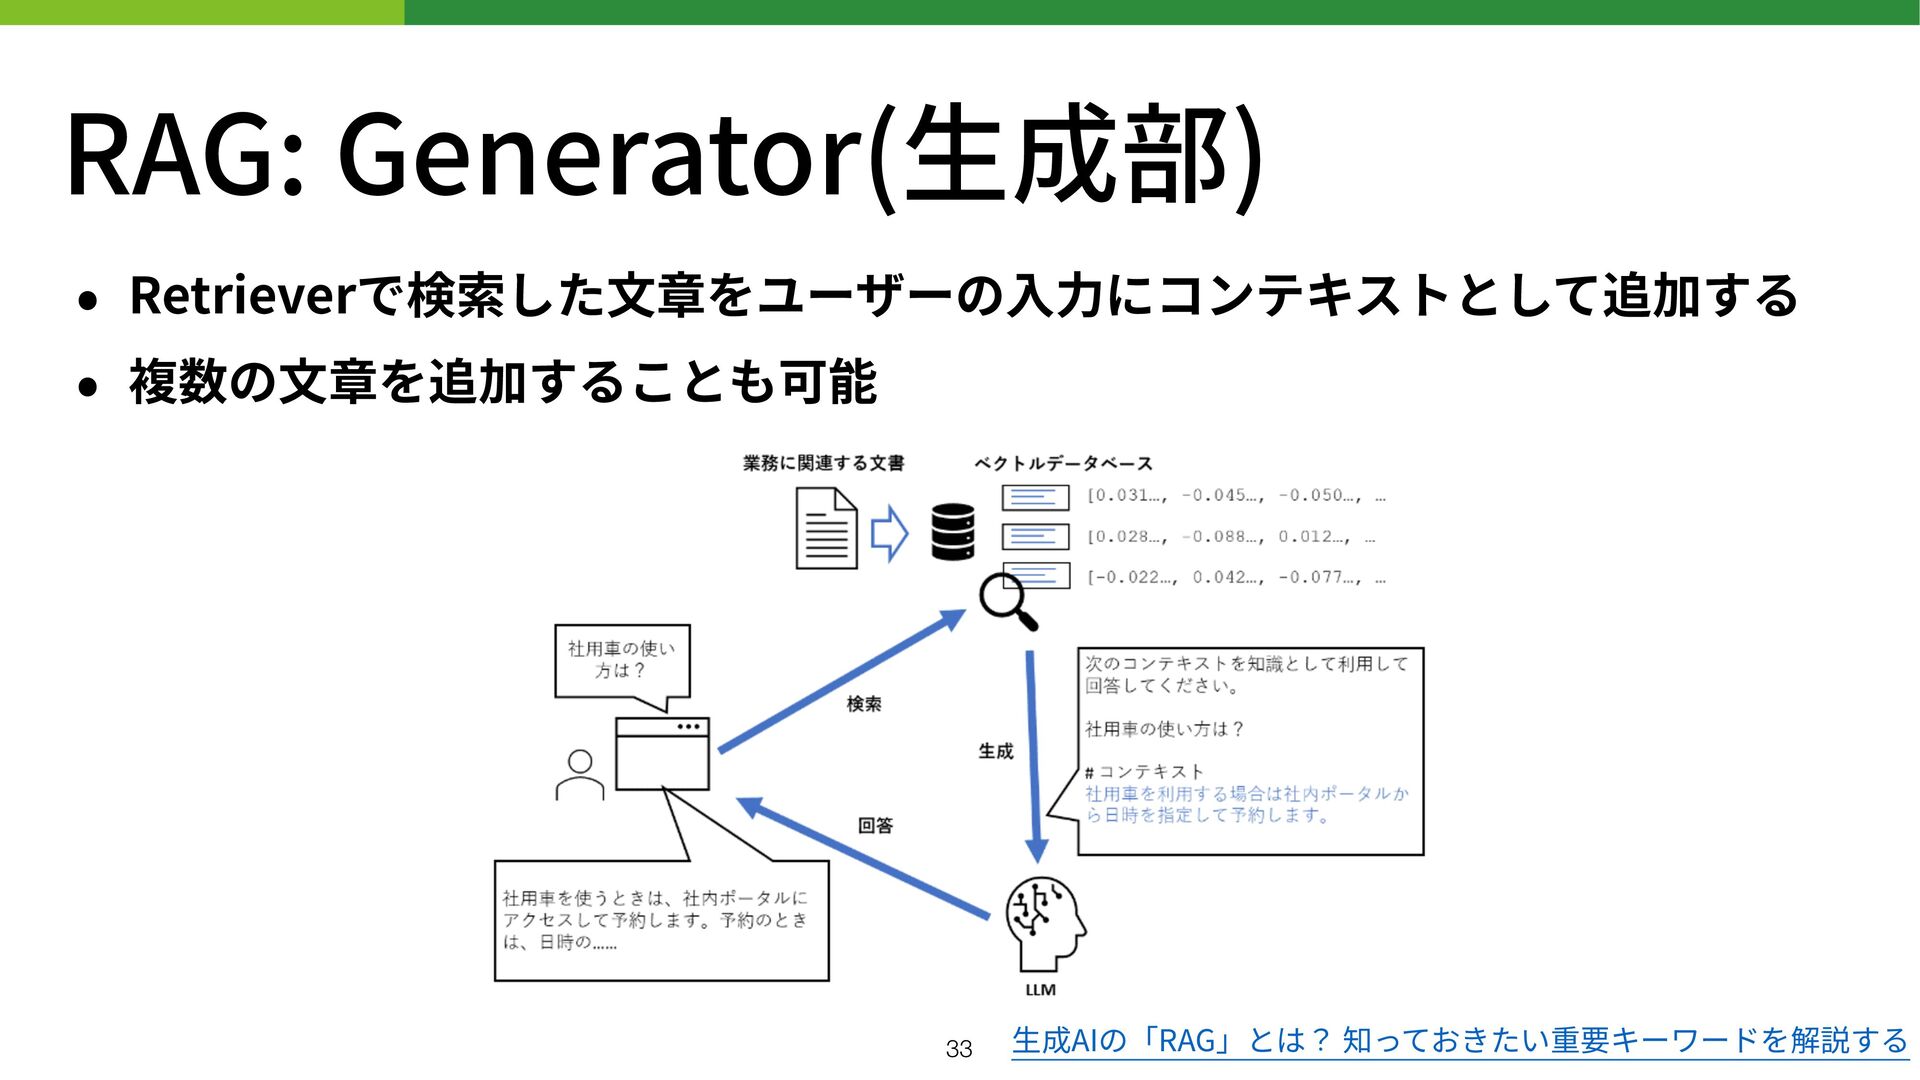
RAG: Generator( 生 成部) • Retrieverで検索した 文 章をユーザーの 入力 にコンテキストとして追加する
• 複数の 文 章を追加することも可能 生 成AIの「RAG」とは? 知っておきたい重要キーワードを解説する 33 -
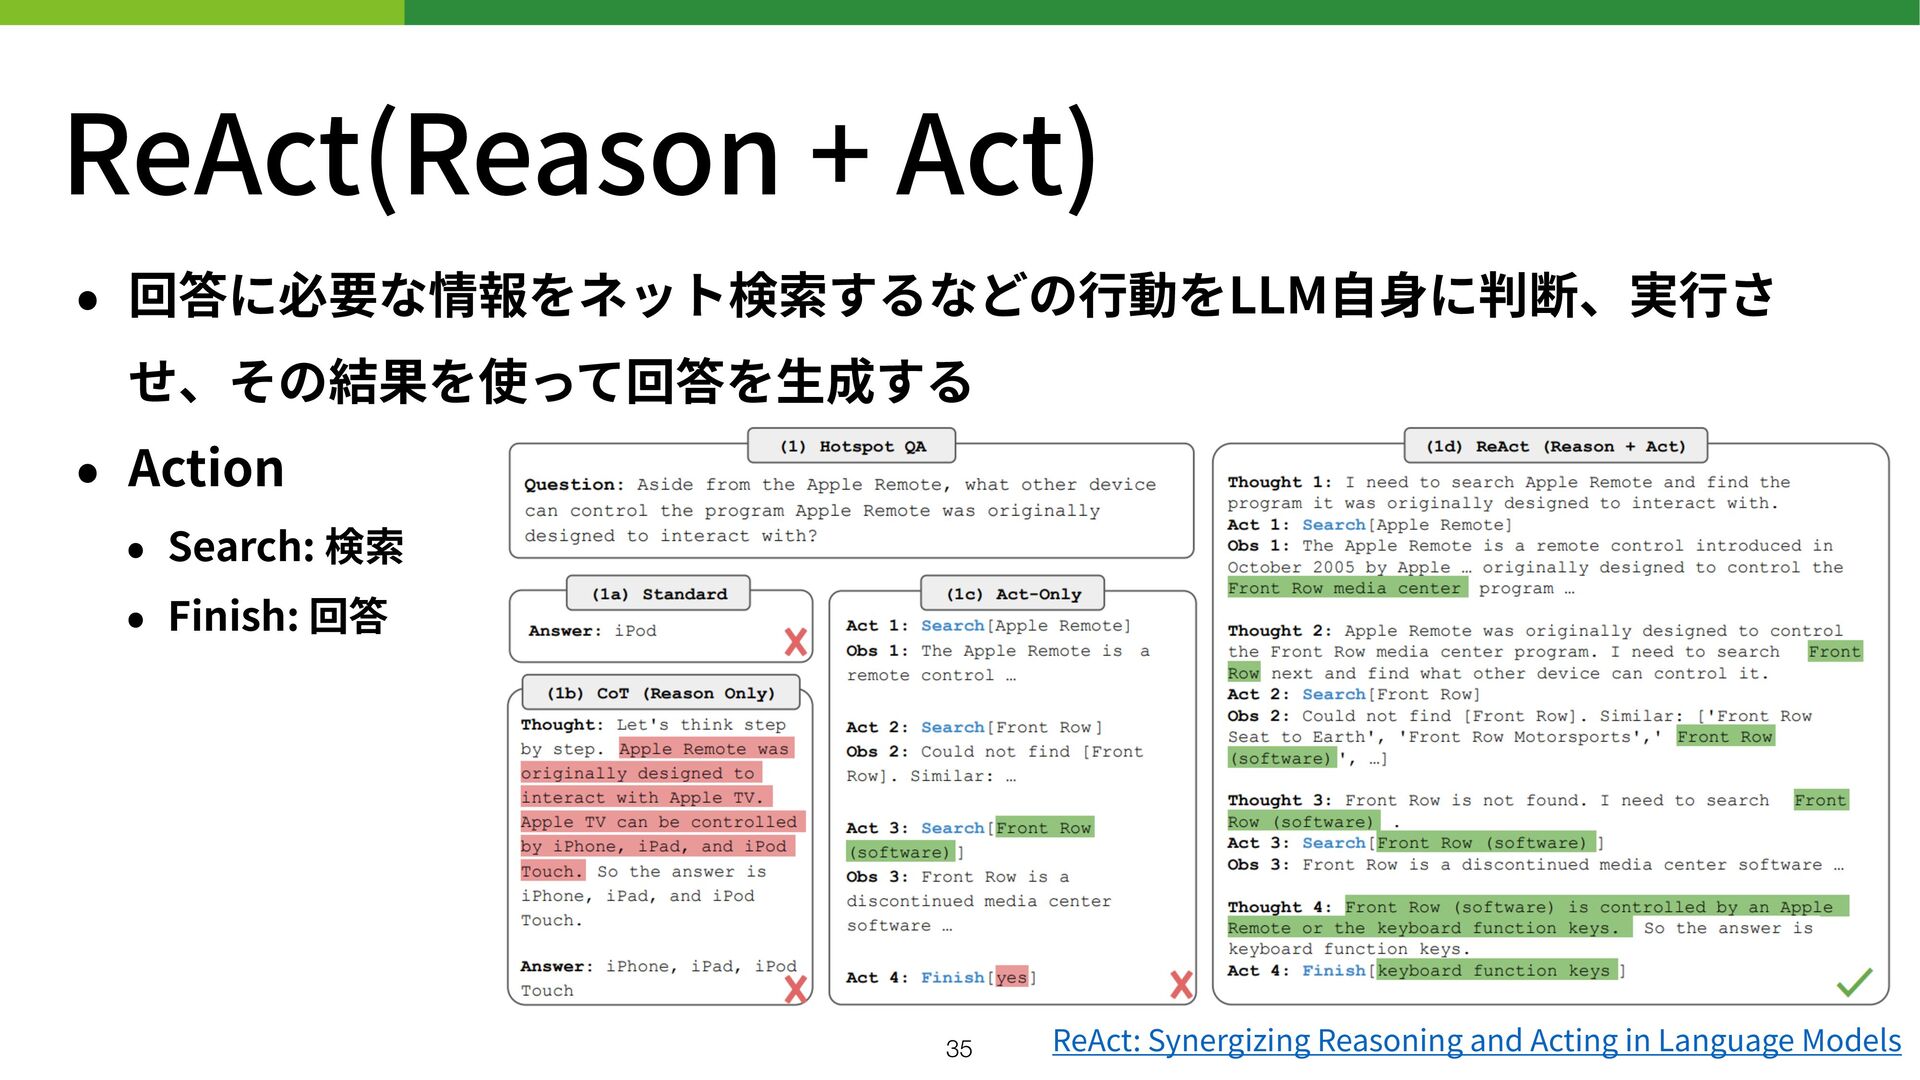
ReAct(Reason + Act) • 回答に必要な情報をネット検索するなどの 行 動をLLM 自身 に判断、実 行
さ せ、その結果を使って回答を 生 成する • Action • Search: 検索 • Finish: 回答 35 ReAct: Synergizing Reasoning and Acting in Language Models -
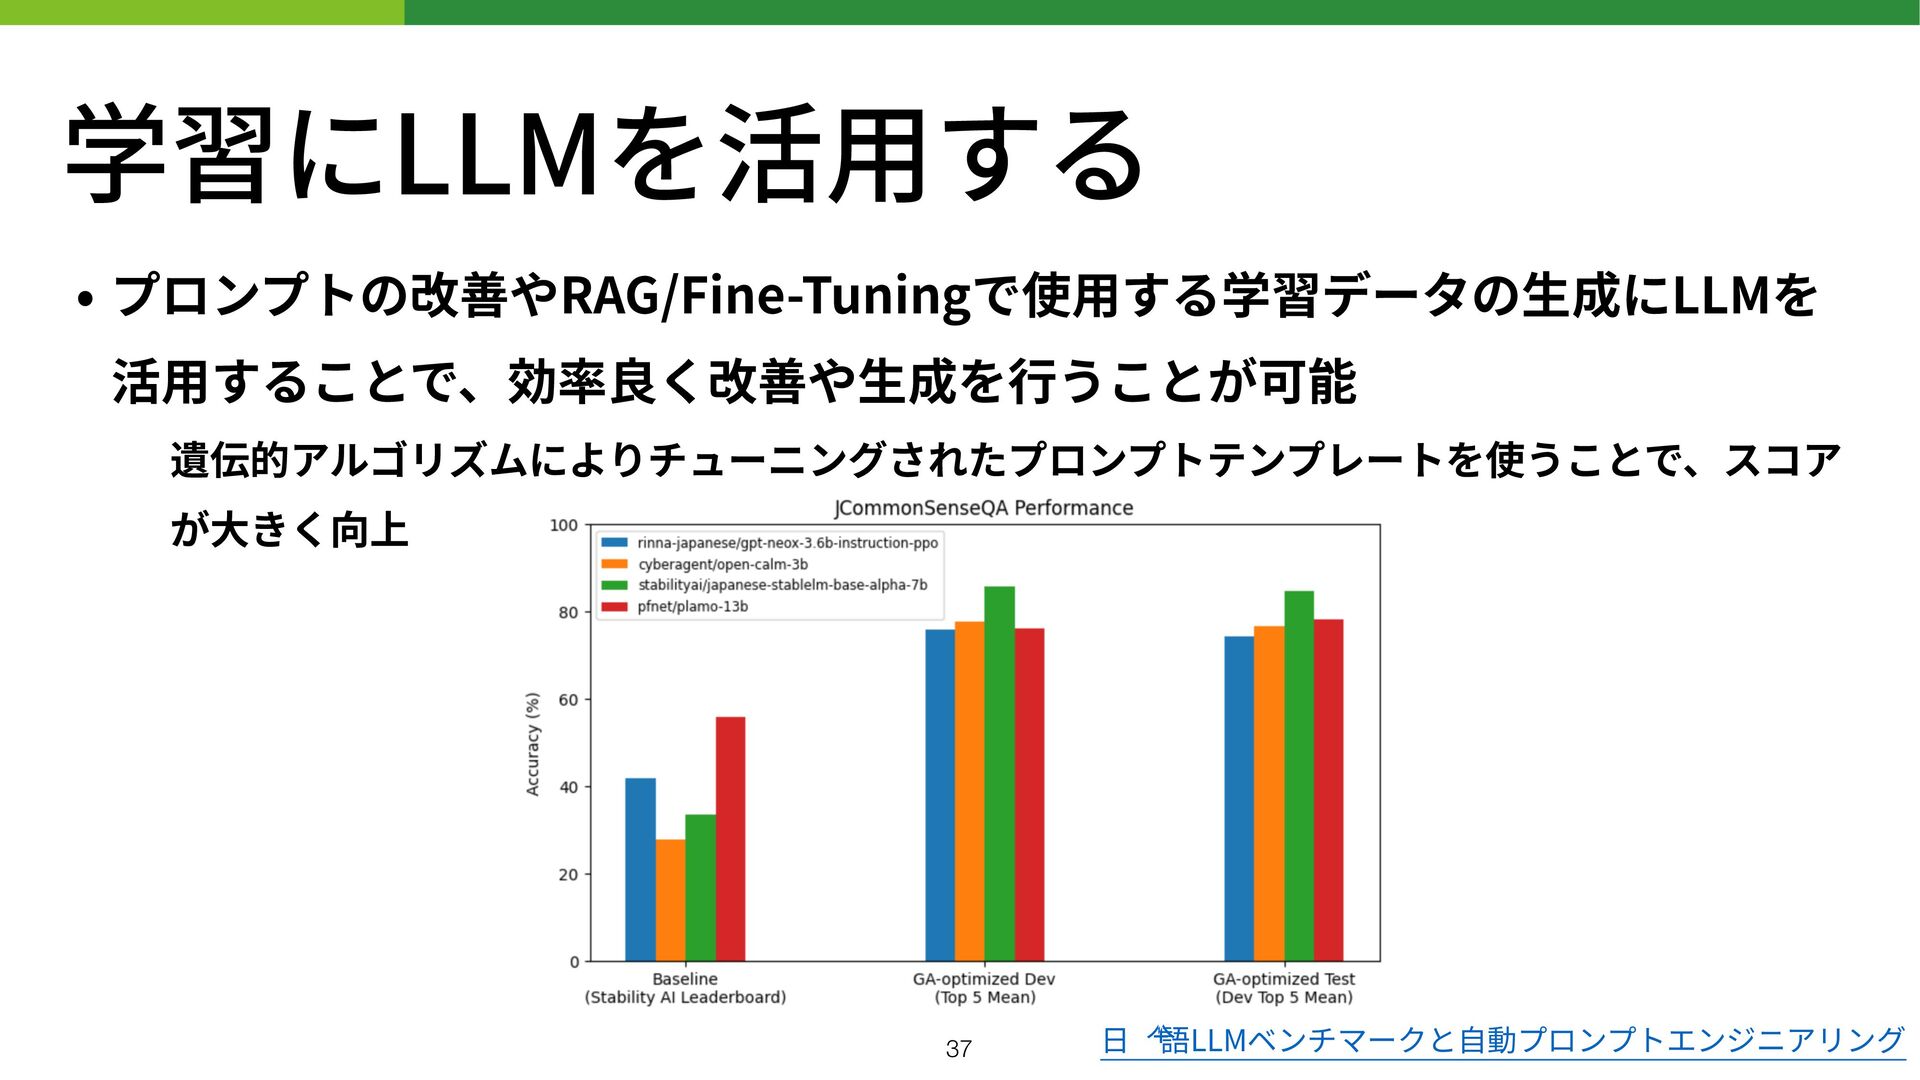
学習にLLMを活 用 する • プロンプトの改善やRAG/Fine-Tuningで使 用 する学習データの 生 成にLLMを 活
用 することで、効率良く改善や 生 成を 行 うことが可能 遺伝的アルゴリズムによりチューニングされたプロンプトテンプレートを使うことで、スコア が 大 きく向上 37 日 本語LLMベンチマークと 自 動プロンプトエンジニアリング -
学習 方 法の 比 較 • Prompting • RAGやFine-Tuningで必要な学習データの蓄積や整理が不要 •
他の 方 法に 比 べて 高 速にフィードバックループを回せる • RAGやFine-Tuningと合わせて使 用 できるため、無駄にはならない • RAG • 新しい知識や会社固有の知識をベースに回答できる • Fine-Tuningに 比 べて、データの準備が容易 • 対話形式でデータを準備するのが基本のFine-Tuningに 比 べ、RAGはテキストを準備するだけで 一 旦は使えるようになる(チャンク化やEmbeddingはライブラリに任せることが可能) • メタデータを活 用 することで参照先(回答の根拠)を確認できる • 類似度検索なので、抽象的な質問や複数ステップを踏まないと答えられない質問が苦 手 • Fine-Tuning • より多くのデータを学習できる • PromptingやRAGに 比 べてコンテキストを消費しないため、コストや処理時間を節約できる • 高 いモデルをFine-Tuningした安いモデルに置き換えることにより、特定タスクやドメインの性能はそのままにコストや処理時間を削減できる • 学習データを更新する際には、モデルの更新を伴うため 手 軽には実 行 できない 38 -
精度の限界: 三豊市と松尾研の例 • 香 川県三豊市のごみ出し案内業務にChatGPTを活 用 しないことを決断 • サービス内容 •
市 民 からのごみの分別や収集 日 に関する問い合わせに対して、三豊市のごみに関する学習をしたAIが24時間 自 動応答する • 正答率99%を本格導 入 の条件にした理由 • ごみ出し案内は正確性が特に求められる。AIが間違った案内をしてしまうとその案内に基づいて 行 動した市 民 や収集業者 などに迷惑が掛かる。職員でも即座に回答できない問い合わせはあるが、時間をいただき調べてから正確な情報を回答し ている。 • AIには少なくとも職員と同等のレベルを求め、それに達しない限り対市 民 向けとしては導 入 できないと考えた。また、AI がどのように回答したかを結局のところ職員が確認する作業が伴い、正答率が低ければそれだけ確認する頻度も上げなけ ればならない。100%は無理としても99%は譲れない条件だった。 • 誤った回答をしないようにAIが答えられない回答や、不安のある回答については「環境衛 生 課へお問合せください」とい う 文言 を表 示 していた。これにより“結局職員の負担は減らない”と分かった。 「チャットGPTを利 用 したごみ出し案内」本格導 入 について ChatGPTでの業務効率化を“断念”──正答率94%でも「ごみ出し案内」をAIに託せなかったワケ 三豊市と松尾研の半年間 40 -
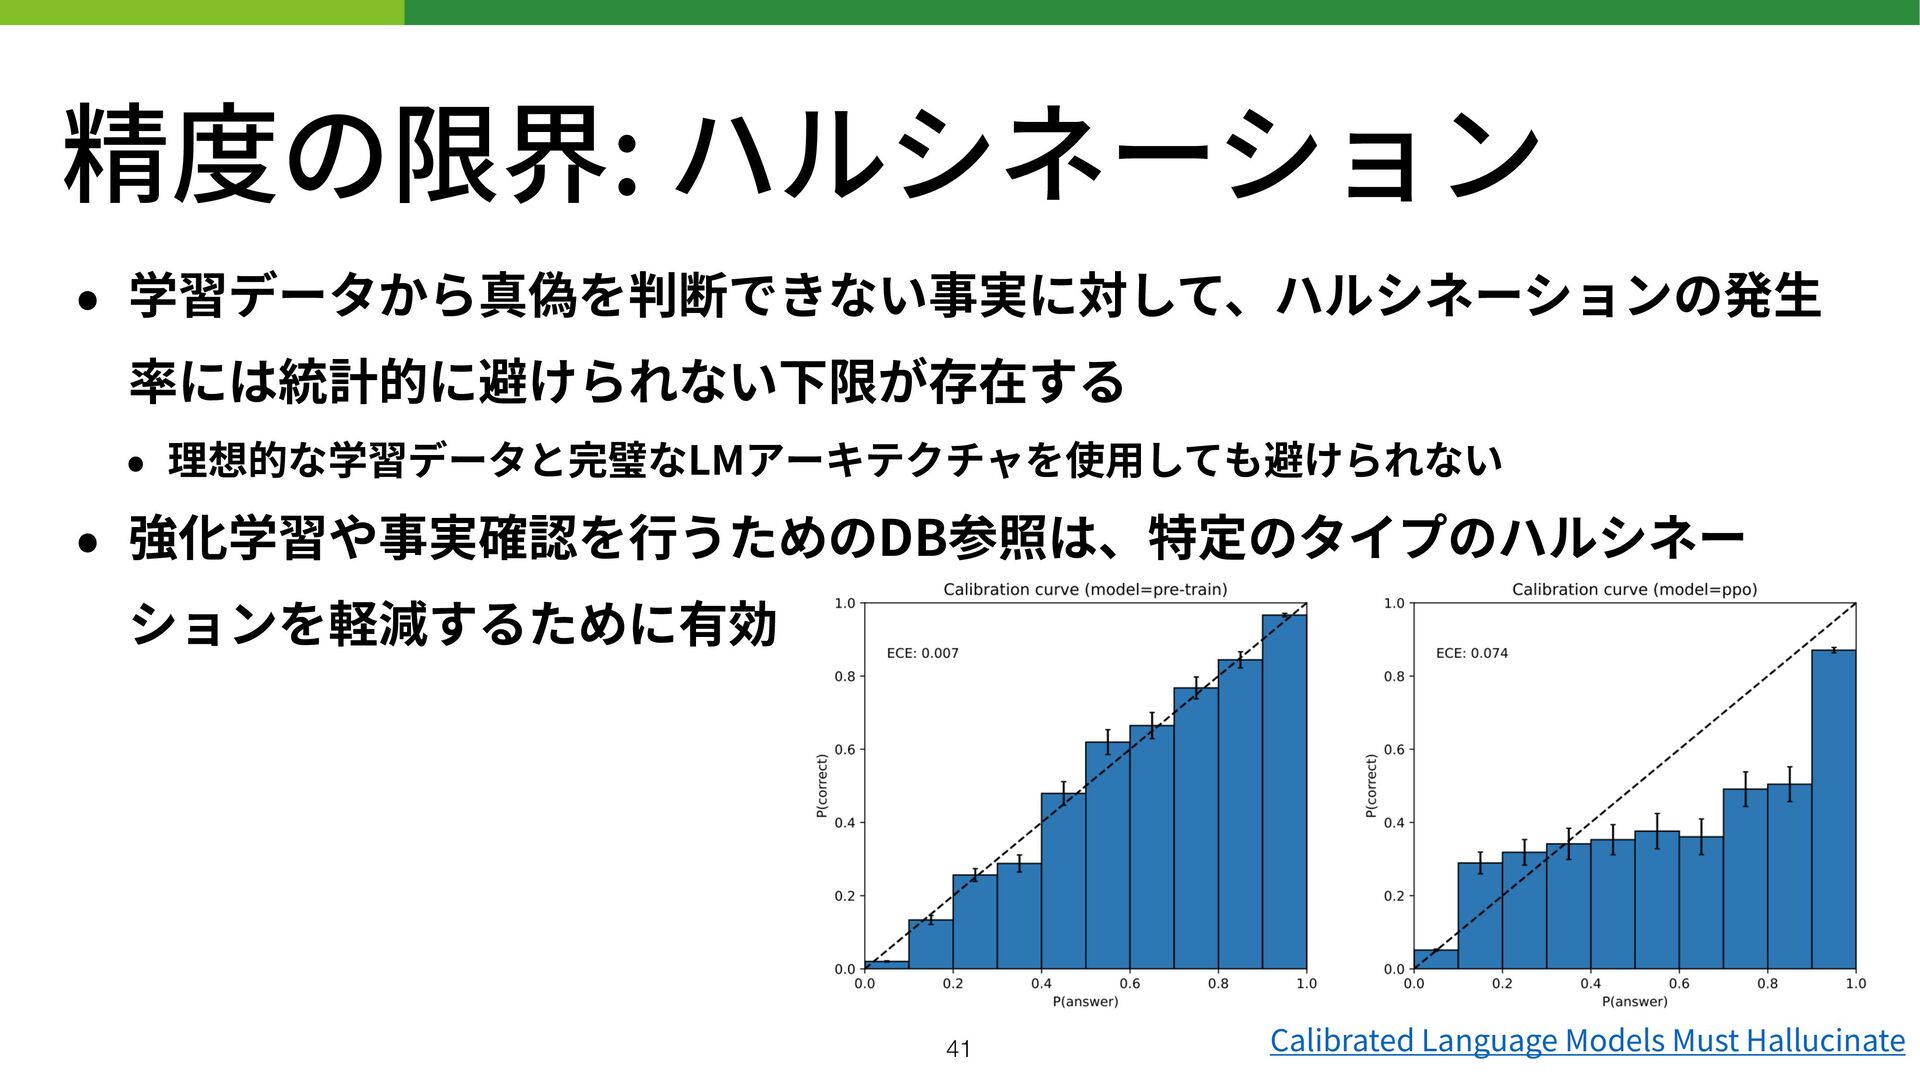
精度の限界: ハルシネーション • 学習データから真偽を判断できない事実に対して、ハルシネーションの発 生 率には統計的に避けられない下限が存在する • 理想的な学習データと完璧なLMアーキテクチャを使 用 しても避けられない
• 強化学習や事実確認を 行 うためのDB参照は、特定のタイプのハルシネー ションを軽減するために有効 Calibrated Language Models Must Hallucinate 41 -
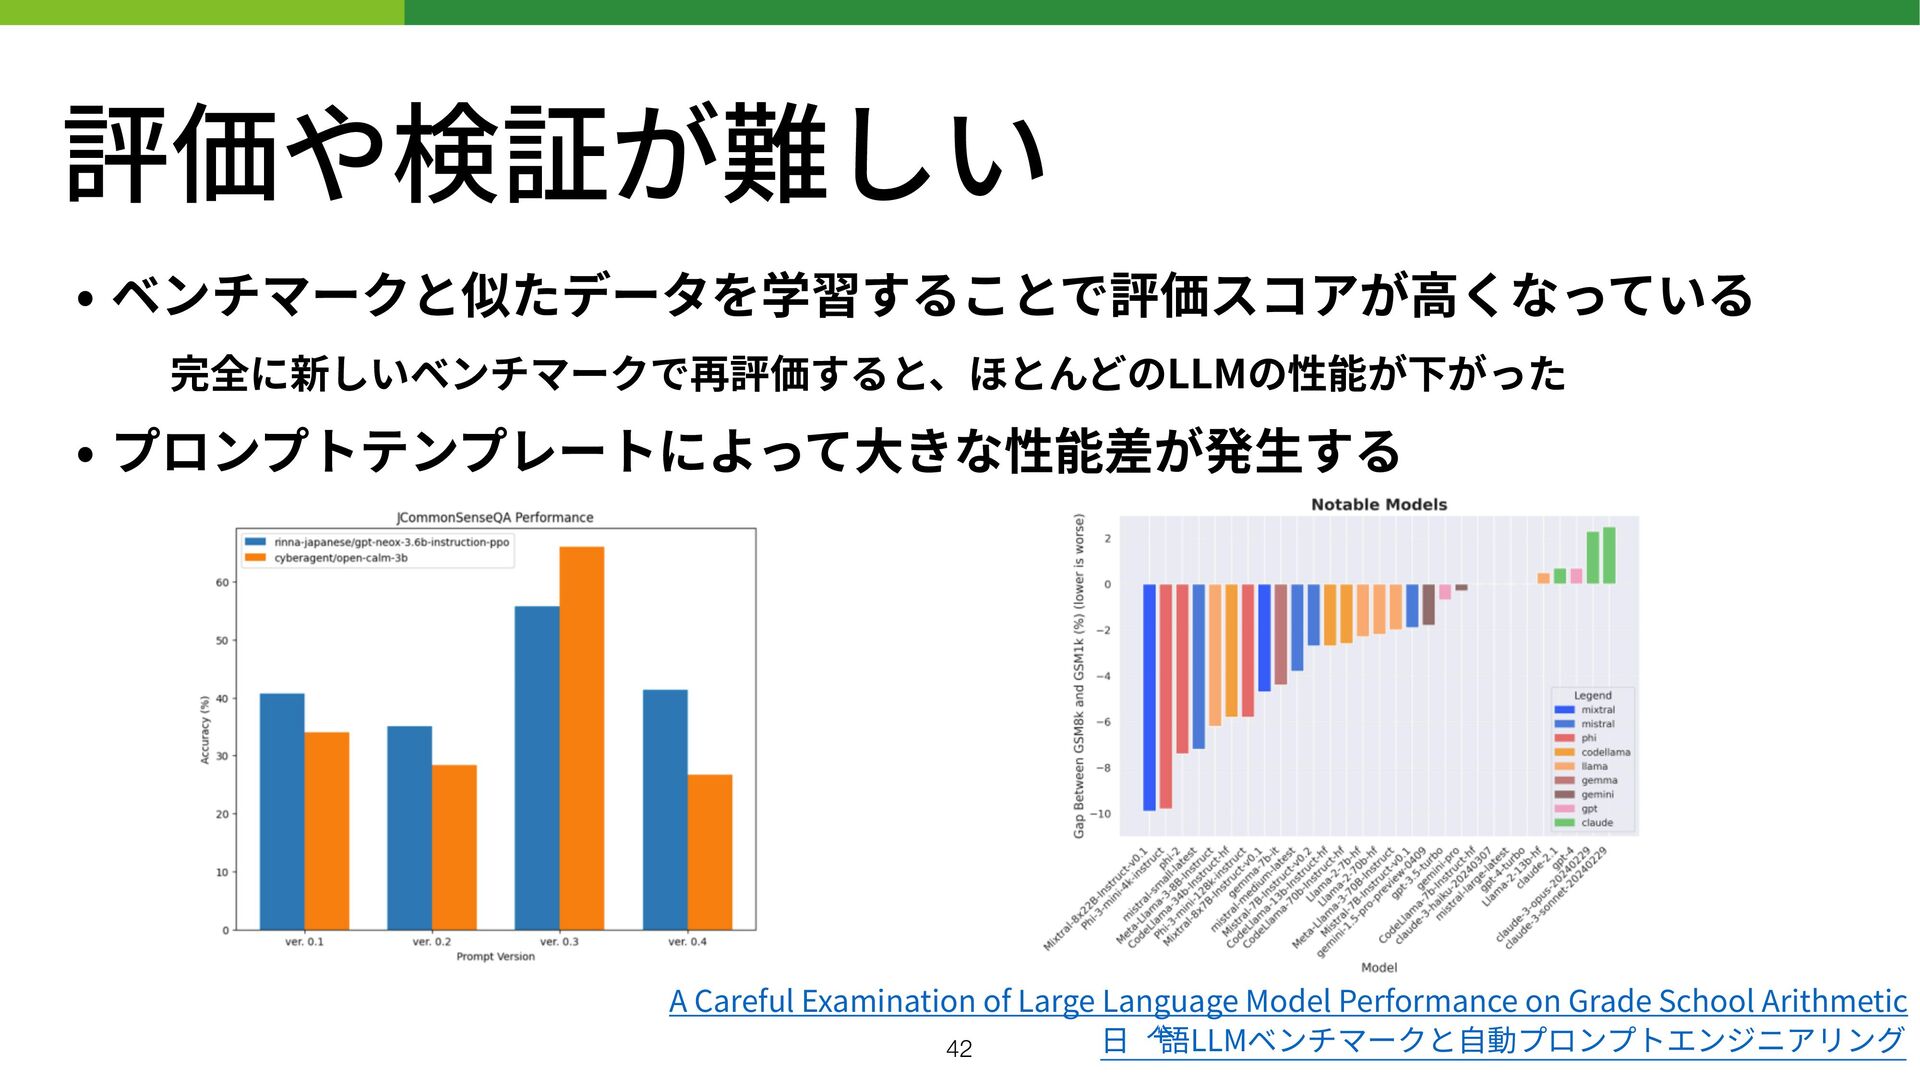
評価や検証が難しい • ベンチマークと似たデータを学習することで評価スコアが 高 くなっている 完全に新しいベンチマークで再評価すると、ほとんどのLLMの性能が下がった • プロンプトテンプレートによって 大 きな性能差が発
生 する 42 A Careful Examination of Large Language Model Performance on Grade School Arithmetic 日 本語LLMベンチマークと 自 動プロンプトエンジニアリング -
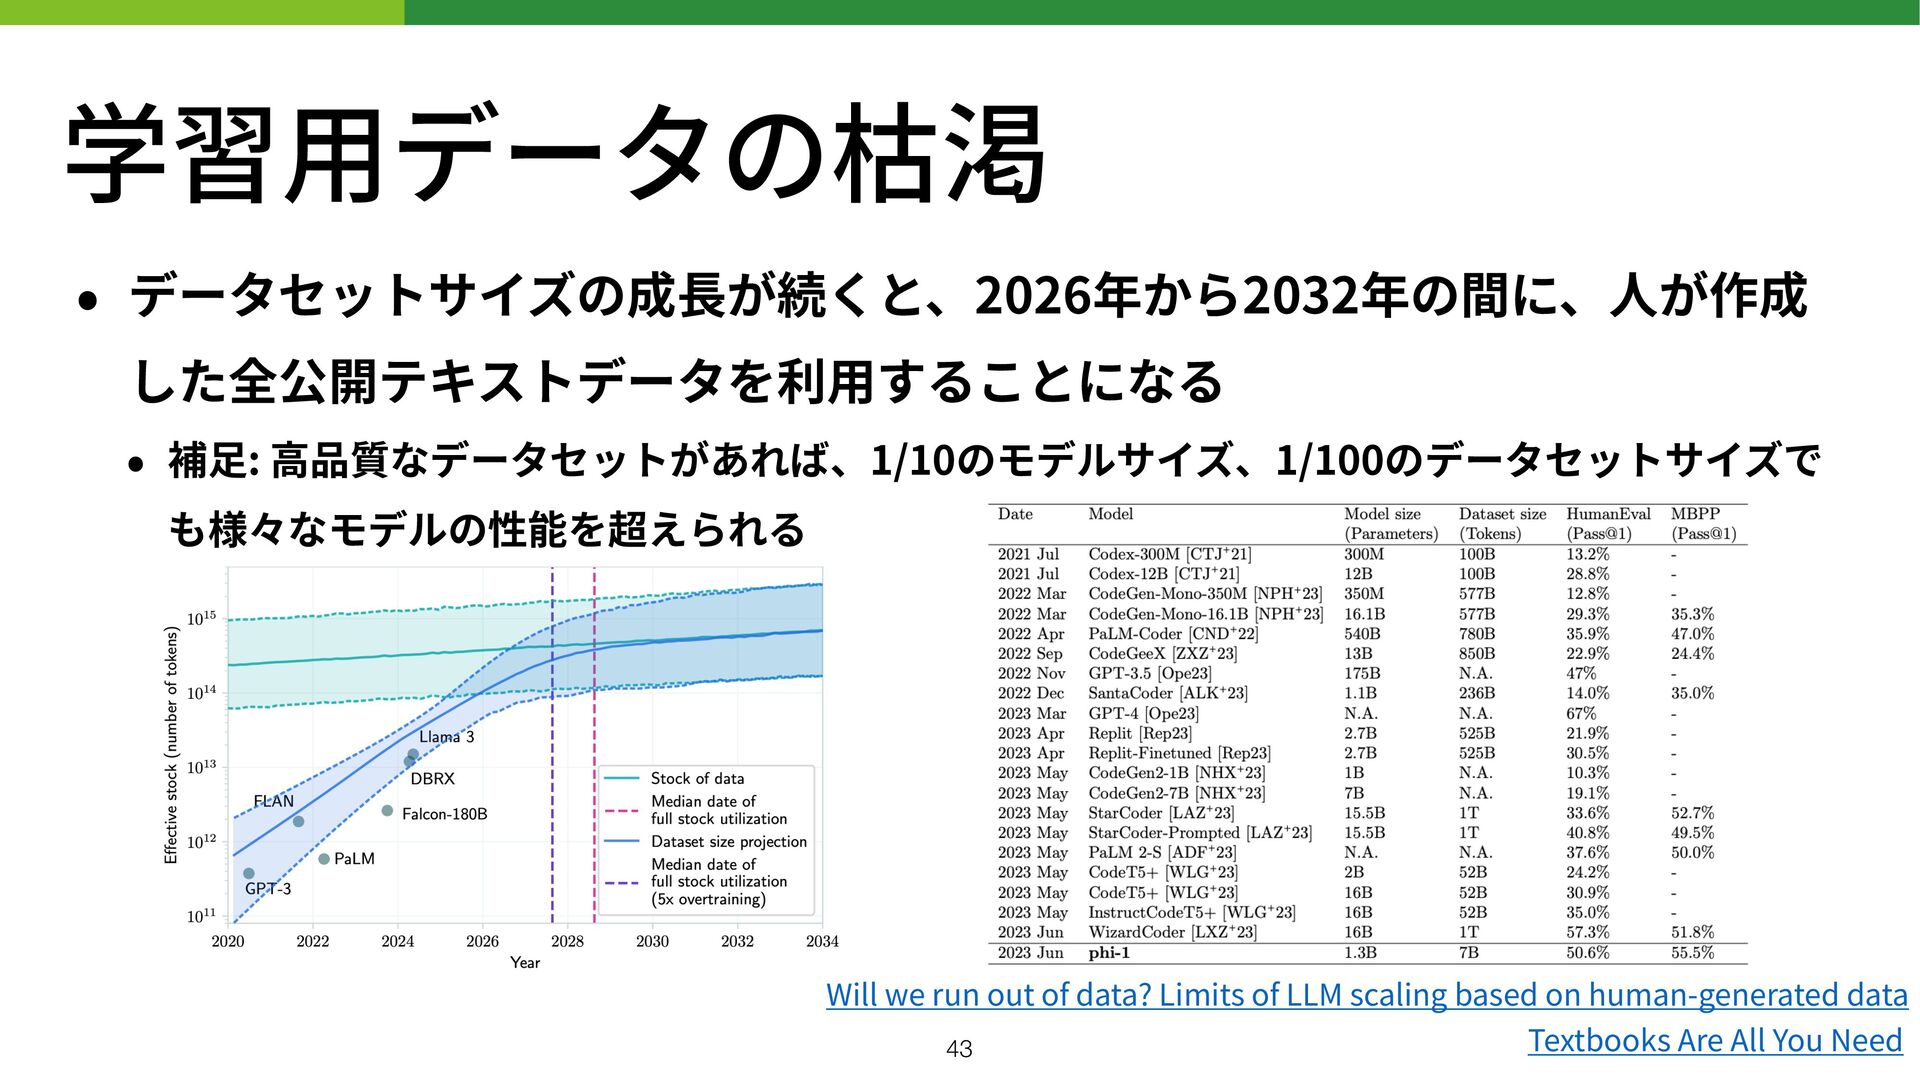
学習 用 データの枯渇 • データセットサイズの成 長 が続くと、2026年から2032年の間に、 人 が作成 した全公開テキストデータを利
用 することになる • 補 足 : 高 品質なデータセットがあれば、1/10のモデルサイズ、1/100のデータセットサイズで も様々なモデルの性能を超えられる Will we run out of data? Limits of LLM scaling based on human-generated data Textbooks Are All You Need 43 -
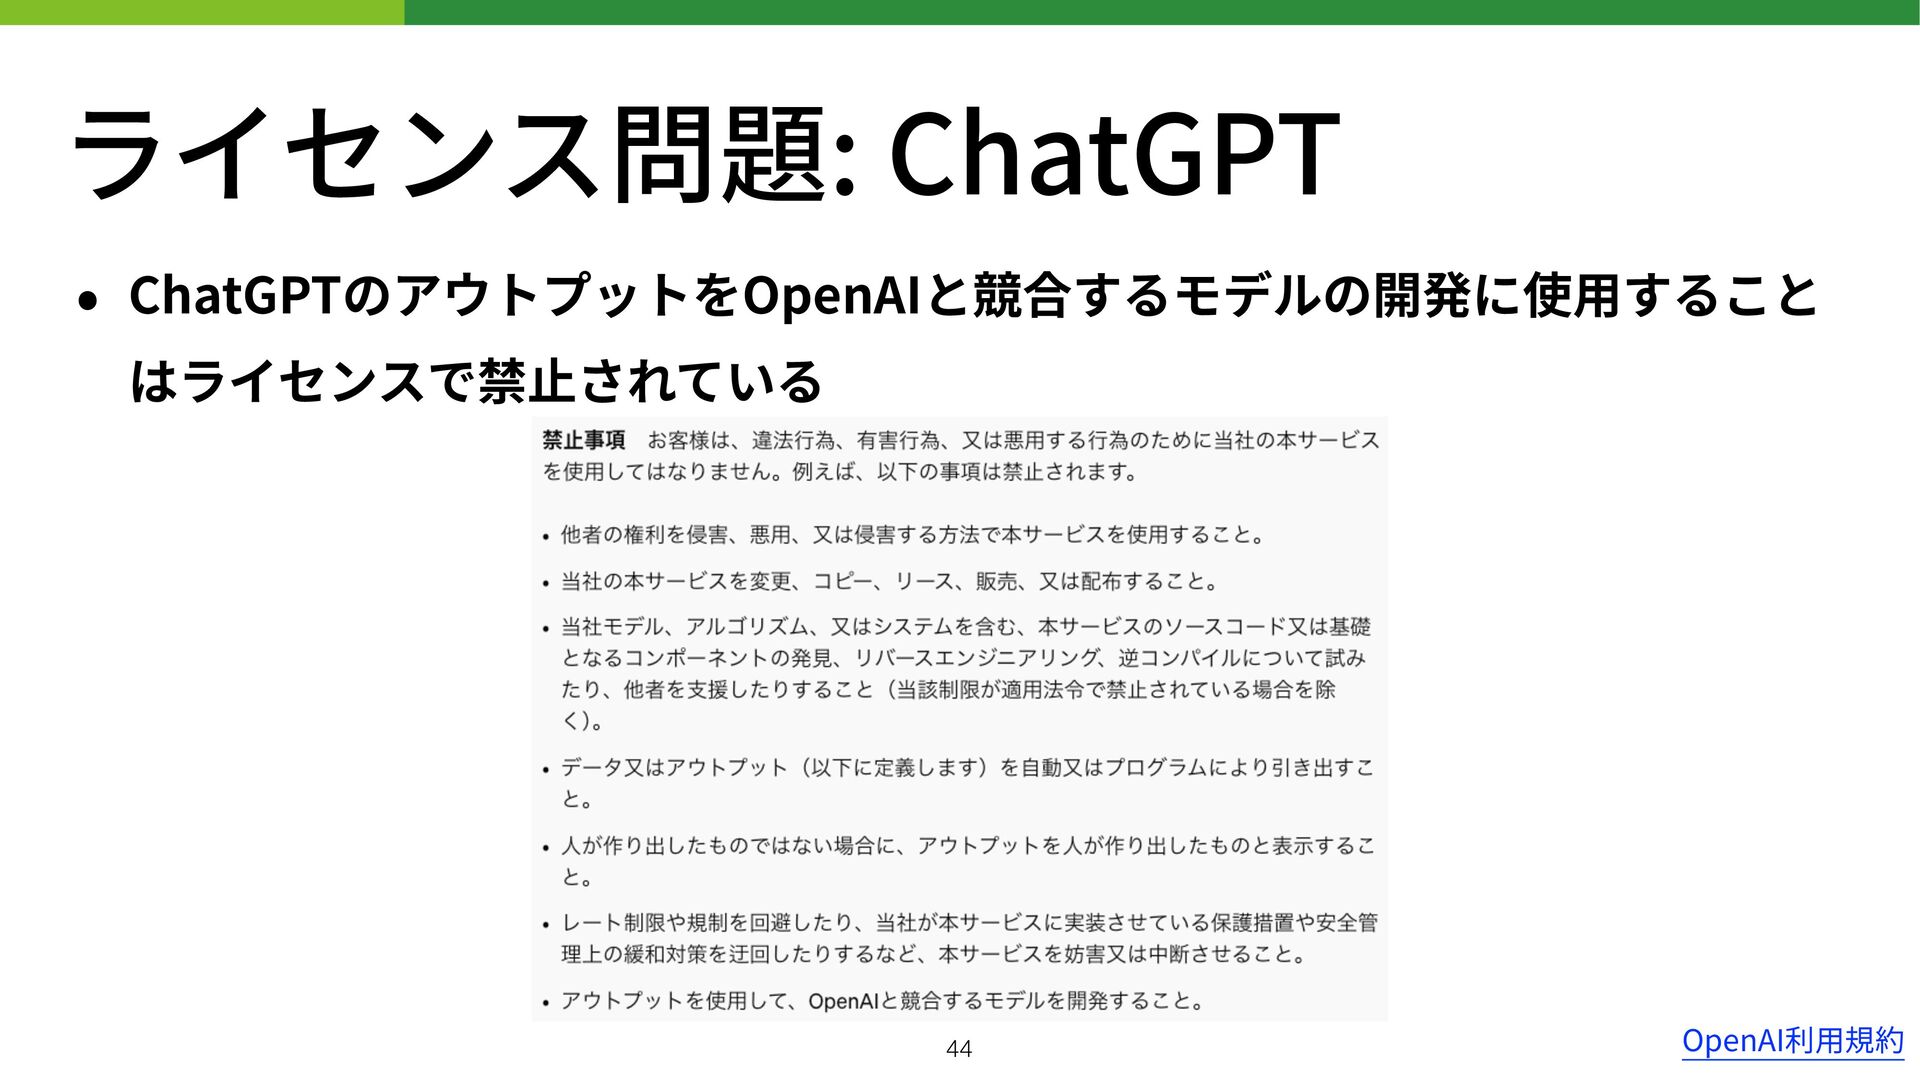
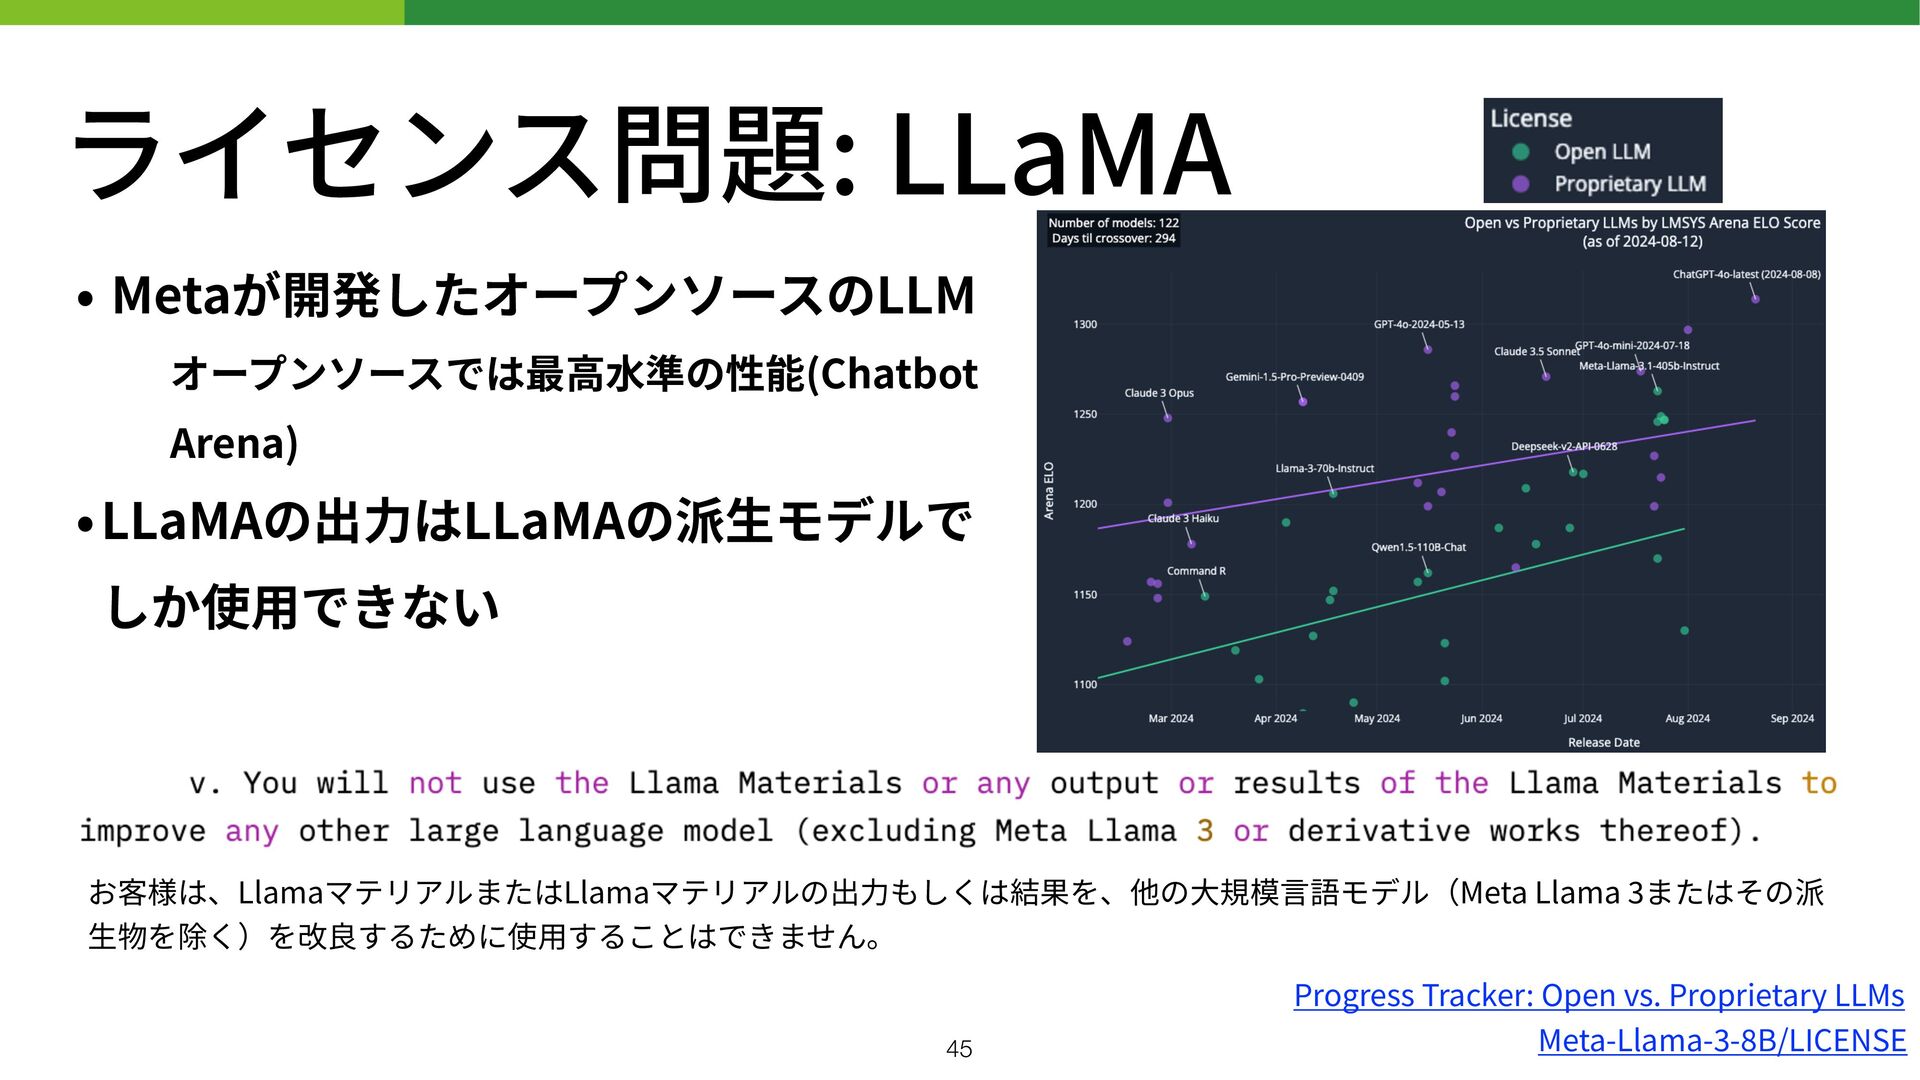
ライセンス問題: LLaMA • Metaが開発したオープンソースのLLM オープンソースでは最 高水 準の性能(Chatbot Arena) •LLaMAの出 力
はLLaMAの派 生 モデルで しか使 用 できない Meta-Llama- 3 - 8 B/LICENSE お客様は、LlamaマテリアルまたはLlamaマテリアルの出 力 もしくは結果を、他の 大 規模 言 語モデル(Meta Llama 3 またはその派 生 物を除く)を改良するために使 用 することはできません。 Progress Tracker: Open vs. Proprietary LLMs 45 -
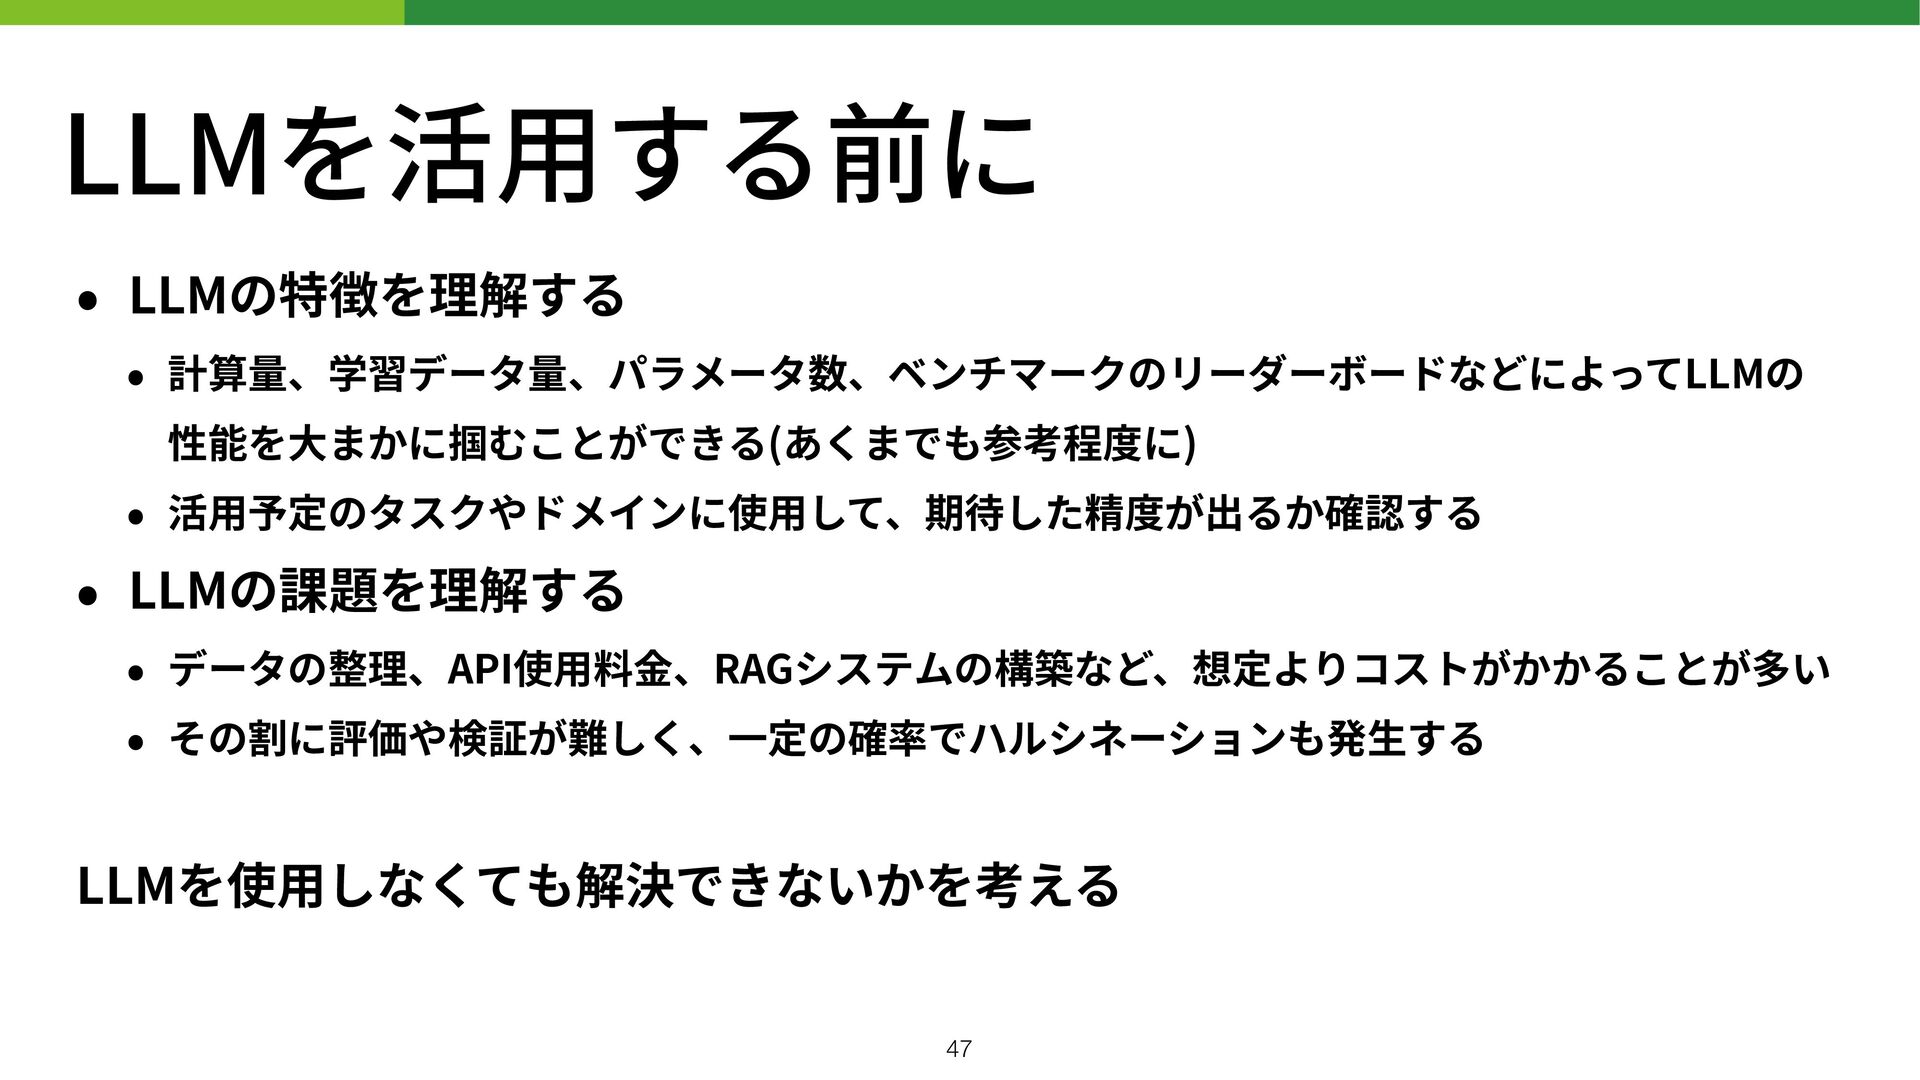
LLMを活 用 する前に • LLMの特徴を理解する • 計算量、学習データ量、パラメータ数、ベンチマークのリーダーボードなどによってLLMの 性能を 大 まかに掴むことができる(あくまでも参考程度に)
• 活 用 予定のタスクやドメインに使 用 して、期待した精度が出るか確認する • LLMの課題を理解する • データの整理、API使 用 料 金 、RAGシステムの構築など、想定よりコストがかかることが多い • その割に評価や検証が難しく、 一 定の確率でハルシネーションも発 生 する LLMを使 用 しなくても解決できないかを考える 47 -
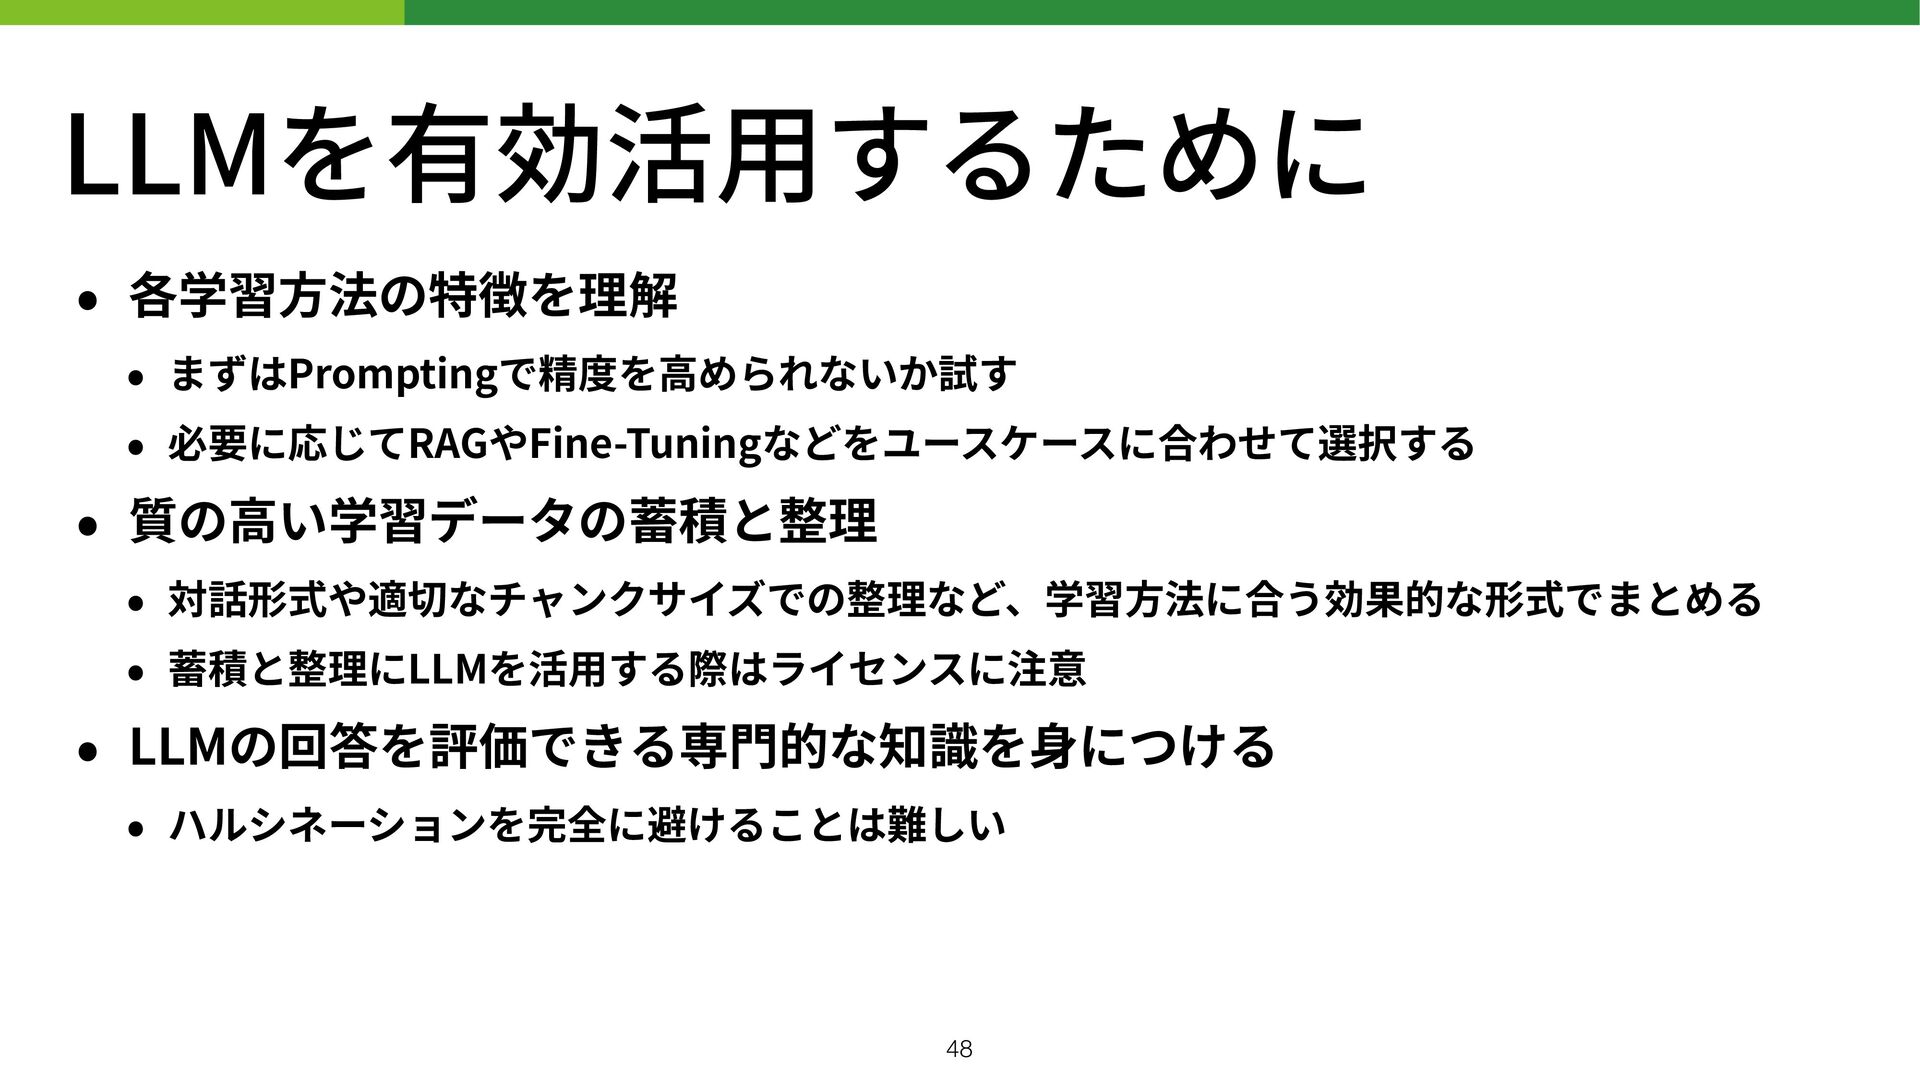
LLMを有効活 用 するために • 各学習 方 法の特徴を理解 • まずはPromptingで精度を 高
められないか試す • 必要に応じてRAGやFine-Tuningなどをユースケースに合わせて選択する • 質の 高 い学習データの蓄積と整理 • 対話形式や適切なチャンクサイズでの整理など、学習 方 法に合う効果的な形式でまとめる • 蓄積と整理にLLMを活 用 する際はライセンスに注意 • LLMの回答を評価できる専 門 的な知識を 身 につける • ハルシネーションを完全に避けることは難しい 48 -
参考資料 • 大 規模 言 語モデル (LLM) の技術と最新動向 • LLMの現在
• 大 規模 言 語モデルを作る、拡張する • 松尾研 LLM 大 規模 言 語モデル講座 講義資料 • Retrieval-based LM (RAG system) ざっくり理解する 50