Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【論文紹介】DINOv3: Self-supervised Learning for Visi...

【論文紹介】DINOv3: Self-supervised Learning for Vision at Unprecedented Scale

DINOv3 is Meta AI's latest vision foundation model that pushes self-supervised learning to an unprecedented scale.

This talk introduces the key ideas behind DINOv3, including:

Large-scale data curation (17B images)
Self-supervised pre-training with DINO and iBOT objectives
Gram Anchoring for dense feature preservation
High-resolution adaptation up to 4K+ inference
Efficient multi-student distillation

We will explore how these innovations enable DINOv3 to achieve state-of-the-art performance across a broad range of computer vision tasks while improving scalability, robustness, and deployment efficiency.

yuyu4Tech

June 02, 2026

Transcript

39 slides
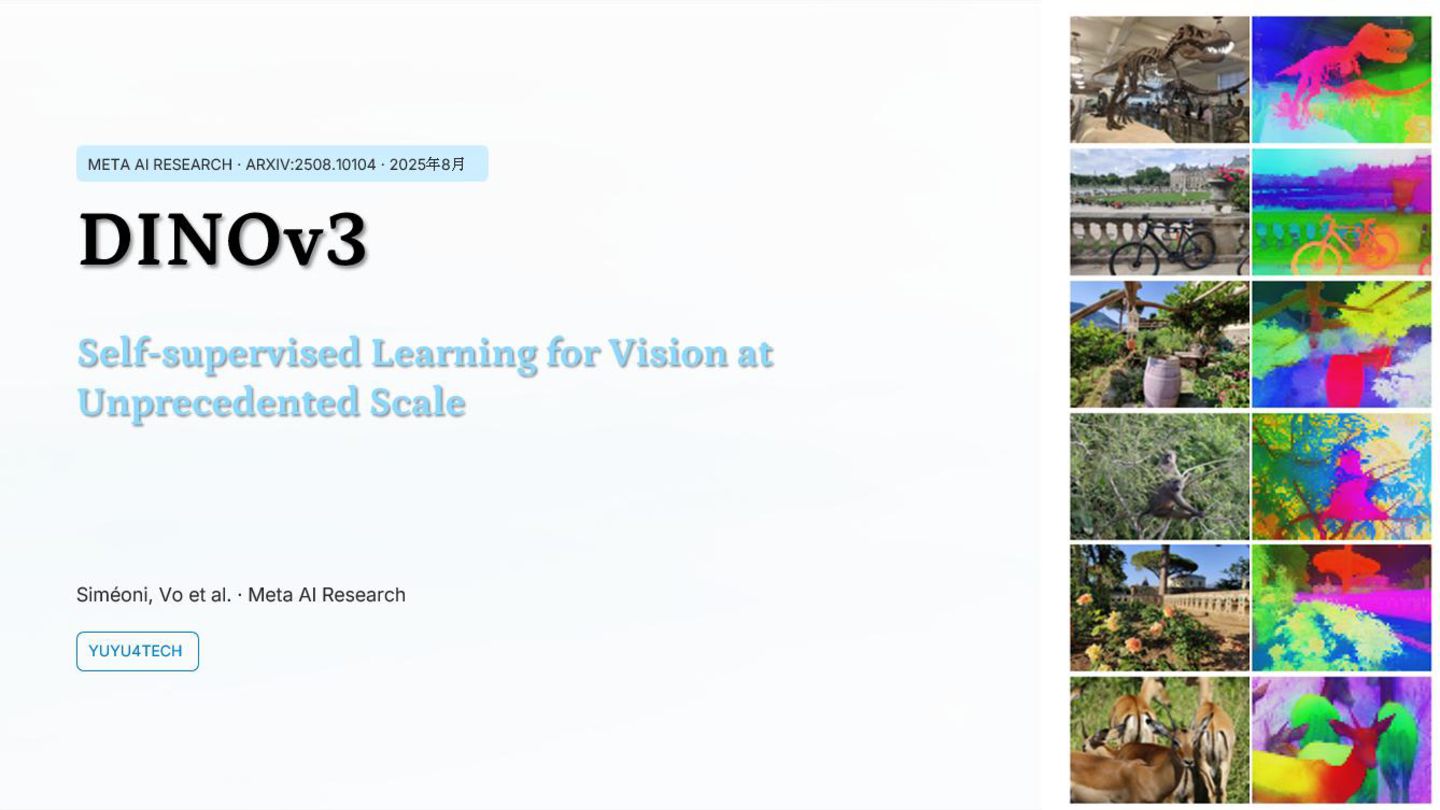
  1. preencoded.png META AI RESEARCH · ARXIV:2508.10104 · 2025年8月 DINOv3 S

    e l f -s u p e r v i s e d U n p r e c e d e n t e d Siméoni, Vo et al. · Meta AI Research YUYU4TECH
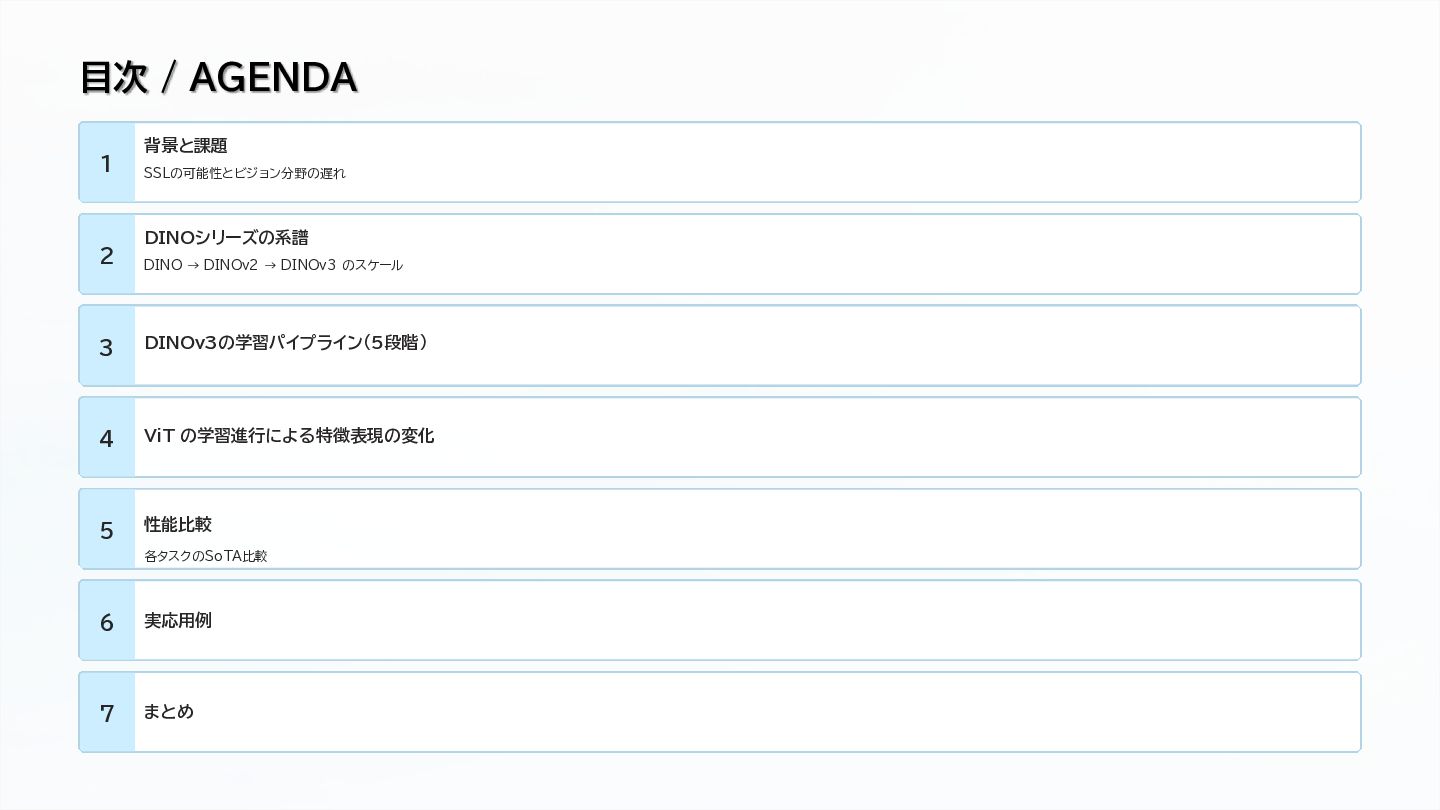
  2. preencoded.png 目次 / AGENDA 1 背景と課題 SSLの可能性とビジョン分野の遅れ 2 DINOシリーズの系譜 DINO

    → DINOv2 → DINOv3 のスケール 3 DINOv3の学習パイプライン(5段階) 4 ViT の学習進行による特徴表現の変化 5 6 性能比較 各タスクのSoTA比較 7 実応用例 まとめ
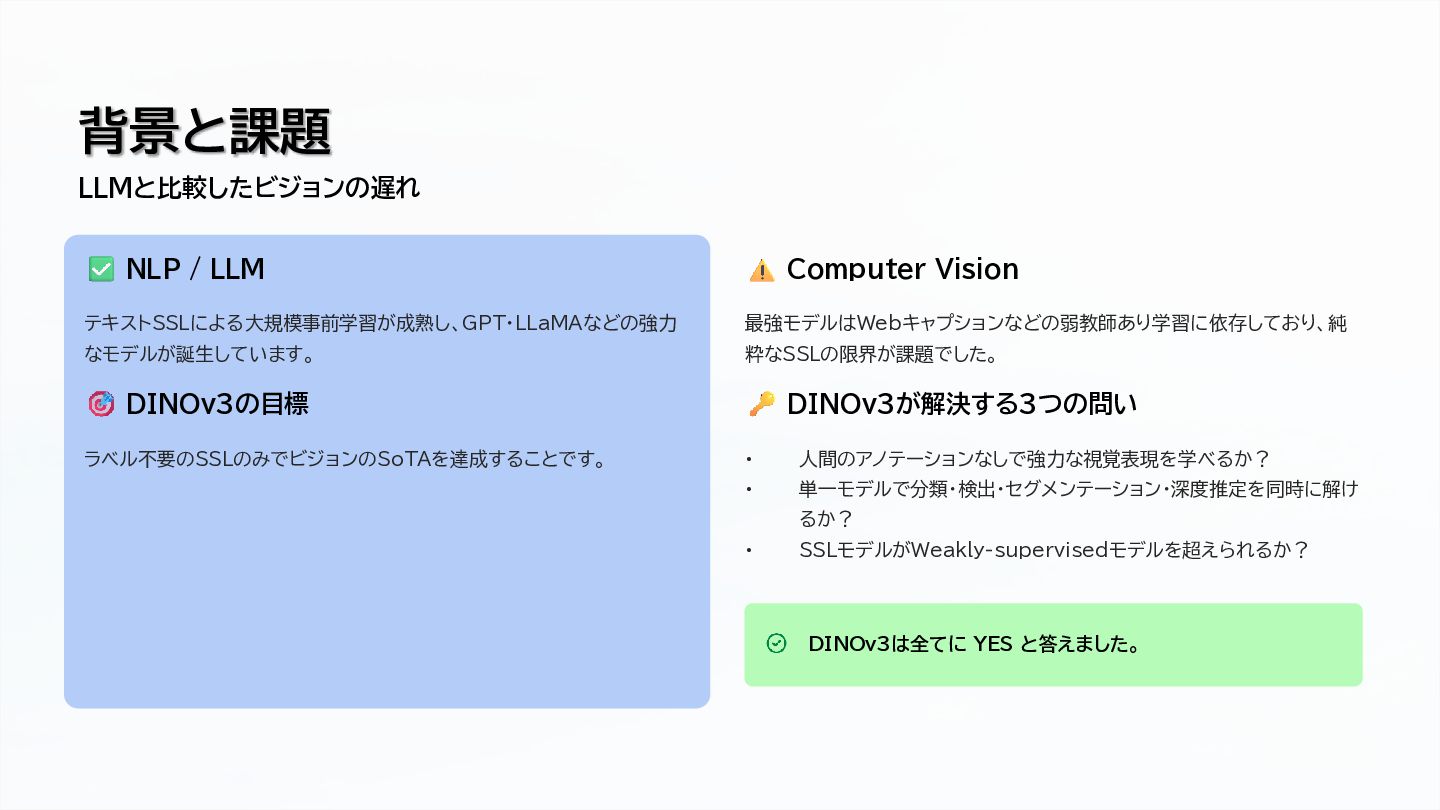
  3. preencoded.png 背景と課題 LLMと比較したビジョンの遅れ NLP / LLM テキストSSLによる大規模事前学習が成熟し、GPT・LLaMAなどの強力 なモデルが誕生しています。 DINOv3の目標 ラベル不要のSSLのみでビジョンのSoTAを達成することです。

    Computer Vision 最強モデルはWebキャプションなどの弱教師あり学習に依存しており、純 粋なSSLの限界が課題でした。 DINOv3が解決する3つの問い • 人間のアノテーションなしで強力な視覚表現を学べるか? • 単一モデルで分類・検出・セグメンテーション・深度推定を同時に解け るか? • SSLモデルがWeakly-supervisedモデルを超えられるか? DINOv3は全てに YES と答えました。
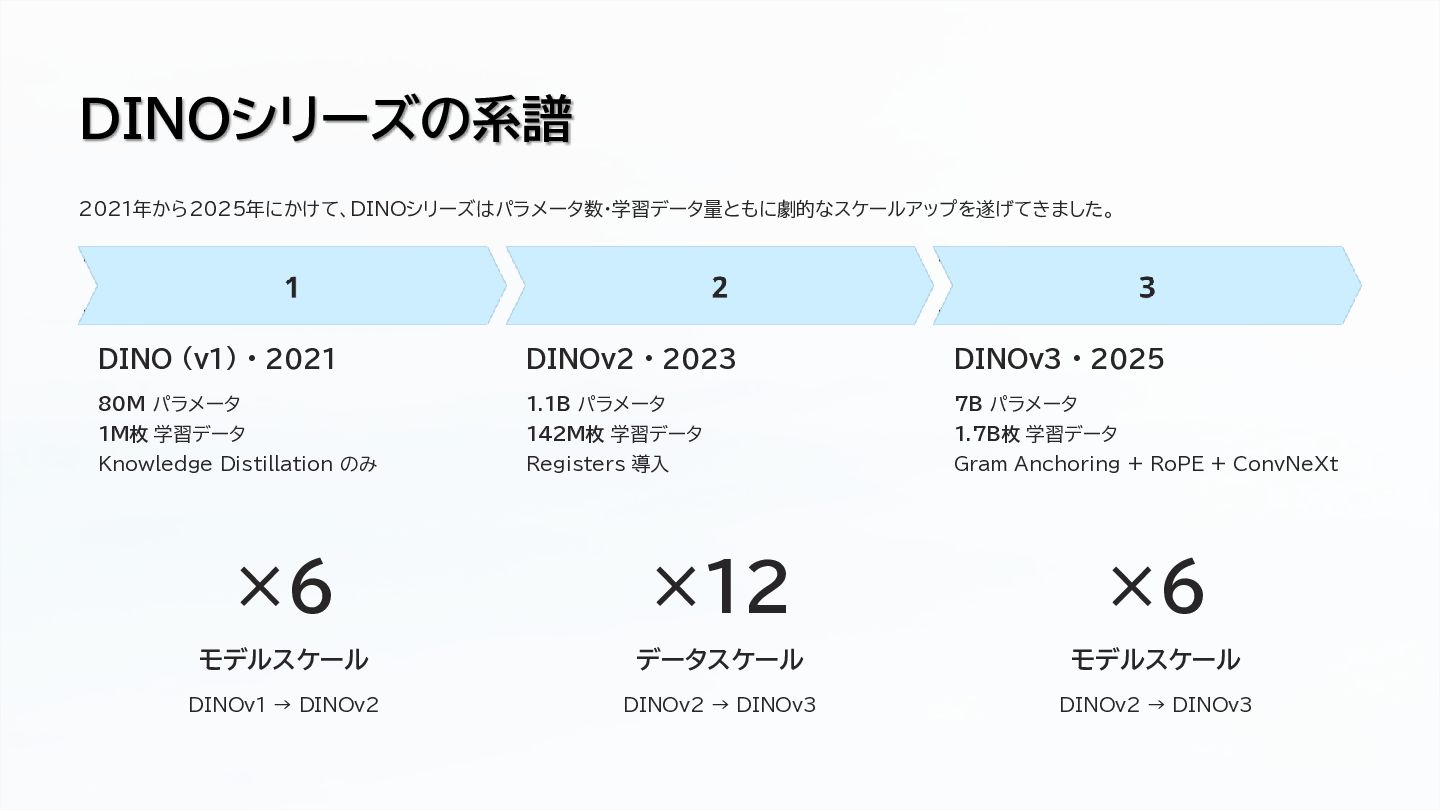
  4. preencoded.png DINOシリーズの系譜 2021年から2025年にかけて、DINOシリーズはパラメータ数・学習データ量ともに劇的なスケールアップを遂げてきました。 DINO (v1) · 2021 80M パラメータ 1M枚

    学習データ Knowledge Distillation のみ DINOv2 · 2023 1.1B パラメータ 142M枚 学習データ Registers 導入 DINOv3 · 2025 7B パラメータ 1.7B枚 学習データ Gram Anchoring + RoPE + ConvNeXt ×6 モデルスケール DINOv1 → DINOv2 ×12 データスケール DINOv2 → DINOv3 ×6 モデルスケール DINOv2 → DINOv3
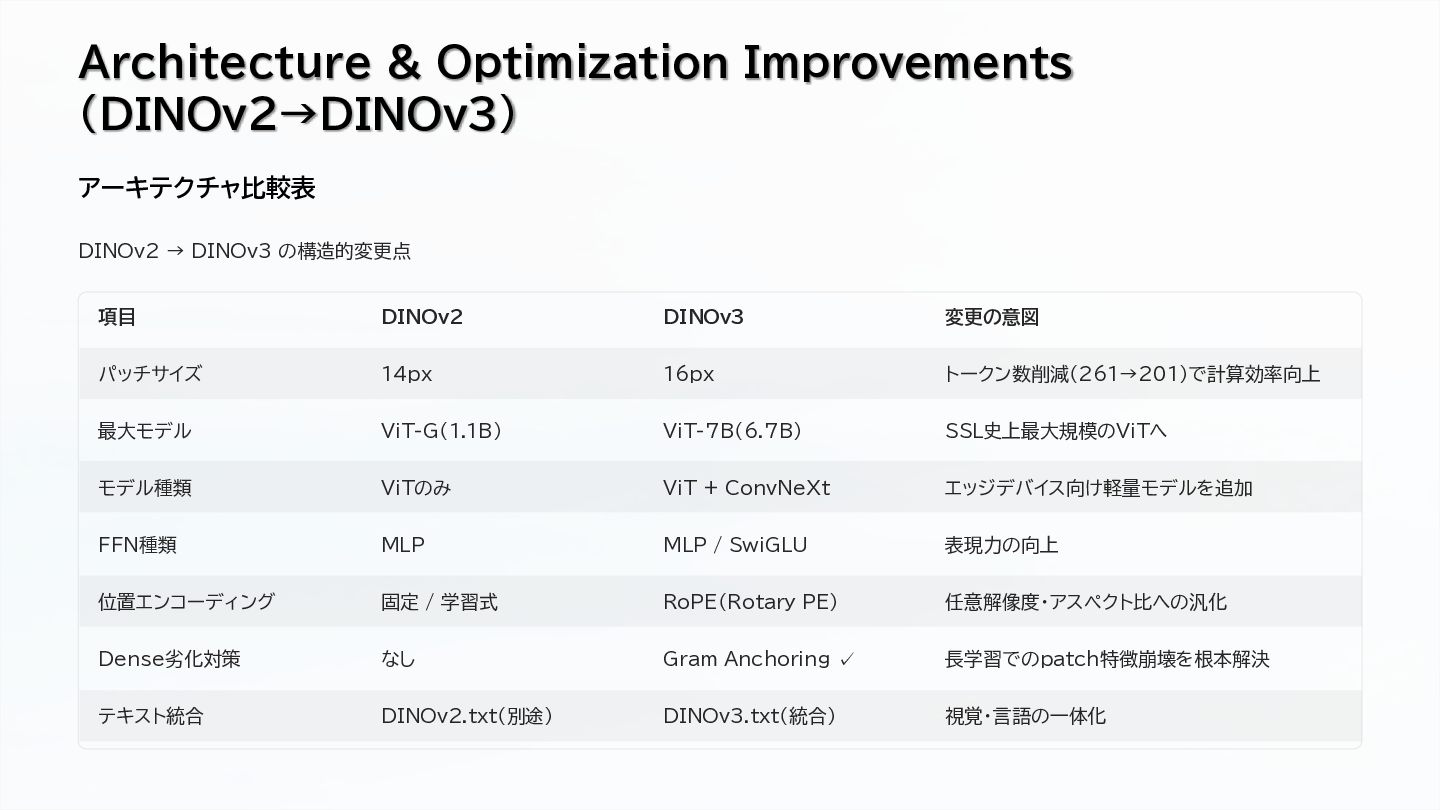
  5. preencoded.png Architecture & Optimization Improvements (DINOv2→DINOv3) アーキテクチャ比較表 DINOv2 → DINOv3

    の構造的変更点 項目 DINOv2 DINOv3 変更の意図 パッチサイズ 14px 16px トークン数削減(261→201)で計算効率向上 最大モデル ViT-G(1.1B) ViT-7B(6.7B) SSL史上最大規模のViTへ モデル種類 ViTのみ ViT + ConvNeXt エッジデバイス向け軽量モデルを追加 FFN種類 MLP MLP / SwiGLU 表現力の向上 位置エンコーディング 固定 / 学習式 RoPE(Rotary PE) 任意解像度・アスペクト比への汎化 Dense劣化対策 なし Gram Anchoring ✓ 長学習でのpatch特徴崩壊を根本解決 テキスト統合 DINOv2.txt(別途) DINOv3.txt(統合) 視覚・言語の一体化
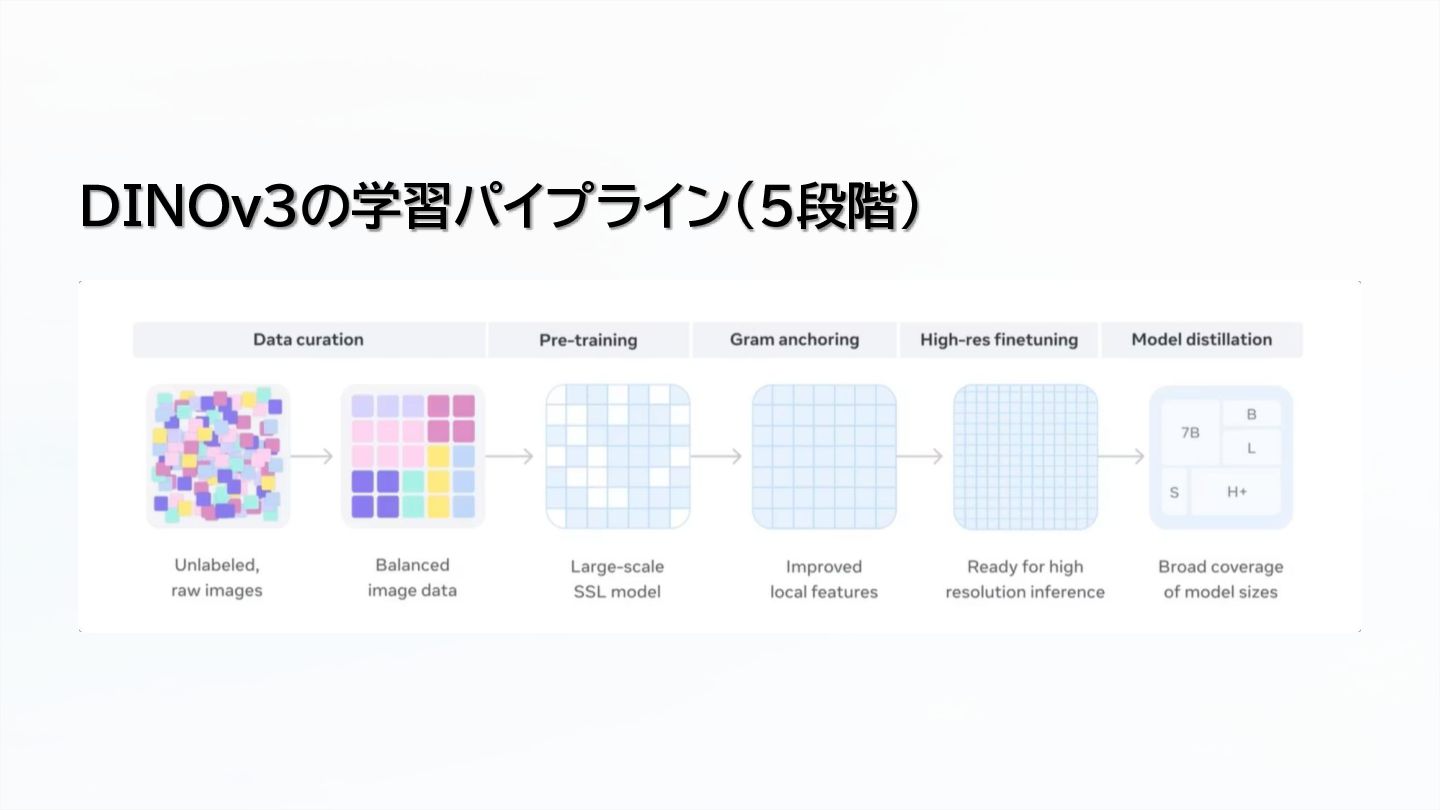
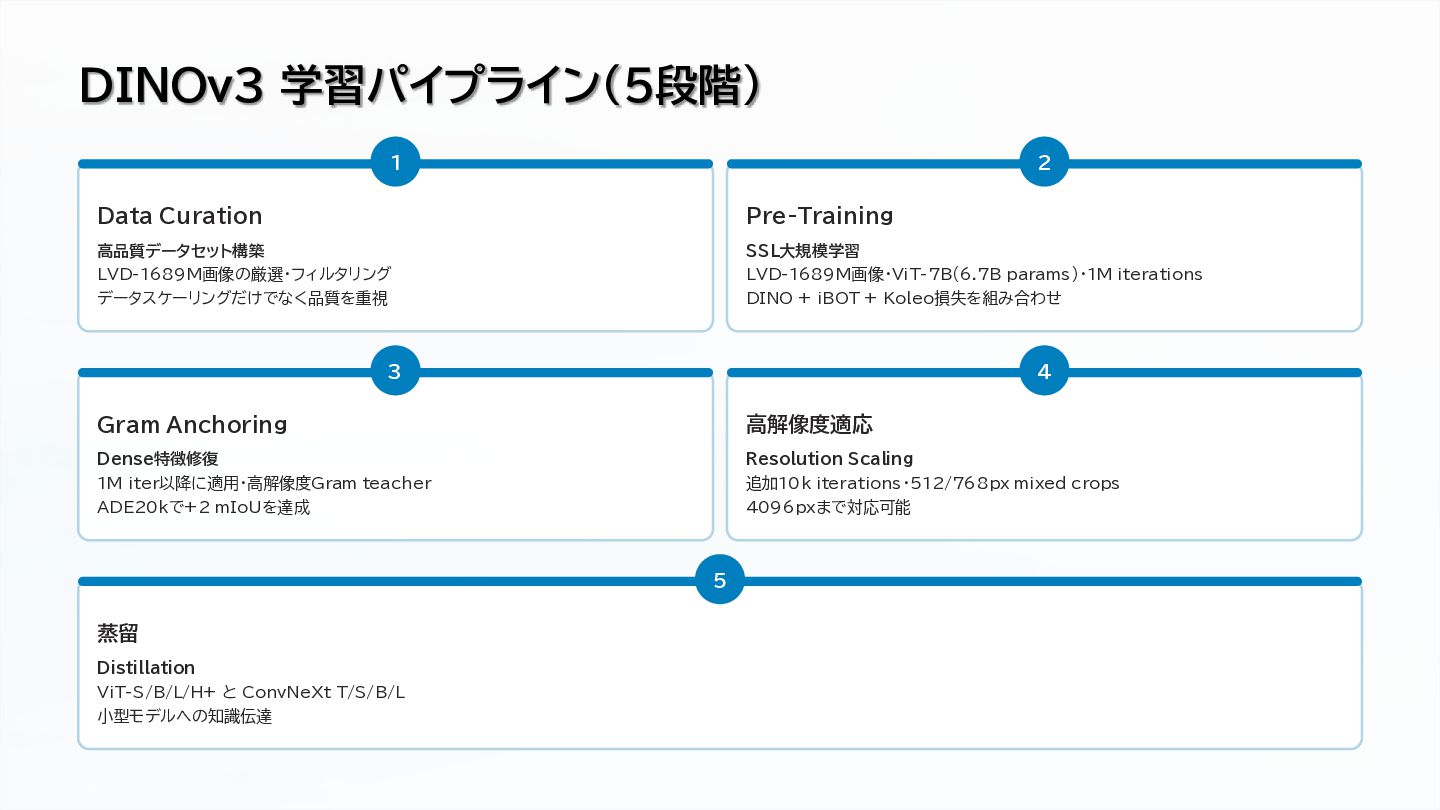
  6. preencoded.png DINOv3 学習パイプライン(5段階) 1 Data Curation 高品質データセット構築 LVD-1689M画像の厳選・フィルタリング データスケーリングだけでなく品質を重視 2

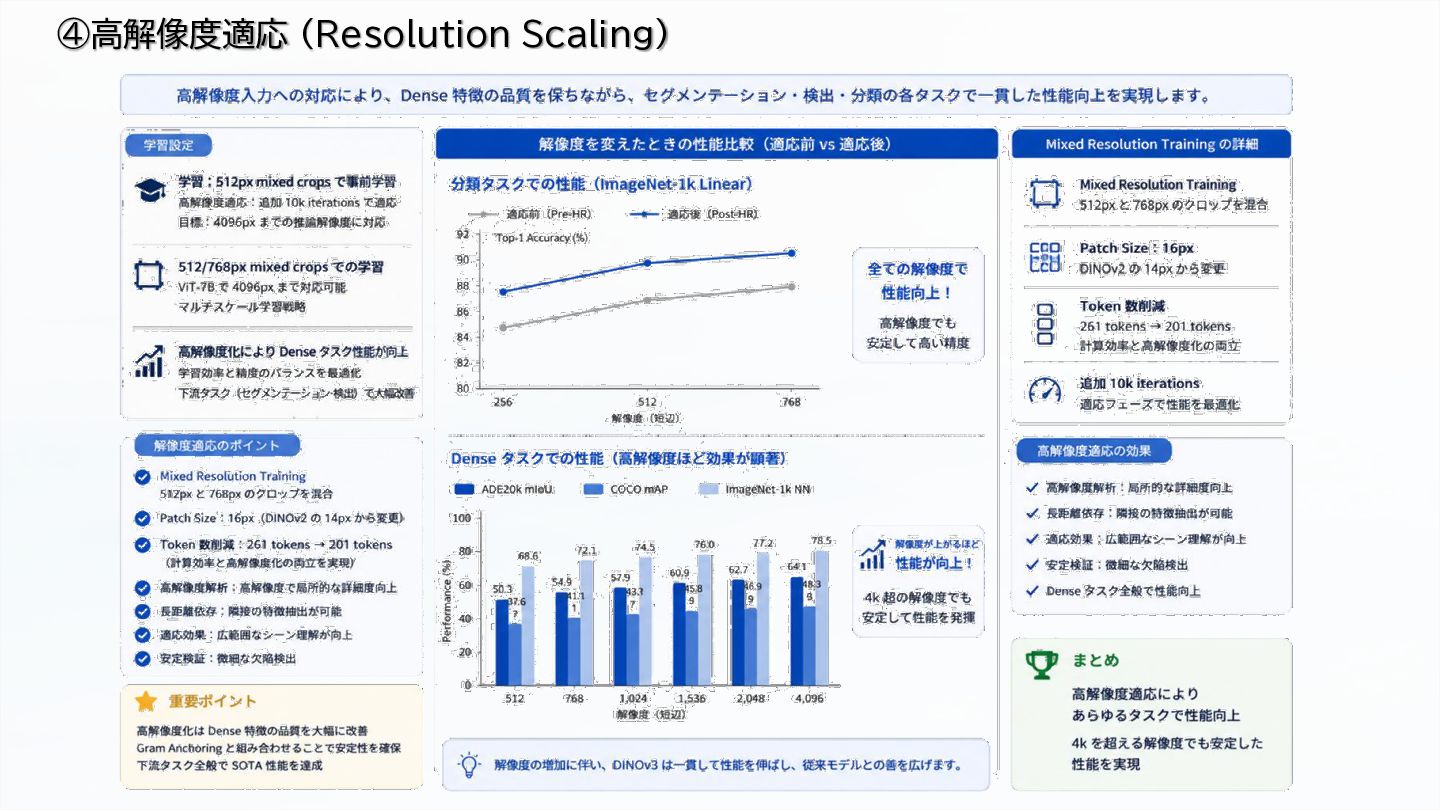
    Pre-Training SSL大規模学習 LVD-1689M画像・ViT-7B(6.7B params)・1M iterations DINO + iBOT + Koleo損失を組み合わせ 3 Gram Anchoring Dense特徴修復 1M iter以降に適用・高解像度Gram teacher ADE20kで+2 mIoUを達成 4 高解像度適応 Resolution Scaling 追加10k iterations・512/768px mixed crops 4096pxまで対応可能 5 蒸留 Distillation ViT-S/B/L/H+ と ConvNeXt T/S/B/L 小型モデルへの知識伝達
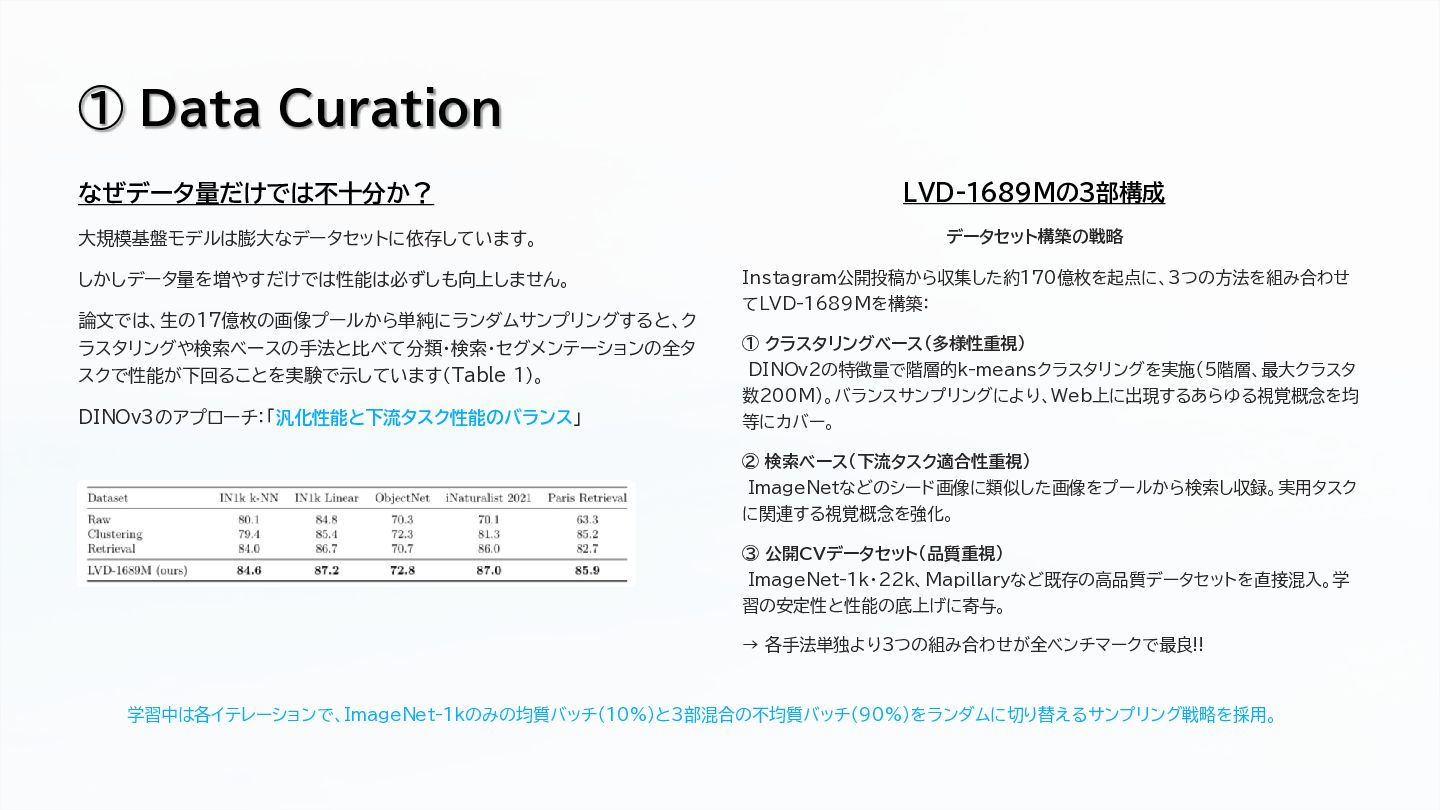
  7. preencoded.png ① Data Curation なぜデータ量だけでは不十分か? 大規模基盤モデルは膨大なデータセットに依存しています。 しかしデータ量を増やすだけでは性能は必ずしも向上しません。 論文では、生の17億枚の画像プールから単純にランダムサンプリングすると、ク ラスタリングや検索ベースの手法と比べて分類・検索・セグメンテーションの全タ スクで性能が下回ることを実験で示しています(Table

    1)。 DINOv3のアプローチ:「汎化性能と下流タスク性能のバランス」 LVD-1689Mの3部構成 データセット構築の戦略 Instagram公開投稿から収集した約170億枚を起点に、3つの方法を組み合わせ てLVD-1689Mを構築: ① クラスタリングベース(多様性重視) DINOv2の特徴量で階層的k-meansクラスタリングを実施(5階層、最大クラスタ 数200M)。バランスサンプリングにより、Web上に出現するあらゆる視覚概念を均 等にカバー。 ② 検索ベース(下流タスク適合性重視) ImageNetなどのシード画像に類似した画像をプールから検索し収録。実用タスク に関連する視覚概念を強化。 ③ 公開CVデータセット(品質重視) ImageNet-1k・22k、Mapillaryなど既存の高品質データセットを直接混入。学 習の安定性と性能の底上げに寄与。 → 各手法単独より3つの組み合わせが全ベンチマークで最良!! 学習中は各イテレーションで、ImageNet-1kのみの均質バッチ(10%)と3部混合の不均質バッチ(90%)をランダムに切り替えるサンプリング戦略を採用。
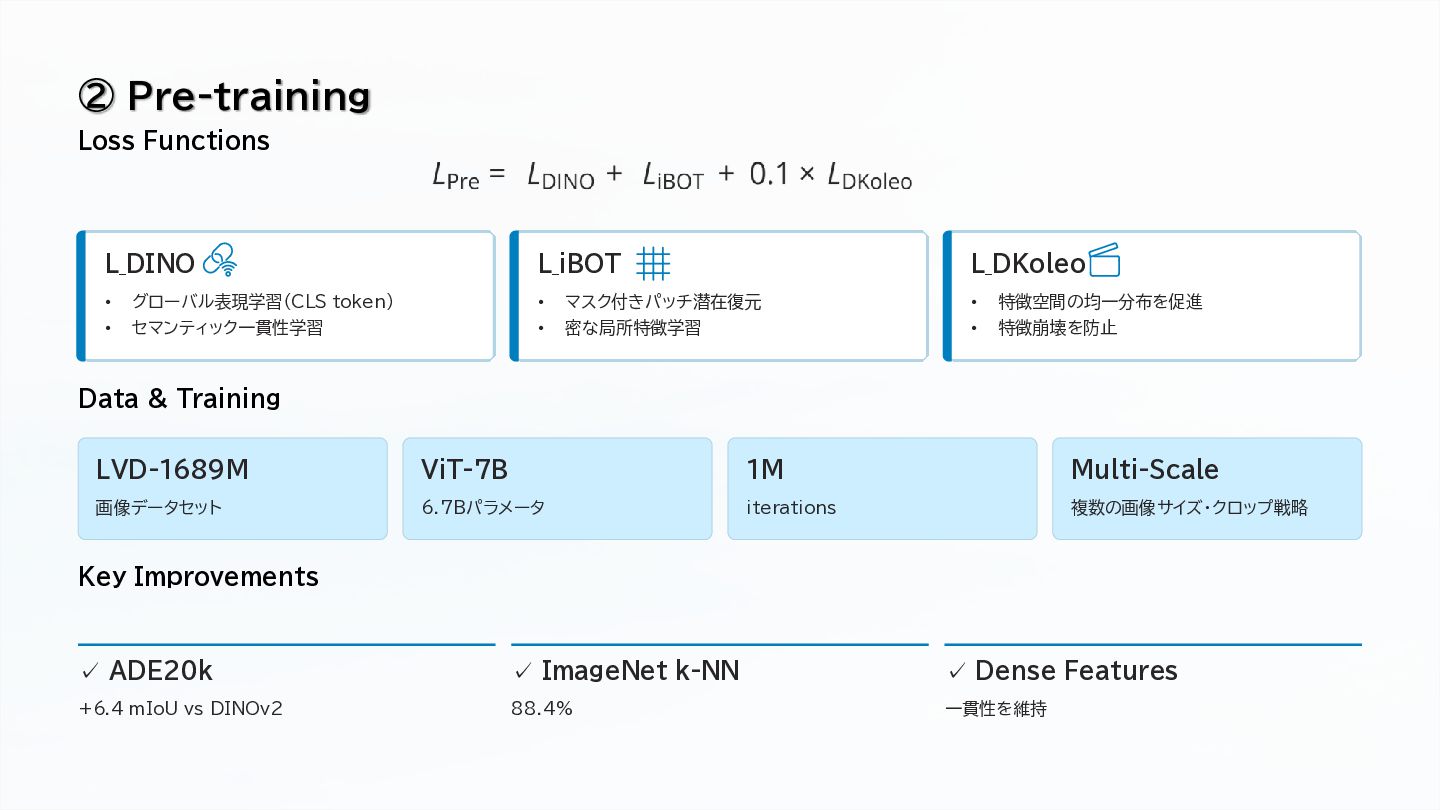
  8. preencoded.png ② Pre-training Loss Functions L_DINO • グローバル表現学習(CLS token) •

    セマンティック一貫性学習 L_iBOT • マスク付きパッチ潜在復元 • 密な局所特徴学習 L_DKoleo • 特徴空間の均一分布を促進 • 特徴崩壊を防止 Data & Training LVD-1689M 画像データセット ViT-7B 6.7Bパラメータ 1M iterations Multi-Scale 複数の画像サイズ・クロップ戦略 Key Improvements ✓ ADE20k +6.4 mIoU vs DINOv2 ✓ ImageNet k-NN 88.4% ✓ Dense Features 一貫性を維持
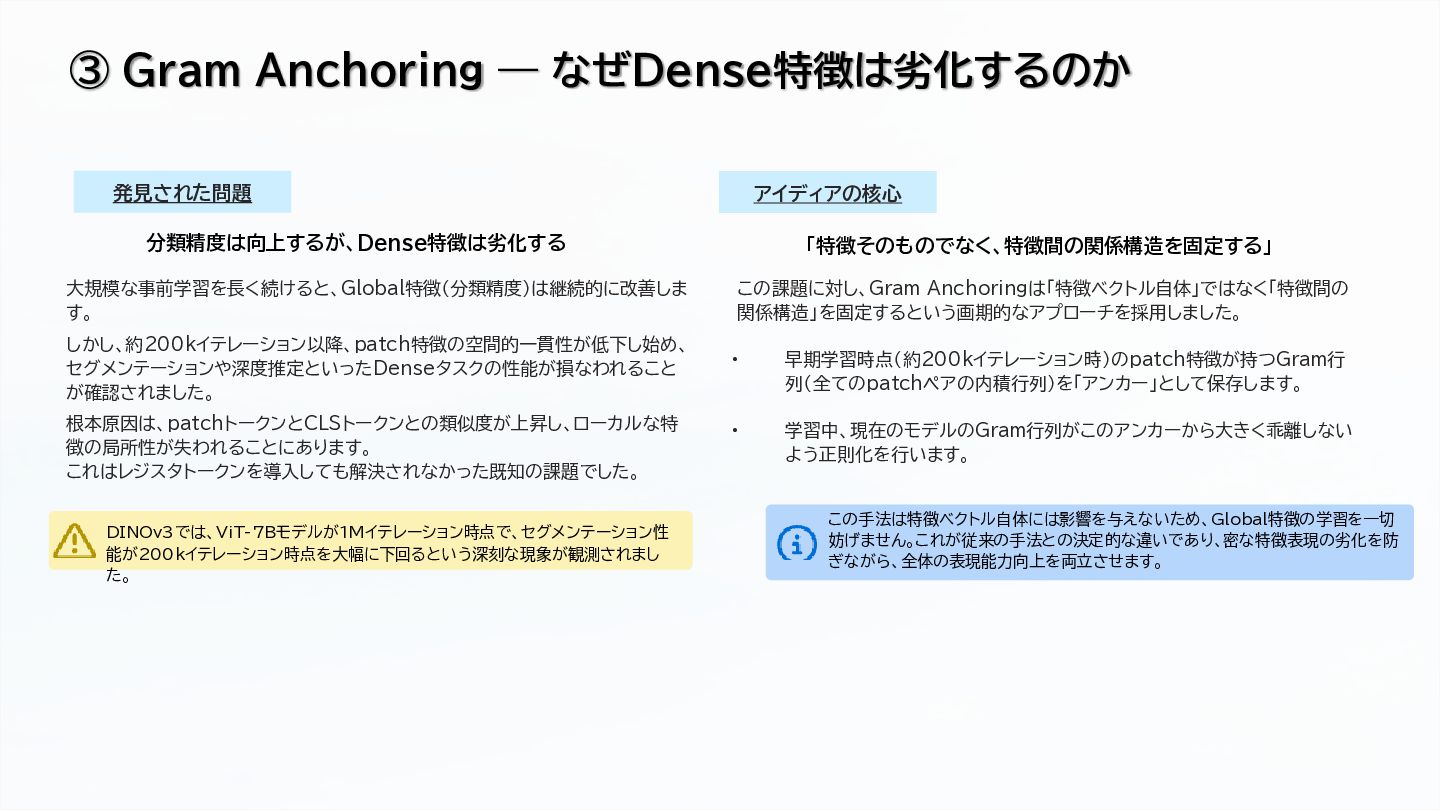
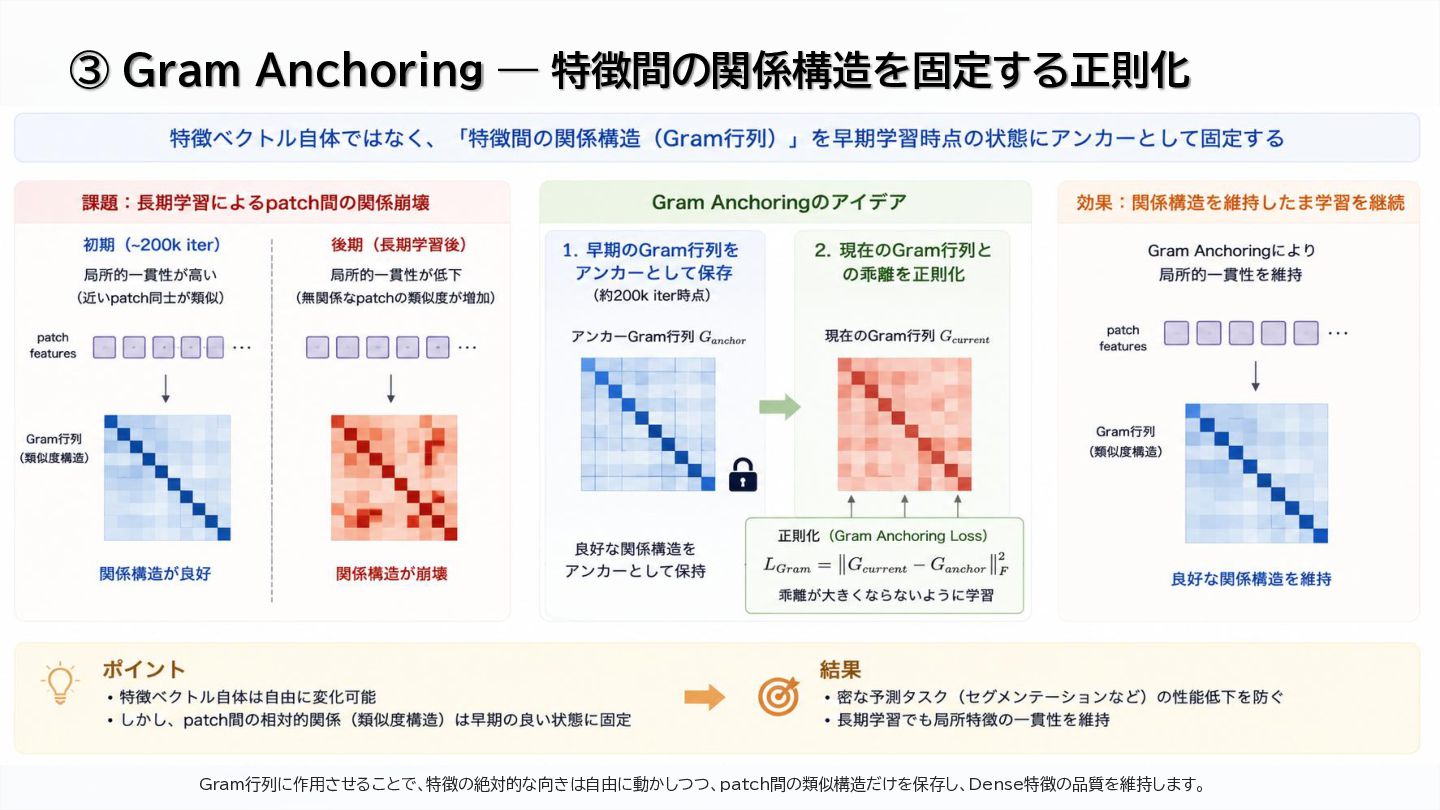
  9. preencoded.png ③ Gram Anchoring ― なぜDense特徴は劣化するのか 発見された問題 分類精度は向上するが、Dense特徴は劣化する 大規模な事前学習を長く続けると、Global特徴(分類精度)は継続的に改善しま す。

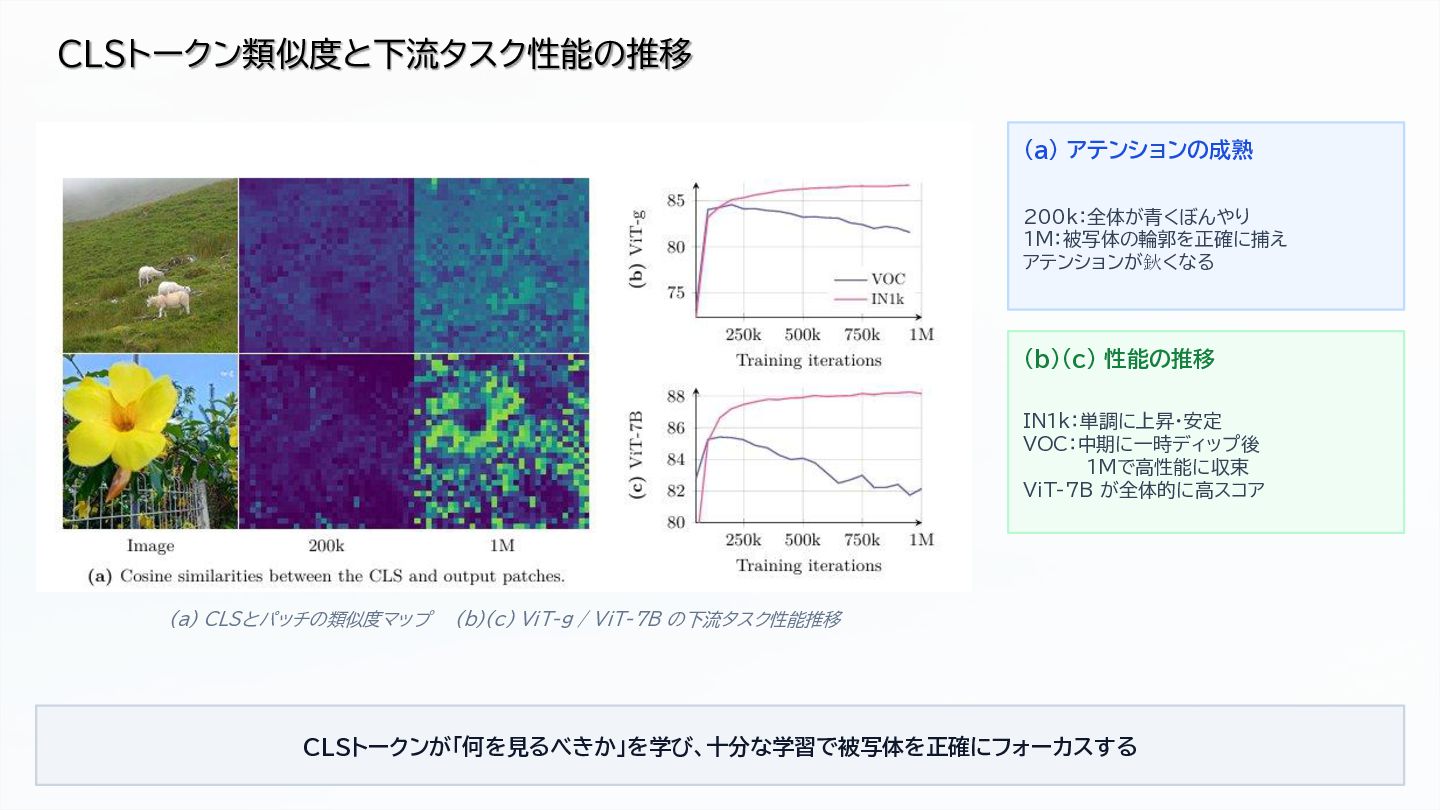
    しかし、約200kイテレーション以降、patch特徴の空間的一貫性が低下し始め、 セグメンテーションや深度推定といったDenseタスクの性能が損なわれること が確認されました。 根本原因は、patchトークンとCLSトークンとの類似度が上昇し、ローカルな特 徴の局所性が失われることにあります。 これはレジスタトークンを導入しても解決されなかった既知の課題でした。 DINOv3では、ViT-7Bモデルが1Mイテレーション時点で、セグメンテーション性 能が200kイテレーション時点を大幅に下回るという深刻な現象が観測されまし た。 「特徴そのものでなく、特徴間の関係構造を固定する」 この課題に対し、Gram Anchoringは「特徴ベクトル自体」ではなく「特徴間の 関係構造」を固定するという画期的なアプローチを採用しました。 • 早期学習時点(約200kイテレーション時)のpatch特徴が持つGram行 列(全てのpatchペアの内積行列)を「アンカー」として保存します。 • 学習中、現在のモデルのGram行列がこのアンカーから大きく乖離しない よう正則化を行います。 この手法は特徴ベクトル自体には影響を与えないため、Global特徴の学習を一切 妨げません。これが従来の手法との決定的な違いであり、密な特徴表現の劣化を防 ぎながら、全体の表現能力向上を両立させます。 アイディアの核心
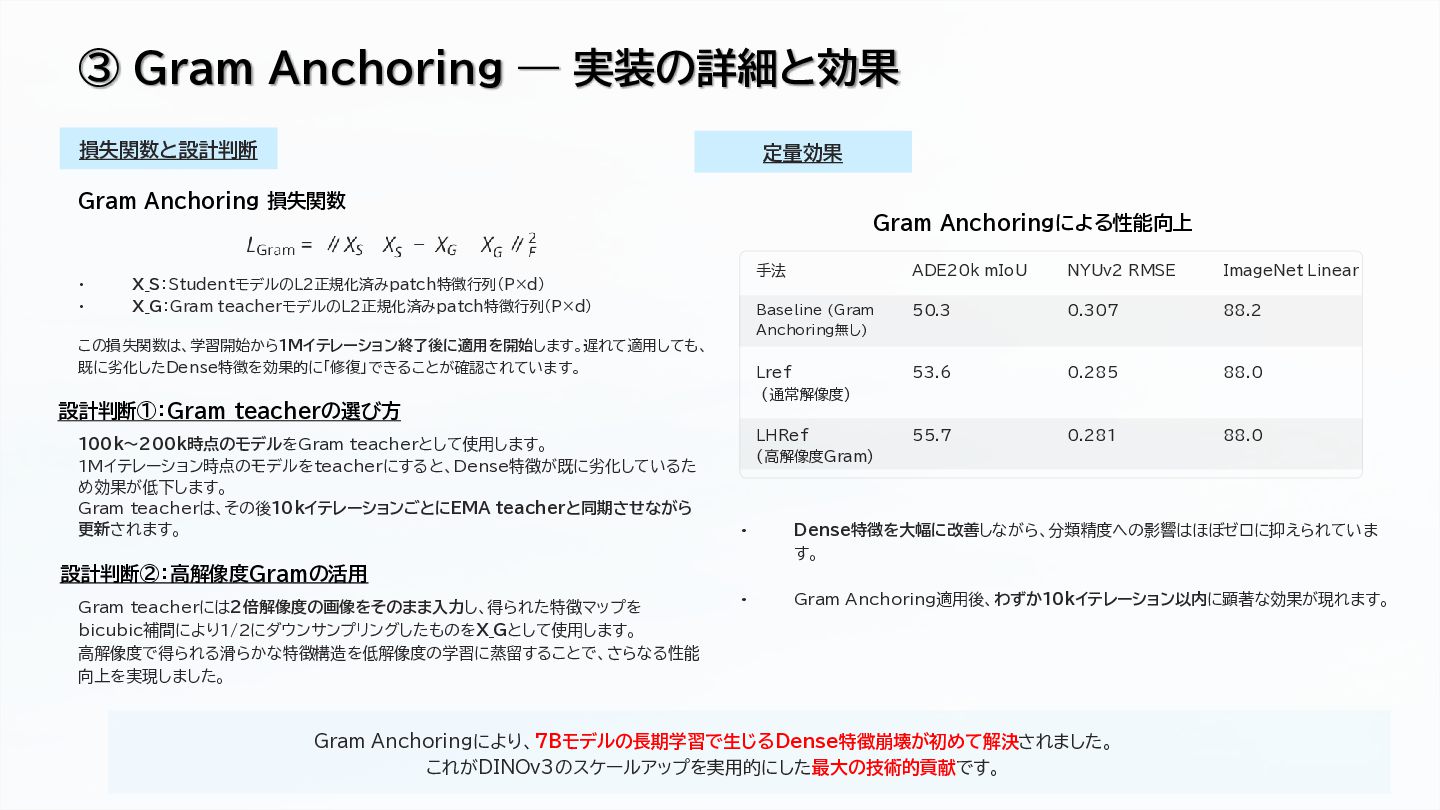
  10. preencoded.png ③ Gram Anchoring ― 実装の詳細と効果 Gram Anchoring 損失関数 •

    X_S:StudentモデルのL2正規化済みpatch特徴行列(P×d) • X_G:Gram teacherモデルのL2正規化済みpatch特徴行列(P×d) この損失関数は、学習開始から1Mイテレーション終了後に適用を開始します。遅れて適用しても、 既に劣化したDense特徴を効果的に「修復」できることが確認されています。 設計判断①:Gram teacherの選び方 100k〜200k時点のモデルをGram teacherとして使用します。 1Mイテレーション時点のモデルをteacherにすると、Dense特徴が既に劣化しているた め効果が低下します。 Gram teacherは、その後10kイテレーションごとにEMA teacherと同期させながら 更新されます。 設計判断②:高解像度Gramの活用 Gram teacherには2倍解像度の画像をそのまま入力し、得られた特徴マップを bicubic補間により1/2にダウンサンプリングしたものをX_Gとして使用します。 高解像度で得られる滑らかな特徴構造を低解像度の学習に蒸留することで、さらなる性能 向上を実現しました。 Gram Anchoringによる性能向上 手法 ADE20k mIoU NYUv2 RMSE ImageNet Linear Baseline (Gram Anchoring無し) 50.3 0.307 88.2 Lref (通常解像度) 53.6 0.285 88.0 LHRef (高解像度Gram) 55.7 0.281 88.0 • Dense特徴を大幅に改善しながら、分類精度への影響はほぼゼロに抑えられていま す。 • Gram Anchoring適用後、わずか10kイテレーション以内に顕著な効果が現れます。 Gram Anchoringにより、7Bモデルの長期学習で生じるDense特徴崩壊が初めて解決されました。 これがDINOv3のスケールアップを実用的にした最大の技術的貢献です。 損失関数と設計判断 定量効果
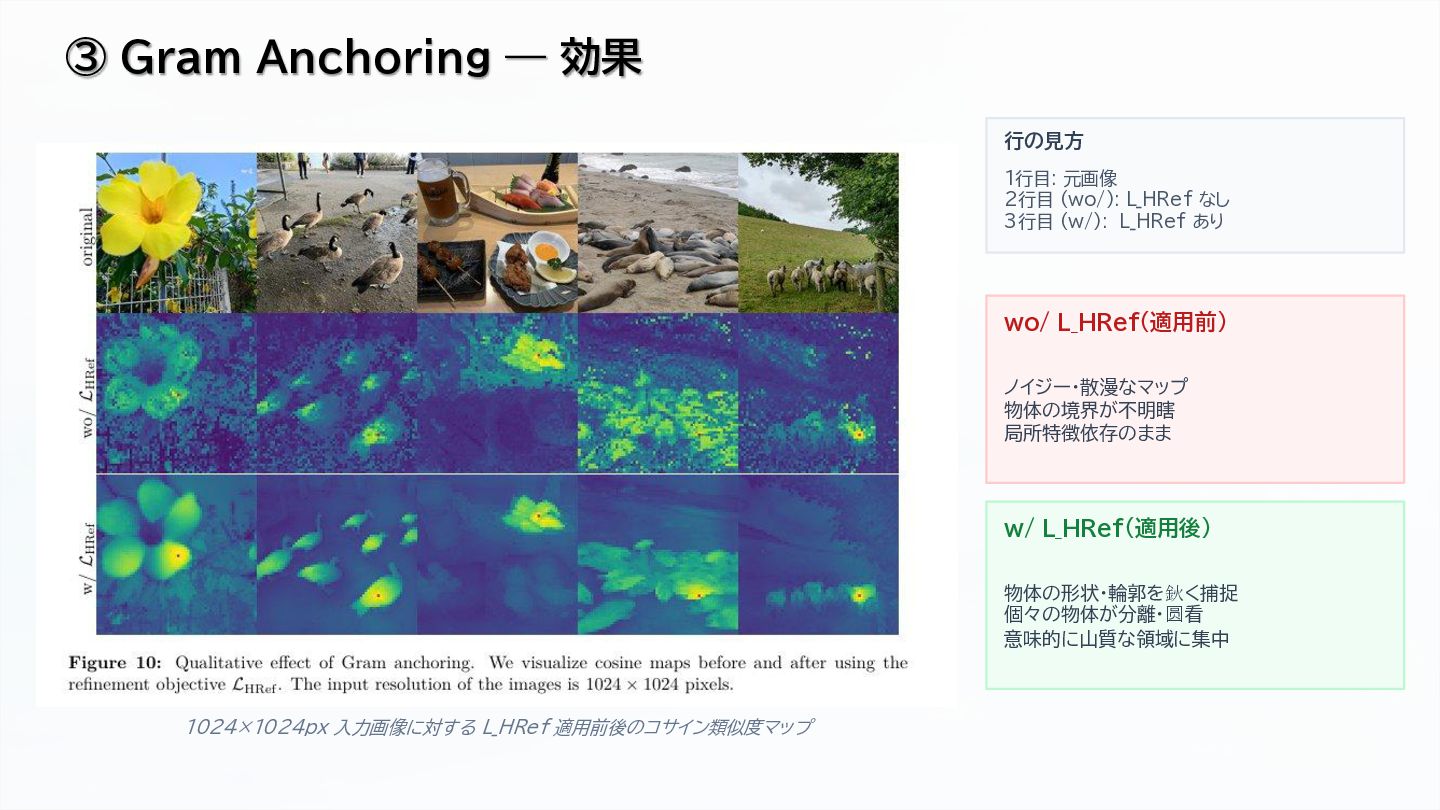
  11. preencoded.png 1024×1024px 入力画像に対する L_HRef 適用前後のコサイン類似度マップ 行の見方 1行目: 元画像 2行目 (wo/):

    L_HRef なし 3行目 (w/): L_HRef あり wo/ L_HRef(適用前) ノイジー・散漫なマップ 物体の境界が不明瞎 局所特徴依存のまま w/ L_HRef(適用後) 物体の形状・輪郭を鈥く捕捉 個々の物体が分離・圆看 意味的に山質な領域に集中 ③ Gram Anchoring ― 効果
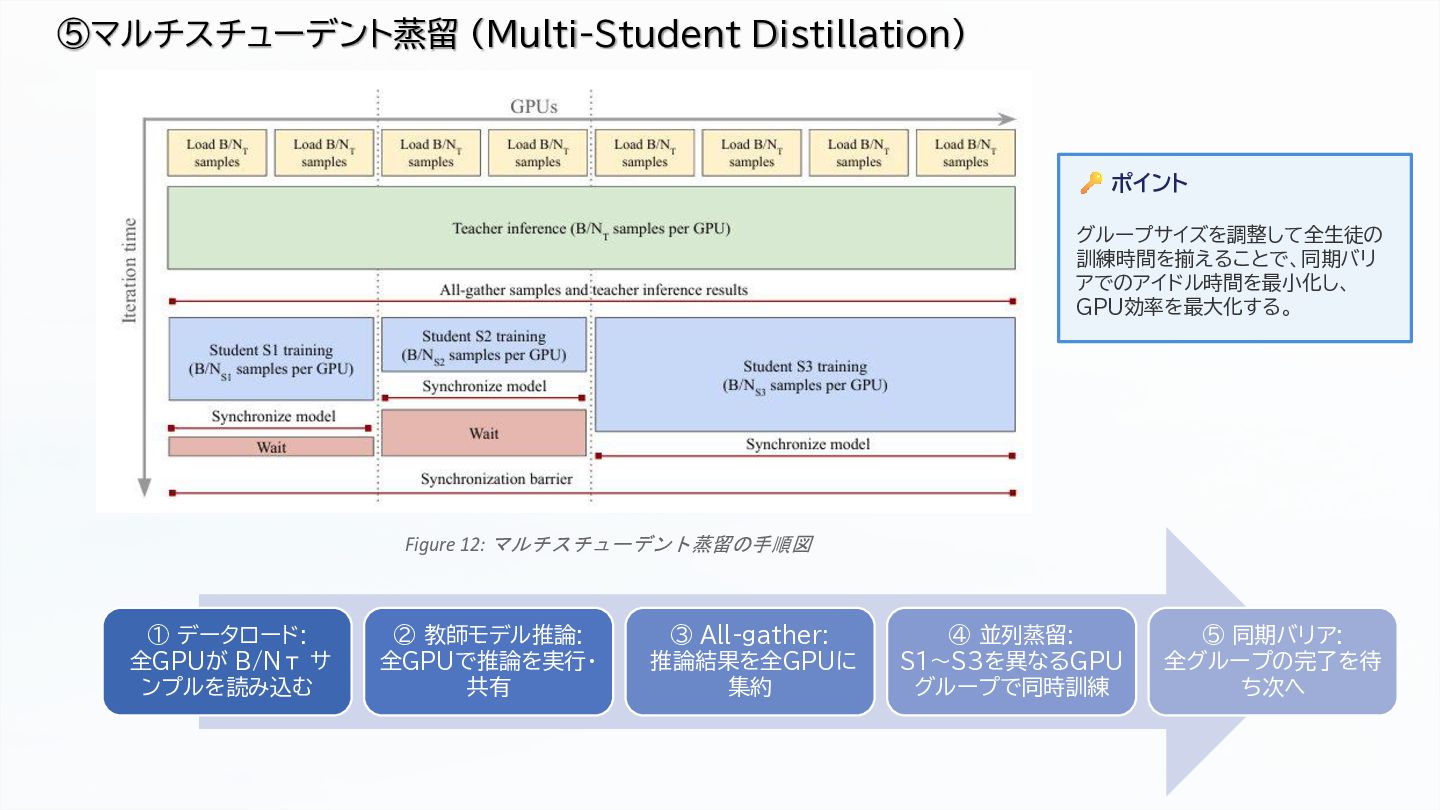
  12. preencoded.png ポイント グループサイズを調整して全生徒の 訓練時間を揃えることで、同期バリ アでのアイドル時間を最小化し、 GPU効率を最大化する。 ⑤マルチスチューデント蒸留 (Multi-Student Distillation) ①

    データロード: 全GPUが B/Nт サ ンプルを読み込む ② 教師モデル推論: 全GPUで推論を実行・ 共有 ③ All-gather: 推論結果を全GPUに 集約 ④ 並列蒸留: S1〜S3を異なるGPU グループで同時訓練 ⑤ 同期バリア: 全グループの完了を待 ち次へ Figure 12: マルチスチューデント蒸留の手順図
  13. preencoded.png (a) CLSとパッチの類似度マップ (b)(c) ViT-g / ViT-7B の下流タスク性能推移 (a) アテンションの成熟

    200k:全体が青くぼんやり 1M:被写体の輪郭を正確に捕え アテンションが鈥くなる (b)(c) 性能の推移 IN1k:単調に上昇・安定 VOC:中期に一時ディップ後 1Mで高性能に収束 ViT-7B が全体的に高スコア CLSトークンが「何を見るべきか」を学び、十分な学習で被写体を正確にフォーカスする CLSトークン類似度と下流タスク性能の推移
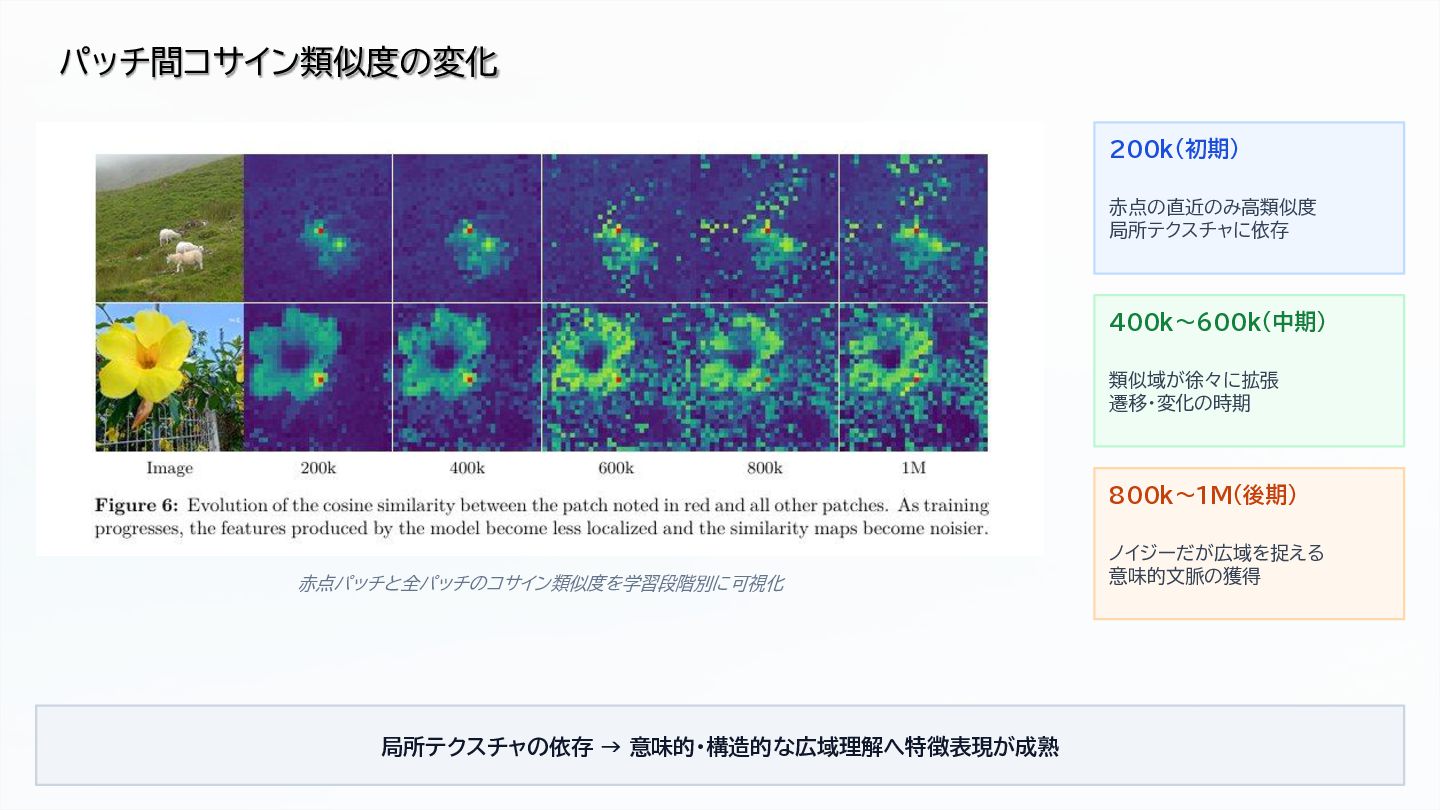
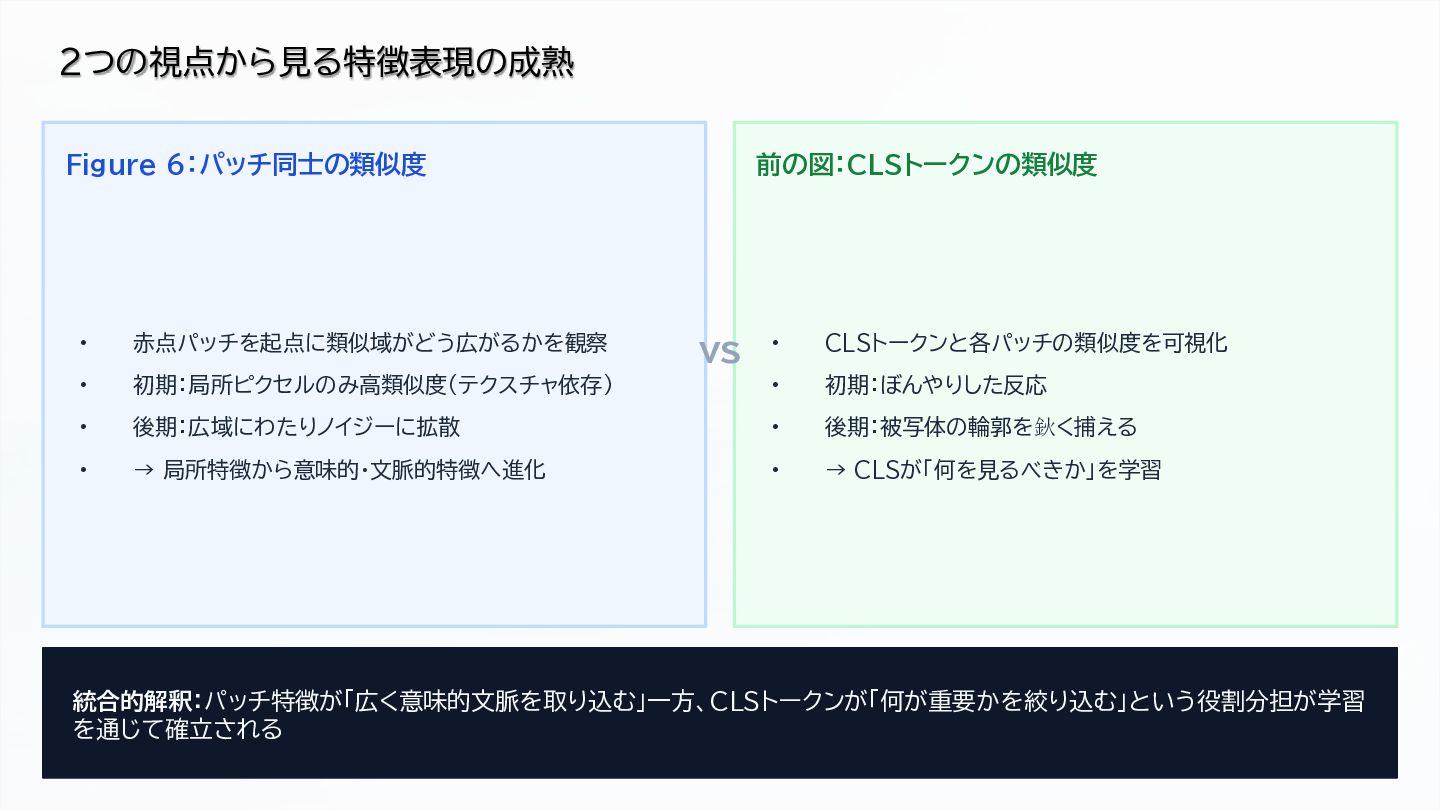
  14. preencoded.png Figure 6:パッチ同士の類似度 • 赤点パッチを起点に類似域がどう広がるかを観察 • 初期:局所ピクセルのみ高類似度(テクスチャ依存) • 後期:広域にわたりノイジーに拡散 •

    → 局所特徴から意味的・文脈的特徴へ進化 前の図:CLSトークンの類似度 • CLSトークンと各パッチの類似度を可視化 • 初期:ぼんやりした反応 • 後期:被写体の輪郭を鈥く捕える • → CLSが「何を見るべきか」を学習 vs 統合的解釈:パッチ特徴が「広く意味的文脈を取り込む」一方、CLSトークンが「何が重要かを絞り込む」という役割分担が学習 を通じて確立される 2つの視点から見る特徴表現の成熟
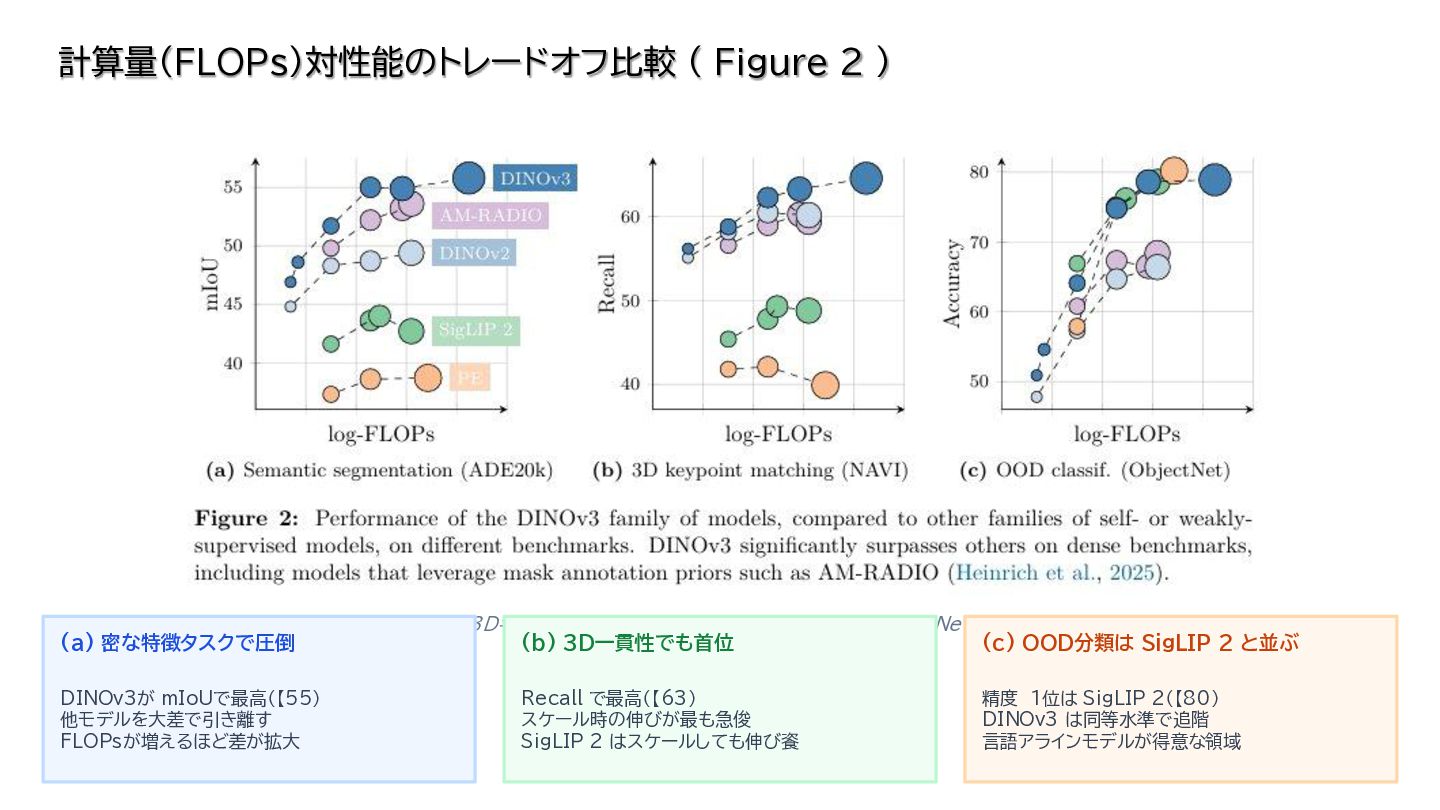
  15. (a) セグメンテーション ADE20k (b) 3Dキーポイントマッチング NAVI (c) OOD分類 ObjectNet —

    円の大きさ = パラメータ数 (a) 密な特徴タスクで圧倒 DINOv3が mIoUで最高(【55) 他モデルを大差で引き離す FLOPsが増えるほど差が拡大 (b) 3D一貫性でも首位 Recall で最高(【63) スケール時の伸びが最も急俊 SigLIP 2 はスケールしても伸び餈 (c) OOD分類は SigLIP 2 と並ぶ 精度 1位は SigLIP 2(【80) DINOv3 は同等水準で追階 言語アラインモデルが得意な領域 計算量(FLOPs)対性能のトレードオフ比較 ( Figure 2 )
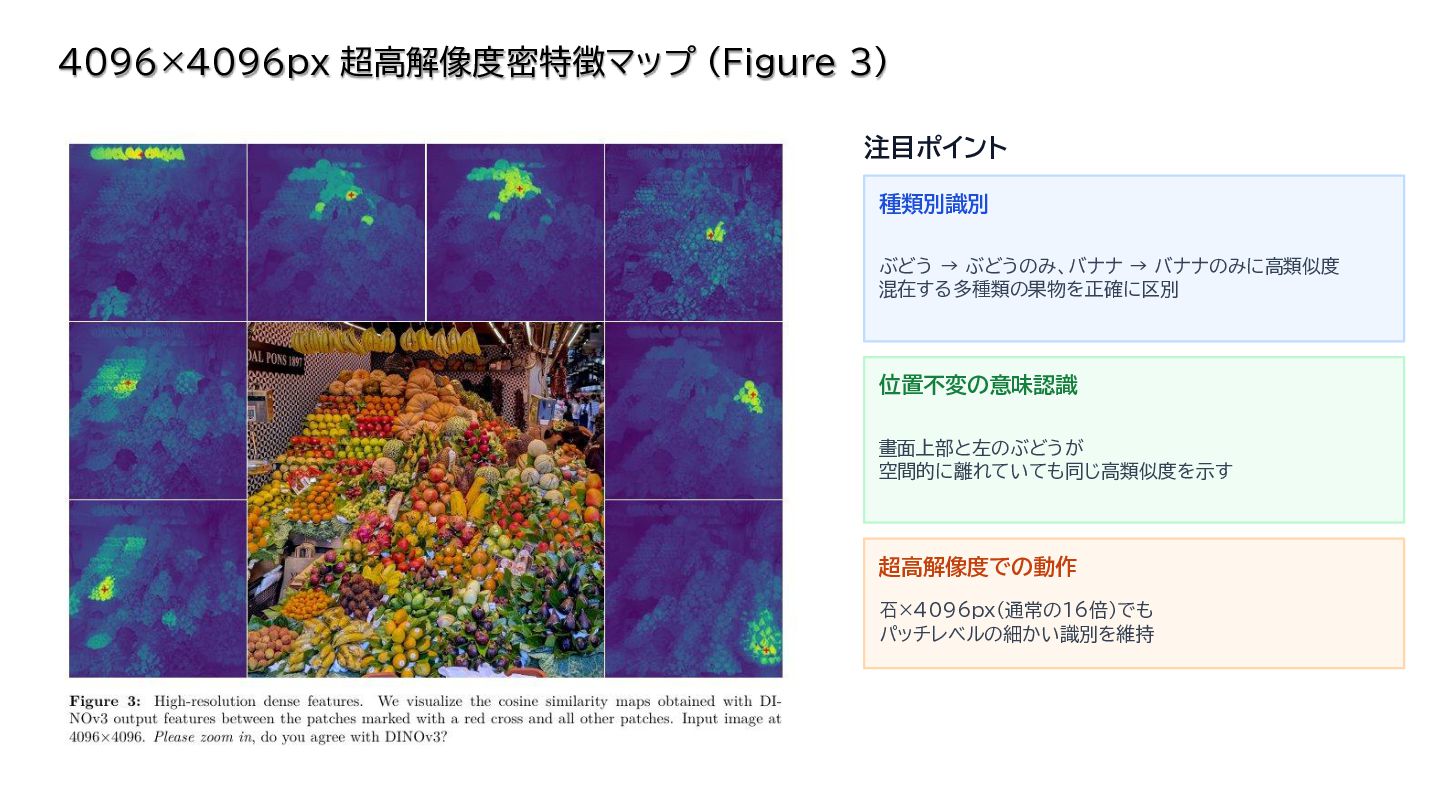
  16. 注目ポイント 種類別識別 ぶどう → ぶどうのみ、バナナ → バナナのみに高類似度 混在する多種類の果物を正確に区別 位置不変の意味認識 畫面上部と左のぶどうが

    空間的に離れていても同じ高類似度を示す 超高解像度での動作 䂖×4096px(通常の16倍)でも パッチレベルの細かい識別を維持 4096×4096px 超高解像度密特徴マップ (Figure 3)
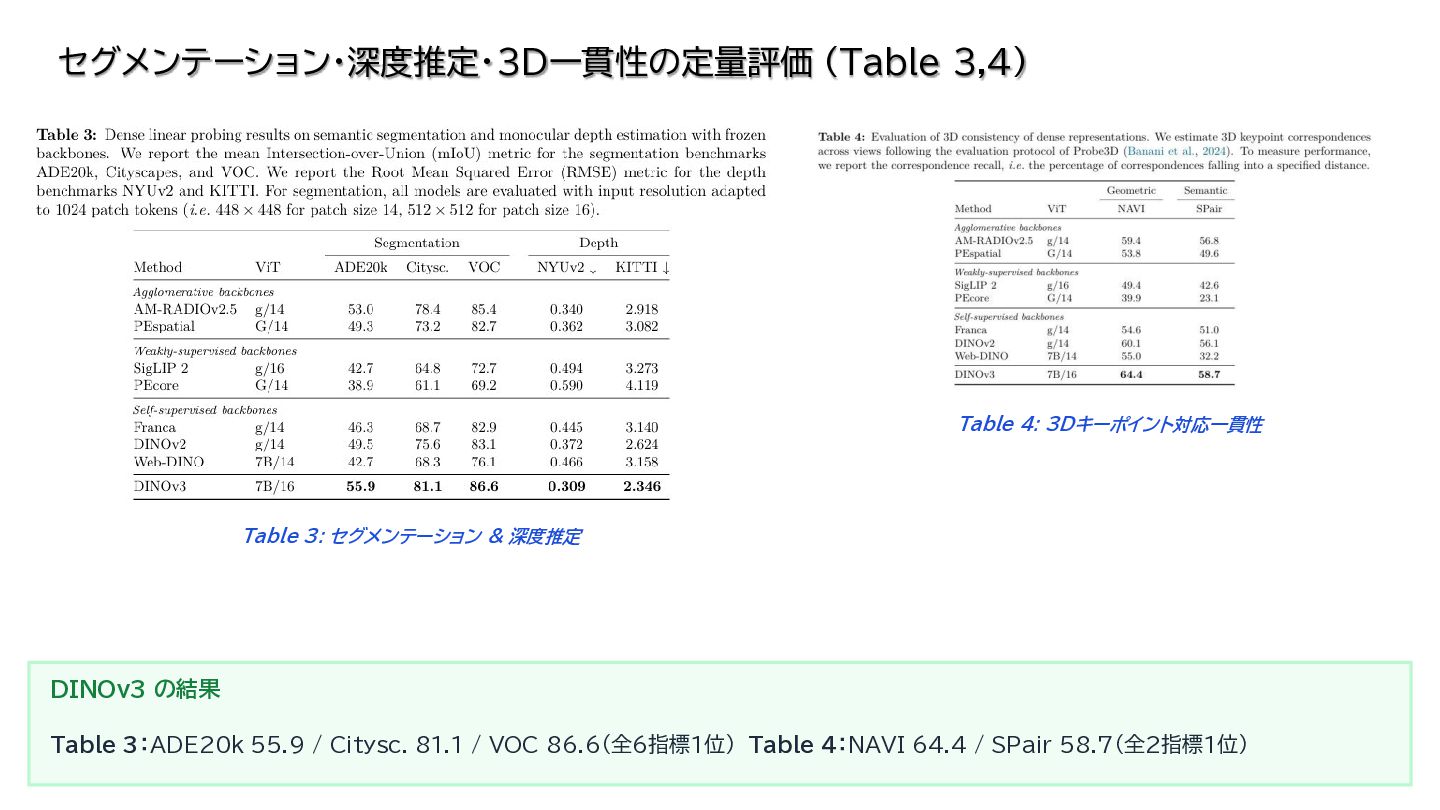
  17. Table 3: セグメンテーション & 深度推定 Table 4: 3Dキーポイント対応一貫性 DINOv3 の結果

    Table 3:ADE20k 55.9 / Citysc. 81.1 / VOC 86.6(全6指標1位) Table 4:NAVI 64.4 / SPair 58.7(全2指標1位) セグメンテーション・深度推定・3D一貫性の定量評価 (Table 3,4)
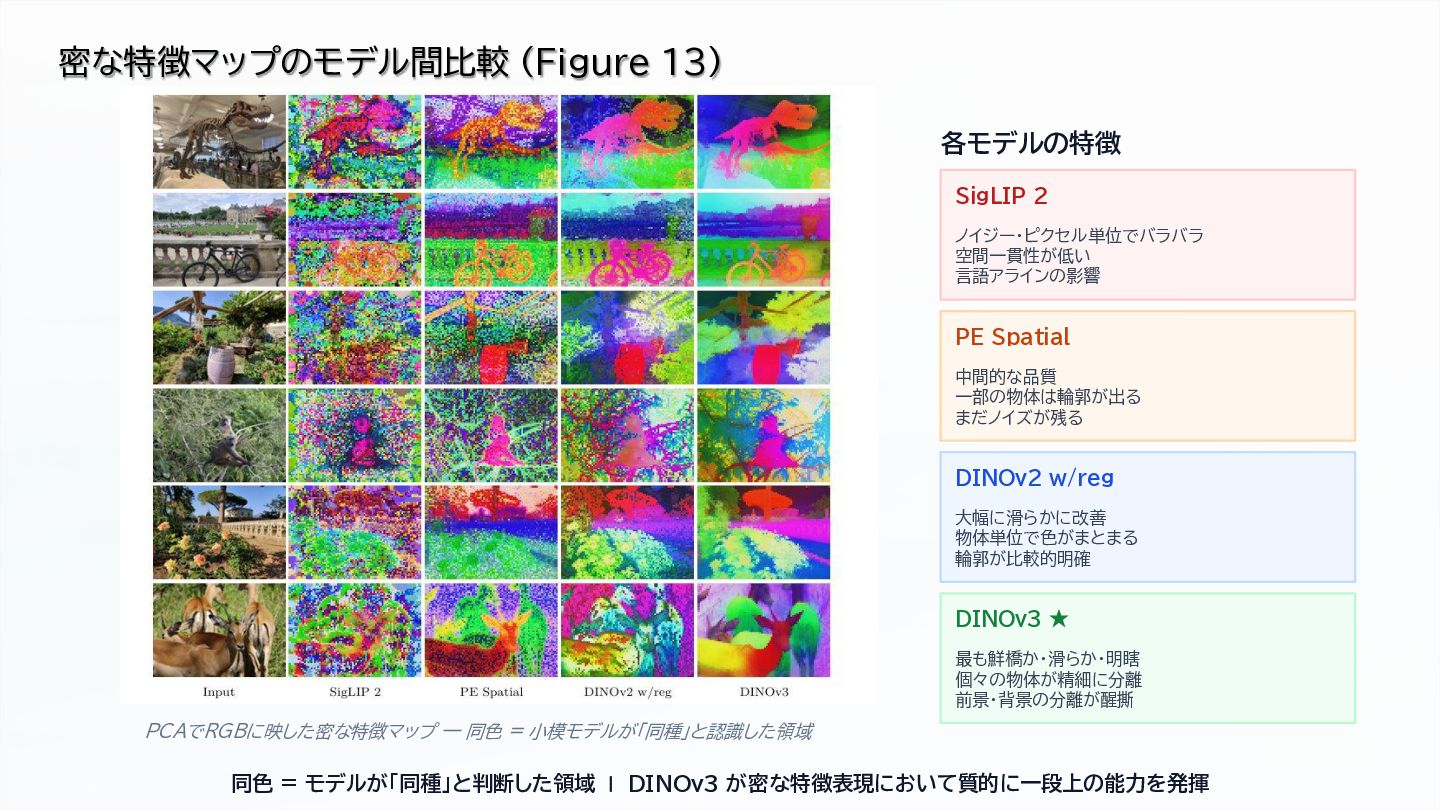
  18. preencoded.png PCAでRGBに映した密な特徴マップ — 同色 = 小模モデルが「同種」と認識した領域 各モデルの特徴 SigLIP 2 ノイジー・ピクセル単位でバラバラ

    空間一貫性が低い 言語アラインの影響 PE Spatial 中間的な品質 一部の物体は輪郭が出る まだノイズが残る DINOv2 w/reg 大幅に滑らかに改善 物体単位で色がまとまる 輪郭が比較的明確 DINOv3 ★ 最も鮮橋か・滑らか・明瞎 個々の物体が精細に分離 前景・背景の分離が醒撕 同色 = モデルが「同種」と判断した領域 ❘ DINOv3 が密な特徴表現において質的に一段上の能力を発揮 密な特徴マップのモデル間比較 (Figure 13)
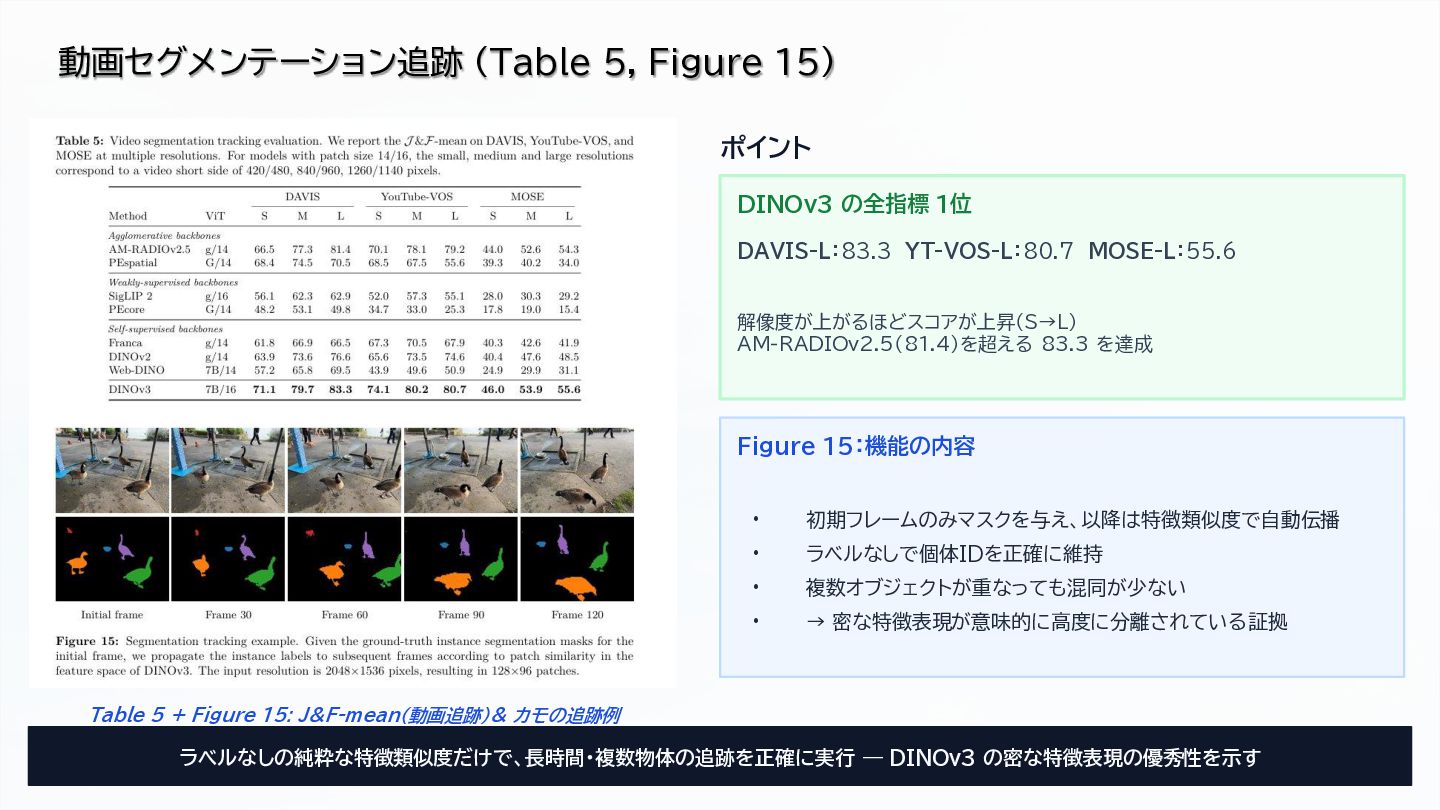
  19. preencoded.png Table 5 + Figure 15: J&F-mean(動画追跡)& カモの追跡例 ポイント DINOv3

    の全指標 1位 DAVIS-L:83.3 YT-VOS-L:80.7 MOSE-L:55.6 解像度が上がるほどスコアが上昇(S→L) AM-RADIOv2.5(81.4)を超える 83.3 を達成 Figure 15:機能の内容 • 初期フレームのみマスクを与え、以降は特徴類似度で自動伝播 • ラベルなしで個体IDを正確に維持 • 複数オブジェクトが重なっても混同が少ない • → 密な特徴表現が意味的に高度に分離されている証拠 ラベルなしの純粋な特徴類似度だけで、長時間・複数物体の追跡を正確に実行 — DINOv3 の密な特徴表現の優秀性を示す 動画セグメンテーション追跡 (Table 5, Figure 15)
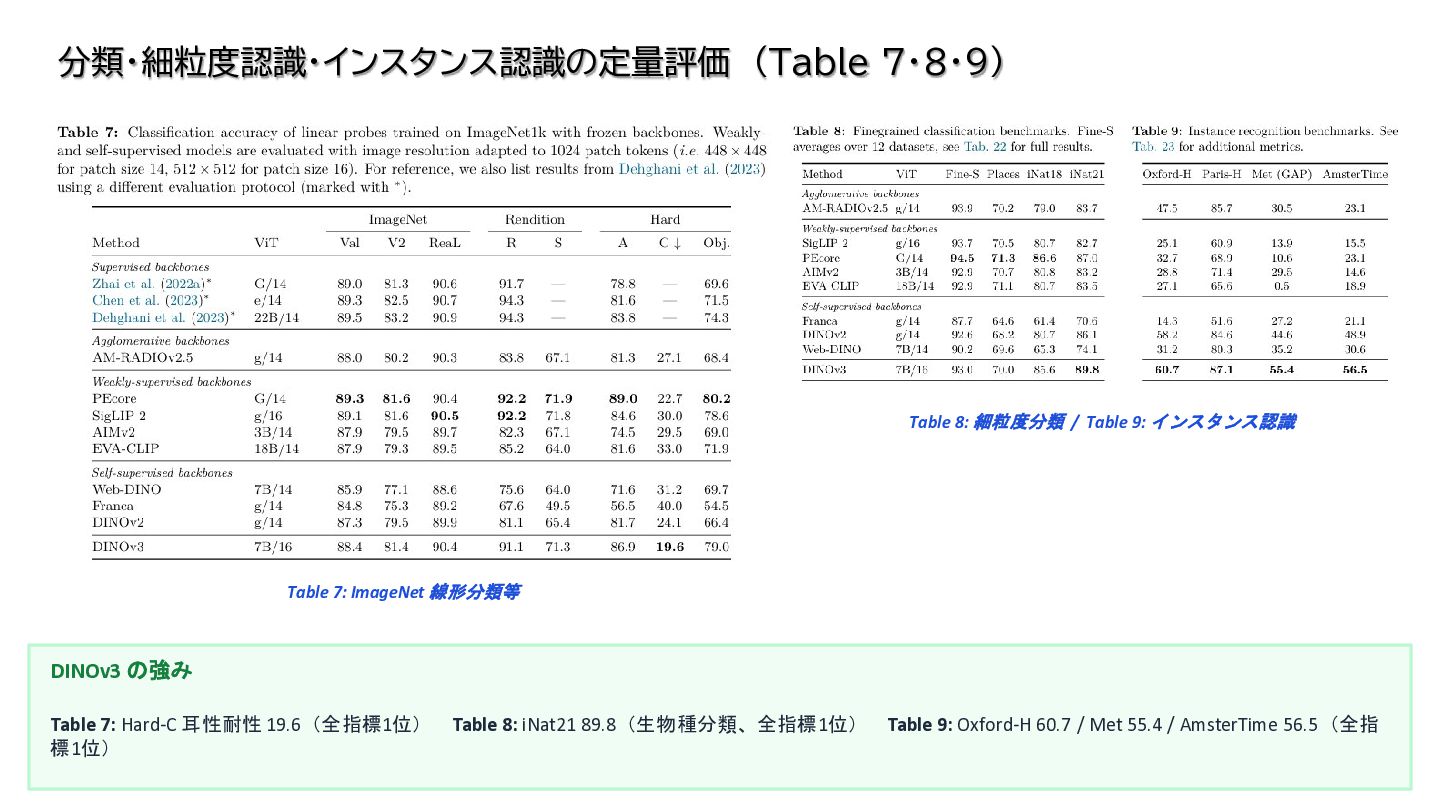
  20. Table 7: ImageNet 線形分類等 Table 8: 細粒度分類 / Table 9:

    インスタンス認識 DINOv3 の強み Table 7: Hard-C 耳性耐性 19.6(全指標1位) Table 8: iNat21 89.8(生物種分類、全指標1位) Table 9: Oxford-H 60.7 / Met 55.4 / AmsterTime 56.5(全指 標1位) 分類・細粒度認識・インスタンス認識の定量評価 (Table 7・8・9)
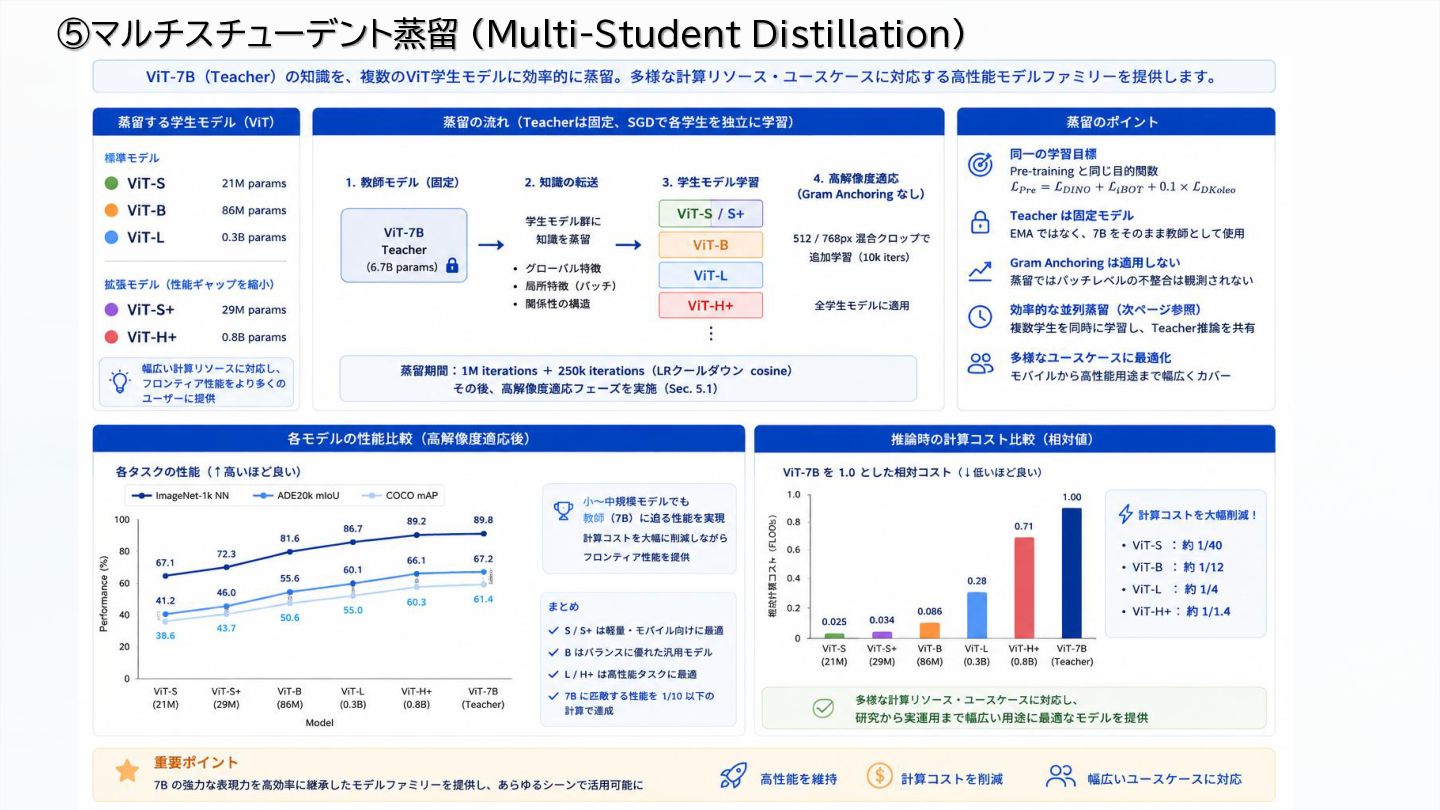
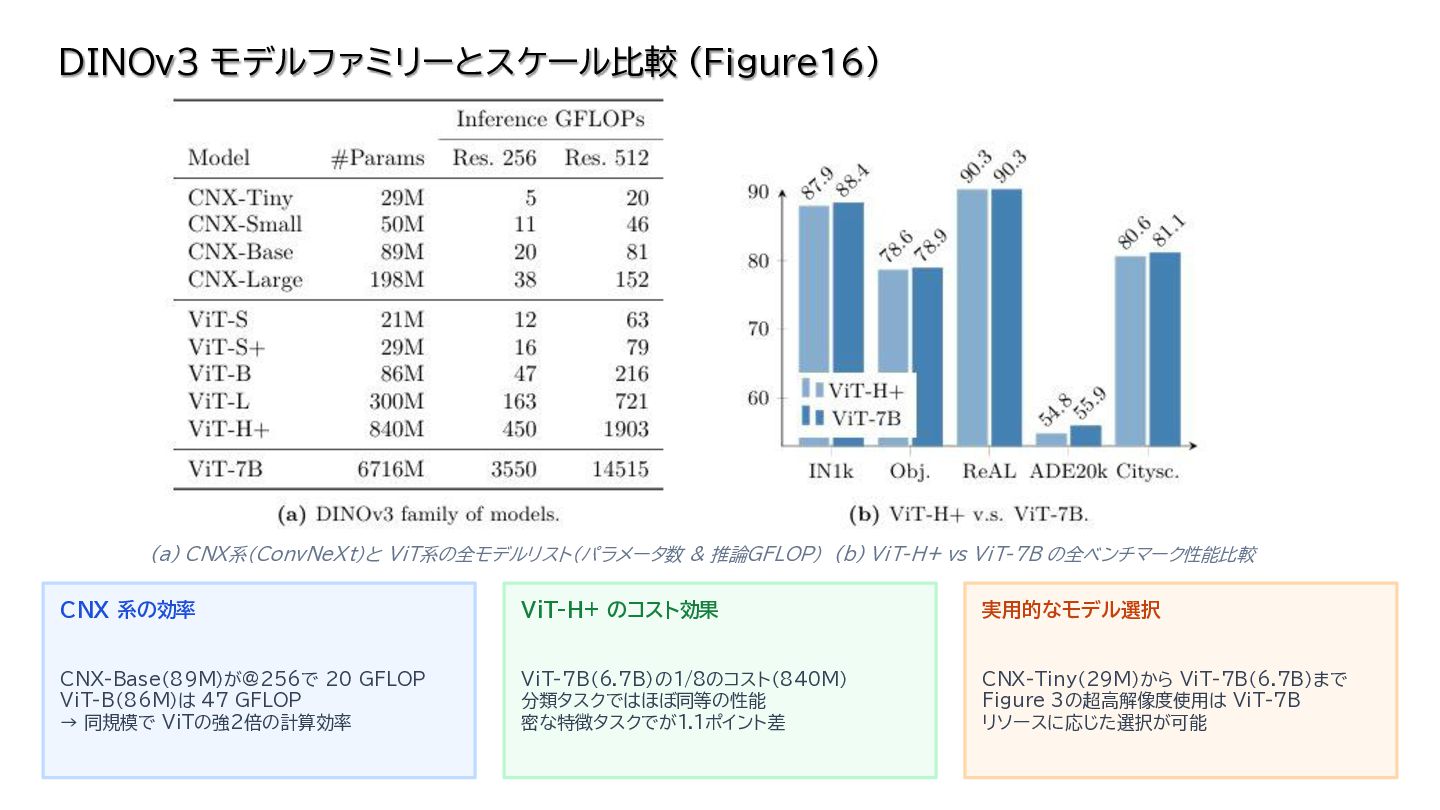
  21. (a) CNX系(ConvNeXt)と ViT系の全モデルリスト(パラメータ数 & 推論GFLOP) (b) ViT-H+ vs ViT-7B の全ベンチマーク性能比較

    CNX 系の効率 CNX-Base(89M)が@256で 20 GFLOP ViT-B(86M)は 47 GFLOP → 同規模で ViTの強2倍の計算効率 ViT-H+ のコスト効果 ViT-7B(6.7B)の1/8のコスト(840M) 分類タスクではほぼ同等の性能 密な特徴タスクでが1.1ポイント差 実用的なモデル選択 CNX-Tiny(29M)から ViT-7B(6.7B)まで Figure 3の超高解像度使用は ViT-7B リソースに応じた選択が可能 DINOv3 モデルファミリーとスケール比較 (Figure16)
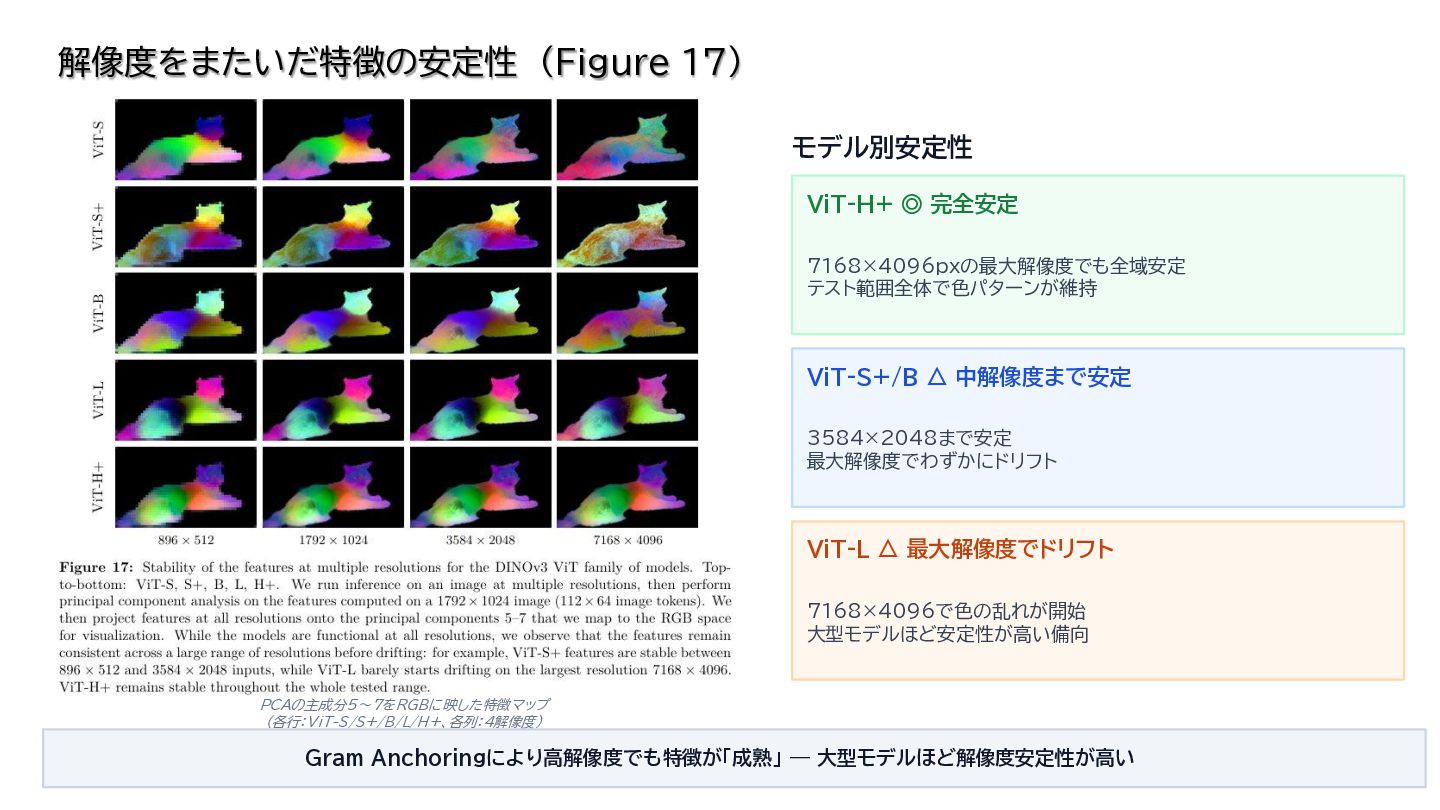
  22. PCAの主成分5~7をRGBに映した特徴マップ (各行:ViT-S/S+/B/L/H+、各列:4解像度) モデル別安定性 ViT-H+ ◎ 完全安定 7168×4096pxの最大解像度でも全域安定 テスト範囲全体で色パターンが維持 ViT-S+/B △

    中解像度まで安定 3584×2048まで安定 最大解像度でわずかにドリフト ViT-L △ 最大解像度でドリフト 7168×4096で色の乱れが開始 大型モデルほど安定性が高い備向 Gram Anchoringにより高解像度でも特徴が「成熟」 — 大型モデルほど解像度安定性が高い 解像度をまたいだ特徴の安定性 (Figure 17)
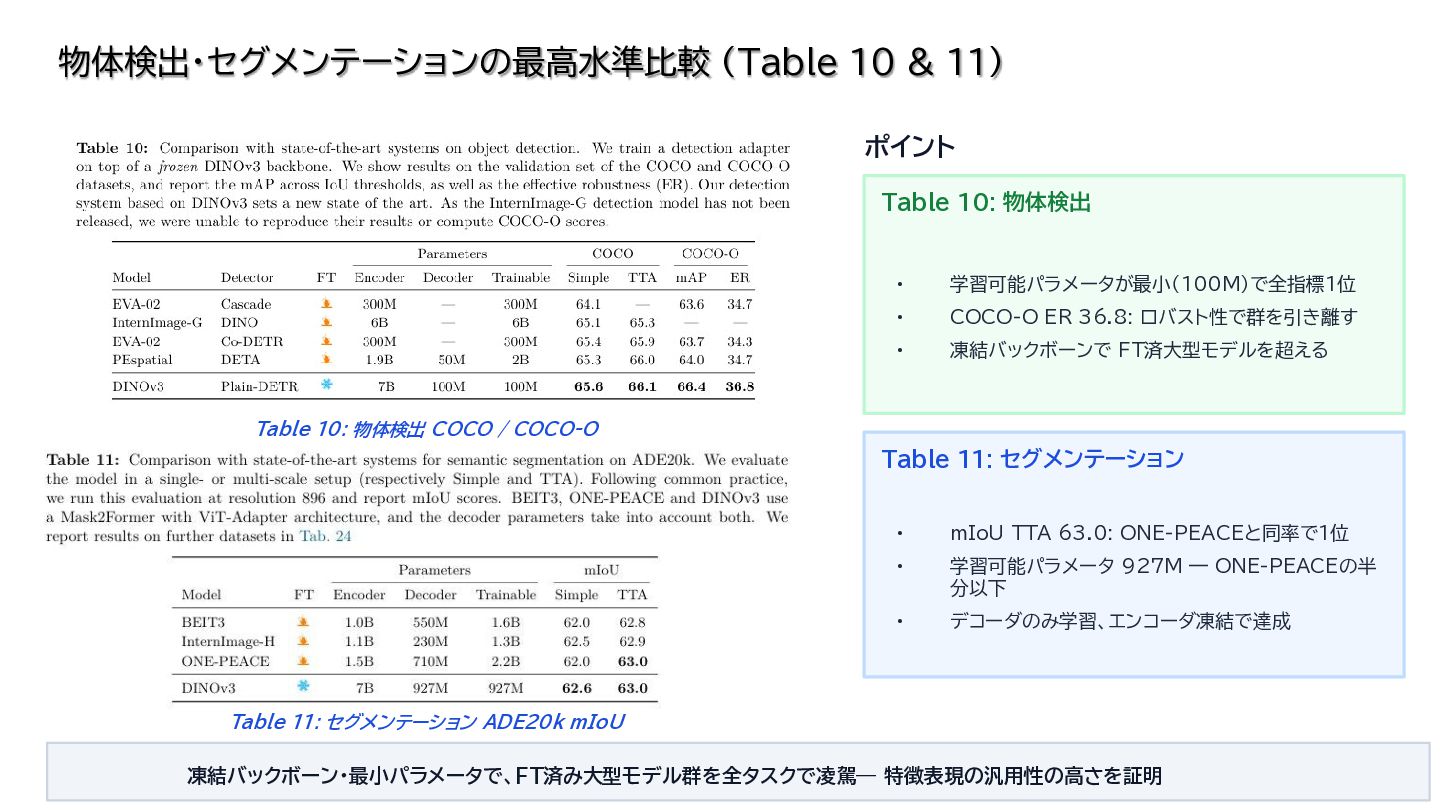
  23. Table 10: 物体検出 COCO / COCO-O Table 11: セグメンテーション ADE20k

    mIoU ポイント Table 10: 物体検出 • 学習可能パラメータが最小(100M)で全指標1位 • COCO-O ER 36.8: ロバスト性で群を引き離す • 凍結バックボーンで FT済大型モデルを超える Table 11: セグメンテーション • mIoU TTA 63.0: ONE-PEACEと同率で1位 • 学習可能パラメータ 927M — ONE-PEACEの半 分以下 • デコーダのみ学習、エンコーダ凍結で達成 凍結バックボーン・最小パラメータで、FT済み大型モデル群を全タスクで凌駕— 特徴表現の汎用性の高さを証明 物体検出・セグメンテーションの最高水準比較 (Table 10 & 11)
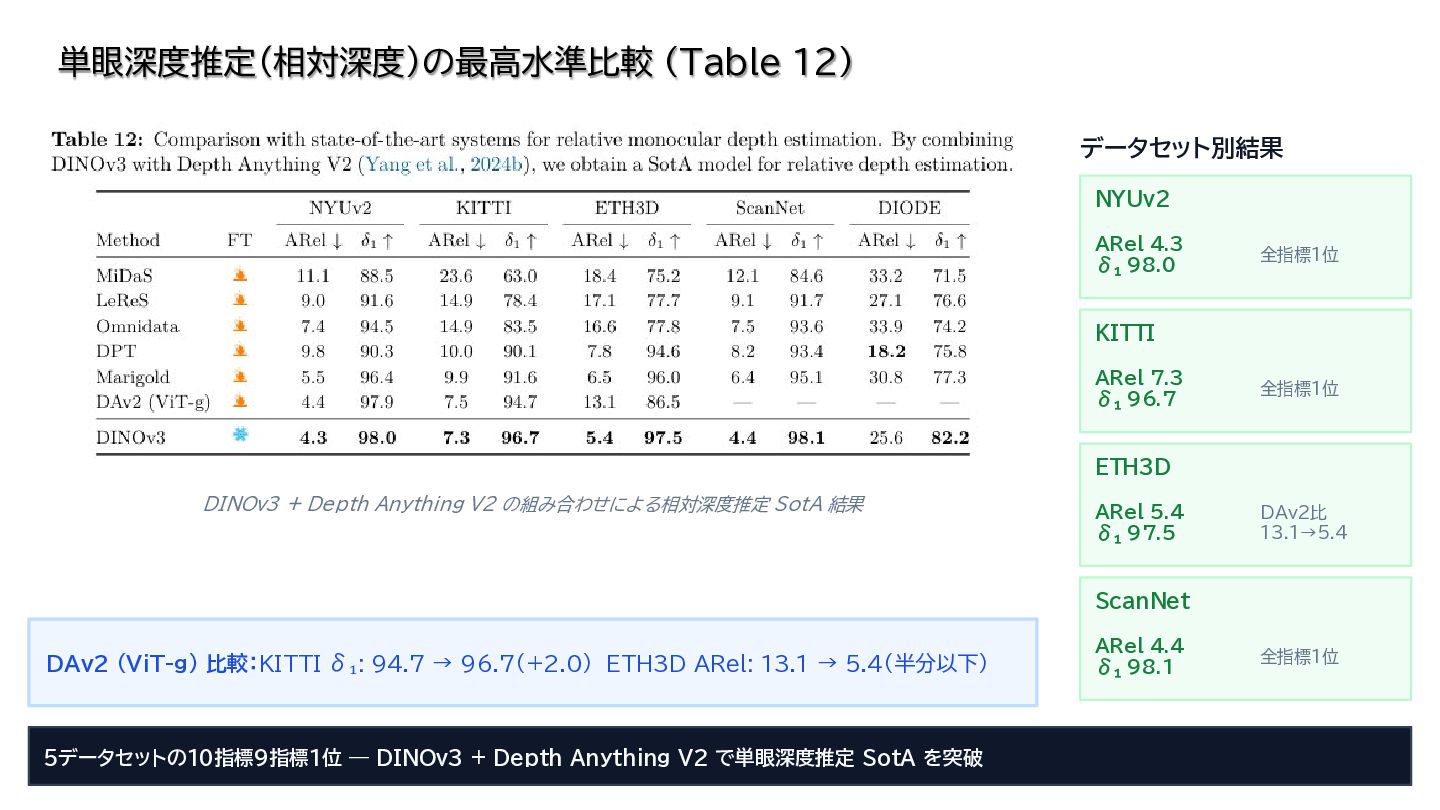
  24. DINOv3 + Depth Anything V2 の組み合わせによる相対深度推定 SotA 結果 データセット別結果 NYUv2

    ARel 4.3 δ₁ 98.0 全指標1位 KITTI ARel 7.3 δ₁ 96.7 全指標1位 ETH3D ARel 5.4 δ₁ 97.5 DAv2比 13.1→5.4 ScanNet ARel 4.4 δ₁ 98.1 全指標1位 DAv2 (ViT-g) 比較:KITTI δ₁: 94.7 → 96.7(+2.0) ETH3D ARel: 13.1 → 5.4(半分以下) 5データセットの10指標9指標1位 — DINOv3 + Depth Anything V2 で単眼深度推定 SotA を突破 単眼深度推定(相対深度)の最高水準比較 (Table 12)
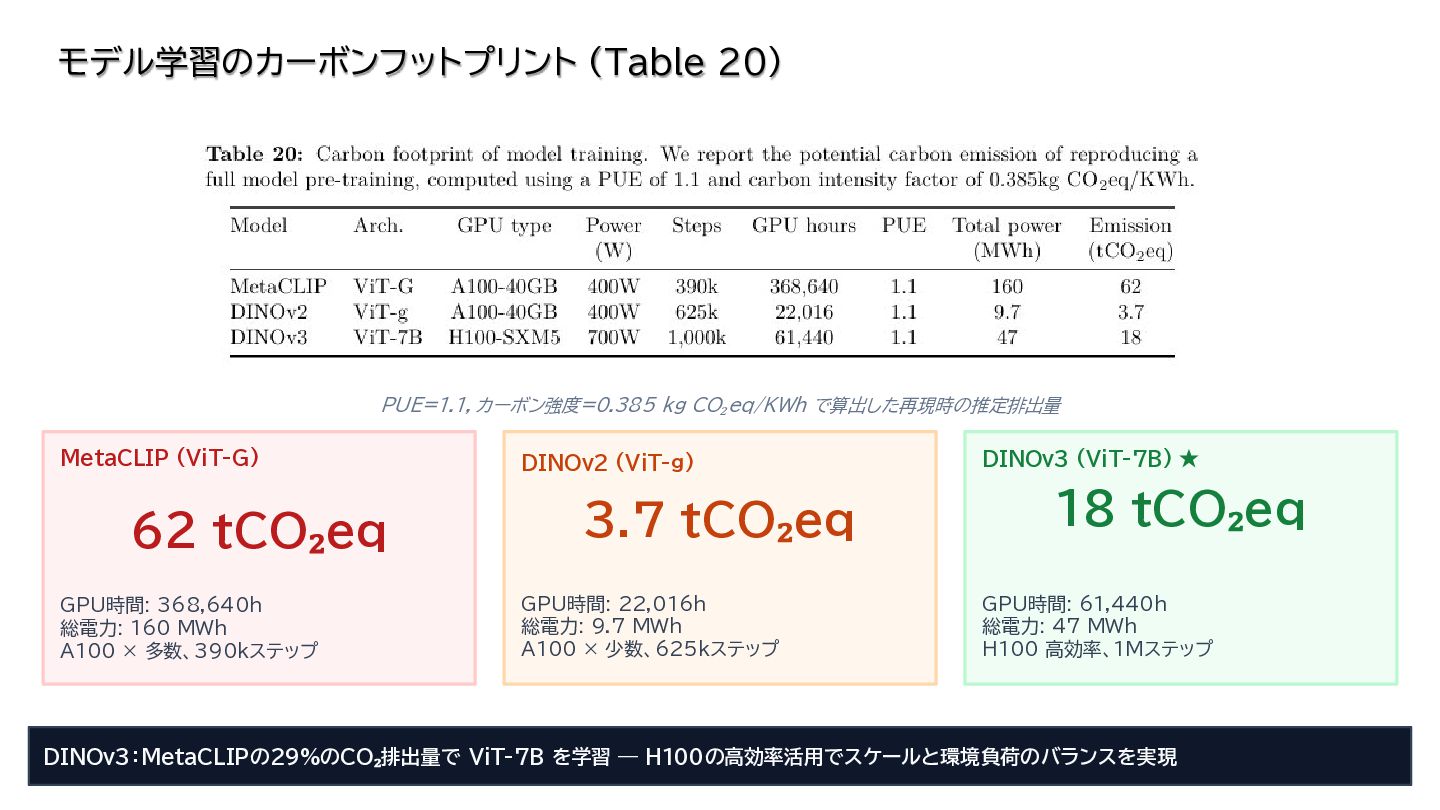
  25. PUE=1.1, カーボン強度=0.385 kg CO₂eq/KWh で算出した再現時の推定排出量 MetaCLIP (ViT-G) 62 tCO₂eq GPU時間:

    368,640h 総電力: 160 MWh A100 × 多数、390kステップ DINOv2 (ViT-g) 3.7 tCO₂eq GPU時間: 22,016h 総電力: 9.7 MWh A100 × 少数、625kステップ DINOv3 (ViT-7B) ★ 18 tCO₂eq GPU時間: 61,440h 総電力: 47 MWh H100 高効率、1Mステップ DINOv3:MetaCLIPの29%のCO₂排出量で ViT-7B を学習 — H100の高効率活用でスケールと環境負荷のバランスを実現 モデル学習のカーボンフットプリント (Table 20)
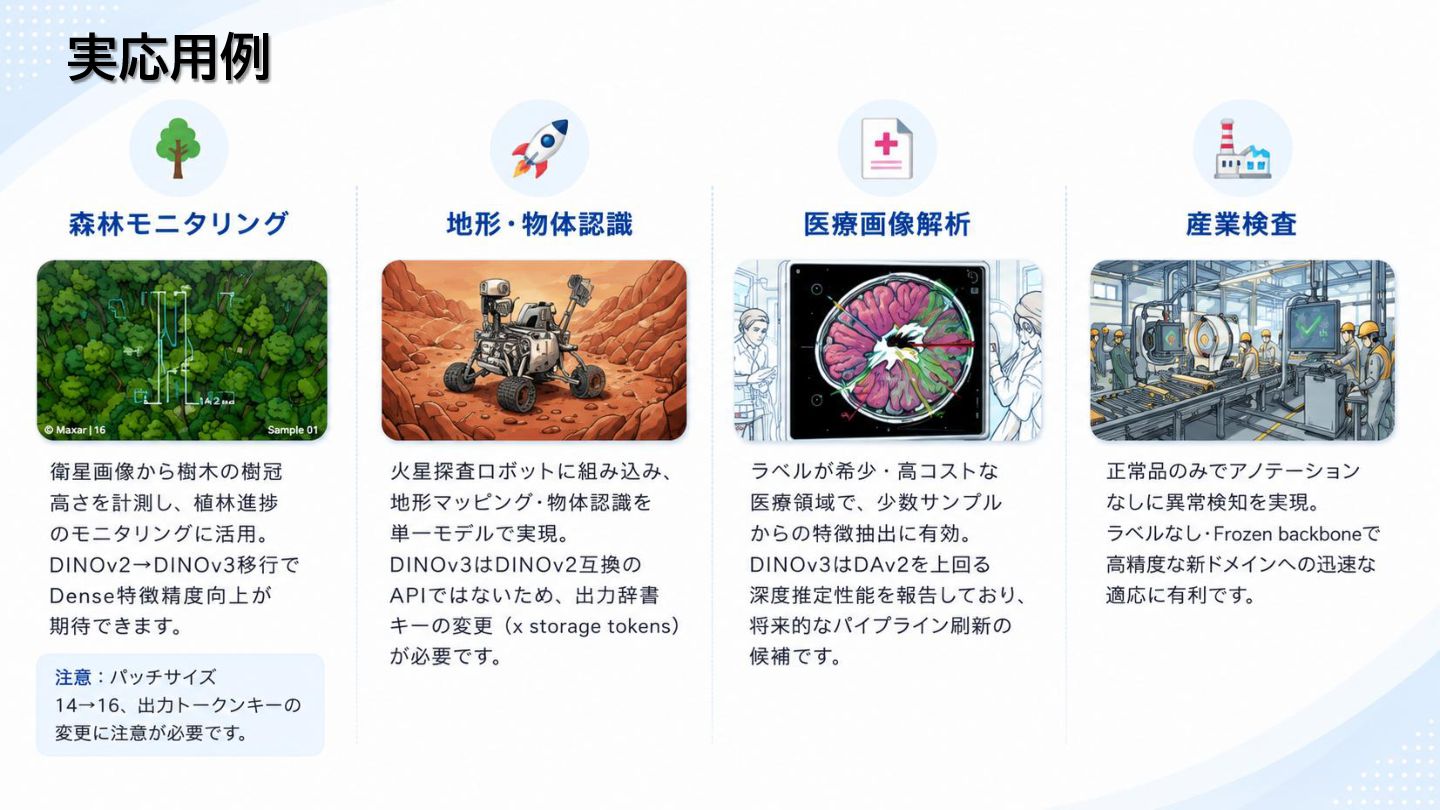
  26. preencoded.png 衛星画像解析(WRI) 衛星画像から樹木の樹冠 高さを計測し、植林進捗 のモニタリングに活用。 DINOv2→DINOv3移 行でDense特徴精度向 上が期待できます。 注意: パッチサイズ

    14→16、出力トークン キーの変更に注意が必要 です。 宇宙探査(NASA JPL) 火星探査ロボットに組み 込み、地形マッピング・物 体認識を単一モデルで実 現。DINOv3は DINOv2互換のAPIで はないため、出力辞書 キーの変更 (x_storage_tokens) が必要です。 医療画像(深度推定) ラベルが希少・高コストな 医療領域で、少数サンプ ルからの特徴抽出に有 効。DINOv3はDAv2を 上回る深度推定性能を報 告しており、将来的なパイ プライン刷新の候補です。 製造・品質検査 正常品のみでアノテー ションなしに異常検知を 実現。ラベルなし・ Frozen backboneで 高精度な新ドメインへの 迅速な適応に有利です。 実応用例
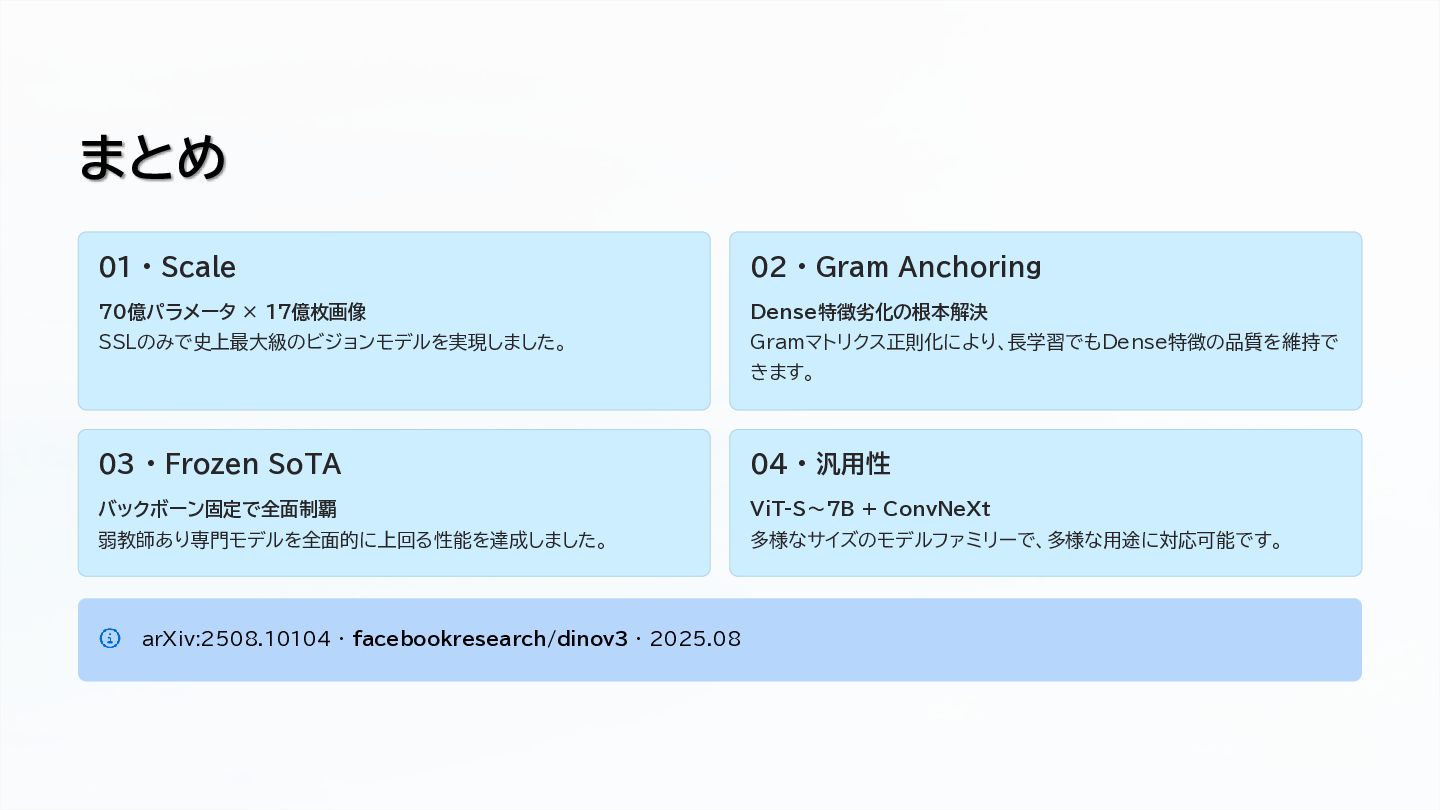
  27. preencoded.png まとめ 01 · Scale 70億パラメータ × 17億枚画像 SSLのみで史上最大級のビジョンモデルを実現しました。 02

    · Gram Anchoring Dense特徴劣化の根本解決 Gramマトリクス正則化により、長学習でもDense特徴の品質を維持で きます。 03 · Frozen SoTA バックボーン固定で全面制覇 弱教師あり専門モデルを全面的に上回る性能を達成しました。 04 · 汎用性 ViT-S〜7B + ConvNeXt 多様なサイズのモデルファミリーで、多様な用途に対応可能です。 arXiv:2508.10104 · facebookresearch/dinov3 · 2025.08

More Decks by yuyu4Tech

Other Decks in Technology