Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【論文紹介】DINOv2: Seeing Without Supervision

【論文紹介】DINOv2: Seeing Without Supervision

A deep dive into Meta AI's self-supervised vision foundation model — exploring how DINOv2 learns robust visual features from 142M curated images without any labels, and why it rivals weakly-supervised methods across classification, segmentation, depth estimation, and beyond.

yuyu4Tech

April 13, 2026

Transcript

38 slides
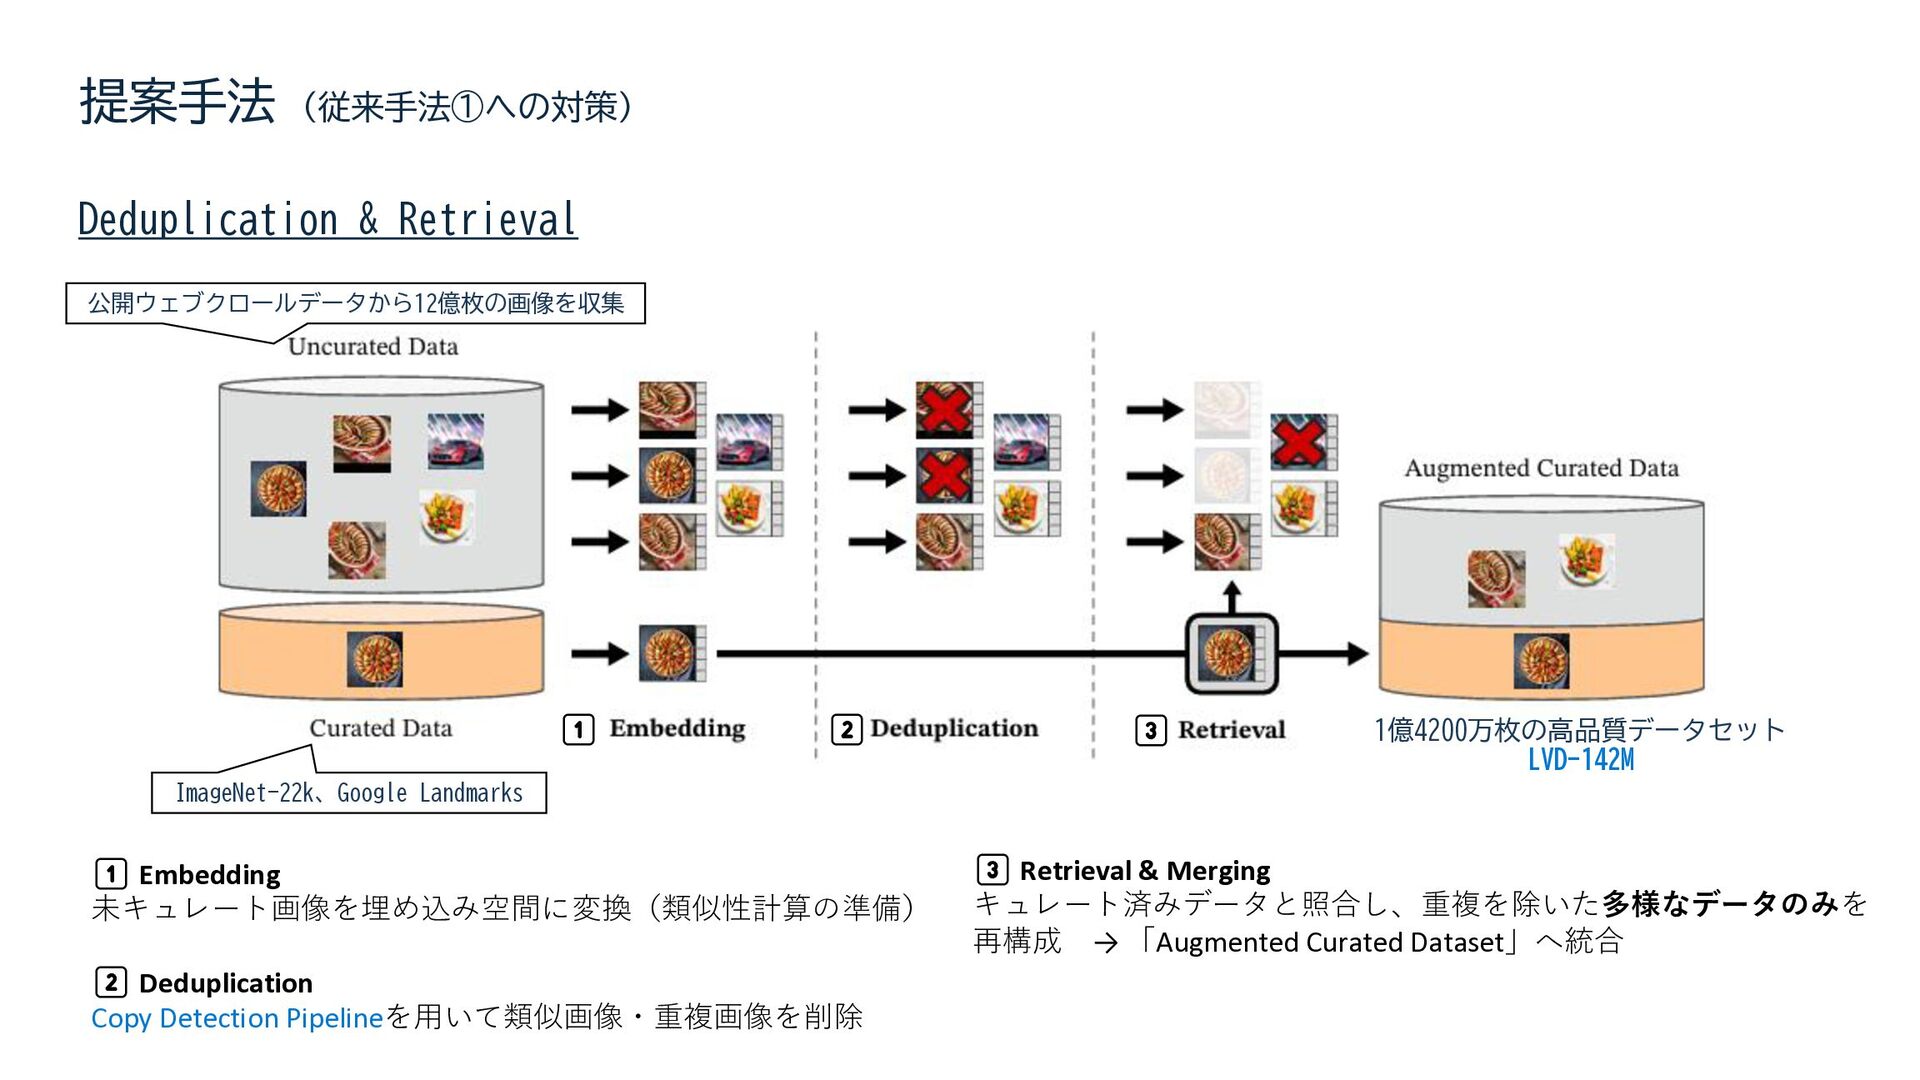
  1. 提案手法 (従来手法①への対策) 1️⃣ Embedding 未キュレート画像を埋め込み空間に変換(類似性計算の準備) 2️⃣ Deduplication Copy Detection Pipelineを用いて類似画像・重複画像を削除

    1️⃣ 2️⃣ 3️⃣ ImageNet-22k、Google Landmarks 1億4200万枚の高品質データセット LVD-142M 公開ウェブクロールデータから12億枚の画像を収集 3️⃣ Retrieval & Merging キュレート済みデータと照合し、重複を除いた多様なデータのみを 再構成 → 「Augmented Curated Dataset」へ統合 Deduplication & Retrieval
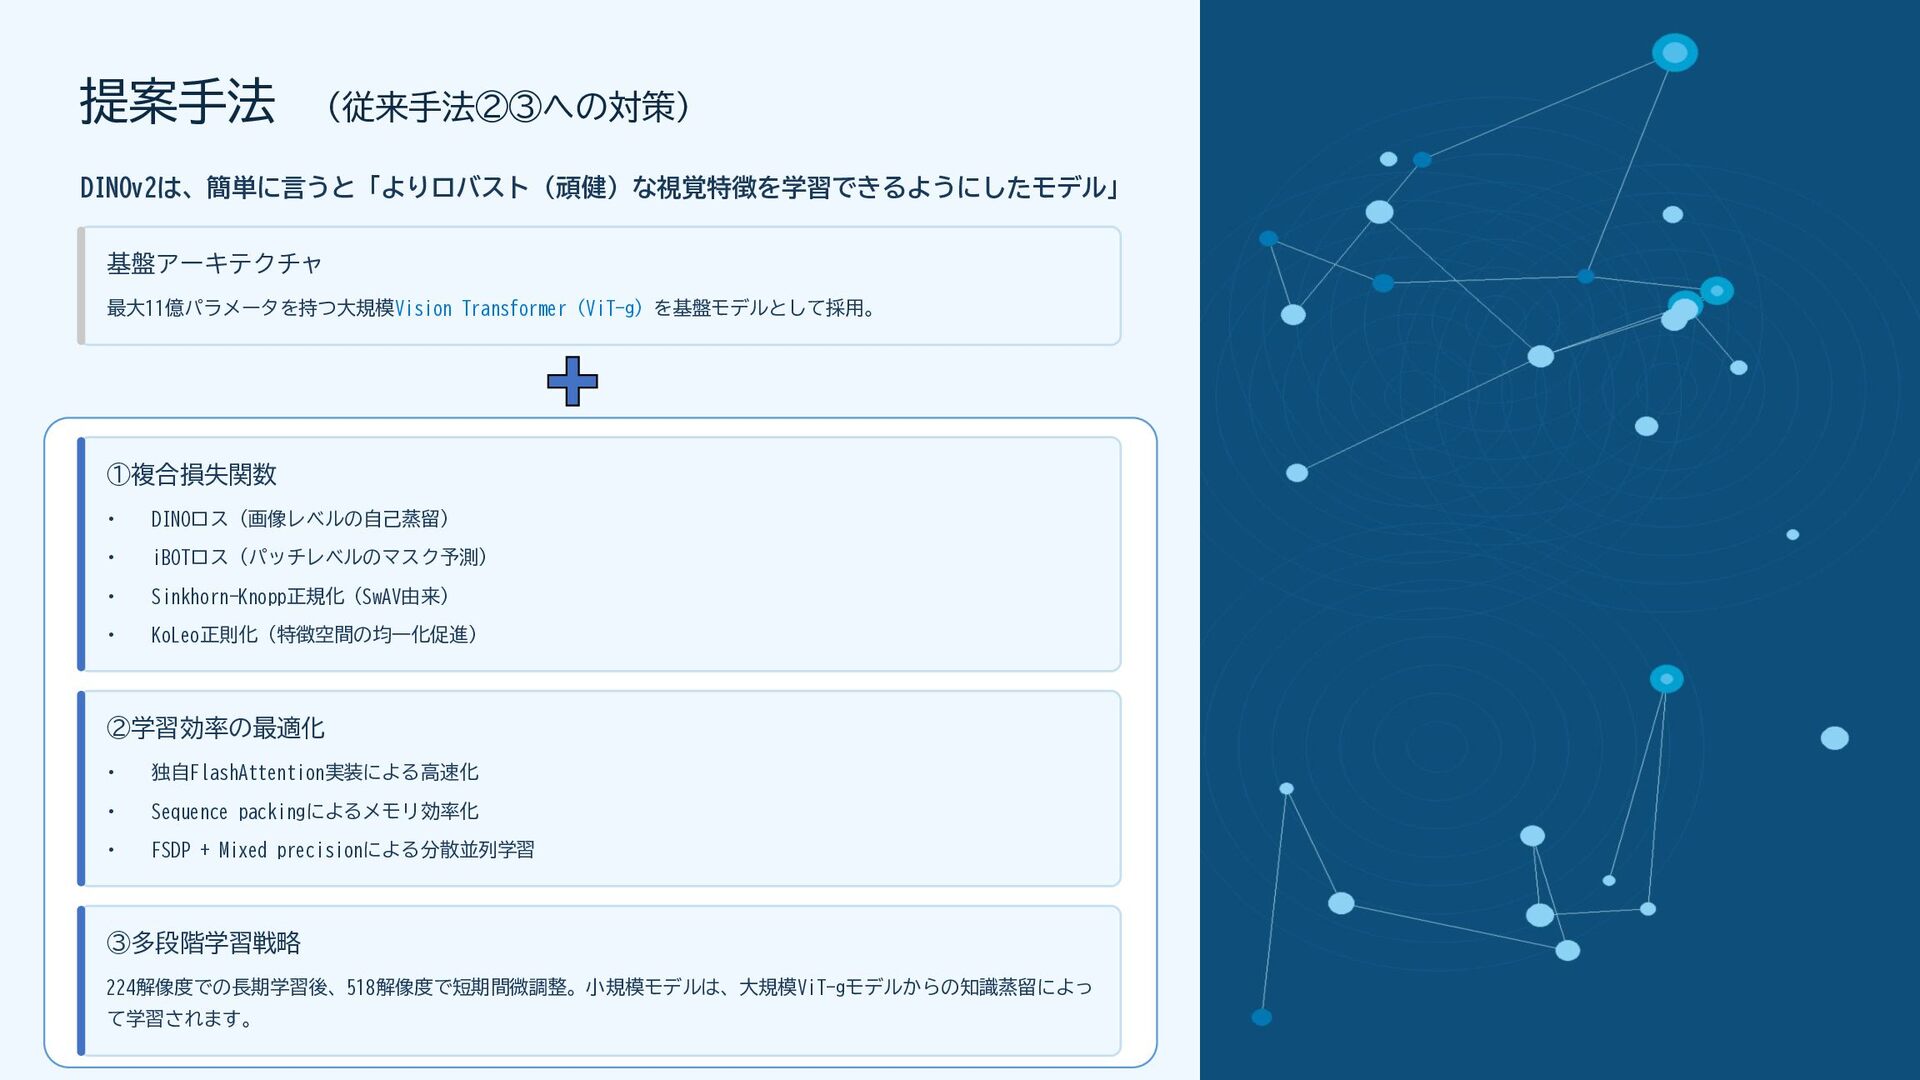
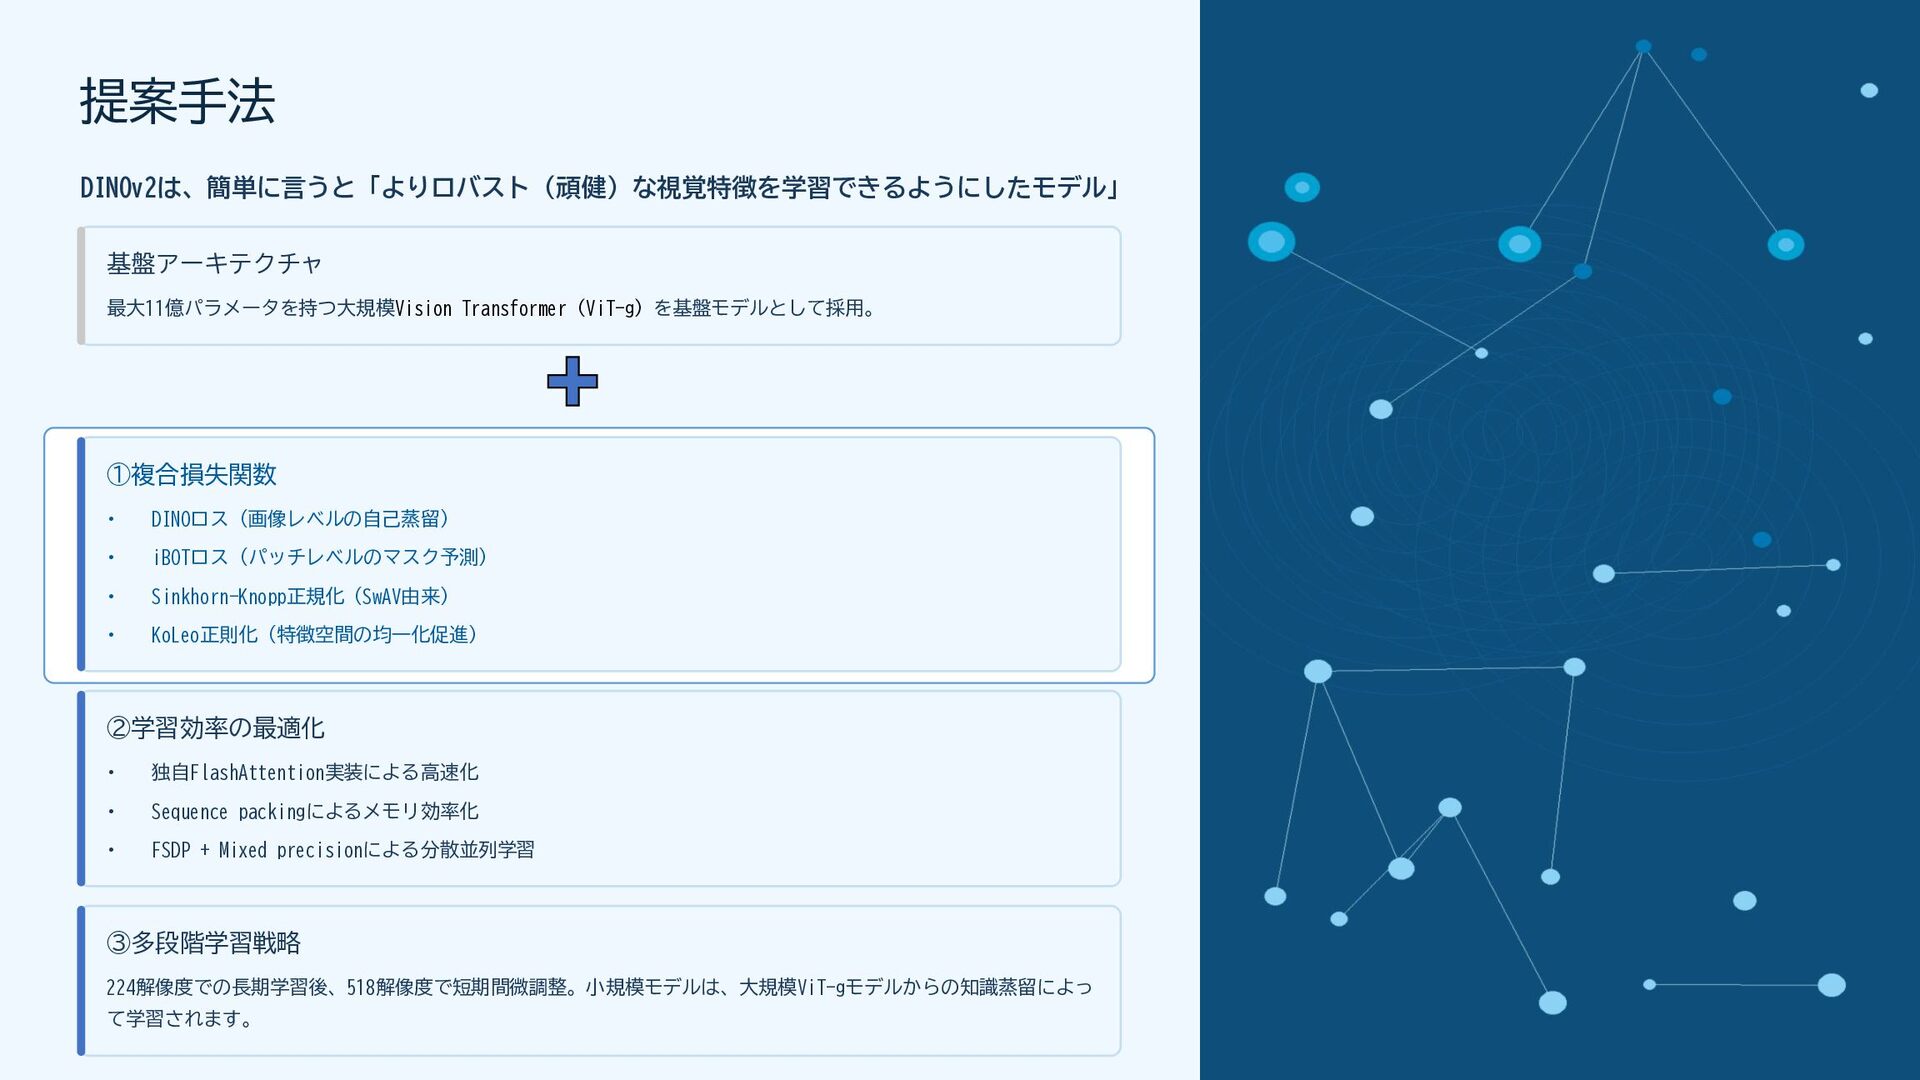
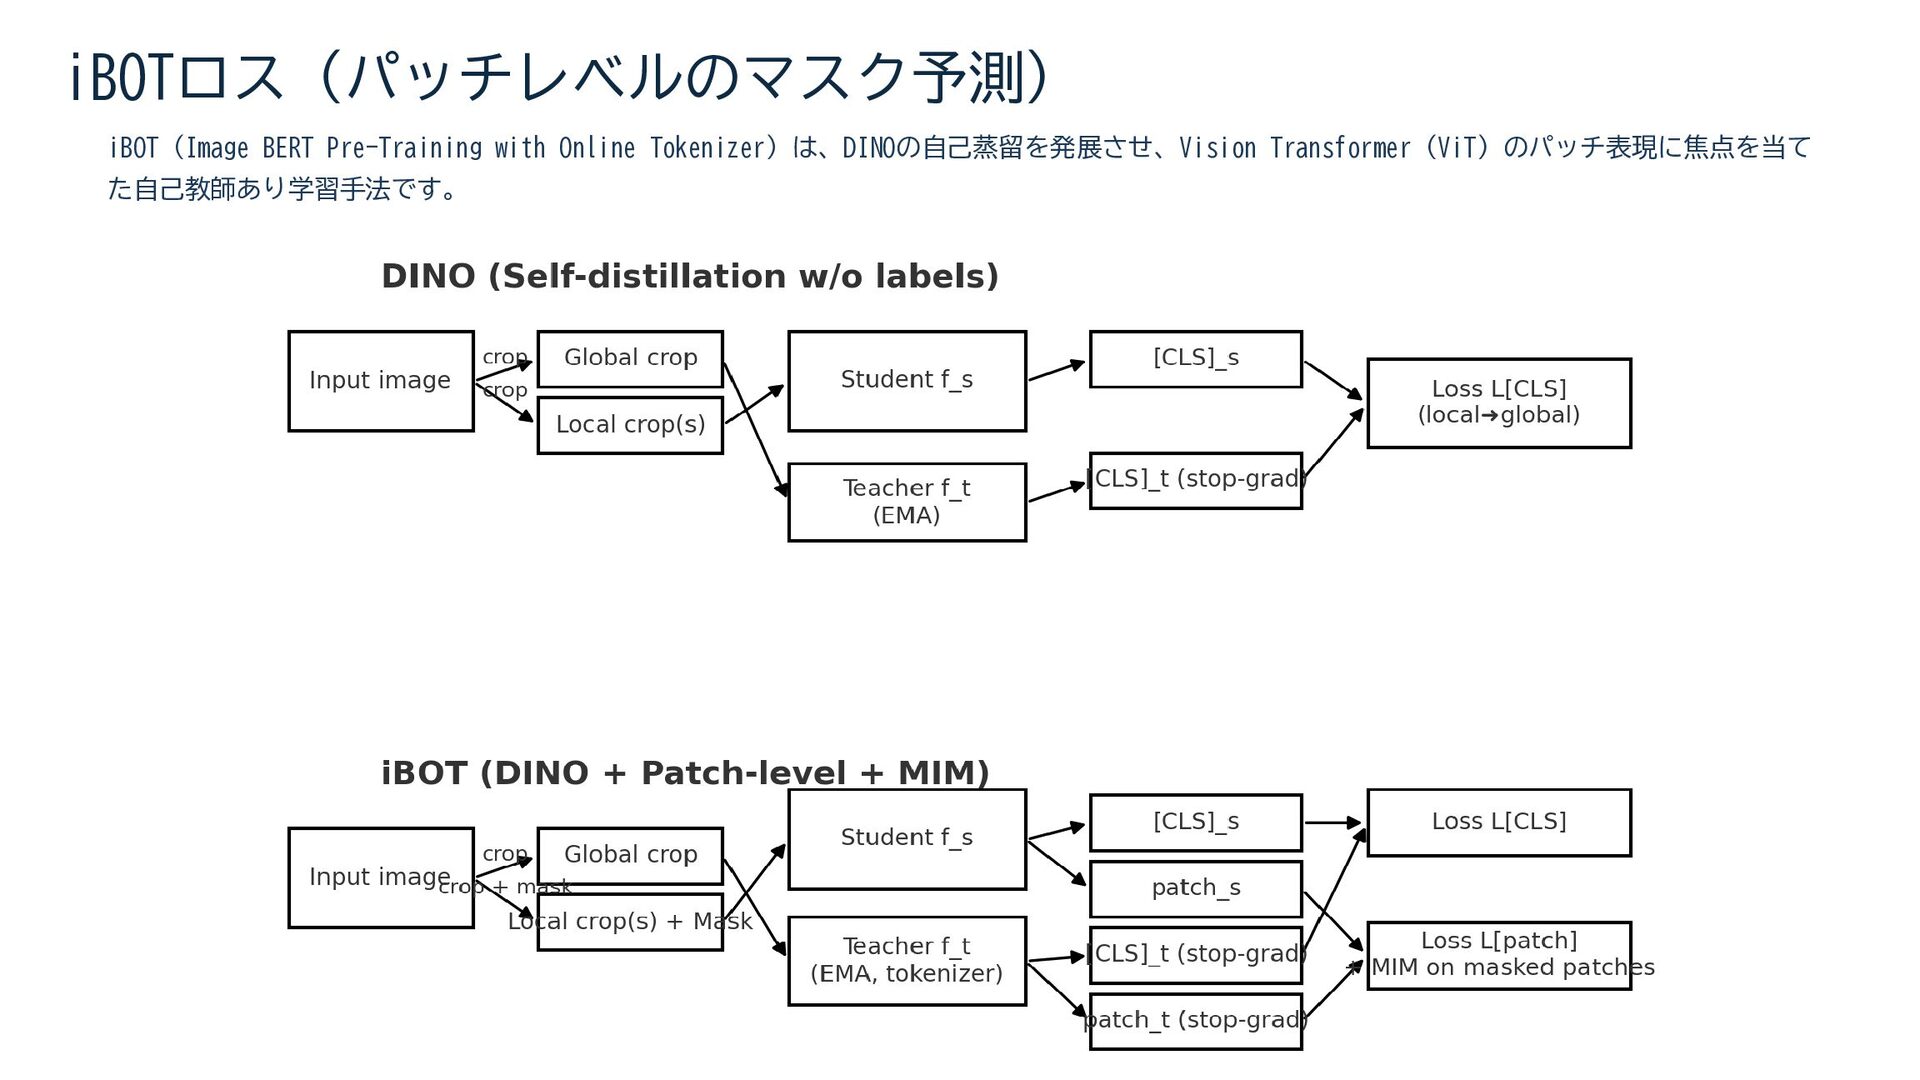
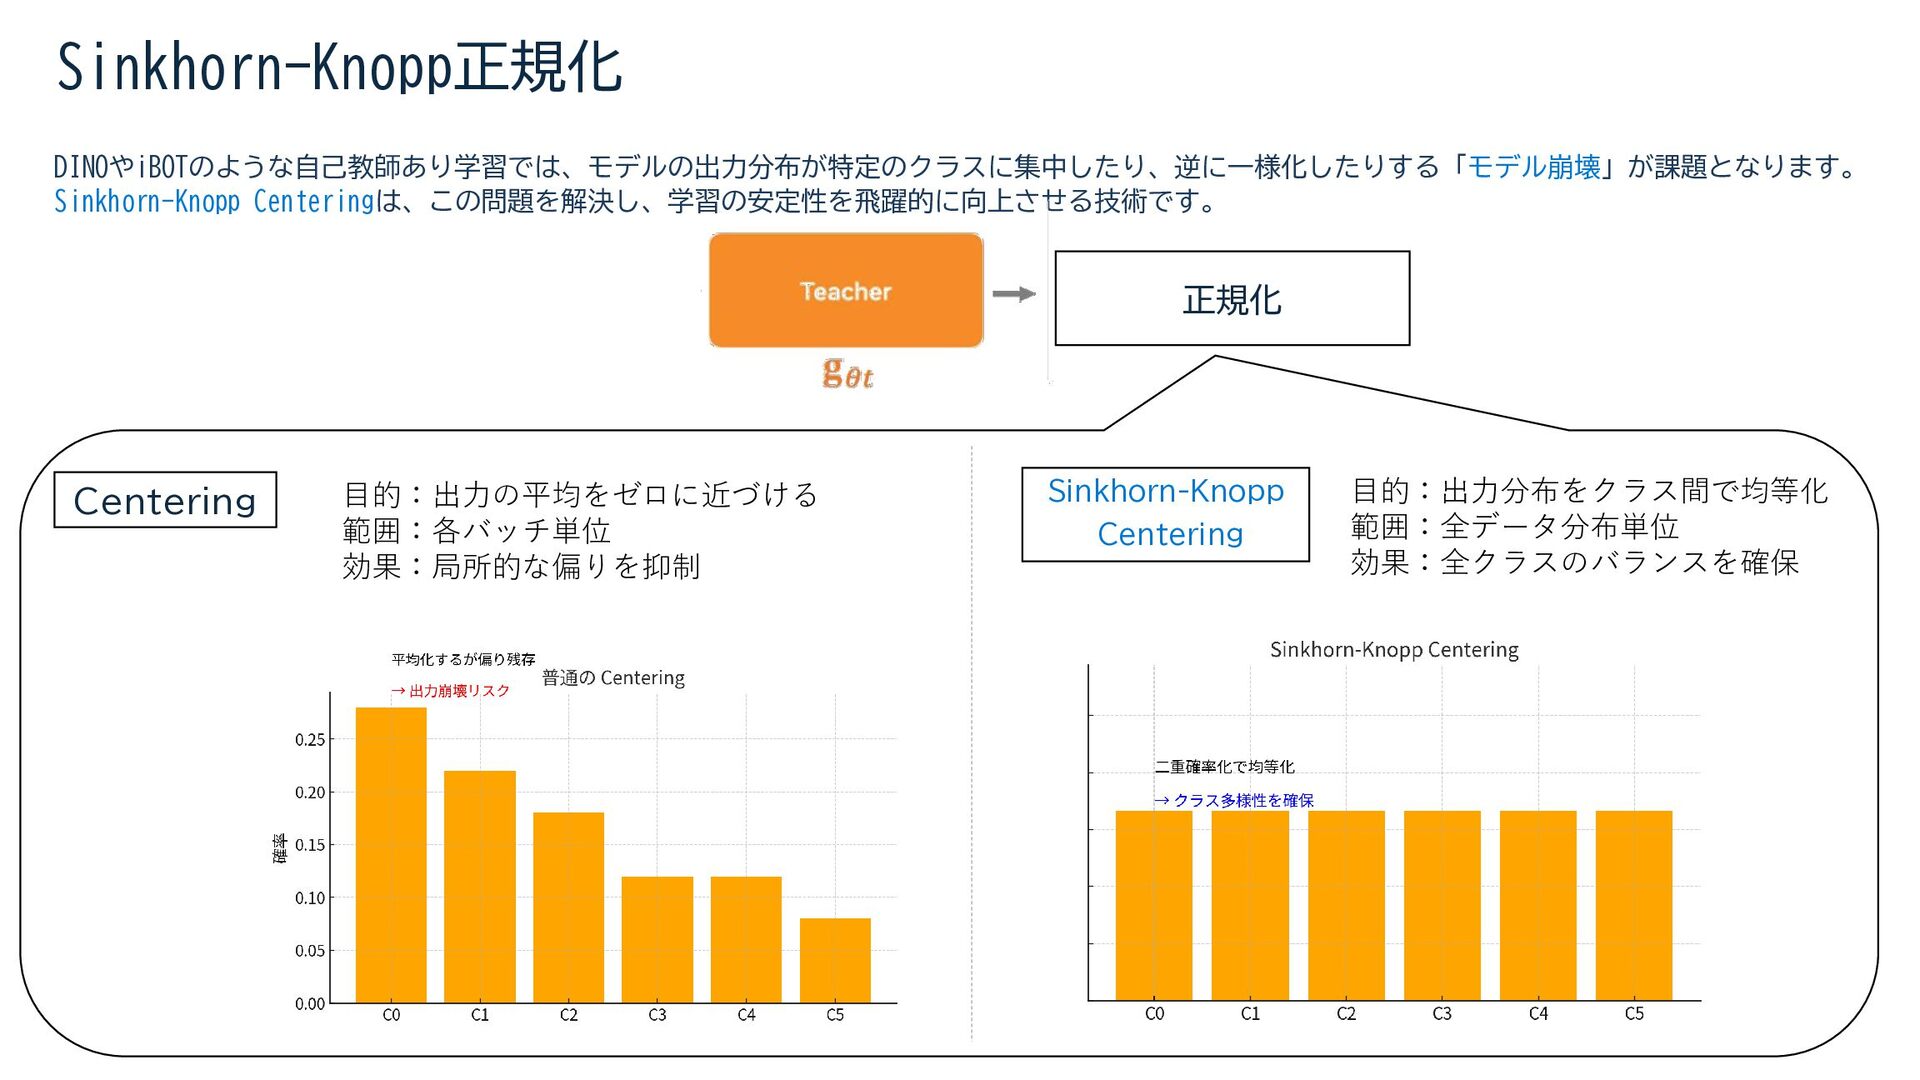
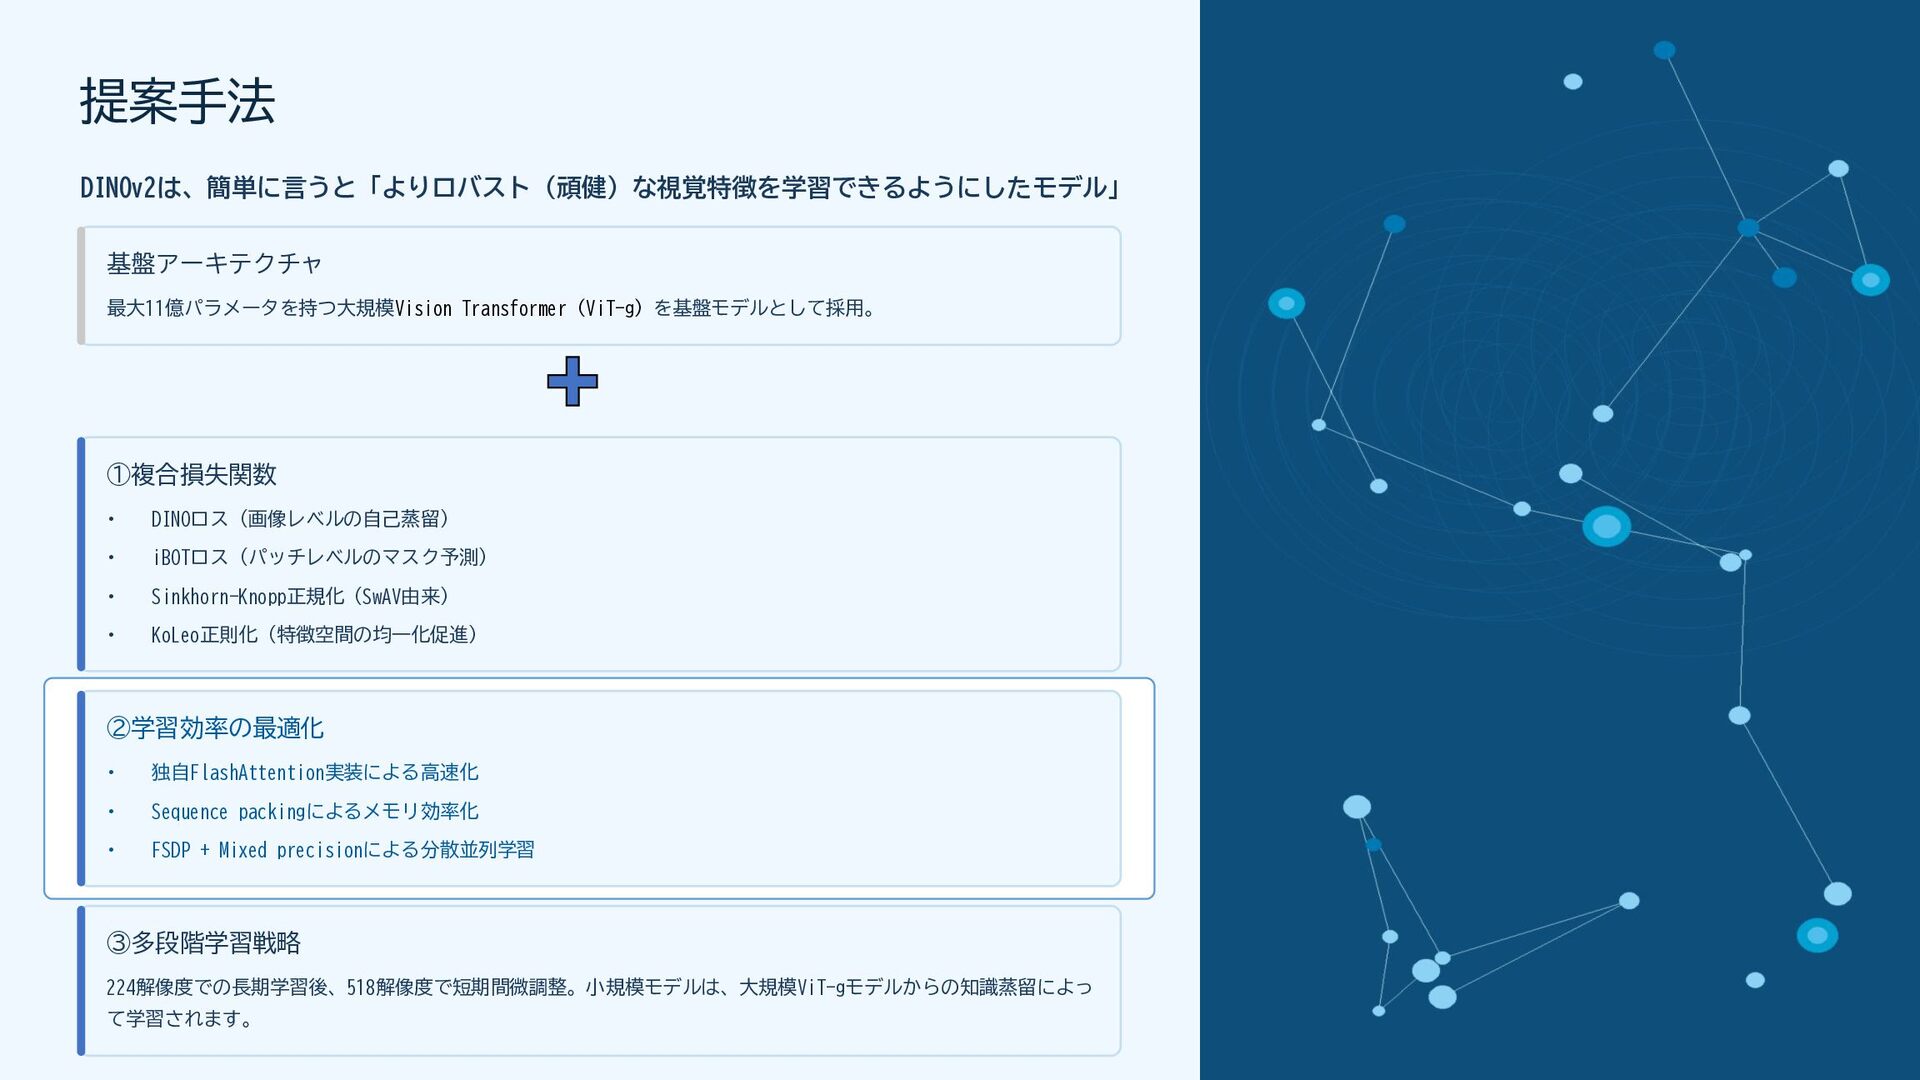
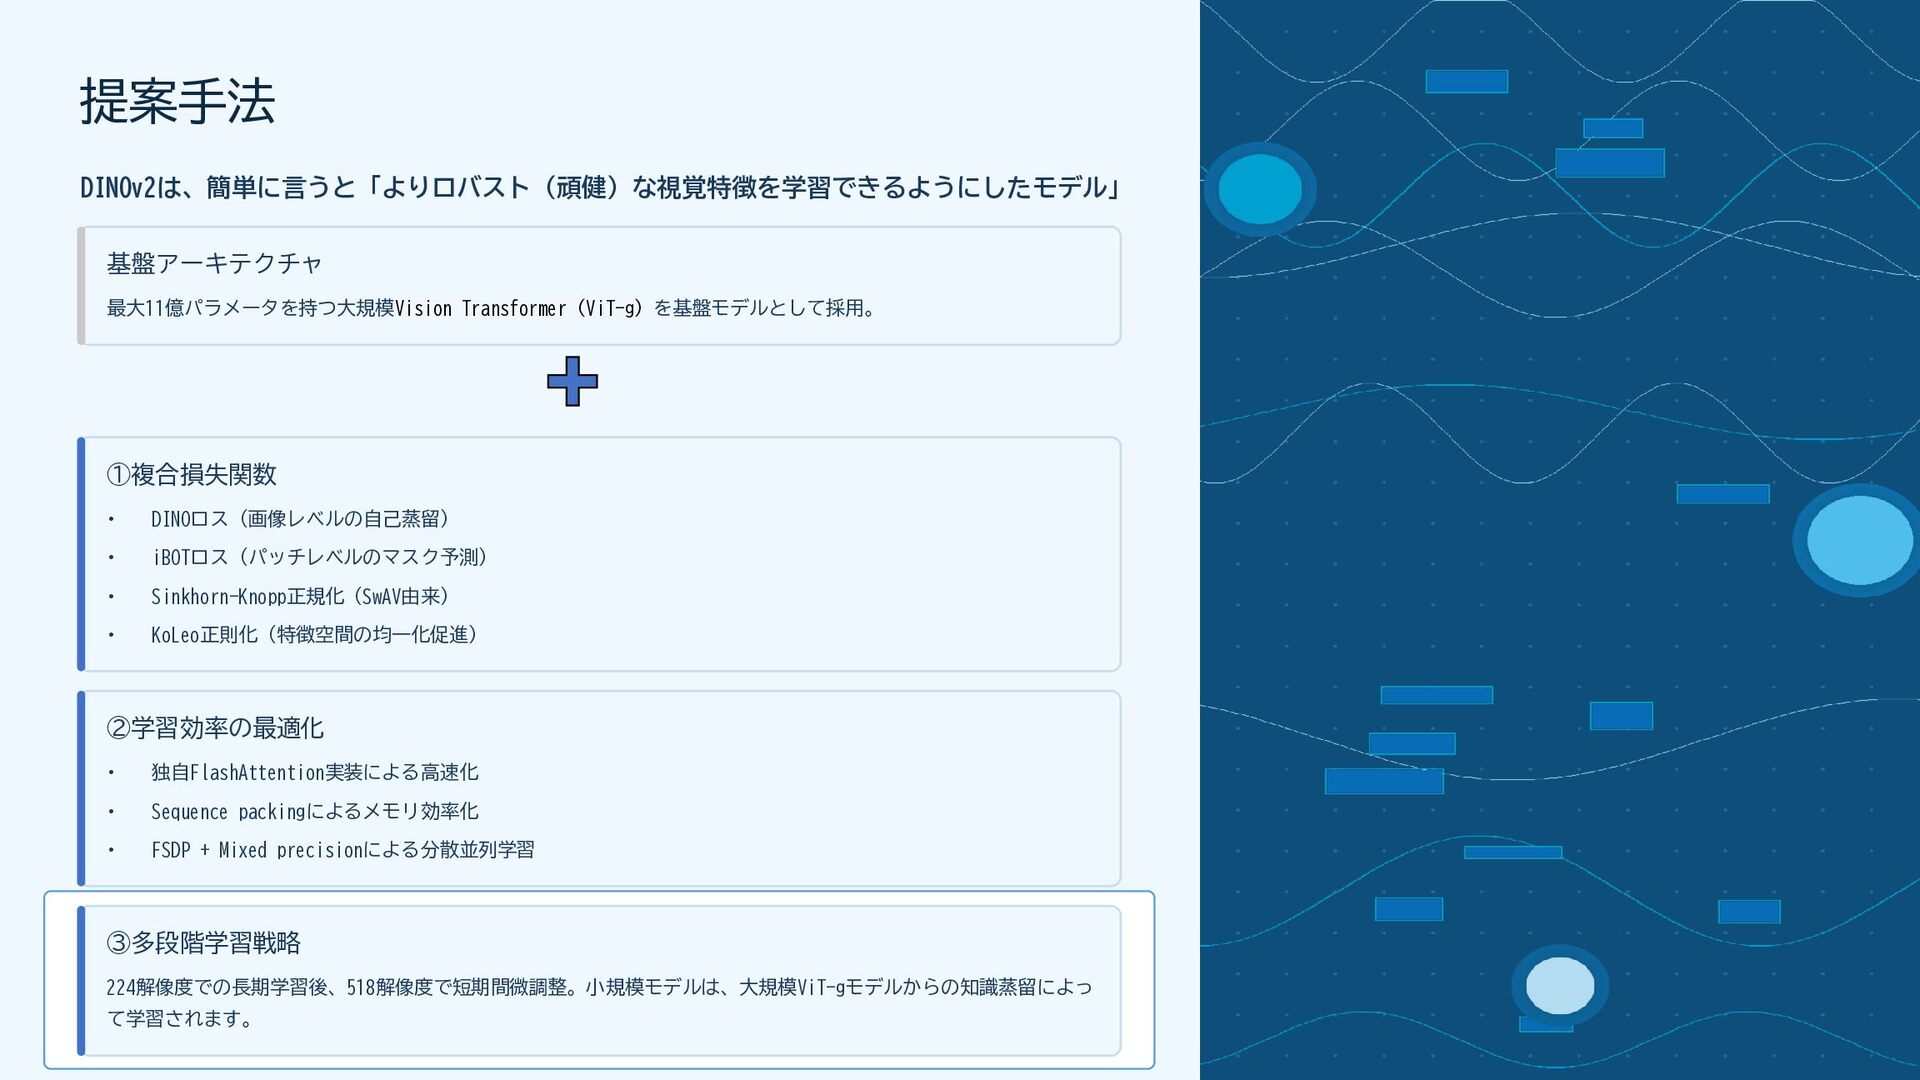
  2. preencoded.png 提案手法 (従来手法②③への対策) DINOv2は、簡単に言うと「よりロバスト(頑健)な視覚特徴を学習できるようにしたモデル」 基盤アーキテクチャ 最大11億パラメータを持つ大規模Vision Transformer (ViT-g) を基盤モデルとして採用。 ①複合損失関数

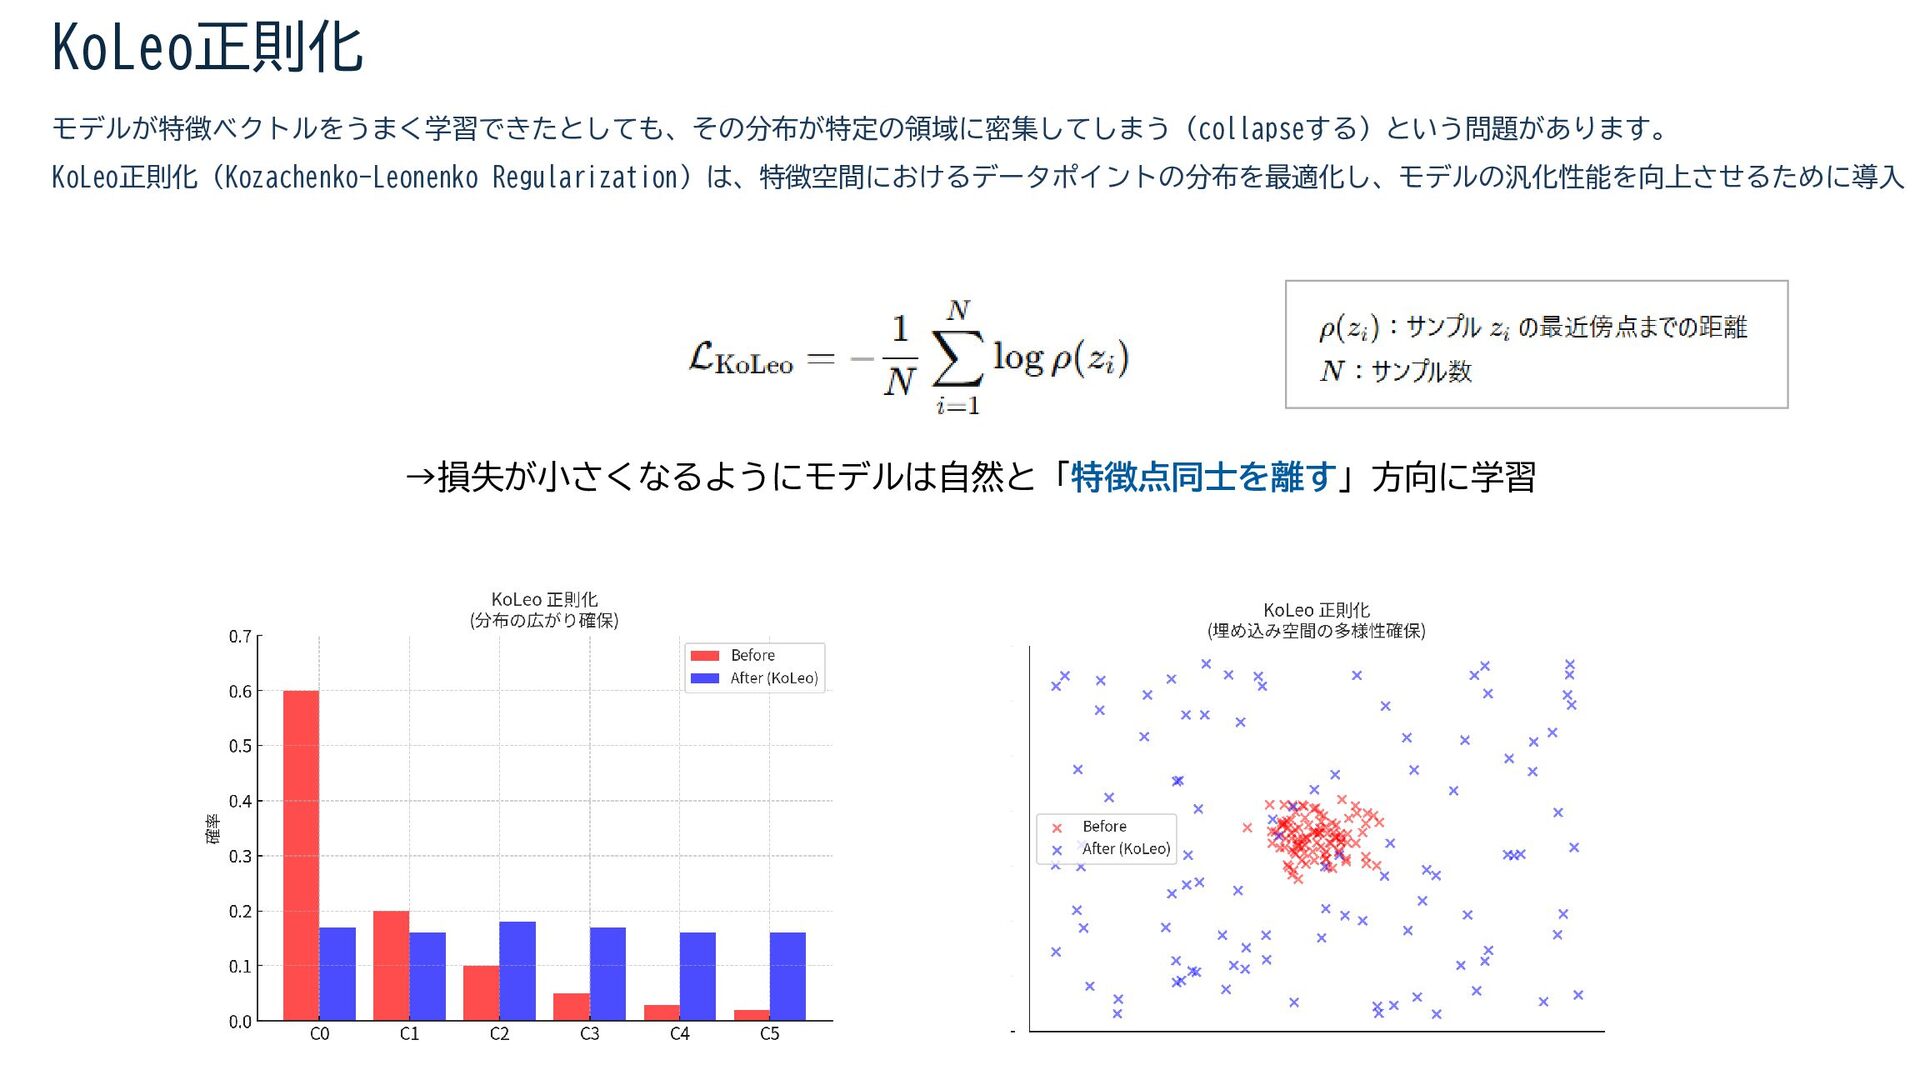
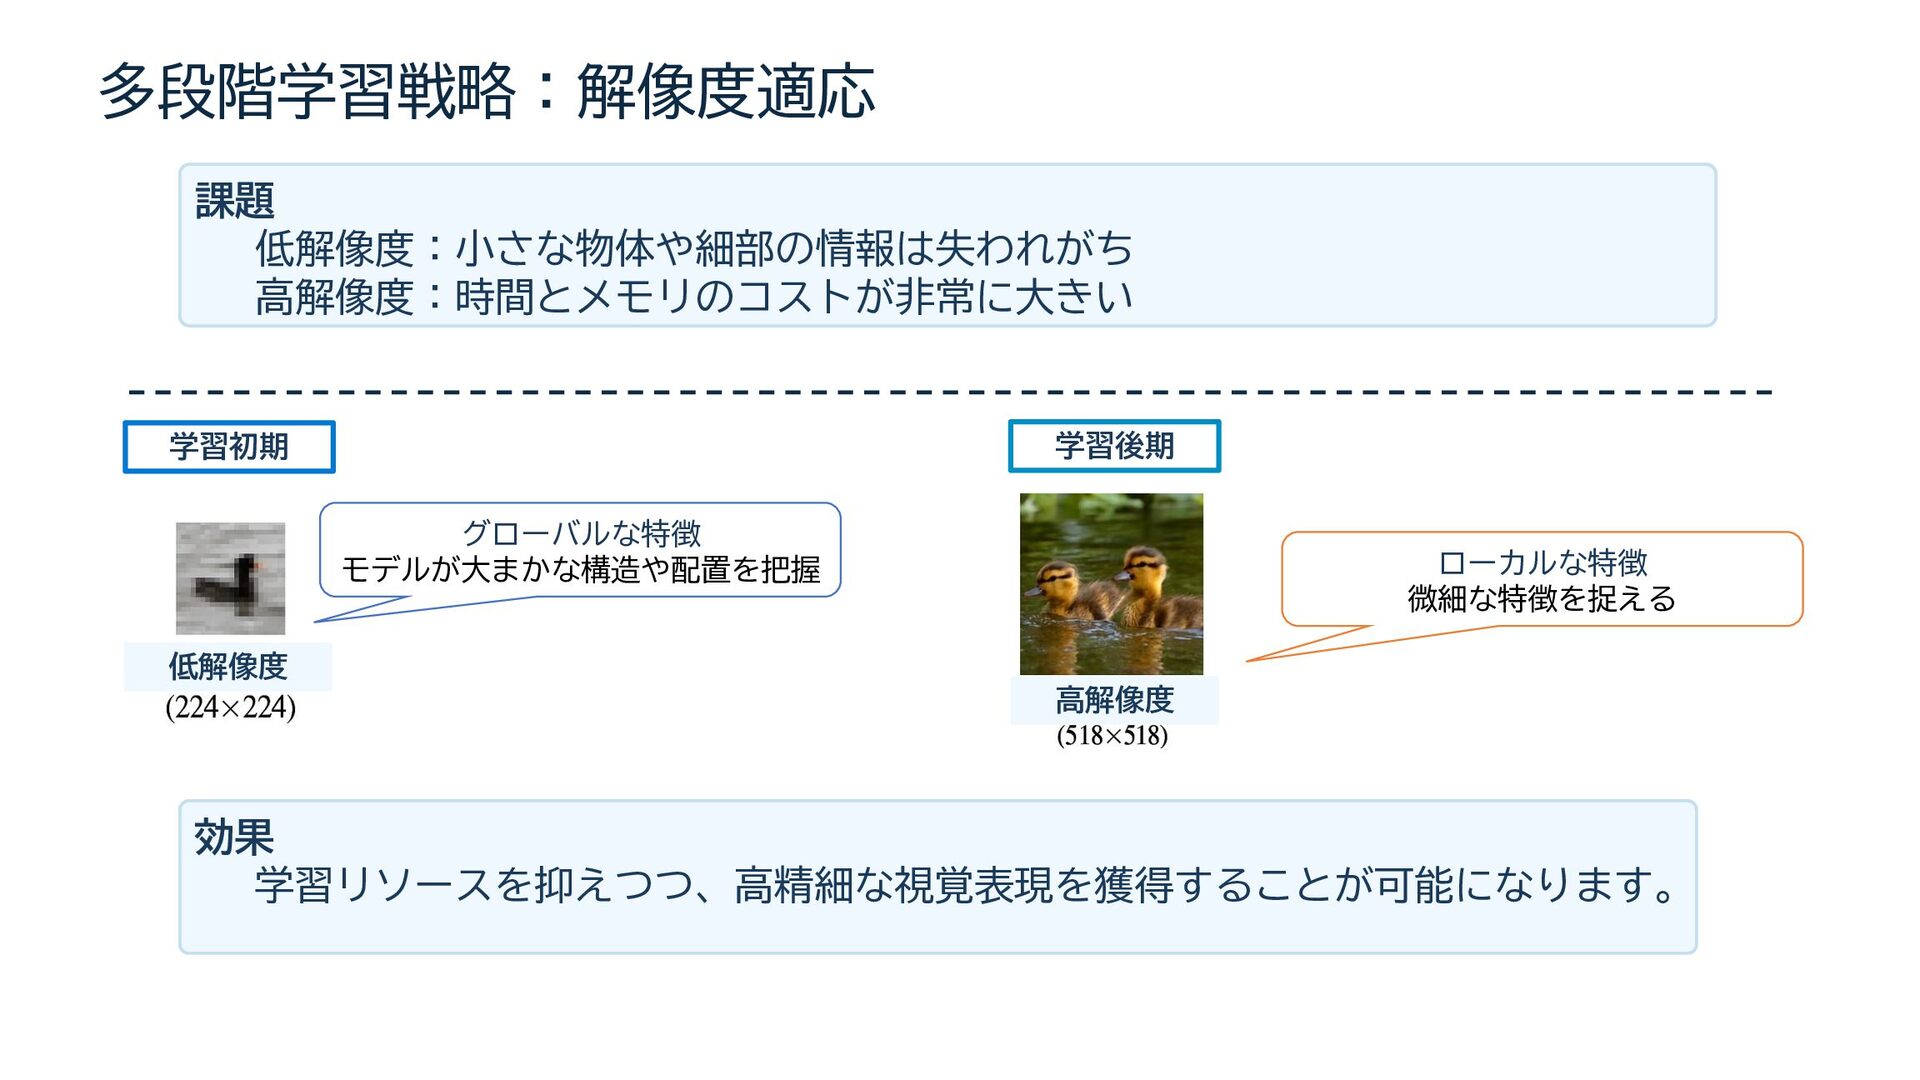
    • DINOロス(画像レベルの自己蒸留) • iBOTロス(パッチレベルのマスク予測) • Sinkhorn-Knopp正規化(SwAV由来) • KoLeo正則化(特徴空間の均一化促進) ②学習効率の最適化 • 独自FlashAttention実装による高速化 • Sequence packingによるメモリ効率化 • FSDP + Mixed precisionによる分散並列学習 ③多段階学習戦略 224解像度での長期学習後、518解像度で短期間微調整。小規模モデルは、大規模ViT-gモデルからの知識蒸留によっ て学習されます。
  3. preencoded.png 提案手法 DINOv2は、簡単に言うと「よりロバスト(頑健)な視覚特徴を学習できるようにしたモデル」 基盤アーキテクチャ 最大11億パラメータを持つ大規模Vision Transformer (ViT-g) を基盤モデルとして採用。 ①複合損失関数 •

    DINOロス(画像レベルの自己蒸留) • iBOTロス(パッチレベルのマスク予測) • Sinkhorn-Knopp正規化(SwAV由来) • KoLeo正則化(特徴空間の均一化促進) ②学習効率の最適化 • 独自FlashAttention実装による高速化 • Sequence packingによるメモリ効率化 • FSDP + Mixed precisionによる分散並列学習 ③多段階学習戦略 224解像度での長期学習後、518解像度で短期間微調整。小規模モデルは、大規模ViT-gモデルからの知識蒸留によっ て学習されます。
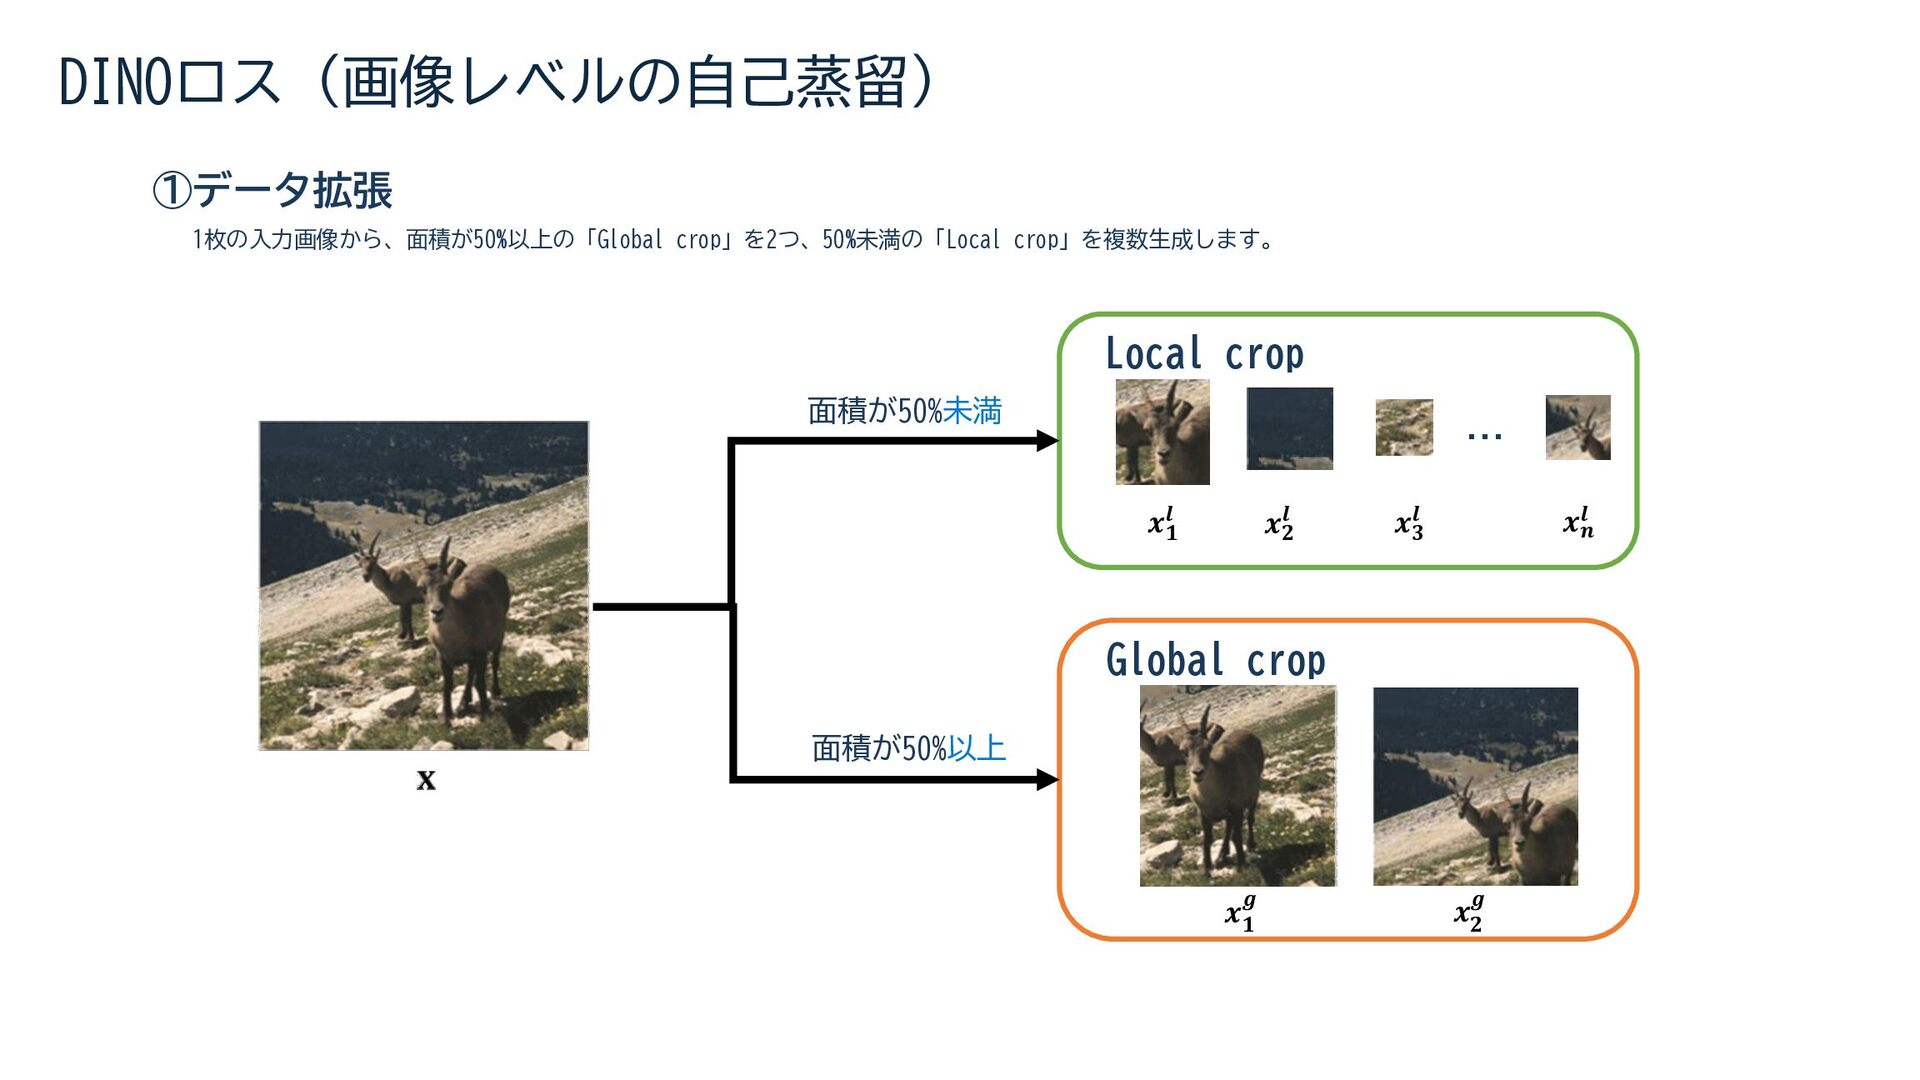
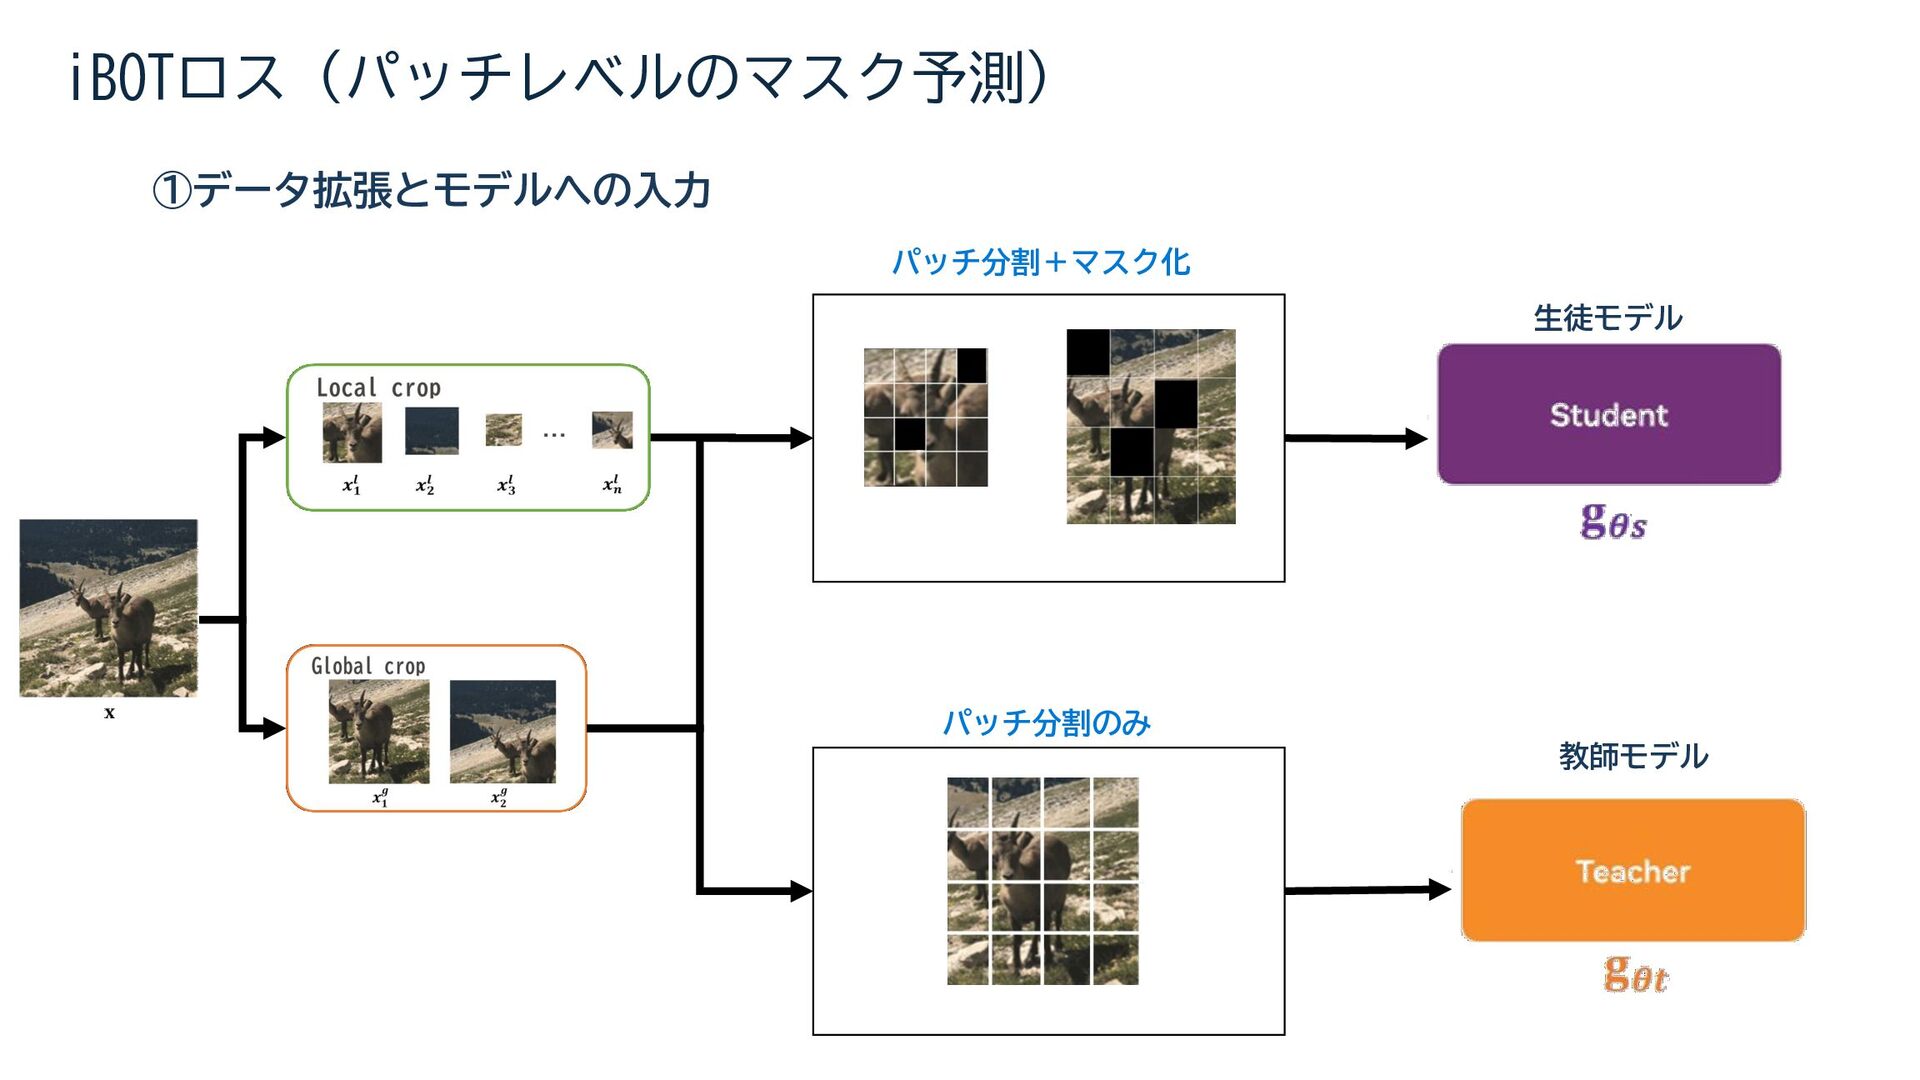
  4. DINOロス(画像レベルの自己蒸留) ①データ拡張 Global crop Local crop 𝒙 𝟐 𝒈 𝒙

    𝟏 𝒈 𝒙𝟏 𝒍 𝒙𝟐 𝒍 𝒙𝟑 𝒍 𝒙𝒏 𝒍 … 面積が50%以上 面積が50%未満 1枚の入力画像から、面積が50%以上の「Global crop」を2つ、50%未満の「Local crop」を複数生成します。
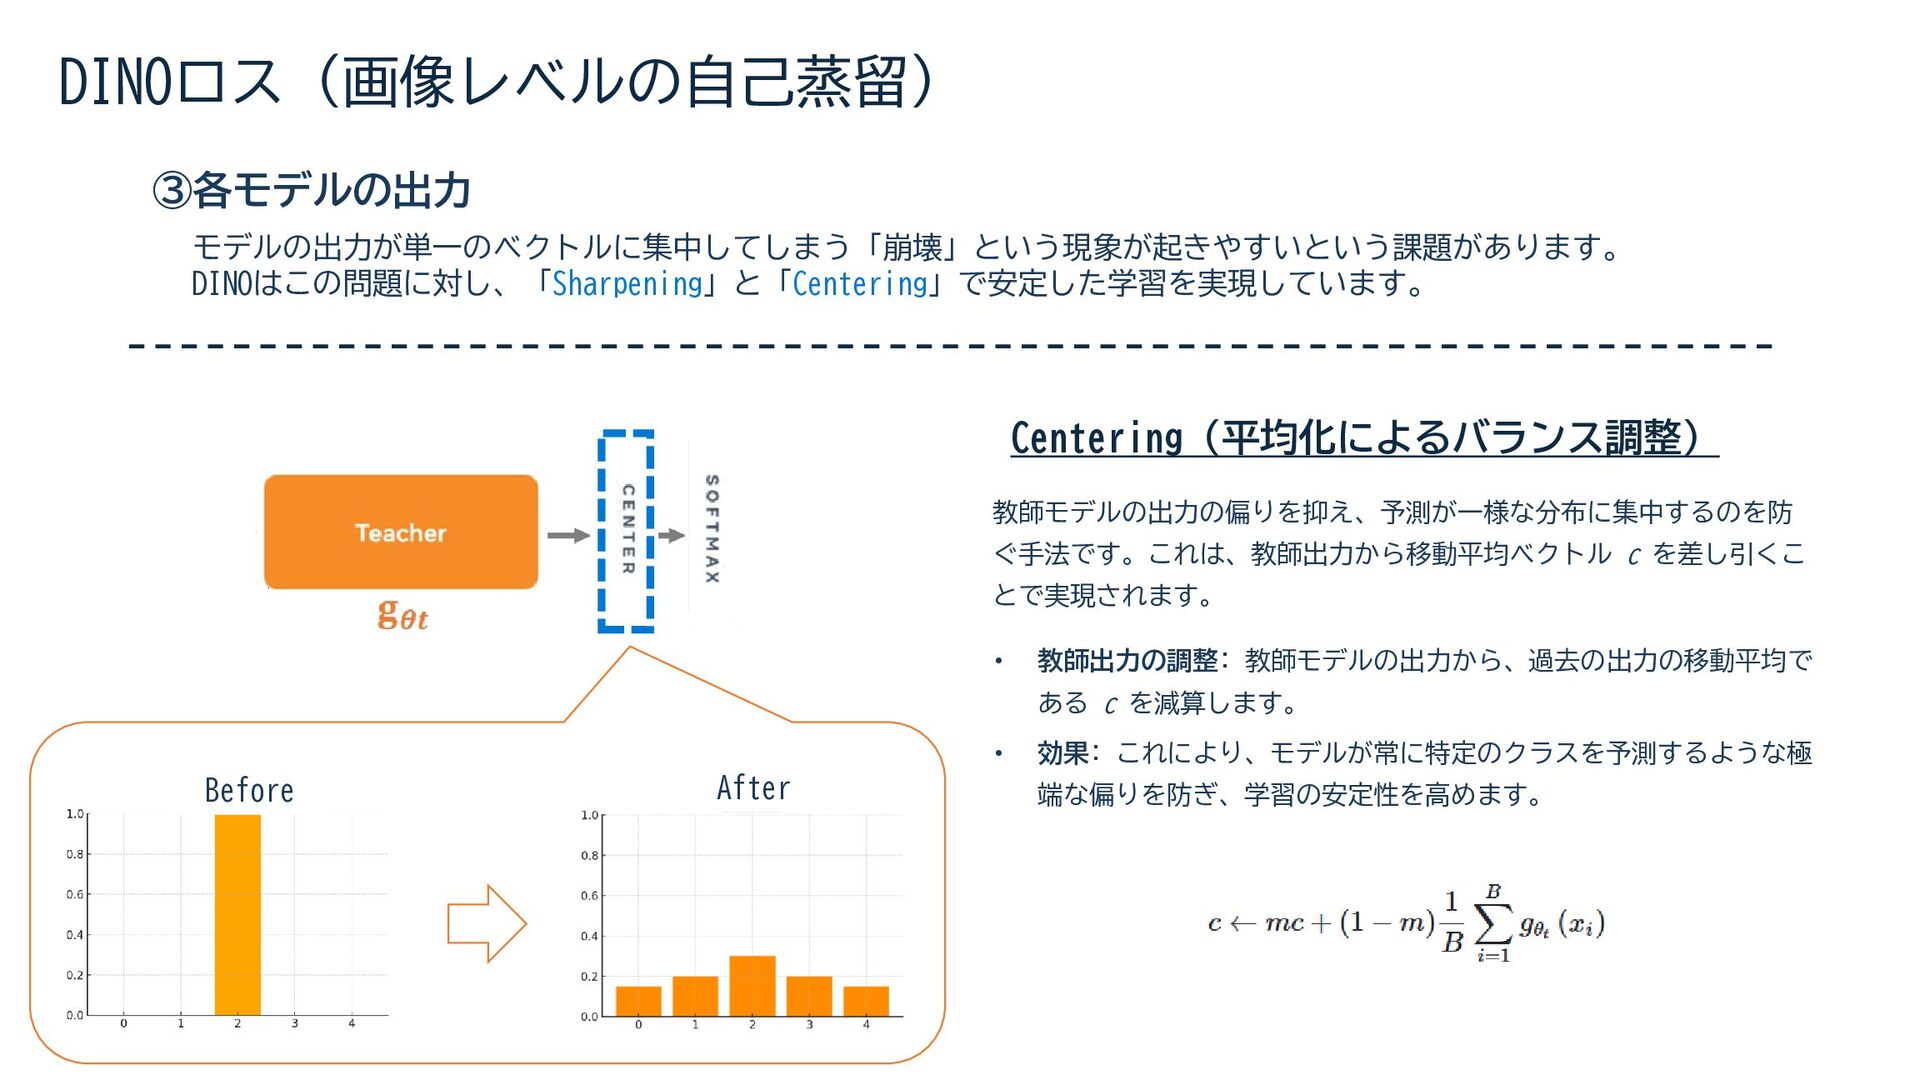
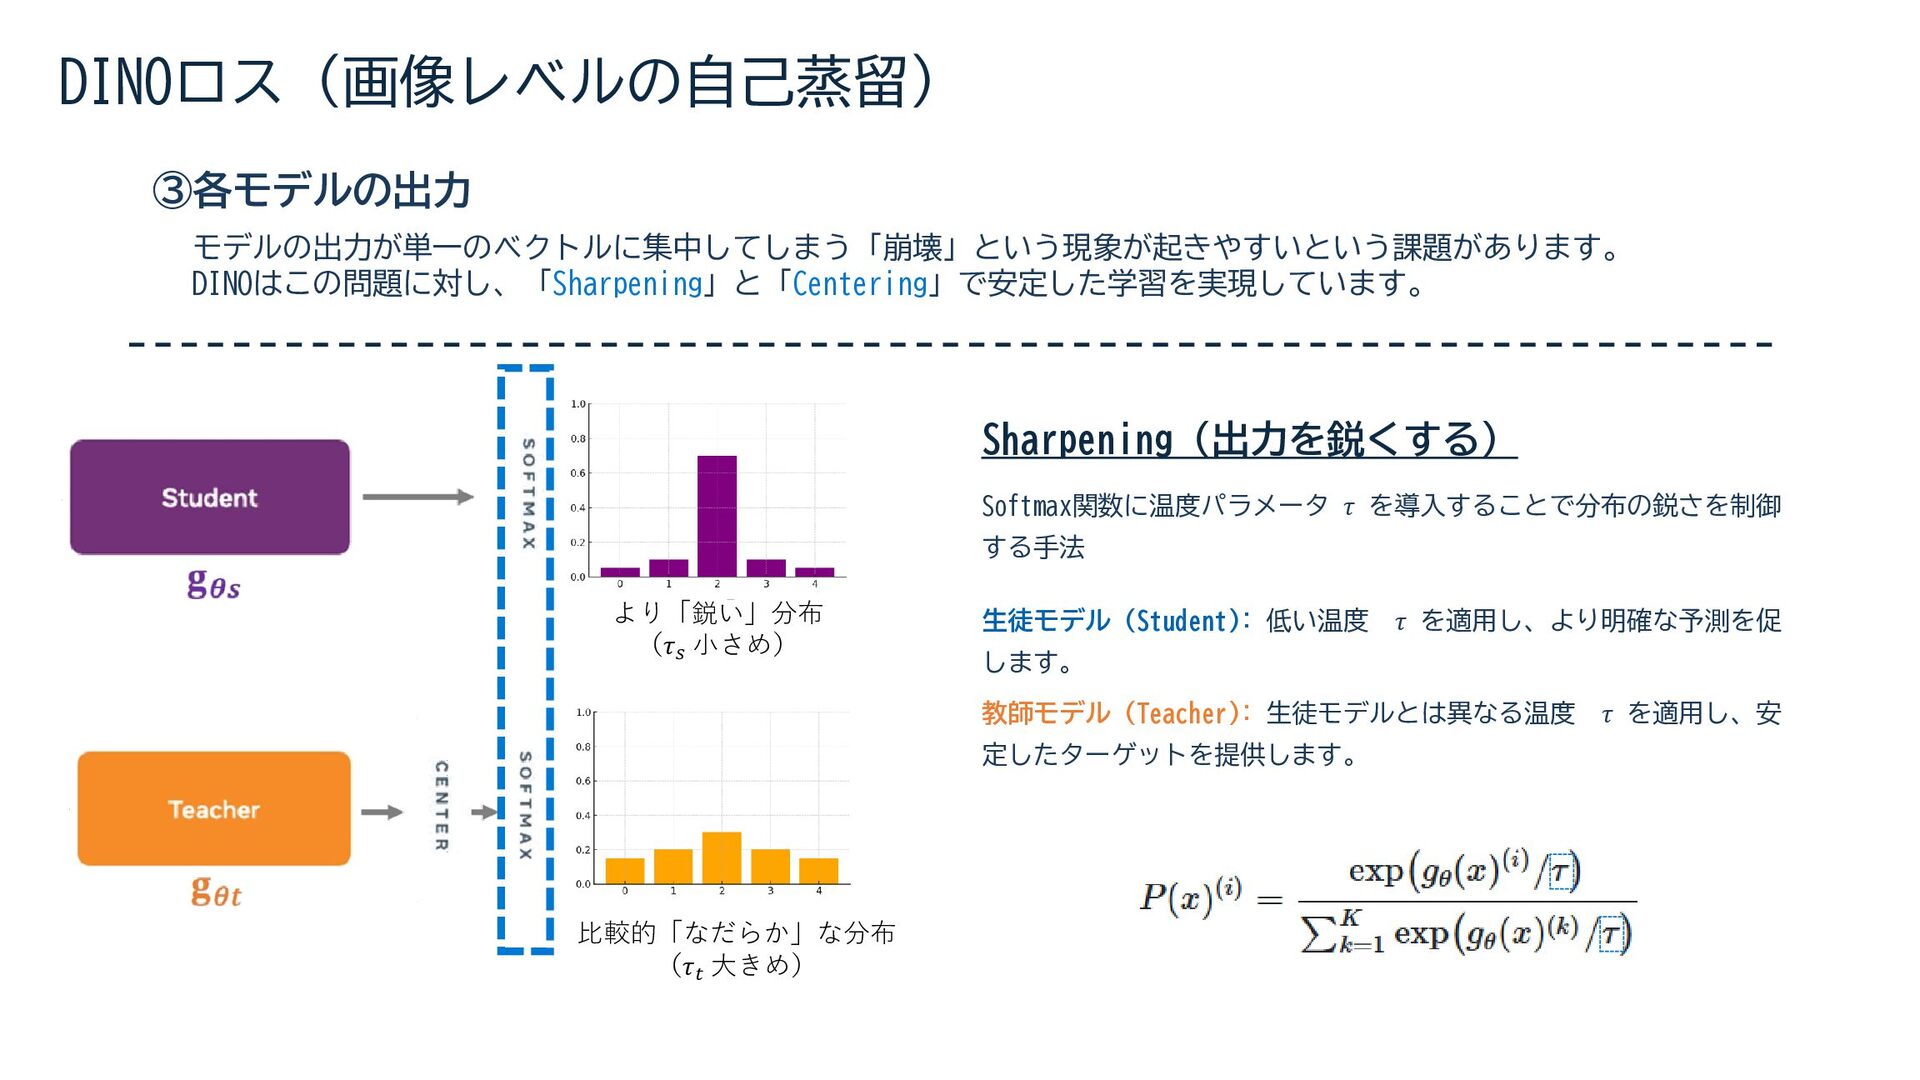
  5. ③各モデルの出力 モデルの出力が単一のベクトルに集中してしまう「崩壊」という現象が起きやすいという課題があります。 DINOはこの問題に対し、「Sharpening」と「Centering」で安定した学習を実現しています。 Sharpening(出力を鋭くする) Softmax関数に温度パラメータ 𝜏 を導入することで分布の鋭さを制御 する手法 生徒モデル (Student):

    低い温度 𝜏 を適用し、より明確な予測を促 します。 教師モデル (Teacher): 生徒モデルとは異なる温度 𝜏 を適用し、安 定したターゲットを提供します。 比較的「なだらか」な分布 (𝜏𝑡 大きめ) より「鋭い」分布 (𝜏𝑠 小さめ) DINOロス(画像レベルの自己蒸留)
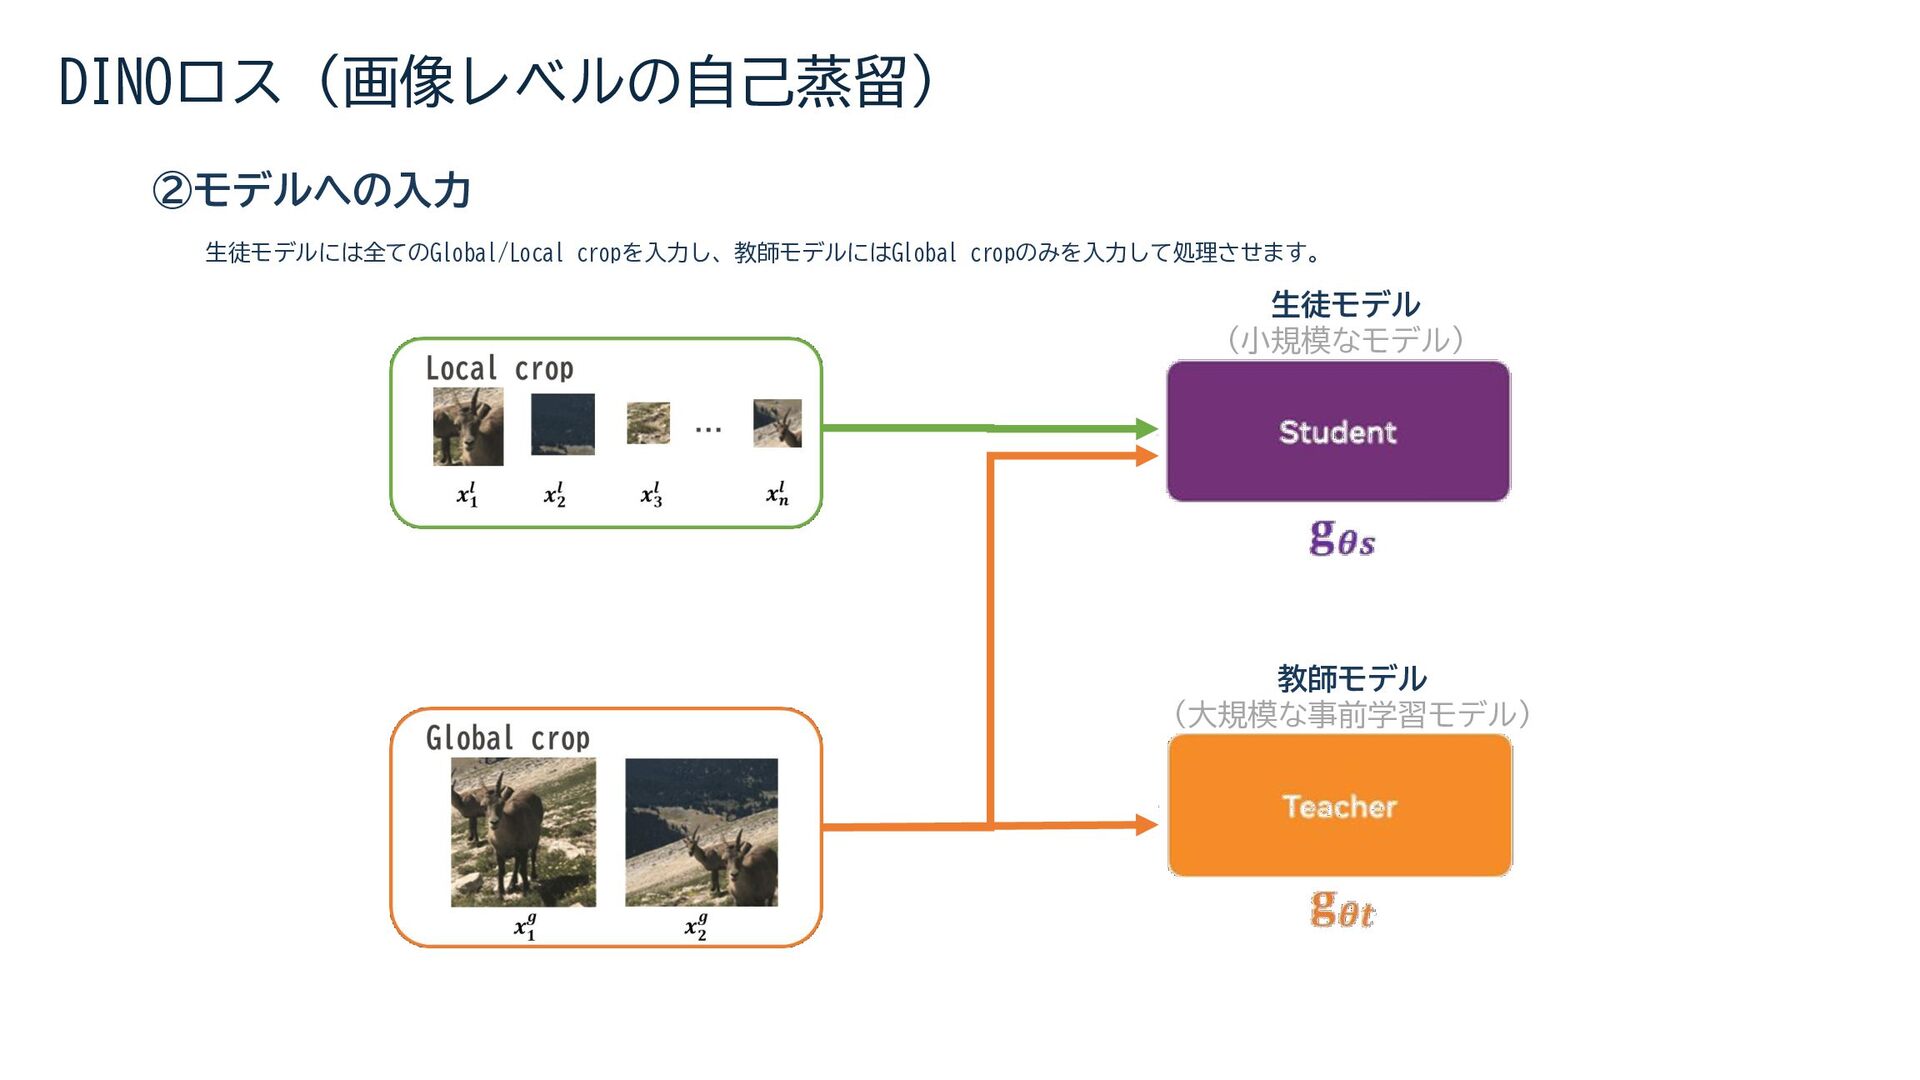
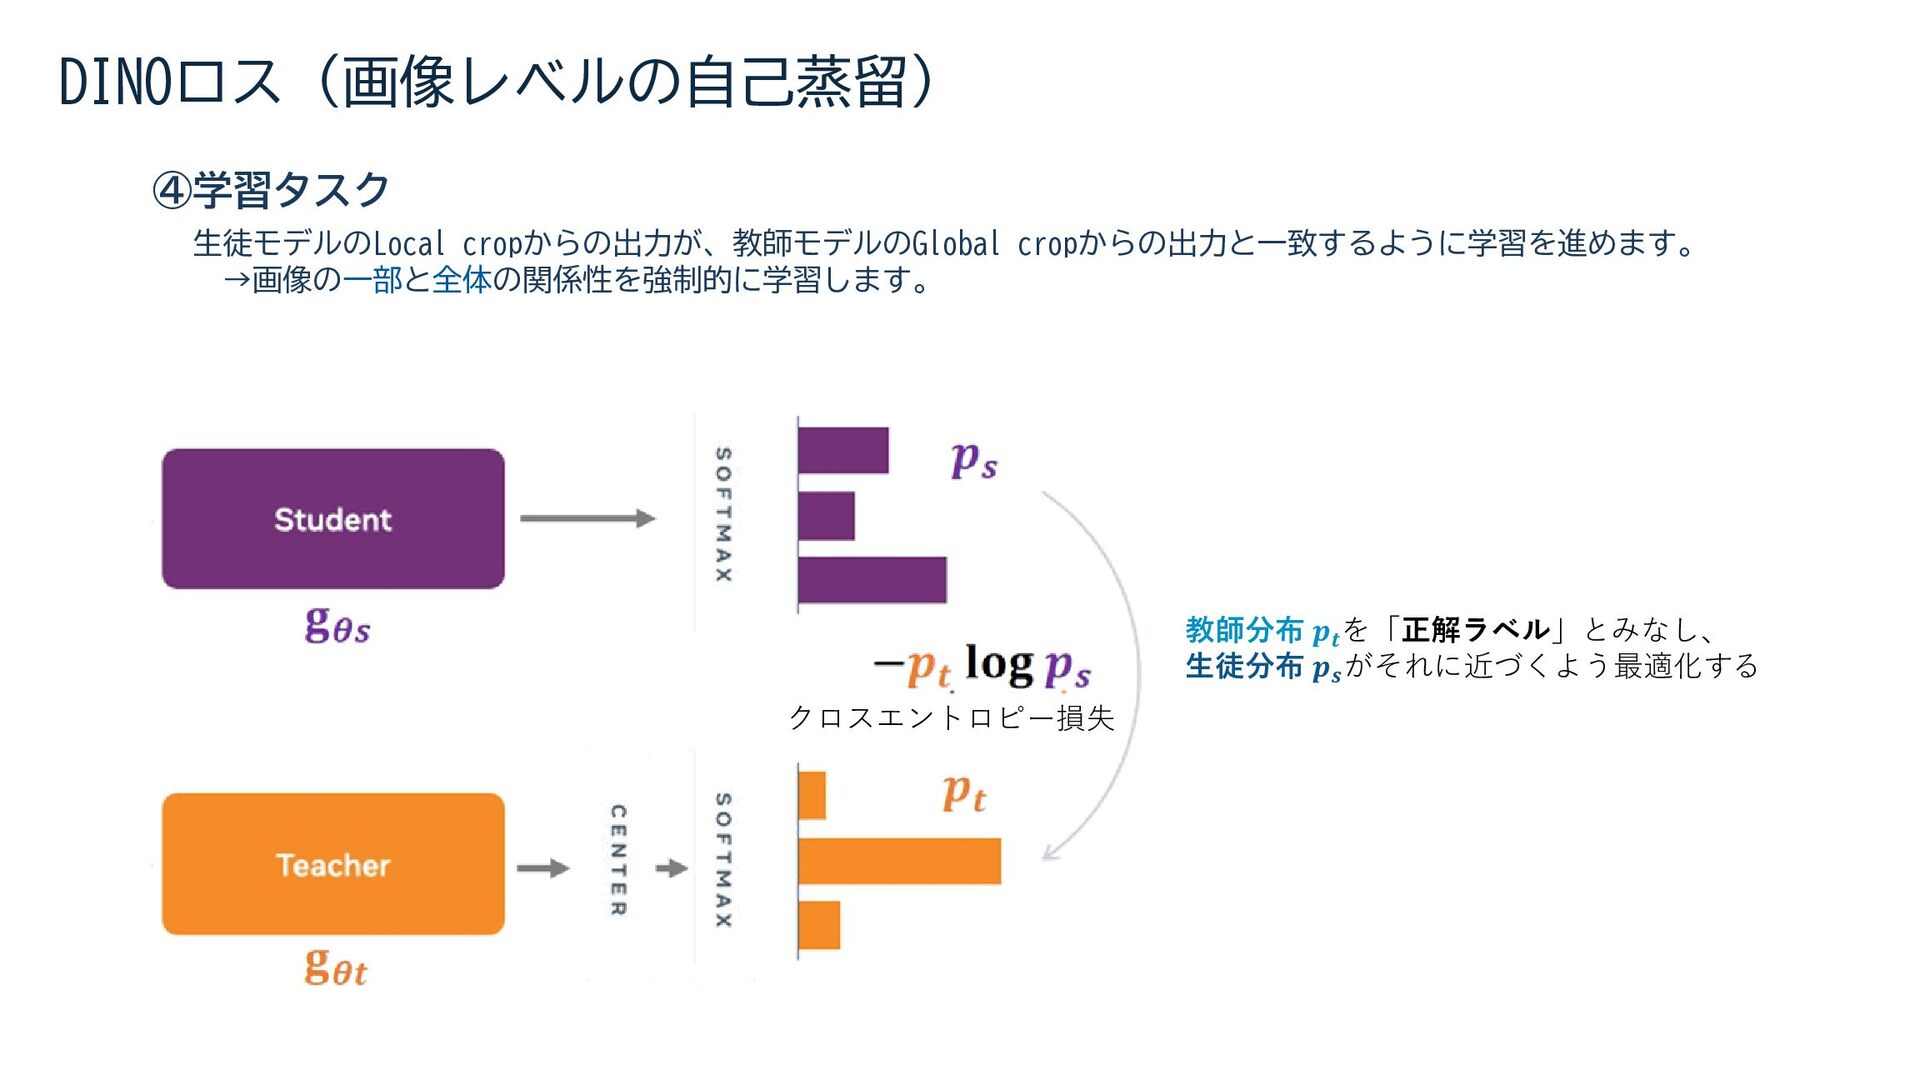
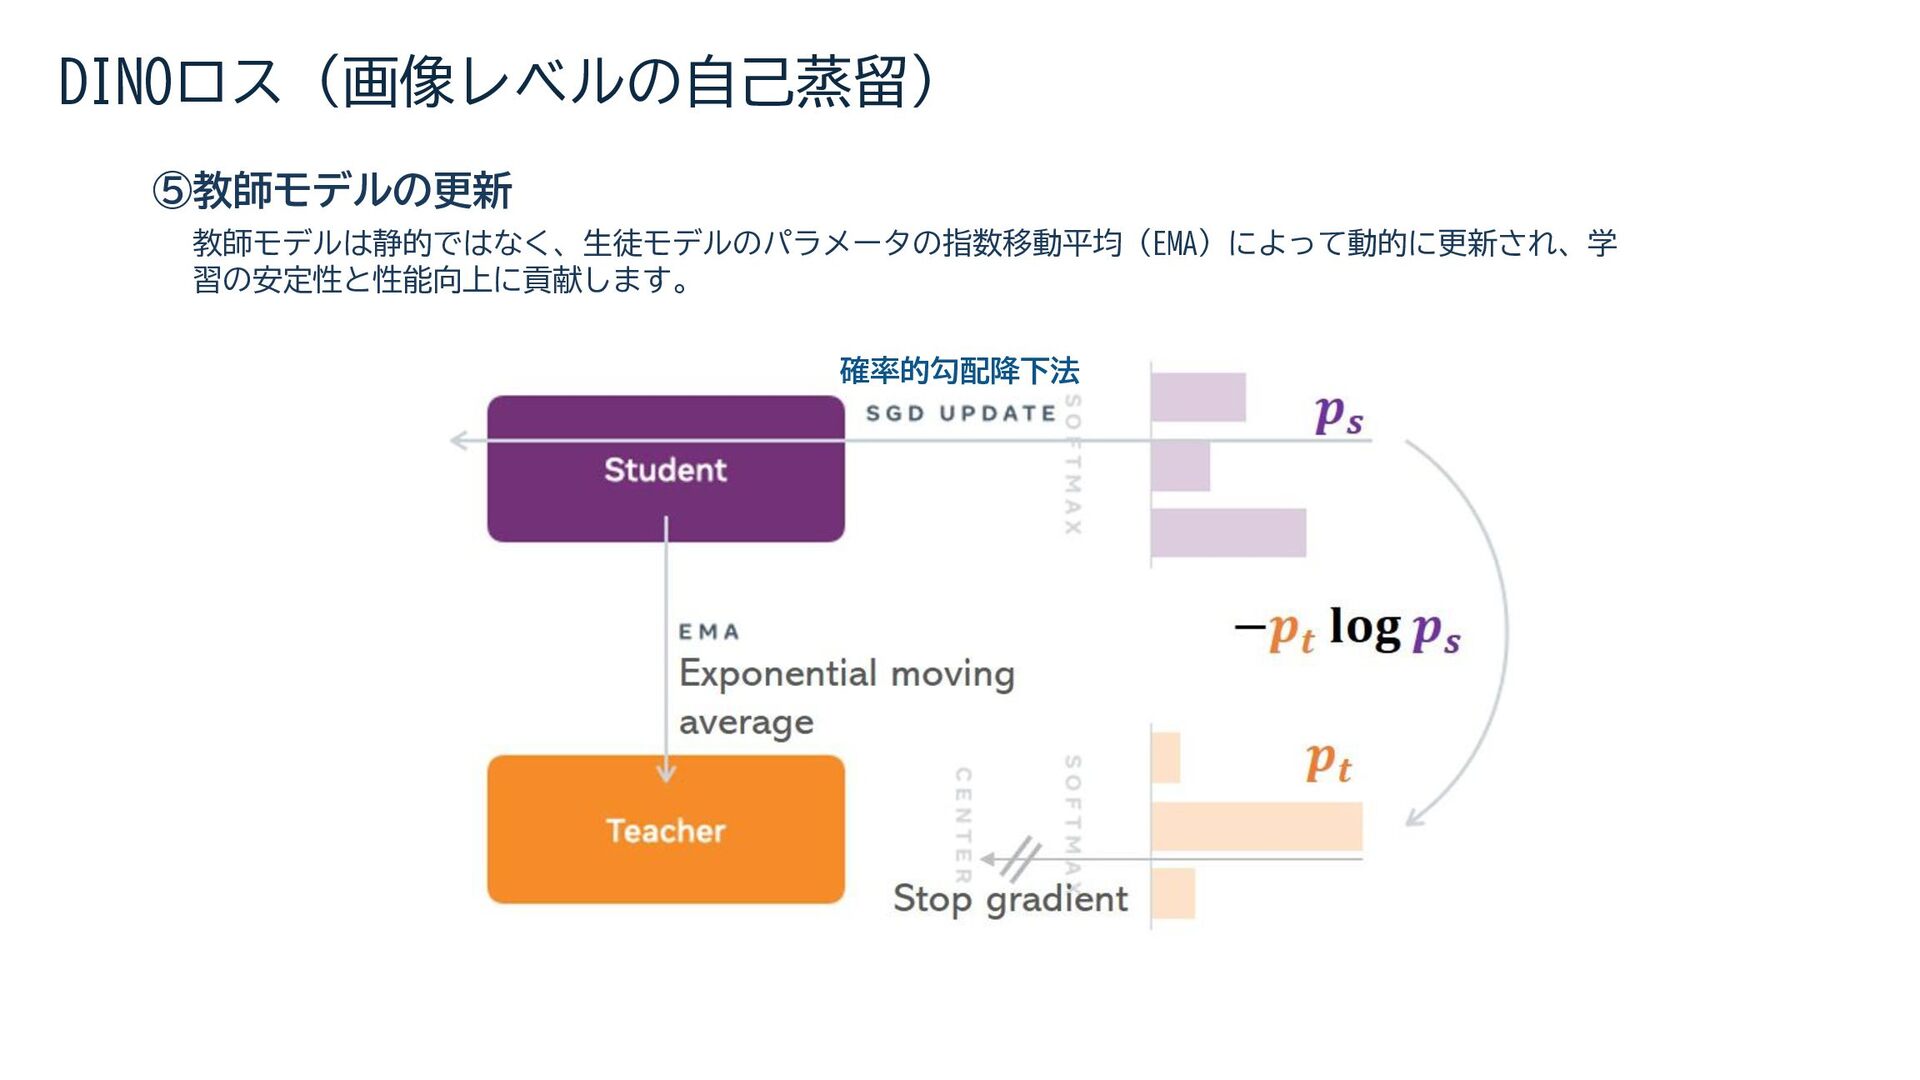
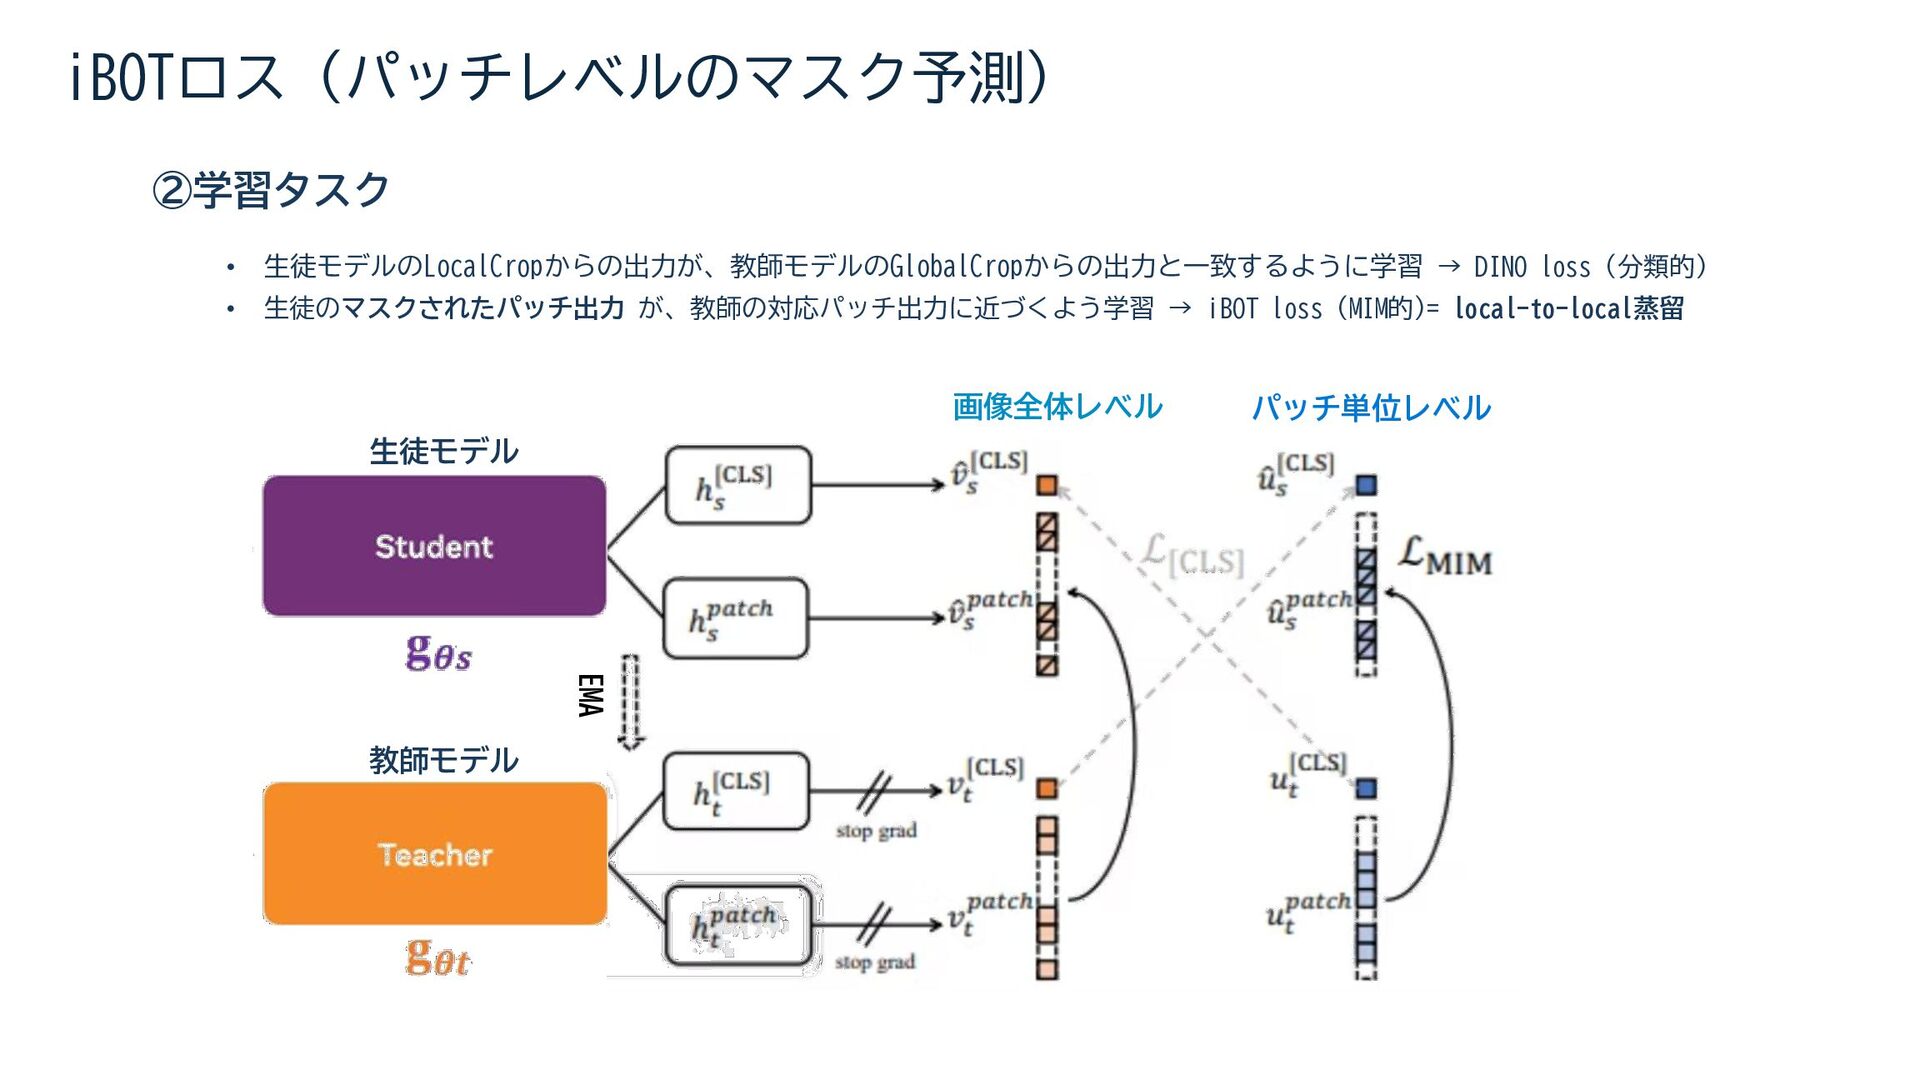
  6. 生徒モデル 教師モデル • 生徒モデルのLocalCropからの出力が、教師モデルのGlobalCropからの出力と一致するように学習 → DINO loss (分類的) • 生徒のマスクされたパッチ出力

    が、教師の対応パッチ出力に近づくよう学習 → iBOT loss (MIM的)= local-to-local蒸留 ②学習タスク iBOTロス(パッチレベルのマスク予測) 画像全体レベル パッチ単位レベル EMA
  7. preencoded.png 提案手法 DINOv2は、簡単に言うと「よりロバスト(頑健)な視覚特徴を学習できるようにしたモデル」 基盤アーキテクチャ 最大11億パラメータを持つ大規模Vision Transformer (ViT-g) を基盤モデルとして採用。 ①複合損失関数 •

    DINOロス(画像レベルの自己蒸留) • iBOTロス(パッチレベルのマスク予測) • Sinkhorn-Knopp正規化(SwAV由来) • KoLeo正則化(特徴空間の均一化促進) ②学習効率の最適化 • 独自FlashAttention実装による高速化 • Sequence packingによるメモリ効率化 • FSDP + Mixed precisionによる分散並列学習 ③多段階学習戦略 224解像度での長期学習後、518解像度で短期間微調整。小規模モデルは、大規模ViT-gモデルからの知識蒸留によっ て学習されます。
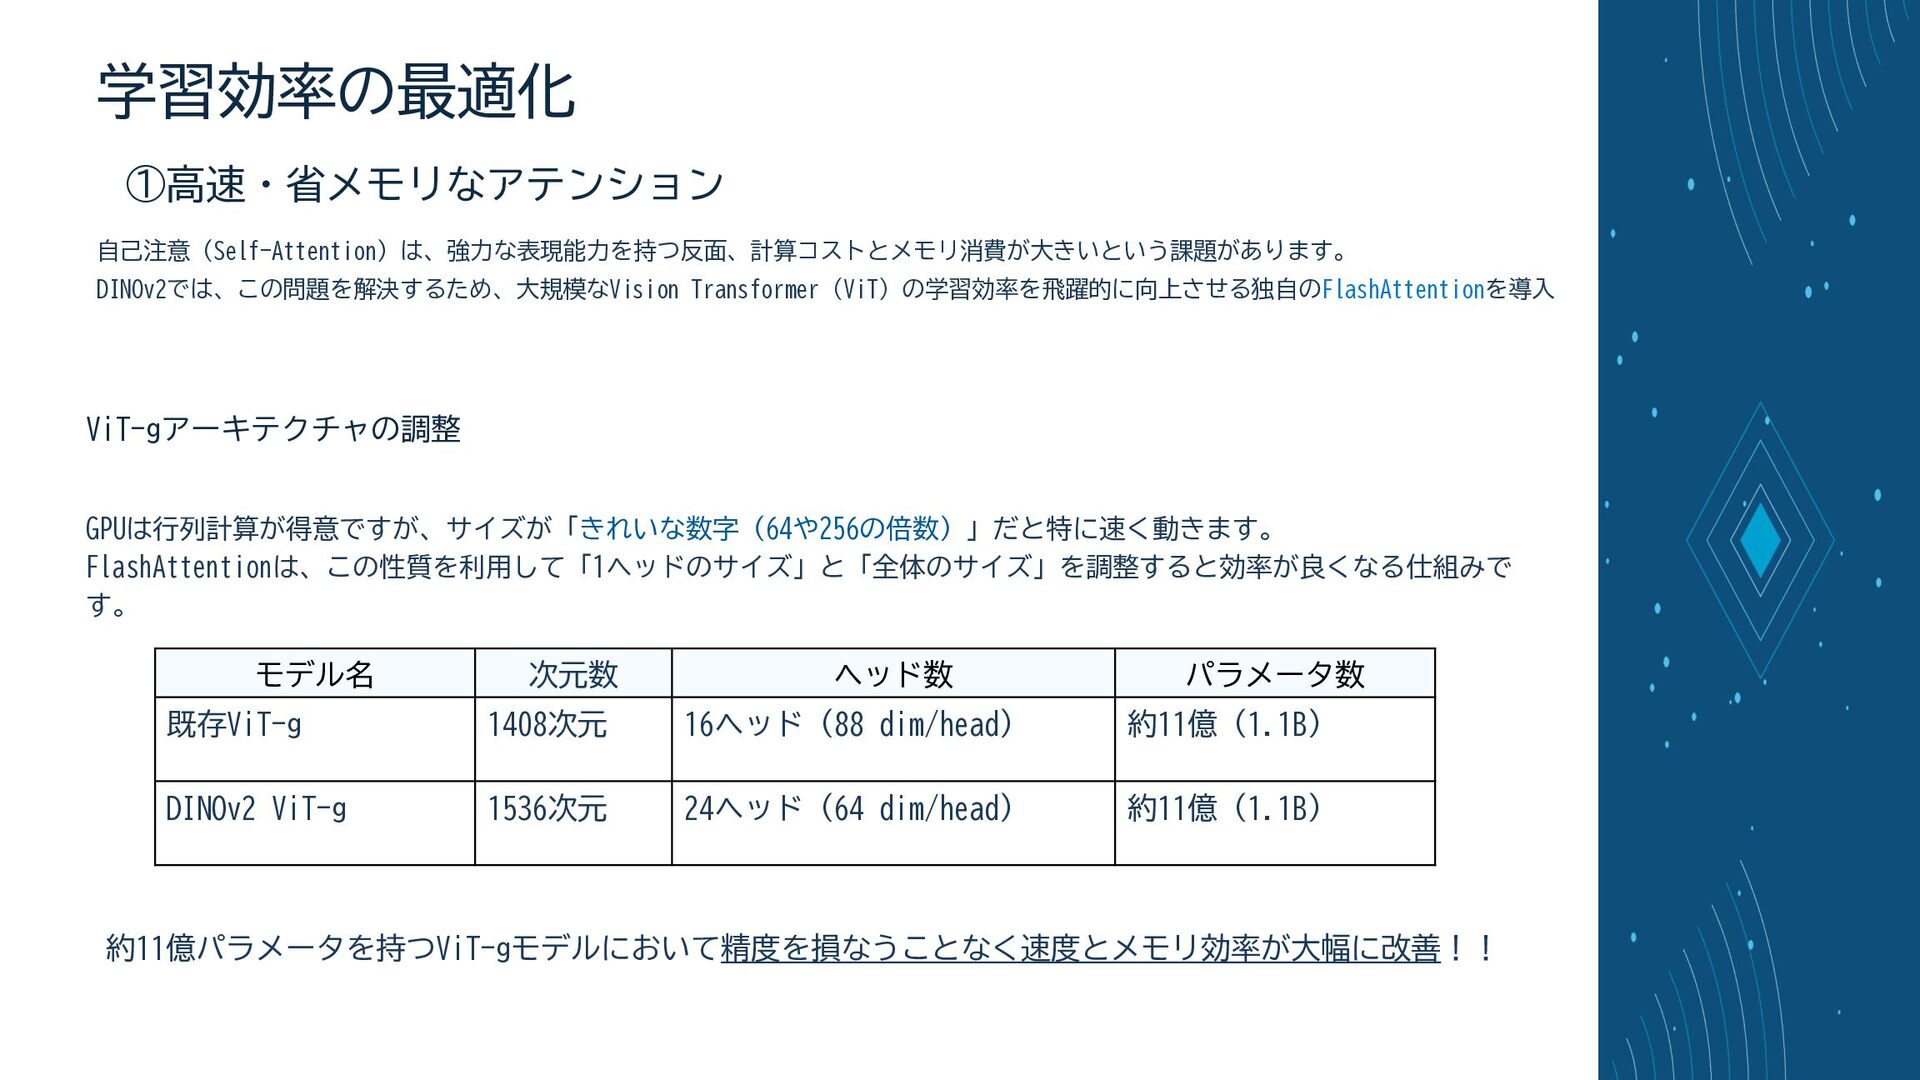
  8. 自己注意(Self-Attention)は、強力な表現能力を持つ反面、計算コストとメモリ消費が大きいという課題があります。 DINOv2では、この問題を解決するため、大規模なVision Transformer(ViT)の学習効率を飛躍的に向上させる独自のFlashAttentionを導入 モデル名 次元数 ヘッド数 パラメータ数 既存ViT-g 1408次元 16ヘッド

    (88 dim/head) 約11億 (1.1B) DINOv2 ViT-g 1536次元 24ヘッド (64 dim/head) 約11億 (1.1B) ViT-gアーキテクチャの調整 約11億パラメータを持つViT-gモデルにおいて精度を損なうことなく速度とメモリ効率が大幅に改善!! GPUは行列計算が得意ですが、サイズが「きれいな数字(64や256の倍数)」だと特に速く動きます。 FlashAttentionは、この性質を利用して「1ヘッドのサイズ」と「全体のサイズ」を調整すると効率が良くなる仕組みで す。 学習効率の最適化 ①高速・省メモリなアテンション
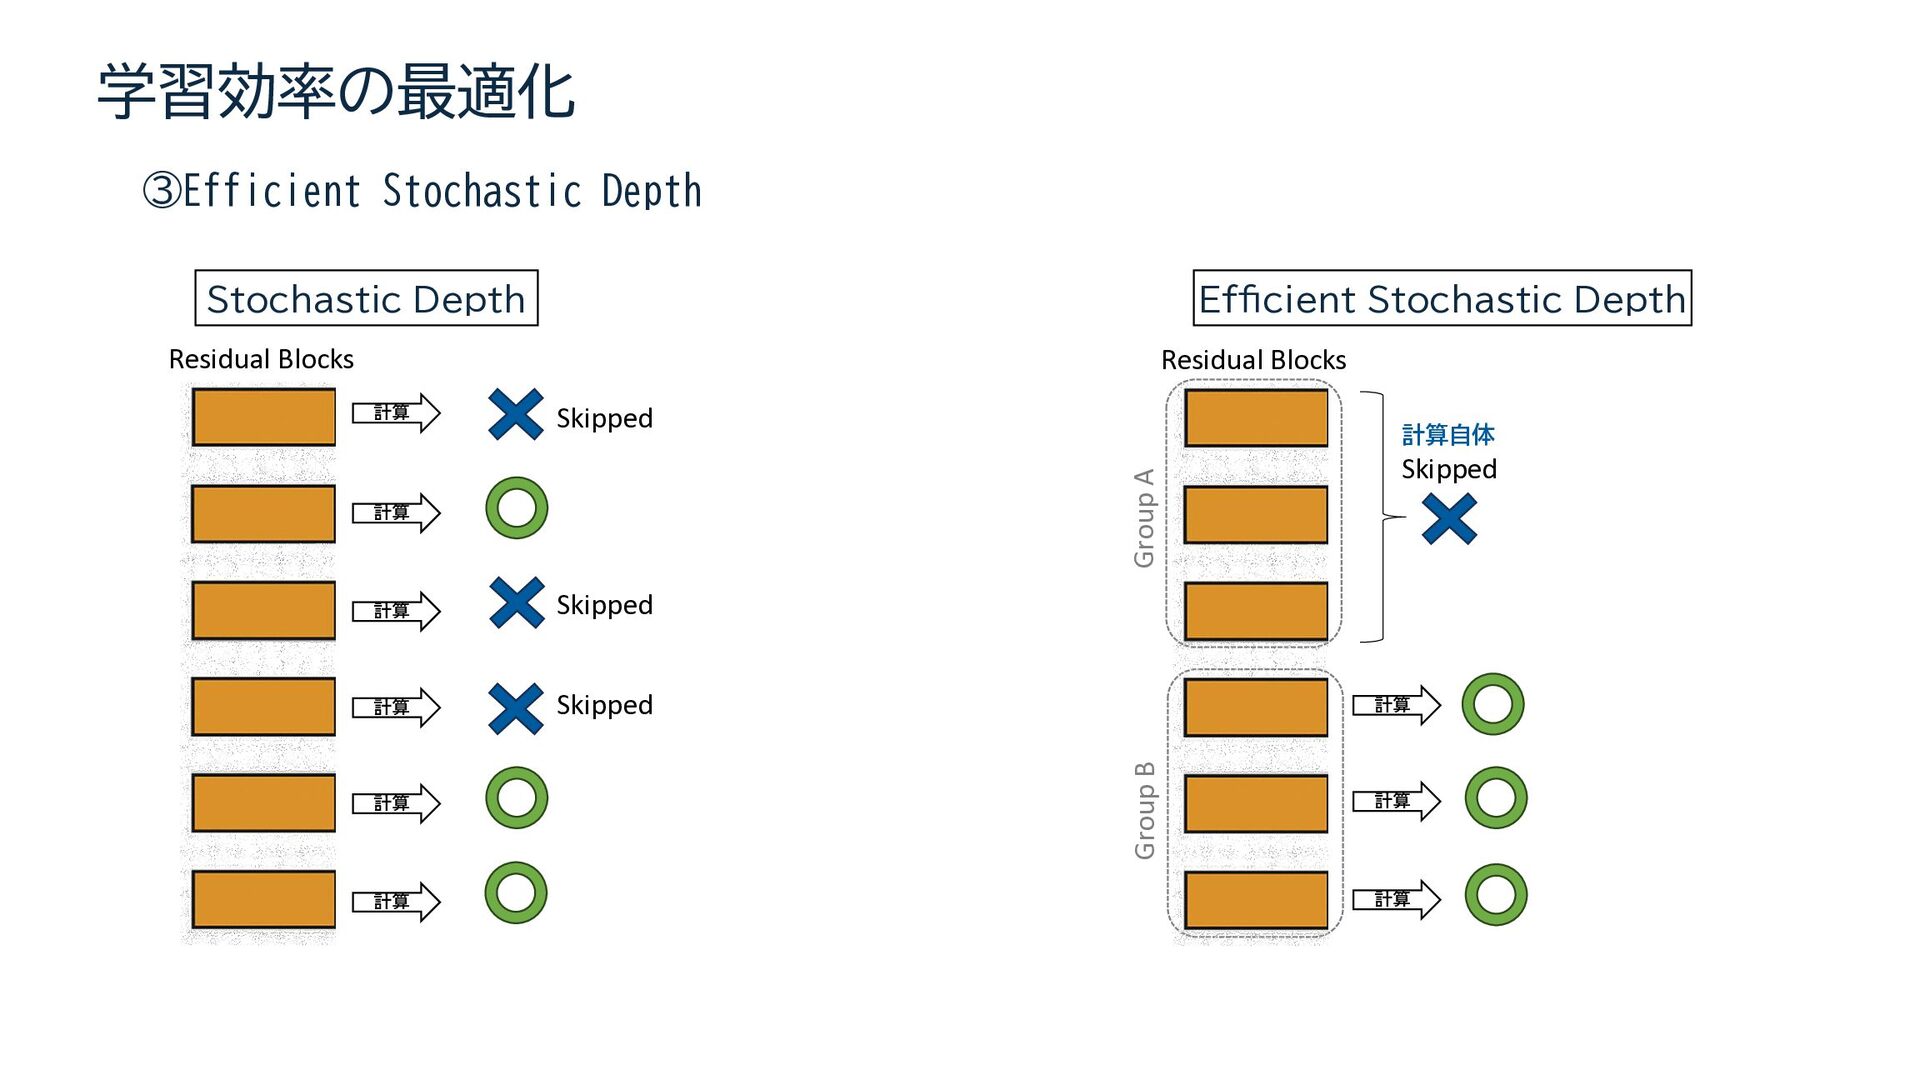
  9. 学習効率の最適化 ③Efficient Stochastic Depth Residual Blocks Stochastic Depth 計算 計算

    計算 計算 計算 計算 Skipped Efficient Stochastic Depth Skipped Skipped Residual Blocks 計算 計算 計算 Skipped Group A Group B 計算自体
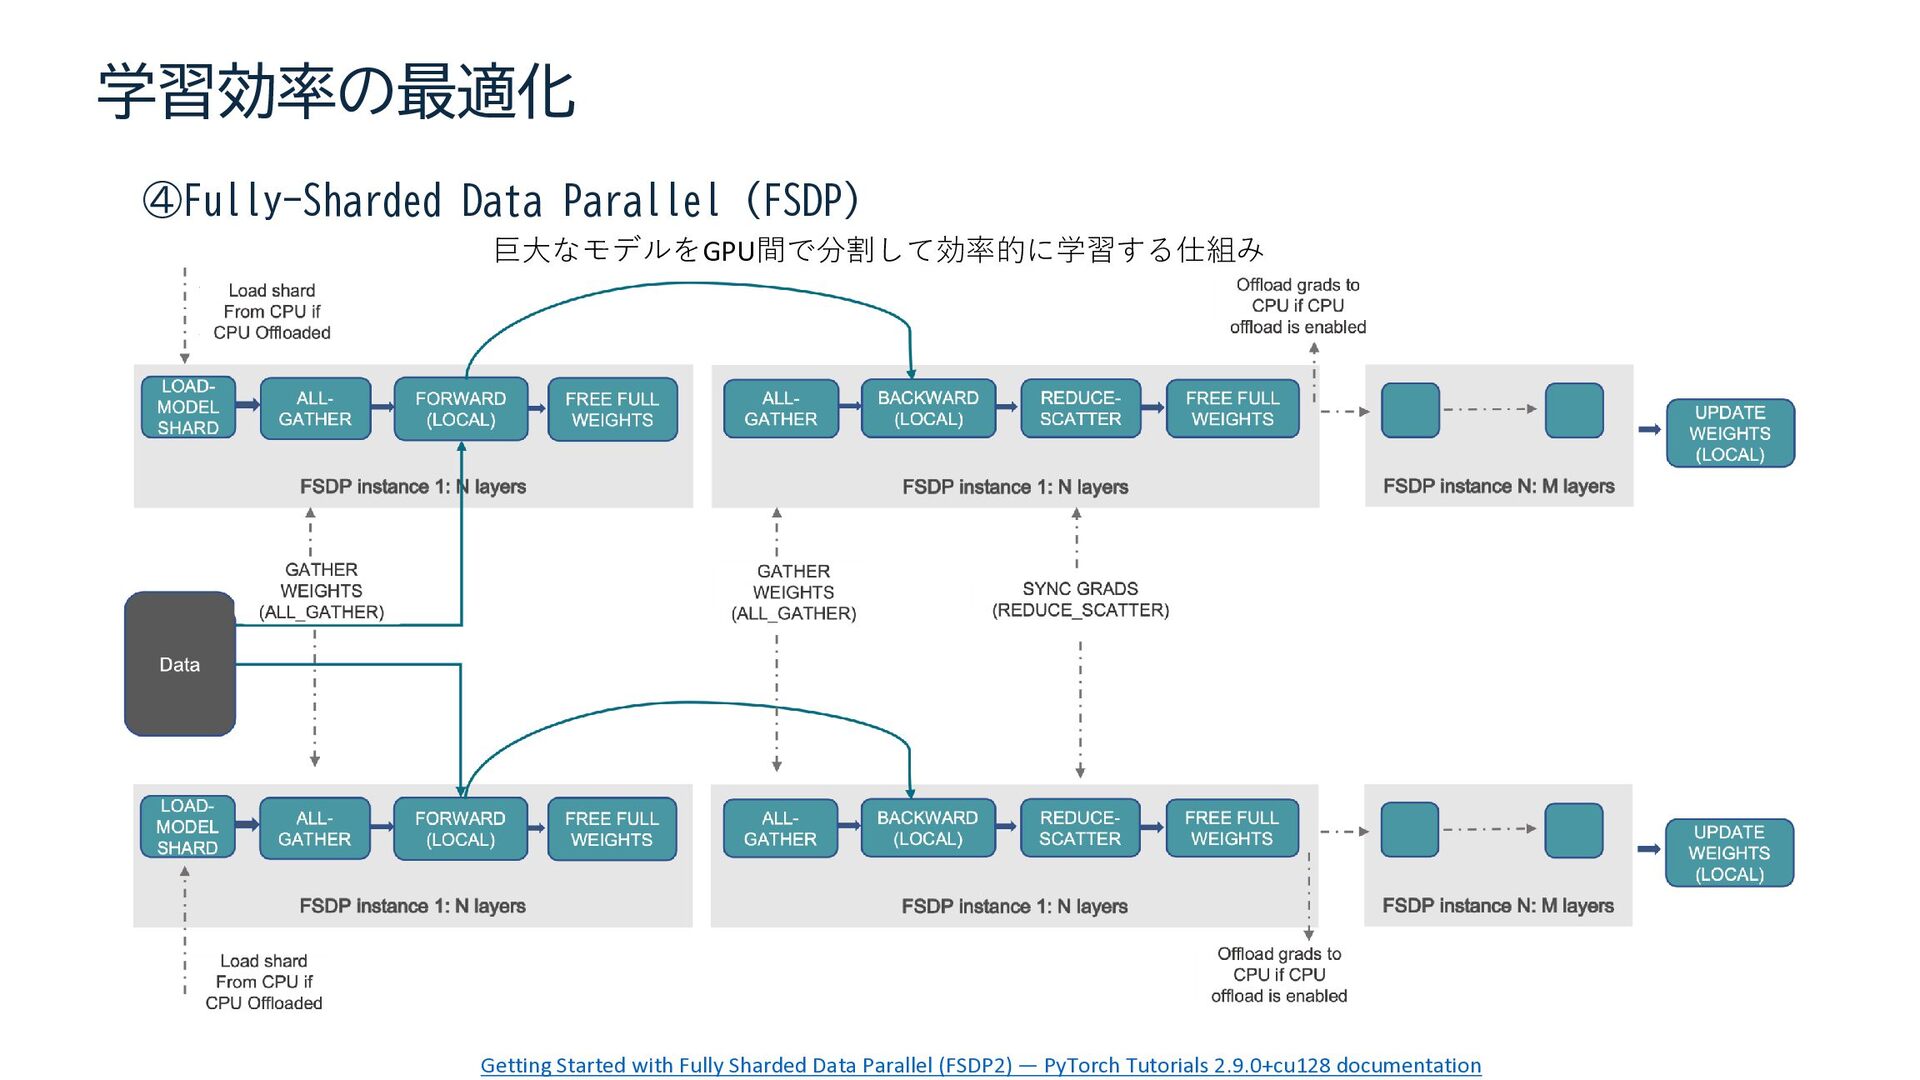
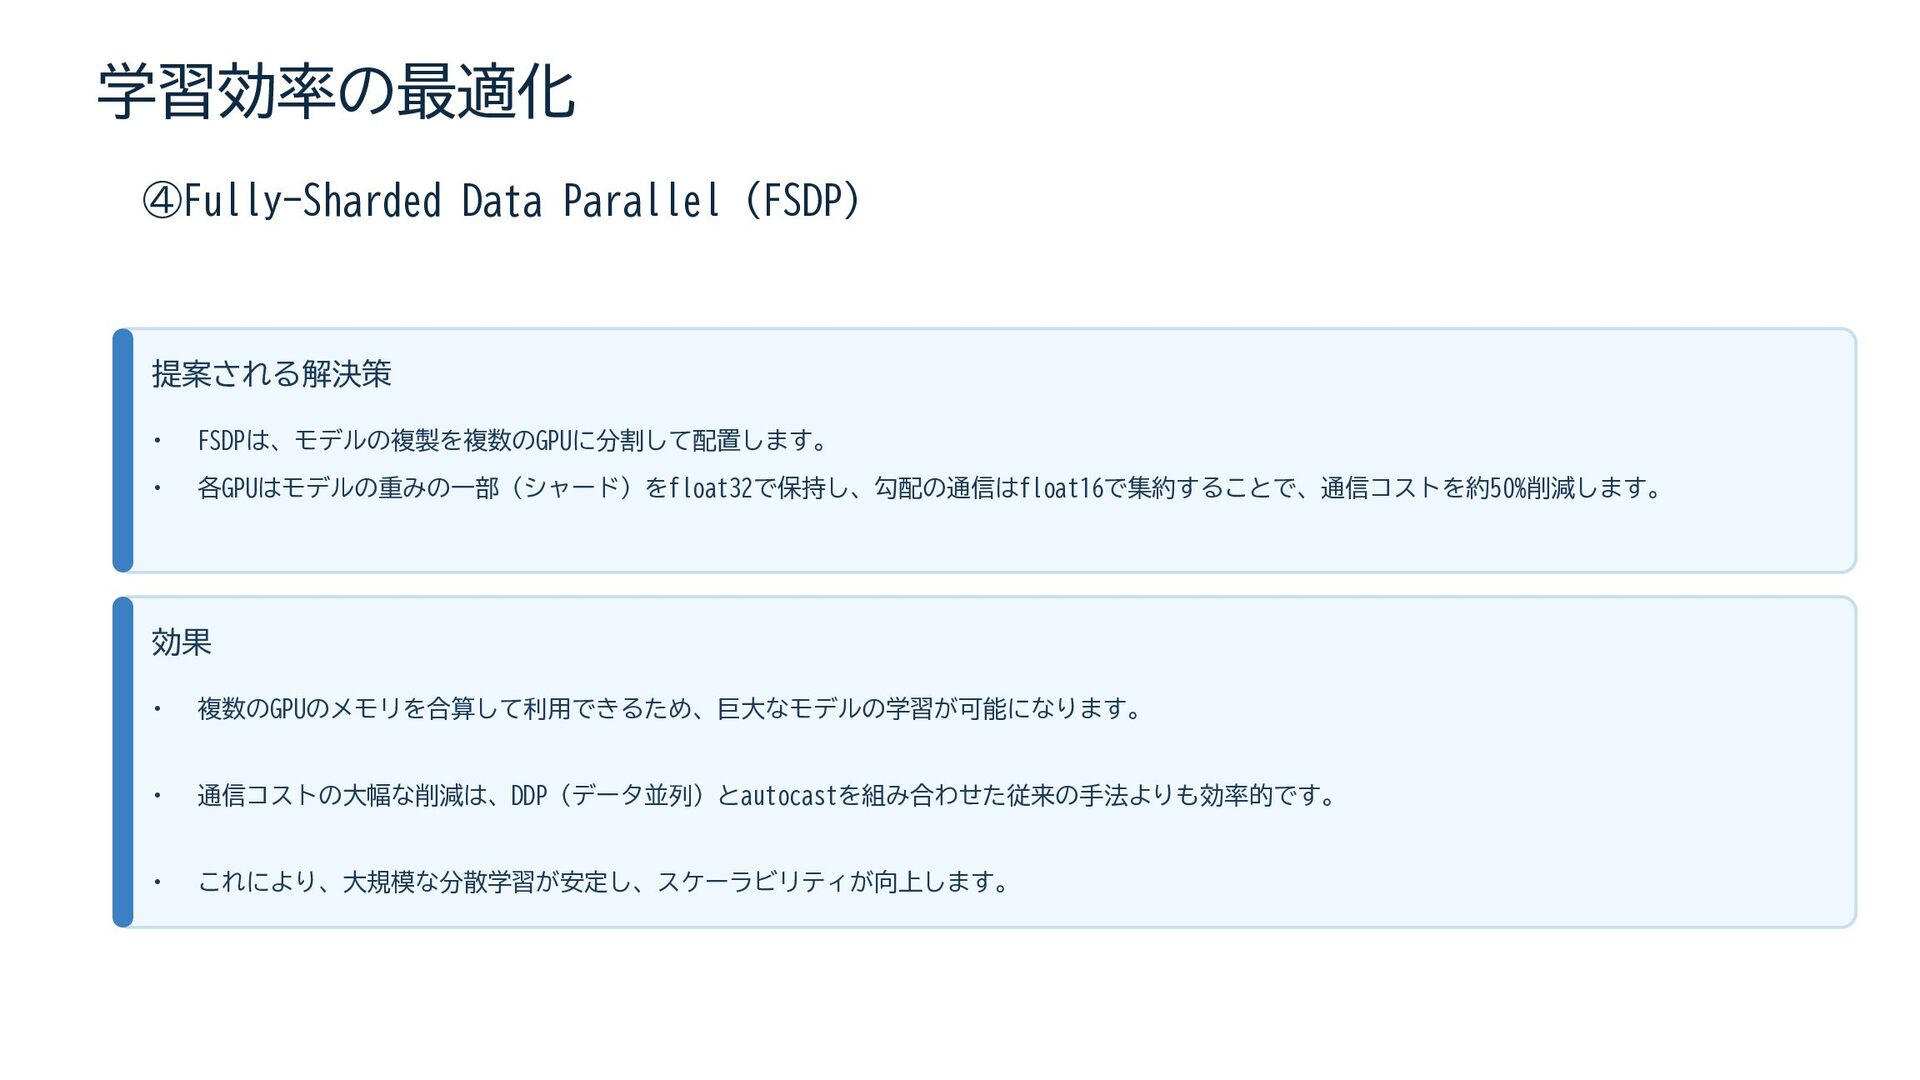
  10. 学習効率の最適化 ④Fully-Sharded Data Parallel (FSDP) 提案される解決策 • FSDPは、モデルの複製を複数のGPUに分割して配置します。 • 各GPUはモデルの重みの一部(シャード)をfloat32で保持し、勾配の通信はfloat16で集約することで、通信コストを約50%削減します。

    効果 • 複数のGPUのメモリを合算して利用できるため、巨大なモデルの学習が可能になります。 • 通信コストの大幅な削減は、DDP(データ並列)とautocastを組み合わせた従来の手法よりも効率的です。 • これにより、大規模な分散学習が安定し、スケーラビリティが向上します。
  11. preencoded.png 提案手法 DINOv2は、簡単に言うと「よりロバスト(頑健)な視覚特徴を学習できるようにしたモデル」 基盤アーキテクチャ 最大11億パラメータを持つ大規模Vision Transformer (ViT-g) を基盤モデルとして採用。 ①複合損失関数 •

    DINOロス(画像レベルの自己蒸留) • iBOTロス(パッチレベルのマスク予測) • Sinkhorn-Knopp正規化(SwAV由来) • KoLeo正則化(特徴空間の均一化促進) ②学習効率の最適化 • 独自FlashAttention実装による高速化 • Sequence packingによるメモリ効率化 • FSDP + Mixed precisionによる分散並列学習 ③多段階学習戦略 224解像度での長期学習後、518解像度で短期間微調整。小規模モデルは、大規模ViT-gモデルからの知識蒸留によっ て学習されます。
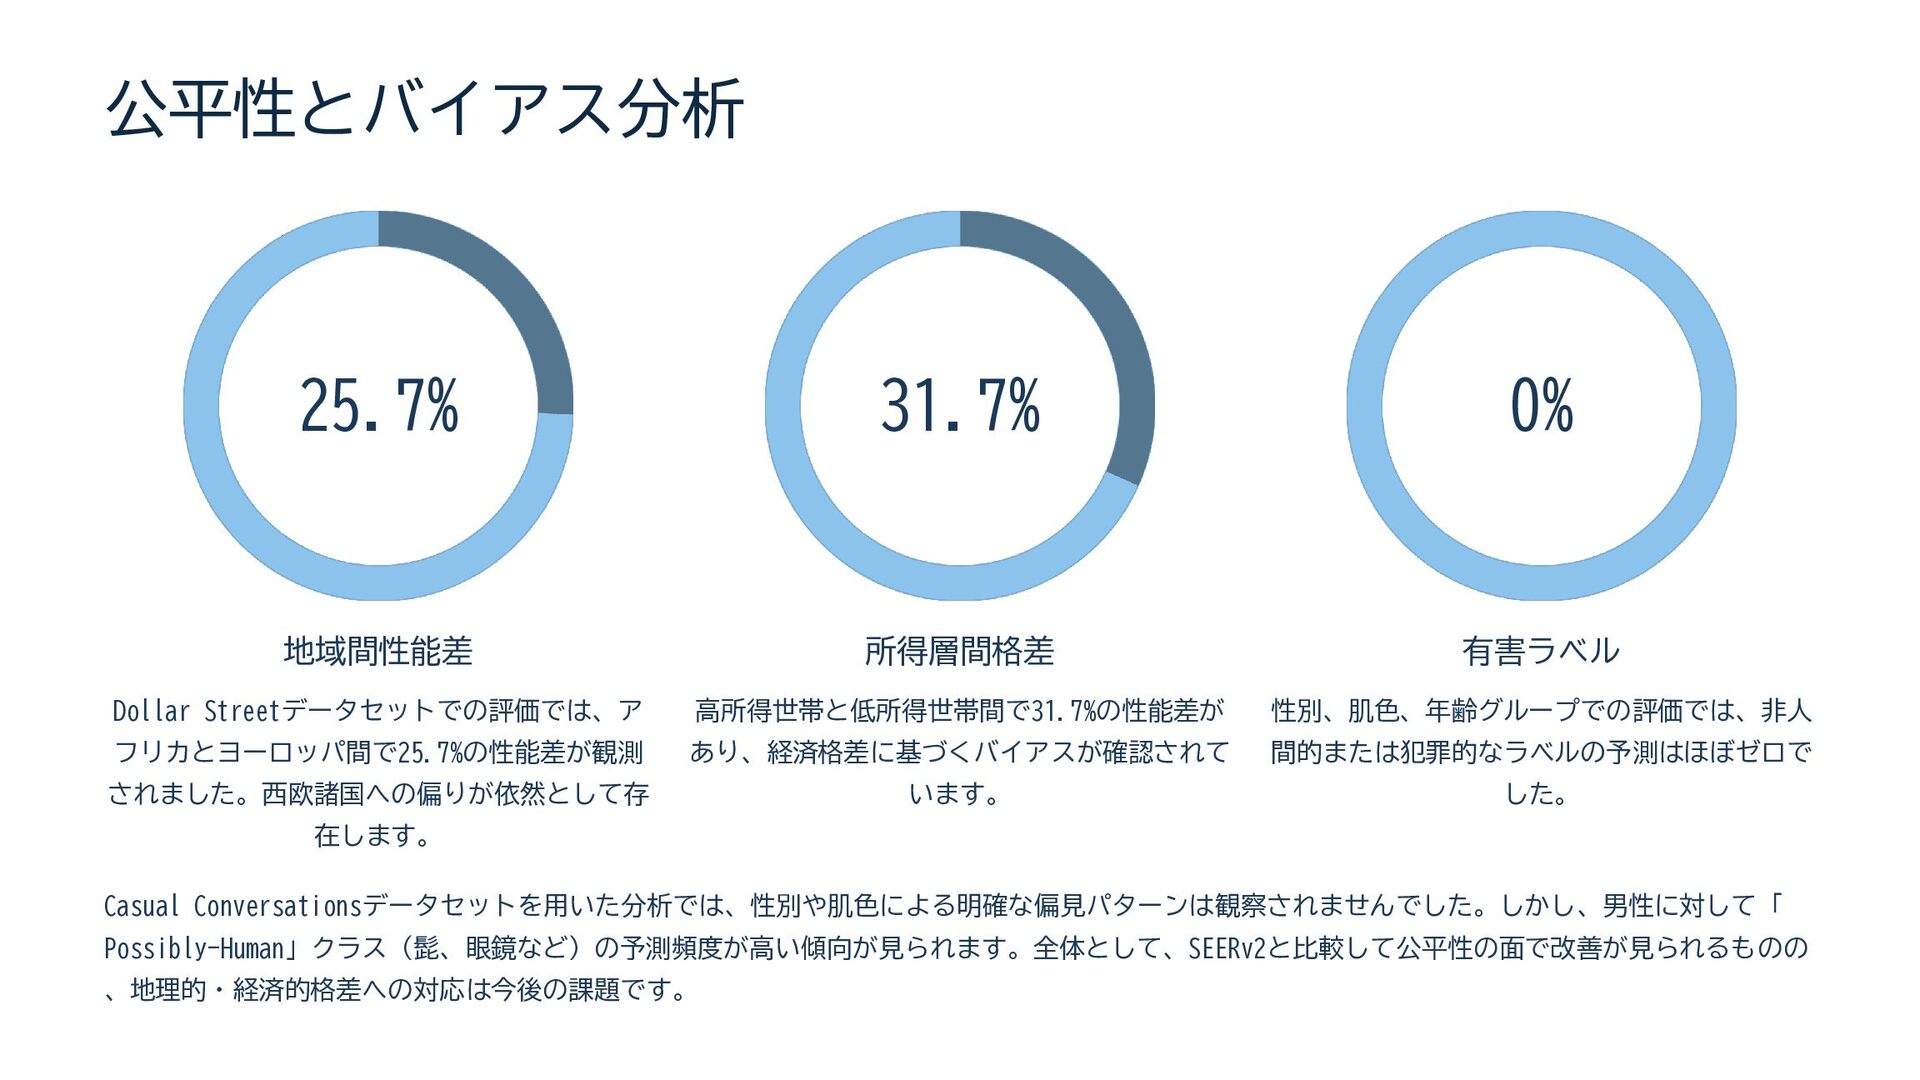
  12. 公平性とバイアス分析 25.7% 地域間性能差 Dollar Streetデータセットでの評価では、ア フリカとヨーロッパ間で25.7%の性能差が観測 されました。西欧諸国への偏りが依然として存 在します。 31.7% 所得層間格差

    高所得世帯と低所得世帯間で31.7%の性能差が あり、経済格差に基づくバイアスが確認されて います。 0% 有害ラベル 性別、肌色、年齢グループでの評価では、非人 間的または犯罪的なラベルの予測はほぼゼロで した。 Casual Conversationsデータセットを用いた分析では、性別や肌色による明確な偏見パターンは観察されませんでした。しかし、男性に対して「 Possibly-Human」クラス(髭、眼鏡など)の予測頻度が高い傾向が見られます。全体として、SEERv2と比較して公平性の面で改善が見られるものの 、地理的・経済的格差への対応は今後の課題です。
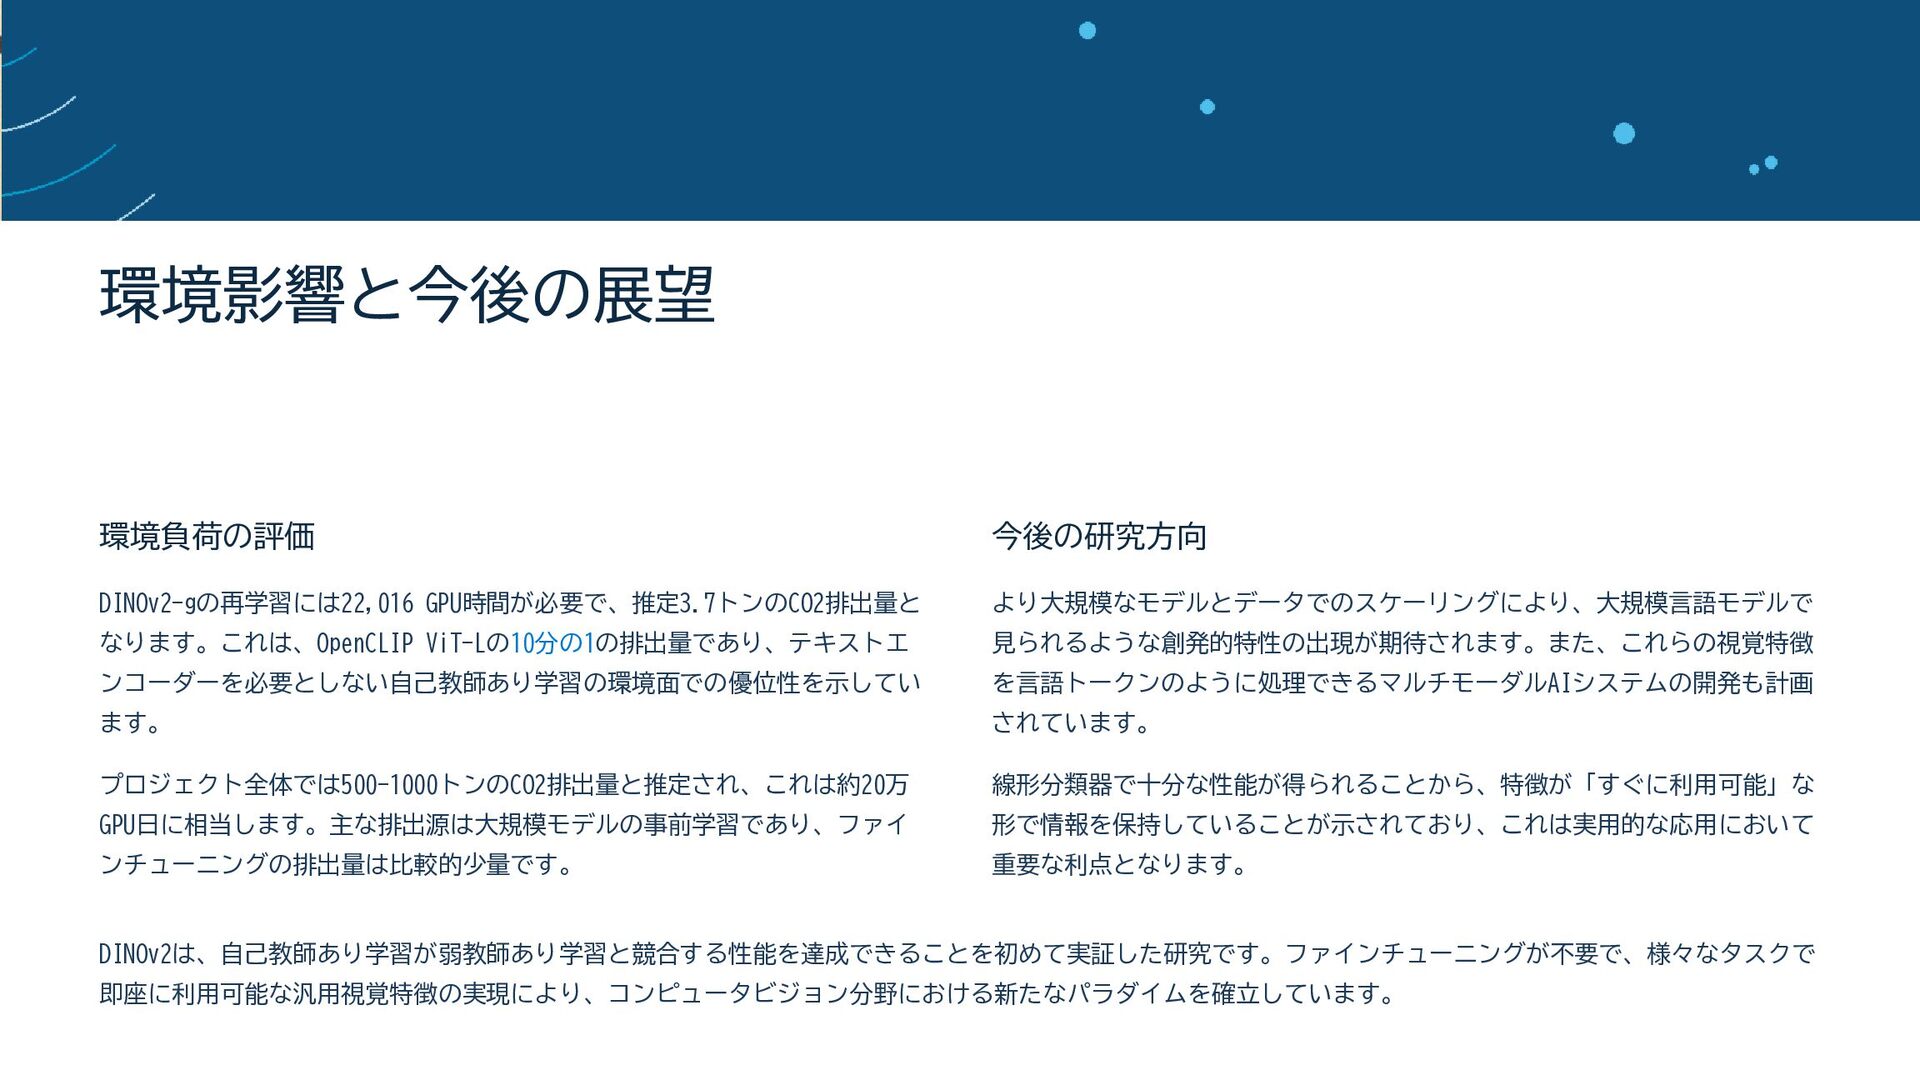
  13. 環境影響と今後の展望 環境負荷の評価 DINOv2-gの再学習には22,016 GPU時間が必要で、推定3.7トンのCO2排出量と なります。これは、OpenCLIP ViT-Lの10分の1の排出量であり、テキストエ ンコーダーを必要としない自己教師あり学習の環境面での優位性を示してい ます。 プロジェクト全体では500-1000トンのCO2排出量と推定され、これは約20万 GPU日に相当します。主な排出源は大規模モデルの事前学習であり、ファイ

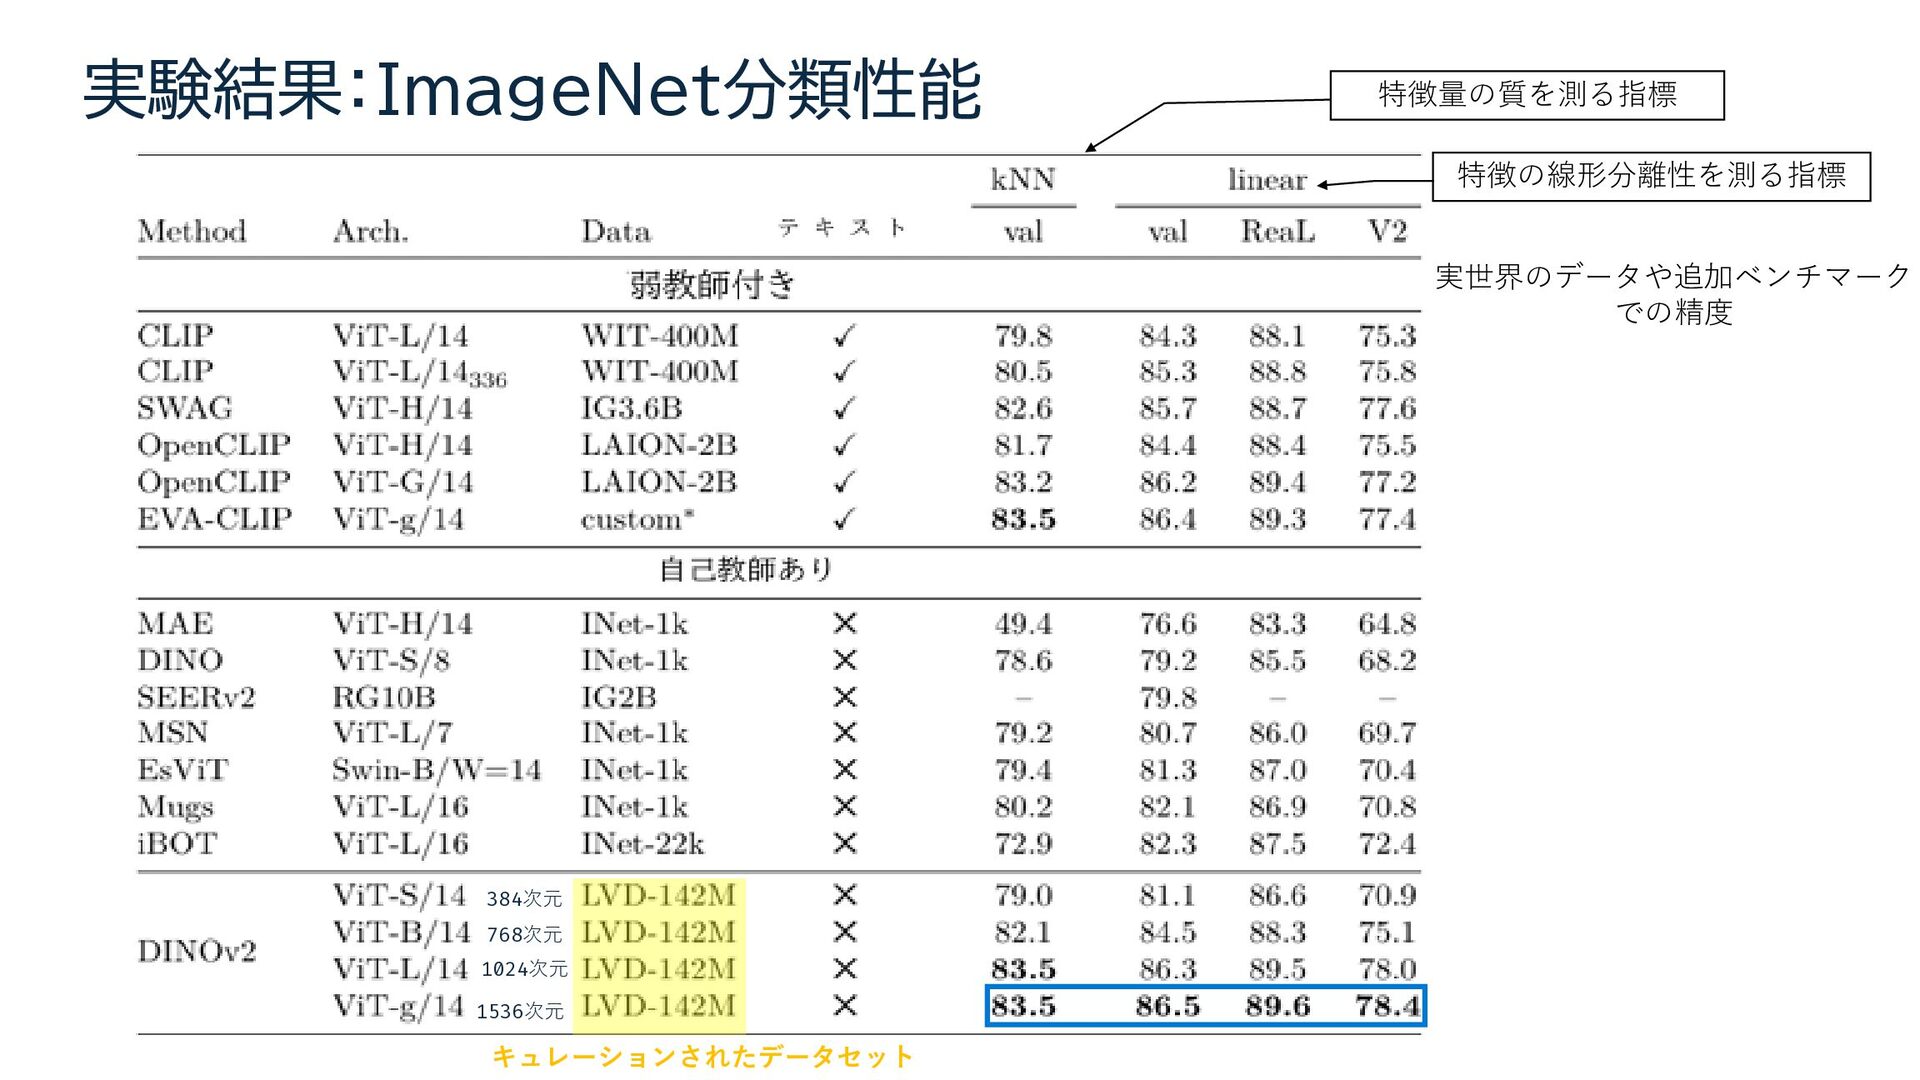
    ンチューニングの排出量は比較的少量です。 今後の研究方向 より大規模なモデルとデータでのスケーリングにより、大規模言語モデルで 見られるような創発的特性の出現が期待されます。また、これらの視覚特徴 を言語トークンのように処理できるマルチモーダルAIシステムの開発も計画 されています。 線形分類器で十分な性能が得られることから、特徴が「すぐに利用可能」な 形で情報を保持していることが示されており、これは実用的な応用において 重要な利点となります。 DINOv2は、自己教師あり学習が弱教師あり学習と競合する性能を達成できることを初めて実証した研究です。ファインチューニングが不要で、様々なタスクで 即座に利用可能な汎用視覚特徴の実現により、コンピュータビジョン分野における新たなパラダイムを確立しています。
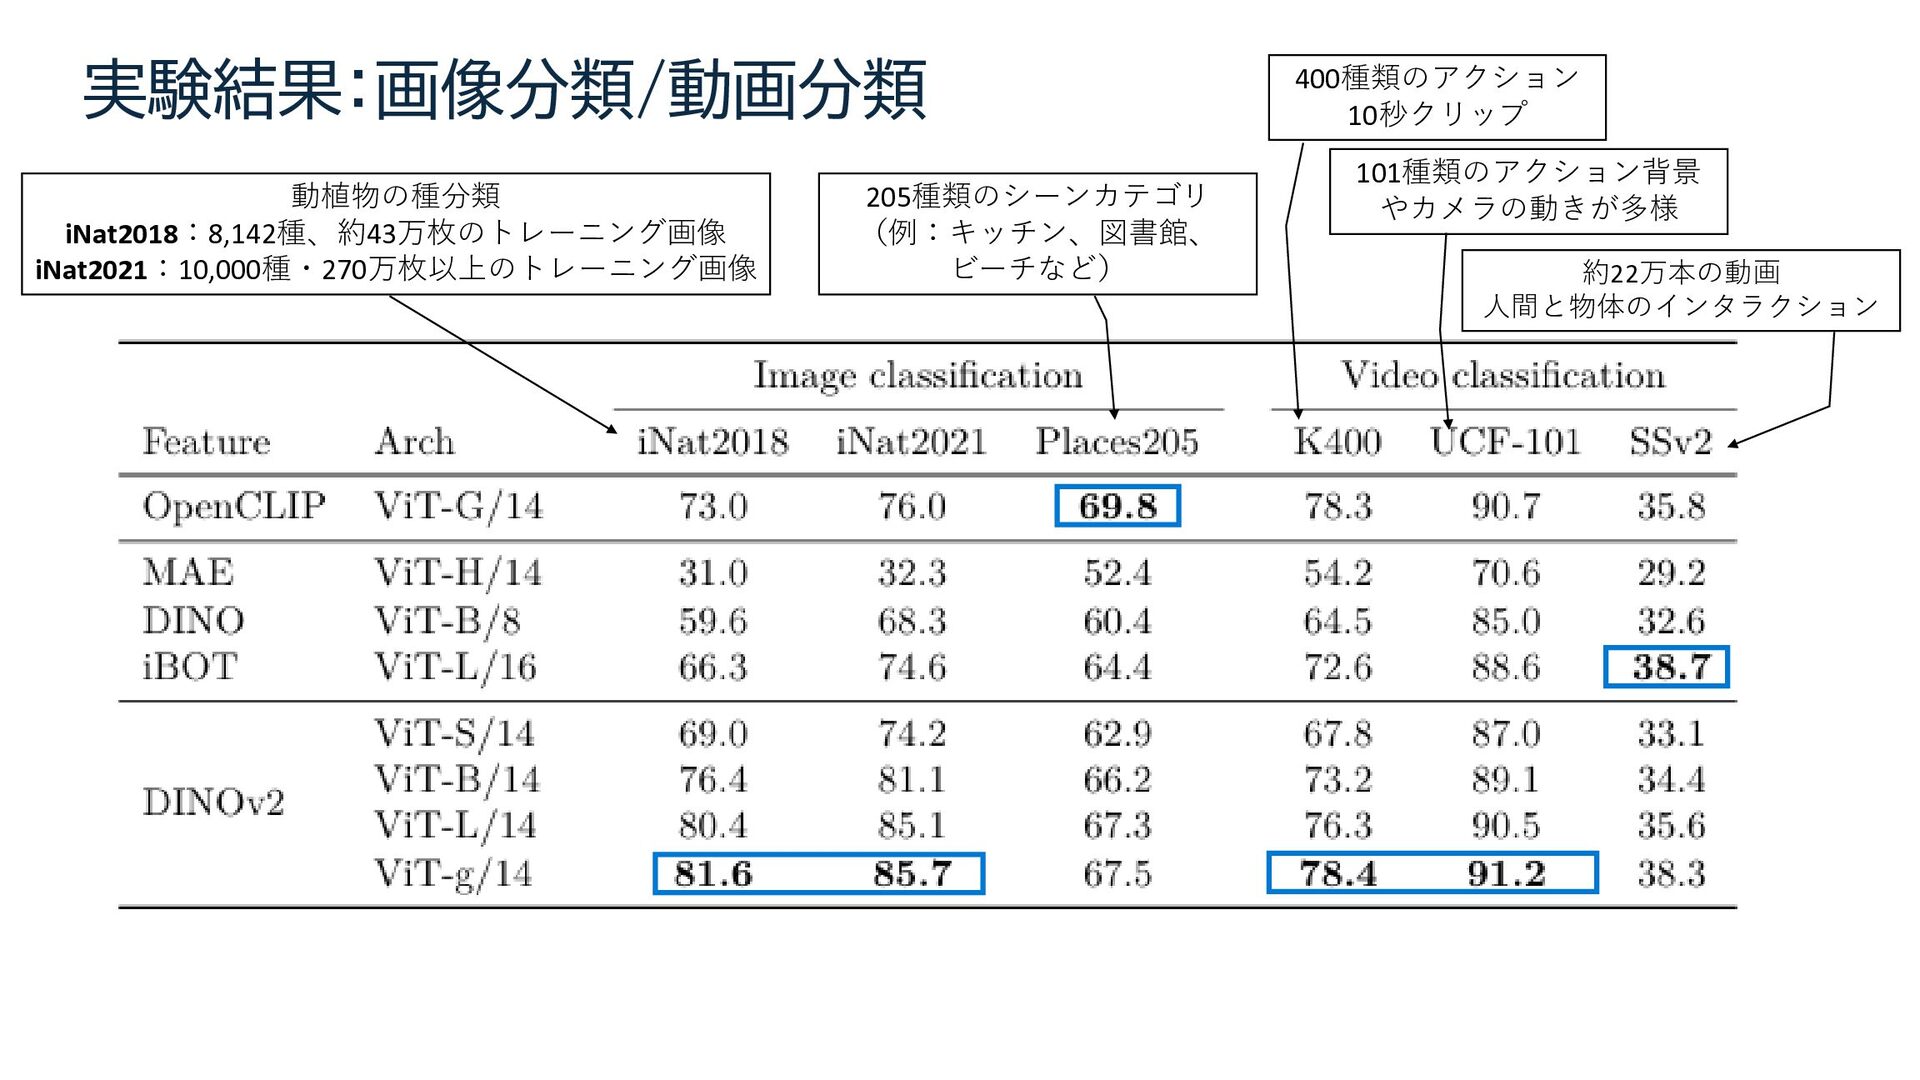
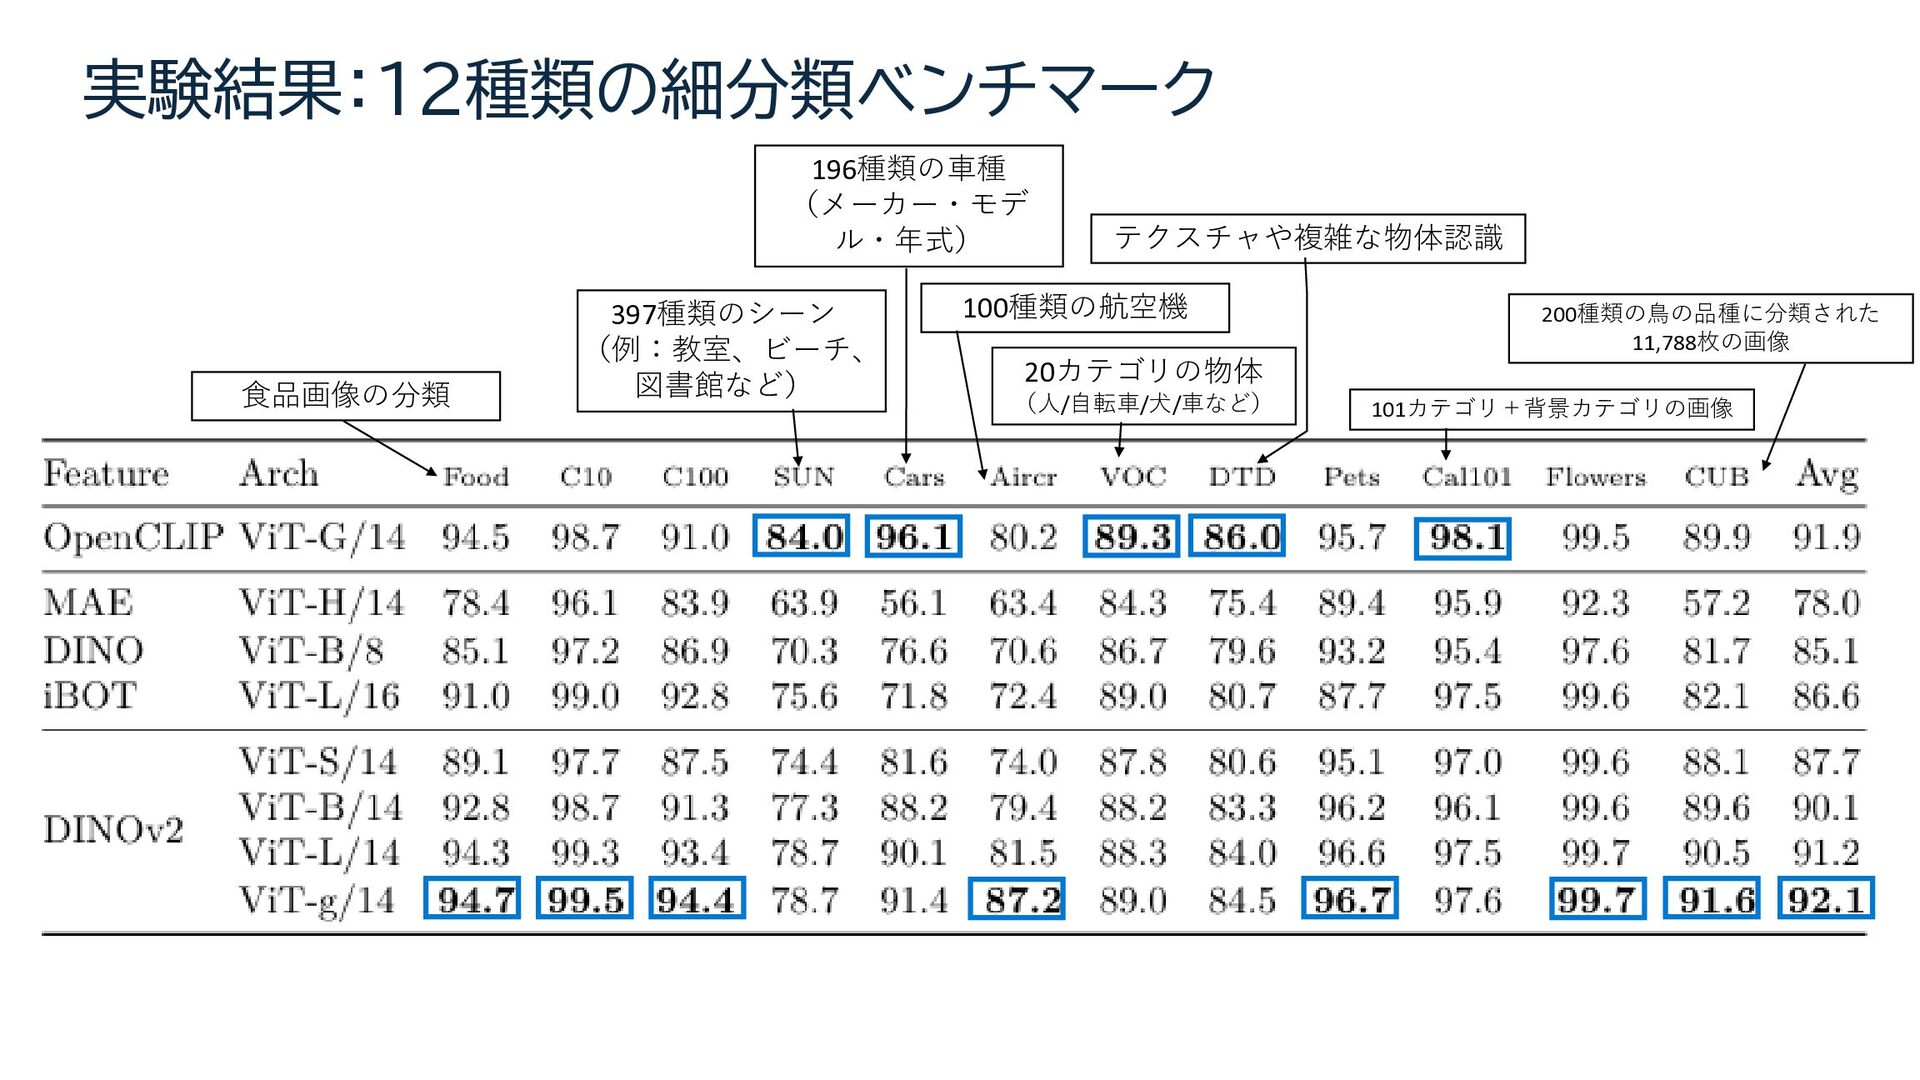
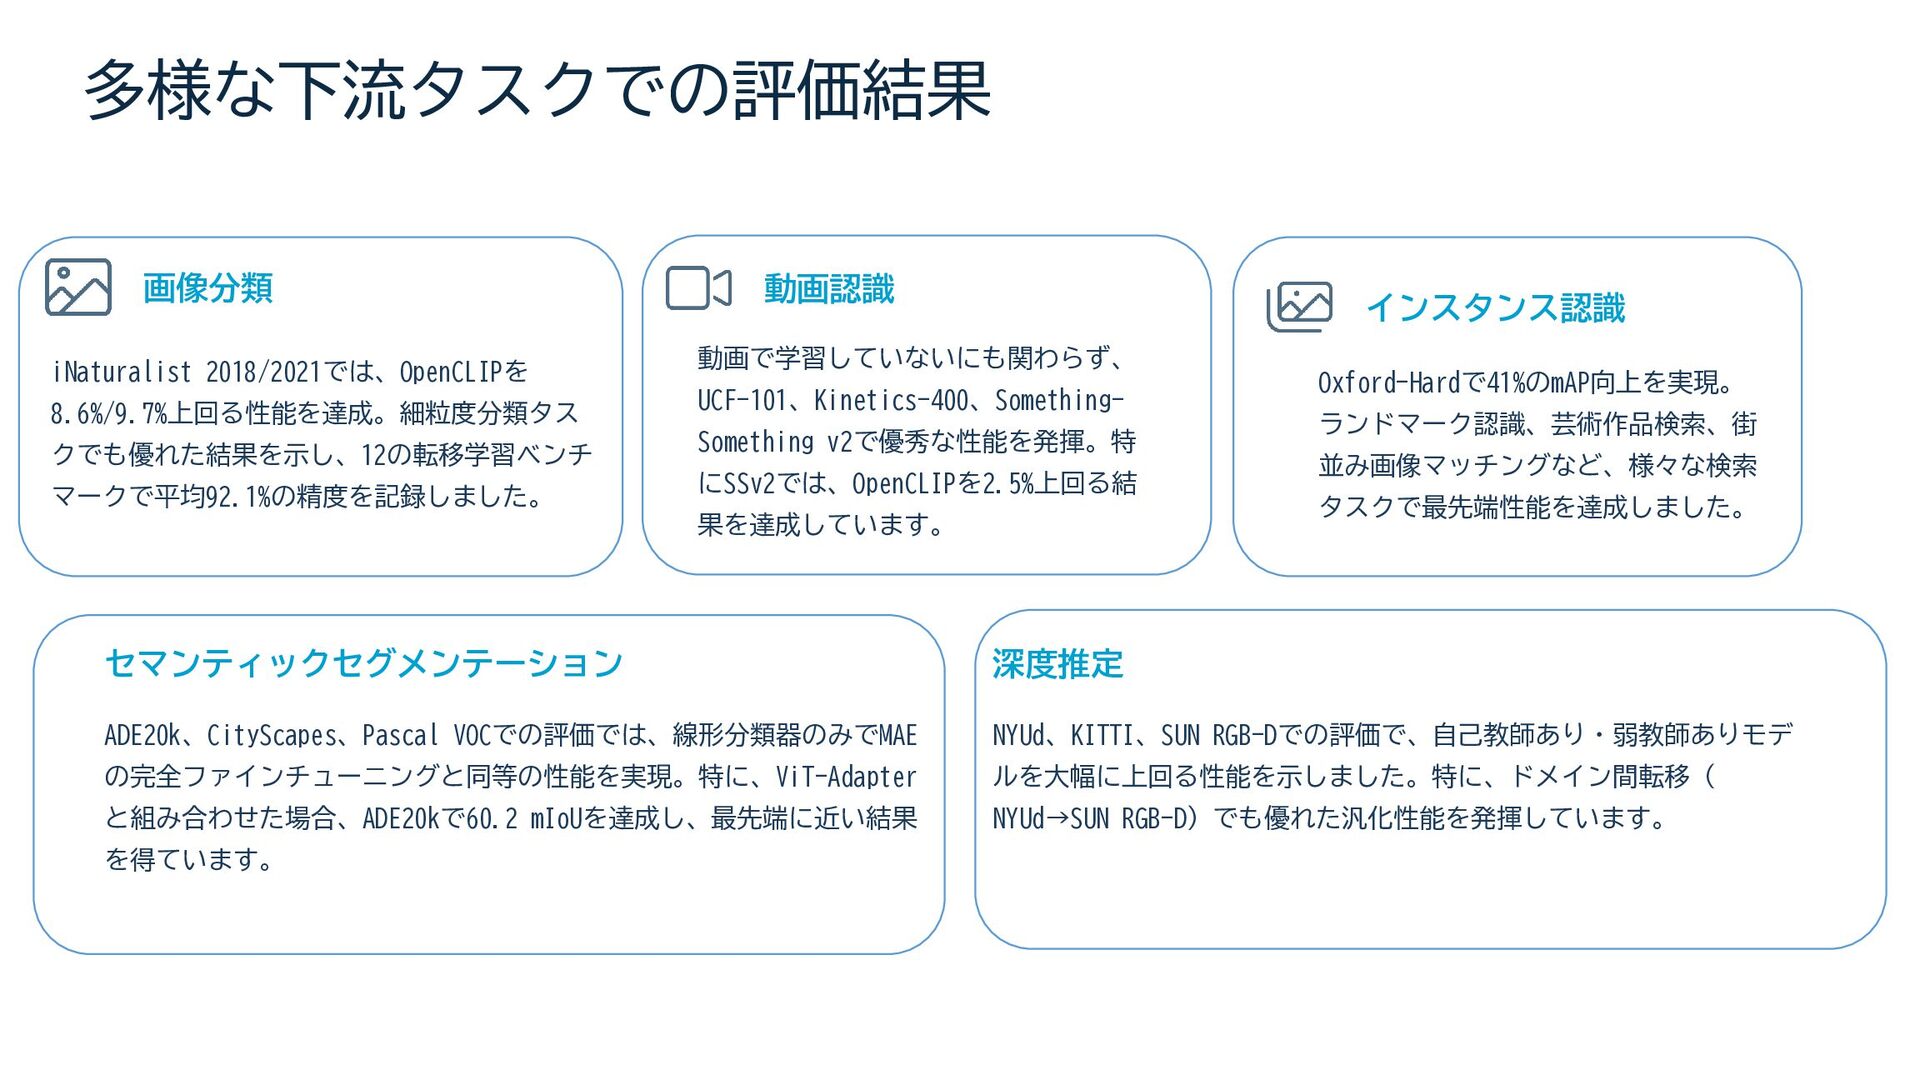
  14. 多様な下流タスクでの評価結果 画像分類 iNaturalist 2018/2021では、OpenCLIPを 8.6%/9.7%上回る性能を達成。細粒度分類タス クでも優れた結果を示し、12の転移学習ベンチ マークで平均92.1%の精度を記録しました。 動画認識 動画で学習していないにも関わらず、 UCF-101、Kinetics-400、Something-

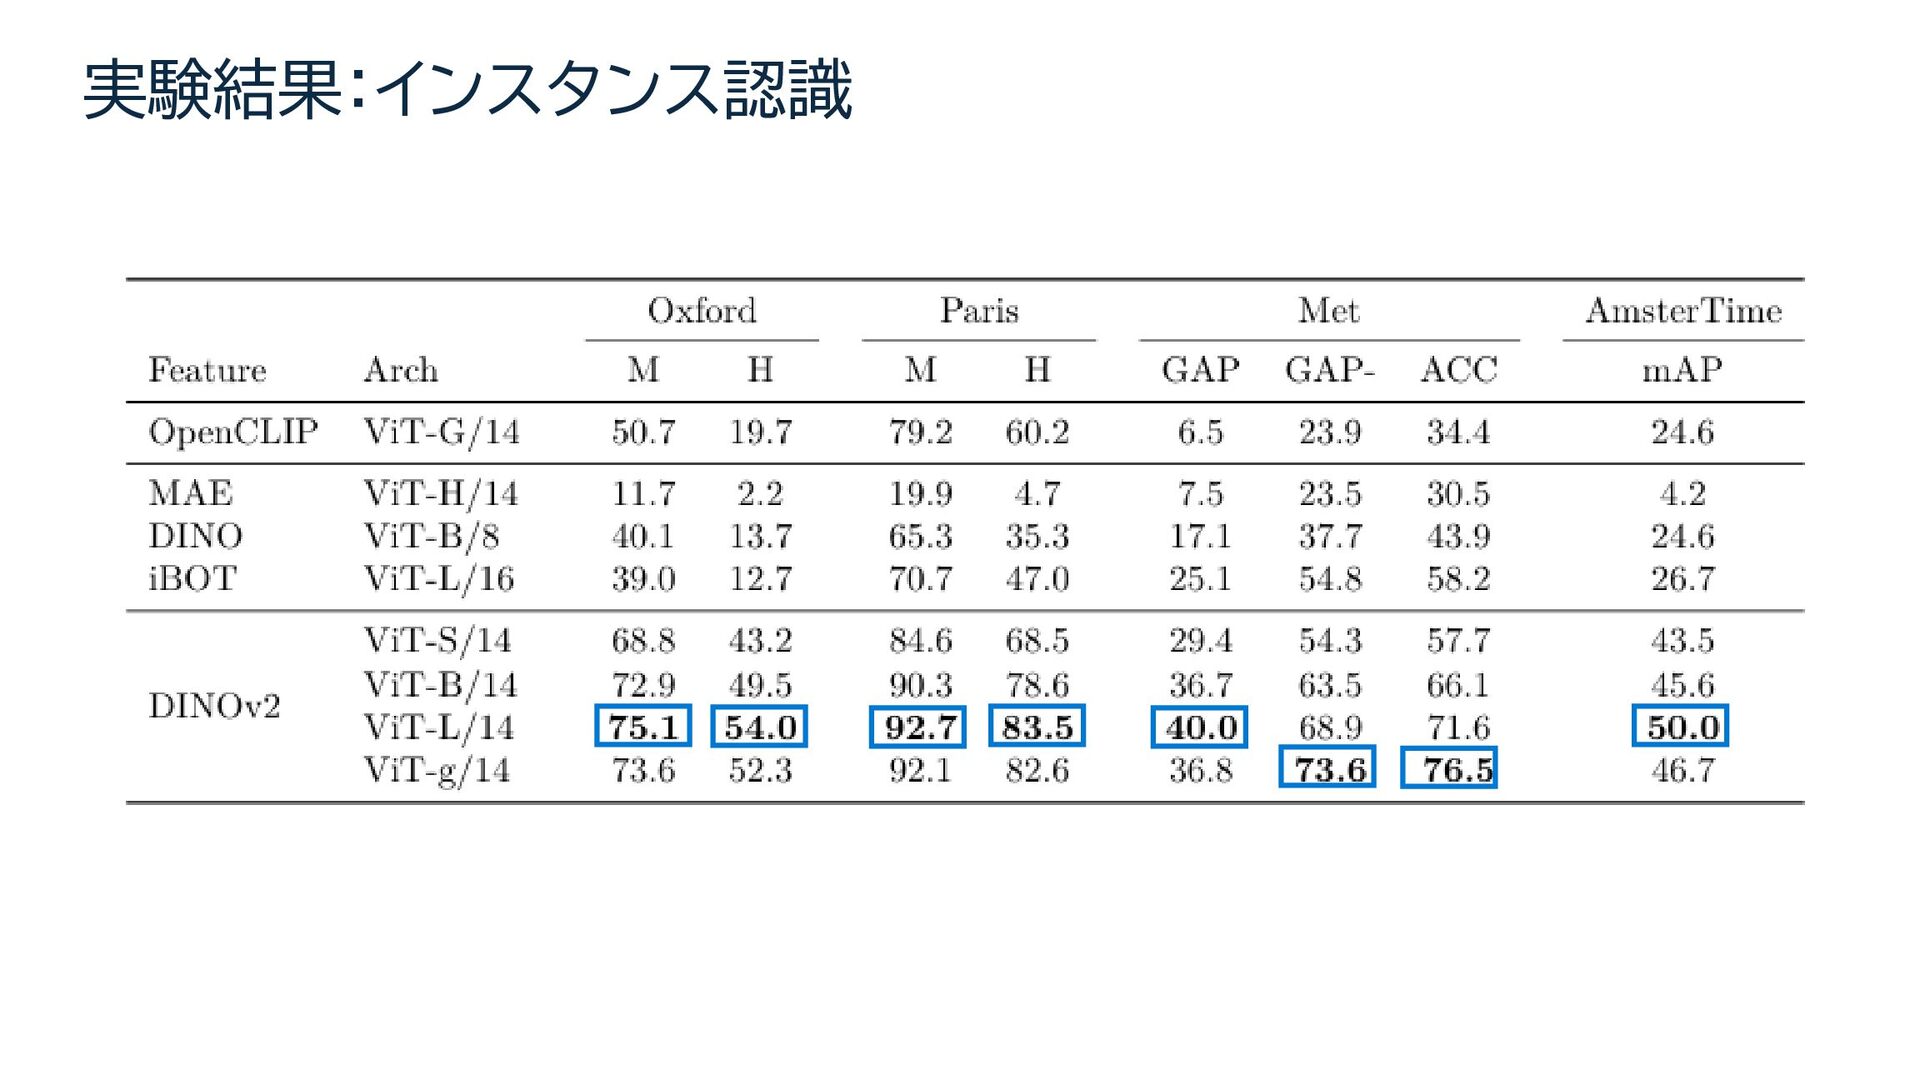
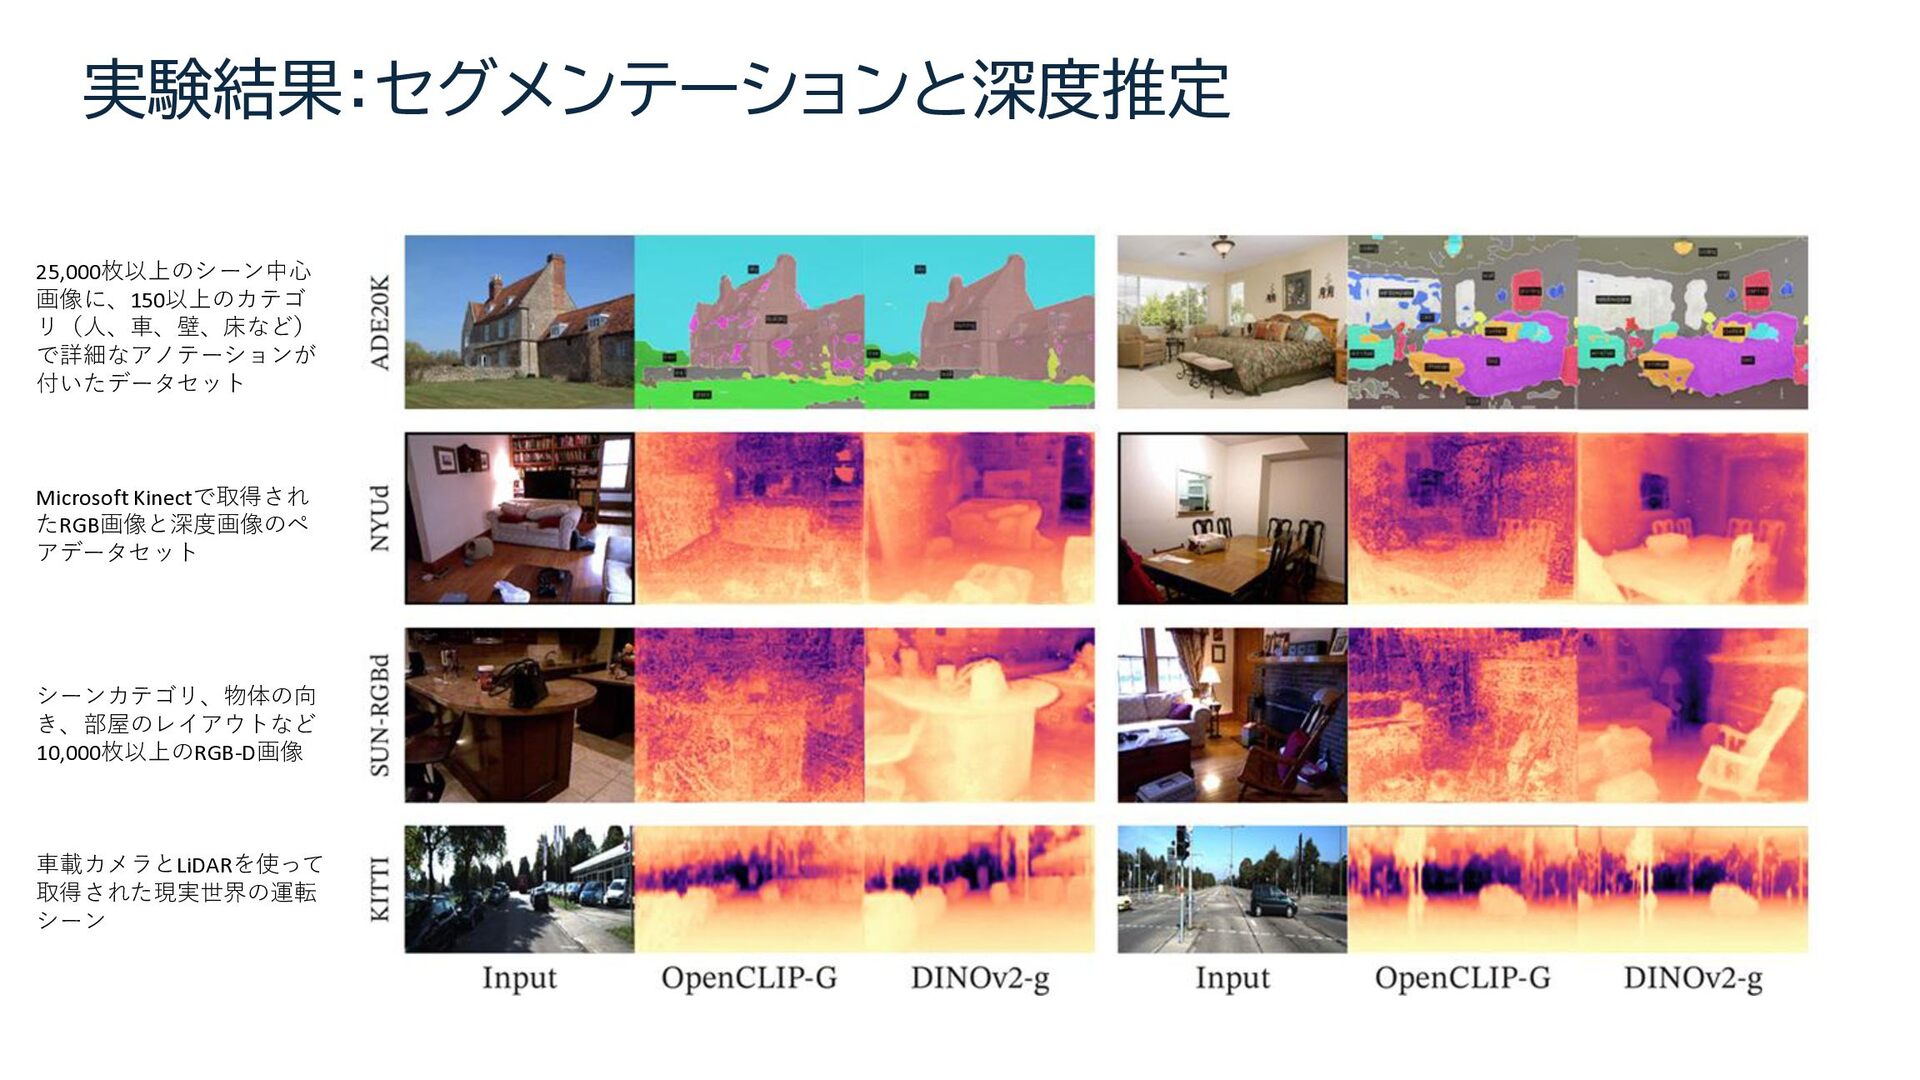
    Something v2で優秀な性能を発揮。特 にSSv2では、OpenCLIPを2.5%上回る結 果を達成しています。 インスタンス認識 Oxford-Hardで41%のmAP向上を実現。 ランドマーク認識、芸術作品検索、街 並み画像マッチングなど、様々な検索 タスクで最先端性能を達成しました。 セマンティックセグメンテーション ADE20k、CityScapes、Pascal VOCでの評価では、線形分類器のみでMAE の完全ファインチューニングと同等の性能を実現。特に、ViT-Adapter と組み合わせた場合、ADE20kで60.2 mIoUを達成し、最先端に近い結果 を得ています。 深度推定 NYUd、KITTI、SUN RGB-Dでの評価で、自己教師あり・弱教師ありモデ ルを大幅に上回る性能を示しました。特に、ドメイン間転移( NYUd→SUN RGB-D)でも優れた汎化性能を発揮しています。
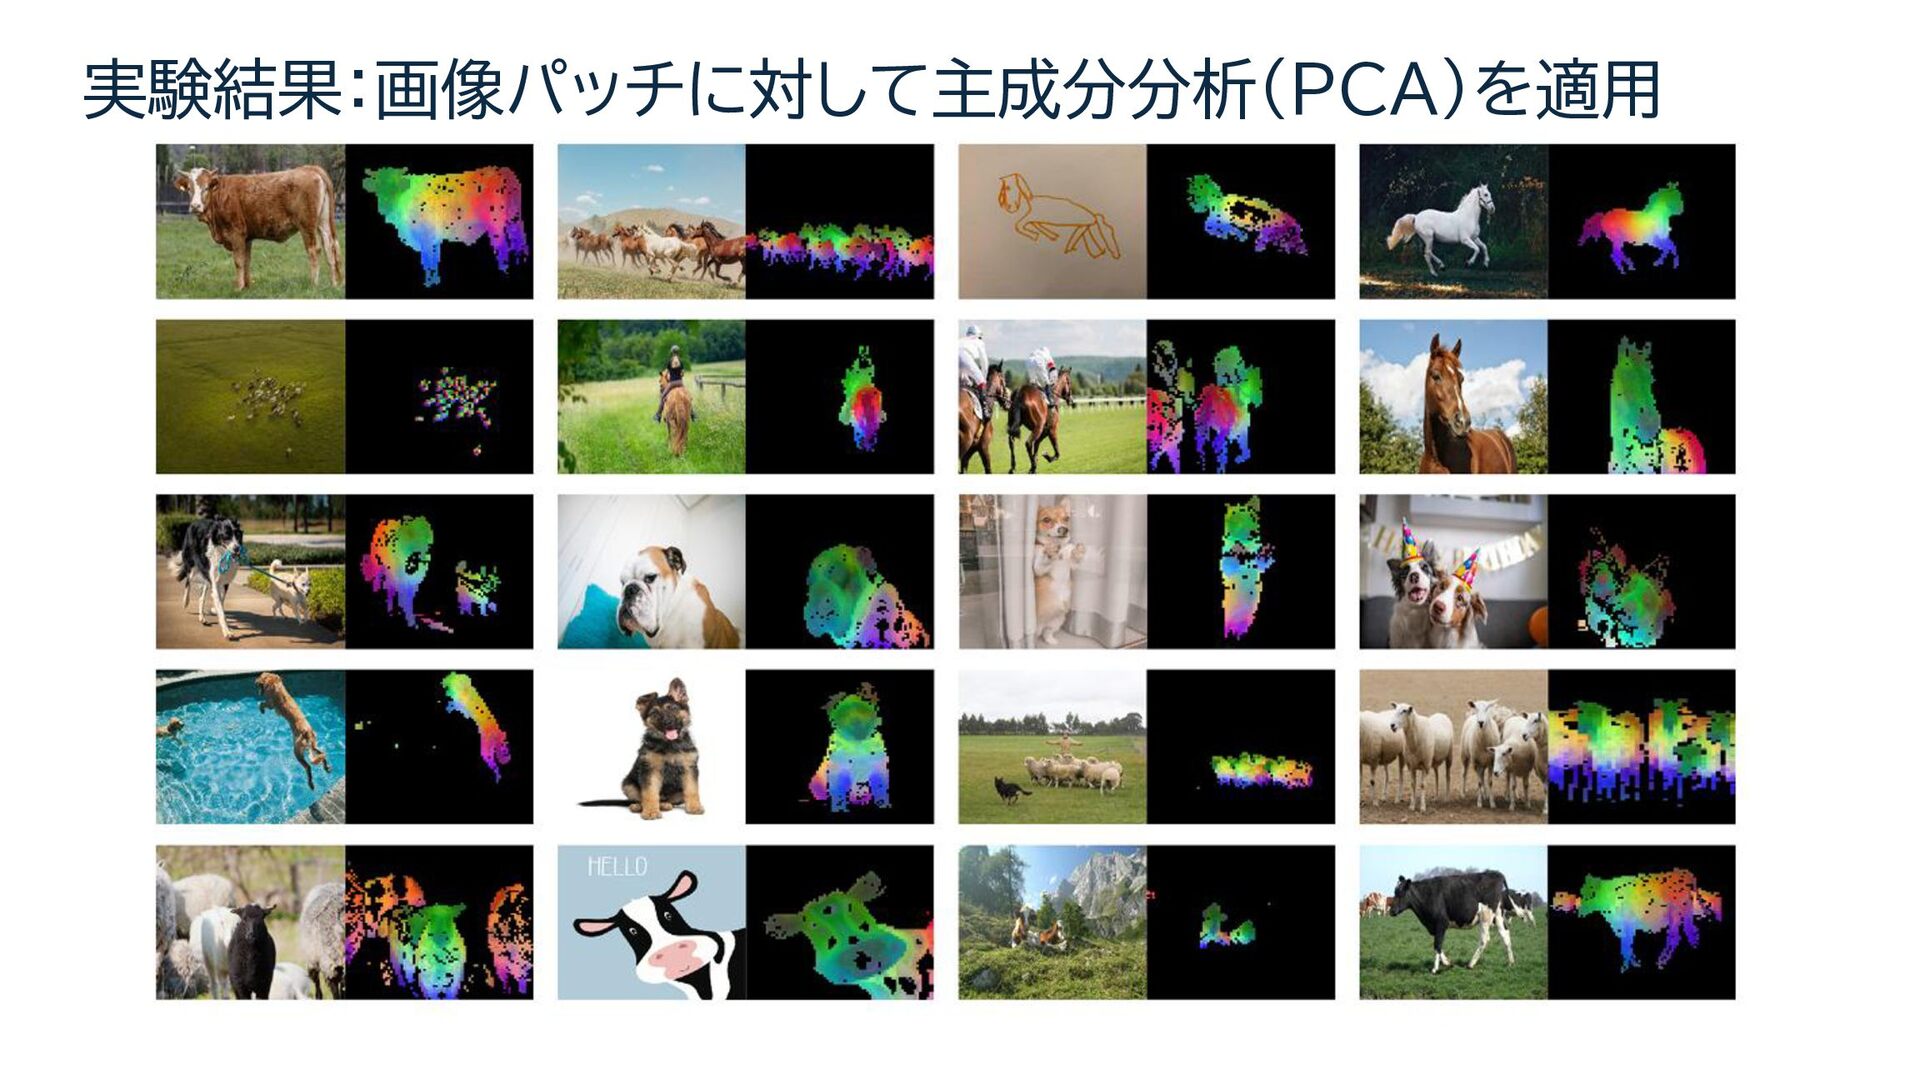
  15. preencoded.png 定性的分析と特徴可視化 PCA成分分析 パッチ特徴のPCA分析により、第1成分 が前景・背景分離を、他の成分がオブ ジェクトの部位に対応することが判明 しました。これは教師なし学習にも関 わらず、意味的な部位解析が自然に学 習されていることを示しています。 パッチマッチング

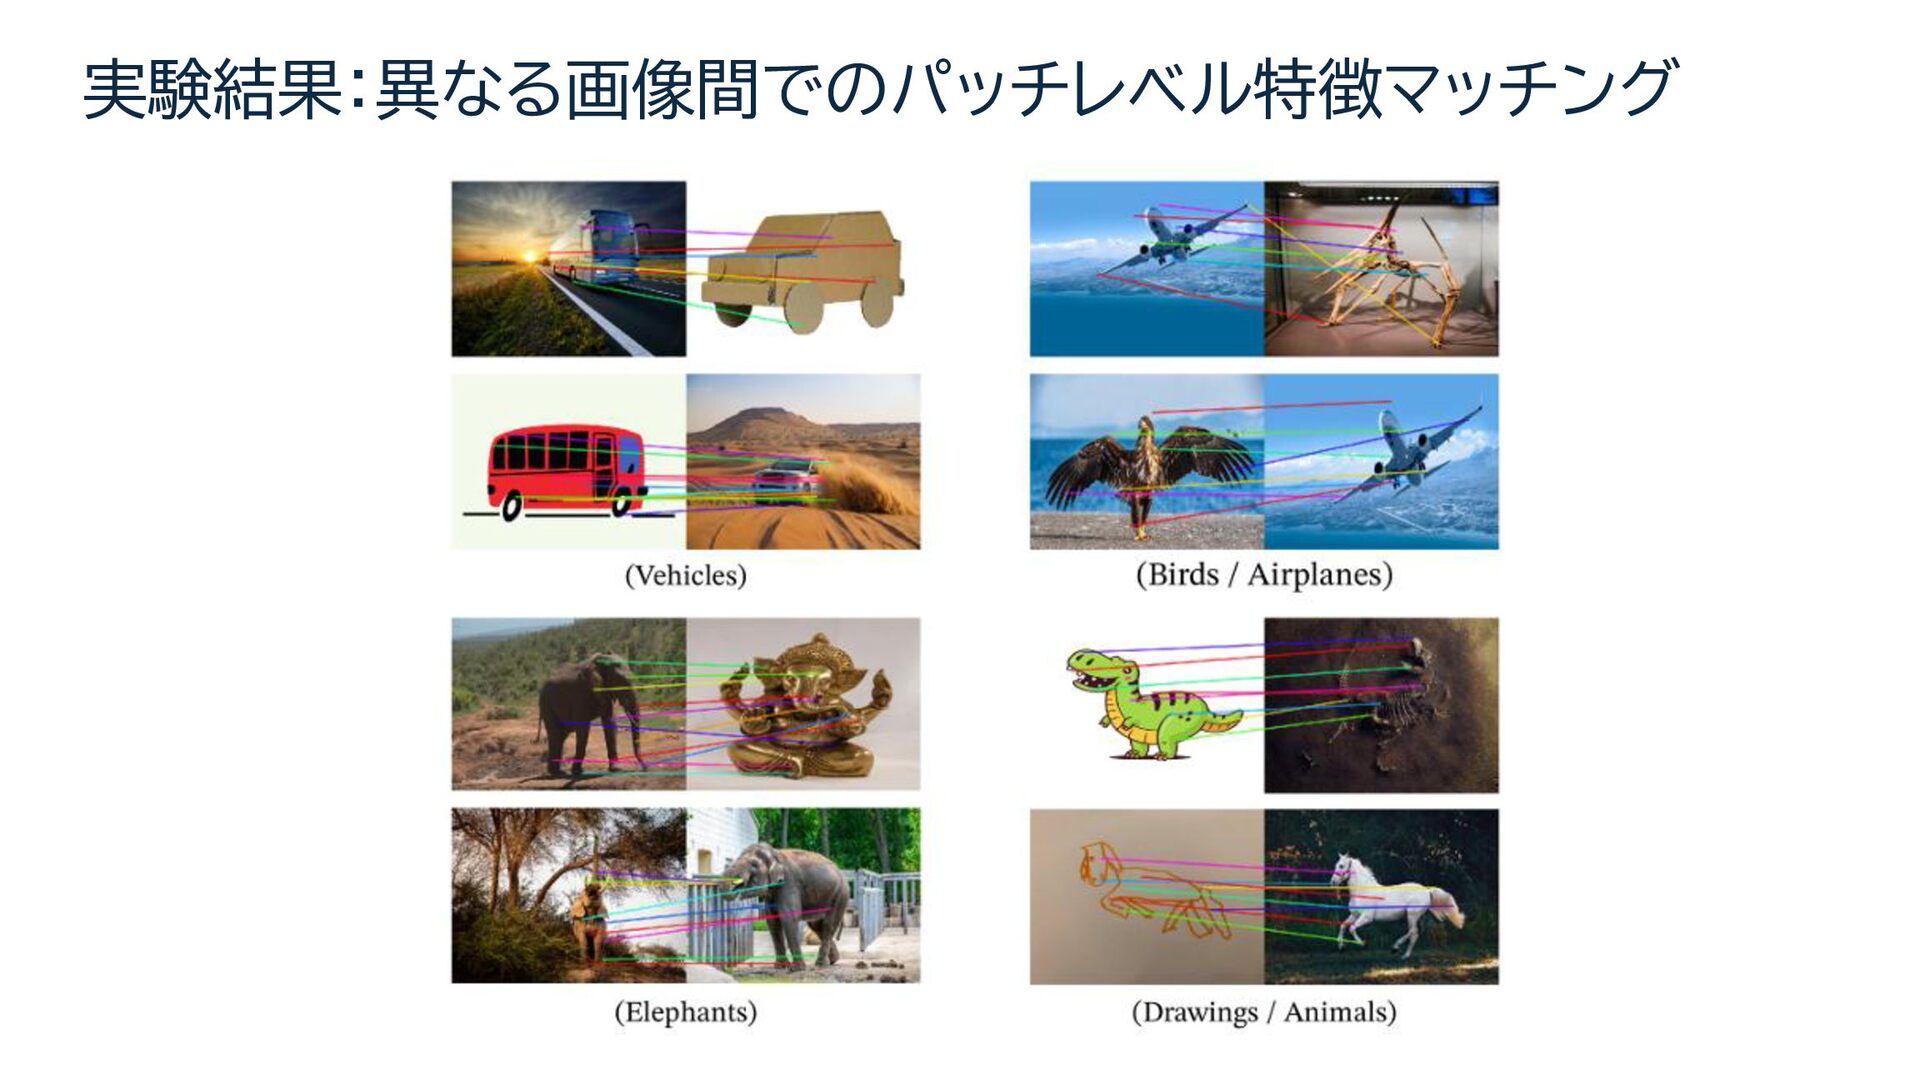
    異なる画像間でのパッチレベル特徴マ ッチングでは、飛行機の翼と鳥の翼、 象の異なるポーズでの対応部位など、 意味的に類似した領域が正確にマッチ ングされることが確認されました。 ドメイン外汎化 動物の写真や絵画など、学習データに ない分布の画像に対しても、深度推定 やセグメンテーションが高品質で実行 されます。これは、学習された特徴が 真にドメイン不変であることを示して います。 線形分離可能性 複雑な深度情報やセグメンテーション 情報が線形分類器で分離可能であるこ とは、特徴空間での情報の整理された 表現を示唆しています。

More Decks by yuyu4Tech

Other Decks in Technology