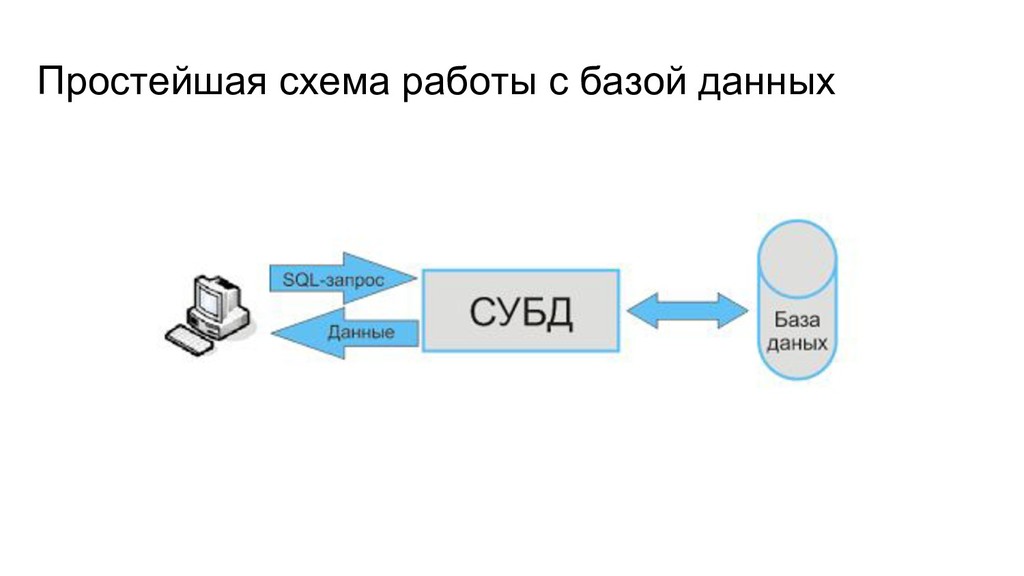
упорядоченным способом. Иными словами, база данных - это хранилище данных. Сами по себе базы данных не представляли бы интереса, если бы не было систем управления базами данных (СУБД). Система управления базами данных - программное обеспечение, предназначенное для хранения и управления данными. Для решения различных задач разрабатывалось всё больше и больше различных СУБД (Реляционные и NoSQL) и программ для работы с ними (MySQL, PostgreSQL, MongoDB, Redis и т.д.) SQL (Structured Query Language) - язык структурированных запросов, основной задачей которого является предоставление простого способа считывания и записи информации в БД.
большое количество сильно отличающихся друг от друга инструментов для работы с базами данных (отдельные программы и подключаемые библиотеки). Так как данные бывают различных видов и типов, начиная со второй половины 20 века было разработано огромное количество разных СУБД и других приложений для работы с БД. СУБД основываются на модели базы данных - это специальные структуры предназначенные для работы с данными. Все СУБД сильно отличаются в том, каким образом они хранят и обрабатывают свои данные. Хотя существуют много решений для работы с БД, популярными и востребованными становятся лишь некоторые из них. Наиболее часто применяемая на сегодняшний день - реляционная система управления базами данных.
данных. Эта модель и определяет, как создаваемая СУБД будет оперировать данными. Существует довольно немного моделей БД, которые предоставляют способы четкого структурирования данных, самая популярная из таких моделей - реляционная модель. Реляционная модель и реляционные БД могут быть очень мощным инструментом, но только если программист знает как с ними обращаться. Недавно, стали набирать популярность NoSQL системы с обещанием избавиться от старых проблем БД и добавить новый функционал. Исключая жесткую структуру данных, при этом сохранив реляционный стиль, эти СУБД предлагают более свободный способ работы с ними и гораздо большие возможности для их настройки.
структуризации, хранения и использования данных. Отношения (англ. relations) дают возможность группировки данных как связанных наборов, представленных в виде таблиц, содержащих упорядоченную информацию (например, имя и адрес человека) и соотносящих значения и атрибуты (его номер паспорта). Благодаря десятилетиям исследований и разработки РСУБД работают производительно и надёжно. В сочетании с большим опытом использования администраторами реляционные базы данных стали выбором, гарантирующим защиту информации от потерь.
с которой работают. На данный момент и, наверное, в ближайшем будущем эти СУБД будут наиболее популярным выбором для хранения данных. Реляционные СУБД используют строго описанные структуры данных - схемы. Схема базы данных включает в себя описание содержания, структуры и ограничений целостности, т.е. она определяет таблицы, поля в каждой таблице, а также отношения между полями и таблицами. Вот некоторые из наиболее популярных систем: • SQLite - довольно мощная встраиваемая СУБД • MySQL - наиболее популярная СУБД • PostgreSQL - самая профессиональная свободно распространяемая СУБД, полностью соответствующая стандартам SQL
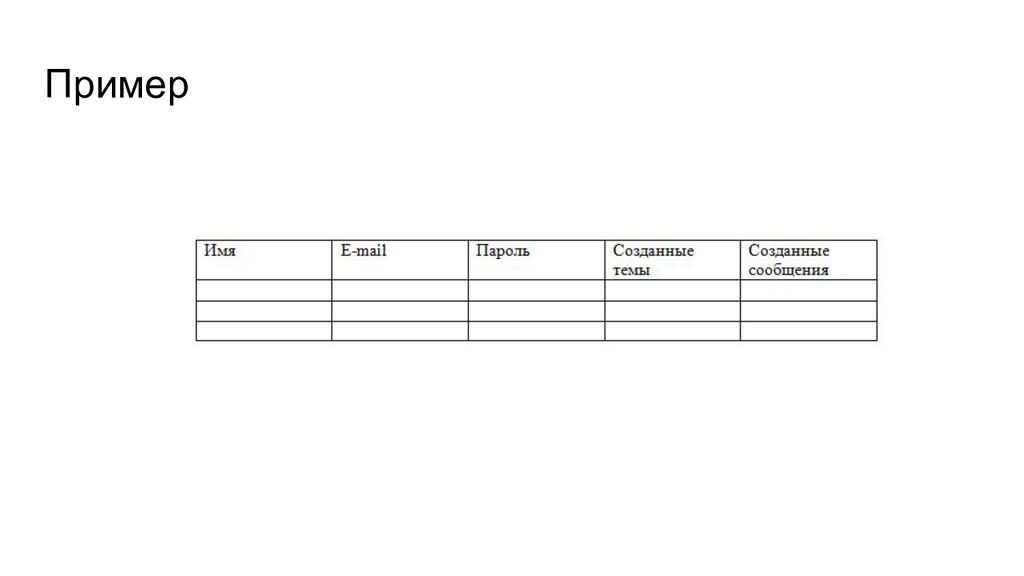
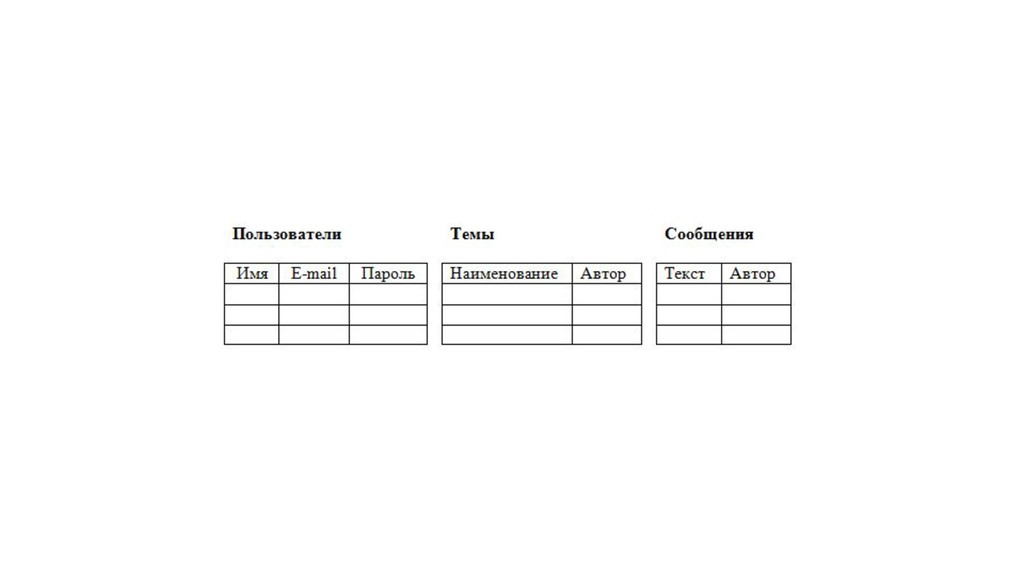
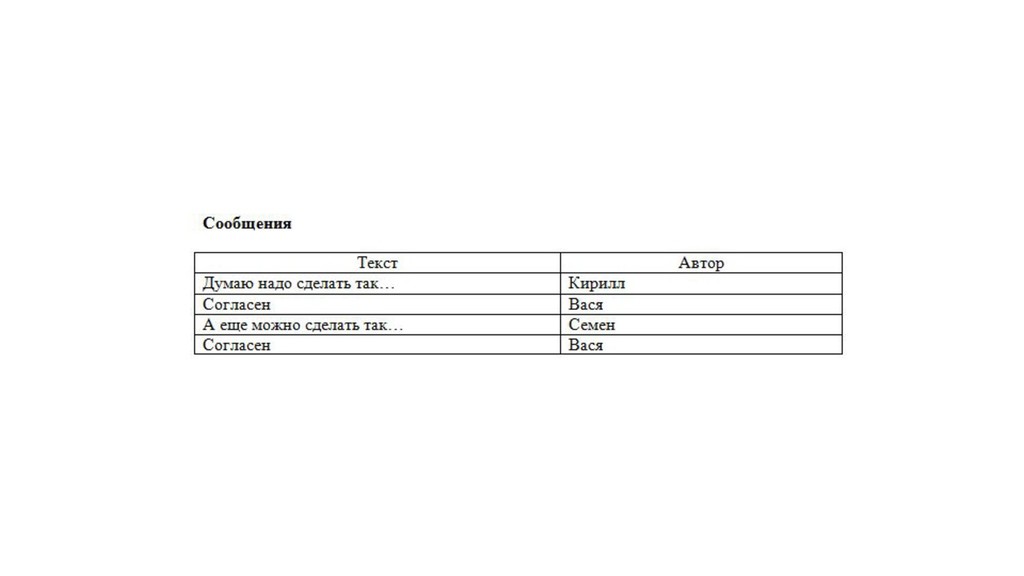
таблиц. Каждая таблица состоит из столбцов (их называют полями или атрибутами) и строк (их называют записями или кортежами). Свойства таблиц в реляционных базах данных следующие: • В таблице не может быть двух одинаковых строк. В математике таблицы, обладающие таким свойством, называют отношениями (relation) • Столбцы располагаются в определенном порядке, который создается при создании таблицы. В таблице может не быть ни одной строки, но обязательно должен быть хотя бы один столбец. • У каждого столбца есть уникальное имя (в пределах таблицы), и все значения в одном столбце имеют один тип (число, текст, дата...). • На пересечении каждого столбца и строки может находиться только атомарное значение. Таблицы, удовлетворяющие этому условию, называют нормализованными.
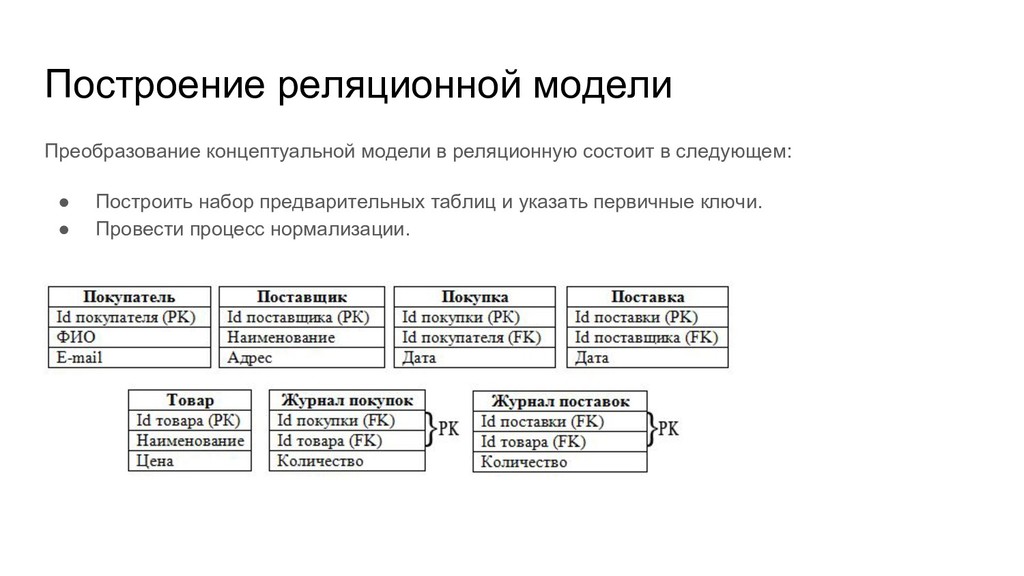
столбец, значения которого во всех строках различны. Первичные ключи могут быть логическими (естественными) и суррогатными (искусственными). На практике лучше использовать суррогатные ключи, т.к. их применение позволяет абстрагировать ключи от реальных данных. Суррогатный ключ представляет собой дополнительное поле в базе данных. Как правило, это порядковый номер записи (хотя вы можете задавать их на свое усмотрение, контролируя, чтобы они были уникальны).
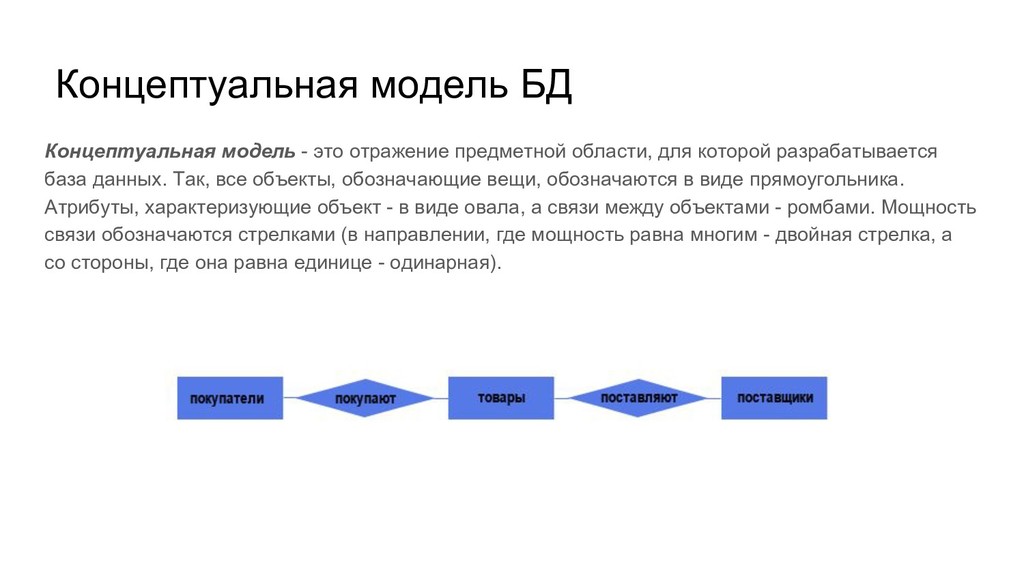
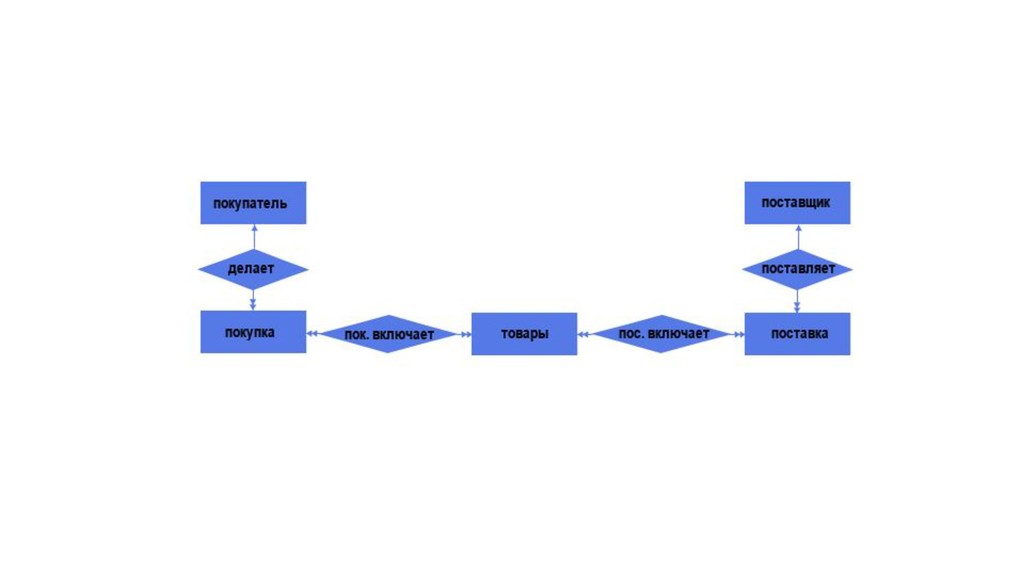
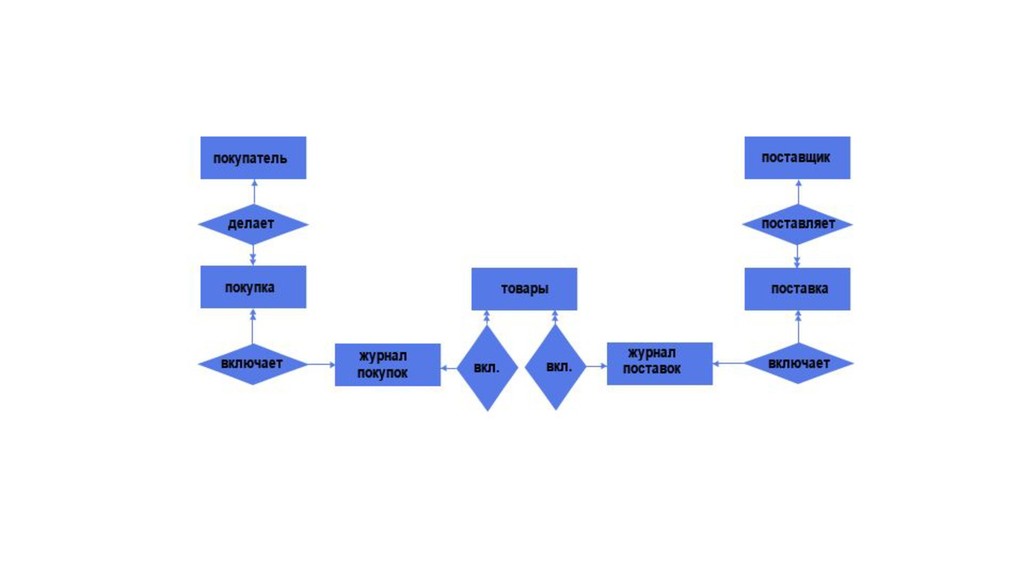
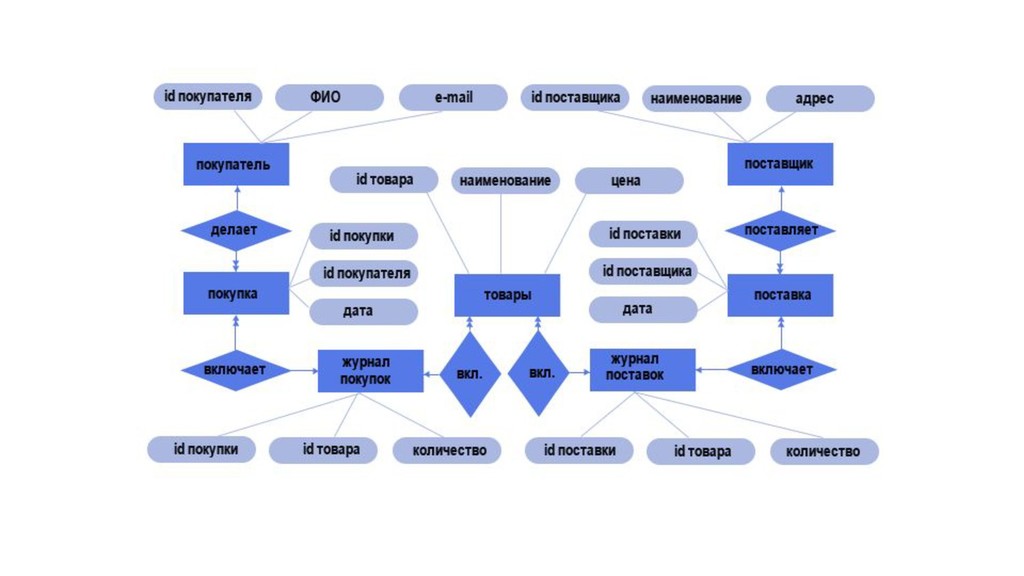
для которой разрабатывается база данных. Так, все объекты, обозначающие вещи, обозначаются в виде прямоугольника. Атрибуты, характеризующие объект - в виде овала, а связи между объектами - ромбами. Мощность связи обозначаются стрелками (в направлении, где мощность равна многим - двойная стрелка, а со стороны, где она равна единице - одинарная).
другой схемой, в которой таблицы имеют более простую и логичную структуру. Различают: • 1НФ - первая нормальная форма • 2НФ - вторая нормальная форма • 3НФ - третья нормальная форма • НФБК - нормальная форма Бойса-Кодда • 4НФ - четвертая нормальная форма • 5НФ - пятая нормальная форма Для реляционных баз данных необходимо, чтобы ее таблицы находились в 1НФ.
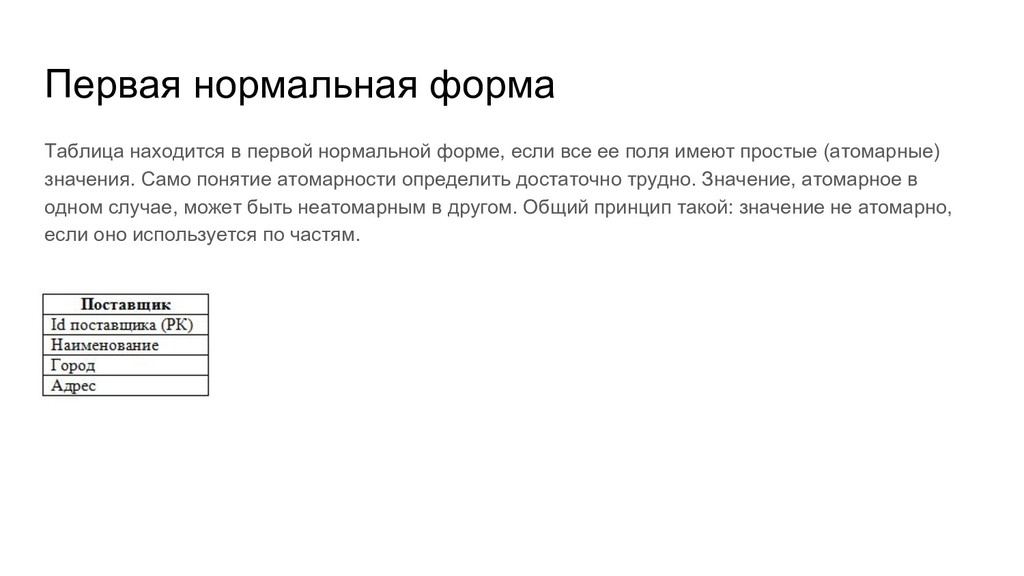
все ее поля имеют простые (атомарные) значения. Само понятие атомарности определить достаточно трудно. Значение, атомарное в одном случае, может быть неатомарным в другом. Общий принцип такой: значение не атомарно, если оно используется по частям.
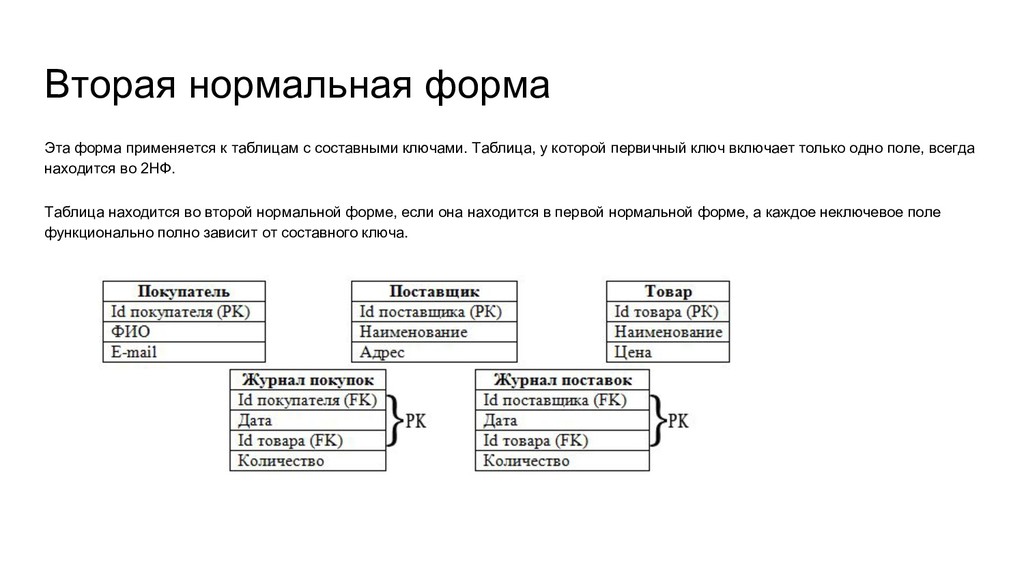
ключами. Таблица, у которой первичный ключ включает только одно поле, всегда находится во 2НФ. Таблица находится во второй нормальной форме, если она находится в первой нормальной форме, а каждое неключевое поле функционально полно зависит от составного ключа.
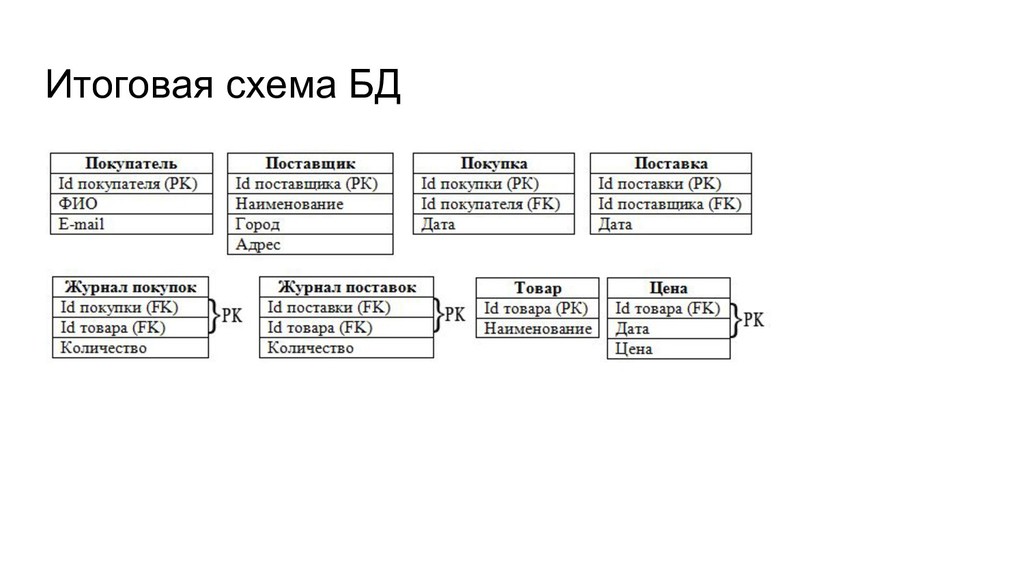
она находится во второй нормальной форме, и каждое неключевое поле нетранзитивно зависит от первичного ключа. Транзитивная зависимость наблюдается в том случае, если одно из двух неключевых полей зависит от первичного ключа, а другое зависит от первого неключевого поля. На примере будет понятнее.
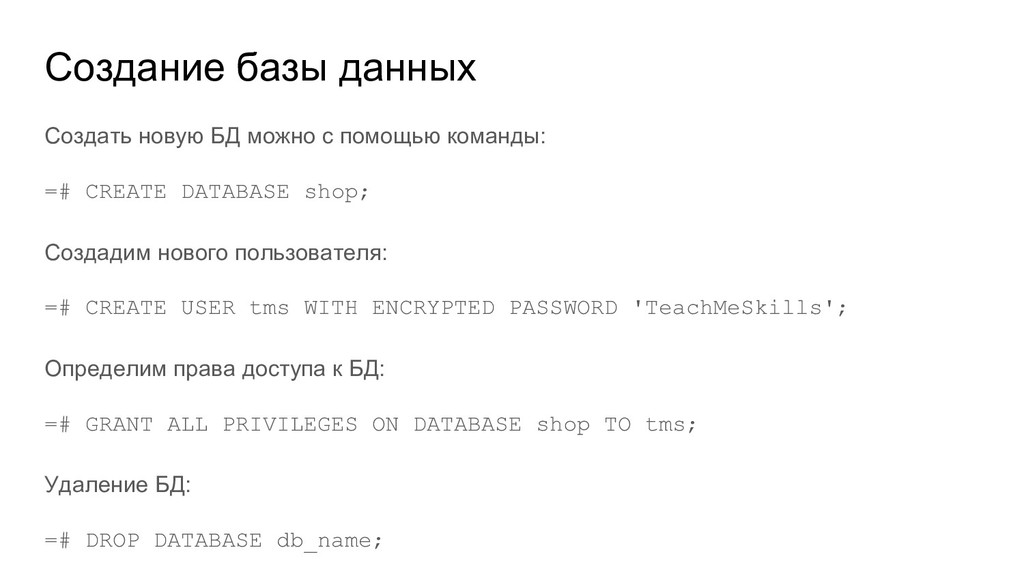
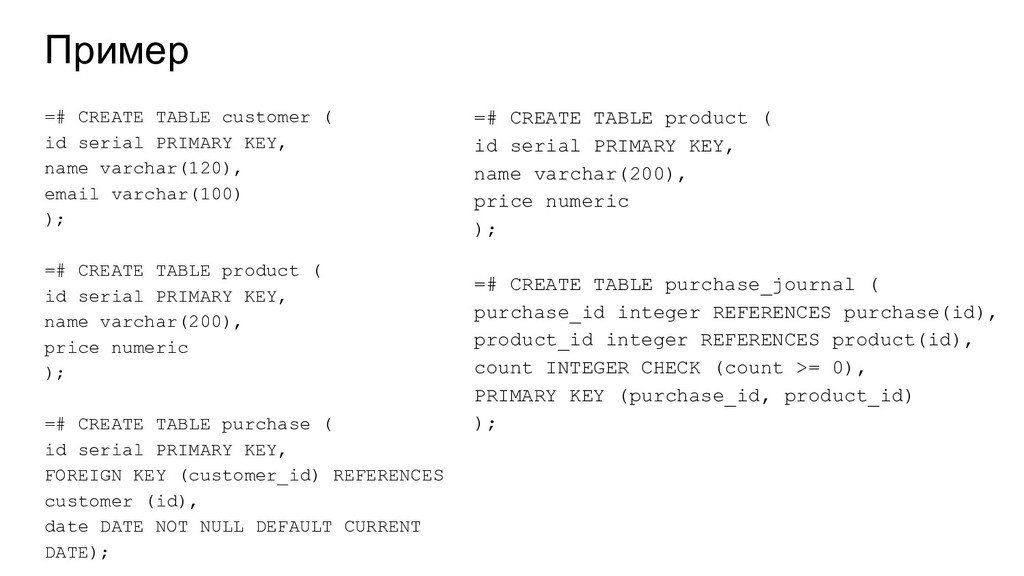
=# CREATE DATABASE shop; Создадим нового пользователя: =# CREATE USER tms WITH ENCRYPTED PASSWORD 'TeachMeSkills'; Определим права доступа к БД: =# GRANT ALL PRIVILEGES ON DATABASE shop TO tms; Удаление БД: =# DROP DATABASE db_name;
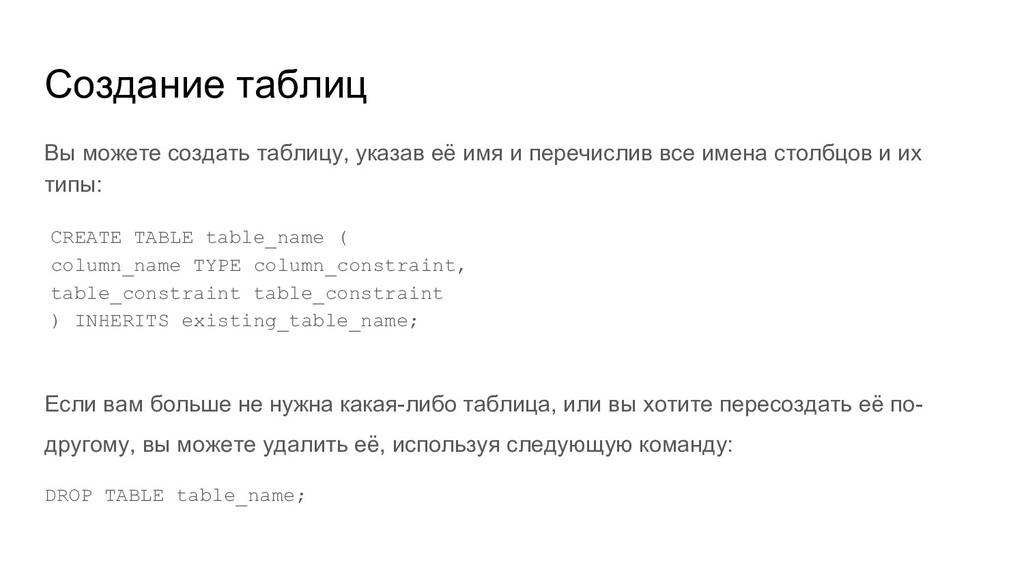
перечислив все имена столбцов и их типы: CREATE TABLE table_name ( column_name TYPE column_constraint, table_constraint table_constraint ) INHERITS existing_table_name; Если вам больше не нужна какая-либо таблица, или вы хотите пересоздать её по- другому, вы можете удалить её, используя следующую команду: DROP TABLE table_name;
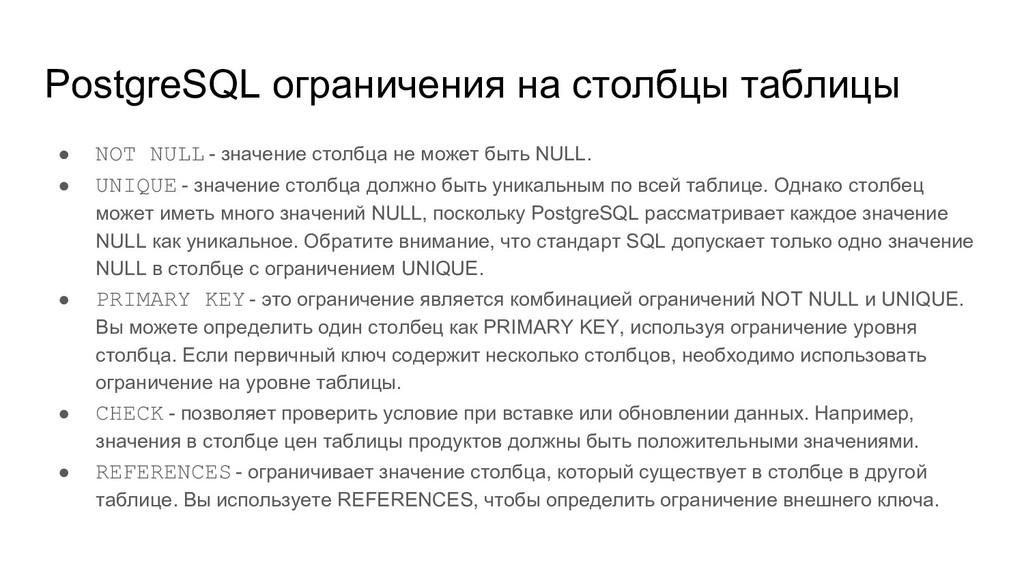
столбца не может быть NULL. • UNIQUE - значение столбца должно быть уникальным по всей таблице. Однако столбец может иметь много значений NULL, поскольку PostgreSQL рассматривает каждое значение NULL как уникальное. Обратите внимание, что стандарт SQL допускает только одно значение NULL в столбце с ограничением UNIQUE. • PRIMARY KEY - это ограничение является комбинацией ограничений NOT NULL и UNIQUE. Вы можете определить один столбец как PRIMARY KEY, используя ограничение уровня столбца. Если первичный ключ содержит несколько столбцов, необходимо использовать ограничение на уровне таблицы. • CHECK - позволяет проверить условие при вставке или обновлении данных. Например, значения в столбце цен таблицы продуктов должны быть положительными значениями. • REFERENCES - ограничивает значение столбца, который существует в столбце в другой таблице. Вы используете REFERENCES, чтобы определить ограничение внешнего ключа.
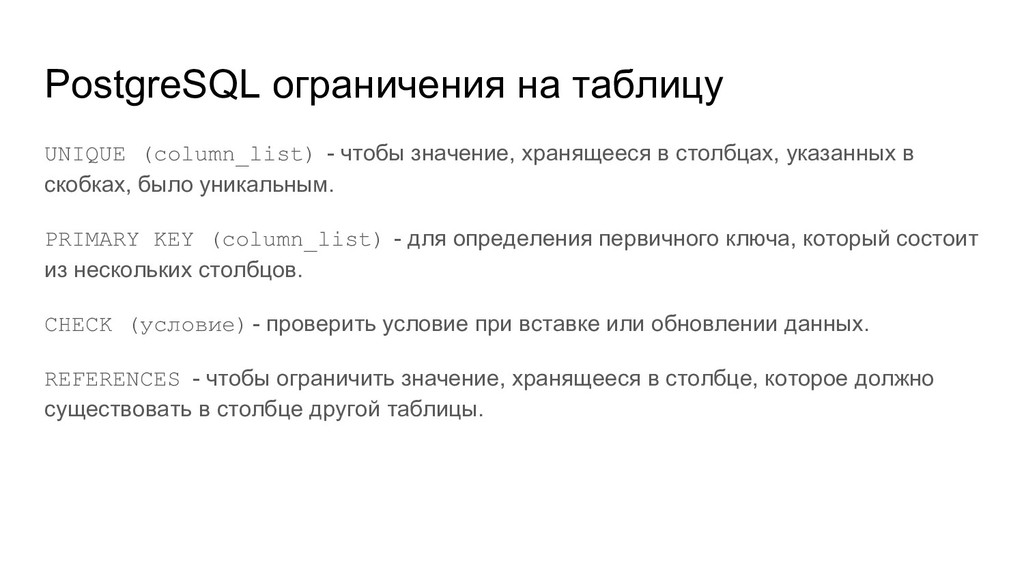
в столбцах, указанных в скобках, было уникальным. PRIMARY KEY (column_list) - для определения первичного ключа, который состоит из нескольких столбцов. CHECK (условие) - проверить условие при вставке или обновлении данных. REFERENCES - чтобы ограничить значение, хранящееся в столбце, которое должно существовать в столбце другой таблицы.
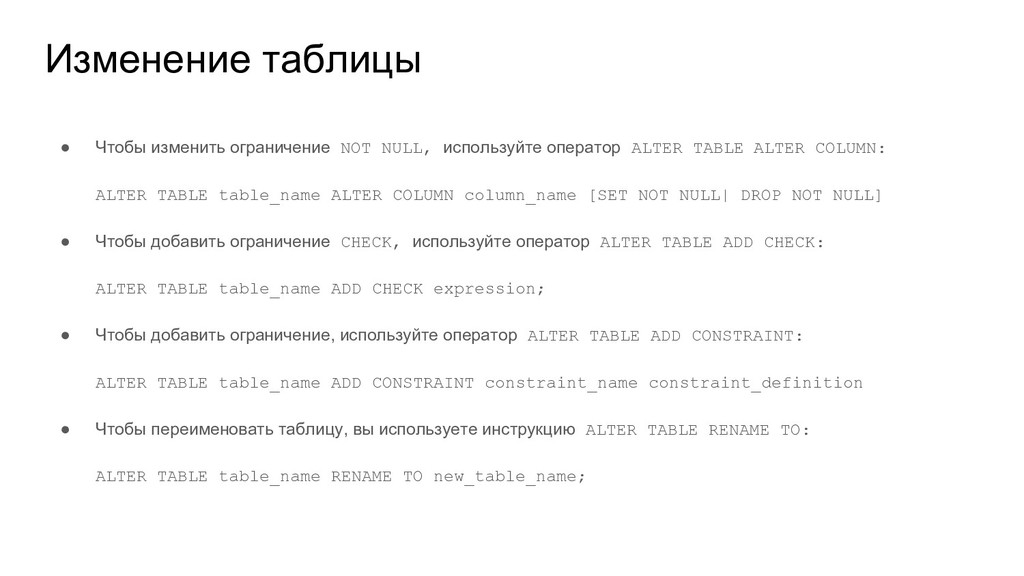
ALTER TABLE ALTER COLUMN: ALTER TABLE table_name ALTER COLUMN column_name [SET NOT NULL| DROP NOT NULL] • Чтобы добавить ограничение CHECK, используйте оператор ALTER TABLE ADD CHECK: ALTER TABLE table_name ADD CHECK expression; • Чтобы добавить ограничение, используйте оператор ALTER TABLE ADD CONSTRAINT: ALTER TABLE table_name ADD CONSTRAINT constraint_name constraint_definition • Чтобы переименовать таблицу, вы используете инструкцию ALTER TABLE RENAME TO: ALTER TABLE table_name RENAME TO new_table_name;
PostgreSQL оператор ALTER TABLE. Синтаксис ALTER TABLE следующий ALTER TABLE table_name action; • Чтобы добавить новый столбец в таблицу, используйте оператор ALTER TABLE ADD COLUMN : ALTER TABLE table_name ADD COLUMN new_column_name TYPE; • Чтобы удалить столбец из таблицы, используйте оператор ALTER TABLE DROP COLUMN : ALTER TABLE table_name DROP COLUMN column_name; • Чтобы переименовать существующий столбец, используйте оператор ALTER TABLE RENAME COLUMN : ALTER TABLE table_name RENAME COLUMN column_name TO new_column_name; • Чтобы изменить значение столбца по умолчанию, используйте команду ALTER TABLE ALTER COLUMN SET DEFAULT или DROP DEFAULT: ALTER TABLE table_name ALTER COLUMN column_name [SET DEFAULT value | DROP DEFAULT]
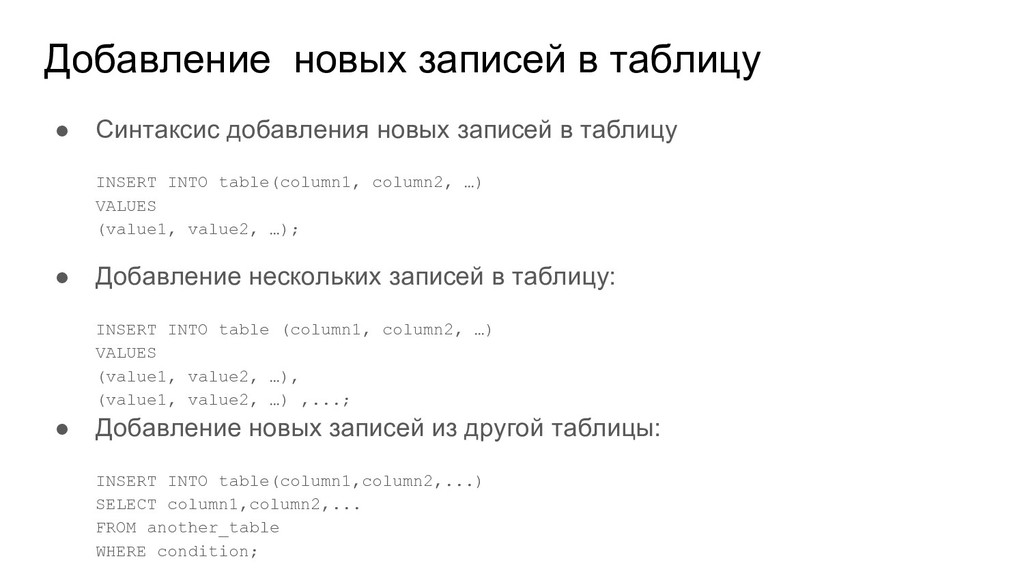
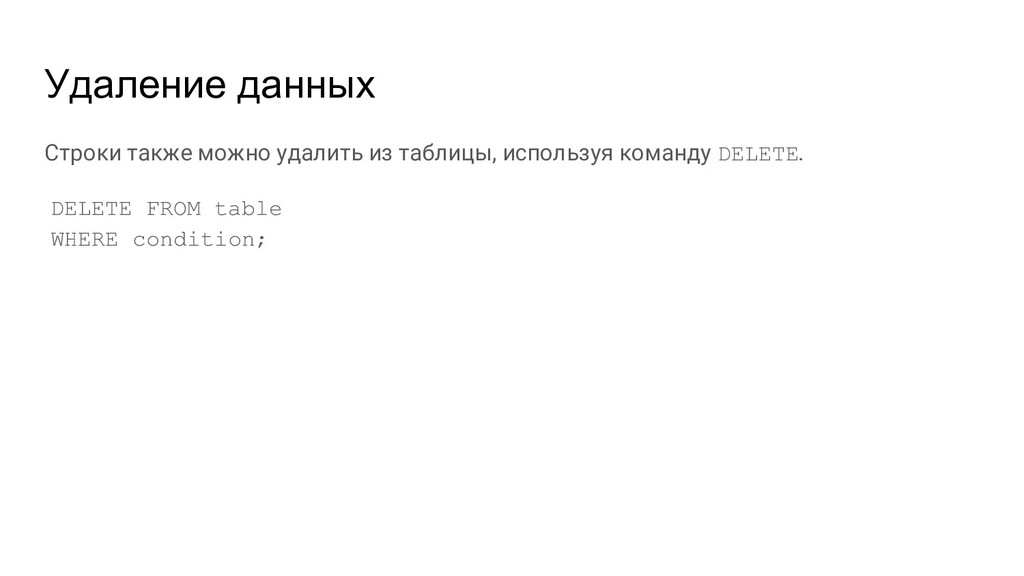
в таблицу INSERT INTO table(column1, column2, …) VALUES (value1, value2, …); • Добавление нескольких записей в таблицу: INSERT INTO table (column1, column2, …) VALUES (value1, value2, …), (value1, value2, …) ,...; • Добавление новых записей из другой таблицы: INSERT INTO table(column1,column2,...) SELECT column1,column2,... FROM another_table WHERE condition;
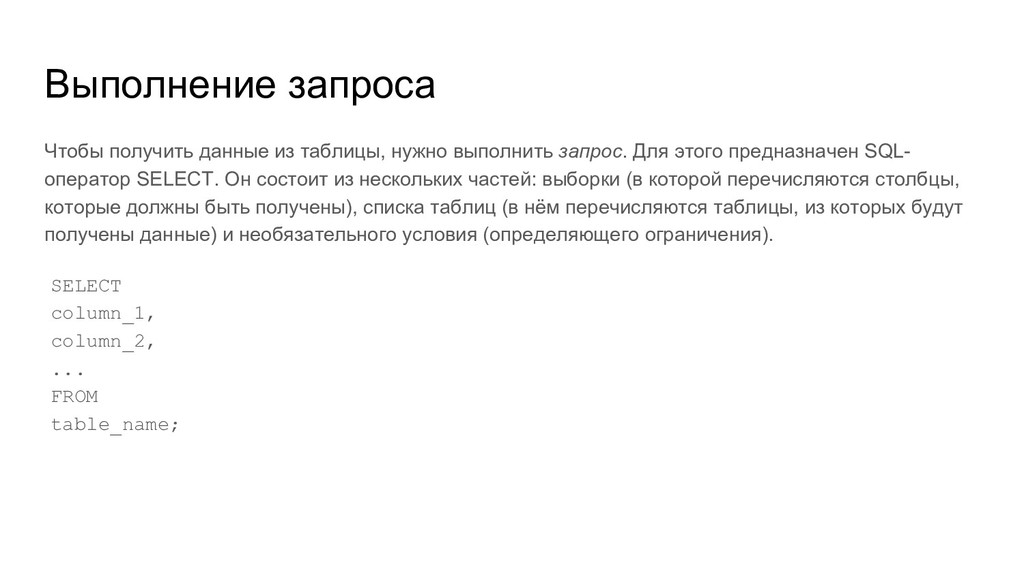
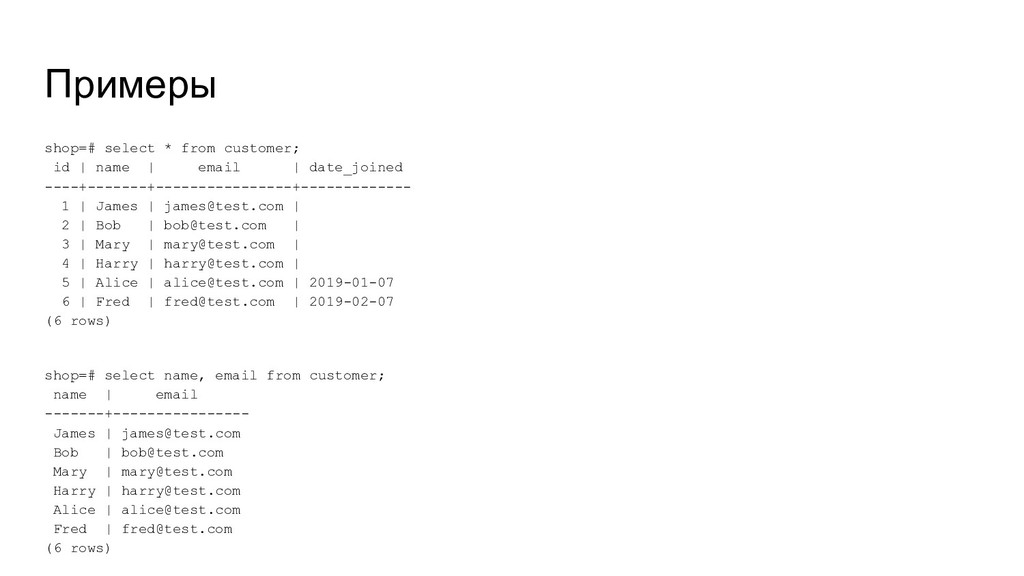
Для этого предназначен SQL- оператор SELECT. Он состоит из нескольких частей: выборки (в которой перечисляются столбцы, которые должны быть получены), списка таблиц (в нём перечисляются таблицы, из которых будут получены данные) и необязательного условия (определяющего ограничения). SELECT column_1, column_2, ... FROM table_name;
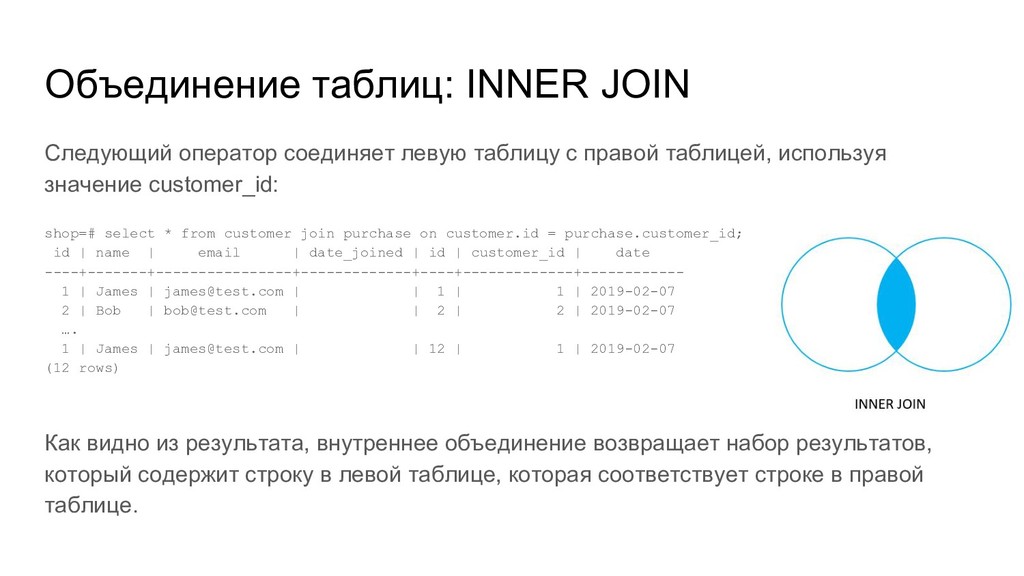
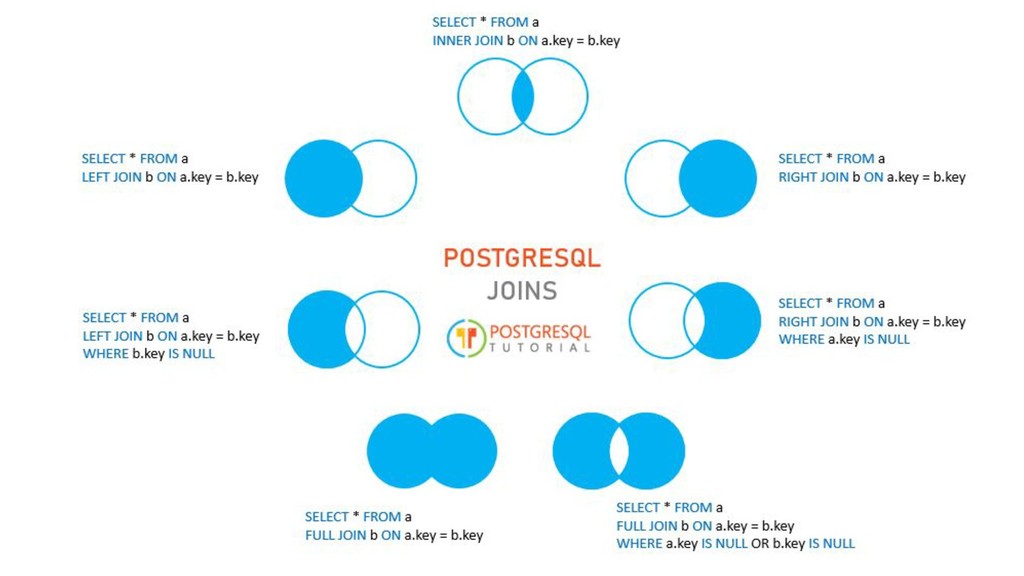
правой таблицей, используя значение customer_id: shop=# select * from customer join purchase on customer.id = purchase.customer_id; id | name | email | date_joined | id | customer_id | date ----+-------+----------------+-------------+----+-------------+------------ 1 | James | [email protected] | | 1 | 1 | 2019-02-07 2 | Bob | [email protected] | | 2 | 2 | 2019-02-07 …. 1 | James | [email protected] | | 12 | 1 | 2019-02-07 (12 rows) Как видно из результата, внутреннее объединение возвращает набор результатов, который содержит строку в левой таблице, которая соответствует строке в правой таблице.
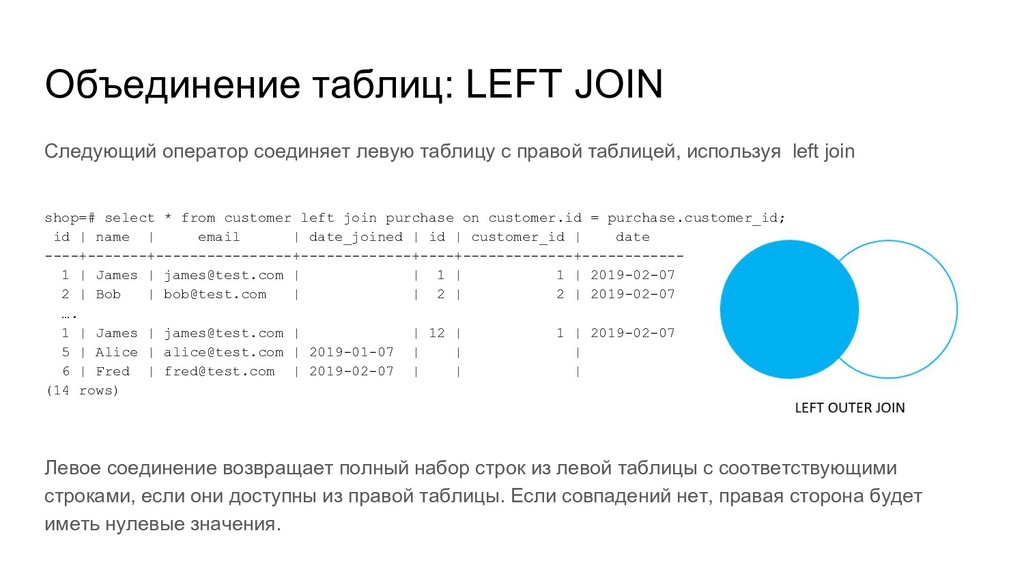
правой таблицей, используя left join shop=# select * from customer left join purchase on customer.id = purchase.customer_id; id | name | email | date_joined | id | customer_id | date ----+-------+----------------+-------------+----+-------------+------------ 1 | James | [email protected] | | 1 | 1 | 2019-02-07 2 | Bob | [email protected] | | 2 | 2 | 2019-02-07 …. 1 | James | [email protected] | | 12 | 1 | 2019-02-07 5 | Alice | [email protected] | 2019-01-07 | | | 6 | Fred | [email protected] | 2019-02-07 | | | (14 rows) Левое соединение возвращает полный набор строк из левой таблицы с соответствующими строками, если они доступны из правой таблицы. Если совпадений нет, правая сторона будет иметь нулевые значения.
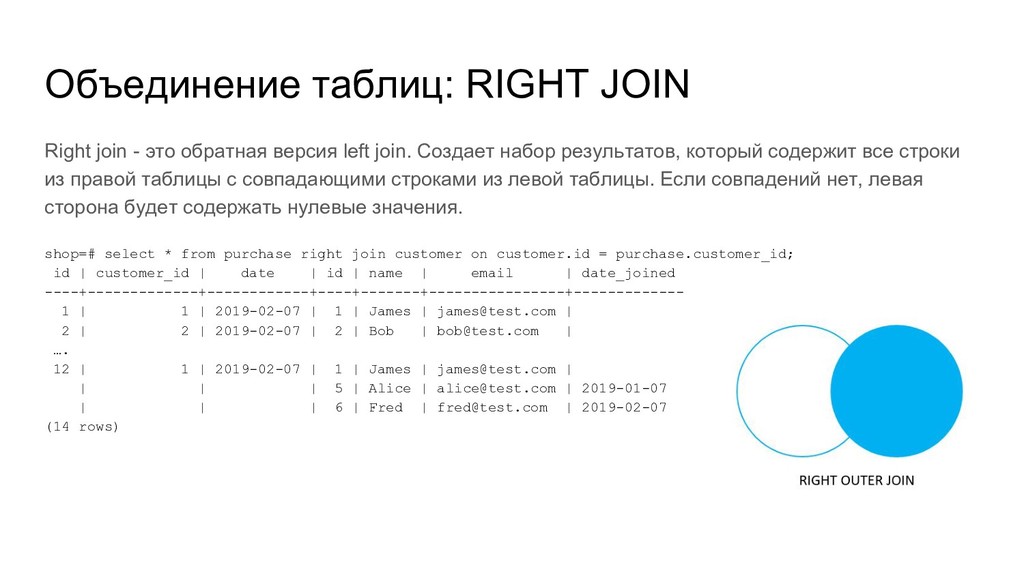
left join. Создает набор результатов, который содержит все строки из правой таблицы с совпадающими строками из левой таблицы. Если совпадений нет, левая сторона будет содержать нулевые значения. shop=# select * from purchase right join customer on customer.id = purchase.customer_id; id | customer_id | date | id | name | email | date_joined ----+-------------+------------+----+-------+----------------+------------- 1 | 1 | 2019-02-07 | 1 | James | [email protected] | 2 | 2 | 2019-02-07 | 2 | Bob | [email protected] | …. 12 | 1 | 2019-02-07 | 1 | James | [email protected] | | | | 5 | Alice | [email protected] | 2019-01-07 | | | 6 | Fred | [email protected] | 2019-02-07 (14 rows)
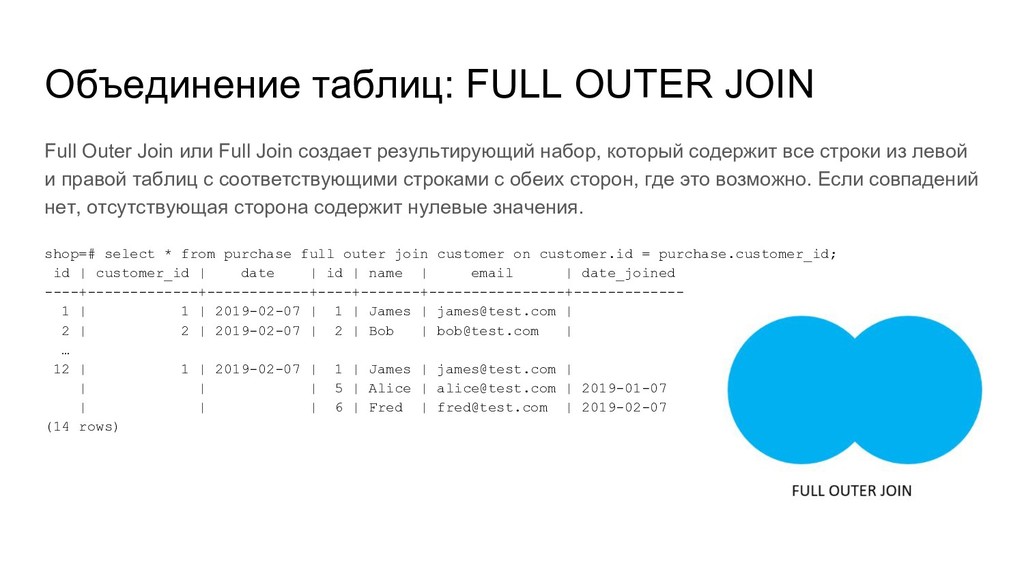
Join создает результирующий набор, который содержит все строки из левой и правой таблиц с соответствующими строками с обеих сторон, где это возможно. Если совпадений нет, отсутствующая сторона содержит нулевые значения. shop=# select * from purchase full outer join customer on customer.id = purchase.customer_id; id | customer_id | date | id | name | email | date_joined ----+-------------+------------+----+-------+----------------+------------- 1 | 1 | 2019-02-07 | 1 | James | [email protected] | 2 | 2 | 2019-02-07 | 2 | Bob | [email protected] | … 12 | 1 | 2019-02-07 | 1 | James | [email protected] | | | | 5 | Alice | [email protected] | 2019-01-07 | | | 6 | Fred | [email protected] | 2019-02-07 (14 rows)
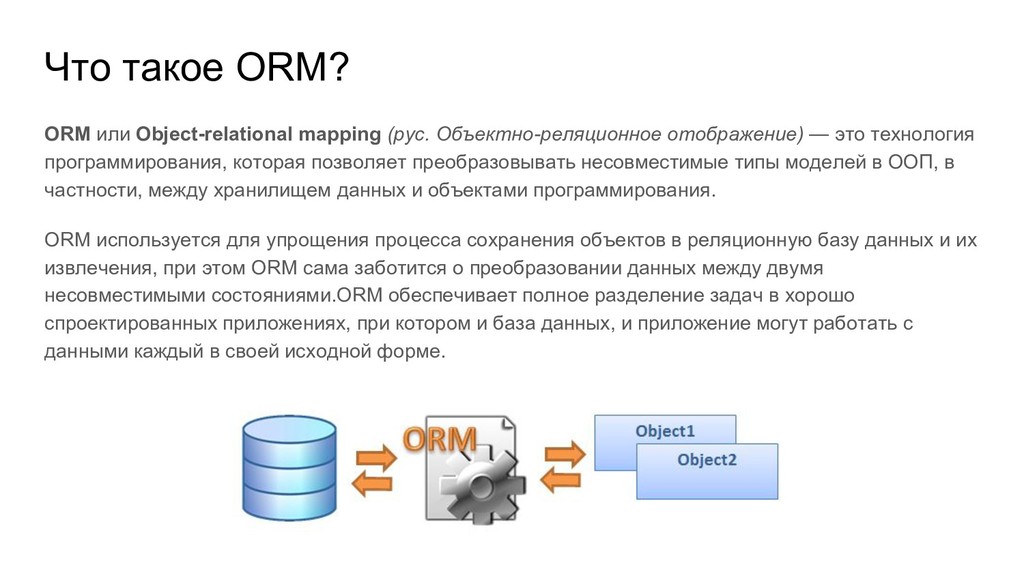
— это технология программирования, которая позволяет преобразовывать несовместимые типы моделей в ООП, в частности, между хранилищем данных и объектами программирования. ORM используется для упрощения процесса сохранения объектов в реляционную базу данных и их извлечения, при этом ORM сама заботится о преобразовании данных между двумя несовместимыми состояниями.ORM обеспечивает полное разделение задач в хорошо спроектированных приложениях, при котором и база данных, и приложение могут работать с данными каждый в своей исходной форме.
для привязки объекта к его данным в БД. ORM как бы создает «виртуальную» схему базы данных в памяти и позволяет манипулировать данными уже на уровне объектов. Отображение показывает как объект и его свойства связаны с одной или несколькими таблицами и их полями в базе данных. ORM использует информацию этого отображения для управления процессом преобразования данных между базой и формами объектов, а также для создания SQL-запросов для вставки, обновления и удаления данных в ответ на изменения, которые приложение вносит в эти объек
разработчика от необходимости работы с SQL и написания большого количества кода, часто однообразного и подверженного ошибкам. Весь генерируемый ORM код предположительно хорошо проверен и оптимизирован, поэтому не нужно в целом задумывается о его тестировании. Это несомненно является плюсом, но в тоже время не стоит забывать и о минусах. Основной из них — это потеря производительности. Это происходит потому, что большинство ORM предназначены для обработки широкого спектра сценариев использования данных, гораздо большего, чем любое отдельное приложение когда-либо сможет использовать. Вопрос о целесообразности использования ORM по большому счету затрагивается только в больших проектах, которые сталкиваются с высокой нагрузкой, здесь приходится выбирать что более приоритетно — удобство или производительность?
исходным кодом для работы с базами данных при помощи языка SQL. Оно реализует технологию программирования ORM (Object-Relational Mapping), которая связывает базы данных с концепциями объектно- ориентированных языков программирования. SQLAlchemy позволяет описывать структуры баз данных и способы взаимодействия с ними прямо на языке Python. SQLAlchemy была выпущена в феврале 2006 и быстро стала одним из самых распространенных инструментов ORM среди разработчиков на Python.
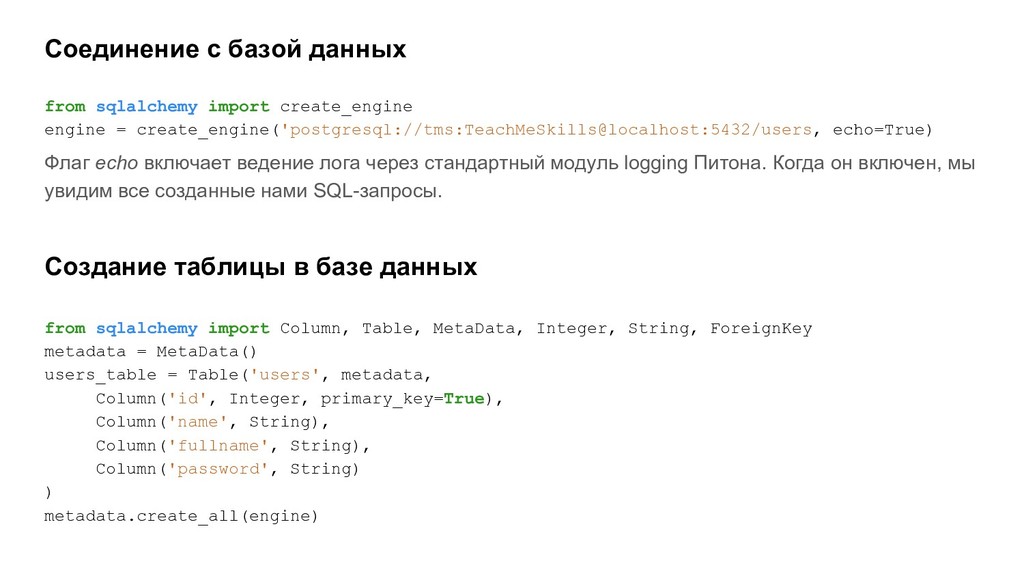
create_engine('postgresql://tms:TeachMeSkills@localhost:5432/users, echo=True) Флаг echo включает ведение лога через стандартный модуль logging Питона. Когда он включен, мы увидим все созданные нами SQL-запросы. Создание таблицы в базе данных from sqlalchemy import Column, Table, MetaData, Integer, String, ForeignKey metadata = MetaData() users_table = Table('users', metadata, Column('id', Integer, primary_key=True), Column('name', String), Column('fullname', String), Column('password', String) ) metadata.create_all(engine)
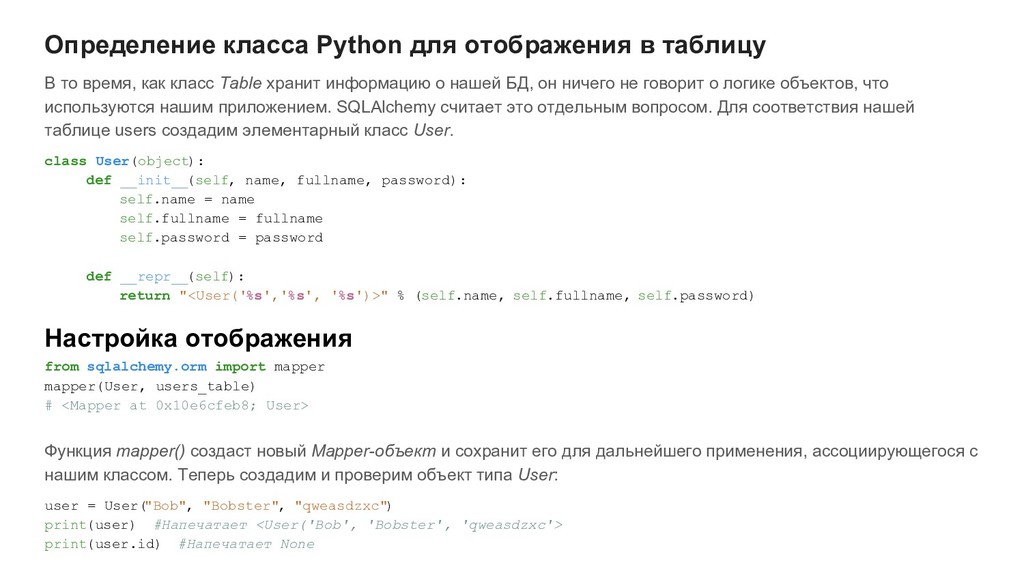
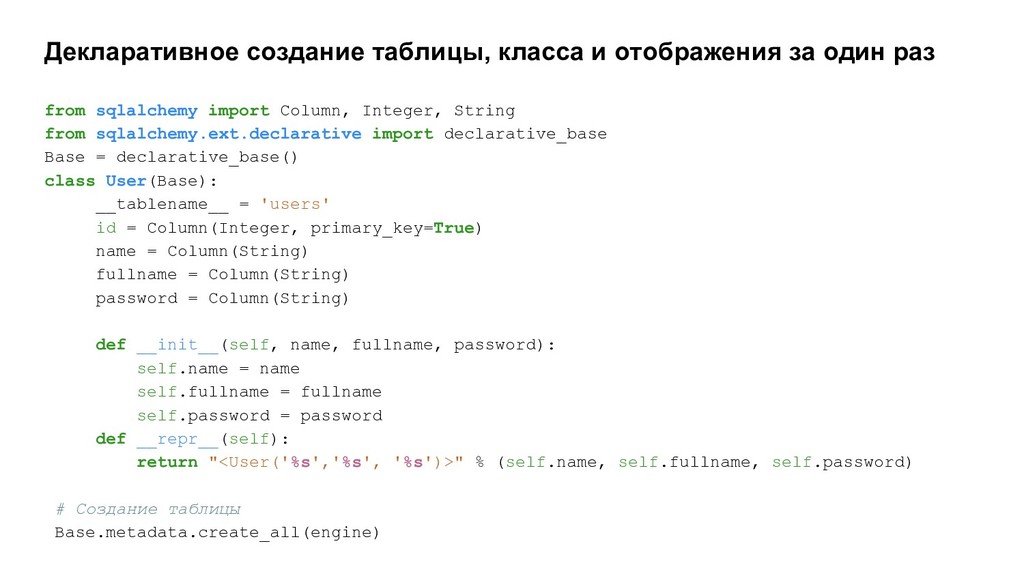
как класс Table хранит информацию о нашей БД, он ничего не говорит о логике объектов, что используются нашим приложением. SQLAlchemy считает это отдельным вопросом. Для соответствия нашей таблице users создадим элементарный класс User. class User(object): def __init__(self, name, fullname, password): self.name = name self.fullname = fullname self.password = password def __repr__(self): return "<User('%s','%s', '%s')>" % (self.name, self.fullname, self.password) Настройка отображения from sqlalchemy.orm import mapper mapper(User, users_table) # <Mapper at 0x10e6cfeb8; User> Функция mapper() создаст новый Mapper-объект и сохранит его для дальнейшего применения, ассоциирующегося с нашим классом. Теперь создадим и проверим объект типа User: user = User("Bob", "Bobster", "qweasdzxc") print(user) #Напечатает <User('Bob', 'Bobster', 'qweasdzxc'> print(user.id) #Напечатает None
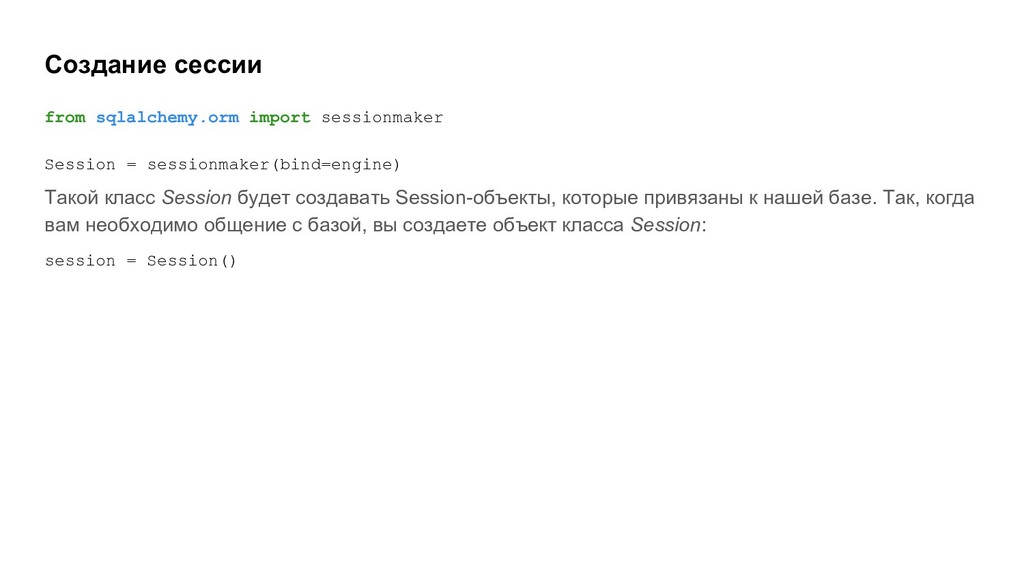
класс Session будет создавать Session-объекты, которые привязаны к нашей базе. Так, когда вам необходимо общение с базой, вы создаете объект класса Session: session = Session()
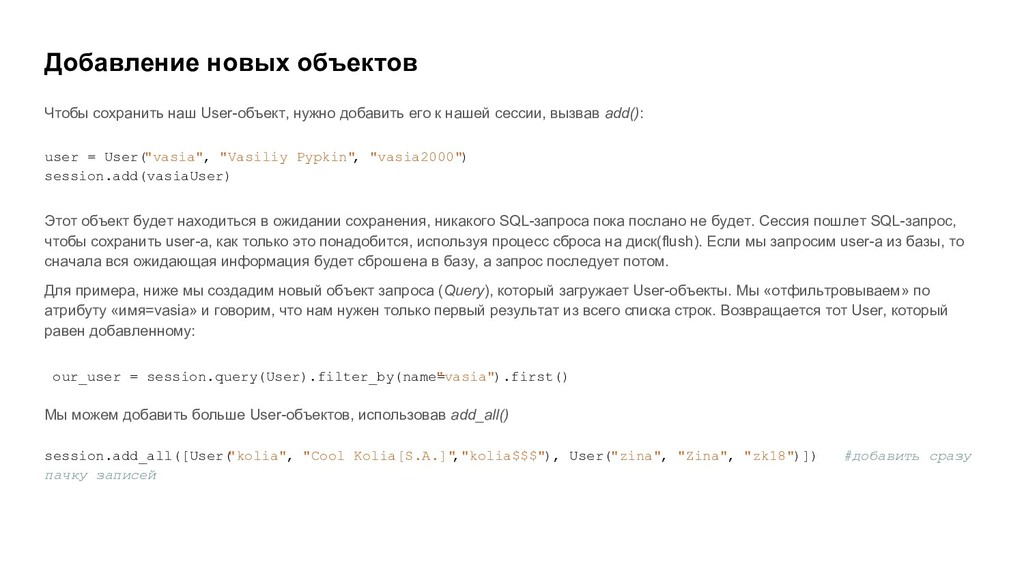
к нашей сессии, вызвав add(): user = User("vasia", "Vasiliy Pypkin" , "vasia2000") session.add(vasiaUser) Этот объект будет находиться в ожидании сохранения, никакого SQL-запроса пока послано не будет. Сессия пошлет SQL-запрос, чтобы сохранить user-a, как только это понадобится, используя процесс сброса на диск(flush). Если мы запросим user-a из базы, то сначала вся ожидающая информация будет сброшена в базу, а запрос последует потом. Для примера, ниже мы создадим новый объект запроса (Query), который загружает User-объекты. Мы «отфильтровываем» по атрибуту «имя=vasia» и говорим, что нам нужен только первый результат из всего списка строк. Возвращается тот User, который равен добавленному: our_user = session.query(User).filter_by(name= "vasia").first() Мы можем добавить больше User-объектов, использовав add_all() session.add_all([User( "kolia", "Cool Kolia[S.A.]" ,"kolia$$$"), User("zina", "Zina", "zk18")]) #добавить сразу пачку записей
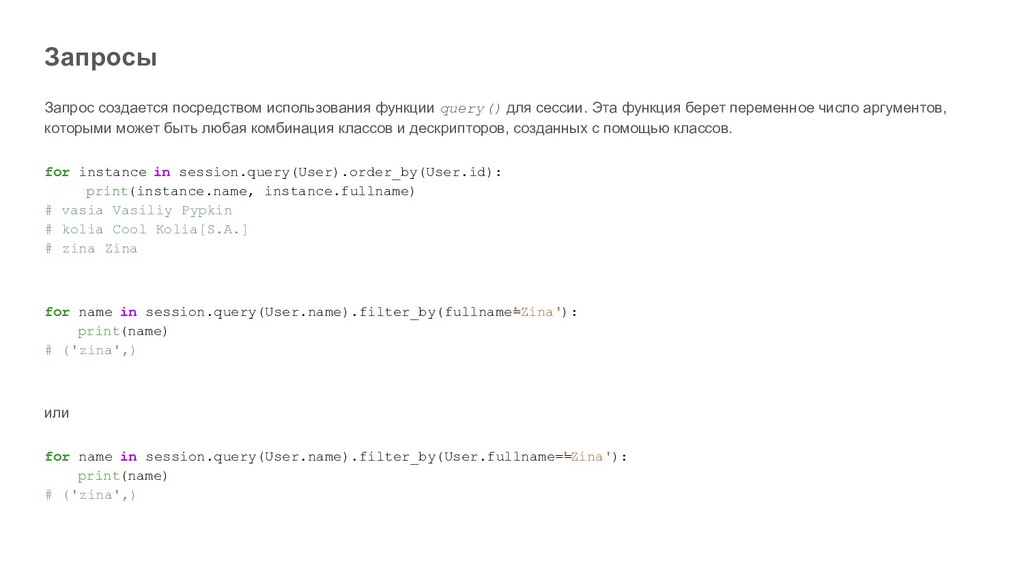
функция берет переменное число аргументов, которыми может быть любая комбинация классов и дескрипторов, созданных с помощью классов. for instance in session.query(User).order_by(User.id): print(instance.name, instance.fullname) # vasia Vasiliy Pypkin # kolia Cool Kolia[S.A.] # zina Zina for name in session.query(User.name).filter_by(fullname= 'Zina'): print(name) # ('zina',) или for name in session.query(User.name).filter_by(User.fullname== 'Zina'): print(name) # ('zina',)


 pawan_pharm
 jdbedics
 cbtlibrary
 frievea
 auctria
 eller86
 masakiokuda
 yatabe
 fmarot
 terasawat
 robintux
 uranoken
 aleyda
 427marketing
 stuffmc
 sergeychernyshev
 asonas
 chriscoyier
 iamctodd
 nonsquared
 raygrieselhuber
 tessaabrams
 shlominoach
 vanstee