Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Karpenter: En el mundo cloud native

Karpenter: En el mundo cloud native

¿Qué pasaría si tu clúster de Kubernetes pudiera adaptarse automáticamente a las necesidades de tus aplicaciones, optimizando recursos y costos? ☁️

En esta charla exploramos cómo Karpenter transforma el escalado de nodos en Amazon EKS, desde la detección de pods pendientes hasta el aprovisionamiento inteligente de infraestructura. También descubrimos cómo utilizar NodePools, EC2NodeClasses e instancias Spot, y cómo gestionar disrupciones y protecciones para construir clústeres más eficientes, flexibles y resilientes.

💡 Porque en el mundo cloud native, no se trata solo de escalar, sino de hacerlo de forma inteligente.

#Kubernetes #Karpenter #AWS #AmazonEKS #CloudNative #DevOps

Avatar for Bianca Torres

Bianca Torres

October 24, 2026

More Decks by Bianca Torres

Other Decks in Technology

Transcript

  1. DEVOPS ENGINEER Hola, soy Bianca Torres Leader · AWS User

    Group Chaclacayo Miembro · KCD Lima AWS Community Builder · Containers WTM Ambassador
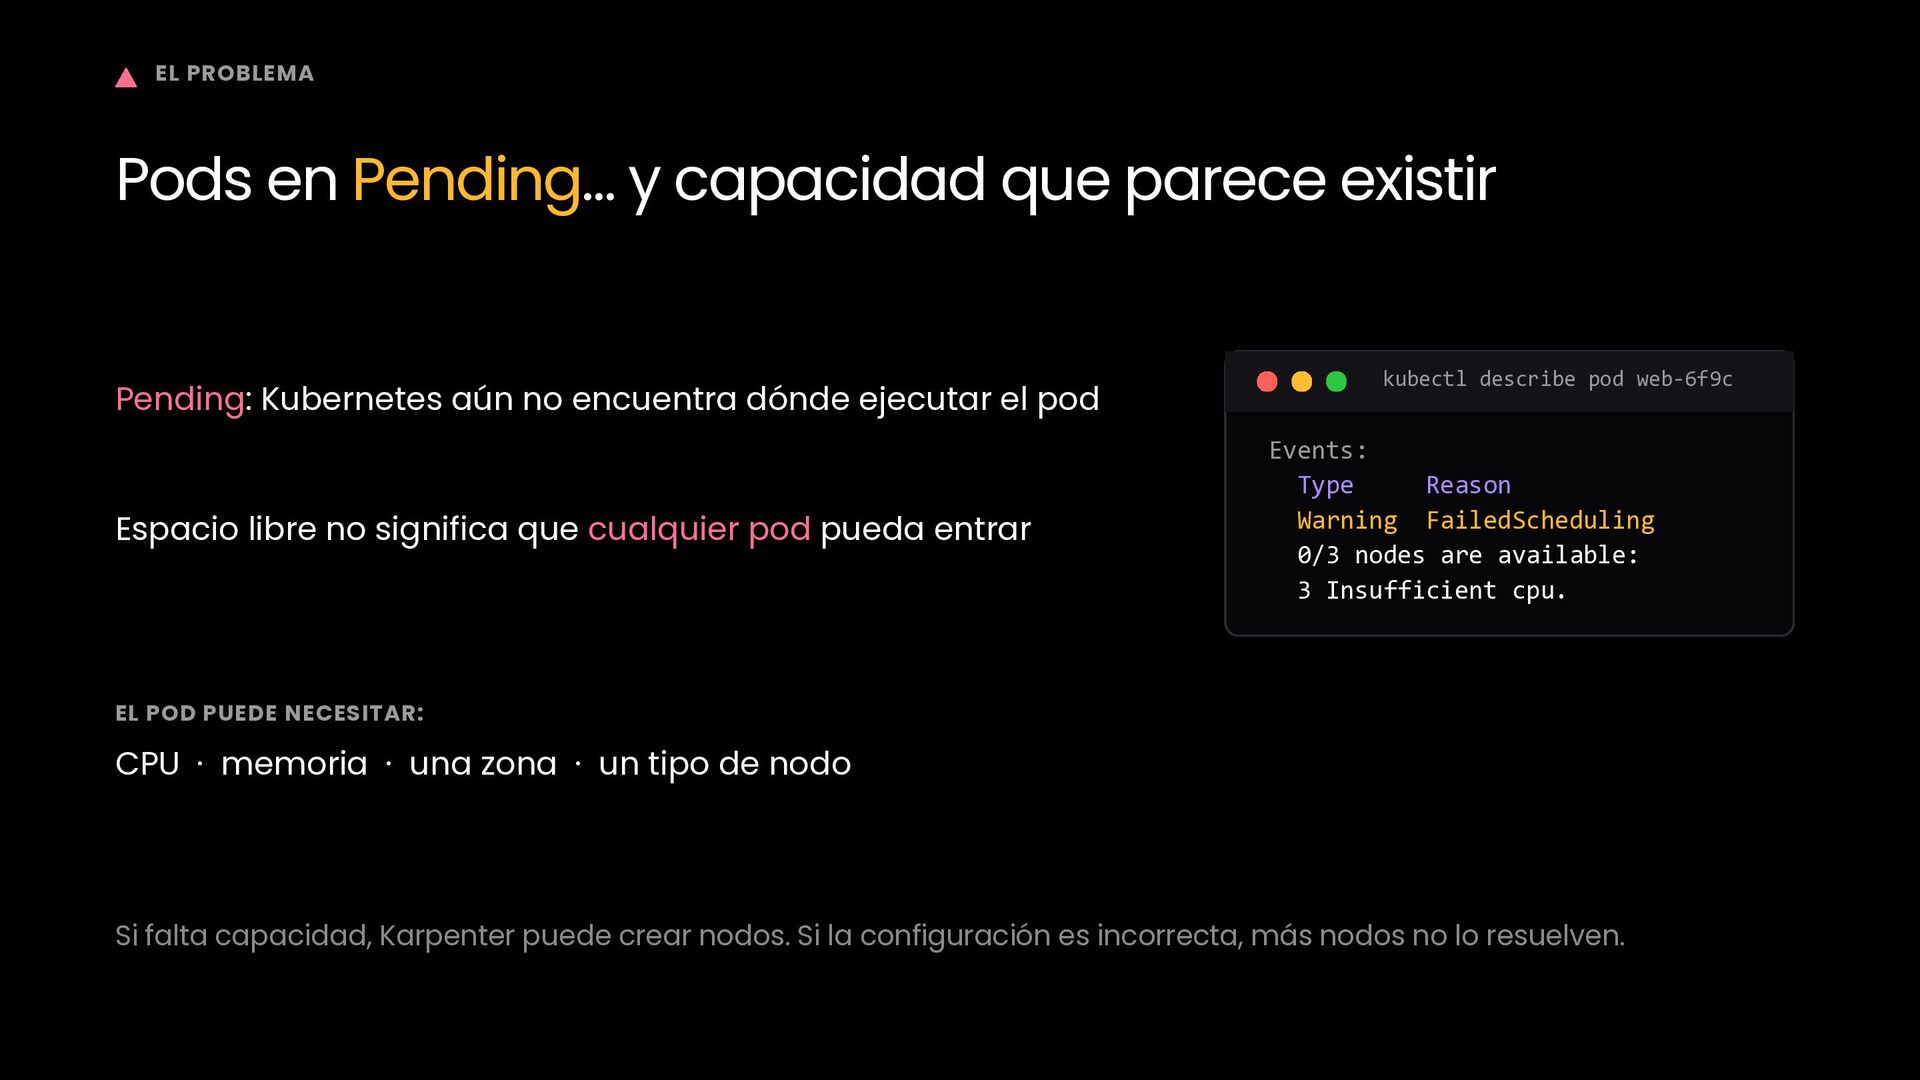
  2. EL PROBLEMA Pods en Pending… y capacidad que parece existir

    Pending: Kubernetes aún no encuentra dónde ejecutar el pod Espacio libre no significa que cualquier pod pueda entrar kubectl describe pod web-6f9c Events: Type Reason Warning FailedScheduling 0/3 nodes are available: 3 Insufficient cpu. EL POD PUEDE NECESITAR: CPU · memoria · una zona · un tipo de nodo Si falta capacidad, Karpenter puede crear nodos. Si la configuración es incorrecta, más nodos no lo resuelven.
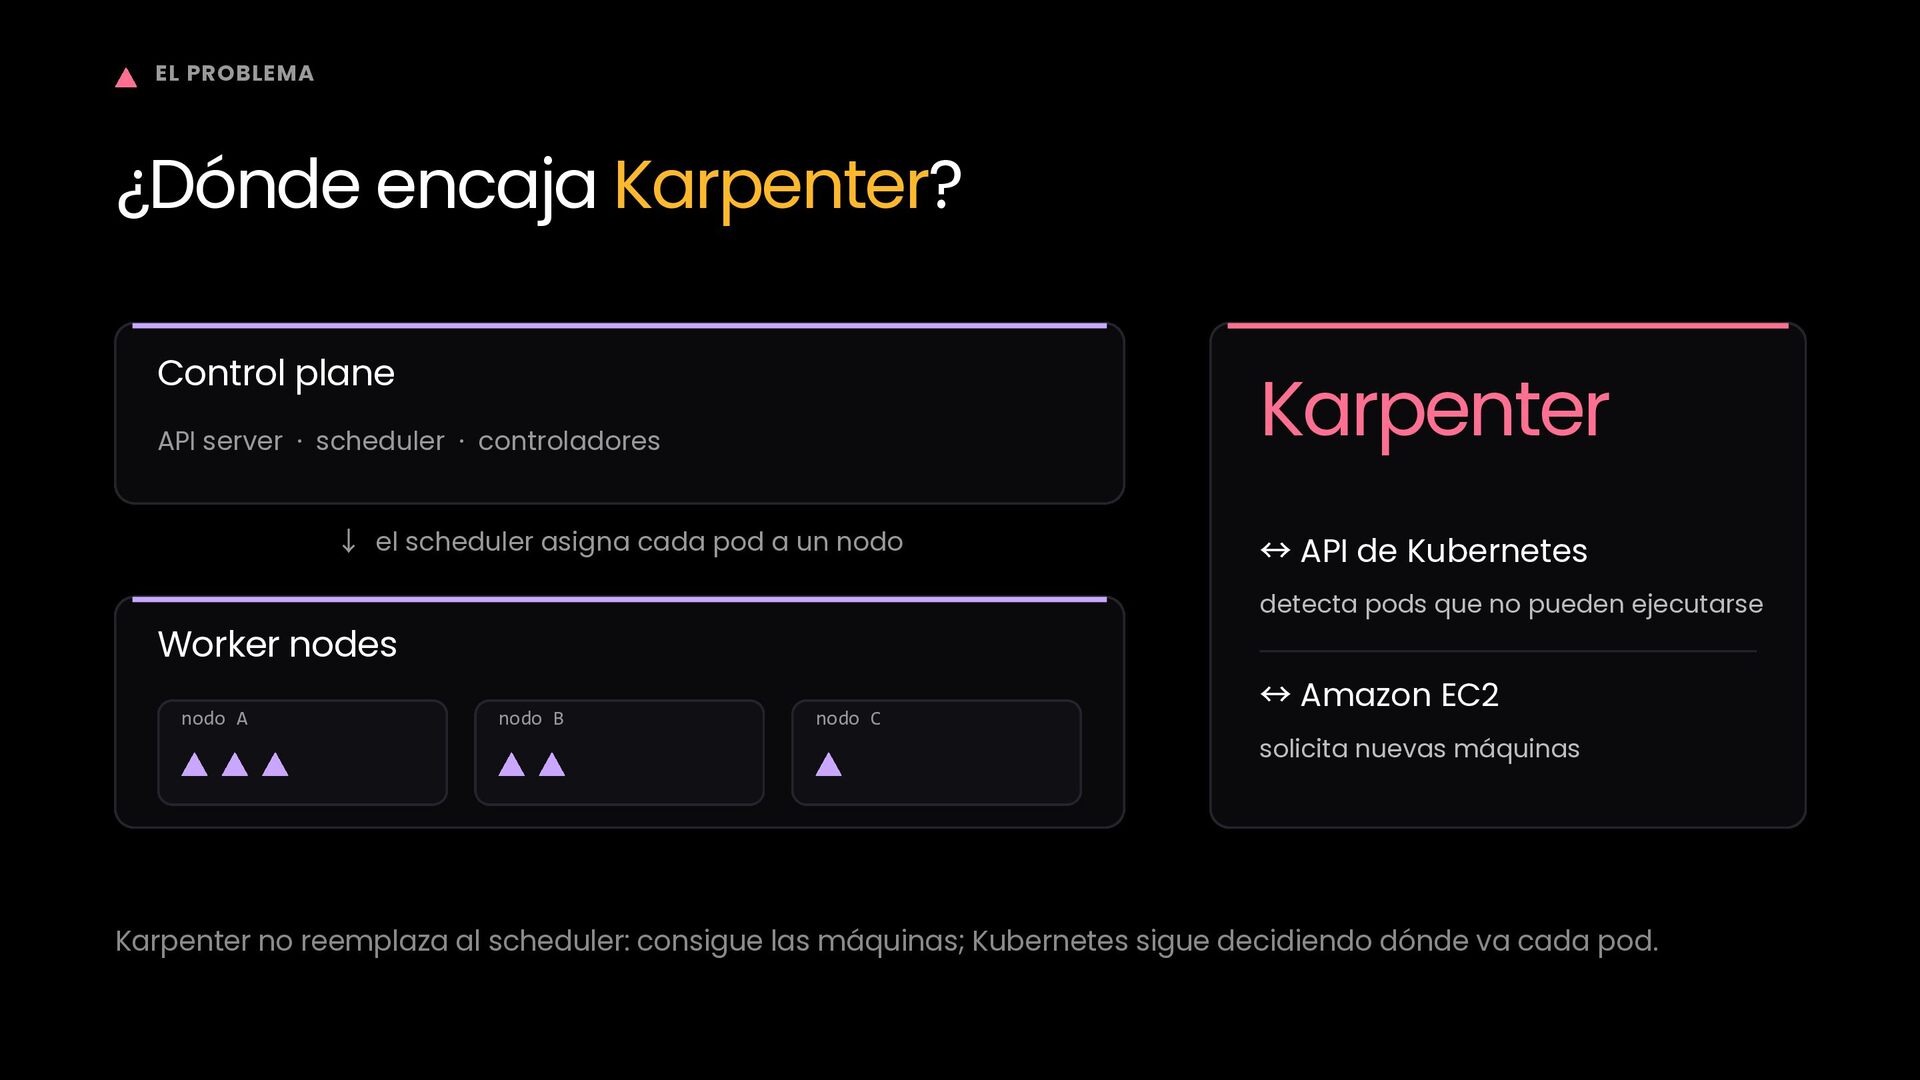
  3. EL PROBLEMA ¿Dónde encaja Karpenter? Control plane Karpenter API server

    · scheduler · controladores ↓ el scheduler asigna cada pod a un nodo detecta pods que no pueden ejecutarse Worker nodes nodo A ↔ API de Kubernetes nodo B nodo C ↔ Amazon EC2 solicita nuevas máquinas Karpenter no reemplaza al scheduler: consigue las máquinas; Kubernetes sigue decidiendo dónde va cada pod.
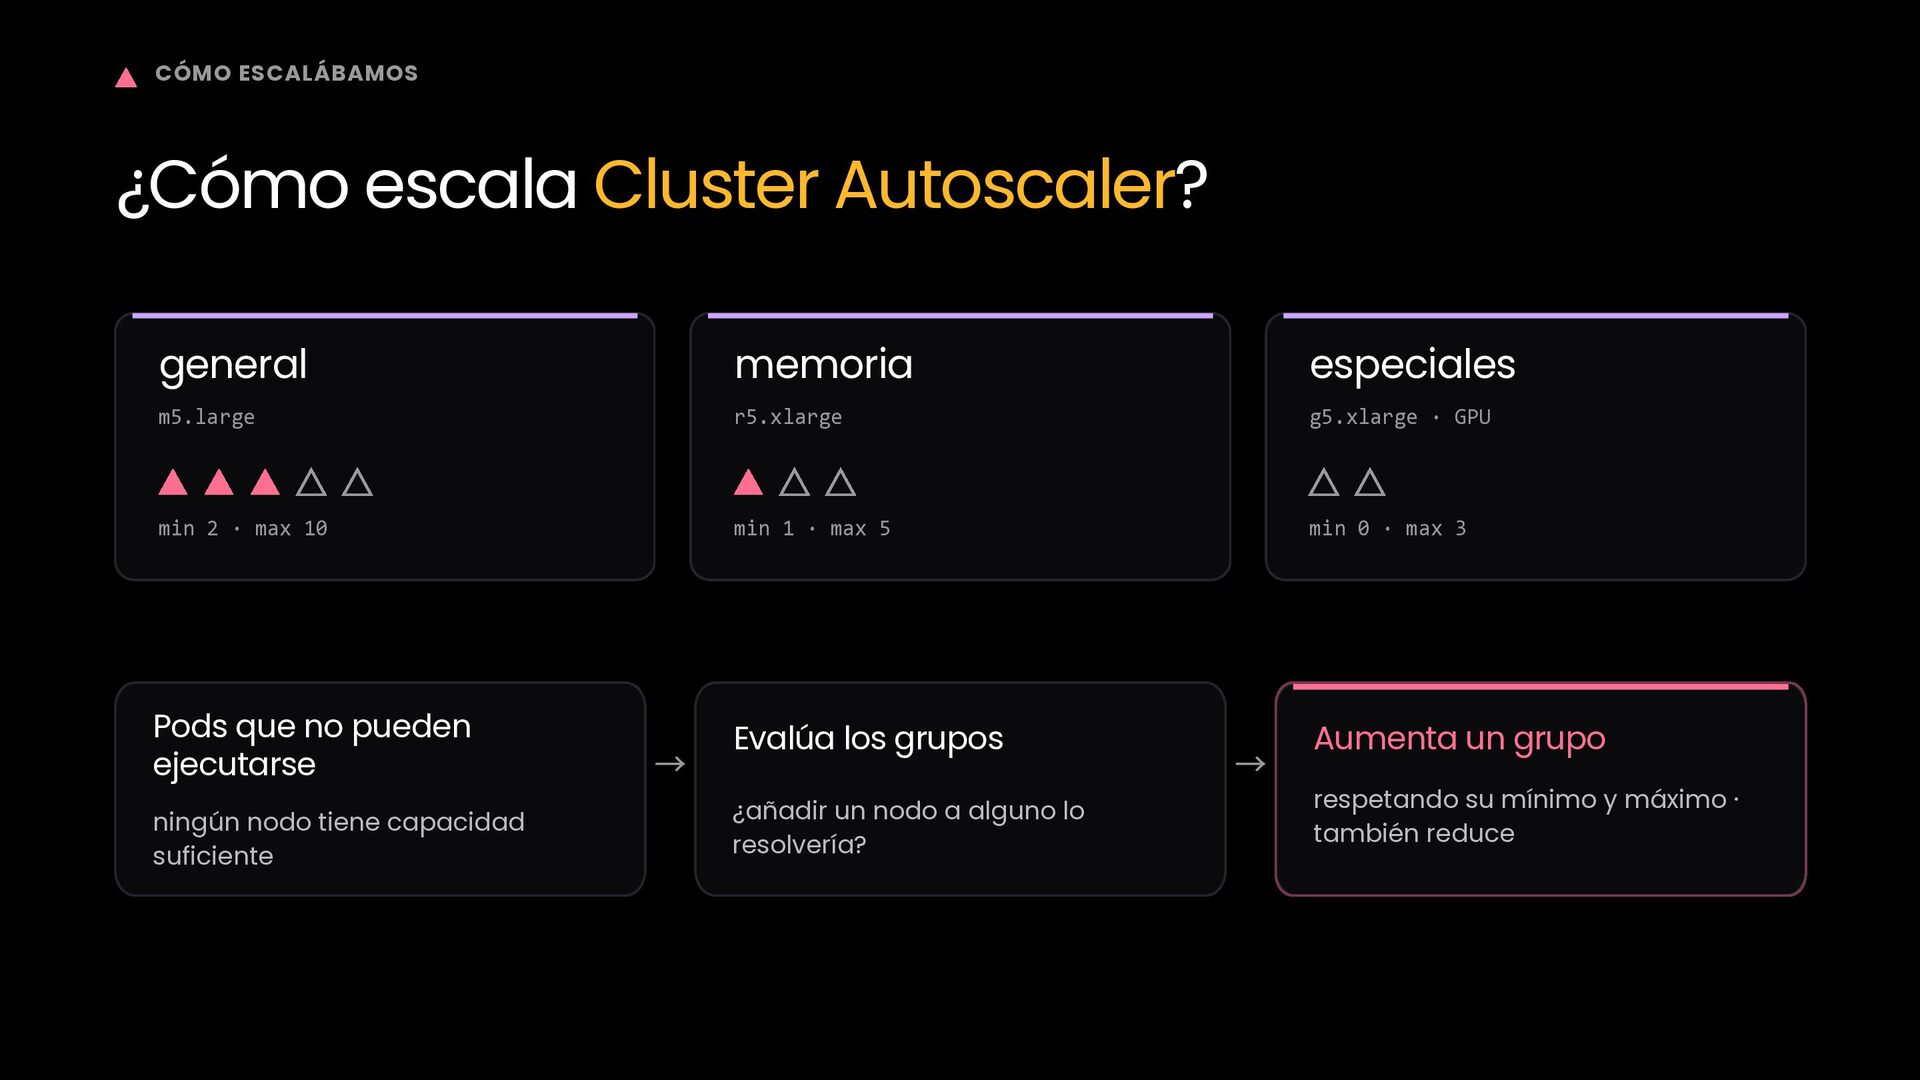
  4. CÓMO ESCALÁBAMOS ¿Cómo escala Cluster Autoscaler? general memoria especiales m5.large

    r5.xlarge g5.xlarge · GPU min 2 · max 10 min 1 · max 5 min 0 · max 3 Pods que no pueden ejecutarse ningún nodo tiene capacidad suficiente → Evalúa los grupos ¿añadir un nodo a alguno lo resolvería? → Aumenta un grupo respetando su mínimo y máximo · también reduce
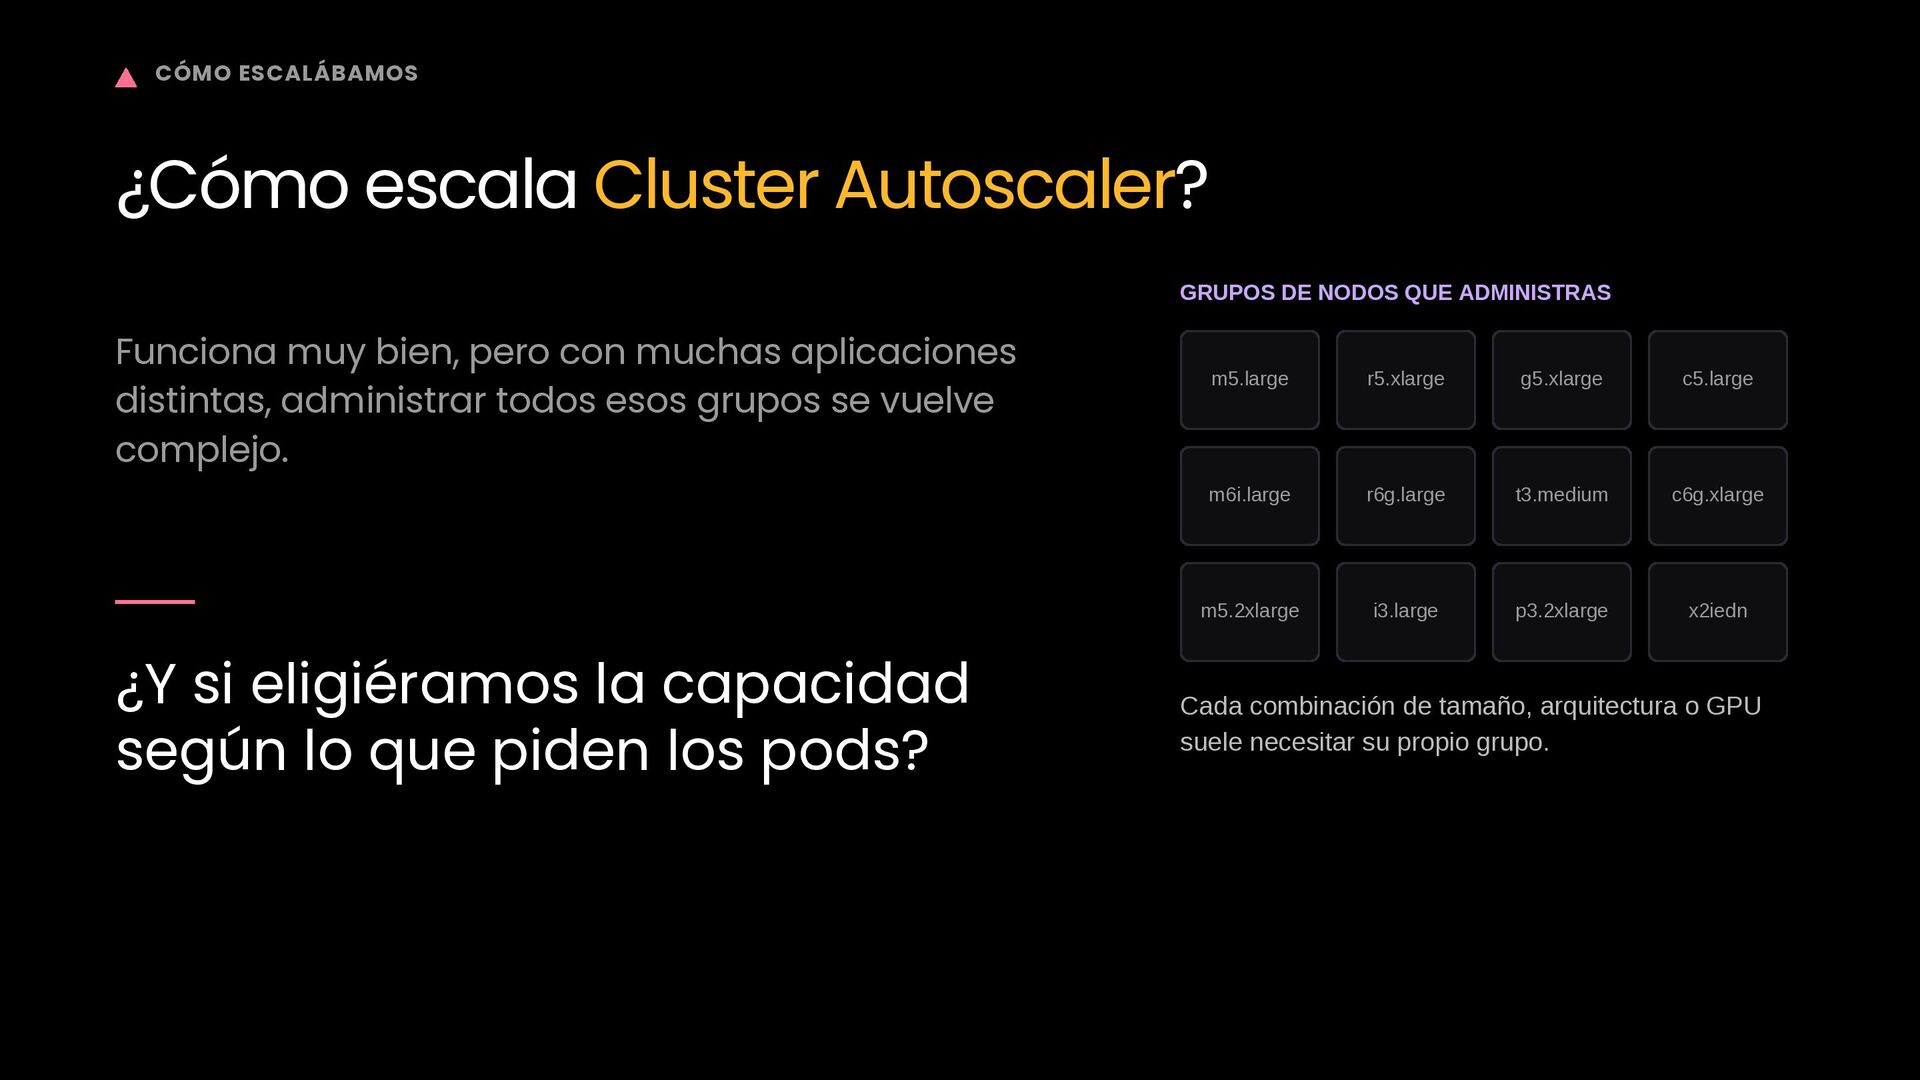
  5. CÓMO ESCALÁBAMOS ¿Cómo escala Cluster Autoscaler? GRUPOS DE NODOS QUE

    ADMINISTRAS Funciona muy bien, pero con muchas aplicaciones distintas, administrar todos esos grupos se vuelve complejo. ¿Y si eligiéramos la capacidad según lo que piden los pods? m5.large r5.xlarge g5.xlarge c5.large m6i.large r6g.large t3.medium c6g.xlarge m5.2xlarge i3.large p3.2xlarge x2iedn Cada combinación de tamaño, arquitectura o GPU suele necesitar su propio grupo.
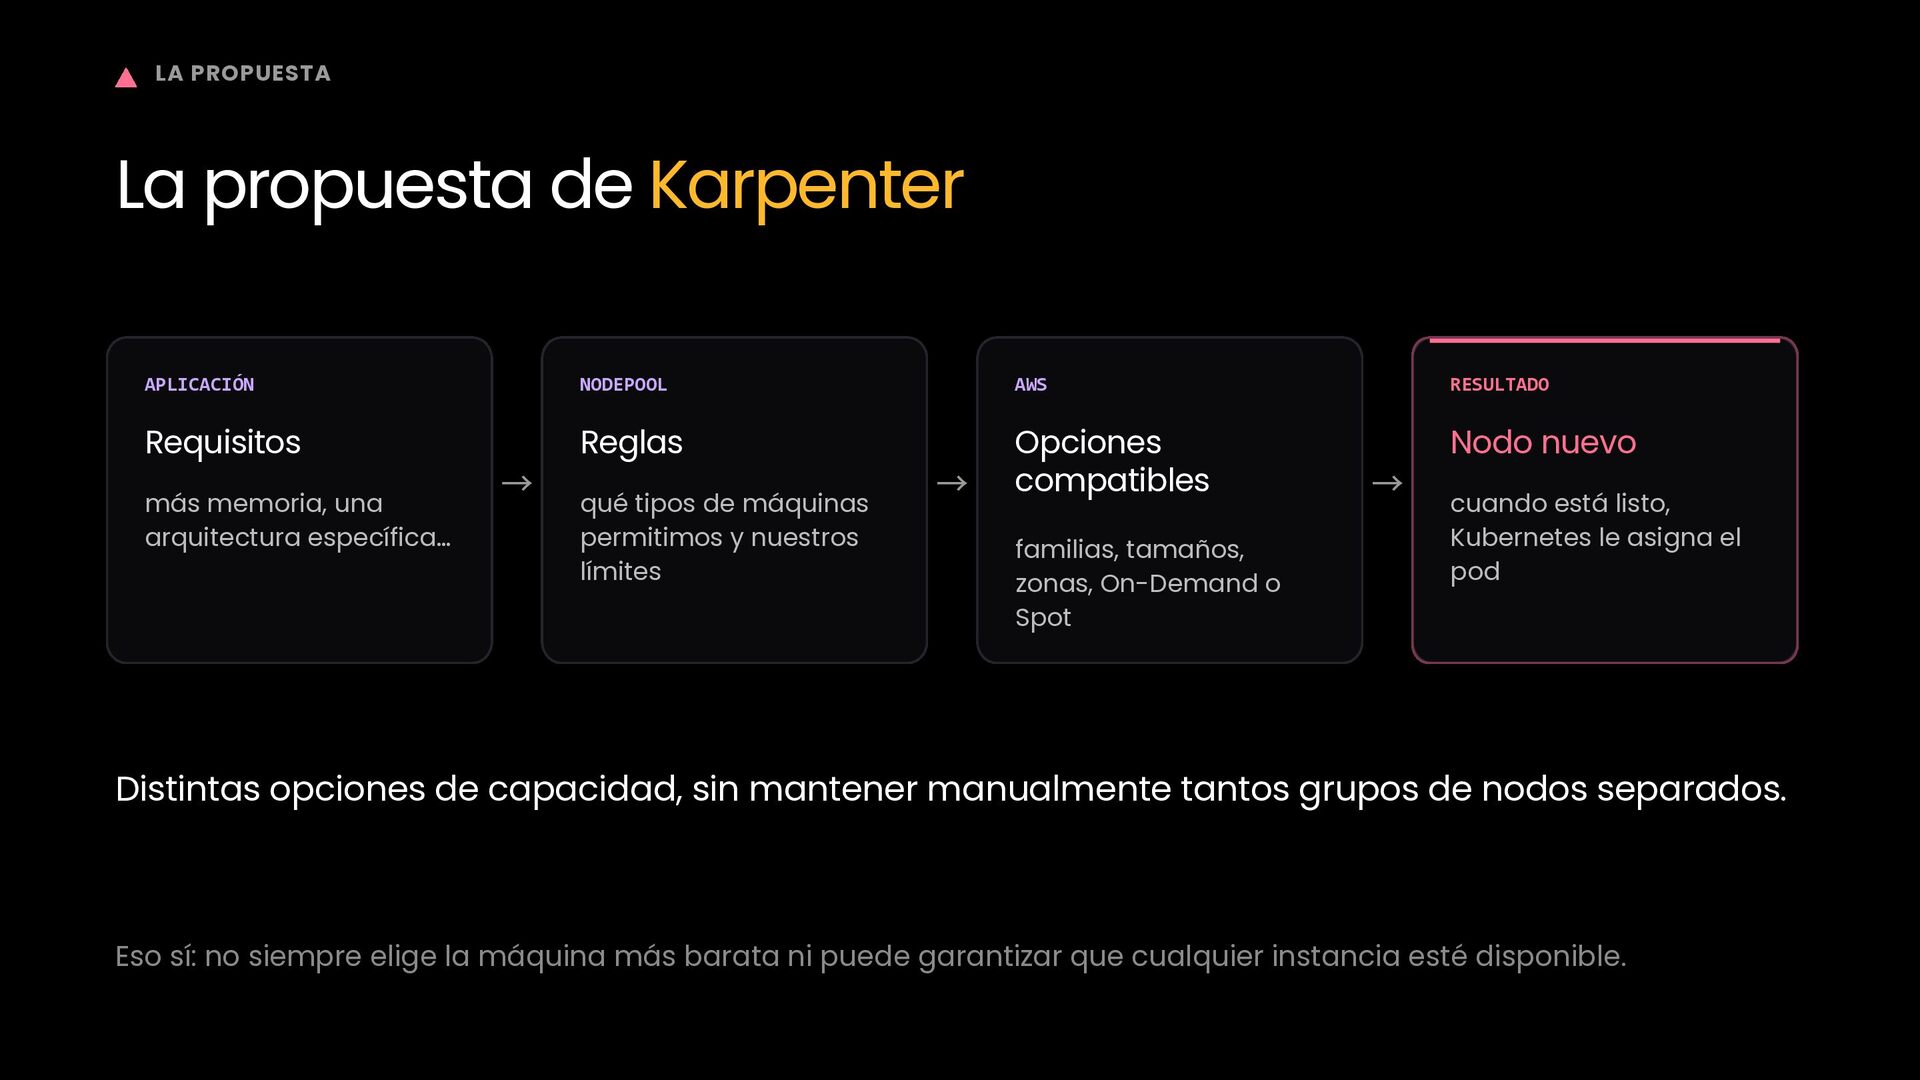
  6. LA PROPUESTA La propuesta de Karpenter APLICACIÓN NODEPOOL AWS RESULTADO

    Requisitos Reglas Opciones compatibles Nodo nuevo más memoria, una arquitectura específica… → qué tipos de máquinas permitimos y nuestros límites → familias, tamaños, zonas, On-Demand o Spot → cuando está listo, Kubernetes le asigna el pod Distintas opciones de capacidad, sin mantener manualmente tantos grupos de nodos separados. Eso sí: no siempre elige la máquina más barata ni puede garantizar que cualquier instancia esté disponible.
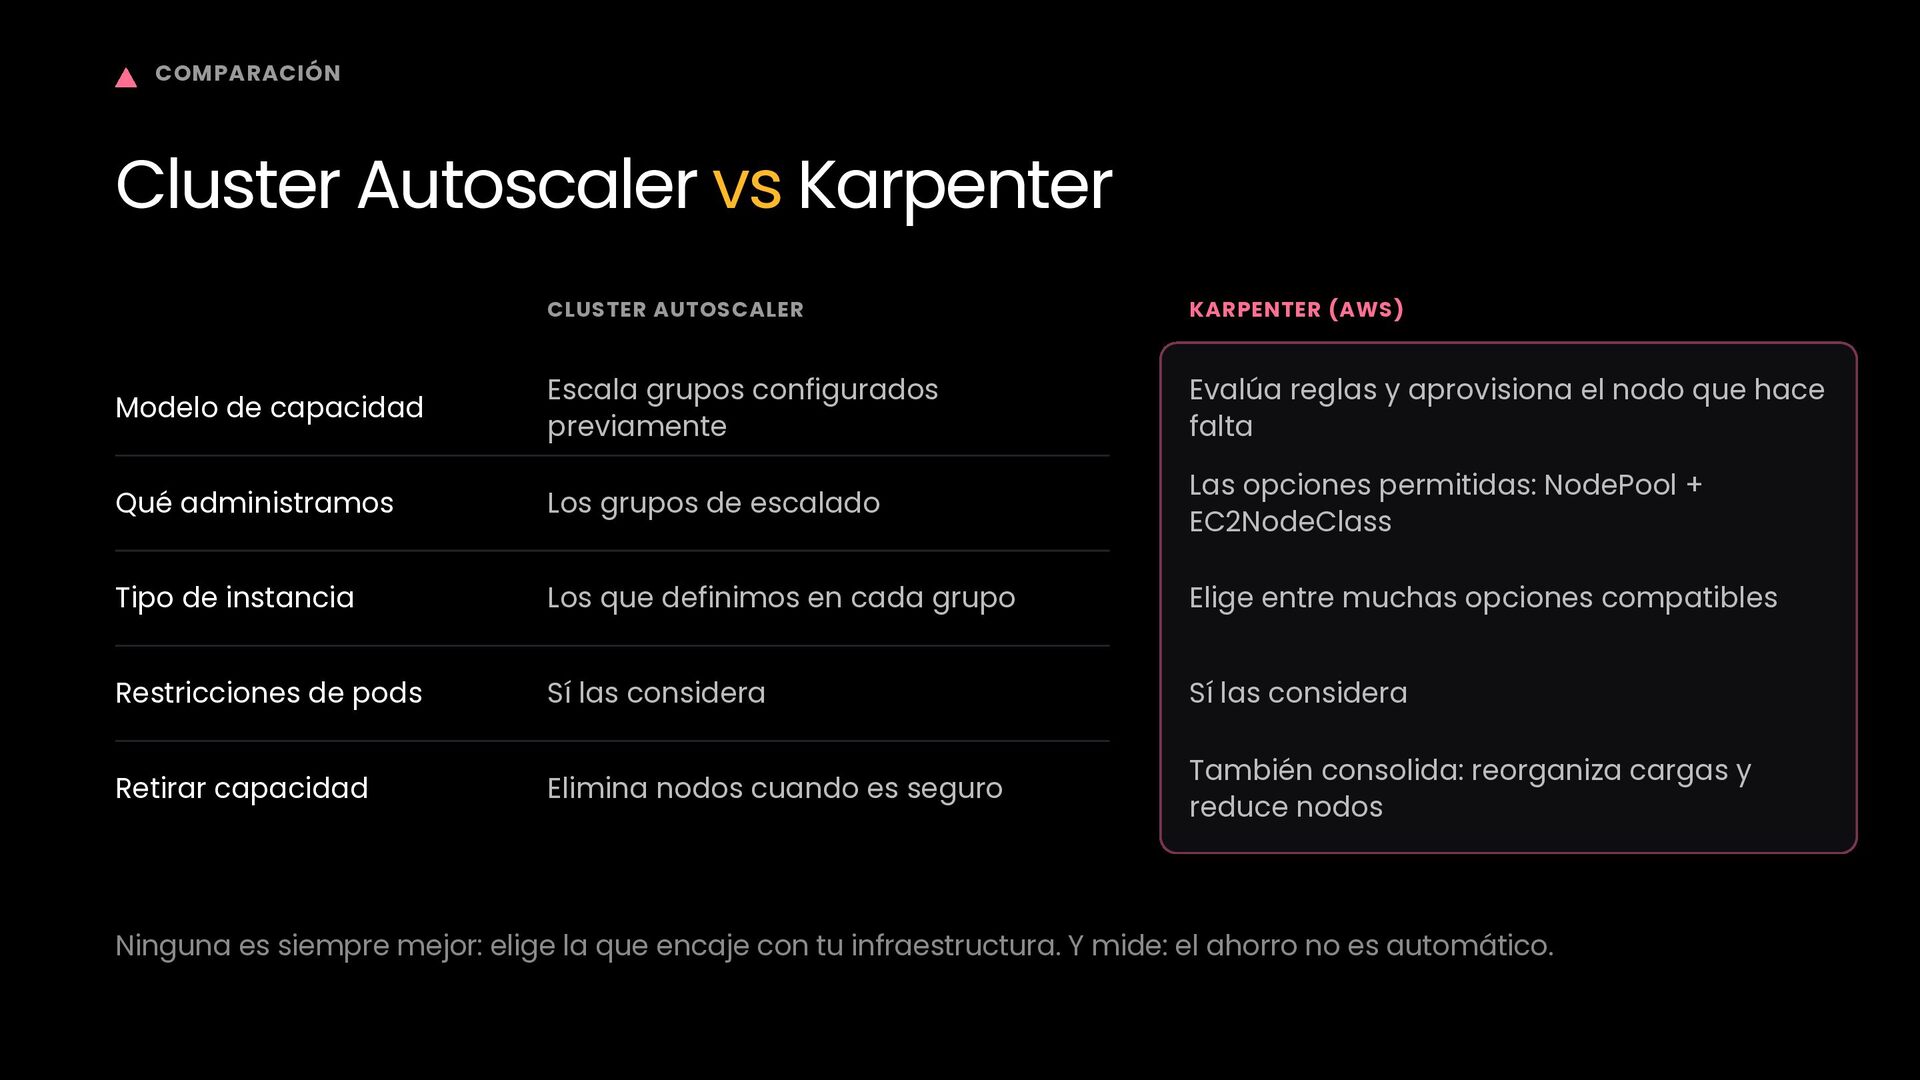
  7. COMPARACIÓN Cluster Autoscaler vs Karpenter CLUSTER AUTOSCALER KARPENTER (AWS) Escala

    grupos configurados previamente Evalúa reglas y aprovisiona el nodo que hace falta Qué administramos Los grupos de escalado Las opciones permitidas: NodePool + EC2NodeClass Tipo de instancia Los que definimos en cada grupo Elige entre muchas opciones compatibles Restricciones de pods Sí las considera Sí las considera Retirar capacidad Elimina nodos cuando es seguro También consolida: reorganiza cargas y reduce nodos Modelo de capacidad Ninguna es siempre mejor: elige la que encaje con tu infraestructura. Y mide: el ahorro no es automático.
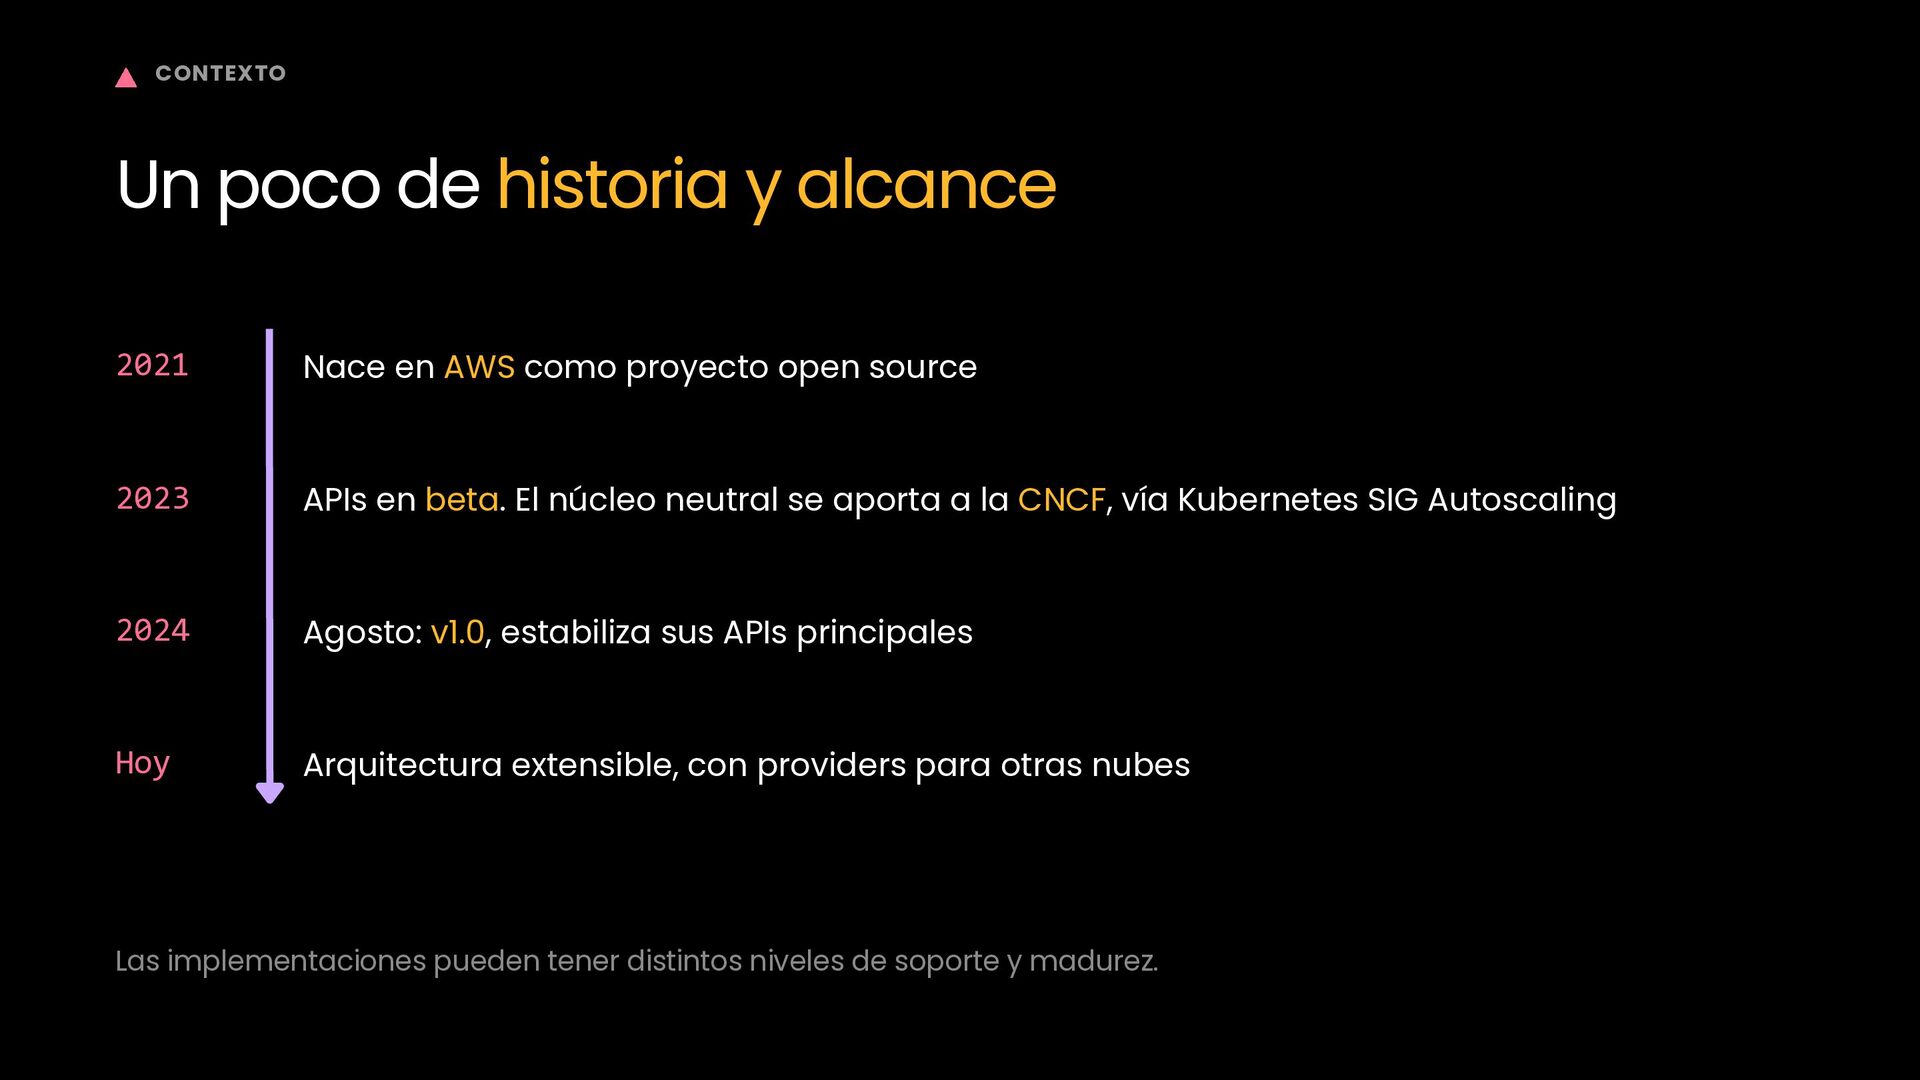
  8. CONTEXTO Un poco de historia y alcance 2021 Nace en

    AWS como proyecto open source 2023 APIs en beta. El núcleo neutral se aporta a la CNCF, vía Kubernetes SIG Autoscaling 2024 Agosto: v1.0, estabiliza sus APIs principales Hoy Arquitectura extensible, con providers para otras nubes Las implementaciones pueden tener distintos niveles de soporte y madurez.
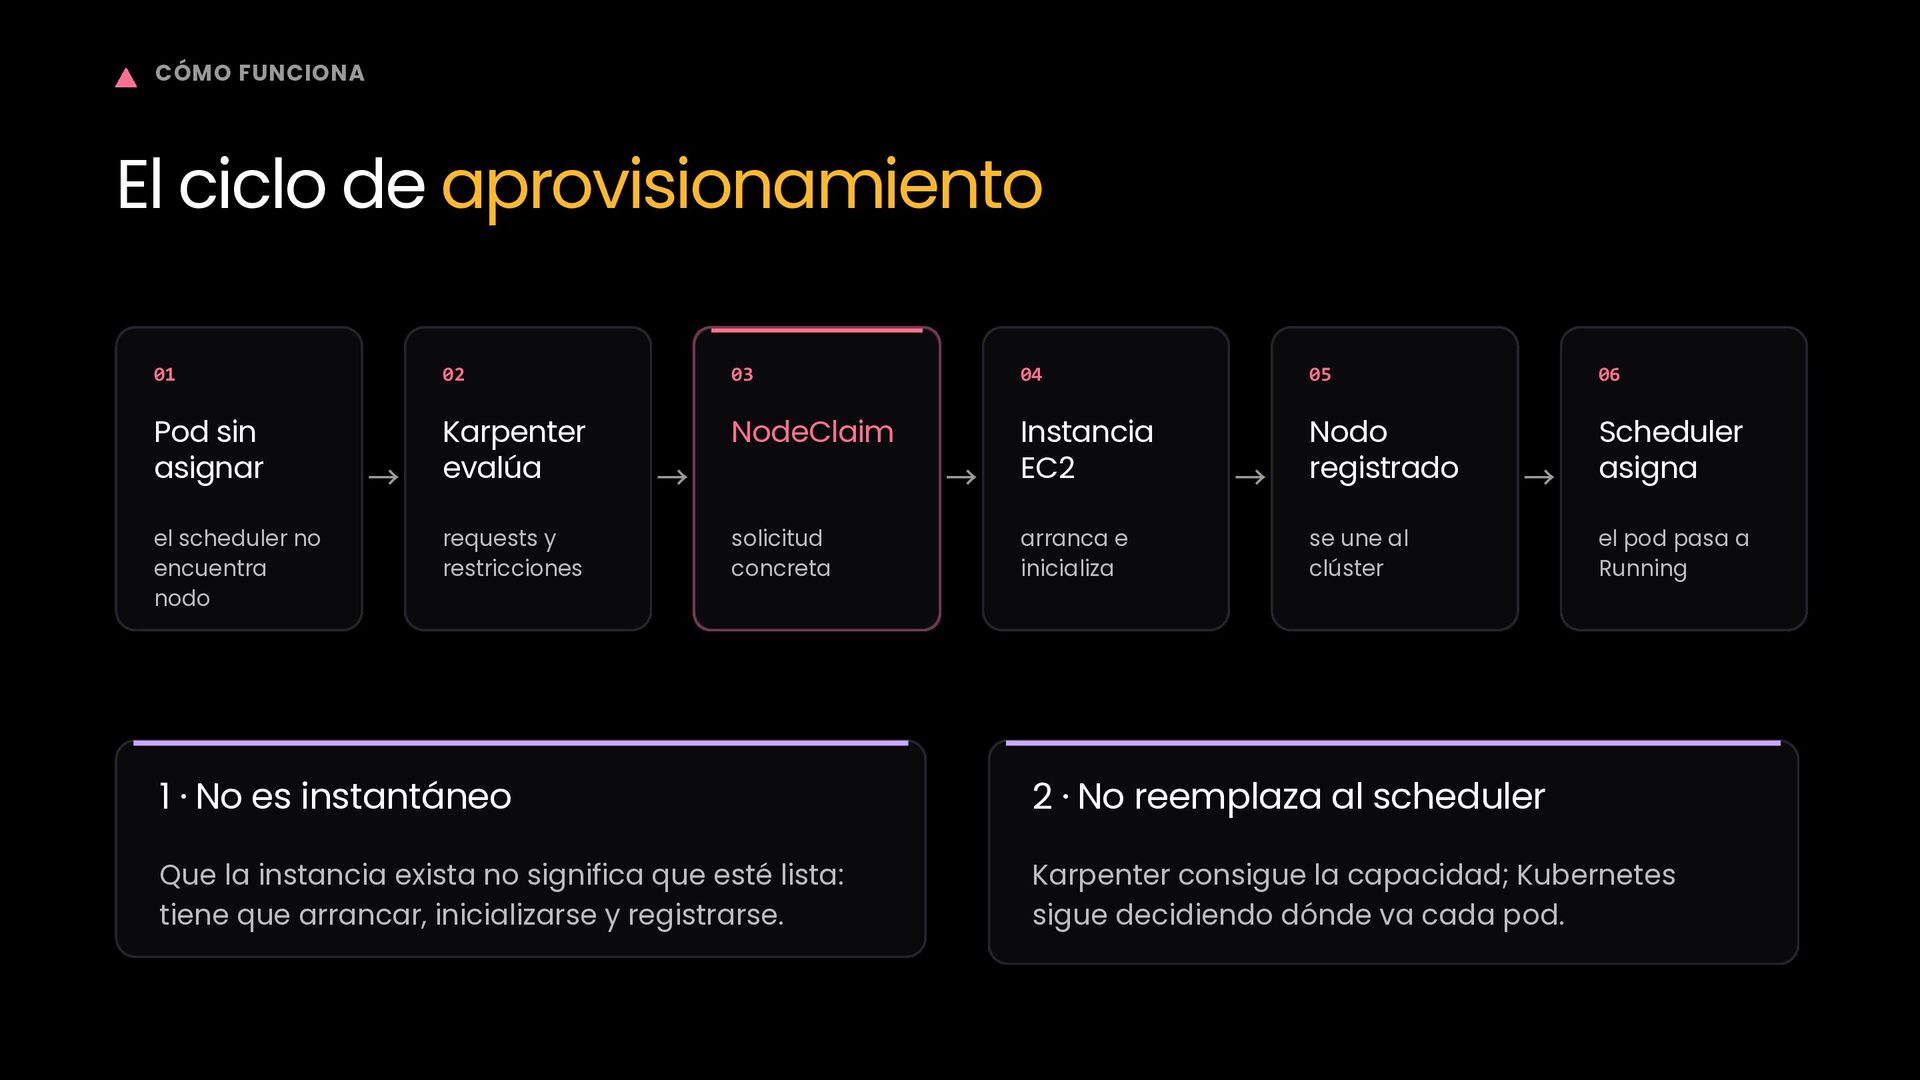
  9. CÓMO FUNCIONA El ciclo de aprovisionamiento 01 02 03 04

    05 06 Pod sin asignar Karpenter evalúa NodeClaim Instancia EC2 Nodo registrado Scheduler asigna el scheduler no encuentra nodo → requests y restricciones → solicitud concreta → arranca e inicializa → → se une al clúster el pod pasa a Running 1 · No es instantáneo 2 · No reemplaza al scheduler Que la instancia exista no significa que esté lista: tiene que arrancar, inicializarse y registrarse. Karpenter consigue la capacidad; Kubernetes sigue decidiendo dónde va cada pod.
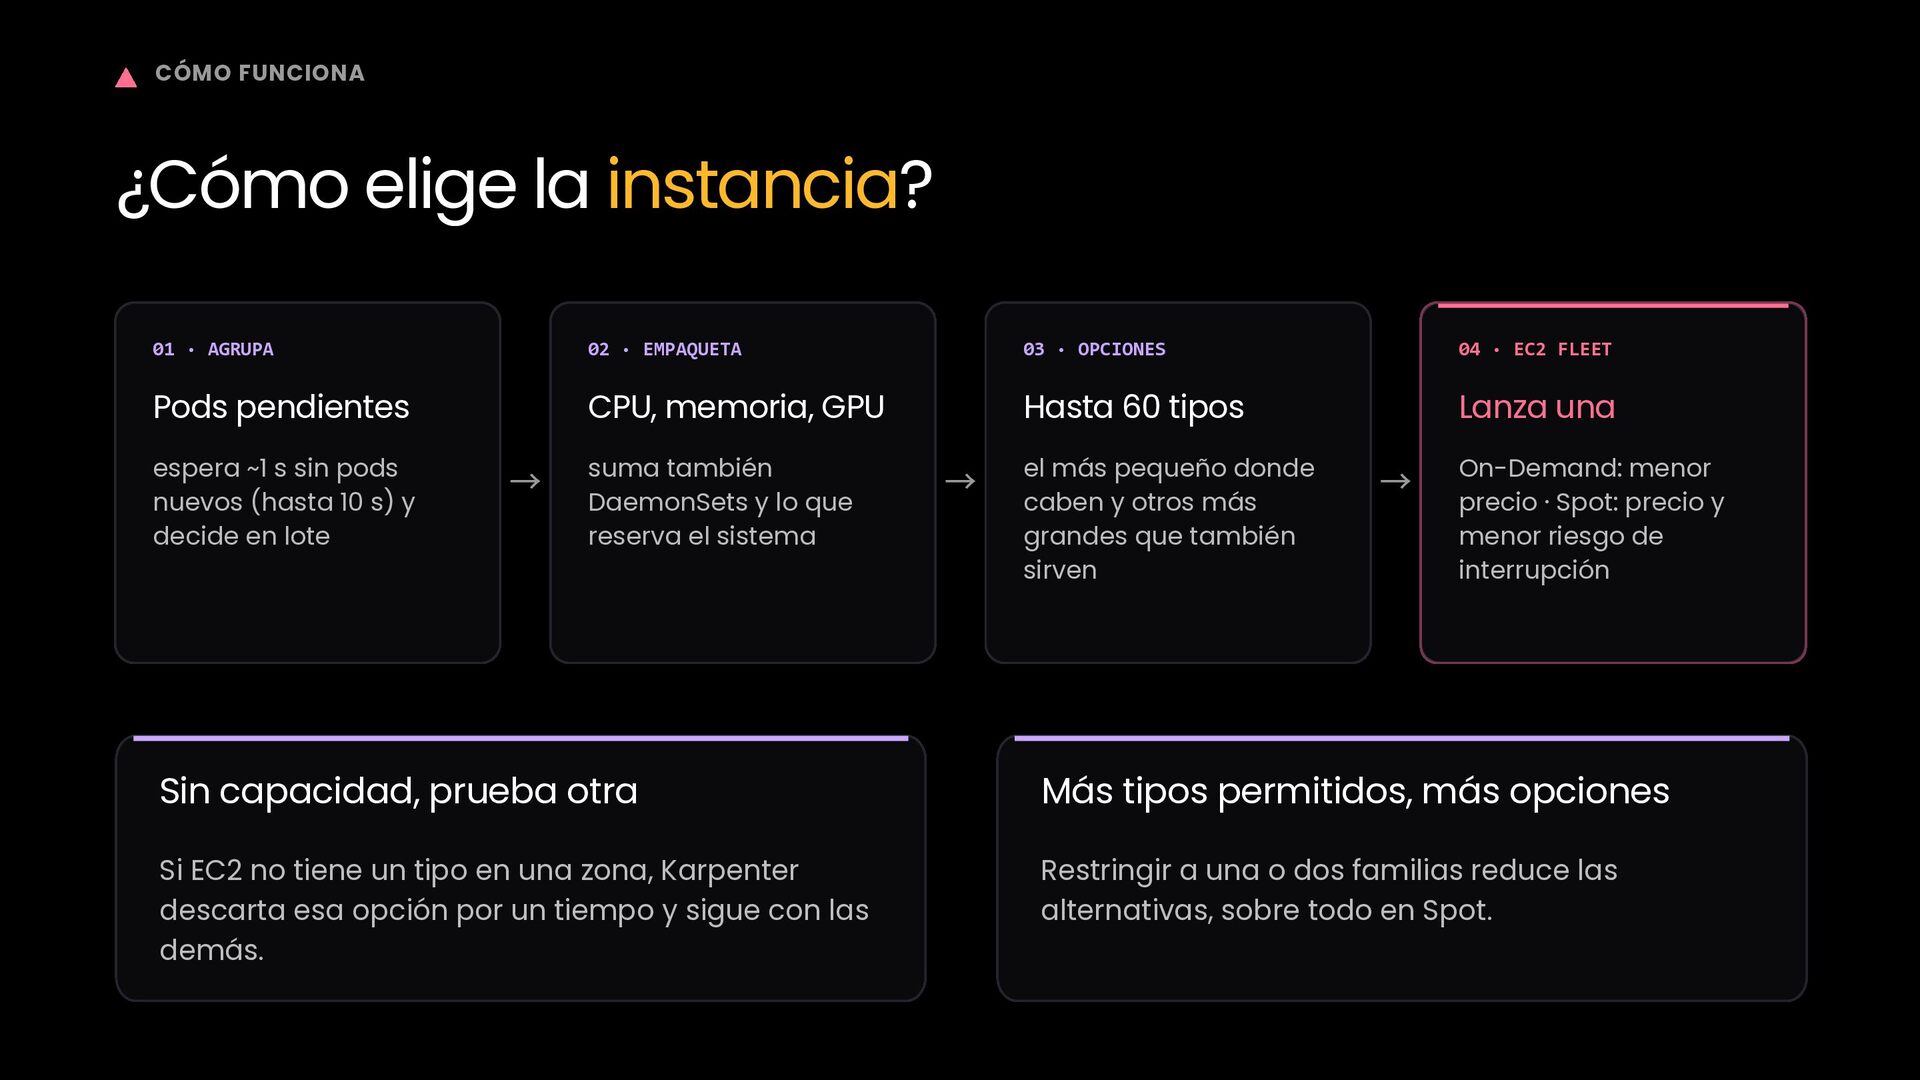
  10. CÓMO FUNCIONA ¿Cómo elige la instancia? 01 · AGRUPA 02

    · EMPAQUETA 03 · OPCIONES 04 · EC2 FLEET Pods pendientes CPU, memoria, GPU Hasta 60 tipos Lanza una espera ~1 s sin pods nuevos (hasta 10 s) y decide en lote → suma también DaemonSets y lo que reserva el sistema → el más pequeño donde caben y otros más grandes que también sirven → On-Demand: menor precio · Spot: precio y menor riesgo de interrupción Sin capacidad, prueba otra Más tipos permitidos, más opciones Si EC2 no tiene un tipo en una zona, Karpenter descarta esa opción por un tiempo y sigue con las demás. Restringir a una o dos familias reduce las alternativas, sobre todo en Spot.
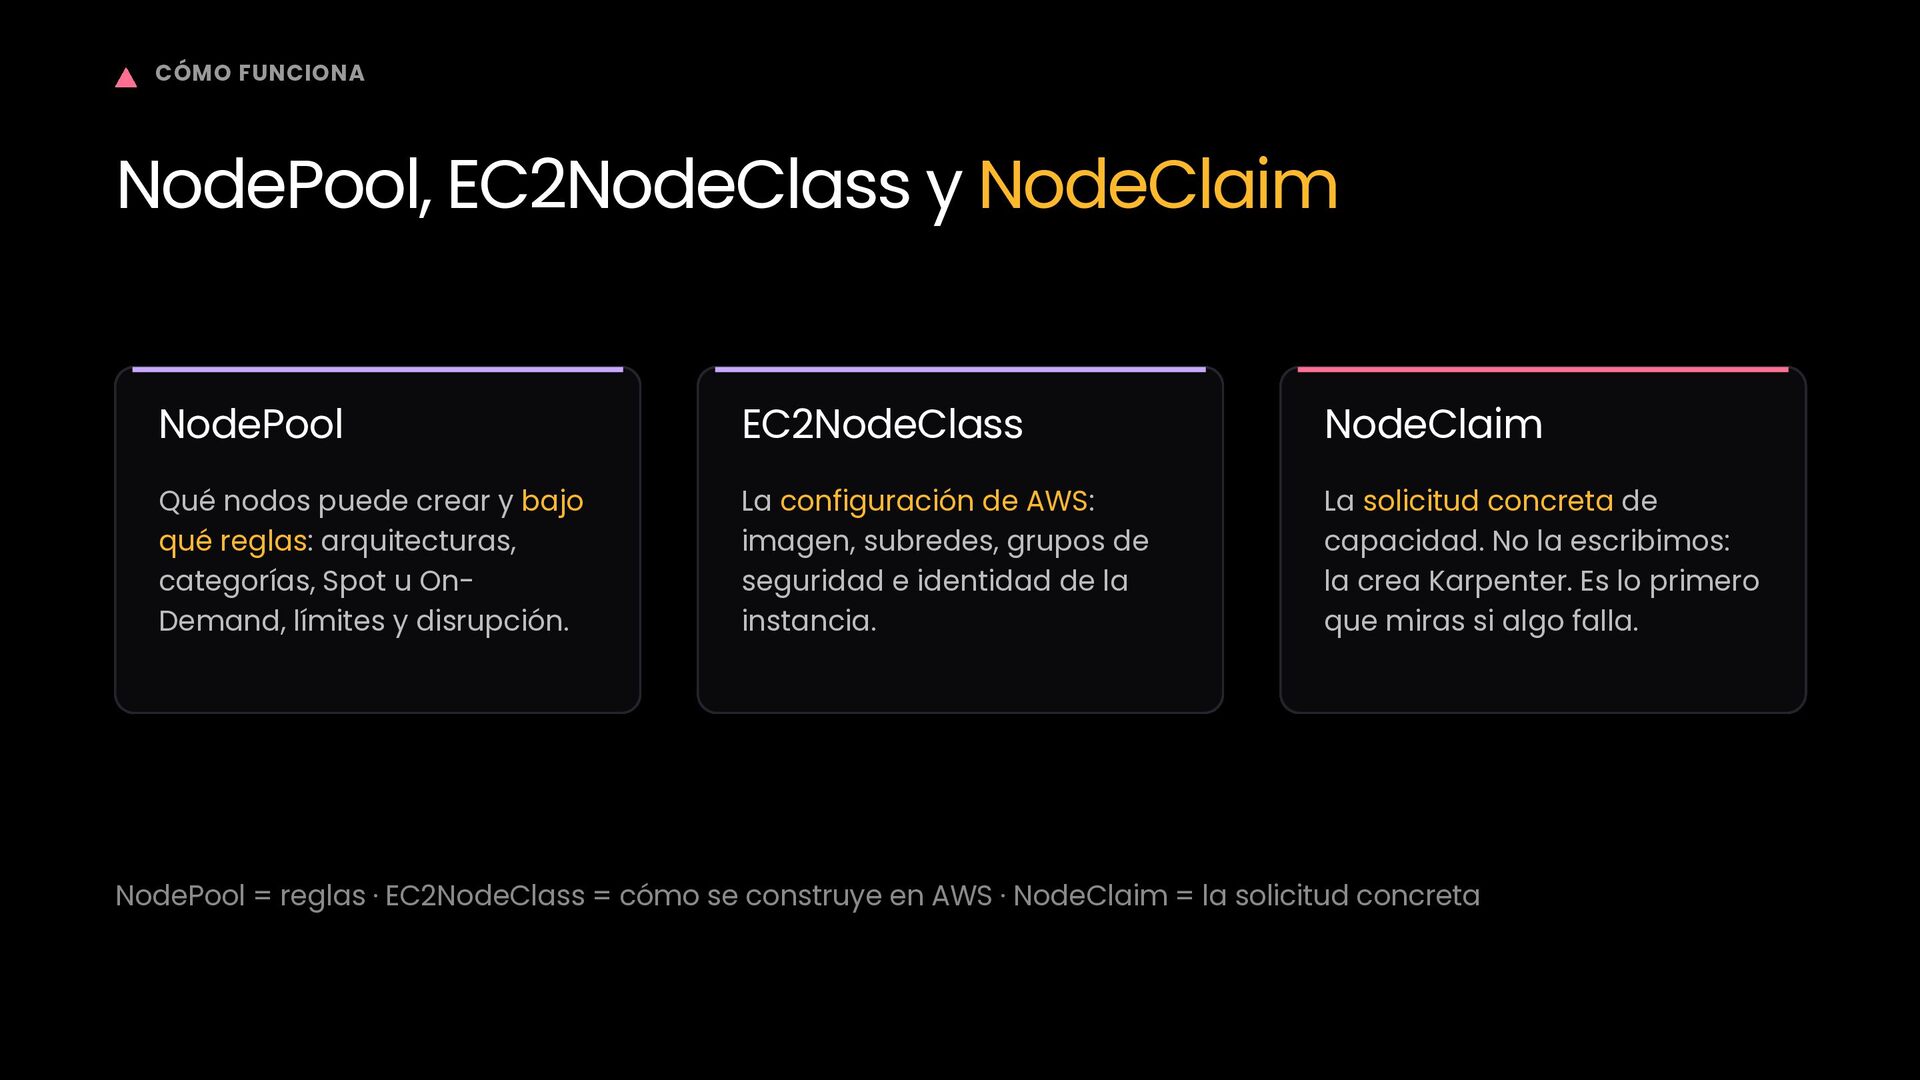
  11. CÓMO FUNCIONA NodePool, EC2NodeClass y NodeClaim NodePool EC2NodeClass NodeClaim Qué

    nodos puede crear y bajo qué reglas: arquitecturas, categorías, Spot u OnDemand, límites y disrupción. La configuración de AWS: imagen, subredes, grupos de seguridad e identidad de la instancia. La solicitud concreta de capacidad. No la escribimos: la crea Karpenter. Es lo primero que miras si algo falla. NodePool = reglas · EC2NodeClass = cómo se construye en AWS · NodeClaim = la solicitud concreta
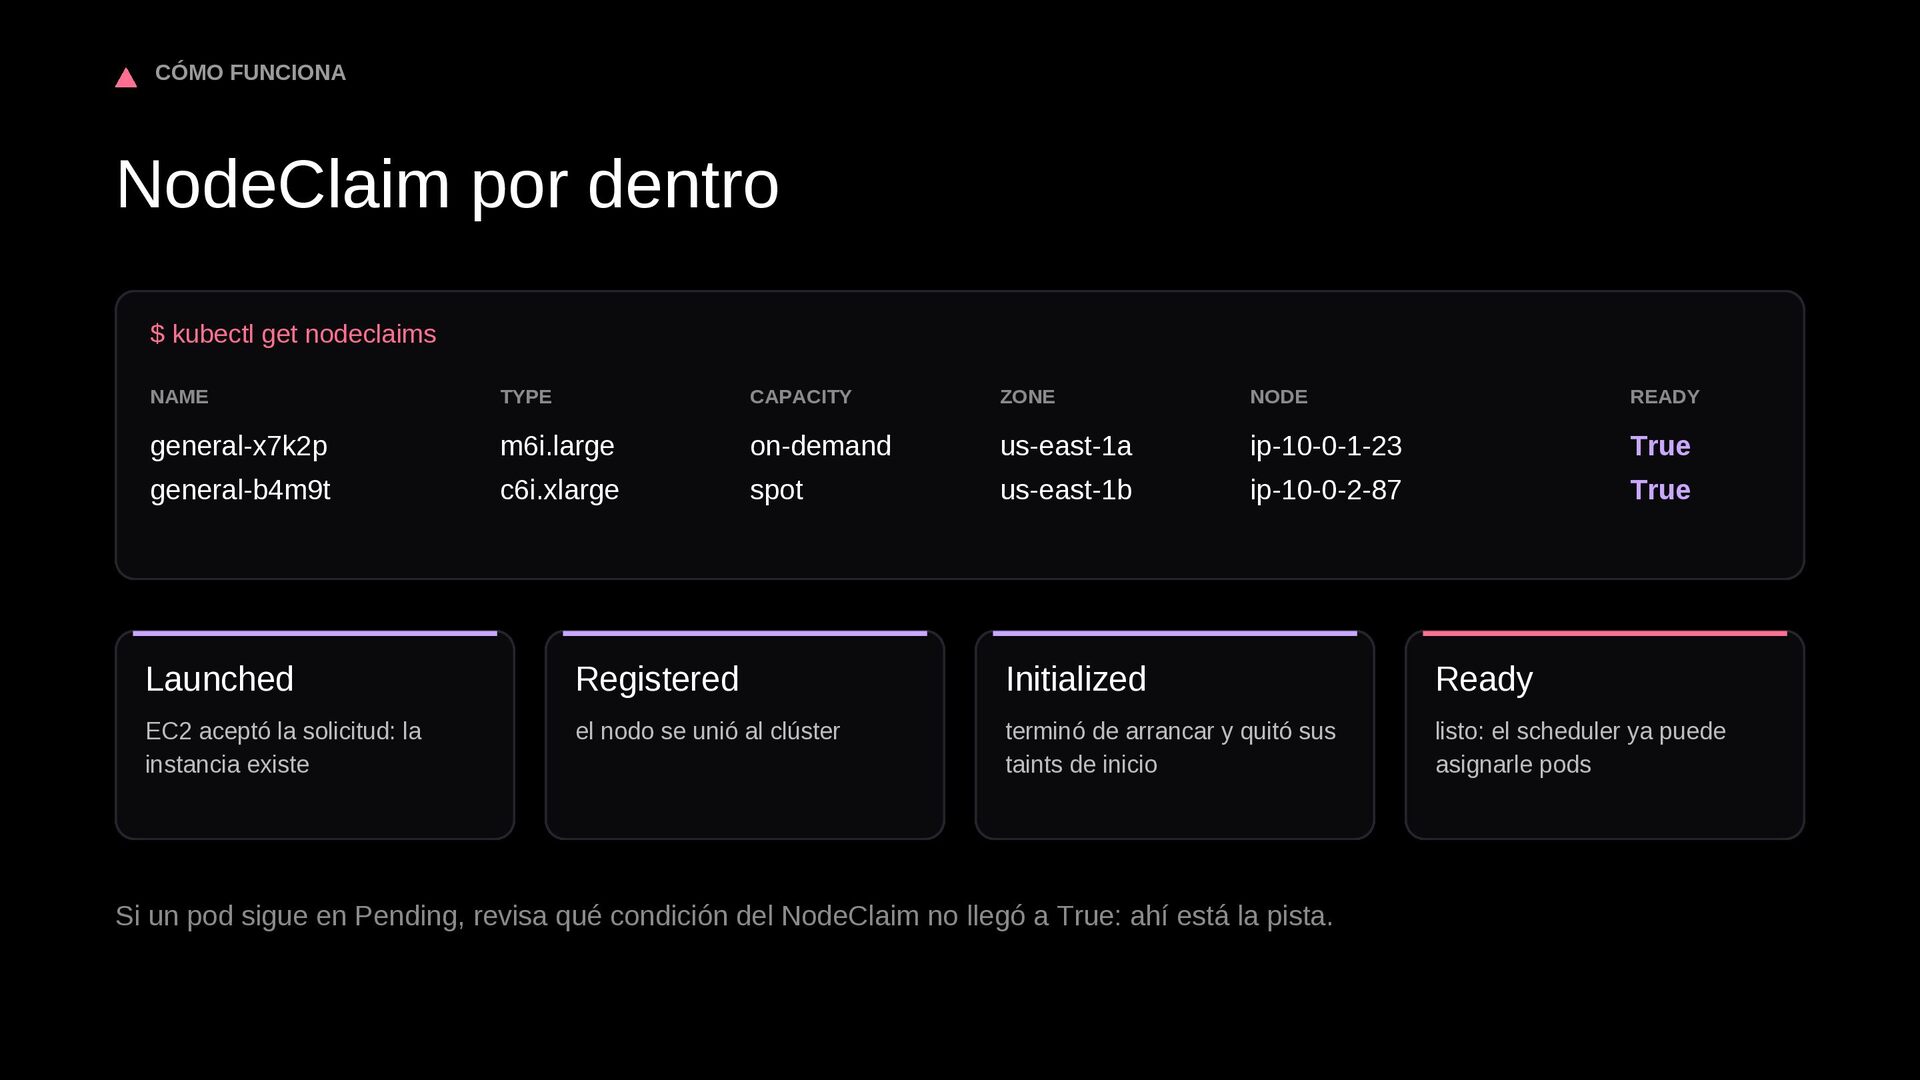
  12. CÓMO FUNCIONA NodeClaim por dentro $ kubectl get nodeclaims NAME

    TYPE CAPACITY ZONE NODE READY general-x7k2p m6i.large on-demand us-east-1a ip-10-0-1-23 True general-b4m9t c6i.xlarge spot us-east-1b ip-10-0-2-87 True Launched Registered Initialized Ready EC2 aceptó la solicitud: la instancia existe el nodo se unió al clúster terminó de arrancar y quitó sus taints de inicio listo: el scheduler ya puede asignarle pods Si un pod sigue en Pending, revisa qué condición del NodeClaim no llegó a True: ahí está la pista.
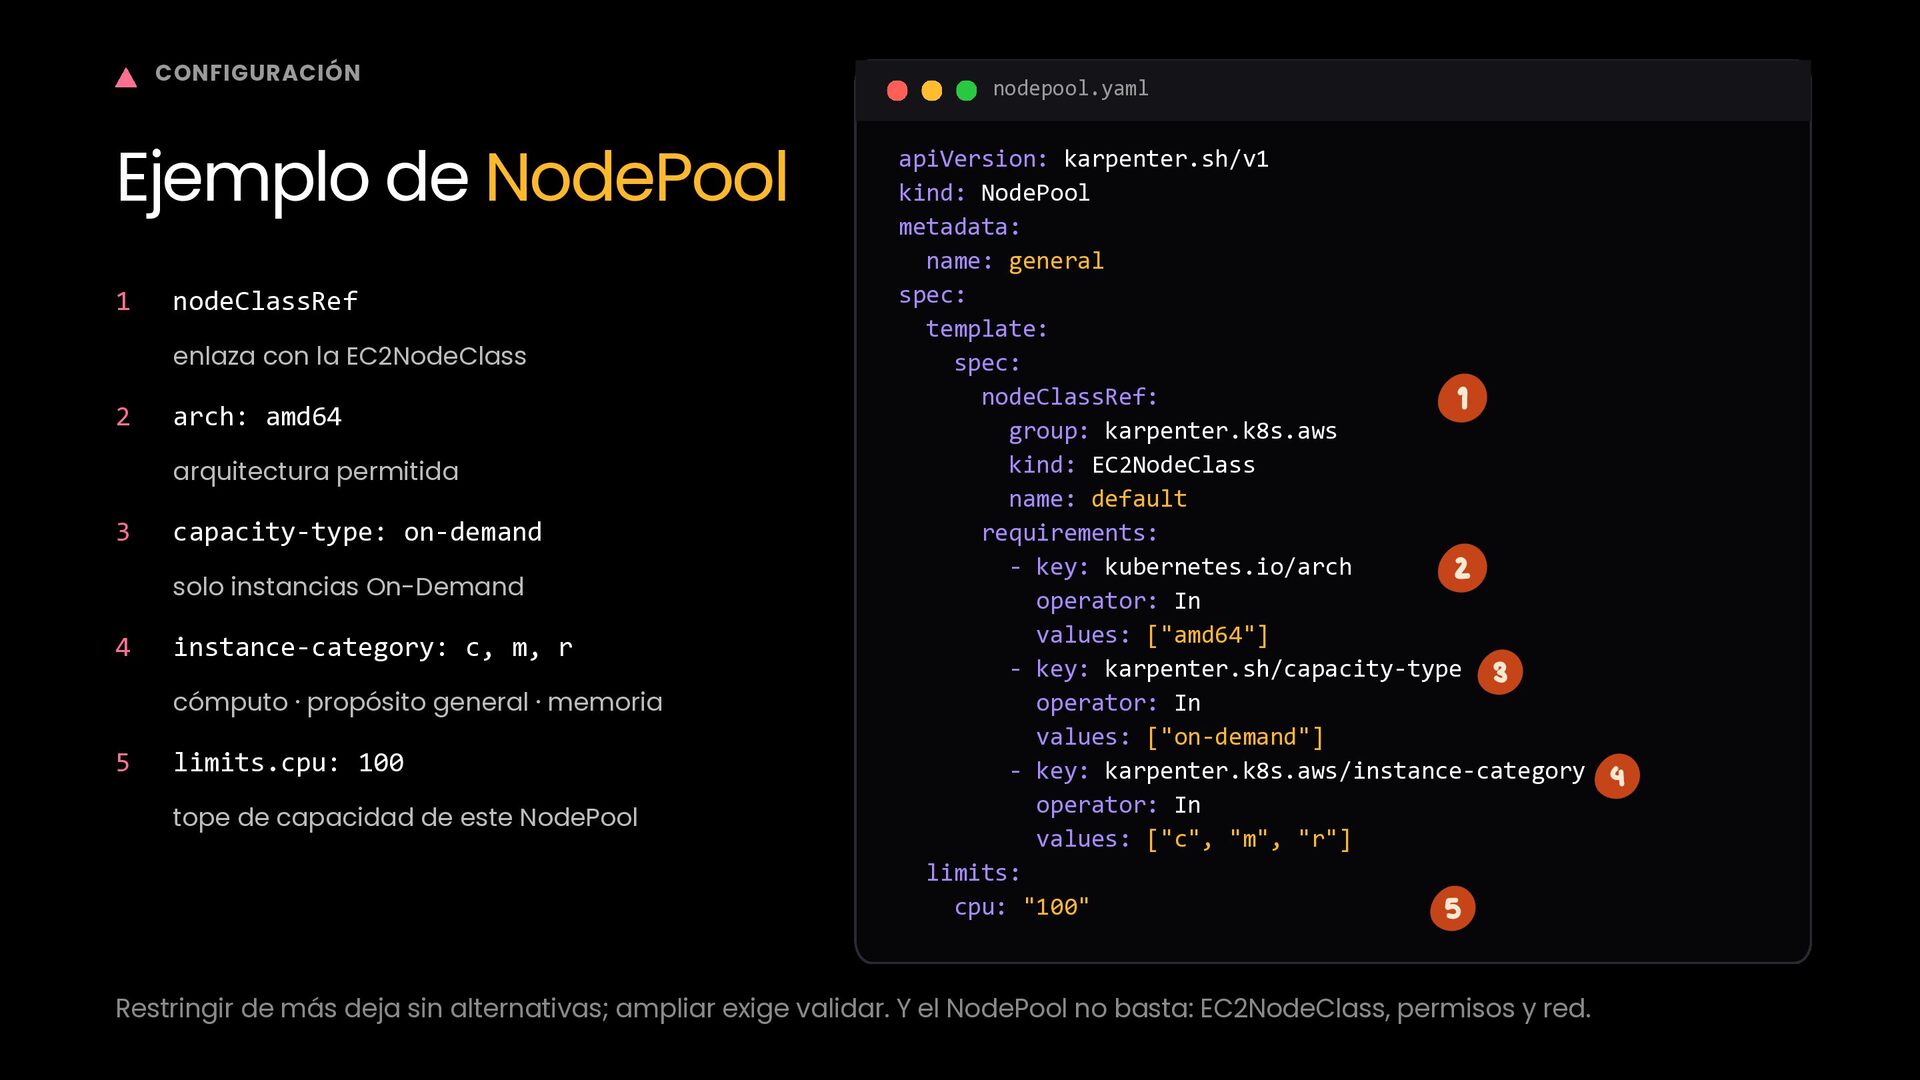
  13. CONFIGURACIÓN Ejemplo de NodePool 1 nodeClassRef enlaza con la EC2NodeClass

    2 arch: amd64 arquitectura permitida 3 capacity-type: on-demand solo instancias On-Demand 4 instance-category: c, m, r cómputo · propósito general · memoria 5 limits.cpu: 100 tope de capacidad de este NodePool nodepool.yaml apiVersion: karpenter.sh/v1 kind: NodePool metadata: name: general spec: template: spec: nodeClassRef: ① group: karpenter.k8s.aws kind: EC2NodeClass name: default requirements: - key: kubernetes.io/arch ② operator: In values: ["amd64"] - key: karpenter.sh/capacity-type ③ operator: In values: ["on-demand"] - key: karpenter.k8s.aws/instance-category ④ operator: In values: ["c", "m", "r"] limits: cpu: "100" ⑤ Restringir de más deja sin alternativas; ampliar exige validar. Y el NodePool no basta: EC2NodeClass, permisos y red.
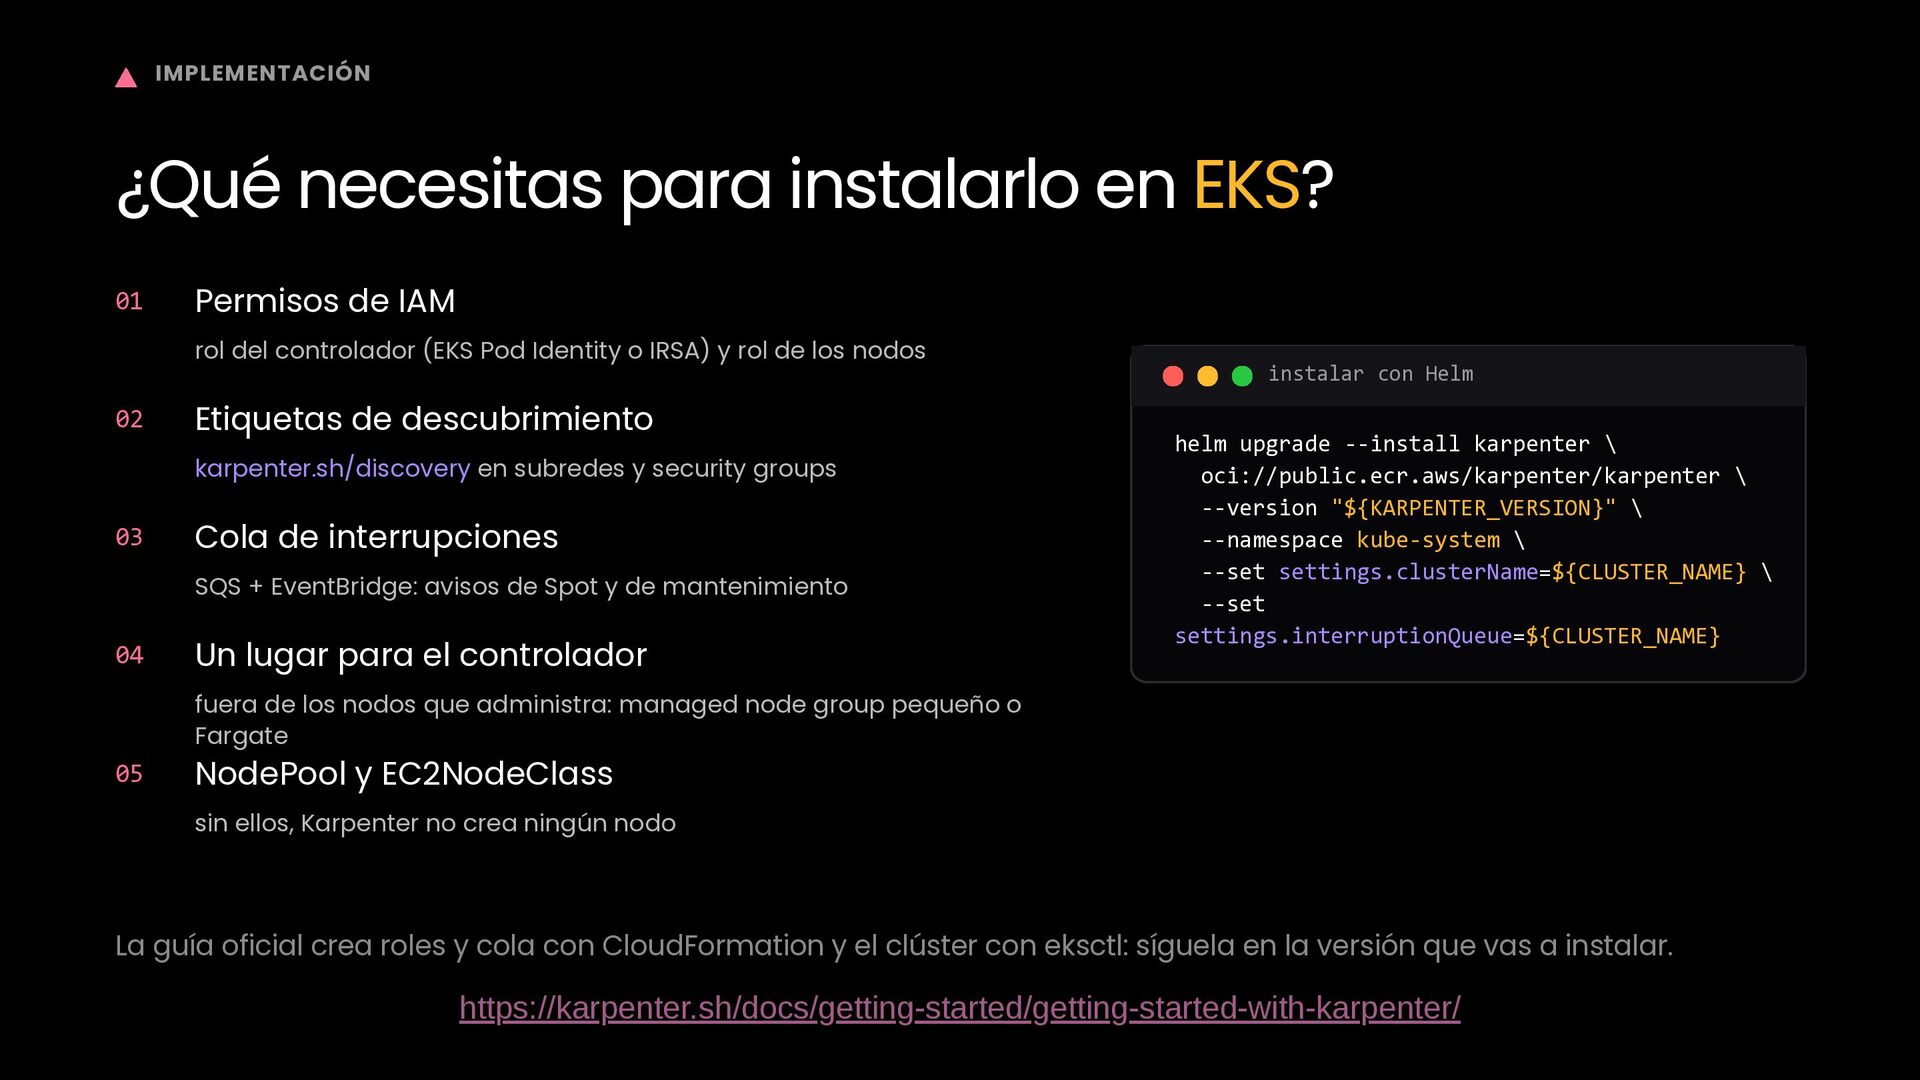
  14. IMPLEMENTACIÓN ¿Qué necesitas para instalarlo en EKS? 01 Permisos de

    IAM rol del controlador (EKS Pod Identity o IRSA) y rol de los nodos 02 Etiquetas de descubrimiento karpenter.sh/discovery en subredes y security groups 03 Cola de interrupciones SQS + EventBridge: avisos de Spot y de mantenimiento 04 Un lugar para el controlador instalar con Helm helm upgrade --install karpenter \ oci://public.ecr.aws/karpenter/karpenter \ --version "${KARPENTER_VERSION}" \ --namespace kube-system \ --set settings.clusterName=${CLUSTER_NAME} \ --set settings.interruptionQueue=${CLUSTER_NAME} fuera de los nodos que administra: managed node group pequeño o Fargate 05 NodePool y EC2NodeClass sin ellos, Karpenter no crea ningún nodo La guía oficial crea roles y cola con CloudFormation y el clúster con eksctl: síguela en la versión que vas a instalar. https://karpenter.sh/docs/getting-started/getting-started-with-karpenter/
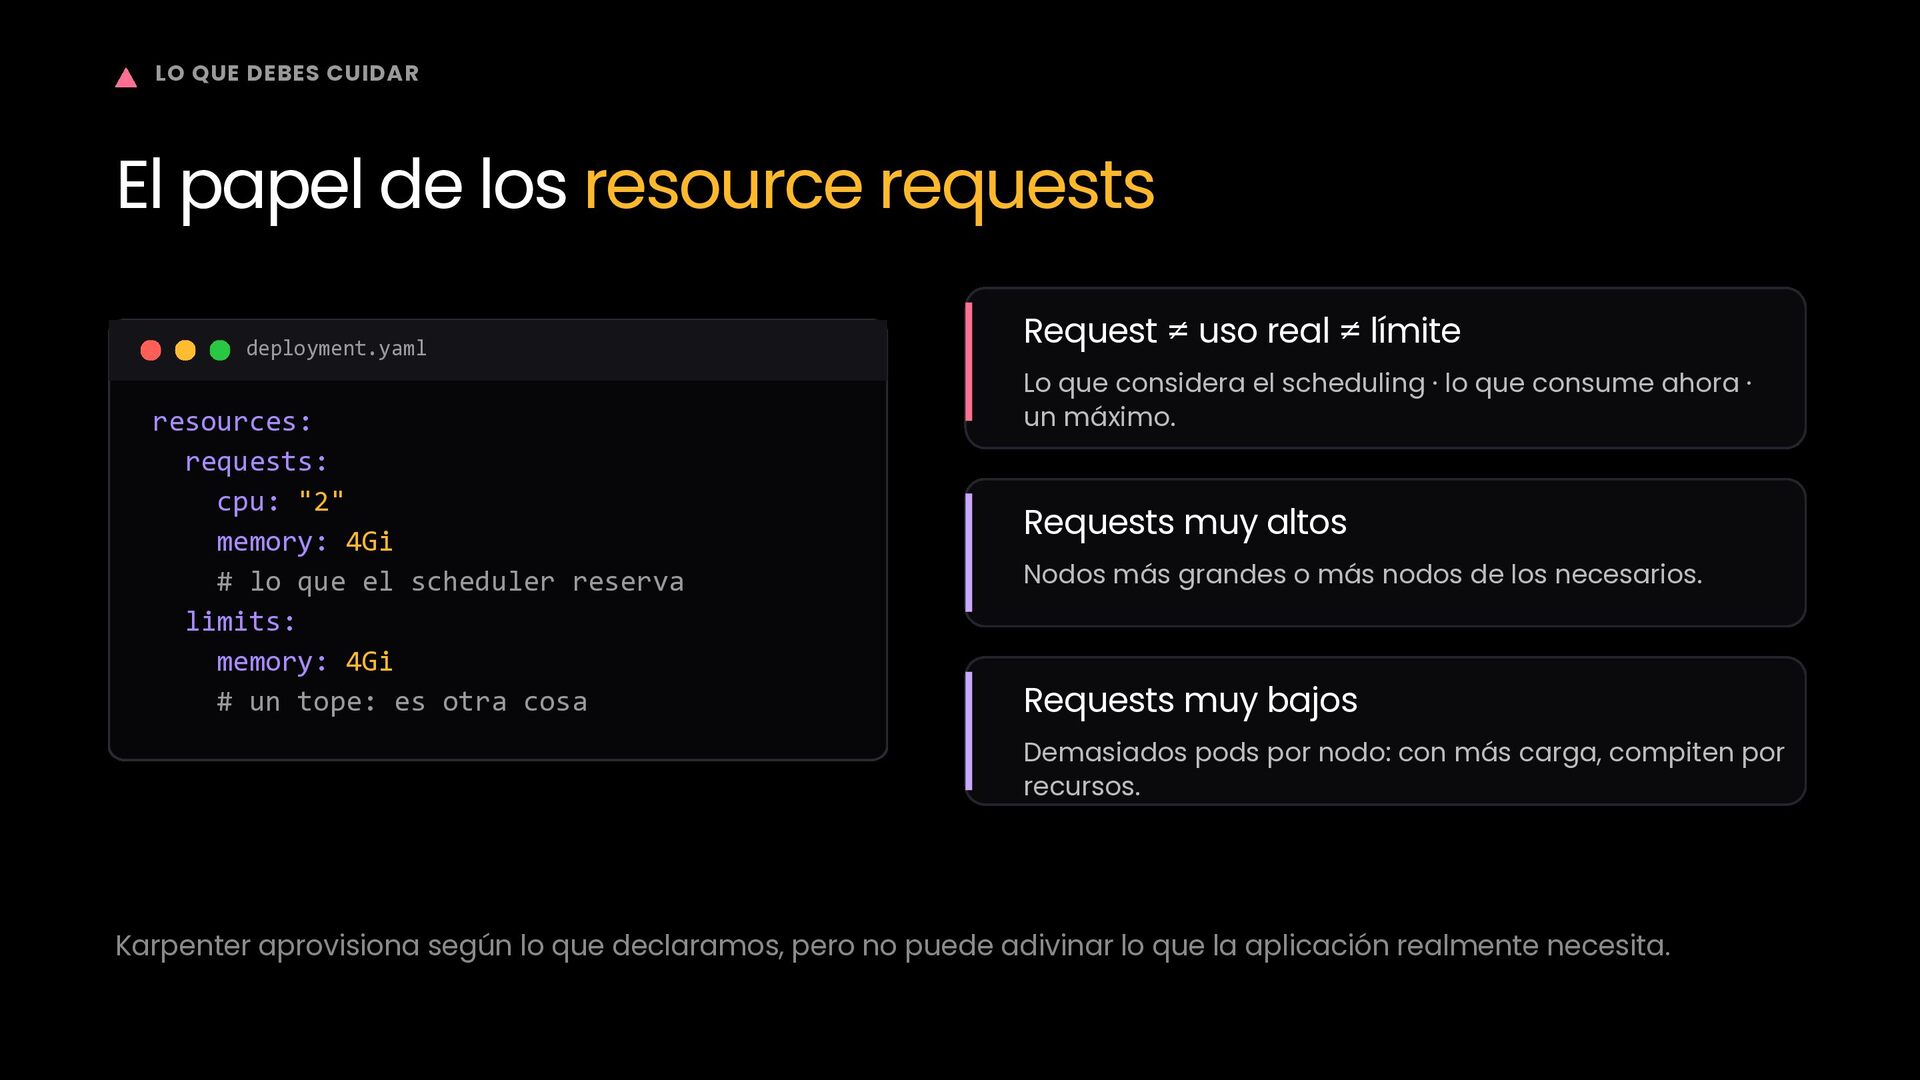
  15. LO QUE DEBES CUIDAR El papel de los resource requests

    deployment.yaml resources: requests: cpu: "2" memory: 4Gi # lo que el scheduler reserva limits: memory: 4Gi # un tope: es otra cosa Request ≠ uso real ≠ límite Lo que considera el scheduling · lo que consume ahora · un máximo. Requests muy altos Nodos más grandes o más nodos de los necesarios. Requests muy bajos Demasiados pods por nodo: con más carga, compiten por recursos. Karpenter aprovisiona según lo que declaramos, pero no puede adivinar lo que la aplicación realmente necesita.
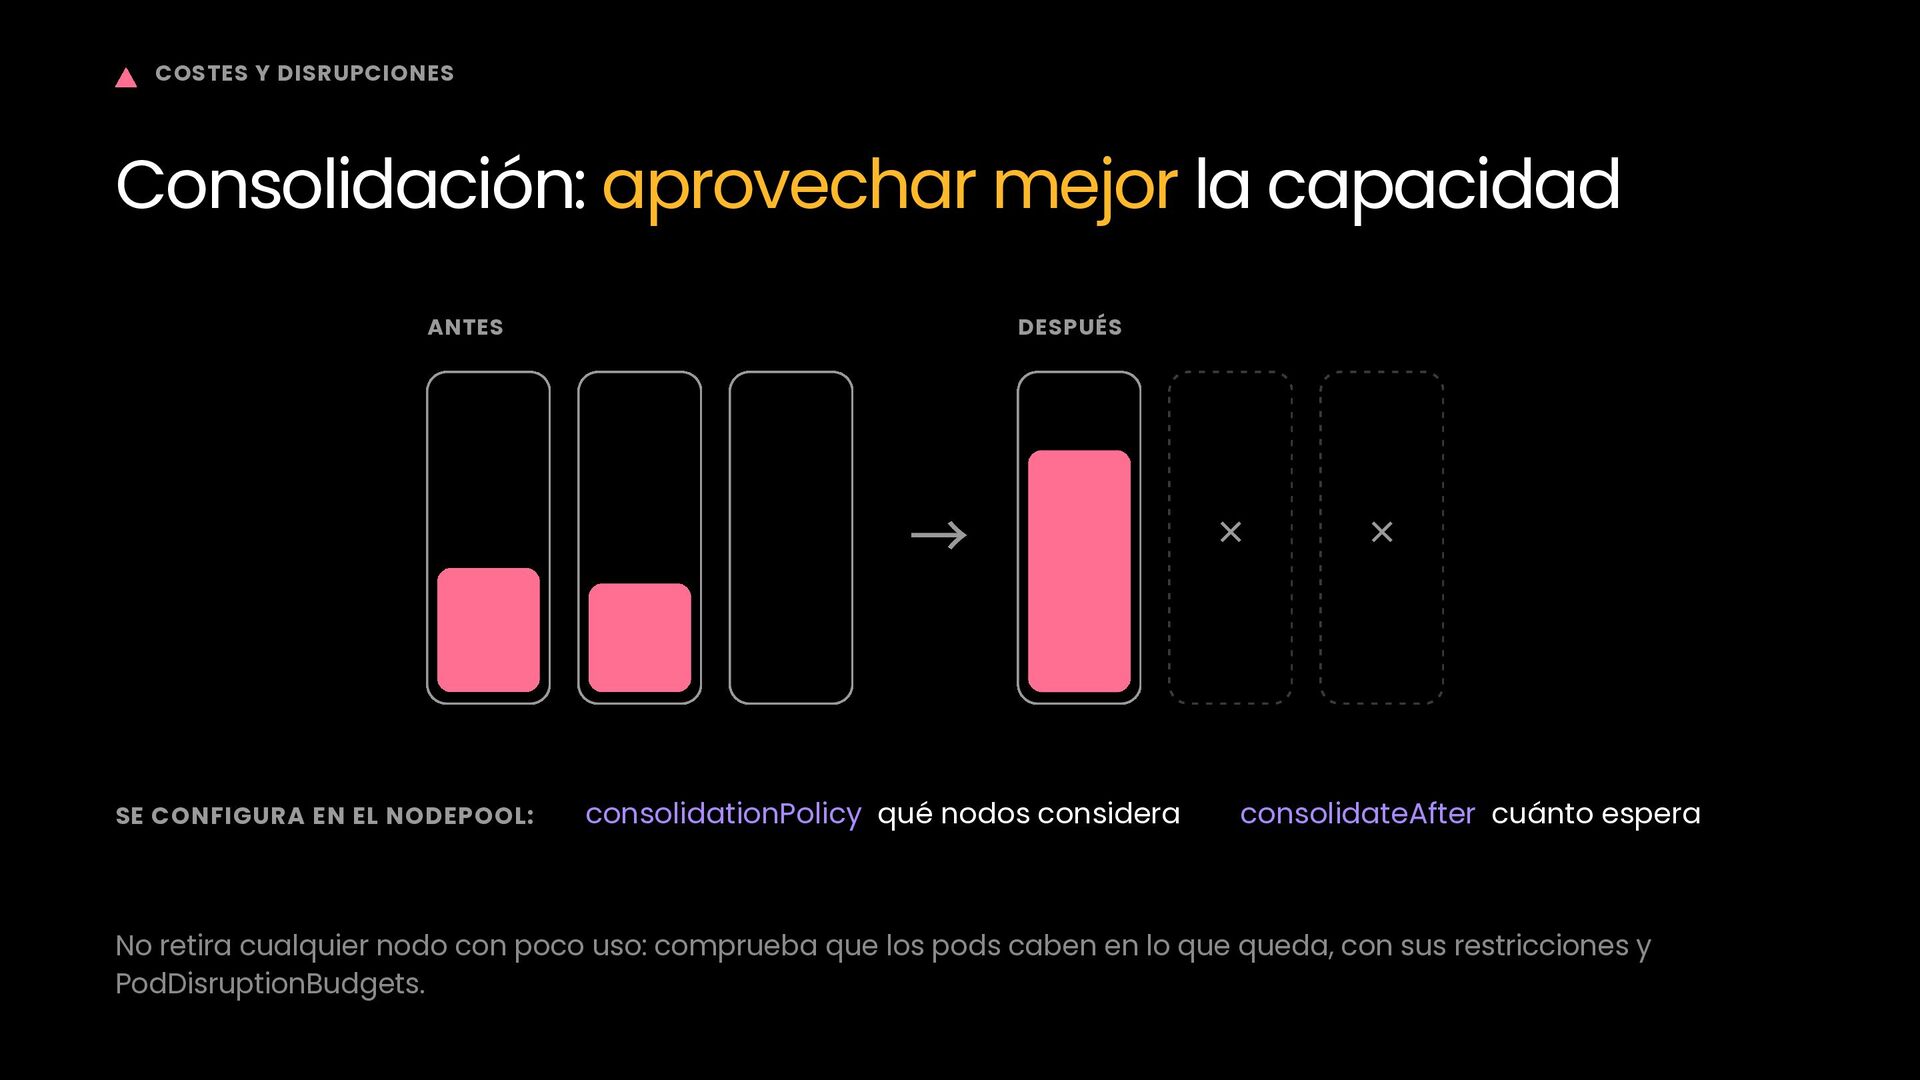
  16. COSTES Y DISRUPCIONES Consolidación: aprovechar mejor la capacidad ANTES DESPUÉS

    → SE CONFIGURA EN EL NODEPOOL: consolidationPolicy qué nodos considera ✕ ✕ consolidateAfter cuánto espera No retira cualquier nodo con poco uso: comprueba que los pods caben en lo que queda, con sus restricciones y PodDisruptionBudgets.
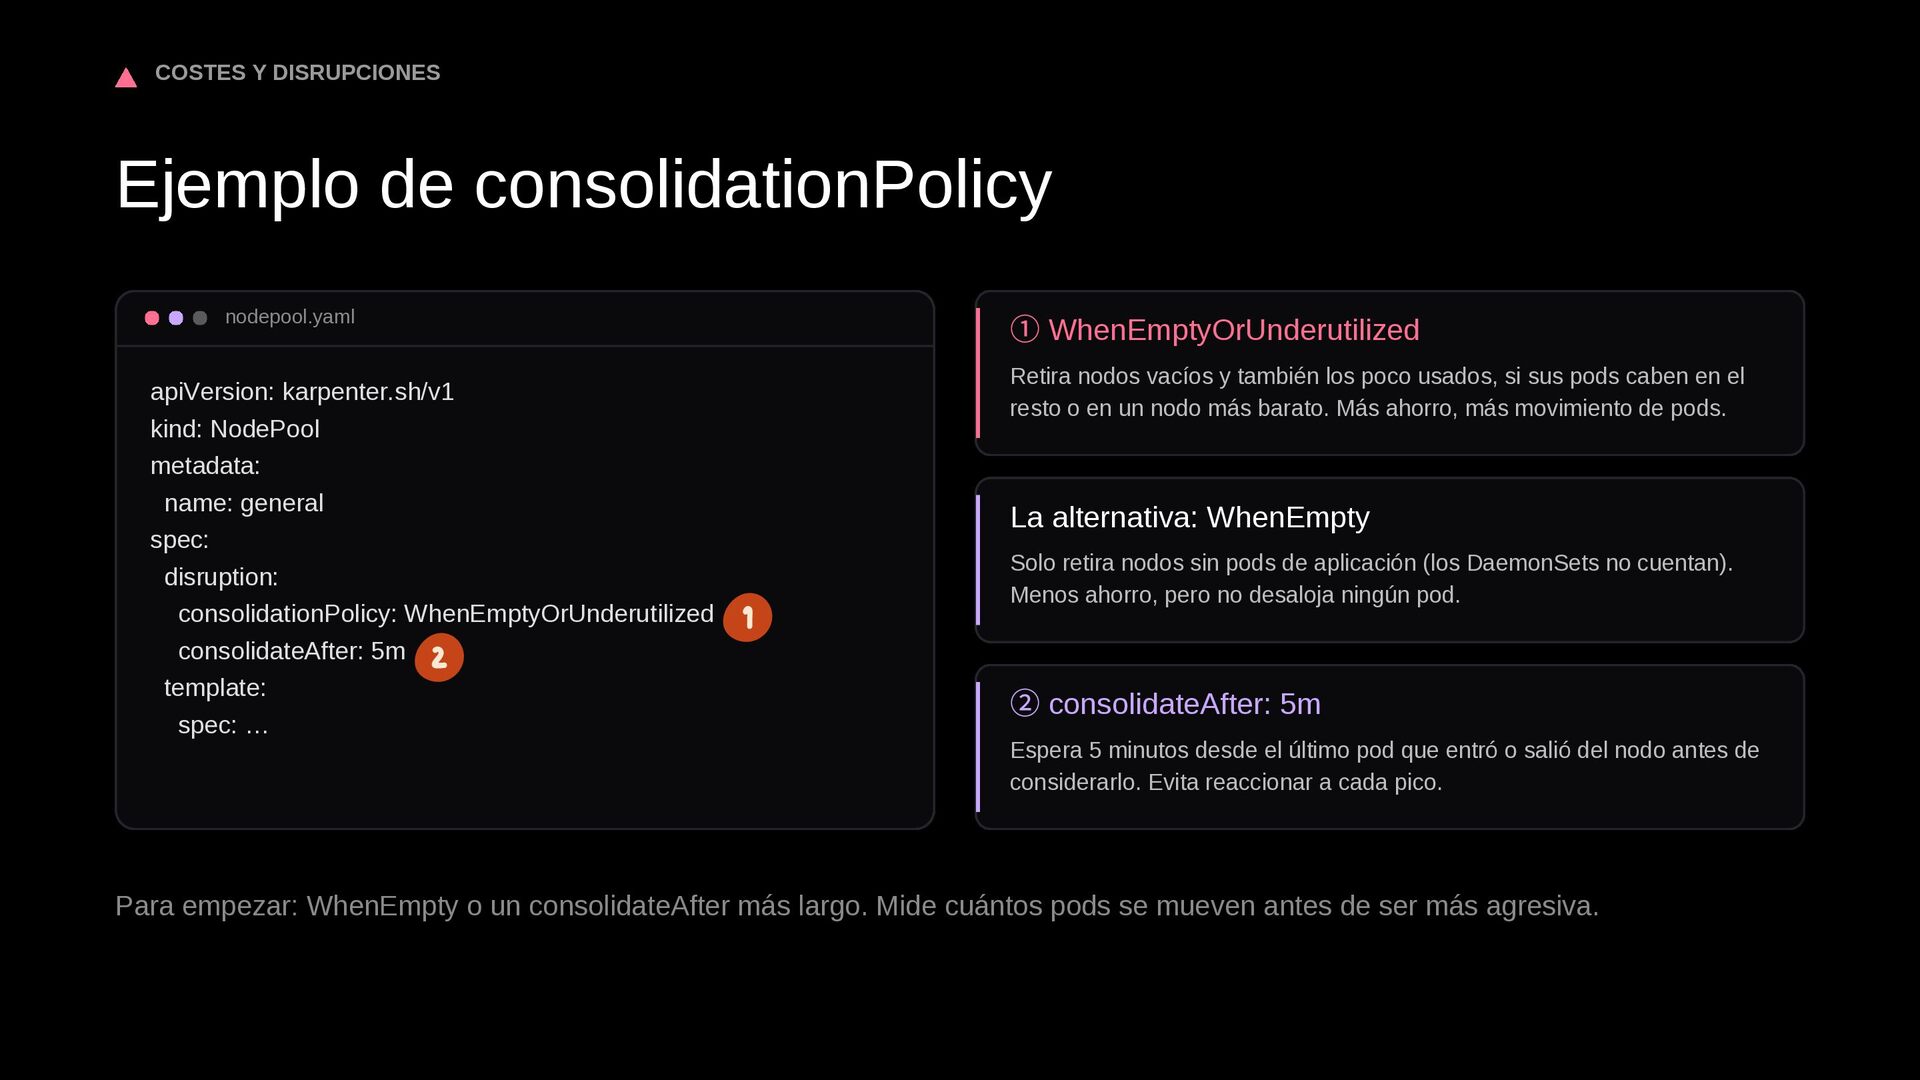
  17. COSTES Y DISRUPCIONES Ejemplo de consolidationPolicy ① WhenEmptyOrUnderutilized nodepool.yaml apiVersion:

    karpenter.sh/v1 kind: NodePool metadata: name: general spec: disruption: consolidationPolicy: WhenEmptyOrUnderutilized consolidateAfter: 5m template: spec: … ② Retira nodos vacíos y también los poco usados, si sus pods caben en el resto o en un nodo más barato. Más ahorro, más movimiento de pods. La alternativa: WhenEmpty ① Solo retira nodos sin pods de aplicación (los DaemonSets no cuentan). Menos ahorro, pero no desaloja ningún pod. ② consolidateAfter: 5m Espera 5 minutos desde el último pod que entró o salió del nodo antes de considerarlo. Evita reaccionar a cada pico. Para empezar: WhenEmpty o un consolidateAfter más largo. Mide cuántos pods se mueven antes de ser más agresiva.
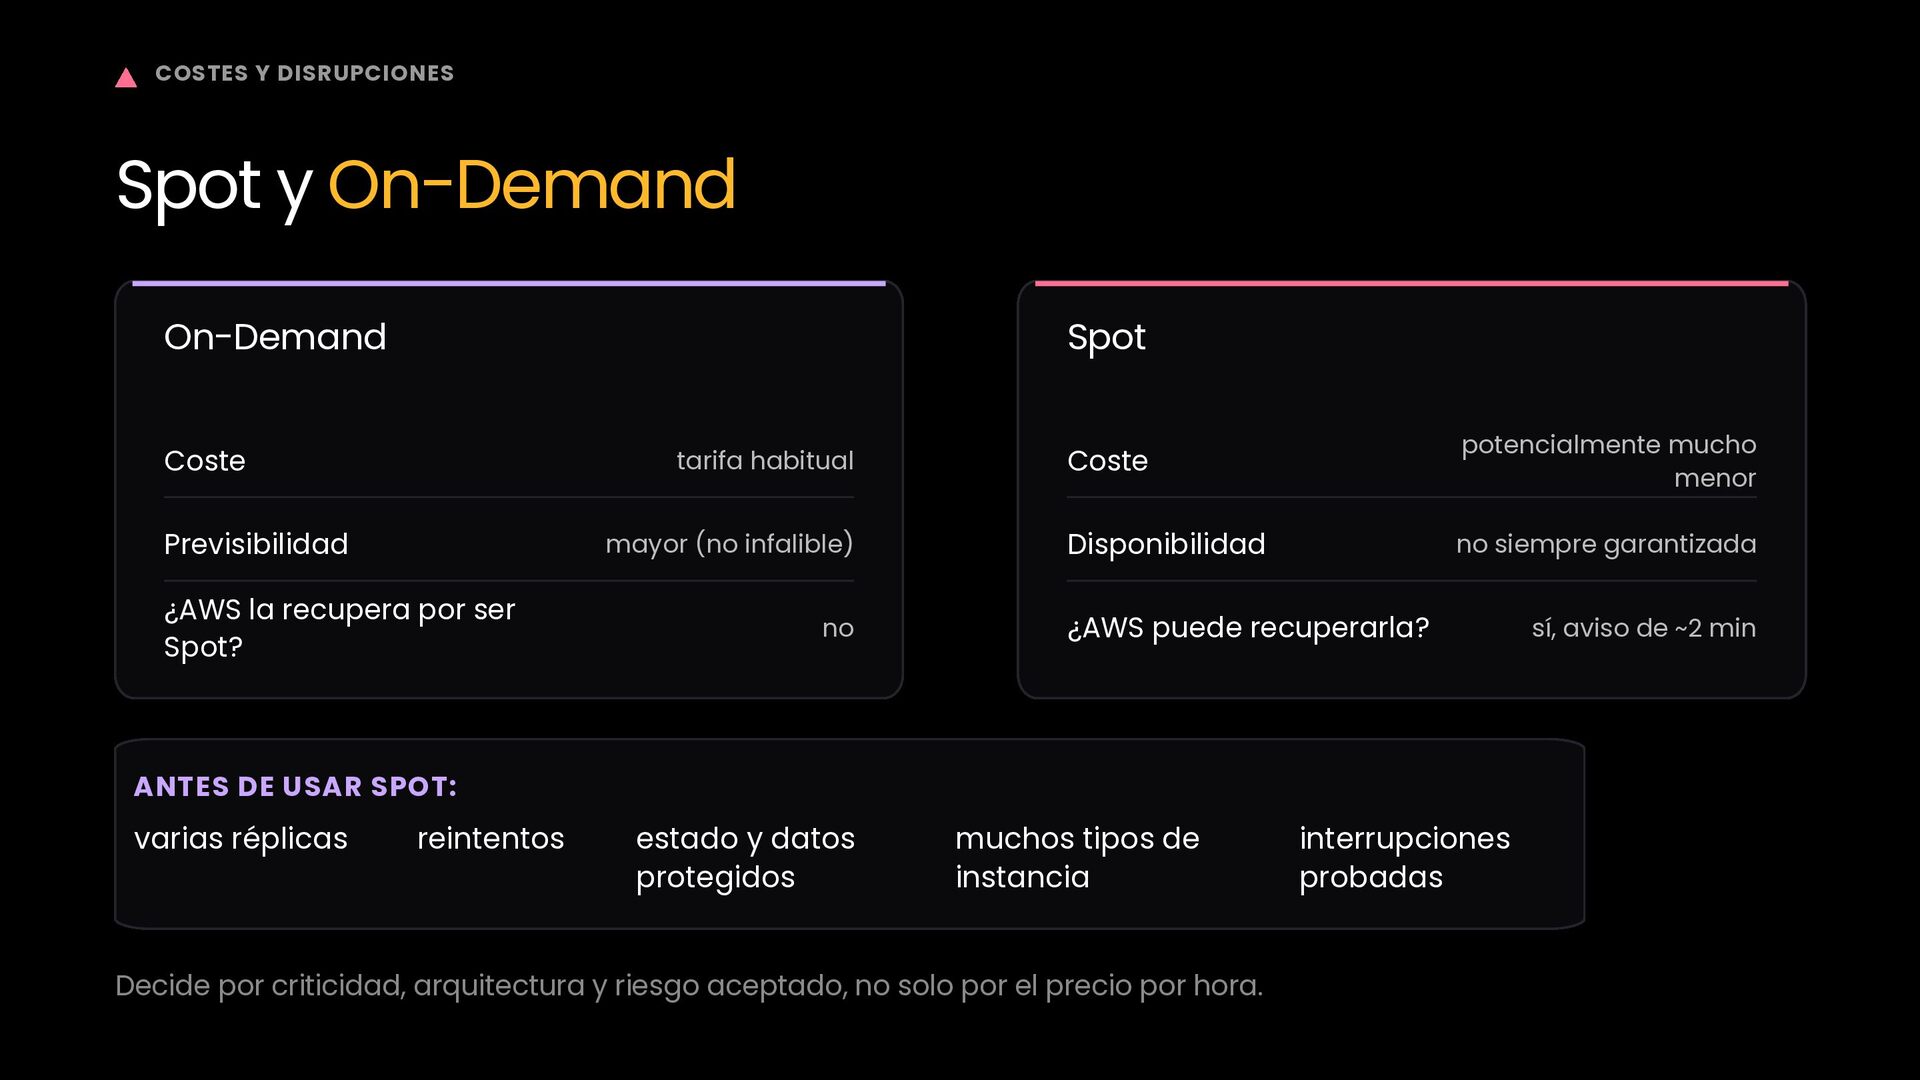
  18. COSTES Y DISRUPCIONES Spot y On-Demand On-Demand Spot Coste tarifa

    habitual Previsibilidad mayor (no infalible) ¿AWS la recupera por ser Spot? no Coste potencialmente mucho menor Disponibilidad no siempre garantizada ¿AWS puede recuperarla? ANTES DE USAR SPOT: varias réplicas reintentos estado y datos protegidos muchos tipos de instancia Decide por criticidad, arquitectura y riesgo aceptado, no solo por el precio por hora. interrupciones probadas sí, aviso de ~2 min
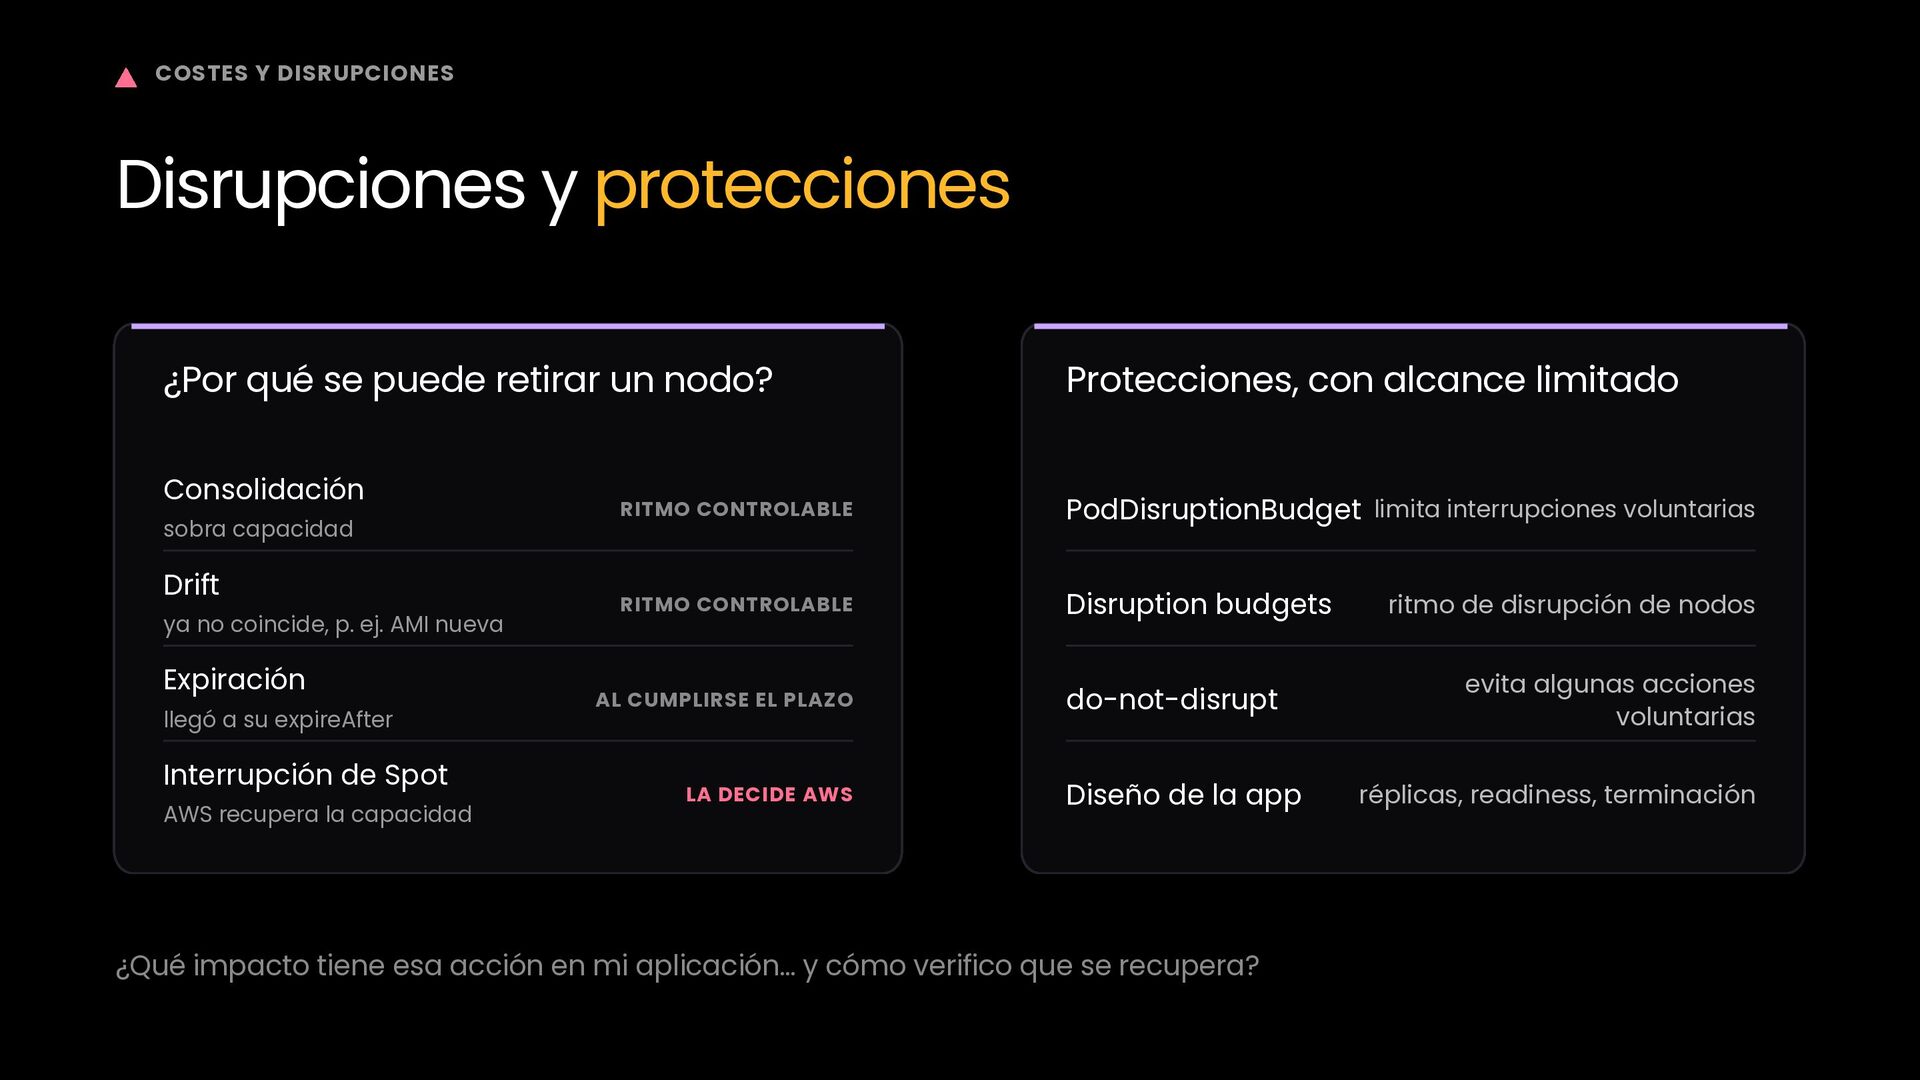
  19. COSTES Y DISRUPCIONES Disrupciones y protecciones ¿Por qué se puede

    retirar un nodo? Consolidación sobra capacidad Drift ya no coincide, p. ej. AMI nueva Expiración llegó a su expireAfter Interrupción de Spot AWS recupera la capacidad Protecciones, con alcance limitado RITMO CONTROLABLE PodDisruptionBudget limita interrupciones voluntarias RITMO CONTROLABLE Disruption budgets AL CUMPLIRSE EL PLAZO LA DECIDE AWS do-not-disrupt Diseño de la app ¿Qué impacto tiene esa acción en mi aplicación… y cómo verifico que se recupera? ritmo de disrupción de nodos evita algunas acciones voluntarias réplicas, readiness, terminación
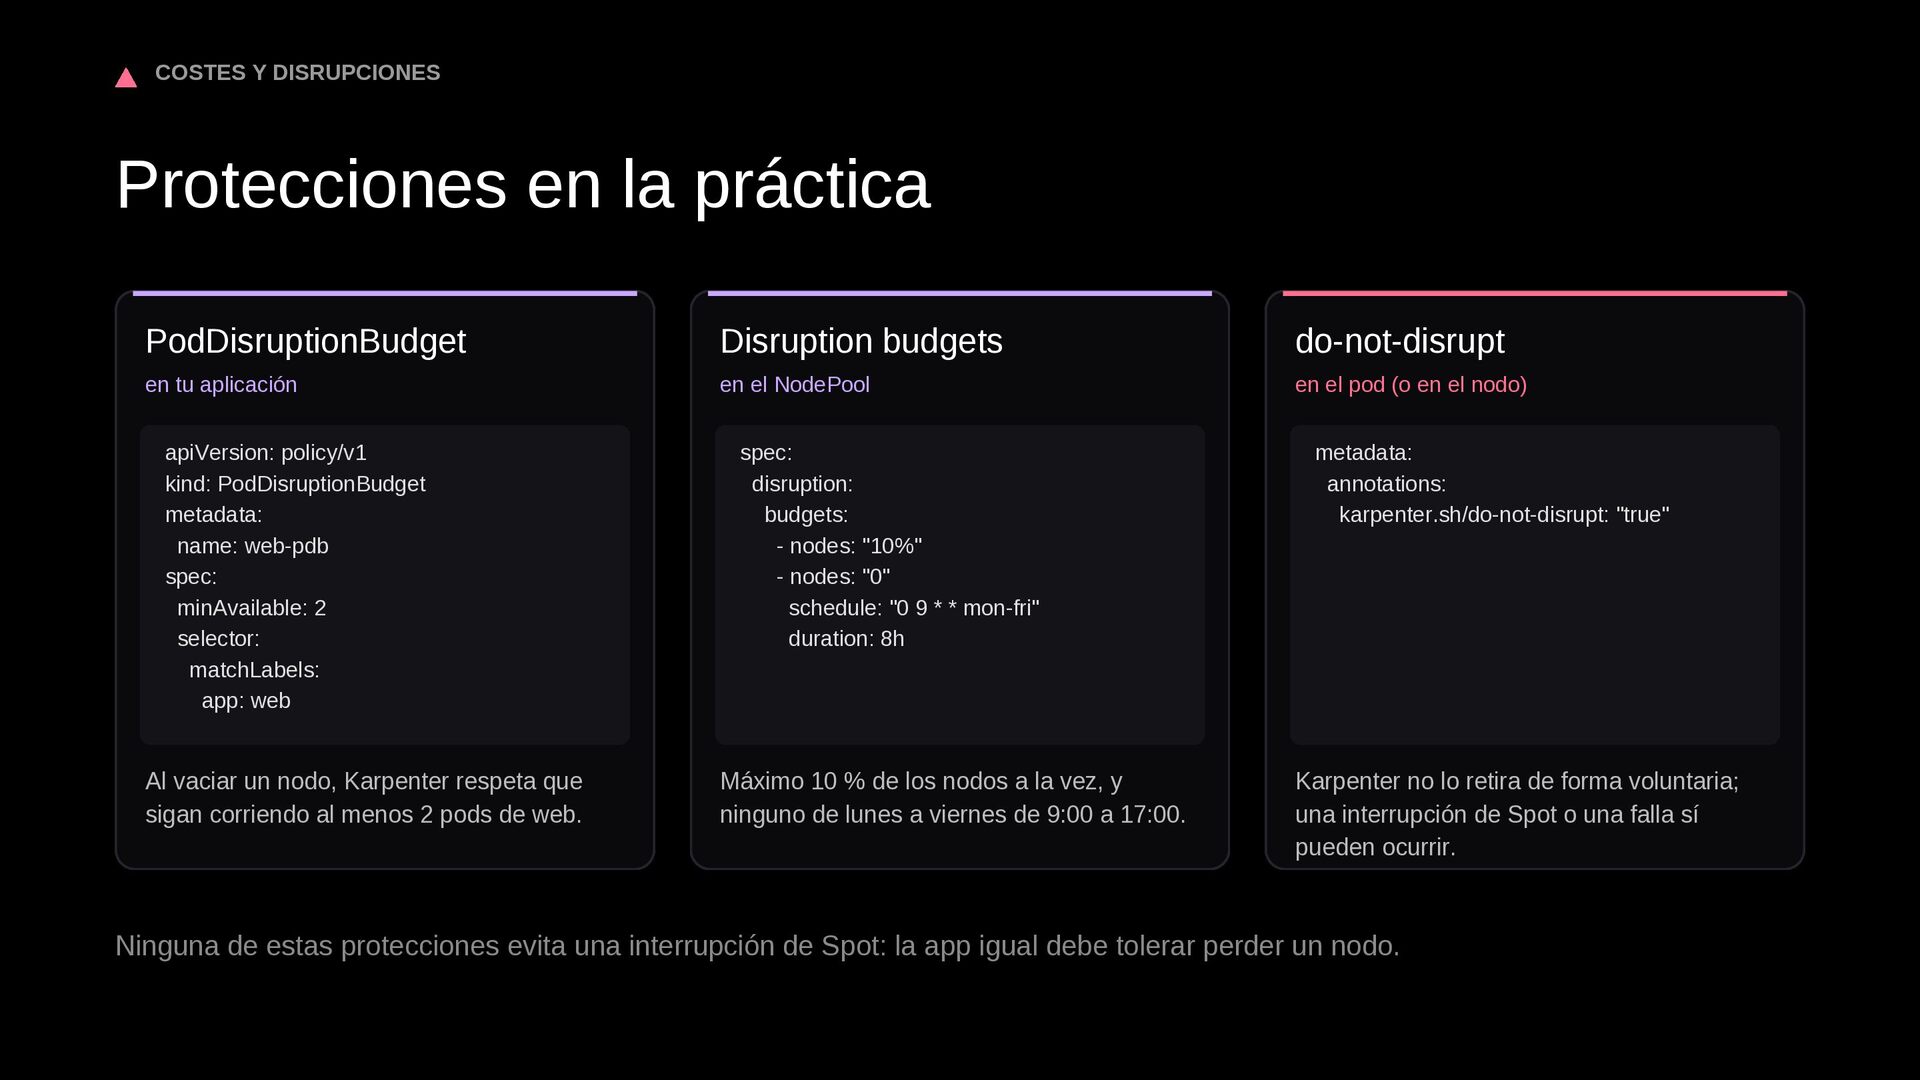
  20. COSTES Y DISRUPCIONES Protecciones en la práctica PodDisruptionBudget Disruption budgets

    do-not-disrupt en tu aplicación en el NodePool en el pod (o en el nodo) apiVersion: policy/v1 kind: PodDisruptionBudget metadata: name: web-pdb spec: minAvailable: 2 selector: matchLabels: app: web Al vaciar un nodo, Karpenter respeta que sigan corriendo al menos 2 pods de web. spec: disruption: budgets: - nodes: "10%" - nodes: "0" schedule: "0 9 * * mon-fri" duration: 8h Máximo 10 % de los nodos a la vez, y ninguno de lunes a viernes de 9:00 a 17:00. metadata: annotations: karpenter.sh/do-not-disrupt: "true" Karpenter no lo retira de forma voluntaria; una interrupción de Spot o una falla sí pueden ocurrir. Ninguna de estas protecciones evita una interrupción de Spot: la app igual debe tolerar perder un nodo.
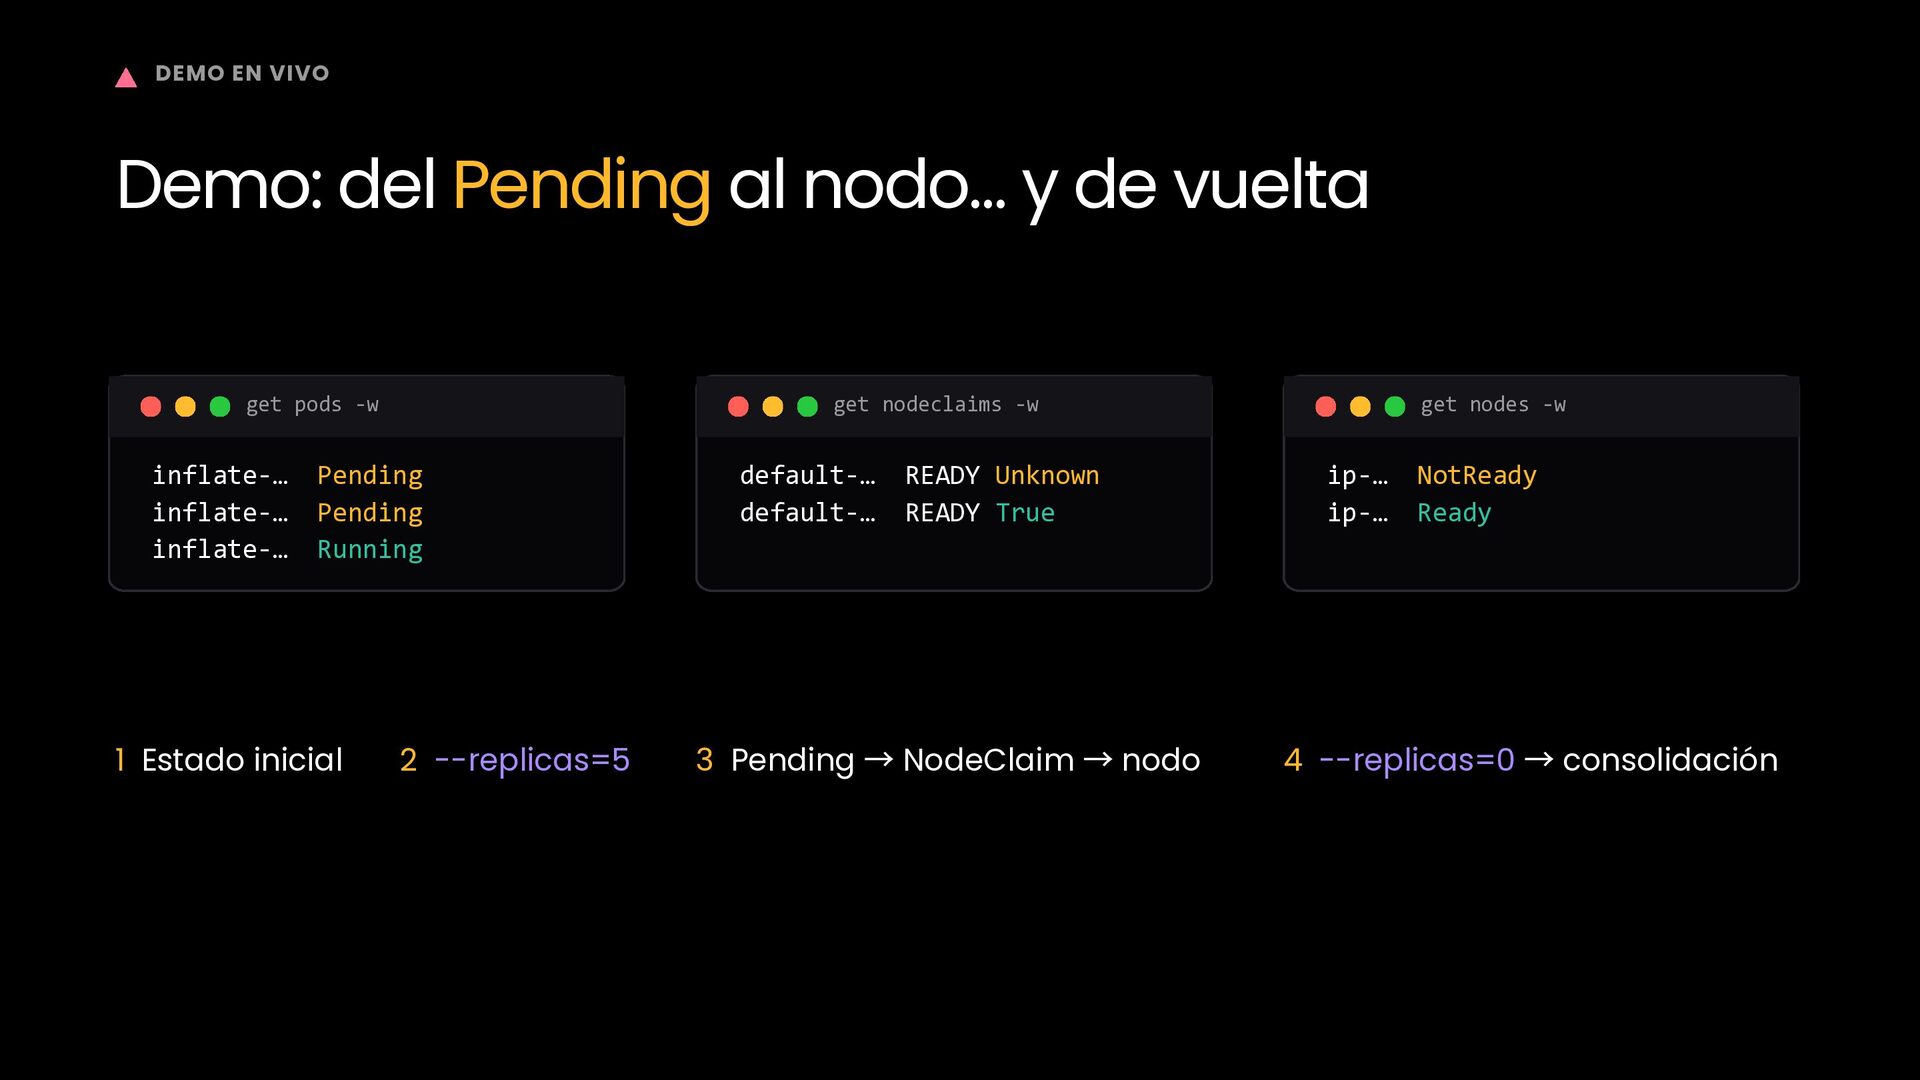
  21. DEMO EN VIVO Demo: del Pending al nodo… y de

    vuelta get pods -w inflate-… inflate-… inflate-… get nodeclaims -w Pending Pending Running 1 Estado inicial 2 --replicas=5 default-… default-… 3 Pending READY Unknown READY True → NodeClaim → nodo get nodes -w ip-… ip-… NotReady Ready 4 --replicas=0 → consolidación
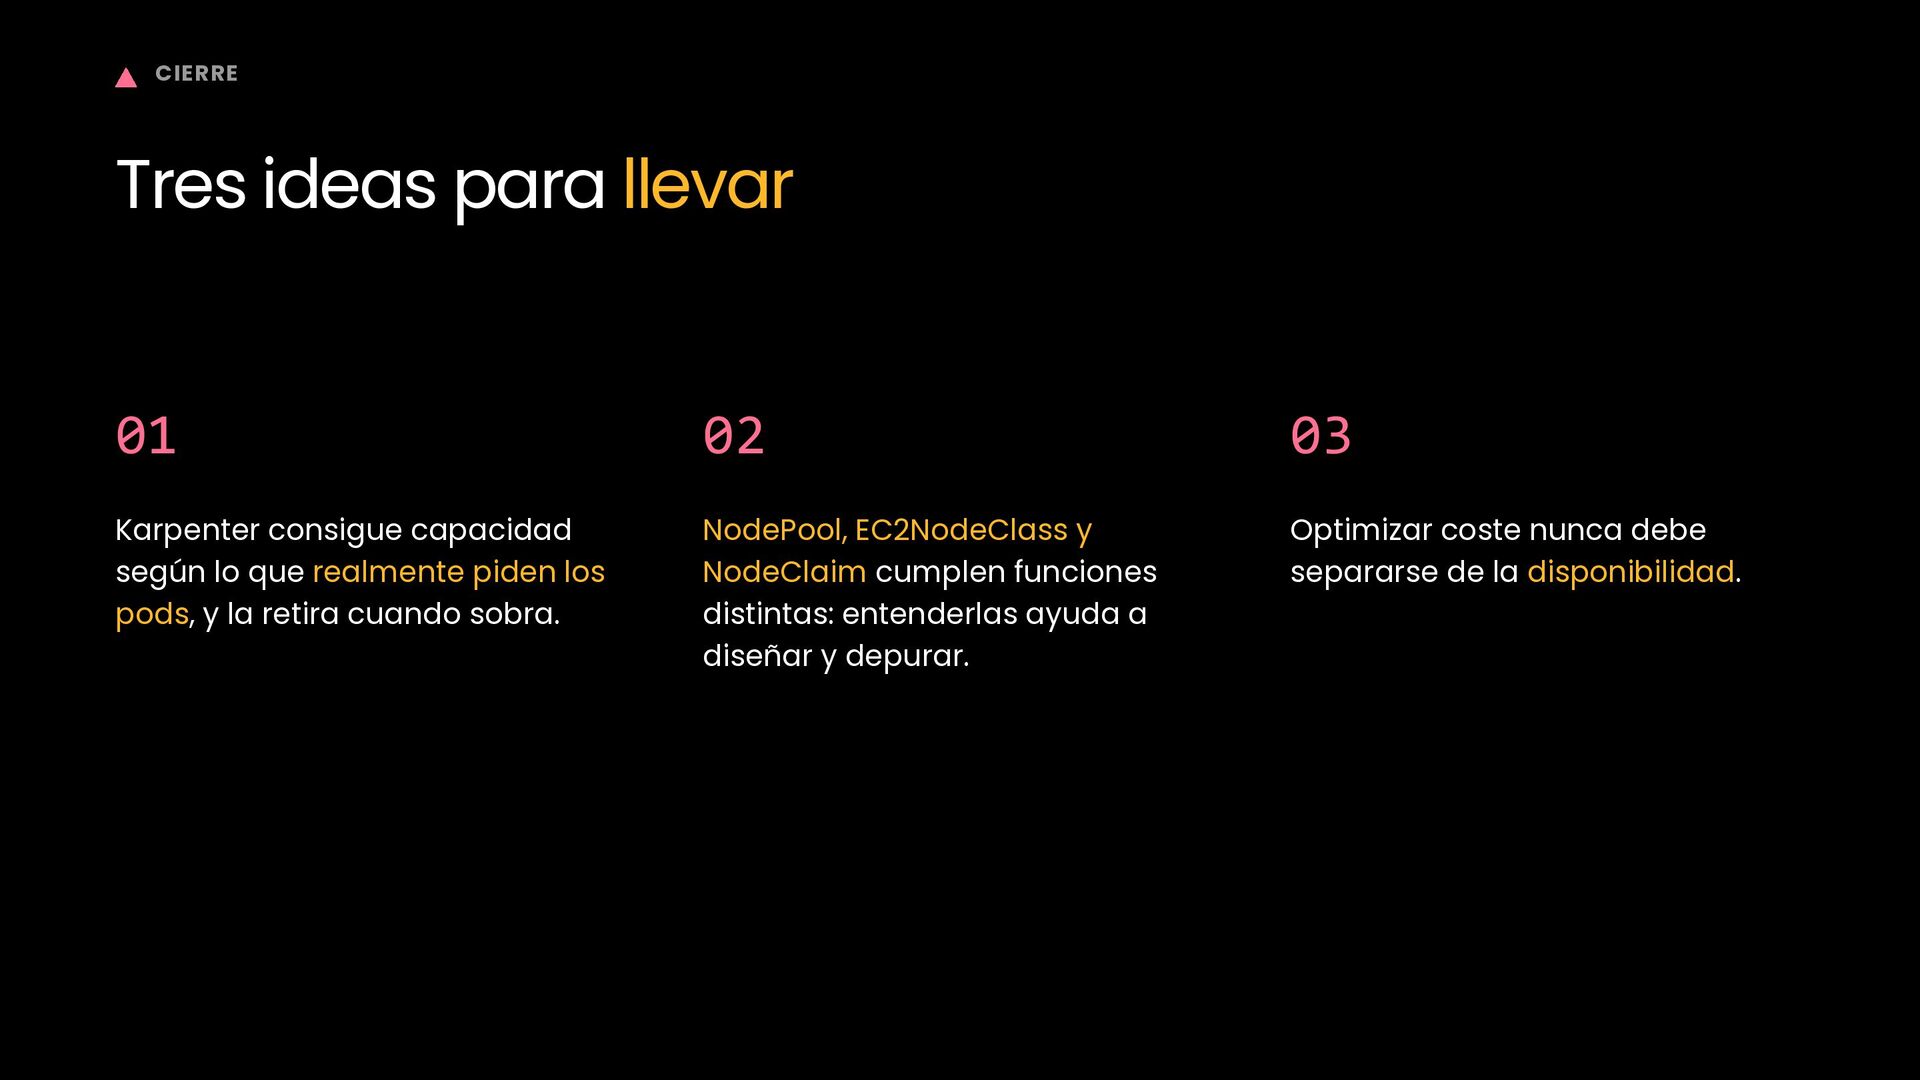
  22. CIERRE Tres ideas para llevar 01 02 03 Karpenter consigue

    capacidad según lo que realmente piden los pods, y la retira cuando sobra. NodePool, EC2NodeClass y NodeClaim cumplen funciones distintas: entenderlas ayuda a diseñar y depurar. Optimizar coste nunca debe separarse de la disponibilidad.
  23. CIERRE ¿Cuándo vale la pena? 01 02 03 Las cargas

    cambian bastante Necesitas muchas opciones de instancia Mantener grupos se volvió difícil Úsalo porque resuelve un problema real que puedes demostrar con métricas, no porque sea nuevo.
  24. REFERENCIAS Referencias oficiales Documentación oficial de Karpenter karpenter.sh/docs Concepto de

    NodePools karpenter.sh/docs/concepts/nodepools Disruption y consolidación karpenter.sh/docs/concepts/disruption Cómo elige el tipo de instancia (FAQ) karpenter.sh/docs/faq Getting started con Karpenter karpenter.sh/docs/getting-started/getting-started-with-karpenter Avisos de interrupción de Spot en EC2 docs.aws.amazon.com/AWSEC2/latest/UserGuide/spot-instance-termination-notices.html Historia del proyecto y v1.0 cncf.io/blog/2024/11/06/karpenter-v1-0-0-beta