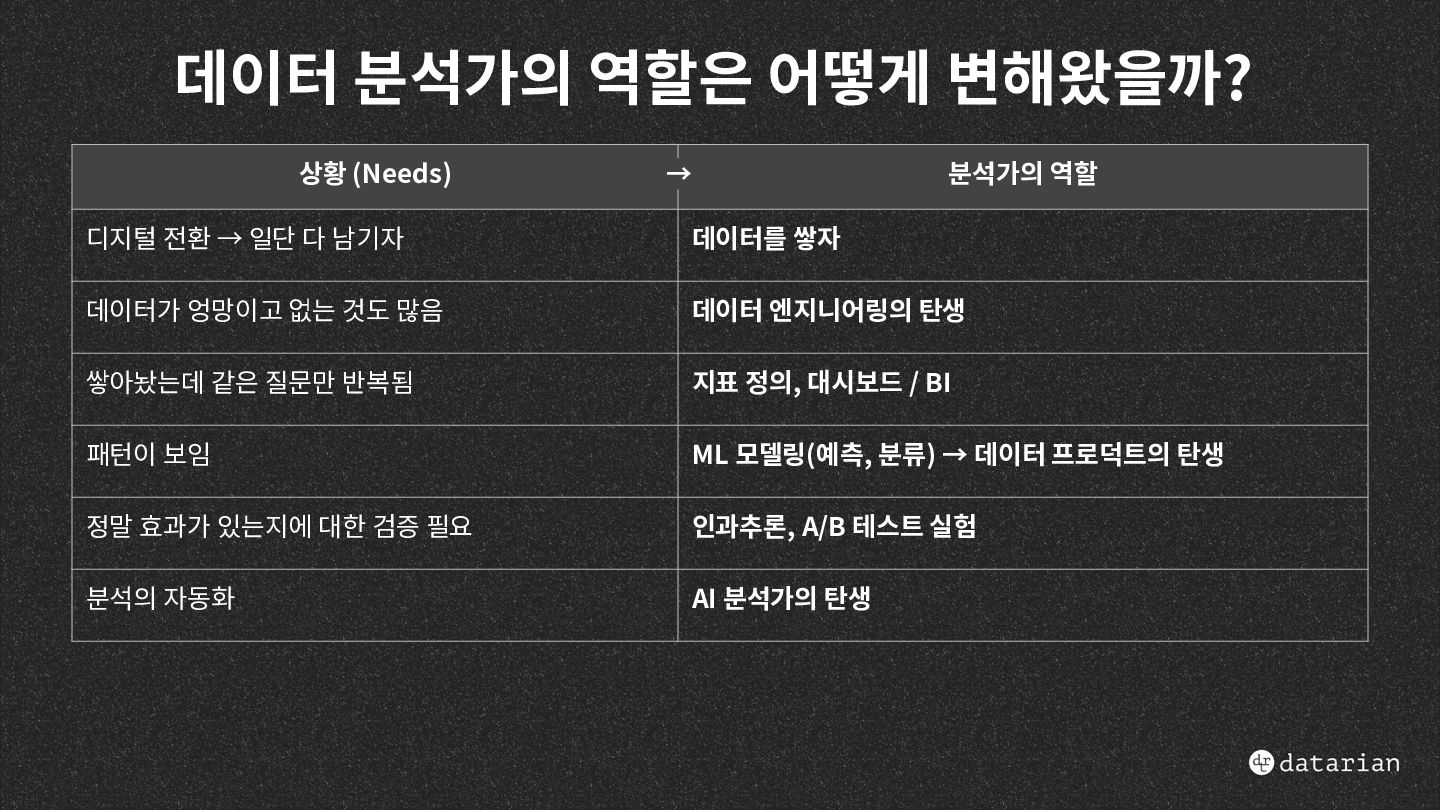
디지털 전환 → 일단 다 남기자 데이터를 쌓자 데이터가 엉망이고 없는 것도 많음 데이터 엔지니어링의 탄생 쌓아놨는데 같은 질문만 반복됨 지표 정의, 대시보드 / BI 패턴이 보임 ML 모델링(예측, 분류) → 데이터 프로덕트의 탄생 정말 효과가 있는지에 대한 검증 필요 인과추론, A/B 테스트 실험 분석의 자동화 AI 분석가의 탄생
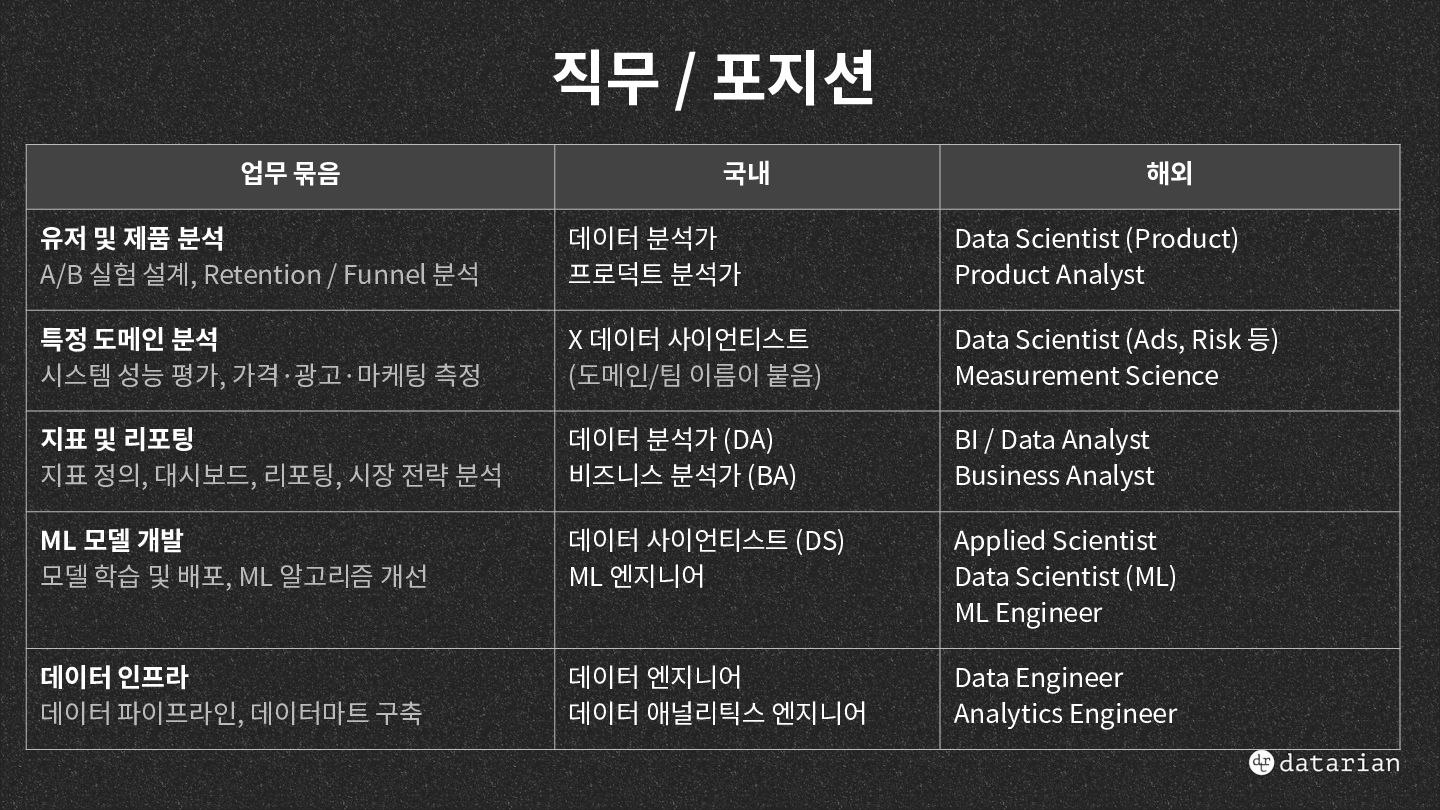
분석 A/B 실험 설계, Retention / Funnel 분석 데이터 분석가 프로덕트 분석가 Data Scientist (Product) Product Analyst 특정 도메인 분석 시스템 성능 평가, 가격·광고·마케팅 측정 X 데이터 사이언티스트 (도메인/팀 이름이 붙음) Data Scientist (Ads, Risk 등) Measurement Science 지표 및 리포팅 지표 정의, 대시보드, 리포팅, 시장 전략 분석 데이터 분석가 (DA) 비즈니스 분석가 (BA) BI / Data Analyst Business Analyst ML 모델 개발 모델 학습 및 배포, ML 알고리즘 개선 데이터 사이언티스트 (DS) ML 엔지니어 Applied Scientist Data Scientist (ML) ML Engineer 데이터 인프라 데이터 파이프라인, 데이터마트 구축 데이터 엔지니어 데이터 애널리틱스 엔지니어 Data Engineer Analytics Engineer
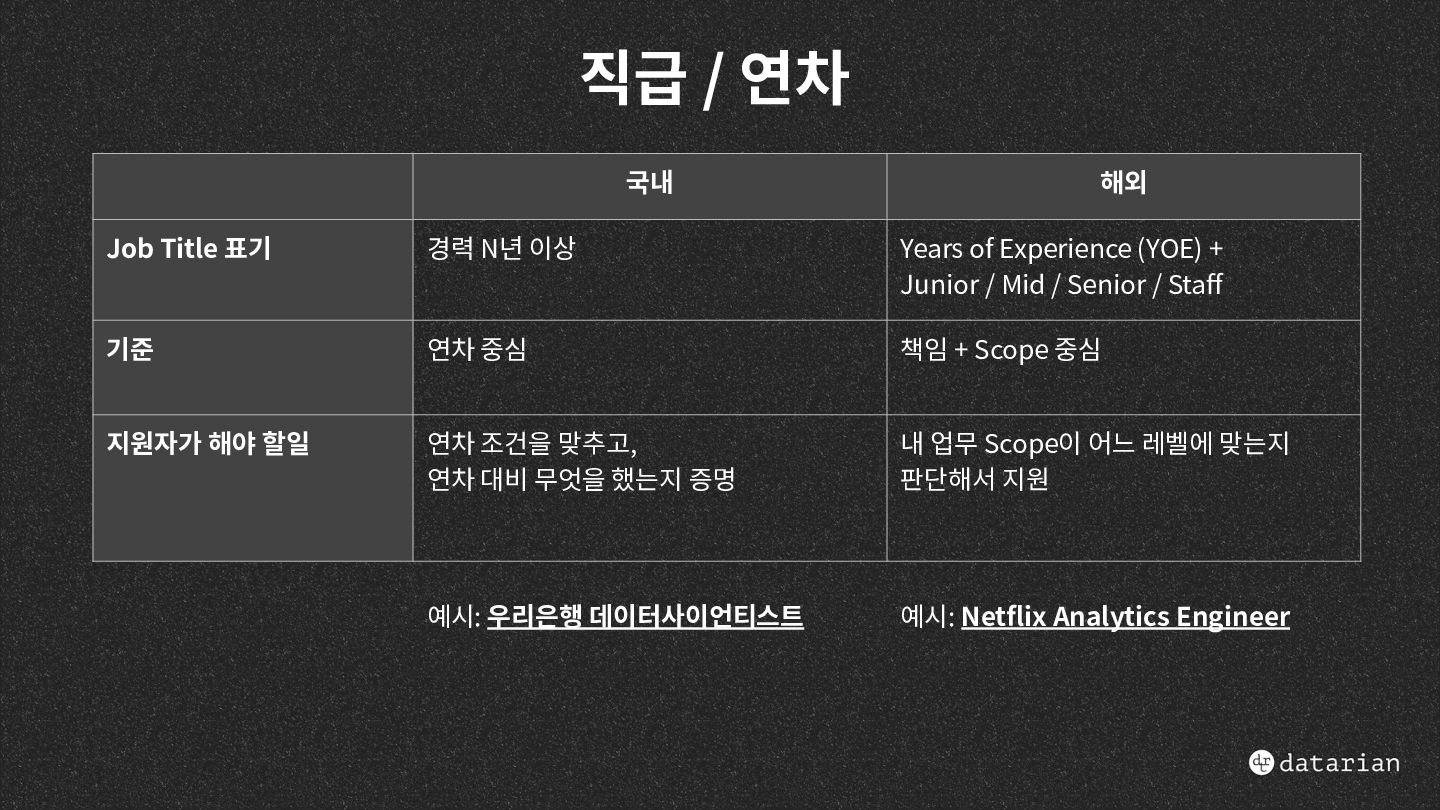
이상 Years of Experience (YOE) + Junior / Mid / Senior / Staff 기준 연차 중심 책임 + Scope 중심 지원자가 해야 할일 연차 조건을 맞추고, 연차 대비 무엇을 했는지 증명 내 업무 Scope이 어느 레벨에 맞는지 판단해서 지원 예시: 우리은행 데이터사이언티스트 예시: Netflix Analytics Engineer
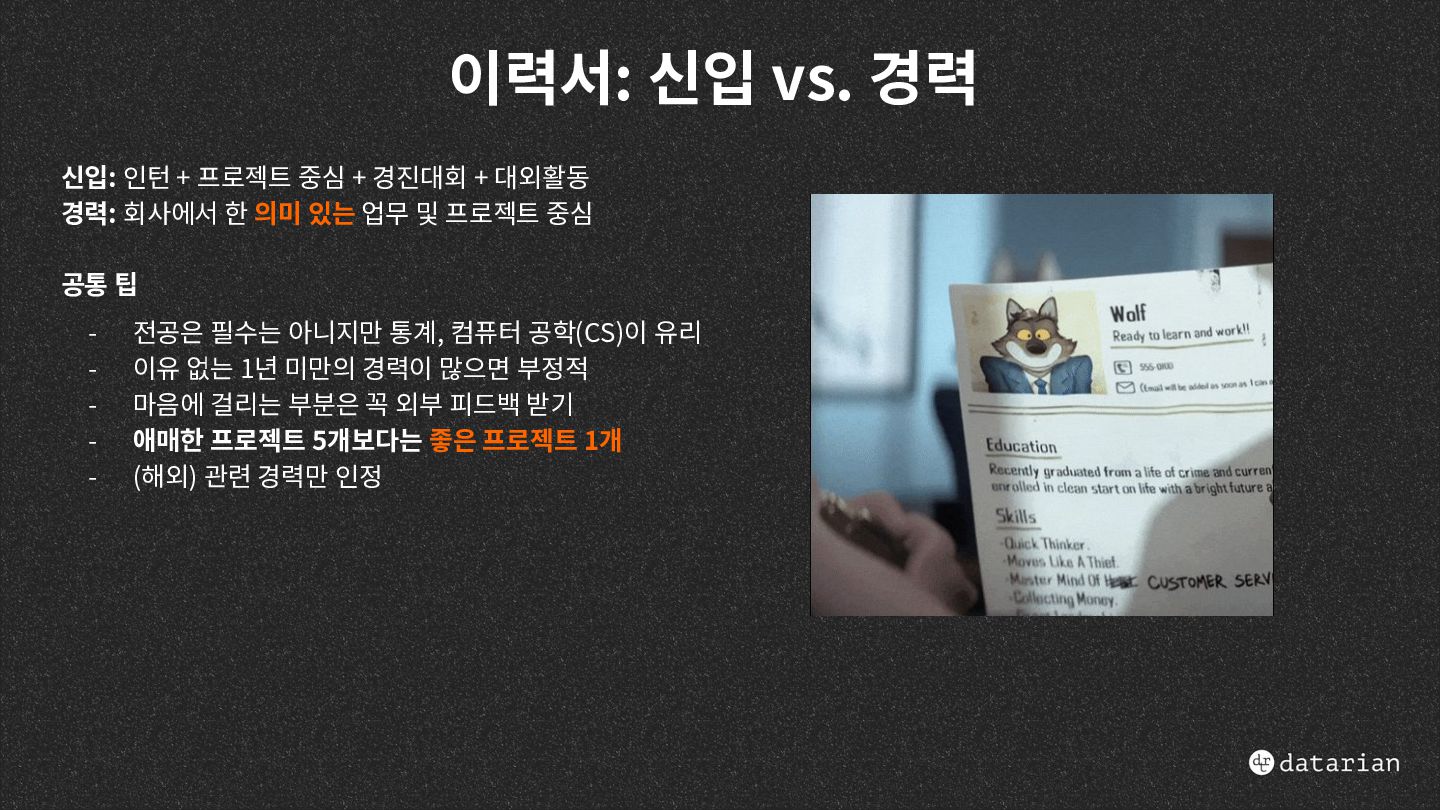
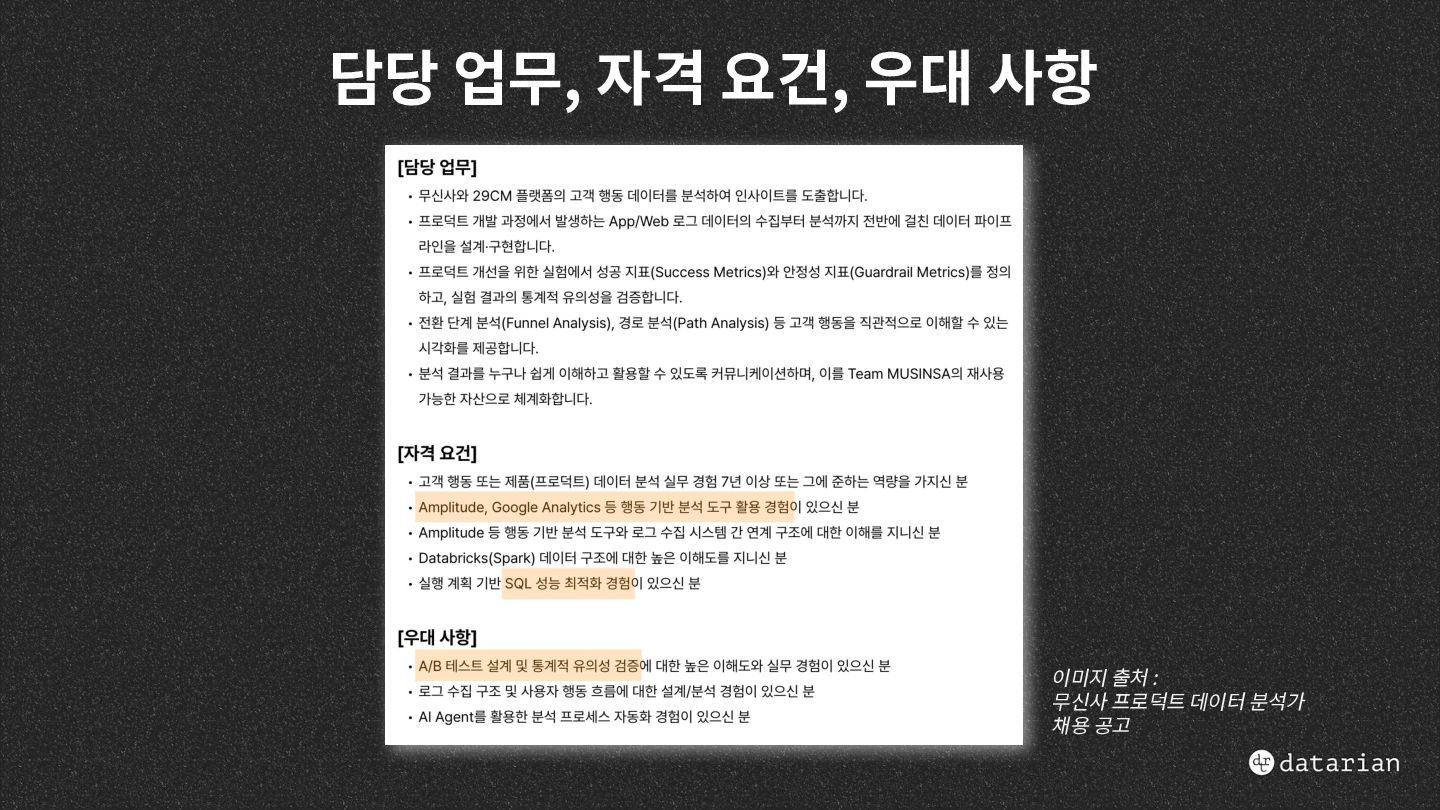
경진대회 + 대외활동 경력: 회사에서 한 의미 있는 업무 및 프로젝트 중심 공통 팁 - 전공은 필수는 아니지만 통계, 컴퓨터 공학(CS)이 유리 이유 없는 1년 미만의 경력이 많으면 부정적 마음에 걸리는 부분은 꼭 외부 피드백 받기 애매한 프로젝트 5개보다는 좋은 프로젝트 1개 (해외) 관련 경력만 인정
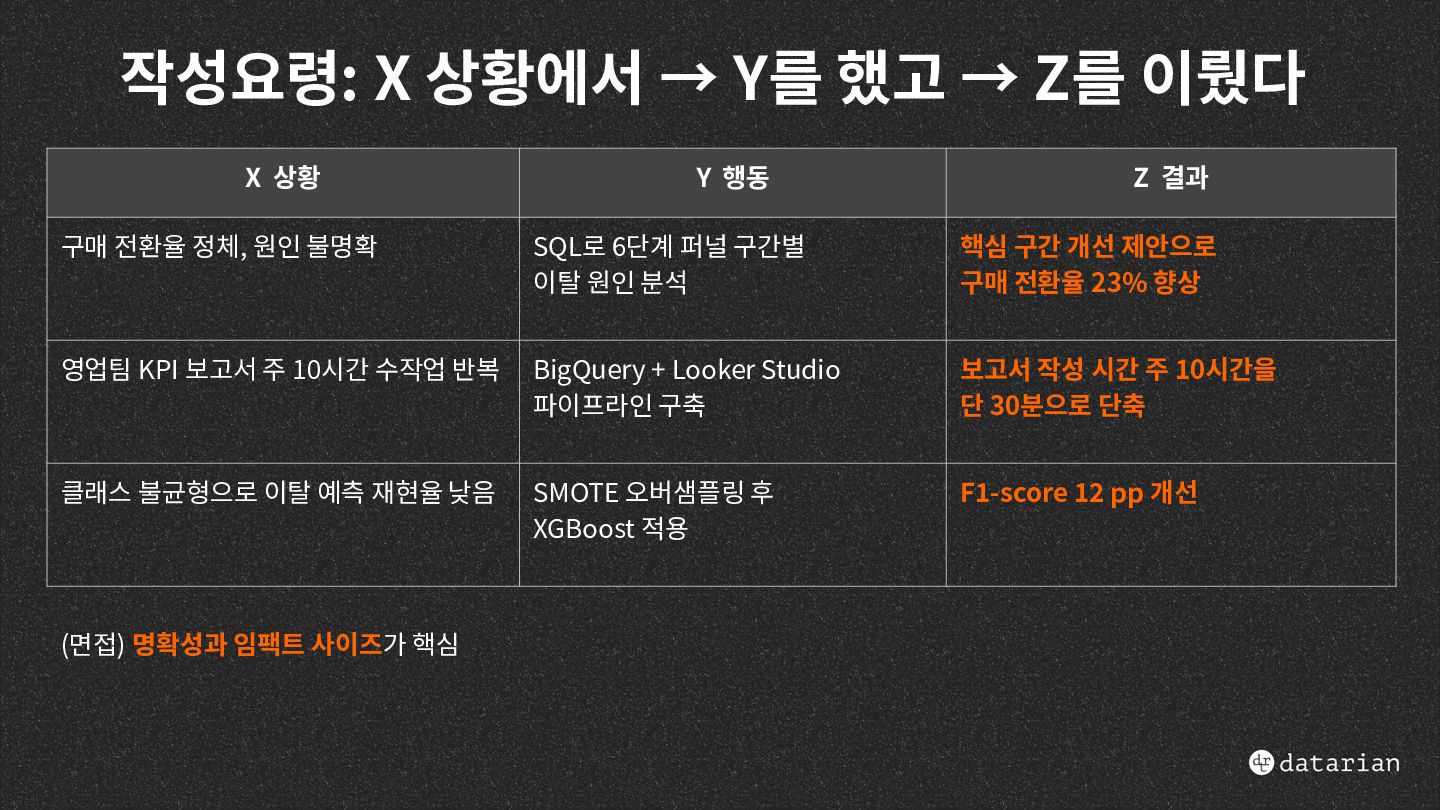
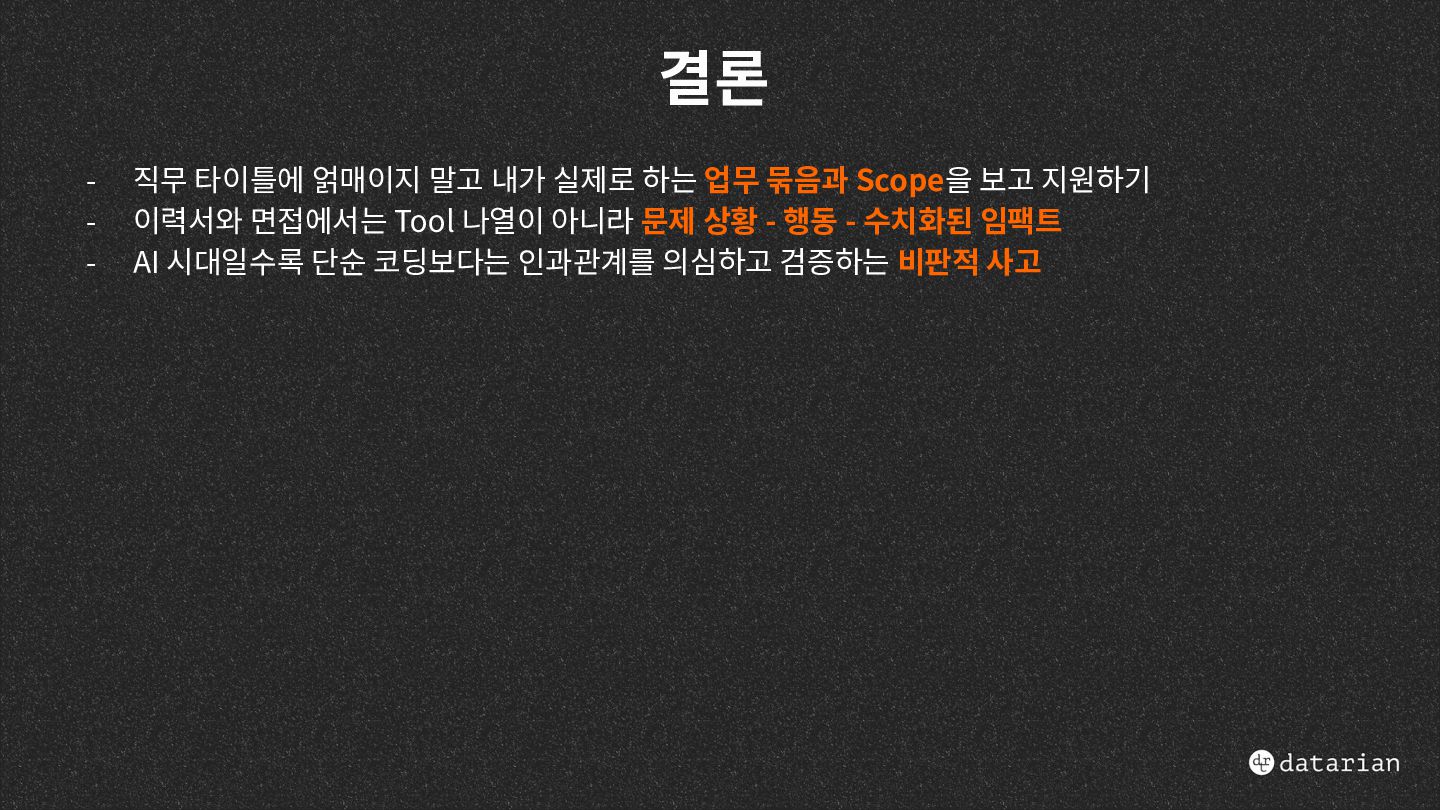
상황 Y 행동 Z 결과 구매 전환율 정체, 원인 불명확 SQL로 6단계 퍼널 구간별 이탈 원인 분석 핵심 구간 개선 제안으로 구매 전환율 23% 향상 영업팀 KPI 보고서 주 10시간 수작업 반복 BigQuery + Looker Studio 파이프라인 구축 보고서 작성 시간 주 10시간을 단 30분으로 단축 클래스 불균형으로 이탈 예측 재현율 낮음 SMOTE 오버샘플링 후 XGBoost 적용 F1-score 12 pp 개선 (면접) 명확성과 임팩트 사이즈가 핵심
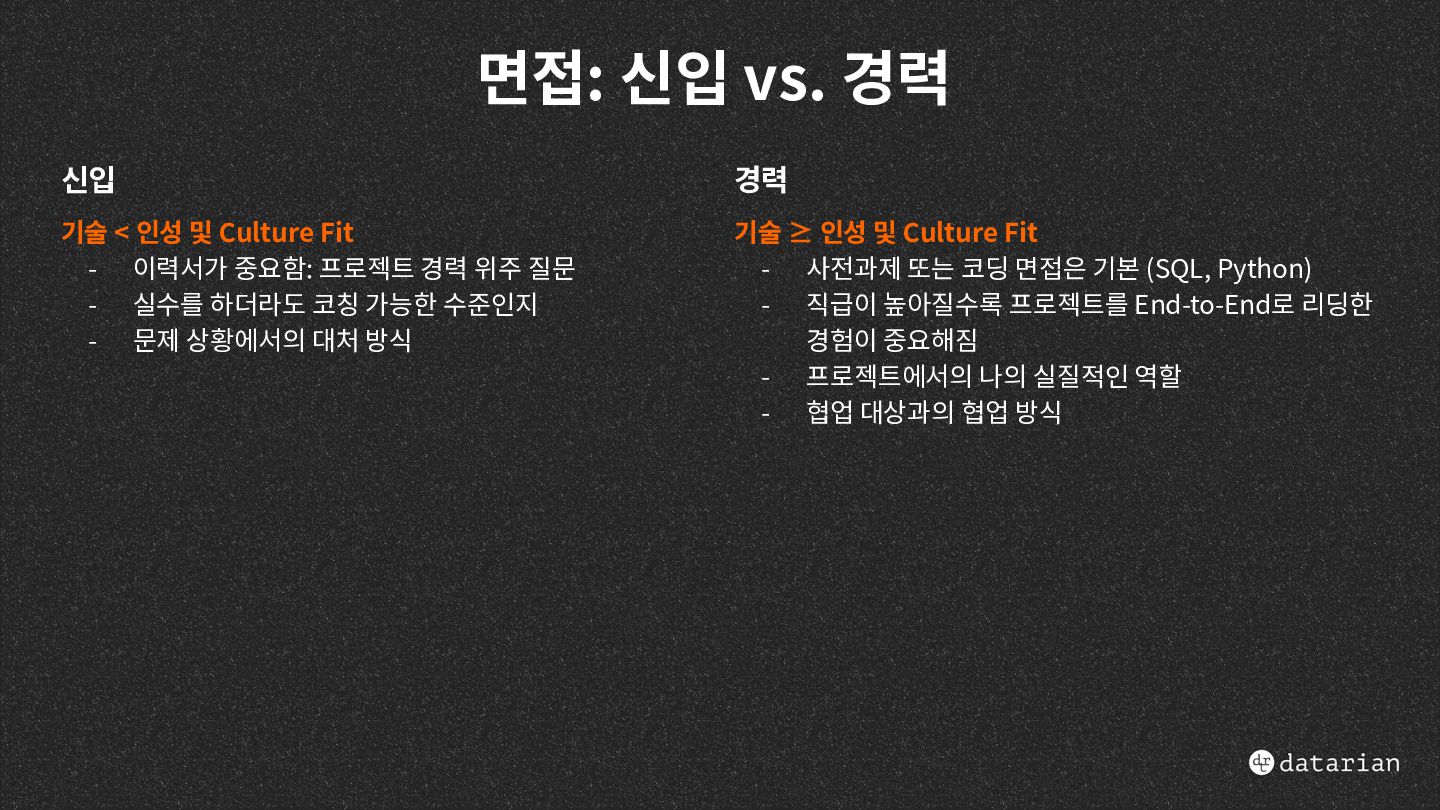
Culture Fit - 이력서가 중요함: 프로젝트 경력 위주 질문 - 실수를 하더라도 코칭 가능한 수준인지 - 문제 상황에서의 대처 방식 기술 ≥ 인성 및 Culture Fit - 사전과제 또는 코딩 면접은 기본 (SQL, Python) - 직급이 높아질수록 프로젝트를 End-to-End로 리딩한 경험이 중요해짐 - 프로젝트에서의 나의 실질적인 역할 - 협업 대상과의 협업 방식
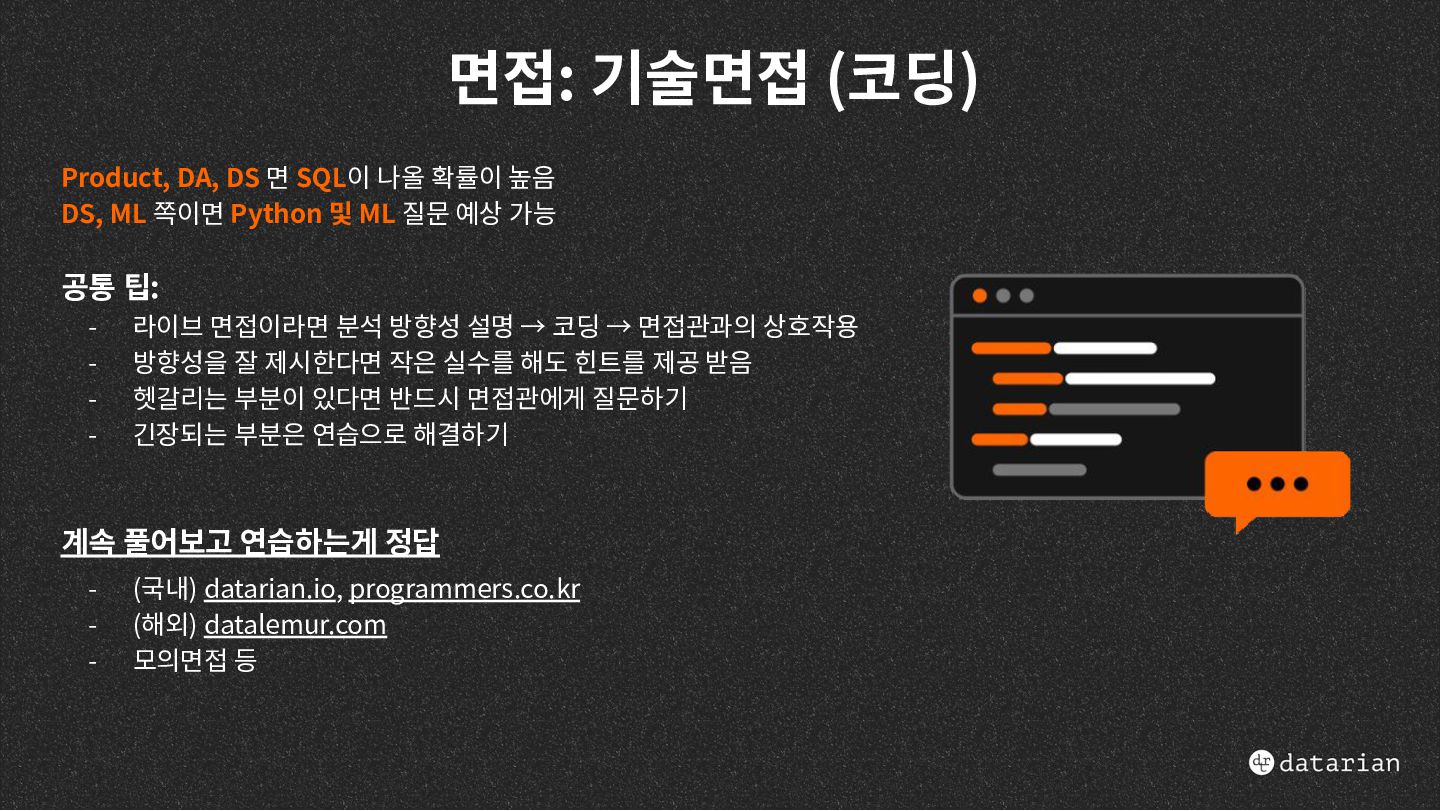
높음 DS, ML 쪽이면 Python 및 ML 질문 예상 가능 공통 팁: - 라이브 면접이라면 분석 방향성 설명 → 코딩 → 면접관과의 상호작용 방향성을 잘 제시한다면 작은 실수를 해도 힌트를 제공 받음 헷갈리는 부분이 있다면 반드시 면접관에게 질문하기 긴장되는 부분은 연습으로 해결하기 계속 풀어보고 연습하는게 정답 - (국내) datarian.io, programmers.co.kr (해외) datalemur.com 모의면접 등
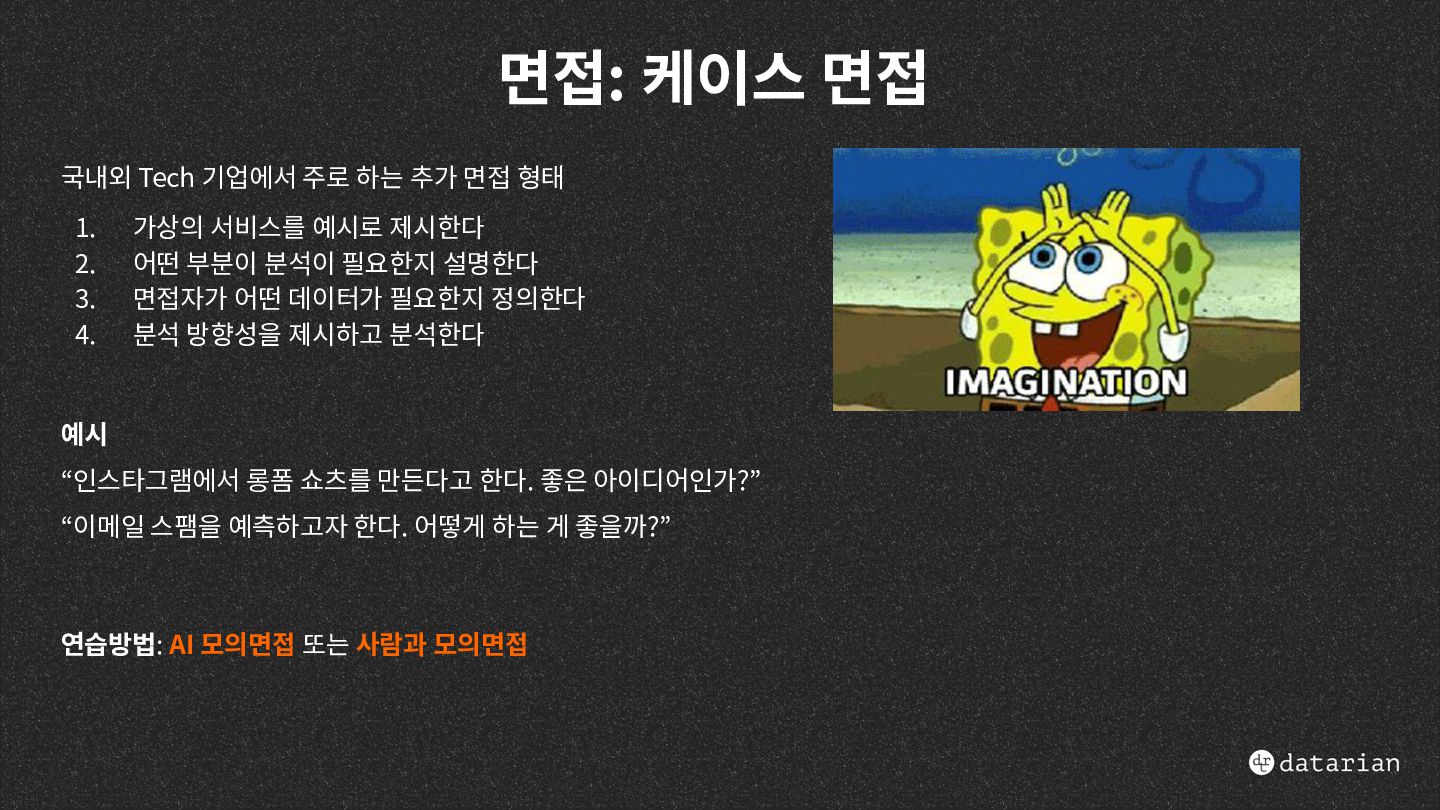
형태 1. 2. 3. 4. 가상의 서비스를 예시로 제시한다 어떤 부분이 분석이 필요한지 설명한다 면접자가 어떤 데이터가 필요한지 정의한다 분석 방향성을 제시하고 분석한다 예시 “인스타그램에서 롱폼 쇼츠를 만든다고 한다. 좋은 아이디어인가?” “이메일 스팸을 예측하고자 한다. 어떻게 하는 게 좋을까?” 연습방법: AI 모의면접 또는 사람과 모의면접
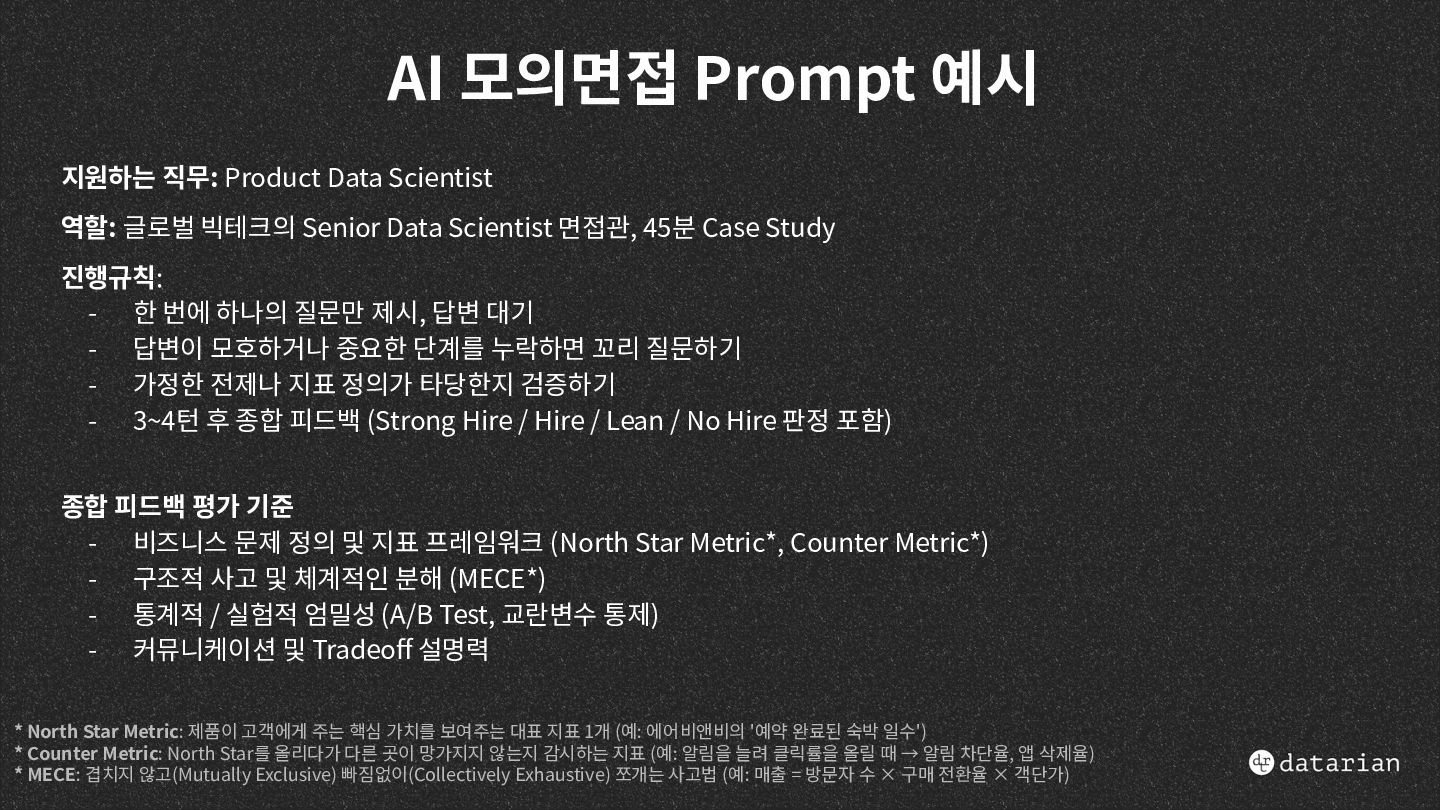
글로벌 빅테크의 Senior Data Scientist 면접관, 45분 Case Study 진행규칙: - 한 번에 하나의 질문만 제시, 답변 대기 - 답변이 모호하거나 중요한 단계를 누락하면 꼬리 질문하기 - 가정한 전제나 지표 정의가 타당한지 검증하기 - 3~4턴 후 종합 피드백 (Strong Hire / Hire / Lean / No Hire 판정 포함) 종합 피드백 평가 기준 - 비즈니스 문제 정의 및 지표 프레임워크 (North Star Metric*, Counter Metric*) - 구조적 사고 및 체계적인 분해 (MECE*) - 통계적 / 실험적 엄밀성 (A/B Test, 교란변수 통제) - 커뮤니케이션 및 Tradeoff 설명력 * North Star Metric: 제품이 고객에게 주는 핵심 가치를 보여주는 대표 지표 1개 (예: 에어비앤비의 '예약 완료된 숙박 일수') * Counter Metric: North Star를 올리다가 다른 곳이 망가지지 않는지 감시하는 지표 (예: 알림을 늘려 클릭률을 올릴 때 → 알림 차단율, 앱 삭제율) * MECE: 겹치지 않고(Mutually Exclusive) 빠짐없이(Collectively Exhaustive) 쪼개는 사고법 (예: 매출 = 방문자 수 × 구매 전환율 × 객단가)
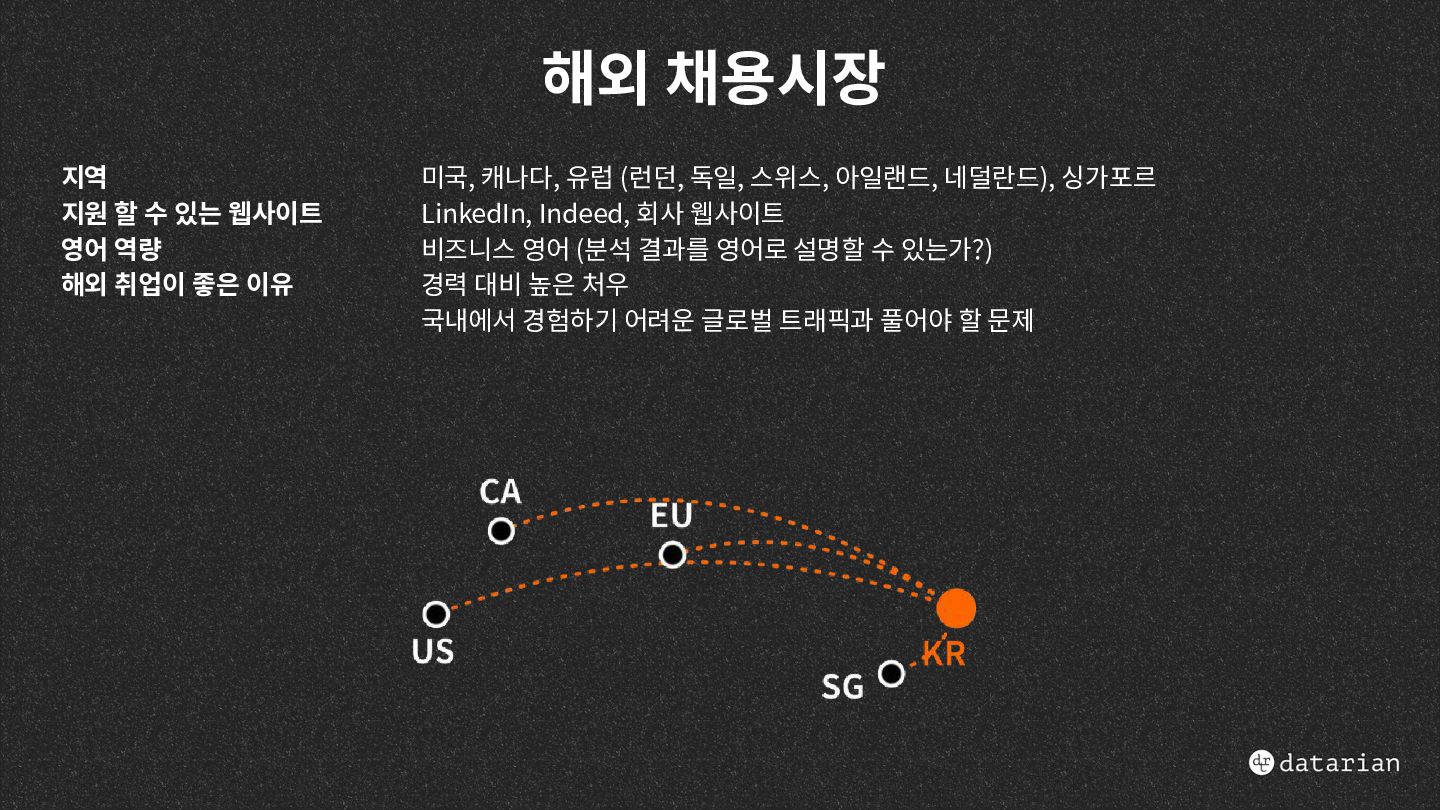
해외 취업이 좋은 이유 미국, 캐나다, 유럽 (런던, 독일, 스위스, 아일랜드, 네덜란드), 싱가포르 LinkedIn, Indeed, 회사 웹사이트 비즈니스 영어 (분석 결과를 영어로 설명할 수 있는가?) 경력 대비 높은 처우 국내에서 경험하기 어려운 글로벌 트래픽과 풀어야 할 문제
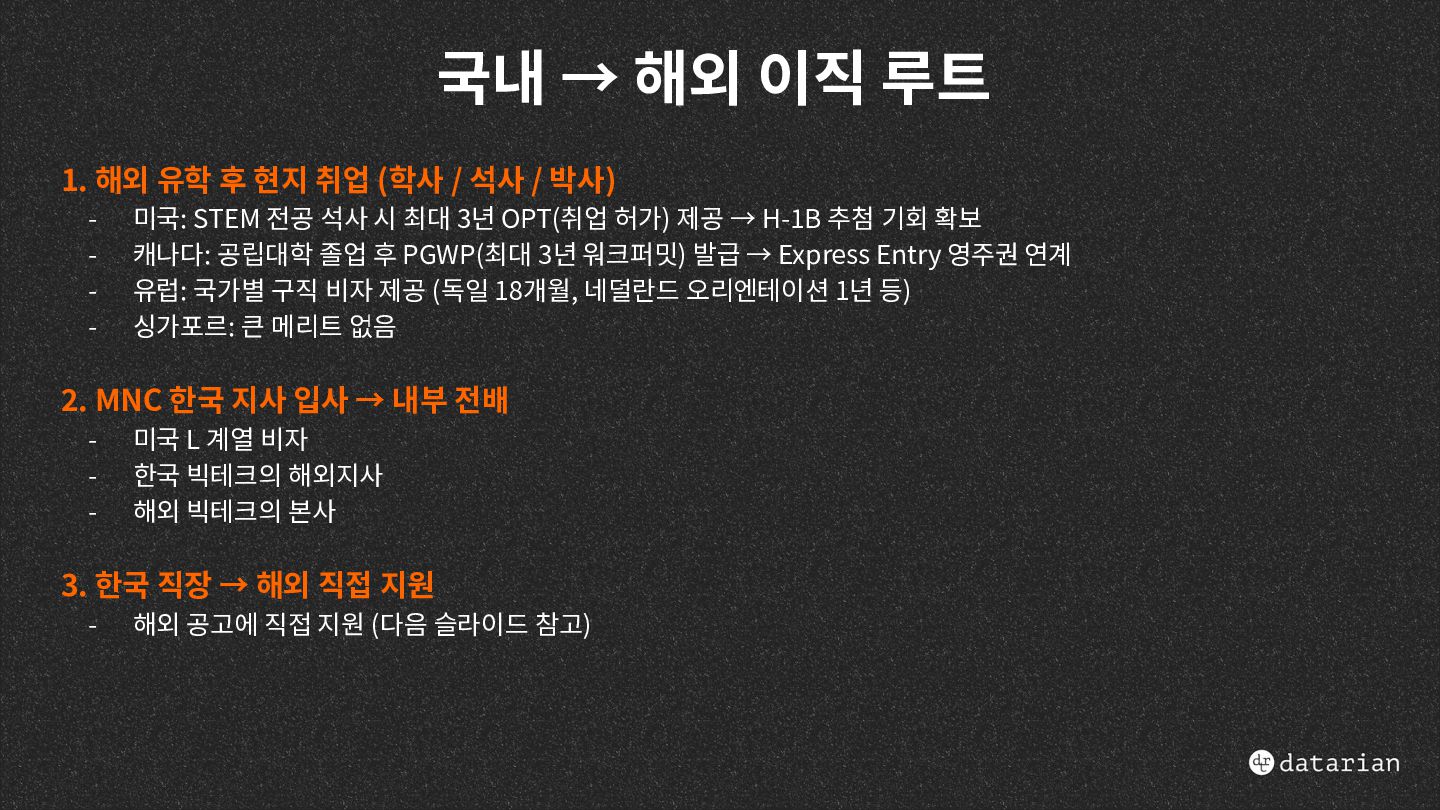
취업 (학사 / 석사 / 박사) - 미국: STEM 전공 석사 시 최대 3년 OPT(취업 허가) 제공 → H-1B 추첨 기회 확보 캐나다: 공립대학 졸업 후 PGWP(최대 3년 워크퍼밋) 발급 → Express Entry 영주권 연계 유럽: 국가별 구직 비자 제공 (독일 18개월, 네덜란드 오리엔테이션 1년 등) 싱가포르: 큰 메리트 없음 2. MNC 한국 지사 입사 → 내부 전배 - 미국 L 계열 비자 한국 빅테크의 해외지사 해외 빅테크의 본사 3. 한국 직장 → 해외 직접 지원 - 해외 공고에 직접 지원 (다음 슬라이드 참고)
안되면 글로벌 채용으로 진행 링크드인 활용 시 좋은 기회가 많이 들어옴 (영문 프로필 필수) 직무 Fit이 가장 중요함 (나의 이력 = 포지션) AI 또는 사람과 모의면접으로 면접 준비 개인적인 경험 - 임팩트가 큰 프로젝트(쿠팡 와우회비 인상)에 참여 유료 모의면접 5회, 해외 테크 면접 형식 학습 링크드인으로 런던, 독일, 캐나다 Product DS 10곳 지원 규모가 크고 책임질 일이 많아 면접에서 할 얘기가 많았음 오퍼 3개 비교 후 협상 (→ Uber 선택)
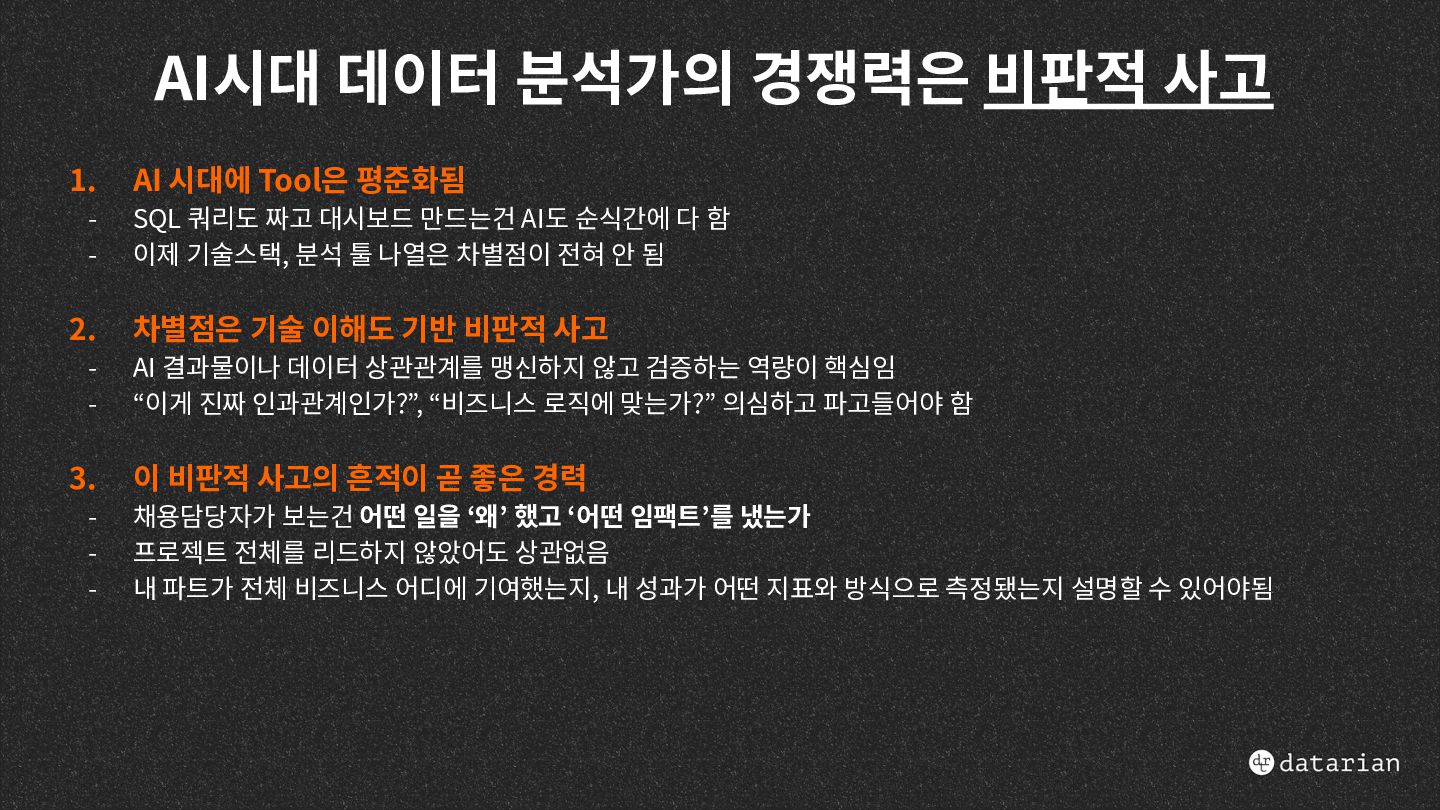
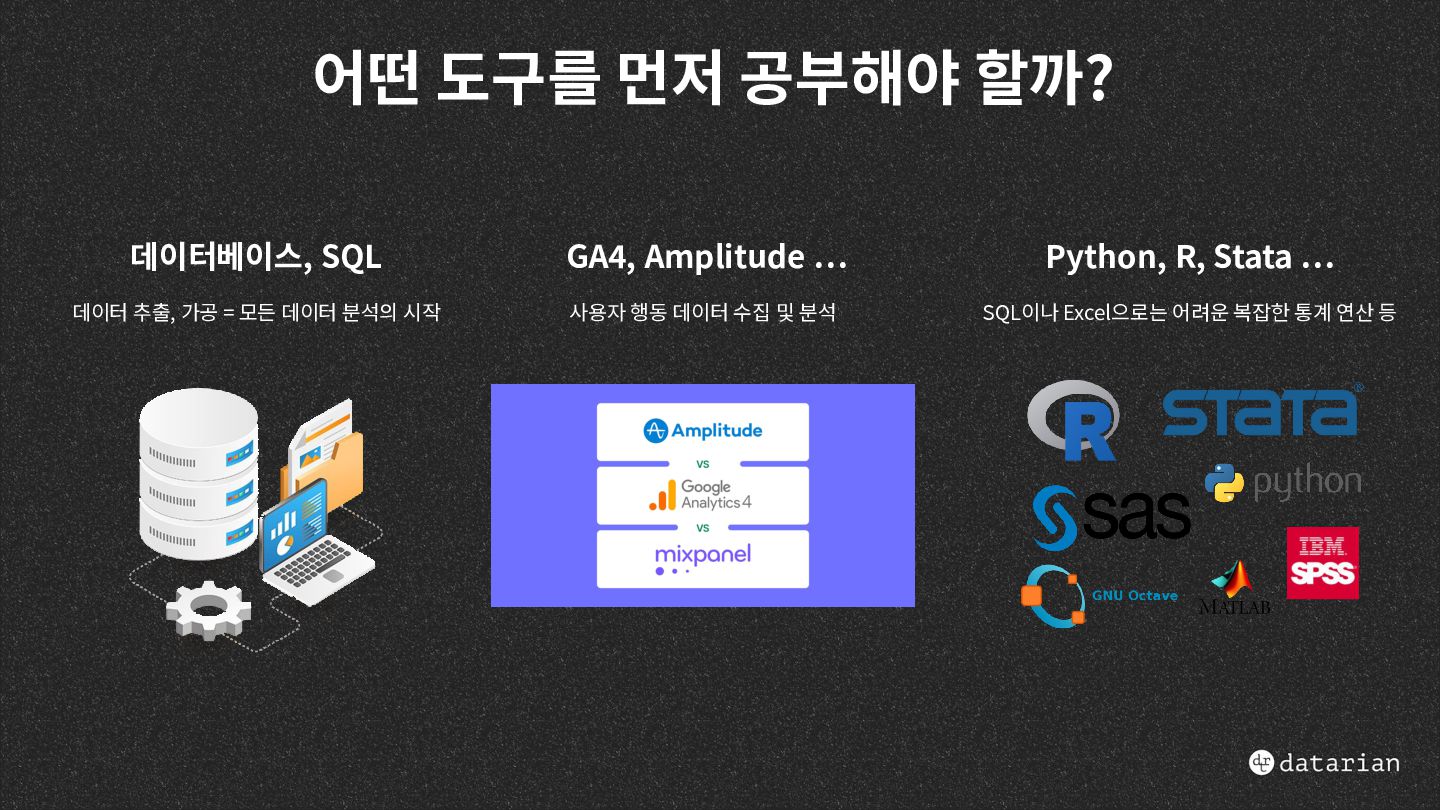
3. - AI 시대에 Tool은 평준화됨 SQL 쿼리도 짜고 대시보드 만드는건 AI도 순식간에 다 함 이제 기술스택, 분석 툴 나열은 차별점이 전혀 안 됨 차별점은 기술 이해도 기반 비판적 사고 AI 결과물이나 데이터 상관관계를 맹신하지 않고 검증하는 역량이 핵심임 “이게 진짜 인과관계인가?”, “비즈니스 로직에 맞는가?” 의심하고 파고들어야 함 이 비판적 사고의 흔적이 곧 좋은 경력 채용담당자가 보는건 어떤 일을 ʻ왜’ 했고 ʻ어떤 임팩트’를 냈는가 프로젝트 전체를 리드하지 않았어도 상관없음 내 파트가 전체 비즈니스 어디에 기여했는지, 내 성과가 어떤 지표와 방식으로 측정됐는지 설명할 수 있어야됨
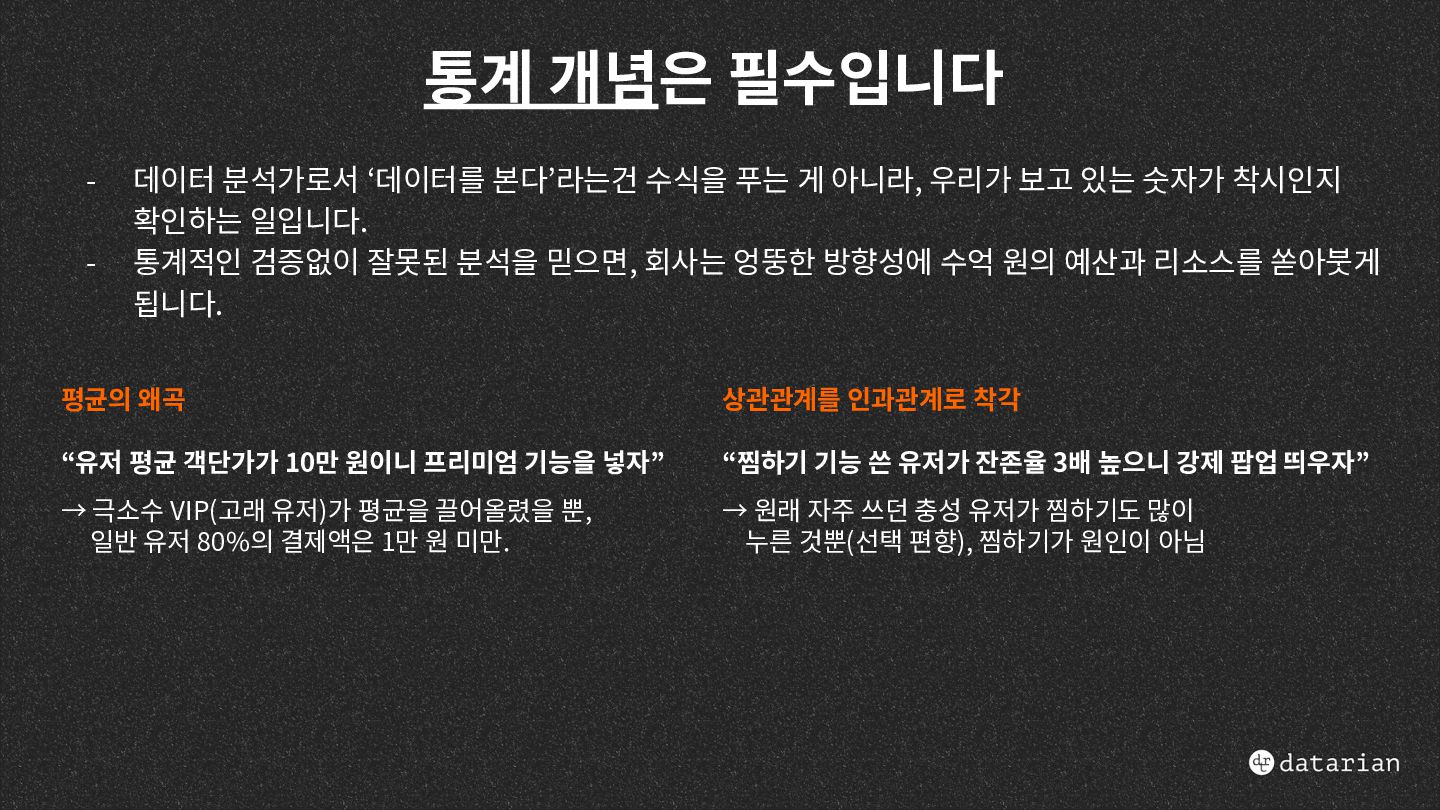
게 아니라, 우리가 보고 있는 숫자가 착시인지 확인하는 일입니다. 통계적인 검증없이 잘못된 분석을 믿으면, 회사는 엉뚱한 방향성에 수억 원의 예산과 리소스를 쏟아붓게 됩니다. 평균의 왜곡 상관관계를 인과관계로 착각 “유저 평균 객단가가 10만 원이니 프리미엄 기능을 넣자” “찜하기 기능 쓴 유저가 잔존율 3배 높으니 강제 팝업 띄우자” → 극소수 VIP(고래 유저)가 평균을 끌어올렸을 뿐, 일반 유저 80%의 결제액은 1만 원 미만. → 원래 자주 쓰던 충성 유저가 찜하기도 많이 누른 것뿐(선택 편향), 찜하기가 원인이 아님
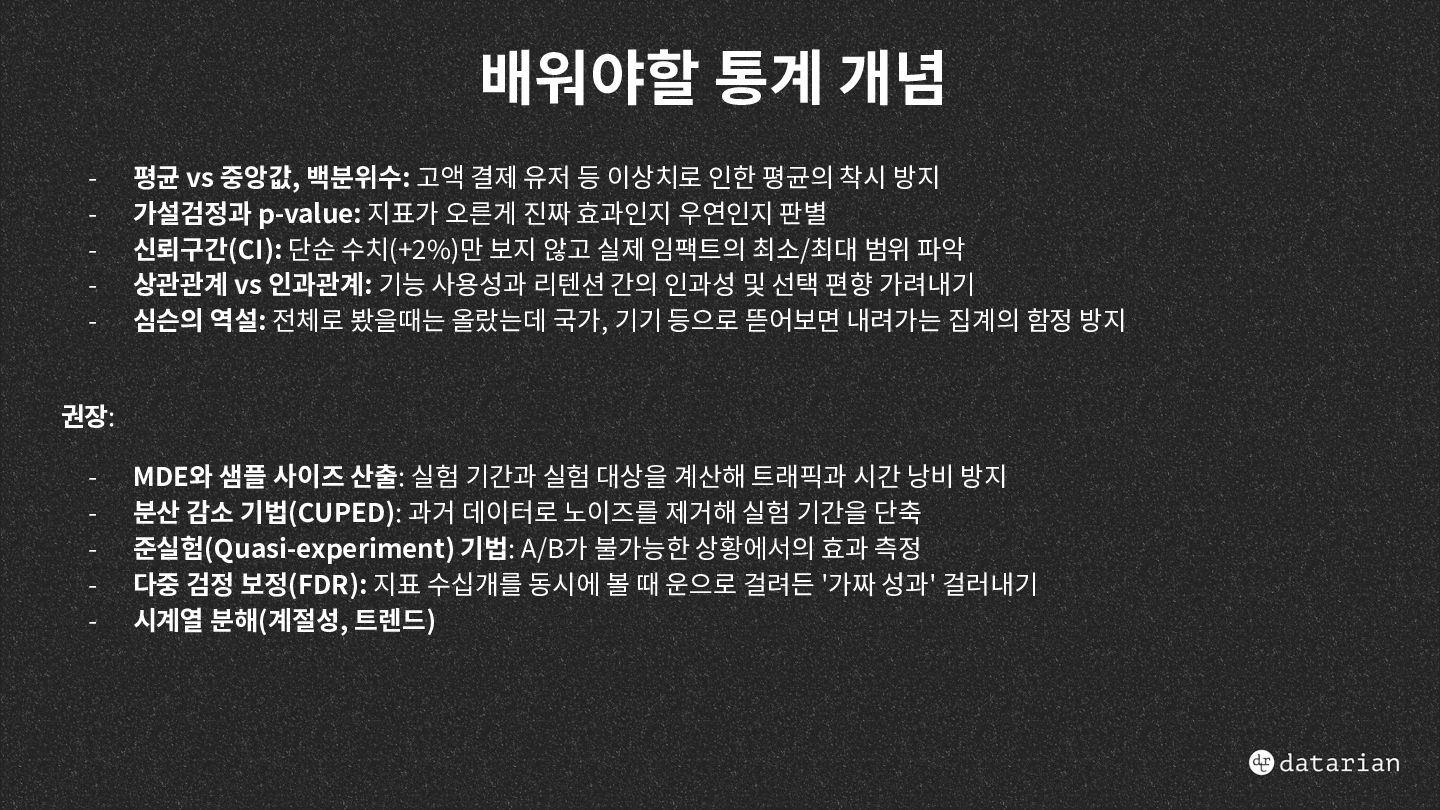
유저 등 이상치로 인한 평균의 착시 방지 가설검정과 p-value: 지표가 오른게 진짜 효과인지 우연인지 판별 신뢰구간(CI): 단순 수치(+2%)만 보지 않고 실제 임팩트의 최소/최대 범위 파악 상관관계 vs 인과관계: 기능 사용성과 리텐션 간의 인과성 및 선택 편향 가려내기 심슨의 역설: 전체로 봤을때는 올랐는데 국가, 기기 등으로 뜯어보면 내려가는 집계의 함정 방지 권장: - MDE와 샘플 사이즈 산출: 실험 기간과 실험 대상을 계산해 트래픽과 시간 낭비 방지 분산 감소 기법(CUPED): 과거 데이터로 노이즈를 제거해 실험 기간을 단축 준실험(Quasi-experiment) 기법: A/B가 불가능한 상황에서의 효과 측정 다중 검정 보정(FDR): 지표 수십개를 동시에 볼 때 운으로 걸려든 '가짜 성과' 걸러내기 시계열 분해(계절성, 트렌드)
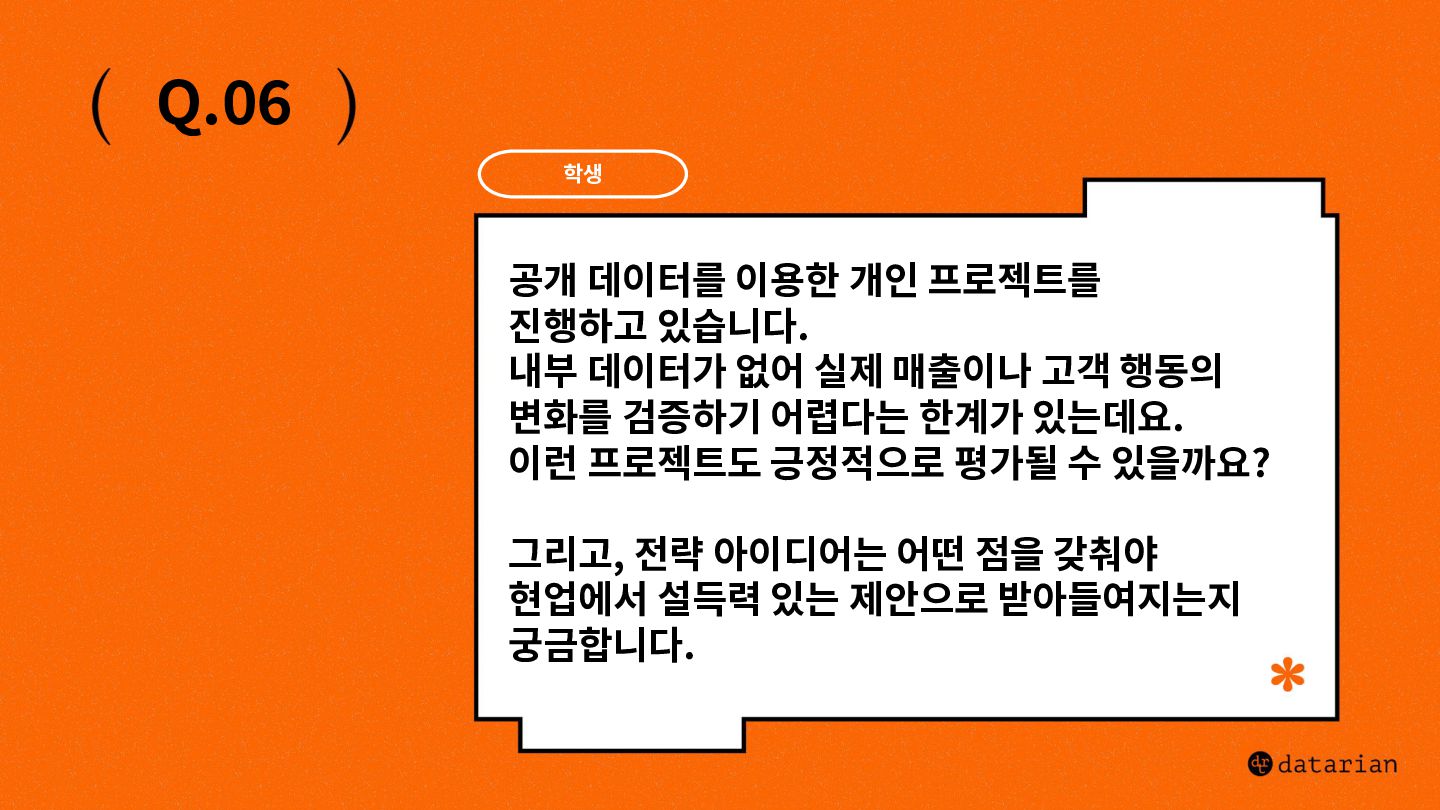
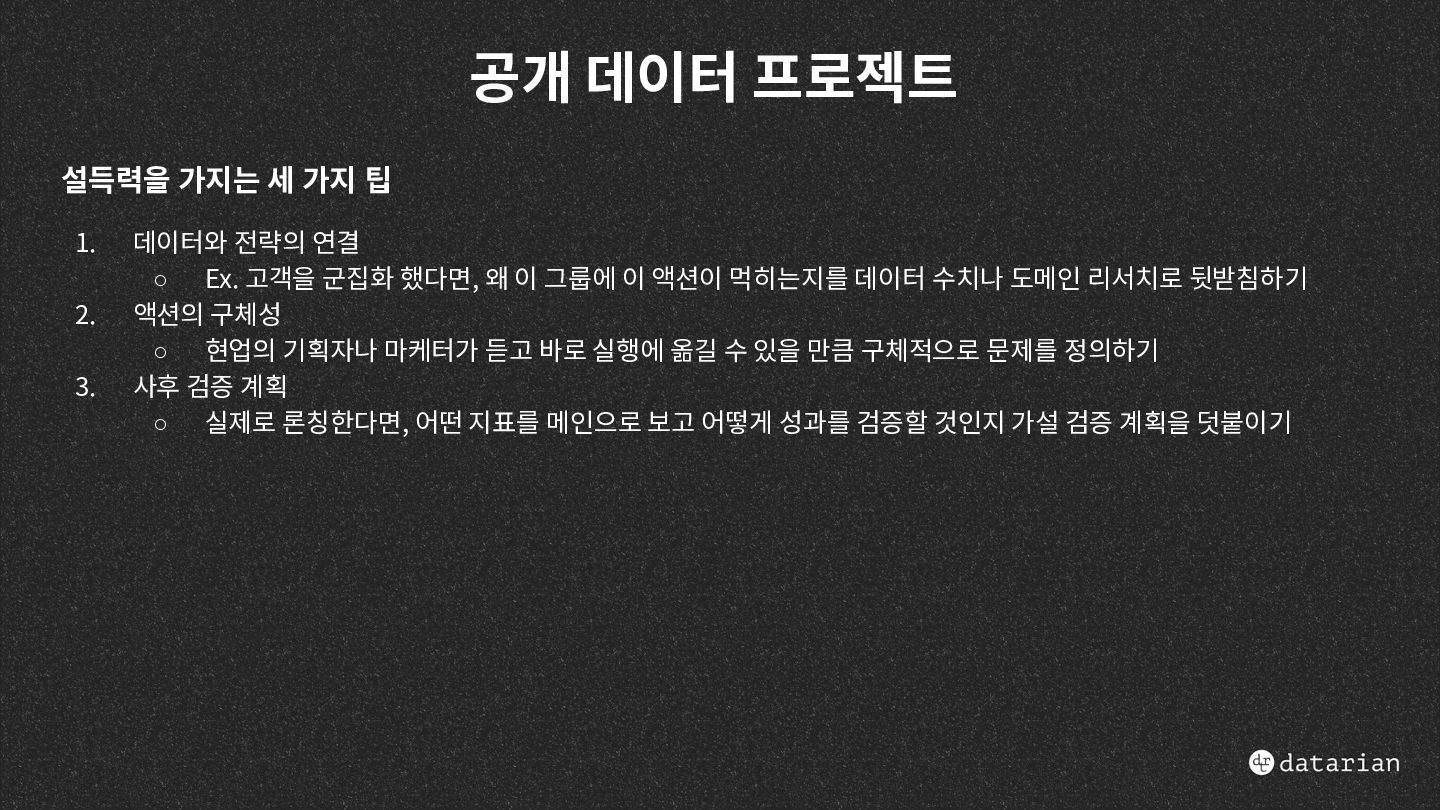
3. 데이터와 전략의 연결 ◦ Ex. 고객을 군집화 했다면, 왜 이 그룹에 이 액션이 먹히는지를 데이터 수치나 도메인 리서치로 뒷받침하기 액션의 구체성 ◦ 현업의 기획자나 마케터가 듣고 바로 실행에 옮길 수 있을 만큼 구체적으로 문제를 정의하기 사후 검증 계획 ◦ 실제로 론칭한다면, 어떤 지표를 메인으로 보고 어떻게 성과를 검증할 것인지 가설 검증 계획을 덧붙이기
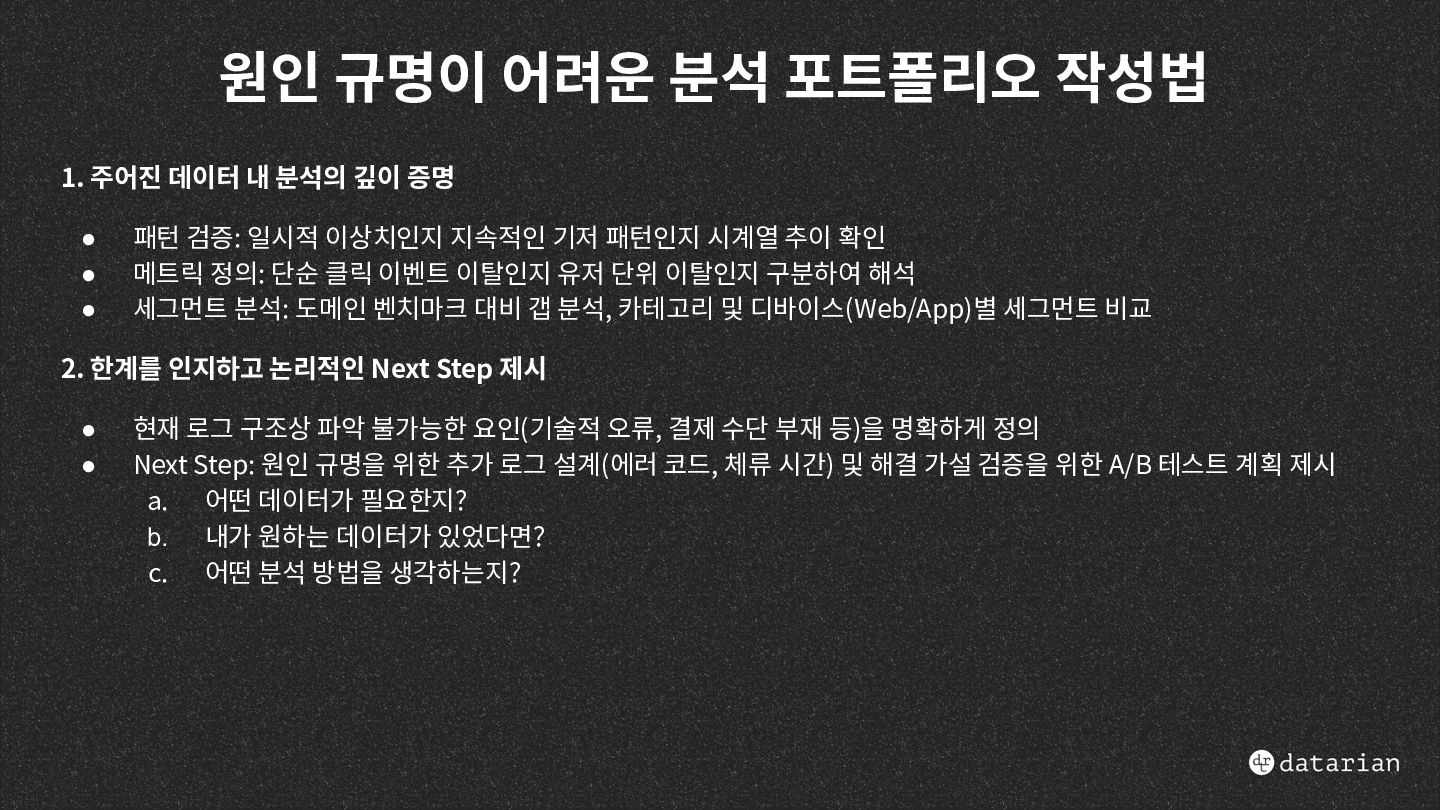
분석의 깊이 증명 • • • 패턴 검증: 일시적 이상치인지 지속적인 기저 패턴인지 시계열 추이 확인 메트릭 정의: 단순 클릭 이벤트 이탈인지 유저 단위 이탈인지 구분하여 해석 세그먼트 분석: 도메인 벤치마크 대비 갭 분석, 카테고리 및 디바이스(Web/App)별 세그먼트 비교 2. 한계를 인지하고 논리적인 Next Step 제시 • • 현재 로그 구조상 파악 불가능한 요인(기술적 오류, 결제 수단 부재 등)을 명확하게 정의 Next Step: 원인 규명을 위한 추가 로그 설계(에러 코드, 체류 시간) 및 해결 가설 검증을 위한 A/B 테스트 계획 제시 a. 어떤 데이터가 필요한지? b. 내가 원하는 데이터가 있었다면? c. 어떤 분석 방법을 생각하는지?
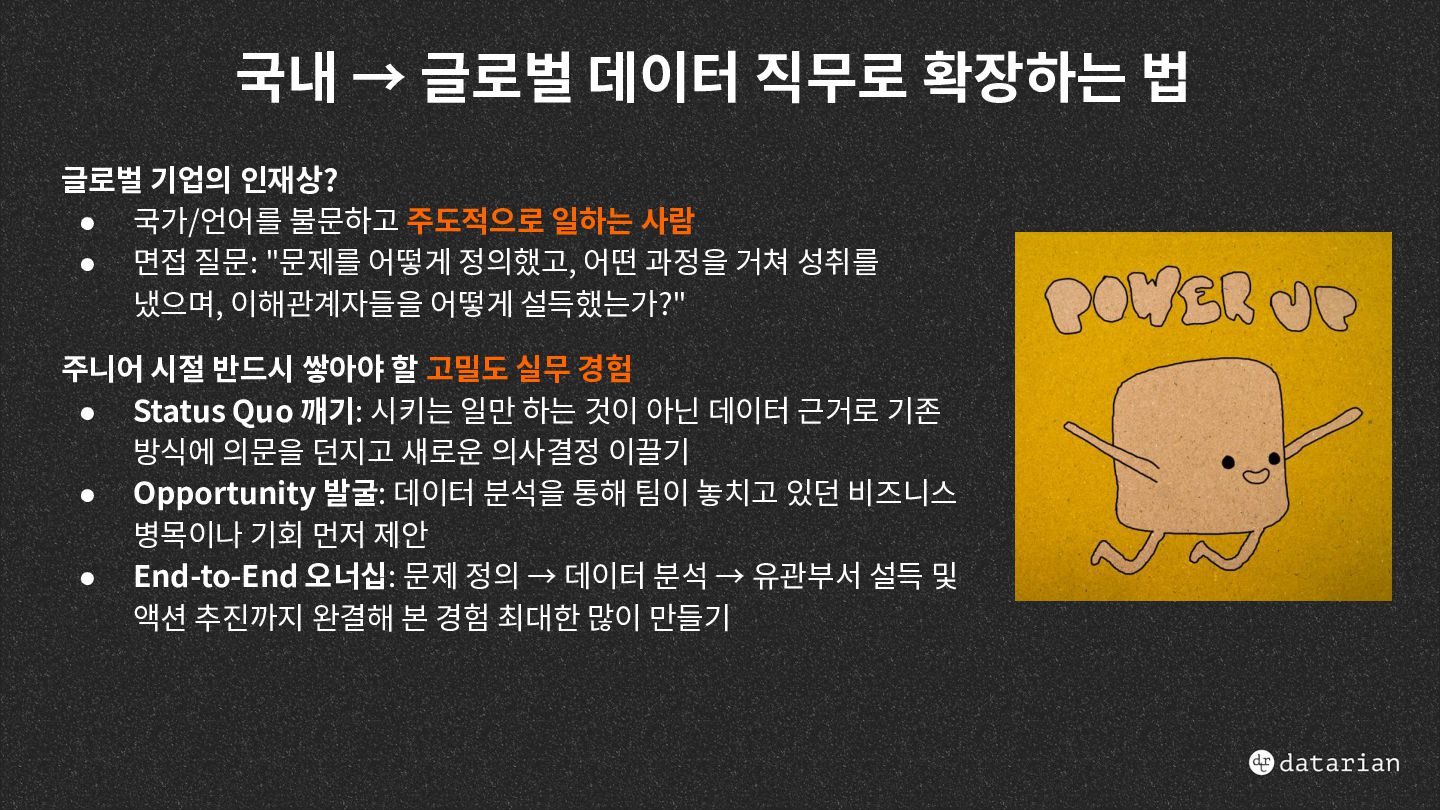
• 국가/언어를 불문하고 주도적으로 일하는 사람 • 면접 질문: "문제를 어떻게 정의했고, 어떤 과정을 거쳐 성취를 냈으며, 이해관계자들을 어떻게 설득했는가?" 주니어 시절 반드시 쌓아야 할 고밀도 실무 경험 • Status Quo 깨기: 시키는 일만 하는 것이 아닌 데이터 근거로 기존 방식에 의문을 던지고 새로운 의사결정 이끌기 • Opportunity 발굴: 데이터 분석을 통해 팀이 놓치고 있던 비즈니스 병목이나 기회 먼저 제안 • End-to-End 오너십: 문제 정의 → 데이터 분석 → 유관부서 설득 및 액션 추진까지 완결해 본 경험 최대한 많이 만들기
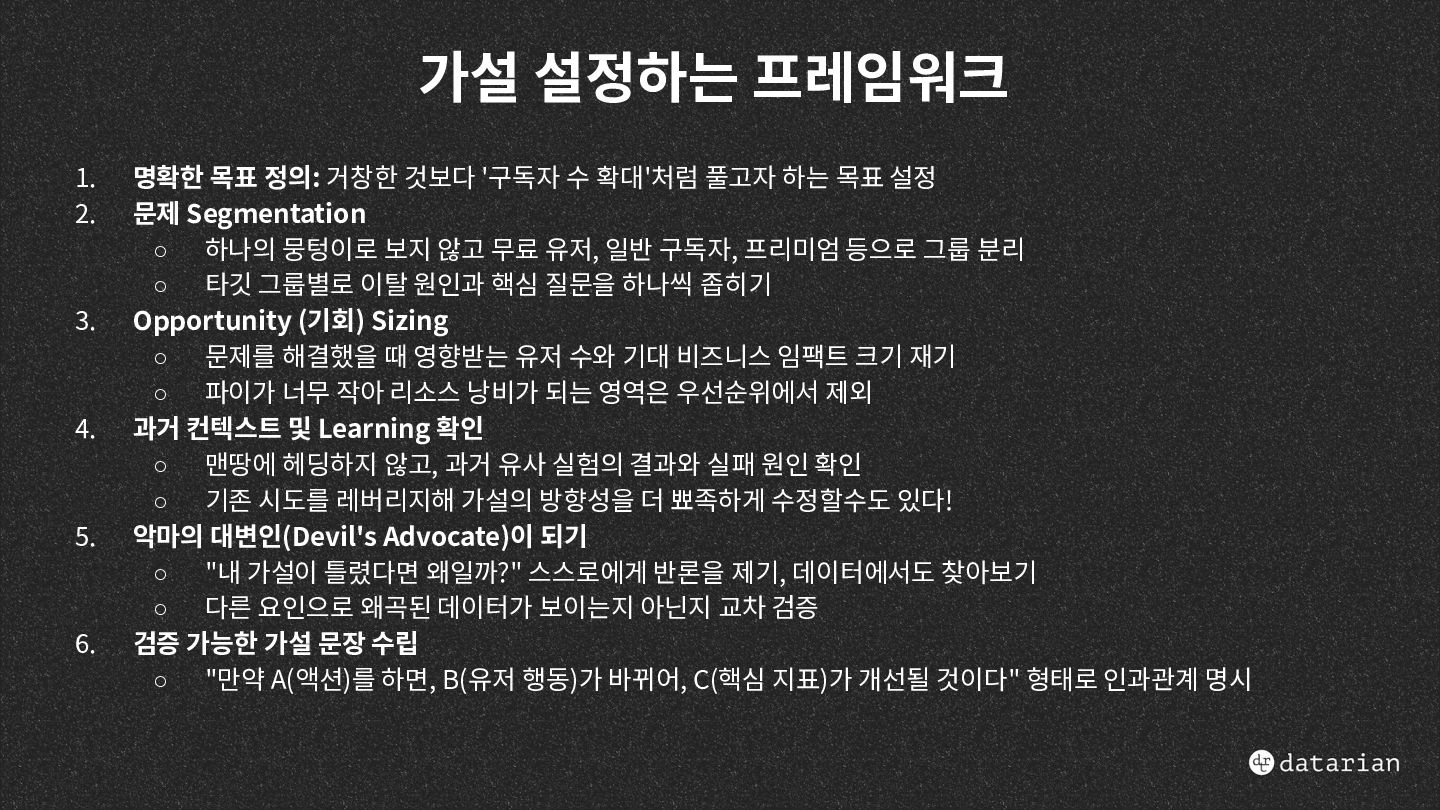
목표 정의: 거창한 것보다 '구독자 수 확대'처럼 풀고자 하는 목표 설정 문제 Segmentation ◦ 하나의 뭉텅이로 보지 않고 무료 유저, 일반 구독자, 프리미엄 등으로 그룹 분리 ◦ 타깃 그룹별로 이탈 원인과 핵심 질문을 하나씩 좁히기 Opportunity (기회) Sizing ◦ 문제를 해결했을 때 영향받는 유저 수와 기대 비즈니스 임팩트 크기 재기 ◦ 파이가 너무 작아 리소스 낭비가 되는 영역은 우선순위에서 제외 과거 컨텍스트 및 Learning 확인 ◦ 맨땅에 헤딩하지 않고, 과거 유사 실험의 결과와 실패 원인 확인 ◦ 기존 시도를 레버리지해 가설의 방향성을 더 뾰족하게 수정할수도 있다! 악마의 대변인(Devil's Advocate)이 되기 ◦ "내 가설이 틀렸다면 왜일까?" 스스로에게 반론을 제기, 데이터에서도 찾아보기 ◦ 다른 요인으로 왜곡된 데이터가 보이는지 아닌지 교차 검증 검증 가능한 가설 문장 수립 ◦ "만약 A(액션)를 하면, B(유저 행동)가 바뀌어, C(핵심 지표)가 개선될 것이다" 형태로 인과관계 명시
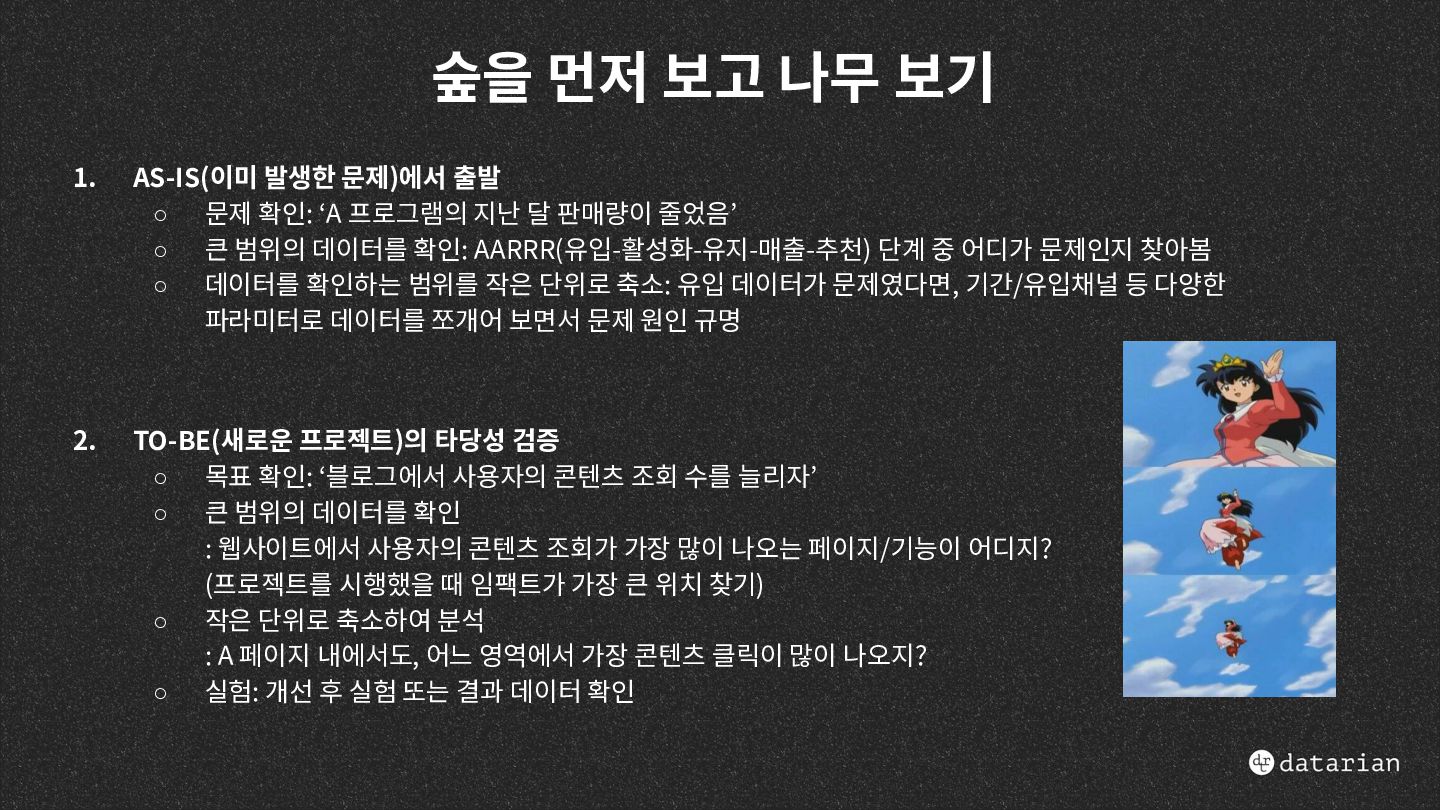
◦ 문제 확인: ʻA 프로그램의 지난 달 판매량이 줄었음’ ◦ 큰 범위의 데이터를 확인: AARRR(유입-활성화-유지-매출-추천) 단계 중 어디가 문제인지 찾아봄 ◦ 데이터를 확인하는 범위를 작은 단위로 축소: 유입 데이터가 문제였다면, 기간/유입채널 등 다양한 파라미터로 데이터를 쪼개어 보면서 문제 원인 규명 2. TO-BE(새로운 프로젝트)의 타당성 검증 ◦ 목표 확인: ʻ블로그에서 사용자의 콘텐츠 조회 수를 늘리자’ ◦ 큰 범위의 데이터를 확인 : 웹사이트에서 사용자의 콘텐츠 조회가 가장 많이 나오는 페이지/기능이 어디지? (프로젝트를 시행했을 때 임팩트가 가장 큰 위치 찾기) ◦ 작은 단위로 축소하여 분석 : A 페이지 내에서도, 어느 영역에서 가장 콘텐츠 클릭이 많이 나오지? ◦ 실험: 개선 후 실험 또는 결과 데이터 확인
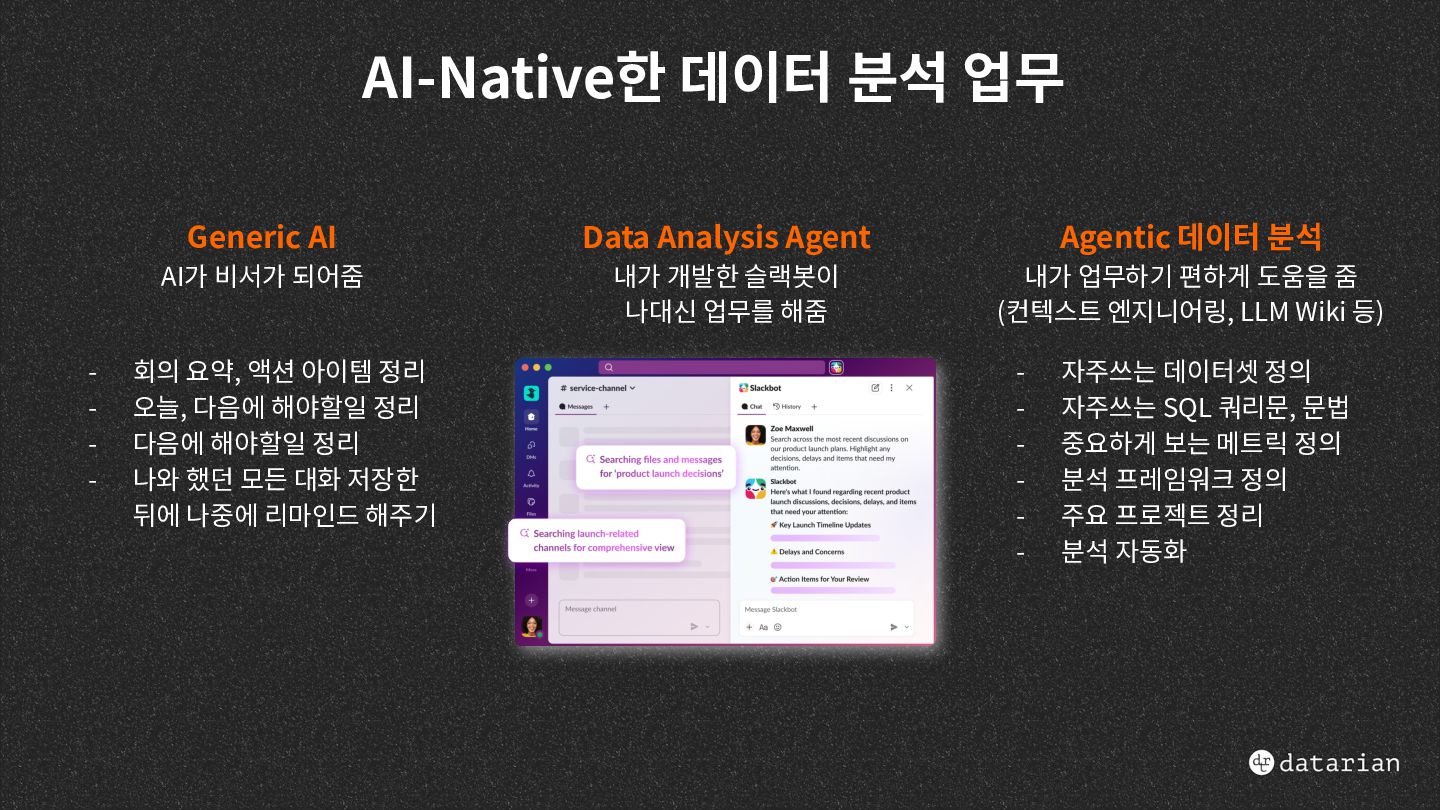
Agentic 데이터 분석 AI가 비서가 되어줌 내가 개발한 슬랙봇이 나대신 업무를 해줌 내가 업무하기 편하게 도움을 줌 (컨텍스트 엔지니어링, LLM Wiki 등) 회의 요약, 액션 아이템 정리 오늘, 다음에 해야할일 정리 다음에 해야할일 정리 나와 했던 모든 대화 저장한 뒤에 나중에 리마인드 해주기 - 자주쓰는 데이터셋 정의 자주쓰는 SQL 쿼리문, 문법 중요하게 보는 메트릭 정의 분석 프레임워크 정의 주요 프로젝트 정리 분석 자동화
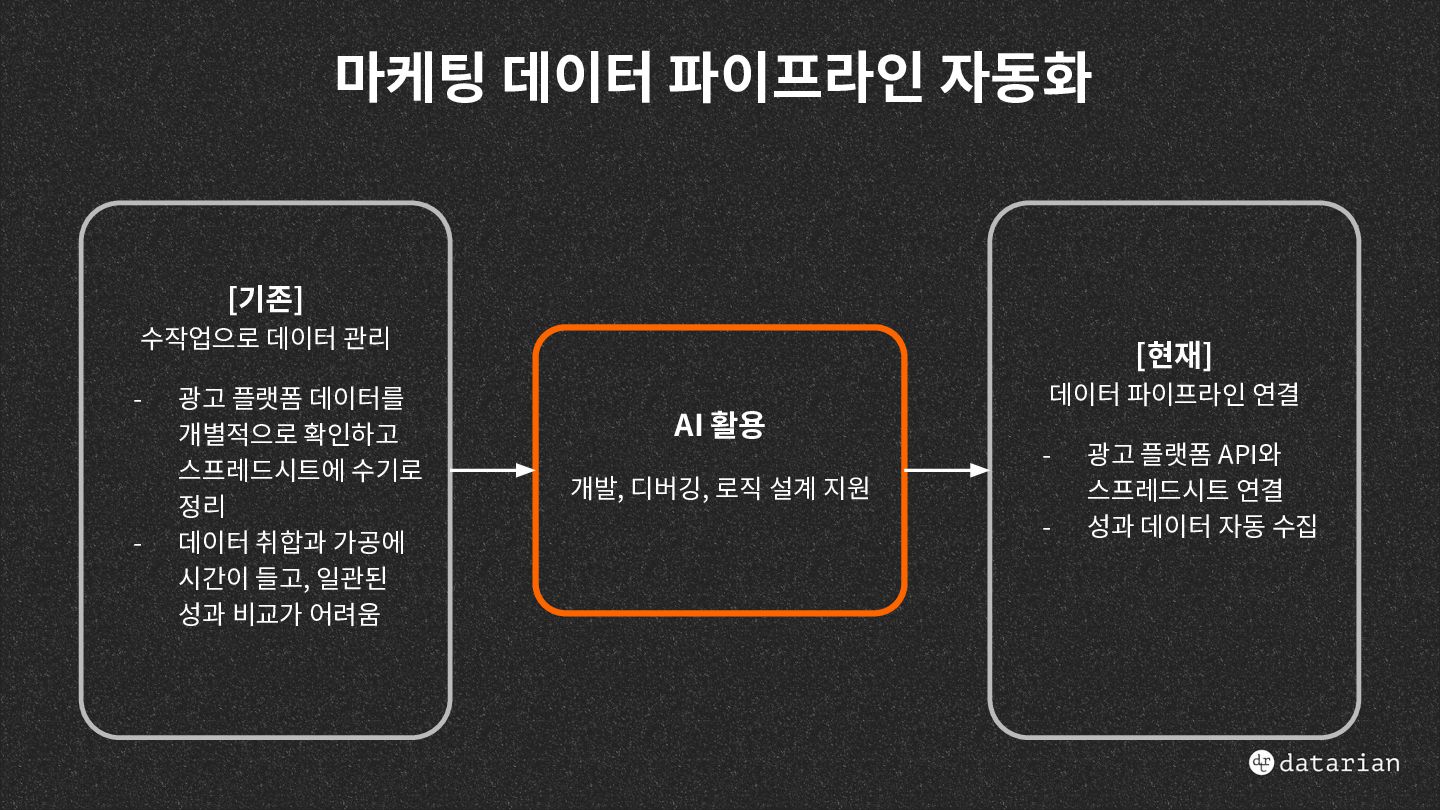
광고 플랫폼 데이터를 개별적으로 확인하고 스프레드시트에 수기로 정리 데이터 취합과 가공에 시간이 들고, 일관된 성과 비교가 어려움 [현재] 데이터 파이프라인 연결 AI 활용 개발, 디버깅, 로직 설계 지원 - 광고 플랫폼 API와 스프레드시트 연결 성과 데이터 자동 수집


 datarian
 so_kotani
 ryushu
 smartgate
 microbaseinc
 rechiba3
 uluru_hr
 tkt42u19421
 adeputra13
 mobilitytechnologies
 advalistar
 fullerene_inc
 sasukefinanciallab
 marketingsoph
 sabderemane
 yeseniaperezcruz
 marcoroth
 tammyeverts
 aleyda
 csswizardry
 hannesfritz
 axbom
 schroneko
 baasie
 signer