Share
Embed
Transcript
29 slides
-
MySQL と PostgreSQL と主キー (良いタイトルが思い浮かばなかったので諦めた・その②) 第 19 回 PostgreSQL アンカンファレンス@オンライン
2020/12/07 まつひさ(hmatsu47) -
自己紹介(前回とまあまあ同じ) 松久裕保(@hmatsu47) https://qiita.com/hmatsu47 名古屋で Web インフラのお守り係をしています MySQL 8.0 の薄い本を作って配っています ◦
Qiitaの記事: https://qiita.com/hmatsu47/items/ceb75caf46e3c761095d ◦ GitHub リポジトリの他、印刷版を勉強会などで無料配布していました ◦ 新型コロナウイルスの関係でオフライン勉強会ができなくなったので、 現在は BOOTH でも配布しています(100円+送料)8.0.22対応版配布中 https://booth.pm/ja/items/2524481 2 -
今日は、 • PostgreSQL アンカンファレンスの登壇枠がガラ空き だったので、予定を変更して登壇枠へ(4 回目) • 前回に続いて今回もネタは他人依存 ◦ ただのオーディエンスのつもりだったので…
◦ 尺も(たぶん)15 分くらいしかありません 3 -
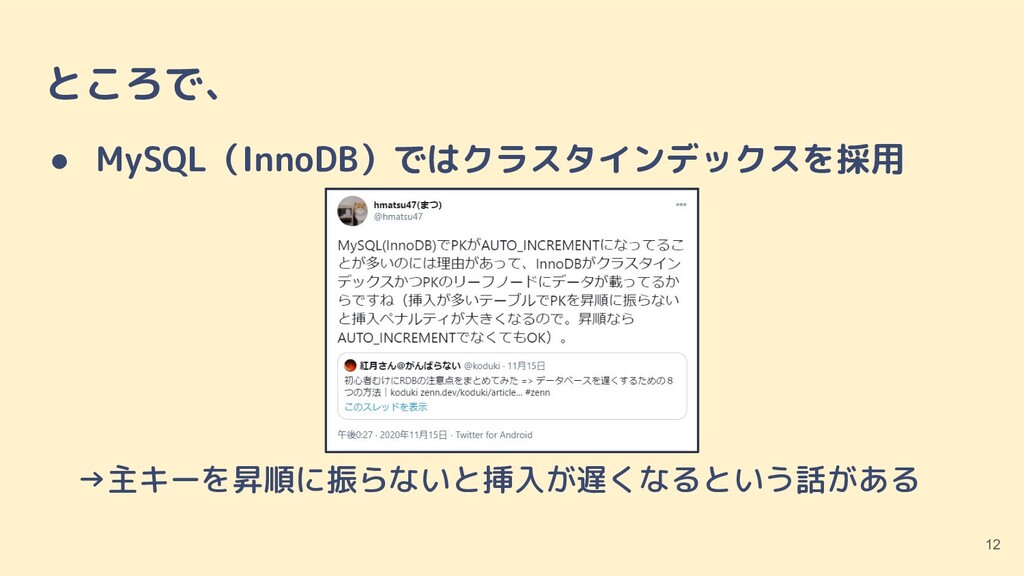
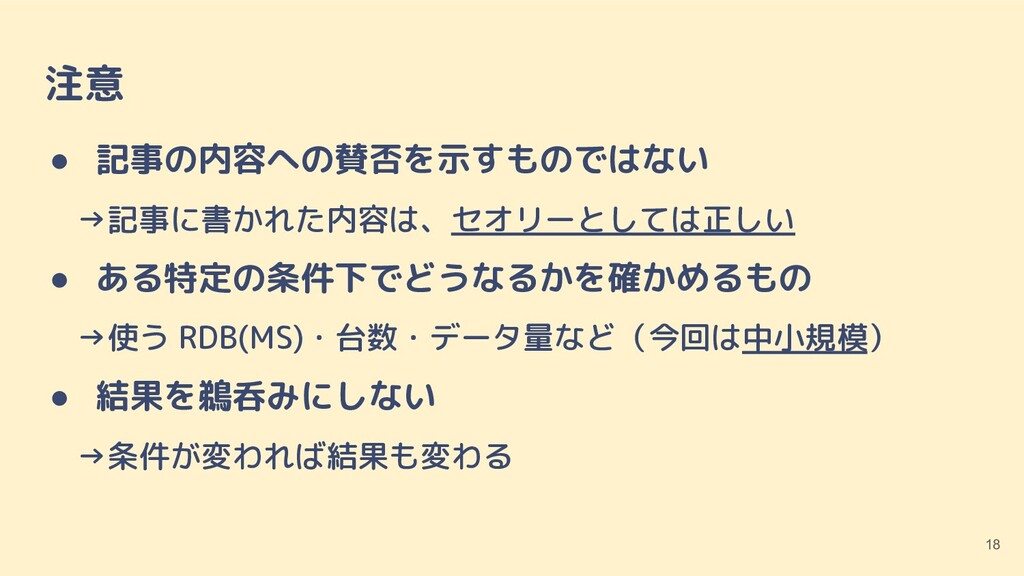
「データベースを遅くするための8つの方法」 • koduki さんが Zenn に掲載された記事 https://zenn.dev/koduki/articles/d3e8984f420b370681f9 • とりあげるのは「シーケンスナンバーを PK
にする」 →PostgreSQL のシーケンス(を元にした serial)、MySQL の AUTO_INCREMENT を主キーに使うべきではない、という話 7 -
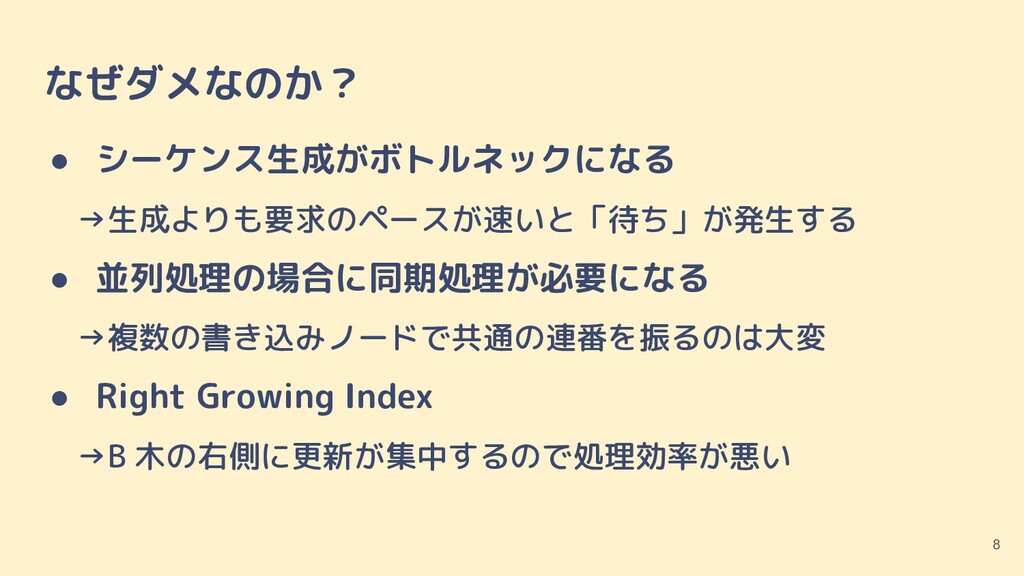
なぜダメなのか? • シーケンス生成がボトルネックになる →生成よりも要求のペースが速いと「待ち」が発生する • 並列処理の場合に同期処理が必要になる →複数の書き込みノードで共通の連番を振るのは大変 • Right Growing
Index →B 木の右側に更新が集中するので処理効率が悪い 8 -
というわけで、PostgreSQL も巻き込んで実験! • 中小規模のシステムを想定 →DB が 1 台(または書き込みノード 1 台のクラスタ)
• 行挿入が瞬間的に遅くなったり波が生じたりしないか? →シーケンス生成のボトルネック確認 • 行数が増えるにつれて行挿入が遅くならないか? →Right Growing Index 問題の確認 13 -
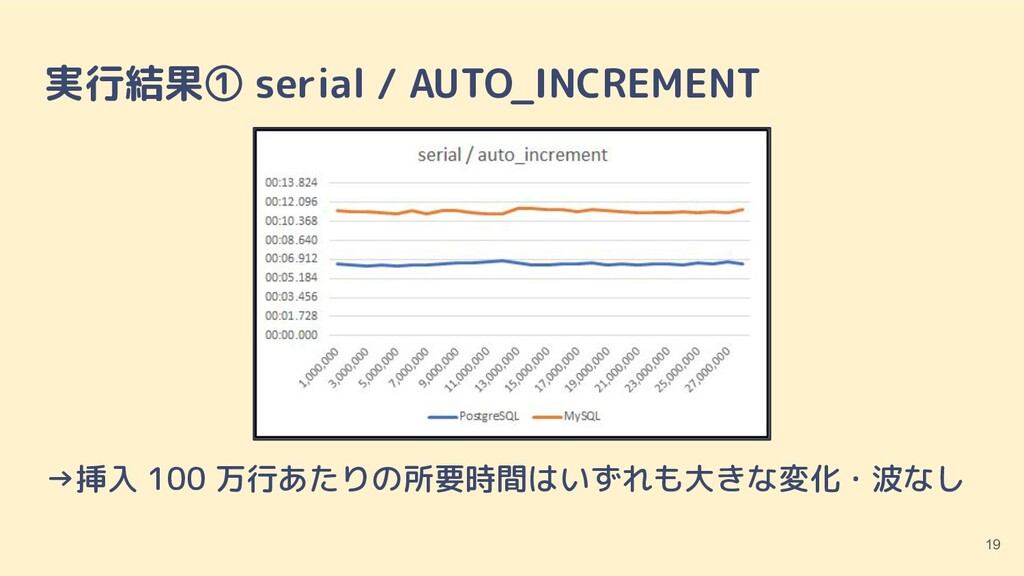
テストの内容(1/2) • 120 万行のデータを 24 並列で挿入(合計 2,880 万行) • 主キーとして以下の
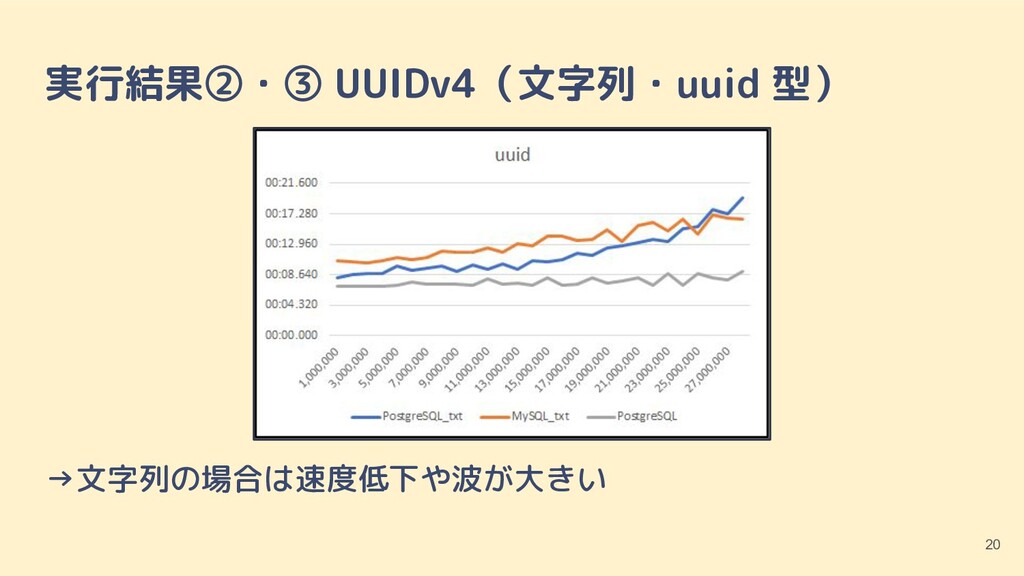
3 種類を使い、挿入 100 万行あたり の所要時間の推移を比較 ◦ ①serial / AUTO_INCREMENT ◦ ②UUIDv4(文字列) ◦ ③UUIDv4(uuid 型)※PostgreSQL のみ 14 -
テストの内容(2/2) • テスト環境は以下のとおり ◦ Amazon(AWS) RDS(MySQL 5.7.31 / PostgreSQL 12.4
R1) ▪ Dedicated Log Writer の性能問題のため MySQL 8.0.21 は使わず ◦ db.m5.xlarge(4vCPU・16GiB Mem) ◦ Single AZ ◦ デフォルトパラメータグループ ▪ ただし MySQL はバイナリログが書き出されないように調整 15 -
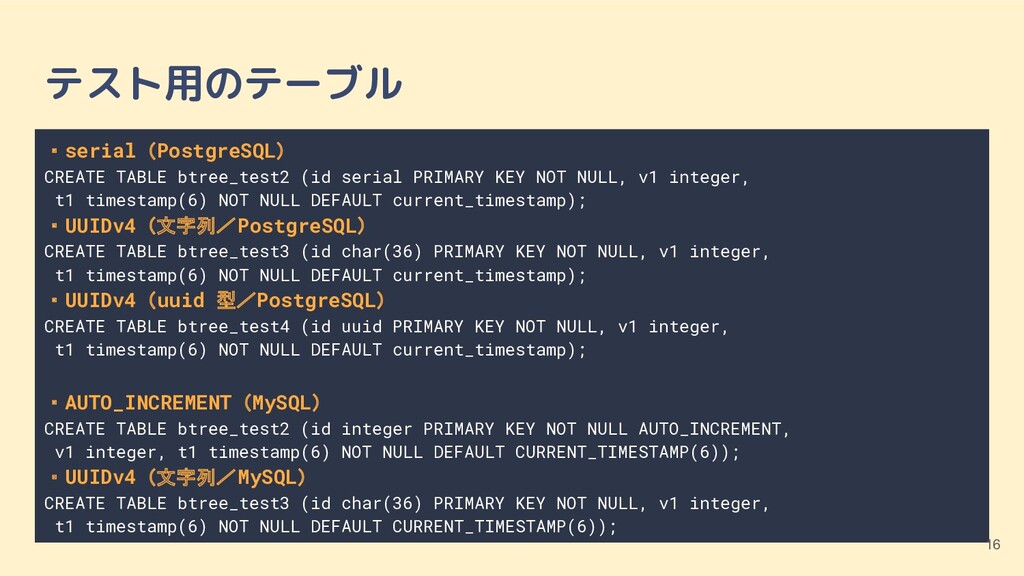
・serial(PostgreSQL) CREATE TABLE btree_test2 (id serial PRIMARY KEY NOT NULL,
v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp); ・UUIDv4(文字列/PostgreSQL) CREATE TABLE btree_test3 (id char(36) PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp); ・UUIDv4(uuid 型/PostgreSQL) CREATE TABLE btree_test4 (id uuid PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp); ・AUTO_INCREMENT(MySQL) CREATE TABLE btree_test2 (id integer PRIMARY KEY NOT NULL AUTO_INCREMENT, v1 integer, t1 timestamp(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6)); ・UUIDv4(文字列/MySQL) CREATE TABLE btree_test3 (id char(36) PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6)); テスト用のテーブル 16 -
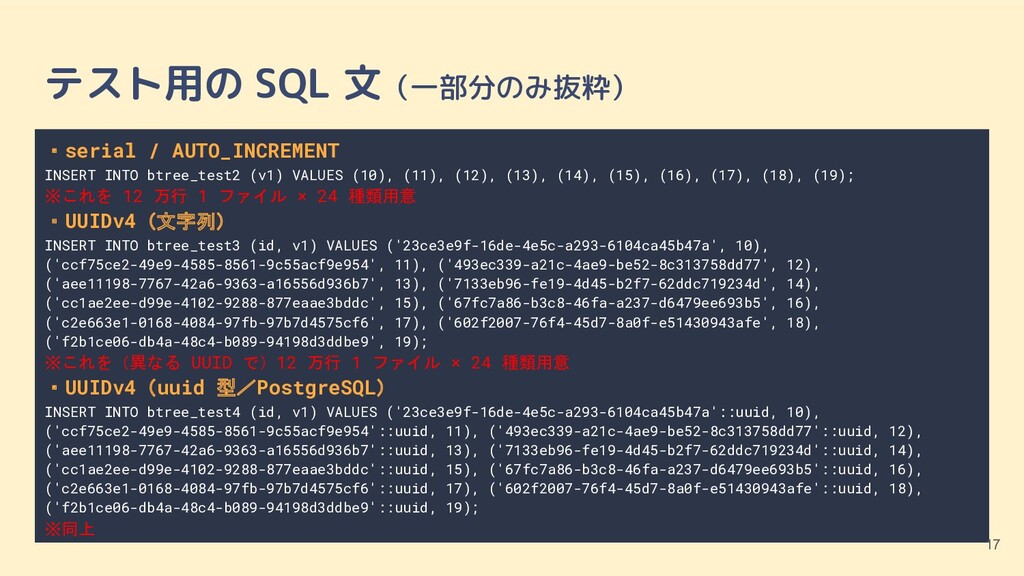
・serial / AUTO_INCREMENT INSERT INTO btree_test2 (v1) VALUES (10), (11),
(12), (13), (14), (15), (16), (17), (18), (19); ※これを 12 万行 1 ファイル × 24 種類用意 ・UUIDv4(文字列) INSERT INTO btree_test3 (id, v1) VALUES ('23ce3e9f-16de-4e5c-a293-6104ca45b47a', 10), ('ccf75ce2-49e9-4585-8561-9c55acf9e954', 11), ('493ec339-a21c-4ae9-be52-8c313758dd77', 12), ('aee11198-7767-42a6-9363-a16556d936b7', 13), ('7133eb96-fe19-4d45-b2f7-62ddc719234d', 14), ('cc1ae2ee-d99e-4102-9288-877eaae3bddc', 15), ('67fc7a86-b3c8-46fa-a237-d6479ee693b5', 16), ('c2e663e1-0168-4084-97fb-97b7d4575cf6', 17), ('602f2007-76f4-45d7-8a0f-e51430943afe', 18), ('f2b1ce06-db4a-48c4-b089-94198d3ddbe9', 19); ※これを(異なる UUID で)12 万行 1 ファイル × 24 種類用意 ・UUIDv4(uuid 型/PostgreSQL) INSERT INTO btree_test4 (id, v1) VALUES ('23ce3e9f-16de-4e5c-a293-6104ca45b47a'::uuid, 10), ('ccf75ce2-49e9-4585-8561-9c55acf9e954'::uuid, 11), ('493ec339-a21c-4ae9-be52-8c313758dd77'::uuid, 12), ('aee11198-7767-42a6-9363-a16556d936b7'::uuid, 13), ('7133eb96-fe19-4d45-b2f7-62ddc719234d'::uuid, 14), ('cc1ae2ee-d99e-4102-9288-877eaae3bddc'::uuid, 15), ('67fc7a86-b3c8-46fa-a237-d6479ee693b5'::uuid, 16), ('c2e663e1-0168-4084-97fb-97b7d4575cf6'::uuid, 17), ('602f2007-76f4-45d7-8a0f-e51430943afe'::uuid, 18), ('f2b1ce06-db4a-48c4-b089-94198d3ddbe9'::uuid, 19); ※同上 テスト用の SQL 文(一部分のみ抜粋) 17 -
ここまでの結果まとめ • serial / AUTO_INCREMENT のほうが高速 ◦ 速度低下や波も小さい ◦ PostgreSQL
の uuid 型は、少し遅くて行数が増えると波が… ◦ この規模なら serial / AUTO_INCREMENT のほうが扱いやすい • MySQL の UUIDv4(文字列)が意外と健闘 ◦ 前評判ほど遅くない? ◦ 行数が増えると PostgreSQL(文字列)より速い? 21 -
準備中に気付いたこと • UUIDv4 を含むテストデータの生成が微妙に遅い ◦ Amazon(AWS) EC2 c5.large (Amazon Linux
2) を使用 ◦ CPU も使い切らないし I/O も頭打ちにならないのに… ◦ シーケンスの生成より遅い! • 乱数生成時のエントロピー不足の問題? ◦ 仮想マシンだし、他の用途に使っていないので、エントロピーが なかなか溜まらないのかも…? 22 -
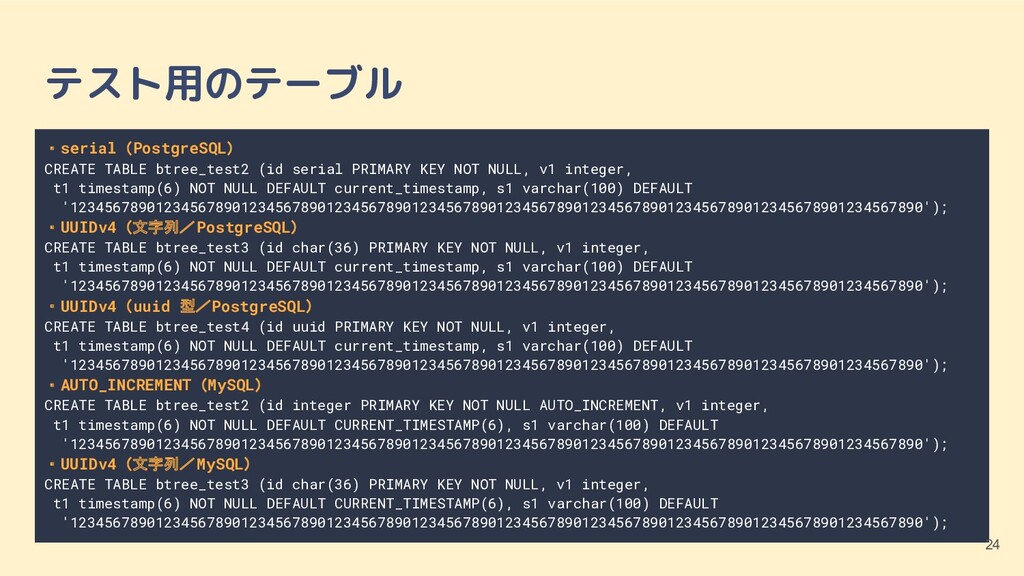
予想と少し違ったので、追試 • 1 行あたりの容量を増やしてみる ◦ varchar(100) の列を追加 ◦ デフォルトで 100
文字入れておく • データを挿入する SQL 文は同じ ◦ ①②③ともそのまま 23 -
・serial(PostgreSQL) CREATE TABLE btree_test2 (id serial PRIMARY KEY NOT NULL,
v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp, s1 varchar(100) DEFAULT '1234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890'); ・UUIDv4(文字列/PostgreSQL) CREATE TABLE btree_test3 (id char(36) PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp, s1 varchar(100) DEFAULT '1234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890'); ・UUIDv4(uuid 型/PostgreSQL) CREATE TABLE btree_test4 (id uuid PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT current_timestamp, s1 varchar(100) DEFAULT '1234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890'); ・AUTO_INCREMENT(MySQL) CREATE TABLE btree_test2 (id integer PRIMARY KEY NOT NULL AUTO_INCREMENT, v1 integer, t1 timestamp(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6), s1 varchar(100) DEFAULT '1234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890'); ・UUIDv4(文字列/MySQL) CREATE TABLE btree_test3 (id char(36) PRIMARY KEY NOT NULL, v1 integer, t1 timestamp(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6), s1 varchar(100) DEFAULT '1234567890123456789012345678901234567890123456789012345678901234567890123456789012345678901234567890'); テスト用のテーブル 24 -
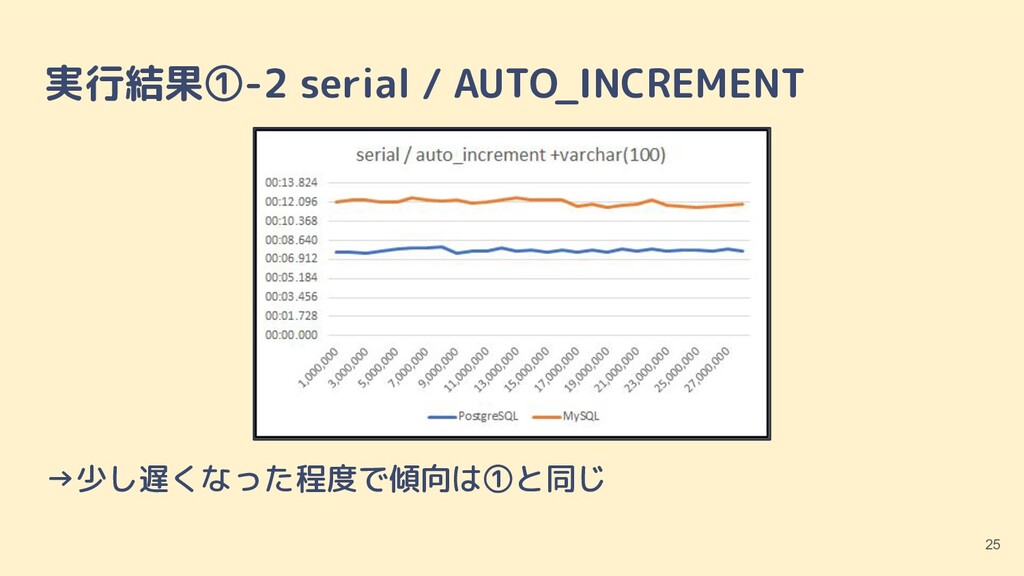
追試の結果まとめ • やっぱり serial / AUTO_INCREMENT のほうが高速 ◦ この規模なら serial
/ AUTO_INCREMENT のほうが… (2 回目) • MySQL の UUIDv4(文字列)は当初想像どおりの遅さ ◦ 挿入時のページ分割が辛い https://qiita.com/SH2/items/654d89759e7e39d999b5 27 -
全体のまとめ(1/2) • 計測は大事 ◦ セオリーや製品固有の特性を知っているのはもちろん大事 ◦ その上で、実際の利用シーンに合わせて試すことが重要 • 他人の計測結果を鵜呑みにしない ◦
条件が変われば結果も変わる ◦ 自らの利用シーンに合わせて計測する 28 -
全体のまとめ(2/2) • 性能に影響を与える要素は意外とたくさんある ◦ たとえば UUIDv4 の生成速度 ▪ 環境によってはシーケンスより遅くなることも ▪
1 台の DB ではなく複数の Web サーバで生成したほうが良いケース もありそう ◦ 一点ばかり注目しない →二値(二項対立)で評価・判断しないほうが良い 29