Upgrade to Pro — share decks privately, control downloads, hide ads and more …

OpenAIのオープンウェイトLLM 「gpt-oss」解説

OpenAIのオープンウェイトLLM 「gpt-oss」解説

OpenAIのオープンウェイト言語モデル gpt-oss-120b/20b を俯瞰し全体像をまとめた技術解説スライド

発表者:河村和紀(かわむら かずき / Kazuki Kawamura)— ソニーグループ R&Dセンター / ソニーCSL 研究員。https://casp.jp/

Other Decks in Research

Transcript

  1. gpt-oss • OpenAIのオープンウェイトモデル • Apache 2.0ライセンス + gpt-oss 使用ポリシー •

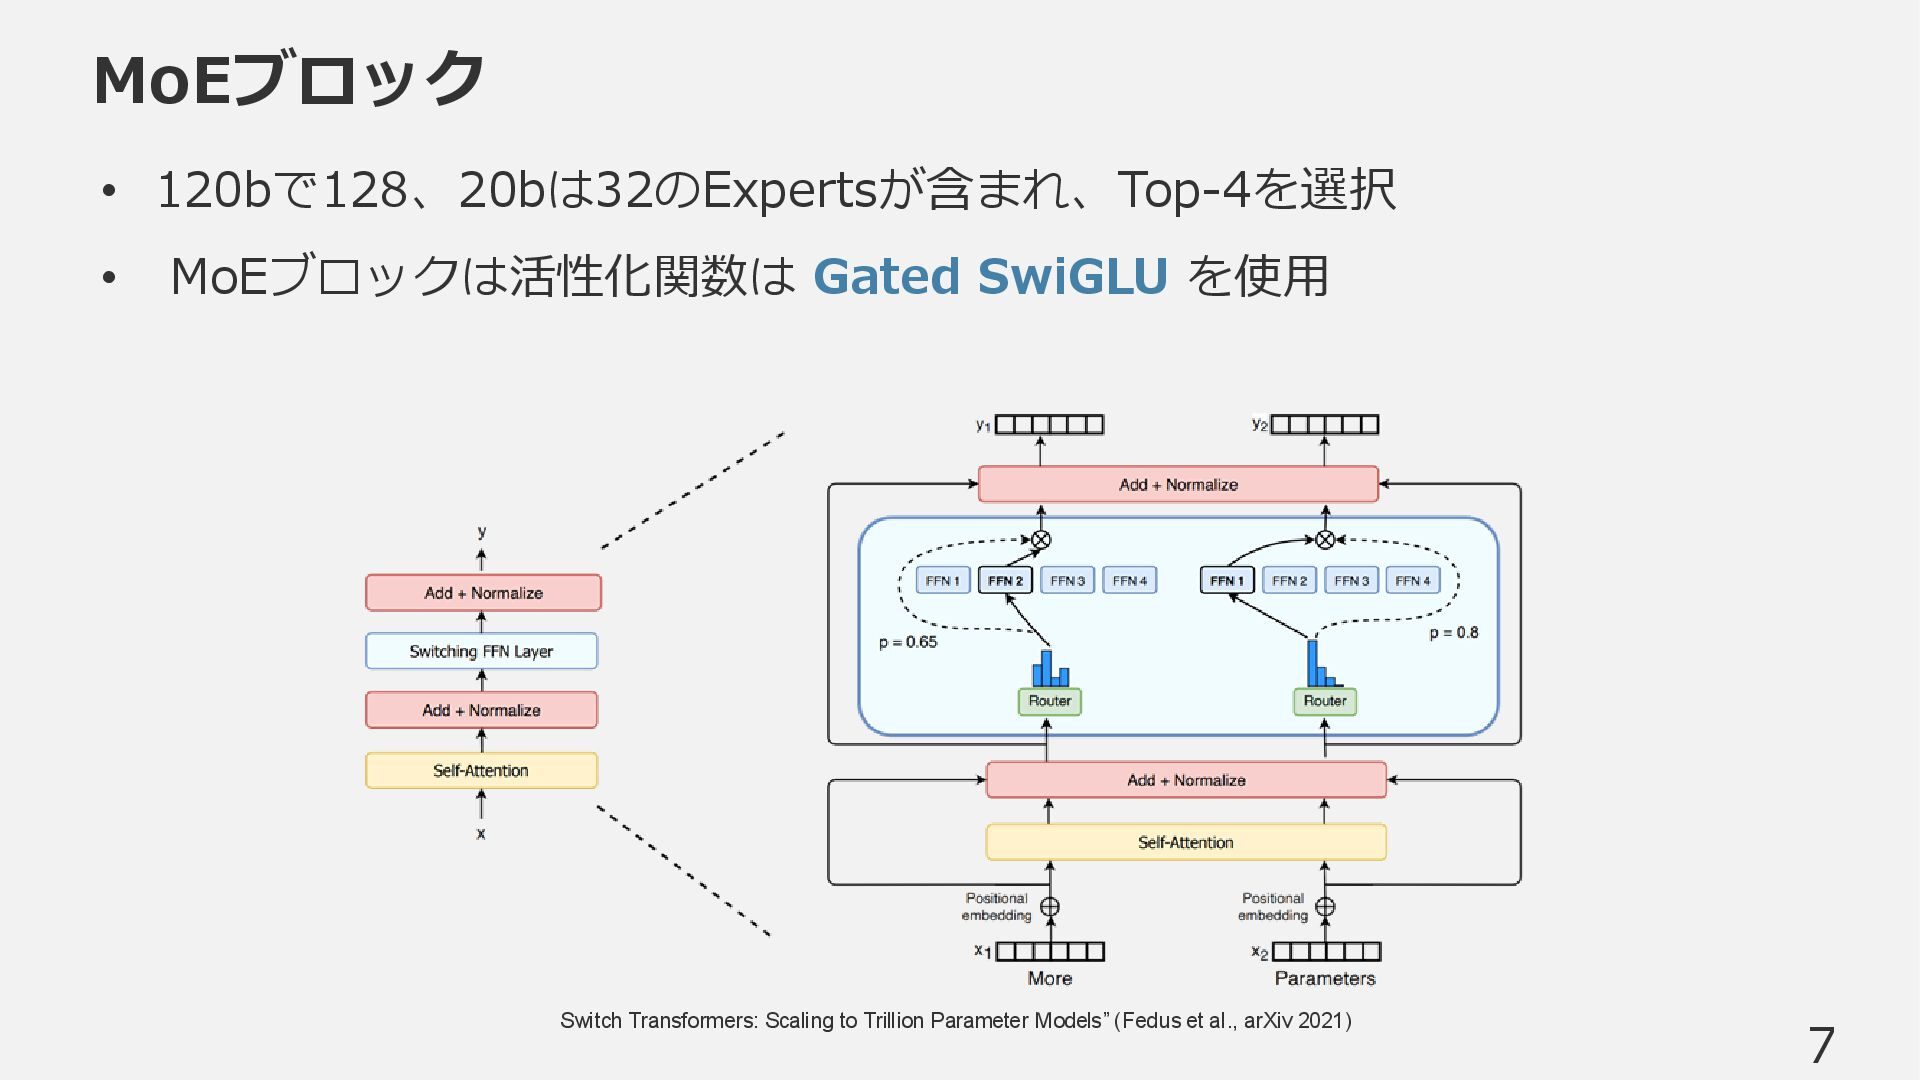
    大規模モデル「gpt-oss-120b」と小規模モデル「gpt-oss-20b」の2モデル • GPT-2/3系の自己回帰Transformerを土台に、MoEを採用 • MXFP4 でメモリ使用を大幅削減し、120bは80GB単GPU/20bは16GBで動作 2
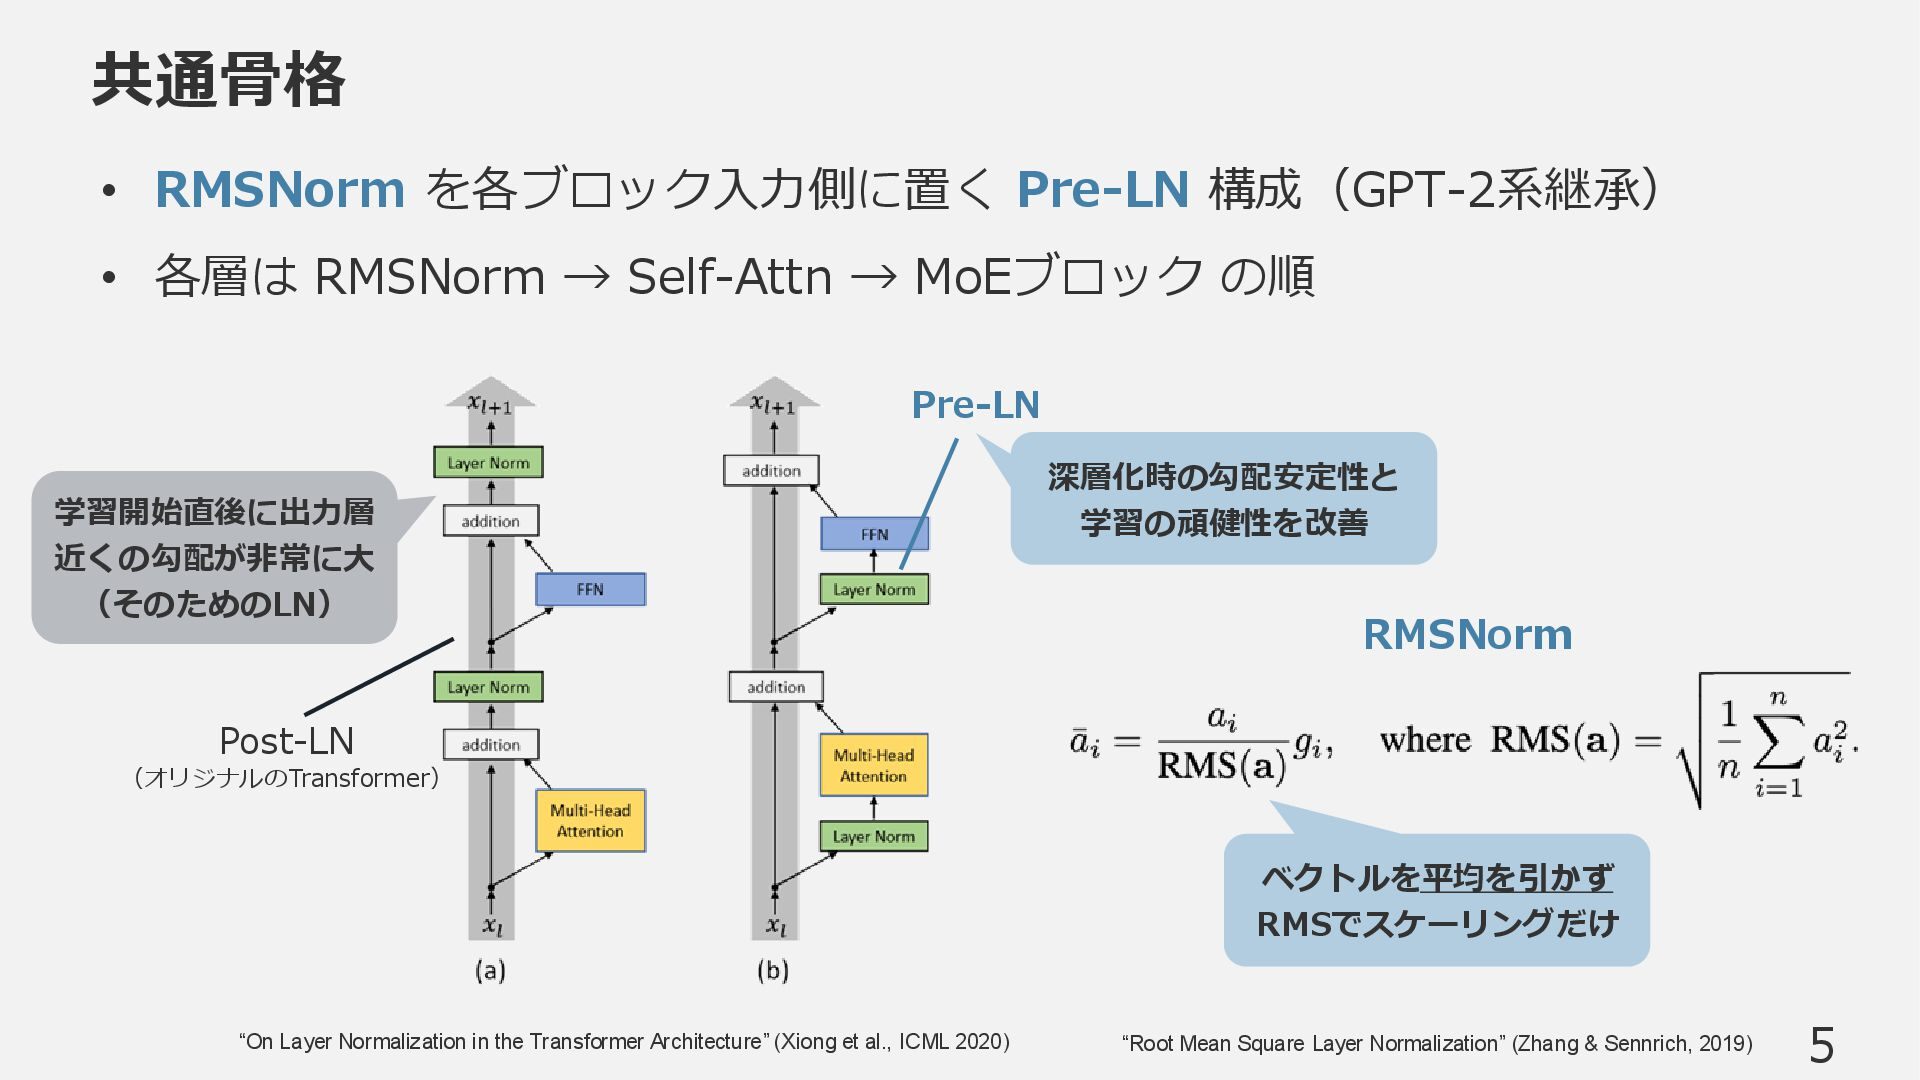
  2. 共通骨格 • RMSNorm を各ブロック入力側に置く Pre-LN 構成(GPT-2系継承) • 各層は RMSNorm →

    Self-Attn → MoEブロック の順 5 “On Layer Normalization in the Transformer Architecture” (Xiong et al., ICML 2020) Post-LN (オリジナルのTransformer) Pre-LN 深層化時の勾配安定性と 学習の頑健性を改善 “Root Mean Square Layer Normalization” (Zhang & Sennrich, 2019) RMSNorm ベクトルを平均を引かず RMSでスケーリングだけ 学習開始直後に出力層 近くの勾配が非常に大 (そのためのLN)
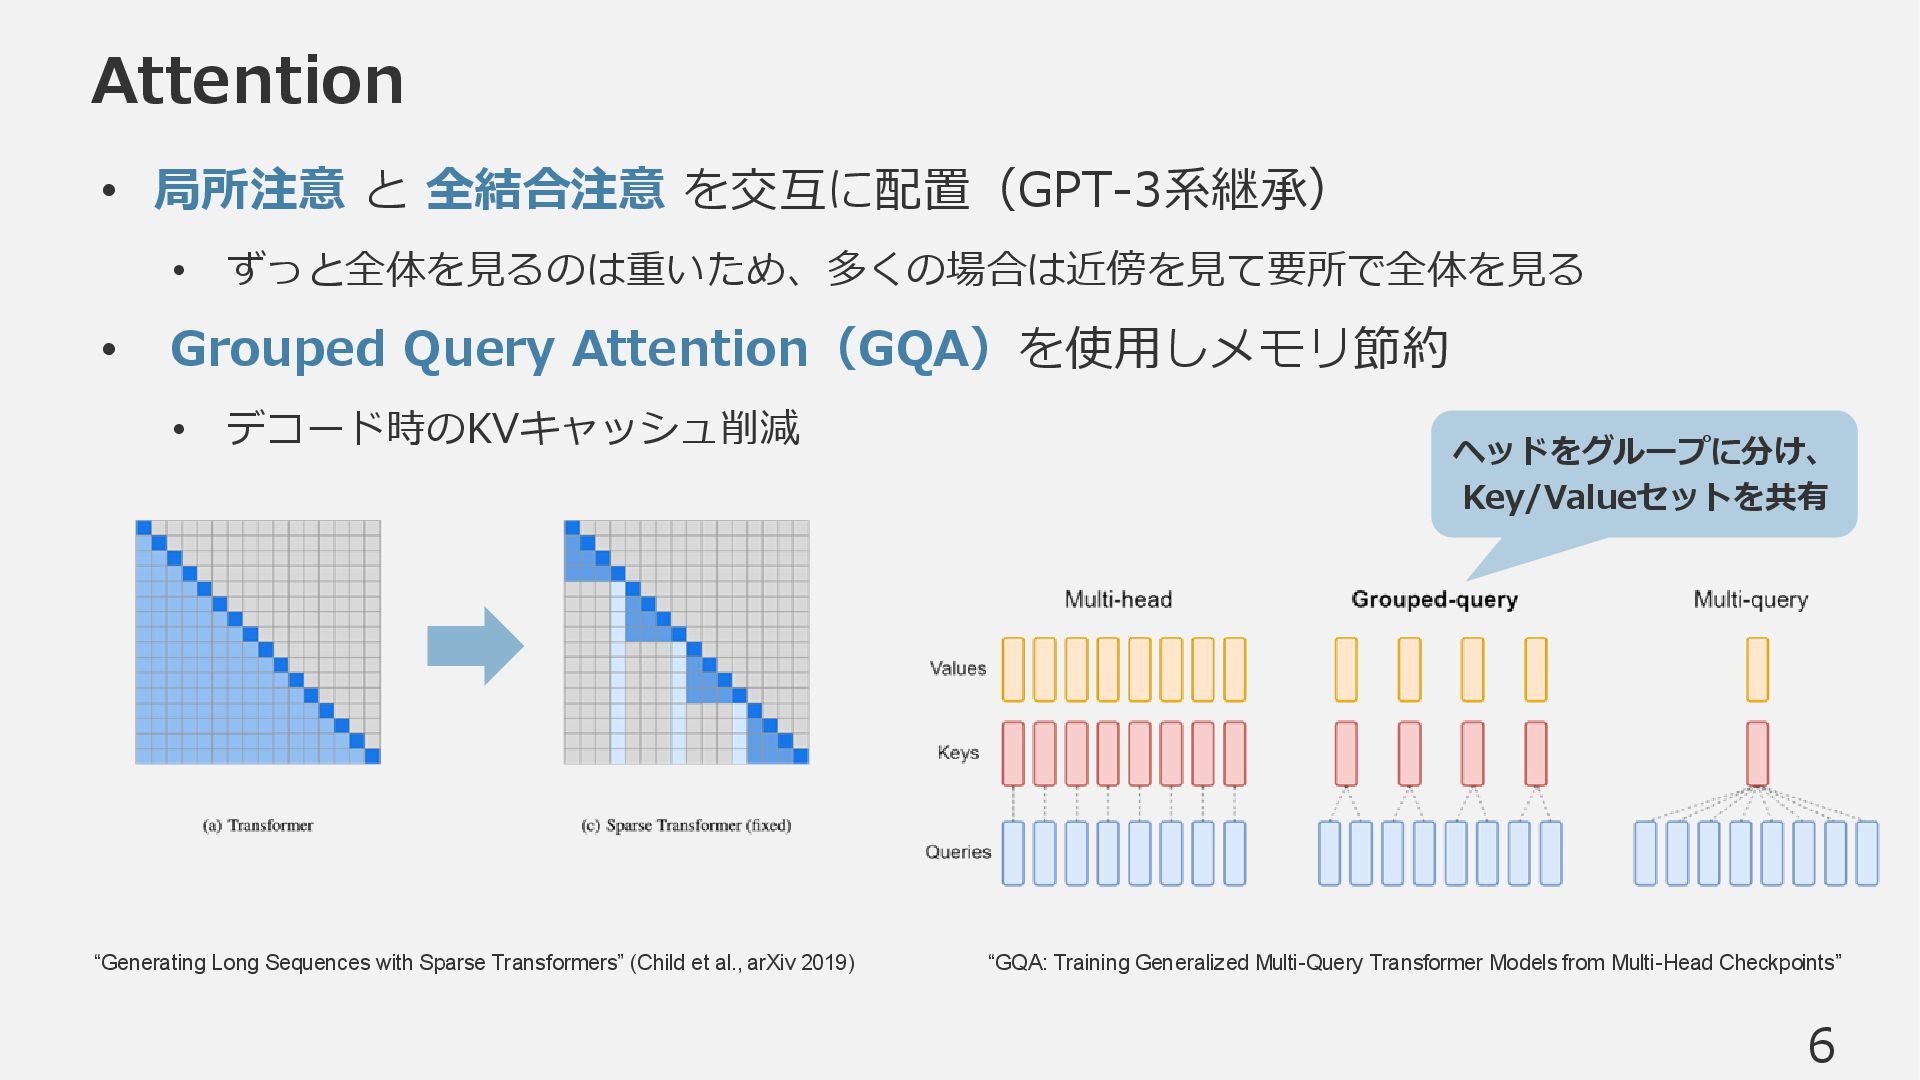
  3. Attention • 局所注意 と 全結合注意 を交互に配置(GPT-3系継承) • ずっと全体を見るのは重いため、多くの場合は近傍を見て要所で全体を見る • Grouped

    Query Attention(GQA)を使用しメモリ節約 • デコード時のKVキャッシュ削減 6 “Generating Long Sequences with Sparse Transformers” (Child et al., arXiv 2019) “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints” ヘッドをグループに分け、 Key/Valueセットを共有
  4. 事前学習 • 数兆トークンに及ぶテキストのみのデータセットで学習 • 特にSTEM(科学、技術、工学、数学)、コーディング、一般知識に重点 • ただし、データの詳細は不明 • モデルの安全性を向上させるため有害なコンテンツ(特に危険なバイオセ キュリティ知識に関するデータ)はフィルタリング

    • GPT-4oで用いられたCBRN(化学、生物、放射性物質、核)の事前学習フィルターを 再利用 • モデルの知識カットオフは2024年6月 • gpt-oss-120bのトレーニングには210万H100時間が必要で、gpt-oss-20b は約10分の1の時間で完了 8
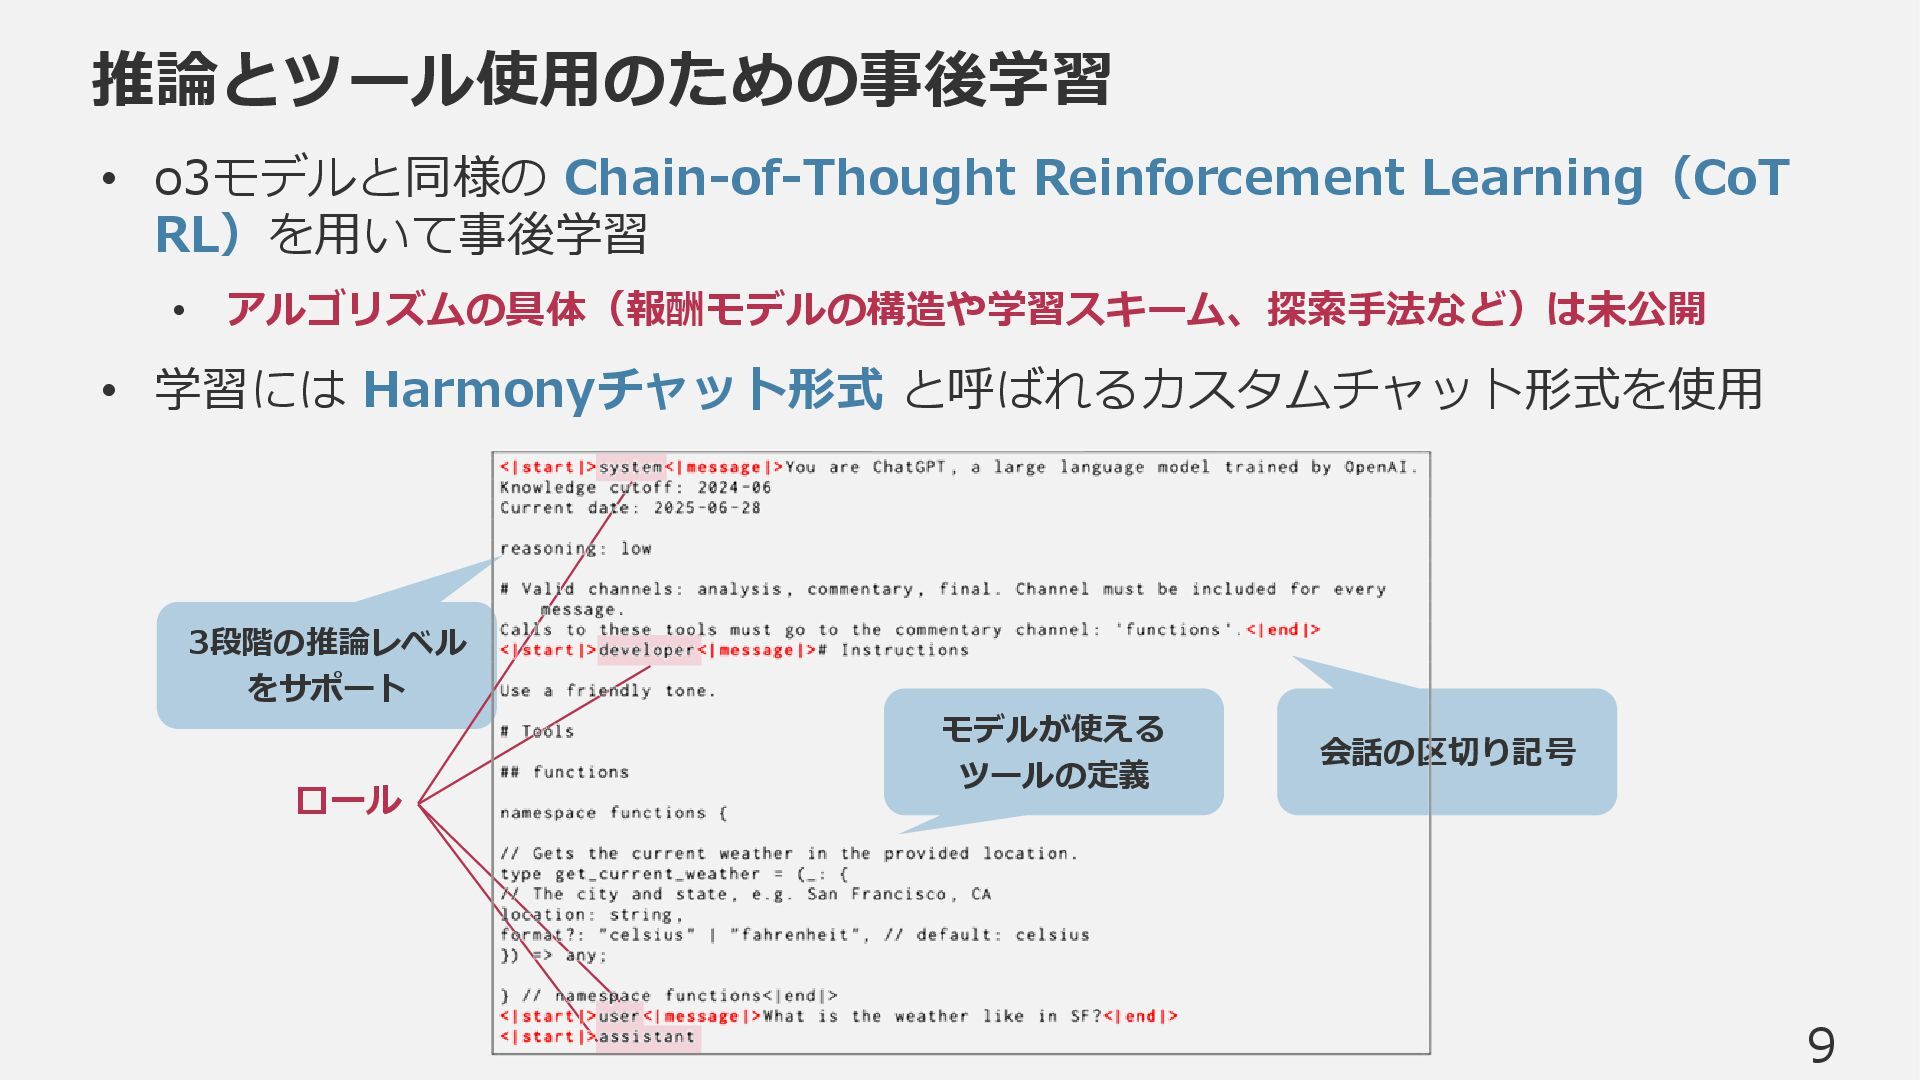
  5. 推論とツール使用のための事後学習 • o3モデルと同様の Chain-of-Thought Reinforcement Learning(CoT RL)を用いて事後学習 • アルゴリズムの具体(報酬モデルの構造や学習スキーム、探索手法など)は未公開 •

    学習には Harmonyチャット形式 と呼ばれるカスタムチャット形式を使用 9 3段階の推論レベル をサポート 会話の区切り記号 ロール モデルが使える ツールの定義