Share
Embed
Transcript
29 slides
-
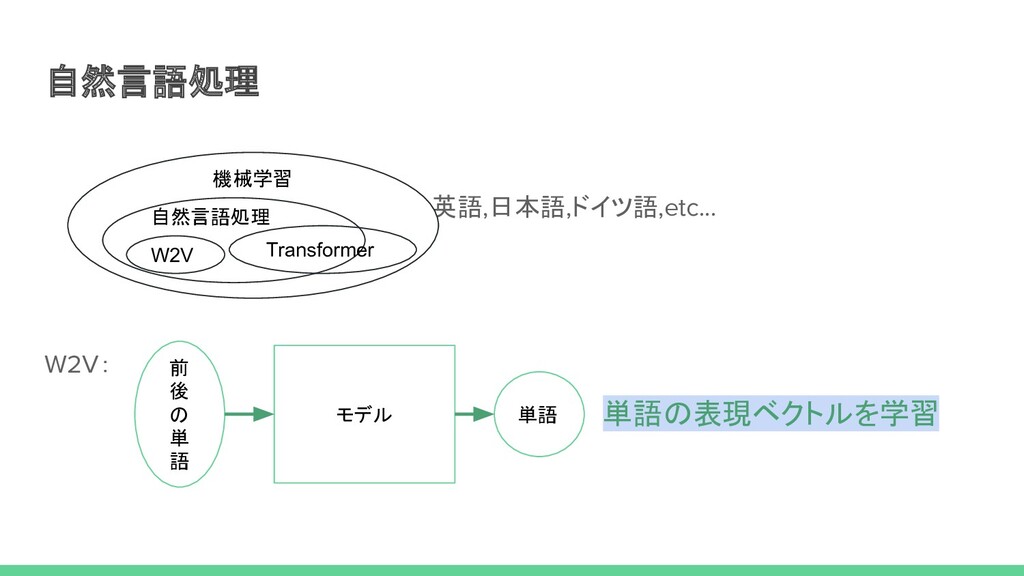
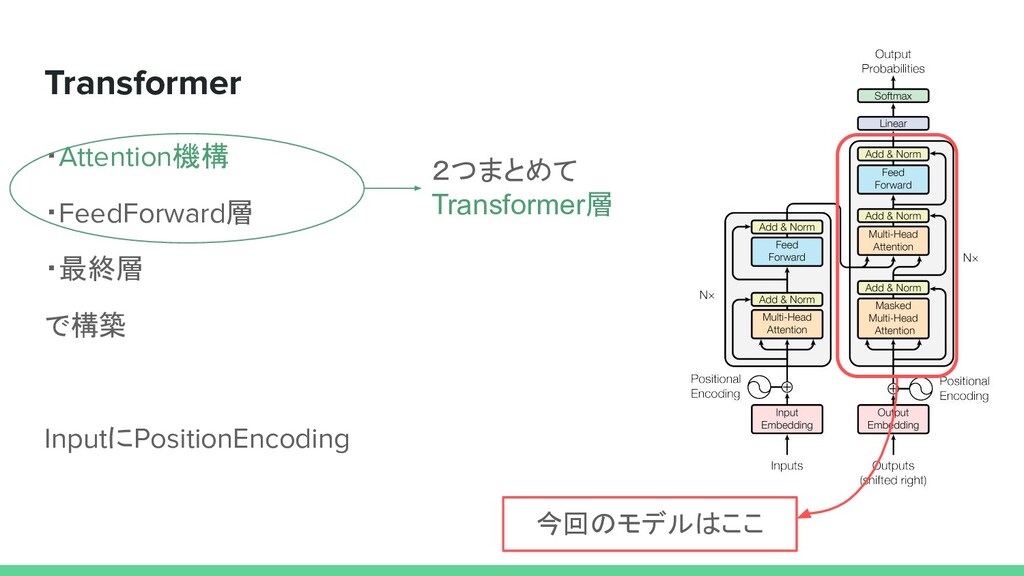
自然言語処理 自然言語:英語,日本語,ドイツ語,etc... W2V: 機械学習 自然言語処理 W2V Transformer 前 後 の
単 語 モデル 単語 単語の表現ベクトルを学習 -
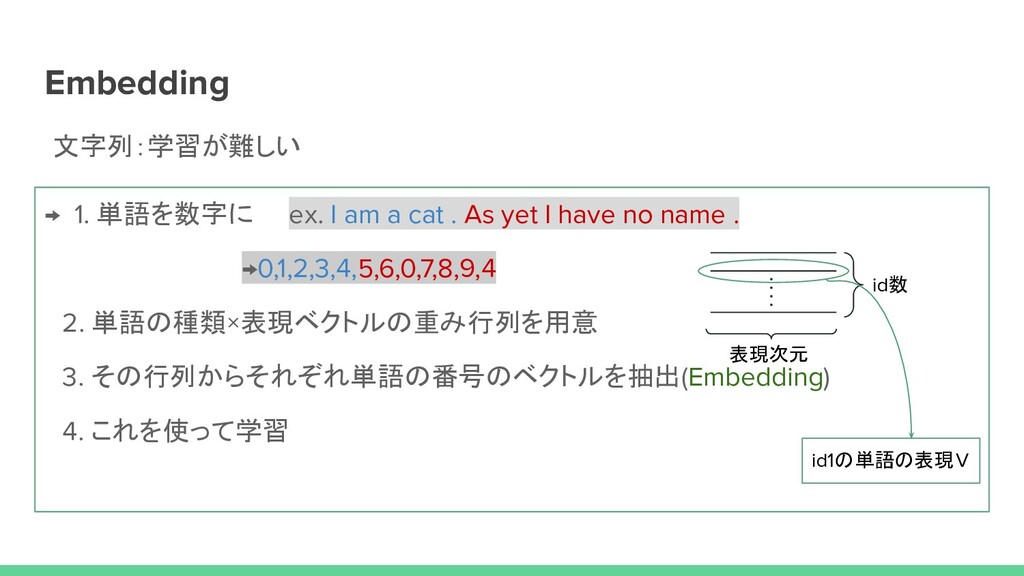
Embedding → 1. 単語を数字に ex. I am a cat . As
yet I have no name . →0,1,2,3,4,5,6,0,7,8,9,4 2. 単語の種類×表現ベクトルの重み行列を用意 3. その行列からそれぞれ単語の番号のベクトルを抽出(Embedding) 4. これを使って学習 文字列:学習が難しい id数 表現次元 id1の単語の表現V -
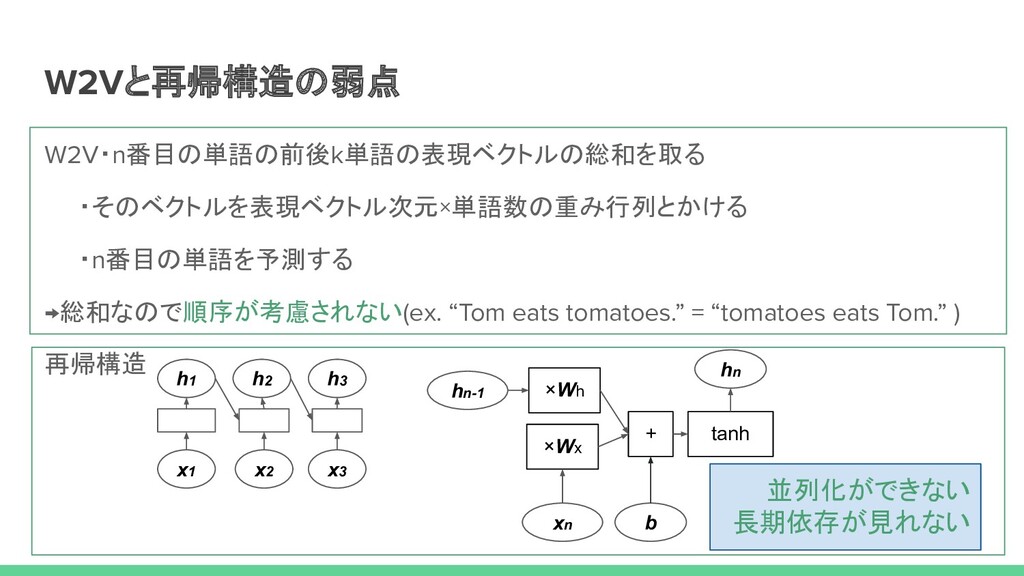
W2Vと再帰構造の弱点 W2V・n番目の単語の前後k単語の表現ベクトルの総和を取る ・そのベクトルを表現ベクトル次元×単語数の重み行列とかける ・n番目の単語を予測する →総和なので順序が考慮されない(ex. “Tom eats tomatoes.” = “tomatoes
eats Tom.” ) 再帰構造 x1 x2 x3 h1 h3 h2 xn hn-1 ×Wh ×Wx + hn tanh b 並列化ができない 長期依存が見れない -
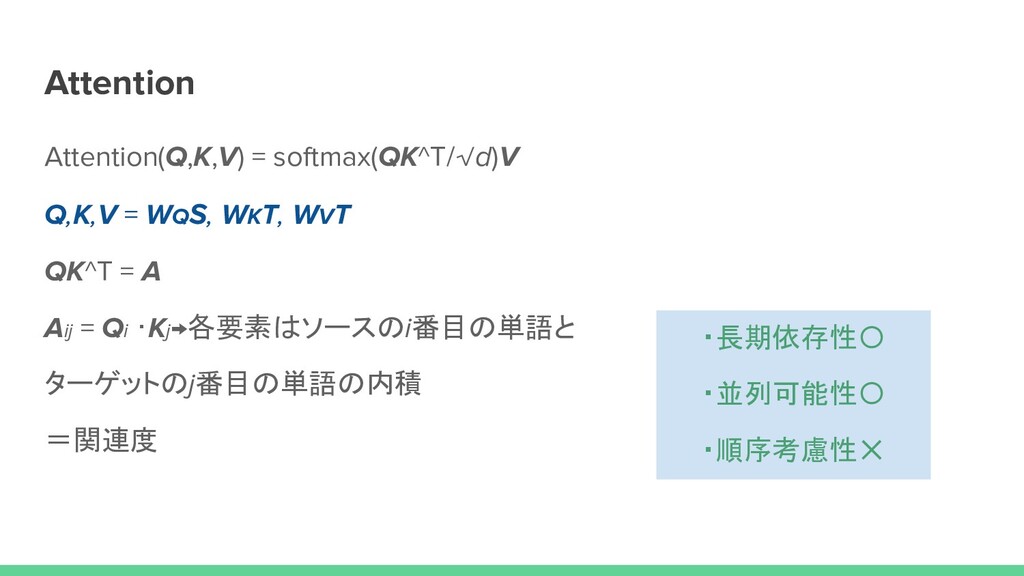
Attention Attention(Q,K,V) = softmax(QK^T/√d)V Q,K,V = WQS, WKT, WVT QK^T
= A Aij = Qi ・Kj→各要素はソースのi番目の単語と ターゲットのj番目の単語の内積 =関連度 ・長期依存性〇 ・並列可能性〇 ・順序考慮性✕ -
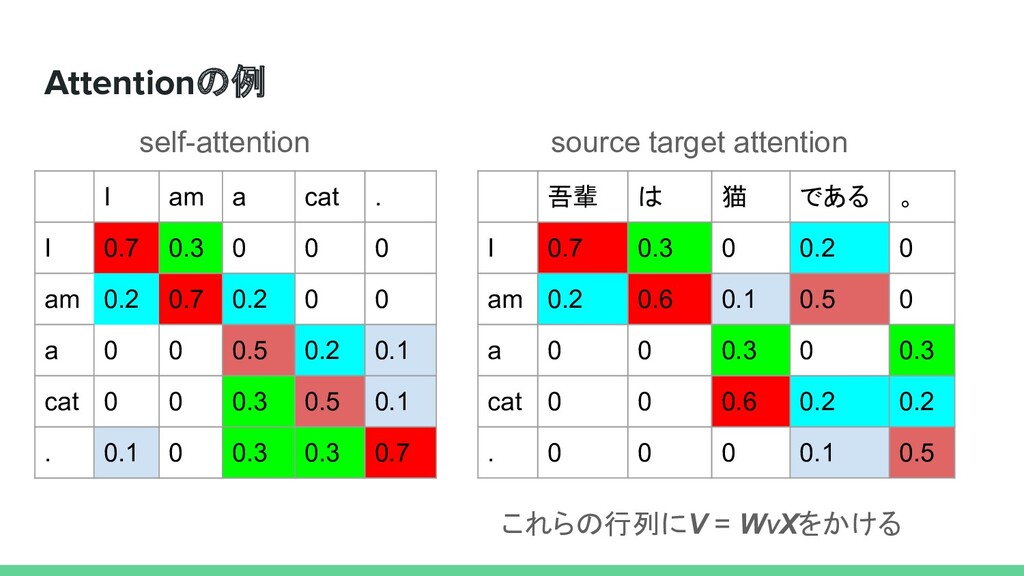
Attentionの例 I am a cat . I 0.7 0.3 0
0 0 am 0.2 0.7 0.2 0 0 a 0 0 0.5 0.2 0.1 cat 0 0 0.3 0.5 0.1 . 0.1 0 0.3 0.3 0.7 吾輩 は 猫 である 。 I 0.7 0.3 0 0.2 0 am 0.2 0.6 0.1 0.5 0 a 0 0 0.3 0 0.3 cat 0 0 0.6 0.2 0.2 . 0 0 0 0.1 0.5 self-attention source target attention これらの行列にV = WVXをかける -
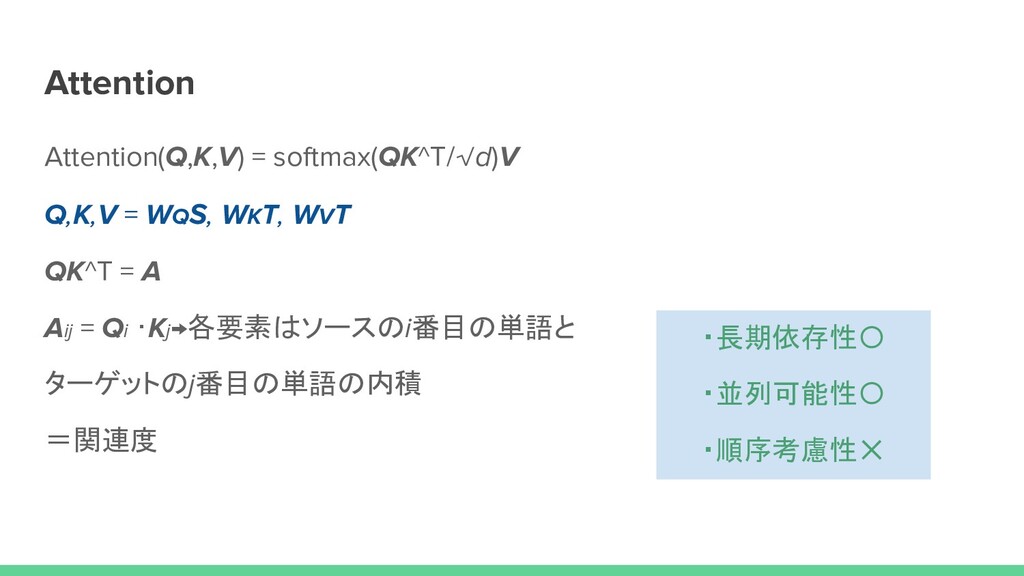
Attention Attention(Q,K,V) = softmax(QK^T/√d)V Q,K,V = WQS, WKT, WVT QK^T
= A Aij = Qi ・Kj→各要素はソースのi番目の単語と ターゲットのj番目の単語の内積 =関連度 ・長期依存性〇 ・並列可能性〇 ・順序考慮性✕ -
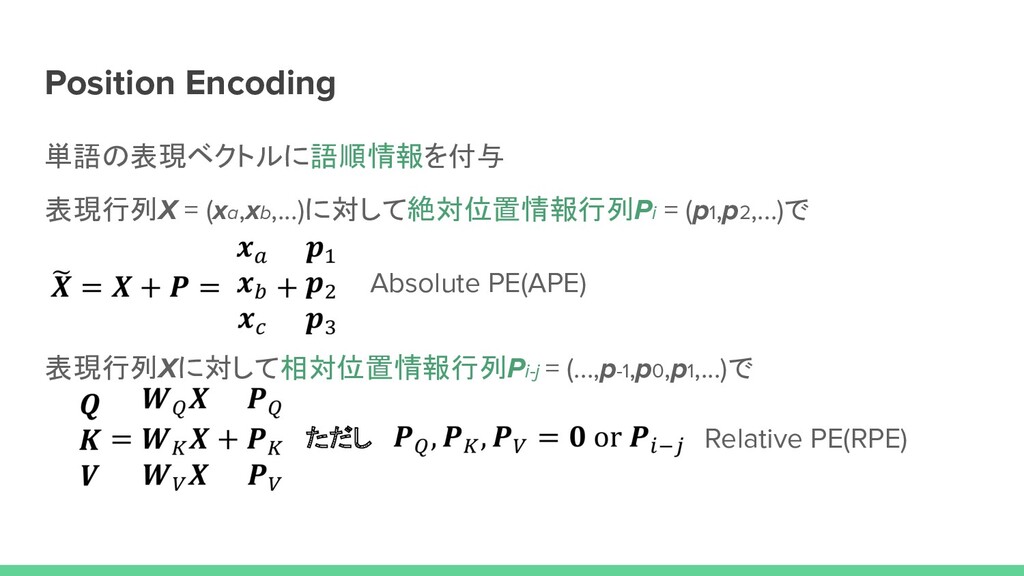
Position Encoding 単語の表現ベクトルに語順情報を付与 表現行列X = (xa,xb,...)に対して絶対位置情報行列Pi = (p1,p2,...)で 表現行列Xに対して相対位置情報行列Pi-j
= (...,p-1,p0,p1,...)で Absolute PE(APE) ただし Relative PE(RPE) -
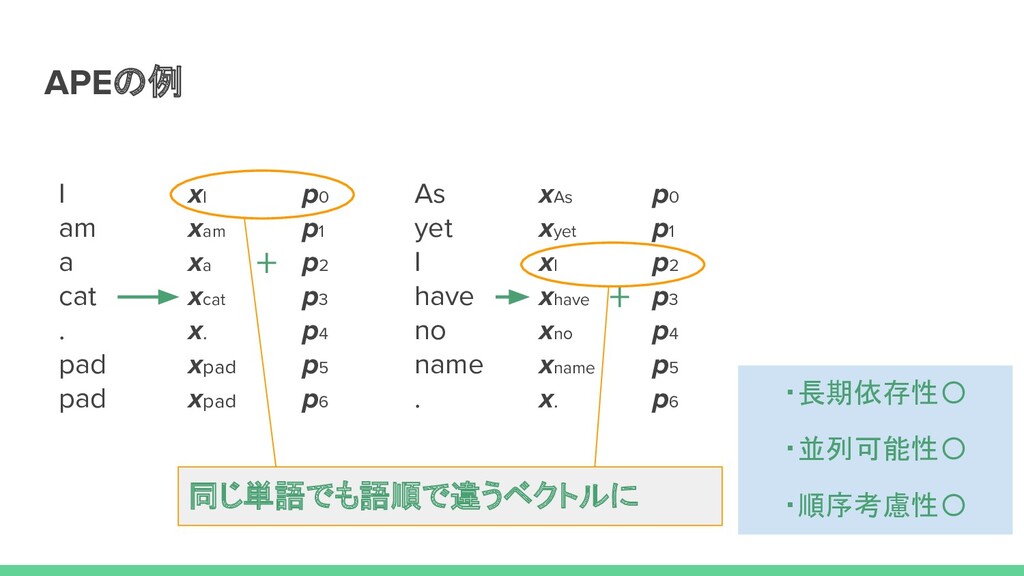
APEの例 I am a cat . pad pad xI xam
xa xcat x. xpad xpad + As yet I have no name . xAs xyet xI xhave xno xname x. p0 p1 p2 p3 p4 p5 p6 + 同じ単語でも語順で違うベクトルに p0 p1 p2 p3 p4 p5 p6 ・長期依存性〇 ・並列可能性〇 ・順序考慮性〇 -
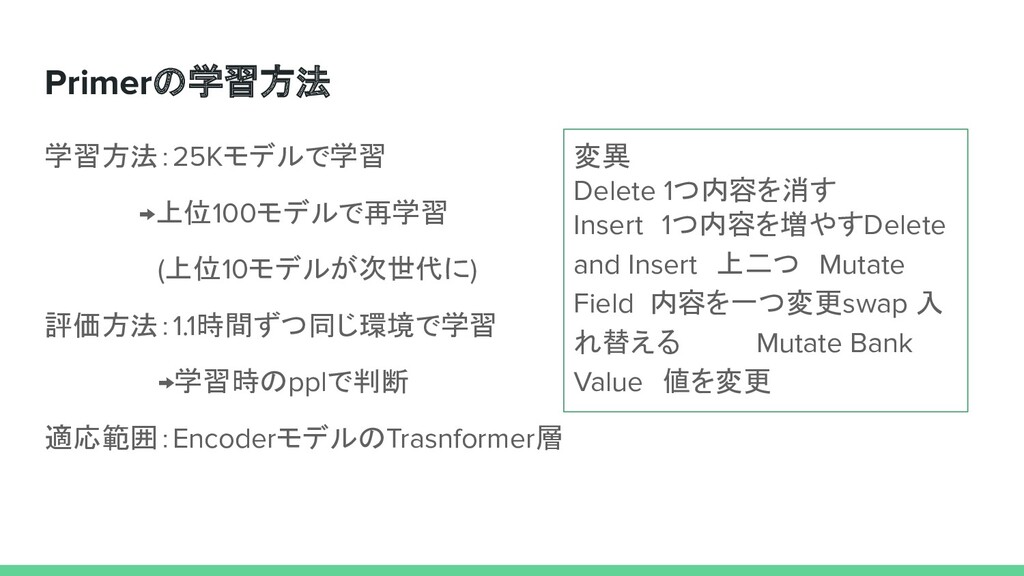
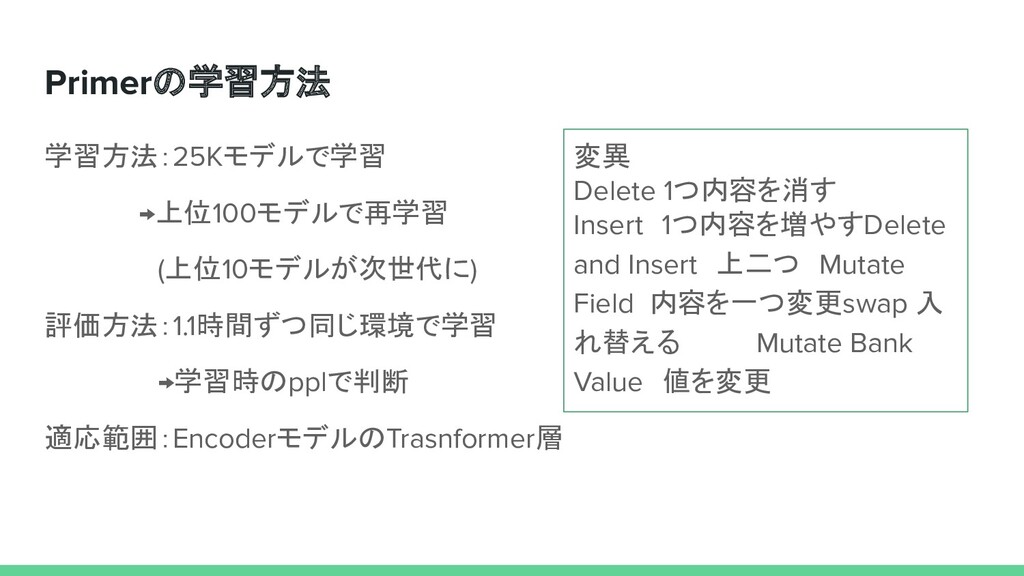
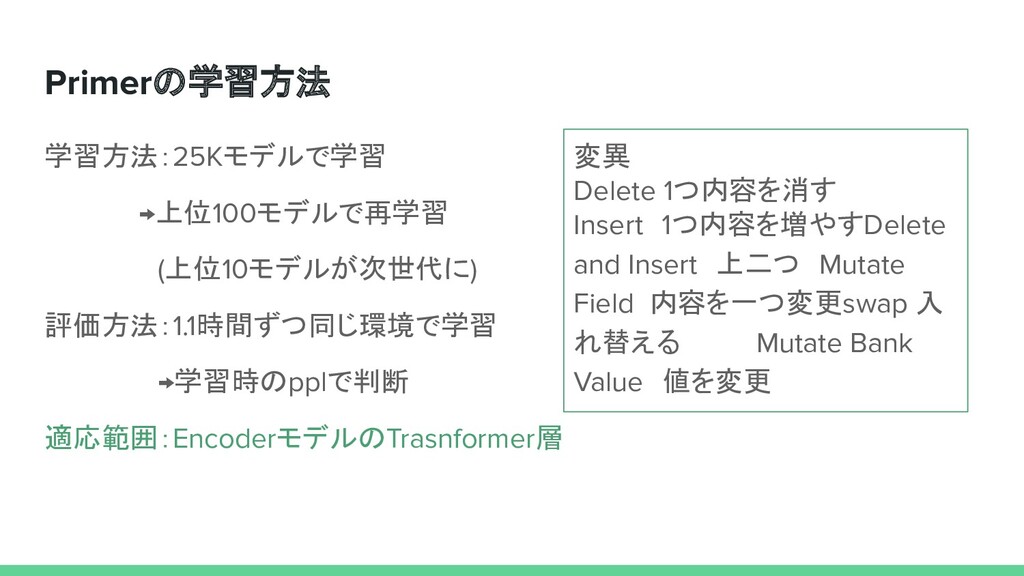
Primerの学習方法 学習方法:25Kモデルで学習 →上位100モデルで再学習 (上位10モデルが次世代に) 評価方法:1.1時間ずつ同じ環境で学習 →学習時のpplで判断 適応範囲:EncoderモデルのTrasnformer層 変異 Delete 1つ内容を消す
Insert 1つ内容を増やすDelete and Insert 上二つ Mutate Field 内容を一つ変更swap 入 れ替える Mutate Bank Value 値を変更 -
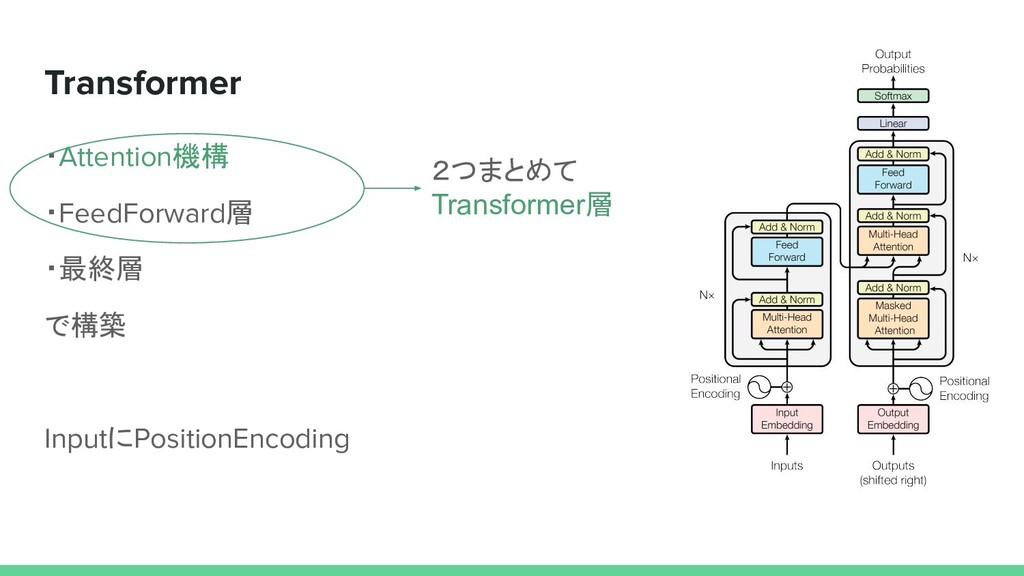
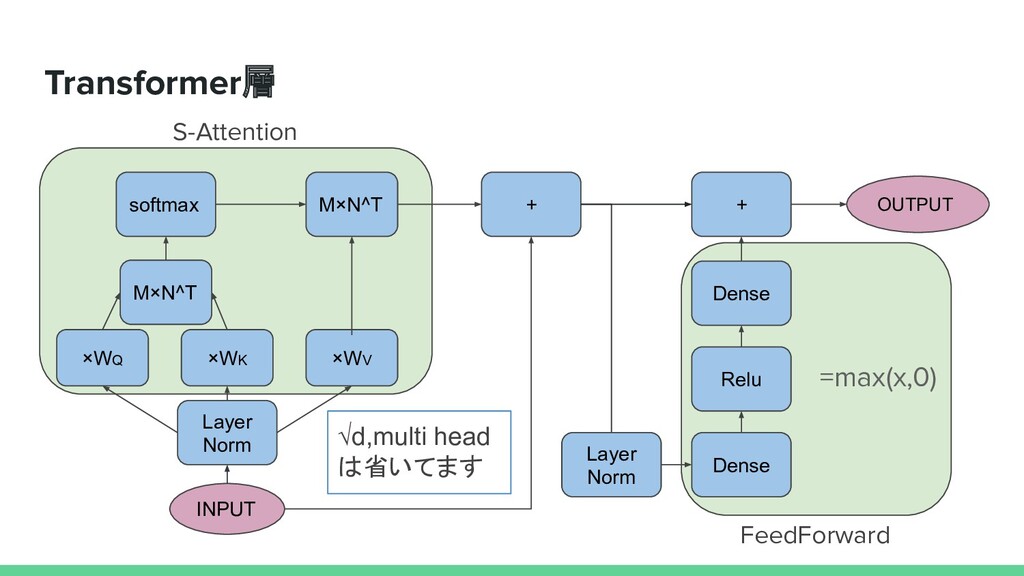
Transformer層 INPUT ×WQ ×WK ×WV M×N^T softmax Layer Norm M×N^T
+ Dense Relu Dense OUTPUT Layer Norm + √d,multi head は省いてます =max(x,0) S-Attention FeedForward -
Primerの学習方法 学習方法:25Kモデルで学習 →上位100モデルで再学習 (上位10モデルが次世代に) 評価方法:1.1時間ずつ同じ環境で学習 →学習時のpplで判断 適応範囲:EncoderモデルのTrasnformer層 変異 Delete 1つ内容を消す
Insert 1つ内容を増やすDelete and Insert 上二つ Mutate Field 内容を一つ変更swap 入 れ替える Mutate Bank Value 値を変更 -
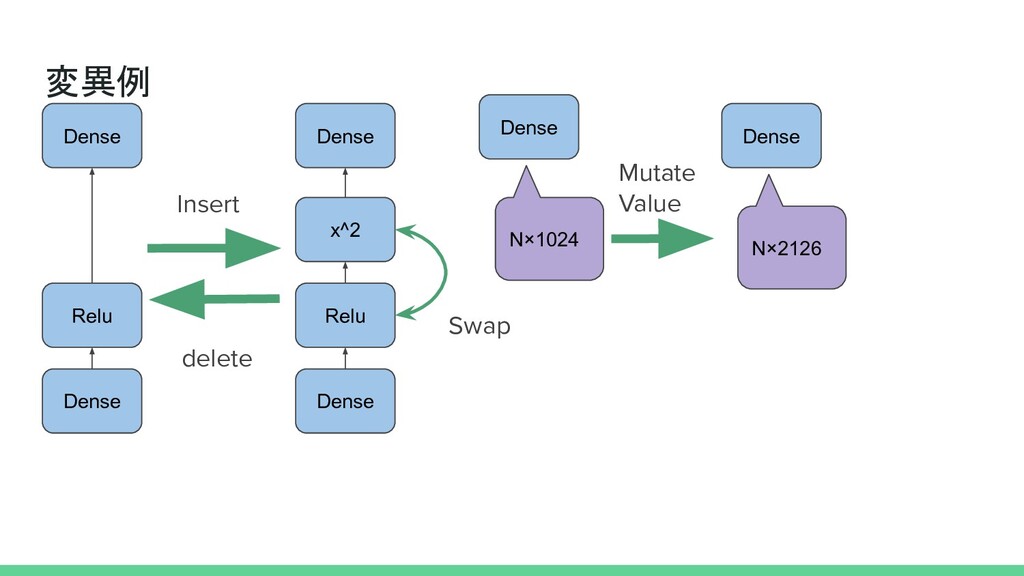
変異例 Dense Relu Dense Relu x^2 Dense Dense Insert delete
Dense N×1024 Mutate Value Dense N×2126 Swap -
Primerの学習方法 学習方法:25Kモデルで学習 →上位100モデルで再学習 (上位10モデルが次世代に) 評価方法:1.1時間ずつ同じ環境で学習 →学習時のpplで判断 適応範囲:EncoderモデルのTrasnformer層 変異 Delete 1つ内容を消す
Insert 1つ内容を増やすDelete and Insert 上二つ Mutate Field 内容を一つ変更swap 入 れ替える Mutate Bank Value 値を変更 -
Encoderモデルの学習 INPUT OUTPUT I am a cat . [PAD] model
[EOS] I am a cat . -
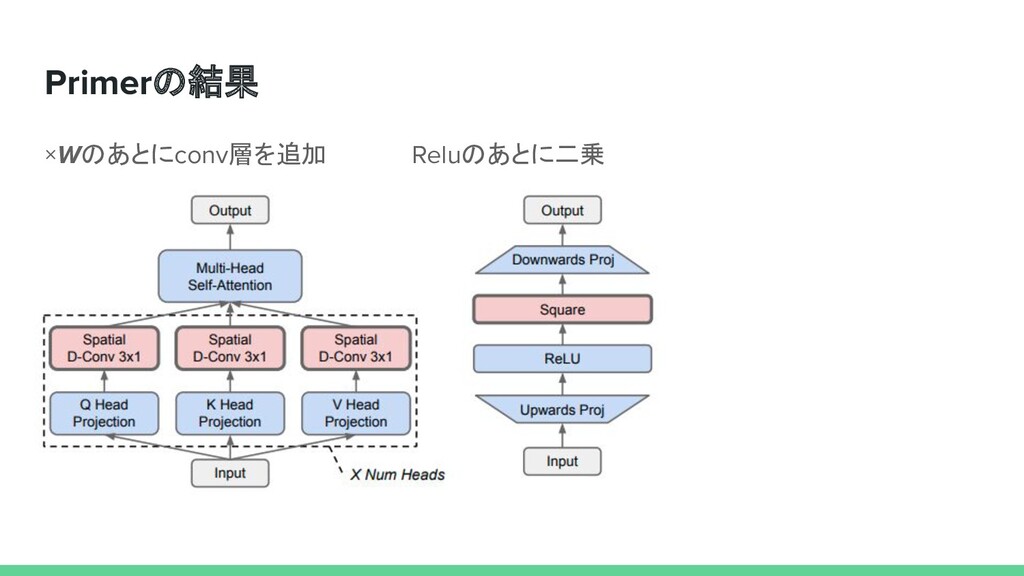
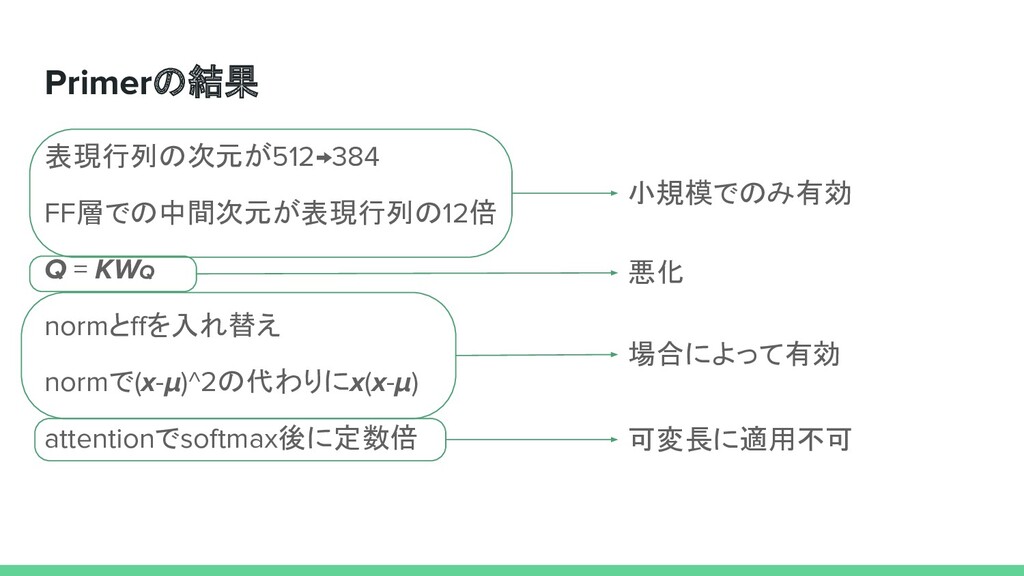
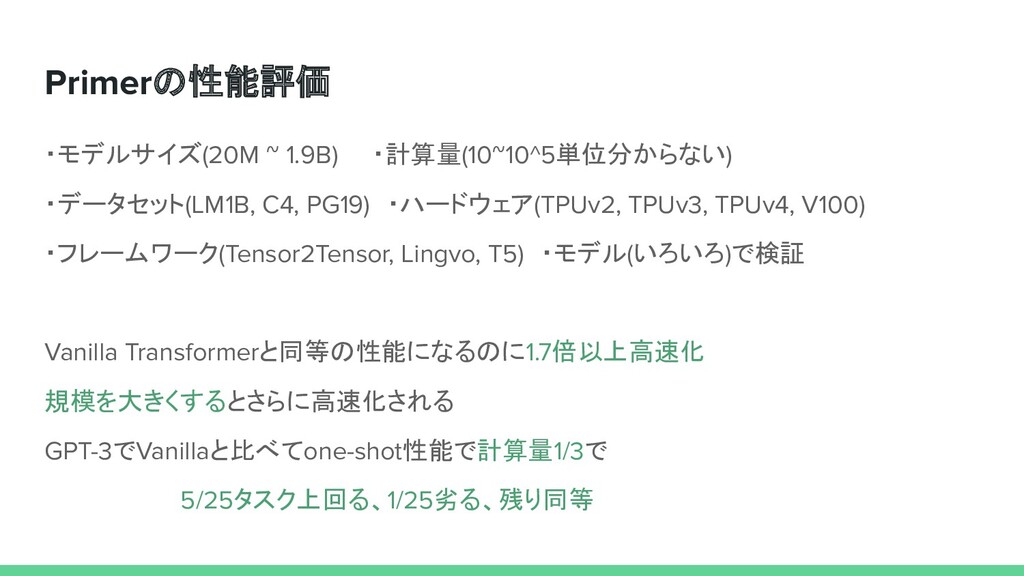
Primerの性能評価 ・モデルサイズ(20M ~ 1.9B) ・計算量(10~10^5単位分からない) ・データセット(LM1B, C4, PG19) ・ハードウェア(TPUv2, TPUv3, TPUv4, V100)
・フレームワーク(Tensor2Tensor, Lingvo, T5) ・モデル(いろいろ)で検証 Vanilla Transformerと同等の性能になるのに1.7倍以上高速化 規模を大きくするとさらに高速化される GPT-3でVanillaと比べてone-shot性能で計算量1/3で 5/25タスク上回る、1/25劣る、残り同等 -
参考文献 Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion
Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin Attention Is All You Need In Neural Information Processing Systems, (NIPS),2017 David R. So, Wojciech Manke, Hanxiao Liu, Zihang Dai, Noam Shazeer, Quoc V. Le Primer: Searching for Efficient Transformers for Language Modeling In Neural Information Processing Systems, (NeurIPS),2021