Share
Embed
[JSAI23]Referring Expression Segmentation With Large-Scale Visual Language Model and Denoising Diffusion Probabilistic Model in Household Tasks
Semantic Machine Intelligence Lab., Keio Univ. PRO
June 01, 2023
Transcript
26 slides
-
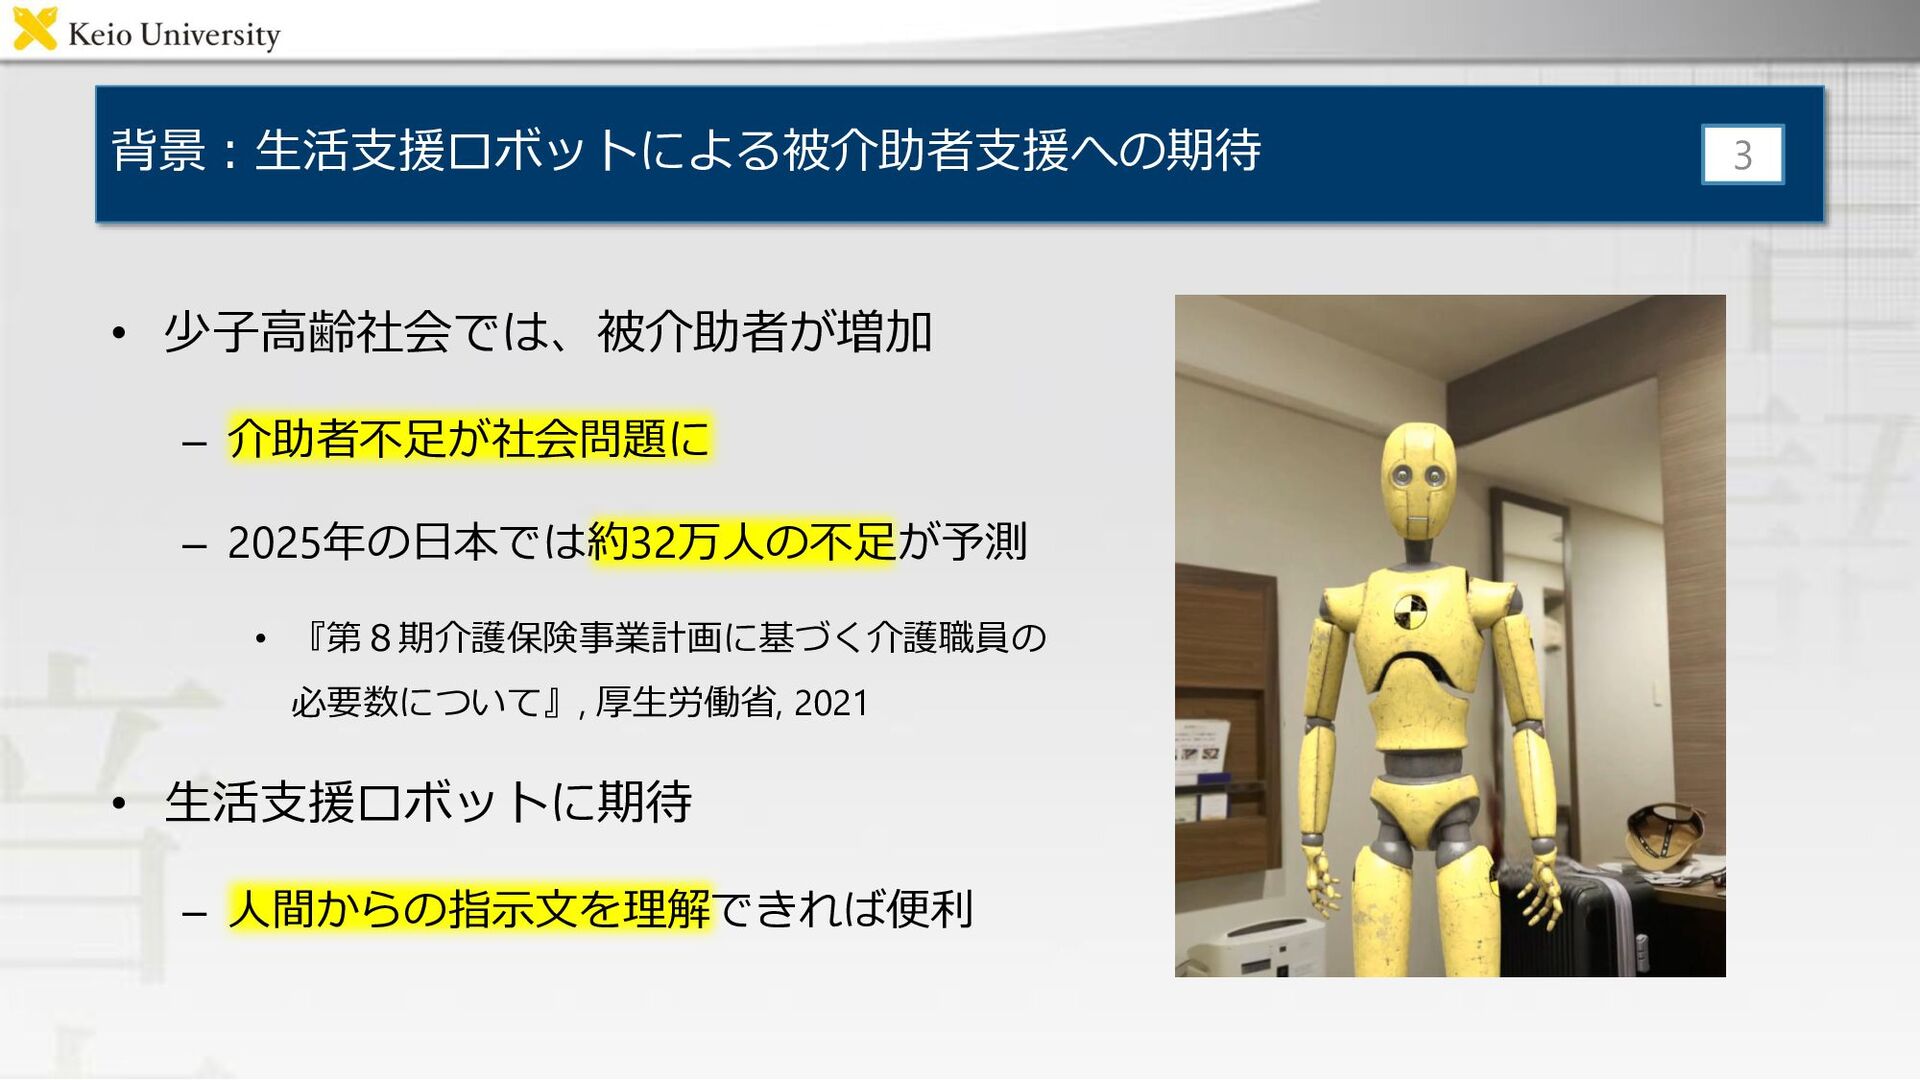
背景:生活支援ロボットによる被介助者支援への期待 • 少子高齢社会では、被介助者が増加 – 介助者不足が社会問題に – 2025年の日本では約32万人の不足が予測 • 『第8期介護保険事業計画に基づく介護職員の 必要数について』,
厚生労働省, 2021 • 生活支援ロボットに期待 – 人間からの指示文を理解できれば便利 3 -
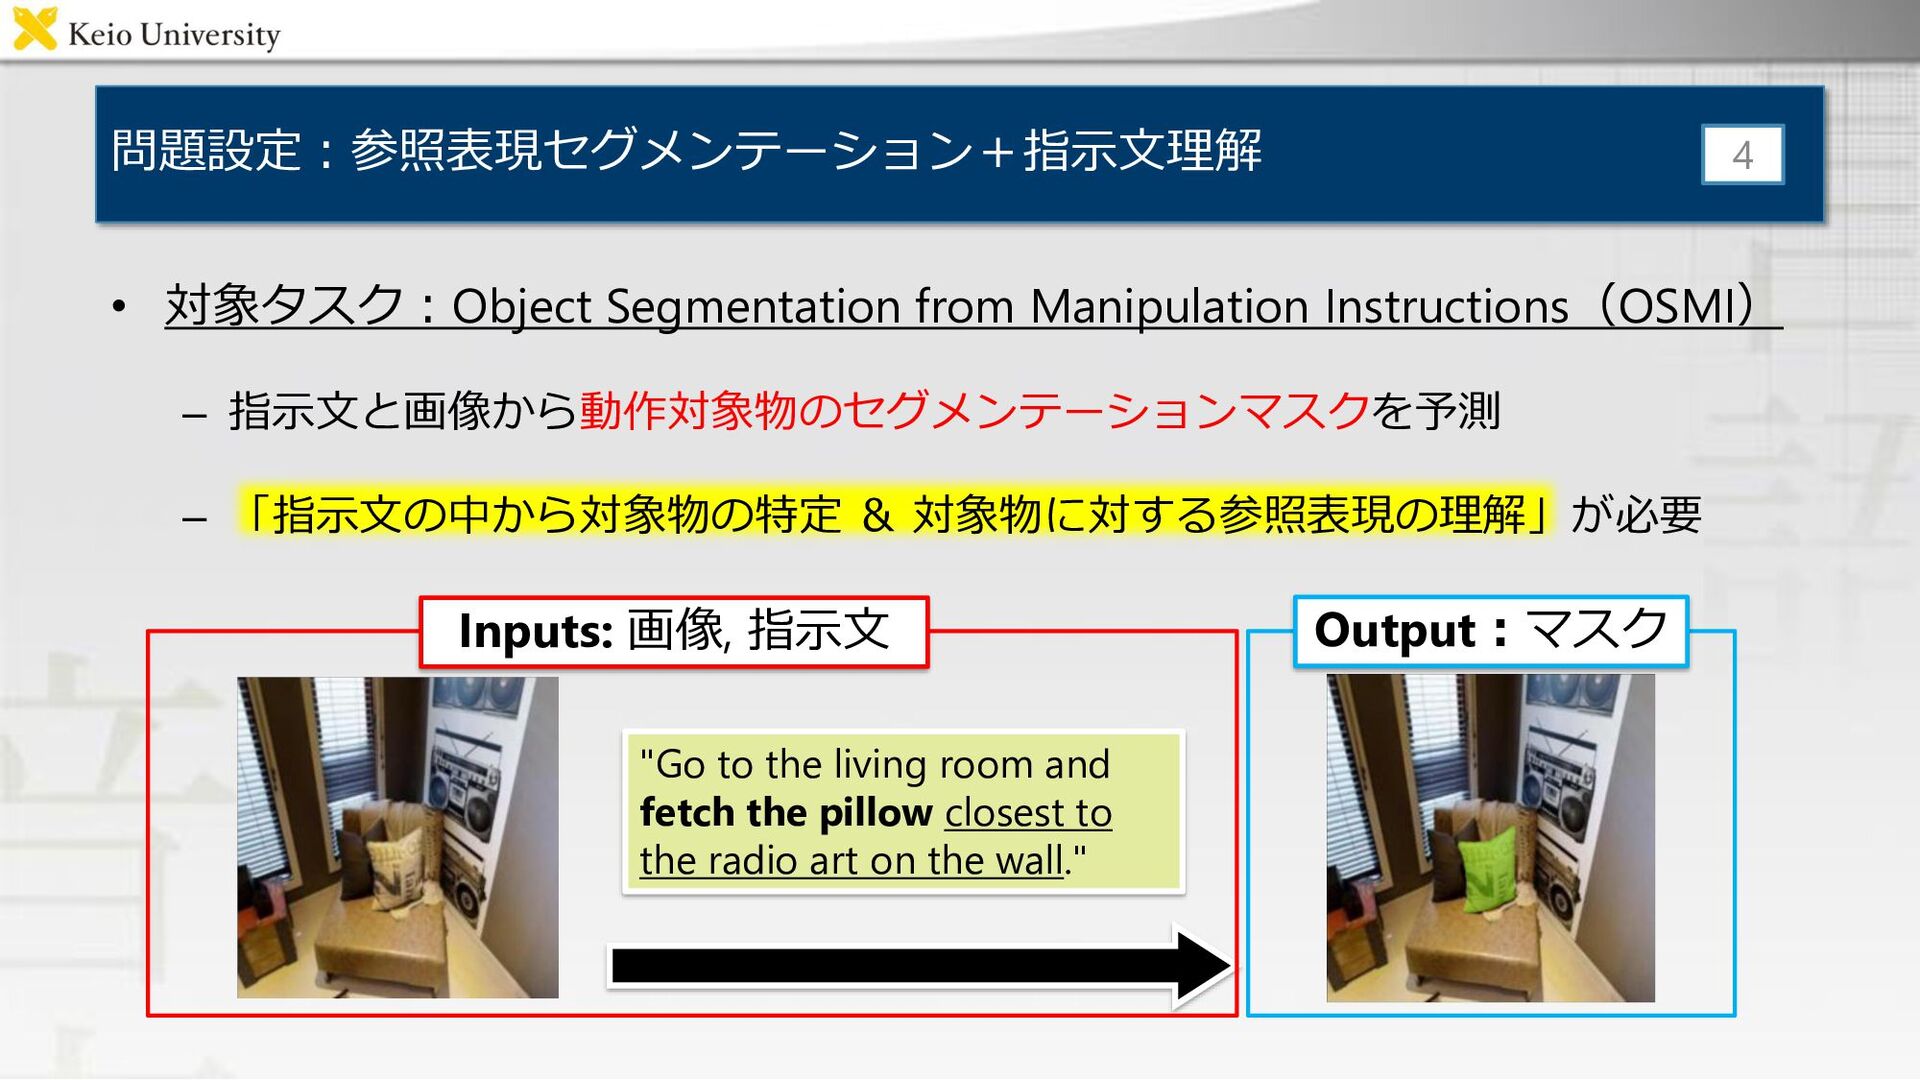
問題設定:参照表現セグメンテーション+指示文理解 • 対象タスク:Object Segmentation from Manipulation Instructions(OSMI) – 指示文と画像から動作対象物のセグメンテーションマスクを予測 –
「指示文の中から対象物の特定 & 対象物に対する参照表現の理解」が必要 4 "Go to the living room and fetch the pillow closest to the radio art on the wall." Inputs: 画像, 指示文 Output:マスク -
“the pillow on the right side above the couch" Inputs:
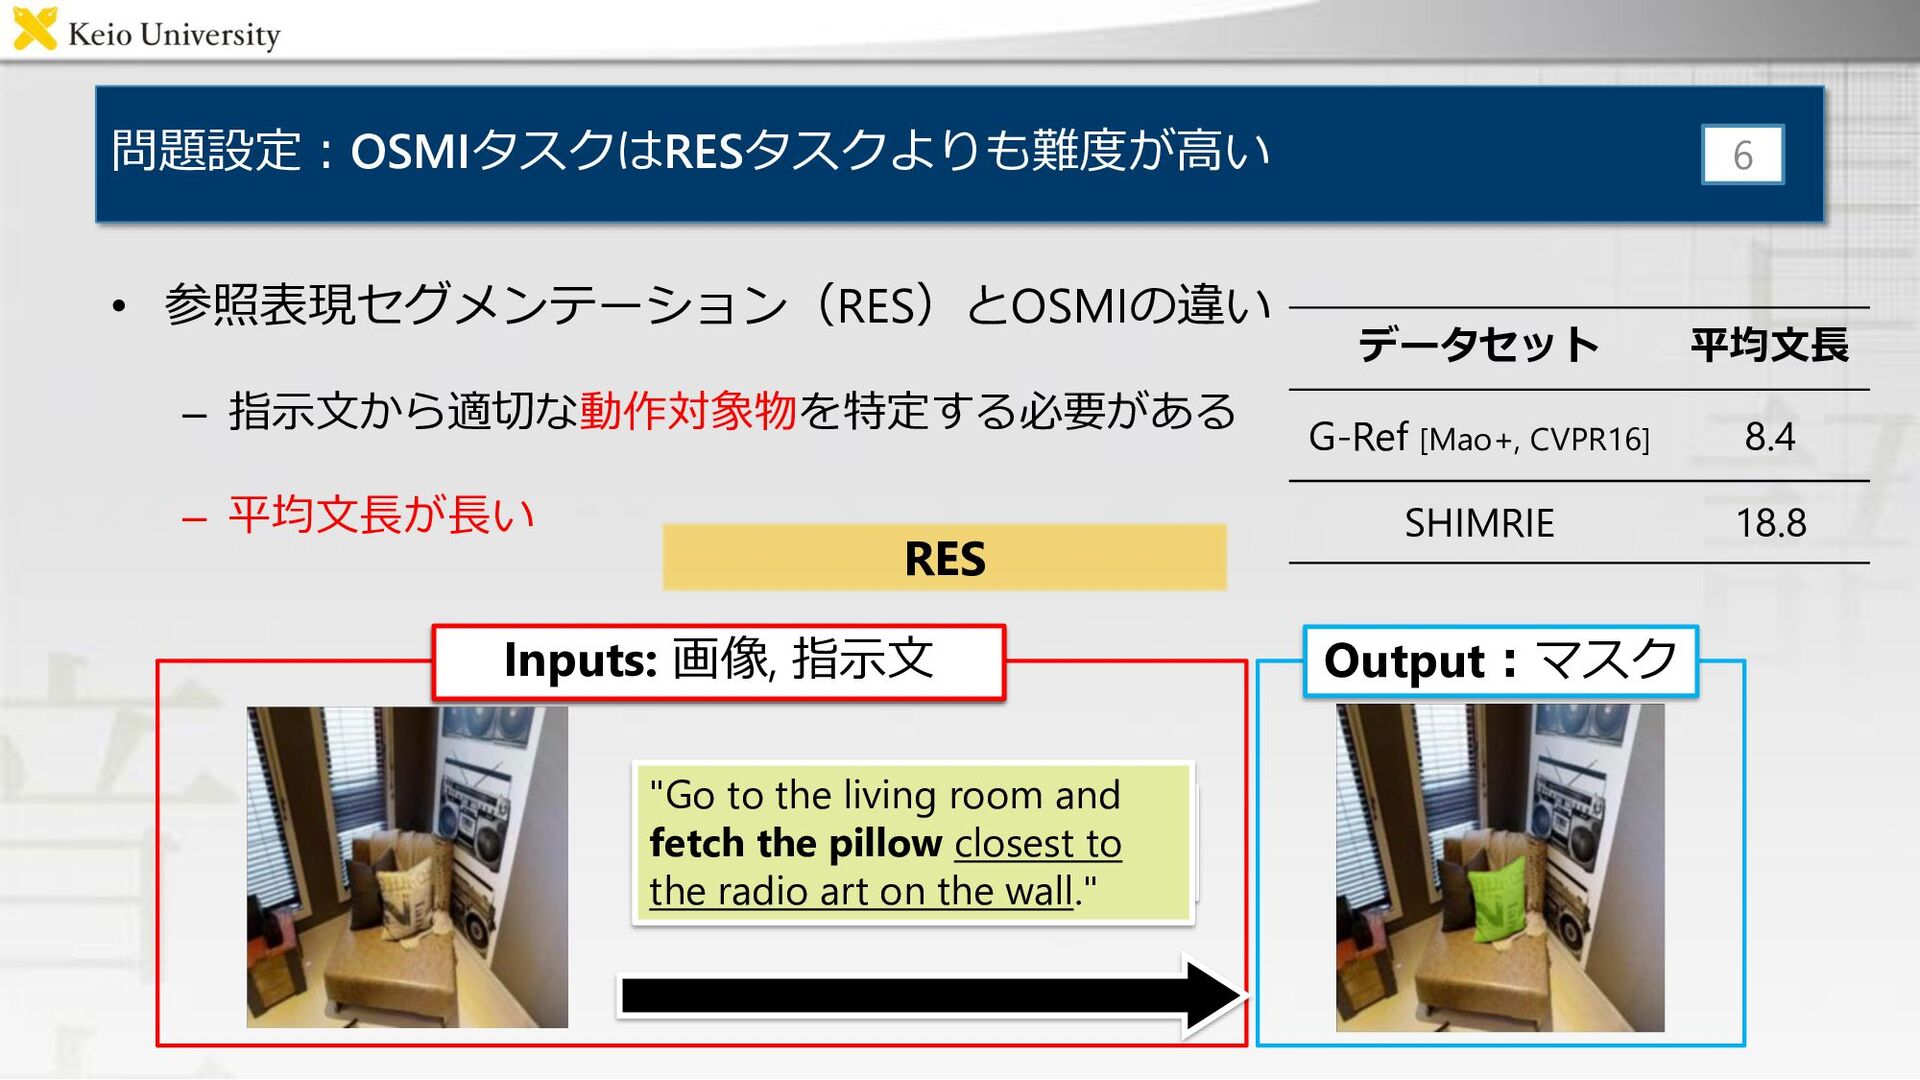
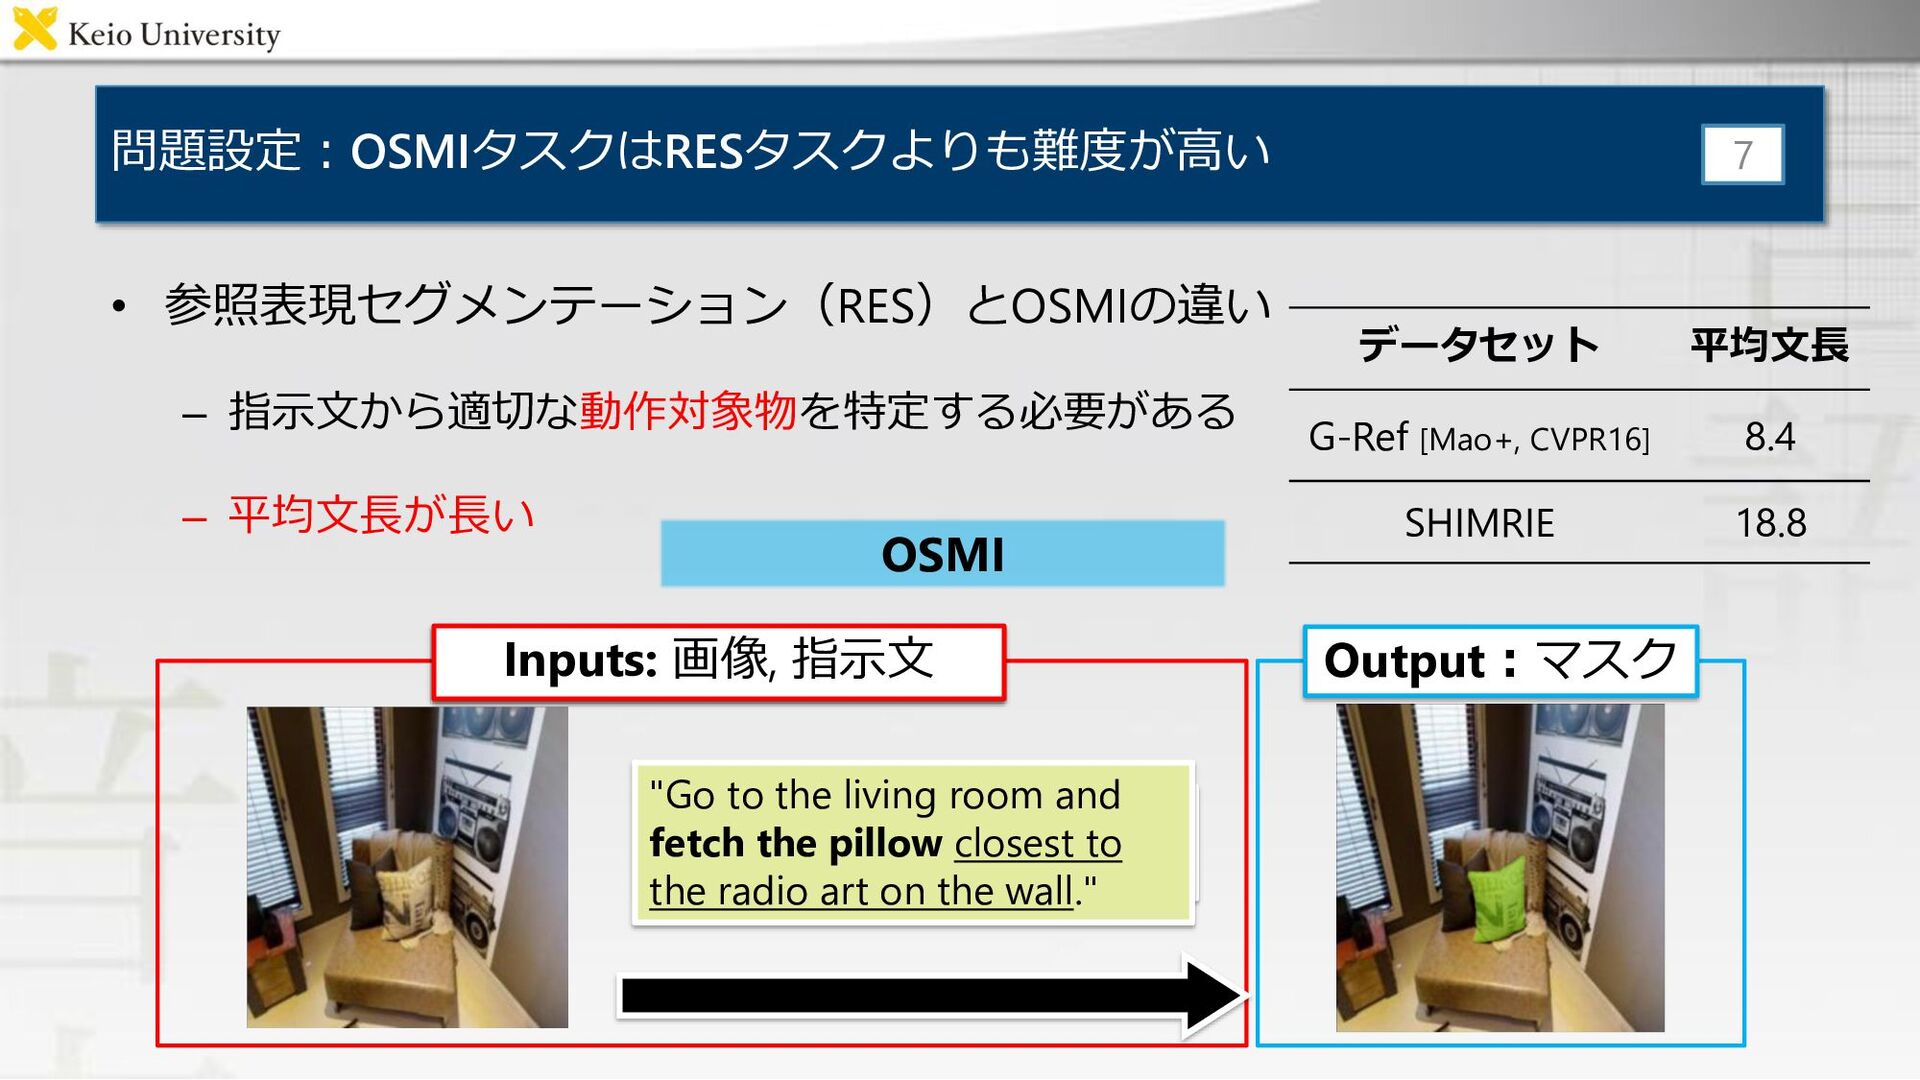
画像, 参照表現 問題設定:OSMIタスクはRESタスクよりも難度が高い • 参照表現セグメンテーション(RES)とOSMIの違い – 指示文から適切な動作対象物を特定する必要がある – 平均文長が長い 6 "Go to the living room and fetch the pillow closest to the radio art on the wall." Inputs: 画像, 指示文 Output:マスク データセット 平均文長 G-Ref [Mao+, CVPR16] 8.4 SHIMRIE 18.8 RES -
“the pillow on the right side above the couch" Inputs:
画像, 参照表現 問題設定:OSMIタスクはRESタスクよりも難度が高い • 参照表現セグメンテーション(RES)とOSMIの違い – 指示文から適切な動作対象物を特定する必要がある – 平均文長が長い 7 "Go to the living room and fetch the pillow closest to the radio art on the wall." Inputs: 画像, 指示文 Output:マスク データセット 平均文長 G-Ref [Mao+, CVPR16] 8.4 SHIMRIE 18.8 OSMI -
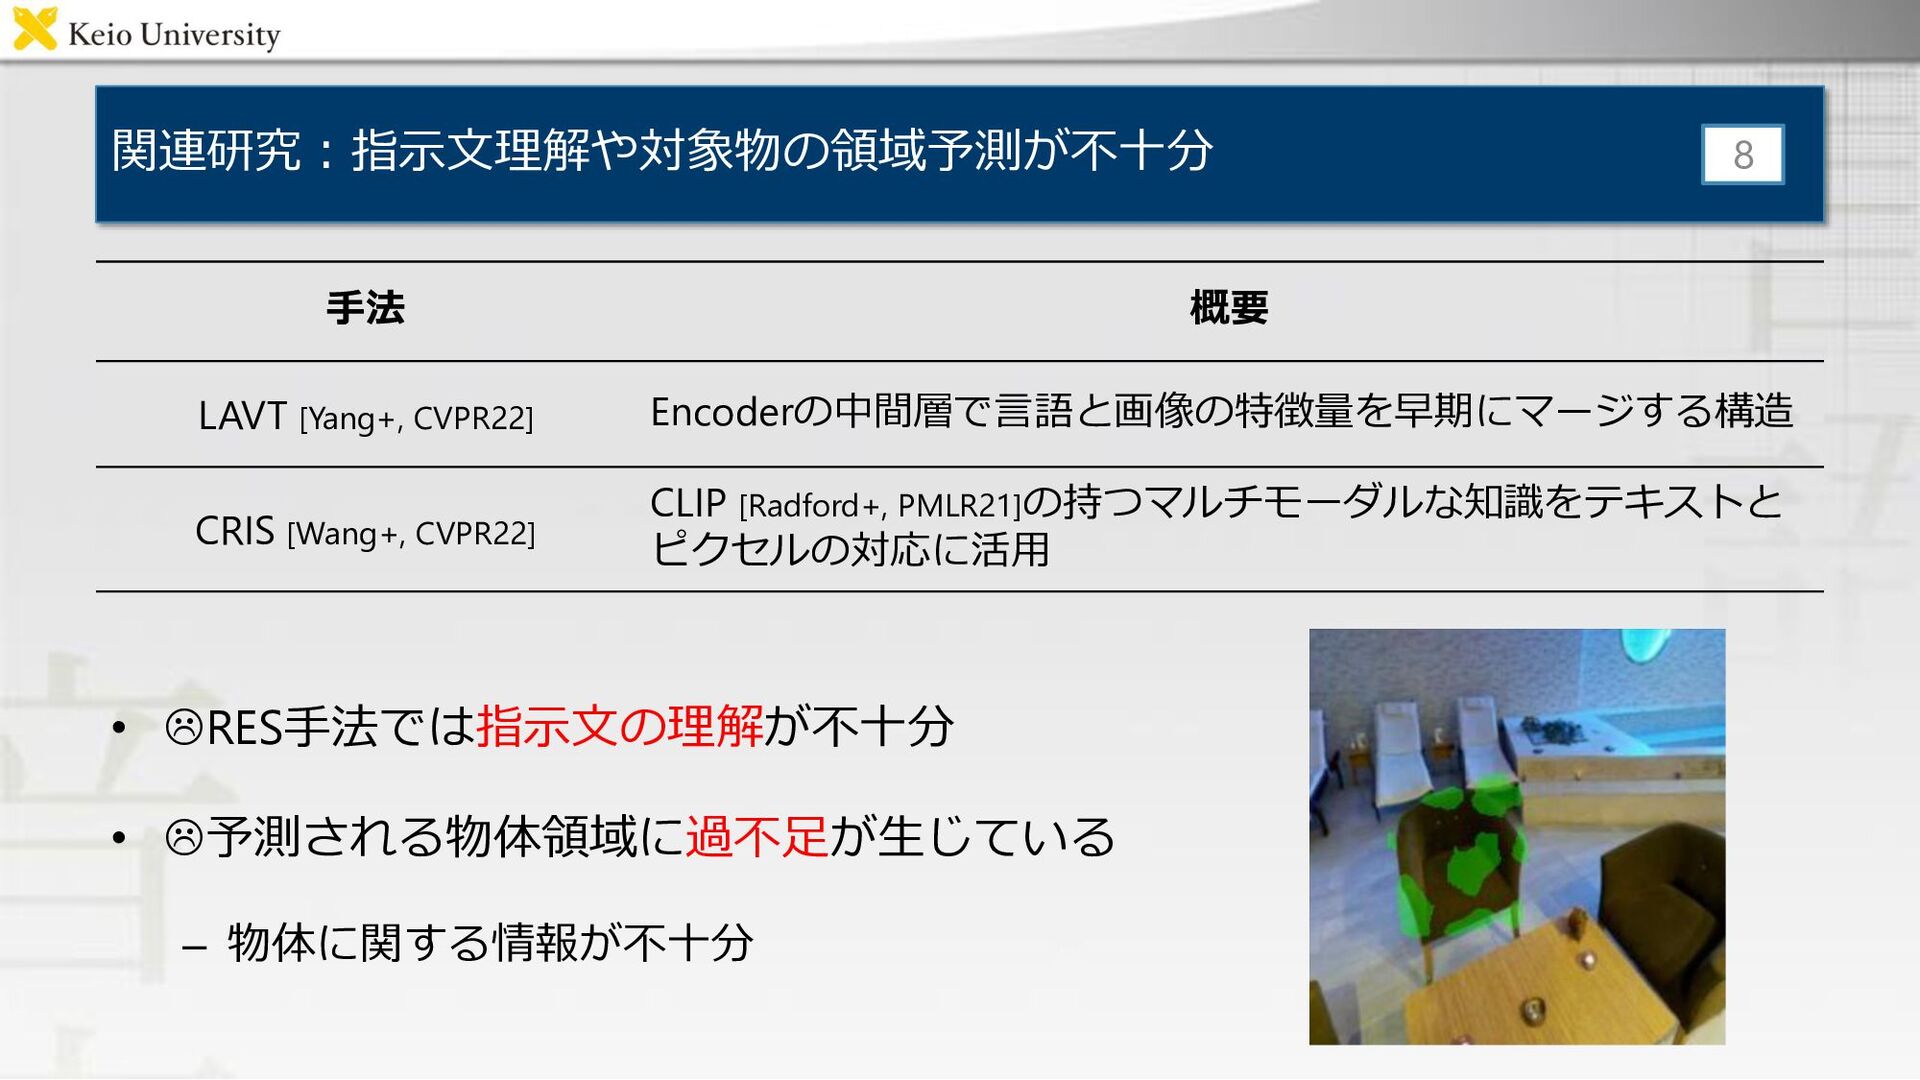
関連研究:指示文理解や対象物の領域予測が不十分 • RES手法では指示文の理解が不十分 • 予測される物体領域に過不足が生じている – 物体に関する情報が不十分 8 手法 概要
LAVT [Yang+, CVPR22] Encoderの中間層で言語と画像の特徴量を早期にマージする構造 CRIS [Wang+, CVPR22] CLIP [Radford+, PMLR21]の持つマルチモーダルな知識をテキストと ピクセルの対応に活用 -
関連研究:指示文理解や対象物の領域予測が不十分 9 手法 概要 LAVT [Yang+, CVPR22] Encoderの中間層で言語と画像の特徴量を早期にマージする構造 CRIS [Wang+,
CVPR22] CLIP [Radford+, PMLR21]の持つマルチモーダルな知識をテキストと ピクセルの対応に活用 昨今、話題となっているSEEM [Zou+, 23]でも OSMIタスクを解くのは難しい -
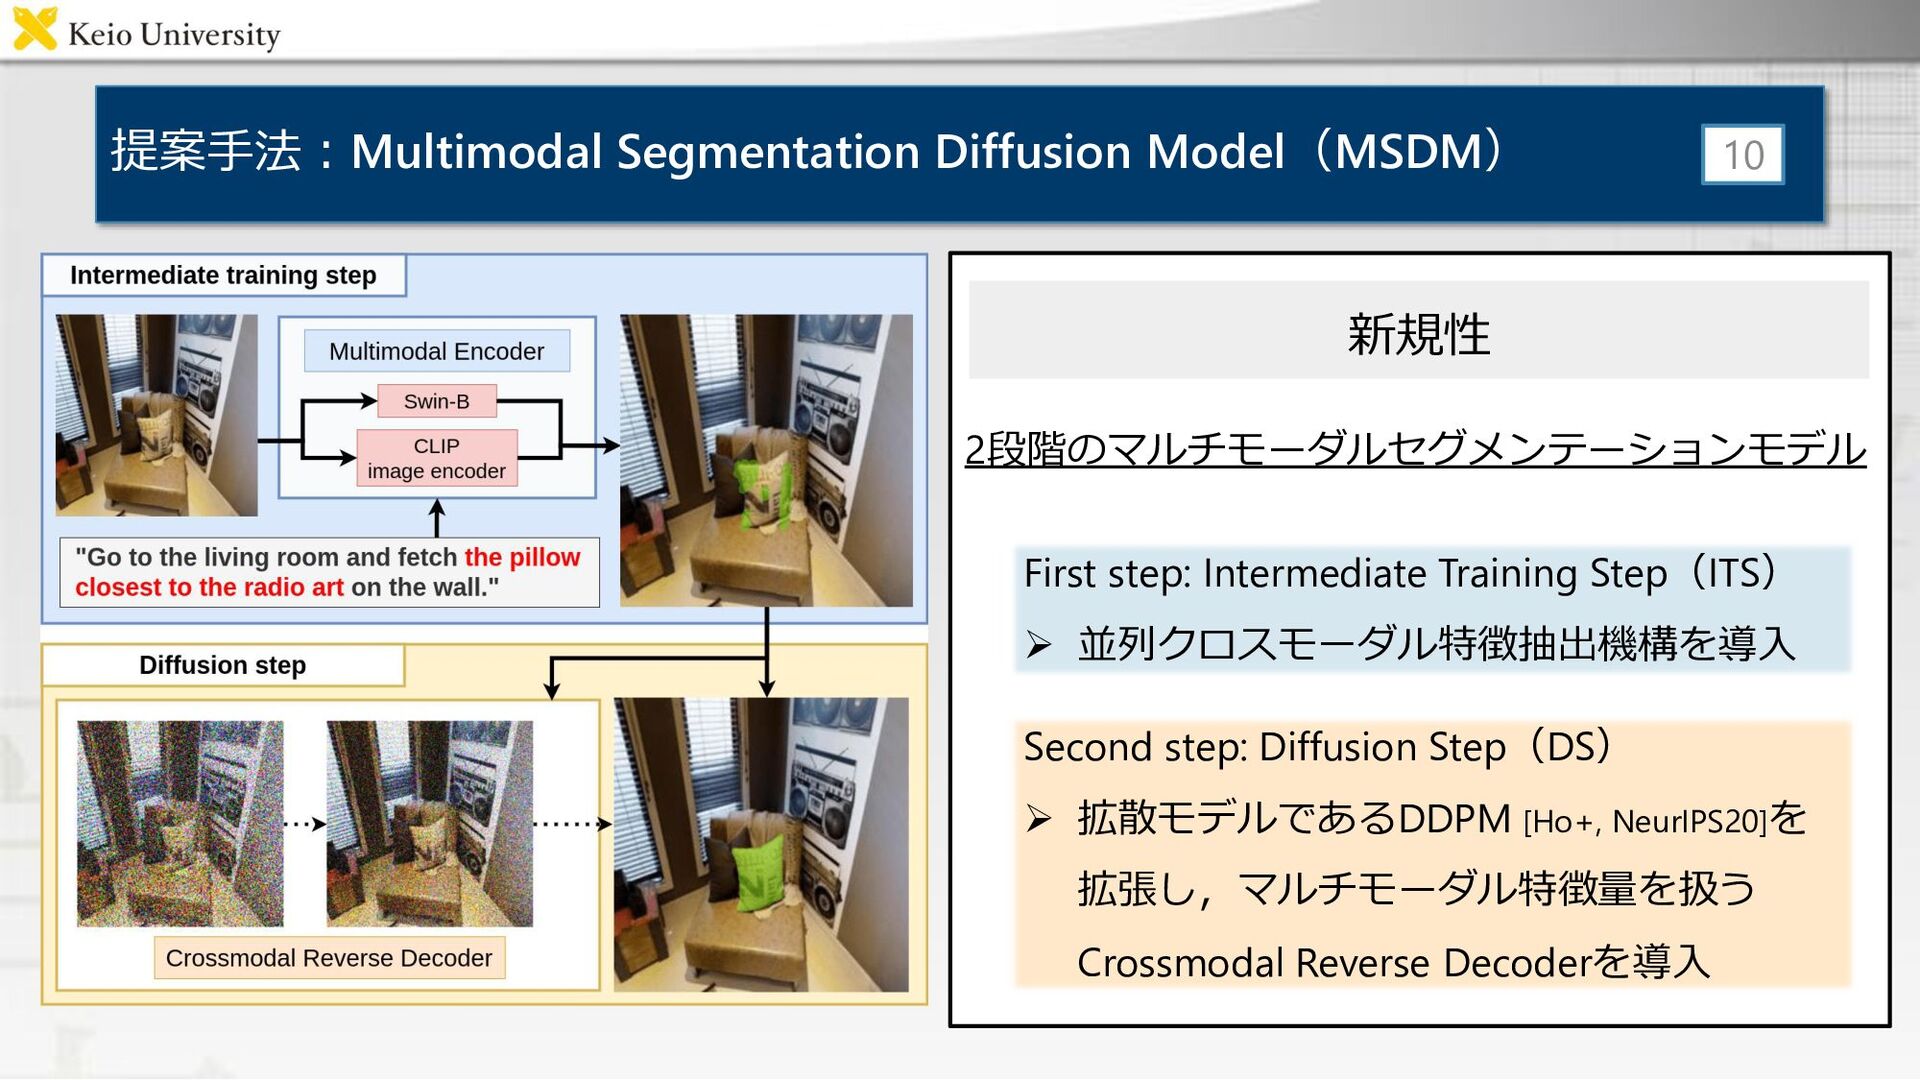
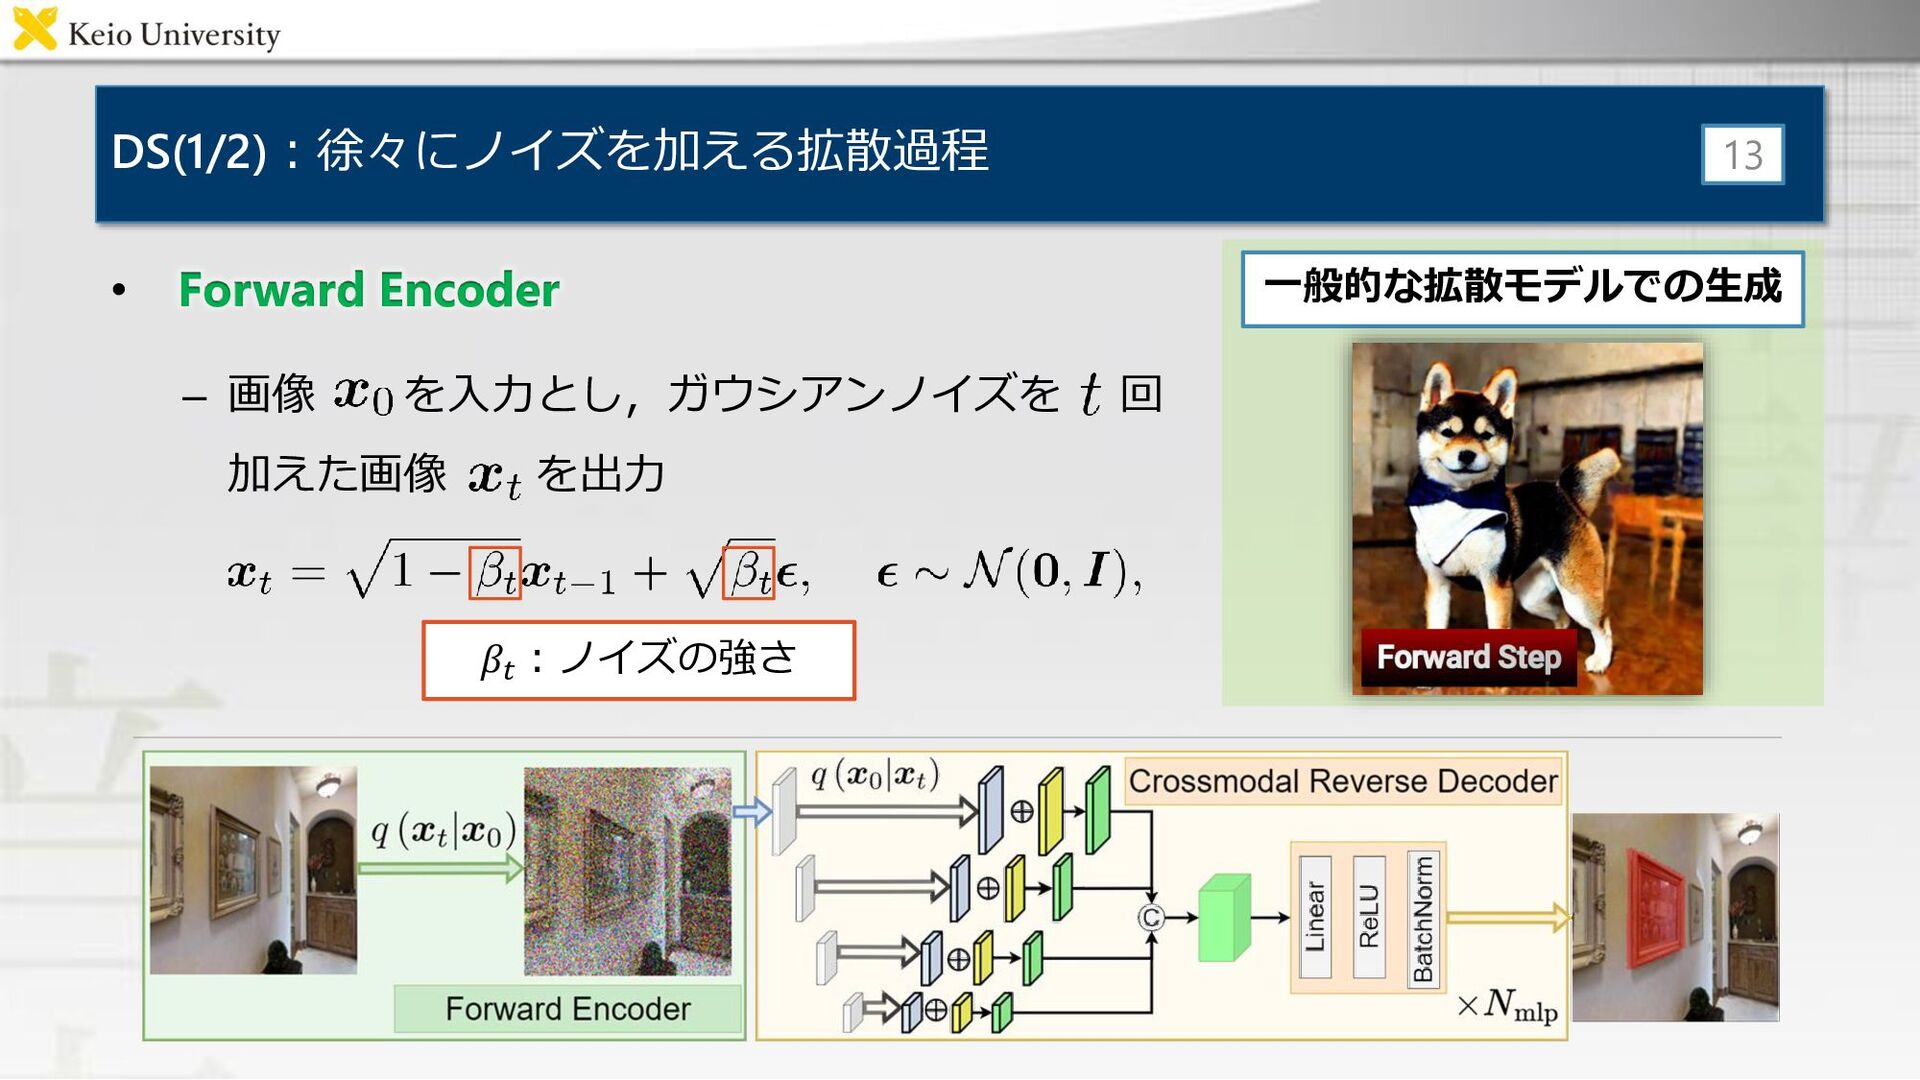
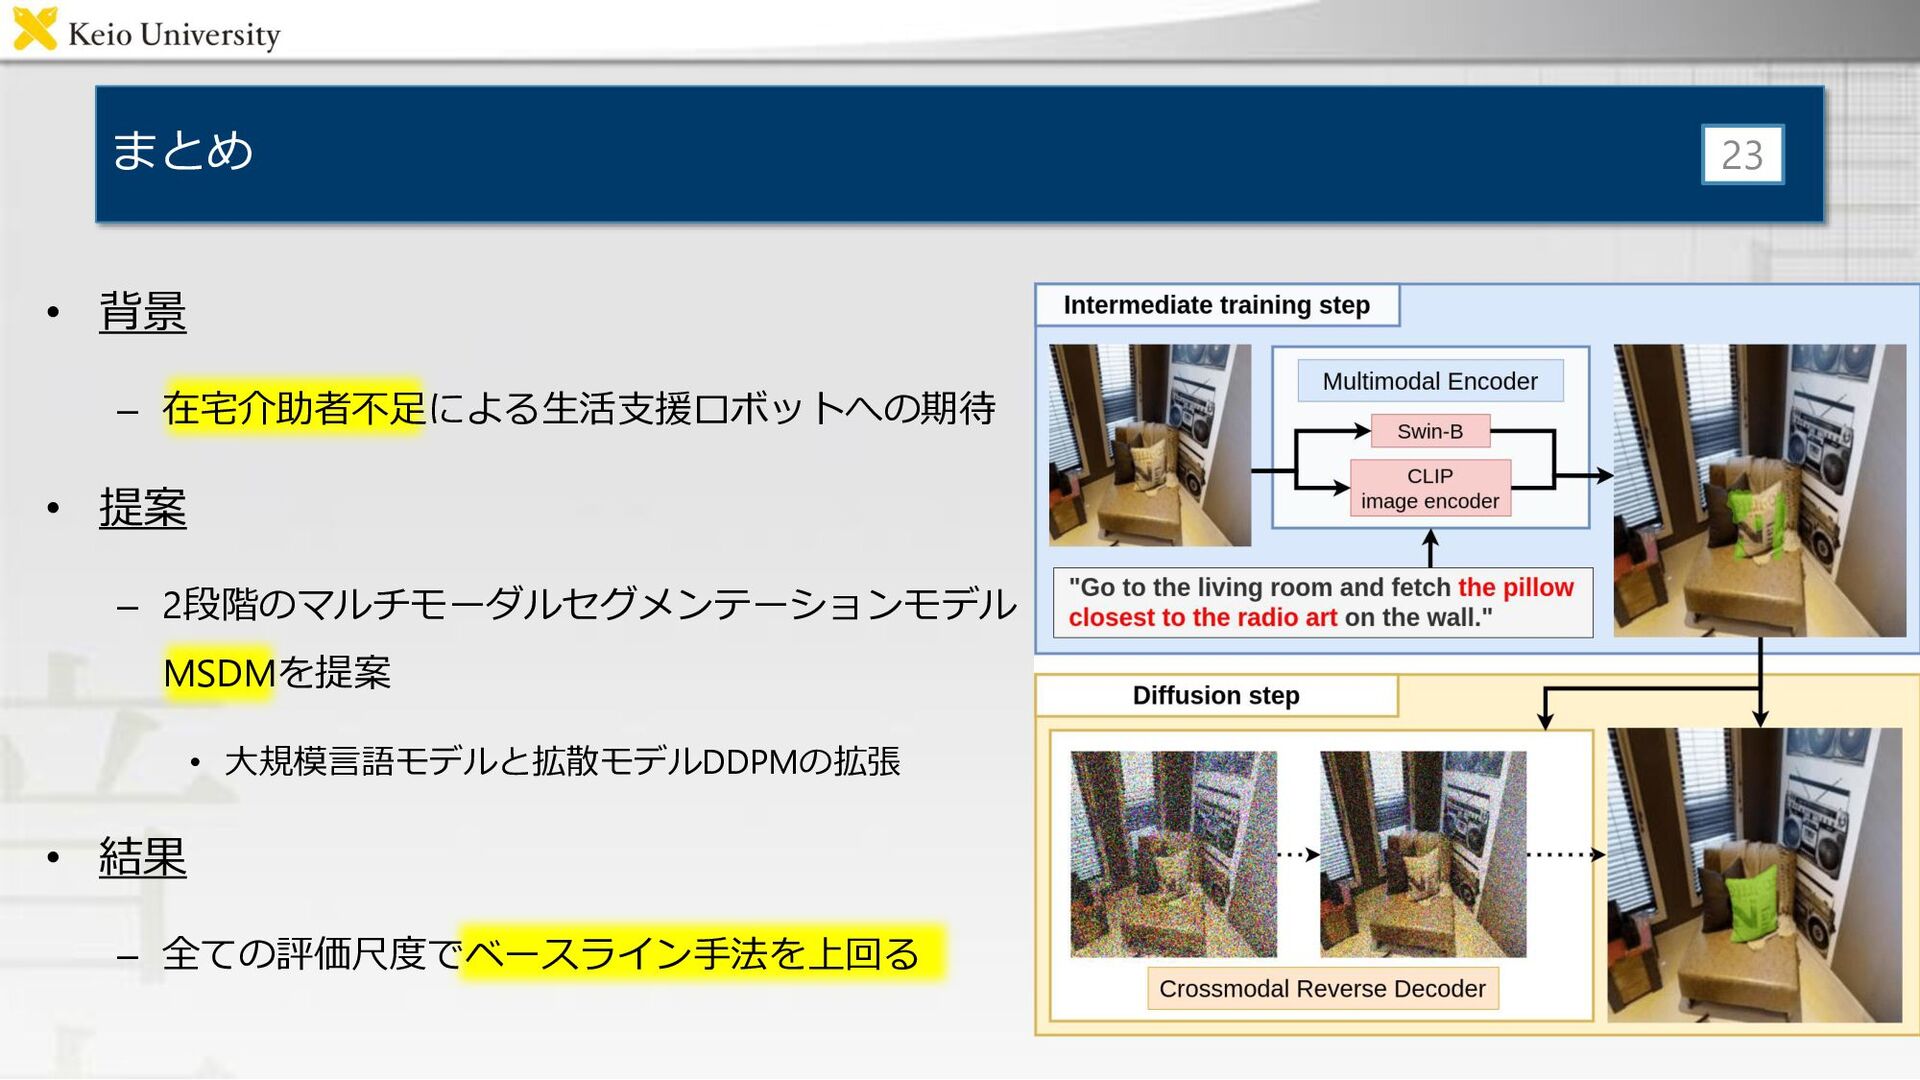
提案手法:Multimodal Segmentation Diffusion Model(MSDM) 新規性 10 2段階のマルチモーダルセグメンテーションモデル First step: Intermediate
Training Step(ITS) ➢ 並列クロスモーダル特徴抽出機構を導入 Second step: Diffusion Step(DS) ➢ 拡散モデルであるDDPM [Ho+, NeurIPS20]を 拡張し,マルチモーダル特徴量を扱う Crossmodal Reverse Decoderを導入 -
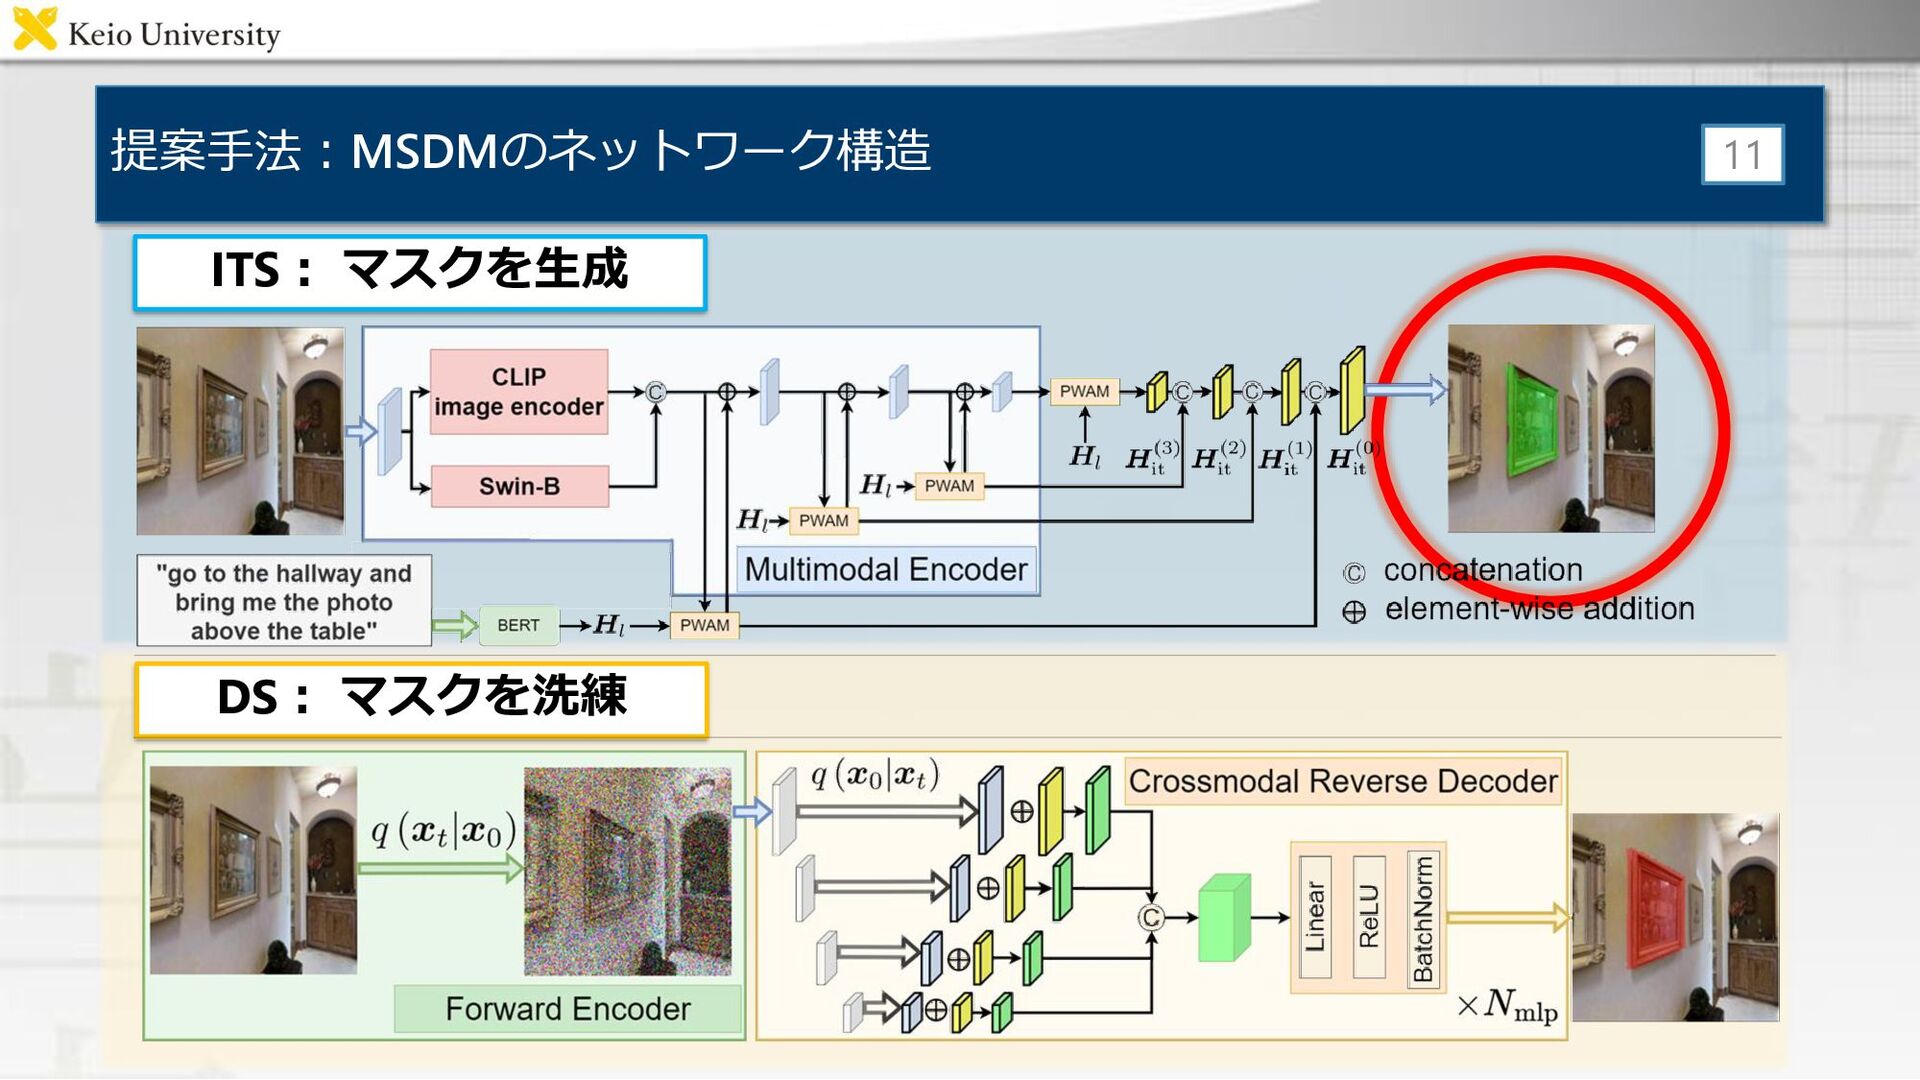
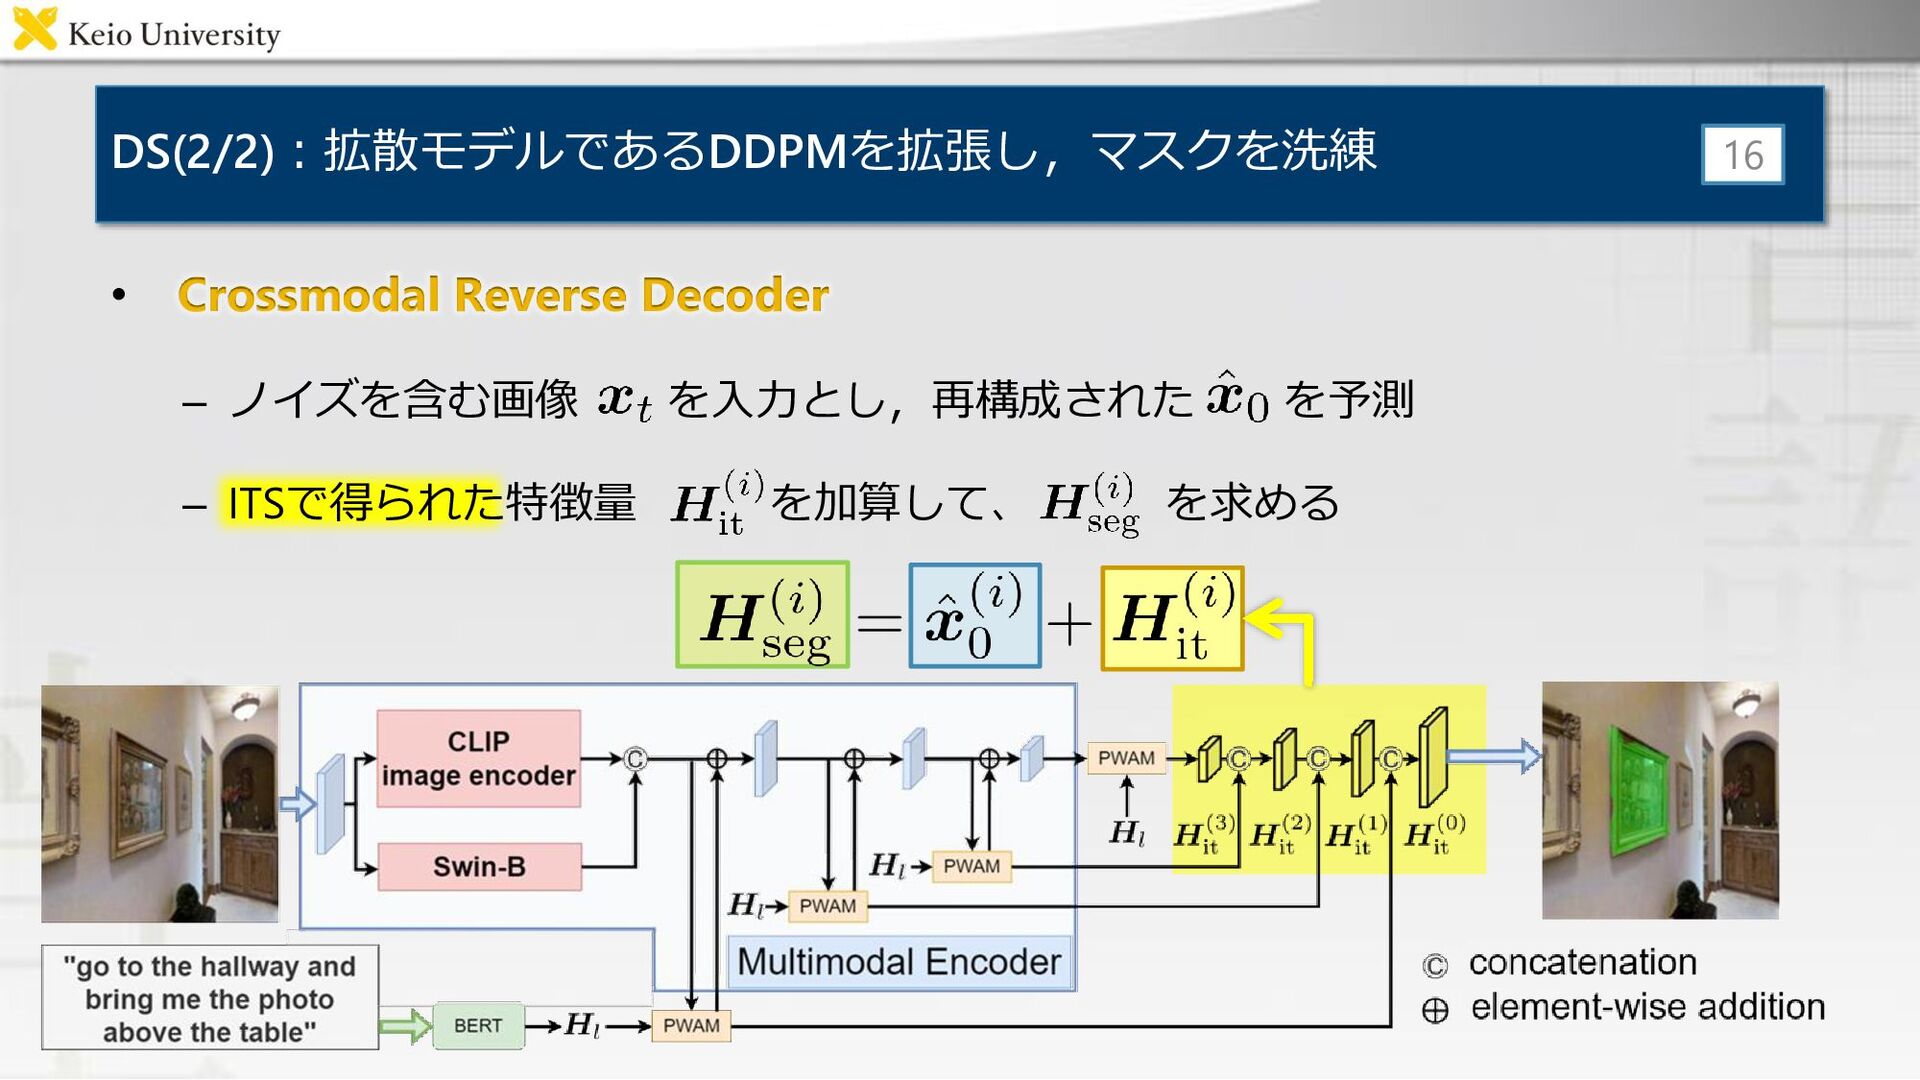
ITS:並列クロスモーダル特徴抽出機構の導入とマスク生成 • Multimodal Encoder – 大規模視覚言語モデルCLIP+多様スケールに対応するSwin Transformer [Liu+, IEEE21] •
PWAM [Yang+, CVPR22] – 言語と画像の特徴量を計算コストを削減してAttention 12 -
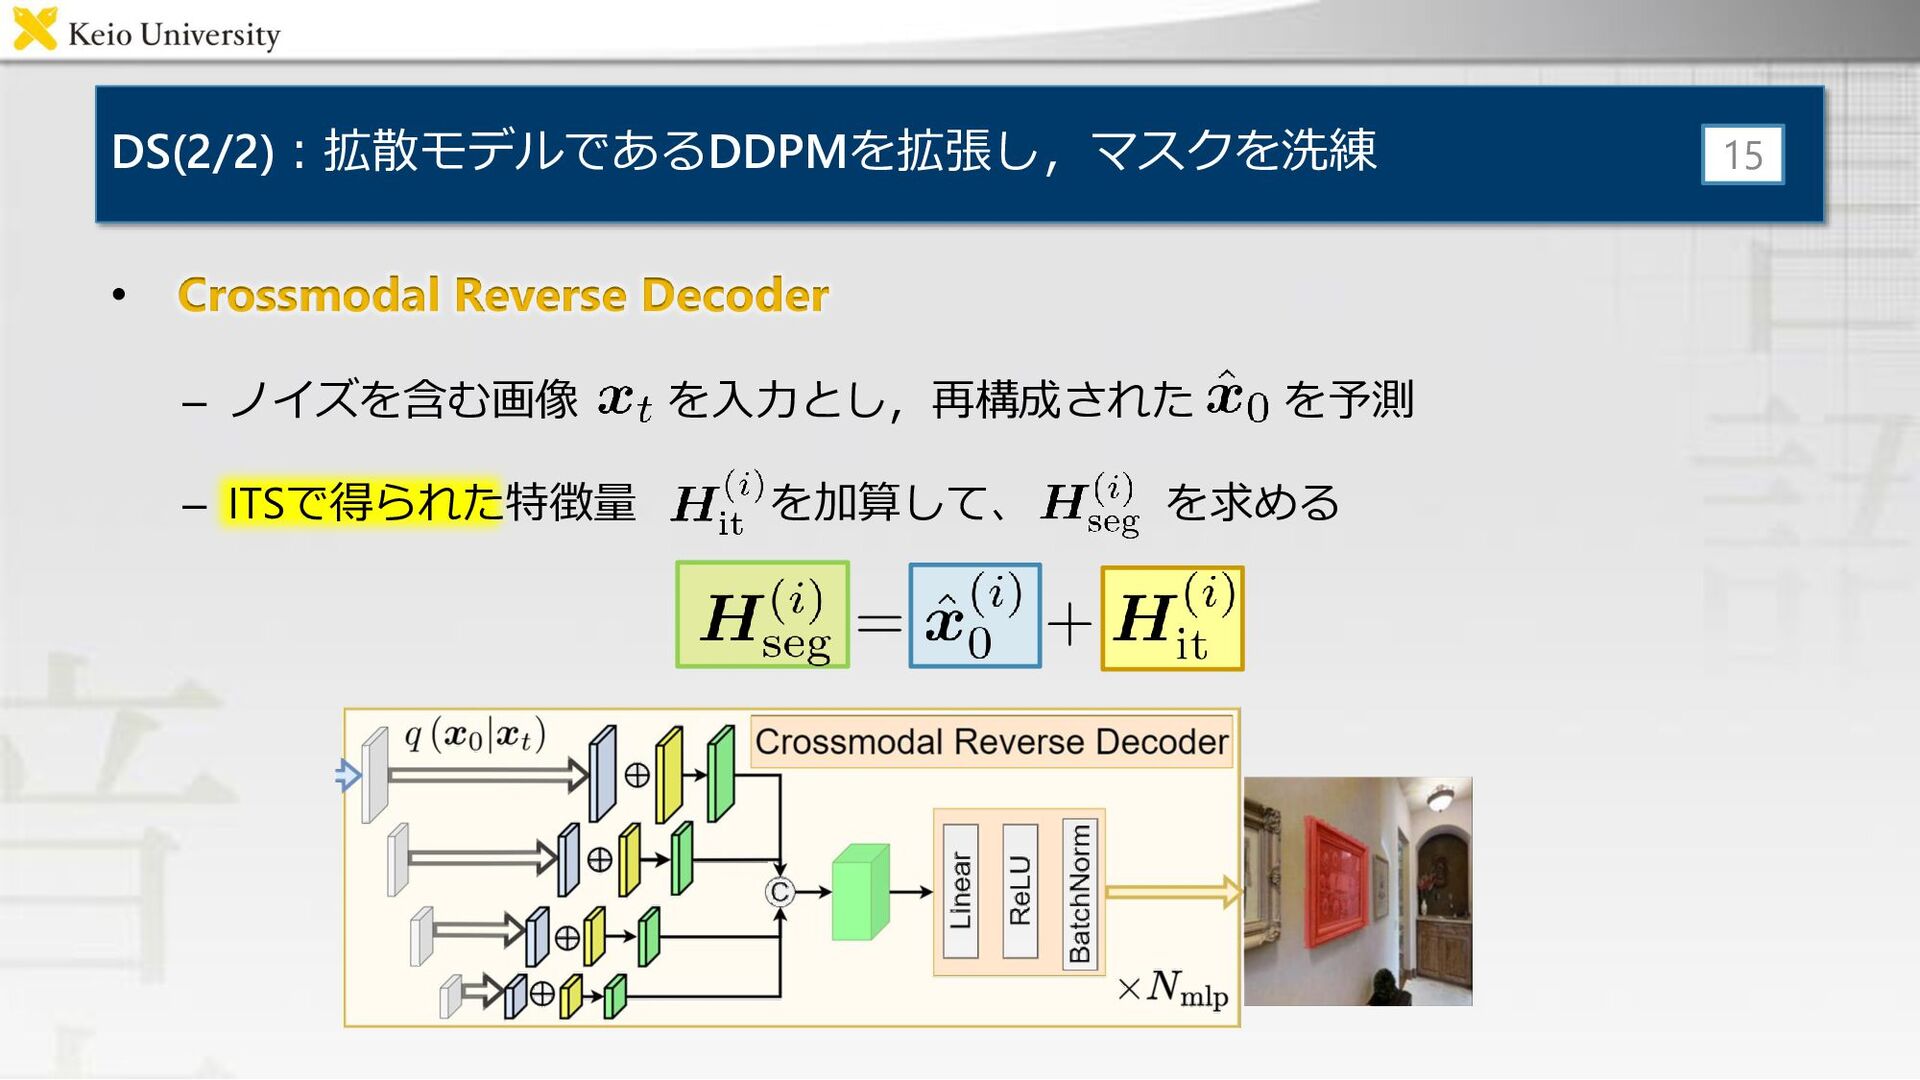
DS(2/2):拡散モデルであるDDPMを拡張し,マスクを洗練 • Crossmodal Reverse Decoder – ノイズを含む画像 を入力とし,再構成された を予測 –
ITSで得られた特徴量 を加算して、 を求める 15 -
DS(2/2):拡散モデルであるDDPMを拡張し,マスクを洗練 • Crossmodal Reverse Decoder – ノイズを含む画像 を入力とし,再構成された を予測 –
ITSで得られた特徴量 を加算して、 を求める 16 -
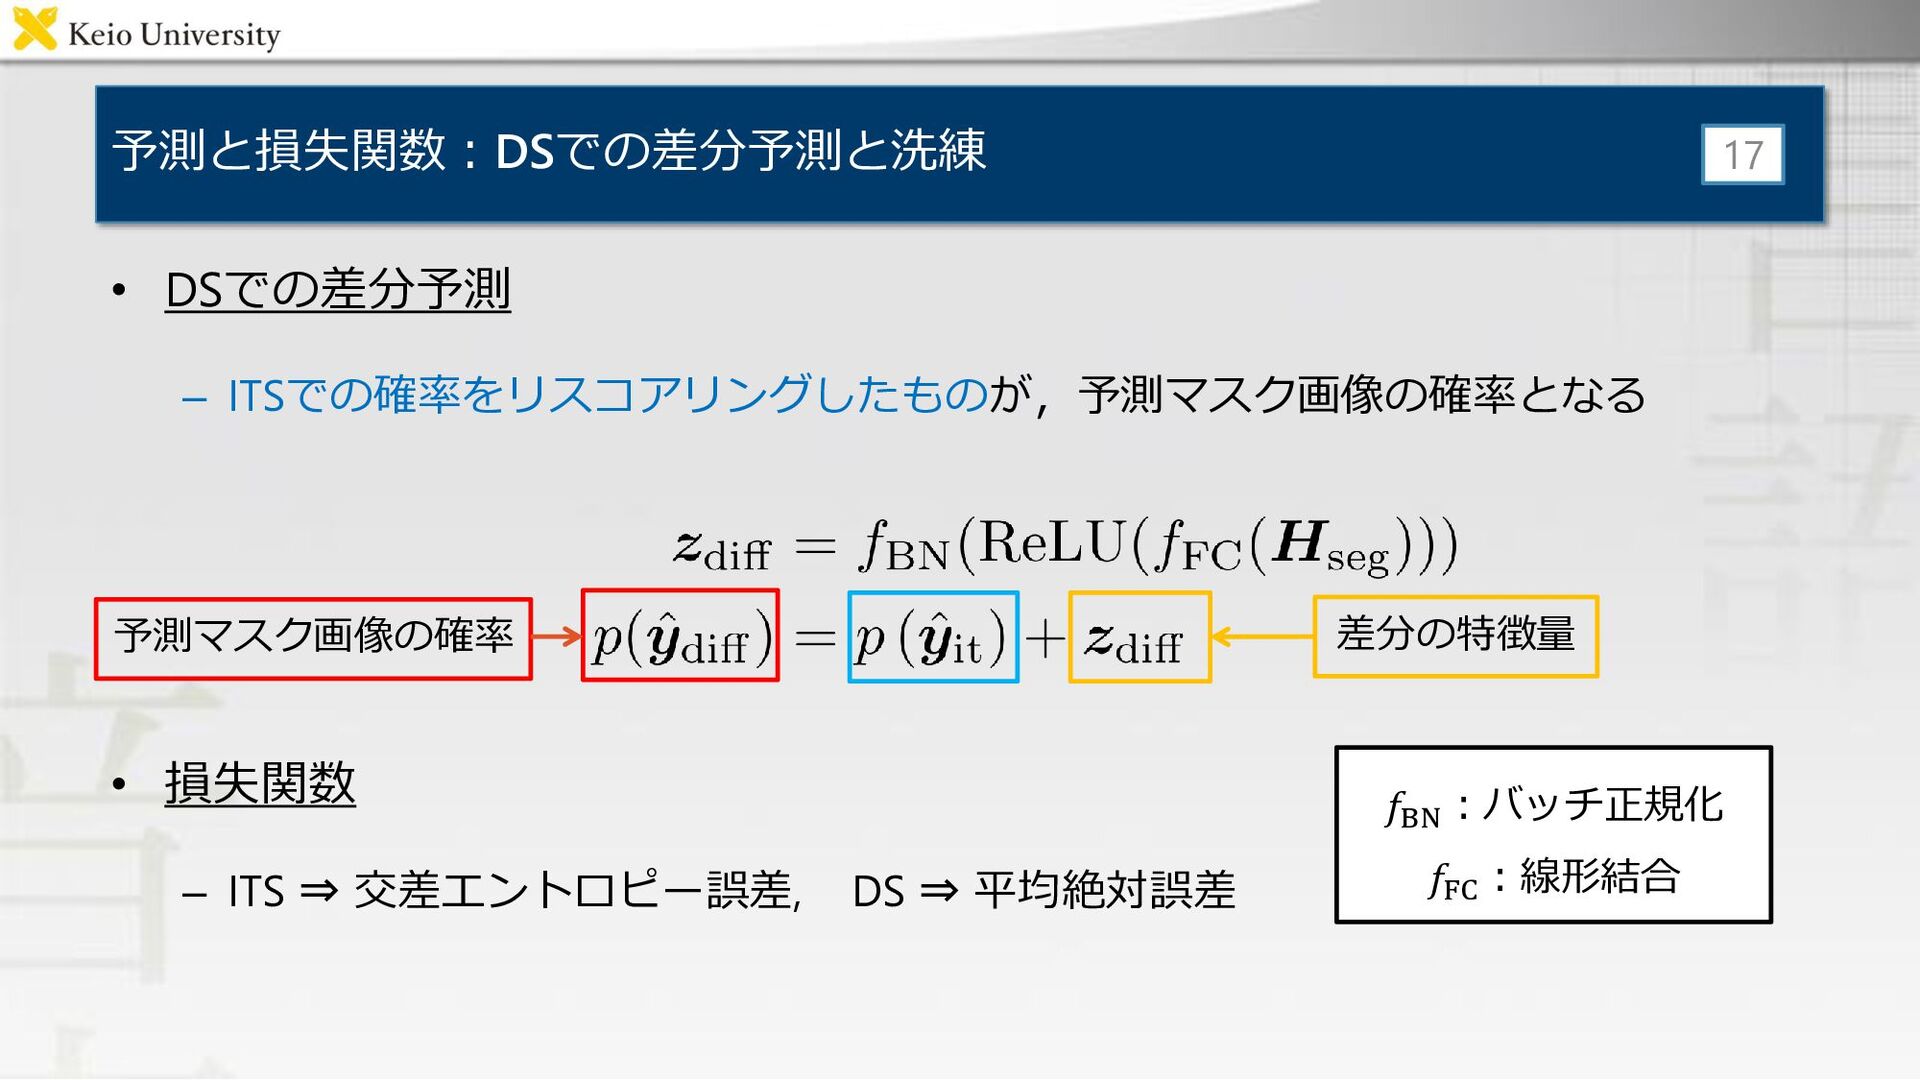
予測と損失関数:DSでの差分予測と洗練 • DSでの差分予測 – ITSでの確率をリスコアリングしたものが,予測マスク画像の確率となる • 損失関数 – ITS ⇒
交差エントロピー誤差, DS ⇒ 平均絶対誤差 17 差分の特徴量 予測マスク画像の確率 𝑓BN :バッチ正規化 𝑓FC :線形結合 -
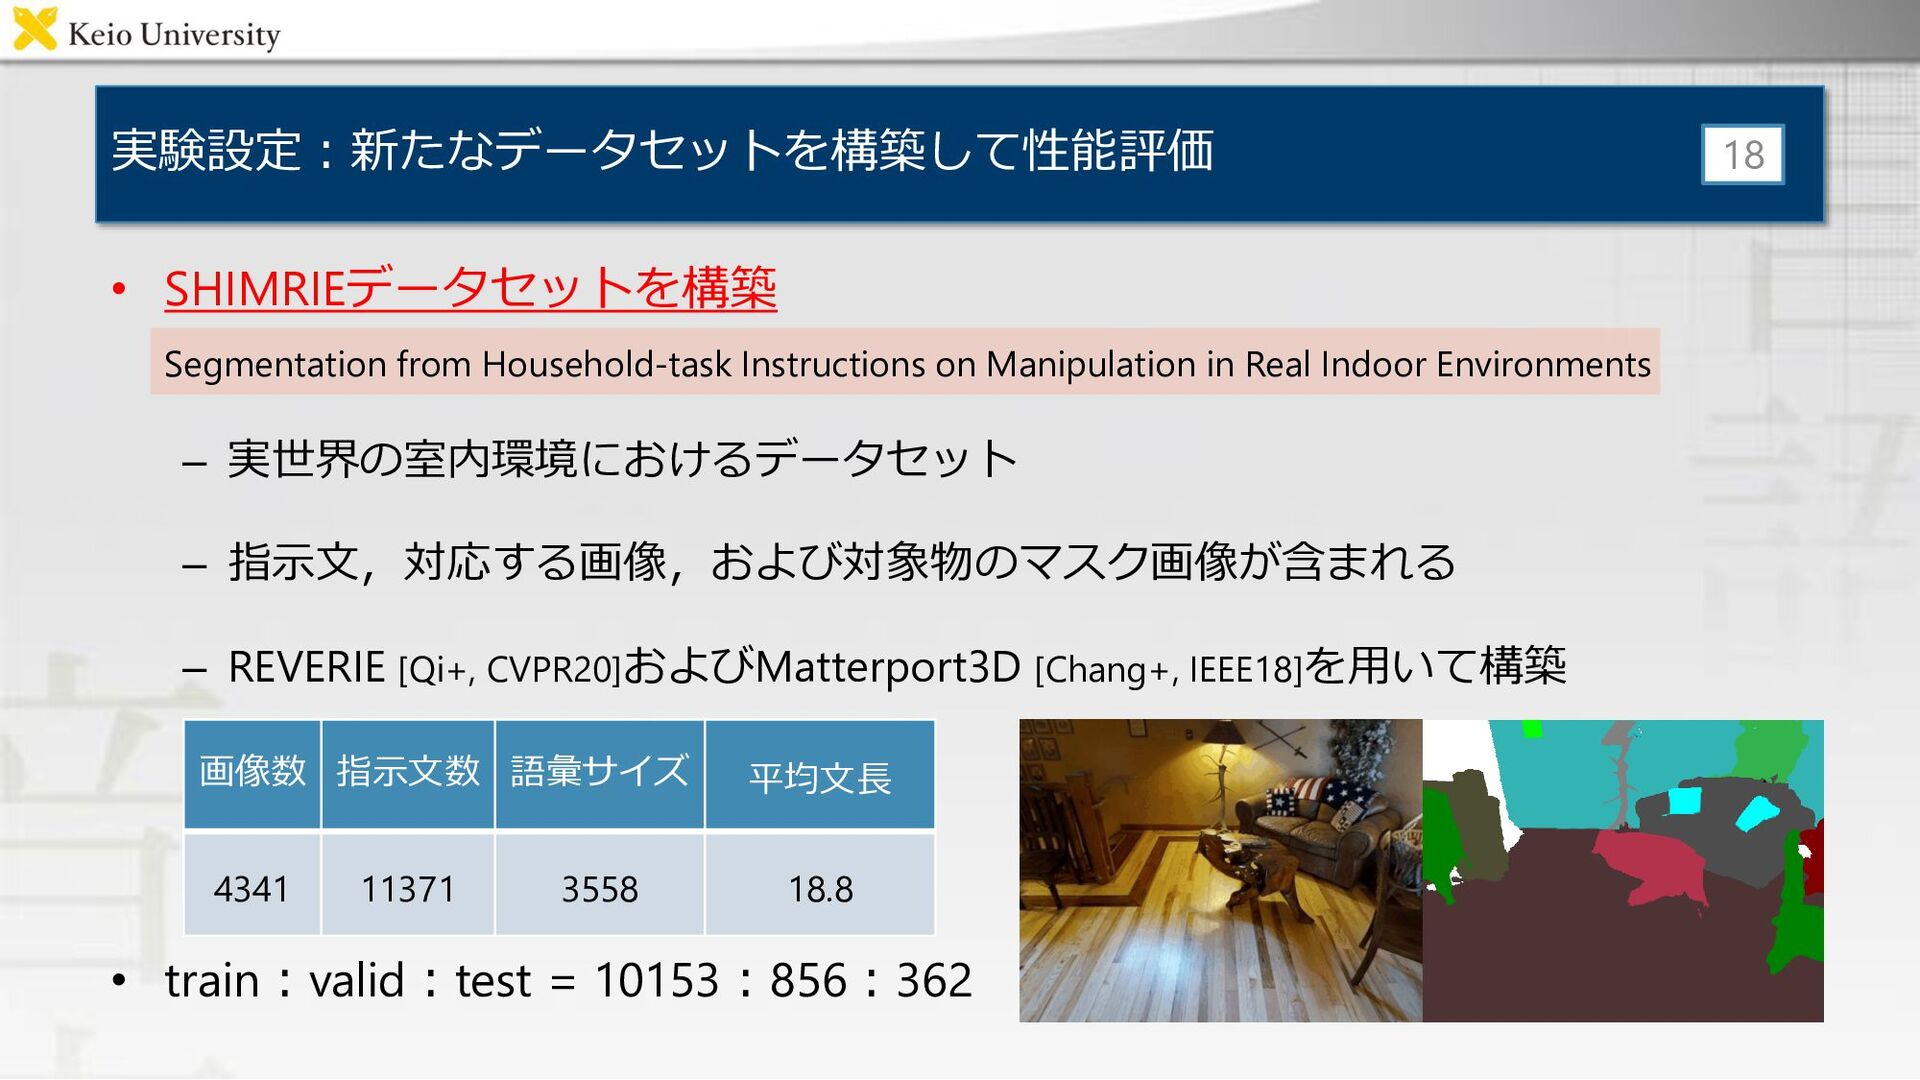
実験設定:新たなデータセットを構築して性能評価 • SHIMRIEデータセットを構築 Segmentation from Household-task Instructions on Manipulation in
Real Indoor Environments – 実世界の室内環境におけるデータセット – 指示文,対応する画像,および対象物のマスク画像が含まれる – REVERIE [Qi+, CVPR20]およびMatterport3D [Chang+, IEEE18]を用いて構築 • train:valid:test = 10153:856:362 18 画像数 指示文数 語彙サイズ 平均文長 4341 11371 3558 18.8 -
定量的結果:全ての評価尺度で既存手法の性能を上回る • 評価指標 – mIoU(mean IoU), oIoU(overall IoU), [email protected] 19
method mIoU oIoU [email protected] (i) LAVT [Yang+,CVPR22] 24.27±3.15 22.25±2.85 21.27±5.66 (ii) Ours (w/o diffusion step) 30.19±3.98 27.08±2.89 31.66±6.52 (iii) Ours 34.40±3.79 31.59±3.03 36.63±6.14 5.92ポイント↑ 4.21ポイント↑ -
まとめ • 背景 – 在宅介助者不足による生活支援ロボットへの期待 • 提案 – 2段階のマルチモーダルセグメンテーションモデル MSDMを提案
• 大規模言語モデルと拡散モデルDDPMの拡張 • 結果 – 全ての評価尺度でベースライン手法を上回る 23 -
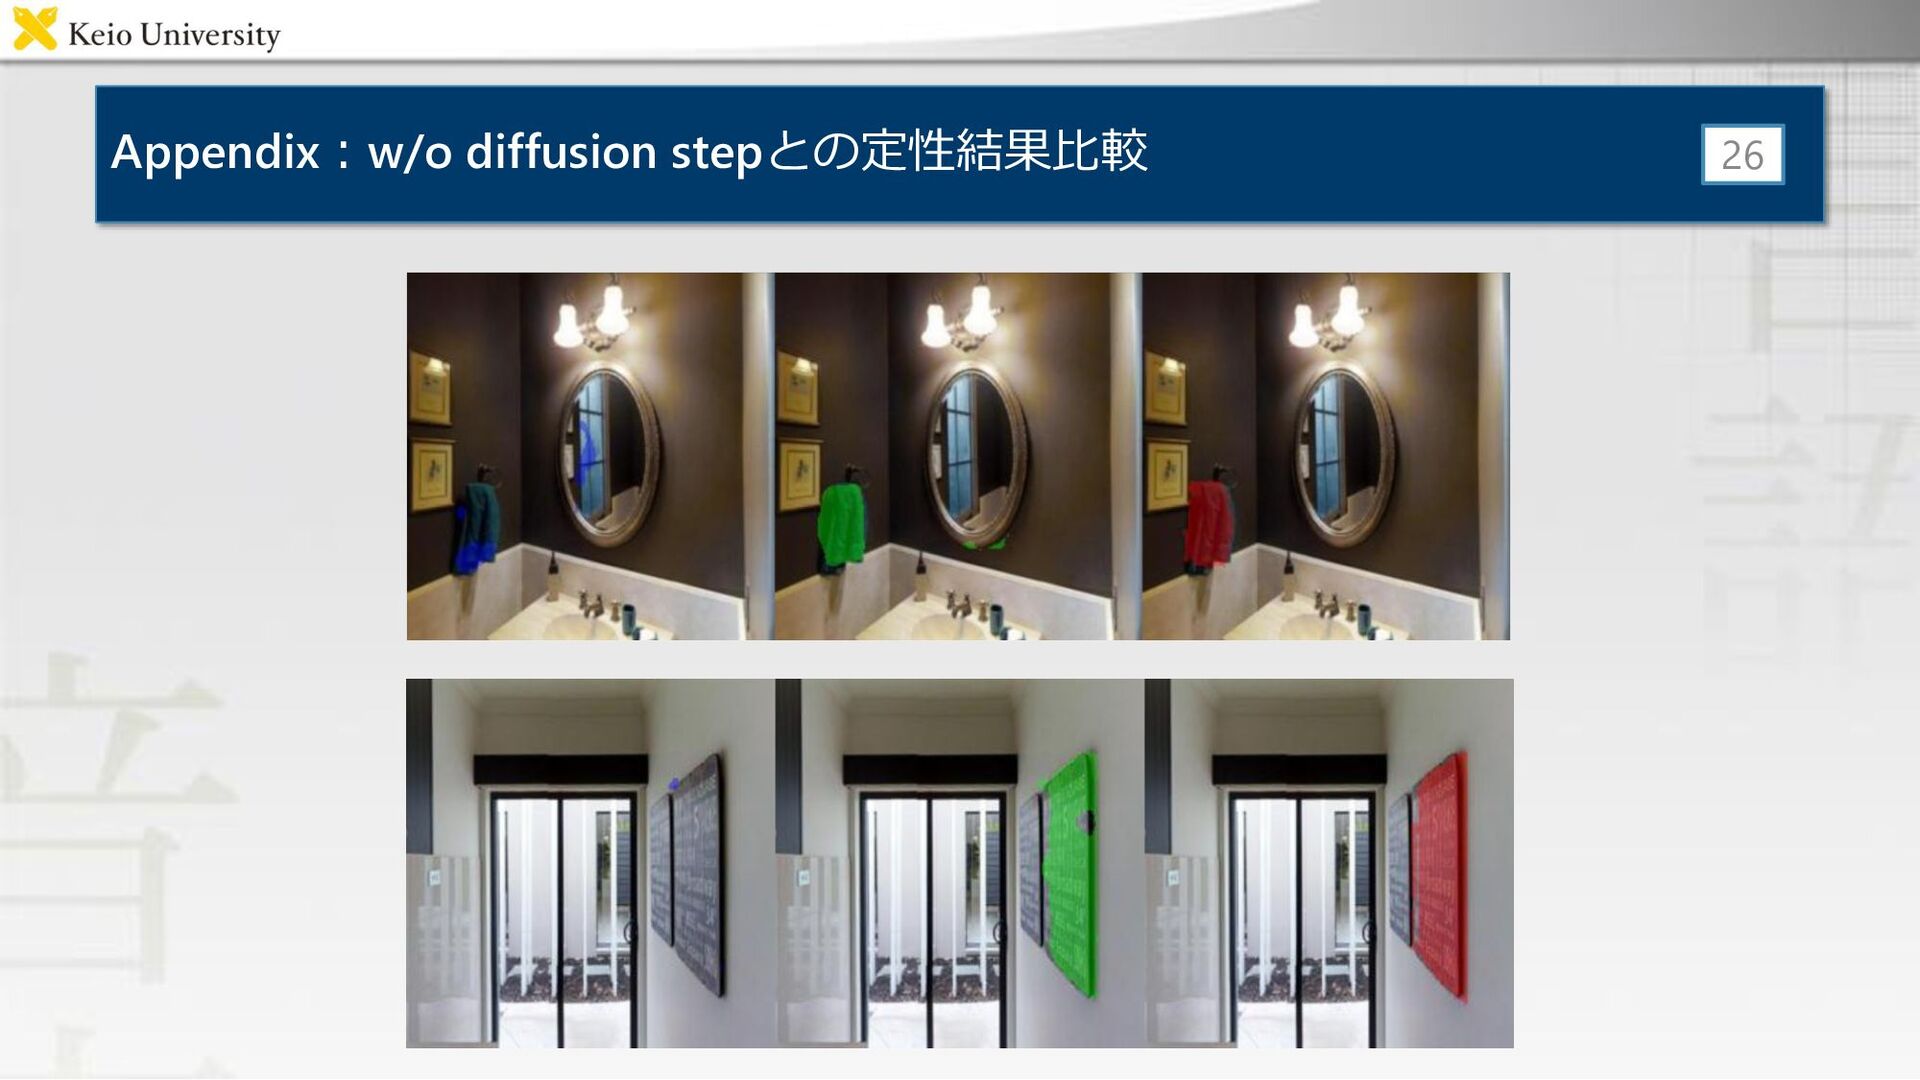
Appendix:特徴量の選択におけるablation study 24 mIoU oIoU [email protected] [email protected] [email protected] [email protected] [email protected]
✔ ✔ ✔ ✔ 34.09±4.14 31.57±3.07 35.52±6.04 27.29±4.93 16.35±3.16 6.35±1.22 1.82±1.33 ✔ ✔ ✔ 34.40±3.79 31.59±3.03 36.63±6.14 27.79±5.28 16.30±2.98 6.41±1.19 0.66±0.62 ✔ ✔ ✔ 33.68±4.37 30.61±4.17 35.80±6.73 26.46±4.66 15.69±3.88 6.08±1.58 0.50±0.41 ✔ ✔ ✔ 33.44±4.52 30.51±3.89 35.03±6.36 26.85±6.02 15.91±4.36 5.25±0.82 1.66±1.48 ✔ ✔ ✔ 32.54±4.97 29.97±4.14 35.30±6.72 26.24±6.26 13.15±3.77 3.26±1.95 0.50±0.41 -
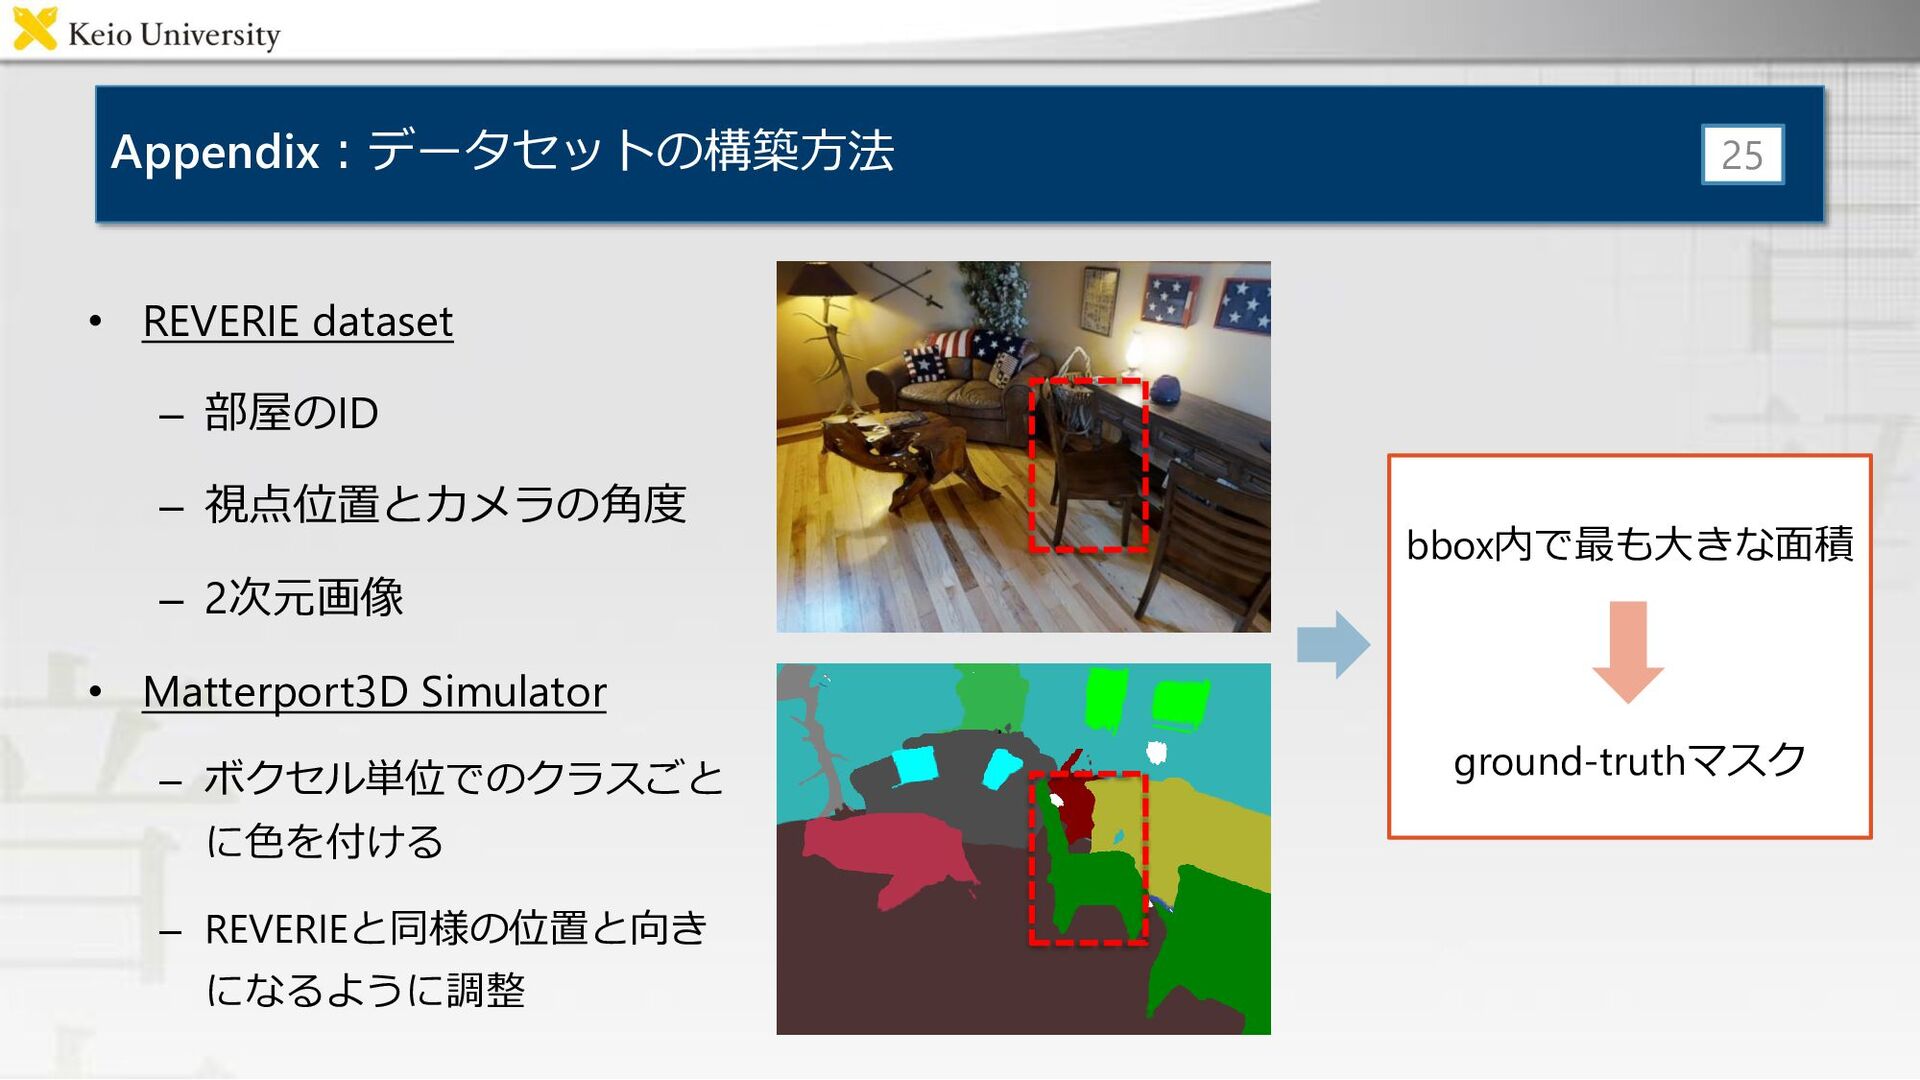
Appendix:データセットの構築方法 • REVERIE dataset – 部屋のID – 視点位置とカメラの角度 – 2次元画像
• Matterport3D Simulator – ボクセル単位でのクラスごと に色を付ける – REVERIEと同様の位置と向き になるように調整 25 bbox内で最も大きな面積 ground-truthマスク -
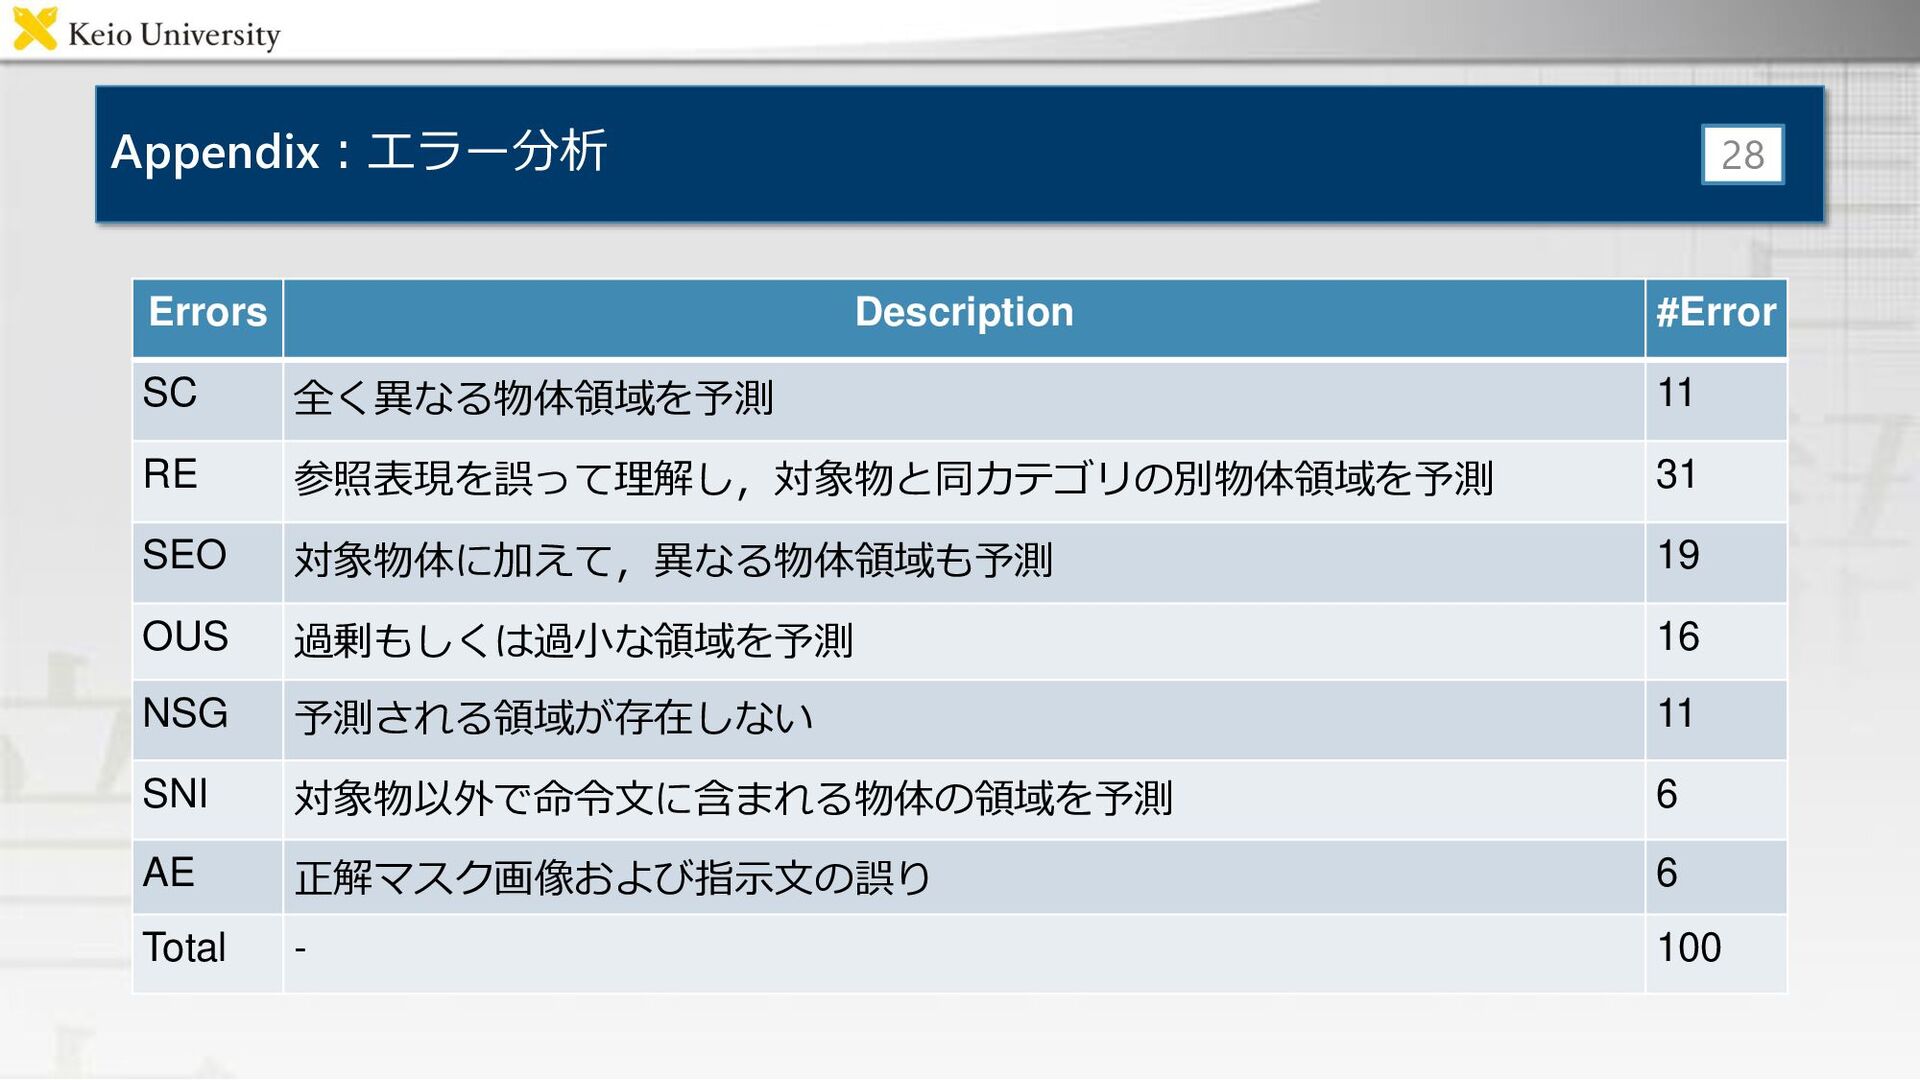
Appendix:エラー分析 28 Errors Description #Error SC 全く異なる物体領域を予測 11 RE 参照表現を誤って理解し,対象物と同カテゴリの別物体領域を予測
31 SEO 対象物体に加えて,異なる物体領域も予測 19 OUS 過剰もしくは過小な領域を予測 16 NSG 予測される領域が存在しない 11 SNI 対象物以外で命令文に含まれる物体の領域を予測 6 AE 正解マスク画像および指示文の誤り 6 Total - 100 -
Appendix: 評価指標 29 • 評価指標 – Mean IoU (mIoU):全サンプルにおけるIoUの平均 –
Overall IoU (oIoU):全サンプルのunion areaの合計とintersection areaの合計の比 – Precision@ (P@ ):IoUが を超えるサンプルの割合