Upgrade to Pro — share decks privately, control downloads, hide ads and more …

人工知能とは/IntroAI02

 人工知能とは/IntroAI02

Avatar for Kazuhisa Fujita

Kazuhisa Fujita

September 30, 2026

More Decks by Kazuhisa Fujita

Other Decks in Education

Transcript

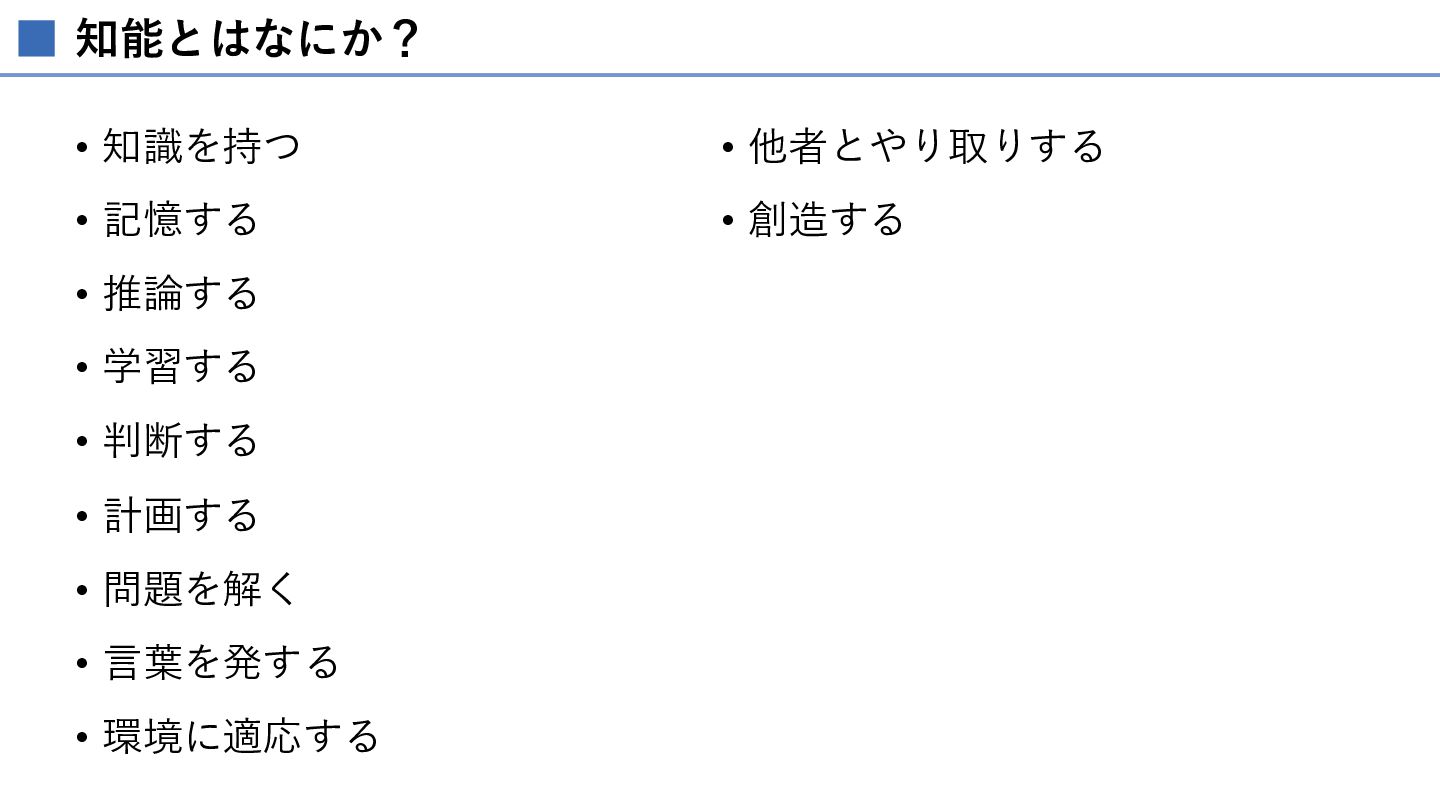
  1. 知能とはなにか? • 知識を持つ • 他者とやり取りする • 記憶する • 創造する •

    推論する • 学習する • 判断する • 計画する • 問題を解く • 言葉を発する • 環境に適応する
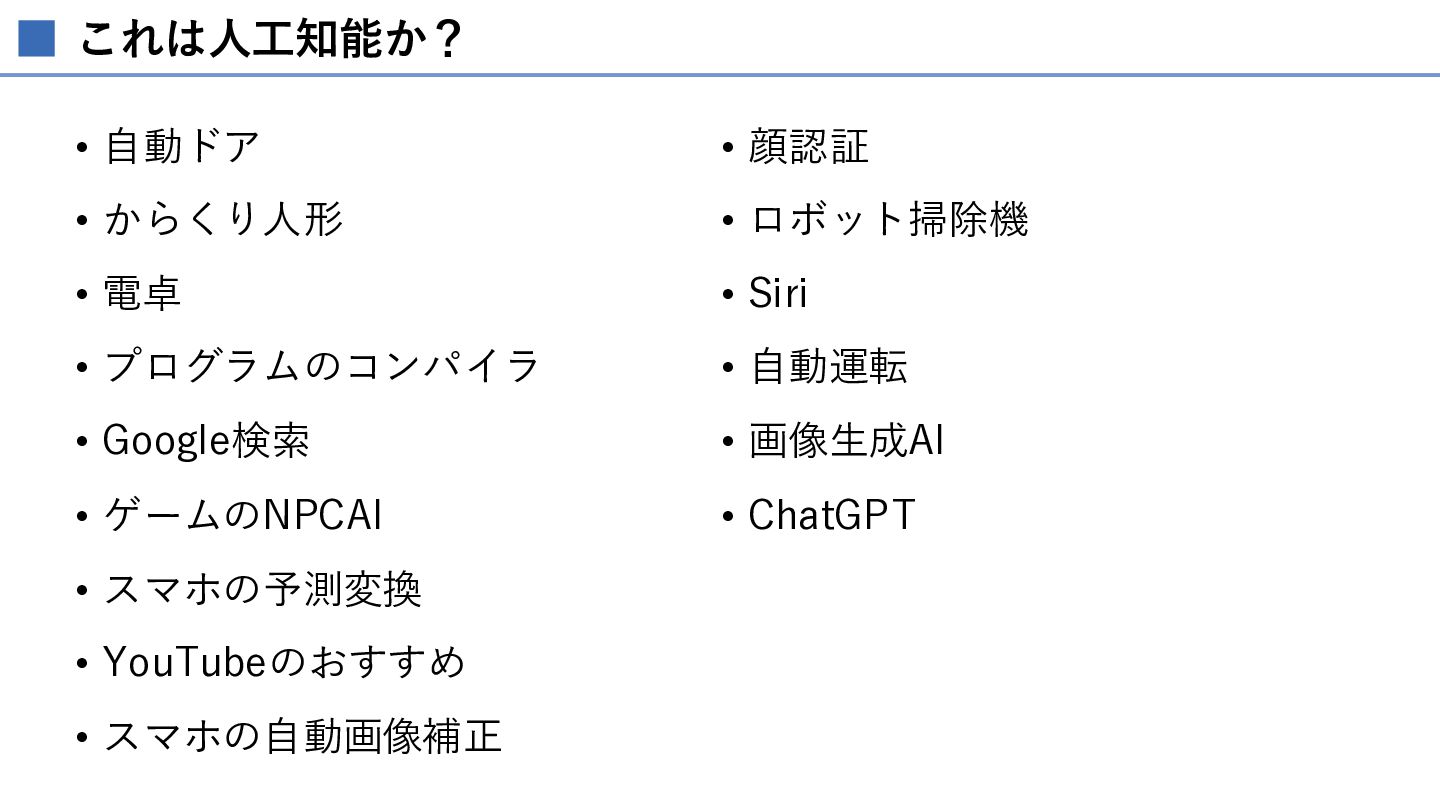
  2. これは人工知能か? • 自動ドア • 顔認証 • からくり人形 • ロボット掃除機 •

    電卓 • Siri • プログラムのコンパイラ • 自動運転 • Google検索 • 画像生成AI • ゲームのNPCAI • ChatGPT • スマホの予測変換 • YouTubeのおすすめ • スマホの自動画像補正
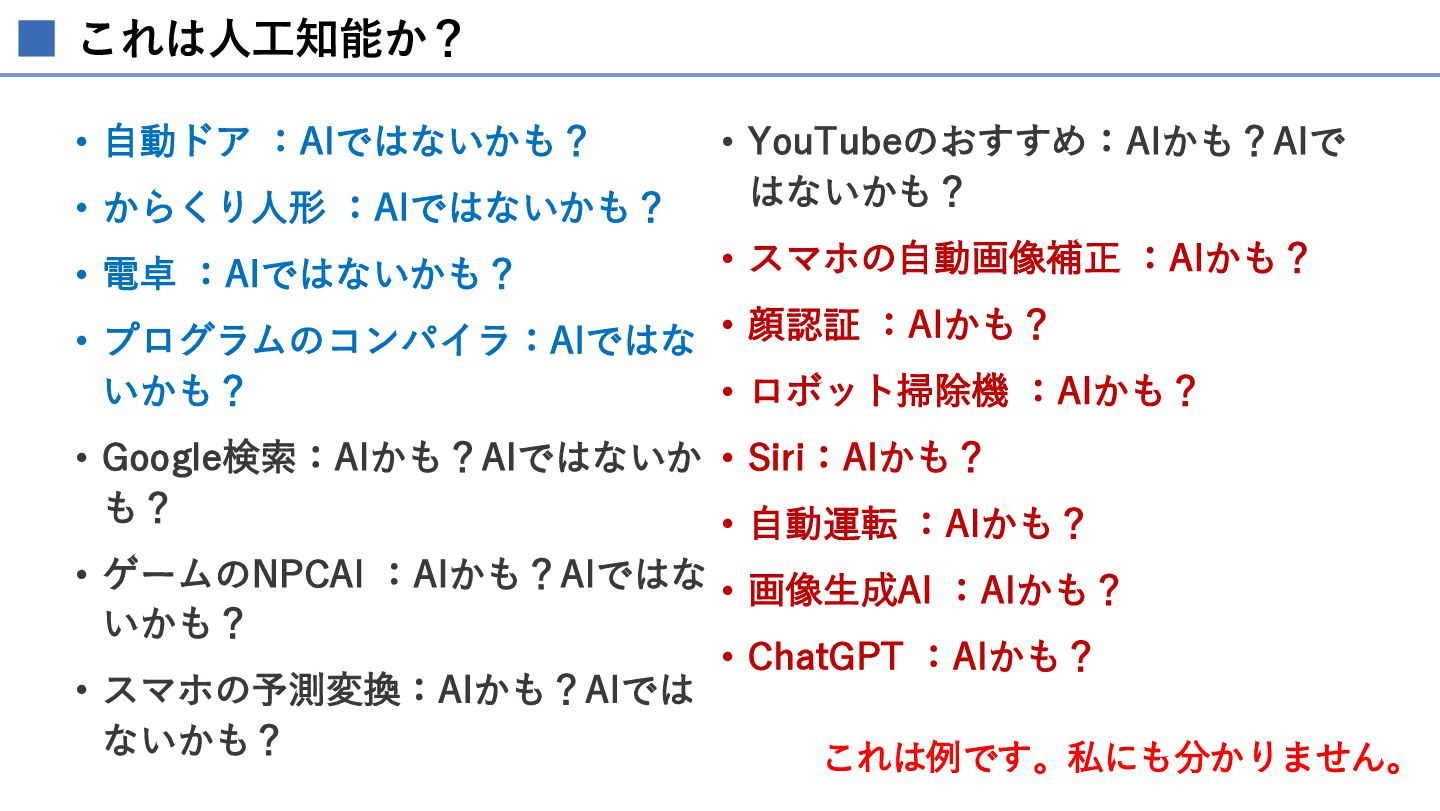
  3. これは人工知能か? • 自動ドア :AIではないかも? • からくり人形 :AIではないかも? • 電卓 :AIではないかも?

    • YouTubeのおすすめ:AIかも?AIで はないかも? • スマホの自動画像補正 :AIかも? • プログラムのコンパイラ:AIではな • 顔認証 :AIかも? いかも? • ロボット掃除機 :AIかも? • Google検索:AIかも?AIではないか • Siri:AIかも? も? • 自動運転 :AIかも? • ゲームのNPCAI :AIかも?AIではな • 画像生成AI :AIかも? いかも? • ChatGPT :AIかも? • スマホの予測変換:AIかも?AIでは ないかも? これは例です。私にも分かりません。
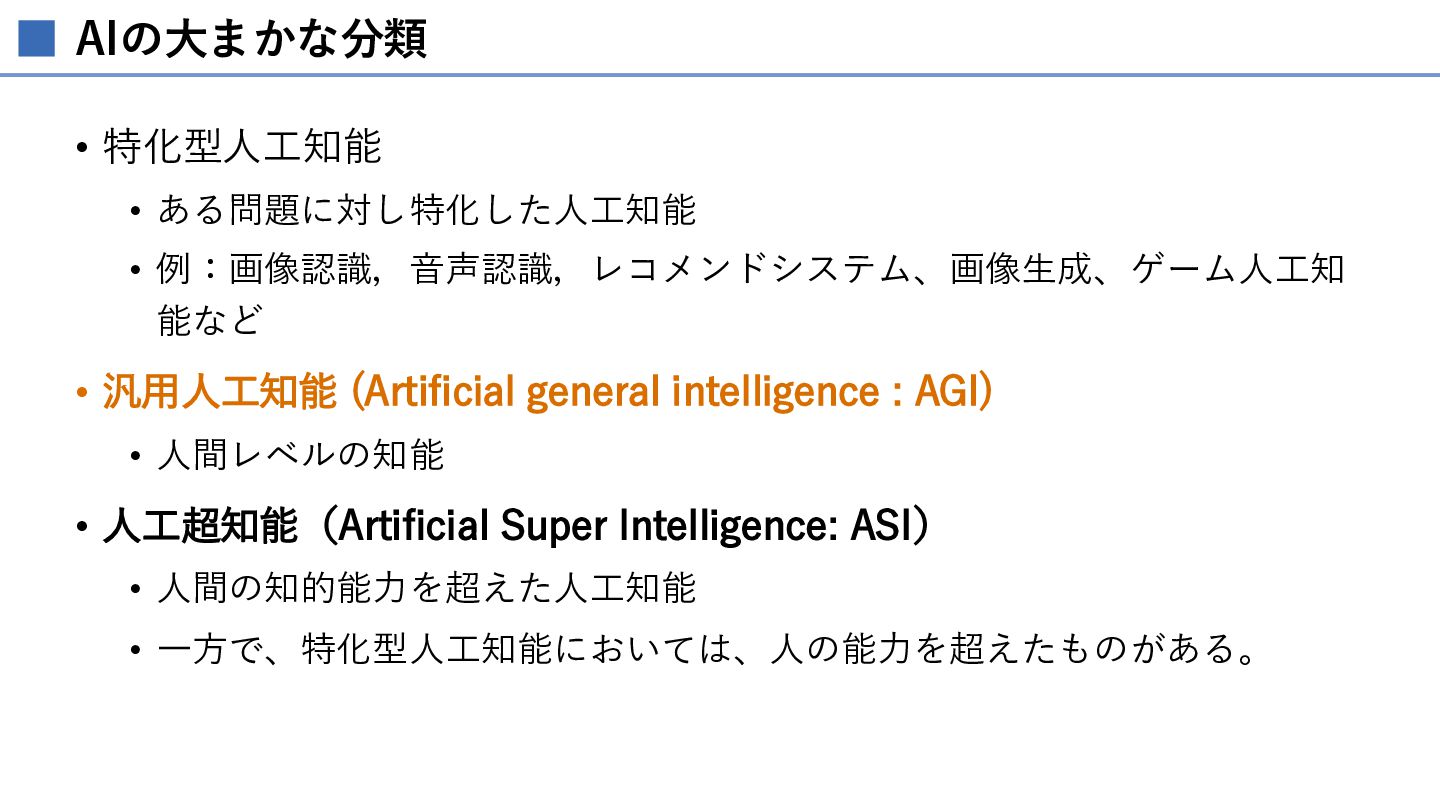
  4. AIの大まかな分類 • 特化型人工知能 • ある問題に対し特化した人工知能 • 例:画像認識,音声認識,レコメンドシステム、画像生成、ゲーム人工知 能など • 汎用人工知能

    (Artificial general intelligence : AGI) • 人間レベルの知能 • 人工超知能(Artificial Super Intelligence: ASI) • 人間の知的能力を超えた人工知能 • 一方で、特化型人工知能においては、人の能力を超えたものがある。
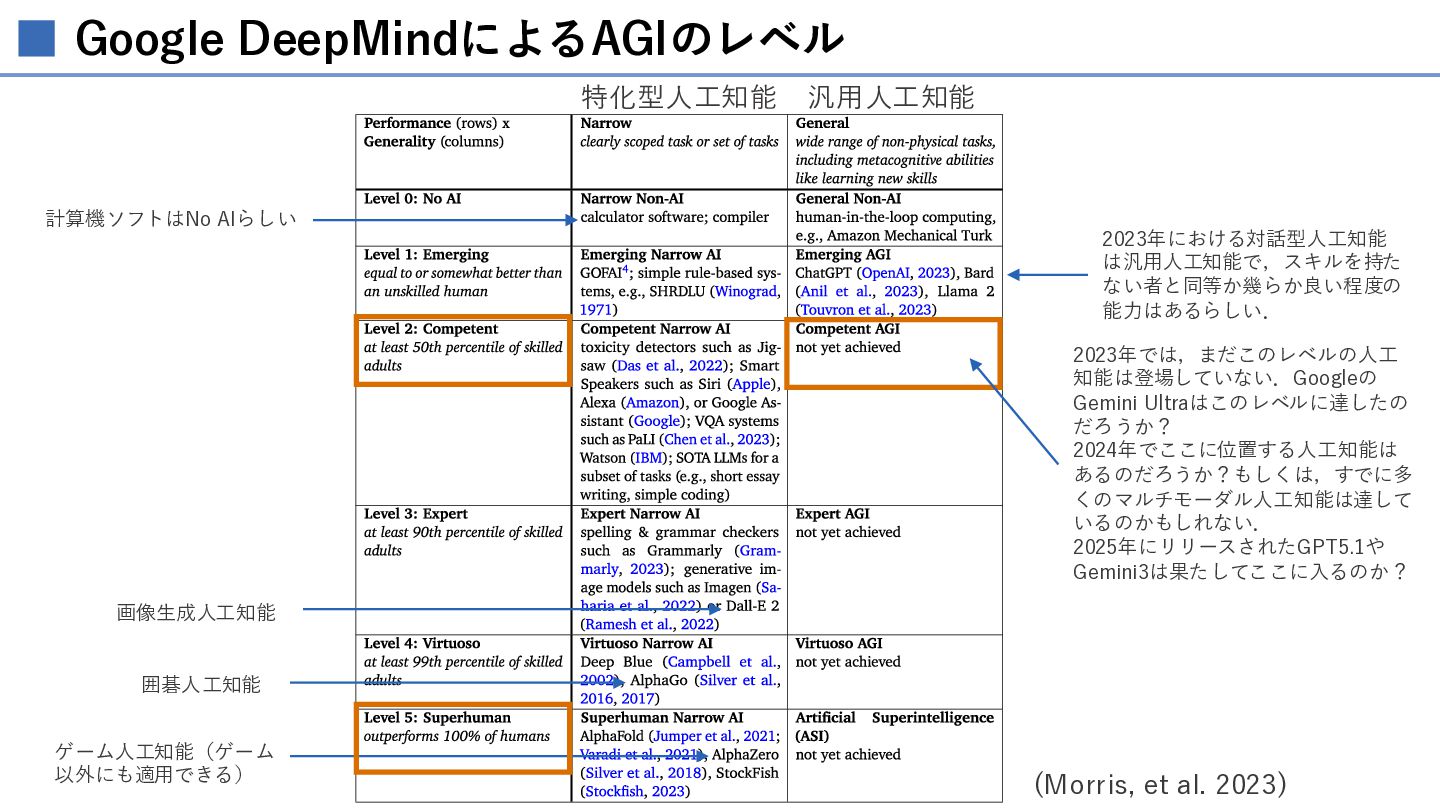
  5. Google DeepMindによるAGIのレベル 特化型人工知能 計算機ソフトはNo AIらしい 汎用人工知能 2023年における対話型人工知能 は汎用人工知能で,スキルを持た ない者と同等か幾らか良い程度の 能力はあるらしい.

    2023年では,まだこのレベルの人工 知能は登場していない.Googleの Gemini Ultraはこのレベルに達したの だろうか? 2024年でここに位置する人工知能は あるのだろうか?もしくは,すでに多 くのマルチモーダル人工知能は達して いるのかもしれない. 2025年にリリースされたGPT5.1や Gemini3は果たしてここに入るのか? 画像生成人工知能 囲碁人工知能 ゲーム人工知能(ゲーム 以外にも適用できる) (Morris, et al. 2023)
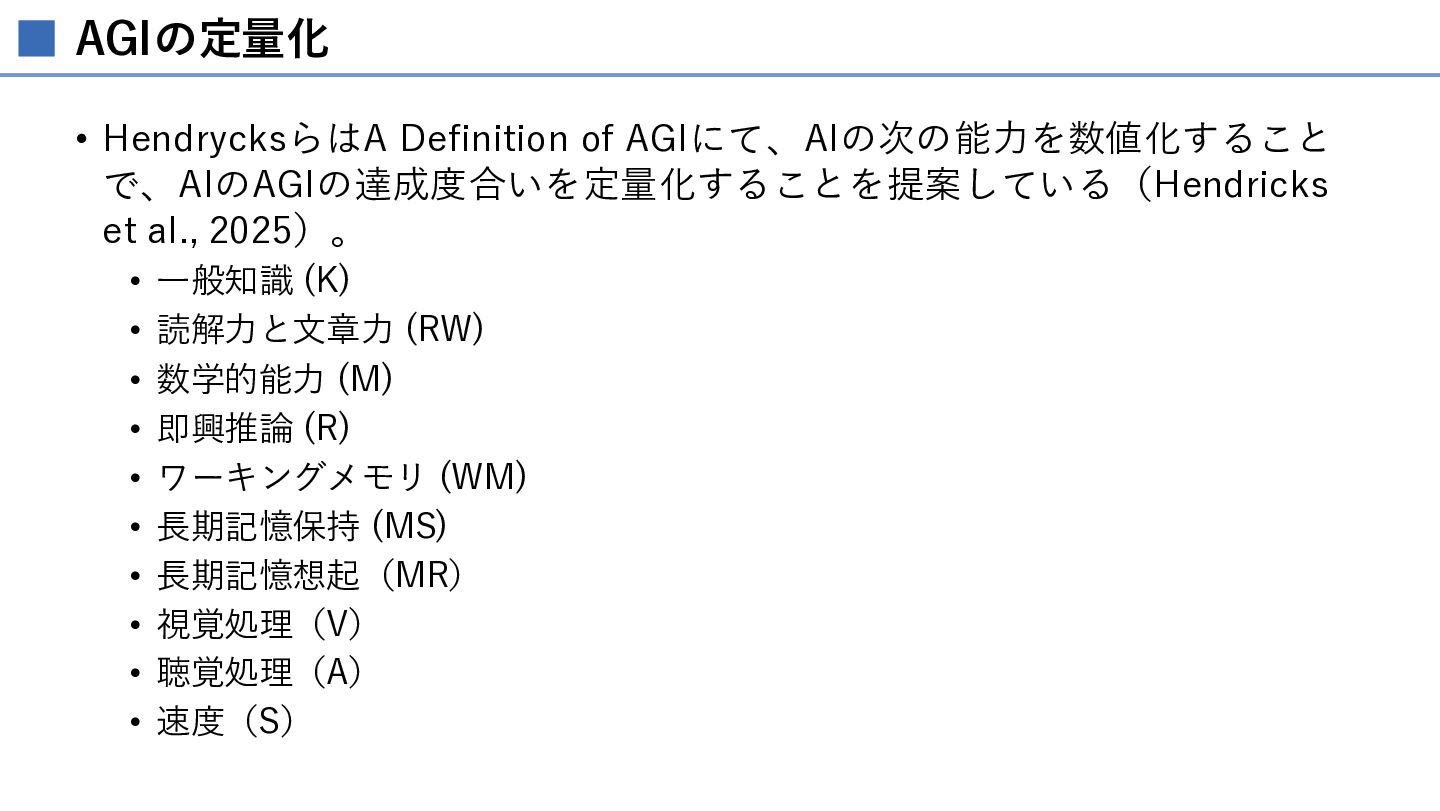
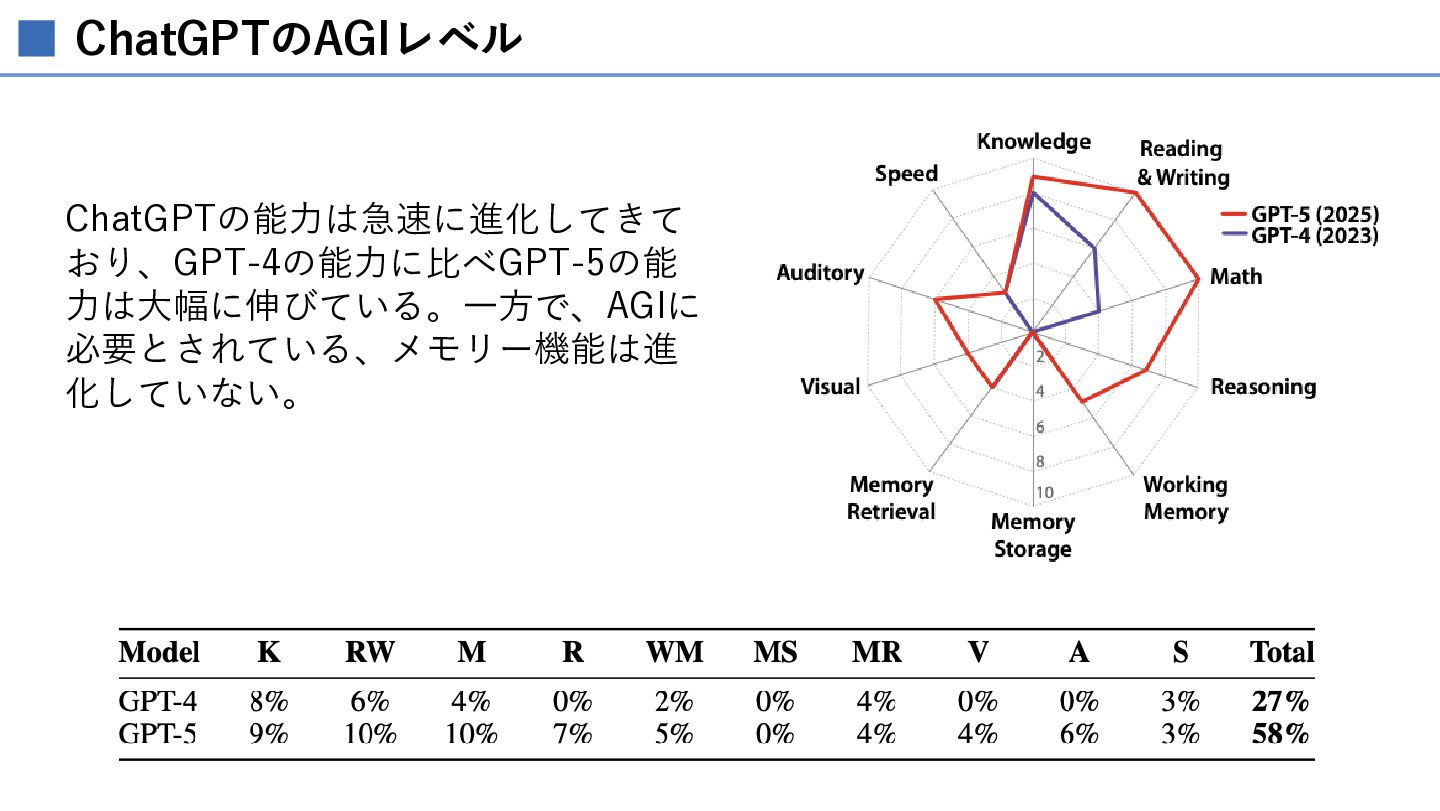
  6. AGIの定量化 • HendrycksらはA Definition of AGIにて、AIの次の能力を数値化すること で、AIのAGIの達成度合いを定量化することを提案している(Hendricks et al., 2025)。

    • 一般知識 (K) • 読解力と文章力 (RW) • 数学的能力 (M) • 即興推論 (R) • ワーキングメモリ (WM) • 長期記憶保持 (MS) • 長期記憶想起(MR) • 視覚処理(V) • 聴覚処理(A) • 速度(S)
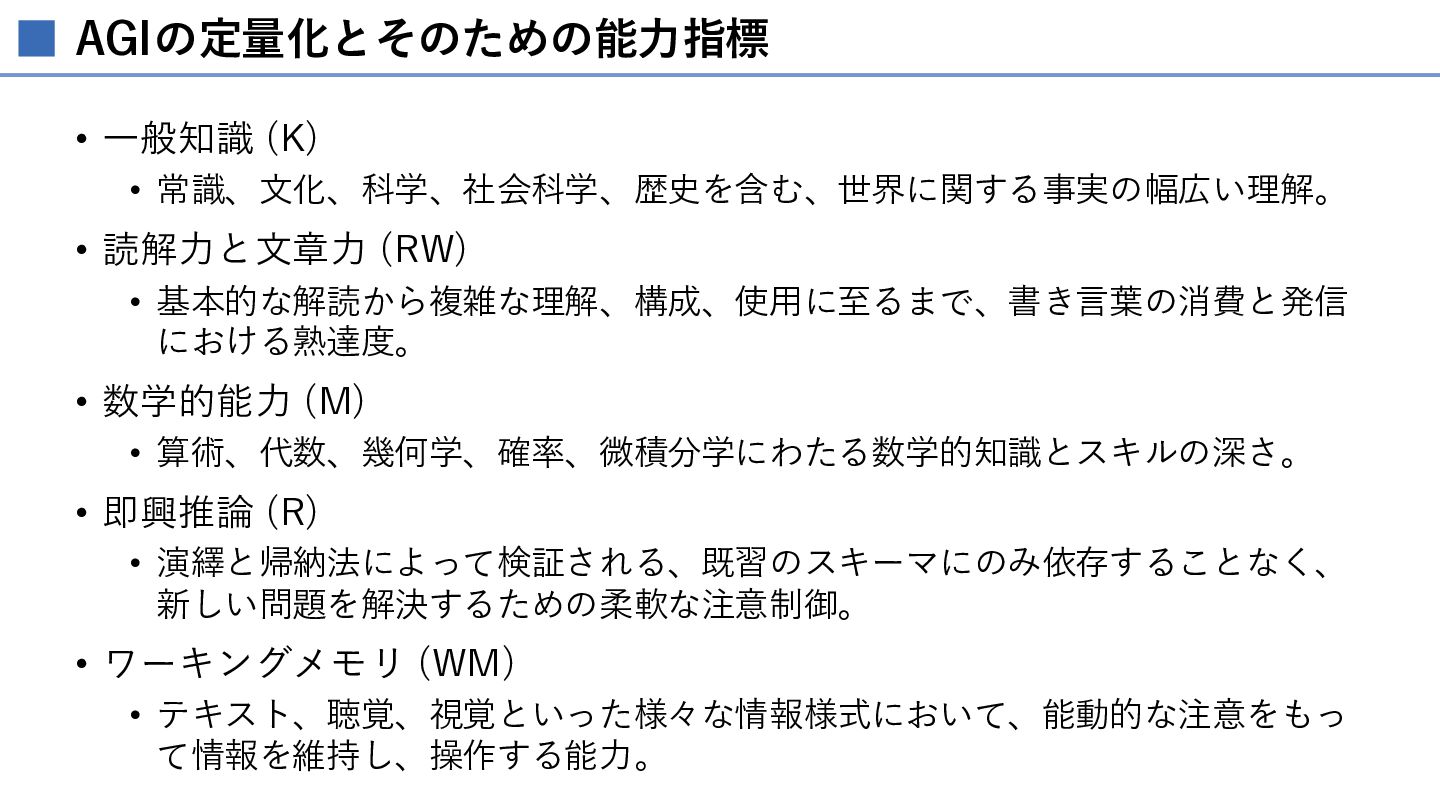
  7. AGIの定量化とそのための能力指標 • 一般知識 (K) • 常識、文化、科学、社会科学、歴史を含む、世界に関する事実の幅広い理解。 • 読解力と文章力 (RW) •

    基本的な解読から複雑な理解、構成、使用に至るまで、書き言葉の消費と発信 における熟達度。 • 数学的能力 (M) • 算術、代数、幾何学、確率、微積分学にわたる数学的知識とスキルの深さ。 • 即興推論 (R) • 演繹と帰納法によって検証される、既習のスキーマにのみ依存することなく、 新しい問題を解決するための柔軟な注意制御。 • ワーキングメモリ (WM) • テキスト、聴覚、視覚といった様々な情報様式において、能動的な注意をもっ て情報を維持し、操作する能力。
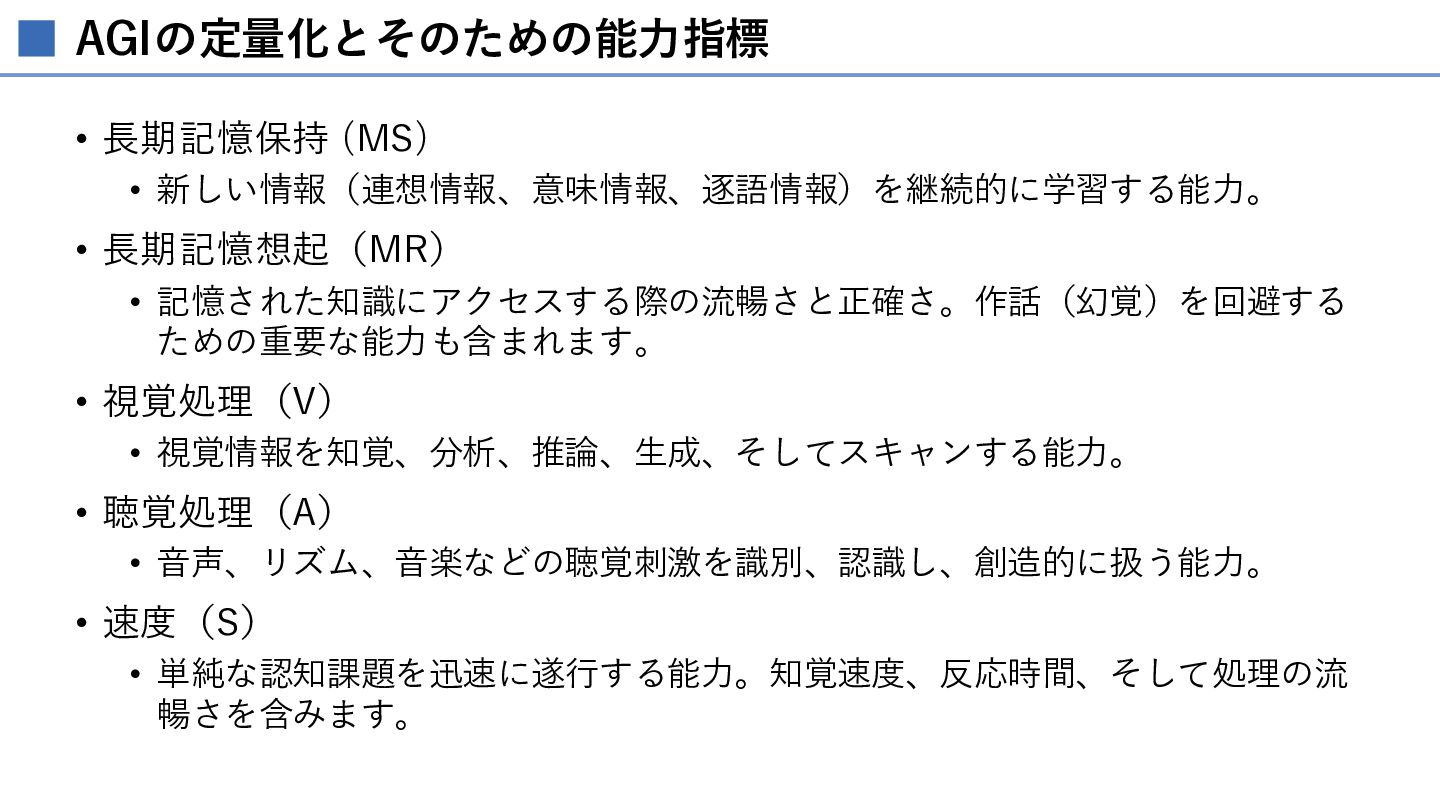
  8. AGIの定量化とそのための能力指標 • 長期記憶保持 (MS) • 新しい情報(連想情報、意味情報、逐語情報)を継続的に学習する能力。 • 長期記憶想起(MR) • 記憶された知識にアクセスする際の流暢さと正確さ。作話(幻覚)を回避する

    ための重要な能力も含まれます。 • 視覚処理(V) • 視覚情報を知覚、分析、推論、生成、そしてスキャンする能力。 • 聴覚処理(A) • 音声、リズム、音楽などの聴覚刺激を識別、認識し、創造的に扱う能力。 • 速度(S) • 単純な認知課題を迅速に遂行する能力。知覚速度、反応時間、そして処理の流 暢さを含みます。
  9. 現代AIはAGIに近いのか • AGIを達成していると考える研究者や技術者もいる。 • 近いと考えられる点: • 多様なタスクをこなす 。 • 言語を扱う

    。 • 画像や音声も扱う 。 • プログラムを書ける 。 • 推論らしいことをする 。 • まだ課題がある点: • 誤りを出す 。ハルシネーションを起こす。 • 長期的な自律性が弱い 。 • 身体を持たない 。 • 目的を自分で形成しない 。 • 現実世界での信頼性が不十分である。
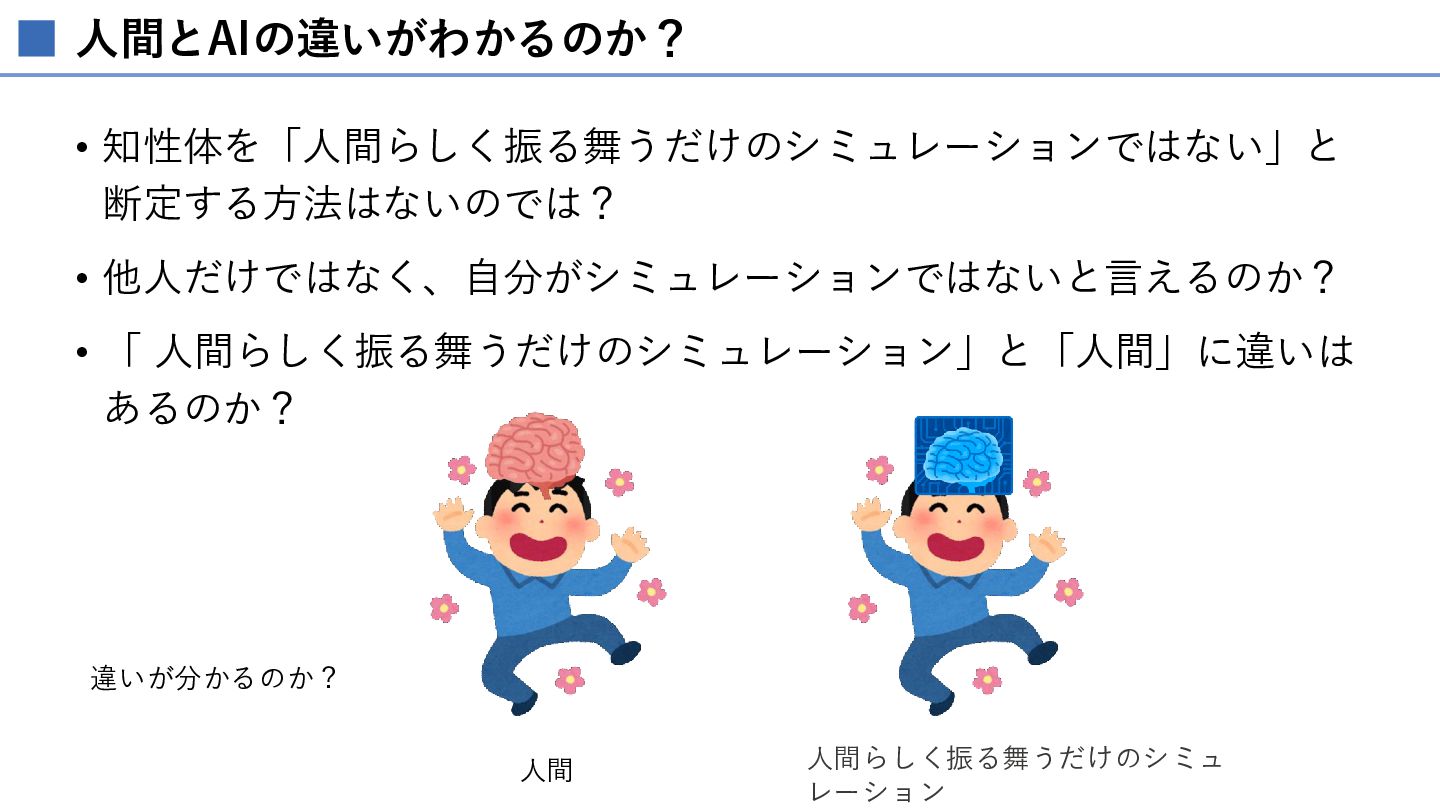
  10. 強いAIと弱いAI • サールは、AI研究を「弱いAI 」と「強いAI」に分類し、後者を否定し た。 • 強いAI • 本当に知能・意識・心を持つAI •

    弱いAI • 人間らしく振る舞うだけのAI • 強いAIと弱いAIの区別において、現在のすべてのAIは弱いAIに分類さ れるだろう。
  11. オートマタ、からくり人形 • コンピュータが登場する前から、人間は「生物の動きを模倣する機械 」を作ってきた。 • 18から19世紀のヨーロッパ(オートマタ)や江戸時代の日本(からくり人 形) • オートマタ:人形が楽器を演奏、鳥が動くなど •

    からくり人形:茶運人形、弓曳童子など • これらは、あらかじめ与えた動作しか出来ないが,動物や人の動きを模倣 する機械であった。 • 目的を持った意味のある動きは、知的であるとすると、オートマタやから くり人形は人工知能の元祖と呼べるものかもしれない。
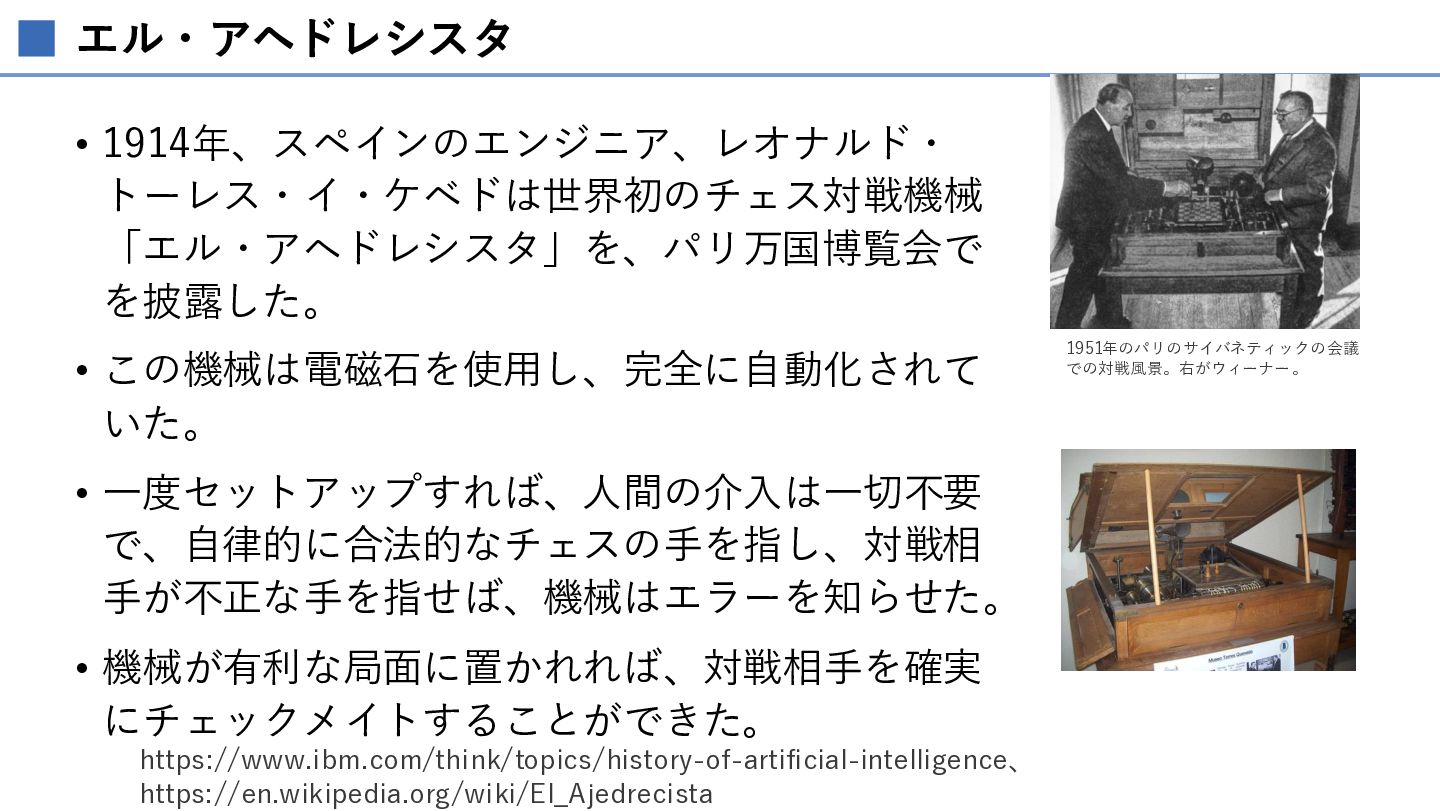
  12. エル・アヘドレシスタ • 1914年、スペインのエンジニア、レオナルド・ トーレス・イ・ケベドは世界初のチェス対戦機械 「エル・アヘドレシスタ」を、パリ万国博覧会で を披露した。 • この機械は電磁石を使用し、完全に自動化されて いた。 •

    一度セットアップすれば、人間の介入は一切不要 で、自律的に合法的なチェスの手を指し、対戦相 手が不正な手を指せば、機械はエラーを知らせた。 • 機械が有利な局面に置かれれば、対戦相手を確実 にチェックメイトすることができた。 https://www.ibm.com/think/topics/history-of-artificial-intelligence、 https://en.wikipedia.org/wiki/El_Ajedrecista 1951年のパリのサイバネティックの会議 での対戦風景。右がウィーナー。
  13. エル・アヘドレシスタの基本動作 • エル・アヘドレシスタがチェスをプレイできたとしたが、これは極め て限定的な局面に限ったものである。 • どのような盤面でもプレイできるのではなく、プレイ手順が決まって いる「キング+ルーク対キング」の盤面だけだけプレイできた。 • 動作の手順 •

    適切に操作すれば理論上必勝の終盤です。戦略は比較的単純です。 • ルークで黒キングの移動領域を区切る • 白キングを近づける • 黒キングを盤端へ追い込む • 白キングに守られたルークで詰ませる
  14. 機械知能の先駆け • オートマタ、からくり人形、エル・アヘドレシスタは機械知能の先駆 けである。 • 見かけは知的な動作をする。 • 外部から見て知的に見えるのならば、機械は知能を持つといえるのか? • 物理的なプログラムで決まった動作をする。

    • オートマタなどは、複雑な動作をカムや歯車の物理的な形状として記憶し ていた(プログラミングされていた) 。 • これは、現代のソフトウェアやRead-Only Memory(ROM、読み取り専用 メモリ)の最も原始的な物だといえる。 • しかし、決まった動作をしかしないので、知能は持っていないのではない か?
  15. アラン・チューリング(1912-1954) • 計算機科学と人工知能の基礎に大きな影響を与えた人物 • 主な功績 • Bombe • エニグマの解読 •

    計算機の活用、人工知能の基礎となる統計的技法の開発と活用の先進的取組 • 機械知能 • 1948年の 『知的機械』(Intelligent Machinery) と 1950年の 『計算する機械と知能』 (Computing Machinery and Intelligence) において、機械知能の可能性を論じた。 • チューリングマシン • アルゴリズムによる計算の本質を表す最も基本的な理論モデル • イミテーション・ゲーム • 対話だけを手がかりに機械が人間らしく振る舞えるかを考える枠組 • チューリングテスト • 対話だけを手がかりに、機械が人間と区別できないかどうかで機械知能を考えるテスト
  16. イミテーション・ゲームとチューリングテスト • 知的機械 • 知的なふるまいを示す機械 • チューリングは、機械がそのようなふるまいを示しうるかを検討した • イミテーション・ゲーム •

    アラン・チューリングが提案した思考実験 • 質問者は、対話だけを手がかりに相手を判別する。 • この枠組みを使って、機械が人間のように応答できるかを考えた。 • 機械が人間と区別できないように会話できるなら、その機械は知的だと言 えるのではないか、と考える。 • 後のチューリングテストの原型となった。
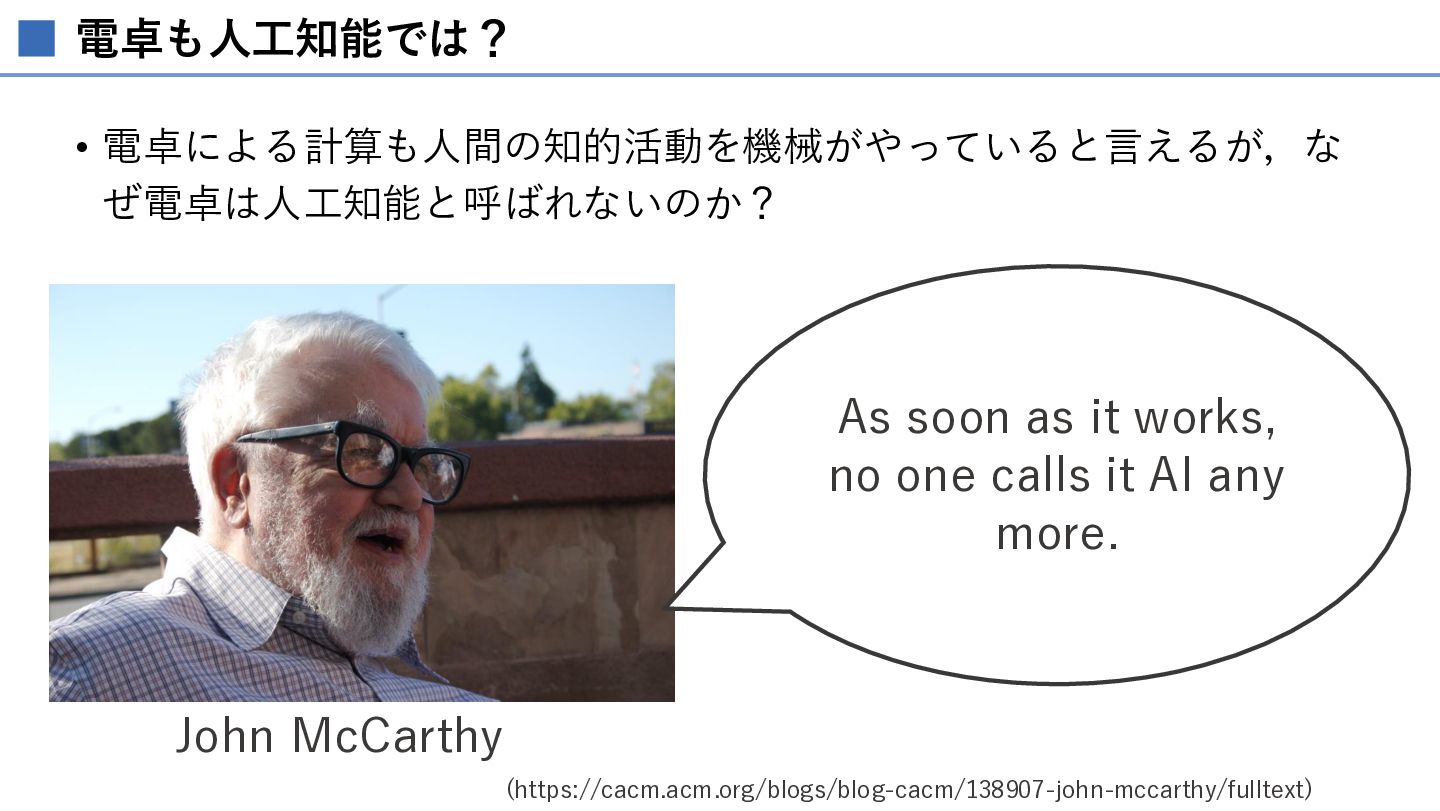
  17. ダートマス会議 • 1956年ダートマスで開催 • 主な提案者 • ジョン・マッカーシー • 「Artificial Intelligence」という言葉を提案した計算機科学者。

    • マービン・ミンスキー • AI研究の先駆者。MITで人工知能研究を発展させた中心人物の一人。パーセプトロンの限界 を指摘したことでも有名。 • クロード・シャノン • 情報理論の創始者。 • ナサニエル・ロチェスター • IBMの研究者。初期のコンピュータ開発やAI研究に関わった。 • 「Artificial Intelligence(人工知能)」という名称が使われ、研究分野としてのAI が形成されるきっかけとなった • ここから「人工知能」が独立した研究分野として始まる。
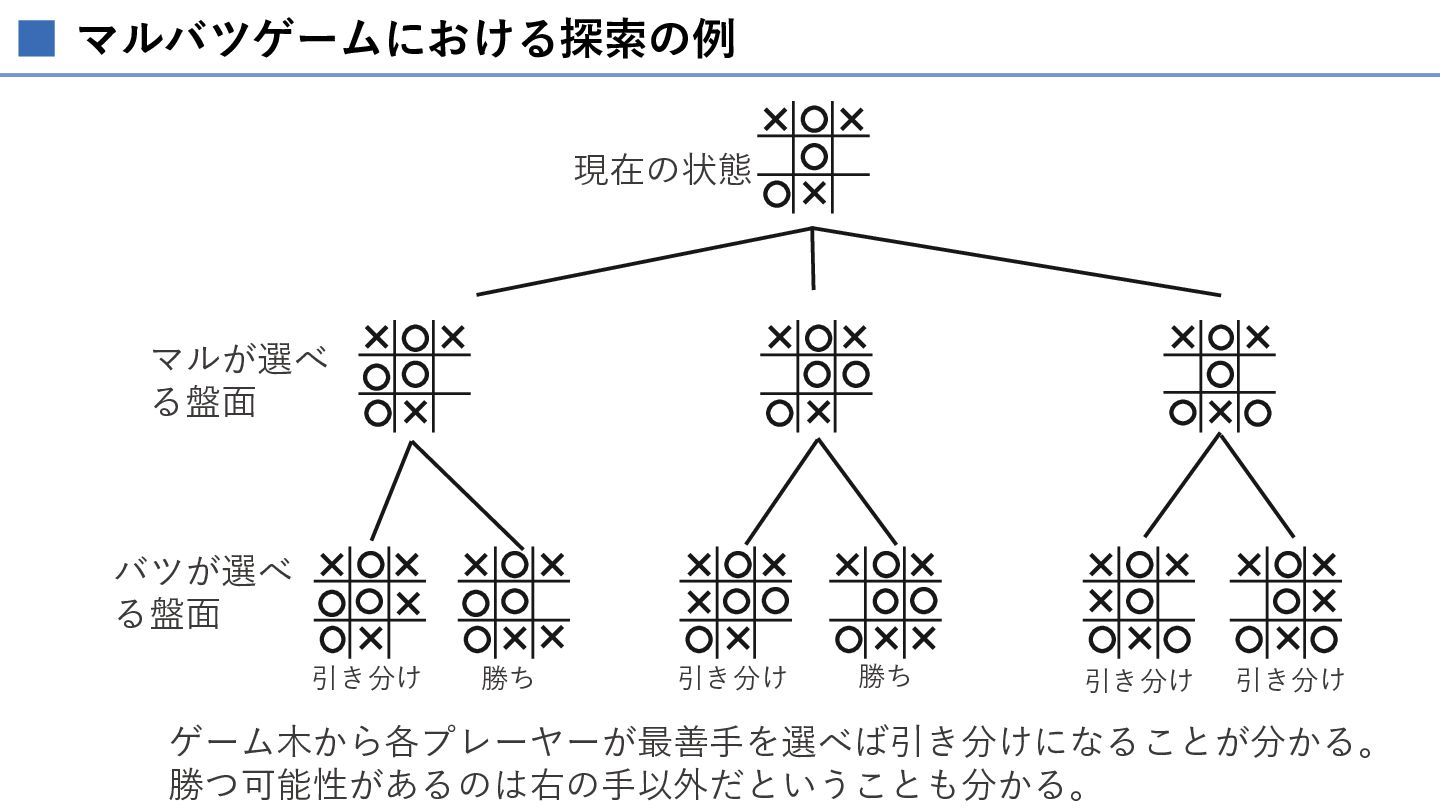
  18. マルバツゲーム • マルバツゲームを考えてみよう。 • ◦とXを交互に3x3のマスに埋めていき3つ並べたほうが勝ち。 • 手順 • 可能な手を調べる。 •

    手を選択する。 • を終局まで繰り返す。 • この手順で、起こりうる手(盤面)を探し、勝つの手が見つける。 • この探索を組み込んだ機械は、マルバツゲームに限らず、様々なボー ドゲームをプレイすることができる。
  19. マルバツゲームにおける探索の例 現在の状態 マルが選べ る盤面 バツが選べ る盤面 引き分け 勝ち 引き分け 勝ち

    引き分け 引き分け ゲーム木から各プレーヤーが最善手を選べば引き分けになることが分かる。 勝つ可能性があるのは右の手以外だということも分かる。
  20. 探索のみを用いたAIがなぜ進化しなかったのか? • すべての可能性を調べれば、理論上は最善手を見つけられるかもしれない。 • しかし、現実では選択肢は爆発的に増える。 • 例えば、ゲームで は一手ごとに多くの選択肢があり、数手先を読むだけでも膨大な数の局 面が生じる。 •

    そのためAIでは、 • 重要そうな選択肢を優先する • 不要な選択肢を省く • 途中の局面を評価する • 経験的なルールを使う • といった工夫が必要になる。 • 一方、探索と学習を組み合わせた手法は進化していった。
  21. 評価関数 • 探索では、すべての未来を最後まで調べることは難しい。 • そこで、途中の状態がどれくらい良いかを数値で評価する。 • この数値を計算する仕組みを評価関数という。 • 例: •

    チェスで駒が多いほど有利 • 王が安全なほど有利 • ゴールに近いほど有利 • スコアが高いほど良い • Deep BlueのようなゲームAIでは、探索と評価関数が重要な役割を果 たした。
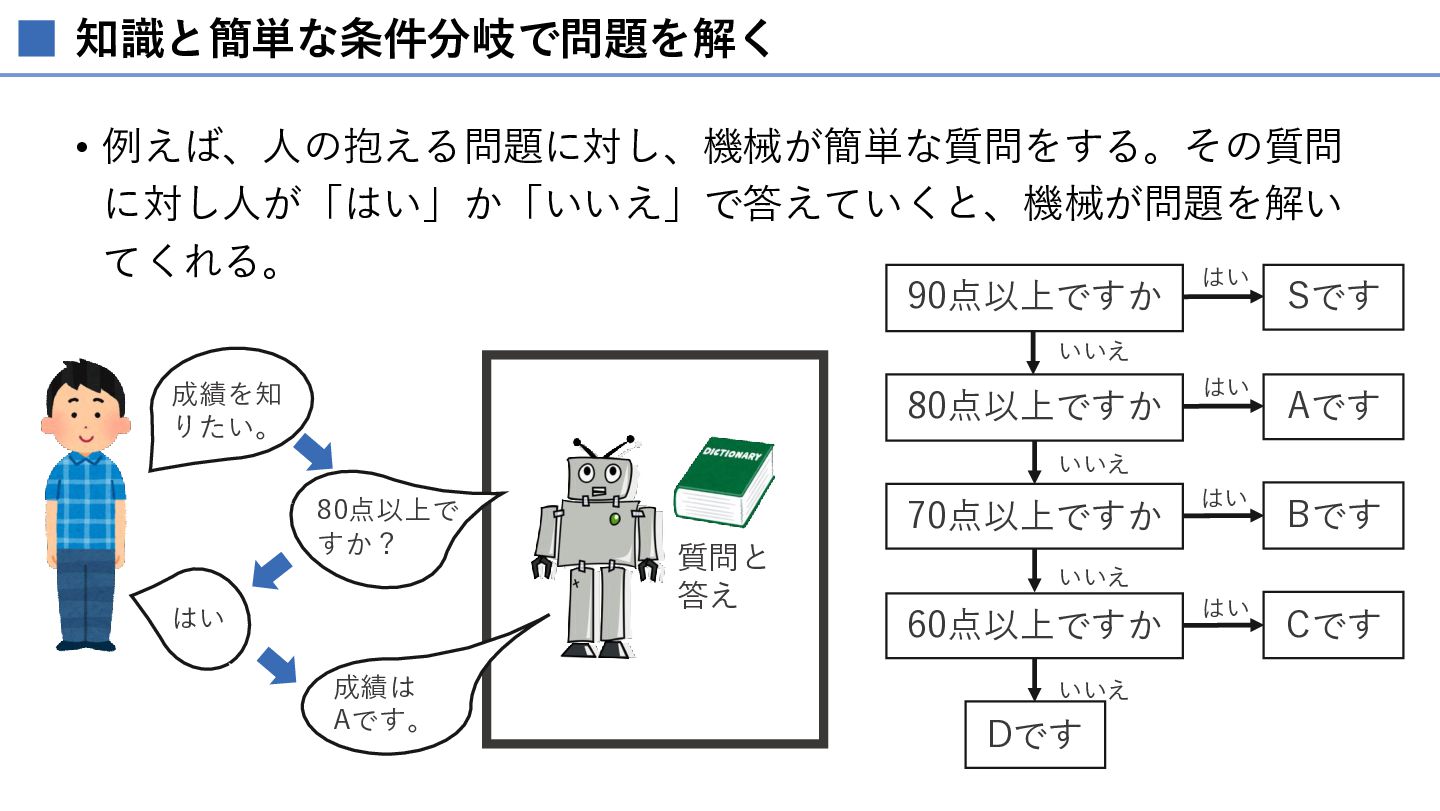
  22. 知識と簡単な条件分岐で問題を解く • 例えば、人の抱える問題に対し、機械が簡単な質問をする。その質問 に対し人が「はい」か「いいえ」で答えていくと、機械が問題を解い てくれる。 はい Sです 90点以上ですか いいえ 成績を知

    りたい。 80点以上ですか はい Aです はい Bです はい Cです いいえ 80点以上で すか? はい 成績は Aです。 70点以上ですか 質問と 答え いいえ 60点以上ですか いいえ Dです
  23. ELIZA(イライザ) • 1960年代にMITのジョセフ・ワイゼンバウムによって開発された、世 界最初期のチャットボット(自然言語処理プログラム)である。 • 仕組み:パターンマッチングと置換 • ELIZAはの動作は、「スクリプト」と呼ばれるルールに基づいたパターン マッチングと文字列の置換によって成り立っている。 •

    入力の分解: ユーザーの入力からキーワードを探す。 • 変換ルール: キーワードが見つかると、あらかじめ定義されたルールに従っ て文を作り替える。 • 例:ユーザーが「私の母は~」と言えば、ELIZAは「あなたの家族についてもっ と教えてください」や「母親についてどう感じますか?」といった定型文を返す。 • オウム返し: キーワードが見つからない場合は、「なるほど」「続けてくだ さい」といった汎用的な相槌を打つ。
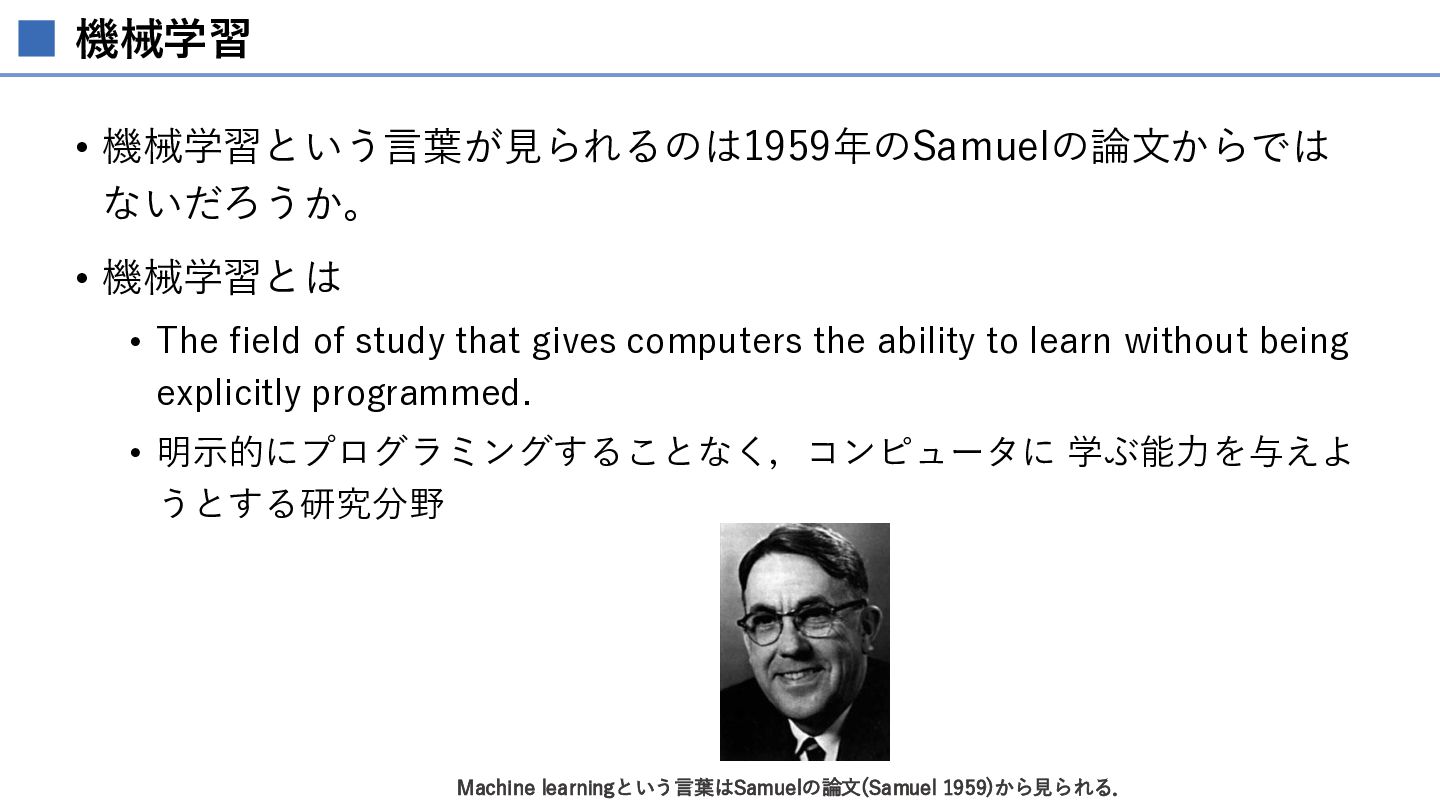
  24. 機械学習 • 機械学習という言葉が見られるのは1959年のSamuelの論文からでは ないだろうか。 • 機械学習とは • The field of

    study that gives computers the ability to learn without being explicitly programmed. • 明示的にプログラミングすることなく,コンピュータに 学ぶ能力を与えよ うとする研究分野 Machine learningという言葉はSamuelの論文(Samuel 1959)から見られる.
  25. 機械学習の基本 • 訓練データを収集する。 • モデルに規則を学ばせる(学習)。 • 学習後のモデルを実用として使う。 • 例: •

    画像 • 犬と猫の画像を集め、犬と猫の違いを学ばせる。学んだモデルは、未知の犬猫画 像を見分ける。 • メール • スパムメールを集め、規則性を学ばせる。その規則に従い、メールを分ける。 • レコメンド • これまでの販売実績を学び、購入履歴から買いそうな商品を提案する。
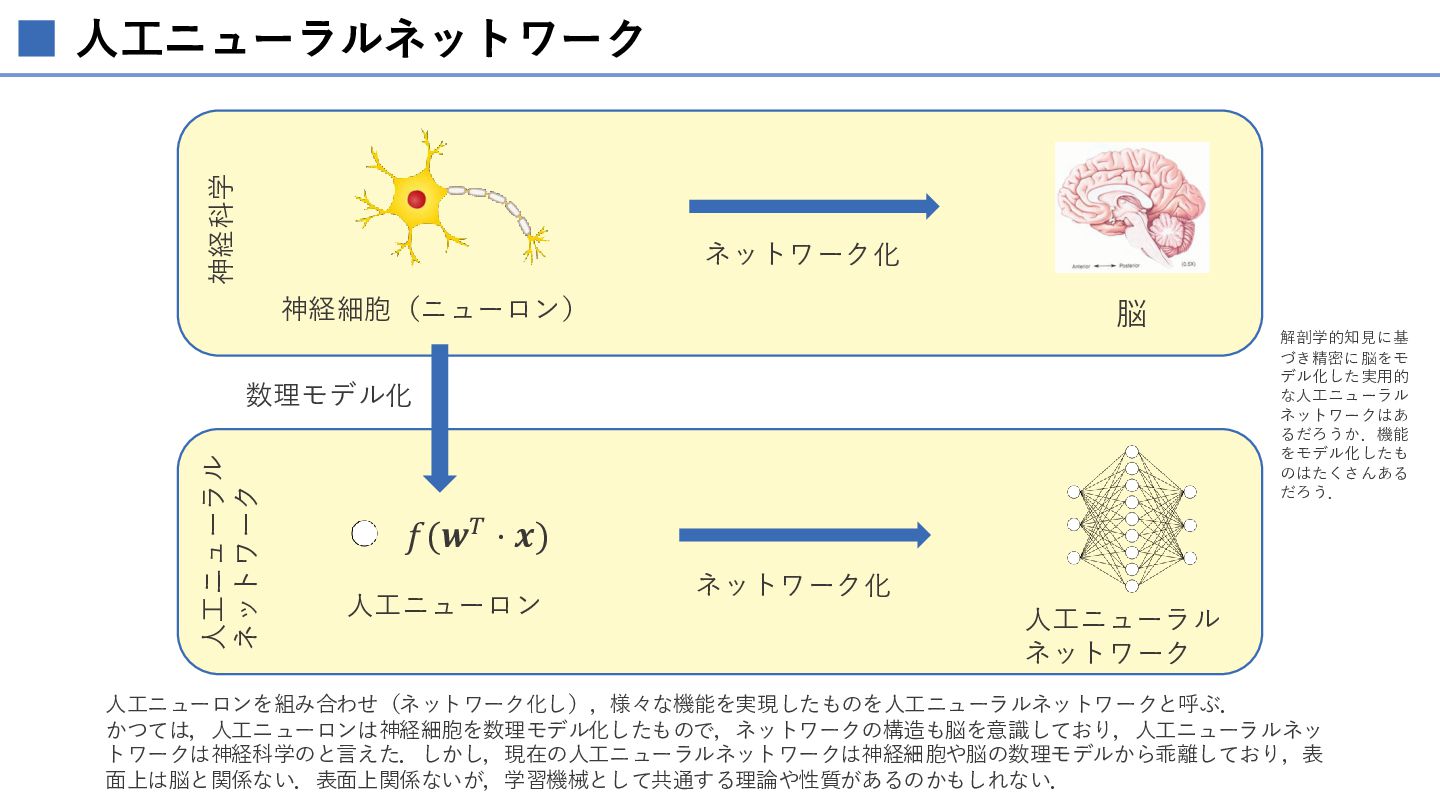
  26. 神経科学 人工ニューラルネットワーク ネットワーク化 神経細胞(ニューロン) 脳 解剖学的知見に基 づき精密に脳をモ デル化した実用的 な人工ニューラル ネットワークはあ

    るだろうか.機能 をモデル化したも のはたくさんある だろう. 人工ニューラル ネットワーク 数理モデル化 𝑓(𝒘𝑇 ⋅ 𝒙) 人工ニューロン ネットワーク化 人工ニューラル ネットワーク 人工ニューロンを組み合わせ(ネットワーク化し),様々な機能を実現したものを人工ニューラルネットワークと呼ぶ. かつては,人工ニューロンは神経細胞を数理モデル化したもので,ネットワークの構造も脳を意識しており,人工ニューラルネッ トワークは神経科学のと言えた.しかし,現在の人工ニューラルネットワークは神経細胞や脳の数理モデルから乖離しており,表 面上は脳と関係ない.表面上関係ないが,学習機械として共通する理論や性質があるのかもしれない.
  27. McCulloch-Pittsモデル (1943年) • McCullochとPittsは1946年の論文でニューラルネットワークで様々な 論理演算ができる事を示した。 • 主な内容 • 閾値論理素子の提案 •

    ニューラルネットワークを構成する、基本素子を示した。 • ニューラルネットワークの提案 • 様々な論理演算をニューラルネットワークで実現できることを示した。 (McCulloch and Pitts 1943) 分かりにくい論文
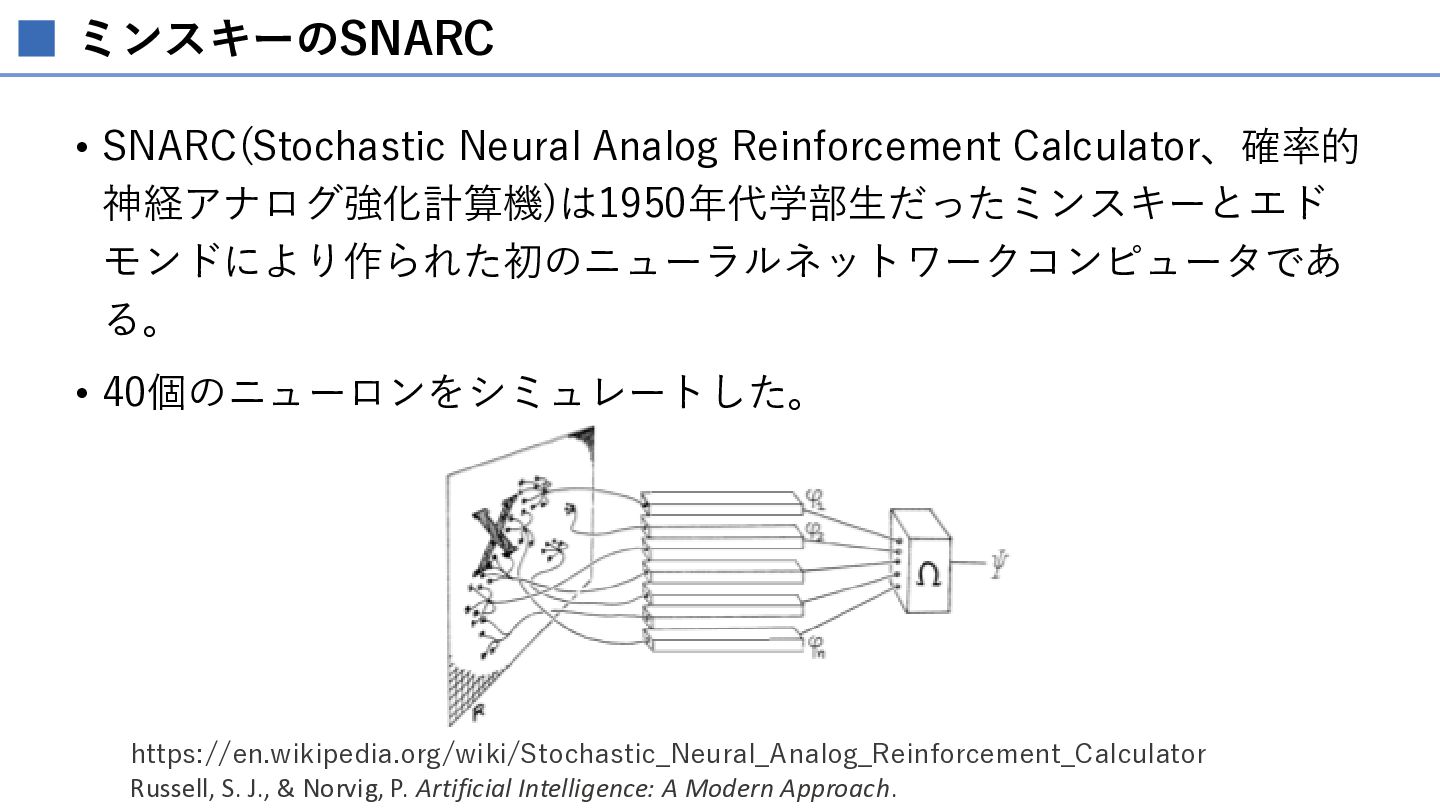
  28. ミンスキーのSNARC • SNARC(Stochastic Neural Analog Reinforcement Calculator、確率的 神経アナログ強化計算機)は1950年代学部生だったミンスキーとエド モンドにより作られた初のニューラルネットワークコンピュータであ る。

    • 40個のニューロンをシミュレートした。 https://en.wikipedia.org/wiki/Stochastic_Neural_Analog_Reinforcement_Calculator Russell, S. J., & Norvig, P. Artificial Intelligence: A Modern Approach.
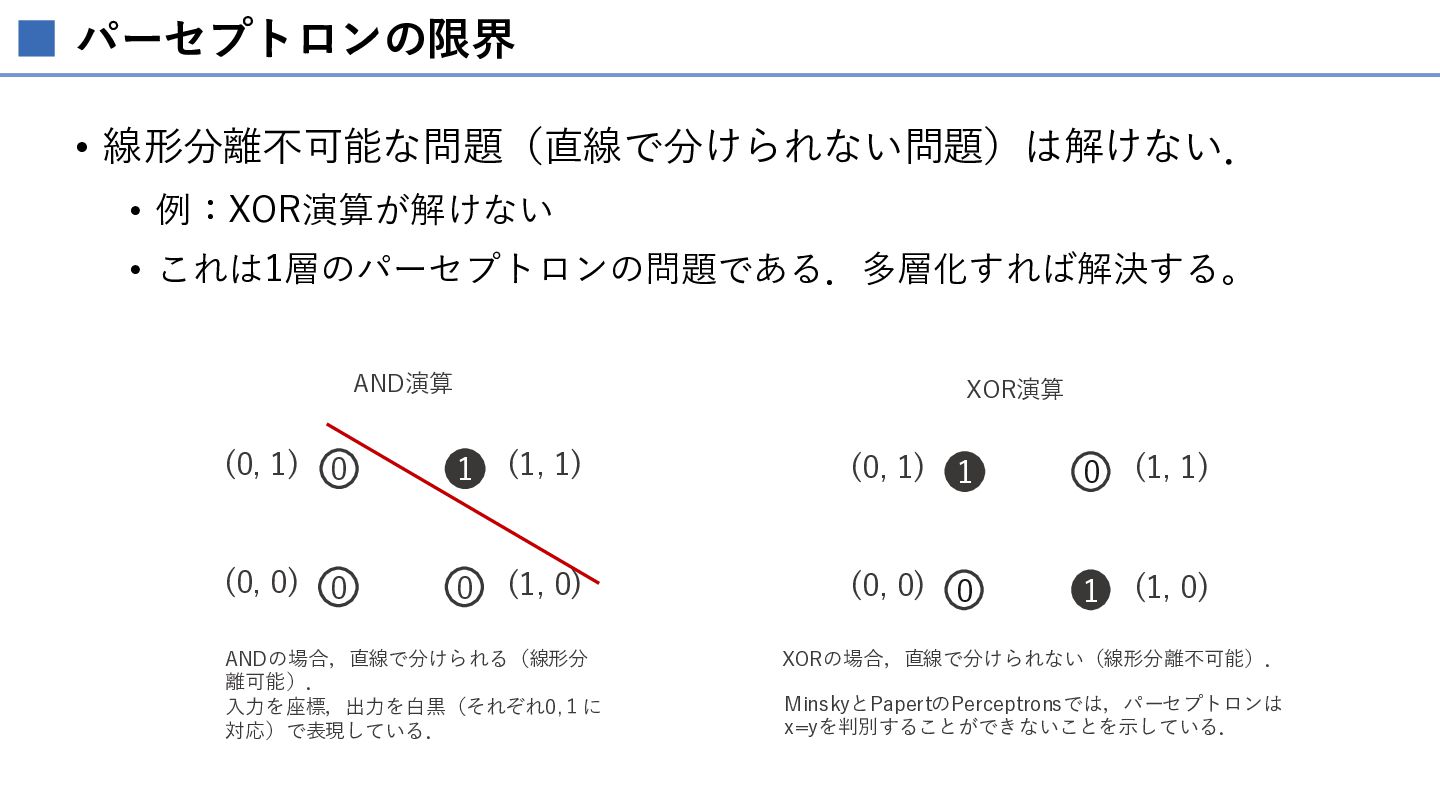
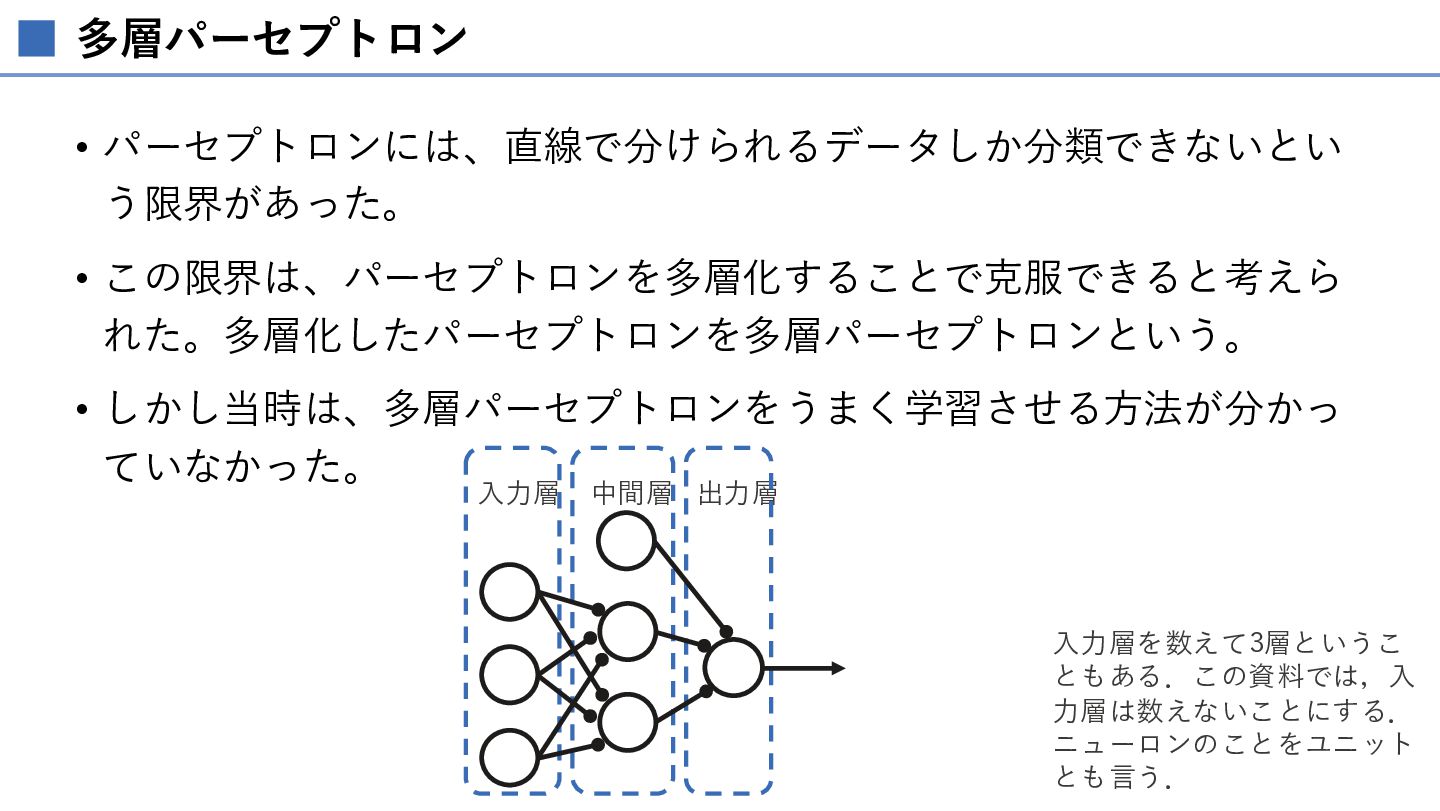
  29. パーセプトロンの限界 • 線形分離不可能な問題(直線で分けられない問題)は解けない. • 例:XOR演算が解けない • これは1層のパーセプトロンの問題である.多層化すれば解決する。 AND演算 XOR演算 (0,

    1) 0 1 (1, 1) (0, 1) 1 0 (1, 1) (0, 0) 0 0 (1, 0) (0, 0) 0 1 (1, 0) ANDの場合,直線で分けられる(線形分 離可能). 入力を座標,出力を白黒(それぞれ0,1に 対応)で表現している. XORの場合,直線で分けられない(線形分離不可能). MinskyとPapertのPerceptronsでは,パーセプトロンは x=yを判別することができないことを示している.
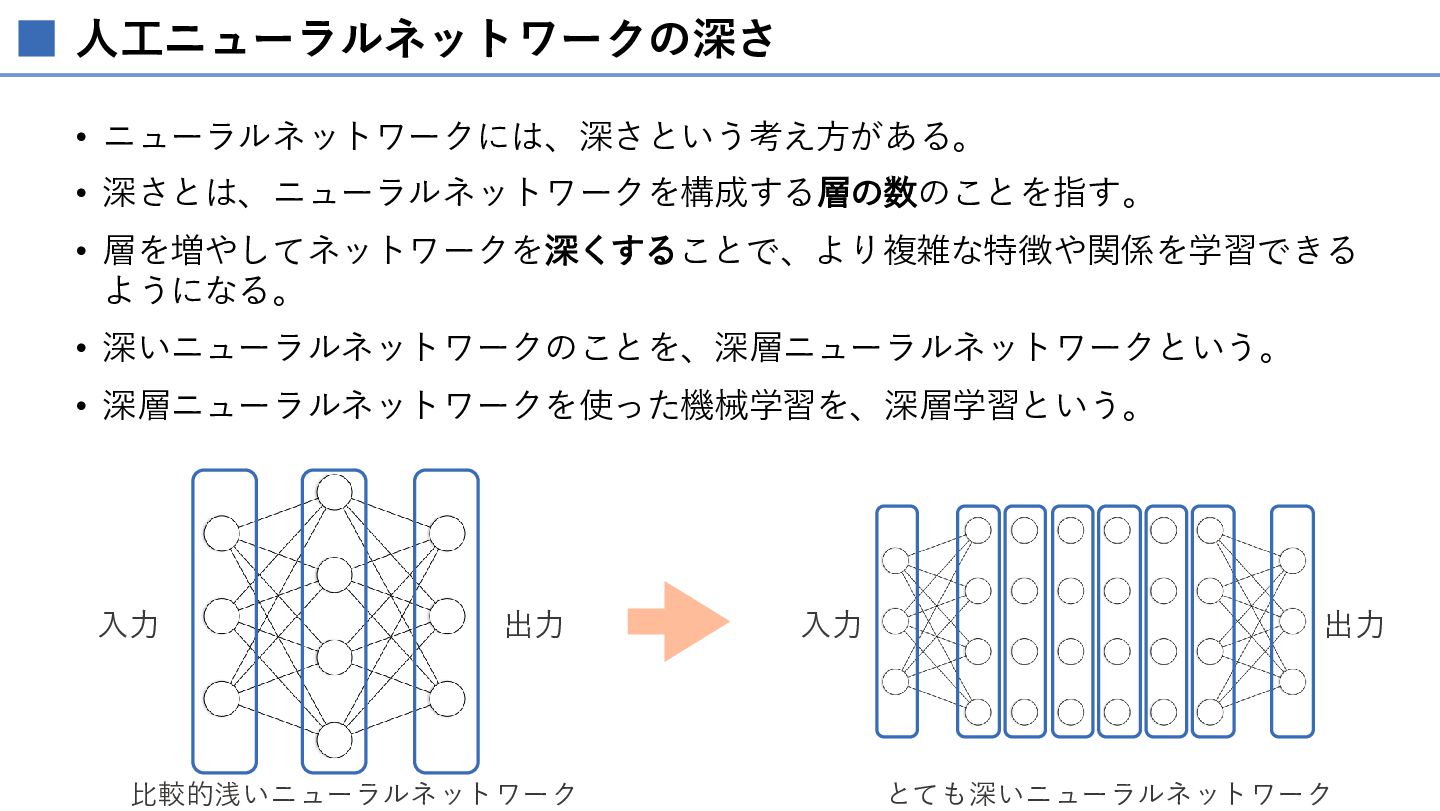
  30. 深層ニューラルネットワーク • 画像を処理する。 • 文字の識別,顔の識別など様々な画像処理タスクに用いられる。 • 畳み込みニューラルネットワークと呼ばれる人工ニューラルネットワーク がよく使われる。 • 言語を処理する(言語モデル)。

    • 対話型人工知能などで使われる。 • Transformerと呼ばれる人工ニューラルネットワークがよく使われる。 • 画像などを作る(画像生成人工知能)。 • 我々の指示に応じた画像を作る。 • 拡散モデルがよく使われる。 対話型人工知能や画像生成人工知能などをあわせて生 成人工知能と呼ぶことがある。 • 拡散モデルを実装するために人工ニューラルネットワークが使われる。
  31. 深層ニューラルネットワークの隆盛 • 深層ニューラルネットワークの考え方は古くから研究されていた。 • 代表例 • 福島邦彦によるネオコグニトロン • Yann LeCunらによるLeNet

    • 研究は続けられていたものの、長い間、人工知能研究のメインストリームではなか った。 • 2012年、画像認識コンテスト ImageNet で深層ニューラルネットワークが従来手 法を大幅に上回る性能を示した。 • このモデルは後にAlexNetと呼ばれる。 • これをきっかけに、世界中で深層ニューラルネットワークの研究・開発・応用が急 速に進んだ。 • その後、深層ニューラルネットワークは画像、音声、自然言語などへ広がり、現在 の生成AIへとつながっていく。
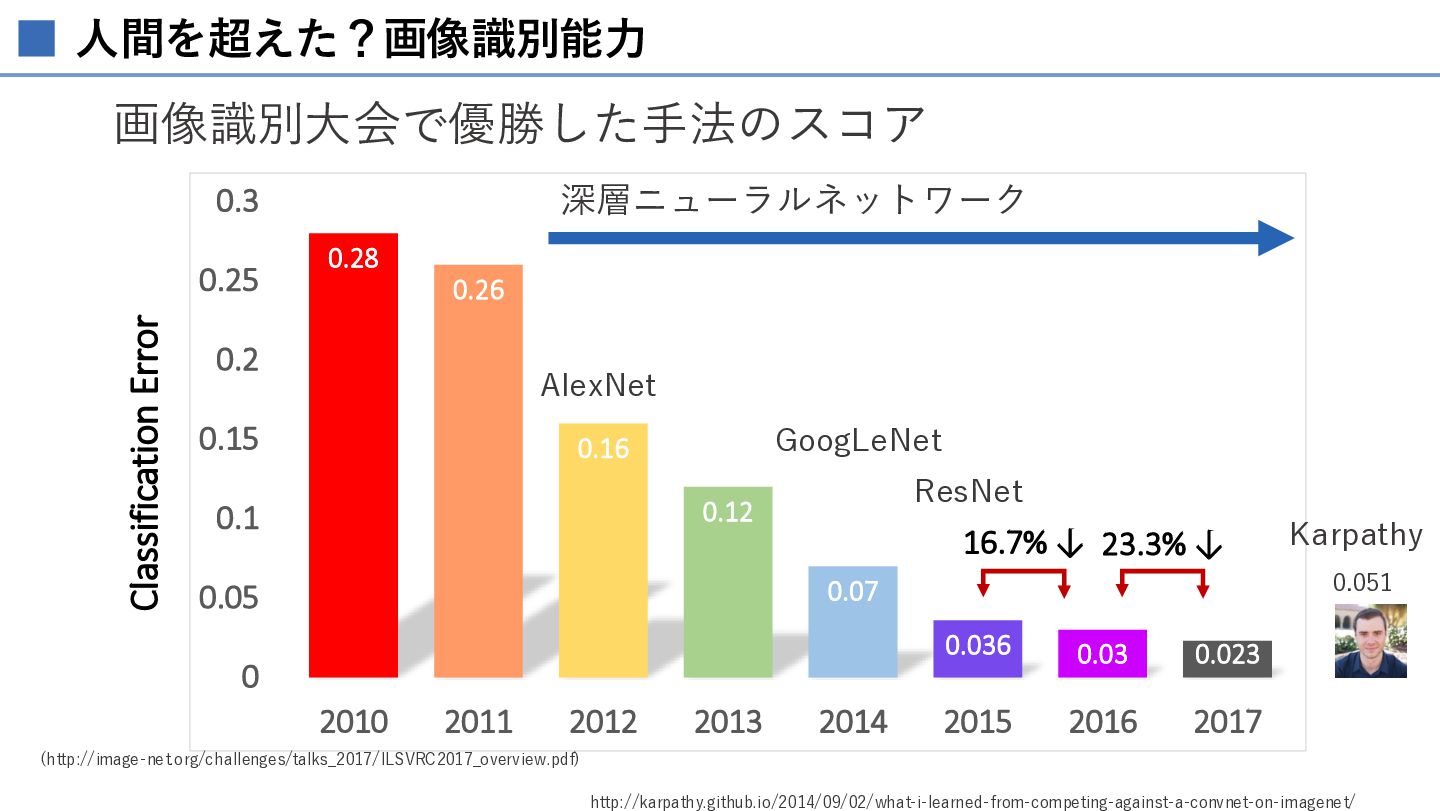
  32. 人間を超えた?画像識別能力 Classification Results (CLS) 画像識別大会で優勝した手法のスコア 深層ニューラルネットワーク 0.3 Classification Error 0.25

    0.28 0.26 0.2 AlexNet 0.15 GoogLeNet 0.16 ResNet 0.12 0.1 16.7% ↓ 23.3% ↓ 0.051 0.07 0.05 0 2010 2011 2012 2013 2014 Karpathy 0.036 0.03 0.023 2015 2016 2017 (http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf) http://karpathy.github.io/2014/09/02/what-i-learned-from-competing-against-a-convnet-on-imagenet/
  33. AI研究とゲーム • AI研究においては、ゲームがしばしば研究対象となっている。 • ルールが明確 • 勝ち負けが明確 • 状態を記述しやすい •

    選択肢を比較できる • 人間にとって「知能的」に見える • よく研究対象となるゲーム • チェッカー、チェス、オセロ、将棋、囲碁、コンピュータゲーム(アタリ のゲームが有名)
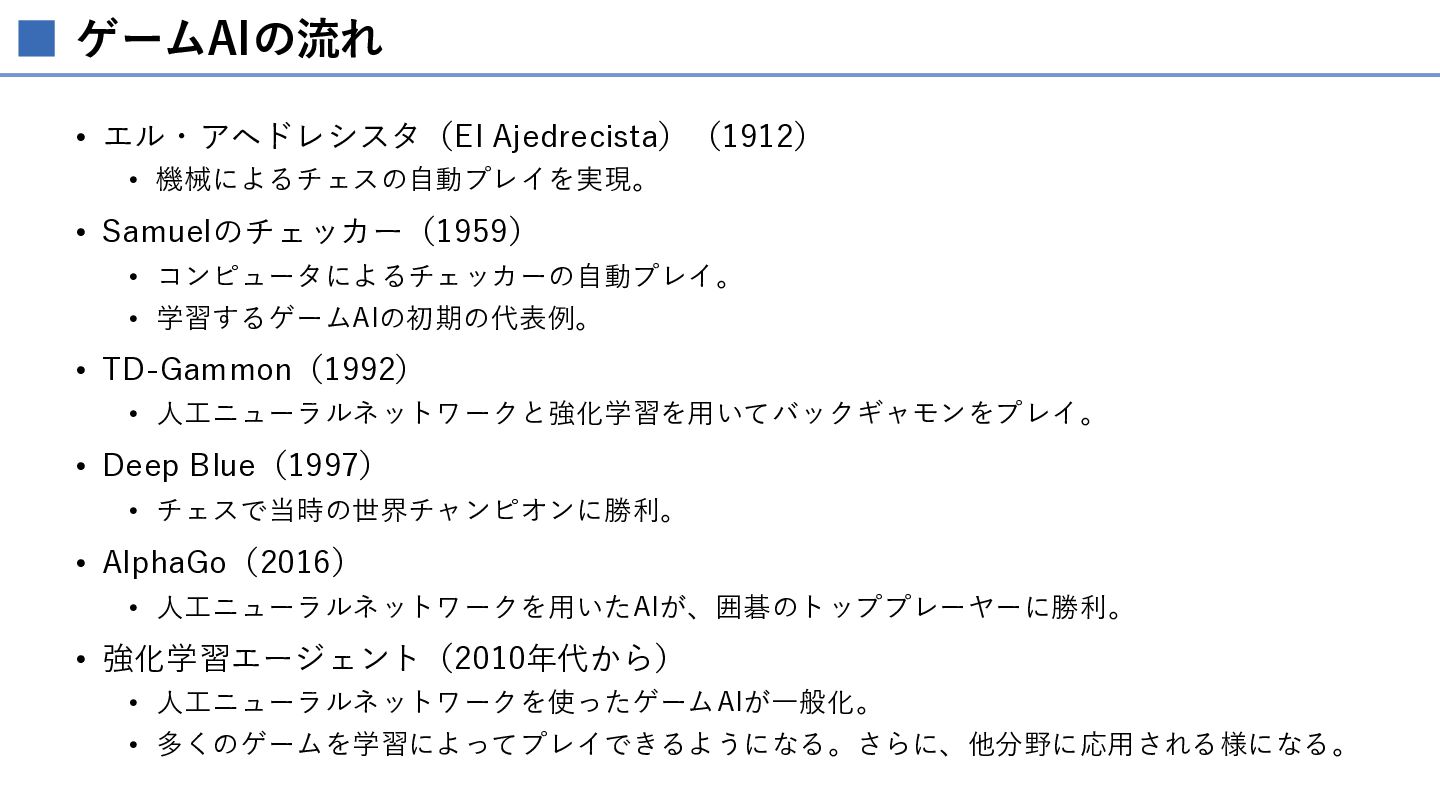
  34. ゲームAIの流れ • エル・アヘドレシスタ(El Ajedrecista)(1912) • 機械によるチェスの自動プレイを実現。 • Samuelのチェッカー(1959) • コンピュータによるチェッカーの自動プレイ。

    • 学習するゲームAIの初期の代表例。 • TD-Gammon(1992) • 人工ニューラルネットワークと強化学習を用いてバックギャモンをプレイ。 • Deep Blue(1997) • チェスで当時の世界チャンピオンに勝利。 • AlphaGo(2016) • 人工ニューラルネットワークを用いたAIが、囲碁のトッププレーヤーに勝利。 • 強化学習エージェント(2010年代から) • 人工ニューラルネットワークを使ったゲームAIが一般化。 • 多くのゲームを学習によってプレイできるようになる。さらに、他分野に応用される様になる。
  35. Deep Blue • 1997年、AIがチェス世界チャンピオンに初勝利 • 「人間の高度な知能の象徴」が機械に敗れた歴史的瞬間 • 勝利の仕組み:圧倒的な「計算力」 • 「しかし、その機械の頭脳は、人間の脳とは全く違う仕組みでした。人間

    がチェスの名人の知識を細かな『評価のルール』としてプログラムし、そ れを1秒間に2億手という、専用ハードウェアの途方もない計算パワーで 『力まかせ』に読み切ることで勝利をもぎ取ったのです。」
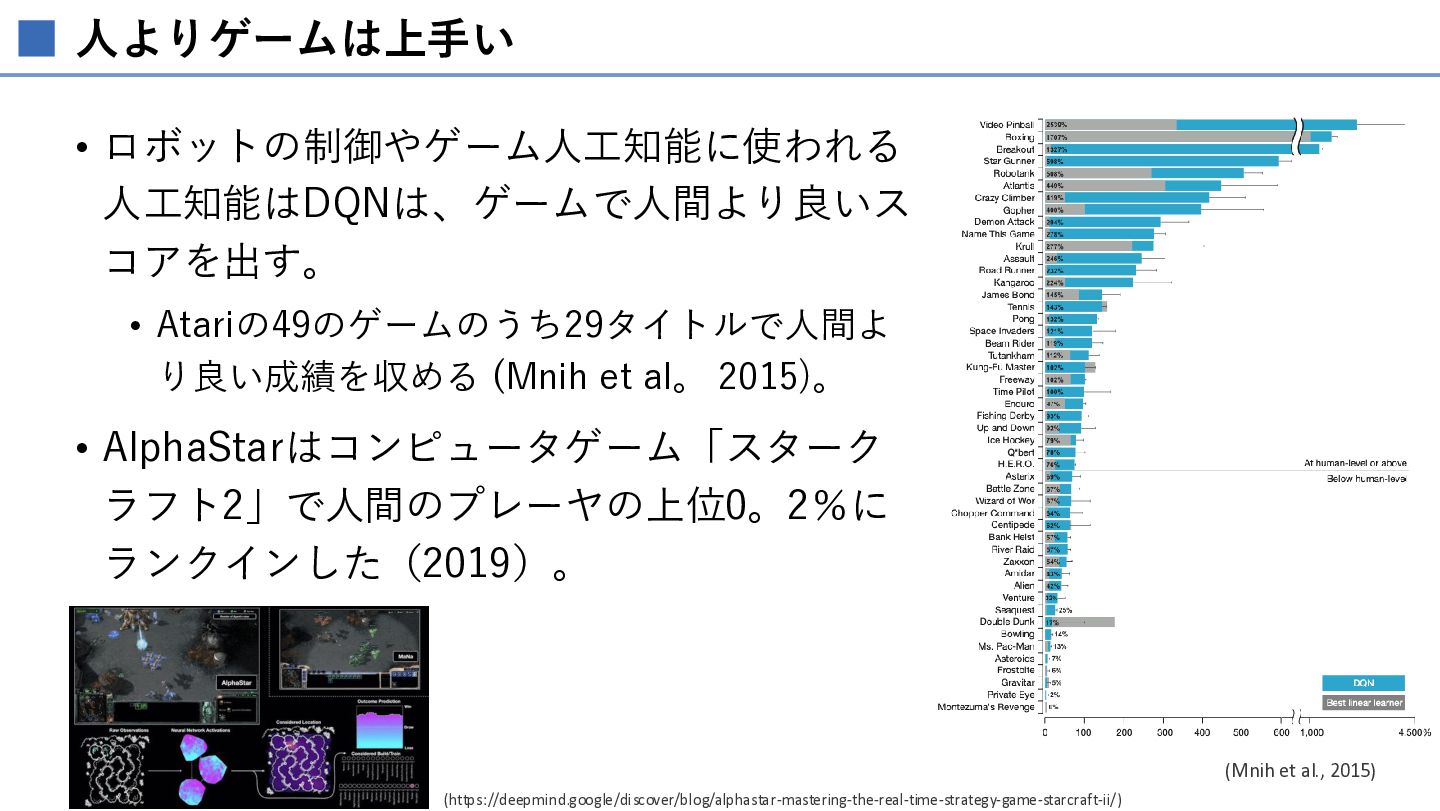
  36. 人よりゲームは上手い • ロボットの制御やゲーム人工知能に使われる 人工知能はDQNは、ゲームで人間より良いス コアを出す。 • Atariの49のゲームのうち29タイトルで人間よ り良い成績を収める (Mnih et

    al。 2015)。 • AlphaStarはコンピュータゲーム「スターク ラフト2」で人間のプレーヤの上位0。2%に ランクインした(2019)。 (Mnih et al., 2015) (https://deepmind.google/discover/blog/alphastar-mastering-the-real-time-strategy-game-starcraft-ii/)
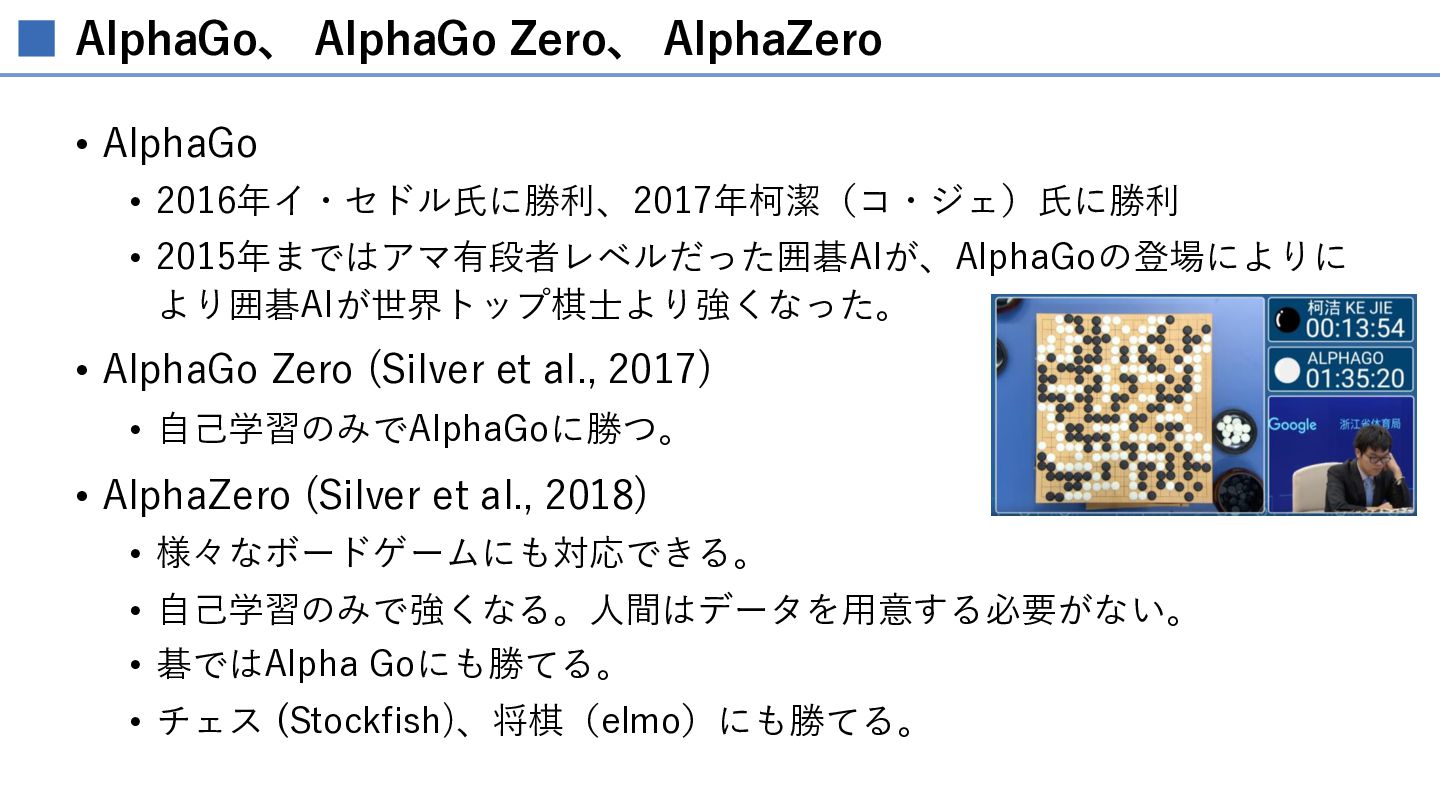
  37. AlphaGo、 AlphaGo Zero、 AlphaZero • AlphaGo • 2016年イ・セドル氏に勝利、2017年柯潔(コ・ジェ)氏に勝利 • 2015年まではアマ有段者レベルだった囲碁AIが、AlphaGoの登場によりに

    より囲碁AIが世界トップ棋士より強くなった。 • AlphaGo Zero (Silver et al., 2017) • 自己学習のみでAlphaGoに勝つ。 • AlphaZero (Silver et al., 2018) • 様々なボードゲームにも対応できる。 • 自己学習のみで強くなる。人間はデータを用意する必要がない。 • 碁ではAlpha Goにも勝てる。 • チェス (Stockfish)、将棋(elmo)にも勝てる。
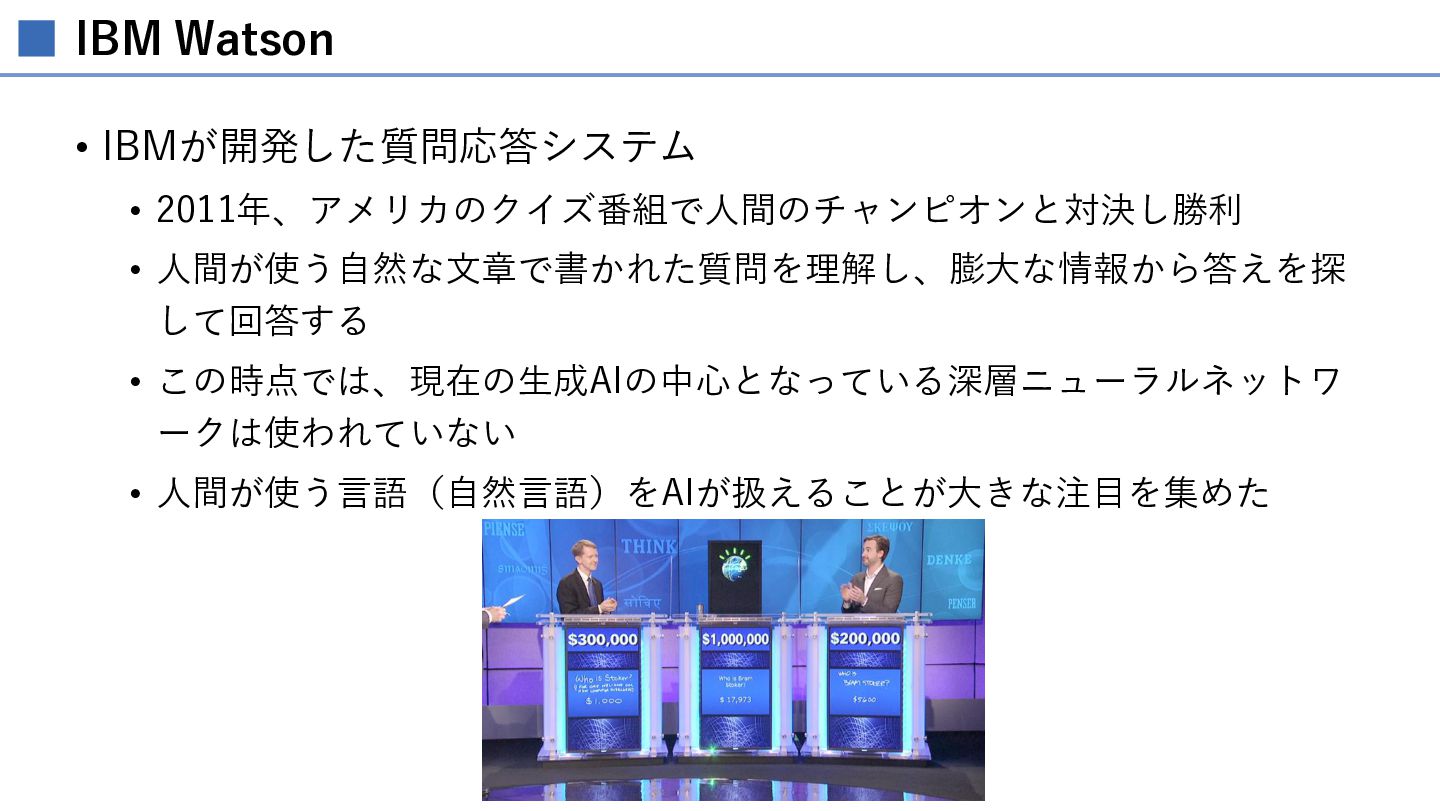
  38. IBM Watson • IBMが開発した質問応答システム • 2011年、アメリカのクイズ番組で人間のチャンピオンと対決し勝利 • 人間が使う自然な文章で書かれた質問を理解し、膨大な情報から答えを探 して回答する •

    この時点では、現在の生成AIの中心となっている深層ニューラルネットワ ークは使われていない • 人間が使う言語(自然言語)をAIが扱えることが大きな注目を集めた
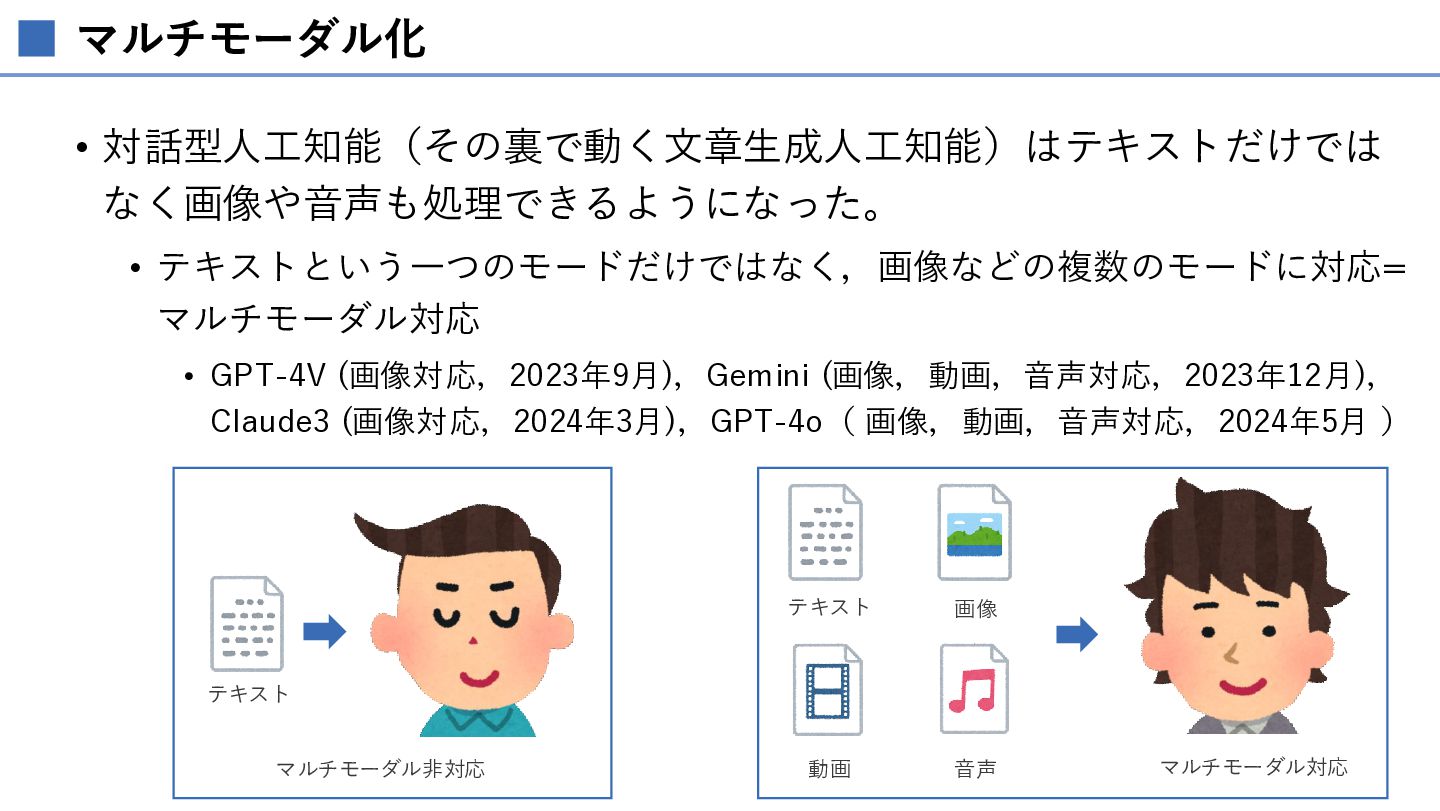
  39. マルチモーダル化 • 対話型人工知能(その裏で動く文章生成人工知能)はテキストだけでは なく画像や音声も処理できるようになった。 • テキストという一つのモードだけではなく,画像などの複数のモードに対応= マルチモーダル対応 • GPT-4V (画像対応,2023年9月),Gemini

    (画像,動画,音声対応,2023年12月), Claude3 (画像対応,2024年3月),GPT-4o( 画像,動画,音声対応,2024年5月 ) テキスト 画像 動画 音声 テキスト マルチモーダル非対応 マルチモーダル対応
  40. AIエージェント • AIエージェント • ユーザーから与えられた指示に基づき、自律的に問題解決やタスク実行を行う ソフトウェア(https://www.ipa.go.jp/digital/kaihatsu/sds-column/aiagent.html) • 例:Codex、Claude Code、GitHub Copilotなど

    • 目的を与えると、エージェントが自分で手順を考えて自律的に作業を進める。 • エージェントが必要に応じてWeb検索、ファイル操作、プログラム実行、外部 ツール利用などを組み合わせる。 • エージェントは、計画 → 実行 → 確認 → 修正を繰り返し、タスク達成を目指 す。 • 開発スタイルの変化 • 人間がコードを書く→ AIにコードを書かせる(Vibe coding)→ AIに開発その ものを任せる(AIエージェント) • 人間の役割は、実装から目的設定・設計・評価へ移りつつある。
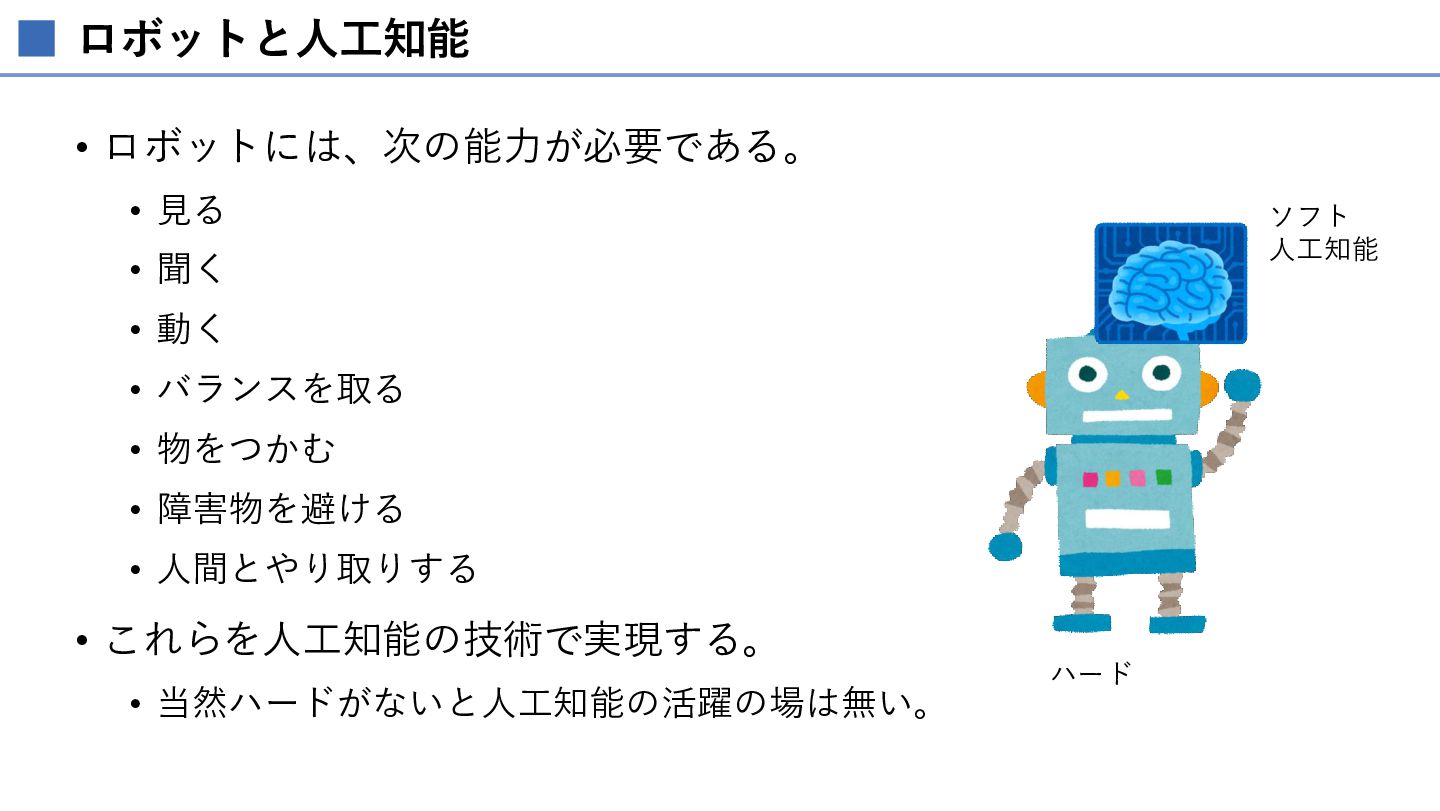
  41. ロボットと人工知能 • ロボットには、次の能力が必要である。 • 見る ソフト 人工知能 • 聞く •

    動く • バランスを取る • 物をつかむ • 障害物を避ける • 人間とやり取りする • これらを人工知能の技術で実現する。 • 当然ハードがないと人工知能の活躍の場は無い。 ハード
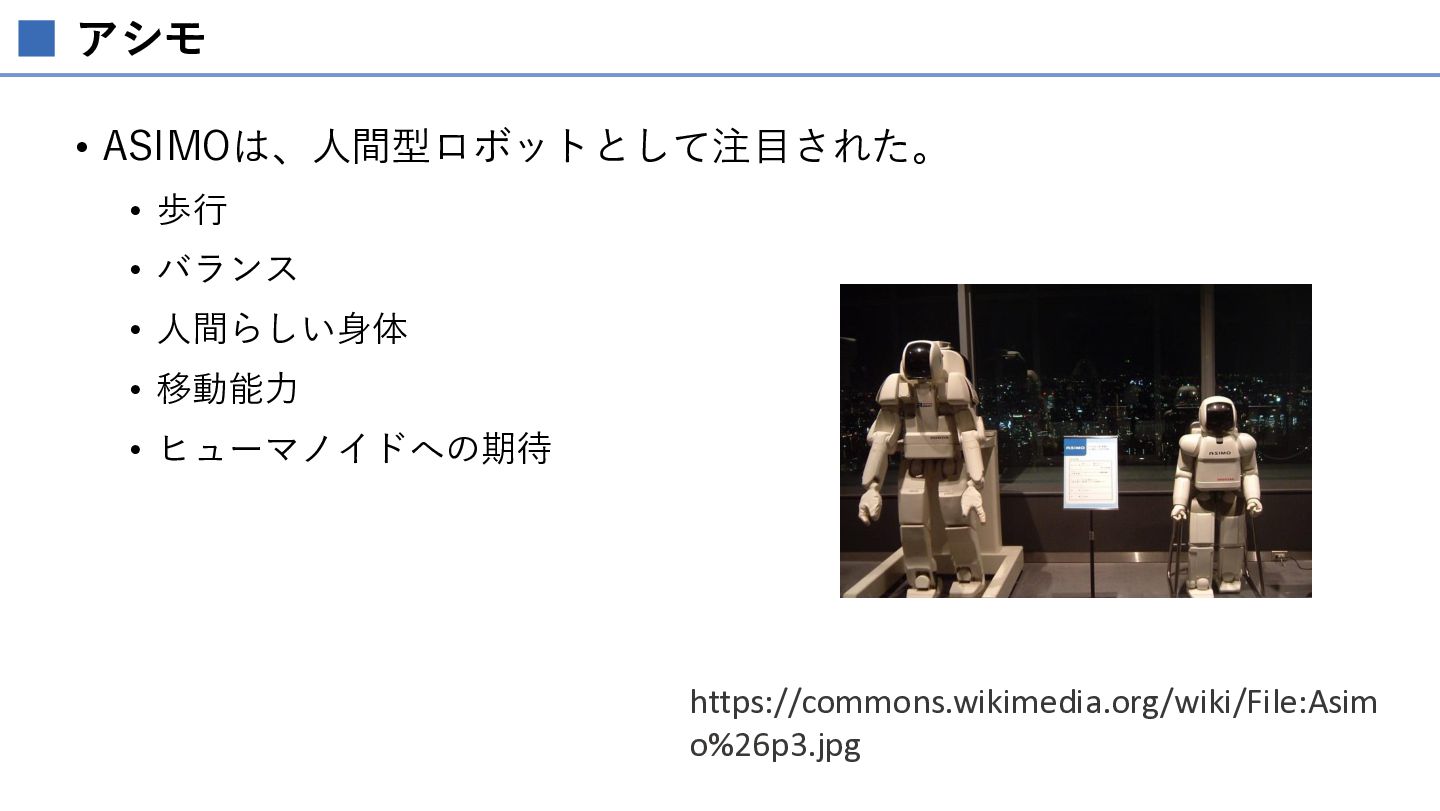
  42. アシモ • ASIMOは、人間型ロボットとして注目された。 • 歩行 • バランス • 人間らしい身体 •

    移動能力 • ヒューマノイドへの期待 https://commons.wikimedia.org/wiki/File:Asim o%26p3.jpg
  43. ルンバ • ルンバ(2002年発売) • AI+ロボットが実用家電として登場する。 • 家庭用自律型サービスロボット • ルンバはシンプルなルール(行動ベースAI)で動く •

    壁にぶつかったら向きを変える • ゴミを検知したら円を描く • 単純な制御だが、結果的に「部屋を綺麗にする」という知能的な行動 を実現する。
  44. フィジカル AI • フィジカル AI により、ロボットや自動運転車などの自律マシンは、現実 の (物理的な) 世界を認識、理解して、複雑な行動ができるようになる。 •

    また、洞察や実行すべきアクションを生成する能力もあることから、よく 「生成フィジカル AI」とも呼ばれる。 • https://www.nvidia.com/ja-jp/glossary/generative-physical-ai/ • よくわからないことが書いてあるが、データから世界を理解する人工知能 (世界モデル)を構築し、世界を理解し自ら動ける人工知能(ロボット) のことを Physical AIと言っている。 • 世界を理解するために、現実世界のセンサー(ロボット)を使うのも可能だが 、バーチャル空間を用い世界モデルを構築しても良い。
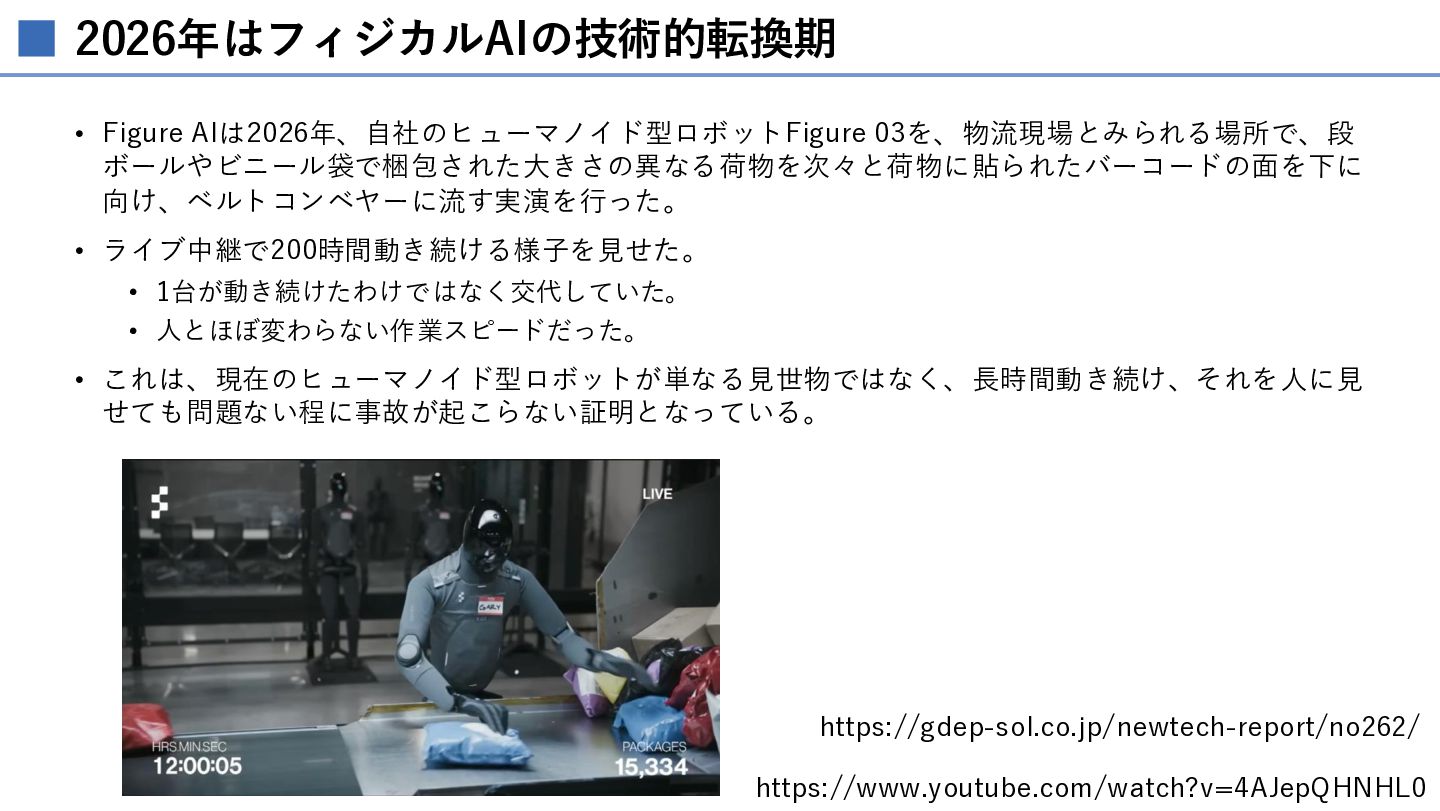
  45. 2026年はフィジカルAIの技術的転換期 • Figure AIは2026年、自社のヒューマノイド型ロボットFigure 03を、物流現場とみられる場所で、段 ボールやビニール袋で梱包された大きさの異なる荷物を次々と荷物に貼られたバーコードの面を下に 向け、ベルトコンベヤーに流す実演を行った。 • ライブ中継で200時間動き続ける様子を見せた。 •

    1台が動き続けたわけではなく交代していた。 • 人とほぼ変わらない作業スピードだった。 • これは、現在のヒューマノイド型ロボットが単なる見世物ではなく、長時間動き続け、それを人に見 せても問題ない程に事故が起こらない証明となっている。 https://gdep-sol.co.jp/newtech-report/no262/ https://www.youtube.com/watch?v=4AJepQHNHL0
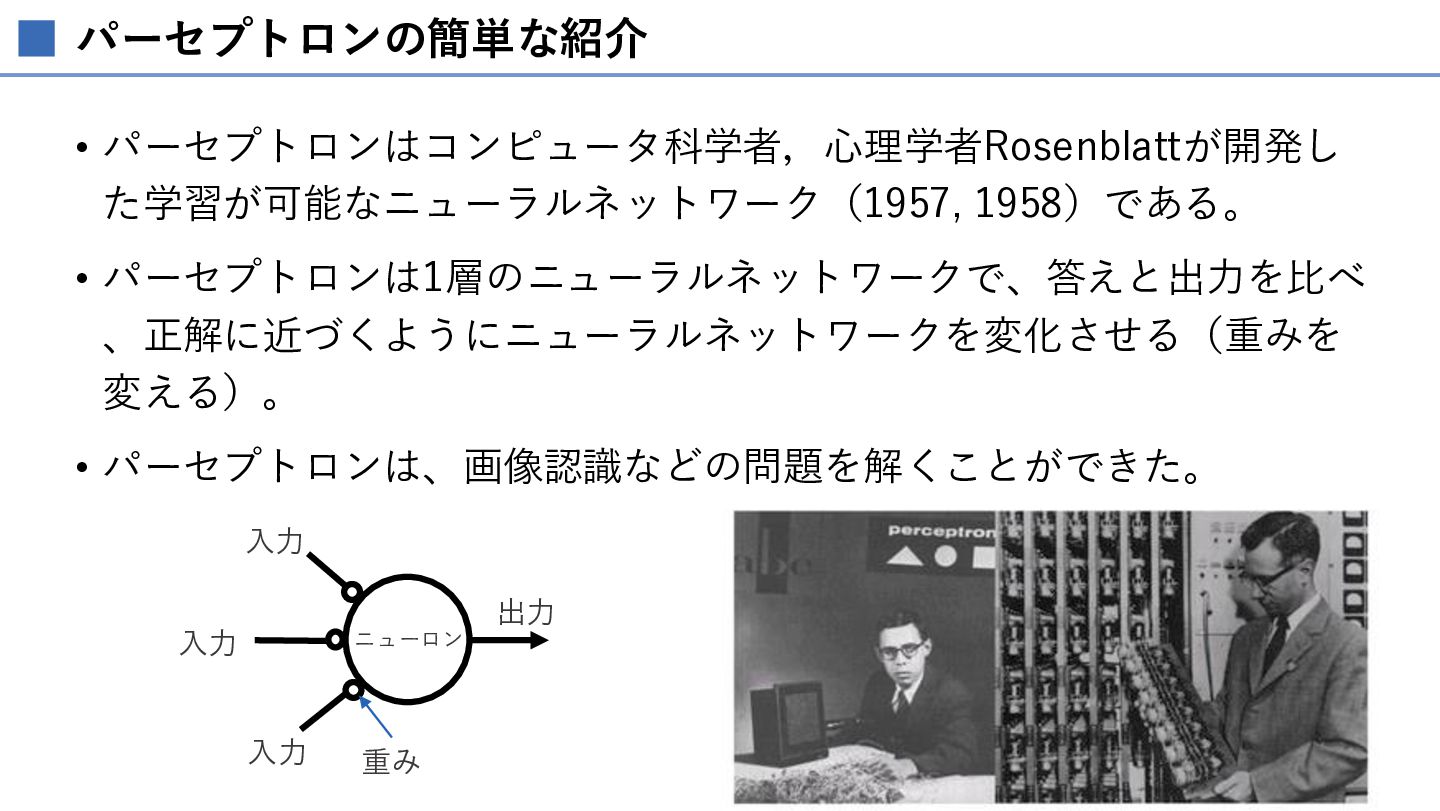
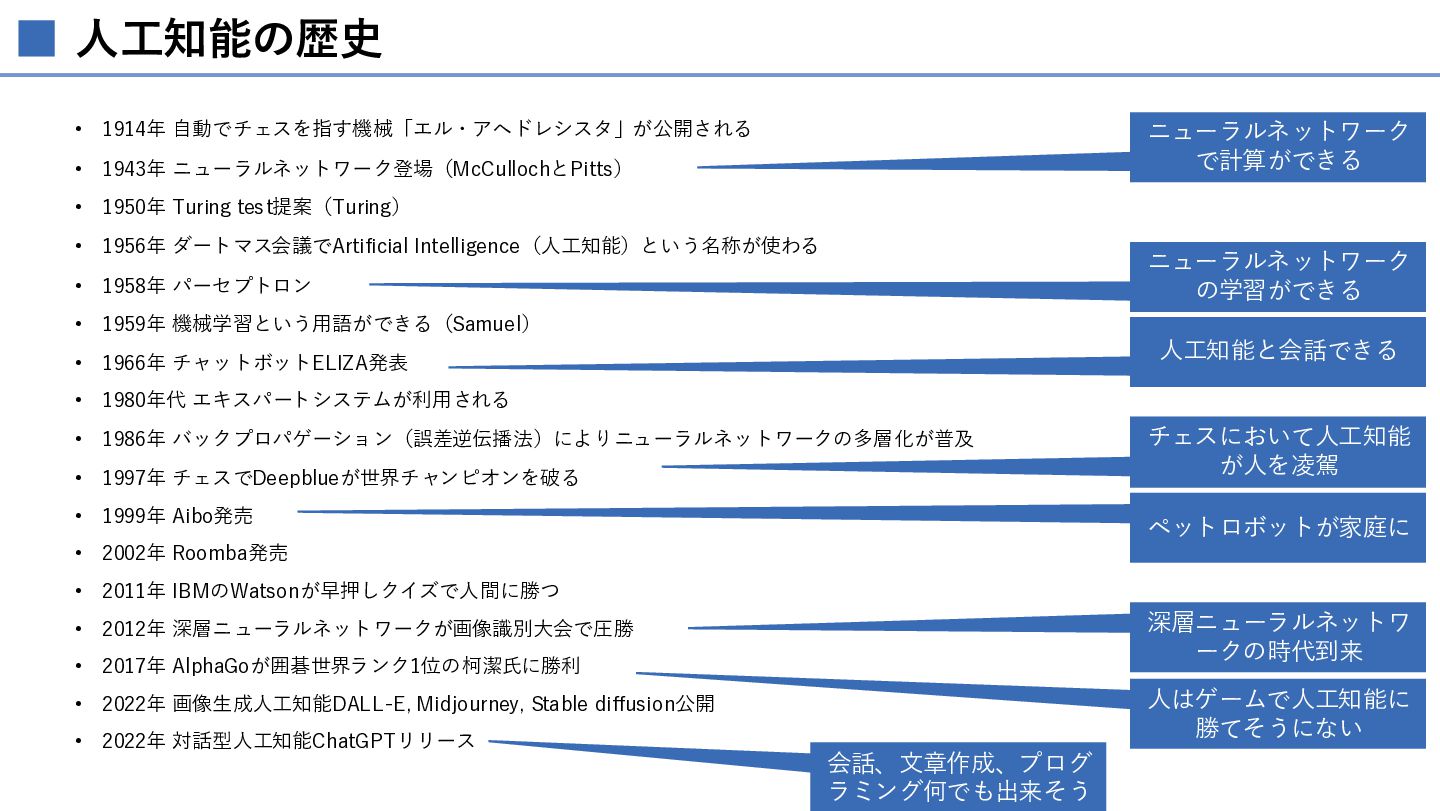
  46. 人工知能の歴史 • 1914年 自動でチェスを指す機械「エル・アヘドレシスタ」が公開される ニューラルネットワーク で計算ができる • 1943年 ニューラルネットワーク登場(McCullochとPitts) •

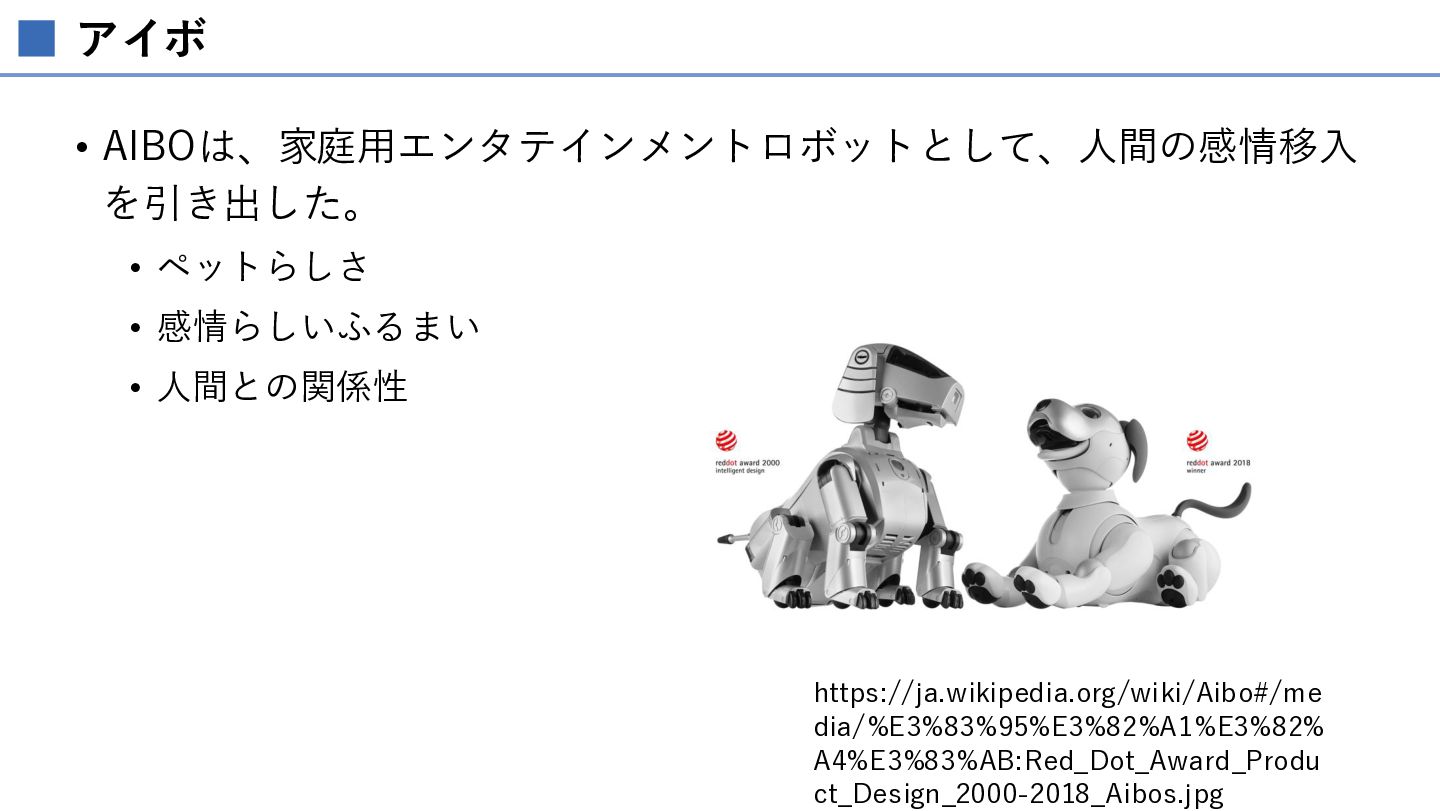
    1950年 Turing test提案(Turing) • 1956年 ダートマス会議でArtificial Intelligence(人工知能)という名称が使わる ニューラルネットワーク の学習ができる • 1958年 パーセプトロン • 1959年 機械学習という用語ができる(Samuel) 人工知能と会話できる • 1966年 チャットボットELIZA発表 • 1980年代 エキスパートシステムが利用される • 1986年 バックプロパゲーション(誤差逆伝播法)によりニューラルネットワークの多層化が普及 • 1997年 チェスでDeepblueが世界チャンピオンを破る • 1999年 Aibo発売 チェスにおいて人工知能 が人を凌駕 ペットロボットが家庭に • 2002年 Roomba発売 • 2011年 IBMのWatsonが早押しクイズで人間に勝つ 深層ニューラルネットワ ークの時代到来 • 2012年 深層ニューラルネットワークが画像識別大会で圧勝 • 2017年 AlphaGoが囲碁世界ランク1位の柯潔氏に勝利 人はゲームで人工知能に 勝てそうにない • 2022年 画像生成人工知能DALL-E, Midjourney, Stable diffusion公開 • 2022年 対話型人工知能ChatGPTリリース 会話、文章作成、プログ ラミング何でも出来そう