Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Kaggleで勝つ データ分析の技術 輪読&勉強会 #3 〜第4章 モデル作成〜
Search
Kazuki Yokoi
April 01, 2020
Programming
540
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Kaggleで勝つ データ分析の技術 輪読&勉強会 #3 〜第4章 モデル作成〜
Kazuki Yokoi
April 01, 2020
More Decks by Kazuki Yokoi
See All by Kazuki Yokoi
ディスカッションメダル荒稼ぎ!君もDiscussionMasterになろう!
kyokoi
0
280
ゼロから始める環境構築~Kaggle編~
kyokoi
0
650
Other Decks in Programming
See All in Programming
エージェントを使い続けるためのメタワーク / Meta-work for keeping using the agent
rkaga
1
240
自サークルのIdPからログアウトできるようになるまで
taiseiue
1
140
RAG の “R” を Swift で覗いてみる 〜「意味から探す」検索の仕組み〜
nao_randd
0
170
Kotlinize Is Not Just Converting to Kotlin
chigichan24
1
140
AWSに止められる覚悟してますか?
morizo_1984
2
540
IBM Bob Dojo #1 仕様駆動開発入門
oniak3ibm
PRO
0
400
JAWS-UG 東京支部が始める、JAWS-UG支部コラボ / JAWS-UG lunchtime LT Collaboration
y0hgi
0
280
パスワード再設定メールのURLについて知っておこう
uyuki234
0
160
[2026-10-09]一枚の布で作らなくてもいい。 信頼性は「パッチワーク」で紡がれる~既存の運用と新しい可能性をつなぎ合わせてきたCREの話~
tosite
0
100
Long Living Tokens, Die, Die, Die! (or: The One Ring is Banned in Modern)
sylph01
0
330
Rでドレミ/Do-Re-Mi_with_R
florets1
0
130
The Rails Doctrine Decade
koic
2
600
Featured
See All Featured
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
Git: the NoSQL Database
bkeepers
PRO
433
67k
GitHub's CSS Performance
jonrohan
1033
470k
Six Lessons from altMBA
skipperchong
29
4.5k
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.2k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
RailsConf 2023
tenderlove
30
1.6k
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
300
Amusing Abliteration
ianozsvald
1
350
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
540
Transcript
Kaggleで勝つ データ分析の技術 輪読&勉強会 #3 〜第4章 モデル作成〜 2020年4月1日 横井 一輝
目次 1. モデルとは何か 2. 分析コンペで使われるモデル 1. GBDT(勾配ブースティング木) 2. ニューラルネット 3.
線形モデル 3. モデルのその他ポイントとテクニック
モデルとは何か
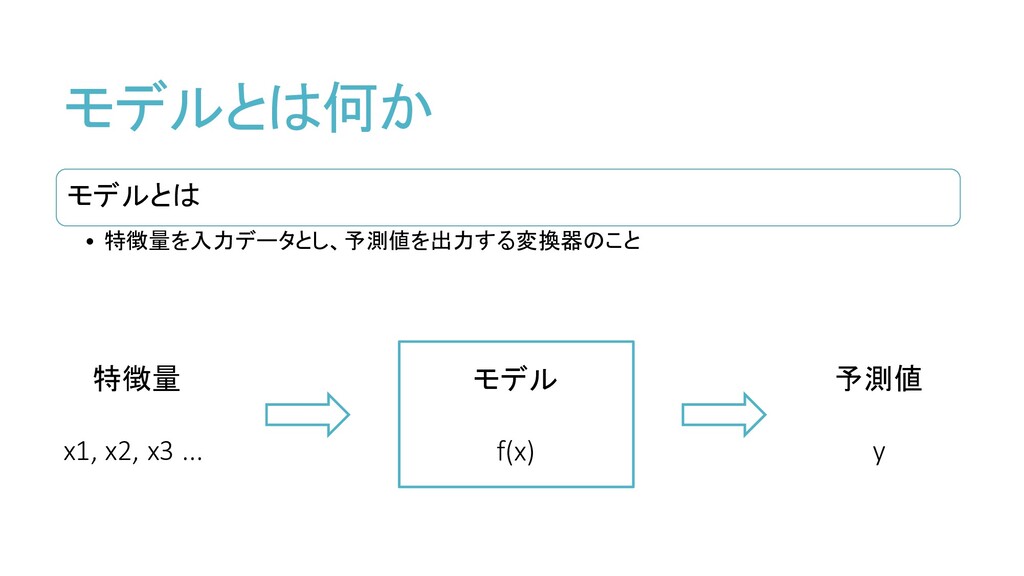
モデルとは • 特徴量を入力データとし、予測値を出力する変換器のこと モデルとは何か モデル f(x) 特徴量 x1, x2, x3
... 予測値 y
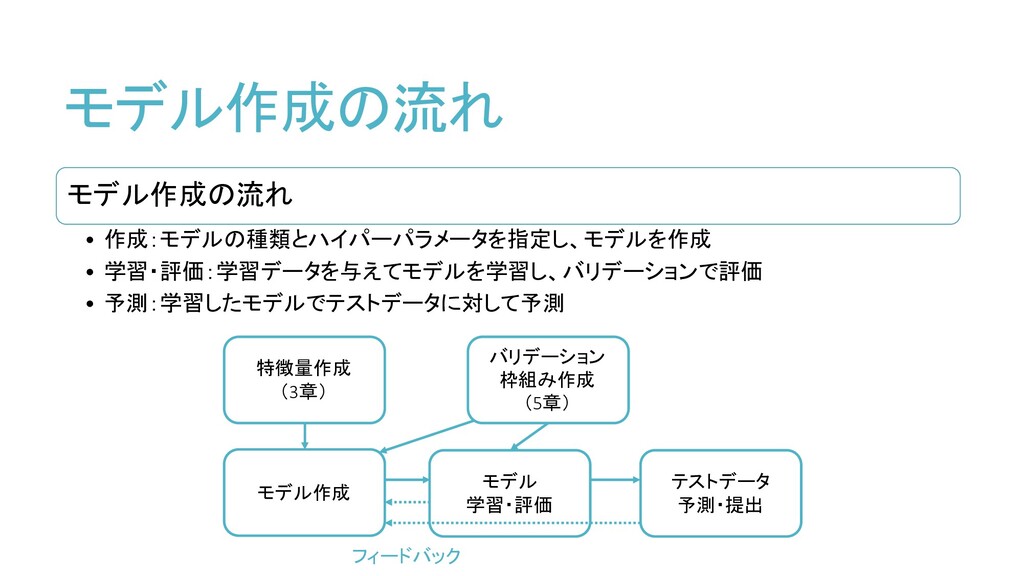
モデル作成の流れ モデル作成の流れ • 作成:モデルの種類とハイパーパラメータを指定し、モデルを作成 • 学習・評価:学習データを与えてモデルを学習し、バリデーションで評価 • 予測:学習したモデルでテストデータに対して予測 特徴量作成 (3章)
モデル作成 モデル 学習・評価 テストデータ 予測・提出 バリデーション 枠組み作成 (5章) フィードバック
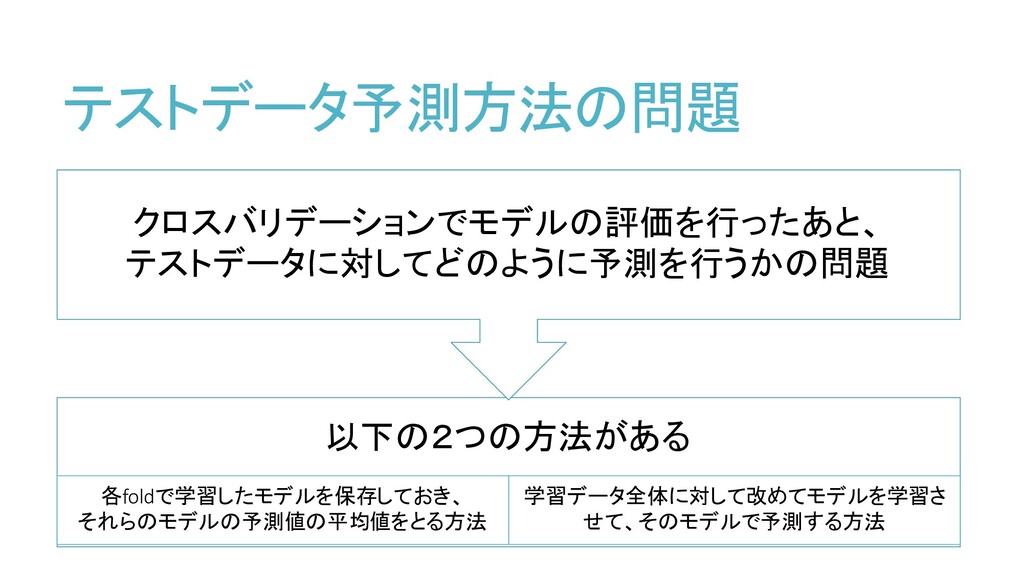
テストデータ予測方法の問題 以下の2つの方法がある 各foldで学習したモデルを保存しておき、 それらのモデルの予測値の平均値をとる方法 学習データ全体に対して改めてモデルを学習さ せて、そのモデルで予測する方法 クロスバリデーションでモデルの評価を行ったあと、 テストデータに対してどのように予測を行うかの問題
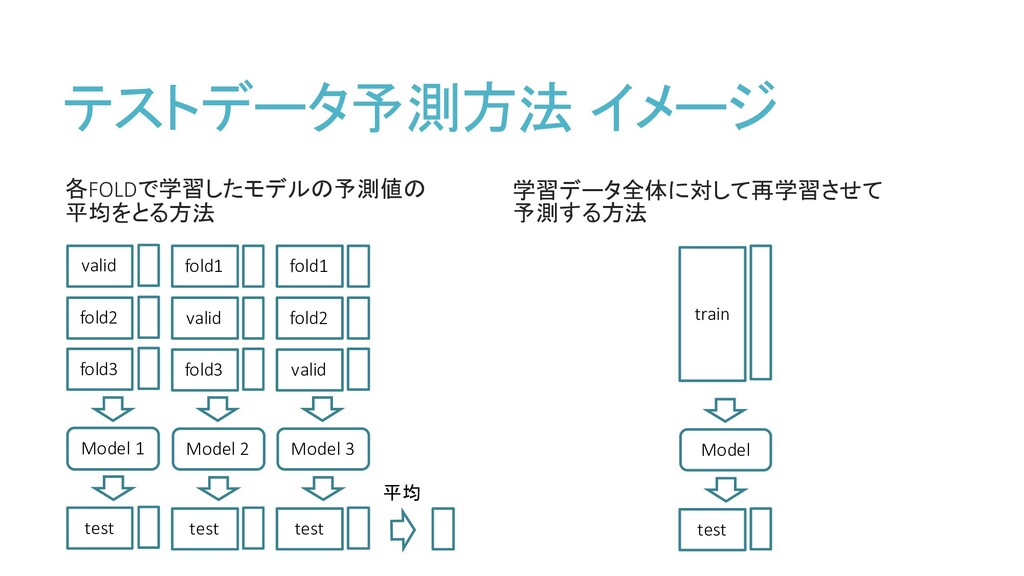
テストデータ予測方法 イメージ 各FOLDで学習したモデルの予測値の 平均をとる方法 学習データ全体に対して再学習させて 予測する方法 valid fold2 fold3 test
Model 1 fold1 valid fold3 test Model 2 fold1 fold2 valid test Model 3 平均 train test Model
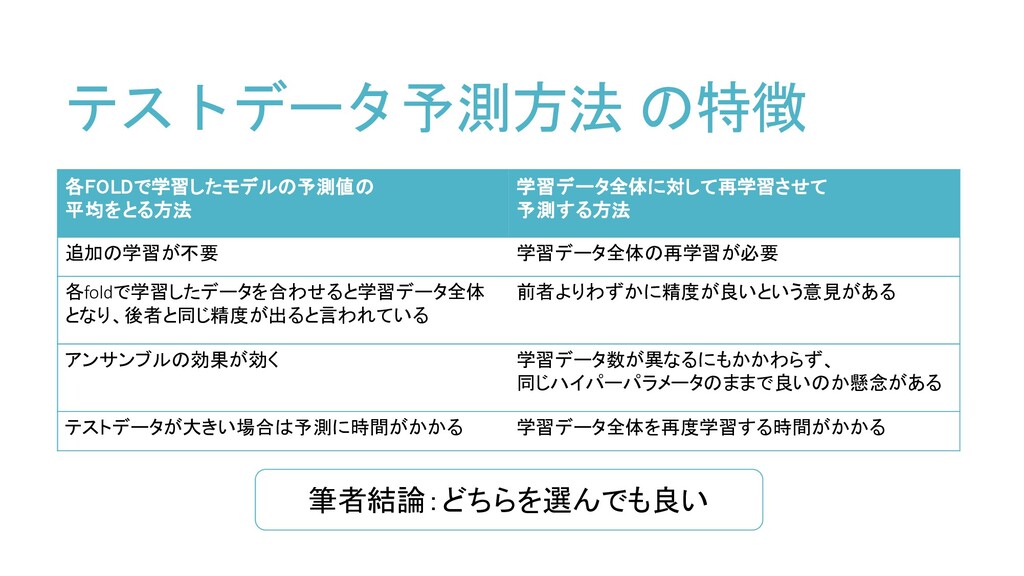
テストデータ予測方法 の特徴 各FOLDで学習したモデルの予測値の 平均をとる方法 学習データ全体に対して再学習させて 予測する方法 追加の学習が不要 学習データ全体の再学習が必要 各foldで学習したデータを合わせると学習データ全体 となり、後者と同じ精度が出ると言われている
前者よりわずかに精度が良いという意見がある アンサンブルの効果が効く 学習データ数が異なるにもかかわらず、 同じハイパーパラメータのままで良いのか懸念がある テストデータが大きい場合は予測に時間がかかる 学習データ全体を再度学習する時間がかかる 筆者結論:どちらを選んでも良い
分析コンペで 使われるモデル
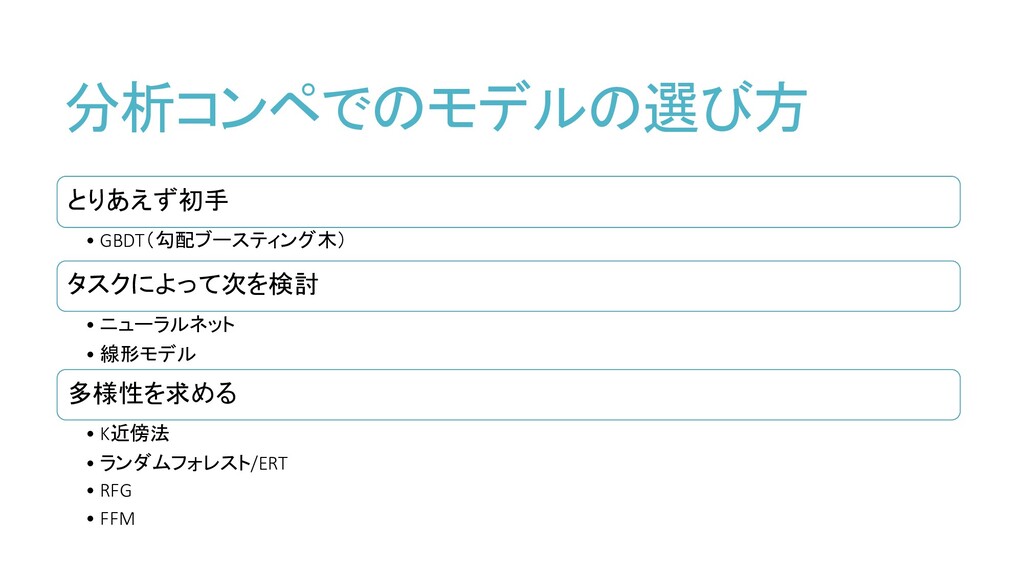
分析コンペでのモデルの選び方 とりあえず初手 • GBDT(勾配ブースティング木) タスクによって次を検討 • ニューラルネット • 線形モデル 多様性を求める
• K近傍法 • ランダムフォレスト/ERT • RFG • FFM
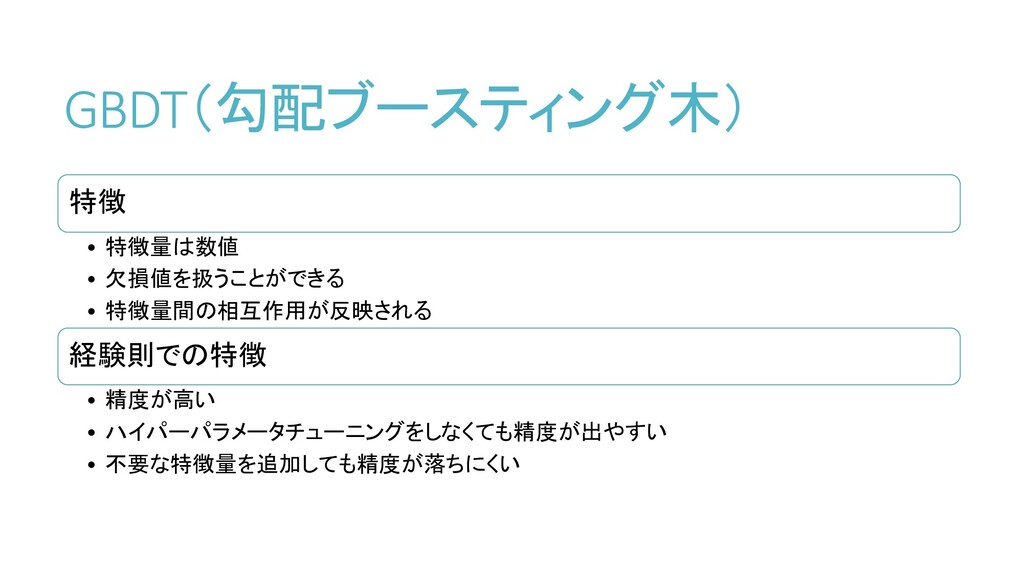
GBDT(勾配ブースティング木) 特徴 • 特徴量は数値 • 欠損値を扱うことができる • 特徴量間の相互作用が反映される 経験則での特徴 •
精度が高い • ハイパーパラメータチューニングをしなくても精度が出やすい • 不要な特徴量を追加しても精度が落ちにくい
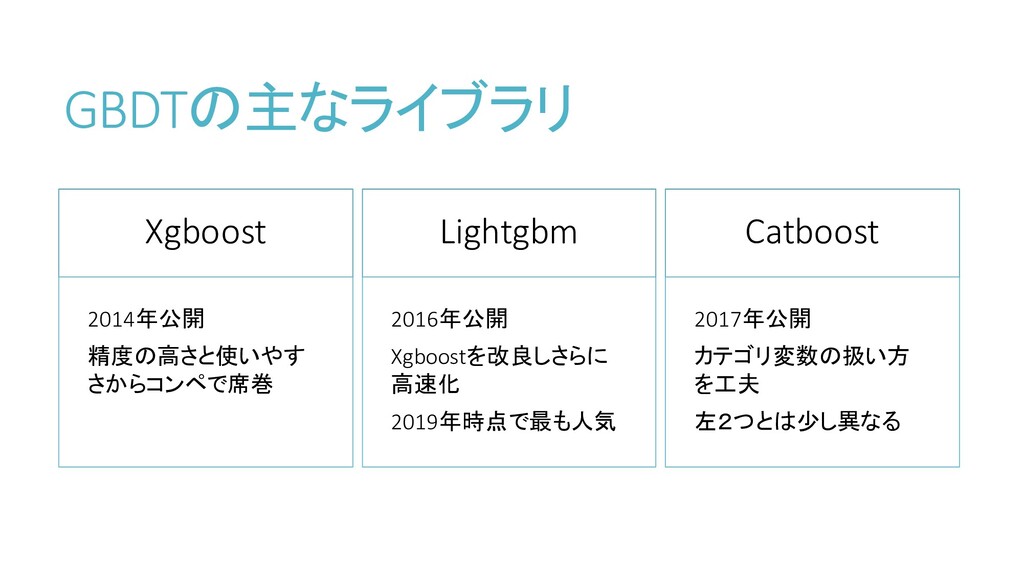
GBDTの主なライブラリ Xgboost 2014年公開 精度の高さと使いやす さからコンペで席巻 Lightgbm 2016年公開 Xgboostを改良しさらに 高速化 2019年時点で最も人気
Catboost 2017年公開 カテゴリ変数の扱い方 を工夫 左2つとは少し異なる
ニューラルネット 特徴 • 特徴量は数値 • 欠損値を扱うことができない • 非線形性や特徴量間の相互作用が反映される • 特徴量を標準化するなどスケーリングする必要がある
経験則での特徴 • ハイパーパラメータ次第で精度が出ないことがある • 他クラス分類に比較的強い
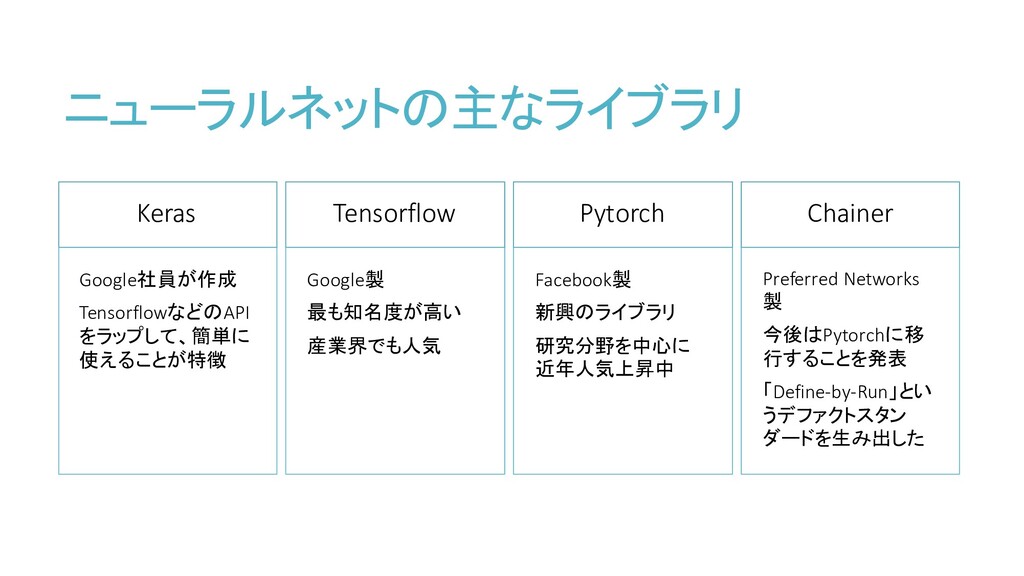
ニューラルネットの主なライブラリ Keras Google社員が作成 TensorflowなどのAPI をラップして、簡単に 使えることが特徴 Tensorflow Google製 最も知名度が高い 産業界でも人気
Pytorch Facebook製 新興のライブラリ 研究分野を中心に 近年人気上昇中 Chainer Preferred Networks 製 今後はPytorchに移 行することを発表 「Define-by-Run」とい うデファクトスタン ダードを生み出した
線形モデル 特徴 • 特徴量は数値 • 欠損値を扱うことはできない • GBDTやニューラルネットと比較して精度はよくない • 非線形性を表現するためには、明示的に特徴量を作成する必要がある
• 相互作用を表現するためには、明示的に特徴量を作成する必要がある • 基本的に標準化が必要 • 特徴量を作るときに丁寧な処理が必要 主なライブラリ • Scikit-learnのlinear_modelモジュール • Vowpal wabbit
モデルの その他のポイントと テクニック
バリデーションとテストのスコアが違う場合 過学習(オーバーフィッティング)を疑う • 過学習とは、学習データの性質やノイズに過剰に適合してしまっている状態 過学習の対策 • バリデーション方法を再検討する(5章参照) • アーリーストッピング機能を使用する •
一定の間バリデーションスコアが上がらない場合、途中で学習を打ち切る機能 • ハイパーパラメータを調整する 以下の可能性も検討する • 学習データとテストデータの分布が異なっている • テストデータのレコード数が少なすぎる
欠損値がある場合 GBDTなら問題なく扱うことが可能 ニューラルネットや線形モデルなどは、欠損値補間が必要 欠損値補間に関しては、第3章を参照
特徴量の数が多い場合 少しずつ特徴量を増やしていき、どのくらいまでなら学習できるのか試 す 特徴選択により、特徴量を落とす方法もある • 相関係数などの統計量から求める方法 • GBDT系のモデルから出力されるFeature Importanceから求める方法 •
特徴量の組みを変えてモデル学習を繰り返し、探索していく方法
Pseudo labeling テストデータに対する予測値を目的変数の値とみなし、 学習データに加えて再度学習するテクニック(半教師あり学習) テストデータの数が学習データの数より多い場合などに有効
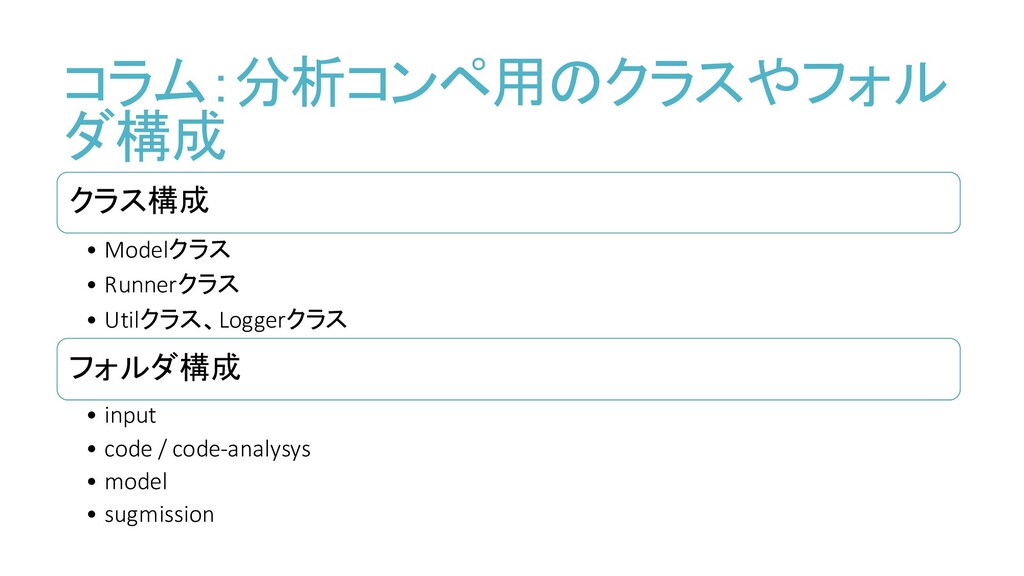
コラム:分析コンペ用のクラスやフォル ダ構成 クラス構成 • Modelクラス • Runnerクラス • Utilクラス、Loggerクラス フォルダ構成
• input • code / code-analysys • model • sugmission
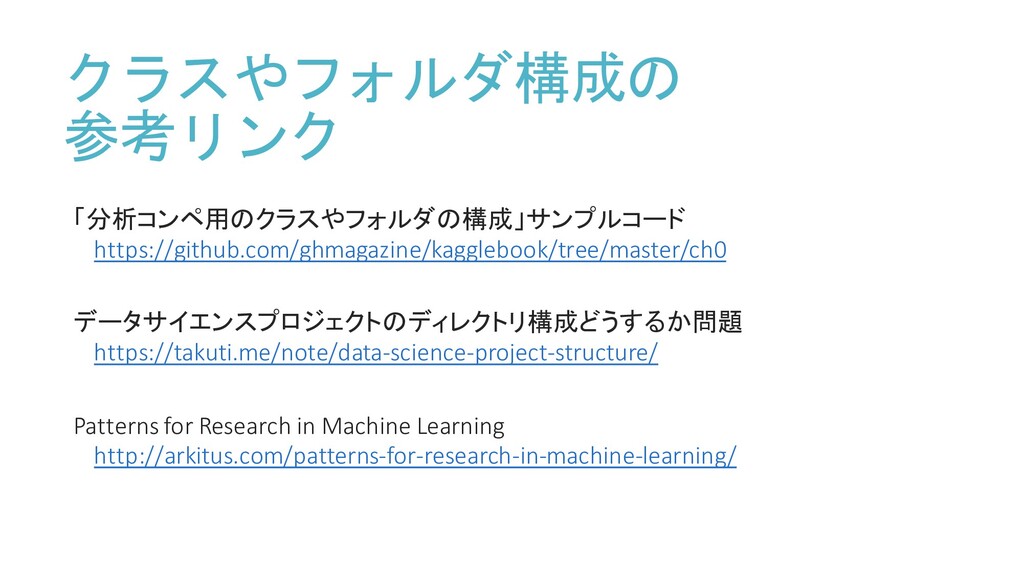
クラスやフォルダ構成の 参考リンク 「分析コンペ用のクラスやフォルダの構成」サンプルコード https://github.com/ghmagazine/kagglebook/tree/master/ch0 データサイエンスプロジェクトのディレクトリ構成どうするか問題 https://takuti.me/note/data-science-project-structure/ Patterns for Research in
Machine Learning http://arkitus.com/patterns-for-research-in-machine-learning/
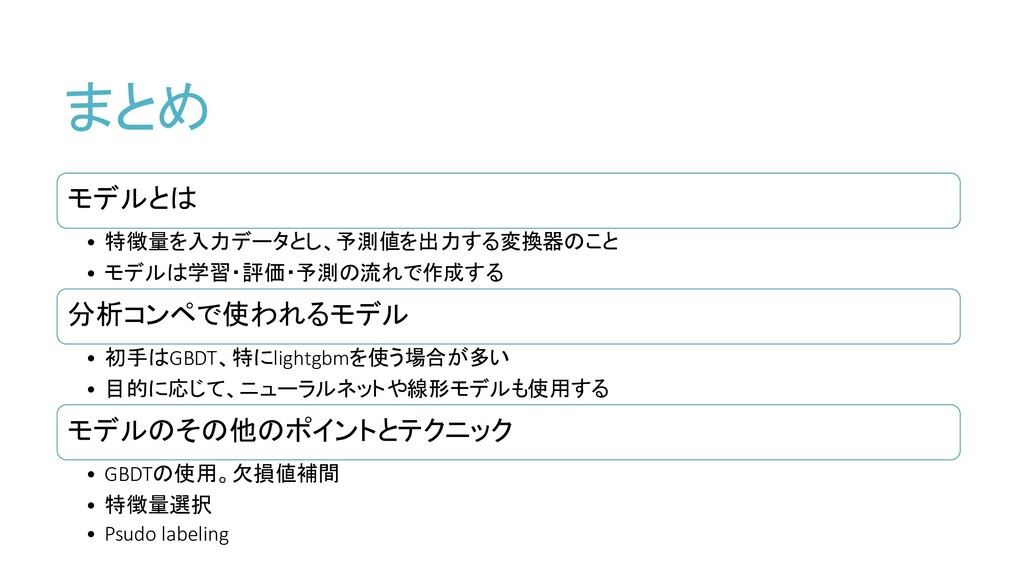
まとめ モデルとは • 特徴量を入力データとし、予測値を出力する変換器のこと • モデルは学習・評価・予測の流れで作成する 分析コンペで使われるモデル • 初手はGBDT、特にlightgbmを使う場合が多い •
目的に応じて、ニューラルネットや線形モデルも使用する モデルのその他のポイントとテクニック • GBDTの使用。欠損値補間 • 特徴量選択 • Psudo labeling


 kyokoi
 rkaga
 taiseiue
 nao_randd
 chigichan24
 morizo_1984
 oniak3ibm
 y0hgi
 uyuki234
 tosite
 sylph01
 florets1
 koic
 axbom
 bkeepers
 jonrohan
 skipperchong
 jnunemaker
 katarinadahlin
 tanoku
 tenderlove
 greggifford
 sarafernandez
 ianozsvald
 jacobtomlinson