Share
Embed
Transcript
42 slides
-
발표자 소개 강성욱 현 NOWCOM Sr.DBOps (2023.7 ~ Present,
LA) 현 SW Maestro 멘토 (2022.4 ~ Present) 현 Microsoft MVP (Developer Technologies) 전 AWS Sr.Solutions Architect (2021.12 ~ 2023.06, KOREA) 전 NHN GLOBAL SRE team manager (2018.08 ~ 2021.10, LA) 전 NEXON AMERICA Sr.DBA (2016.04 ~ 2018.05, LA) 데이터에 관심이 많으며, 세상을 데이터로 바라보는 것을 즐깁니다. 세일즈맨으로 시작하여, DBA, 데이터 엔지니어, 사업가로 다양한 영역을 넘나들고 있습니다. Sungwook-kang [email protected] k-devcon.com sungwookkang.com -
시작 전 안내사항 AI와 관련된 기술적인 내용은 다루지 않습니다.
데이터베이스 관점에서 벡터DB를 구축 및 활용하는 방법을 소개 합니다. -
벡터(Vector)란? 벡터는 서로 다른 특성이나 품질을 기반으로 개체를 설명하는
수학적 데이터 표현 각 벡터는 단어나 그림과 같은 단일 데이터 요소를 나타내며 여러 특성을 설명하는 값 모음으로 구성 이러한 변수를 "기능" 또는 ”차수"라고도 표현 그림은 픽셀 값의 벡터로 표현될 수 있지만 전체 문장은 단어 임베딩의 벡터로 표현될 수 있음 -
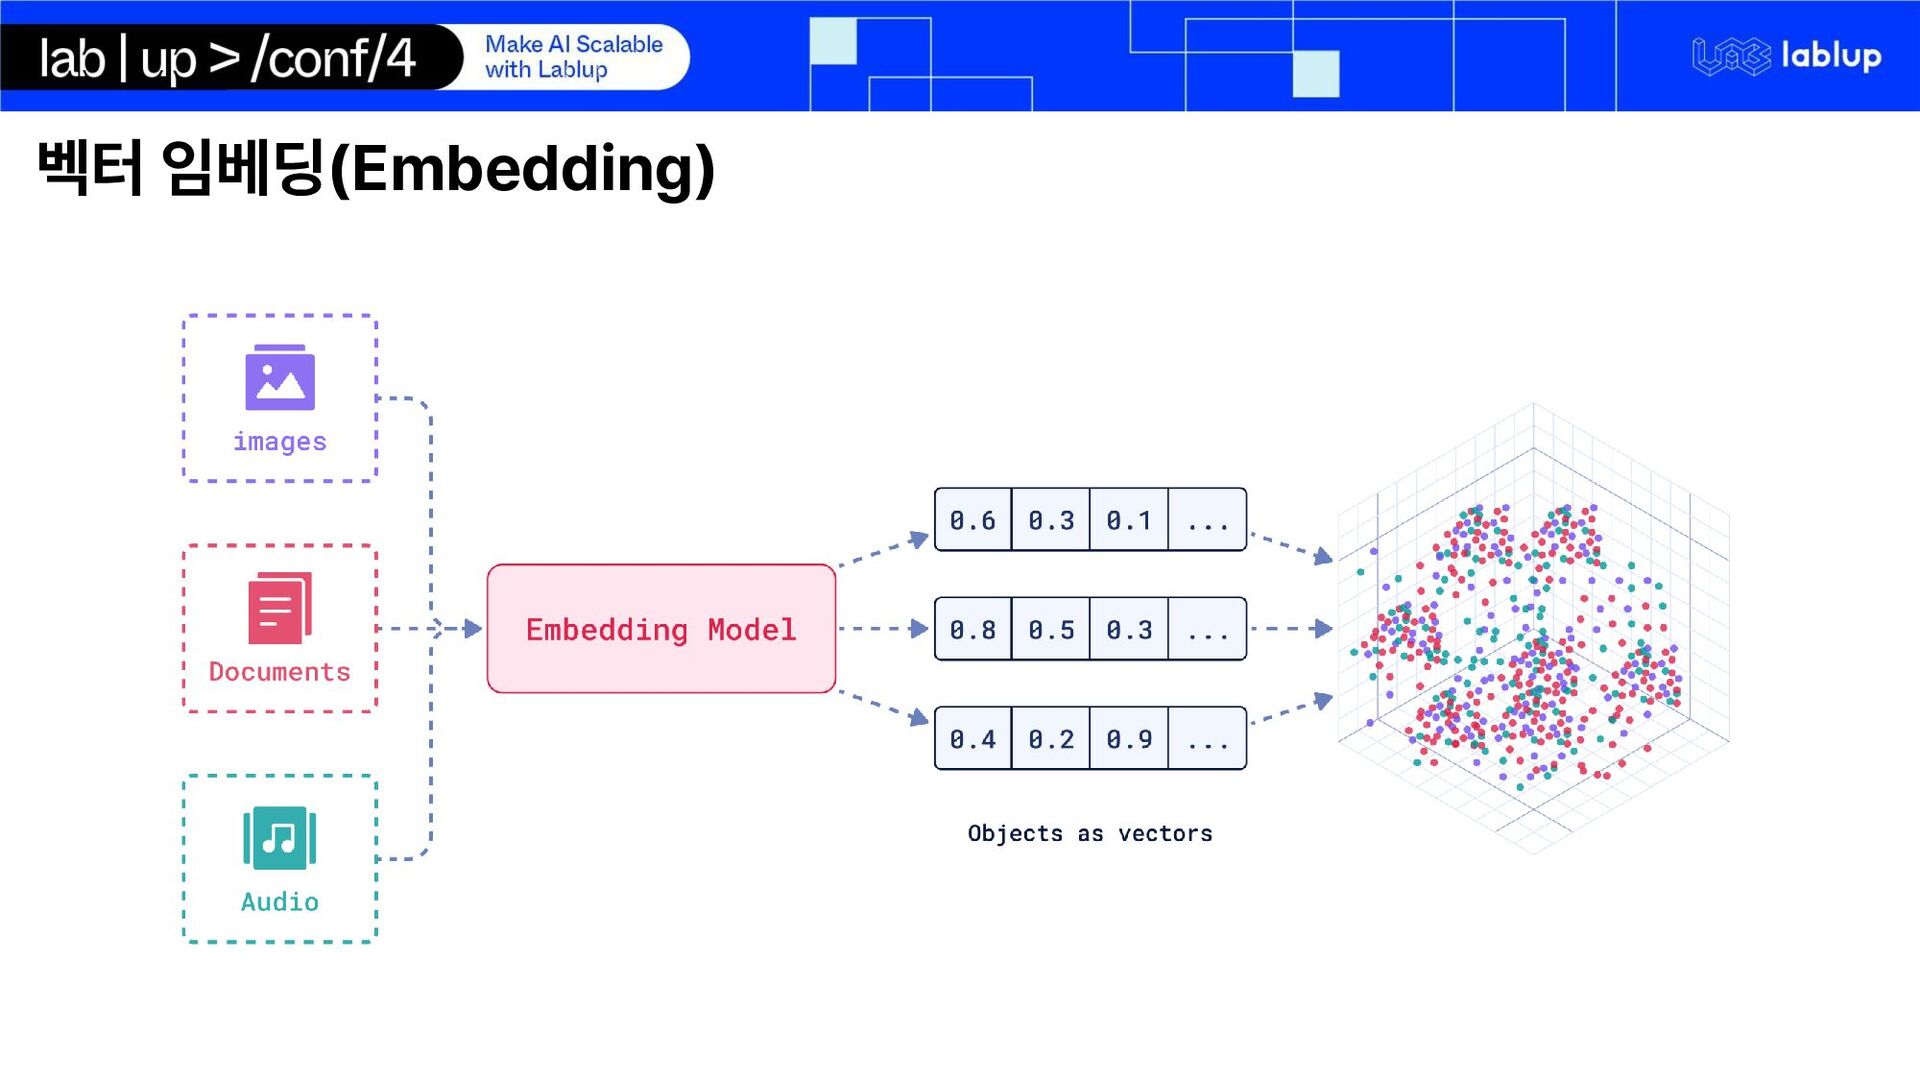
벡터 임베딩(Embedding) 임베딩이라고도 하는 벡터 임베딩은 대규모 언어 모델
및 기타 AI 모델에 의해 생성 기계가 잘 이해할 수 있게 고차원의 벡터 형태로 변환 해주는 작업 – 자연어와 같은 텍스트 – 이미지같은 비정형 데이터를 각 벡터 임베딩 사이의 거리는 벡터 데이터베이스 또는 벡터 검색 엔진이 벡터 간의 유사성을 결정 거리는 데이터 객체의 여러 차원을 나타낼 수 있으므로, 머신 러닝과 AI가 패턴, 관계 및 기본 구조를 이해할 수 있음 -
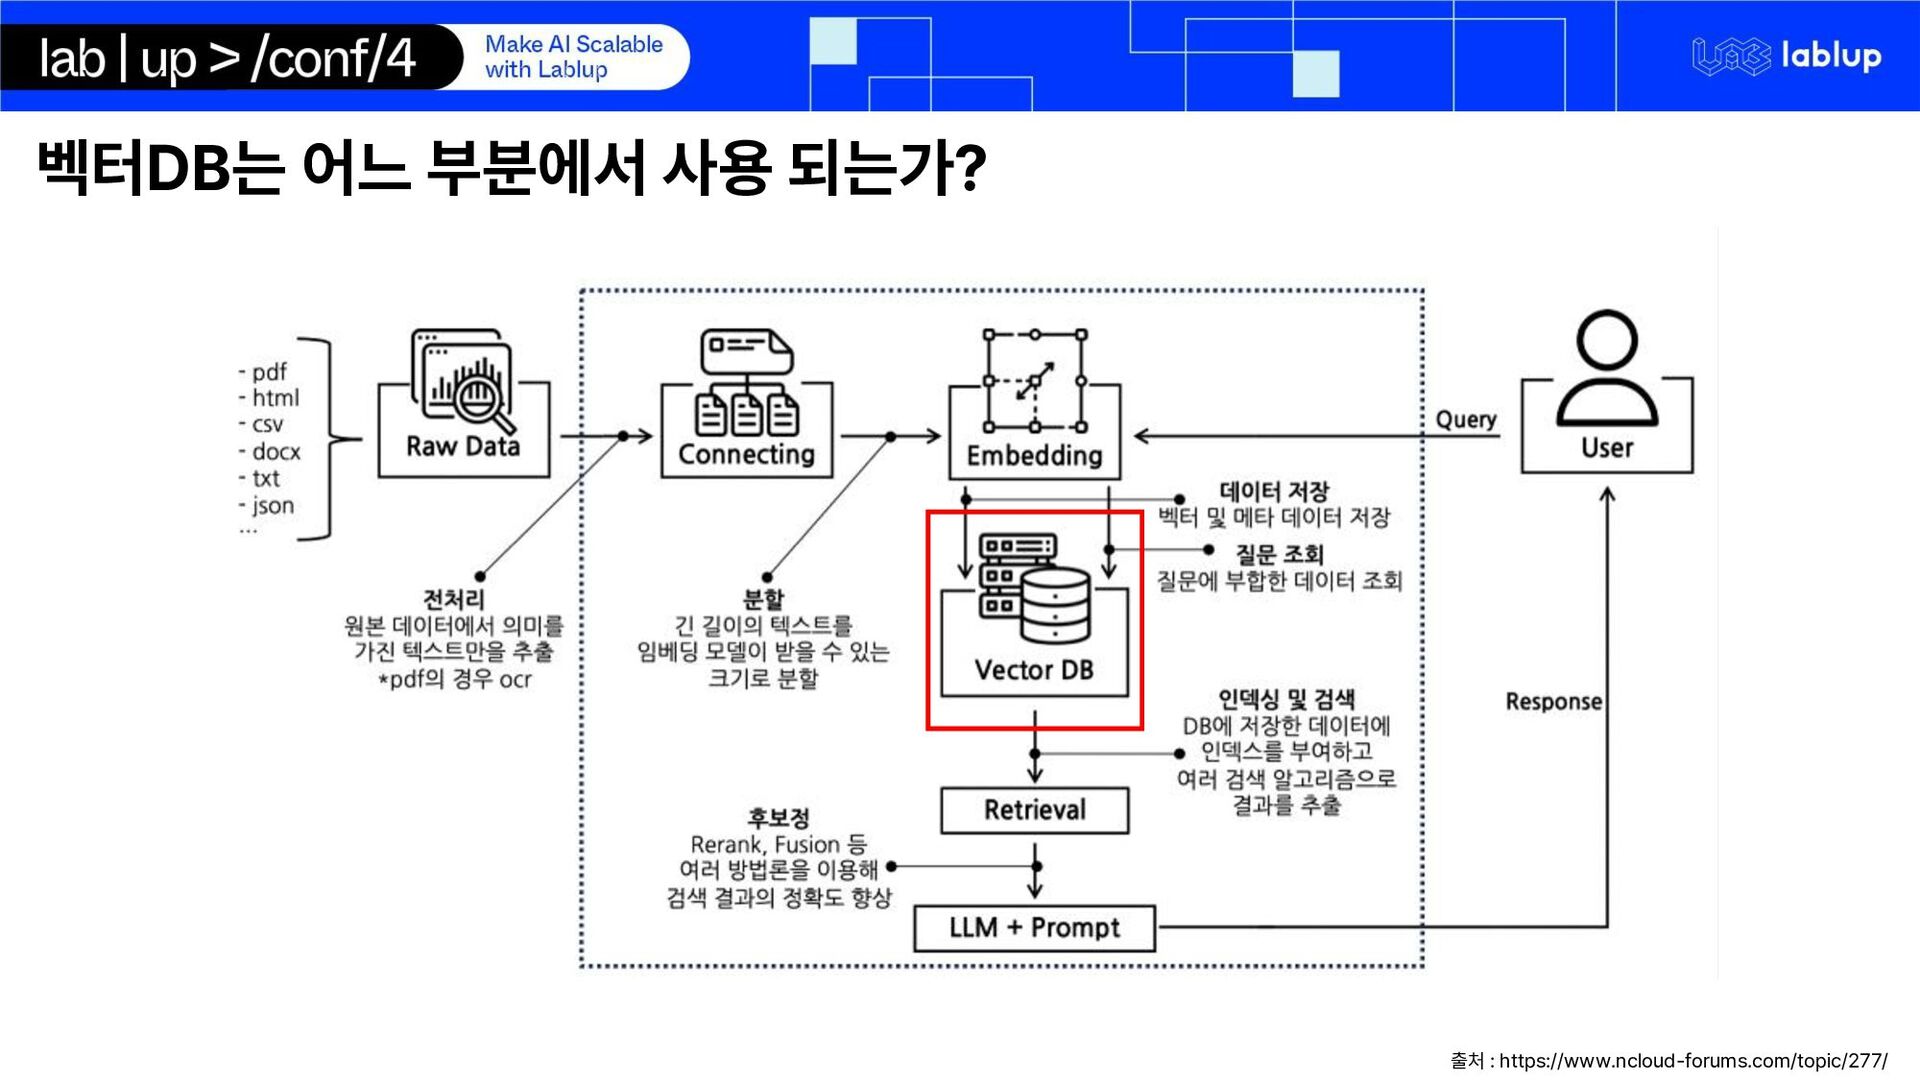
벡터(Vector) 데이터베이스 벡터 데이터베이스는 정보를 벡터로 저장하는 데이터베이스
벡터 임베딩의 강력한 기능을 활용하여 이미지, 텍스트 또는 센서 데이터와 같은 비정형 데이터와 반정형 데이터로 구성된 대규모 데이터셋을 인덱싱하고 검색 벡터 데이터베이스는 인덱싱 전략을 사용하여 특정 쿼리 벡터와 유사한 벡터를 쉽게 검색 (기계 학습 과 같은 경우에 특히 유익) 벡터 데이터베이스는 메타데이터 저장 및 필터링을 가능하게 하고, 확장 가능하며, 동적 데이터 변경을 허용하고, 백업을 수행하고, 보안 기능을 제공 -
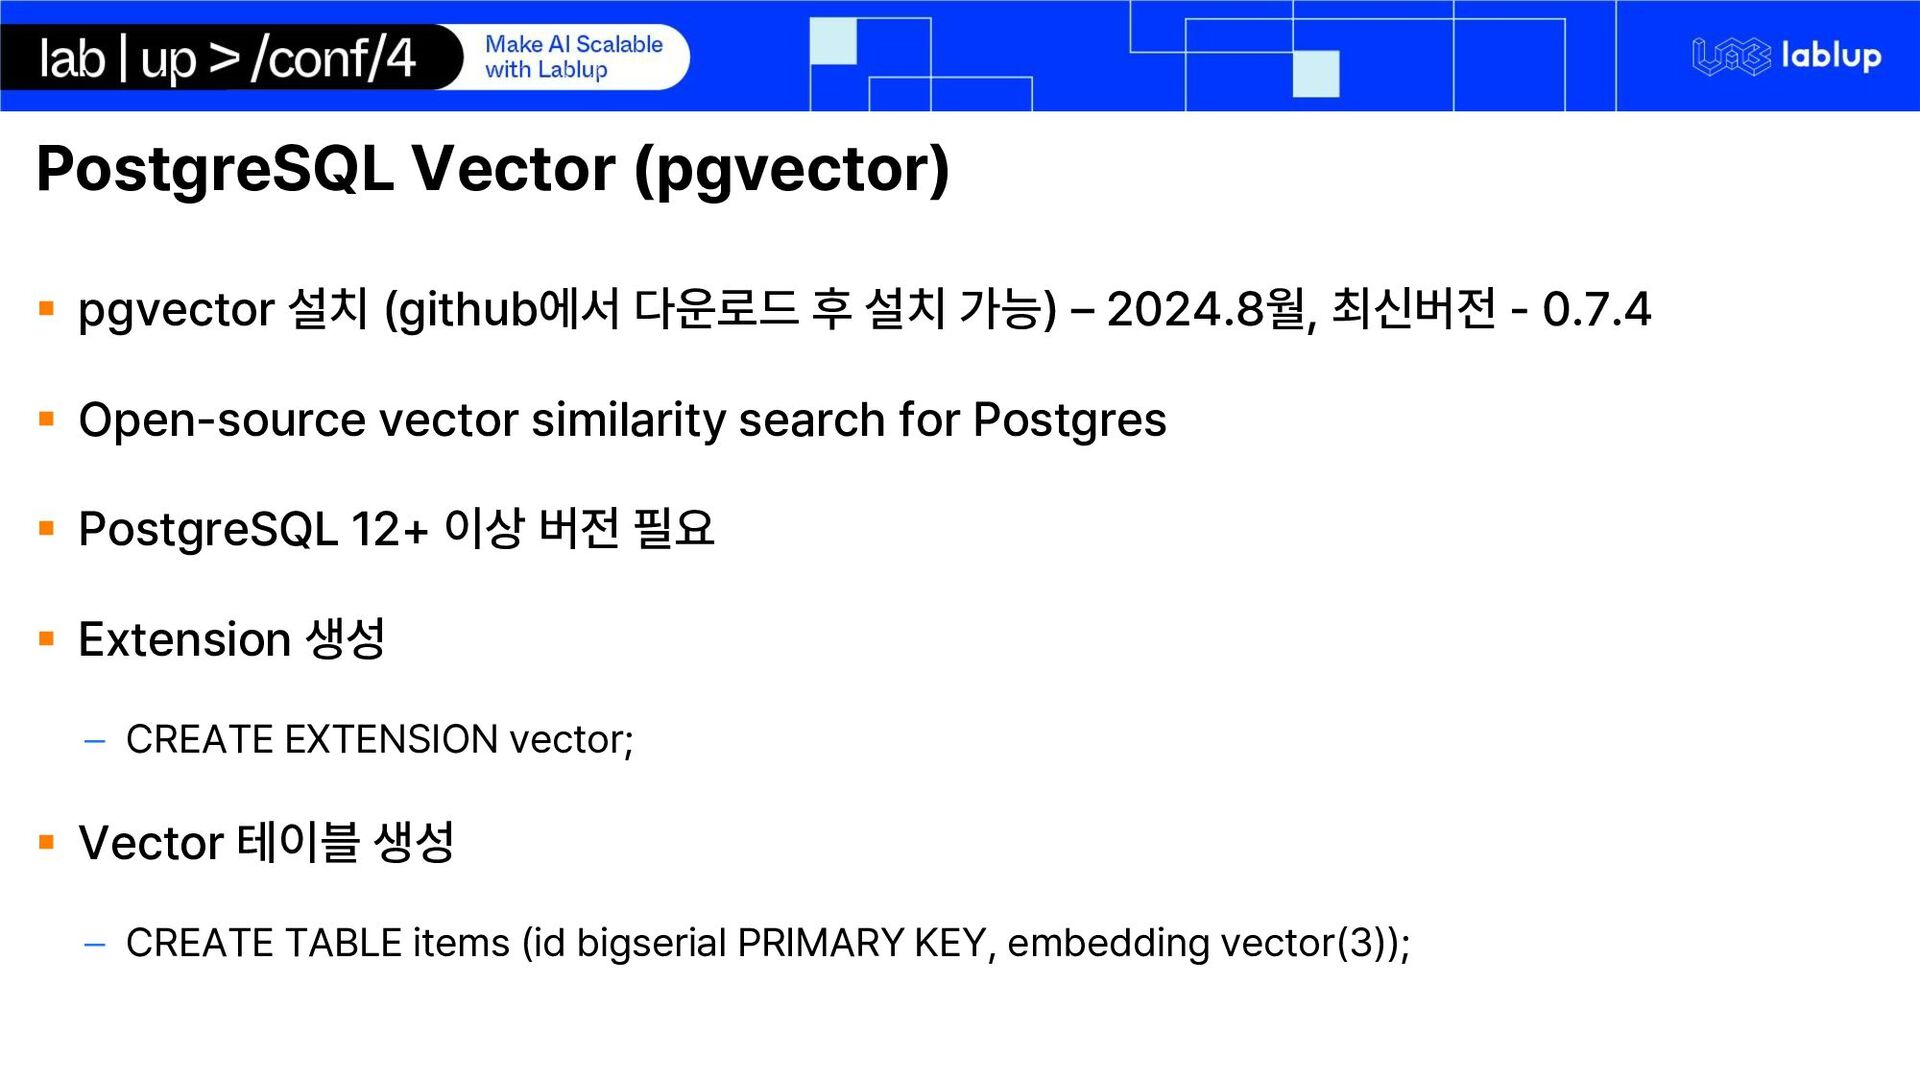
PostgreSQL Vector (pgvector) pgvector 설치 (github에서 다운로드 후 설치
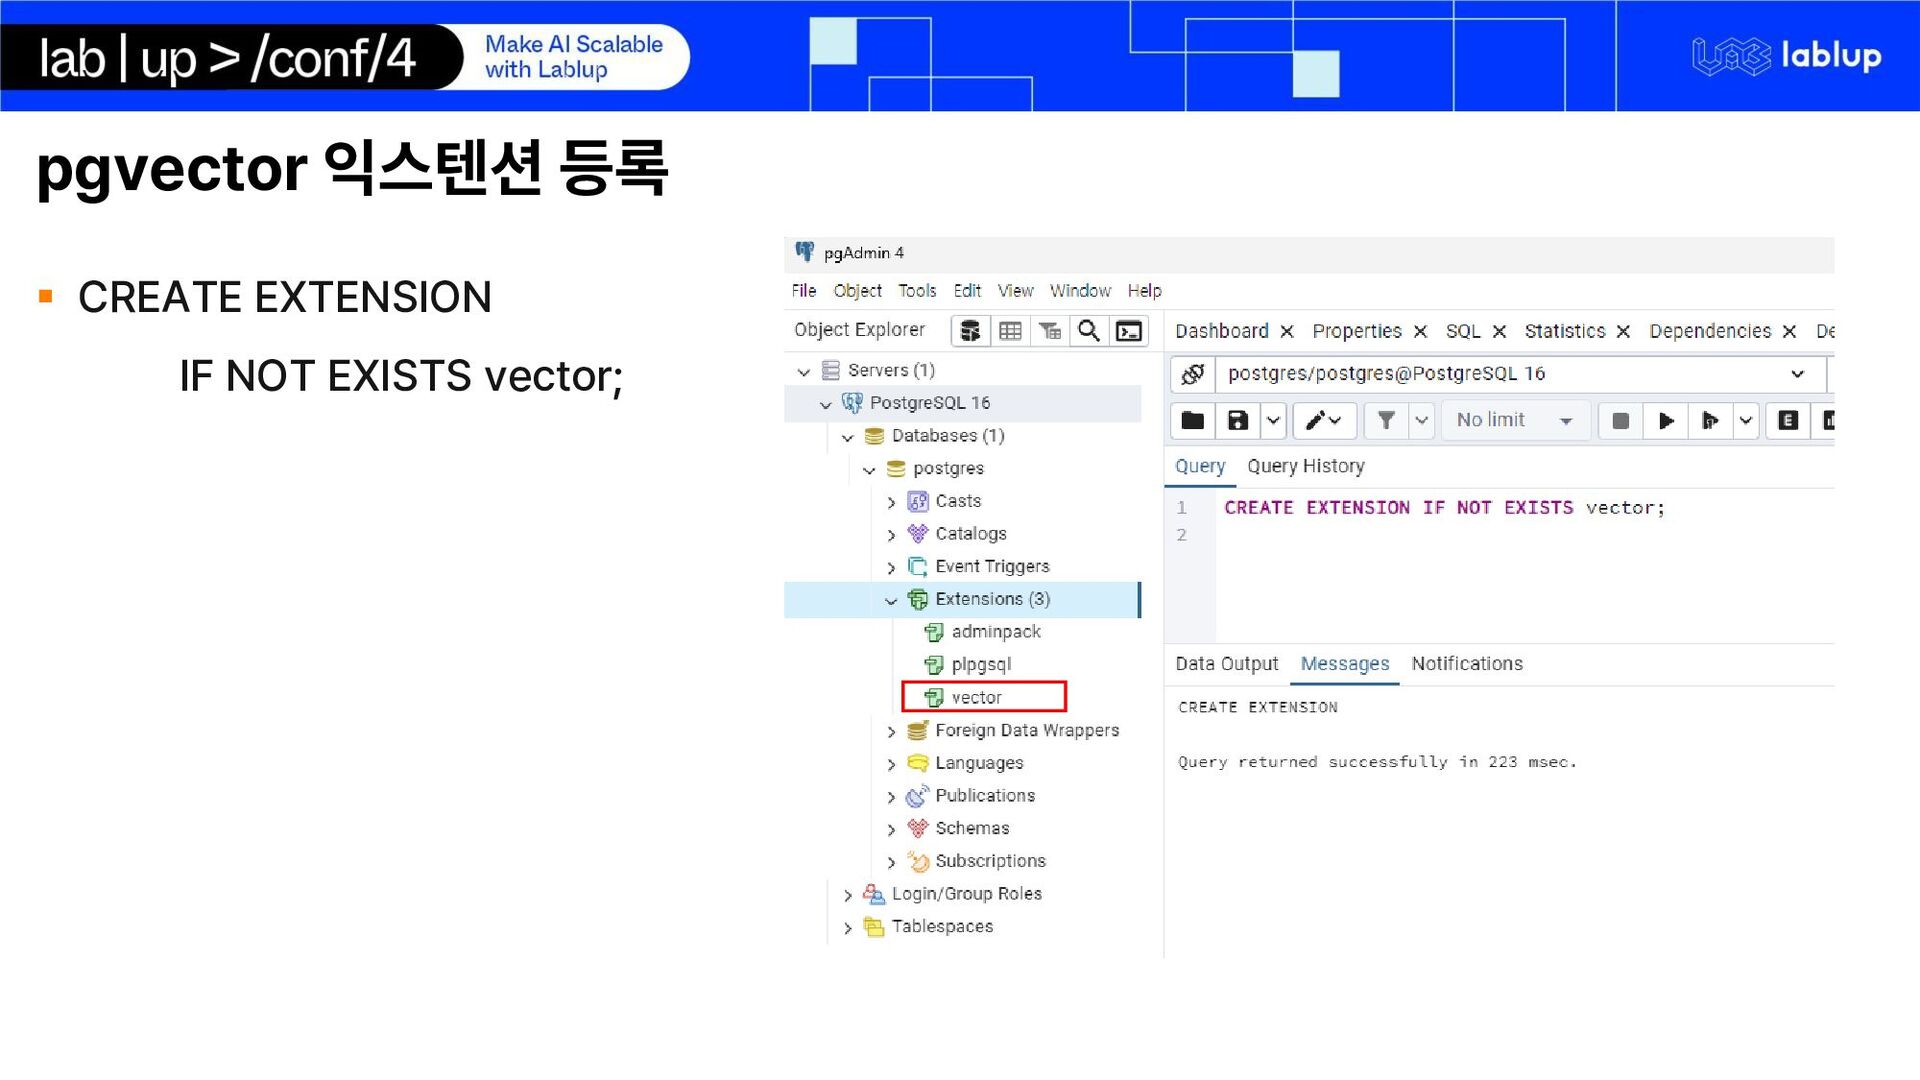
가능) – 2024.8월, 최신버전 - 0.7.4 Open-source vector similarity search for Postgres PostgreSQL 12+ 이상 버전 필요 Extension 생성 – CREATE EXTENSION vector; Vector 테이블 생성 – CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3)); -
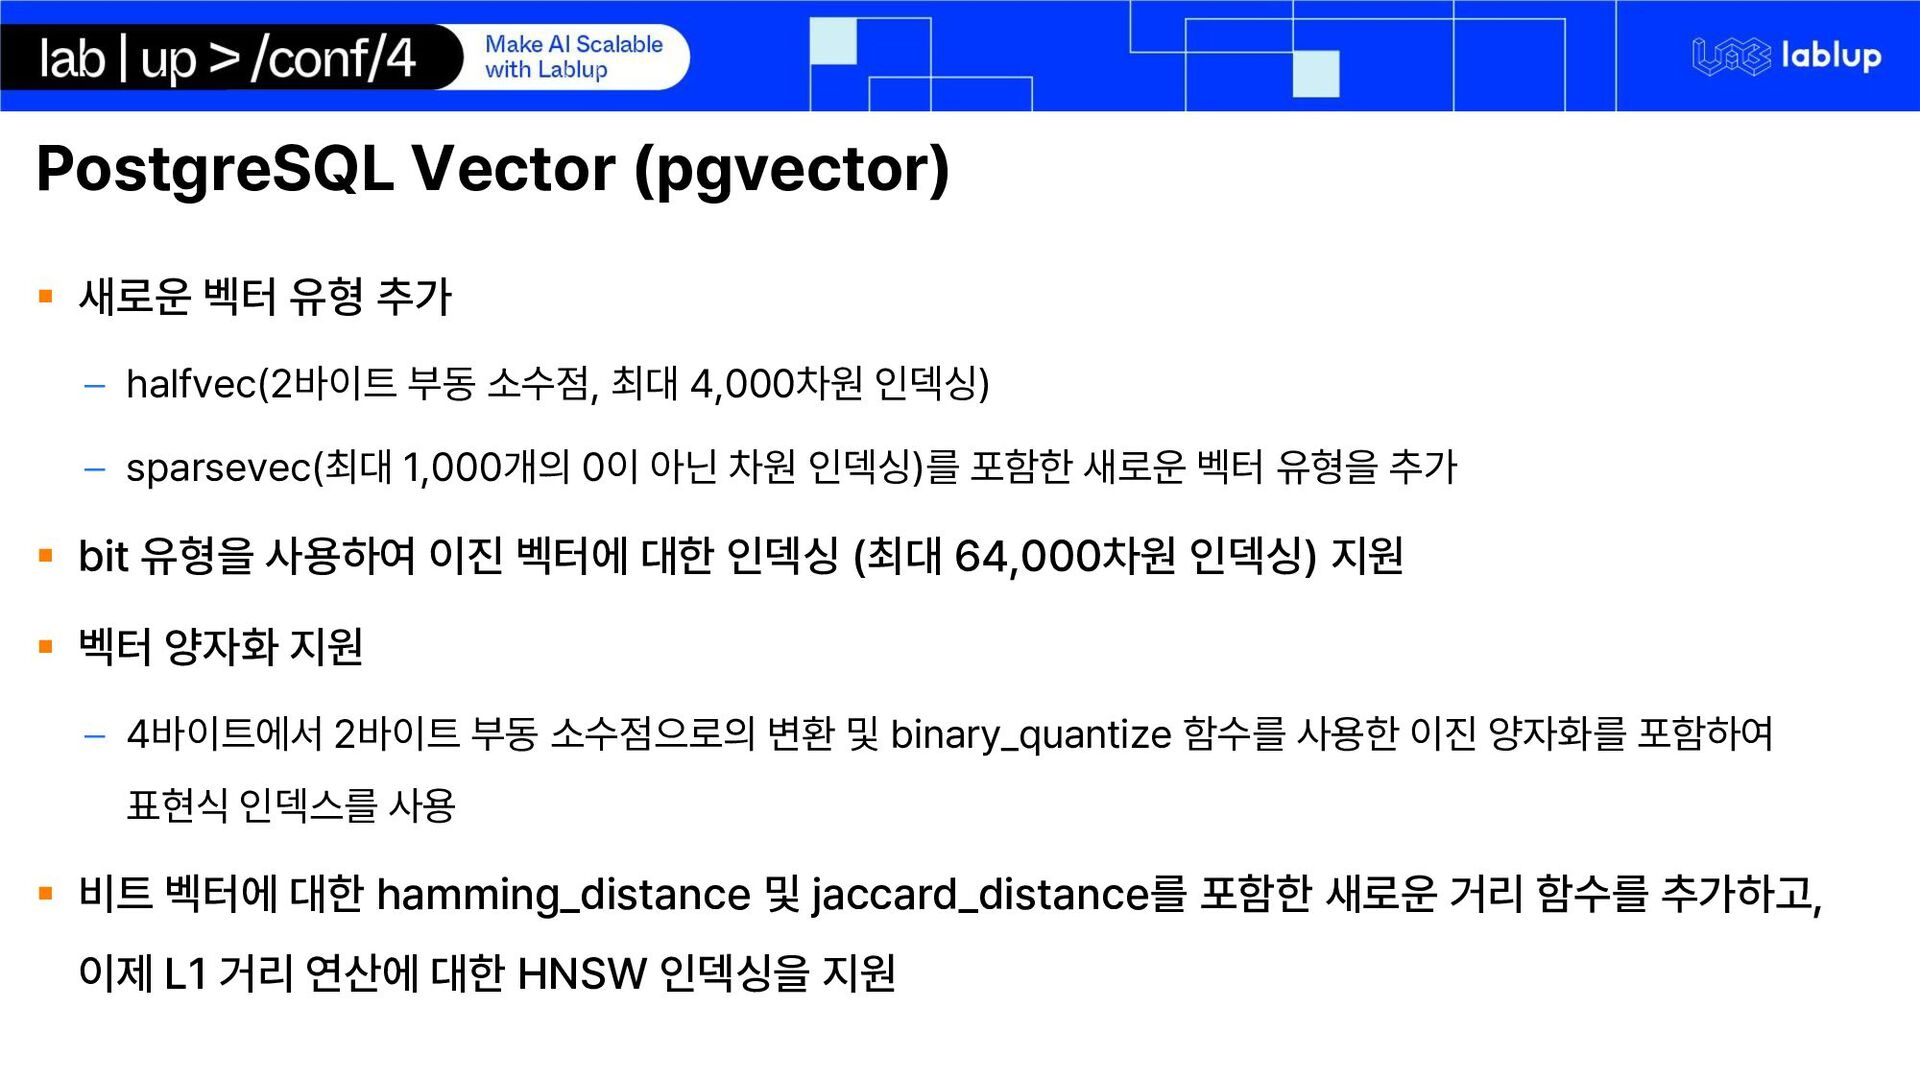
PostgreSQL Vector (pgvector) 새로운 벡터 유형 추가 – halfvec(2바이트
부동 소수점, 최대 4,000차원 인덱싱) – sparsevec(최대 1,000개의 0이 아닌 차원 인덱싱)를 포함한 새로운 벡터 유형을 추가 bit 유형을 사용하여 이진 벡터에 대한 인덱싱 (최대 64,000차원 인덱싱) 지원 벡터 양자화 지원 – 4바이트에서 2바이트 부동 소수점으로의 변환 및 binary_quantize 함수를 사용한 이진 양자화를 포함하여 표현식 인덱스를 사용 비트 벡터에 대한 hamming_distance 및 jaccard_distance를 포함한 새로운 거리 함수를 추가하고, 이제 L1 거리 연산에 대한 HNSW 인덱싱을 지원 -
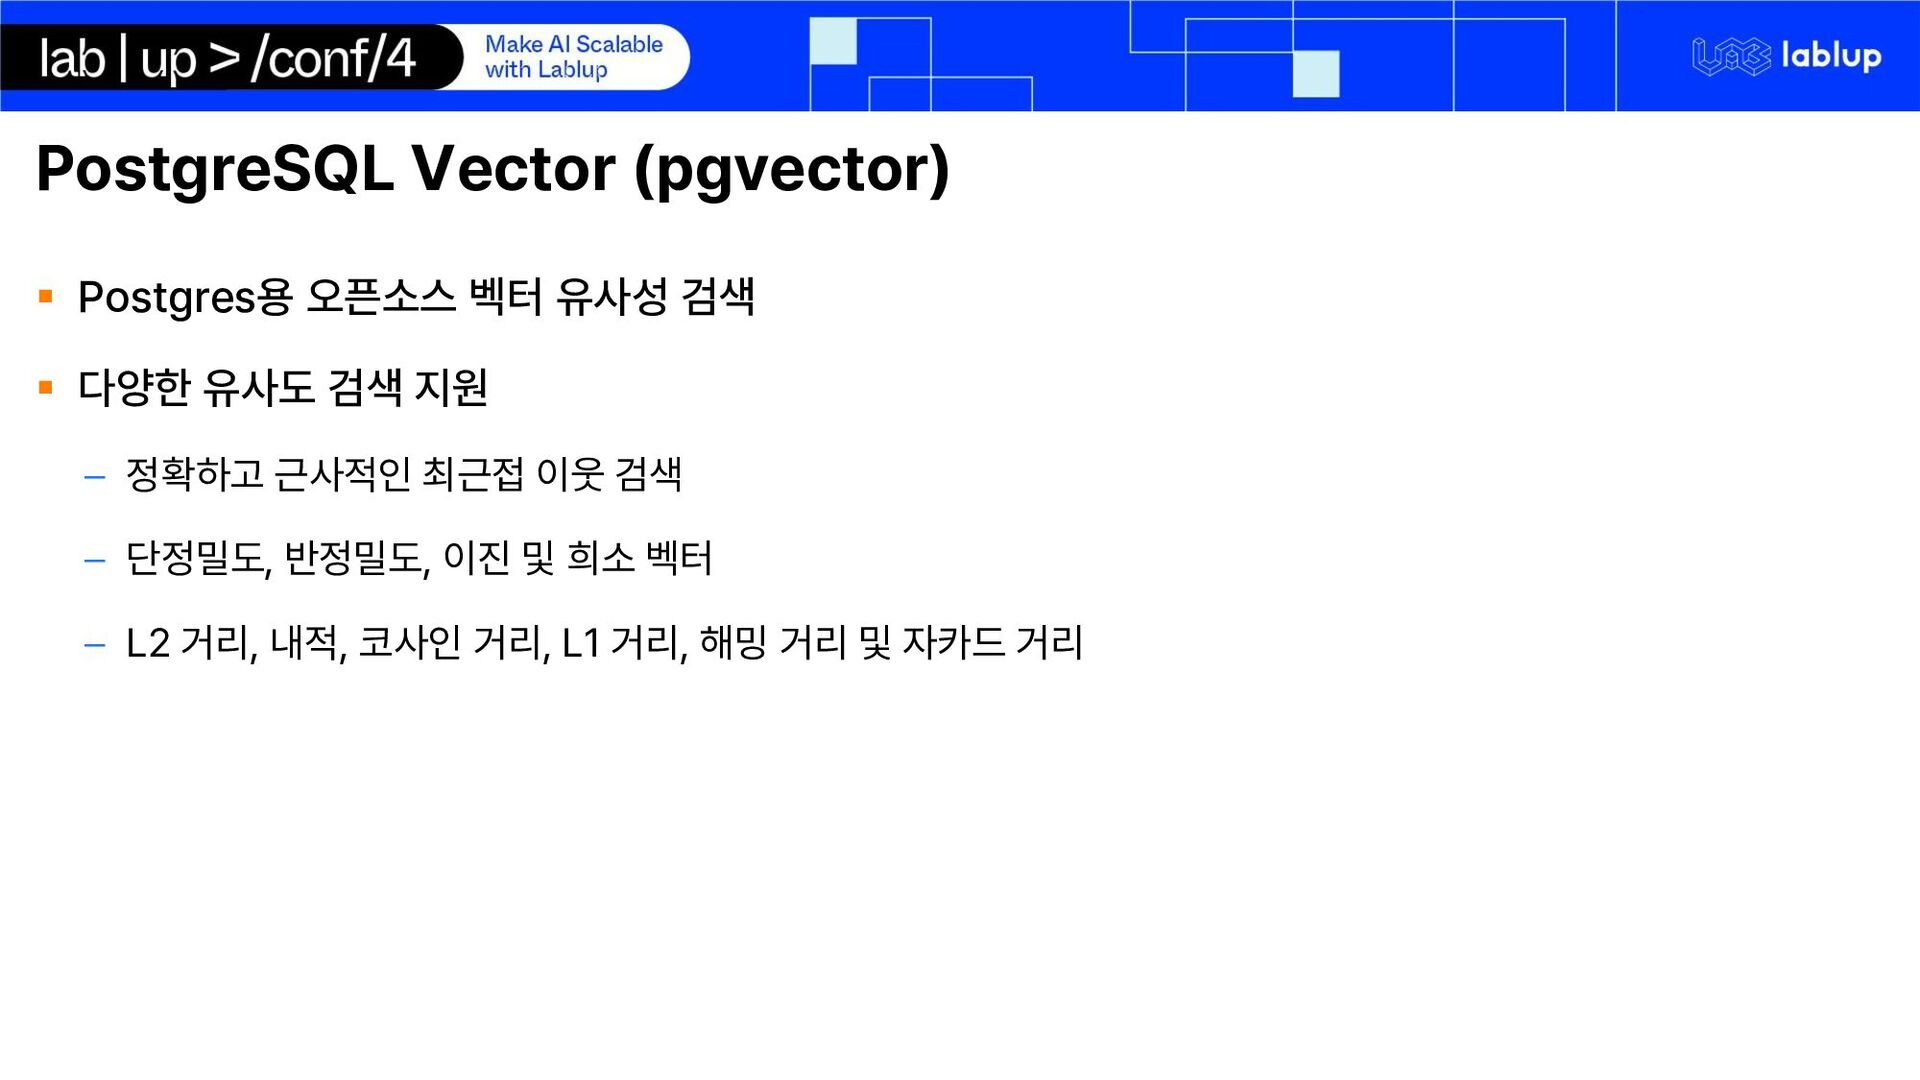
PostgreSQL Vector (pgvector) Postgres용 오픈소스 벡터 유사성 검색
다양한 유사도 검색 지원 – 정확하고 근사적인 최근접 이웃 검색 – 단정밀도, 반정밀도, 이진 및 희소 벡터 – L2 거리, 내적, 코사인 거리, L1 거리, 해밍 거리 및 자카드 거리 -
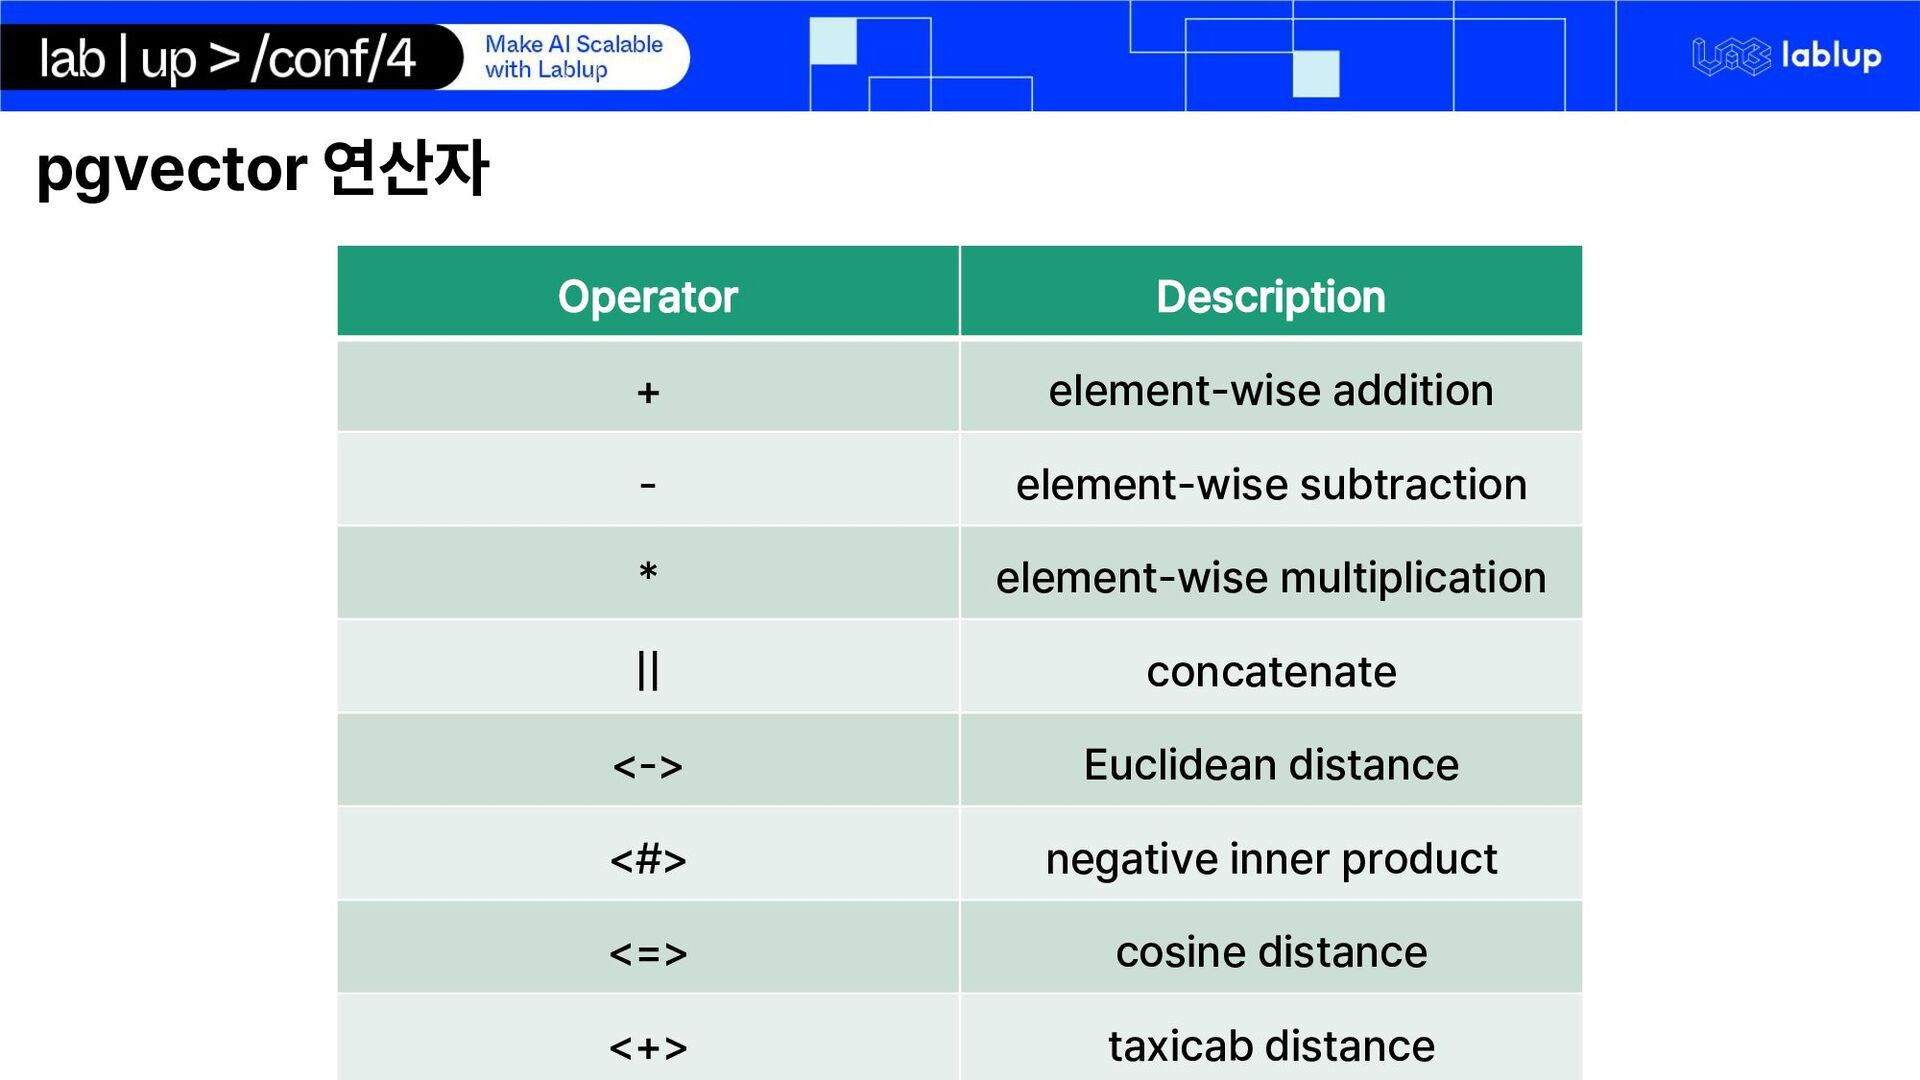
pgvector 연산자 Operator Description + element-wise addition - element-wise subtraction
* element-wise multiplication || concatenate <-> Euclidean distance <#> negative inner product <=> cosine distance <+> taxicab distance -
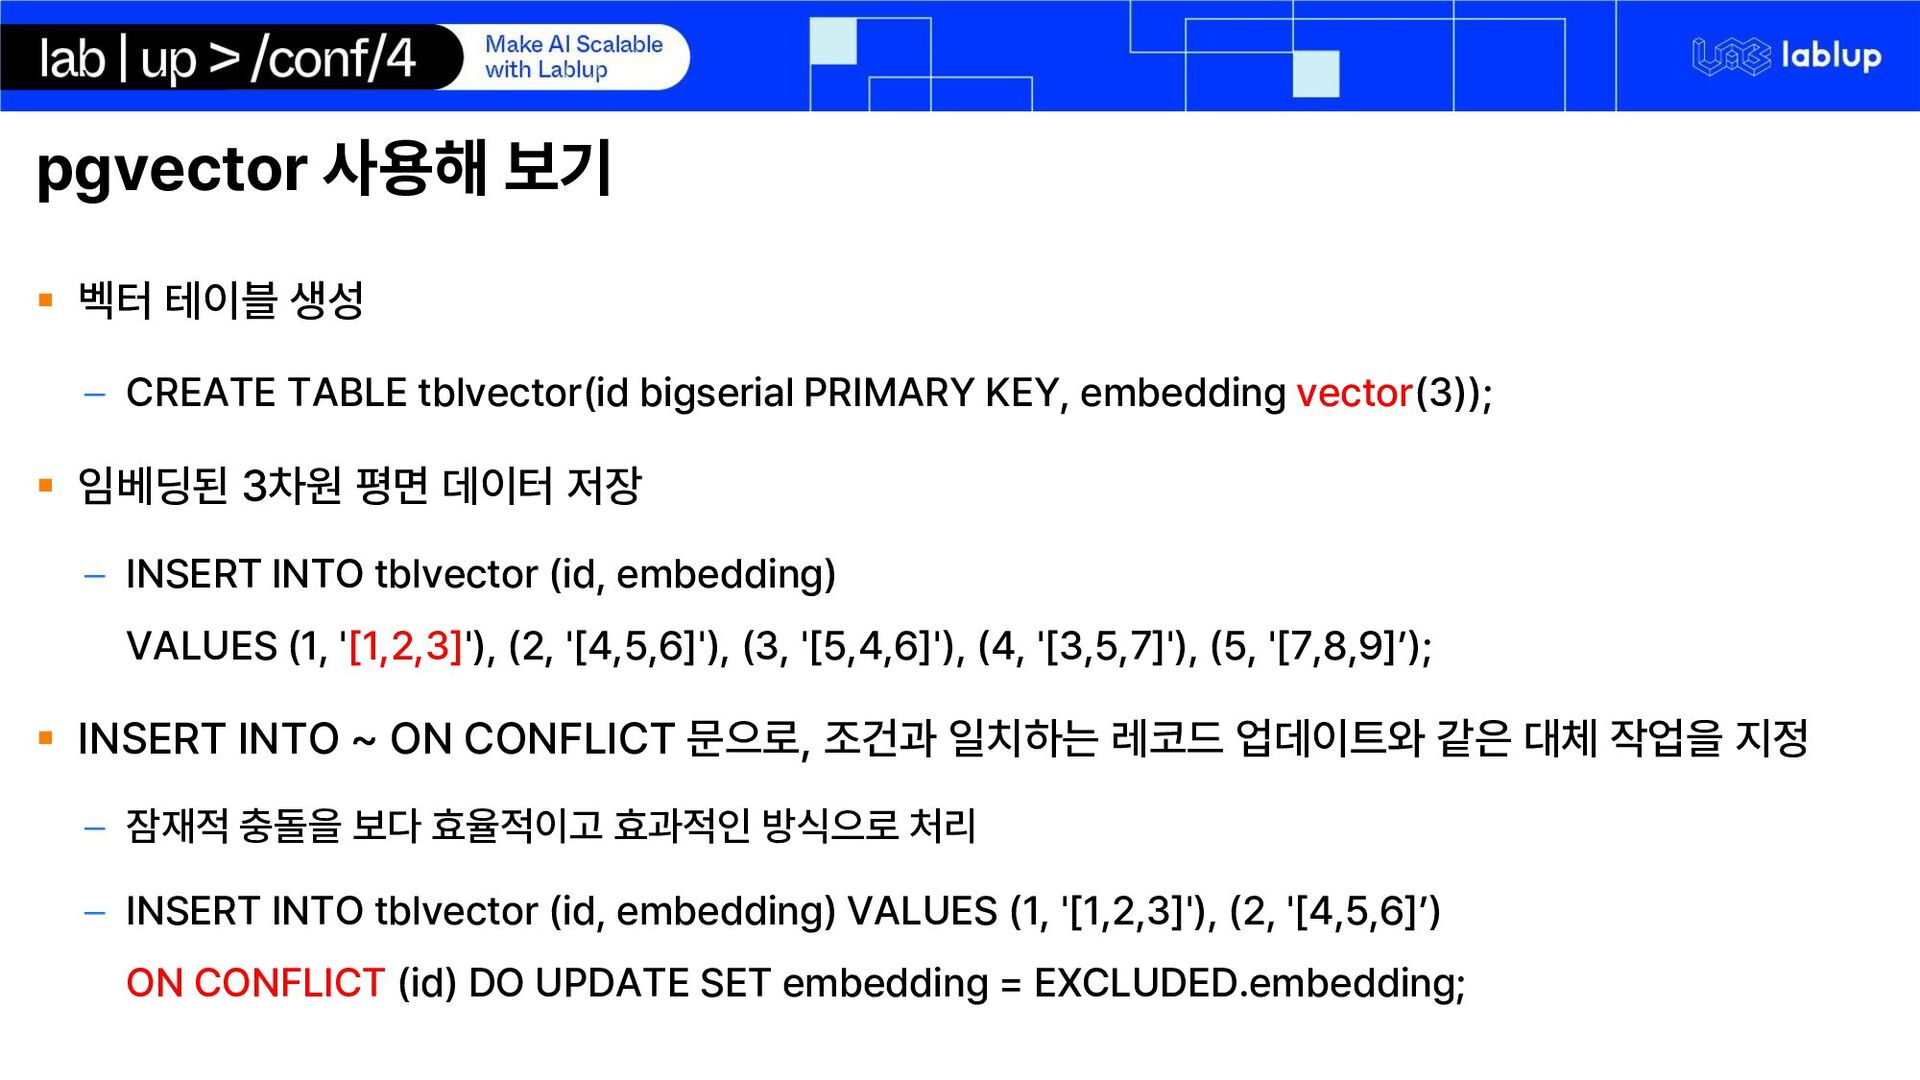
pgvector 사용해 보기 벡터 테이블 생성 – CREATE TABLE
tblvector(id bigserial PRIMARY KEY, embedding vector(3)); 임베딩된 3차원 평면 데이터 저장 – INSERT INTO tblvector (id, embedding) VALUES (1, '[1,2,3]'), (2, '[4,5,6]'), (3, '[5,4,6]'), (4, '[3,5,7]'), (5, '[7,8,9]’); INSERT INTO ~ ON CONFLICT 문으로, 조건과 일치하는 레코드 업데이트와 같은 대체 작업을 지정 – 잠재적 충돌을 보다 효율적이고 효과적인 방식으로 처리 – INSERT INTO tblvector (id, embedding) VALUES (1, '[1,2,3]'), (2, '[4,5,6]’) ON CONFLICT (id) DO UPDATE SET embedding = EXCLUDED.embedding; -
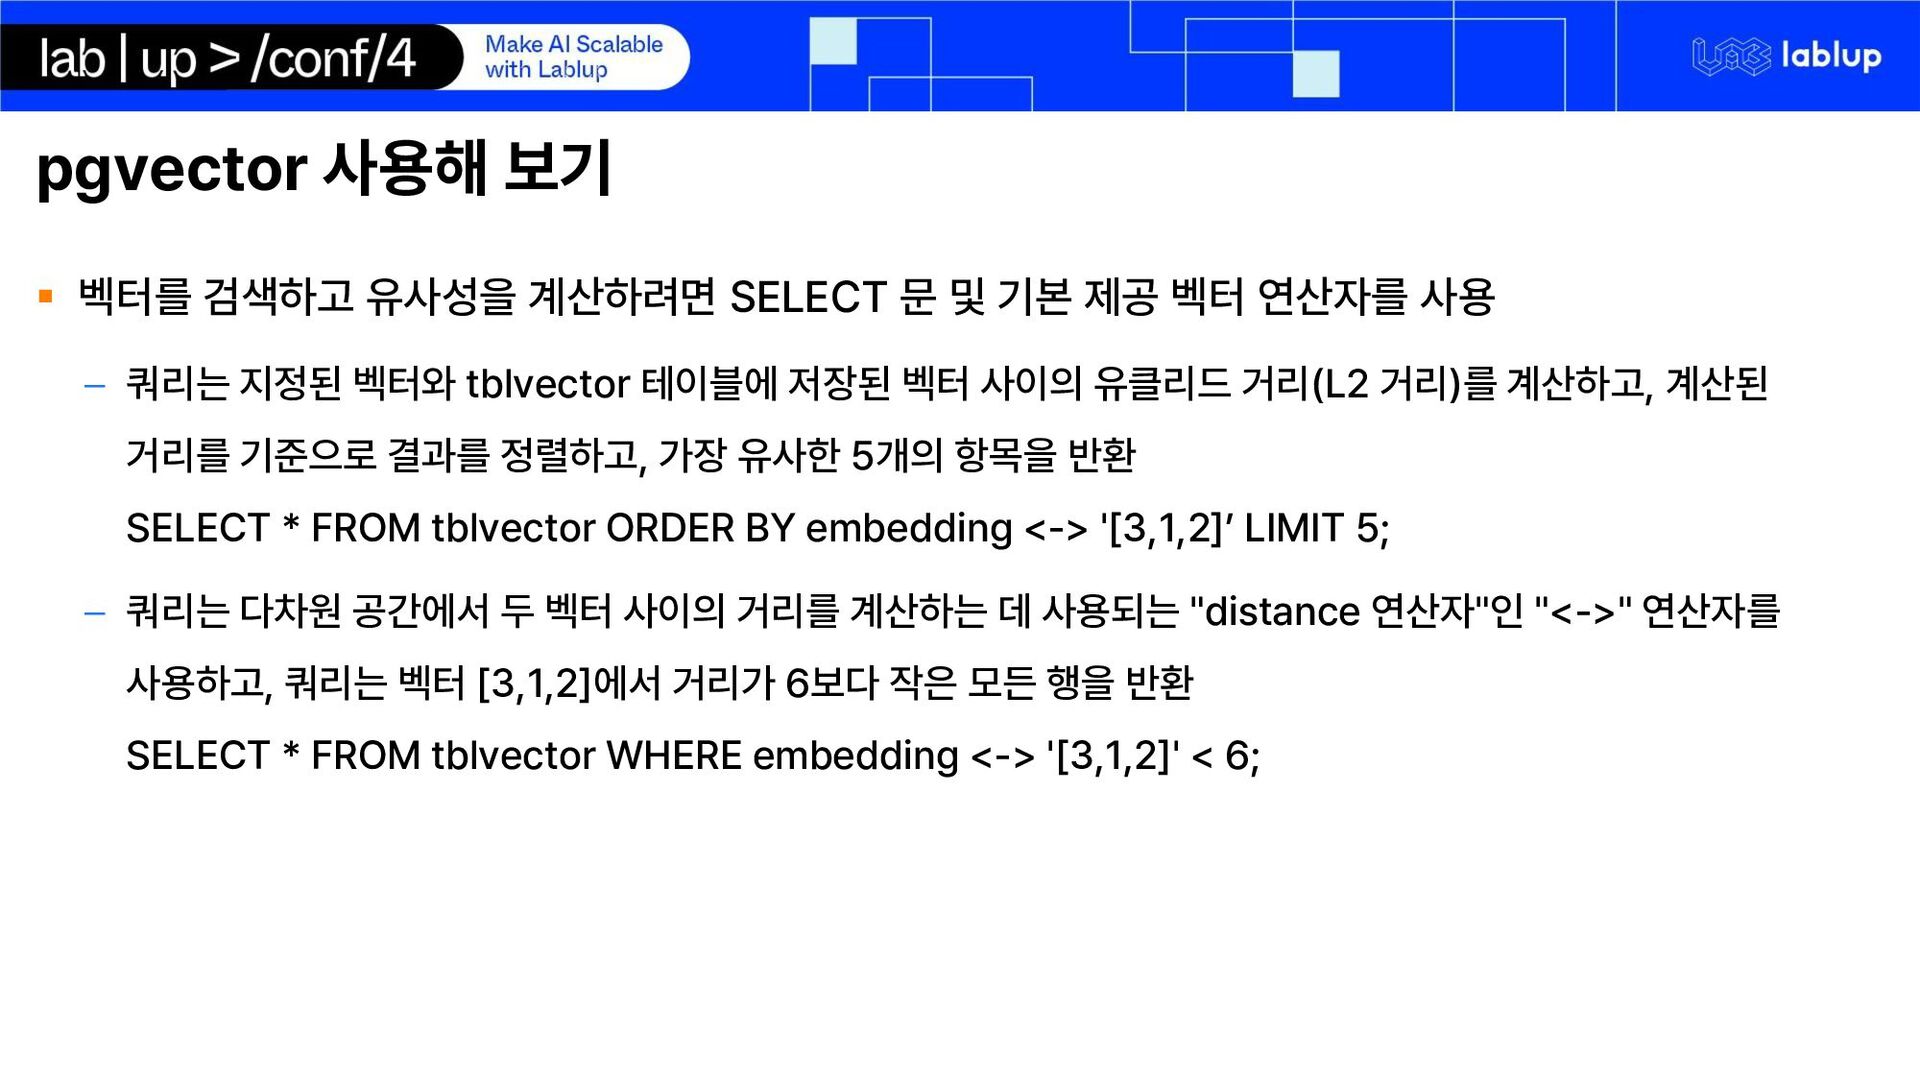
pgvector 사용해 보기 벡터를 검색하고 유사성을 계산하려면 SELECT 문
및 기본 제공 벡터 연산자를 사용 – 쿼리는 지정된 벡터와 tblvector 테이블에 저장된 벡터 사이의 유클리드 거리(L2 거리)를 계산하고, 계산된 거리를 기준으로 결과를 정렬하고, 가장 유사한 5개의 항목을 반환 SELECT * FROM tblvector ORDER BY embedding <-> '[3,1,2]’ LIMIT 5; – 쿼리는 다차원 공간에서 두 벡터 사이의 거리를 계산하는 데 사용되는 "distance 연산자"인 "<->" 연산자를 사용하고, 쿼리는 벡터 [3,1,2]에서 거리가 6보다 작은 모든 행을 반환 SELECT * FROM tblvector WHERE embedding <-> '[3,1,2]' < 6; -
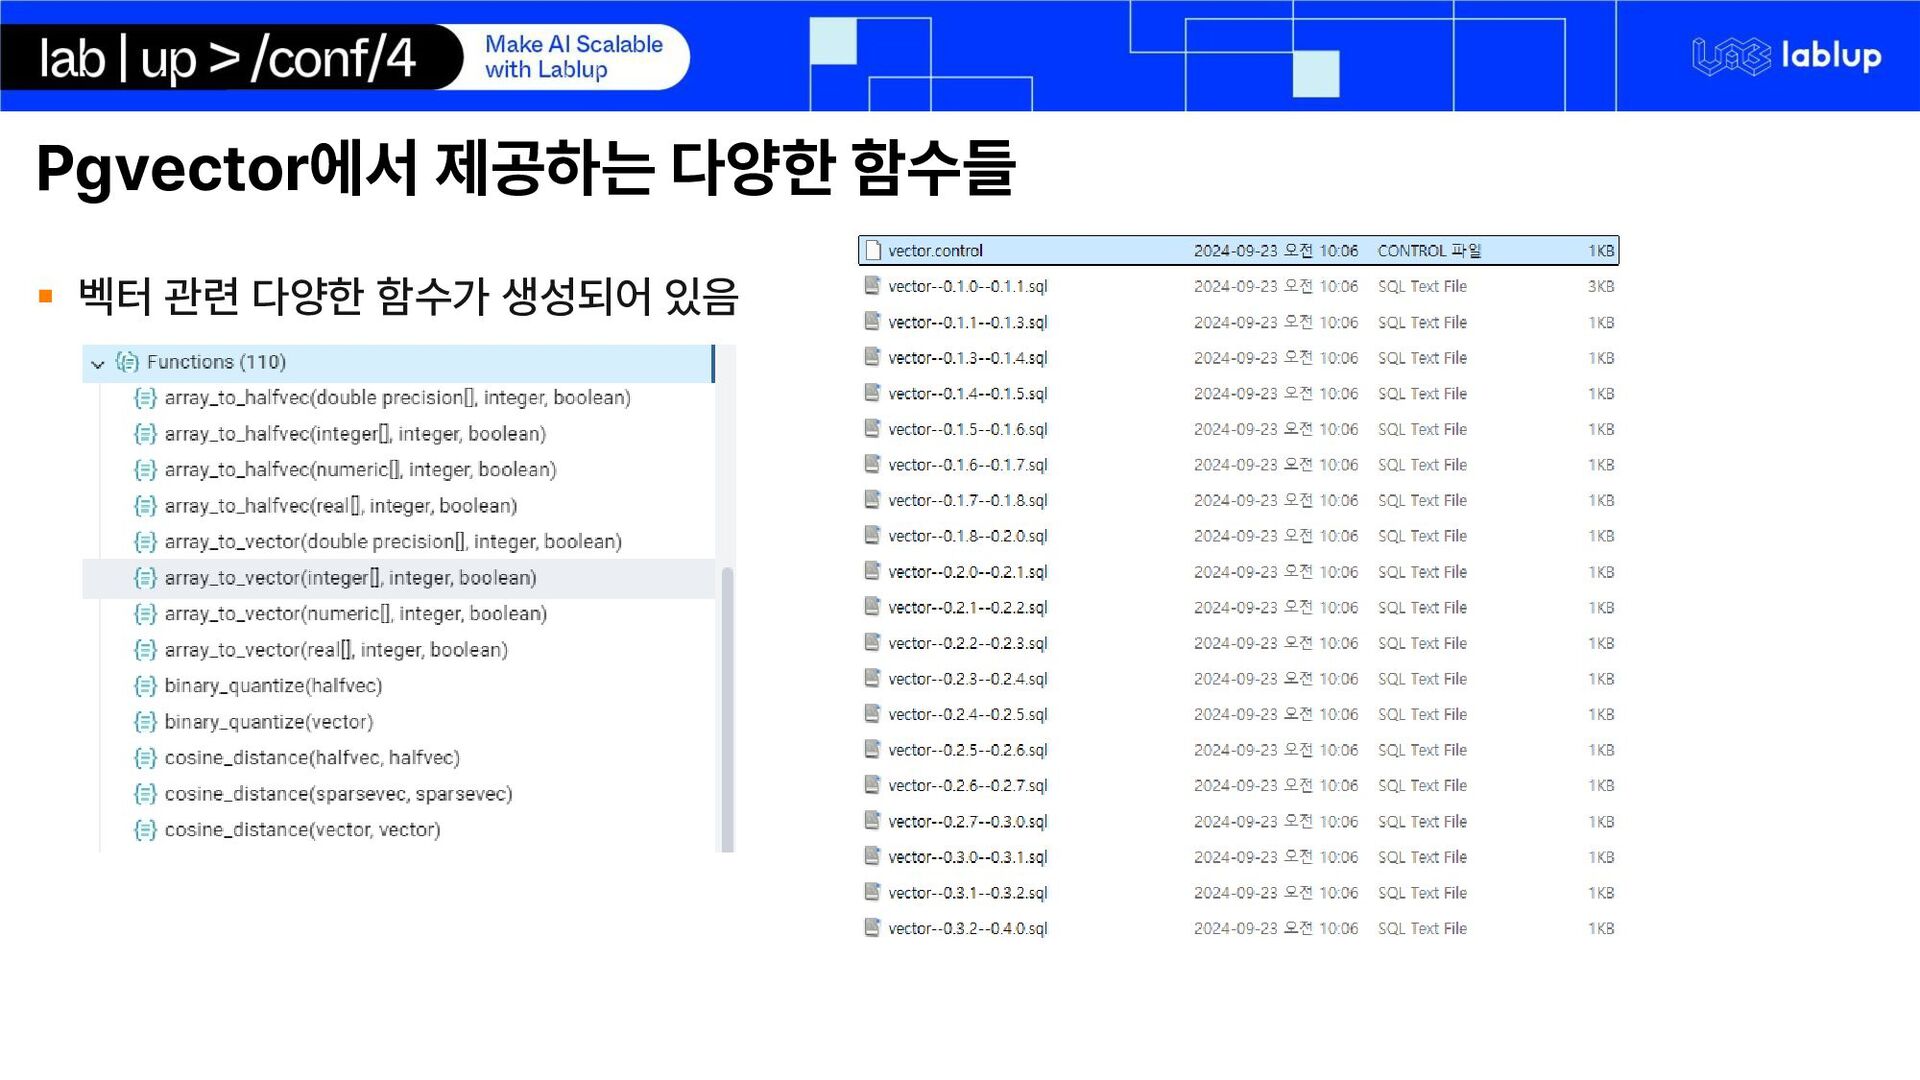
pgvector 제공 함수 cosine_distance (두 벡터 간 코사인 거리를
계산) – cosine_distance(vector, vector) inner_product (두 벡터의 내적을 계산) – inner_product(vector, vector) l2_distance (두 벡터 간 유클리드 거리(L2)를 계산) – l2_distance(vector, vector) l1_distance (두 벡터 간의 택시 거리(L1이라고도 함)를 계산) – l1_distance(vector, vector) -
pgvector 제공 함수 vector_dims(vector) – 지정된 벡터의 차원을 반환
vector_norms(vector) – 지정된 벡터의 유클리드 놈을 계산 -
pgvector 인덱스 인덱스가 없으면 확대하여 정확한 검색을 수행하므로 성능이
저하되지만 완벽한 재현을 제공 근사한 인접 항목을 검색하기 위해 실행 성능에 대한 재현을 교환하는 인덱스를 데이터에 생성 가능 지원되는 인덱스 형식 – IVVFlat (플랫 압축을 사용한 반전 파일) – HNSW (계층적 탐색 가능한 작은 세계) IVFFlat 인덱스는 HNSW보다 빌드 시간이 더 빠르고 메모리를 덜 사용하지만 쿼리 성능은 더 낮음(속도- 리콜 장단점 측면에서) 컬럼을 인덱싱 하려면 차원이 정의되어 있어야 함 – 최대 2000개의 차원까지 인덱싱 가능. 2000개 넘을 경우 벡터를 저장할 수 있지만 인덱싱은 할 수 없음 -
포켓몬을 추천해줘! – Pgvector 설치 – 익스텐션 등록 –
포켓몬 데이터 임데이 후 저장 – OpenAI 임베딩 모델을 사용한 검색 DEMO -
pgvector 설치 Github에서 다운로드 받아 빌드 후 익스텐션으로 설치
사용 – https://github.com/pgvector/pgvector Container 도 제공 – docker pull pgvector/pgvector -
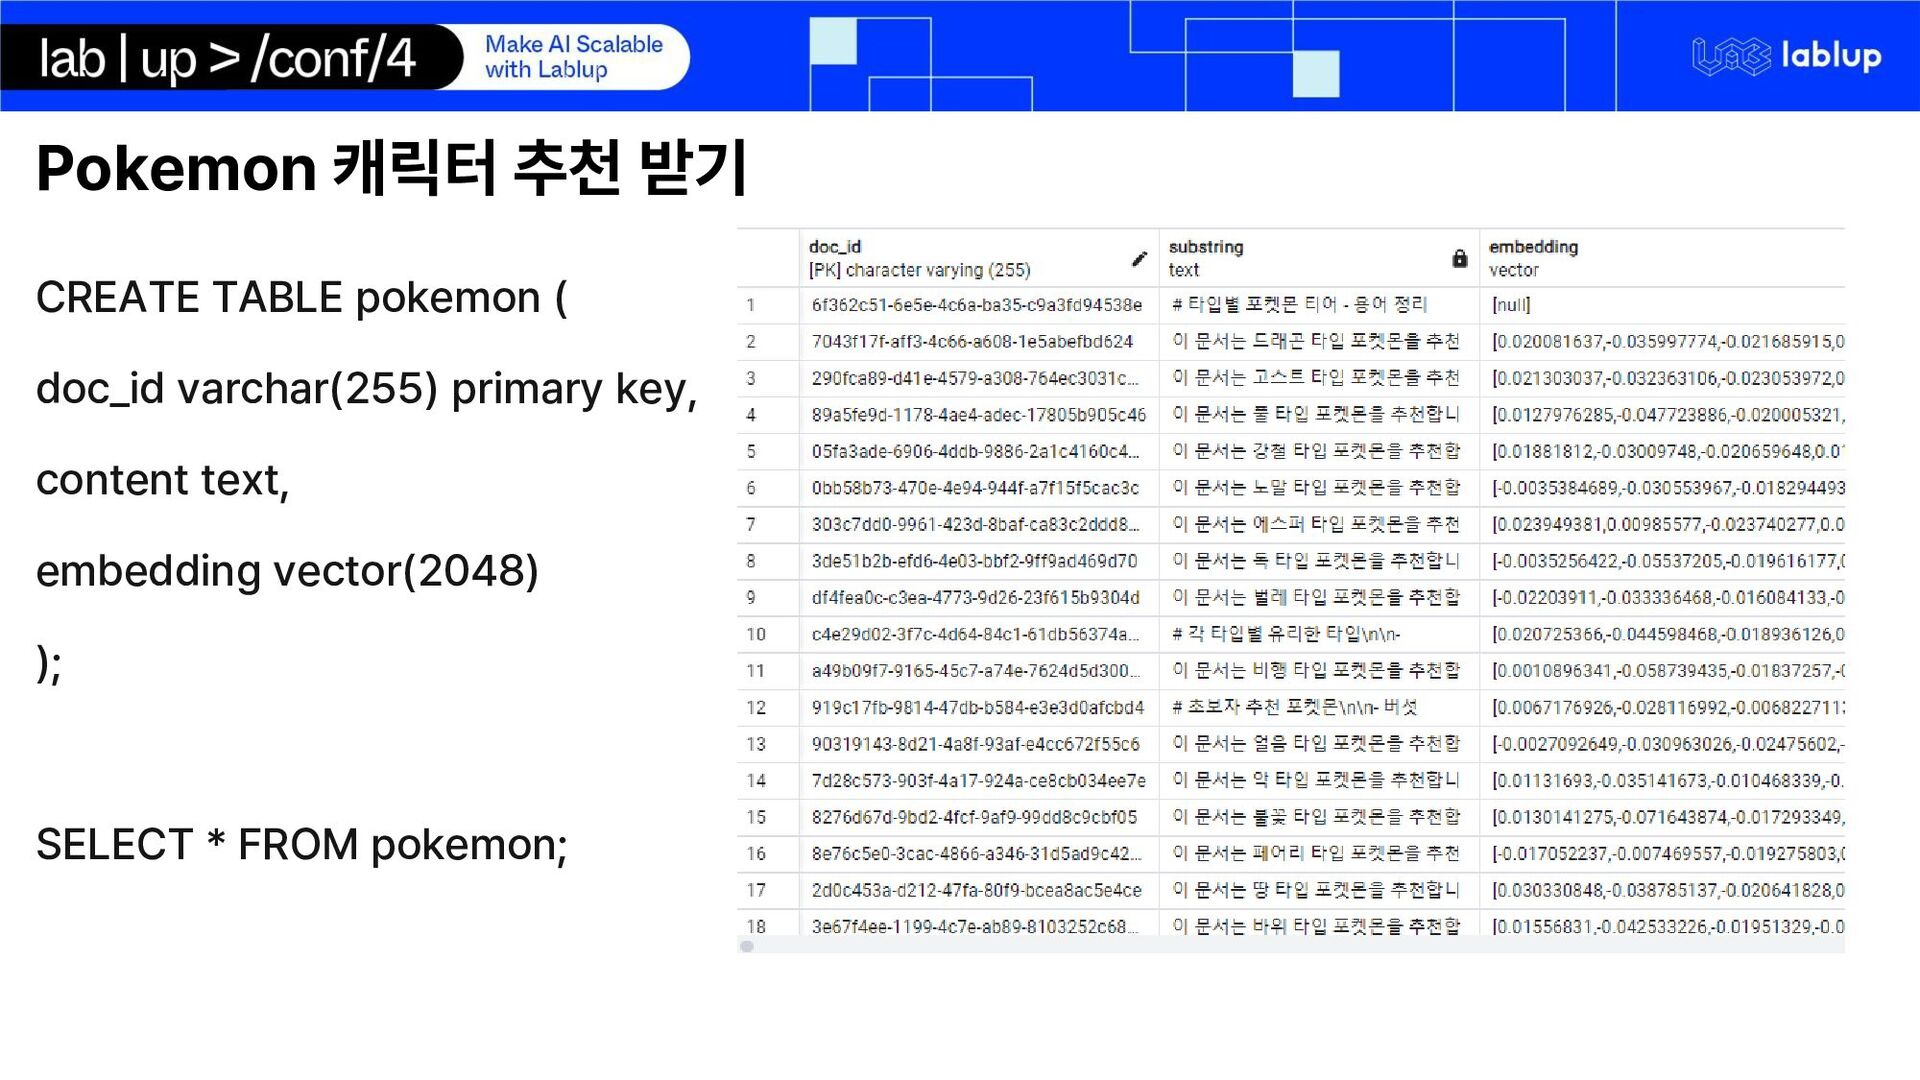
Pokemon 캐릭터 추천 받기 CREATE TABLE pokemon ( doc_id varchar(255)
primary key, content text, embedding vector(2048) ); SELECT * FROM pokemon; -
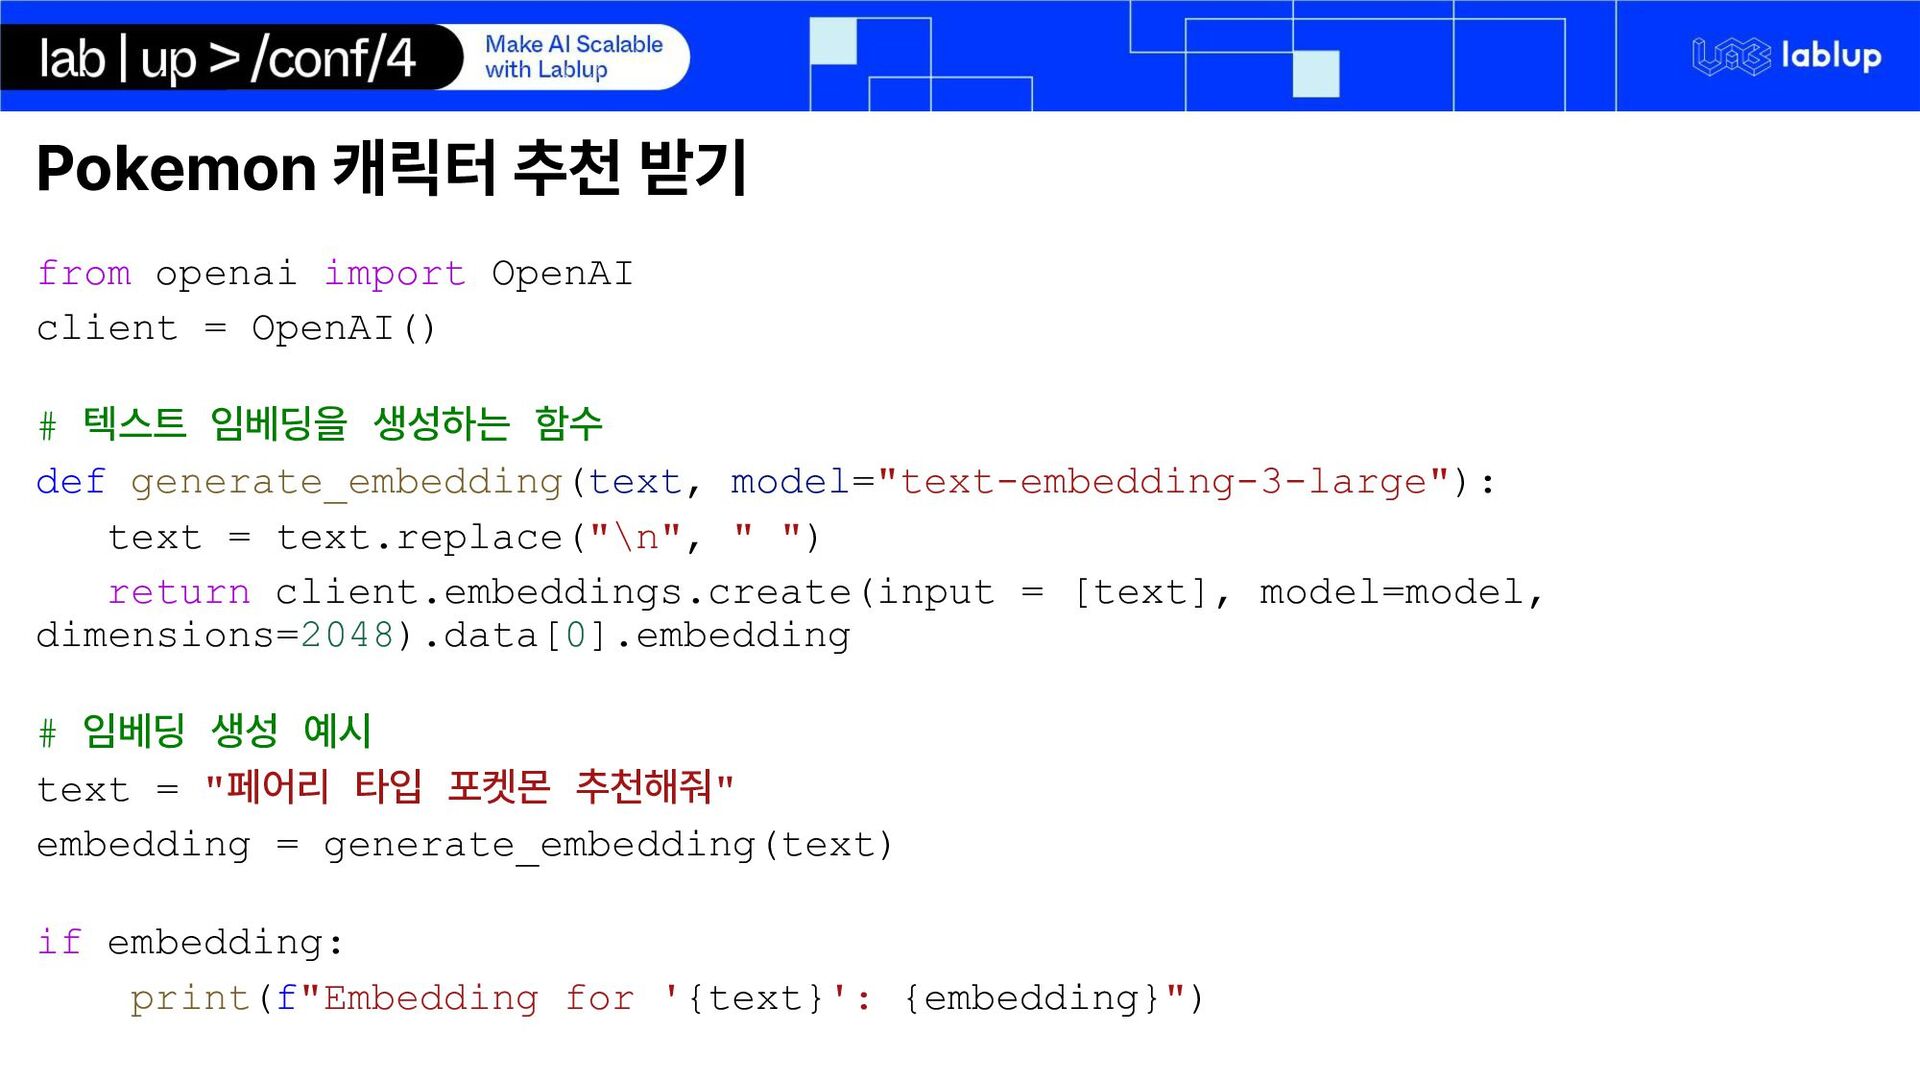
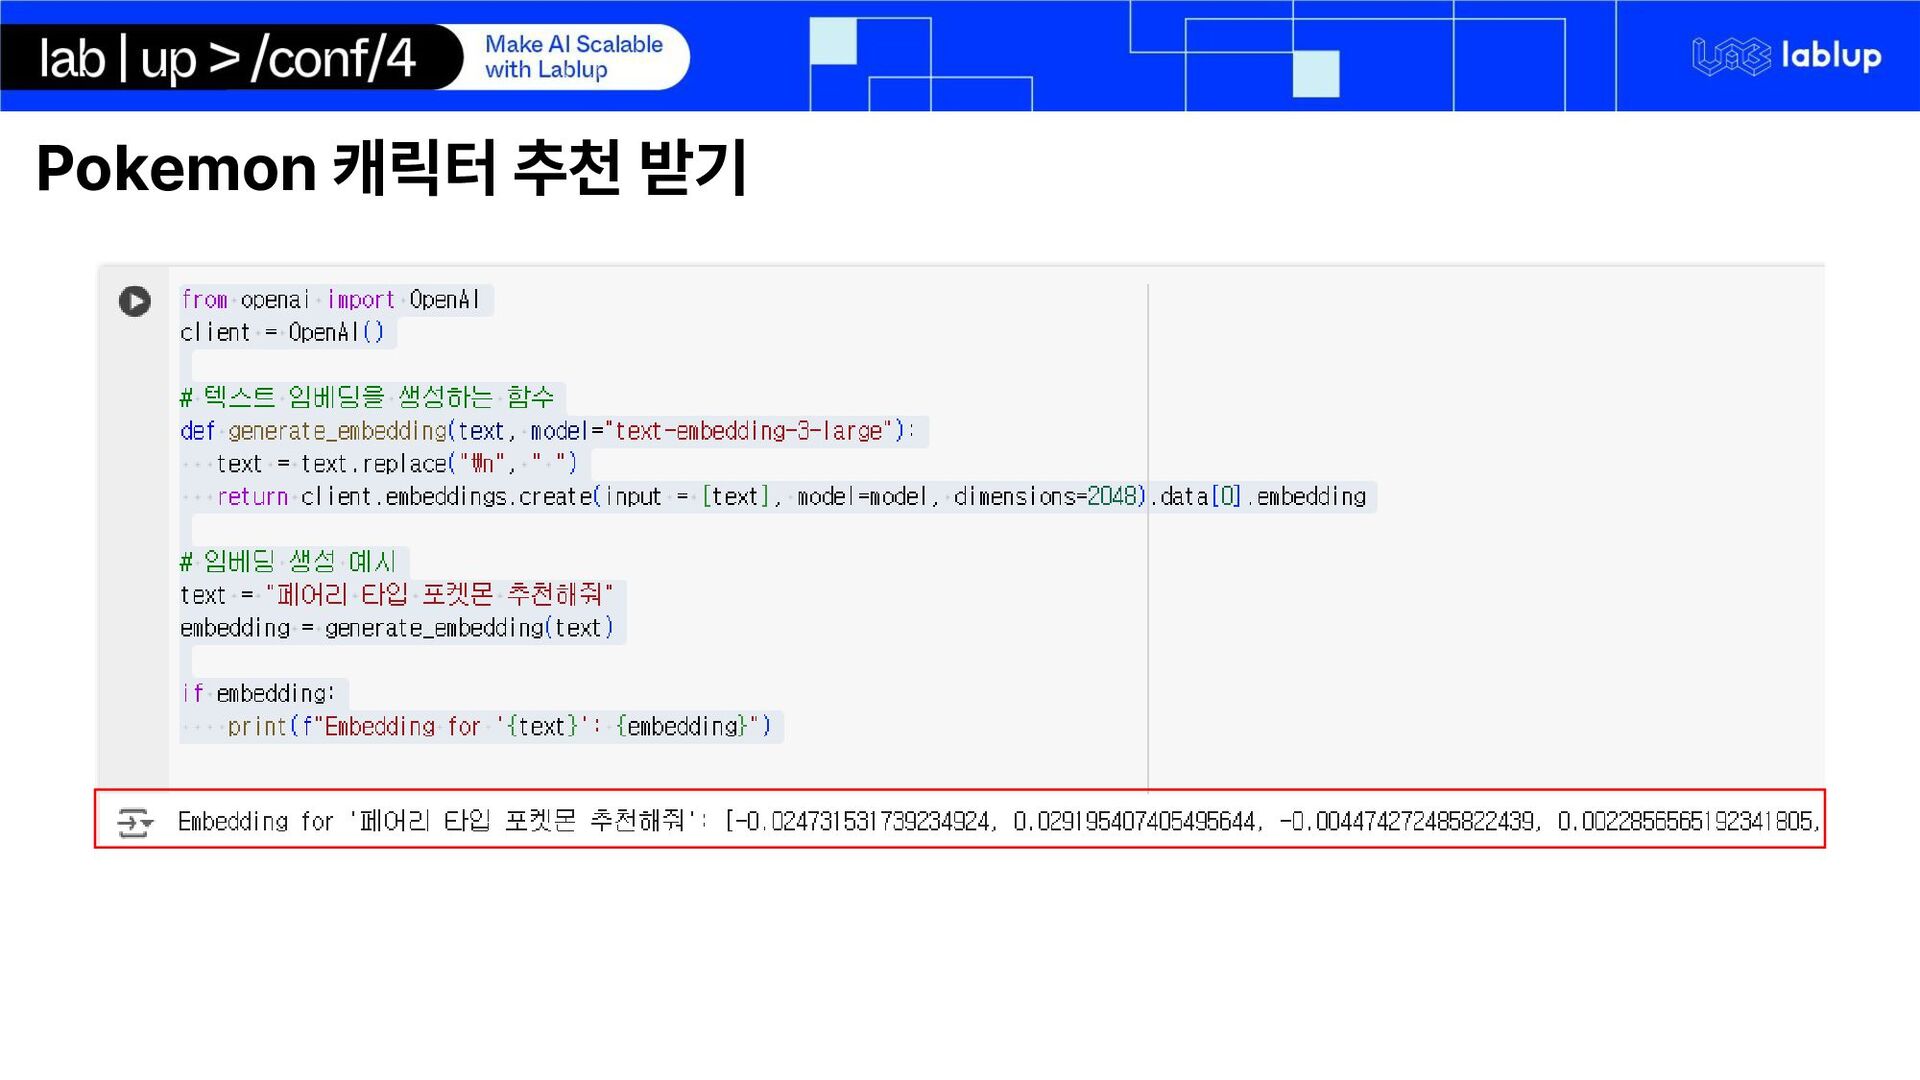
Pokemon 캐릭터 추천 받기 from openai import OpenAI client =
OpenAI() # 텍스트 임베딩을 생성하는 함수 def generate_embedding(text, model="text-embedding-3-large"): text = text.replace("\n", " ") return client.embeddings.create(input = [text], model=model, dimensions=2048).data[0].embedding # 임베딩 생성 예시 text = "페어리 타입 포켓몬 추천해줘" embedding = generate_embedding(text) if embedding: print(f"Embedding for '{text}': {embedding}") -
SELECT * FROM pokemon ORDER BY embedding <-> ‘[vector_value’]
LIMIT 1; Pokemon 캐릭터 추천 받기 -
MySQL에서 Vector Data type MySQL 9.0.0에서 Vector 데이터 타입
제공 MySQL HeatWave, Enterprise Edition에서 제공 MySQL Community 경우 UDF로 컴포넌트 만들어서 동일한 기능 사용 가능 – 현재 시점에서는 MySQL 소스에 포함하여 빌드 필요 벡터 컬럼은 이진 문자열 값 또는 목록 형식의 문자열로 4바이트 부동 소수점 값으로 구성 VECTOR 컬럼의 길이는 2048 ~ 16383 가능 (기본값 2048) VECTOR CREATE TABLE 명령으로 InnoDB에 테이블 생성 – CREATE TABLE v1 (c1 VECTOR(5000)); -
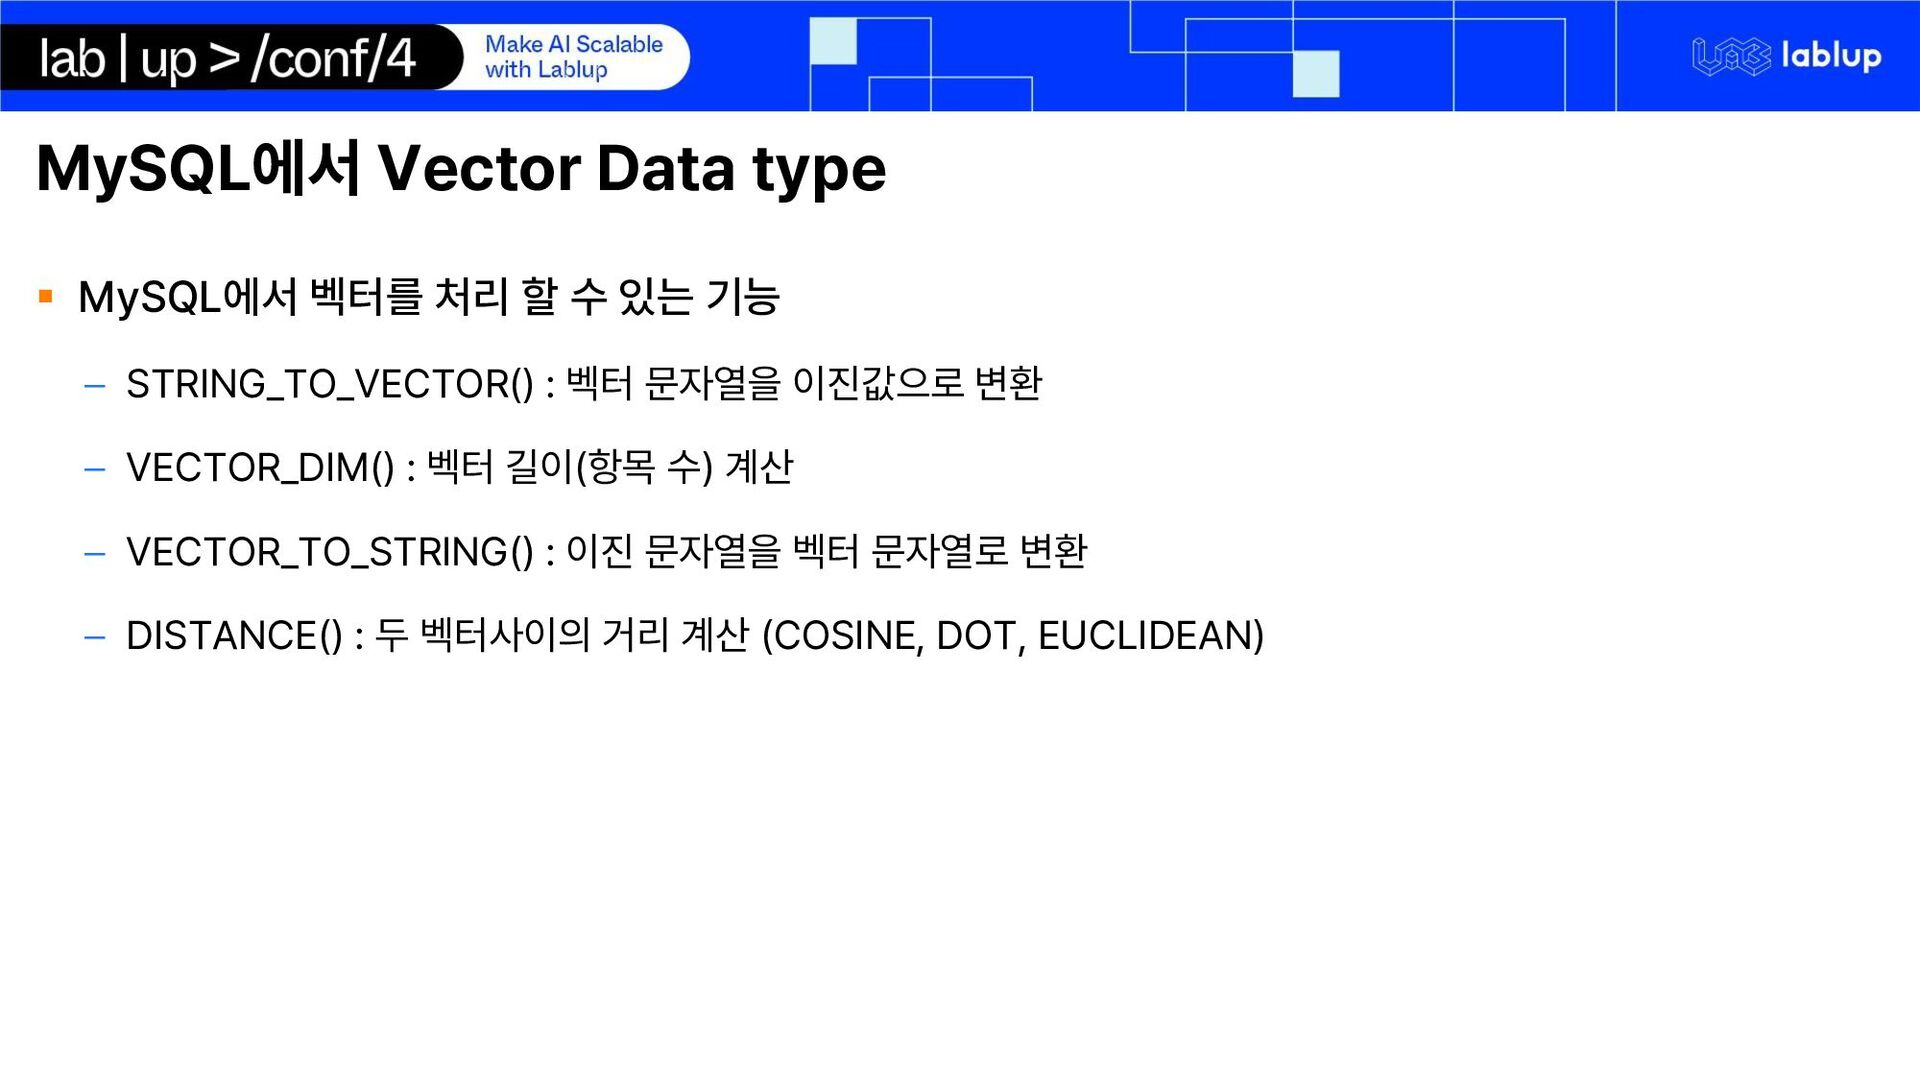
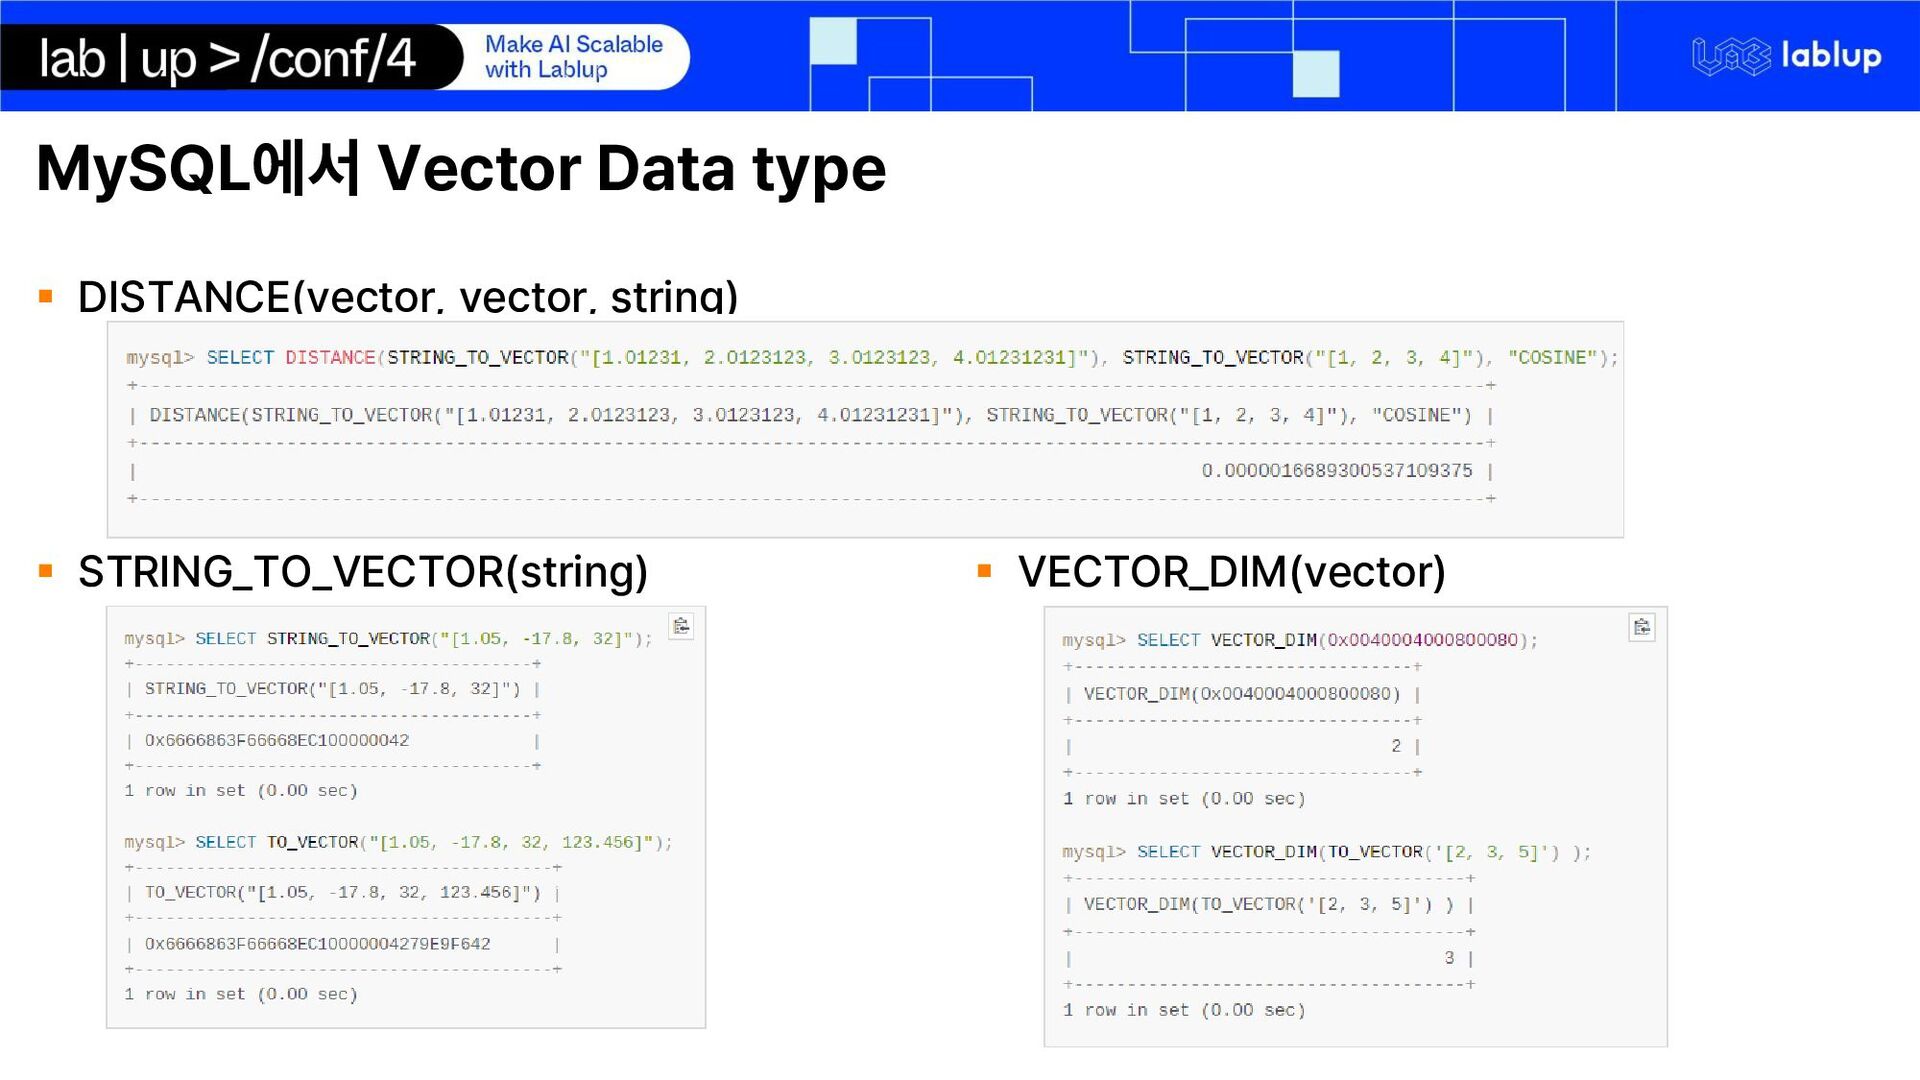
MySQL에서 Vector Data type MySQL에서 벡터를 처리 할 수
있는 기능 – STRING_TO_VECTOR() : 벡터 문자열을 이진값으로 변환 – VECTOR_DIM() : 벡터 길이(항목 수) 계산 – VECTOR_TO_STRING() : 이진 문자열을 벡터 문자열로 변환 – DISTANCE() : 두 벡터사이의 거리 계산 (COSINE, DOT, EUCLIDEAN) -
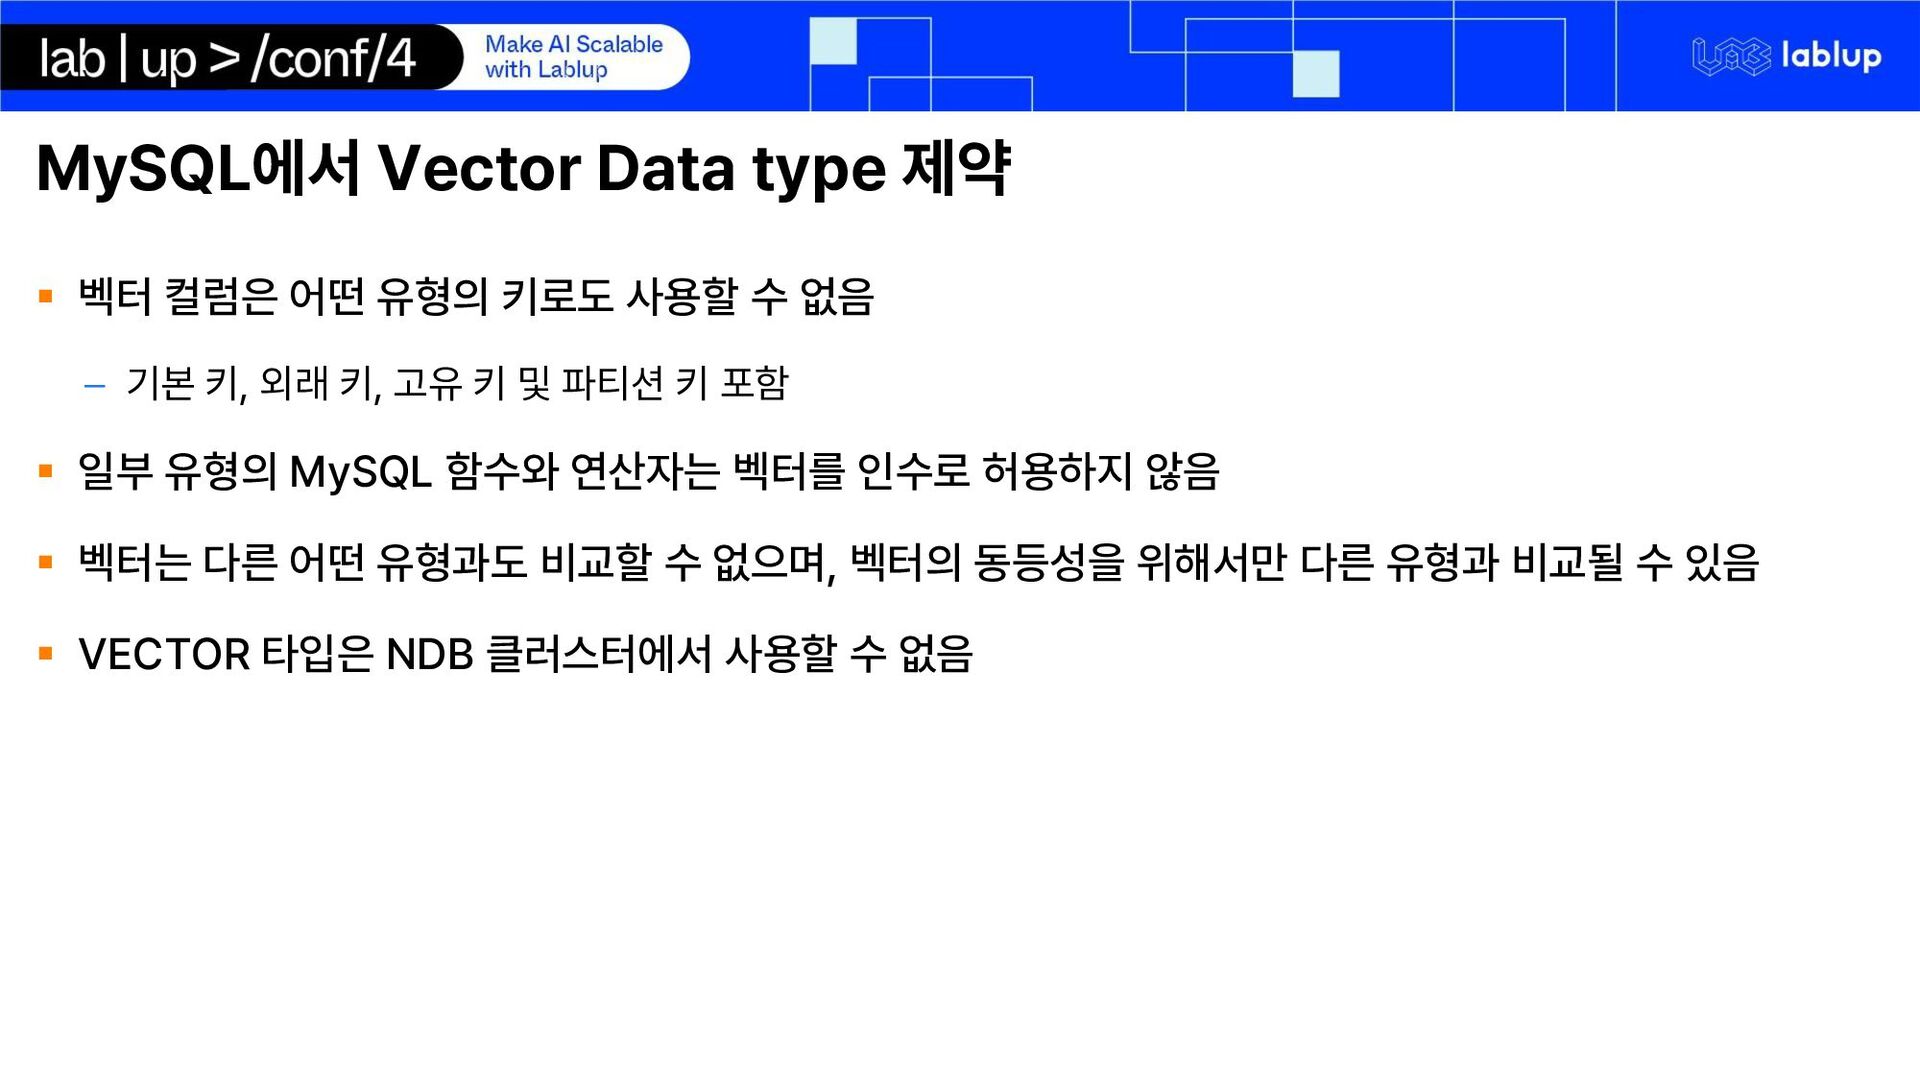
MySQL에서 Vector Data type 제약 벡터 컬럼은 어떤 유형의
키로도 사용할 수 없음 – 기본 키, 외래 키, 고유 키 및 파티션 키 포함 일부 유형의 MySQL 함수와 연산자는 벡터를 인수로 허용하지 않음 벡터는 다른 어떤 유형과도 비교할 수 없으며, 벡터의 동등성을 위해서만 다른 유형과 비교될 수 있음 VECTOR 타입은 NDB 클러스터에서 사용할 수 없음 -
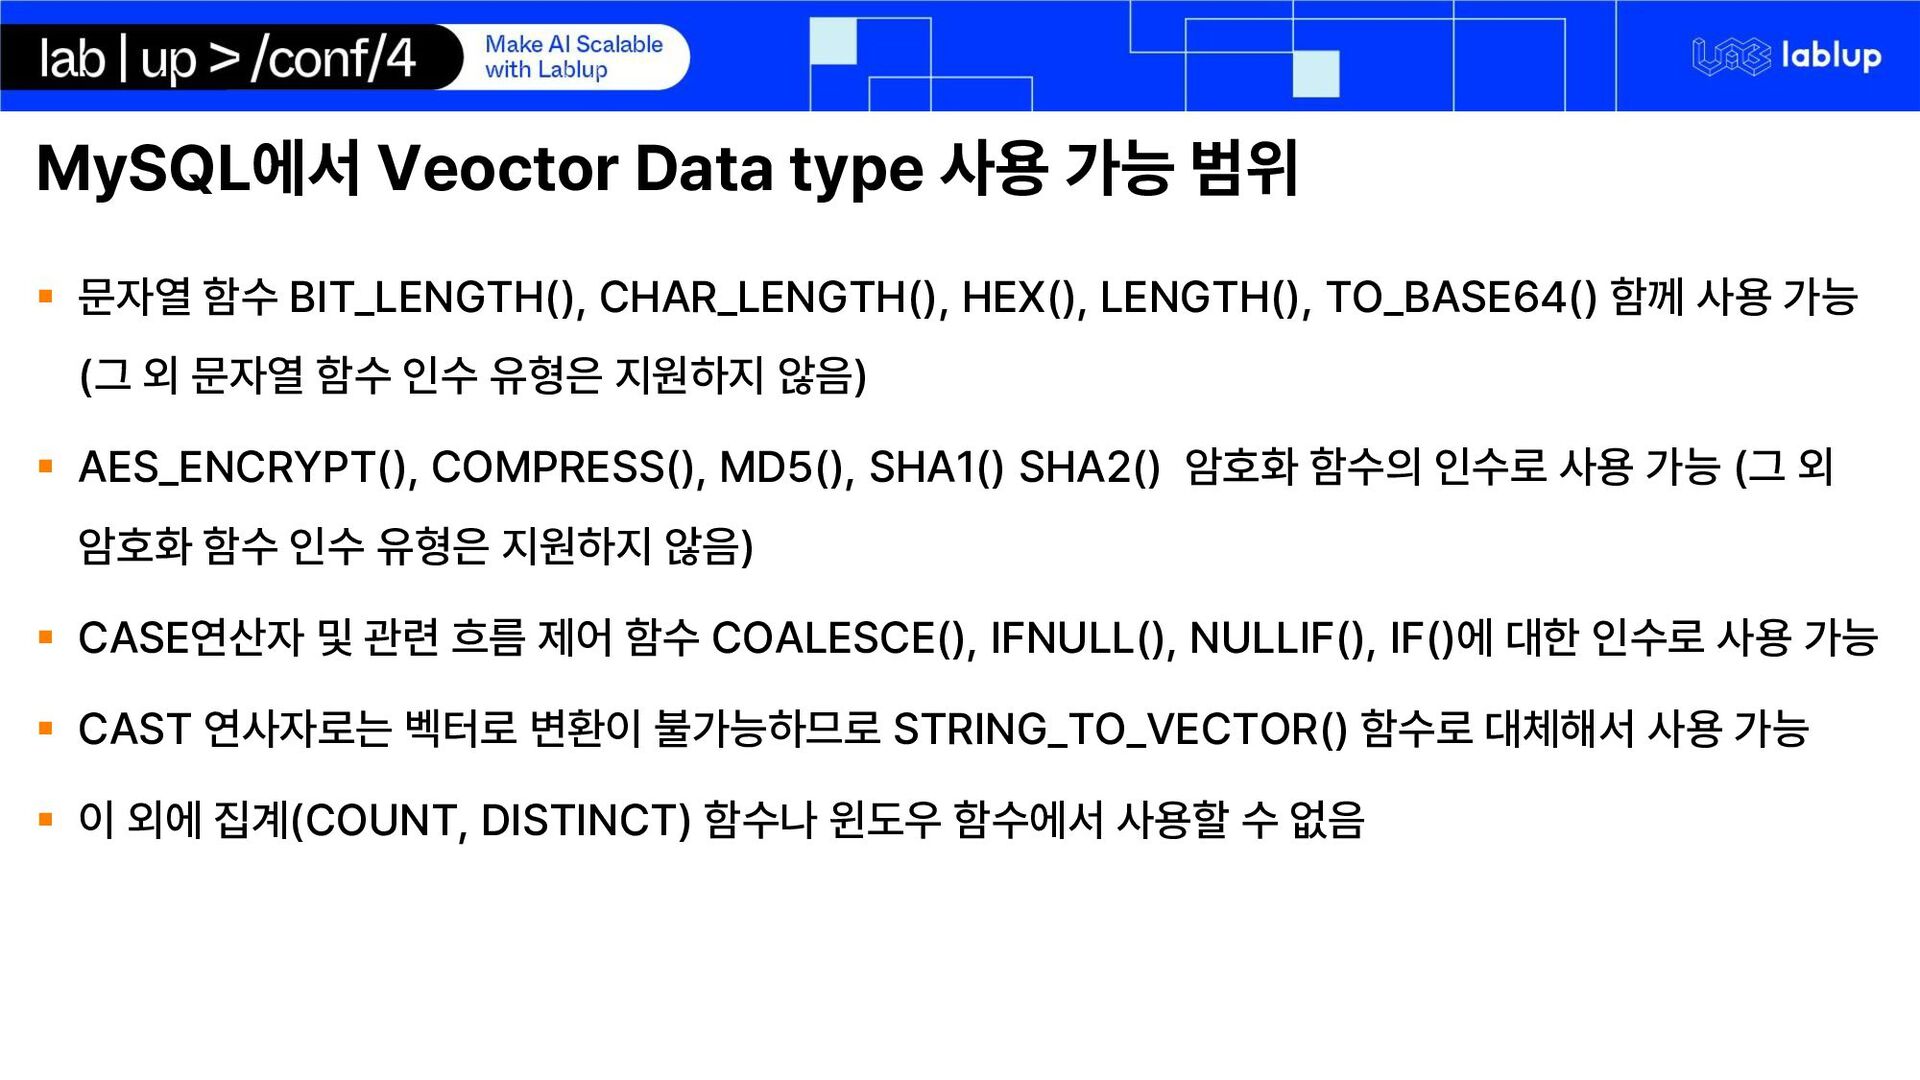
MySQL에서 Veoctor Data type 사용 가능 범위 문자열 함수
BIT_LENGTH(), CHAR_LENGTH(), HEX(), LENGTH(), TO_BASE64() 함께 사용 가능 (그 외 문자열 함수 인수 유형은 지원하지 않음) AES_ENCRYPT(), COMPRESS(), MD5(), SHA1() SHA2() 암호화 함수의 인수로 사용 가능 (그 외 암호화 함수 인수 유형은 지원하지 않음) CASE연산자 및 관련 흐름 제어 함수 COALESCE(), IFNULL(), NULLIF(), IF()에 대한 인수로 사용 가능 CAST 연사자로는 벡터로 변환이 불가능하므로 STRING_TO_VECTOR() 함수로 대체해서 사용 가능 이 외에 집계(COUNT, DISTINCT) 함수나 윈도우 함수에서 사용할 수 없음 -
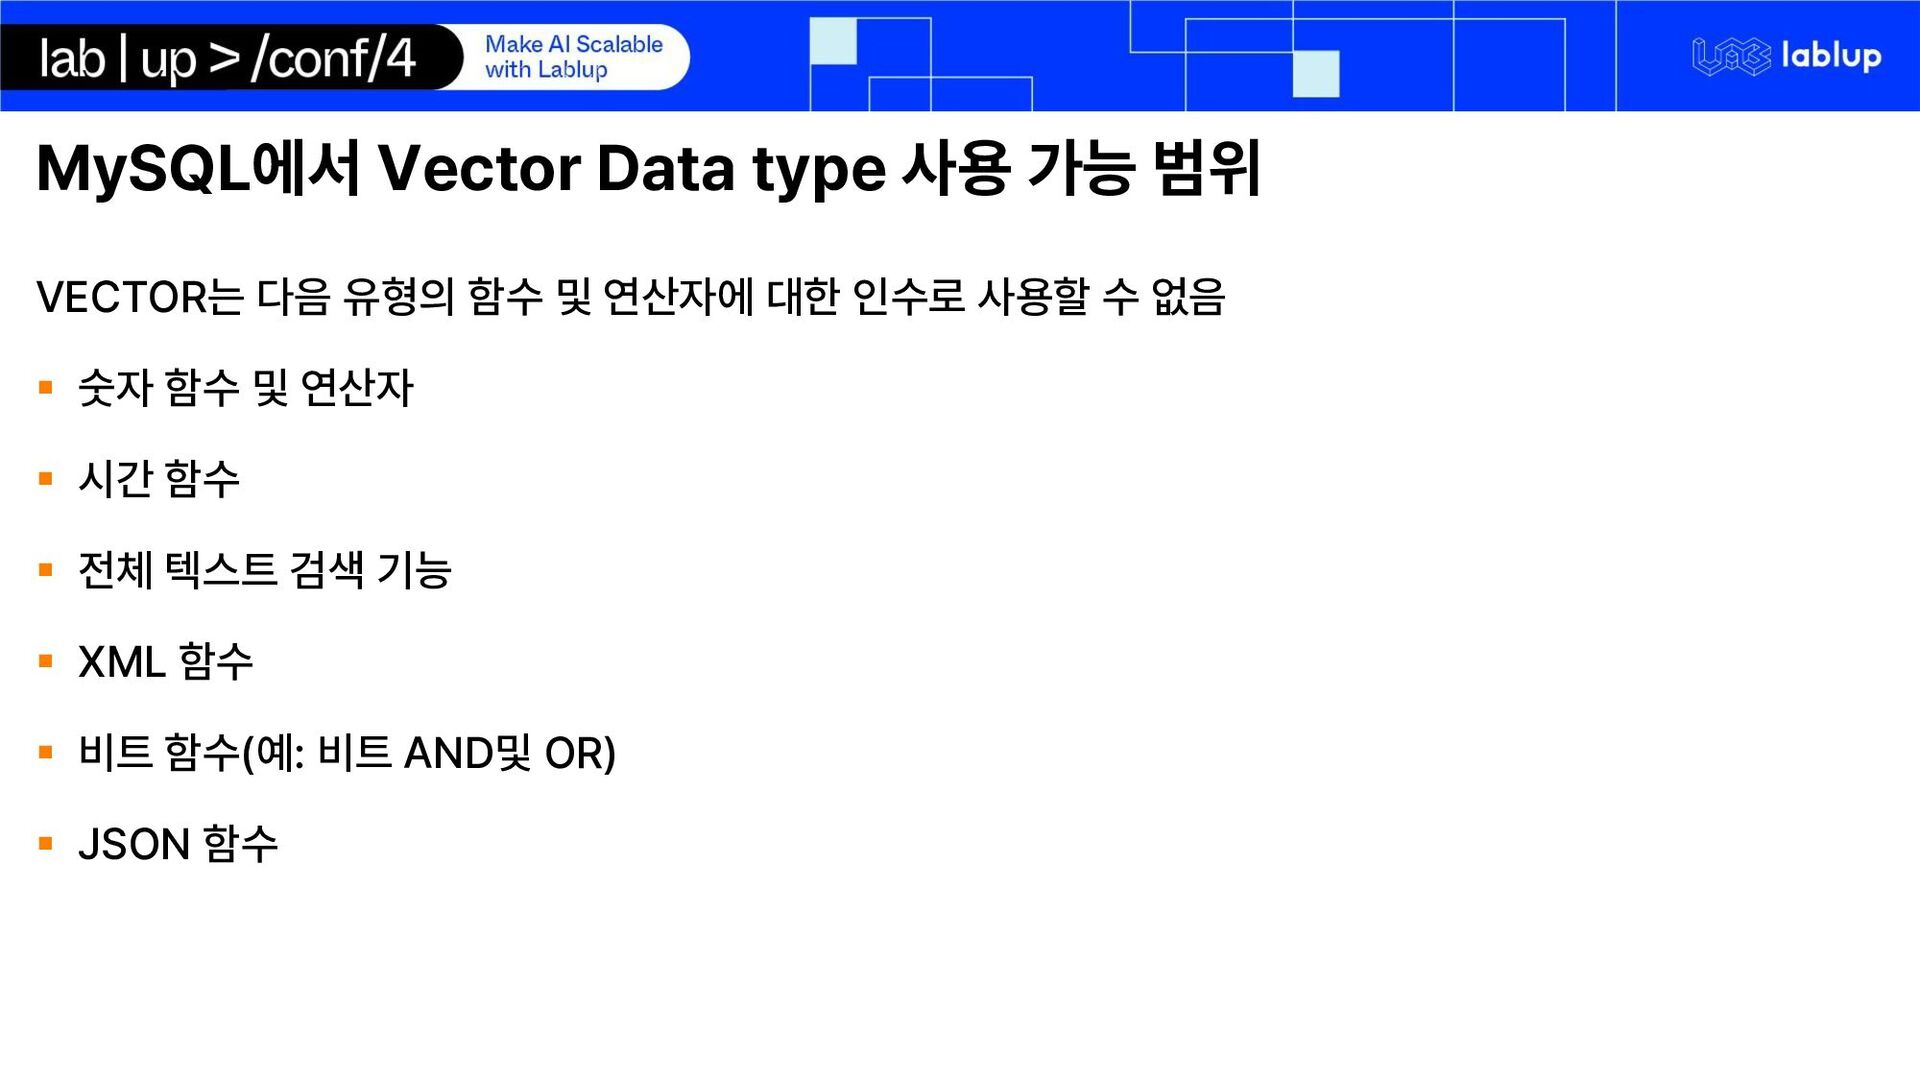
MySQL에서 Vector Data type 사용 가능 범위 VECTOR는 다음 유형의
함수 및 연산자에 대한 인수로 사용할 수 없음 숫자 함수 및 연산자 시간 함수 전체 텍스트 검색 기능 XML 함수 비트 함수(예: 비트 AND및 OR) JSON 함수 -
SQL Server 벡터 SQL 데이터베이스에 벡터를 저장하는 데 사용할
수 있는 특정 데이터 유형은 없음 벡터는 컬럼스토어 인덱스를 통해 SQL 데이터베이스에 효율적으로 저장 벡터 데이터를 포함하는 열을 만들어 테이블에 벡터를 매우 쉽게 저장 벡터 요소당 한 행씩 저장. 그런 다음 컬럼스토어 인덱스를 사용하여 벡터를 효율적으로 저장하고 검색 열 저장소의 내부 최적화( SIMD AVX-512 명령어를 사용하여 벡터 연산을 가속화) 덕분에 거리 계산이 매우 빠름 가장 일반적인 거리는 코사인 유사도인데, 제공하는 SQL 함수를 사용하여 쉽게 계산 -
SQL Server에서 코사인 유사도 계산 코사인 유사도는 두 벡터
a 와 b 가 주어졌을 때 다음 공식을 사용하여 SQL에서 계산 SELECT SUM(a.value * b.value) / (SQRT(SUM(a.value * a.value)) * SQRT(SUM(b.value * b.value))) FROM vectors_values -
참고 자료 https://blogs.oracle.com/mysql/post/mysql-vector-datatype-create-your-operations- part-1 https://blogs.oracle.com/mysql/post/mysql-vector-datatype-create-your-operations- part-2 https://dev.mysql.com/doc/refman/9.0/en/vector.html
https://dev.mysql.com/doc/refman/9.0/en/vector-functions.html https://devblogs.microsoft.com/azure-sql/vector-similarity-search-with-azure-sql- database-and-openai/ https://github.com/pgvector/pgvector