Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Qwen3 Technical Reportを読む
Search
Mizuki Baba
May 20, 2026
Research
10
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Qwen3 Technical Reportを読む
Qwen3のTechnical ReportをClaudeといっしょにSlideにまとめたものになります。
Mizuki Baba
May 20, 2026
Other Decks in Research
See All in Research
L’albédo:levier d’atténuation du changement climatique dans les systèmes fourragers
institutdelelevage
PRO
0
140
Pesée et pointage par imagerie 3D : PHENO3D entre en phase de test terrains
institutdelelevage
PRO
0
110
Hitting the buffers
beale
0
280
山中市政が招いた組織崩壊:よこはま安心ボックスを例に
sishi
0
350
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
710
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
340
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
120
全国町字単位空き家率推定データver1.0データ仕様
microbaseinc
0
290
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
840
Prithvi-EO-2.0
satai
3
100
モデル評価を効率的にする方法
ftakahashi
0
220
山中市政の総括:相反する二つの顔
sishi
0
220
Featured
See All Featured
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
990
ラッコキーワード サービス紹介資料
rakko
1
5.3M
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
820
We Are The Robots
honzajavorek
0
400
Building an army of robots
kneath
307
47k
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Save Time (by Creating Custom Rails Generators)
garrettdimon
PRO
33
5.2k
Navigating Weather and Climate Data
rabernat
0
560
30 Presentation Tips
portentint
PRO
1
430
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.5k
Transcript
Qwen3 Technical Report を読む Qwen3 Technical Report を読む 1 /
80
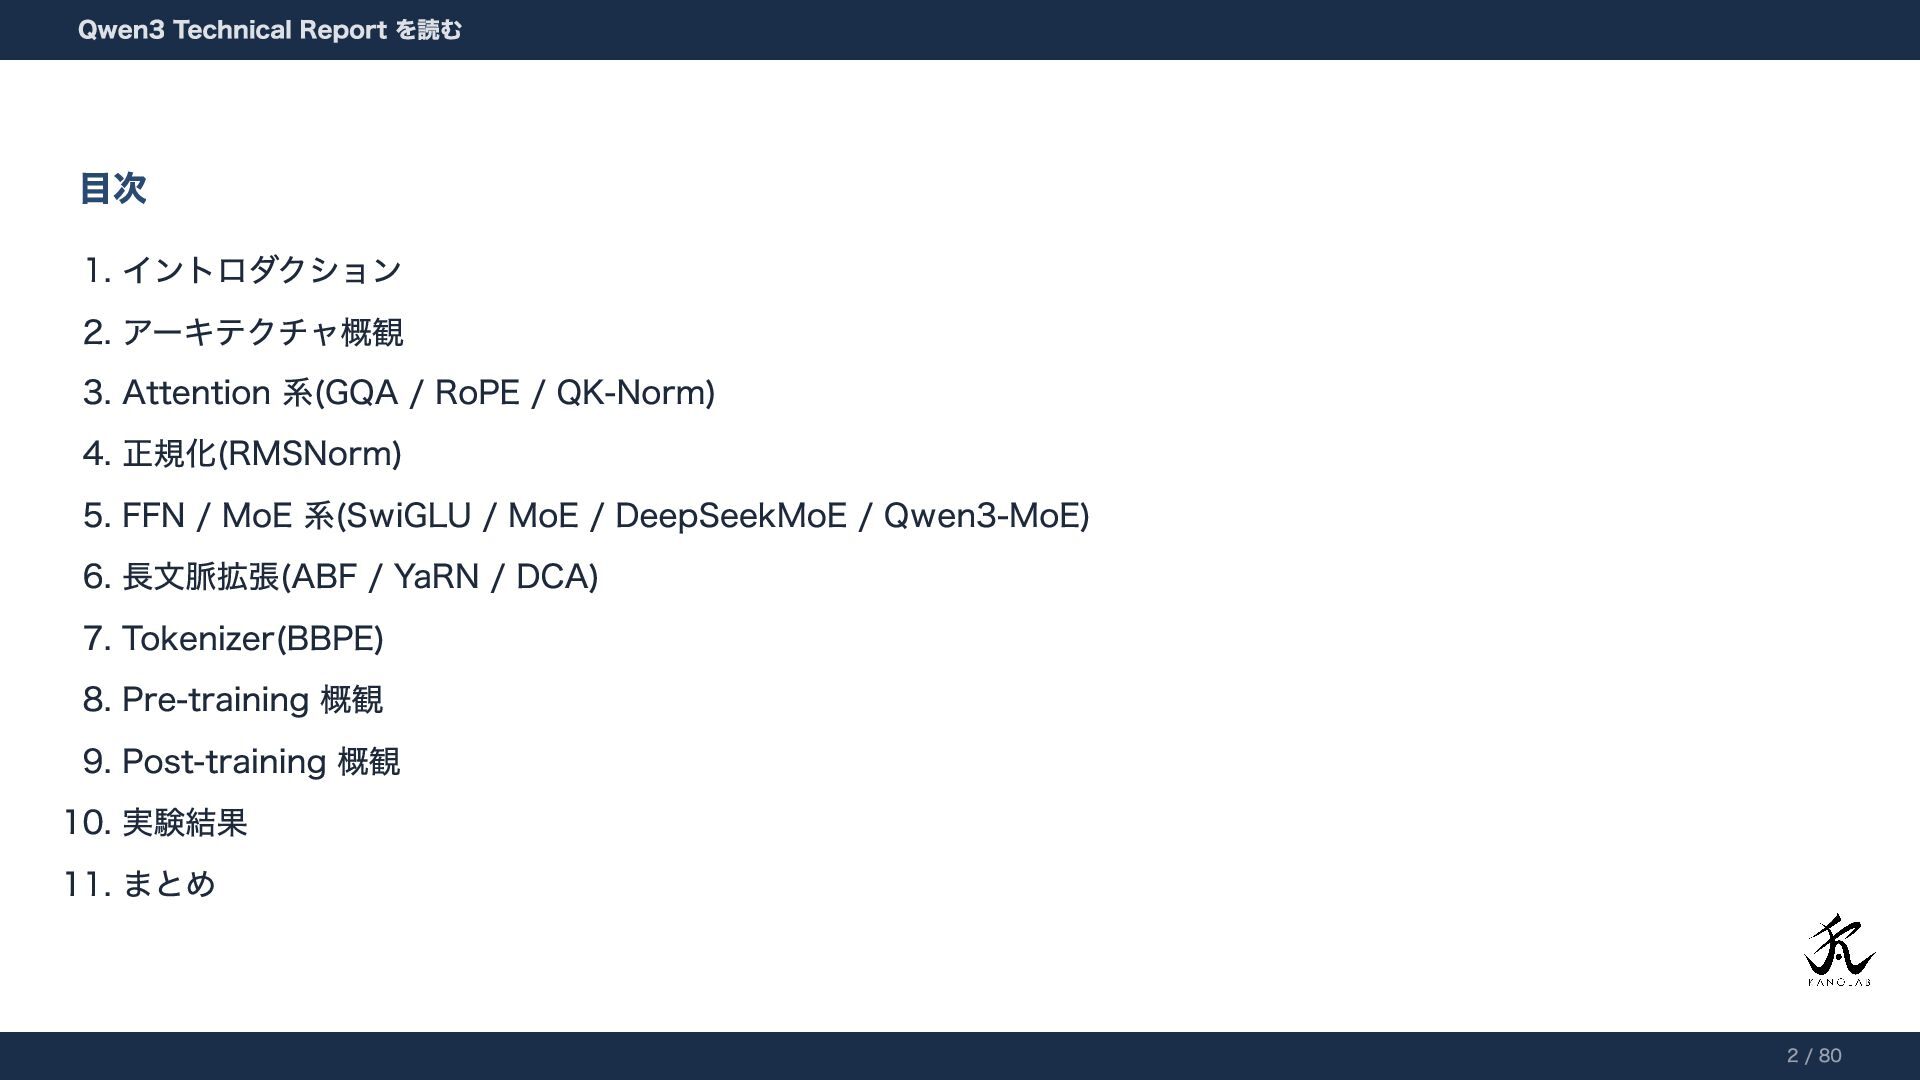
目次 1. イントロダクション 2. アーキテクチャ概観 3. Attention 系(GQA / RoPE
/ QK-Norm) 4. 正規化(RMSNorm) 5. FFN / MoE 系(SwiGLU / MoE / DeepSeekMoE / Qwen3-MoE) 6. 長文脈拡張(ABF / YaRN / DCA) 7. Tokenizer(BBPE) 8. Pre-training 概観 9. Post-training 概観 10. 実験結果 11. まとめ Qwen3 Technical Report を読む 2 / 80
1. イントロダクション Qwen3 Technical Report を読む 3 / 80
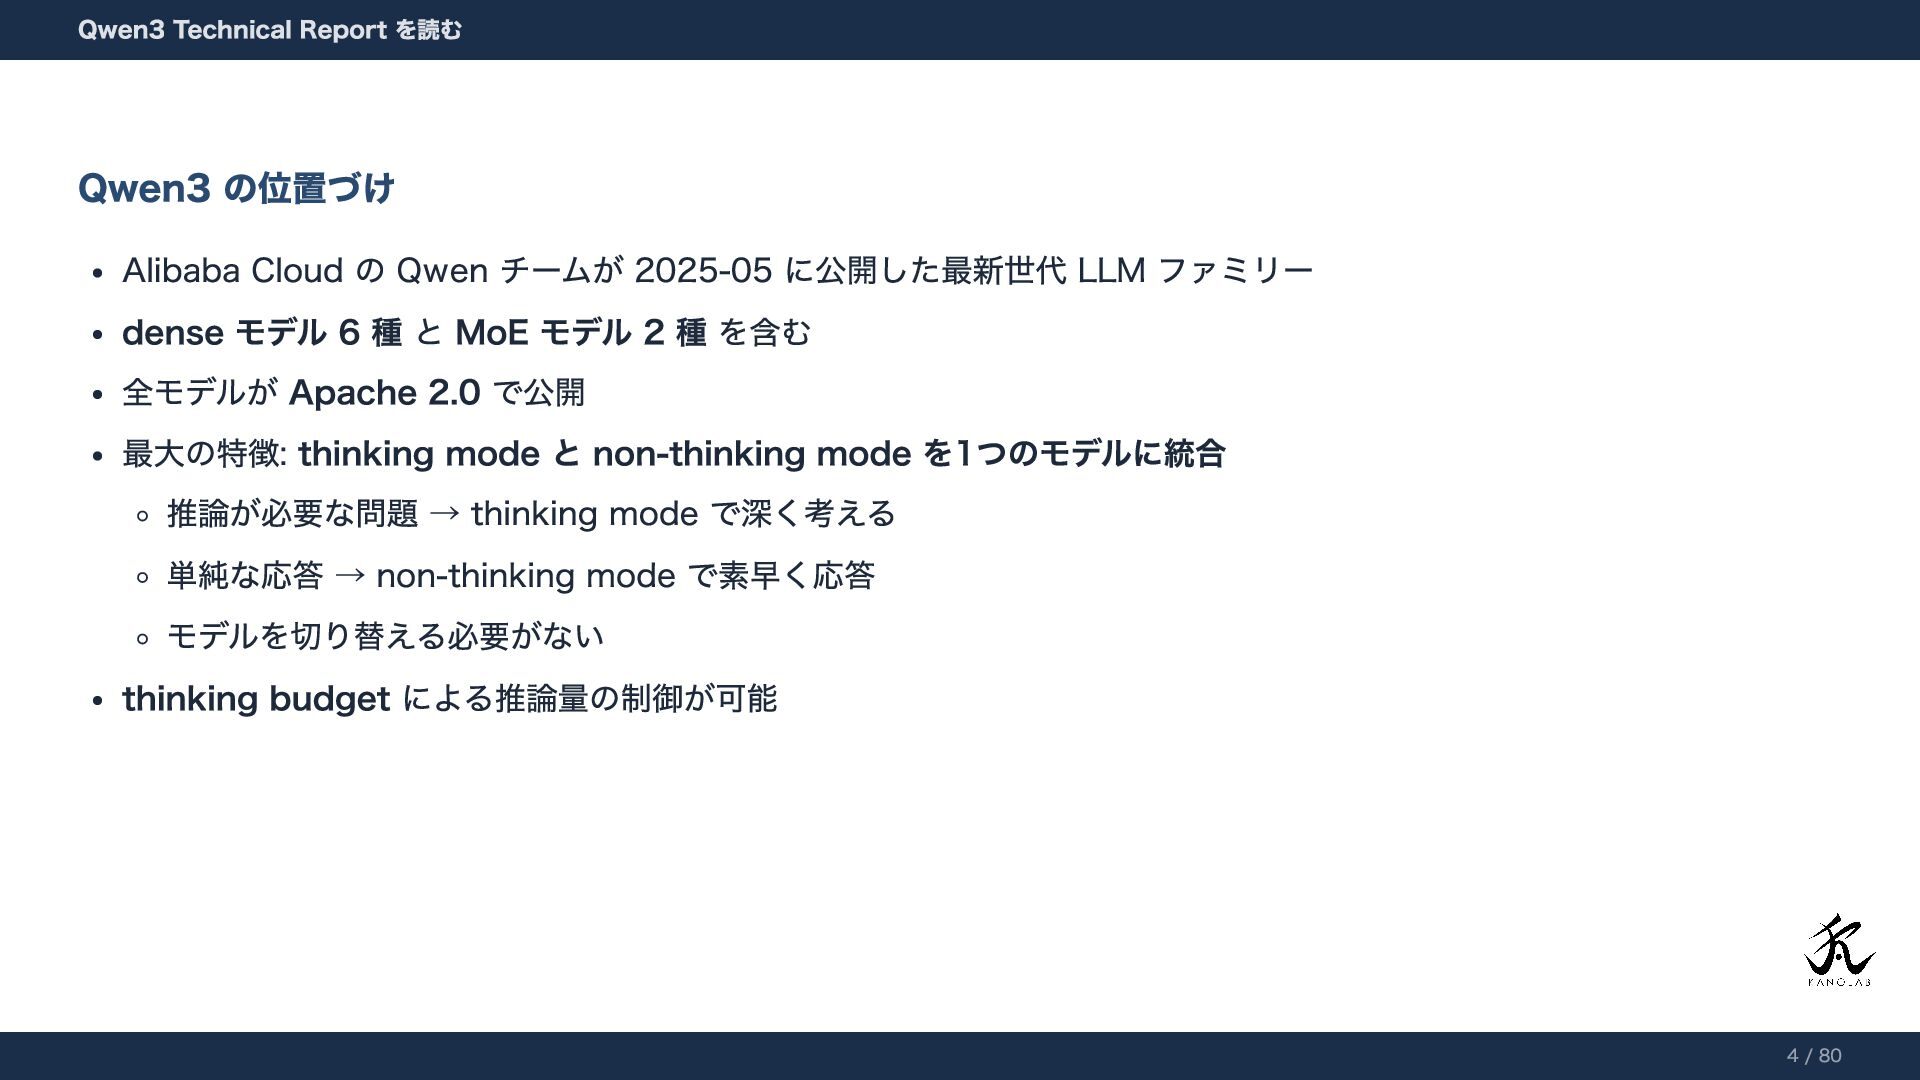
Qwen3 の位置づけ Alibaba Cloud の Qwen チームが 2025-05 に公開した最新世代 LLM
ファミリー dense モデル 6 種 と MoE モデル 2 種 を含む 全モデルが Apache 2.0 で公開 最大の特徴: thinking mode と non-thinking mode を1つのモデルに統合 推論が必要な問題 → thinking mode で深く考える 単純な応答 → non-thinking mode で素早く応答 モデルを切り替える必要がない thinking budget による推論量の制御が可能 Qwen3 Technical Report を読む 4 / 80
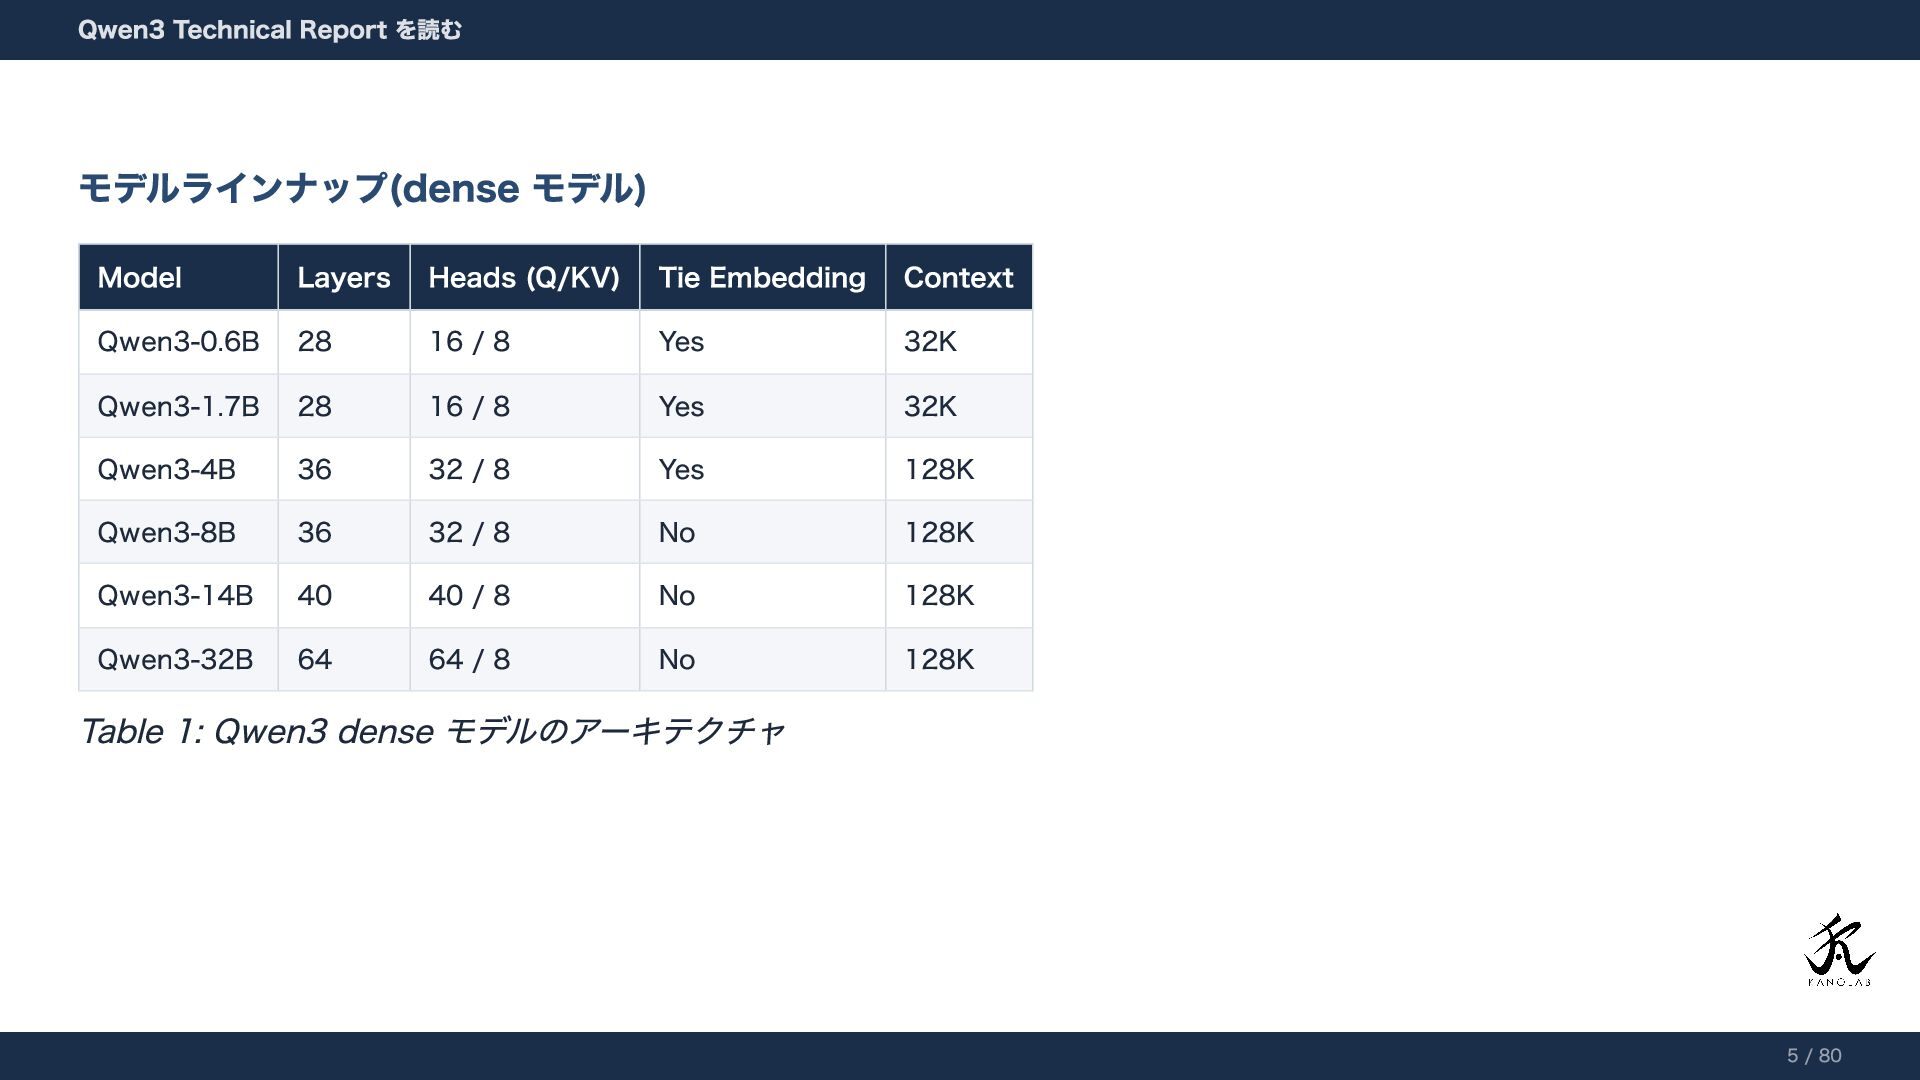
モデルラインナップ(dense モデル) Model Layers Heads (Q/KV) Tie Embedding Context Qwen3-0.6B
28 16 / 8 Yes 32K Qwen3-1.7B 28 16 / 8 Yes 32K Qwen3-4B 36 32 / 8 Yes 128K Qwen3-8B 36 32 / 8 No 128K Qwen3-14B 40 40 / 8 No 128K Qwen3-32B 64 64 / 8 No 128K Table 1: Qwen3 dense モデルのアーキテクチャ Qwen3 Technical Report を読む 5 / 80
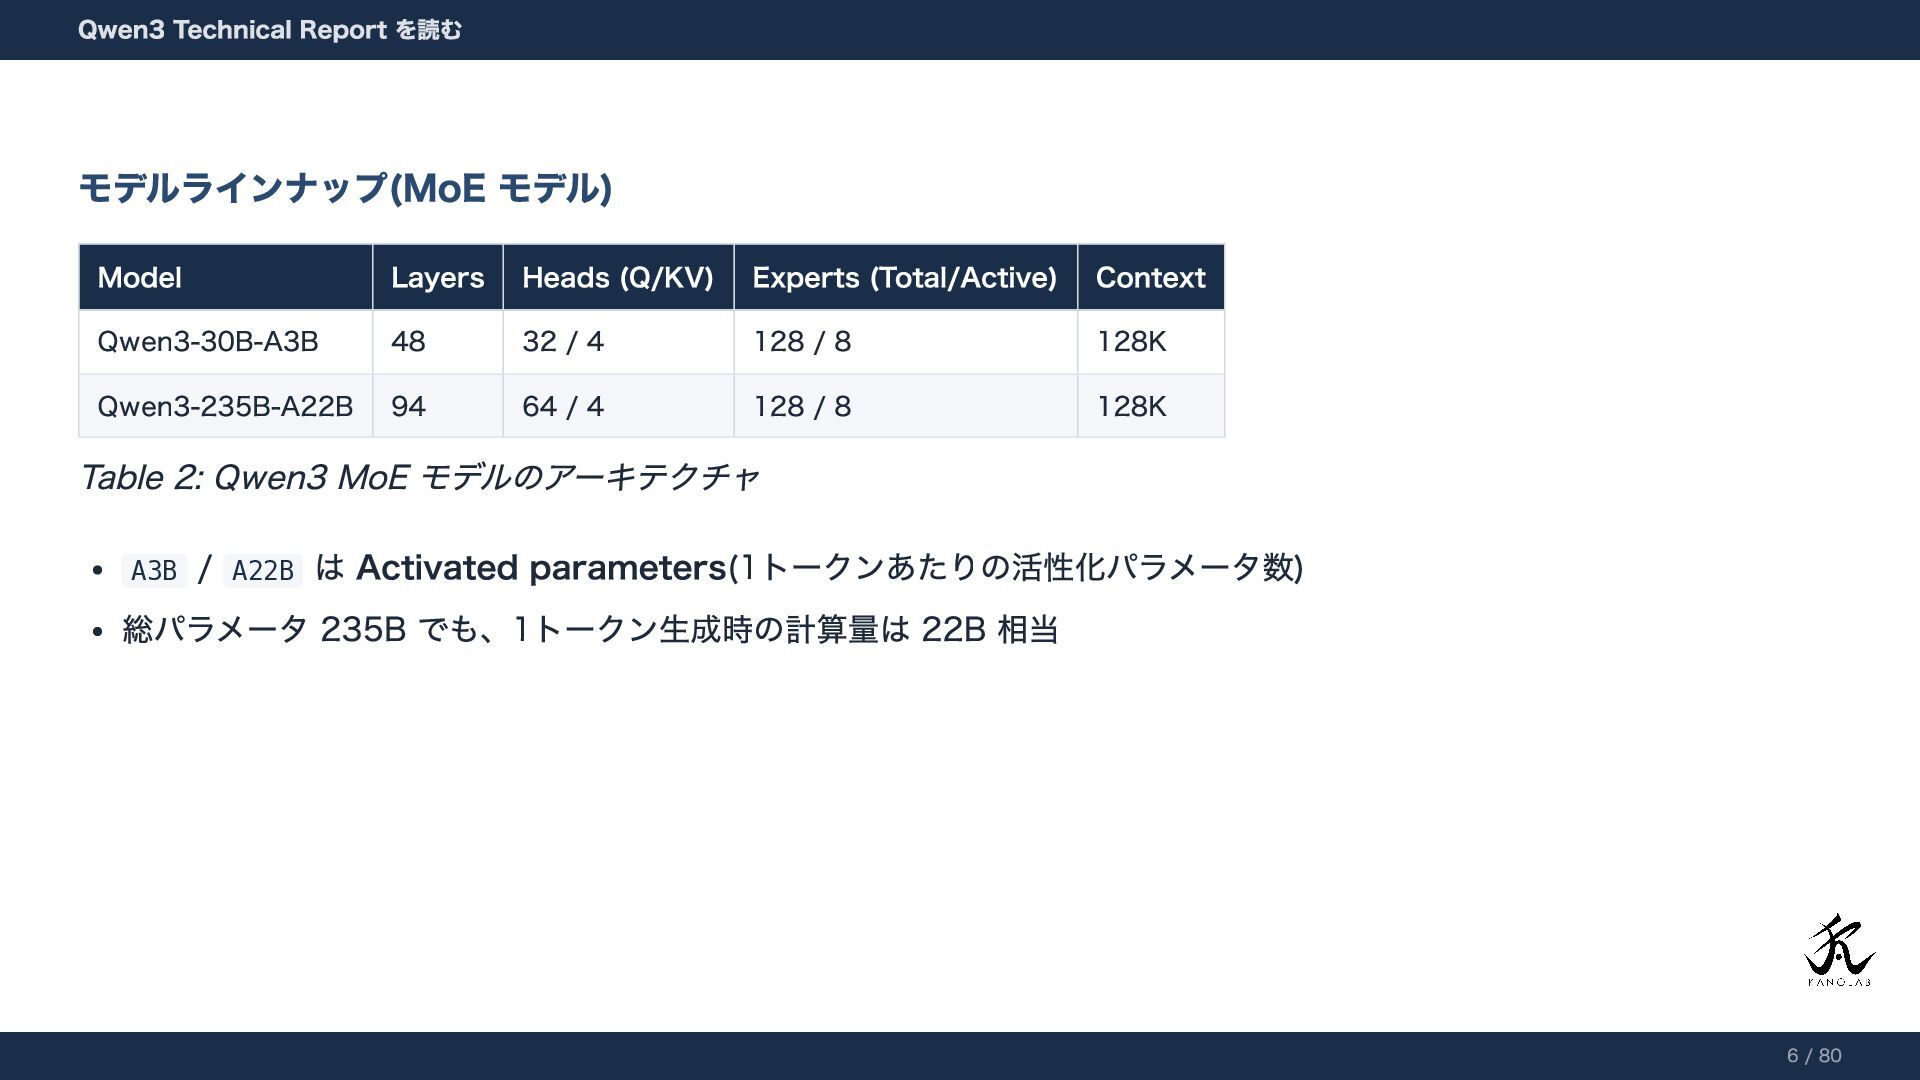
モデルラインナップ(MoE モデル) Model Layers Heads (Q/KV) Experts (Total/Active) Context Qwen3-30B-A3B
48 32 / 4 128 / 8 128K Qwen3-235B-A22B 94 64 / 4 128 / 8 128K Table 2: Qwen3 MoE モデルのアーキテクチャ A3B / A22B は Activated parameters(1トークンあたりの活性化パラメータ数) 総パラメータ 235B でも、1トークン生成時の計算量は 22B 相当 Qwen3 Technical Report を読む 6 / 80
2. アーキテクチャ概観 Qwen3 Technical Report を読む 7 / 80
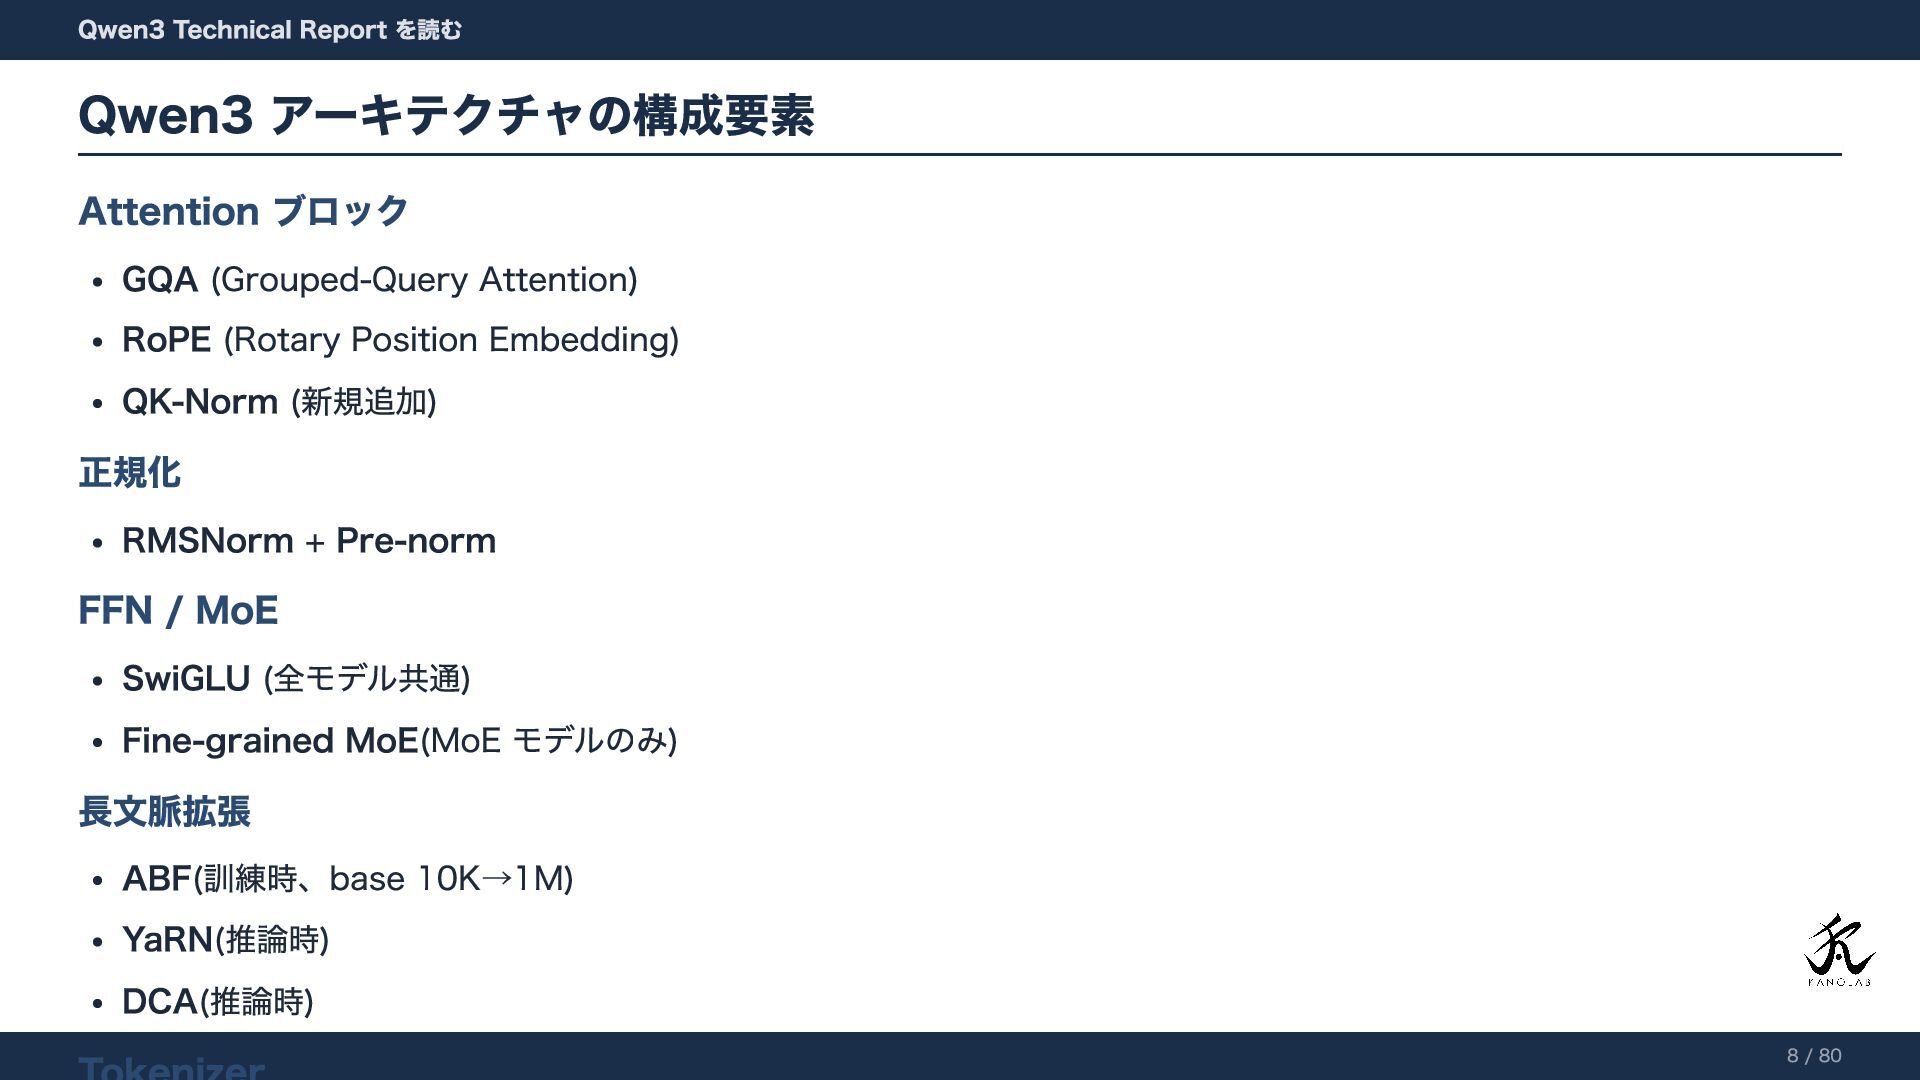
Attention ブロック GQA (Grouped-Query Attention) RoPE (Rotary Position Embedding) QK-Norm
(新規追加) 正規化 RMSNorm + Pre-norm FFN / MoE SwiGLU (全モデル共通) Fine-grained MoE(MoE モデルのみ) 長文脈拡張 ABF(訓練時、base 10K→1M) YaRN(推論時) DCA(推論時) Qwen3 Technical Report を読む Qwen3 アーキテクチャの構成要素 8 / 80
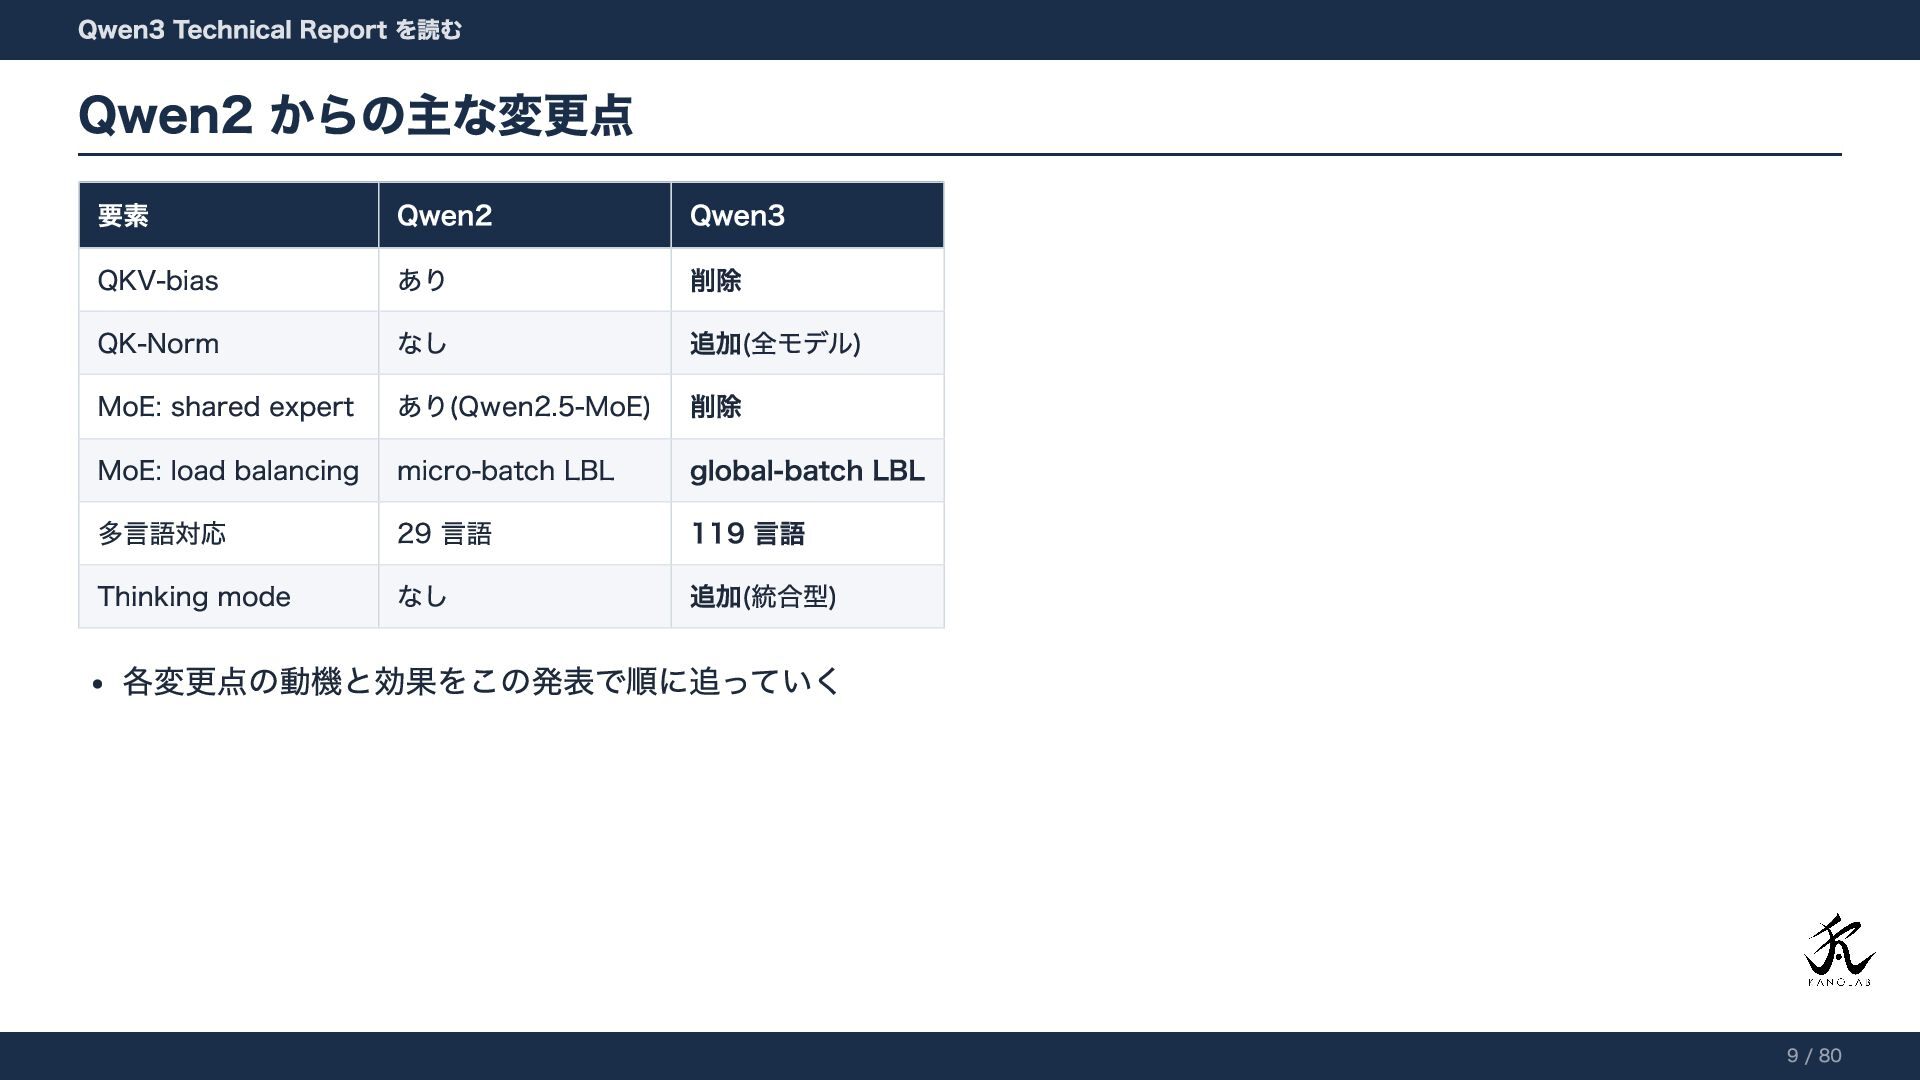
要素 Qwen2 Qwen3 QKV-bias あり 削除 QK-Norm なし 追加(全モデル) MoE:
shared expert あり(Qwen2.5-MoE) 削除 MoE: load balancing micro-batch LBL global-batch LBL 多言語対応 29 言語 119 言語 Thinking mode なし 追加(統合型) 各変更点の動機と効果をこの発表で順に追っていく Qwen3 Technical Report を読む Qwen2 からの主な変更点 9 / 80
3. Attention 系 Qwen3 Technical Report を読む 10 / 80
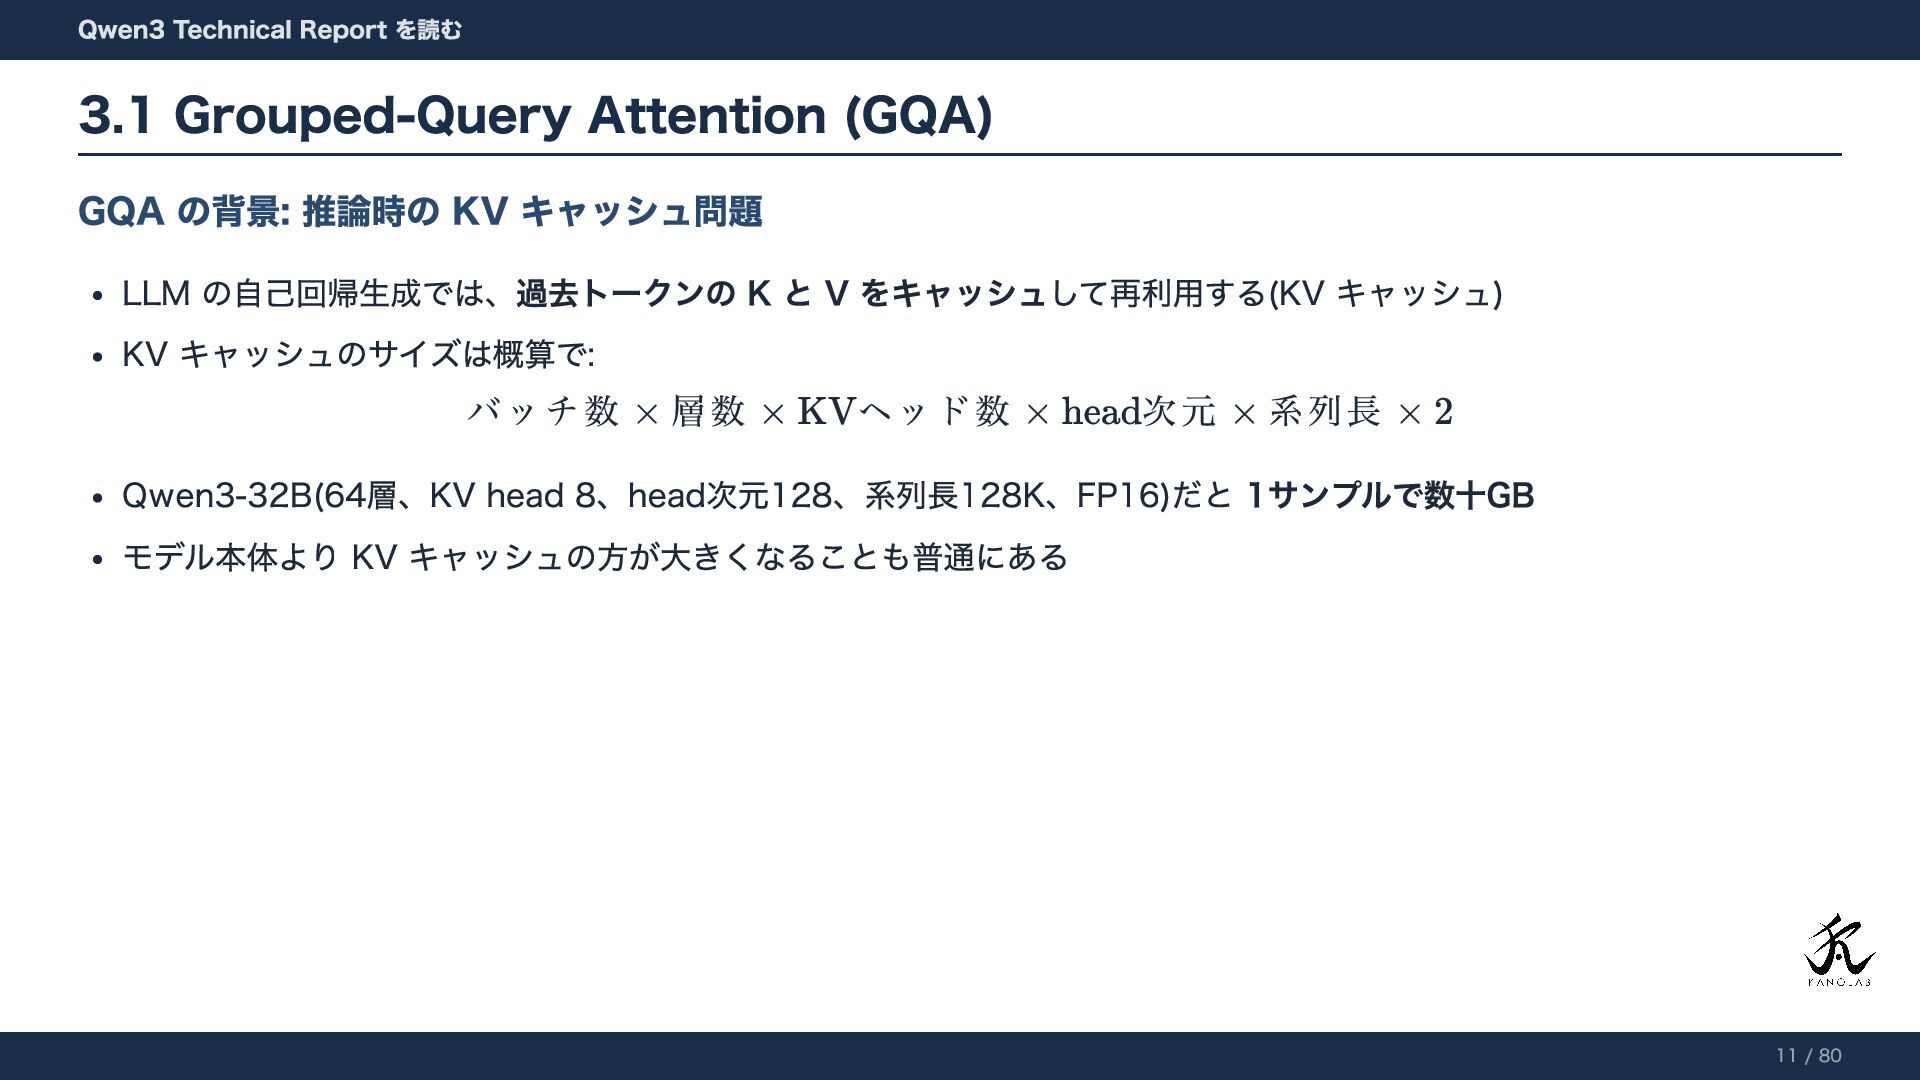
GQA の背景: 推論時の KV キャッシュ問題 LLM の自己回帰生成では、過去トークンの K と V
をキャッシュして再利用する(KV キャッシュ) KV キャッシュのサイズは概算で: バッチ数 層数 ヘッド数 次元 系列長 Qwen3-32B(64層、KV head 8、head次元128、系列長128K、FP16)だと 1サンプルで数十GB モデル本体より KV キャッシュの方が大きくなることも普通にある Qwen3 Technical Report を読む 3.1 Grouped-Query Attention (GQA) 11 / 80
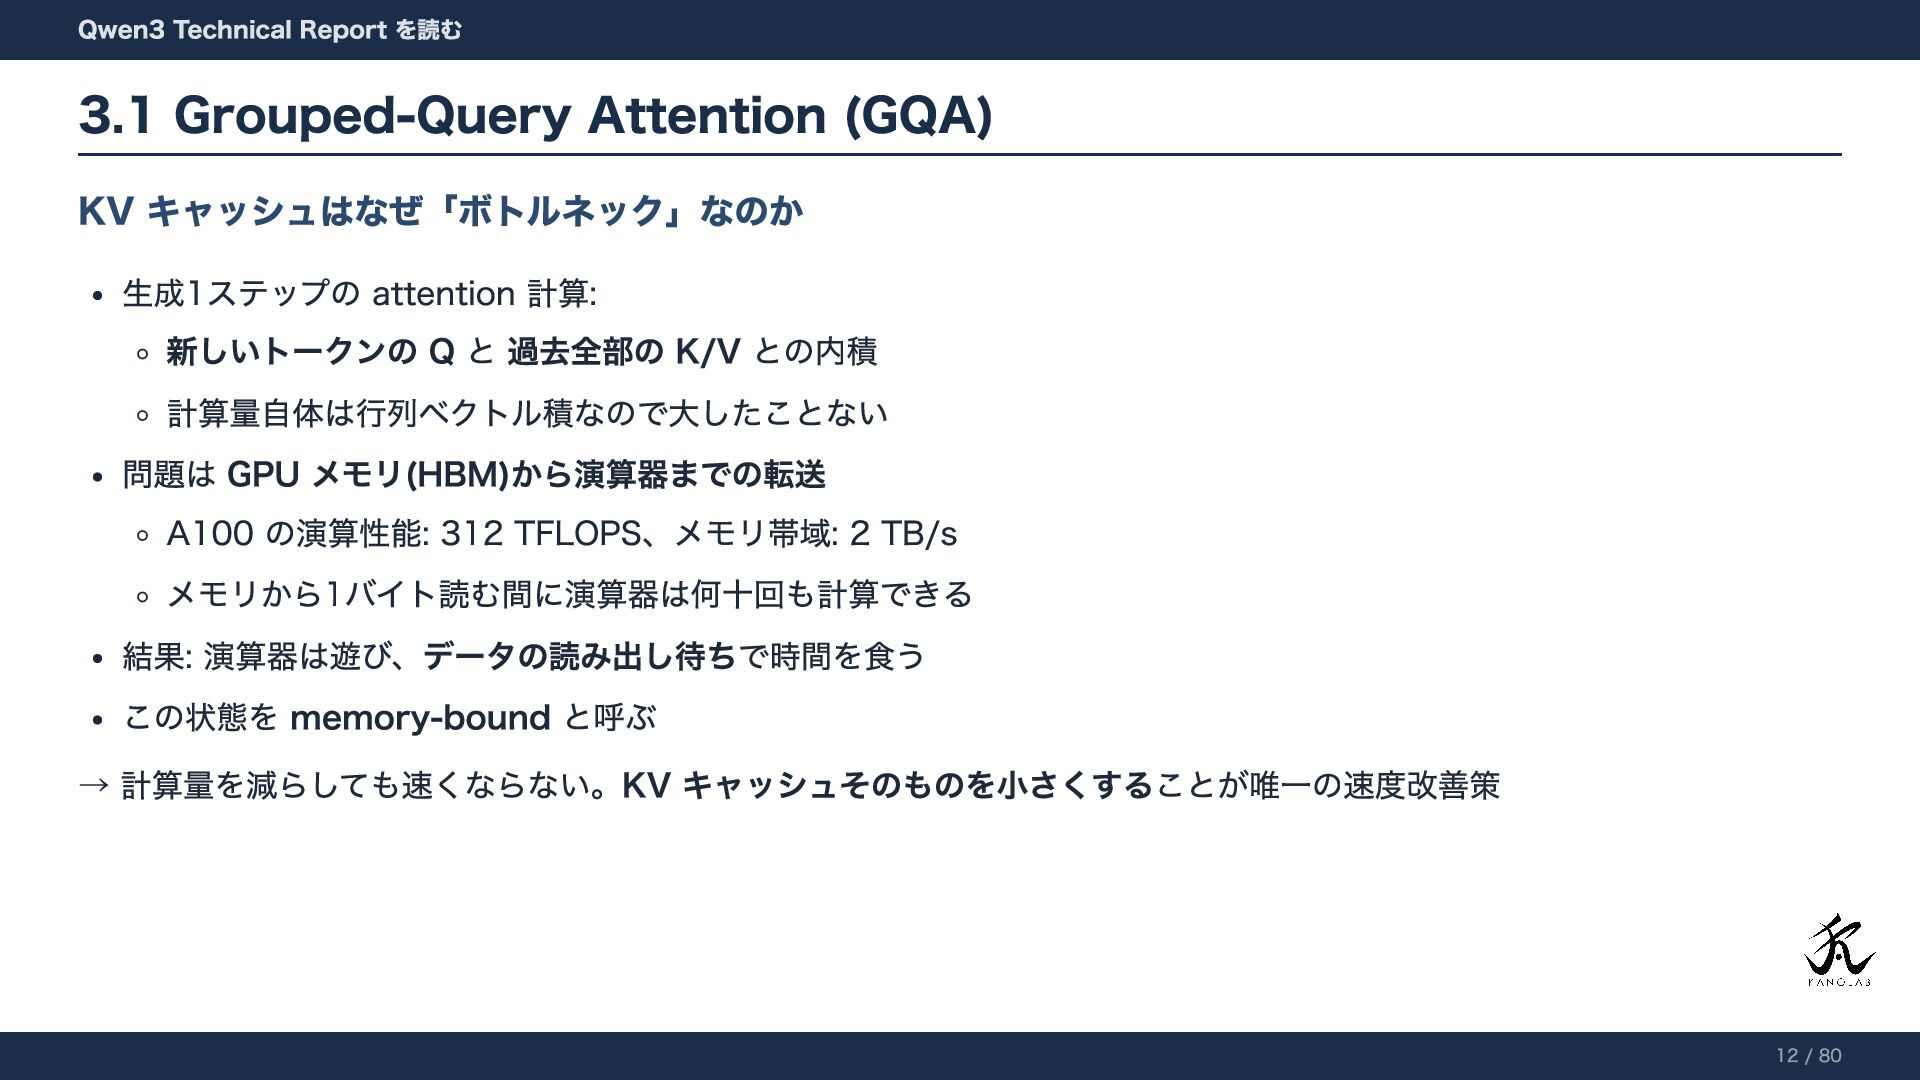
KV キャッシュはなぜ「ボトルネック」なのか 生成1ステップの attention 計算: 新しいトークンの Q と 過去全部の K/V
との内積 計算量自体は行列ベクトル積なので大したことない 問題は GPU メモリ(HBM)から演算器までの転送 A100 の演算性能: 312 TFLOPS、メモリ帯域: 2 TB/s メモリから1バイト読む間に演算器は何十回も計算できる 結果: 演算器は遊び、データの読み出し待ちで時間を食う この状態を memory-bound と呼ぶ → 計算量を減らしても速くならない。KV キャッシュそのものを小さくすることが唯一の速度改善策 Qwen3 Technical Report を読む 3.1 Grouped-Query Attention (GQA) 12 / 80
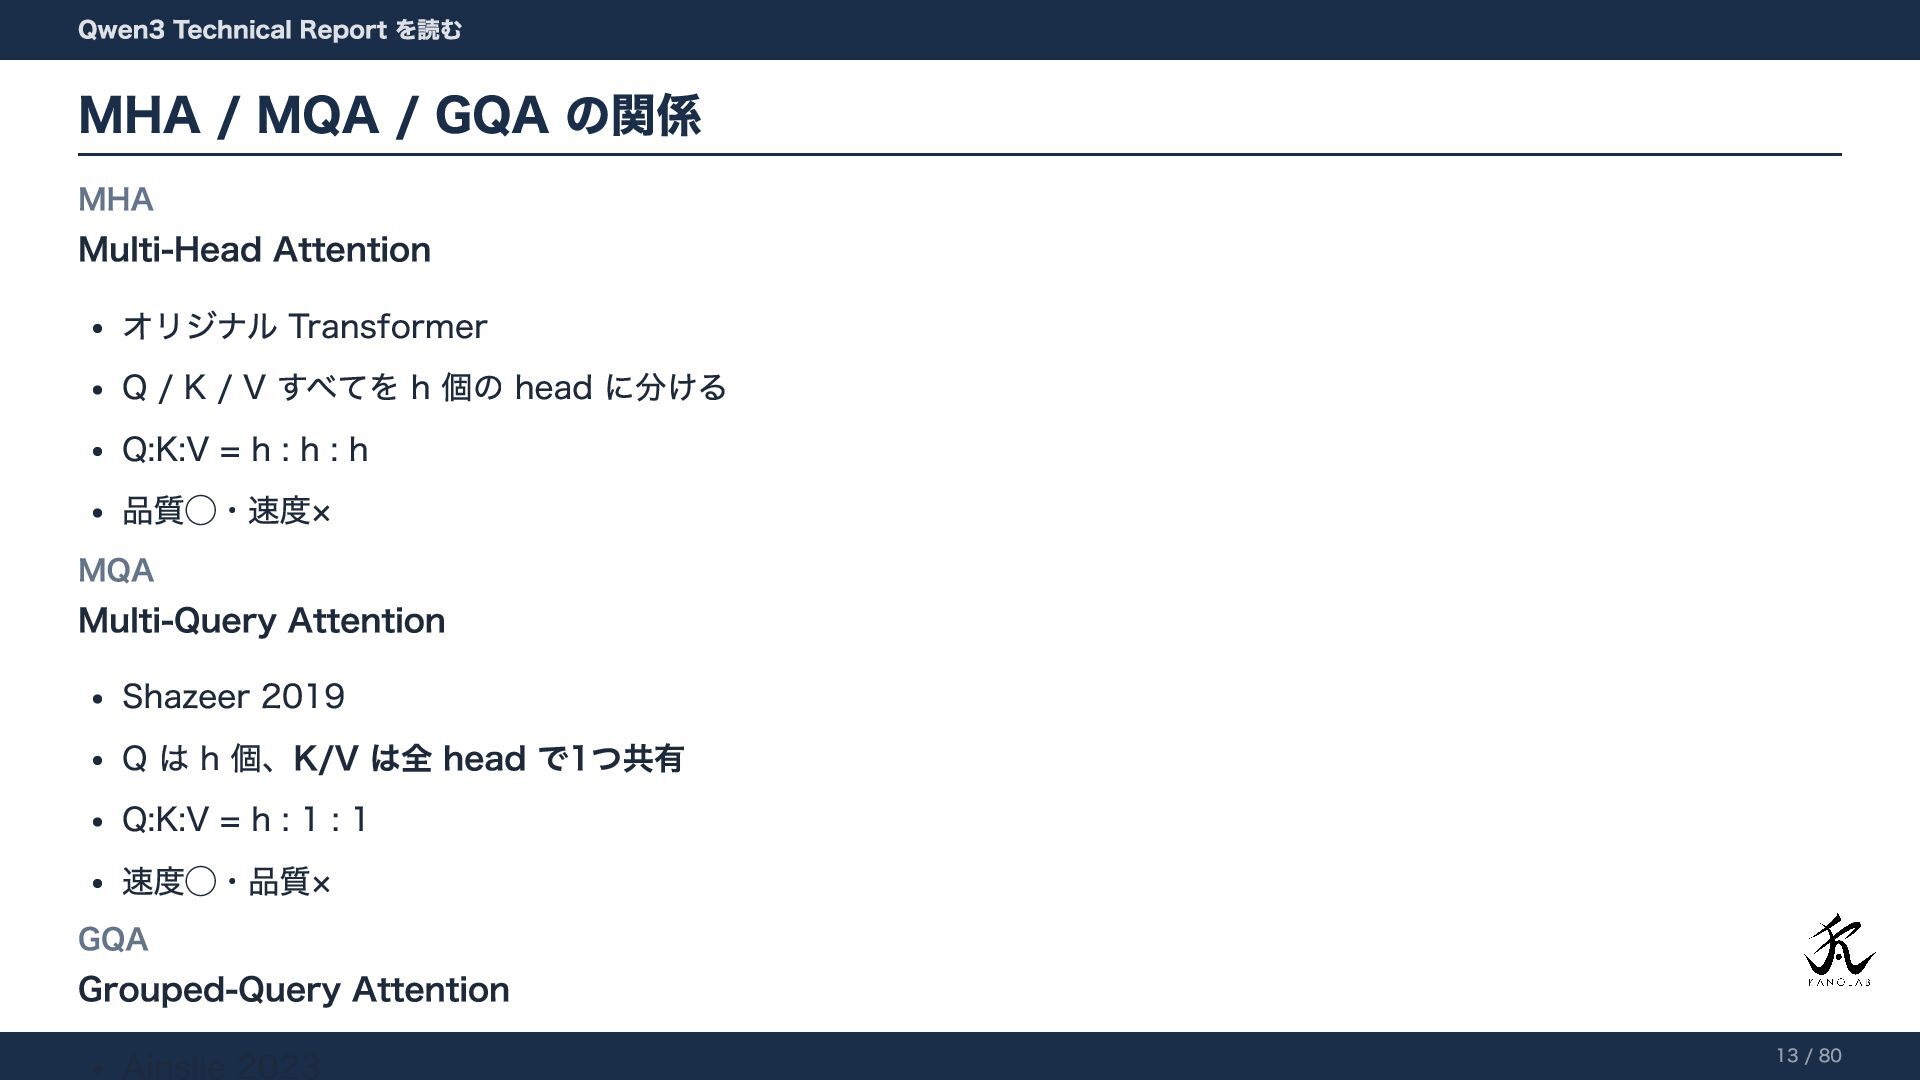
MHA Multi-Head Attention オリジナル Transformer Q / K / V
すべてを h 個の head に分ける Q:K:V = h : h : h 品質◯・速度× MQA Multi-Query Attention Shazeer 2019 Q は h 個、K/V は全 head で1つ共有 Q:K:V = h : 1 : 1 速度◯・品質× GQA Grouped-Query Attention Ainslie 2023 Qwen3 Technical Report を読む MHA / MQA / GQA の関係 13 / 80
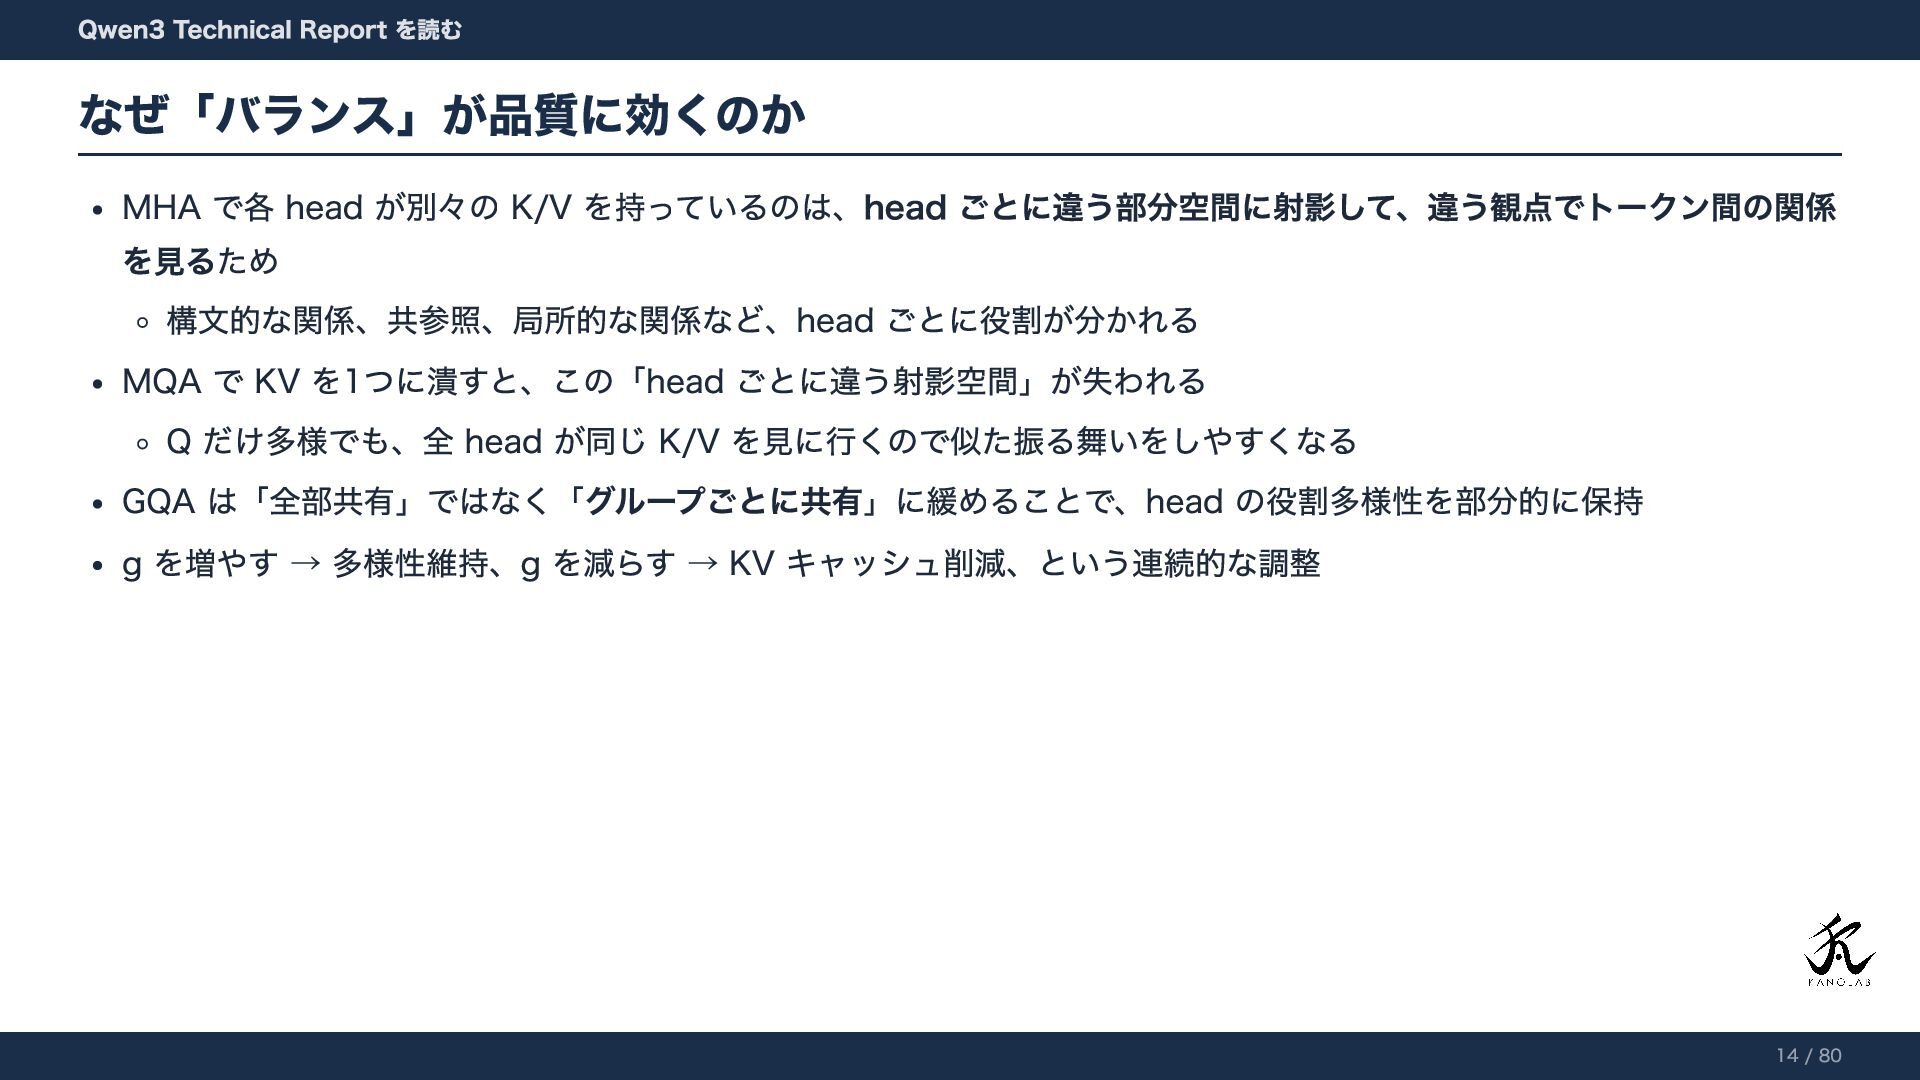
MHA で各 head が別々の K/V を持っているのは、head ごとに違う部分空間に射影して、違う観点でトークン間の関係 を見るため 構文的な関係、共参照、局所的な関係など、head ごとに役割が分かれる
MQA で KV を1つに潰すと、この「head ごとに違う射影空間」が失われる Q だけ多様でも、全 head が同じ K/V を見に行くので似た振る舞いをしやすくなる GQA は「全部共有」ではなく「グループごとに共有」に緩めることで、head の役割多様性を部分的に保持 g を増やす → 多様性維持、g を減らす → KV キャッシュ削減、という連続的な調整 Qwen3 Technical Report を読む なぜ「バランス」が品質に効くのか 14 / 80
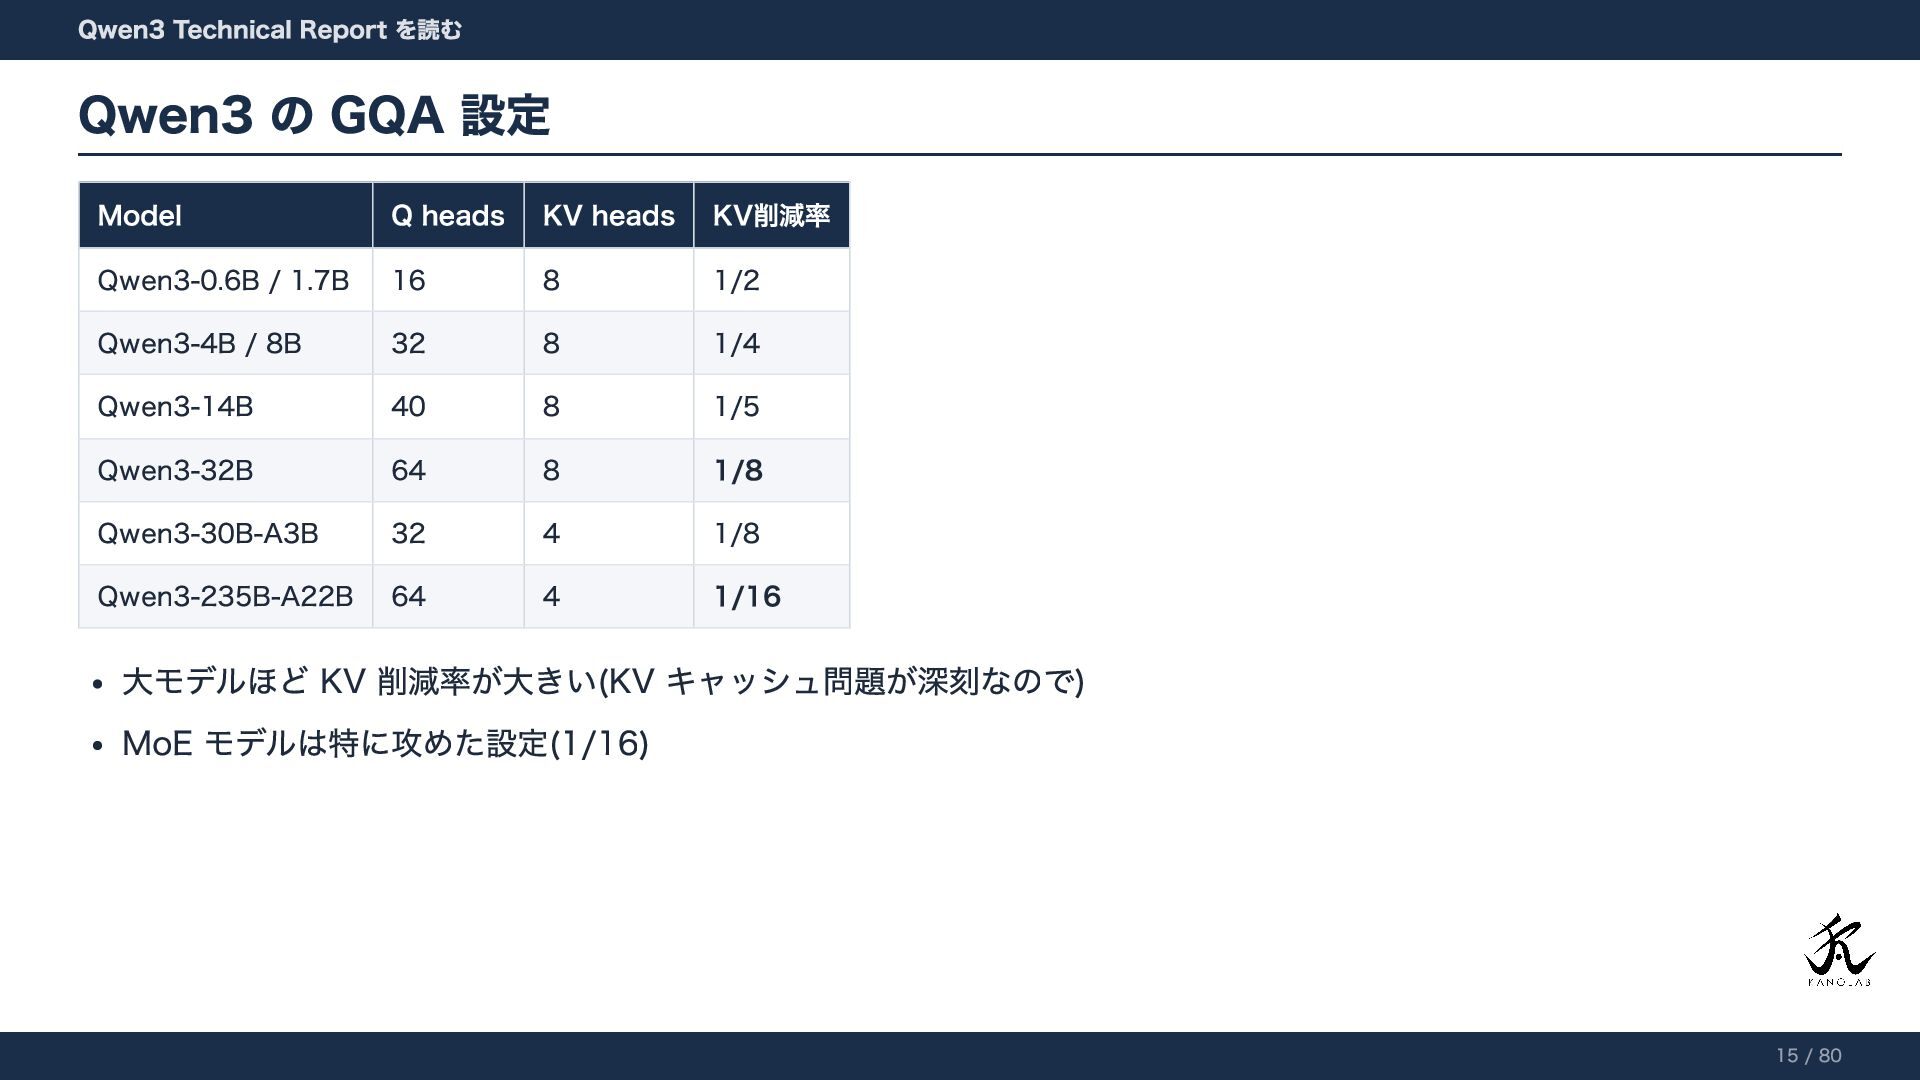
Model Q heads KV heads KV削減率 Qwen3-0.6B / 1.7B 16
8 1/2 Qwen3-4B / 8B 32 8 1/4 Qwen3-14B 40 8 1/5 Qwen3-32B 64 8 1/8 Qwen3-30B-A3B 32 4 1/8 Qwen3-235B-A22B 64 4 1/16 大モデルほど KV 削減率が大きい(KV キャッシュ問題が深刻なので) MoE モデルは特に攻めた設定(1/16) Qwen3 Technical Report を読む Qwen3 の GQA 設定 15 / 80
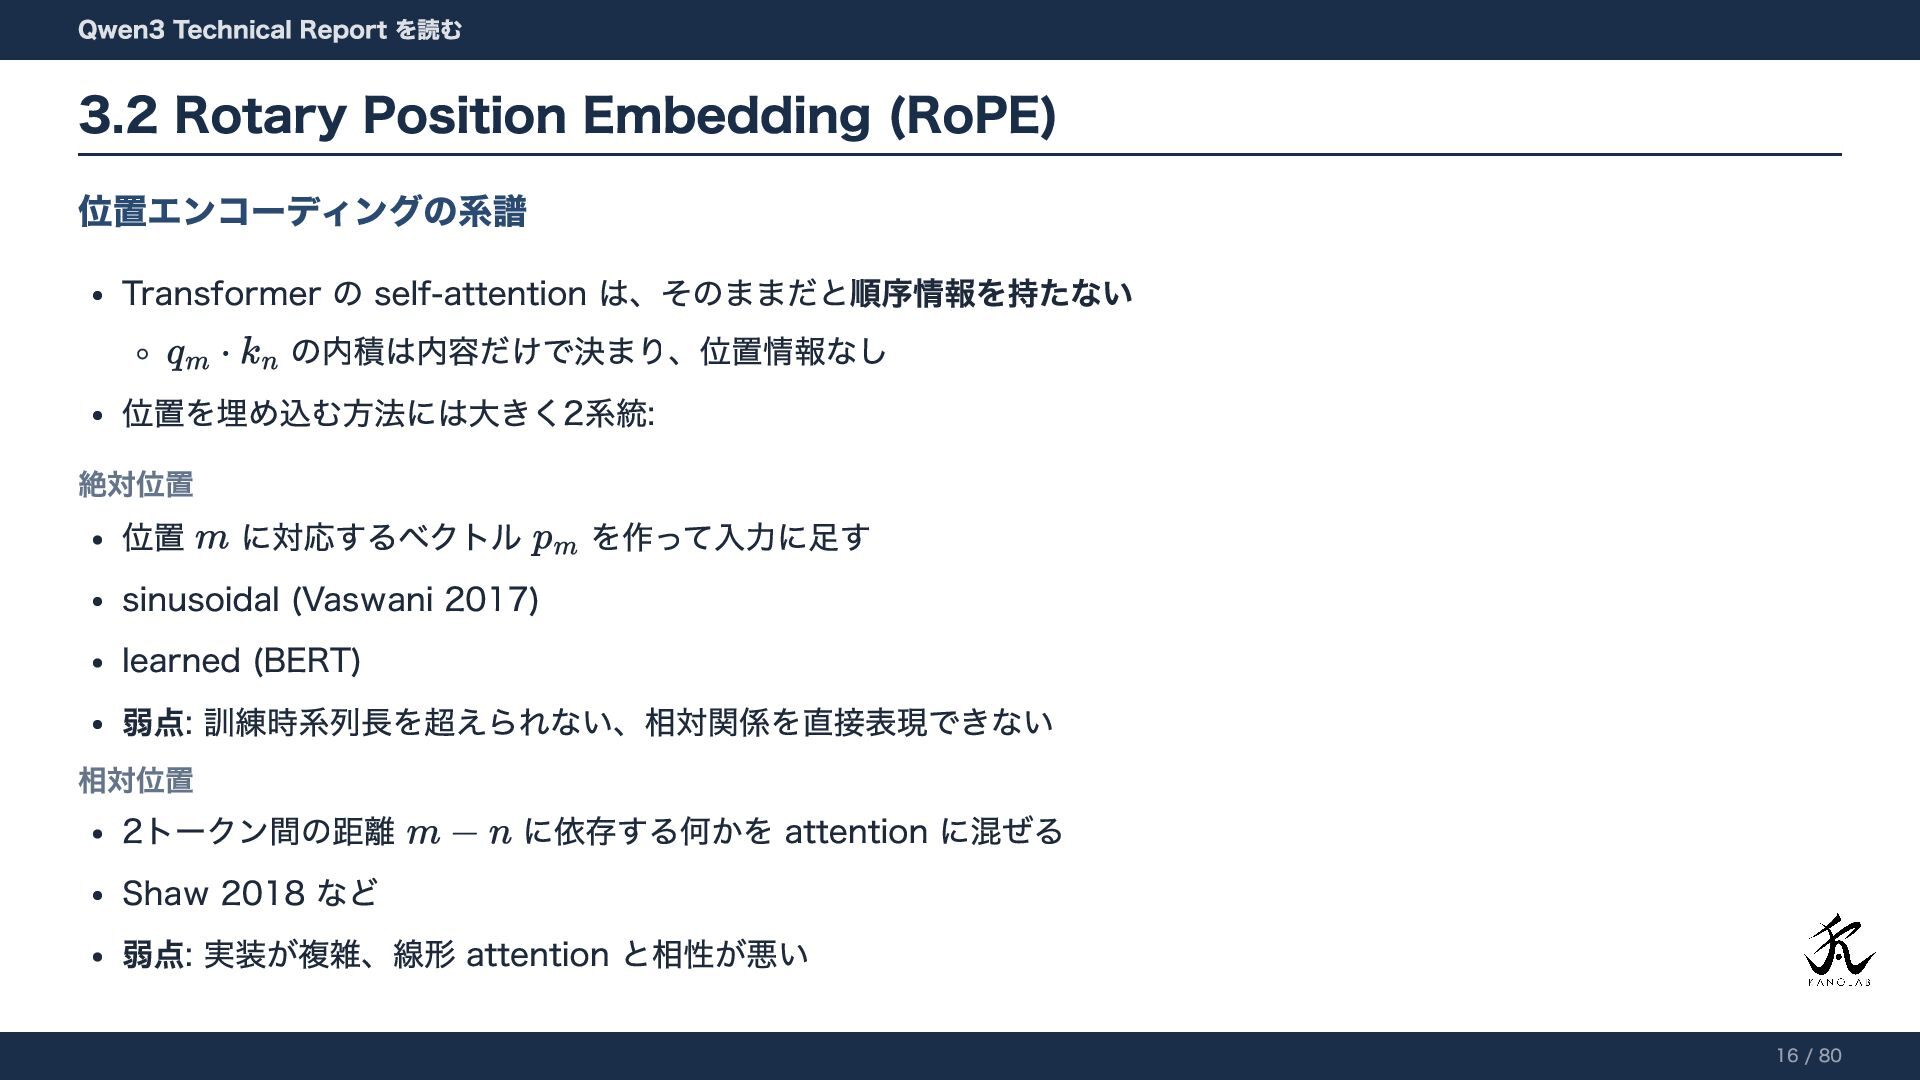
位置エンコーディングの系譜 Transformer の self-attention は、そのままだと順序情報を持たない の内積は内容だけで決まり、位置情報なし 位置を埋め込む方法には大きく2系統: 絶対位置 位置 に対応するベクトル
を作って入力に足す sinusoidal (Vaswani 2017) learned (BERT) 弱点: 訓練時系列長を超えられない、相対関係を直接表現できない 相対位置 2トークン間の距離 に依存する何かを attention に混ぜる Shaw 2018 など 弱点: 実装が複雑、線形 attention と相性が悪い Qwen3 Technical Report を読む 3.2 Rotary Position Embedding (RoPE) 16 / 80
RoPE の狙い 絶対位置を埋め込んでいるのに、内積を取ると結果が相対位置にしか依存しない 両者のいいとこ取り しかも後付けではなく、q と k を直接変換する形で実現 Qwen3 Technical
Report を読む 3.2 Rotary Position Embedding (RoPE) 17 / 80
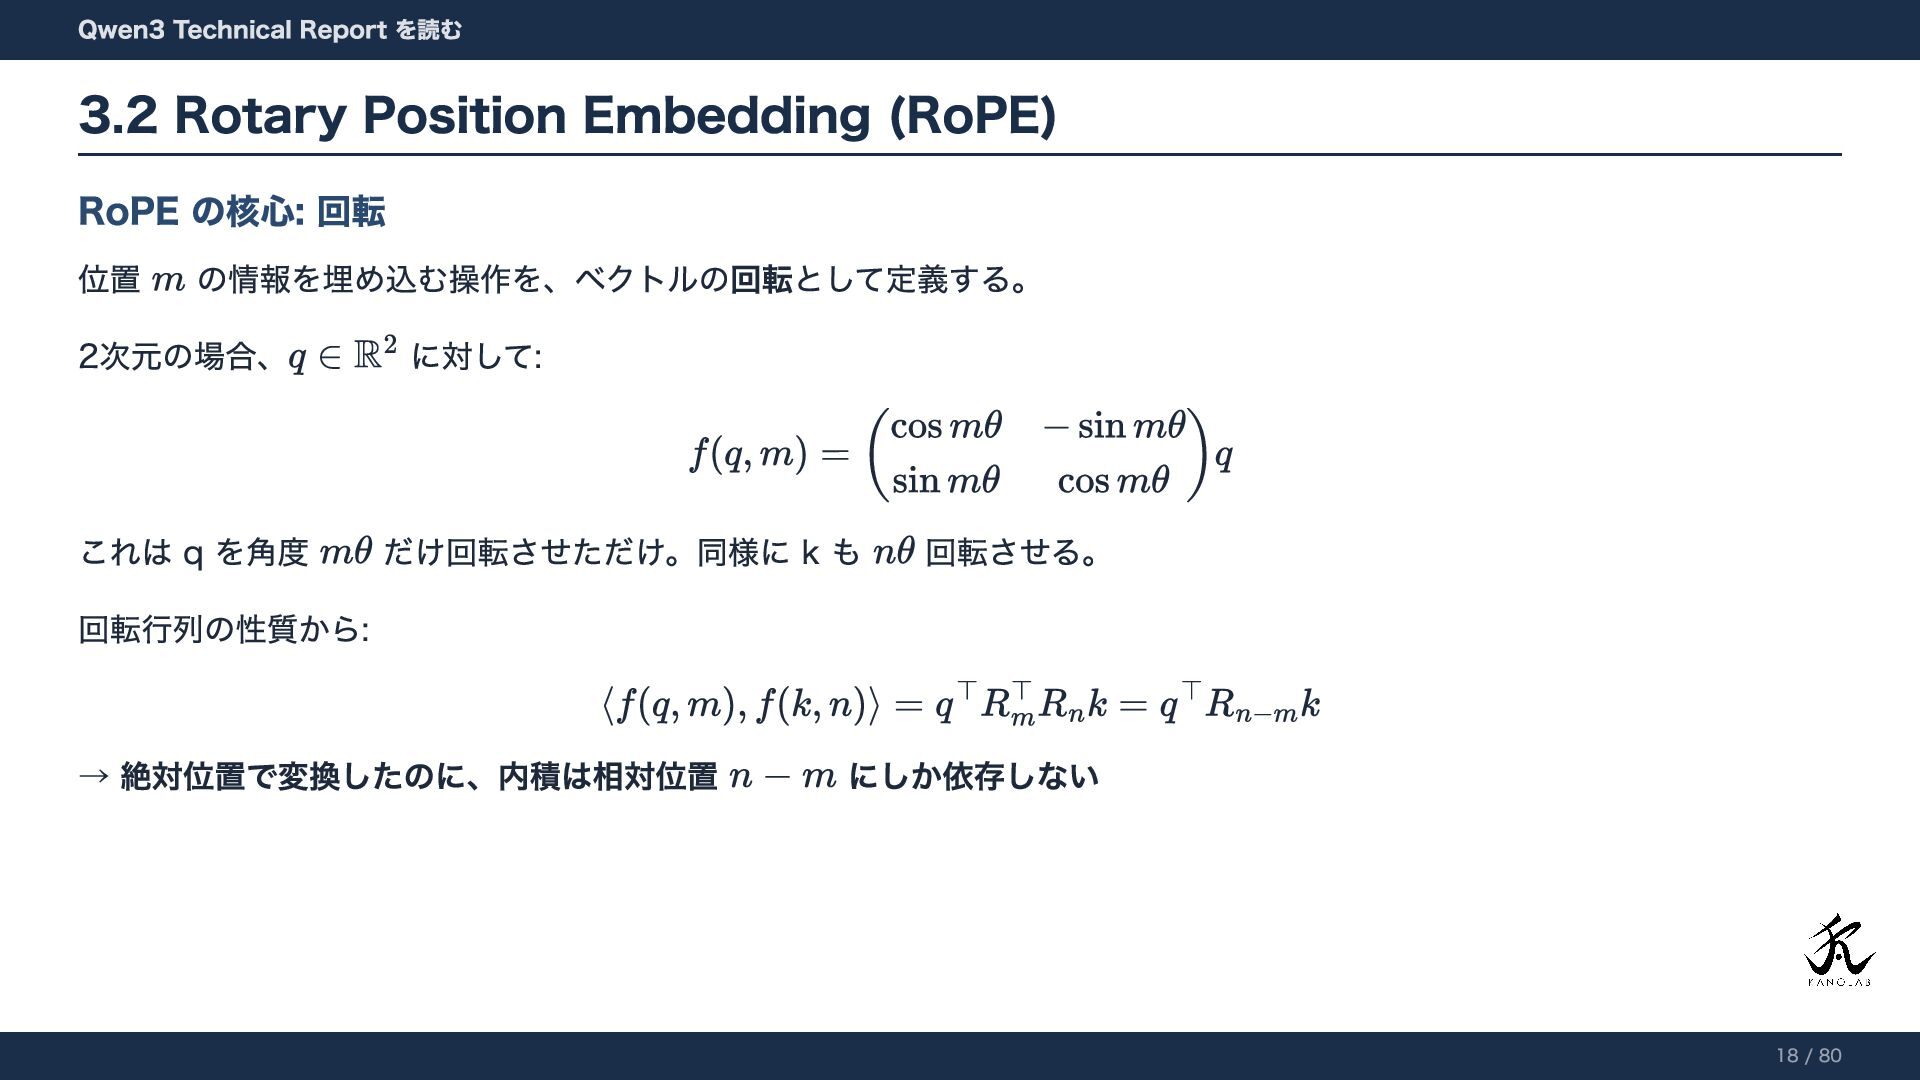
RoPE の核心: 回転 位置 の情報を埋め込む操作を、ベクトルの回転として定義する。 2次元の場合、 に対して: これは q を角度
だけ回転させただけ。同様に k も 回転させる。 回転行列の性質から: → 絶対位置で変換したのに、内積は相対位置 にしか依存しない Qwen3 Technical Report を読む 3.2 Rotary Position Embedding (RoPE) 18 / 80
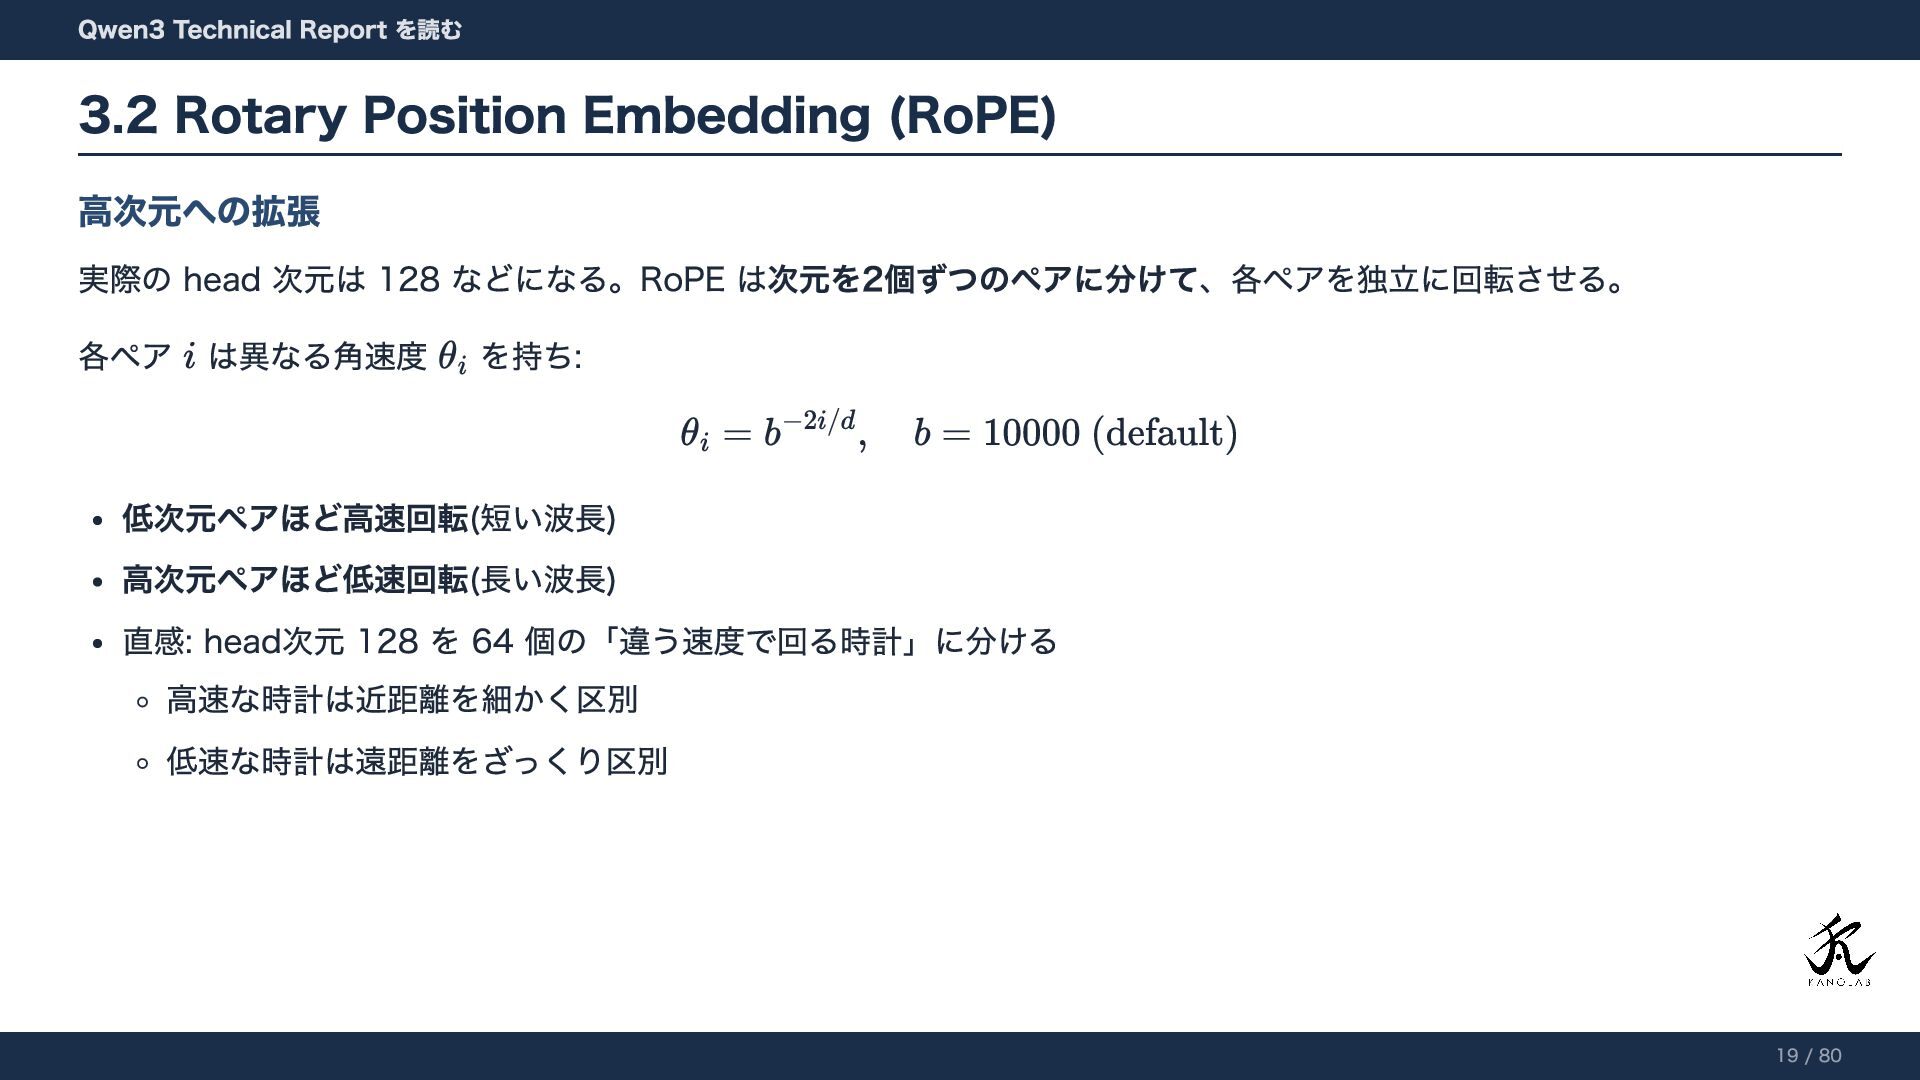
高次元への拡張 実際の head 次元は 128 などになる。RoPE は次元を2個ずつのペアに分けて、各ペアを独立に回転させる。 各ペア は異なる角速度 を持ち:
低次元ペアほど高速回転(短い波長) 高次元ペアほど低速回転(長い波長) 直感: head次元 128 を 64 個の「違う速度で回る時計」に分ける 高速な時計は近距離を細かく区別 低速な時計は遠距離をざっくり区別 Qwen3 Technical Report を読む 3.2 Rotary Position Embedding (RoPE) 19 / 80
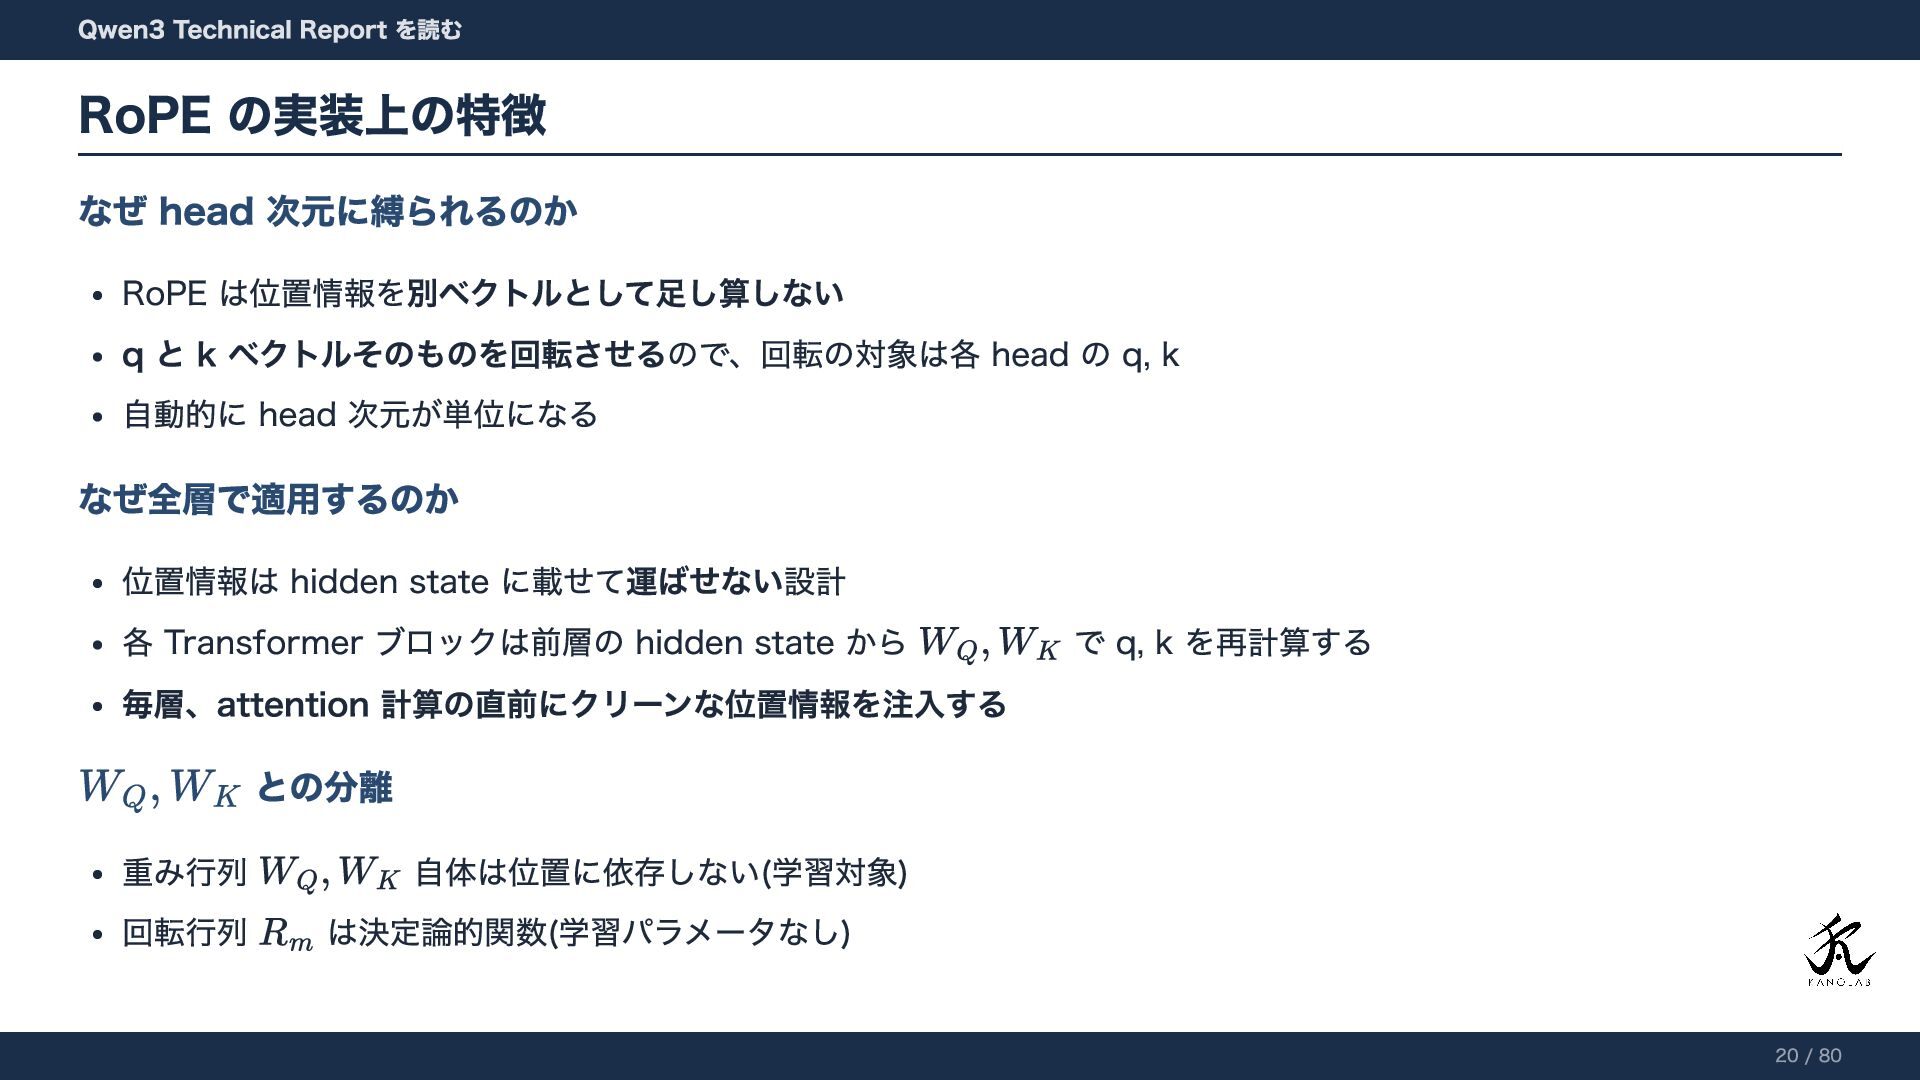
なぜ head 次元に縛られるのか RoPE は位置情報を別ベクトルとして足し算しない q と k ベクトルそのものを回転させるので、回転の対象は各 head
の q, k 自動的に head 次元が単位になる なぜ全層で適用するのか 位置情報は hidden state に載せて運ばせない設計 各 Transformer ブロックは前層の hidden state から で q, k を再計算する 毎層、attention 計算の直前にクリーンな位置情報を注入する との分離 重み行列 自体は位置に依存しない(学習対象) 回転行列 は決定論的関数(学習パラメータなし) Qwen3 Technical Report を読む RoPE の実装上の特徴 20 / 80
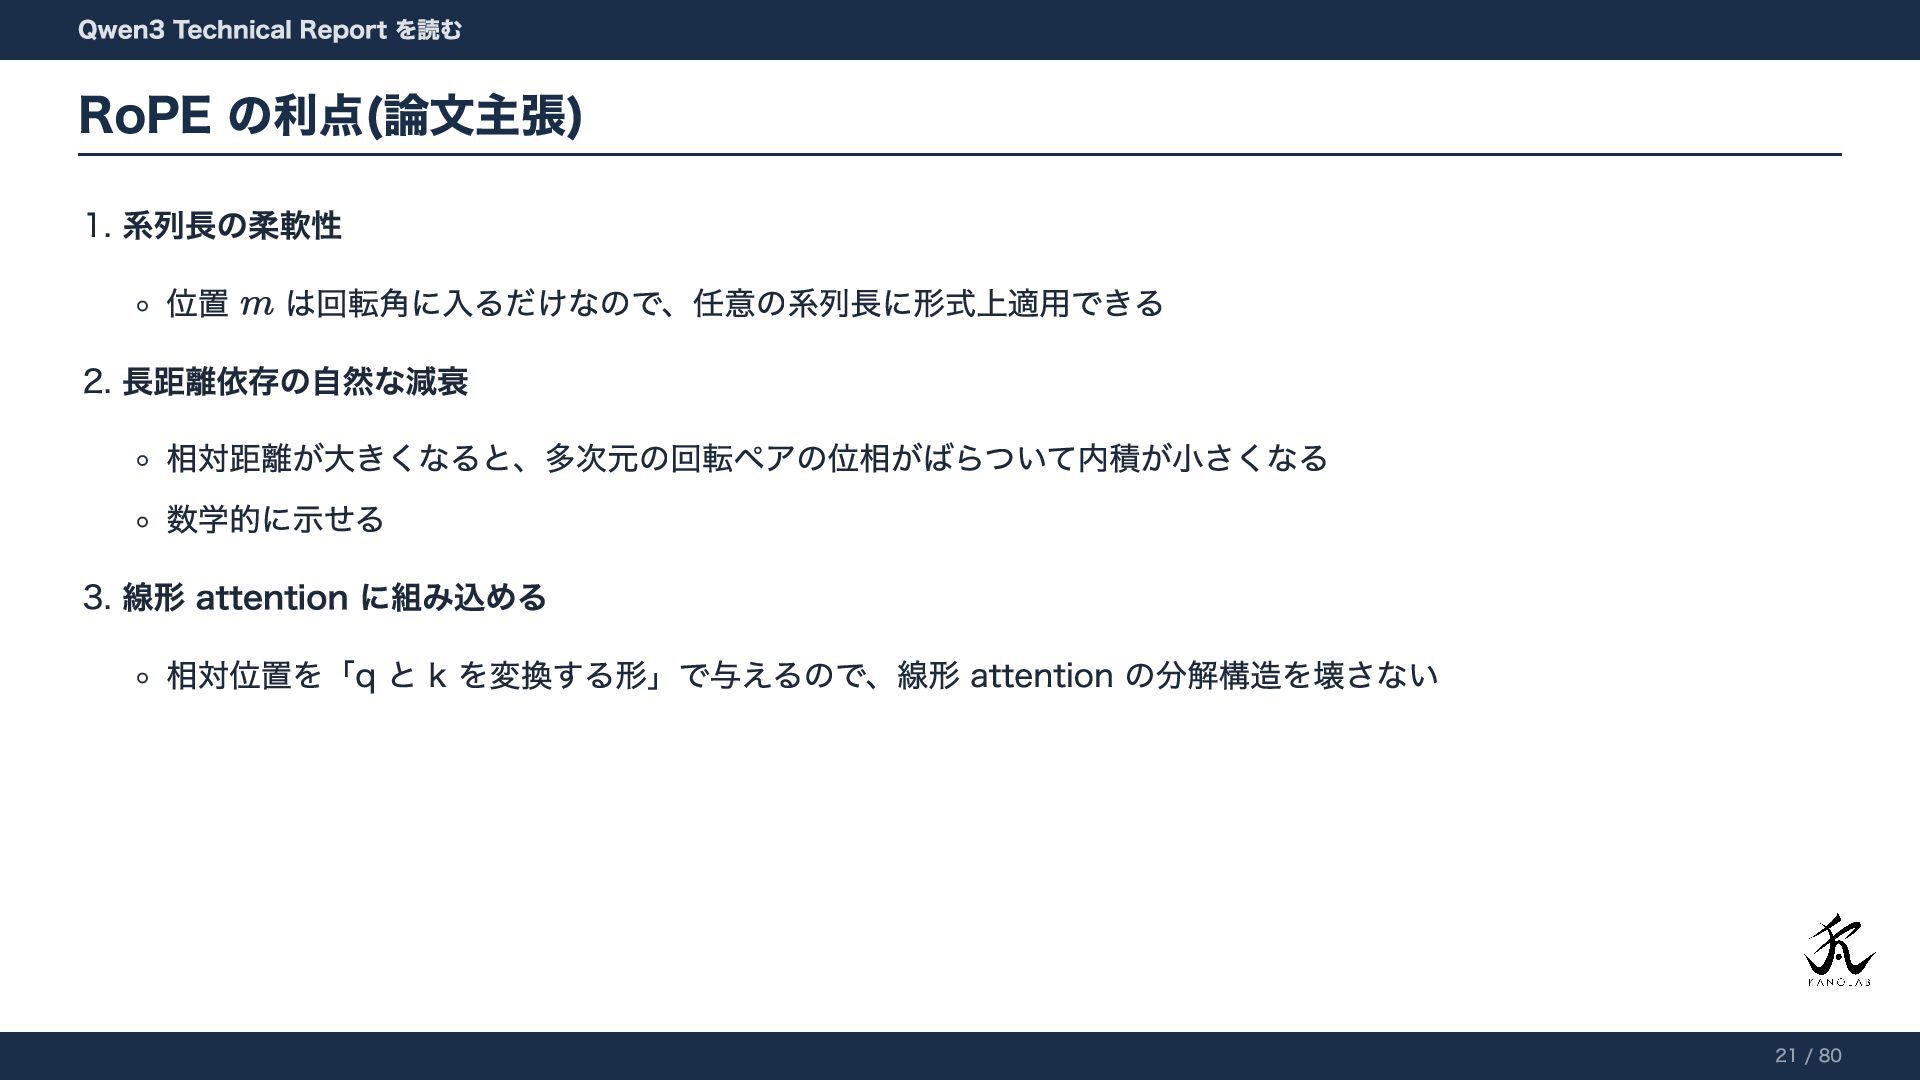
1. 系列長の柔軟性 位置 は回転角に入るだけなので、任意の系列長に形式上適用できる 2. 長距離依存の自然な減衰 相対距離が大きくなると、多次元の回転ペアの位相がばらついて内積が小さくなる 数学的に示せる 3. 線形
attention に組み込める 相対位置を「q と k を変換する形」で与えるので、線形 attention の分解構造を壊さない Qwen3 Technical Report を読む RoPE の利点(論文主張) 21 / 80
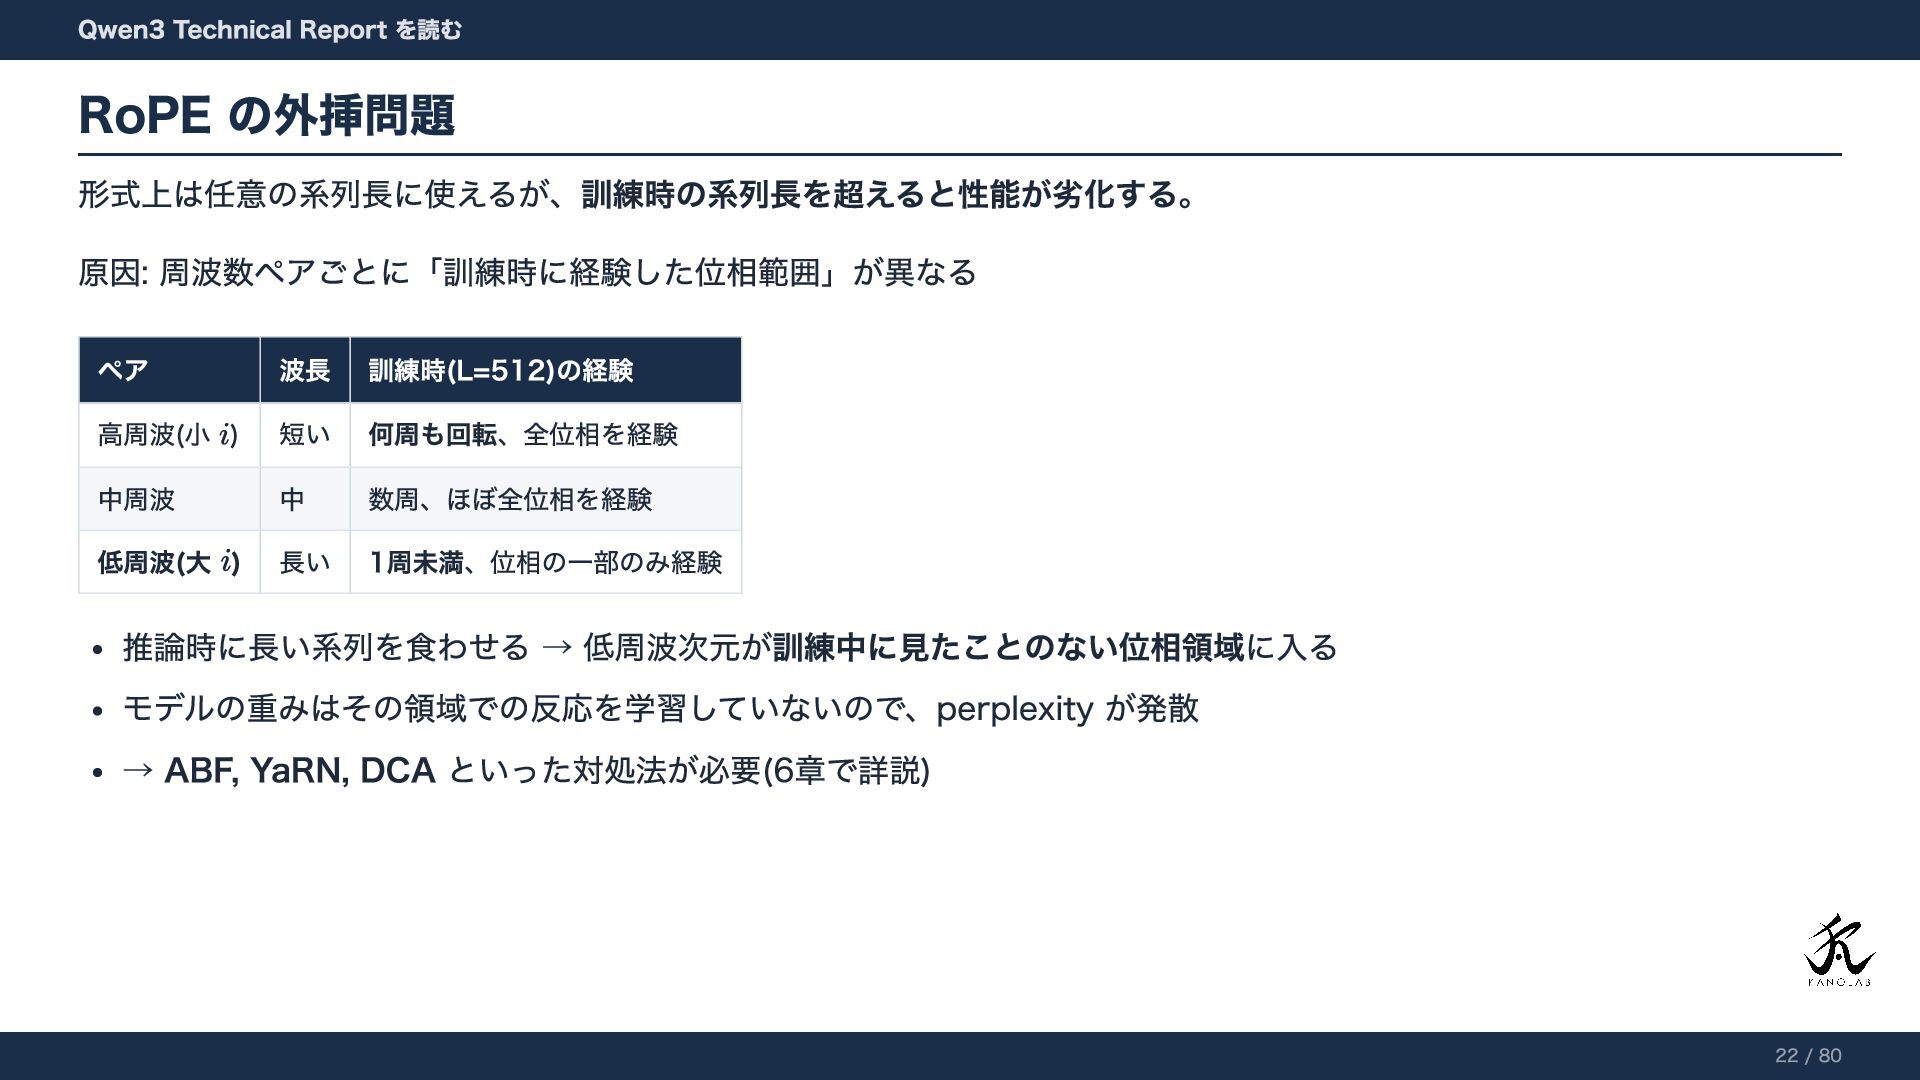
形式上は任意の系列長に使えるが、訓練時の系列長を超えると性能が劣化する。 原因: 周波数ペアごとに「訓練時に経験した位相範囲」が異なる ペア 波長 訓練時(L=512)の経験 高周波(小 ) 短い 何周も回転、全位相を経験
中周波 中 数周、ほぼ全位相を経験 低周波(大 ) 長い 1周未満、位相の一部のみ経験 推論時に長い系列を食わせる → 低周波次元が訓練中に見たことのない位相領域に入る モデルの重みはその領域での反応を学習していないので、perplexity が発散 → ABF, YaRN, DCA といった対処法が必要(6章で詳説) Qwen3 Technical Report を読む RoPE の外挿問題 22 / 80
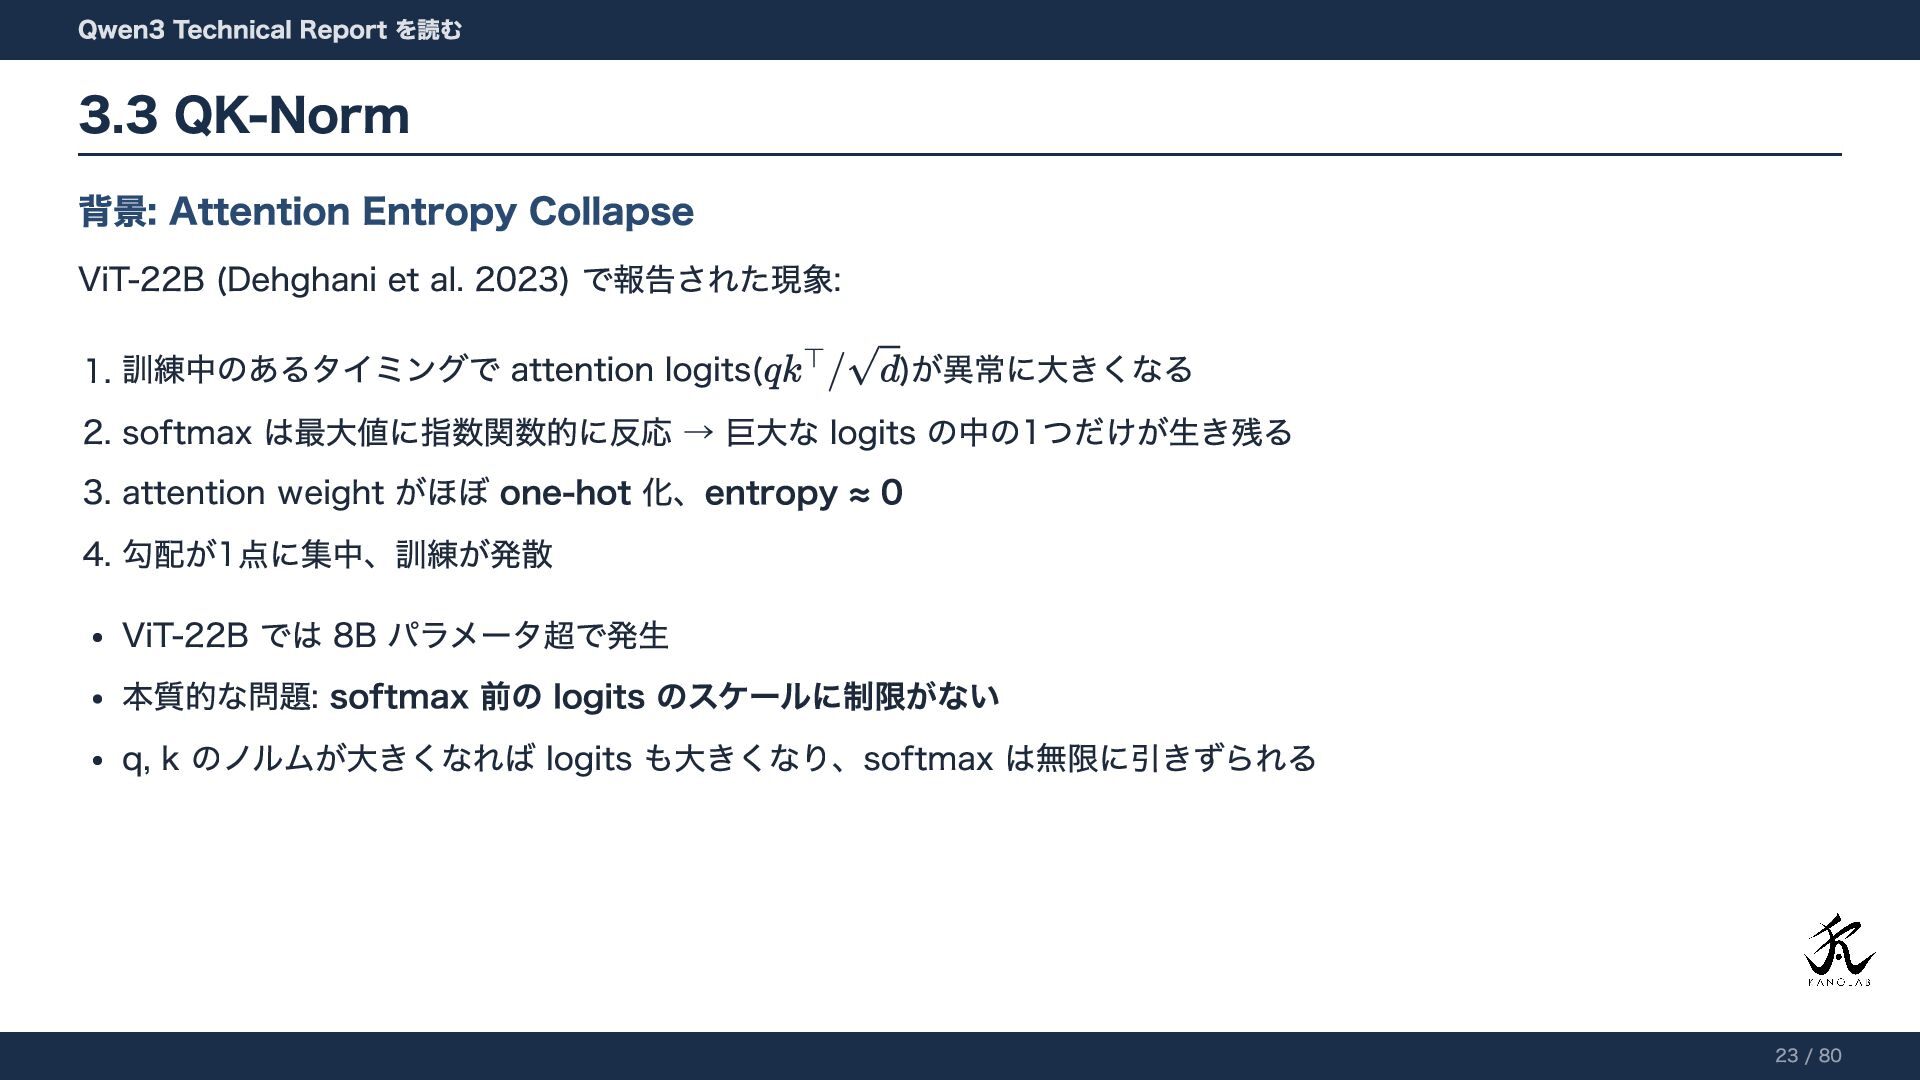
背景: Attention Entropy Collapse ViT-22B (Dehghani et al. 2023) で報告された現象:
1. 訓練中のあるタイミングで attention logits( )が異常に大きくなる 2. softmax は最大値に指数関数的に反応 → 巨大な logits の中の1つだけが生き残る 3. attention weight がほぼ one-hot 化、entropy ≈ 0 4. 勾配が1点に集中、訓練が発散 ViT-22B では 8B パラメータ超で発生 本質的な問題: softmax 前の logits のスケールに制限がない q, k のノルムが大きくなれば logits も大きくなり、softmax は無限に引きずられる Qwen3 Technical Report を読む 3.3 QK-Norm 23 / 80
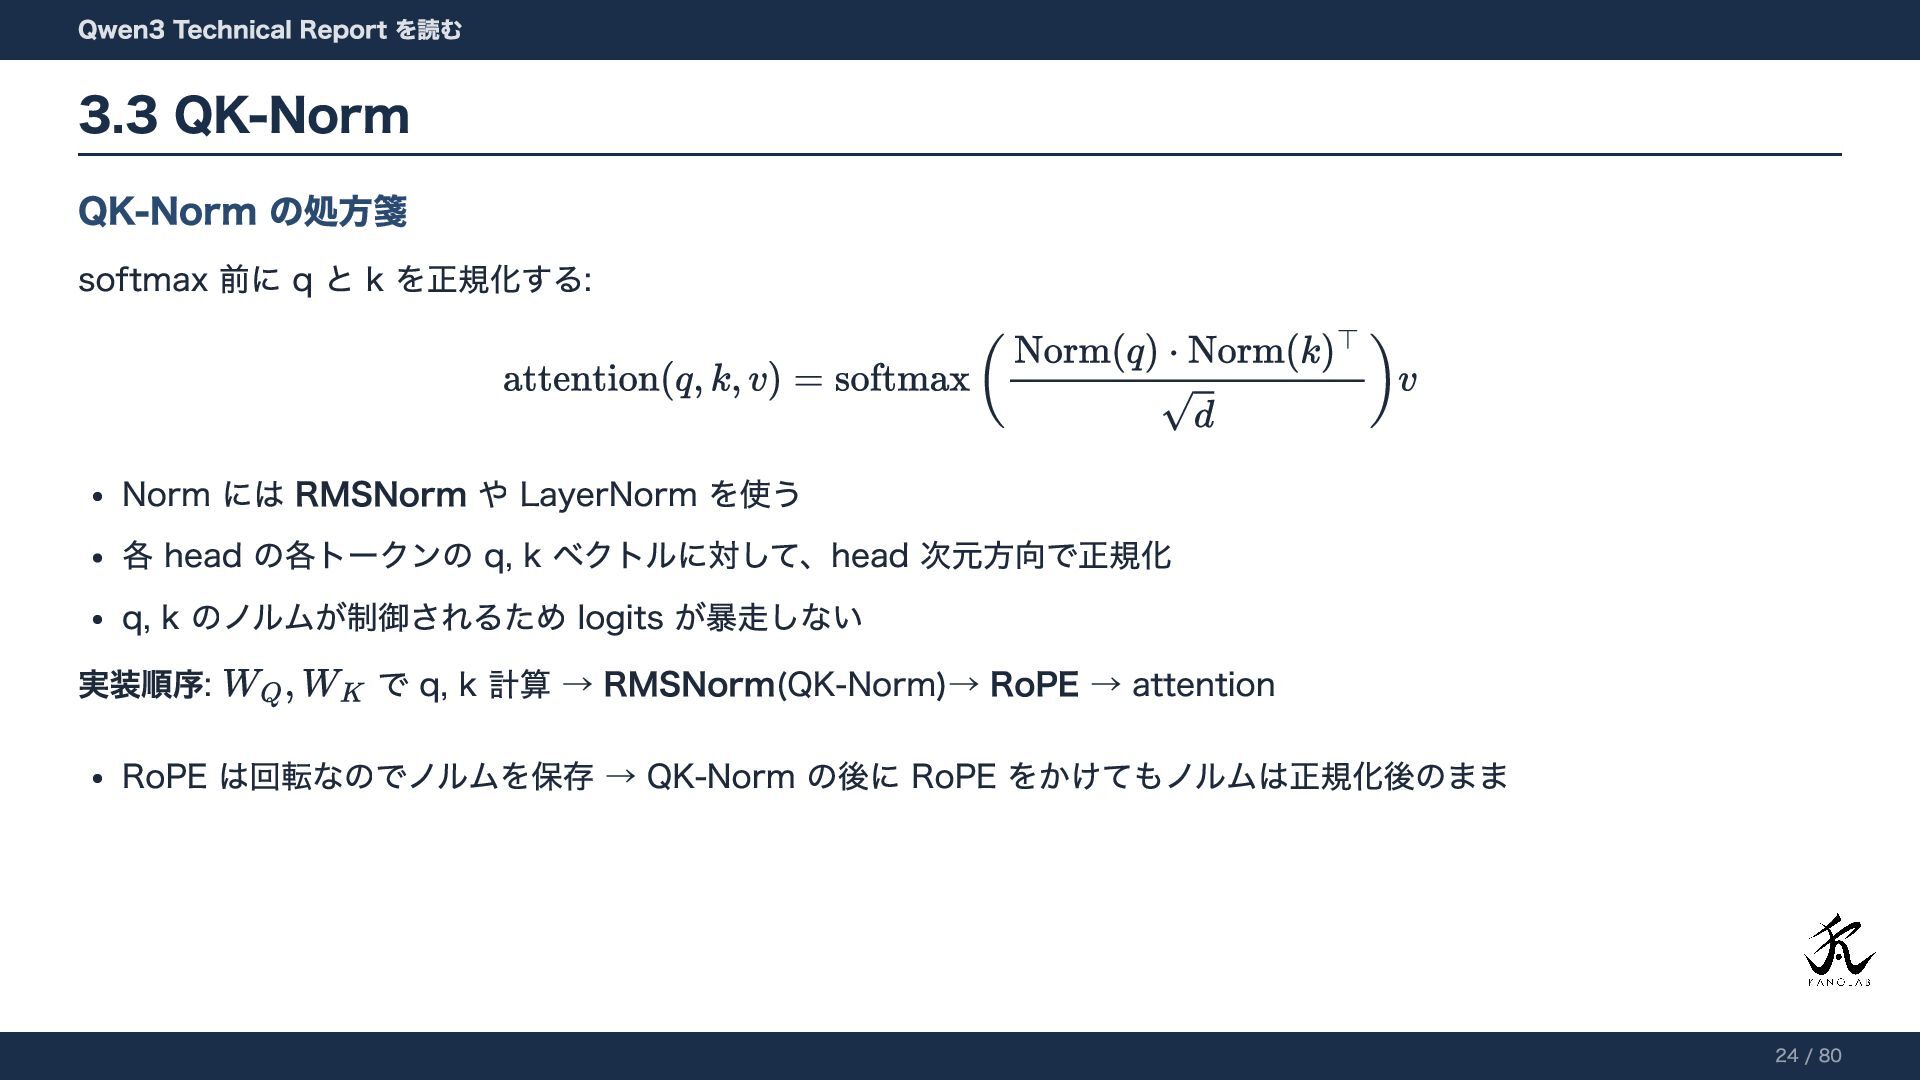
QK-Norm の処方箋 softmax 前に q と k を正規化する: Norm には
RMSNorm や LayerNorm を使う 各 head の各トークンの q, k ベクトルに対して、head 次元方向で正規化 q, k のノルムが制御されるため logits が暴走しない 実装順序: で q, k 計算 → RMSNorm(QK-Norm)→ RoPE → attention RoPE は回転なのでノルムを保存 → QK-Norm の後に RoPE をかけてもノルムは正規化後のまま Qwen3 Technical Report を読む 3.3 QK-Norm 24 / 80
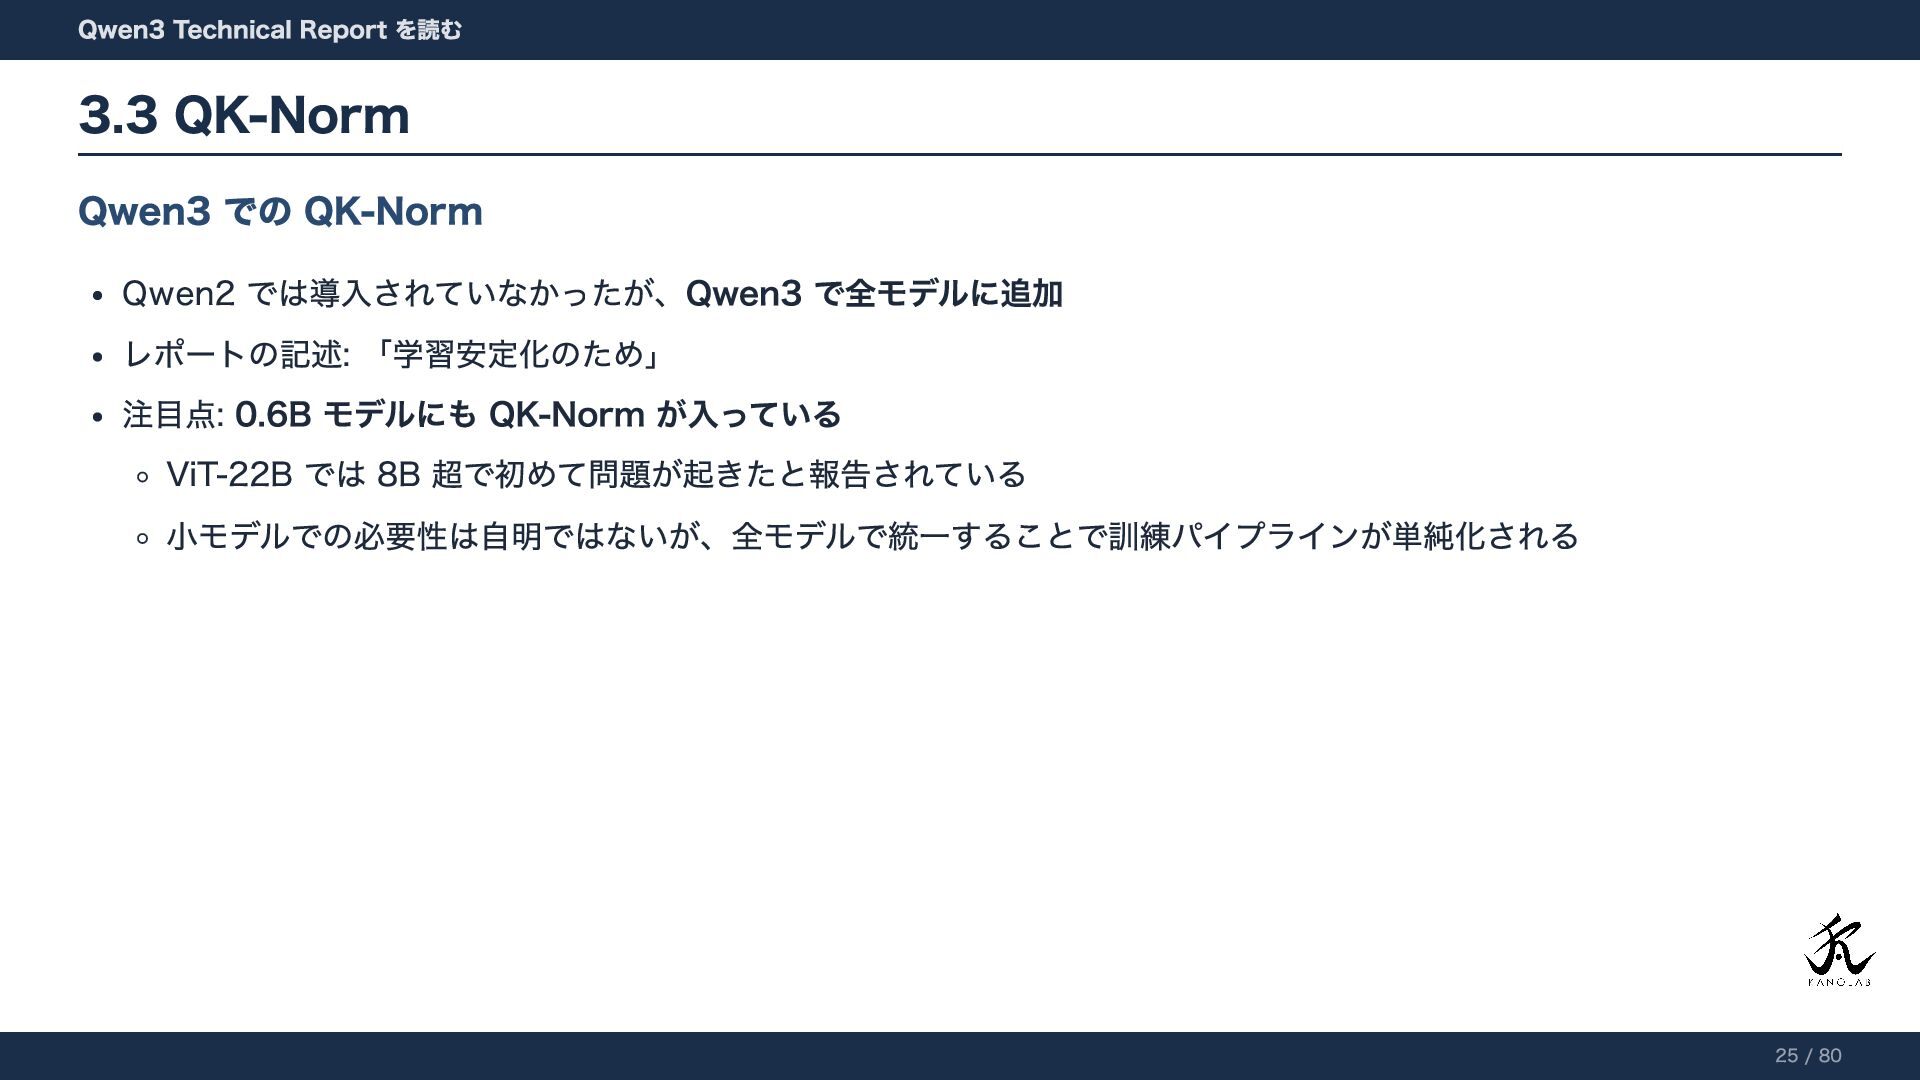
Qwen3 での QK-Norm Qwen2 では導入されていなかったが、Qwen3 で全モデルに追加 レポートの記述: 「学習安定化のため」 注目点: 0.6B
モデルにも QK-Norm が入っている ViT-22B では 8B 超で初めて問題が起きたと報告されている 小モデルでの必要性は自明ではないが、全モデルで統一することで訓練パイプラインが単純化される Qwen3 Technical Report を読む 3.3 QK-Norm 25 / 80
4. 正規化: RMSNorm Qwen3 Technical Report を読む 26 / 80
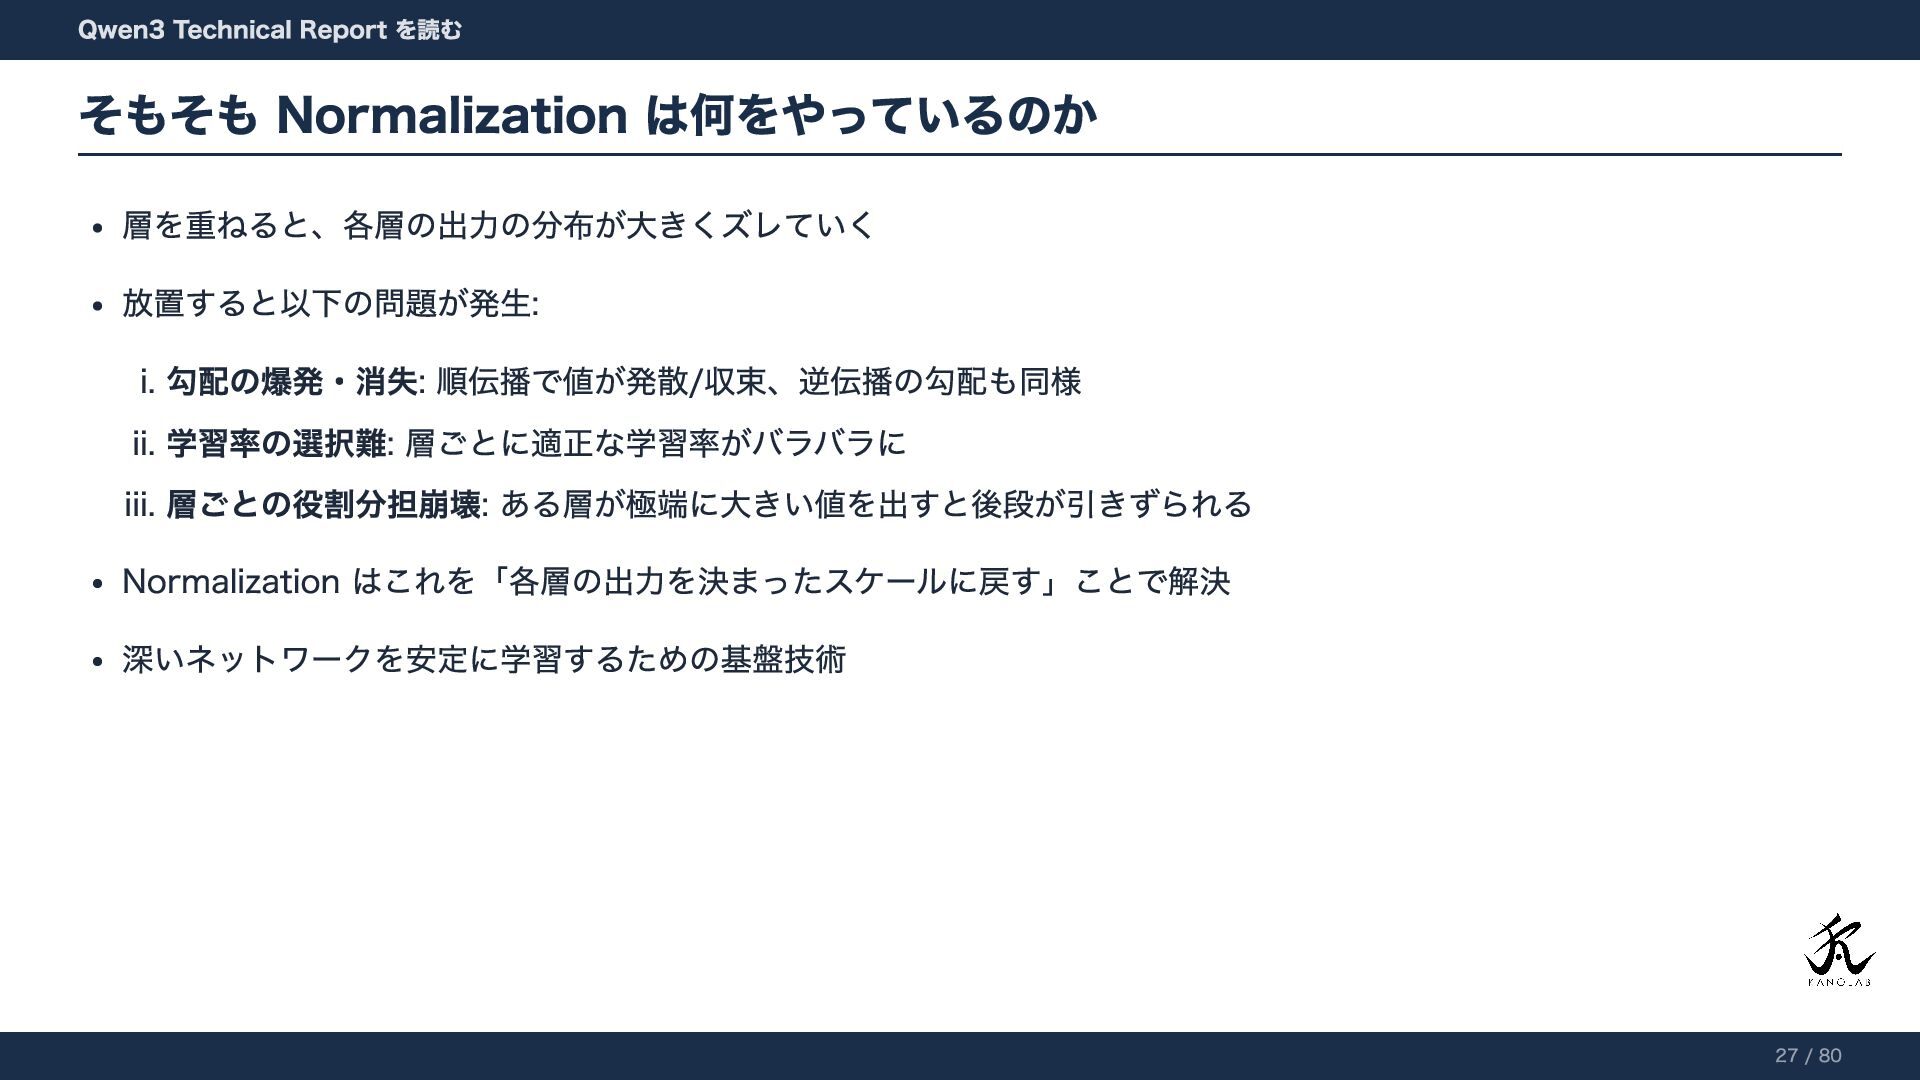
層を重ねると、各層の出力の分布が大きくズレていく 放置すると以下の問題が発生: i. 勾配の爆発・消失: 順伝播で値が発散/収束、逆伝播の勾配も同様 ii. 学習率の選択難: 層ごとに適正な学習率がバラバラに iii. 層ごとの役割分担崩壊:
ある層が極端に大きい値を出すと後段が引きずられる Normalization はこれを「各層の出力を決まったスケールに戻す」ことで解決 深いネットワークを安定に学習するための基盤技術 Qwen3 Technical Report を読む そもそも Normalization は何をやっているのか 27 / 80
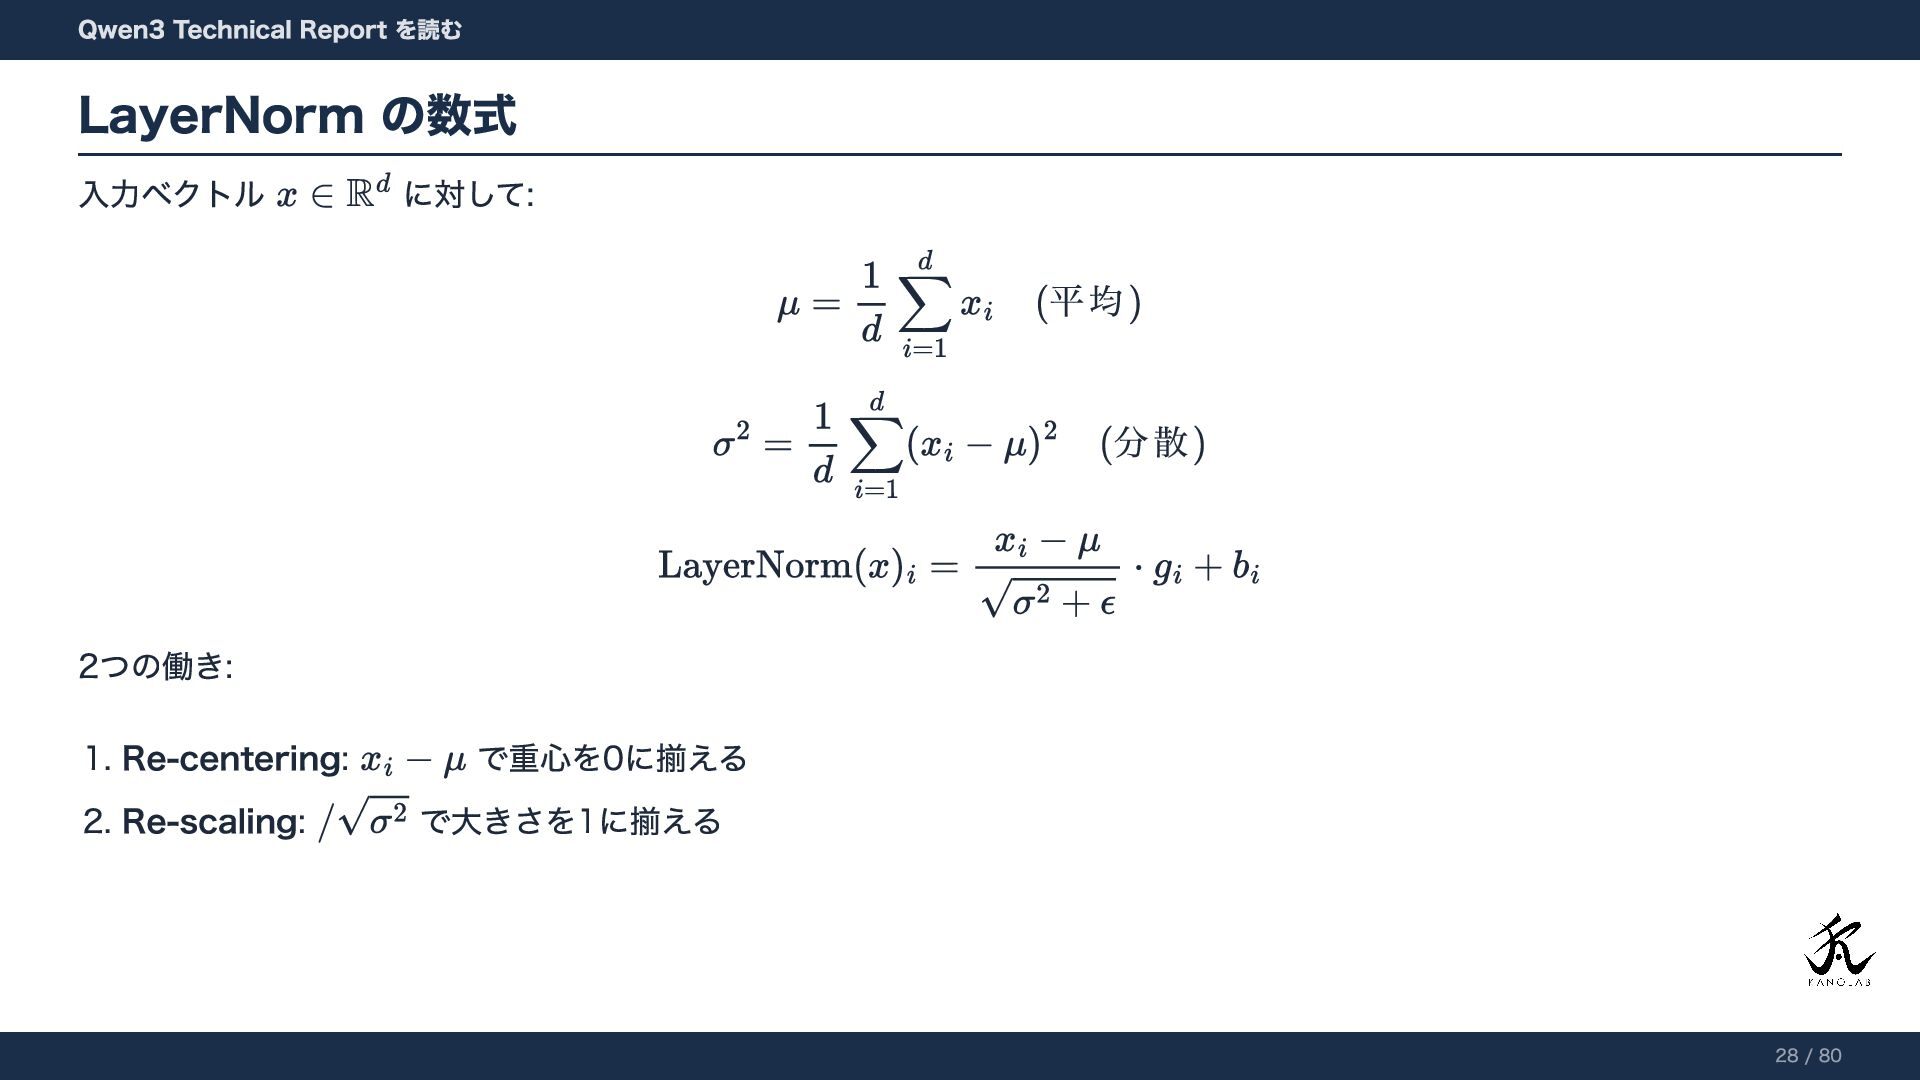
入力ベクトル に対して: 平均 分散 2つの働き: 1. Re-centering: で重心を0に揃える 2. Re-scaling:
で大きさを1に揃える Qwen3 Technical Report を読む LayerNorm の数式 28 / 80
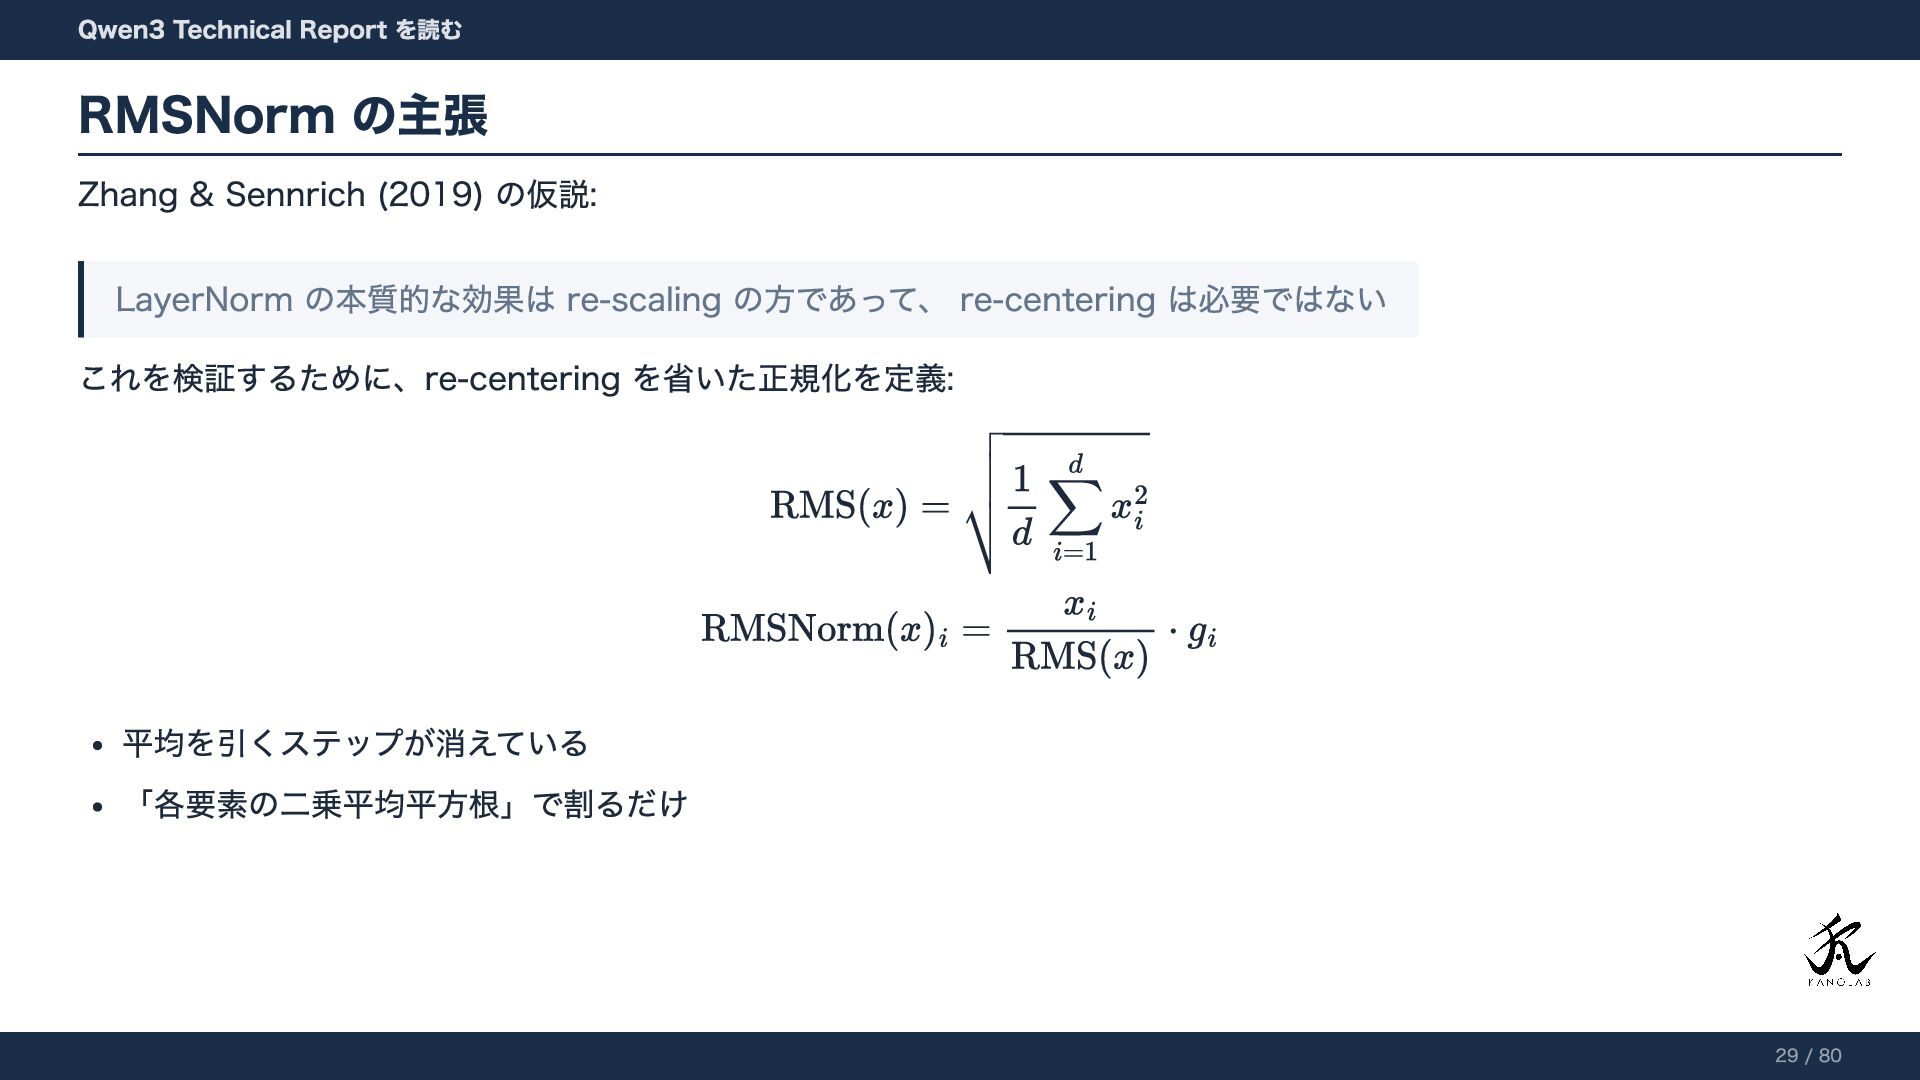
Zhang & Sennrich (2019) の仮説: LayerNorm の本質的な効果は re-scaling の方であって、 re-centering
は必要ではない これを検証するために、re-centering を省いた正規化を定義: 平均を引くステップが消えている 「各要素の二乗平均平方根」で割るだけ Qwen3 Technical Report を読む RMSNorm の主張 29 / 80
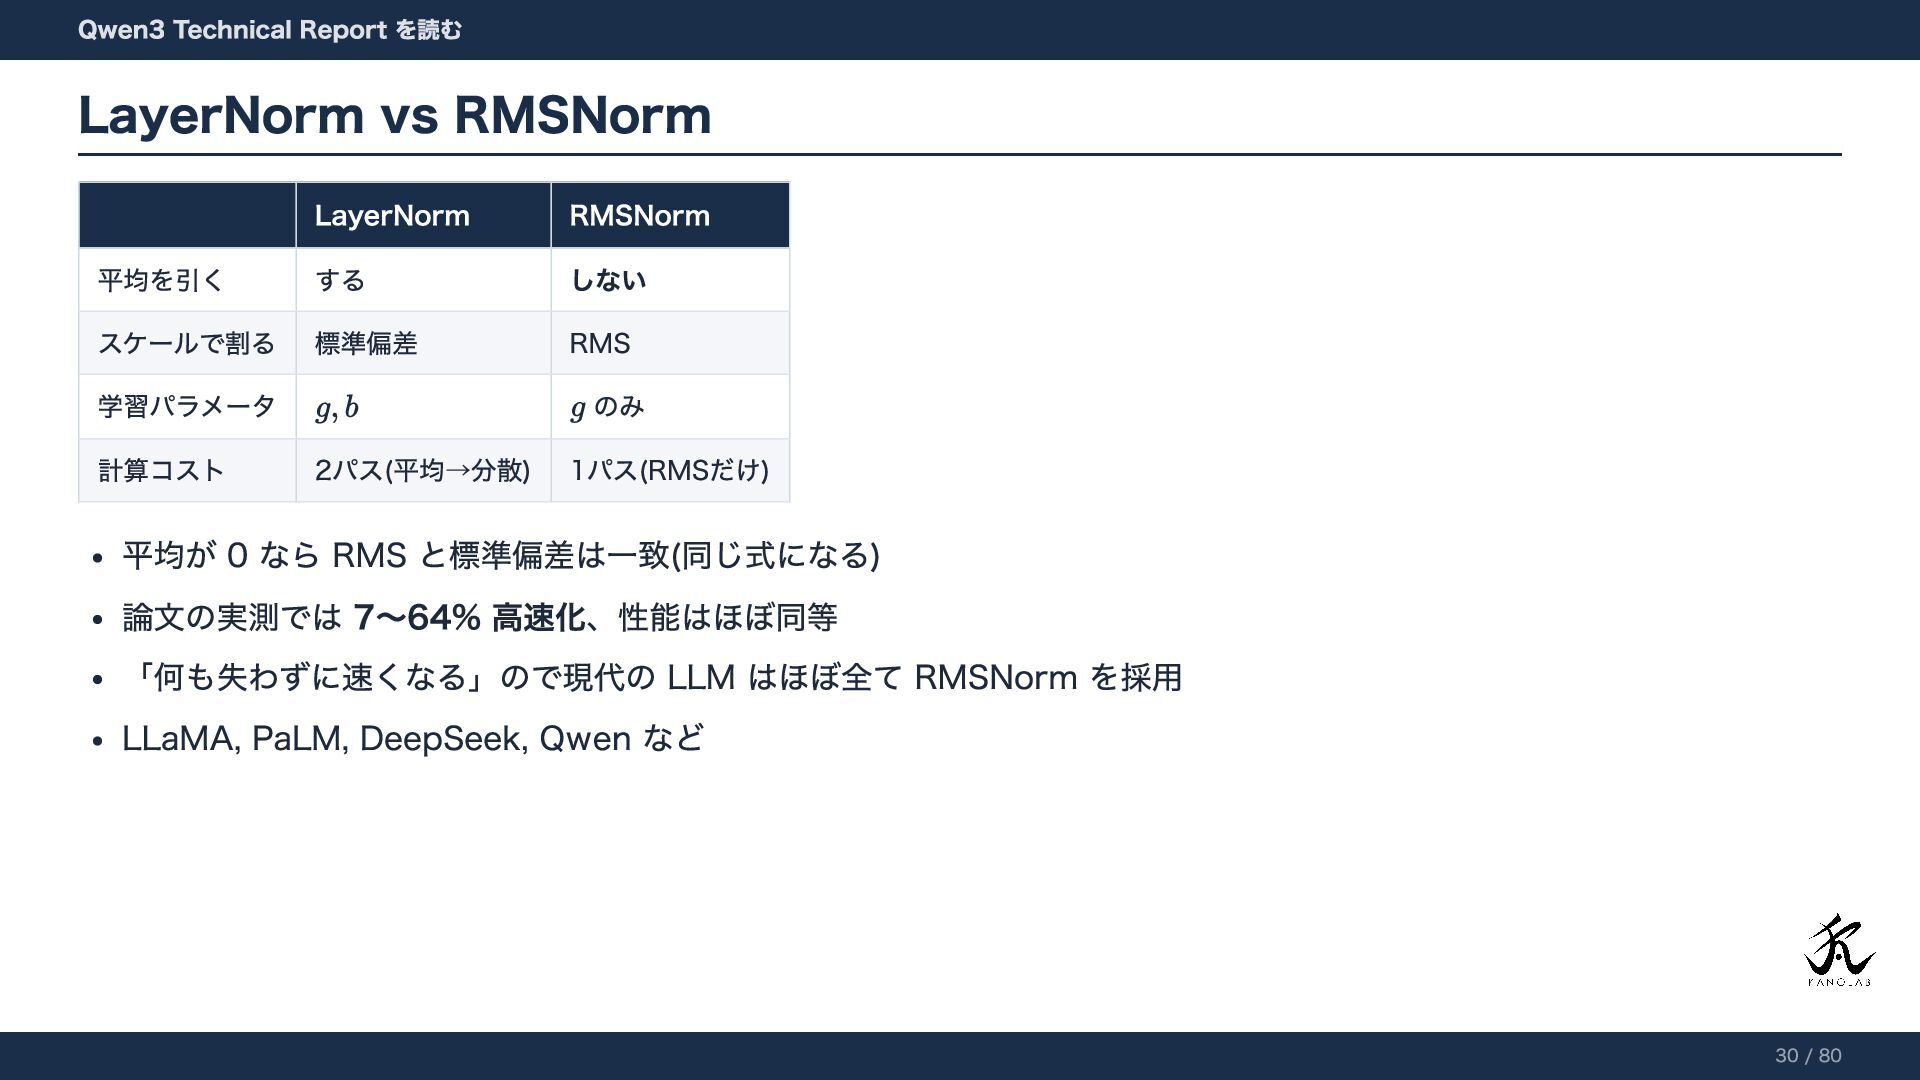
LayerNorm RMSNorm 平均を引く する しない スケールで割る 標準偏差 RMS 学習パラメータ のみ
計算コスト 2パス(平均→分散) 1パス(RMSだけ) 平均が 0 なら RMS と標準偏差は一致(同じ式になる) 論文の実測では 7〜64% 高速化、性能はほぼ同等 「何も失わずに速くなる」ので現代の LLM はほぼ全て RMSNorm を採用 LLaMA, PaLM, DeepSeek, Qwen など Qwen3 Technical Report を読む LayerNorm vs RMSNorm 30 / 80
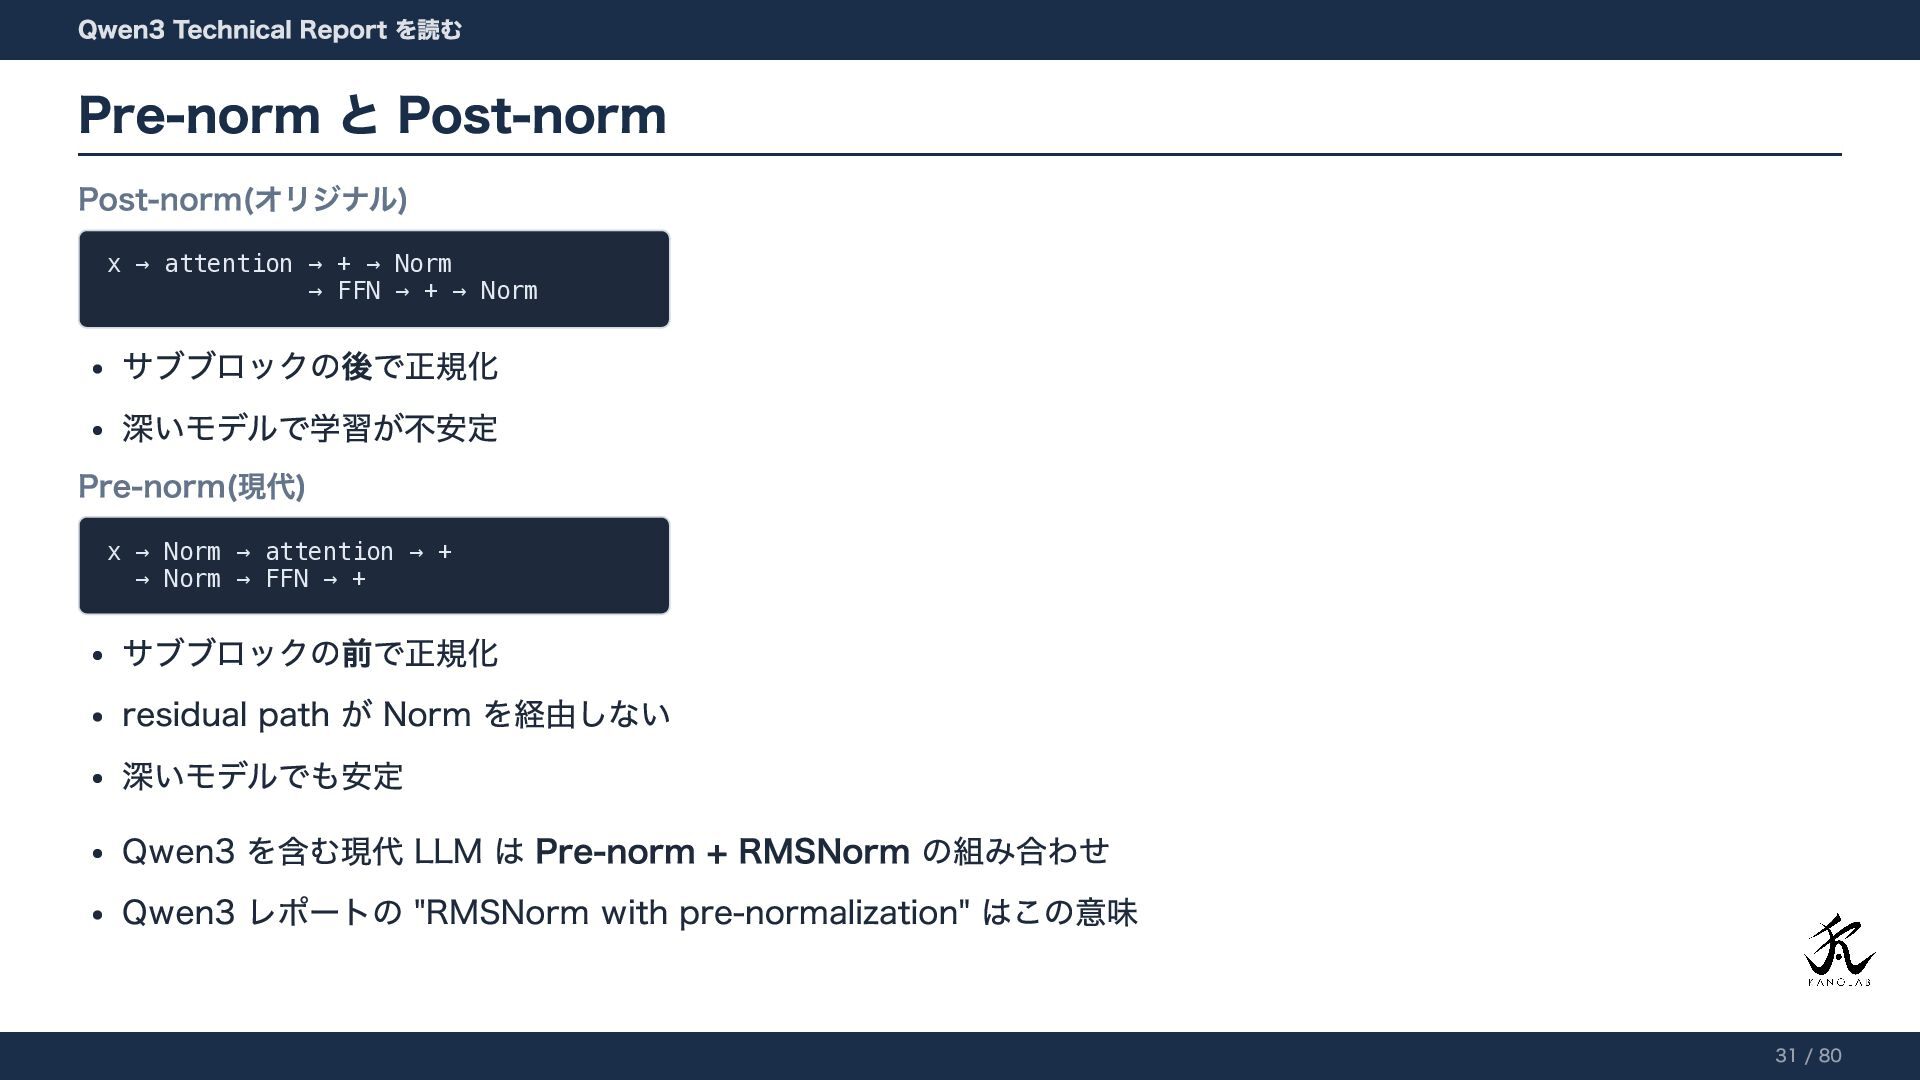
Post-norm(オリジナル) x → attention → + → Norm → FFN
→ + → Norm サブブロックの後で正規化 深いモデルで学習が不安定 Pre-norm(現代) x → Norm → attention → + → Norm → FFN → + サブブロックの前で正規化 residual path が Norm を経由しない 深いモデルでも安定 Qwen3 を含む現代 LLM は Pre-norm + RMSNorm の組み合わせ Qwen3 レポートの "RMSNorm with pre-normalization" はこの意味 Qwen3 Technical Report を読む Pre-norm と Post-norm 31 / 80
5. FFN / MoE 系 Qwen3 Technical Report を読む 32
/ 80
Transformer の各ブロックは attention と FFN の2つのサブブロックから成る。 オリジナルの FFN は2層 MLP:
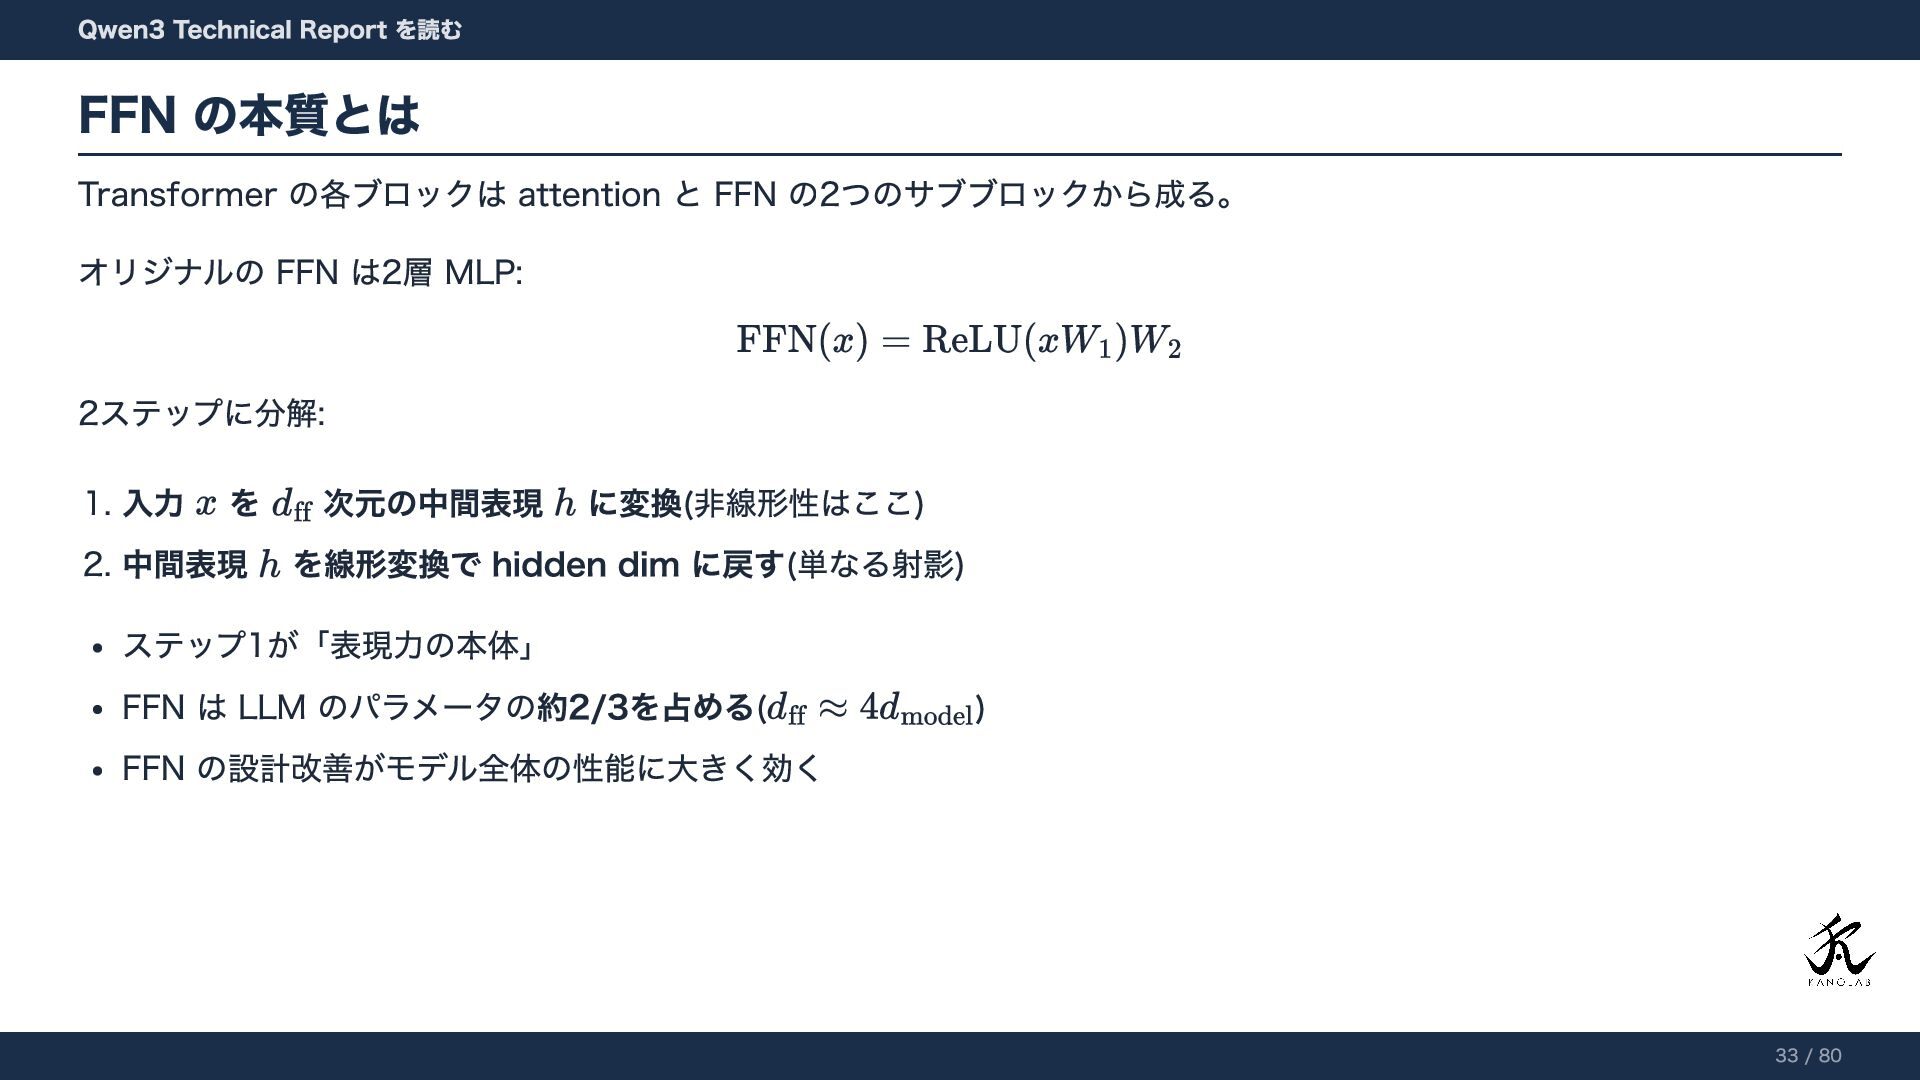
2ステップに分解: 1. 入力 を 次元の中間表現 に変換(非線形性はここ) 2. 中間表現 を線形変換で hidden dim に戻す(単なる射影) ステップ1が「表現力の本体」 FFN は LLM のパラメータの約2/3を占める( ) FFN の設計改善がモデル全体の性能に大きく効く Qwen3 Technical Report を読む FFN の本質とは 33 / 80
関数 数式 特徴 ReLU シンプル、dying ReLU 問題 GELU 滑らかな ReLU、BERT/GPT-2
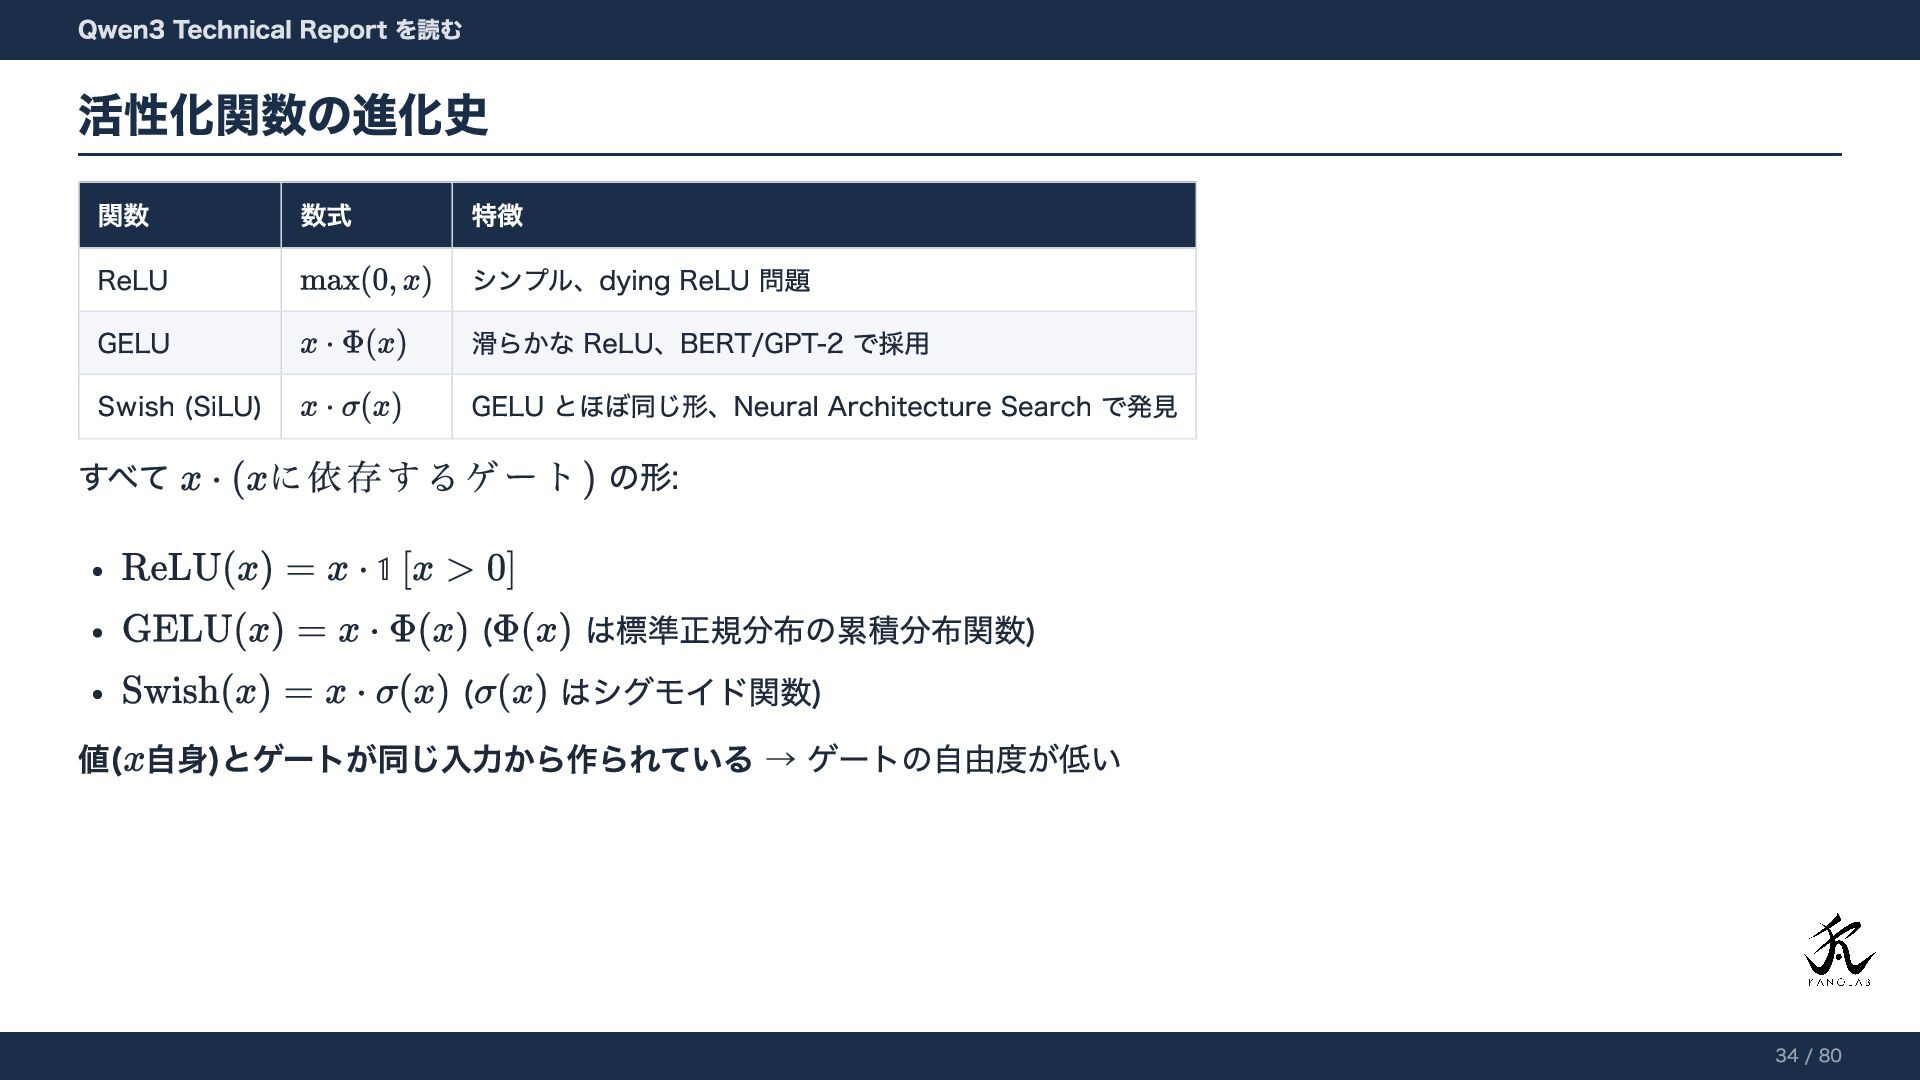
で採用 Swish (SiLU) GELU とほぼ同じ形、Neural Architecture Search で発見 すべて に依存するゲート の形: 𝟙 ( は標準正規分布の累積分布関数) ( はシグモイド関数) 値( 自身)とゲートが同じ入力から作られている → ゲートの自由度が低い Qwen3 Technical Report を読む 活性化関数の進化史 34 / 80
Dauphin et al. (2017) の Gated Linear Unit: : 要素ごとの積
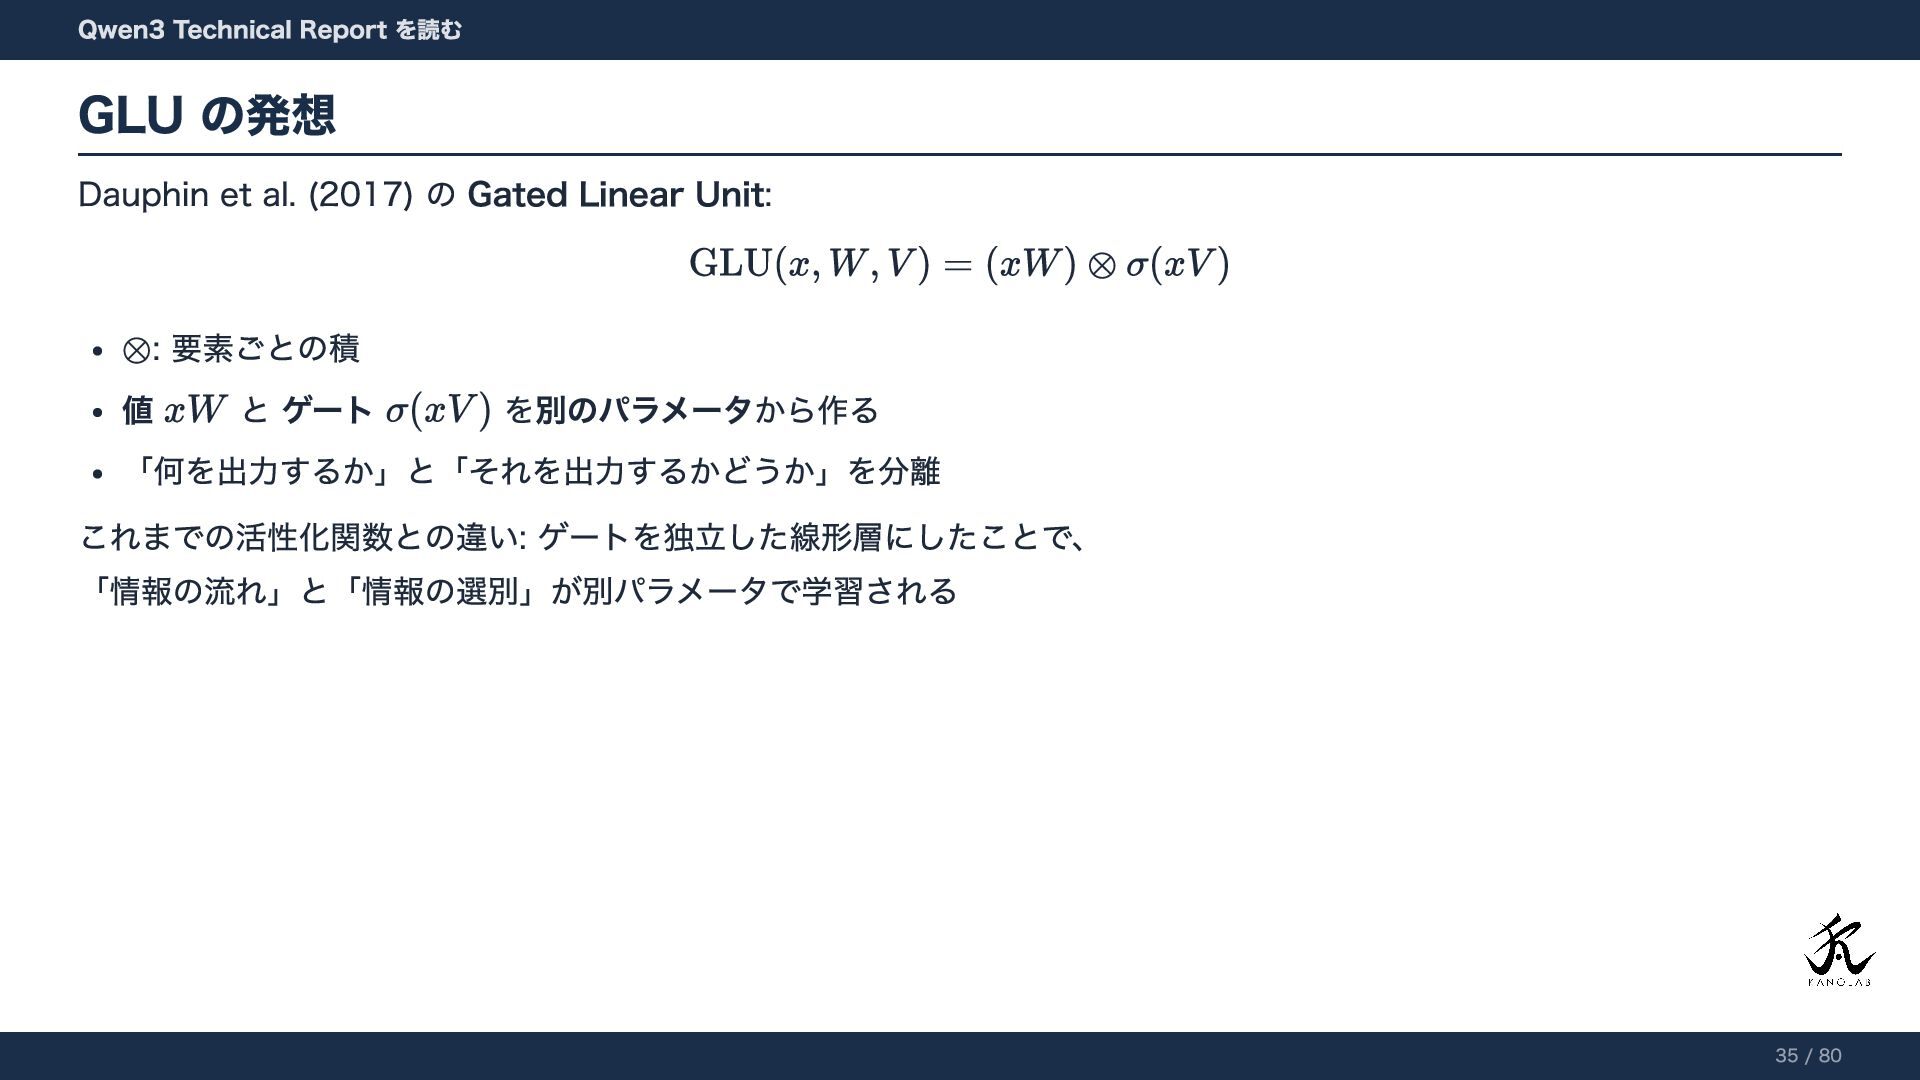
値 と ゲート を別のパラメータから作る 「何を出力するか」と「それを出力するかどうか」を分離 これまでの活性化関数との違い: ゲートを独立した線形層にしたことで、 「情報の流れ」と「情報の選別」が別パラメータで学習される Qwen3 Technical Report を読む GLU の発想 35 / 80
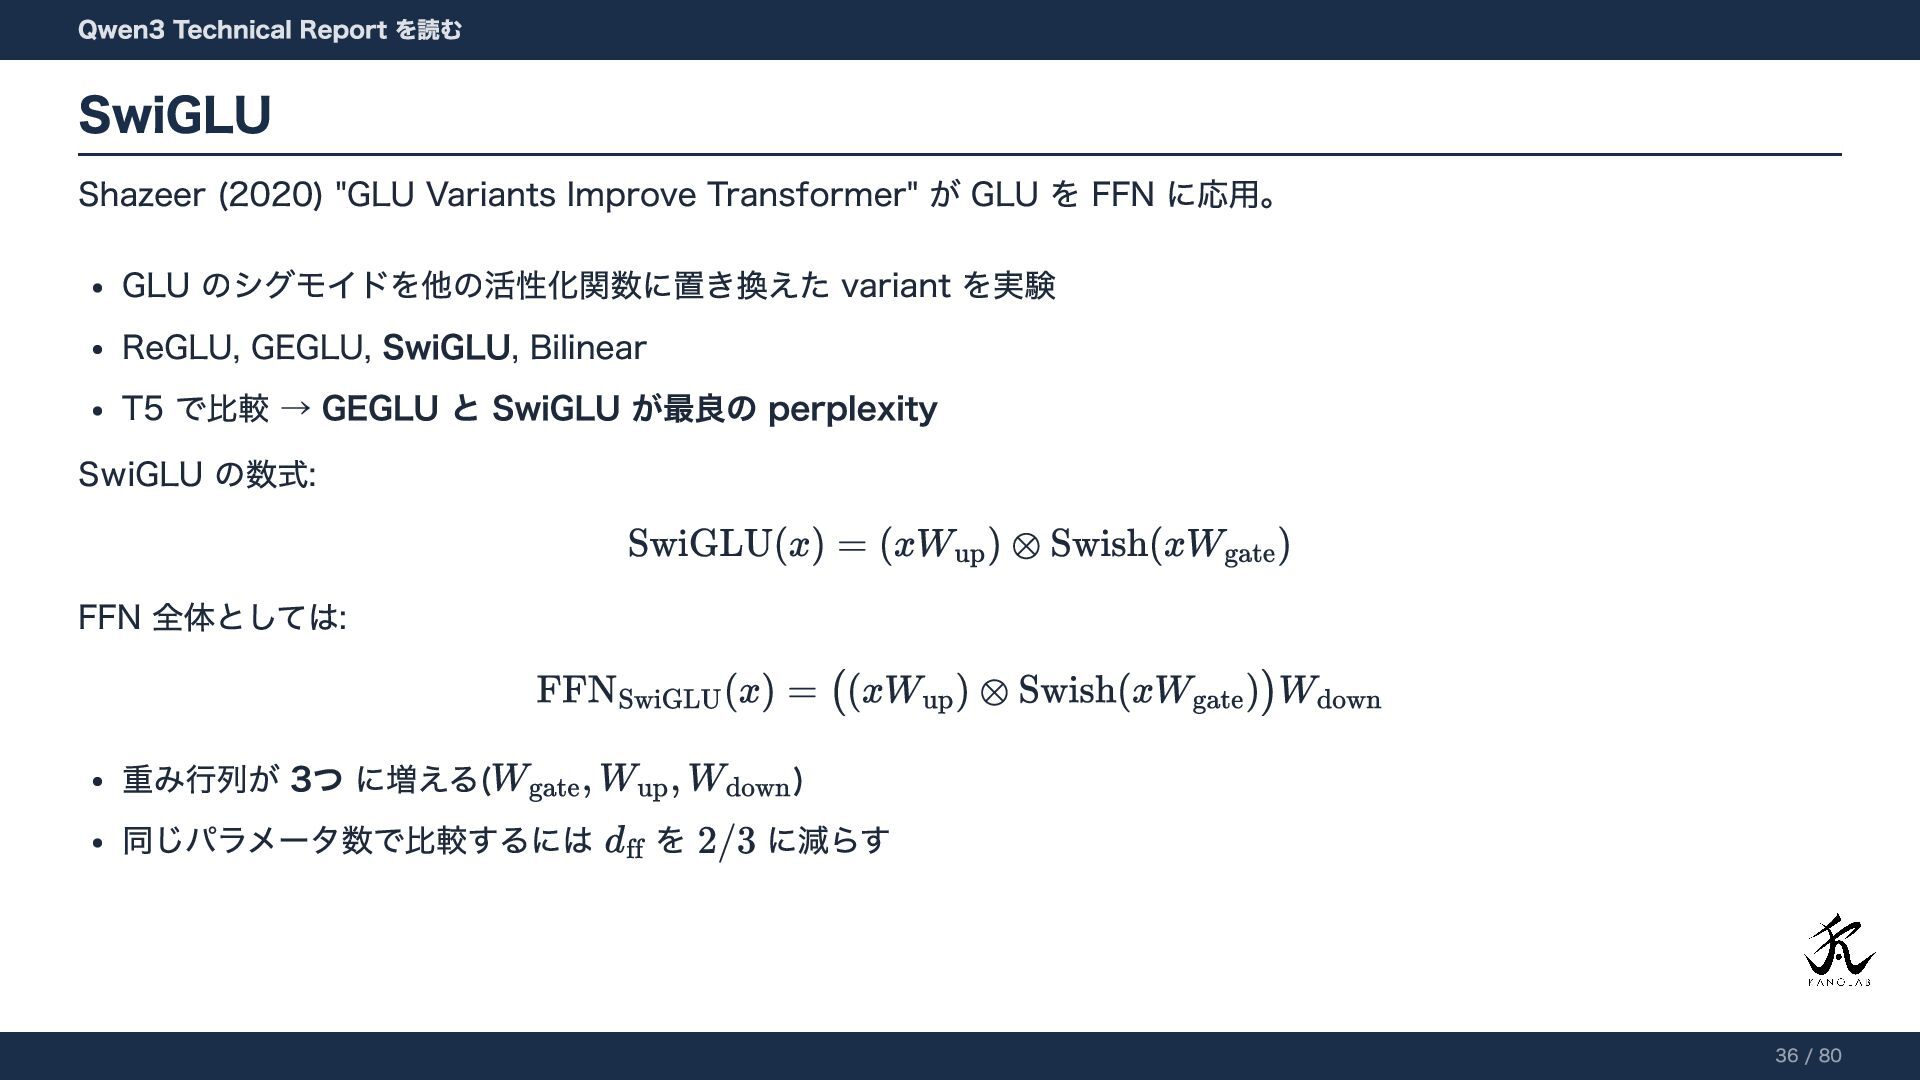
Shazeer (2020) "GLU Variants Improve Transformer" が GLU を FFN
に応用。 GLU のシグモイドを他の活性化関数に置き換えた variant を実験 ReGLU, GEGLU, SwiGLU, Bilinear T5 で比較 → GEGLU と SwiGLU が最良の perplexity SwiGLU の数式: FFN 全体としては: 重み行列が 3つ に増える( ) 同じパラメータ数で比較するには を に減らす Qwen3 Technical Report を読む SwiGLU 36 / 80
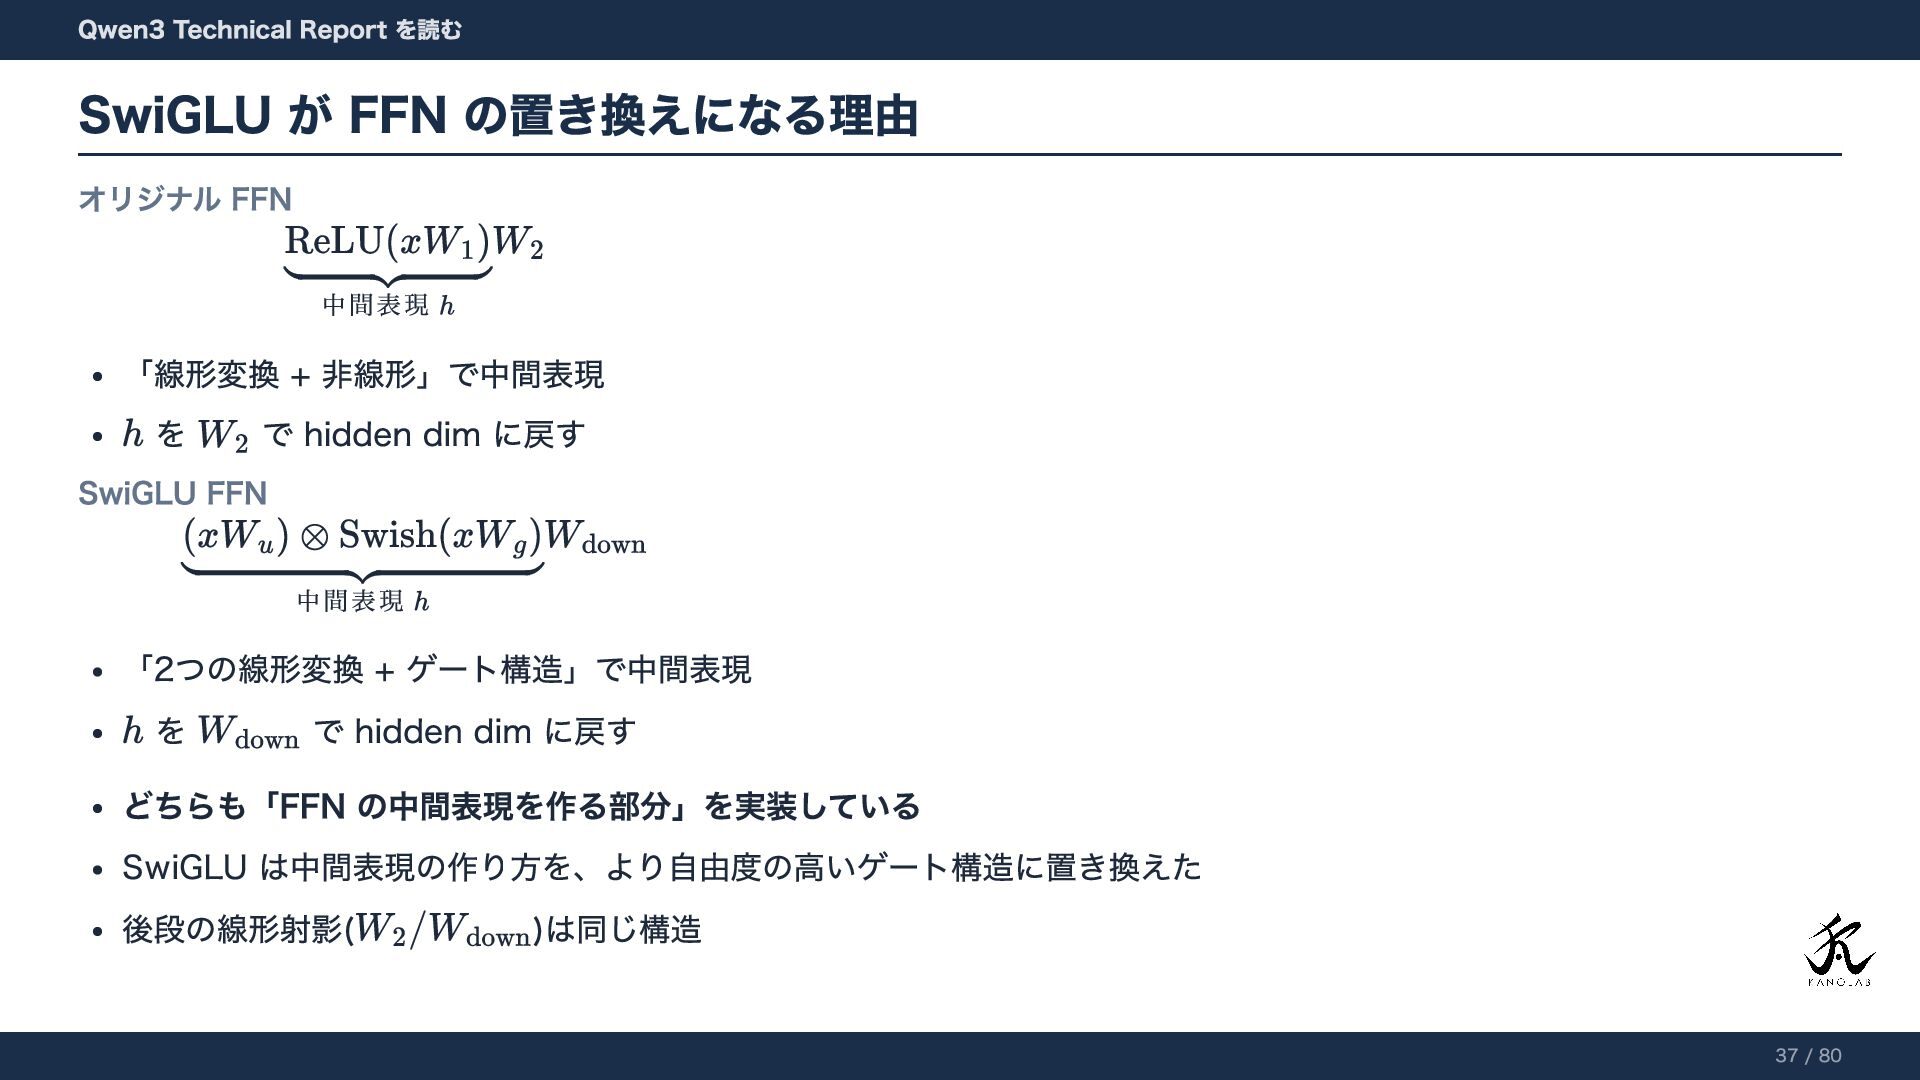
オリジナル FFN 中間表現 「線形変換 + 非線形」で中間表現 を で hidden dim
に戻す SwiGLU FFN 中間表現 「2つの線形変換 + ゲート構造」で中間表現 を で hidden dim に戻す どちらも「FFN の中間表現を作る部分」を実装している SwiGLU は中間表現の作り方を、より自由度の高いゲート構造に置き換えた 後段の線形射影( )は同じ構造 Qwen3 Technical Report を読む SwiGLU が FFN の置き換えになる理由 37 / 80
5.2 MoE の基礎 Qwen3 Technical Report を読む 38 / 80
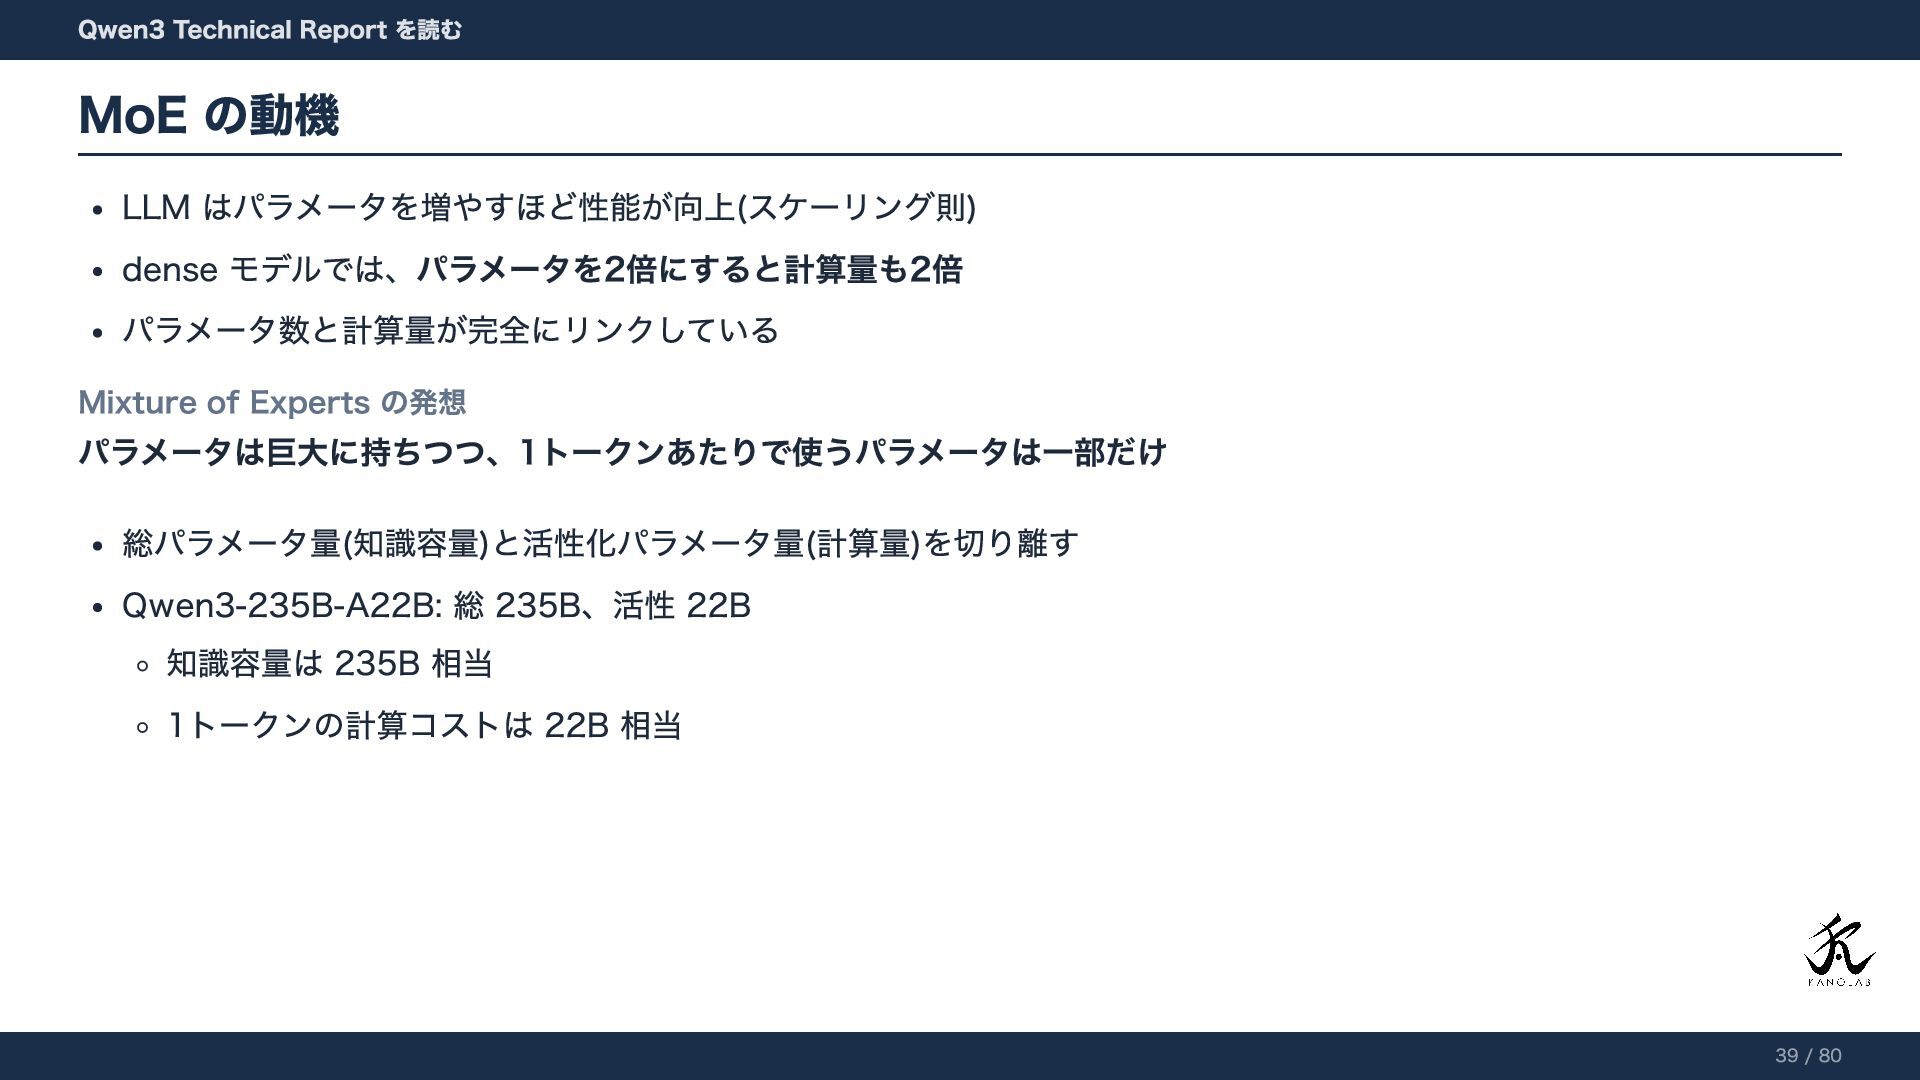
LLM はパラメータを増やすほど性能が向上(スケーリング則) dense モデルでは、パラメータを2倍にすると計算量も2倍 パラメータ数と計算量が完全にリンクしている Mixture of Experts の発想 パラメータは巨大に持ちつつ、1トークンあたりで使うパラメータは一部だけ
総パラメータ量(知識容量)と活性化パラメータ量(計算量)を切り離す Qwen3-235B-A22B: 総 235B、活性 22B 知識容量は 235B 相当 1トークンの計算コストは 22B 相当 Qwen3 Technical Report を読む MoE の動機 39 / 80
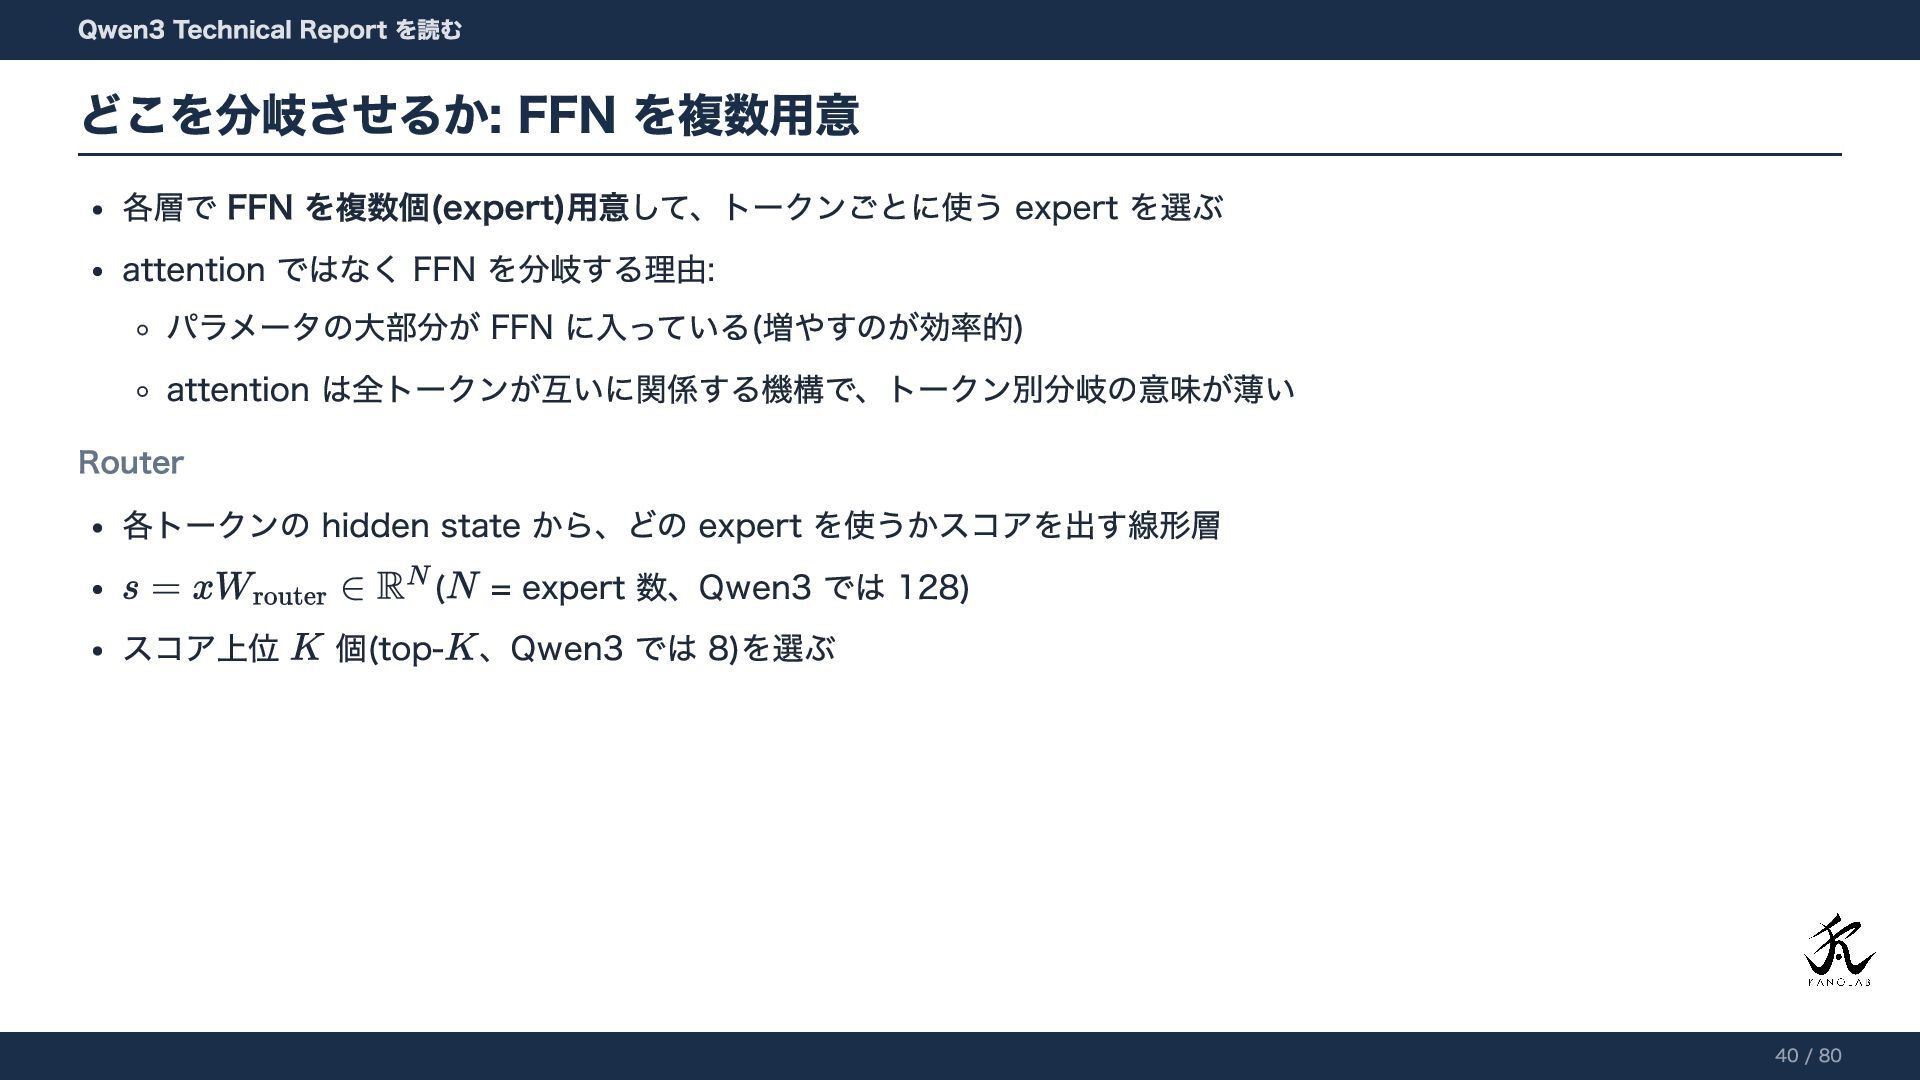
各層で FFN を複数個(expert)用意して、トークンごとに使う expert を選ぶ attention ではなく FFN を分岐する理由: パラメータの大部分が
FFN に入っている(増やすのが効率的) attention は全トークンが互いに関係する機構で、トークン別分岐の意味が薄い Router 各トークンの hidden state から、どの expert を使うかスコアを出す線形層 ( = expert 数、Qwen3 では 128) スコア上位 個(top- 、Qwen3 では 8)を選ぶ Qwen3 Technical Report を読む どこを分岐させるか: FFN を複数用意 40 / 80
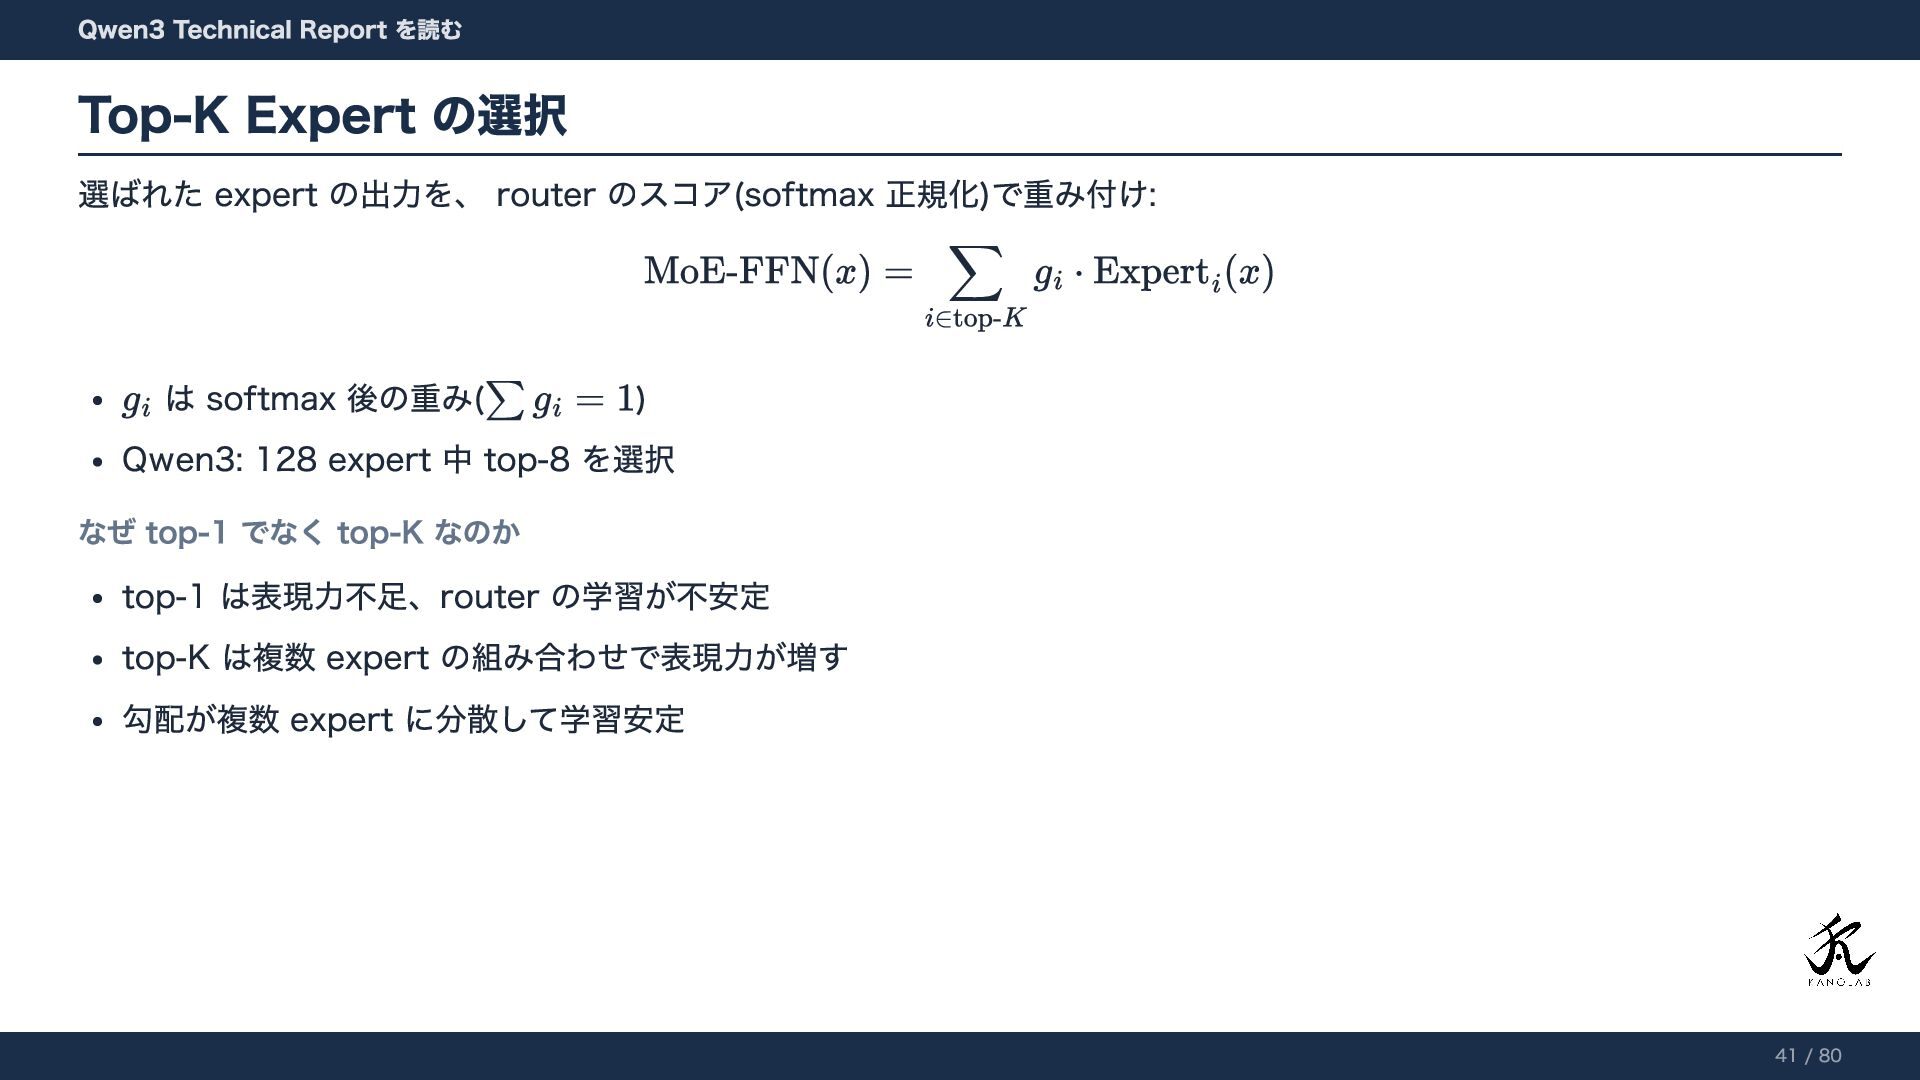
選ばれた expert の出力を、 router のスコア(softmax 正規化)で重み付け: は softmax 後の重み( )
Qwen3: 128 expert 中 top-8 を選択 なぜ top-1 でなく top-K なのか top-1 は表現力不足、router の学習が不安定 top-K は複数 expert の組み合わせで表現力が増す 勾配が複数 expert に分散して学習安定 Qwen3 Technical Report を読む Top-K Expert の選択 41 / 80
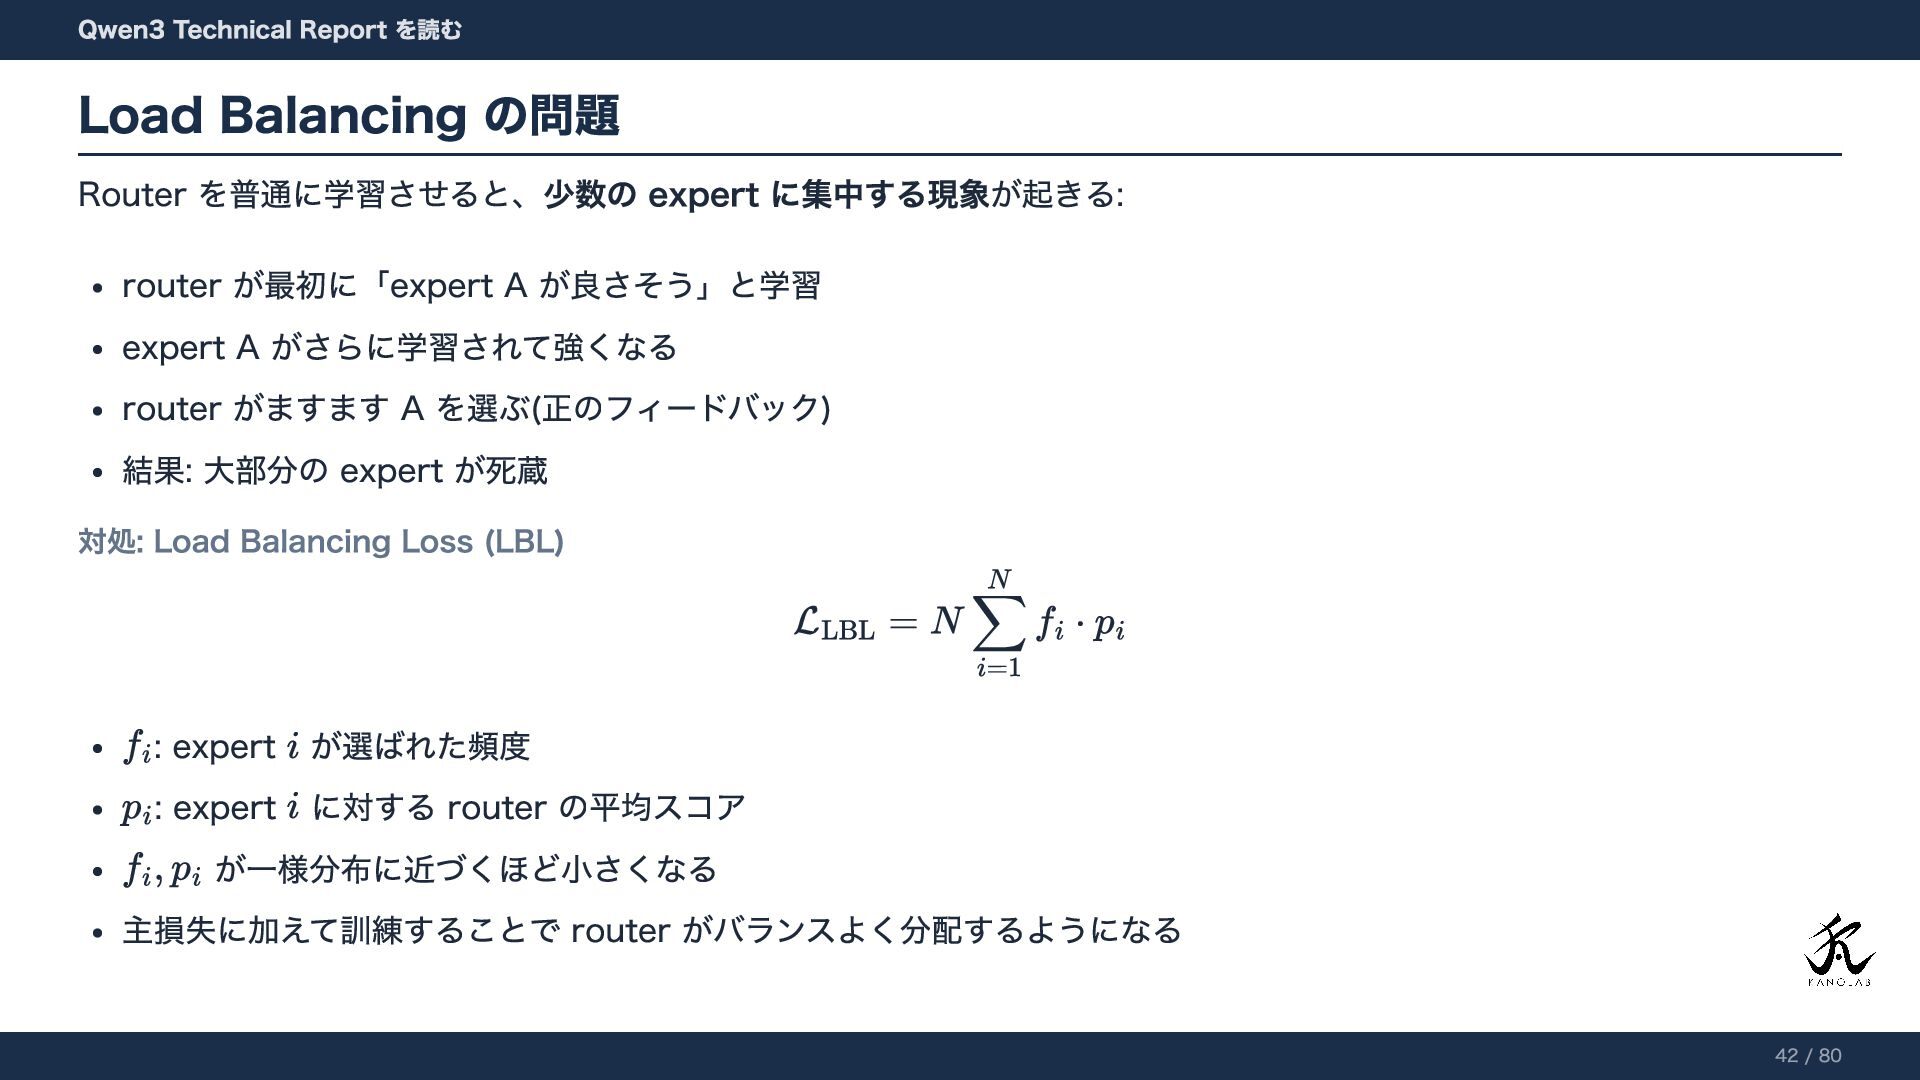
Router を普通に学習させると、少数の expert に集中する現象が起きる: router が最初に「expert A が良さそう」と学習 expert A
がさらに学習されて強くなる router がますます A を選ぶ(正のフィードバック) 結果: 大部分の expert が死蔵 対処: Load Balancing Loss (LBL) : expert が選ばれた頻度 : expert に対する router の平均スコア が一様分布に近づくほど小さくなる 主損失に加えて訓練することで router がバランスよく分配するようになる Qwen3 Technical Report を読む Load Balancing の問題 42 / 80
5.3 DeepSeekMoE の2つの工夫 Qwen3 Technical Report を読む 43 / 80
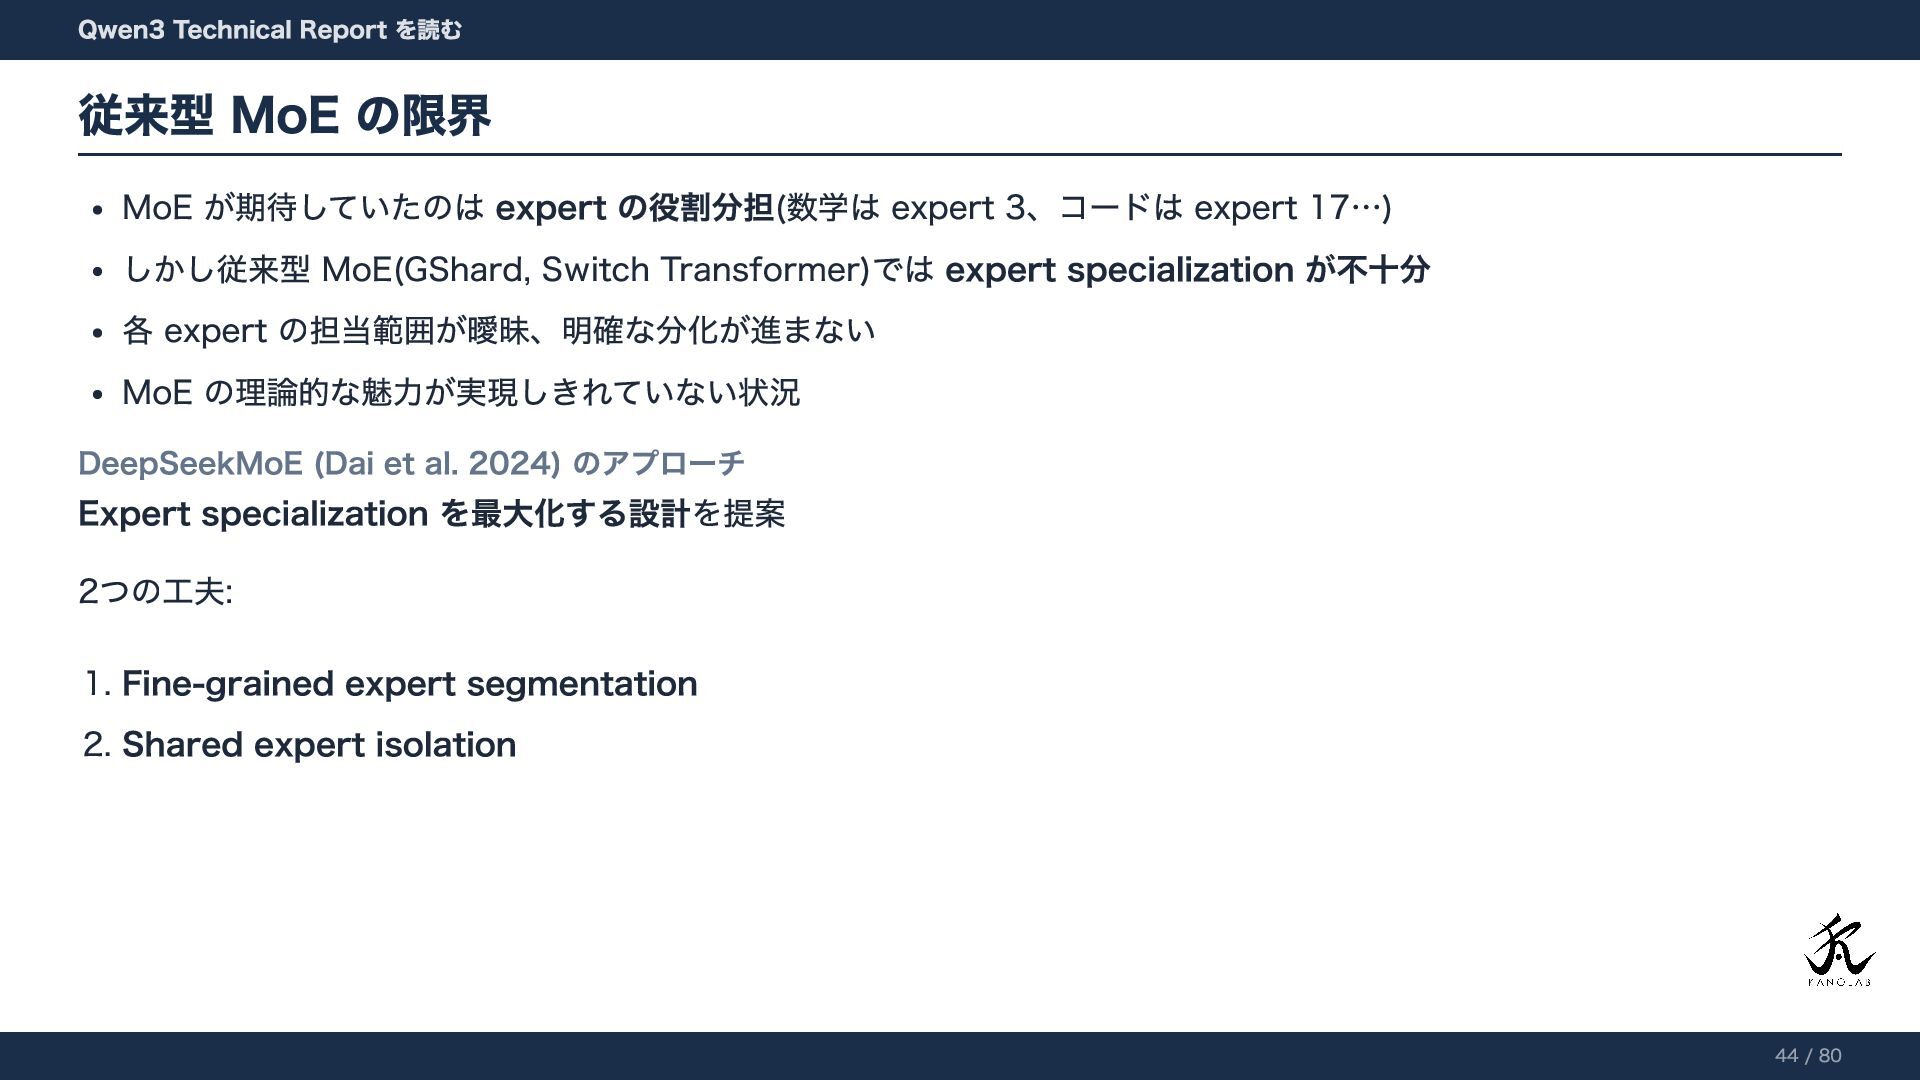
MoE が期待していたのは expert の役割分担(数学は expert 3、コードは expert 17…) しかし従来型 MoE(GShard,
Switch Transformer)では expert specialization が不十分 各 expert の担当範囲が曖昧、明確な分化が進まない MoE の理論的な魅力が実現しきれていない状況 DeepSeekMoE (Dai et al. 2024) のアプローチ Expert specialization を最大化する設計を提案 2つの工夫: 1. Fine-grained expert segmentation 2. Shared expert isolation Qwen3 Technical Report を読む 従来型 MoE の限界 44 / 80
Expert をもっと細かく分ける 発想。 各 expert の中間次元( )を 分の1に縮める 代わりに expert
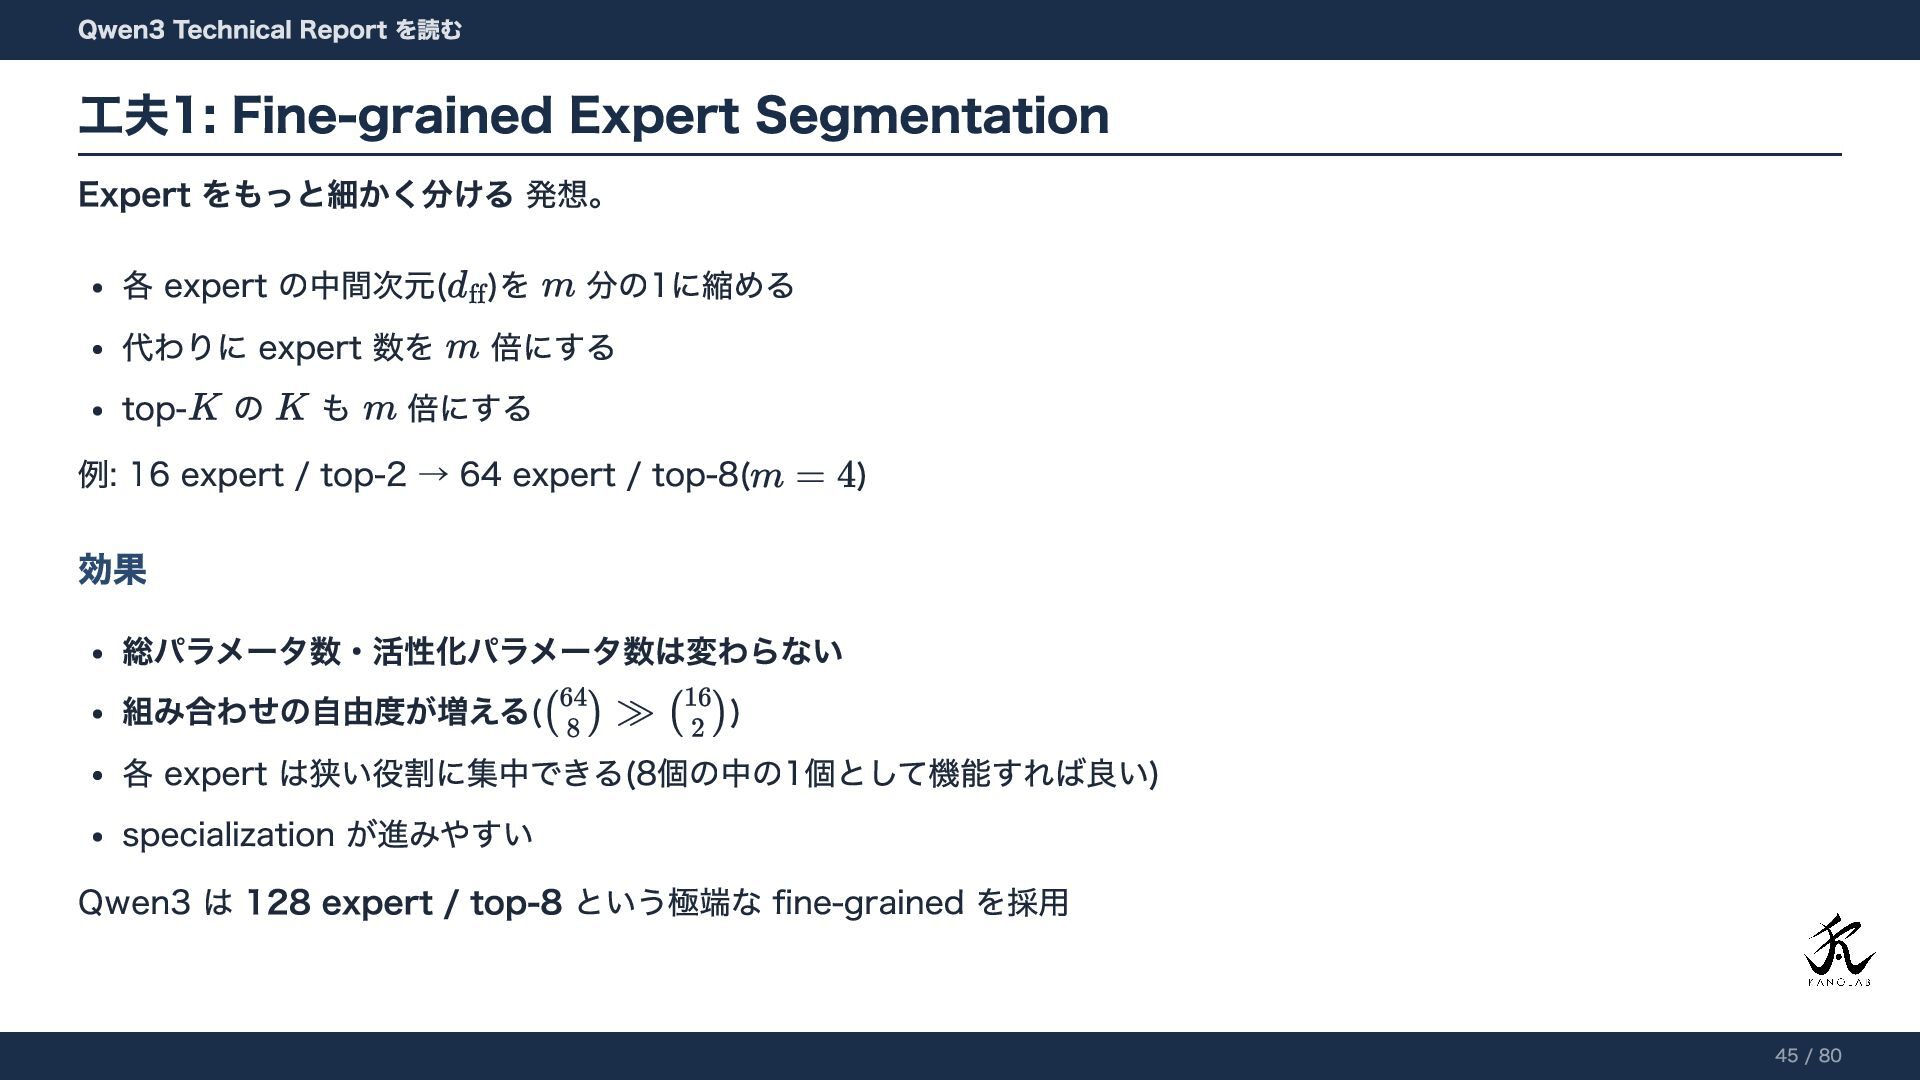
数を 倍にする top- の も 倍にする 例: 16 expert / top-2 → 64 expert / top-8( ) 効果 総パラメータ数・活性化パラメータ数は変わらない 組み合わせの自由度が増える( ) 各 expert は狭い役割に集中できる(8個の中の1個として機能すれば良い) specialization が進みやすい Qwen3 は 128 expert / top-8 という極端な fine-grained を採用 Qwen3 Technical Report を読む 工夫1: Fine-grained Expert Segmentation 45 / 80
一部の expert を常に全トークンが使う共通 expert として分離する 狙い 文法、一般常識、論理構造などの共通知識を shared expert に集約
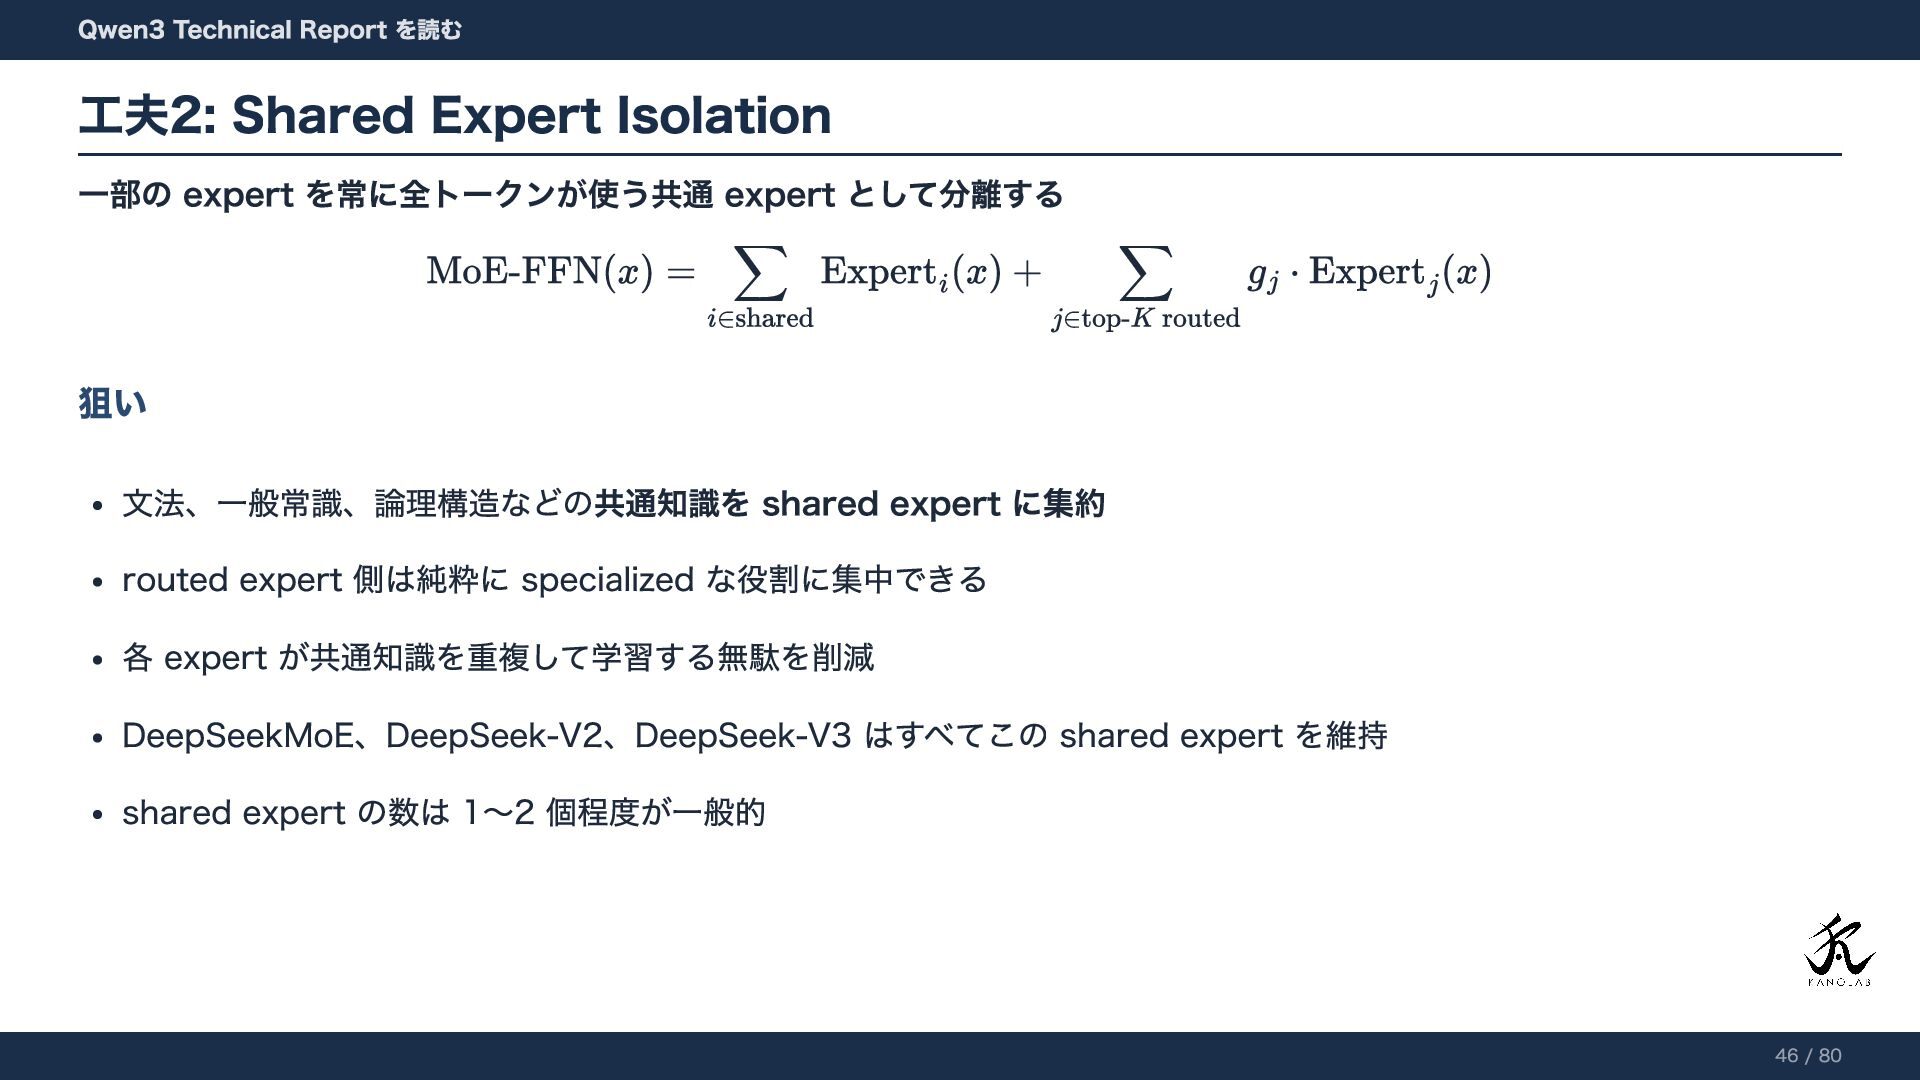
routed expert 側は純粋に specialized な役割に集中できる 各 expert が共通知識を重複して学習する無駄を削減 DeepSeekMoE、DeepSeek-V2、DeepSeek-V3 はすべてこの shared expert を維持 shared expert の数は 1〜2 個程度が一般的 Qwen3 Technical Report を読む 工夫2: Shared Expert Isolation 46 / 80
5.4 Qwen3 の MoE 設計 Qwen3 Technical Report を読む 47
/ 80
要素 DeepSeekMoE Qwen3-MoE Fine-grained segmentation ✓ ✓ 採用 Shared expert
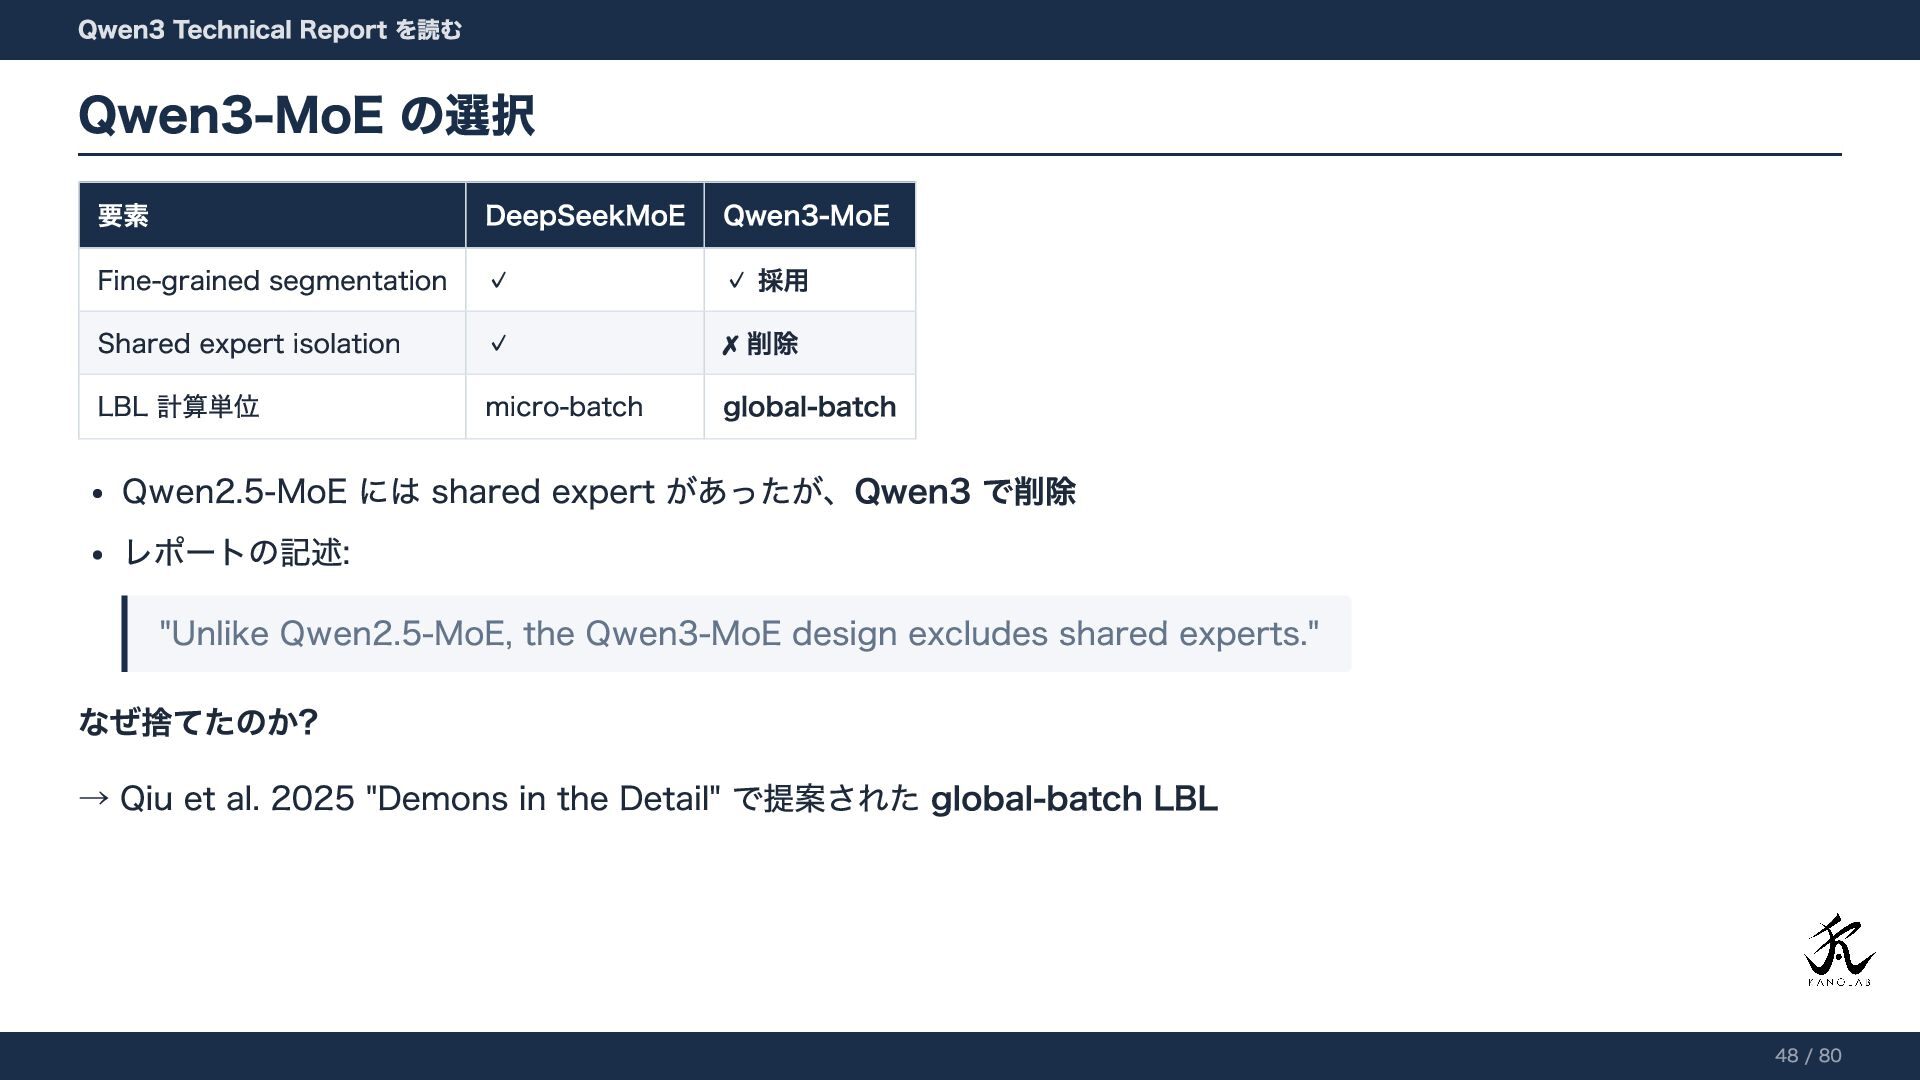
isolation ✓ ✗ 削除 LBL 計算単位 micro-batch global-batch Qwen2.5-MoE には shared expert があったが、Qwen3 で削除 レポートの記述: "Unlike Qwen2.5-MoE, the Qwen3-MoE design excludes shared experts." なぜ捨てたのか? → Qiu et al. 2025 "Demons in the Detail" で提案された global-batch LBL Qwen3 Technical Report を読む Qwen3-MoE の選択 48 / 80
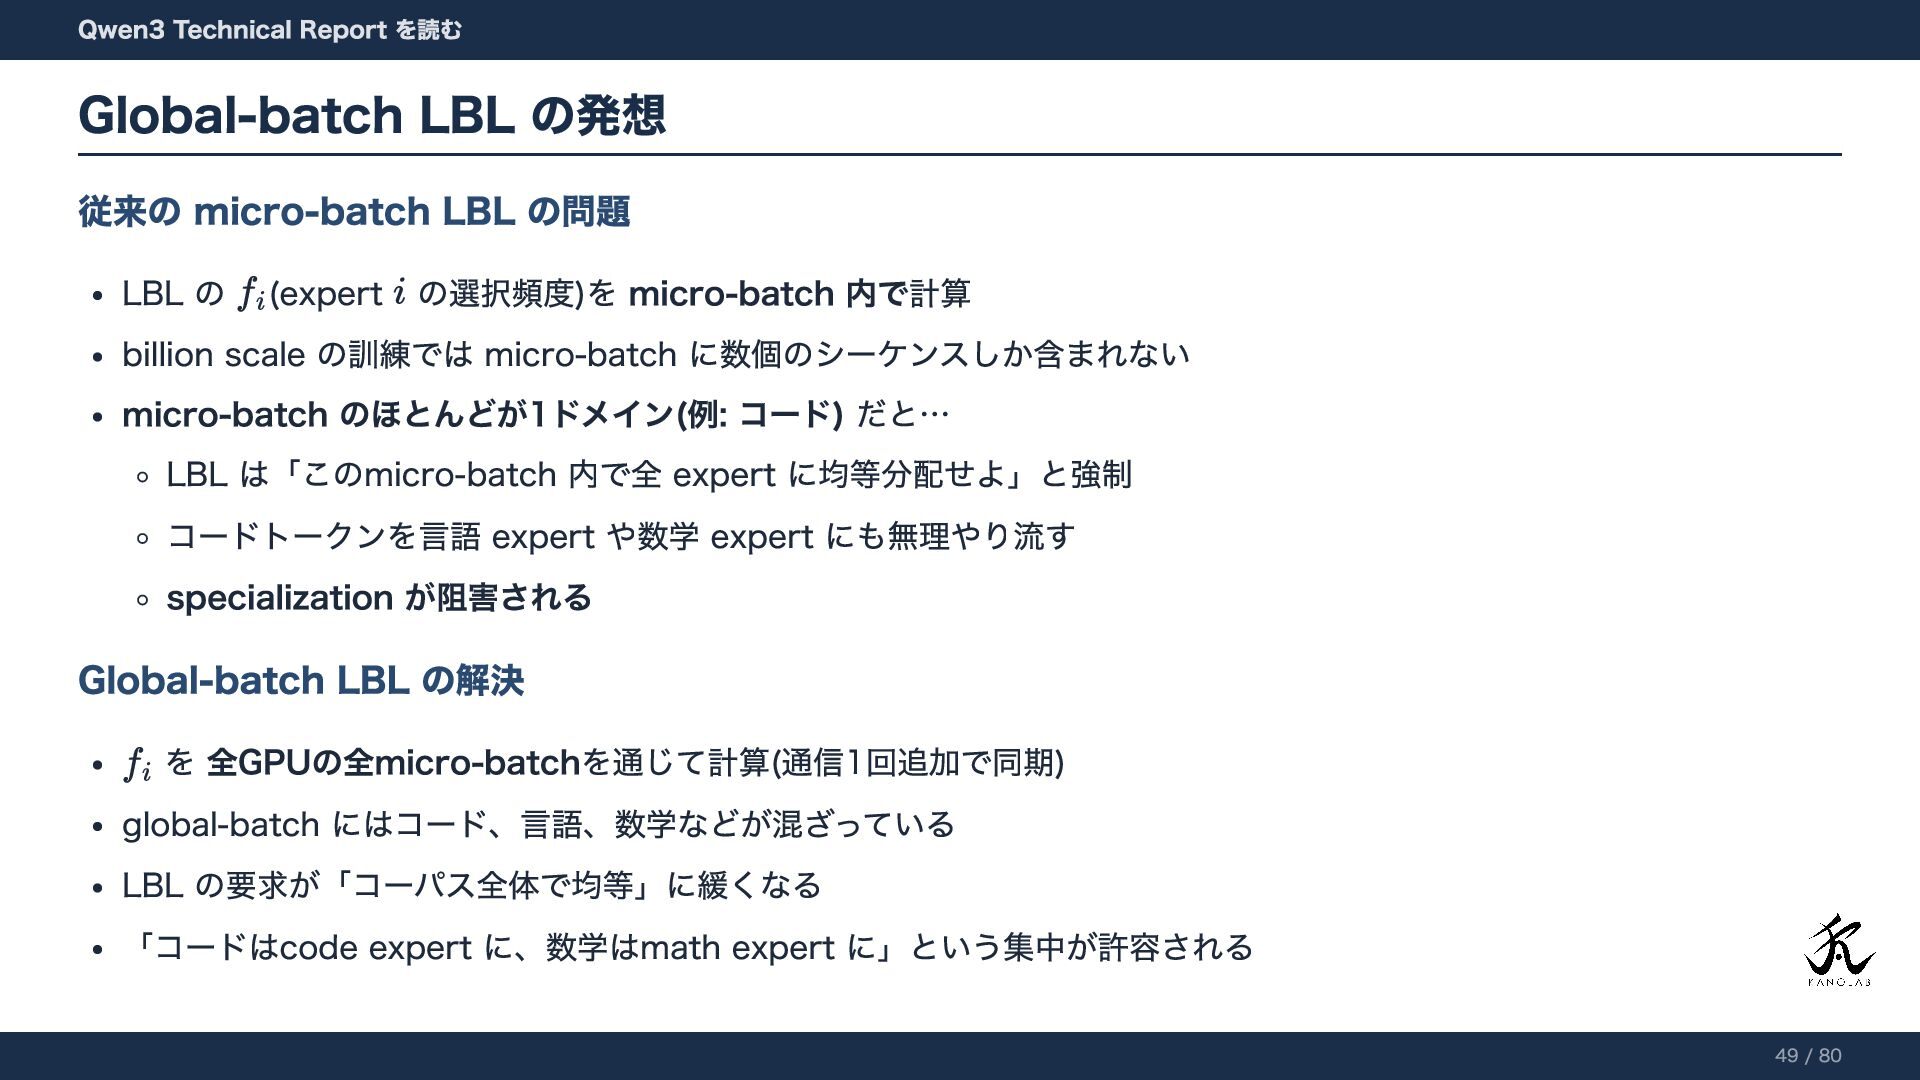
従来の micro-batch LBL の問題 LBL の (expert の選択頻度)を micro-batch 内で計算
billion scale の訓練では micro-batch に数個のシーケンスしか含まれない micro-batch のほとんどが1ドメイン(例: コード) だと… LBL は「このmicro-batch 内で全 expert に均等分配せよ」と強制 コードトークンを言語 expert や数学 expert にも無理やり流す specialization が阻害される Global-batch LBL の解決 を 全GPUの全micro-batchを通じて計算(通信1回追加で同期) global-batch にはコード、言語、数学などが混ざっている LBL の要求が「コーパス全体で均等」に緩くなる 「コードはcode expert に、数学はmath expert に」という集中が許容される Qwen3 Technical Report を読む Global-batch LBL の発想 49 / 80
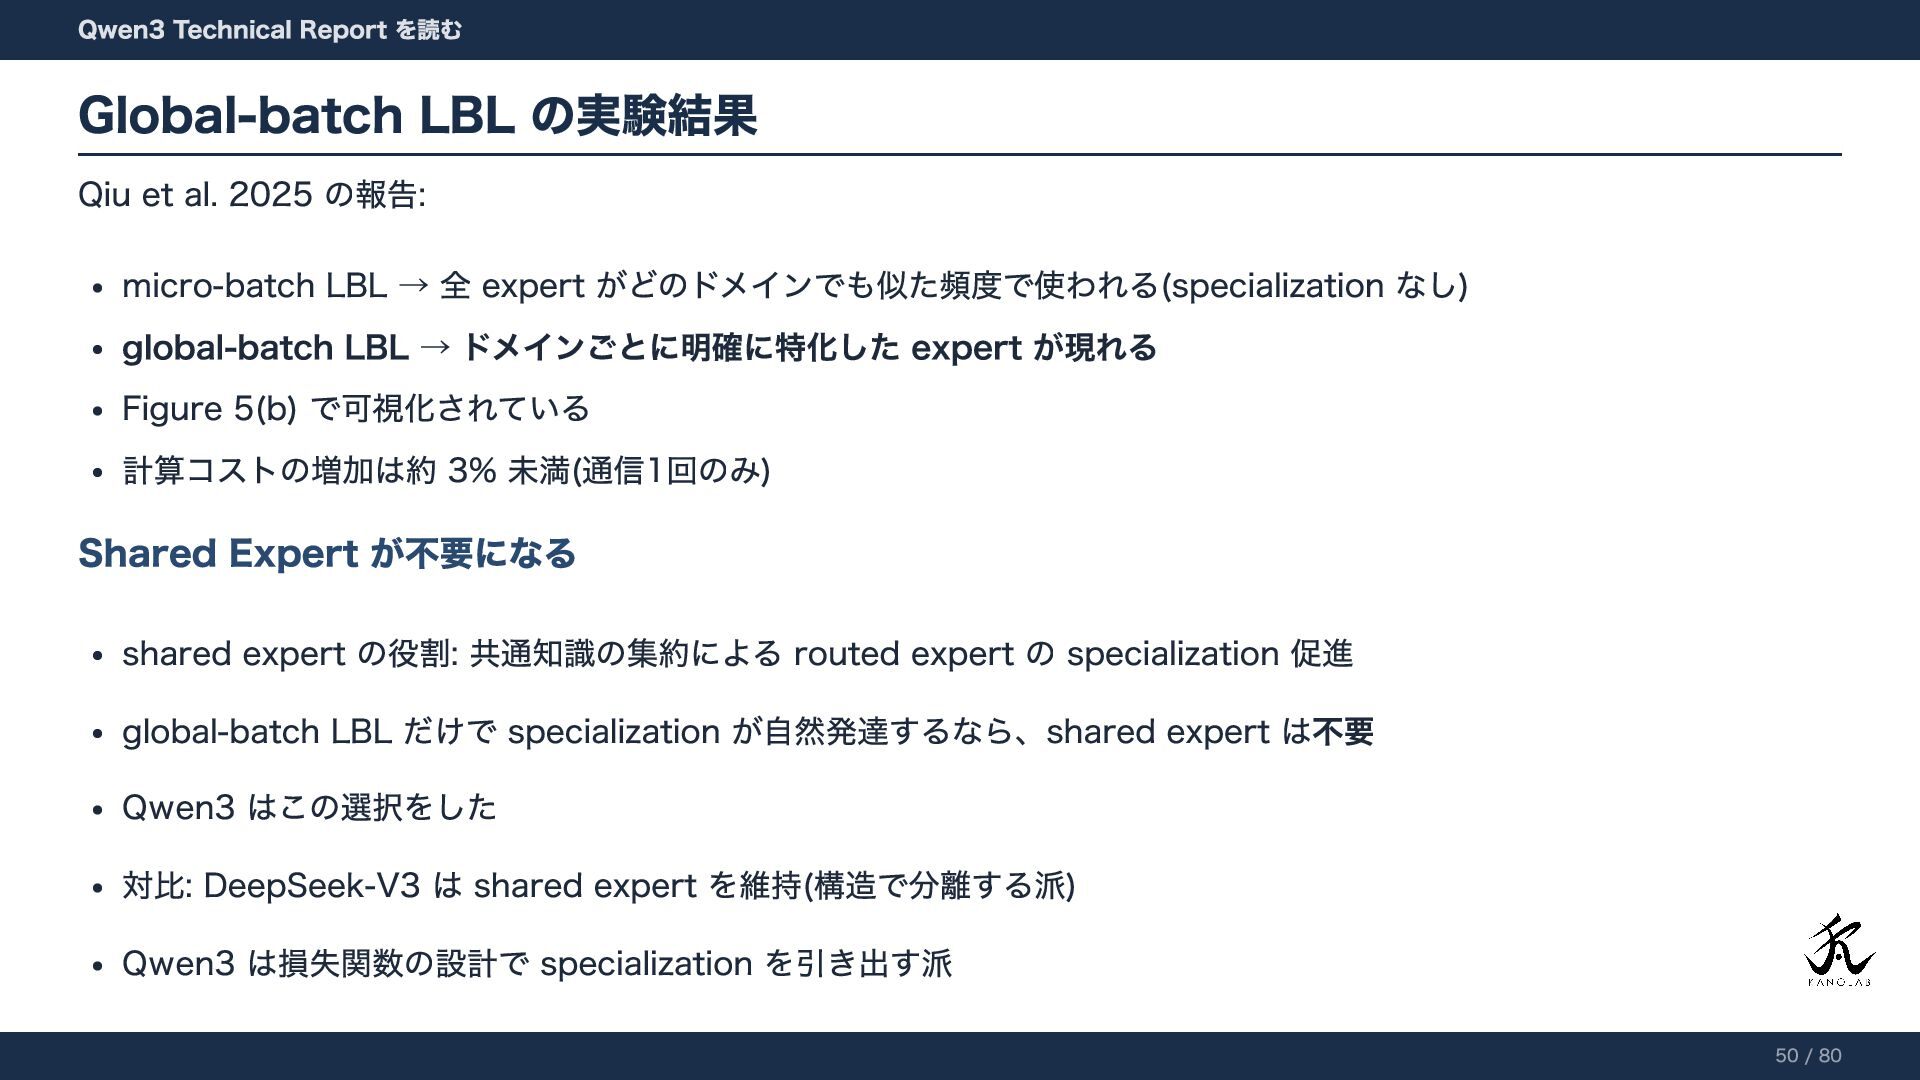
Qiu et al. 2025 の報告: micro-batch LBL → 全 expert
がどのドメインでも似た頻度で使われる(specialization なし) global-batch LBL → ドメインごとに明確に特化した expert が現れる Figure 5(b) で可視化されている 計算コストの増加は約 3% 未満(通信1回のみ) Shared Expert が不要になる shared expert の役割: 共通知識の集約による routed expert の specialization 促進 global-batch LBL だけで specialization が自然発達するなら、shared expert は不要 Qwen3 はこの選択をした 対比: DeepSeek-V3 は shared expert を維持(構造で分離する派) Qwen3 は損失関数の設計で specialization を引き出す派 Qwen3 Technical Report を読む Global-batch LBL の実験結果 50 / 80
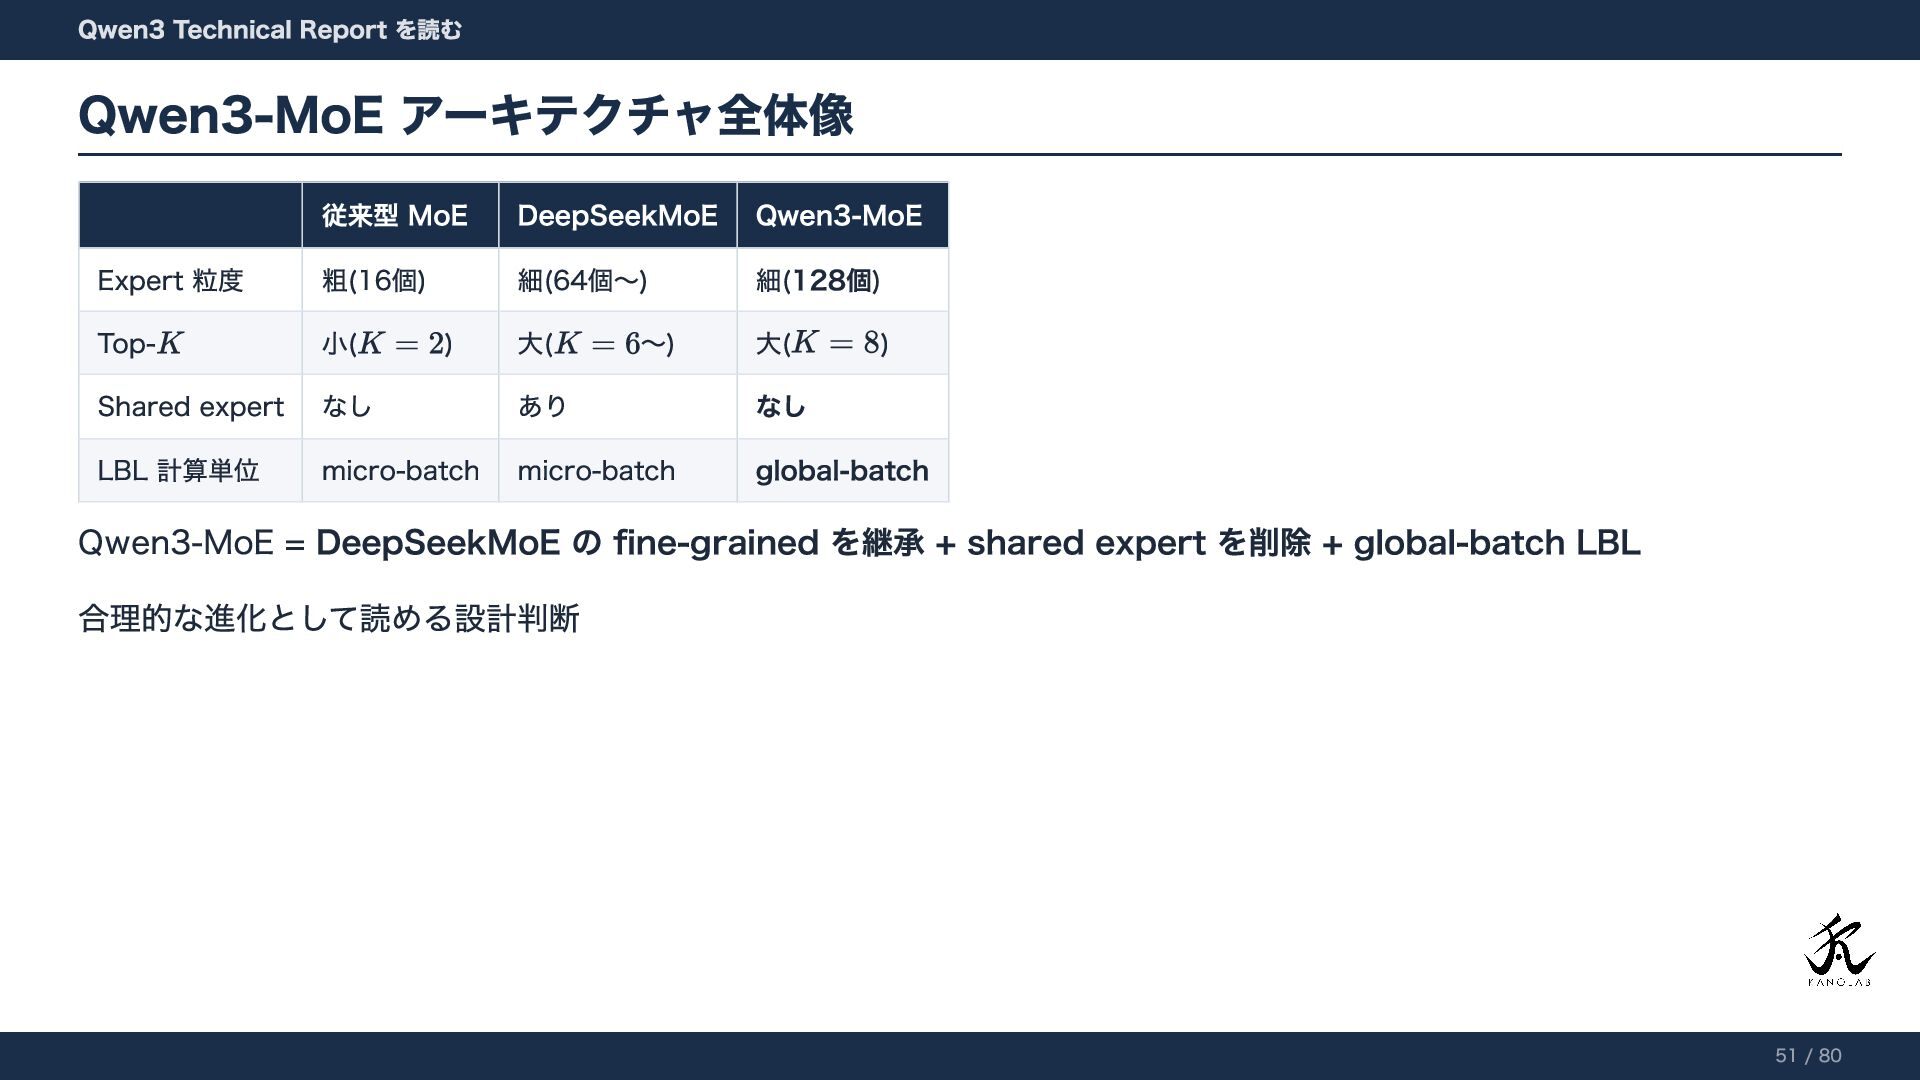
従来型 MoE DeepSeekMoE Qwen3-MoE Expert 粒度 粗(16個) 細(64個〜) 細(128個) Top-
小( ) 大( 〜) 大( ) Shared expert なし あり なし LBL 計算単位 micro-batch micro-batch global-batch Qwen3-MoE = DeepSeekMoE の fine-grained を継承 + shared expert を削除 + global-batch LBL 合理的な進化として読める設計判断 Qwen3 Technical Report を読む Qwen3-MoE アーキテクチャ全体像 51 / 80
6. 長文脈拡張の3層構造 Qwen3 Technical Report を読む 52 / 80
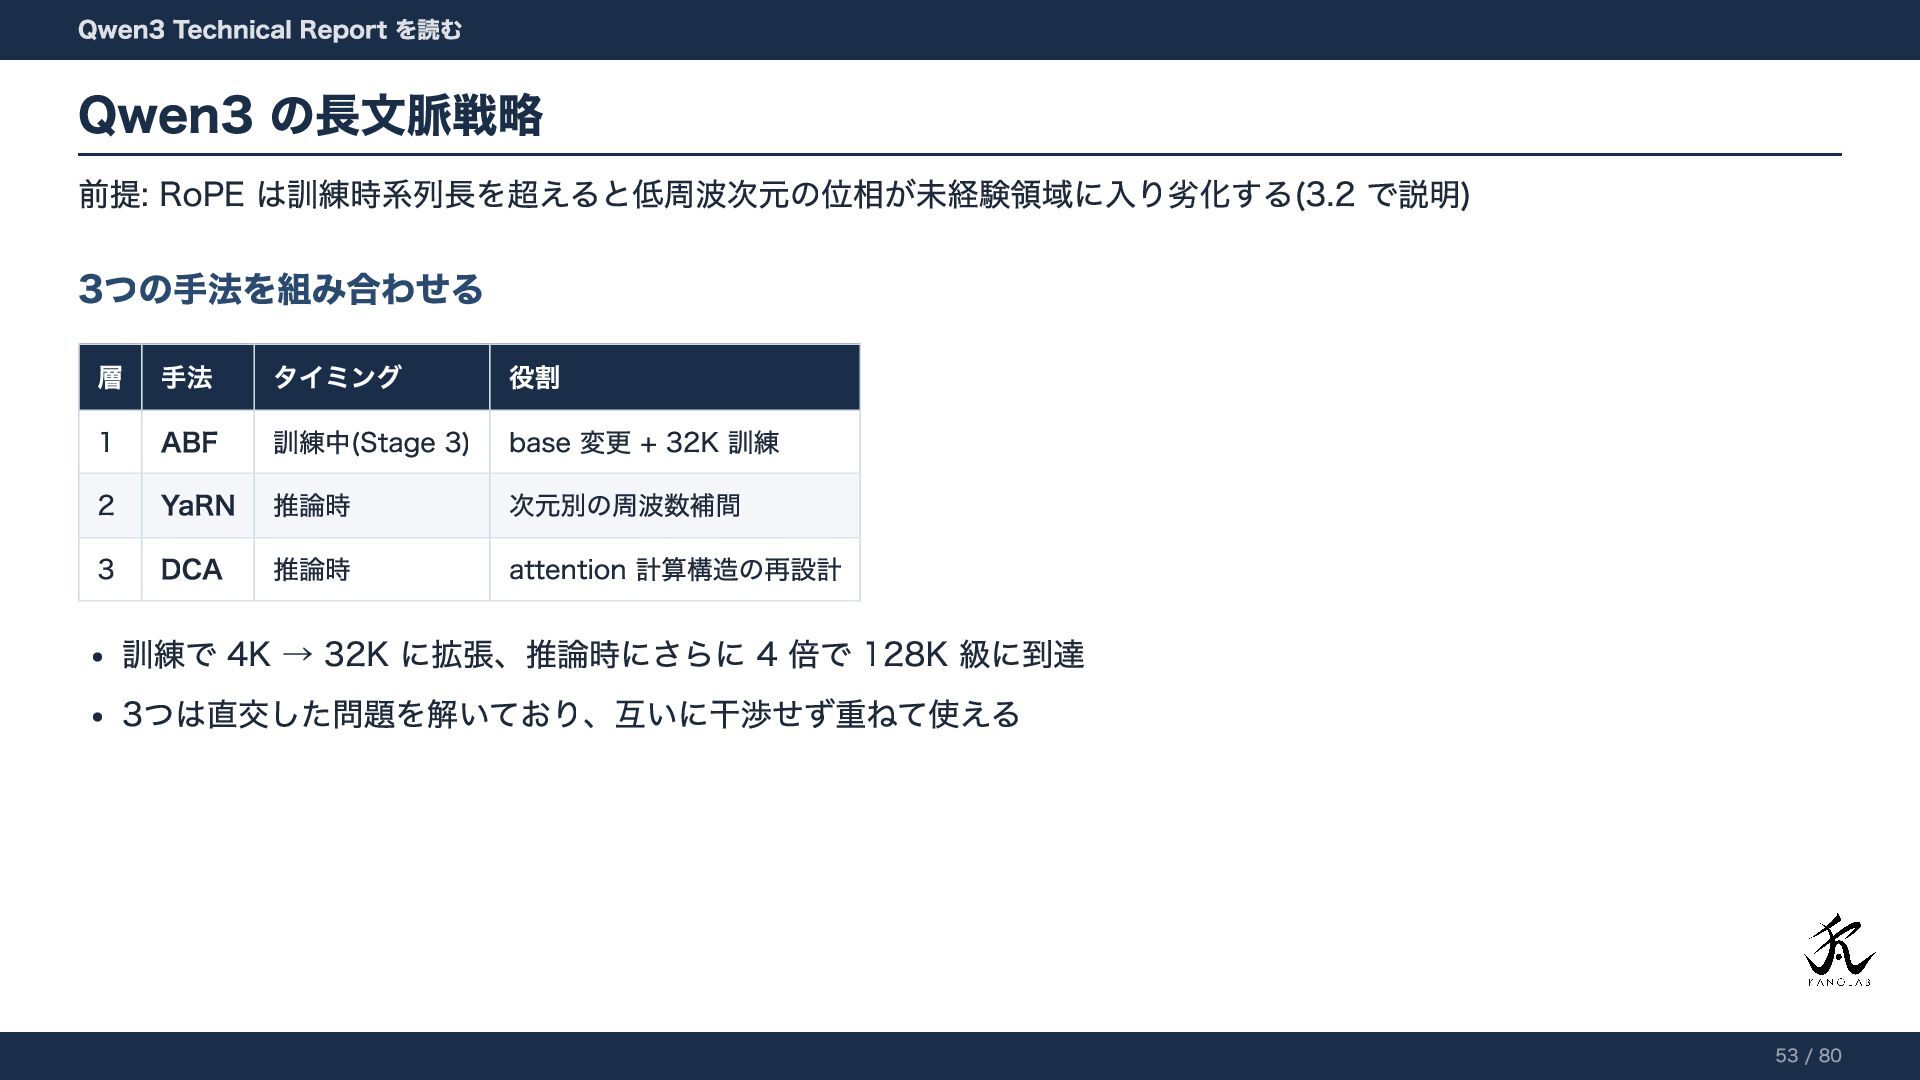
前提: RoPE は訓練時系列長を超えると低周波次元の位相が未経験領域に入り劣化する(3.2 で説明) 3つの手法を組み合わせる 層 手法 タイミング 役割 1
ABF 訓練中(Stage 3) base 変更 + 32K 訓練 2 YaRN 推論時 次元別の周波数補間 3 DCA 推論時 attention 計算構造の再設計 訓練で 4K → 32K に拡張、推論時にさらに 4 倍で 128K 級に到達 3つは直交した問題を解いており、互いに干渉せず重ねて使える Qwen3 Technical Report を読む Qwen3 の長文脈戦略 53 / 80
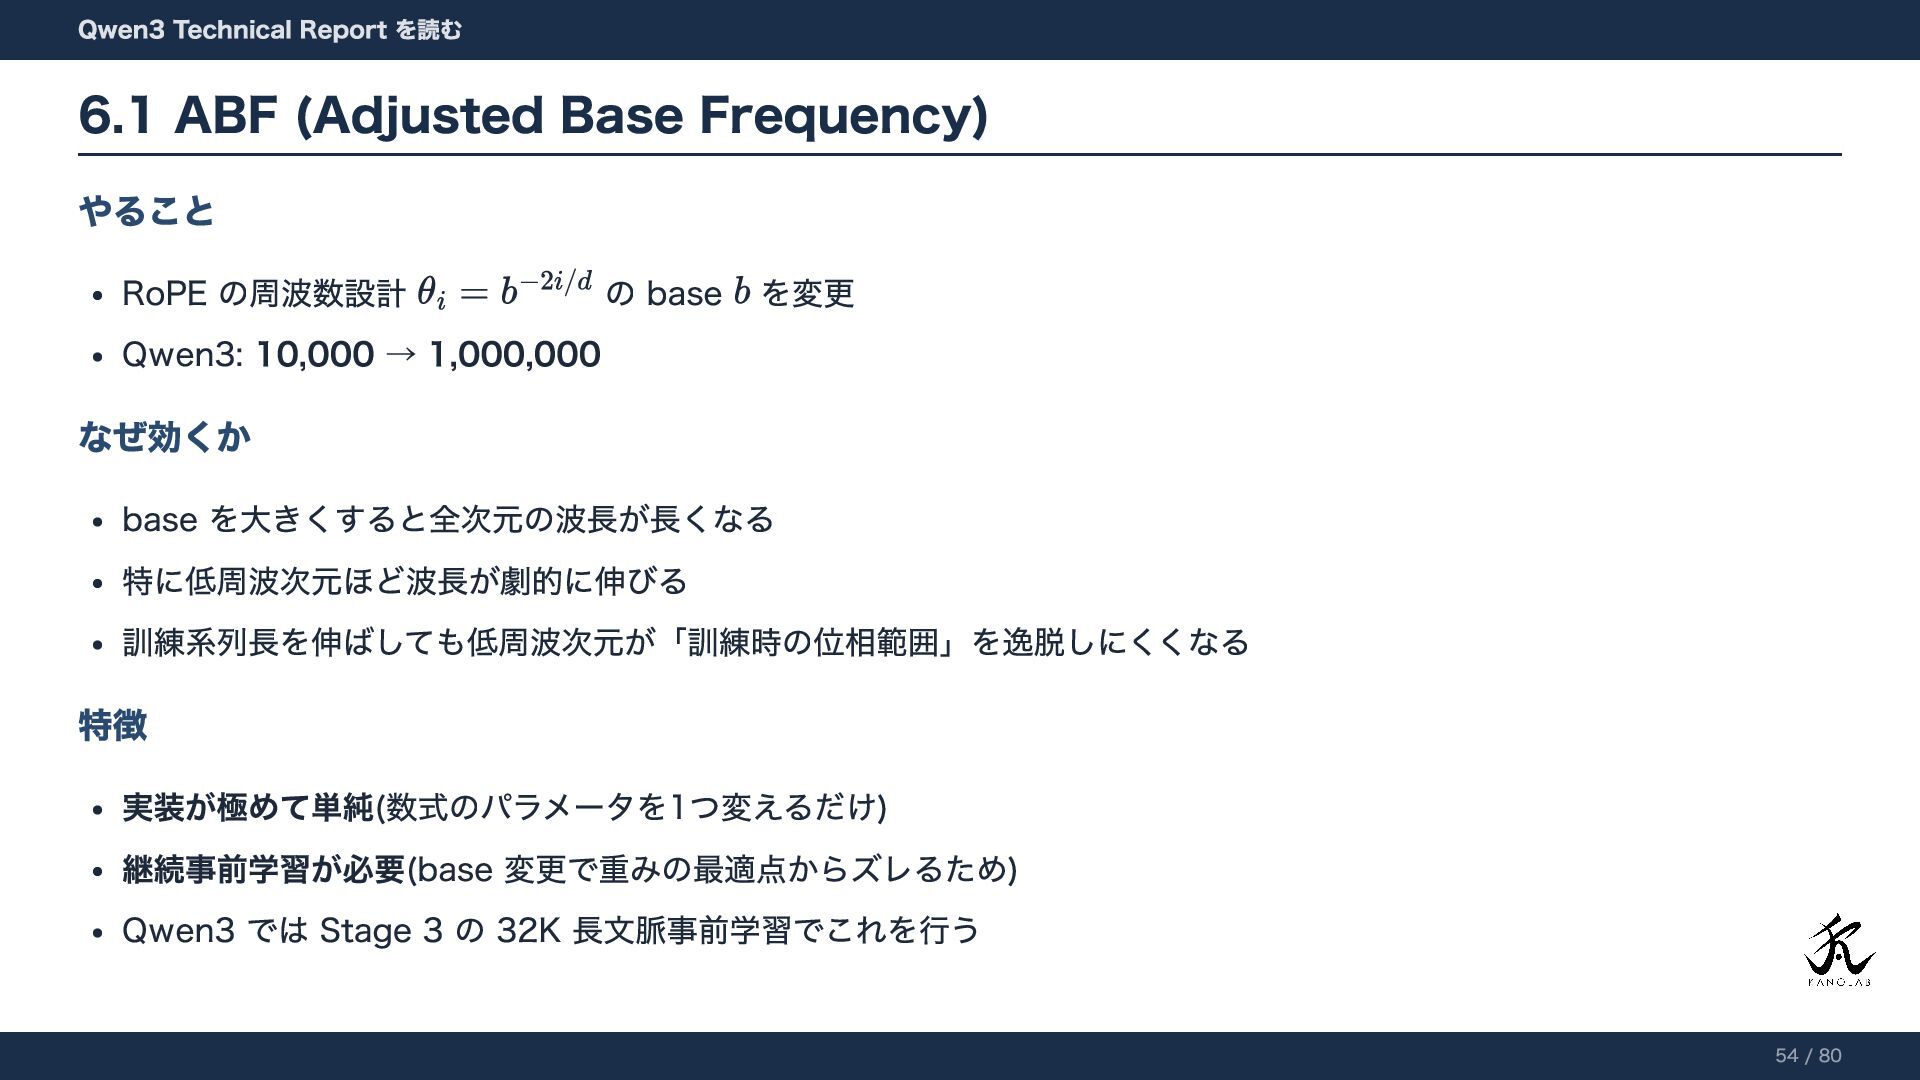
やること RoPE の周波数設計 の base を変更 Qwen3: 10,000 → 1,000,000
なぜ効くか base を大きくすると全次元の波長が長くなる 特に低周波次元ほど波長が劇的に伸びる 訓練系列長を伸ばしても低周波次元が「訓練時の位相範囲」を逸脱しにくくなる 特徴 実装が極めて単純(数式のパラメータを1つ変えるだけ) 継続事前学習が必要(base 変更で重みの最適点からズレるため) Qwen3 では Stage 3 の 32K 長文脈事前学習でこれを行う Qwen3 Technical Report を読む 6.1 ABF (Adjusted Base Frequency) 54 / 80
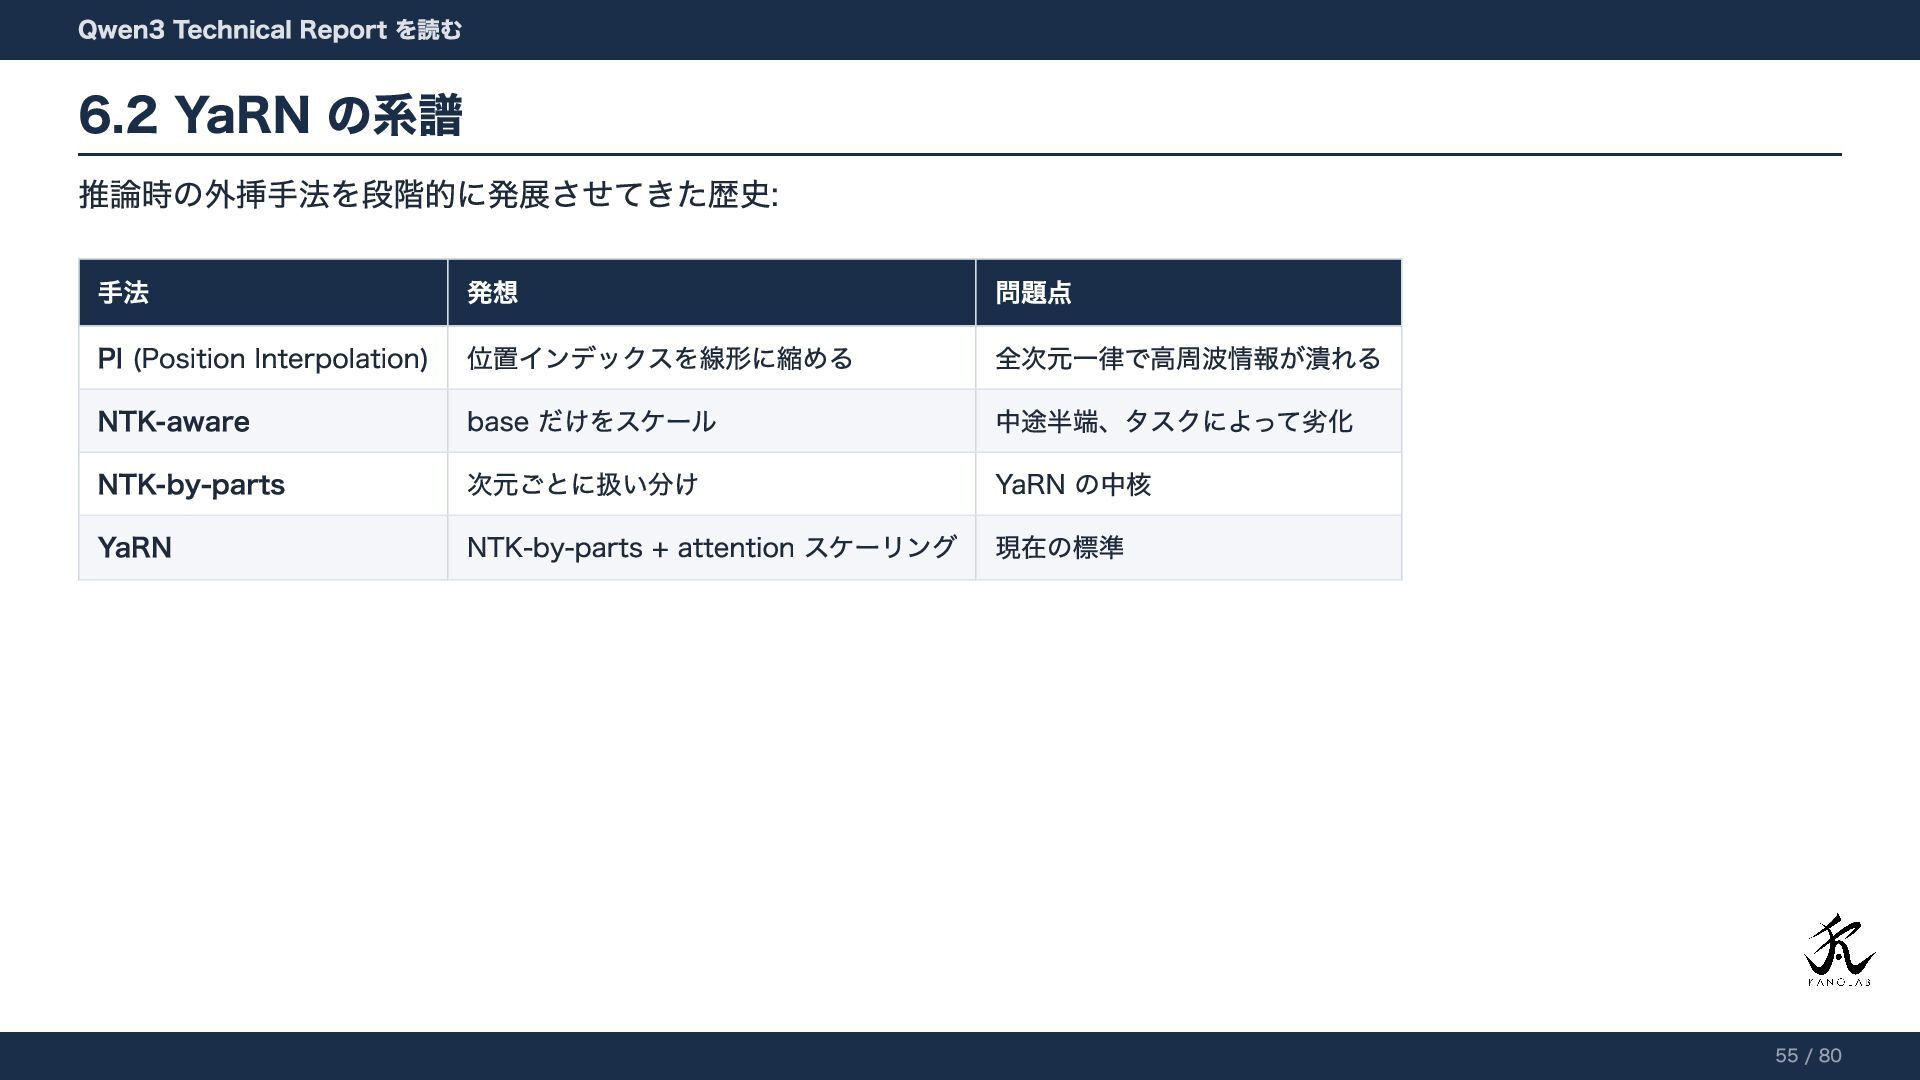
推論時の外挿手法を段階的に発展させてきた歴史: 手法 発想 問題点 PI (Position Interpolation) 位置インデックスを線形に縮める 全次元一律で高周波情報が潰れる NTK-aware
base だけをスケール 中途半端、タスクによって劣化 NTK-by-parts 次元ごとに扱い分け YaRN の中核 YaRN NTK-by-parts + attention スケーリング 現在の標準 Qwen3 Technical Report を読む 6.2 YaRN の系譜 55 / 80
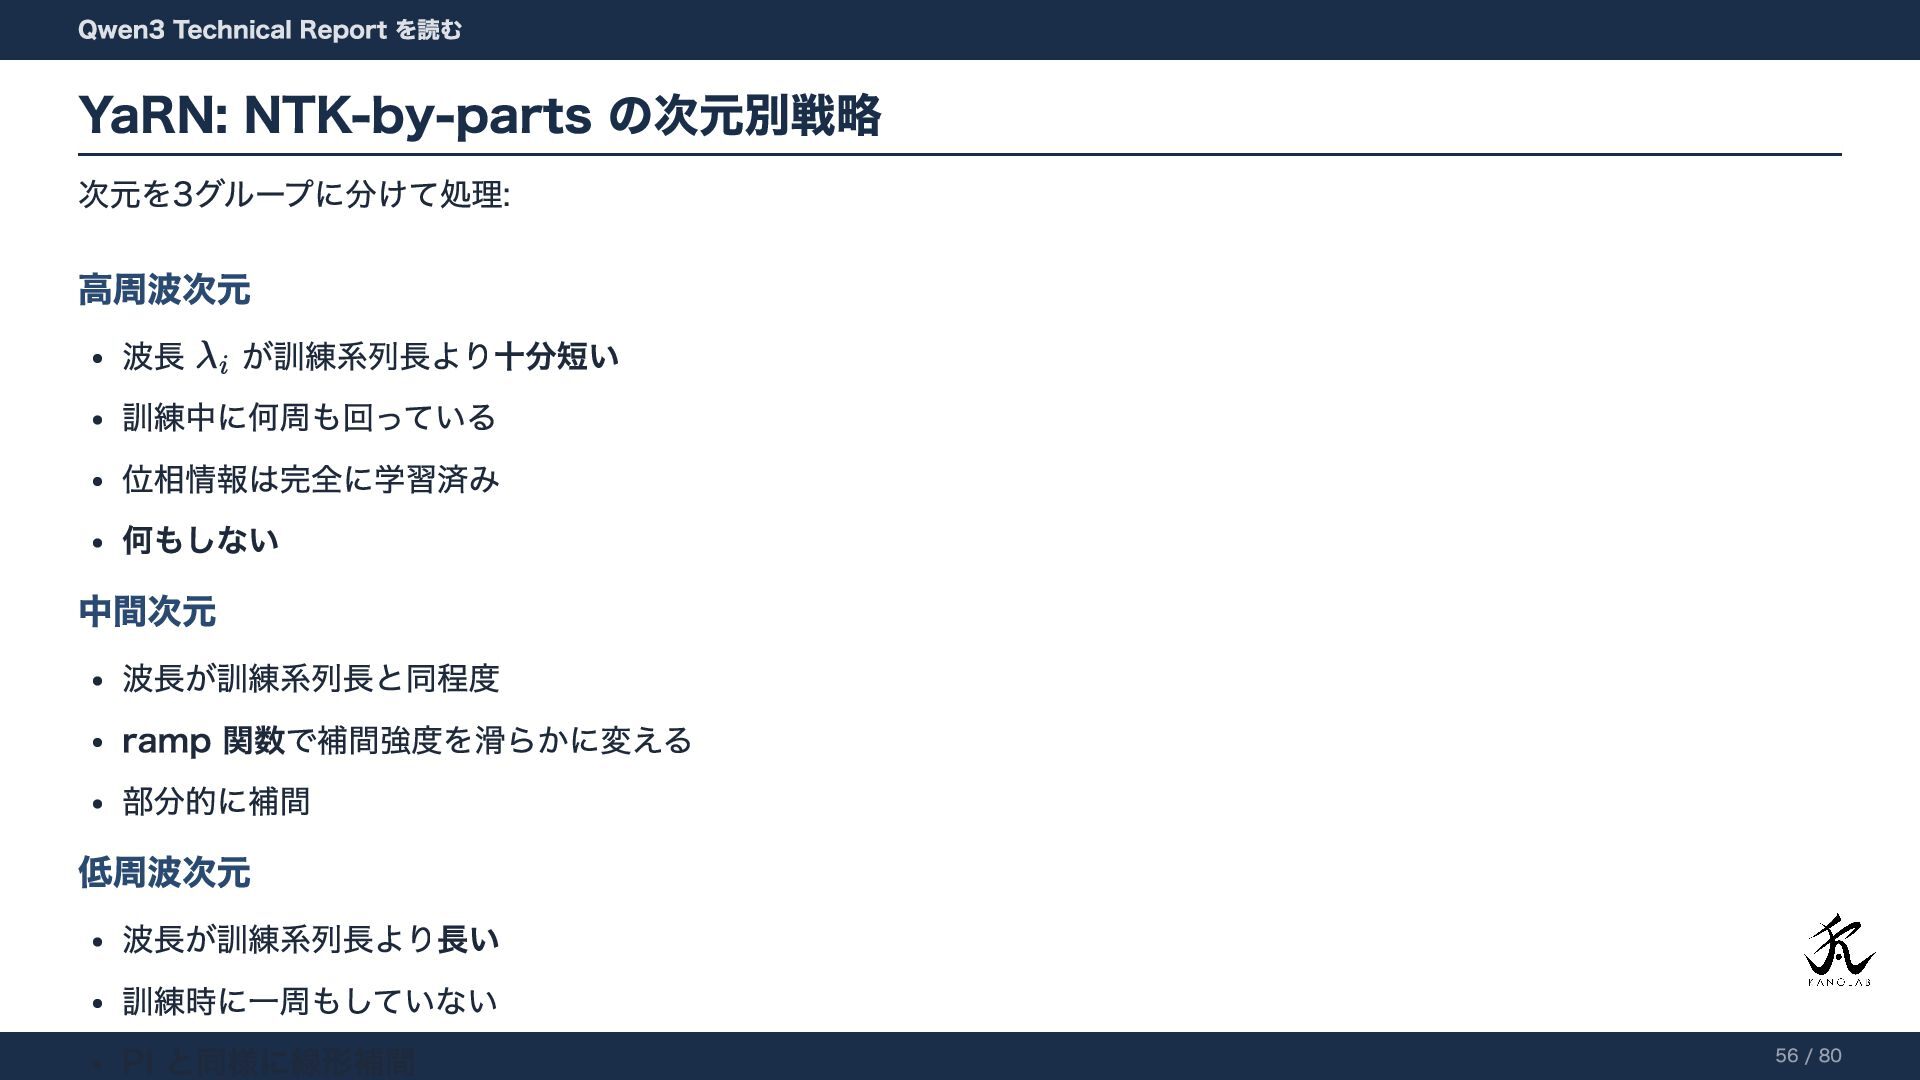
次元を3グループに分けて処理: 高周波次元 波長 が訓練系列長より十分短い 訓練中に何周も回っている 位相情報は完全に学習済み 何もしない 中間次元 波長が訓練系列長と同程度 ramp
関数で補間強度を滑らかに変える 部分的に補間 低周波次元 波長が訓練系列長より長い 訓練時に一周もしていない PI と同様に線形補間 Qwen3 Technical Report を読む YaRN: NTK-by-parts の次元別戦略 56 / 80
YaRN とは別のアプローチ YaRN: RoPE の周波数を操作 DCA: attention 計算そのものを再構成 発想 相対位置
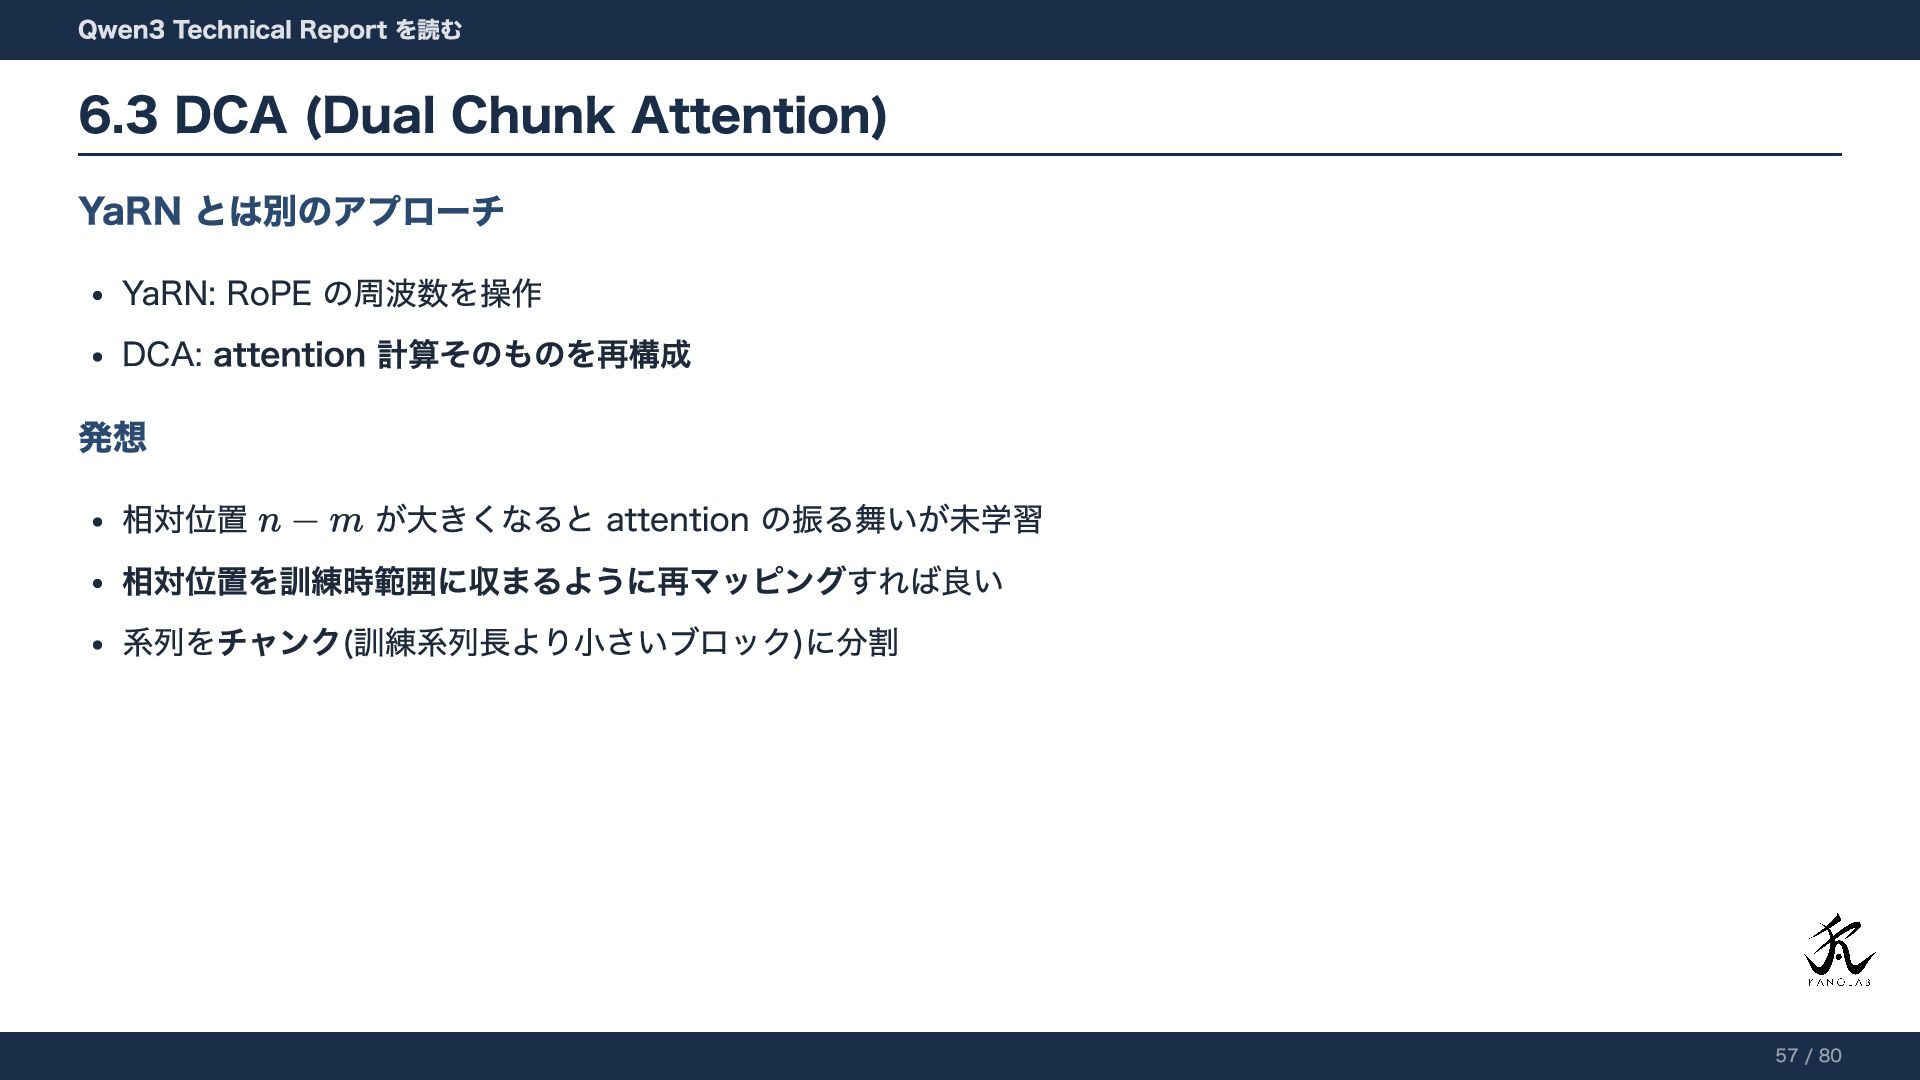
が大きくなると attention の振る舞いが未学習 相対位置を訓練時範囲に収まるように再マッピングすれば良い 系列をチャンク(訓練系列長より小さいブロック)に分割 Qwen3 Technical Report を読む 6.3 DCA (Dual Chunk Attention) 57 / 80
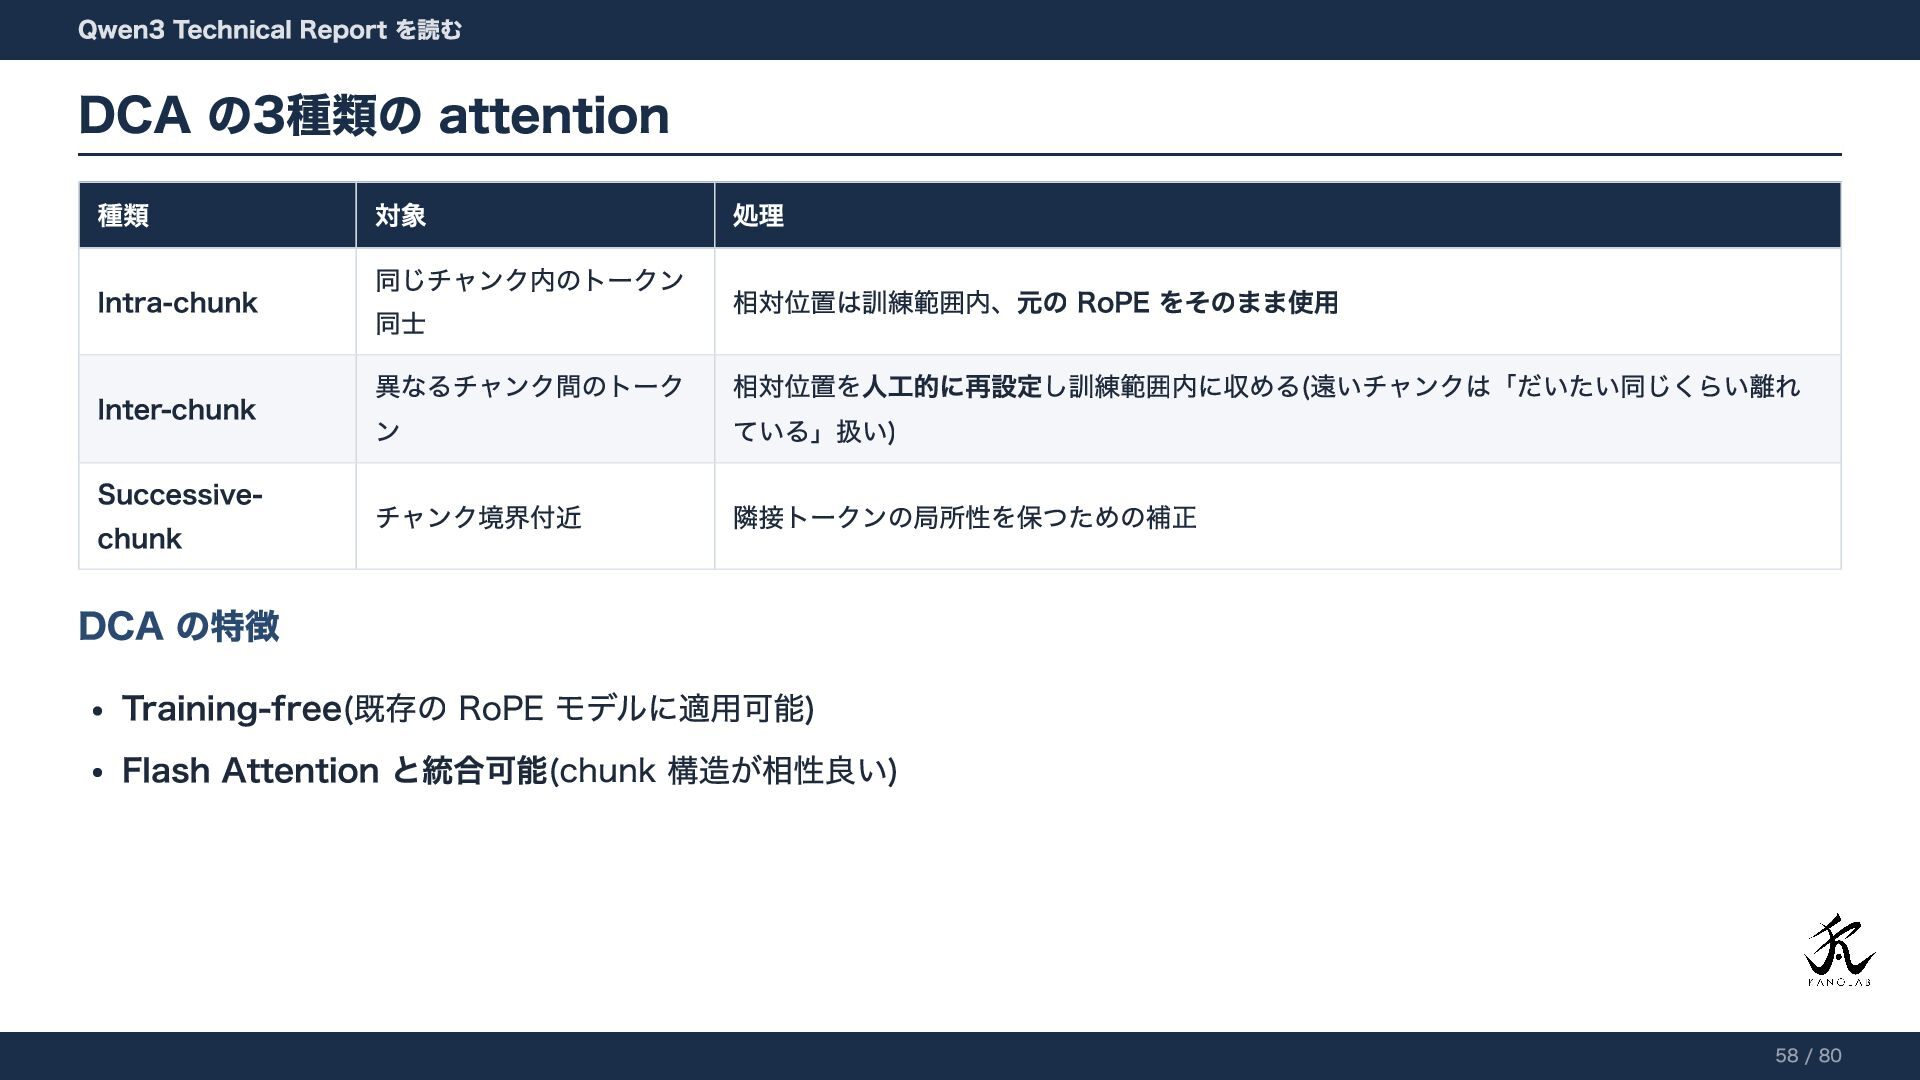
種類 対象 処理 Intra-chunk 同じチャンク内のトークン 同士 相対位置は訓練範囲内、元の RoPE をそのまま使用 Inter-chunk
異なるチャンク間のトーク ン 相対位置を人工的に再設定し訓練範囲内に収める(遠いチャンクは「だいたい同じくらい離れ ている」扱い) Successive- chunk チャンク境界付近 隣接トークンの局所性を保つための補正 DCA の特徴 Training-free(既存の RoPE モデルに適用可能) Flash Attention と統合可能(chunk 構造が相性良い) Qwen3 Technical Report を読む DCA の3種類の attention 58 / 80
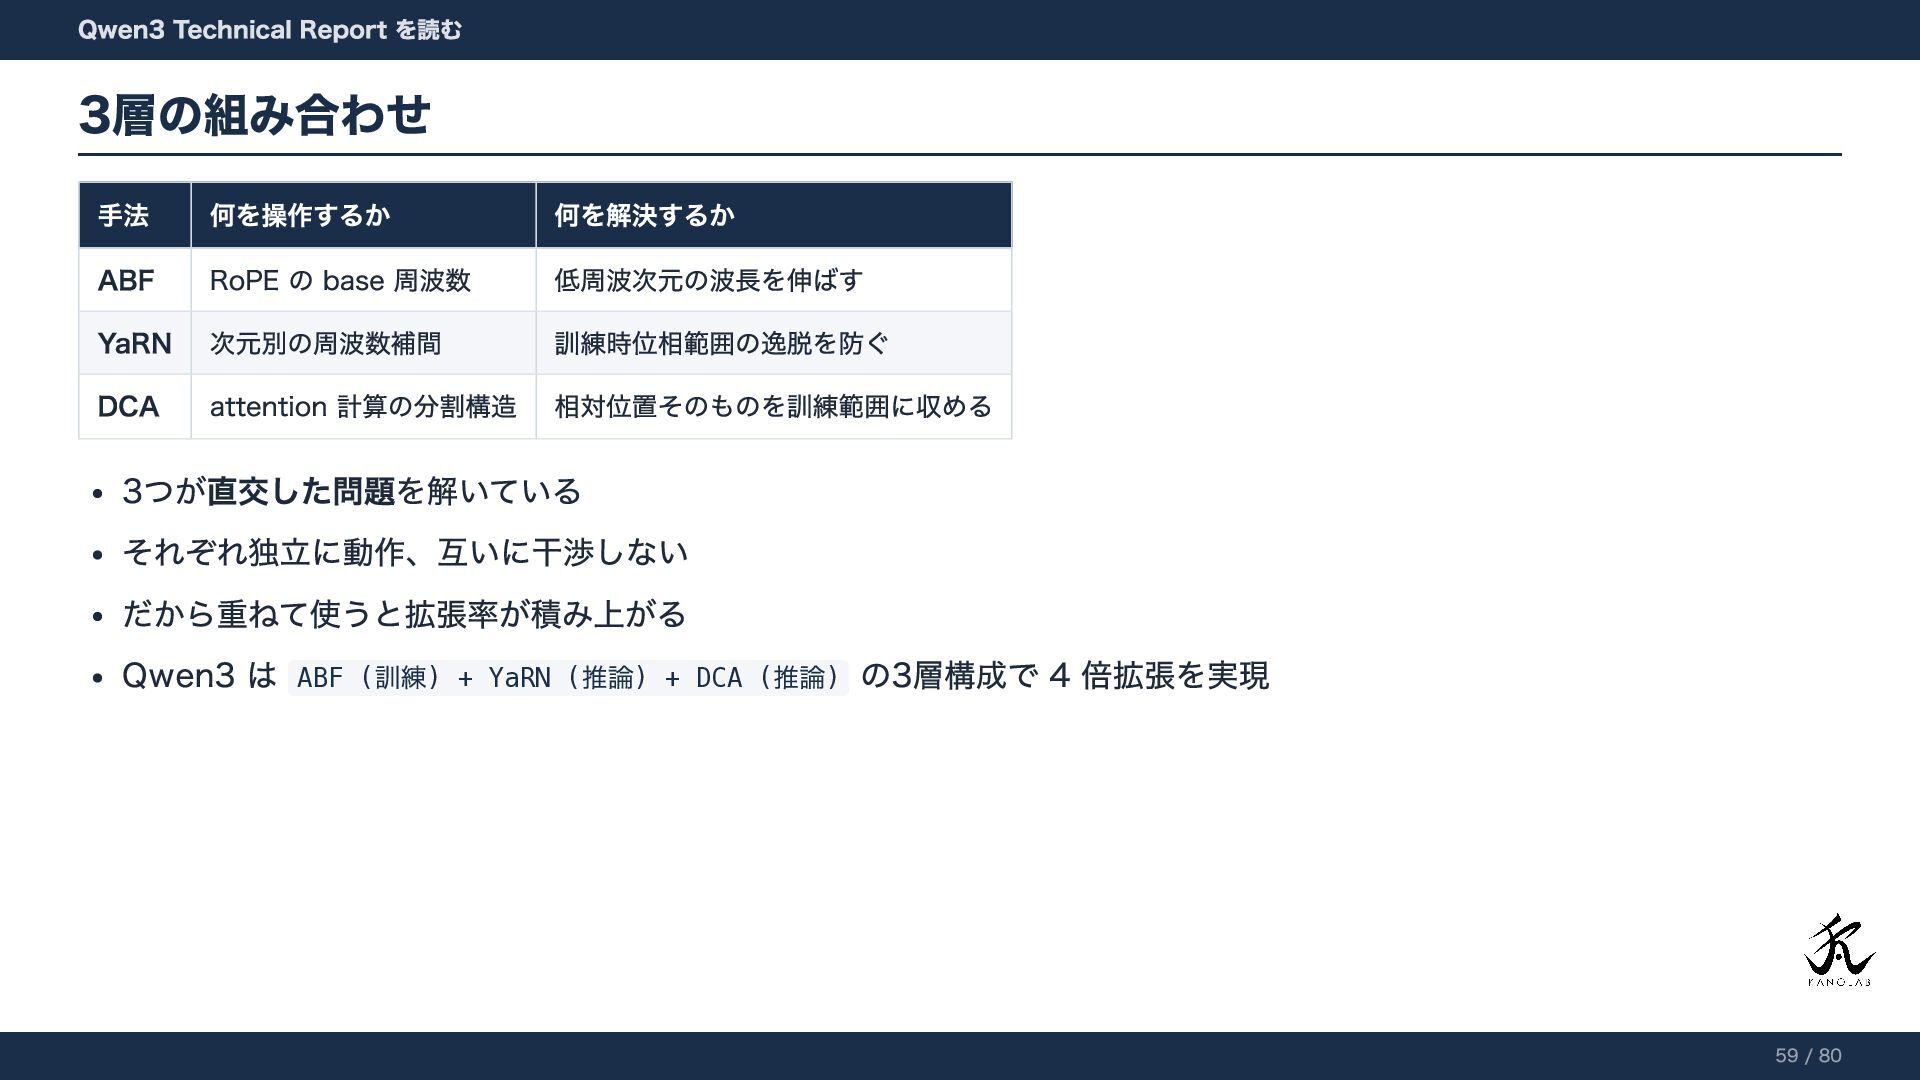
手法 何を操作するか 何を解決するか ABF RoPE の base 周波数 低周波次元の波長を伸ばす YaRN
次元別の周波数補間 訓練時位相範囲の逸脱を防ぐ DCA attention 計算の分割構造 相対位置そのものを訓練範囲に収める 3つが直交した問題を解いている それぞれ独立に動作、互いに干渉しない だから重ねて使うと拡張率が積み上がる Qwen3 は ABF ( 訓練) + YaRN ( 推論) + DCA ( 推論) の3層構成で 4 倍拡張を実現 Qwen3 Technical Report を読む 3層の組み合わせ 59 / 80
7. Tokenizer: BBPE Qwen3 Technical Report を読む 60 / 80
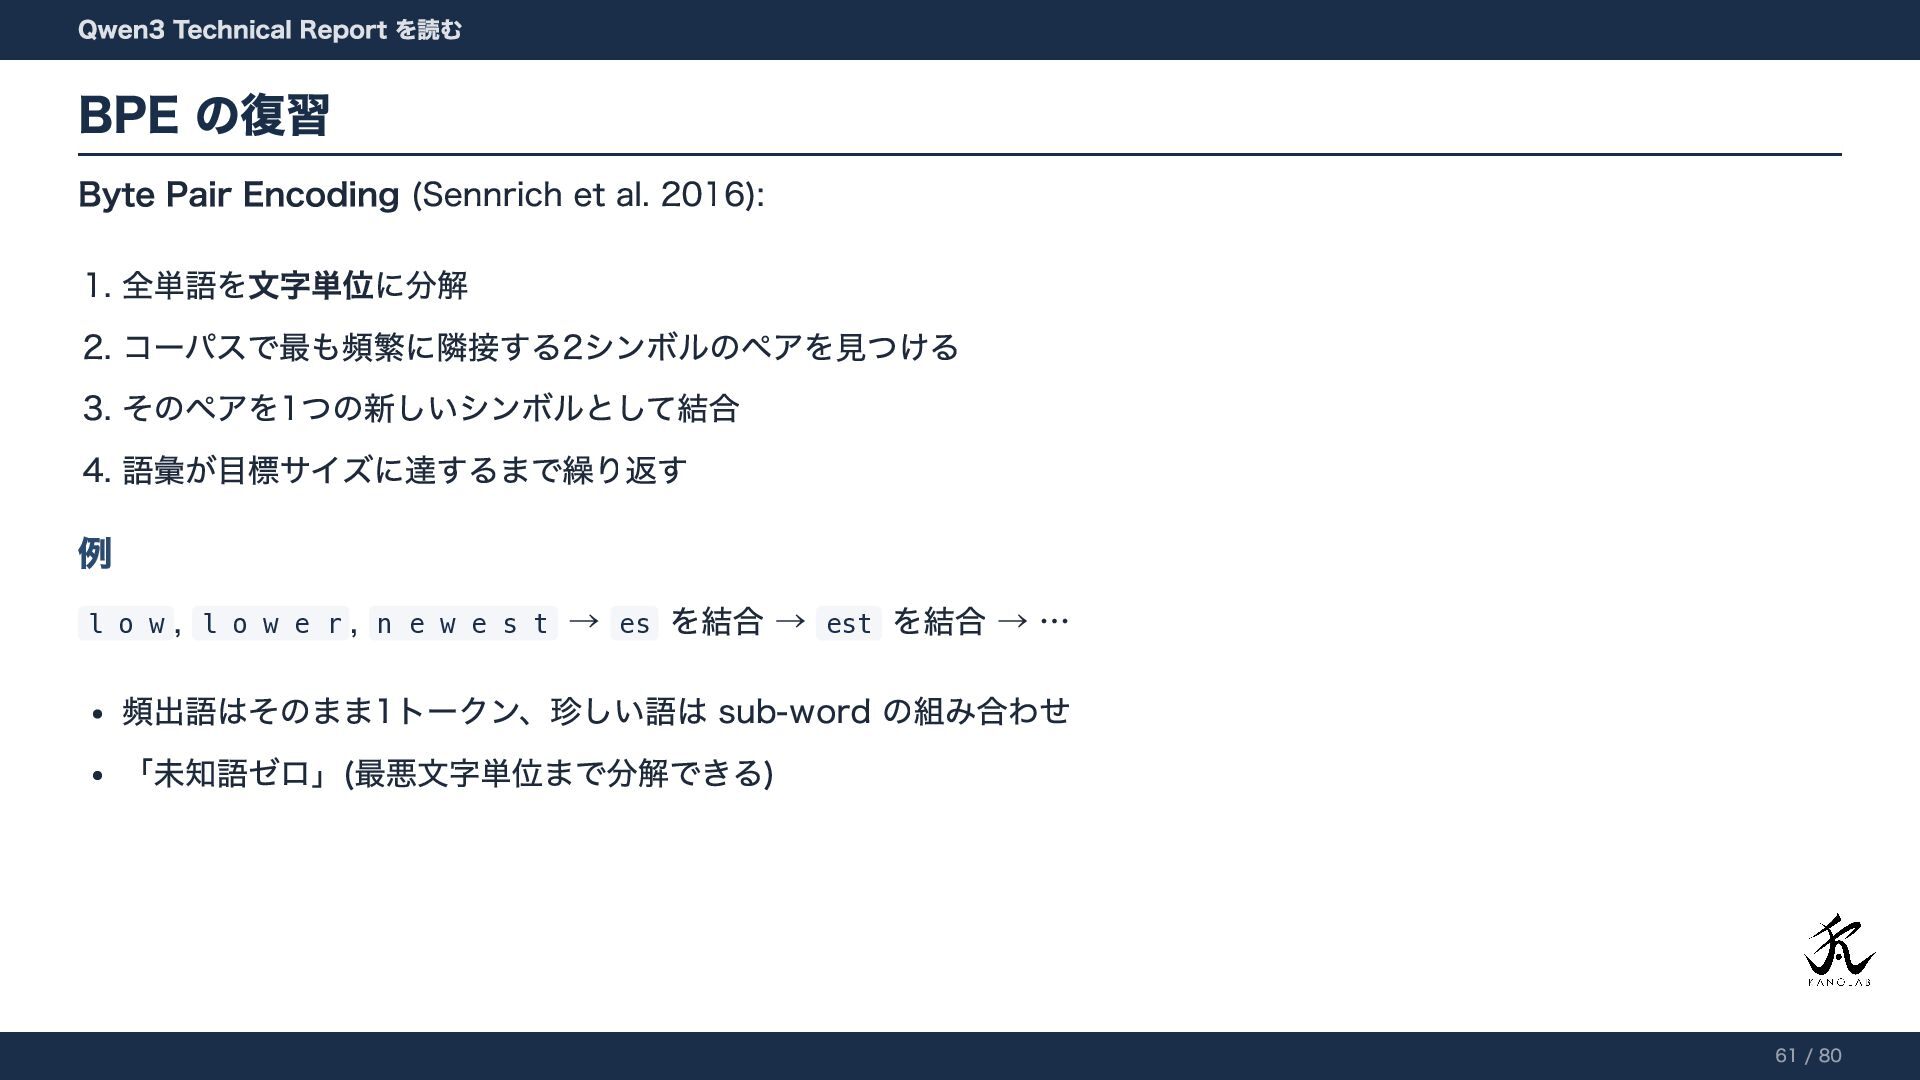
Byte Pair Encoding (Sennrich et al. 2016): 1. 全単語を文字単位に分解 2.
コーパスで最も頻繁に隣接する2シンボルのペアを見つける 3. そのペアを1つの新しいシンボルとして結合 4. 語彙が目標サイズに達するまで繰り返す 例 l o w , l o w e r , n e w e s t → es を結合 → est を結合 → … 頻出語はそのまま1トークン、珍しい語は sub-word の組み合わせ 「未知語ゼロ」(最悪文字単位まで分解できる) Qwen3 Technical Report を読む BPE の復習 61 / 80
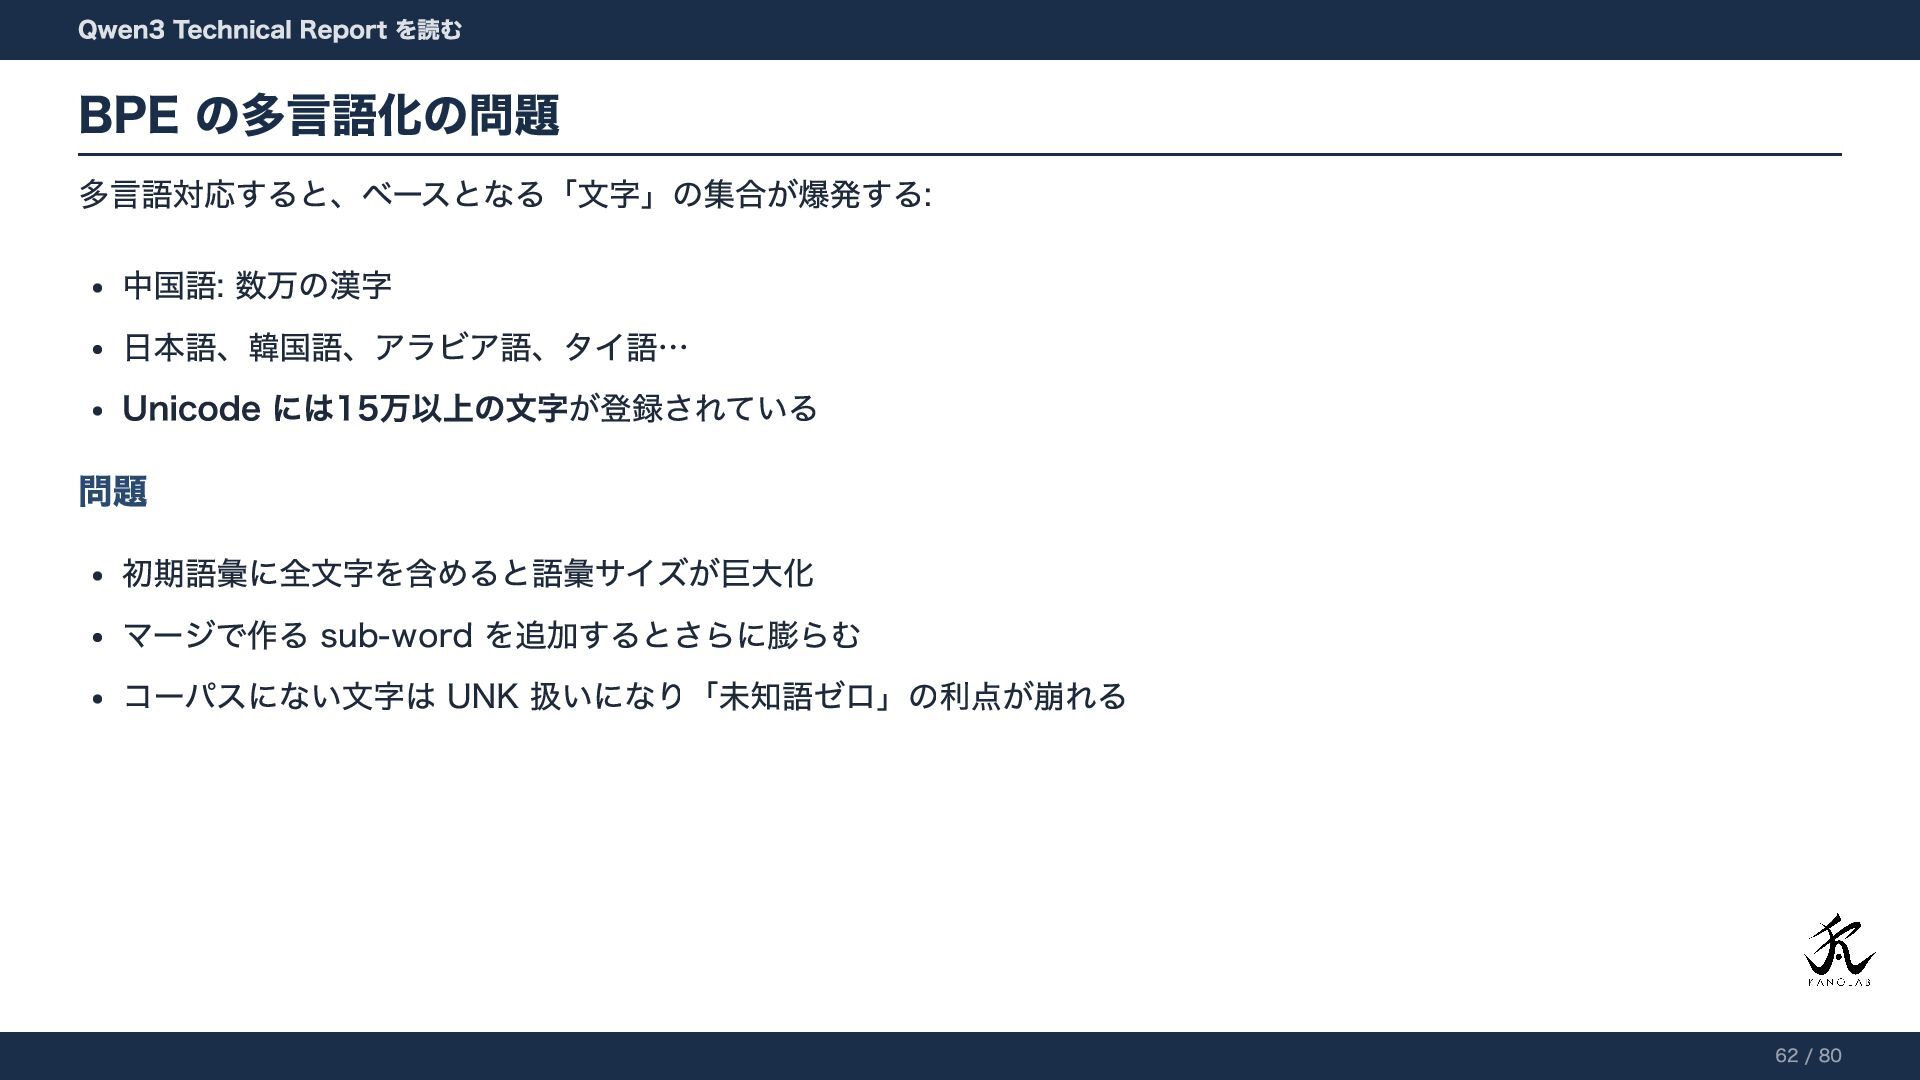
多言語対応すると、ベースとなる「文字」の集合が爆発する: 中国語: 数万の漢字 日本語、韓国語、アラビア語、タイ語… Unicode には15万以上の文字が登録されている 問題 初期語彙に全文字を含めると語彙サイズが巨大化 マージで作る sub-word
を追加するとさらに膨らむ コーパスにない文字は UNK 扱いになり「未知語ゼロ」の利点が崩れる Qwen3 Technical Report を読む BPE の多言語化の問題 62 / 80
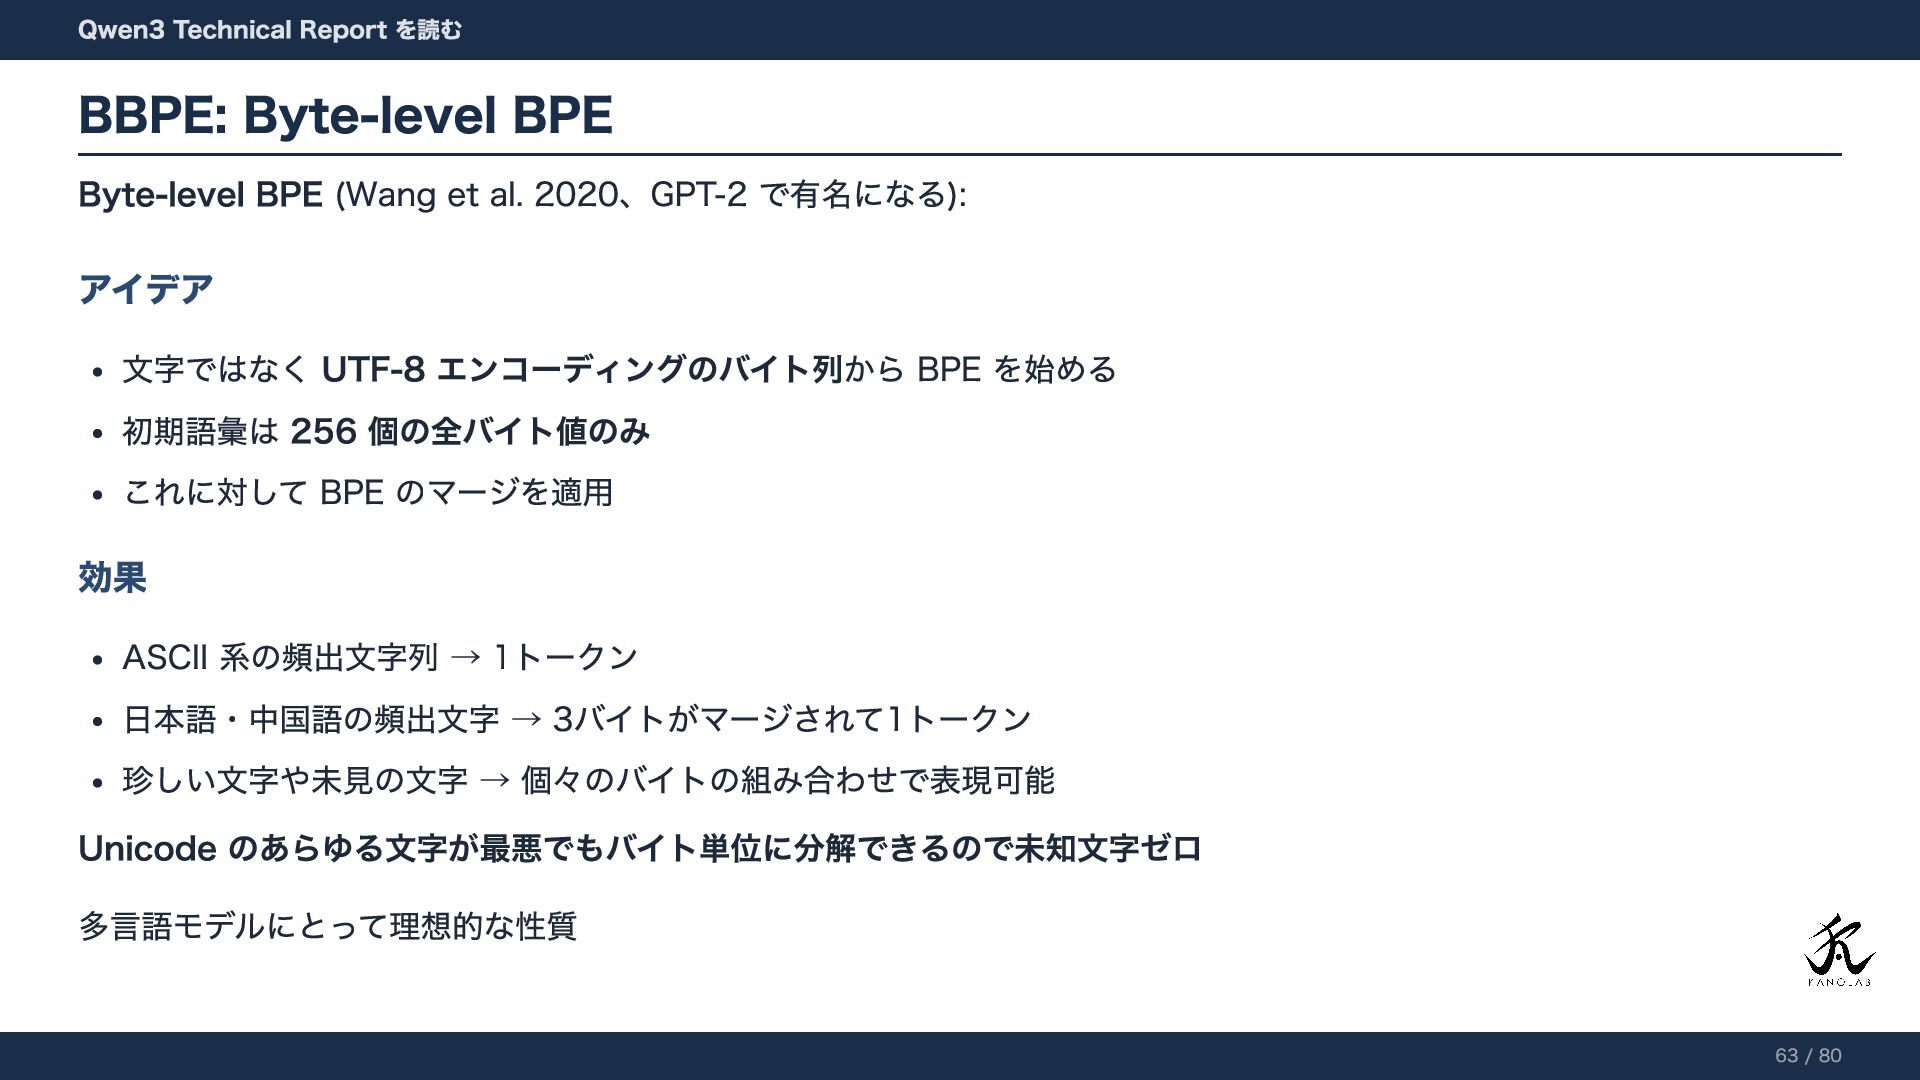
Byte-level BPE (Wang et al. 2020、GPT-2 で有名になる): アイデア 文字ではなく UTF-8
エンコーディングのバイト列から BPE を始める 初期語彙は 256 個の全バイト値のみ これに対して BPE のマージを適用 効果 ASCII 系の頻出文字列 → 1トークン 日本語・中国語の頻出文字 → 3バイトがマージされて1トークン 珍しい文字や未見の文字 → 個々のバイトの組み合わせで表現可能 Unicode のあらゆる文字が最悪でもバイト単位に分解できるので未知文字ゼロ 多言語モデルにとって理想的な性質 Qwen3 Technical Report を読む BBPE: Byte-level BPE 63 / 80
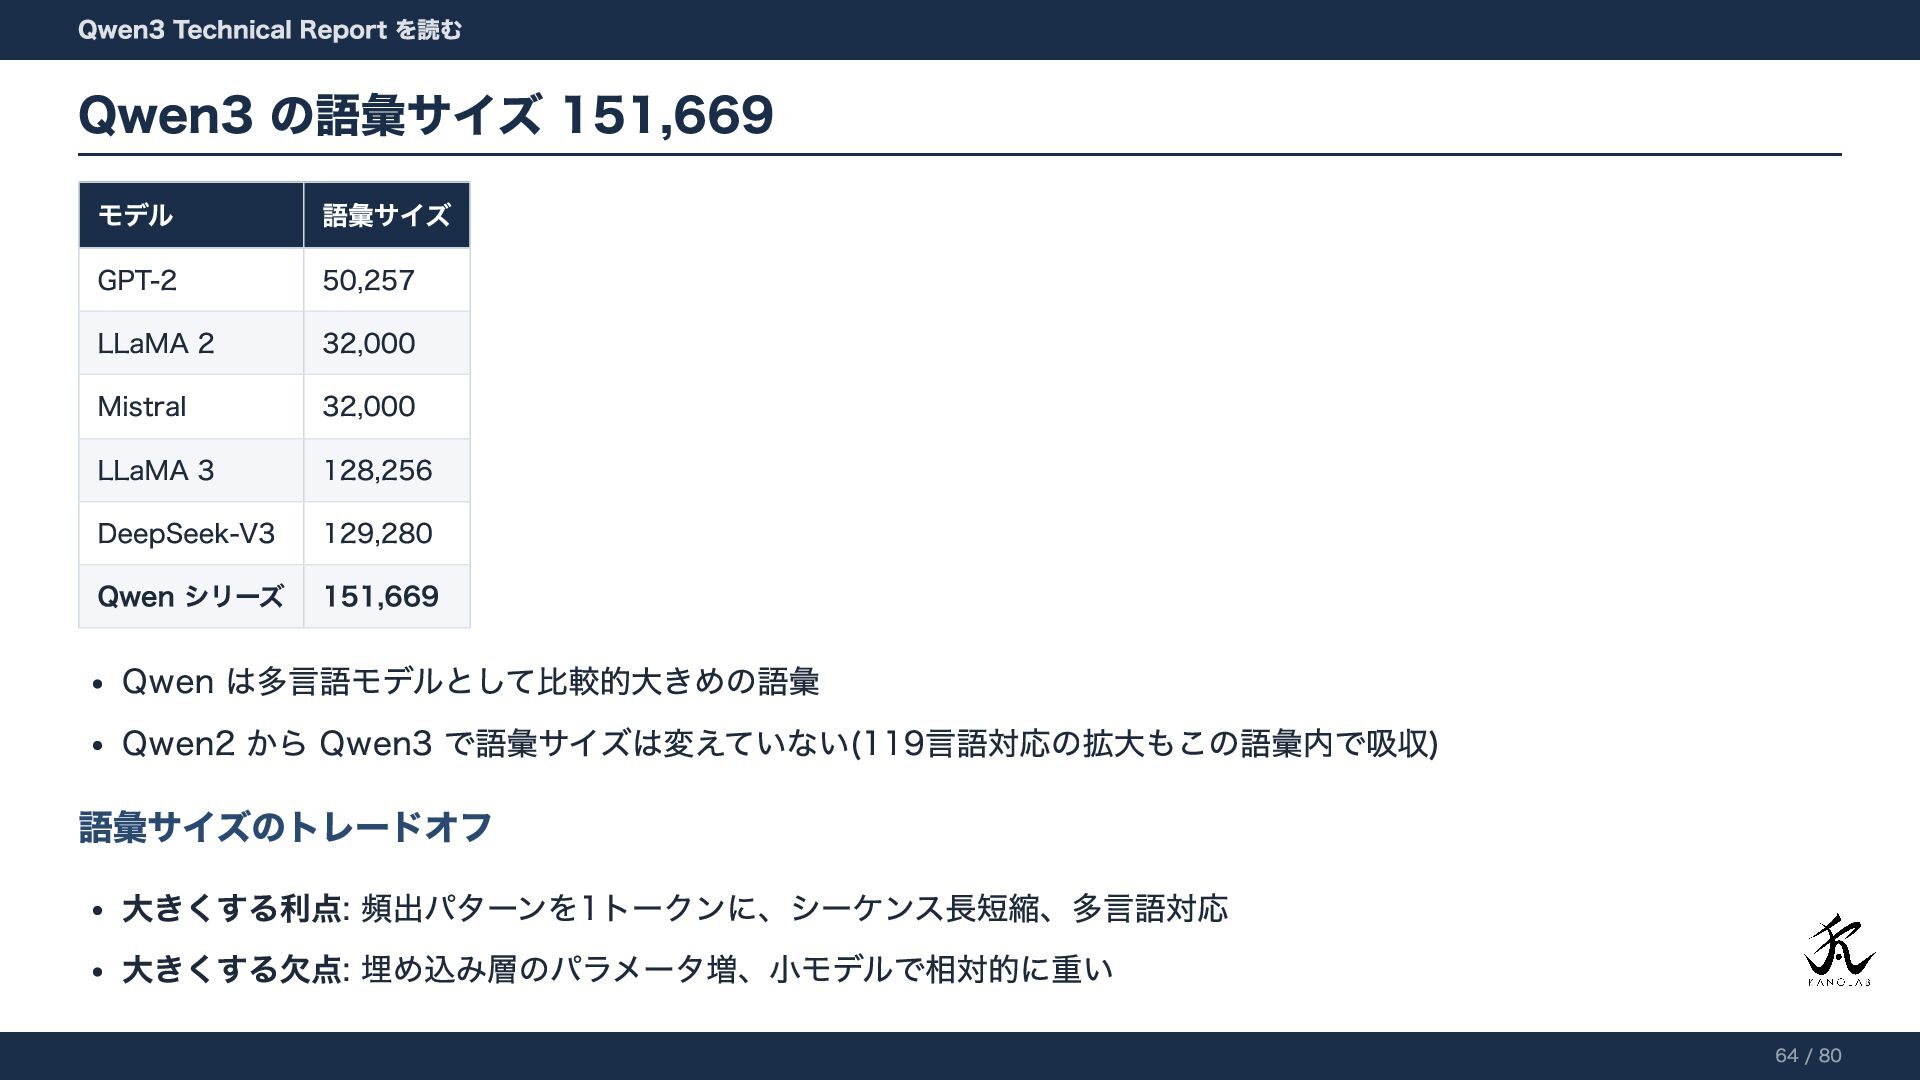
モデル 語彙サイズ GPT-2 50,257 LLaMA 2 32,000 Mistral 32,000 LLaMA
3 128,256 DeepSeek-V3 129,280 Qwen シリーズ 151,669 Qwen は多言語モデルとして比較的大きめの語彙 Qwen2 から Qwen3 で語彙サイズは変えていない(119言語対応の拡大もこの語彙内で吸収) 語彙サイズのトレードオフ 大きくする利点: 頻出パターンを1トークンに、シーケンス長短縮、多言語対応 大きくする欠点: 埋め込み層のパラメータ増、小モデルで相対的に重い Qwen3 Technical Report を読む Qwen3 の語彙サイズ 151,669 64 / 80
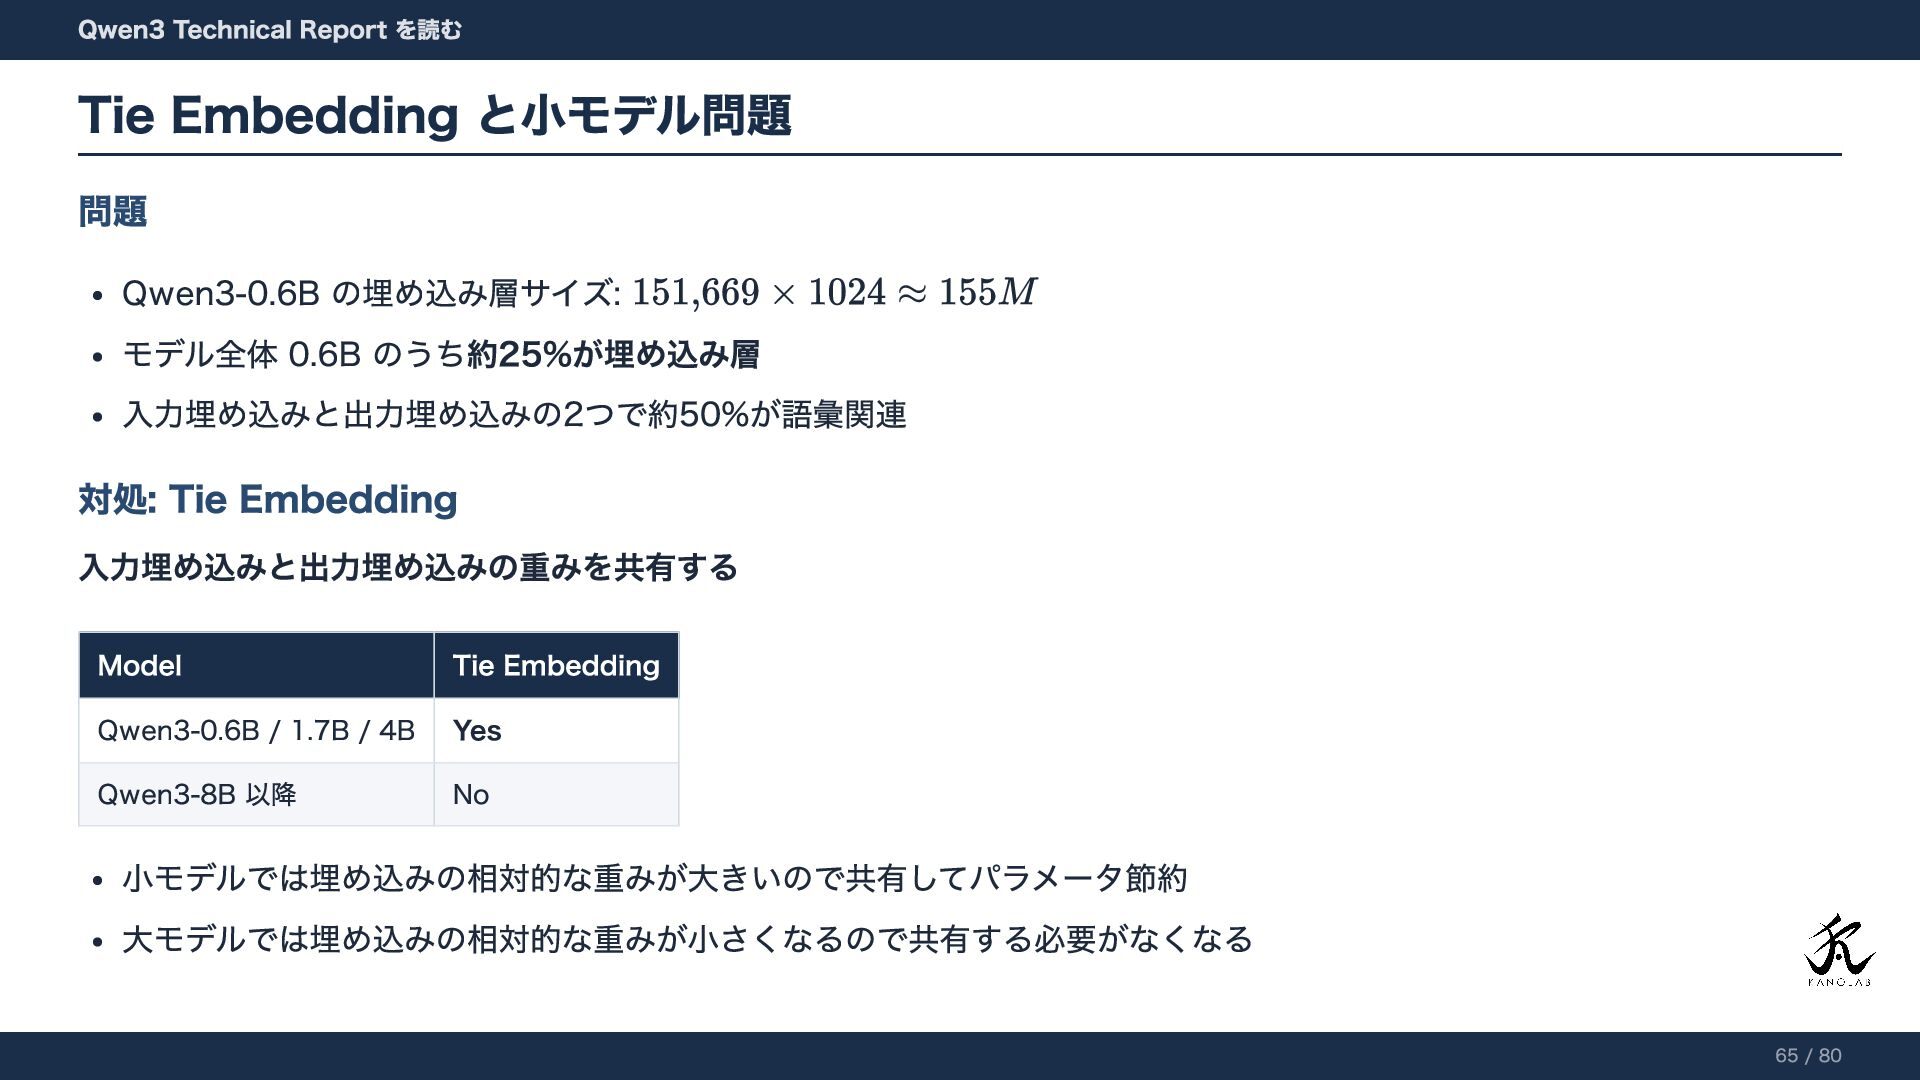
問題 Qwen3-0.6B の埋め込み層サイズ: モデル全体 0.6B のうち約25%が埋め込み層 入力埋め込みと出力埋め込みの2つで約50%が語彙関連 対処: Tie Embedding
入力埋め込みと出力埋め込みの重みを共有する Model Tie Embedding Qwen3-0.6B / 1.7B / 4B Yes Qwen3-8B 以降 No 小モデルでは埋め込みの相対的な重みが大きいので共有してパラメータ節約 大モデルでは埋め込みの相対的な重みが小さくなるので共有する必要がなくなる Qwen3 Technical Report を読む Tie Embedding と小モデル問題 65 / 80
8. Pre-training 概観 Qwen3 Technical Report を読む 66 / 80
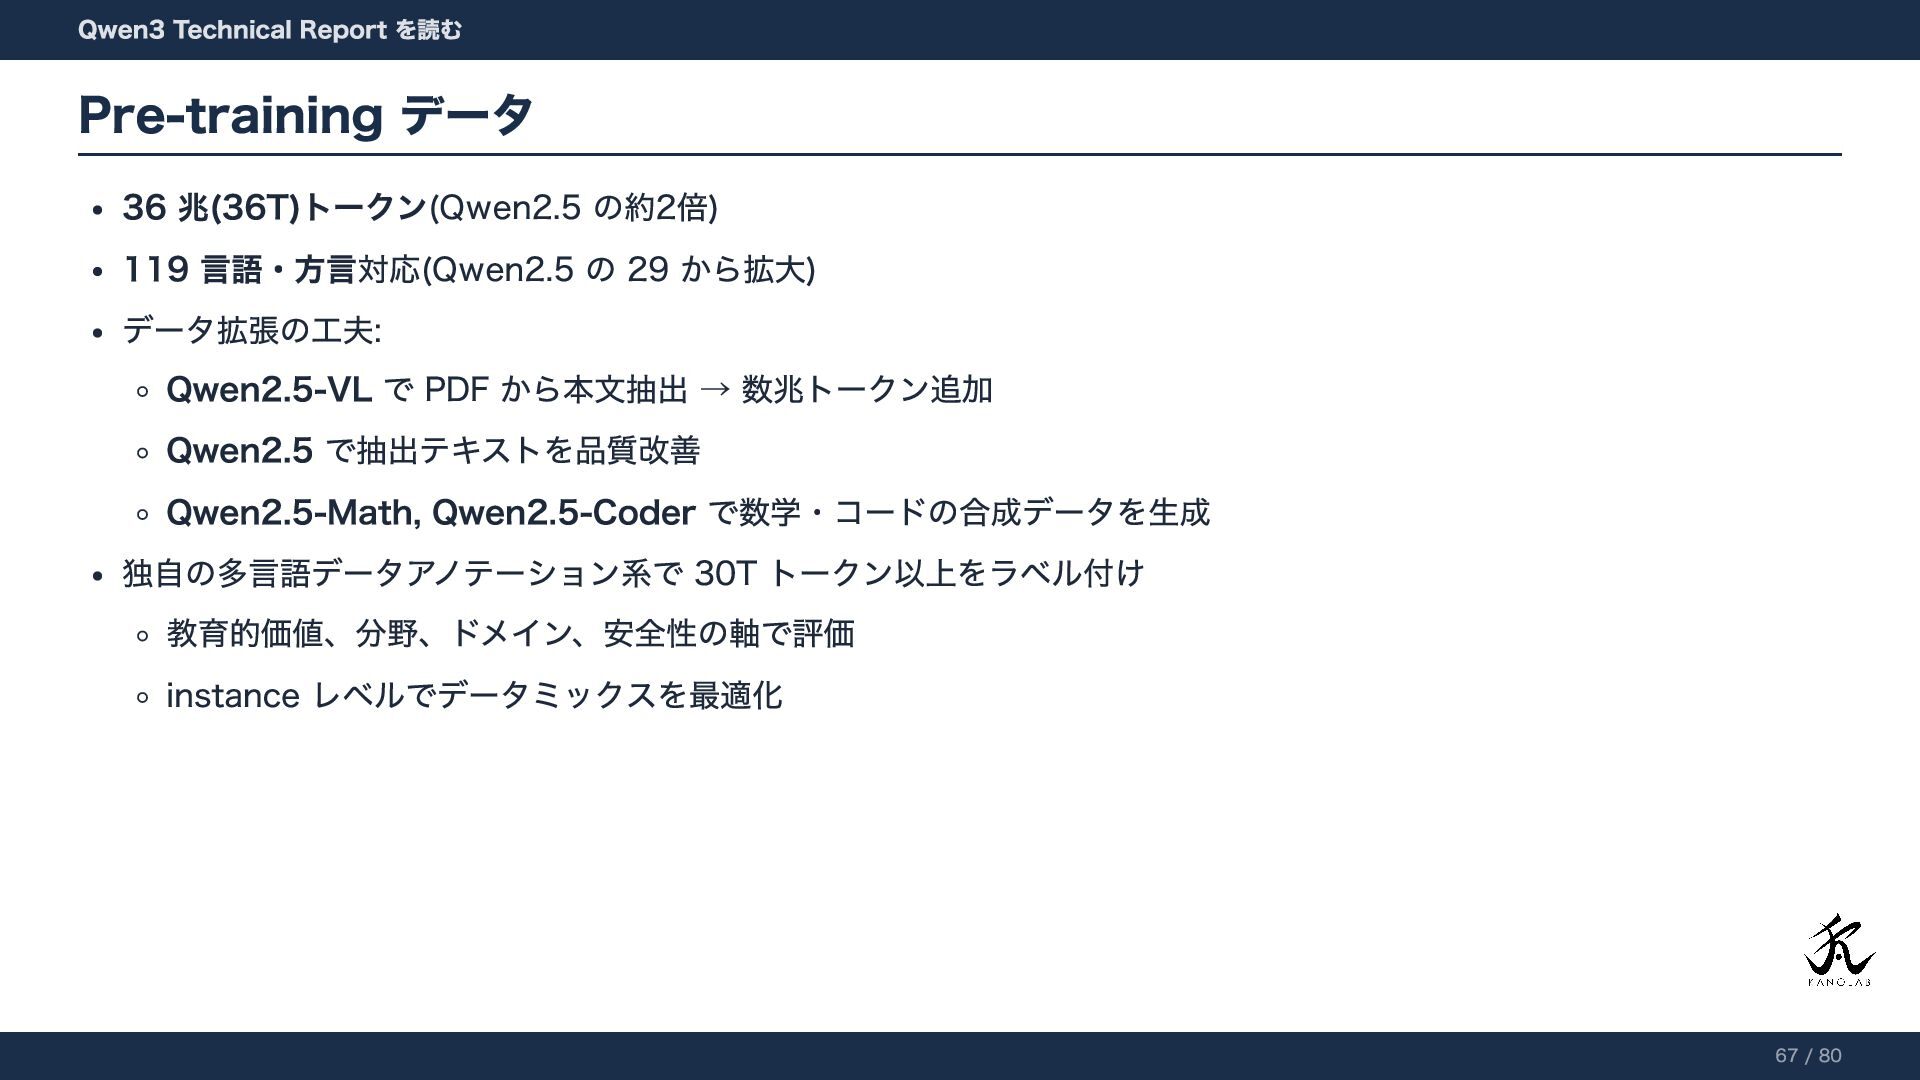
36 兆(36T)トークン(Qwen2.5 の約2倍) 119 言語・方言対応(Qwen2.5 の 29 から拡大) データ拡張の工夫: Qwen2.5-VL
で PDF から本文抽出 → 数兆トークン追加 Qwen2.5 で抽出テキストを品質改善 Qwen2.5-Math, Qwen2.5-Coder で数学・コードの合成データを生成 独自の多言語データアノテーション系で 30T トークン以上をラベル付け 教育的価値、分野、ドメイン、安全性の軸で評価 instance レベルでデータミックスを最適化 Qwen3 Technical Report を読む Pre-training データ 67 / 80
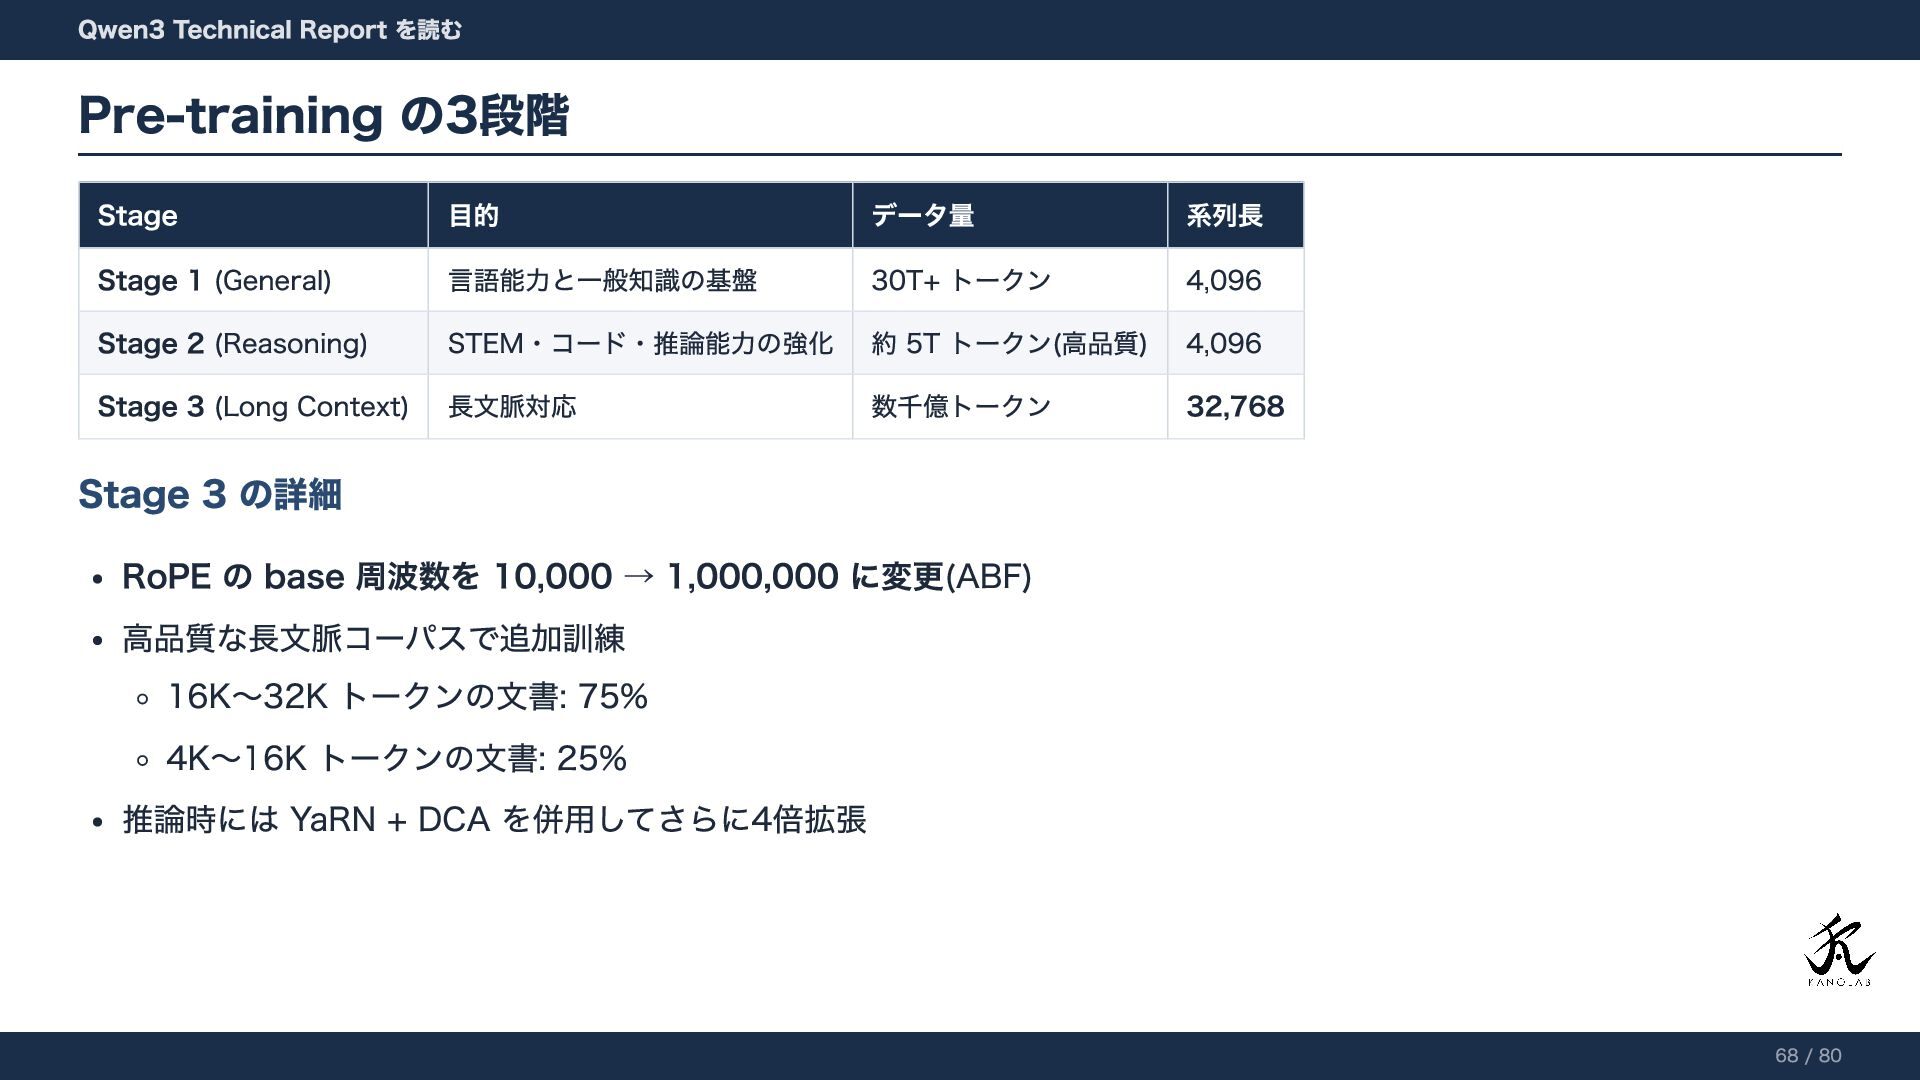
Stage 目的 データ量 系列長 Stage 1 (General) 言語能力と一般知識の基盤 30T+ トークン
4,096 Stage 2 (Reasoning) STEM・コード・推論能力の強化 約 5T トークン(高品質) 4,096 Stage 3 (Long Context) 長文脈対応 数千億トークン 32,768 Stage 3 の詳細 RoPE の base 周波数を 10,000 → 1,000,000 に変更(ABF) 高品質な長文脈コーパスで追加訓練 16K〜32K トークンの文書: 75% 4K〜16K トークンの文書: 25% 推論時には YaRN + DCA を併用してさらに4倍拡張 Qwen3 Technical Report を読む Pre-training の3段階 68 / 80
9. Post-training 概観 Qwen3 Technical Report を読む 69 / 80
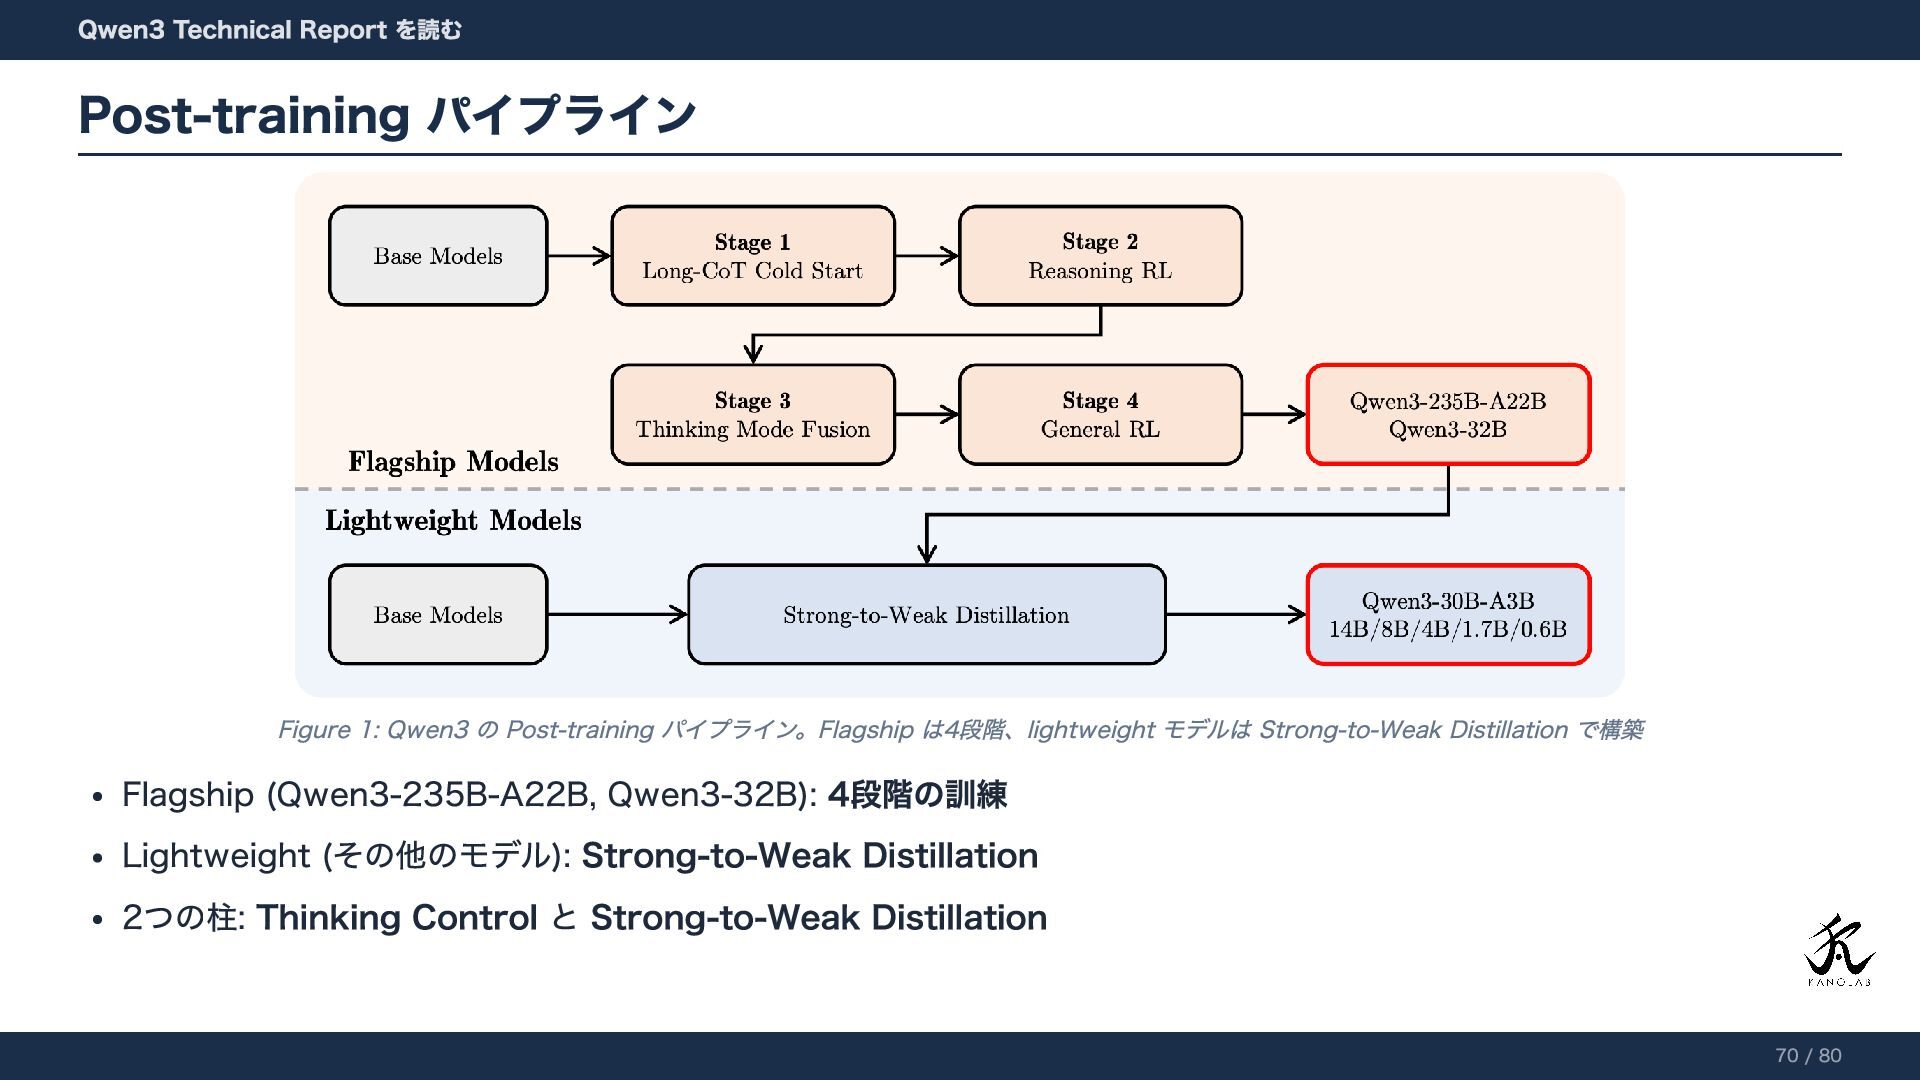
Figure 1: Qwen3 の Post-training パイプライン。Flagship は4段階、lightweight モデルは Strong-to-Weak Distillation
で構築 Flagship (Qwen3-235B-A22B, Qwen3-32B): 4段階の訓練 Lightweight (その他のモデル): Strong-to-Weak Distillation 2つの柱: Thinking Control と Strong-to-Weak Distillation Qwen3 Technical Report を読む Post-training パイプライン 70 / 80
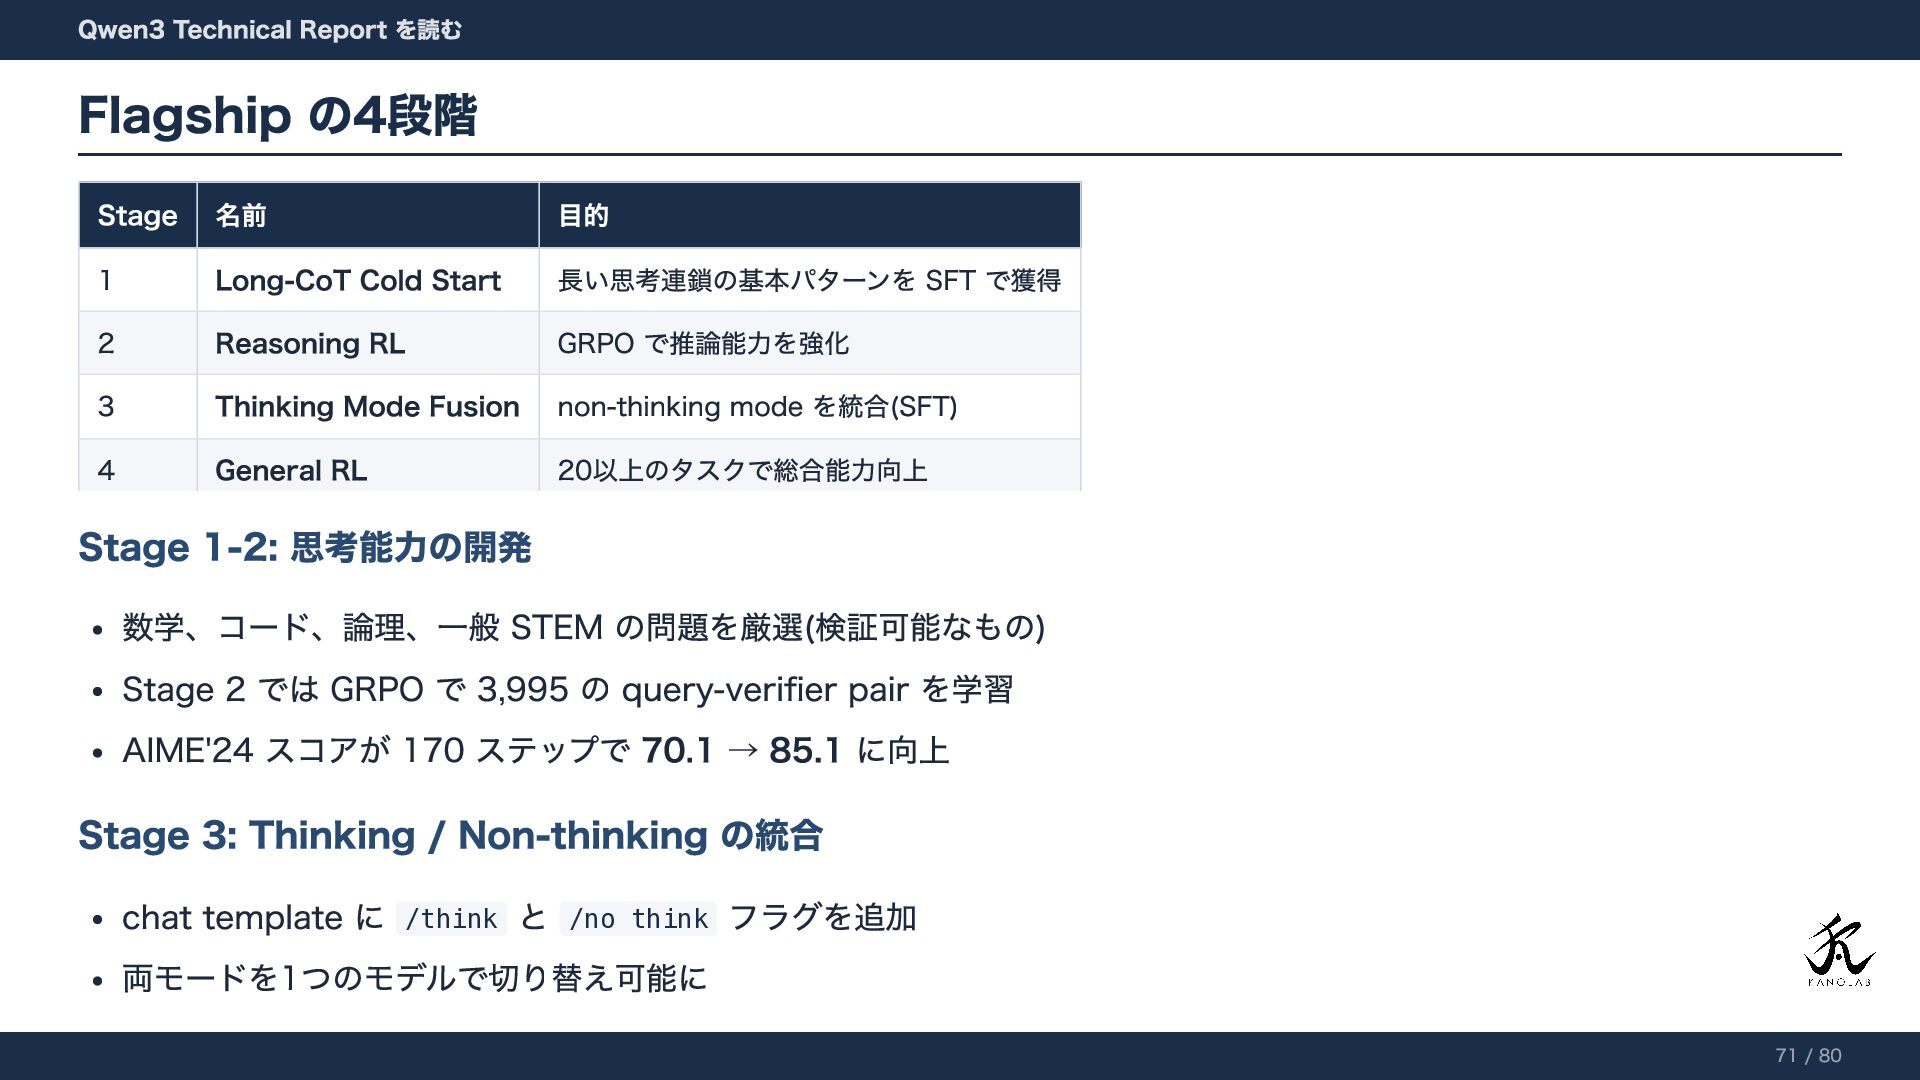
Stage 名前 目的 1 Long-CoT Cold Start 長い思考連鎖の基本パターンを SFT で獲得
2 Reasoning RL GRPO で推論能力を強化 3 Thinking Mode Fusion non-thinking mode を統合(SFT) 4 General RL 20以上のタスクで総合能力向上 Stage 1-2: 思考能力の開発 数学、コード、論理、一般 STEM の問題を厳選(検証可能なもの) Stage 2 では GRPO で 3,995 の query-verifier pair を学習 AIME'24 スコアが 170 ステップで 70.1 → 85.1 に向上 Stage 3: Thinking / Non-thinking の統合 chat template に /think と /no think フラグを追加 両モードを1つのモデルで切り替え可能に Qwen3 Technical Report を読む Flagship の4段階 71 / 80
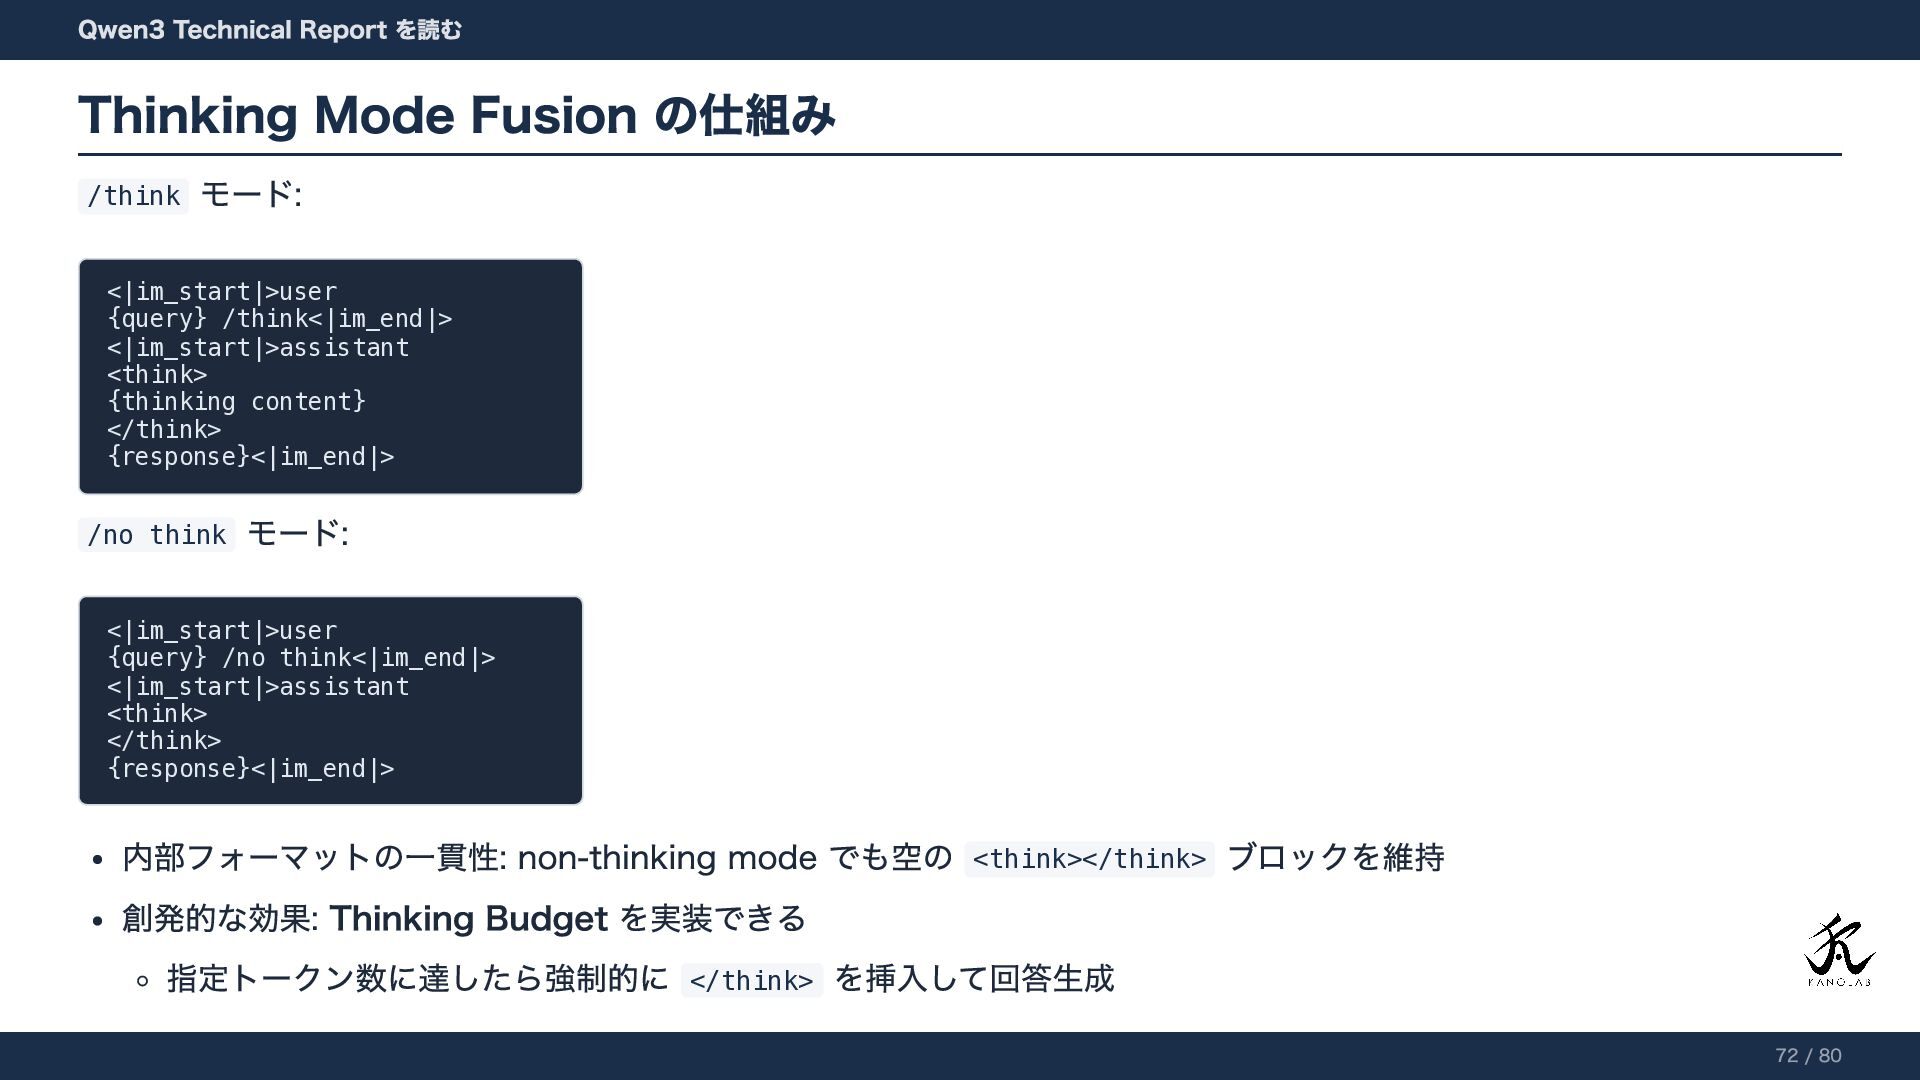
/think モード: <|im_start|>user {query} /think<|im_end|> <|im_start|>assistant <think> {thinking content} </think>
{response}<|im_end|> /no think モード: <|im_start|>user {query} /no think<|im_end|> <|im_start|>assistant <think> </think> {response}<|im_end|> 内部フォーマットの一貫性: non-thinking mode でも空の <think></think> ブロックを維持 創発的な効果: Thinking Budget を実装できる 指定トークン数に達したら強制的に </think> を挿入して回答生成 Qwen3 Technical Report を読む Thinking Mode Fusion の仕組み 72 / 80
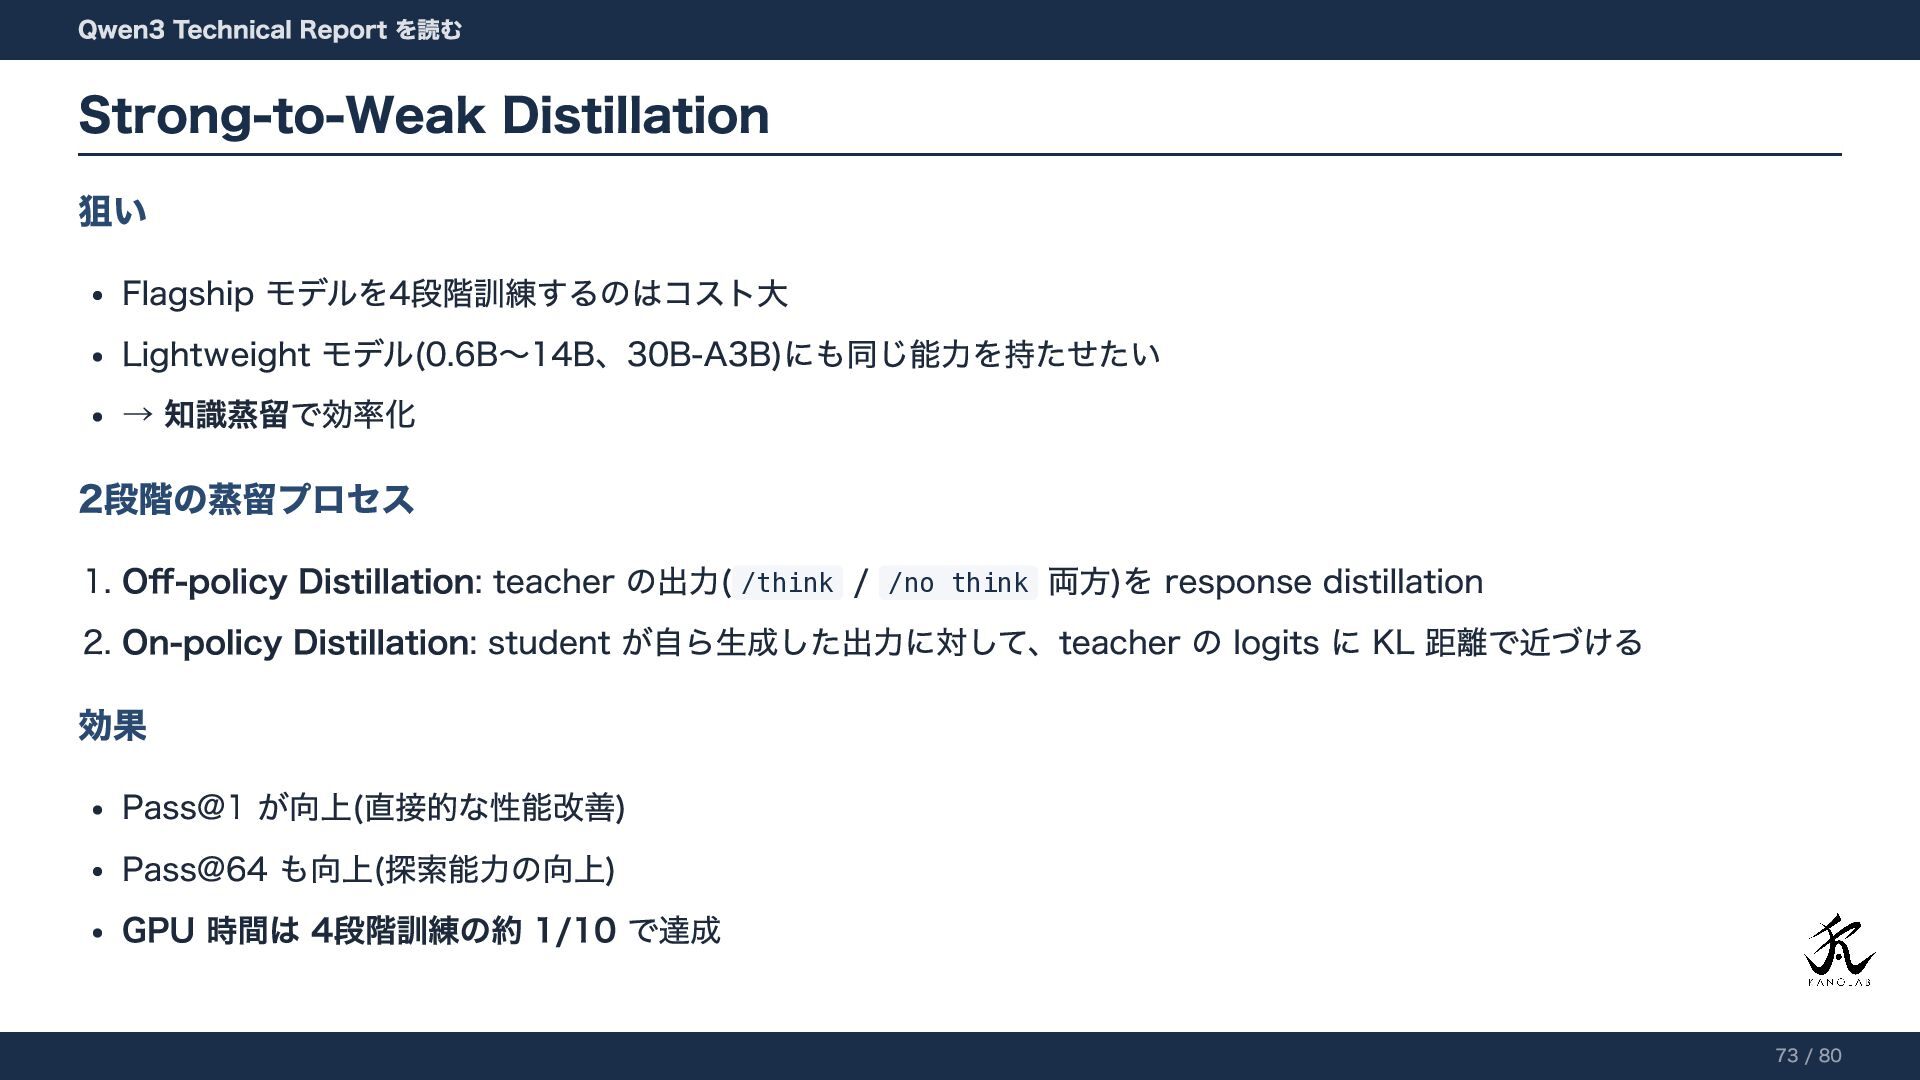
狙い Flagship モデルを4段階訓練するのはコスト大 Lightweight モデル(0.6B〜14B、30B-A3B)にも同じ能力を持たせたい → 知識蒸留で効率化 2段階の蒸留プロセス 1. Off-policy
Distillation: teacher の出力(/think / /no think 両方)を response distillation 2. On-policy Distillation: student が自ら生成した出力に対して、teacher の logits に KL 距離で近づける 効果 Pass@1 が向上(直接的な性能改善) Pass@64 も向上(探索能力の向上) GPU 時間は 4段階訓練の約 1/10 で達成 Qwen3 Technical Report を読む Strong-to-Weak Distillation 73 / 80
10. 実験結果 Qwen3 Technical Report を読む 74 / 80
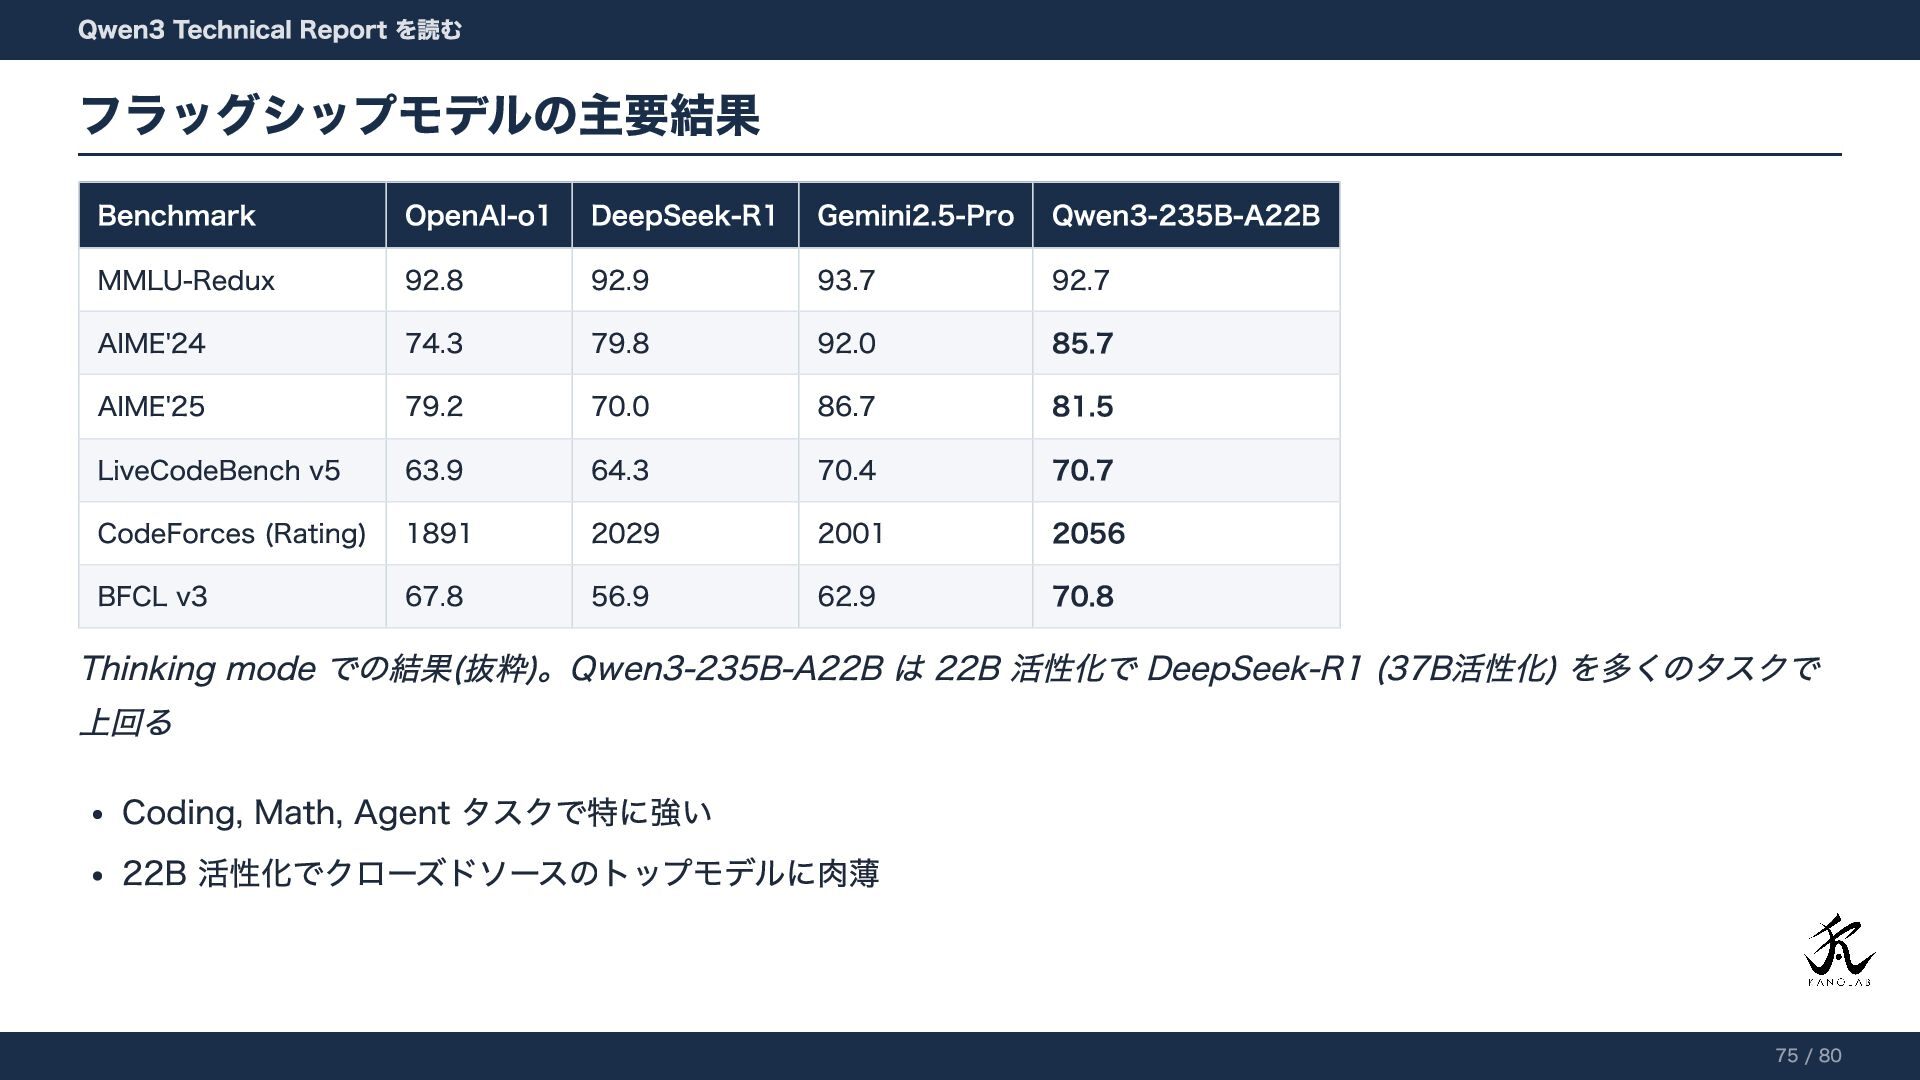
Benchmark OpenAI-o1 DeepSeek-R1 Gemini2.5-Pro Qwen3-235B-A22B MMLU-Redux 92.8 92.9 93.7 92.7
AIME'24 74.3 79.8 92.0 85.7 AIME'25 79.2 70.0 86.7 81.5 LiveCodeBench v5 63.9 64.3 70.4 70.7 CodeForces (Rating) 1891 2029 2001 2056 BFCL v3 67.8 56.9 62.9 70.8 Thinking mode での結果(抜粋)。Qwen3-235B-A22B は 22B 活性化で DeepSeek-R1 (37B活性化) を多くのタスクで 上回る Coding, Math, Agent タスクで特に強い 22B 活性化でクローズドソースのトップモデルに肉薄 Qwen3 Technical Report を読む フラッグシップモデルの主要結果 75 / 80
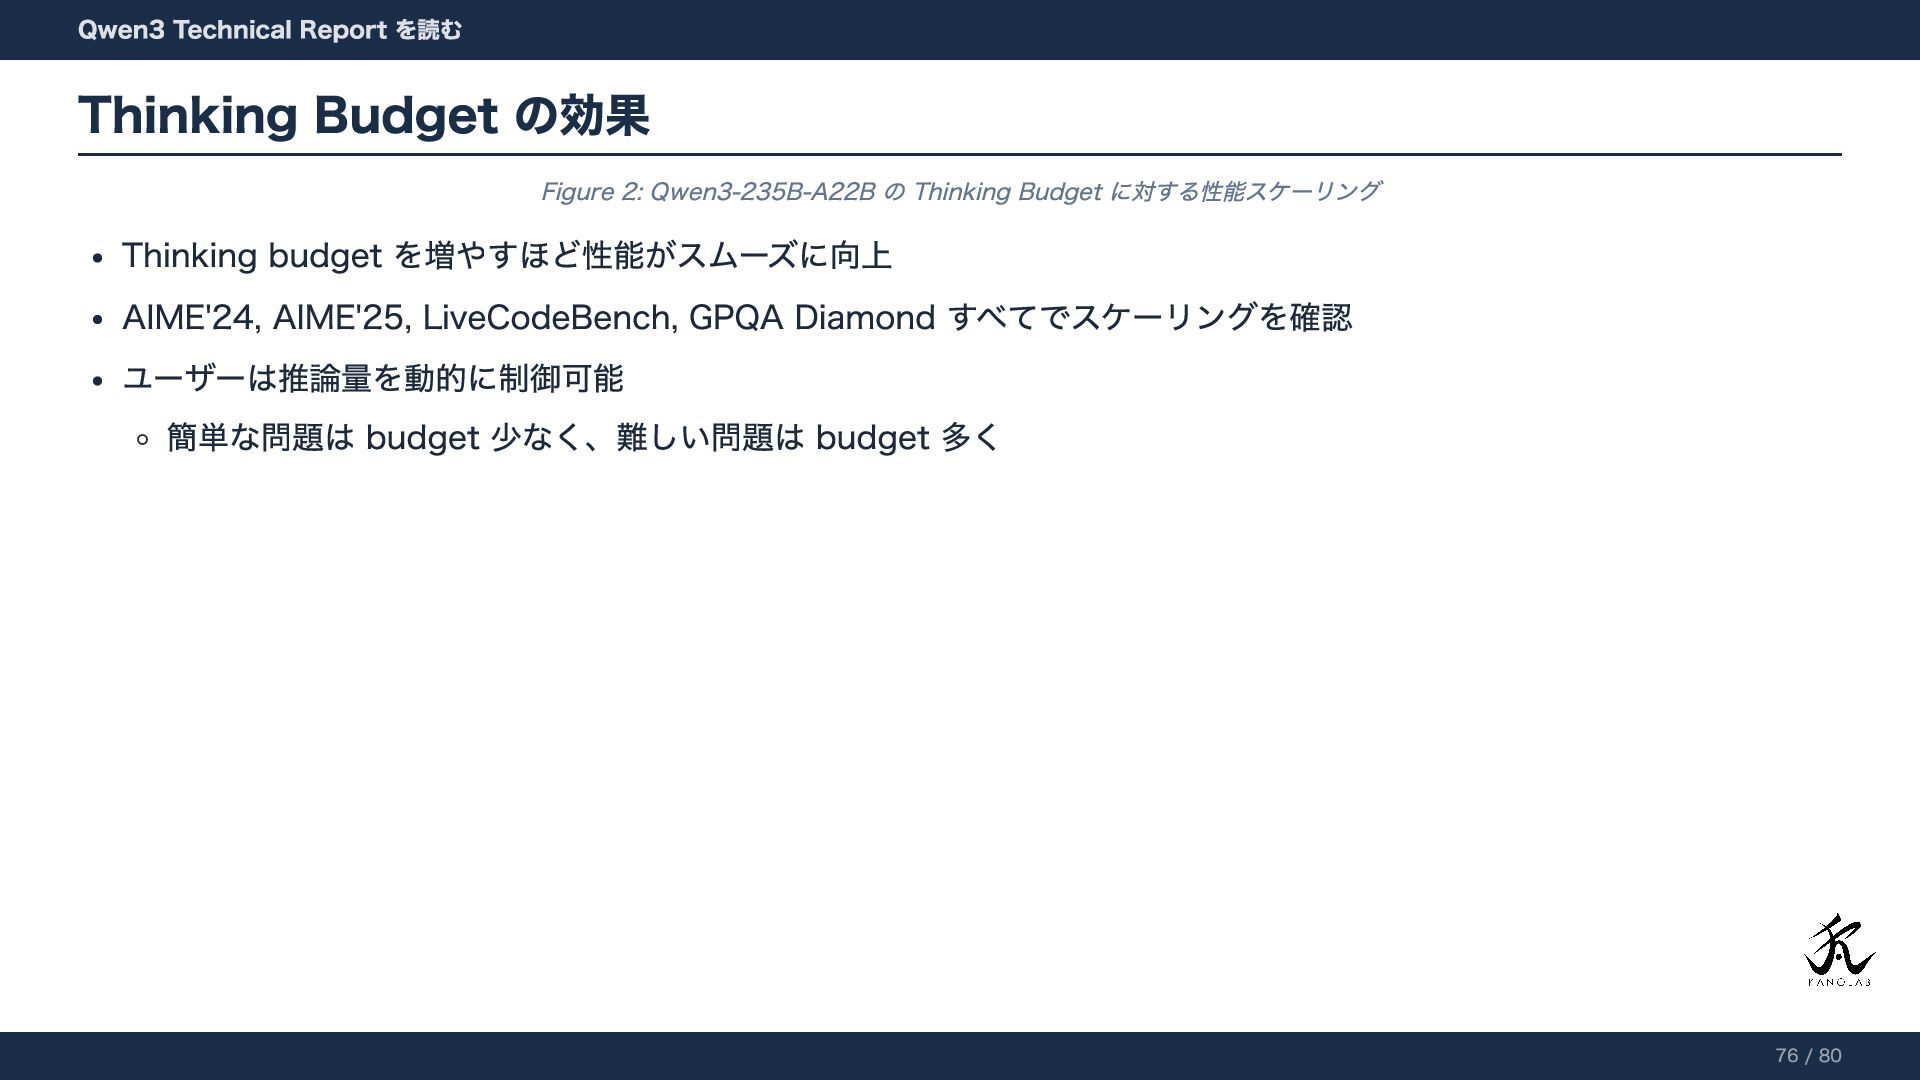
Figure 2: Qwen3-235B-A22B の Thinking Budget に対する性能スケーリング Thinking budget を増やすほど性能がスムーズに向上
AIME'24, AIME'25, LiveCodeBench, GPQA Diamond すべてでスケーリングを確認 ユーザーは推論量を動的に制御可能 簡単な問題は budget 少なく、難しい問題は budget 多く Qwen3 Technical Report を読む Thinking Budget の効果 76 / 80
11. まとめ Qwen3 Technical Report を読む 77 / 80
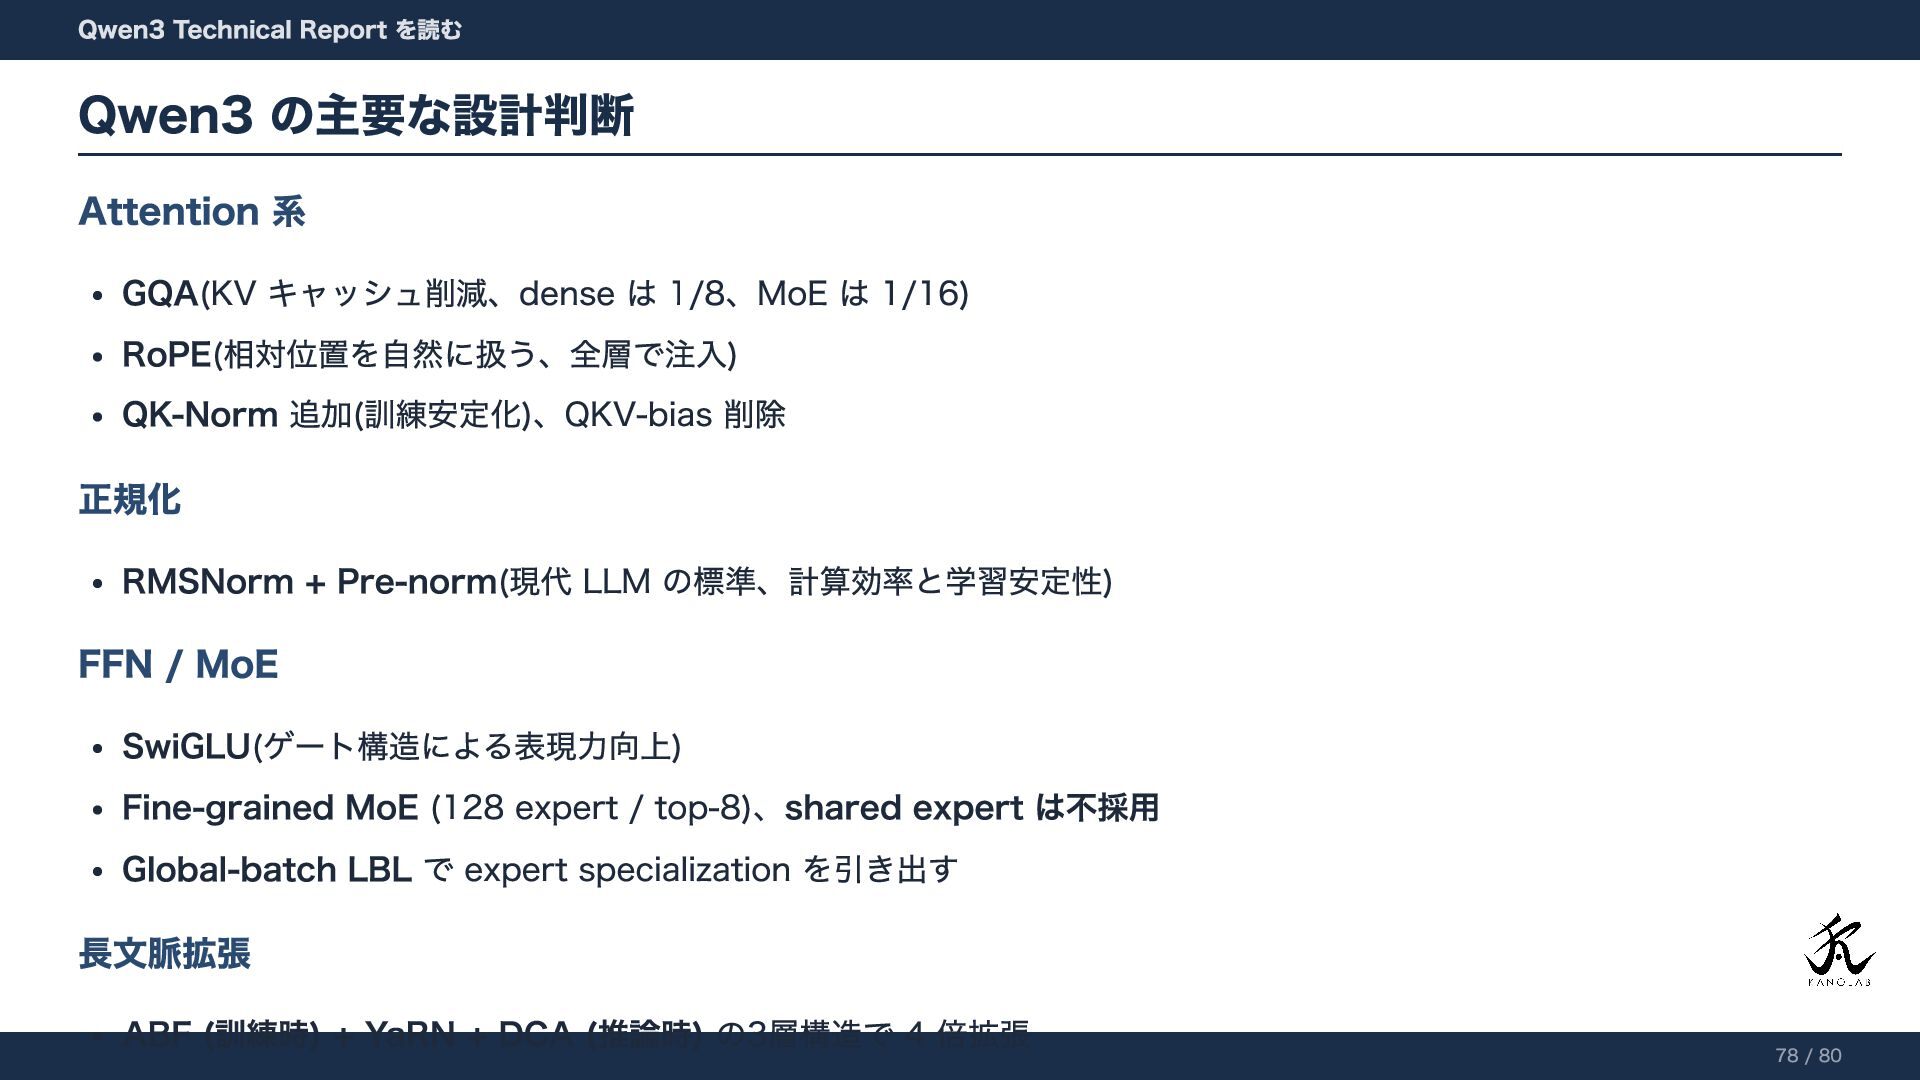
Attention 系 GQA(KV キャッシュ削減、dense は 1/8、MoE は 1/16) RoPE(相対位置を自然に扱う、全層で注入) QK-Norm
追加(訓練安定化)、QKV-bias 削除 正規化 RMSNorm + Pre-norm(現代 LLM の標準、計算効率と学習安定性) FFN / MoE SwiGLU(ゲート構造による表現力向上) Fine-grained MoE (128 expert / top-8)、shared expert は不採用 Global-batch LBL で expert specialization を引き出す 長文脈拡張 ABF (訓練時) + YaRN + DCA (推論時) の3層構造で 4 倍拡張 Qwen3 Technical Report を読む Qwen3 の主要な設計判断 78 / 80
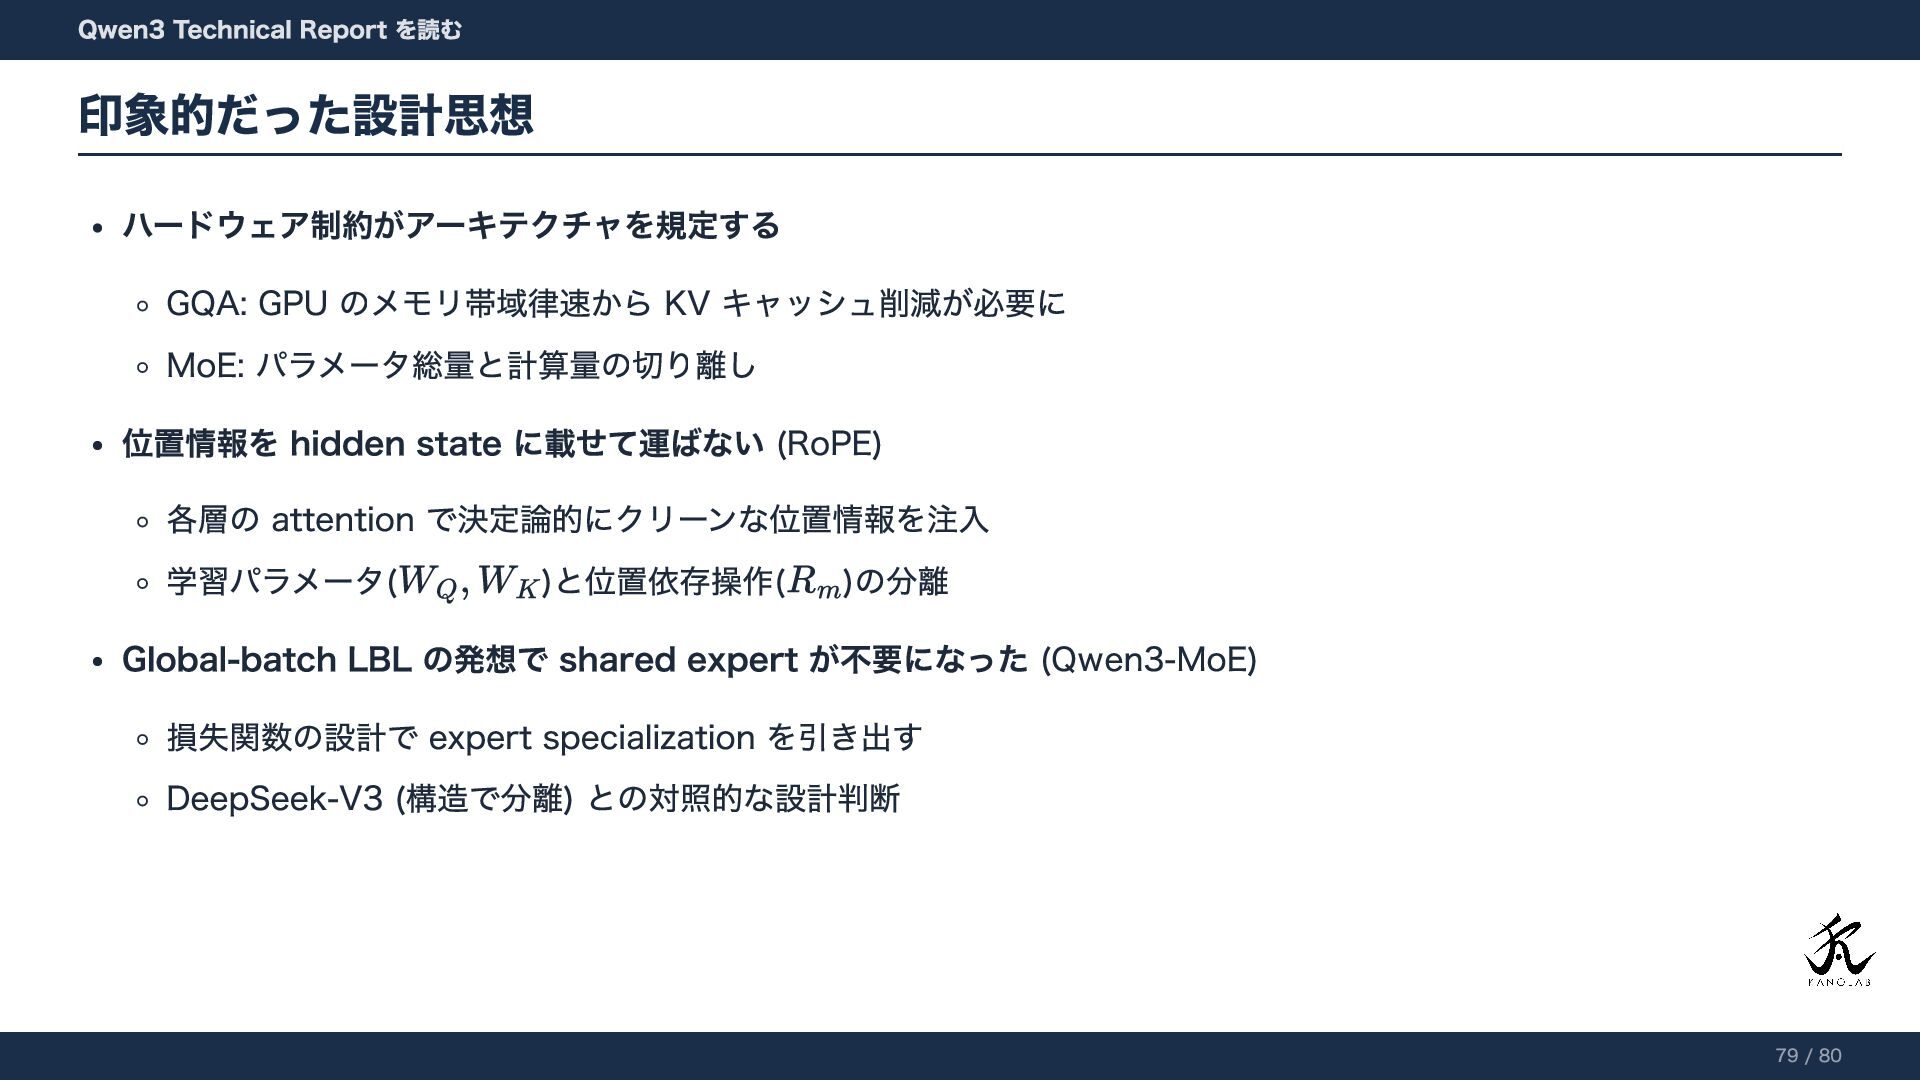
ハードウェア制約がアーキテクチャを規定する GQA: GPU のメモリ帯域律速から KV キャッシュ削減が必要に MoE: パラメータ総量と計算量の切り離し 位置情報を hidden
state に載せて運ばない (RoPE) 各層の attention で決定論的にクリーンな位置情報を注入 学習パラメータ( )と位置依存操作( )の分離 Global-batch LBL の発想で shared expert が不要になった (Qwen3-MoE) 損失関数の設計で expert specialization を引き出す DeepSeek-V3 (構造で分離) との対照的な設計判断 Qwen3 Technical Report を読む 印象的だった設計思想 79 / 80
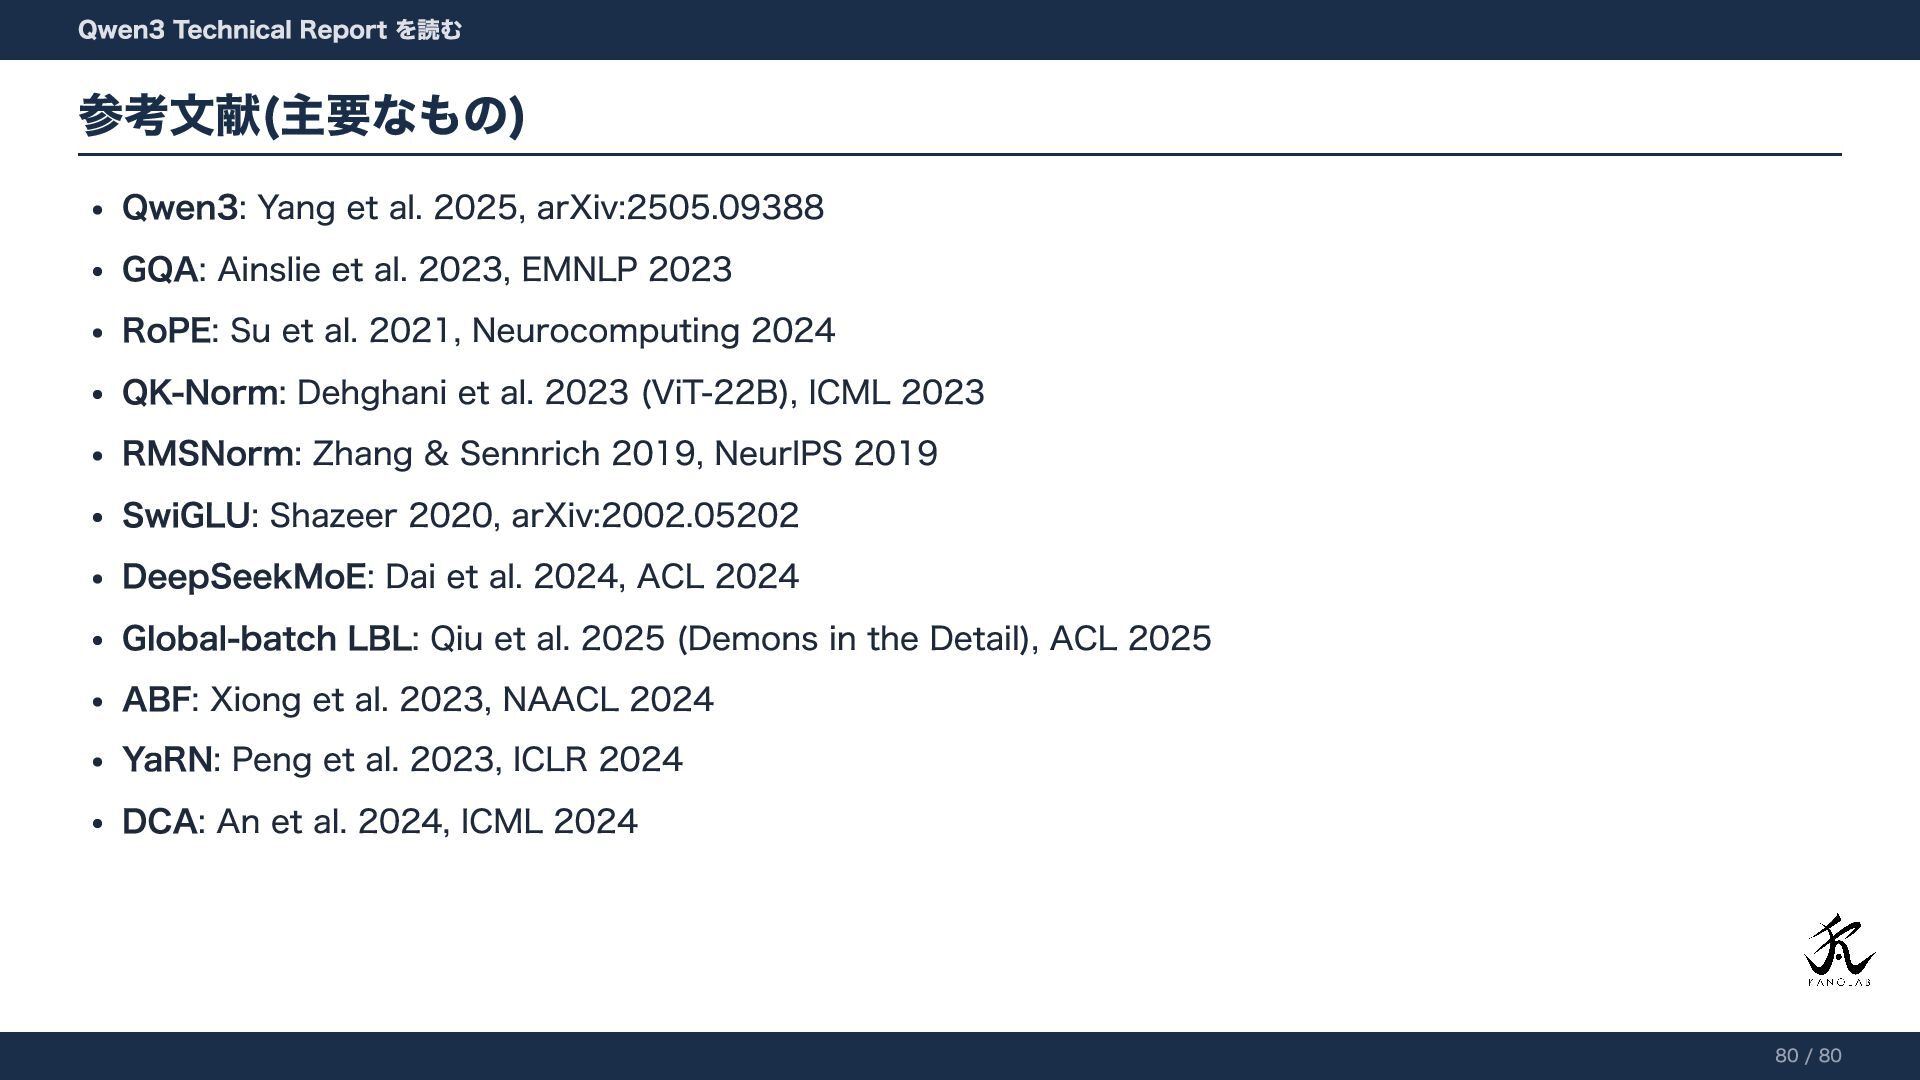
Qwen3: Yang et al. 2025, arXiv:2505.09388 GQA: Ainslie et al.
2023, EMNLP 2023 RoPE: Su et al. 2021, Neurocomputing 2024 QK-Norm: Dehghani et al. 2023 (ViT-22B), ICML 2023 RMSNorm: Zhang & Sennrich 2019, NeurIPS 2019 SwiGLU: Shazeer 2020, arXiv:2002.05202 DeepSeekMoE: Dai et al. 2024, ACL 2024 Global-batch LBL: Qiu et al. 2025 (Demons in the Detail), ACL 2025 ABF: Xiong et al. 2023, NAACL 2024 YaRN: Peng et al. 2023, ICLR 2024 DCA: An et al. 2024, ICML 2024 Qwen3 Technical Report を読む 参考文献(主要なもの) 80 / 80


 institutdelelevage
 beale
 sishi
 kogoro
 xspa2012
 satai
 microbaseinc
 ontheslope
 ftakahashi
 katarinadahlin
 addyosmani
 frankvandijk
 rakko
 marcoroth
 honzajavorek
 kneath
 marcelosomers
 garrettdimon
 rabernat
 portentint
 ivargrimstad