Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
2016/02/17 情報検索
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
nishi-k
February 16, 2016
Education
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
2016/02/17 情報検索
nishi-k
February 16, 2016
Transcript
10 slides
- 情報検索- 第7回 B3勉強会 2016年2月17日 自然言語処理研究室 学部3年 西山 浩気
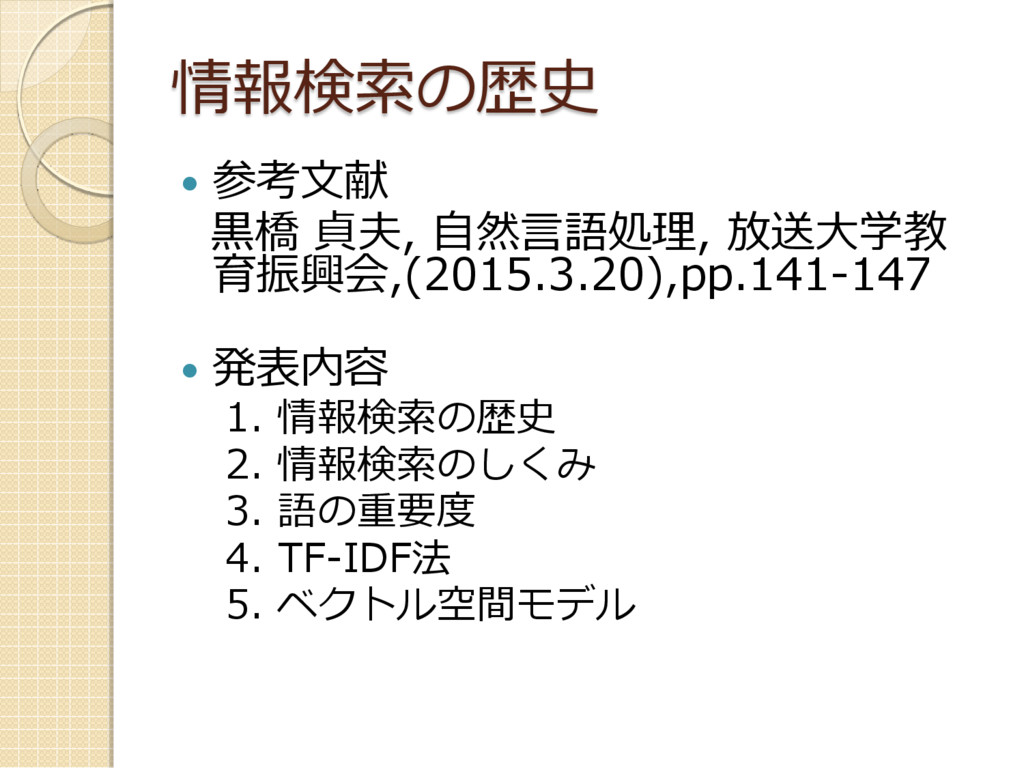
情報検索の歴史 参考文献 黒橋 貞夫, 自然言語処理, 放送大学教 育振興会,(2015.3.20),pp.141-147 発表内容
1. 情報検索の歴史 2. 情報検索のしくみ 3. 語の重要度 4. TF-IDF法 5. ベクトル空間モデル
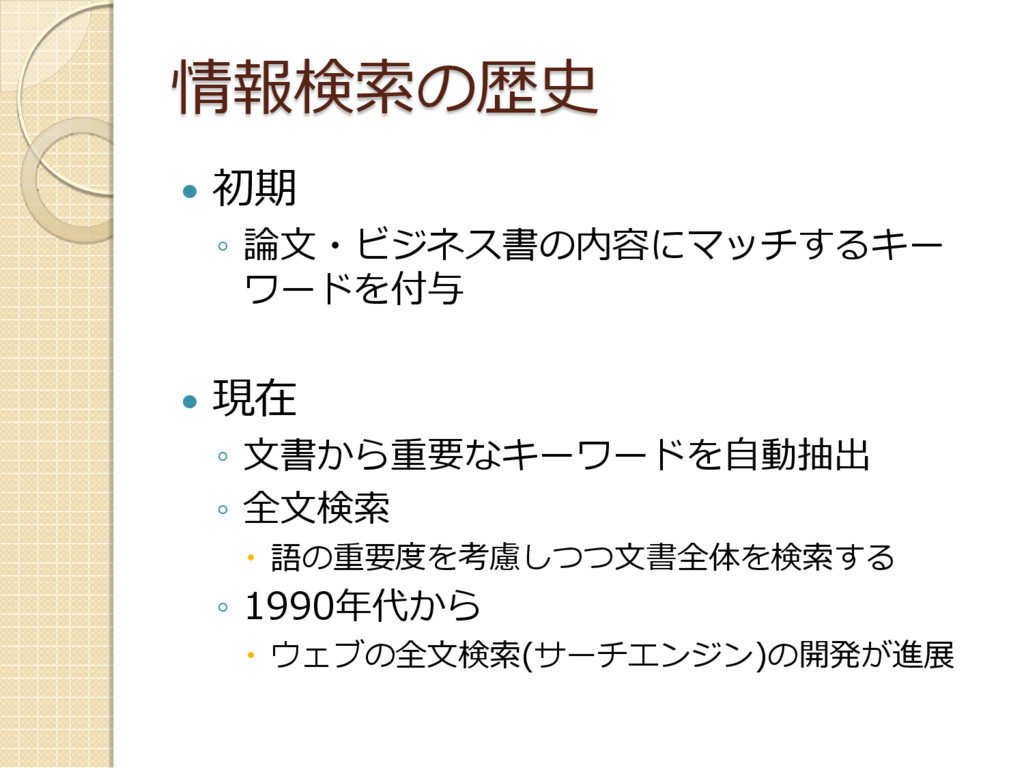
情報検索の歴史 初期 ◦ 論文・ビジネス書の内容にマッチするキー ワードを付与 現在 ◦ 文書から重要なキーワードを自動抽出
◦ 全文検索 語の重要度を考慮しつつ文書全体を検索する ◦ 1990年代から ウェブの全文検索(サーチエンジン)の開発が進展
情報検索の仕組み 転置インデックス ◦ あらゆる語がどの文書に出現するかを表 す索引 文書1 言語、コンピュータ、問題 文書2 コンピュータ、問題
文書3 言語、問題、情報 文書4 問題、情報 文書5 情報、コンピュータ 言語 文書1、文書3 コンピュータ 文書1、文書2、文書5 問題 文書1、文書2、文書3、文書4 情報 文書3、文書4、文書5
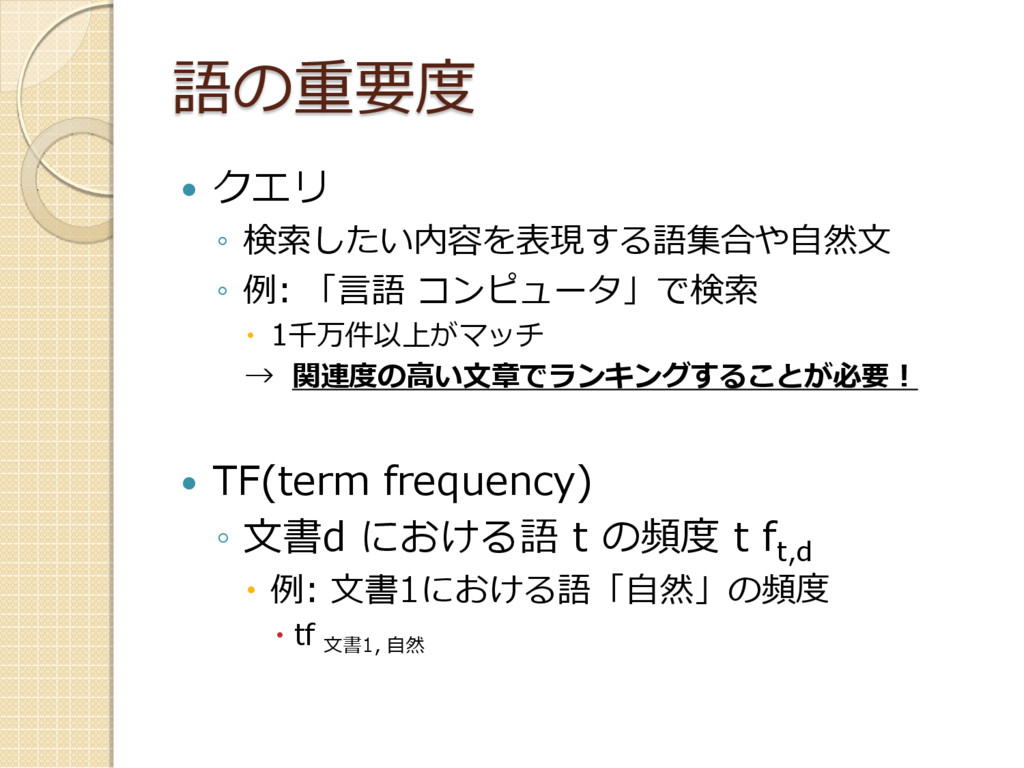
語の重要度 クエリ ◦ 検索したい内容を表現する語集合や自然文 ◦ 例: 「言語 コンピュータ」で検索
1千万件以上がマッチ → 関連度の高い文章でランキングすることが必要! TF(term frequency) ◦ 文書d における語 t の頻度 t f t,d 例: 文書1における語「自然」の頻度 tf 文書1, 自然
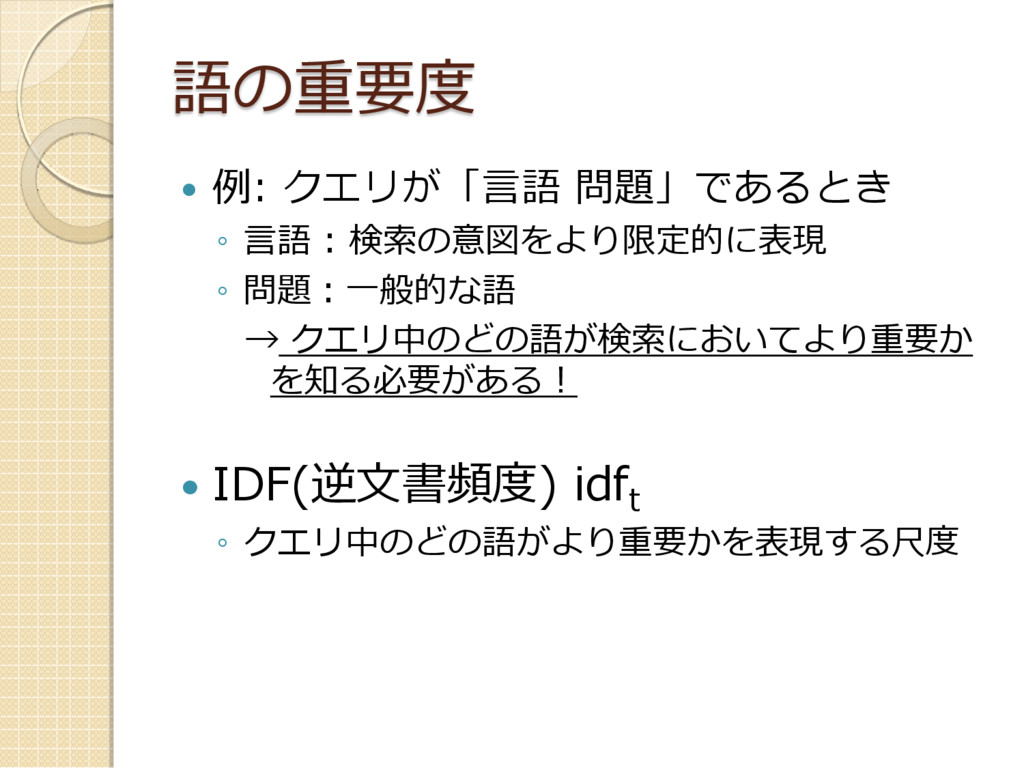
語の重要度 例: クエリが「言語 問題」であるとき ◦ 言語 : 検索の意図をより限定的に表現 ◦
問題:一般的な語 → クエリ中のどの語が検索においてより重要か を知る必要がある! IDF(逆文書頻度) idf t ◦ クエリ中のどの語がより重要かを表現する尺度
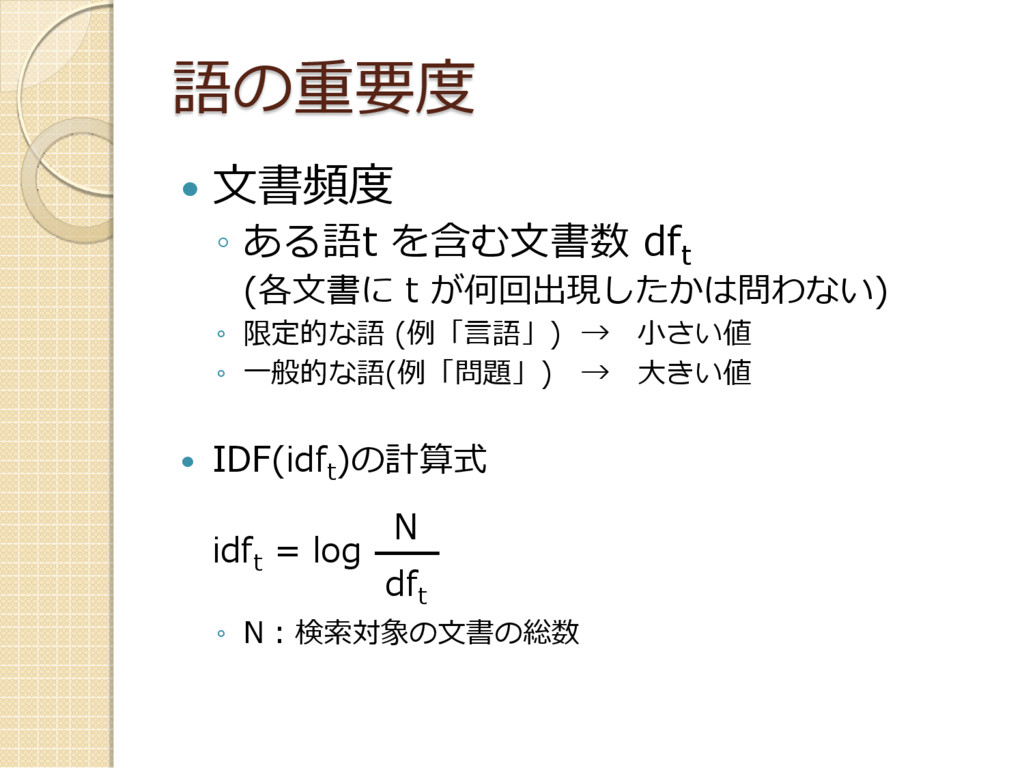
語の重要度 文書頻度 ◦ ある語t を含む文書数 df t (各文書に t
が何回出現したかは問わない) ◦ 限定的な語 (例「言語」) → 小さい値 ◦ 一般的な語(例「問題」) → 大きい値 IDF(idf t )の計算式 idf t = log ◦ N : 検索対象の文書の総数 N df t
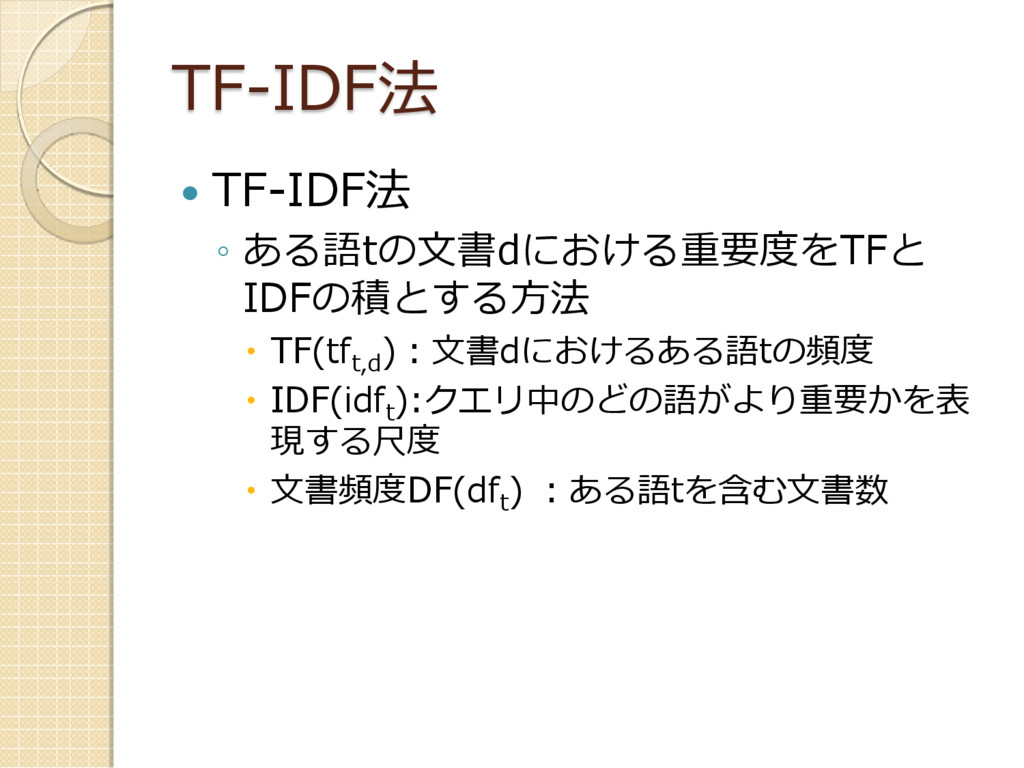
TF-IDF法 TF-IDF法 ◦ ある語tの文書dにおける重要度をTFと IDFの積とする方法 TF(tf t,d ):文書dにおけるある語tの頻度
IDF(idf t ):クエリ中のどの語がより重要かを表 現する尺度 文書頻度DF(df t ) :ある語tを含む文書数
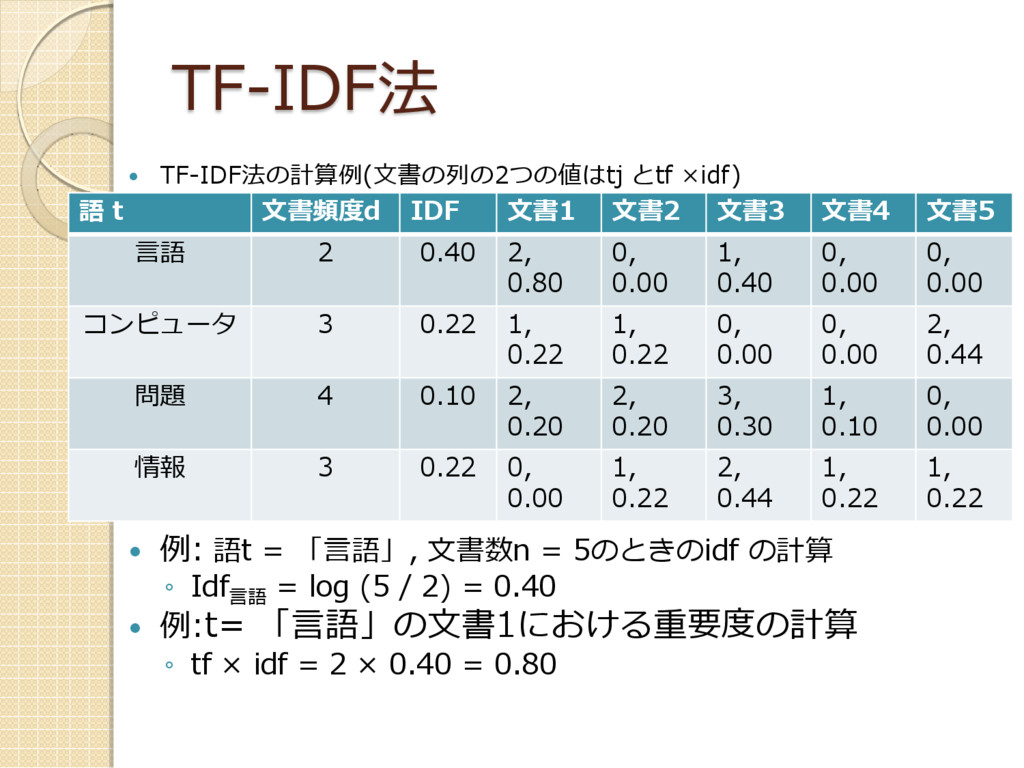
TF-IDF法 TF-IDF法の計算例(文書の列の2つの値はtj とtf ×idf) 例: 語t = 「言語」,
文書数n = 5のときのidf の計算 ◦ Idf 言語 = log (5 / 2) = 0.40 例:t= 「言語」の文書1における重要度の計算 ◦ tf × idf = 2 × 0.40 = 0.80 語 t 文書頻度d IDF 文書1 文書2 文書3 文書4 文書5 言語 2 0.40 2, 0.80 0, 0.00 1, 0.40 0, 0.00 0, 0.00 コンピュータ 3 0.22 1, 0.22 1, 0.22 0, 0.00 0, 0.00 2, 0.44 問題 4 0.10 2, 0.20 2, 0.20 3, 0.30 1, 0.10 0, 0.00 情報 3 0.22 0, 0.00 1, 0.22 2, 0.44 1, 0.22 1, 0.22
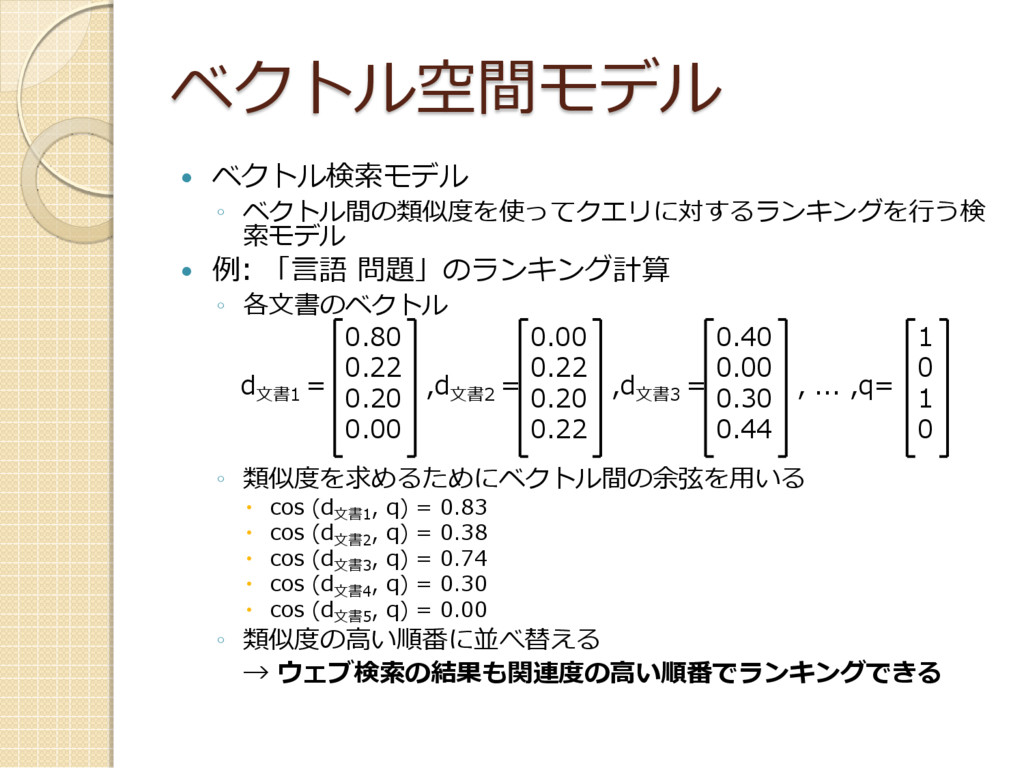
ベクトル空間モデル ベクトル検索モデル ◦ ベクトル間の類似度を使ってクエリに対するランキングを行う検 索モデル 例: 「言語 問題」のランキング計算
◦ 各文書のベクトル ◦ 類似度を求めるためにベクトル間の余弦を用いる cos (d 文書1 , q) = 0.83 cos (d 文書2 , q) = 0.38 cos (d 文書3 , q) = 0.74 cos (d 文書4 , q) = 0.30 cos (d 文書5 , q) = 0.00 ◦ 類似度の高い順番に並べ替える → ウェブ検索の結果も関連度の高い順番でランキングできる d 文書1 = 0.80 0.22 0.20 0.00 ,d 文書2 = 0.00 0.22 0.20 0.22 ,d 文書3 = 0.40 0.00 0.30 0.44 , ... ,q= 1 0 1 0
More Decks by nishi-k
See All by nishi-k
自動抽出した換喩表現を用いた係り受け関係のずれの解消
nishiyama
0
390
日本語解析システム「雪だるま」における表記ゆれの拡張とまとめあげ
nishiyama
0
1.2k
多段解析法による形態素解析を用いた音声合成用読み韻律情報設定法とその単語辞書構成
nishiyama
0
270
画像検索を用いた語義別画像付き辞書の構築
nishiyama
0
190
質問応答に基づく対災害情報分析システム
nishiyama
0
280
対話システム
nishiyama
0
340
動詞名詞換言辞書の構築と敬語の常体への換言
nishiyama
0
580
情報検索2
nishiyama
0
140
文脈の解析
nishiyama
0
540
Other Decks in Education
See All in Education
Session 3 - Diplomasi
adeputra13
0
460
El Geoparque Mundial UNESCO Volcanes de Calatrava de la Investigación Científica a la Transposición Didáctica en el aula
juanmartin2026
1
58k
2026年度秋学期 統計学 第2回 統計資料の収集と読み方 (2026. 10. 6)
akiraasano
PRO
0
310
Introduction - Lecture 1 - Web Technologies (1019888BNR)
signer
PRO
0
6.6k
2026年度秋学期 統計学 第3回 クロス集計と感度・特異度,データの可視化 (2026. 10. 13)
akiraasano
PRO
0
300
Sekolah Sabat - Triwulan 4 2026 - Pelajaran 7
hiola
0
8.1k
HTTP APIs in Python
madhuri28
0
120
[2026後期火5] 論理学(京都大学文学部 後期 第1回)「名前はあるのに、誰なのかわからない」
yatabe
0
190
Session 6 - Teknik Lobby dan Negosiasi
adeputra13
0
510
DRONEGEOGRAFÍA: INNOVACIÓN DIDÁCTICA Y FOTOGRAMETRÍA 3D PARA LA COHESIÓN TERRITORIAL Y LA CIUDADANÍA ACTIVA
juanmartin2026
0
60k
LEGO Geometry Tutorial
arnoknobbe
0
810
Web Application Frameworks - Lecture 3 - Web Technologies (1019888BNR)
signer
PRO
0
3.6k
Featured
See All Featured
Being A Developer After 40
akosma
PRO
92
590k
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
450
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.9k
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
560
Music & Morning Musume
bryan
48
7.5k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.6k
Un-Boring Meetings
codingconduct
0
500
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
660
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.4k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
680
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
380
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k


 nishiyama
 adeputra13
 juanmartin2026
 akiraasano
 signer
 hiola
 madhuri28
 yatabe
 arnoknobbe
 akosma
 helenjbeal
 addyosmani
 nikkihalliwell
 bryan
 ivargrimstad
 codingconduct
 konakalab
 aleyda
 reverentgeek
 dugsong
 philnash