Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
情報検索2
Search
nishi-k
March 01, 2016
Education
140
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
情報検索2
nishi-k
March 01, 2016
More Decks by nishi-k
See All by nishi-k
自動抽出した換喩表現を用いた係り受け関係のずれの解消
nishiyama
0
390
日本語解析システム「雪だるま」における表記ゆれの拡張とまとめあげ
nishiyama
0
1.2k
多段解析法による形態素解析を用いた音声合成用読み韻律情報設定法とその単語辞書構成
nishiyama
0
250
画像検索を用いた語義別画像付き辞書の構築
nishiyama
0
190
質問応答に基づく対災害情報分析システム
nishiyama
0
280
対話システム
nishiyama
0
330
動詞名詞換言辞書の構築と敬語の常体への換言
nishiyama
0
570
2016/02/17 情報検索
nishiyama
0
180
文脈の解析
nishiyama
0
520
Other Decks in Education
See All in Education
Comentario del plano urbano de Madrid hasta 1860 (1ª parte )
juanmartin2026
1
75k
[2026前期火5] 論理学(京都大学文学部 前期 第14回)「計算は、証明ではない——ハルシネーションを三層ハーモニーで診る」
yatabe
0
260
AI Generated Beer
lonbrew
0
120
Beyond the Prompt: Programming as a Pathway to Statistical Thinking
minecr
0
360
Visionary Initiative: Future Intelligence — Laying the foundations for the future of science, intelligence, and society | Science Tokyo
sciencetokyo
PRO
0
320
sepm-training-sample
levii
0
230
Center for Entrepreneurship Education | Science Tokyo (Institute of Science Tokyo)
sciencetokyo
PRO
0
400
武藤の処世術を書いてみた
mutomasa
0
120
チームの鏡になるー自分の癖を知ると、チームのパターンが見えてくる@スクフェス仙台
saorimurooka
0
180
0526
cbtlibrary
0
280
データマネジメント試験対策教材1〜データマネジメント基礎〜
yoshimura_datam
1
730
形骸化しない社内勉強会の取り組み - オーナーシップの作り方 / In-house study session
soudai
PRO
1
270
Featured
See All Featured
Accessibility Awareness
sabderemane
1
210
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.1k
Google's AI Overviews - The New Search
badams
0
1.6k
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.2k
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
720
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
The SEO identity crisis: Don't let AI make you average
varn
0
560
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.6k
Designing Experiences People Love
moore
143
24k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.4k
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
Transcript
-情報検索(2)- 第9回 B3勉強会 2016年2月3日 自然言語処理研究室 学部3年 西山 浩気
はじめに 参考文献 黒橋 貞夫, 自然言語処理, 放送大学教 育振興会,(2015.3.20),pp.146-153 発表内容
◦ 1. 情報検索の評価 ◦ 2. ウェブ検索の仕組み ◦ 3. ページランク
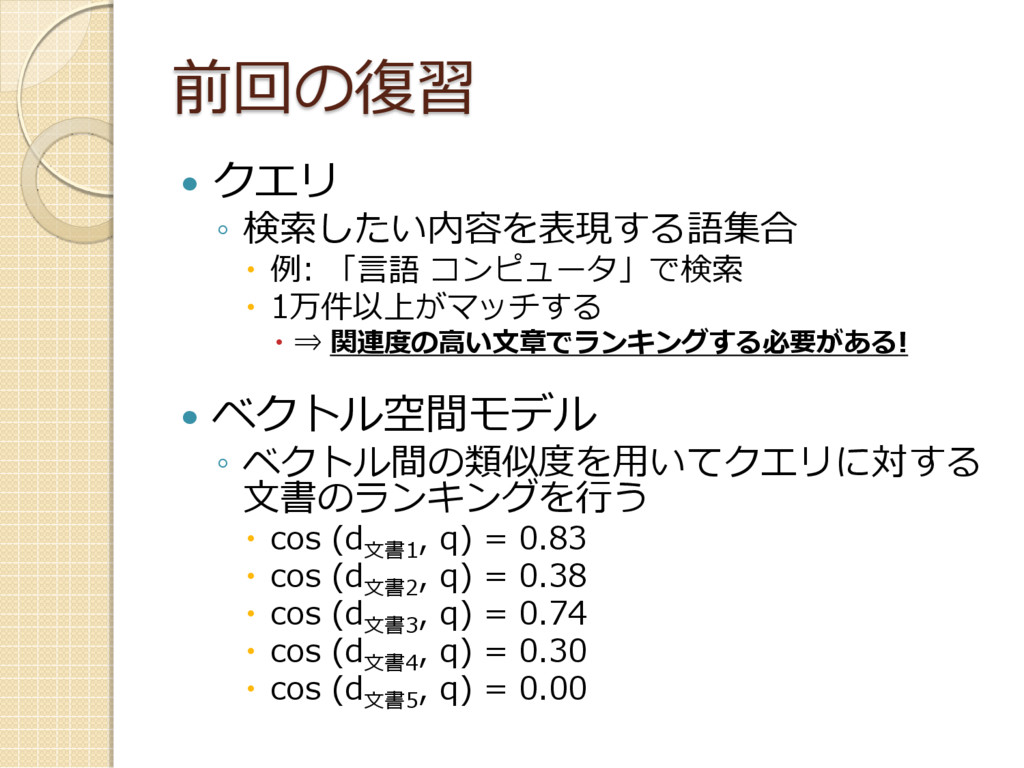
前回の復習 クエリ ◦ 検索したい内容を表現する語集合 例: 「言語 コンピュータ」で検索
1万件以上がマッチする ⇒ 関連度の高い文章でランキングする必要がある! ベクトル空間モデル ◦ ベクトル間の類似度を用いてクエリに対する 文書のランキングを行う cos (d 文書1 , q) = 0.83 cos (d 文書2 , q) = 0.38 cos (d 文書3 , q) = 0.74 cos (d 文書4 , q) = 0.30 cos (d 文書5 , q) = 0.00
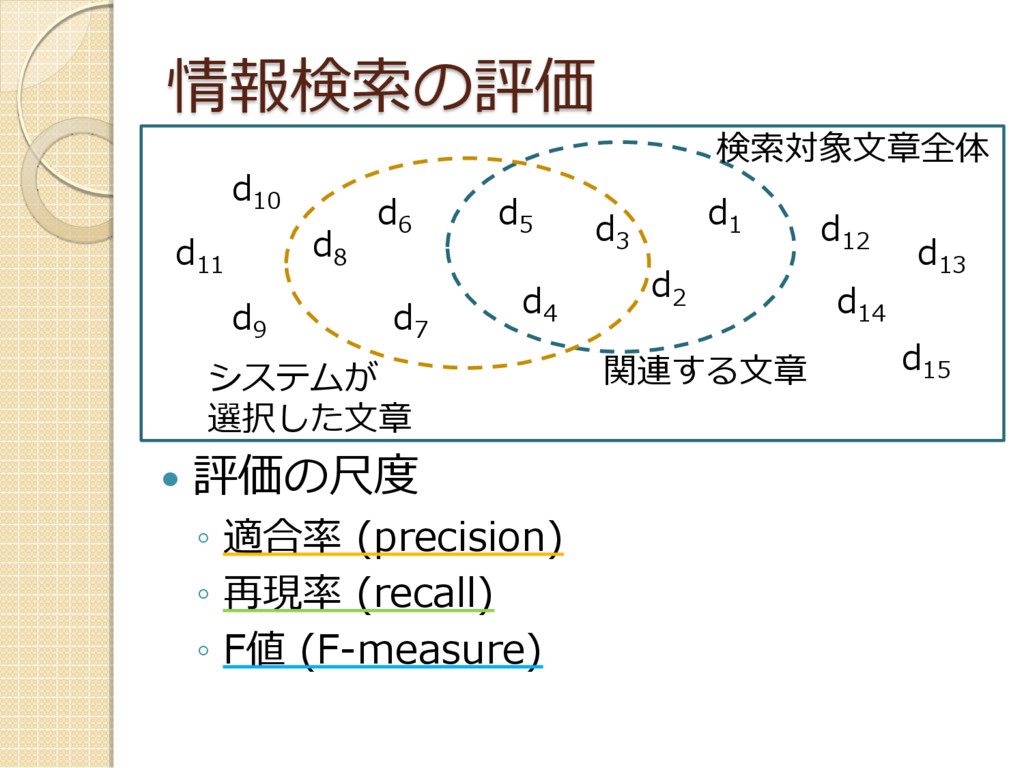
情報検索の評価 評価の尺度 ◦ 適合率 (precision) ◦ 再現率 (recall) ◦
F値 (F-measure) d 4 d 5 d 2 d 1 d 3 d 6 d 7 d 8 d 9 d 11 d 10 d 12 d 13 d 14 d 15 関連する文章 システムが 選択した文章 検索対象文章全体
適合率、再現率、F値 適合率 = |システムの選択文書 ∩ 関連文書| |システムの選択文書| = 3
/ 6 = 0.5 再現率 = |システムの選択文書 ∩ 関連文書| |関連文書| = 3 / 5 = 0.6 F値 = 2 × 適合率 × 再現率 適合率 + 再現率 = 2 × 0.5 × 0.6 = 0.6 0.5 + 0.6
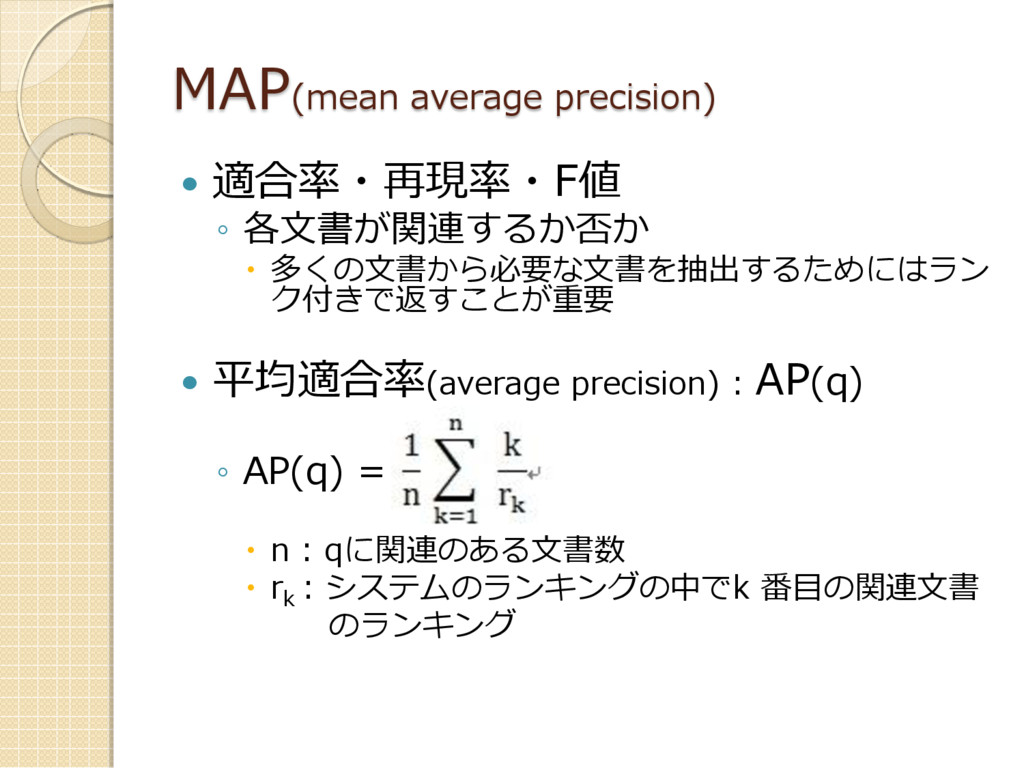
適合率・再現率・F値 ◦ 各文書が関連するか否か 多くの文書から必要な文書を抽出するためにはラン ク付きで返すことが重要 平均適合率(average precision)
: AP(q) ◦ AP(q) = n : qに関連のある文書数 r k : システムのランキングの中でk 番目の関連文書 のランキング MAP(mean average precision)
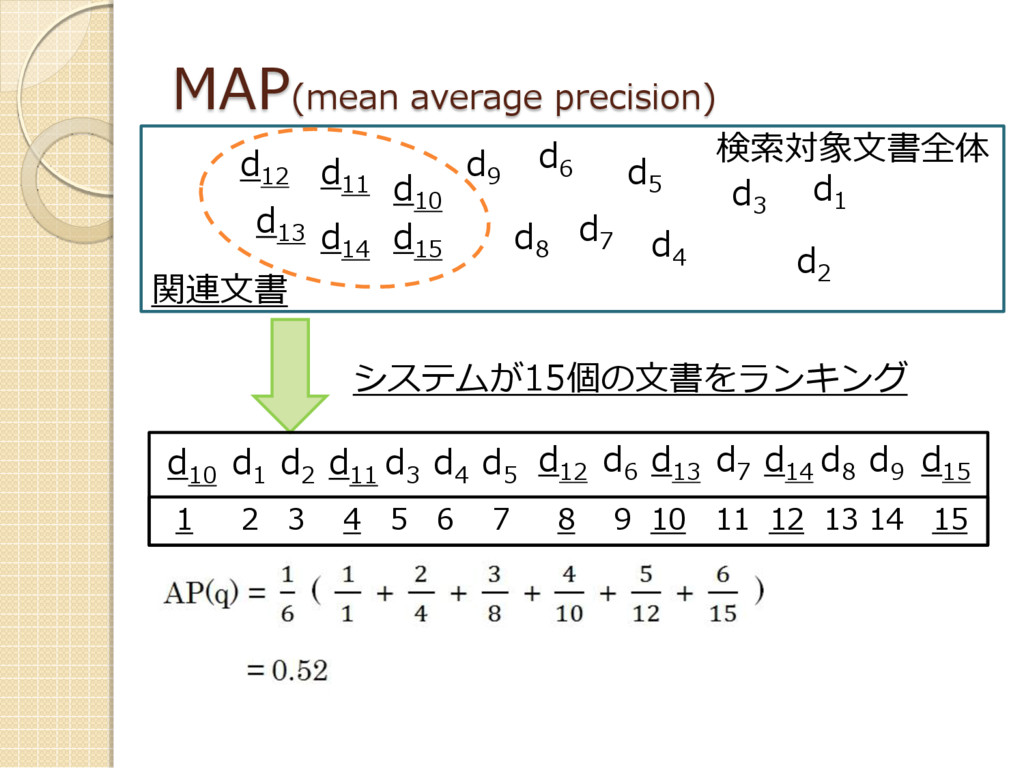
MAP(mean average precision) d 4 d 5 d 2 d
1 d 3 d 6 d 7 d 8 d 9 d 11 d 10 d 12 d 13 d 14 d 15 検索対象文書全体 システムが15個の文書をランキング 関連文書 d 10 d 1 d 2 d 11 d 3 d 4 d 5 d 12 d 6 d 13 d 7 d 14 d 8 d 9 d 15 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
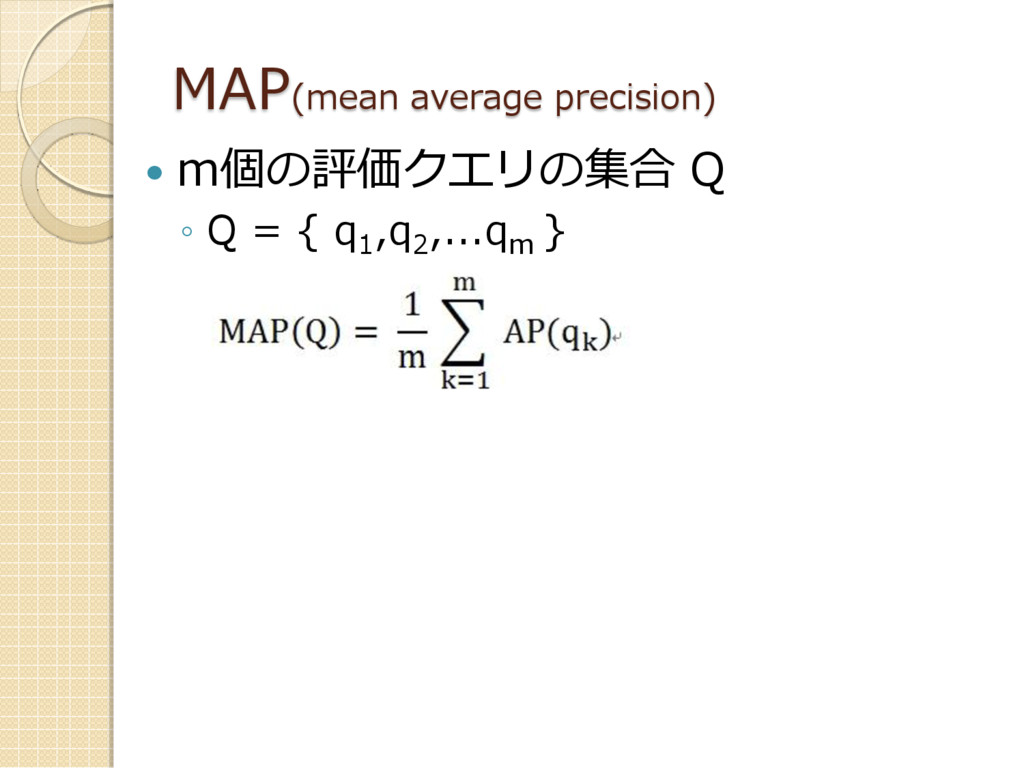
MAP(mean average precision) m個の評価クエリの集合 Q ◦ Q = {
q 1 ,q 2 ,...q m }
ウェブ検索の仕組み 誘導型(navigational) ◦ 存在することが予想されるページを見つ けることが目的(企業や行政) クエリは企業名など クエリとは独立に、ページの重要度を考える
調査型(informational) ◦ 何を調べたいかが明確でない クエリとページの関連度が重要 ページの重要度も重要
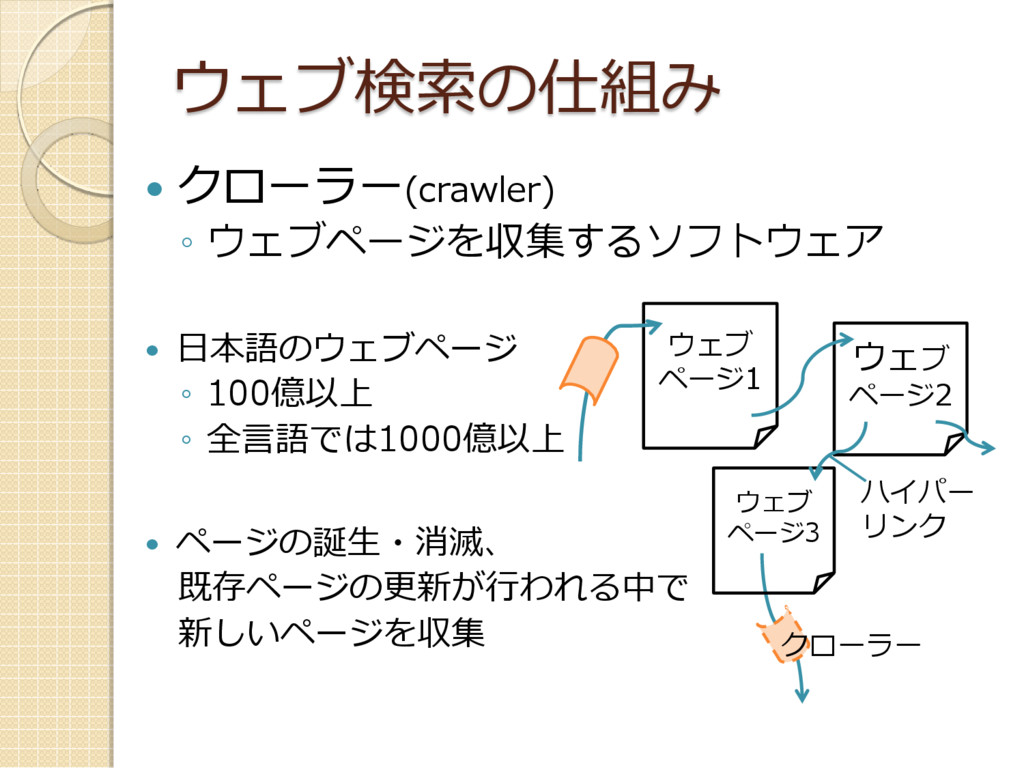
クローラー(crawler) ◦ ウェブページを収集するソフトウェア 日本語のウェブページ ◦ 100億以上 ◦ 全言語では1000億以上
ページの誕生・消滅、 既存ページの更新が行われる中で 新しいページを収集 ウェブ検索の仕組み ハイパー リンク ウェブ ページ1 ウェブ ページ2 ウェブ ページ3 クローラー
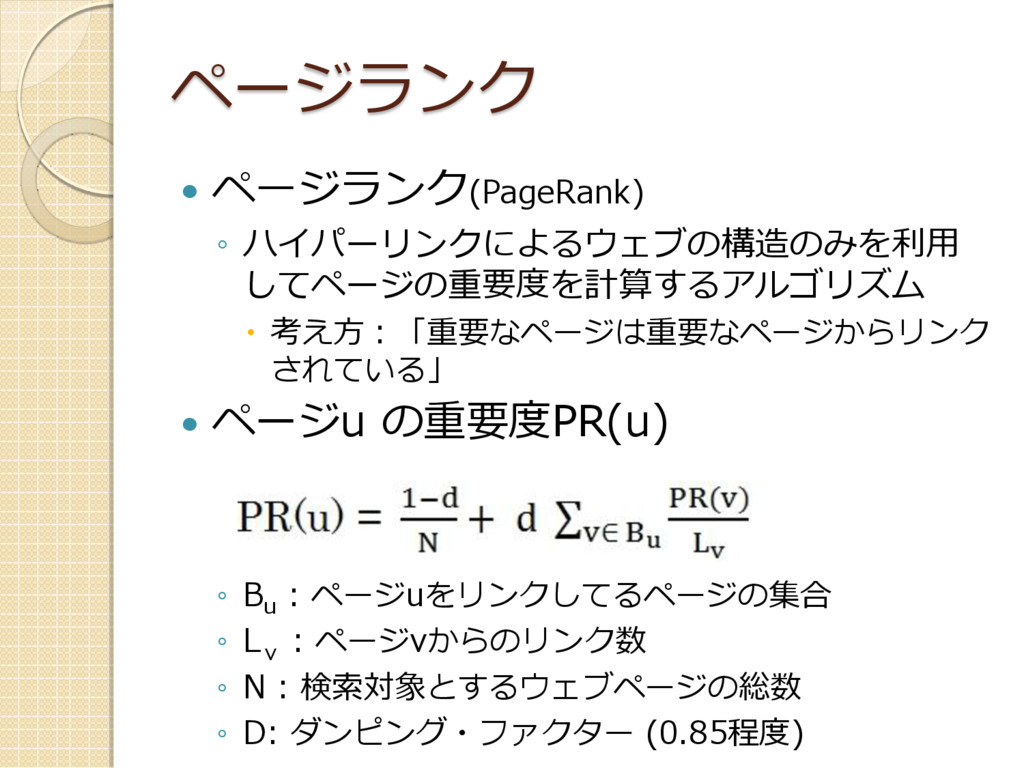
ページランク ページランク(PageRank) ◦ ハイパーリンクによるウェブの構造のみを利用 してページの重要度を計算するアルゴリズム 考え方:「重要なページは重要なページからリンク されている」
ページu の重要度PR(u) ◦ B u : ページuをリンクしてるページの集合 ◦ L v : ページvからのリンク数 ◦ N : 検索対象とするウェブページの総数 ◦ D: ダンピング・ファクター (0.85程度)
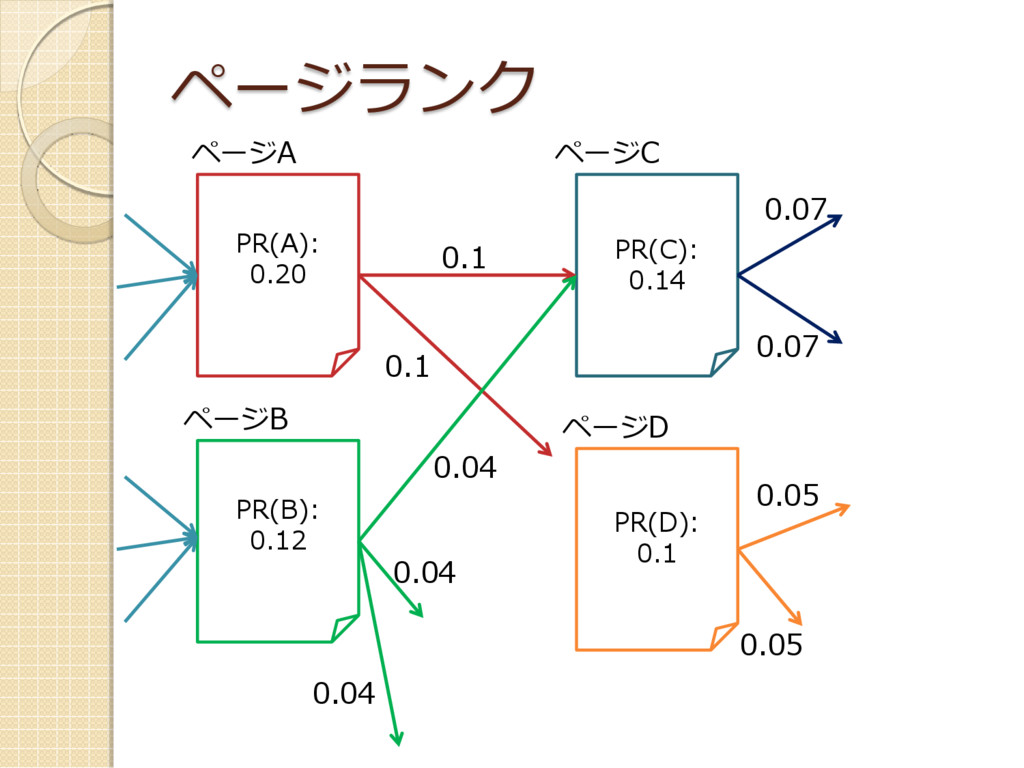
ページランク PR(A): 0.20 PR(B): 0.12 ページA ページB ページC 0.1 0.1
0.04 0.04 0.04 ページD 0.05 0.05 0.07 0.07 PR(C): 0.14 PR(D): 0.1


 nishiyama
 juanmartin2026
 yatabe
 lonbrew
 minecr
 sciencetokyo
 levii
 mutomasa
 saorimurooka
 cbtlibrary
 yoshimura_datam
 soudai
 sabderemane
 soysaucechin
 badams
 aleyda
 jlugia
 portentint
 danielanewman
 varn
 addyosmani
 moore
 maggiecrowley
 wjessup