Share
Embed
oku-slide-stat2-7
数理統計学特論II
第7回 漸近理論
奥 牧人 (未病研究センター)
2022/07/27
2023/08/02
2024/07/31
2025/07/30
2026/07/29
Makito Oku
March 29, 2022
Transcript
32 slides
-
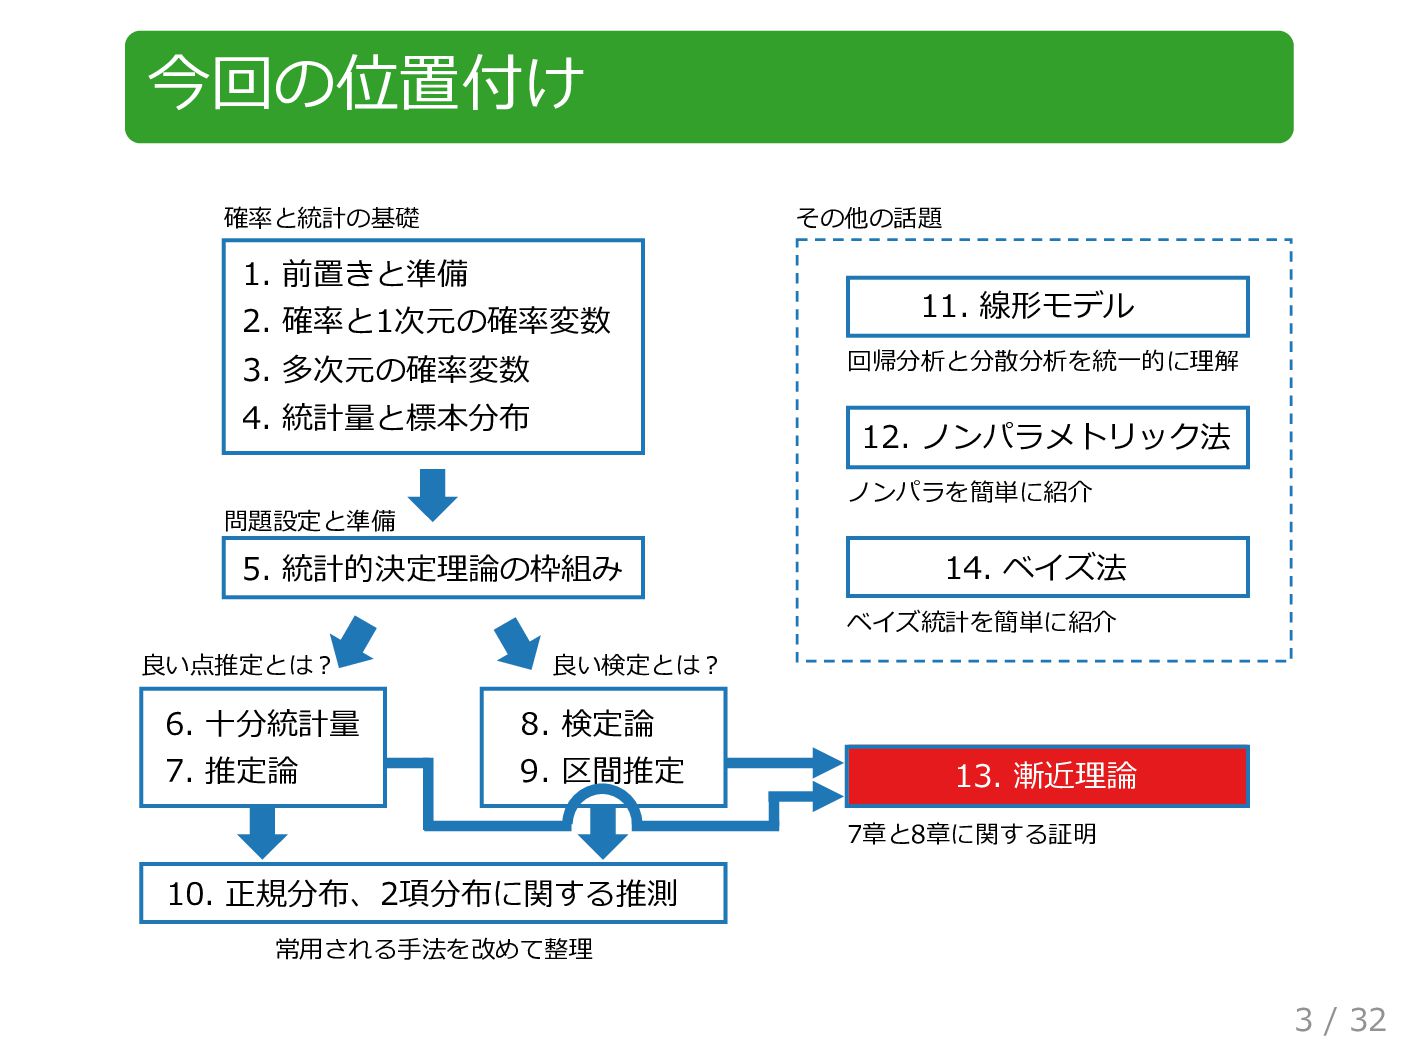
今回の位置付け 1. 前置きと準備 2. 確率と1次元の確率変数 3. 多次元の確率変数 4. 統計量と標本分布 5.
統計的決定理論の枠組み 6. ⼗分統計量 7. 推定論 8. 検定論 9. 区間推定 10. 正規分布、2項分布に関する推測 その他の話題 11. 線形モデル 12. ノンパラメトリック法 13. 漸近理論 14. ベイズ法 確率と統計の基礎 良い点推定とは︖ 良い検定とは︖ 問題設定と準備 7章と8章に関する証明 回帰分析と分散分析を統⼀的に理解 常⽤される⼿法を改めて整理 ベイズ統計を簡単に紹介 ノンパラを簡単に紹介 3 / 32 -
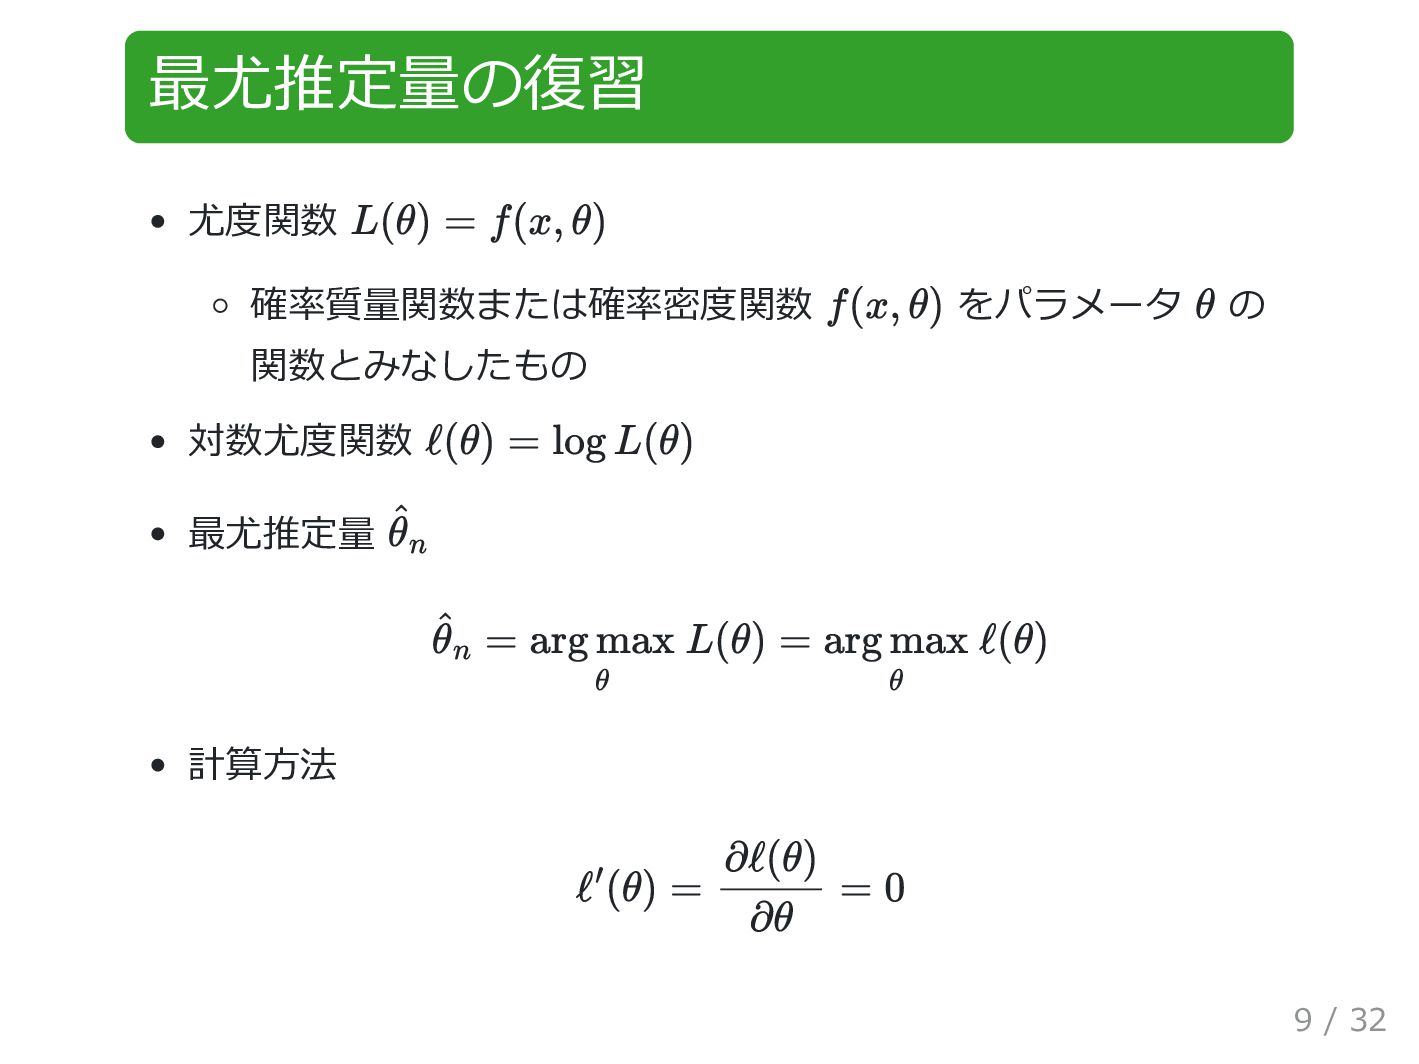
最尤推定量の復習 尤度関数 確率質量関数または確率密度関数 をパラメータ の 関数とみなしたもの 対数尤度関数 最尤推定量 計算方法 L(θ)
= f(x, θ) f(x, θ) θ ℓ(θ) = log L(θ) ^ θn ^ θn = arg max θ L(θ) = arg max θ ℓ(θ) ℓ ′ (θ) = ∂ℓ(θ) ∂θ = 0 9 / 32 -
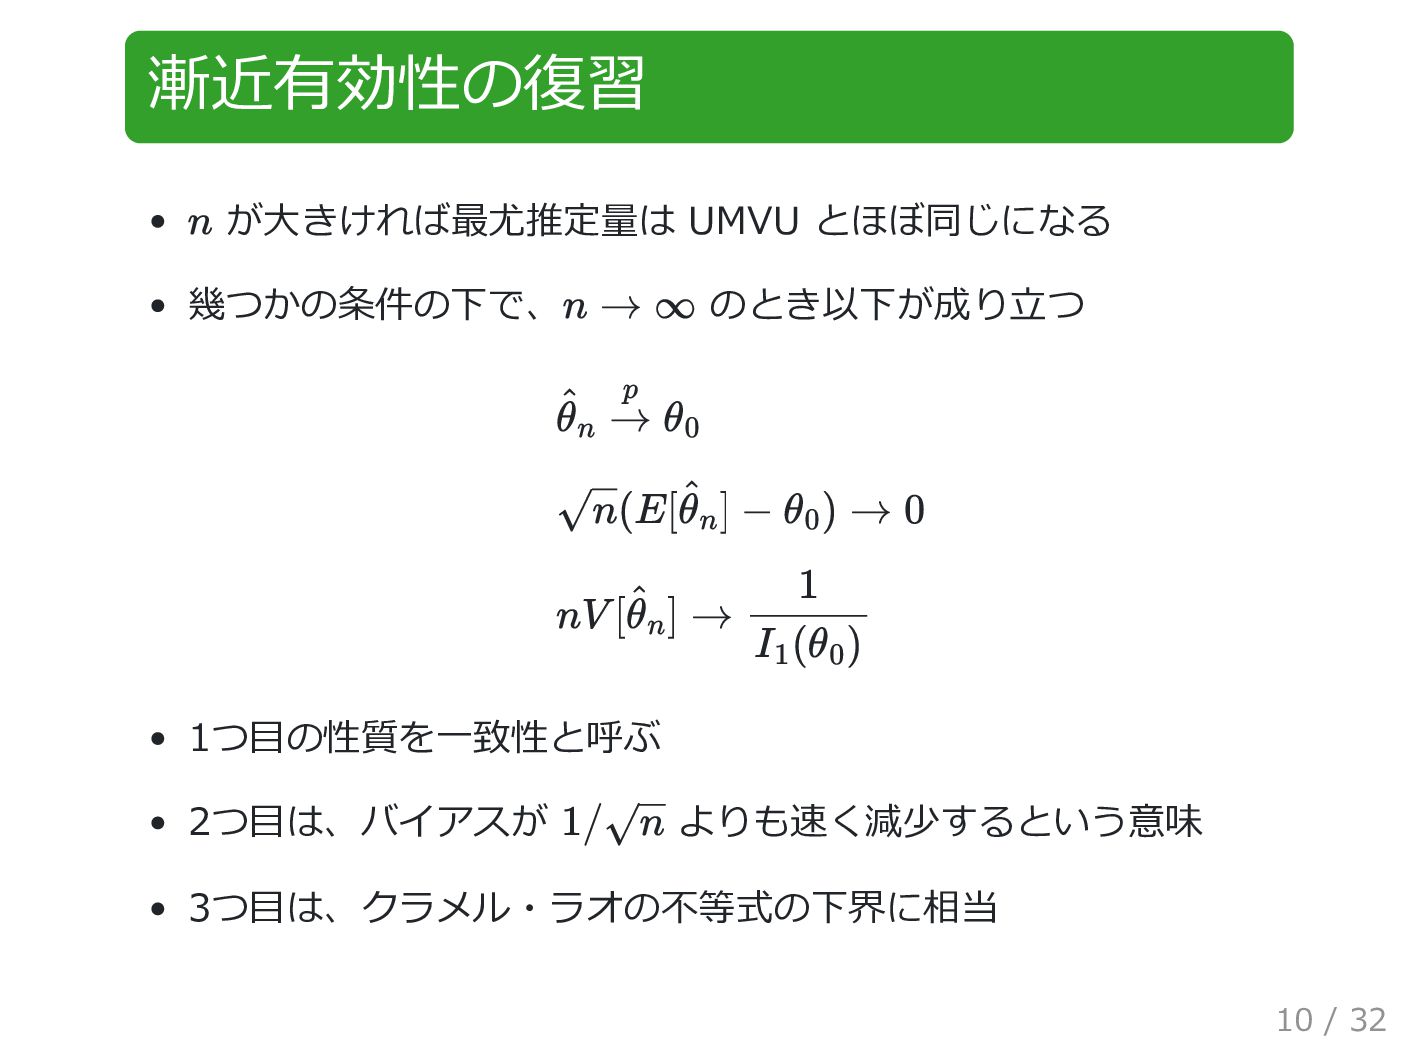
漸近有効性の復習 が大きければ最尤推定量は UMVU とほぼ同じになる 幾つかの条件の下で、 のとき以下が成り立つ 1つ目の性質を一致性と呼ぶ 2つ目は、バイアスが よりも速く減少するという意味 3つ目は、クラメル・ラオの不等式の下界に相当
n n → ∞ ^ θn p → θ0 √n(E[ ^ θn ] − θ0 ) → 0 nV [ ^ θn ] → 1 I1 (θ0 ) 1/√n 10 / 32 -
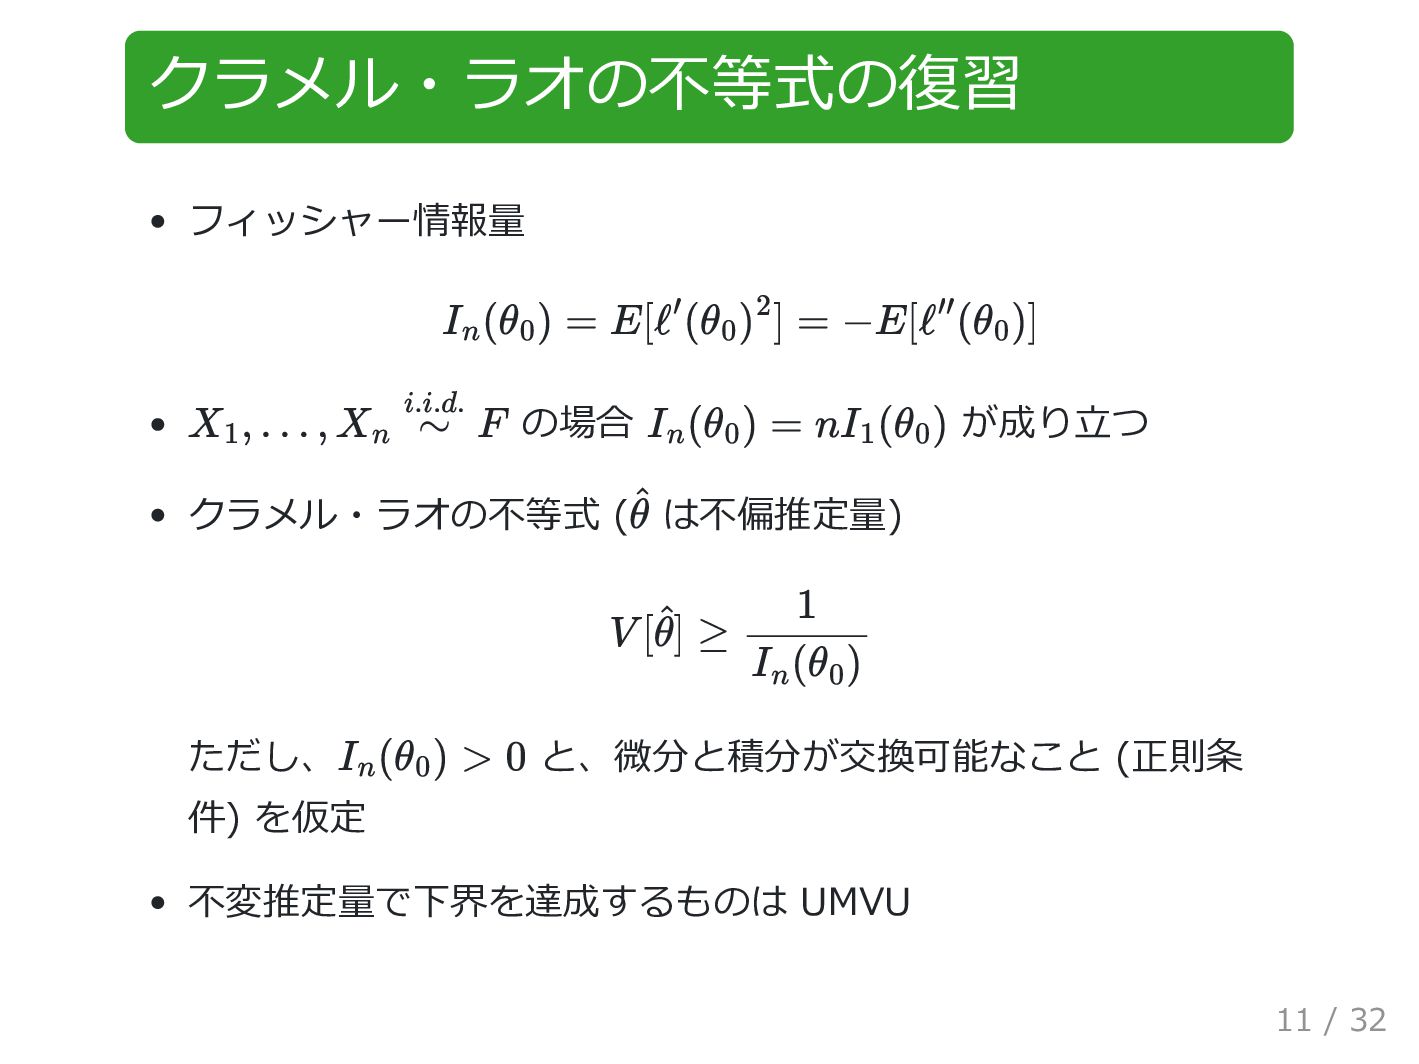
クラメル・ラオの不等式の復習 フィッシャー情報量 の場合 が成り立つ クラメル・ラオの不等式 ( は不偏推定量) ただし、 と、微分と積分が交換可能なこと (正則条
件) を仮定 不変推定量で下界を達成するものは UMVU In (θ0 ) = E[ℓ ′ (θ0 ) 2 ] = −E[ℓ ′′ (θ0 )] X1 , … , Xn i.i.d. ∼ F In (θ0 ) = nI1 (θ0 ) ^ θ V [ ^ θ] ≥ 1 In (θ0 ) I n (θ 0 ) > 0 11 / 32 -
話の流れ まず、1つ目の一致性 を示す。 カルバック・ライブラー情報量が非負となることを使う。 大数の法則も使う。 この授業では、参考書にある厳密な証明は省略する。 次に、2つ目と3つ目に正規分布への収束も加えた以下を示す。 中心極限定理と大数の法則を使う。 ^ θn
p → θ0 √n( ^ θn − θ0 ) d → N (0, 1 I1 (θ0 ) ) 12 / 32 -
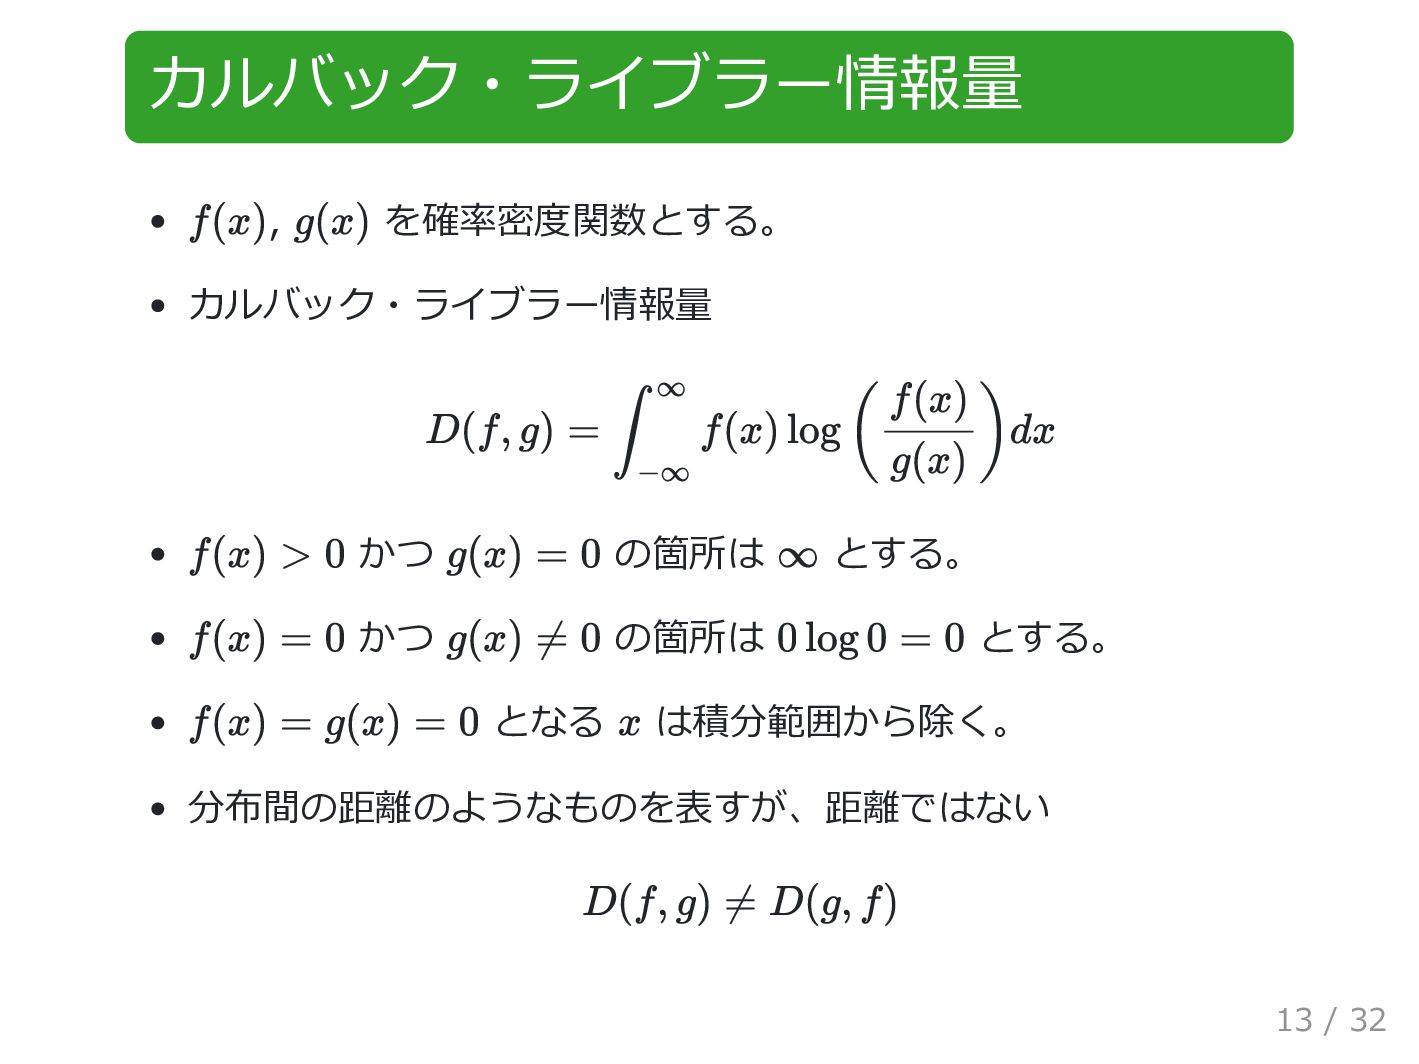
カルバック・ライブラー情報量 , を確率密度関数とする。 カルバック・ライブラー情報量 かつ の箇所は とする。 かつ の箇所は とする。
となる は積分範囲から除く。 分布間の距離のようなものを表すが、距離ではない f(x) g(x) D(f, g) = ∫ ∞ −∞ f(x) log ( f(x) g(x) )dx f(x) > 0 g(x) = 0 ∞ f(x) = 0 g(x) ≠ 0 0 log 0 = 0 f(x) = g(x) = 0 x D(f, g) ≠ D(g, f) 13 / 32 -
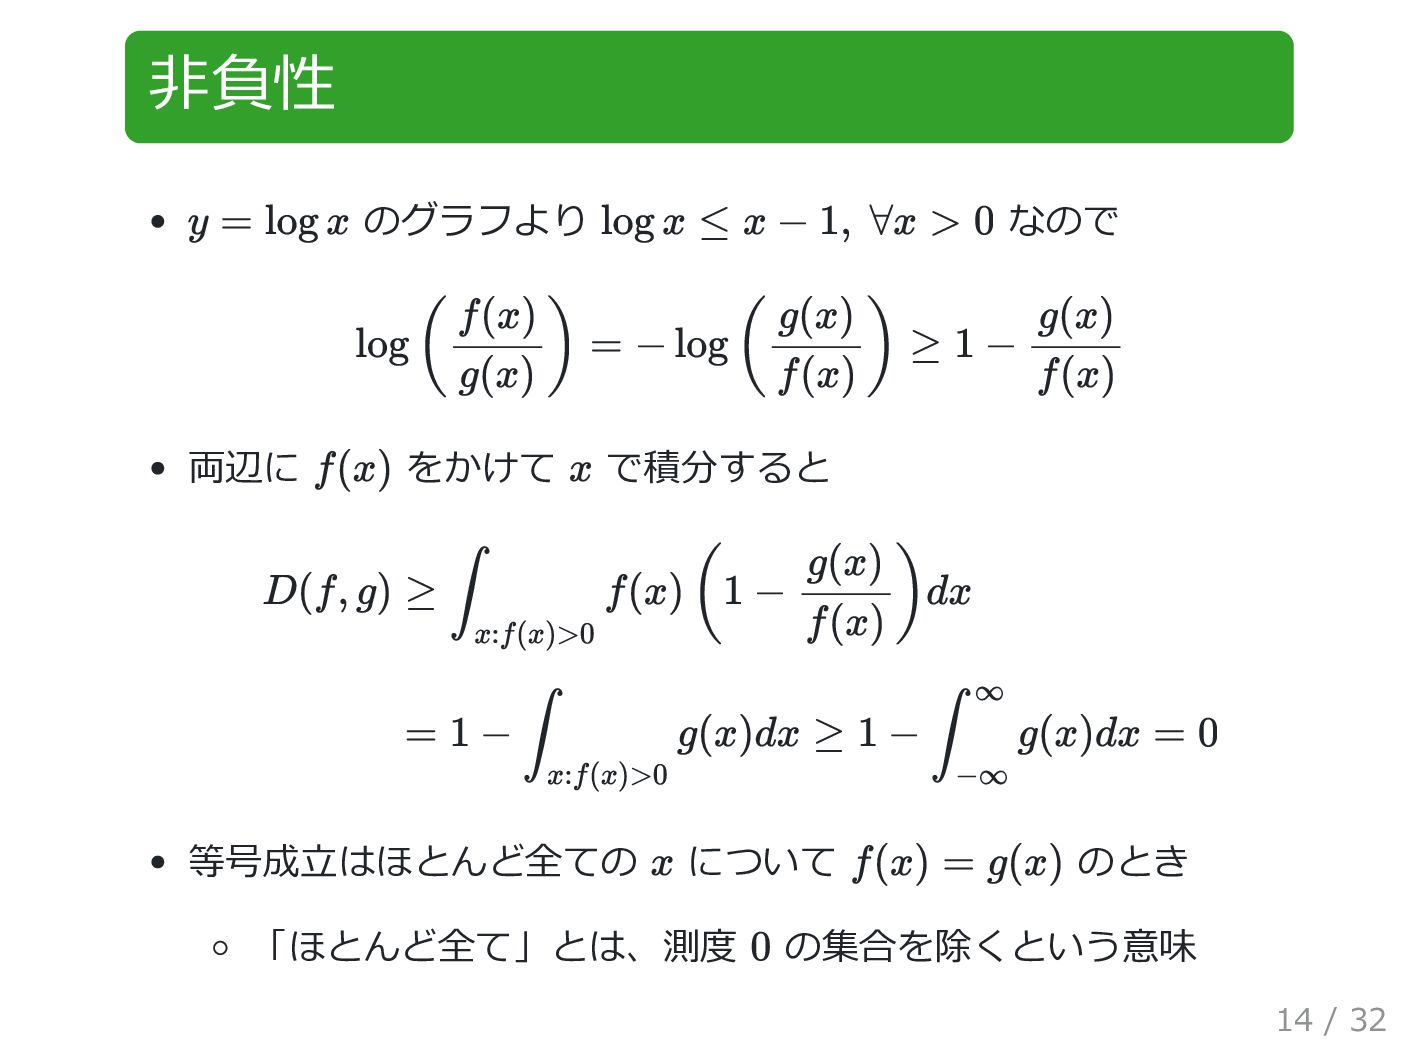
非負性 のグラフより なので 両辺に をかけて で積分すると 等号成立はほとんど全ての について のとき 「ほとんど全て」とは、測度
の集合を除くという意味 y = log x log x ≤ x − 1, ∀x > 0 log ( f(x) g(x) ) = − log ( g(x) f(x) ) ≥ 1 − g(x) f(x) f(x) x D(f, g) ≥ ∫ x:f(x)>0 f(x) (1 − g(x) f(x) )dx = 1 − ∫ x:f(x)>0 g(x)dx ≥ 1 − ∫ ∞ −∞ g(x)dx = 0 x f(x) = g(x) 0 14 / 32 -
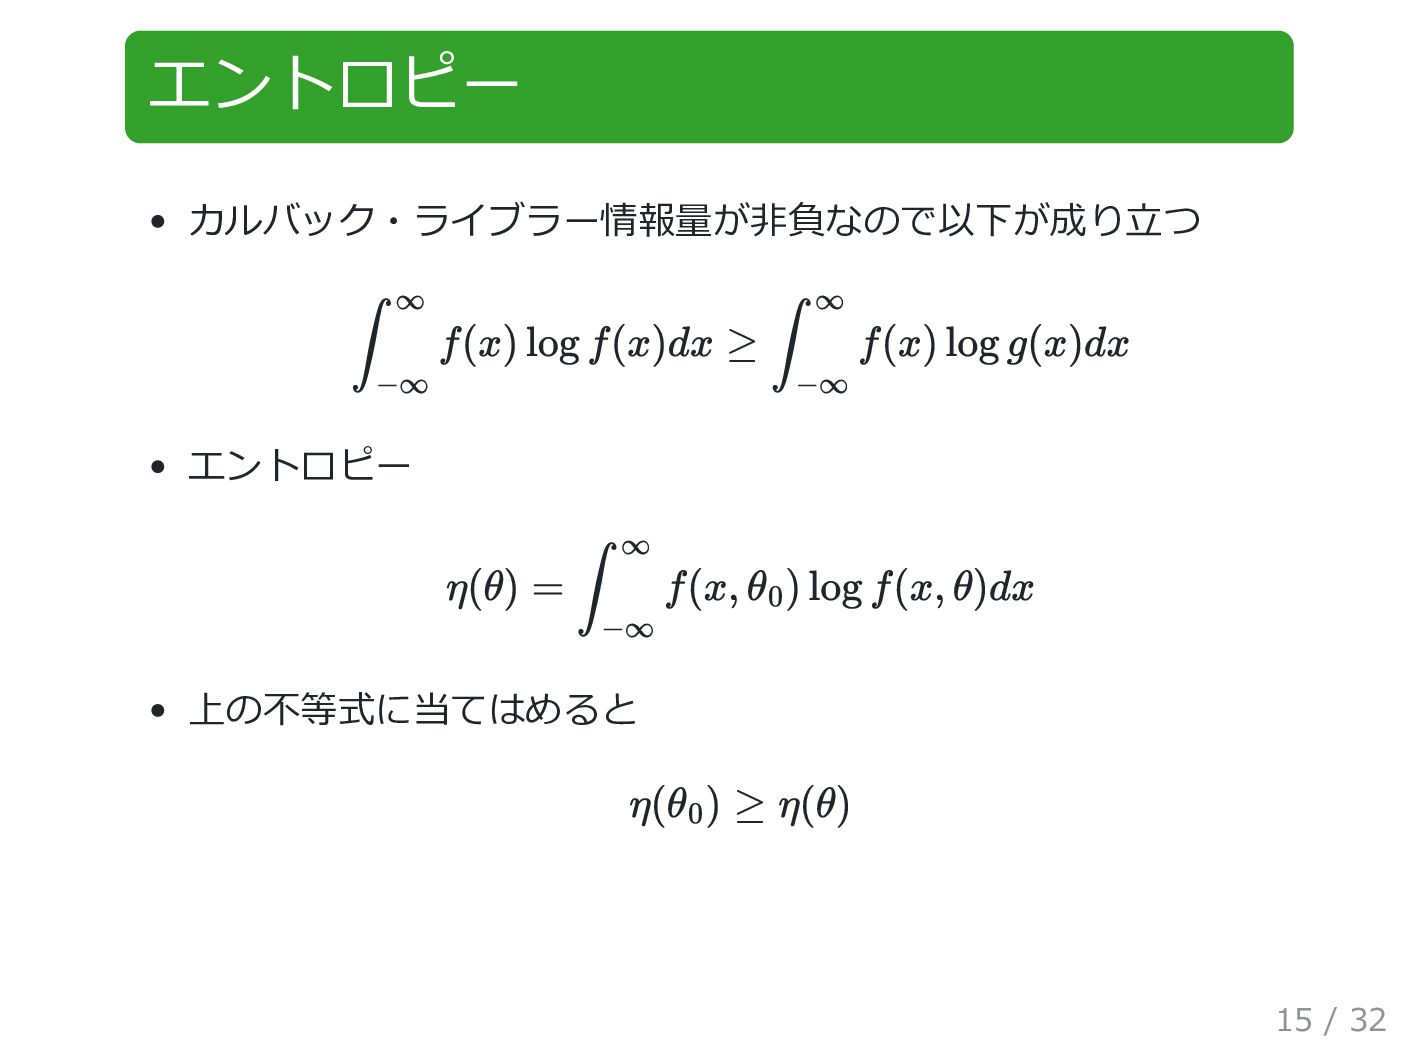
エントロピー カルバック・ライブラー情報量が非負なので以下が成り立つ エントロピー 上の不等式に当てはめると ∫ ∞ −∞ f(x) log f(x)dx
≥ ∫ ∞ −∞ f(x) log g(x)dx η(θ) = ∫ ∞ −∞ f(x, θ0 ) log f(x, θ)dx η(θ0 ) ≥ η(θ) 15 / 32 -
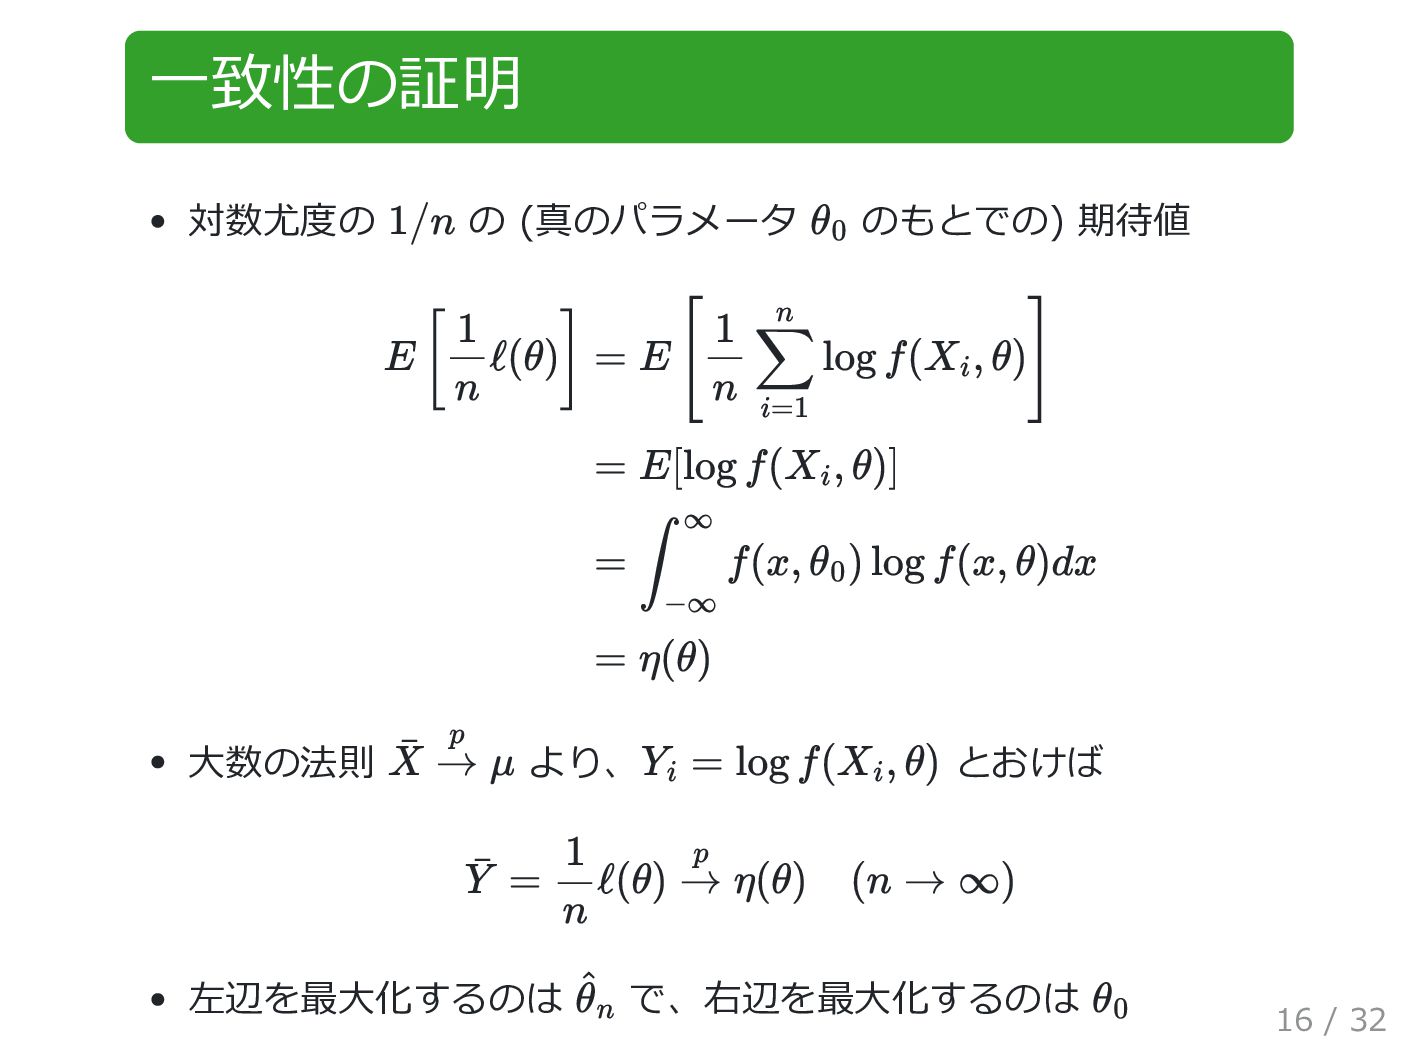
一致性の証明 対数尤度の の (真のパラメータ のもとでの) 期待値 大数の法則 より、 とおけば 左辺を最大化するのは
で、右辺を最大化するのは 1/n θ0 E [ 1 n ℓ(θ)] = E [ 1 n n ∑ i=1 log f(Xi , θ)] = E[log f(Xi , θ)] = ∫ ∞ −∞ f(x, θ0 ) log f(x, θ)dx = η(θ) ¯ X p → μ Yi = log f(Xi , θ) ¯ Y = 1 n ℓ(θ) p → η(θ) (n → ∞) ^ θn θ0 16 / 32 -
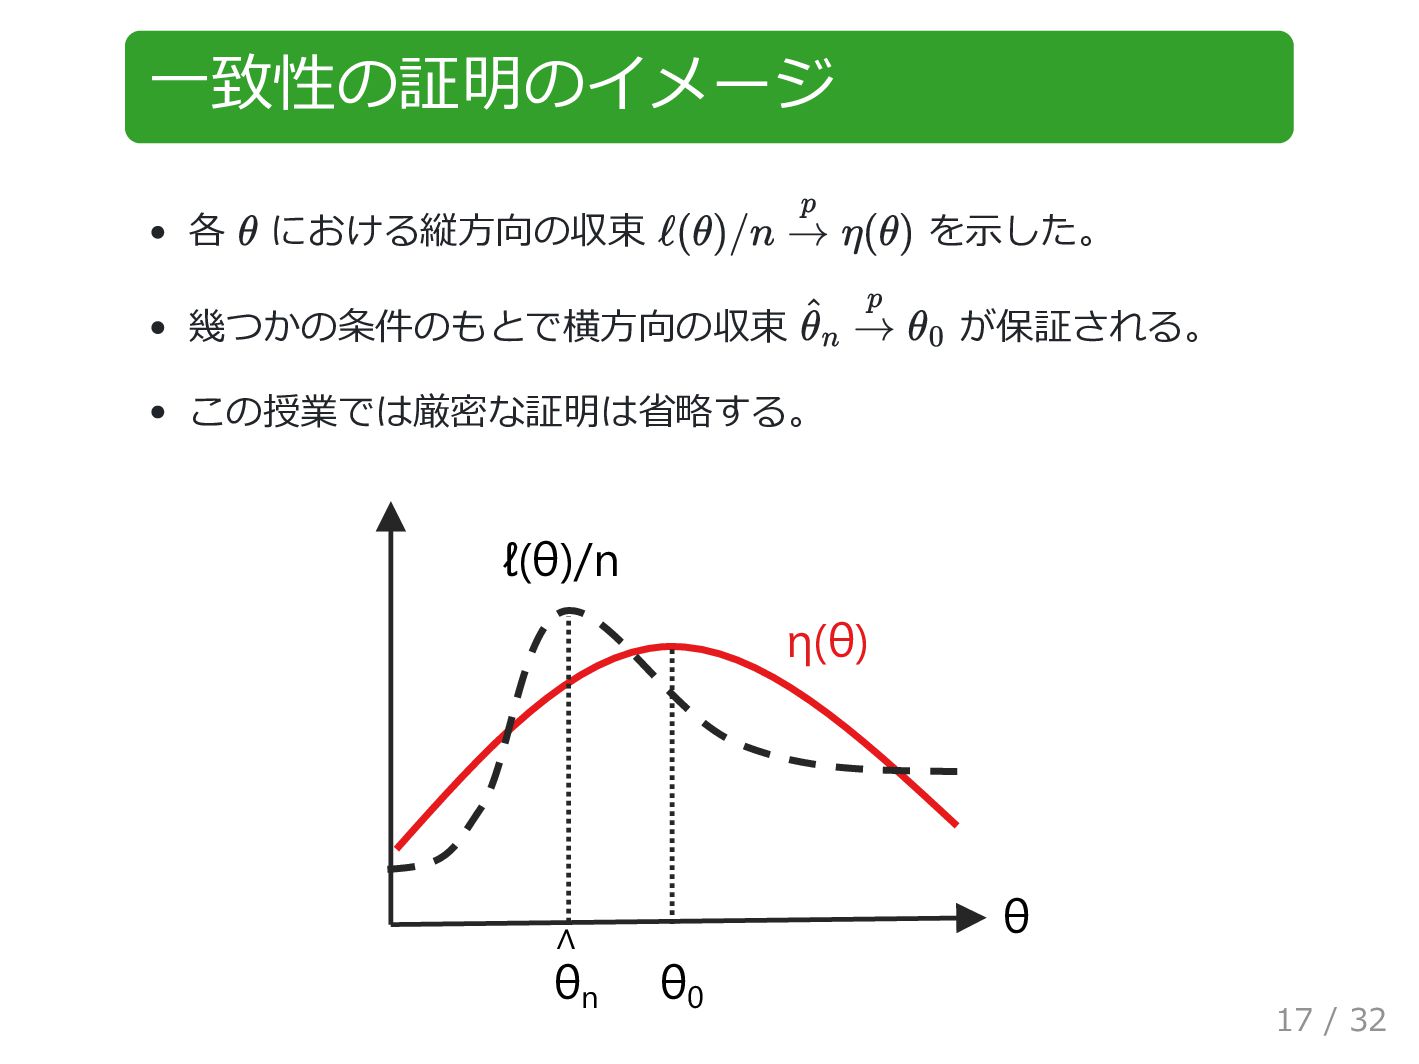
一致性の証明のイメージ 各 における縦方向の収束 を示した。 幾つかの条件のもとで横方向の収束 が保証される。 この授業では厳密な証明は省略する。 ∧ θ θ0
η(θ) ℓ(θ)/n θn θ ℓ(θ)/n p → η(θ) ^ θn p → θ0 17 / 32 -
漸近分布の証明 続いて、漸近分布に関する以下の性質を示す 中間値の定理 (一定の条件下で が存在) これに を当てはめると、 ここで は と
の間の値、また、 も成立 √n( ^ θn − θ0 ) d → N (0, 1 I1 (θ0 ) ) c ∈ (a, b) f ′ (c) = f(b) − f(a) b − a f = ℓ ′ ℓ ′′ (θ ∗ ) = ℓ ′ ( ^ θn ) − ℓ ′ (θ0 ) ^ θn − θ0 θ ∗ ^ θn θ0 ℓ ′ ( ^ θn ) = 0 18 / 32 -
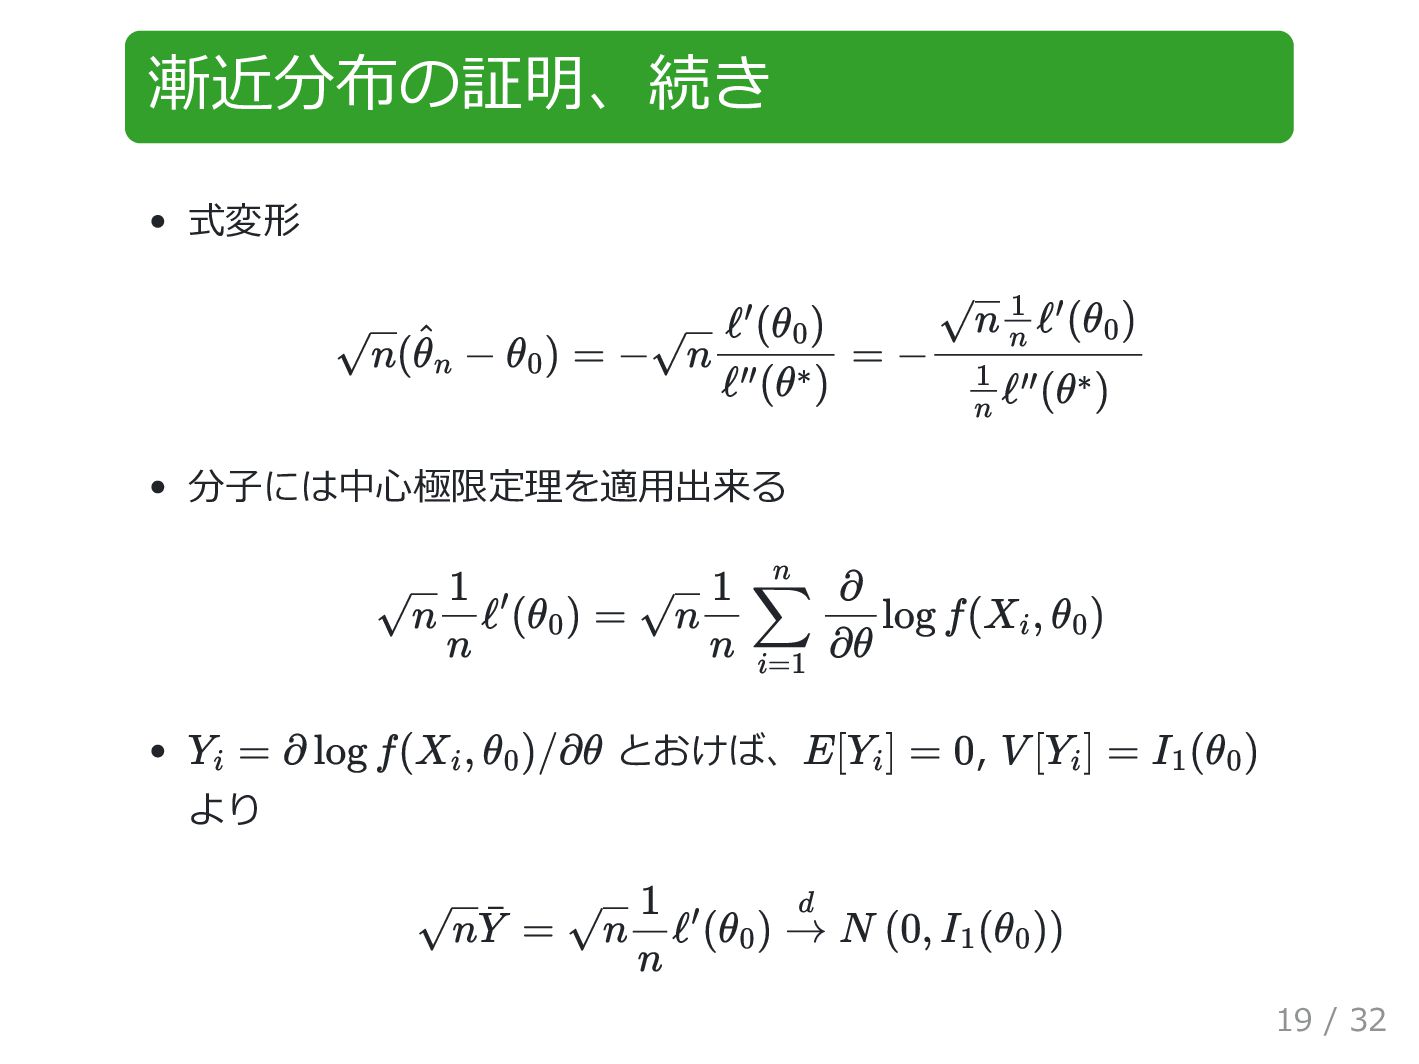
漸近分布の証明、続き 式変形 分子には中心極限定理を適用出来る とおけば、 , より √n( ^ θn −
θ0 ) = −√n ℓ ′ (θ0 ) ℓ′′ (θ∗ ) = − √n 1 n ℓ ′ (θ0 ) 1 n ℓ′′ (θ∗ ) √n 1 n ℓ ′ (θ0 ) = √n 1 n n ∑ i=1 ∂ ∂θ log f(Xi , θ0 ) Yi = ∂ log f(Xi , θ0 )/∂θ E[Yi ] = 0 V [Yi ] = I1 (θ0 ) √n ¯ Y = √n 1 n ℓ ′ (θ0 ) d → N (0, I1 (θ0 )) 19 / 32 -
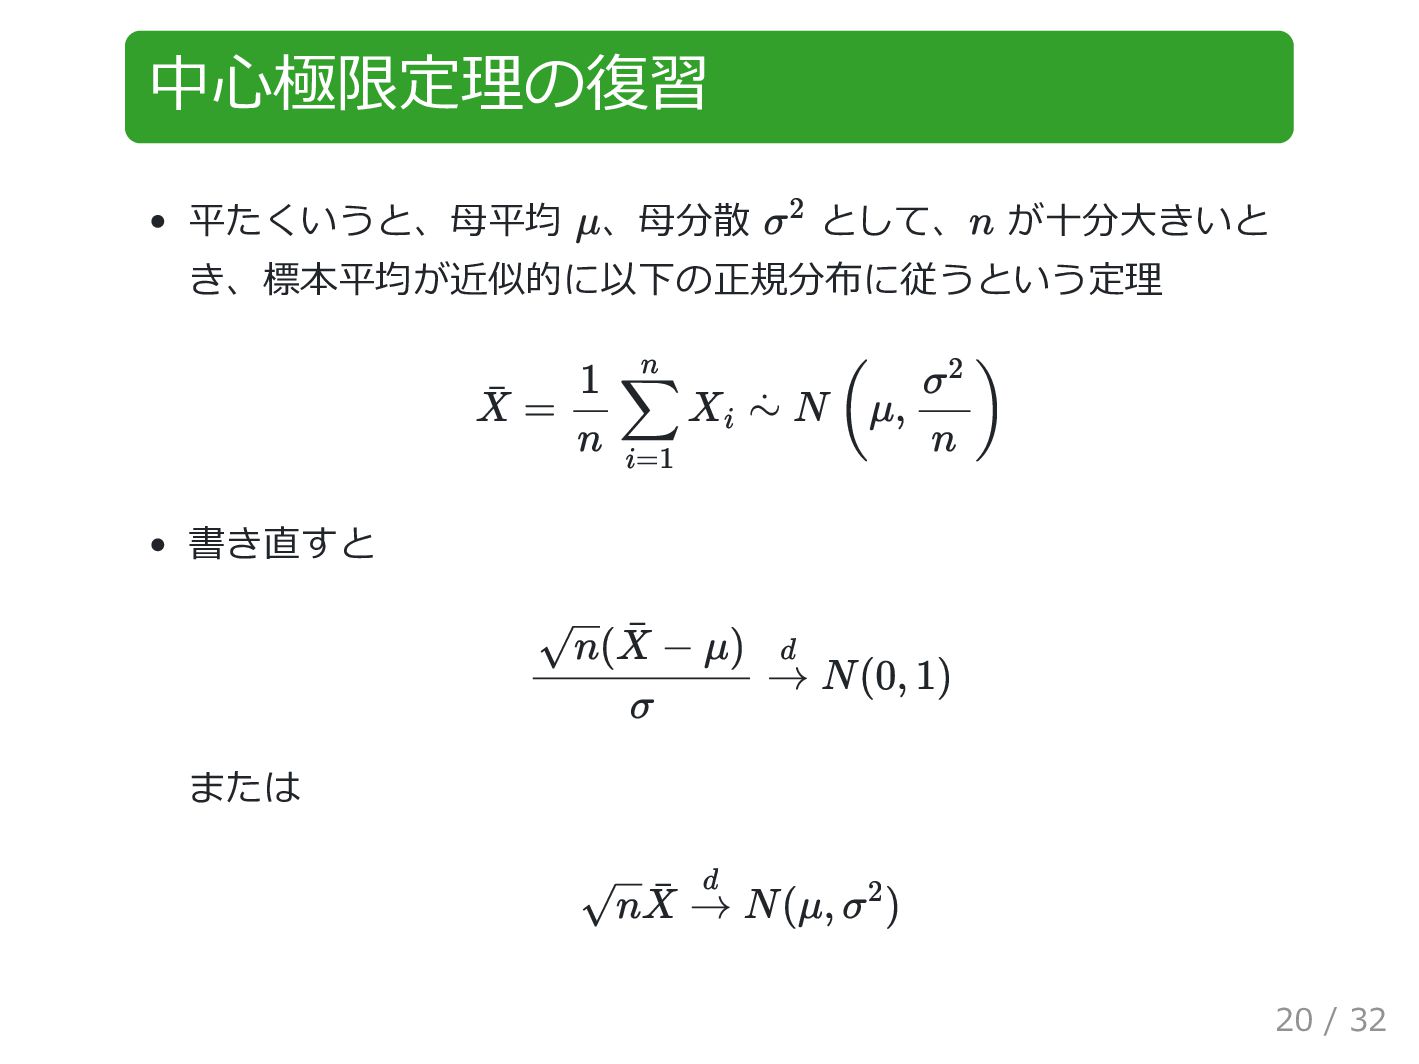
中心極限定理の復習 平たくいうと、母平均 、母分散 として、 が十分大きいと き、標本平均が近似的に以下の正規分布に従うという定理 書き直すと または μ σ
2 n ¯ X = 1 n n ∑ i=1 Xi ⋅ ∼ N (μ, σ 2 n ) √n( ¯ X − μ) σ d → N (0, 1) √n ¯ X d → N (μ, σ 2 ) 20 / 32 -
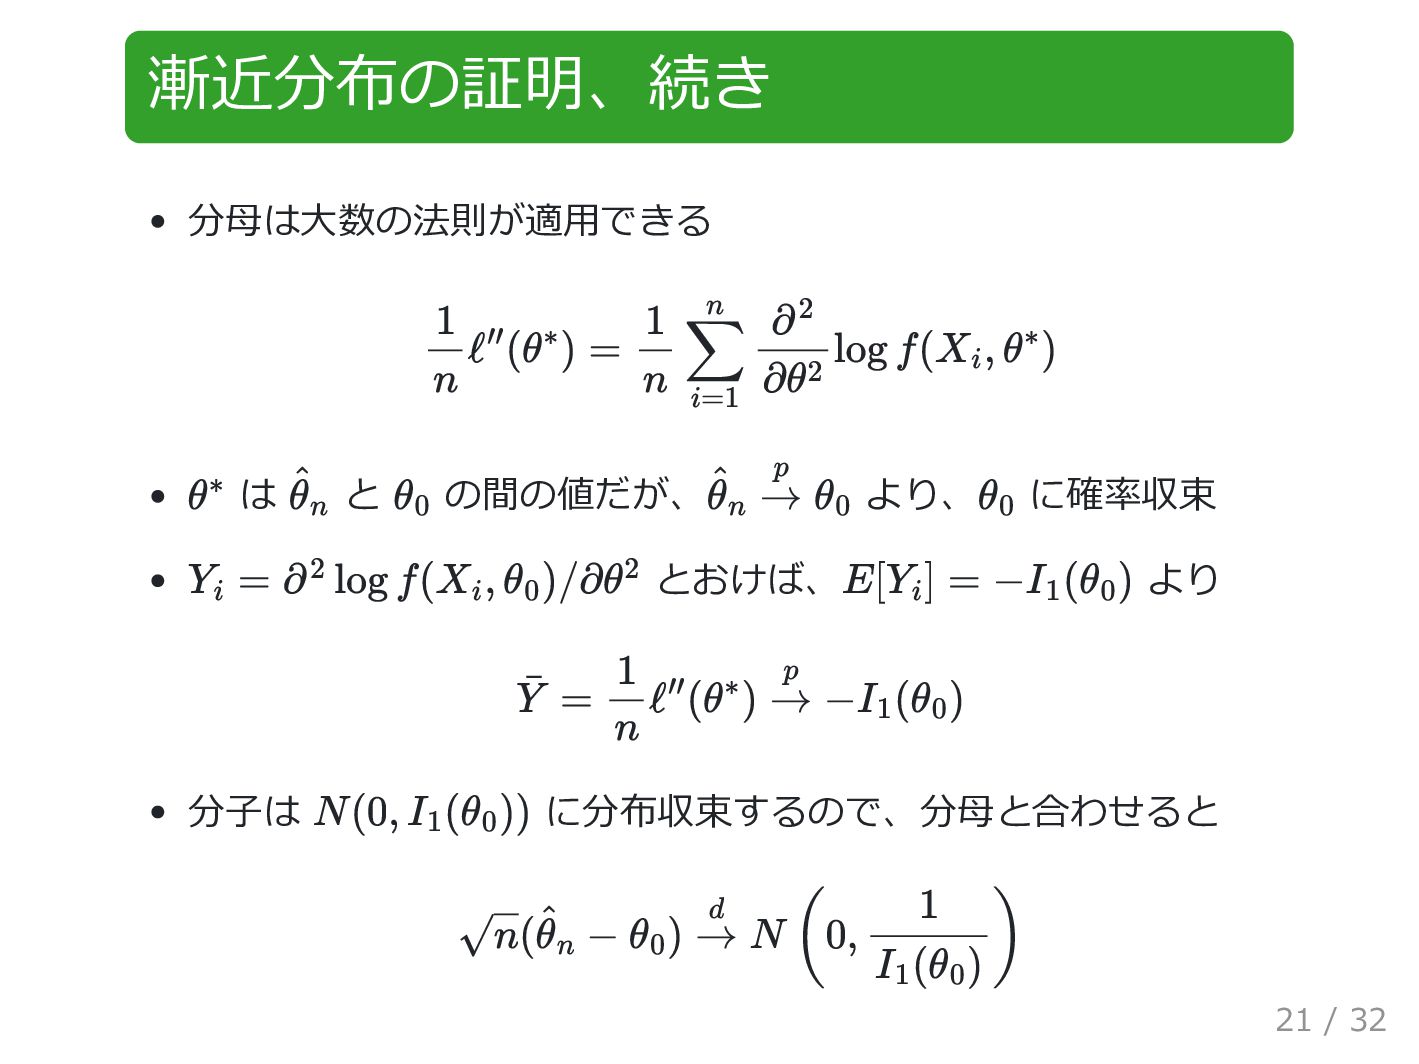
漸近分布の証明、続き 分母は大数の法則が適用できる は と の間の値だが、 より、 に確率収束 とおけば、 より 分子は
に分布収束するので、分母と合わせると 1 n ℓ ′′ (θ ∗ ) = 1 n n ∑ i=1 ∂ 2 ∂θ2 log f(Xi , θ ∗ ) θ ∗ ^ θn θ0 ^ θn p → θ0 θ0 Yi = ∂ 2 log f(Xi , θ0 )/∂θ 2 E[Yi ] = −I1 (θ0 ) ¯ Y = 1 n ℓ ′′ (θ ∗ ) p → −I1 (θ0 ) N (0, I1 (θ0 )) √n( ^ θn − θ0 ) d → N (0, 1 I1 (θ0 ) ) 21 / 32 -
おまけ 証明で用いたカルバック・ライブラー情報量とフィッシャー情報 量は関係がある。 カルバック・ライブラー情報量を次のように書く でテイラー展開すると (参考) 関数 の まわりのテイラー展開 D(f(x,
θ0 ), f(x, θ)) = D(θ0 , θ) θ ≈ θ0 D(θ0 , θ) ≈ I1 (θ0 ) 2 (θ − θ0 ) 2 f(x) x = a f(x) = f(a) + f ′ (a)(x − a) + f ′′ (a) 2 (x − a) 2 + ⋯ 22 / 32 -
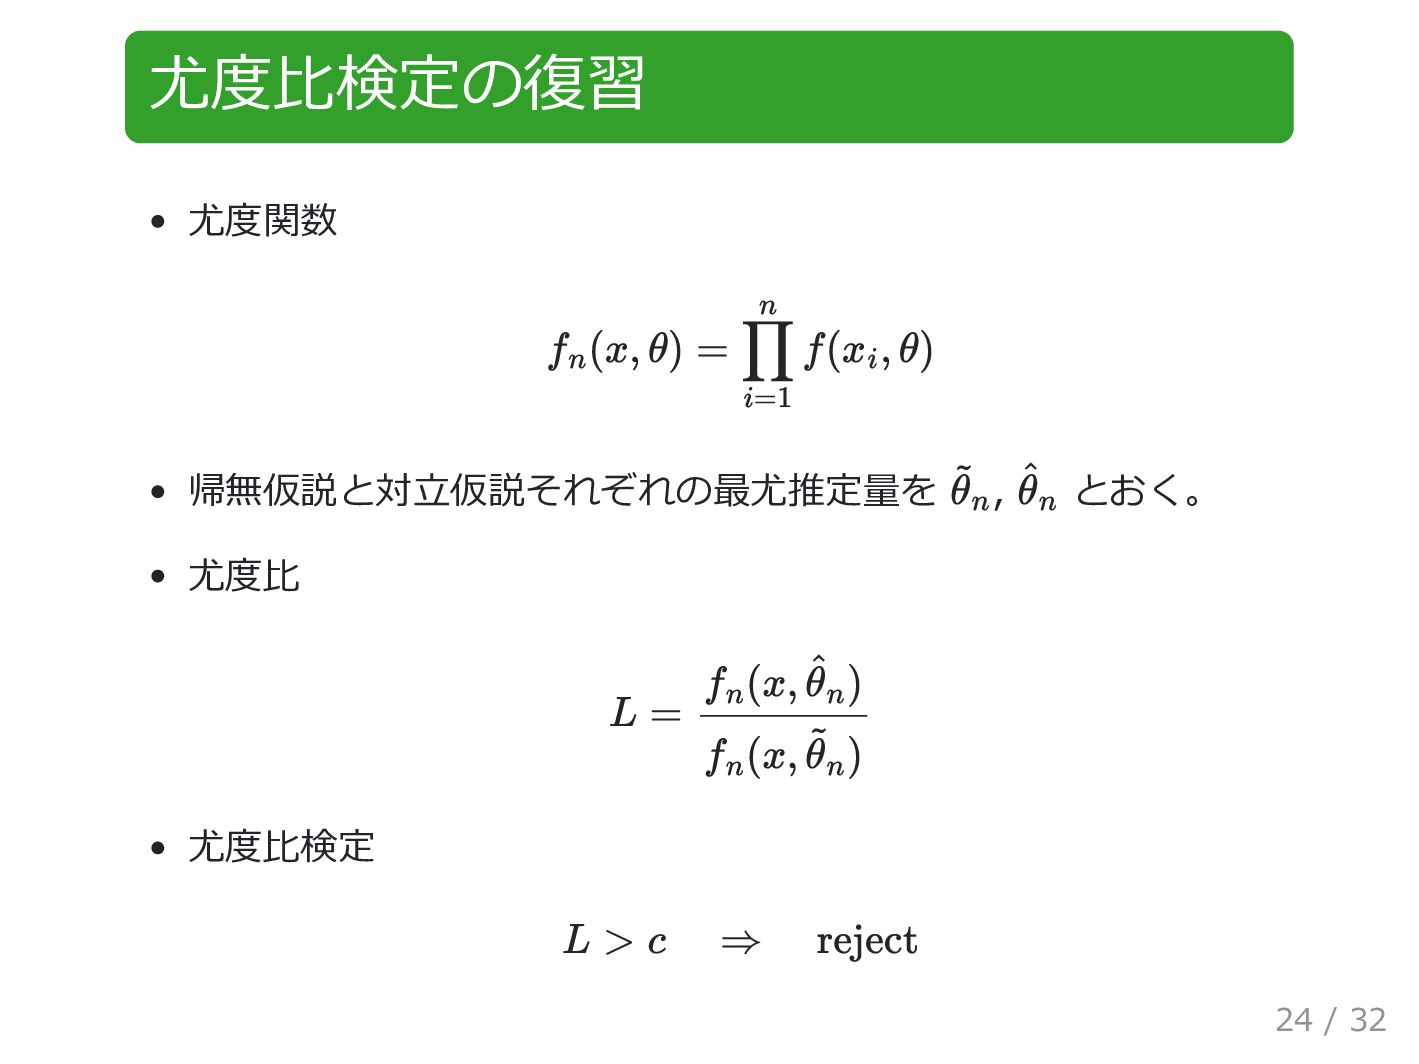
尤度比検定の復習 尤度関数 帰無仮説と対立仮説それぞれの最尤推定量を , とおく。 尤度比 尤度比検定 fn (x, θ)
= n ∏ i=1 f(xi , θ) ~ θn ^ θn L = fn (x, ^ θn ) fn (x, ~ θn ) L > c ⇒ reject 24 / 32 -
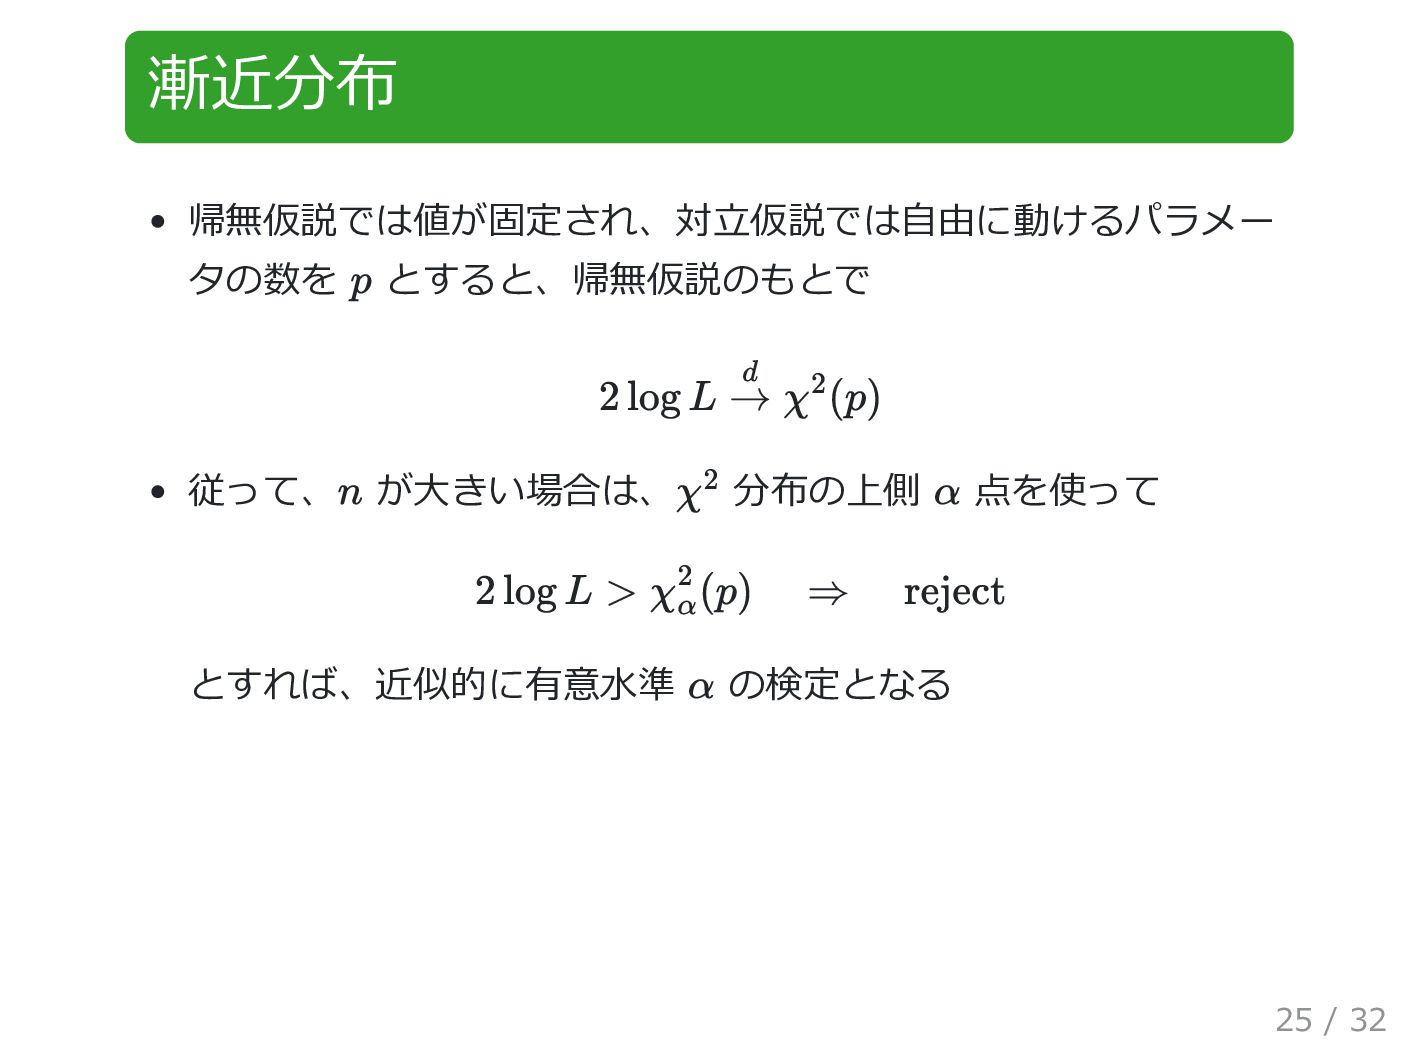
漸近分布 帰無仮説では値が固定され、対立仮説では自由に動けるパラメー タの数を とすると、帰無仮説のもとで 従って、 が大きい場合は、 分布の上側 点を使って とすれば、近似的に有意水準 の検定となる
p 2 log L d → χ 2 (p) n χ 2 α 2 log L > χ 2 α (p) ⇒ reject α 25 / 32 -
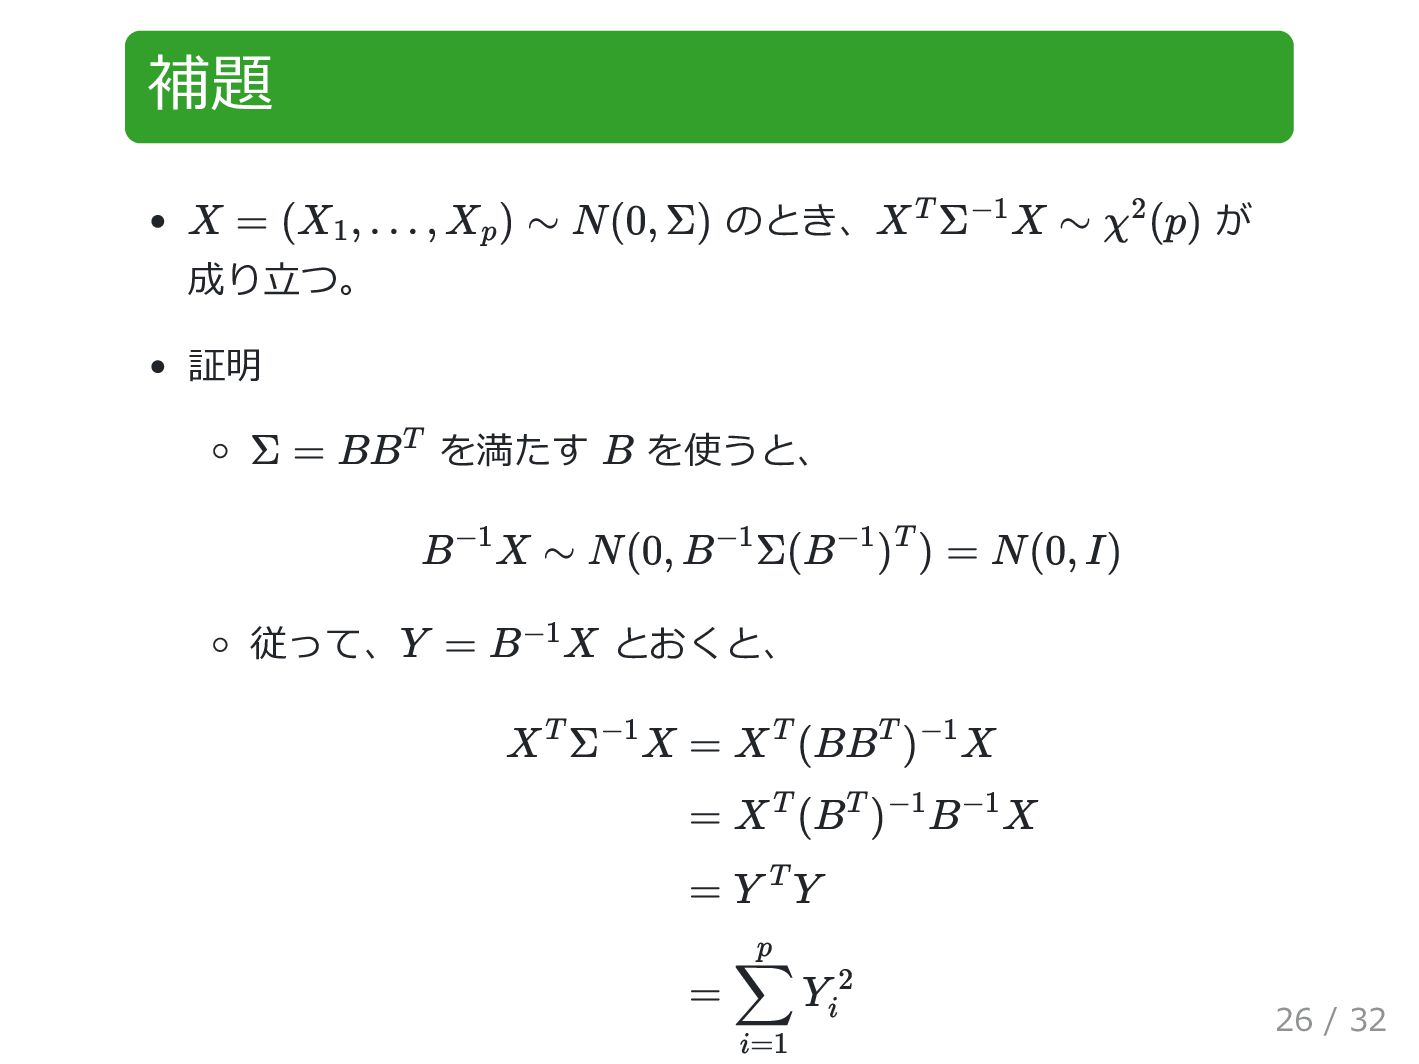
補題 のとき、 が 成り立つ。 証明 を満たす を使うと、 従って、 とおくと、 X
= (X1 , … , Xp ) ⊤ ∼ N (0, Σ) X ⊤ Σ −1 X ∼ χ 2 (p) Σ = BB ⊤ B B −1 X ∼ N (0, B −1 Σ(B −1 ) ⊤ ) = N (0, I) Y = B −1 X X ⊤ Σ −1 X = X ⊤ (BB ⊤ ) −1 X = X ⊤ (B ⊤ ) −1 B −1 X = Y ⊤ Y = p ∑ i=1 Y 2 i 26 / 32 -
証明 この授業では局外母数が無い場合のみを扱う。そのとき、 を のまわりで展開すると ここで はヘッセ行列で、 は と を結ぶ線分上の点 これを上式に代入すると、
より、 2 log L = 2ℓ( ^ θn ) − 2ℓ(θ0 ) ℓ(θ0 ) ^ θn ℓ(θ0 ) = ℓ( ^ θn ) + (θ0 − ^ θn ) ⊤ ∇ℓ( ^ θn ) + 1 2 (θ0 − ^ θn ) ⊤ H(θ0 − ^ θn ) Hij = ∂ 2 ∂θi ∂θj ℓ(θ ∗ ) H θ∗ θ 0 ^ θ n ∇ℓ( ^ θ) = 0 2 log L = −(θ0 − ^ θn ) ⊤ H(θ0 − ^ θn ) 27 / 32 -
証明、続き 一方、 のフィッシャー情報行列 の各要素は 従って、 の一致性の証明のときと同様に考えると 大数の法則より n = 1
I(θ) I ij (θ) = E [ ∂ ∂θi ℓ(θ) ∂ ∂θj ℓ(θ)] = −E [ ∂ 2 ∂θi ∂θj ℓ(θ)] ^ θn E [ 1 n Hij ] = E [ 1 n n ∑ i=1 ∂ 2 ∂θi ∂θj log f(Xi , θ ∗ )] = −Iij (θ ∗ ) 1 n H p → E [ 1 n H] = −I(θ ∗ ) 28 / 32 -
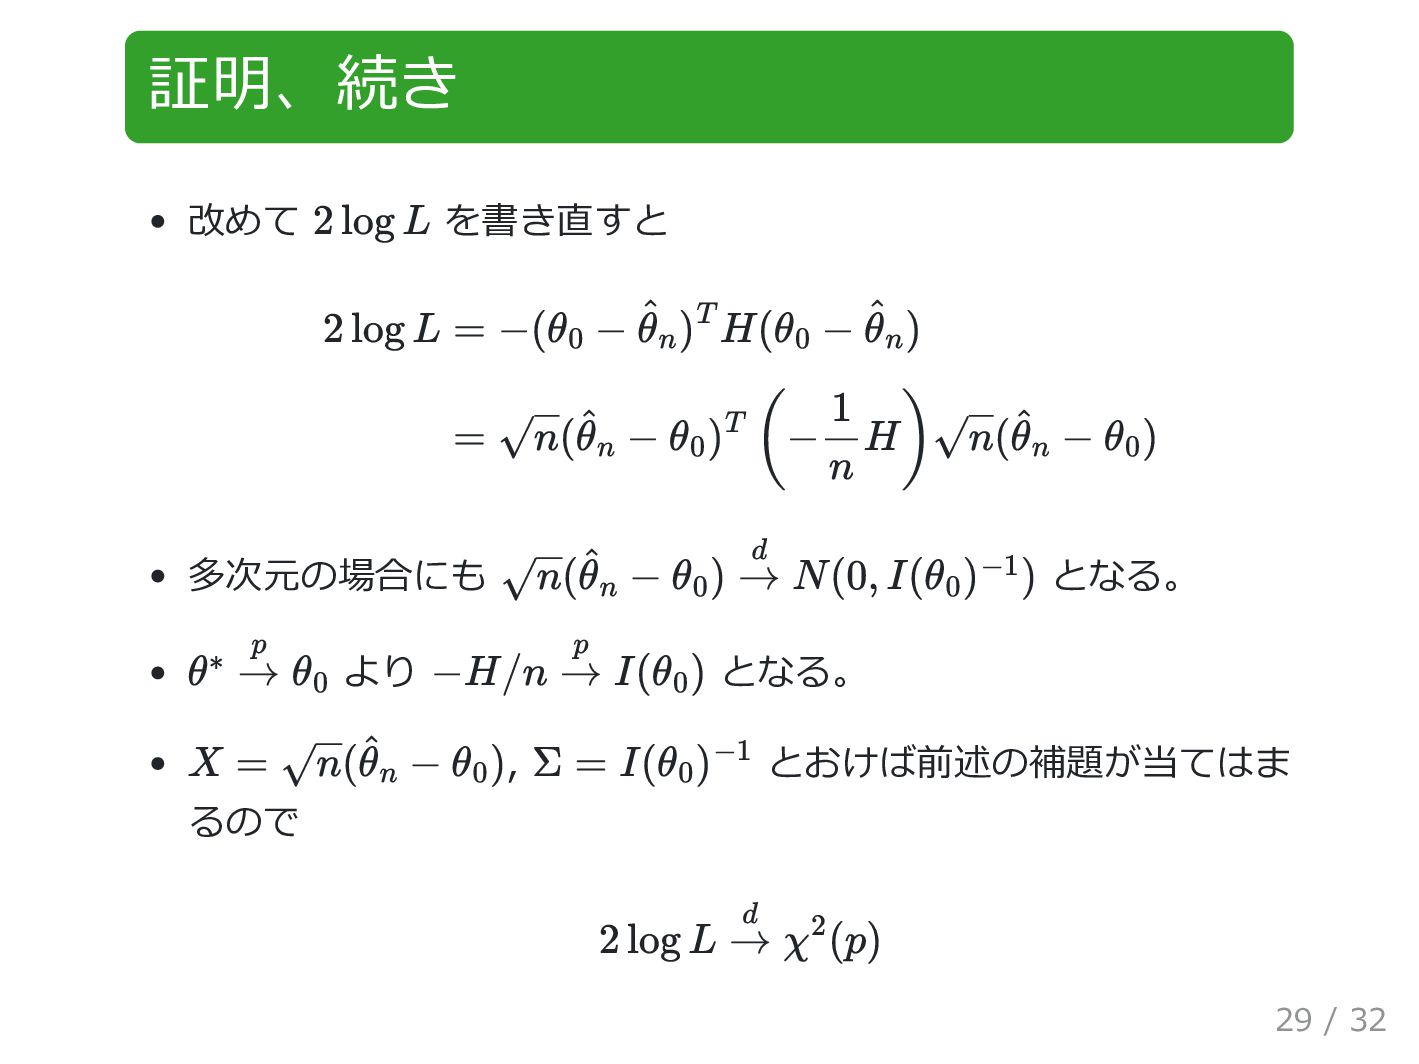
証明、続き 改めて を書き直すと 多次元の場合にも となる。 より となる。 , とおけば前述の補題が当てはま るので
2 log L 2 log L = −(θ0 − ^ θn ) ⊤ H(θ0 − ^ θn ) = √n( ^ θn − θ0 ) ⊤ (− 1 n H)√n( ^ θn − θ0 ) √n( ^ θ n − θ 0 ) d → N (0, I(θ 0 )−1 ) θ ∗ p → θ0 −H/n p → I(θ0 ) X = √n( ^ θn − θ0 ) Σ = I(θ0 ) −1 2 log L d → χ 2 (p) 29 / 32 -
まとめ 最尤推定と尤度比検定の漸近特性に関する証明の概要を説明しまし た。 1. 最尤推定量の漸近有効性 ! 最尤推定量の漸近有効性の証明に使う用語を複数あげられる? ! カルバック・ライブラー情報量の意味を説明できる? 2.
尤度比検定の漸近分布 ! 対数尤度比が漸近的に 分布に従う理由を説明できる? χ2 30 / 32