Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Driving AI Adoption Using In-House GPUs to Serv...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
po3rin
September 04, 2026
Technology
600
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Driving AI Adoption Using In-House GPUs to Serve Qwen
po3rin
September 04, 2026
More Decks by po3rin
See All by po3rin
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
6.4k
検索設計から 推論設計への重心移動と Recall-First Retrieval
po3rin
5
2.4k
LLMで複雑な検索条件アセットから脱却する!! 生成的検索インタフェースの設計論
po3rin
4
1.6k
C-Shared Buildで突破するAI Agent バックテストの壁
po3rin
0
560
嗚呼、当時の本番環境の状態で AI Agentを再評価したいなぁ...
po3rin
0
640
Temporal Knowledge Graphで作る! 時間変化するナレッジを扱うAI Agentの世界
po3rin
7
2.5k
自作LLM Native GORM Pluginで実現する AI Agentバックテスト基盤構築
po3rin
2
1.3k
麻雀点数計算問題生成タスクから学ぶ Single Agentの限界と Agentic Workflowの底力
po3rin
5
3.4k
LLMOpsのパフォーマンスを支える技術と現場で実践した改善
po3rin
8
1.3k
Other Decks in Technology
See All in Technology
これだけは抑えておきたい!後悔しない re:Invent の過ごし方 / AWS re:Invent 2026 prestudy
kinunori
2
660
バックオフィスに染み出すTypeScript ── clasp で安全に仕組みを作る
nealle
1
160
AIコーディングはじめました
miso
0
130
Devin プロモコードの受け取りと適用(2026.10.27)
kinopeee
1
830
E2Eってつらくないですか?E2Eの管理コストを下げる手段とその実践
akaboshinit
6
2.9k
AI時代の開発はウォーターフォールに回帰する? / development-with-ai-back-to-wf
okamototakuyasr2
0
170
Content Mapper APIの応用例~CSS Modules、言語ファイル~
uhyo
2
500
FinOpsを導入してマルチプロダクトのコスト最適化を実現する
kworkdev
PRO
0
110
reInvent2026stby LT00 "Change your life!"
shinichirokawano
1
540
ALBのLCU予約とトラフィックの波によるプロダクト理解 / Understanding ALB LCU and Traffic Spikes
mito201
1
130
[re:Invent2026事前勉強会(有志開催)]続きは、ラスベガスの廊下で / continue-in-the-vegas-hallway
sh_fk2
0
490
推論基盤と Scale-Up Interconnect の現状と制約から俯瞰する技術動向
markunet
2
740
Featured
See All Featured
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.4k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.3k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
290
Exploring anti-patterns in Rails
aemeredith
4
560
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
Let's Do A Bunch of Simple Stuff to Make Websites Faster
chriscoyier
508
140k
Git: the NoSQL Database
bkeepers
PRO
433
67k
WENDY [Excerpt]
tessaabrams
14
40k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Statistics for Hackers
jakevdp
799
230k
Transcript
Driving AI Adoption Using In-House GPUs to Serve Qwen Qwen
Meetup Tokyo LayerX Hiromu Nakamura (@po3rin) 2026/09/04
Hiromu Nakamura Hiromu Nakamura AI-UX/MLOps TechLead AI/MLOps Engineer. Interested in
Information Retrieval Nagoya Univ ~ Graduate School of Science M3, Inc. AI・ML Team MLOps & Data Engineering po3rin LayerX Inc. AI-UX/MLOps TechLead
Driving AI Adoption Using In-House GPUs to Serve Qwen 1.
Introduction
1 Driving AI Adoption Using In-House GPUs to Serve Qwen
社内AIコスト爆あがり😭 * トークンをとにかく使え!!のフェーズは終わり。。。 * トークン利用量を増やしながらコストは下げるという 直感的には逆のことをやっていく必要がある
2 Driving AI Adoption Using In-House GPUs to Serve Qwen
💻 社内GPUサーバーを使おう! * ちょっと前にML学習用に買ったもの (RTX 6000 Ada × 4) * 従量課金を固定費へ (電気代はかかるが) * LayerXでは一部のワークロードをすでに社内GPU上での推論に移行している
3 Driving AI Adoption Using In-House GPUs to Serve Qwen
Qwen3.8 27Bが超主力!! 今日話すこと * Qwenでどのようなワークロードを置き換えているか * どのような推論基盤を構築したか * どのようにスループットを上げているか
Driving AI Adoption Using In-House GPUs to Serve Qwen 2.
Workloads running with Qwen
Driving AI Adoption Using In-House GPUs to Serve Qwen
移すタスクを見極める3軸 * 頻度(一日に何回走るか) * 難易度(フロンティア級の推論が要るか) * 許容条件(どこまでの待ち時間やタスク失敗を許せるか) 👀 狙い目は高頻度かつ低 中難易度で、応答時間と精度の許容幅が大きいタスク!! ~ 4
5 Driving AI Adoption Using In-House GPUs to Serve Qwen
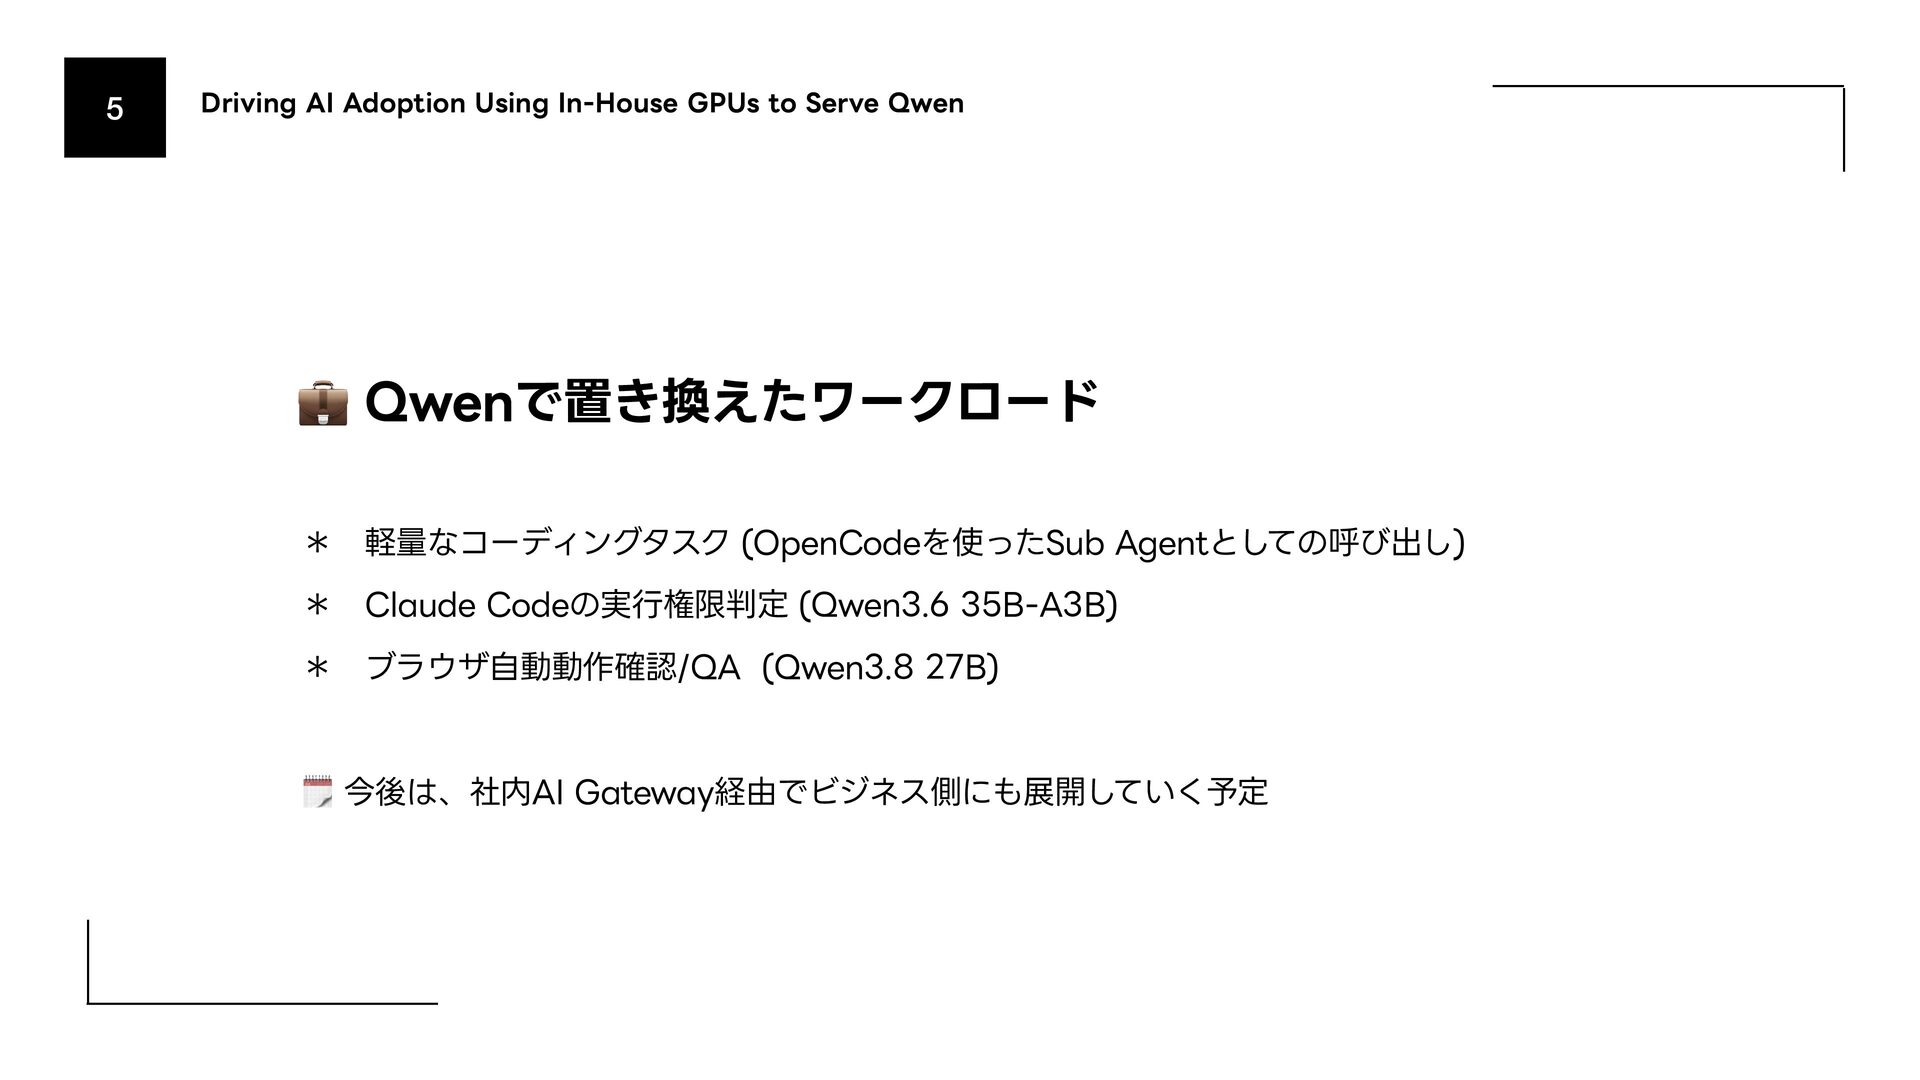
💼 Qwenで置き換えたワークロード * 軽量なコーディングタスク (OpenCodeを使ったSub Agentとしての呼び出し) * Claude Codeの実行権限判定 (Qwen3.6 35B-A3B) * ブラウザ自動動作確認/QA (Qwen3.8 27B) 🗓 今後は、社内AI Gateway経由でビジネス側にも展開していく予定
6 Driving AI Adoption Using In-House GPUs to Serve Qwen
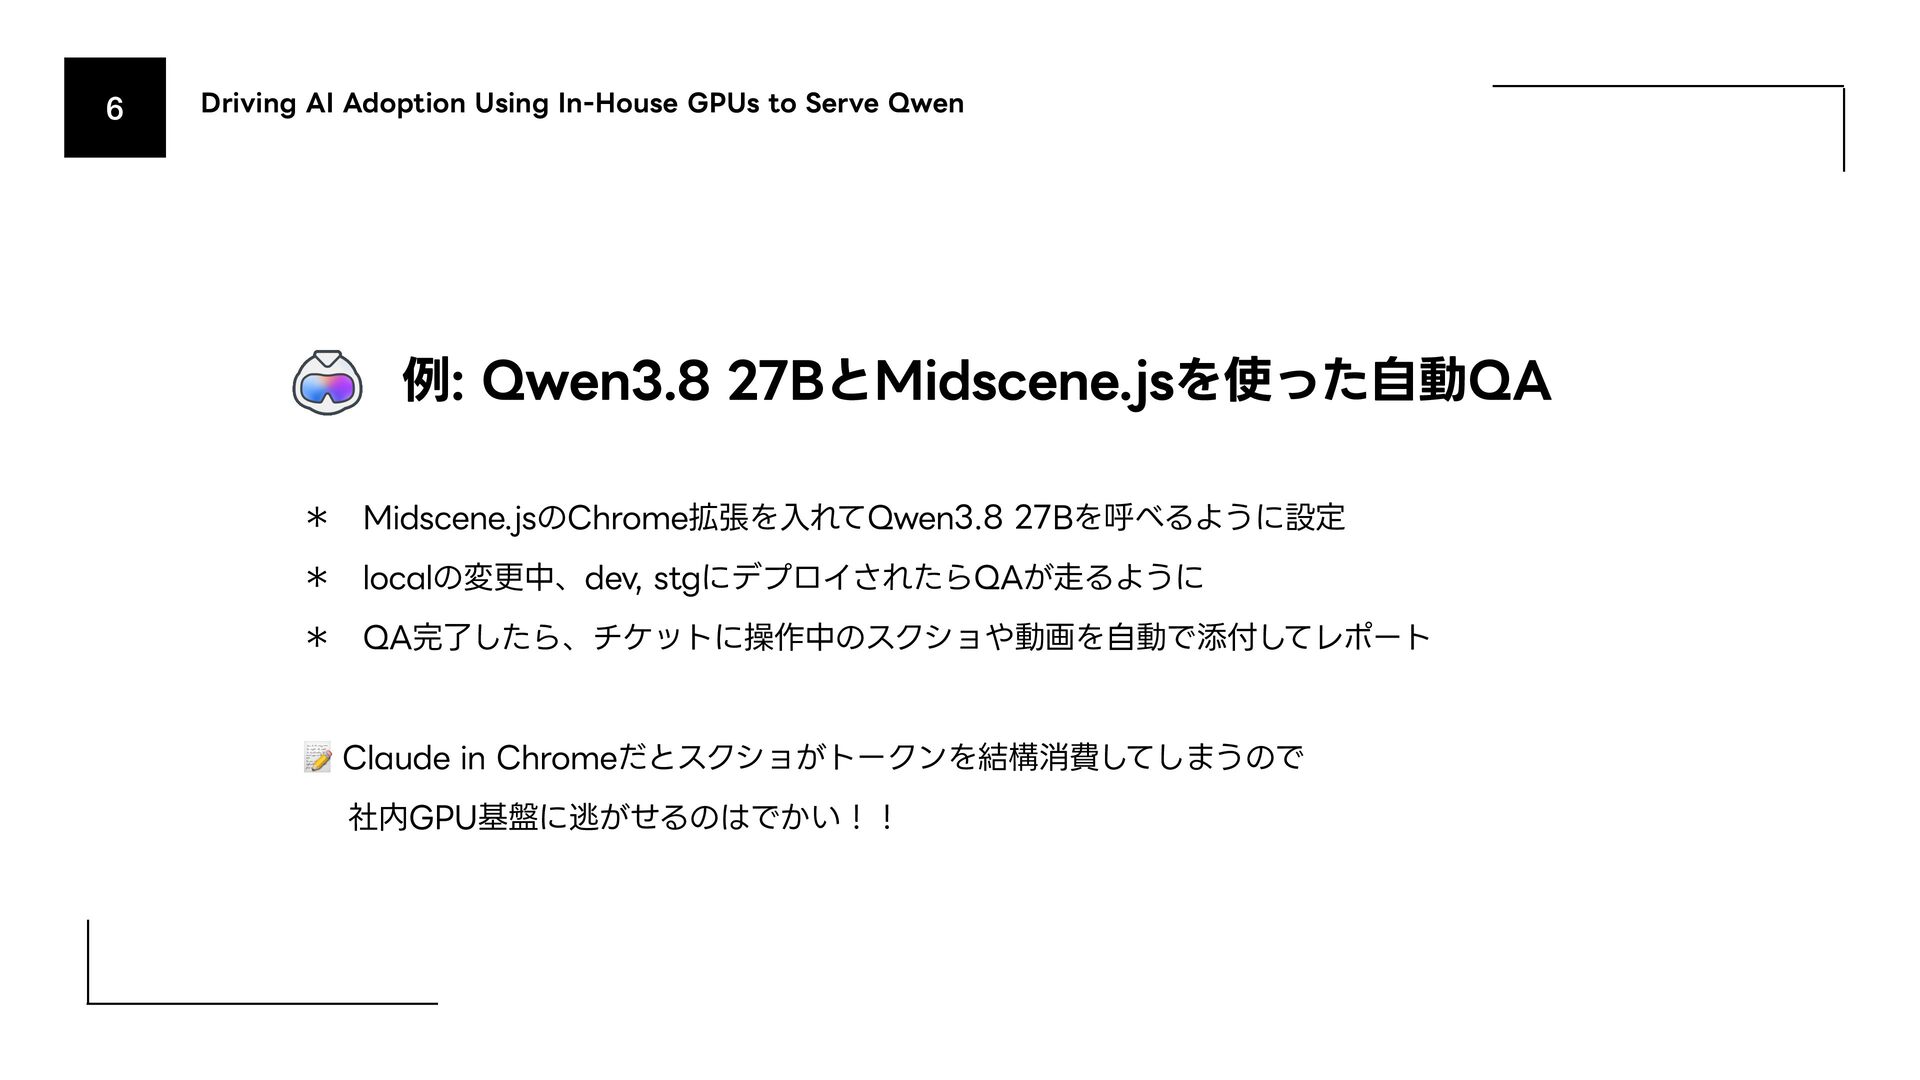
例: Qwen3.8 27BとMidscene.jsを使った自動QA * Midscene.jsのChrome拡張を入れてQwen3.8 27Bを呼べるように設定 * localの変更中、dev, stgにデプロイされたらQAが走るように * QA完了したら、チケットに操作中のスクショや動画を自動で添付してレポート 📝 Claude in Chromeだとスクショがトークンを結構消費してしまうので 社内GPU基盤に逃がせるのはでかい!!
Driving AI Adoption Using In-House GPUs to Serve Qwen 3.
Open-weight model inference infrastructure
7 Driving AI Adoption Using In-House GPUs to Serve Qwen
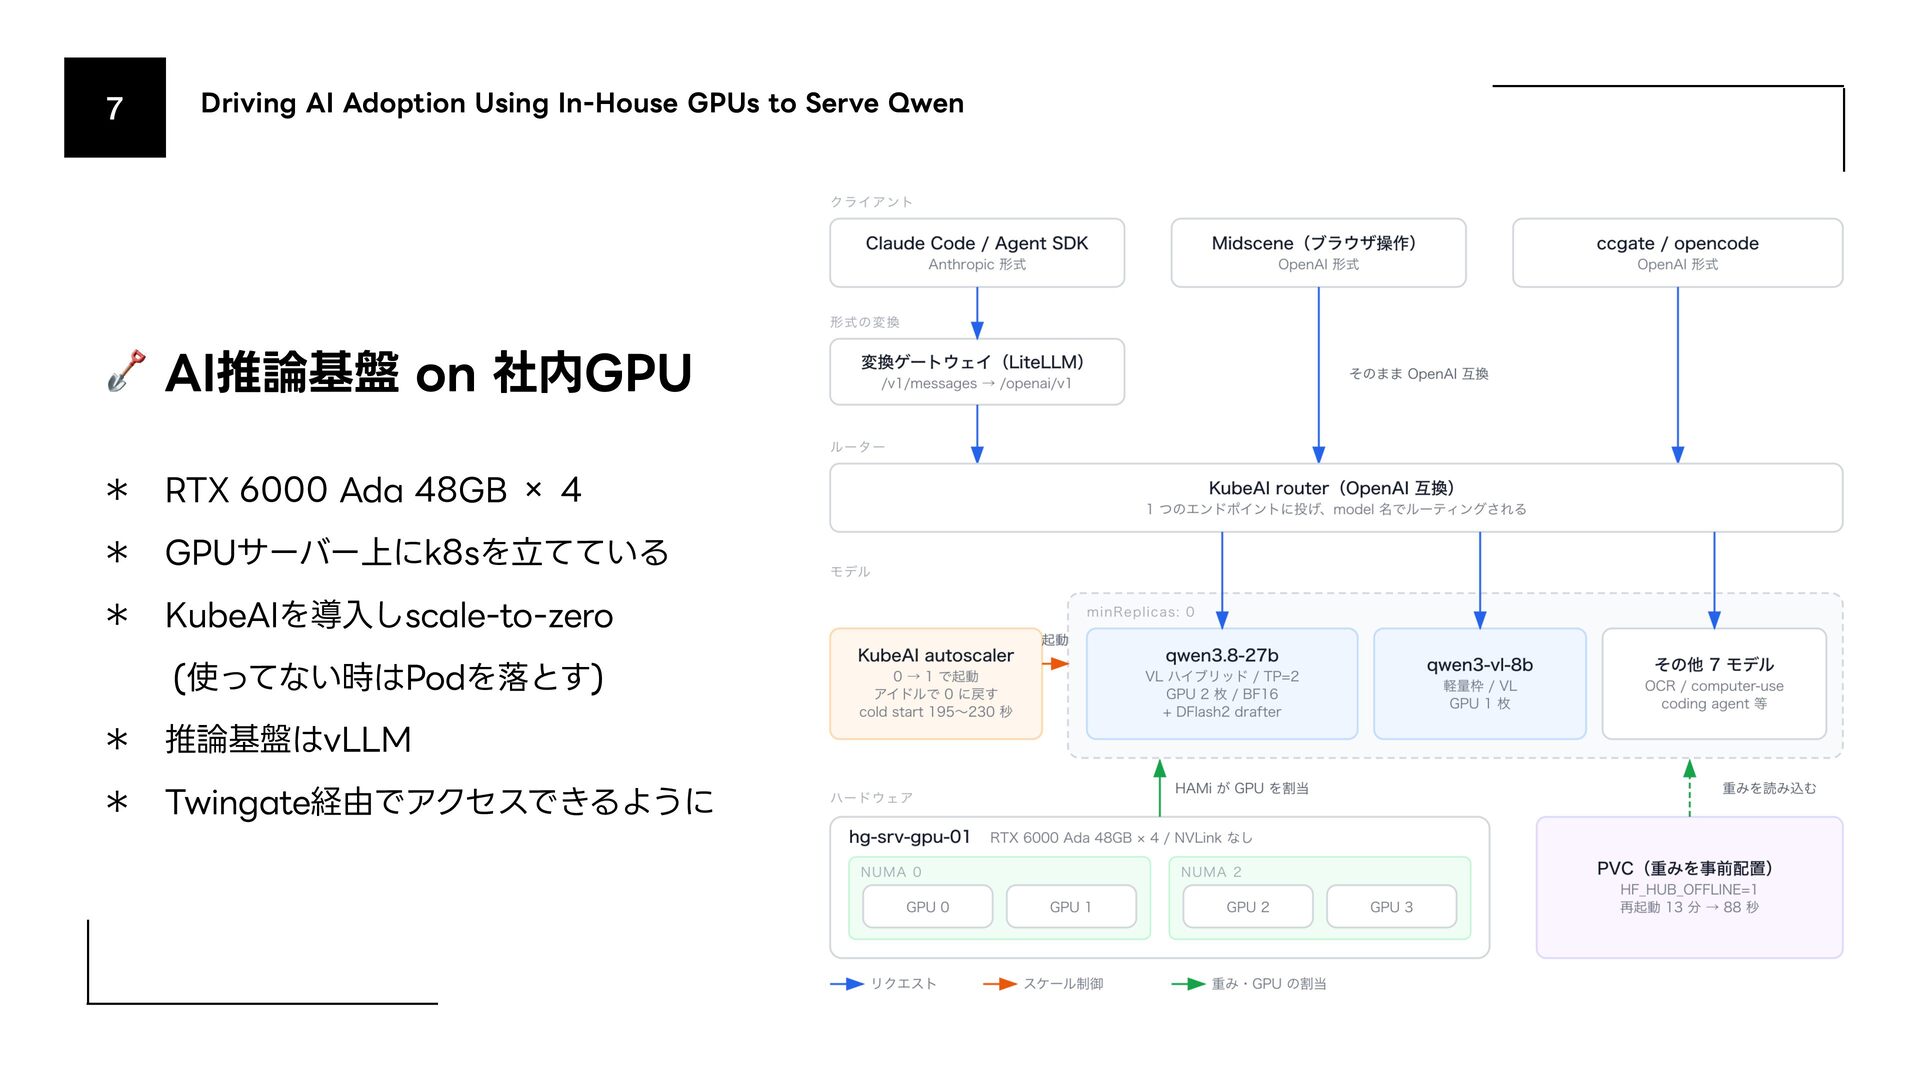
AI推論基盤 on 社内GPU * RTX 6000 Ada 48GB × 4 * GPUサーバー上にk8sを立てている * KubeAIを導入しscale-to-zero (使ってない時はPodを落とす) * 推論基盤はvLLM * Twingate経由でアクセスできるように
8 Driving AI Adoption Using In-House GPUs to Serve Qwen
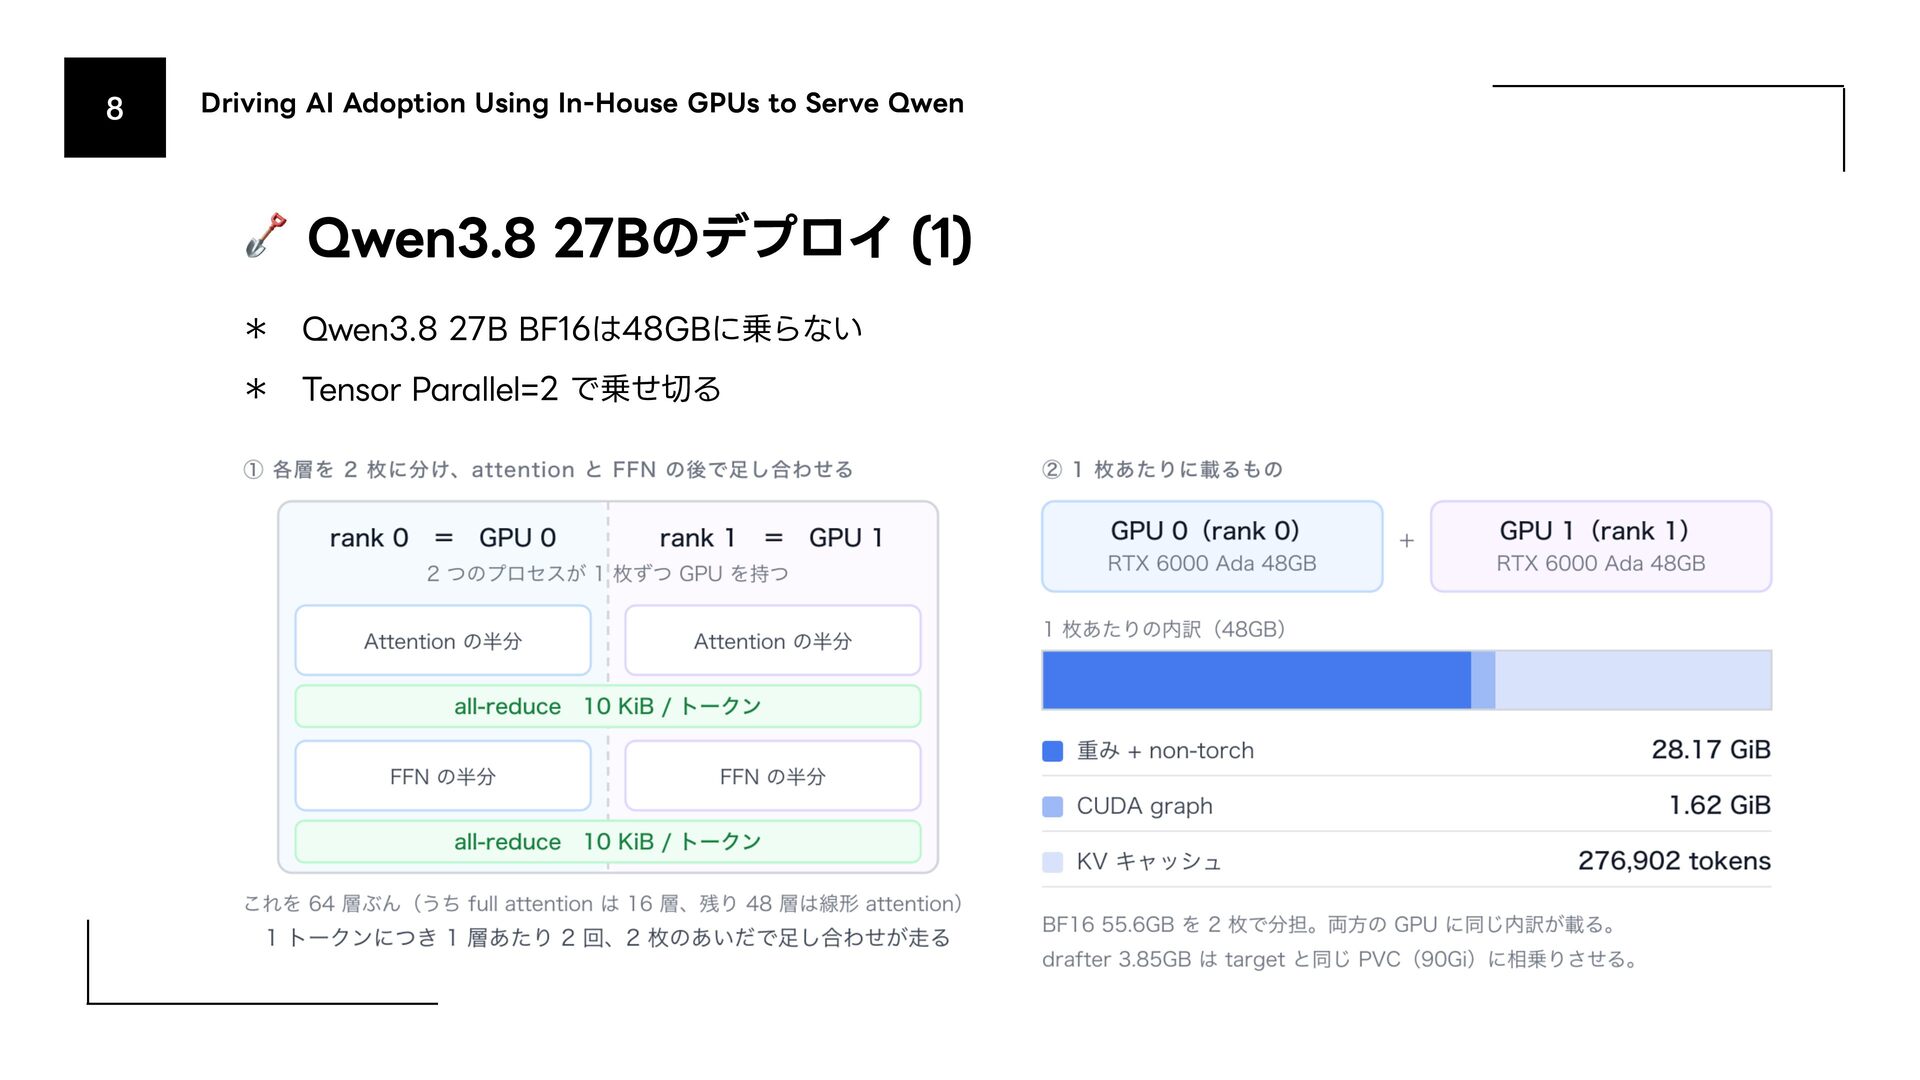
Qwen3.8 27Bのデプロイ (1) * Qwen3.8 27B BF16は48GBに乗らない * Tensor Parallel=2 で乗せ切る
9 Driving AI Adoption Using In-House GPUs to Serve Qwen
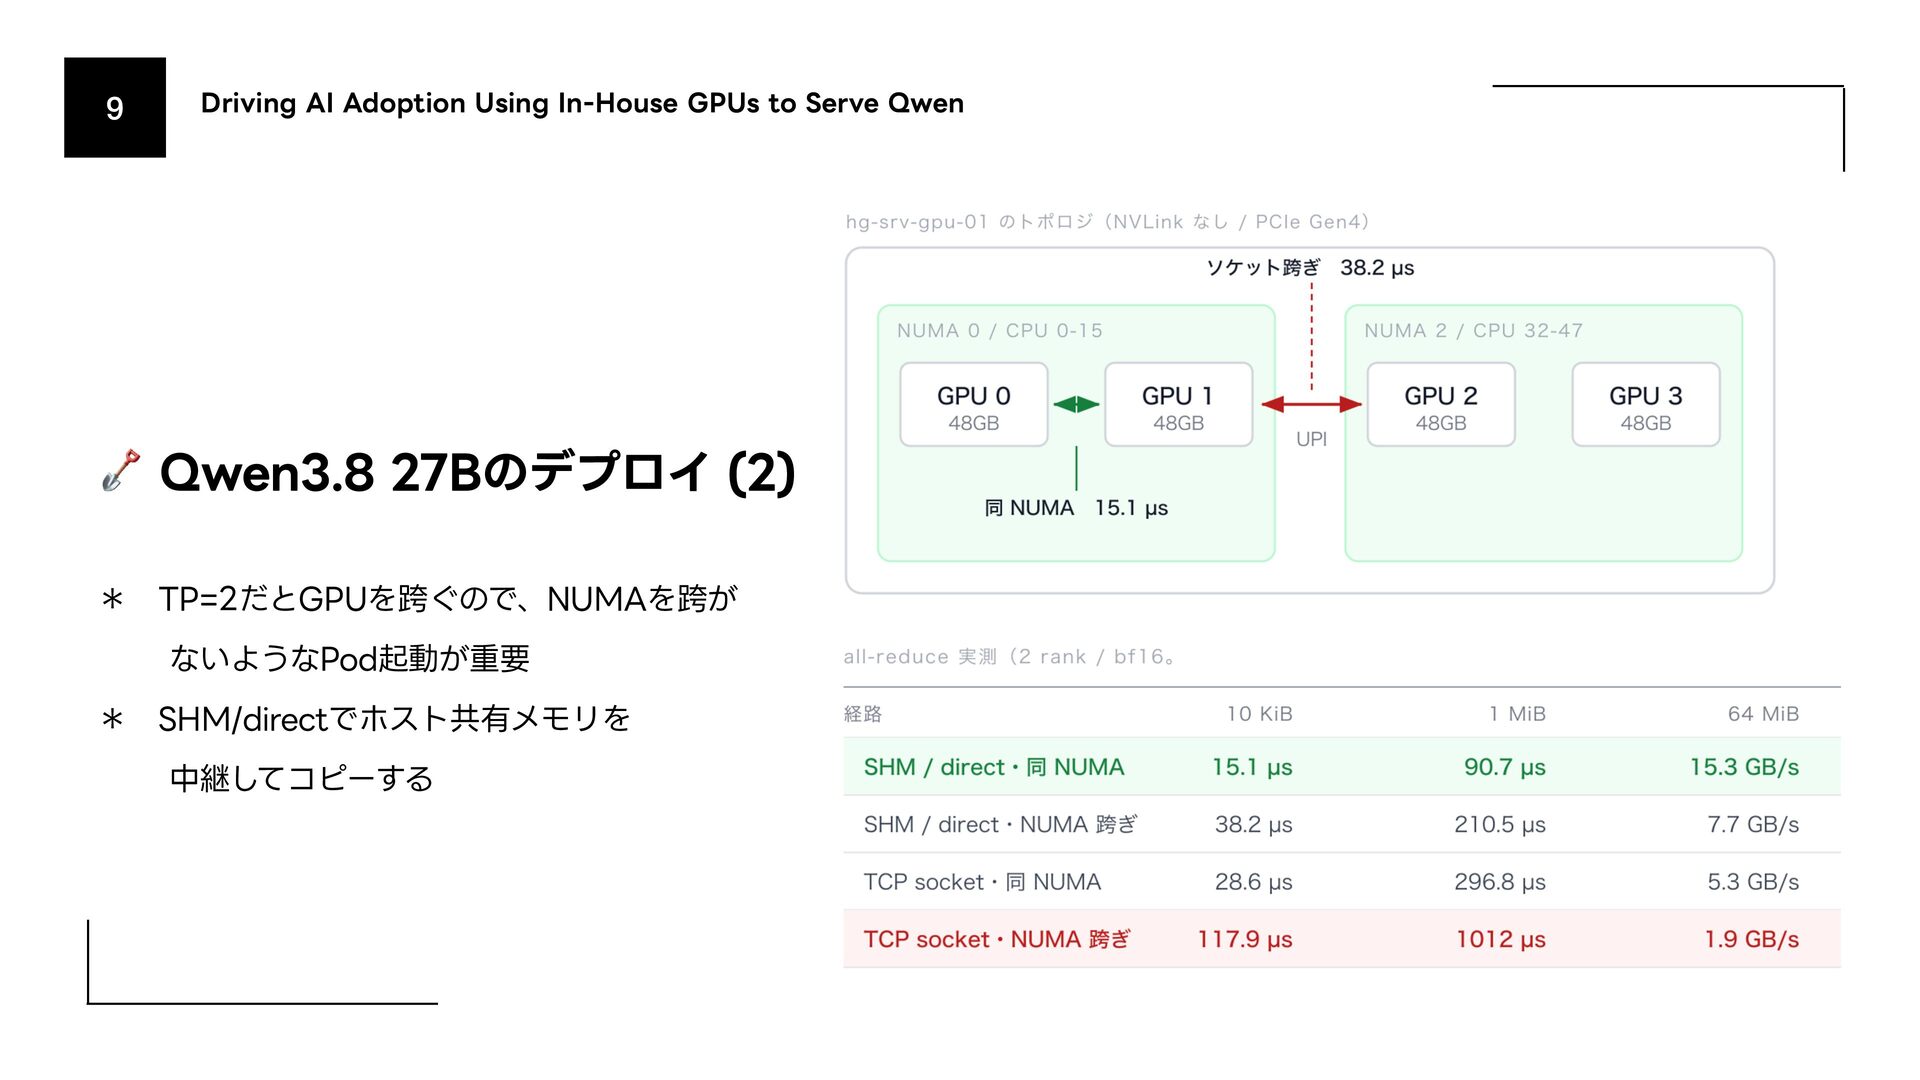
Qwen3.8 27Bのデプロイ (2) * TP=2だとGPUを跨ぐので、NUMAを跨が ないようなPod起動が重要 * SHM/directでホスト共有メモリを 中継してコピーする
Driving AI Adoption Using In-House GPUs to Serve Qwen
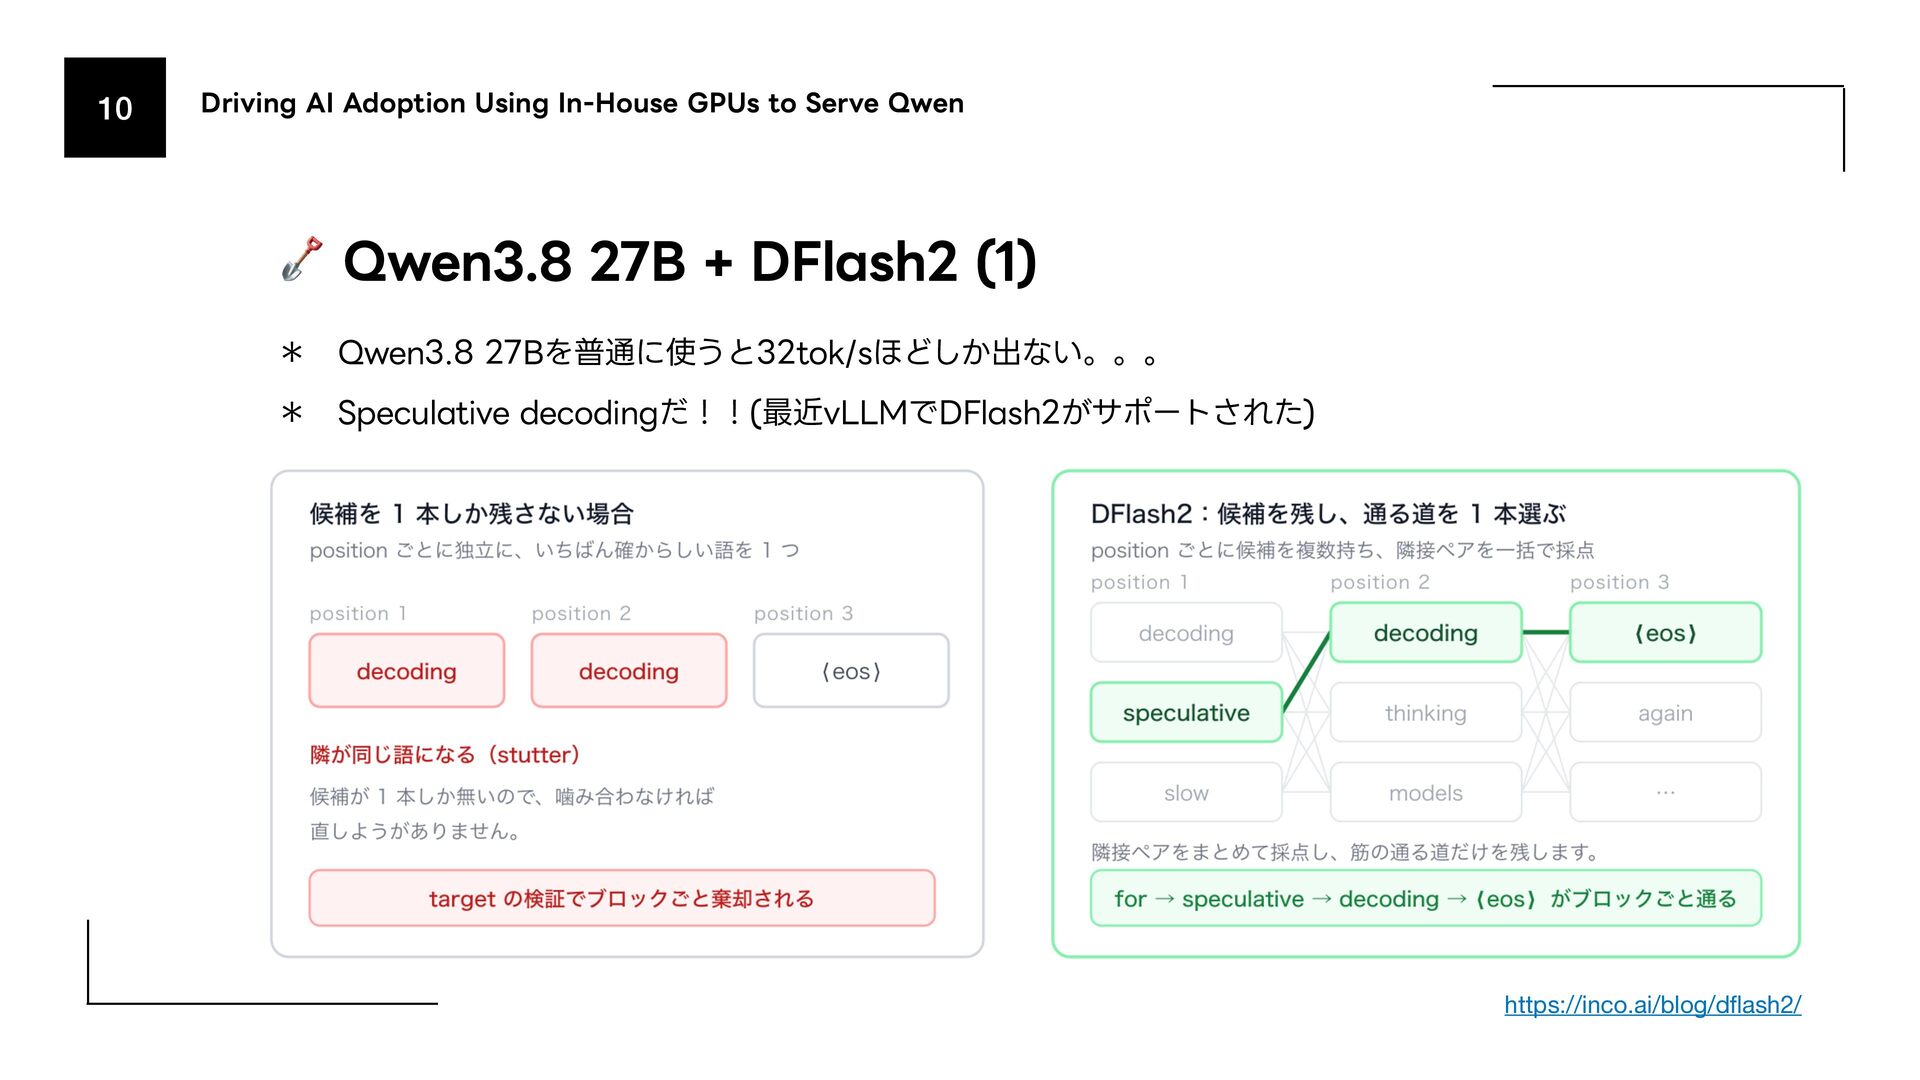
Qwen3.8 27B + DFlash2 (1) * Qwen3.8 27Bを普通に使うと32tok/sほどしか出ない。。。 * Speculative decodingだ!!(最近vLLMでDFlash2がサポートされた) https://inco.ai/blog/d ash2/ fl 10
11 Driving AI Adoption Using In-House GPUs to Serve Qwen
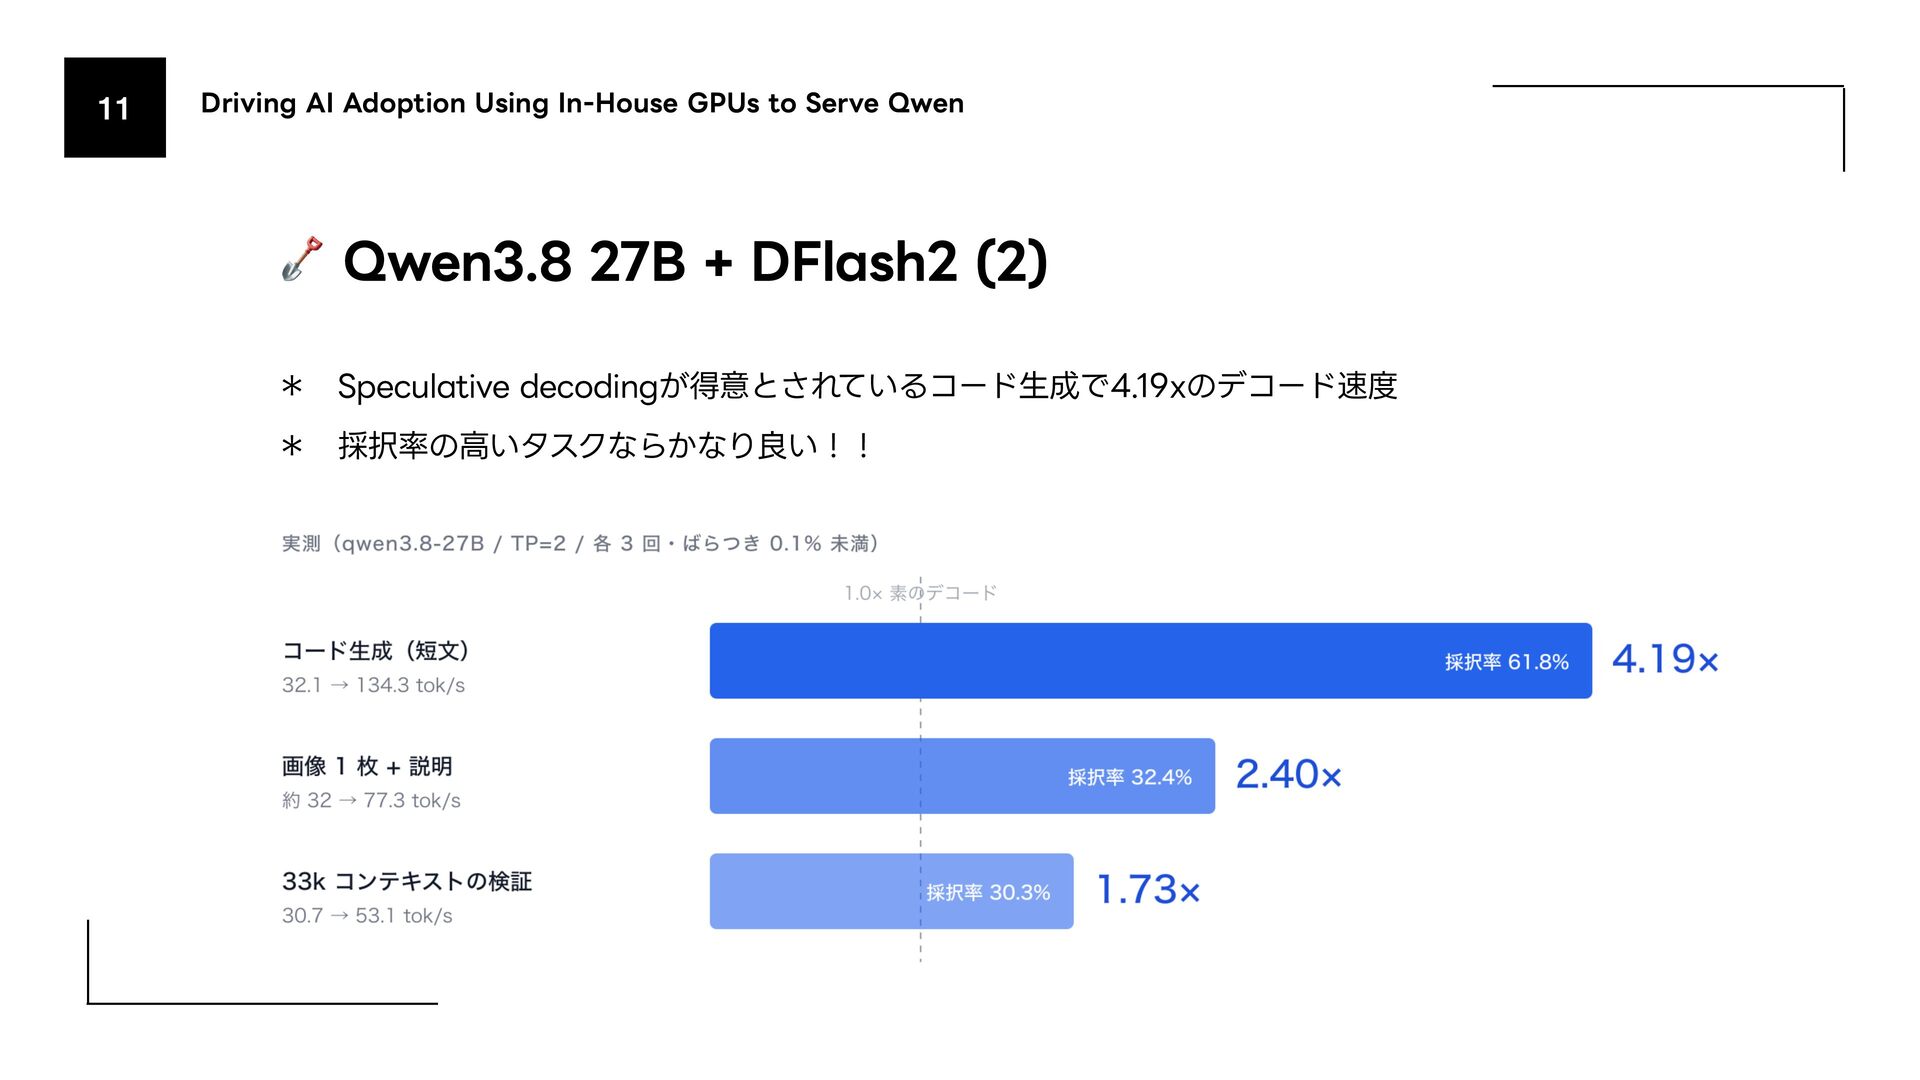
Qwen3.8 27B + DFlash2 (2) * Speculative decodingが得意とされているコード生成で4.19xのデコード速度 * 採択率の高いタスクならかなり良い!!
12 Driving AI Adoption Using In-House GPUs to Serve Qwen
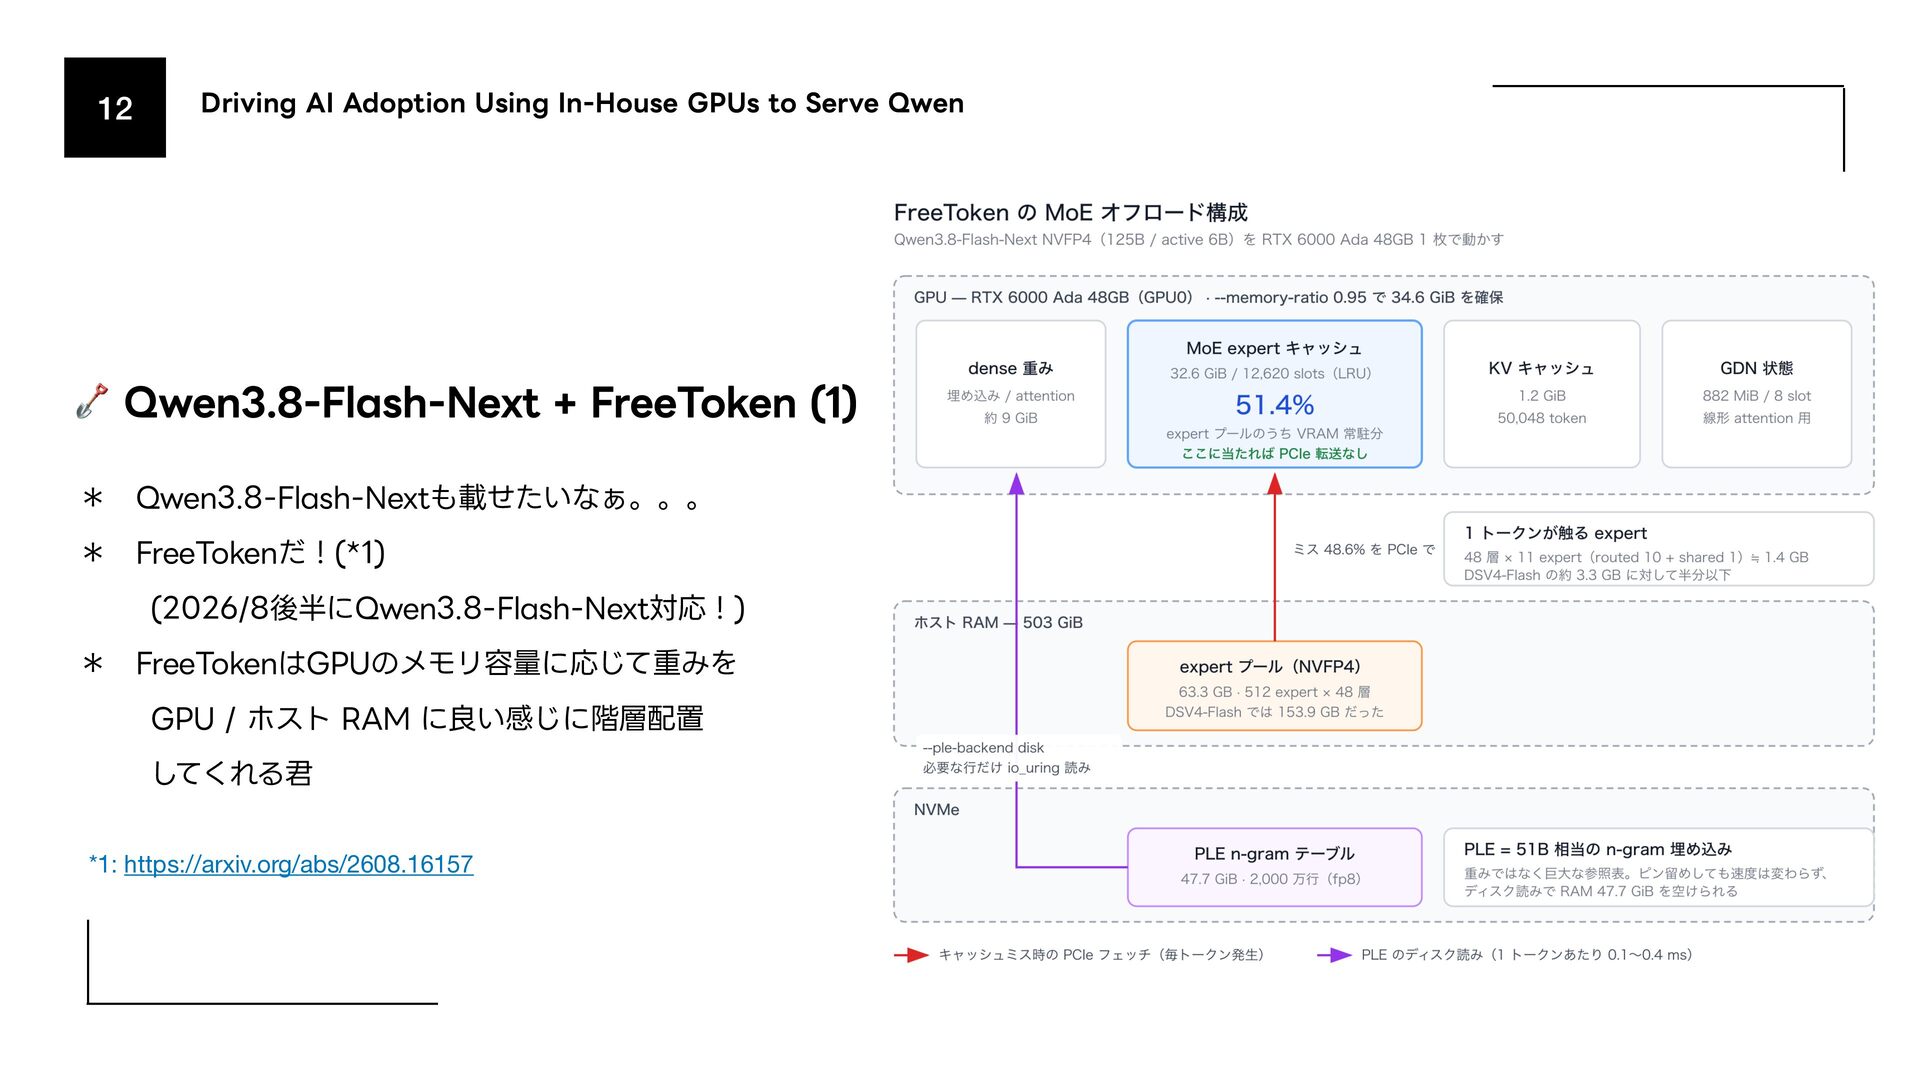
Qwen3.8-Flash-Next + FreeToken (1) * Qwen3.8-Flash-Nextも載せたいなぁ。。。 * FreeTokenだ!(*1) (2026/8後半にQwen3.8-Flash-Next対応!) * FreeTokenはGPUのメモリ容量に応じて重みを GPU / ホスト RAM に良い感じに階層配置 してくれる君 *1: https://arxiv.org/abs/2608.16157
13 Driving AI Adoption Using In-House GPUs to Serve Qwen
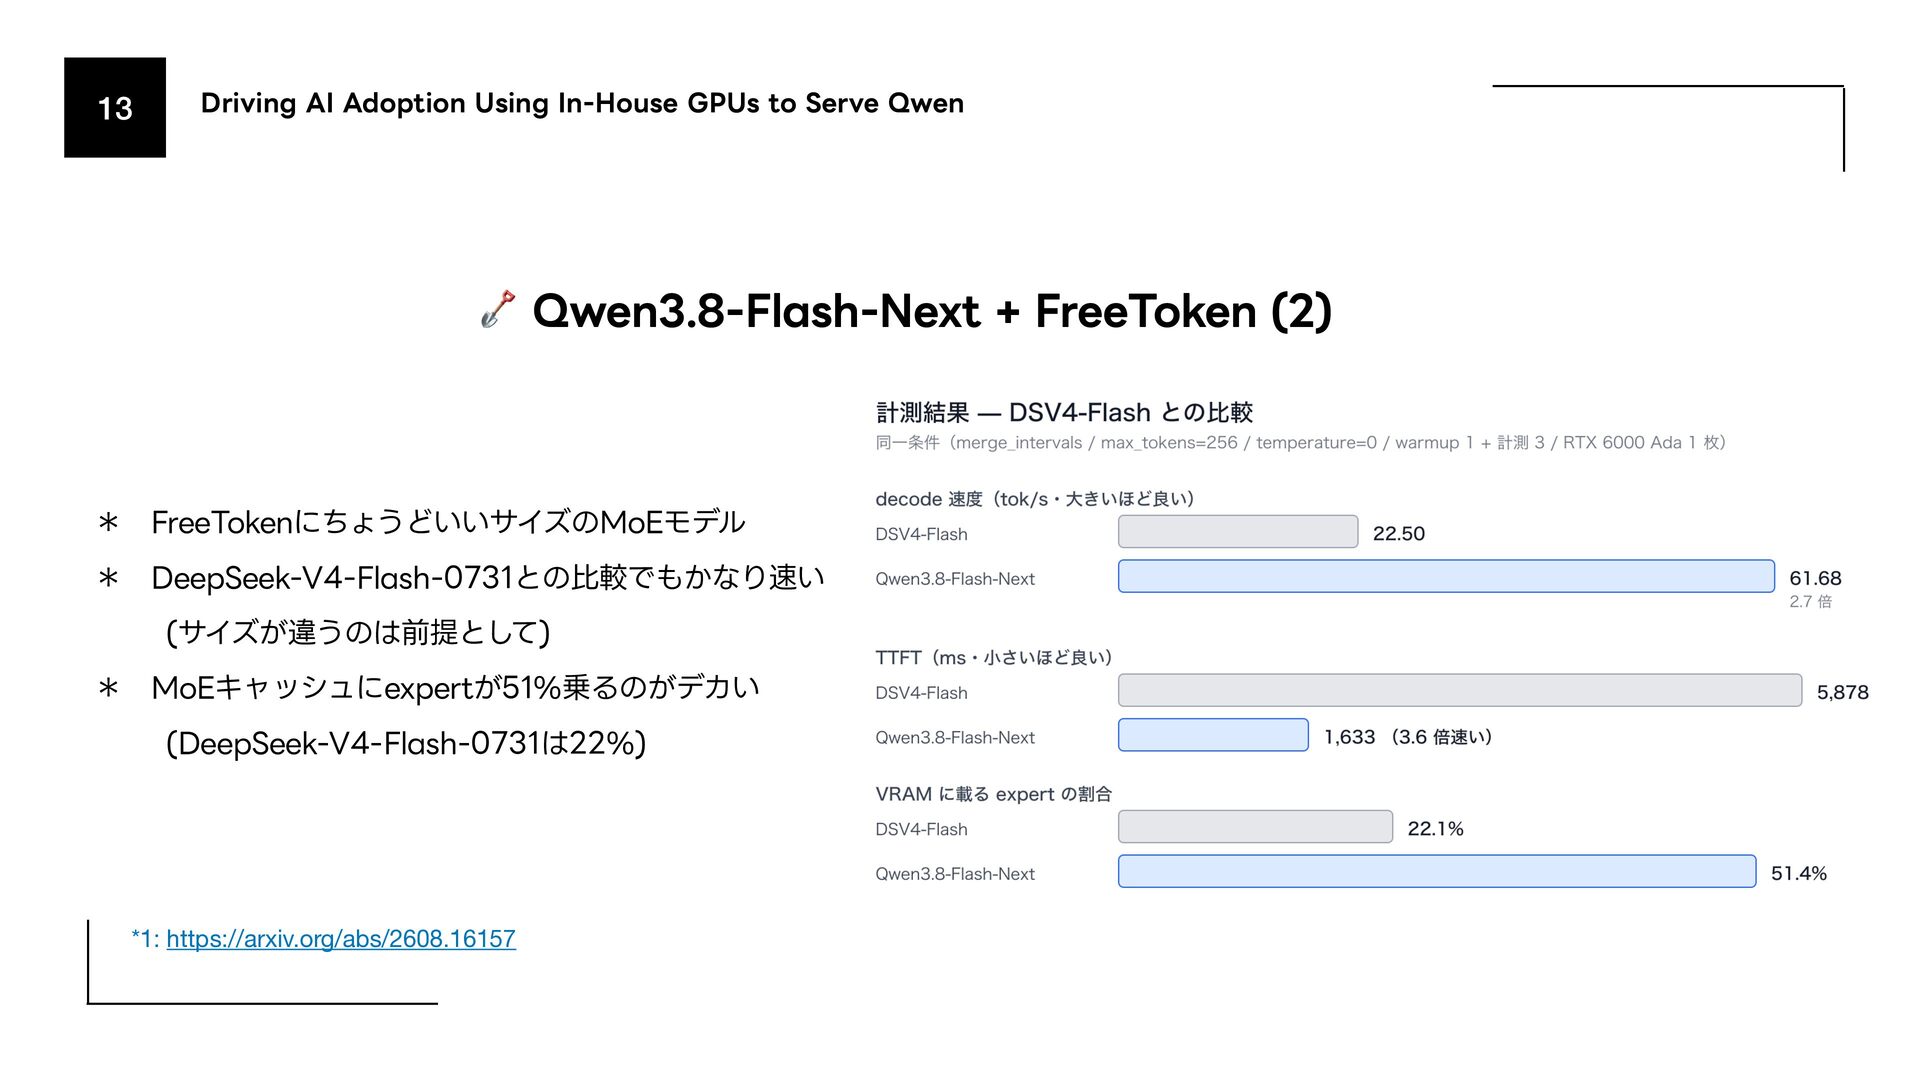
Qwen3.8-Flash-Next + FreeToken (2) * FreeTokenにちょうどいいサイズのMoEモデル * DeepSeek-V4-Flash-0731との比較でもかなり速い (サイズが違うのは前提として) * MoEキャッシュにexpertが51%乗るのがデカい (DeepSeek-V4-Flash-0731は22%) *1: https://arxiv.org/abs/2608.16157
Driving AI Adoption Using In-House GPUs to Serve Qwen 4.
Conclusion
14 Driving AI Adoption Using In-House GPUs to Serve Qwen
🙌 Qwenと社内GPU基盤でコスト削減に成功 * 個人のQA利用だけでも一日4000円ほど削減できている。 * 社内展開して、全社でのAI利用を後押し。ビジネス職種でも使えるようにAI Gateway整備中 * Qwen3.8 27Bが良すぎる。
15 Driving AI Adoption Using In-House GPUs to Serve Qwen
😫 課題 * 全社員を捌くにはまだスループットが足りない。GPU欲しい。 * Qwen3.8-Flash-Next + FreeTokenがKubeAIに乗らない(FreeTokenをサポートしてない) ので、KubeAIのサポート状況に完全依存している構成をやめるのも一手。
16 Driving AI Adoption Using In-House GPUs to Serve Qwen
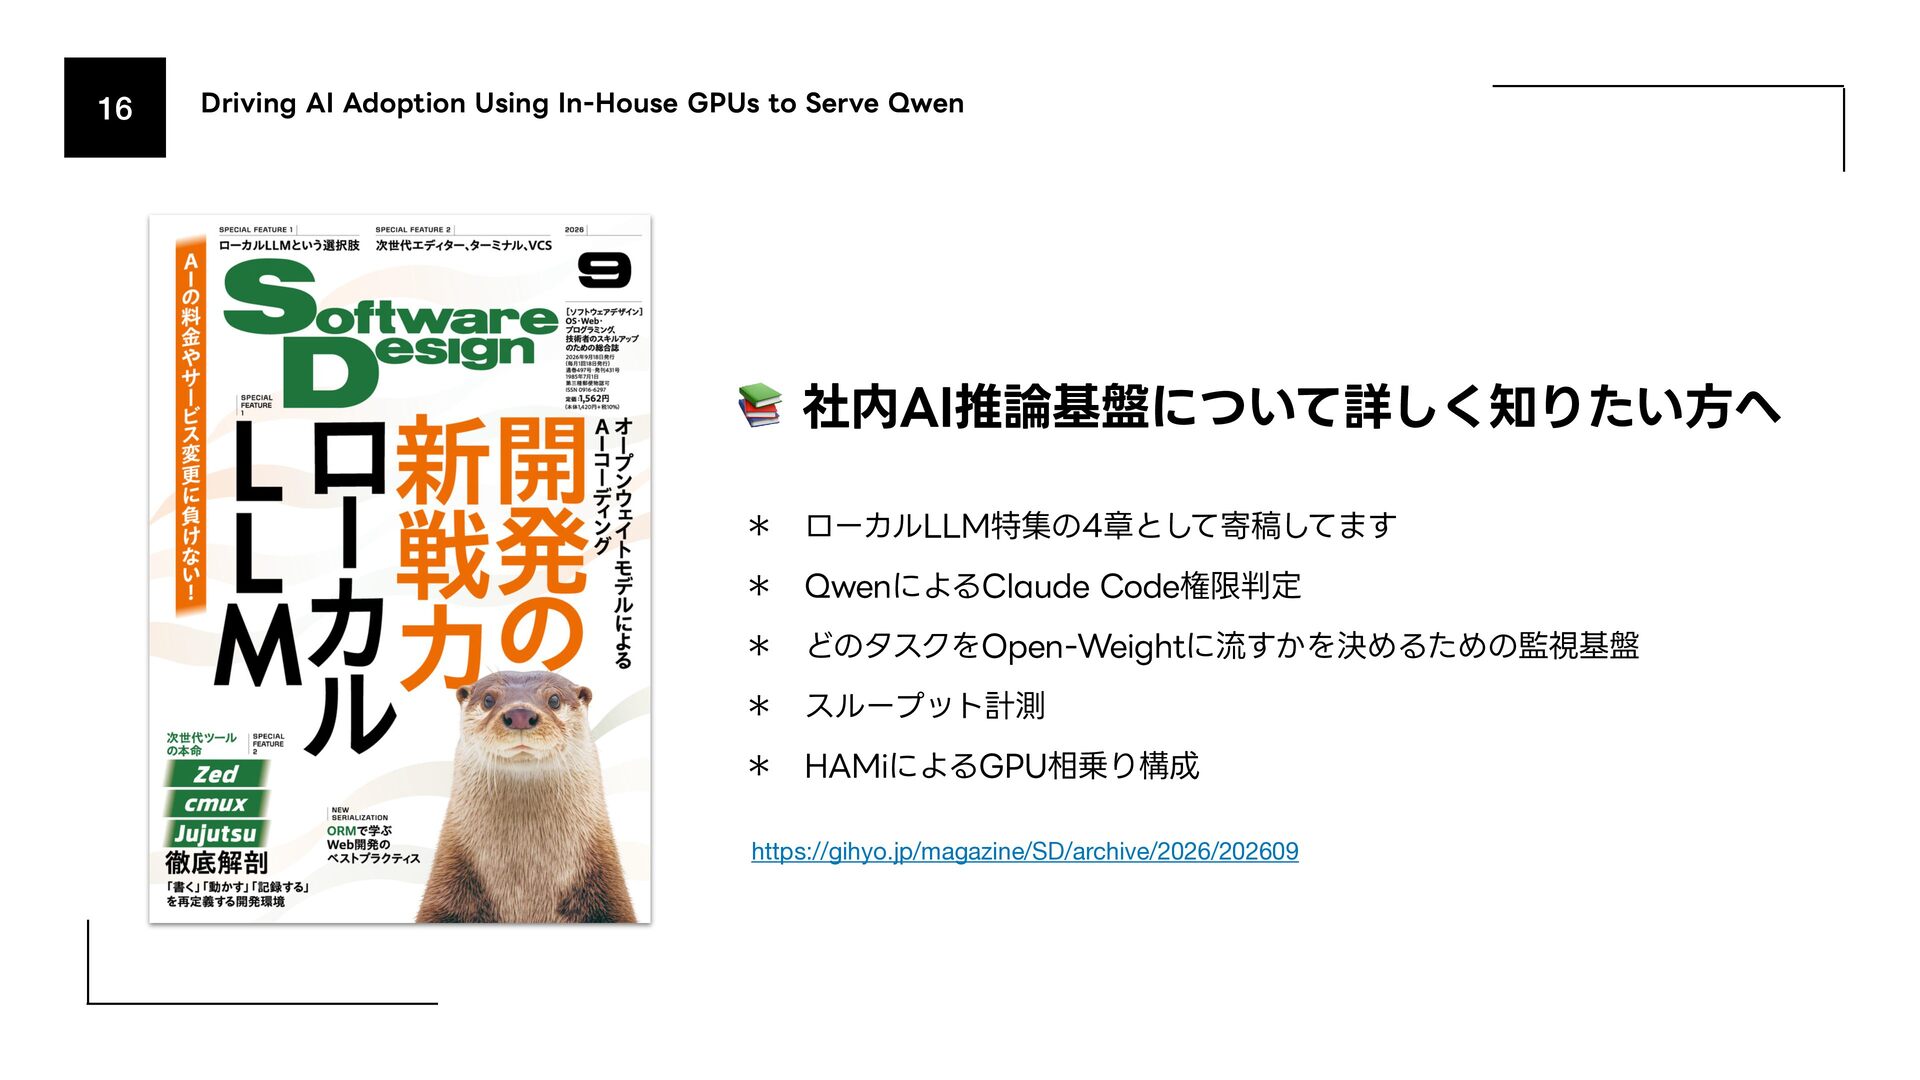
📚 社内AI推論基盤について詳しく知りたい方へ * ローカルLLM特集の4章として寄稿してます * QwenによるClaude Code権限判定 * どのタスクをOpen-Weightに流すかを決めるための監視基盤 * スループット計測 * HAMiによるGPU相乗り構成 https://gihyo.jp/magazine/SD/archive/2026/202609
Driving AI Adoption Using In-House GPUs to Serve Qwen Qwen
Meetup Tokyo LayerX Hiromu Nakamura (@po3rin) 2026/09/04


 po3rin
 kinunori
 nealle
 miso
 kinopeee
 akaboshinit
 okamototakuyasr2
 uhyo
 kworkdev
 shinichirokawano
 mito201
 sh_fk2
 markunet
 ipullrank
 tomoyanonymous
 soudai
 aleyda
 davidcarrasco
 aemeredith
 tanoku
 chriscoyier
 bkeepers
 tessaabrams
 chrisshort
 jakevdp