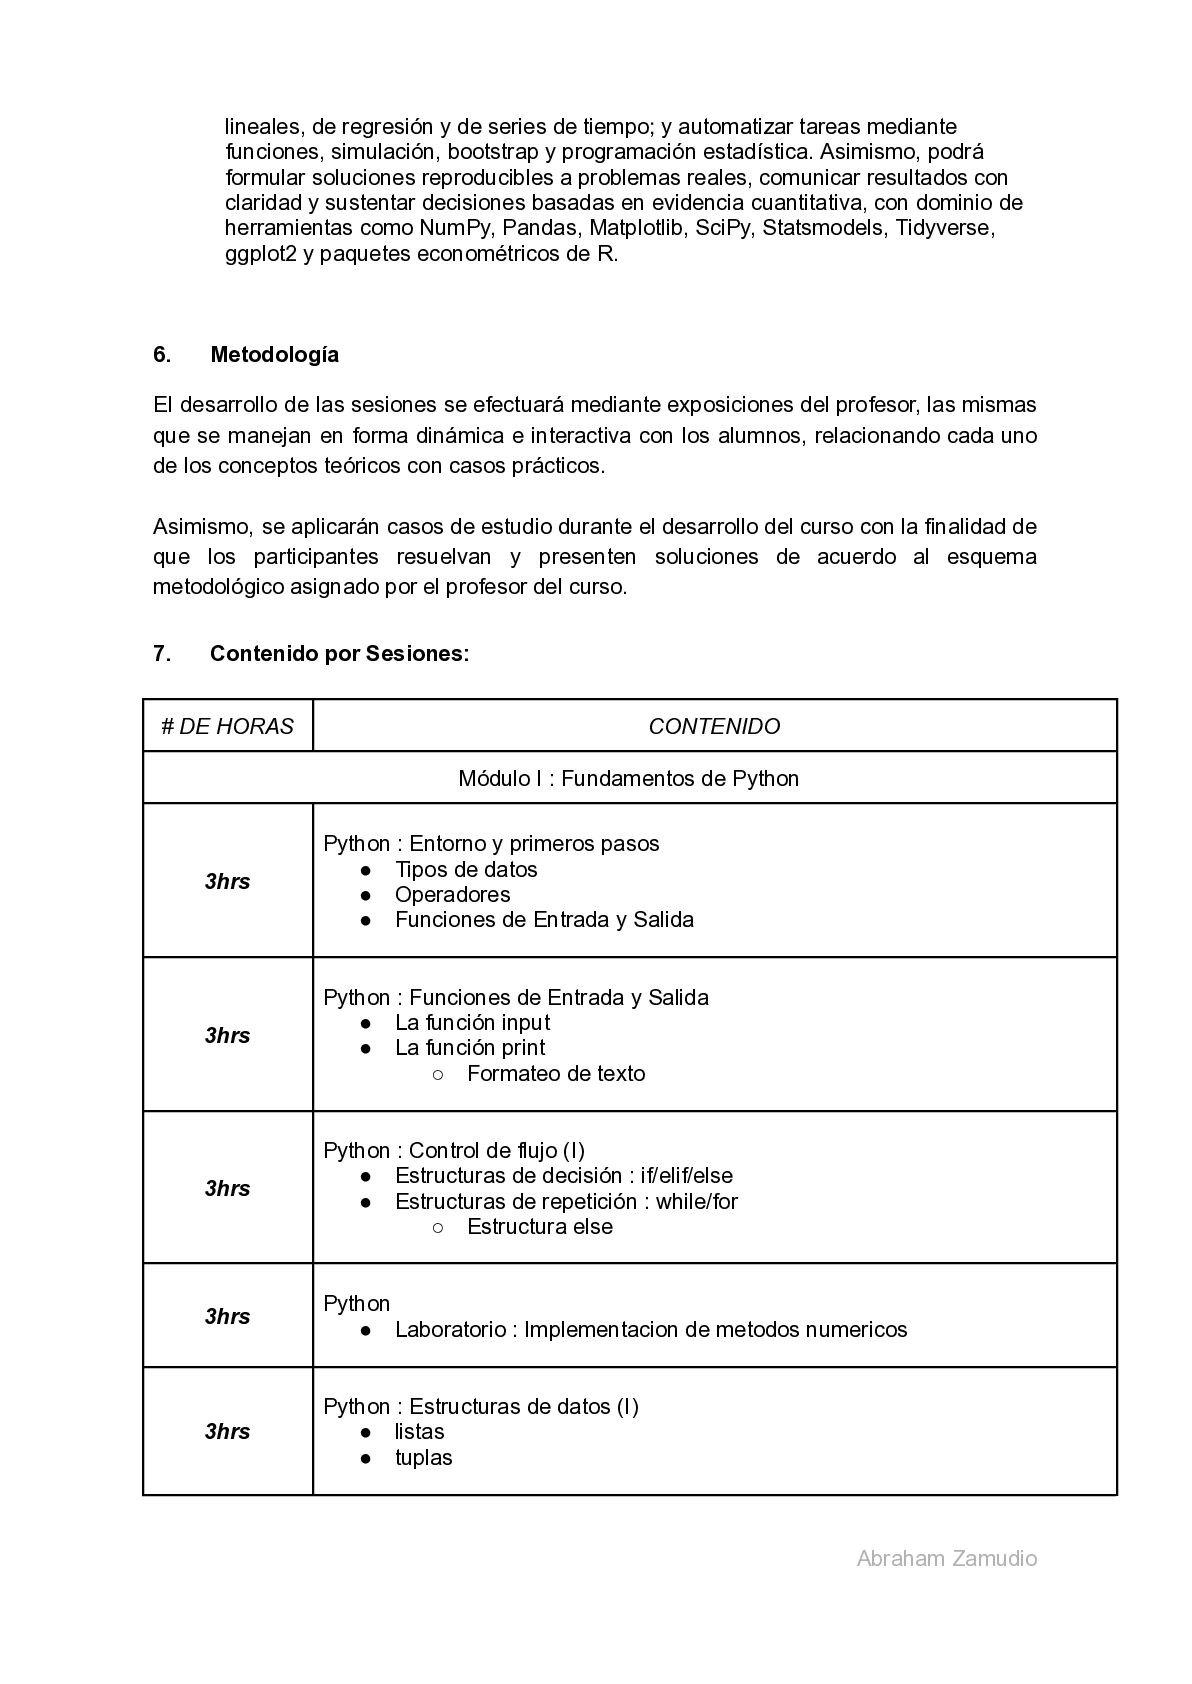
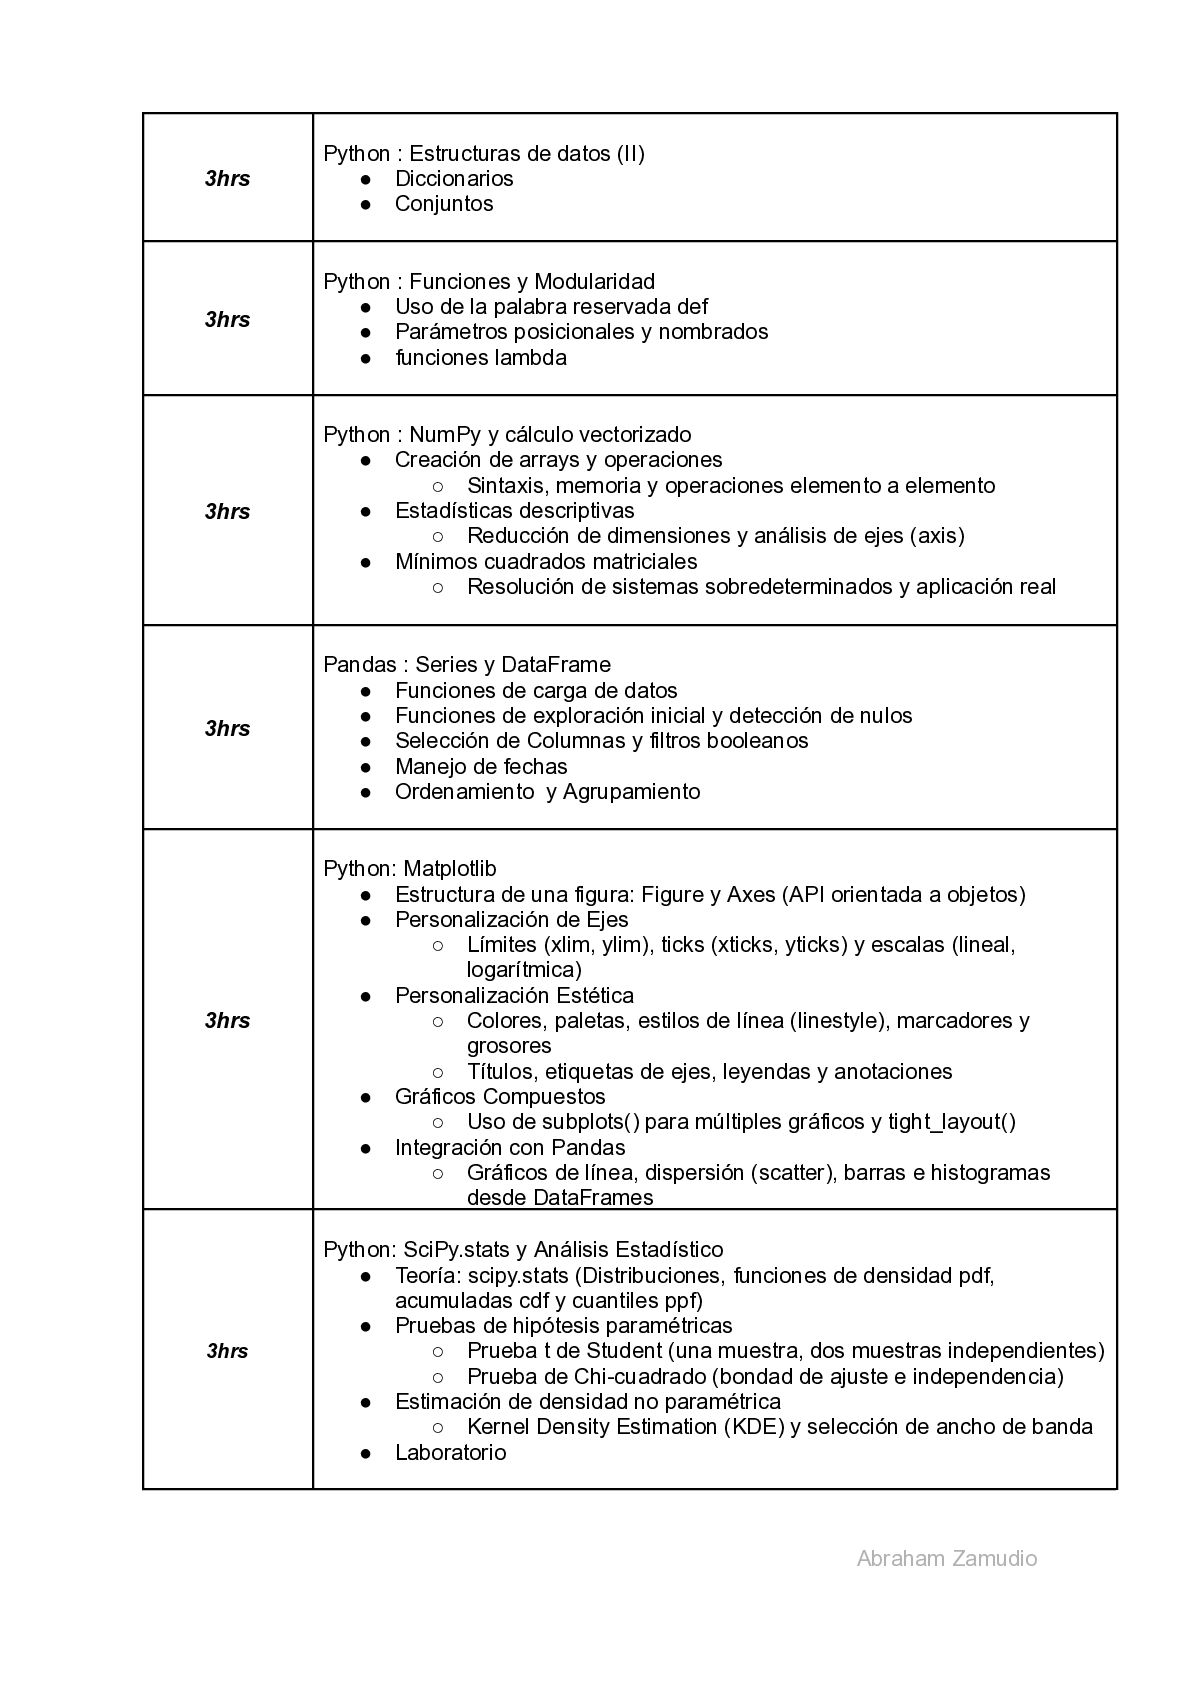
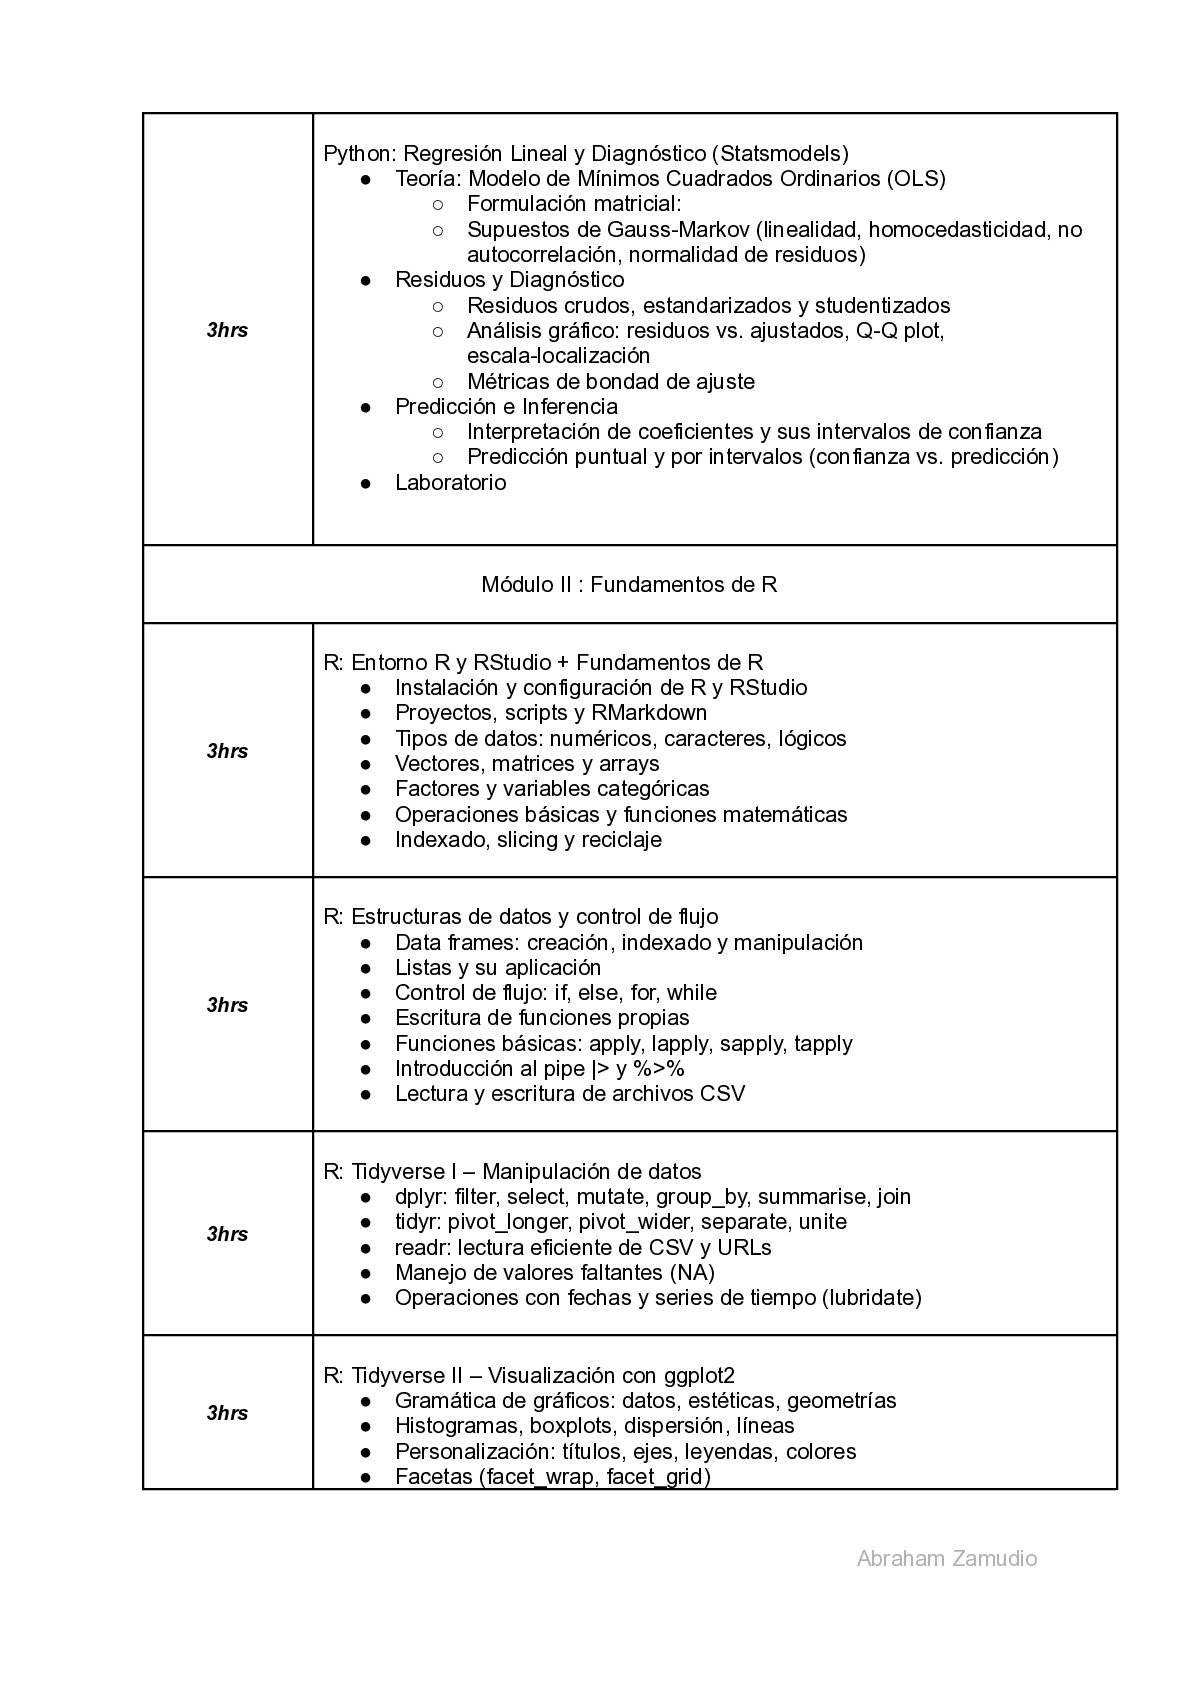
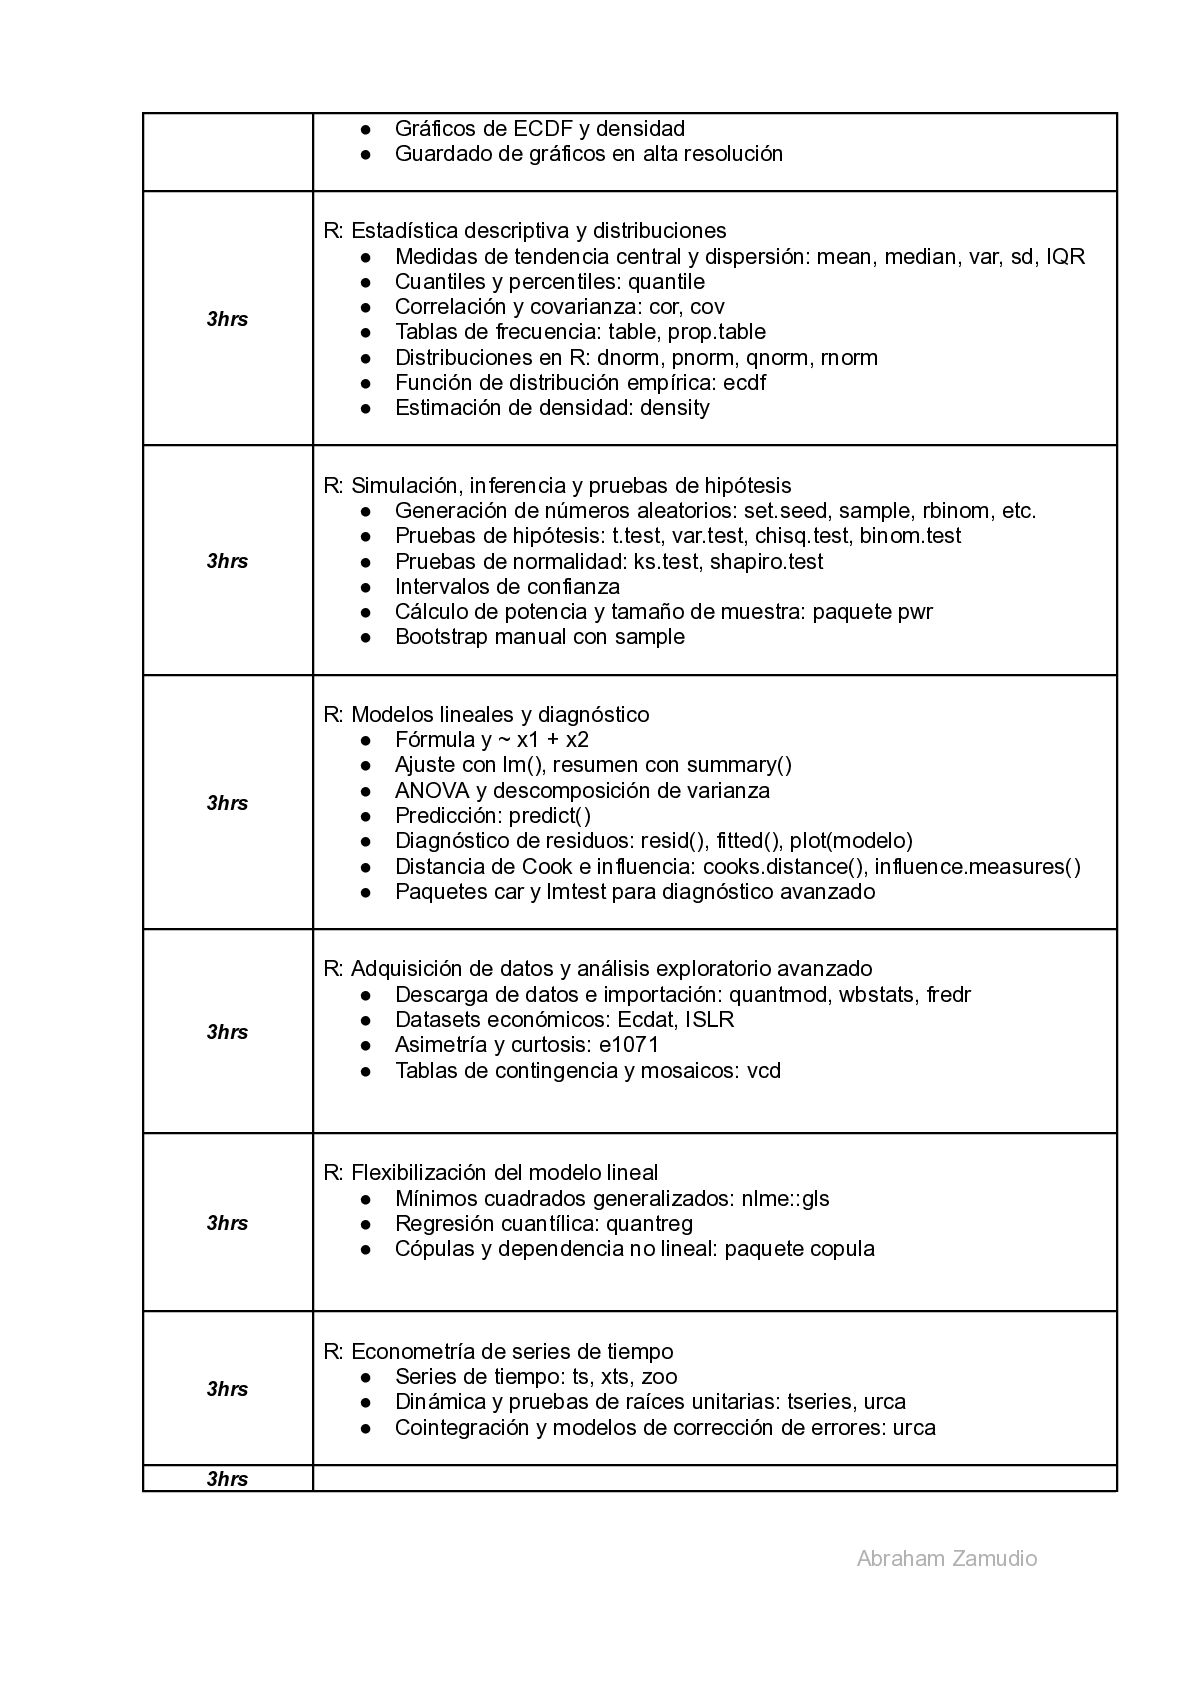
Series y DataFrame, carga de datos, exploración inicial, detección de nulos, selección de columnas, filtros booleanos, manejo de fechas, ordenamiento y agrupamiento. Estas competencias son centrales para el análisis exploratorio de datos y para la preparación de información antes del modelamiento. Luego se trabaja con Matplotlib, abordando la estructura de una figura mediante Figure y Axes, la API orientada a objetos, la personalización de ejes, límites, ticks y escalas, así como colores, paletas, estilos de línea, marcadores, grosores, títulos, etiquetas, leyendas y anotaciones. Se revisan gráficos compuestos con subplots y tight_layout, y la integración con Pandas para construir gráficos de línea, dispersión, barras e histogramas desde DataFrames. Esta parte fortalece la capacidad de comunicar hallazgos mediante visualizaciones claras y profesionales. Posteriormente, el curso introduce SciPy.stats y el análisis estadístico, cubriendo distribuciones, funciones de densidad, funciones acumuladas y cuantiles, pruebas de hipótesis paramétricas como la prueba t de Student para una y dos muestras independientes, la prueba de Chi-cuadrado para bondad de ajuste e independencia, y la estimación de densidad no paramétrica mediante Kernel Density Estimation, incluyendo la selección de ancho de banda. Finalmente, el módulo cierra con regresión lineal y diagnóstico usando Statsmodels, donde se estudia el modelo de Mínimos Cuadrados Ordinarios, su formulación matricial, los supuestos de Gauss-Markov, el análisis de residuos crudos, estandarizados y studentizados, los gráficos de diagnóstico como residuos versus ajustados, Q-Q plot y escala-localización, las métricas de bondad de ajuste, la interpretación de coeficientes e intervalos de confianza, y la predicción puntual y por intervalos. Este recorrido permite que el estudiante no solo ajuste modelos, sino que evalúe críticamente su validez y utilidad. El segundo módulo, orientado a los fundamentos de R, complementa y amplía la formación anterior desde una perspectiva estadística y de manipulación de datos igualmente potente. Comienza con el entorno R y RStudio, instalación y configuración, proyectos, scripts y RMarkdown, tipos de datos, vectores, matrices, arrays, factores y variables categóricas, operaciones básicas, funciones matemáticas, indexado, slicing y reciclaje. Luego se abordan estructuras de datos y control de flujo, incluyendo data frames, listas, if, else, for, while, escritura de funciones propias, funciones básicas como apply, lapply, sapply y tapply, introducción al pipe y lectura y escritura de archivos CSV. Con ello se busca que el estudiante adquiera autonomía para manipular datos y automatizar tareas en R. El curso continúa con Tidyverse I, centrado en la manipulación de datos mediante dplyr, tidyr, readr y lubridate. Se estudian funciones como filter, select, mutate, group_by, summarise y join; pivot_longer, pivot_wider, separate y unite; lectura eficiente de CSV y URLs; manejo de valores faltantes; y operaciones con fechas y series de tiempo. Después se desarrolla Tidyverse II, dedicado a la visualización con ggplot2, donde se revisa la gramática de gráficos, datos, estéticas y geometrías, histogramas, boxplots, dispersión y líneas, personalización de títulos, ejes, leyendas y colores, facetas con facet_wrap y facet_grid, gráficos de ECDF y densidad, y guardado de gráficos en alta resolución. Esta sección es fundamental para el análisis exploratorio y la comunicación visual de resultados. Más adelante se estudia estadística descriptiva y distribuciones en R, con medidas de tendencia central y dispersión, cuantiles y percentiles, correlación y covarianza, tablas de frecuencia, distribuciones dnorm, pnorm, qnorm y rnorm, función de distribución empírica y estimación de densidad. Luego se aborda simulación, inferencia y pruebas de hipótesis, incluyendo generación de números aleatorios, Abraham Zamudio


 robintux
 3l4l5
 akiraasano
 bunnchinn3
 pawan_pharm
 naochim2026
 kaityo256
 fmarot
 bvr7352
 hiola
 juanmartin2026
 ainischool
 keathley
 smashingmag
 marketingsoph
 signer
 addyosmani
 honzajavorek
 inesmontani
 gr2m
 katiecoart
 malarkey
 bermonpainter
 thoeni