Upgrade to Pro — share decks privately, control downloads, hide ads and more …

通時的な類似度行列に基づく単語の意味変化の分析

 通時的な類似度行列に基づく単語の意味変化の分析

言語処理学会第32回年次大会(NLP2026) 招待論文セッション
https://www.jstage.jst.go.jp/article/jnlp/32/4/32_1189/_article/-char/ja

hajime kiyama

March 09, 2026

Transcript

55 slides
  1. 通時的な類似度行列に基づく 単語の意味変化の分析 木山朔1 相田太一2 小町守1 小木曽智信3 高村大也4 持橋大地3,5 1一橋大学 2東京都立大学

    3国立国語研究所 4産業技術総合研究所 5統計数理研究所 2026年3月9日 招待論文セッション@NLP2026
  2. 背景:2つの時期と複数時期の意味変化 [Periti and Tahmasebi, 2024b] ◼ 2つの時期の意味変化 [Cassotti+, 2023][Periti and

    Tahmasebi, 2024a][Aida and Bollegala, 2024][Periti+, 2024] ◼ どの単語が意味変化したかを検出 ◼ 2つの時期間で意味変化の度合いを計測 ◼ 意味変化度合いがアノテーションされたデータセットが存在 ◼ 複数時期の意味変化 [Kulkarni+, 2015] [Hu+, 2019] [Giulianelli+, 2020] ◼ ある単語がどのように意味変化するかを分析 ◼ 変化点検出や語義の割合を計測 ◼ アノテーションされたデータセットは存在しない ◼ 既存手法には課題が存在 3
  3. 背景:2つの時期と複数時期の意味変化 [Periti and Tahmasebi, 2024b] ◼ 2つの時期の意味変化 [Cassotti+, 2023][Periti and

    Tahmasebi, 2024a][Aida and Bollegala, 2024][Periti+, 2024] ◼ どの単語が意味変化したかを検出 ◼ 2つの時期間で意味変化の度合いを計測 ◼ 意味変化度合いがアノテーションされたデータセットが存在 ◼ 複数時期の意味変化 [Kulkarni+, 2015] [Hu+, 2019] [Giulianelli+, 2020] ◼ ある単語がどのように意味変化するかを分析 ◼ 変化点検出や語義の割合を計測 ◼ アノテーションされたデータセットは存在しない ◼ 既存手法には課題が存在 4
  4. 背景:2つの時期と複数時期の意味変化 [Periti and Tahmasebi, 2024b] ◼ 2つの時期の意味変化 [Cassotti+, 2023][Periti and

    Tahmasebi, 2024a][Aida and Bollegala, 2024][Periti+, 2024] ◼ どの単語が意味変化したかを検出 ◼ 2つの時期間で意味変化の度合いを計測 ◼ 意味変化度合いがアノテーションされたデータセットが存在 ◼ 複数時期の意味変化 [Kulkarni+, 2015] [Hu+, 2019] [Giulianelli+, 2020] ◼ ある単語がどのように意味変化するかを分析 ◼ 変化点検出や語義の割合を計測 ◼ アノテーションされたデータセットは存在しない ◼ 既存手法には課題が存在 5 本研究はこちら!!!
  5. 背景:複数時期の意味変化の課題1 ◼ 隣接時期間における変化点検出 [Kulkarni+, 2015] ◼ 隣り合う時期同士で意味変化度合いを計測 ◼ 2つの時期間の意味変化の自然な拡張 ◼

    具体的な意味の遷移はわからない ◼ 変化が複数ある場合に元に戻るのか? ◼ それとも別の語義に変わりきるのか? 6 任意の時期間の情報を 考慮した分析手法が必要 [Periti and Tahmasebi, 2024b]より引用
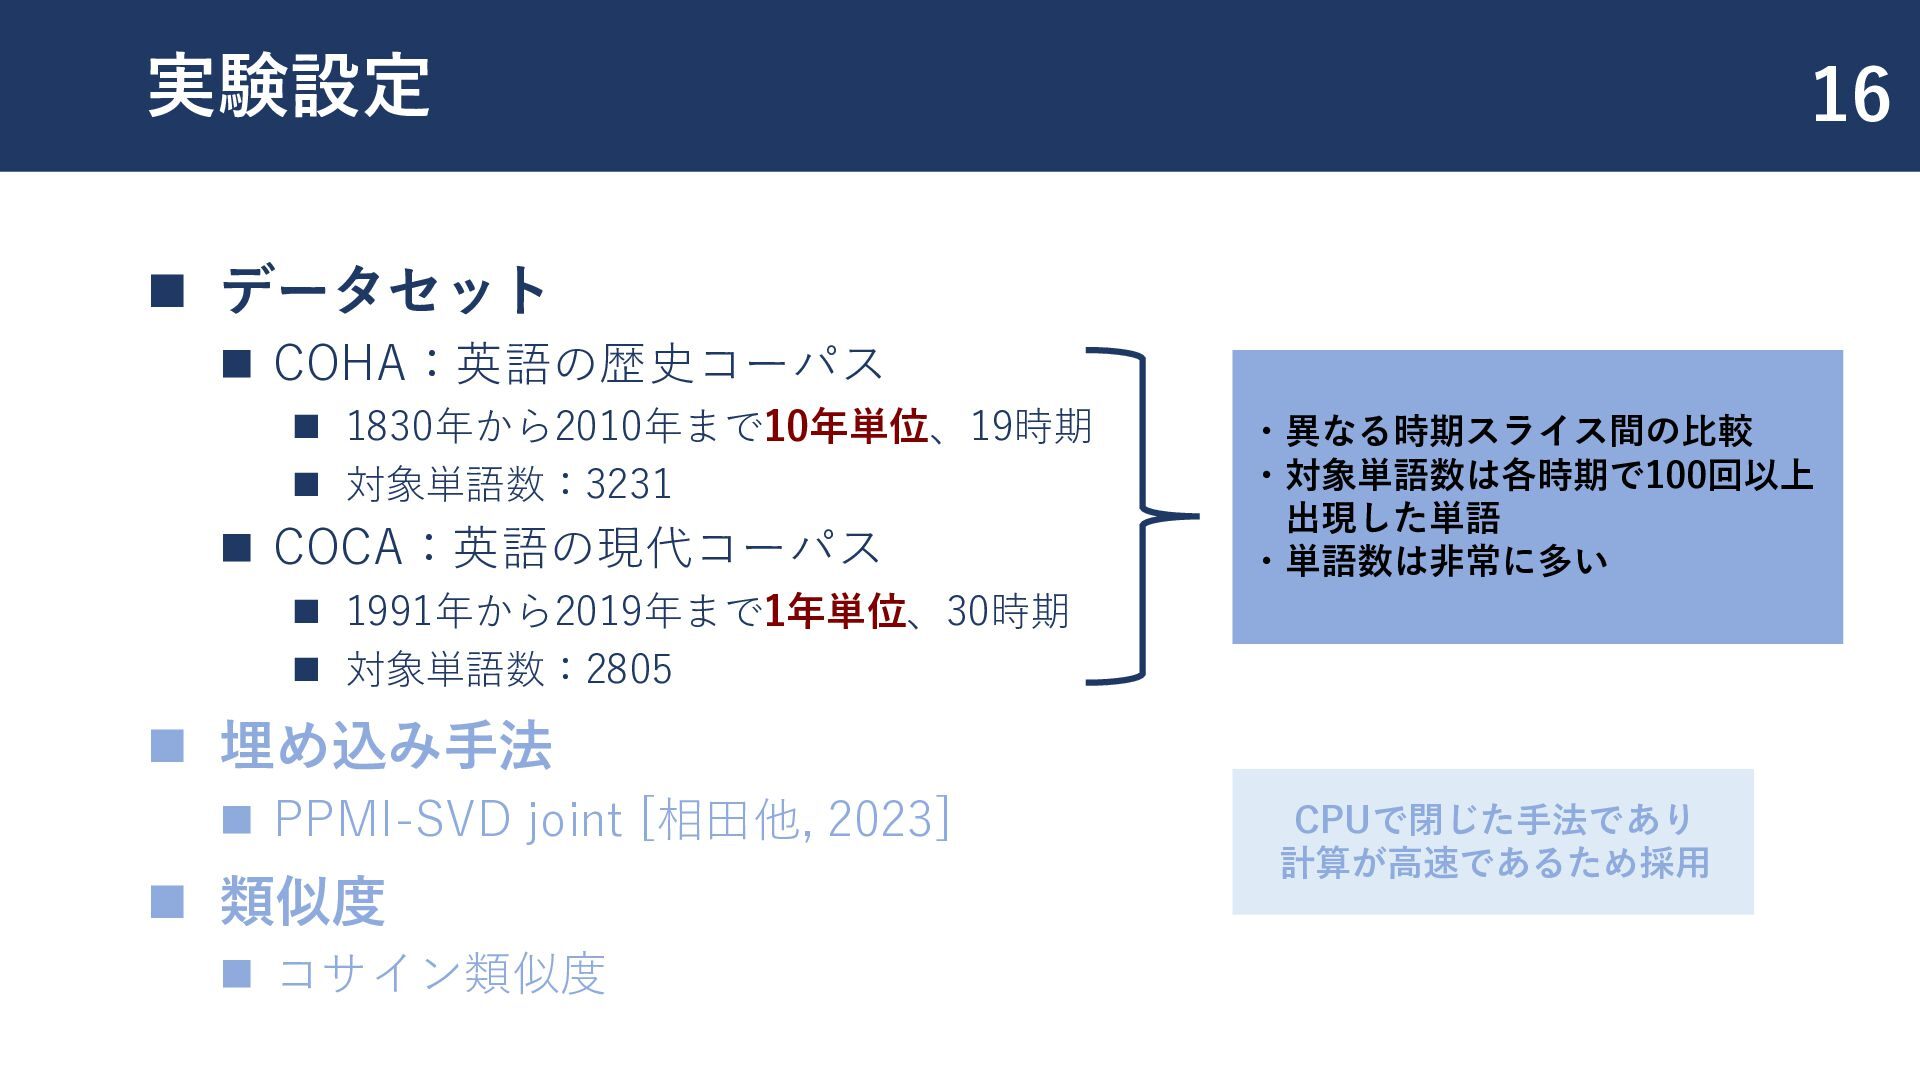
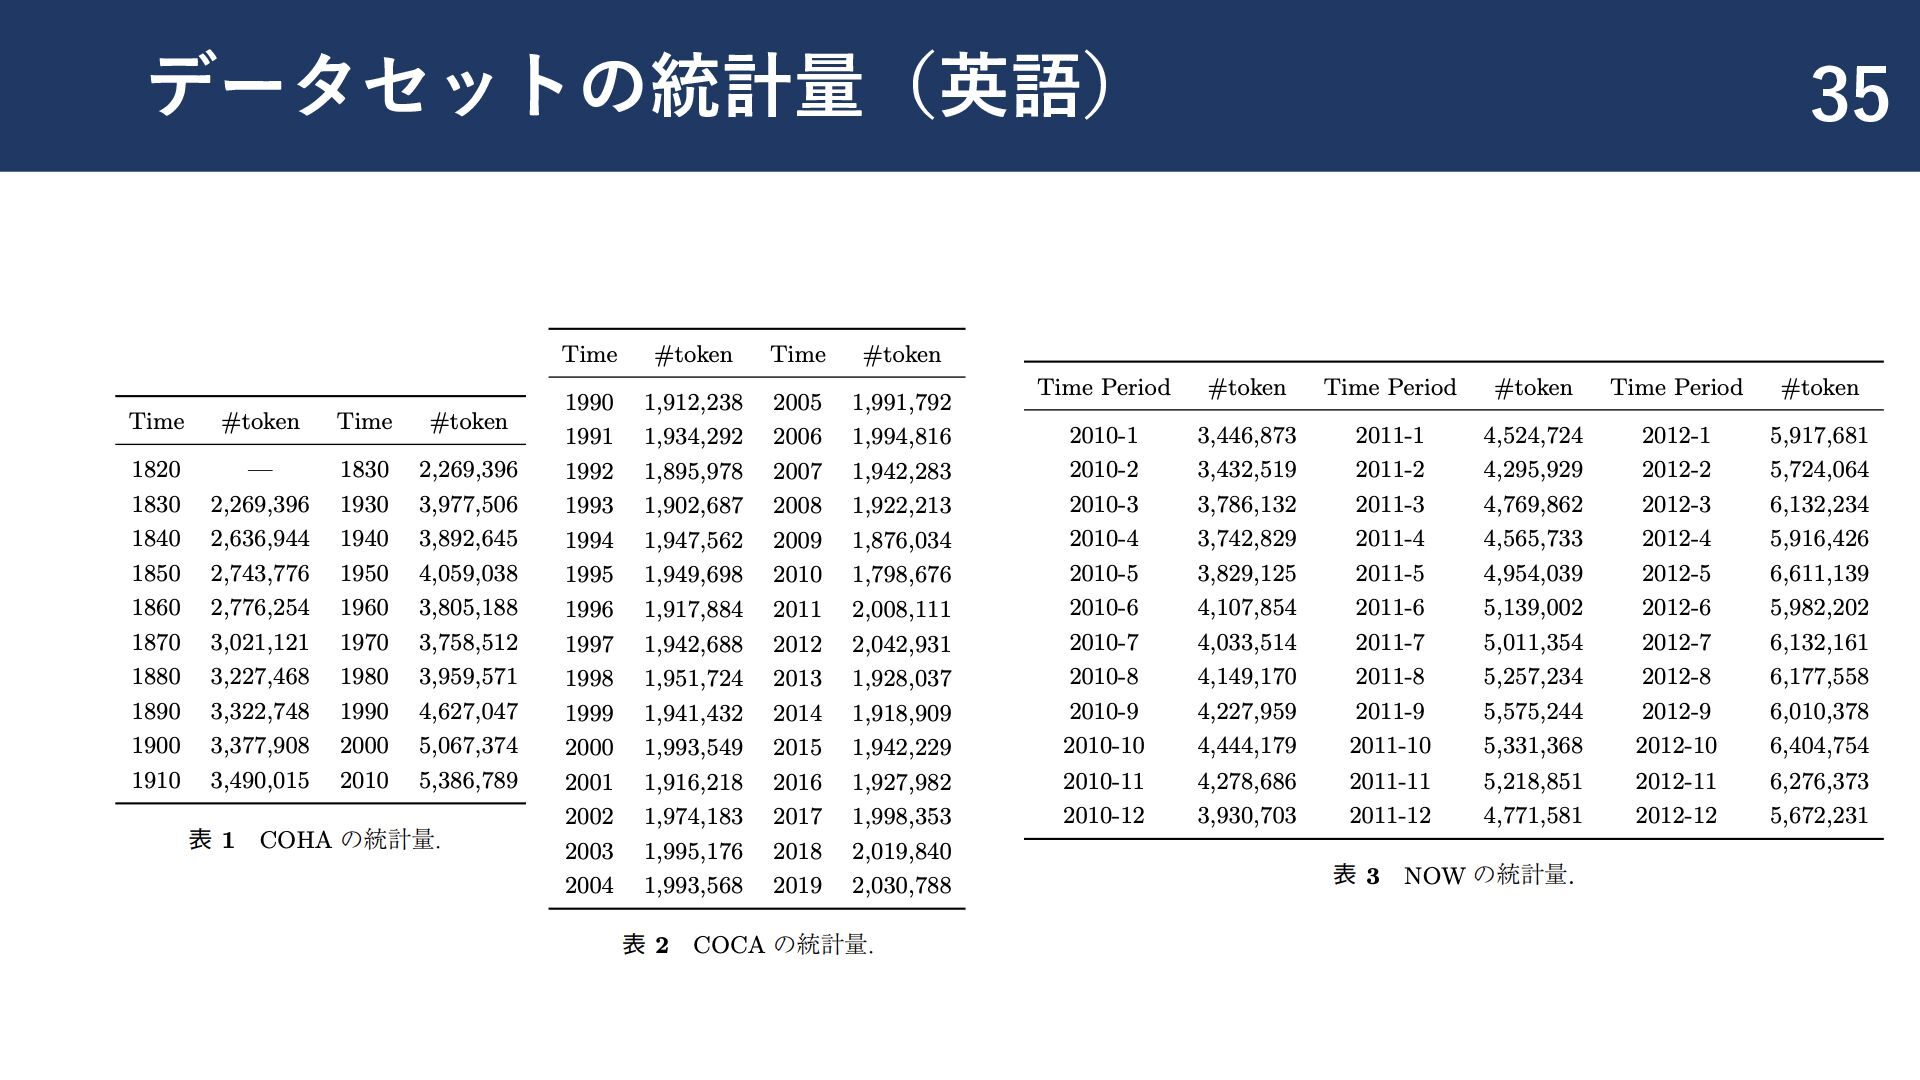
  6. 実験設定 ◼ データセット ◼ COHA:英語の歴史コーパス ◼ 1830年から2010年まで10年単位、19時期 ◼ 対象単語数:3231 ◼

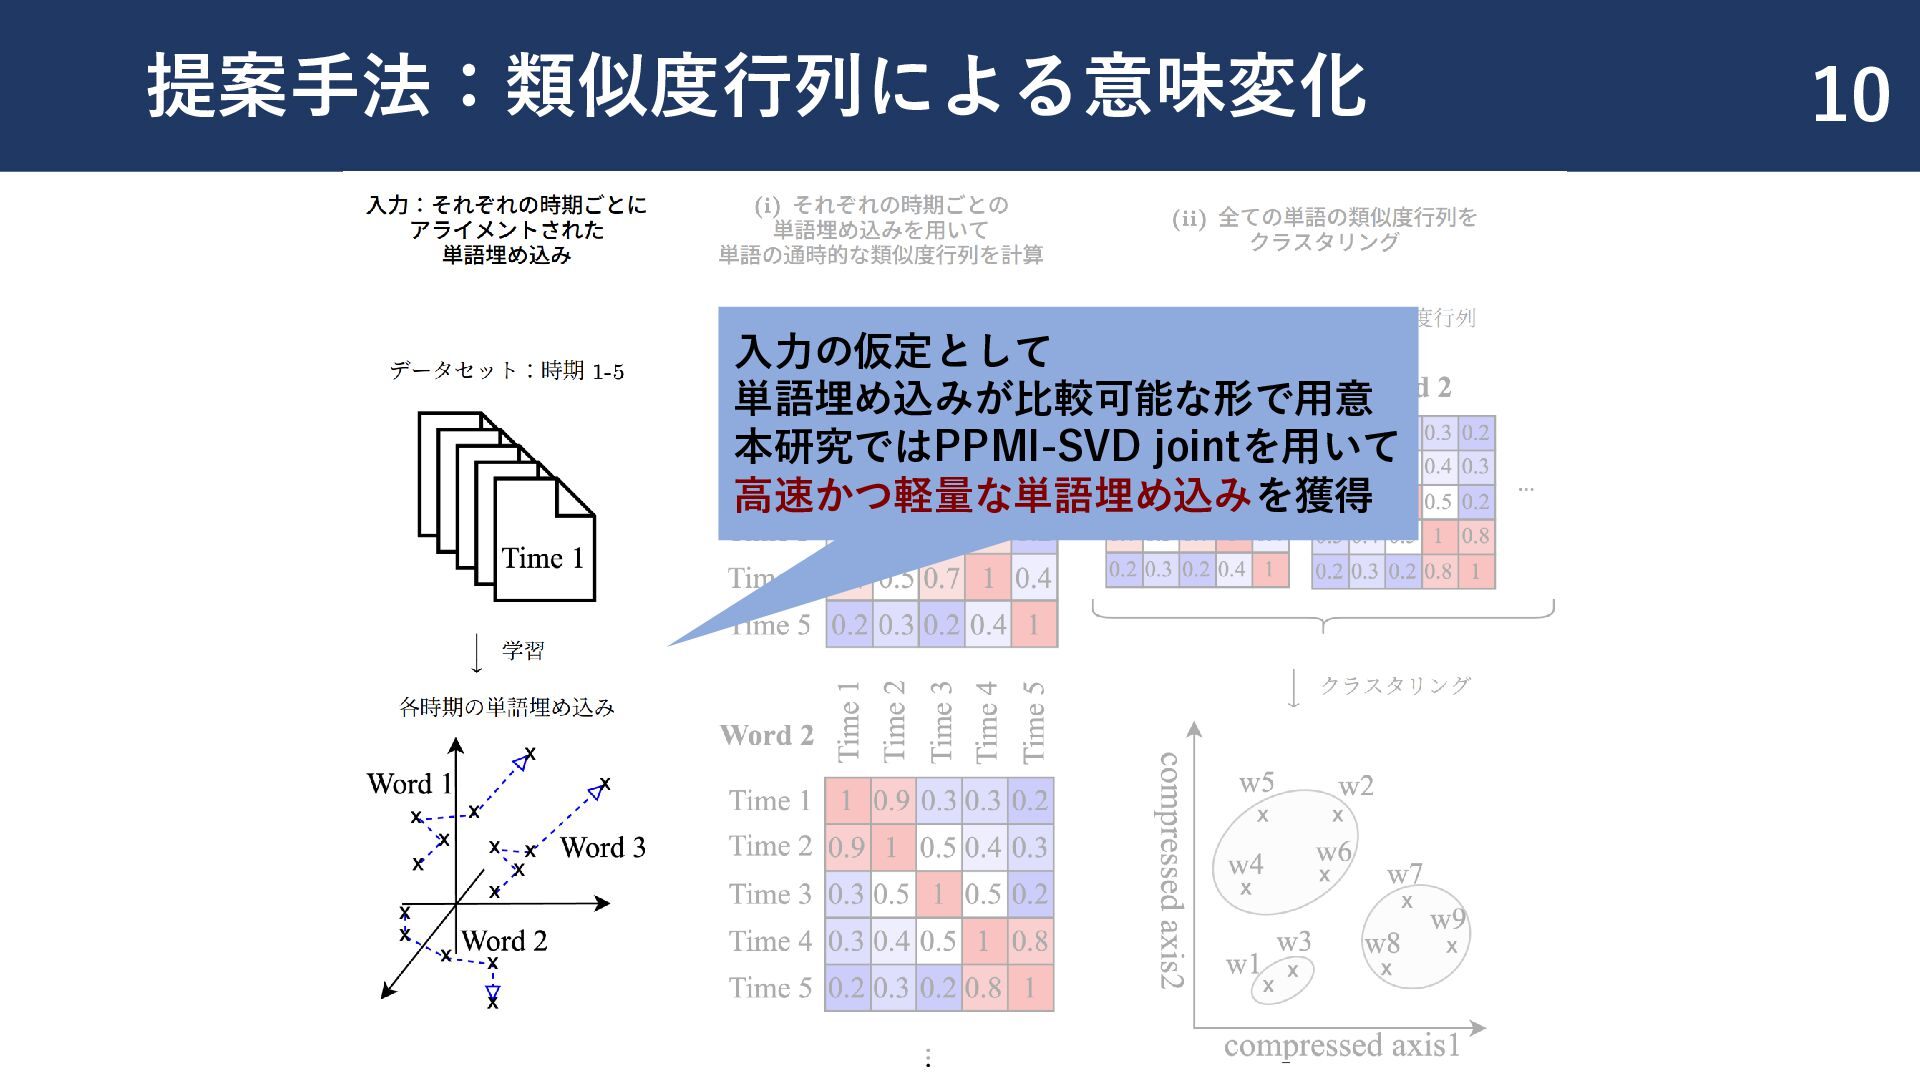
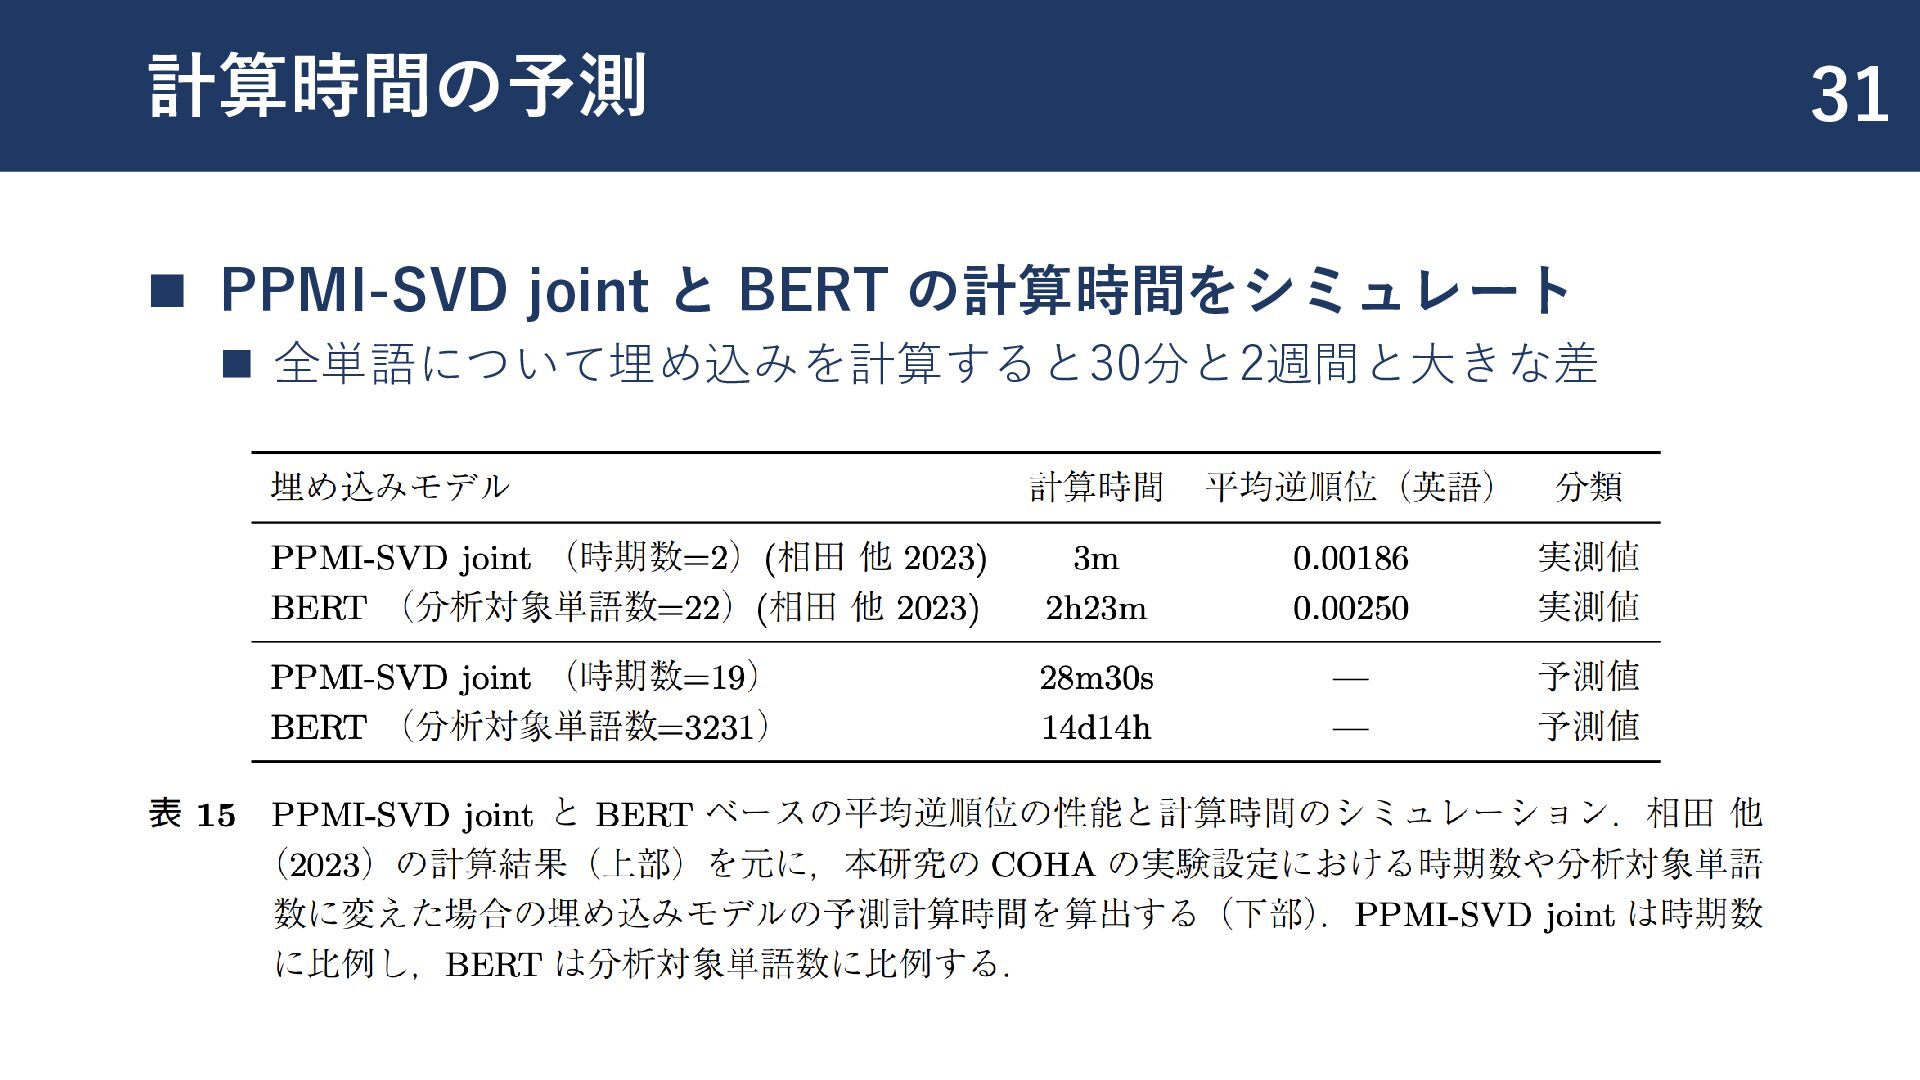
    COCA:英語の現代コーパス ◼ 1991年から2019年まで1年単位、30時期 ◼ 対象単語数:2805 ◼ 埋め込み手法 ◼ PPMI-SVD joint [相田他, 2023] ◼ 類似度 ◼ コサイン類似度 16 ・異なる時期スライス間の比較 ・対象単語数は各時期で100回以上 出現した単語 ・単語数は非常に多い CPUで閉じた手法であり 計算が高速であるため採用
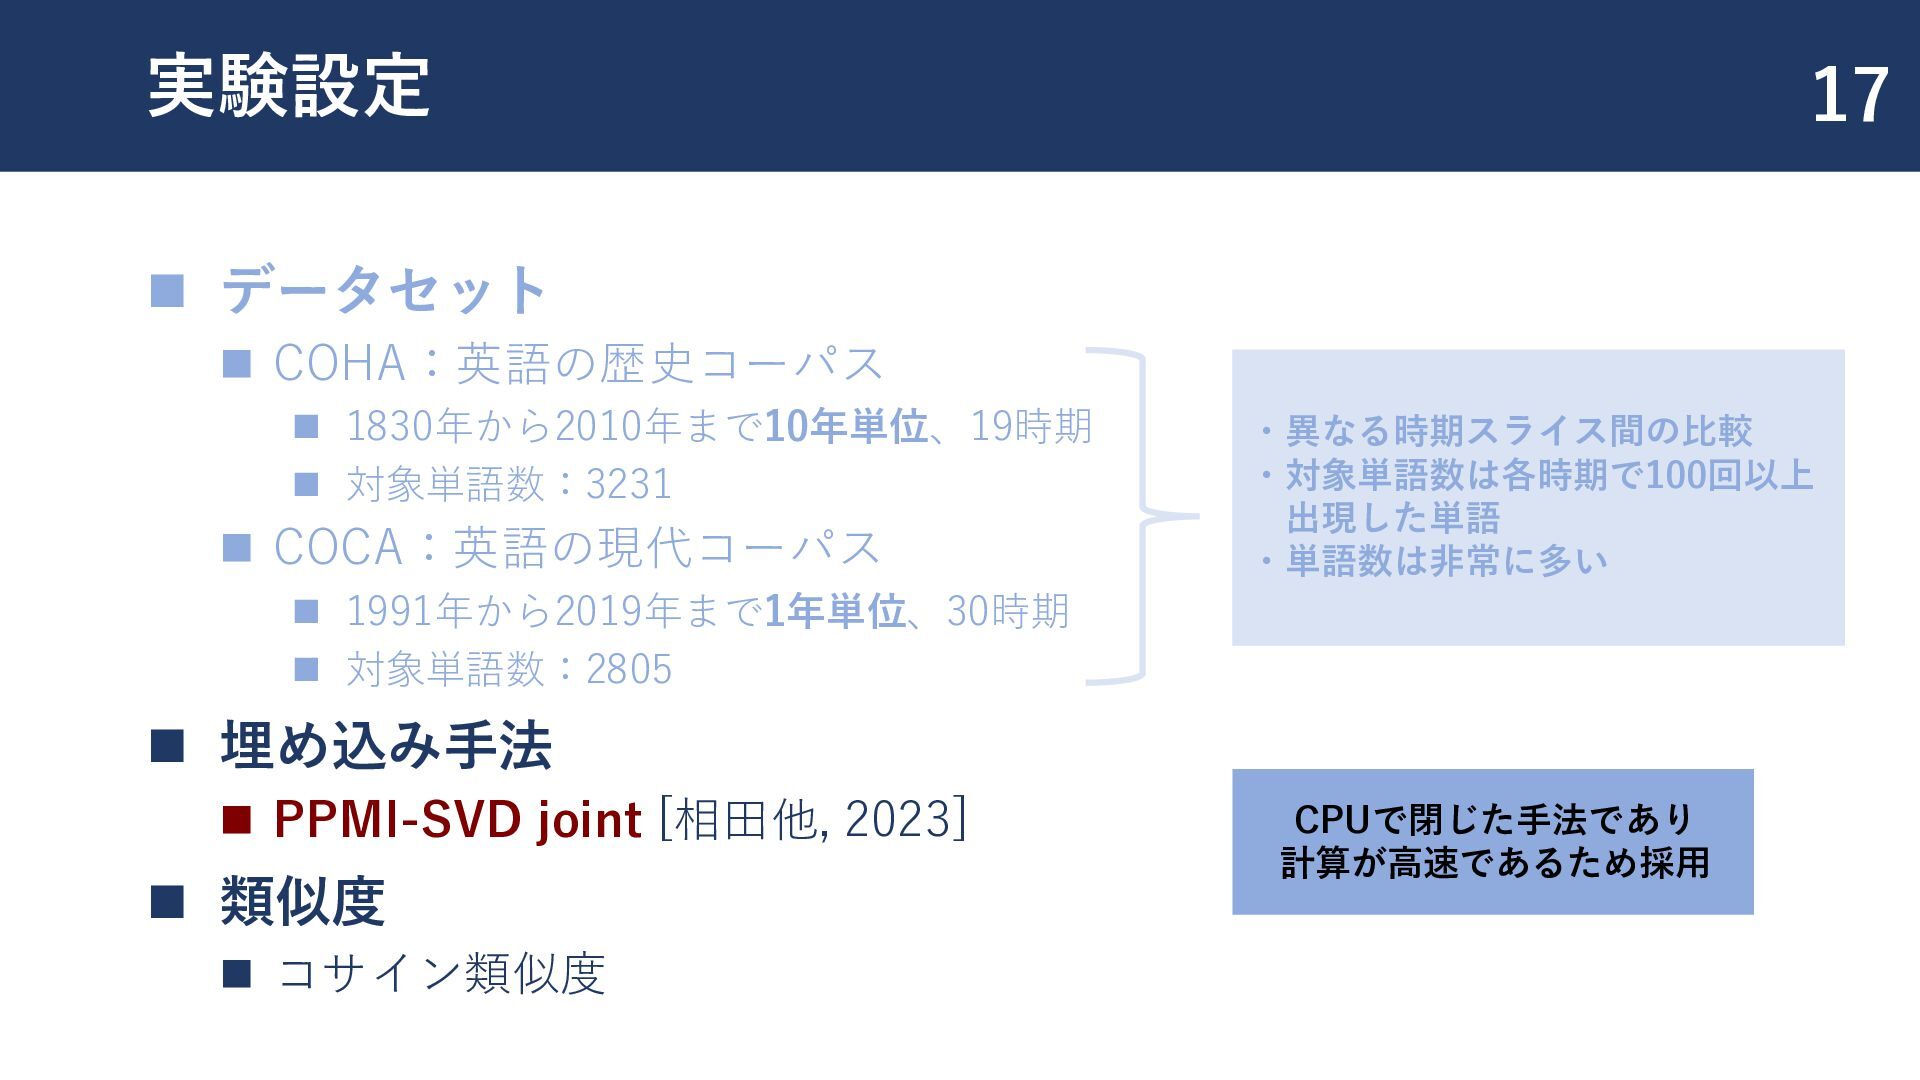
  7. 実験設定 ◼ データセット ◼ COHA:英語の歴史コーパス ◼ 1830年から2010年まで10年単位、19時期 ◼ 対象単語数:3231 ◼

    COCA:英語の現代コーパス ◼ 1991年から2019年まで1年単位、30時期 ◼ 対象単語数:2805 ◼ 埋め込み手法 ◼ PPMI-SVD joint [相田他, 2023] ◼ 類似度 ◼ コサイン類似度 17 ・異なる時期スライス間の比較 ・対象単語数は各時期で100回以上 出現した単語 ・単語数は非常に多い CPUで閉じた手法であり 計算が高速であるため採用
  8. 埋め込み手法:PPMI-SVD joint ◼ PPMI-SVD [Levy and Goldberg, 2014] ◼ 正の自己相互情報量行列を特異値分解

    ◼ SGNS に理論的に一致 ◼ PPMI-SVD joint [相田他, 2023] ◼ 複数時期のPPMI行列を 文脈語を共有し同時に圧縮 ◼ 高速かつ軽量な単語埋め込み 18 [相田他, 2023]より引用 単語の共起関係の行列
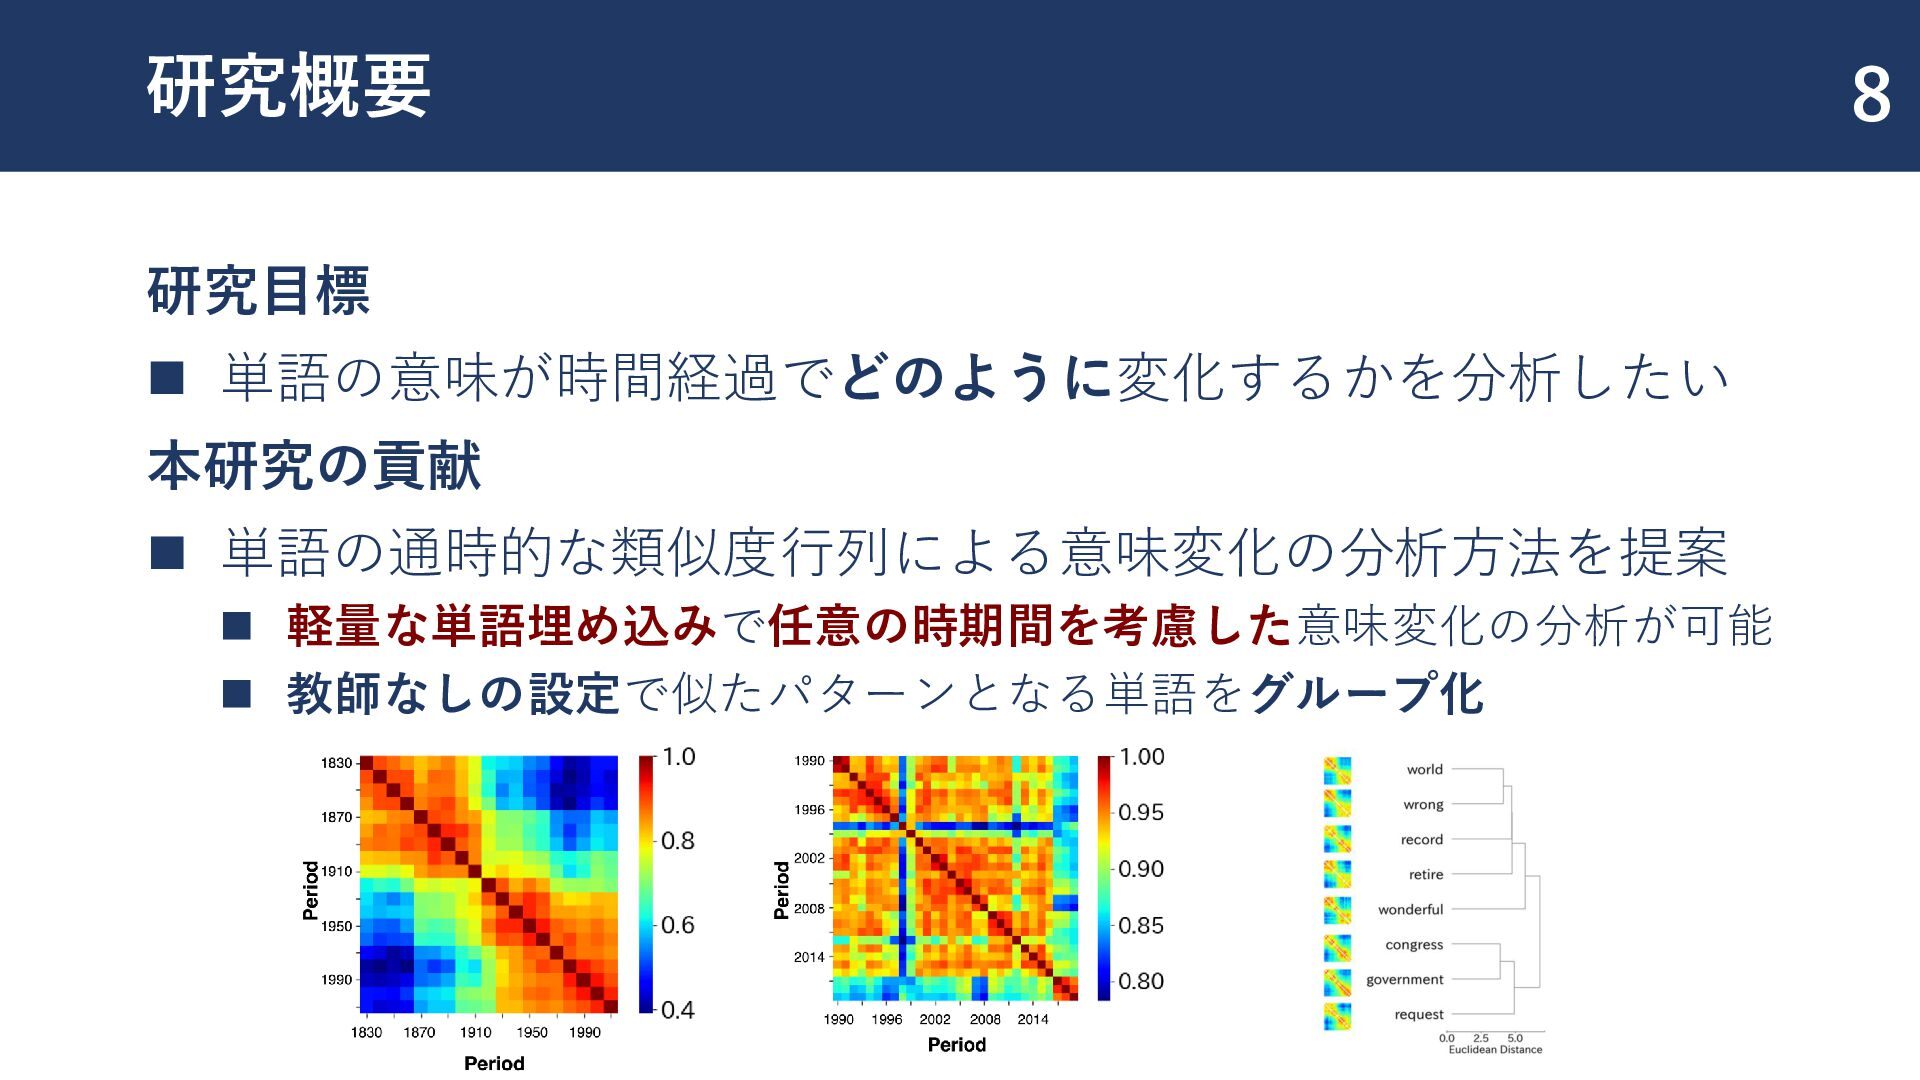
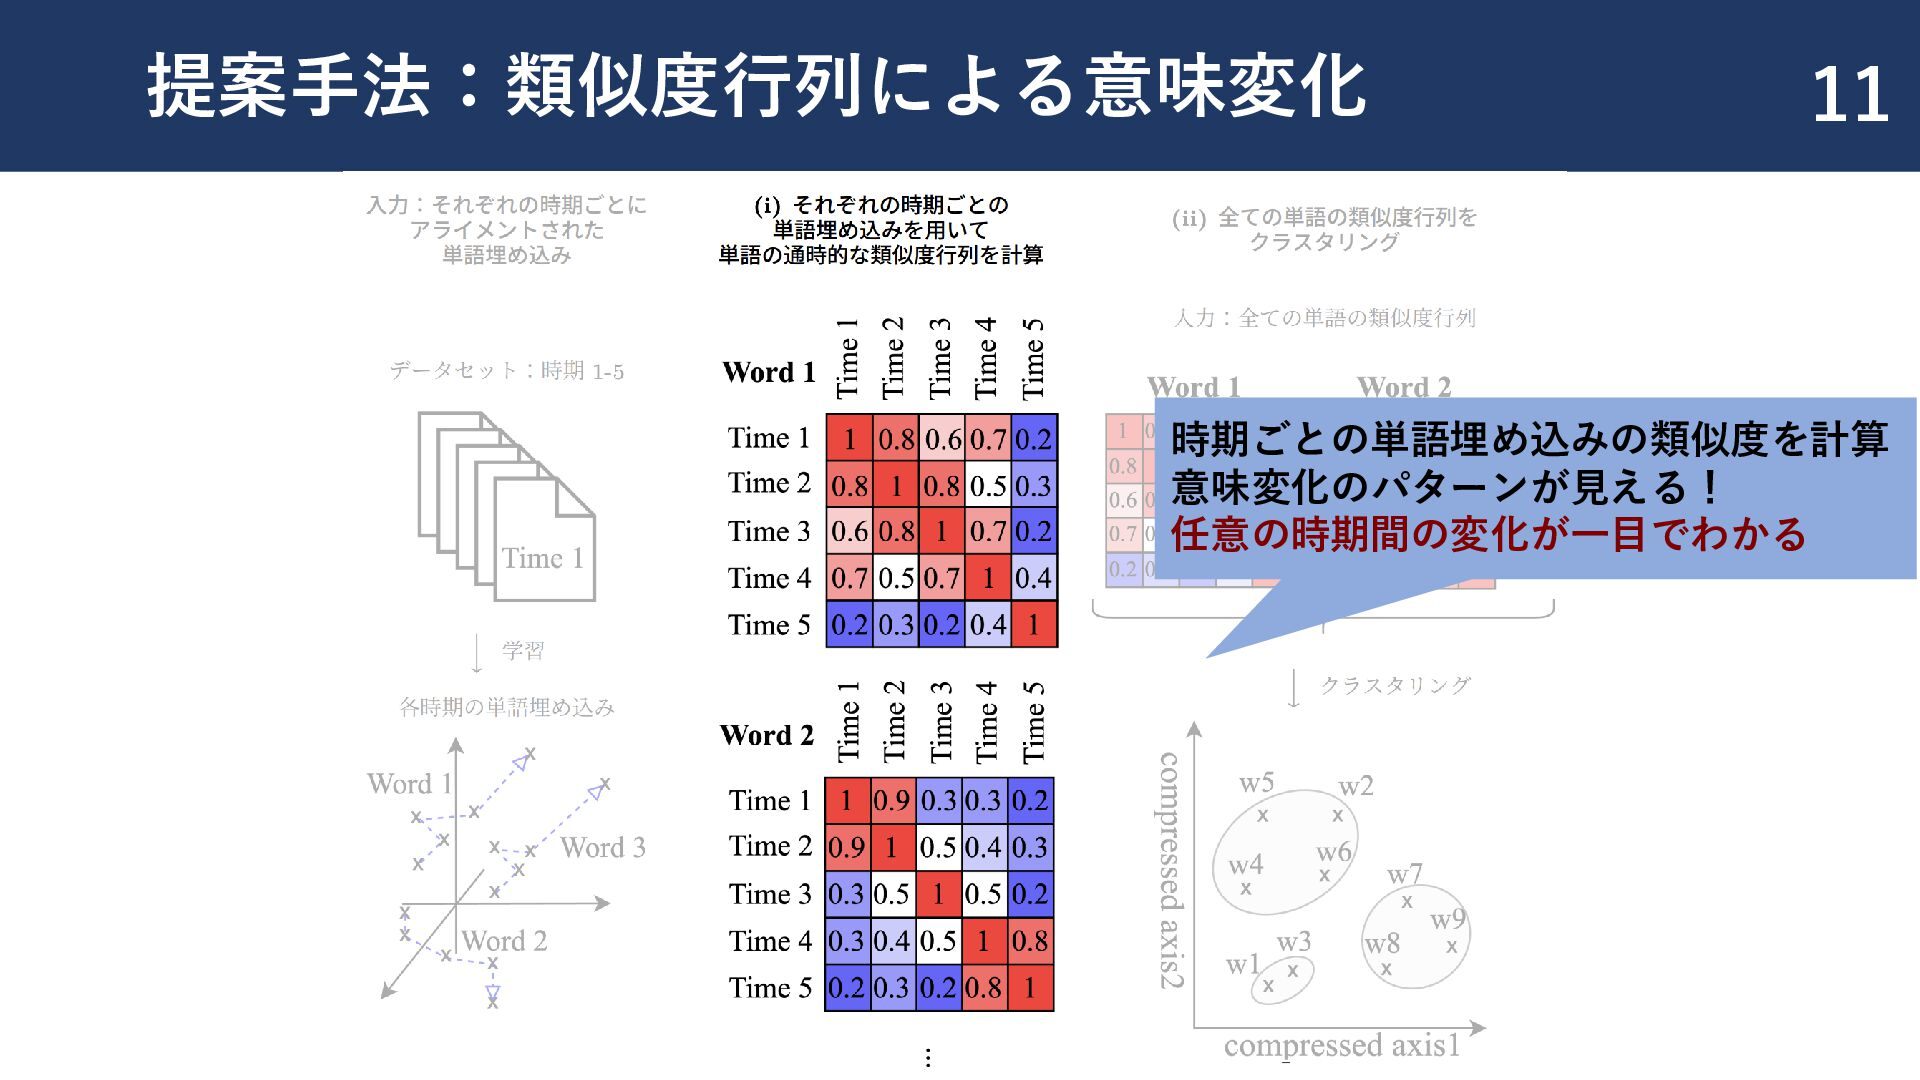
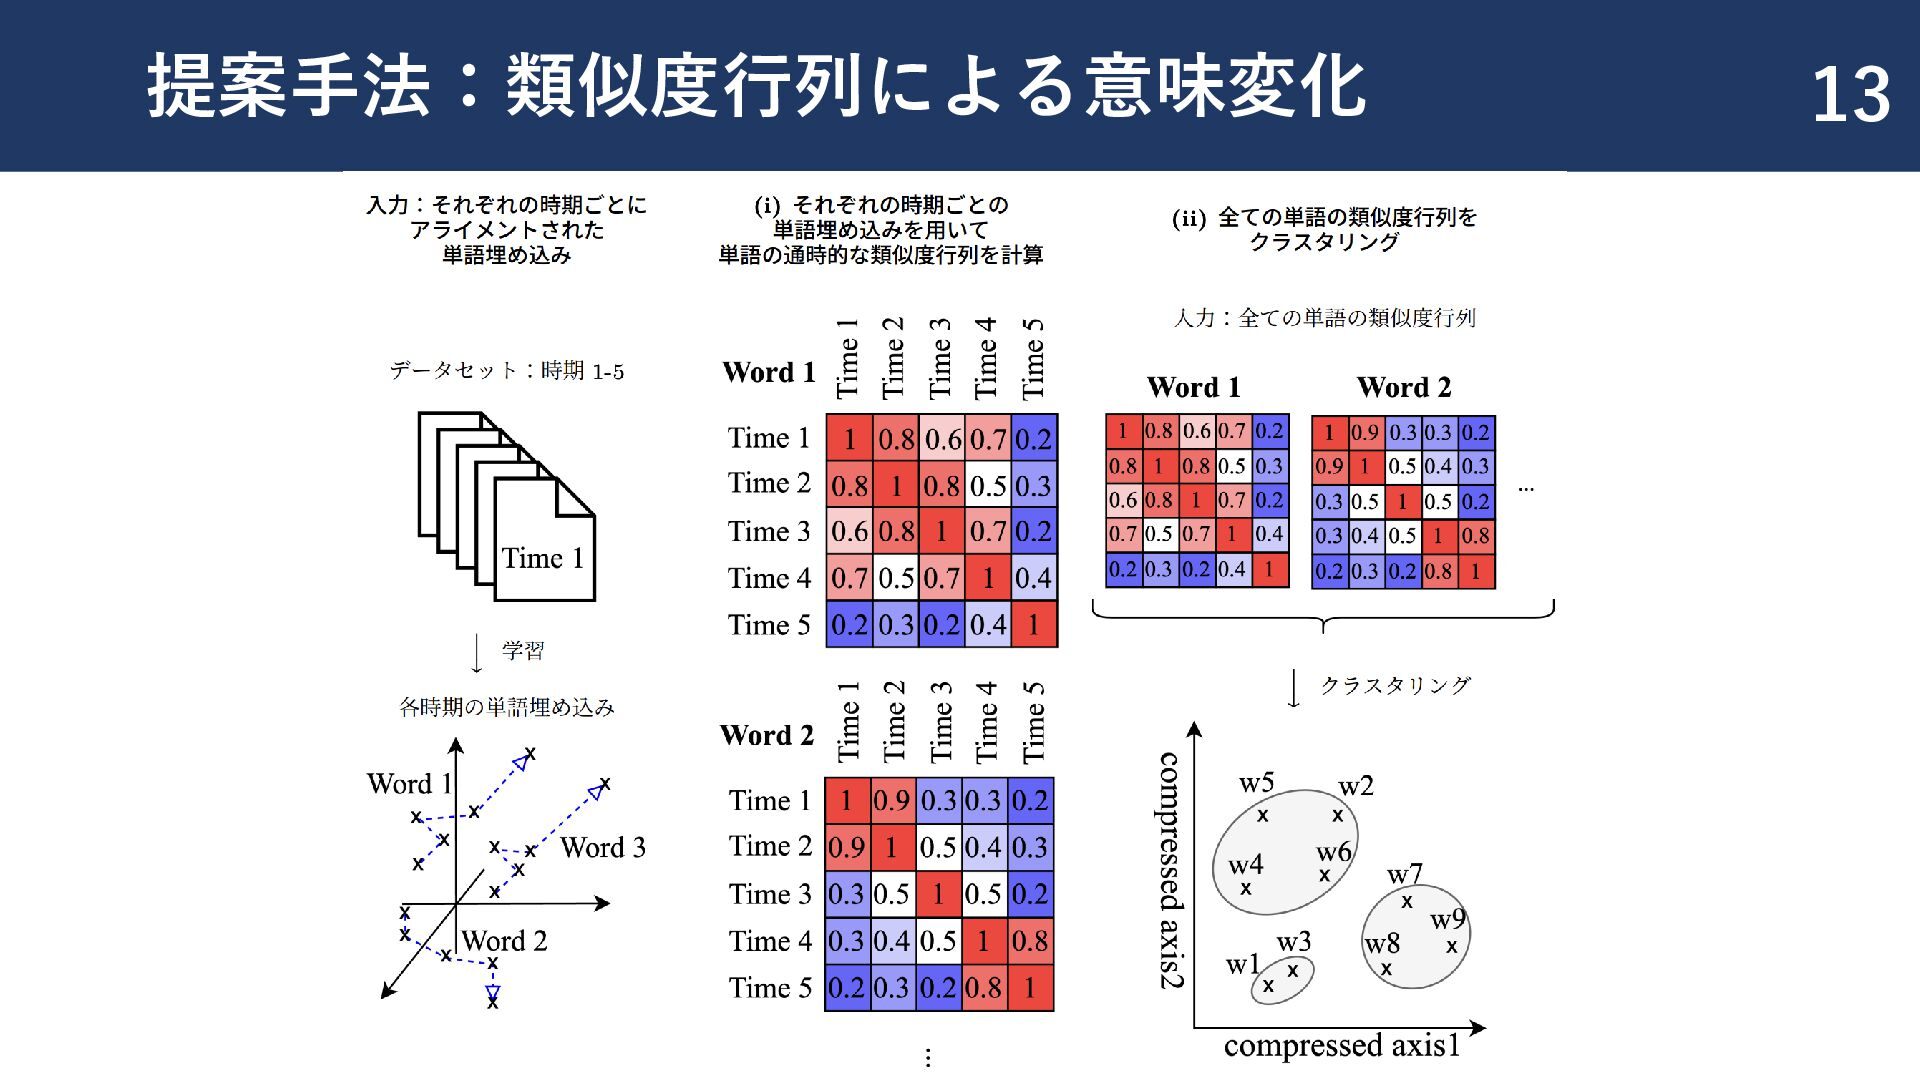
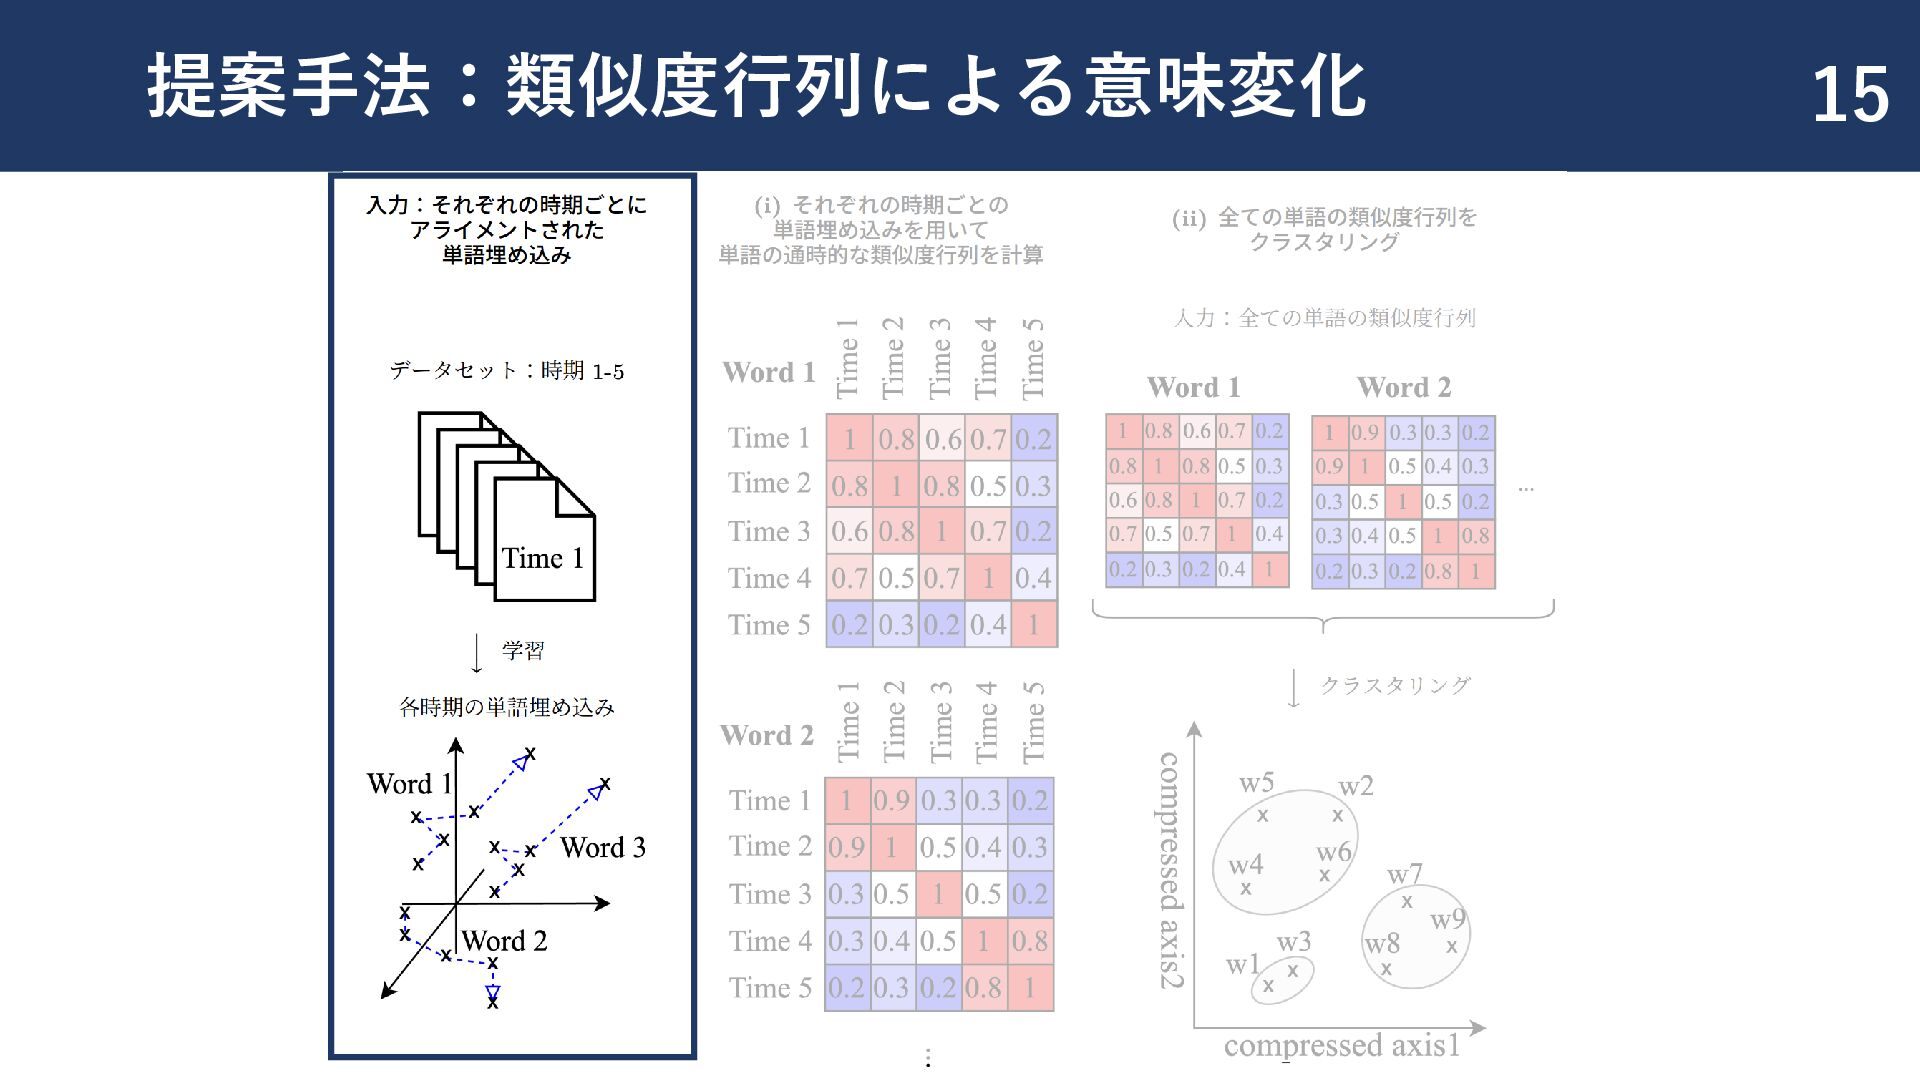
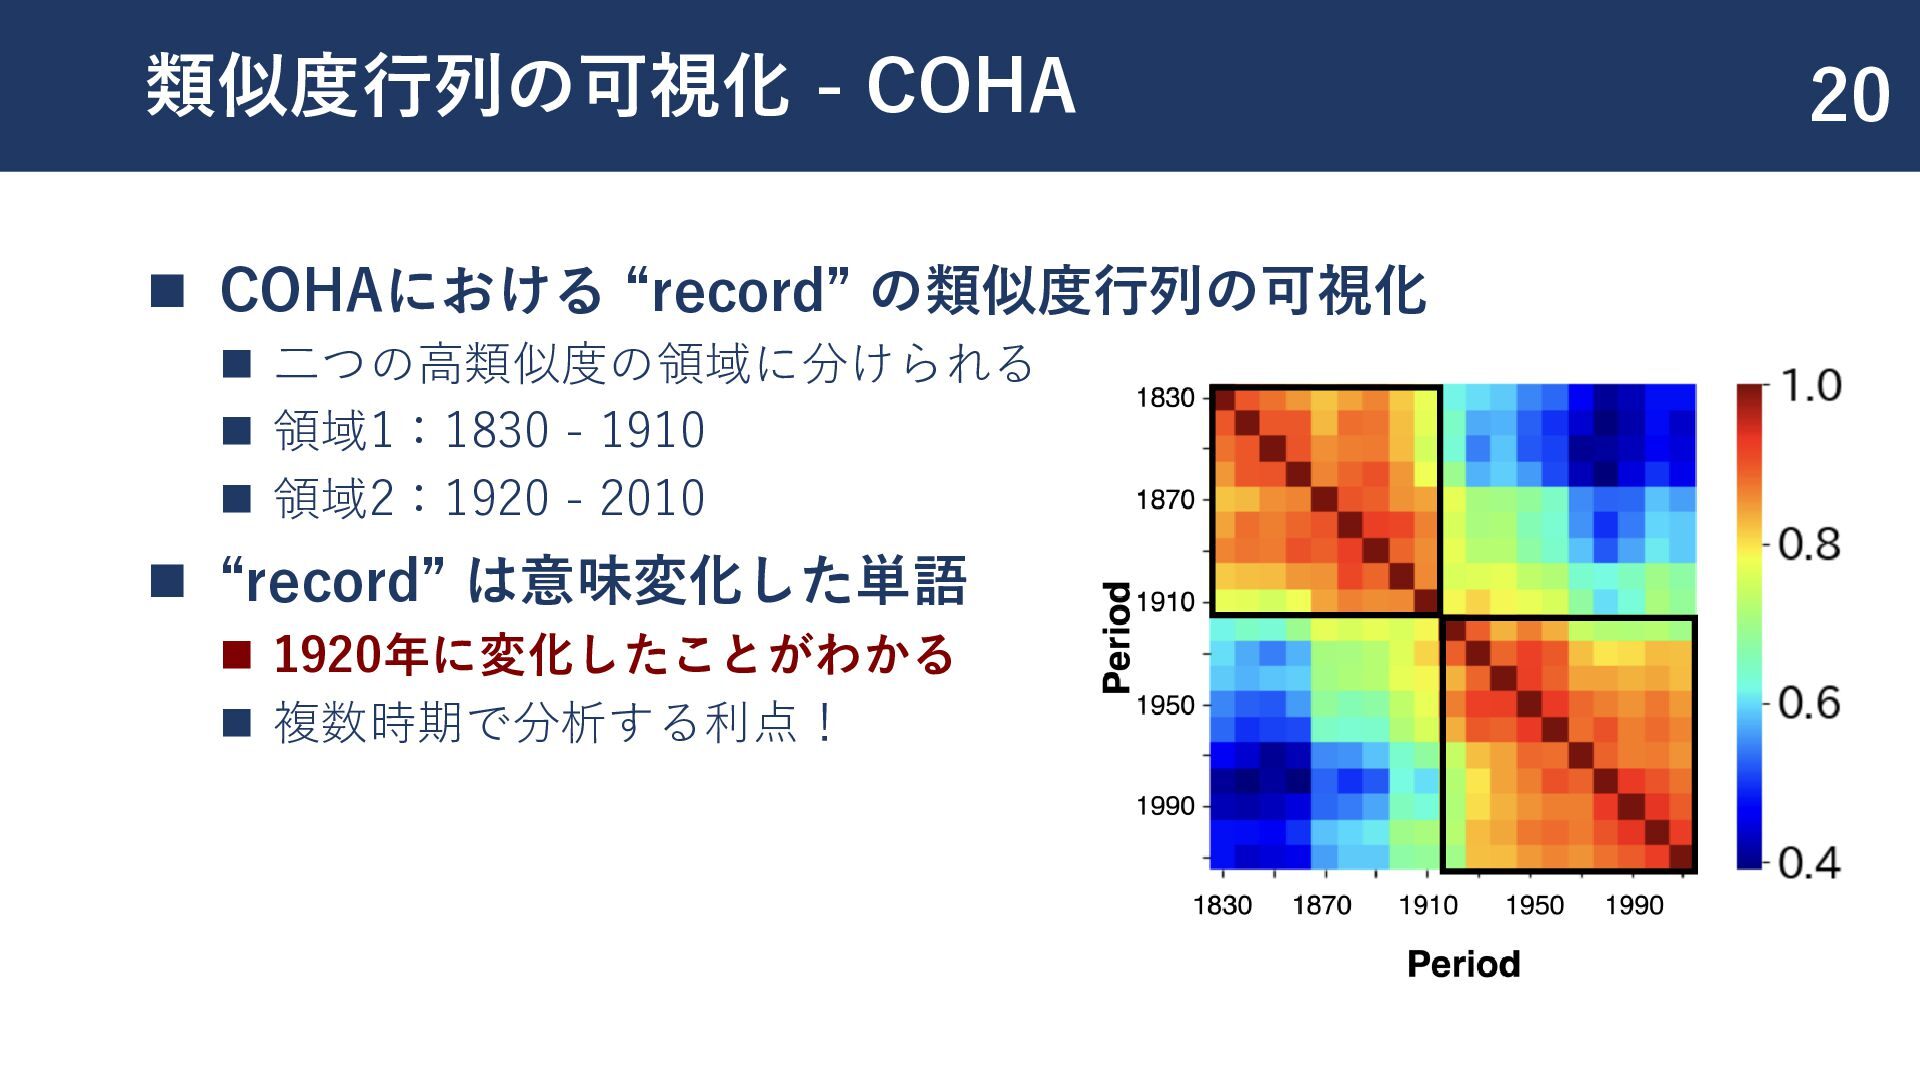
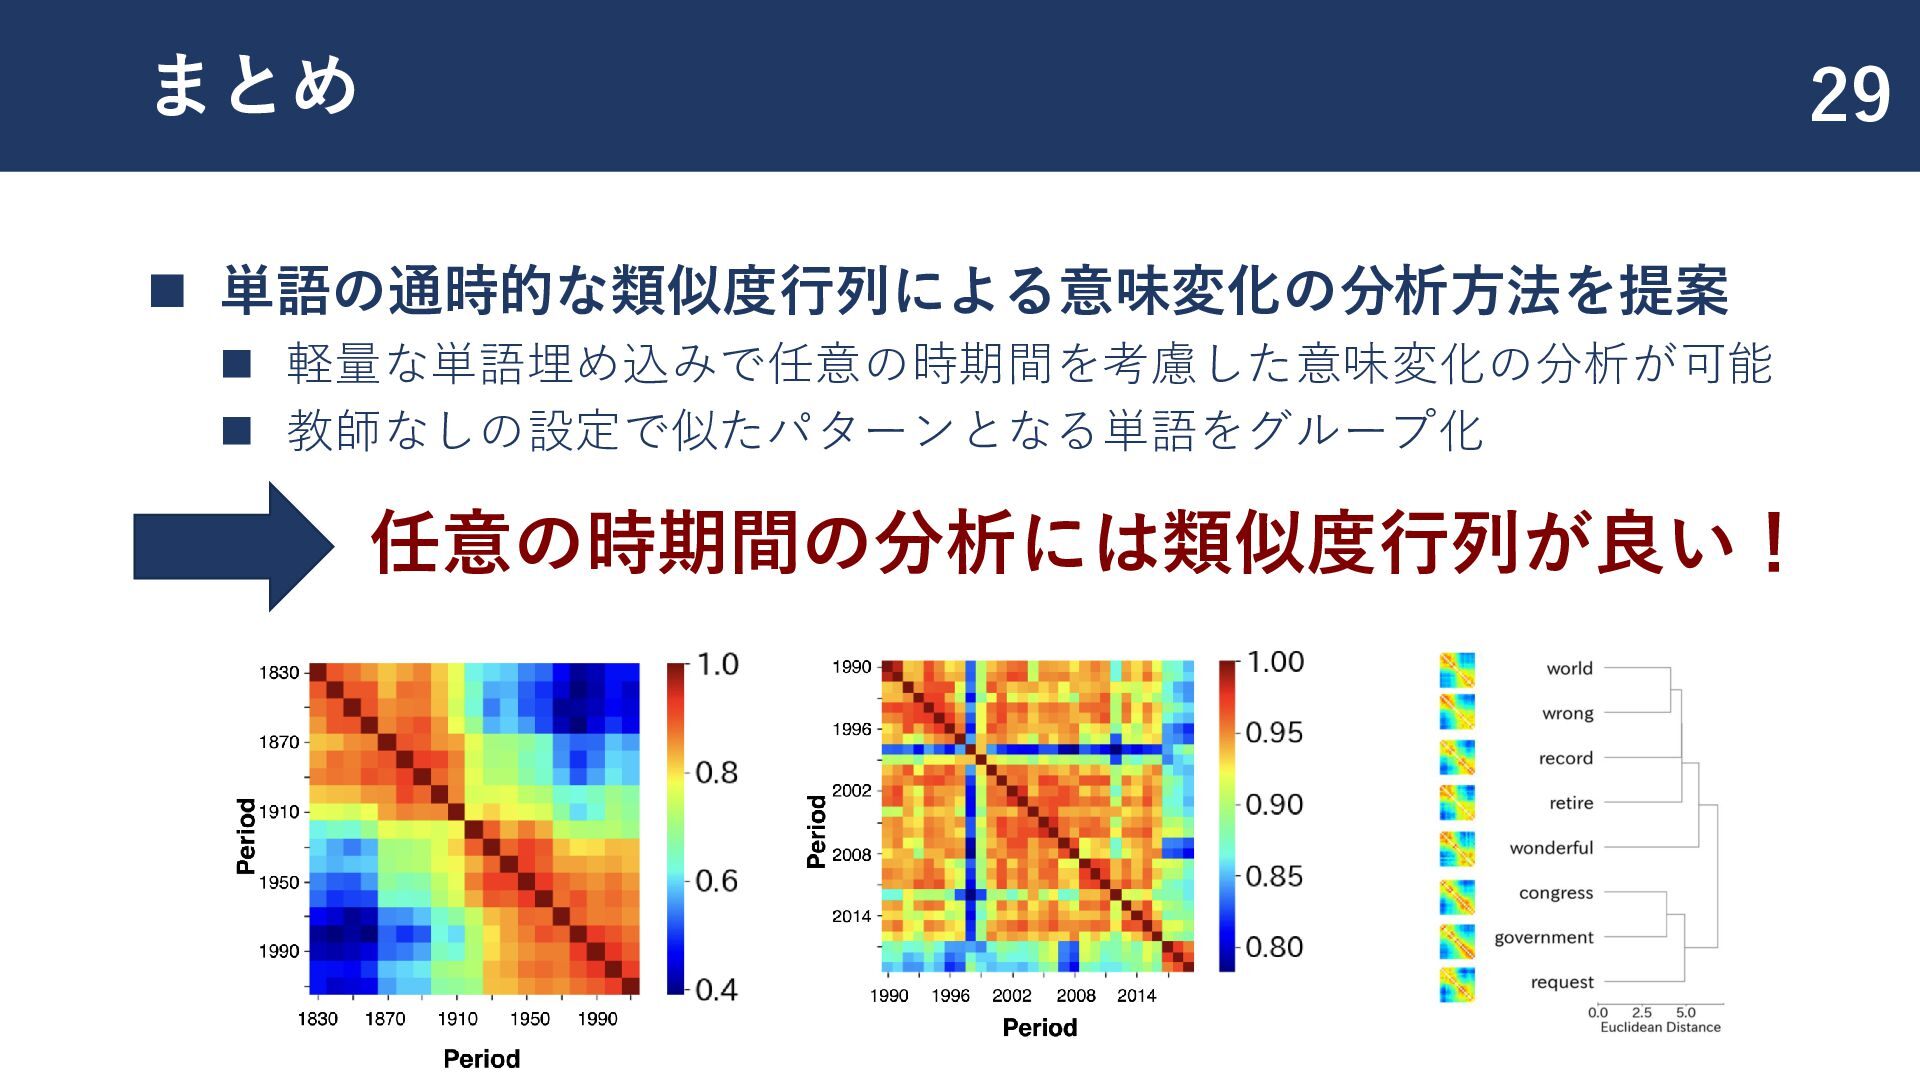
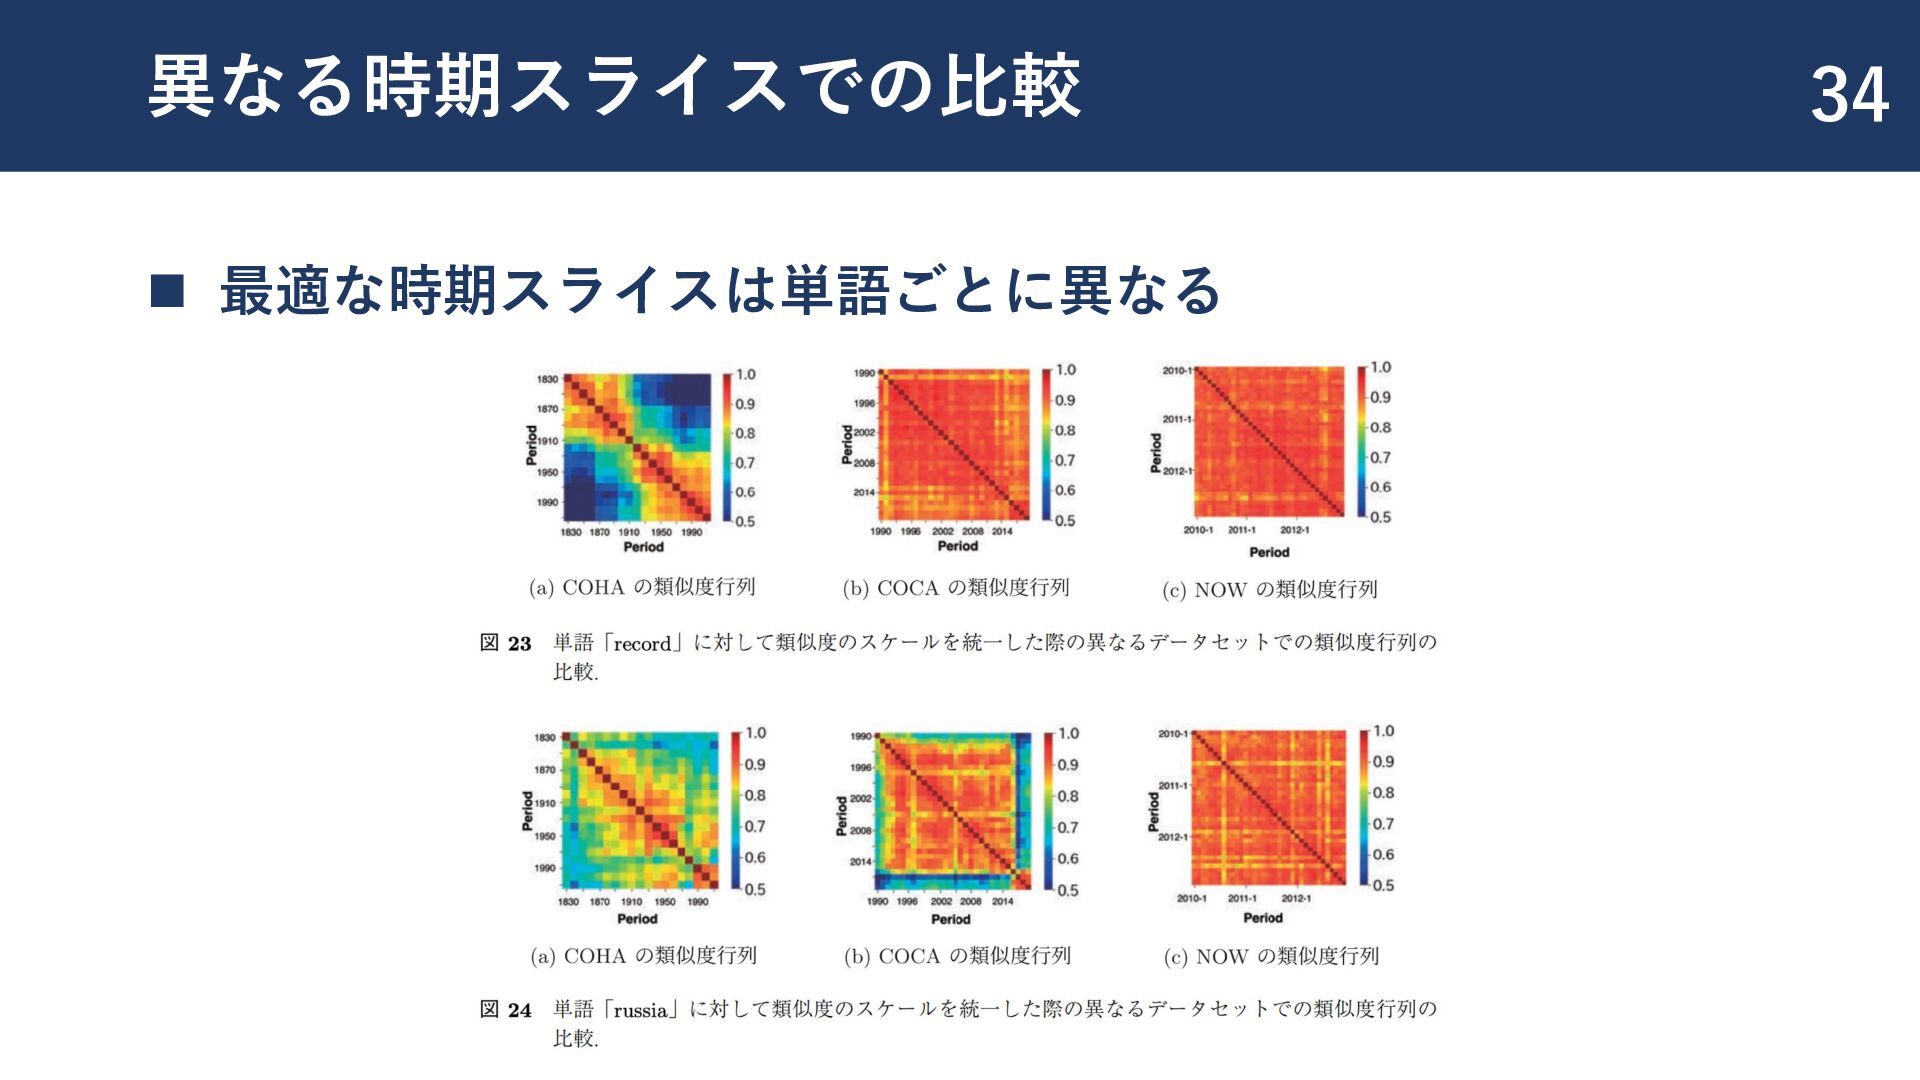
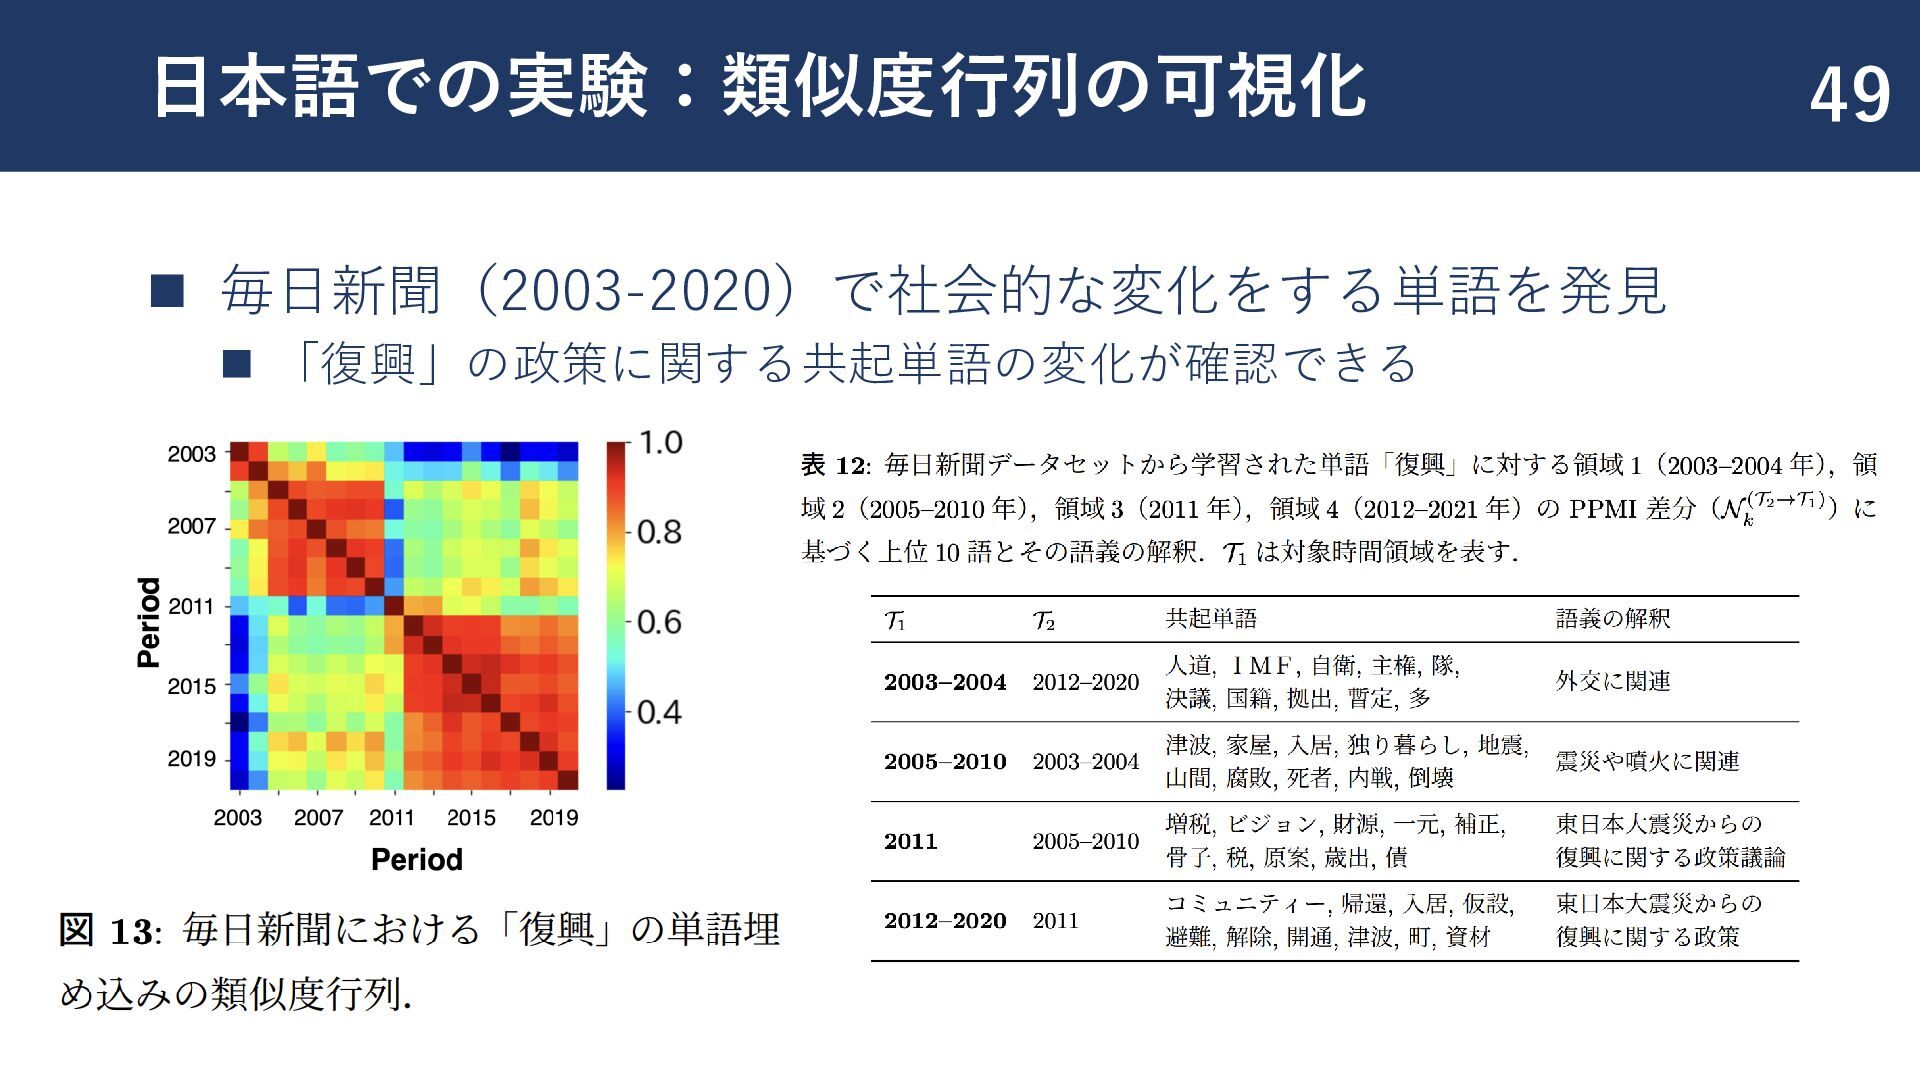
  9. 類似度行列の可視化 - COHA ◼ COHAにおける “record” の類似度行列の可視化 ◼ 二つの高類似度の領域に分けられる ◼

    領域1:1830 - 1910 ◼ 領域2:1920 - 2010 ◼ “record” は意味変化した単語 ◼ 1920年に変化したことがわかる ◼ 複数時期で分析する利点! 20
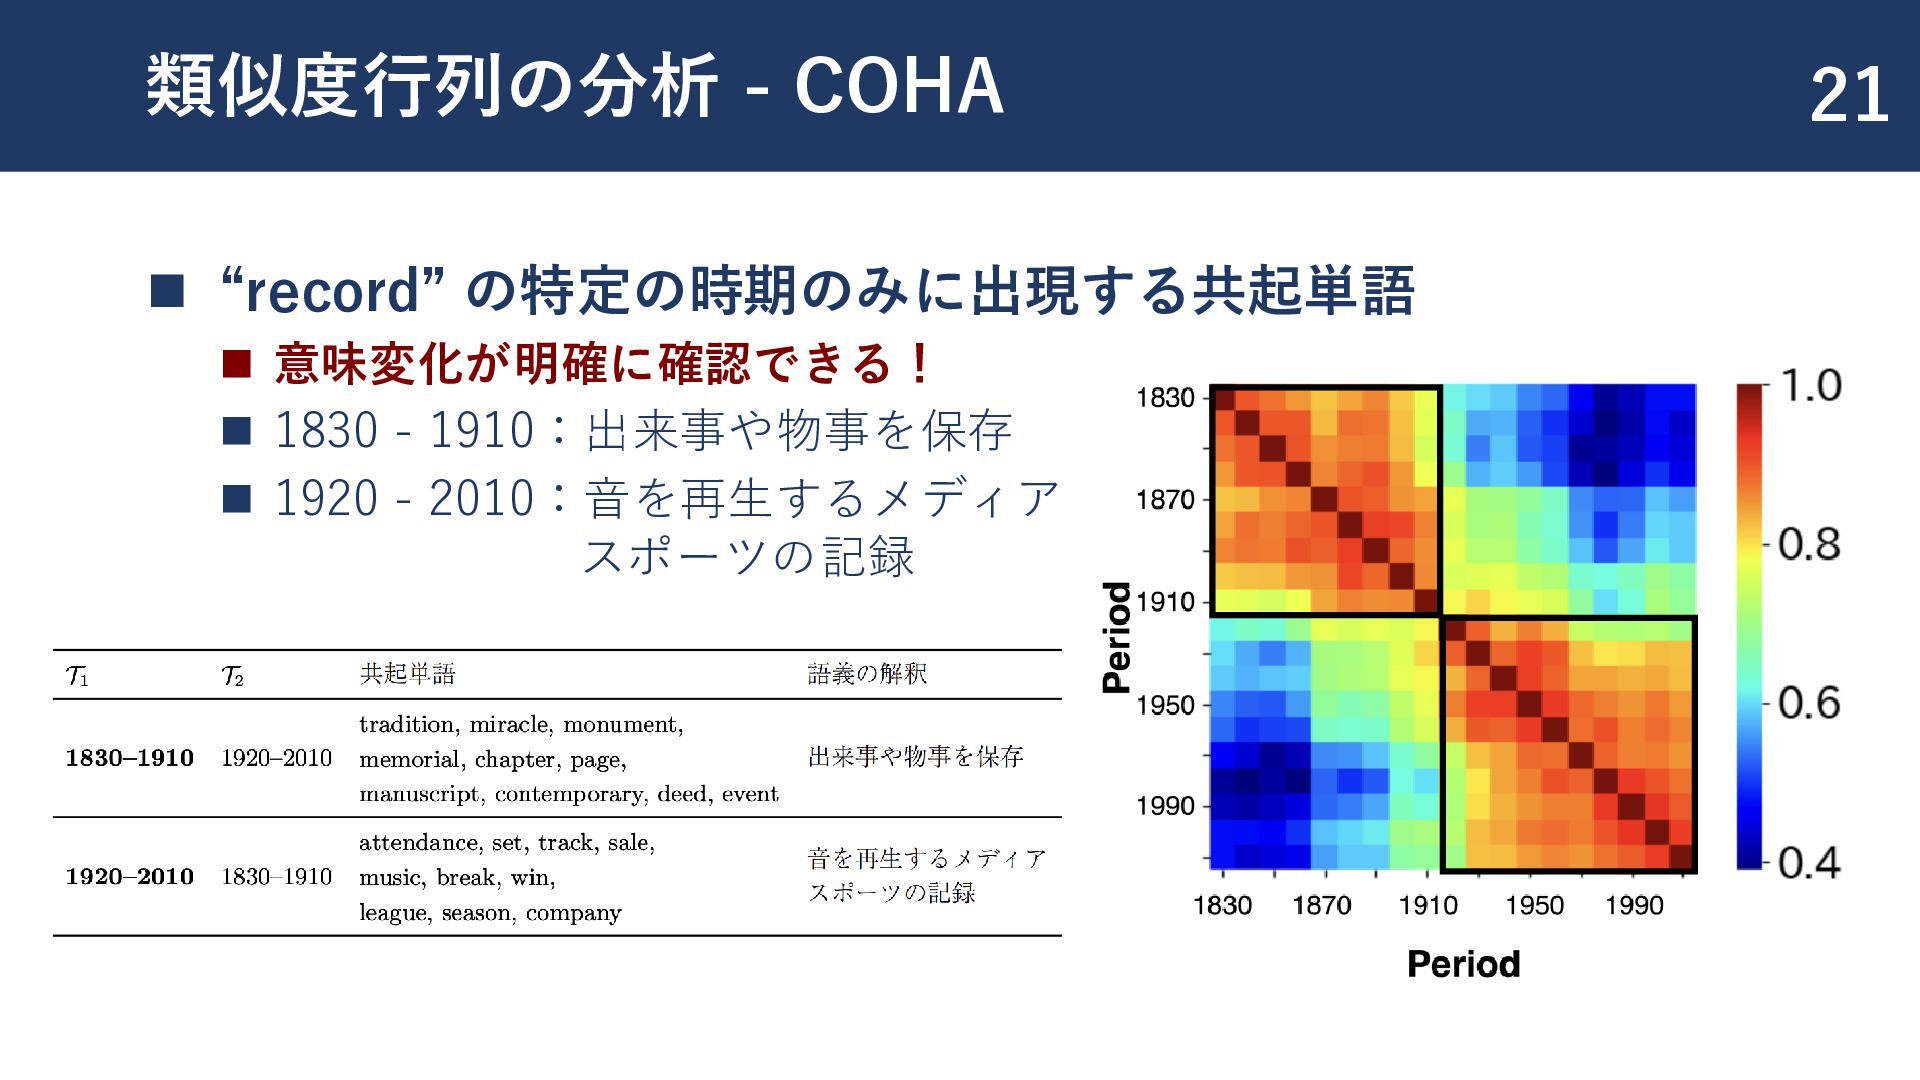
  10. 類似度行列の分析 - COHA ◼ “record” の特定の時期のみに出現する共起単語 ◼ 意味変化が明確に確認できる! ◼ 1830

    - 1910:出来事や物事を保存 ◼ 1920 - 2010:音を再生するメディア スポーツの記録 21
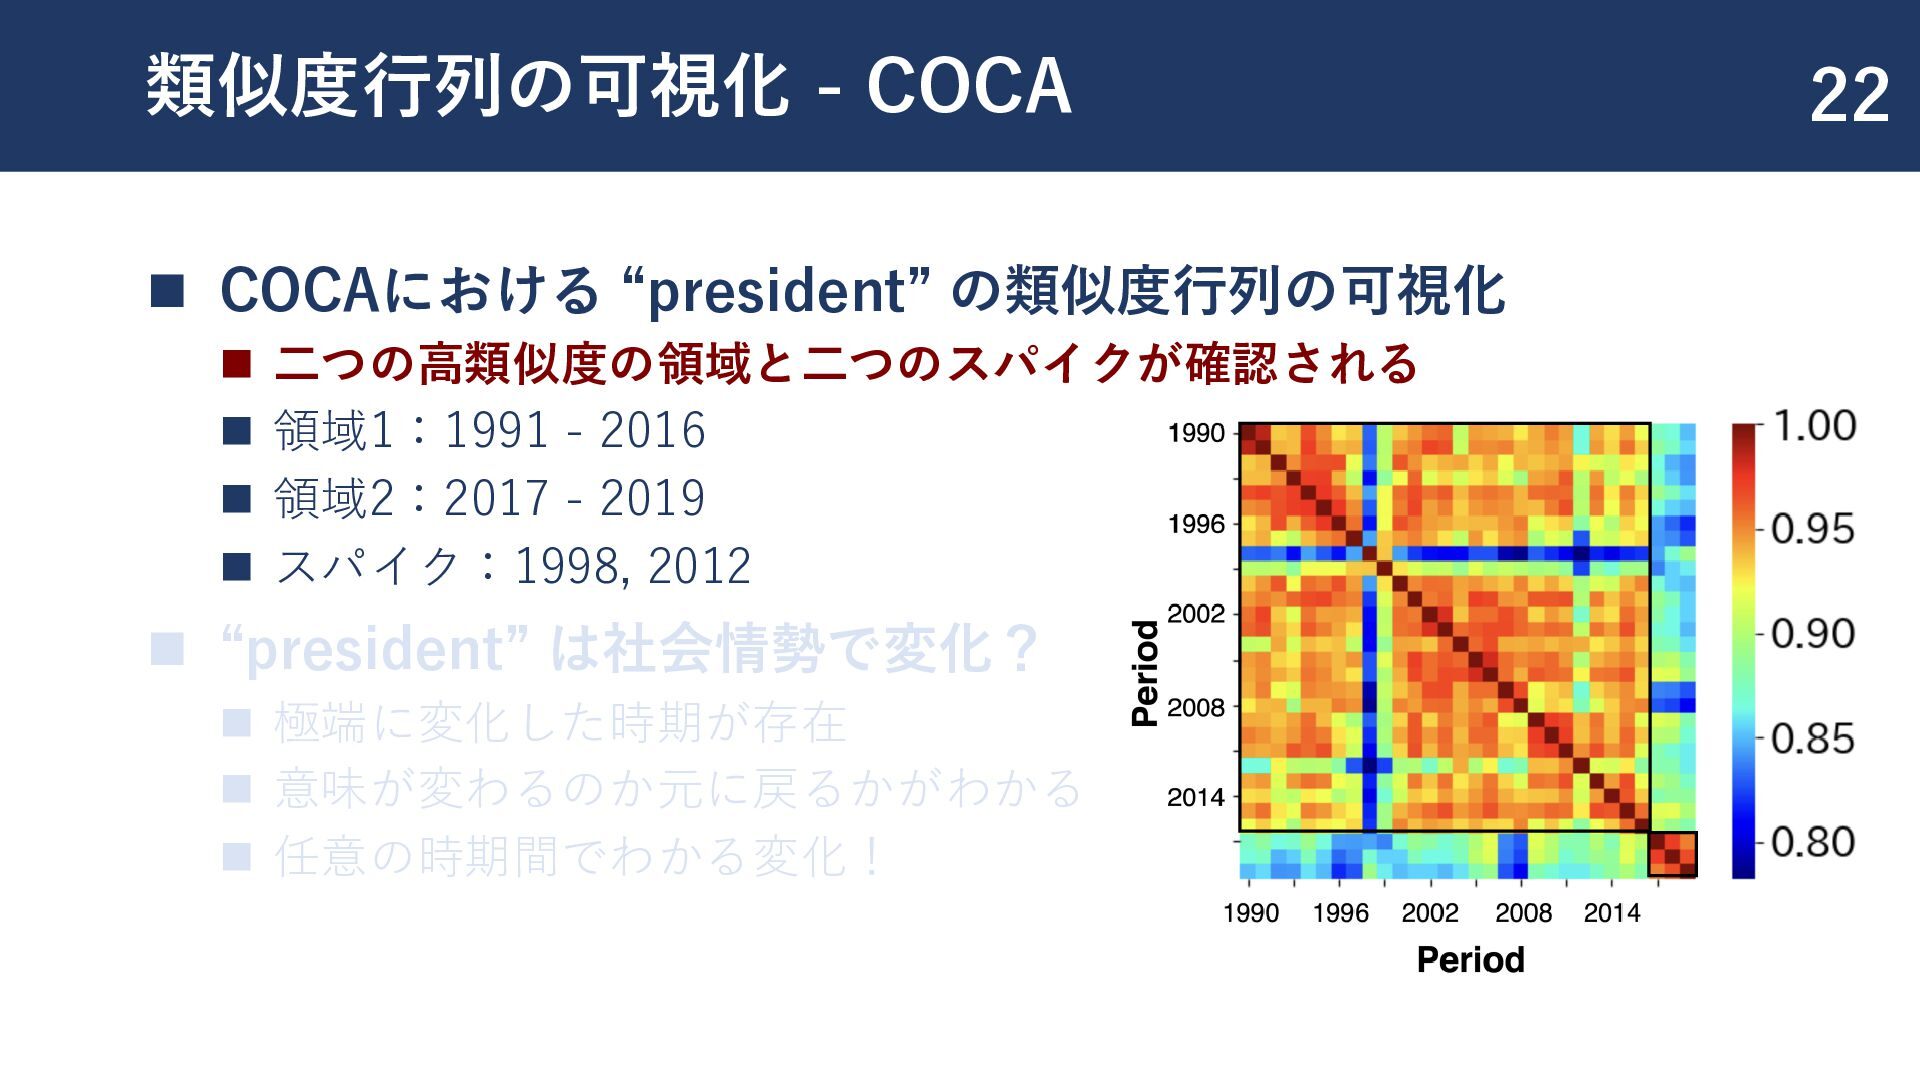
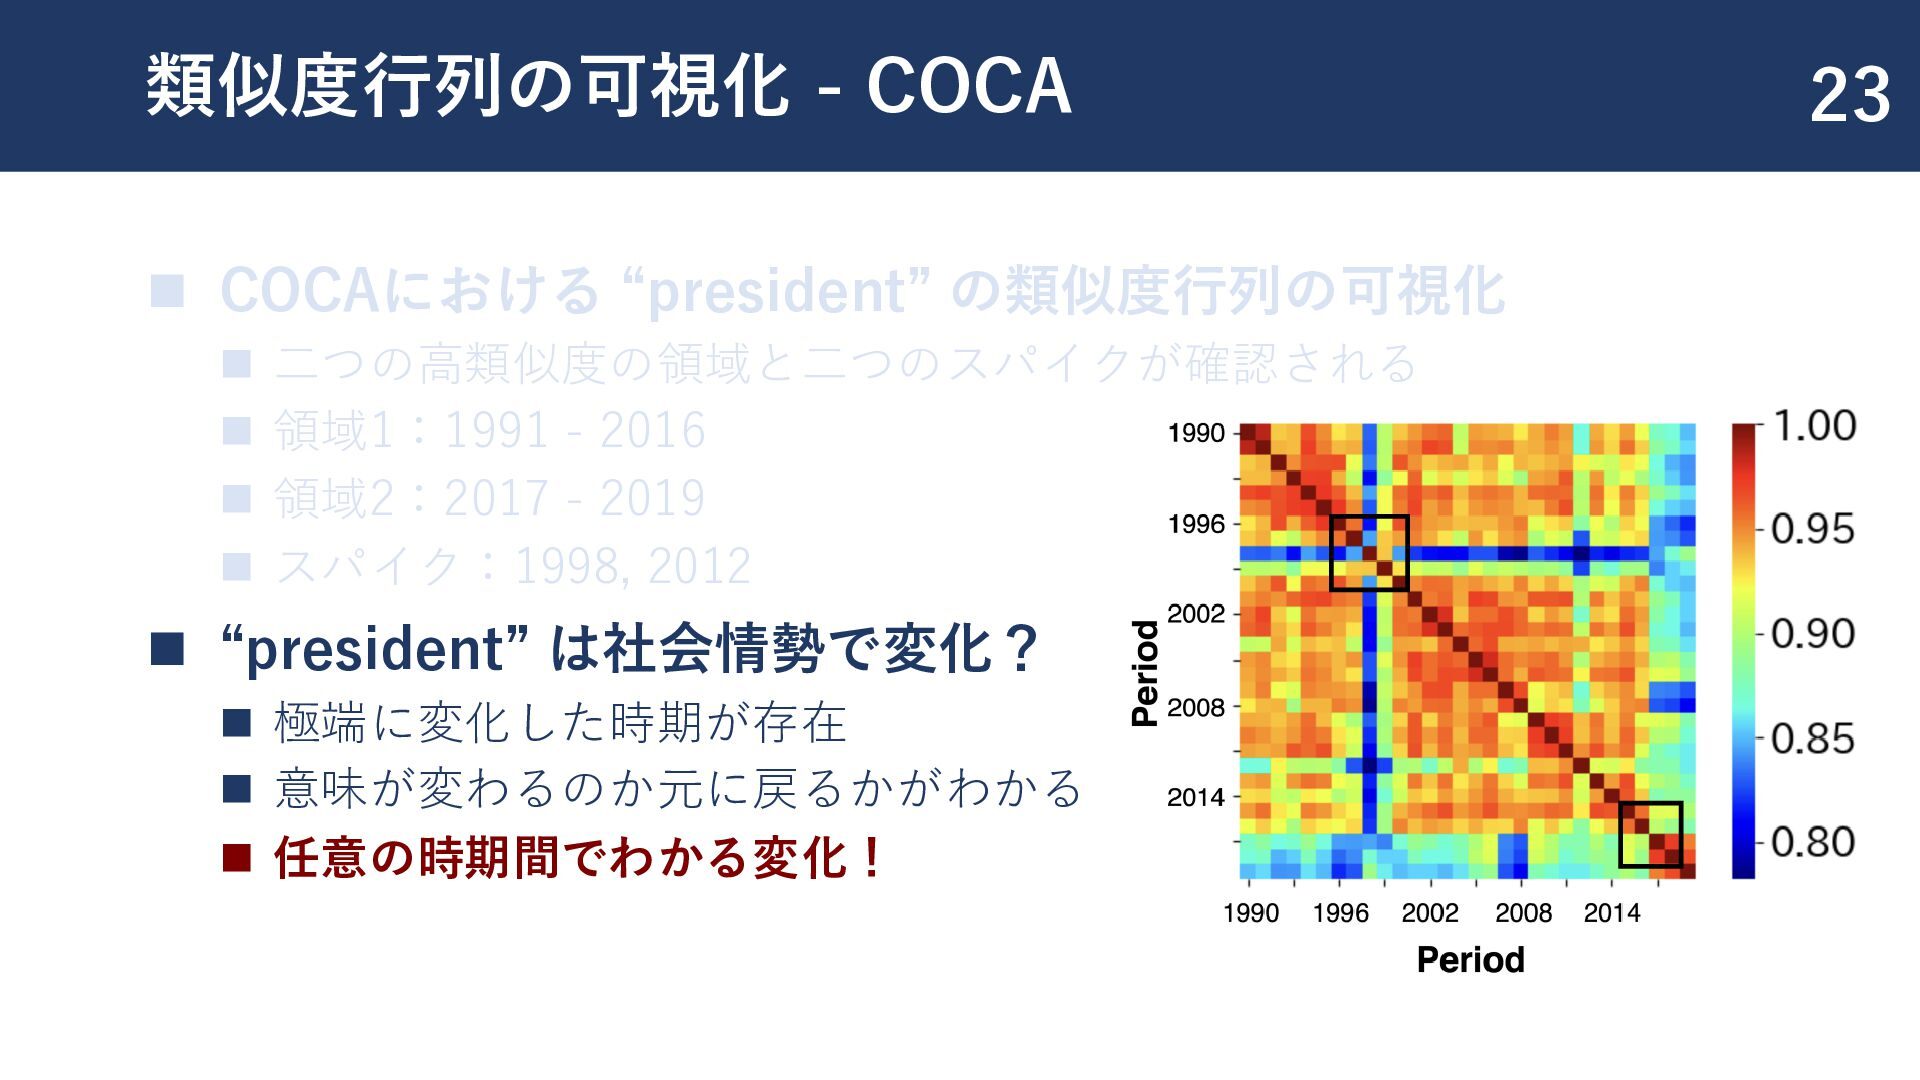
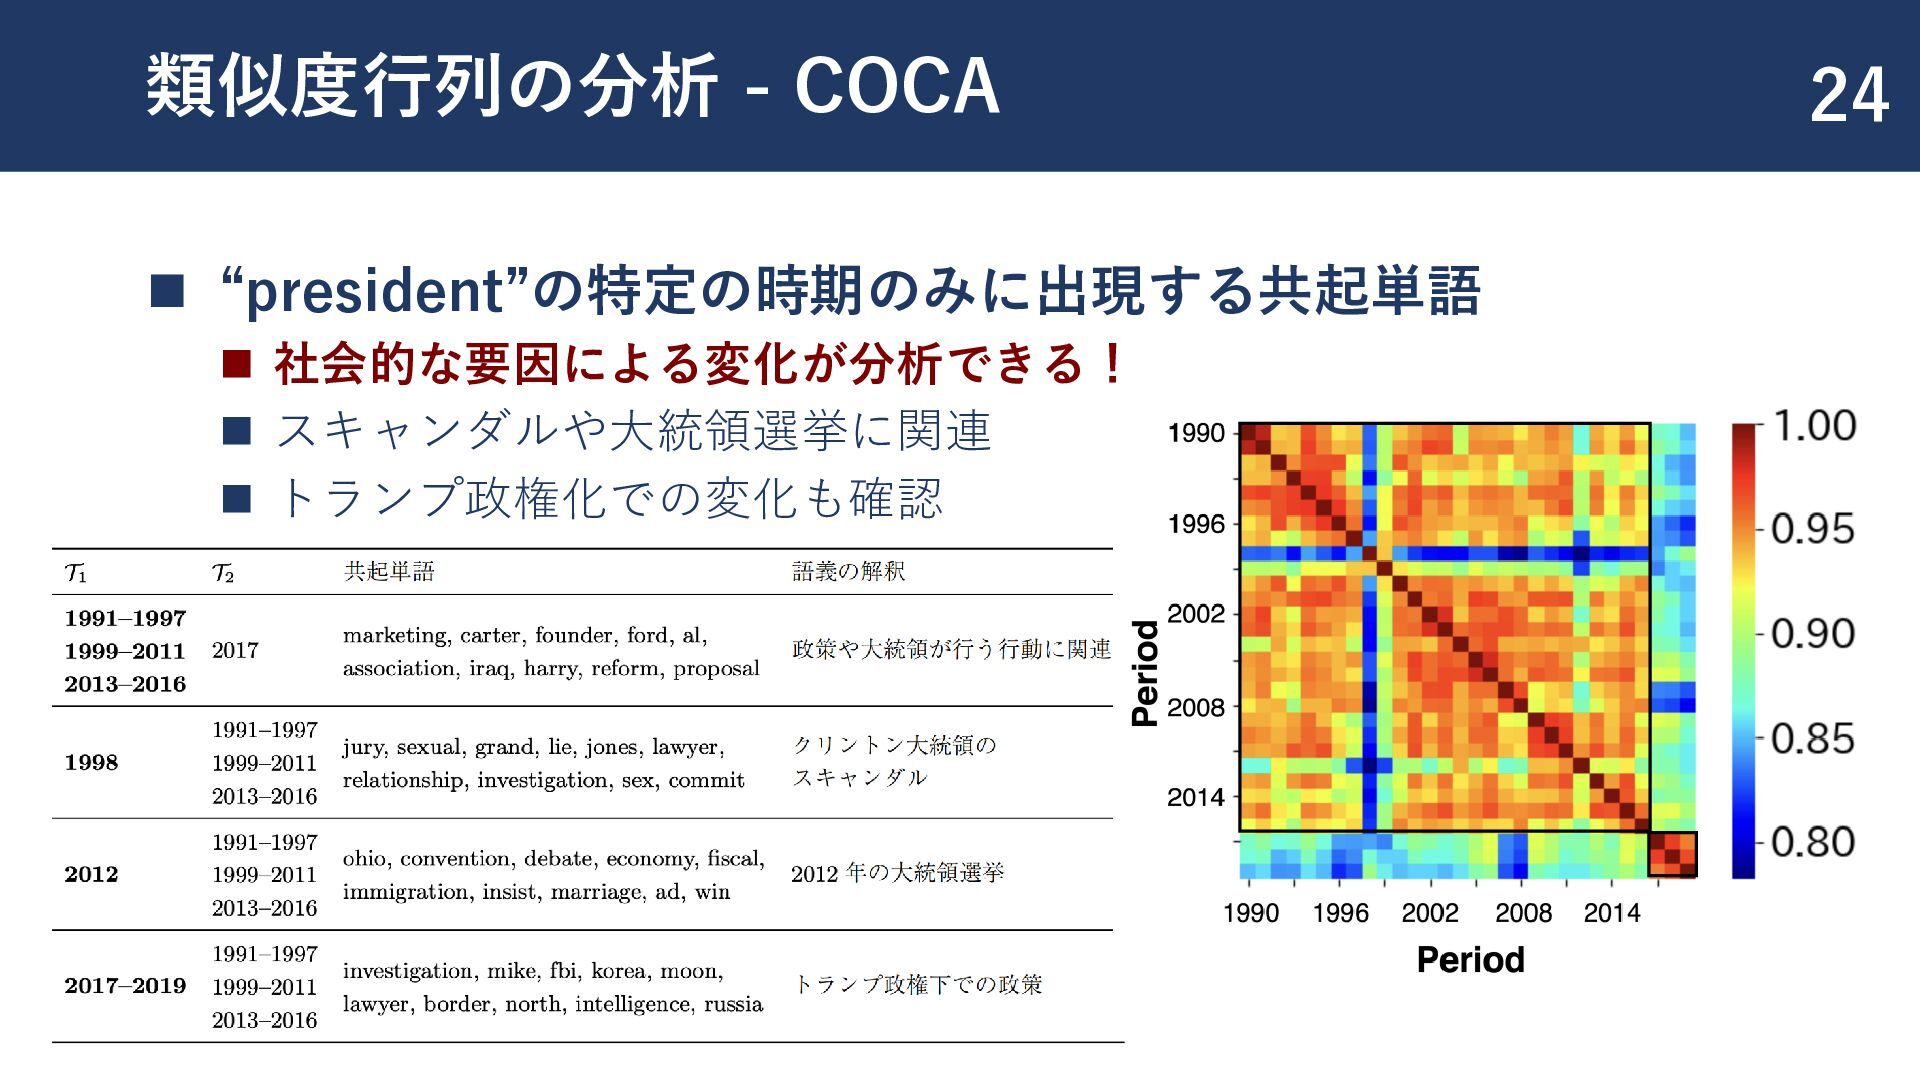
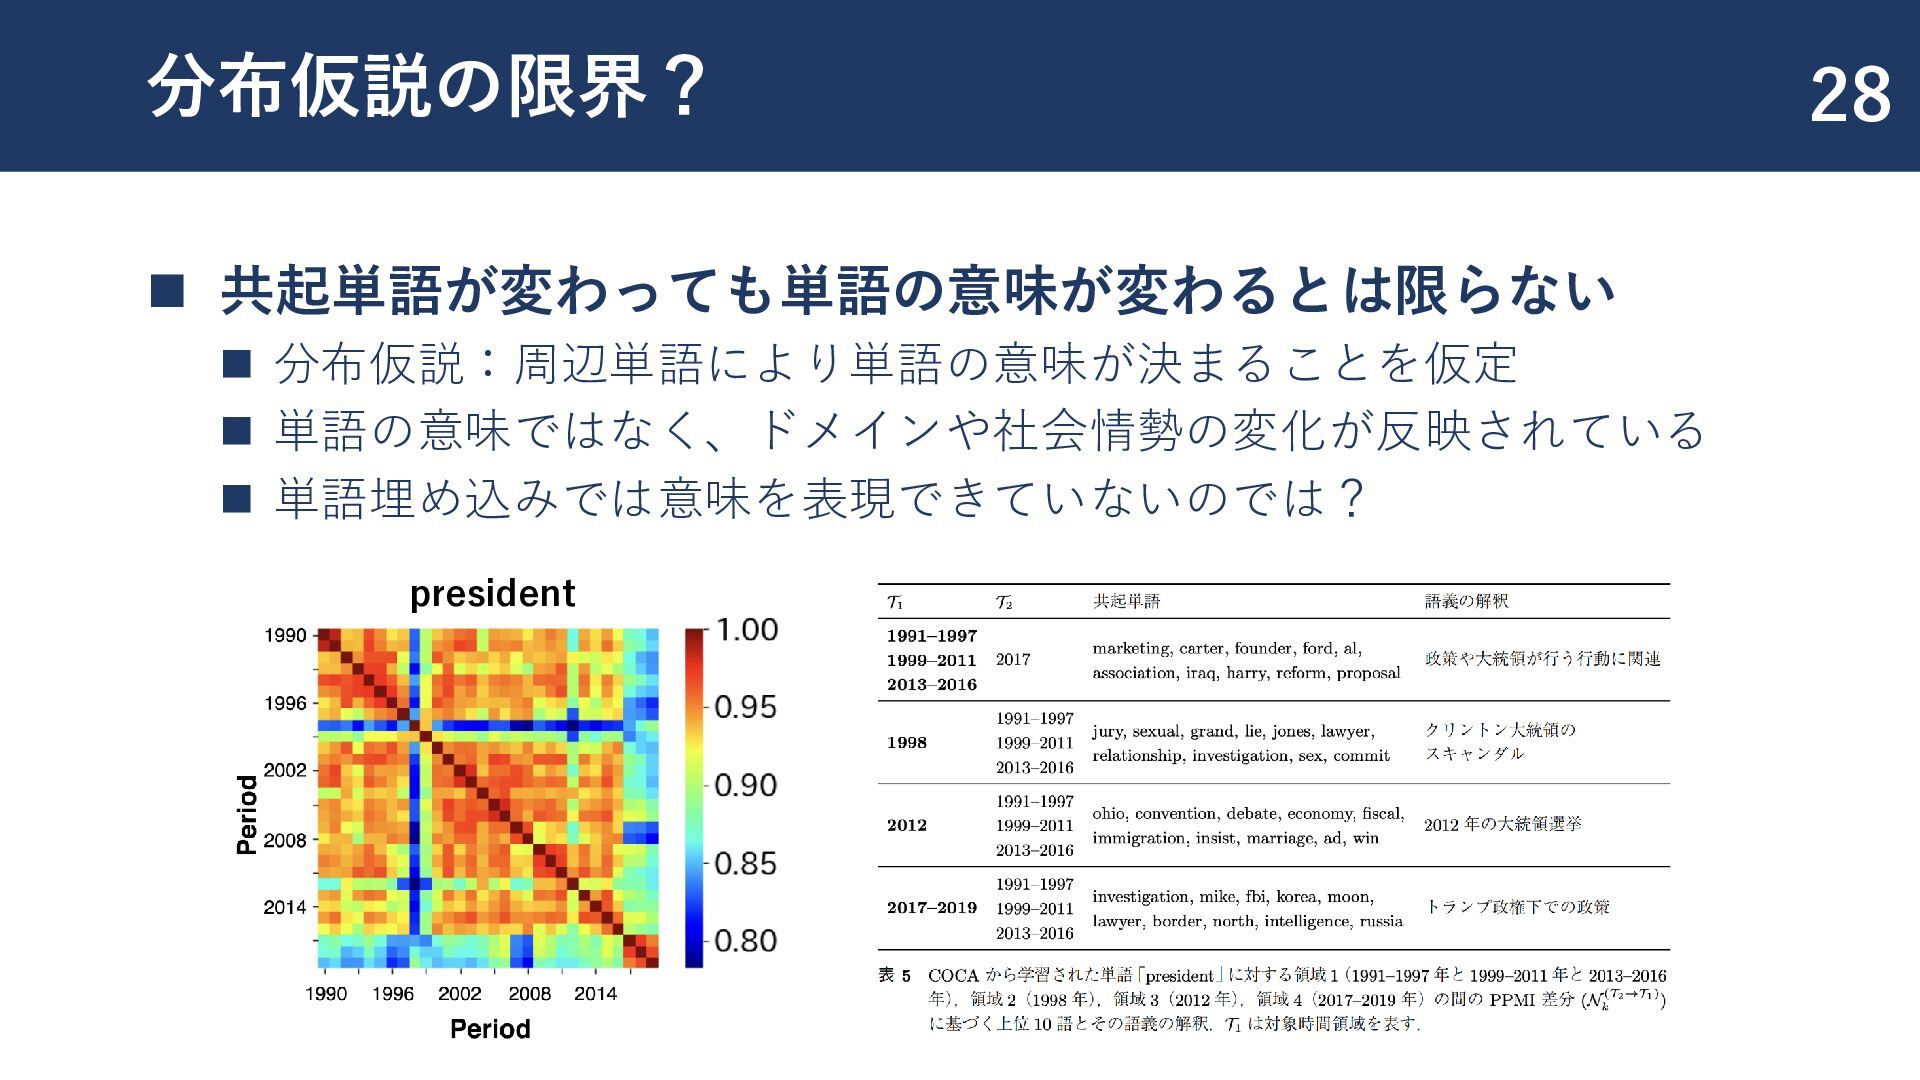
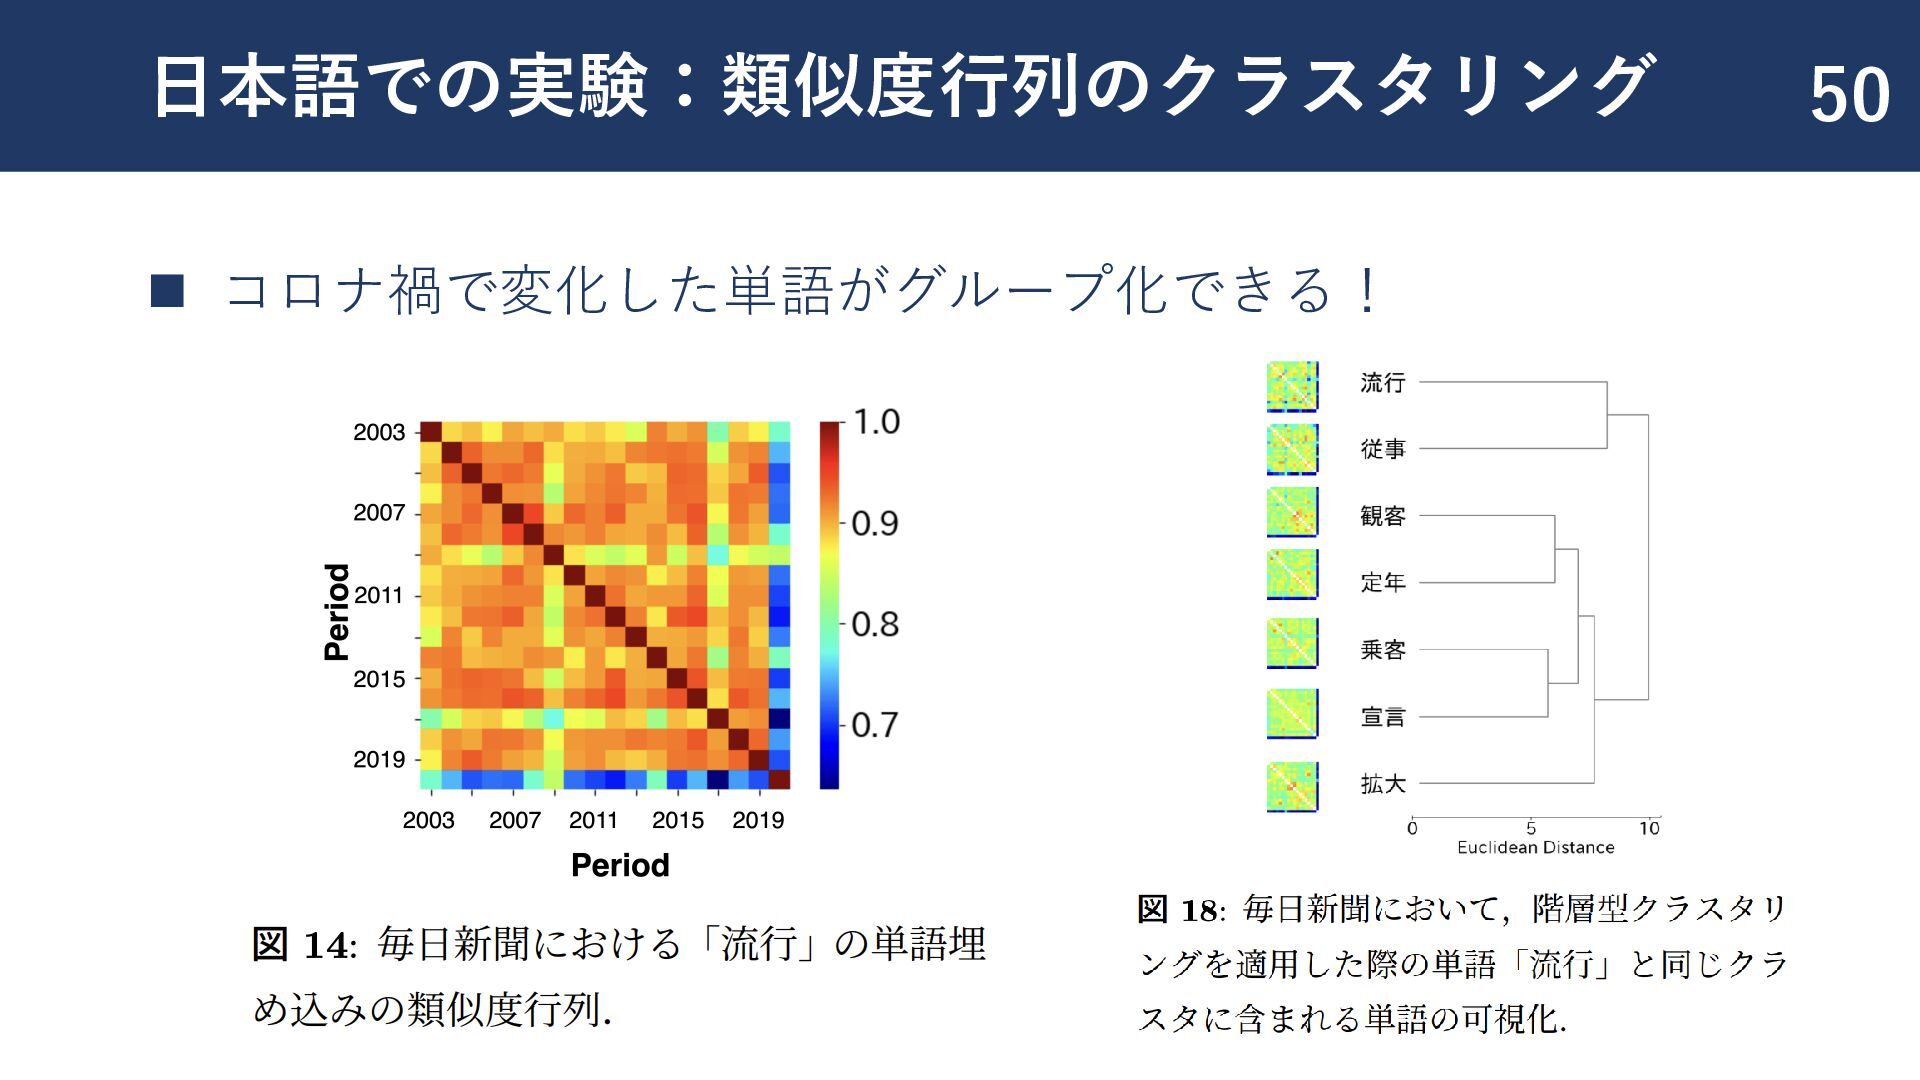
  11. 類似度行列の可視化 - COCA ◼ COCAにおける “president” の類似度行列の可視化 ◼ 二つの高類似度の領域と二つのスパイクが確認される ◼

    領域1:1991 - 2016 ◼ 領域2:2017 - 2019 ◼ スパイク:1998, 2012 ◼ “president” は社会情勢で変化? ◼ 極端に変化した時期が存在 ◼ 意味が変わるのか元に戻るかがわかる ◼ 任意の時期間でわかる変化! 22
  12. 類似度行列の可視化 - COCA ◼ COCAにおける “president” の類似度行列の可視化 ◼ 二つの高類似度の領域と二つのスパイクが確認される ◼

    領域1:1991 - 2016 ◼ 領域2:2017 - 2019 ◼ スパイク:1998, 2012 ◼ “president” は社会情勢で変化? ◼ 極端に変化した時期が存在 ◼ 意味が変わるのか元に戻るかがわかる ◼ 任意の時期間でわかる変化! 23
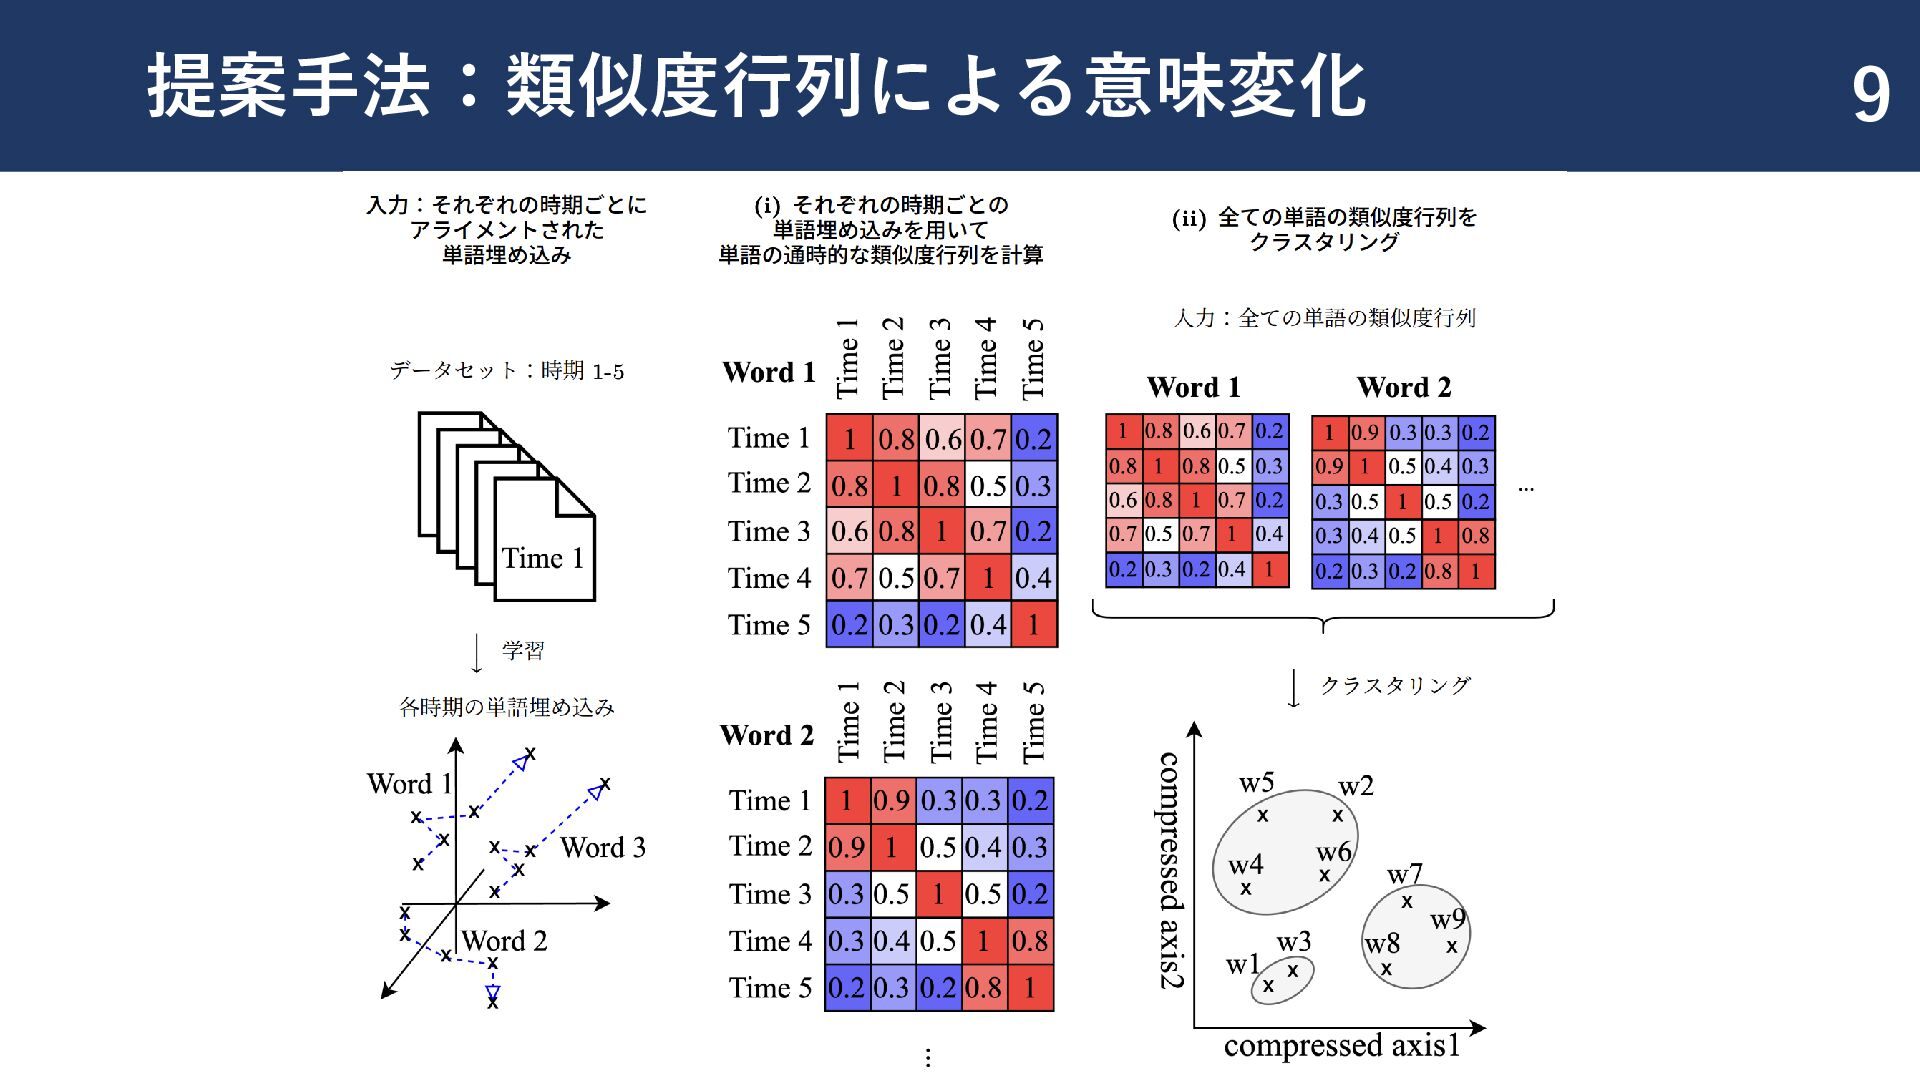
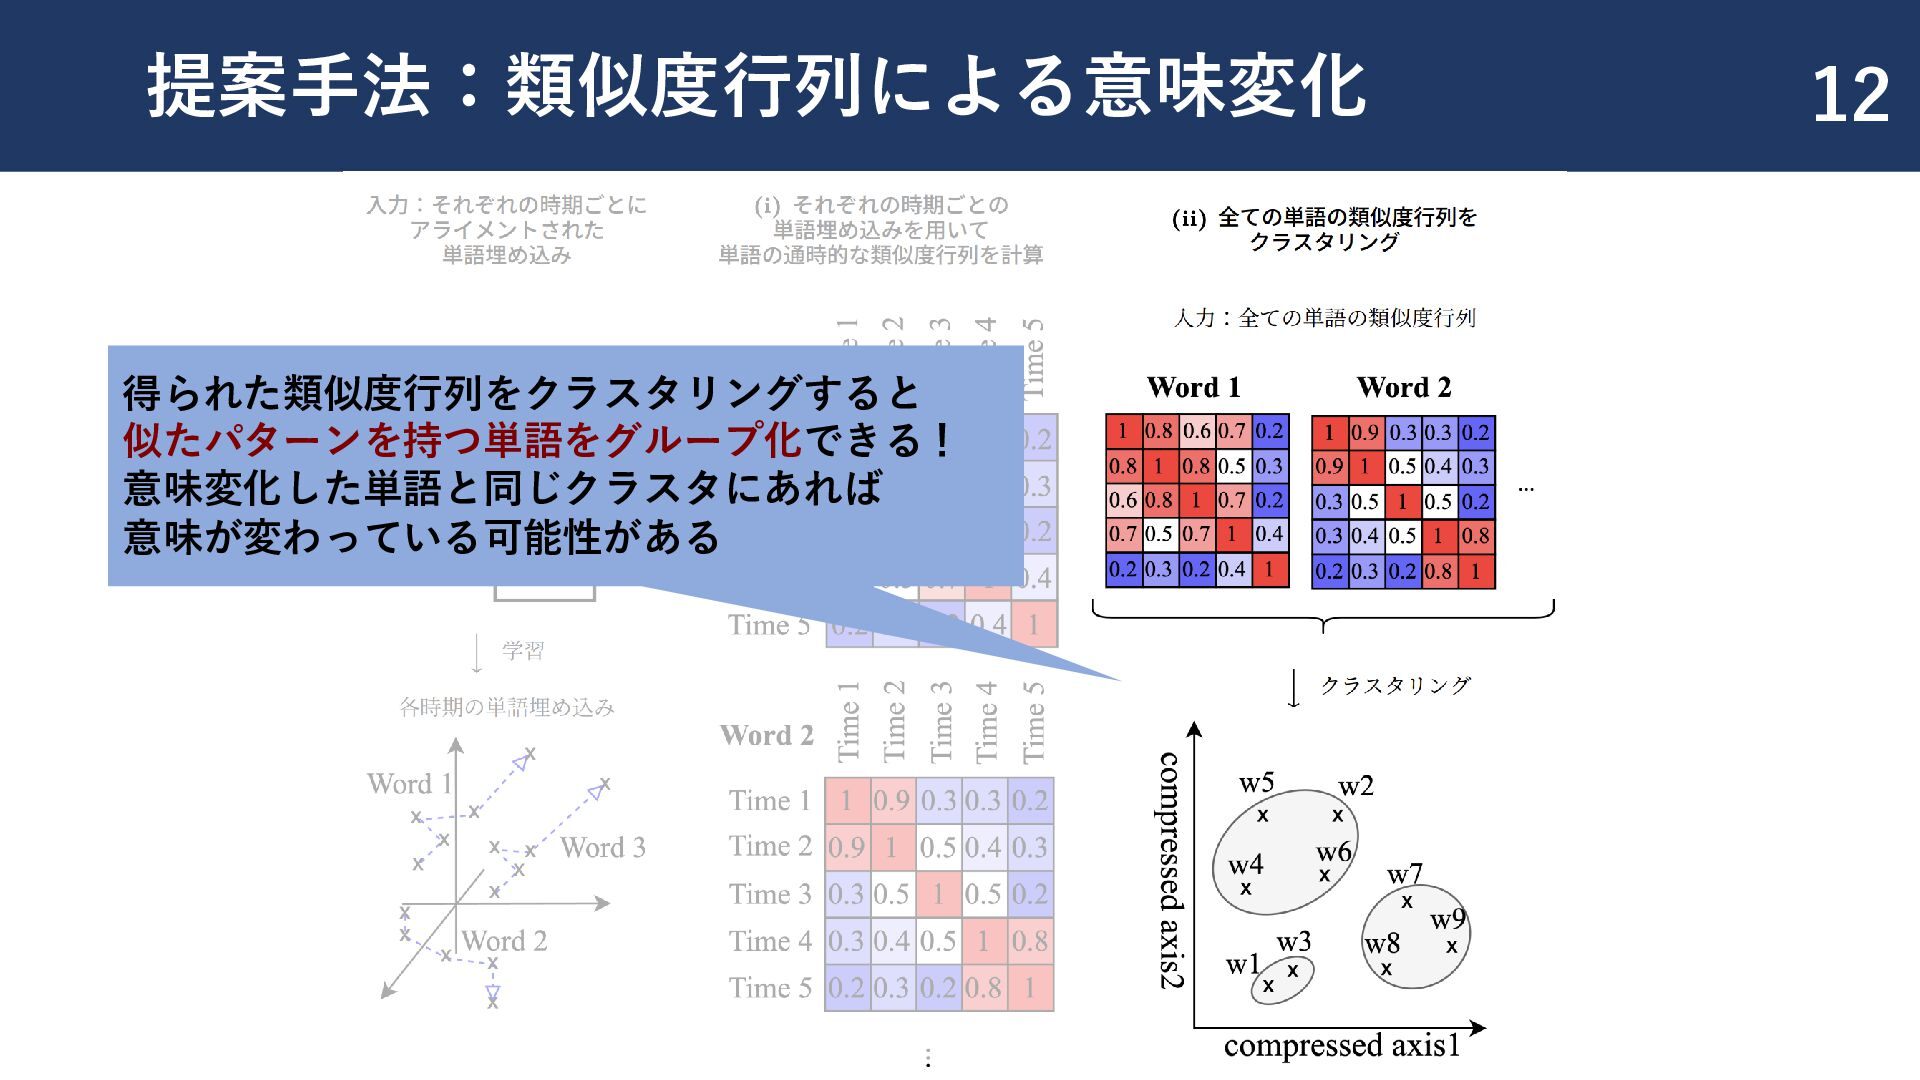
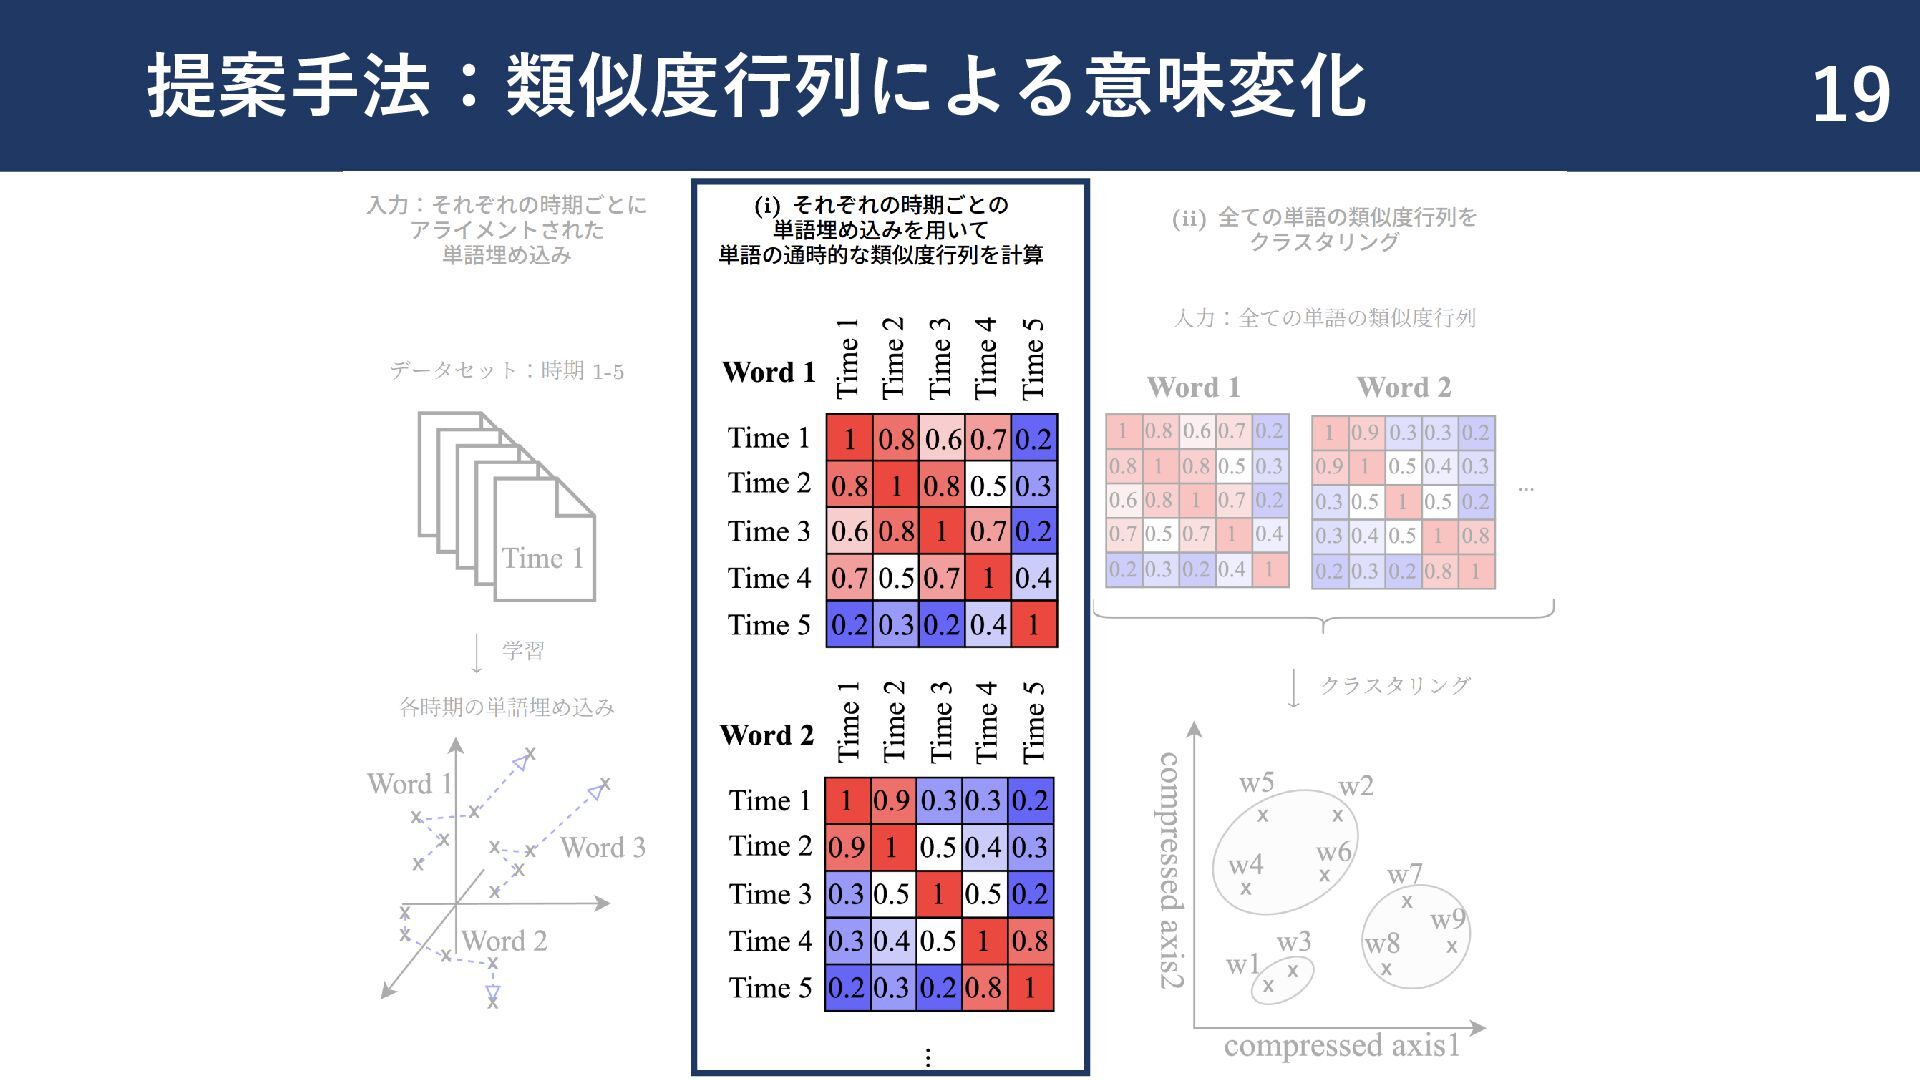
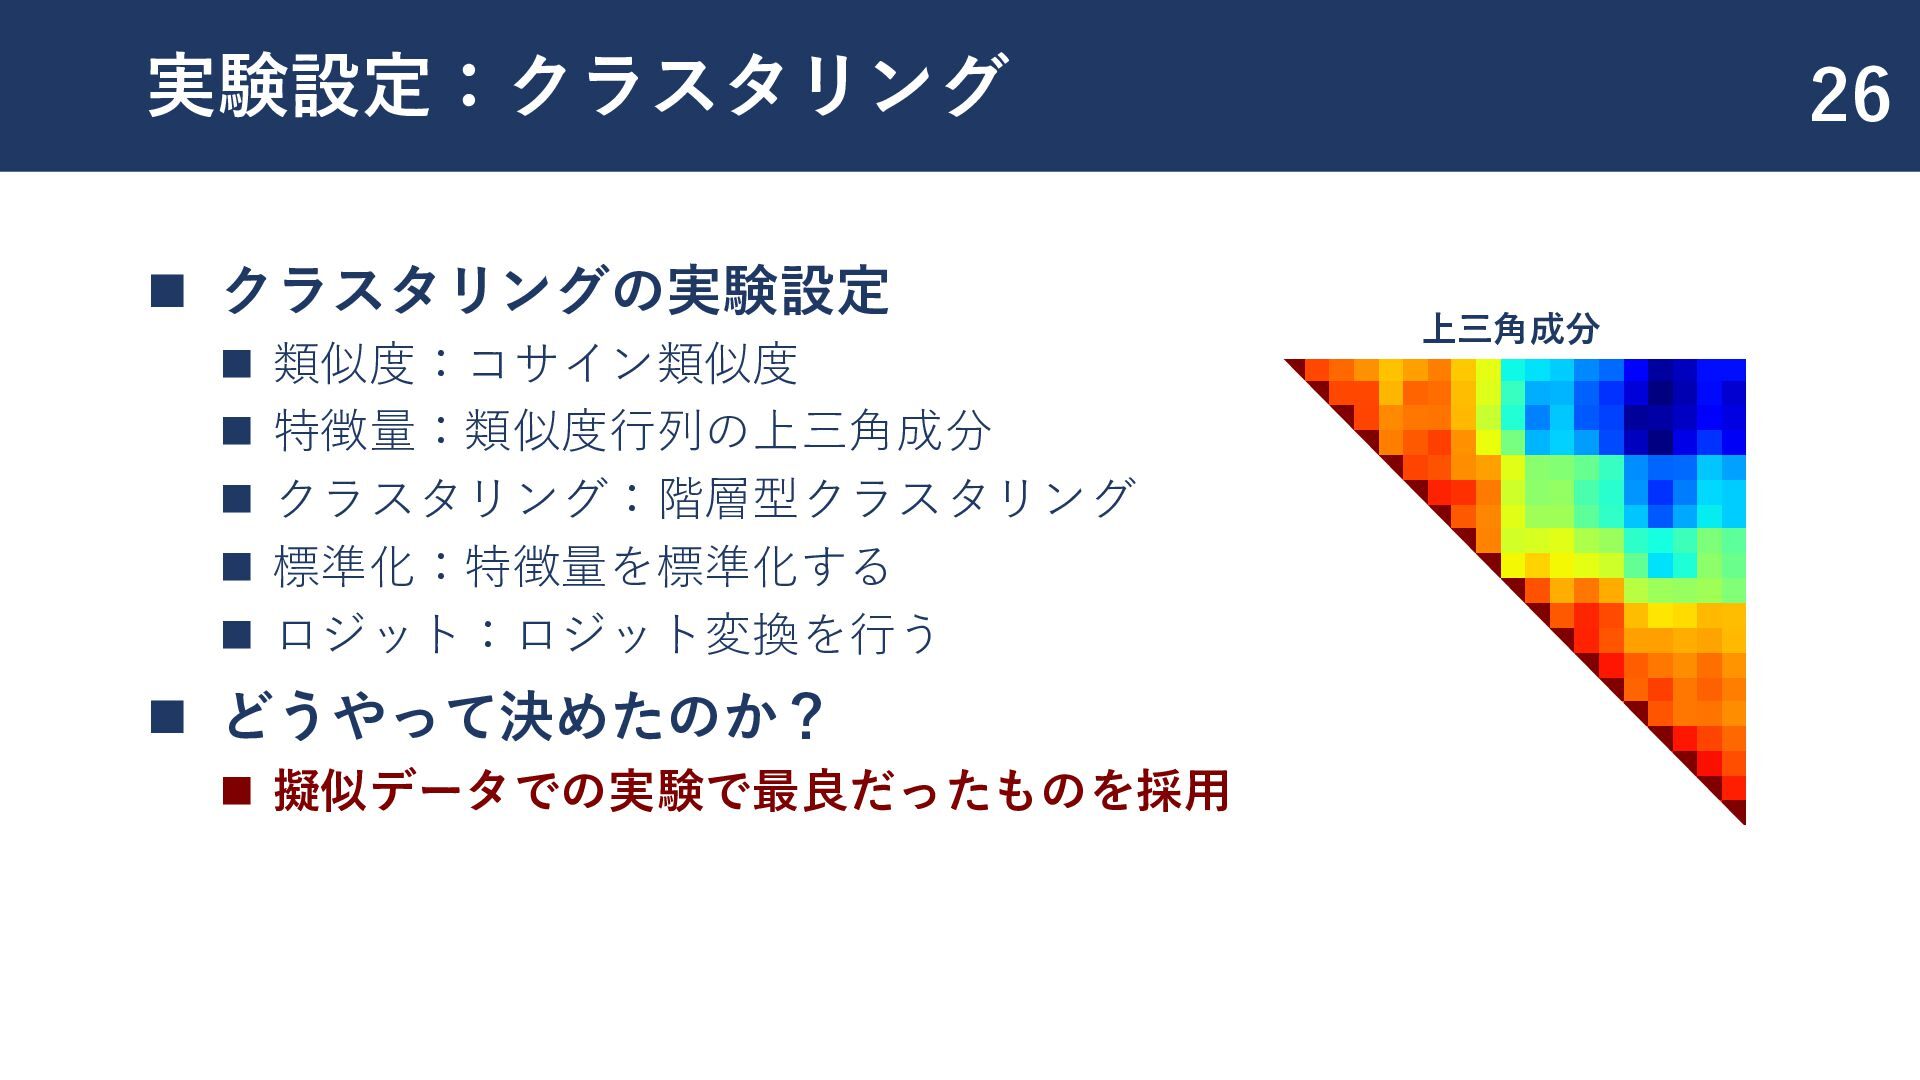
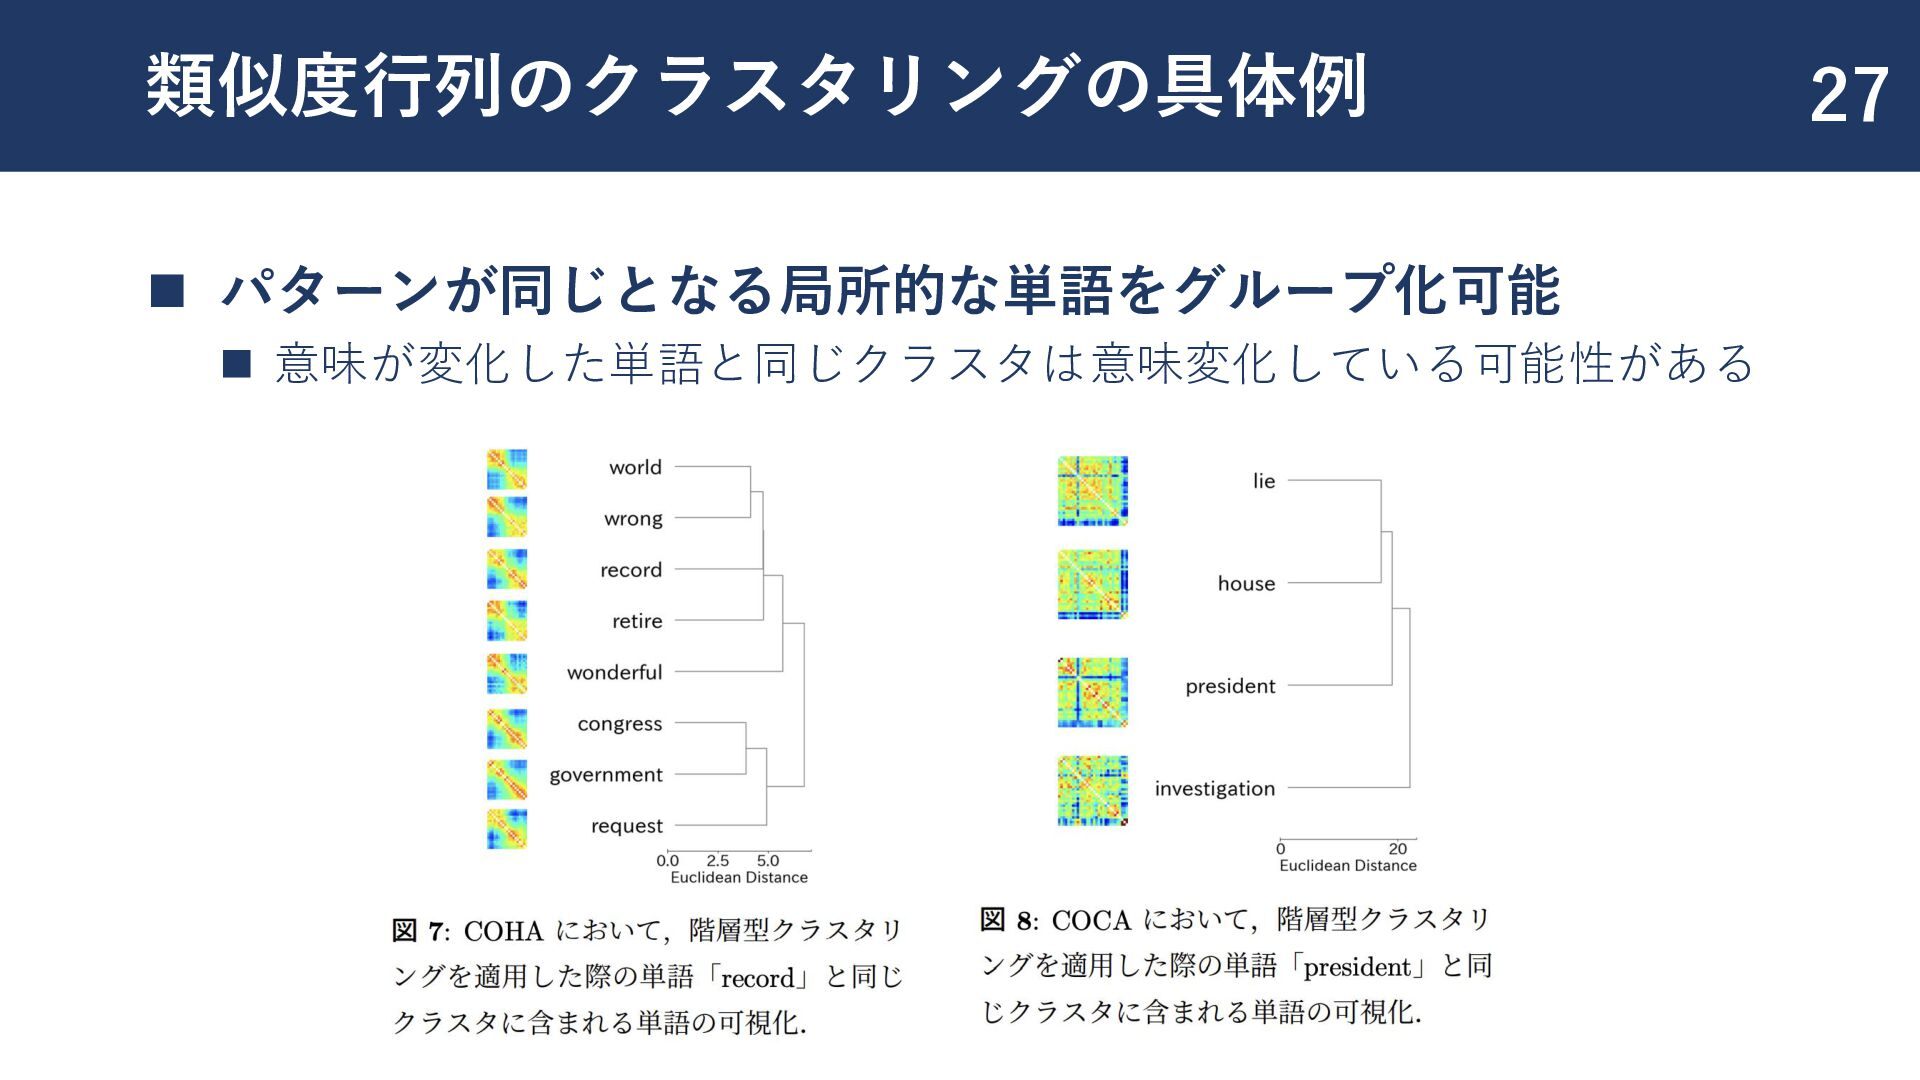
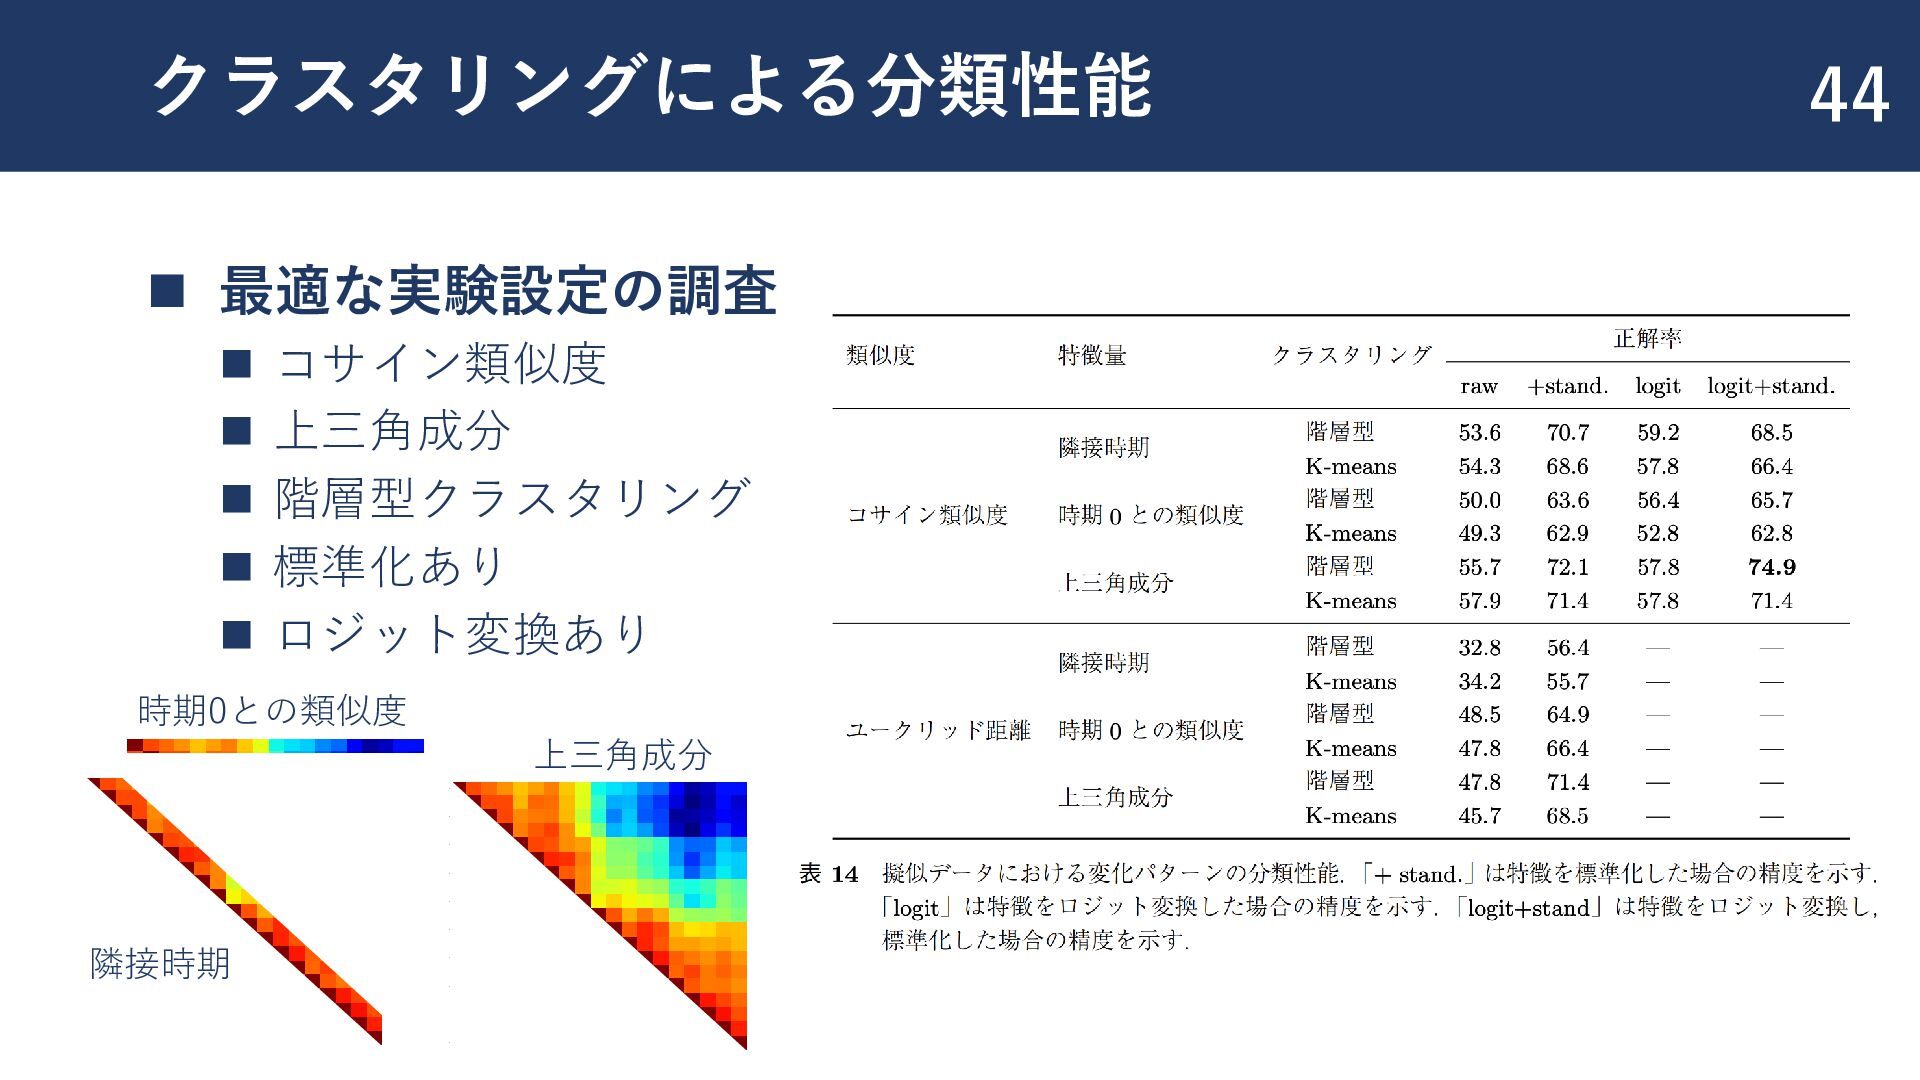
  13. 実験設定:クラスタリング ◼ クラスタリングの実験設定 ◼ 類似度:コサイン類似度 ◼ 特徴量:類似度行列の上三角成分 ◼ クラスタリング:階層型クラスタリング ◼

    標準化:特徴量を標準化する ◼ ロジット:ロジット変換を行う ◼ どうやって決めたのか? ◼ 擬似データでの実験で最良だったものを採用 26 上三角成分
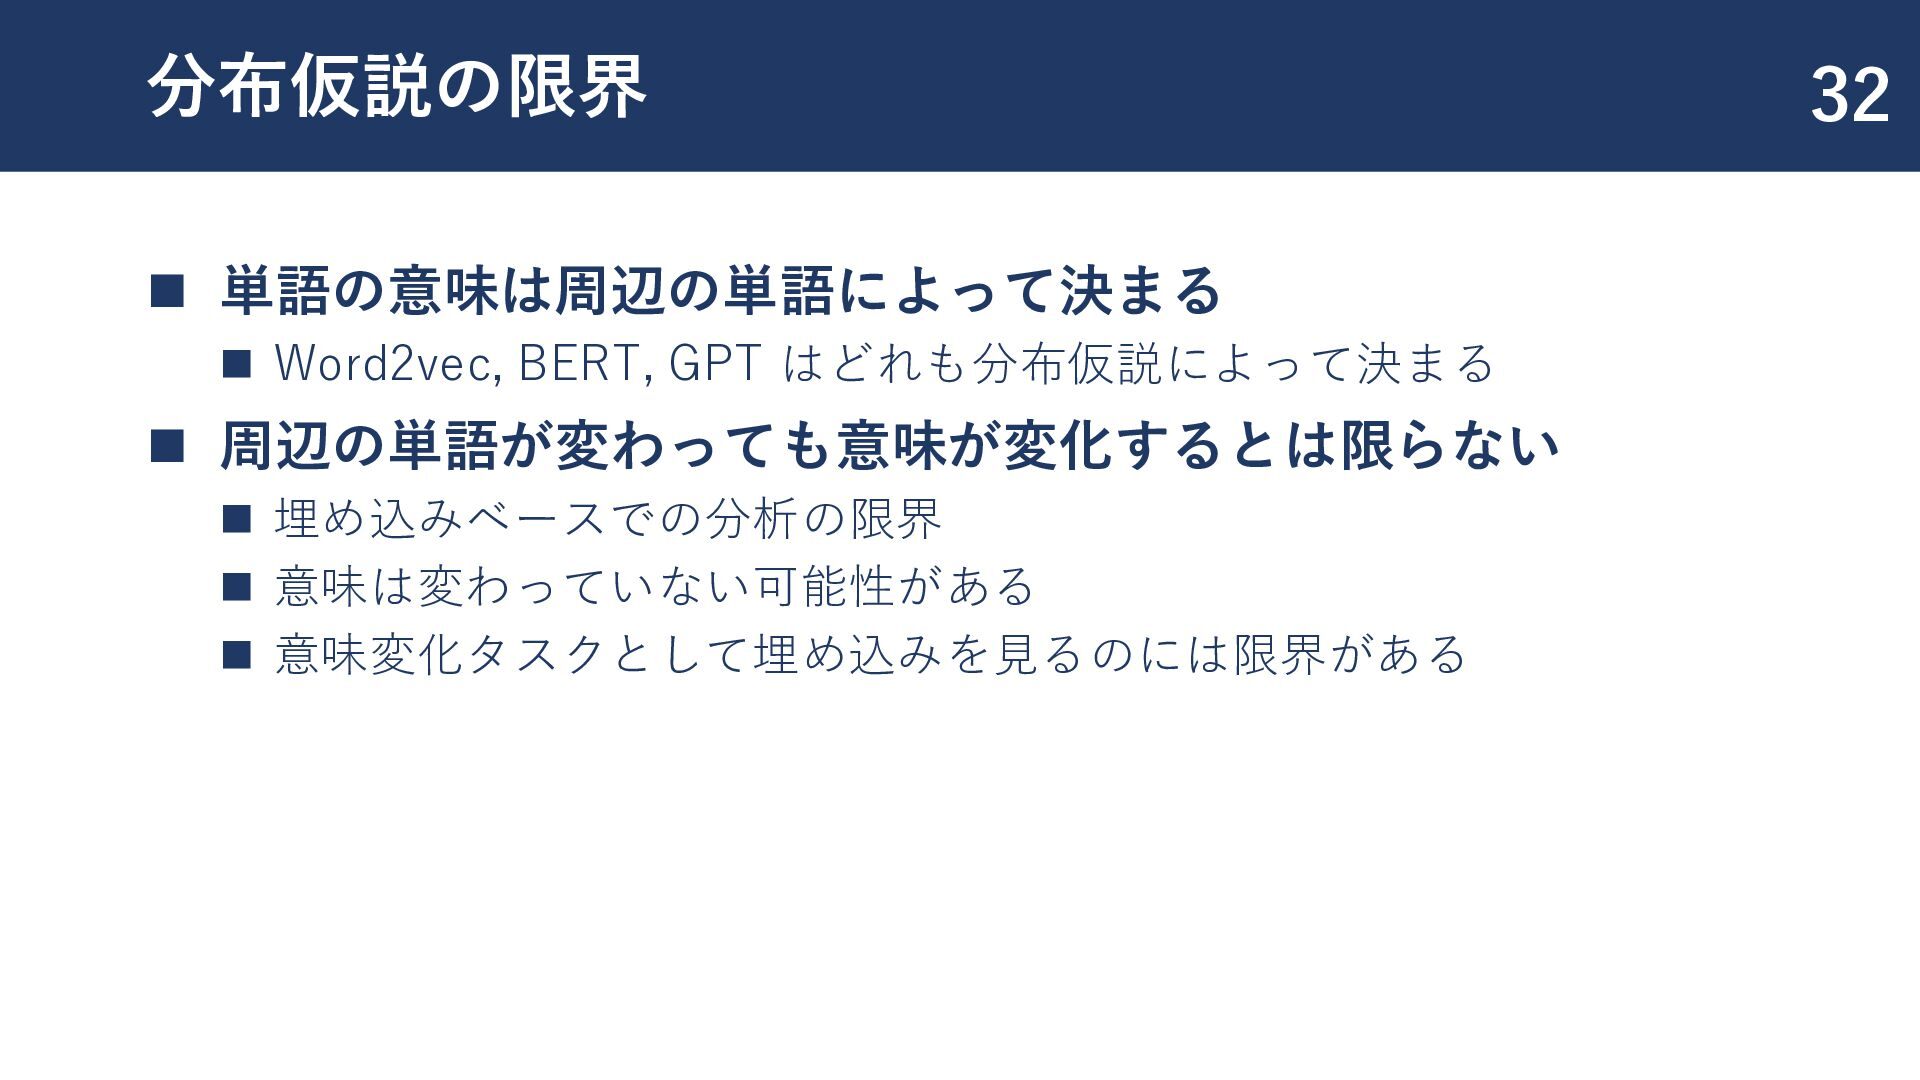
  14. 分布仮説の限界 ◼ 単語の意味は周辺の単語によって決まる ◼ Word2vec, BERT, GPT はどれも分布仮説によって決まる ◼ 周辺の単語が変わっても意味が変化するとは限らない

    ◼ 埋め込みベースでの分析の限界 ◼ 意味は変わっていない可能性がある ◼ 意味変化タスクとして埋め込みを見るのには限界がある 32
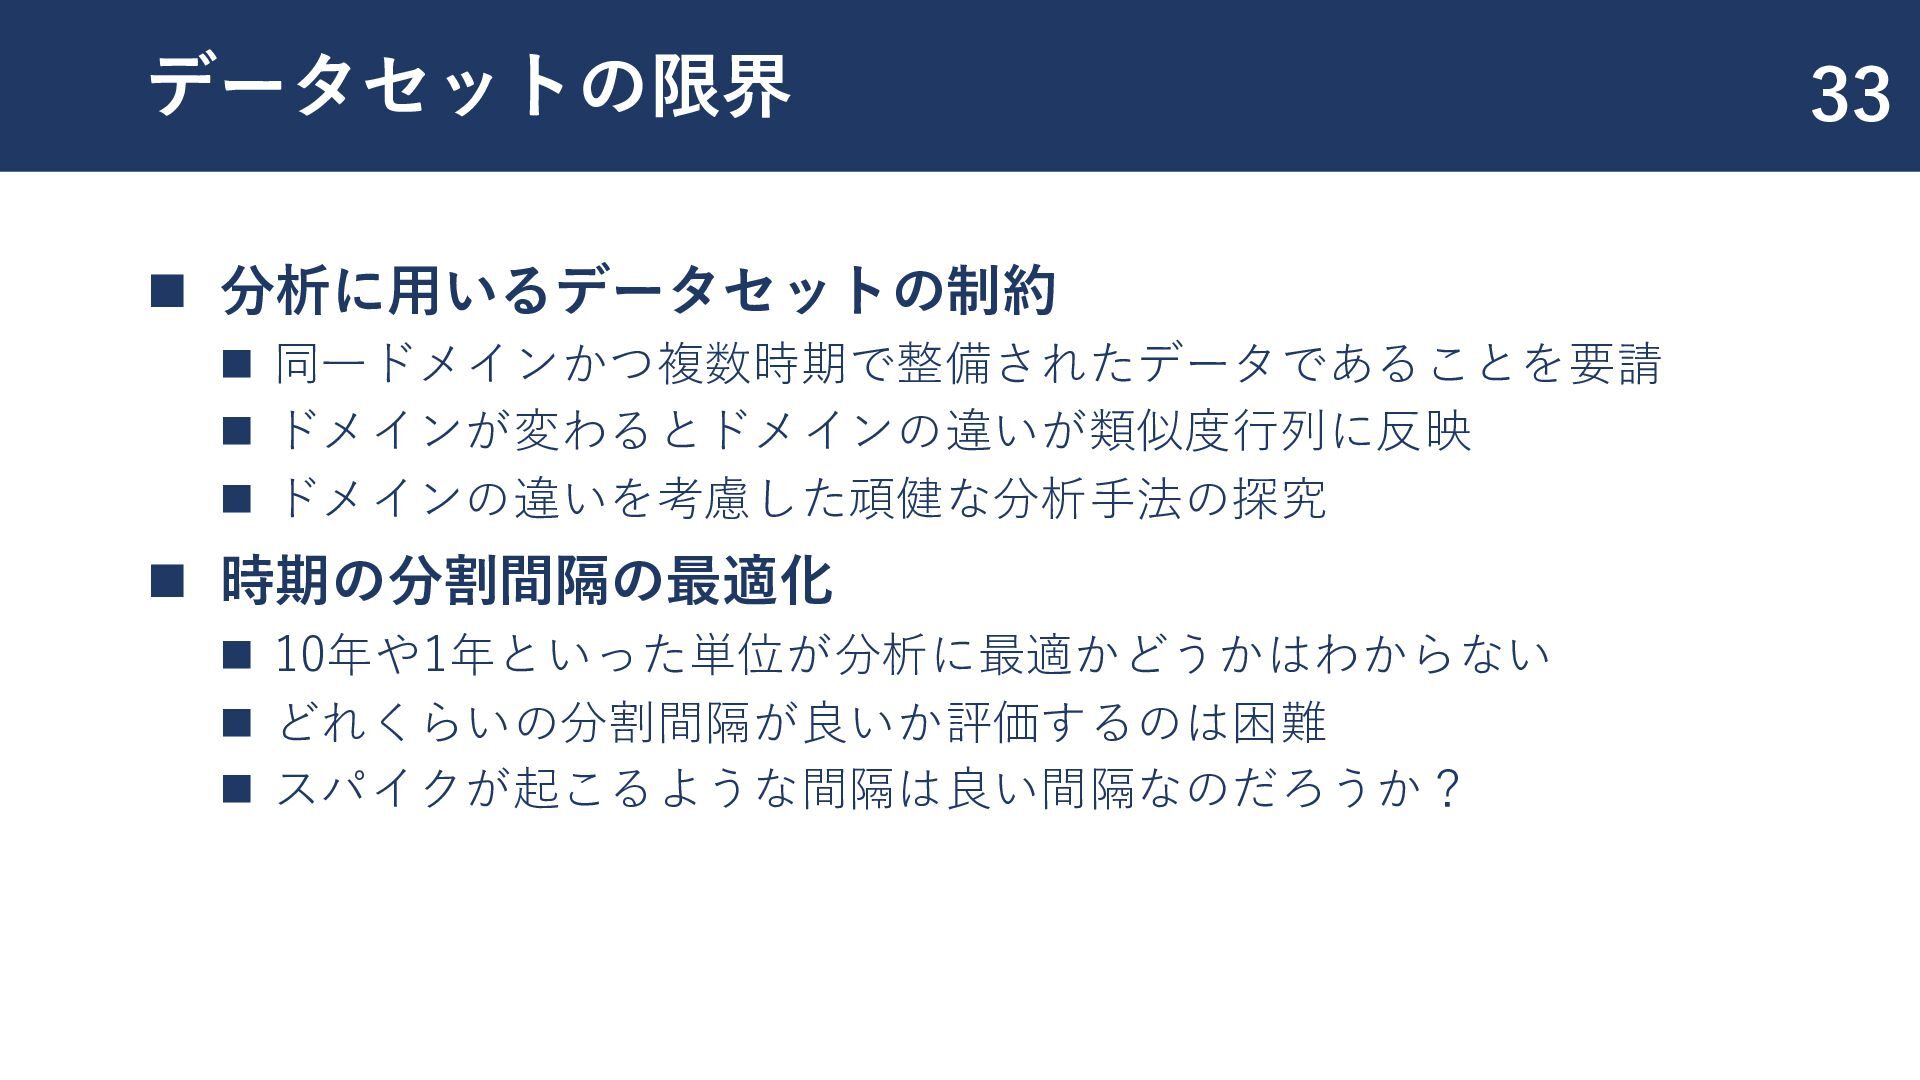
  15. データセットの限界 ◼ 分析に用いるデータセットの制約 ◼ 同一ドメインかつ複数時期で整備されたデータであることを要請 ◼ ドメインが変わるとドメインの違いが類似度行列に反映 ◼ ドメインの違いを考慮した頑健な分析手法の探究 ◼

    時期の分割間隔の最適化 ◼ 10年や1年といった単位が分析に最適かどうかはわからない ◼ どれくらいの分割間隔が良いか評価するのは困難 ◼ スパイクが起こるような間隔は良い間隔なのだろうか? 33
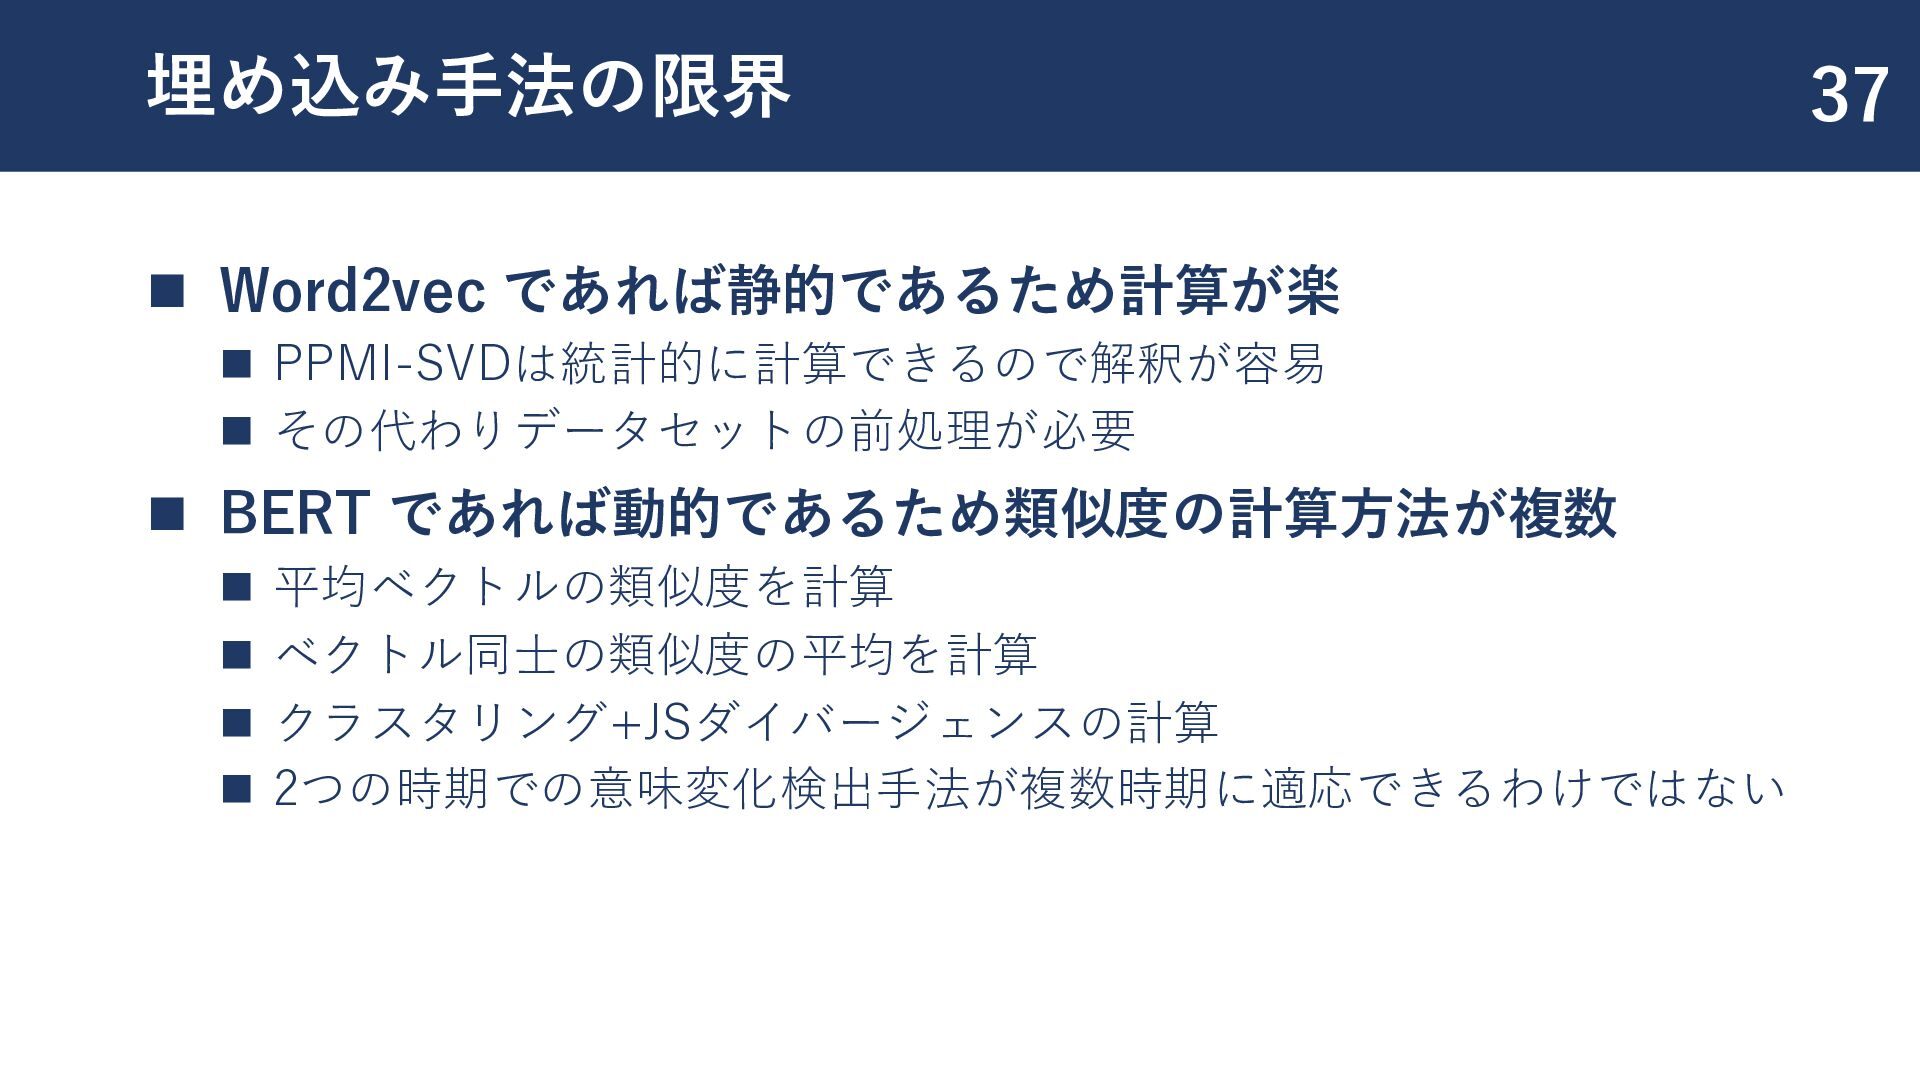
  16. 埋め込み手法の限界 ◼ Word2vec であれば静的であるため計算が楽 ◼ PPMI-SVDは統計的に計算できるので解釈が容易 ◼ その代わりデータセットの前処理が必要 ◼ BERT

    であれば動的であるため類似度の計算方法が複数 ◼ 平均ベクトルの類似度を計算 ◼ ベクトル同士の類似度の平均を計算 ◼ クラスタリング+JSダイバージェンスの計算 ◼ 2つの時期での意味変化検出手法が複数時期に適応できるわけではない 37
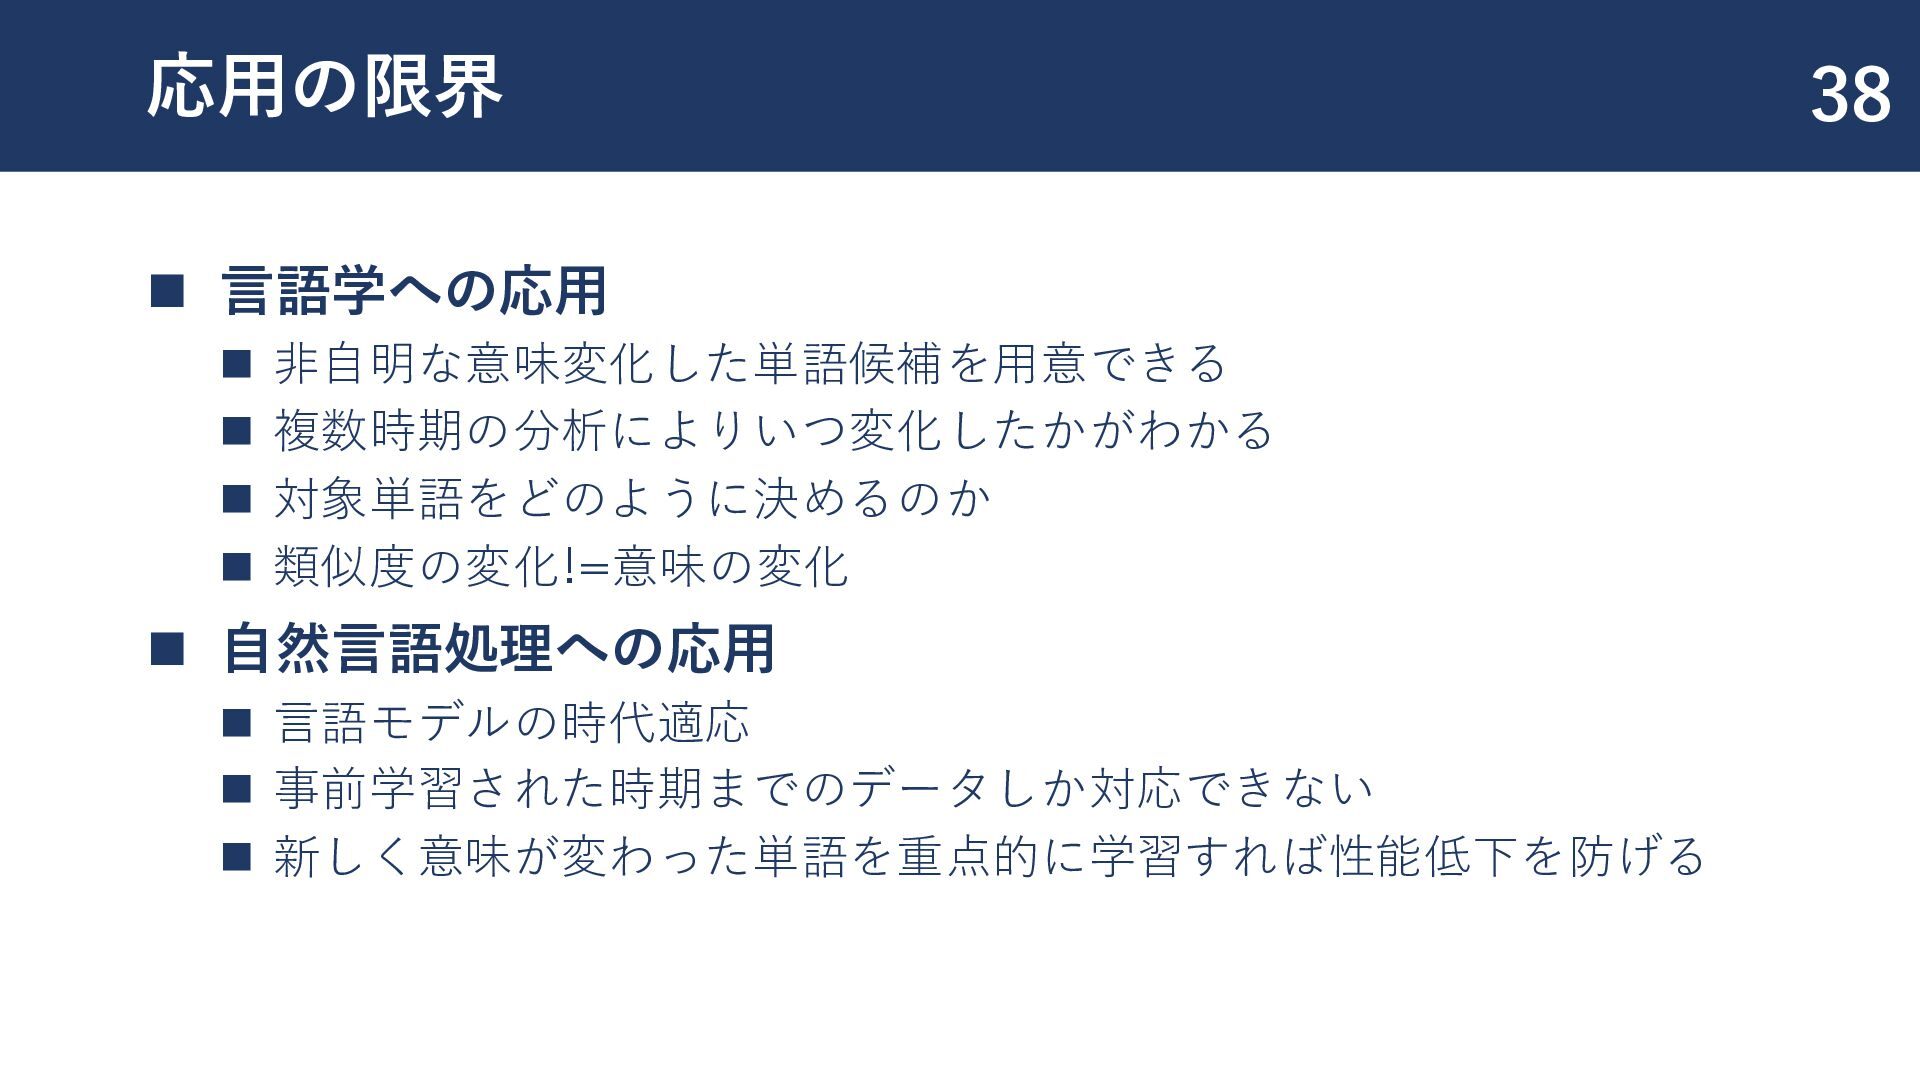
  17. 応用の限界 ◼ 言語学への応用 ◼ 非自明な意味変化した単語候補を用意できる ◼ 複数時期の分析によりいつ変化したかがわかる ◼ 対象単語をどのように決めるのか ◼

    類似度の変化!=意味の変化 ◼ 自然言語処理への応用 ◼ 言語モデルの時代適応 ◼ 事前学習された時期までのデータしか対応できない ◼ 新しく意味が変わった単語を重点的に学習すれば性能低下を防げる 38
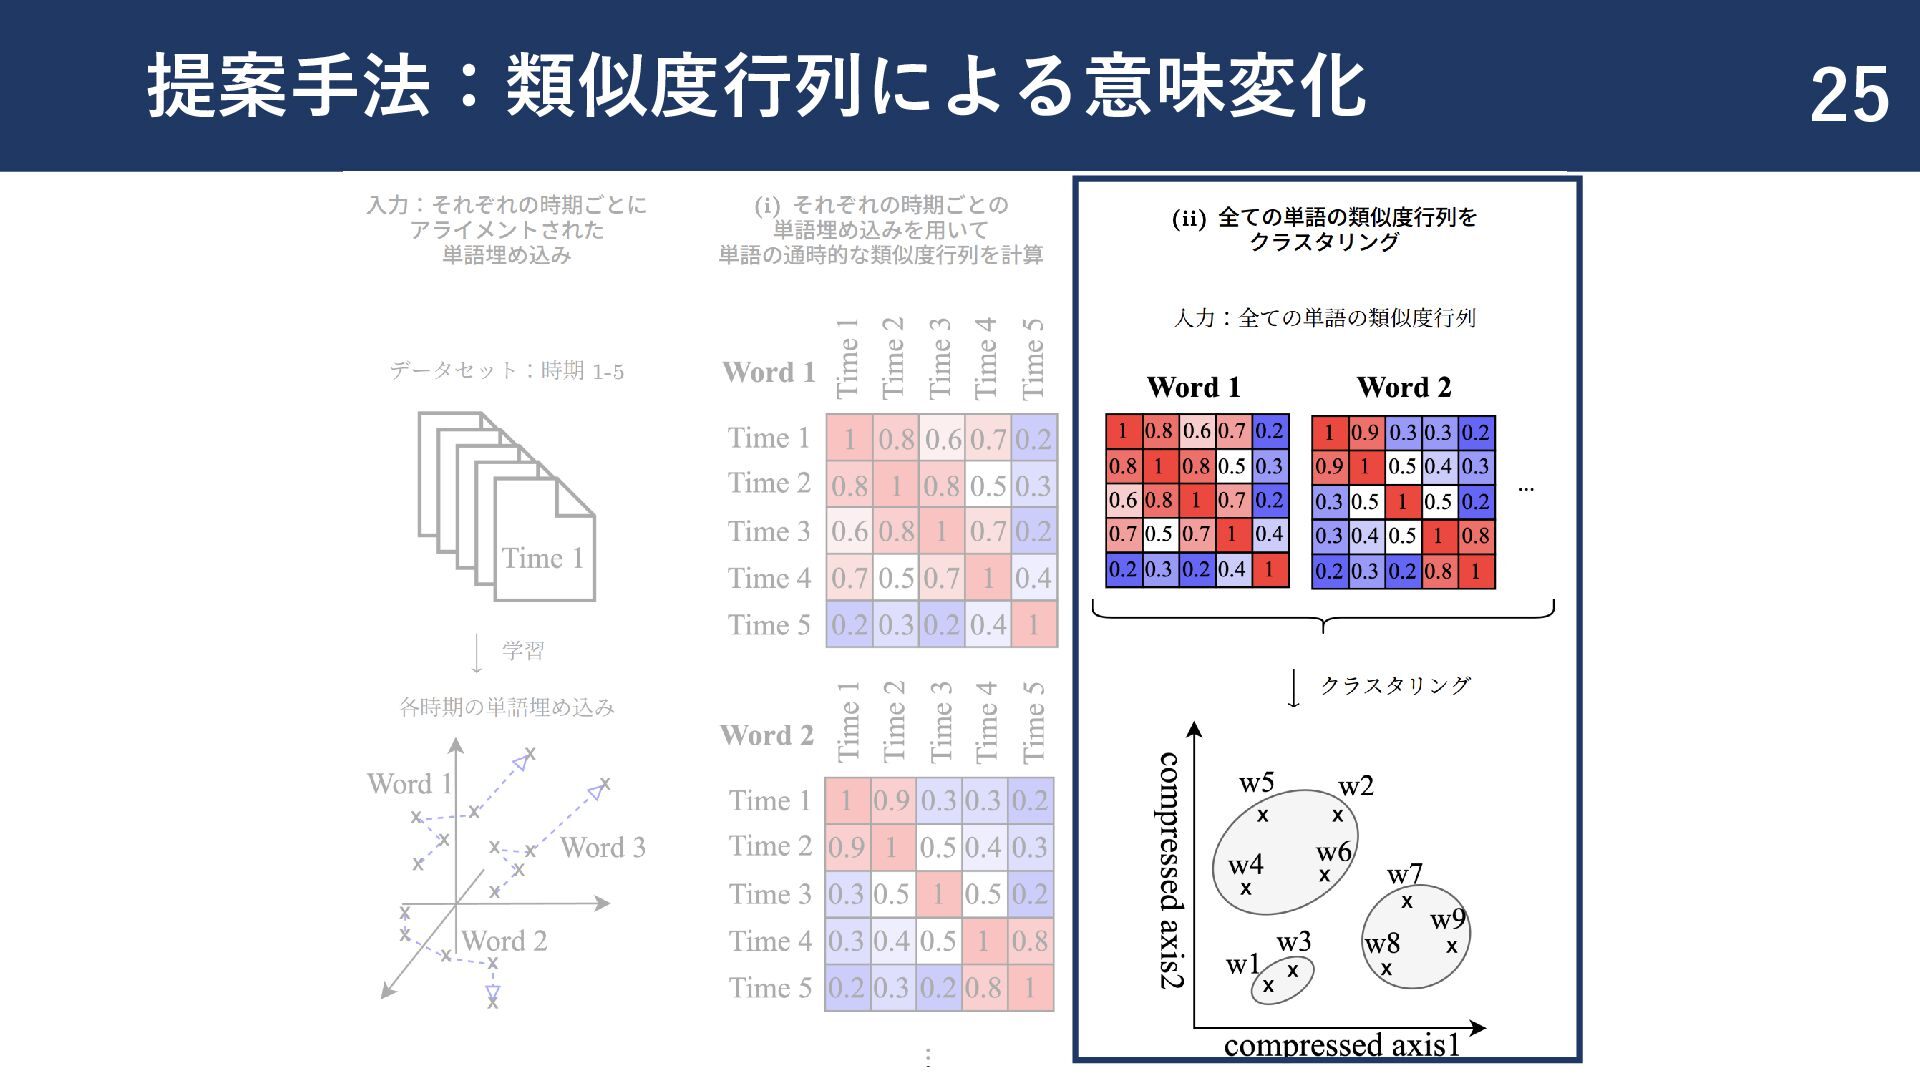
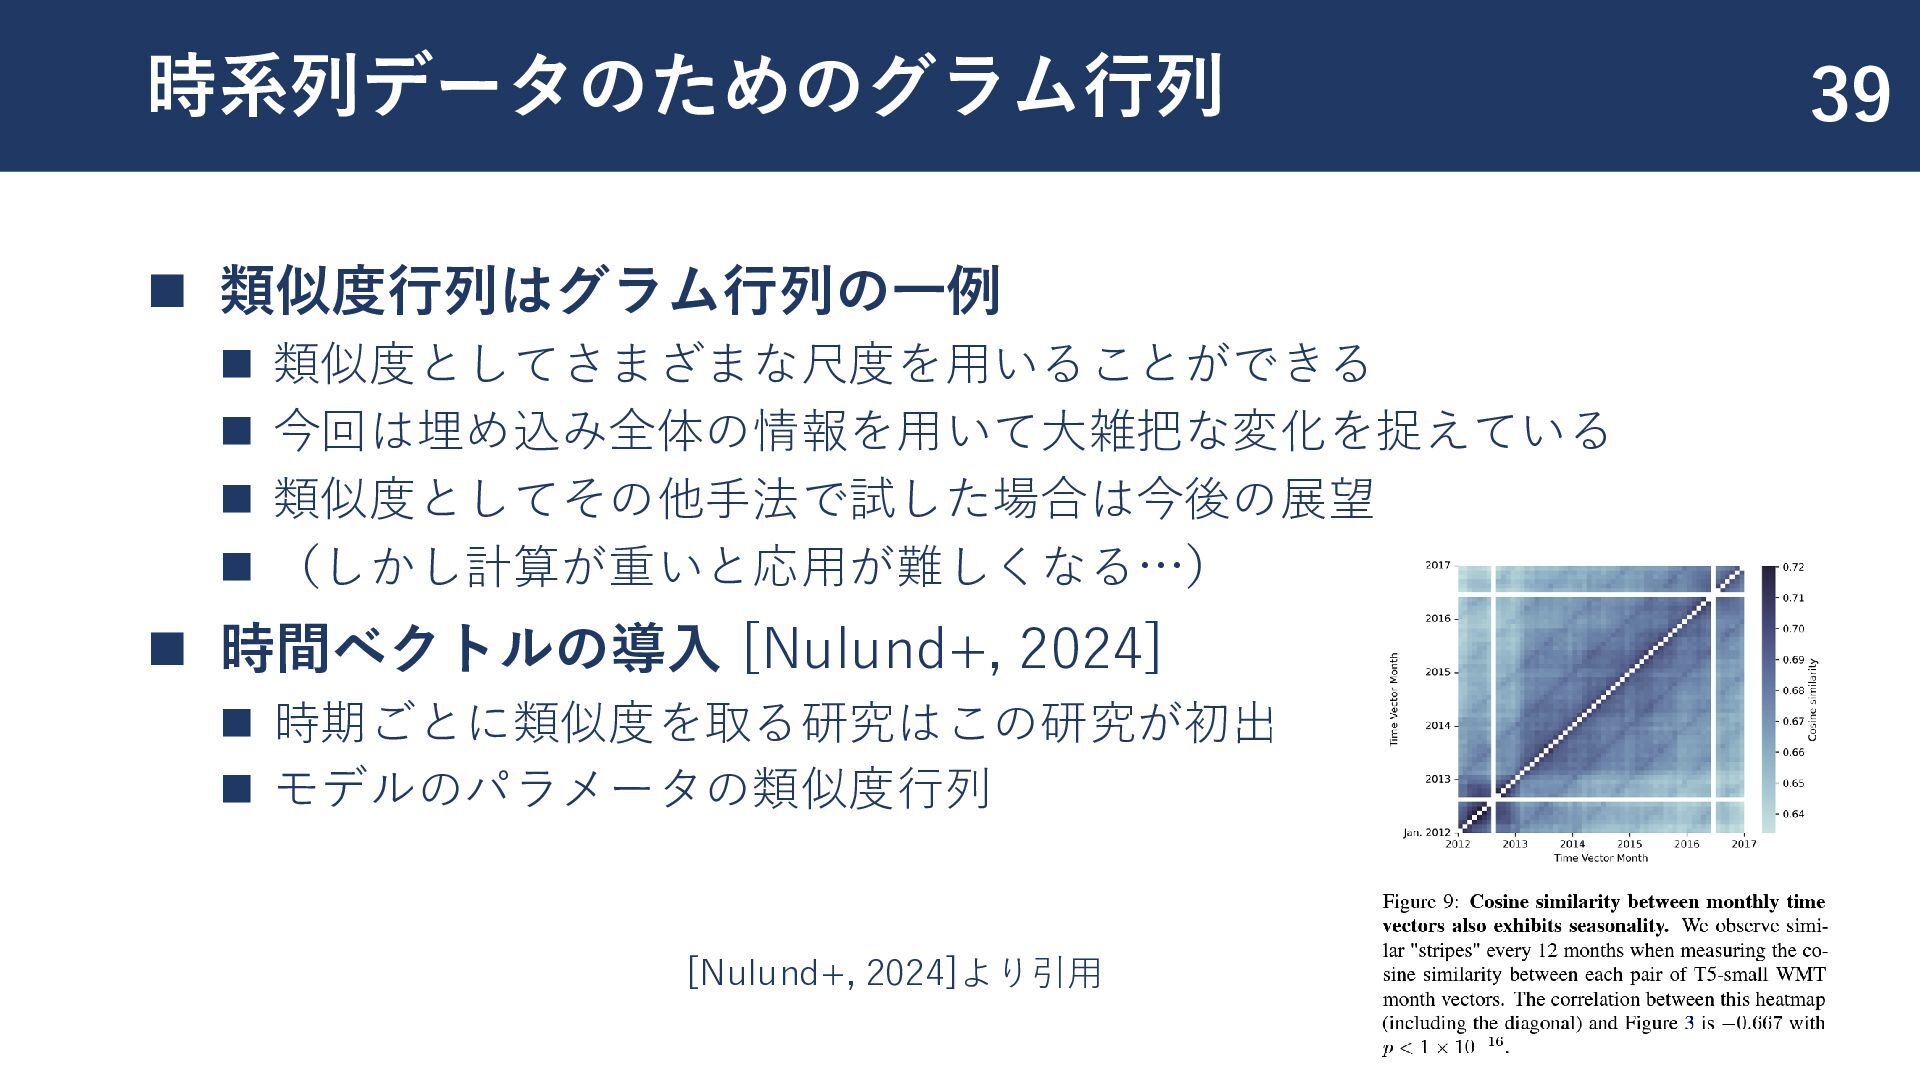
  18. 時系列データのためのグラム行列 ◼ 類似度行列はグラム行列の一例 ◼ 類似度としてさまざまな尺度を用いることができる ◼ 今回は埋め込み全体の情報を用いて大雑把な変化を捉えている ◼ 類似度としてその他手法で試した場合は今後の展望 ◼

    (しかし計算が重いと応用が難しくなる…) ◼ 時間ベクトルの導入 [Nulund+, 2024] ◼ 時期ごとに類似度を取る研究はこの研究が初出 ◼ モデルのパラメータの類似度行列 39 [Nulund+, 2024]より引用
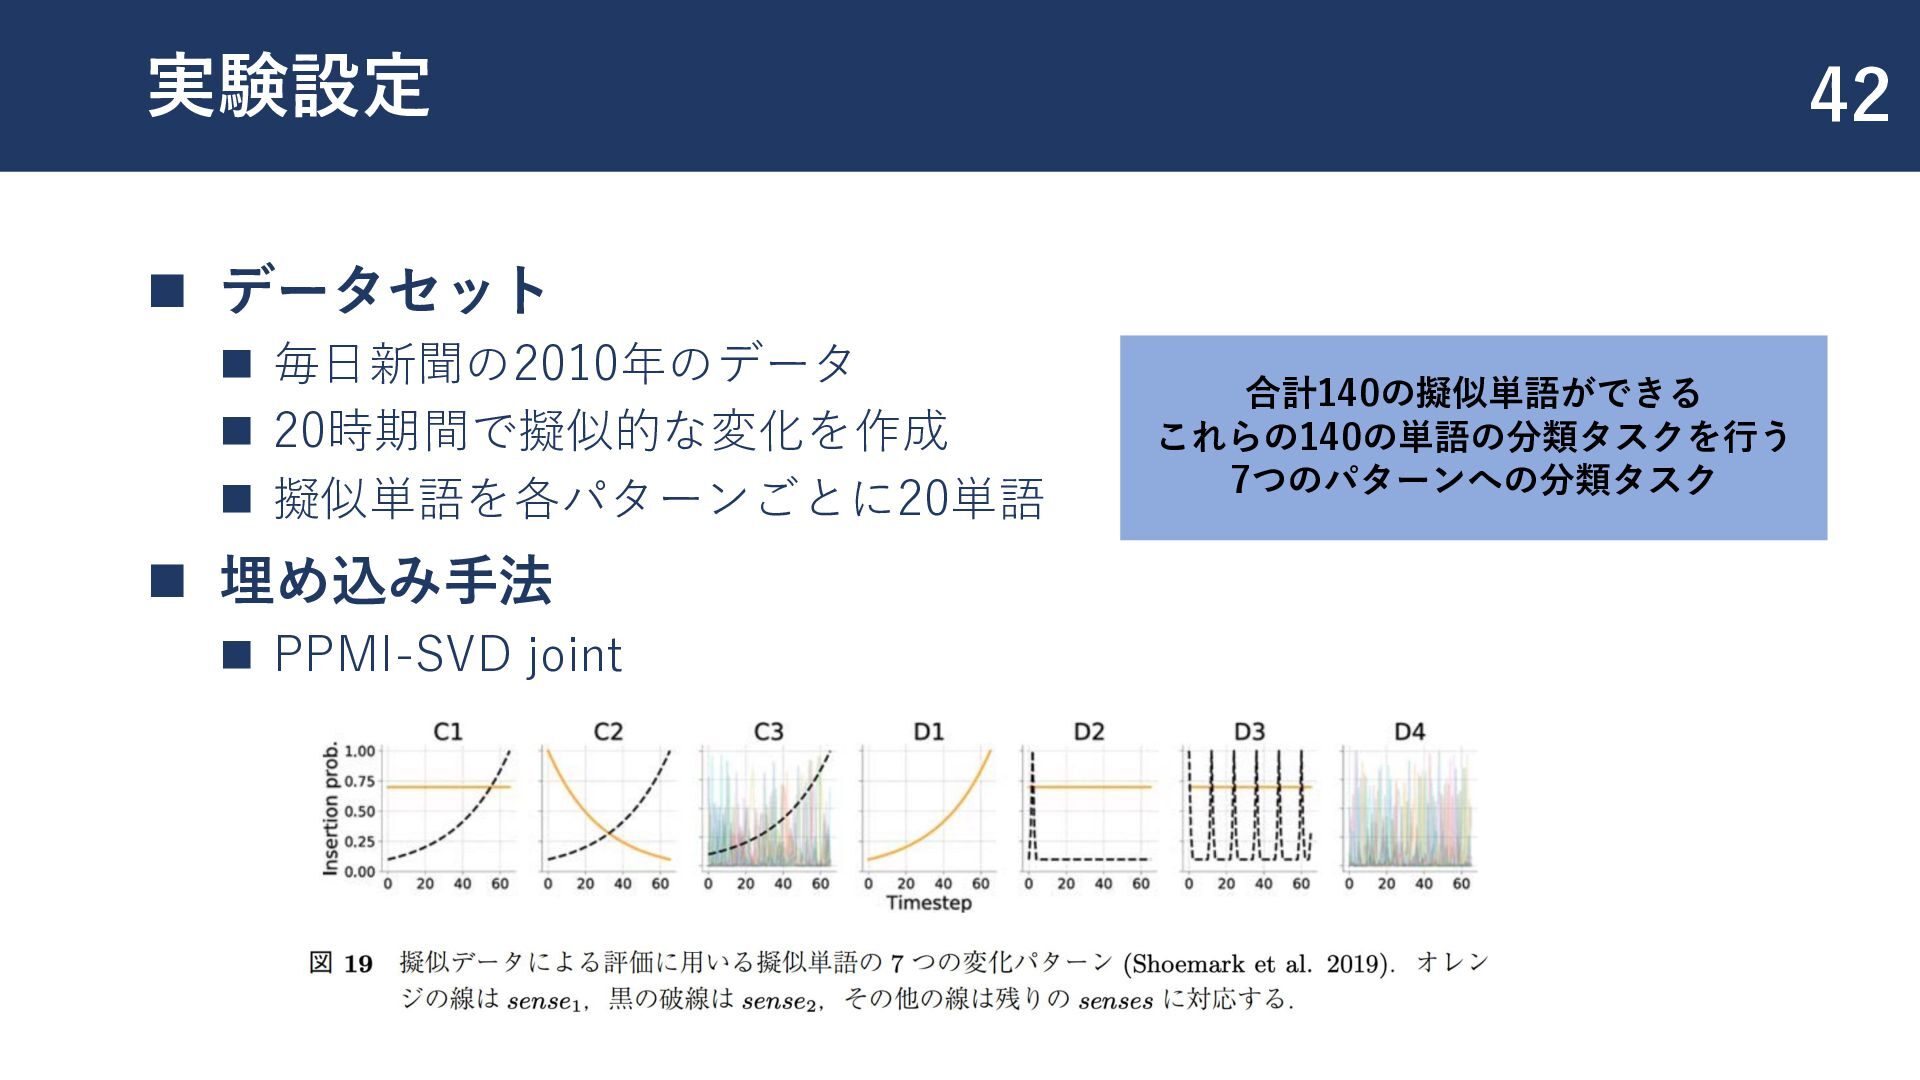
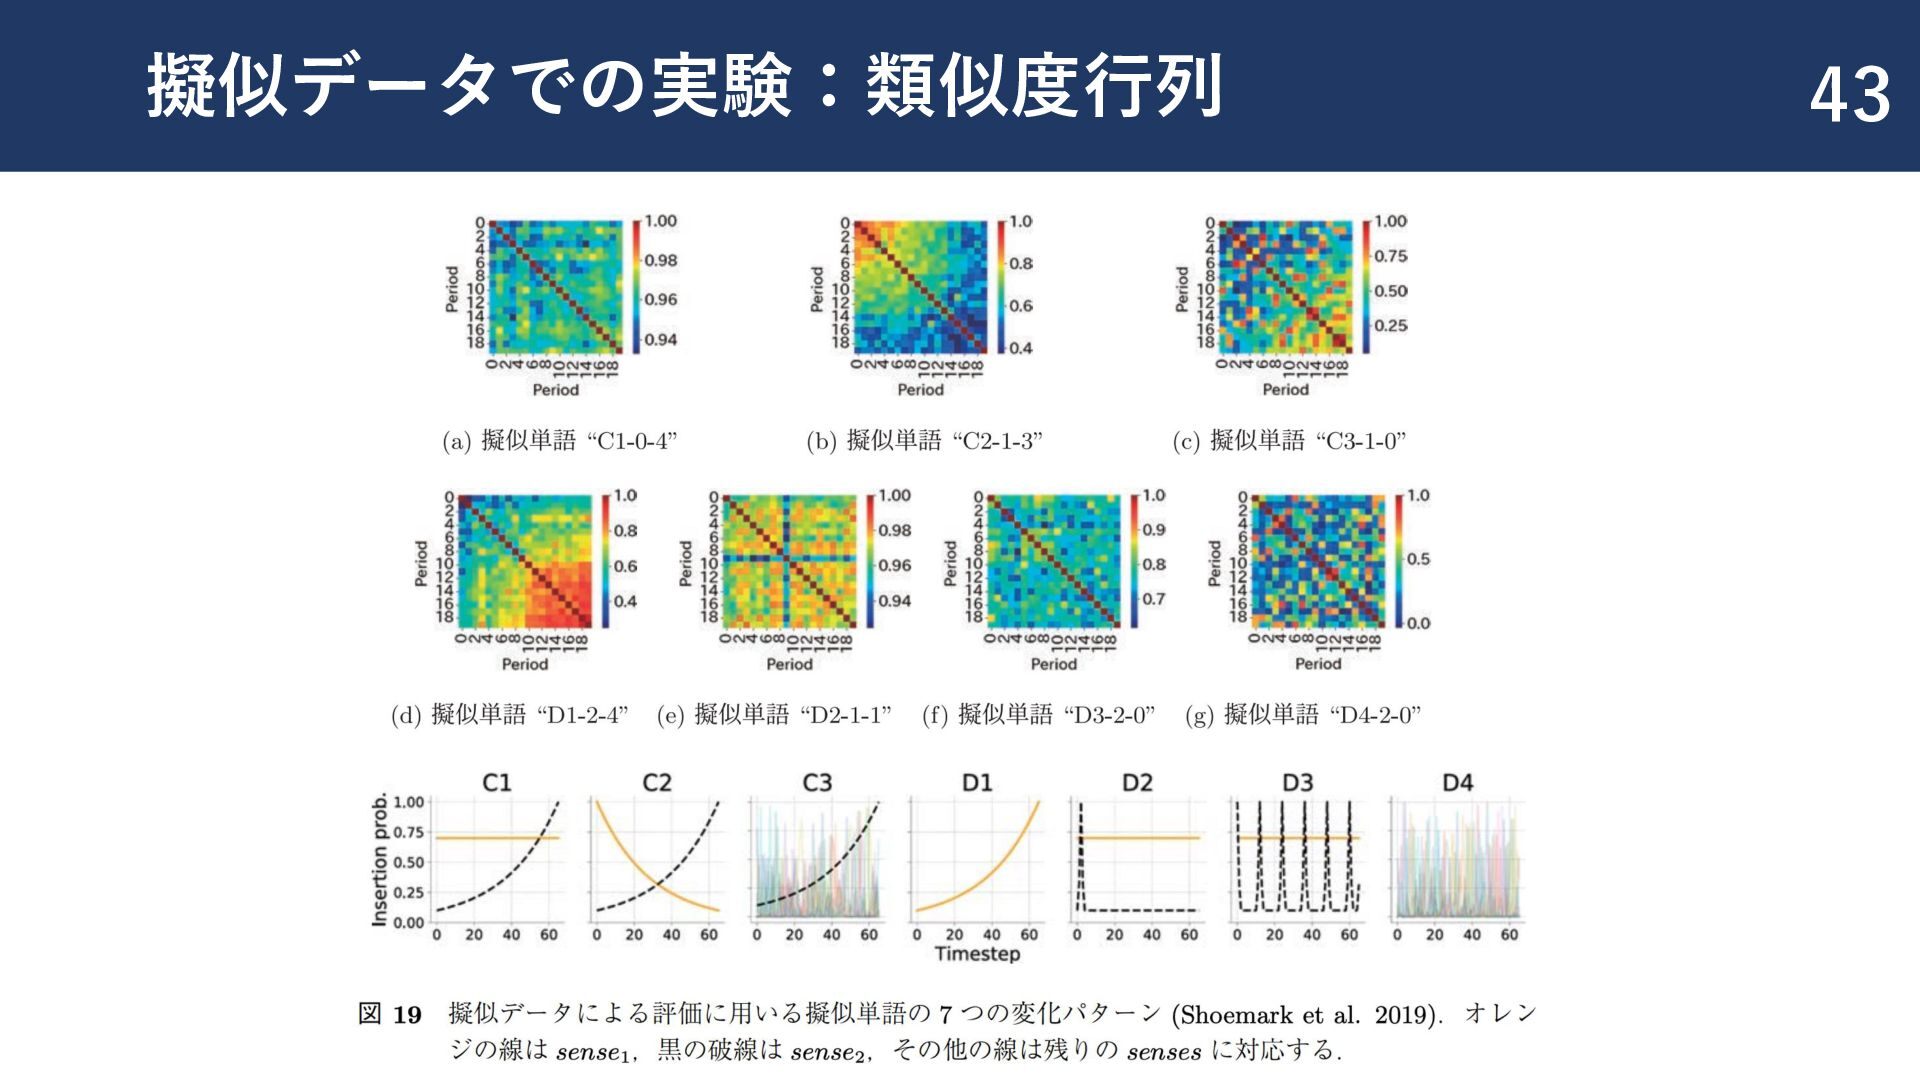
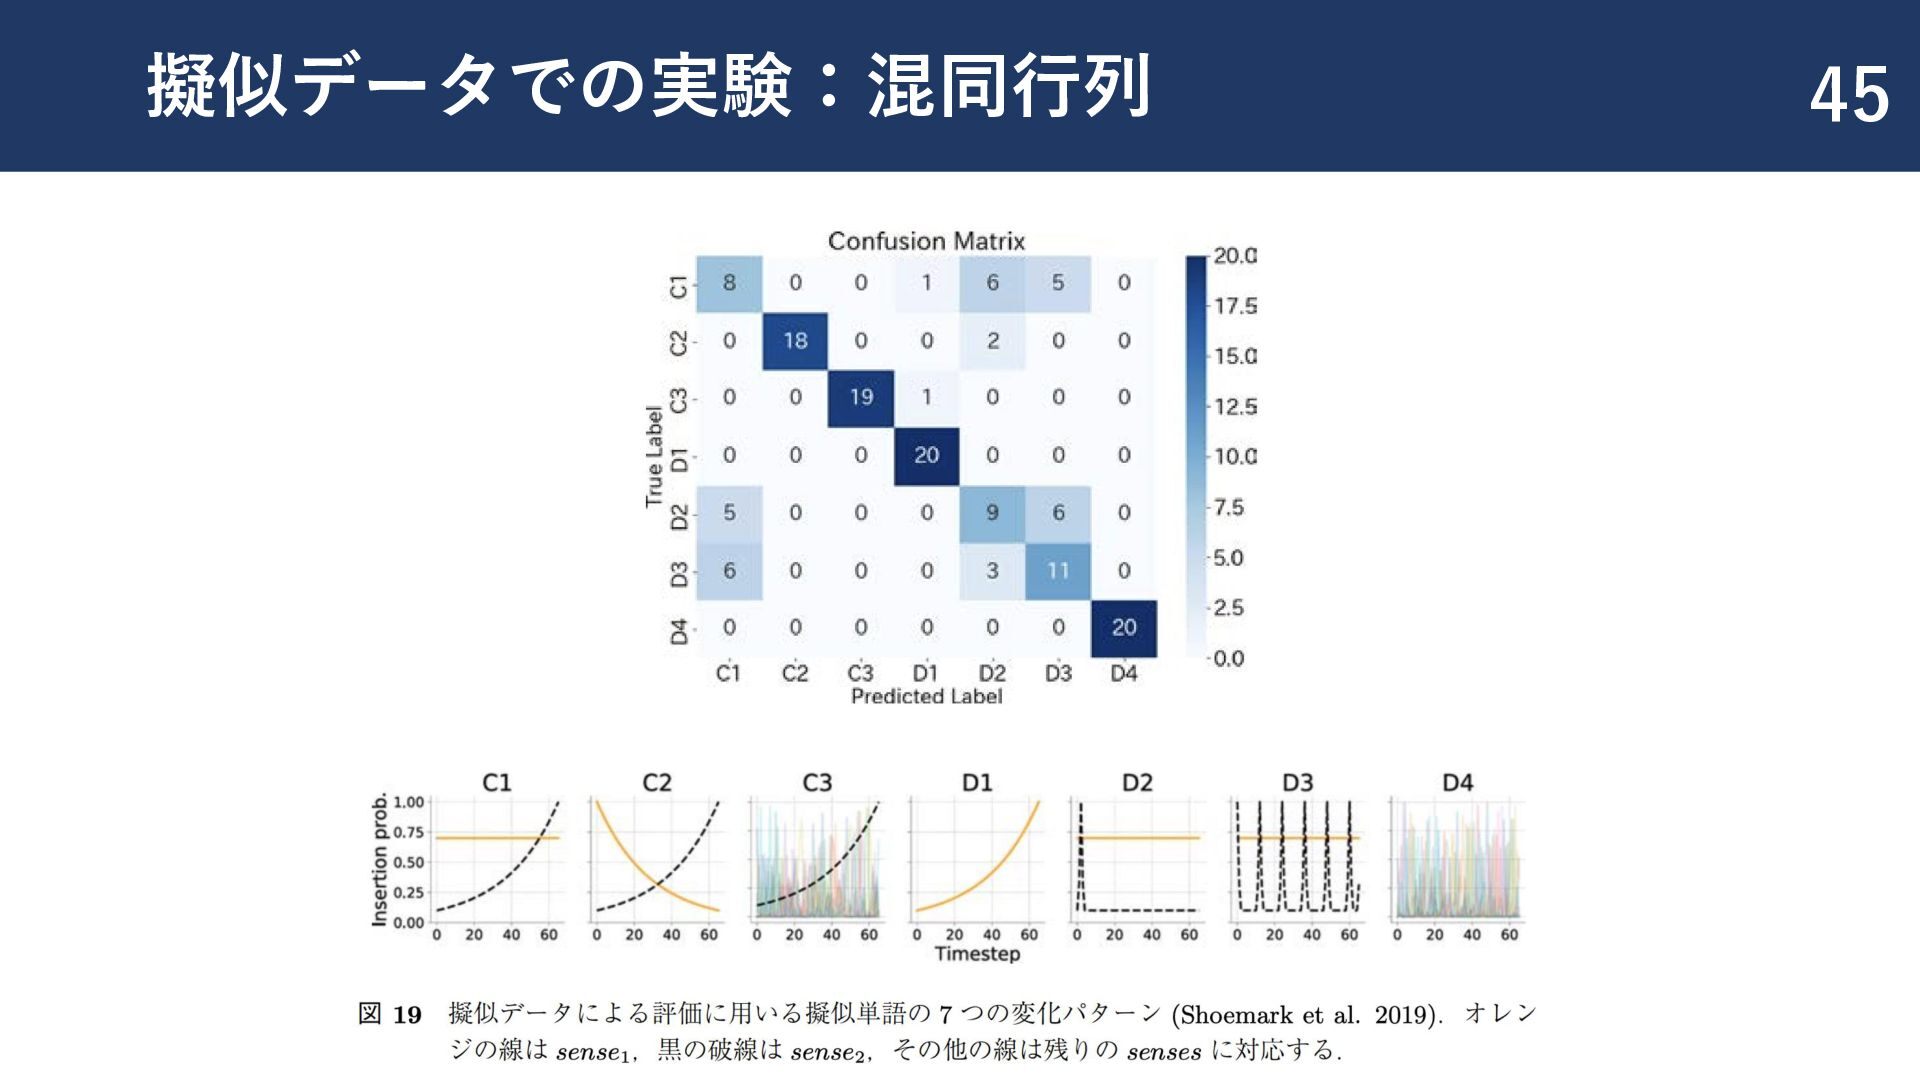
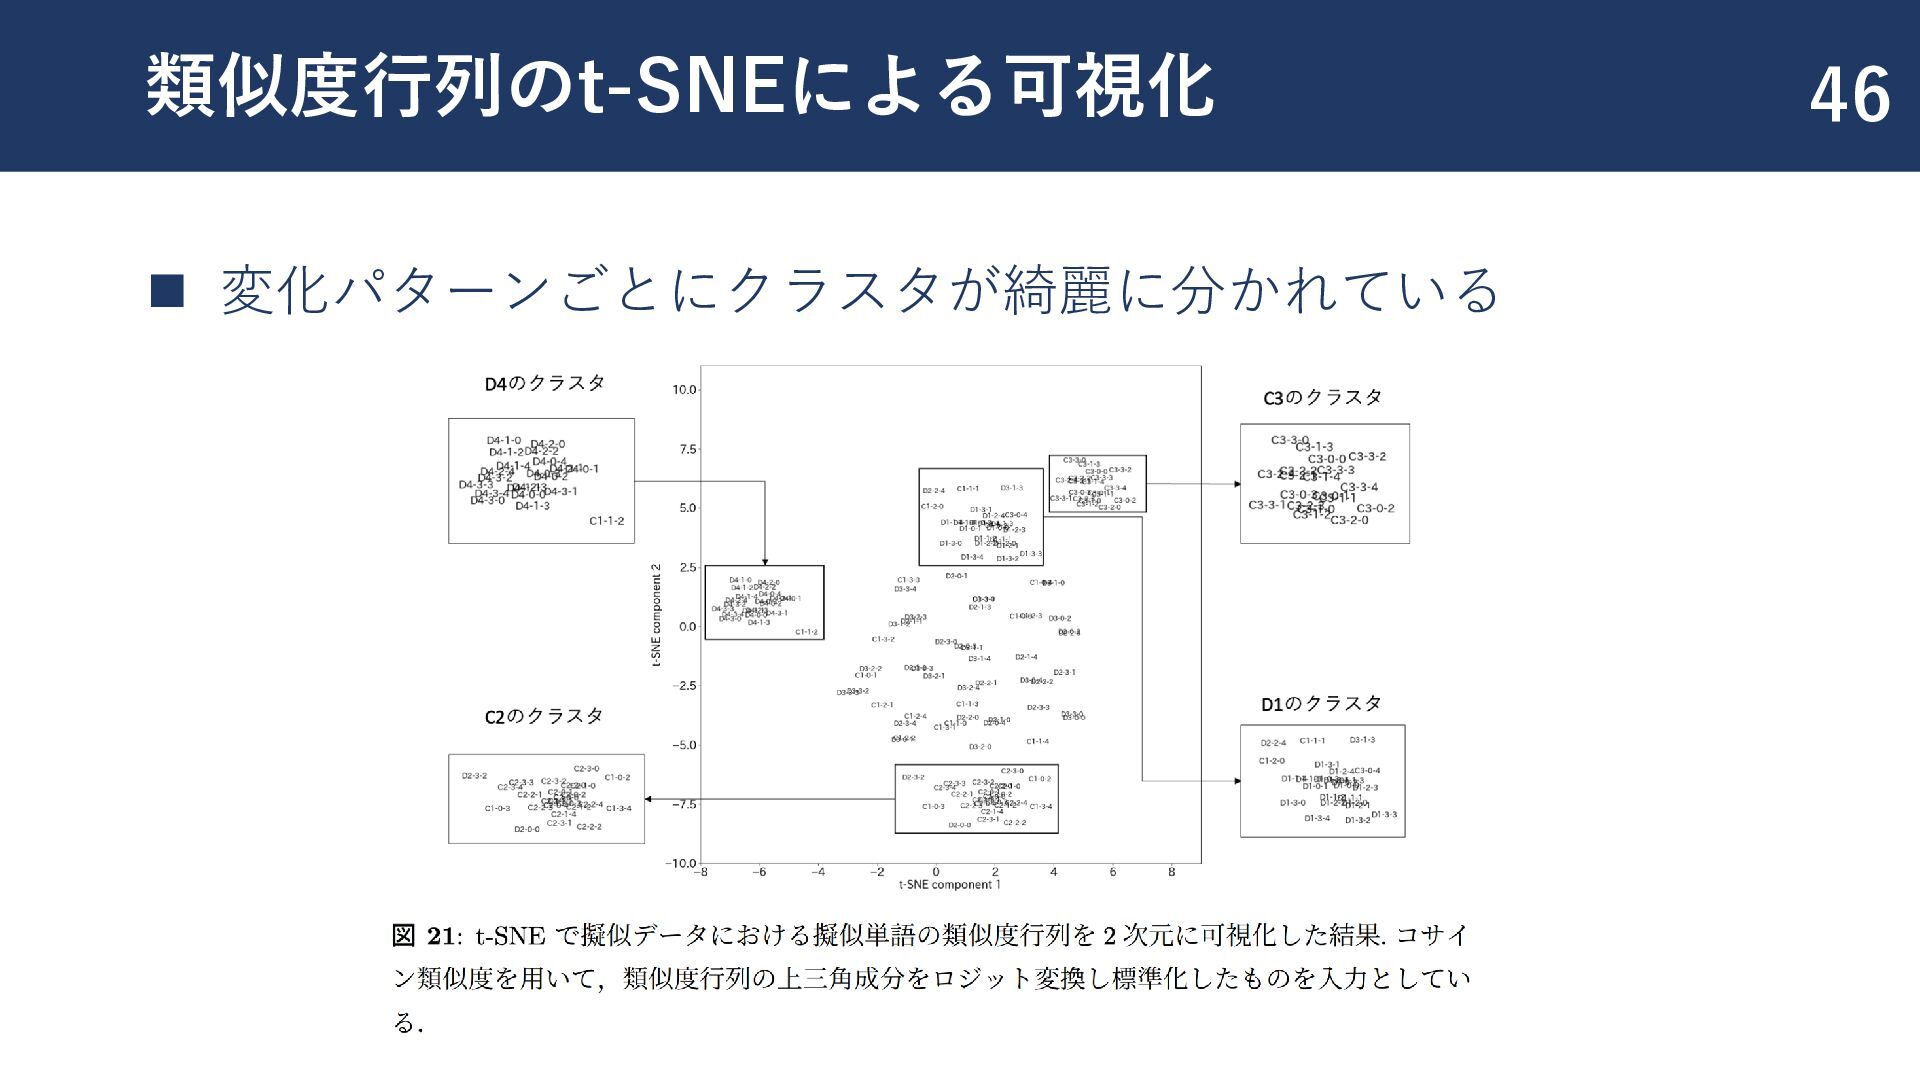
  19. 変化パターンの分類 41 ◼ [Shoemark+,2017] の7つの変化パターンの分類タスクを実施 ◼ C1:新しい意味の獲得 ◼ C2:意味の転移 ◼

    C3:雑多な意味の獲得 ◼ D1:特定の意味の増加 ◼ D2:特定の時期間に敏感 ◼ D3:周期的に敏感な変化 ◼ D4:純粋なノイズ
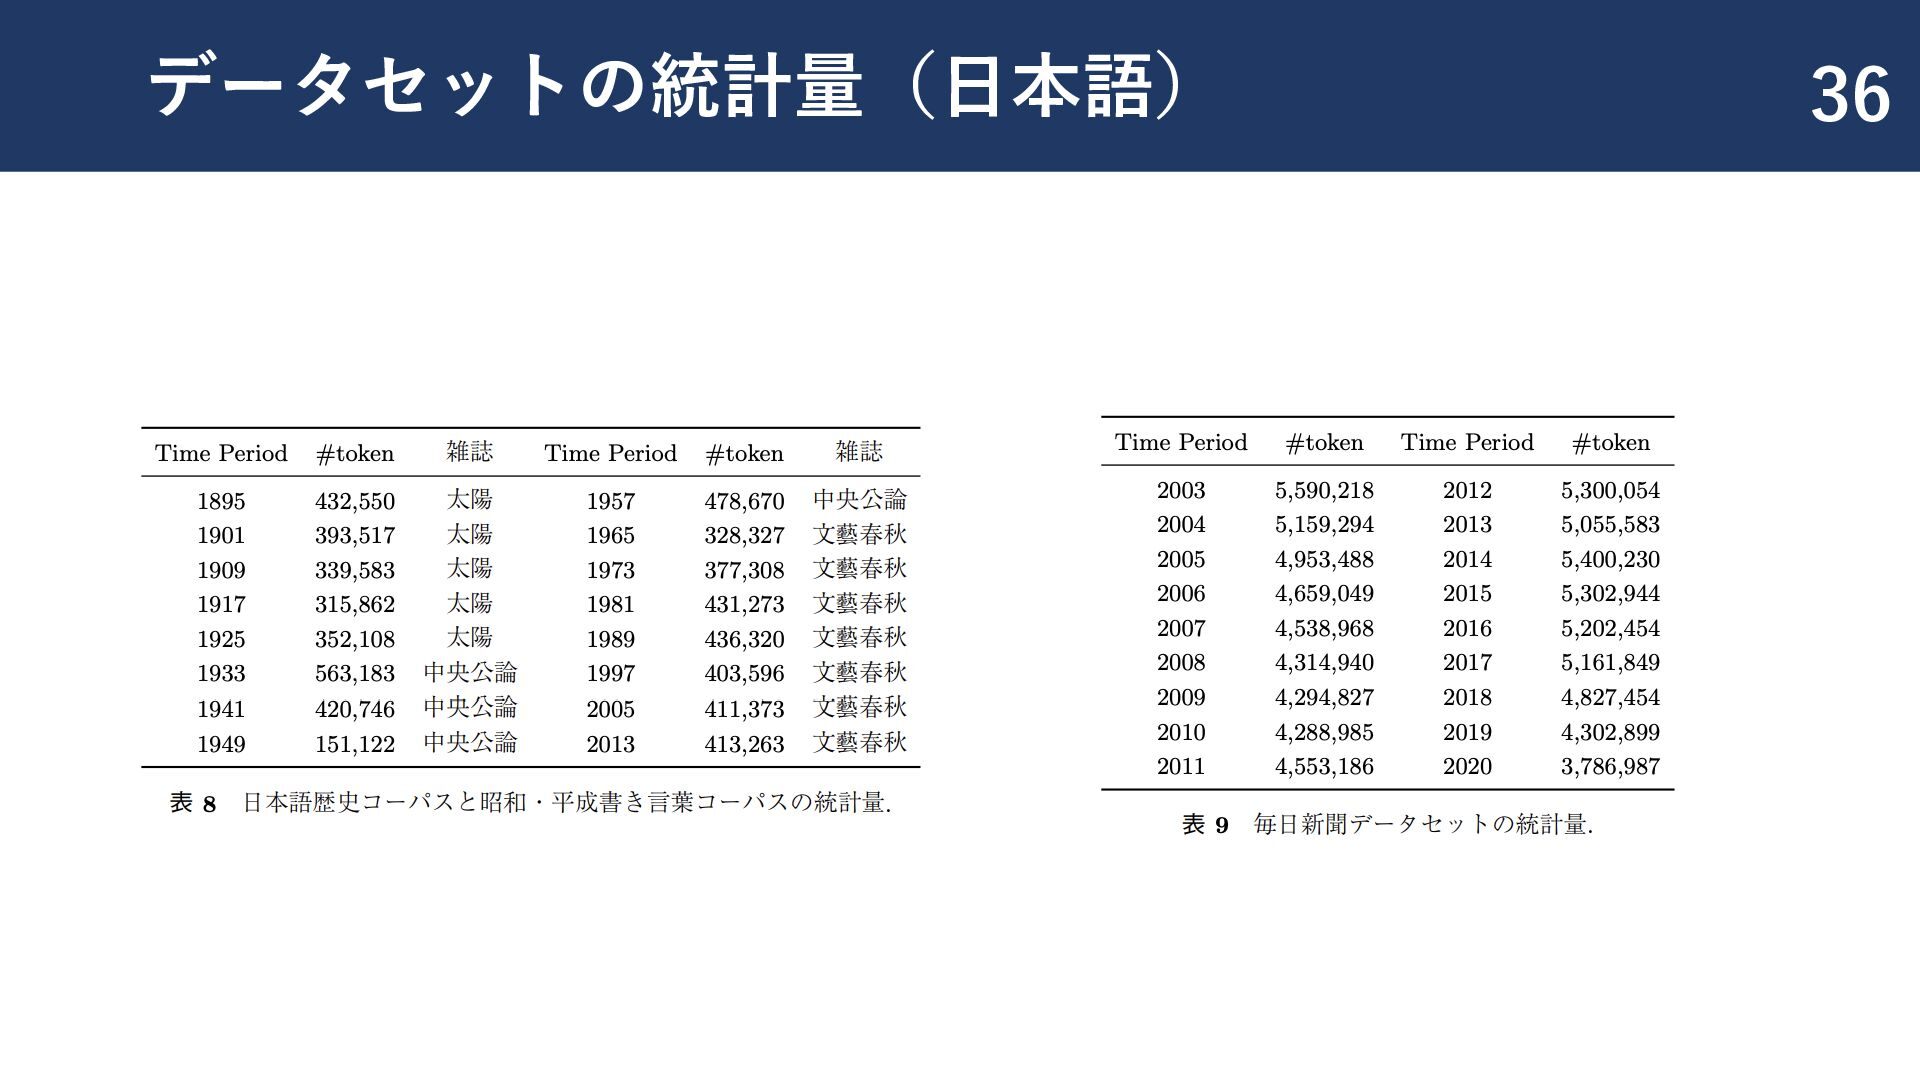
  20. 実験設定 ◼ データセット ◼ 毎日新聞の2010年のデータ ◼ 20時期間で擬似的な変化を作成 ◼ 擬似単語を各パターンごとに20単語 ◼

    埋め込み手法 ◼ PPMI-SVD joint 42 合計140の擬似単語ができる これらの140の単語の分類タスクを行う 7つのパターンへの分類タスク
  21. 関連研究1 [Hamilton+,2016] Diachronic Word Embeddings Reveal Statistical Laws of Semantic

    Change [Cassotti+, 2023] XL-LEXEME: WiC Pretrained Model for Cross- Lingual LEXical sEMantic changE [Periti and Tahmasebi, 2024a] A Systematic Comparison of Contextualized Word Embeddings for Lexical Semantic Change [Periti and Tahmasebi, 2024b] Towards a Complete Solution to Lexical Semantic Change: an Extension to Multiple Time Periods and Diachronic Word Sense Induction [Aida and Bollegala, 2024] A Semantic Distance Metric Learning approach for Lexical Semantic Change Detection 52
  22. 関連研究2 [Periti+, 2024] Analyzing Semantic Change through Lexical Replacements [Kulkarni+,

    2015] Statistically Significant Detection of Linguistic Change [Hu+, 2019] Diachronic Sense Modeling with Deep Contextualized Word Embeddings: An Ecological View [Giulianelli+, 2020] Analysing Lexical Semantic Change with Contextualised Word Representations 53
  23. 関連研究3 [相田他, 2023] 異なる時期での意味の違いを捉える単語分散表現 の結合学習 [Levy and Goldberg, 2014] Neural

    Word Embedding as Implicit Matrix Factorization [Shoemark+, 2017] Room to Glo: A Systematic Comparison of Semantic Change Detection Approaches with Word Embeddings [Nulund+, 2024] Time is Encoded in the Weights of Finetuned Language Models 54

More Decks by hajime kiyama

Other Decks in Research