Share
Embed
ソースを読む時の思考プロセスの例-MkDocs
以下動画のスライドです。
https://youtu.be/Lk3-vmVEzao
Satoru Takeuchi PRO
October 26, 2025
Transcript
14 slides
-
はじめに • ソースコードを読むプロセスの一例を紹介 ◦ 唯一絶対の最適な方法ではない ◦ 人によって、場面によって読みかたはさまざま ◦ AIは使っていない ▪
結果に再現性がないのと、何を使うかでかなり結果が変わるので扱いづらい • 紹介の流れ ◦ 動機 ◦ 方針 ◦ 読む -
動機 • 動機があってはじめて、どこをどう読めばいいかがわかる • 今回は「Markdownのhtmlへのレンダリングはどうやってるの?」という素朴な疑問 を解消したかった • ツールはいろいろある ◦ Mkdocs:
FastAPIで使われている。Python製 ◦ Jekyll: GitHub Pages標準。Ruby製 ◦ Hugo: 高速。Go製 • Mkdocsを読むことにした ◦ 📝 この手の題材で本を書いていて、その本の中で紹介するコードは全部 Pythonにしたい • 読むバージョンは最新の1.6.1 ◦ とくに古いものを読む動機が無い -
方針 • 方針を決めておくと漫然と読んで迷走してしまう事は避けやすい • 今回の方針 ◦ レンダリングに関係ないところは全無視 ▪ 興味のあるところ以外を読んでもキリがない ◦
エラー処理系は無視 ▪ 処理をざっと理解したいだけなので、細かいところは気にしなくていい ▪ より興味が出た時に、あとで読めばいい -
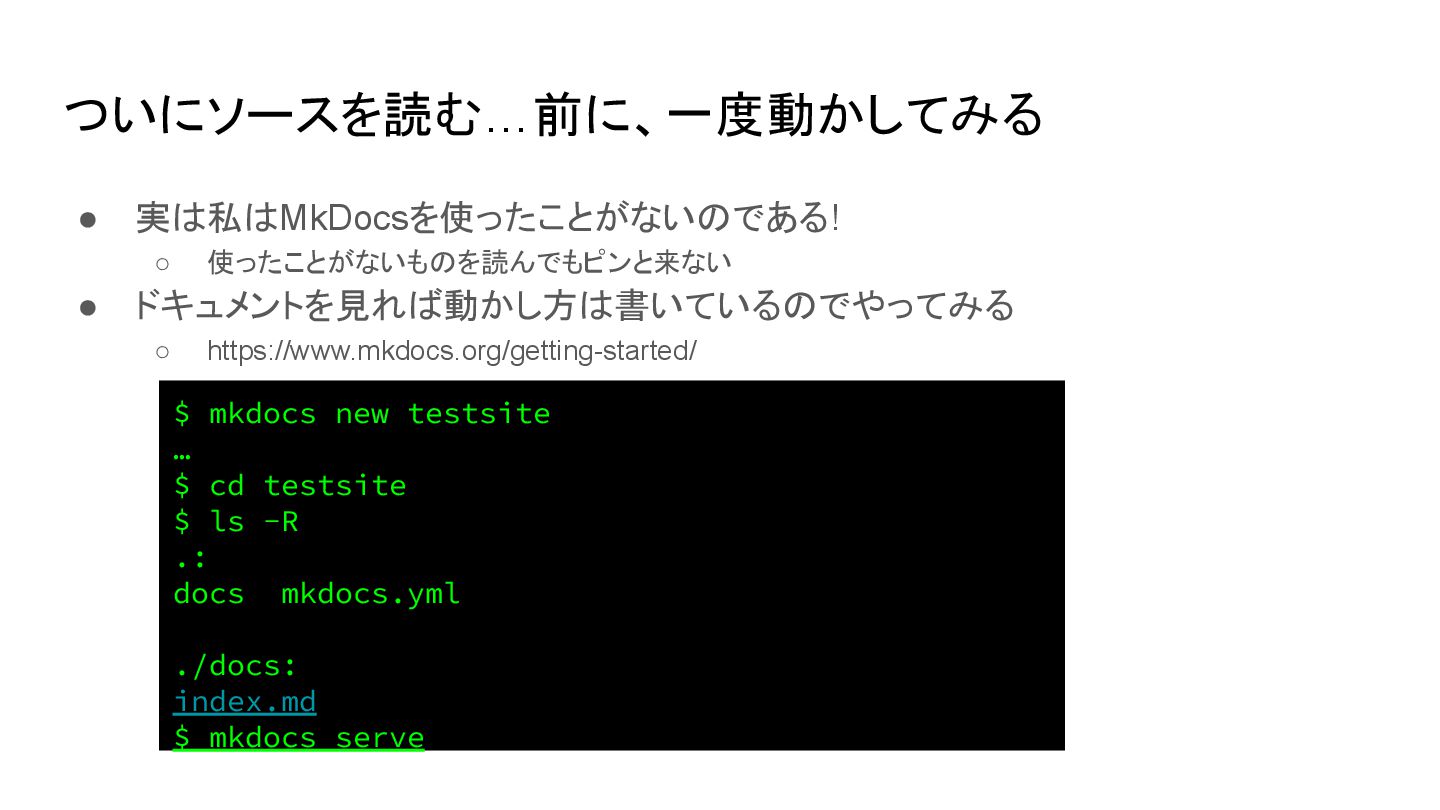
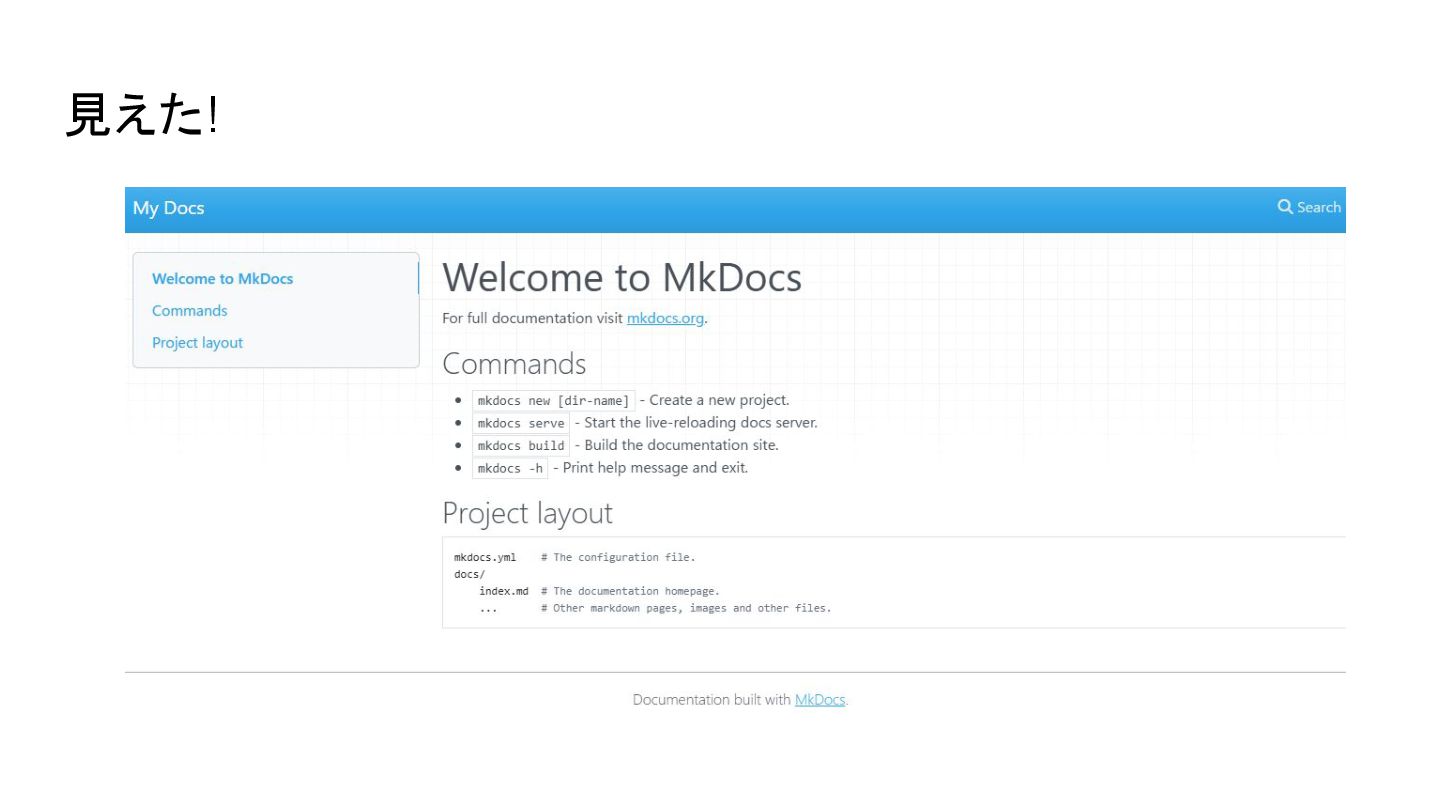
ついにソースを読む…前に、一度動かしてみる • 実は私はMkDocsを使ったことがないのである! ◦ 使ったことがないものを読んでもピンと来ない • ドキュメントを見れば動かし方は書いているのでやってみる ◦ https://www.mkdocs.org/getting-started/ $
mkdocs new testsite … $ cd testsite $ ls -R .: docs mkdocs.yml ./docs: index.md $ mkdocs serve -
ついにソースを読む…のではなくドキュメントを読む • 「どこから読むか」を知る必要がある ◦ 全部読みたくない(MkDocsは2万行くらいある) ▪ 📝 規模が小さければmainから読んでいたかもしれない ◦ ドキュメントを見るとソースコードの構造が書いてあることがある
• dev-guideというディレクトリがあった ◦ …が、3rd party pluginを開発する人向けだったので読んでもしかたない • 他にも大したこと書いてそうなドキュメントは無かった。空振り -
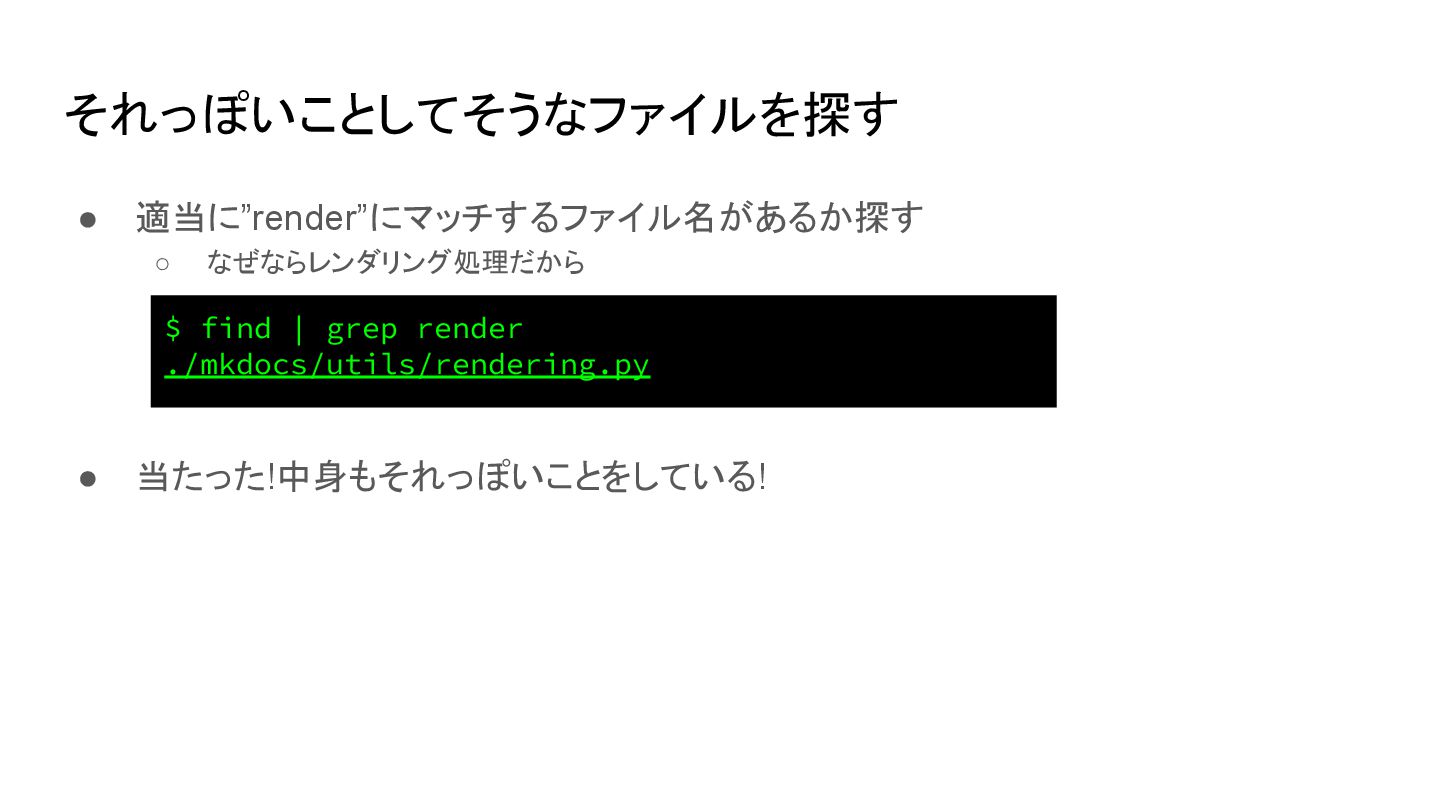
それっぽいことしてそうなファイルを探す • 適当に”render”にマッチするファイル名があるか探す ◦ なぜならレンダリング処理だから • 当たった!中身もそれっぽいことをしている! $ find |
grep render ./mkdocs/utils/rendering.py -
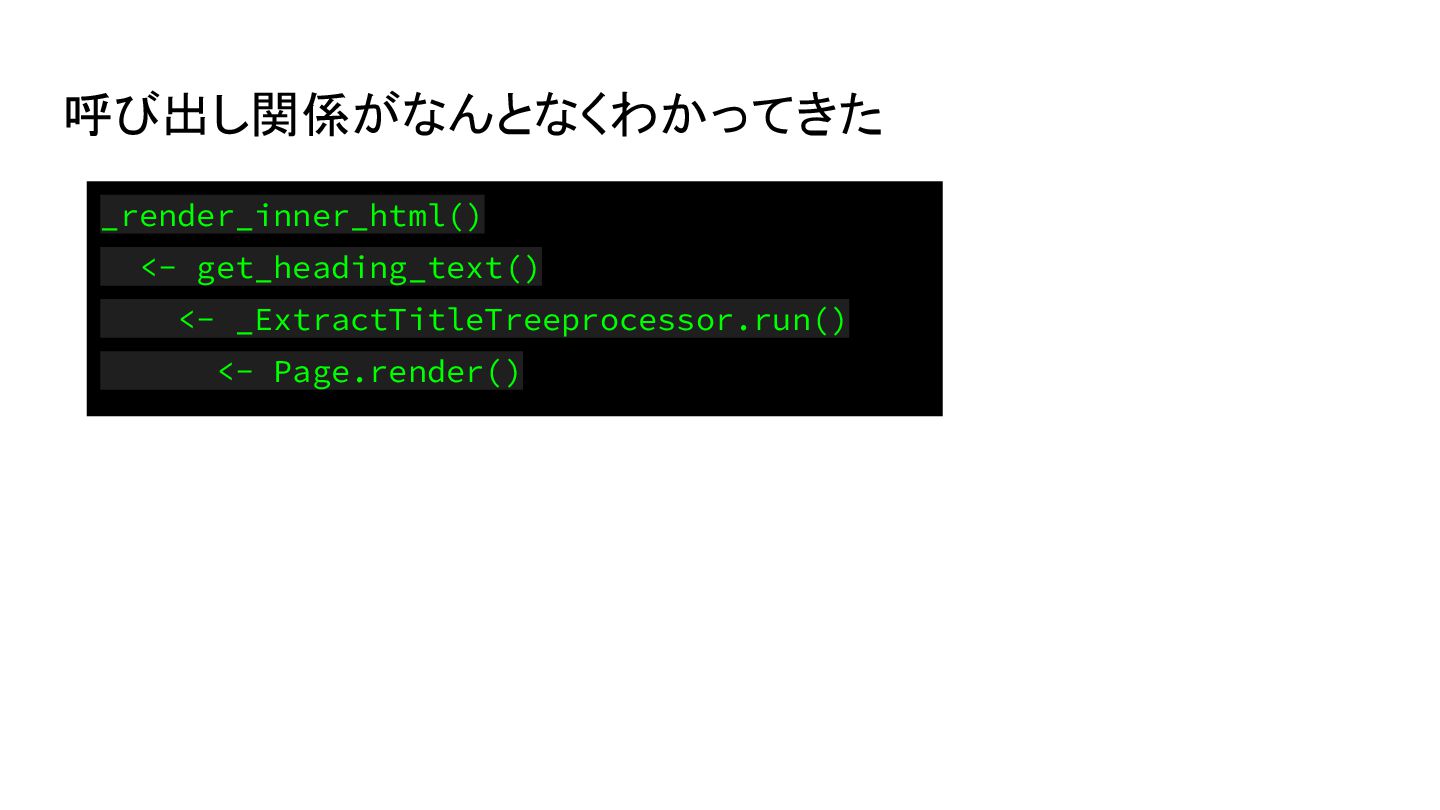
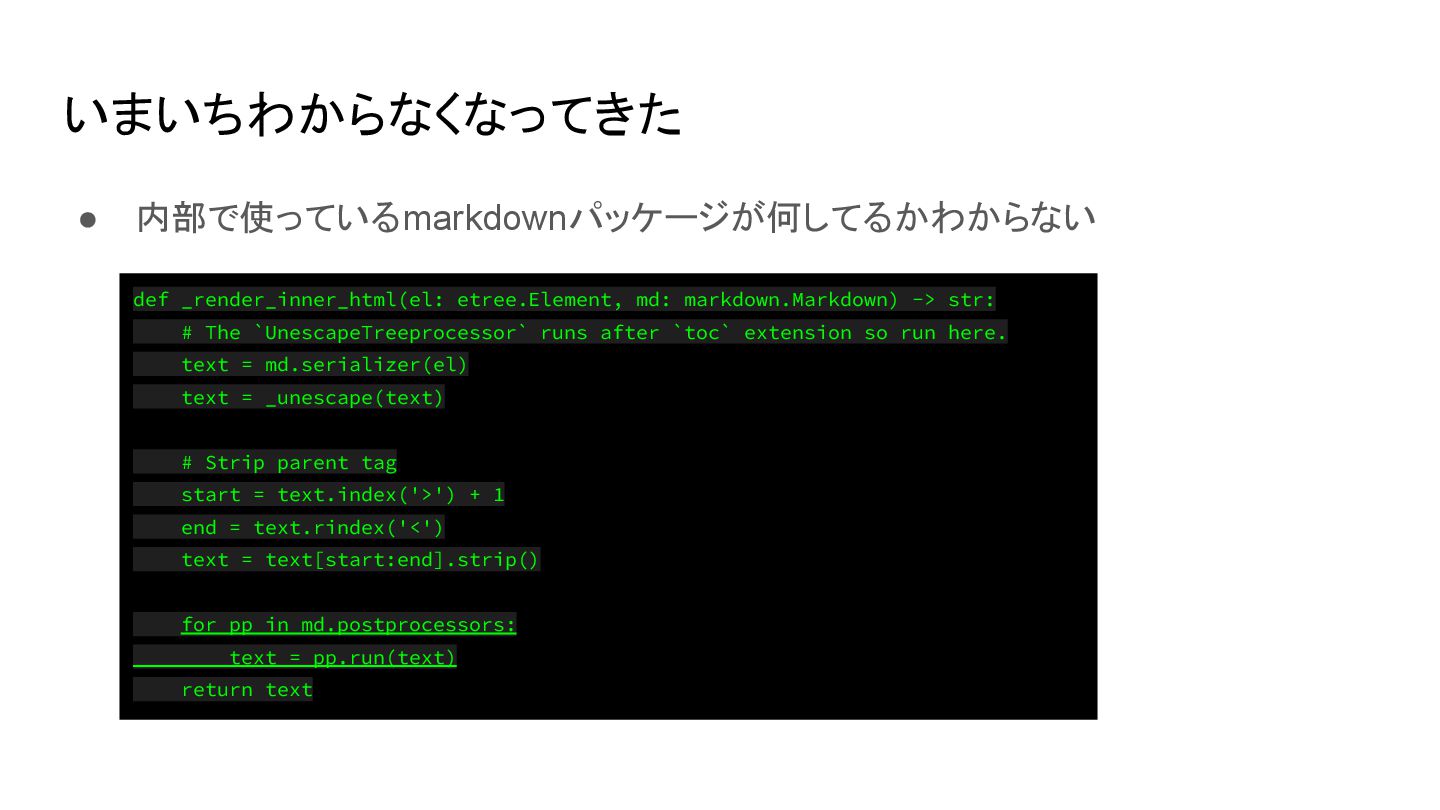
いまいちわからなくなってきた • 内部で使っているmarkdownパッケージが何してるかわからない def _render_inner_html(el: etree.Element, md: markdown.Markdown) -> str:
# The `UnescapeTreeprocessor` runs after `toc` extension so run here. text = md.serializer(el) text = _unescape(text) # Strip parent tag start = text.index('>') + 1 end = text.rindex('<') text = text[start:end].strip() for pp in md.postprocessors: text = pp.run(text) return text -
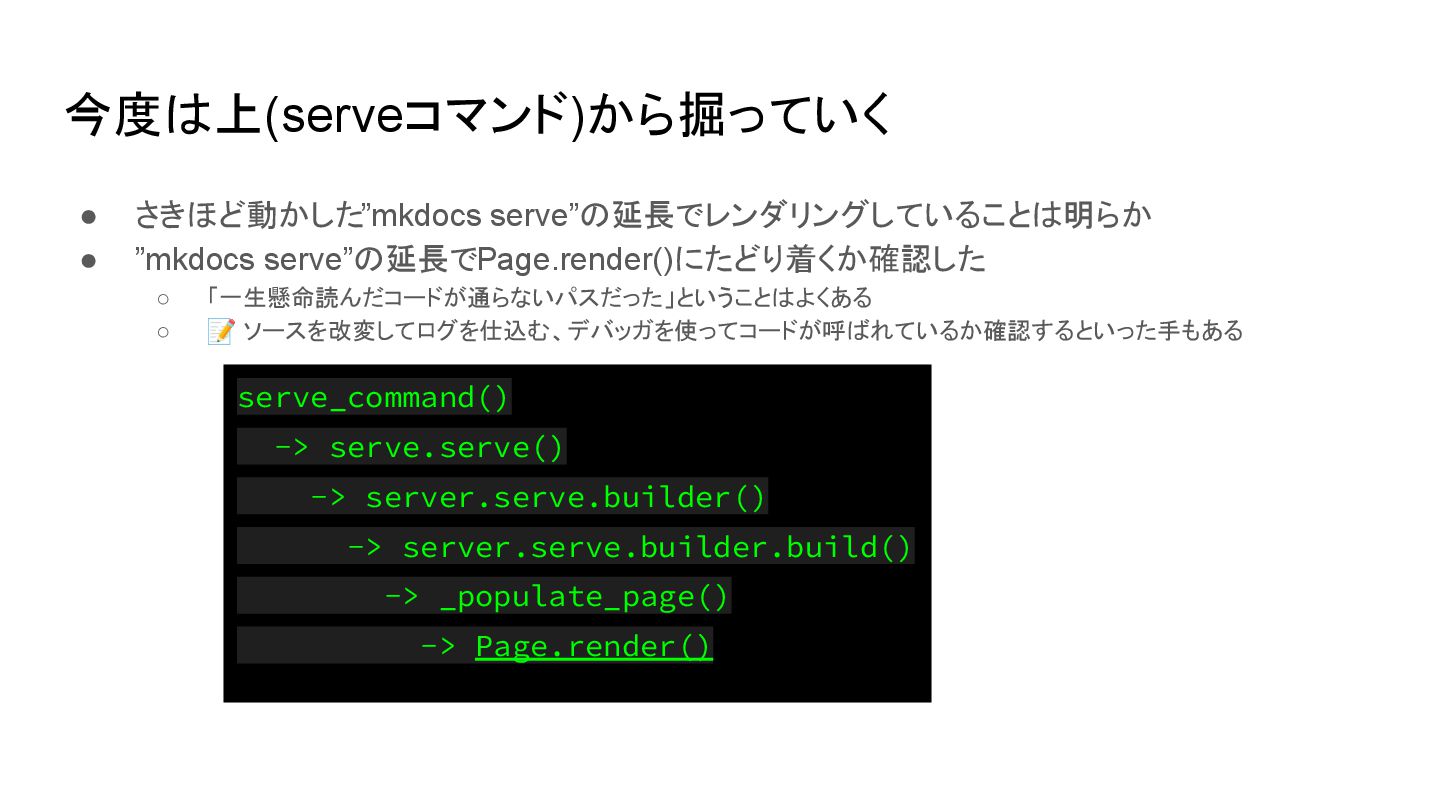
今度は上(serveコマンド)から掘っていく • さきほど動かした”mkdocs serve”の延長でレンダリングしていることは明らか • ”mkdocs serve”の延長でPage.render()にたどり着くか確認した ◦ 「一生懸命読んだコードが通らないパスだった」ということはよくある ◦
📝 ソースを改変してログを仕込む、デバッガを使ってコードが呼ばれているか確認するといった手もある serve_command() -> serve.serve() -> server.serve.builder() -> server.serve.builder.build() -> _populate_page() -> Page.render() -
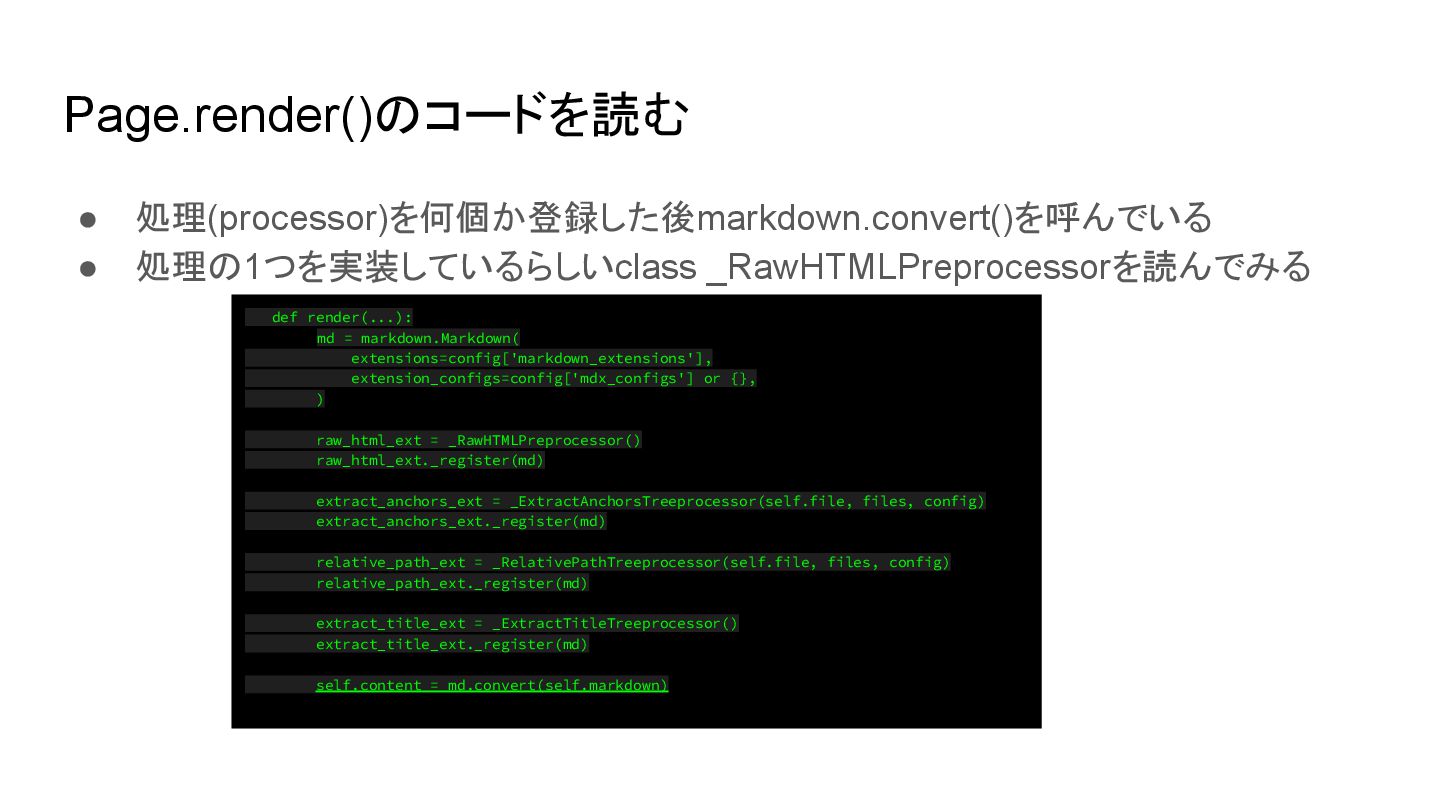
• 処理(processor)を何個か登録した後markdown.convert()を呼んでいる • 処理の1つを実装しているらしいclass _RawHTMLPreprocessorを読んでみる Page.render()のコードを読む def render(...): md =
markdown.Markdown( extensions=config['markdown_extensions'], extension_configs=config['mdx_configs'] or {}, ) raw_html_ext = _RawHTMLPreprocessor() raw_html_ext._register(md) extract_anchors_ext = _ExtractAnchorsTreeprocessor(self.file, files, config) extract_anchors_ext._register(md) relative_path_ext = _RelativePathTreeprocessor(self.file, files, config) relative_path_ext._register(md) extract_title_ext = _ExtractTitleTreeprocessor() extract_title_ext._register(md) self.content = md.convert(self.markdown) -
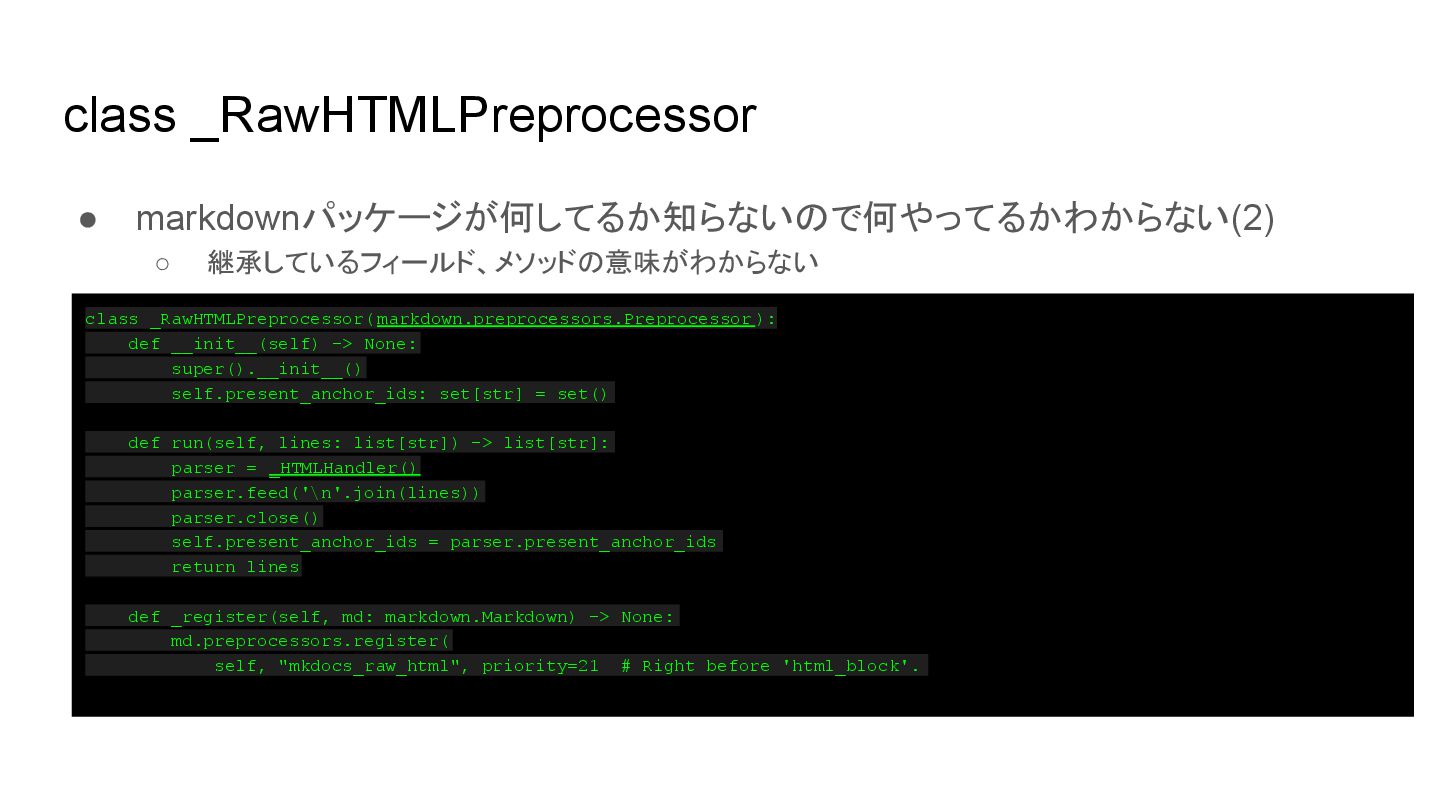
• markdownパッケージが何してるか知らないので何やってるかわからない(2) ◦ 継承しているフィールド、メソッドの意味がわからない class _RawHTMLPreprocessor class _RawHTMLPreprocessor(markdown.preprocessors.Preprocessor ): def
__init__(self) -> None: super().__init__() self.present_anchor_ids: set[str] = set() def run(self, lines: list[str]) -> list[str]: parser = _HTMLHandler() parser.feed('\n'.join(lines)) parser.close() self.present_anchor_ids = parser.present_anchor_ids return lines def _register(self, md: markdown.Markdown) -> None: md.preprocessors.register( self, "mkdocs_raw_html", priority=21 # Right before 'html_block'. -
結論 • 私の知りたいことはMkDocsだけを読んでもわからない • さらにmarkdownパッケージの仕様あるいはコードを読まなければならない • ただし無駄だったわけではない ◦ 読まなければ何もわからなかった。一歩前進 ◦
この後markdownパッケージが何物かわかれば「それをどう使っているか」は既に知っている • 続く?