Share
Embed
Active Convolution, Deformable Convolution ―形状・スケールを学習可能なConvolution―
「夏のトップカンファレンス論文読み会」発表資料です。
https://www.slideshare.net/YosukeShinya/active-convolution-deformable-convolution-convolution より移行。
Yosuke Shinya
September 18, 2017
Transcript
35 slides
-
自己紹介 2007~2014 東京大学 話者認識 形状の数式表現、Mixed Reality 2014~2015 三菱電機 車内センシング(ドライバモニタ) 2015~
デンソー(東京支社) 車外センシング(物体検出等) 技術動向調査(論文・特許) http://toyota.jp/technology/safety/toyota_safety_sense_p/ より引用 三菱電機公式サイトより引用 ※本発表は個人として行うものであり 所属組織を代表するものではありません -
CNNのモジュール • Convolution • Activation ReLU, LReLU, PReLU, RReLU, ELU,
SELU, NG, tanh, Maxout, … • Normalization Batch Normalization, Weight Normalization, Layer Normalization, Batch Renormalization, … ︙ ︙ CNNの根幹である Convolution はこのままで良いのか? -
目次、紹介論文 • 前置き - Receptive Field, Effective Receptive Field -
Atrous Convolution, Dilated Convolution • Active Convolution Active Convolution: Learning the Shape of Convolution for Image Classification [Yunho Jeon+, CVPR2017] https://arxiv.org/abs/1703.09076 (arXiv投稿:2017/3/27) • Deformable Convolution Deformable Convolutional Networks [Jifeng Dai+, ICCV2017] https://arxiv.org/abs/1703.06211 (arXiv投稿:2017/3/17) -
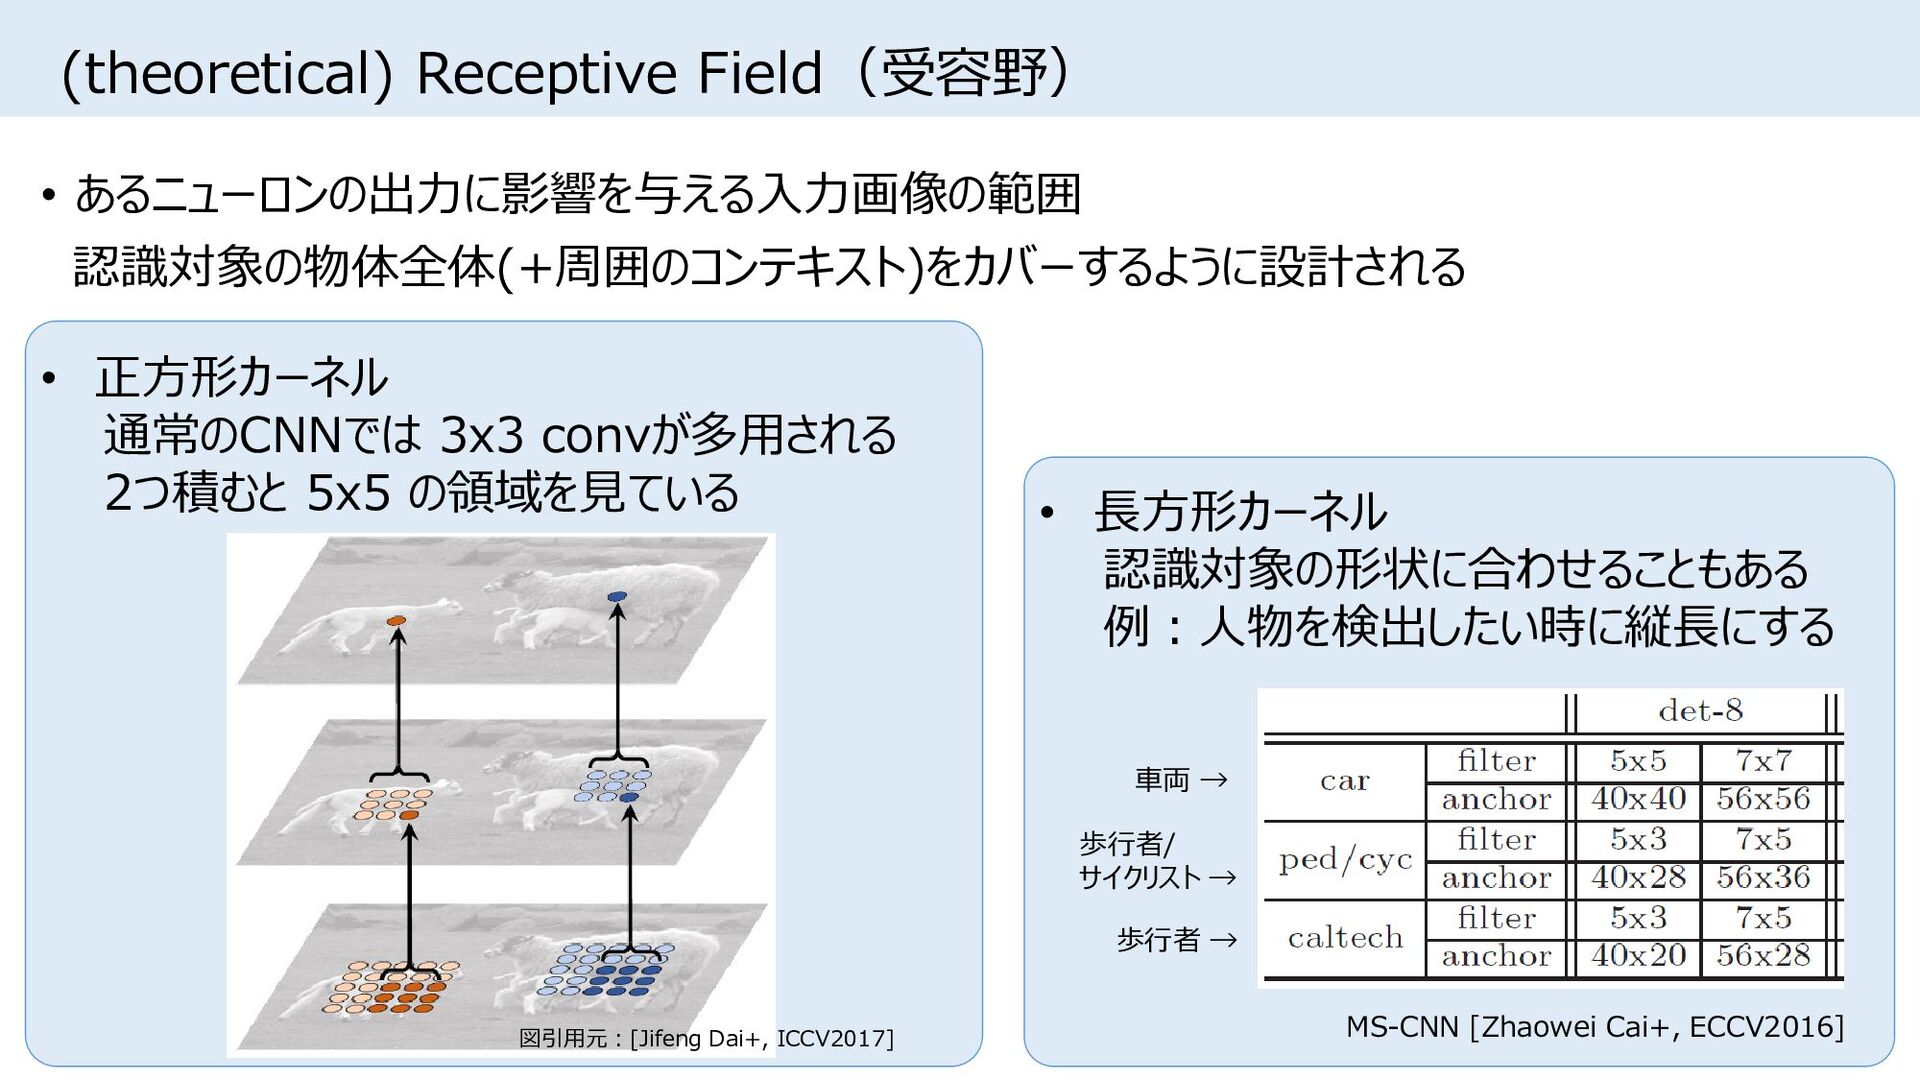
(theoretical) Receptive Field(受容野) • あるニューロンの出力に影響を与える入力画像の範囲 認識対象の物体全体(+周囲のコンテキスト)をカバーするように設計される • 長方形カーネル 認識対象の形状に合わせることもある 例:人物を検出したい時に縦長にする
• 正方形カーネル 通常のCNNでは 3x3 convが多用される 2つ積むと 5x5 の領域を見ている MS-CNN [Zhaowei Cai+, ECCV2016] 車両 → 歩行者/ サイクリスト → 歩行者 → 図引用元:[Jifeng Dai+, ICCV2017] -
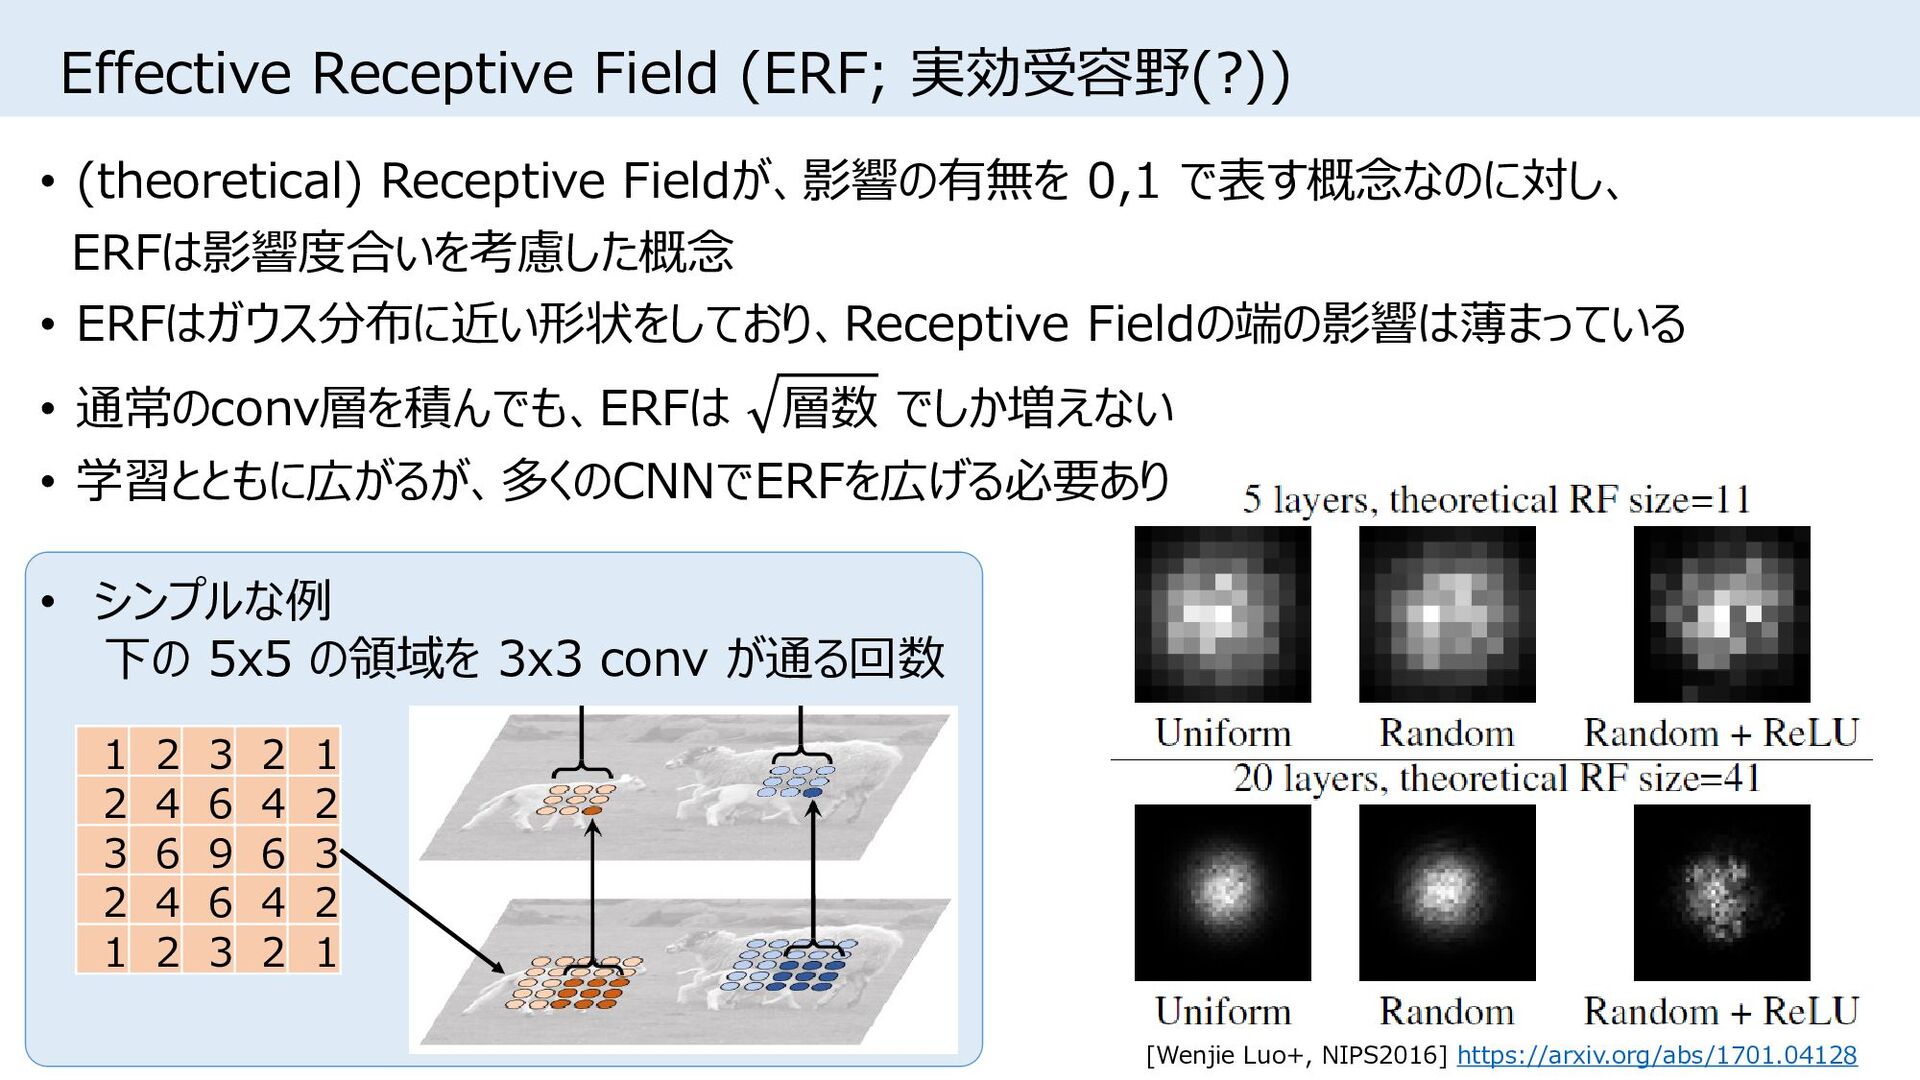
Effective Receptive Field (ERF; 実効受容野(?)) • (theoretical) Receptive Fieldが、影響の有無を 0,1
で表す概念なのに対し、 ERFは影響度合いを考慮した概念 • ERFはガウス分布に近い形状をしており、Receptive Fieldの端の影響は薄まっている • 通常のconv層を積んでも、ERFは 層数 でしか増えない • 学習とともに広がるが、多くのCNNでERFを広げる必要あり 1 2 3 2 1 2 4 6 4 2 3 6 9 6 3 2 4 6 4 2 1 2 3 2 1 • シンプルな例 下の 5x5 の領域を 3x3 conv が通る回数 [Wenjie Luo+, NIPS2016] https://arxiv.org/abs/1701.04128 -
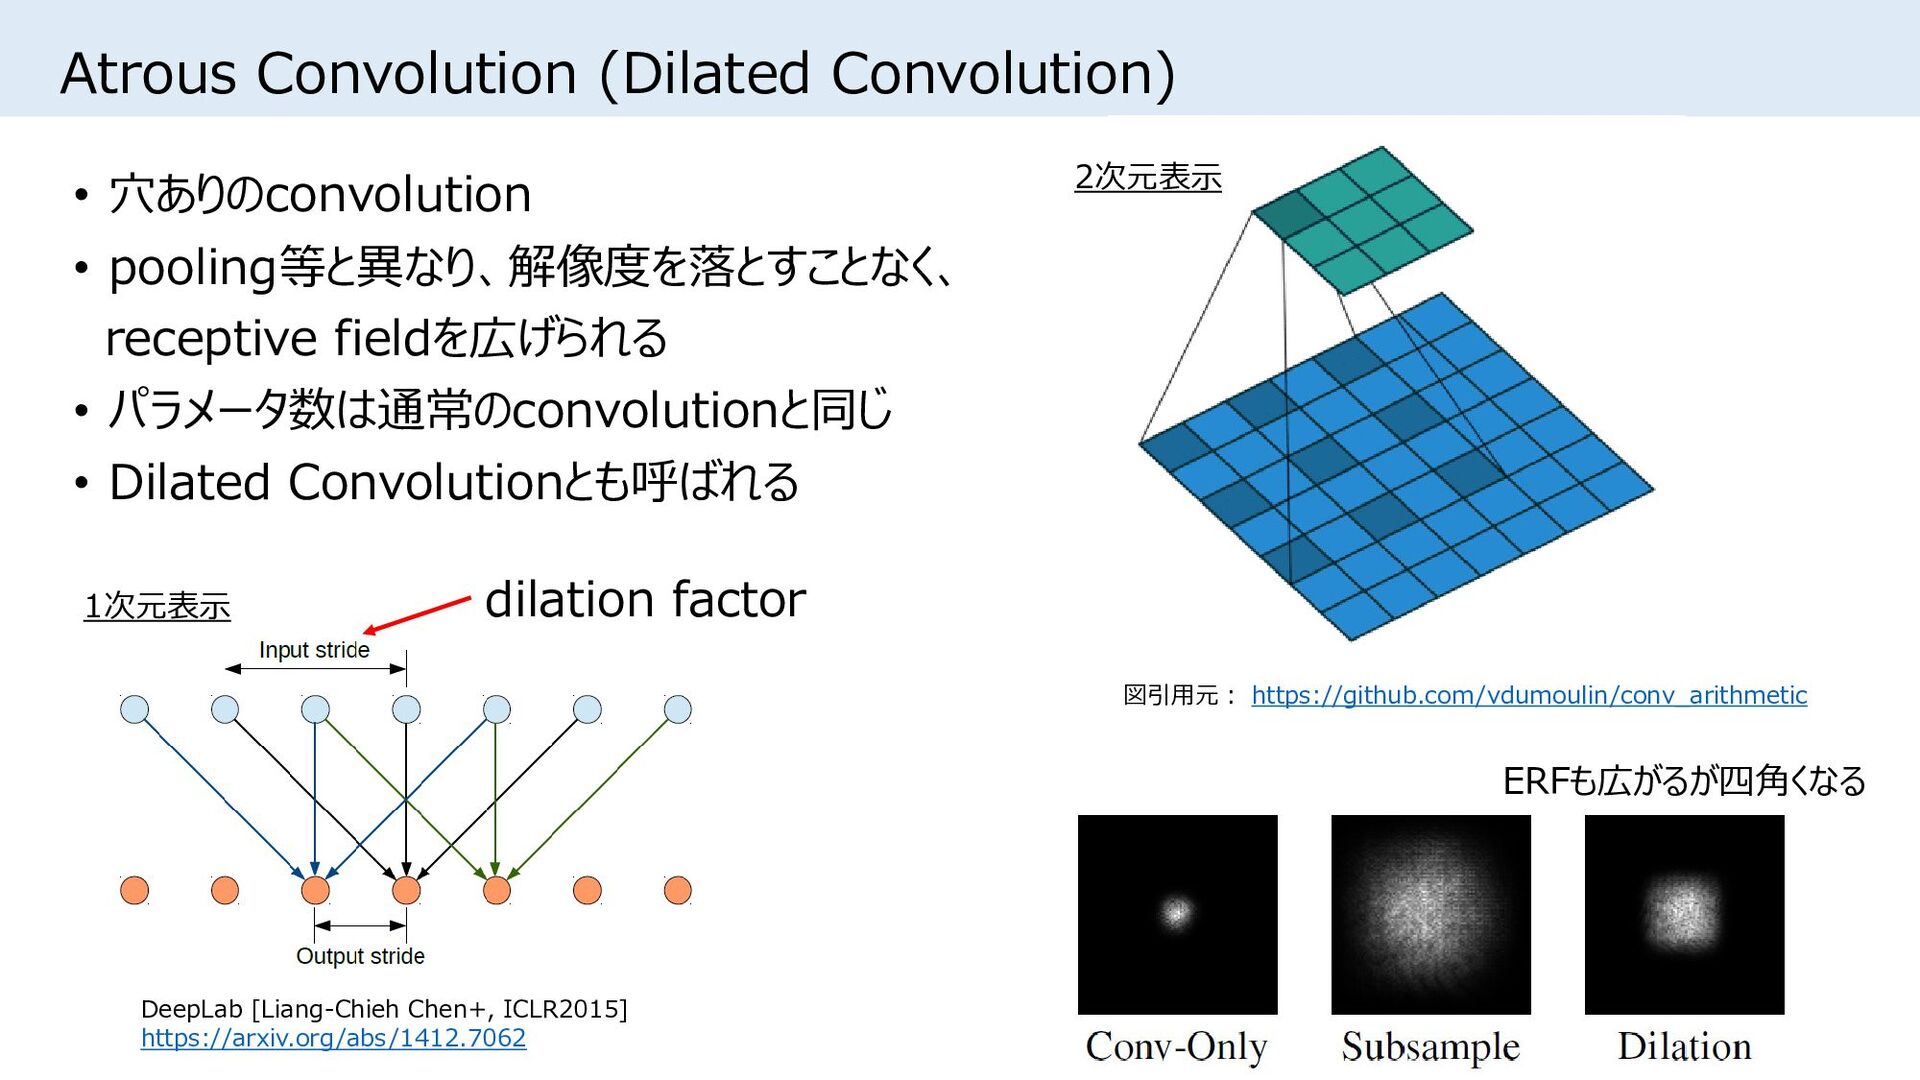
Atrous Convolution (Dilated Convolution) • 穴ありのconvolution • pooling等と異なり、解像度を落とすことなく、 receptive fieldを広げられる
• パラメータ数は通常のconvolutionと同じ • Dilated Convolutionとも呼ばれる 図引用元: https://github.com/vdumoulin/conv_arithmetic DeepLab [Liang-Chieh Chen+, ICLR2015] https://arxiv.org/abs/1412.7062 dilation factor ERFも広がるが四角くなる 1次元表示 2次元表示 -
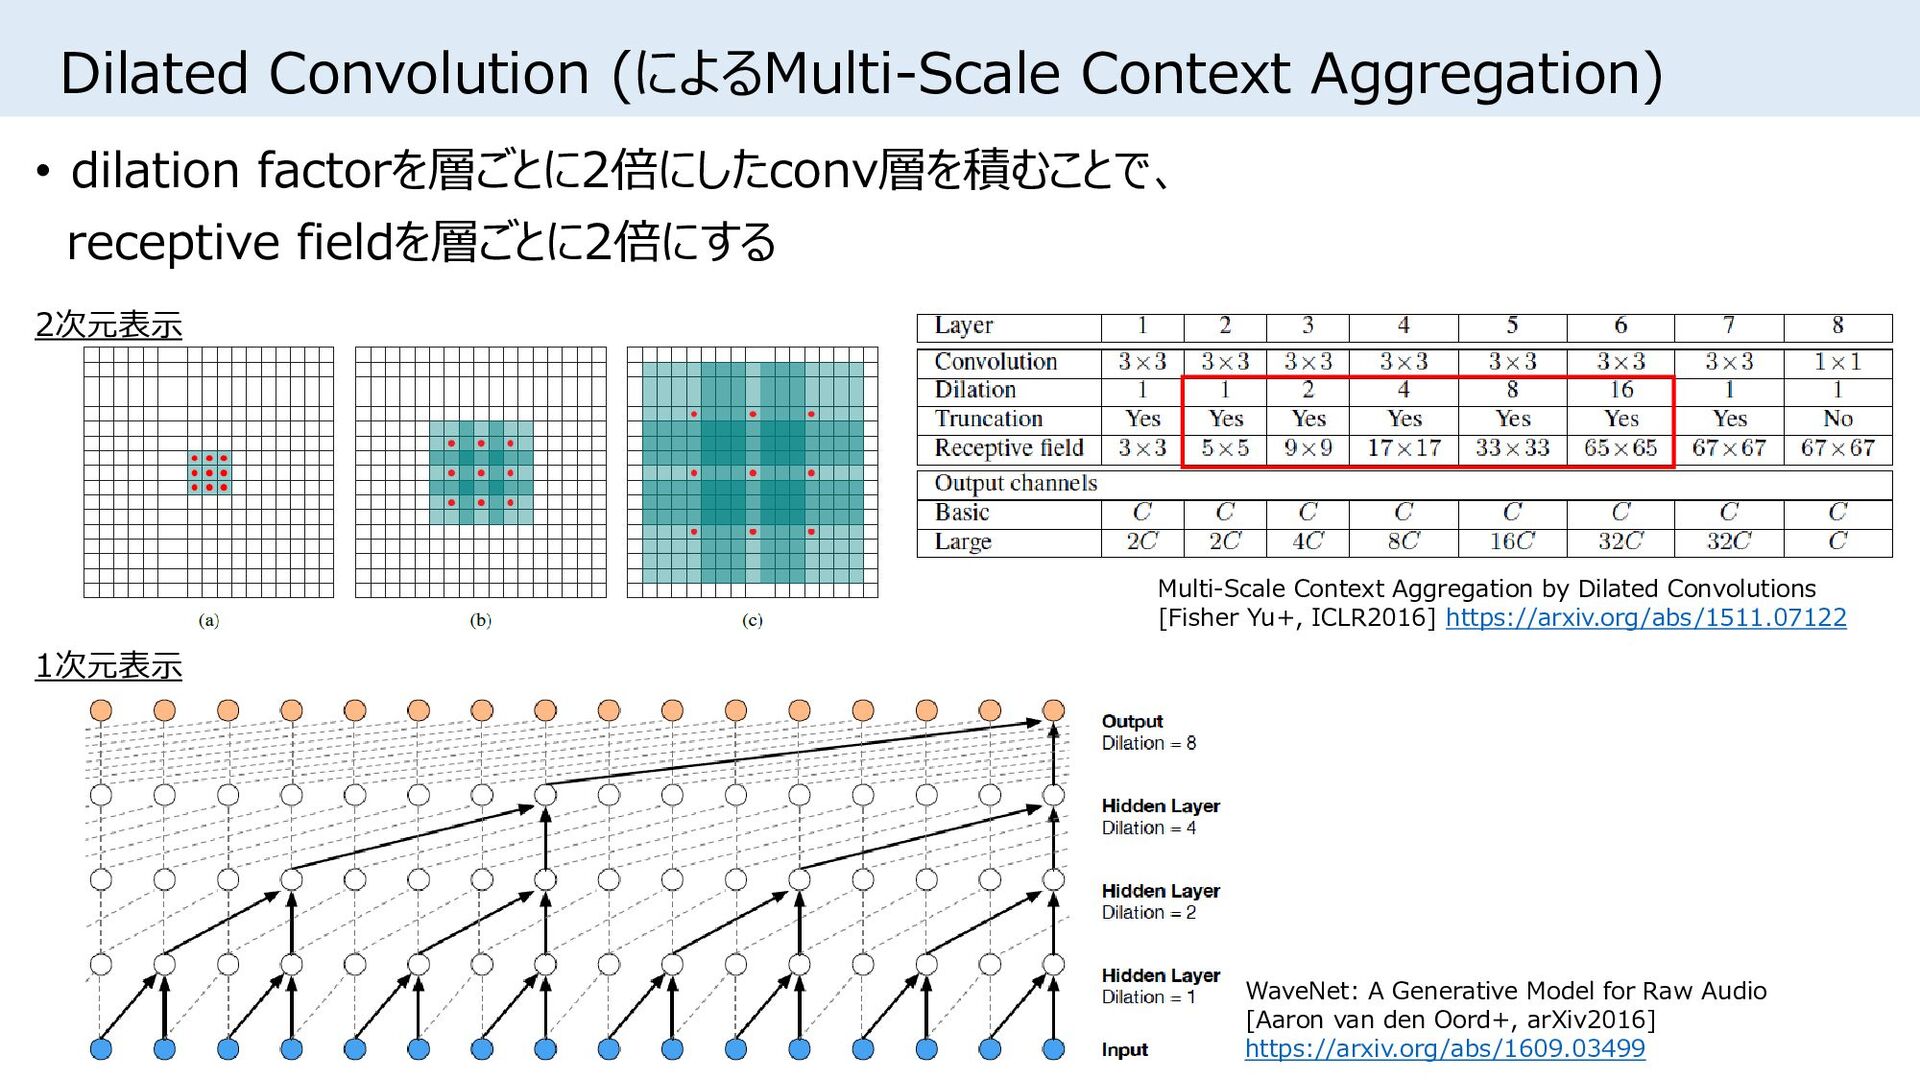
Dilated Convolution (によるMulti-Scale Context Aggregation) • dilation factorを層ごとに2倍にしたconv層を積むことで、 receptive fieldを層ごとに2倍にする
Multi-Scale Context Aggregation by Dilated Convolutions [Fisher Yu+, ICLR2016] https://arxiv.org/abs/1511.07122 WaveNet: A Generative Model for Raw Audio [Aaron van den Oord+, arXiv2016] https://arxiv.org/abs/1609.03499 2次元表示 1次元表示 -
従来のConvolutionの問題点 (1) 形状が固定 • 物体の形状は基本的に、RFのような矩形でもERFのような円形でもない • 物体ごとに形状は異なる (2) スケールが固定 •
Dilated Convolutionでreceptive fieldが広げられても、所詮は手設計の値 • 物体ごとにスケールは異なる → Convolutionの形状・スケールを、学習によって決めるべき -
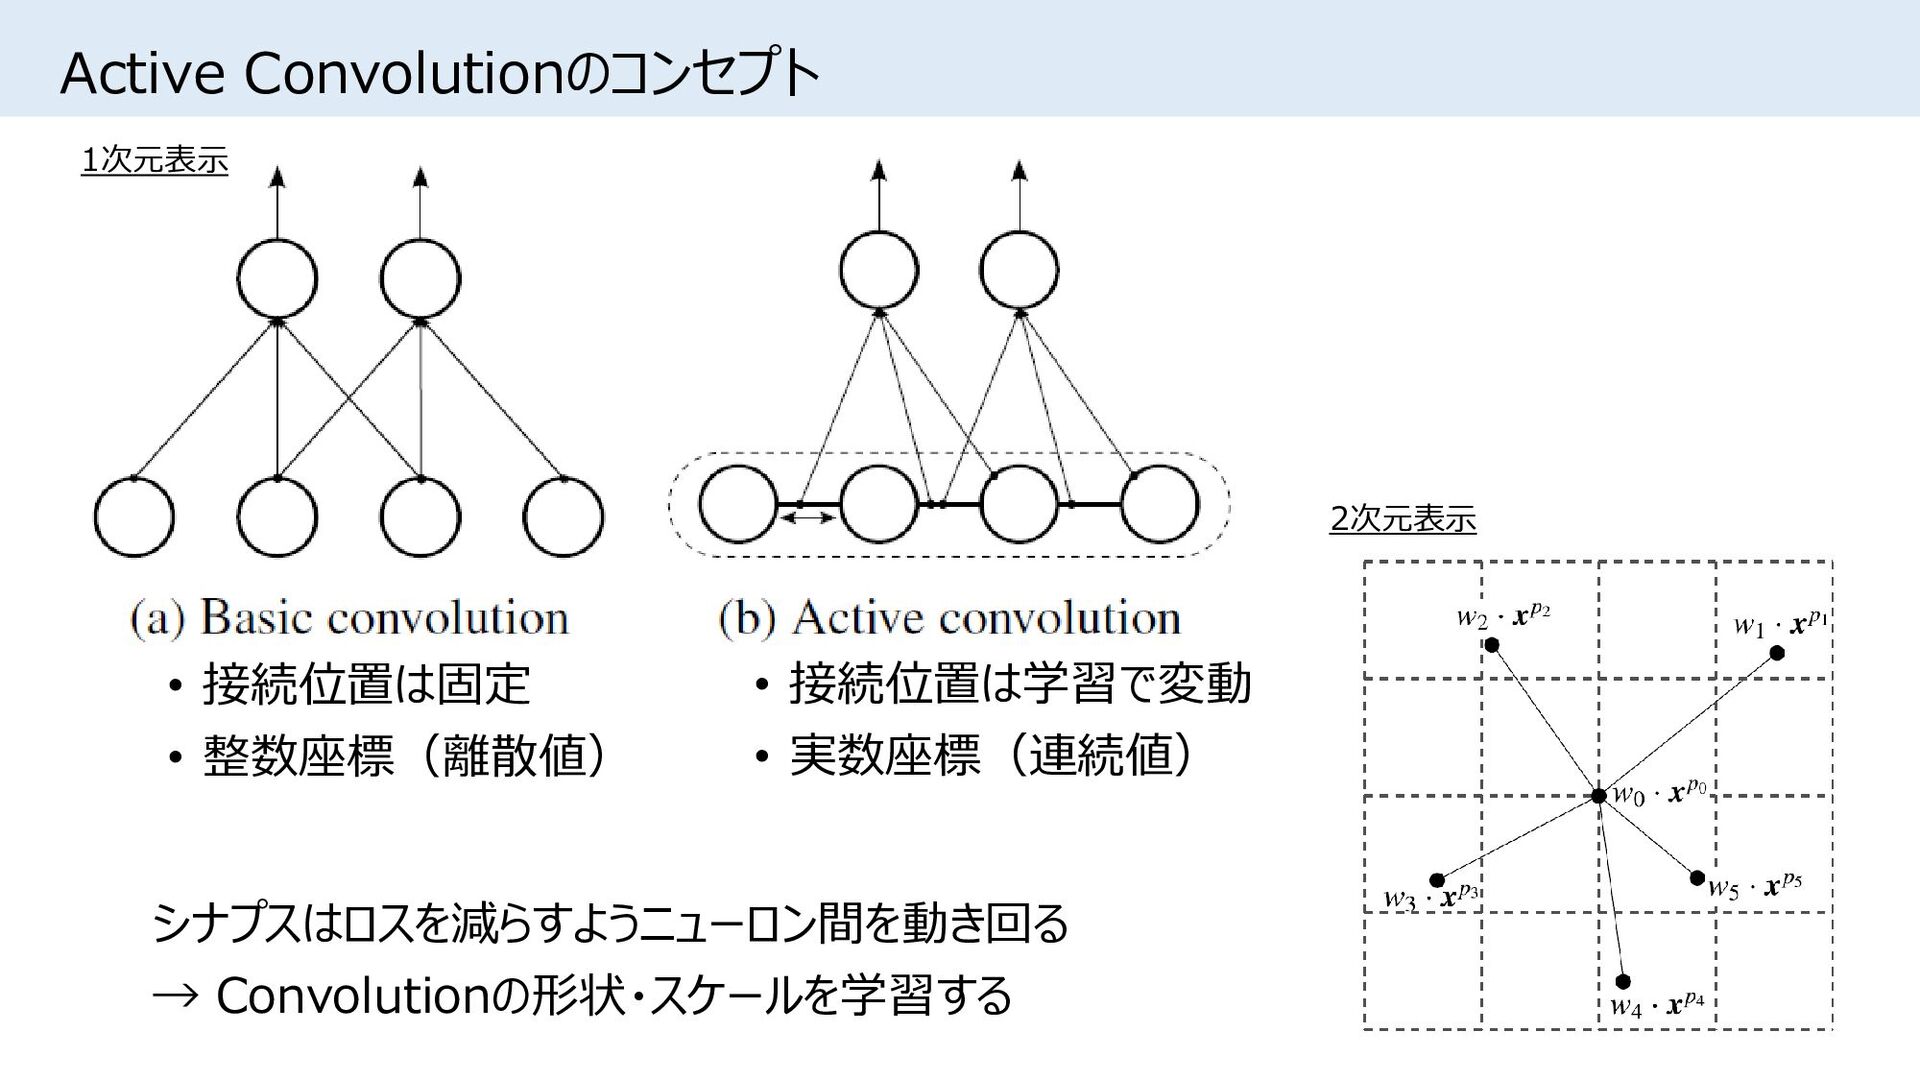
Active Convolutionのコンセプト • 接続位置は固定 • 整数座標(離散値) • 接続位置は学習で変動 • 実数座標(連続値)
シナプスはロスを減らすようニューロン間を動き回る → Convolutionの形状・スケールを学習する 1次元表示 2次元表示 -
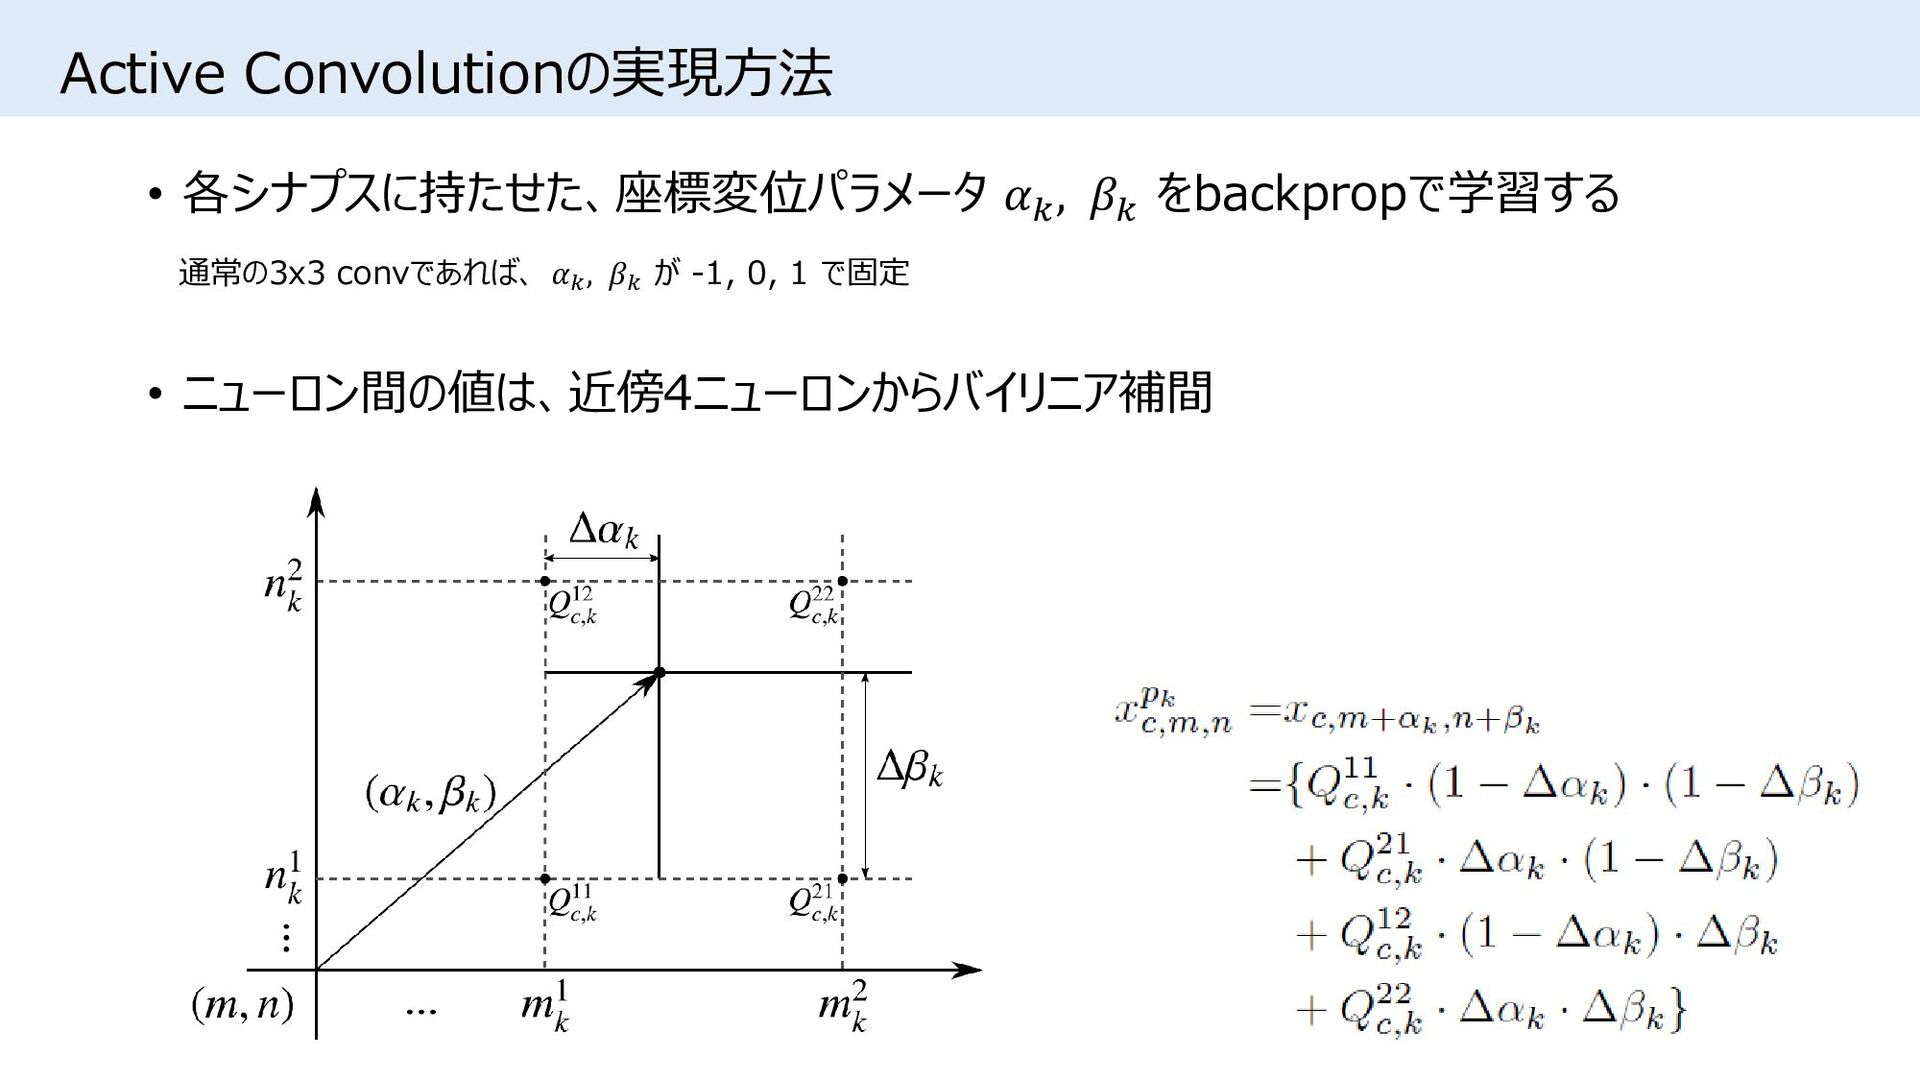
Active Convolutionの実現方法 • 各シナプスに持たせた、座標変位パラメータ 𝛼𝑘 , 𝛽𝑘 をbackpropで学習する 通常の3x3 convであれば、
𝛼𝑘 , 𝛽𝑘 が -1, 0, 1 で固定 • ニューロン間の値は、近傍4ニューロンからバイリニア補間 -
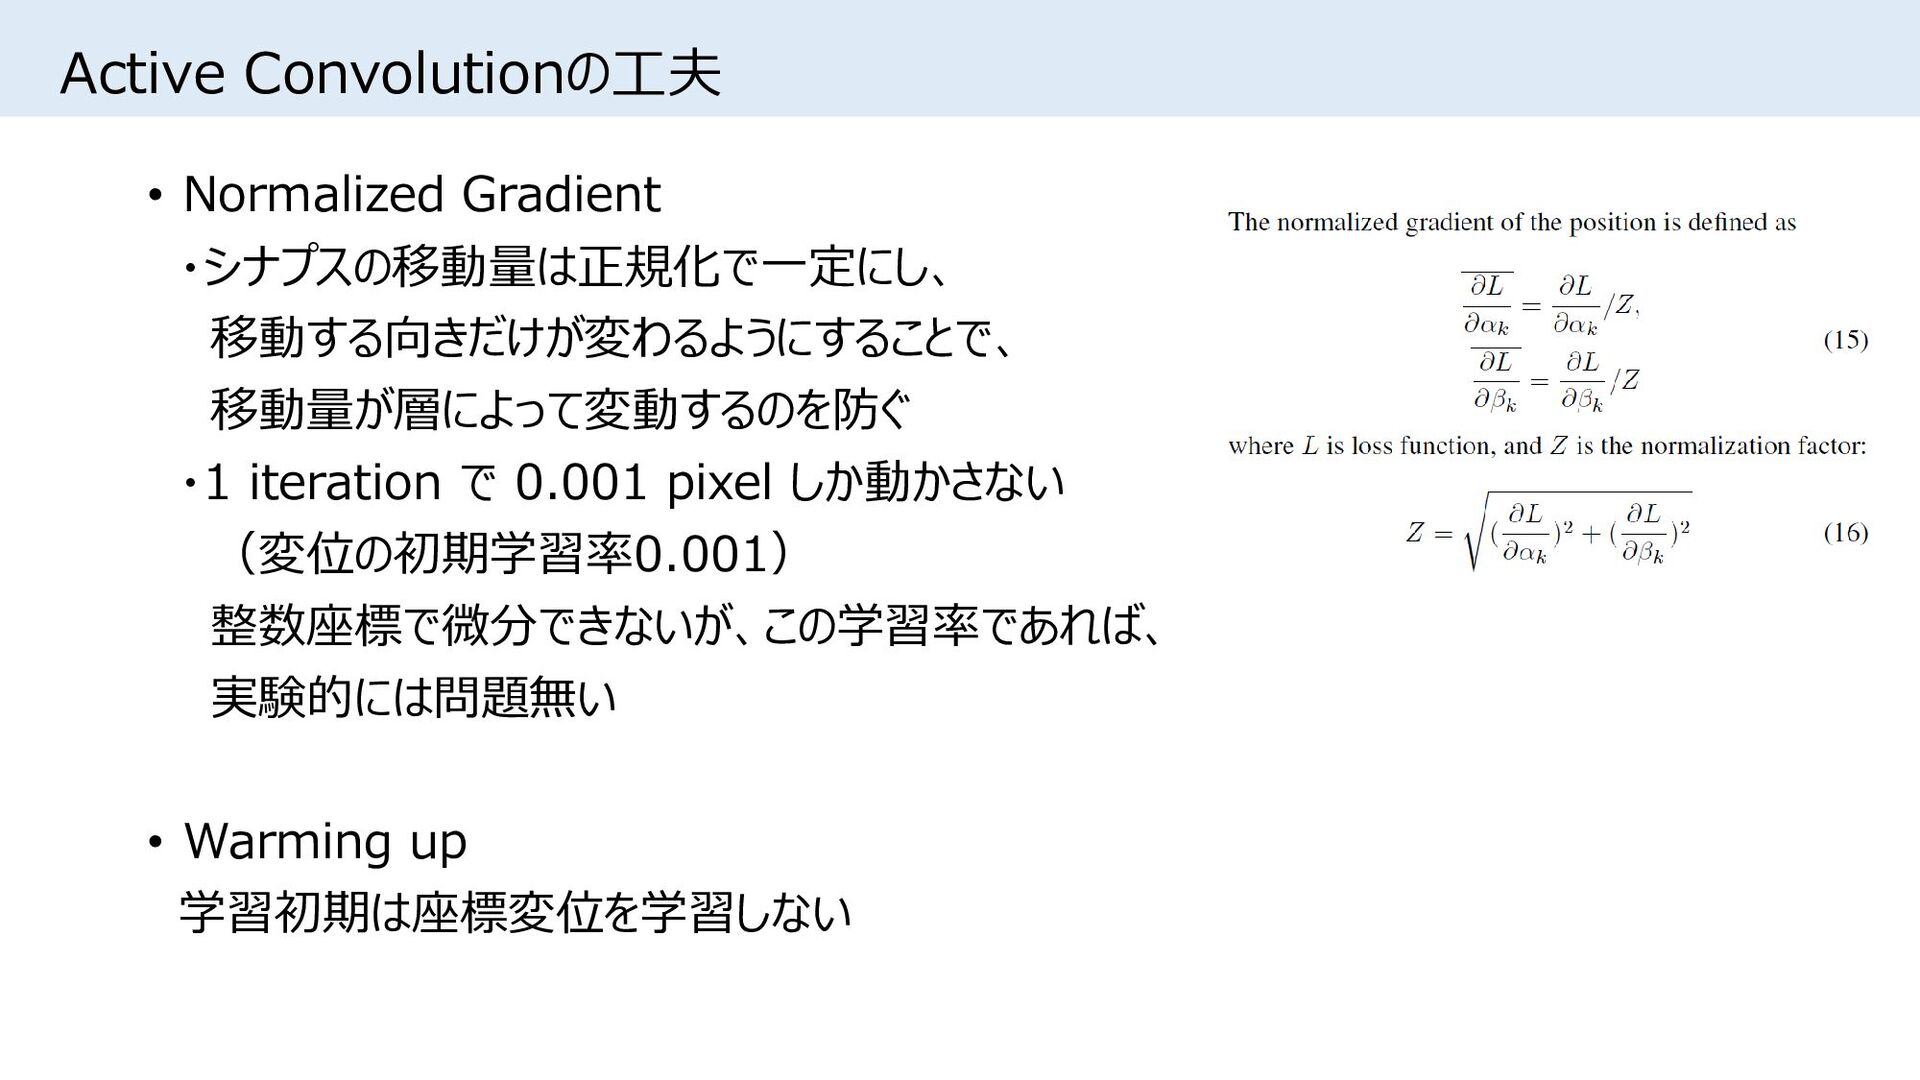
Active Convolutionの工夫 • Normalized Gradient ・シナプスの移動量は正規化で一定にし、 移動する向きだけが変わるようにすることで、 移動量が層によって変動するのを防ぐ ・1 iteration
で 0.001 pixel しか動かさない (変位の初期学習率0.001) 整数座標で微分できないが、この学習率であれば、 実験的には問題無い • Warming up 学習初期は座標変位を学習しない -
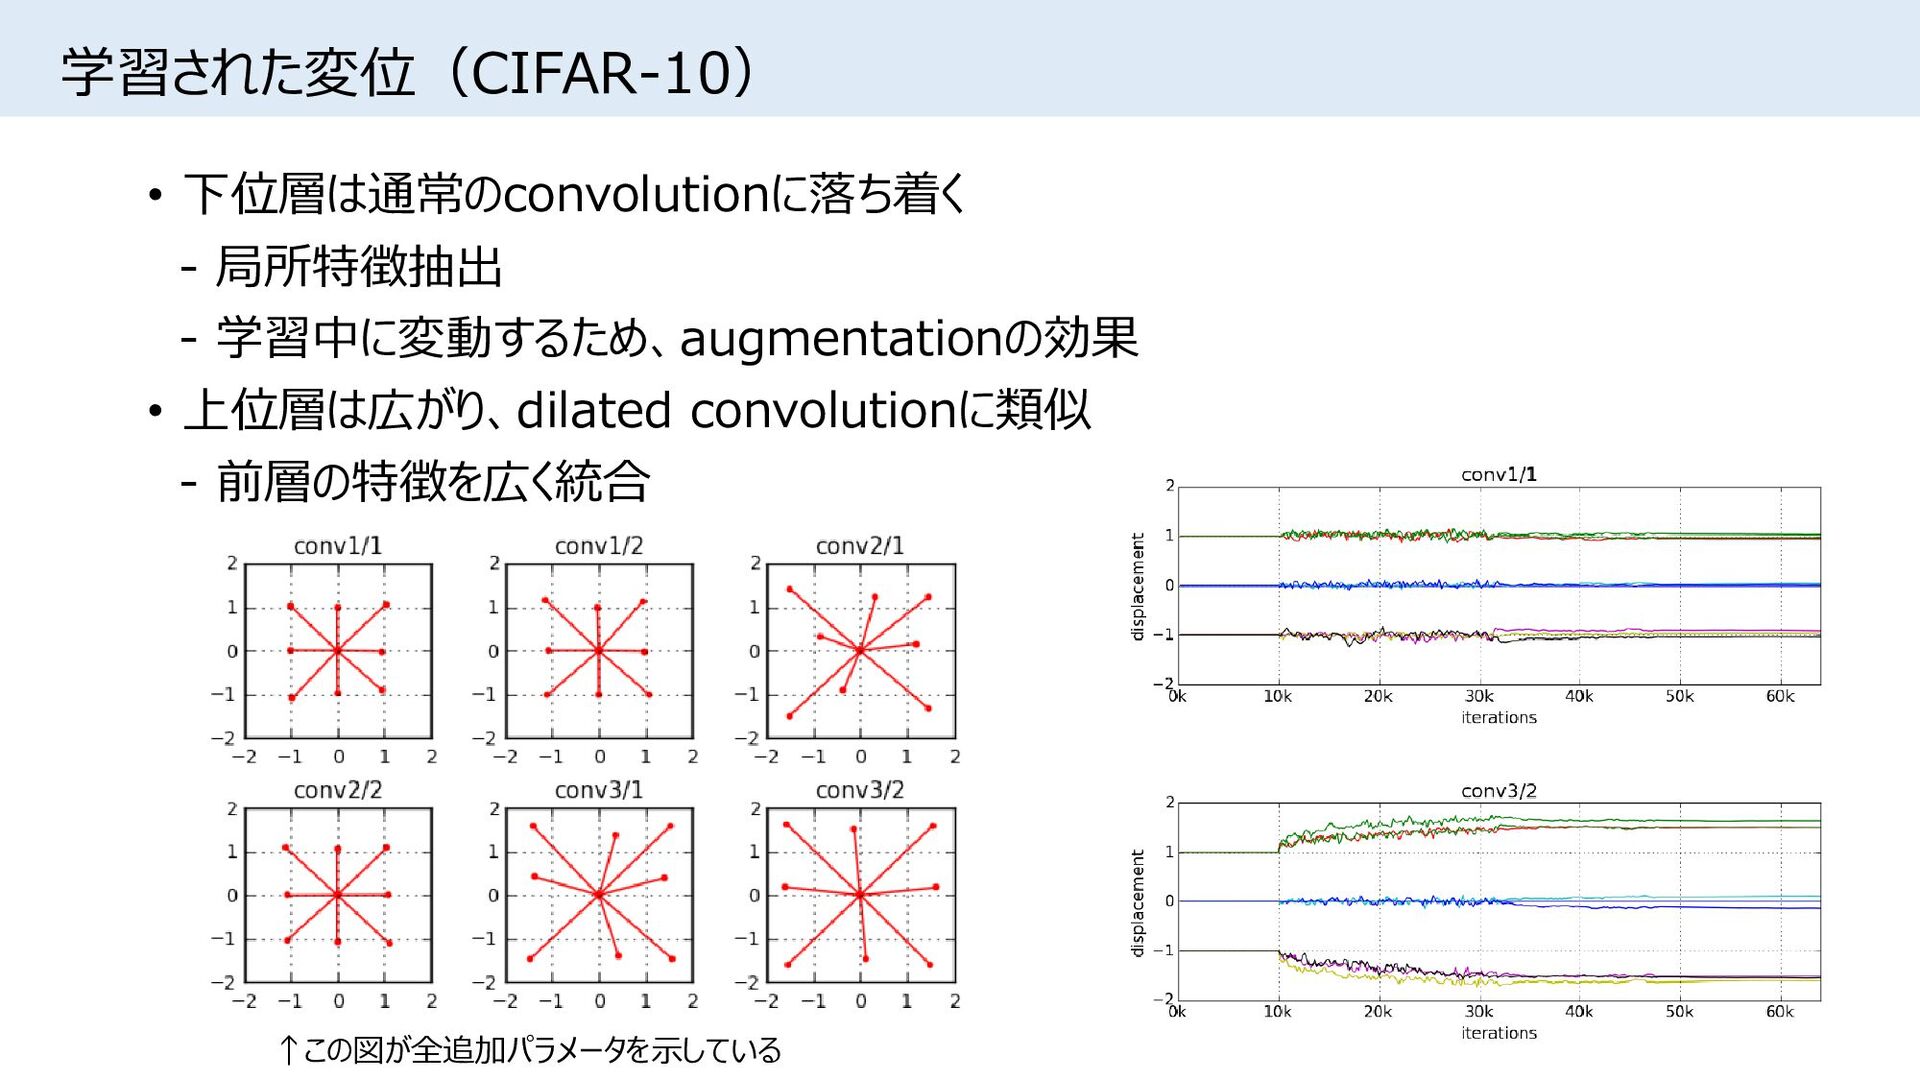
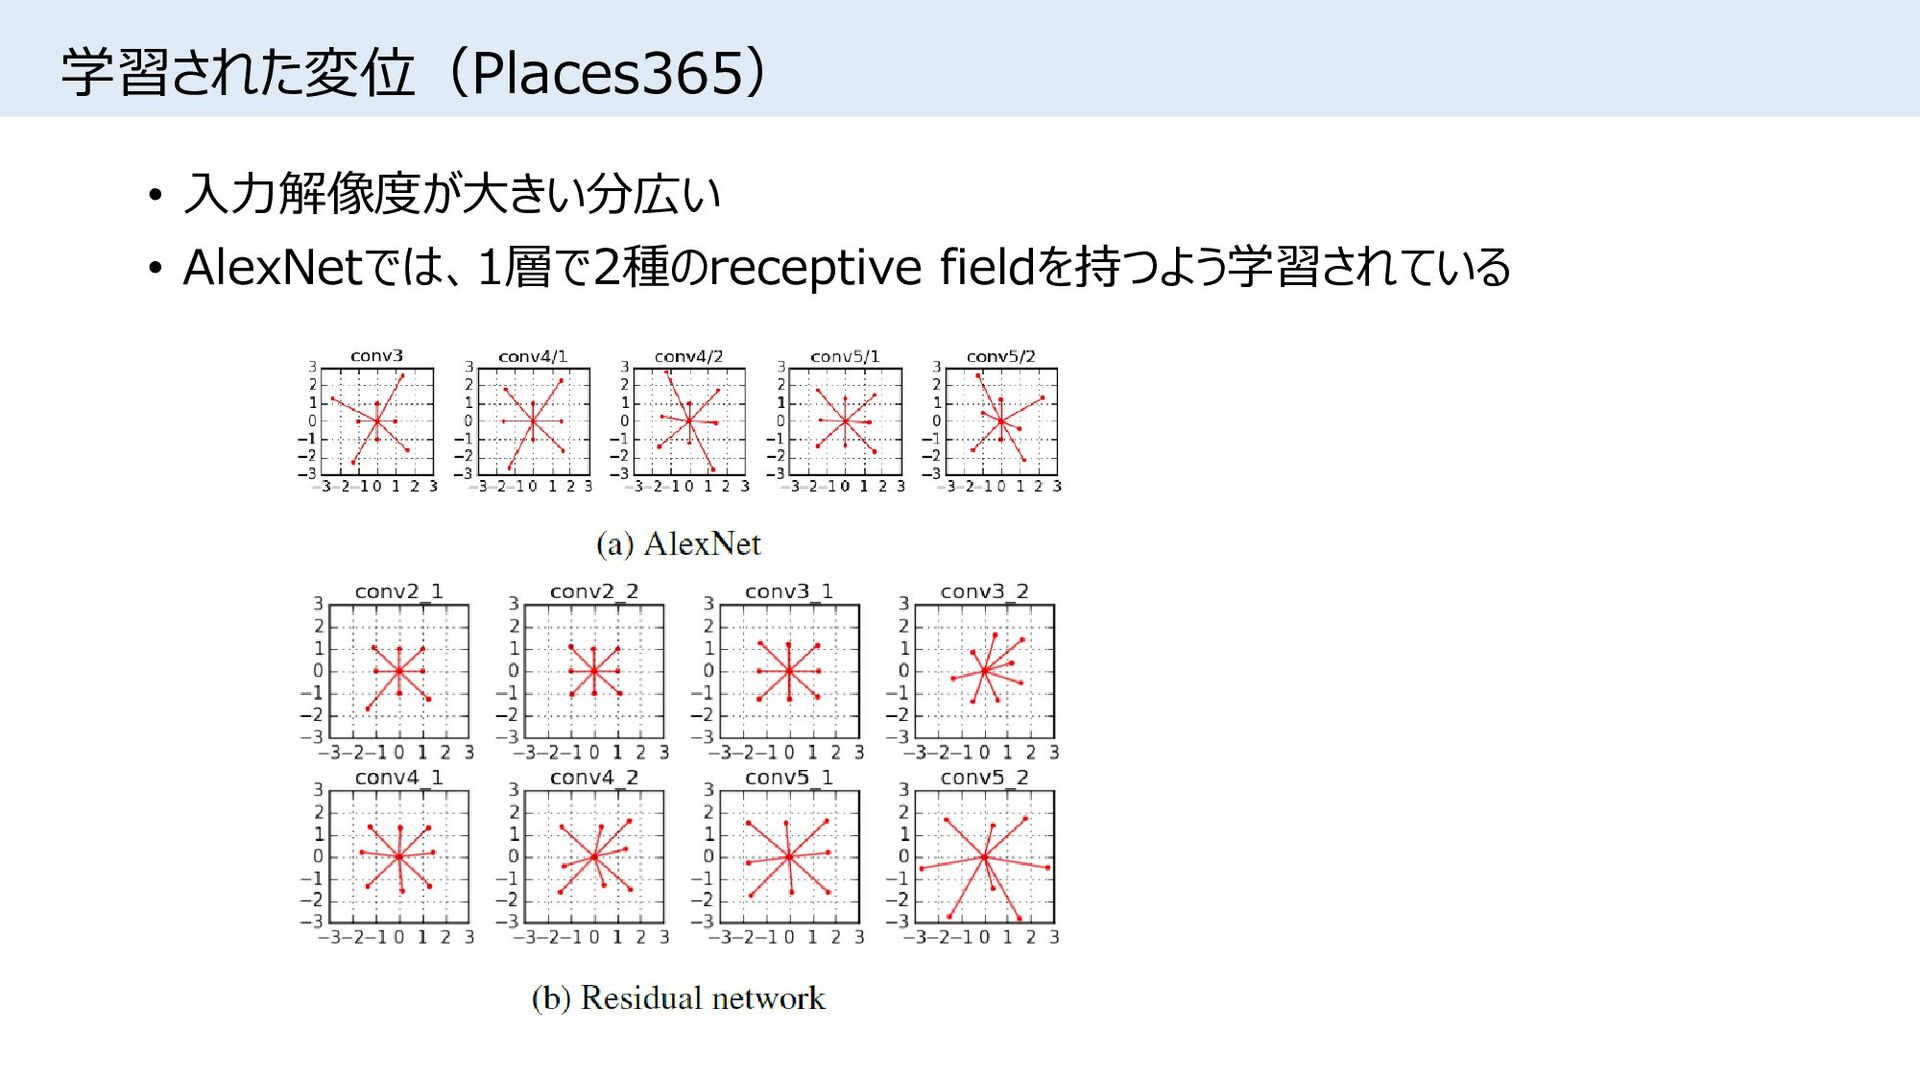
学習された変位(CIFAR-10) • 下位層は通常のconvolutionに落ち着く - 局所特徴抽出 - 学習中に変動するため、augmentationの効果 • 上位層は広がり、dilated convolutionに類似
- 前層の特徴を広く統合 ↑この図が全追加パラメータを示している -
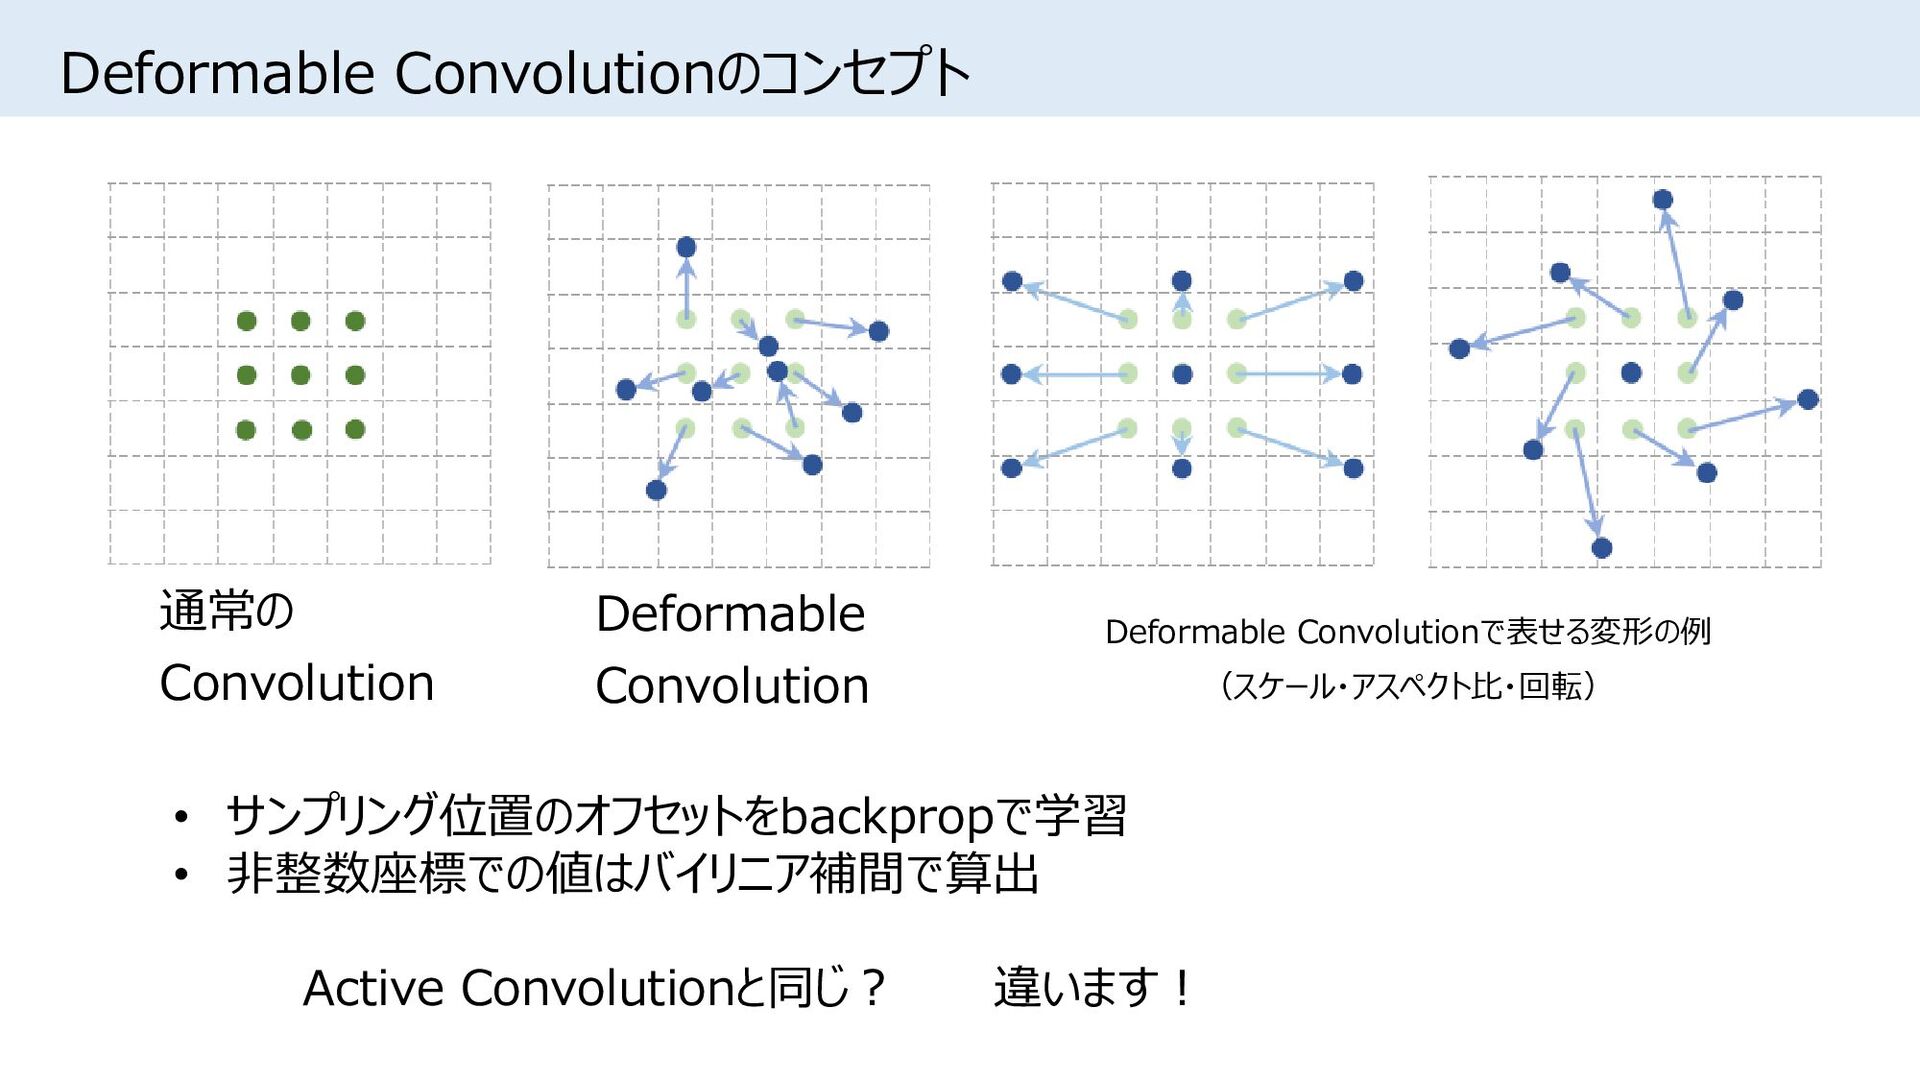
Deformable Convolutionのコンセプト 通常の Convolution Deformable Convolution • サンプリング位置のオフセットをbackpropで学習 • 非整数座標での値はバイリニア補間で算出
Deformable Convolutionで表せる変形の例 (スケール・アスペクト比・回転) Active Convolutionと同じ? 違います! -
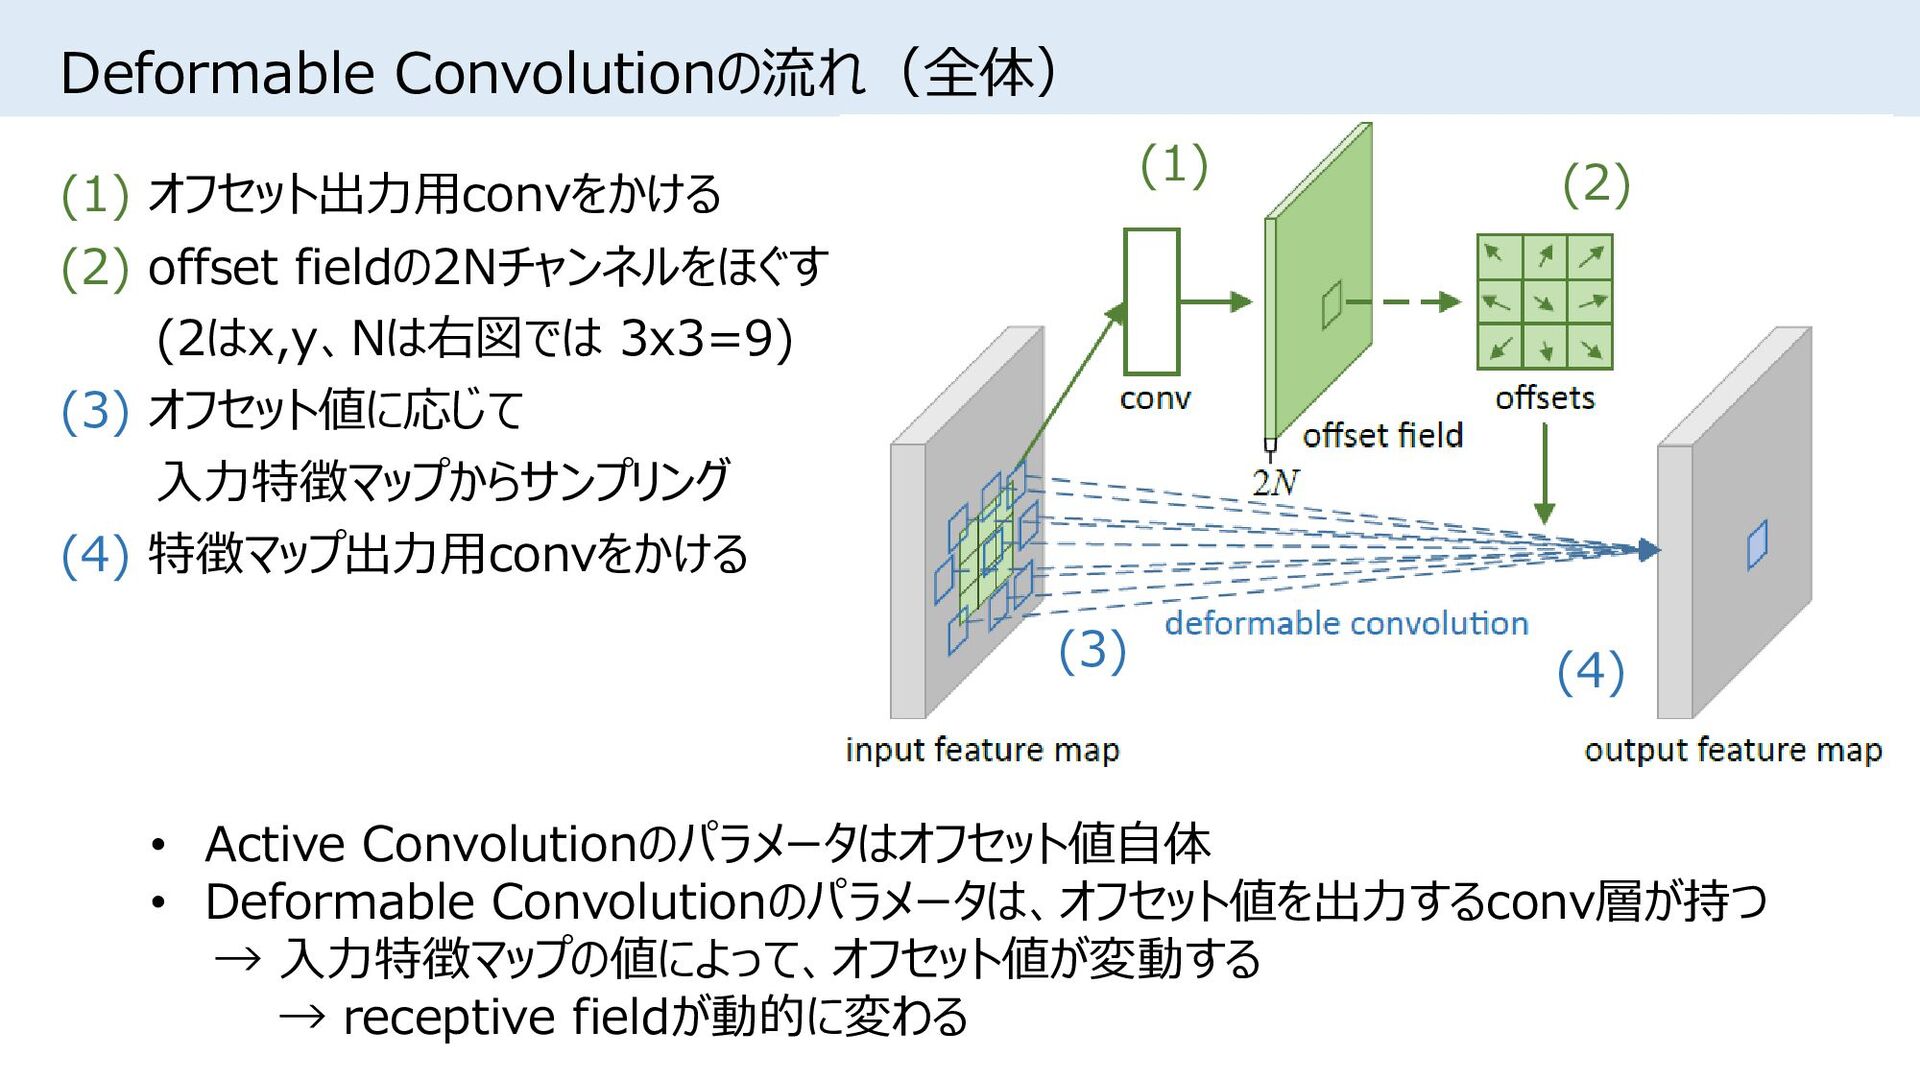
Deformable Convolutionの流れ(全体) (1) オフセット出力用convをかける (2) offset fieldの2Nチャンネルをほぐす (2はx,y、Nは右図では 3x3=9) (3)
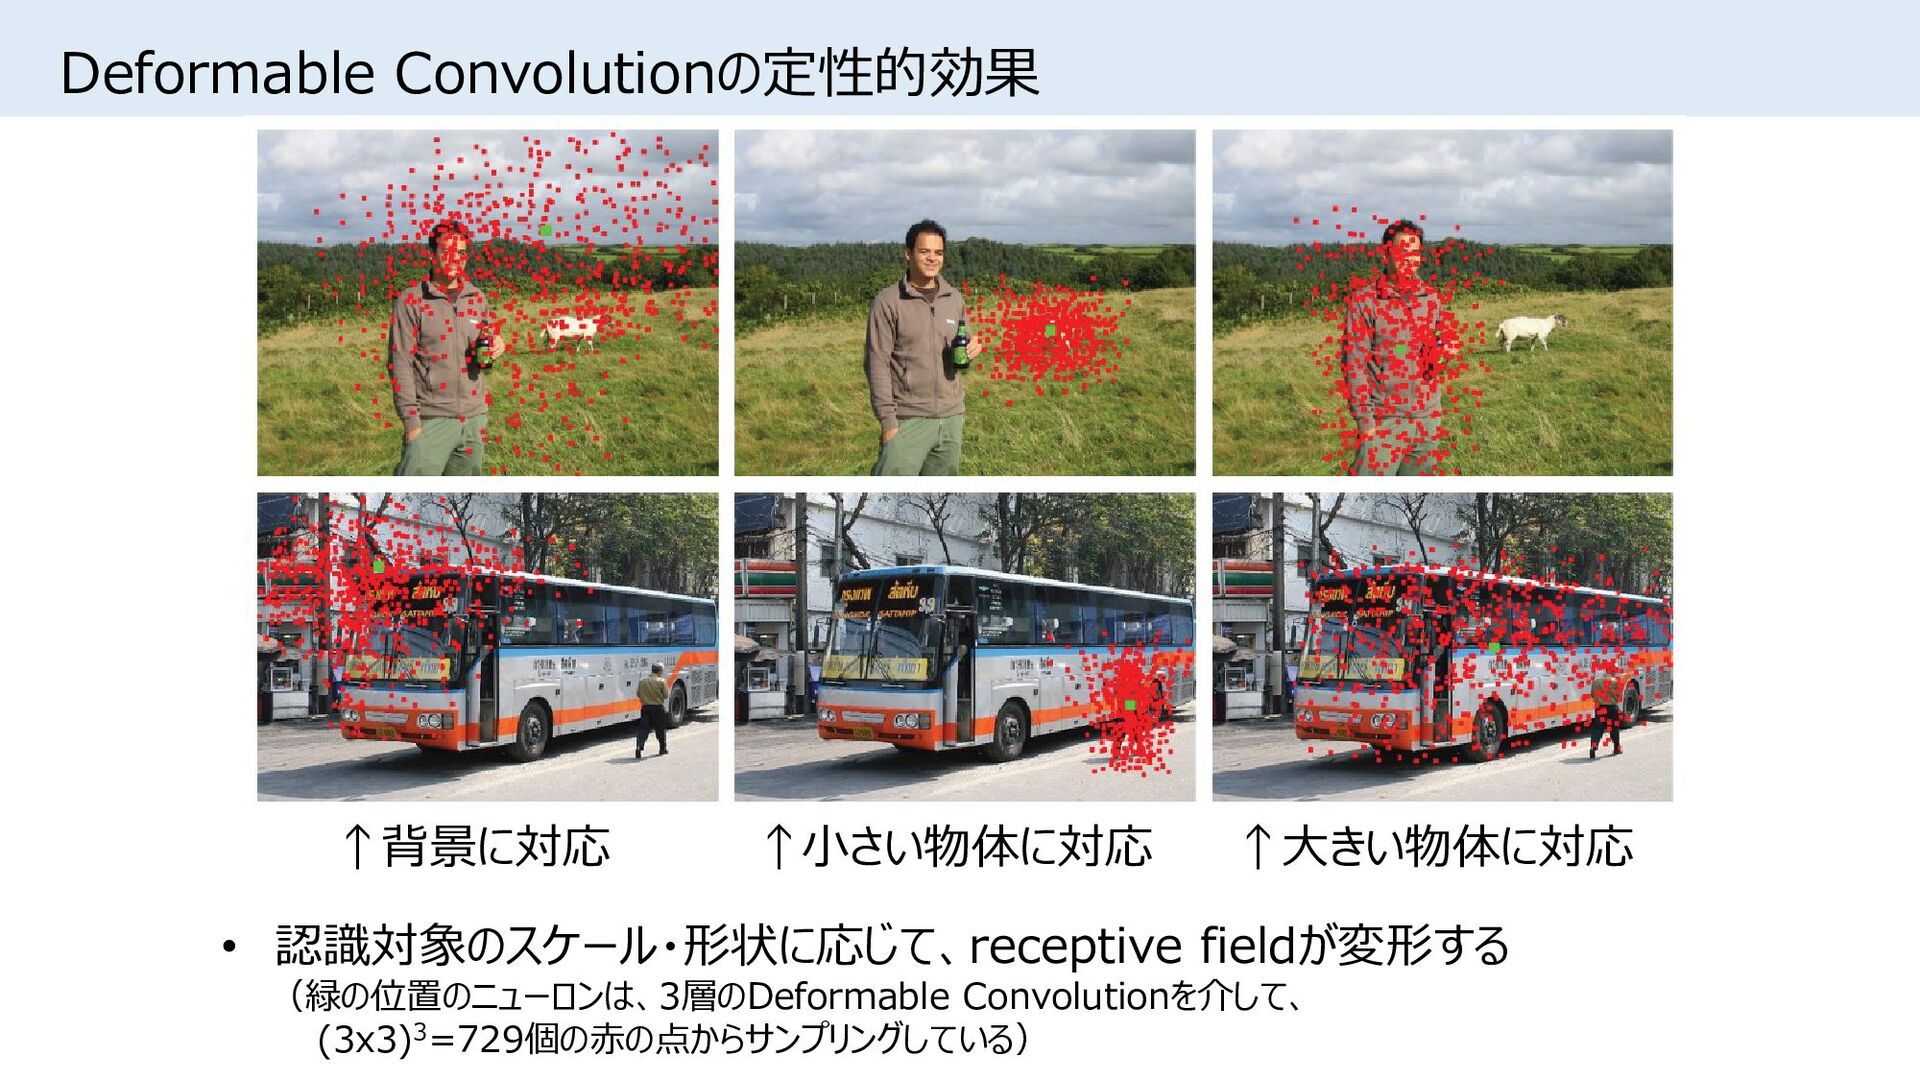
オフセット値に応じて 入力特徴マップからサンプリング (4) 特徴マップ出力用convをかける • Active Convolutionのパラメータはオフセット値自体 • Deformable Convolutionのパラメータは、オフセット値を出力するconv層が持つ → 入力特徴マップの値によって、オフセット値が変動する → receptive fieldが動的に変わる (1) (2) (3) (4) -
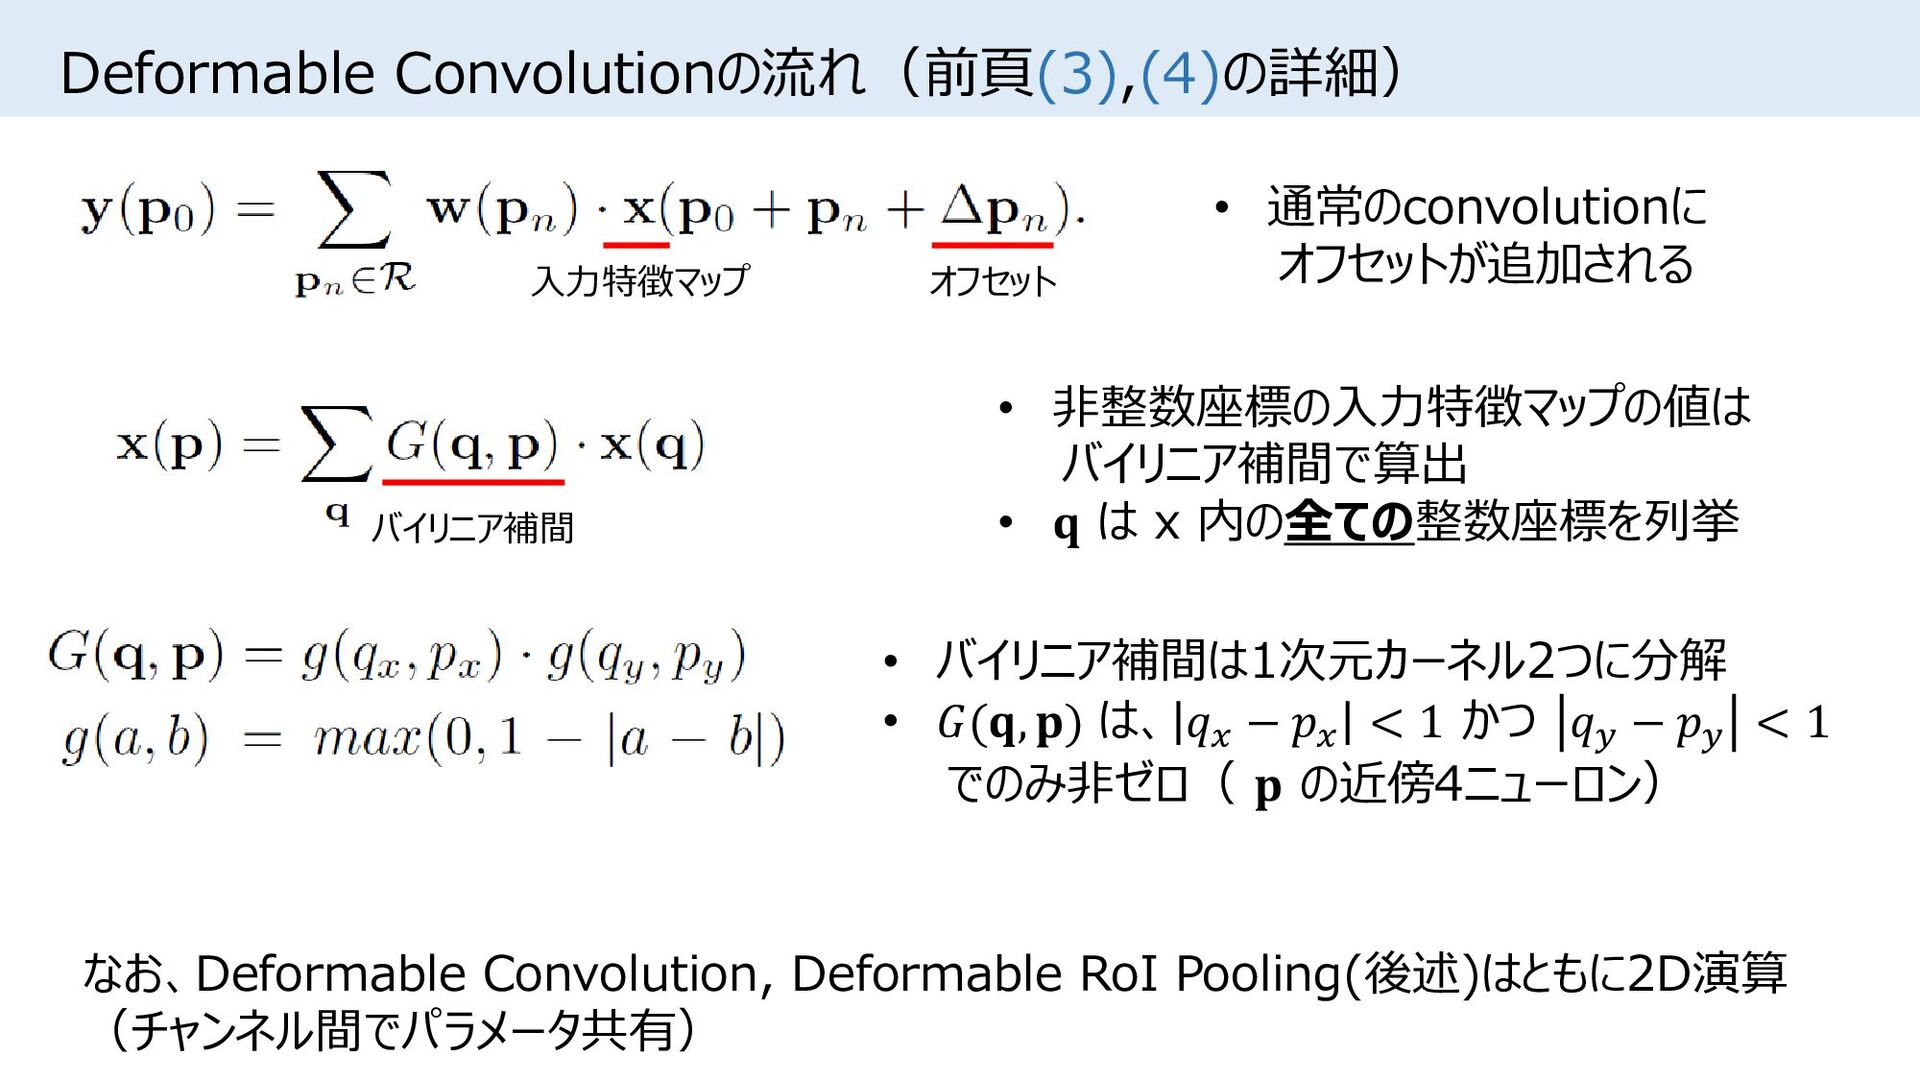
Deformable Convolutionの流れ(前頁(3),(4)の詳細) • 非整数座標の入力特徴マップの値は バイリニア補間で算出 • 𝐪 は x 内の全ての整数座標を列挙
• バイリニア補間は1次元カーネル2つに分解 • 𝐺(𝐪, 𝐩) は、 𝑞𝑥 − 𝑝𝑥 < 1 かつ 𝑞𝑦 − 𝑝𝑦 < 1 でのみ非ゼロ( 𝐩 の近傍4ニューロン) • 通常のconvolutionに オフセットが追加される 入力特徴マップ バイリニア補間 オフセット なお、Deformable Convolution, Deformable RoI Pooling(後述)はともに2D演算 (チャンネル間でパラメータ共有) -
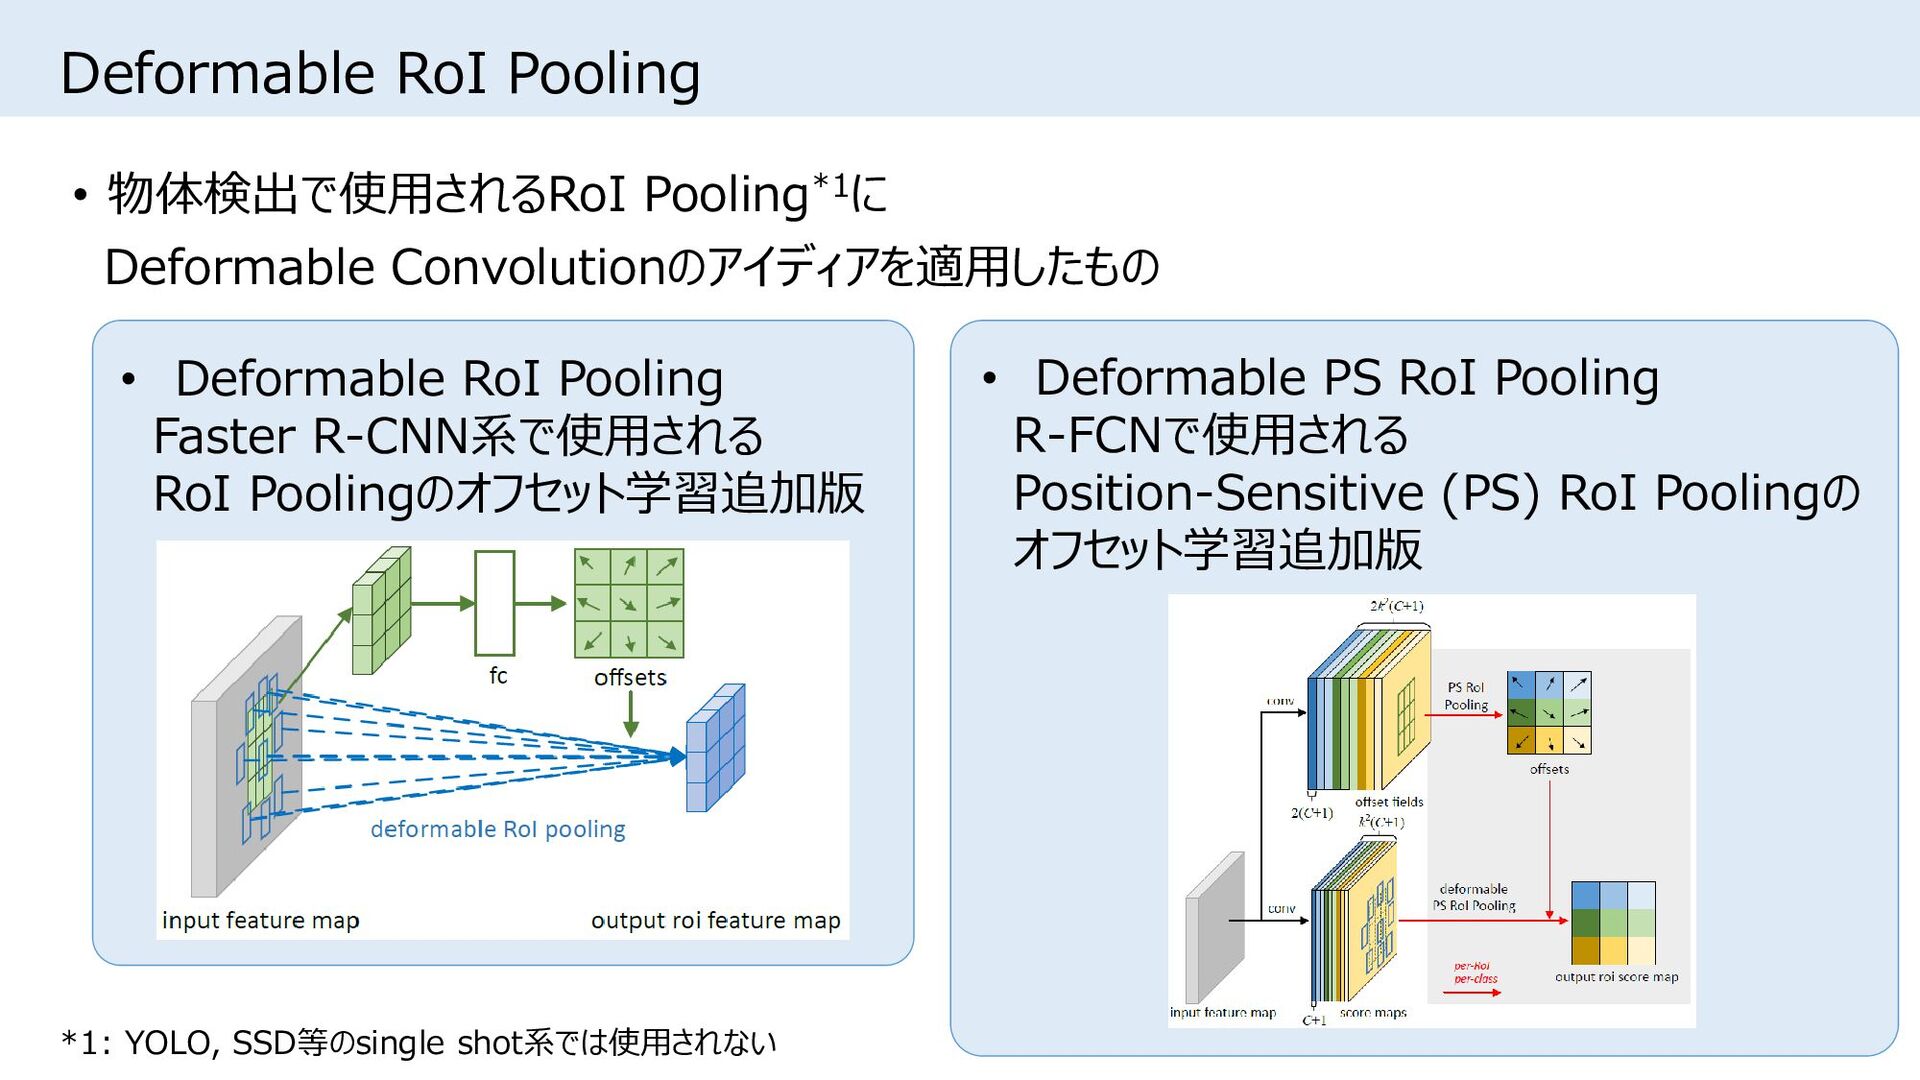
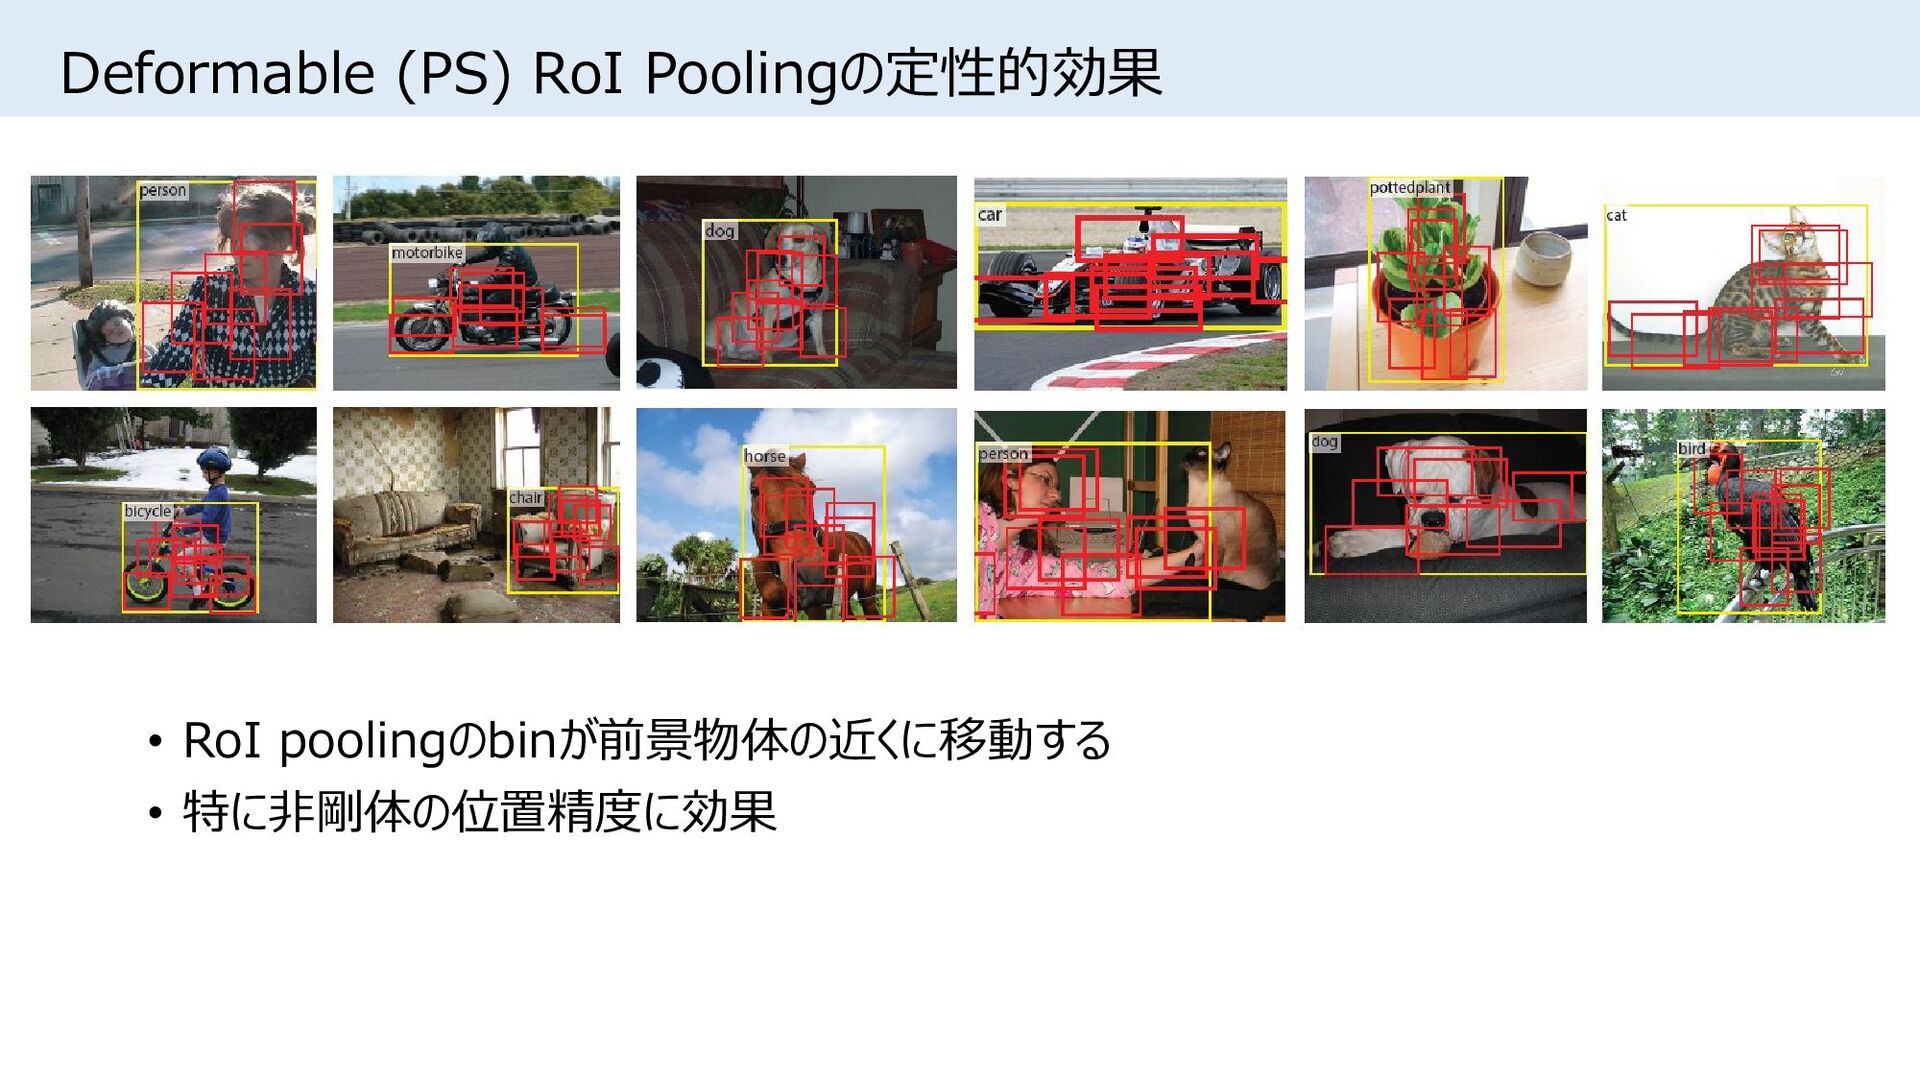
Deformable RoI Pooling • 物体検出で使用されるRoI Pooling*1に Deformable Convolutionのアイディアを適用したもの • Deformable
RoI Pooling Faster R-CNN系で使用される RoI Poolingのオフセット学習追加版 • Deformable PS RoI Pooling R-FCNで使用される Position-Sensitive (PS) RoI Poolingの オフセット学習追加版 *1: YOLO, SSD等のsingle shot系では使用されない -
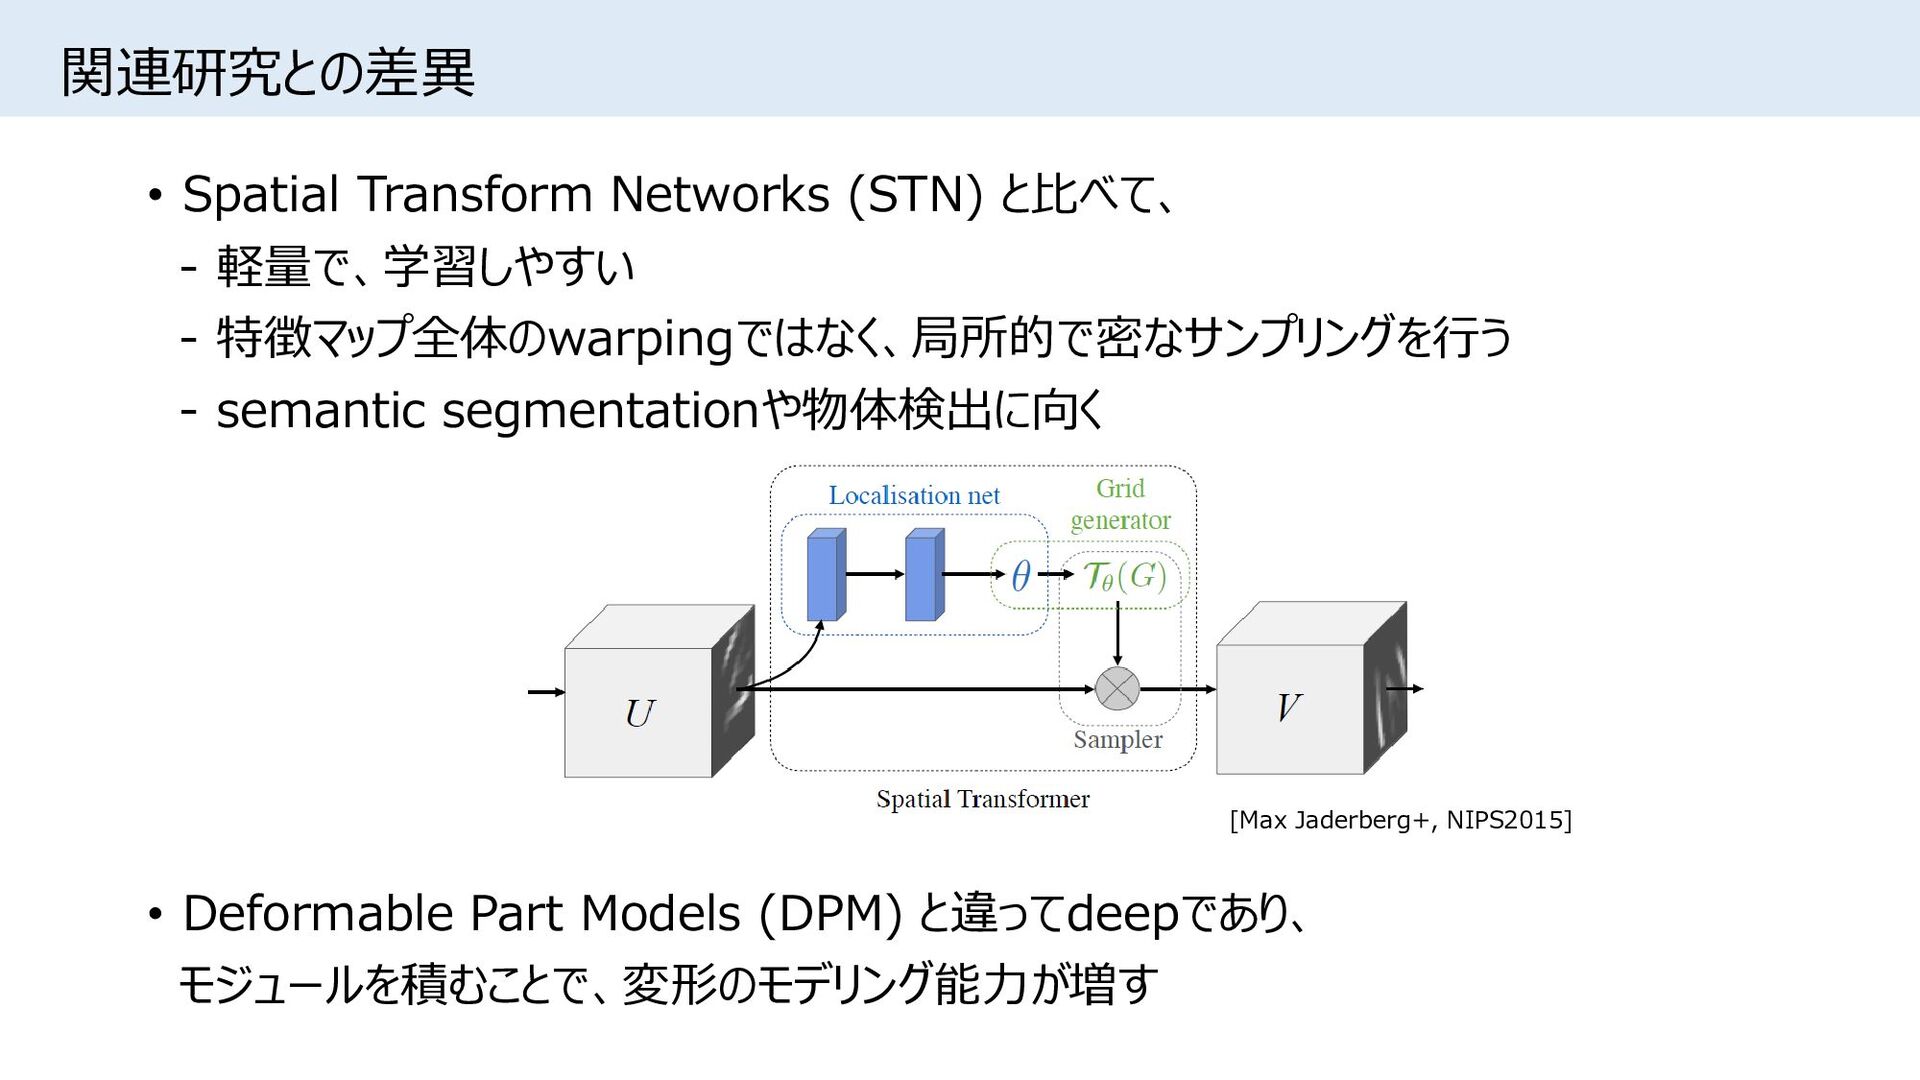
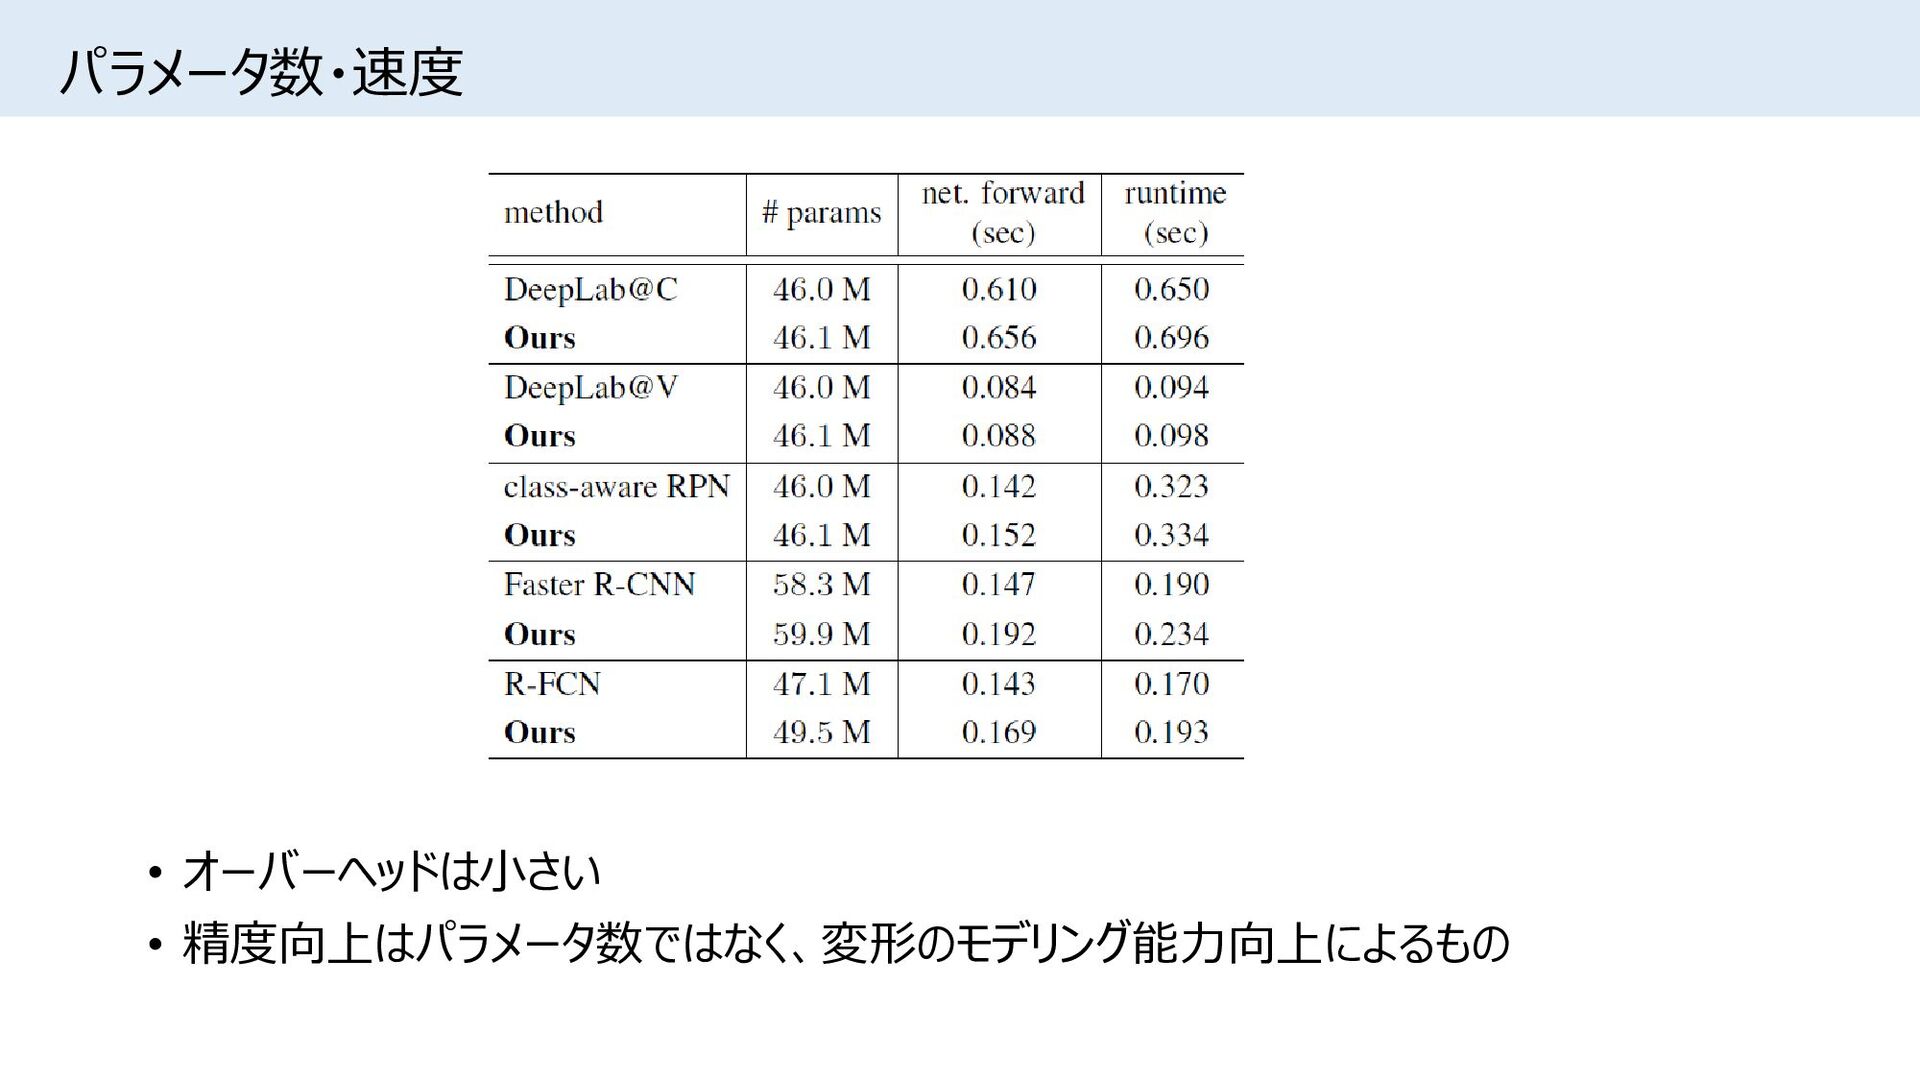
関連研究との差異 • Spatial Transform Networks (STN) と比べて、 - 軽量で、学習しやすい -
特徴マップ全体のwarpingではなく、局所的で密なサンプリングを行う - semantic segmentationや物体検出に向く • Deformable Part Models (DPM) と違ってdeepであり、 モジュールを積むことで、変形のモデリング能力が増す [Max Jaderberg+, NIPS2015] -
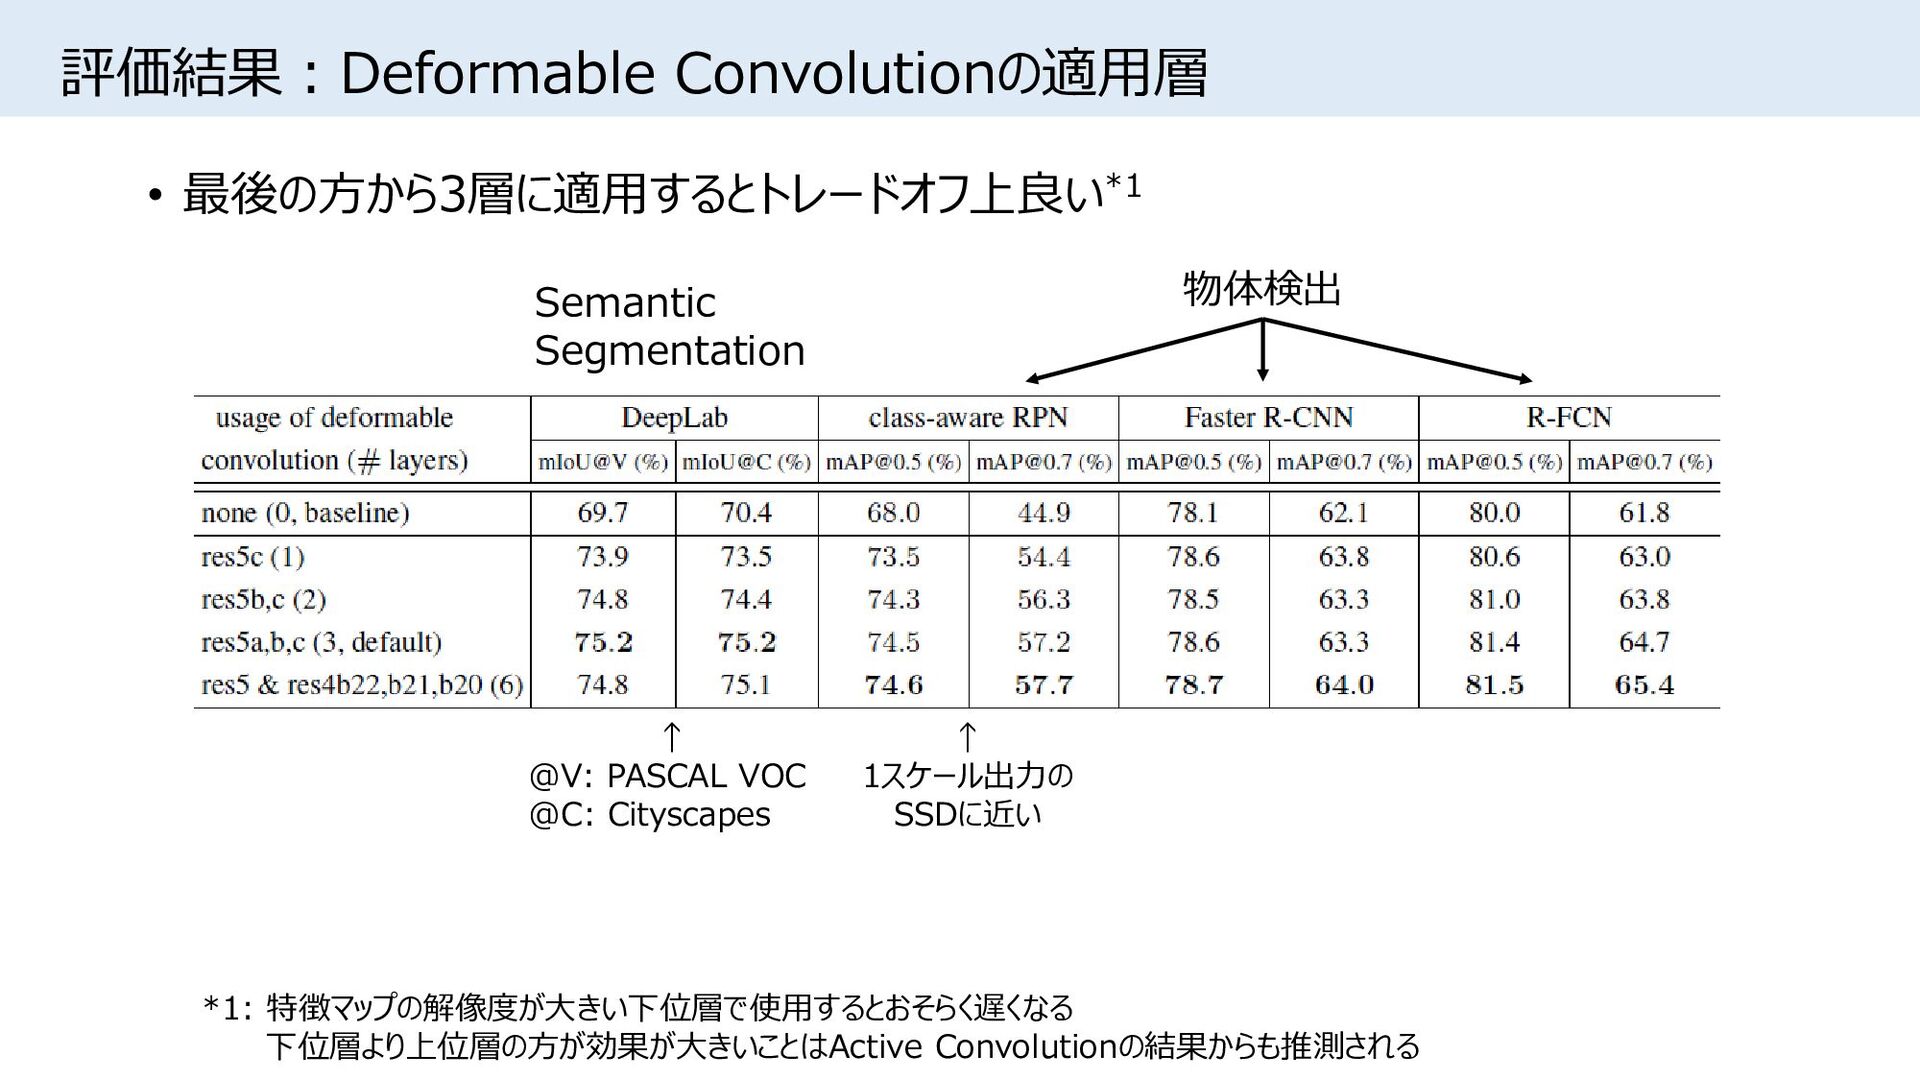
評価結果:Deformable Convolutionの適用層 • 最後の方から3層に適用するとトレードオフ上良い*1 ↑ 1スケール出力の SSDに近い ↑ @V: PASCAL
VOC @C: Cityscapes *1: 特徴マップの解像度が大きい下位層で使用するとおそらく遅くなる 下位層より上位層の方が効果が大きいことはActive Convolutionの結果からも推測される Semantic Segmentation 物体検出 -
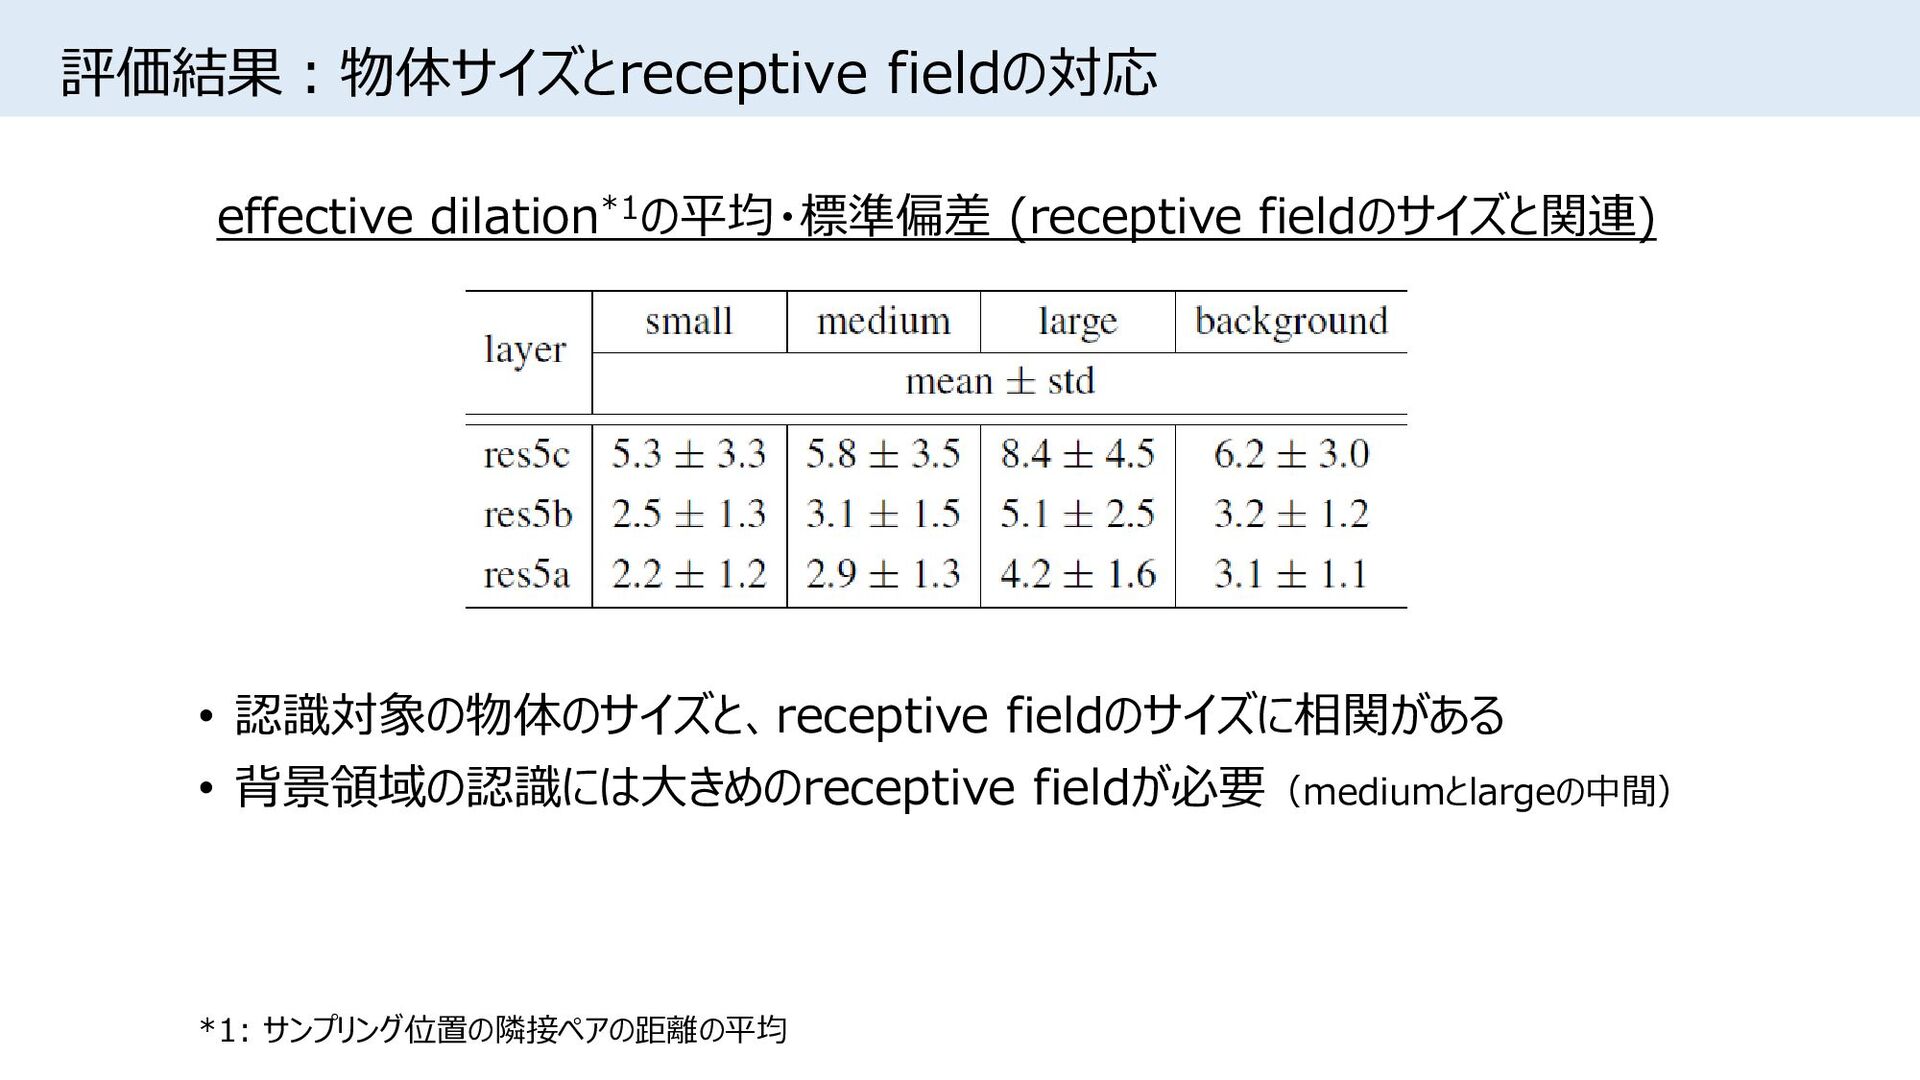
評価結果:物体サイズとreceptive fieldの対応 • 認識対象の物体のサイズと、receptive fieldのサイズに相関がある • 背景領域の認識には大きめのreceptive fieldが必要(mediumとlargeの中間) effective dilation*1の平均・標準偏差
(receptive fieldのサイズと関連) *1: サンプリング位置の隣接ペアの距離の平均 -
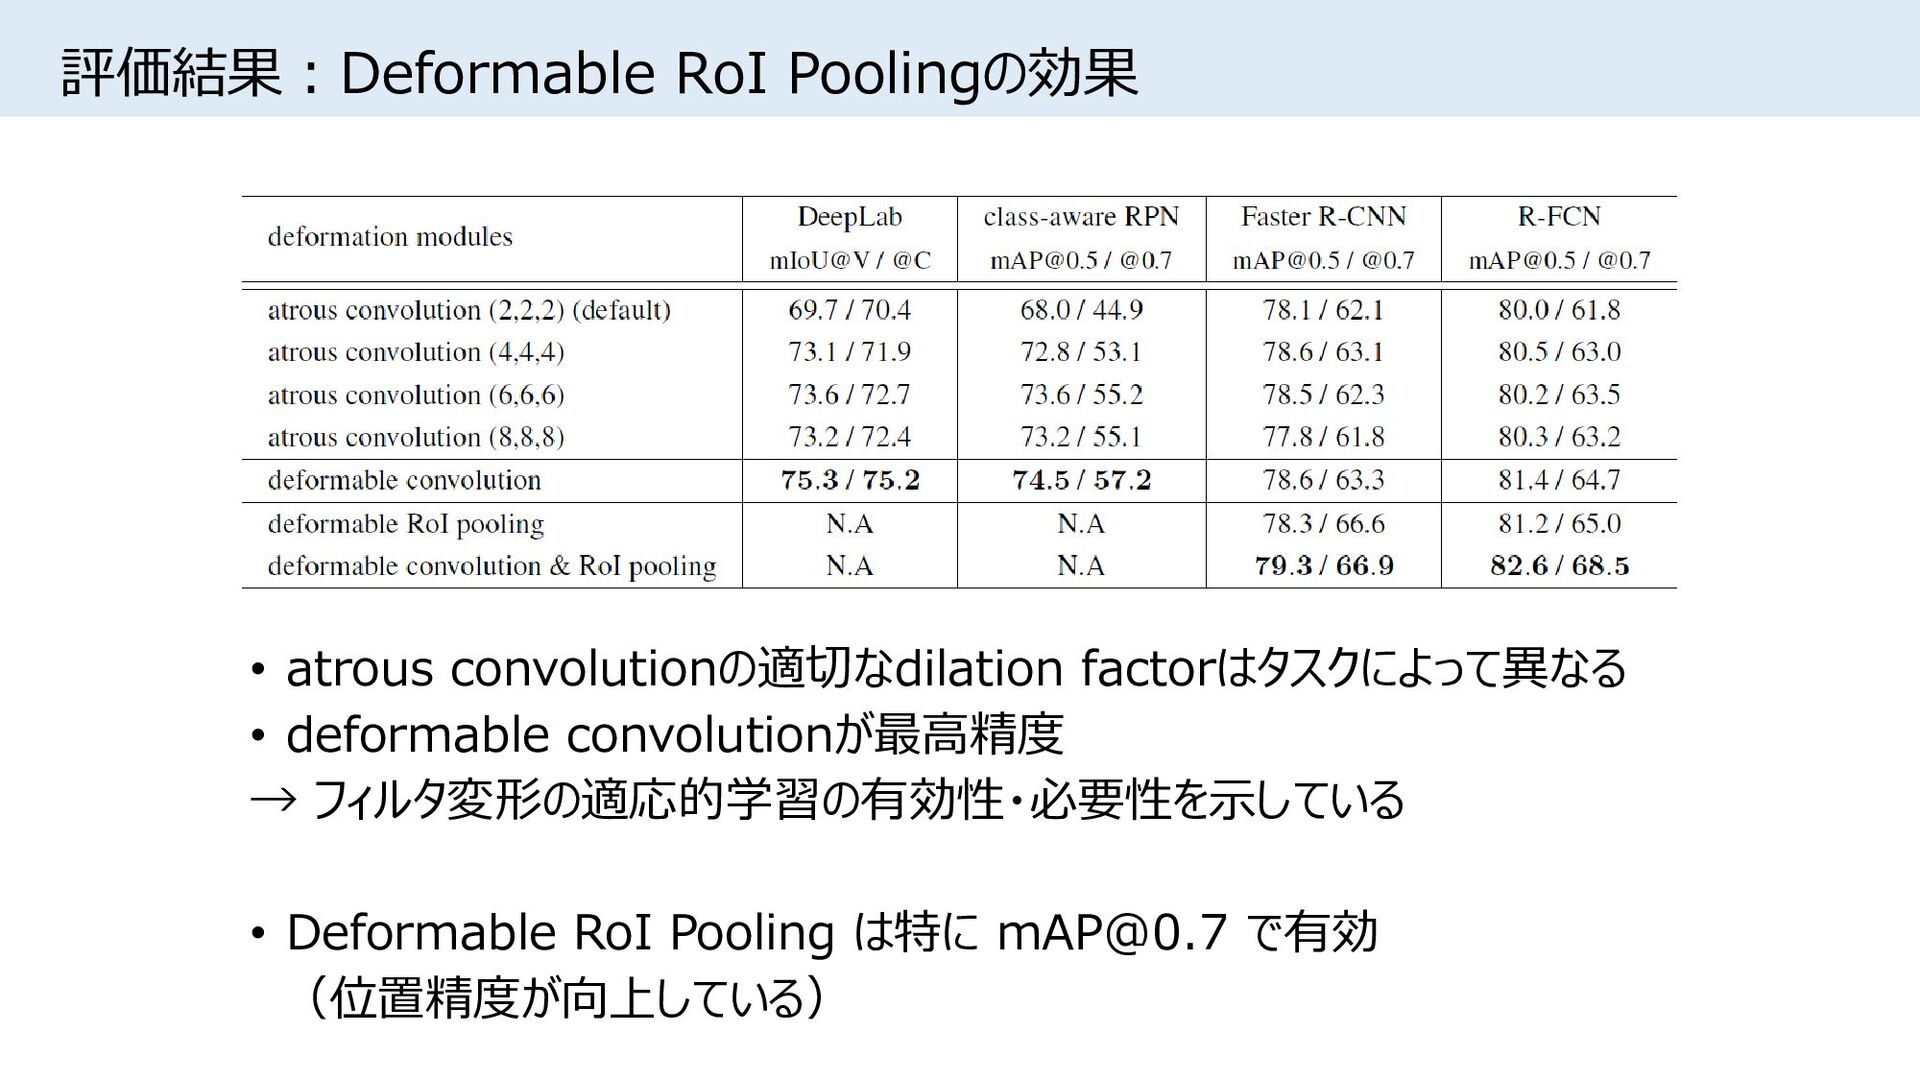
評価結果:Deformable RoI Poolingの効果 • atrous convolutionの適切なdilation factorはタスクによって異なる • deformable convolutionが最高精度
→ フィルタ変形の適応的学習の有効性・必要性を示している • Deformable RoI Pooling は特に [email protected] で有効 (位置精度が向上している) -
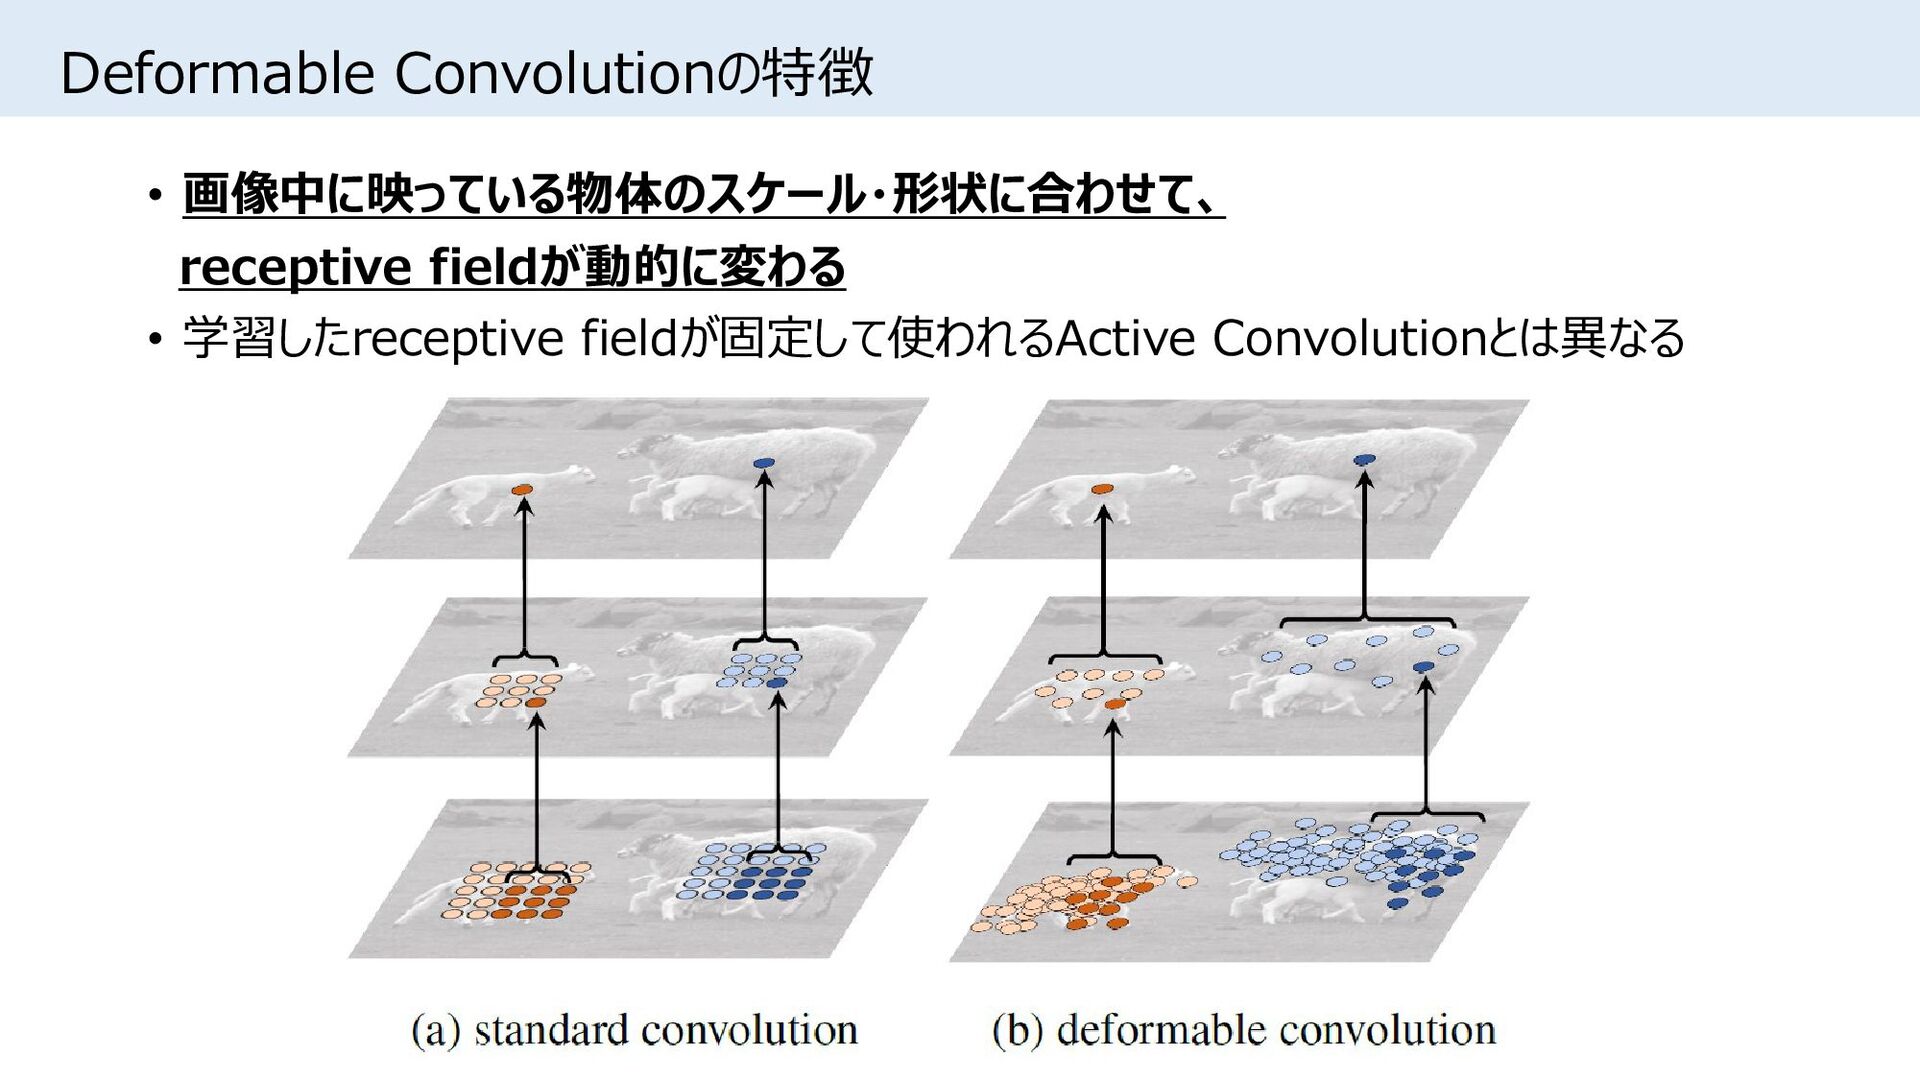
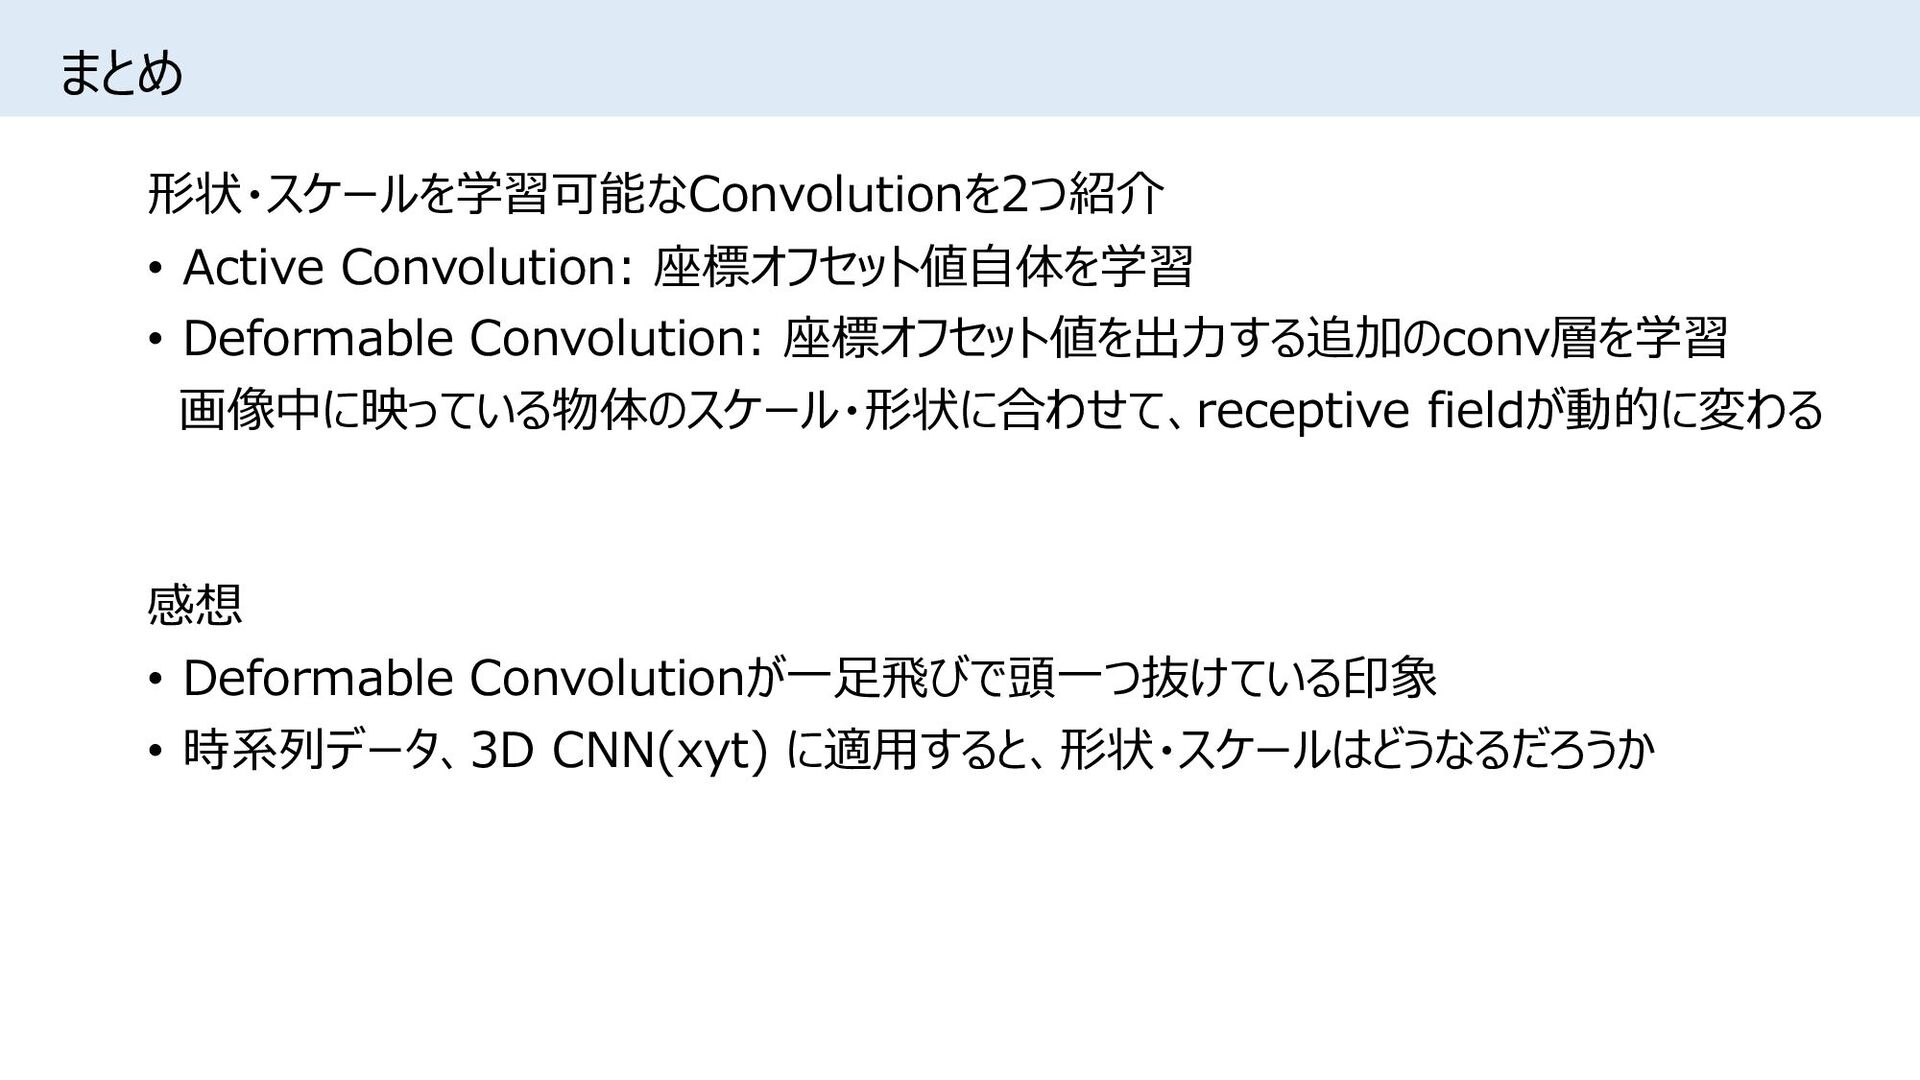
まとめ 形状・スケールを学習可能なConvolutionを2つ紹介 • Active Convolution: 座標オフセット値自体を学習 • Deformable Convolution: 座標オフセット値を出力する追加のconv層を学習
画像中に映っている物体のスケール・形状に合わせて、receptive fieldが動的に変わる 感想 • Deformable Convolutionが一足飛びで頭一つ抜けている印象 • 時系列データ、3D CNN(xyt) に適用すると、形状・スケールはどうなるだろうか -
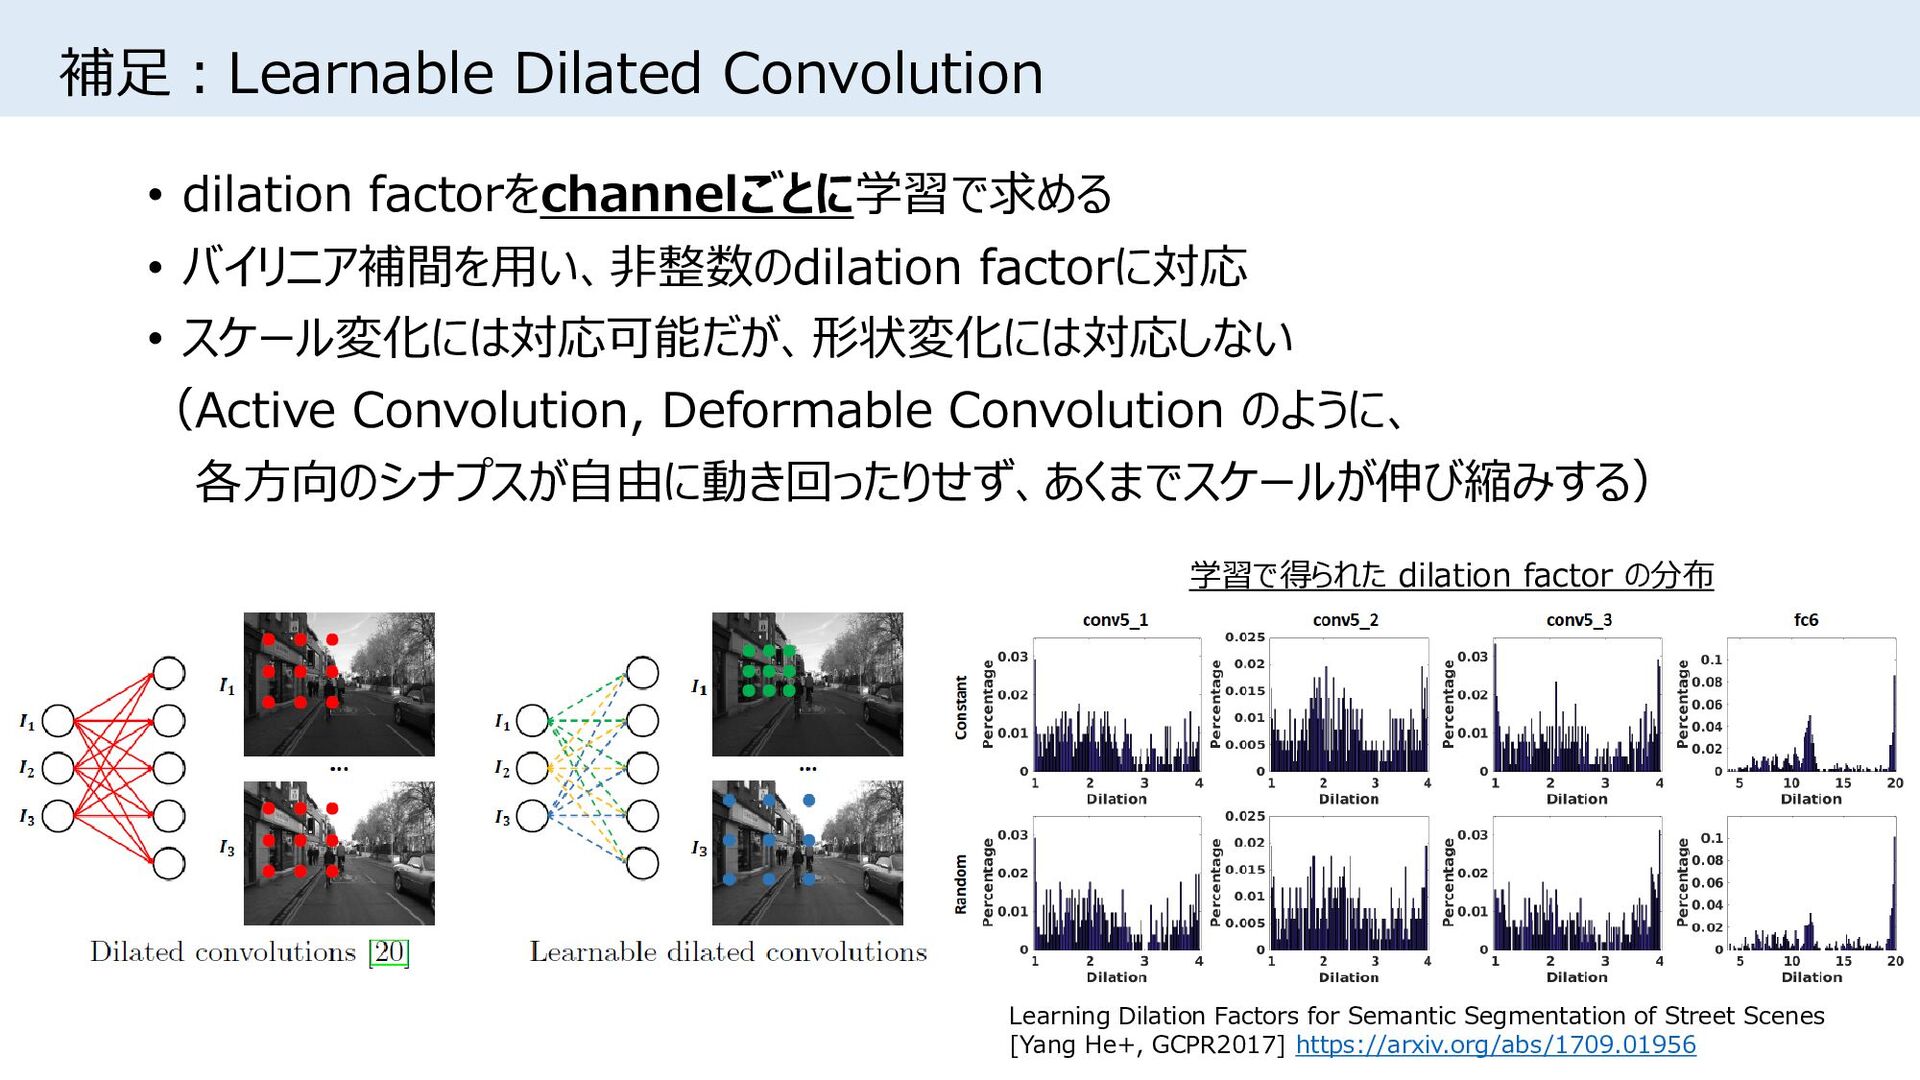
補足:Learnable Dilated Convolution • dilation factorをchannelごとに学習で求める • バイリニア補間を用い、非整数のdilation factorに対応 •
スケール変化には対応可能だが、形状変化には対応しない (Active Convolution, Deformable Convolution のように、 各方向のシナプスが自由に動き回ったりせず、あくまでスケールが伸び縮みする) Learning Dilation Factors for Semantic Segmentation of Street Scenes [Yang He+, GCPR2017] https://arxiv.org/abs/1709.01956 学習で得られた dilation factor の分布 -
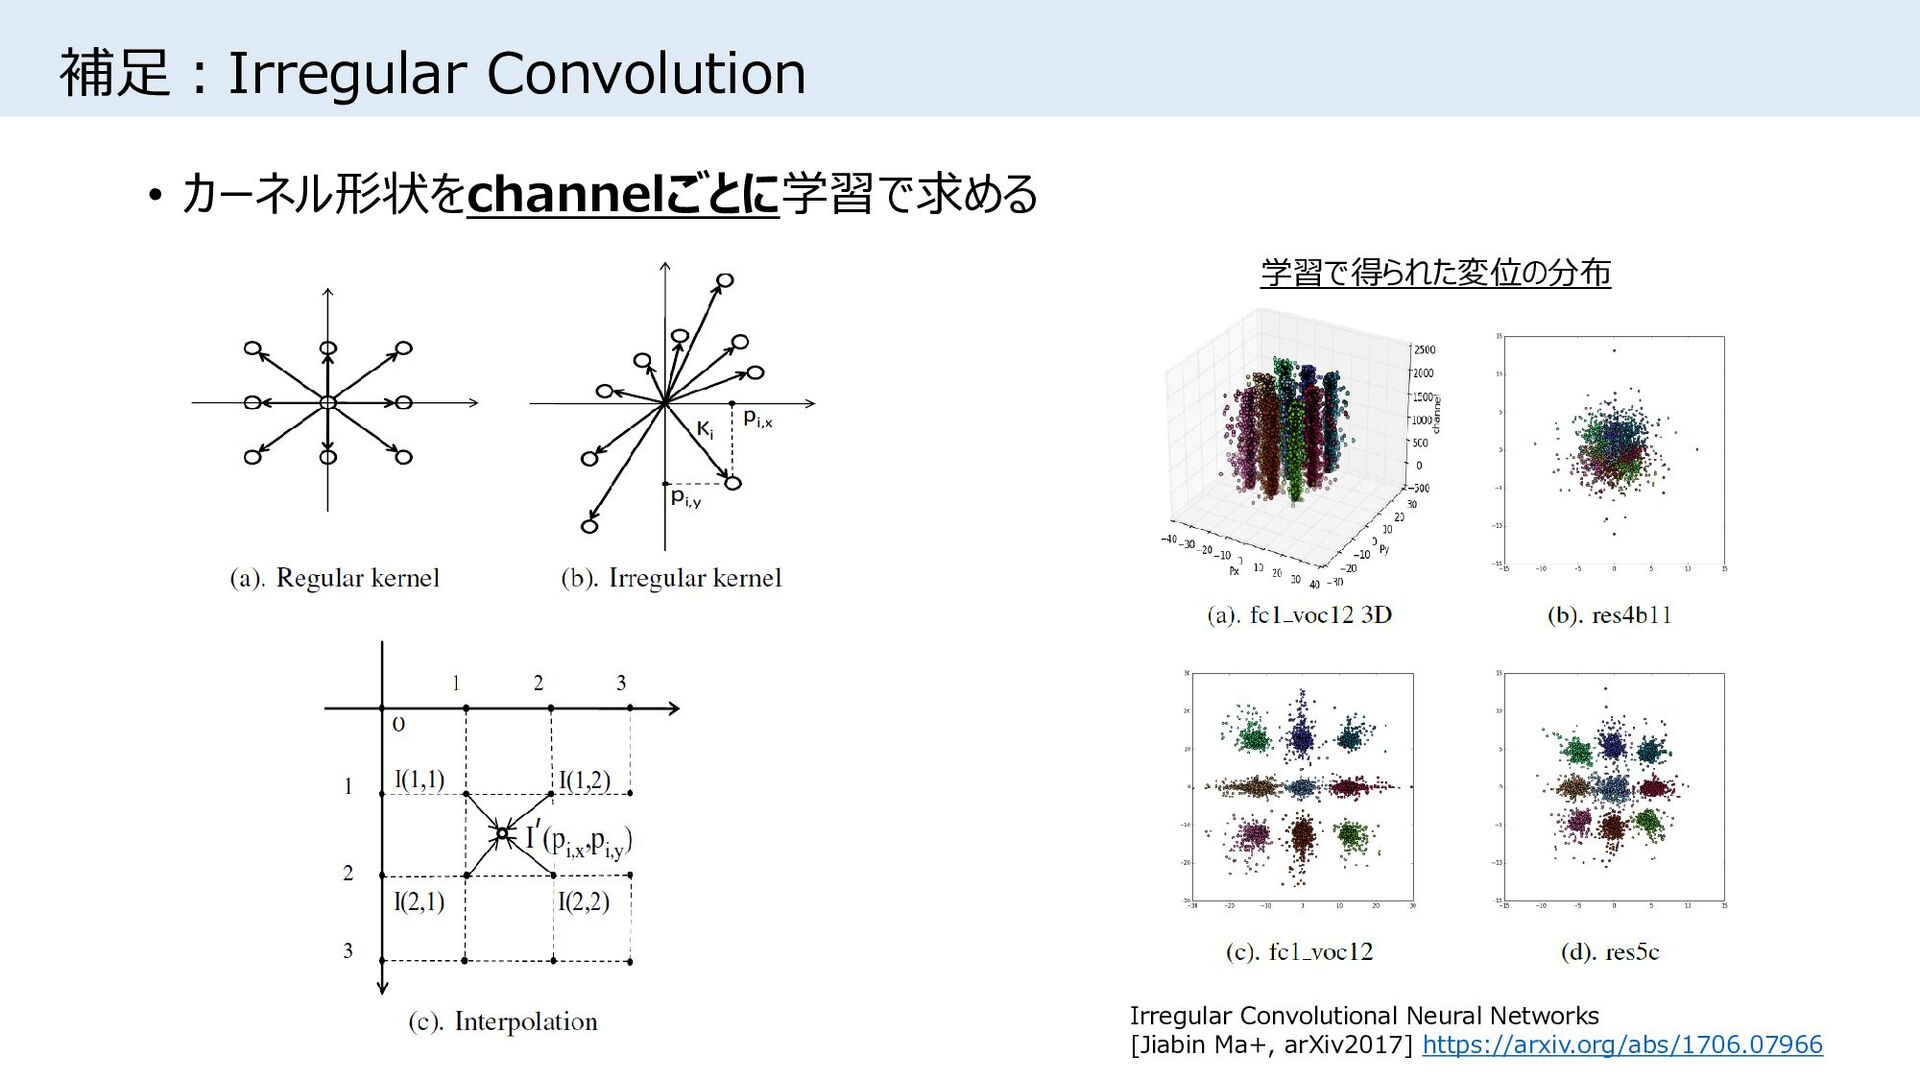
補足:Irregular Convolution • カーネル形状をchannelごとに学習で求める Irregular Convolutional Neural Networks [Jiabin Ma+,
arXiv2017] https://arxiv.org/abs/1706.07966 学習で得られた変位の分布 -
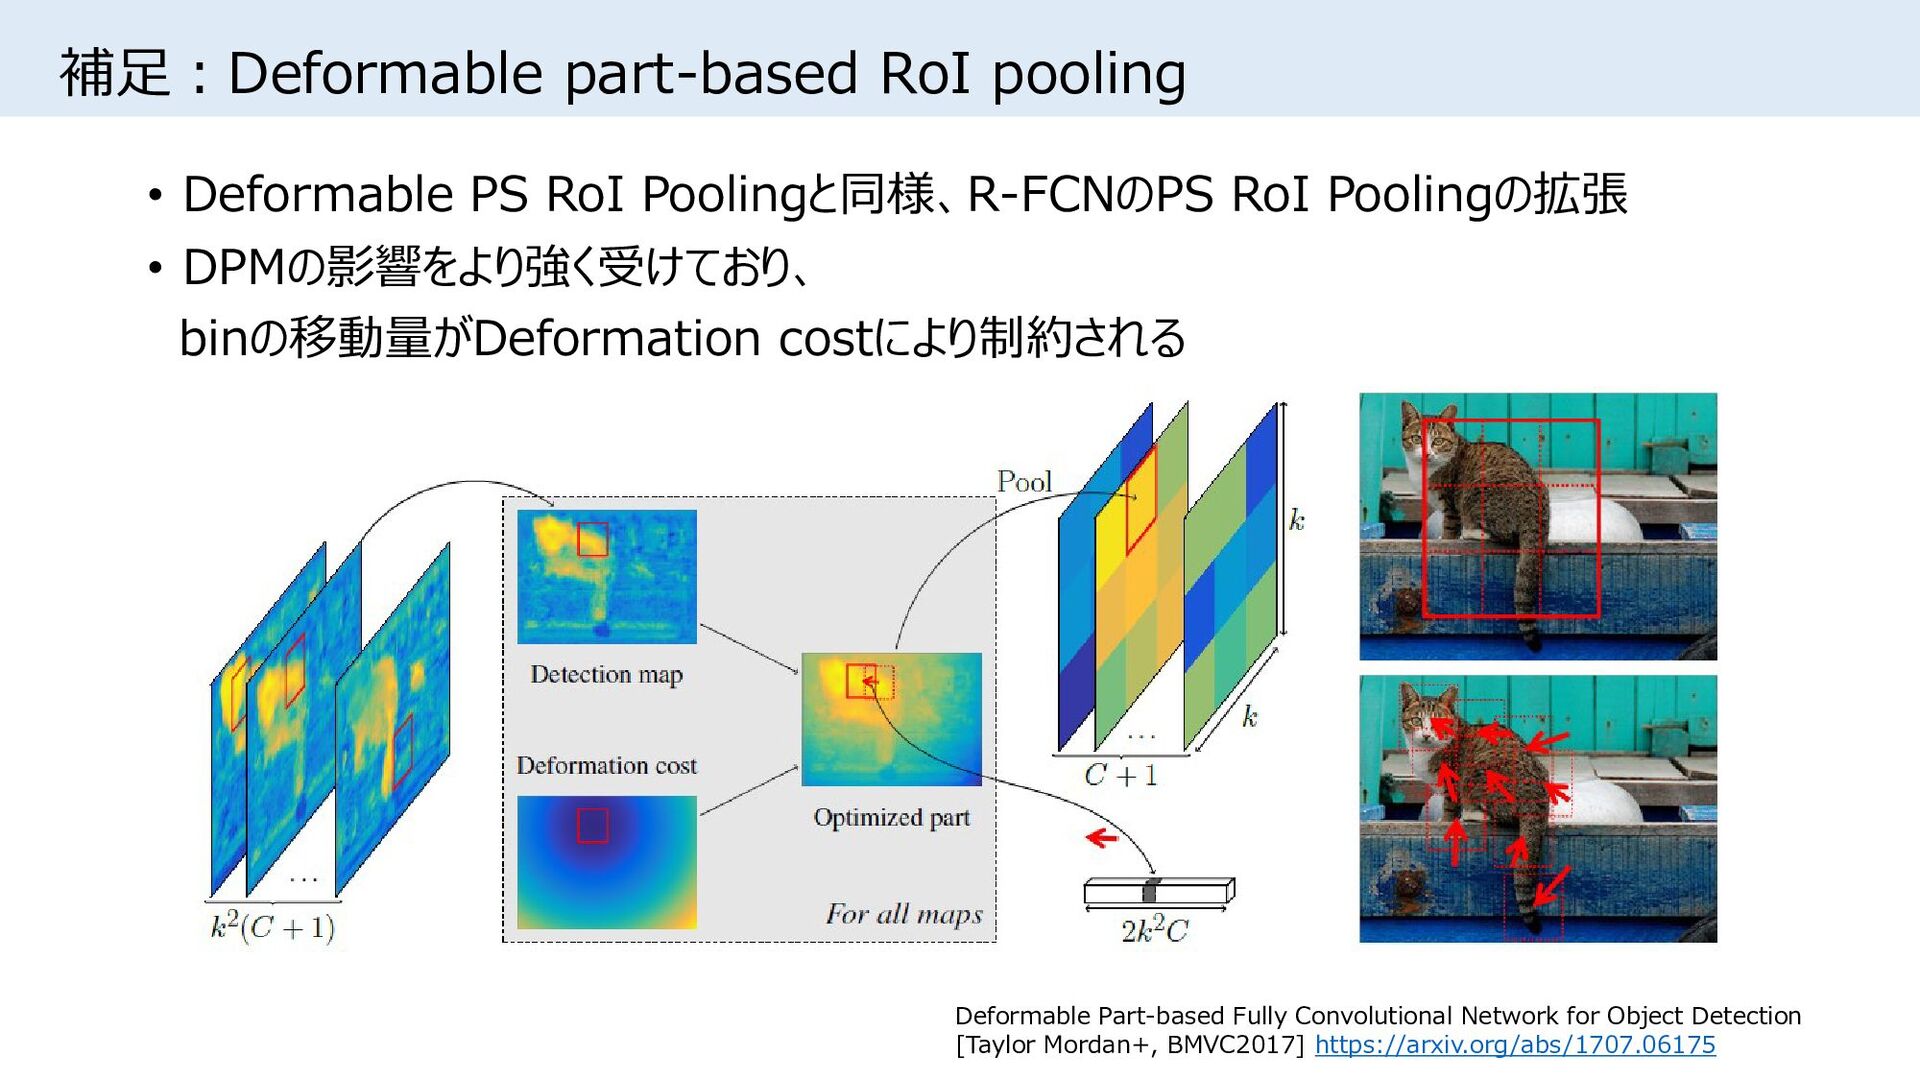
補足:Deformable part-based RoI pooling • Deformable PS RoI Poolingと同様、R-FCNのPS RoI
Poolingの拡張 • DPMの影響をより強く受けており、 binの移動量がDeformation costにより制約される Deformable Part-based Fully Convolutional Network for Object Detection [Taylor Mordan+, BMVC2017] https://arxiv.org/abs/1707.06175