Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
GPU上でのNLP向け深層学習の実装について
Search
Yuya Unno
November 11, 2015
Technology
17
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
GPU上でのNLP向け深層学習の実装について
Yuya Unno
November 11, 2015
Transcript
24 slides
GPU上でのNLP向け深層学習 の実装について (株)Preferred Infrastructure 海野 裕也
概要 l データごとに構造の異異なる⾃自然⾔言語処理理の様な 分野で、効率率率的な学習をするにはどうすればよ いか? l 論論⽂文ベースで幾つかの⼯工夫を紹介 2
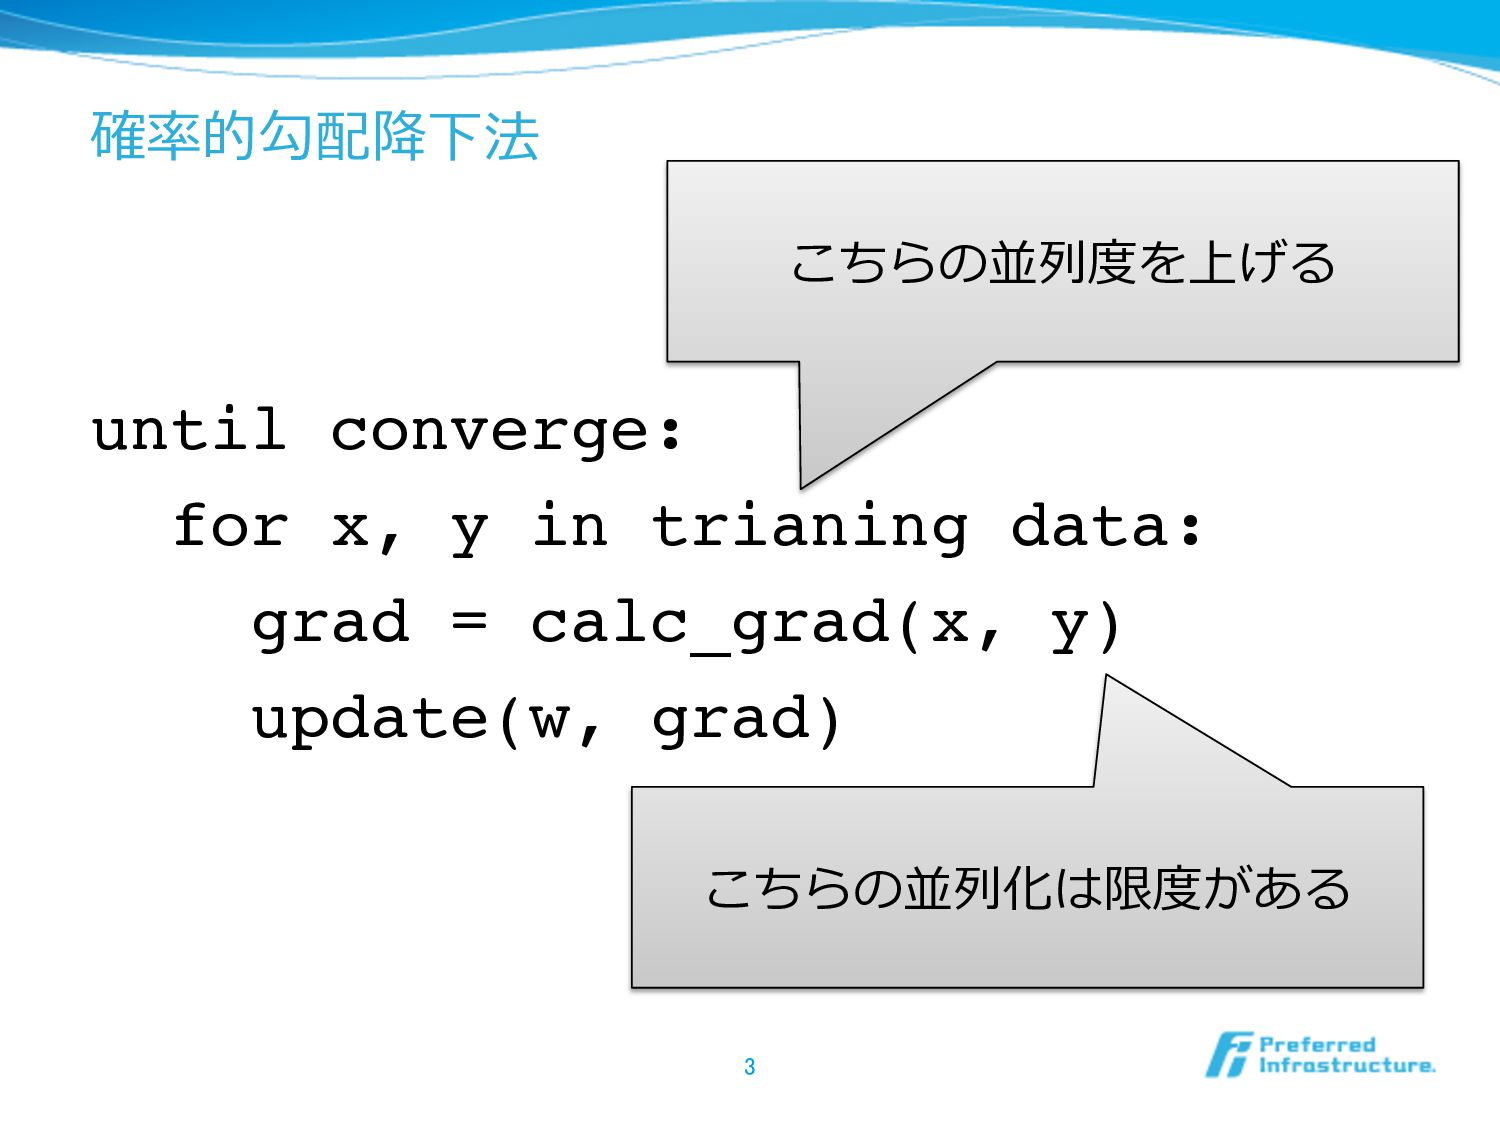
確率率率的勾配降降下法 until converge: for x, y in trianing data: grad
= calc_grad(x, y) update(w, grad) 3 こちらの並列列化は限度度がある こちらの並列列度度を上げる
ミニバッチ並列列化 until converge: for {x, y} in trianing data: grad
= calc_grad({x, y}) update(w, grad) 4 ⼀一度度にたくさん計算する 並列列に計算できる
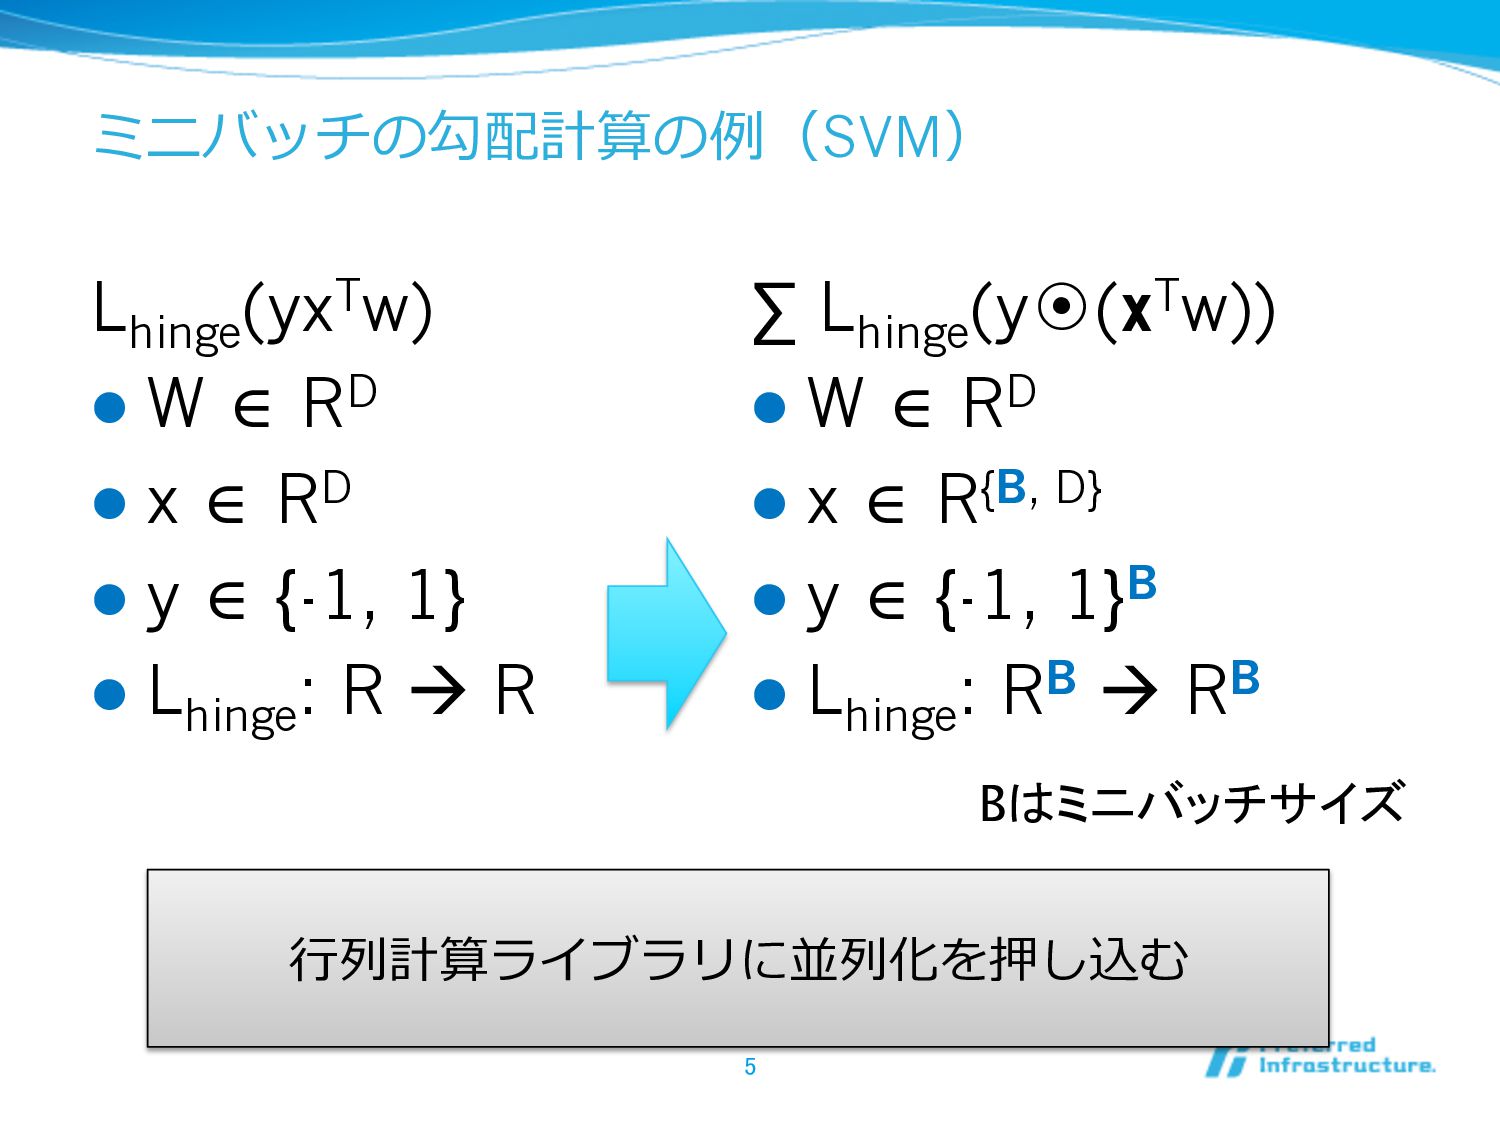
ミニバッチの勾配計算の例例(SVM) L hinge (yxTw) l W ∈ RD l x
∈ RD l y ∈ {-1, 1} l L hinge : R à R 5 ∑ L hinge (y⦿(xTw)) l W ∈ RD l x ∈ R{B, D} l y ∈ {-1, 1}B l L hinge : RB à RB Bはミニバッチサイズ ⾏行行列列計算ライブラリに並列列化を押し込む
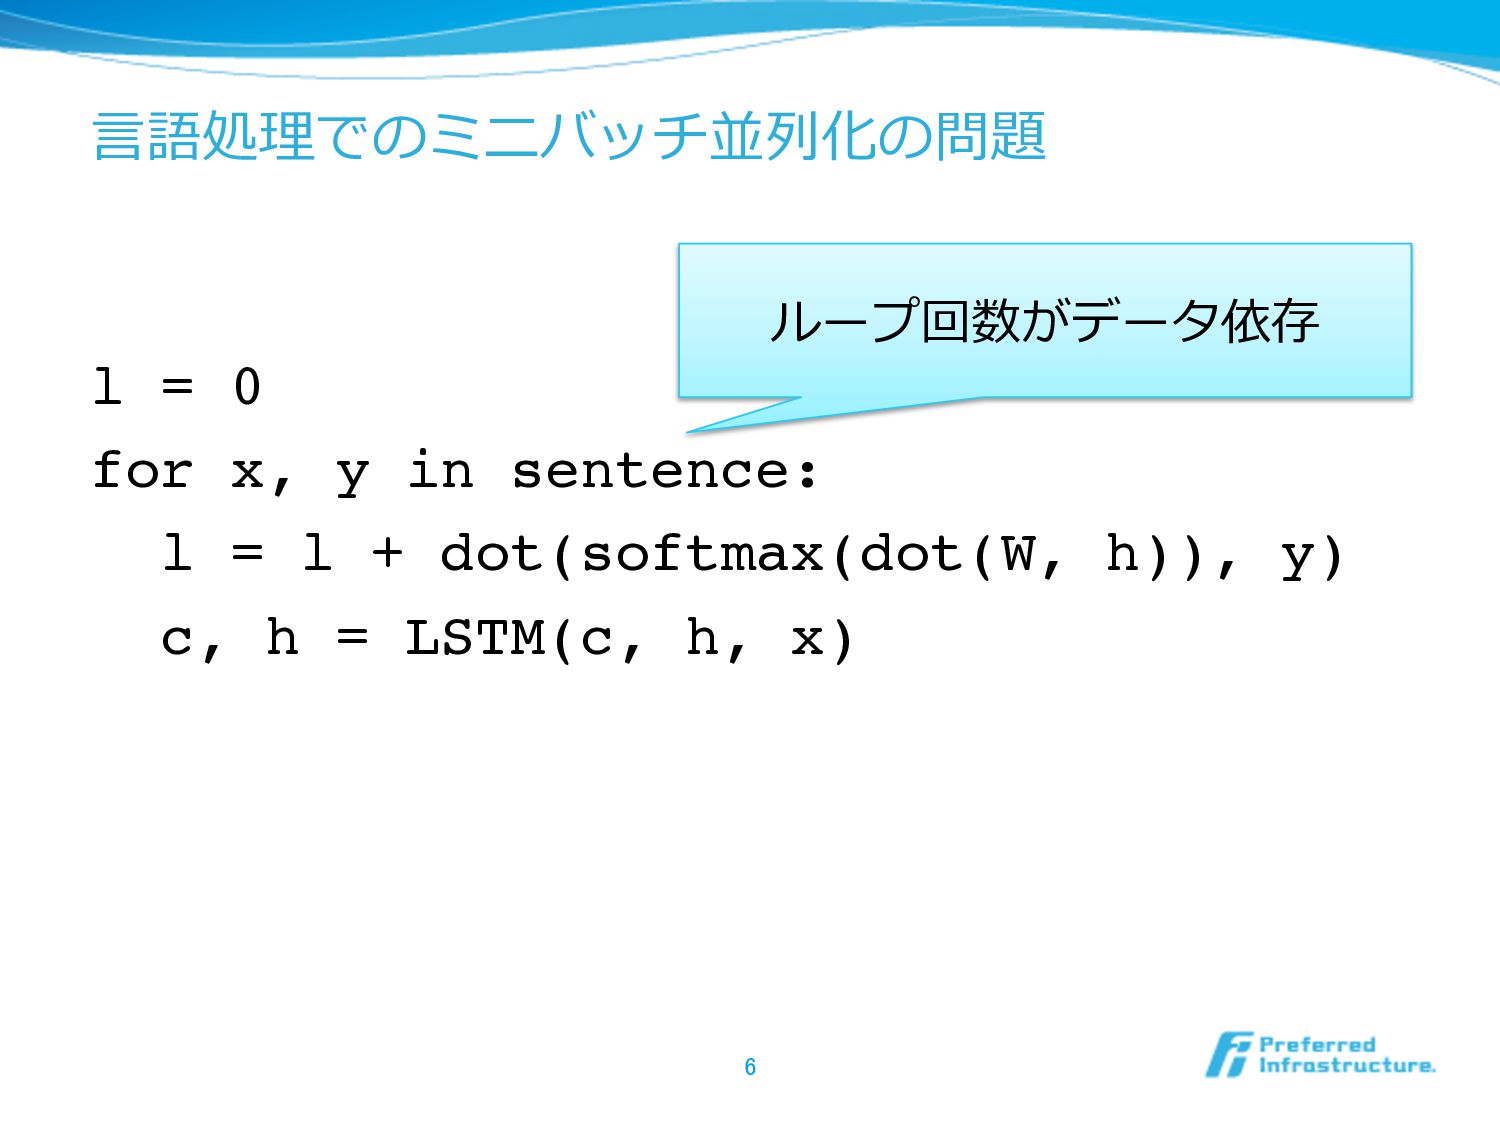
⾔言語処理理でのミニバッチ並列列化の問題 l = 0 for x, y in sentence: l
= l + dot(softmax(dot(W, h)), y) c, h = LSTM(c, h, x) 6 ループ回数がデータ依存
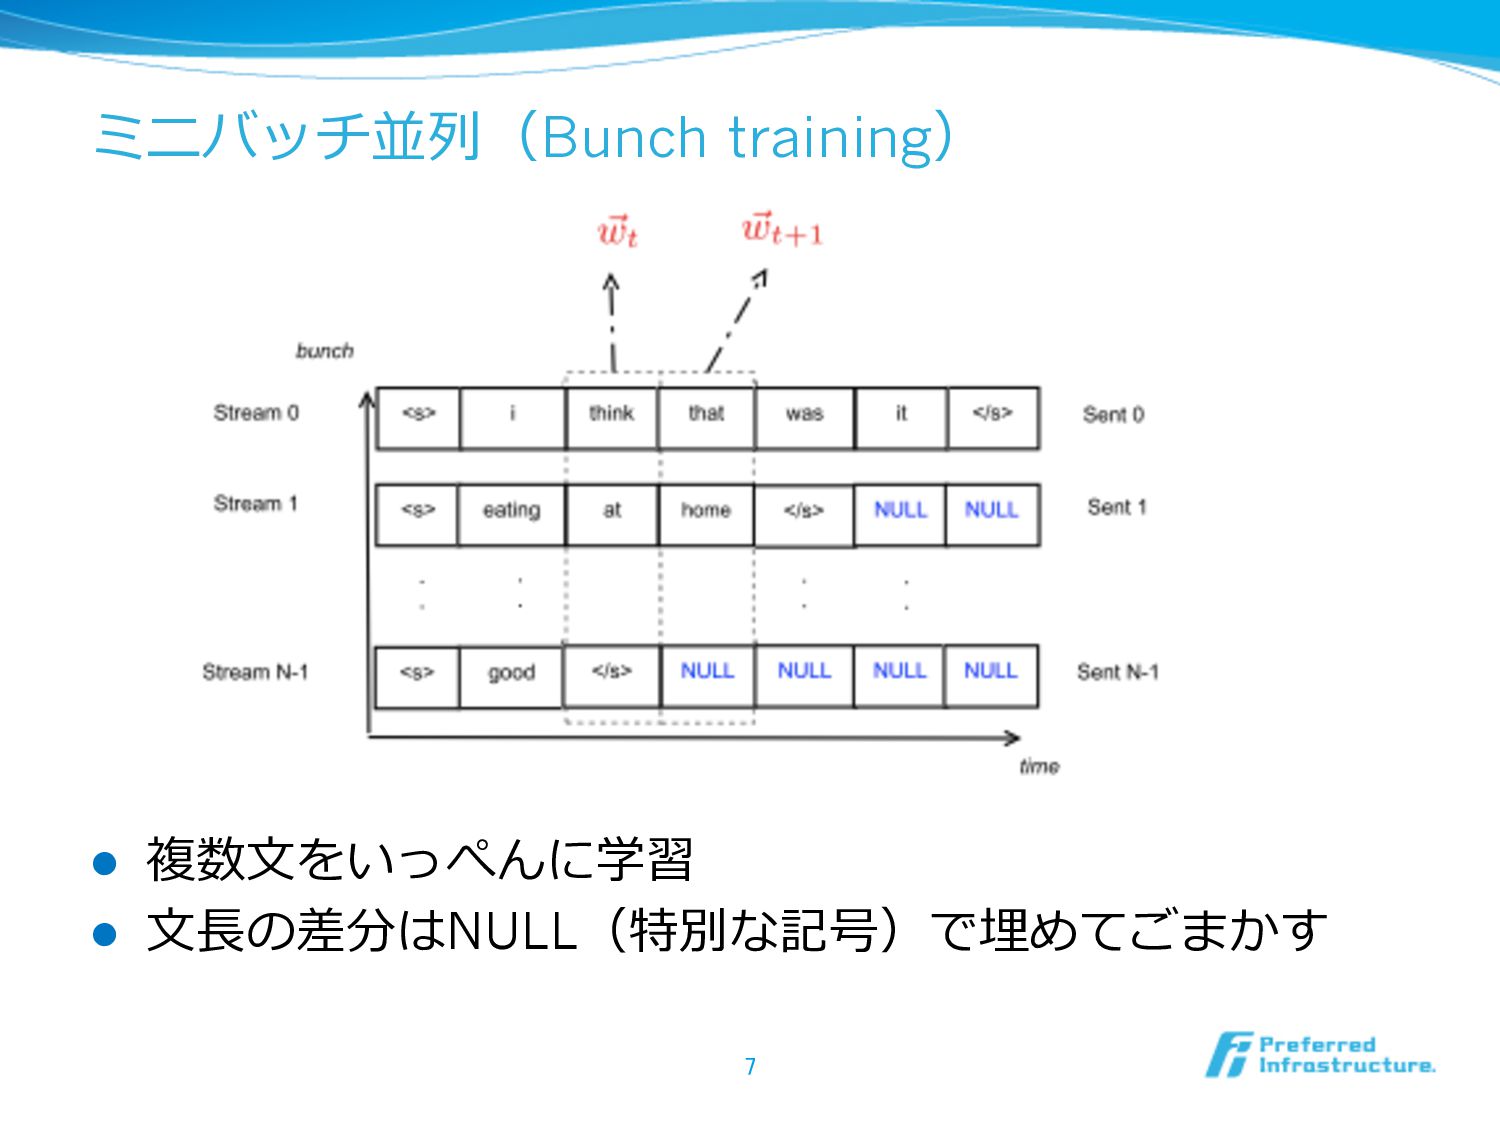
ミニバッチ並列列(Bunch training) l 複数⽂文をいっぺんに学習 l ⽂文⻑⾧長の差分はNULL(特別な記号)で埋めてごまかす 7
NULL埋めによる無駄 8 l ⽂文⻑⾧長はガンマ分布に従うとして[古橋12]、複数サンプリ ングした中で最⼤大⻑⾧長に合わせた時の計算効率率率をプロット 0 0.2 0.4 0.6 0.8
1 1.2 1 2 4 8 16 32 64 128 256
Sentence splicing [Chen+14] l NULLで埋めずに、次々に⽂文を処理理する l 実装は単純ではない気がするが 9
Splicingの効果 l Splicingしないと、50並列列程度度で性能は頭打ち 10
Pipeline [Chen+15] l 層ごとにGPUが担当して、層が深くなるごとに別GPUが 計算を⾏行行う 11
短いチャンクに切切る[Doetsch+14] l 単に短いチャンクに切切って並列列度度を上げる l NULLの量量も減る l 本当に⻑⾧長い依存は学習できなくなる 12
計算グラフを解析 [Hwang+15] l 計算グラフを強連結成分分解 l Recurrentの部分は1つの強連結成分に押し込める l 各強連結成分ごとに並列列計算する 13
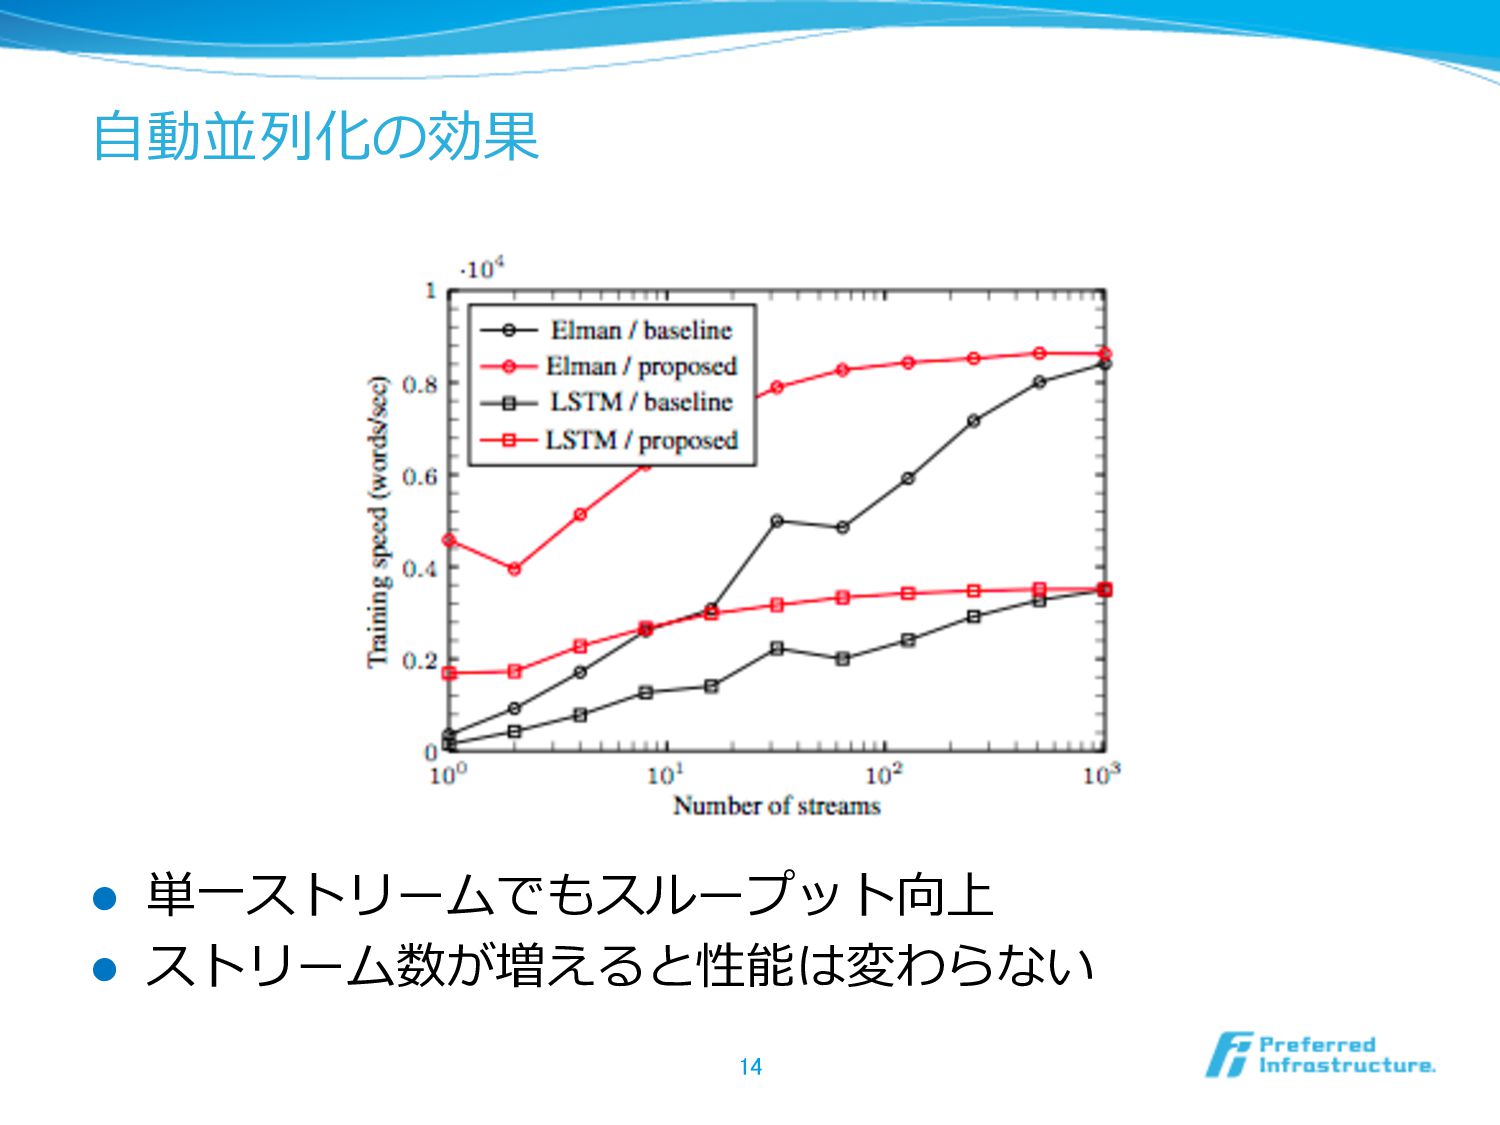
⾃自動並列列化の効果 l 単⼀一ストリームでもスループット向上 l ストリーム数が増えると性能は変わらない 14
おまけ:Bucketing l 予め幾つかの⽂文⻑⾧長⽤用のネットワークを⽤用意して、 処理理データが収まる最⼩小のネットワークを利利⽤用 する l TensorFlowで使われている 15
並列列化の⼯工夫まとめ l ゼロ埋め l ⽂文⻑⾧長の違うデータに0を埋めて、無理理やり計算 l スプライシング l ストリームごとに次々データを流流す l
パイプライン l 層ごとに別GPUを割り当ててスループットを稼ぐ l チャンク l ⽂文を無理理やり切切って⽂文⻑⾧長の差を緩和 l グラフ解析 l 計算系列列中の独⽴立立部分を抽出して⾃自動割当 16
この辺から本題 l 今までみたのは全てシンプルなRecurrentだった ので、基本的に⽂文⻑⾧長(EOSのタイミング)しか 違いがない l より複雑なネットワークの並列列処理理には更更に⼯工 夫が必要 l Encoder-decoderモデル
l Recursive neural network l Attentionモデル系 l Memory networks系 17
並列列化のレベル l GPUデバイス内 l SIMD, メモリ, スレッド, カーネル l メモリ帯域:
~1TB/sec l GPUデバイス間(マルチGPU) l PCI-ex (~100GB/sec) l マシン間 l InfiniBand (~50GB/sec), Ethernet (~1GB/sec) 18
バッチ vs オンライン l ミニバッチサイズを増やしても実時間での精度度 向上が早くなってないように感じる l バッチ学習とオンライン学習と同じ議論論 l 更更新頻度度をあげようとすると、CPUの⽅方が有利利
な可能性は無いか? 19
実装レベルで⽐比較
⽬目についた実装を調査 l Embedding l Recurrent l Recursive 21
Embedding l word2vec l CPU実装、スレッドで並列列化、ロックしないで更更新(ミニバッ チにはしていない)、勾配を陽に持たない l gensim l Python実装、Cythonで⾼高速化
l Polyglot2 l Python実装、Cythonとblasで⾼高速化 l Chainer (word2vec example) l Python実装、cupyでGPUサポート、ミニバッチ 22
Recurrent l theano-rnn l Python実装、theanoでGPU、batchsizeでchunkを作る l Passage l Python実装、theanoでGPU、iteratorでミニバッチを作り、 余ったところはゼロ埋め
l DL4J (rnn example) l Java実装、ND4JでGPU、iteratorでミニバッチを作り、 batchsizeでchunkを作る l Chainer (ptb example) l Python実装、CuPyでGPU、batchsizeでchunkを作る 23
Recursive l Stanford core nlp l Java実装、再帰関数で実装、ミニバッチしていない l deep-recursive l
C++実装、Eigen利利⽤用、データ単位で処理理(ミニバッチしていな い) l RecursiveNeuralTensorNetwork l Python実装、theano利利⽤用、Treeをstack操作に変換してから学 習しているがミニバッチしていなさそう l Chainer (sentiment example) l Python実装、CuPyでGPU、再帰関数で実装、ミニバッチして いない 24
More Decks by Yuya Unno
See All by Yuya Unno
深層学習で切り拓くパーソナルロボットの未来 @東京大学 先端技術セミナー 工学最前線
unnonouno
0
31
深層学習時代の自然言語処理ビジネス @DLLAB 言語・音声ナイト
unnonouno
0
58
ベンチャー企業で言葉を扱うロボットの研究開発をする @東京大学 電子情報学特論I
unnonouno
0
53
PFNにおけるセミナー活動 @NLP2018 言語処理研究者・技術者の育成と未来への連携WS
unnonouno
0
27
進化するChainer @JSAI2017
unnonouno
0
35
予測型戦略を知るための機械学習チュートリアル @BigData Conference 2017 Spring
unnonouno
0
33
深層学習フレームワーク Chainerとその進化
unnonouno
0
43
深層学習による機械とのコミュニケーション @DeNA TechCon 2017
unnonouno
0
49
最先端NLP勉強会 “Learning Language Games through Interaction” @第8回最先端NLP勉強会
unnonouno
0
33
Other Decks in Technology
See All in Technology
「AIチャットからもできないの?」と言われたら ~業務アプリをMCP対応するときの認証・認可の勘所
oidfj
0
300
Go初心者のクラウドエンジニアが、デプロイを通して旨味を知っていく話
ryudai
1
170
AIエージェントの監視、思考を見るか行動を見るか / Monitoring AI Agents: Thoughts or Actions
yusukeshimizu
2
190
2026-11-11 Tamachi.sre#7 PaCにインフラリソースの命を救われました。 / PaC saves the infra resource life
masasuzu
0
120
アラートを見直していたら営業組織への理解にちょっとだけ繋がった話
z63d
1
170
「いつか使う」の「いつか」は来ない 〜AI駆動開発における「作らない」判断について〜
ikki0006
0
200
ゼロから作るWebアプリの新定番!?Amplify Gen 2 × AWS Blocksで実現する「開発速度とRDBの柔軟性のいいとこ取り」
amixedcolor
1
240
Sizing, Benchmarking and Performance Tuning Apache Flink Clusters
rmetzger
0
150
Steering と Hook (チームの決まりを守らせる) | 目指せ Kiro マスター 06
inariku
PRO
2
110
SREのためのFinOps入門
muziyoshiz
3
1.4k
自治体AIコンタクトセンター、何をどこに任せる?~Amazon Connect Customer +Amazon Bedrockの実践知~ / 20261107 Satoshi Torano
shift_evolve
PRO
1
130
In-Context Learning再入門。ICLの勾配降下的解釈の研究動向を追ってみる。
dai08srhg
1
810
Featured
See All Featured
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.7k
How STYLIGHT went responsive
nonsquared
100
6.4k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
280
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
940
Statistics for Hackers
jakevdp
799
230k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
480
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.3k
Facilitating Awesome Meetings
lara
57
7.2k
GitHub's CSS Performance
jonrohan
1033
470k
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
Ruling the World: When Life Gets Gamed
codingconduct
0
440


 unnonouno
 oidfj
 ryudai
 yusukeshimizu
 masasuzu
 z63d
 ikki0006
 amixedcolor
 rmetzger
 inariku
 muziyoshiz
 shift_evolve
 dai08srhg
 irinanazarova
 nonsquared
 bermonpainter
 stuffmc
 chikuwait
 jakevdp
 tamaranovitovic
 inesmontani
 lara
 jonrohan
 caitiem20
 codingconduct