Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Gunosy研究会]Personalized Collaborative Clustering
Search
ysekky
April 10, 2014
Research
1.5k
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Gunosy研究会]Personalized Collaborative Clustering
ysekky
April 10, 2014
More Decks by ysekky
See All by ysekky
スタートアップの開発サイクルに学ぶ 研究活動の進め方 / research practices inspired by startup business strategy
ysekky
0
2.5k
[論文紹介] A Method to Anonymize Business Metrics to Publishing Implicit Feedback Datasets (Recsys2020) / recsys20-reading-gunosy-datapub
ysekky
3
2.9k
JSAI2020 OS-12 広告とAI オープニング / JSAI2020-OS-12-ads-and-ai-opening
ysekky
0
2.3k
JSAI2020インダストリアルセッション - Gunosyにおける研究開発 / jsai2020-gunosy-rd-examples
ysekky
1
840
ウェブサービス事業者における研究開発インターン[株式会社Gunosy] - テキストアナリティクスシンポジウム2019 / research-intern-case-study-at-gunosy
ysekky
0
3.1k
Gunosyにおけるニュース記事推薦/ news-recommendation-in-gunosy-webdbf2019
ysekky
1
1.6k
DEIM2019技術報告セッション - Gunosyの研究開発 / deim-2019-sponsor-session-gunosy-research
ysekky
0
1.3k
Analysis of Bias in Gathering Information Between User Attributes in News Application (ABCCS 2018)
ysekky
1
2.5k
世代による政治ニュース記事の閲覧傾向の違いの分析 - JSAI2018 / Analysis of differences in viewing behavior of politics news by age
ysekky
0
4.2k
Other Decks in Research
See All in Research
SLAMはどこまで解決されたのか?
tomonom
0
1.4k
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
370
Développer des solutions de réduction des émissions de méthane entérique : 1ers résultats Méthane 2030
institudelelevage
PRO
0
200
Cross-Media Information Spaces and Architectures
signer
PRO
0
380
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
進化?迷走?CasualConc ファミリーアプリの現在地 @ 英語コーパス学会 2026
casualconc
0
120
生成AIなんでも展示会vol6 LT登壇資料 NexteraBERT
rikkabotan7
0
170
HackSick vol.7 LT資料【LLMアーキテクチャ入門・事前学習時の躓き所解説】 スパースなAttention・状態空間モデル
rikkabotan7
0
210
COMETAを用いたデータ民主化運動の歴史
sazimai
0
270
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
satai
3
150
OWASP AISVS - C7
shiell
2
800
人間中心の意思決定支援AI
yukinobaba
PRO
7
4.1k
Featured
See All Featured
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
How to train your dragon (web standard)
notwaldorf
97
6.8k
Jess Joyce - The Pitfalls of Following Frameworks
techseoconnect
PRO
1
430
Crafting Experiences
bethany
1
370
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Mobile First: as difficult as doing things right
swwweet
225
10k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
58k
The Invisible Side of Design
smashingmag
301
52k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
930
Transcript
論文紹介: Personalized Collabora0ve Clustering Yisong Yue, Ching Wang, Khalid
El-‐Arini, Carlos Guestrin WWW 2014 Yoshifumi Seki@Gunosy研究会 2014.04.02
クラスタリングの基準は人によって異なる スポーツ系 時代劇系 ホモ 萌え
目的 • クラスタリングをユーザごとに最適化したい – あるアイテムをどのように分類するかはユーザに よって異なる – ユーザごとにモデルをつくろうとするとユーザごと に多くのデータ量が必要になる
• あるユーザにとってのアイテム同士の類似度 を他のユーザのクラスタも含めて推測する – 協調フィルタリングのように定式化する
やっていること • アイテムの特徴量と、ユーザごとのアイテム 間類似度計算行列を、教師データから学習 する – 教師データはユーザが何と何を同一クラスタとし て、何と何を同一クラスタとしなかったか – アイテムの特徴量はD次元で共通化。
– 類似度計算行列をユーザごとに設計することで ユーザごとにクラスタリングの基準を変える
教師データ • 対象 – M人のユーザ (u1 ~ uM)
• 各ユーザがCm個のクラスタを持つ – N個のアイテム • クラスタ – y = {ym} (1): 各ユーザごとのクラスタ集合 • ym = {Ym^1,…, Ym^Cm} (2): ユーザmのクラスタ集合 • Ym^i: ユーザmのクラスタiのアイテム集合 • 表現方法 – y_{m,i,j} • ユーザmにおいてアイテムi, jが同じクラスタ=> 1 • アイテムi, jが同じクラスタにない=> -‐1
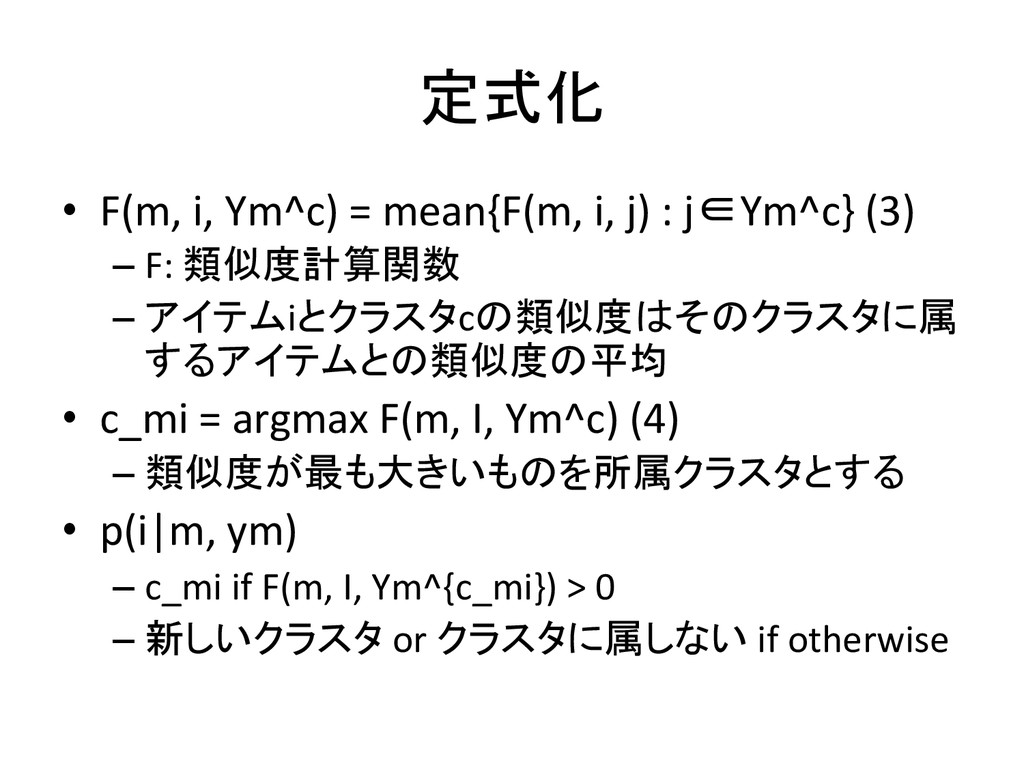
定式化 • F(m, i, Ym^c) = mean{F(m, i, j) :
j∈Ym^c} (3) – F: 類似度計算関数 – アイテムiとクラスタcの類似度はそのクラスタに属 するアイテムとの類似度の平均 • c_mi = argmax F(m, I, Ym^c) (4) – 類似度が最も大きいものを所属クラスタとする • p(i|m, ym) – c_mi if F(m, I, Ym^{c_mi}) > 0 – 新しいクラスタ or クラスタに属しない if otherwise
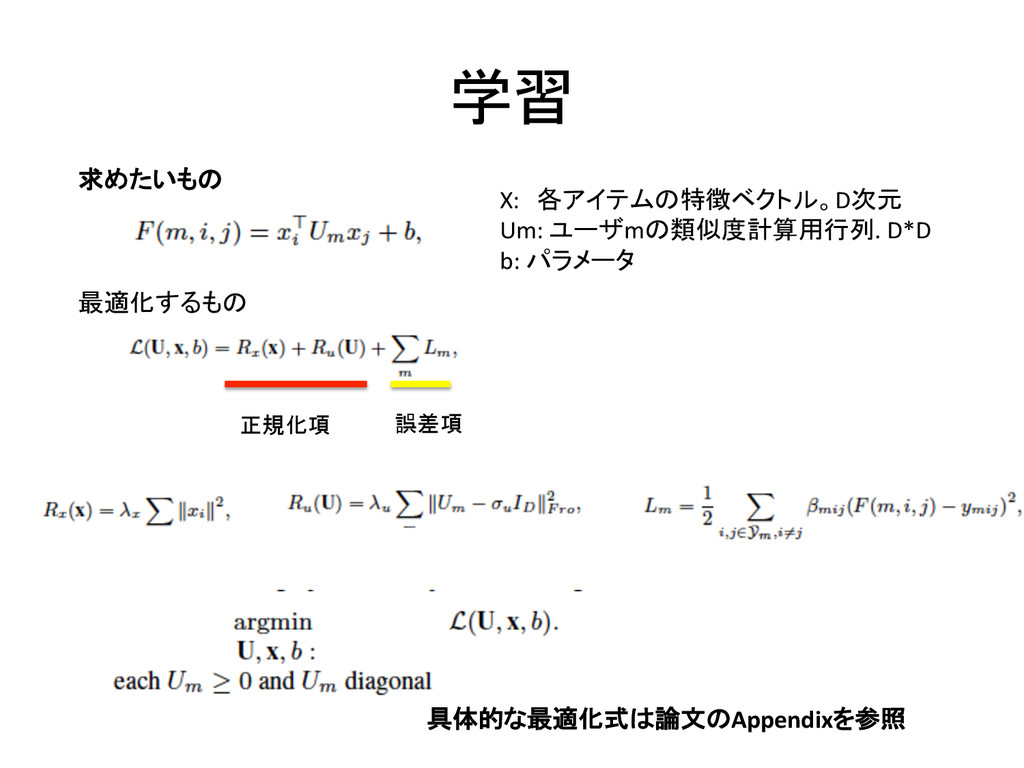
学習 X: 各アイテムの特徴ベクトル。D次元 Um: ユーザmの類似度計算用行列. D*D b: パラメータ 具体的な最適化式は論文のAppendixを参照
求めたいもの 最適化するもの 正規化項 誤差項
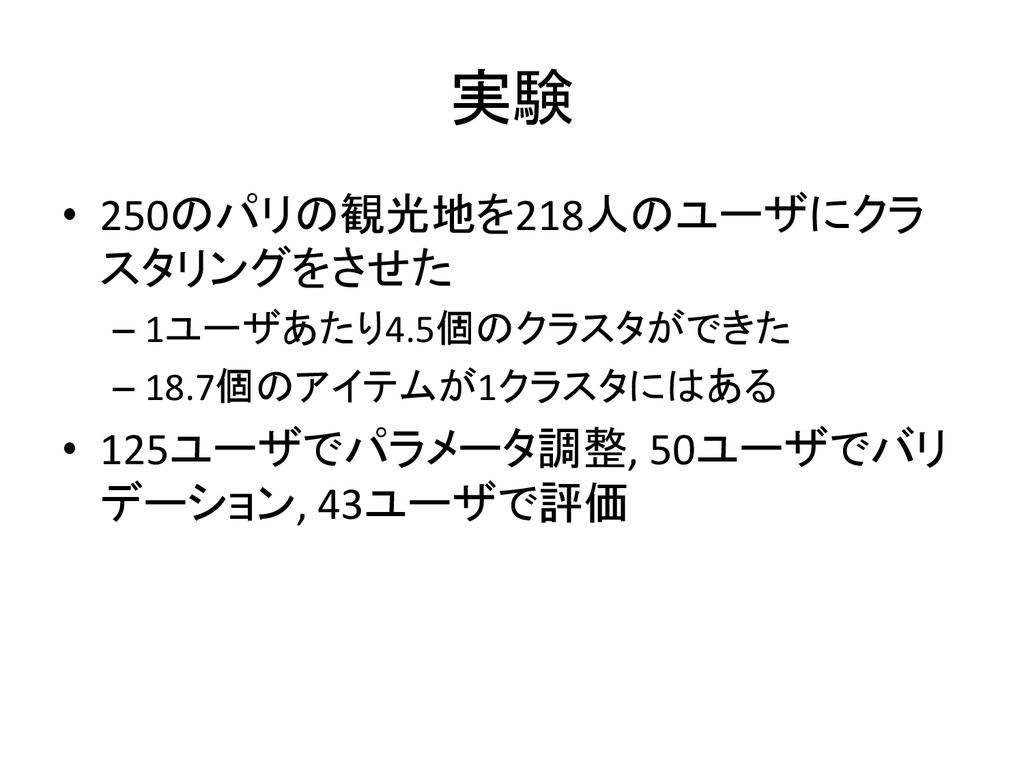
実験 • 250のパリの観光地を218人のユーザにクラ スタリングをさせた – 1ユーザあたり4.5個のクラスタができた – 18.7個のアイテムが1クラスタにはある •
125ユーザでパラメータ調整, 50ユーザでバリ デーション, 43ユーザで評価
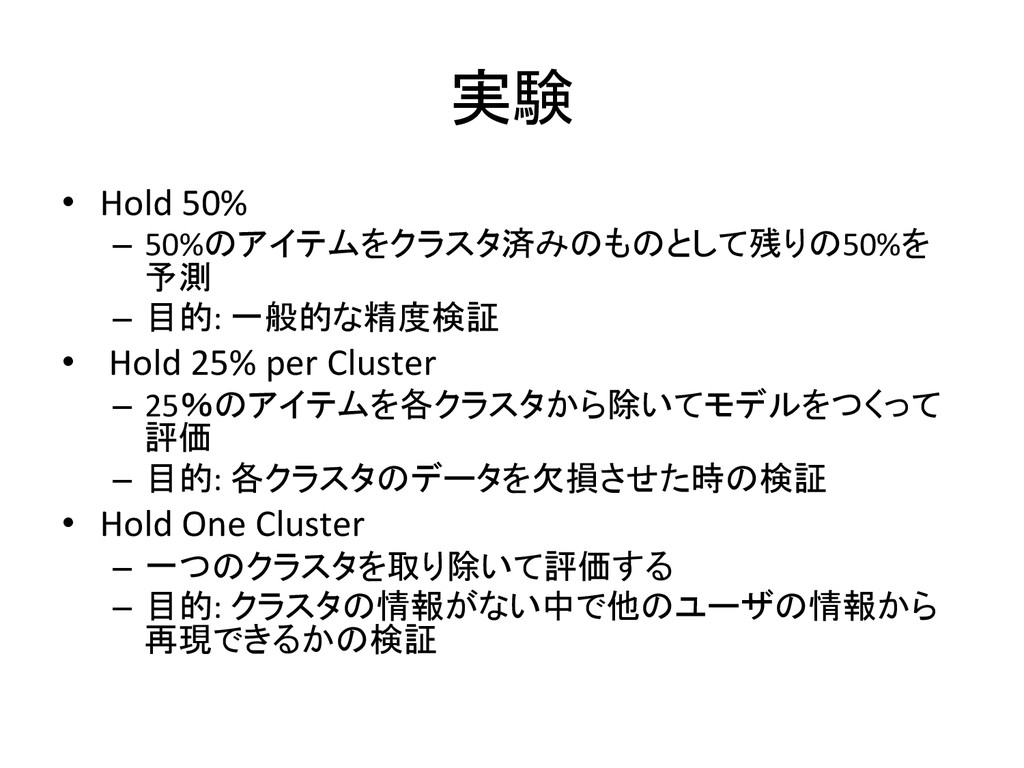
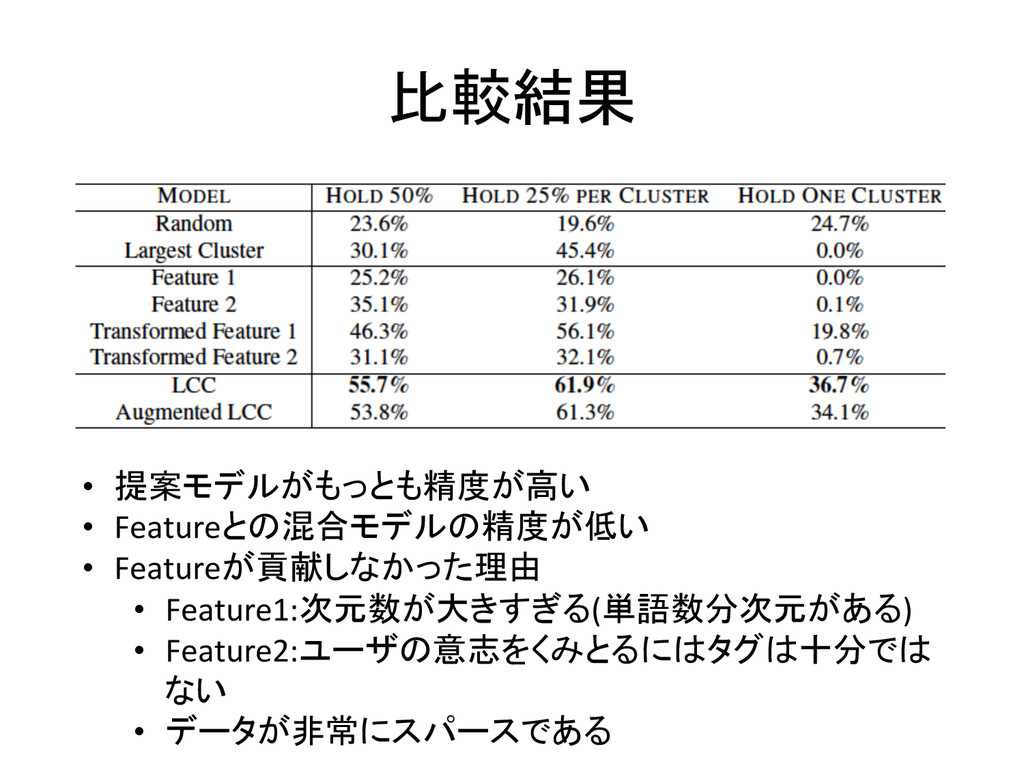
実験 • Hold 50% – 50%のアイテムをクラスタ済みのものとして残りの50%を 予測 –
目的: 一般的な精度検証 • Hold 25% per Cluster – 25%のアイテムを各クラスタから除いてモデルをつくって 評価 – 目的: 各クラスタのデータを欠損させた時の検証 • Hold One Cluster – 一つのクラスタを取り除いて評価する – 目的: クラスタの情報がない中で他のユーザの情報から 再現できるかの検証
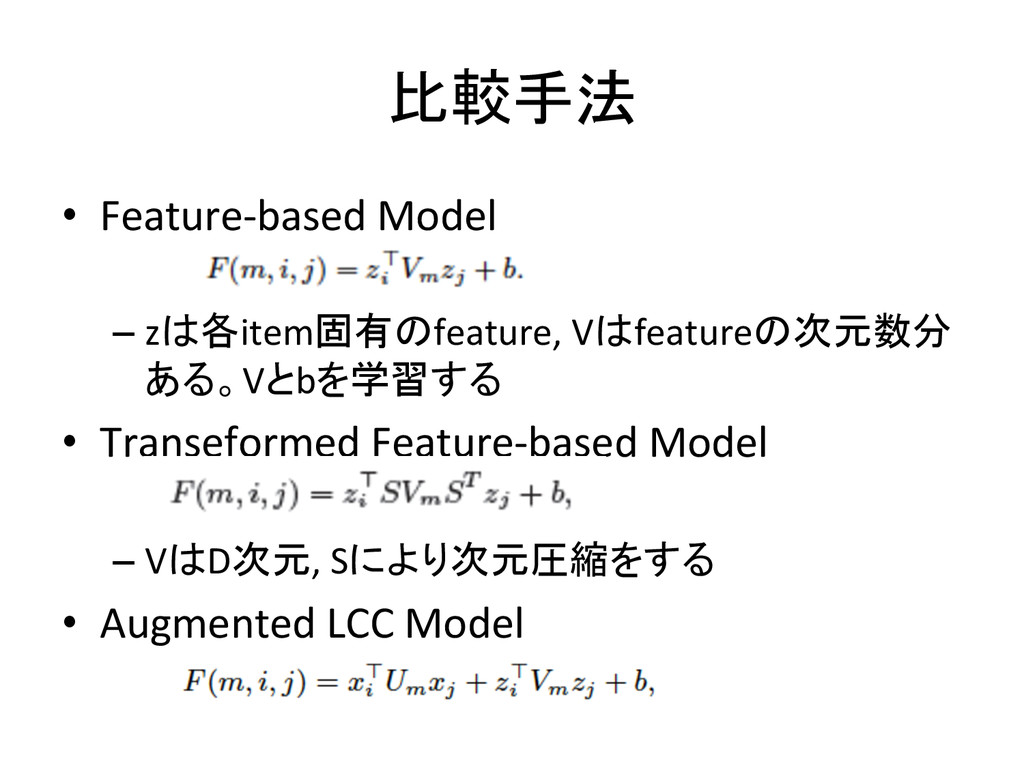
比較手法 • Feature-‐based Model – zは各item固有のfeature, Vはfeatureの次元数分 ある。Vとbを学習する •
Transeformed Feature-‐based Model – VはD次元, Sにより次元圧縮をする • Augmented LCC Model
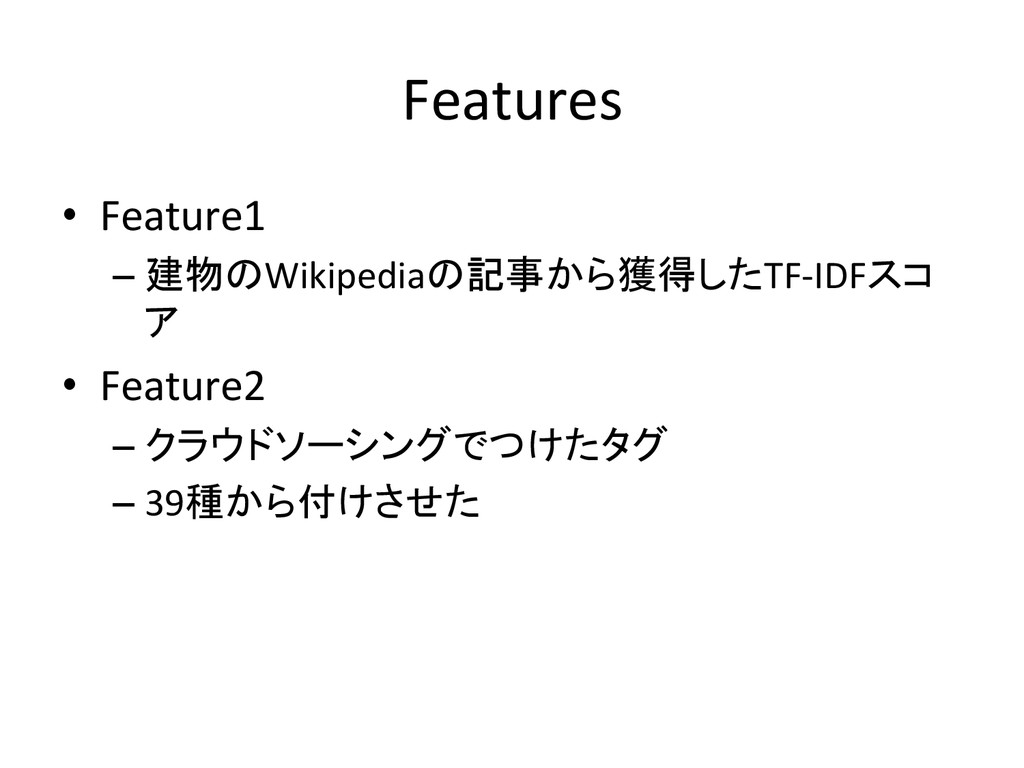
Features • Feature1 – 建物のWikipediaの記事から獲得したTF-‐IDFスコ ア • Feature2
– クラウドソーシングでつけたタグ – 39種から付けさせた
比較結果 • 提案モデルがもっとも精度が高い • Featureとの混合モデルの精度が低い • Featureが貢献しなかった理由
• Feature1:次元数が大きすぎる(単語数分次元がある) • Feature2:ユーザの意志をくみとるにはタグは十分では ない • データが非常にスパースである
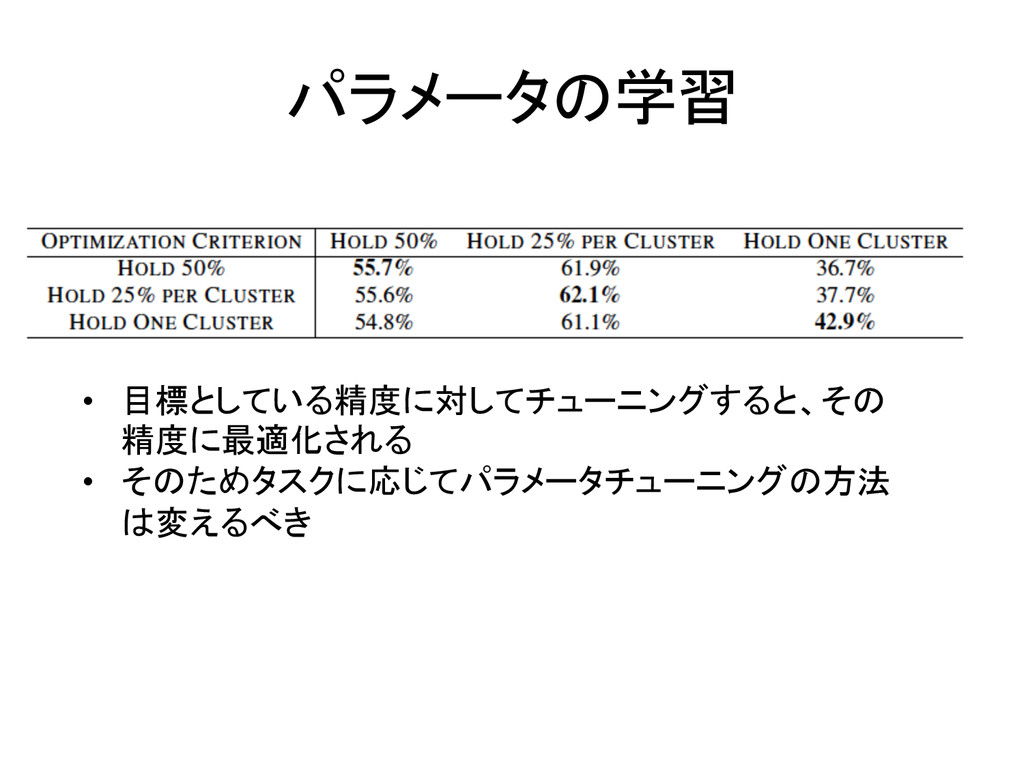
パラメータの学習 • 目標としている精度に対してチューニングすると、その 精度に最適化される • そのためタスクに応じてパラメータチューニングの方法 は変えるべき
逐次的に学習させる
まとめ • ユーザごとのクラスタリングを他のユーザの情報と組みあ わせて潜在変数を学習することで最適化することができて いる – 未知のクラスタを推定できるのは非常に興味深い •
ただ協調フィルタリングと同等の課題は抱えていると考え られる – 新規アイテムや新規ユーザには活用できない、各アイテムに 十分な評価データがないといけないなど協調フィルタリングと 同じような課題はある – コンテンツ情報とのハイブリッドはシンプルな方法では無理。工 夫が必要。 • アイテム数やクラスタ数が大きくなるととてもつらくなりそう


 ysekky
 tomonom
 rfujii
 institudelelevage
 signer
 dk999
 casualconc
 rikkabotan7
 sazimai
 satai
 shiell
 yukinobaba
 axbom
 soudai
 notwaldorf
 techseoconnect
 bethany
 sugarenia
 swwweet
 destraynor
 tammyeverts
 nwiizo
 smashingmag
 nmsamuel