Share
Embed
CUDA Memo
ytakano
May 31, 2016
Transcript
20 slides
-
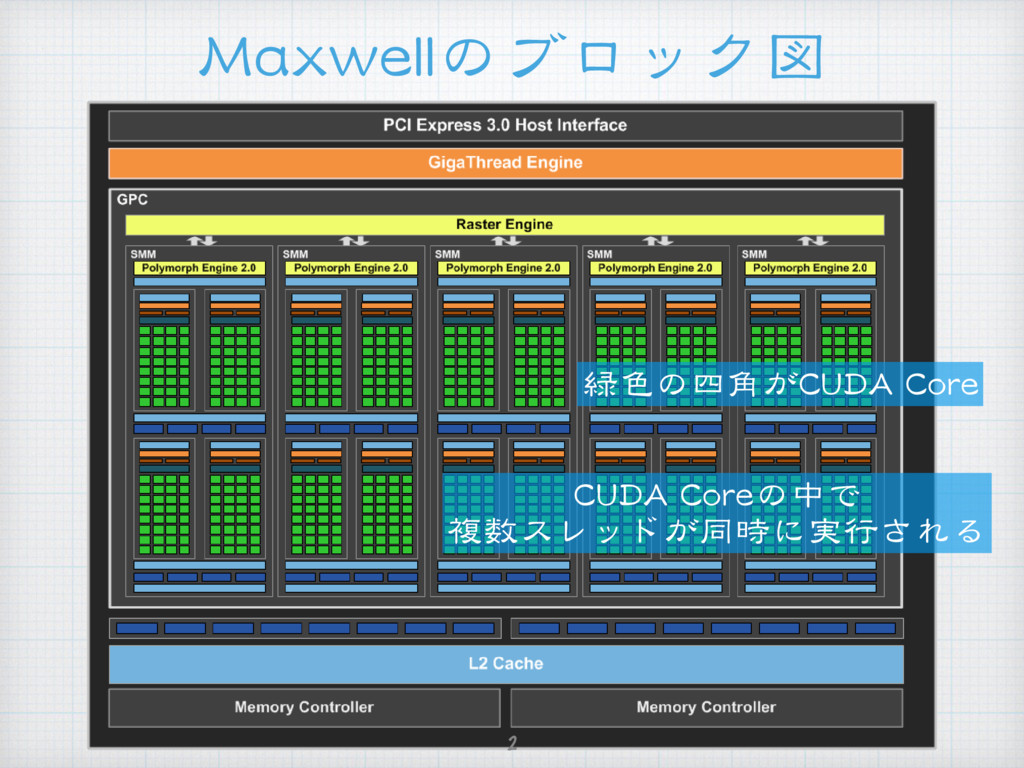
Maxwellのブロック図 GM107 GPU には、1 基の GPC、5 基の Maxwell ストリーミング・プロセッサ(SMM)、2 基の
64 ビッ ト・メモリ・コントローラ(合計 128 ビット)が搭載されています。これは、同チップのフル実装であり、 GeForce GTX 750 Ti での出荷時と同じ構成になっています。 緑色の四角がCUDA Core CUDA Coreの中で 複数スレッドが同時に実行される 2 -
カーネル関数定義 カーネル関数 GPUに実行させる関数 __global__ void kernel() { } ホストから呼び出し可能な関数 __device__
void func() { } デバイスからのみ呼び出し可能な関数 4 -
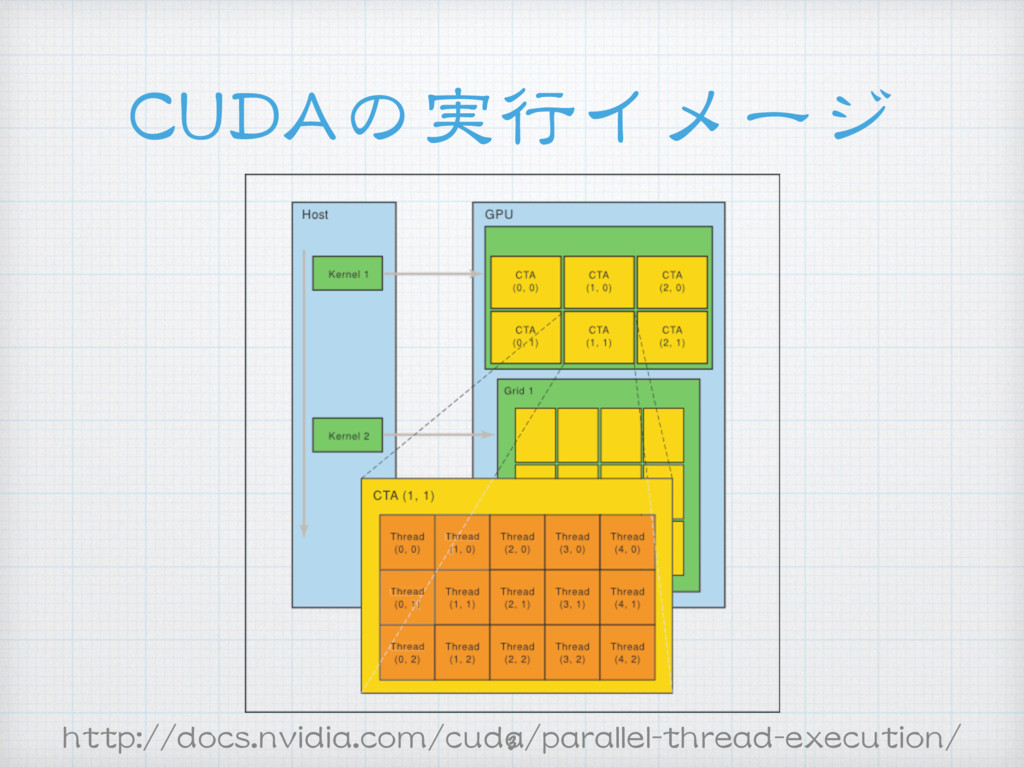
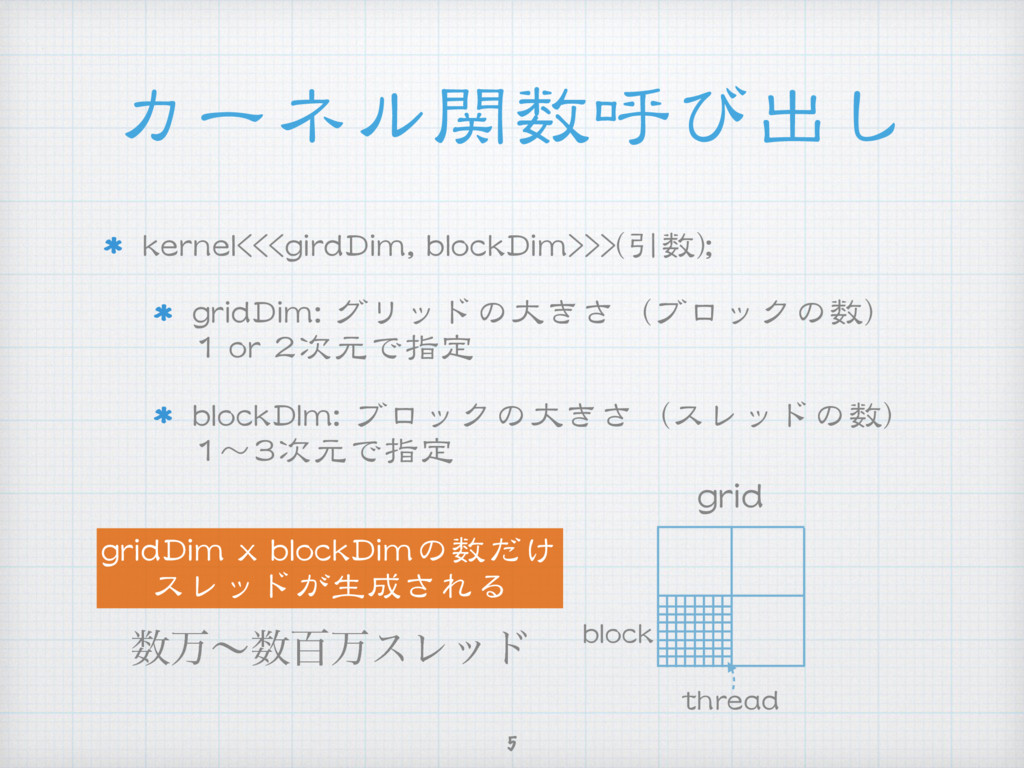
カーネル関数呼び出し kernel<<<girdDim, blockDim>>>(引数); gridDim: グリッドの大きさ(ブロックの数) 1 or 2次元で指定 blockDIm: ブロックの大きさ(スレッドの数)
1〜3次元で指定 grid block thread gridDim x blockDimの数だけ スレッドが生成される ສʙඦສεϨου 5 -
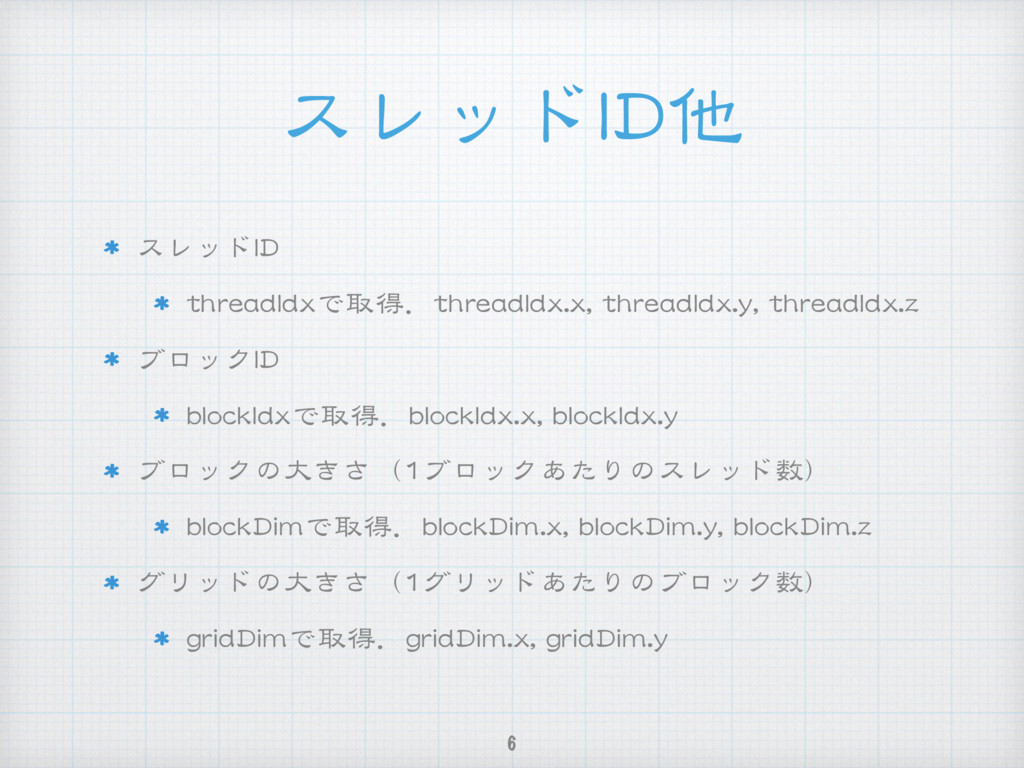
スレッドID他 スレッドID threadIdxで取得.threadIdx.x, threadIdx.y, threadIdx.z ブロックID blockIdxで取得.blockIdx.x, blockIdx.y ブロックの大きさ(1ブロックあたりのスレッド数) blockDimで取得.blockDim.x,
blockDim.y, blockDim.z グリッドの大きさ(1グリッドあたりのブロック数) gridDimで取得.gridDim.x, gridDim.y 6 -
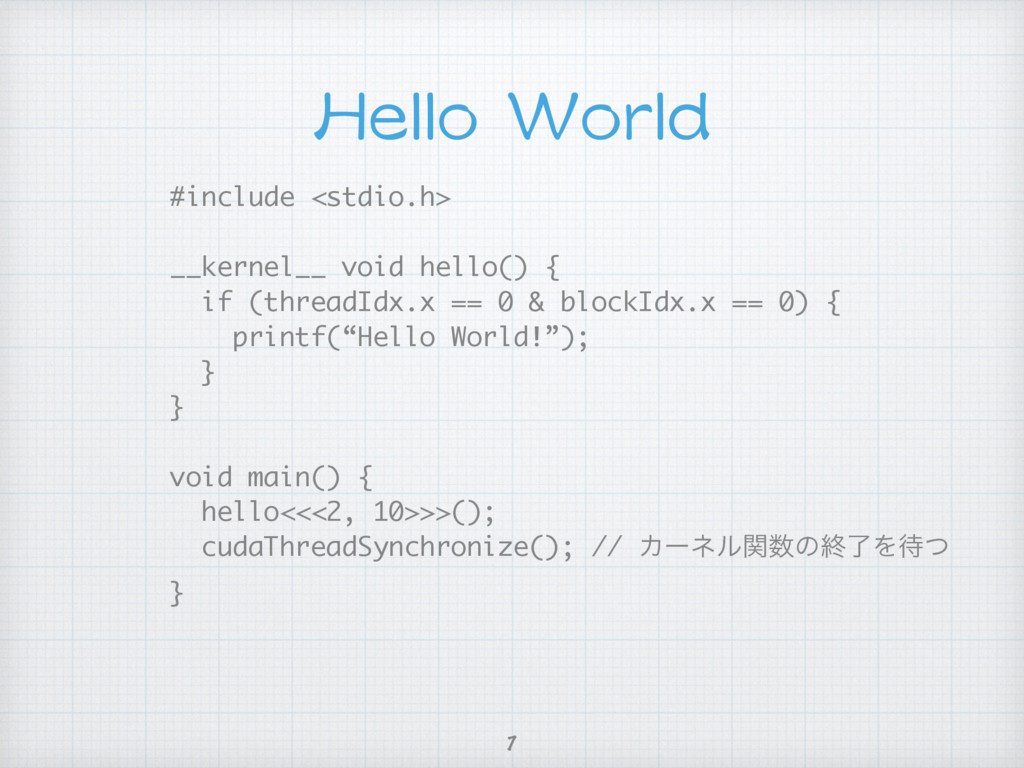
Hello World #include <stdio.h> __kernel__ void hello() { if (threadIdx.x
== 0 & blockIdx.x == 0) { printf(“Hello World!”); } } void main() { hello<<<2, 10>>>(); cudaThreadSynchronize(); // ΧʔωϧؔͷऴྃΛͭ } 7 -
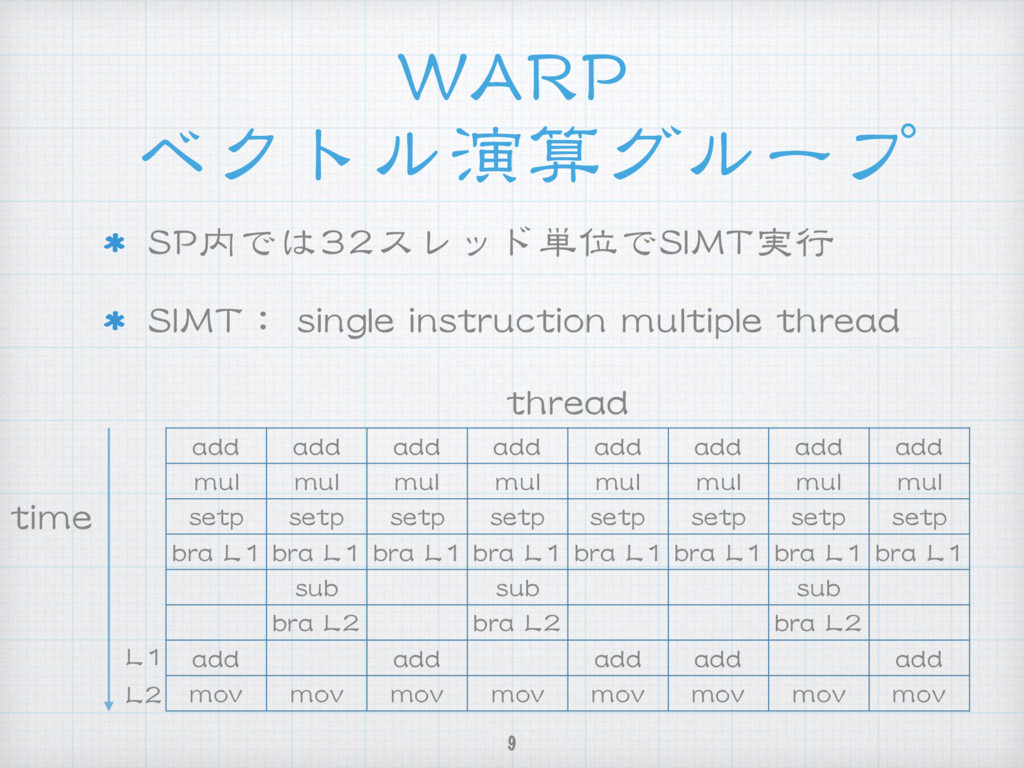
WARP ベクトル演算グループ SP内では32スレッド単位でSIMT実行 SIMT: single instruction multiple thread add add
add add add add add add mul mul mul mul mul mul mul mul setp setp setp setp setp setp setp setp bra L1 bra L1 bra L1 bra L1 bra L1 bra L1 bra L1 bra L1 sub sub sub bra L2 bra L2 bra L2 add add add add add mov mov mov mov mov mov mov mov thread time L1 L2 9 -
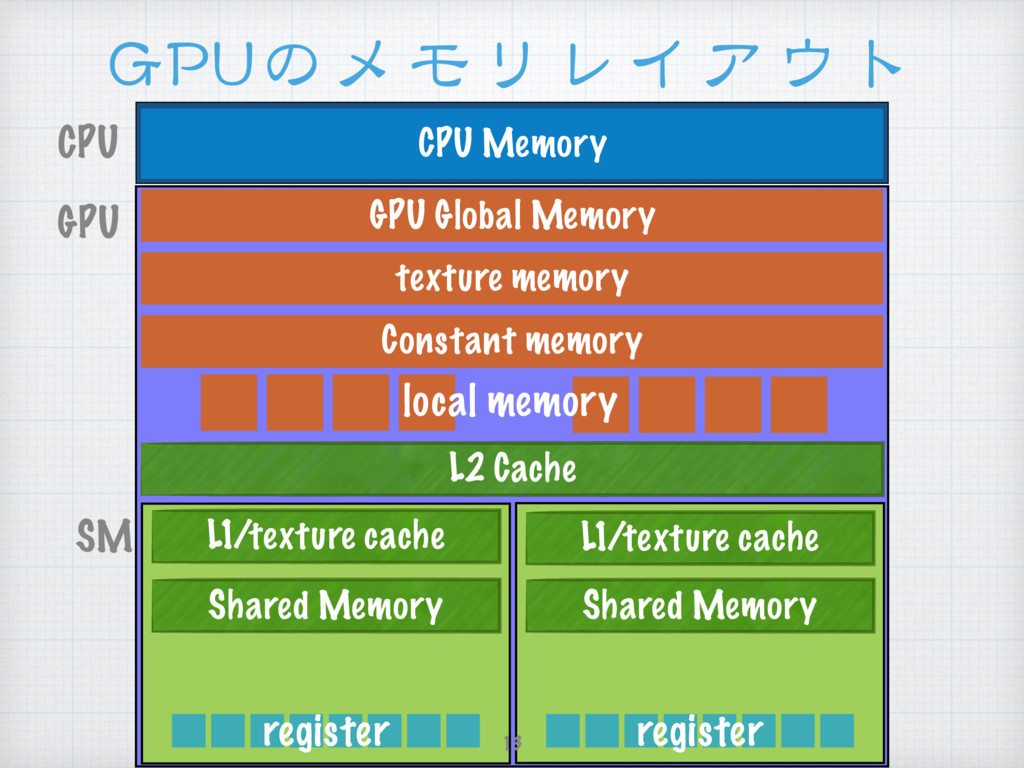
GPUのメモリレイアウト CPU Memory GPU Global Memory L2 Cache Shared Memory
texture memory Constant memory L1/texture cache Shared Memory L1/texture cache local memory register register GPU CPU SM 13 -
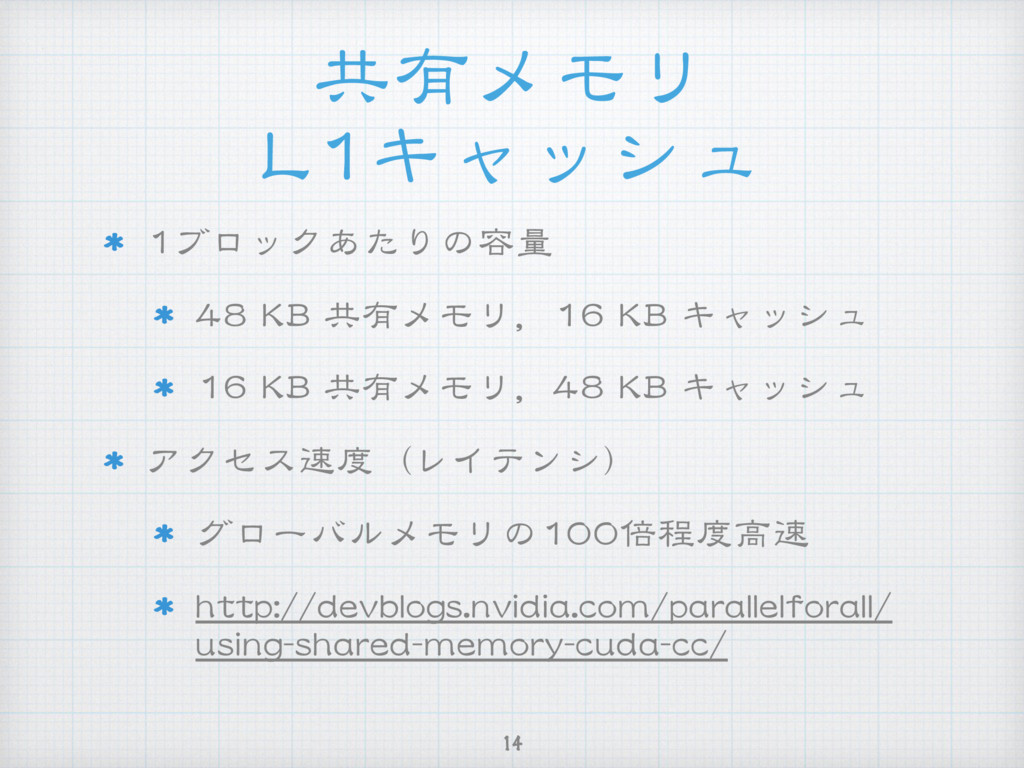
共有メモリ L1キャッシュ 1ブロックあたりの容量 48 KB 共有メモリ,16 KB キャッシュ 16 KB
共有メモリ,48 KB キャッシュ アクセス速度(レイテンシ) グローバルメモリの100倍程度高速 http://devblogs.nvidia.com/parallelforall/ using-shared-memory-cuda-cc/ 14 -
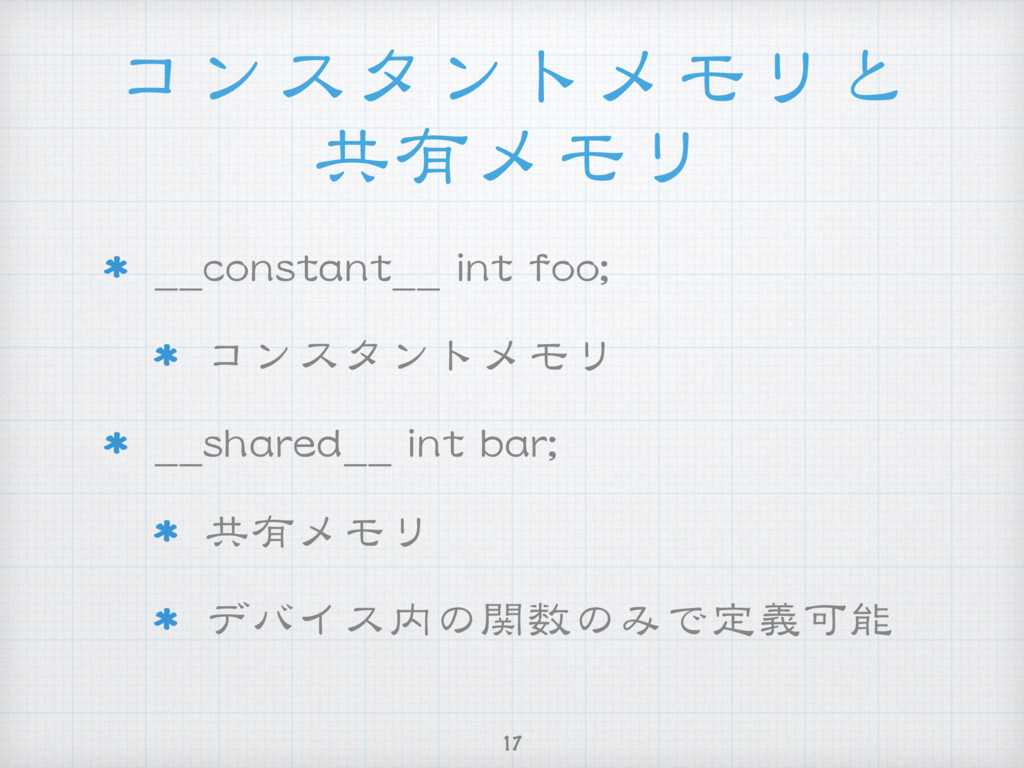
コンスタントメモリと 共有メモリ __constant__ int foo; コンスタントメモリ __shared__ int bar; 共有メモリ
デバイス内の関数のみで定義可能 17 -
コンスタントメモリへの データ転送 __constant__ int foo; __constant__ int bar[100]; int func()
{ int i = 100; int j[100]; cudaMemcpyToSymbol(foo, &i, sizeof(i)); cudaMemcpyToSymbol(bar, j, sizeof(j)); } 配列でも,そうじゃなくても&はいらない 18 -
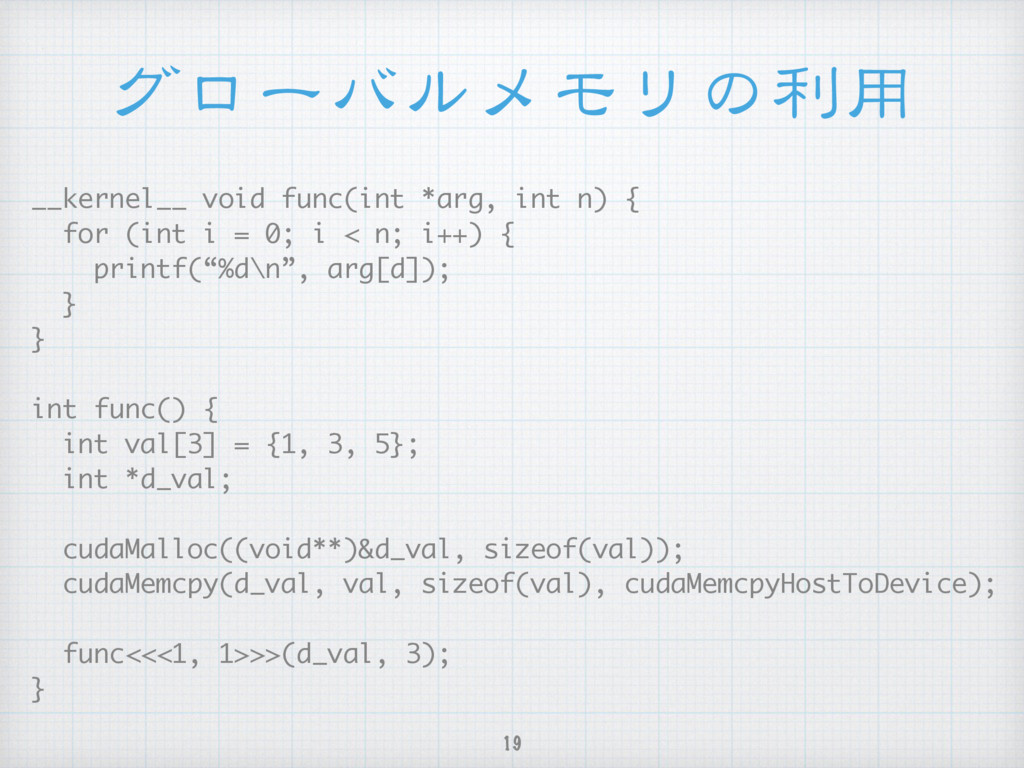
グローバルメモリの利用 __kernel__ void func(int *arg, int n) { for (int
i = 0; i < n; i++) { printf(“%d\n”, arg[d]); } } int func() { int val[3] = {1, 3, 5}; int *d_val; cudaMalloc((void**)&d_val, sizeof(val)); cudaMemcpy(d_val, val, sizeof(val), cudaMemcpyHostToDevice); func<<<1, 1>>>(d_val, 3); } 19 -
今回触れなかったこと テクスチャメモリ コアとメモリ間の距離に差があるメモリ イメージ的にはNUMA的なメモリ ストリームと非同期実行 GPUへのメモリコピーとGPUでの計算を同時に行える いわゆるパイプライン化 マルチGPU より高速に計算できる 多数のメモリの種類
pinned memory, mapped memory, unified memory 20