Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Scikit-learnで学ぶ機械学習入門
Search
Takami Sato
July 19, 2014
Technology
4.9k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Scikit-learnで学ぶ機械学習入門
Takami Sato
July 19, 2014
Other Decks in Technology
See All in Technology
AI coding 整合正規方法
philipz
0
500
Claude in Chrome 入門 / Introduction to Claude in Chrome
cielo1985
0
890
研究開発部の紹介 / Sansan R&D Profile
sansan33
PRO
5
25k
リアーキテクチャ後の障害ゼロを目指したShadow Testingの取り組み
nihonbuson
PRO
1
170
AI時代、データエンジニアが一番おもろい
genshun9
0
690
AgentCore Runtime上にAgentic Coding基盤を構築・展開する際の設計ポイントと限界点 / Design considerations and limitations when building an agentic coding platform on AgentCore Runtime
har1101
5
690
GoのInterface内部構造から学ぶ!最高パフォーマンスを出すコード設計
yappli_developers
1
260
現場で役立つ技術負債の効果的な返済方法
masuda220
PRO
11
5.1k
2026-09-18 gotanda.sre Terraformで複数環境作ったり、複数Stateに分割したりそれとTerragrunt / Terraform multi envs and multi states
masasuzu
4
700
EventBridge に「合流」はない ― サーバーレスのワークフローを育てるということ / No Join in EventBridge
yusukeshimizu
2
480
Why Agent Cost Needs Observability
nttcom
0
140
サーバーレスをどこまで使う? WebRTC対戦ゲームで選んだVPSとの共存設計
kaidouji85
0
350
Featured
See All Featured
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
460
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
1
330
Building a Scalable Design System with Sketch
lauravandoore
464
34k
Evolving SEO for Evolving Search Engines
ryanjones
0
300
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
The Curse of the Amulet
leimatthew05
3
15k
Statistics for Hackers
jakevdp
799
230k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.6k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3k
How to make the Groovebox
asonas
2
2.4k
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Site-Speed That Sticks
csswizardry
13
1.5k
Transcript
Scikit-learnで学ぶ機械学習入門 佐藤 貴海 @tkm2261 2014/07/19@機械学習勉強会 2014年7月19日 機械学習勉強会 1
今日の目的 • 機械学習の雰囲気感じる – 『こいつ・・・動くぞ!』くらい – わかりやすさ>>>厳密性 – 理論勉強するのも、 威力を知ったあとの方が捗る
• 深入りはしない – 紹介量を優先 2014年7月19日 機械学習勉強会 2
自己紹介 専門:経営工学/最適化 所属:(株)ブレインパッド 入社2年目 業務:データ分析全般 (何でも屋さん) 機械学習との出会い: ⇒研究が現在実用性皆無の半正定値計画問題 ⇒精神の逃げ道として機械学習を趣味で始める ⇒研究が詰んで、趣味が本職に
趣味で始めたので言語、画像など幅広く遊んでます この前、多摩川のほとりで1人燻製してきました。 2014年7月19日 機械学習勉強会 3
Scikit-learnってなに? • Pythonの機械学習ライブラリ – 無料・有料含めて、コレほど充実したライブラリは他にない – ほぼデファクトスタンダード状態 (と思っている) 2014年7月19日 機械学習勉強会
4 利点 (対R) ・高速 ・省メモリ ・Pythonなので言語基盤がしっかりしている ・検索しやすい 欠点 (対R) ・カテゴリカル変数の処理(factor型は無い) ・環境構築が面倒
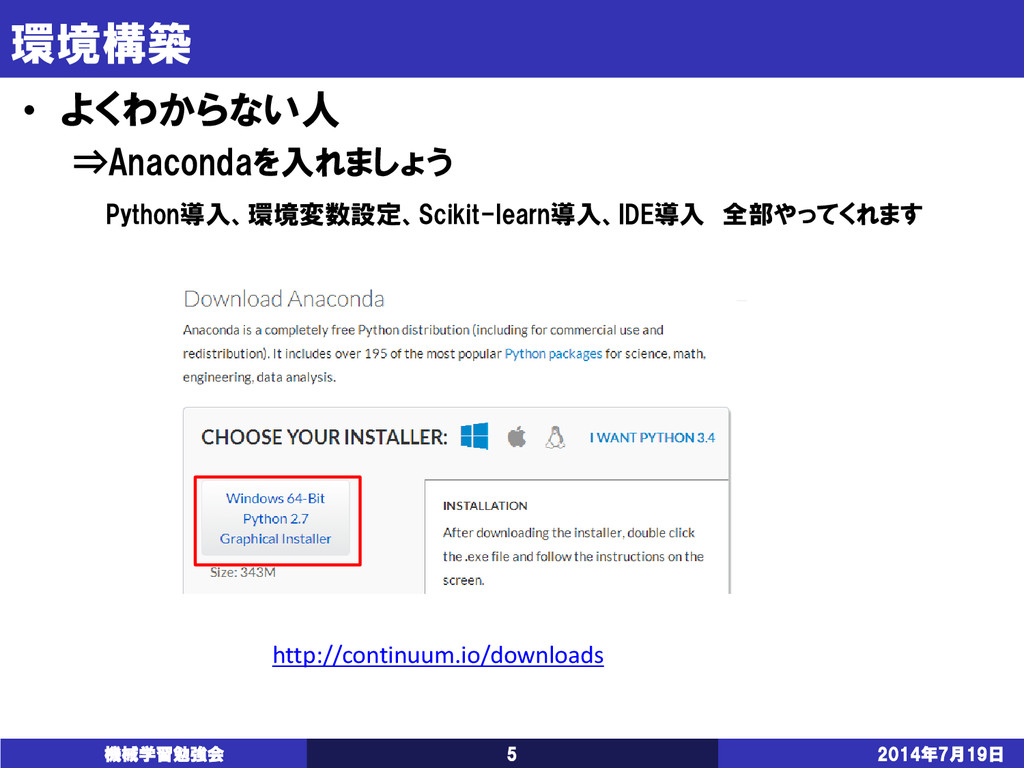
環境構築 • よくわからない人 ⇒Anacondaを入れましょう Python導入、環境変数設定、Scikit-learn導入、IDE導入 全部やってくれます 2014年7月19日 機械学習勉強会 5 http://continuum.io/downloads
環境構築 2014年7月19日 機械学習勉強会 6 • こだわりたい人 • Windowsユーザ ⇒GohlkeのページでMKLビルドのNumpyを入れましょう 保証はないので、自己責任で
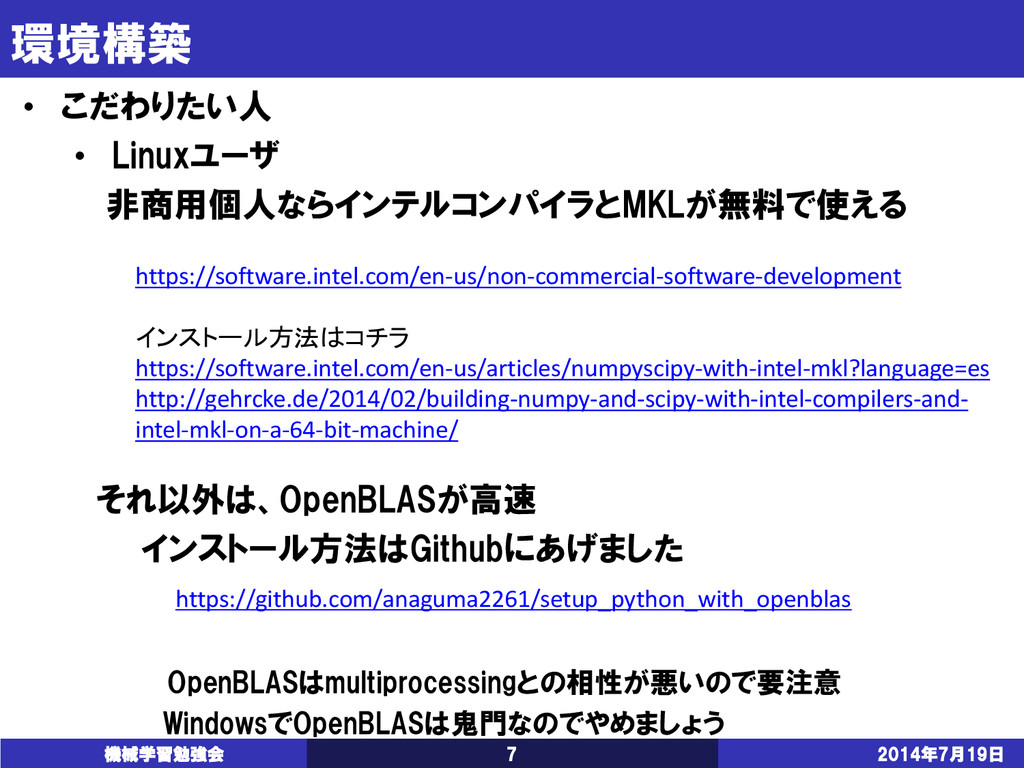
環境構築 2014年7月19日 機械学習勉強会 7 • こだわりたい人 • Linuxユーザ 非商用個人ならインテルコンパイラとMKLが無料で使える それ以外は、OpenBLASが高速
インストール方法はGithubにあげました OpenBLASはmultiprocessingとの相性が悪いので要注意 WindowsでOpenBLASは鬼門なのでやめましょう https://software.intel.com/en-us/non-commercial-software-development インストール方法はコチラ https://software.intel.com/en-us/articles/numpyscipy-with-intel-mkl?language=es http://gehrcke.de/2014/02/building-numpy-and-scipy-with-intel-compilers-and- intel-mkl-on-a-64-bit-machine/ https://github.com/anaguma2261/setup_python_with_openblas
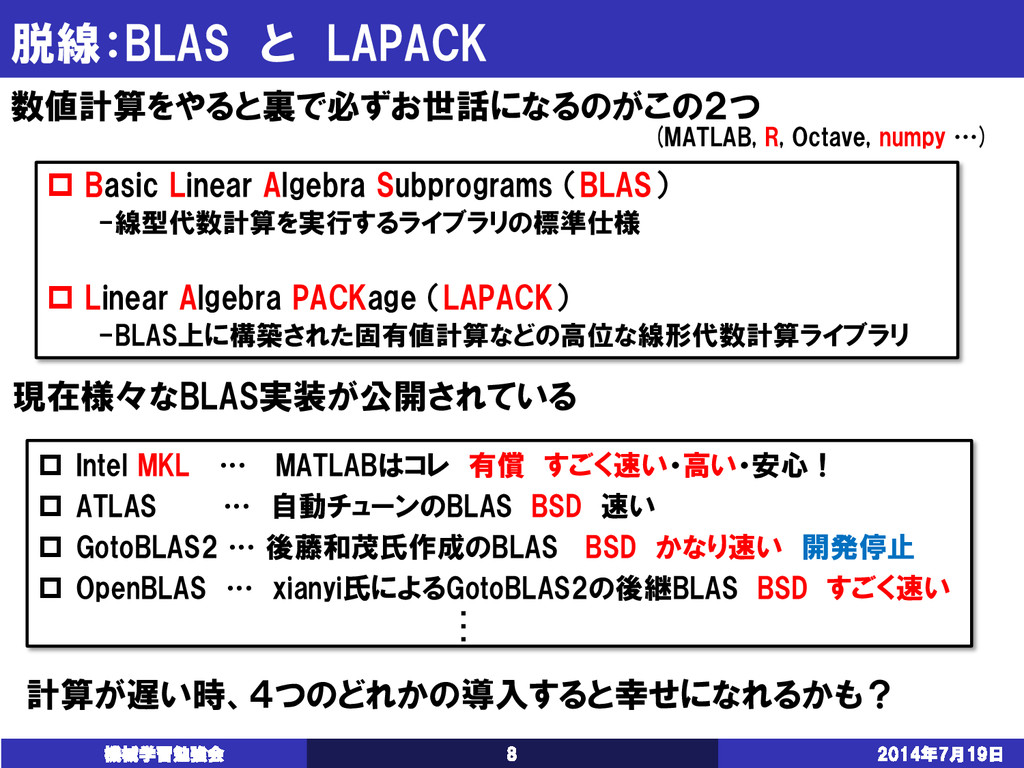
2014年7月19日 機械学習勉強会 8 脱線:BLAS と LAPACK 数値計算をやると裏で必ずお世話になるのがこの2つ Basic Linear
Algebra Subprograms (BLAS) -線型代数計算を実行するライブラリの標準仕様 Linear Algebra PACKage (LAPACK) -BLAS上に構築された固有値計算などの高位な線形代数計算ライブラリ 現在様々なBLAS実装が公開されている Intel MKL … MATLABはコレ 有償 すごく速い・高い・安心! ATLAS … 自動チューンのBLAS BSD 速い GotoBLAS2 … 後藤和茂氏作成のBLAS BSD かなり速い 開発停止 OpenBLAS … xianyi氏によるGotoBLAS2の後継BLAS BSD すごく速い (MATLAB, R, Octave, numpy …) 計算が遅い時、4つのどれかの導入すると幸せになれるかも? ・ ・ ・
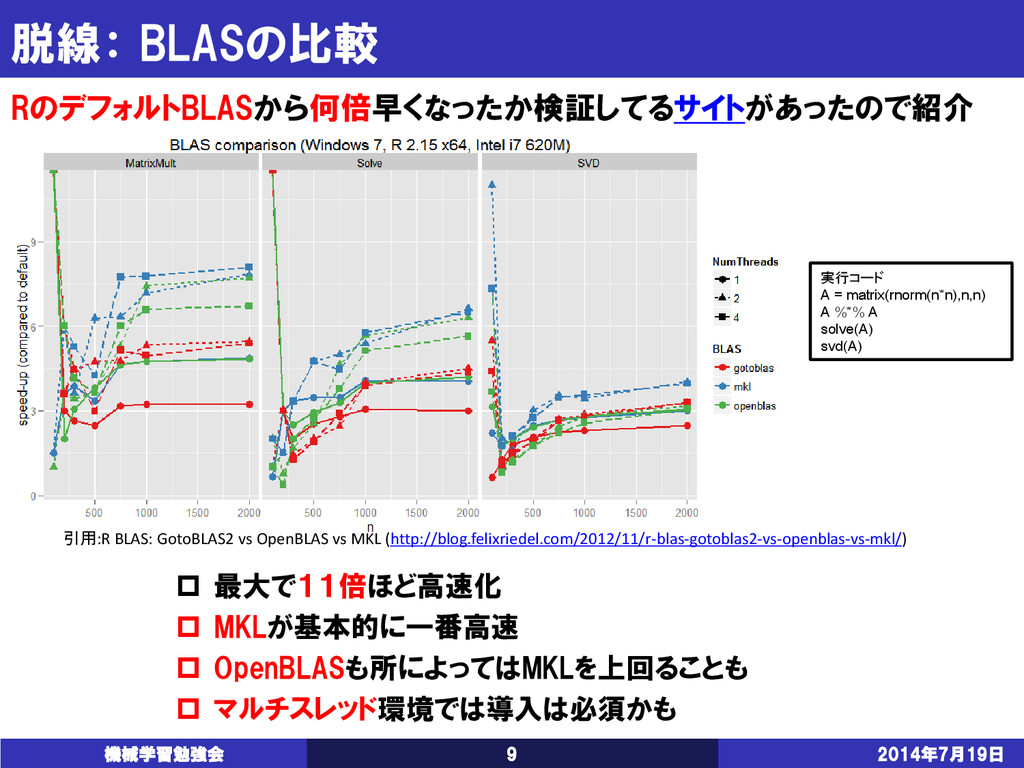
脱線: BLASの比較 2014年7月19日 機械学習勉強会 9 引用:R BLAS: GotoBLAS2 vs OpenBLAS
vs MKL (http://blog.felixriedel.com/2012/11/r-blas-gotoblas2-vs-openblas-vs-mkl/) 実行コード A = matrix(rnorm(n*n),n,n) A %*% A solve(A) svd(A) RのデフォルトBLASから何倍早くなったか検証してるサイトがあったので紹介 最大で11倍ほど高速化 MKLが基本的に一番高速 OpenBLASも所によってはMKLを上回ることも マルチスレッド環境では導入は必須かも
2014年7月19日 機械学習勉強会 10 Scikit-learnの前に機械学習の流れもおさらい 脱線してますが、
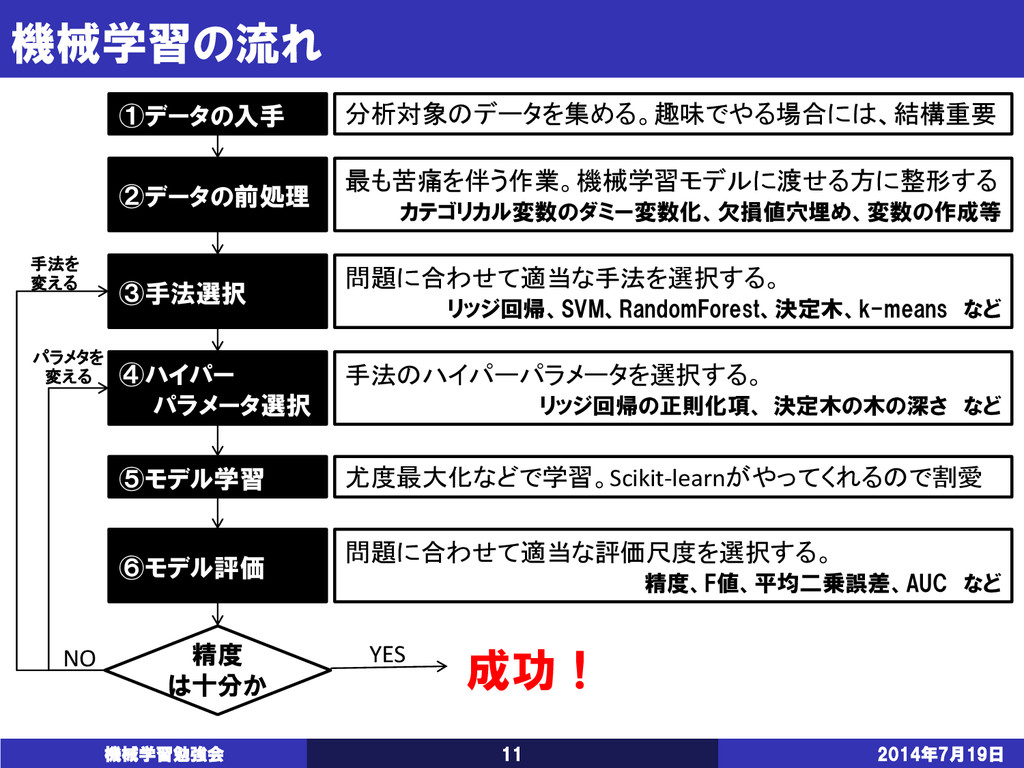
機械学習の流れ 2014年7月19日 機械学習勉強会 11 分析対象のデータを集める。趣味でやる場合には、結構重要 最も苦痛を伴う作業。機械学習モデルに渡せる方に整形する カテゴリカル変数のダミー変数化、欠損値穴埋め、変数の作成等 問題に合わせて適当な手法を選択する。 リッジ回帰、SVM、RandomForest、決定木、k-means など
手法のハイパーパラメータを選択する。 リッジ回帰の正則化項、 決定木の木の深さ など 尤度最大化などで学習。Scikit-learnがやってくれるので割愛 問題に合わせて適当な評価尺度を選択する。 精度、F値、平均二乗誤差、AUC など ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価 精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える
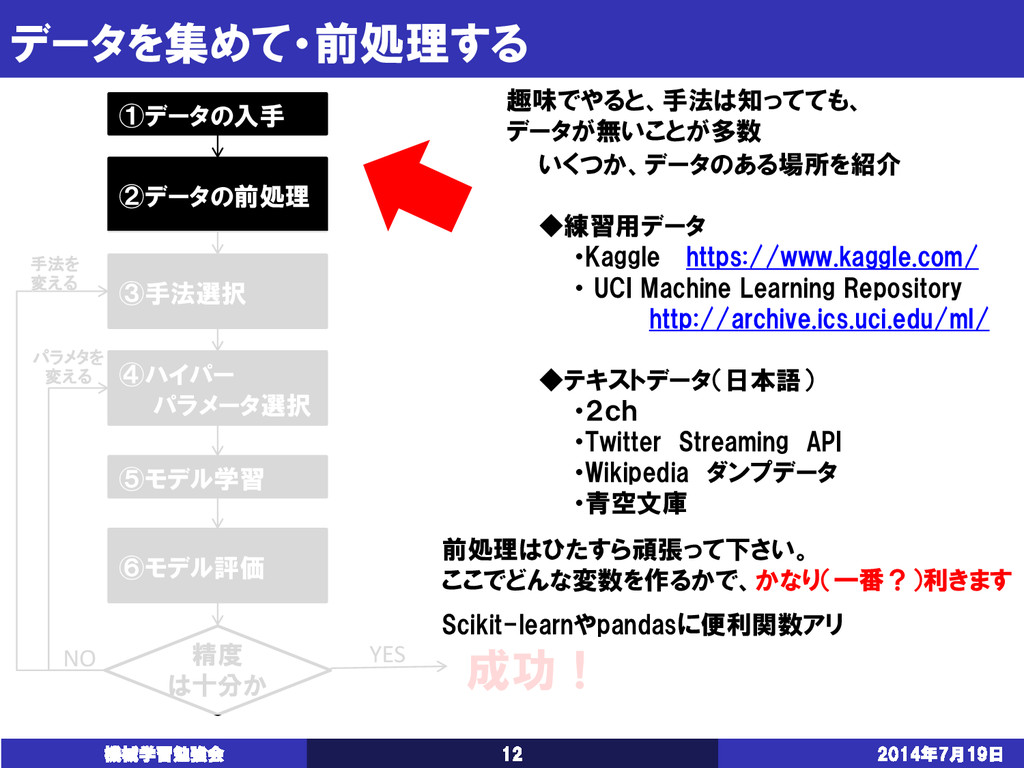
データを集めて・前処理する 2014年7月19日 機械学習勉強会 12 ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価
精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える 趣味でやると、手法は知ってても、 データが無いことが多数 いくつか、データのある場所を紹介 ◆練習用データ ・Kaggle https://www.kaggle.com/ ・ UCI Machine Learning Repository http://archive.ics.uci.edu/ml/ ◆テキストデータ(日本語) ・2ch ・Twitter Streaming API ・Wikipedia ダンプデータ ・青空文庫 前処理はひたすら頑張って下さい。 ここでどんな変数を作るかで、かなり(一番?)利きます Scikit-learnやpandasに便利関数アリ
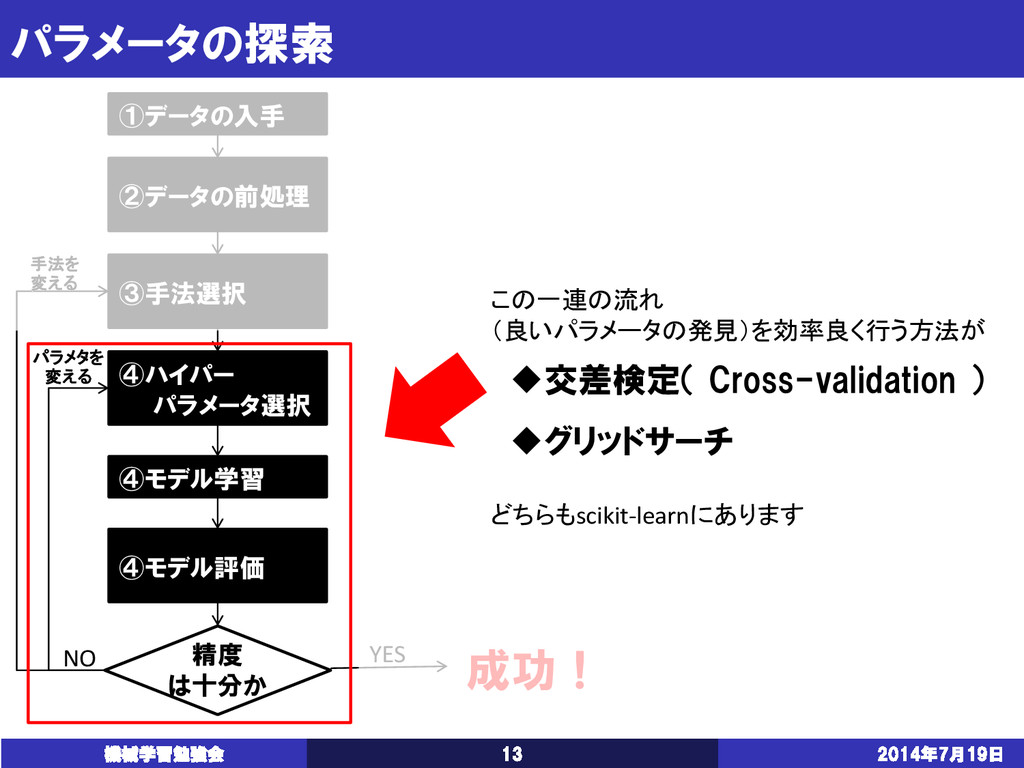
パラメータの探索 2014年7月19日 機械学習勉強会 13 ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ④モデル評価
精度 は十分か ④モデル学習 NO YES 成功! 手法を 変える パラメタを 変える この一連の流れ (良いパラメータの発見)を効率良く行う方法が 交差検定( Cross-validation ) グリッドサーチ どちらもscikit-learnにあります
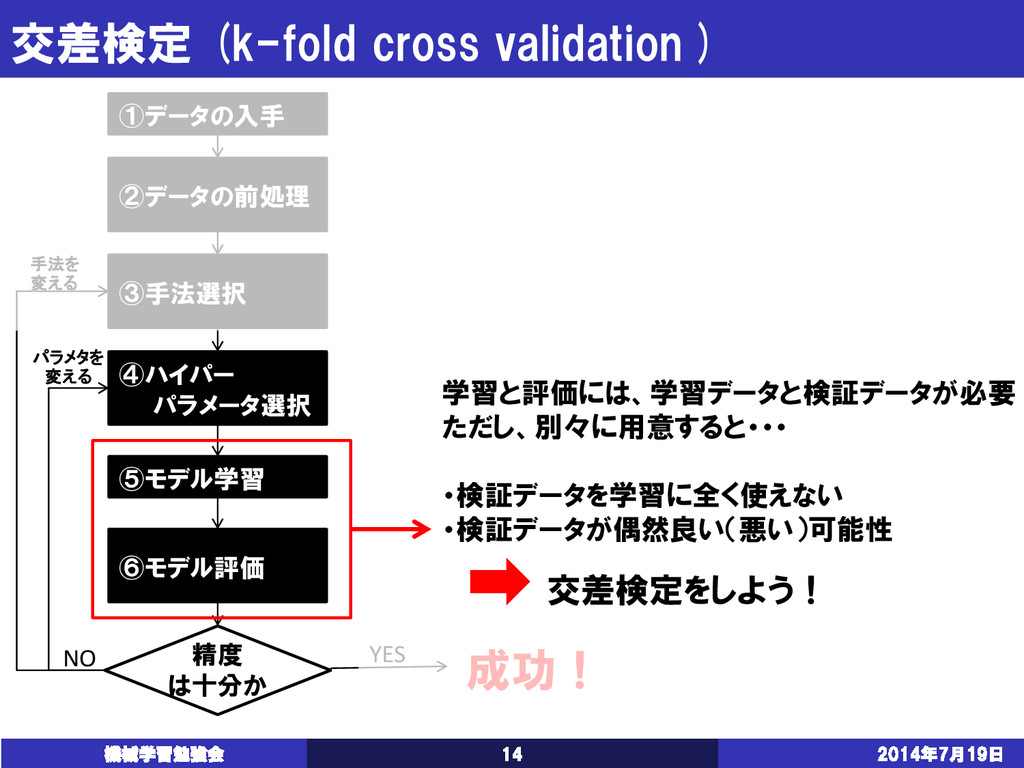
交差検定 (k-fold cross validation ) 2014年7月19日 機械学習勉強会 14 ①データの入手 ②データの前処理
③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価 精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える 学習と評価には、学習データと検証データが必要 ただし、別々に用意すると・・・ ・検証データを学習に全く使えない ・検証データが偶然良い(悪い)可能性 交差検定をしよう!
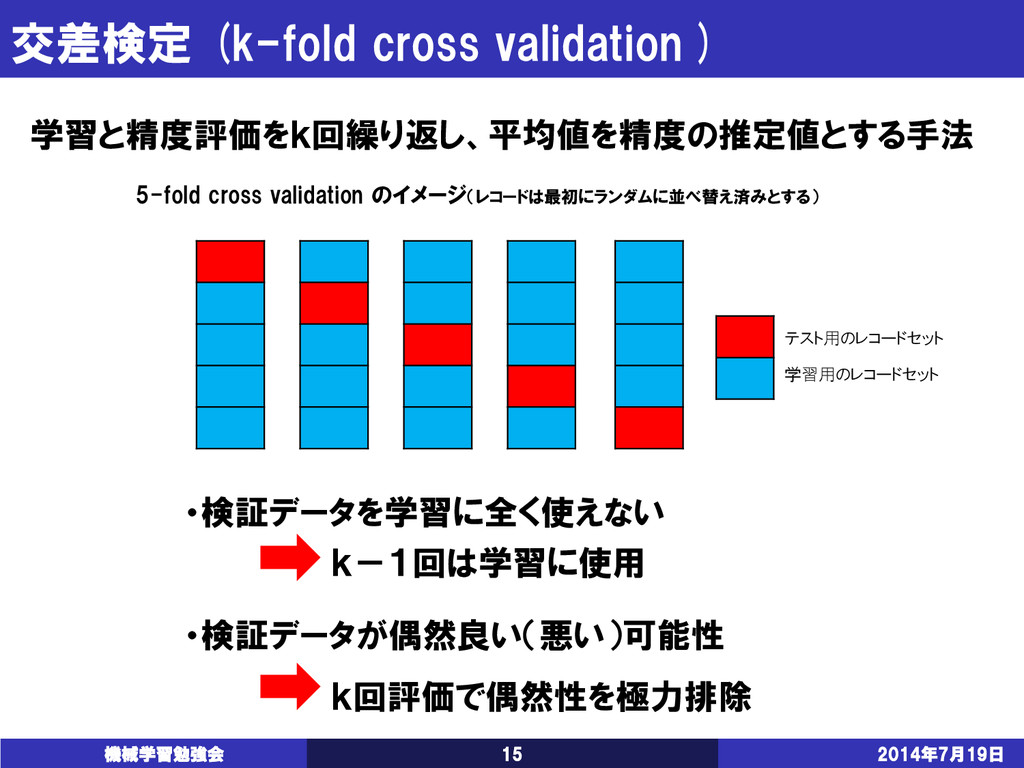
交差検定 (k-fold cross validation ) 2014年7月19日 機械学習勉強会 15 5-fold cross
validation のイメージ(レコードは最初にランダムに並べ替え済みとする) テスト用のレコードセット 学習用のレコードセット 学習と精度評価をk回繰り返し、平均値を精度の推定値とする手法 ・検証データを学習に全く使えない k-1回は学習に使用 ・検証データが偶然良い(悪い)可能性 k回評価で偶然性を極力排除
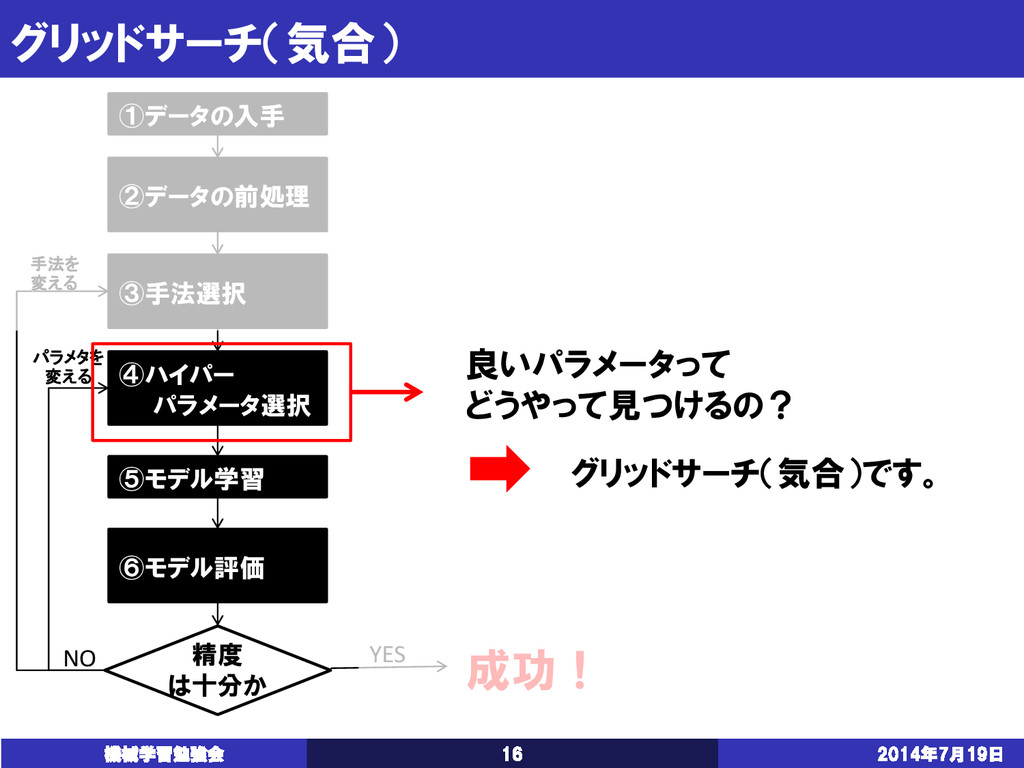
グリッドサーチ(気合) 2014年7月19日 機械学習勉強会 16 ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価
精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える 良いパラメータって どうやって見つけるの? グリッドサーチ(気合)です。
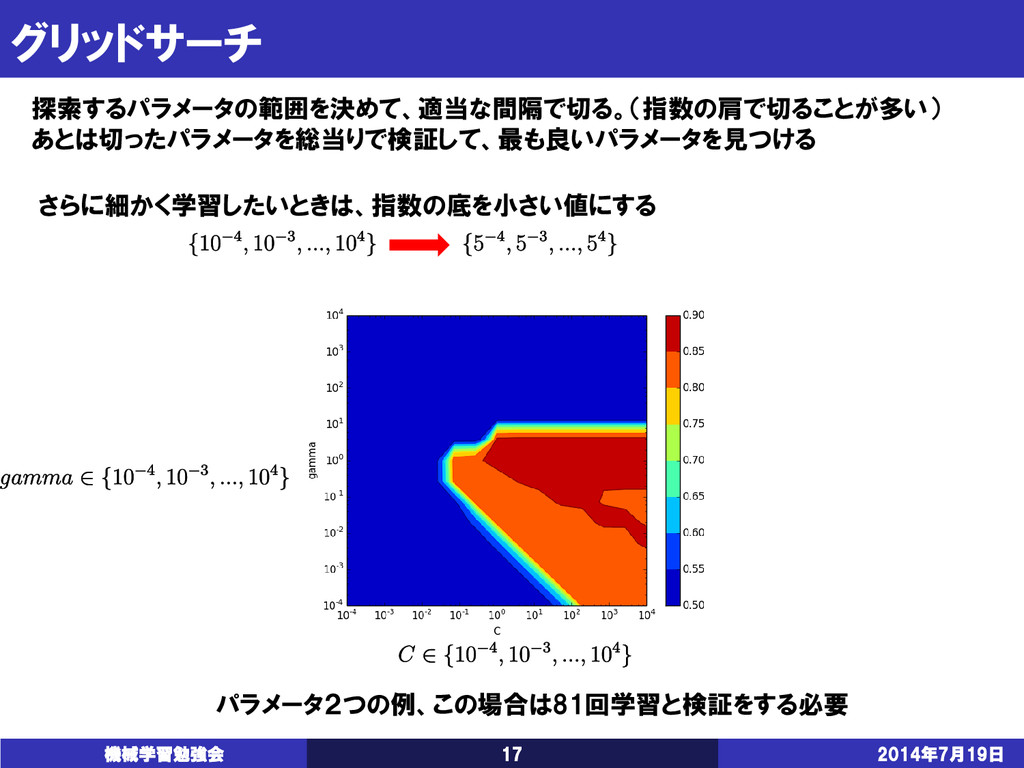
グリッドサーチ 2014年7月19日 機械学習勉強会 17 探索するパラメータの範囲を決めて、適当な間隔で切る。(指数の肩で切ることが多い) あとは切ったパラメータを総当りで検証して、最も良いパラメータを見つける パラメータ2つの例、この場合は81回学習と検証をする必要 さらに細かく学習したいときは、指数の底を小さい値にする
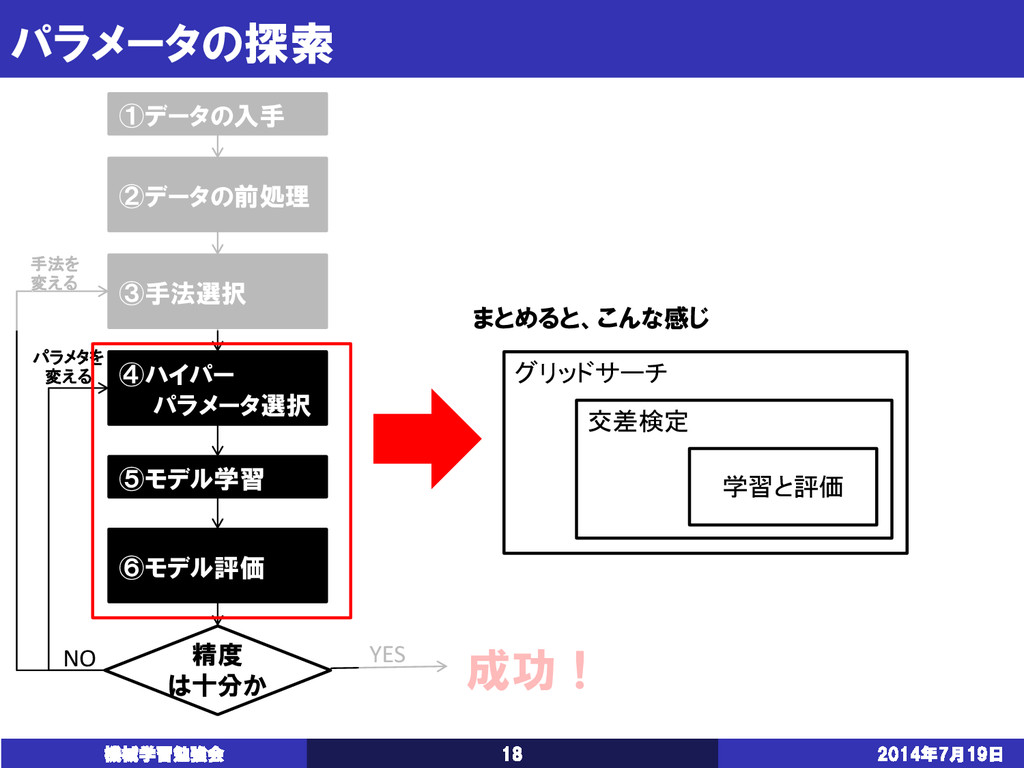
パラメータの探索 2014年7月19日 機械学習勉強会 18 ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価
精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える グリッドサーチ 交差検定 学習と評価 まとめると、こんな感じ
パラメータの探索 2014年7月19日 機械学習勉強会 19 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要
パラメータの探索 2014年7月19日 機械学習勉強会 20 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:解けるの?
パラメータの探索 2014年7月19日 機械学習勉強会 21 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:解けるの? A:気合です
パラメータの探索 2014年7月19日 機械学習勉強会 22 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:本当に解けるの?
パラメータの探索 2014年7月19日 機械学習勉強会 23 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:本当に解けるの? A:完全並列出来る計算なので 810台サーバがあれば
最近のGoogleは真顔でこのぐらい言ってきます
パラメータの探索 2014年7月19日 機械学習勉強会 24 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:クラスタ組めない
パラメータの探索 2014年7月19日 機械学習勉強会 25 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:クラスタ組めない A:弊社の を買って下さい
パラメータの探索 2014年7月19日 機械学習勉強会 26 先ほどのパラメータ(81種)を10-fold 交差検定すると 810回学習と検証が必要 Q:クラスタ組めない A:弊社の を買って下さい
最近はクラウド上の機械学習も有ります。 http://jp.techcrunch.com/2014/06/17/20140616microsoft-announces-azure-ml- cloud-based-machine-learning-platform-that-can-predict-future-events/
2014年7月19日 機械学習勉強会 27 これで、今日からデータサイエンティスト
・・・とは行かない 2014年7月19日 機械学習勉強会 28 ①データの入手 ②データの前処理 ③手法選択 ④ハイパー パラメータ選択 ⑥モデル評価
精度 は十分か ⑤モデル学習 NO YES 成功! 手法を 変える パラメタを 変える 適切な手法の選択が 機械学習で 最も重要かつ 難しい問題
適切な手法の選択 2014年7月19日 機械学習勉強会 29 Q:常に最適な手法ってあるの? A:ありません Q:どうやったら最適な手法を選べるの? A:機械学習を体系的に学び、 経験を積んで、更に運が必要 Q:詰んでない?
A:なんとかするのが、今日の議題
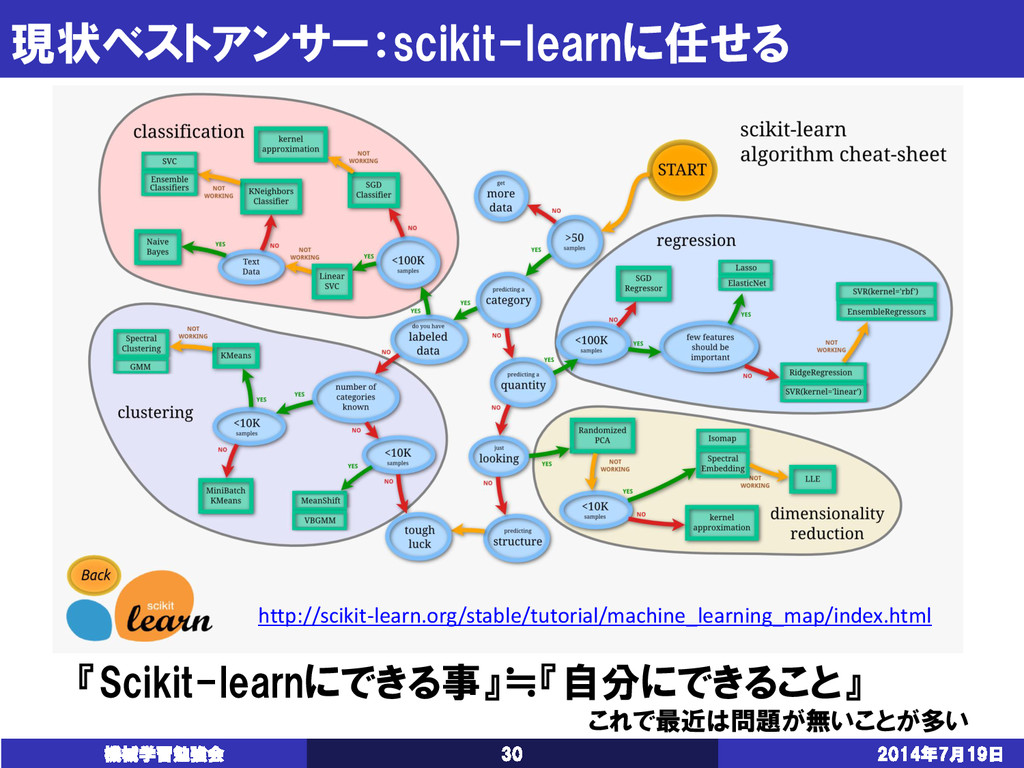
現状ベストアンサー:scikit-learnに任せる 2014年7月19日 機械学習勉強会 30 『Scikit-learnにできる事』≒『自分にできること』 これで最近は問題が無いことが多い http://scikit-learn.org/stable/tutorial/machine_learning_map/index.html
実装の雰囲気 2014年7月19日 機械学習勉強会 31 import numpy from sklearn.cross_validation import cross_val_score
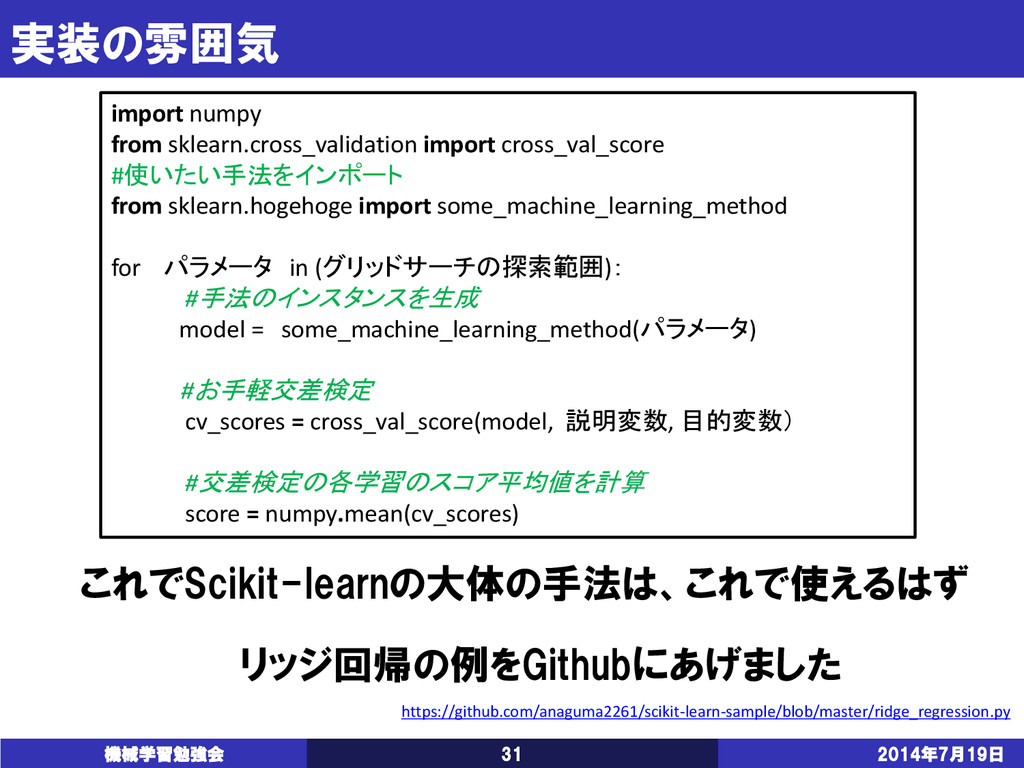
#使いたい手法をインポート from sklearn.hogehoge import some_machine_learning_method for パラメータ in (グリッドサーチの探索範囲): #手法のインスタンスを生成 model = some_machine_learning_method(パラメータ) #お手軽交差検定 cv_scores = cross_val_score(model, 説明変数, 目的変数) #交差検定の各学習のスコア平均値を計算 score = numpy.mean(cv_scores) これでScikit-learnの大体の手法は、これで使えるはず リッジ回帰の例をGithubにあげました https://github.com/anaguma2261/scikit-learn-sample/blob/master/ridge_regression.py
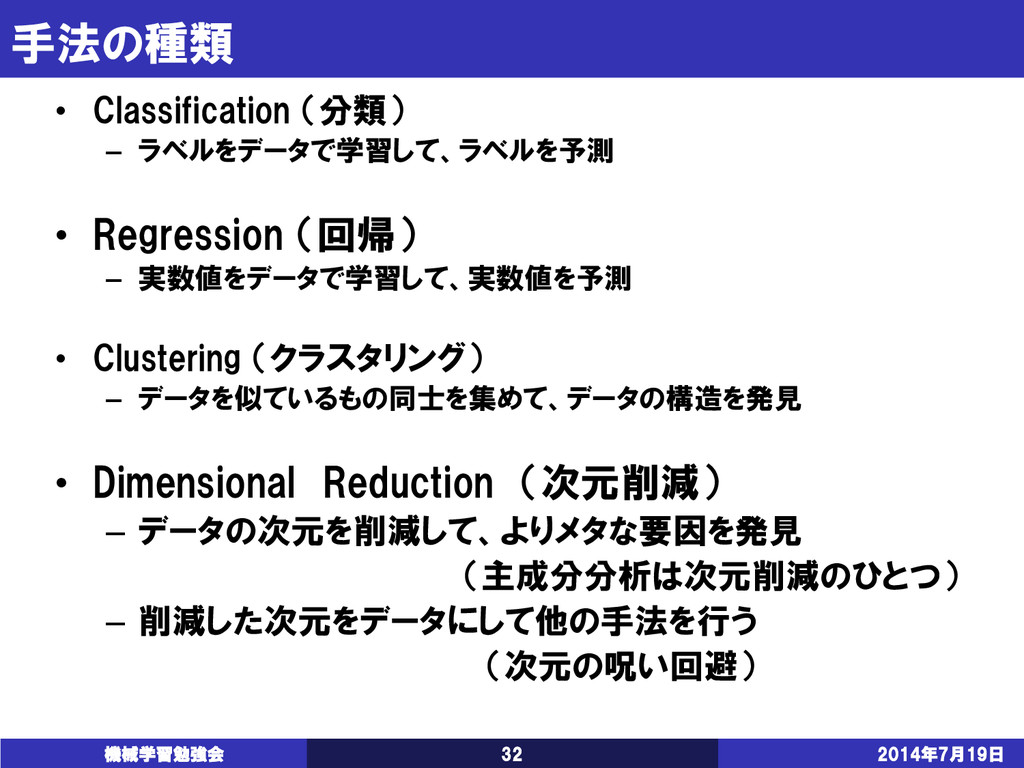
手法の種類 • Classification (分類) – ラベルをデータで学習して、ラベルを予測 • Regression (回帰) –
実数値をデータで学習して、実数値を予測 • Clustering (クラスタリング) – データを似ているもの同士を集めて、データの構造を発見 • Dimensional Reduction (次元削減) – データの次元を削減して、よりメタな要因を発見 (主成分分析は次元削減のひとつ) – 削減した次元をデータにして他の手法を行う (次元の呪い回避) 2014年7月19日 機械学習勉強会 32
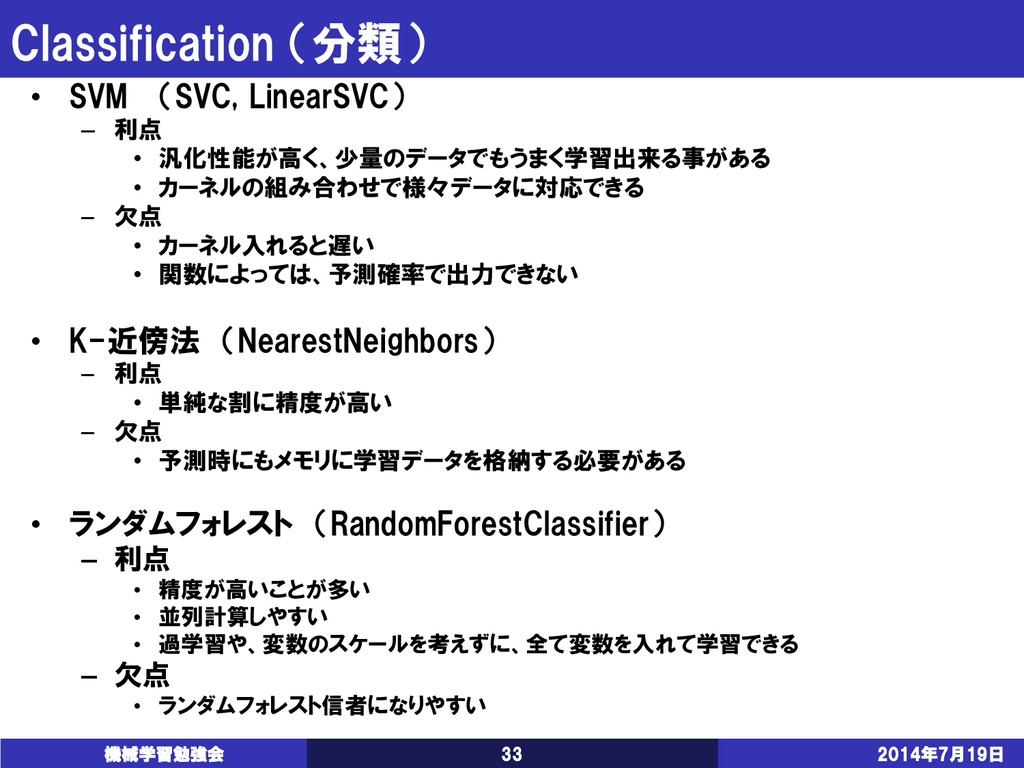
Classification (分類) • SVM (SVC, LinearSVC) – 利点 • 汎化性能が高く、少量のデータでもうまく学習出来る事がある
• カーネルの組み合わせで様々データに対応できる – 欠点 • カーネル入れると遅い • 関数によっては、予測確率で出力できない • K-近傍法 (NearestNeighbors) – 利点 • 単純な割に精度が高い – 欠点 • 予測時にもメモリに学習データを格納する必要がある • ランダムフォレスト (RandomForestClassifier) – 利点 • 精度が高いことが多い • 並列計算しやすい • 過学習や、変数のスケールを考えずに、全て変数を入れて学習できる – 欠点 • ランダムフォレスト信者になりやすい 2014年7月19日 機械学習勉強会 33
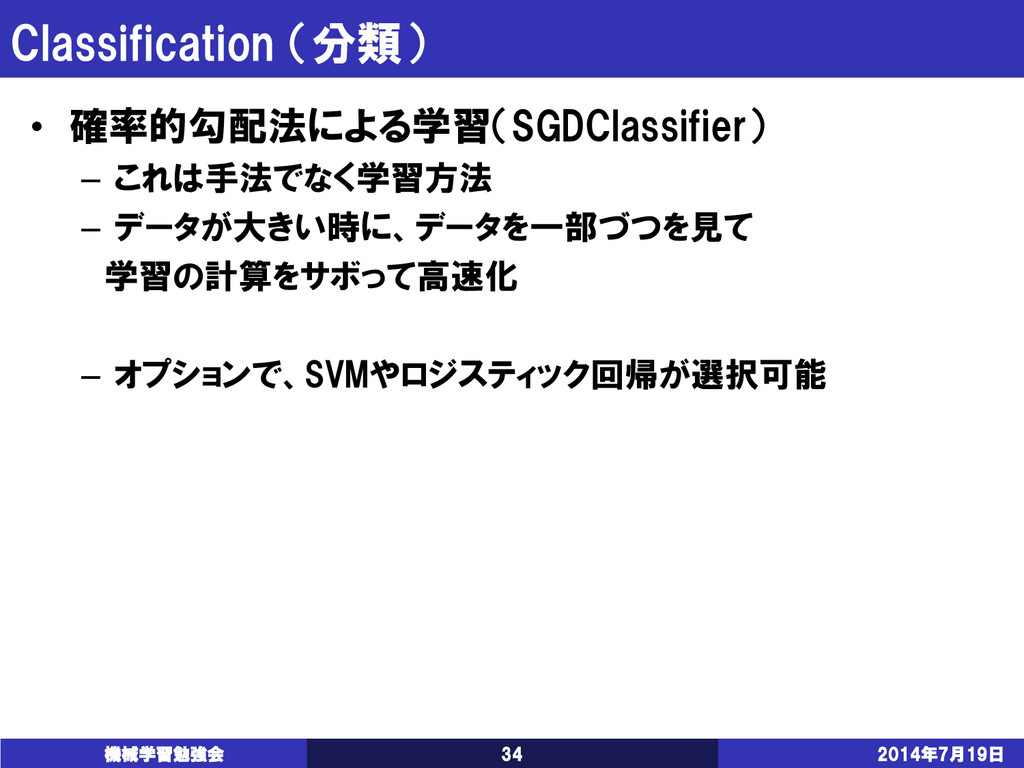
Classification (分類) • 確率的勾配法による学習(SGDClassifier) – これは手法でなく学習方法 – データが大きい時に、データを一部づつを見て 学習の計算をサボって高速化 –
オプションで、SVMやロジスティック回帰が選択可能 2014年7月19日 機械学習勉強会 34
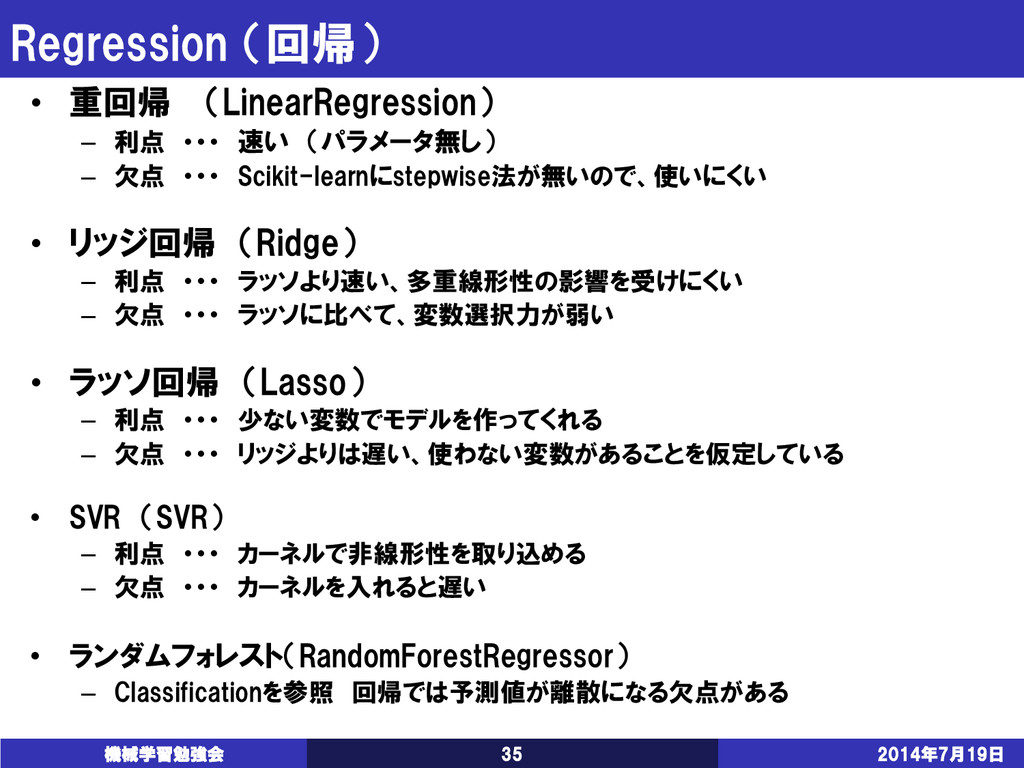
Regression (回帰) 2014年7月19日 機械学習勉強会 35 • 重回帰 (LinearRegression) – 利点
・・・ 速い (パラメータ無し) – 欠点 ・・・ Scikit-learnにstepwise法が無いので、使いにくい • リッジ回帰 (Ridge) – 利点 ・・・ ラッソより速い、多重線形性の影響を受けにくい – 欠点 ・・・ ラッソに比べて、変数選択力が弱い • ラッソ回帰 (Lasso) – 利点 ・・・ 少ない変数でモデルを作ってくれる – 欠点 ・・・ リッジよりは遅い、使わない変数があることを仮定している • SVR (SVR) – 利点 ・・・ カーネルで非線形性を取り込める – 欠点 ・・・ カーネルを入れると遅い • ランダムフォレスト(RandomForestRegressor) – Classificationを参照 回帰では予測値が離散になる欠点がある
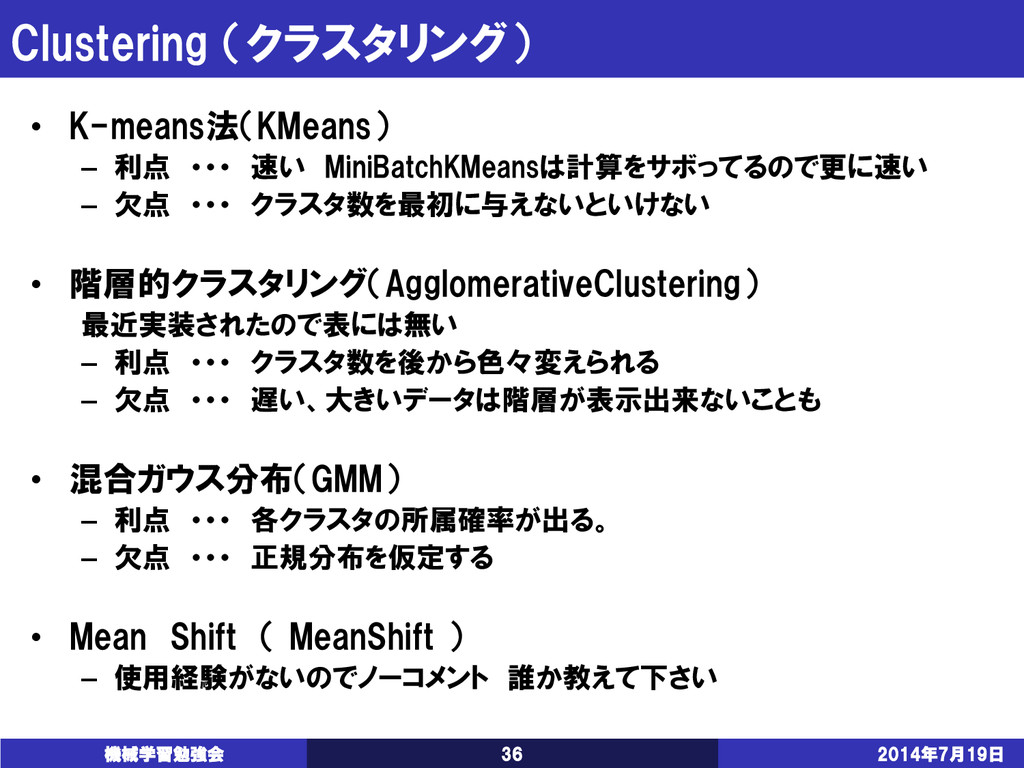
Clustering (クラスタリング) • K-means法(KMeans) – 利点 ・・・ 速い MiniBatchKMeansは計算をサボってるので更に速い –
欠点 ・・・ クラスタ数を最初に与えないといけない • 階層的クラスタリング(AgglomerativeClustering) 最近実装されたので表には無い – 利点 ・・・ クラスタ数を後から色々変えられる – 欠点 ・・・ 遅い、大きいデータは階層が表示出来ないことも • 混合ガウス分布(GMM) – 利点 ・・・ 各クラスタの所属確率が出る。 – 欠点 ・・・ 正規分布を仮定する • Mean Shift ( MeanShift ) – 使用経験がないのでノーコメント 誰か教えて下さい 2014年7月19日 機械学習勉強会 36
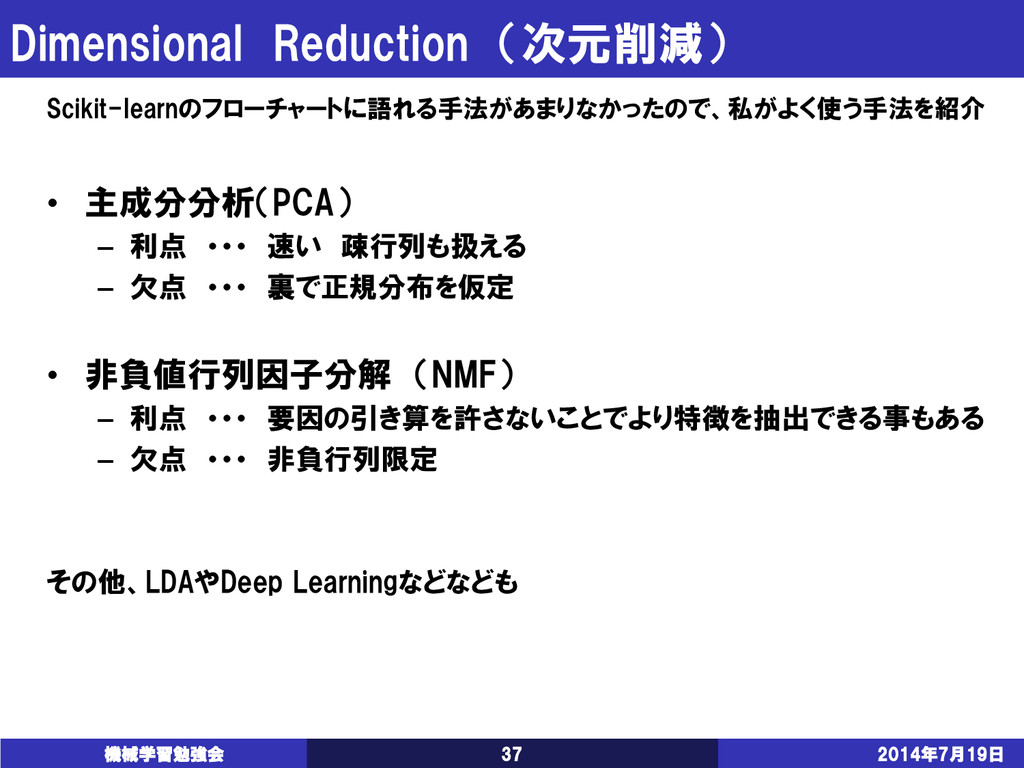
Dimensional Reduction (次元削減) 2014年7月19日 機械学習勉強会 37 Scikit-learnのフローチャートに語れる手法があまりなかったので、私がよく使う手法を紹介 • 主成分分析(PCA) –
利点 ・・・ 速い 疎行列も扱える – 欠点 ・・・ 裏で正規分布を仮定 • 非負値行列因子分解 (NMF) – 利点 ・・・ 要因の引き算を許さないことでより特徴を抽出できる事もある – 欠点 ・・・ 非負行列限定 その他、LDAやDeep Learningなどなども


 philipz
 cielo1985
 sansan33
 nihonbuson
 genshun9
 har1101
 yappli_developers
 masuda220
 masasuzu
 yusukeshimizu
 nttcom
 kaidouji85
 kimpetersen
 helenjbeal
 lauravandoore
 ryanjones
 davidcarrasco
 leimatthew05
 jakevdp
 aleyda
 eileencodes
 asonas
 chriscoyier
 csswizardry